继承与字符串表示
让一个类「站在另一个类的肩膀上」:属性查找沿着继承链往上走,重复代码因此消失;顺便让对象学会把自己说成一句人话。
0. 本讲导读
上一讲你已经会写类了:class 语句造出一个类对象,调用类会走 __init__ 造出一个实例,self.x = ... 往实例上挂实例属性(instance attribute),写在 class 体里的赋值挂出类属性(class attribute),点表达式 obj.attr 先查实例再查类。
但只要你真的拿这套东西去建模一个稍微像样的系统,马上会撞上一堵墙。这一讲的幻灯片从一个很具体的场景切入:做一个 Spotify。你会需要 User、Artist、Song、Playlist、Album 这几个类。写着写着你会发现两件很别扭的事:
Album和Playlist的play方法一个字都不差——都是「把里面的歌一首首放出来」。你把同一段代码抄了两遍。Artist和User也有一堆共同的东西:都有name,都能被关注,都有播放列表。你又抄了一遍。
抄代码的代价不是「打字累」,而是改一处要记得改两处。哪天 play 要加一行「记录播放次数」,你改了 Playlist 忘了改 Album,bug 就埋下了。更深层的问题是:Album 和 Playlist 之间那个「专辑就是一种播放列表」的关系,在代码里完全没有被表达出来。你心里知道,Python 不知道。
本讲补上的第一样东西是继承(inheritance):一种在语言层面表达「A 是一种 B」的手段。写出 class Album(Playlist): 之后,Album 不需要重写 play,它白拿 Playlist 的 play。这不是「复制一份过来」,而是属性查找时多走一步——上一讲那条「先查实例,再查类」的规则,本讲要正式扩写成「先查实例,再查类,再沿着继承链一层层往上查」。所以这一讲的核心仍然是老问题:一个名字是怎么被查到的。
本讲补上的第二样东西是字符串表示(string representation)。你自己写的对象,直接 print 出来是 <__main__.Account object at 0x7f...> 这种鬼东西。一个好的对象应该表现得像它所代表的那种数据——分数应该能打印成 1/2,歌应该能打印成 All Too Well by Taylor Swift (5:27)。Python 给每个对象规定了两种字符串表示(str 给人看、repr 给解释器看),并且提供了 __str__ / __repr__ 两个特殊方法(special method)让你接管它们。
这两块内容合在一起,正好构成本讲最后那个练习:重构(refactor)上一讲的 Spotify 代码——用继承消掉重复,用 __str__ 让每个对象会自我介绍。往后看,Lab 06 全是继承题,Project Ants 里几乎每一种蚂蚁都是 Ant 的子类,Bee、Insect 之间的继承层次是整个项目的骨架。这一讲的属性查找规则不熟,Ants 会寸步难行。
- 继承表达 is-a 关系:
class Sub(Base):声明「一个 Sub 是一种 Base」。子类(subclass)继承基类(base class / superclass)的属性和方法——不是拷贝,而是查不到时往上找。 - 点表达式的完整求值规则:求点号左边 → 若是实例,先查实例属性 → 查它的类 → 递归地查各级超类 → 都没有则
AttributeError。子类里同名的定义会「挡住」超类的定义,这就是重写(override)。 super().method(args)从超类开始找method,并自动把 self 传进去;写成Base.method(self, args)效果相同,但self必须手写。两种写法都常见,混着写就会报TypeError。- 子类重写
__init__时,必须自己调super().__init__(...),否则基类那些self.x = ...一行都不会执行,之后取obj.x直接AttributeError。 - 组合(composition)表达 has-a 关系:
Bank的实例属性里装着 一串Account。is-a 用继承,has-a 用组合,别搞反。 type(obj)给出恰好是哪个类;isinstance(obj, C)沿继承链判断,子类的实例也算 C 的实例。- 每个对象有两种字符串表示:
repr(给解释器看,惯例上是「能求值回一个相等对象的 Python 表达式」,交互式提示符打印的就是它)和str(给人看,print和 f-string 用的是它)。分别由__repr__和__str__定制。
1. 动机:Spotify 代码里那些抄了两遍的东西
先把问题摆到台面上。上一讲的课堂练习是给 Spotify 设计一组类,头脑风暴的结果大致是这样:
| 类 | 它代表什么 | 它跟别的类什么关系 |
|---|---|---|
User | 一个用户 | 可以关注(follow)一个 Artist;有若干 Playlist |
Artist | 一个歌手 | 创作 Song;发行 Album;会被 User 关注 |
Song | 一首歌 | 由某个 Artist 创作 |
Playlist | 一个歌单 | 由多首 Song 组成,属于某个 User |
Album | 一张专辑 | 由多首 Song 组成,由某个 Artist 发行 |
如果只用上一讲的工具(class、__init__、实例属性、方法),你写出来的 Playlist 和 Album 会长成这样:
class Playlist:
    def __init__(self, name, songs, owner):
        self.name = name
        self.songs = songs
        self.owner = owner
        self.total_duration_sec = sum([s.duration_sec for s in songs])
        self.owner.playlists.append(self)

    def play(self):
        for song in self.songs:
            song.play()


class Album:                      # 没有继承,什么都得自己写
    def __init__(self, name, songs, artist):
        self.name = name
        self.songs = songs
        self.owner = artist
        self.total_duration_sec = sum([s.duration_sec for s in songs])
        self.owner.playlists.append(self)
        self.owner.albums.append(self)

    def play(self):               # ←←← 和 Playlist.play 一模一样
        for song in self.songs:
            song.play()
两个 play 完全相同,两个 __init__ 有五行里的四行相同。这就是幻灯片里说的「a lot of repeated code」。
判断该不该用继承,有个屡试不爽的语感测试:把两个类名套进「一个 ___ 是一种 ___」这句话,读起来通顺吗?
- 「一张专辑是一种歌单」——通顺。专辑无非是所有者恰好是歌手的歌单。✓ 用继承
- 「一个歌手是一种用户」——通顺。歌手也有名字、也能关注别人、也有 Liked Songs。✓ 用继承
- 「一个银行是一种账户」——不通顺。银行有很多账户,不是账户。✗ 该用组合
- 「一个歌单是一种歌」——不通顺。歌单装着歌。✗ 该用组合
「是一种」= is-a = 继承;「有一些」= has-a = 组合。第 8 节会正式讲组合。
注意「Album 是一种 Playlist」这个判断里藏着一层意思:Album 能做的事,Playlist 全都能做;Album 只是多了一点东西、或者把某件事做得不太一样。专辑比歌单多的是「它会被登记到歌手的 albums 列表里」,不一样的是「所有者被限定成 Artist」。除此之外它就是个歌单。这种「基本一样、稍有不同」正是继承要处理的情形。
反过来说,如果两个类只是碰巧有几个同名方法,但概念上毫无从属关系(比如 Song 和 Advertisement 都有 play),硬要给它们造一个共同父类往往是过度设计。继承首先是一个建模决定,其次才是一个省代码手段。
本讲的正式讲解会先离开 Spotify,改用一个更小、更容易画环境图的例子:Account 和 CheckingAccount(银行账户 / 支票账户)。因为继承的所有关键机制——重写、super()、类属性查找——在这个例子里五行代码就能演完。把机制吃透之后,第 11 节再回到 Spotify 做完整重构。
2. 继承:is-a 关系与子类的定义
继承(inheritance)描述子类(subclass,又叫 child class)与基类(base class,又叫 parent class / superclass)之间的一种 is-a 关系。
子类继承基类的属性和方法——「继承」在这里的准确含义是:子类的实例能访问、能使用基类里定义的那些名字。一个 Playlist 可以被 play,所以一个 Album 也可以被 play,哪怕 Album 自己一个字都没写。
语法
定义子类只需要在类名后面加一对括号,里面写基类名:
class 子类名(基类名):
    <类体>
本讲的运行例子是账户。先看基类 Account:
class Account:
    interest = 0.02                      # 类属性:所有账户共享的默认利率

    def __init__(self, account_holder):
        self.balance = 0
        self.holder = account_holder

    def deposit(self, amount):
        self.balance = self.balance + amount
        return self.balance

    def withdraw(self, amount):
        if amount > self.balance:
            return 'Insufficient funds'
        self.balance = self.balance - amount
        return self.balance
这里没有任何新东西,全是上一讲的内容:interest 是类属性(写在类体里、不带 self.),balance 和 holder 是实例属性(在 __init__ 里用 self. 挂上去)。
现在定义支票账户。它跟普通账户几乎一样,只有两点不同:取款要收 1 元手续费,利率低一些(0.01)。
class CheckingAccount(Account):
    withdraw_charge = 1
    interest = 0.01

    def withdraw(self, amount):
        return Account.withdraw(self, amount + self.withdraw_charge)
请数一下这个类没有写什么:没有 __init__、没有 deposit。但下面这些全都能跑:
>>> emma = CheckingAccount('Emma')     # 用的是 Account.__init__
>>> emma.balance
0
>>> emma.holder
'Emma'
>>> emma.deposit(100)                  # 用的是 Account.deposit
100
这就是继承在做的事。CheckingAccount 里查不到 __init__,Python 就去它的基类 Account 里查,查到了就用。
继承不是把基类的代码复制进子类。子类的类对象里根本没有 deposit 这个名字。发生的事情是:查找 emma.deposit 时,先查 emma 这个实例(没有),再查 CheckingAccount 类(没有),再顺着「基类」这根指针走到 Account(有了)。属性查找是一个运行时沿链搜索的过程,不是一次性的代码拷贝。
这一点有个可以直接验证的推论:基类改了,子类立刻跟着变。因为子类每次用 deposit 都是现查现用的。
重写(override)
CheckingAccount 自己定义了一个 withdraw,而 Account 里也有一个 withdraw。这时对 emma.withdraw 的查找会在 CheckingAccount 这一层就命中,根本走不到 Account。子类的定义「挡住」了基类的同名定义,这叫重写(override,也译作覆盖)。
类属性同理:Account.interest 是 0.02,但 CheckingAccount.interest 是 0.01,后者重写了前者。
| 名字 | CheckingAccount 里有吗 | 查 emma.<名字> 最终用的是 |
|---|---|---|
deposit | 没有 | Account.deposit(继承) |
__init__ | 没有 | Account.__init__(继承) |
withdraw | 有 | CheckingAccount.withdraw(重写) |
interest | 有(0.01) | CheckingAccount.interest(重写) |
withdraw_charge | 有(1) | CheckingAccount.withdraw_charge(新增) |
balance | — | 实例属性,由 Account.__init__ 挂上去 |
3. 一次 withdraw 调用里到底发生了什么
这一节把幻灯片上那段交互记录逐步拆开。这是本讲最该慢下来看的一段。
>>> sriya = Account('Sriya')
>>> sriya.deposit(100)
100
>>> sriya.withdraw(50)
50
>>> emma = CheckingAccount('Emma')
>>> emma.deposit(100)
100
>>> emma.withdraw(50)
49
前四行没什么可说的:sriya 是普通账户,存 100 取 50 剩 50。关键在最后一行——为什么是 49 而不是 50。
emma.withdraw,算子数是 50。先求算子。emma.withdraw:先求点号左边的 emma,在全局帧查到一个 CheckingAccount 实例。withdraw 的属性。实例上只有 balance 和 holder(__init__ 挂的),没有 withdraw。CheckingAccount 里找。找到了——就是子类自己定义的那个。于是把它绑定(bind)成一个绑定方法,self 已经锁定为 emma。(注意:查找到此为止,Account.withdraw 被挡住了。)50。新建一帧 f1: CheckingAccount.withdraw,绑定 self = emma、amount = 50。return Account.withdraw(self, amount + self.withdraw_charge)。先算实参:self.withdraw_charge —— 实例上没有,CheckingAccount 上有,得 1;所以第二个实参是 50 + 1 = 51。Account.withdraw:点号左边求值成类对象 Account,在它里面查 withdraw,得到那个普通函数(不是绑定方法——左边是类不是实例,没有 self 可绑)。f2: Account.withdraw,绑定 self = emma(手写传进去的)、amount = 51。51 > 100 为假,不返回 'Insufficient funds';self.balance = 100 - 51 = 49,改的是 emma 的 balance;返回 49。return 出去。最终显示 49。把两帧画出来,注意两帧里的 self 是同一个对象——这是理解继承的关键:整个过程只有一个 emma,没有「父类那一半」和「子类那一半」之分。
Global frame
    Account         ──→ class Account
    CheckingAccount ──→ class CheckingAccount   [base: Account]
    sriya           ──→ Account instance #1
    emma            ──→ CheckingAccount instance #2

class Account                       class CheckingAccount(Account)
    interest        0.02                withdraw_charge  1
    __init__        func                interest         0.01
    deposit         func                withdraw         func
    withdraw        func

Account instance #1                 CheckingAccount instance #2
    balance   50                        balance   49      ← 被 f2 改掉
    holder    'Sriya'                   holder    'Emma'
                                        (实例上没有 withdraw / interest)

f1: CheckingAccount.withdraw   [parent=Global]
    self    ──→ instance #2
    amount  50
    正在算  Account.withdraw(self, 50 + 1)

f2: Account.withdraw           [parent=Global]
    self    ──→ instance #2      ← 和 f1 里的 self 指向同一个对象
    amount  51
    返回值  49
误区一:以为 CheckingAccount 的实例里有两份 balance。没有。Account.__init__ 里的 self.balance = 0 中的 self 就是那个 CheckingAccount 实例,属性直接挂在它身上。一个实例就是一个属性字典,继承层次多深都只有这一个字典。
误区二:以为 emma.withdraw(50) 会先跑 Account.withdraw 再跑子类的。不会。属性查找一旦命中就停,只会调到 CheckingAccount.withdraw。基类那个方法之所以也执行了,纯粹是因为子类的代码自己显式调用了它。如果你在子类里写:
class CheckingAccount(Account):
    withdraw_charge = 1
    def withdraw(self, amount):
        return amount            # 完全不碰基类
那基类的 withdraw 永远不会被执行,取钱也不会扣余额。调不调基类,是你写代码时的选择,不是语言自动做的。
误区三:以为参数里的 self.withdraw_charge 可以写成 withdraw_charge。不行。withdraw_charge 是类属性,它不在 withdraw 这一帧的作用域链上。函数帧的 parent 是定义处的环境(这里是全局帧),类体不构成一个函数能往上查的作用域。直接写会报:
NameError: name 'withdraw_charge' is not defined
要拿类属性,只能通过 self.withdraw_charge 或 CheckingAccount.withdraw_charge 这样的点表达式。
为什么第 6 步一定要写 self.withdraw_charge 而不是 CheckingAccount.withdraw_charge?
在目前这段代码里,两种写法结果都是 1。但它们的含义不同,而且差别马上就会显现:
CheckingAccount.withdraw_charge:写死去CheckingAccount这个类上取。self.withdraw_charge:从当前这个对象出发往上查。如果实例上有自己的withdraw_charge(比如第 5 节里手续费 0.5 的那个账户),就用实例的;如果哪天又有个CheckingAccount的子类把手续费改成 3,用self.写的这段代码不用改一个字就能正确收 3 块。
这就是所谓的动态查找(dynamic lookup):方法体里写 self.x,具体取到哪个 x 要到运行时、看 self 究竟是谁才知道。这是继承体系里绝大多数灵活性的来源。默认就该写 self.,除非你确实想要「无论如何都用这个类上的那个值」。
4. 两种调用基类的写法:Account.withdraw(self, …) 与 super()
幻灯片把同一个 CheckingAccount.withdraw 写了两遍,这不是重复,是在对比两种等价写法。
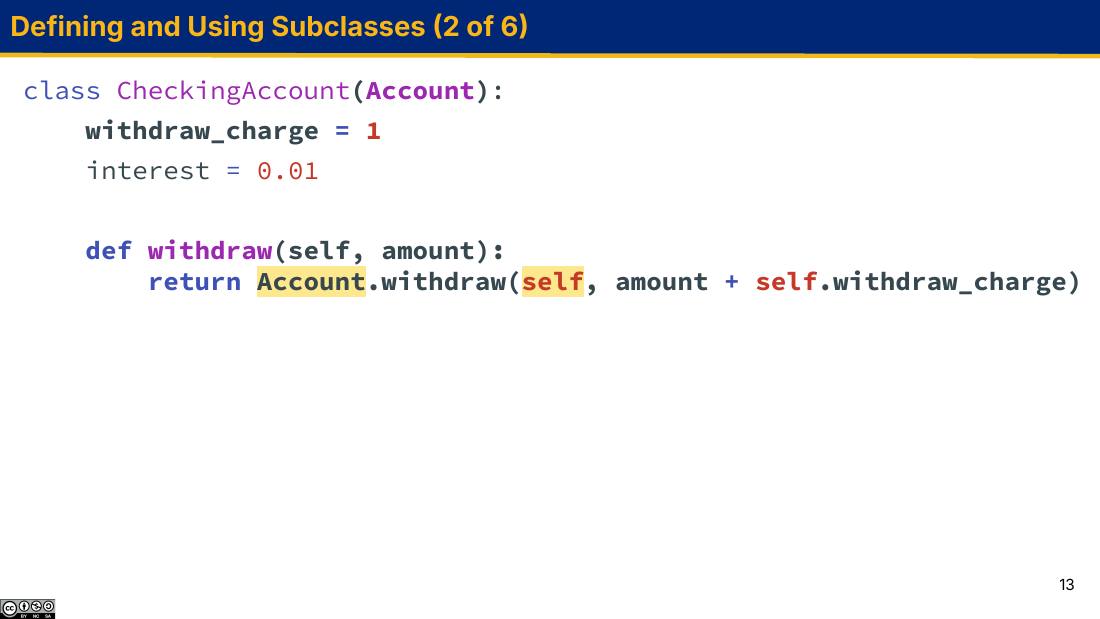
self 被高亮是有原因的——通过类取出来的 withdraw 是一个普通函数,它的第一个形参 self 没有被任何东西自动填上,必须你亲手把当前对象传进去。这里传的 self 就是那个 CheckingAccount 实例,所以基类方法里的 self.balance 改的正是它的余额。class CheckingAccount(Account):
withdraw_charge = 1
interest = 0.01
def withdraw(self, amount):
return Account.withdraw(self, amount + self.withdraw_charge)
写法二用内建函数 super():
class CheckingAccount(Account):
    withdraw_charge = 1
    interest = 0.01

    def withdraw(self, amount):
        return super().withdraw(amount + self.withdraw_charge)
super() 的含义是:「从我的超类开始查这个名字,并且把当前的 self 自动补上」。所以 super().withdraw(51) 拿到的是一个已经绑定好 self 的方法,你不能再手写一遍 self。
Account.withdraw(self, x) | super().withdraw(x) | |
|---|---|---|
| 从哪里开始查名字 | 写死的 Account 类 | 当前类的超类(由类定义决定) |
| 取出来的东西 | 普通函数(unbound) | 绑定方法(self 已绑好) |
self 谁来给 | 你手写 | 自动 |
| 基类改名后 | 要改这一行 | 不用改 |
| 能否在类外使用 | 能,Account.withdraw(obj, 5) 随处可写 | 不能,super() 只在类体内的方法里有意义 |
为什么 super() 更受推荐?因为它把「我的父亲是谁」这个信息只写一遍——写在 class CheckingAccount(Account): 那一行。哪天你把继承关系改成 class CheckingAccount(SavingsAccount):,用 super() 的代码自动跟着变;用类名硬写的代码则会悄悄地继续调用 Account,而且不报错——这是最难查的那类 bug。
CS 61A 的作业和考试两种写法都会出现,Ants 项目的框架代码里 super() 用得很多,所以两种都必须认得。
把两种写法混起来,是初学继承时最高频的报错,而且报错信息看起来很莫名其妙。
错法 A:用了 super() 还手写 self——
def withdraw(self, amount):
    return super().withdraw(self, amount + self.withdraw_charge)   # ✗
TypeError: Account.withdraw() takes 2 positional arguments but 3 were given
「takes 2 but 3 were given」里的 2 指的是 self 和 amount。super().withdraw 已经悄悄把 self 算作第 1 个了,你又塞了 self 和 amount,一共 3 个。看到「多给了一个参数」,第一反应就该是「self 传重了」。
错法 B:用了类名却忘了写 self——
def withdraw(self, amount):
    return Account.withdraw(amount + self.withdraw_charge)         # ✗
TypeError: Account.withdraw() missing 1 required positional argument: 'amount'
这条报错特别容易读岔:明明传了一个数,怎么说缺 amount?因为你传的那个 51 被当成了 self,amount 就空着了。看到「缺最后一个参数」,第一反应就该是「self 忘传了」。顺带说,就算侥幸没报错(比如方法只有 self 一个形参),你也会把一个数字当成账户对象来用,接着在 self.balance 处炸成 AttributeError: 'int' object has no attribute 'balance'。
记住这条规则就不会错:点号左边是实例,self 自动补;点号左边是类,self 自己写。
emma.withdraw(50)            # 左边是实例 → self=emma 自动
CheckingAccount.withdraw(emma, 50)   # 左边是类 → self 手写
super().withdraw(51)         # super() 特殊:查找从超类开始,但 self 仍自动
super() 之所以能「自动」,是因为它知道当前方法帧里的 self 是谁——它是在方法内部调用的,Python 替你把上下文接了过去。
5. 在子类里重写 __init__
到目前为止 CheckingAccount 借用了基类的 __init__。但如果子类需要多存一点东西,或者想让调用者多传一个参数,就得自己写 __init__。
需求:允许开户时指定手续费,不指定就用默认的 1。
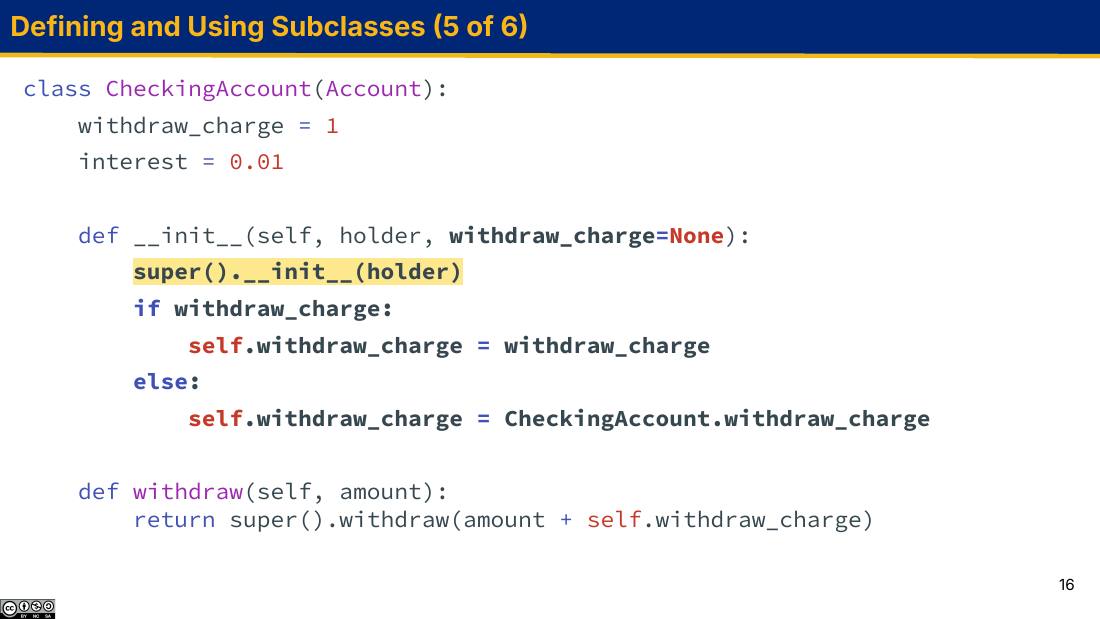
__init__。被高亮的第一行是全部要点:子类一旦定义了 __init__,基类的 __init__ 就被彻底挡住了,必须自己显式把它叫回来,否则 self.balance 和 self.holder 根本不会被创建。super().__init__(holder) 只传 holder——self 由 super() 自动补上。class CheckingAccount(Account):
withdraw_charge = 1
interest = 0.01
def __init__(self, holder, withdraw_charge=None):
super().__init__(holder)
if withdraw_charge:
self.withdraw_charge = withdraw_charge
else:
self.withdraw_charge = CheckingAccount.withdraw_charge
def withdraw(self, amount):
return super().withdraw(amount + self.withdraw_charge)
>>> emma = CheckingAccount('Emma')
>>> emma.withdraw_charge
1
>>> amy = CheckingAccount('Amy', 0.5)
>>> amy.withdraw_charge
0.5
>>> amy.deposit(100)
100
>>> amy.withdraw(50)
49.5
CheckingAccount('Amy', 0.5):调用一个类 → 造一个空实例,然后调 __init__。查 __init__:CheckingAccount 里有,用它。f1: CheckingAccount.__init__,绑定 self=新实例、holder='Amy'、withdraw_charge=0.5。super().__init__(holder) → 帧 f2: Account.__init__,self=同一个实例、account_holder='Amy'。执行 self.balance = 0、self.holder = 'Amy'。此刻实例上才有了 balance 和 holder。if withdraw_charge: 中 0.5 为真 → self.withdraw_charge = 0.5。这在实例上新建了一个属性,它会挡住类属性 1。amy.withdraw(50):查 withdraw → 实例没有 → CheckingAccount 有 → 帧 f3,amount=50。self.withdraw_charge:实例上有 0.5,直接返回,不再往类上查。实参 = 50 + 0.5 = 50.5。super().withdraw(50.5) → 帧 f4: Account.withdraw。50.5 > 100 假 → self.balance = 100 - 50.5 = 49.5 → 返回 49.5。class CheckingAccount(Account)
withdraw_charge 1 ← 类属性,一份
interest 0.01
__init__ / withdraw func
emma (没传手续费) amy (传了 0.5)
balance 0 balance 49.5
holder 'Emma' holder 'Amy'
withdraw_charge 1 withdraw_charge 0.5
↑ ↑
else 分支写上去的实例属性, if 分支写上去的实例属性,
值恰好等于类属性,但是 值来自调用者
实例上确实存了一份
注意 else 分支:self.withdraw_charge = CheckingAccount.withdraw_charge 把类属性的值抄了一份到实例上。这一句其实可以不写——不写的话 emma.withdraw_charge 照样能通过类属性查到 1。幻灯片这样写是为了让「每个账户都有自己的手续费」这件事在实例层面统一、显式。代价是:以后改 CheckingAccount.withdraw_charge = 2,已经开出去的账户不会跟着变,因为它们实例上已经存了自己的一份。这是一个有意的设计取舍,不是 bug。
误区一:子类写了 __init__ 但忘了调 super().__init__(...)。这是继承里最经典的错误。
class Artist(User):
    def __init__(self, name):
        self.albums = []          # ✗ 忘了 super().__init__(name)
>>> a = Artist('Taylor Swift')
>>> a.name
AttributeError: 'Artist' object has no attribute 'name'
关键在于:创建实例时不报错,一切看起来都好;直到很久以后某个地方取 name,才炸出一个看上去毫无关系的 AttributeError。诊断口诀:报「实例没有某属性」,先回去看这个属性该在哪个 __init__ 里被赋值,再看那个 __init__ 到底跑没跑过。
误区二:if withdraw_charge: 判的是真假性,不是「有没有传」。传 0 会走到 else:
>>> free = CheckingAccount('Free', 0)
>>> free.withdraw_charge
1
本想开一个免手续费账户,结果被收了 1 块。0 是 falsy,和 None 一样进 else。要严格区分「没传」和「传了 0」,条件得写成 if withdraw_charge is not None:。幻灯片上的写法在这个场景下是可以接受的(没人开 0 手续费的支票账户),但你要知道它为什么可以接受,而不是照抄。
误区三:把 super().__init__(holder) 写成 super().__init__(self, holder)。同第 4 节,TypeError: Account.__init__() takes 2 positional arguments but 3 were given。
6. 点表达式求值的完整规则
上一讲给过一个简化版规则(先查实例、再查类)。有了继承之后,规则要补上「再往上」这一步。这是本讲唯一需要背下来的东西,而且考试年年考。
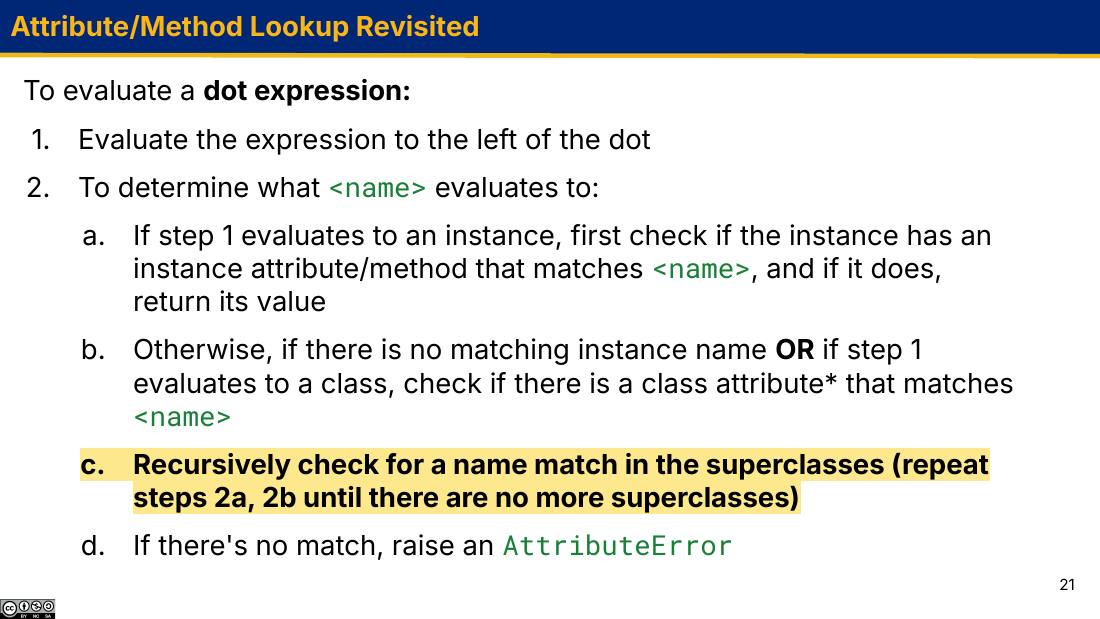
把它拆成人话,一条一条对着念:
<表达式>.<name>
bank.accounts[0].balance 就是从左往右一层层来的。求完之后,结果要么是一个实例,要么是一个类(也可能是别的对象,规则一样)。<name>。找到就返回它的值,结束。<name>。找到就返回,结束。(若这一步取到的是函数、且第 1 步是实例,取出来的是绑定方法。)AttributeError。用这条规则把前面所有结果重新验算一遍:
| 点表达式 | 2a 实例 | 2b 类 CheckingAccount | 2c 超类 Account | 结果 |
|---|---|---|---|---|
emma.balance | 命中 0 | — | — | 0 |
emma.deposit | 无 | 无 | 命中 | 绑定方法 Account.deposit |
emma.withdraw | 无 | 命中 | (不查) | 绑定方法 CheckingAccount.withdraw |
emma.interest | 无 | 命中 0.01 | (不查) | 0.01 |
sriya.interest | 无 | (不适用) | 命中 0.02 | 0.02 |
CheckingAccount.deposit | (跳过 2a) | 无 | 命中 | 普通函数 |
emma.rate | 无 | 无 | 无 | AttributeError |
最后一行的真实报错分两种,取决于点号左边是什么:
>>> emma.rate
AttributeError: 'CheckingAccount' object has no attribute 'rate'

>>> CheckingAccount.rate
AttributeError: type object 'CheckingAccount' has no attribute 'rate'
两句话的差别是 'CheckingAccount' object 和 type object 'CheckingAccount'。读到 type object,说明你点的是类不是实例——这条信息在调试时很有用,比如你本想写 emma.balance 却手滑写成了 CheckingAccount.balance。
为什么 2b 里说「或者第 1 步得到的本来就是个类」
因为类没有「实例属性」这一说,直接从 2b 起步。这也解释了一个初学者常问的问题:为什么 Account.balance 会报错,而 sriya.balance 好好的?因为 balance 是在 __init__ 里用 self.balance = 0 挂到某个具体实例上的,类身上从来就没有过这个名字。
这套规则和第 1 讲的作用域链形式上很像(查不到就往 parent 走),但是两条完全不同的链,千万别混:
| 名字查找(作用域链) | 属性查找(继承链) | |
|---|---|---|
| 触发它的写法 | 光秃秃一个名字 x | 点表达式 obj.x |
| 沿什么走 | 帧的 parent(由函数定义的位置决定) | 实例 → 类 → 超类(由 class 语句决定) |
| 尽头是 | 全局帧 | 没有超类的那个类 |
| 找不到时 | NameError | AttributeError |
在方法体里写 withdraw_charge(没有 self.)走的是左边这条链,所以查不到,报 NameError;写 self.withdraw_charge 走的是右边这条链,才能查到类属性。这是第 3 节那个误区的根本原因。
误以为「子类查不到就查父类」对赋值也成立。不成立。查找会往上走,赋值绝不往上走。
>>> emma.interest            # 查找:一路走到 CheckingAccount,得 0.01
0.01
>>> emma.interest = 0.08     # 赋值:直接在 emma 这个实例上创建一个新属性
>>> emma.interest
0.08
>>> CheckingAccount.interest # 类属性纹丝不动
0.01
obj.x = v 永远只做一件事:在 obj 自己身上绑定 x。它不会去修改类属性,也不会去修改超类的属性。第 7 节整节都在讲这件事的后果。
7. 类属性、实例属性与继承的相互作用
上一讲你已经知道「类属性只有一份、被所有实例共享」。加上继承之后,「一份」这个说法要说得更精确:一份属于定义它的那个类。子类重写了就是子类自己新的一份,子类没重写就共用基类那一份。
下面这段交互把四种情况全试了一遍,输出是真实跑出来的:
>>> a = Account('A')
>>> b = Account('B')
>>> emma = CheckingAccount('Emma')
>>> a.interest, b.interest, emma.interest
(0.02, 0.02, 0.01)

>>> Account.interest = 0.05          # ① 改基类的类属性
>>> a.interest, b.interest
(0.05, 0.05)
>>> emma.interest                    # CheckingAccount 有自己的,不受影响
0.01

>>> a.interest = 0.08                # ② 给某个实例赋值
>>> a.interest, b.interest, Account.interest
(0.08, 0.05, 0.05)
Account.interest = 0.05 修改的是 Account 这个类对象上的绑定。a 和 b 实例上都没有 interest,每次取值都要走到 Account,所以两个都变成 0.05。共享不是「值被复制了三份」,而是「三条查找路径终点是同一个格子」。emma.interest 的查找在 CheckingAccount 就命中了 0.01,压根走不到 Account,所以基类怎么改都跟它无关。a.interest = 0.08 在实例 a 上创建了一个新的实例属性。从此 a.interest 在 2a 就命中,再也不往上走。b 身上什么都没变,还是查到类属性 0.05。Account.interest 本身也没被动过,仍是 0.05。可以直接看实例的属性字典来确认第 3 步真的往 a 身上加了东西:
>>> a.__dict__
{'balance': 0, 'holder': 'A', 'interest': 0.08}
>>> b.__dict__
{'balance': 0, 'holder': 'B'}
| 你写的 | 实际改了谁 | 谁会看到变化 |
|---|---|---|
Account.interest = 0.05 | Account 类对象 | 所有没有自己 interest 的 Account 实例;以及没重写 interest 的子类及其实例 |
CheckingAccount.interest = 0.03 | CheckingAccount 类对象 | 只有 CheckingAccount(及其子类)的实例 |
a.interest = 0.08 | 实例 a | 只有 a |
self.interest = 0.08(在方法里) | 当前那个实例 | 只有当前那个实例 |
如果类属性是可变对象(列表、字典),共享就会变得非常危险:
class Playlist:
    songs = []          # ✗ 类属性列表,所有实例共用同一个列表!

    def add(self, song):
        self.songs.append(song)     # 没有赋值,只是修改那个共享列表
self.songs.append(...) 里没有赋值,走的是「查找 → 拿到那个共享列表 → 改它」。于是 A 用户加的歌,B 用户也看得见。这不是继承特有的坑,但在继承体系里更难发现,因为那个列表可能定义在三层之上的某个基类里。规则很简单:可变的默认值要在 __init__ 里用 self.songs = [] 创建,每个实例一份。本讲的 Bank.__init__ 里写 self.accounts = [] 而不是把 accounts = [] 写在类体里,正是这个原因。
什么该当类属性?「这个类的所有实例都一样、而且不随实例变化的东西」——利率的默认值、手续费的默认值、蚂蚁的造价和血量上限(Ants 项目里到处都是这种类属性)。它同时充当「默认值 + 文档」:读代码的人一眼就知道支票账户默认收 1 块。
什么该当实例属性?「每个对象各不相同的东西」——余额、户主、名字、这只蚂蚁当前还剩多少血。
8. 组合:has-a 关系,以及 type() 与 isinstance()
组合(composition)描述两个类之间的 has-a 关系:一个银行有很多账户;一门课有很多学生;一个歌单有很多首歌。
组合在语法上没有任何新东西——就是把别的对象存进实例属性里。它值得单独讲,是因为初学者太容易在该用组合的地方用继承。
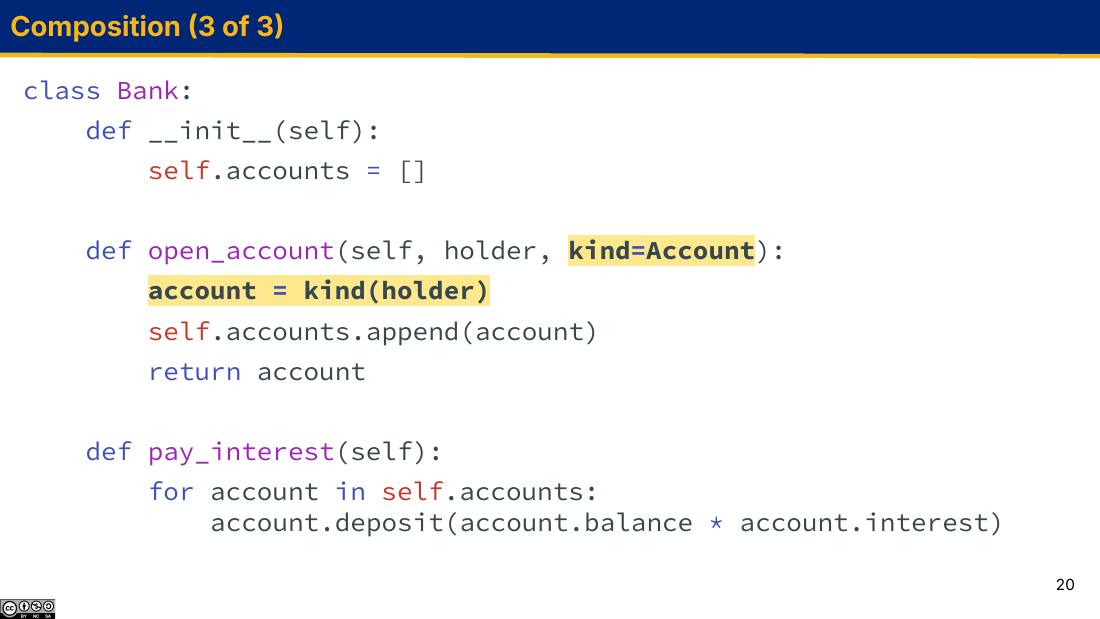
Bank 只用组合:它有一个 accounts 列表。被高亮的两处是这段代码真正精彩的地方——kind=Account 把一个类当成普通的默认参数值,kind(holder) 则是调用这个参数来造对象。类在 Python 里是一等值,可以传参、可以存变量、可以当默认值。class Bank:
def __init__(self):
self.accounts = []
def open_account(self, holder, kind=Account):
account = kind(holder)
self.accounts.append(account)
return account
def pay_interest(self):
for account in self.accounts:
account.deposit(account.balance * account.interest)
>>> bank = Bank()
>>> sriya = bank.open_account('Sriya')
>>> emma = bank.open_account('Emma', CheckingAccount)
>>> sriya.deposit(100)
100
>>> emma.deposit(100)
100
>>> bank.pay_interest()
>>> sriya.balance
102.0
>>> emma.balance
101.0
bank.open_account('Sriya'):kind 用默认值 Account。kind(holder) = Account('Sriya'),造出一个普通账户,append 进 bank.accounts,并返回它。所以 sriya 和 bank.accounts[0] 是同一个对象(别名)。bank.open_account('Emma', CheckingAccount):kind 被绑到 CheckingAccount 这个类对象。kind(holder) 就成了 CheckingAccount('Emma')。同一行代码,造出了不同类的对象。deposit(100):emma 用的是继承来的 Account.deposit,两人余额都变成 100。pay_interest() 遍历 self.accounts。第一个是 sriya:sriya.interest 查到 Account.interest = 0.02,存入 100 * 0.02 = 2.0,余额 102.0。emma:emma.interest 查到的是 CheckingAccount.interest = 0.01,存入 100 * 0.01 = 1.0,余额 101.0。bank.accounts 里装的就是 sriya / emma 本人(别名,不是拷贝),所以在循环里改余额,外面的 sriya.balance 立刻看得见。pay_interest 只有两行,却能对两种不同的账户做正确的事——因为它从头到尾没有问过「你是哪一类账户」,只是写 account.interest,让属性查找规则去决定取到哪个值。这种「同一段代码,对不同类型的对象各自做对的事」叫多态(polymorphism),是继承最主要的收益。
继承和组合解决的是完全不同的问题,别拿一个去顶另一个:
| 继承 inheritance | 组合 composition | |
|---|---|---|
| 表达的关系 | is-a(是一种) | has-a(有一个 / 有一些) |
| 写法 | class Sub(Base): | self.parts = [...] |
| 例子 | Album 是 Playlist;Artist 是 User | Bank 有 Accounts;Playlist 有 Songs |
| 带来什么 | 共享实现、多态 | 把复杂对象拼装出来 |
| 误用后果 | 让 Bank 继承 Account,于是「银行」也有了 balance,语义完全错乱 | 让 Album 组合一个 Playlist,于是每次都要写 album.playlist.play(),别扭且丢失多态 |
一个类同时用两者是常态:Album 继承 Playlist(is-a),同时组合了一串 Song(has-a)。
type() vs isinstance()
有了继承,「这个对象是什么类型」就有了两种答案,Python 用两个不同的函数分别回答:
>>> type(sriya)
<class 'Account'>
>>> type(emma)
<class 'CheckingAccount'>
>>> isinstance(sriya, Account)
True
>>> isinstance(emma, Account)
True
>>> isinstance(sriya, CheckingAccount)
False
>>> isinstance(emma, CheckingAccount)
True
注意其中最关键的一行:isinstance(emma, Account) 是 True。这正是 is-a 关系在语言层面的体现——一个支票账户就是一个账户。而 type(emma) 只回答「它恰好是哪个类造出来的」,是 CheckingAccount,不是 Account。
type(obj) | isinstance(obj, C) | |
|---|---|---|
| 返回什么 | 一个类对象 | True / False |
| 回答的问题 | 「它恰好属于哪个类?」 | 「它算不算一个 C?」 |
| 看继承链吗 | 不看,只看直接所属的类 | 看,沿继承链一路往上 |
emma 与 Account | type(emma) == Account → False | isinstance(emma, Account) → True |
| 什么时候用 | 需要精确区分层次时(少见) | 绝大多数情况 |
用 type(x) == SomeClass 做类型判断,会把子类全部漏掉。比如给 Bank 加一个「统计普通账户数量」的方法:
def count_accounts(self):
    return len([a for a in self.accounts if type(a) == Account])     # 漏掉子类
如果你的本意是「所有账户」,这样写会把 CheckingAccount 全部排除掉,而且不报任何错,只是数字偏小。要「所有账户」就该用 isinstance(a, Account)。
反过来,如果你的本意就是「只要恰好是 Account、不要子类」,那 type(a) == Account 才是对的。先想清楚要问哪个问题,再选函数。
9. 字符串表示:str 与 repr
换一个话题,但动机是同一个:一个对象应该表现得像它所代表的那种数据。你造了一个 Rational 类来表示分数,那它至少应该能被打印成 1/2,而不是:
>>> print(sriya)
<__main__.Account object at 0x7f2c1a3d5f70>
这行默认输出里唯一有用的信息是那串十六进制的内存地址——它能告诉你「两次打印出来的是不是同一个对象」,除此以外毫无价值。
Python 的做法是:每个对象都有两种字符串表示,用途不同。
str | repr | |
|---|---|---|
| 给谁看 | 人(human-readable) | Python 解释器(legible to the interpreter) |
| 惯例上应该是 | 好读的描述 | 一个能求值回相等对象的 Python 表达式 |
| 什么时候被用 | print(x)、f-string 里的 {x}、str(x) | 交互式提示符直接回显、repr(x)、容器里的元素 |
| 由谁定制 | __str__ | __repr__ |
repr:给解释器看的那一份
repr 函数返回一个字符串,按惯例这个字符串应当是一个 Python 表达式,把它求值回来能得到一个相等的对象。对大多数类型来说:
eval(repr(obj)) == obj
eval 是一个内建函数,接受一个字符串,把它当成 Python 表达式来求值。所以 repr 相当于「把对象序列化成源代码」。
更常用的一个事实是:你在交互式解释器里输入一个表达式,回显出来的那行就是它的 repr。
>>> 3e5
300000.0
>>> print(repr(3e5))
300000.0
这两行输出一样,说明提示符回显走的就是 repr。字符串的例子对比更明显:
>>> s = 'hello'
>>> s
'hello'
>>> print(s)
hello
直接输入 s,回显的是带引号的 'hello'——因为 'hello' 才是一个能求值回这个字符串的 Python 表达式。而 print(s) 用的是 str,给人看的当然不带引号。这就是你写 doctest 时「什么时候要打引号」的全部依据:doctest 比对的是解释器回显,也就是 repr。
不是所有对象都有「能求值回来」的表示。这时 repr 退而求其次,给一个带尖括号的描述:
>>> repr(min)
'<built-in function min>'
注意 repr 的返回值是一个字符串,所以在提示符下它自己又被 repr 了一次,于是外面多了一层单引号。<built-in function min> 显然不是合法的 Python 表达式——惯例就是惯例,做不到时按惯例用尖括号包一个描述。你在开头看到的 <__main__.Account object at 0x...> 正是这种「做不到」的默认形式。
str:给人看的那一份
str 的结果就是 print 打出来的东西,也是 f-string 插值时用的东西。标准库里的 Fraction 把两者区分得很典型:
>>> from fractions import Fraction
>>> frac = Fraction(1, 2)
>>> repr(frac)
'Fraction(1, 2)'
>>> str(frac)
'1/2'
>>> print(frac)
1/2
>>> f'My fraction is {frac}'
'My fraction is 1/2'
逐行对照一遍:
repr(frac) 得到 'Fraction(1, 2)'——把这串字符原样粘回解释器,确实能造出一个相等的分数。它面向的是「重建这个对象」。str(frac) 得到 '1/2'——数学课本上分数就长这样。它面向的是「让人读懂」。print(frac) 打出 1/2,没有引号:print 用 str,而且打印字符串时不加引号。{frac} 同样走 str,所以拼出 'My fraction is 1/2'。整个 f-string 的结果本身是个字符串,提示符回显时带上了外层引号。对绝大多数类型(整数、浮点数、列表……)str 和 repr 结果相同,所以平时感觉不到区别。字符串本身和 Fraction 是两个最容易看出差别的例子。
误以为 print 一个列表会对元素用 str。不会——容器打印元素时用的是 repr:
>>> names = ['ann', 'bob']
>>> print(names)
['ann', 'bob']
外层的方括号是列表的 str,但里面两个元素带着引号,说明它们走的是 repr。这解释了一个很常见的困惑:明明给自己的类写了漂亮的 __str__,一 print 列表还是一堆 <... object at 0x...>。要让对象在列表里也好看,得写 __repr__。
10. __repr__ 与 __str__
repr(x) 和 str(x) 这两个内建函数,实际上是去找对象的特殊方法(special method) __repr__ 和 __str__ 并调用它们。你在自己的类里定义这两个方法,就接管了对象的字符串表示。
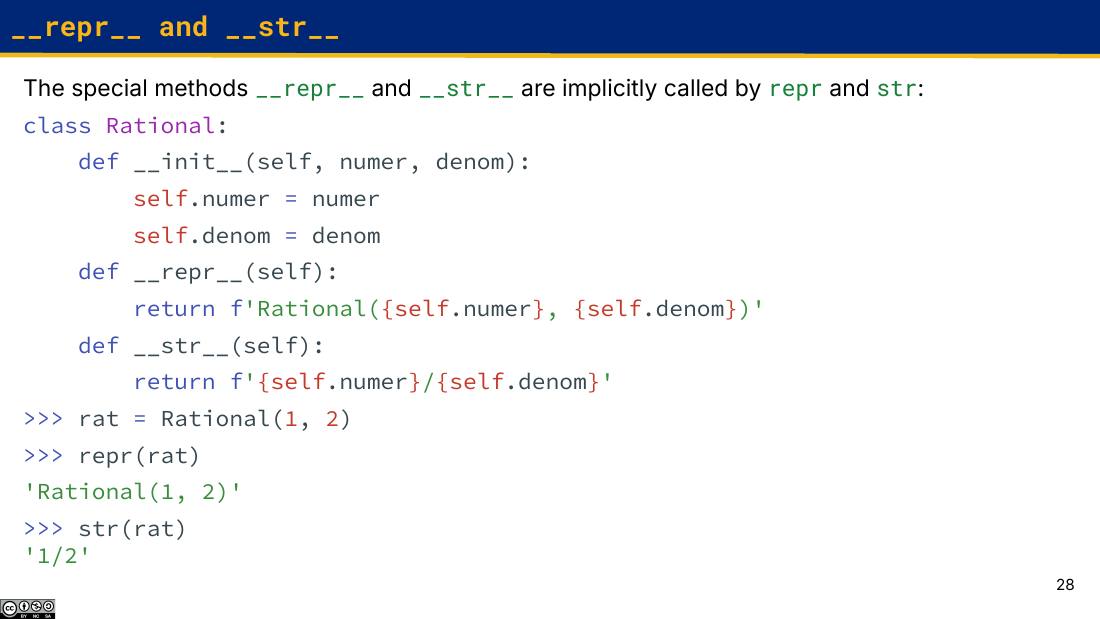
Rational 对象的两副面孔。__repr__ 拼出的字符串长得跟构造它的那行代码一模一样——这正是「能求值回一个相等对象」这条惯例的实现方式:把类名和各个属性值原样拼出来。__str__ 则完全不管 Python 语法,只管人怎么读分数。两个方法都返回字符串,不是 print。class Rational:
def __init__(self, numer, denom):
self.numer = numer
self.denom = denom
def __repr__(self):
return f'Rational({self.numer}, {self.denom})'
def __str__(self):
return f'{self.numer}/{self.denom}'
>>> rat = Rational(1, 2)
>>> repr(rat)
'Rational(1, 2)'
>>> str(rat)
'1/2'
>>> rat                      # 提示符回显 → __repr__
Rational(1, 2)
>>> print(rat)               # print → __str__
1/2
>>> [rat, rat]               # 容器里的元素 → __repr__
[Rational(1, 2), Rational(1, 2)]
print(rat) 到底经过了几手
print(rat):算子 print,算子数 rat(一个 Rational 实例)。print 拿到这个对象,需要一个字符串才能往屏幕上写,于是对它调用 str(rat)。str 去找 rat 的 __str__——按第 6 节那套点表达式规则:实例上没有 → Rational 类上有。取到绑定方法。self = rat。执行 return f'{self.numer}/{self.denom}':查 self.numer 得 1,查 self.denom 得 2,拼成 '1/2'。str 把 '1/2' 交还给 print,print 把这 3 个字符写到屏幕并换行。print 本身返回 None。关键:__str__ 里写的是 return,不是 print。打印这件事是 print 干的,__str__ 的职责只是「交出一个字符串」。
只写一个的话,写哪个?
两者之间有一条单向的兜底规则:
| 类里定义了 | repr(x) 得到 | str(x) 得到 |
|---|---|---|
| 两个都有 | __repr__ 的结果 | __str__ 的结果 |
只有 __repr__ | __repr__ 的结果 | 也是 __repr__ 的结果(兜底) |
只有 __str__ | <__main__.X object at 0x…>(不兜底) | __str__ 的结果 |
| 都没有 | <__main__.X object at 0x…> | |
兜底是单向的:str 找不到 __str__ 会退回去用 __repr__;反过来 repr 绝不会用 __str__。所以如果只写一个,写 __repr__——它一份顶两份,而且能让对象在列表里、在调试输出里都好看。
这条兜底规则不是特例,用第 6 节的属性查找就能解释:str(x) 去查 x 的 __str__,实例没有、类没有、超类……一路查到所有类的共同祖先 object,而 object.__str__ 的实现恰好就是「调用 self.__repr__()」。兜底本身就是一次继承。同理,你没写 __repr__ 时用到的 object.__repr__ 就是那个打印内存地址的实现。
误区一:在 __str__ 里用 print 而不是 return。
def __str__(self):
    print(f'{self.numer}/{self.denom}')     # ✗
>>> print(rat)
1/2
TypeError: __str__ returned non-string (type NoneType)
屏幕上先冒出一个 1/2(那是你自己 print 的),紧接着报错——因为函数没有 return,隐式返回了 None,而 print 拿到 None 没法当字符串用。这个报错很好认:看到 returned non-string (type NoneType),就是把 return 写成 print 了。
误区二:__repr__ 返回的字符串里漏了引号。如果属性是字符串,拼 repr 时要保留引号,否则 eval 回不来:
def __repr__(self):
    return f'Account({self.holder})'        # 得到 'Account(Sriya)',eval 会 NameError
def __repr__(self):
    return f'Account({self.holder!r})'      # 得到 "Account('Sriya')"  ✓
{x!r} 是 f-string 的语法,表示「对 x 用 repr 而不是 str」。CS 61A 不会考 !r,但知道有这个东西能帮你理解 repr 的「可求值」惯例到底有多讲究。
误区三:以为 __str__ 能自动继承出漂亮结果。它确实会被继承——但继承的是基类的实现。第 11 节里 Artist 没写 __str__,用的就是 User.__str__,正好返回名字,符合预期;但如果基类的 __str__ 写死了 'User: ' + self.name,子类打印出来就会顶着一个「User:」前缀。基类的字符串表示要写得对子类也成立,通常靠 self.__class__.__name__ 或者干脆让子类重写。
11. 实战:用继承重构 Spotify
重构(refactoring)是「在不改变外部行为的前提下重新组织已有代码」。关键词是「不改变外部行为」——重构之后所有 doctest 必须照样通过,改的只是代码的组织方式。
这次要做两件事:Artist 继承 User、Album 继承 Playlist,并且给各个类加上 __str__。起始代码是课程网站 Lecture 14 下的 14.py,用 python3 -m doctest 14.py 跑测试(没有输出就是全过)。
User:先把基类写对
class User:
    def __init__(self, name: str):
        self.name = name
        self.following = []
        self.followers = 0

        # NOTE: be careful, order matters!
        self.playlists = []
        self.liked_songs = Playlist('Liked Songs', [], self)

    def follow(self, user):
        self.following.append(user)
        user.followers += 1

    def __str__(self):
        return self.name
follow 这个方法值得看一眼:它同时改了两个对象。self.following.append(user) 改的是关注者的列表,user.followers += 1 改的是被关注者的计数。方法的 self 不代表「只能碰自己」——只要拿得到别的对象的引用,就能改它。
rebecca.follow:实例上没有 → User 类上有 → 绑定方法,self = rebecca。self = rebecca、user = taylor(一个 Artist 实例)。self.following.append(user):先查 self.following 拿到 rebecca 那个列表对象,然后 append 就地修改它。列表里放进去的是 taylor 本人,不是拷贝——所以 rebecca.following[0] is taylor 为 True。user.followers += 1 等价于 user.followers = user.followers + 1。右边是一次属性查找(taylor 实例上有 followers,值 0),左边是一次属性赋值,把 taylor 实例上的 followers 重新绑到 1。return,返回 None。所以 doctest 里 >>> rebecca.follow(taylor) 下面一行输出都没有——这是对的,不要给它加返回值。__init__ 里的语句顺序不是随便排的
起始代码里那句 NOTE: be careful, order matters! 说的就是这两行:
self.playlists = []
self.liked_songs = Playlist('Liked Songs', [], self)
为什么必须是这个顺序?因为 Playlist.__init__ 的最后一行是 self.owner.playlists.append(self)——新建歌单时它会反过来把自己登记到 owner 的 playlists 列表里。而这里传进去的 owner 就是那个还在建造中的 User。如果 self.playlists = [] 还没执行,这个列表就不存在:
>>> rebecca = User('Rebecca')
AttributeError: 'User' object has no attribute 'playlists'
这是一个循环依赖:User 造 Playlist,Playlist 又要访问 User 的属性。解决办法就是「被别人依赖的东西先初始化」。这类 bug 在 Ants 项目里也会遇到,报错信息永远是 'X' object has no attribute 'y',而真正的原因是赋值语句排错了顺序。
Artist:这一节的主角
class Artist(User):
    def __init__(self, name: str):
        super().__init__(name)
        self.albums = []
整个类只有三行。Artist 比 User 多的只有一个 albums 列表,其余全部继承:name、following、followers、playlists、liked_songs、follow、__str__,一个都不用重写。doctest 里这几行因此自动成立:
>>> taylor = Artist('Taylor Swift')
>>> taylor.followers
0
>>> len(taylor.playlists)
1
>>> taylor.liked_songs is taylor.playlists[0]
True
>>> str(taylor)
'Taylor Swift'
str(taylor) 走的是继承来的 User.__str__,返回 self.name。这就是第 10 节说的「基类的字符串表示要写得对子类也成立」——return self.name 没有写死任何类名,所以对 Artist 一样正确。
还有一个细节:super().__init__(name) 必须在 self.albums = [] 之前吗?在这个例子里两种顺序都能跑。但把 super().__init__() 放第一行是强烈推荐的习惯:基类初始化过程中可能会调用别的方法(比如这里会去造 Playlist),而那些方法可能依赖对象已经处于「基类那部分已就绪」的状态。
Song:__str__ 的实战
class Song:
    def __init__(self, name: str, artist: Artist, duration_sec: int):
        self.name = name
        self.artist = artist
        self.duration_sec = duration_sec

    def __str__(self):
        minutes = self.duration_sec // 60
        seconds = self.duration_sec % 60
        return f'{self.name} by {self.artist} ({minutes}:{seconds})'

    def play(self):
        print(self)
两处需要停下来看:
第一处:f'... by {self.artist} ...'。self.artist 是一个 Artist 对象,不是字符串。f-string 插值时会对它调用 str,于是走到 User.__str__,得到 'Taylor Swift'。这就是给 User 写 __str__ 的回报:这里不用写 self.artist.name,写 self.artist 就够了。(写 .name 也对,但那样 Song 就必须知道 Artist 内部有个叫 name 的属性,抽象屏障被捅破了一点。)
第二处:def play(self): print(self)。print(self) 会对 self 调用 str,也就是这个类自己的 __str__。所以 play 就一行,因为 __str__ 已经把「一首歌该怎么显示」这件事说清楚了。方法体里出现 print(self) 是「我已经写好 __str__」的典型信号。
all_too_well.play → 实例无 → Song 类有 → 绑定方法。新建帧,self = 那首歌。print(self)。print 需要字符串 → 调 str(self) → 找到 Song.__str__ → 新建一帧。__str__ 帧里:minutes = 327 // 60 = 5,seconds = 327 % 60 = 27。{self.name} → 'All Too Well';{self.artist} → 对 Artist 对象调 str → 又进一层,执行 User.__str__ 返回 'Taylor Swift';{minutes} → '5';{seconds} → '27'。'All Too Well by Taylor Swift (5:27)',返回给 str,str 交给 print。All Too Well by Taylor Swift (5:27)(无引号),play 返回 None。{minutes}:{seconds} 不补零。本讲的 doctest 恰好都躲过了这个问题(327→5:27、217→3:37、162→2:42,秒数都是两位),但你自己试一个:
>>> str(Song('X', taylor, 305))
'X by Taylor Swift (5:5)'          # 本该是 5:05
要补零得写 {seconds:02d}。这道题不要求补零,doctest 怎么写就怎么实现——但你得知道这是被 doctest 的取值范围掩盖掉的,而不是代码本来就对。这也顺带说明一件事:doctest 通过不等于实现正确,它只保证「这几个输入下对」。
Playlist 与 Album
class Playlist:
    def __init__(self, name: str, songs: list[Song], owner: User):
        self.name = name
        self.songs = songs
        self.owner = owner
        self.total_duration_sec = sum([song.duration_sec for song in self.songs])
        self.owner.playlists.append(self)

    def play(self):
        for song in self.songs:
            song.play()


class Album(Playlist):
    def __init__(self, name: str, songs: list[Song], artist: Artist):
        super().__init__(name, songs, artist)
        self.owner.albums.append(self)
Album 也只有两行。play 一个字都不用写——重构前抄了两遍的那段代码,现在只剩一份。这就是本讲开头那个动机的兑现。
三个细节:
super().__init__(name, songs, artist)把artist传给了基类的owner形参。形参名不需要一致,位置对上就行。Album把它叫artist是为了在签名上表达「专辑的所有者必须是歌手」。- 第二行写的是
self.owner.albums.append(self)而不是artist.albums.append(self)。两者在这里等价,但用self.owner更稳——它读的是对象当前的真实状态,万一基类的__init__对 owner 做了什么处理,也不会读到过时的值。 - 一张专辑会被登记两次:基类那行把它 append 进
artist.playlists,子类这行又 append 进artist.albums。这是有意的——专辑是歌单,理应出现在歌单列表里;同时它又是专辑,所以另有一份索引。这正是 is-a 关系在数据上的体现。
Album → 造一个空实例 → 查 __init__:Album 上有,用它。帧 f1:self=新实例、name='Red'、songs=[两首歌]、artist=taylor。super().__init__(name, songs, artist) → 从超类 Playlist 开始查 __init__,找到。帧 f2:self=同一个实例、name='Red'、songs=[两首歌]、owner=taylor。self.name、self.songs、self.owner。sum([song.duration_sec for song in self.songs]):列表推导得 [327, 217],求和 544,挂成 self.total_duration_sec。对上了 doctest 里的 544。self.owner.playlists.append(self):taylor.playlists 本来是 [liked_songs],现在变成 [liked_songs, red]。f2 返回 None。self.owner.albums.append(self) → taylor.albums 从 [] 变成 [red]。所以 len(taylor.albums) 是 1,red is taylor.albums[0] 是 True(列表里存的就是那个对象本身)。red.play():查 play → 实例无 → Album 类无 → 超类 Playlist 有。遍历 self.songs,对每首歌调 song.play(),各打印一行。class User class Playlist
__init__ follow __str__ __init__ play
↑ ↑
│ base │ base
│ │
class Artist(User) class Album(Playlist)
__init__(只加 albums) __init__(只加 albums 登记)
follow ← 继承 play ← 继承
__str__ ← 继承
taylor : Artist red : Album
name 'Taylor Swift' name 'Red'
following [] songs [all_too_well, trouble]
followers 0 owner ─────→ taylor
playlists [liked_songs, red] ←──── 被 Playlist.__init__ 登记
albums [red] ←──── 被 Album.__init__ 登记
liked_songs ──→ Playlist('Liked Songs', [], taylor)
把 14.py 补完后跑 python3 -m doctest 14.py:没有任何输出就是 50 条 doctest 全部通过。加 -v 可以看到详细统计。
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
继承 class Sub(Base): | 表达 is-a;子类可访问基类的属性与方法 | 把 has-a 关系(Bank 有 Account)写成继承 |
| 属性查找 | 实例 → 类 → 超类 → 超类的超类 → AttributeError;命中即停 | 以为基类和子类的同名方法会都执行 |
| 重写 override | 子类同名定义挡住基类的;要用基类版本必须显式调 | 重写后忘了调基类,功能悄悄丢失 |
super().m(args) | 从超类查 m,self 自动补 | 多传一个 self → takes 2 positional arguments but 3 were given |
Base.m(self, args) | 等价写法,self 必须手写 | 漏写 self → missing 1 required positional argument |
子类 __init__ | 写了就必须自己调 super().__init__(...) | 忘了调 → 很久之后才炸 'X' object has no attribute 'name' |
| 类属性 | 属于定义它的那个类,一份;子类可重写出自己的一份 | 可变类属性(songs = [])被所有实例共享 |
| 属性赋值 | obj.x = v 永远只在 obj 自己身上绑定 | 以为 emma.interest = 0.08 改了类属性 |
| 组合 composition | has-a,把别的对象存进实例属性 | 该组合的地方硬套继承,语义错乱 |
type(x) | 恰好属于哪个类,不看继承链 | type(a) == Account 把子类实例全漏掉 |
isinstance(x, C) | 沿继承链判断,子类实例算 C 的实例 | — |
repr / __repr__ | 给解释器看;提示符回显、容器里的元素用它 | 只写 __str__,结果 print(列表) 还是内存地址 |
str / __str__ | 给人看;print 和 f-string 用它 | 写成 print(...) 而非 return → __str__ returned non-string (type NoneType) |
| 兜底方向 | str 缺失 → 用 __repr__;反向不成立 | 只写一个时写错了那一个 |
一页纸的求值规则
<expr>.<name>
1. 求 <expr>
2. 若结果是实例 → 查实例自己的属性 ── 命中 → 返回(函数则绑定成方法)
                          │未命中
                          ↓
   查该实例所属的类 ─────────── 命中 → 返回
   (若第 1 步结果本就是类,从这里开始)
                          │未命中
                          ↓
   查超类,重复上一步 ─────────── 命中 → 返回
                          │一直没有超类了
                          ↓
                  AttributeError

赋值 <expr>.<name> = v :不查找、不上溯,直接绑在 <expr> 求出的那个对象上。
动手练习
五道题,都能在本机用 python3 验证。先自己推,再展开答案。
练习 1:查找路径
class A:
    x = 1
    def f(self):
        return self.x

class B(A):
    x = 2

class C(B):
    def f(self):
        return super().f() + 10

c = C()
c.f() 的值是多少?A().f() 呢?如果再执行 c.x = 100,c.f() 又是多少?
看答案
c.f() 是 12。
c.f:实例无 → C 上有 → 用 C.f,self = c。super().f():从 C 的超类 B 开始查 f,B 上没有 → A 上有 → 调 A.f,self 仍然是 c。A.f 里 return self.x:从 c 出发查 x。实例无 → C 无 → B 有,得 2。注意:不是 A.x 的 1!方法虽然定义在 A 里,但 self.x 的查找是从 self 的真实类型 C 开始的。C.f:2 + 10 = 12。A().f() 是 1:self 是一个 A 实例,查 x 在 A 上命中 1。
c.x = 100 之后 c.f() 是 110:c 实例上有了自己的 x = 100,第 3 步在 2a 就命中,不再往上走。
这道题的要害是动态查找:self.x 的结果由 self 是谁决定,跟这段代码写在哪个类里没有关系。
练习 2:忘了 super
class Animal:
    def __init__(self, name):
        self.name = name
        self.legs = 4

class Bird(Animal):
    def __init__(self, name):
        self.legs = 2

b = Bird('Tweety')
创建 b 会报错吗?b.legs 是多少?b.name 呢?怎么改?
看答案
创建 b 不报错。Bird.__init__ 顺利执行完,只是它没干 Animal.__init__ 该干的事。
b.legs 是 2:Bird.__init__ 确实挂上了。
b.name 报错:
AttributeError: 'Bird' object has no attribute 'name'
因为 self.name = name 那一行在 Animal.__init__ 里,而它从未被执行——子类定义了 __init__,属性查找在 Bird 就命中并停止了。
改法:
class Bird(Animal):
    def __init__(self, name):
        super().__init__(name)     # 先把基类那套跑完(name=..., legs=4)
        self.legs = 2              # 再覆盖成 2
顺序不能反:super().__init__(name) 会把 legs 设成 4,所以覆盖必须在它之后。
这道题的教训:这类 bug 的报错地点和真正的错误地点相隔很远。看到 'X' object has no attribute 'y',第一件事是去找 self.y = ... 写在哪个 __init__ 里,第二件事是确认那个 __init__ 有没有被调到。
练习 3:共享的列表
class Team:
    members = []
    def add(self, name):
        self.members.append(name)

a, b = Team(), Team()
a.add('ann')
b.add('bob')
a.members 是什么?如果把 add 改成 self.members = self.members + [name],结果又是什么?
看答案
第一种写法:a.members 是 ['ann', 'bob'],b.members 也是 ['ann', 'bob'],Team.members 同样是 ['ann', 'bob']——三个名字指向同一个列表对象。
原因:self.members.append(name) 里没有赋值。它做的是「查找 self.members(实例无 → 类上命中那个共享列表)→ 对这个列表调 append 就地修改」。两个实例查到的是同一个列表,自然互相看得见。
第二种写法:a.members 是 ['ann'],b.members 是 ['bob'],Team.members 仍是 []。
因为 self.members = ... 是一次赋值:右边先求值(查到共享的空列表,拼出一个新列表 ['ann']),左边把这个新列表绑在 a 这个实例上。从此 a.members 在 2a 就命中,跟类属性再无瓜葛。
两种写法都不是好设计。正确做法是给每个实例自己的列表:
class Team:
    def __init__(self):
        self.members = []
    def add(self, name):
        self.members.append(name)
这道题浓缩了本讲最容易被忽略的一条:obj.x.append(v) 是「查找 + 变异」,obj.x = v 是「赋值」,两者在继承体系里的行为天差地别。
练习 4:str 与 repr
class Point:
    def __init__(self, x, y):
        self.x, self.y = x, y
    def __repr__(self):
        return f'Point({self.x}, {self.y})'

p = Point(1, 2)
下面五行分别输出什么?
>>> p
>>> print(p)
>>> str(p)
>>> [p]
>>> f'{p}'
再问:如果把 __repr__ 改名成 __str__,这五行又分别输出什么?
看答案
只有 __repr__ 时:
>>> p
Point(1, 2)
>>> print(p)
Point(1, 2)
>>> str(p)
'Point(1, 2)'
>>> [p]
[Point(1, 2)]
>>> f'{p}'
'Point(1, 2)'
提示符回显和容器元素本来就用 repr;print、str、f-string 想用 __str__,类里没有,一路查到 object.__str__,它的实现就是转去调 __repr__。所以五处全都好看。注意 str(p) 那行外面有引号(str 返回的是个字符串,提示符回显它时又 repr 了一次),print(p) 那行没有。
只有 __str__ 时:
>>> p
<__main__.Point object at 0x7f...>
>>> print(p)
Point(1, 2)
>>> str(p)
'Point(1, 2)'
>>> [p]
[<__main__.Point object at 0x7f...>]
>>> f'{p}'
'Point(1, 2)'
第 1 行和第 4 行退化了,因为 repr 不会回头去用 __str__。这就是「只写一个就写 __repr__」的理由。
练习 5:把 Album 的 __str__ 写出来
给第 11 节的 Playlist 加一个 __str__,让它满足:
>>> str(love_songs)
'Love Songs by Rebecca (3 songs)'
>>> str(red)
'Red by Taylor Swift (2 songs)'
要求:Album 一个字都不用写。想清楚为什么可以做到,以及 {self.owner} 这一处插值背后连锁调用了几个 __str__。
看答案
class Playlist:
    # ... __init__ 和 play 不变 ...

    def __str__(self):
        return f'{self.name} by {self.owner} ({len(self.songs)} songs)'
为什么 Album 不用写:查 str(red) 的 __str__ → red 实例上没有 → Album 类上没有 → 超类 Playlist 上有,用它,self = red。因为方法体里全部用 self. 取值、没有写死任何类名或属性来源,所以对 Album 一样成立。
{self.owner} 背后:对 red 来说 self.owner 是 taylor,一个 Artist。f-string 对它调 str → Artist 类上没有 __str__ → 超类 User 上有 → 返回 self.name 即 'Taylor Swift'。所以这一行代码里发生了两次沿继承链的方法查找,各自都在超类才命中。
验算 str(love_songs):self.name = 'Love Songs';self.owner = rebecca,是个 User,__str__ 在自己类上就命中,返回 'Rebecca';len(self.songs) = 3。拼成 'Love Songs by Rebecca (3 songs)'。✓
如果要求 Album 打印成 'Red by Taylor Swift (2 songs) [ALBUM]' 呢?那就在 Album 里重写,并复用基类的成果:
class Album(Playlist):
    def __str__(self):
        return super().__str__() + ' [ALBUM]'
注意这里 super().__str__() 后面的括号——__str__ 是个方法,要调用它才拿到字符串。漏掉括号会得到一个方法对象,然后报 TypeError: unsupported operand type(s) for +: 'method' and 'str'。报错里出现 'method' 这个词,基本都是忘了写括号。