异常 II:防御式编程、测试与调试
程序出错时到底发生了什么、怎么让它出得响亮、怎么接住它,以及怎么把「盯着代码发呆」换成一套可重复的排查流程。
0. 本讲导读
到目前为止,你写的每一段代码都是假定一切顺利写出来的:divide(a, b) 假定 b 不是 0,lst[i] 假定 i 没越界,next(it) 假定迭代器还有东西。上一讲的迭代器和生成器把这个假设推到了极致——一个耗尽的迭代器再取值就会抛 StopIteration,而 for 循环之所以能正常结束,恰恰是因为它在内部接住了这个异常。
换句话说:异常不是「程序坏了」的信号,它是 Python 的一种正常控制流机制。 第 1 讲的「异常 I」教了你怎么读报错,这一讲要教你三件更主动的事。
raise 让函数在收到荒唐输入时立刻停下、大声报错,而不是返回一个悄悄错掉的值,让 bug 在三百行之外才爆炸。try 语句在特定位置拦截特定异常,让程序在可预期的坏情况下仍然走完流程。这一讲和前十讲的气质不太一样:它讲的不是某个新的语言特性,而是怎么写出别人(和三个月后的你)能看懂、能维护、坏了能修的程序。这些东西在期末不会以「写出 try 的语法」的形式来考,但它决定了你后面做 Ants、Scheme 解释器这些大项目时,是两小时搞定还是两天卡死。
再往后一讲就是期中复习,考试范围包含到复习课为止的全部内容——所以本讲的 try/raise/常见异常表都在范围内。
- 异常(exception)是程序执行期间遇到非常规情况时被抛出(raise / throw)的对象。抛出会沿调用栈向上传播,沿途把每一帧都弹掉,直到被某个
try接住,或者一路冲到顶层打印出 traceback 并终止程序。 - traceback 要从下往上读:最后一行是异常的类型和消息(「出了什么事」),倒数第二组 File 行是真正出事的那一行,往上是把你带到那里的调用链。
raise ValueError('...')比assert更有表达力:异常类本身就说明了错误的种类,消息说明细节。不要什么都不做——悄悄失败(fail silently)的代价是 bug 在离案发现场很远的地方才被发现。try语句四个 suite 的执行时机完全不同:try一定进;except只在匹配的异常发生时进;else只在try完全没出事时进;finally无论如何都进。- 裸写
except:会连KeyboardInterrupt都吞掉,等于把「大声失败」的好处全部抵消。永远写明要接哪一类异常。 - type hints(
def add(a: int, b: int) -> int:)在运行时不被强制检查——Python 是动态类型语言。它们的价值在于给人看,以及给 linter 这类静态分析工具看。 - 测试驱动开发(TDD)的顺序是「先写测试,再写代码」。测试覆盖率(test coverage)只告诉你「哪些行被执行过」,不告诉你「行为对不对」——100% 覆盖率的测试套件照样可以什么都没测出来。
1. 复习:异常是什么,以及为什么要让程序「大声地失败」
课上给的定义只有一句话:
异常(exception)是程序执行过程中,在出现非标准行为时被抛出(raised / thrown)的错误。
这句话里有两个词值得抠。
第一个是「执行过程中」。这把异常和另一类错误划清了界限。SyntaxError 是在 Python 还没开始执行你的程序时、把源码解析成可执行形式的阶段就报出来的——所以文件里只要有一处语法错,整个文件一行都不会跑。而 ZeroDivisionError 这种是执行到那一行才发生的,前面的代码已经跑完了,副作用(比如 print)也已经发生了。这个区别在调试时非常实用:如果你在文件开头加了一句 print("start") 却连它都没打出来,那基本可以断定是语法错误。
第二个是「抛出」。异常不是「返回」,它不沿着正常的返回路径走。当一个异常被抛出时,当前正在执行的语句立刻中断,当前这一帧被丢弃,控制权交还给调用它的那一帧——但不是以「函数返回了一个值」的方式回去的,而是带着「我这里出事了」的状态回去。如果调用者也没管,就继续往上弹。这个过程叫栈展开(stack unwinding),下一节会画出来。
为什么不能「什么都不做」
课上在讲 raise 时抛了一个问题:「为什么要抛异常?我们不能就什么都不做吗?」 这个问题值得认真回答,因为它是整讲的思想基础。
假设你写一个求平方根的函数,遇到负数输入时「什么都不做」——就让它自然地算下去:
>>> def square_root(x):
...     return x ** 0.5
...
>>> square_root(16)
4.0
>>> square_root(-4)
(1.2246467991473532e-16+2j)
它没有报错。它返回了一个复数——这是 Python 对 (-4) ** 0.5 的合法解释。如果你的程序后面拿这个值去比大小,就会撞上:
>>> square_root(-4) > 1
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: '>' not supported between instances of 'complex' and 'int'
看看这个报错发生在哪里:它发生在比大小那一行,而真正的病根在 square_root(-4) 那次调用。这两处可能隔着几十行、几个函数、甚至几个文件。你要花的调试时间,全部浪费在「从症状倒推回病因」上。
更糟的情况是它连报错都不报,只是算出一个错误但看起来正常的数字,然后你的成绩单上多了一个 D。
一个函数一旦发现自己的前提被违反,最好的做法是立刻停下来、抛出异常。 异常抛出的位置离病因最近,traceback 会直接把你指到那一行。你损失的只是「程序继续跑下去」的机会——而在前提已经被违反的情况下,程序继续跑下去本来就没有意义。
反过来说,这条原则也解释了为什么裸写 except: 是危险的:它把一切异常都吞掉,等于系统性地关掉了所有「大声失败」的机制,让程序回到悄悄算错的状态。课上原话是「remember, we don't want to fail silently」。
2. 读懂 traceback:一次完整的调试演示
课上的调试演示用的是 11-debug.py,这段代码来自 John DeNero 教授的调试视频。它只有九行,却塞进了三个层次完全不同的 bug。我们把它当成一个完整的案例走一遍——这一节是本讲最值得慢慢读的部分。
def f(x):
    return g(x - 1)

def g(y):
    return abs(h(y) - h(1 /* y)

def h(z):
    z * z

print(f(12))
print(f(1))
第一层:连一行都跑不起来
直接运行:
$ python3 11-debug.py
  File "/tmp/11-debug.py", line 10
    return abs(h(y) - h(1 /* y)
                           ^
SyntaxError: invalid syntax
Traceback (most recent call last): 这一行。 这是 SyntaxError 最显眼的标志——它不是在执行期间发生的,所以根本没有调用栈可以打印。print(f(12)) 那一行的输出也没有出现。因为 Python 是先把整个文件解析完再开始执行的,解析阶段一失败,一行都不会跑。^ 指向 *。Python 说的是「我读到这里读不下去了」,不一定是「错在这个字符」。这里 /* 显然是手滑(C 系语言的注释符号跑到 Python 里来了),另外 abs( 的括号也少配了一个。return abs(h(y) - h(1 / y))。括号数一下:abs(、h(、h( 三个开,末尾要有三个闭。SyntaxError 报的行号经常比真正出错的行大 1。典型场景是上一行的括号没闭合:
>>> x = (1 + 2
... y = 3
  File "<stdin>", line 2
    y = 3
    ^^^^^
SyntaxError: invalid syntax
错的是第 1 行的 (,但 Python 是读到第 2 行才发现「这个括号里怎么冒出来一个赋值语句」。所以看到 SyntaxError,先看报错行的上一行。
第二层:跑起来了,但类型不对
修好语法后再跑:
$ python3 11-debug.py
Traceback (most recent call last):
  File "/tmp/11-debug.py", line 10, in <module>
    print(f(12))
  File "/tmp/11-debug.py", line 2, in f
    return g(x - 1)
  File "/tmp/11-debug.py", line 5, in g
    return abs(h(y) - h(1 / y))
TypeError: unsupported operand type(s) for -: 'NoneType' and 'NoneType'
这是本讲最需要练熟的技能:把这一坨东西读出信息来。
TypeError: unsupported operand type(s) for -: 'NoneType' and 'NoneType'。翻译成人话:有人拿两个 None 做减法。 异常类型 TypeError 说明「类型不对」,消息说明了具体是哪个运算符(-)和哪两个类型。line 5, in g,代码是 return abs(h(y) - h(1 / y))。这是案发现场——减法就在这里。所以 h(y) 和 h(1 / y) 都返回了 None。None?答案是「函数体执行完了却没有执行到任何 return」。去看 h:def h(z): 下面写的是 z * z,没有 return。z * z 是一个表达式语句——它被求值了,结果被算出来了,然后被直接扔掉。python3 -i 进去手动调一次 h(3)。你会发现 REPL 里什么都不显示(None 在 REPL 里不回显),而 print(h(3)) 打出 None。假设成立。def h(z): return z * z。剩下几行 File 是怎么走到案发现场的路径。从上往下是调用发生的顺序:全局帧(<module>)调用了 f,f 调用了 g,g 里出的事。「most recent call last」这句话就是这个意思:最近的调用排在最后。
异常发生的那一刻,Python 把当时还活着的所有帧从底到顶列了出来。所以 traceback 的长度 = 出事时的调用深度。看到几十行重复的 traceback,基本就是递归没收住。
第三层:类型也对了,但输入本身有问题
把 h 修好之后:
$ python3 11-debug.py
120.99173553719008
Traceback (most recent call last):
  File "/tmp/11-debug.py", line 11, in <module>
    print(f(1))
  File "/tmp/11-debug.py", line 2, in f
    return g(x - 1)
  File "/tmp/11-debug.py", line 5, in g
    return abs(h(y) - h(1 / y))
ZeroDivisionError: division by zero
f(12) 成功了,打出 120.99173553719008。算一下就知道它是对的:f(12) → g(11) → abs(11² − (1/11)²) = abs(121 − 0.008264…) = 120.9917…。
f(1) 却炸了。f(1) → g(1 - 1) = g(0) → 1 / 0。
前两个 bug 是代码写错了,改代码就行。第三个不是——g 的代码没错,是输入 y = 0 落在了这个函数根本没定义的地方。这时你有三个选择,而选哪个是设计决策,不是对错问题:
- 什么都不做,让
ZeroDivisionError自然抛出。可以接受——报错信息已经足够清楚了。课上的解答文件就是把print(f(1))注释掉了事。 - 抛一个更有信息量的异常:在
g开头写if y == 0: raise ValueError('y must be nonzero')。调用者一看就知道是自己传错了参数,而不是去猜g内部哪里除了零。 - 接住它:用
try包起来,返回一个约定好的默认值。只有在「0 是一个合法输入、并且有明确的应对方案」时才这么做。
异常抛出时,栈上到底发生了什么
这是本讲对「求值过程」这个母题的回答。以 f(1) 为例,把帧一层层画出来。
正常展开阶段——每次调用用户定义的函数就新建一帧:
| f | func f(x) [parent=Global] |
| g | func g(y) [parent=Global] |
| h | func h(z) [parent=Global] |
| 当前表达式 | print(f(1)) |
| x | 1 |
| 当前表达式 | g(x - 1),实参已求值为 0 |
| y | 0 |
| 当前表达式 | abs(h(y) - h(1 / y)) 里的 1 / y |
abs(h(y) - h(1 / y))。按求值规则,先求算子 abs,再求算子数 h(y) - h(1 / y)。h(y) - h(1 / y):先算左边 h(y) = h(0)。这一步是成功的——新建帧 f3,z 绑定 0,返回 0,f3 正常弹出。h(1 / y)。要先求实参 1 / y,也就是 1 / 0。除法运算在这里抛出 ZeroDivisionError。注意:h 的帧根本没有被创建——参数都还没算完,怎么会有帧。try,所以 f2 被丢弃,异常带着「我从 f2 的第 5 行来」这条记录传给调用者 f1。关键:g 没有「返回」任何值,return 那一行根本没执行完。try,f1 被丢弃,记录再加一条「经过 f1 的第 2 行」。try。到顶了,Python 把累积的这几条记录格式化成 traceback 打印到 stderr,然后以非零状态码退出。print(f(1)) 里的 print 一次都没被调用。抛出瞬间的栈 → 展开中 → 展开中 → 到顶
───────────────── ─────────── ───────── ────────
f2: g y=0 ← 抛出 (丢弃) (丢弃) (丢弃)
f1: f x=1 f1: f x=1 ← 到我 (丢弃) (丢弃)
Global Global Global ← 到我 打印 traceback
程序终止
沿途记录(这就是 traceback 的内容,从下往上是弹出顺序):
line 11, in <module> print(f(1))
line 2, in f return g(x - 1)
line 5, in g return abs(h(y) - h(1 / y))
ZeroDivisionError: division by zero
初学者常把「函数出错了」和「函数返回了 None」混为一谈。它们在环境图上是两回事:返回 None 的帧有一个「返回值 = None」的条目,调用者拿到 None 继续往下算;抛出异常的帧连返回值条目都不会有,调用者也不会继续往下算——它自己也一起被弹掉。这正是第二层 bug(h 返回 None)和第三层 bug(除零抛异常)的本质区别。
3. Python 常见异常速查:每一个都配真实报错
课上给了三页表格,列出十三个常见异常。光背「什么意思」没用——真正有用的是看到这个异常名,能立刻反推出「我大概干了什么蠢事」。下面这张表把课上的定义和真实报错并排放在一起,报错信息都是在 Python 3.10 上实际跑出来的。
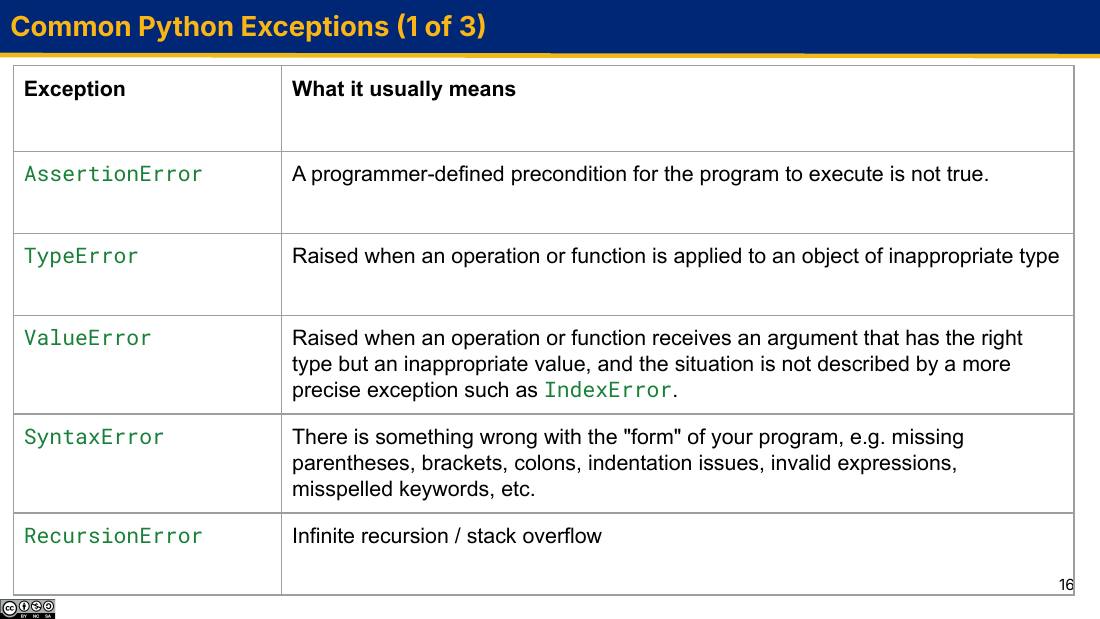
ValueError 的定义值得逐字读:「参数类型是对的,但值不合适,而且没有更精确的异常(如 IndexError)来描述这个情况」——这句话正好点出了 TypeError、ValueError、IndexError 三者的分工。| 异常 | 课上的定义 | 一句能触发它的代码 + 真实报错 |
|---|---|---|
AssertionError | 程序员定义的前置条件不成立 | assert n >= 0, 'n must be non-negative'AssertionError: n must be non-negative |
TypeError | 把某个操作或函数用在了类型不合适的对象上 | 1 + 'a'TypeError: unsupported operand type(s) for +: 'int' and 'str' |
ValueError | 类型对,但值不合适,且没有更精确的异常可用 | int('hello')ValueError: invalid literal for int() with base 10: 'hello' |
SyntaxError | 程序的「形式」不对:括号、方括号、冒号、缩进、拼错的关键字等 | def f(x)(漏冒号)SyntaxError: expected ':' |
RecursionError | 无限递归 / 栈溢出 | 没有 base case 的递归RecursionError: maximum recursion depth exceeded |
KeyError | 访问字典里不存在的键 | {'a': 1}['b']KeyError: 'b' |
NameError | 访问一个不存在的名字,常见原因是拼错 | undefined_nameNameError: name 'undefined_name' is not defined |
IndexError | 序列索引越界 | [1, 2, 3][5]IndexError: list index out of range |
StopIteration | 迭代器里的元素取完了 | next(iter([]))StopIteration(消息为空) |
UnboundLocalError | 引用了函数里的局部变量,但它还没被绑定过值 | 见下方专门讨论UnboundLocalError: local variable 'x' referenced before assignment |
ZeroDivisionError | 除以零 | 1 / 0ZeroDivisionError: division by zero |
RuntimeError | 检测到一个不属于其他任何类别的错误 | 通常由库代码抛出 |
AttributeError | 属性引用或赋值失败(讲到 OOP 时会大量遇到) | (3).fooAttributeError: 'int' object has no attribute 'foo' |
最容易混淆的一组:TypeError vs ValueError vs IndexError
这三个的边界,靠一句话就能划清:先问类型对不对,再问值合不合适,最后问有没有更专门的异常。
| 表达式 | 异常 | 为什么是它 |
|---|---|---|
int('hello') | ValueError | int 本来就接受 str,类型没问题;是 'hello' 这个值没法解释成整数 |
int([1, 2]) | TypeError | int 根本不接受列表,类型就不对 |
len(5) | TypeError | object of type 'int' has no len()——整数这个类型没有长度 |
[1, 2, 3][5] | IndexError | 5 类型对(是整数)、值也「不合适」,但存在更精确的异常,所以用 IndexError 而不是 ValueError |
[1, 2, 3]['a'] | TypeError | list indices must be integers or slices, not str——索引的类型就不对 |
'abc'[0] = 'z' | TypeError | 'str' object does not support item assignment——不可变类型上不存在「按下标赋值」这个操作 |
UnboundLocalError:这个值得单独讲
它是这十三个里唯一一个需要动用「作用域」知识才能理解的。看这段代码:
def f():
    if False:
        x = 1
    x = x + 1
    return x

f()
Traceback (most recent call last):
  File "/tmp/ub.py", line 6, in <module>
    f()
  File "/tmp/ub.py", line 4, in f
    x = x + 1
UnboundLocalError: local variable 'x' referenced before assignment
x 出现在 x = 1 和 x = x + 1 的左边。x 被登记为 f 的局部名字。这个登记是静态的、编译期的——跟 if False 这一支实际上跑不跑没有任何关系。if False 的 suite 被跳过,所以 f1 里并没有 x 这个绑定。x = x + 1:要先求值右边的 x。查 f1——x 已经被登记为局部名字,所以 Python 不会去 parent 帧找;而 f1 里它又还没有值。这就是「local variable referenced before assignment」。x 的赋值,x 就不是局部名字,Python 会顺着 parent 一路往上找到全局帧;找不到才报 NameError。count = 0
def bump():
count = count + 1 # UnboundLocalError
return count
写代码的人以为「读全局的 count,加一,再写回去」。但 count = ... 这个赋值让 count 变成了 bump 的局部名字,于是右边的 count 也只在局部帧里找,找不到。
在 61A 的范围内,正确做法不是用 global(课上没教,也不推荐),而是把值传进去、把结果返回来:def bump(count): return count + 1。这正是这门课反复强调的「函数应该靠参数和返回值跟外界打交道」。
RecursionError:递归没收住时到底发生了什么
把阶乘的 base case 去掉:
def fact(n):
    return n * fact(n - 1)

fact(5)
fact(5) → 新建 f1,n=5,要算 5 * fact(4),于是先去算 fact(4)。f1 还没结束,它挂在栈上等着。fact(4) → f2,n=4,要算 4 * fact(3),f2 也挂着。fact(3)、fact(2)、fact(1)、fact(0)。到 fact(0) 时,如果有 base case if n == 0: return 1,就会在这里返回 1,然后逐层回代:1*1=1 → 2*1=2 → 3*2=6 → 4*6=24 → 5*24=120。fact(0) 继续调 fact(-1),然后 fact(-2)、fact(-3)……永远碰不到一个让它停下来的条件。sys.getrecursionlimit()),超过就抛 RecursionError。Traceback (most recent call last):
File "/tmp/rec.py", line 3, in <module>
fact(5)
File "/tmp/rec.py", line 2, in fact
return n * fact(n - 1)
File "/tmp/rec.py", line 2, in fact
return n * fact(n - 1)
... (中间省略大量重复)
File "/tmp/rec.py", line 2, in fact
return n * fact(n - 1)
[Previous line repeated 996 more times]
RecursionError: maximum recursion depth exceeded
[Previous line repeated 996 more times] 这一行是 RecursionError 的招牌。看到超长且重复的 traceback,先去检查:base case 写了吗?递归调用真的在往 base case 靠近吗? 第二个问题更隐蔽——fact(n) 里如果不小心写成 fact(n) 而不是 fact(n - 1),问题参数永远不变,同样跑不到底。
4. 防御式编程:assert、type hints 与 raise
防御式编程(defensive programming)指的是一整套「预防 bug」的技术。第 1 讲已经见过其中两样,这一讲补上第三样,也是最有表达力的一样。
assert:把假设写成代码
语法是 assert <condition>, <message>。如果 <condition> 是 falsy,就抛出 AssertionError,消息是 <message>;是 truthy 就当这行不存在。
>>> def fact(n):
...     assert n >= 0, 'n must be non-negative'
...     return 1 if n == 0 else n * fact(n - 1)
...
>>> fact(-1)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "<stdin>", line 2, in fact
AssertionError: n must be non-negative
注意 assert 用的是真假性(truthiness),不是「必须等于 True」。assert lst 在 lst 是空列表时会失败——这正是想要的效果。
assert (n >= 0, 'n must be non-negative') # 永远不会失败!这样写等价于 assert <一个二元组>。非空元组永远是 truthy,所以这条断言在任何输入下都通过,你的防线彻底失效。Python 会给一个警告:SyntaxWarning: assertion is always true, perhaps remove parentheses?——但只是警告,不是错误,很容易被忽略。assert 是语句不是函数,条件和消息之间是逗号分隔的两个部分,不要加括号。
type hints:写给人和工具看的注释
类型提示把「这个参数应该是什么类型」这件本来只存在于文档字符串里(甚至只存在于作者脑子里)的信息,写成了代码的一部分:
def add(a: int, b: int) -> int:
    return a + b
学了容器之后,类型提示可以写得更精确:
def to_string(lst: list[str]) -> str:
    total = ""
    for s in lst:
        total += s
    return total
list[str] 的意思是「一个元素全是 str 的 list」。同理还有 dict[str, int]、tuple[int, int] 等等。
Python 是动态类型(dynamically typed)语言,它不会在运行时检查类型提示。下面这段代码一句警告都不会给:
>>> def add(a: int, b: int) -> int:
...     return a + b
...
>>> add('hello', ' world')
'hello world'
标注说返回 int,实际返回了 str,Python 毫不在意。类型提示不是运行时的保险,assert 和 raise 才是。
那类型提示的价值在哪?在静态分析工具(static analysis tool)——不执行代码、只分析源码文本的工具。课上提到的两个概念要分清:
| 概念 | 定义 | 例子 |
|---|---|---|
| 静态分析工具 | 不执行代码就能分析写好的代码的工具 | 类型检查器、linter、formatter |
| linter | 一类静态分析工具,针对代码的「最佳实践」给出反馈 | Ruff、Pylint |
| formatter | 能自动修复某些风格问题的静态分析工具 | Ruff(既是 linter 也是 formatter)、Black |
课上顺带提了一句:大多数主流 linter 都有 VS Code 扩展,装上之后写代码时问题会直接标在编辑器里。
raise:抛出比 AssertionError 更有信息量的异常
assert 有一个局限:它只能抛 AssertionError。而 AssertionError 这个名字本身不携带任何信息——它只说明「有个断言挂了」。如果你想告诉调用者「问题出在值上」还是「问题出在类型上」,就得自己挑一个异常类抛。
语法:raise <exception>,其中 <exception> 可以是一个异常类,也可以是一个异常实例(想带消息时就用实例)。
raise TypeError
raise ValueError('n must be a positive integer')
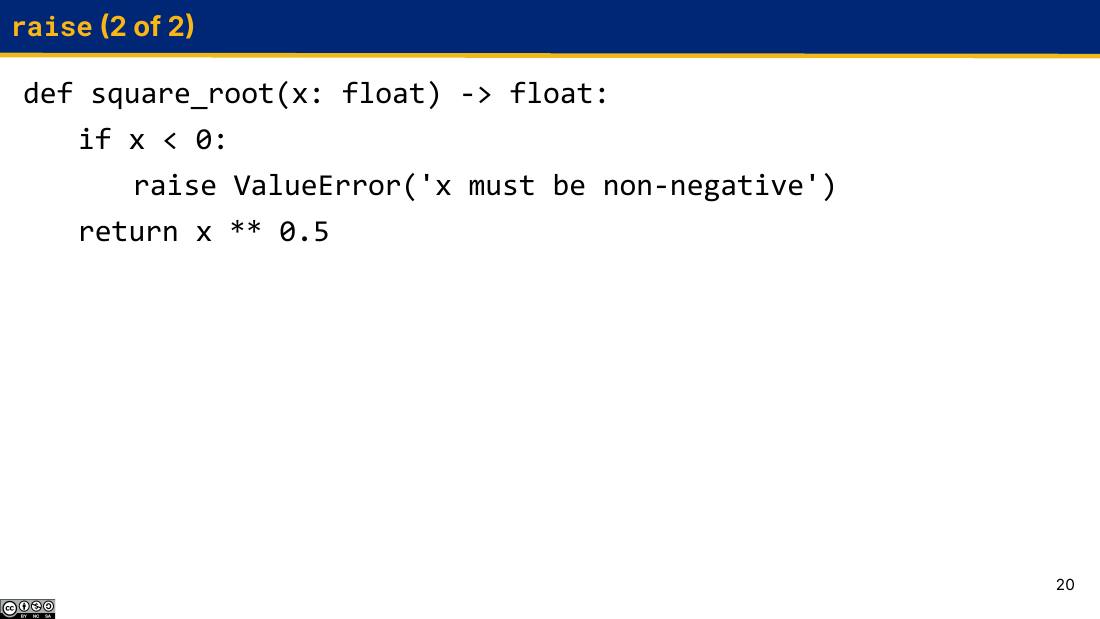
square_root 例子。三行代码同时用上了三样东西:类型提示标明契约,守卫子句(guard clause)在函数最开头检查前提,raise ValueError 用最贴切的异常类型报告违约。这是本讲推荐的标准函数骨架。>>> def square_root(x: float) -> float:
... if x < 0:
... raise ValueError('x must be non-negative')
... return x ** 0.5
...
>>> square_root(16)
4.0
>>> square_root(-4)
Traceback (most recent call last):
File "<stdin>", line 1, in <module>
File "<stdin>", line 3, in square_root
ValueError: x must be non-negative
对照第 1 节那个不做检查的版本(它悄悄返回了 (1.2246467991473532e-16+2j)),差别一目了然:现在 traceback 直接指向 square_root 的第 3 行,消息就是人话,调用者不需要理解这个函数的内部实现就知道自己错在哪。
raise 和 return 都会立刻结束当前函数的执行,但去向完全不同:
return v | raise E('...') | |
|---|---|---|
| 当前帧 | 标记「返回值 = v」后弹出 | 直接弹出,没有返回值 |
| 调用者 | 拿到 v,从调用表达式的位置继续往下算 | 调用者也被中断;除非它有 try,否则也一起弹出 |
| 最终去向 | 值一层层回代 | 异常一层层上抛,直到被接住或到达顶层 |
| 能否跨越多层 | 不能,只回到直接调用者 | 能,可以一口气穿过几十层 |
assert 还是 raise?
| 场景 | 推荐 | 理由 |
|---|---|---|
| 检查自己写的代码内部不该发生的情况 | assert | 写起来短,意思是「这里要是挂了就是我自己的 bug」 |
| 检查外部传进来的参数是否合法 | raise ValueError / raise TypeError | 调用者可以针对性地 except ValueError 接住它,AssertionError 接起来含义太模糊 |
| 需要在错误里带上具体的值 | raise + f-string | 如 raise ValueError(f"'{vowel}' is not a valid vowel.") |
用 python3 -O(大写字母 O,表示 optimize)运行程序时,所有 assert 语句会被整个跳过。所以生产代码里对用户输入的校验绝不能只靠 assert——那是 raise 的活。在 61A 的作业里你不会用到 -O,但知道这件事能帮你理解「为什么课上要专门教 raise」。
5. 分解与代码风格:让 bug 无处藏身
这一节讲的东西没有语法可背,但它回答了一个很实际的问题:为什么有的代码你一眼就能看出 bug,有的代码盯半小时也看不出来?
问题分解(decomposition)
在 61A 里,你通常实现的是单个函数或者小项目。而真实世界的代码库可能有成百上千个文件、上百万行代码。课上的原话是:因此,把问题分解成子问题、把不同部分的关注点分开,以避免重复,是至关重要的。最基本的手段就是写辅助函数(helper function)。
怎么判断一个函数该拆了?课上提到 linter 能做圈复杂度分析(cyclomatic complexity analysis):给出一个数字,衡量函数有多「复杂」,从而告诉你什么时候该把东西拆出去或减少重复。
课上的演示是 ruff check complexity.py,例子长这样(来自 Ruff 官方文档的 complex-structure 规则):
def normalize_status(status):
    if status == "new":
        return "queued"
    if status == "queued":
        return "running"
    if status == "running":
        return "done"
    if status == "failed":
        return "retry"
    if status == "cancelled":
        return "closed"
    return "unknown"
这个函数完全正确,但它的问题是:每加一个状态就要加两行 if,而这些 if 的形状一模一样——重复的结构在暗示数据被写死进了控制流。改成把数据从代码里抽出来:
STATUS_TRANSITIONS = {
    "new": "queued",
    "queued": "running",
    "running": "done",
    "failed": "retry",
    "cancelled": "closed",
}


def normalize_status(status):
    return STATUS_TRANSITIONS.get(status, "unknown")
函数体从 11 行变成 1 行,圈复杂度从 6 降到 1。更重要的是:新增一个状态现在只需要改数据,不需要碰逻辑。 第 8 讲学的字典,用处正在于此:把「查表」这件事从控制流里搬进数据里。
每个 if、每个 elif、每个 while、每个 and/or 都会让路径数翻倍或加一。路径越多,需要写的测试用例就越多,能藏 bug 的角落也越多。「这个函数需要多少个测试才能测全」是判断该不该拆分的一个很好用的直觉。
代码风格(code style)
课上引用了一个具体的定义(Řechtáčková 等,2025):代码风格缺陷(code style defect)是指「一段功能正确、但可以写得更清晰、更优雅、更符合惯例的代码」。
注意「功能正确」这四个字:风格问题不是 bug。那为什么要在意?课上给的理由很直接:代码不只是写给机器看的,也是写给同行(和未来的自己)看的。可读的代码更好维护、更好调试。
Linter 和 formatter 能帮上忙。课上的演示是 ruff format format.py——把一个故意写得很丑的文件(乱七八糟的空格、把一整个字典写在一行上、不一致的引号)自动排版成规范格式。
直接关系。回想第 2 节那个 h(z): z * z 的 bug——它之所以难发现,是因为「少了个 return」这件事在源码里看不见:没有多出来的字符,只有少了的字符。而 linter 恰恰擅长发现这类「不见了的东西」和「形状不对的东西」。风格工具真正的收益不是让代码好看,而是把一部分 bug 变成肉眼可见的。
6. 测试驱动开发与测试覆盖率
测试驱动开发(test-driven development,TDD)是一种软件工程实践,课上把它拆成了五步:
顺序是这一整套方法的全部要点:测试写在代码之前。为什么这个顺序重要?
「写测试」这个动作,本质上是在回答「这个函数在什么输入下应该给出什么输出」。如果你答不上来,那说明你其实还不知道自己要写什么——这时候动手写代码,写出来的东西必然是含糊的。
反过来,一旦测试写好了,你就有了一个客观的完成标准,而不是「我看着差不多了」。61A 里每道题给的 doctest 就是助教替你完成的第 1、2 步;你自己写代码时,也应该在动手前先给自己补几个 doctest,尤其是边界情况。
课上给了两条写测试的理由:
- 把软件验证这件事自动化,尤其对于多人同时开发的大型互联代码库。
- 在边界情况真正出事之前把它们抓出来,并确保它们被处理了。
测试的四种类型
| 类型 | 定义 | 在 61A 里对应什么 |
|---|---|---|
| 手动测试(manual test) | 自己跑程序、自己调函数,肉眼检查是否正确 | python3 -i hw04.py 然后手打几个调用 |
| 单元测试(unit test) | 检查代码中一个孤立的、小的部分(例如单个函数)是否正确的代码 | Python doctest——课上明确点名它是单元测试的例子 |
| 集成测试(integration test) | 检查多个部分组合起来是否正常工作的代码 | 下一节 generate_grade_report 的那几个测试 |
| 端到端测试(end-to-end / E2E test) | 检查整个系统是否正常工作 | Ants 项目跑一整局游戏 |
这四类的区别是「一次测多大一块」。它们的取舍很直白:单元测试跑得快、出错时能精确定位到某个函数,但测不出「各部分接在一起时会不会打架」;端到端测试最接近真实使用,但一旦挂了,你只知道「系统坏了」,得自己去翻是哪一环。所以实践中是金字塔形:大量单元测试 + 少量集成测试 + 极少量 E2E。
测试框架
大多数编程语言都有测试框架(testing framework),让写测试和跑测试变得容易。课上提了两个:
doctest | pytest | |
|---|---|---|
| 来源 | Python 内置模块 | 需要单独安装 |
| 测试写在哪 | 函数的 docstring 里,形如 >>> 调用 加下一行的期望输出 | 单独的测试文件,函数名以 test_ 开头,用 assert 断言 |
| 怎么跑 | python3 -m doctest -v file.py | pytest tests/test_xxx.py |
| 适合 | 又当文档又当测试的简单例子 | 更重的场景:参数化、fixture、覆盖率插件 |
doctest 失败时长这样,格式非常好读:
$ python3 -m doctest bad.py
**********************************************************************
File "/tmp/bad.py", line 3, in bad.add
Failed example:
    add(1, 2)
Expected:
    4
Got:
    3
**********************************************************************
1 items had failures:
   1 of   1 in bad.add
***Test Failed*** 1 failures.
Expected 和 Got 这两行,就是调试流程第 3 步「期望值和实际值差在哪」的直接答案。 很多同学看到红字就慌了直接改代码——先把这两行读完,往往差异本身就把 bug 指出来了(差 1?符号反了?类型不对?返回了 None?)。
测试覆盖率
测试覆盖率(test coverage):跑完一整套测试后,源代码中被执行到的行数占总行数的百分比。
课上对它的评价相当克制,几条都值得记住:
看这个函数:
def sign_label(n):
    label = "non-negative"
    if n < 0:
        label = "negative"
    return label
只用一个测试 sign_label(-1) == "negative",函数体的每一行都会被执行:先给 label 赋初值、检查条件、进 if 改掉它、返回。覆盖率报告会得意地告诉你 100%。
但这个测试完全没有验证 n >= 0 时的行为。假如第 2 行被手滑写成 label = "nonnegative"(少了连字符),这个测试照样通过——因为它走的那条路径上,这个值立刻就被覆盖掉了。真正会暴露这个 bug 的是 sign_label(3),而它根本没被写出来。
结论:覆盖率是「有没有漏测」的下限检查工具,不是「测得对不对」的证明。 它能告诉你「第 7 行从来没跑过,去补个测试」,但它永远不会告诉你「这条路径上的值其实是错的」。课上那道 count vowel 练习的「挑战题」问的正是这件事。
7. 测试实战一:把覆盖率提到 100%,然后发现它没用
课上的第一个练习用的是 count_vowel_occurrences.py。函数本身不难,难的是怎么看待它的测试。
def count_vowel_occurrences(text: str, vowel: str) -> int:
    """
    Counts the number of times a specific vowel appears in the given text.
    The search is case-insensitive.
    ...
    Raises:
    ValueError: If the 'vowel' argument is not a single character or
                not a valid vowel (a, e, i, o, u).

    Doctests:
    -- Standard Cases --
    >>> count_vowel_occurrences("hello world", "o")
    2

    -- Edge Case: Vowel Not Present --
    >>> count_vowel_occurrences("myth", "y")
    Traceback (most recent call last):
        ...
    ValueError: 'y' is not a valid vowel.
    """
    # Guard clause 1: Ensure vowel is a single character
    if len(vowel) != 1:
        raise ValueError("Vowel must be a single character.")

    # Guard clause 2: Ensure the character is actually a vowel
    if vowel.lower() not in "aeiou":
        raise ValueError(f"'{vowel}' is not a valid vowel.")

    # Standardize inputs to lowercase for case-insensitivity
    text_lower = text.lower()
    vowel_lower = vowel.lower()

    # Count and return
    return text_lower.count(vowel_lower)
先注意这个函数示范了前面几节的全部要点:类型提示写明契约、两个守卫子句在最开头挡住非法输入、raise ValueError 带具体消息、docstring 里连「会抛什么异常」都写清楚了。这就是防御式编程写出来的样子。
doctest 怎么测「会抛异常」
这是很多人第一次见的写法:
>>> count_vowel_occurrences("myth", "y")
Traceback (most recent call last):
    ...
ValueError: 'y' is not a valid vowel.
doctest 对 traceback 有特殊处理:只要以 Traceback (most recent call last): 开头,中间那些 File ... 行可以用 ... 一笔带过,doctest 只比对最后那一行「异常类型: 消息」。 这个设计很合理——traceback 里的文件路径和行号会随着代码移动而变化,不该被写死进测试。
写 doctest 测异常时,下面这两种写法都不行:
# 错误写法 1:只写异常行,没有 Traceback 开头
>>> count_vowel_occurrences("myth", "y")
ValueError: 'y' is not a valid vowel.

# 错误写法 2:消息写得不完全一致(少了句号)
>>> count_vowel_occurrences("myth", "y")
Traceback (most recent call last):
    ...
ValueError: 'y' is not a valid vowel
第一种 doctest 会当成「期望函数正常返回,并打印出这行文本」,于是报告 Exception raised 与预期不符。第二种是字符串比对失败——doctest 比的是逐字符相等,一个句号都不能少。
练习本身:一个 doctest 达成 100% 覆盖率
课上让你先跑覆盖率报告(uv run pytest --doctest-modules --cov=count_vowel_occurrences --cov-report=html count_vowel_occurrences.py,然后打开 htmlcov/index.html),根据结果补一个 doctest 让覆盖率到 100%。
count_vowel_occurrences("hello world", "o"):len("o") != 1 为假 → 跳过第一个 raise;"o" in "aeiou" 为真 → 跳过第二个 raise;然后三行正常逻辑全部执行。count_vowel_occurrences("myth", "y"):len("y") != 1 为假 → 跳过;"y" not in "aeiou" 为真 → 执行第二个 raise,函数就此结束。raise ValueError("Vowel must be a single character.")。len(vowel) != 1 为真的调用即可:>>> count_vowel_occurrences("hello", "ou")
Traceback (most recent call last):
...
ValueError: Vowel must be a single character.
挑战题:100% 覆盖率,然后呢
课上紧接着说:「即使你用一个 doctest 就能达到 100% 覆盖率,这些测试其实并没有全面覆盖这个函数的行为。」 这就是上一节那个 sign_label 例子的现实版。官方解答里补的 doctest 是这些(我把它们按测试意图分了组):
| doctest | 期望 | 它在测哪个「行为」,而不是哪一行 |
|---|---|---|
count_vowel_occurrences("banana", "a") | 3 | 同一个元音出现多次时是否全部数到(1 次的例子测不出「只数了第一个」这种 bug) |
count_vowel_occurrences("Ice Cream", "i") | 1 | 文本里的大写 I 能否被小写的 i 匹配到——大小写不敏感的一半 |
count_vowel_occurrences("Apples are awesome", "A") | 3 | 参数是大写 A 时能否匹配小写的 a——大小写不敏感的另一半 |
count_vowel_occurrences("", "e") | 0 | 空字符串这个边界 |
count_vowel_occurrences("crypt", "u") | 0 | 元音合法但一次都没出现——注意这和「元音非法」是两种完全不同的情况,前者返回 0,后者抛异常 |
count_vowel_occurrences("hello", "ou") | ValueError: Vowel must be a single character. | 守卫子句 1 |
count_vowel_occurrences("hello", "x") | ValueError: 'x' is not a valid vowel. | 守卫子句 2,且 x 不是元音 |
"Apples are awesome" 数出 3 是最值得算一遍的: 小写化后是 "apples are awesome",其中 a 出现在 apples、are、awesome 三处开头,正好 3 个。
覆盖率驱动你去补测试,但补什么测试要靠你对「行为」的理解。 上面 7 个 doctest 里,只有最后两个是覆盖率报告能提示你去写的;前面五个全都落在「已经 100% 覆盖」的那几行上,覆盖率工具对它们一个字都不会说。
写测试时的正确提问方式不是「哪一行没跑过」,而是「这个函数的规格说明里,有几种不同的输入类别?」——正常值、零/空、多次出现、大小写、非法值……每一类至少一个。
8. 测试实战二:三个失败的测试,三种不同的 bug
第二个练习给了一个成绩分析工具 src/grade_analytics.py 和一套 pytest 测试 tests/test_grade_analytics.py,跑起来有三个测试失败。任务是根据测试输出反推 bug 并修好。这是本讲「调试流程」的完整实战。
源码里有五个函数,前四个是单元测试的对象,最后一个 generate_grade_report 是把前面几个串起来的集成函数:
def calculate_average(grades: list) -> float:
    """Returns 0.0 if the list is empty."""
    return round(sum(grades) / len(grades), 2)


def get_range_extremes(grades: list) -> tuple:
    if not grades:
        return (None, None)
    return (max(grades), min(grades))


def map_score_to_letter(score: float) -> str:
    if score >= 85:
        return "A"
    elif score >= 80:
        return "B"
    elif score >= 70:
        return "C"
    elif score >= 60:
        return "D"
    else:
        return "F"


def apply_curved_bonus(grades: list, bonus_points: float) -> list:
    curved_grades = []
    for grade in grades:
        new_grade = grade + bonus_points
        if new_grade > 100:
            new_grade = 100
        curved_grades.append(new_grade)
    return curved_grades


def generate_grade_report(student_data: dict, bonus: float = 0.0) -> dict:
    report = {}
    for student, scores in student_data.items():
        if not scores:
            report[student] = "F"
            continue
        avg_score = calculate_average(scores)
        report[student] = map_score_to_letter(avg_score)
    return report
Bug 1:docstring 说了,代码没做
失败的测试是:
def test_calculate_average_empty():
    """Test calculate_average handles empty lists gracefully without throwing ZeroDivisionError."""
    assert calculate_average([]) == 0.0
AssertionError,而是 ZeroDivisionError: division by zero。这个区别很关键——AssertionError 意味着「函数跑完了但答案不对」,其他异常意味着「函数根本没跑完」。calculate_average([]) 执行 sum([]) / len([]),即 0 / 0。除数为零。>>> sum([]) / len([]) 立刻得到 ZeroDivisionError: division by zero。假设成立。def calculate_average(grades: list) -> float:
if not grades: # FIX
return 0.0
return round(sum(grades) / len(grades), 2)
用 if not grades 而不是 if len(grades) == 0:空列表是 falsy,这是 Python 惯例写法,和同一个文件里 get_range_extremes 的写法保持一致。顺带注意:get_range_extremes 早就正确处理了空列表——同一份代码里两个函数对同一个边界的处理不一致,本身就是「这里有 bug」的强烈信号。
Bug 2:边界值差了 5 分
这个测试用了 pytest 的参数化(parametrize),一行 @pytest.mark.parametrize 把 8 组输入输出变成 8 个独立的测试:
@pytest.mark.parametrize("score, expected_letter", [
    (95, "A"), (90, "A"), (85, "B"), (80, "B"),
    (72, "C"), (60, "D"), (55, "F"), (0, "F")
])
def test_map_score_to_letter_boundaries(score, expected_letter):
    assert map_score_to_letter(score) == expected_letter
| score | 期望 | 当前代码给出 | 走了哪个分支 |
|---|---|---|---|
| 95 | A | A | 95 >= 85 真 |
| 90 | A | A | 90 >= 85 真 |
| 85 | B | A 失败 | 85 >= 85 真 → 返回 A |
| 80 | B | B | 80 >= 85 假、80 >= 80 真 |
| 72 | C | C | 落到 >= 70 |
| 60 | D | D | 落到 >= 60 |
| 55 | F | F | else |
| 0 | F | F | else |
只有 score = 85 这一组失败。docstring 说「Assumes a standard 10-point scale」——十分制的档位应该是 90/80/70/60,而代码第一档写成了 85。
    if score >= 90:     # FIX
        return "A"
因为分档函数最容易错的就是档位边界:>= 写成 >、阈值差 1、档位顺序颠倒。一个好的测试集会在每个边界上取三个点:刚好等于(90)、刚好低于(89 或 85)、明显高于(95)。这里的 8 组用例正是这么设计的。
另外注意这个函数写成 elif 链是有意的:如果全写成独立的 if,虽然因为每支都 return 而结果相同,但读者就必须逐条确认「上面那个真的会 return 吗」。elif 直接告诉读者「这几支互斥且有序」。
Bug 3:参数收下了,但从来没用
这是三个里最难发现的,因为代码本身没有任何一行是错的。
def test_generate_grade_report_with_curve():
    class_data = {
        "Jordan": [78, 78],     # Average = 78 -> C raw
        "Taylor": [55, 58]      # Average = 56.5 -> F raw
    }
    # Giving a 3-point curve will push Jordan to an 81 (B) and Taylor to 59.5 (F)
    expected_output = {"Jordan": "B", "Taylor": "F"}
    assert generate_grade_report(class_data, bonus=3.0) == expected_output
{'Jordan': 'C', 'Taylor': 'F'},期望是 {'Jordan': 'B', 'Taylor': 'F'}。Taylor 对了,Jordan 错了——这个「一半对一半错」的模式很有信息量。bonus 这个参数在函数体里被用了吗?回去看 generate_grade_report 的函数体——bonus 出现在形参列表里,函数体里一次都没出现。同理 apply_curved_bonus 这个函数写好了却从来没被调用过。generate_grade_report({"X": [10]}, bonus=90)。如果结果还是 {'X': 'F'},就坐实了 bonus 没起作用。 for student, scores in student_data.items():
if not scores:
report[student] = "F"
continue
# FIX: 1. Apply curve if applicable
if bonus > 0:
curved_scores = apply_curved_bonus(scores, bonus)
else:
curved_scores = scores
# 2. Calculate the average score
avg_score = calculate_average(curved_scores)
# 3. Map average score to letter grade
report[student] = map_score_to_letter(avg_score)
验证:把修好的版本代进四个集成测试
| 输入 | 加分后的分数 | 平均分 | 字母 | 期望 |
|---|---|---|---|---|
Alex [90, 92, 94],bonus=0 | 不变 | round(276/3, 2) = 92.0 | A | A ✓ |
Charlie [70, 80, 75],bonus=0 | 不变 | round(225/3, 2) = 75.0 | C | C ✓ |
Jordan [78, 78],bonus=3 | [81, 81] | 81.0 | B(81 ≥ 80) | B ✓ |
Taylor [55, 58],bonus=3 | [58, 61] | 59.5 | F(59.5 < 60) | F ✓ |
MissingStudent [] | if not scores 直接 continue,不会走到 calculate_average | F | F ✓ | |
PerfectStudent [100, 100] | 不变 | 100.0 | A | A ✓ |
Taylor 那一行值得多看一眼:59.5 < 60,所以还是 F,差 0.5 分。这就是为什么测试作者在注释里写下了 Taylor to 59.5 (F)——他刻意挑了一个「加了分但还是不够」的例子,用来检验加分逻辑没有被过度实现(比如误写成加 3 分再向上取整)。
| bug | 类型 | 怎么被发现 | 怎么预防 |
|---|---|---|---|
calculate_average([]) | 漏掉边界情况 | 测试抛出非 AssertionError 的异常 | 写函数时先列一遍「空/零/负/单元素」 |
score >= 85 | 边界值写错 | 参数化测试里恰好一组失败 | 每个阈值都写「等于/略小于」两个测试 |
bonus 未使用 | 功能没实现 | 集成测试失败,且只错一半 | linter 能报「参数从未使用」;或者先写测试(TDD) |
9. try 语句:优雅地接住异常
前面所有内容都在教你怎么让程序正确地失败。这一节相反:怎么让程序在遇到可预期的坏情况时,仍然走完流程。
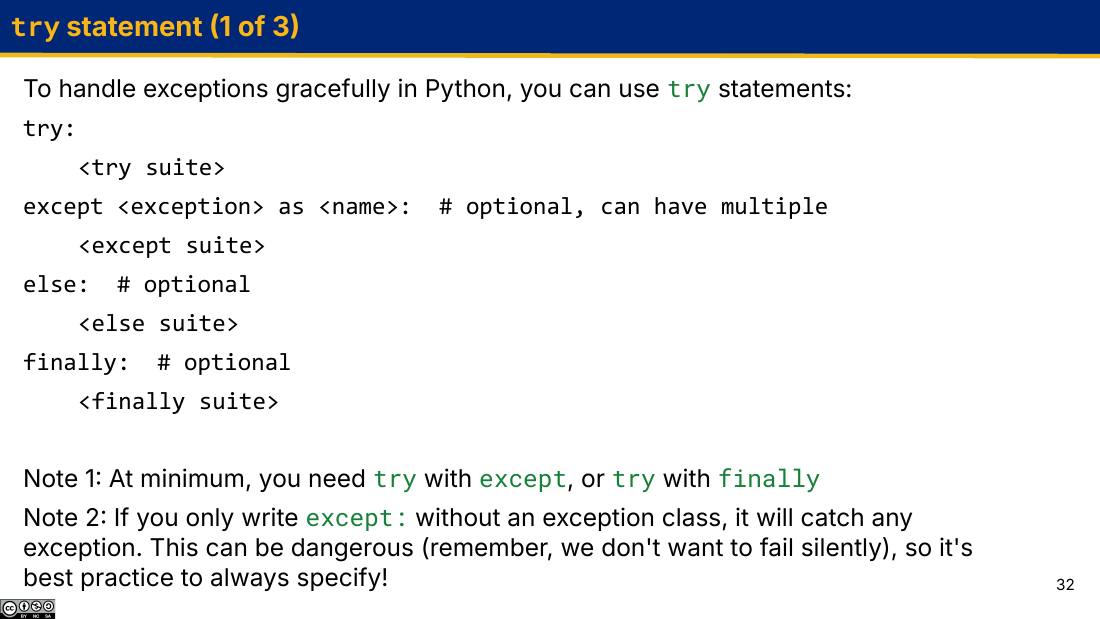
try 语句的完整形态:一个 try,可选的一个或多个 except(可以用 as <name> 把异常对象绑到名字上),可选的 else,可选的 finally。最少要有 try + except,或者 try + finally——只写一个 try 是语法错误。try:
<try suite>
except <exception> as <name>: # 可选,可以有多个
<except suite>
else: # 可选
<else suite>
finally: # 可选
<finally suite>
课上给了两条注记:
- Note 1:最少需要
try配except,或者try配finally。 - Note 2:如果只写
except:而不指定异常类,它会接住任何异常。这很危险(记住,我们不想悄悄失败),所以最佳实践是永远写明。
四个 suite 各自什么时候执行
这是本节唯一需要精确记忆的东西。
| suite | 执行时机 | 不执行的情况 |
|---|---|---|
try | 总是进入(这是入口) | —(但可能执行到一半就被异常打断) |
except E | try 里抛出的异常是 E 或 E 的子类时 | 没出异常时;出的异常类型不匹配时 |
else | try 完整跑完且没出任何异常时 | 只要出了异常就不执行——哪怕异常已经被 except 接住了 |
finally | 无论如何都执行:正常结束、异常被接住、异常没被接住继续上抛,甚至 try 里执行了 return | 几乎没有 |
课上的例子把这四种情况全串起来了:
def safe_divide(numerator, denominator):
    try:
        result = numerator / denominator
    except ZeroDivisionError:
        result = 'Undefined'
    else:
        print(f"The result of the division is: {result}")
    finally:
        print("Cleanup")
    return result
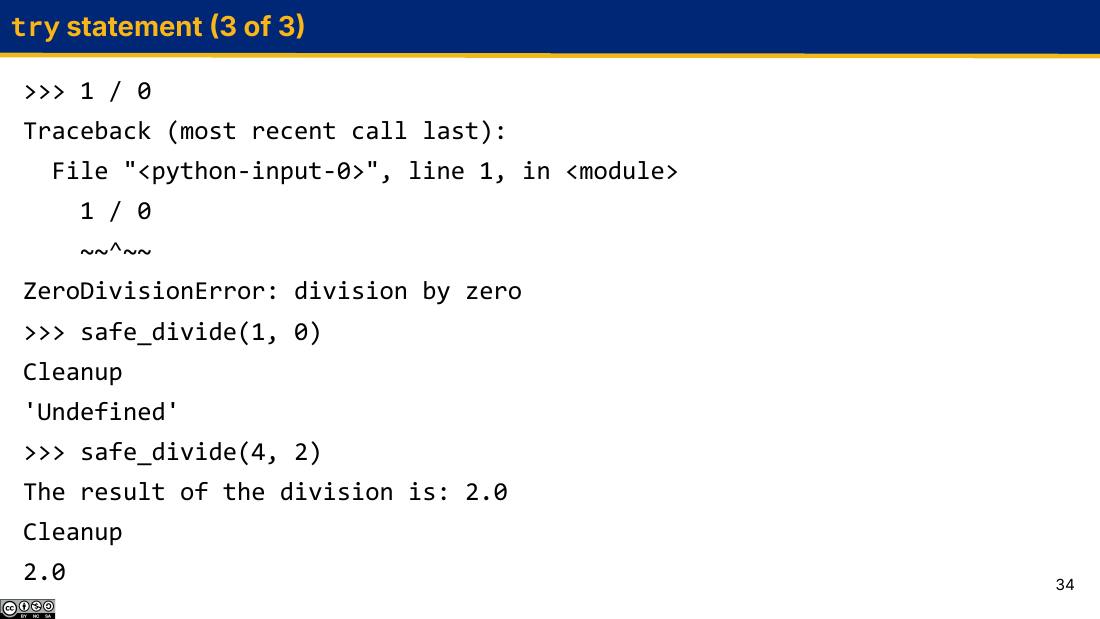
1 / 0 没有任何保护,直接打出 traceback 终止;safe_divide(1, 0) 接住了同一个异常,只打出 Cleanup 然后返回 'Undefined';safe_divide(4, 2) 一切正常,先打 else 里的那行,再打 Cleanup。注意 safe_divide(1, 0) 的输出里没有「The result of the division is」——这就是 else 和 finally 的区别。>>> 1 / 0
Traceback (most recent call last):
File "<python-input-0>", line 1, in <module>
1 / 0
~~^~~
ZeroDivisionError: division by zero
>>> safe_divide(1, 0)
Cleanup
'Undefined'
>>> safe_divide(4, 2)
The result of the division is: 2.0
Cleanup
2.0
幻灯片上那两行本地可能看不到,因为它们来自较新的 Python:~~^~~ 这种「用波浪线标出整个表达式、用尖号标出确切出问题的运算符」的细粒度定位是 Python 3.11 起加入的;把 REPL 输入的文件名显示成 <python-input-0>(而不是老的 <stdin>)则来自 Python 3.13 的新交互式解释器。在 3.10 上跑同一句,你只会得到 File "<stdin>", line 1, in <module>。异常类型和消息在各版本上是一样的,不用担心对不上。
逐调用推演
numerator = 1,denominator = 0。进入 try suite。numerator / denominator = 1 / 0 → 抛出 ZeroDivisionError。赋值语句左边的 result 从来没有被绑定过——因为右边就没算出来。try。检查 except ZeroDivisionError:类型匹配 ✓。异常在这里被「消费」掉了,不再往上传播。result = 'Undefined'。现在 f1 里终于有了 result 这个绑定。else——因为 try 里出过异常。所以 The result of the division is: 不会被打印。finally:打印 Cleanup。return result,返回 'Undefined'。REPL 显示 'Undefined'(带引号,因为它是字符串的 repr)。4 / 2 求值成 2.0(注意 / 永远返回 float),绑定给 result。try suite 完整跑完,没出异常。except——它们只在出异常时才被考察。else:打印 The result of the division is: 2.0。finally:打印 Cleanup。return result → 2.0。为什么要有 else?把它并进 try 不行吗
能跑,但语义变了。如果把 print(...) 直接写在 try 里:
try:
    result = numerator / denominator
    print(f"The result of the division is: {result}")   # 挪进来了
except ZeroDivisionError:
    result = 'Undefined'
现在这个 try 同时保护着两条语句。如果 print 那一行因为某种原因抛出了 ZeroDivisionError(听起来不可能,但换成别的异常类型就完全可能),它也会被这个 except 接住,而你以为接住的是除法的错。
try suite 要尽可能短
try 里应该只放那一句你真正预期会出事的代码。「出事之后要做的收尾」放 except,「没出事才做的后续」放 else,「无论如何都要做的清理」放 finally。这样每个异常都被它对应的那段代码接住,不会张冠李戴。
用 as 拿到异常对象
except ZeroDivisionError as e 会把异常对象绑定到 e。异常是对象,可以被检查:
>>> try:
...     1 / 0
... except ZeroDivisionError as e:
...     print(type(e).__name__)
...     print(e)
...     print(repr(e))
...     print(e.args)
...
ZeroDivisionError
division by zero
ZeroDivisionError('division by zero')
('division by zero',)
print(e) 打出的就是消息文本(也就是 traceback 最后那一行冒号之后的部分)。这在写日志或者给用户提示时很有用。
多个 except 的匹配顺序
except 子句是从上到下依次尝试匹配的,第一个匹配上的胜出,剩下的全部跳过——和 if/elif 链完全一样。而且匹配用的是子类关系:except Exception 能接住几乎所有异常,因为它们都是 Exception 的子类。
>>> try:
...     int('x')
... except Exception as e:
...     print('generic caught first:', type(e).__name__)
... except ValueError:
...     print('never')
...
generic caught first: ValueError
抛出的确实是 ValueError,但因为 except Exception 排在前面且 ValueError 是 Exception 的子类,它先匹配上了。后面那个 except ValueError 永远不可能被执行到——这是死代码。
规则和 if/elif 一样:越具体的写在越前面。
课上说裸写 except: 很危险,具体危险在哪:它会连 KeyboardInterrupt(你按 Ctrl-C)和 SystemExit 一起接住。写个死循环再套上裸 except,你会发现 Ctrl-C 按不停它,只能去杀进程。
此外它还会吞掉 NameError——也就是你打错字造成的错误。你以为自己在处理「网络超时」,实际上把「函数名拼错了」也一起静悄悄地处理掉了,然后花两小时找一个本来一秒钟就能看见的 typo。
finally 的一个陷阱
>>> def g():
...     try:
...         return 1
...     finally:
...         return 2
...
>>> g()
2
try 里的 return 1 已经准备好返回值 1 了,但在真正返回之前必须先执行 finally——而 finally 里的 return 2 把它顶掉了。同理,如果 finally 里 return,连正在传播的异常都会被丢弃。所以 finally 里不要写 return,它只该做清理(关文件、释放锁、打日志)。
回到起点:for 循环其实一直在用 try
上一讲讲迭代器时说过,for 循环遇到 StopIteration 就正常结束。现在你有能力理解那句话的真正含义了——for x in it: ... 大致等价于:
it = iter(iterable)
while True:
    try:
        x = next(it)
    except StopIteration:
        break
    <循环体>
StopIteration 完美地说明了这一点:迭代器耗尽根本不是错误,它是每次 for 循环都必然会发生的正常事件。Python 选择用异常机制来传递这个信号,因为异常能一次跨越多层调用回到需要知道这件事的地方,而返回值做不到(next 返回什么值都可能和一个真实元素撞车)。
这也解释了上一讲那个坑:在生成器函数里写 raise StopIteration 是不行的,Python 3.7 起会把它转成 RuntimeError: generator raised StopIteration,就是为了防止这个「控制流信号」被误用。要结束生成器请用 return。
10. 调试方法:从「盯着代码看」到一套可重复的流程
顺带一个冷知识:「bug」这个词并不是计算机时代才有的。课上引的维基百科说,用 bug 指代缺陷至少从 1870 年代起就是工程行话,远早于电子计算机和软件。1947 年前后,Grace Hopper 在哈佛研究 Mark II 和 Mark III 时,操作员把 Mark II 的一个故障追查到了一只卡在继电器里的飞蛾;他们把飞蛾取出来贴在日志本上,注明「第一个真正找到 bug 的案例」。
五步流程
课上给的通用调试流程,和前面几节的实战完全对应:
calculate_average 的 docstring 直接告诉了你「空列表要返回 0.0」。bonus 可能压根没被用过」。大部分人的调试是这样的:看到红字 → 觉得「大概是这里吧」 → 改一行 → 再跑 → 还是错 → 再乱改。这样做的问题是:你永远不知道刚才那次修改到底有没有帮上忙,而且每改一次都可能引入新的 bug。
正确做法是:假设要说得足够具体,具体到能设计出一个「如果假设成立就会出现 X,不成立就会出现 Y」的实验。 然后先做实验,确认了再改代码。这比乱改快得多。
课上还专门补了一句:这一讲有意不涉及 AI 辅助编程工具,可能会在之后的特别专题讲。相应地,在讲期中复习建议时也提醒过:用大模型学习要小心,它们可能会产生幻觉、给出超纲或不正确的信息;把它们当成「换个说法解释概念」或「生成练习题」的工具是可以的,但必须自己核对正确性。
进阶调试手段
| 手段 | 怎么用 | 什么时候用它最合适 |
|---|---|---|
python3 -i code.py | 跑完文件后停在 REPL 里,文件里定义的所有名字都在,可以手动调函数 | 想拿几组不同的输入快速试探一个函数的行为 |
| 环境图 / Python Tutor | 把代码贴进 pythontutor.com 一步步看帧的变化。记得真的写一句调用——只有 def 什么都不会发生 | 怀疑是作用域、别名、可变性的问题 |
pdb 模块 | 在代码里插入断点(breakpoint)——暂停执行、检查当前状态的位置 | bug 藏在循环的第 137 次迭代里,print 会刷屏 |
| 调试器(debugger) | 图形界面加断点、看状态。VS Code 的 Python debugger 就是一个 | 同上,而且不想改动源码 |
课上顺带交代了这条技能线往后怎么走:CS 61B 学 IntelliJ 调试器(Java),CS 61C、161、162 学 gdb(C 语言)。「在断点处暂停、检查当前状态」这个心智模型是通用的,换语言只是换按钮。
print 调试实战:make_acronym
课上最后一个练习:读源码、跑 pytest、用 print 调试找出并修复 bug。
def make_acronym(phrase: str) -> str:
    """
    Converts a given phrase into an uppercase acronym.
    Words can be separated by one or more spaces.
    """
    words = phrase.split(" ")
    acronym = ""
    for i in range(len(words)):
        current_word = words[i]
        first_letter = current_word[0]
        acronym += first_letter
    return acronym
def test_make_acronym_simple():
    assert make_acronym("central processing unit") == 'CPU'

def test_make_acronym_whitespace():
    assert make_acronym("  user   interface  ") == 'UI'

def test_make_acronym_long():
    assert make_acronym("Hyper  Text Markup Language") == 'HTML'

def test_make_acronym_empty():
    assert make_acronym("") == ''
"central processing unit":.split(" ") 得到 ['central', 'processing', 'unit'],首字母拼出 'cpu'。期望 'CPU' → 失败,全是小写。这是 bug A:没有转大写。" user interface ":.split(" ") 得到 ['', '', 'user', '', '', 'interface', '', '']。第 0 个元素是空字符串 '',''[0] → IndexError: string index out of range。这是 bug B:用 split(" ") 处理连续空格。"Hyper Text Markup Language":得到 ['Hyper', '', 'Text', 'Markup', 'Language']——中间那个 '' 来自两个连续空格。同样 IndexError。"":"".split(" ") 得到 [''](不是空列表!),循环跑一次,''[0] → IndexError。怎么用 print 找出来? 在最可疑的地方打印中间量。经验法则是:打印「循环变量」和「你以为它是什么的那个东西」。
def make_acronym(phrase: str) -> str:
    words = phrase.split(" ")
    print('DEBUG words =', words)              # ← 加这一行
    acronym = ""
    for i in range(len(words)):
        current_word = words[i]
        print('DEBUG i =', i, 'word =', repr(current_word))   # ← 和这一行
        first_letter = current_word[0]
        acronym += first_letter
    return acronym
DEBUG words = ['', '', 'user', '', '', 'interface', '', '']
DEBUG i = 0 word = ''
Traceback (most recent call last):
  ...
IndexError: string index out of range
第一行就把真相打出来了。 你以为 words 是 ['user', 'interface'],实际它有 8 个元素,一半是空串。
- 用
repr()而不是直接打印字符串。print(current_word)遇到空串会打出一个空行,你根本看不出来;print(repr(current_word))打出'',一目了然。空格、换行、'1'和1的区别也全靠repr。 - 加前缀。 每行都写
DEBUG之类的标记,一来输出里好找,二来事后grep DEBUG就能把它们全删干净——调试用的 print 一定要在提交前删掉。 - 一次只打印一件事。 一口气加十行 print,输出就变成噪音了。按「假设」来加:你怀疑
words不对,就只打words。
修复
def make_acronym(phrase: str) -> str:
    # FIX 1: .split() 不带参数会按任意长度的空白切分,并丢掉空串
    words = phrase.split()
    acronym = ""
    for i in range(len(words)):
        current_word = words[i]
        first_letter = current_word[0]
        acronym += first_letter
    # FIX 2: 整个缩写转成大写
    return acronym.upper()
split() 和 split(" ") 是两个不同的函数
| 输入 | .split(" ") | .split() |
|---|---|---|
"a b" | ['a', 'b'] | ['a', 'b'] |
"a b"(两个空格) | ['a', '', 'b'] | ['a', 'b'] |
" a b " | ['', '', 'a', 'b', '', ''] | ['a', 'b'] |
"" | [''] | [] |
"a\tb\nc" | ['a\tb\nc'](制表符/换行不算分隔符) | ['a', 'b', 'c'] |
不带参数的 split() 按任意长度的连续空白切分,并自动丢弃两端产生的空串。要按「单词」切,几乎永远该用它。课上的提示「Google is your friend for unfamiliar methods」说的就是这种事——用一个方法之前,花十秒查一下它在边界输入下的行为,能省掉一小时调试。
验证修复
| 输入 | phrase.split() | 首字母 | .upper() | 期望 |
|---|---|---|---|---|
"central processing unit" | ['central', 'processing', 'unit'] | 'cpu' | 'CPU' | CPU ✓ |
" user interface " | ['user', 'interface'] | 'ui' | 'UI' | UI ✓ |
"Hyper Text Markup Language" | ['Hyper', 'Text', 'Markup', 'Language'] | 'HTML' | 'HTML' | HTML ✓ |
"" | [] | '' | '' | '' ✓ |
最后一行值得注意:[] 让 range(len(words)) 变成 range(0),循环体一次都不执行,acronym 保持初值 "","".upper() 还是 ""。空输入这个边界是被 split() 顺手解决的,不需要额外的 if。 这是选对工具的红利。
11. 本讲小结
异常机制速查
| 动作 | 语法 | 发生了什么 |
|---|---|---|
| 断言前提 | assert <cond>, <msg> | 条件 falsy 时抛 AssertionError(<msg>);不要加括号 |
| 主动抛出 | raise ValueError('...') | 当前帧立刻弹出,异常沿栈上抛,没有返回值 |
| 接住 | except E as e: | 只在异常是 E 或其子类时进;e 绑定异常对象 |
| 没出事才做 | else: | try 完整跑完且无异常时进;异常被接住也不进 |
| 无论如何都做 | finally: | 总是执行;里面别写 return |
四种「函数结束」方式的对比
| 结束方式 | 调用者拿到什么 | 能跨越几层 | 典型场景 |
|---|---|---|---|
执行 return v | v | 1 层 | 正常算完了 |
函数体跑完没 return | None | 1 层 | 只做副作用的函数;也可能是忘写 return 的 bug |
raise 且无人接 | 什么都拿不到,自己也被弹出 | 任意多层 | 前提被违反 |
raise 且被上游 try 接住 | 上游的 except suite 接管控制权 | 到第一个匹配的 try 为止 | 可预期的坏情况 |
读 traceback 的四步
Traceback (most recent call last):?没有 → SyntaxError,程序一行都没跑,去看报错行及其上一行。RecursionError,去检查 base case。测试与工具
| 概念 | 一句话 |
|---|---|
| TDD | 规格 → 写测试 → 写代码 → 跑测试 → 循环。测试在代码之前。 |
| 单元 / 集成 / E2E 测试 | 一次测一个函数 / 一次测几个部分的配合 / 一次测整个系统 |
| doctest / pytest | 内置、写在 docstring 里 / 需安装、写在 test_*.py 里用 assert |
| 测试覆盖率 | 跑测试时被执行到的代码行占比。只测「有没有跑过」,不测「对不对」。 |
| 静态分析工具 | 不执行代码就分析源码的工具 |
| linter / formatter | 对「最佳实践」给反馈 / 自动修复风格问题。Ruff 两样都是 |
| 圈复杂度 | 衡量函数「有多复杂」的数字,用来判断该不该拆函数 |
| 代码风格缺陷 | 功能正确、但可以写得更清晰/优雅/符合惯例的代码 |
- 让程序大声地失败。 前提被违反时立刻
raise,别让它悄悄算出一个错的数。裸except:是这条原则的反面。 - traceback 从下往上读。 最后一行说「出了什么事」,倒数第二组 File 行说「在哪出的事」,上面几行说「怎么走到那里的」。
- 调试是「观察 → 假设 → 实验」,不是「猜 → 改 → 再猜」。 假设要具体到能设计出实验;验证过了再动代码。
12. 动手练习
练习 1:这段代码会打印什么
def risky(n):
    try:
        print('A')
        result = 10 / n
        print('B')
    except ZeroDivisionError:
        print('C')
        result = -1
    else:
        print('D')
    finally:
        print('E')
    return result

print(risky(2))
print(risky(0))
看答案
A
B
D
E
5.0
A
C
E
-1
risky(2):进 try → 打 A → 10 / 2 = 5.0 成功 → 打 B(B 在 try 里面,它跑完了)→ 没出异常,所以跳过 except、进 else → 打 D → finally 打 E → 返回 5.0。
risky(0):进 try → 打 A → 10 / 0 抛 ZeroDivisionError,print('B') 那一行根本没执行 → except 匹配,打 C,result = -1 → 出过异常,所以 else 不进,D 不打 → finally 打 E → 返回 -1。
最容易错的两处:(a) 以为异常被接住了 else 就会执行——不会,else 的条件是「压根没出过异常」;(b) 以为 B 在 risky(0) 里也会打——不会,try suite 从抛异常那一刻就被截断了。
练习 2:挑异常类型
下面每一句会抛出什么异常?先自己想,再对答案。
(a)  {'a': 1, 'b': 2}['c']
(b)  [10, 20, 30][3]
(c)  int('3.14')
(d)  'abc' + 5
(e)  len(42)
(f)  print(undefind_variable)
(g)  next(iter(''))
看答案
| 异常 | 真实消息 | 为什么 | |
|---|---|---|---|
| (a) | KeyError | 'c' | 字典里没有这个键。消息就是那个键本身,没有多余的话 |
| (b) | IndexError | list index out of range | 长度 3 的列表合法索引是 0、1、2 |
| (c) | ValueError | invalid literal for int() with base 10: '3.14' | 类型对(是 str),但 '3.14' 不是一个十进制整数字面量。想要 3 得写 int(float('3.14')) |
| (d) | TypeError | can only concatenate str (not "int") to str | + 用在了 str 和 int 之间 |
| (e) | TypeError | object of type 'int' has no len() | 整数这个类型没有长度概念 |
| (f) | NameError | name 'undefind_variable' is not defined | 拼错了(少了个 e)。NameError 十有八九是 typo |
| (g) | StopIteration | (空) | 空字符串的迭代器一上来就耗尽了 |
(c) 是最值得琢磨的:为什么不是 TypeError?因为 int 接受字符串参数——类型没问题,是这个值没法解释。对比 int([1, 2]) 才是 TypeError: int() argument must be a string, a bytes-like object or a real number, not 'list'。
练习 3:给函数加防线
下面这个函数计算列表的平均值,但它有两个没被处理的坏情况。请用本讲学的技术加上防线,并说明你为什么选了那个异常类型。
def average(nums):
    return sum(nums) / len(nums)
看答案
两个坏情况:(1) nums 是空列表 → ZeroDivisionError: division by zero;(2) nums 里混进了非数字 → sum(['a']) 抛 TypeError: unsupported operand type(s) for +: 'int' and 'str',而这个消息里那个莫名其妙的 'int' 其实是 sum 的初值 0,对调用者来说毫无帮助。
def average(nums: list) -> float:
    """返回 nums 的算术平均值。

    >>> average([1, 2, 3])
    2.0
    >>> average([])
    Traceback (most recent call last):
        ...
    ValueError: cannot average an empty sequence
    """
    if len(nums) == 0:
        raise ValueError('cannot average an empty sequence')
    for x in nums:
        if not isinstance(x, (int, float)):
            raise TypeError(f'all elements must be numbers, got {x!r}')
    return sum(nums) / len(nums)
为什么第一个用 ValueError: [] 的类型是对的(确实是个 list),只是这个值没法求平均。这正好落在课上给 ValueError 的定义上:「类型对但值不合适,且没有更精确的异常」。
为什么第二个用 TypeError: 元素的类型就不对。{x!r} 是 f-string 里的 repr 转换,会把字符串带引号打出来——got 'a' 比 got a 清楚得多。
为什么不用 assert: 这是在校验外部传进来的参数,调用者可能想针对性地 except ValueError 接住空列表这种情况;AssertionError 接起来含义太模糊,而且 python3 -O 会把它整个跳过。
练习 4:为什么这个测试通过了却没意义
def letter_grade(score):
    if score >= 90:
        return 'A'
    elif score >= 80:
        return 'B'
    else:
        return 'F'


def test_letter_grade():
    assert letter_grade(95) == 'A'
    assert letter_grade(85) == 'B'
    assert letter_grade(50) == 'F'
这三个断言让 letter_grade 的每一行都被执行过,覆盖率 100%。但如果有人把 score >= 90 手滑写成 score >= 91,测试还会通过吗?该补哪些用例?
看答案
还会通过。 95 >= 91 仍然为真,85 和 50 本来就不走第一支。这个 bug 完全逃过了 100% 覆盖率的测试。
该补的是每个阈值上的三个点:
| 阈值 | 刚好等于 | 刚好低于 | 明显高于 |
|---|---|---|---|
| 90 | letter_grade(90) == 'A' ← 这个能抓到 >= 91 的 bug | letter_grade(89) == 'B' | letter_grade(100) == 'A' |
| 80 | letter_grade(80) == 'B' | letter_grade(79) == 'F' | (已被 85 覆盖) |
这正是第 8 节 map_score_to_letter 的参数化测试的设计思路:(95, "A") 和 (90, "A") 成对出现,(85, "B") 和 (80, "B") 成对出现——每一档都测「档内的普通值」和「档的下边界」两个点。当时正是 (85, "B") 这一组抓到了「第一档阈值写成 85」的 bug。
要带走的规律:>= 和 > 的区别、阈值差 1 这类 bug,只有「刚好等于阈值」的用例能抓住。 写分档函数时,闭着眼睛先把每个阈值本身写成一个测试。
练习 5:栈展开的顺序
def a():
    print('a start')
    b()
    print('a end')

def b():
    print('b start')
    try:
        c()
    except ValueError:
        print('b caught it')
    print('b end')

def c():
    print('c start')
    raise ValueError('boom')
    print('c end')

a()
打印顺序是什么?如果把 b 里的 except ValueError 改成 except TypeError,又会怎样?
看答案
原版:
a start
b start
c start
b caught it
b end
a end
c 里的 print('c end') 永远不会执行——raise 之后那一行是死代码。异常抛出后 c 的帧被弹掉,撞上 b 里的 try,ValueError 匹配,异常在这里被消费掉,不再往上传。所以 b 能正常跑完(打出 b end),a 也能正常跑完(打出 a end)。
改成 except TypeError 之后:
a start
b start
c start
Traceback (most recent call last):
  File "...", line 20, in <module>
    a()
  File "...", line 3, in a
    b()
  File "...", line 9, in b
    c()
  File "...", line 16, in c
    raise ValueError('boom')
ValueError: boom
ValueError 不是 TypeError 的子类,所以这个 except 不匹配,异常穿过 b 继续上抛。于是 b end 和 a end 都不会打印——b 和 a 的帧都被弹掉了。
这道题要建立的直觉:异常向上传播时,沿途每一帧「还没执行完的部分」全部作废。 它和 return 只回一层是完全不同的控制流。也正因为这个「作废」的威力太大,才需要 finally —— 如果 b 里有个必须关掉的文件,只有写在 finally 里才保证被关。