期中复习:把前十一讲拆开的零件重新装回去
四道往年考题,一道一道推到底——生成器、树递归、网格搜索、高阶函数与闭包,外加一个被 doctest 骗了一整节课的真实故事。
0. 本讲导读
这一讲没有新概念。它只做一件事:把 Lecture 01 到 Lecture 11 学过的零件,放进四道真实的往年考题里,看它们怎么互相咬合。
这件事比听起来重要。你现在的状态多半是这样的:单独问「什么是生成器」你答得出,单独问「树递归怎么写」你也答得出,但拿到一道题——它既不说「这是生成器题」,也不说「这里要用树递归」——你就卡在第一行不知道该写什么。考试考的正是这一步:从题面到「该用哪个零件」的那次跳跃。
所以本讲的读法和前十一讲完全不同。前面的笔记你可以顺着读;这一份,每道题的题面给出来之后,请你先合上笔记自己写一遍,写完再看后面的推演。看懂别人的解法几乎没有收益,卡住之后再看解法才有。
本讲的四道题分别来自:
| 题目 | 出处 | 核心考点 |
|---|---|---|
| One Cent | CS 61A Fall 2022 Final Q7 | 生成器函数、yield、无穷迭代器、filter 的惰性 |
| Escape Lumon | DATA C88C Spring 2025 Midterm Q7 | 树递归计数、用参数携带「一路走来的状态」 |
| All Treeils Lead to Rome | CS 61A Summer 2023 Midterm Q6 (a)(b) | 树的数据抽象、列表推导式、all / sum / max |
| Multi Compose | CS 61A Summer 2024 Midterm Q6 | 高阶函数、闭包、返回函数的递归、or 短路 |
在四道题之前,本讲还有两块内容值得单独讲:一是对 Lecture 11 的更正——那节课的 print 调试练习里,调试用的 print 输出神秘地消失了,原因不在代码,而在 doctest 模块本身;二是一道 WWPD(What Would Python Display) 形式的 try-finally 题,它把异常处理的执行顺序钉死。这两块都是期中范围内的东西。
doctest在某个 example 抛出异常时,完全不显示这个 example 期间的print输出;没抛异常时,print出来的内容会被算进「实际输出」从而让本来能通过的 doctest 失败。这不是 bug,是设计。finally子句无论如何都会执行——正常结束、异常传出、甚至try里已经执行了return,都要先跑完finally才真正离开函数。- 生成器里的滑动窗口写法:
start = start[1:] + next(coin)——丢掉最老的一个元素、接上一个新的。这是处理「连续 k 个元素」类问题的标准套路。 - 「从起点走到终点、路上累积某种量」的计数问题,标准骨架是带额外参数的辅助函数:
helper(位置..., 累积量)。累积量必须作为参数往下传,不能用外层变量攒——因为不同分支的路径互不相干。 - 「在一个序列里选一个子序列」的递归骨架永远是两条分支:用第一个 或 不用第一个,然后对剩下的部分递归。
or恰好能把「先试第一条,不行再试第二条」写成一行。 - 返回函数的递归函数,返回值是函数对象不是数。判断「有没有解」要看返回的是不是
None,而None是 falsy、函数对象是 truthy——这就是or能用的原因。
1. 更正 Lecture 11:doctest 为什么把 print 吞了
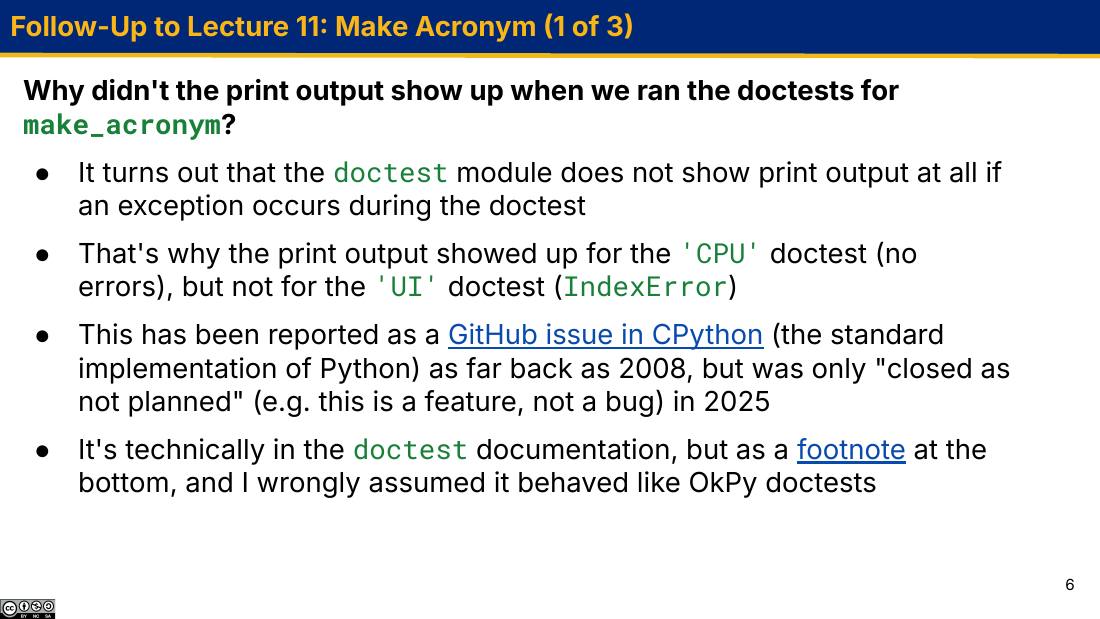
Lecture 11 的最后一个练习是 print 调试:给一个有 bug 的 make_acronym(把 'central processing unit' 变成 'CPU'),要求插 print 找出 bug。课上现场演示时出了怪事——插好的 print 语句,在跑 doctest 时一行输出都没有。
这不是学生写错了,也不是讲师写错了。是 doctest 模块本身的行为。
自己动手复现一次
光看结论没用,跑一遍才记得住。把下面这段存成 acr.py:
def make_acronym(phrase):
    """
    >>> make_acronym('central processing unit')
    'CPU'
    >>> make_acronym('user  interface')
    'UI'
    """
    words = phrase.split(' ')
    acronym = ''
    for w in words:
        print('DEBUG: w =', repr(w))
        acronym += w[0].upper()
    return acronym
注意第二条 doctest 里 'user interface' 中间是两个空格——这正是原练习里的 bug 来源:split(' ') 按单个空格切,两个空格中间会切出一个空字符串,而 ''[0] 会炸。
运行 python3 -m doctest -v acr.py,真实输出的关键部分是:
Got:
    DEBUG: w = 'central'
    DEBUG: w = 'processing'
    DEBUG: w = 'unit'
    'CPU'
Trying:
    make_acronym('user  interface')
Expecting:
    'UI'
**********************************************************************
File "/tmp/l12/acr.py", line 5, in acr.make_acronym
Failed example:
    make_acronym('user  interface')
Exception raised:
    Traceback (most recent call last):
      ...
      File "/tmp/l12/acr.py", line 12, in make_acronym
        acronym += w[0].upper()
    IndexError: string index out of range
>>> 开头的 example 单独执行,执行期间把标准输出(stdout)重定向到一个缓冲区——也就是说 print 打出来的东西不会直接到屏幕上,而是先被收集起来。DEBUG: 三行)加上表达式的值 'CPU',一起构成「实际输出(Got)」,拿去跟 Expecting 的 'CPU' 比。四行 ≠ 一行,所以这条本来能过的 doctest,因为你加了 print 反而挂了。Exception raised: 加 traceback。那份被收集起来的 print 输出就此丢弃,一个字都不显示。「我在循环里加了 print,什么都没打出来,说明循环一次都没进去。」——在 doctest 下这个推理是错的。 上面的实验里 for 循环明明跑了两轮('user' 和 ''),第二轮才炸,但你在报错那条 example 里看不到任何 DEBUG:。
诊断路径应该是:先确认测试框架会不会显示 print,再下「代码没执行到」的结论。最省事的验证方法是绕开框架直接跑:python3 -i acr.py 然后手动敲 make_acronym('user interface'),print 输出立刻就出来了。
那为什么 OkPy 里加 print 就没事?
你在做 lab 和 hw 时用的 python3 ok,加了 print("DEBUG: ...") 之后既能看到输出,测试也照样能过。这不是 doctest 的功劳,是 61A 课程组多年前写 OkPy 时自己加的。
做法是这样的:doctest 模块除了「一行命令跑完」的简单用法外,还提供一套高级 API,允许你替换掉它内部负责「判断实际输出算不算对」的那个组件——OutputChecker。OkPy 定义了 OutputChecker 的一个子类,用正则表达式识别出以 DEBUG: 之类前缀开头的行,在比对之前把它们从实际输出里剥掉。剥完再交给原来的比对逻辑。
这件事的漂亮之处在于:OkPy 没有去改 CPython 的 doctest 源码,也没有重写一个测试框架。它只是替换了整台机器上的一个零件,因为 doctest 的作者当初把「怎么比对输出」这件事单独抽象成了一个对象,而不是硬编码在主流程里。
这正是本课反复讲的:把「做什么」和「怎么做」用一层接口隔开,隔开之后「怎么做」就可以被换掉。 你在数据抽象那一讲用 label(t) / branches(t) 把「树怎么存」藏起来,跟这里是同一件事,只是规模不同。
结论:这门课的三条 takeaway
- 不要在没验证的情况下做假设。 讲师当时以为 doctest 的行为和 OkPy 一样,因为她一直用的是 OkPy。
- 文档是你的朋友。 这个行为其实写在 doctest 官方文档里,只不过是页面最底下的一条脚注。
- 抽象的力量。 见上面那个
OutputChecker的故事。
顺带一个对期中有用的推论:考试里让你判断一段代码「显示什么」时,问的永远是把这段代码敲进交互式解释器(>>> 提示符)会看到什么,不是在 doctest 或 ok 里看到什么。 交互式解释器的规则很简单——print 调用一次打一行,最后表达式的值如果不是 None 再打一行。下一节就是一道这种题。
2. WWPD:try / except / else / finally 的执行顺序
try 语句语义自己编的等价题,每一段都真的跑过——你可以照着自己在终端里验证一遍。Lecture 11 给出了 try 语句的完整形状:
try:
    <try suite>
except <exception> as <name>:    # 可选,可以有多个
    <except suite>
else:                             # 可选
    <else suite>
finally:                          # 可选
    <finally suite>
四个 suite 什么时候跑,是期中最容易被考的「求值顺序」之一。先把规则摆出来:
| 子句 | 什么时候执行 | 关键点 |
|---|---|---|
try | 总是先执行;一旦某行抛异常,这一行之后的 try suite 全部跳过 | 不是「整块跑完再看」,是「炸在哪停在哪」 |
except | 只在 try suite 抛出的异常属于它写的那个类(或其子类)时执行 | 类型对不上就当作没写,异常继续往外传 |
else | 只在 try suite 完整跑完且没抛异常时执行 | 「没出事才做的收尾」,和 except 互斥 |
finally | 无论如何都执行:正常、被 catch、没被 catch、甚至 try 里 return 了 | 清理资源用;它执行完之后异常才继续往外传 |
另外两条语法约束:最少要写 try + except,或者 try + finally(光有 try 不行);except: 后面不写异常类会捕获一切异常,这很危险——静悄悄地吞掉错误是我们最不想要的,所以永远写清楚要抓哪个类。
第一题:把 Lecture 11 的 safe_divide 逐帧走一遍
def safe_divide(numerator, denominator):
    try:
        result = numerator / denominator
    except ZeroDivisionError:
        result = 'Undefined'
    else:
        print(f"The result of the division is: {result}")
    finally:
        print("Cleanup")
    return result
问:在交互式解释器里依次敲 safe_divide(1, 0) 和 safe_divide(4, 2),各显示什么?
f1: safe_divide,绑定 numerator = 1、denominator = 0。1 / 0 → 抛出 ZeroDivisionError。赋值语句 result = ... 没有完成,此刻帧里还没有 result 这个名字。except:写的是 ZeroDivisionError,类型对上了 → 执行 result = 'Undefined'。现在帧里 result 绑定到字符串 'Undefined'。else suite 跳过——因为 try suite 是抛着异常出来的,不是干净跑完的。所以那行 The result of the division is: 不会打印。finally suite 执行 → 屏幕上出现 Cleanup。return result → 返回 'Undefined'。交互式解释器把返回值 repr 出来,屏幕上出现 'Undefined'(带引号,因为它是字符串的 repr,不是 print)。合起来,两次调用的真实屏幕输出(我在 Python 3.10 上跑过)是:
>>> safe_divide(1, 0)
Cleanup
'Undefined'
>>> safe_divide(4, 2)
The result of the division is: 2.0
Cleanup
2.0
两个细节值得停一下:
4 / 2得到的是2.0不是2。Python 的/永远返回 float,哪怕整除得尽。要整数除法得用//。WWPD 题里漏掉这个.0就算错。- 第二次调用里
The result...出现在Cleanup之前。else在finally之前跑,顺序不能颠倒。
第二题:return 和 finally 谁先谁后
这是 finally 最反直觉的地方。
def f():
    try:
        return 'try'
    finally:
        print('finally runs')

>>> f()
finally runs
'try'
return 'try' 已经执行了,函数「应该」立刻结束才对——但 finally runs 还是打出来了,而且打在返回值之前。
return 'try' 时,Python 先求值 'try' 这个表达式,把结果 'try' 记在一边(当作待返回的值)。try 语句。离开 try 语句这件事本身就会触发 finally suite——不管你是正常走完的、抛异常走的,还是 return 走的。print('finally runs') 执行,屏幕上出现一行。finally 跑完了,这时才真正把第 1 步记下的 'try' 交出去,函数结束。交互式解释器显示 'try'。如果 finally suite 里自己也有 return,它会覆盖掉之前记下的返回值:
def g():
    try:
        return 'try'
    finally:
        return 'finally'

>>> g()
'finally'
更糟的是,finally 里的 return 会把正在往外传的异常直接吞掉——函数看起来正常返回了,错误无声无息地消失。这是真实项目里排查起来最痛苦的一类 bug,也是「不要让程序静悄悄地失败」这条原则的反面教材。结论:finally 里只做清理(关文件、打日志),永远别写 return。
第三题:没被接住的异常,finally 还跑吗
def k():
    try:
        raise ValueError('boom')
    except TypeError:
        print('never')
    finally:
        print('k cleanup')

>>> k()
k cleanup
Traceback (most recent call last):
  ...
ValueError: boom
逐步看:raise ValueError('boom') 抛出 ValueError;except TypeError 类型对不上,不执行,never 永远不会打印;异常此时处于「正在往外传」的状态;但离开 try 语句要先跑 finally,所以 k cleanup 先打出来;finally 结束后异常才继续往外传,最终由解释器打出 traceback。
finally 是「离开 try 语句时的通行费」——不管你从哪个出口走(正常、异常、return),都得先交这笔费。
3. One Cent:生成器做滑动窗口
题面(CS 61A Fall 2022 Final Q7)。 在潘尼游戏(Penney's Game)里,两名玩家各选一串互不相同的三次抛硬币结果(每次是 'H' 正面或 'T' 反面)。然后开始反复抛硬币,谁选的那串先出现,谁就赢。
例子:玩家 1 选 "HHH",玩家 2 选 "THH",实际抛出的序列是 HTTHTHTTHTHTHH。最后三次抛出的 THH 先出现(HHH 从头到尾没出现过),所以玩家 2 赢。
(a) 生成器 three_flips
先写生成器函数 three_flips。输入是一个可能无穷的迭代器 coin,每个元素是 'H' 或 'T'。它要不断产出连续三次抛硬币结果拼成的字符串——注意是滑动的,不是三个三个切开:
def three_flips(coin):
    '''
    >>> a = three_flips(iter("HTTHHT"))
    >>> next(a)      # 第 0、1、2 次抛
    'HTT'
    >>> next(a)      # 第 1、2、3 次抛
    'TTH'
    >>> next(a)      # 第 2、3、4 次抛
    'THH'
    >>> next(a)      # 第 3、4、5 次抛
    'HHT'
    '''
    start = ___(a)___
    ___(b)___:
        yield start
        start = ___(c)___ + ___(d)___
怎么想到的
先把 doctest 摊开看清楚。原始序列是 H T T H H T,产出的四个值是:
第几次 next | 产出 | 用到原序列的下标 |
|---|---|---|
| 1 | 'HTT' | 0, 1, 2 |
| 2 | 'TTH' | 1, 2, 3 |
| 3 | 'THH' | 2, 3, 4 |
| 4 | 'HHT' | 3, 4, 5 |
两条关键观察:
- 相邻两次产出重叠两个字符。
'HTT'的后两位'TT'就是'TTH'的前两位。所以从上一个值得到下一个值,只需要「砍掉最前面一个字符、在后面接一个新字符」——这就是滑动窗口。 - 每次产出只额外消耗一个新元素。 第一次产出要吃掉 3 个,之后每次只吃 1 个。这一点决定了
next(coin)该写在哪儿——写多了会把序列吃穿。
为什么必须用生成器而不是先把 coin 转成 list 再切片?因为题面写了 coin 可能是无穷的。list(coin) 会永远跑下去。生成器的价值就在于它「用多少算多少」,这也是 Lecture 10 的核心。
填空
def three_flips(coin):
    start = next(coin) + next(coin) + next(coin)
    while True:
        yield start
        start = start[1:] + next(coin)
- (a)
next(coin) + next(coin) + next(coin)——先手动吃掉三个,拼成第一个窗口。这里能这么写,是因为 Python 的+从左往右求值,三次next依次拿到第 0、1、2 个元素。 - (b)
while True——无限循环。备选项for x in coin是错的:for会自己从coin里取元素,和循环体里的next(coin)抢,一轮吃两个,产出的窗口会跳着走。 - (c)
start[1:]——去掉最老的那一位,留下后两位。 - (d)
next(coin)——接上一个新的。备选项coin是错的(那是把迭代器对象跟字符串相加,直接TypeError),coin.pop()更错——迭代器没有pop方法。
a = three_flips(iter("HTTHHT")):函数体一行都还没执行。调用生成器函数只是造出一个生成器对象。这是 Lecture 10 最容易忘的一点。next(a):从函数体开头执行。next(coin) 三次分别得到 'H'、'T'、'T',start = 'HTT'。此时 coin 已被消耗到第 3 个元素之前。while True,执行 yield start → 产出 'HTT',函数在 yield 这一行冻结,局部帧(含 start = 'HTT' 和 coin 的当前位置)原样保留。next(a):从 yield 的下一行继续。start[1:] 是 'TT',next(coin) 拿到第 3 个元素 'H',于是 start = 'TTH'。while 顶部(条件恒真),再次 yield start → 产出 'TTH'。和 doctest 一致。next 次数 冻结位置 start 的值 coin 已消耗到(下标) — 尚未启动 (不存在) 0 1 yield 那一行 'HTT' 3 2 yield 那一行 'TTH' 4 3 yield 那一行 'THH' 5 4 yield 那一行 'HHT' 6 ← 已耗尽 5 —— 见下 ——
官方 doctest 的最后一行写着「第五次 next(a) 会抛 StopIteration」。在今天的 Python 上跑,得到的其实是别的东西。我实测(Python 3.10):
>>> next(a)
Traceback (most recent call last):
  File "...", line 5, in three_flips
    start = start[1:] + next(coin)
StopIteration

The above exception was the direct cause of the following exception:

Traceback (most recent call last):
  File "...", line 16, in <module>
    next(a)
RuntimeError: generator raised StopIteration
原因:从 Python 3.7 起(PEP 479),生成器函数体内部逃逸出来的 StopIteration 会被自动转成 RuntimeError。设计动机是防止「生成器里某个 next 意外耗尽」被误当成「这个生成器正常结束了」——那种 bug 极难发现。
考试时如果题面明确写了预期是 StopIteration,按题面答即可;但你自己在本机验证时看到 RuntimeError,不要以为是自己写错了。「生成器正常结束」的正确写法是让函数体自然执行完或写 return,而不是靠里面的 next 炸掉。
(b) penney:用 filter 找第一个命中
def penney(coin, p1, p2):
    '''返回潘尼游戏的胜者:玩家 1 选 p1,玩家 2 选 p2。

    >>> penney(iter("HTTHTHTTHTHTHH"), "THH", "HHH")
    1
    >>> penney(iter("HTTHTHTTHTHTHH"), "HHH", "THH")
    2
    >>> penney(iter("HTTHTHTTHTHTHH"), "HTT", "THH")   # HTT 先出现
    1
    '''
    it = ___(a)___(lambda x: ___(b)___, ___(c)___)
    if next(it) == p1:
        return 1
    return 2
怎么想到的
骨架已经把答案框死了:it 是某个东西,next(it) 取出来的第一个值直接拿来跟 p1 比。所以 it 必须是「所有出现过的三连窗口里,只保留是 p1 或 p2 的那些」的迭代器——它的第一个元素就是「先出现的那一串」。
「从一串东西里挑出满足条件的」——这是 filter(函数, 可迭代对象)。加上第一个参数已经写好是 lambda,答案立刻明朗:
it = filter(lambda x: x in [p1, p2], three_flips(coin))
- (a)
filter - (b)
x in [p1, p2]——判断这个三连窗口是不是两名玩家中某一个选的串 - (c)
three_flips(coin)——被筛的对象是所有滑动窗口。备选项里的coin是错的:coin里的元素是单个字符'H'/'T',永远不会等于三字符的p1;(p1, p2)更错——那是把答案本身当输入筛。
three_flips(coin) 产出的窗口依次是:'HTT'、'TTH'、'THT'、'HTH'、……filter 拿到第一个窗口 'HTT',用 lambda 检查:'HTT' in ['HTT', 'THH'] → True,保留。next(it) 得到 'HTT'。到此为止,生成器只被推动了一次,后面十来次抛硬币根本没有被计算过——filter 和生成器一样是惰性的。'HTT' == p1 → 返回 1。与 doctest 一致。题面说「假设在硬币用完之前一定有人赢」。如果 filter 不是惰性的——比如它非要先把所有满足条件的窗口都找出来再返回——那么当 coin 是无穷迭代器时,这个函数永远不会返回。
惰性求值让你可以对「无穷长的数据」写出「有限时间返回」的代码,只要你只取有限个。这就是 Lecture 10 讲迭代器/生成器的真正理由,不是为了省内存那么简单。
误区一:把 lambda x: x in [p1, p2] 写成 lambda x: x == p1 or x == p2 之后又写成 lambda x: x == p1 or p2。 后者是经典错误:x == p1 or p2 按优先级是 (x == p1) or p2,当 x != p1 时整个表达式的值是 p2(一个非空字符串,truthy),于是任何窗口都会被保留,函数会把第一个窗口当成赢家。
误区二:以为 filter 返回列表。 Python 3 里 filter 返回的是迭代器,所以能直接 next(it)。如果你写 it[0],报错是 TypeError: 'filter' object is not subscriptable。
4. Escape Lumon:在网格上做树递归
题面(DATA C88C Spring 2025 Midterm Q7)。 Helly 是 Lumon 公司的新员工,她被锁在办公楼里出不去,必须至少收集 3 张安全徽章才能离开。同事 Mark 给了她一张走廊地图,用 Python 的嵌套列表(list of lists)表示:每个格子是 0 或 1,1 表示这里能捡到一张徽章。
实现 count_paths(grid):返回从左上角走到右下角、途中只能向右或向下移动、并且捡到至少 3 张徽章的不同路径数。
def count_paths(grid):
    """
    >>> simple_grid = [
    ...     [1, 0, 0],
    ...     [1, 0, 0],
    ...     [1, 0, 0],
    ... ]
    >>> count_paths(simple_grid)
    1

    >>> # R = 向右, D = 向下
    >>> # 路径 1: RRDD, 路径 2: RDRD, 路径 3: RDDR, 路径 4: DRRD, 路径 5: DRDR
    >>> complex_grid = [
    ...     [1, 0, 1],
    ...     [0, 1, 0],
    ...     [0, 0, 1],
    ... ]
    >>> count_paths(complex_grid)
    5

    >>> zeros_grid = [
    ...     [0, 0, 0],
    ...     [0, 0, 0],
    ...     [0, 0, 0],
    ... ]
    >>> count_paths(zeros_grid)
    0
    """
    def helper(row, col, badges):
        if row >= len(grid) or col >= len(grid[0]):
            return ___(a)___
        badges += ___(b)___
        if ___(c)___:
            if badges >= 3:
                return ___(d)___
            else:
                return ___(e)___
        return ___(f)___
    return ___(g)___
先把 doctest 翻译成人话
三个 doctest 各卡一个点,值得逐个手算:
simple_grid:徽章全在第 0 列。 3×3 网格从左上到右下一共有 $\binom{4}{2} = 6$ 条路径(走 4 步,其中挑 2 步向下)。但只有一条路径能踩满第 0 列的三个 1:先一路向下走到底,再一路向右——DDRR。其余五条路径都在某一步提前拐右,就永远回不到第 0 列了(不能向左)。答案 1。
complex_grid:6 条路径里 5 条合格。 逐条数:
| 路径 | 经过的格子 | 徽章数 | 算不算 |
|---|---|---|---|
| RRDD | (0,0)1 (0,1)0 (0,2)1 (1,2)0 (2,2)1 | 3 | ✔ |
| RDRD | (0,0)1 (0,1)0 (1,1)1 (1,2)0 (2,2)1 | 3 | ✔ |
| RDDR | (0,0)1 (0,1)0 (1,1)1 (2,1)0 (2,2)1 | 3 | ✔ |
| DRRD | (0,0)1 (1,0)0 (1,1)1 (1,2)0 (2,2)1 | 3 | ✔ |
| DRDR | (0,0)1 (1,0)0 (1,1)1 (2,1)0 (2,2)1 | 3 | ✔ |
| DDRR | (0,0)1 (1,0)0 (2,0)0 (2,1)0 (2,2)1 | 2 | ✘ |
zeros_grid:一张徽章都没有,六条路径全不合格,答案 0。它顺便告诉你:函数返回的是「合格路径数」,不是「路径数」——如果你写成先数路径再判断,会得到 6。
怎么想到的:这是一棵树,不是一张网格
「从起点到终点有多少条路」这个问法,跟 Lecture 06 的 count_partitions 是同一个形状。关键在于把「走一步」看成一次分叉:
站在格子 (r, c) 上,你只有两个选择:向右到 (r, c+1),或者向下到 (r+1, c)。所以
从 (r,c) 出发的合格路径数 = 从 (r,c+1) 出发的合格路径数 + 从 (r+1,c) 出发的合格路径数
这就把一个问题拆成两个同构的、更靠近终点的子问题。所有可能的走法展开成一棵二叉树,每片叶子对应一条走到底的路径(或一条撞墙作废的路径)。这就是树递归(tree recursion)。
但光有位置还不够。「至少 3 张徽章」这个条件不是只看终点格子就能判断的,它取决于你一路怎么走过来。这就是为什么骨架里 helper 有第三个参数 badges:
当「这条路合不合格」取决于沿途累积的信息时,就把那份信息做成递归函数的一个额外参数,一路往下传。到达终点(base case)时,参数里就装着这一整条路的全部历史,直接用它下判断。
这类参数在 61A 里通常叫 accumulator(累加器)。badges 就是一个。
逐个填空
def count_paths(grid):
    def helper(row, col, badges):
        if row >= len(grid) or col >= len(grid[0]):
            return 0
        badges += grid[row][col]
        if row == len(grid) - 1 and col == len(grid[0]) - 1:
            if badges >= 3:
                return 1
            else:
                return 0
        return helper(row, col + 1, badges) + helper(row + 1, col, badges)
    return helper(0, 0, 0)
| 空 | 答案 | 为什么 |
|---|---|---|
| (a) | 0 | 走出了网格 ⇒ 这条路作废 ⇒ 它贡献 0 条合格路径。不是 -1(数量不可能为负),也不是 1(走出界不算一条路)。 |
| (b) | grid[row][col] | 当前格子的值本身就是 0 或 1,直接加就是「有徽章 +1、没有 +0」。不需要 if。 |
| (c) | row == len(grid) - 1 and col == len(grid[0]) - 1 | 「在右下角」= 行是最后一行 且 列是最后一列。len(grid) 是行数,len(grid[0]) 是列数。 |
| (d) | 1 | 到了终点且徽章够 ⇒ 这条路算一条合格路径。 |
| (e) | 0 | 到了终点但徽章不够 ⇒ 不合格 ⇒ 贡献 0。 |
| (f) | helper(row, col + 1, badges) + helper(row + 1, col, badges) | 向右的所有走法 加上 向下的所有走法。两条支路走的格子集合不同,不会重复计数。 |
| (g) | helper(0, 0, 0) | Helly 从左上角出发,手里 0 张徽章。徽章是「已收集数」不是「还需要几张」,所以初值是 0 不是 3。 |
三个顺序问题,一个都不能错
badges += grid[row][col] 再检查越界,当 row 等于行数时立刻 IndexError: list index out of range。递归函数里,「先确认参数合法,再用参数」是铁律。simple_grid 看不出差别(右下角是 0),但 complex_grid 的右下角是 1——顺序写反的话六条路径的徽章数全部少 1,count_paths(complex_grid) 会返回 0。验证:把 simple_grid 完整展开
下面是 count_paths(simple_grid) 的真实调用树(我加了打印语句跑出来的,缩进表示调用深度)。badges= 标的是捡过当前格子之后的值:
helper(0, 0, 0)  badges=1
  helper(0, 1, 1)  badges=1
    helper(0, 2, 1)  badges=1
      helper(0, 3, 1) → 0   越界(列出界)
      helper(1, 2, 1)  badges=1
        helper(1, 3, 1) → 0   越界
        helper(2, 2, 1) → 0   终点,但 badges=1 < 3
        = 0
      = 0
    helper(1, 1, 1)  badges=1
      helper(1, 2, 1)  … = 0
      helper(2, 1, 1)  … = 0
      = 0
    = 0                        ← 第一步向右的全部走法:0 条
  helper(1, 0, 1)  badges=2
    helper(1, 1, 2)  badges=2
      helper(1, 2, 2)  … = 0
      helper(2, 1, 2)  … = 0
      = 0
    helper(2, 0, 2)  badges=3
      helper(2, 1, 3)  badges=3
        helper(2, 2, 3) → 1   终点,badges=3 ≥ 3  ✔
        helper(3, 1, 3) → 0   越界(行出界)
        = 1
      helper(3, 0, 3) → 0     越界
      = 1
    = 1
  = 1                          ← 第一步向下的全部走法:1 条
TOTAL 1
逐层回代看得很清楚:唯一那个 1 来自最深处的 helper(2, 2, 3)——也就是路径 DDRR。它一路往上加,经过 helper(2,1,3)、helper(2,0,2)、helper(1,0,1),最后和「第一步向右」那半边的 0 相加,得到 1。
误区一:想用一个外部计数器代替参数。 有人会写:
def count_paths(grid):
    badges = 0                    # ✗ 错
    total = 0
    def helper(row, col):
        nonlocal badges, total
        badges += grid[row][col]
        ...
这会错得很惨。因为两条支路走的是不同的路径,向右那条捡的徽章不该算进向下那条。用 nonlocal 的话,第一条支路捡的徽章会留在 badges 里,被第二条支路继承——结果是各条路径互相污染。
写成参数就没有这个问题:badges 是 helper 的形参,每次调用新建一帧,badges += ... 只改本帧里那个名字的绑定(整数是不可变的,+= 等价于重新绑定)。父帧的 badges 分毫不动,所以两个子调用拿到的是同一个起始值的两份独立副本。
误区二:把 len(grid[0]) 写成 len(grid)。 正方形网格上测不出来,一到长方形网格就崩。记清楚:grid 是「行的列表」,len(grid) = 行数 = 有几个 row;grid[0] 是第一行,len(grid[0]) = 列数。
误区三:以为要判重。 「向右」和「向下」两条支路的第一步就不同,之后无论怎么走都不可能变成同一条路径。所以直接相加,不会重复计数。
5. All Treeils Lead to Rome:树的数据抽象 + 递归
题面(CS 61A Summer 2023 Midterm Q6)。 定义:Treeil 是这样一种树——它的每一个非叶节点,都恰好有一个子节点的 label 等于该节点自己的 label。换个说法:从任何节点出发,都存在唯一一条通往叶子的路径,路径上所有节点的 label 全都相同。
先把 Lecture 09 的树 ADT 摆出来,后面全靠它:
def tree(root_label, branches=[]):
    for branch in branches:
        assert is_tree(branch), 'branches must be trees'
    return [root_label] + list(branches)

def label(tree):
    return tree[0]

def branches(tree):
    return tree[1:]

def is_leaf(tree):
    return not branches(tree)
做树题时,一律用 label(t) 和 branches(t),绝不写 t[0] 和 t[1:]。不是为了好看——考试会明确扣分,而且真实原因是:树碰巧是用列表实现的,但你的代码不该依赖这一点。你在 Lecture 08 学的抽象屏障(abstraction barrier)说的就是这件事。
(a) is_treeil:把定义翻译成代码
def is_treeil(t):
    """
    >>> t1 = tree(1)
    >>> is_treeil(t1)
    True
    >>> t2 = tree(1, [tree(2), tree(3)])
    >>> is_treeil(t2)
    False
    >>> t3 = tree(1, [tree(1, [tree(1), tree(3)]), tree(2)])
    >>> is_treeil(t3)
    True
    >>> t4 = tree(1, [tree(1, [tree(1), tree(1)]), tree(2)])
    >>> is_treeil(t4)
    False
    >>> t5 = tree(2, [tree(3, [tree(1)]), tree(2, [tree(2)])])
    >>> is_treeil(t5)
    False
    """
    if ___(a)___:
        return True
    else:
        match_one = ___(b)___([b for b in branches(t) if ___(c)___]) == 1
        return ___(d)___ and ___(e)___([___(f)___ for b in branches(t)])
先把五个 doctest 手算一遍
| 树 | 形状 | 结果 | 为什么 |
|---|---|---|---|
t1 | 光秃秃一个 label 为 1 的叶子 | True | 没有非叶节点,条件空真成立 |
t2 | 1 → [2, 3] | False | 根的 label 是 1,两个孩子是 2 和 3,0 个匹配,不是「恰好 1 个」 |
t3 | 1 → [1 → [1, 3], 2] | True | 根 1 的孩子是 {1, 2},恰好 1 个匹配;子树 1 的孩子是 {1, 3},也恰好 1 个;再往下都是叶子 |
t4 | 1 → [1 → [1, 1], 2] | False | 根这一层没问题,但中间那个 label 为 1 的节点有两个 label 为 1 的孩子——「恰好一个」被破坏 |
t5 | 2 → [3 → [1], 2 → [2]] | False | 根 2 的孩子是 {3, 2},恰好 1 个匹配,看似没问题;但左子树 3 → [1] 的孩子里没有 label 为 3 的,它自己不是 treeil |
t4 和 t5 是这道题的全部难点所在:t4 说明「恰好一个」不能放宽成「至少一个」;t5 说明光检查根这一层不够,每个后代都要检查。 这两件事对应最终代码里的两个条件,用 and 连起来。
填空
def is_treeil(t):
    if is_leaf(t):
        return True
    else:
        match_one = len([b for b in branches(t) if label(t) == label(b)]) == 1
        return match_one and all([is_treeil(b) for b in branches(t)])
| 空 | 答案 | 说明 |
|---|---|---|
| (a) | is_leaf(t)(等价写法:not branches(t)、branches(t) == []) | 定义只约束非叶节点,所以叶子无条件是 treeil |
| (b) | len | 「恰好一个」= 满足条件的孩子个数为 1。len(列表) 就是计数 |
| (c) | label(t) == label(b) | 筛出「label 与父节点相同」的孩子。注意是 label(b) 不是 b——b 是一棵树 |
| (d) | match_one | 第一个条件:本层恰好一个匹配 |
| (e) | all | 第二个条件:每一棵子树都得是 treeil。any 只要一棵满足就行,会放过 t5 |
| (f) | is_treeil(b) | 递归调用。递归的对象是子树,不是子树的 label |
t5 = tree(2, [tree(3, [tree(1)]), tree(2, [tree(2)])])
is_treeil(t5):is_leaf(t5) 为假(有两棵子树),进 else。match_one:branches(t5) 是 [tree(3,[tree(1)]), tree(2,[tree(2)])],它们的 label 分别是 3 和 2。label(t5) 是 2。筛出的列表长度是 1 → match_one = True。match_one 为 True,and 不能短路,必须求右边的 all([...])。列表推导式开始逐个算。is_treeil(tree(3, [tree(1)]))。它不是叶子。label 是 3,唯一的孩子 label 是 1。筛出的列表是空的,长度 0 ≠ 1 → match_one = False。False and ... → 短路,右边的 all([is_treeil(tree(1))]) 根本不求值。直接返回 False。is_treeil(tree(2, [tree(2)]))。label 2,孩子 label 2 → 匹配 1 个 → match_one = True;all([is_treeil(tree(2))]),而 tree(2) 是叶子 → True。所以这棵返回 True。all([False, True]) → False。于是 True and False → False。is_treeil(t5) 返回 False,和 doctest 一致。这是树递归里绕不开的一条:all([]) 是 True,any([]) 是 False。
记法:all 在找反例,空列表里找不到反例,所以为真(数学上叫「空真」,vacuous truth);any 在找例证,空列表里找不到例证,所以为假。
这条规则让很多树递归不需要单独写叶子的 base case:叶子的 branches(t) 是空的,all([... for b in branches(t)]) 自动返回 True,递归自然停住。
(b) max_treeil:最大的 treeil 子树有多少个节点
现在 t 不一定是 treeil。求:t 的所有子树中,是 treeil 的那些里面,节点数最多的是多少个节点。可以假设 is_treeil 已经写好了。
def max_treeil(t):
    """
    >>> max_treeil(t1)     # tree(1)
    1
    >>> max_treeil(t2)     # 1 -> [2, 3]
    1
    >>> max_treeil(t3)     # 1 -> [1 -> [1, 3], 2]
    5
    >>> max_treeil(t4)     # 1 -> [1 -> [1, 1], 2]
    1
    >>> max_treeil(t5)     # 2 -> [3 -> [1], 2 -> [2]]
    2
    """
    if ___(a)___:
        return 1
    elif ___(b)___:
        return 1 + ___(c)___
    else:
        return max([___(d)___ for b in branches(t)])
怎么想到的
骨架分三支,逐支追问「什么情况下走这支」:
max 取子树里的最大值——这显然是「当前这棵树自己不是 treeil,只能到子树里去找」的情况。is_treeil(t)。is_leaf(t)。剩下 (c):既然第二支要返回「t 的节点总数」,那就是 1(根自己) + 所有子树的节点数之和。而当 t 是 treeil 时,它的每棵子树也都是 treeil(这是定义递归成立的直接推论),所以 max_treeil(b) 返回的就是 b 的节点总数。于是:
def max_treeil(t):
    if is_leaf(t):
        return 1
    elif is_treeil(t):
        return 1 + sum([max_treeil(b) for b in branches(t)])
    else:
        return max([max_treeil(b) for b in branches(t)])
第二支必须是 sum,第三支必须是 max,绝不能对调:
- 第二支(t 是 treeil):
sum——要的是「t 一共有多少节点」,各子树的节点数得加起来。用max只会数到最大的那一棵,漏掉别的。 - 第三支(t 不是 treeil):
max——要的是「哪棵子树里藏着最大的 treeil」,各子树的结果互相竞争,取最大。用sum会把好几棵互不相连的 treeil 加到一起,那不是一棵树。
判据:子结果之间是「拼在一起构成一个整体」还是「互相竞争选一个」? 前者用 sum,后者用 max。
t5 = 2 → [3 → [1], 2 → [2]]。前面已经算出 is_treeil(t5) 是 False。
max_treeil(t5)
  is_leaf? 否
  is_treeil(t5)? 否  →  走第三支:max([...])
  ├─ max_treeil(3 → [1])
  │    is_leaf? 否
  │    is_treeil? 否(孩子 label 是 1,没有 3)→ 第三支
  │    └─ max_treeil(1)   叶子 → 1
  │    = max([1]) = 1
  └─ max_treeil(2 → [2])
       is_leaf? 否
       is_treeil? 是(孩子 label 2 恰好匹配一个)→ 第二支
       └─ max_treeil(2)   叶子 → 1
       = 1 + sum([1]) = 2
  = max([1, 2]) = 2
答案 2 对应的是右边那棵 2 → [2]——整棵 t5 里最大的 treeil 子树,两个节点。
t3 = 1 → [1 → [1, 3], 2],整棵是 treeil,一共 5 个节点(根、中间那个 1、它的两个孩子 1 和 3、还有根的另一个孩子 2)。
max_treeil(t3):不是叶子;is_treeil(t3) 为 True → 第二支,1 + sum([max_treeil(1 → [1,3]), max_treeil(2)])。max_treeil(1 → [1, 3]):不是叶子;是 treeil(孩子 label 是 1 和 3,恰好一个匹配 1)→ 第二支,1 + sum([max_treeil(1), max_treeil(3)]) = 1 + sum([1, 1]) = 3。max_treeil(2):叶子 → 1。1 + sum([3, 1]) = 1 + 4 = 5。✔误区一:漏掉叶子那一支,直接 max([...]) 会崩。 如果把第一支去掉、又把第二支写错,走到叶子时 branches(t) 是空列表,max([]) 报 ValueError: max() arg is an empty sequence。sum([]) 是 0 不报错,max([]) 会报错——这个不对称经常坑人。
误区二:把 (a) 填成 is_treeil(t)。 那样整棵 t3 一进来就返回 1,而正确答案是 5。is_treeil(t) or is_leaf(t) 同理错。顺序上必须先判叶子,再判 treeil。(严格说,叶子那一支其实被第二支覆盖了——叶子也是 treeil,走第二支得 1 + sum([]) = 1,结果一样。但写出来更清楚,也省一次 is_treeil 的递归。)
误区三:以为「不是 treeil 的树,答案一定在某棵子树里」不成立。 它成立,而且这正是第三支的依据:一棵 treeil 子树要么就是 t 本身,要么完全落在某一棵 branches(t) 里面(子树不可能横跨两个分支)。所以 t 自己出局时,去每棵子树里各找一个最大的,再取最大,一个都不会漏。
6. Multi Compose:返回函数的递归
题面(CS 61A Summer 2024 Midterm Q6)。 实现 multi_compose(funcs, x, y):输入一个函数列表和两个整数 x、y,返回一个复合函数,它对输入 x 的输出是 y;这个复合函数由 funcs 里的某个子序列依次施加而成。约束:
- 函数只能按它们在列表里的先后顺序施加——下标 i 的函数必须在下标 i+1 的函数之前施加。
- 每个函数用 0 次或 1 次。
- 若不存在这样的复合函数,返回
None;若存在多个,返回其中任意一个。 - 可以假设
x != y。 - 解法必须用给定的
safe_compose。
def safe_compose(f, g):
    """
    >>> composed = safe_compose(lambda x: x + 1, lambda x: x * 2)
    >>> composed(5)
    11
    >>> safe_compose(lambda x: x, None) is None and safe_compose(None, lambda x: x) is None
    True
    """
    if f is None or g is None:
        return None
    def composed(x):
        return f(g(x))
    return composed
safe_compose(f, g) 返回的是 f 套在 g 外面:composed(x) 先算 g(x),再把结果喂给 f。所以 g 先施加、f 后施加。这个顺序后面是解题关键。另外它对 None 是「传染性」的:任一参数是 None,结果就是 None。
def multi_compose(funcs, x, y):
    """
    >>> add_one, double = lambda x: x + 1, lambda x: x * 2
    >>> sub_three, square = lambda x: x - 3, lambda x: x ** 2
    >>> list_of_funcs = [add_one, double, sub_three, square]
    >>> double_then_square = multi_compose(list_of_funcs, 3, 36)
    >>> double_then_square
    Function
    >>> double_then_square(1)      # (1 * 2) ** 2 --> 4
    4
    >>> square_then_double = multi_compose(list_of_funcs, 3, 18)
    >>> square_then_double         # None
    >>> all_funcs = multi_compose(list_of_funcs, 3, 25)
    >>> all_funcs(1)               # (((1 + 1) * 2) - 3) ** 2 --> 1
    1
    >>> negate = multi_compose(list_of_funcs, 100, -100)
    >>> negate                     # None
    """
    if x == y:
        return lambda x: ___(a)___
    if ___(b)___:
        return None
    return ___(c)___ or multi_compose(___(d)___)
先读懂题在问什么
这道题最容易被读错的地方:x 和 y 只是用来「挑出该用哪些函数」的样本,返回的函数并不是只对 x 有效。
看第一个 doctest:multi_compose(list_of_funcs, 3, 36)。要在 [add_one, double, sub_three, square] 里按顺序挑一个子序列,使得对 3 施加后得到 36。手算一下:double(3) = 6,square(6) = 36。✔ 所以挑中的子序列是 [double, square](跳过 add_one 和 sub_three)。
返回的函数是「先 double 再 square」这个复合函数本身。所以下一行 double_then_square(1) 得到 (1 * 2) ** 2 = 4——用的是别的输入,答案自然不是 36。
第二个 doctest 是反例:multi_compose(list_of_funcs, 3, 18) 返回 None。square(3) = 9、double(9) = 18 确实能凑出 18,但 square 在列表里排在 double 后面,不允许先 square 再 double。顺序约束在这里咬人。
| 调用 | 挑中的子序列 | 验算 |
|---|---|---|
multi_compose(L, 3, 36) | [double, square] | 3 →6 →36 |
multi_compose(L, 3, 18) | 无解(需要 square 在 double 前) | None |
multi_compose(L, 3, 25) | [add_one, double, sub_three, square] 全用 | 3 →4 →8 →5 →25 |
multi_compose(L, 50, 100) | [double] | 50 →100 |
multi_compose(L, 50, 48) | [sub_three]… 慢着 | 见下 |
multi_compose(L, 100, -100) | 无解 | None |
multi_compose(L, 50, 48) 的 doctest 里那个变量叫 sub_two,注释写 2 - 2 --> 0——因为挑中的是 [add_one, sub_three]:50 → 51 → 48。所以对输入 2 就是 2 → 3 → 0。名字只是人给的标签,真正决定行为的是被挑中的那串函数。
怎么想到的:子序列 = 每个元素「选」或「不选」
「在一个序列里按原顺序挑一个子序列」这类问题,递归骨架永远是同一个:盯住第一个元素,只问一个问题——用它,还是不用它?
- 用
funcs[0]:那么它必须最先施加。x立刻变成funcs[0](x),剩下的活交给funcs[1:]。 - 不用
funcs[0]:x原封不动,剩下的活交给funcs[1:]。
两条分支都把列表缩短了 1,所以一定会终止。这和 Lecture 06 的 count_partitions(用不用当前这个数)、和上一节 Escape Lumon(向右还是向下)是同一个模板。
再看 base case。递归到什么时候能宣布成功?当 x 已经等于 y 了——剩下的函数一个都不用挑,直接返回一个「什么都不做」的函数。什么时候宣布失败?当函数用完了 x 还不等于 y。
填空
def multi_compose(funcs, x, y):
    if x == y:
        return lambda x: x
    if not funcs:
        return None
    return safe_compose(multi_compose(funcs[1:], funcs[0](x), y), funcs[0]) \
           or multi_compose(funcs[1:], x, y)
| 空 | 答案 | 说明 |
|---|---|---|
| (a) | x | 成功的 base case,返回恒等函数 lambda x: x。注意 lambda 的形参 x 遮蔽了外层的 x——这里要的就是「原样返回收到的东西」,而不是「永远返回外层那个 x」。 |
| (b) | not funcs | 函数用完了(空列表是 falsy)还没凑出 y ⇒ 这条路走不通,返回 None。 |
| (c) | safe_compose(multi_compose(funcs[1:], funcs[0](x), y), funcs[0]) | 「用 funcs[0]」这条分支,是全题最难的一格。拆开见下。 |
| (d) | funcs[1:], x, y | 「不用 funcs[0]」这条分支:x 不变,函数列表去掉第一个。 |
把 (c) 拆开看
multi_compose(funcs[1:], funcs[0](x), y)。含义是「假设我已经把 funcs[0] 施加在 x 上了,现在的值是 funcs[0](x);请用剩下的函数 funcs[1:] 把它变成 y」。它返回的是剩下那一段的复合函数,或者 None。funcs[0] 拼起来。谁先谁后?funcs[0] 要先施加。而 safe_compose(f, g) 是 f(g(x))——g 先跑。所以 funcs[0] 必须放在第二个参数位置,「剩下那一段」放第一个。None(说明「先用 funcs[0]」这条路走不通),safe_compose(None, funcs[0]) 会返回 None——这正是 safe_compose 那两行 if f is None or g is None 存在的理由。失败信号被自动传播出来,你不用自己写 if。or:None 是 falsy,函数对象是 truthy。所以「用 funcs[0]」这条路成功时,or 短路,右边那条分支根本不会被计算,直接返回这个函数;失败(None)时才去算右边的「不用 funcs[0]」。写成 safe_compose(funcs[0], multi_compose(funcs[1:], funcs[0](x), y)) 是最常见的错。它意味着先跑剩下那一段、再跑 funcs[0],顺序完全颠倒。
这个错不会报错,只会算出错的数——这才是最坑的地方。multi_compose(L, 3, 36) 会返回一个函数,但 那个函数(1) 得到的是 double(square(1)) = 2 而不是 4。
防错口诀:compose(f, g) 读作「f after g」——右边的先跑。写的时候把它跟数学里的 $f \circ g$ 对齐,含义完全一样。
写成 multi_compose(funcs[1:], x, y) 放进 safe_compose 里,就等于说「我打算用 funcs[0],但我假装它没被用过」。「用了这个函数」这件事,唯一的体现方式就是把 x 换成 funcs[0](x) 再往下传。 这跟 Escape Lumon 里 badges += grid[row][col] 是完全一样的思想:递归参数携带的是「走到这一步为止的状态」。
验证:完整展开 multi_compose(L, 3, 36)
下面是真实运行时的调用树(我加打印跑出来的,缩进=深度)。L = [add_one, double, sub_three, square]。每一行括号里第一项是剩余函数列表、第二项是当前的值、第三项是目标 36。
mc([add_one, double, sub_three, square], 3, 36)
  ├─ 用 add_one → mc([double, sub_three, square], 4, 36)
  │    ├─ 用 double → mc([sub_three, square], 8, 36)
  │    │    ├─ 用 sub_three → mc([square], 5, 36)
  │    │    │    ├─ 用 square → mc([], 25, 36) → 函数空了 → None
  │    │    │    └─ 不用      → mc([], 5, 36)  → 函数空了 → None
  │    │    │    = None
  │    │    └─ 不用 sub_three → mc([square], 8, 36)
  │    │         ├─ 用 square → mc([], 64, 36) → None
  │    │         └─ 不用      → mc([], 8, 36)  → None
  │    │         = None
  │    │    = None
  │    └─ 不用 double → mc([sub_three, square], 4, 36)
  │         ├─ 用 sub_three → mc([square], 1, 36) → … → None
  │         └─ 不用         → mc([square], 4, 36) → … → None
  │         = None
  │    = None                    ← 「用 add_one」整条路走不通
  └─ 不用 add_one → mc([double, sub_three, square], 3, 36)
       ├─ 用 double → mc([sub_three, square], 6, 36)
       │    ├─ 用 sub_three → mc([square], 3, 36) → … → None
       │    └─ 不用         → mc([square], 6, 36)
       │         └─ 用 square → mc([], 36, 36)
       │                        x == y  ✔  返回 lambda x: x
       │         = safe_compose(lambda x: x, square)  → 一个函数
       │    = 那个函数
       └─ = safe_compose(那个函数, double)  → 最终答案
  = 最终答案(先 double 再 square)
mc([], 36, 36) 命中 x == y,返回恒等函数 I = lambda x: x。注意 x == y 的检查在 not funcs 之前,所以列表空了也没关系。mc([square], 6, 36):它做的是 safe_compose(I, square),得到函数 A,其中 A(t) = I(square(t)) = t ** 2。mc([sub_three, square], 6, 36):「用 sub_three」那支返回 None,or 转到「不用」那支,拿到 A。mc([double, sub_three, square], 3, 36):「用 double」那支是 safe_compose(A, double),得到 B,其中 B(t) = A(double(t)) = (t * 2) ** 2。None,or 取右边,返回 B。B(1) = (1 * 2) ** 2 = 4。与 doctest 一致。B(3) = (3*2)**2 = 36 = y,也对。B ──→ func composed(x) [parent = f2]
f2: safe_compose [parent=Global]
f ──→ A (即 lambda t: t ** 2 那一层)
g ──→ double
composed ──→ func composed(x) [parent=f2]
f1: safe_compose [parent=Global] ← 造出 A 的那次调用
f ──→ I (lambda x: x)
g ──→ square
composed ──→ func composed(x) [parent=f1]
调用 B(1) 时:
新建 f3: composed [parent=f2],x ──→ 1
求 f(g(x)):g 在 f2 里查到 double → double(1) = 2
f 在 f2 里查到 A → A(2)
调用 A(2) 时:
新建 f4: composed [parent=f1],x ──→ 2
求 f(g(x)):g 在 f1 里查到 square → square(2) = 4
f 在 f1 里查到 I → I(4) = 4
B(1) = 4
这张图是这道题真正的价值所在:safe_compose 每被调用一次,就留下一帧;返回的 composed 函数的 parent 指向那一帧,于是它「记住」了当时的 f 和 g。 一串嵌套的 safe_compose 调用,就在内存里串成一条帧的链条——这就是闭包(closure),也是 Lecture 03、04 讲高阶函数和环境图时那些练习的真正用途。
看到 multi_compose(list_of_funcs, 3, 36) 就以为该返回 36。不是。 doctest 里那一行显示的是 Function(试卷上用来表示「一个函数对象」的占位写法;在真实解释器里你会看到 <function safe_compose.<locals>.composed at 0x...>)。
而 square_then_double 那一行下面什么都没有——因为返回值是 None,交互式解释器不显示 None。这是 WWPD 题的常考点:None 在 >>> 下不打印任何东西。
7. 考试范围地图:十一讲各自会怎么考
期中的范围是本讲(含)之前的全部内容。把十一讲列出来,配上「它在题里长什么样」,你就知道自己该补哪一块。表里的「典型考法」全部来自上面这四道题以及本讲用到的知识点,不是我编的题型分类。
| 讲次 | 主题 | 典型考法 |
|---|---|---|
| 01 | Welcome, Coding Environment, Functions, Exceptions I | 求值顺序(算子先于算子数)、print vs return 的显示差异、纯函数与非纯函数 |
| 02 | Control | WWPD:and/or 短路后的值(不一定是布尔)、truthy/falsy、while 结束时循环变量到底是几 |
| 03 | Higher-Order Functions | 返回函数的函数、lambda、把函数当参数传(本讲 Multi Compose 的全部难点) |
| 04 | Environments | 画环境图:帧、parent、名字查找顺序、闭包(Multi Compose 最后那张图) |
| 05 | Recursion | 单支递归:base case 选在哪、递归调用后怎么用返回值 |
| 06 | Tree Recursion | 多支递归:「用不用当前这个元素」、计数问题(Escape Lumon、Multi Compose) |
| 07 | Sequences and Containers | 切片 s[1:]、列表推导式、len/sum/max/min/all/any、嵌套列表 |
| 08 | Mutability and Data Abstraction | 别名与就地修改、抽象屏障(树题里只用 label/branches) |
| 09 | Trees | 树递归的标准骨架、is_leaf 作 base case(All Treeils) |
| 10 | Iterators and Generators | next 推动一步、yield 冻结与恢复、惰性、filter/map 返回迭代器(One Cent) |
| 11 | Exceptions II | 常见异常类型认脸、try/except/else/finally 的执行顺序、assert 与 raise |
四道题各自暴露了哪块短板
如果你在某道题上卡住了,卡的位置基本能定位到具体一讲:
| 你卡在…… | 说明你要补的是 |
|---|---|
想不到 three_flips 要用滑动窗口,或不知道生成器调用后函数体没执行 | Lecture 10:yield 的冻结/恢复语义 |
知道要递归,但不知道 badges 该放哪儿 | Lecture 05/06:递归函数的参数就是「状态」 |
写 is_treeil 时忘了递归检查子树(只查了根这一层) | Lecture 09:树的性质几乎都要「本层 + 所有子树」两部分 |
max_treeil 里 sum 和 max 用反 | Lecture 07:sum「拼起来」,max「选一个」 |
safe_compose 的参数顺序搞反 | Lecture 03:compose(f, g) 读作「f after g」 |
看不懂 multi_compose 返回的为什么是函数不是数 | Lecture 03/04:返回函数 + 闭包 |
Escape Lumon 和 Multi Compose 表面上一个是网格、一个是函数列表,但它们的递归骨架逐字对应:
| Escape Lumon | Multi Compose | |
|---|---|---|
| 成功的 base case | 到终点且 badges >= 3 → 1 | x == y → lambda x: x |
| 失败的 base case | 越界 → 0 | not funcs → None |
| 分支一 | 向右:helper(row, col+1, badges) | 用它:funcs[1:], funcs[0](x) |
| 分支二 | 向下:helper(row+1, col, badges) | 不用它:funcs[1:], x |
| 怎么合并两支 | +(要数出全部) | or(任意一个就够) |
| 状态怎么传 | badges 做参数 | x 做参数 |
唯一的实质区别在最后两行:题目问「有多少条」就用 + 把两支相加,问「给我一个」就用 or 短路取第一个成功的。拿到新题时先问这一句,骨架就出来了。
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
| doctest 与 print | 正常结束时 print 内容被算进「实际输出」;抛异常时 print 内容一个字都不显示 | 看到没输出就断定「这行没执行」。用 python3 -i 或 pytest 复核 |
try/except/else/finally | else 只在没异常时跑;finally 无论如何都跑,包括 try 里已 return | 在 finally 里写 return,会覆盖返回值并吞掉异常 |
| 生成器状态 | 调用生成器函数不执行任何代码;每次 next 从上次 yield 处恢复 | 用 for x in coin 又在循环体里 next(coin),一轮吃两个元素 |
| 生成器里的 StopIteration | Python ≥3.7:函数体内逃逸的 StopIteration 会变成 RuntimeError | 依赖「里面的 next 炸掉」来结束生成器 |
| 滑动窗口 | start = start[1:] + next(it):丢最老的、接一个新的 | 把 next(coin) 写多次,窗口跳着走 |
| 累加器参数 | 沿途累积的信息做成参数往下传,每帧一份独立副本 | 用 nonlocal 计数,两条支路互相污染 |
| base case 的顺序 | 先排除非法(越界),再判成功(终点);先判叶子,再判性质 | 顺序反了导致 IndexError 或结果恒为 1 |
| 抽象屏障 | 树一律用 label(t)/branches(t)/is_leaf(t) | 写 t[0]、t[1:],考试直接扣分 |
all / any 空列表 | all([]) 是 True,any([]) 是 False | 因此叶子常常不需要单独写 base case |
sum vs max | 子结果「拼成整体」用 sum,「互相竞争」用 max | max([]) 报 ValueError,sum([]) 是 0 |
compose(f, g) | 读作「f after g」:g 先跑,f 后跑 | 参数写反,不报错但结果全错 |
or 做「先试 A 再试 B」 | None falsy、函数对象 truthy,所以 A or B 正好是「A 不行就 B」 | 忘了 or 短路,以为两支都会算 |
| 返回函数 vs 返回值 | multi_compose 返回函数对象;None 在 >>> 下不显示 | 以为 multi_compose(L, 3, 36) 该显示 36 |
动手练习
五道题,全部基于本讲内容。请先自己写/自己算,再展开答案。
练习 1:WWPD
下面这段在交互式解释器里依次执行,屏幕上出现什么?
>>> def mystery(n):
...     try:
...         return 10 // n
...     except ZeroDivisionError:
...         print('div by zero')
...         return -1
...     finally:
...         print('done', n)
...
>>> mystery(5)
>>> mystery(0)
>>> print(mystery(0))
看答案
>>> mystery(5)
done 5
2
>>> mystery(0)
div by zero
done 0
-1
>>> print(mystery(0))
div by zero
done 0
-1
mystery(5): 10 // 5 算出 2,return 把 2 记在一边 → 离开 try 语句要交「通行费」,finally 执行,打出 done 5 → 才真正返回 2 → 解释器显示 2。注意 // 是整除,结果是 2 不是 2.0。
mystery(0): 10 // 0 抛 ZeroDivisionError → 被 except 接住,打出 div by zero,return -1 把 -1 记下 → finally 打出 done 0 → 返回 -1 → 解释器显示 -1。
print(mystery(0)): 前两行是函数内部 print 出来的,第三行 -1 是 print 打的。这一行和上一行的屏幕内容完全一样,但来源不同:上一行的 -1 来自解释器显示返回值(用 repr),这一行来自 print(用 str)。对整数两者看不出区别,换成字符串就能看出——返回 '-1' 时上一行显示 '-1' 带引号,这一行显示 -1 不带。
练习 2:改一行会怎样
把 three_flips 的最后一行从 start = start[1:] + next(coin) 改成 start = start[1:] + next(coin) + next(coin),那么 a = three_flips(iter("HTTHHTHT")) 之后连续三次 next(a) 分别得到什么?
看答案
'HTT'、'TTHH'、'THHTH'——窗口会越来越长。
逐步推:初始 start = 'HTT'(吃掉下标 0,1,2),第一次 next(a) 产出 'HTT'。恢复后 start[1:] 是 'TT'(长度 2),再拼上两个新元素 'H'、'H'(下标 3,4)→ 'TTHH',长度 4。第二次产出 'TTHH'。再恢复:start[1:] 是 'THH'(长度 3),拼上 'T'、'H'(下标 5,6)→ 'THHTH',长度 5。
教训:「砍掉一个 + 接上一个」这对操作必须配平,窗口长度才恒定。 砍 1 接 2,长度每轮涨 1。这也解释了为什么 for x in coin 配合循环体里的 next(coin) 是错的——for 自己吃一个、循环体再吃一个,等于每轮消耗 2。
练习 3:把门槛改掉
如果 Lumon 的规则从「至少 3 张徽章」改成「恰好 3 张」,count_paths 要改哪里?对 simple_grid、complex_grid、zeros_grid 的答案分别变成多少?
看答案
只改一个字符:if badges >= 3: → if badges == 3:。三个 doctest 的答案都不变(1、5、0)——因为这三张图上没有任何一条路径能收到 4 张或更多。
但这道题真正要问的是:能不能顺便加个剪枝,一旦 badges > 3 就提前返回 0? 在「恰好 3 张」的规则下可以,因为徽章数只增不减,超了就再也回不来了:
if badges > 3:
    return 0
这一句要放在 badges += grid[row][col] 之后、终点判断之前。而在原来的「至少 3 张」规则下,这个剪枝是错的——超过 3 张恰恰是合格的。
顺带一提:如果把 3 抽成参数 k,就得到一个更通用的函数。这正是 Lecture 03 讲的「把变化的部分参数化」。
练习 4:为什么这个 is_treeil 是错的
有人这样写 is_treeil。它在五个 doctest 里有几个是对的?错的那些为什么错?
def is_treeil(t):
    if is_leaf(t):
        return True
    return len([b for b in branches(t) if label(t) == label(b)]) == 1
看答案
实测结果是 [True, False, True, True, True],而正确答案是 [True, False, True, False, False]。五个里错两个:t4 和 t5。
病根只有一个:它只检查了根这一层,一次递归调用都没有,子树里出的问题它全看不见。
t4 = 1 → [1 → [1, 1], 2]:根的 label 是 1,两个孩子的 label 是 1 和 2,恰好一个匹配 → 返回True。但中间那个1 → [1, 1]有两个 label 为 1 的孩子,破坏了「恰好一个」。这个版本根本没往下看。t5 = 2 → [3 → [1], 2 → [2]]:根的 label 是 2,孩子 label 是 3 和 2,恰好一个匹配 → 返回True。但左子树3 → [1]的孩子里没有 label 为 3 的,它自己就不是 treeil。同样没往下看。
补上 and all([is_treeil(b) for b in branches(t)]) 就全对了。
这是树题最高频的错误类型:树的性质几乎总是「本层的局部条件 且 每棵子树也满足同样的性质」。写完一个树函数先自问:递归调用在哪儿? 一个都没有的话,它八成漏掉了子树。
另一个值得注意的点:t1、t2、t3 三个 doctest 全过,代码却是错的。测试通过不等于代码对——这正是 Lecture 11 讲测试覆盖率时说的「100% 覆盖也不意味着所有执行路径都被考虑到了」。出题人特意放了 t4 和 t5 两个 doctest,就是为了堵这两个漏洞。
练习 5:multi_compose 的两支能不能对调
把最后一行的两支对调,写成
return multi_compose(funcs[1:], x, y) \
       or safe_compose(multi_compose(funcs[1:], funcs[0](x), y), funcs[0])
结果还对吗?multi_compose(L, 3, 36) 会返回什么?
看答案
仍然是正确的——题面明说「若存在多个符合条件的复合函数,返回其中任意一个」。对调只是改变了搜索顺序:原版先试「用第一个函数」,改版先试「不用第一个函数」。两个版本对全部七个 doctest 给出的结果都一致(有解/无解一致,且返回的函数都满足 f(x) == y)。
变的是搜多少个节点。我给两个版本都加了计数器,数 multi_compose 被调用了多少次:
| 调用 | 原版(先「用」) | 改版(先「不用」) |
|---|---|---|
multi_compose(L, 3, 36) | 23 次 | 13 次 |
multi_compose(L, 3, 25) | 5 次 | 31 次 |
multi_compose(L, 50, 100) | 18 次 | 10 次 |
multi_compose(L, 50, 48) | 11 次 | 22 次 |
multi_compose(L, 3, 18)(无解) | 31 次 | 31 次 |
规律很清楚:(3, 36) 的解要跳过 add_one,所以「先试不用」的改版更快(原版要先把「用 add_one」那整棵子树白算一遍——见第 6 节调用树的左半边);而 (3, 25) 的解是全部四个函数都用,原版一路「用、用、用、用」5 步就撞上答案,改版反倒要绕一大圈。无解时(3, 18)两版都必须把 16 种子序列全试一遍,31 次一样多。
真正不能动的是两个 base case 的顺序:if x == y 必须在 if not funcs 之前。如果反过来,mc([], 36, 36) 会先撞上 not funcs 返回 None,整道题就废了——第 6 节调用树最深处那个成功点,恰恰就是「函数已经用完、同时 x 正好等于 y」。