迭代器与生成器
把「一串值」和「算到哪儿了」装进同一个对象里,于是序列可以无限长、可以只在需要时才被算出来——递归也可以一边算一边吐结果。
0. 本讲导读
到目前为止,你处理「一堆值」的方式只有一种:先把它们全部装进一个列表,再遍历这个列表。list_partitions(6, 4) 会先算出全部 9 个分法、拼成一个二维列表,然后你才能看第一个。写树的递归时也一样:count_paths 先把所有路径数完,才返回一个数。
这套做法有两个躲不开的代价。
第一,你必须付出全部计算,哪怕只想要第一个结果。list_partitions(60, 50) 有 966370 个分法,在我的机器上要跑将近 3 秒、并且把这 96 万个字符串同时留在内存里——而如果你只是想看看前 3 个长什么样,这 3 秒和这块内存全都白花了。
第二,有些序列根本装不进列表。「所有偶数」「斐波那契数列的每一项」「一个不断产生随机数的流」,它们没有末尾,list() 会一直跑到内存耗尽。
本讲给出的解决办法,是把「一串值」这件事拆成两层:
- 可迭代对象(iterable)——「这里有一串值」。列表、元组、字符串、字典、range 都是。
- 迭代器(iterator)——「我读到第几个了」。它是一个独立的对象,同时记着「值从哪来」和「当前位置」,你每次向它要一个值,它才去算/取一个值。
把位置信息独立成一个对象,序列就不必真的存在于内存里了:只要有人能回答「下一个是什么」,就够了。生成器(generator)正是让你用写函数的方式来回答这个问题——把 return 换成 yield,一个普通函数就变成了一台「按需产值的机器」,而且它能递归。本讲最后那个 yield_partitions 只有 6 行,却能在 0 秒内吐出 60 = 10 + 50 这第一个分法,而列表版要跑 3 秒。
与前后讲的关系:上一讲讲树(tree)的递归,本讲末尾的 yield_paths 就是把上一讲的 count_paths 从「数出来」改成「一条条吐出来」——递归的骨架一模一样,只是返回方式变了。下一讲讲异常(exception)II,而 StopIteration 正是本讲会反复见到的一个异常,两讲直接接得上。教材对应 §4.2 Implicit Sequences,作业是 Lab 05 与 HW 04。
- iterable 是「书」,iterator 是「书签」。 对 iterable 调
iter得到一个 iterator;对 iterator 调next得到下一个值;没有下一个了就抛StopIteration。 - 迭代器是一次性的、有状态的。 已经
next过的元素永远回不去;把一个迭代器传给别的函数,位置会跟着一起传过去。 - 所有迭代器都是可迭代对象,反之不成立。
iter(iterable)返回一个新的迭代器;iter(iterator)返回它自己(同一个对象)。 map/filter/zip/reversed返回的都是惰性(lazy)的迭代器:不调next,里面的函数一次都不会被调用。要看全部内容就套一层list/tuple/sorted。- 函数体里出现
yield,这个函数就变成生成器函数。 调用它不执行任何函数体代码,只返回一个生成器对象;每次next才把函数体从上次暂停的地方恢复,跑到下一个yield停住。 yield from <iterable>把那个 iterable 里的元素逐个让出去。递归生成器必须用yield from;写成yield会让出一个生成器对象本身,结果里就会出现<generator object ...>。
1. 复习:for 循环里到底放了什么
本讲要拆开 for 循环的内部机制,所以先把你已经会用的两件事摆出来,等下好对照。
字典可以直接放进 for 循环
你已经知道用 .keys()、.values()、.items() 遍历字典。其实字典本身就能直接进 for,此时遍历的是键:
>>> roman_numerals = {'I': 1, 'V': 5, 'X': 10}
>>> for key in roman_numerals:
...     print(key)
...
I
V
X
也就是说 for key in d 和 for key in d.keys() 效果相同。这件小事在本讲的意义是:「能放进 for 循环」是一种资格,字典有、列表有、字符串有、range 有,而它们内部的存储方式完全不同(字典是哈希表,range 连元素都不存)。既然存储方式各不相同,for 却能一视同仁地遍历它们,说明 for 依赖的不是「存储方式」,而是某个统一的接口。这个接口就是本讲的主角。
遍历字典的过程中不能增删键,否则 Python 会当场报错:
>>> for k in roman_numerals:
...     roman_numerals['L'] = 50
...
Traceback (most recent call last):
  ...
RuntimeError: dictionary changed size during iteration
报错信息说得很直白:迭代过程中字典的大小变了。为什么 Python 要专门检查这个?因为遍历字典时有一个「读到哪儿了」的位置,而增删键可能触发哈希表重排,位置就失去意义了。列表没有这层检查——第 3 节会看到,正因为没有检查,列表在迭代中被改会得到更诡异的结果。
树的遍历顺序:同样三行代码,位置一换结果全变
上一讲的树 ADT 继续沿用(本讲的随堂代码里原样带着它):
def tree(root_label, branches=[]):
    for branch in branches:
        assert is_tree(branch), 'branches must be trees'
    return [root_label] + list(branches)

def label(tree):
    return tree[0]

def branches(tree):
    return tree[1:]

def is_leaf(tree):
    return not branches(tree)
下面三个函数长得几乎一样,只差 print 放在哪儿。用同一棵树 t = tree(3, [tree(-1), tree(1, [tree(2, [tree(1)]), tree(3)]), tree(1, [tree(-1)])]) 跑一遍:
| 函数 | 代码 | 对 t 的输出 | 它到底在做什么 |
|---|---|---|---|
print_treeA |
|
3 -1 1 2 1 3 1 -1 |
先序:每个节点恰好打印一次,先打自己再打子树 |
print_treeB |
|
3 3 1 2 1 3 1 |
打印次数 = 分支数。叶子一次都不打印(没有分支就不进循环),有 3 个分支的根被打印 3 次 |
print_treeC |
|
-1 1 2 3 1 -1 1 3 |
后序:先把所有子树打完,最后才打自己,所以根的 3 出现在最后一行 |
这张表值得盯久一点,因为本讲后半段所有生成器递归都建立在同一个直觉上:「在递归调用之前做事」和「在递归调用之后做事」,产生的顺序完全不同。等下把 print 换成 yield,这个直觉一字不改地继续成立——只不过结果不再是打到屏幕上,而是被一个个「让」给调用方。
2. iterable 与 iterator:书和书签
两个定义,先记住字面意思,再看为什么要分开。
- 可迭代对象(iterable):任何能被顺序处理的对象。换句话说,能放进
for循环的就是 iterable。例:列表、元组、字典、字符串、range。 - 迭代器(iterator):提供对某个 iterable 的元素的按序访问。
- 对 iterable 调用
iter就能造出一个 iterator。 - 对 iterator 调用
next就能取到下一个元素。
- 对 iterable 调用
课堂上用的比喻很到位:iterable 是书,iterator 是书签。书本身没有「读到哪儿」这个概念,书里的字是死的、可以被很多人同时读;书签才知道位置。同一本书可以夹很多个书签,各自独立地往前走。
>>> lst = [1, 2, 3]        # iterable:一本书
>>> tracker = iter(lst)    # iterator:夹进去的一个书签
>>> next(tracker)
1
>>> next(tracker)
2
>>> next(tracker)
3
>>> next(tracker)
Traceback (most recent call last):
  ...
StopIteration
lst = [1, 2, 3]:全局帧里 lst 绑定到一个列表对象。这个对象自己不含任何「位置」信息。iter(lst):Python 新建一个 list_iterator 对象,它内部记着两样东西——指向 lst 那个列表对象的引用、以及一个初始为 0 的下标。名字 tracker 绑定到这个新对象。注意:列表没有被复制。next(tracker):读出下标 0 处的元素 1,把内部下标改成 1,返回 1。这一步改变了 tracker 的状态——迭代器是可变的。next 同理,分别返回 2、3,内部下标依次变成 2、3。next:下标 3 已经越过列表末尾,没有「下一个」可返回了。它不返回 None、不返回 False,而是抛出 StopIteration 异常。next(tracker) 还是 StopIteration,没有任何办法把它倒回去。想重新读,只能 iter(lst) 造一个新的书签。Global frame
lst ──→ [1, 2, 3] ← 列表对象(无位置)
tracker ──→ list_iterator ← 迭代器对象
.source ──→ 同一个 [1, 2, 3](不是副本)
.index ──→ 0 → 1 → 2 → 3 随每次 next 递增
next(tracker) 第 4 次:.index == 3 已越界 → raise StopIteration
这里的 .source / .index 是我为了讲清楚起的名字,CPython 内部字段不叫这个,你在 Python 里访问不到它们(tracker.index 会报 AttributeError)。但「一个引用 + 一个位置」这个心智模型是准确的。
for 循环其实就是 iter + next + 捕获 StopIteration
现在可以回答第 1 节留下的问题了。for x in lst: ... 这行代码,Python 做的是:
in 后面的表达式,得到一个对象。iter,拿到一个迭代器。这一步就是 for 要求对象必须是 iterable 的原因——不是 iterable 就没法 iter。next:每拿到一个值,就把它绑定到循环变量 x 上,然后执行一遍循环体。next 抛出 StopIteration 时,for 捕获这个异常并正常结束循环(不是报错退出)。所以 for 从来没有假设过被遍历的东西「是列表」「有 len」「能用下标访问」。它只需要对方能交出一个会 next 的书签。字典、range、文件对象长得千差万别,却都能进 for,原因就在这儿。这也解释了为什么第 1 节的字典能直接遍历:字典的 iter 交出的书签,走的是键。
对 iterable 直接调 next。 列表是「书」,不是「书签」,它自己不知道读到哪儿了:
>>> next([1, 2, 3])
Traceback (most recent call last):
  ...
TypeError: 'list' object is not an iterator
报错信息里的 is not an iterator 说得很准:列表是 iterable,但不是 iterator。必须先 iter。
反过来,对不是 iterable 的东西调 iter:
>>> iter(5)
Traceback (most recent call last):
  ...
TypeError: 'int' object is not iterable
这两条报错要能一眼分清:not an iterator = 你少调了一次 iter;not iterable = 这东西根本就不是一串值。
把迭代器当列表用。 迭代器只支持一个操作:next。别的都不行:
>>> t = iter([1, 2, 3])
>>> len(t)
Traceback (most recent call last):
  ...
TypeError: object of type 'list_iterator' has no len()
>>> t[0]
Traceback (most recent call last):
  ...
TypeError: 'list_iterator' object is not subscriptable
这不是 Python 偷懒。迭代器压根不知道自己还剩几个元素——本讲后面那个「所有偶数」的生成器有无穷多个元素,len 该返回什么?也不知道第 0 个是什么——它可能早就被 next 消费掉了。
3. 书被改了,书签会怎样
第 2 节强调过:iter(lst) 没有复制 lst。迭代器只是记着「那本书在哪儿」。所以如果有人在你读的过程中改了这本书,你的书签会读到改过之后的内容。课堂上的第二个例子专门演示这件事,它比看上去烧脑:
>>> lst = [1, 3, 2, 7]
>>> iter1 = iter(lst)
>>> next(iter1)
1
>>> lst.append(5)
>>> next(iter1)
3
>>> iter2 = iter(lst)
>>> next(iter2)
1
>>> lst[1] = -10
>>> next(iter2)
-10
lst = [1, 3, 2, 7],iter1 = iter(lst):iter1 的位置是 0,指着 lst 这个对象本身。next(iter1) → 读下标 0 得 1,iter1 的位置变成 1。lst.append(5):原地修改(mutation),lst 变成 [1, 3, 2, 7, 5]。iter1 指的还是同一个对象,位置仍是 1,没受影响。next(iter1) → 读下标 1 得 3,位置变成 2。追加发生在末尾,暂时看不出影响——但如果继续 next 下去,iter1 会一路读到那个新加的 5。书变厚了,书签自然会多读几页。iter2 = iter(lst):又夹了一个新书签,位置从 0 开始。iter1 和 iter2 是两个独立的对象,位置互不干扰(此刻 iter1 在 2,iter2 在 0)。next(iter2) → 读下标 0 得 1,iter2 位置变成 1。lst[1] = -10:把下标 1 处的元素换掉,lst 变成 [1, -10, 2, 7, 5]。next(iter2) → 读下标 1。此刻下标 1 上装的已经是 -10 了,于是返回 -10,不是 3。迭代器读的是「读的那一刻」列表里的内容,而不是创建书签时的快照。时刻 lst 的内容 iter1.index iter2.index ───────────────────────────────────────────────────────────── 初始 [1, 3, 2, 7] 0 (不存在) next(iter1) [1, 3, 2, 7] 1 (不存在) append(5) [1, 3, 2, 7, 5] 1 (不存在) next(iter1) [1, 3, 2, 7, 5] 2 (不存在) iter(lst) [1, 3, 2, 7, 5] 2 0 next(iter2) [1, 3, 2, 7, 5] 2 1 lst[1] = -10 [1, -10, 2, 7, 5] 2 1 next(iter2) [1, -10, 2, 7, 5] 2 2 → 返回 -10
三句话概括这一节:
- 迭代器不拷贝数据,它只记位置。数据是共享的。
- 多个迭代器可以指向同一个 iterable,各走各的。
iter1和iter2就是这样。 - 在迭代过程中修改底层容器,是自找麻烦。这段代码能跑通、结果也可以逐步推出来,但真实项目里没人愿意维护这种代码。上一节字典宁可直接抛
RuntimeError,列表这里连报错都没有,只是安静地给你一个你没预料到的值——后者其实更危险。
迭代器不但记着位置,还随身带着这个位置到处走。这带来一个非常容易踩的后果:
>>> c = iter([1, 2, 3, 4])
>>> next(c)
1
>>> list(c)
[2, 3, 4]
>>> list(c)
[]
第一次 list(c) 只拿到 [2, 3, 4]——因为 1 已经被消费掉了;而这次 list 又把剩下的三个全部消费光,所以第二次 list(c) 得到空列表。这不是 bug,是迭代器的定义。「同一个迭代器遍历两遍,第二遍是空的」是本讲最高频的错因,第 5 节还会以另一种面目再遇到它。
4. iterator vs iterable:包含关系与「为什么要多这一层」
初学者最容易糊涂的一句话:所有 iterator 都是 iterable,但不是所有 iterable 都是 iterator。
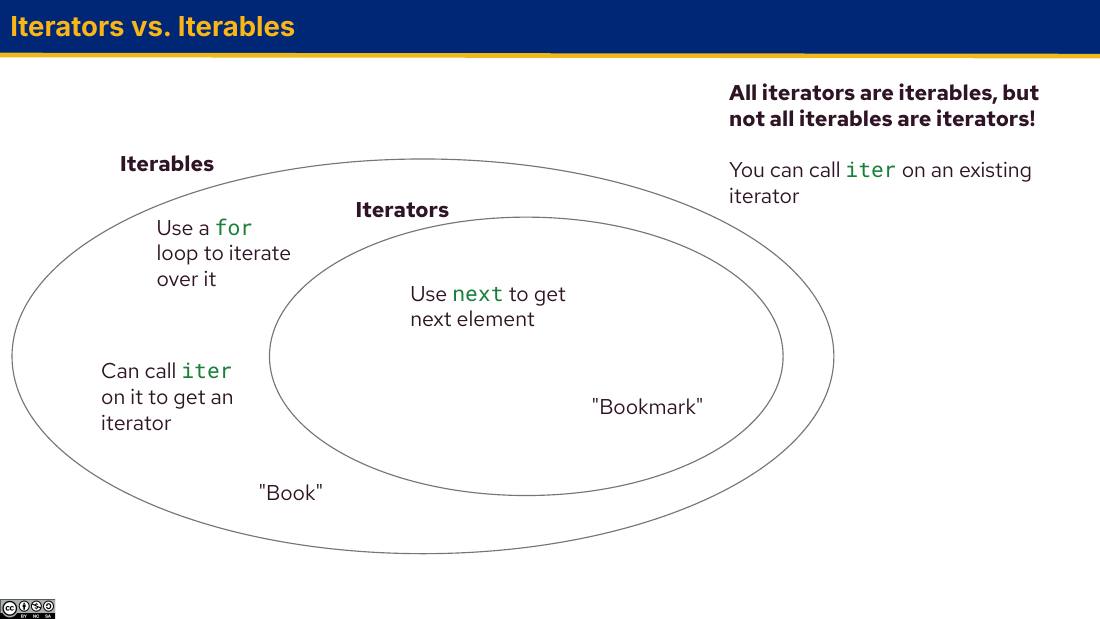
为什么迭代器也算 iterable?因为它满足 iterable 的定义:能放进 for 循环。第 3 节最后 list(c) 那个例子已经证明了这一点——list 内部就是在遍历它。
那对一个已经是迭代器的对象调 iter 会怎样?
>>> a = iter([1, 2, 3])
>>> iter(a) is a
True
返回的就是原对象本身,不是新书签。这条规则看起来是个技术细节,其实很关键:正因为 iter(iterator) 返回自己,第 2 节里 for 的第 2 步(无条件先调一次 iter)才能对迭代器同样适用——for x in some_iterator 不会莫名其妙地从头开始,而是从当前位置继续。
| 操作 | 对 iterable(如 list) | 对 iterator(如 list_iterator) |
|---|---|---|
for x in obj | 可以,每次从头 | 可以,从当前位置继续,且用完即废 |
iter(obj) | 返回一个新迭代器,位置为 0 | 返回 obj 自己(iter(a) is a 为 True) |
next(obj) | TypeError: 'list' object is not an iterator | 返回下一个元素,或抛 StopIteration |
len(obj) | 可以 | TypeError: object of type 'list_iterator' has no len() |
obj[0] | 可以(序列类型) | TypeError: 'list_iterator' object is not subscriptable |
| 能遍历几次 | 无限次 | 一次 |
为什么要多这一层?
如果只是想遍历列表,for x in lst 就够了,凭什么还要 iter / next?课上给了三条理由,每一条都值得展开。
理由一:迭代器是加在 iterable 之上的一层抽象(abstraction)。 用迭代器写的代码,对「值是从哪儿来的」不做任何假设:可能来自列表,可能来自文件的每一行,可能来自网络,也可能是现算出来的(第 6 节的生成器)。只要对方能 next,你的代码就能用。于是提供数据的一方可以随时改内部实现——把列表换成数据库查询——而下游代码一行都不用改。这正是这门课反复强调的「用接口隔离实现」,只不过换了个场景。
理由二:迭代器把「元素」和「位置」打包进同一个对象。 这意味着位置可以被传递。看这段代码:
>>> def take_two(it):
...     return [next(it), next(it)]
...
>>> t = iter([10, 20, 30, 40, 50])
>>> take_two(t)
[10, 20]
>>> take_two(t)
[30, 40]
>>> next(t)
50
两次调用 take_two,第二次自动从 30 接着来——因为「读到哪儿了」这个信息装在 t 里,跟着参数一起传进了函数。如果传的是列表,take_two 就必须额外接一个「起始下标」参数,还得想办法把新下标传回来。迭代器让「进度」变成一个可以传参的值。
由此还派生出一个很实用的保证:每个元素只会被处理一次。多个函数轮流从同一个迭代器取值,谁也不会重复处理别人已经处理过的元素。
理由三:迭代器阻止你改动原始的 iterable。 拿到一个迭代器,你能做的只有 next——没有 append、没有下标赋值。把迭代器而不是列表交给别人,就等于说「你只能读,不能改」。(当然,第 3 节说过,如果别人手上另有那个列表的引用,他照样能改;迭代器保护的是通过它本身发起的修改。)
把这三条串起来:迭代器是一个只读的、一次性的、自带进度的取值接口。「只读」让它安全,「自带进度」让它可传递,「不假设来源」让它通用。接下来两节要讲的所有东西——map/filter、生成器——都是在这个接口上做文章。
5. 内置的惰性函数:map、filter、zip、reversed
Python 有一批内置函数,它们的返回值不是列表,而是迭代器,并且惰性(lazily)计算——需要一个值的时候才算一个,而不是一上来把全部结果算完。
| 函数 | 产生的元素 | 返回的对象类型 |
|---|---|---|
map(func, iterable) | 对 iterable 里每个 x,产出 func(x) | map 对象 |
filter(func, iterable) | 只产出使 func(x) 为真的那些 x | filter 对象 |
zip(first_iter, second_iter) | 产出同下标配对的元组 (x, y, ...),可以 zip 两个以上 | zip 对象 |
reversed(sequence) | 逆序产出序列中的元素 | 逆序迭代器 |
它们全都是迭代器,所以第 3、4 节讲的规矩一条不落地适用:一次性、不能 len、不能下标。
>>> map(abs, [-1, 2, -3])
<map object at 0x7ec7e9593ee0>
>>> list(map(abs, [-1, 2, -3]))
[1, 2, 3]
直接在交互式解释器里敲 map(...),看到的是 <map object at 0x...> 而不是结果——这几乎是每个人第一次用 map 时的困惑。它不是出错了,是这个对象还没开始算。
zip 的长度规则
>>> list(zip([1, 2], [3, 4]))
[(1, 3), (2, 4)]
>>> list(zip([1, 2], [3, 4, 5], [6, 7]))
[(1, 3, 6), (2, 4, 7)]
第二个例子里第二个列表有 3 个元素,但结果只有 2 个元组:zip 在最短的那个 iterable 用完时就停,多出来的 5 被丢掉。这个「以最短为准」的规则等下做 palindrome 时会用上。
把迭代器变回能看的东西
想看完整内容,就把元素倒进一个容器:
| 函数 | 作用 |
|---|---|
list(iterable) | 造一个含全部元素的列表 |
tuple(iterable) | 造一个含全部元素的元组 |
sorted(iterable) | 造一个排好序的列表;和 min/max 一样可以传 key 函数 |
注意这三个都会把迭代器抽干:它们必须看到每一个元素才能完成工作(sorted 甚至必须看完全部才能排序)。所以一旦 list(t) 过一次,t 就空了。
惰性到底惰到什么程度
课上这个例子是本节的核心,把它一步一步看完,你对「惰性」的理解就到位了。
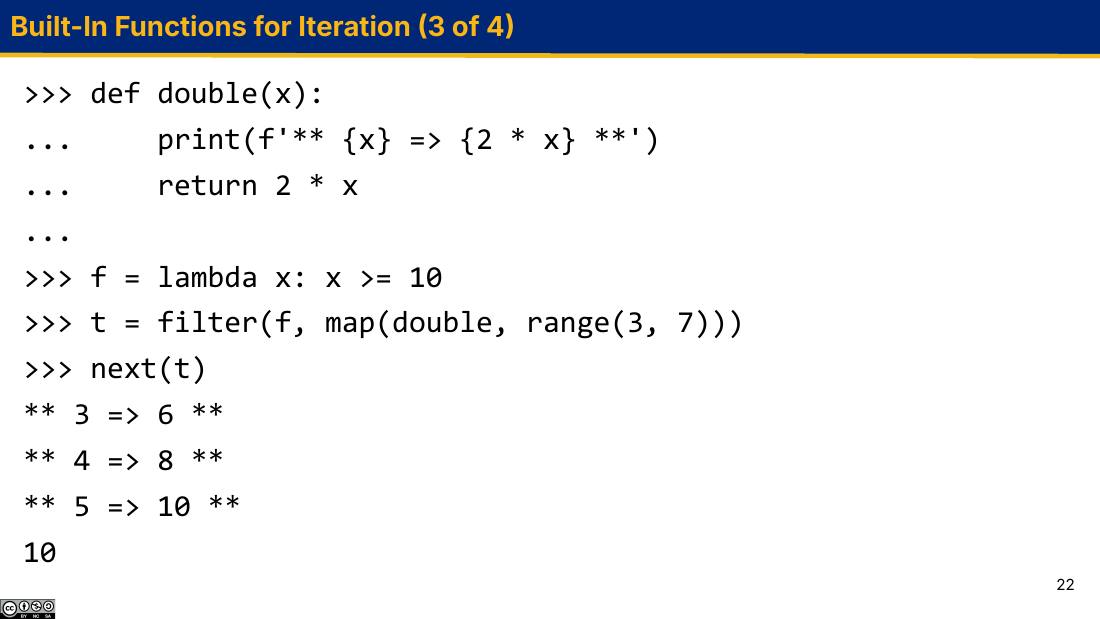
>>> def double(x):
...     print(f'** {x} => {2 * x} **')
...     return 2 * x
...
>>> f = lambda x: x >= 10
>>> t = filter(f, map(double, range(3, 7)))
>>> next(t)
** 3 => 6 **
** 4 => 8 **
** 5 => 10 **
10
range(3, 7) 代表 3、4、5、6 这四个数。map(double, range(3, 7)):什么都没发生。它只是造了一个 map 对象,记着「函数是 double、源头是那个 range」。double 一次都没被调用——屏幕上没有任何打印,这是证据。filter(f, ...):同样什么都没发生,只是造了个 filter 对象,记着「判据是 f、源头是那个 map 对象」。整条 t = ... 语句执行完,屏幕上依然一片空白。next(t)。filter 要交出一个值,于是向它的源头 map 要一个:map 向 range 要到 3,调用 double(3) → 打印 ** 3 => 6 **,交出 6。filter 检查 f(6) 即 6 >= 10 → False,丢弃,继续要。4,double(4) 打印 ** 4 => 8 ** 并交出 8。f(8) 为假,继续。5,double(5) 打印 ** 5 => 10 ** 并交出 10。f(10) 即 10 >= 10 → True。filter 立刻返回 10 并停下。6 此刻还没被 double 处理过。第一次 next 只做了「找到第一个合格值」所必需的最少工作。继续往下要:
>>> next(t)
** 6 => 12 **
12
>>> list(t)
[]
next(t):从上次停下的地方继续。map 从 range 要到 6,double(6) 打印 ** 6 => 12 ** 交出 12;f(12) 为真,返回 12。list(t):filter 继续向 map 要值,map 向 range 要——range 已经给完了 3、4、5、6,抛 StopIteration;map 把它传下去,filter 也抛。list 捕获后结束,得到 []。[10, 12]。因为 10 和 12 早就被前两次 next 消费掉了。这就是第 3 节那条「同一个迭代器遍历两遍,第二遍是空的」在真实场景里的样子。惰性求值带来两个实际好处:
- 省计算:只想要第一个结果,就只付第一个结果的代价。上面
double被调了 3 次而不是 4 次。 - 省内存:中间结果不必同时存在。
filter(f, map(double, range(10 ** 9)))这行代码瞬间完成,而[double(x) for x in range(10 ** 9)]会把机器撑爆。
代价是:结果只能看一遍,而且要用 list 包一层才能打印出来。
把同一个 map/filter 对象用两次。 这是本讲最常见的 bug,长这样:
>>> s = [-4, -3, -2, 3, 2, 4]
>>> mp = map(abs, s)
>>> min(mp)
2
>>> list(mp)          # 想再看看都有哪些绝对值
[]
min 为了找最小值必须看完全部元素,mp 就此被抽干。不报错,只是安静地给你一个空列表——比报错难查得多。要用两次,就写成 abs_vals = list(map(abs, s)),先落成列表再说。
reversed 要求参数是序列(有长度、能按下标倒着取),迭代器不行:
>>> reversed(map(abs, [1, -2]))
Traceback (most recent call last):
  ...
TypeError: 'map' object is not reversible
>>> reversed(iter([1, 2, 3]))
Traceback (most recent call last):
  ...
TypeError: 'list_iterator' object is not reversible
想想也合理:要倒着给你,就得先知道最后一个在哪儿;而迭代器连自己还剩几个都不知道。reversed(range(3)) 倒是可以(range 是序列),得到的是一个 range_iterator,list 之后是 [2, 1, 0]。
6. 生成器:用写函数的方式造迭代器
map 和 filter 好用,但它们能表达的模式很窄——「每个都变换一下」「筛掉一些」。如果我想要的序列是「先 x 再 -x」,或者「树里所有和为 total 的路径」,怎么办?
手写一个迭代器类是可以的(那要等学完面向对象),但 Python 给了一条捷径:把 return 换成 yield,函数就变成了迭代器。
- 生成器函数(generator function):函数体里出现了
yield的函数。 - 生成器对象(generator object):调用生成器函数得到的返回值。可以对它调
next,按顺序拿到被 yield 出来的值。
课上专门提醒过:题目里这两个词有时会被混用,虽然它们不是一回事。看不出题面指的是哪个,就在考试时问监考、在小测里报 issue。自己写代码时最好分清楚——「生成器函数」是那段 def,「生成器对象」是调用它得到的东西。
>>> def plus_minus(x):
...     yield x
...     yield -x
...
>>> plus_minus(5)
<generator object plus_minus at 0x78d032746420>
>>> gen = plus_minus(5)
>>> next(gen)
5
>>> next(gen)
-5
>>> next(gen)
Traceback (most recent call last):
  ...
StopIteration
先看第一行输出:plus_minus(5) 的值不是 5,也不是 -5,而是一个生成器对象。这说明调用生成器函数时发生的事,跟调用普通函数完全不同。
调用生成器函数时,函数体一行都不执行
这是本节最反直觉、也最重要的一点。用带副作用的例子来验证:
>>> def noisy():
...     print('start')
...     yield 1
...     print('middle')
...     yield 2
...     print('end')
...
>>> h = noisy()
>>> # 什么都没打印!
>>> next(h)
start
1
>>> next(h)
middle
2
>>> next(h)
end
Traceback (most recent call last):
  ...
StopIteration
h = noisy():Python 看到 noisy 的函数体里有 yield,于是不执行函数体,只创建一个帧并把它挂起,连同「下一句该从函数体第一行开始」这个信息一起打包成生成器对象返回。print('start') 没有执行,所以屏幕上什么都没有。next(h):那个挂起的帧被恢复,从函数体第一行开始执行。打印 start,走到 yield 1。yield 1 做两件事:把 1 交给 next 的调用方作为返回值;把当前帧原地冻结——局部变量全部保留,执行位置记在 yield 1 这一行。函数没有返回、没有结束,只是暂停。next(h):帧被解冻,从 yield 1 的下一句继续。打印 middle,走到 yield 2,交出 2,再次冻结。next(h):解冻,打印 end,然后函数体走到了尽头。此时生成器自动抛出 StopIteration——注意 end 是打印出来了的,异常发生在它之后。h 报废,再 next 永远是 StopIteration。h = noisy()
┌─ 创建帧 f1: noisy [parent=Global],但立刻挂起 ─┐
│ 局部变量:(无) │
│ 下一条待执行:print('start') │
└────────────────────────────────────────────────┘
Global frame: h ──→ generator object(内部持有上面这一帧)
next(h) 第 1 次:恢复 f1 → print('start') → 到 yield 1
f1 冻结,下一条待执行 = print('middle');返回值 1 交给调用方
next(h) 第 2 次:恢复 f1 → print('middle') → 到 yield 2
f1 冻结,下一条待执行 = print('end');返回值 2 交给调用方
next(h) 第 3 次:恢复 f1 → print('end') → 函数体结束
f1 销毁 → raise StopIteration
对比一下你熟悉的普通函数:普通函数的帧在 return 时就消失了,局部变量随之作废;生成器的帧则在 yield 处存活着被冻起来,等下一次 next 把它唤醒。「函数可以暂停并保留现场」是生成器唯一的新东西,其余全是它的推论。
| 对比项 | 普通函数 | 生成器函数 |
|---|---|---|
| 调用时 | 立刻执行函数体 | 不执行任何函数体代码,返回生成器对象 |
| 返回值 | return 后面那个值(没写就是 None) | 一个生成器对象 |
| 能返回几个值 | 一个(return 一执行函数就结束) | 任意多个,一次 next 交出一个 |
| 帧的命运 | return 时销毁 | yield 时冻结保留,下次 next 恢复 |
| 结束方式 | 返回值给调用方 | 函数体跑完 → 抛 StopIteration |
| 能否放进 for | 不能 | 能——生成器对象是迭代器 |
既然生成器对象是迭代器,第 4 节那条规则也适用:
>>> g = plus_minus(5)
>>> iter(g) is g
True
>>> list(plus_minus(5))
[5, -5]
>>> for v in plus_minus(5):
...     print(v)
...
5
-5
误区一:对生成器函数调 next。
>>> next(plus_minus)
Traceback (most recent call last):
  ...
TypeError: 'function' object is not an iterator
plus_minus 是函数对象,plus_minus(5) 才是生成器对象。少写一对括号就是这条报错。
误区二:以为调用了生成器函数就等于跑了它。 下面这行代码什么都不做:
>>> def f():
...     print('side effect')
...     yield 1
...
>>> f()
<generator object f at 0x...>
side effect 没有被打印。如果你把生成器当成「一个会打印东西的函数」来用,会以为程序坏了。必须有人 next 它、for 它、或者 list 它,函数体才会真的跑。
误区三:在生成器里写 return <值>,以为能拿到这个值。
>>> def g2():
...     yield 1
...     return 99
...
>>> list(g2())
[1]
99 不在结果里。在生成器函数中,return 的作用是提前结束(等价于函数体跑完),返回值被塞进 StopIteration 异常里,普通的 for / list 看不到它。所以生成器里只写光秃秃的 return 用来提前收工,别指望它传值。
误区四:把 yield 写在函数外面。
    yield 5
    ^^^^^^^
SyntaxError: 'yield' outside function
这是 SyntaxError,整个文件一行都跑不了。
7. 无限生成器:列表做不到的事
生成器最能体现价值的地方,是表示没有尽头的序列。因为它每次只算一个值,「总共有多少个」根本不影响它能不能被创建。
>>> def evens():
...     i = 0
...     while True:
...         yield i
...         i += 2
...
>>> gen = evens()
>>> next(gen)
0
>>> next(gen)
2
while True 在普通函数里是死循环,是 bug;在生成器里它是特性。原因就是第 6 节那条:yield 会把帧冻住,控制权交回调用方。循环是被「暂停」的,不是在空转。
gen = evens():建帧、挂起。i 此刻还不存在(i = 0 都没执行)。next(gen):恢复,执行 i = 0,进入 while True,条件为真,执行 yield i → 交出 0,冻结。此刻帧里 i 是 0,下一条待执行是 i += 2。next(gen):恢复,执行 i += 2 → i 变成 2;回到 while 条件,仍为真;执行 yield i → 交出 2,冻结。next 都重复第 3 步,i 一直是上次冻结时的值加 2。局部变量 i 跨越多次 next 一直活着,这正是帧被保留的直接后果。f1: evens [parent=Global] (被 gen 这个生成器对象持有) next 第 1 次结束时: i ──→ 0 暂停在 yield i next 第 2 次结束时: i ──→ 2 暂停在 yield i next 第 3 次结束时: i ──→ 4 暂停在 yield i ... 对比普通函数:每次调用都是一个全新的帧,i 每次都从头开始。
对无限生成器调 list。
>>> gen = evens()
>>> list(gen)
(无限循环,程序卡死;Ctrl+C 打断会看到 KeyboardInterrupt,
 放任不管则最终 MemoryError)
list 的工作是「一直 next 到 StopIteration 为止」,而 evens() 永远不会 StopIteration。sorted、min、max、sum、tuple 同理,全都会卡死。
正确的取法是只取有限个:
>>> gen = evens()
>>> [next(gen) for _ in range(5)]
[0, 2, 4, 6, 8]
或者在 for 里配合 break。这也是判断题里的常客:看到 list(某无限生成器),答案就是「卡死」,不是某个列表。
无限生成器把「序列」和「存储」彻底解耦了。evens() 这个对象在内存里只占几十字节——它存的不是无穷多个偶数,而是一条产生偶数的规则加上当前进度。这跟数学里写 $a_n = 2n$ 而不是把所有 $a_n$ 列出来是同一种想法。
8. yield from:把一整串值转手让出去
经常会遇到这种需求:我这个生成器要产出的值,一部分来自另一个 iterable。比如「先把 a 里的元素全给出去,再把 b 里的全给出去」:
def a_then_b(a, b):
    for x in a:
        yield x
    for x in b:
        yield x
这段代码没错,但 for x in a: yield x 这个模式太常见了,Python 给了专门的语法:
def a_then_b(a, b):
    yield from a
    yield from b
>>> list(a_then_b([1, 2], [3, 4]))
[1, 2, 3, 4]
yield from <iterable> 的意思是:把这个 iterable 里的元素一个一个地 yield 出去,直到它耗尽。它不是「yield 一个 iterable」——这个区别下面就要吃它的亏。
yield x:让出一个值 x。
yield from xs:让出 xs 里的每一个值,相当于 for v in xs: yield v。
所以 yield from 后面必须跟一个 iterable(列表、字符串、另一个生成器都行),跟一个整数会报 TypeError: 'int' object is not iterable。
递归生成器
课上说得明白:用 yield from 的一个常见理由,就是递归地调用生成器函数。 看这个倒计时:
def countdown(k):
    if k > 0:
        yield k
        yield from countdown(k - 1)
    else:
        yield 'Blastoff!'
>>> list(countdown(3))
[3, 2, 1, 'Blastoff!']
这个结构和上一讲所有树递归、和第 1 节的 print_treeA 是同一个骨架:先处理自己(yield k),再把「更小的同类问题」的全部结果转手让出去(yield from countdown(k - 1))。把它真的展开一层层看:
countdown(3) 创建生成器 G3(不执行函数体)。list 开始反复 next(G3)。3 > 0 为真,执行 yield 3 → 产出 3,G3 冻结在这一行。yield from countdown(2)。这一句先调用 countdown(2) 得到生成器 G2,然后 G3 把控制权转给 G2:next(G2) → G2 里 2 > 0 为真,yield 2 → 产出 2。这个 2 穿过 G3 直达 list。此刻 G3 冻在 yield from 那一行,G2 冻在 yield 2。yield from G2 里,于是 next(G2) → G2 执行 yield from countdown(1),创建 G1,next(G1) → yield 1 → 产出 1。此刻三层帧全部活着:G3 冻在 yield from,G2 冻在 yield from,G1 冻在 yield 1。yield from countdown(0),创建 G0,next(G0) → 0 > 0 为假,走 else,yield 'Blastoff!' → 产出 'Blastoff!'。这就是 base case。StopIteration。G1 的 yield from 捕获它、认为 G0 耗尽,于是 G1 继续往下——函数体也到头了 → G1 抛 StopIteration。同理逐层上传:G2 结束、G3 结束。list 收到 StopIteration,停止。list 收集到的依次是 3、2、1、'Blastoff!',即 [3, 2, 1, 'Blastoff!']。list ← 'Blastoff!'
└─ G3: countdown k=3 暂停在 yield from countdown(k-1)
└─ G2: countdown k=2 暂停在 yield from countdown(k-1)
└─ G1: countdown k=1 暂停在 yield from countdown(k-1)
└─ G0: countdown k=0 暂停在 yield 'Blastoff!'
每一层的 k 都独立保存在自己的帧里,互不干扰。
一个值要从 G0 传到 list,得穿过三层 yield from。
忘了 from 会怎样
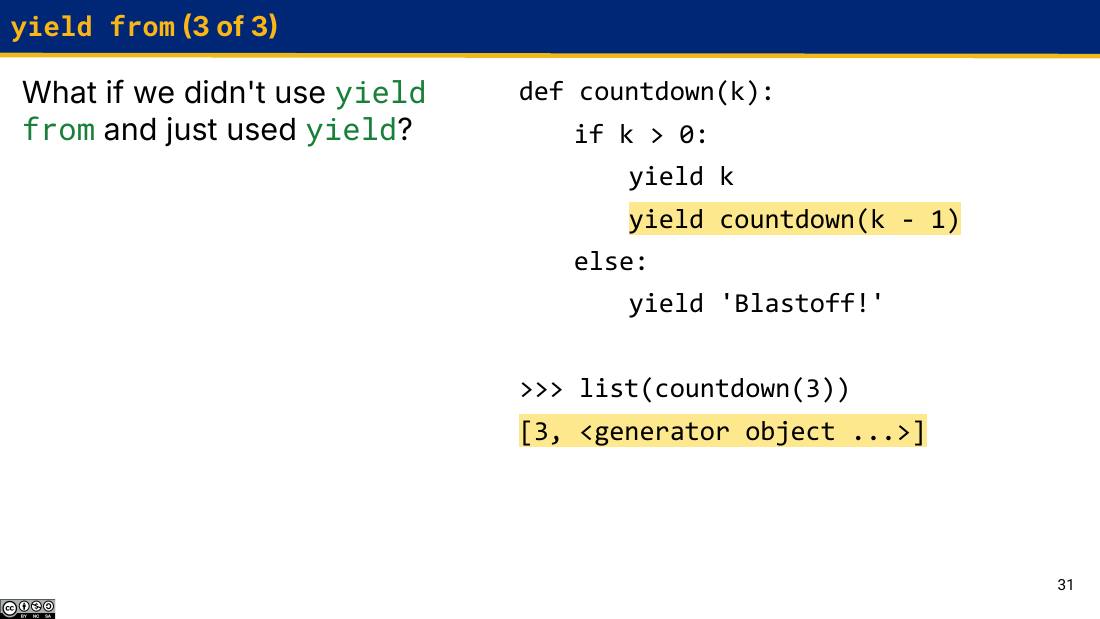
def countdown(k):
    if k > 0:
        yield k
        yield countdown(k - 1)      # 少了一个 from
    else:
        yield 'Blastoff!'
>>> list(countdown(3))
[3, <generator object countdown at 0x7f7b63b46420>]
yield 3 → 产出 3。yield countdown(2)。先求值算子数 countdown(2)——按第 6 节的规则,这只是创建一个生成器对象,函数体一行不跑。然后 yield 把这个对象本身当成一个普通的值让出去。StopIteration。list 收到的两个元素是 3 和那个从未被 next 过的生成器对象。它里面的 2、1、'Blastoff!' 永远不会被算出来——没人向它要过值。看到输出里冒出 <generator object ...>,99% 是漏了 from。 这个报错很友好,因为它根本不报错——程序照常运行,只是结果里混进了一个你不认识的对象。诊断口诀:
- 结果里有
<generator object>→ 某处该写yield from却写了yield。 - 反过来,
yield from后面跟了个非 iterable(比如yield from label(t),而 label 是个整数)→TypeError: 'int' object is not iterable。
还有一个更隐蔽的变体:想让出一个列表本身作为单个元素时,必须用 yield。第 11 节的 yield_paths 产出的每个元素都是一条路径(一个列表),那里就必须写 yield [label(t)] + path,写成 yield from 会把路径拆成一个个数字。
9. 三个同心圆:iterable、iterator、generator
三个名词到这儿全都出场了,把关系一次理清。
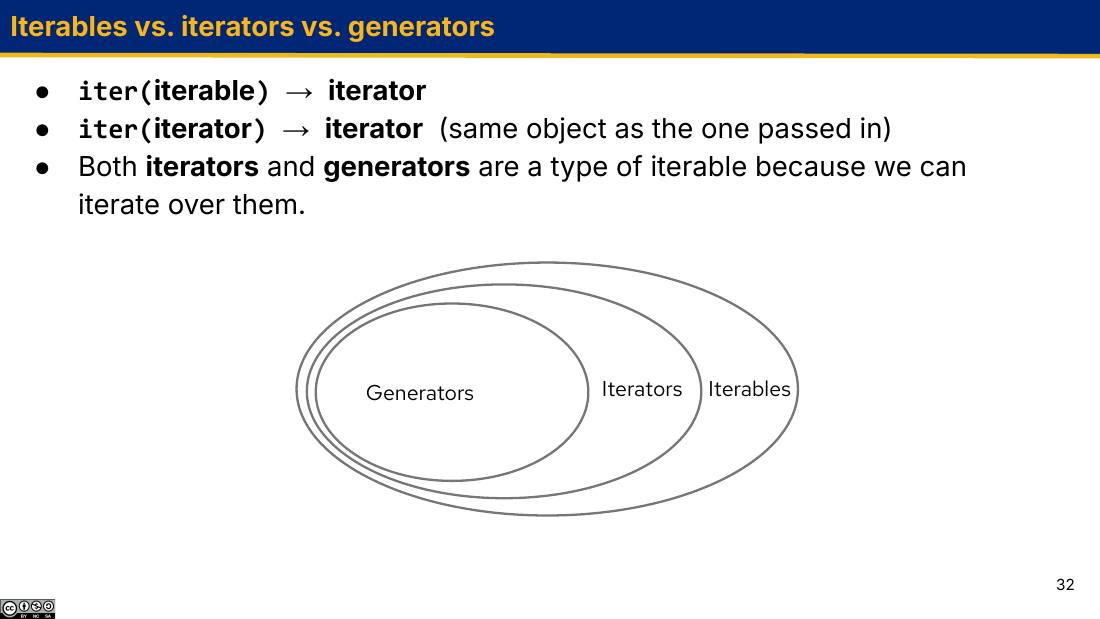
| iterable | iterator | generator object | |
|---|---|---|---|
| 典型例子 | list、tuple、str、dict、range | iter(lst)、map/filter/zip/reversed 的返回值 | 调用生成器函数的返回值 |
能进 for | ✓ | ✓ | ✓ |
能 next | ✗ | ✓ | ✓ |
iter(x) 返回 | 一个新迭代器 | x 自己 | x 自己 |
| 能重复遍历 | ✓(每次 for 拿新书签) | ✗ | ✗ |
| 元素存在内存里吗 | 通常是(range 除外) | 不一定 | 不存,用时才算 |
| 怎么造出来 | 字面量、构造函数 | iter(...) 或内置惰性函数 | 写一个含 yield 的函数并调用它 |
用一句话串起来:iterable 是「有一串值」这个资格;iterator 在此之上加了「记着读到哪儿」;generator 则是「用一段暂停/恢复的函数体来现算这一串值」的迭代器。 每往里一层,能力更强,但也更「一次性」。
「生成器函数」不在这三个圈里的任何一个。它是一个普通的函数对象,只不过调用它会生产出圈内的东西。plus_minus 不是 iterable(for x in plus_minus 会报 TypeError: 'function' object is not iterable),plus_minus(5) 才是。
10. 案例研究:从 count_partitions 到 yield_partitions
这一节把整讲的东西合起来用一次。题目是 Lecture 06 见过的整数分拆(partition):把正整数 n 写成若干个不超过 m 的正整数之和,各部分按递增顺序排列,问有多少种写法。n = 6, m = 4 时有 9 种:
6 = 2 + 4        6 = 1 + 1 + 4      6 = 3 + 3
6 = 1 + 2 + 3    6 = 1 + 1 + 1 + 3  6 = 2 + 2 + 2
6 = 1 + 1 + 2 + 2                   6 = 1 + 1 + 1 + 1 + 2
6 = 1 + 1 + 1 + 1 + 1 + 1
第一步:原始的计数版本
def count_partitions_original(n, m):
    if n == 0:
        return 1
    elif n < 0:
        return 0
    elif m == 0:
        return 0
    else:
        with_m = count_partitions_original(n - m, m)
        without_m = count_partitions_original(n, m - 1)
        return with_m + without_m
核心的拆分思路是对「最大的那部分用不用 m」做二分:要么这个分法里至少用一次 m(剩下要凑 n - m,还能继续用 m),要么完全不用 m(凑 n,但只能用到 m - 1)。两类不重不漏,加起来就是全部。
第二步:合并 base case,为改写做准备
随堂代码给了一个等价的简化版,它把「n < 0」和「m == 0」并成一个失败出口,并把「n == 0」这个成功出口挪进 else:
def count_partitions_simplified(n, m):
    if n < 0 or m == 0:
        return 0
    else:
        exact_match = 0
        if n == m:
            exact_match = 1
        with_m = count_partitions_simplified(n - m, m)
        without_m = count_partitions_simplified(n, m - 1)
        return exact_match + with_m + without_m
为什么这么改?因为 n == 0 那个 base case 的含义是「刚好凑满了,算一种分法」,但它不知道自己是怎么凑满的——返回 1 就完了。等下我们要返回的不是数量而是分法本身,就必须在还知道最后一块是什么的时候记下来。n == m 正是那个时刻:还剩 n 要凑,而允许的最大部分恰好是 m == n,那就直接用一块 m 填满,这是一种分法。
第三步:返回列表而不是数量
把每个 return <数> 换成 return <列表>,加法换成列表拼接:
def list_partitions(n, m):
    if n < 0 or m == 0:
        return []
    else:
        exact_match = []
        if n == m:
            exact_match = [[m]]
        with_m = [p + [m] for p in list_partitions(n - m, m)]
        without_m = list_partitions(n, m - 1)
        return exact_match + with_m + without_m
| 计数版 | 列表版 | 为什么这样对应 |
|---|---|---|
return 0 | return [] | 「0 种分法」= 「空的分法列表」 |
exact_match = 1 | exact_match = [[m]] | 那一种分法就是 [m];外面再套一层,因为返回的是分法的列表 |
count(n - m, m) | [p + [m] for p in list_partitions(n - m, m)] | 子问题的每个分法都要补上刚用掉的那个 m;加在末尾是为了保持递增顺序 |
+(数相加) | +(列表拼接) | 把三部分结果并起来 |
随堂代码里还有一个 list_partitions_str,除了把 p + [m] 换成 f"{p} + {m}"、把 [[m]] 换成 [str(m)],其余一模一样,输出形如 '1 + 2 + 3'。
第四步:改成生成器
列表版有个硬伤:它必须把全部分法算完才返回。list_partitions(60, 50) 要生成 966370 个分法,在我的机器上要跑约 3 秒,而且这 96 万个结果同时占着内存。生成器版可以边算边给:
def yield_partitions(n, m):
    if n > 0 and m > 0:
        if n == m:
            yield str(m)
        for p in yield_partitions(n - m, m):
            yield f"{p} + {m}"
        yield from yield_partitions(n, m - 1)
逐行对照列表版:
| 行 | 做什么 | 为什么是这个写法 |
|---|---|---|
if n > 0 and m > 0: | 失败出口取反 | 生成器不需要 return []——什么都不 yield,自然就是空序列。所以直接把「不失败」的条件包在外面,else 分支可以省掉 |
if n == m: yield str(m) | 产出「一块 m 填满」这个分法 | 对应 exact_match = [[m]]。这里用 yield 而非 yield from:str(m) 是一个结果。(顺带一提,yield from str(m) 会把 '12' 拆成 '1'、'2',因为字符串也是 iterable) |
for p in yield_partitions(n - m, m): yield f"..." | 递归拿到子问题的每个分法,补上 + m 再产出 | 这里不能用 yield from——每个 p 都要加工之后才能交出去。这正是 yield from 的适用边界:原样转发用 yield from,要加工就得 for + yield |
yield from yield_partitions(n, m - 1) | 不用 m 的那一支,结果原样转发 | 不需要任何加工,所以 yield from 正合适 |
gen = yield_partitions(6, 4):建帧、挂起,什么都没算。next(gen):恢复。6 > 0 and 4 > 0 为真。n == m?6 != 4,跳过。for p in yield_partitions(2, 4),向子生成器要第一个 p。(2, 4):2 != 4,跳过 exact_match;进入 for p in yield_partitions(-2, 4) —— -2 > 0 为假,这个生成器一个值都不产出,for 直接结束(这就是失败出口,无需写 return []);接着 yield from yield_partitions(2, 3)。(2, 3):2 != 3;for p in yield_partitions(-1, 3) 空转;yield from yield_partitions(2, 2)。(2, 2):n == m 命中!yield str(2) → 产出 '2'。这个值原样穿过 (2,3)、(2,4) 两层 yield from,回到第 3 步那个 for,绑定给 p。yield f"{p} + {m}" = yield '2 + 4' → 第一个值是 '2 + 4',也就是 6 = 2 + 4。此时所有帧冻结,剩下 8 个分法一个都没算。>>> gen = yield_partitions(6, 4)
>>> next(gen)
'2 + 4'
>>> next(gen)
'1 + 1 + 4'
>>> list(yield_partitions(6, 4))
['2 + 4', '1 + 1 + 4', '3 + 3', '1 + 2 + 3', '1 + 1 + 1 + 3', '2 + 2 + 2', '1 + 1 + 2 + 2', '1 + 1 + 1 + 1 + 2', '1 + 1 + 1 + 1 + 1 + 1']
9 个,和计数版的答案对上了。
惰性到底快多少
>>> s = list(yield_partitions(60, 50))   # 要等几秒
>>> len(s)
966370
>>> gen = yield_partitions(60, 50)       # 瞬间完成
>>> next(gen)
'10 + 50'
>>> next(gen)
'1 + 9 + 50'
两种写法算的是同一件事,差别只在什么时候算。list(...) 把 966370 个分法全算出来(约 3 秒),只为了让你看第一个;next(gen) 只做了「找出第一个分法」所必需的那几十次递归调用,感觉不到耗时。如果你的程序只需要前几个结果、或者会在中途 break,生成器版省下的就是几乎全部的计算。
这四个版本值得整体回看一遍:递归的骨架从头到尾没变过——永远是「用一次 m」+「不用 m」+「恰好填满」这三支。变的只有「结果怎么攒起来」:数量用 +,列表用拼接,生成器用 yield。这就是这门课反复训练的能力:先把问题的递归结构想清楚,再决定用什么形式承载答案。
11. 随堂练习:palindrome 与 min_abs_indices
起始代码是课程网站 Lecture 10 下的 10.py,用 python3 -m doctest 10.py 跑测试(没有输出就是全过)。
palindrome:判断回文
def palindrome(s) -> bool:
    """
    Return `True` if a sequence `s` is the same forward and backward
    (e.g. if `s` is a palindrome), or `False` otherwise.

    >>> palindrome([3, 1, 4, 1, 5])
    False
    >>> palindrome([3, 1, 4, 1, 3])
    True
    >>> palindrome('seveneves')
    True
    >>> palindrome('seven eves')
    False
    """
题目要什么。 判断序列正着读和倒着读是否一样。注意 doctest 里既有列表又有字符串,所以实现不能只对其中一种奏效。最后一个例子 'seven eves' 说明空格算一个字符——不要自作聪明去掉空格。
怎么想到的。 直觉是「把 s 倒过来,和 s 比一比」。倒过来用 reversed(s)。于是第一版:
return reversed(s) == s # 错的
拿 'aba' 试一下,得到 False——明明是回文。原因是 reversed(s) 返回的是一个迭代器对象,拿一个迭代器去和字符串比较,比的是「这两个是不是同一个对象」,永远是 False。第 5 节强调过:惰性函数的返回值不是你想要的那串值,必须先落进容器。改成:
return list(reversed(s)) == list(s)
两边都套 list,把类型统一成列表再比。右边的 list(s) 不能省:s 是字符串时,list(reversed('aba')) 是 ['a', 'b', 'a'],而 'aba' 是字符串,两者永不相等。
第二种写法(用 zip)。 挑战要求用 zip 和 reversed。思路换成「逐位对比」:把正序和倒序配对,如果每一对的两个元素都相等,就是回文。
return all([a == b for a, b in zip(s, reversed(s))])
reversed('aba') 产出 'a'、'b'、'a'(倒序)。zip('aba', reversed('aba')) 把两者同下标配对:('a','a')、('b','b')、('a','a')。注意 zip 也是惰性的,此刻还没真的配。a, b = ... 是解包,得到 [True, True, True]。遍历这一步把 zip 抽干了,但没关系——结果已经落成列表。all([True, True, True]) → True。(all 的含义是「全部为真」,空列表也返回 True,正好符合「空序列是回文」。)'ab':配对是 ('a','b')、('b','a'),推导式得到 [False, False],all 返回 False。这个写法其实做了双倍的比较——第 i 位和倒数第 i 位比了两次。但它对,而且很直观。
reversed(s) == s:比的是迭代器对象和序列,恒为False。list(reversed(s)) == s:字符串输入时恒为False(列表 ≠ 字符串)。- 用
s[::-1] == s(切片反转)对列表和字符串都能跑,但这题的挑战明确要求用reversed——而且s[::-1]对一般的 iterable 不成立。 - 把
reversed(s)存进变量后用两次:r = reversed(s); list(r) == list(s) and all(...r...),第二次r已经空了。
min_abs_indices:找出绝对值最小的所有下标
def min_abs_indices(s) -> list[int]:
    """
    Returns a list of all indices of elements in s
    whose absolute value is equal to the minimum absolute value of s.

    >>> min_abs_indices([-4, -3, -2, 3, 2, 4])
    [2, 4]
    >>> min_abs_indices([1, 2, 3, 4, 5])
    [0]
    """
题目要什么。 先算出 s 中所有元素绝对值的最小值,再返回所有绝对值等于它的元素的下标。两个容易读漏的点:返回的是下标不是元素值;可能有多个(第一个 doctest 里 -2 和 2 绝对值都是 2,下标 2 和 4 都要)。
怎么想到的。 拆成两步就清楚了:
map(abs, s),再喂给 min:min_abs = min(map(abs, s))。for i in range(len(s)),保留满足 abs(s[i]) == min_abs 的那些 i。第 2 步如果直接 for x in s,你会拿到元素却不知道它在第几位,只能再想办法找回下标——那是弯路。要什么就遍历什么。
def min_abs_indices(s):
    min_abs = min(map(abs, s))
    return [i for i in range(len(s)) if abs(s[i]) == min_abs]
第二种写法(不用列表推导式)。 挑战要求只用迭代内置函数。「从一堆候选里挑出满足条件的」就是 filter;候选是所有下标,即 range(len(s)):
def min_abs_indices(s):
    min_abs = min(map(abs, s))
    f = lambda i: abs(s[i]) == min_abs
    return list(filter(f, range(len(s))))
两点值得注意:f 是一个闭包,它用到了外层的 s 和 min_abs——这是第 3 讲高阶函数的老本行,只是这次被 filter 调用;末尾的 list(...) 不能省,因为 filter 返回的是迭代器,而 doctest 期望的输出是 [2, 4],不是 <filter object at 0x...>。
map(abs, s) 惰性产出 4, 3, 2, 3, 2, 4;min 把它抽干,得到 min_abs = 2。range(len(s)) 即 range(6),候选下标 0..5。abs(s[0])=4 ✗;abs(s[1])=3 ✗;abs(s[2])=abs(-2)=2 ✓;abs(s[3])=3 ✗;abs(s[4])=abs(2)=2 ✓;abs(s[5])=4 ✗。[2, 4],与 doctest 一致。第二个 doctest [1,2,3,4,5]:最小绝对值 1,只有下标 0 满足,返回 [0]。把 map 对象存起来用两次——第 5 节那个坑在这题里最容易复现:
abs_vals = map(abs, s)
min_abs = min(abs_vals)
return [i for i in range(len(s)) if abs_vals[i] == min_abs]
两处都错:abs_vals 已被 min 抽干;而且 map 对象不支持下标,会报 TypeError: 'map' object is not subscriptable。要么像标准解法那样直接写 abs(s[i]),要么一开始就 abs_vals = list(map(abs, s))。
另一个常见错误是返回元素而不是下标:[x for x in s if abs(x) == min_abs] 会得到 [-2, 2]。读 doctest 的时候就该发现输出是 [2, 4]——两个正数,而原列表里根本没有 4 以外的正 4,说明它们是位置不是值。
12. 随堂练习:yield_paths(递归生成器)
def yield_paths(t, total):
    """
    Yield each path from the root node to any other node in the tree
    that adds up to the target total.
    >>> t = tree(3, [tree(-1), tree(1, [tree(2, [tree(1)]), tree(3)]), tree(1, [tree(-1)])])
    >>> list(yield_paths(t, 3))  # path does not have to go to a leaf
    [[3], [3, 1, -1]]
    >>> list(yield_paths(t, 4))
    [[3, 1], [3, 1]]
    >>> list(yield_paths(t, 5))
    []
    >>> list(yield_paths(t, 6))
    [[3, 1, 2]]
    >>> list(yield_paths(t, 7))
    [[3, 1, 2, 1], [3, 1, 3]]
    """
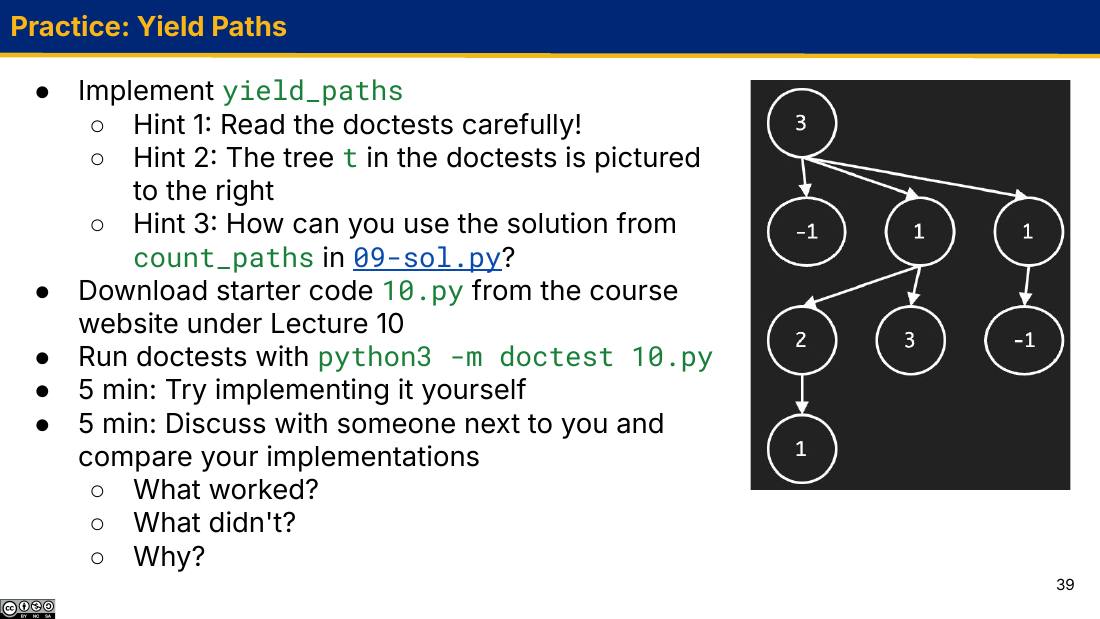
题目要什么。 三个关键点全藏在 doctest 里:
list(yield_paths(t, 3))的结果里有[3]——只含根节点的路径也算,而且那句注释明说了path does not have to go to a leaf,路径可以在任何节点停下。list(yield_paths(t, 4))得到[[3, 1], [3, 1]]——两条一模一样的路径。因为根有两个标签为 1 的孩子,它们是不同的节点,各算一条。所以不能去重。list(yield_paths(t, 5))是[]——一条都没有时,什么都不 yield,list得到空列表。生成器天然支持这个,不需要特判。
怎么想到的。 提示说「参考上一讲 count_paths」。那个函数是数有多少条和为 total 的路径:
def count_paths(t, total):
    if label(t) == total:
        found = 1
    else:
        found = 0
    return found + sum([count_paths(b, total - label(t)) for b in branches(t)])
它的递归结构是:当前节点自己算不算一条(label(t) == total),加上每个分支里、目标减去当前标签之后还有多少条。第 10 节刚练过同一套改造手法——把「数量」换成「东西本身」:
| count_paths | yield_paths | 为什么 |
|---|---|---|
found = 1 | yield [label(t)] | 「找到一条」= 「产出一条路径」。这条路径只有当前节点自己,所以是 [label(t)] |
found = 0(else 分支) | 什么都不写 | 「0 条」= 「不 yield」。生成器不需要 else |
count_paths(b, total - label(t)) | for path in yield_paths(b, total - label(t)) | 子树里的每条路径,都要拿出来加工 |
sum([...]) | yield [label(t)] + path | 子树给的 path 是从 b 出发的,要变成「从 t 出发」就得在前面接上当前标签 |
剩下要想明白的只有一件事:为什么目标是 total - label(t)? 因为路径必须从根出发,所以当前节点的标签是一定会被算进去的。既然它已经贡献了 label(t),那么子树里的那一段就只需要凑出 total - label(t)。
def yield_paths(t, total):
    if label(t) == total:
        yield [label(t)]

    for b in branches(t):
        for path in yield_paths(b, total - label(t)):
            yield [label(t)] + path
代码逐行讲
if label(t) == total: yield [label(t)] —— 「路径就到我为止」这一种情况。注意这里没有 return:yield 完之后代码继续往下走,因为即使当前节点自己就凑够了,它的子树里可能还有更长的路径也凑够(total=3 时 [3] 和 [3, 1, -1] 就同时存在,后者靠 1 + (-1) = 0 凑回来)。写了 return 就会漏掉 [3, 1, -1]。for b in branches(t) —— 每个分支都要试。叶子节点没有分支,这个循环不执行一次,递归自然终止:这就是 base case,不需要写 if is_leaf(t)。for path in yield_paths(b, total - label(t)) —— 递归调用返回的是一个生成器对象;用 for 遍历它,每次拿到一条「从 b 出发、和为 total - label(t)」的路径。yield [label(t)] + path —— 加工后再让出。这里必须是 yield 而不能是 yield from:我们要交出的是「一条路径」,它本身是一个列表;写成 yield from [label(t)] + path 会把这个列表拆成一个个数字吐出来,结果会变成 [3, 1, -1, ...] 这样的扁平数字流。[label(t)] + path 是新建一个列表([label(t)] 在前),不是 path.append。用 + 而不是原地修改,避免了多条路径共享同一个列表对象的别名(aliasing)问题。验证:完整展开 yield_paths(t, 3)
yield_paths(t, 3),label(t) = 3。3 == 3 ✓ → 产出 [3]。这是结果里的第一个。for b in branches(t),新目标一律是 3 - 3 = 0。tree(-1),目标 0。 -1 == 0?否。它是叶子,for b in branches 不执行。这个生成器一个值都不产出,外层的 for path in ... 直接结束。tree(1, [tree(2, [tree(1)]), tree(3)]),目标 0。 1 == 0?否。往下:
· 孙子
tree(2, [tree(1)]),目标 0 - 1 = -1:2 == -1?否 → 曾孙 tree(1),目标 -1 - 2 = -3:1 == -3?否,叶子,无产出。
· 孙子
tree(3),目标 -1:3 == -1?否,叶子,无产出。
整棵子树一无所获。
tree(1, [tree(-1)]),目标 0。 1 == 0?否。进入它的分支:孙子 tree(-1),目标 0 - 1 = -1。-1 == -1 ✓ → 孙子产出 [-1]。[-1] 被第三个分支的 for path 接住,它 yield [1] + [-1] = [1, -1]。[1, -1] 被顶层的 for path 接住,顶层 yield [3] + [1, -1] = [3, 1, -1]。StopIteration。list 收集到的是 [[3], [3, 1, -1]],与 doctest 一致 ✓再看 total = 4 为什么会出现两条相同的 [3, 1]:顶层 3 == 4?否,不产出。三个分支的新目标都是 4 - 3 = 1。第一个分支标签 -1 != 1,无;第二个分支标签 1 == 1 ✓ 产出 [1],回代成 [3, 1];第三个分支标签也是 1 == 1 ✓ 产出 [1],回代成另一个 [3, 1]。两条路径走的是不同的边,只是标签恰好相同——所以结果里有两个 [3, 1],这不是 bug。
- 在第一个
if里写return(或elif/else把后面的 for 挡住):list(yield_paths(t, 3))会变成[[3]],漏掉[3, 1, -1]。找到一条路径不代表更长的路径不存在。 - 递归时忘了减
label(t),写成yield_paths(b, total):目标一直不变,结果全乱。可以拿total=6检验,正确答案是[[3, 1, 2]](3+1+2=6)。 - 用
yield from让出加工后的路径:yield from [label(t)] + path会把路径拆成散装数字。判断标准很简单——你想让出的是「一个东西」还是「一串东西」。 - 用
path.insert(0, label(t))代替[label(t)] + path:这是原地修改子生成器给你的那个列表。这题里恰好也能过(每个 path 只被用一次),但一旦上层把同一个列表对象再传给别处就会出诡异 bug。递归里拼接结果,优先用+造新对象。 - 只考虑叶子路径:写成
if is_leaf(t) and label(t) == total。total=3时[3](根本身)就会丢掉,doctest 那句注释就是专门防这个的。
回头看第 1 节的 print_treeA:print(label(tree)) 在前、递归在后。yield_paths 的骨架完全一样——yield 自己这一条在前,遍历分支在后。把树递归里的 print 换成 yield,你就得到了一个能被 for、被 list、被 next 使用的版本,而且不必先把所有结果攒进一个列表。这是生成器在树/图搜索里最典型的用法。
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
| iterable(可迭代对象) | 能进 for 循环的东西。「书」 | 对它调 next → TypeError: 'list' object is not an iterator |
| iterator(迭代器) | iter(iterable) 得到。「书签」,记着位置,只能 next | 一次性:遍历过就空了,第二次 list 得到 [] |
iter | 对 iterable 造新书签;对 iterator 返回它自己 | 以为 iter(it) 能把 it 倒回开头 |
next | 取下一个;没有了就抛 StopIteration | 以为耗尽时返回 None |
| 底层可变性 | iter 不复制数据,改了原容器会读到新值 | 字典迭代中增删键 → RuntimeError: dictionary changed size during iteration |
map/filter/zip/reversed | 返回惰性迭代器;不 next 就一次都不算 | 直接打印看到 <map object at 0x...>;同一个对象用两次第二次为空 |
zip | 同下标配对,以最短的为准 | 以为多出来的元素会配 None |
list/tuple/sorted | 把迭代器抽干,落成容器 | 对无限生成器用 → 死循环 / MemoryError |
| 生成器函数 | 函数体里有 yield;调用它不执行任何函数体代码 | 以为调用了就会打印/计算;对函数本身 next → 'function' object is not an iterator |
| 生成器对象 | 调用生成器函数的返回值,是迭代器;yield 处冻结帧,下次 next 从那里继续 | 以为 yield 像 return 一样结束函数 |
生成器里的 return | 提前结束(等价于函数体跑完) | 以为 return 99 会让 99 出现在结果里 |
yield from xs | 把 xs 里的每个元素逐个让出,等价于 for v in xs: yield v | 递归时漏写 from → 结果里出现 <generator object ...> |
什么时候用 yield | 要让出一个值(哪怕它本身是列表) | yield from [label(t)] + path 会把路径拆成散装数字 |
| 递归生成器 | 骨架和普通递归一样:自己这份用 yield,子问题原样转发用 yield from,要加工就 for + yield | 在产出后写 return,挡住了更长的解 |
| 失败出口 | 生成器不需要 return []——什么都不 yield 就是空序列 | 习惯性写 else: return [],在生成器里会提前终止函数 |
三个圈速记
iterable  ⊇  iterator  ⊇  generator object

能进 for  ─────────────────────────────→  三者都能
能 next   ────────────  iterator 起才能  ─→
iter(x)   ──  新书签  ──  返回 x 自己  ──→  返回 x 自己
遍历几次  ──  无限次  ──     一次      ──→      一次
一段代码里最该问自己的三个问题
next、能不能遍历第二遍。list/min/sum/for 抽干过它。next 之前,里面的函数一次都没被调用。动手练习
练习 1:这段代码打印什么
>>> s = [1, 2, 3, 4]
>>> t = iter(s)
>>> next(t)
>>> u = iter(s)
>>> next(u)
>>> s[1] = 20
>>> next(t)
>>> list(u)
>>> list(t)
看答案
依次是 1、1、20、[20, 3, 4]、[3, 4]。
| 语句 | 结果 | t 的位置 | u 的位置 | s 的内容 |
|---|---|---|---|---|
t = iter(s) | — | 0 | — | [1,2,3,4] |
next(t) | 1 | 1 | — | [1,2,3,4] |
u = iter(s) | — | 1 | 0 | [1,2,3,4] |
next(u) | 1 | 1 | 1 | [1,2,3,4] |
s[1] = 20 | — | 1 | 1 | [1,20,3,4] |
next(t) | 20 | 2 | 1 | [1,20,3,4] |
list(u) | [20,3,4] | 2 | 4(耗尽) | [1,20,3,4] |
list(t) | [3,4] | 4(耗尽) | 4 | [1,20,3,4] |
两个要点:t 和 u 是两个独立的书签,位置互不影响;但它们指着同一个列表,所以 s[1] = 20 之后谁读到下标 1 都得到 20。
练习 2:惰性的代价
下面这段代码运行后,屏幕上打印了几行 calling?result 是什么?
def f(x):
    print('calling')
    return x * x

nums = map(f, [1, 2, 3])
result = [n for n in nums if n > 100]
total = sum(nums)
看答案
打印 3 行 calling,result 是 [],total 是 0。
nums = map(f, [1, 2, 3]):0 行。只是造了个 map 对象,f一次都没被调用。- 列表推导式遍历
nums,把它整个抽干:f(1)、f(2)、f(3)依次被调用,打印 3 行calling,产出 1、4、9。没有一个大于 100,所以result是[]。 sum(nums):nums已经空了,sum一个元素也拿不到,返回0。不报错,也不会再打印calling。
这就是「迭代器只能遍历一次」造成的静默错误:total 本该是 14,实际是 0,程序却一切正常。要修就在第一行写 nums = list(map(f, [1, 2, 3]))。
练习 3:生成器执行顺序
def g():
    print('A')
    yield 1
    print('B')
    yield 2

gen = g()
print('C')
for x in gen:
    print(x)
看答案
输出:C、A、1、B、2。
gen = g():建帧后立刻挂起,A 不会被打印。print('C') → 打印 C。所以 C 反而排在 A 前面。for 先 iter(gen)(返回 gen 自己),再 next:帧恢复 → 打印 A → yield 1 交出 1 并冻结 → 循环体 print(x) 打印 1。next:从 yield 1 之后继续 → 打印 B → 交出 2 → 循环体打印 2。next:函数体到头 → StopIteration → for 正常结束。关键是理解控制权在生成器和调用方之间来回切换:函数体不是一口气跑完的,它每 yield 一次就把控制权交回去一次。
练习 4:写一个生成器
实现 evens_up_to(n),按从小到大的顺序 yield 出 0 到 n(含 n)之间的所有偶数。list(evens_up_to(7)) 应得 [0, 2, 4, 6],list(evens_up_to(0)) 应得 [0],list(evens_up_to(-1)) 应得 []。再用它写一个 evens_then_odds(n):先 yield 所有偶数,再 yield 所有奇数。
看答案
def evens_up_to(n):
    i = 0
    while i <= n:
        yield i
        i += 2

def odds_up_to(n):
    i = 1
    while i <= n:
        yield i
        i += 2

def evens_then_odds(n):
    yield from evens_up_to(n)
    yield from odds_up_to(n)
验证:list(evens_up_to(7)):i = 0 → yield 0 → 2 → yield 2 → 4 → yield 4 → 6 → yield 6 → 8,8 <= 7 为假,循环结束,函数体到头 → StopIteration,得 [0, 2, 4, 6] ✓
list(evens_up_to(-1)):一进函数 0 <= -1 就是假,一个 yield 都没执行,直接结束 → [] ✓ 这正是第 10 节说的「生成器的失败出口不需要写任何东西」。
list(evens_then_odds(7)) 得 [0, 2, 4, 6, 1, 3, 5, 7]:两个 yield from 依次把两个子生成器抽干,顺序就是书写顺序。
如果把 evens_then_odds 写成 yield evens_up_to(n),结果会是 [<generator object>, <generator object>]——漏 from 的经典症状。
练习 5:改写成生成器
下面这个函数返回一棵树里所有叶子的标签组成的列表。把它改写成生成器 yield_leaves(t),使 list(yield_leaves(t)) 得到同样的结果。
def leaf_labels(t):
    if is_leaf(t):
        return [label(t)]
    result = []
    for b in branches(t):
        result = result + leaf_labels(b)
    return result
看答案
def yield_leaves(t):
    if is_leaf(t):
        yield label(t)
    for b in branches(t):
        yield from yield_leaves(b)
三处改动,每处都对应本讲的一条规则:
return [label(t)]→yield label(t)。返回「装着一个标签的列表」变成「让出一个标签」。注意不再需要那对方括号,因为yield一次就代表一个元素。- 不需要
result = []和累加。生成器的结果是「让出过的东西的序列」,不需要一个容器来攒。 result + leaf_labels(b)→yield from yield_leaves(b)。子树给回来的是一串标签,原样转发,所以用yield from。
为什么原来的 if is_leaf(t): return ... 现在可以不写 else?因为叶子的 branches(t) 是空的,下面那个 for 一次都不执行,效果和 return 一样。这跟 yield_paths 里的处理是同一个道理。
用 t = tree(3, [tree(-1), tree(1, [tree(2, [tree(1)]), tree(3)]), tree(1, [tree(-1)])]) 验证:叶子按先序依次是 -1、1(2 下面那个)、3、-1,所以两个版本都得到 [-1, 1, 3, -1]。
练习 6:判断对错
下面每句话对不对?
iter(iter([1, 2, 3]))会返回一个全新的迭代器。- 一个生成器对象可以放进
for循环。 len(map(abs, [-1, 2]))返回 2。- 生成器函数里必须至少有一个
yield。 list(filter(lambda x: x > 0, iter([1, -2, 3])))返回[1, 3]。
看答案
- 错。 对迭代器调
iter返回它自己,iter(a) is a为True。这是「不能把迭代器倒回开头」的技术原因。 - 对。 生成器对象是迭代器,迭代器是 iterable,所以能进
for。但只能进一次。 - 错。
TypeError: object of type 'map' has no len()。迭代器不知道自己还有几个元素。 - 对——这就是生成器函数的定义:函数体里有
yield(或yield from)的函数。没有yield的就是普通函数,调用它会立刻执行函数体。 - 对。
filter的第二个参数可以是任何 iterable,迭代器当然也行;list把结果抽干得到[1, 3]。但要注意那个iter([1, -2, 3])已经被消费光了,如果之前存过变量,之后就用不了了。