树
一棵树的每个分支还是一棵树——这个自我指涉的定义,让「处理一棵树」的代码几乎总能写成三行。
0. 本讲导读
到目前为止你见过的数据都是「平的」:一个列表装一串数,一个字典装一堆键值对。想表示「这个东西里面还有同样类型的东西,层层套下去」——一个文件夹里有文件夹、一个公司部门下面还有部门、一个算术表达式的操作数还是算术表达式——现有的工具就开始别扭了。
本讲引入树(tree)。树的定义只有一句话,但这句话是递归的:
一棵树由一个带标签(label)的根节点(root node),以及一列分支(branches)组成;而每个分支本身又是一棵树。
请盯着最后半句看几秒钟。它就是本讲全部的技术含量所在:数据结构自己是递归的,所以处理它的函数也应该是递归的。在第 6 讲学递归时,你面对的是数字——n 变成 n - 1,那种「变小」是人为约定的。而树不一样:「更小的同类问题」是写在数据结构定义里的,一棵树的分支,天然就是一棵更小的树。你不需要发明如何把问题变小,你只需要把它读出来。
本讲和前后讲的关系是这样的:
- 接上一讲:Lecture 08 讲了抽象数据类型(Abstract Data Type,ADT)——构造器 + 选择器 + 抽象屏障。本讲的树就是一个完整的 ADT 实例:构造器
tree(label, branches),选择器label(t)和branches(t)。你在上一讲学的「不许越过屏障直接写t[0]」这条纪律,在本讲会被反复用到——而且这里违反屏障的代价特别大,因为树是嵌套的,你一旦开始手写下标,代码马上会变得没人看得懂。 - 接第 6、7 讲:递归和列表推导式(list comprehension)。本讲几乎每个函数都是「对
branches(t)里的每一棵子树递归一次,再把结果合起来」,写出来就是一个列表推导式套一个sum。 - 往后看:Lecture 10 的迭代器与生成器会用
yield from重写本讲的遍历函数;再往后的 Scheme 部分,程序本身就是树(语法树),本讲的思维方式会原样搬过去。
另外,本讲开头还留了一道上一讲的尾巴:flip_dict。它是字典(dict)的练习,跟树无关,但它示范了一个非常典型的判断——「这个位置现在装的是一个值,还是一个列表?」——所以第 1 节先把它做掉。
- 树 = 一个根标签 + 一列分支,每个分支还是一棵树。这个定义是递归的,所以处理树的代码也是递归的。
- 本课程用的树 ADT 把树表示成列表:
[根标签, 分支1, 分支2, ...]。构造器tree、选择器label/branches、判定is_tree/is_leaf——只许通过这五个函数碰树。 - 没有分支的树叫叶子(leaf)。
is_leaf(t)就是not branches(t):空列表为假。注意叶子仍然是一棵完整的树,不是「树里面的一个数」。 - 深度(depth)是节点的性质(该节点到根有几条边),高度(height)是树的性质(最深的叶子的深度)。
- 树递归的通用形状:
[f(b) for b in branches(t)]得到「每个分支的答案」,再用sum/max/tree(...)把它们合成本层的答案。 - 树递归的 base case 常常不用单独写:叶子的
branches(t)是[],列表推导式自然产出空列表,sum([], 0)自然是 0,递归自然停下。 - 把一列列表拼成一个列表用
sum(列表的列表, [])。第二个参数[]不能省,否则sum默认从0开始加,报TypeError: unsupported operand type(s) for +: 'int' and 'list'。 - 要「造一棵新树」(比如
double)就必须走构造器tree(...),不能写列表字面量;要「把树折成一个值」(比如count_leaves)就用sum/max合并。分清这两类,几乎所有树题都能套。
1. 热身:flip_dict——上一讲的一条尾巴
题目:写一个 flip_dict(dct),把字典的键和值对调,返回一个新字典。假设原来的值都能当键用(也就是都不可变)。麻烦在于:原字典里可能有重复的值——两个不同的键映射到同一个值。对调之后这个值成了键,而字典的键不能重复,那对应的多个原键怎么办?
看 doctest 就知道答案:
>>> lengths = {'cat': 3, 'hat': 3, 'bottle': 6, 'a': 1, 'mat': 3, 'an': 2, 'in': 2}
>>> flip_dict(lengths)
{3: ['cat', 'hat', 'mat'], 6: 'bottle', 1: 'a', 2: ['an', 'in']}
规则被 doctest 定死了,一个字都不能猜错:
- 某个值只出现一次 → 新字典里它的值就是那个键本身(
6: 'bottle',不是6: ['bottle'])。 - 某个值出现多次 → 新字典里它的值是一个列表,按原来的插入顺序装着所有对应的键(
3: ['cat', 'hat', 'mat'])。
这个「一个的时候是裸值、多个的时候是列表」的接口其实是很糟糕的设计(调用方每次都得判断类型),但它逼你写出本讲要练的那个判断,所以照做。
思路:边走边升级
难点在于,你在遍历到 'hat' 的时候,并不知道后面还会不会出现第三个长度为 3 的词。所以不能一开始就决定「这个位置该放裸值还是放列表」。办法是边走边升级:默认放裸值,等真的撞上第二个时,再把已经放进去的裸值和新来的键一起打包成列表;从第三个开始就直接往那个列表上 append。
于是每处理一个 (key, val) 都要分三种情况:
val 还没在新字典里出现过 → new_dct[val] = key,放裸值。val 出现过,且当前存的是裸值 → 升级成列表:new_dct[val] = [原来的裸值, key]。val 出现过,且当前存的已经是列表 → new_dct[val].append(key),直接变异这个列表。区分第 2、3 种情况需要问「new_dct[val] 现在是不是一个 list」。课上给了三种写法:
| 写法 | 说明 | 课程推荐度 |
|---|---|---|
type(x) is list | type(x) 返回类型对象本身,用 is 判断是不是同一个类型对象 | 推荐 |
type(x) == list | 同上,但用 ==。类型对象没有自定义 __eq__,效果一样,只是语义上「同一性」比「相等」更准确 | 可用,但不如上一种 |
isinstance(x, list) | 子类也算数(比如 list 的子类)。在 61A 范围内和上面等价 | 可用 |
代码
def flip_dict(dct):
    new_dct = {}
    for key, val in dct.items():
        if val in new_dct:
            if type(new_dct[val]) is list:
                new_dct[val].append(key)
            else:
                new_dct[val] = [new_dct[val], key]
        else:
            new_dct[val] = key
    return new_dct
逐行看:
dct.items()一次拿出(键, 值)这一对,配合for key, val in ...直接解包成两个名字。写成for key in dct: val = dct[key]也对,但多一次查表。val in new_dct——对字典用in,查的是键,不是值。这里val正是新字典的键,所以问的就是「这个值之前出现过吗」。new_dct[val] = [new_dct[val], key]:右边先求值(读出旧的裸值),组成一个两元素列表,再整体赋给左边。右先左后,所以不会读到已经被覆盖的值。new_dct[val].append(key):这一句没有重新绑定字典里的槽位,它是把字典里那个列表对象就地变异了。这正是上一讲讲的可变性——因为new_dct[val]和列表本身是同一个对象,改它就等于改字典里的内容。
为什么输出的顺序是那样
拿 lengths 走一遍。Python 3.7 起字典保持插入顺序,所以遍历顺序就是字面量里的书写顺序:
('cat', 3) → 3 不在 → new_dct = {3: 'cat'}
('hat', 3) → 3 在,且是 str → new_dct = {3: ['cat','hat']}
('bottle', 6) → 6 不在 → new_dct = {3: ['cat','hat'], 6: 'bottle'}
('a', 1)   → 1 不在 → {..., 1: 'a'}
('mat', 3) → 3 在,且已是 list → append → {3: ['cat','hat','mat'], ...}
('an', 2)  → 2 不在 → {..., 2: 'an'}
('in', 2)  → 2 在,且是 str → {..., 2: ['an','in']}
注意最后 3 仍然排在最前面:append 和 new_dct[val] = ... 都只是更新已有的键,不会把它挪到末尾。字典的插入顺序只由「这个键第一次被加进来的时刻」决定。
误区一:无脑一律用列表。写成 new_dct.setdefault(val, []).append(key) 很漂亮,但结果是 {3: ['cat','hat','mat'], 6: ['bottle'], ...},doctest 直接挂:期望 6: 'bottle',实际 6: ['bottle']。题目要的接口就是不统一的,别自作主张。
误区二:把判断写成 if type(new_dct[val]) is str。看起来能过前两个 doctest,但键的类型不一定是字符串——roman_numerals 那个例子里翻过来的值是 'I'、'V' 没错,可换一个 {1: 'a', 2: 'a'} 这样的输入,原键是 int,你的 is str 判断就全错。要判断的是「装的是不是列表」,不是「装的是不是原来那种类型」。
误区三:直接 dct[val] = key 改原字典。题目要的是新字典。改原字典既会破坏调用方的数据,还会让你在遍历过程中改动被遍历的字典,Python 会直接报 RuntimeError: dictionary changed size during iteration。
这道题真正和后面有关的一点是:「这个位置装的是一个元素,还是一个装着元素的容器?」这个判断,在树的世界里会以另一种形式回来——「这个东西是一个标签,还是一棵子树?」区别在于,树 ADT 用 is_leaf 把这个判断封装好了,你不用再写 type(...) is list。
2. 树是什么:同一件事的三种说法
课上给了两个定义,加上一个「相对」视角,一共三种说法。它们描述的是同一个东西,但在不同场合好用。
说法一(结构式):根 + 分支
一棵树(tree)是一种数据结构,由一个带标签(label)的根节点(root node)和一列分支(branches)组成,而这列分支是一列(子)树。
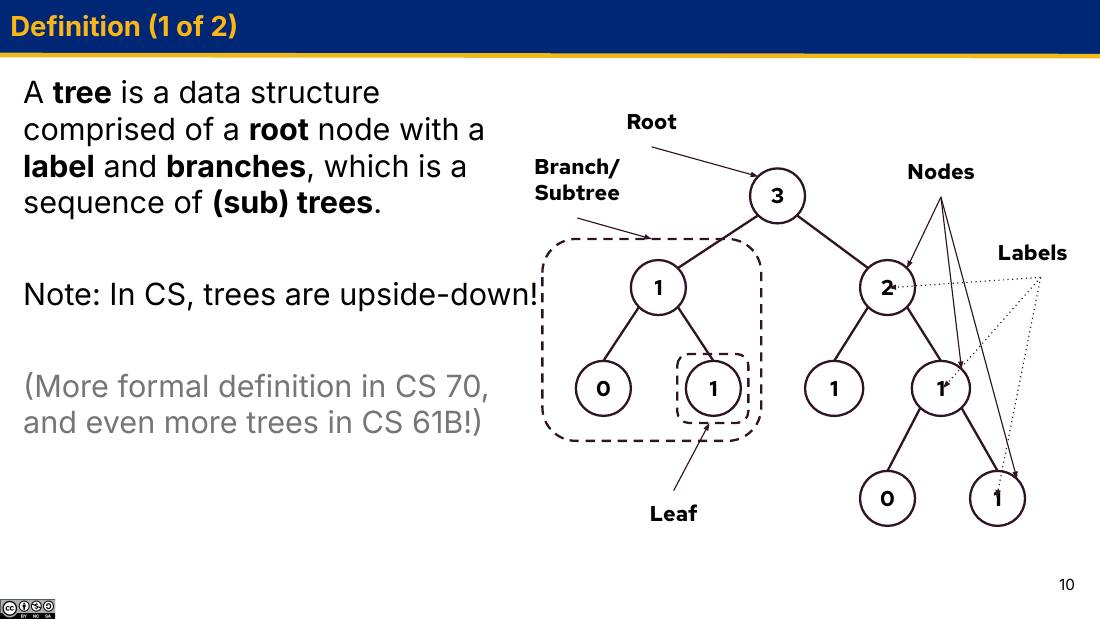
3 是根(root);圆圈是节点(node),圈里写的数字是标签(label);虚线框住的整块(根为 1、下面挂着 0 和 1)是根的一个分支(branch),它自己也是一棵完整的树,所以又叫子树(subtree);被小虚线框住的那个孤零零的 1 是叶子(leaf)——它没有分支,但它仍然是一棵树。另外注意计算机里的树是倒着长的:根在上,叶子在下。这张图有三个地方值得停下来想清楚,它们是后面所有 bug 的源头:
- 「节点」和「标签」不是一回事。节点是那个圆圈(连同它下面挂的所有东西),标签只是圈里写的那个值。图里有两个标签都是
1的节点,但它们是不同的节点。当你写label(t),你拿到的是一个数;当你写branches(t)[0],你拿到的是一棵树,不是一个数。 - 叶子是树,不是标签。这是初学者最常栽的地方。
tree(1)造出来的东西[1]是一棵合法的树,而整数1不是。写tree(3, [1, 2])会直接崩:
>>> tree(3, [1, 2])
AssertionError: branches must be trees
- 分支是「一列」,不是「两个」。图上画的都是每个节点最多两个孩子,容易让人以为树就是二叉的。CS 61A 的树 ADT 允许任意多个分支——0 个、1 个、5 个都行。别去写
left = branches(t)[0]; right = branches(t)[1]这种代码,除非题目明确保证是二叉树(本讲的fib_tree就是这样一个例外)。
说法二(递归式)与说法三(相对式)
为什么要有两个说法?因为它们回答不同的问题。
| 递归视角 | 相对视角 | |
|---|---|---|
| 怎么说 | 树的分支也是树 | 节点有父节点和若干子节点 |
| 回答的问题 | 「这个函数该怎么写」 | 「这两个节点是什么关系」 |
| 典型句子 | 「对每个分支递归调用自己」 | 「3 是 0 的祖先」「这两个节点是兄弟」 |
| 在 61A 的地位 | 写代码全靠它 | 读题、画图、口头描述时用 |
递归视角之所以宝贵,是因为它把「变小」直接写进了数据结构。回想第 6 讲写 factorial(n) 时,你得自己想到「n - 1 是更小的同类问题」;写 sum_digits(n) 时,你得想到 n // 10。这些「变小」的方式是你发明的,想不到就卡住。而树不用发明:branches(t) 里的每一棵都比 t 小,而且和 t 是同一类东西。递归的两个要件(更小、同类)白送给你。
换句话说,树递归的难点从来不是「怎么递归」,而是「拿到各个分支的答案之后,怎么合成本层的答案」。本讲后半段的四个练习,练的全是这最后一步。
为什么值得学:树在真实世界里到处都是
课上举了四类:
- 文件系统:一个目录里有文件和目录,目录里还有文件和目录。
du -sh算目录总大小,本质就是本讲的count_leaves换个合并方式。 - 层级组织:政治的、社会的、公司的架构图。
- 家谱。
- 语法树(syntax tree):语言学里分析句子结构(LING 100),计算机里分析程序结构(CS 164)。这一条对 61A 尤其重要——课程后半段学 Scheme 时你会发现,Scheme 程序本身就是一棵树,解释器做的事就是在这棵树上递归。
共同点是:层级(谁在谁下面)加上自相似(每一层长得都一样)。只要一个东西满足这两条,树就是它的自然表示。
3. 术语:深度是节点的事,高度是树的事
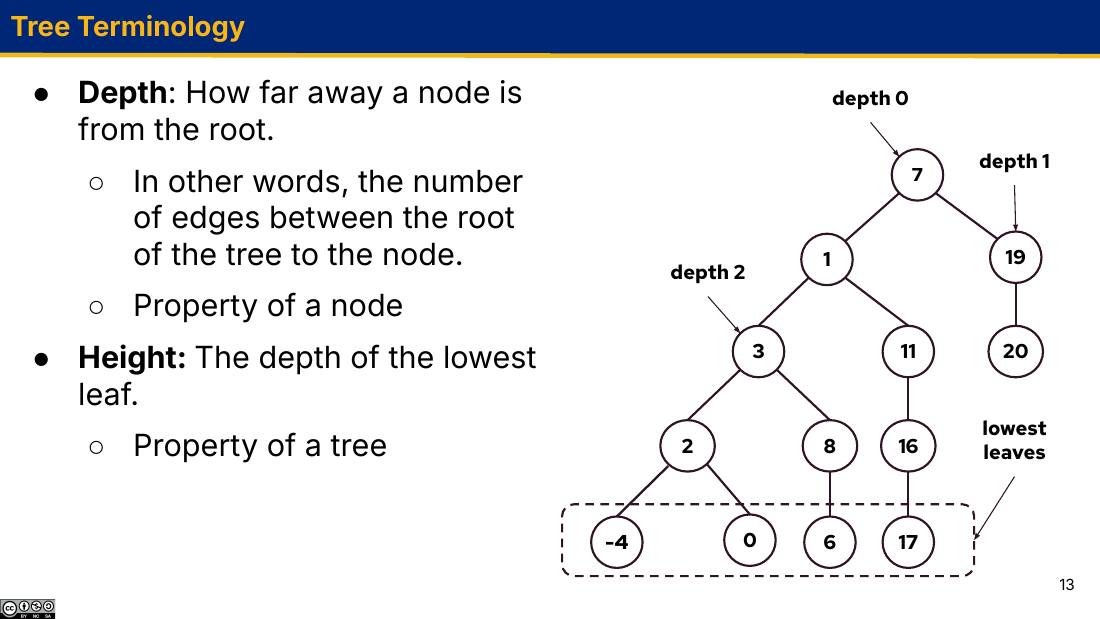
7 的深度是 0;它的两个孩子 1 和 19 深度是 1;3、11、20 深度是 2。虚线框住的 -4、0、6、17 是最深的叶子,深度都是 4,所以整棵树的高度是 4。注意 20 也是叶子(它没有孩子),但它只有深度 2,不是最深的。深度(depth):一个节点离根有多远,也就是从根到该节点之间的边(edge)数。根自己的深度是 0。深度是节点的性质。
高度(height):最深的叶子的深度。高度是整棵树的性质。
「深度是节点的性质、高度是树的性质」这句话不是文字游戏,它决定了函数签名长什么样:
- 问深度,你必须指着某个具体节点问,所以「求深度」这类函数通常写成「一边往下走一边把当前深度作为参数传下去」(第 11 节的
count_paths就是这个套路的近亲)。 - 问高度,你只要给一棵树就够了,所以
height(t)只需一个参数,而且是标准的树递归形状:
def height(t):
    """返回树 t 的高度(最深叶子的深度)。"""
    if is_leaf(t):
        return 0
    return 1 + max([height(b) for b in branches(t)])
为什么是 1 + max(...)?因为把根挂上去之后,每个分支里所有节点的深度都整体加一。所以「以 t 为根时的最大深度」= 「各分支自己的最大深度」里最大的那个,再加上根到分支根的那一条边。
用图里 19 那一支验证一下。t = tree(19, [tree(20)]):
height(tree(19, [tree(20)]))
  is_leaf? branches = [[20]],非空 → 不是叶子
  → 1 + max([ height(tree(20)) ])
        height(tree(20)):
            branches = [] → is_leaf 为真 → 返回 0
  → 1 + max([0]) = 1 + 0 = 1
对上图:19 在深度 1,20 在深度 2,以 19 为根的这棵子树高度确实是 1。
这里的 base case 不能省。本讲后面会反复说「树递归的 base case 常常不用写」,但 height 是例外:如果去掉 if is_leaf(t),叶子会走到 1 + max([]),而 max 对空列表是要报错的:
>>> max([])
ValueError: max() arg is an empty sequence
区别在于 sum 有一个「空的时候返回什么」的默认值(0,或你给的第二个参数),而 max 没有天然的默认值。所以凡是用 max / min 合并的树递归,base case 必须显式写。(也可以写 max([...], default=0),但 61A 里习惯直接写 base case,更清楚。)
另一个常见混淆:把高度定义成「节点层数」。有些教材把只有一个节点的树的高度记作 1。CS 61A 用的是边数口径:单节点树的高度是 0。考试按课程口径来。
还有几个描述位置关系的词,课上没展开但读题时会碰到,一并列在这里:
| 术语 | 含义 | 对照上图 |
|---|---|---|
| root(根) | 整棵树最顶上那个节点 | 7 |
| parent(父节点) | 正上方直接相连的那个节点 | 3 的父节点是 1 |
| child(子节点) | 正下方直接相连的节点,可以有多个 | 1 的孩子是 3 和 11 |
| leaf(叶子) | 没有子节点的节点 | -4、0、6、17、20 |
| branch / subtree(分支 / 子树) | 以某个子节点为根的整棵树 | 以 19 为根、含 20 的那一整块 |
| depth(深度) | 该节点到根的边数,节点的性质 | 11 的深度是 2 |
| height(高度) | 最深叶子的深度,树的性质 | 整棵树高度 4 |
4. 树 ADT:构造器与选择器
上一讲的结论是:要表示一种数据,就定义一个构造器负责造,若干选择器负责取,其余代码只准通过它们打交道。树完全照这个套路来。课程给的实现只有八行:
def tree(root_label, branches=[]):
    for branch in branches:
        assert is_tree(branch), 'branches must be trees'
    return [root_label] + list(branches)

def label(tree):
    return tree[0]

def branches(tree):
    return tree[1:]
底层表示:一个「头 + 尾」的列表
一棵树被表示成一个列表:第 0 个元素是根标签,从第 1 个元素开始,每个元素都是一棵子树(也是列表)。
[3, [1], [2, [1], [1]]]
 ↑   ↑    ↑
 │   │    └── 第 2 个分支:根标签 2,两个分支 [1] 和 [1]
 │   └─────── 第 1 个分支:根标签 1,没有分支 → 是叶子
 └─────────── 根标签

画成图:
          3
         / \
        1   2
           / \
          1   1
课上给的交互记录,逐条对照着看:
>>> t = tree(3, [tree(1), tree(2, [tree(1), tree(1)])])
>>> t
[3, [1], [2, [1], [1]]]
>>> label(t)
3
>>> branches(t)
[[1], [2, [1], [1]]]
>>> label(branches(t)[1])
2
>>> is_leaf(t)
False
>>> is_leaf(branches(t)[0])
True
三个关键点:
branches(t)返回的是一列树,不是一列标签。所以branches(t)的元素不能直接拿去做算术,要先label一下——label(branches(t)[1])才是2。branches(t)[1]是第二个分支(下标从 0 开始)。在真实代码里请尽量避免手写下标,用for b in branches(t)。is_leaf(branches(t)[0])是True,因为第一个分支[1]只有标签、没有子分支。
逐行读构造器
求值 tree(3, [tree(1), tree(2, [tree(1), tree(1)])]):
tree 还没开始跑,Python 就得先算出第二个实参 [tree(1), tree(2, [...])] 这个列表字面量的值。tree(1):形参 root_label = 1,branches 用默认值 [],for 循环一次都不执行,返回 [1] + list([]) 即 [1]。tree(2, [tree(1), tree(1)]):同样先把内层两个 tree(1) 算成 [1]、[1],然后 tree 检查这两个都 is_tree,返回 [2] + [[1], [1]] 即 [2, [1], [1]]。[[1], [2, [1], [1]]],最外层 tree 才真正开始执行:检查两个分支都是树,返回 [3] + [[1], [2, [1], [1]]]。[3, [1], [2, [1], [1]]]。树是从叶子往根造出来的——最里面的 tree(1) 最先执行完,最外面的 tree(3, ...) 最后执行完。这和后面 fib_tree 的执行顺序完全一致。
构造器里两个细节值得说:
(一)assert is_tree(branch) 是干什么的。它在造树的当场检查每个分支确实是树。这行不是必须的(去掉了程序照跑),但它把「传错东西」这个错误提前到出错的那一行暴露出来。没有它,你会在几十行之后某个 label(b) 处收到一句莫名其妙的 TypeError: 'int' object is not subscriptable,然后完全不知道那个 int 是从哪来的。有了它,报错是:
>>> tree(5, [1])
AssertionError: branches must be trees
(二)为什么是 list(branches) 而不是直接 branches。两个理由:
- 兼容性:
[root_label] + branches要求branches必须是 list,传元组就报TypeError: can only concatenate list (not "tuple") to list。加了list(...)之后,传元组、传生成器都能用:tree(3, (tree(1), tree(2)))照样返回[3, [1], [2]]。 - 切断别名:
list(branches)做的是浅拷贝(shallow copy),造出一个新的外层列表。这样调用方后来往自己那个列表里append东西,不会偷偷改到已经造好的树。
浅拷贝只切断了外层的别名,子树对象本身还是共享的。这是上一讲可变性内容的直接延续,实测:
>>> b = tree(1)
>>> t = tree(3, [b])
>>> t
[3, [1]]
>>> b.append([2])          # 直接变异 b 这个列表
>>> t
[3, [1, [2]]]              # t 跟着变了!
>>> branches(t)[0] is b
True
在 61A 的作业里几乎不会有人故意这么写,但它解释了一件重要的事:树 ADT 是「不可变风格」的——所有函数都是造新树,没人原地改树。你也应该照这个风格写。第 10 节的 double 就是范例:它不改 t,它返回一棵全新的树。
误区一:branches=[] 是不是那个著名的「可变默认参数」坑?形式上是(默认值只在 def 执行时求值一次,所有调用共享同一个空列表),但这里安全,因为 tree 从头到尾没有变异 branches——它只读取(for 遍历)和拷贝(list(...))。假如有人把最后一行改成 branches.insert(0, root_label); return branches,那个共享的默认列表就会被污染,第二次调用 tree(5) 会返回 [5, 3] 之类的鬼东西。可变默认参数本身不危险,危险的是变异它。
误区二:忘了第二个参数要装的是树。tree(3, [1, 2])、tree(3, tree(1)) 都会报 AssertionError: branches must be trees。第二个尤其隐蔽:tree(1) 的值是 [1],是个列表,所以 for branch in branches 能跑,但遍历出来的元素是整数 1,is_tree(1) 为假。正确写法是 tree(3, [tree(1)])——第二个参数永远是一个「装着树的列表」。
误区三:label(t) 传了个非树进去。label(3) 报 TypeError: 'int' object is not subscriptable(整数不能取下标);label([]) 报 IndexError: list index out of range。看到这两个报错,基本可以断定「你把一个标签当成子树,或者把空列表当成树了」。
抽象屏障:为什么不许写 t[0]
label(t) 的函数体就是 t[0],那直接写 t[0] 不是更短吗?短是短,但:
走屏障:label(t) / branches(t) | 越过屏障:t[0] / t[1:] | |
|---|---|---|
| 可读性 | sum([f(b) for b in branches(t)]) 一眼看出在遍历子树 | sum([f(b) for b in t[1:]]) 得停下来想「t[1:] 是啥」 |
| 换实现 | 把树改成字典 {'label': ..., 'branches': [...]},只需改这四个函数 | 全项目搜 [0] 和 [1:],改到吐,还改不干净 |
| 出错时 | 越界会在选择器里炸,位置明确 | 下标写错(比如写成 t[1] 想拿第一个分支)静默返回一棵树,后面才炸 |
| 考试 | 得分 | 扣分——61A 明确要求树题只用 ADT 函数 |
顺带说一个真会犯的错:想拿「第一个分支」,写成 t[1] 是对的(因为 t[0] 是标签),但如果你脑子里想的是「branches(t) 的第 0 个」,正确写法是 branches(t)[0]。两者恰好等价,但混着用迟早写错一个。统一走选择器就没有这个问题。
5. is_tree 与 is_leaf:用递归验证递归结构
def is_tree(tree):
    if type(tree) != list or len(tree) < 1:
        return False
    for branch in branches(tree):
        if not is_tree(branch):
            return False
    return True

def is_leaf(tree):
    return not branches(tree)
is_tree:定义怎么写,验证就怎么写
is_tree 是本讲第一个递归函数,而且它的结构逐字对应树的递归定义:「一棵树是一个列表,第 0 项是标签,其余各项都是树」。
验证 is_tree([3, [1], [2, [1]]]):
is_tree([3, [1], [2, [1]]])
    type 是 list ✓,len = 3 ≥ 1 ✓
    branches = [[1], [2, [1]]]
    ├─ is_tree([1])
    │      type list ✓,len 1 ≥ 1 ✓
    │      branches = []  → for 循环体一次都不执行
    │      → return True                      ← base case(隐式的!)
    ├─ is_tree([2, [1]])
    │      type list ✓,len 2 ≥ 1 ✓
    │      branches = [[1]]
    │      └─ is_tree([1]) → True
    │      → return True
    → 两个分支都是树 → return True
再看一个失败的:is_tree([3, 1])
is_tree([3, 1])
    type list ✓,len 2 ≥ 1 ✓
    branches = [1]
    └─ is_tree(1)
           type(1) != list → return False     ← 在这里判死
    not False 为真 → return False
两个细节:
- base case 藏在
for循环里。is_tree没有写if is_leaf(tree): return True,因为叶子的branches是[],for循环体零次执行,直接落到最后一行return True。「对空列表做循环 = 什么都不做」正是树递归能省掉 base case 的原因,这个模式在第 7 节还会再遇到三次。 len(tree) < 1这个检查不能省。空列表[]不是合法的树——树必须至少有一个标签。如果去掉这个检查,is_tree([])会返回True,然后label([])就会炸出IndexError: list index out of range。实测:
>>> is_tree([])
False
>>> is_tree(3)
False
>>> is_tree([3, 1])
False
>>> is_tree([3, [1]])
True
is_tree 是唯一一个允许越过抽象屏障的函数(准确说,它和 tree、label、branches、is_leaf 一起构成屏障本身)。它必须知道「树是用列表实现的」,否则没法检查 type(tree) != list。这不矛盾:屏障的实现方当然知道底层长什么样,屏障约束的是使用方。
另外注意它在函数体里调用了 branches(tree) 而不是 tree[1:]——即使在屏障内部,能走选择器还是走选择器。
is_leaf:为什么一个 not 就够了
is_leaf(tree) 的定义是「没有分支」,代码 return not branches(tree) 依赖 Python 的一条规则:空列表在布尔语境下是假值(falsy)。
>>> bool([])
False
>>> bool([[1]])
True
>>> is_leaf(tree(3))              # branches 是 []
True
>>> is_leaf(tree(3, [tree(1)]))   # branches 是 [[1]]
False
写成 return len(branches(tree)) == 0 或 return branches(tree) == [] 完全等价,只是啰嗦。但不要写成下面这些:
误区一:return branches(tree) is []。永远返回 False。is 判断的是「同一个对象」,而 branches 用切片 tree[1:] 每次都造一个新列表,它和字面量 [] 永远不是同一个对象。这是上一讲 is vs == 的经典陷阱在树上的再现。
误区二:if is_leaf(t): return t——把叶子当标签用。叶子是一棵树 [3],不是数 3。想要标签得写 label(t)。这个错误在第 9 节的 leaves 里会有一个真实的报错版本。
误区三:以为「标签是 0 / 空字符串的节点」是叶子。is_leaf 看的是 branches,跟标签的值毫无关系。tree(0, [tree(1)]) 不是叶子;tree(0) 是。
最后把这五个函数放在一起,这是本讲要背下来的全部接口:
| 函数 | 角色 | 参数 | 返回 |
|---|---|---|---|
tree(label, branches=[]) | 构造器 | 一个标签 + 一个装着树的列表 | 一棵新树 |
label(t) | 选择器 | 一棵树 | 根标签(一个值) |
branches(t) | 选择器 | 一棵树 | 一个装着树的列表(可能为空) |
is_tree(x) | 判定 | 任意对象 | True / False |
is_leaf(t) | 判定 | 一棵树 | 没有分支时为 True |
6. 手写一棵树:怎么把图翻译成代码
考试和作业里最常见的一类小题是:给你一张树的图,写出构造它的表达式;或者给你一个表达式,画出树。这一节把这个来回走通。
从图到代码:从根开始,一层一层往里塞
目标是这棵树:
          5
        / | \
       1  3  2
       |  |
       0  4
          |
          6
5,它有三个孩子,所以骨架是 tree(5, [___, ___, ___])。1,1 下面挂一个 0。0 没有孩子,所以是 tree(0);于是这一支是 tree(1, [tree(0)])。3,下面挂 4,4 下面挂 6。从最里面往外写:tree(6) → tree(4, [tree(6)]) → tree(3, [tree(4, [tree(6)])])。2 没有孩子 → tree(2)。tree(5, [tree(1, [tree(0)]), tree(3, [tree(4, [tree(6)])]), tree(2)])。写成一行读起来非常难受。课上给的建议是按分支换行对齐:
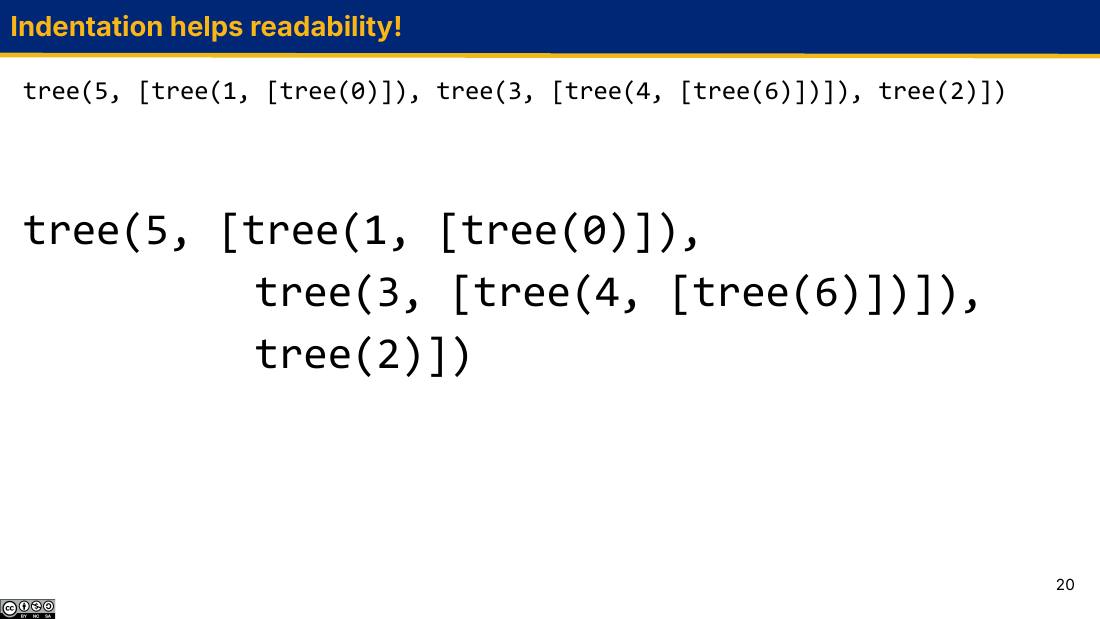
5 有三个孩子」这件事变成了视觉上的三行对齐,数括号的痛苦少了一大半。Python 允许在没闭合的括号内部任意换行,所以这样写不需要续行符。tree(5, [tree(1, [tree(0)]),
tree(3, [tree(4, [tree(6)])]),
tree(2)])
从代码到图:数括号不如数「参数位置」
反过来读表达式时,不要一个一个数括号。抓住一条规则:tree( 后面第一个逗号之前的东西是标签,方括号里逗号分隔的每一项是一个孩子。
验证一下上面那棵树的底层表示:
>>> t = tree(5, [tree(1, [tree(0)]), tree(3, [tree(4, [tree(6)])]), tree(2)])
>>> t
[5, [1, [0]], [3, [4, [6]]], [2]]
把这个列表和图对照:5 后面跟着三个东西,正好三个孩子;[1, [0]] 是「标签 1,一个孩子 0」;[2] 只有标签,是叶子。
有一个快速自检:一棵树的底层列表里,方括号的对数 = 节点数。上面 [5, [1, [0]], [3, [4, [6]]], [2]] 数一数:外层 1 对 + [1,[0]] 1 对 + [0] 1 对 + [3,...] 1 对 + [4,[6]] 1 对 + [6] 1 对 + [2] 1 对 = 7 对,图上正好 7 个节点(5、1、0、3、4、6、2)。数不对说明你抄漏了括号。
误区一:叶子写成裸标签。把 tree(3, [tree(1), tree(2)]) 写成 tree(3, [1, 2])——这是本讲头号错误。报错是 AssertionError: branches must be trees。记住口诀:方括号里只能放 tree(...)。
误区二:只有一个孩子时忘了方括号。写 tree(1, tree(0))。这个报错更迷惑:tree(0) 的值是 [0],是个列表,for branch in [0] 能跑,遍历出整数 0,is_tree(0) 为假 → 同样是 AssertionError: branches must be trees。正确写法 tree(1, [tree(0)])。
误区三:把「深度」和「分支个数」搞混。tree(5, [tree(1), tree(2), tree(3)]) 是一个根带三个并列的孩子(高度 1);tree(5, [tree(1, [tree(2, [tree(3)])])]) 是一条链(高度 3)。画图时前者横着排,后者竖着排。
一道随堂题
课上问过:已经定义好树 ADT,求值 tree(5, [1]) 会显示什么?
答案不是列表,是报错:AssertionError: branches must be trees。理由前面说过——1 不是树。如果构造器里没有那行 assert,它会安静地返回 [5, 1],而这个东西 is_tree 判为 False,是个「伪树」,交给任何树函数都会在某个更深的地方崩掉。断言的价值就在这里:让错误在制造现场暴露,而不是在案发现场。
7. 树递归的通用形状
接下来四节全是练习,但它们其实是同一个模板的四次变奏。先把模板立起来,后面每道题只需要说清楚「它在哪个位置填了什么」。
def f(t):
    if is_leaf(t):              # ← 有时可省
        return <叶子的答案>
    else:
        sub = [f(b) for b in branches(t)]   # 每个分支的答案
        return <把 sub 和 label(t) 合成本层答案>
三个位置,每个位置的填法决定了这道题的全部:
| 函数 | 递归得到什么(sub 里装的) | 怎么合并 | 要不要显式 base case |
|---|---|---|---|
count_leaves | 每个分支的叶子数(一堆 int) | sum(sub) | 要(叶子返回 1) |
leaves | 每个分支的叶子标签列表(一堆 list) | sum(sub, []) | 要(叶子返回 [label(t)]) |
double | 每个分支加倍后的新树(一堆树) | tree(2 * label(t), sub) | 不要 |
height | 每个分支的高度(一堆 int) | 1 + max(sub) | 要(max([]) 会炸) |
count_paths | 每个分支里符合条件的路径数 | found + sum(sub),且往下传的参数会变 | 不要 |
为什么 base case 有时可以省
这是树递归和数字递归最不一样的地方,值得单独讲。看 double(第 10 节的答案):
def double(t):
    new_branches = []
    for b in branches(t):
        new_branches.append(double(b))
    return tree(2 * label(t), new_branches)
它没有 base case,但不会无限递归。为什么?
把 double(tree(3))(一棵只有根的树)展开:
double([3])
    new_branches = []
    branches([3]) 是 []
    for b in []:        ← 循环体一次都不执行,没有任何递归调用发生
    return tree(2 * 3, [])
         = tree(6, [])
         = [6]
关键是第 4 行:叶子的 branches(t) 是空列表,遍历空列表 = 什么都不做。递归调用不是被某个 if 拦住的,而是压根没有机会发生。
换成列表推导式写法看得更清楚:[double(b) for b in branches(t)],当 branches(t) 是 [] 时,这个表达式的值就是 [],里面一次 double 都没调用。
树递归的隐式 base case = 空的分支列表。只要你的合并操作对空列表有意义(sum([]) 是 0、sum([], []) 是 []、tree(x, []) 是一片叶子),你就不需要写 if is_leaf(t)。
反过来,必须写 base case 的两种情况:
(1) 合并操作对空列表没有意义——max([])、min([]) 直接 ValueError;
(2) 叶子的答案不等于「合并零个东西的结果」——count_leaves 里叶子要返回 1,而 sum([]) 是 0,两者不同,所以必须显式区分。
两种合并:sum 的两副面孔
本讲有两处用到 sum,它们做的事完全不同,别搞混:
| 写法 | sub 里装的是 | 结果 | 省掉第二个参数会怎样 |
|---|---|---|---|
sum(sub) | 数字,如 [1, 2, 1] | 数字 4 | 没事,默认从 0 开始加 |
sum(sub, []) | 列表,如 [[1], [2, 3], [4]] | 列表 [1, 2, 3, 4] | 报错,见下 |
sum(seq, start) 做的事是:从 start 开始,依次 + 上 seq 的每个元素。start 不写时默认是整数 0。所以拼列表时如果忘了写 []:
>>> sum([[1], [2, 3], [4]], [])
[1, 2, 3, 4]
>>> sum([[1], [2, 3], [4]])
TypeError: unsupported operand type(s) for +: 'int' and 'list'
报错说的是「int 加 list 不行」——那个 int 就是默认起点 0。看到这条报错,条件反射地去找漏写的 , []。
sum(列表的列表, []) 是把「一堆小袋子」倒进「一个大袋子」——这个操作有个通用名字叫扁平化(flatten)。它在树上特别常用,因为「每个分支给我一个列表,我要把它们接起来」正是树遍历的标准动作。[[0], [6], [2]] → [0, 6, 2]。
注意它只扁平一层:sum([[[1]], [[2]]], []) 得到的是 [[1], [2]],不是 [1, 2]。在树递归里这正好够用,因为每层只需要合并一层。
8. fib_tree:用递归造一棵树
前面的函数都是「拿到一棵树,算点什么」。这一节反过来:递归地造出一棵树。这是树 ADT 真正有意思的用法。
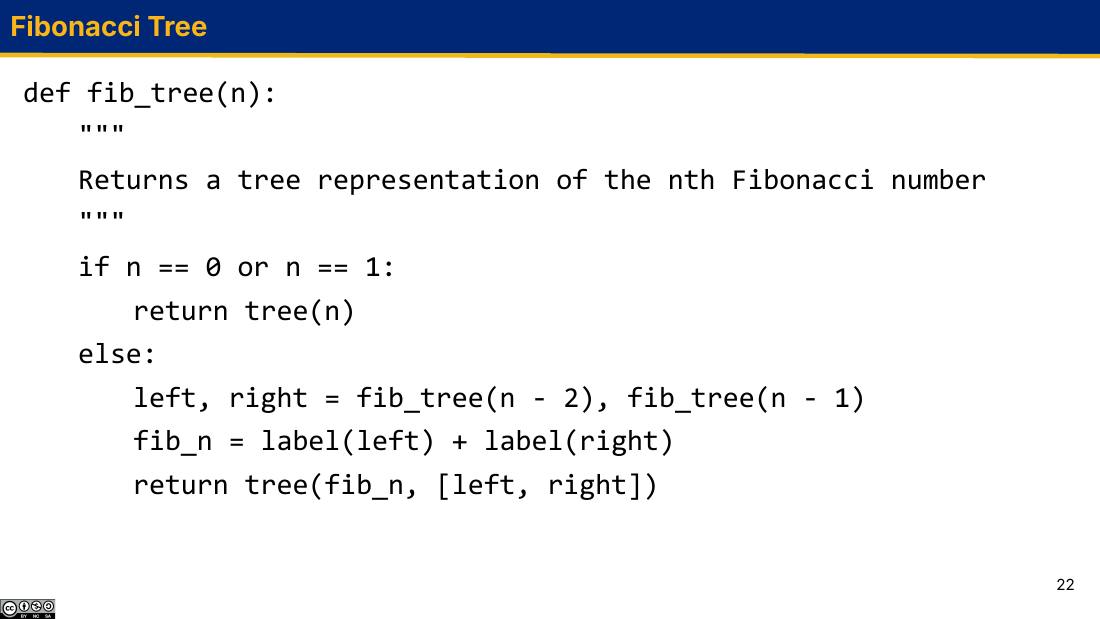
fib_tree(n) 返回一棵树,它的根标签是第 n 个斐波那契数,而它的两个分支分别是 fib_tree(n-2) 和 fib_tree(n-1)。注意根标签不是硬算出来的,而是由两个子树的标签相加得到——递归结构直接编码了递推关系。def fib_tree(n):
"""
Returns a tree representation of the nth Fibonacci number
"""
if n == 0 or n == 1:
return tree(n)
else:
left, right = fib_tree(n - 2), fib_tree(n - 1)
fib_n = label(left) + label(right)
return tree(fib_n, [left, right])
逐行读
if n == 0 or n == 1: return tree(n)——base case。斐波那契数列fib(0) = 0、fib(1) = 1,两者都是「直接知道答案」,造一片叶子返回。注意返回的是tree(n)(一棵树),不是n(一个数)。left, right = fib_tree(n - 2), fib_tree(n - 1)——多重赋值。右边是一个元组表达式,整个右边先完全求值完,再一次性绑定左边两个名字。求值顺序是从左到右:先算完fib_tree(n - 2)(造出一整棵树),再算fib_tree(n - 1)。fib_n = label(left) + label(right)——这是全函数的精髓。本层的根标签不是靠公式算的,而是从两个已经造好的子树身上「读」出来的。label(left)就是fib(n-2),label(right)就是fib(n-1),相加正是fib(n)。递归假设在这里被兑现:我不需要知道子树是怎么造的,我只需要相信它的根标签是对的。return tree(fib_n, [left, right])——用构造器把标签和两棵子树装成新树。注意[left, right]这个方括号:branches参数必须是装着树的列表,而left、right本身已经是树了,所以直接装进去就行,不要再套一层tree(...)。
真的展开一遍
算 fib_tree(3)。为了看清顺序,把每一步都写出来:
fib_tree(3)
  n=3,不是 base case
  ├─ left  = fib_tree(1)
  │            n=1 → return tree(1) = [1]                  ← 触底
  ├─ right = fib_tree(2)
  │            n=2,不是 base case
  │            ├─ left  = fib_tree(0) → tree(0) = [0]      ← 触底
  │            ├─ right = fib_tree(1) → tree(1) = [1]      ← 触底
  │            ├─ fib_n = label([0]) + label([1]) = 0 + 1 = 1
  │            └─ return tree(1, [[0], [1]]) = [1, [0], [1]]
  ├─ fib_n = label([1]) + label([1, [0], [1]]) = 1 + 1 = 2
  └─ return tree(2, [[1], [1, [0], [1]]]) = [2, [1], [1, [0], [1]]]
实测确认:
>>> fib_tree(3)
[2, [1], [1, [0], [1]]]
>>> fib_tree(4)
[3, [1, [0], [1]], [2, [1], [1, [0], [1]]]]
>>> fib_tree(5)
[5, [2, [1], [1, [0], [1]]], [3, [1, [0], [1]], [2, [1], [1, [0], [1]]]]]
把 fib_tree(5) 画成图(左分支是 n-2,右分支是 n-1):
                       5
                 /            \
                2              3
              /   \          /    \
             1     1        1      2
                  / \      / \    /  \
                 0   1    0   1  1    1
                                     / \
                                    0   1
数一数叶子:1、0、1、0、1、1、0、1——8 片。而 8 正好是 fib(6)。这不是巧合:
fib_tree(n) 这棵树,画的其实就是朴素递归版 fib(n) 的完整调用结构——每个节点是一次函数调用,每片叶子是一次触底。所以「fib_tree(n) 有多少片叶子」= 「朴素递归算 fib(n) 要触底多少次」。实测:
>>> [count_leaves(fib_tree(n)) for n in range(9)]
[1, 1, 2, 3, 5, 8, 13, 21, 34]
叶子数本身又是一串斐波那契数。这正是第 6 讲说「朴素递归 fib 的时间复杂度是指数级」的可视化证据:树的节点数随 n 指数增长,而其中大量子树是完全重复的——上图里 [1, [0], [1]] 这棵子树出现了三次,每一次都是从头重算的。
误区一:base case 写成 return n。返回了一个整数而不是树。后果:上一层的 label(left) 会对整数取下标,报 TypeError: 'int' object is not subscriptable。递归函数的返回类型必须自始至终一致——说好返回树就每条路径都返回树。
误区二:最后写成 tree(fib_n, [tree(left), tree(right)])。多套了一层构造器。tree(left) 的意思是「造一棵根标签为 left 的叶子」,而 left 是个列表,于是你得到 [[1]] 这种「标签是一棵树」的怪物。它甚至不会立刻报错(tree 不检查标签的类型),要等到后面某个地方对标签做算术才炸。
误区三:左右搞反,写成 fib_tree(n-1), fib_tree(n-2)。标签算出来的值不变(加法可交换),但树的形状左右镜像了。如果题目或 doctest 要求特定形状(比如比较 fib_tree(3) == [2, [1], [1, [0], [1]]]),就会失败。课程约定是左 n-2、右 n-1,所以树看起来是往右边倒的。
误区四:漏掉 n == 0。只写 if n == 1,那么 fib_tree(0) 会走 else 分支,去算 fib_tree(-2) 和 fib_tree(-1),一路往负数递归下去,最后 RecursionError: maximum recursion depth exceeded in comparison。
课上还提到可以把这段代码贴到 code.cs61a.org,用 autodraw() 把 fib_tree(5) 直接画出来。自学时强烈建议做一次——把上面那张手画的图和工具画的图对照,能一次性确认你对「哪边是左分支」的理解是对的。
9. count_leaves 与 leaves:把一棵树折成一个答案
这两个函数是一对:一个数叶子有几片,一个把叶子的标签收集成列表。它们的骨架一模一样,只有「合并方式」不同,正好用来体会第 7 节那张表。
count_leaves
def count_leaves(t):
    """Returns the number of leaves in the tree t"""
    if is_leaf(t):
        return 1
    else:
        branch_counts = [count_leaves(b) for b in branches(t)]
        return sum(branch_counts)
读法:「一棵树的叶子数 = 它各个分支的叶子数之和;除非它本身就是叶子,那就是 1。」这句话几乎是代码的逐字翻译。
用 t = tree(3, [tree(1), tree(2, [tree(1), tree(1)])]),图是:
          3
         / \
        1   2
           / \
          1   1
展开:
count_leaves([3, [1], [2, [1], [1]]])
    is_leaf? branches = [[1], [2,[1],[1]]] 非空 → 否
    branch_counts = [ count_leaves([1]),  count_leaves([2,[1],[1]]) ]
                      │                    │
                      │                    ├─ is_leaf? 否
                      │                    ├─ branch_counts = [count_leaves([1]), count_leaves([1])]
                      │                    │                   = [1, 1]
                      │                    └─ return sum([1,1]) = 2
                      └─ is_leaf? branches = [] → 是 → return 1
    branch_counts = [1, 2]
    return sum([1, 2]) = 3
图上确实 3 片叶子(左边的 1,以及 2 下面的两个 1)。
这里的 base case 必须写。原因在第 7 节说过:叶子应该返回 1,但如果省掉 base case,叶子会走到 sum([]),得到 0——整个函数会对任何树都返回 0。这是个典型的不报错但全错的 bug,比崩溃更难查。
leaves:收集标签
def leaves(t):
    """
    Return a list of all the leaf labels of the tree `t`
    >>> leaves(tree(2))
    [2]
    >>> leaves(tree(3, [tree(1), tree(2)]))
    [1, 2]
    >>> leaves(tree(5, [tree(1, [tree(0)]), tree(3, [tree(4, [tree(6)])]), tree(2)]))
    [0, 6, 2]
    """
    if is_leaf(t):
        return [label(t)]
    else:
        return sum([leaves(b) for b in branches(t)], [])
怎么想到的
第一个 doctest 就把两件事定死了:leaves(tree(2)) 返回 [2] 而不是 2。所以:
[label(t)]——外面这层方括号不是装饰,是把「一个标签」包装成「一个只有一项的列表」,这样它才能和别的分支的结果拼在一起。[leaves(b) for b in branches(t)] 的值形如 [[0], [6], [2]]。这不是我们要的答案,我们要的是 [0, 6, 2]。sum(列表的列表, [])。第二个参数 [] 是起点,不能省。验证第三个 doctest,t = tree(5, [tree(1, [tree(0)]), tree(3, [tree(4, [tree(6)])]), tree(2)]),底层是 [5, [1, [0]], [3, [4, [6]]], [2]]:
leaves([5, [1,[0]], [3,[4,[6]]], [2]])
  不是叶子,三个分支
  ├─ leaves([1, [0]])
  │     不是叶子(branches = [[0]])
  │     └─ leaves([0]) → 是叶子 → return [0]
  │     sum([ [0] ], []) = [0]
  ├─ leaves([3, [4, [6]]])
  │     不是叶子
  │     └─ leaves([4, [6]])
  │           不是叶子
  │           └─ leaves([6]) → 是叶子 → return [6]
  │           sum([ [6] ], []) = [6]
  │     sum([ [6] ], []) = [6]
  └─ leaves([2]) → 是叶子 → return [2]

  内层结果列表 = [ [0], [6], [2] ]
  sum([ [0], [6], [2] ], []) = [] + [0] + [6] + [2] = [0, 6, 2]  ✓
注意结果的顺序:[0, 6, 2] 而不是 [0, 2, 6]。顺序完全由 branches(t) 的顺序决定——列表推导式从左到右遍历分支,sum 从左到右拼接。这叫深度优先、从左到右的遍历顺序,是本课程所有树函数的默认行为。
误区一:base case 写成 return label(t),忘了方括号。这是最高频的错。真实报错:
>>> leaves(tree(3, [tree(1), tree(2)]))
TypeError: can only concatenate list (not "int") to list
因为 sum([1, 2], []) 想算 [] + 1,而列表只能和列表相加。看到这条报错就去检查「我是不是有一条 return 交出了裸值」。
误区二:sum 忘了第二个参数。写成 sum([leaves(b) for b in branches(t)]):
>>> leaves(tree(3, [tree(1), tree(2)]))
TypeError: unsupported operand type(s) for +: 'int' and 'list'
这次报的是 int + list,那个 int 是 sum 的默认起点 0。两条报错的方向正好相反,可以用来区分是哪个错:list + int 是 base case 忘了包列表,int + list 是 sum 忘了 []。
误区三:用 += 累加却忘了初始化。有人喜欢写循环版:
def leaves(t):
    if is_leaf(t):
        return [label(t)]
    result = []
    for b in branches(t):
        result += leaves(b)     # 或 result.extend(leaves(b))
    return result
这个版本是对的,和 sum(..., []) 等价。但如果把 result += leaves(b) 写成 result.append(leaves(b)),append 会把整个子列表当成一个元素塞进去,而且每往深一层就多套一层括号,结果是一堆嵌套垃圾:
>>> leaves(tree(5, [tree(1, [tree(0)]), tree(3, [tree(4, [tree(6)])]), tree(2)]))
[[[0]], [[[6]]], [2]]
要逐个塞就得用 extend(或 +=)。这个 append / extend 之分是上一讲可变列表内容的直接延续。
误区四:把「叶子标签」和「所有标签」搞混。leaves 只收集叶子的标签。想收集所有节点的标签,代码要改成没有 base case 的形状:return [label(t)] + sum([all_labels(b) for b in branches(t)], [])。差别在于 base case 那一支被并进了通用情形。
10. double:造出一棵新树
前两个函数把树折成一个数或一个列表。double 是另一类:输入一棵树,输出一棵树——把每个节点的标签翻倍。
def double(t):
    """
    Return a new tree ADT which is the result of
    doubling the labels of every node in the original tree `t`.
    >>> double(tree(1)) == tree(2)
    True
    >>> double(tree(3, [tree(1), tree(2)])) == tree(6, [tree(2), tree(4)])
    True
    """
    new_branches = []
    for b in branches(t):
        new_branches.append(double(b))
    return tree(2 * label(t), new_branches)
怎么想到的
先读 doctest。double(tree(1)) == tree(2)——注意这里用的是 ==,而 doctest 期望 True。这说明:
- 返回值必须是一棵结构完全相同、标签全部翻倍的树。因为树的底层是列表,
==会逐元素递归比较,所以[2] == [2]为真。 - doctest 没有要求返回的是同一个对象(那要用
is),但函数名叫「return a new tree」,说明不该原地修改t。
接着套第 7 节的模板。这一层要产出的是「一棵树」,而造树只能用构造器 tree(标签, 分支列表),所以问题变成两个:
2 * label(t)。[double(b) for b in branches(t)]。double(b) 返回的是树,正好能直接当 branches 参数用。课上给的写法用了显式循环 + append,和列表推导式完全等价:
# 官方解答里给出的等价写法一:列表推导式
return tree(label(t) * 2, [double(b) for b in branches(t)])
注意这里的 append 是正确的(和上一节 leaves 里的错误用法形成对照):因为 double(b) 返回的是一棵树,而 new_branches 要装的正是一棵一棵的树,所以「整个塞进去」才对。上一节 leaves 里 leaves(b) 返回的是一列标签,而我们要的也是一列标签,所以必须摊开。区别在于「递归返回的东西」和「我要装的东西」层级是否一致。
为什么不需要 base case
官方解答还给了第三种写法,并且注明了它的缺点:
# 官方解答里给出的等价写法二:显式 base case
# 缺点:重复代码(标签翻倍写了两遍)
if is_leaf(t):
    return tree(label(t) * 2)
else:
    return tree(label(t) * 2, [double(b) for b in branches(t)])
这个版本没错,只是啰嗦。因为 tree(x) 和 tree(x, []) 是同一回事(默认参数就是 []),而叶子的 [double(b) for b in branches(t)] 恰好就求值成 []。两条分支合并成一条即可。
手动验证第二个 doctest:double(tree(3, [tree(1), tree(2)])),底层 [3, [1], [2]]。
double([3, [1], [2]])
    new_branches = []
    branches = [[1], [2]]
    ├─ b = [1]
    │     double([1])
    │         new_branches = []
    │         branches([1]) = []  → for 循环零次
    │         return tree(2 * 1, []) = [2]
    │     new_branches = [[2]]
    └─ b = [2]
          double([2])
              branches([2]) = [] → for 循环零次
              return tree(2 * 2, []) = [4]
          new_branches = [[2], [4]]
    return tree(2 * 3, [[2], [4]])
         = tree(6, [[2], [4]])
         = [6, [2], [4]]

比较:tree(6, [tree(2), tree(4)]) = [6, [2], [4]]
[6, [2], [4]] == [6, [2], [4]]  →  True  ✓
再看一个大一点的,能看出「结构不变、只有标签变」:
>>> t = tree(5, [tree(1, [tree(0)]), tree(3, [tree(4, [tree(6)])]), tree(2)])
>>> t
[5, [1, [0]], [3, [4, [6]]], [2]]
>>> double(t)
[10, [2, [0]], [6, [8, [12]]], [4]]
>>> t
[5, [1, [0]], [3, [4, [6]]], [2]]
最后一行是关键:t 一点没变。因为 double 从头到尾没有对 t 或它的任何子列表做过变异操作,它只是读(label、branches)和造新的(tree)。这就是「不可变风格」的写法,也是本课程处理树的默认姿势。
误区一:直接改原树。有人会写:
def double(t):
    t[0] = t[0] * 2                 # 越过屏障 + 原地变异
    for b in branches(t):
        double(b)
    return t
这段代码能过 doctest(因为返回的树标签确实翻倍了),但它有两个严重问题。第一,t[0] = ... 越过了抽象屏障,考试直接扣分。第二,它把调用方的树给改了——double(t) 之后 t 本身也变成了 [10, ...],而 docstring 明说要「return a new tree」。更糟的是这个 bug 在别名(aliasing)场景下会连锁扩散:如果两棵树共享同一棵子树对象,翻倍一棵会连带改到另一棵。
还有一个隐蔽点:for b in branches(t): double(b) 里的 b 是 t[1:] 切片出来的新列表的元素,但元素本身(子树列表对象)还是原来那些,所以 b[0] = ... 确实会改到原树。这种「浅拷贝切断了外层却没切断内层」的行为,正是上一讲反复强调的坑。
误区二:返回列表字面量。写成 return [2 * label(t)] + [double(b) for b in branches(t)]。结果碰巧对,但它假设了「树就是一个列表」。一旦树 ADT 换成字典实现,这行立刻失效。造树必须走 tree(...)。
误区三:忘了给 tree 传第二个参数。写成 return tree(2 * label(t)),所有分支被丢掉,返回的永远是一片叶子。doctest 第一条(double(tree(1)) == tree(2))照样通过,第二条才挂——只跑第一个 doctest 就宣布做完,是自学时最容易掉的坑。用 python3 -m doctest 09.py 跑全部。
误区四:把 2 * label(t) 写成 2 * t。t 是列表,2 * [3, [1]] 在 Python 里是合法的——它把列表重复两遍得到 [3, [1], 3, [1]]。不报错,但结果完全是垃圾,而且这个「垃圾」还恰好长得像一棵树(is_tree 会判 False,因为里面有裸的 3)。
11. count_paths:让信息往下走
前面所有函数的信息流向都是从下往上:子树算完,把答案交给父节点合并。count_paths 引入一个新东西——还需要把信息从上往下传。这是树递归里难度上一个台阶的地方,也是考试爱考的地方。
def count_paths(t, total):
    """
    Return the number of paths from the root node to any other node in the tree
    that adds up to the target total.
    >>> t = tree(3, [tree(-1), tree(1, [tree(2, [tree(1)]), tree(3)]), tree(1, [tree(-1)])])
    >>> count_paths(t, 3)  # path does not have to go to a leaf
    2
    >>> count_paths(t, 4)
    2
    >>> count_paths(t, 5)
    0
    >>> count_paths(t, 6)
    1
    >>> count_paths(t, 7)
    2
    """
题目到底要什么
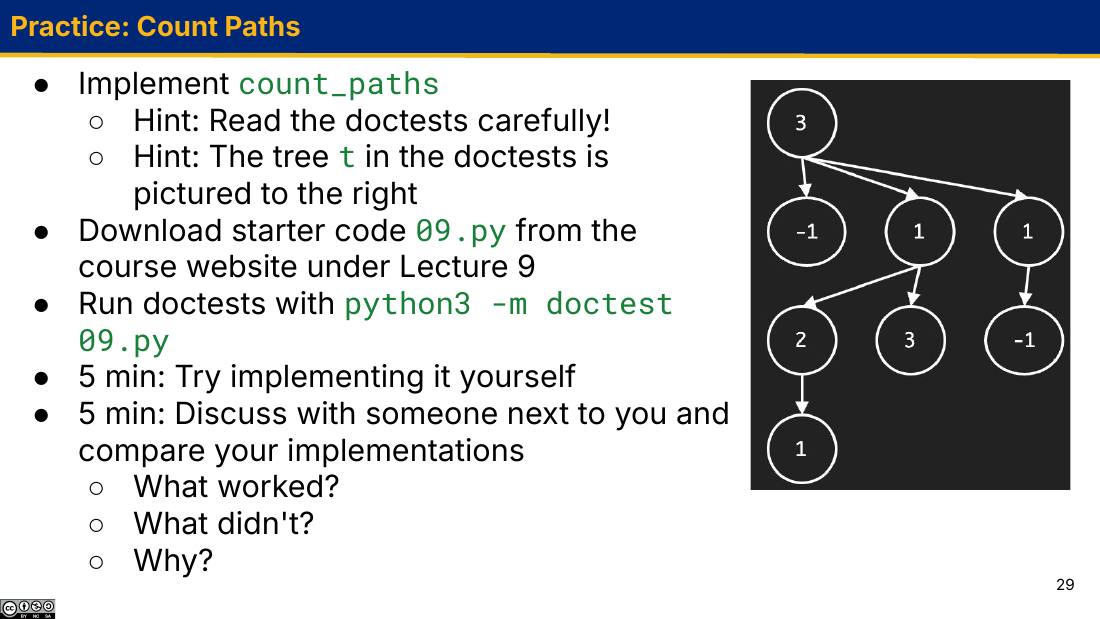
t:根 3 有三个孩子 -1、1、1;中间那个 1 又有两个孩子 2(下挂 1)和 3;右边那个 1 有一个孩子 -1。题目提示「仔细读 doctest」——因为「路径」的确切含义只能从 doctest 里推出来。写成文本树:
t = tree(3, [tree(-1),
             tree(1, [tree(2, [tree(1)]), tree(3)]),
             tree(1, [tree(-1)])])

                3
             /  |  \
           -1   1    1
               / \    \
              2   3    -1
              |
              1
docstring 说的是「从根节点到任意其它节点的路径」,而 count_paths(t, 3) 那行的注释又补了一句「path does not have to go to a leaf」(路径不必走到叶子)。把两条合起来,再对着答案反推,规则是:
一条路径是从根出发、每次走到某个孩子、在任意节点停下所经过的那串节点。包括「只有根一个节点」这条长度为 0 的路径。路径的和 = 沿途所有节点标签之和。
为什么能确定包含「只有根」这条?因为 count_paths(t, 3) 的答案是 2。把所有从根出发的路径穷举出来:
| 路径(沿途标签) | 和 |
|---|---|
3(只有根) | 3 |
3 → -1 | 2 |
3 → 1(中间那支) | 4 |
3 → 1 → 2 | 6 |
3 → 1 → 2 → 1 | 7 |
3 → 1 → 3 | 7 |
3 → 1(右边那支) | 4 |
3 → 1 → -1(右边那支) | 3 |
数一数:和为 3 的有 2 条(「只有根」和「右支 3→1→-1」)→ count_paths(t, 3) == 2 ✓。和为 4 的有 2 条 ✓。和为 5 的 0 条 ✓。和为 6 的 1 条 ✓。和为 7 的 2 条 ✓。如果不算「只有根」那条,count_paths(t, 3) 就只有 1,doctest 会挂。这就是「读 doctest」的实际含义——它把定义里含糊的地方钉死了。
怎么想到的:把「已经走了多少」变成「还差多少」
第一反应通常是:「往下递归的时候,得知道从根到现在累加了多少。」于是想给函数加一个参数 so_far。但函数签名是题目给死的 count_paths(t, total),只有两个参数,不能加。
关键的一步转念:与其往下传「已经攒了多少」,不如往下传「还差多少」。这两者是等价的信息,但后者能复用同一个参数位。
把 total 重新理解成:「从当前这棵子树的根出发,我需要凑出多少」。
站在根 3、目标 7:走到孩子 1 那里时,根的 3 已经花掉了,所以对孩子来说问题变成了「从你出发,凑出 7 - 3 = 4」。于是递归调用就是 count_paths(b, total - label(t))。
这个技巧有个名字叫把状态编码进参数,第 6 讲的 count_partitions(n, m) 用的是同一招。凡是「需要携带上下文往下走」的递归,先看能不能把上下文吸收进已有参数。
剩下的就是本层要不要计数:如果 label(t) == total,说明「从当前根出发、只取根这一个节点」就正好凑够了,这是一条合法路径,计 1。
代码
def count_paths(t, total):
    if label(t) == total:
        found = 1
    else:
        found = 0
    return found + sum([count_paths(b, total - label(t)) for b in branches(t)])
逐行:
if label(t) == total: found = 1——本层自己贡献的路径数(0 或 1)。注意找到之后不能 return:即使当前节点正好凑够,它的子孙里可能还有别的路径(比如再走一个+2一个-2)。所以要继续往下找。total - label(t)——往下传的新目标。这是全题的核心,写成total就全错(见下)。sum([...])——各分支找到的路径数相加。这里不需要 base case:叶子的branches是[],sum([])是0,函数直接返回found,正确。
验证:完整展开 count_paths(t, 7)
count_paths([3, [-1], [1,[2,[1]],[3]], [1,[-1]]], 7)
  label = 3,3 != 7 → found = 0
  往下传的目标:7 - 3 = 4
  │
  ├─ count_paths([-1], 4)
  │     label = -1 != 4 → found = 0
  │     branches = [] → sum([]) = 0
  │     → 0
  │
  ├─ count_paths([1, [2,[1]], [3]], 4)
  │     label = 1 != 4 → found = 0
  │     往下传:4 - 1 = 3
  │     ├─ count_paths([2, [1]], 3)
  │     │     label = 2 != 3 → found = 0
  │     │     往下传:3 - 2 = 1
  │     │     └─ count_paths([1], 1)
  │     │           label = 1 == 1 → found = 1        ← 命中!路径 3→1→2→1
  │     │           branches = [] → 0
  │     │           → 1
  │     │     → 0 + 1 = 1
  │     └─ count_paths([3], 3)
  │           label = 3 == 3 → found = 1              ← 命中!路径 3→1→3
  │           branches = [] → 0
  │           → 1
  │     → 0 + sum([1, 1]) = 2
  │
  └─ count_paths([1, [-1]], 4)
        label = 1 != 4 → found = 0
        往下传:4 - 1 = 3
        └─ count_paths([-1], 3)
              label = -1 != 3 → found = 0
              → 0
        → 0 + 0 = 0

  → 0 + sum([0, 2, 0]) = 2   ✓
展开对上了表格里「和为 7 的两条路径」:3→1→2→1 和 3→1→3。
再快速看 count_paths(t, 3) 的两次命中在哪:
count_paths(t, 3)
  label = 3 == 3 → found = 1                    ← 命中 1:路径「只有根」
  往下传:3 - 3 = 0
  ├─ count_paths([-1], 0)          -1 != 0 → 0
  ├─ count_paths([1, ...], 0)      1 != 0,往下传 0-1 = -1
  │     ├─ count_paths([2,[1]], -1)   2 != -1,往下传 -1-2 = -3
  │     │     └─ count_paths([1], -3) → 0
  │     │     → 0
  │     └─ count_paths([3], -1)  → 0
  │     → 0
  └─ count_paths([1, [-1]], 0)     1 != 0,往下传 0-1 = -1
        └─ count_paths([-1], -1)   -1 == -1 → 1    ← 命中 2:路径 3→1→-1
        → 1
  → 1 + sum([0, 0, 1]) = 2   ✓
注意目标值一路变成了负数,这完全正常——total 只是个数字,没有「必须为正」的约束。不要自作聪明加 if total < 0: return 0 的剪枝,因为标签可以是负数,往下走还可能加回来(右支的 -1 就是靠这个被找到的)。
误区一:递归时忘了减,写成 count_paths(b, total)。这是最常见的错。它不报错,但答案全乱:
>>> [count_paths(t, x) for x in range(3, 8)]   # 错误版本
[2, 0, 0, 0, 0]
>>> [count_paths(t, x) for x in range(3, 8)]   # 正确版本
[2, 2, 0, 1, 2]
错误版本变成了「数树里标签等于 total 的节点有几个」——total=3 时恰好也是 2(根的 3 和中支下面的 3),所以第一个 doctest 照样通过,从第二个才开始挂。又一次说明必须跑全部 doctest。
误区二:命中之后直接 return。写成:
if label(t) == total:
    return 1                      # ← 错:不再往下找了
return sum([count_paths(b, total - label(t)) for b in branches(t)])
这会漏掉「经过一个恰好命中的节点、继续往下还能再命中」的路径。用 t2 = tree(1, [tree(0)])、total = 1 一试:正确答案是 2(路径 1 和路径 1→0),错误版本返回 1。
误区三:以为路径必须走到叶子。那样 count_paths(t, 3) 只会数出 1 条(3→1→-1,因为 -1 是叶子),而「只有根」那条不算。doctest 的注释 # path does not have to go to a leaf 就是专门来堵这个误解的。
误区四:以为路径可以不从根开始。题目说的是「from the root node to any other node」——起点必须是根,只有终点自由。如果起点也自由,count_paths(t, 3) 会数出更多条(比如中支单独的 3)。这类「路径起点是否自由」的变体在考试里都出现过,读题时务必确认。
误区五:found 忘了初始化。只写 if label(t) == total: found = 1 而没有 else 分支,那么不命中时 found 这个名字根本没被绑定,最后一行会报 UnboundLocalError: local variable 'found' referenced before assignment。
这道题真正教的是一个可以迁移的套路:当递归需要「知道上面发生了什么」时,把那个上下文塞进参数,并在每次往下递归时更新它。
同一个套路的其它化身:求某节点的深度(往下传 depth + 1)、判断是否为二叉搜索树(往下传允许的取值区间)、打印带缩进的树(往下传缩进层数)。识别信号是:光靠子树自己算不出答案,还得知道「我是怎么走到这儿的」。
本讲小结
树 ADT 速查
| 你想干的事 | 怎么写 | 不能写 |
|---|---|---|
| 造一片叶子 | tree(5) | 5、[5] |
| 造一个带孩子的节点 | tree(5, [tree(1), tree(2)]) | tree(5, [1, 2])、tree(5, tree(1)) |
| 取根标签 | label(t) | t[0] |
| 取所有子树 | branches(t) | t[1:] |
| 取第一个子树的标签 | label(branches(t)[0]) | t[1](那是子树不是标签) |
| 判断是不是叶子 | is_leaf(t) | branches(t) is [](永远为 False) |
| 遍历所有子树 | for b in branches(t) | 手写 branches(t)[0]、[1]… |
四类树函数,四种合并方式
| 类型 | 返回什么 | 合并方式 | base case | 例子 |
|---|---|---|---|---|
| 计数 | 一个数 | sum(sub) | 看叶子答案是否等于 sum([])=0 | count_leaves(要)count_nodes(不要) |
| 收集 | 一个列表 | sum(sub, []) | 叶子返回 [label(t)],要 | leaves |
| 取极值 | 一个数 | max(sub) / min(sub) | 要(max([]) 报 ValueError) | height |
| 造新树 | 一棵树 | tree(新标签, sub) | 不要 | double |
报错速查
| 报错 | 八成是因为 |
|---|---|
AssertionError: branches must be trees | 第二个参数里混进了裸标签,或者忘了方括号 |
TypeError: 'int' object is not subscriptable | 把标签当树用了:对整数调用 label / branches |
IndexError: list index out of range | 对空列表 [] 调用 label——它不是合法的树 |
TypeError: unsupported operand type(s) for +: 'int' and 'list' | sum(列表的列表) 忘了第二个参数 [] |
TypeError: can only concatenate list (not "int") to list | 某条 return 交出了裸值,该交列表 |
ValueError: max() arg is an empty sequence | 用 max 合并却没写 base case,叶子走到了 max([]) |
UnboundLocalError: local variable 'found' referenced before assignment | if 里赋了值但没写 else,某条路径上名字没绑定 |
RecursionError: maximum recursion depth exceeded | base case 漏了一种情况,或者递归时没有真正变小 |
| 不报错但答案全是 0 | 该写的 base case 省了,叶子返回了 sum([]) = 0 |
三条要记住的话
- 分支是树,不是标签。本讲一半的 bug 来自忘记这一条。
branches(t)的每个元素都需要再label()一下才能拿去做算术。 - 「变小」是免费的,「合并」才是题目。写树递归时不要纠结递归怎么写(永远是
[f(b) for b in branches(t)]),把力气花在「拿到各分支的答案后怎么合成本层答案」。 - base case 写不写,取决于合并操作对空列表是否有意义。
sum有默认起点所以常常可省;max没有所以必须写;叶子答案和「零个东西合并的结果」不一致时(count_leaves)也必须写。
动手练习
建议先关掉答案自己做,做完再对。全部代码可以直接贴进 09.py 跑。
练习 1:WWPD(What Would Python Display)
设 t = tree(1, [tree(2, [tree(3)]), tree(4)])。下面每行分别显示什么?
>>> t
>>> label(branches(t)[0])
>>> is_leaf(branches(t)[1])
>>> branches(branches(t)[0])[0]
>>> label(t) + label(branches(t)[1])
>>> tree(1, [2])
看答案
>>> t
[1, [2, [3]], [4]]
>>> label(branches(t)[0])
2
>>> is_leaf(branches(t)[1])
True
>>> branches(branches(t)[0])[0]
[3]
>>> label(t) + label(branches(t)[1])
5
>>> tree(1, [2])
AssertionError: branches must be trees
逐条说明:
t的图是:根1,两个孩子2和4;2下面挂一个3。底层就是[1, [2, [3]], [4]]。branches(t)是[[2, [3]], [4]],第 0 项是子树[2, [3]],它的label是2。branches(t)[1]是[4],没有分支,所以is_leaf为True。- 第四行显示的是
[3],不是3——它是一棵树(一片叶子),不是一个数。这是本讲最容易答错的一行。 - 第五行:
1 + 4 = 5。注意必须先label,直接写t + branches(t)[1]会把两个列表拼起来,得到[1, [2, [3]], [4], 4]——不报错但毫无意义。 - 最后一行:
2不是树,构造器的断言拦下来了。
练习 2:count_nodes
写 count_nodes(t),返回树 t 里节点的总数(包括根和所有内部节点,不只是叶子)。要求不写显式 base case,并说明为什么可以不写。
>>> count_nodes(tree(1, [tree(2, [tree(3)]), tree(4)]))
4
>>> count_nodes(tree(5, [tree(1, [tree(0)]), tree(3, [tree(4, [tree(6)])]), tree(2)]))
7
>>> count_nodes(tree(9))
1
看答案
def count_nodes(t):
    return 1 + sum([count_nodes(b) for b in branches(t)])
为什么不需要 base case:叶子的 branches(t) 是 [],列表推导式产出 [],sum([]) 是 0,于是返回 1 + 0 = 1——正好就是「一片叶子有 1 个节点」的正确答案。「叶子的答案」恰好等于「零个分支合并的结果加上本层贡献」,所以两条分支自然合并成了一条。
对比 count_leaves:叶子应返回 1,但通用情形算出来是 sum([]) = 0(本层不额外贡献),两者不一致,所以 count_leaves 必须写 base case。能不能省 base case,就看这一条对不对得上。
手动验证第一个 doctest:
count_nodes([1, [2,[3]], [4]])
  = 1 + sum([ count_nodes([2,[3]]),  count_nodes([4]) ])
                │                      │
                │                      └─ 1 + sum([]) = 1
                └─ 1 + sum([ count_nodes([3]) ])
                         └─ 1 + sum([]) = 1
                   = 1 + 1 = 2
  = 1 + sum([2, 1]) = 1 + 3 = 4  ✓
练习 3:max_label
写 max_label(t),返回树 t 中所有标签的最大值。标签可以是负数。
>>> max_label(tree(1, [tree(2, [tree(3)]), tree(4)]))
4
>>> max_label(tree(3, [tree(9), tree(2, [tree(-1)])]))
9
>>> max_label(tree(7))
7
看答案
两种写法都对:
# 写法一:显式 base case
def max_label(t):
    if is_leaf(t):
        return label(t)
    return max([label(t)] + [max_label(b) for b in branches(t)])

# 写法二:不写 base case
def max_label(t):
    return max([label(t)] + [max_label(b) for b in branches(t)])
这里 max 也能省掉 base case,看起来和第 3 节 height 的结论矛盾,其实不矛盾。关键在于 max 的参数是 [label(t)] + [...]——它永远至少有一个元素(本层的标签),所以即使分支列表为空,max([label(t)]) 也是合法的,返回 label(t),正确。
而 height 写的是 1 + max([height(b) for b in branches(t)]),max 的参数完全来自分支,叶子时就是 max([]) → ValueError。
结论修正得更准确一点:base case 能不能省,看的是「通用情形那行代码在叶子上会不会崩、结果对不对」,而不是「用了 sum 还是 max」。
常见错误:写成 max(label(t), max_label(b) for b in branches(t))——语法错误(生成器表达式不能和其它参数并列而不加括号),报 SyntaxError: Generator expression must be parenthesized。另一个:写成 max([max_label(b) for b in branches(t)]),忘了把本层的标签也算进去,那么 max_label(tree(9, [tree(1)])) 会返回 1 而不是 9。
练习 4:找 bug
下面三个 leaves 的实现各有一处错。分别说出:错在哪、跑起来是什么现象(报什么错,或者输出什么)。测试用 t = tree(3, [tree(1), tree(2)]),正确答案是 [1, 2]。
# A
def leaves(t):
    if is_leaf(t):
        return label(t)
    return sum([leaves(b) for b in branches(t)], [])

# B
def leaves(t):
    if is_leaf(t):
        return [label(t)]
    return sum([leaves(b) for b in branches(t)])

# C
def leaves(t):
    if is_leaf(t):
        return [label(t)]
    return [leaves(b) for b in branches(t)]
看答案
A:base case 忘了包成列表。叶子返回的是裸的 1、2,于是外层要算 sum([1, 2], []),也就是 [] + 1:
TypeError: can only concatenate list (not "int") to list
口诀:报错说「list 加不了 int」→ 是某条 return 交出了裸值。
B:sum 忘了第二个参数 []。默认起点是整数 0,于是要算 0 + [1]:
TypeError: unsupported operand type(s) for +: 'int' and 'list'
口诀:报错说「int 加不了 list」→ 是 sum 漏了 , []。
C:没有扁平化。这个版本不报错,但返回的是嵌套列表:
>>> leaves(tree(3, [tree(1), tree(2)]))
[[1], [2]]
而且树越深嵌套越多:leaves(tree(5, [tree(1, [tree(0)]), tree(3, [tree(4, [tree(6)])]), tree(2)])) 会得到 [[[0]], [[[6]]], [2]]。这类不报错的 bug 最危险——它会安静地一路传下去,直到某个远处的地方才炸。
三个错误合起来说明一件事:递归函数的每条 return 必须返回同一种「形状」的东西。leaves 说好返回「一个装标签的扁平列表」,那么 base case 和递归情形都得交出这个形状。
练习 5:print_tree
写 print_tree(t, indent=0),按层级缩进打印整棵树,每层缩进两个空格。这道题练的是第 11 节那个「把上下文往下传」的套路。
>>> print_tree(tree(5, [tree(1, [tree(0)]), tree(3, [tree(4, [tree(6)])]), tree(2)]))
5
  1
    0
  3
    4
      6
  2
看答案
def print_tree(t, indent=0):
    print('  ' * indent + str(label(t)))
    for b in branches(t):
        print_tree(b, indent + 1)
要点:
indent是往下传的上下文,含义是「当前节点的深度」。默认值0让调用方可以只写print_tree(t)。整数是不可变的,所以这个默认参数没有可变默认值的坑。- 先打印自己,再递归打印孩子。顺序反过来的话,孩子会打印在父节点上面,缩进就没意义了。
- 这个函数没有返回值(返回
None),它靠副作用工作。所以千万不要写return print_tree(b, indent + 1)——那样打印完第一个分支就返回了,后面的分支全被跳过。 str(label(t))的str不能省:' ' * indent是字符串,字符串不能和整数相加,会报TypeError: can only concatenate str (not "int") to str。- 没有 base case,理由和
double一样:叶子的branches是[],for循环零次执行,递归自然停止。
把它和 count_paths 对照:两者都在往下递归时更新一个参数(indent + 1 对 total - label(t)),都是「子树光靠自己算不出答案,还得知道自己在什么位置」的典型。凡是看到这种需求,先想能不能加一个带默认值的参数。