可变性与数据抽象
对象可以被改,这既是威力也是麻烦;而把「数据长什么样」和「拿数据干什么」彻底分开,是控制这份麻烦的办法。
0. 本讲导读
上一讲你学会了用列表(list)装一串东西,用切片取出其中一段,用 for 和列表推导式(list comprehension)批量加工它们。但有一件事一直被绕开:列表是可以被改的。lst.append(3) 这一行执行完,到底是「lst 这个名字现在指向一个新列表」,还是「lst 指的还是原来那个列表,只不过那个列表本身长大了一格」?
这两种说法听起来差不多,实际后果天差地别。如果是前者,别的名字不受影响;如果是后者,所有指向那个列表的名字都会一起「变」——哪怕它们在别的函数里、别的帧里,哪怕你压根没碰过它们。这门课接下来的一半 bug 都来自没想清楚这件事。
本讲的前半段(第 1–5 节)就是把这件事讲透:什么叫可变(mutable),什么叫不可变(immutable),改名字和改对象为什么必须分开想,以及两个新容器——不可变的元组(tuple)和可变的字典(dictionary)。
后半段(第 6–12 节)看起来是另一个话题:数据抽象(data abstraction)。它问的是:当你要在程序里表示「一个有理数」「一个银行账户」「一个二维坐标」时,该怎么组织代码?答案是抽象数据类型(Abstract Data Type,ADT):写一个构造器(constructor)负责造出这个东西,写若干选择器(selector)负责从里面取出属性,然后其余所有代码只许通过这两类函数打交道。
这两半为什么放在同一讲?因为它们是同一个故事的两面。可变性给了你很多种表示数据的方式(列表、字典、甚至一个闭包函数),而数据抽象保证:你随时可以换一种实现,而调用方一行都不用改。反过来说,如果调用方到处直接写 x['numer'],那你就永远被锁死在「字典」这个实现上——想加个约分、想换成元组、想换成闭包,全都办不到。
往前看:本讲的 ADT 会在 Lab 04、HW 03 里反复出现;下一讲的树(tree)本身就是一个用 ADT 定义的递归数据结构,构造器 tree(label, branches) 和选择器 label(t)、branches(t) 正是本讲这套东西的直接应用。本讲不扎实,下一讲会寸步难行。
- 可变性是「对象」的性质,不是「名字」的性质。「
x是可变的」这句话没有意义;有意义的是「x当前指向的那个对象是可变的」。 x = ...改的是名字绑定(binding),只影响当前帧里的那一个名字;x.append(...)、x[0] = ...、d[k] = v改的是对象本身,所有指向该对象的名字会一起「看到」变化。- 两个名字指向同一个对象叫别名(aliasing)。判断是不是同一个对象用
is,判断内容是否相等用==。别名主要有三个来源:直接赋值、传参、把对象放进另一个容器。 - 默认参数值只在
def语句执行时求值一次,之后一直挂在函数对象身上。默认值如果是可变对象,所有调用共享它——这是 Python 最著名的坑之一。 - 元组不可变,字典可变;字典的键必须是可哈希(hashable)的,实践上就是「必须不可变」。
{[1, 2]: 3}直接报TypeError: unhashable type: 'list'。 - 一个 ADT = 一个构造器 + 若干选择器。它们的函数体是唯一允许触碰底层表示的地方,这条线叫抽象屏障(abstraction barrier)。
- 只要没人越过屏障,你就能把实现从列表换成字典、再换成一个闭包,而所有调用方代码原封不动照样跑。这就是数据抽象唯一的、也是全部的价值。
1. 可变与不可变:为什么突然要关心这个
课程给的定义只有两句话:
一个对象是可变的(mutable),如果它能被改变。
一个对象是不可变的(immutable),如果它不能被改变。
请注意主语是对象(object)。这不是咬文嚼字。在 Python 里,「名字」和「对象」是两样东西:名字住在帧(frame)里,对象住在别的地方,名字通过一根箭头指向对象。「可变 / 不可变」描述的是箭头指向的那一端,跟箭头本身、跟名字叫什么,全都无关。
那么问题来了:既然能改是一种能力,为什么还要有不可变的东西?课上给的理由很朴素——有时候我们就是不希望东西被改,比如只读数据。展开说有三层:
- 安全:你把一个元组传给别人写的函数,可以确信回来以后它还是原样。传列表就不能确信。
- 可以当字典的键:字典要靠键的值来定位条目,如果键能被偷偷改掉,放进去的东西就再也找不到了。所以 Python 规定只有不可变对象才能当键(详见第 5 节)。
- 推理简单:一个不可变对象,你在程序任何位置看到它,值都一样。可变对象则必须问「现在是第几行?谁在这之前动过它?」
Python 内建类型的可变性分布如下。这张表值得背下来,因为几乎每道 WWPD(What Would Python Display)题都要用到它。
| 类型 | 例子 | 可变? | 能当字典的键? |
|---|---|---|---|
int | 42 | 不可变 | 能 |
float | 3.14 | 不可变 | 能 |
bool | True | 不可变 | 能 |
str | 'go bears' | 不可变 | 能 |
NoneType | None | 不可变 | 能 |
tuple | (1, 2, 3) | 不可变 | 能(前提:里面装的也全都不可变) |
list | [1, 2, 3] | 可变 | 不能 |
dict | {'a': 1} | 可变 | 不能 |
「不可变」不代表「这个名字指的东西永远不变」。x = 2 之后再 x = 4,完全合法——你没有改动整数 2(也确实改不动),你只是把 x 这根箭头挪到了整数 4 上。整数 2 还好端端待在那儿。这个区别就是第 3 节的全部内容。
2. 元组:不可变的序列
元组(tuple)就是一个不能被修改的列表。上一讲学的关于序列的一切——索引、切片、len、in、for 遍历、+ 拼接——对元组全都成立,唯独「改」这一类操作不行。
怎么写一个元组
>>> tup = (1, 2, 3)
>>> tup = 1, 2, 3        # 括号可以省,但建议写上
>>> tup
(1, 2, 3)
真正决定「这是一个元组」的其实是逗号,不是括号。这导致一个必须记住的坑:
>>> t = (1)
>>> t
1
>>> type(t)
<class 'int'>
>>> t = (1,)          # 单元素元组,逗号不能省
>>> t
(1,)
>>> type(t)
<class 'tuple'>
>>> len(t)
1
(1) 里的括号被当成了「改变运算优先级的括号」,跟 (1 + 2) 里的那对括号是同一回事,所以求值结果就是整数 1。
元组解包
>>> tup = (1, 2, 3)
>>> a, b, c = tup      # tuple unpacking
>>> a
1
>>> b
2
>>> c
3
元组解包(tuple unpacking)是赋值语句的一个扩展:等号左边写若干个名字,右边给一个长度相同的序列,Python 会按位置一一绑定。它在本讲后面会用得非常多——遍历字典的 items() 时,每一项都是一个二元组,直接解包比写 item[0]、item[1] 清楚得多。
a, b, c = tup 执行时发生了什么:
tup,在当前环境里查到那个元组对象 (1, 2, 3)。ValueError:右边不够分时是 ValueError: not enough values to unpack (expected 3, got 2),右边多出来时是 ValueError: too many values to unpack (expected 2)。a → 1,b → 2,c → 3。注意整个过程没有新建帧,赋值语句从来不新建帧。改不动
>>> tup = (1, 2, 3)
>>> tup[1]
2
>>> tup[0] = 'go bears'
Traceback (most recent call last):
  ...
TypeError: 'tuple' object does not support item assignment
读(tup[1])没问题,写(tup[0] = ...)直接抛异常。元组也没有 append、pop、remove 这些方法——它们全是「改」,元组一个都不提供。
元组的不可变是「浅」的。元组保证的是「我第 i 格里那根箭头不会换指向」,但箭头指向的对象如果本身可变,它照样能被改:
>>> tp = (1, [2, 3])
>>> tp[1].append(4)      # 没有改元组,改的是元组里那个列表
>>> tp
(1, [2, 3, 4])
>>> tp[0] = 9            # 这才是改元组
Traceback (most recent call last):
  ...
TypeError: 'tuple' object does not support item assignment
tp[1].append(4) 合法,因为它做的是「取出第 1 格的箭头指向的那个列表对象,然后改那个列表」。元组本身的两根箭头一根没动。这个细节在第 5 节讲「哪些元组能当字典的键」时会立刻用到。
| 对比项 | list | tuple |
|---|---|---|
| 字面量写法 | [1, 2, 3] | (1, 2, 3) 或 1, 2, 3 |
| 可变性 | 可变 | 不可变 |
索引 / 切片 / len / in | 都支持 | 都支持 |
元素赋值 x[0] = v | 可以 | TypeError |
append / pop / remove | 有 | 没有 |
| 能否作为字典的键 | 不能 | 能(内部元素也须不可变) |
| 典型用途 | 会增删改的一串同类数据 | 固定几项、语义上是「一个整体」的记录,如坐标、(标题, 类型) |
3. 名字改变 vs. 对象改变
这是本讲最重要的一节,也是最容易自以为懂了的一节。课上把它总结成一句话:名字的改变不等于变异(Name changes are not the same as mutation)。一个表达式的值可以变,原因可能是名字变了,也可能是对象变了。
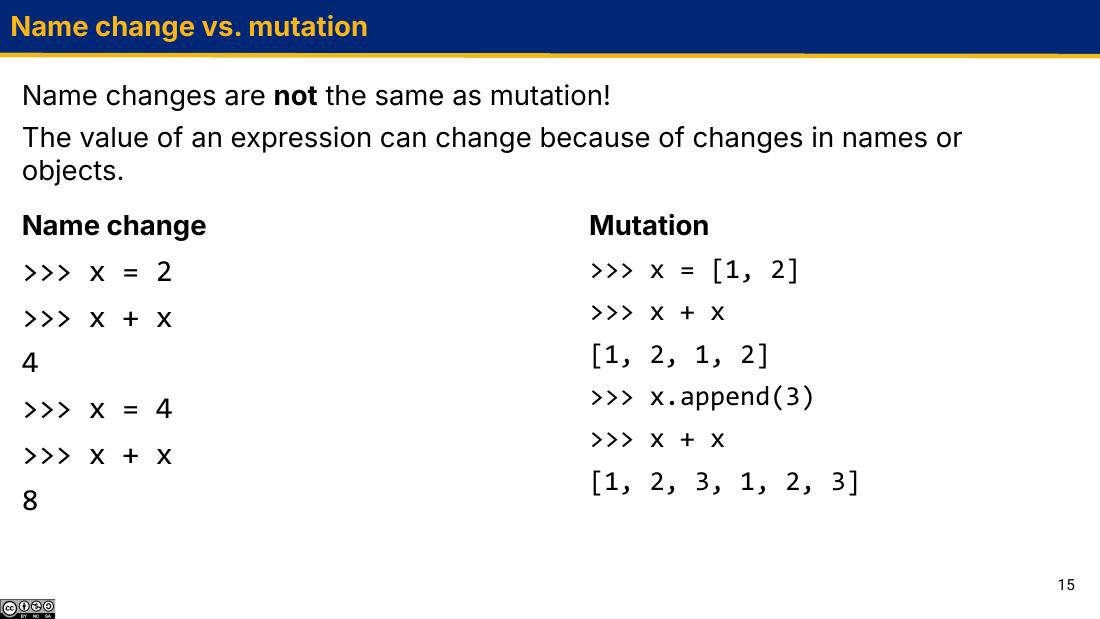
x + x 这个一字不改的表达式给出不同的结果。左栏靠把 x 重新绑到另一个整数上(名字变了,对象没变);右栏靠往 x 指向的那个列表里塞东西(名字没变,对象变了)。机制完全不同,看结果却分不出来,所以必须靠环境图去分辨。左栏:名字改变
>>> x = 2
>>> x + x
4
>>> x = 4
>>> x + x
8
执行 x = 2 之后
Global frame
    x ────→ 2                (整数对象 2)

执行 x + x:查 x 得 2,算 2 + 2 = 4

执行 x = 4 之后
Global frame
    x ────→ 4                (箭头挪到了整数对象 4)
                             整数对象 2 一根汗毛没动

执行 x + x:查 x 得 4,算 4 + 4 = 8
右栏:对象改变
>>> x = [1, 2]
>>> x + x
[1, 2, 1, 2]
>>> x.append(3)
>>> x + x
[1, 2, 3, 1, 2, 3]
执行 x = [1, 2] 之后
Global frame
    x ────→ ┌───┬───┐
            │ 1 │ 2 │        (列表对象 L)
            └───┴───┘

执行 x + x:查 x 得 L,+ 造一个全新的列表 [1, 2, 1, 2](L 没变)

执行 x.append(3) 之后
Global frame
    x ────→ ┌───┬───┬───┐
            │ 1 │ 2 │ 3 │    (还是那个 L,只是长了一格)
            └───┴───┴───┘
    x 这根箭头从头到尾没动过

执行 x + x:查 x 得 L,现在 L 是 [1, 2, 3],算出 [1, 2, 3, 1, 2, 3]
x.append(3) 究竟是怎么被求值的:
x.append:查 x 得到列表对象 L,再从 L 身上取出 append 这个绑定方法(bound method)——它已经「记住」了自己属于 L。3,得到整数 3。x → L 完全没被触碰。append 返回 None。所以 y = x.append(3) 会让 y 变成 None——这是初学者高频错误,见下面的误区框。把变异方法当成「返回新列表的函数」用:
>>> x = [1, 2]
>>> x = x.append(3)     # 错!
>>> x
>>> print(x)
None
>>> x + [4]
Traceback (most recent call last):
  ...
TypeError: unsupported operand type(s) for +: 'NoneType' and 'list'
append 改完 L 就返回 None,你却把这个 None 重新绑给了 x,于是那个已经变成 [1, 2, 3] 的列表再也没有名字指着它了。正确写法就是光秃秃一行 x.append(3),不要赋值。同理 lst.sort()、d.update(...) 也都返回 None。
怎么一眼看出一行代码是「改名字」还是「改对象」?看等号左边:
- 左边是光秃秃一个名字(
x = ...、a, b = ...)→ 改名字绑定,只影响当前帧。 - 左边带了方括号(
x[0] = ...、d['k'] = ...)→ 改对象。 - 根本没有等号,是方法调用(
x.append(...)、d.pop(...))→ 通常是改对象。
4. 别名与可变默认参数:可变性最会咬人的两个地方
如果一个可变对象自始至终只有一个名字指着它,可变性其实很无害。麻烦全部来自同一个对象被多个名字指着——这叫别名(aliasing)。
别名从哪来
>>> a = [1, 2, 3]
>>> b = a               # 来源一:直接赋值
>>> c = a[:]            # 切片会造一个新列表,不是别名
>>> a.append(4)
>>> a
[1, 2, 3, 4]
>>> b
[1, 2, 3, 4]
>>> c
[1, 2, 3]
>>> a is b
True
>>> a is c
False
>>> a == c
False
Global frame
    a ──┐
        ├──→ L1: [1, 2, 3, 4]      ← a.append(4) 改的是这个对象
    b ──┘
    c ─────→ L2: [1, 2, 3]         ← a[:] 当时复制出来的另一个对象

a is b  →  True   (同一个对象)
a is c  →  False  (两个对象,只是当初内容相同)
a == c  →  False  (现在连内容都不同了)
b = a 这一行做的事只有一件:求值右边得到列表对象 L1,然后让名字 b 也指向 L1。它没有复制任何东西。之后不管你从 a 还是从 b 去改 L1,另一边都会「看到」。
别名的三个来源,记住它们就能预判绝大多数 bug:
| 来源 | 例子 | 后果 |
|---|---|---|
| 赋值 | b = a | a 和 b 是同一个对象 |
| 传参 | f(a),def f(lst): ... | 函数帧里的 lst 和调用方的 a 是同一个对象 |
| 放进容器 | pair = [a, a] | pair[0] 和 pair[1] 是同一个对象 |
第二条尤其要紧,因为它意味着函数可以改到调用方的数据:
>>> def add_four(lst):
...     lst.append(4)
...
>>> nums = [1, 2, 3]
>>> add_four(nums)
>>> nums
[1, 2, 3, 4]
| add_four | func add_four(lst) |
| nums | → L1 |
| lst | → L1(同一个对象) |
| 返回值 | None |
f1 里的 lst 和全局帧里的 nums 指着同一个列表 L1。lst.append(4) 改的是 L1,所以 f1 消失之后,nums 看到的还是那个被改过的 L1。
lst += [4] 和 lst = lst + [4] 对列表来说不是一回事:
>>> def f(lst):
...     lst += [4]        # 对 list 而言等价于 lst.extend([4]),是变异
...
>>> a = [1, 2, 3]
>>> f(a)
>>> a
[1, 2, 3, 4]

>>> def g(lst):
...     lst = lst + [5]   # 造一个新列表,再把本地名字 lst 绑过去
...
>>> b = [1, 2, 3]
>>> g(b)
>>> b
[1, 2, 3]
g 里的重新绑定只改了 g 自己那一帧里的名字 lst,帧一销毁就什么都没剩下。这正是第 3 节那条判据的直接应用:等号左边是光秃秃一个名字,就只改名字。
可变默认参数
现在来看课上那道 WWPD。先自己想清楚答案,再往下看。
>>> def f(s=[]):
...     s.append(len(s))
...     return s
...
>>> f()
[0]
>>> f()
[0, 1]
>>> f([5])
[5, 1]
>>> f()
[0, 1, 2]
很多人预期四次都是 [0]。要理解真实结果,得先想清一个问题:默认值 [] 这个表达式,是在什么时候被求值的?
默认参数值在 def 语句被执行的那一刻求值,一次,结果被存进函数对象里。以后每次调用,只要没传这个参数,形参就绑到那同一个对象上。
def f(s=[]):。求值默认值表达式 [],得到一个空列表对象 D。造出函数对象 func f(s=[]),把 D 挂在它身上,再把名字 f 绑到这个函数对象。此后 [] 这个表达式再也不会被求值第二次。f():没传实参,形参 s 绑到 D。len(s) 是 0,s.append(0) 把 D 改成 [0],返回 D。显示 [0]。f():s 又绑到同一个 D,而 D 现在是 [0]。len(s) 是 1,追加 1,D 变成 [0, 1]。显示 [0, 1]。f([5]):这次传了实参,s 绑到调用现场新造的列表 [5],跟 D 无关。len(s) 是 1,追加 1,得到 [5, 1]。D 仍然是 [0, 1]。f():又回到 D,它是 [0, 1],len 是 2,追加 2,得到 [0, 1, 2]。Global frame
f ────→ func f(s=[])
│
└── 默认值 ──→ D: [0, 1, 2] ← 三次无参调用都在改它
f2: f [parent=Global] (第二次 f() 的帧)
s ────→ D 同一个对象,不是副本
返回值 ──→ D
f3: f [parent=Global] (f([5]) 的帧)
s ────→ L: [5, 1] 调用现场新造的列表,与 D 无关
怎么避免?标准做法是用 None 当默认值,在函数体里再造新对象:
>>> def f(s=None):
...     if s is None:
...         s = []          # 每次调用都执行一次,每次造一个新列表
...     s.append(len(s))
...     return s
...
>>> f()
[0]
>>> f()
[0]
None 是不可变的,做默认值绝对安全;而 s = [] 这一行在函数体里,每次调用都会重新执行,所以每次都得到一个全新的空列表。这里用 is None 而不是 == None,也不是 if not s:——后者会把调用方明确传进来的空列表也一并当成「没传」,那是另一个 bug。
5. 字典:键值对容器
字典(dictionary)是由键值对(key-value pair,也叫 entry)组成的容器,在别的语言里常叫 map 或 hashmap。列表用「位置」找元素,字典用「键」找元素。
为什么需要它?因为现实里大量数据天然就是「从一组值到另一组值的映射」:
- 姓名 → 邮箱地址
- 学生 → 等第成绩
- 姓名 → 家庭住址
- IP 地址 → 域名
这些如果硬用列表存,你就得维护两个平行列表并保证下标一一对应,还得靠线性扫描去查——又笨又易错。字典把「查找」这件事直接做成了语言原语。
字典在概念上是无序的容器——你不该依赖它的顺序来写逻辑。不过从 Python 3.7 起,官方文档保证字典会按插入顺序遍历。所以你打印出来看到的顺序是可预测的(这对 doctest 很重要),但「无序」仍然是理解字典的正确心智模型:它的定位靠键,不靠位置。
增、查、改、删
>>> roman_numerals = {'I': 1, 'V': 5, 'X': 10}
>>> roman_numerals['I']
1
>>> roman_numerals['L'] = 50          # 新增一条
>>> roman_numerals
{'I': 1, 'V': 5, 'X': 10, 'L': 50}
>>> roman_numerals['V'] = 'five'      # 修改已有的一条
>>> roman_numerals
{'I': 1, 'V': 'five', 'X': 10, 'L': 50}
>>> del roman_numerals['V']           # 删除一条
>>> roman_numerals
{'I': 1, 'X': 10, 'L': 50}
注意 roman_numerals['L'] = 50 和 roman_numerals['V'] = 'five' 语法完全一样,行为却分「新增」和「修改」——取决于键在不在。也注意值的类型不必统一('five' 是字符串,其余是整数),Python 不管这个。这两行都是变异:字典对象被改了,所有指向它的名字都会看到。
键的两条规矩
>>> {1: 'one', 2: 'two', 1: 'ONE'}     # 规矩一:键不能重复
{1: 'ONE', 2: 'two'}
>>> {[1, 2]: 3}                        # 规矩二:键必须可哈希
Traceback (most recent call last):
  ...
TypeError: unhashable type: 'list'
>>> dct = {(1, 2): 3}                  # 元组可以
>>> dct[(1, 2)]
3
>>> dct = {(1, [2, 3]): 4}             # 但装了列表的元组不行
Traceback (most recent call last):
  ...
TypeError: unhashable type: 'list'
第一条:字面量里写重复键不会报错,后写的覆盖先写的——所以 1 的值是 'ONE';同时 1 保持它第一次出现的位置,所以打印出来 1 在 2 前面。
第二条更重要。可哈希(hashable)的意思是这个对象能算出一个稳定不变的哈希值,字典靠它来决定条目存放在哪。想想如果允许列表当键会怎样:
k = [1, 2] 能当键,d[k] = 'hi'。字典按 [1, 2] 的哈希值把这条记录放进某个位置。k.append(3)。k 现在是 [1, 2, 3],哈希值理应变了。d[k]。字典按 [1, 2, 3] 的新哈希值去找——那个位置什么都没有。记录明明还在字典里,却永远取不出来了。(1, [2, 3]) 也不行:它虽然是元组,但里面装着可变的列表,整体哈希值一样会飘。反过来说,「元组能当键」这件事非常有用——你可以用 (标题, 类型) 这样的复合键,这正是第 11 节 film_appearances 那道题的数据长相。
遍历
>>> pokemon = {'charizard': 'fire', 'squirtle': 'water', 'pikachu': 'electric'}
>>> for name in pokemon.keys():
...     print(name)
...
charizard
squirtle
pikachu
>>> for pokemon_type in pokemon.values():
...     print(pokemon_type)
...
fire
water
electric
>>> for name, pokemon_type in pokemon.items():
...     print(f"{name}: {pokemon_type}")
...
charizard: fire
squirtle: water
pikachu: electric
items() 给出的每一项都是一个 (键, 值) 二元组,所以 for name, pokemon_type in ... 用的正是第 2 节的元组解包——每轮循环把当前那个二元组拆成两个名字。
for x in some_dict:(不写 .keys())遍历的是键,不是值。这是最容易记反的一条。同理 'charizard' in pokemon 检查的是键,不是值。想按值检查得写 'fire' in pokemon.values()。
取值:方括号 vs. get
>>> pokemon['bulbasaur']
Traceback (most recent call last):
  ...
KeyError: 'bulbasaur'
>>> pokemon.get('bulbasaur')            # 键不存在时返回 None,不报错
>>> pokemon.get('bulbasaur', 'grass')   # 也可以指定一个兜底值
'grass'
>>> pokemon.pop('squirtle')             # 删除并返回被删掉的值
'water'
>>> pokemon
{'charizard': 'fire', 'pikachu': 'electric'}
第二行在交互式解释器里什么都不显示——因为返回值是 None,而 Python 的 REPL 对 None 不打印任何东西。这一点在 WWPD 题里是个高频考点:「什么都不显示」和「显示 None」是两种不同的答案,前者对应表达式求值为 None,后者对应你显式调用了 print(None)。
| 操作 | 写法 | 键不存在时 | 会改动字典吗 |
|---|---|---|---|
| 取值 | d[k] | KeyError | 否 |
| 取值(安全) | d.get(k) | 返回 None | 否 |
| 取值(带兜底) | d.get(k, default) | 返回 default | 否 |
| 存 / 改 | d[k] = v | 新增一条 | 是 |
| 删 | del d[k] | KeyError | 是 |
| 删并取回 | d.pop(k) | KeyError | 是 |
| 判断键在不在 | k in d | 返回 False | 否 |
| 条目数 | len(d) | — | 否 |
字典推导式
和列表推导式同一个套路,只是花括号里要写 键: 值 两部分:
>>> {x: x * x for x in range(4)}
{0: 0, 1: 1, 2: 4, 3: 9}
>>> d = {'a': 1, 'b': 2}
>>> {v: k for k, v in d.items()}       # 键值互换
{1: 'a', 2: 'b'}
>>> {x % 3: x for x in range(7)}       # 键会重复!
{0: 6, 1: 4, 2: 5}
最后一行值得手推一遍。x 依次取 0..6,产生的键值对是 0:0, 1:1, 2:2, 0:3, 1:4, 2:5, 0:6。键重复时后写的覆盖先写的,所以 0 最后是 6、1 最后是 4、2 最后是 5;而顺序按各个键第一次出现的先后,即 0、1、2。
遍历字典的同时增删条目会直接崩:
>>> d = {'a': 1, 'b': 2}
>>> for k in d:
...     d[k + '!'] = 0
...
Traceback (most recent call last):
  ...
RuntimeError: dictionary changed size during iteration
改已有键的值是允许的(大小没变),但增和删不行。要边遍历边增删,就先把键固定下来:for k in list(d.keys()):——list(...) 会先把所有键抓成一个独立的列表,之后动字典就不影响这个列表了。
6. 什么是抽象
课上给抽象下的定义只有一行:知道它做什么,不必知道它怎么做(know what it does, not how it works)。结论是:我们可以在完全不了解实现的情况下使用它。
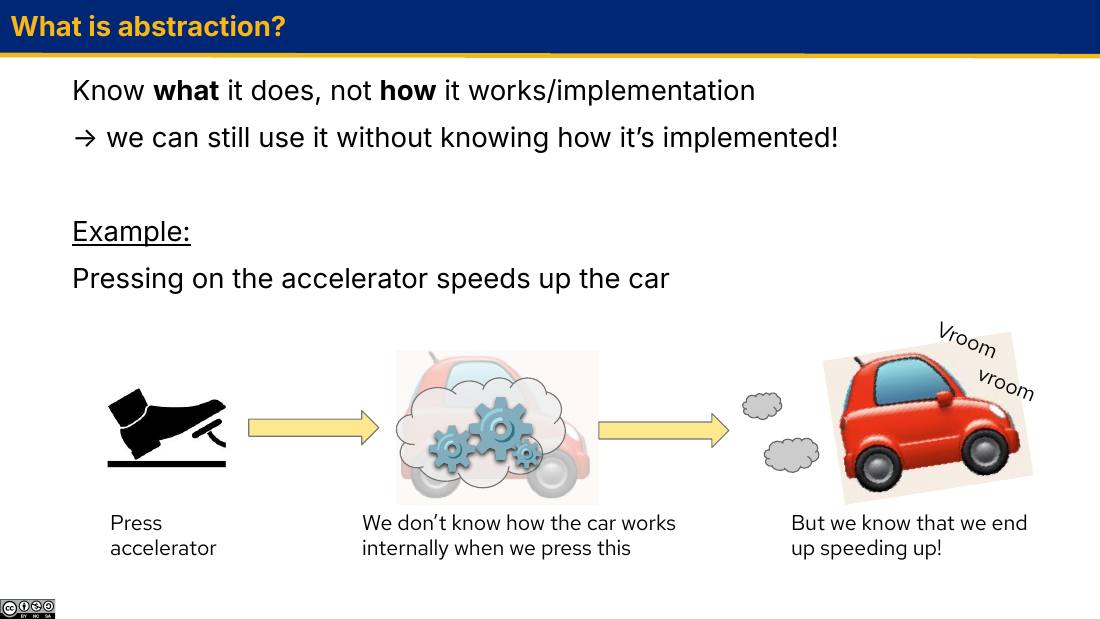
你其实一直在享受抽象。max([1, 3, 2]) 返回 3,可你从来没读过 max 的源码:它是遍历一遍取最大,还是先排序再取最后一个?不知道,也不需要知道。你只知道它的行为契约:给我一个可迭代对象,还我里面最大的那个元素。
这带来两个好处,两个都很实在:
- 使用方省心:脑子里要装的东西少了。写代码时你只需要记住「
max给最大值」,而不是一整套实现细节。 - 实现方自由:只要行为契约不变,实现随便换。Python 明天把
max改成更快的算法,你的代码一个字都不用动。
到目前为止,你用的抽象都是函数抽象(functional abstraction):函数名 + 参数 + 返回值构成契约,函数体是被藏起来的实现。本讲要做的,是把同一套思想用到数据上:怎么把「一个有理数长什么样」这件事也藏起来?
7. 用可变类型做「原型 ADT」:一个会记账的函数
先看一个课上给出的、还没抽象化的做法:怎么在代码里表示「一个银行账户」?一个想法是把「函数」和「可变类型」拼起来。
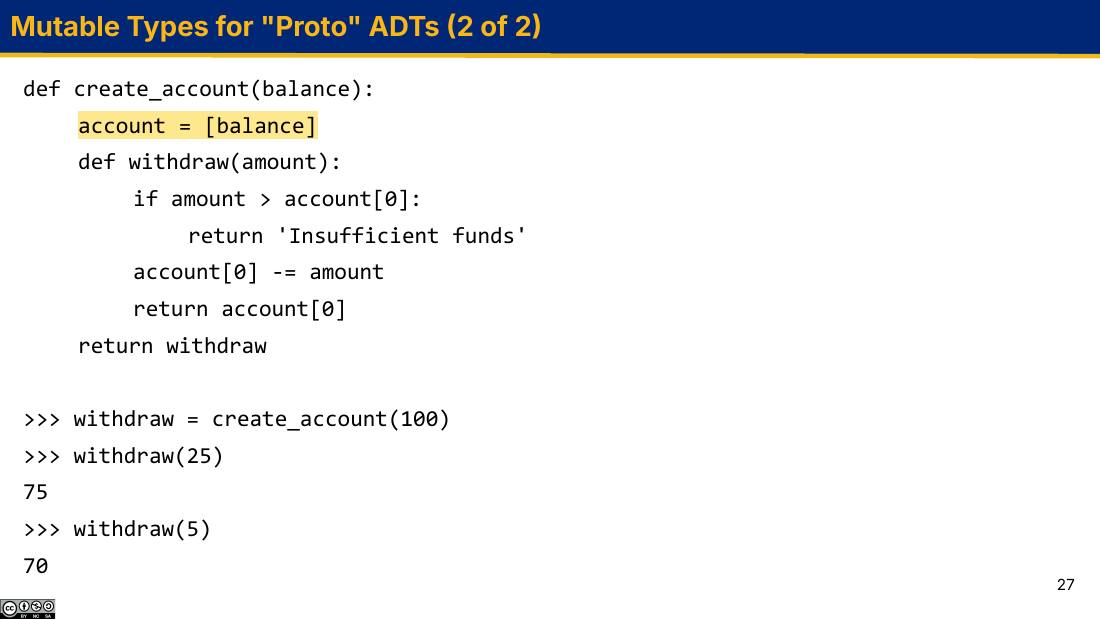
account = [balance] 是全部关键:把余额装进一个列表。这样内层的 withdraw 就能靠「改列表这个对象」来更新余额,而不必给外层帧里的名字重新赋值——后者在只学过 def 和赋值的情况下是做不到的。def create_account(balance):
account = [balance]
def withdraw(amount):
if amount > account[0]:
return 'Insufficient funds'
account[0] -= amount
return account[0]
return withdraw
>>> withdraw = create_account(100)
>>> withdraw(25)
75
>>> withdraw(5)
70
注意这个 withdraw 有记忆:第二次调用知道余额已经是 75 了。它是怎么记住的?必须画环境图才说得清。
def create_account(balance)::全局帧里绑定 create_account → 函数对象,其 parent 是 Global。create_account(100):新建帧 f1,parent = Global,形参 balance → 100。account = [balance]:先求值右边,造出列表对象 A = [100];再在 f1 里绑定 account → A。def withdraw(amount)::造出函数对象 func withdraw(amount),它的 parent 是 f1(函数的 parent 永远是「定义它的那一帧」),并在 f1 里绑定 withdraw → 这个函数对象。return withdraw:返回这个函数对象。全局帧里 withdraw 绑到它。f1 这一帧不能被丢掉——返回的函数对象还记着「我的 parent 是 f1」。withdraw(25):新建帧 f2,parent = f1(不是 Global!),amount → 25。amount > account[0]:amount 在 f2 里查到 25;account 在 f2 里没有,顺 parent 到 f1,查到 A,A[0] 是 100。25 > 100 为假,跳过 return 'Insufficient funds'。account[0] -= amount,即 account[0] = account[0] - amount。等号左边带方括号,所以这是改对象,不是改名字:A 从 [100] 变成 [75]。f1 里的绑定 account → A 完全没动。return account[0] 返回 75。f2 消失,但 A 被 f1 指着,活得好好的。withdraw(5):新建帧 f3,parent 仍是 f1。查到的 A 现在是 [75]。5 > 75 为假,A 变成 [70],返回 70。记忆就是这么来的:状态存在 f1 里那个列表对象上。Global frame
create_account ──→ func create_account(balance) [parent=Global]
withdraw ────────→ func withdraw(amount) [parent=f1] ┐
│ 同一个函数对象
f1: create_account [parent=Global] │
balance ──→ 100 ← 从头到尾没被用过第二次 │
account ──→ A: [70] ← 真正的余额住在这里 │
withdraw ───────────────────────────────────────────────┘
返回值 ──→ func withdraw
f3: withdraw [parent=f1] (已执行完,仅示意)
amount ──→ 5
返回值 ──→ 70
为什么非得写 account = [balance],不能直接在 withdraw 里写 balance -= amount?因为 balance -= amount 展开是 balance = balance - amount,等号左边是光秃秃一个名字——这会在 f2 自己这一帧里新建一个绑定 balance,f1 里的 balance 纹丝不动。更糟的是,Python 一看到函数体里有对 balance 的赋值,就把它整体当成局部名字,于是等号右边那次读取会直接报 UnboundLocalError: local variable 'balance' referenced before assignment。用列表把状态「装起来」,然后变异那个列表,就绕开了这个限制。
这个方案能跑,但课上马上指出它的两个问题:
- 多个属性很难受。账户还要有户主名、开户日期、利率……全塞进
account[0]、account[1]、account[2],谁记得住哪个下标是什么? - 换实现就崩。哪天你想把账户从列表换成字典(
{'owner': ..., 'balance': ...}),那么所有写了account[0]的代码——包括withdraw——统统要改。而现实中「所有代码」可能散落在几十个文件里。
第二条才是致命伤。解决它的办法叫「关注点分离」,也就是下一节的 ADT。
8. 抽象数据类型:构造器与选择器
一个抽象数据类型(Abstract Data Type,ADT)由两部分组成:
- 一个构造器(constructor)函数,负责造出该 ADT 的一个实例;
- 一个或多个选择器(selector)函数,每个负责返回该实例的一个属性。
ADT 是函数式数据抽象(functional data abstraction)的一个例子。
如果你学过面向对象编程(OOP),可能会觉得这写法很别扭——用类不是更自然吗?但要记住:不是所有语言都有 OOP,比如这门课后半学期要学的 Scheme 就没有。而构造器 + 选择器这套东西,只需要「函数」这一个概念就能实现,任何语言都做得到。
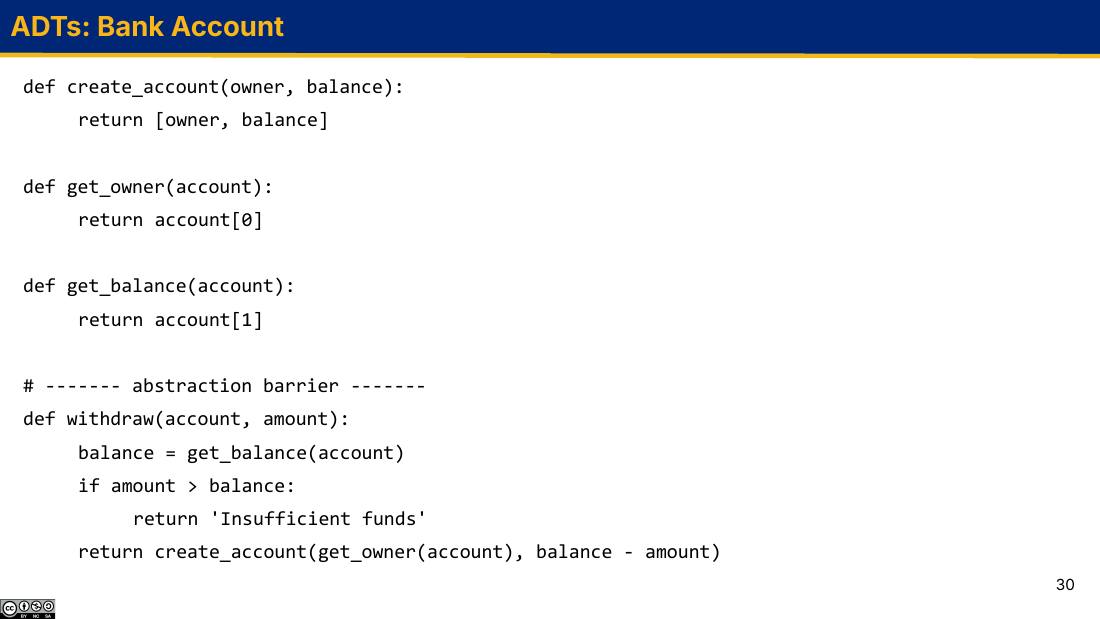
create_account 决定账户「长什么样」(一个 [owner, balance] 列表),两个选择器 get_owner、get_balance 负责把属性取出来。中间那行注释就是抽象屏障:屏障以下的 withdraw 从头到尾没有出现过一个方括号下标。def create_account(owner, balance):
return [owner, balance]
def get_owner(account):
return account[0]
def get_balance(account):
return account[1]
# ------- abstraction barrier -------
def withdraw(account, amount):
balance = get_balance(account)
if amount > balance:
return 'Insufficient funds'
return create_account(get_owner(account), balance - amount)
把它和第 7 节的版本对照,三个变化:
| 对比项 | 第 7 节:闭包版 | 本节:ADT 版 |
|---|---|---|
| 账户是什么 | 一个记住状态的函数 | 一个 [owner, balance] 列表 |
| 取余额 | account[0](直接下标) | get_balance(account)(走选择器) |
| 取钱的效果 | 变异原账户,余额减少 | 不改原账户,返回一个新账户 |
| 换底层实现 | 所有用到下标的代码都要改 | 只改构造器和选择器三个函数 |
第三行值得多说一句。这个 withdraw 走的是不可变风格:它不动传进来的那个账户,而是用构造器造一个余额更少的新账户返回。手动追踪一遍:
追踪 acct = create_account('Alice', 100) 然后 acct2 = withdraw(acct, 25):
create_account('Alice', 100):新建帧 f1,owner → 'Alice',balance → 100。返回新列表 L1 = ['Alice', 100]。全局帧 acct → L1。withdraw(acct, 25):新建帧 f2,account → L1(别名,不是副本),amount → 25。balance = get_balance(account):调用 get_balance(L1),新建帧 f3,返回 L1[1] 即 100。f2 里绑定 balance → 100。25 > 100,为假,跳过。create_account(get_owner(account), balance - amount)。按求值顺序:先算内层的 get_owner(L1) 得 'Alice',再算 100 - 25 得 75,最后调用 create_account('Alice', 75),得到另一个新列表 L2 = ['Alice', 75]。acct2 → L2。此刻 acct 仍然是 ['Alice', 100]——一个字节都没被改过。>>> acct = create_account('Alice', 100)
>>> acct2 = withdraw(acct, 25)
>>> acct
['Alice', 100]
>>> acct2
['Alice', 75]
>>> withdraw(acct2, 1000)
'Insufficient funds'
这两种风格没有绝对的对错,是一个设计选择。变异风格省内存、写起来直接,但任何持有这个账户的代码都会「莫名其妙地」看到余额变化;不可变风格每次造新对象,但历史状态自动保留、没有别名带来的意外。真实系统里两种都有。本讲的重点不在于选哪种,而在于:不管你选哪种,调用方都只通过构造器和选择器打交道。
9. 抽象屏障:违反它的代码应该被烧掉
- ADT 之外的一切代码,都在抽象屏障之外。
- 在屏障之外,绝不能对 ADT 的底层实现做任何假设。这么做叫违反抽象屏障(violating the abstraction barrier)。
- 屏障之内——也就是构造器和选择器的函数体——是唯一允许直接触碰底层表示的地方。
「做假设」具体指什么?指你的代码里出现了任何只有知道底层表示才写得出来的东西:
| 屏障之外写了 | 它假设了什么 | 应该写成 |
|---|---|---|
account[1] | 账户是个序列,余额在下标 1 | get_balance(account) |
account['balance'] | 账户是个字典,键叫 'balance' | get_balance(account) |
[owner, balance] | 账户就是这样一个列表 | create_account(owner, balance) |
len(account) == 2 | 账户有长度、且是 2 | ADT 该提供的话,就加一个选择器 |
x['numer'] | 有理数是字典 | numer(x) |
为什么这么严格?看一个具体的爆炸现场。假设你写了这么一个「聪明」的加法,绕过选择器直接读字典:
# 屏障之外,违反了抽象屏障
def bad_add(x, y):
    return {'numer': x['numer'] * y['denom'] + y['numer'] * x['denom'],
            'denom': x['denom'] * y['denom']}
只要有理数还是用字典实现的,它能跑:
>>> bad_add(rational(1, 2), rational(1, 3))
{'numer': 5, 'denom': 6}
现在有人(可能就是三个月后的你)决定把有理数改成元组实现——这是完全合法的重构,构造器和选择器同步改好,行为一模一样:
def rational(n, d):
    return (n, d)

def numer(x):
    return x[0]

def denom(x):
    return x[1]
>>> bad_add(rational(1, 2), rational(1, 3))
Traceback (most recent call last):
  ...
TypeError: tuple indices must be integers or slices, not str
这个报错还算幸运的——它至少崩了。更危险的情况是违反屏障之后代码不崩,但悄悄算错。比如账户从 [owner, balance] 改成 [balance, owner],那么屏障之外的 account[0] 会安安静静地把余额当成户主名返回,一路传下去,直到某个八竿子打不着的地方才炸。这就是为什么 61A 在这一点上寸步不让:屏障之外看见方括号下标,就是错的,不管它当前能不能跑。
作业和考试里判断「有没有违反屏障」,有一条机械但极其好用的判据:把这一行代码单独拎出来看,如果它读得出 ADT 底层是列表 / 字典 / 元组 / 闭包,就违反了。合法的代码里,ADT 实例只应该以三种方式出现:作为选择器的实参、作为构造器的返回值、作为一个整体被传来传去或比较。
10. 有理数 ADT:换掉实现,调用方一行不改
课上用有理数把整套思路完整走了一遍。为什么要自己造有理数?Python 明明有浮点数。因为浮点数没有无限精度:
>>> 1 / 3
0.3333333333333333
>>> 1 / 3 + 1 / 3 + 1 / 3
1.0
>>> 0.1 + 0.2
0.30000000000000004
而一个有理数可以精确地表示成「分子 + 分母」两个整数。整数在 Python 里是任意精度的,所以只要我们自己管好这两个数,就能做到零误差。
屏障之内:构造器与选择器
def rational(n, d):
    return {'numer': n, 'denom': d}

def numer(x):
    return x['numer']

def denom(x):
    return x['denom']
就这三个函数,构成了「有理数」这个 ADT 的全部实现细节。字典只在这三个函数体里出现过,别处不许再出现。
屏障之外:用有理数干活
# ------- abstraction barrier -------
def add_rationals(x, y):
    nx, dx = numer(x), denom(x)
    ny, dy = numer(y), denom(y)
    return rational(nx * dy + ny * dx, dx * dy)

def mul_rationals(x, y):
    return rational(numer(x) * numer(y), denom(x) * denom(y))

def print_rational(x):
    print(numer(x), '/', denom(x))

def rationals_are_equal(x, y):
    return numer(x) * denom(y) == numer(y) * denom(x)
这四个函数背后是四个中学数学公式。加法通分:
$$\frac{n_x}{d_x} + \frac{n_y}{d_y} = \frac{n_x d_y + n_y d_x}{d_x d_y}$$乘法分子分母各自相乘:
$$\frac{n_x}{d_x} \times \frac{n_y}{d_y} = \frac{n_x n_y}{d_x d_y}$$相等判断用交叉相乘而不是分别比较分子分母——因为 rational(1, 2) 和 rational(2, 4) 是同一个数,但两个字典并不相等:
请把这四个函数体逐字扫一遍:没有一个方括号字符串下标,没有一个花括号字面量。它们只通过 rational、numer、denom 三个函数与有理数打交道。这就是「没有违反抽象屏障」的样子。
跑一遍
>>> half = rational(1, 2)
>>> print_rational(half)
1 / 2
>>> third = rational(1, 3)
>>> print_rational(mul_rationals(half, third))
1 / 6
>>> print_rational(add_rationals(third, third))
6 / 9
print_rational(add_rationals(third, third)) 为什么打印 6 / 9 而不是 2 / 3:
print_rational,得到函数对象。再求值算子数 add_rationals(third, third)——注意算子数要先算完,外层调用才开始。third 在全局帧里查到字典 {'numer': 1, 'denom': 3},两个实参是同一个对象(别名,但这里没人变异它,所以无害)。add_rationals,x 和 y 都绑到那个字典。nx, dx = numer(x), denom(x):右边先求值成元组 (1, 3)(这里悄悄用了元组解包),再绑定 nx → 1、dx → 3。下一行同理 ny → 1、dy → 3。nx * dy + ny * dx = 1 * 3 + 1 * 3 = 6;算 dx * dy = 3 * 3 = 9。rational(6, 9),返回新字典 {'numer': 6, 'denom': 9}。print_rational 的实参。函数体里 print(numer(x), '/', denom(x)) 打印 6 / 9。公式本身没错——只是没人负责约分。加上约分:换实现的时刻
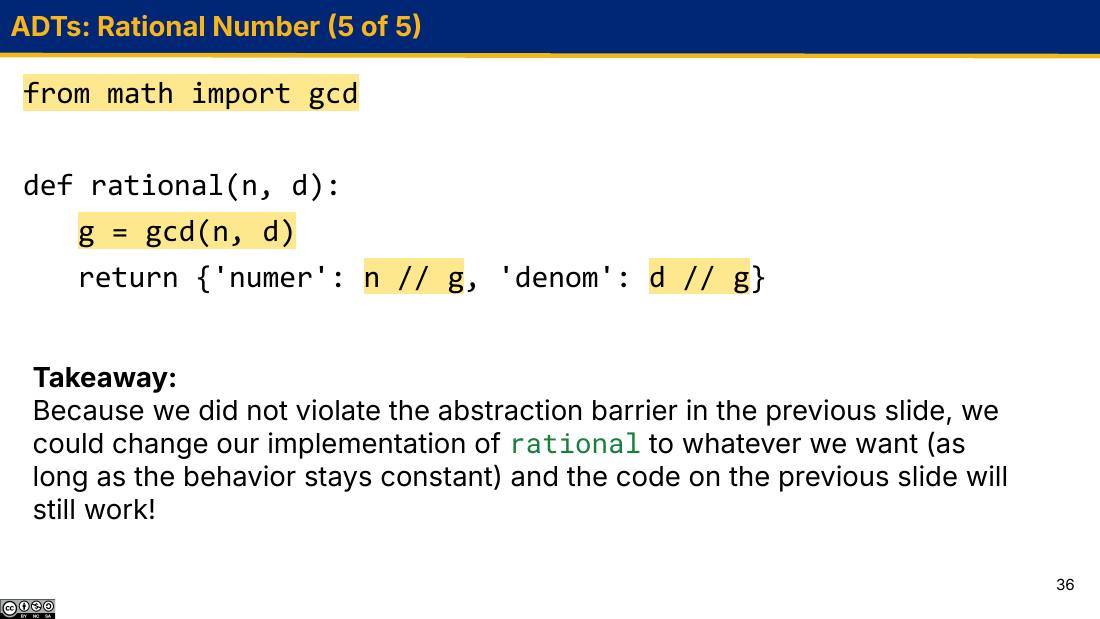
rational 一个函数:先算出分子分母的最大公约数 g,再把两者整除掉 g 之后存进字典。下方的 Takeaway 是本讲的落点——正因为前一页的代码没有违反抽象屏障,我们可以随意更换 rational 的实现(只要行为不变),那些代码照样能跑。from math import gcd
def rational(n, d):
g = gcd(n, d)
return {'numer': n // g, 'denom': d // g}
>>> print_rational(add_rationals(third, third))
2 / 3
>>> print_rational(rational(42, 100))
21 / 50
停下来看清楚发生了什么:add_rationals、mul_rationals、print_rational、rationals_are_equal 一个字符都没改,结果却自动变成约分过的了。原因是它们造有理数时用的是 rational(...),而 rational 的新版本顺手把约分做了。
这就是数据抽象的全部回报:实现的改动被关在屏障之内。如果 add_rationals 当初写成 return {'numer': ..., 'denom': ...},那它造出来的有理数就绕过了新的 rational,永远不会被约分——你得挨个去改每一处。屏障不是给你添麻烦的规矩,它是你日后能改动代码的唯一保障。
// 是整除,结果仍是整数;写成 / 会得到浮点数,有理数瞬间退化成你一开始就想避免的浮点近似(rational(1, 3) 会存成 {'numer': 1.0, 'denom': 3.0})。另外 gcd(0, 5) 是 5,但 gcd(0, 0) 是 0,此时 n // g 会抛 ZeroDivisionError——分母为 0 的有理数本来就没意义,这个 ADT 没有处理这种输入。
11. 实战一:film_appearances
随堂练习的第一题,起始代码在 08.py:
def film_appearances(movies: dict[tuple[str], list[str]],
                     target_actor: str, target_genre: str) -> int:
    """
    Given a dictionary mapping a tuple of the movie's title and genre
    to a list of the actors in that movie, the name of a target actor,
    and a target genre, return the number of times the target actor appears
    in movies of the target genre.
    """
题目到底要什么
先把数据结构看清楚——这道题一大半难度在这里。movies 是一个字典,它的
- 键是一个二元组
(电影标题, 类型); - 值是一个列表,里面装着这部电影的演员名字。
movies = {
    ('Star Wars: Episode IV - A New Hope', 'Sci-Fi'): [
        'Mark Hamill',
        'Harrison Ford',
        'Carrie Fisher',
    ],
    ('Blade Runner 2049', 'Sci-Fi'): [
        'Harrison Ford',
        'Ryan Gosling',
        'Ana de Armas',
    ],
    ('No Time to Die', 'Action'): [
        'Daniel Craig',
        'Ana de Armas',
    ],
}
要返回的是:在类型等于 target_genre 的电影里,target_actor 出现了几次。四条 doctest 覆盖了四种情况:
| 调用 | 期望 | 考的是什么 |
|---|---|---|
film_appearances(movies, 'Harrison Ford', 'Sci-Fi') | 2 | 正常情况,跨多部电影累计 |
film_appearances(movies, 'Ana de Armas', 'Action') | 1 | 该演员也演过别的类型,不能算进去 |
film_appearances(movies, 'Harrison Ford', 'Romance') | 0 | 类型根本不存在 → 返回 0,不是报错 |
film_appearances(movies, 'Saoirse Ronan', 'Action') | 0 | 演员不存在 → 返回 0,不是报错 |
后两条是边界情况,它们其实在告诉你:不要试图用 movies[某个键] 去查,因为查不到会 KeyError。老老实实遍历。
怎么想到的
「数一数满足条件的东西有几个」这类问题的固定套路是计数器 + 遍历 + 条件判断:设一个 total = 0,遍历所有候选,符合条件就 += 1,最后 return total。骨架直接就能写出来。真正要想的只有两个问题:
问题一:遍历什么?判断条件同时需要「类型」(在键里)和「演员表」(在值里),所以必须同时拿到键和值——用 movies.items()。如果只写 for movie in movies:,拿到的只有键(那个二元组),还得再 movies[movie] 取值,绕。
问题二:键怎么拆?items() 的每一项是 ((标题, 类型), 演员列表)——一个二元组,它的第一项本身又是个二元组。可以写 for key, cast in movies.items(): 再用 key[1] 取类型,但更清楚的是嵌套解包:
for (title, genre), cast in movies.items():
左边的形状和右边每一项的形状一模一样,Python 会一层层拆下去。这就是第 2 节元组解包在真实场景里的用法。
条件怎么写?两件事同时成立:类型对得上(genre == target_genre),并且演员在这部片的演员表里(target_actor in cast)。in 用在列表上就是「有没有这个元素」,正是我们要的。
代码逐行讲
    total = 0
    for (title, genre), cast in movies.items():
        if genre == target_genre and target_actor in cast:
            total += 1
    return total
total = 0:计数器必须在循环之外初始化。写在循环里面,每轮都会被清零,最后只能得到 0 或 1。for (title, genre), cast in movies.items()::每轮拿一个条目并拆成三个名字。title 这一轮用不上,但解包时必须给它一个位置——形状要对得上。if genre == target_genre and target_actor in cast::and 会短路——类型不匹配时,右边的 in 查找压根不执行。把便宜的判断放左边是好习惯。total += 1:total 是整数(不可变),这里是重新绑定而不是变异,但因为就在同一帧里,效果正是我们要的累加。return total:必须写在循环外面。写在 for 里面(哪怕缩进对齐 total += 1 之后一行),函数会在第一轮就返回,结果永远是 0 或 1。验证
手动追踪 film_appearances(movies, 'Harrison Ford', 'Sci-Fi'):
movies → 那个字典(别名),target_actor → 'Harrison Ford',target_genre → 'Sci-Fi'。total → 0。title = 'Star Wars: Episode IV - A New Hope',genre = 'Sci-Fi',cast = ['Mark Hamill', 'Harrison Ford', 'Carrie Fisher']。'Sci-Fi' == 'Sci-Fi' 为真 → 继续算右边;'Harrison Ford' in cast 为真。total 变成 1。genre = 'Sci-Fi',cast = ['Harrison Ford', 'Ryan Gosling', 'Ana de Armas']。两个条件都为真。total 变成 2。genre = 'Action'。'Action' == 'Sci-Fi' 为假 → and 短路,右边的 in 不求值,整个条件为假。total 保持 2。return 2。与 doctest 一致。film_appearances(movies, 'Harrison Ford', 'Romance'):三轮里 genre 分别是 Sci-Fi、Sci-Fi、Action,没有一个等于 'Romance',条件全假,total 始终是 0,返回 0。边界情况自动就对了——因为我们是遍历,不是查表。for movie in movies:之后写movie[1]想取类型——这是对的(键是二元组),但很多人会误以为movie是值,然后写if target_actor in movie,结果在拿演员名字跟「标题、类型」这两个字符串比,永远是False,返回 0。if target_actor in movies.values():——values()给出的是一堆列表,in会拿'Harrison Ford'这个字符串去跟整个列表比是否相等,永远是False。- 把
return total缩进到for里面:函数在第一部电影处理完就返回了。这是 61A 全学期最高频的错误之一,写完循环一定要检查return的缩进层级。 - 用
movies[(title, genre)]再取一次演员表:能跑,但多此一举——items()已经把值给你了。
12. 实战二:Coordinate ADT
第二题要求实现一个表示二维坐标 (x, y) 的 ADT,以及一个求两点距离的函数 distance。可以用已经导入的 sqrt。附加挑战:不用任何内建数据结构(列表 / 元组 / 字典),只用高阶函数(HOF)实现。
from math import sqrt

def coordinate(x, y):
    """
    >>> coord1 = coordinate(1, 2)
    >>> coord2 = coordinate(4, 6)
    >>> get_x(coord1)
    1
    >>> get_x(coord2)
    4
    >>> get_y(coord1)
    2
    >>> get_y(coord2)
    6
    >>> distance(coord1, coord2)
    5.0
    """
题目到底要什么
doctest 里没有一行暴露坐标的内部长相——这是刻意的。它只规定了接口:coordinate(x, y) 造一个坐标,get_x / get_y 取出两个分量,distance(a, b) 返回欧几里得距离。注意最后一条期望是 5.0 而不是 5:sqrt 返回浮点数,doctest 是逐字符比较的,返回整数 5 就算错。
怎么想到的
最直接的实现只要三行:
def coordinate(x, y):
    return [x, y]

def get_x(coord):
    return coord[0]

def get_y(coord):
    return coord[1]
用元组 (x, y) 或字典 {'x': x, 'y': y} 也一样好。三种实现互相替换时,distance 一个字都不用改——只要它老老实实走选择器。这就是我们要的效果,先把它写出来:
def distance(a, b):
    ax, ay = get_x(a), get_y(a)
    bx, by = get_x(b), get_y(b)
    return sqrt((ax - bx) ** 2 + (ay - by) ** 2)
现在来看挑战版:不许用列表、元组、字典,怎么把两个数存起来?
这时候要回想第 7 节那个闭包账户。它教了一件事:函数可以记住东西。create_account 返回的 withdraw 之所以记得余额,是因为它的 parent 指向 create_account 那一帧,而余额就在那一帧里。同样的机制:如果 coordinate(x, y) 返回一个在自己体内定义的函数,那个函数就自动「记住」了 x 和 y。
接下来的问题是:返回的函数拿什么参数?我们需要一个函数既能给出 x 又能给出 y。那就让它接受一个「你要哪个属性」的参数——传 "x" 给你 x,传 "y" 给你 y。这个想法一旦有了,代码就是官方解答的样子:
def coordinate(x, y):
    def select(attribute):
        if attribute == "x":
            return x
        elif attribute == "y":
            return y
    return select

def get_x(coord):
    return coord("x")

def get_y(coord):
    return coord("y")
注意此时一个「坐标」在 Python 眼里就是一个函数对象:
>>> coord1 = coordinate(1, 2)
>>> coord1
<function coordinate.<locals>.select at 0x7f3c5d1c60e0>
看起来很荒谬,但只要选择器工作正常,屏障之外的代码根本不在乎。distance 一个字都不用改,因为它从来没假设过坐标是什么。
代码逐行讲
def select(attribute): 定义在 coordinate 的函数体里,所以它的 parent 是 coordinate 的那一帧——x 和 y 就住在那儿。这是它能「记住」的唯一原因。if attribute == "x": return x:attribute 在 select 自己的帧里;x 在这一帧找不到,顺 parent 链上溯到 coordinate 的帧才找到。return select:返回函数对象本身,不是 select(...) 的调用结果。写成 return select() 会立刻报 TypeError: coordinate.<locals>.select() missing 1 required positional argument: 'attribute'。get_x(coord) 里的 coord("x"):coord 是个函数,所以可以直接调用。这一行是整个设计的枢纽——「取属性」被实现成了「调用函数」。elif 之后没有 else:传进一个不认识的属性名(比如 coord("z"))会走到函数体末尾,隐式返回 None。ADT 没规定这种情况该怎么办,所以不处理也算合格。Global frame
coordinate ──→ func coordinate(x, y) [parent=Global]
get_x ──→ func get_x(coord) [parent=Global]
coord1 ──→ func select(attribute) [parent=f1] ← 「坐标」就是这个函数对象
coord2 ──→ func select(attribute) [parent=f2] ← 另一个 select,parent 不同
f1: coordinate [parent=Global]
x ──→ 1
y ──→ 2
select ──→ func select(attribute) [parent=f1]
返回值 ──→ func select [parent=f1]
f2: coordinate [parent=Global]
x ──→ 4
y ──→ 6
select ──→ func select(attribute) [parent=f2]
返回值 ──→ func select [parent=f2]
关键在于 coord1 和 coord2 是两个不同的函数对象,虽然都是同一个 def 语句造出来的。每次调用 coordinate 都会新建一帧,也都会执行一次 def select,造出一个 parent 指向那一帧的新函数对象。两个坐标各自记着各自的 x、y,互不干扰。
验证
追踪 distance(coord1, coord2),一直算到 5.0:
distance,parent=Global,a → coord1 那个函数对象,b → coord2 那个。get_x(a):新建帧 f4: get_x,coord → coord1。执行 return coord("x")。coord("x"):coord1 是那个 parent 为 f1 的 select,所以新建帧 f5: select [parent=f1],attribute → "x"。attribute == "x" 为真,执行 return x。x 在 f5 里找不到 → 顺 parent 到 f1 → 找到 1。f5 返回 1,f4 也返回 1。ax → 1。get_y(a) 走一遍,新建的 select 帧 parent 还是 f1,取到 y = 2。ay → 2。(这两个调用写在同一行 ax, ay = get_x(a), get_y(a),右边先从左到右求值成元组 (1, 2),再解包绑定。)bx, by = get_x(b), get_y(b):这次调用的是 parent 为 f2 的那个 select,所以查到的是 f2 里的 x=4、y=6。bx → 4,by → 6。(ax - bx) ** 2 = (1 - 4) ** 2 = (-3) ** 2 = 9。(ay - by) ** 2 = (2 - 6) ** 2 = (-4) ** 2 = 16。9 + 16 = 25,sqrt(25) = 5.0(浮点数)。返回 5.0,与 doctest 逐字符一致。同一个 distance,配三套完全不同的构造器 / 选择器(列表版、字典版、闭包版)都能跑出 5.0。「坐标是什么」这个问题的答案,被彻底关在了 coordinate、get_x、get_y 三个函数体里。屏障之外的世界只知道「有个东西能被 get_x 问出横坐标」。当有人告诉你「数据抽象有什么用」,这就是答案。
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
| 可变 / 不可变 | 是对象的性质。list、dict 可变;int、float、str、bool、None、tuple 不可变 | 说「x 是可变的」;忘了元组的不可变是浅的,(1, [2]) 里的列表照样能改 |
| 名字改变 | x = ...,只改当前帧里的一个绑定 | 以为函数里 lst = lst + [1] 能改到调用方的列表 |
| 对象改变(变异) | x[0] = v、x.append(v)、d[k] = v、del d[k],所有别名同时看到 | x = x.append(3) 把 x 变成 None |
| 别名 | 来自赋值、传参、放进容器。is 比身份,== 比内容 | b = a 不复制;要副本得写 a[:] 或 list(a) |
| 元组 | 逗号决定它是元组;单元素要写 (1,);支持解包 | (1) 是 int;tup[0] = v 报 TypeError: 'tuple' object does not support item assignment |
| 可变默认参数 | 默认值在 def 执行时求值一次,挂在函数对象上被所有调用共享 | def f(s=[]);正确写法是 s=None 加 if s is None: s = [] |
| 字典 | 键值对容器,靠键定位;keys() / values() / items() / get / pop / in / del | for k in d 遍历的是键;d[缺失键] 抛 KeyError,要兜底用 d.get(k, default) |
| 键必须可哈希 | 只有不可变对象能当键;元组可以,但内部元素也须不可变 | {[1, 2]: 3} 和 {(1, [2, 3]): 4} 都报 TypeError: unhashable type: 'list' |
| 字典推导式 | {k_expr: v_expr for ... in ...};键重复时后写的覆盖先写的 | 没注意到键会碰撞,{x % 3: x for x in range(7)} 只剩 3 条 |
| 抽象 | 知道它做什么,不必知道它怎么做 | 为了「效率」提前窥探实现细节 |
| ADT | 一个构造器 + 若干选择器;实现细节只出现在它们的函数体里 | 选择器写了却不用,直接下标访问 |
| 抽象屏障 | 屏障之外不许对底层表示做任何假设 | 屏障外写 x['numer'];换实现后报 TypeError: tuple indices must be integers or slices, not str,或者更糟——不报错但算错 |
| 闭包做 ADT | 返回的内层函数 parent 指向外层帧,因而「记住」了外层的名字 | return select() 写成了调用;忘了每次调用外层都会造一个新的内层函数对象 |
动手练习
练习 1(WWPD):元组与可变性
>>> lst = [1, 2]
>>> t = (lst, 3)
>>> lst.append(9)
>>> t
______
>>> t[0] = [1, 2]
______
>>> d = {}
>>> d[t] = 'hi'
______
看答案
>>> t
([1, 2, 9], 3)
>>> t[0] = [1, 2]
TypeError: 'tuple' object does not support item assignment
>>> d[t] = 'hi'
TypeError: unhashable type: 'list'
第一问:t 的第 0 格存的是一根指向 lst 那个列表的箭头。lst.append(9) 改的是列表对象,元组的两根箭头没动,所以合法,打印出来就看到 [1, 2, 9]。
第二问:这才是「改元组」,直接 TypeError。哪怕新值和原值长得一样也不行——检查在赋值这个动作上,不在值上。
第三问:t 里装着可变的列表,整体哈希值会飘,Python 拒绝把它当键。报错信息指的是元组里面那个 list。
练习 2(WWPD):默认参数与字典
>>> def tally(item, counts={}):
...     if item in counts:
...         counts[item] += 1
...     else:
...         counts[item] = 1
...     return counts
...
>>> tally('a')
______
>>> tally('a')
______
>>> tally('b', {})
______
>>> tally('b')
______
看答案
>>> tally('a')
{'a': 1}
>>> tally('a')
{'a': 2}
>>> tally('b', {})
{'b': 1}
>>> tally('b')
{'a': 2, 'b': 1}
默认值那个空字典在 def 执行时造出来一次,之后一直挂在 tally 这个函数对象上。第一、二、四次调用都在改同一个字典 D:先 {'a': 1},再 {'a': 2},最后加进 'b' 变成 {'a': 2, 'b': 1}。第三次调用显式传了一个新字典,跟 D 无关,所以是 {'b': 1},并且它没有污染 D。
顺带注意第四问的顺序:'a' 先插入所以排在前面。修法照旧:counts=None 加上 if counts is None: counts = {}。
练习 3(WWPD):字典推导式与遍历
>>> d = {'a': 1, 'b': 2, 'c': 1}
>>> {v: k for k, v in d.items()}
______
>>> 1 in d
______
>>> 'a' in d
______
>>> len({x // 2: x for x in range(5)})
______
看答案
>>> {v: k for k, v in d.items()}
{1: 'c', 2: 'b'}
>>> 1 in d
False
>>> 'a' in d
True
>>> len({x // 2: x for x in range(5)})
3
第一问:依次产生 1:'a'、2:'b'、1:'c'。键 1 重复,后写的 'c' 覆盖 'a';位置按 1 第一次出现的先后,排在 2 前面。键值互换会丢数据,因为原来的值不保证互不相同。
第二、三问:in 对字典查的是键。1 是值不是键,所以 False。
第四问:x 取 0..4,键 x // 2 依次是 0, 0, 1, 1, 2 —— 只有 0、1、2 三个不同的键,长度是 3(值分别是 1、3、4)。
练习 4:递归 + ADT
用第 10 节的有理数 ADT,写一个 sum_rationals(rats),把一个元组里的所有有理数加起来。空元组返回 rational(0, 1)。要求:用递归,且不许违反抽象屏障。
def sum_rationals(rats):
    """
    >>> r = (rational(1, 2), rational(1, 3), rational(1, 6))
    >>> print_rational(sum_rationals(r))
    36 / 36
    """
看答案
def sum_rationals(rats):
    if len(rats) == 0:
        return rational(0, 1)
    return add_rationals(rats[0], sum_rationals(rats[1:]))
思路:递归的对象是元组,不是有理数。rats[0] 取出第一个有理数,rats[1:] 是剩下那一段(切片对元组同样可用,得到的还是元组)。base case 是空元组,此时该返回「加法单位元」——也就是 0,用 ADT 写就是 rational(0, 1)。注意全程只用了 rational 和 add_rationals,没碰过任何字典。
把它真的展开(用未约分版的 rational,即不带 gcd 的那版):
sum_rationals((1/2, 1/3, 1/6))
= add_rationals(1/2, sum_rationals((1/3, 1/6)))
= add_rationals(1/2, add_rationals(1/3, sum_rationals((1/6,))))
= add_rationals(1/2, add_rationals(1/3, add_rationals(1/6, sum_rationals(()))))
= add_rationals(1/2, add_rationals(1/3, add_rationals(1/6, rational(0, 1))))   ← 触底
触底之后逐层回代,每一步套 $\frac{n_x d_y + n_y d_x}{d_x d_y}$:
第 4 层:add_rationals(1/6, 0/1)
        分子 = 1 * 1 + 0 * 6 = 1
        分母 = 6 * 1 = 6            →  1/6

第 3 层:add_rationals(1/3, 1/6)
        分子 = 1 * 6 + 1 * 3 = 9
        分母 = 3 * 6 = 18           →  9/18

第 2 层:add_rationals(1/2, 9/18)
        分子 = 1 * 18 + 9 * 2 = 36
        分母 = 2 * 18 = 36          →  36/36

第 1 层:返回 36/36
print_rational 于是打印 36 / 36——数值上确实等于 1,只是没约分。如果换成带 gcd 的构造器,同一份 sum_rationals 会打印 1 / 1,而函数本身一个字符都不用改。
练习 5:找出违反抽象屏障的地方
下面四行代码都在第 8 节那个银行账户 ADT(构造器 create_account(owner, balance),选择器 get_owner / get_balance)的屏障之外。哪些违反了屏障?怎么改?
a) def is_rich(account):
       return get_balance(account) > 1000000

b) def rename(account, new_owner):
       account[0] = new_owner

c) def deposit(account, amount):
       return [get_owner(account), get_balance(account) + amount]

d) def transfer(src, dst, amount):
       return (withdraw(src, amount), deposit(dst, amount))
看答案
a) 合法。只用了选择器 get_balance,完全不知道账户内部长什么样。
b) 违反。account[0] 假设了账户是序列、且户主在下标 0。而且它还顺手变异了传进来的账户——这个 ADT 的其它操作都是不可变风格,混着来会让别名问题防不胜防。改法是造一个新账户:
def rename(account, new_owner):
    return create_account(new_owner, get_balance(account))
c) 违反。选择器用对了,但返回值直接写成 [..., ...] 这个列表字面量,等于假设「账户就是一个两元素列表」。一旦构造器改成字典实现,deposit 造出来的东西就不再是合法账户,下一次把它交给 get_balance 就会报 TypeError: list indices must be integers or slices, not str。改法是走构造器:
def deposit(account, amount):
    return create_account(get_owner(account), get_balance(account) + amount)
d) 合法(就屏障而言)。它把账户整个传给别的函数、把结果整个装进元组返回,从头到尾没有窥探过内部结构。这正是「ADT 实例作为一个整体被传来传去」的合法用法。(至于 withdraw 可能返回字符串 'Insufficient funds' 而不是账户,那是另一个问题——是这个 ADT 接口设计上的粗糙之处,不是屏障违规。)