序列与容器
一个名字终于可以装下一堆值。列表、切片、for 循环、列表推导式——以及「复制」这件事从此开始变得危险。
0. 本讲导读
到上一讲为止,你手里的值都是一个一个的:一个数、一个布尔值、一个字符串、一个函数。写 count_partitions 这种树递归时,你能算出「有多少种分法」,但没法把那些分法本身留下来——因为你没有任何办法让一个名字同时指向多个值。
这个限制比看上去严重。想一想「求这组数的平均值」:你不知道这组数有几个,所以没法写 def average(a, b, c);想一想「把这句话里每个词都翻译一遍」:句子的长度是运行时才知道的。凡是数据的个数在写代码时还不确定的问题,用目前的工具都写不出来。
本讲补上的是容器(container):一个值,内部装着别的值。有了它,「一组数据」本身成了可以命名、可以传参、可以返回的一个值,而「数据有几个」变成了运行时才回答的问题。CS 61A 的下半场——数据抽象、树、链表、Scheme 里的表——全部建立在这一讲上。
但容器带来的不只是方便。列表是可变(mutable)的,这意味着从今天起,「两个名字指向同一个值」这件事第一次会产生可观察的后果:改了一边,另一边跟着变。本讲的切片、浅拷贝、is 与 ==,讲的都是同一个问题的不同侧面——到底有几个对象,谁在指着谁。这个问题下一讲(可变性与数据抽象)会正面展开,本讲先把它摆到台面上。
往回看:本讲的 sum_list_rec 用的还是第 5、6 讲的递归骨架,只不过「更小的问题」从「更小的数」变成了「更短的列表」。往前看:Lab 03 的主题就是 Sequences 与 Recursion,而项目 Cats 从头到尾都在切列表、切字符串。
- 容器(container)是一组值的集合;序列(sequence)是有顺序的容器。Python 里的
str、list、range都是序列,本讲讲的索引、切片、in、len、for对它们基本通用。 - 索引从 0 开始;
lst[i]只是getitem(lst, i)的语法糖,它和函数调用一样是个表达式,求值成一个值。 - 凡是写着「end」的地方(
range的终点、切片的终点)都不含终点。range(a, b)的长度是b - a。 - 切片会造出一个新列表,而且是浅拷贝(shallow copy):新列表里的每个格子仍然指向原来那些对象。所以外层改动互不影响,内层嵌套的列表却是共享的。
==问「内容一样吗」,is问「是同一个对象吗」。a == b为真而a is b为假,是列表的常态。append/extend/insert/remove这些方法就地修改列表并返回None。写lst = lst.append(4)会让lst变成None——这是本讲最高频的 bug。- 空容器是 falsy,非空容器是 truthy。所以判断「列表空不空」直接写
if not lst:。
1. 容器、序列与列表基础
两个定义,先分清
容器(container):一个装着若干个值的值。
序列(sequence):有顺序的容器——每个元素有确定的位置,你可以问「第 0 个是谁」。
「有顺序」这三个字是关键。下一讲会遇到集合(set)和字典(dict),它们是容器但不是序列:你不能问一个 set 的「第 0 个元素」,因为它根本没有第 0 个。本讲的所有语法——索引、切片、for 的遍历顺序——都依赖「有顺序」这个前提。
Python 里最常见的三个序列类型:
| 类型 | 例子 | 元素是什么 | 能改吗 |
|---|---|---|---|
str(字符串) | 'hello' | 单个字符(本身也是长度为 1 的字符串) | 不能 |
list(列表) | [1, 'abc', True] | 任意值,可以混着放 | 能 |
range | range(5) | 一串连续整数 | 不能 |
本讲讲列表的语法时,请随时记着:其中很大一部分对字符串同样成立。len、索引、切片、in、for 遍历,字符串全都支持。真正的分水岭只有一条——字符串不能改。
造一个列表
用方括号把若干个表达式逗号分隔起来,就是一个列表字面量(list literal):
>>> lst = [1, 'abc', True]   # can mix and match data types
>>> len(lst)
3
第一行发生的事,用第 1 讲的求值规则拆开是这样的:
[1, 'abc', True]。方括号里的三个子表达式从左到右各自求值,得到 1、'abc'、True 三个值。lst 绑定到这个列表对象上——注意,绑定的不是「三个值」,而是「那一个列表」。第 3 步值得多想一秒。lst 这个名字在当前帧里只占一格,它指向的是一个整体。列表内部装着三个指向元素的引用,但那是列表的事,不是环境的事。这个区分在讲别名时会变得性命攸关。
len(lst) 返回元素个数 3。注意 len 数的是顶层的格子数,不管格子里装的是什么——哪怕某个格子里装的是另一个有 100 个元素的列表,它也只算 1 个。
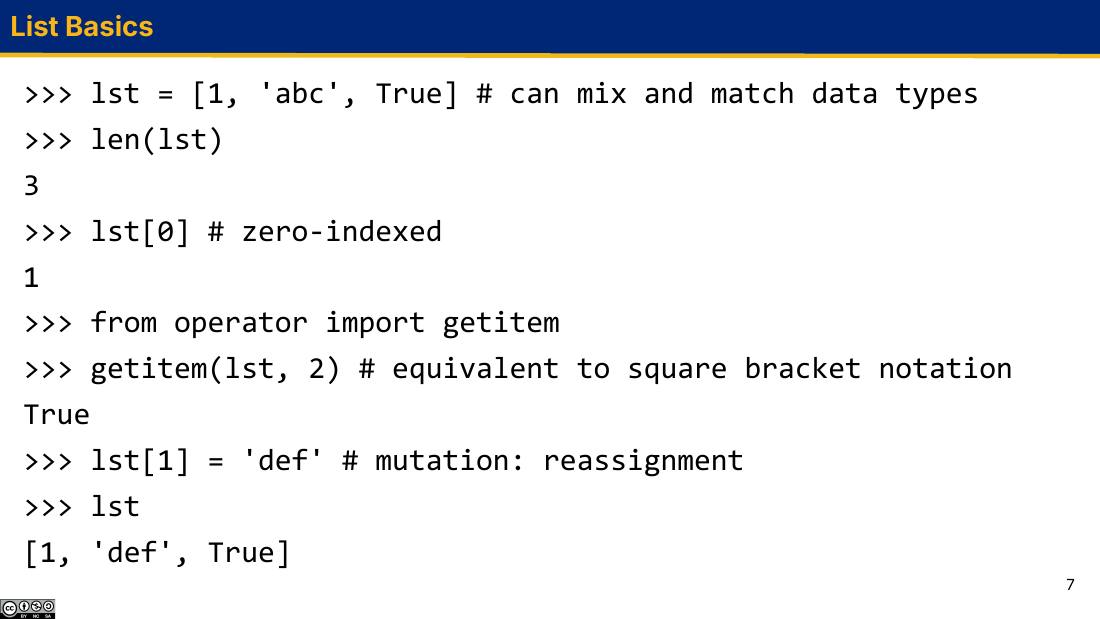
len 数顶层元素个数;下标从 0 开始;lst[i] 和 getitem(lst, i) 是同一件事的两种写法。最后一行 lst[1] = 'def' 是本课程第一次出现的「改动已有对象」——它没有造新列表,而是把原列表 1 号格子里的东西换掉了。索引:方括号是函数调用的语法糖
>>> lst[0]      # zero-indexed
1
>>> from operator import getitem
>>> getitem(lst, 2)     # equivalent to square bracket notation
True
幻灯片特意把 getitem 拿出来讲,不是为了让你以后写 getitem(lst, 2)——没人这么写。它想说的是一件观念上的事:
lst[0] 不是什么新语法,它就是一个普通的调用表达式,只是穿了件方括号的外衣。所以第 1 讲那套求值规则完全适用:先求值 lst 得到列表对象,再求值 0 得到整数,然后把 getitem 施加到这两个实参上,返回一个值。
推论:方括号里可以放任意表达式,只要它求值成整数。lst[i + 1]、lst[len(lst) - 1]、lst[f(x)] 都合法,因为它们都是「先求值成一个整数,再传给 getitem」。
为什么从 0 开始?把下标理解成「离开头有多远」就顺了:第 0 个元素离开头 0 步,第 1 个离开头 1 步。长度为 3 的列表,合法下标是 0、1、2;最后一个元素的下标是 len(lst) - 1。
下标越界会得到一个非常明确的错误:
>>> lst = [1, 'abc', True]
>>> lst[3]
Traceback (most recent call last):
  ...
IndexError: list index out of range
Python 还支持负数下标,从右边数起:lst[-1] 是最后一个,lst[-2] 是倒数第二个。等价关系是 lst[-k] 就是 lst[len(lst) - k]。这个特性在本讲最后的凯撒密码练习里会被用得很巧妙。
表达式(lst = ['a', 'b', 'c']) | 结果 | 说明 |
|---|---|---|
lst[0] | 'a' | 第一个 |
lst[2] | 'c' | 最后一个,下标 = len(lst) - 1 |
lst[-1] | 'c' | 倒数第一,等价于 lst[2] |
lst[-3] | 'a' | 倒数第三,等价于 lst[0] |
lst[3] | IndexError | 越界 |
lst[-4] | IndexError | 反方向也会越界 |
下标必须是整数,写成字符串或浮点数都会炸,而且报错信息完全不同:
>>> lst['0']
Traceback (most recent call last):
  ...
TypeError: list indices must be integers or slices, not str
>>> lst[1.0]
Traceback (most recent call last):
  ...
TypeError: list indices must be integers or slices, not float
看到 TypeError: list indices must be...,说明你算下标的那个表达式类型不对。最常见的来源是用了 / 而不是 //:lst[len(lst) / 2] 里 / 的结果永远是 float,哪怕它是 2.0。改成 lst[len(lst) // 2] 就好了。
下标赋值:本课程第一次「改动一个值」
>>> lst = [1, 'abc', True]
>>> lst[1] = 'def'      # mutation: reassignment
>>> lst
[1, 'def', True]
这两行值得停下来。lst[1] = 'def' 是一条赋值语句,但它跟你见过的所有赋值都不一样:
x = 5 | lst[1] = 'def' | |
|---|---|---|
| 改的是什么 | 当前帧里名字 x 的绑定 | 列表对象内部第 1 个格子的内容 |
| 环境图上哪里变了 | 帧里多一行 / 改一行 | 帧里一个字都没变,变的是堆上的那个列表 |
| 别的名字看得见吗 | 看不见(别的名字有自己的绑定) | 看得见——只要它也指着这个列表 |
| 术语 | 重新绑定(rebinding) | 变异(mutation) |
「帧里一个字都没变」是理解可变性的钥匙。画个图看看 lst[1] = 'def' 前后:
执行前
  Global frame
    lst ──┐
          ▼
        列表对象 @id1
        ┌─────┬───────┬──────┐
        │  0  │   1   │  2   │
        ├─────┼───────┼──────┤
        │  1  │ 'abc' │ True │
        └─────┴───────┴──────┘

执行 lst[1] = 'def' 之后
  Global frame
    lst ──┐          ← 绑定没动,还是指向 @id1
          ▼
        列表对象 @id1  ← 还是同一个对象,只是 1 号格换了内容
        ┌─────┬───────┬──────┐
        │  0  │   1   │  2   │
        ├─────┼───────┼──────┤
        │  1  │ 'def' │ True │
        └─────┴───────┴──────┘
字符串则完全不给你这个机会:
>>> s = 'hello'
>>> s[0]
'h'
>>> s[0] = 'j'
Traceback (most recent call last):
  ...
TypeError: 'str' object does not support item assignment
这条报错信息要记住——它是「你想改一个不可变对象」的标准信号。想要「改过的字符串」,只能造一个新的:s = 'j' + s[1:]。本讲末尾的凯撒密码正是因为这个限制,才要先把字符攒进一个列表、最后再 join 成字符串。
2. for 循环与 range
用 while 遍历列表有什么不好
有了列表和 len,你其实已经能用第 2 讲的 while 遍历它了:
lst = ['a', 'b', 'c']
i = 0
while i < len(lst):
    print(lst[i])
    i += 1
这段代码能跑,但四行里有三行跟「打印每个元素」这件事毫无关系:i = 0 是初始化、i < len(lst) 是边界、i += 1 是更新。三行样板代码,每一行都是一个能出错的地方——i 从 1 开始就漏掉第一个,条件写成 <= 就 IndexError,忘了 i += 1 就死循环。
for 循环把这三行全部收进语法里:
for <var> in <iterable>:
    <suite>
>>> lst = ['a', 'b', 'c']
>>> for elem in lst:
...     print(elem)
...
a
b
c
执行 for 循环时到底发生了什么
for 是一条复合语句,和 if、while 一样由 header 加缩进的 suite 组成。它的执行过程是:
in 后面的表达式(这里是 lst),得到一个可迭代对象(iterable)。这一步只做一次,不是每轮都做。<var> 这个名字绑定到该元素上(在当前帧里,跟普通赋值一样),然后执行一遍 suite。第 2 步里「跟普通赋值一样」这句话有两个后果,都很重要。
后果一:for 不新建帧。 和 while 一样,循环变量就是当前帧里的一个普通名字。所以循环结束之后它还在,值是最后一次绑定的那个:
>>> for elem in ['a', 'b', 'c']:
...     pass
...
>>> elem
'c'
后果二:改循环变量不会影响原列表。 这是初学者最常摔的一跤:
>>> lst = [1, 2, 3]
>>> for elem in lst:
...     elem = elem * 2
...
>>> lst
[1, 2, 3]
第 2 轮开始时(elem 被绑定到列表的 1 号元素)
  Global frame
    lst  ──┐
    elem ──┼──┐
           ▼  │
        列表 @id1
        ┌───┬───┬───┐
        │ 1 │ 2 │ 3 │
        └───┴─▲─┴───┘
              └───────┘   elem 和列表的 1 号格 指向同一个值 2

执行 elem = elem * 2 之后
  Global frame
    lst  ──┐
    elem ──── 4      ← 只是把 elem 改指到新算出来的 4
           ▼
        列表 @id1
        ┌───┬───┬───┐
        │ 1 │ 2 │ 3 │   ← 列表一个字没变
        └───┴───┴───┘
道理和 x = 5 一模一样:elem = ... 改的是名字的绑定,而列表的格子是另一处存放引用的地方。要真的改列表,必须走下标赋值 lst[i] = ...——也就是说你需要下标,而 for elem in lst 恰恰不给你下标。这就引出了 range。
range:一串按需生成的整数
range(end)               # 从 0 开始
range(start, end)        # 从 start 开始
range(start, end, step)  # 步长为 step
end 是不含的(exclusive)。 所以 range(start, end) 的长度是 end - start,不是 end - start + 1。range(5) 给出 0、1、2、3、4 —— 五个数,没有 5。
这个约定不是为了折磨你。正因为 end 不含,range(len(lst)) 才恰好是「所有合法下标」:长度为 3 的列表,下标是 0、1、2,而 range(3) 正好给这三个。如果 end 含在内,这里就得永远写 range(len(lst) - 1),反而更容易错。
| 写法 | 产生的整数 | 长度 |
|---|---|---|
range(5) | 0, 1, 2, 3, 4 | 5 |
range(2, 5) | 2, 3, 4 | 3(= 5 − 2) |
range(2, 10, 3) | 2, 5, 8 | 3 |
range(5, 0, -1) | 5, 4, 3, 2, 1 | 5 |
range(5, 5) | (什么都没有) | 0 |
range(5, 2) | (什么都没有,步长为正却要往回走) | 0 |
后两行值得留意:range 为空时,for 循环体一次都不执行,而且不会报错。程序「什么也没干就结束了」的时候,先怀疑 range 是不是空的。
还要说清一件事:range(1000000) 不会在内存里造一百万个整数。range 对象只记住 start、end、step 三个数,用到第几个才算第几个。所以它在交互式解释器里直接显示自己是这样:
>>> range(5)
range(0, 5)
>>> list(range(5))
[0, 1, 2, 3, 4]
想看到里面的数,得用 list(...) 把它铺开。(这和后面 map / filter 的显示是同一回事。)
按下标遍历
>>> lst = ['a', 'b', 'c']
>>> for i in range(len(lst)):
...     print(i)
...
0
1
2
这就是「需要下标时」的标准写法。回到刚才那个「把每个元素翻倍」的需求,现在能写对了:
>>> lst = [1, 2, 3]
>>> for i in range(len(lst)):
...     lst[i] = lst[i] * 2
...
>>> lst
[2, 4, 6]
区别只在于赋值语句的左边:elem = ... 改名字,lst[i] = ... 改列表。
什么时候用 for x in lst,什么时候用 for i in range(len(lst))?
- 只需要「每个元素的值」——用前者。它更短、更不容易错。
- 需要下标本身(要改列表、要比较相邻元素
lst[i]和lst[i+1]、要同时遍历两个等长列表)——用后者。
不要因为「看起来更专业」而无脑写 range(len(lst))。多出来的那个 i 是多出来的一个出错机会。
序列解包:一次绑定多个名字
如果被遍历的每个元素本身是一个序列,可以在 for 的变量位置写多个名字,一次拆开:
>>> lst = [[1, 2], [3, 4], [5, 6]]
>>> for x, y in lst:     # sequence unpacking
...     print(x, y)
...
1 2
3 4
5 6
每一轮做的事是:取出一个元素(比如 [1, 2]),然后同时把 x 绑到它的第 0 个、y 绑到第 1 个。这叫序列解包(sequence unpacking)。它要求每个元素的长度恰好等于名字的个数,否则报错:
>>> for x, y in [[1, 2], [3, 4, 5]]:
...     print(x, y)
...
1 2
Traceback (most recent call last):
  ...
ValueError: too many values to unpack (expected 2)
注意它是跑到第二轮才炸的——第一轮已经打印出 1 2。这是循环里所有类型错误的共同特征:前面几轮的副作用已经发生了。
enumerate 把「值」和「下标」一起给你,正好配合解包使用:
>>> lst = ['a', 'b', 'c']
>>> for i, elem in enumerate(lst):    # sequence unpacking
...     print(i, elem)
...
0 a
1 b
2 c
enumerate(lst) 概念上产生 (0, 'a')、(1, 'b')、(2, 'c') 这一串成对的东西,解包后 i 拿下标、elem 拿值。这是「既要值又要下标」时最干净的写法——比 for i in range(len(lst)) 再 lst[i] 好读,也少一次索引。
enumerate 给出的顺序是 (下标, 值),不是 (值, 下标)。写反了不会报错,只会安静地给你一个错误答案——这比报错难查得多:
>>> lst = [10, 20, 30]
>>> total = 0
>>> for elem, i in enumerate(lst):   # 写反了!
...     total += elem
...
>>> total
3
你以为在加 10 + 20 + 30 = 60,实际加的是 0 + 1 + 2 = 3,因为 elem 拿到的是下标。调试口诀:结果小得离谱、或者恰好等于「0 + 1 + … + (n−1)」,就去看 enumerate 的两个名字是不是反了。
下划线:一个不打算用的名字
>>> for _ in range(3):    # _ is convention for an unused variable
...     print('Go bears!')
...
Go bears!
Go bears!
Go bears!
_ 在 Python 里就是一个普通的合法名字,没有任何特殊语法含义。用它纯粹是一种约定:告诉读代码的人「这个循环我只关心重复三次,根本不在乎当前是第几轮」。你写成 for i in range(3) 完全等价,只是读者会花半秒钟去找 i 在哪用了,然后发现没用。
3. 成员判断:in 比你想的浅
<value> in <sequence> 是一个表达式,求值成 True 或 False,问的是「这个值是不是该序列的某一个元素」。
>>> lst = [1, 2, [3, 4]]
>>> 2 in lst
True
>>> 3 in lst
False
>>> [3, 4] in lst
True
>>> len(lst)
3
中间那行是整段的重点:3 in lst 是 False,尽管 3 明明「在里面」。原因是 lst 只有三个元素:1、2、[3, 4]。3 不是其中任何一个,它是第三个元素的元素。
in 只看一层。它逐个取出序列的顶层元素,拿每个去和左边的值做 == 比较,有一个相等就返回 True。它不会递归下钻到嵌套的列表里。
len 也是同样的「只看一层」:len([1, 2, [3, 4]]) 是 3,不是 4。这两个函数的口径是一致的——顶层有几个格子,就是几个元素。
既然比较用的是 ==,那 [3, 4] in lst 为真就顺理成章:lst[2] == [3, 4] 成立(两个列表内容相同),所以 in 认账。注意它不要求是同一个对象——右边那个 [3, 4] 是刚刚新建的列表,和 lst 里装的根本不是一个东西,但 == 为真就够了。这一点在下一节 is vs == 里会再提。
字符串上的 in 不一样
字符串是唯一的例外:对 str 来说,in 判断的是子串(substring),不是「某个字符」:
>>> 'b' in 'abc'
True
>>> 'bc' in 'abc'      # 子串也算
True
>>> 'ac' in 'abc'      # 必须连续
False
>>> 'bc' in ['a', 'b', 'c']    # 列表就不吃这一套
False
| 表达式 | 结果 | 为什么 |
|---|---|---|
2 in [1, 2, [3, 4]] | True | 2 是顶层元素 |
3 in [1, 2, [3, 4]] | False | 3 藏在嵌套列表里,in 不下钻 |
[3, 4] in [1, 2, [3, 4]] | True | 顶层第 2 个元素与它 == |
[3] in [1, 2, [3, 4]] | False | [3] == [3, 4] 不成立 |
'bc' in 'abc' | True | 字符串特例:查连续子串 |
'bc' in ['a','b','c'] | False | 列表里没有名为 'bc' 的元素 |
2 in range(5) | True | range 也是序列 |
另外,in 在 for 语句里的那个 in 跟这个 in 是两个完全不同的东西:前者是 for 语法的一部分(关键字),后者是一个运算符。看到 in 先看它前面是不是 for。
4. 切片:取出一段,顺手复制一份
索引一次只能拿一个元素。想拿「第 1 到第 3 个」,用切片(slicing):
>>> lst = ['a', 'b', 'c', 'd', 'e']
>>> lst[1:3]      # end is exclusive
['b', 'c']
>>> lst[1:]       # default end is len(lst)
['b', 'c', 'd', 'e']
>>> lst[:2]       # default start is 0
['a', 'b']
>>> lst[::2]      # default step is 1
['a', 'c', 'e']
语法是 lst[start:end:step],三个部分各有默认值:
| 省略的部分 | 默认值 | 记法 |
|---|---|---|
start | 0 | 「从头开始」 |
end | len(lst) | 「一直到尾」 |
step | 1 | 「一个不落」 |
和 range 一样,end 不含。所以 lst[1:3] 拿的是下标 1 和 2,两个元素,长度恰好是 3 - 1 = 2。
把下标想成元素之间的「刀口」,而不是元素本身:
   'a'   'b'   'c'   'd'   'e'
  0     1     2     3     4     5
刀口 0 在最左边,刀口 5 在最右边。lst[1:3] 就是「在刀口 1 和刀口 3 处各切一刀,取中间那段」——中间夹着 'b' 和 'c'。这个模型让「end 不含」变得自然:刀口 3 左边的东西才被取走。它同时解释了为什么 lst[2:2] 是空列表(同一刀口切两下,中间什么都没有),以及为什么 lst[:2] + lst[2:] 恰好拼回原列表。
切片永远不越界
这是切片和索引最大的行为差异,也是它好用的原因之一:
>>> lst = [1, 2]
>>> lst[5]
Traceback (most recent call last):
  ...
IndexError: list index out of range
>>> lst[1:5]      # 切片不报错,能拿多少拿多少
[2]
>>> lst[5:9]
[]
切片超出范围只会给你一个更短(甚至为空)的列表,永远不会 IndexError。 这个性质对写递归极其友好:lst[1:] 哪怕在 lst 只有一个元素、甚至是空列表时,也安安静静地返回 [],不需要你先判断长度。第 9 节的 sum_list_rec 就靠这一点。
切片赋值:这是变异
>>> lst = ['a', 'b', 'c', 'd', 'e']
>>> lst[1:3] = ['go', 'bears']    # slicing assignment mutates
>>> lst
['a', 'go', 'bears', 'd', 'e']
把切片写在赋值号左边,效果是「把这一段整个换成右边那些元素」。它改的是原列表,跟 lst[1] = 'def' 一样属于变异。
有意思的是,新旧长度不必相等——列表会自己伸缩:
>>> z = [1, 2, 3, 4, 5]
>>> z[1:3] = [9]          # 两个换一个,列表变短
>>> z
[1, 9, 4, 5]
>>> z = [1, 2, 3]
>>> z[1:2] = [7, 8, 9]    # 一个换三个,列表变长
>>> z
[1, 7, 8, 9, 3]
切片取值:造出一个新列表
切片写在赋值号右边时,行为完全不同——它不碰原列表,而是新建一个:
>>> lst
['a', 'go', 'bears', 'd', 'e']
>>> temp = lst[1:3]       # slicing creates a (shallow) copy
>>> temp[1] = 'stanford'
>>> lst
['a', 'go', 'bears', 'd', 'e']
>>> temp
['go', 'stanford']
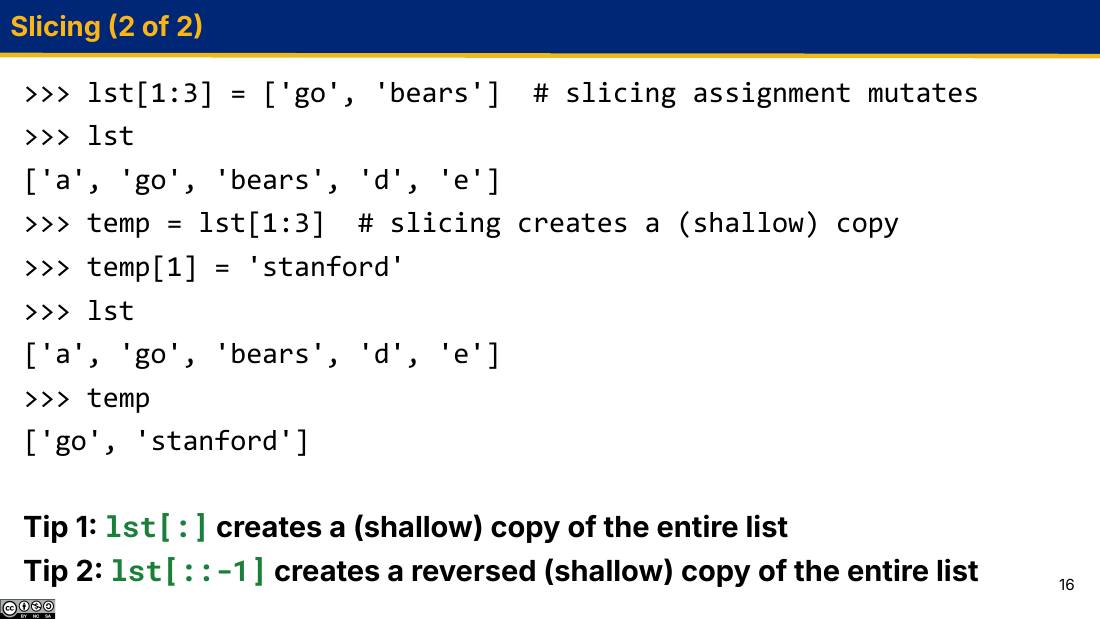
lst[1:3] 出现在赋值号两侧,做的是截然不同的两件事:在左边(第 1 行)是变异,把原列表那一段换掉;在右边(第 4 行)是取值并复制,造出一个独立的新列表 temp,所以后面改 temp[1] 时 lst 纹丝不动。最下面两条 Tip 是整门课都会反复用到的惯用法。temp = lst[1:3] 之后
Global frame
lst ──▶ 列表 @A ['a', 'go', 'bears', 'd', 'e']
│ │
│ │ (只是内容上巧合相同的引用)
temp ──▶ 列表 @B ['go', 'bears']
▲
└── @B 是一个全新的对象,@A 和 @B 是两个列表
temp[1] = 'stanford' 之后
lst ──▶ 列表 @A ['a', 'go', 'bears', 'd', 'e'] ← 没动
temp ──▶ 列表 @B ['go', 'stanford'] ← 只有 @B 的 1 号格变了
由此得到两条一定要背下来的惯用法(幻灯片上的 Tip 1 和 Tip 2):
| 写法 | 作用 | 典型用途 |
|---|---|---|
lst[:] | 整个列表的(浅)拷贝 | 函数里不想弄脏调用方传进来的列表 |
lst[::-1] | 倒序的(浅)拷贝 | 反转,且不破坏原列表 |
lst[1:] | 去掉第一个元素的拷贝 | 列表上的递归:「首元素 + 其余」 |
lst[:-1] | 去掉最后一个元素的拷贝 | 从尾部递归 |
lst[::-1] 之所以能反转,是因为 step 为 -1 表示从右往左走,而 start / end 省略时会自动取「最右」和「最左之外」。这是个惯用法,记住形状即可,不必每次现推。
误区一:以为 lst[:] 和 lst 是一回事。 它们内容相同(== 为真),但是两个对象(is 为假)。这正是它作为「拷贝」的价值所在。
误区二:以为 lst[::-1] 会把原列表反转。 它不会,它返回一个新列表;原列表原封不动。真想就地反转,用 lst.reverse()——但那个方法返回 None,别拿它的返回值。
误区三:字符串上做切片赋值。 字符串不可变,s[1:3] = 'xy' 会报 TypeError: 'str' object does not support item assignment。但字符串取值切片完全没问题:'hello'[1:3] 得到 'el'。
5. 嵌套列表与浅拷贝:copy 到底复制了什么
列表的元素可以是任意值——包括另一个列表。这叫嵌套列表(nested list),是后面「树」「矩阵」「链表」的物质基础。
访问嵌套元素就是连着写两次索引:
>>> lst = [1, 2, [3, 4]]
>>> lst[2]
[3, 4]
>>> lst[2][0]
3
lst[2][0] 依然只是普通的表达式求值:先算 lst[2] 得到那个内层列表,再对结果取 [0]。和 f(x)(y) 是完全同一个道理——上一步的结果就是下一步的操作对象。
浅拷贝的真面目
现在把切片拷贝和嵌套列表放到一起,本讲最关键的一段就出现了:
>>> lst = [1, 2, [3, 4]]
>>> copy = lst[:]      # careful, this is a shallow copy!
>>> lst[1] = 'go'
>>> lst
[1, 'go', [3, 4]]
>>> copy
[1, 2, [3, 4]]
>>> lst[2][0] = 'bears'
>>> lst
[1, 'go', ['bears', 4]]
>>> copy
[1, 2, ['bears', 4]]
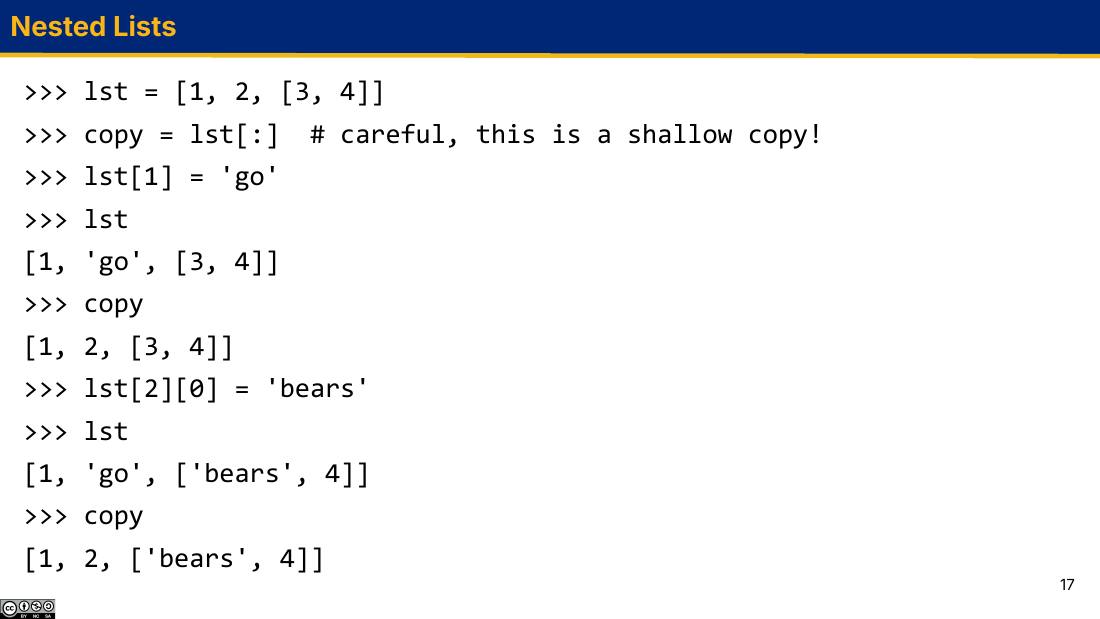
lst[1] = 'go' 之后 copy 毫无变化,而 lst[2][0] = 'bears' 之后 copy 却跟着变了。区别在于第一次改的是「外层列表的格子」(两个列表各有各的格子),第二次改的是「内层那个列表本身」(两个外层列表共用同一个内层列表)。这个不对称让所有人第一次都看不懂。画出来就一目了然了:
① lst = [1, 2, [3, 4]]

  lst ──▶ 列表 @A
          ┌───┬───┬─────┐
          │ 1 │ 2 │  ·──┼──▶ 列表 @C  ┌───┬───┐
          └───┴───┴─────┘             │ 3 │ 4 │
                                      └───┴───┘

② copy = lst[:]     ← 新建列表 @B,把 @A 每个格子里的「引用」原样抄一份

  lst  ──▶ 列表 @A
           ┌───┬───┬─────┐
           │ 1 │ 2 │  ·──┼──┐
           └───┴───┴─────┘  │
                            ├──▶ 列表 @C  ┌───┬───┐
  copy ──▶ 列表 @B          │             │ 3 │ 4 │
           ┌───┬───┬─────┐  │             └───┴───┘
           │ 1 │ 2 │  ·──┼──┘
           └───┴───┴─────┘

   关键:@A 和 @B 是两个不同的列表对象,
        但它们的 2 号格 指向的是「同一个」 @C。

③ lst[1] = 'go'    ← 只改 @A 的 1 号格

  lst  ──▶ @A [1, 'go', ·──▶@C]
  copy ──▶ @B [1,  2 ,  ·──▶@C]     ← @B 完全不受影响

④ lst[2][0] = 'bears'
   先算 lst[2] → 拿到 @C 本身;再把 @C 的 0 号格改成 'bears'

  lst  ──▶ @A [1, 'go', ·──┐
                           ├──▶ @C ['bears', 4]   ← 被改的是这里
  copy ──▶ @B [1,  2 ,  ·──┘

   于是 copy 显示为 [1, 2, ['bears', 4]] —— 它并没有「被改」,
   它只是一直指着那个 @C,而 @C 变了。
浅拷贝(shallow copy)复制的是「格子里的引用」,不是「引用指向的对象」。所以:
- 拷贝出来的是一个新的外层列表——改外层格子(
lst[i] = ...)互不影响。 - 但内层的嵌套对象还是同一个——通过任一条路径去变异它(
lst[i][j] = ...、lst[i].append(...)),另一条路径都看得见。
判断口诀:看赋值号左边有几层方括号。一层(lst[1] = ...)动的是拷贝自己的格子;两层及以上(lst[2][0] = ...)动的是共享的那个内层对象。
验证「共享」这件事,可以直接问 Python:
>>> lst = [1, 2, [3, 4]]
>>> copy = lst[:]
>>> lst is copy
False
>>> lst[2] is copy[2]
True
外层不是同一个,内层是同一个。这两行把「浅拷贝」四个字彻底说清了。
「浅」不是缺陷,只是一个需要知道的事实。要真正独立的副本(深拷贝),得自己递归地拷:
def deep_copy(lst):
    result = []
    for elem in lst:
        if type(elem) == list:
            result.append(deep_copy(elem))
        else:
            result.append(elem)
    return result
(标准库里有 copy.deepcopy,但 61A 不用它。这段代码本身是一个漂亮的递归练习:base case 是「元素不是列表,直接放进去」,递归步是「元素是列表,就拷它的拷贝」。)
用乘法造二维列表,会造出一排别名。 这是浅拷贝陷阱最出名的形态:
>>> grid = [[0, 0, 0]] * 3
>>> grid
[[0, 0, 0], [0, 0, 0], [0, 0, 0]]
>>> grid[0][0] = 'X'
>>> grid
[['X', 0, 0], ['X', 0, 0], ['X', 0, 0]]
* 3 只是把同一个引用重复放了三次,三行其实是同一个列表。改一行就是改三行。正确写法是让每一行都是新建的:
>>> grid = [[0, 0, 0] for _ in range(3)]
>>> grid[0][0] = 'X'
>>> grid
[['X', 0, 0], [0, 0, 0], [0, 0, 0]]
因为列表推导式每一轮都重新求值一次 [0, 0, 0],每轮造一个新列表。(列表推导式见第 7 节。)
6. 身份与相等:is 和 == 问的不是同一个问题
>>> a = [1, 2, 3]
>>> b = [1, 2, 3]
>>> a == b
True
>>> a is b
False
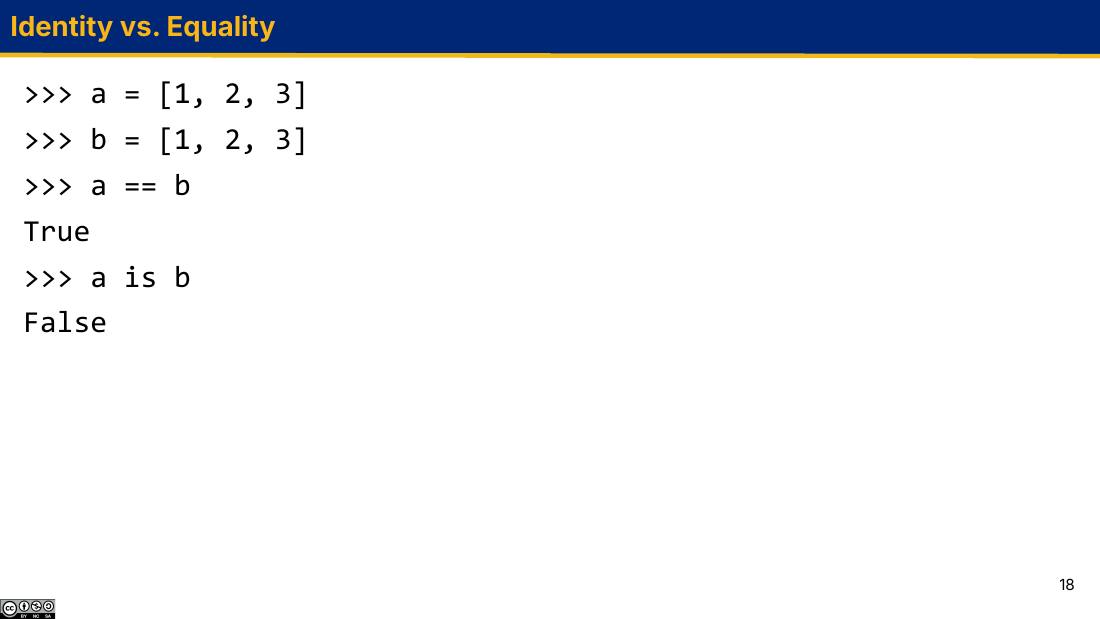
== 为真;但它们是内存里两个独立的东西,所以 is 为假。整门课后面讲别名、讲可变数据、讲环境图,用的都是 is 这个口径。==(equality,相等) | is(identity,同一) | |
|---|---|---|
| 问的问题 | 内容一样吗? | 是同一个对象吗? |
| 怎么判断 | 逐个元素比较(嵌套的会递归比) | 比较内存地址(id()) |
[1,2] == [1,2] | True | — |
[1,2] is [1,2] | — | False |
| 关系 | a is b 为真 ⟹ a == b 为真;反过来不成立 | |
为什么每写一次 [1, 2, 3] 就得到一个新对象?因为列表可变。如果 Python 偷懒让两个字面量共用一个列表,那 a.append(4) 就会莫名其妙地把 b 也改了——没有人能接受这种事。所以每一次求值列表字面量,都必然新建一个对象。
那么什么时候 is 才为真?只有当两个名字确实指着同一个对象时:
>>> a = [1, 2, 3]
>>> b = a            # 只是给同一个列表起了第二个名字
>>> a is b
True
>>> b.append(4)
>>> a
[1, 2, 3, 4]
>>> c = a[:]         # 切片造新对象
>>> a is c
False
>>> a == c
True
b = a 这行没有造任何列表,它只是让 b 和 a 指向同一处。这种「一个对象两个名字」的情况叫别名(aliasing),是下一讲的主角。is 就是检测别名的工具。
b = a  之后(别名)          c = a[:] 之后(拷贝)

  a ──┐                        a ──┐
      ├──▶ 列表 @X                 ├──▶ 列表 @X  [1,2,3,4]
  b ──┘                        b ──┘
                               c ────▶ 列表 @Y  [1,2,3,4]

  a is b → True                a is c → False
  改 @X,a 和 b 都看得见        a == c → True(内容碰巧一样)
                               改 @Y,a 和 b 都看不见
拿 is 去比较数字或字符串,会得到「有时对有时错」的诡异结果。
>>> x = 1000
>>> y = int('1000')
>>> x is y
False
>>> x == y
True
>>> s1 = 'hello'
>>> s2 = ''.join(['h', 'e', 'l', 'l', 'o'])
>>> s1 is s2
False
>>> s1 == s2
True
但如果你把 y = int('1000') 换成 y = 1000,x is y 很可能变成 True——因为 CPython 会缓存小整数、也会把同一段代码里的相同字面量合并成一个常量。这些都是实现细节,不是语言保证,换个 Python 版本、换个执行方式(脚本 vs 交互式)结果就可能不同,绝对不能依赖。(较新的 Python 看到 256 is 256 这类写法还会警告 SyntaxWarning: "is" with a literal. Did you mean "=="?)
规矩:比较「值相不相等」永远用 ==;只有在问「是不是同一个对象」时才用 is。 唯一常见的例外是 x is None——判断 None 惯例上用 is,因为 None 全程序只有一个。
拿双胞胎打比方:两个长得一模一样的人,== 说「是的,一样」;is 说「不,这是两个人」。而一个人有小名和大名,is 才会说「是的,同一个人」。
7. 列表推导式:把「造一个新列表」写成一个表达式
「对列表里每个元素做点什么,得到一个新列表」这个模式出现的频率高到离谱。用 for 循环写出来永远是同一副骨架:
squares = []
for x in range(5):
    squares.append(x ** 2)
列表推导式(list comprehension)把这三行压成一个表达式:
[<map_expression> for <var> in <iterable>]
>>> [x for x in range(5)]
[0, 1, 2, 3, 4]
>>> [x ** 2 for x in range(5)]
[0, 1, 4, 9, 16]
求值过程
<iterable>(这里是 range(5)),只做一次。<var> 绑到它,然后求值 <map_expression>,把得到的值 append 进结果列表。注意第 3 步:<map_expression> 写在最前面,但它是最后才被求值的——每一轮都要先有 x 才能算 x ** 2。读推导式的正确顺序是先读中间的 for,再回头读开头的表达式。
列表推导式是一个表达式,不是语句。这意味着它能出现在任何需要值的地方:函数实参里、return 后面、另一个推导式里面。而 for 循环是语句,只能单独占一行。这就是推导式真正的价值——它让「造一个列表」成为一件可以内联的事。
另一个后果:推导式的结果总是一个新列表,原列表不会被改动。
加过滤条件
>>> [x ** 2 for x in range(5) if x % 2 == 0]
[0, 4, 16]
在最后加 if <condition>,含义是:条件为假的元素直接跳过,连算都不算。所以结果列表比原来短——这里 5 个变成了 3 个。手动展开一遍:
| x | x % 2 == 0 | 算 x ** 2 吗 | 结果列表 |
|---|---|---|---|
| 0 | True | 算,得 0 | [0] |
| 1 | False | 跳过 | [0] |
| 2 | True | 算,得 4 | [0, 4] |
| 3 | False | 跳过 | [0, 4] |
| 4 | True | 算,得 16 | [0, 4, 16] |
另一个 if:条件表达式
>>> [x ** 2 if x % 2 == 0 else x + 1 for x in range(5)]
[0, 2, 4, 4, 16]
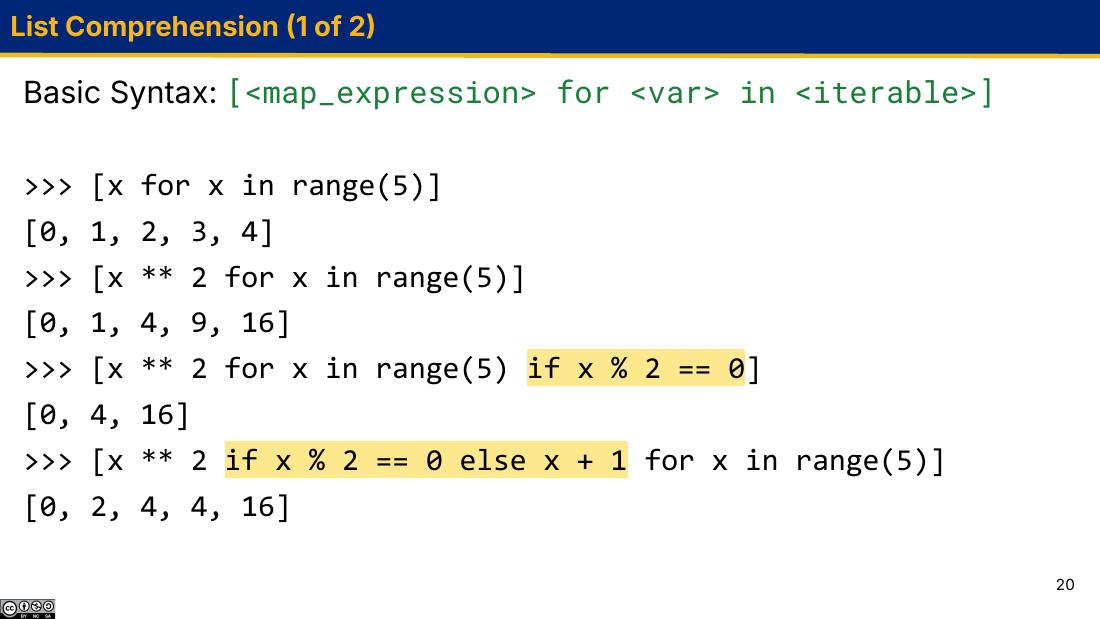
if 在 for 后面,是过滤器,结果只剩 3 个元素;最后一行的 if ... else ... 在 for 前面,是条件表达式(属于 map 表达式的一部分),每个元素都保留、只是算法不同,所以结果仍有 5 个元素。位置决定语义。过滤 if | 条件表达式 if ... else | |
|---|---|---|
| 位置 | 在 for ... in ... 之后 | 在 for 之前(属于 map 表达式) |
有没有 else | 不能有 | 必须有 |
| 结果长度 | 可能变短 | 和原序列一样长 |
| 作用 | 决定「要不要这个元素」 | 决定「这个元素算成什么」 |
逐个元素算一遍 [x ** 2 if x % 2 == 0 else x + 1 for x in range(5)]:
| x | 偶数? | 用哪个分支 | 值 |
|---|---|---|---|
| 0 | 是 | x ** 2 | 0 |
| 1 | 否 | x + 1 | 2 |
| 2 | 是 | x ** 2 | 4 |
| 3 | 否 | x + 1 | 4 |
| 4 | 是 | x ** 2 | 16 |
结果 [0, 2, 4, 4, 16]。注意里面出现了两个 4,分别来自 2 ** 2 和 3 + 1——它们走的是不同的分支。
<a> if <cond> else <b> 这个条件表达式(conditional expression)不是推导式专有的语法,它在任何地方都能用:y = 1 if x > 0 else -1。它和 if 语句的区别是老问题——表达式求值成一个值,语句只产生效果。
把两个 if 的位置搞混,会得到语法错误或者错误答案。
>>> [x for x in range(5) if x % 2 == 0 else 0]
  File "<stdin>", line 1
    [x for x in range(5) if x % 2 == 0 else 0]
                                       ^^^^
SyntaxError: invalid syntax
过滤 if 后面不允许跟 else——想想也对,「不满足条件时改成 0」根本不是「过滤」。要那个效果,就得把整个 if ... else ... 挪到前面去:[x if x % 2 == 0 else 0 for x in range(5)],得到 [0, 0, 2, 0, 4]。
什么时候不该用
推导式还能用在字典、集合等其它容器上(下一讲会见到)。但幻灯片提醒的那句话值得认真对待:可读性 vs 简洁性。
下面这种就已经过头了:
[y for x in lst for y in x if y > 0 and y % 3 != 1]
它是合法的,但没人能一眼看懂。真需要这种复杂度时,要么拆成多行写,要么老老实实用 for 循环。推导式是为了让代码更好读才存在的;如果它让代码更难读,那就用错地方了。
8. 列表方法:增、删,以及那个要命的 None
方法(method)是「绑在某个对象上的函数」,用点号调用:lst.append(7)。现在只需要知道它的行为,机制(面向对象)在后面的课里讲。
添加元素
>>> lst = [1, 2, 3]
>>> lst.append(7)
>>> lst
[1, 2, 3, 7]
>>> lst.extend([4, 5])
>>> lst
[1, 2, 3, 7, 4, 5]
>>> lst.insert(1, 'a')
>>> lst
[1, 'a', 2, 3, 7, 4, 5]
>>> [1, 2, 3] + [4, 5]
[1, 2, 3, 4, 5]
| 写法 | 做什么 | 改原列表吗 | 返回什么 |
|---|---|---|---|
lst.append(x) | 把 x 作为一个元素加到末尾 | 改 | None |
lst.extend(s) | 把 s 的每个元素逐个加到末尾 | 改 | None |
lst.insert(i, x) | 在下标 i 处插入 x,后面的整体右移 | 改 | None |
a + b | 拼接 | 不改 | 一个新列表 |
append 和 extend 的差别是必考点,看清楚:
>>> a = [1, 2]
>>> a.append([3, 4])
>>> a
[1, 2, [3, 4]]        # 长度 3,末尾多了一个「列表元素」
>>> b = [1, 2]
>>> b.extend([3, 4])
>>> b
[1, 2, 3, 4]          # 长度 4,多了两个元素
一句话:append 加的是「一个东西」,extend 加的是「一批东西」。 lst.extend(s) 的效果等价于 for x in s: lst.append(x)。
顺带一个后果:extend 的参数必须可迭代,否则报错;而 append 什么都收:
>>> [1, 2].extend(3)
Traceback (most recent call last):
  ...
TypeError: 'int' object is not iterable
删除元素
>>> lst = [1, 'a', 2, 3, 7, 4, 5]
>>> lst.remove('b')
Traceback (most recent call last):
  ...
ValueError: list.remove(x): x not in list
>>> lst.remove('a')
>>> lst
[1, 2, 3, 7, 4, 5]
>>> lst.pop()
5
>>> lst
[1, 2, 3, 7, 4]
>>> lst.pop(2)
3
>>> lst
[1, 2, 7, 4]
| 写法 | 按什么删 | 返回什么 | 失败时 |
|---|---|---|---|
lst.remove(x) | 按值,只删第一个匹配的 | None | ValueError: list.remove(x): x not in list |
lst.pop() | 删最后一个 | 被删掉的那个元素 | 空列表时 IndexError: pop from empty list |
lst.pop(i) | 按下标删 | 被删掉的那个元素 | 越界时 IndexError: pop index out of range |
pop 是这一组里唯一有返回值的方法——它既改列表又给你东西,所以 x = lst.pop() 是完全正常的写法。而 x = lst.append(7) 就是个 bug。
这是本讲最高频的 bug,没有之一:把变异方法的返回值拿去用。
>>> lst = [1, 2, 3]
>>> lst = lst.append(4)     # ✗ 想「更新 lst」,实际把它变成了 None
>>> lst
>>> print(lst)
None
>>> lst.append(5)
Traceback (most recent call last):
  ...
AttributeError: 'NoneType' object has no attribute 'append'
注意第 3 行:交互式解释器什么都不显示(因为值是 None),这一点很迷惑人——很多人以为「没输出说明成功了」。真正的爆炸推迟到下一次用 lst 时才发生,报错信息是 AttributeError: 'NoneType' object has no attribute ...。
看到 'NoneType' object has no attribute,第一反应就该是:我是不是把某个返回 None 的方法的结果赋给了名字。
正确写法是只调用,不赋值:
>>> lst = [1, 2, 3]
>>> lst.append(4)        # ✓ 它直接改了 lst 指向的那个列表
>>> lst
[1, 2, 3, 4]
同样的坑还有 lst = lst.sort()、lst = lst.reverse()、lst = lst.extend(...)。想要「排好序的新列表」用 sorted(lst)(函数,有返回值),想要「就地排序」用 lst.sort()(方法,返回 None)。
一边遍历一边删,会漏掉元素。
>>> v = [1, 2, 3, 4]
>>> for e in v:
...     if e % 2 == 0:
...         v.remove(e)
...
>>> v
[1, 3]
这次碰巧对了,换一组数据就露馅:
>>> v = [2, 4, 6]
>>> for e in v:
...     if e % 2 == 0:
...         v.remove(e)
...
>>> v
[4]
原因:for 是按下标往前推进的。删掉下标 0 的 2 之后,列表变成 [4, 6],但循环下一轮要取的是下标 1,也就是 6——4 被整个跳过了。删掉 6 之后列表只剩 [4],下标 2 已越界,循环结束。
规矩:绝不在遍历一个列表的同时增删它。 要过滤,就造一个新列表:v = [e for e in v if e % 2 != 0]。(同理,在循环里 append 也可能造成永不终止的循环。)
9. 序列的真假性与一批常用函数
空容器是 falsy
第 2 讲的 falsy 名单里有一项叫「空容器」,现在可以坐实了:
>>> not []      # empty list is falsy
True
>>> not [1]
False
>>> not ''
True
>>> not [0]     # 里面装着 falsy 的东西,但列表本身非空
False
最后一行要看清:[0] 是非空列表,所以它 truthy,尽管它唯一的元素是 falsy 的 0。容器的真假性只取决于「空不空」,与内容毫无关系。
直接后果是判断空列表的惯用写法:
| 写法 | 评价 |
|---|---|
if not lst: | 推荐。最短,最惯用 |
if len(lst) == 0: | 可以,写递归的 base case 时反而更点题 |
if lst == []: | 不推荐。多造了一个空列表对象,还只对列表有效 |
if lst is []: | 错的。永远是 False——右边那个 [] 是刚新建的对象,不可能和 lst 同一 |
list() 与 sum()
>>> list('abc')      # convert things into lists
['a', 'b', 'c']
>>> sum([1, 2, 3])
6
>>> sum([1, 2, 3], 10)      # optional start
16
list(x) 把任何可迭代对象铺开成列表。对字符串它按字符拆;对 range 它把整数全算出来;对已有列表它做一次浅拷贝(list(lst) 和 lst[:] 效果一样)。
sum 的第二个参数是起始值,默认 0。所以 sum([1,2,3], 10) 算的是 10 + 1 + 2 + 3 = 16。这个参数在「累加时要有个初值」的场合有用。
all() 与 any()
>>> is_even = [x % 2 == 0 for x in range(5)]
>>> is_even
[True, False, True, False, True]
>>> all(is_even)
False
>>> all([])
True
>>> any(is_even)
True
>>> any([])
False
all(s):s 里每一个元素都 truthy 吗?any(s):至少有一个吗?两者判断的都是真假性,不是「等于 True」,所以 all([1, 'hi', [0]]) 也是 True。
all([]) 是 True,any([]) 是 False。 这不是随手定的。
all 问「有没有反例」——空集合里找不出反例,所以为真(数学上叫空真,vacuous truth:「这个空盒子里所有的球都是红的」这句话没法被证伪)。any 问「有没有正例」——空集合里当然一个也找不出,所以为假。
记法:all 从 True 出发,遇到假就翻;any 从 False 出发,遇到真就翻。空序列谁也遇不到,就停在出发点。
max() 与 min(),以及 key
>>> max([1, 2, 3])
3
>>> min([1, 2, 3])
1
>>> max(['apple', 'pear', 'banana'])      # alphabetically highest
'pear'
>>> max(['apple', 'pear', 'banana'], key=lambda s: len(s))
'banana'
字符串之间的大小是字典序比较:先比第一个字符,相同再比第二个……'pear' 的 'p' 排在 'apple' 的 'a' 和 'banana' 的 'b' 之后,所以它最大。
key 参数是本讲和高阶函数的接口。它的含义是:不要直接比较元素本身,先把每个元素喂给 key,比较返回的结果;但最终返回的仍是原元素。
max(['apple', 'pear', 'banana'], key=lambda s: len(s))
| 元素 | key(元素) | 当前最大 |
|---|---|---|
'apple' | 5 | 'apple'(key = 5) |
'pear' | 4 | 'apple'(4 < 5,不换) |
'banana' | 6 | 'banana'(6 > 5,换) |
返回的是 'banana' 这个字符串本身,而不是它的 key 值 6。这一点非常关键:key 只影响「谁赢」,不影响「返回什么」。
注意 key=lambda s: len(s) 里传的是函数本身,不是调用结果。写成 key=len(s) 会直接报 NameError: name 's' is not defined——这里根本没有叫 s 的名字。其实这个例子写成 key=len 更干净,len 本身就是一个函数。
map / filter / reduce
这三个是第 3 讲高阶函数在序列上的具体化身,也是「用函数处理一整个序列」的经典三件套。
>>> map(lambda x: x * x, [1, 2, 3])
<map object ...>
>>> list(map(lambda x: x * x, [1, 2, 3]))
[1, 4, 9]
>>> filter(lambda x: x > 2, [1, 2, 3, 4, 5])
<filter object ...>
>>> list(filter(lambda x: x > 2, [1, 2, 3, 4, 5]))
[3, 4, 5]
>>> from functools import reduce
>>> reduce(lambda x, y: x + y, [1, 2, 3, 4, 5])
15
>>> reduce(lambda x, y: x + y, [1, 2, 3, 4, 5], 10)   # optional start
25
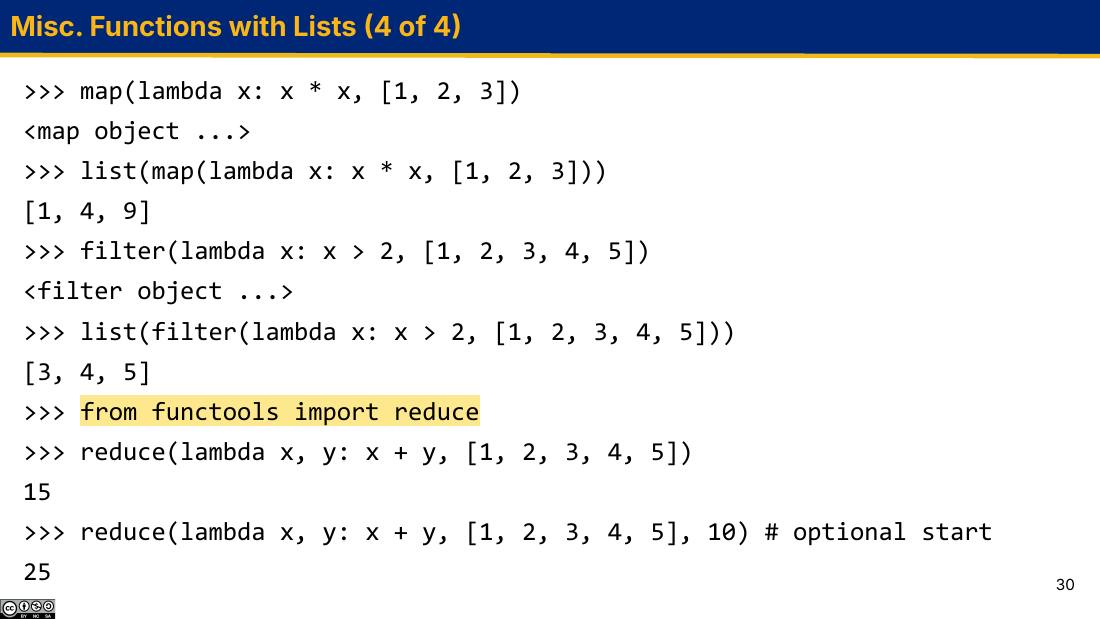
map 和 filter 直接求值时显示的是 <map object ...> / <filter object ...> 而不是列表——它们返回的是「按需产生元素」的惰性对象,必须用 list(...) 包一层才能看到内容。reduce 不在内置函数里,要 from functools import reduce;它接受一个两参数函数,把序列一路折叠成单个值。| 函数 | 参数 | 干什么 | 等价的列表推导式 |
|---|---|---|---|
map(f, s) | f 收一个参数 | 对每个元素施加 f | [f(x) for x in s] |
filter(pred, s) | pred 收一个参数、返回真假 | 留下让 pred 为真的元素 | [x for x in s if pred(x)] |
reduce(f, s) | f 收两个参数 | 两两折叠成一个值 | (没有等价的推导式) |
reduce 的展开过程值得写清楚,因为它和前两个不是一类东西:
reduce(lambda x, y: x + y, [1, 2, 3, 4, 5]) 没有起始值时,先拿第一个元素当初始的累积值,然后逐个折进去:
累积值 = 1                (直接取第一个元素)
累积值 = f(1, 2)  = 3     (折进 2)
累积值 = f(3, 3)  = 6     (折进 3)
累积值 = f(6, 4)  = 10    (折进 4)
累积值 = f(10, 5) = 15    (折进 5)
                  → 15
给了起始值 10 之后,初始的累积值变成 10,第一个元素也要被折进去:
累积值 = 10
累积值 = f(10, 1) = 11
累积值 = f(11, 2) = 13
累积值 = f(13, 3) = 16
累积值 = f(16, 4) = 20
累积值 = f(20, 5) = 25
                  → 25
误区一:忘了 list(...)。 直接把 map(...) 的结果当列表用,会得到看不懂的输出,或者 TypeError:
>>> len(map(lambda x: x * x, [1, 2, 3]))
Traceback (most recent call last):
  ...
TypeError: object of type 'map' has no len()
误区二:map / filter 对象只能用一次。 它是惰性的,元素取完就没了:
>>> m = map(lambda x: x * x, [1, 2, 3])
>>> list(m)
[1, 4, 9]
>>> list(m)      # 第二次就空了
[]
误区三:reduce 在空序列上没有起始值会炸。
>>> from functools import reduce
>>> reduce(lambda x, y: x + y, [])
Traceback (most recent call last):
  ...
TypeError: reduce() of empty iterable with no initial value
因为它连「第一个元素」都拿不到。给个起始值就没事:reduce(lambda x, y: x + y, [], 0) 返回 0。
10. 随堂练习一:sum_list,一个问题的两种解法
随堂代码 07.py 的第一题,要求把同一个功能用迭代写一遍、再用递归写一遍。这不是凑数——它是本讲最有价值的一次对照实验:同一个「遍历序列」的需求,迭代靠下标推进,递归靠切片缩短。
def sum_list_iter(lst: list) -> int:
    """
    Given a list of integers, return the sum of
    all the elements iteratively (don't just use `sum`).

    >>> sum_list_iter([])
    0
    >>> sum_list_iter([1, 2, 3])
    6
    >>> sum_list_iter([4, 6434, 16, 20, 46, 7])
    6527
    """
顺便认识一下签名里的 lst: list 和 -> int,它们叫类型注解(type hint):写给人看的说明,Python 运行时完全不检查。你传个字符串进去它照样跑(然后在别的地方炸)。
迭代版
思路是累加器(accumulator)模式,第 2 讲的老朋友:设一个变量存「到目前为止的和」,扫一遍列表,每见到一个元素就加进去。
def sum_list_iter(lst):
    total = 0
    for elem in lst:
        total += elem
    return total
三个决定,每一个都值得说明为什么:
total = 0 而不是 total = lst[0]。 后者在空列表上会 IndexError,而 doctest 第一条就是 sum_list_iter([])。而且 0 是加法的单位元——从它出发,空列表自然地得到 0。for elem in lst 而不是 for i in range(len(lst))。 我们只要值,不要下标,所以用短的那个。return 在循环外面。 缩进进循环里的话,第一轮就返回了——那是本课程最经典的缩进 bug。追踪 sum_list_iter([1, 2, 3]):
| 轮次 | elem | 进入时 total | total += elem 后 |
|---|---|---|---|
| — | — | — | 0(初始化) |
| 1 | 1 | 0 | 1 |
| 2 | 2 | 1 | 3 |
| 3 | 3 | 3 | 6 |
列表取完,循环结束,return 6 | |||
空列表时:循环体一次都不执行,直接 return total,得到初始值 0。边界情况不需要任何特殊处理——这正是「初值取单位元」的好处。
while 版本,以及官方参考解答里的一个坑
题目鼓励你「用另一种循环再写一遍」。while 版本长这样:
def sum_list_iter(lst):
    total = 0
    i = 0
    while i < len(lst):
        total += lst[i]
        i += 1          # ← 这一行不能少
    return total
课程发布的参考解答 07-sol.py 里,那段被注释为 ALTERNATE SOLUTION 的 while 版本漏掉了 i += 1:
# ALTERNATE SOLUTION:
total = 0
i = 0
while i < len(lst):
    total += lst[i]
return total
这段代码在非空列表上会死循环(i 永远是 0,条件永远为真,total 一路加 lst[0])。它之所以没被 doctest 抓到,是因为它写在第一个 return total 后面,永远执行不到——属于死代码。
这里如实指出来,不是挑刺,而是因为它恰好演示了两个真实教训:(a) return 后面的代码不会执行,所以它错了也没人知道;(b) while 循环忘记更新变量就是死循环。 for 之所以更安全,正是因为它把「更新」这一步收进了语法里,不给你忘的机会。
递归版
递归的关键一步永远是同一句话:怎么把这个问题变成一个「同构但更小」的问题?
之前几讲里,「更小」意味着更小的数字(n - 1、n // 10)。在列表上,「更小」意味着更短的列表。而第 4 节已经给了现成的工具:lst[1:] 是「去掉第一个元素之后的那截」,而且它在任何长度上都不会越界。
于是分解方式自己就冒出来了:
列表的和 = 第一个元素 + 剩下那截的和
def sum_list_rec(lst):
    if len(lst) == 0:
        return 0
    else:
        return lst[0] + sum_list_rec(lst[1:])
0——注意这跟迭代版的初值是同一个 0,来自同一个理由。lst[0] + sum_list_rec(lst[1:])。 直接把上面那句中文翻译成代码。len(lst[1:]) == len(lst) - 1,严格递减,且下界是 0,正好撞上 base case。终止性有保证。现在真的展开一遍 sum_list_rec([1, 2, 3]),一层一层下到底再回代:
sum_list_rec([1, 2, 3])
  len([1,2,3]) == 0 ?  否
  → 1 + sum_list_rec([2, 3])
        │
        │  sum_list_rec([2, 3])
        │    len([2,3]) == 0 ?  否
        │    → 2 + sum_list_rec([3])
        │          │
        │          │  sum_list_rec([3])
        │          │    len([3]) == 0 ?  否
        │          │    → 3 + sum_list_rec([])
        │          │          │
        │          │          │  sum_list_rec([])
        │          │          │    len([]) == 0 ?  是  ← base case
        │          │          │    → return 0
        │          │          ▼
        │          │    → 3 + 0 = 3
        │          ▼
        │    → 2 + 3 = 5
        ▼
  → 1 + 5 = 6
递归的两个方向看得清清楚楚:下行时列表越切越短 [1,2,3] → [2,3] → [3] → [],回代时加法从最里层往外一层层算完 0 → 3 → 5 → 6。
注意每一层的加法都卡在那里等:1 + ??? 里的 ??? 不算出来,这一层就没法返回。这就是为什么要有四个函数帧同时存在。
对应的帧长这样(每次调用都新建一帧,parent 都是 Global,因为 sum_list_rec 定义在全局):
Global frame
    sum_list_rec ──▶ func sum_list_rec(lst) [parent=Global]

f1: sum_list_rec   [parent=Global]
      lst   ──▶ [1, 2, 3]
      正在算: 1 + sum_list_rec([2, 3])      ← 挂起,等 f2

f2: sum_list_rec   [parent=Global]
      lst   ──▶ [2, 3]        ← 注意:这是切片造出来的「新列表」
      正在算: 2 + sum_list_rec([3])         ← 挂起,等 f3

f3: sum_list_rec   [parent=Global]
      lst   ──▶ [3]
      正在算: 3 + sum_list_rec([])          ← 挂起,等 f4

f4: sum_list_rec   [parent=Global]
      lst   ──▶ []
      len(lst) == 0 成立 → 返回 0           ← 第一个真正返回的帧

回代:f4 返回 0 → f3 得 3+0=3 → f2 得 2+3=5 → f1 得 1+5=6
「首元素 + 其余」这个分解方式,是列表递归的标准骨架,往后会反复出现:
def f(lst):
    if not lst:          # 或 len(lst) == 0
        return <空列表时的答案>
    else:
        return <用 lst[0] 和 f(lst[1:]) 的结果拼出答案>
换个「拼」法就是另一道题:lst[0] * f(lst[1:]) 求乘积(base case 返回 1);max(lst[0], f(lst[1:])) 求最大值(base case 得单独处理单元素,因为「空列表的最大值」不存在);f(lst[1:]) + [lst[0]] 就是反转。学到 Scheme 的时候你会发现,这个骨架在那边有个名字,叫 car 和 cdr。
误区一:写成 sum_list_rec(lst[1]),少了冒号。 那传进去的是一个整数而不是列表,下一层 len(2) 立刻报错:
TypeError: object of type 'int' has no len()
误区二:base case 写成 len(lst) == 1,返回 lst[0]。 对非空列表算得没错,但 sum_list_rec([]) 根本走不到 base case——长度 0 不等于 1,于是进 else 分支去取 lst[0]:
>>> sum_list_rec([])
Traceback (most recent call last):
  ...
IndexError: list index out of range
doctest 第一条就是空列表,一测就现原形。选 base case 的准则:它必须是递归一定会到达的那个最小情况,而不是「看起来最简单」的那个。 长度每次减 1 且下界是 0,所以「长度为 0」才是必经之地;「长度为 1」在从空列表出发时会被直接跳过。
误区三:忘了 return。 写成 lst[0] + sum_list_rec(lst[1:]) 单独一行,函数返回 None,上一层做 1 + None 就炸:
TypeError: unsupported operand type(s) for +: 'int' and 'NoneType'
递归版有个迭代版没有的代价:每一层 lst[1:] 都新建一个列表。长度为 n 的列表会造出 n 个新列表,总共复制约 n²/2 个元素引用。迭代版是 Θ(n) 时间、Θ(1) 额外空间;这个递归版是 Θ(n²) 时间、Θ(n²) 空间。
在 61A 的题目规模下无所谓,但要知道「用切片做递归」是有代价的。想避开它,可以改成传下标:def helper(i): return 0 if i == len(lst) else lst[i] + helper(i + 1)——这样不切片,只递归。
11. 随堂练习二:凯撒密码 decode 与 encode
第二题把本讲的东西全用上了:字符串遍历、index 查位置、模运算绕圈、列表 append 攒结果、join 拼回字符串——外加一个漂亮的负数索引小技巧。
题目要什么
ALPHABET = 'abcdefghijklmnopqrstuvwxyz'
凯撒密码(Caesar cipher),移位 3:加密时每个字母在字母表上右移 3 位(a → d,b → e,……,z 绕回到 c),解密就是反过来左移 3 位。空格保持不变,输入只含小写字母和空格。
>>> encode('hello')
'khoor'
>>> decode('khoor')
'hello'
>>> decode('pdb wkh irufh eh zlwk brx')
'may the force be with you'
>>> 'go bears' == decode(encode('go bears'))
True
先解决「怎么表示一个字母的位置」
字母本身没法直接做算术('a' + 3 会报 TypeError: can only concatenate str (not "int") to str)。所以要先把字母换成数字,算完再换回来。ALPHABET 这个字符串就是那张对照表:
>>> ALPHABET.index('d')     # 字母 → 位置
3
>>> ALPHABET[3]            # 位置 → 字母
'd'
index 返回第一次出现的下标。ALPHABET 里每个字母只出现一次,所以这个「第一次」就是唯一一次,映射是一一对应的。(找不到时报 ValueError: substring not found,本题保证输入合法,不会遇到。)
于是整个流程固定为三步:字母 → 位置 → 移位后的位置 → 字母。
另一个约束:字符串不能改
直觉上你想写 result = result + new_char 一路拼。这能跑,但 starter code 给的骨架不是这样——它先建一个列表 decoded_chars = [],把字符一个个 append 进去,最后:
return "".join(decoded_chars)
sep.join(iterable) 把可迭代对象里的字符串用 sep 连起来。','.join(['a','b','c']) 得到 'a,b,c';这里 sep 是空字符串 "",所以就是原样粘在一起。
为什么绕这一圈?因为字符串不可变——result = result + c 每次都要造一个全新的字符串并把已有内容整个复制过去,n 个字符总共复制 Θ(n²) 次。而列表可变,append 是直接往末尾塞,最后 join 一次成型,总共 Θ(n)。「用可变的列表攒中间结果,最后转成不可变的字符串」是标准套路,Cats 项目里会反复用到。
encode:模运算处理绕圈
def encode(message):
    encoded_chars = []

    for char in message:
        if char == " ":
            encoded_chars.append(" ")
        else:
            original_index = ALPHABET.index(char)
            encoded_index = (original_index + 3) % len(ALPHABET)
            encoded_chars.append(ALPHABET[encoded_index])

    return "".join(encoded_chars)
for char in message——直接遍历字符串,每轮 char 是一个长度为 1 的字符串。不需要 range(len(message)),因为我们不关心位置。ALPHABET.index(' ') 会 ValueError——空格不在字母表里。(original_index + 3) % 26。 加 3 之后可能超出 25,取模把它拉回 0–25 的范围。% 在这里的作用是「绕圈」:它把一条直线接成了一个环。len(ALPHABET) 而不是硬写 26。 这样换个字母表也不用改代码。encode('hello'),逐字符走:
char | original_index | +3 | % 26 | 新字母 | encoded_chars |
|---|---|---|---|---|---|
'h' | 7 | 10 | 10 | 'k' | ['k'] |
'e' | 4 | 7 | 7 | 'h' | ['k','h'] |
'l' | 11 | 14 | 14 | 'o' | ['k','h','o'] |
'l' | 11 | 14 | 14 | 'o' | ['k','h','o','o'] |
'o' | 14 | 17 | 17 | 'r' | ['k','h','o','o','r'] |
"".join(['k','h','o','o','r']) → 'khoor',与 doctest 一致。
再看绕圈那一档:encode('z')。ALPHABET.index('z') 是 25,25 + 3 = 28,28 % 26 = 2,ALPHABET[2] 是 'c'。如果没有 % 26,ALPHABET[28] 会直接 IndexError: string index out of range。
decode:为什么可以不写 %
def decode(message):
    decoded_chars = []

    for char in message:
        if char == " ":
            decoded_chars.append(" ")
        else:
            encoded_index = ALPHABET.index(char)
            # This is fine even for encoded_index < 3
            # because Python supports negative indexing
            decoded_index = encoded_index - 3
            decoded_chars.append(ALPHABET[decoded_index])

    return "".join(decoded_chars)
结构和 encode 一模一样,只是 +3 换成 -3。但注意——这里没有取模,却依然正确。这是本题最巧的一处。
问题出在前三个字母:'a'(0)、'b'(1)、'c'(2)减 3 之后是负数。看 decode('a'):
encoded_index = ALPHABET.index('a') = 0
decoded_index = 0 - 3 = -3
ALPHABET[-3]  = ?

  ALPHABET = 'abcdefghijklmnopqrstuvwxyz'
  正下标:   0  1  2  ...        23 24 25
  负下标:                      -3 -2 -1
                                 x  y  z

ALPHABET[-3] = 'x'
而 encode('x') 确实等于 'a'(23 + 3 = 26,26 % 26 = 0,ALPHABET[0] 是 'a')。所以 decode('a') 应该得到 'x' ——结果正确。
为什么这么巧?因为 Python 的负数索引规则是 lst[-k] == lst[len(lst) - k],而 -3 + 26 = 23 恰恰就是 (0 - 3) % 26 的值。负数索引在这里天然地帮你做完了取模。
但这只在下溢不超过一圈时成立。如果移位量是 30,0 - 30 = -30,而 ALPHABET[-30] 会直接 IndexError: string index out of range。写 % len(ALPHABET) 永远是安全的;靠负数索引是「知道这题移 3 位」才敢用的捷径。
完整验证一条:decode('pdb wkh irufh eh zlwk brx')。取前三个字符和那个空格:
char | 是空格? | encoded_index | -3 | ALPHABET[...] |
|---|---|---|---|---|
'p' | 否 | 15 | 12 | 'm' |
'd' | 否 | 3 | 0 | 'a' |
'b' | 否 | 1 | −2 | 'y'(负索引绕回) |
' ' | 是 | — | — | 直接 append ' ' |
'w' | 否 | 22 | 19 | 't' |
攒出 ['m','a','y',' ','t', ...],join 之后开头是 'may t...',正是 'may the force be with you'。
最后一条 doctest 'go bears' == decode(encode('go bears')) 检验的是互逆性:先 encode 得到 'jr ehduv',再 decode 应当原样回来。这种「往返测试(round-trip test)」是检验一对互逆函数的最佳手段——它不需要你手算出中间结果就能查出错。
误区一:忘了处理空格。 直接对空格调 index:
>>> ALPHABET.index(' ')
Traceback (most recent call last):
  ...
ValueError: substring not found
误区二:decode 里也照抄 % len(ALPHABET)。 这其实没错——(0 - 3) % 26 在 Python 里就是 23,因为 Python 的 % 对负数取模结果符号跟除数走,永远非负。(这一点和 C、Java 不同,那些语言 -3 % 26 得到 -3。)所以写取模反而更稳妥。
>>> (0 - 3) % 26
23
>>> -3 % 26
23
误区三:用字符串拼接却忘了赋值。 如果你不用列表而用字符串攒结果,写成 result + new_char 单独一行是无效的——字符串不可变,加法只是算出一个新串然后扔掉。必须写 result = result + new_char。这也是 starter code 用列表 + append 的原因之一:append 是变异,不需要重新赋值,少一个出错点。
注意 encode 和 decode 的代码只差一个符号。看到这种情况,可以抽出一个更一般的函数:
def shift(message, k):
    chars = []
    for char in message:
        if char == " ":
            chars.append(" ")
        else:
            i = ALPHABET.index(char)
            chars.append(ALPHABET[(i + k) % len(ALPHABET)])
    return "".join(chars)

def encode(message):
    return shift(message, 3)

def decode(message):
    return shift(message, -3)
这就是第 3 讲高阶函数那一课的母题在这里的回响:把变化的部分(移位量)提成参数,重复的部分(流程)只写一次。
本讲小结
序列操作速查
| 写法 | 含义 | 改原对象吗 | 返回什么 |
|---|---|---|---|
len(s) | 顶层元素个数 | 否 | int |
s[i] | 取第 i 个(负数从右数) | 否 | 那个元素;越界 IndexError |
lst[i] = x | 换掉第 i 个 | 是 | (语句,无值) |
s[a:b:c] | 切片,b 不含 | 否 | 新的同类型对象(浅拷贝) |
lst[a:b] = t | 整段替换,长度可变 | 是 | (语句,无值) |
x in s | 顶层是否有元素 == x(字符串是查子串) | 否 | bool |
a + b | 拼接 | 否 | 新列表 / 新字符串 |
lst.append(x) | 末尾加一个元素 | 是 | None |
lst.extend(s) | 末尾加 s 的每个元素 | 是 | None |
lst.insert(i, x) | 在 i 处插入 | 是 | None |
lst.remove(x) | 按值删第一个匹配 | 是 | None;没有则 ValueError |
lst.pop() / lst.pop(i) | 删末尾 / 删下标 i | 是 | 被删的元素 |
sorted(lst) | 排序 | 否 | 新列表 |
lst.sort() | 就地排序 | 是 | None |
函数速查
| 函数 | 作用 | 要点 |
|---|---|---|
list(s) | 转成列表 | 对列表相当于浅拷贝 |
range(a, b, c) | 整数序列 | b 不含;惰性,用 list() 才看得到内容 |
enumerate(s) | 产生 (下标, 值) | 顺序是下标在前 |
sum(s, start=0) | 求和 | 第二参数是起始值 |
all(s) / any(s) | 全真 / 有真 | all([]) 为 True,any([]) 为 False |
max(s, key=f) | 最大值 | 按 f(x) 比较,但返回原元素 |
map(f, s) | 逐个施加 f | 惰性,只能消费一次 |
filter(pred, s) | 筛选 | 惰性,只能消费一次 |
reduce(f, s, init) | 折叠 | 要 from functools import reduce;f 收两个参数 |
sep.join(s) | 用 sep 连接字符串 | s 的元素必须都是字符串 |
四个必须分清的对子
| 对子 | 区别 |
|---|---|
== vs is | 内容一样 vs 同一个对象。列表比较一律用 == |
lst[i] = x vs elem = x | 改列表内部 vs 改名字绑定。for 里改循环变量对列表无效 |
| 左边的切片 vs 右边的切片 | lst[1:3] = ... 变异原列表;t = lst[1:3] 造新列表 |
append vs extend | 加一个东西 vs 加一批东西 |
三条最容易踩的线
lst = lst.append(x)—— 变异方法返回None,这行把列表弄丢了。下次用它就是AttributeError: 'NoneType' object has no attribute ...。- 浅拷贝只拷一层 ——
copy = lst[:]之后lst[2] is copy[2]仍为True。[[0]*3]*3造出来的三行是同一行。 - 边遍历边增删 —— 元素会被跳过或永远循环。要过滤就用列表推导式造新列表。
与前后讲的接口
第 5、6 讲的递归骨架在本讲换了一副皮:「更小的问题」从更小的数变成了更短的列表,lst[1:] 就是这一讲的 n - 1。第 3 讲的高阶函数在本讲有了具体用武之地:map、filter、max(key=...) 全都靠「把函数当参数」。
下一讲会把本讲最后按下不表的那件事挑明:可变性。别名到底怎么产生、函数参数传的是什么、可变默认参数为什么是陷阱,以及怎么用数据抽象把这些危险关进笼子里。本讲的浅拷贝、is、变异方法,是那一讲的全部前置知识。
动手练习
练习 1:Python 会显示什么
逐行写出输出(没有输出就写「无」):
>>> lst = [1, [2, 3], 4]
>>> len(lst)
>>> 2 in lst
>>> [2, 3] in lst
>>> lst[1][1]
>>> lst[1:]
>>> lst[3:]
>>> lst.append([5])
>>> lst
看答案
>>> len(lst)
3
>>> 2 in lst
False
>>> [2, 3] in lst
True
>>> lst[1][1]
3
>>> lst[1:]
[[2, 3], 4]
>>> lst[3:]
[]
>>> lst.append([5])
(无输出,返回 None)
>>> lst
[1, [2, 3], 4, [5]]
逐条说明:
len只数顶层,[2, 3]算一个元素,所以是 3 不是 4。2 in lst为False:in不下钻,2 藏在嵌套列表里。这是全讲最容易错的一问。[2, 3] in lst为True:顶层 1 号元素与它==(不要求是同一个对象)。lst[3:]起点超出范围,但切片不越界,给空列表;换成lst[3]就是IndexError了。append返回None,交互式解释器对None什么都不打印。它加的是一个元素[5],所以列表末尾多了一个嵌套列表,长度变成 4 而不是 5。
练习 2:别名与拷贝
下面这段执行完,a、b、c 各是什么?
>>> a = [1, 2, [3, 4]]
>>> b = a
>>> c = a[:]
>>> b.append(5)
>>> c[0] = 'x'
>>> a[2].append(6)
看答案
>>> a
[1, 2, [3, 4, 6], 5]
>>> b
[1, 2, [3, 4, 6], 5]
>>> c
['x', 2, [3, 4, 6]]
初始
  a ──┐
      ├──▶ @A [1, 2, ·──▶ @C [3, 4]]
  b ──┘        (b = a 是别名,没有新建对象)
  c ────▶ @B [1, 2, ·──▶ @C]     (c = a[:] 新建 @B,但 2 号格还是指 @C)

b.append(5)  → 改的是 @A         → a、b 都看到 5;c 看不到
c[0] = 'x'   → 改的是 @B 的 0 号格 → 只有 c 变
a[2].append(6) → 先算 a[2] 拿到 @C,再改 @C
               → @A 和 @B 的 2 号格都指着 @C,所以 a、b、c 全都看到 6
三条修改覆盖了三种情况:改别名共享的外层对象(b 和 a 一起变)、改拷贝自己的格子(只有 c 变)、改被共享的内层对象(三个全变)。看懂这题,浅拷贝就算过关了。
练习 3:两个 if 的位置
写出下面三个表达式的值:
>>> [x * 2 for x in [1, 2, 3, 4] if x > 2]
>>> [x * 2 if x > 2 else 0 for x in [1, 2, 3, 4]]
>>> [x * 2 for x in [1, 2, 3, 4] if x > 2 if x % 2 == 0]
看答案
[6, 8]
[0, 0, 6, 8]
[8]
第一个是过滤:只有 3 和 4 通过,各乘 2 得 [6, 8],长度从 4 变成 2。
第二个是条件表达式:四个元素一个不少,只是 1 和 2 走 else 分支变成 0,得 [0, 0, 6, 8],长度还是 4。「结果长度变没变」是区分这两种 if 最快的办法。
第三个:过滤条件可以连写多个,效果是「与」。要同时满足 > 2 和「偶数」的只有 4,得 [8]。写成 if x > 2 and x % 2 == 0 完全等价,而且更好读。
练习 4:写代码
实现 count_occurrences(lst, x),返回 x 在 lst 里出现的次数。要求写两版:一版迭代,一版递归,都不许用 lst.count。
>>> count_occurrences([1, 2, 1, 3, 1], 1)
3
>>> count_occurrences([], 5)
0
>>> count_occurrences([[1], [1], 2], [1])
2
看答案
def count_occurrences_iter(lst, x):
    count = 0
    for elem in lst:
        if elem == x:
            count += 1
    return count


def count_occurrences_rec(lst, x):
    if len(lst) == 0:
        return 0
    elif lst[0] == x:
        return 1 + count_occurrences_rec(lst[1:], x)
    else:
        return count_occurrences_rec(lst[1:], x)
迭代版就是累加器骨架,初值取 0(计数的单位元)。递归版是「首元素 + 其余」骨架:base case 是空列表(数出来是 0),递归步看首元素算不算数,算就 1 +,不算就直接把结果传上去。
两个要点:
- 用
==而不是is。 第三条 doctest 就是为此设计的:[[1], [1], 2]里的两个[1]和传进来的[1]是三个不同的对象,用is会得到 0,用==才得到 2。 - 递归的两个分支都要
return。else那支很容易漏写return,一漏就返回None,上层做1 + None报TypeError: unsupported operand type(s) for +: 'int' and 'NoneType'。
追踪 count_occurrences_rec([1, 2, 1], 1):
count([1,2,1], 1)   lst[0]=1 == 1  → 1 + count([2,1], 1)
  count([2,1], 1)   lst[0]=2 != 1  →     count([1], 1)
    count([1], 1)   lst[0]=1 == 1  → 1 + count([], 1)
      count([], 1)  空             → 0
    回代:1 + 0 = 1
  回代:      1
回代:1 + 1 = 2
回代结果 2,与 [1, 2, 1] 里 1 出现两次相符。顺带注意中间那层:lst[0] 是 2,不等于 1,它什么都不加,直接把下层的结果原样返回上去——这一层是「透明」的。
练习 5:这段代码错在哪
下面这个函数想「把列表里所有奇数删掉」,但它有 bug。指出 bug、说清为什么,并给出两种改法。
def remove_odds(lst):
    for elem in lst:
        if elem % 2 == 1:
            lst.remove(elem)
    return lst
看答案
bug:一边遍历一边删。 实测:
>>> remove_odds([1, 3, 5])
[3]
>>> remove_odds([1, 3, 2, 5])
[3, 2]
为什么:for 在内部是按下标 0、1、2…… 往前推进的。以 [1, 3, 5] 为例:
| 循环取的下标 | 此刻列表 | 取到的 elem | 动作 | 动作后列表 |
|---|---|---|---|---|
| 0 | [1, 3, 5] | 1 | 删 1 | [3, 5] |
| 1 | [3, 5] | 5(3 被跳过了!) | 删 5 | [3] |
| 2 | [3] | 下标 2 已越界 | 循环结束 | [3] |
删掉一个元素后,后面所有元素整体左移一格,而循环的下标还在往右走——于是每删一个就漏检一个。
改法一:造新列表(推荐)。
def remove_odds(lst):
    return [elem for elem in lst if elem % 2 == 0]
干净、无副作用。缺点是它不改原列表,调用方必须接住返回值。
改法二:真要就地改,就遍历一份拷贝。
def remove_odds(lst):
    for elem in lst[:]:      # 遍历拷贝,删的是原列表
        if elem % 2 == 1:
            lst.remove(elem)
    return lst
lst[:] 是一个独立的新列表,遍历它时原列表怎么删都不影响推进。这正是第 4 节 Tip 1 的实际用途。
顺带一个隐藏问题:即使修好了,lst.remove(elem) 删的是第一个等于 elem 的元素,不一定是当前这个。列表里有重复值时会出乱子。这也是「改法一」更值得推荐的原因——它压根不需要考虑这些。