树递归:一个问题,两条以上的岔路
当「把大问题拆成一个小问题」不够用时——学会把它拆成互斥的几个小问题,然后把答案加起来。
0. 本讲导读
上一讲讲完了递归的基本机制:一个函数在自己的函数体里调用自己,靠 base case(基础情形) 收尾,靠递归情形(recursive case)把问题变小。你写过的 sum_digits、factorial、cascade 都长成同一个样子:一次递归调用,把 n 变成 n // 10 或 n - 1,然后对返回值做点加工。
这类递归的调用结构是一条链:fact(4) 叫 fact(3),fact(3) 叫 fact(2)……一根竹竿,捅到底,再一层层收回来。
但有一大类问题,一条链根本装不下。举个最短的例子:
上 4 级台阶,每次可以迈 1 级或 2 级,一共有几种走法?
你在第 0 级上站着,面前有两个互不相容的选择:迈 1 级,或者迈 2 级。选了哪个,剩下的问题就变成「上 3 级」或者「上 2 级」——都还是同一个问题,只是规模小了。而这两条路上的走法互不重叠(第一步迈 1 的走法,绝不可能同时是第一步迈 2 的走法),所以总数就是两者之和。
关键在于:你不能只走其中一条。两条都得走,两个答案都得要。于是在同一个递归情形里,你必须写下两次递归调用。调用结构不再是一根竹竿,而是一棵倒着长的树——这就是本讲的主角:树递归(tree recursion)。
本讲要回答三个问题:
- 什么时候该想到树递归?(答案:「数有多少种方法」「试遍所有选择」这类问题)
- 怎么写出来?(答案:找到一个把可能性劈成互斥两半的「决策点」,每一半发一次递归调用,再合并)
- 代价是什么?(答案:同一个子问题会被反复重算,次数按指数增长)
往后看:这一讲的思维方式——「枚举选择、合并结果」——会一路用到 Lab 04、HW 02、以及后面的项目里。第 17 讲讲的记忆化(memoization)就是专门用来治本讲第 9 节那个「重复计算」病的。而当你之后学到「树」这个数据结构时(第 9 讲),会发现处理它的函数常常也是树递归——但这是两件不同的事,第 3 节会专门澄清。
- 树递归的定义只有一句话:一个函数如果在单个递归情形里发出超过一次递归调用,它就是树递归的。叫「树」是因为把调用关系画出来是一棵倒长的树,跟「树这种数据结构」没有必然关系。
- 识别信号:题目问的是「有多少种方法」「有几种走法」「数一数所有可能」,或者需要「把 A 情况下的所有做法,和互斥的 B 情况下的所有做法加在一起」。
- 写法套路:找一个决策点(第一步迈 1 还是 2?这个
m用不用?),把全部可能性劈成互斥且穷尽的几类,每类发一次递归调用,最后return它们的和。 - base case 通常不止一个。除了「成功」的那个(返回 1),几乎总还要有「失败/越界」的那个(返回 0)。漏掉后者,参数就会一路减到负数,触发
RecursionError: maximum recursion depth exceeded。 - 朴素
fib(n)的调用次数是 $2 \cdot \mathrm{fib}(n{+}1) - 1$,随 $n$ 指数级增长:fib(30)要调用 2 692 537 次函数,其中绝大多数是在把同一个子问题算了一遍又一遍。 - 永远从「这个调用应该返回什么」的角度想,不要试图在脑子里跟踪整棵树。相信递归调用会给你正确答案(这叫 recursive leap of faith),你只负责把它们正确地合并起来。
1. 热身:cascade 的四个版本,只有两个是对的
先用一道单链递归的题热身,它考的是本课最容易被忽略的一点:递归调用前后的语句,执行时机完全不同。你如果在这道题上还含糊,后面画树递归的调用树时一定会乱。
cascade(123) 要打印出这样的「瀑布」:
123
12
1
12
123
下面四个实现里,哪些能得到上面这个输出?先自己判断,再往下看。
def cascadeA(n):
    if n < 10:
        print(n)
    else:
        print(n)
        cascadeA(n // 10)
        print(n)

def cascadeB(n):
    print(n)
    if n >= 10:
        cascadeB(n // 10)
        print(n)

def cascadeC(n):
    print(n)
    if n < 10:
        cascadeC(n // 10)
        print(n)

def cascadeD(n):
    print(n)
    cascadeD(n // 10)
    print(n)
A 和 B 都对
先看 A。它把两种情况写得明明白白:n < 10(一位数)时只打印一次;否则打印、递归、再打印。
cascadeA(123):123 < 10 为假,走 else。打印 123。cascadeA(123 // 10) 即 cascadeA(12)。当前这一帧就停在这里等着,第 3 行 print(n) 还没执行。cascadeA(12):12 < 10 为假,走 else。打印 12,然后调用 cascadeA(1),也停下来等。cascadeA(1):1 < 10 为真。打印 1。函数体到头,返回 None。这是 base case,栈开始往回收。cascadeA(12) 那一帧,它接着执行被搁置的 print(n)。这一帧里 n 是 12,打印 12,返回。cascadeA(123) 那一帧,执行它被搁置的 print(n)。这一帧里 n 是 123,打印 123,返回。打印顺序:123, 12, 1, 12, 123。✓
第 5、6 步是全部要点:每一帧都有自己的 n。cascadeA(12) 那一帧里的 n 从头到尾都是 12,不会因为调用了 cascadeA(1) 而变成 1。所以「回来时打印的还是原来那个 n」——瀑布才对称。
Global frame
    cascadeA  ──→ func cascadeA(n)

f1: cascadeA [parent=Global]
    n ──→ 123          当前停在 cascadeA(n // 10) 这一行,等它返回
                       后面还有一句 print(n) 没执行

f2: cascadeA [parent=Global]
    n ──→ 12           当前停在 cascadeA(n // 10) 这一行
                       后面还有一句 print(n) 没执行

f3: cascadeA [parent=Global]
    n ──→ 1            走 if 分支,print(1) 已执行,即将返回 None
注意每一帧的 parent 都是 Global,不是「上一帧」。父帧由函数定义在哪里决定,跟谁调用了它无关——cascadeA 定义在全局,所以它的每一次调用都新建一个 parent 为 Global 的帧。这一点在树递归里更要紧:调用树很深很宽,但所有帧的 parent 全是 Global。
再看 B。它注意到「打印 n」这件事两个分支都要做,于是提到 if 外面去,只在 n >= 10 时才多做「递归 + 再打印」。执行下来输出与 A 完全一样,我在本机跑过:
>>> cascadeB(123)
123
12
1
12
123
>>> cascadeB(5)
5
讲义在这里问了一个不那么技术、但很重要的问题:两个都对,哪个更好?课程给的答案是:A 更可读(readable),B 更简洁(concise);如果二者只能选一个,95% 的情况下选可读。理由很实在——代码写一遍,读一百遍,而且读的人常常是三个月后的你自己。B 省下的那一行,换来的是「为什么 print 在 if 外面」这个需要想一下才明白的问题。
C 错在把条件写反了
cascadeC 和 B 只差一个符号:if n < 10 而不是 if n >= 10。这一个符号让它彻底坏掉,而且是两种不同的坏法:
cascadeC(123):打印 123;123 < 10 为假,if 整块跳过;函数结束。输出只有一行 123——递归一次都没发生。cascadeC(5):打印 5;5 < 10 为真,调用 cascadeC(5 // 10) 即 cascadeC(0);打印 0;0 < 10 为真,调用 cascadeC(0 // 10) 即 cascadeC(0)……n 卡在 0 上再也不变了。>>> cascadeC(5)
5
0
0
0
... (几百行 0)
Traceback (most recent call last):
...
RecursionError: maximum recursion depth exceeded while getting the str of an object
这条报错信息值得认识一下。RecursionError 意味着调用栈深度超过了 Python 的默认上限(sys.getrecursionlimit() 通常是 1000)。后面那句 while getting the str of an object 只是说「爆栈的那一刻,解释器正在执行 print 内部的字符串转换」——不要被它误导去查 print 的用法,病根是递归不收敛。
看到 RecursionError,99% 的原因是下面两条之一,按顺序自查:
- 递归调用没有让问题变小,或者变小的方向跑偏了。
cascadeC(0)调用cascadeC(0 // 10)=cascadeC(0),参数原地踏步。 - base case 的条件永远不会被满足。比如参数会跳过 base case 那个值(
n每次减 2,base case 却写的是n == 1,遇到偶数就直奔负数),或者压根忘了写 base case。
调试手段:在函数第一行插一句 print('call with n =', n),跑一次,看参数序列是怎么变化的。参数序列会一眼告诉你它冲向了哪里。
D 连 base case 都没有
cascadeD 干脆把 if 删掉了。它是「无条件递归」的教科书样本:
>>> cascadeD(123)
123
12
1
0
0
0
...
RecursionError: maximum recursion depth exceeded while getting the str of an object
前三行还挺像样,因为 123 → 12 → 1 确实在变小。但到了 cascadeD(1),没有任何条件拦住它,它照样调用 cascadeD(1 // 10) = cascadeD(0),然后就永远停在 0 了。
- 递归调用之前的语句在「下沉」时执行,之后的语句在「回升」时执行。想控制输出顺序,就是在控制这两句话摆在哪边。这条在树递归里同样成立,只是「下沉/回升」变成了在整棵树上做深度优先遍历。
- base case 必须真的能被够到。写完递归函数,先问自己一句:「从我给的参数出发,反复套用递归情形里的那个变换,一定会撞上 base case 的条件吗?」答不上来就是有 bug。
2. 复习:sum_odd_squares,以及「递归怎么记住额外状态」
随堂练习 06.py 里的第一题,要求同一个功能分别用迭代和递归写一遍。它本身不是树递归,但它教了一个之后处处要用的技巧:当递归需要携带一个额外的信息时,用一个 helper 函数多加一个参数。
题面(docstring 的人话版):给一个非负整数 n,从最右边一位算作第 0 位往左数,奇数位上的数字要平方后再加,偶数位上的数字直接加。
>>> sum_odd_squares_iterative(5)
5
>>> sum_odd_squares_iterative(123)   # 1 + (2*2) + 3 = 8
8
>>> sum_odd_squares_iterative(243580)
86
先把 123 掰开看清楚位置是怎么编号的——位置从右往左数,跟书写顺序相反,这是最容易看错的地方:
| 数字 | 1 | 2 | 3 |
|---|---|---|---|
| 位置 | 2 | 1 | 0 |
| 奇数位? | 否 | 是 | 否 |
| 贡献 | 1 | 2 × 2 = 4 | 3 |
合计 1 + 4 + 3 = 8。✓
迭代版
迭代版就是第 2 讲那个 sum_digits 的骨架(反复 % 10 取末位、// 10 砍掉末位),只是多带一个计数器记住「现在扒到第几位了」:
def sum_odd_squares_iterative(n: int) -> int:
    position = 0
    total = 0
    while n > 0:
        digit = n % 10
        if position % 2 == 1:
            total += digit * digit
        else:
            total += digit
        n = n // 10
        position += 1
    return total
追踪 sum_odd_squares_iterative(123):
| 轮次 | 进入时 n | position | digit | 加了什么 | 轮末 total | 轮末 n |
|---|---|---|---|---|---|---|
| 1 | 123 | 0 | 3 | 3(偶数位) | 3 | 12 |
| 2 | 12 | 1 | 2 | 2*2 = 4(奇数位) | 7 | 1 |
| 3 | 1 | 2 | 1 | 1(偶数位) | 8 | 0 |
| (第 4 次检查) | 0 | 条件 0 > 0 为假,退出循环,return 8 | ||||
顺带回答一个边界:n = 0 时循环一次都不进,返回 0。这恰好是对的——0 的各位数字之和就是 0。
递归版:额外状态往哪放?
递归版有个真实的坎。你很自然会想写:
def sum_odd_squares_recursive(n):
    if n == 0:
        return 0
    return (n % 10) + sum_odd_squares_recursive(n // 10)      # ← 平方在哪判断?
问题立刻暴露:函数只有 n 一个参数,它没法知道「当前这一位是第几位」。迭代版有 position 这个变量一路带着,递归版每一次调用都是崭新的一帧,帧与帧之间不共享局部变量。
你可能想到把位置编码进 n 里——比如「看剩下几位数」。但更直接、也是本课标准做法的,是再加一个参数。既然题目规定了外部接口只能传一个 n,那就在里面定义一个多参数的 helper 函数:
def sum_odd_squares_recursive(n: int) -> int:
    def helper(n: int, is_odd: bool) -> int:
        if n == 0:
            return 0
        elif is_odd:
            return ((n % 10) ** 2) + helper(n // 10, not is_odd)
        else:
            return (n % 10) + helper(n // 10, not is_odd)
    return helper(n, False)
三处细节值得说清楚:
- 为什么传
is_odd而不是position?因为我们只关心奇偶,不关心具体是第几位。传布尔值,翻转就是not is_odd,比position + 1再% 2少绕一道。两种写法都对。 - 初始值为什么是
False?最右边一位是位置 0,是偶数位,所以第一次调用时「当前不是奇数位」。传True会让sum_odd_squares_recursive(5)返回 25 而不是 5。 helper里的n遮蔽了外层的n。这不是 bug——helper有自己的形参n,它的帧里n就是自己那个。外层的n只在最后return helper(n, False)那一次被读到。
helper(123, False)
  = (123 % 10) + helper(12, True)          # 位置 0,偶,不平方
  = 3          + helper(12, True)
                     helper(12, True)
                       = (12 % 10) ** 2 + helper(1, False)   # 位置 1,奇,平方
                       = 4              + helper(1, False)
                                              helper(1, False)
                                                = (1 % 10) + helper(0, True)
                                                = 1        + helper(0, True)
                                                                 helper(0, True) = 0   ← base case
                                                = 1 + 0 = 1
                       = 4 + 1 = 5
  = 3 + 5 = 8                                                   ✓
注意回代的方向:先一路下沉到 helper(0, True) 拿到 0,再一层层往上把加法做完。在 helper(0, True) 返回之前,3 + ... 这个加法一次都没算过——加号左边的 3 早就算好了,右边的操作数还是一个「悬而未决」的调用。这就是为什么帧要留在栈上。
课上有一道随堂投票题:「True or false:sum_odd_squares_recursive 是高阶函数(higher-order function)吗?」
答案是 False。高阶函数的定义是「接受函数作为参数」或「返回一个函数」——两条占一条即可。sum_odd_squares_recursive 在体内 def 了一个 helper,但它既没有把函数当参数收进来,也没有把 helper 返回出去(它返回的是 helper(n, False) 的结果,一个整数)。
「函数体里出现了 def」不等于「高阶函数」。判断时死盯两处:形参列表里有没有函数?return 后面跟的是函数名还是调用?return helper 是高阶函数,return helper(n, False) 不是。
3. 树递归到底是什么
把定义拆成两半读:
- 「超过 1 次递归调用」——数的是代码里写了几个递归调用,不是运行时一共发生了多少次调用。
fact(n)会调用自己 n 次,但代码里只写了一处fact(n - 1),所以它不是树递归。 - 「在单个递归情形里」——如果一个函数有两个分支,分支 A 里写了一次递归调用,分支 B 里也写了一次,但每次执行只走其中一条,那它也不是树递归,因为任何一次调用都只发出一个「儿子」。
| 代码形状 | 是树递归吗 | 为什么 |
|---|---|---|
return n * fact(n - 1) | 否 | 一处递归调用,调用链是一根竹竿 |
if is_odd: return f(n // 10)else: return 1 + f(n // 10) | 否 | 写了两处,但每次执行只走一条,每个调用仍只有一个儿子 |
return fib(n - 1) + fib(n - 2) | 是 | 同一次执行里发出两个调用,每个调用有两个儿子 |
a = f(n - m)b = f(n, m - 1)return a + b | 是 | 同上,只是把两个调用先各自绑了名字 |
为什么叫「树」:把「谁调用了谁」画成图,一个调用是一个结点,它发出的每次递归调用是一条向下的边。单链递归画出来是一条竖线;两个调用画出来就是每个结点分两个叉,整体像一棵倒栽的树——根在最上面(最初的那次调用),叶子在最下面(各个 base case)。
单链递归 fact(4)              树递归 fib(4)

  fact(4)                        fib(4)
    │                           ╱      ╲
  fact(3)                  fib(3)      fib(2)
    │                     ╱     ╲      ╱    ╲
  fact(2)             fib(2)   fib(1) fib(1) fib(0)
    │                ╱     ╲
  fact(1)        fib(1)   fib(0)
    │
  fact(0)   ← 叶子只有 1 个       ← 叶子有 5 个
什么样的题该往树递归上想
把这三条翻译成做题时的自问自答:
课程后面会讲树(tree)这种数据结构——有根结点、有若干分支的那种数据。处理它的函数经常写成树递归(因为要对每个分支各发一次递归调用),但这只是碰巧:
fib是树递归,但它处理的是一个整数,跟树这种数据结构毫无关系。- 一个只有单条分支的链状树,遍历它的递归函数每次只发一个调用,那就不是树递归。
「树递归」形容的是调用的形状,「树」形容的是数据的形状。两者独立。
4. Fibonacci:把调用树整棵画出来
Fibonacci(斐波那契)数列的定义本身就是递归的:
- 第 0 个是
0 - 第 1 个是
1 - 第 n 个 = 前两个之和
即 0, 1, 1, 2, 3, 5, 8, 13, …。第 3 讲写过迭代版:
def fib(n):
    curr, nxt = 0, 1
    k = 0
    while k < n:
        curr, nxt = nxt, curr + nxt
        k += 1
    return curr
这个迭代版是对的,也快,但它跟数学定义之间隔着一层需要动脑筋的翻译:你得想明白 curr, nxt 这两个变量在循环里滚动地代表着什么。而递归版几乎是把定义抄下来——三个 clause 分别对应定义里的三条:
def fib(n):
    if n == 0:
        return 0
    elif n == 1:
        return 1
    else:
        return fib(n - 1) + fib(n - 2)
这是本讲第一个真正的树递归——else 分支里出现了两个 fib 调用。
为什么需要两个 base case?因为递归情形要往回够两格。如果只写 if n == 0: return 0,那么 fib(1) 会去算 fib(0) + fib(-1),而 fib(-1) 又会去算 fib(-2) + fib(-3)……一路奔向负无穷。规则:递归情形每次最多往回退 k 格,就至少要有 k 个连续的 base case 挡住。
手工展开 fib(4)
下面这段是本节的核心,请一行一行读。缩进代表调用的深度:
fib(4)
= fib(3) + fib(2)                     ← 先把左边的 fib(3) 算完,右边一动不动地等着

  fib(3) = fib(2) + fib(1)
    fib(2) = fib(1) + fib(0)
      fib(1) = 1                      ← base case
      fib(0) = 0                      ← base case
    fib(2) = 1 + 0 = 1
    fib(1) = 1                        ← base case
  fib(3) = 1 + 1 = 2

  fib(2) = fib(1) + fib(0)            ← 现在才轮到最外层那个右操作数
    fib(1) = 1
    fib(0) = 0
  fib(2) = 1 + 0 = 1

= 2 + 1 = 3                           ✓  数列 0,1,1,2,3 的第 4 项确实是 3
这里藏着一个必须说清的求值顺序问题。return fib(n - 1) + fib(n - 2) 是一个加法表达式,Python 求值它时:先完整求值左操作数 fib(n - 1)(这意味着把左边那整棵子树跑到底),再求值右操作数 fib(n - 2),最后才做加法。两个调用不是并行的,是严格一前一后。
所以任何时刻,栈上其实只有一条从根到当前结点的路径——树的最大深度是 n,栈最深也就 n 层。「树很宽」和「栈很深」是两回事:宽度带来的是时间开销,深度带来的才是空间开销。
Global frame
    fib ──→ func fib(n)

f1: fib [parent=Global]   n ──→ 4   正在算 fib(n-1),加号右边的 fib(2) 还没碰
f2: fib [parent=Global]   n ──→ 3   正在算 fib(n-1),加号右边的 fib(1) 还没碰
f3: fib [parent=Global]   n ──→ 2   正在算 fib(n-1),加号右边的 fib(0) 还没碰
f4: fib [parent=Global]   n ──→ 1   走 elif 分支,即将返回 1

栈深 4 层,而不是「fib(4) 的整棵树有 9 个结点所以 9 层」。
数一数:同一个子问题被算了几遍
课上让大家去 recursionvisualizer.com 跑一次 virfib(5),然后问「你注意到了什么」。(vir 取自 Virahanka,最早提出这个数列的印度数学家。)要注意到的就是:调用树上有大量长得一模一样的子树,同一个 fib(k) 被从头算了很多次。
把 fib(5) 的调用树画全(每个结点写它的参数):
                        fib(5)
                 ╱                  ╲
            fib(4)                   fib(3)
          ╱        ╲               ╱       ╲
     fib(3)        fib(2)      fib(2)      fib(1)
    ╱     ╲       ╱     ╲     ╱     ╲
 fib(2)  fib(1) fib(1) fib(0) fib(1) fib(0)
 ╱    ╲
fib(1) fib(0)
我在本机加了一个计数器实际跑了一遍 fib(5),各参数被调用的次数是:
| 参数 n | 0 | 1 | 2 | 3 | 4 | 5 | 合计 |
|---|---|---|---|---|---|---|---|
| 被调用次数 | 3 | 5 | 3 | 2 | 1 | 1 | 15 |
算一个 fib(5)(结果才是 5)要发生 15 次函数调用,其中 fib(1) 被从零开始算了 5 遍。这不是实现写得糙——这是这个递归结构的固有代价。往大了看更吓人:
fib(n) | 返回值 | 函数调用总次数 |
|---|---|---|
fib(5) | 5 | 15 |
fib(6) | 8 | 25 |
fib(30) | 832 040 | 2 692 537 |
fib(50) | 12 586 269 025 | 约 4.07 × 10¹⁰ |
前三行是我实际跑出来的计数,最后一行按公式推的。这个公式本身很漂亮,也值得记:计算 fib(n) 所需的调用次数恰好是
验证一下:$C(5) = 2 \cdot \mathrm{fib}(6) - 1 = 2 \cdot 8 - 1 = 15$ ✓;$C(30) = 2 \cdot \mathrm{fib}(31) - 1 = 2 \cdot 1346269 - 1 = 2692537$ ✓。
为什么是这个式子?因为这棵树的叶子全是 fib(1)(返回 1)或 fib(0)(返回 0),而最终结果是所有叶子值之和,所以返回 1 的叶子恰好有 $\mathrm{fib}(n)$ 个。再加上返回 0 的叶子,总叶子数是 $\mathrm{fib}(n+1)$(这里用到 $\mathrm{fib}(n) + \mathrm{fib}(n-1) = \mathrm{fib}(n+1)$)。最后套用二叉树的性质:每个内部结点都恰好有 2 个儿子的二叉树,结点总数 = 2 × 叶子数 − 1。
由于 $\mathrm{fib}(n)$ 本身按黄金比例 $\varphi = \frac{1+\sqrt{5}}{2} \approx 1.618$ 的幂次增长,调用次数是 $\Theta(\varphi^n)$——指数级。n 每增加 1,工作量乘以约 1.618;n 每增加 15,工作量翻大约一千倍。
初学者常犯的第一个 Fibonacci 错误是把 base case 的返回值写反:
def fib(n):
    if n == 0:
        return 1        # ✗ 应该是 0
    elif n == 1:
        return 1
    return fib(n - 1) + fib(n - 2)
这段代码不会报错,它会安安静静地返回整个数列向左平移一位的结果:fib(0) 得 1,fib(5) 得 8 而不是 5。不报错的 bug 比报错的 bug 危险得多。写完递归函数,务必手算一两个最小的输入去对答案,而不是只跑 fib(10) 看它「像个 Fibonacci 数」。
第二个常见错误是只写一个 base case:
def fib(n):
    if n == 0:
        return 0
    return fib(n - 1) + fib(n - 2)
>>> fib(5)
Traceback (most recent call last):
  ...
RecursionError: maximum recursion depth exceeded in comparison
注意这次的尾巴是 in comparison——爆栈发生在执行 n == 0 这个比较的时候。只要看到 RecursionError,先数 base case 够不够。
读到这里你可能想问:写 fib 的时候,我真的要在脑子里把那棵有 15 个结点的树想清楚吗?
不。而且千万别这么做。正确的思考方式只有两步:
- 假设
fib(n - 1)和fib(n - 2)已经能给我正确答案(不管它们内部怎么算的)。 - 那么在这个假设下,我该怎么用它们拼出
fib(n)?——加起来。
再加上「base case 是对的」和「参数确实在朝 base case 变小」,整个函数就是对的(这本质上是数学归纳法)。展开调用树是用来分析效率和调试的,不是用来构思代码的。构思时展开树,你写三行就会晕。
5. count_partitions:从「选或不选」到三个 base case
fib 是「数学定义天生递归」的例子,你几乎不用动脑就能抄出来。count_partitions 不一样——它的递归结构需要你自己发明。这是本讲最重要的一道题,也是 61A 的经典题目。
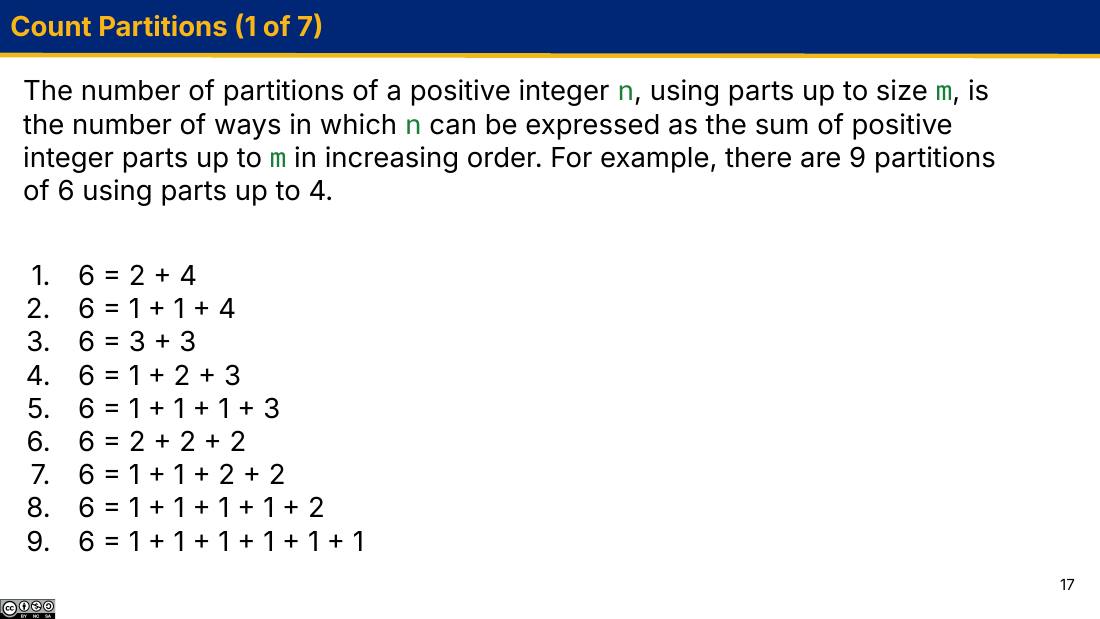
题目:正整数 n 用不超过 m 的部分(part)做划分(partition)的方案数,是指把 n 写成若干个不超过 m 的正整数之和、且这些数按递增顺序排列的写法总数。
例如 count_partitions(6, 4) == 9:
| # | 划分 | 用了 4 吗 |
|---|---|---|
| 1 | 6 = 2 + 4 | 用了 |
| 2 | 6 = 1 + 1 + 4 | 用了 |
| 3 | 6 = 3 + 3 | 没用 |
| 4 | 6 = 1 + 2 + 3 | 没用 |
| 5 | 6 = 1 + 1 + 1 + 3 | 没用 |
| 6 | 6 = 2 + 2 + 2 | 没用 |
| 7 | 6 = 1 + 1 + 2 + 2 | 没用 |
| 8 | 6 = 1 + 1 + 1 + 1 + 2 | 没用 |
| 9 | 6 = 1 + 1 + 1 + 1 + 1 + 1 | 没用 |
先把「递增顺序」这个约定的作用说透:它不是在限制答案的形式,而是在定义什么算「同一种划分」。2 + 4 和 4 + 2 是同一个划分的两种写法,规定按递增排列后就只剩一种。少了这个约定,count_partitions(6, 4) 数出来的就是完全不同的东西(那叫 composition,组合数会大得多)。
找到那个分叉点
面对这道题,第一反应往往是想「怎么把 n 变小」。n - 1?n // 2?都走不通,因为你根本不知道下一个部分该取多大。
换个问法:能不能问一个「是/否」问题,把 9 种划分干净地劈成两堆?
看上面那张表的最后一列——问题就在那儿:「这个划分里,用没用到最大的那个尺寸 m(这里是 4)?」
- 用了至少一个 4:第 1、2 两种。
- 一个 4 都没用:第 3 到 9 种,共 7 种。
2 + 7 = 9。互斥(一个划分不可能既用了 4 又没用 4),穷尽(不存在第三种情况)。这正是第 3 节说的「情况 A + 互斥的情况 B」。
接下来把这两堆各自变成一个同类型的、更小的子问题:
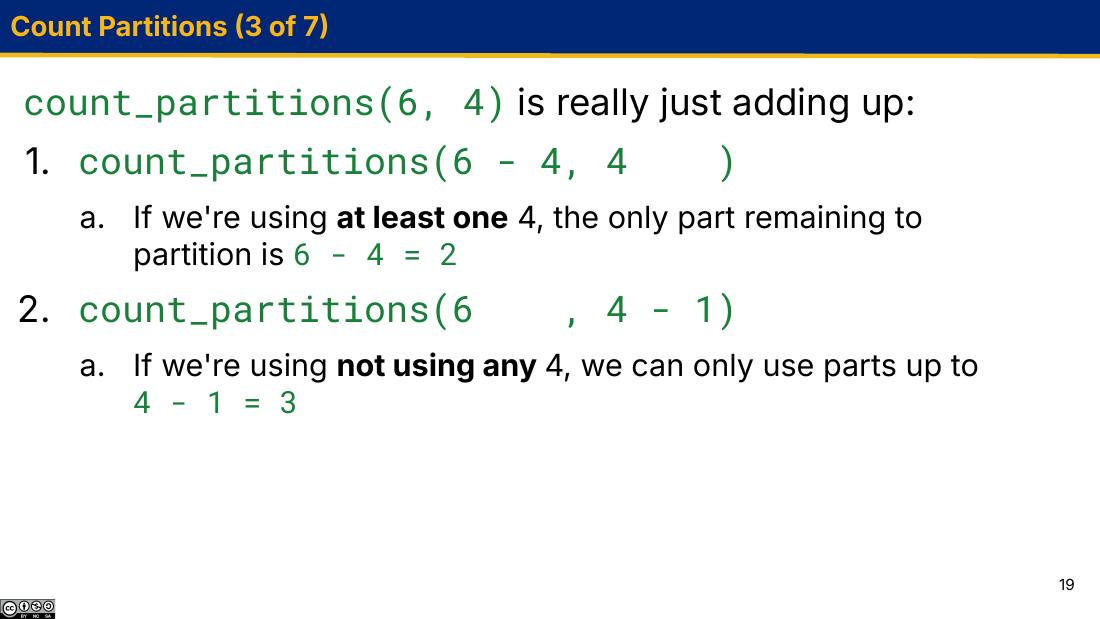
6 - 4 = 2。而剩下这 2 还能不能再用 4?能——题目只说部分「不超过 m」,没说 m 只能用一次。所以子问题是 count_partitions(2, 4),即 count_partitions(n - m, m),m 保持不变。count_partitions(6, 3),即 count_partitions(n, m - 1),n 保持不变。count_partitions(n - m, m) + count_partitions(n, m - 1)。这里有三个几乎人人踩过的坑:
- 把第一个调用写成
count_partitions(n - m, m - 1)。「用了一个 4 之后就不能再用 4 了」——这是把「划分」当成了「每种尺寸只能用一次」。可6 = 2 + 2 + 2里 2 用了三次,是合法划分。用掉一个 m 之后,m 依然可用。 - 把第二个调用写成
count_partitions(n - 1, m - 1)。「不用 m」这个决定没有花掉 n 的任何一部分,n 凭什么减?两个参数每次只能动一个,动哪个由「这一支到底发生了什么」决定。 - 忘了 m 会一路降到 0。「不用 m」这一支每次把 m 减 1,减到 0 时就再也没有可用的部分了——这是下面第三个 base case 的来源。
base case:一个一个补出来
讲义把这份代码分了 4 张幻灯片,从只有 else 分支开始,一次补一个 base case。这个顺序值得原样复述一遍,因为它展示的正是真实的写代码过程:先写递归情形,再问「什么时候递归该停」。
def count_partitions(n, m):
    ...
    else:
        with_m = count_partitions(n - m, m)
        without_m = count_partitions(n, m - 1)
        return with_m + without_m
n == 0 时返回 1。n 减到 0,意味着刚才那一串选择正好把原数凑满了——这就是一种成功的划分,记 1 种。说得更严谨点:「把 0 划分成若干正整数之和」只有一种办法,就是什么都不取(空划分)。这不是特殊约定,是把定义推到边界的自然结果。
n < 0 时返回 0。n 变成负数,说明刚才那一支「用了一个 m」用超了——比如 count_partitions(2, 4) 会去试 count_partitions(2 - 4, 4) = count_partitions(-2, 4)。这条路走不通,贡献 0 种方案。这个 base case 是绝对不能省的:省了它,n 会一路减到负无穷,直接
RecursionError。m == 0 时返回 0。可用的最大尺寸降到 0,意味着没有任何正整数可以用了。此时若 n 还大于 0(n 等于 0 的情况已被第一条截走),就凑不满,贡献 0 种方案。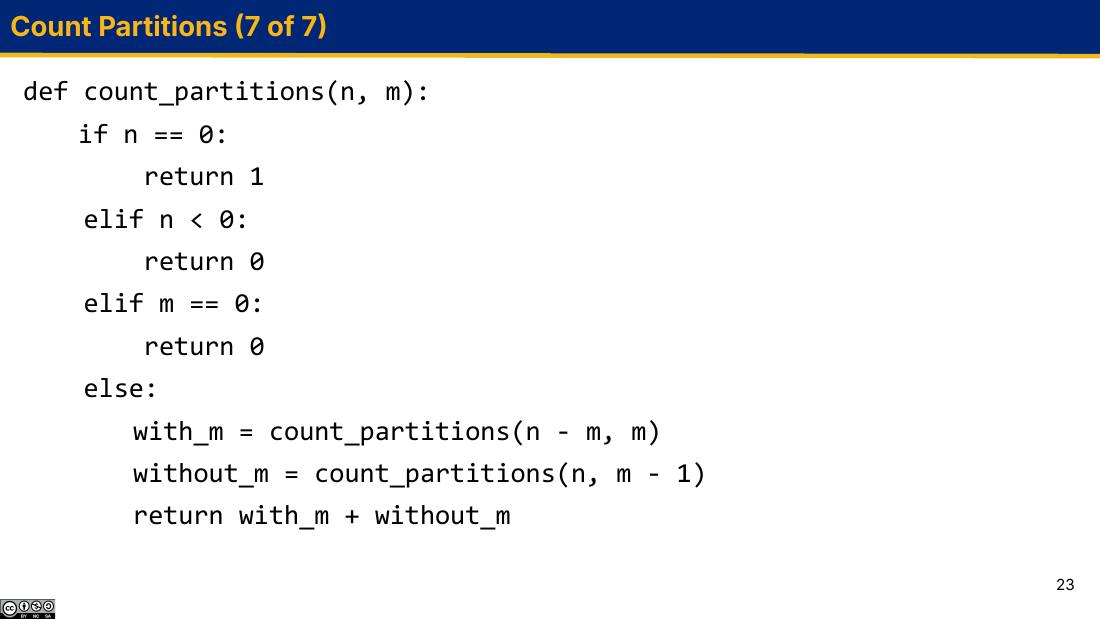
def count_partitions(n, m):
    if n == 0:
        return 1
    elif n < 0:
        return 0
    elif m == 0:
        return 0
    else:
        with_m = count_partitions(n - m, m)
        without_m = count_partitions(n, m - 1)
        return with_m + without_m
n == 0 要写在最前面
把 m == 0 挪到第一位会怎样?我实测过:对所有 n >= 1 的输入,两种写法结果完全一致;唯一有分歧的是直接调用 count_partitions(0, 0)——正确写法返回 1,调换后返回 0。
为什么实际结果不受影响?因为 n 一旦归零,那次调用一进门就被第一条截住返回 1 了,根本没机会继续把 m 减下去。所以 (0, 0) 这个组合在递归过程中到不了。
但语义上 count_partitions(0, 0) 应该是 1(用「不超过 0 的部分」去划分 0,答案还是那个空划分)。把 n == 0 放在最前,是在表达「凑满了就是成功,跟还剩多少种尺寸可用无关」。顺序体现的是意图,即使当前测例看不出差别,也该按意图写。
完整展开一个小例子
count_partitions(6, 4) 的树有 59 个结点(我加计数器数过),太大画不下。换个能画全的:count_partitions(4, 2),答案应该是 3(4 = 2+2、4 = 1+1+2、4 = 1+1+1+1)。
cp(4,2)
├── with_m    = cp(2,2)          # 用了一个 2,还剩 2 要凑
│   ├── with_m    = cp(0,2)  → 1     ← n == 0,成功!对应 4 = 2+2
│   └── without_m = cp(2,1)
│       ├── with_m    = cp(1,1)
│       │   ├── with_m    = cp(0,1) → 1   ← 成功,对应 4 = 2+1+1
│       │   └── without_m = cp(1,0) → 0   ← m == 0,没尺寸可用了
│       │   小计 cp(1,1) = 1 + 0 = 1
│       └── without_m = cp(2,0) → 0       ← m == 0
│       小计 cp(2,1) = 1 + 0 = 1
│   小计 cp(2,2) = 1 + 1 = 2
└── without_m = cp(4,1)          # 一个 2 都不用,只能用 1
    ├── with_m    = cp(3,1)
    │   ├── with_m    = cp(2,1) = 1       ← 同上,展开略;对应 4 = 1+1+1+1
    │   └── without_m = cp(3,0) → 0
    │   小计 cp(3,1) = 1
    └── without_m = cp(4,0) → 0
    小计 cp(4,1) = 1 + 0 = 1

cp(4,2) = 2 + 1 = 3   ✓
把每个返回 1 的叶子和一种真实划分对上号,是理解这道题最有效的方式:
| 叶子 | 到达它走过的决策序列 | 对应的划分 |
|---|---|---|
cp(0,2)(经 cp(2,2)) | 用一个 2 → 用一个 2 | 4 = 2 + 2 |
cp(0,1)(经 cp(2,2)→cp(2,1)→cp(1,1)) | 用一个 2 → 弃用 2 → 用一个 1 → 用一个 1 | 4 = 1 + 1 + 2 |
cp(0,1)(经 cp(4,1) 那一支) | 弃用 2 → 用 1 四次 | 4 = 1 + 1 + 1 + 1 |
树递归函数返回的那个数,等于调用树上返回 1 的叶子的个数。每一片这样的叶子,对应一条从根走到底的完整决策序列,也就是一个真实的解。返回 0 的叶子是走死了的分支。
所以「这个函数为什么是对的」可以完全不看代码地论证:只要每条决策序列对应恰好一个解、每个解对应恰好一条决策序列,计数就不重不漏。
顺手记几个可以自查的值(都是我跑出来的):count_partitions(6, 4) == 9,count_partitions(6, 6) == 11,count_partitions(5, 5) == 7,count_partitions(2, 3) == 2。
最后一个值得琢磨:count_partitions(2, 3) 里 m > n。第一支 cp(2 - 3, 3) = cp(-1, 3) 撞上 n < 0 返回 0(合理:2 根本装不下一个 3),第二支 cp(2, 2) = 2。总共 2 种,正是 2 = 2 和 2 = 1 + 1。不需要为「m 比 n 大」写特判——n < 0 那条 base case 已经把它顺手处理了。
6. 练习:count_stairs
题目:你要爬 n 级台阶,每次可以迈 1 级或 2 级。一共有多少种不同的走法?
>>> count_stairs(3)   # 2 then 1;1 then 2;或 1, 1, 1
3
>>> count_stairs(2)   # 迈 2 级;或迈两次 1 级
2
>>> count_stairs(4)
5
怎么想到的
套第 3 节那三个自问:
于是:
- 第一步迈 1 级 → 站在第 1 级上,还剩
n - 1级要爬 →count_stairs(n - 1)种 - 第一步迈 2 级 → 站在第 2 级上,还剩
n - 2级要爬 →count_stairs(n - 2)种
关键的一步在于承认:「站在第 1 级上,还剩 n−1 级要爬」跟「站在地面,要爬 n−1 级」是完全同一个问题。台阶不记得你是怎么上来的,剩下的选择完全一样。这种「历史无关」正是问题能被递归拆开的前提——如果规则是「不能连续迈两次 1 级」,那就得再带一个参数记住上一步迈了几级。
base case
递归情形往回退两格,所以至少需要两个连续的 base case(第 4 节讲过的规则)。06-sol.py 里的写法是把它们合成一行:
def count_stairs(n: int) -> int:
    # If you're 1 step away from the top or already at the top,
    # there's only 1 way to get there
    if n == 1 or n == 0:
        return 1
    return count_stairs(n - 1) + count_stairs(n - 2)
n == 1→ 1:只剩 1 级,只能迈 1 级上去,1 种走法。n == 0→ 1:已经在顶上了,什么都不用做,这本身算 1 种走法。
n == 0 返回 1 而不是 0,是这道题最容易卡住的地方。想通它有两条路:
路子一(从含义出发):一次调用返回 1,含义是「这条决策路径走通了,凑出了一个合法方案」。n 恰好减到 0,意味着刚才那串迈步不多不少正好爬完——那当然是一个合法方案,必须记 1。这跟 count_partitions 里 n == 0 返回 1 是同一个道理。
路子二(从一致性倒推):已知 count_stairs(2) 应该是 2。按递归情形,count_stairs(2) = count_stairs(1) + count_stairs(0) = 1 + count_stairs(0)。要让它等于 2,就必须有 count_stairs(0) = 1。拿不准某个 base case 该返回什么,就用一个你已知答案的最小输入把它解出来。这是极其实用的技巧。
另一种同样正确、而且更容易推广的写法是把「越界」单独拎出来:
def count_stairs(n):
    if n < 0:
        return 0        # 迈过头了,走不通
    elif n == 0:
        return 1        # 正好到顶,记一种
    return count_stairs(n - 1) + count_stairs(n - 2)
我把两个版本对 n = 0..7 都跑了一遍,结果完全一致:1, 1, 2, 3, 5, 8, 13, 21。第二种写法的好处是骨架能直接搬到「每次可迈 1、2 或 3 级」上去——只要加一个 count_stairs(n - 3),base case 一个字都不用改。第一种写法就得再补一个 n == 2。
非常多人会这样写 base case,因为「1 级台阶 1 种,2 级台阶 2 种」听起来天经地义:
def count_stairs(n):
    if n == 1:
        return 1
    elif n == 2:
        return 2
    return count_stairs(n - 1) + count_stairs(n - 2)
对 n >= 1 它确实全对(1, 2, 3, 5, 8, 13, 21,我跑过)。但:
>>> count_stairs(0)
Traceback (most recent call last):
  ...
RecursionError: maximum recursion depth exceeded in comparison
因为 n = 0 从一开始就跳过了两个 base case,一头栽进 count_stairs(-1) + count_stairs(-2),然后一路负下去。
这个 bug 的可怕之处在于:doctest 里只有 2、3、4,它能完美通过全部测试。写完 base case,必须单独问一句:「参数能不能绕过我写的所有 base case?」把 n == 2 换成 n == 0(或者加一条 n < 0 兜底),就再也漏不掉了。
验证 count_stairs(4)
cs(4) = cs(3) + cs(2)

  cs(3) = cs(2) + cs(1)
    cs(2) = cs(1) + cs(0)
      cs(1) = 1            ← base case
      cs(0) = 1            ← base case
    cs(2) = 1 + 1 = 2
    cs(1) = 1
  cs(3) = 2 + 1 = 3

  cs(2) = cs(1) + cs(0) = 1 + 1 = 2

cs(4) = 3 + 2 = 5    ✓
把 5 种走法列出来对一下:1+1+1+1、1+1+2、1+2+1、2+1+1、2+2。正好 5 种。注意 1+1+2 和 2+1+1 算两种——这里顺序是有意义的,跟 count_partitions 里「递增顺序」的约定刚好相反。
count_stairs 的递推式 f(n) = f(n-1) + f(n-2) 跟 Fibonacci 一模一样,只是初值不同:count_stairs(n) == fib(n + 1)。count_stairs(4) = 5 = fib(5) ✓。
这不是巧合,而是「同一个递归结构可以描述完全不同的问题」的一个例子。你不需要认出这层关系才能做题——但认出来之后,第 9 节讲的加速手段可以原样搬过来。
7. 练习:mario_number
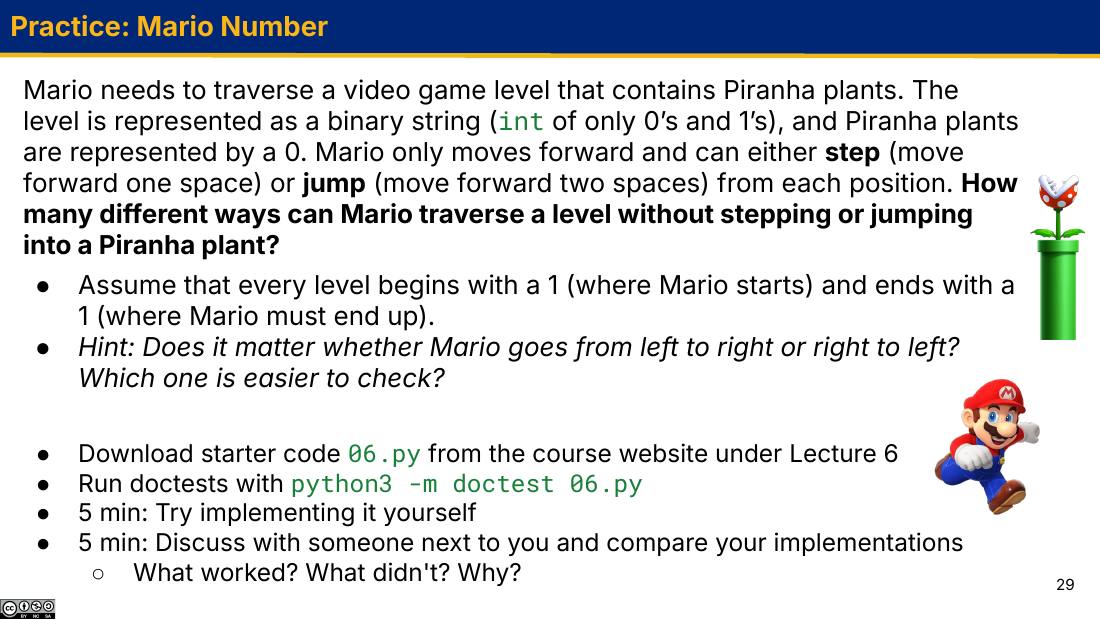
题目:关卡用一个只由 0 和 1 组成的整数表示,0 是食人花(Piranha plant),踩上去就死。Mario 从最左位出发(题目保证是 1),必须停在最右位(题目保证也是 1)。每一步可以 step(前进一格)或 jump(前进两格)。问有多少种不踩到食人花的走法。
>>> mario_number(10101)    # jump, jump
1
>>> mario_number(11101)    # 从左到右:step, step, jump 或 jump, jump
2
>>> mario_number(100101)
0
先解决 Hint:为什么必须从右往左
这道题的骨架跟 count_stairs 几乎一样(每步走 1 格或 2 格,数走法),唯一多出来的是「有些格子不能踩」。难点不在递归结构,在怎么把「去掉一格」这个操作用整数算术表达出来。
手上只有整数运算,能砍数字的只有两招:
| 想砍掉 | 操作 | 可行吗 |
|---|---|---|
| 最右一位 | level // 10 | ✓ 一步到位,不需要知道位数 |
| 最左一位 | 要先求出位数 d,再 level % 10**(d-1) | ✗ 麻烦,而且有致命问题 |
「致命问题」是前导零会被整数悄悄吃掉。以 10101 为例,砍掉最左那位应该得到关卡 0101,但作为整数它就是 101——那个 0(食人花)凭空消失了,关卡长度从 4 变成 3。这种 bug 不报错,只是答案错,最难查。
所以答案是:从右往左走。反过来看 Mario 的路径完全等价——一条从左到右的路径倒过来,就是一条从右到左、每步同样走 1 格或 2 格的路径,一一对应,数量相同。而从右往左,「走过一格」正好就是 // 10。
换个角度想会更顺:与其问「Mario 从起点出发第一步怎么走」,不如问 「Mario 是怎么到达终点(最右位)的?」 只有两种可能:
- 从左边紧邻的那一格 step 过来 → 那么在此之前他要解决的是「走到倒数第二格」这个子问题 →
level // 10(把终点这一格删掉,新的终点就是倒数第二格) - 从左边隔一格 jump 过来 → 子问题是「走到倒数第三格」 →
level // 100(删掉两格)
这两种到达方式互斥且穷尽,答案相加。「最后一步是怎么来的」往往比「第一步往哪去」更好写成代码,因为它把变化留在了数字末尾。
代码
def mario_number(level: int) -> int:
    if level == 1:
        return 1
    elif level % 10 == 0:
        return 0
    else:
        step = mario_number(level // 10)
        jump = mario_number(level // 100)
        return step + jump
逐行说为什么:
if level == 1: return 1——关卡只剩 Mario 的起点这一格了,他已经站在这儿,不用走,这本身是 1 种完整走法。跟count_stairs(0) == 1同一个道理。
(为什么判== 1而不是< 10?题目保证关卡以 1 开头,而从右边砍永远只会剩下原关卡的前缀,前缀的第一位还是 1。所以能出现的单位数只有1和0,后者由下一条处理。)elif level % 10 == 0: return 0——level % 10是最右一位,也就是这个子问题里 Mario 要落脚的那一格。是 0 就是食人花,落不了脚,这条路贡献 0 种走法。
这一条还顺手兜住了越界:level // 100有可能把数字砍成0(比如mario_number(11)里11 // 100 == 0),而0 % 10 == 0,返回 0。语义正好对:「从起点左边跳进来」是不存在的走法。- 递归情形——两个到达方式各发一次调用,相加返回。写成两个有名字的变量(
step/jump)而不是挤成一行,是为了让读代码的人一眼看出这两支各代表什么,跟第 1 节 cascade 那里说的「选可读」是同一条原则。
验证 mario_number(11101)
关卡 11101 的格子从左到右是 1 1 1 0 1,下标 0 到 4。人工枚举:从 0 出发,走到 4,不能踩下标 3(那是 0)。可行路径是 0→1→2→4(step, step, jump)和 0→2→4(jump, jump),共 2 种。
mario_number(11101)          末位 1,安全,继续
├── step = mario_number(1110)
│      末位 0 → 食人花 → 返回 0        (不能 step 落到下标 3)
└── jump = mario_number(111)
    │  末位 1,安全,继续
    ├── step = mario_number(11)
    │   │  末位 1,安全,继续
    │   ├── step = mario_number(1)   → 1     ← base case,走通了
    │   └── jump = mario_number(0)   → 0     ← 0 % 10 == 0,越过了起点
    │   mario_number(11) = 1 + 0 = 1
    └── jump = mario_number(1)       → 1     ← base case,走通了
    mario_number(111) = 1 + 1 = 2

mario_number(11101) = 0 + 2 = 2      ✓
两片走通的叶子,正好对应上面人工枚举出的两条路径。再看另外两个 doctest:
| 调用 | 关卡格子 | 推演要点 | 结果 |
|---|---|---|---|
mario_number(10101) | 1 0 1 0 1 | step = mario_number(1010) 末位 0 → 0;jump = mario_number(101),它的 step 支 mario_number(10) 末位 0 → 0,jump 支 mario_number(1) → 1 | 1(jump, jump) |
mario_number(100101) | 1 0 0 1 0 1 | step 支 mario_number(10010) 末位 0 → 0;jump 支 mario_number(1001),它的两支分别是 mario_number(100)(末位 0 → 0)和 mario_number(10)(末位 0 → 0),合计 0 | 0(起点后面连着两朵食人花,第一步就没地方落) |
- 把 jump 写成
mario_number(level // 10 // 10)之外的东西,比如mario_number(level // 20)。// 100才是「删掉两位」;// 20是除以 20,跟数位毫无关系。 - 检查中间那格有没有食人花。jump 是跳过中间那格,中间是不是 0 无所谓——
mario_number(10101)能走通,正是因为可以从 1 跳过 0 落到 1。只有落脚的格子才需要检查,而落脚格恰好总是当前level的末位。 - base case 顺序写反成先判
level % 10 == 0再判level == 1:这里不会出问题(1 % 10 == 1,不满足第一条),但养成「成功情形写在前面」的习惯能省掉很多这类思考。 - 担心
level // 100把数字砍成负数或报错。不会——整数除法最小只会到0,而0会被level % 10 == 0正确地当作「非法路径」处理。这个巧合值得留意:0 既表示「食人花」又表示「跳出边界」,两种情形的正确返回值都是 0,所以一条判断就够了。
8. 树递归的通用套路与自查清单
把前面四道题(fib、count_partitions、count_stairs、mario_number)并排放在一起,骨架完全一样:
| 决策点 | 分支 A | 分支 B | 「成功」base case | 「失败」base case | |
|---|---|---|---|---|---|
fib(n) | (无,是数学递推) | fib(n-1) | fib(n-2) | n == 1 → 1 | n == 0 → 0 |
count_partitions(n, m) | 用不用 m | cp(n-m, m) | cp(n, m-1) | n == 0 → 1 | n < 0 → 0;m == 0 → 0 |
count_stairs(n) | 第一步迈 1 还是 2 | cs(n-1) | cs(n-2) | n == 0 → 1 | n < 0 → 0 |
mario_number(level) | 最后一步是 step 还是 jump | mn(level//10) | mn(level//100) | level == 1 → 1 | level % 10 == 0 → 0 |
fib 在这张表里是个特例——它没有真正的「决策」,只是数学递推恰好长成两个调用。另外三道都严格遵循同一个模板:
def solve(状态):
    if 这条路走通了:
        return 1
    if 这条路走死了:
        return 0
    分支A = solve(做了选择 A 之后的状态)
    分支B = solve(做了选择 B 之后的状态)
    return 分支A + 分支B
mario_number 选「最后一步」,就是因为它对应 // 10。max / min;判断能否做到就 or。调试自查清单
树递归写错了往往只体现为「答案差一点」,比死循环还难查。按下面的顺序排查:
| 症状 | 最可能的原因 | 怎么确认 |
|---|---|---|
RecursionError | 缺 base case,或参数绕过了 base case(例如每次减 2 却只判 == 1) | 函数第一行加 print(参数),看参数序列冲向哪里 |
| 答案比正确值大 | 分支不互斥,同一个方案被数了两遍 | 用最小的输入手工列出所有方案,跟叶子一一对上号 |
| 答案比正确值小 | 分支不穷尽(漏了一种选择),或某个「成功」base case 误写成返回 0 | 同上;重点检查 n == 0 那条返回的是 1 还是 0 |
| 答案恰好差 1,或整体平移一位 | base case 的返回值写错(fib(0) 返回 1 而不是 0 那类) | 手算最小的两三个输入,别只看大输入「像不像」 |
| 某些输入对、某些输入炸 | base case 覆盖不全(count_stairs 用 n==1 / n==2 那个例子) | 专门试 0、1、负数、以及 doctest 里没有的边界 |
| 只返回 0 | 递归调用的返回值没被用上,例如写了 solve(...) 却忘了 return | 检查每个分支是不是都有 return |
这个错误在树递归里格外常见,因为你写了两行调用,很容易只顾着算、忘了交货:
def count_stairs(n):
    if n == 1 or n == 0:
        return 1
    count_stairs(n - 1) + count_stairs(n - 2)   # ✗ 算了,但没 return
>>> count_stairs(4)
>>> print(count_stairs(4))
None
在交互式解释器里什么都不显示(因为返回值是 None,解释器不打印 None),乍看像是「卡住了」。一旦这个 None 被外层拿去做加法,才会炸出真正的错误:
TypeError: unsupported operand type(s) for +: 'NoneType' and 'NoneType'
看到 NoneType 出现在算术错误里,先去找哪个函数漏了 return。
有人会想用一个全局计数器代替返回值:
total = 0
def count_stairs(n):
    global total
    if n == 1 or n == 0:
        total += 1
    else:
        count_stairs(n - 1)
        count_stairs(n - 2)
它能算出答案,但每次调用前必须手动把 total 归零,函数不能嵌套使用,也没法被别的函数当成子问题调用——它不再是一个「问什么答什么」的函数,而是一台带残留状态的机器。61A 全程要求写纯粹靠返回值沟通的递归:每次调用只看自己的参数,只通过 return 交出结果。这样你才能安心地做「recursive leap of faith」。
9. 代价:同一个子问题被算了几千遍
回到第 4 节那张表:fib(30) 要 2 692 537 次调用,fib(50) 要约 4 × 10¹⁰ 次。这个开销来自一件很蠢的事——同一个子问题被从零开始重算了无数遍。
看 fib(5) 那棵树:fib(3) 这棵子树出现了 2 次,fib(2) 出现了 3 次,fib(1) 出现了 5 次。而 fib(3) 的答案是 2,第一次算出来之后,第二次完全可以直接抄。可朴素递归不记事,每次都老老实实从头再来。
                        fib(5)
                 ╱                  ╲
            fib(4)                  fib(3) ★  ← 和左边深处那个 fib(3) 完全一样
          ╱        ╲               ╱      ╲
     fib(3) ★     fib(2) ★    fib(2) ★   fib(1)
    ╱     ╲       ╱     ╲     ╱     ╲
 fib(2)★ fib(1) fib(1) fib(0) fib(1) fib(0)
 ╱    ╲
fib(1) fib(0)

fib(1) 被完整计算了 5 次,fib(0) 3 次,fib(2) 3 次,fib(3) 2 次。
为什么树递归特别容易撞上这个?因为不同的决策序列可能走到同一个状态。爬楼梯时「先 1 后 2」和「先 2 后 1」都会让你站在第 3 级上,剩下的子问题一模一样,但递归会把这两条路各自往下走到底。
治法预告:记住算过的答案
解决办法叫记忆化(memoization):拿一个字典把「算过的参数 → 结果」存起来,下次先查表。第 17 讲会正式讲,这里先看一眼它的威力有多大——下面这段我在本机跑过:
def memo(f):
    cache = {}
    def memoized(n):
        if n not in cache:
            cache[n] = f(n)
        return cache[n]
    return memoized

def fib(n):
    if n == 0:
        return 0
    elif n == 1:
        return 1
    return fib(n - 1) + fib(n - 2)

fib = memo(fib)          # 把名字 fib 重新绑定到包装后的版本上
| 朴素递归 | 记忆化之后 | |
|---|---|---|
fib(30) 进入函数体的次数 | 2 692 537 | 31 |
| 增长量级 | $\Theta(\varphi^n)$,指数 | $\Theta(n)$,线性 |
从 269 万次降到 31 次,代码本体一个字没改。之所以恰好是 31 次,是因为 n 只有 0 到 30 这 31 个可能的取值,每个值真正算一次,其余全部命中缓存。
这里有个容易忽略但很关键的细节:fib = memo(fib) 这一句必须把结果绑回 fib 这个名字。因为 fib 的函数体里写的是 fib(n - 1)——它在调用时去全局帧查 fib 这个名字,查到的是那一刻绑定的值。重新绑定之后,递归调用自动走的就是带缓存的那个版本了。如果写成 fast_fib = memo(fib),内部的递归调用仍然指向没缓存的原版,加速就只发生在最外面一层,等于没加速。(第 3 讲讲的「名字在求值时才查找」,在这里结出了果实。)
记忆化只在「同一组参数总是给出同一个结果」时有效,而且只有当状态空间比调用树小得多时才划算。fib 是极端好的例子:树有几百万个结点,状态却只有 31 种。
而对那些「每片叶子都是一个不同的解」的问题(比如要真的列出所有划分,而不是数数),叶子数本身就等于答案的数量,指数级的工作量是无法避免的——你总得把每个解生成一遍。能优化掉的是重复劳动,不是问题本身的规模。
递归的另一面:它不只是算数字
本讲最后,课程演示了一个真实世界的递归应用——维基百科哲学现象(Wikipedia Philosophy Phenomenon):在约 97% 的英文维基条目上,不停点击正文里的第一个链接,最终都会走到 Philosophy 这一条。
随堂代码 06-wikipedia.py 把这个过程写成了递归。它的骨架值得看,因为它的 base case 比课堂例题多,而且每一个都对应一种真实世界里会发生的意外:
def find_philosophy(current_url, visited=None, depth=0, max_depth=50):
    if visited is None:
        visited = set()
    # Base Case 1: 到达 Philosophy —— 成功
    # Base Case 2: depth >= max_depth —— 走太久了,放弃
    # Base Case 3: current_url in visited —— 兜圈子了,放弃
    # Base Case 4: 页面上找不到任何可用链接 —— 死胡同,放弃
    ...
    return find_philosophy(next_link, visited, depth + 1, max_depth)   # 递归情形
三点值得留意(这个 demo 是老师让 Gemini 写完再改的,课程明确说不要求看懂全部代码):
- 它不是树递归——每次只跟一个链接,递归情形里只有一次调用,是一根链。课上顺手抛了个问题:如果改成搜索前 2 个(或前 n 个)链接呢?那就变成树递归了:一个页面发出 n 次递归调用,合并方式从「返回那一条路的结果」变成「任一条通了就算通」(
or)。 visited这个集合是必需的,因为网页链接会成环(A 的第一个链接指向 B,B 的第一个链接指向 A)。max_depth是第二道保险。现实世界的递归常常需要这种「防走不动」的 base case,而课堂题目里参数单调变小,天然就有保证。visited=None然后在函数体里visited = set(),而不是直接写visited=set()当默认参数——这是 Python 的一个著名坑(可变默认参数在多次调用间被共享),第 8 讲讲可变性时会算总账。
10. 本讲小结
| 概念 | 一句话 | 要点 |
|---|---|---|
| 树递归(tree recursion) | 单个递归情形里发出超过一次递归调用 | 数的是代码里写了几处调用,不是运行时调用了多少次 |
| 「树」这个词 | 形容调用的形状,不是数据的形状 | 树递归可以处理整数;处理树数据结构的函数也可能不是树递归 |
| 适用场景 | 数方案数 / 遍历选择 / 「A 情况的所有做法 + 互斥 B 情况的所有做法」 | 看到「有多少种方法」基本可以直接往这上面套 |
| base case 个数 | 递归情形往回退 k 格,就至少要 k 个连续的 base case | fib 退 2 格,所以 n==0 和 n==1 都要有 |
| 返回 1 vs 返回 0 | 1 = 「这条路走通了,记一个方案」;0 = 「这条路走死了」 | n == 0 返回 1 表示「恰好凑满」,不是「什么都没有」 |
| 求值顺序 | f(a) + f(b) 是先把左边整棵子树跑完,再跑右边 | 栈的最大深度 = 树的高度,不是结点总数 |
| 效率 | 朴素 fib(n) 调用 $2\,\mathrm{fib}(n{+}1)-1$ 次,$\Theta(\varphi^n)$ | 病根是同一个子问题被重算;记忆化可降到 $\Theta(n)$ |
RecursionError | 爆栈了 | 先查 base case 够不够、参数是不是绕过了它 |
本讲出现过的四份代码(都能直接跑)
def fib(n):
    if n == 0:
        return 0
    elif n == 1:
        return 1
    else:
        return fib(n - 1) + fib(n - 2)


def count_partitions(n, m):
    if n == 0:
        return 1
    elif n < 0:
        return 0
    elif m == 0:
        return 0
    else:
        with_m = count_partitions(n - m, m)
        without_m = count_partitions(n, m - 1)
        return with_m + without_m


def count_stairs(n):
    if n == 1 or n == 0:
        return 1
    return count_stairs(n - 1) + count_stairs(n - 2)


def mario_number(level):
    if level == 1:
        return 1
    elif level % 10 == 0:
        return 0
    else:
        step = mario_number(level // 10)
        jump = mario_number(level // 100)
        return step + jump
「有多少种方法做 X」= 找一个把所有做法劈成互斥两堆的问题,两堆各递归一次,相加。
剩下的力气全花在 base case 上:哪种情况算做成了(返回 1),哪种情况算做砸了(返回 0),以及参数会不会绕过它们。
11. 动手练习
练习 1:判断是不是树递归
下面四个函数,哪些是树递归的?
def a(n):
    if n == 0:
        return 0
    return n % 10 + a(n // 10)

def b(n):
    if n < 2:
        return n
    if n % 2 == 0:
        return b(n // 2)
    else:
        return b(n - 1)

def c(n):
    if n <= 0:
        return 1
    return c(n - 1) + c(n - 1)

def d(n, k):
    if k == 0 or n == 0:
        return 1
    return d(n - 1, k) + d(n, k - 1)
看答案
c 和 d 是树递归;a 和 b 不是。
a:代码里只有一处递归调用 → 不是。这是典型的单链递归(数位求和)。b:代码里写了两处b(...),但它们分属if和else,任何一次执行只会走其中一条,每个结点只有一个儿子 → 不是。这是本题的陷阱:数的不是「代码里出现了几次函数名」,而是「一次执行会发出几次调用」。c:c(n-1) + c(n-1),同一次执行发出两次调用 → 是。有意思的是它两支参数完全相同,所以c(n)的返回值是 $2^n$,而它要花 $2^{n+1}-1$ 次调用去算这个数——重复计算的极致例子。d:两次调用各改一个参数 → 是。它算的是从(n, k)走到边界的格子路径数,也就是组合数 $\binom{n+k}{k}$。
练习 2:手算 count_partitions(5, 3)
不许跑代码,用「用不用 3」这个决策把它展开,算出 count_partitions(5, 3),并把每一种划分写出来验证。
看答案
答案是 5。
cp(5,3) = cp(2,3) + cp(5,2)          # 用一个 3,剩 2;或不用 3,最大降到 2

  cp(2,3) = cp(-1,3) + cp(2,2)
          = 0        + cp(2,2)        # -1 < 0 → 0(2 装不下一个 3)
    cp(2,2) = cp(0,2) + cp(2,1)
            = 1       + cp(2,1)       # n == 0 → 1,对应 5 = 2+3
      cp(2,1) = cp(1,1) + cp(2,0)
              = cp(1,1) + 0           # m == 0 → 0
        cp(1,1) = cp(0,1) + cp(1,0) = 1 + 0 = 1     # 对应 5 = 1+1+3
      cp(2,1) = 1
    cp(2,2) = 1 + 1 = 2
  cp(2,3) = 0 + 2 = 2

  cp(5,2) = cp(3,2) + cp(5,1)
    cp(3,2) = cp(1,2) + cp(3,1)
      cp(1,2) = cp(-1,2) + cp(1,1) = 0 + 1 = 1      # 对应 5 = 1+2+2
      cp(3,1) = cp(2,1) + cp(3,0) = 1 + 0 = 1       # 对应 5 = 1+1+1+2
    cp(3,2) = 1 + 1 = 2
    cp(5,1) = cp(4,1) + cp(5,0) = 1 + 0 = 1         # 对应 5 = 1+1+1+1+1
  cp(5,2) = 2 + 1 = 3

cp(5,3) = 2 + 3 = 5   ✓
五种划分:5 = 2+3、5 = 1+1+3、5 = 1+2+2、5 = 1+1+1+2、5 = 1+1+1+1+1。恰好 5 个返回 1 的叶子,一一对应。
练习 3:改造 count_stairs
现在每次可以迈 1 级、2 级或 3 级。写出 count_stairs3(n),并算出 count_stairs3(4)。
看答案
def count_stairs3(n):
    if n < 0:
        return 0
    elif n == 0:
        return 1
    return count_stairs3(n - 1) + count_stairs3(n - 2) + count_stairs3(n - 3)
count_stairs3(4) 得 7。我跑过 n = 0..7:1, 1, 2, 4, 7, 13, 24, 44。
手工列出 4 级的 7 种走法验证:1+1+1+1、1+1+2、1+2+1、2+1+1、2+2、1+3、3+1。✓
这道题真正的考点是 base case。如果你沿用 if n == 1 or n == 0: return 1,那么 count_stairs3(4) 会走到 count_stairs3(-1)(因为 4−2−3 = −1),而 −1 既不等于 0 也不等于 1,于是一路负下去 → RecursionError。
用 n < 0 → 0 加 n == 0 → 1 这一对,是唯一一种加多少种步长都不用改的写法:任何越界都被 n < 0 兜住,任何刚好走完都被 n == 0 记为 1。第 8 节的五步法里说「补 base case 时检查参数会不会绕过它」,指的就是这个。
练习 4:找 bug
下面这个 count_partitions 只跟正确版本差三个字符,跑出来 count_partitions(6, 4) 得 2 而不是 9。指出错在哪;然后回答一个更有意思的问题:它数出来的那 2 种,究竟是哪 2 种?
def count_partitions(n, m):
    if n == 0:
        return 1
    elif n < 0:
        return 0
    elif m == 0:
        return 0
    else:
        with_m = count_partitions(n - m, m - 1)
        without_m = count_partitions(n, m - 1)
        return with_m + without_m
看答案
错在第一支写成了 count_partitions(n - m, m - 1),多减了一个 m。正确的是 count_partitions(n - m, m)。
语义上的差别:正确版本说的是「至少用一个 m」——用掉一个之后,剩下的部分还可以接着用 m,所以 m 不变。这个错误版本说的是「恰好用一个 m」——用完一次就把 m 划掉了。
于是它算的是每种尺寸最多用一次的划分数,也就是把 n 写成若干个互不相同的、不超过 m 的正整数之和的方案数。对 n = 6, m = 4,这样的划分恰好有 2 种:
6 = 2 + 46 = 1 + 2 + 3
(原来 9 种里的另外 7 种全都重复用了某个尺寸:3+3、2+2+2、1+1+4 等等,全被这个版本排除掉了。)我用穷举法对 (6,4) (6,6) (5,5) (4,4) (10,10) (7,4) 等多组参数验证过,这个「错误」实现的输出和「互异部分划分数」完全吻合。
这才是这道题真正的教训:一个错误的递归往往不是「胡算一气」,而是在正确地解另一个问题。所以 debug 树递归时,与其盯着代码看,不如问自己:「这一支递归调用,在现实里对应哪句话?」——把 (n - m, m - 1) 念成「用掉一个 m,并且从此不再用 m」,错误立刻自己现形了。
练习 5:换一种合并方式
把 count_stairs 改成 can_reach(n, forbidden):仍然每次迈 1 级或 2 级,但第 forbidden 级是坏的,不能踩(可以跨过去)。返回 True 或 False,表示能不能从地面(第 0 级)到达第 n 级。假设 0 < forbidden < n。
看答案
def can_reach(n, forbidden):
    if n == forbidden:
        return False       # 这一级踩不得,这条路走死了
    elif n == 0:
        return True        # 回到地面,说明整条路径合法
    elif n < 0:
        return False       # 迈过头了
    return can_reach(n - 1, forbidden) or can_reach(n - 2, forbidden)
三个要点:
- 合并方式从
+变成了or。问「有几种」就相加,问「能不能」就取or,问「最少几步」就取min。递归骨架完全不变,只换合并算子——这是树递归最值钱的一点通用性。 - 成功/失败的返回值从 1/0 变成
True/False,含义一一对应。 n == forbidden必须写在n == 0前面吗?题目保证forbidden > 0,所以两者不会同时成立,顺序无所谓。但如果放宽到forbidden可能为 0,就必须让n == forbidden在前——把「禁止」放在「成功」之前,才是安全的默认习惯。
顺带一个免费好处:or 会短路。只要左边那支返回 True,右边 can_reach(n - 2, forbidden) 根本不会被求值——整棵右子树都省了。相比之下 + 版本必须把两棵子树都跑完,因为它要把两个数都拿到手。「能不能」类问题天然比「有几种」类问题快,这就是原因。