递归:让函数调用它自己
把一个大问题拆成一个「同样形状但更小」的问题,交给自己去做,然后用它的答案拼出自己的答案。全部秘密都在环境图里。
0. 本讲导读
到上一讲为止,你手上有两件重复执行代码的工具,而它们其实是同一件:while 循环把一段代码重复到条件不成立;环境图告诉你每调用一次函数就新建一帧。本讲要做的事,是把这两件东西接到一起——让一个函数在自己的函数体里调用自己。
为什么值得专门花一讲?因为有一大类问题,用循环写出来极其别扭,用递归写出来几乎就是把问题的定义原样抄下来。最典型的是阶乘:数学书上写的是
这个式子里,「阶乘」这个概念是用它自己定义的。你要是用 while 去实现它,得先在脑子里把这个定义展开成「从 1 乘到 n」,再配一个计数器、一个累乘器、一个更新语句。而递归的写法就是把上面那行式子翻译成 Python,一个字都不用多想。
更要紧的是往后看:树(tree)、链表(linked list)、Scheme 的表达式求值——这些数据结构本身就是用「自己」定义的(一棵树的分支还是树,一个链表的 rest 还是链表)。处理这类结构时,递归不是「一种可选风格」,而是唯一自然的写法。Scheme 甚至根本没有循环语句,那门语言里所有的重复都靠递归。
本讲会把递归拆成三个部件反复练,然后把 fact(3) 的环境图一帧一帧完整画出来——不画这张图,递归永远停留在「好像懂了但一写就错」的状态。之后是三种真实会遇到的崩溃方式(RecursionError、少写 return、base case 够不着)、迭代与递归的互相翻译、自引用、互递归,最后落到随堂练习 sum_digits 和 Luhn 算法上。
这一讲是 Lab 03 和 HW 02 的正面依据(HW 02 的阅读材料直接写着「Section 1.7」),也是下一讲树递归的地基。下一讲的每一个函数里都会出现两次以上递归调用,如果现在还没能把一次递归调用的过程说清楚,那时候会彻底跟不上。
- 一个函数直接或间接调用自己,就叫递归函数(recursive function)。每次递归调用都把大问题拆成更小的子问题,直到抵达最简单的那个——base case(基线情形)。
- 写递归就是回答三个问题:最简单的输入是什么、该返回什么(base case);怎么把问题变小(recursive case);拿到子问题的答案后怎么拼出自己的答案。
- 递归信仰之跃(recursive leap of faith):写第三步时,直接假定递归调用已经给出了正确答案,不要在脑子里往下展开。展开是解释器的事,不是你的事。
- 在环境图里,每一次递归调用都是一次普普通通的函数调用,各自有一帧。同名的形参在不同帧里是不同的绑定,互不干扰——这正是递归能「记住」中间状态的原因。
- 递归必须一路下到 base case,再一层层回代上来。只下不回是拿不到结果的。
- 迭代是递归的一个特例。任何
while循环都能改写成递归,反之亦然;把循环里那些被反复覆盖的变量变成函数的参数,就是翻译的关键手法。 - 递归比迭代更费内存(每层一个帧),层数太深会得到
RecursionError: maximum recursion depth exceeded——CPython 默认的递归上限是 1000 层。
1. 递归是什么:从排队买 taco 说起
先给定义,再讲为什么这个定义能干活。
一个函数是递归的(recursive),如果它调用自己——直接调用(函数体里出现自己的名字)或间接调用(A 调 B,B 又调 A)都算。
每做一次递归调用,我们就把较大的问题拆成更小的子问题,一直拆到最简单的那个子问题(base case)为止。
「用自己定义自己」听上去像循环论证,凭什么不会转圈转到死?关键就在「更小」和「最简单的那个」这两个限定。只要每次都严格变小,而且小到某个地步就不再往下拆、直接给答案,整件事就一定会停。
排队买 taco
课上用的例子是这样的:你在一条很长的队伍里买 taco,队伍长到你看不见队头。问题是——你排在第几个?
你直接数不出来,因为你看不到前面有多少人。但你能做一件事:拍拍前面那个人的肩膀,问他排第几。
请注意这个过程里的三个事实,它们逐字对应到代码上:
- 每个人做的事完全一样:问前面的人,把答案加 1,报出去。一模一样的行为,用在队伍里的每一个位置——这就是「同一个函数被调用很多次」。
- 队头是特殊的。他是唯一一个不提问的人。如果队头也去问前面的人,这条队伍就会问到墙上去,永远回不来。队头就是 base case。
- 问题必须先一路传到头,答案才开始往回走。在队头开口之前,中间所有人都卡在原地等着——他们的「我要把听到的数加 1」这件事还没做,正悬在半空。这些「悬在半空的人」在 Python 里就是一个个还没执行完的帧(frame)。
第三条是最容易被忽略、却在环境图上最显眼的一条。它解释了为什么递归比循环费内存:队伍有多长,同时挂着的帧就有多少个。
为什么要用递归,而不是循环
课上给了三条理由,一条比一条实在。
| 理由 | 说明 |
|---|---|
| 迭代其实是递归的特例 | 你已经会写的 while 循环,是递归能表达的一小类情形。递归是更一般的工具,不是循环的替代品 |
| 有些问题递归表达更自然 | 典型是处理递归数据结构(recursive data structure):树(比如你电脑的文件系统——文件夹里装着文件夹)、链表(linked list)。这些结构本身就是「用自己定义的」,用循环处理要额外维护一堆状态 |
| 有些语言根本没有循环 | 本课后半段要学的 Scheme 就没有 while。那门语言里所有重复都是递归 |
反过来,课上也明确讲了递归的两个代价,别把递归当万能药:
| 代价 | 说明 |
|---|---|
| 吃内存 | 递归比迭代占用更多栈帧(stack frame)。层数太深会栈溢出(stack overflow)——是的,那个著名的问答网站就是拿这个当名字的。在 Python 里这个错误叫 RecursionError,第 5 节会真的把它触发一次给你看 |
| 有时候就是没循环顺手 | 「从 1 加到 100」这种线性推进的任务,写成 while 更直白。别为了递归而递归 |
一个粗糙但很好用的判据:如果问题的定义里出现了问题本身,就用递归。
「n 的阶乘 = n 乘以 (n-1) 的阶乘」——定义里出现了阶乘,递归。
「一个文件夹的总大小 = 里面所有文件的大小 + 里面所有子文件夹的总大小」——定义里出现了「文件夹的总大小」,递归。
「把 1 到 100 加起来」——定义里只有加法,循环就够(当然它也能写成递归,见第 6 节)。
2. 递归函数的解剖:三个部件
把排队那个故事翻译成写代码的步骤,就得到一份永远适用的模板。课上把它叫做「递归函数的解剖(anatomy of a recursive function)」。
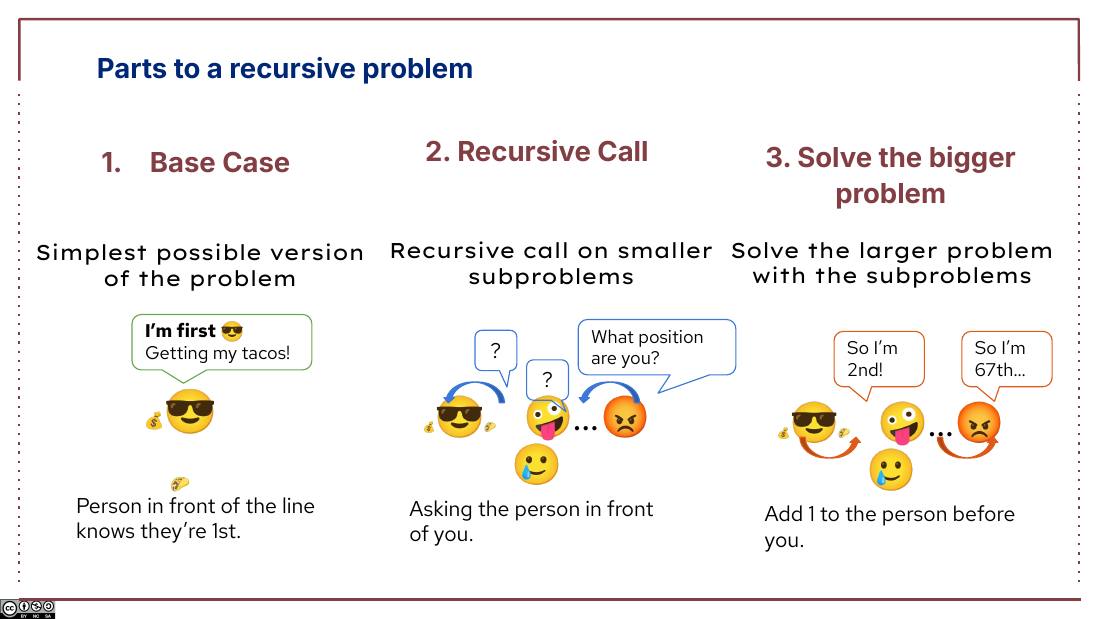
- 一个或多个 base case(基线情形)
- 我可能收到的最简单的输入是什么?在那种情况下我该返回什么?
- 换个问法:递归在什么时候停下来?
- 一个或多个 recursive case(递归情形)
- 怎么把问题拆成更小的、形状相同的子问题?
- 解决更大的问题(递归信仰之跃)
- 假设子问题的答案我已经拿到了,怎么用它拼出当前这个问题的答案?
注意措辞:base case 和 recursive case 都可能有多个。下一讲的树递归里,一个函数有两个 base case、两个递归调用是常态。
第 3 步为什么叫「信仰之跃」
这是初学递归时唯一真正的心理障碍,值得单独说清楚。
写 fact(n) 的递归情形时,你要写下 return n * fact(n - 1)。此刻大多数人的脑子会开始往下追:「fact(n-1) 又会调用 fact(n-2),然后 fact(n-3)……」——追了三层就晕了,于是得出结论「递归好难」。
不要追。 正确的心态是:
写递归情形的时候,假定 fact(n - 1) 已经正确地返回了 (n-1) 的阶乘。它怎么算出来的,不关你的事——那是解释器的工作。
你只需要回答一个小得多的问题:「手里已经有 (n-1)! 了,怎么得到 n!?」 答案是乘个 n。写完,收工。
为什么这个「假定」是合法的、不是自我欺骗?因为它其实是数学归纳法(mathematical induction):
fact(0) 返回 1,这是定义)。fact(n-1) 对,那么 fact(n) 也对」(因为 n! 确实等于 n × (n-1)!)。fact(n) 都对。所以「信仰之跃」不是要你闭眼相信玄学,而是要你相信一个你刚刚自己证明过的东西。检查递归函数对不对,只需查这两件事:base case 对不对、递归情形的拼装逻辑对不对——永远不需要在脑子里展开三层以上。
归纳法要成立,递归调用的参数必须朝 base case 的方向严格前进。fact(n - 1) 每次减 1,sum_digits(n // 10) 每次砍掉一位——都在稳稳地变小。要是写成 fact(n)(没变小)或者 fact(n + 1)(反着走),归纳的链条就断了,程序会一路撞到 RecursionError。第 5 节有真实例子。
递归函数一定要写 if 吗
课上出过一道 True/False 投票题:「所有递归函数都必须有某种 if-else 语句。」
答案是 False——但要注意它 False 在什么地方。
每个递归函数都必须有 base case,也就是必须有某种「在这种情况下不再递归」的分支逻辑。但「分支逻辑」不等于「非得写 if/else 这个语法」。第 4 节讲的 fact 可以写成条件表达式,第 8 节的互递归里 luhn_sum_double 的 base case 判断也可以换个形状。举个能跑的例子:
>>> def fact(n):
...     return 1 if n == 0 else n * fact(n - 1)
...
>>> fact(5)
120
这里一个 if 语句都没有(1 if n == 0 else ... 是条件表达式,是一个表达式不是语句),但 base case 依然存在。
所以准确的说法是:递归函数必须有 base case,也就是必须有「某个分支不再递归」;至于用什么语法写出这个分支,是自由的。 考试里遇到这种绝对化的措辞(「必须」「所有」),先找反例。
3. countdown:递归调用放在 print 前面还是后面
课上第一个投票题是:「哪一种 countdown 的实现会在调用 countdown(5) 时逐行打印出 5、4、3、2、1、Blastoff!?」
这道题看着无聊,其实是全讲最好的一个入门题——它逼你分清「递归调用发生的时刻」和「打印发生的时刻」。下面两个实现只差两行代码的顺序,输出完全相反。(这两版是照着投票题的设定写的示例,两段都在本机跑过。)
def countdown_a(n):
    if n <= 0:
        print('Blastoff!')
    else:
        print(n)
        countdown_a(n - 1)      # 先打印,再递归

def countdown_b(n):
    if n <= 0:
        print('Blastoff!')
    else:
        countdown_b(n - 1)      # 先递归,再打印
        print(n)
实测输出:
>>> countdown_a(5)
5
4
3
2
1
Blastoff!
>>> countdown_b(5)
Blastoff!
1
2
3
4
5
countdown_a 是倒计时,countdown_b 是正着数。为什么?
n = 5。5 <= 0 为假,走 else。先执行 print(5) → 屏幕出现 5。countdown_a(4),新建帧 f2。此时 f1 还没执行完,它停在这条调用语句上等着。4,调用 countdown_a(3)……如此下去,屏幕依次出现 5、4、3、2、1。n = 0,0 <= 0 为真,打印 Blastoff!,函数体走完,返回 None。n = 5,走 else。第一条语句就是 countdown_b(4)——还没打印任何东西,就先钻下去了。n = 0,打印 Blastoff!,返回。这是屏幕上出现的第一行。print(n),而 f5 里的 n 是 1 → 打印 1。n,即 2;再回到 f3 打印 3……直到 f1 打印 5。- 递归有「下去」和「回来」两个阶段。 写在递归调用之前的代码在下潜时执行(顺序:外→内),写在递归调用之后的代码在回溯时执行(顺序:内→外)。同一批语句,摆在调用的哪一边,输出顺序就整个反过来。
- 每一帧都有自己那份
n。 f5 回来之后打印的是1,不是0也不是5——因为n是形参,在每个帧里独立绑定。f6 里n变成 0 这件事,丝毫不影响 f5 里的n。这一点和while循环完全相反:循环里那个变量只有一份,改了就是改了。
把「回溯阶段每帧的 n 各不相同」这件事画出来,就是下面这张图。注意六个帧同时存在,各自记着自己的 n:
Global frame
    countdown_b  ──→ func countdown_b(n) [parent=Global]

f1: countdown_b [parent=Global]   n ──→ 5    ← 停在 countdown_b(n-1) 这一句,后面还有 print(n) 没跑
f2: countdown_b [parent=Global]   n ──→ 4    ← 同上
f3: countdown_b [parent=Global]   n ──→ 3    ← 同上
f4: countdown_b [parent=Global]   n ──→ 2    ← 同上
f5: countdown_b [parent=Global]   n ──→ 1    ← 同上
f6: countdown_b [parent=Global]   n ──→ 0    ← 走 if 分支,打印 Blastoff! 后返回 None

回溯时依次执行 f5 的 print(1)、f4 的 print(2)、f3 的 print(3)、f2 的 print(4)、f1 的 print(5)
看清楚上图里每一帧的 parent——全是 Global,不是「上一帧」。上一讲讲过,一个帧的 parent 由被调用的那个函数是在哪里定义的决定,而不是由「谁调用了它」决定。countdown_b 定义在全局,所以它每一次被调用产生的帧,parent 都是 Global。
「f2 的 parent 是 f1」是初学递归时最常见的画图错误。帧之间那种「f1 在等 f2」的关系是调用栈关系,跟环境图里的 parent 箭头是两回事。
4. fact:把环境图一帧一帧画出来
阶乘的定义:非负整数 n 的阶乘,是从 n 到 1 所有整数的乘积。
边界情况单独规定:0! = 1。(这不是随便定的——空乘积按约定等于 1,就像空求和等于 0。有了它,后面的递归定义才对 n = 1 成立。)
关键的一步观察是把定义重写成递归形式:
为什么可以这么写?把 5! 展开看:
后面那一串「4 × 3 × 2 × 1」正好就是 4! 的定义。子问题和原问题形状完全一样,只是规模小了 1。 这就是递归能上场的信号。
翻译成代码
def fact(n):
    if n == 0:
        return 1
    else:
        return n * fact(n - 1)
对照第 2 节的三个部件:
| 部件 | 代码 | 它在回答什么 |
|---|---|---|
| base case | if n == 0: return 1 | 最简单的输入是 0,答案直接是 1,不做任何递归调用 |
| recursive case | fact(n - 1) | 把问题从 n 缩小到 n-1,朝 0 走一步 |
| 拼装 | n * ... | 拿到 (n-1)! 之后,乘上 n 就是 n! |
整个函数体只有四行,而且每一行都能在数学定义里找到对应。这就是第 0 节说的「把定义原样抄下来」。
fact(3) 的完整环境图
下面这段是本讲的核心,请一行一行读。不要跳。
def fact(n): ...:创建一个函数对象 func fact(n) [parent=Global],把名字 fact 绑定到它。函数体一行都没执行。fact(3):先求算子 fact(查到函数对象),再求算子数 3。新建帧 f1,parent = Global,绑定 n = 3。n == 0 → 3 == 0 → False,走 else。要求值 n * fact(n - 1)。n 查到 3;右边 fact(n - 1) 是一个调用表达式,先算实参 n - 1 = 2,然后新建帧 f2,parent = Global,绑定 n = 2。f1 就此挂起——它的乘法还没做完。2 == 0 为假,要算 n * fact(n - 1),实参 2 - 1 = 1,新建帧 f3,n = 1。f2 挂起。1 == 0 为假,实参 1 - 1 = 0,新建帧 f4,n = 0。f3 挂起。0 == 0 → True!执行 return 1,不做递归调用。 到底了。此刻栈上一共挂着四个帧,全局帧算上是五个。这是整个过程中内存占用最高的一瞬间:
Global frame
    fact  ──→ func fact(n) [parent=Global]

f1: fact [parent=Global]
    n  ──→ 3          挂起在:  return n * fact(2)        返回值: 待定
f2: fact [parent=Global]
    n  ──→ 2          挂起在:  return n * fact(1)        返回值: 待定
f3: fact [parent=Global]
    n  ──→ 1          挂起在:  return n * fact(0)        返回值: 待定
f4: fact [parent=Global]
    n  ──→ 0          执行:    return 1                  返回值: 1   ← base case
1。控制权回到 f3 里那个悬着的乘法:n * fact(0),现在变成 1 * 1。注意这个 n 是 f3 里的 n,值为 1。f3 返回 1。n * fact(1) 变成 2 * 1 = 2。这里的 n 是 f2 里的 2。f2 返回 2。n * fact(2) 变成 3 * 2 = 6。这里的 n 是 f1 里的 3。f1 返回 6。fact(3) 的值是 6。确实 3! = 6。用一张表把「下去」和「回来」并排放,最能看清全貌:
| 帧 | 该帧里 n 的值 | 下潜时它做了什么 | 回溯时它算了什么 | 返回值 |
|---|---|---|---|---|
| f1 | 3 | 调用 fact(2),挂起 | 3 * 2 | 6 |
| f2 | 2 | 调用 fact(1),挂起 | 2 * 1 | 2 |
| f3 | 1 | 调用 fact(0),挂起 | 1 * 1 | 1 |
| f4 | 0 | 命中 base case,不调用 | — | 1 |
写成一行展开式(这就是「真的展开到 base case 再逐层回代」):
fact(3)
= 3 * fact(2)
= 3 * (2 * fact(1))
= 3 * (2 * (1 * fact(0)))
= 3 * (2 * (1 * 1))          ← base case 触底,开始回代
= 3 * (2 * 1)
= 3 * 2
= 6
- 必须盯住不同帧里的输入。
n这个名字在四个帧里有四个不同的值。回溯时用的是本帧那份,不是最新那份。 - 递归要一路走到栈底,再一路走回来。 只下不回拿不到结果——f1 的乘法必须等 f2 的返回值。
- base case 是停止点:在 base case 里不做递归调用。哪怕只在某条路径上漏掉这个「不调用」,整棵调用链就永远回不来。
用 while 写的阶乘只有一个帧,里面 n 被反复覆盖;用递归写的阶乘有 n+1 个帧,每个帧都原封不动地保存着自己那份 n,谁也不会被谁覆盖。
| 对比项 | while 版 | 递归版 |
|---|---|---|
| 帧数 | 1 个(调用一次函数) | n + 1 个 |
| 中间状态存在哪 | 手工维护的累乘器变量,被反复重新绑定 | 帧本身就是中间状态,不用你操心 |
| 看得到历史吗 | 看不到,旧值被覆盖就没了 | 看得到,所有历史值同时挂在栈上 |
| 内存 | 常数 | 正比于 n |
「不用手工维护中间状态」正是递归写起来短的原因,「所有中间状态同时占着内存」正是递归会 RecursionError 的原因。这是同一件事的两面。
5. 递归会怎么崩:三种真实的失败
课上做了一个 demo:「如果拿一个很大的数去调 fact 会怎样?为什么?」 还有一道投票题:「执行 fact(-1) 会发生什么?」 这两个问题的答案是同一个东西,值得连着讲。下面三段都在本机(CPython 3.10)真跑过,报错信息是原样复制的。
失败一:栈太深 —— RecursionError
fact(900) 能算出来(结果是个 2270 位的整数,Python 的 int 没有上限)。但把参数换成 3000:
>>> fact(3000)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "<stdin>", line 5, in fact
    return n * fact(n - 1)
  File "<stdin>", line 5, in fact
    return n * fact(n - 1)
  File "<stdin>", line 5, in fact
    return n * fact(n - 1)
  [Previous line repeated 995 more times]
  File "<stdin>", line 2, in fact
    if n == 0:
RecursionError: maximum recursion depth exceeded in comparison
三件事值得注意:
[Previous line repeated 995 more times]——Python 知道你在原地打转,帮你把重复的栈帧折叠了。看到这一行,基本可以确定是递归出了问题。- 错误不是在 3000 层才发生的,而是在大约第 1000 层。CPython 默认的递归深度上限是 1000(
sys.getrecursionlimit()返回1000),到了就主动抛错。 - 结尾那句
in comparison表示上限是在执行if n == 0:这个比较时被撞破的——不同的代码这句尾巴会不一样,不用纠结。
为什么会有这个上限? 回到第 3 节那张图:递归到第 k 层时,栈上同时挂着 k 个帧,每个帧都占一块内存。这块区域叫调用栈(call stack),它的大小是有限的。撑爆它就是栈溢出(stack overflow)。Python 与其让操作系统在真溢出时把整个进程杀掉(那时你连报错都看不到),不如自己先设一道 1000 层的软限制,抛一个能被捕获、能看懂的 RecursionError。
while 循环跑 100 万次也不会有这个问题——因为它从头到尾只有一个帧。这就是第 1 节说的「递归吃内存」的具体含义:它吃的不是你的数据的内存,是调用栈的内存,而且吃的量正比于递归深度。
失败二:base case 够不着 —— fact(-1)
投票题问 fact(-1) 会发生什么。很多人会猜「返回 1」或者「返回 -1」。真实结果:
>>> fact(-1)
Traceback (most recent call last):
  ...
RecursionError: maximum recursion depth exceeded in comparison
n = -1。-1 == 0 → False,走 else,调用 fact(-2)。n = -2。-2 == 0 → False,调用 fact(-3)。n = -3……参数确实在每次变小,但它是朝着负无穷变小的,永远不会等于 0。n == 0 永远为假,递归永不终止,撞上 1000 层上限 → RecursionError。这个例子把第 2 节那句「必须朝 base case 的方向严格前进」变成了具体教训:「变小」不够,得「朝着 base case 变」。 修法有两种,各有取舍:
| 改法 | 代码 | 效果 |
|---|---|---|
| 放宽 base case | if n <= 0: return 1 | fact(-1) 返回 1,不再崩。但数学上 (-1)! 根本没定义,悄悄返回一个假答案,比崩掉更危险 |
| 显式拒绝 | assert n >= 0, 'n must be non-negative' 写在函数开头 | fact(-1) 立刻抛 AssertionError: n must be non-negative,错误信息直指真正的原因 |
本课的 doctest 一般会写明函数只接受非负整数,所以 05.py 那样不加检查也算对。但要能说清楚自己的函数在非法输入上是什么行为——这是第 2 讲就强调过的习惯。
n == 1
「阶乘是从 n 乘到 1,所以停在 1」听起来很合理:
def fact(n):
    if n == 1:          # 错在这里
        return 1
    else:
        return n * fact(n - 1)
fact(5) 照样返回 120,doctest 里的正常样例全过。但是:
>>> fact(0)
Traceback (most recent call last):
  ...
RecursionError: maximum recursion depth exceeded in comparison
0 == 1 为假 → 调用 fact(-1) → fact(-2) → ……跟上面是同一个坑。base case 必须覆盖「最简单的合法输入」,而不是「最常见的那个终点」。 题目白纸黑字写了 0! = 1,就说明 0 是合法输入,base case 必须接得住它。
诊断口诀:写完 base case,拿题目允许的最小输入代进去走一遍。
失败三:递归情形忘了写 return
这是初学者最高频的错,而且它的报错信息乍看和递归毫无关系。
def sum_digits(n):
    if n < 10:
        return n
    else:
        sum_digits(n // 10) + n % 10      # 忘了 return
>>> sum_digits(123)
Traceback (most recent call last):
  ...
TypeError: unsupported operand type(s) for +: 'NoneType' and 'int'
n = 123)走 else,先要算 sum_digits(12)。n = 12)也走 else,先要算 sum_digits(1)。n = 1):1 < 10 为真,return 1。这一层是对的,因为 base case 那行有 return。1 + 2 = 3,然后……把 3 扔了。因为那一行只是一个表达式语句,没有 return。f2 的函数体执行完毕,返回 None。sum_digits(12) + n % 10,也就是 None + 3 → TypeError。注意报错发生的位置:崩在 f1,但真正的 bug 在 f2 那一层的写法上。这类错误的识别特征是:报错信息里出现 'NoneType',而你根本没写过 None。 一旦看到,第一反应就该是「哪条执行路径漏了 return」。
| 症状 | 大概率原因 | 先查哪里 |
|---|---|---|
RecursionError + [Previous line repeated N more times] | base case 够不着,或参数没变小 | 把最小合法输入代进去;检查递归调用的实参是不是严格朝 base case 走 |
TypeError: ... 'NoneType' and 'int' | 某条路径漏了 return | 数一数函数体里有几条 return,是不是每条分支都有 |
函数「什么都不返回」,print 出来是 None | 递归调用写了但结果没被 return,或整个函数只有 print | 同上;另外确认不是用 print 冒充 return |
| 结果偏大/偏小一点点 | 拼装那一步的算式错了(比如加了 n 而不是 n % 10) | 手推一个两位数的最小例子,比如 sum_digits(12) |
6. 实战一:sum_digits,从迭代翻译成递归
随堂练习的起始代码在 05.py,题面是:
def sum_digits(n: int) -> int:
    """
    Returns the sum of the digits of a non-negative integer n.

    >>> sum_digits(0)
    0
    >>> sum_digits(5)
    5
    >>> sum_digits(123)
    6
    >>> sum_digits(3094153)
    25
    """
这个函数在第 2 讲写过一版 while 循环。现在要求用递归重写。为什么用一道做过的题?因为它能把「迭代和递归其实在做同一件事」摆到台面上。
题目到底要什么
把四个 doctest 逐个翻译:
| 调用 | 期望 | 它在考什么 |
|---|---|---|
sum_digits(0) | 0 | 边界:0 只有一位,和就是 0。base case 必须接住它 |
sum_digits(5) | 5 | 边界:一位数不该被拆,直接返回自己 |
sum_digits(123) | 6 | 1+2+3,最小的「真·递归」情形 |
sum_digits(3094153) | 25 | 3+0+9+4+1+5+3;中间有个 0,专门防你写出「遇到 0 就停」的错误逻辑 |
怎么想到的
递归的第一个动作永远是:找出「把问题变小一点点」的那个操作。 对一个整数来说,可用的工具是第 2 讲学过的两个运算符:
| 表达式 | n = 3094153 时 | 含义 |
|---|---|---|
n % 10 | 3 | 取出最后一位 |
n // 10 | 309415 | 砍掉最后一位,剩下的部分 |
有了这两个,三个部件就凑齐了:
n // 10。位数每次减 1,稳稳朝一位数走。n < 10。sum_digits(n // 10) 已经正确返回了「前面所有位的和」,那么加上被砍掉的那一位 n % 10,就是全部位的和。第 3 步只需要想一层:「前面那些位的和 + 最后一位」。不要去想 3094153 会怎样一路拆到 3。
代码
这是 05-sol.py 里的实现(本仓库用 python3 -m doctest 05-sol.py 实测通过):
def sum_digits(n: int) -> int:
    if n < 10:
        return n
    else:
        last = n % 10
        all_but_last = n // 10
        return sum_digits(all_but_last) + last
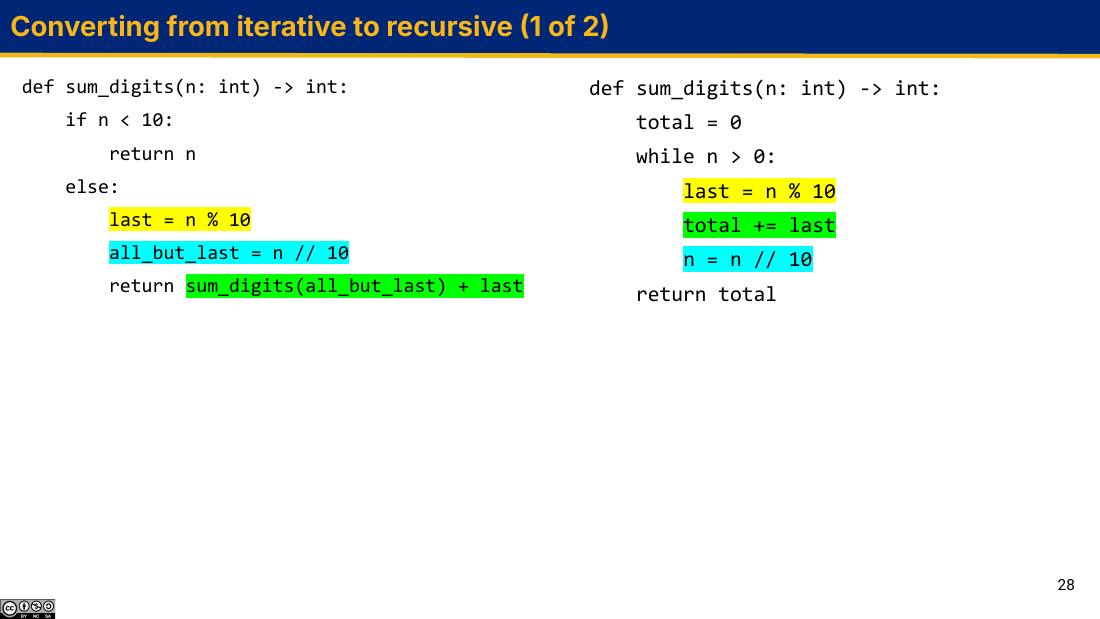
把两版并排读,能看出一条通用的翻译规律:
| 迭代版的做法 | 递归版的对应物 |
|---|---|
while n > 0:(继续的条件) | if n < 10: ... else: ...(停止的条件,正好取反) |
n = n // 10(把状态写回同一个名字) | sum_digits(n // 10)(把新状态作为实参传给下一层) |
total += last(累加到一个变量上) | ... + last(累加发生在回溯时,靠返回值相加) |
total = 0(累加器初值) | base case 的返回值(这里是 n 本身) |
return total | 每一层都 return,值一层层传上去 |
验证:手动追踪 sum_digits(123)
n = 123。123 < 10 为假 → last = 123 % 10 = 3,all_but_last = 123 // 10 = 12。要算 sum_digits(12) + 3,挂起。n = 12。12 < 10 为假 → last = 2,all_but_last = 1。要算 sum_digits(1) + 2,挂起。n = 1。1 < 10 为真 → return 1。触底。1 + 2 = 3,返回 3。(这里的 last 是 f2 的 last,值为 2。)3 + 3 = 6,返回 6。(这里的 last 是 f1 的 last,值为 3。)sum_digits(123) = 6,与 doctest 一致。Global frame
sum_digits ──→ func sum_digits(n) [parent=Global]
f1: sum_digits [parent=Global]
n ──→ 123
last ──→ 3
all_but_last ──→ 12 挂起在: return sum_digits(12) + last
f2: sum_digits [parent=Global]
n ──→ 12
last ──→ 2
all_but_last ──→ 1 挂起在: return sum_digits(1) + last
f3: sum_digits [parent=Global]
n ──→ 1 返回值: 1 ← base case,没有 last / all_but_last
last 和 all_but_last 不是形参,是函数体里赋值产生的局部名字。它们同样绑在各自的帧里:f1 的 last 是 3,f2 的 last 是 2,互不干扰。
还要注意 f3 里根本没有 last 这个名字——base case 分支里那两行赋值语句压根没执行。环境图上不要给它画。
另一种拆法:用参数携带中间状态
课上给了第二种从迭代翻译过来的写法,形状更贴近原来的 while 循环:
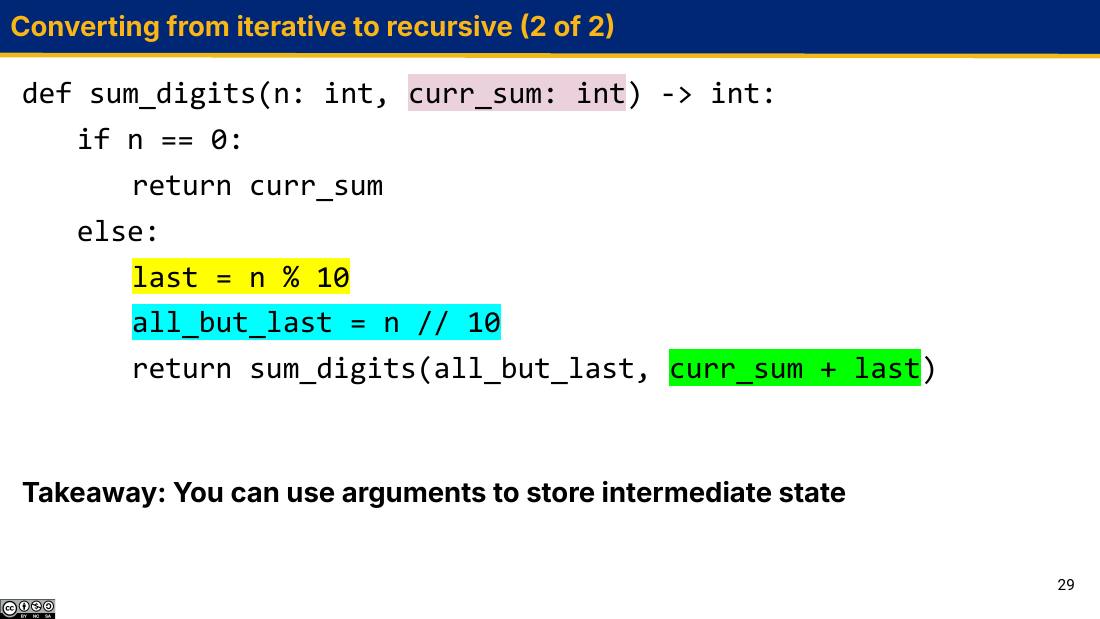
def sum_digits(n: int, curr_sum: int) -> int:
    if n == 0:
        return curr_sum
    else:
        last = n % 10
        all_but_last = n // 10
        return sum_digits(all_but_last, curr_sum + last)
调用方式是 sum_digits(123, 0),那个 0 就是迭代版里的 total = 0。追踪一遍:
| 帧 | n | curr_sum | 做了什么 |
|---|---|---|---|
| f1 | 123 | 0 | last = 3,调用 sum_digits(12, 0 + 3) |
| f2 | 12 | 3 | last = 2,调用 sum_digits(1, 3 + 2) |
| f3 | 1 | 5 | last = 1,调用 sum_digits(0, 5 + 1) |
| f4 | 0 | 6 | 命中 base case,return 6 |
然后 f3、f2、f1 依次原样把 6 交上去,什么也不加。
| 对比项 | 第一版(无累加器) | 第二版(带 curr_sum) |
|---|---|---|
| 加法发生在哪个阶段 | 回溯时,一层层往上加 | 下潜时,实参里就加好了 |
| base case 返回什么 | n(最后剩的那一位) | curr_sum(已经攒好的和) |
| base case 条件 | n < 10 | n == 0 |
| 回溯路上还干活吗 | 干:每层做一次加法 | 不干:原样把值传上去 |
| 调用方式 | sum_digits(123) | sum_digits(123, 0),必须传初值 |
课上的 takeaway 一句话:可以用参数来保存中间状态。 这个技巧的正式名字叫累加器参数(accumulator),往后写「需要边走边攒东西」的递归时会反复用到。
05.py 的 doctest 写的是 sum_digits(0)、sum_digits(123)——只传一个参数。第二版直接交上去会报:
TypeError: sum_digits() missing 1 required positional argument: 'curr_sum'
要用第二版,得给 curr_sum 一个默认值(def sum_digits(n, curr_sum=0):),或者外面再包一层。所以这一版是用来理解「迭代 ↔ 递归」翻译规律的教学版本,交作业时按第一版写。
n == 0 但拼装用第一版的形状
幻灯片上第一版的注释列了几个可选的 base case:n == 0、n <= 9、n < 10。它们确实都能用,但不能随便混搭。
def sum_digits(n):
    if n == 0:
        return 0                                  # 注意这里返回 0,不是 n
    else:
        return sum_digits(n // 10) + n % 10
这一版是对的(sum_digits(5):5 != 0 → sum_digits(0) + 5 = 0 + 5 = 5 ✓;四个 doctest 实测全过)。n == 0 配 return n 也对,因为那一刻 n 恰好就是 0。真正会错的是把 n < 10 和 return 0 配到一起:
>>> sum_digits(123)         # 期望 6
5
>>> sum_digits(3094153)     # 期望 25
22
因为触底时 n 是最高位(123 拆到最后是 1,3094153 拆到最后是 3),return 0 把这一位丢掉了,所以每次都正好少了最高位那么多。base case 的条件和它的返回值是配套的,改一个必须检查另一个。
/ 代替 //
>>> 123 / 10
12.3
/ 得到浮点数。写成 sum_digits(n / 10) 后,n 变成 12.3、1.23、0.123、0.0123……永远大于 0 但永远到不了整数,而且 % 作用在浮点数上得到的也是浮点数。最终结果是一个莫名其妙的小数,或者干脆 RecursionError。整数上的递归几乎总是用 //。
7. 自引用:函数体里提到自己的名字
自引用(self-reference)指的是:一个函数在自己的函数体里提到自己的名字。
你可能会说:那不就是递归吗?——不完全是。递归是「调用自己」,自引用是「提到自己」。提到而不调用时,会发生一些很有意思的事。课上用 print_sums 演示(下面这段是这个经典例子的标准写法,本机跑过):
def print_sums(x):
    print(x)
    def next_sum(y):
        return print_sums(x + y)
    return next_sum
先看它怎么用:
>>> print_sums(1)(2)(3)
1
3
6
三次调用,打出 1、3、6,也就是 1、1+2、1+2+3 的前缀和。这个函数把「上一次的累计值」记住了,而且没用任何全局变量、没用任何循环。它是怎么记住的?
print_sums(1),用它的返回值再调用 (2),再用那个返回值调用 (3)。print_sums(1):新建帧 f1,x = 1。执行 print(x) → 屏幕出现 1。然后执行 def next_sum(y):,在 f1 里创建一个函数对象 func next_sum(y) [parent=f1]。最后 return next_sum——把这个函数对象交出去。注意函数体里的 print_sums(x + y) 一个字都没执行。(2)。新建帧 f2,y = 2,parent = f1(因为 next_sum 是在 f1 里定义的)。return print_sums(x + y)。求值 x + y:y 在 f2 里查到是 2;x 在 f2 里没有,顺着 parent 到 f1 查到 1。所以 x + y = 3。print_sums(3):新建帧 f3,x = 3,parent = Global。打印 3,再造一个 next_sum(这次 parent = f3),返回它。(3):新建帧 f4,y = 3,parent = f3。求 x + y:x 沿 parent 到 f3 查到 3,得 6。调用 print_sums(6),打印 6,返回又一个 next_sum。next_sum 函数对象。交互式解释器会把它显示成 <function print_sums.<locals>.next_sum at 0x...>——不过因为这里没把它接住,只看到三行打印。Global frame
print_sums ──→ func print_sums(x) [parent=Global]
f1: print_sums [parent=Global]
x ──→ 1
next_sum ──→ func next_sum(y) [parent=f1] ← 这个函数对象被 return 出去了
返回值 ──→ func next_sum(y) [parent=f1]
f2: next_sum [parent=f1] ← parent 是 f1,不是 Global
y ──→ 2
正在算: print_sums(x + y)
y 在 f2 找到 = 2
x 在 f2 找不到 → 去 parent f1 找 → 1
⇒ x + y = 3
print_sums 之所以能「记住」上一次的和,靠的不是它调用了自己,而是:
next_sum是在 f1 里定义的,所以它的 parent 是 f1;- f1 里绑着
x = 1; - 即使
print_sums(1)已经返回了,f1 并没有消失——因为那个被交出去的函数对象还指着它。
这就是上一讲讲的闭包式的名字查找:沿着 parent 链往外找。递归在这里只是「顺手」用了一下:next_sum 的函数体里调用了 print_sums,形成了间接的自我调用。
print_sums 的函数体里没有出现 print_sums,但 next_sum 的函数体里出现了。执行 def next_sum(y): 这条语句时,Python 完全不看函数体里那个 print_sums 是什么——它只是把函数体当作一段还没执行的代码存起来。等到 next_sum 真被调用时,才会去环境里查 print_sums 这个名字。
这正是递归为什么能成立的底层原因:def fact(n): ... return n * fact(n - 1) 里那个 fact,在定义 fact 的时候还查不到(名字还没绑好呢),但那时候根本不需要查。等到 fact 被调用、执行到那一行时,全局帧里 fact 早就绑好了。
推论(很实用):如果你在函数定义之后把这个名字重新绑到别的东西上,递归就会跟着变。这也是为什么不要给自己的函数起 sum、list 这类和内置名冲突的名字。
8. 互递归:两个函数互相调用
互递归(mutual recursion)是递归的一个特例:两个或更多函数互相调用,谁也不直接调用自己,但绕一圈还是回到了自己身上。这正好落进第 1 节那句定义里的「间接调用」。
课上的例子是判断奇偶(下面这版是这个经典例子的标准写法,本机跑过):
def is_even(n):
    if n == 0:
        return True
    else:
        return is_odd(n - 1)

def is_odd(n):
    if n == 0:
        return False
    else:
        return is_even(n - 1)
先弄清它凭什么是对的。这两个函数其实是把奇偶性的一个递归定义直接抄下来了:
- 0 是偶数(不是奇数)。
- 对 n > 0:n 是偶数,当且仅当 n-1 是奇数;n 是奇数,当且仅当 n-1 是偶数。
is_even(4):4 == 0 为假 → 返回 is_odd(3) 的值。is_odd(3):3 == 0 为假 → 返回 is_even(2) 的值。is_even(2):2 == 0 为假 → 返回 is_odd(1) 的值。is_odd(1):1 == 0 为假 → 返回 is_even(0) 的值。is_even(0):0 == 0 为真 → return True。触底。True 被原样往上交五层——f4 返回 True,f3 返回 True……最终 is_even(4) 得 True。✓换成奇数验证一遍:is_even(7) → is_odd(6) → is_even(5) → is_odd(4) → is_even(3) → is_odd(2) → is_even(1) → is_odd(0) → False。实测 is_even(7) 确实是 False。
注意触底时落在哪个函数里决定了答案:n 是偶数就落在 is_even(0)(返回 True),n 是奇数就落在 is_odd(0)(返回 False)。整条链条的作用就是「走 n 步,看最后停在哪个函数」。
- 每个函数都要有自己的 base case。 上面两个函数各有一个
n == 0,缺一个就会在某种奇偶性的输入上永远转下去。 - 「变小」是整条链条上的事,不是单个函数的事。
is_even自己并不直接调用is_even,但每绕一圈 n 减了 2,仍然稳稳朝 0 走。 - 定义顺序不影响。
is_even的函数体里用到了is_odd,而is_odd定义在它后面——这完全没问题,理由就是上一节那条:函数体里的名字是被调用时才查的。只要在第一次调用is_even之前两个def都执行过就行。
def is_even(n):
    if n == 0:
        return True
    else:
        return is_odd(n - 1)

def is_odd(n):
    return is_even(n - 1)      # 没有 base case
is_even(4) 依然返回 True(它触底在 is_even(0),走的那条路上没经过 is_odd 的 base case)。测试碰巧全过。 但 is_even(7) 会一路走到 is_odd(0) → is_even(-1) → is_odd(-2) → …… → RecursionError。
这是互递归特有的坑:bug 只在一半的输入上暴露。测互递归时,两条分支的代表性输入都要测到。
当问题在两种状态之间来回切换时。判断奇偶是「奇 ↔ 偶」;下一节的 Luhn 算法是「这一位不翻倍 ↔ 下一位要翻倍」。
一个可以对照的替代方案是:用一个额外的参数记住当前状态(比如 def helper(n, should_double)),把两个函数并成一个。两种写法都对;互递归的好处是每个函数只干一件事,函数名本身就说明了当前处在哪个状态,读起来不用在脑子里追踪那个布尔标志。
9. 实战二:Luhn 算法(互递归)
Luhn 算法是真实世界里用来校验信用卡号的算法——它能挡掉大部分「手抖打错一位」的输入。规则只有两条:
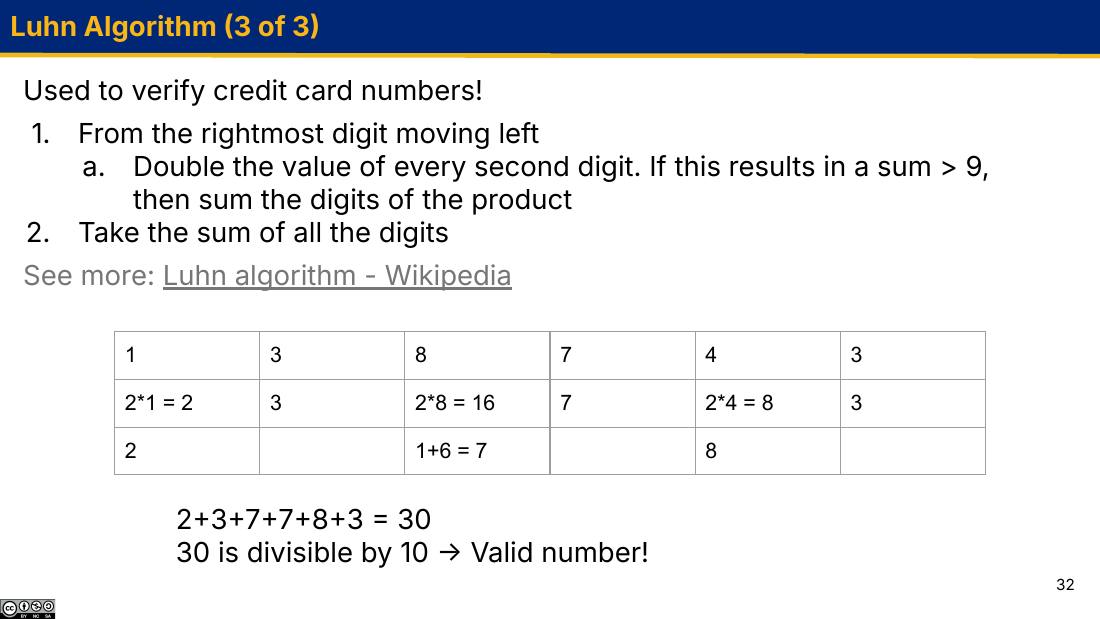
- 从最右边那一位开始往左数:把每隔一位(也就是右起第 2、4、6……位)的数字翻倍。如果翻倍的结果大于 9,就把这个乘积的各位数字加起来。
- 把处理完的所有数字求和。
如果这个和能被 10 整除,就是一个合法的卡号。
题目到底要什么
05.py 要求实现 luhn_sum(n),返回上面那个和(不判断能不能被 10 整除,只算和)。doctest:
def luhn_sum(n: int) -> int:
    """
    >>> luhn_sum(5)
    5
    >>> luhn_sum(52)  # (5*2) + 2 --> (1+0) + 2 --> 3
    3
    >>> luhn_sum(138743)  # from lecture slides
    30
    >>> luhn_sum(17893729974)
    60
    """
逐个读:
| 调用 | 期望 | 它在考什么 |
|---|---|---|
luhn_sum(5) | 5 | 只有一位时,那一位是右起第 1 位,不翻倍,直接返回自己 |
luhn_sum(52) | 3 | 右起第 1 位是 2(不动),右起第 2 位是 5(翻倍 → 10 → 1+0 = 1)。1 + 2 = 3。这条专门考「翻倍后大于 9 要拆开加」 |
luhn_sum(138743) | 30 | 幻灯片上那个例子 |
luhn_sum(17893729974) | 60 | 11 位,位数是奇数,检验「谁翻倍」的判定不会因为总位数而错位 |
怎么想到的
先看卡在哪里。用第 6 节 sum_digits 的骨架来写:从右往左一位位剥,每剥一位加进和里。但这道题里每一位的处理方式不一样——有的原样加,有的要翻倍再拆。所以剥到某一位时,你必须知道「我现在处理的是该翻倍的位,还是不该翻倍的位」。
这就是一个典型的两状态来回切换的问题,正好落进第 8 节那句判据。两条路:
def helper(n, should_double),每层把 should_double 取反传下去。可行,但每次读代码都得追踪那个布尔值。luhn_sum 负责「当前这位不翻倍」,luhn_sum_double 负责「当前这位要翻倍」。处理完一位就调用对方去处理剩下的。状态藏在「你现在人在哪个函数里」这件事本身。题目明确要求用互递归,所以走第 2 条。剩下三个小问题:
问题一:翻倍后大于 9 怎么办? 规则说「把乘积的各位数字加起来」。这不就是刚写完的 sum_digits 吗?sum_digits(16) = 7。而且乘积小于等于 9 时(比如 4 * 2 = 8)sum_digits(8) = 8,正好原样返回。一个函数把两种情况都盖住了,一行 if 都不用写。 这是这道题最漂亮的一步。
问题二:base case 是什么? 和 sum_digits 一样:n < 10,只剩一位了。但两个函数的 base case 返回的东西不同——luhn_sum 直接返回那一位,luhn_sum_double 要返回翻倍处理后的那一位。
问题三:从哪头开始? n % 10 取到的是最右边那一位,而规则也是「从最右边数起」。天作之合:最外层调用 luhn_sum(右起第 1 位不翻倍),它剥掉一位后交给 luhn_sum_double(右起第 2 位要翻倍),再交回 luhn_sum……自动交替。
代码
这是 05-sol.py 里的实现(本仓库用 python3 -m doctest 05-sol.py 实测四个 doctest 全过):
def luhn_sum(n: int) -> int:
    if n < 10:
        return n
    else:
        last = n % 10
        all_but_last = n // 10
        return last + luhn_sum_double(all_but_last)

def luhn_sum_double(n: int) -> int:
    last = n % 10
    all_but_last = n // 10
    luhn_digit = sum_digits(last * 2)
    if n < 10:
        return luhn_digit
    else:
        return luhn_digit + luhn_sum(all_but_last)
逐行讲,以及为什么是这样而不是别样
| 行 | 为什么这样写 |
|---|---|
luhn_sum: if n < 10: return n | 进入 luhn_sum 意味着「当前这位不翻倍」,所以只剩一位时原样返回。luhn_sum(5) → 5 ✓ |
return last + luhn_sum_double(all_but_last) | 当前这位原样加;剩下的部分交给对方,因为下一位该翻倍了 |
luhn_sum_double: 三行赋值写在 if 之前 | 关键结构差异。base case 也需要 luhn_digit——只剩一位时那一位仍然要翻倍处理。写在 if 里面就得写两遍,所以提到前面 |
luhn_digit = sum_digits(last * 2) | 翻倍 + 「大于 9 就拆开加」两条规则合成一句。sum_digits 对一位数是恒等的,所以不需要额外判断 |
if n < 10: return luhn_digit | 只剩一位,返回处理后的值,不是 n |
return luhn_digit + luhn_sum(all_but_last) | 加上处理后的这一位;剩下的交回 luhn_sum,因为下一位又不翻倍了 |
luhn_sum_double 里 n // 10 在 base case 里算了但没用上
当 n 是一位数时,all_but_last = n // 10 等于 0,这个值算出来之后根本没被用到——base case 那条 return luhn_digit 里没有它。这不是 bug,只是为了少写两行重复代码付出的一点点无用功。能看出「哪些计算在某条路径上是白算的」,说明你真的在追踪执行过程,而不是在读代码的形状。
验证:手动追踪 luhn_sum(138743)
luhn_sum(138743):last = 3(右起第 1 位,不翻倍),all_but_last = 13874。返回 3 + luhn_sum_double(13874)。luhn_sum_double(13874):last = 4(右起第 2 位,翻倍),luhn_digit = sum_digits(4 * 2) = sum_digits(8) = 8,all_but_last = 1387。返回 8 + luhn_sum(1387)。luhn_sum(1387):last = 7(不翻倍),all_but_last = 138。返回 7 + luhn_sum_double(138)。luhn_sum_double(138):last = 8(翻倍),8 * 2 = 16 大于 9,luhn_digit = sum_digits(16) = 1 + 6 = 7,all_but_last = 13。返回 7 + luhn_sum(13)。luhn_sum(13):last = 3(不翻倍),all_but_last = 1。返回 3 + luhn_sum_double(1)。luhn_sum_double(1):last = 1,luhn_digit = sum_digits(1 * 2) = 2。1 < 10 为真 → return 2。触底。3 + 2 = 5;第 4 层得 7 + 5 = 12;第 3 层得 7 + 12 = 19;第 2 层得 8 + 19 = 27;第 1 层得 3 + 27 = 30。luhn_sum(138743) = 30,与幻灯片和 doctest 一致。30 % 10 == 0,所以这是个合法号码。把每一层摊平成表,和幻灯片那三行表格逐格对应:
| 层 | 函数 | 参数 n | last | 这一位贡献了多少 | 为什么 |
|---|---|---|---|---|---|
| 1 | luhn_sum | 138743 | 3 | 3 | 右起第 1 位,原样 |
| 2 | luhn_sum_double | 13874 | 4 | 8 | 4×2 = 8,不超过 9 |
| 3 | luhn_sum | 1387 | 7 | 7 | 原样 |
| 4 | luhn_sum_double | 138 | 8 | 7 | 8×2 = 16 > 9,拆成 1+6 |
| 5 | luhn_sum | 13 | 3 | 3 | 原样 |
| 6 | luhn_sum_double | 1 | 1 | 2 | 1×2 = 2;base case,不再往下 |
| 合计 | 30 | 3+8+7+7+3+2 = 30 ✓ | |||
再快速验一遍最短的两条 doctest:
luhn_sum(5):5 < 10直接命中 base case,返回5。✓luhn_sum(52):last = 2,all_but_last = 5→2 + luhn_sum_double(5)。luhn_sum_double(5):luhn_digit = sum_digits(10) = 1 + 0 = 1,5 < 10→ 返回1。总计2 + 1 = 3。✓ 和 doctest 注释里写的(5*2) + 2 --> (1+0) + 2 --> 3一字不差。
luhn_sum_double 的 base case 返回 n
    if n < 10:
        return n              # 错:忘了这一位也要翻倍
luhn_sum(52) 会返回 2 + 5 = 7 而不是 3。「触底那一位」并不因为它是最后一位就免于处理。 一个稳妥的自查方法:拿一个刚好在 base case 就要做特殊处理的最小输入(这里是两位数 52)跑一遍。
luhn_digit = last * 2 # 错:漏了 sum_digits
luhn_sum(138743) 会返回 3 + 8 + 7 + 16 + 3 + 2 = 39 而不是 30——错在 8×2=16 那一位上,正好多了 9(16 和 1+6=7 差 9)。看到「结果比期望大 9 的倍数」,几乎一定是这个 bug。
return last + luhn_sum(all_but_last) # 在 luhn_sum 里调用了 luhn_sum
这样写没有任何一位会被翻倍,luhn_sum 退化成了 sum_digits:luhn_sum(138743) 返回 1+3+8+7+4+3 = 26。互递归的要害就是「交给对方」这四个字——写完之后检查每个 return 里调用的是不是另一个函数。
虽然不在本讲要求内,但值得知道它为什么有效:如果你把某一位从 a 打成了 b,那么这一位的贡献变化量在两种情况下都不可能是 10 的倍数(除非 a = b),所以校验和不再被 10 整除,错误就被发现了。这也是为什么规则里要有「大于 9 就拆开加」——不拆的话,翻倍会把变化量放大到 10 的倍数上,漏掉一部分错误。
10. 递归与迭代:怎么选,怎么互相翻译
课上有一句话值得单独拎出来:「迭代其实是递归的一个特例。」 这不是修辞,是可以验证的事实——任何 while 循环都能机械地改写成递归。
翻译规则
把第 6 节那张对照表提炼成一份可以照着做的清单:
| 迭代里的东西 | 递归里的对应物 | 为什么 |
|---|---|---|
循环变量(i、n) | 函数的参数 | 迭代靠覆盖同一个名字推进;递归靠把新值传给下一层推进 |
累加器(total) | 要么是额外的参数(下潜时累加),要么由返回值相加完成(回溯时累加) | 两种都行,见第 6 节两版 sum_digits |
初始化(total = 0) | 调用时传的初值,或 base case 的返回值 | 「什么都还没加时的答案」 |
循环条件(while n > 0) | base case 条件取反(if n == 0: ...) | 循环说「什么时候继续」,递归说「什么时候停」 |
更新语句(n = n // 10) | 递归调用的实参(f(n // 10)) | 同一个算式,只是去处不同 |
循环后的 return total | 每层都 return,值一路交上去 | 递归没有「循环之后」,只有「返回给调用者」 |
拿第 2 讲写过的「1 加到 n」练一次手(两版都跑过,n = 100 时都得 5050):
# 迭代版
def sum_to(n):
    i, total = 1, 0
    while i <= n:
        total += i
        i += 1
    return total

# 递归版
def sum_to(n):
    if n == 0:
        return 0
    else:
        return sum_to(n - 1) + n
递归版短得多,而且不需要任何循环变量。但它在 n = 100000 时会 RecursionError,迭代版不会。这就是全部的取舍。
选择清单
| 维度 | 迭代(while) | 递归 |
|---|---|---|
| 帧数 | 1 个 | 正比于递归深度 |
| 内存 | 常数 | 正比于深度,深了会 RecursionError |
| 中间状态存在哪 | 手工维护的变量,反复覆盖 | 帧本身,自动保存,不用你管 |
| 擅长什么 | 线性推进、次数明确的重复 | 递归定义的数据(树、链表)、递归定义的问题(阶乘、组合计数) |
| 典型 bug | 忘了更新 → 死循环 | base case 够不着 → RecursionError;漏 return → TypeError 里冒出 NoneType |
| 怎么验证正确性 | 循环不变式 | 数学归纳法:查 base case + 查拼装逻辑 |
- 「最小的输入是什么?答案是什么?」 ——写出 base case。写不出来,说明你还没想清楚问题的边界。
- 「怎么让输入小一点点?」 ——整数用
// 10或- 1;往后学的列表用切片s[1:];树用它的分支。 - 「假设小一号的答案已经在手上了,怎么补出这一层?」 ——这是信仰之跃,只准想一层。
三句都答上来,代码基本就是把答案抄下来。答不上来第 1 句,八成是题目还没读懂;答不上来第 3 句,八成是拆问题的方式不对,换一种拆法。
HW 02 第一题 num_eights 的题面里白纸黑字写着:「Use recursion; the tests will fail if you use any assignment statements or loops.」——不许用赋值语句、不许用循环,连自己新定义的辅助函数里也不许。
这个限制不是刁难。它逼你把中间状态全部通过参数和返回值传递,这正是本讲第 6 节那个「累加器参数」技巧要练的东西,也是后面学 Scheme 时唯一可用的手法。真做的时候,把第 6 节那两版 sum_digits 拿出来对照着看。
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
| 递归函数 | 直接或间接调用自己的函数 | 把「间接」漏掉,看不出互递归也是递归 |
| 三个部件 | base case / recursive case / 拼装,缺一不可;每样都可能有多个 | 只写了递归调用,忘了 base case → RecursionError |
| base case | 最简单的合法输入,在这里不做递归调用直接给答案 | 写成 n == 1 导致 fact(0) 无限递归;条件和返回值不配套 |
| 信仰之跃 | 写拼装时假定递归调用已给出正确答案,只想一层 | 在脑子里往下展开三层,然后放弃 |
| 为什么合法 | 它就是数学归纳法:base case 是奠基,拼装是归纳步 | — |
| 「变小」 | 参数必须朝 base case 的方向严格前进 | fact(-1):确实每次变小,但朝着负无穷 → 永远够不着 n == 0 |
| 环境图 | 每次递归调用 = 一次普通调用 = 一个新帧;同名形参在不同帧里各自独立 | 以为 f2 的 parent 是 f1;实际由函数定义在哪决定,全是 Global |
| 下潜 / 回溯 | 递归调用之前的代码在下潜时跑(外→内),之后的在回溯时跑(内→外) | countdown 里 print 放在递归调用前后,输出顺序整个反过来 |
RecursionError | CPython 默认递归上限 1000 层;报错里带 [Previous line repeated N more times] | 看到它先查 base case 够不够得着,而不是去调 setrecursionlimit |
漏 return | 递归情形没写 return,该层返回 None | TypeError: unsupported operand type(s) for +: 'NoneType' and 'int'——看到 NoneType 就查 return |
| 自引用 | 函数体里提到自己的名字;名字是被调用时才查的 | 以为 def 的时候就要能查到那个名字 |
| 互递归 | 两个函数互相调用;状态藏在「现在在哪个函数里」 | 只给一个函数写 base case → bug 只在一半输入上暴露 |
| 累加器参数 | 用参数携带中间状态,累加发生在下潜阶段 | 改了函数签名,doctest 的调用形式对不上 → TypeError: missing 1 required positional argument |
| 迭代 ↔ 递归 | 循环变量 → 参数;更新语句 → 递归调用的实参;循环条件取反 → base case | 用 / 而不是 //,参数变浮点数,永远到不了 base case |
| 取舍 | 递归省脑力费内存;迭代费脑力省内存 | 为了递归而递归;或者遇到树还硬写循环 |
- 写递归只回答三个问题:最小输入返回什么、怎么变小、拿到小答案怎么拼。第三问只准想一层。
- 环境图上,递归调用就是普通调用:一次一帧,各帧的
n互不干扰,parent 全是 Global。递归的全部「记忆力」都来自这些同时挂着的帧。 - 崩了先看两处:base case 够不够得着(
RecursionError)、每条路径有没有return(NoneType)。
动手练习
五道题。先在纸上写出答案,再展开对照——直接看答案等于没做。第 2、3 题请真的把帧画出来。
练习 1:WWPD(输出顺序)
下面这个函数,mystery(3) 会打印什么?按顺序写出每一行。
def mystery(n):
    if n == 0:
        return
    print('down', n)
    mystery(n - 1)
    print('up', n)
看答案
down 3
down 2
down 1
up 1
up 2
up 3
推演:print('down', n) 在递归调用之前,所以它在下潜阶段执行,顺序 3、2、1;print('up', n) 在递归调用之后,在回溯阶段执行,顺序 1、2、3。
三个帧同时挂着,各自记着自己的 n:f1 的 n 是 3,f2 是 2,f3 是 1。回溯时 f3 先醒来打印 up 1,然后 f2 打印 up 2,最后 f1 打印 up 3。
顺带注意 base case 里那句光秃秃的 return:它返回 None,等价于 return None。这里不需要返回值,只需要「停下来别再递归」,所以这么写是合适的。
练习 2:找 bug(RecursionError)
下面这个函数想数出正整数 n 有多少位。count_digits(4224) 会发生什么?
def count_digits(n):
    if n == 0:
        return 0
    else:
        return count_digits(n // 10) + 1
再看这一个,同样的题目。count_digits(1234) 返回 4,看起来没问题——那 count_digits(4224) 呢?
def count_digits(n):
    if n == 1:
        return 1
    else:
        return count_digits(n // 10) + 1
看答案
第一个是对的,返回 4。追踪:count_digits(4224) → count_digits(422) + 1 → count_digits(42) + 1 + 1 → count_digits(4) + 1 + 1 + 1 → count_digits(0) + 1 + 1 + 1 + 1 → 0 + 4 → 4。base case n == 0 返回 0(零位),和条件配套。
(唯一的小瑕疵:count_digits(0) 返回 0,但 0 写出来是一位。题目限定正整数,不算错——但要说得出来。)
第二个在 count_digits(4224) 上会 RecursionError,而在 count_digits(1234) 上却正确返回 4。 这正是它阴险的地方。
| 输入 | n 依次取 | 结果 |
|---|---|---|
1234 | 1234 → 123 → 12 → 1 | 撞上 n == 1,返回 1 + 1 + 1 + 1 = 4 ✓ |
4224 | 4224 → 422 → 42 → 4 → 0 → 0 → 0 → … | 4 // 10 是 0,而 0 // 10 还是 0,n == 1 永远为假 → RecursionError |
两条教训:
- base case 必须覆盖递归实际能到达的所有终点。 这里
n // 10的终点是0,不是1——最高位一旦被砍掉就直接变 0,压根不会在 1 上停留(除非最高位恰好是 1)。 - 「测了几个例子都过」不等于对。 首位是 1 的数全过,其余全崩。测试时要专门挑会走到不同分支的输入。
顺带一提:0 // 10 == 0 是递归里非常常见的一个「吸收态」——参数掉进去就再也变不了,条件永远不满足。写整数递归时,习惯性检查一下 0 会不会成为死角。
练习 3:画环境图
对下面的调用,写出:一共新建了几个帧、每个帧里 n 的值、每个帧的返回值。
def f(n):
    if n <= 1:
        return 1
    else:
        return n + f(n - 2)

f(7)
看答案
4 个帧(不含全局帧),返回 16。
| 帧 | n | 做了什么 | 返回值 |
|---|---|---|---|
| f1 | 7 | 7 <= 1 假 → 7 + f(5) | 7 + 9 = 16 |
| f2 | 5 | 5 + f(3) | 5 + 4 = 9 |
| f3 | 3 | 3 + f(1) | 3 + 1 = 4 |
| f4 | 1 | 1 <= 1 真 → base case | 1 |
展开式:f(7) = 7 + f(5) = 7 + (5 + f(3)) = 7 + (5 + (3 + f(1))) = 7 + (5 + (3 + 1)) = 16。
两个要点:
- 参数每次减 2,所以 7 → 5 → 3 → 1,永远碰不到 0。base case 写成
n <= 1而不是n == 0或n == 1,正是为了同时接住奇数链和偶数链(f(6)会走 6 → 4 → 2 → 0,靠<=接住 0)。base case 的条件要覆盖递归实际能到达的所有终点,这是很容易漏的一点。 - 四个帧的 parent 都是 Global,不是彼此。
练习 4:写代码(递归 count_up)
实现 count_up(n),从 1 打印到 n,每行一个。不许用循环,不许用额外参数(调用形式必须是 count_up(5))。
>>> count_up(5)
1
2
3
4
5
看答案
def count_up(n):
    if n <= 0:
        return
    count_up(n - 1)
    print(n)
思维路径:一开始你多半会写 print(n) 再 count_up(n - 1)——但那样打出来是 5、4、3、2、1,方向反了。而参数只能递减(递增就没有终点了),怎么办?
答案是第 3 节那条:把打印挪到递归调用之后,让它在回溯阶段执行。 下潜时一言不发地钻到 n = 0,回溯时从最里层开始打印,于是 1 先出来,5 最后出来。
验证 count_up(3):f1(n=3) 先调 f2;f2(n=2) 先调 f3;f3(n=1) 先调 f4;f4(n=0) 命中 base case 直接返回。然后 f3 打印 1,f2 打印 2,f1 打印 3。✓
这道题的价值在于:「递归的参数在变小」和「输出顺序由小到大」是可以同时成立的,只要把工作放到回溯阶段做。很多看似「必须正着来」的问题都能这样解决。
练习 5:改写成互递归
把下面这个用参数记状态的函数,改写成一对互递归的函数(功能不变:把一个正整数的奇数位——从右起第 1、3、5……位——加起来)。
def sum_odd_positions(n, is_odd_pos=True):
    if n == 0:
        return 0
    last = n % 10
    rest = sum_odd_positions(n // 10, not is_odd_pos)
    if is_odd_pos:
        return last + rest
    else:
        return rest
看答案
def sum_odd(n):          # 当前这一位算进去
    if n == 0:
        return 0
    return n % 10 + sum_even(n // 10)

def sum_even(n):         # 当前这一位跳过
    if n == 0:
        return 0
    return sum_odd(n // 10)
入口是 sum_odd(n)。验证 sum_odd(12345):
| 调用 | n % 10 | 算不算 | 往下交给谁 |
|---|---|---|---|
sum_odd(12345) | 5 | 算 | sum_even(1234) |
sum_even(1234) | 4 | 跳过 | sum_odd(123) |
sum_odd(123) | 3 | 算 | sum_even(12) |
sum_even(12) | 2 | 跳过 | sum_odd(1) |
sum_odd(1) | 1 | 算 | sum_even(0) → 0 |
结果 5 + 3 + 1 = 9。两版跑出来一致。
两件事要看清:
- 两个函数都必须有
n == 0的 base case,否则位数为奇/偶时会有一半输入崩掉(第 8 节的坑)。 sum_even的函数体里压根没用n % 10——「跳过这一位」的字面实现就是不去读它。这比在一个函数里用if is_odd_pos判断要直白得多,也正是luhn_sum/luhn_sum_double那对函数的结构。