后训练(二):可验证奖励强化学习 RLVR
当奖励不再来自一个会被骗的偏好模型,而来自一段确定性的验证程序时,强化学习可以被真正推到极限——这就是从 GPT-3.5 到 o1/R1 的那一步。
0. 本讲导读
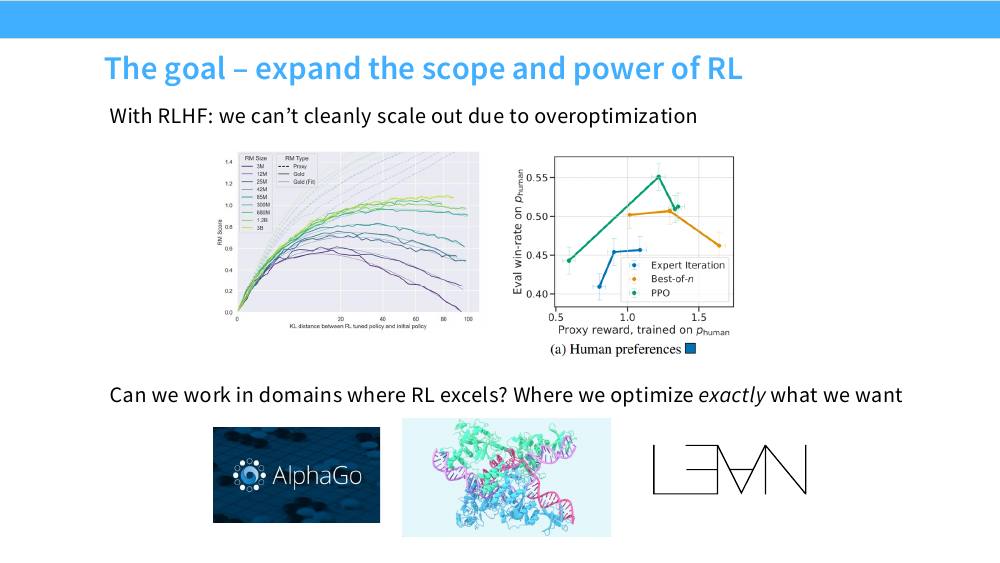
到上一讲为止,我们手里的配方是:预训练 → 中期训练 → SFT → RLHF。这条流水线能把一个基础模型推到大致 GPT-3.5 的水平——会聊天、会跟随指令、语气得体。但它撞上了一堵墙:RLHF 的奖励来自一个学出来的奖励模型(reward model, RM),而奖励模型是一个有限样本拟合出来的代理(proxy)。你越用力优化它,策略就越会跑到 RM 的分布外区域去骗分,真实人类满意度先升后降。这叫过优化(overoptimization)。结果是:RLHF 的 KL 预算只能给到很小,训练几百步就得停,没法干净地 scale。
本讲要回答的问题是:有没有一类任务,我们能写下一个不会被骗的奖励? 如果有,就可以把 RL 的算力预算从"几百步"放大到"几千步、几万步",看看模型能力的天花板在哪里。答案是有——数学题有标准答案,代码有单元测试,形式化证明有 Lean 检查器。这类"奖励由程序判定"的强化学习就是本讲的主题:可验证奖励强化学习(Reinforcement Learning from Verifiable Rewards, RLVR)。
本讲的结构和讲师给的两条主线一致:先讲算法(PPO → GRPO 以及 GRPO 的各种修正),再讲案例(DeepSeek-R1、Kimi K1.5、Qwen3)。算法部分我们会把 GRPO 从策略梯度一路推下来,并把它已知的几个偏置(长度偏置、std 归一化)掰开讲清楚;案例部分则关注真实配方里的工程细节:冷启动 SFT、多阶段训练、奖励设计、rollout 与训练的解耦、以及蒸馏。
- RLVR 的本质不是新算法,而是新奖励。 把 RM 换成验证器,你优化的就恰好是你想要的东西,于是可以放心地 scale RL 步数。
- GRPO = PPO 去掉价值网络 + 组内 z-score 作为优势。 在线(rollout 后立刻更新)情形下,它退化成"带组归一化奖励的策略梯度",实现可以短到一百行。
- GRPO 的两个归一化项都是有偏的:除以 $\mathrm{std}$ 会放大过易/过难题目的权重;除以 $|o_i|$ 会让模型在答错时倾向于写更长。Dr. GRPO 把两者去掉后,奖励曲线不变但输出长度显著下降。
- R1-Zero 证明了纯 RL 可以从基础模型直接长出长 CoT;但 R1 的完整配方仍然需要冷启动 SFT + 多阶段 RL + 常规 RLHF,最后再蒸馏到小模型。
- PRM 和 MCTS 在 R1 里都被明确列为失败尝试:前者会被 reward hack 且难以标注,后者在 token 级别的巨大分支因子下无法 scale。简单的 outcome reward + GRPO 反而赢了。
- RL 系统效率是主要瓶颈:on-policy 意味着每一步都要跑(慢的)推理,训练框架与推理框架不同,长 CoT 又让 batch 极不均匀。
1. 从 RLHF 到 RLVR
过优化:为什么 RLHF 不能一直练下去
回忆 RLHF 的目标函数(上一讲):
$$ \max_\theta \ \E_{x\sim\mathcal{D},\, y\sim\pi_\theta(\cdot|x)}\big[r_\phi(x,y)\big] - \beta\,\KL\big(\pi_\theta(\cdot|x)\,\|\,\pi_{\mathrm{ref}}(\cdot|x)\big) $$这里 $r_\phi$ 是从人类偏好对(Bradley–Terry)拟合出来的奖励模型。问题出在 $r_\phi \ne r^\star$:它只在训练偏好数据覆盖的分布附近近似真实人类偏好。RL 的优化器不知道这件事,它会尽职尽责地找 $r_\phi$ 的最大值点——而那个点常常是一个人类看了会皱眉的输出(超长回答、堆砌 markdown 列表、过度谄媚)。经验规律是:真实质量随 $\sqrt{\KL}$ 先增后减,RM 越小、偏好数据越少,掉头越早。
那个 $\beta\KL$ 项就是承认这一点的补丁:它不是在正则化模型,它是在限制你敢用多少 RL。所以 RLHF 里 KL 预算是一个必须小心调的超参,而不是一个可以随算力放大的旋钮。讲师的判断很直接:只要奖励是学出来的,RL 就没法干净地 scale out。
「过优化 = 模型过拟合训练数据」。不是。策略网络在 RL 阶段可能只跑了几百个 optimizer step、见了几万条 prompt,远谈不上过拟合。过优化是奖励函数本身的泛化误差被优化器放大——是 $r_\phi$ 过拟合,不是 $\pi_\theta$ 过拟合。换个更大的策略模型救不了,换个更大/更准的 RM 才能把掉头点往后推。
换掉奖励:验证器代替偏好模型
RLVR 的做法极其朴素:把 $r_\phi(x,y)$ 换成一个程序 $\mathrm{verify}(x,y)\in\{0,1\}$。
| 任务 | 验证器 | 奖励 |
|---|---|---|
| 数学(有唯一数值/表达式答案) | 抽取 \boxed{} 内容,与标准答案做符号等价判定(SymPy / 规则) | 1 = 答案等价,0 = 否则 |
| 竞赛编程 | 编译 + 跑隐藏测试用例 | 通过率或全通过 = 1 |
| 形式化证明(Lean / Coq) | 类型检查器 | 证明通过 = 1 |
| 软件工程(SWE-bench 式) | 应用补丁后跑仓库测试,检查 PASS_TO_FAIL 是否被修好 | 测试转绿 = 1 |
| 格式约束 | 正则匹配 <think>…</think> 标签是否闭合 | 格式合法 = 小额正奖励 |
这个奖励有三个 RM 没有的性质。第一,它不可微、但也不可被欺骗:模型没法通过"写得更像正确答案"来拿分,只能真的算对。第二,它没有分布外问题:无论策略漂移到哪里,验证器的判定都同样可靠,因此 KL 预算可以放得很宽甚至去掉。第三,它便宜且可无限生成:一道题的奖励标注成本是一次程序调用,不是一次人类比较,这意味着你可以采样 $G=64$ 条 rollout 而不心疼。
RLHF 像是让学生对着一位会看走眼的助教刷分:刷得越狠,助教的盲区被利用得越彻底。RLVR 则是让学生对着标准答案刷分:刷得越狠,学生就真的越会做题。整门课到这里的关键转折就是这一句话——把奖励从"估计"变成"计算",RL 的算力就从负担变成了红利。
可验证的边界在哪里
代价是适用范围窄。"写一首关于秋天的诗"没有验证器;"证明命题 X"如果不要求 Lean 形式化,也只能靠模型判分。真实配方的处理方式是分层的:可验证任务用验证器(R1 的 stage-1/stage-3 RL),不可验证任务退回到 RM 或 LLM-as-judge(R1 用 DeepSeek-V3 当裁判生成 600k 条推理类 SFT 数据,最后一步 RLHF 也仍然复用 V3 的偏好流水线)。
还有一类更隐蔽的边界:验证器正确但奖励信号有毒。Kimi K1.5 明确把选择题和判断题排除出 RL 数据集,理由是假阳性——四选一瞎猜就有 25% 的奖励,模型会学会"跳过推理直接猜",这在梯度上和"学会推理"是同一个方向。同理,代码任务如果测试用例太弱,模型会学会写只满足测试而不满足题意的代码。验证器不会被语言骗,但会被规格漏洞骗。
"RLVR 不会 reward hack"是一个过强的说法。准确的说法是:RLVR 把 reward hacking 从"模型层面的不可控失败"降级成了"验证器规格层面的可审计 bug"。前者你只能靠 KL 惩罚硬压,后者你可以去加测试用例、去掉选择题、加格式检查——是工程问题,不是学习理论问题。
2. 为什么 RLVR 现在这么关键
能力跃迁:这门课的最后一块拼图
讲师在开场把整门课定位了一下:预训练 + RLHF ≈ GPT-3.5,今天这一讲把我们一路带到 o1 / R1。这不是修辞。o1 类模型与 GPT-4 类模型在 AIME、GPQA、竞赛编程上的差距不是几个点,而是几十个点;而制造这个差距的技术,本质上就是"在可验证任务上做大规模 RL"。
更重要的是能力的形态变了。RLHF 优化的是"人类看着舒服",它改的是风格;RLVR 优化的是"答案对不对",它逼出来的是过程——模型必须自己发明能提高正确率的思考策略,因为这是唯一能提高奖励的路径。
长 CoT 的自发涌现
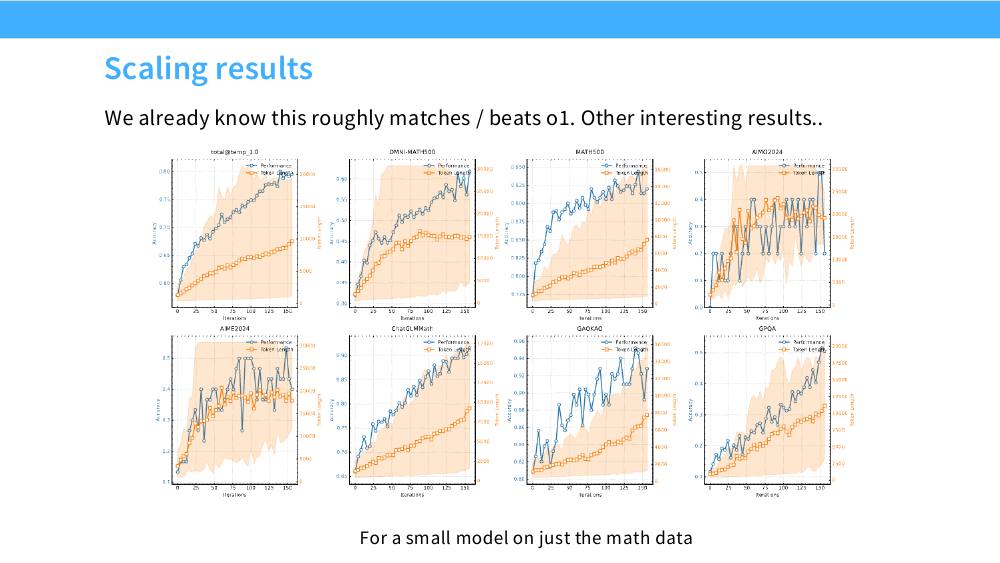
R1-Zero 最出名的一张图:在没有任何长思维链监督数据的情况下,只用"答案对 = 1"这个奖励做 GRPO,模型的平均回答长度从几百 token 一路涨到接近 10000 token,并且这个增长在训练 8000 步后仍未饱和。
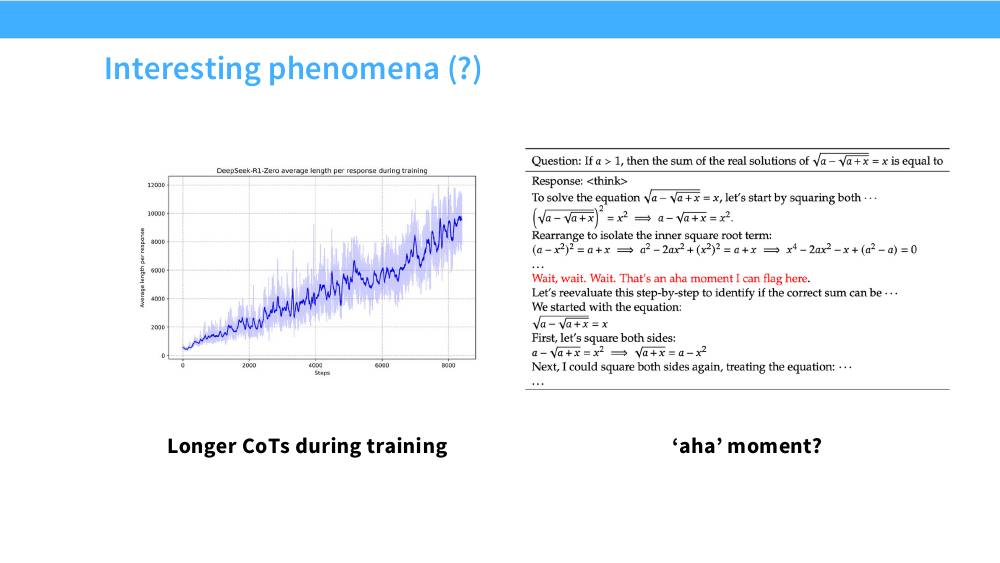
为什么长度会自己涨?直觉是:在 outcome reward 下,任何能提高 $\Pr[\text{答对}]$ 的行为都会被强化。而对 Transformer 来说,多写 token = 多做串行计算——写下中间结果相当于把工作记忆外置到上下文里,让后续 token 可以 attend 到它。枚举候选、验算、回溯、换方法,这些都需要 token 预算。所以"写得更长"是提高正确率最容易被梯度找到的方向之一。
但讲师立刻泼了冷水,这一点很重要:
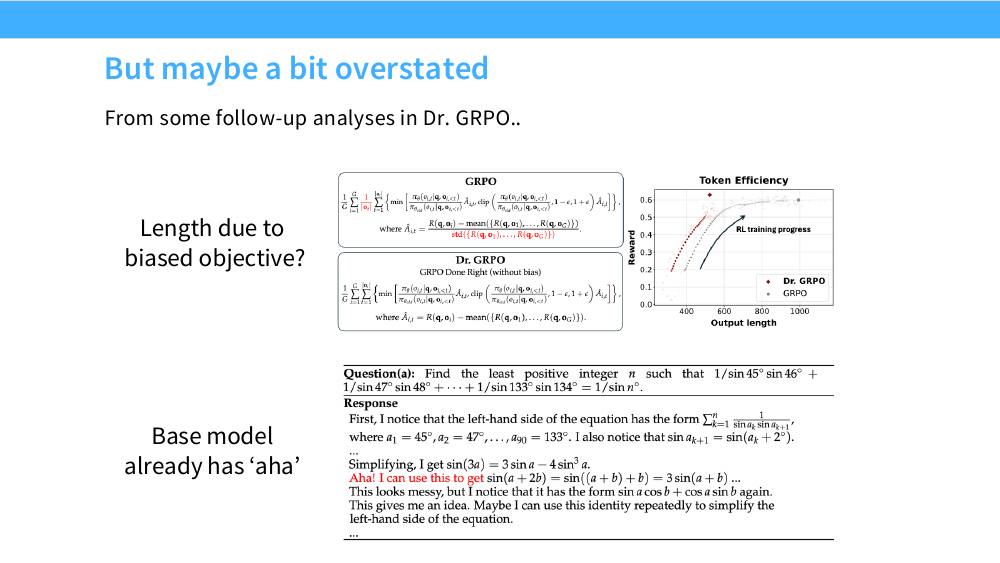
这是本讲讲师反复强调的治学态度:看到一条漂亮的涌现曲线,先问它有没有可能是目标函数的偏置造成的。长度增长这个现象同时有三个候选解释——(a) 真实的推理能力增长,(b) $1/|o_i|$ 归一化的长度偏置,(c) 训练分布里难题占比上升。三者都存在,比例未知。R1 的贡献是真实的,但"aha moment 是 RL 涌现出的自我意识"这类叙事被显著夸大了。
可以 scale 的 RL 意味着什么
RLHF 时代 RL 是流水线末端的一道"抛光工序",占总算力不到 1%。RLVR 时代 RL 变成了一个独立的 scaling 轴:你可以往里投更多题目、更多 rollout、更多训练步,性能持续上升;而且它同时买到了推理时的 scaling——训出来的模型会用更多 test-time token 换更高准确率(第 10 节详述)。这是为什么 2025 年之后所有前沿实验室的算力分配都在往后训练倾斜。
3. 策略梯度基础:从 REINFORCE 到 PPO
要理解 GRPO 为什么长成那个样子,必须先把策略梯度这条线捋一遍。讲师用三句话概括了整个 PPO 的来历:尝试一:策略梯度(方差太大);尝试二:TRPO(在当前策略附近把问题线性化);尝试三:PPO(把比值 clip 在 $\varepsilon$ 内)。
REINFORCE:对不可微目标求梯度
我们要最大化 $J(\theta)=\E_{z\sim p_\theta}[R(z)]$,其中 $z$ 是一条完整的生成序列,$R$ 是一个黑盒、不可微的奖励(验证器就是黑盒)。梯度不能穿过 $R$,但可以穿过采样分布:
$$ \nabla_\theta \E_{p_\theta}[R(z)] = \nabla_\theta \sum_z p_\theta(z) R(z) = \sum_z R(z)\,\nabla_\theta p_\theta(z) = \sum_z p_\theta(z) R(z)\,\frac{\nabla_\theta p_\theta(z)}{p_\theta(z)} = \E_{p_\theta}\big[R(z)\,\nabla_\theta \log p_\theta(z)\big] $$中间那一步 $\nabla_\theta p = p\,\nabla_\theta\log p$ 就是 log-derivative trick。结论极其直观:把每条采样序列的对数似然梯度,按它拿到的奖励加权求和。奖励高的序列,提高它的概率;奖励低的,压低。对语言模型来说 $\log p_\theta(z)=\sum_t \log \pi_\theta(z_t|z_{<t})$,所以这就是一个带权重的交叉熵——实现上和 SFT 只差一个系数。
基线与方差缩减
REINFORCE 无偏但方差爆炸。原因很好理解:假设某道题上所有 rollout 的奖励都是 $0.9\sim1.0$,那么每条序列都被"往上推",梯度里绝大部分是共同的、无信息的分量,真正有用的信号(哪条更好)淹没在里面。
关键恒等式:对任意不依赖动作的 $b(s)$,
$$ \E_{z\sim p_\theta}\big[b(s)\,\nabla_\theta\log p_\theta(z)\big] = b(s)\sum_z \nabla_\theta p_\theta(z) = b(s)\,\nabla_\theta\underbrace{\textstyle\sum_z p_\theta(z)}_{=1}=0 $$所以可以把奖励换成 $R(z)-b(s)$ 而不改变梯度的期望,只改变方差。这就是 Sutton & Barto 里的 baselining。最优(近似方差最小)的选择是 $b(s)=V^\pi(s)=\E[R\mid s]$,于是 $R-V$ 就是优势(advantage) $A$。
PPO 的做法是再训一个价值网络 $V_\phi$ 来估计这个基线,并用 GAE(generalized advantage estimation)把它和实际回报混合:
$$ \hat A_t^{\text{GAE}} = \sum_{l\ge 0}(\gamma\lambda)^l\,\delta_{t+l},\qquad \delta_t = r_t + \gamma V_\phi(s_{t+1}) - V_\phi(s_t) $$讲师指出一个有趣的细节:在语言模型的场景里,这其实是一个 bandit 问题——只有序列末尾有一个大的稠密奖励,中间没有环境交互。取 $\gamma=\lambda=1$ 时 GAE 退化成 $\hat A_t = \big(\sum_{l\ge t} r_l\big) - V_\phi(s_t)$,也就是reward-to-go 减去价值估计,而且实践中这个设置就能工作得很好。记住这一点:整个价值网络在这里唯一的作用,就是给出一个标量基线 $V(q)$。
PPO:把"别走太远"写进目标
如果每采一批 rollout 只更新一次,那策略梯度就够了;但那样样本利用率太低。要在同一批 rollout 上做多个 epoch 的更新,就变成了 off-policy,需要重要性采样比值 $\rho_t=\pi_\theta(a_t|s_t)/\pi_{\theta_{\text{old}}}(a_t|s_t)$,而这个比值一旦偏离 1 太远,估计就崩了。TRPO 用 KL 信赖域约束解决,PPO 用一个更糙但更好实现的办法:clip。
$$ L^{\text{CLIP}}(\theta)=\E_t\Big[\min\big(\rho_t \hat A_t,\ \mathrm{clip}(\rho_t,\,1-\varepsilon,\,1+\varepsilon)\,\hat A_t\big)\Big] $$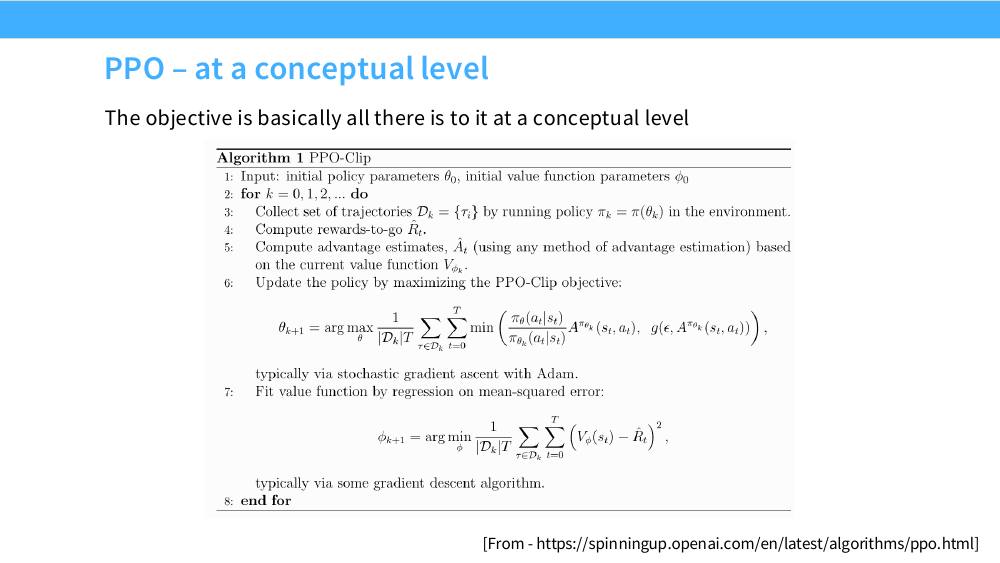
$\min$ 的作用是单边的:当 $\hat A_t>0$ 时它把 $\rho_t$ 的收益封顶在 $1+\varepsilon$(不许因为这条好就无限提高概率);当 $\hat A_t<0$ 时封顶在 $1-\varepsilon$。注意 clip 只是让梯度归零,并不阻止参数继续移动——这是 PPO 众多"看起来对但实际很微妙"的地方之一。典型 $\varepsilon=0.2$(AlpacaFarm 的 cliprange 就是 0.2)。
PPO 在实践中的补丁
讲师特别提醒:"如果你看到一篇关于 PPO 的博客长成这样(指一篇列举了几十个实现细节的帖子),你就知道自己有麻烦了。"以 AlpacaFarm 的 PPO 实现为例,真实代码里至少还有这些东西:
- 奖励整形:逐 token 加 KL 惩罚 $-\beta\log\frac{\pi_\theta}{\pi_{\mathrm{ref}}}$,只在最后一个 token 上加完整的 RM 奖励。注意这里 KL 是塞进奖励里的,不是加在 loss 上——两种做法梯度不同。
- KL clip:对那些 $\log\pi_\theta < \log\pi_{\mathrm{ref}}$ 的序列把 KL 惩罚裁掉。理由纯粹是稳定性——万一模型炸了,这能阻止 KL 项跟着发散。
- 优势白化、价值损失 clip、梯度裁剪、rollout 与训练的 batch 大小解耦……
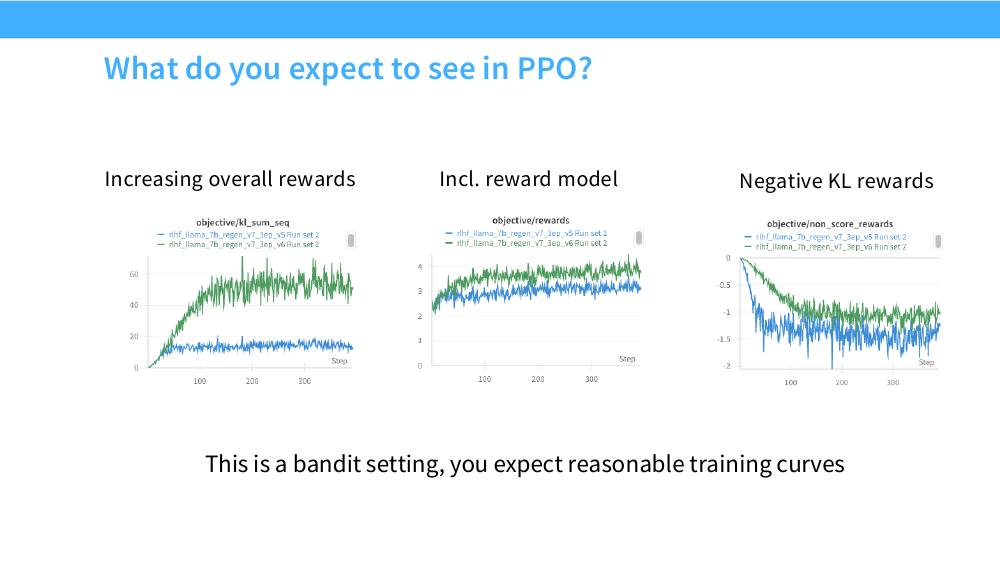
那为什么还要再发明一个算法
| 方案 | 问题 |
|---|---|
| PPO | 实现复杂(几十个细节都会影响结果);价值模型吃显存,而且它自己也需要调参和预热 |
| DPO | 数据不天然是成对的(Bradley–Terry 形式);离线——虽然可以迭代成在线,但那就失去了 DPO"不用采样"的简洁性 |
把"价值模型吃显存"量化一下:RLHF 的 PPO 同时要驻留四份模型——策略、参考模型、奖励模型、价值模型。其中策略和价值模型都要训练。以 7B、bf16 + AdamW 为例,一个可训练模型大约需要:权重 14 GB + 梯度 14 GB + fp32 master/一阶/二阶动量 $3\times 28=84$ GB ≈ **112 GB**。去掉价值网络就直接省下这 112 GB(还省掉它的前反向计算)。在 RLVR 里奖励模型也被验证器替换掉了,于是只剩策略 + 参考模型两份——显存压力少了一半以上,这也是 GRPO 能被写进百行脚本的物理原因。
4. GRPO 完整推导
GRPO(Group Relative Policy Optimization)出自 DeepSeekMath,配方只有三句话:从 PPO 出发 → 删掉价值函数 → 把优势定义为"组内 z-score"。
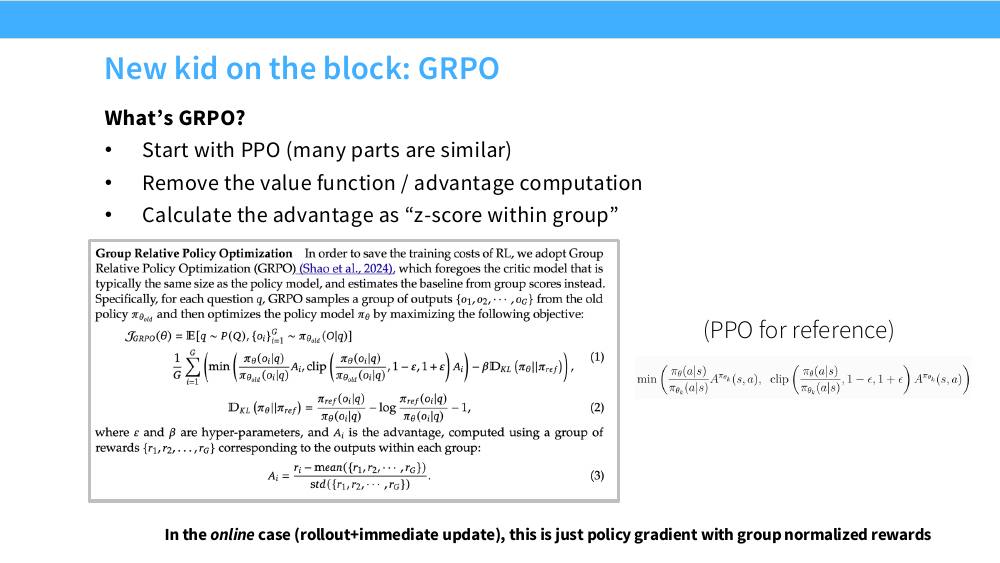
组内采样与优势
对每个 prompt $q$,从旧策略采一组 $G$ 条完整输出 $\{o_1,\dots,o_G\}$,各自跑验证器得到 $\{r_1,\dots,r_G\}$,然后
$$ \hat A_i \;=\; \frac{r_i - \mathrm{mean}(r_1,\dots,r_G)}{\mathrm{std}(r_1,\dots,r_G)} $$这个标量被广播到 $o_i$ 的每一个 token:$\hat A_{i,t}=\hat A_i$,$\forall t$。也就是说 GRPO 完全放弃了 token 级的信用分配——一条答对的推理链里,每个 token 都同等地被奖励,哪怕其中有几步是错的(错了但蒙对了)。这看起来很粗糙,但在实践中出乎意料地有效,原因是组内对比已经提供了足够强的信号,而 token 级信用分配本来就是一个几乎无法可靠估计的量。
为什么可以省掉价值网络
在 bandit 设定下,最优基线就是这道题的期望奖励 $V(q)=\E_{o\sim\pi_\theta(\cdot|q)}[r(q,o)]$。PPO 的做法是用一个神经网络去回归它;GRPO 的做法是直接用蒙特卡洛估计它:
$$ \hat V(q) = \frac{1}{G}\sum_{j=1}^{G} r_j \quad\Longrightarrow\quad \hat A_i \propto r_i - \frac{1}{G}\sum_j r_j $$严格来说 $r_i$ 出现在均值里会引入 $O(1/G)$ 的相关性偏置,无偏版本是 leave-one-out:$b_i=\frac{1}{G-1}\sum_{j\ne i} r_j$,这就是 RLOO(REINFORCE Leave-One-Out)。两者在 $G$ 稍大时差别很小。
所以核心 trade-off 是:用 $G$ 倍的采样换掉一个价值网络。 这笔账在 RLVR 场景下非常划算,因为
- rollout 本来就要做,而且推理引擎(vLLM/SGLang)的吞吐远高于训练引擎;同一个 prompt 的 $G$ 条采样还能共享 prefix KV cache,边际成本低于 $G$ 倍。
- 价值网络在 LLM 上本来就难训:它要对"半截的推理链"打分,而半截序列在预训练分布里几乎没出现过;它的目标又随策略漂移而不断变化,是典型的非平稳回归。
- 验证器奖励是二值的,蒙特卡洛方差本来就有上界($\mathrm{Var}\le 1/4$),$G=8\sim64$ 的估计已经够准。
目标函数与 KL 项的位置
$$ \mathcal{J}_{\text{GRPO}}(\theta)=\E\left[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_{t=1}^{|o_i|} \left\{\min\Big(\rho_{i,t}\hat A_i,\ \mathrm{clip}(\rho_{i,t},1-\varepsilon,1+\varepsilon)\hat A_i\Big) - \beta\, \mathbb{D}_{\mathrm{KL}}\big[\pi_\theta\|\pi_{\mathrm{ref}}\big]_{i,t}\right\}\right] $$其中 $\rho_{i,t}=\dfrac{\pi_\theta(o_{i,t}\mid q,o_{i,<t})}{\pi_{\theta_{\text{old}}}(o_{i,t}\mid q,o_{i,<t})}$。有两处值得单独拎出来:
(一)KL 在损失里,不在奖励里。 PPO-RLHF 把 KL 惩罚塞进逐 token 奖励再走 GAE,GRPO 则把它作为一个独立的正则项直接加在损失上。后者更干净:优势的计算完全不受 $\beta$ 影响,你可以把 $\beta$ 调成 0 而不需要改动优势管线(很多 RLVR 实现确实就设 $\beta=0$——因为验证器不会被骗,也就不需要 KL 来拴住模型)。
(二)KL 用的是 k3 估计量。
$$ \mathbb{D}_{\mathrm{KL}}\big[\pi_\theta\|\pi_{\mathrm{ref}}\big] \approx \frac{\pi_{\mathrm{ref}}(o_{i,t})}{\pi_\theta(o_{i,t})} - \log\frac{\pi_{\mathrm{ref}}(o_{i,t})}{\pi_\theta(o_{i,t})} - 1 $$令 $u=\log\frac{\pi_{\mathrm{ref}}}{\pi_\theta}$,则该式为 $e^{u}-u-1\ge 0$,取期望恰为 KL 的无偏估计,且逐样本恒非负——这比朴素的 $-u$(无偏但会取负值、方差大)好用得多。
最小实现
因为没有价值网络,GRPO 的核心代码短得惊人。下面是 nano-aha-moment 那一类实现的骨架:
def group_advantages(rewards, group_size, eps=1e-4):
    """rewards: (B*G,)  —— 每个 prompt 采 G 条 rollout,按 prompt 连续排列"""
    r = rewards.view(-1, group_size)                 # (B, G)
    adv = (r - r.mean(1, keepdim=True)) / (r.std(1, keepdim=True) + eps)
    return adv.view(-1)                              # (B*G,)   组内 z-score


def grpo_loss(logp, logp_old, logp_ref, adv, mask, beta=0.0, clip_eps=0.2):
    """logp/logp_old/logp_ref/mask: (N, T)   adv: (N,)"""
    ratio = torch.exp(logp - logp_old)                # (N, T)
    a = adv.unsqueeze(1)                              # (N, 1) 整条序列共享同一优势
    pg = torch.min(ratio * a,
                   torch.clamp(ratio, 1 - clip_eps, 1 + clip_eps) * a)

    log_r = logp_ref - logp                           # k3 估计量:无偏且恒非负
    kl = torch.exp(log_r) - log_r - 1.0               # (N, T)

    per_token = -(pg - beta * kl)                     # (N, T)
    # 原版 GRPO:先对每条序列按 |o_i| 归一化,再对组求平均(第 5 节会说这一步有问题)
    return ((per_token * mask).sum(1) / mask.sum(1)).mean()
那个 eps=1e-4 不是可有可无的:当一组 rollout 全对或全错时 $\mathrm{std}=0$,没有它就会得到 NaN。更彻底的做法是直接丢弃全对/全错的 group——它们的优势全为 0,本来就不产生梯度,还白白占着 batch。DAPO 的"动态采样"就是把这一步做成显式策略:不断补采直到 batch 里有足够多的非退化 group。
GRPO 干的事情,用一句话说就是"同一道题做 $G$ 遍,做得比平均好的那几遍加强,比平均差的那几遍削弱"。它不需要知道"好在哪一步",也不需要一个模型来预测"这道题大概能得几分"——同组的兄弟样本就是最好的基线。这也解释了为什么 $G$ 不能太小:$G=2$ 时 z-score 永远是 $\pm 1$,信号退化成纯粹的成对比较。
在线情形下它就是策略梯度
如果每采一批 rollout 只做一次梯度更新(严格 on-policy),那么 $\pi_\theta=\pi_{\theta_{\text{old}}}$,所有 $\rho_{i,t}=1$,clip 永不触发,$\min$ 也没有作用。此时目标退化为
$$ \nabla_\theta \mathcal{J} = \E\Big[\frac{1}{G}\sum_i \hat A_i \nabla_\theta \log \pi_\theta(o_i\mid q)\Big] $$——一个朴素的、带组归一化奖励的 REINFORCE。讲师强调这一点,是想说明GRPO 的全部魔力都在优势的构造上,而不在 PPO 那套 clip 机制上。clip 只有在你为了摊薄 rollout 成本而做多轮 inner-loop 更新(off-policy)时才开始起作用。
5. 对 GRPO 的批评与修正
GRPO 好用,但它那两个归一化项——除以 $\mathrm{std}$、除以 $|o_i|$——都不是"无害的实现细节",而是实实在在改变了你在优化的目标。讲师在这里插入了一段 RL 的正统检查:什么样的变换才是"合法的基线"?
std 归一化:一个不合法的基线
第 3 节证明过:减去任何与动作无关的 $b(s)$ 保持无偏。但除以一个量不在这个定理的保护范围内。$\mathrm{std}(r_1,\dots,r_G)$ 有两个问题:其一,它是从同一批样本算出来的,和 $r_i$ 相关,因此即使在单题内部也引入偏置;其二,更严重的是它改变了不同题目之间的相对权重。
设某道题的成功率为 $p$,奖励是 0/1,则组内奖励的标准差 $\mathrm{std}=\sqrt{p(1-p)}$。GRPO 给这道题的梯度乘上了 $1/\sqrt{p(1-p)}$:
| 成功率 $p$ | 0.5 | 0.8 | 0.9 | 0.95 | 0.99 |
|---|---|---|---|---|---|
| $\mathrm{std}$ | 0.500 | 0.400 | 0.300 | 0.218 | 0.099 |
| 相对权重 $\propto 1/\mathrm{std}$ | 1.0× | 1.25× | 1.67× | 2.3× | 5.0× |
也就是说 GRPO 系统性地放大了"太简单"和"太难"的题目的权重,而这些恰恰是信息量最低的题目——它们几乎不改变模型排序,只是把偶发的一两条异常 rollout 的影响放大了 5 倍。$p=0.5$ 附近那些"刚好在能力边界上"的题目,反而权重最小。
修正很简单:去掉分母,$\hat A_{i}=R(q,o_i)-\mathrm{mean}(R(q,o_1),\dots,R(q,o_G))$。这就是 Dr. GRPO("GRPO Done Right",Liu et al. 2025)的做法,讲师指出它已经非常接近 REINFORCE with leave-one-out(RLOO)。
长度归一化:为什么错误答案会越写越长
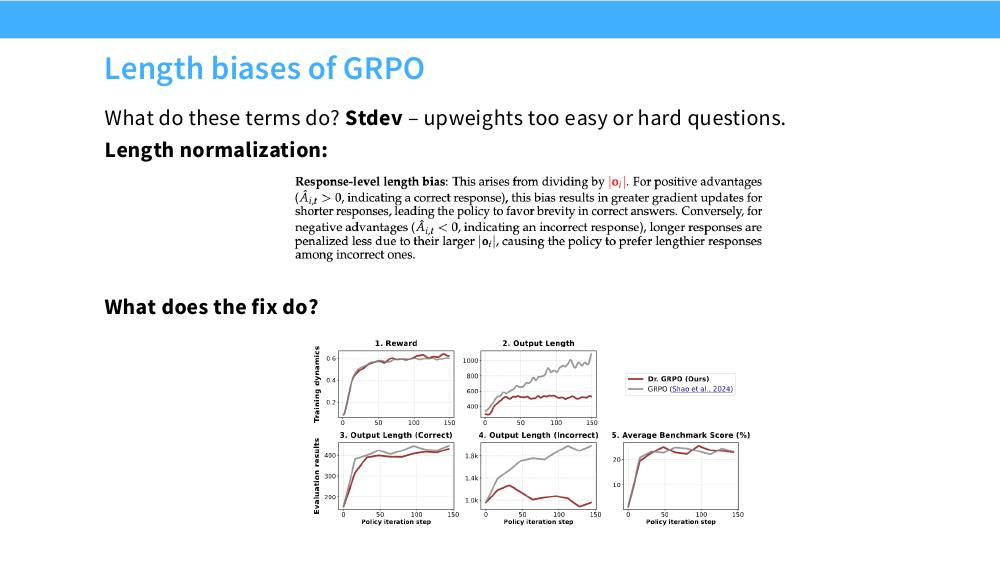
GRPO 的每条序列贡献是 $\frac{1}{|o_i|}\sum_{t}(\cdot)$。由于 $\hat A_i$ 对整条序列是常数,这条序列的总梯度尺度正比于 $\hat A_i$ 本身,与长度无关;但每个 token 分到的梯度是 $\hat A_i/|o_i|$。于是:
- $\hat A_i>0$(答对):$|o_i|$ 越小,每个 token 被加强得越猛 → 偏好简短的正确答案。
- $\hat A_i<0$(答错):$|o_i|$ 越大,每个 token 被惩罚得越轻 → 偏好冗长的错误答案。
在 RL 早期和难题上,错误 rollout 占多数,于是第二项主导,平均长度被推着往上走。修正:把 $\frac{1}{|o_i|}$ 换成一个与样本无关的常数(例如全局最大长度 $L_{\max}$,或者 batch 内 token 总数)。
token-level 还是 sequence-level 归一化
这是同一个问题的另一种问法。把一个 batch 的损失聚合起来有两种写法:
$$ \mathcal{L}_{\text{seq}}=\frac{1}{N}\sum_{i=1}^{N}\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}\ell_{i,t} \qquad\text{vs.}\qquad \mathcal{L}_{\text{tok}}=\frac{1}{\sum_i |o_i|}\sum_{i=1}^{N}\sum_{t=1}^{|o_i|}\ell_{i,t} $$sequence-level(原版 GRPO):每条序列权重相同,因此一条 200 token 的短回答里每个 token 的权重是 2000 token 长回答里 token 的 10 倍。token-level(DAPO 的做法):每个 token 权重相同,长序列因而对损失贡献更大。
哪个"对"取决于你认为学习的单位是什么。DAPO 的论证是:长 CoT 场景下,长序列里包含更多"值得学"的模式(回溯、验算),sequence-level 归一化会把它们稀释掉;而且冗长的、重复的、乱码式的错误输出在 sequence-level 下惩罚被摊薄了,模型学不会不要这样写。实践中 token-level 归一化对长 CoT 训练的稳定性有明显帮助。
clip-higher 与熵坍塌
PPO 的对称 clip $[1-\varepsilon,1+\varepsilon]$ 在 LLM 上有一个不对称的后果。考虑一个概率极低的 token($\pi_{\theta_{\text{old}}}=0.01$)和一个概率很高的 token($\pi_{\theta_{\text{old}}}=0.9$),取 $\varepsilon=0.2$:前者一步最多涨到 $0.012$,后者最多涨到 $1.08$(被 1 截断)。也就是说 clip 上界对低概率 token 的抑制远强于对高概率 token 的抑制——探索性的 token 很难被提上来,而已经占优的 token 却能持续巩固。结果是策略熵单调坍塌:训练几百步后所有 rollout 几乎一模一样,group 内 std 趋近 0,梯度消失,训练停滞。
DAPO 的 clip-higher:把上下界解耦,$\varepsilon_{\text{low}}=0.2$ 保持不变(防止崩坏),$\varepsilon_{\text{high}}=0.28$ 放宽(给低概率 token 更大的上升空间)。配合"动态采样"(丢弃全对/全错的 group、补采到 batch 满)和"超长惩罚整形"(对被截断的输出给软惩罚而不是直接判 0),构成了 DAPO 的四件套。
把采样温度调高来对抗熵坍塌通常是治标不治本,而且会污染 on-policy 假设:训练时算的 $\log\pi_\theta$ 是温度 1 下的,采样时用的却是温度 $T$ 下的分布,二者不一致,重要性比值失真。正确的做法是从目标函数层面留住熵(clip-higher、显式熵正则、丢弃退化 group),而不是从采样器层面伪造多样性。
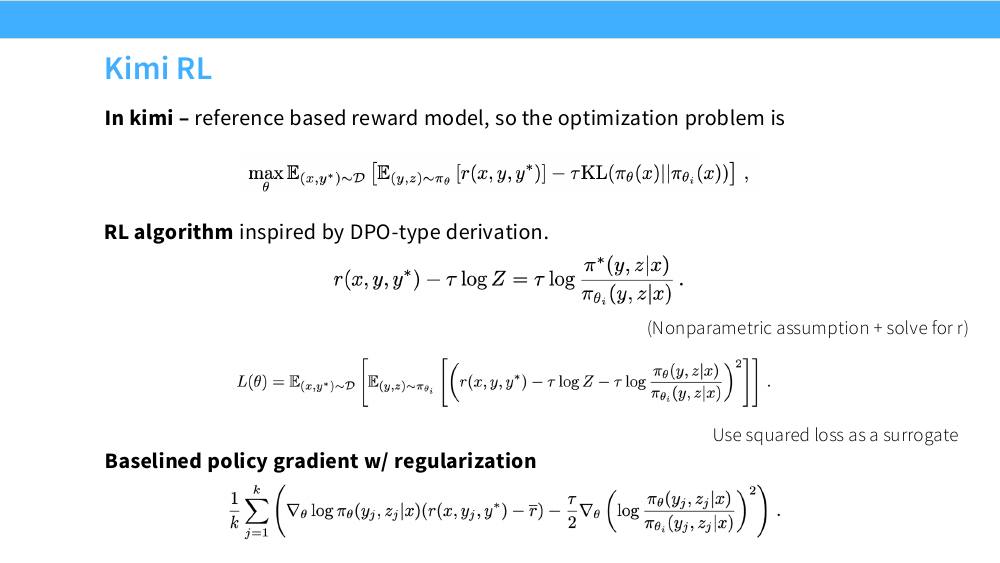
Kimi 的另一条路线
PPO 与 GRPO 在 LLM 场景下的对比
| 维度 | PPO(RLHF 式) | GRPO(RLVR 式) |
|---|---|---|
| 基线来源 | 学习一个价值网络 $V_\phi(s_t)$ | 同题 $G$ 条 rollout 的奖励均值(蒙特卡洛) |
| 常驻模型数 | 4:策略 + 参考 + 奖励模型 + 价值模型 | 2:策略 + 参考($\beta=0$ 时甚至只要 1) |
| 显存(7B、AdamW 粗估) | 两份可训练模型 ≈ 224 GB + 两份推理模型 ≈ 28 GB | 一份可训练模型 ≈ 112 GB + 参考模型 14 GB |
| 优势粒度 | token 级(GAE 沿时间回传) | 序列级(整条共享一个标量) |
| 采样开销 | 每 prompt 1 条即可 | 每 prompt $G=8\sim64$ 条 |
| KL 的位置 | 塞进逐 token 奖励,再走 GAE | 作为独立正则项加在损失上(k3 估计量) |
| 关键超参 | $\varepsilon$、$\gamma$、$\lambda$、价值损失系数、价值预热步数、$\beta$ | $G$、$\varepsilon$(或 $\varepsilon_{\text{low}},\varepsilon_{\text{high}}$)、$\beta$ |
| 典型失败模式 | 价值网络发散 → 优势估计全错;奖励模型被 hack | 熵坍塌;全对/全错 group 导致梯度稀疏;长度膨胀 |
| 适配奖励 | 稠密或稀疏皆可,天然支持 RM | 最适合稀疏、二值、可验证的终局奖励 |
6. 最简 RL:拒绝采样、best-of-n 与 STaR 式自训练
在跳进 R1 的完整配方之前,值得先问一个务实的问题:如果我只想要一点点 RL 的好处,最省事的做法是什么? 讲师在 Kimi 的消融部分把这个问题挑明了:"我们能不能避开 RL 那套负梯度,只从正样本里学?"
三级阶梯
| 方法 | 做什么 | 训练成本 | 推理成本 |
|---|---|---|---|
| best-of-n(验证器重排) | 推理时采 $n$ 条,用验证器/RM 选最好的一条输出 | 零 | $n$ 倍 |
| 拒绝采样微调 RFT / STaR / expert iteration | 采样 → 只保留验证器判对的 → 当作 SFT 数据微调 → 重复 | SFT 级别 | 1 倍 |
| GRPO / PPO | 正确样本加强,错误样本压低,在线迭代 | RL 全套 | 1 倍 |
best-of-n 是把 RL 挪到推理时:它不改模型,只是用验证器筛。这在有验证器的场景下是免费的准确率提升($n=64$ 的 pass@64 往往比 pass@1 高 20–30 个点),代价是推理算力线性上涨。RFT/STaR 则是把 best-of-n 的结果蒸馏回模型自己:自采样、自筛选、自训练,因此也叫"自训练"或"专家迭代"。
负梯度到底值多少
RFT 和 GRPO 的唯一本质区别是:RFT 只有正梯度。这看起来只是少了一半信息,但影响不小。考虑一道题模型有 10% 概率答对:RFT 会把那 10% 的正确路径的概率往上推,但它不知道剩下 90% 错在哪个方向,概率质量只能从"所有其他地方"被动地被挤走;GRPO 则会显式地把那 90% 的路径压下去,把质量定向地转移给正确路径。前者是"抬高一个点",后者是"抬高一个点并且铲平周围"。
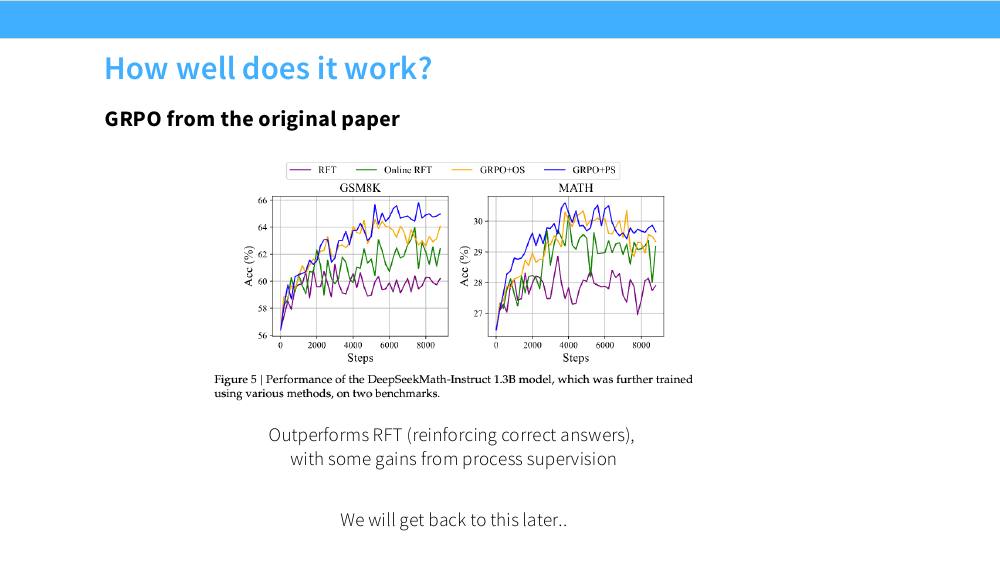
两组实验都支持负梯度有用。第 4 节那张 DeepSeekMath 图里,GRPO > Online RFT > RFT,顺序非常干净。Kimi 的消融更彻底:
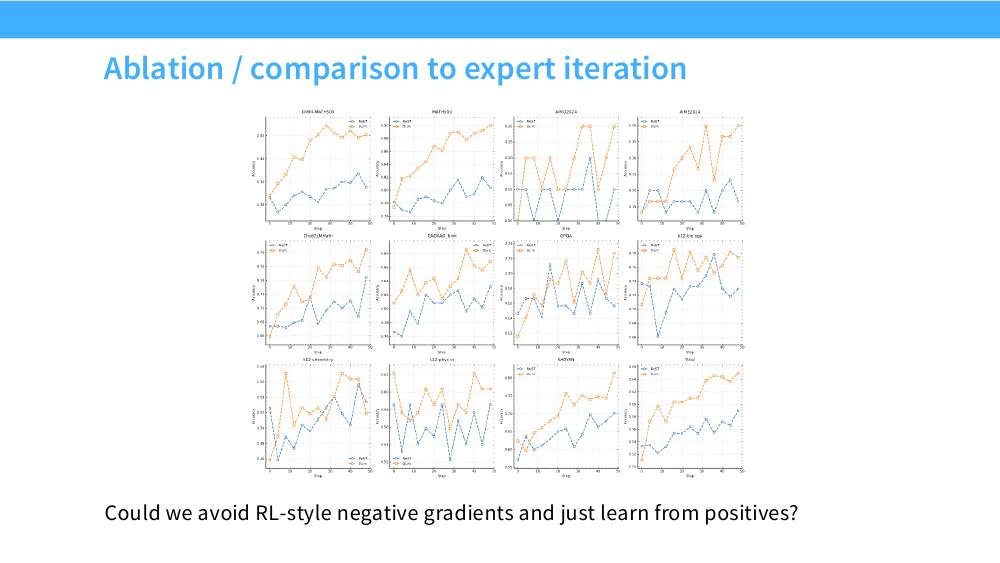
为什么 RFT 会更早饱和?因为它的数据分布是自我强化的:每轮只保留模型已经会做的题,模型越训越确信自己已经会的东西,采样多样性下降,能被筛出来的"新会做的题"越来越少。GRPO 靠压低错误路径腾出概率质量,反而能维持更长时间的有效探索。不过反过来说——如果你只有很少的算力,RFT 仍然是性价比最高的第一步,R1 的第三阶段(600k 条推理数据的 SFT)本质上就是一次大规模拒绝采样。
7. 案例研究:DeepSeek-R1 的完整配方
讲师挑了三个有代表性的开放模型:DeepSeek-R1(后续大量 RLVR 工作的原点,细节最多)、Kimi K1.5(与 R1 同期、同样用 RL 打平 o1,细节互补)、Qwen3(最新的开放推理模型,低数据 RLVR 与新的 scaling 结果)。
R1 为什么重要
- 性能超过 OpenAI o1——第一个公开可复现的证据,说明这条路不是某家实验室的独门秘方。
- 开放的 RL 配方,而且相当简单——GRPO + 规则奖励,没有花哨的东西。
- 终结了关于 MCTS / PRM 必要性的猜测——在 R1 之前,社区普遍猜测 o1 用了蒙特卡洛树搜索或过程奖励模型;R1 论文专门写了一节"不成功的尝试",说这两条路他们都试了都不行。
- 关于 SFT 的洞见——R1-Zero 证明纯 RL 可行,distill-R1 证明能力可以廉价地转移给小模型。
R1-Zero:一个受控实验
R1-Zero 是不做任何 SFT、直接在基础模型上跑 RL 的版本,它的价值在于把变量控制到了最少:
| 组件 | 设置 |
|---|---|
| 基础模型 | DeepSeek-V3 Base(未经任何指令微调) |
| 算法 | GRPO(沿用 DeepSeekMath),不使用过程监督 |
| 奖励 1:准确性 | 规则判定答案是否正确(数学抽取 \boxed{},代码跑编译器/测试) |
| 奖励 2:格式 | 是否把推理放在 <think>…</think> 标签里 |
| 数据 | 未公开 |
| 结果 | 比 o1 略差,但已经远超同期开放模型 |
注意奖励里没有任何关于"要写多长""要怎么推理"的信号,只有对错和格式。第 2 节那条长度曲线就是在这个设定下跑出来的,这也是它有说服力的原因。R1-Zero 的问题也很实际:可读性差、语言混杂(中英文在同一条 CoT 里来回切换)。讲师觉得后一点很有意思:RL 会自然地导向混合语言——因为验证器只看最终答案,中间用什么语言思考完全不受约束,模型于是收敛到某种对它自己最"高效"的混合表示。
从 R1-Zero 到 R1:四阶段流水线
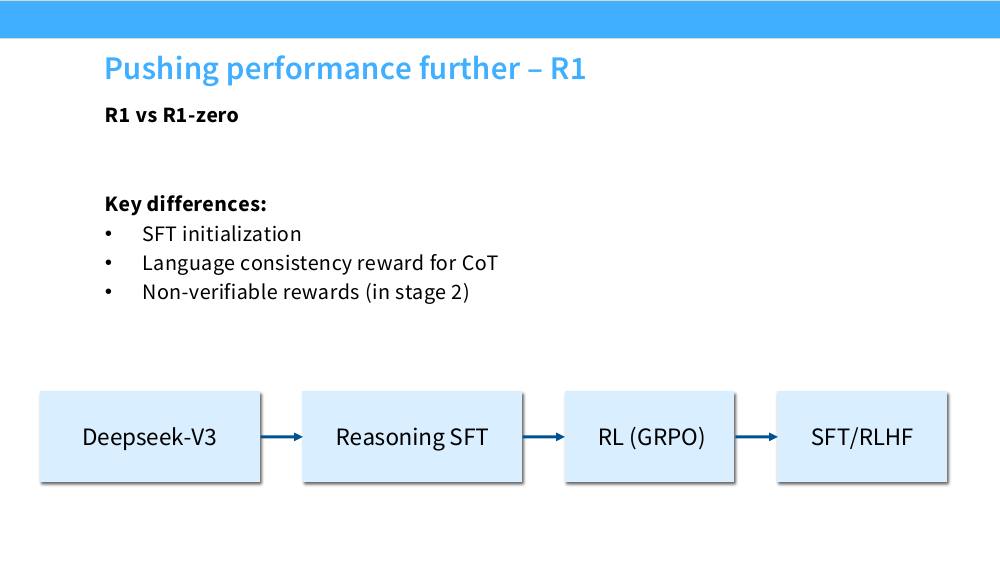
- 冷启动 SFT:先用一批长 CoT 数据做 SFT。R1 论文的说法是"先收集普通的长 CoT,再做一些验证/润色",声称的好处是可读性/可解释性。讲师直言:这批数据的来源说得不太清楚。
- 推理 RL(GRPO):本质上和 R1-Zero 一样,唯一的小改动是加了语言一致性损失——按目标语言 token 在 CoT 中的占比给奖励,用来压住语言混杂。代价是基准分数略微下降,DeepSeek 明确说这是为了人类可读性而付出的对齐税。
- SFT(大规模拒绝采样):用上一步的模型采样,配上 600k 条推理数据(其中不可验证的任务——比如"写一个 X 的证明"——用 DeepSeek-V3 当裁判打分筛选)+ 200k 条非推理数据(直接复用 V3 的 SFT 集),训 2 个 epoch。
- RLHF:可验证任务继续用 R1-Zero 式的规则奖励,不可验证任务走 V3 的偏好流水线——但算法仍然是 GRPO。也就是说 GRPO 在这里也被当成通用的 RLHF 优化器用,而不只是 RLVR 专用。
R1 的流水线告诉我们两件事。第一,纯 RL 能行,但不好用——R1-Zero 证明了可行性,R1 说明工业级模型仍然需要 SFT 冷启动来控制格式、语言和可读性。第二,顺序很重要:先做推理 RL 再做通用 RLHF。反过来做的话,RLHF 学到的"讨人喜欢的短回答"风格会和长 CoT 直接冲突。
冷启动到底需要多少数据
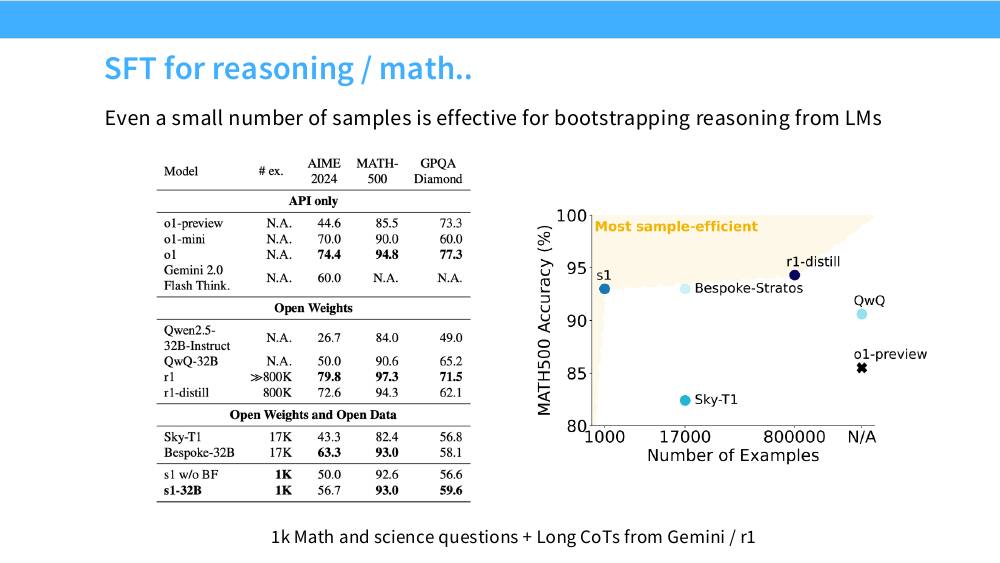
这个现象和 LIMA 时代关于 SFT 的判断是一致的:SFT 主要是在"引出格式与行为模式",而不是在"注入知识"。基础模型在预训练里已经见过大量数学推导,它缺的是"遇到难题时应该慢慢来、写下中间步骤、检查自己"这个行为先验。1000 条示范就足以把这个先验装上去。真正需要大规模数据的是提升能力上限那部分——那是 RL 的活。
蒸馏:让不会推理的模型学会推理
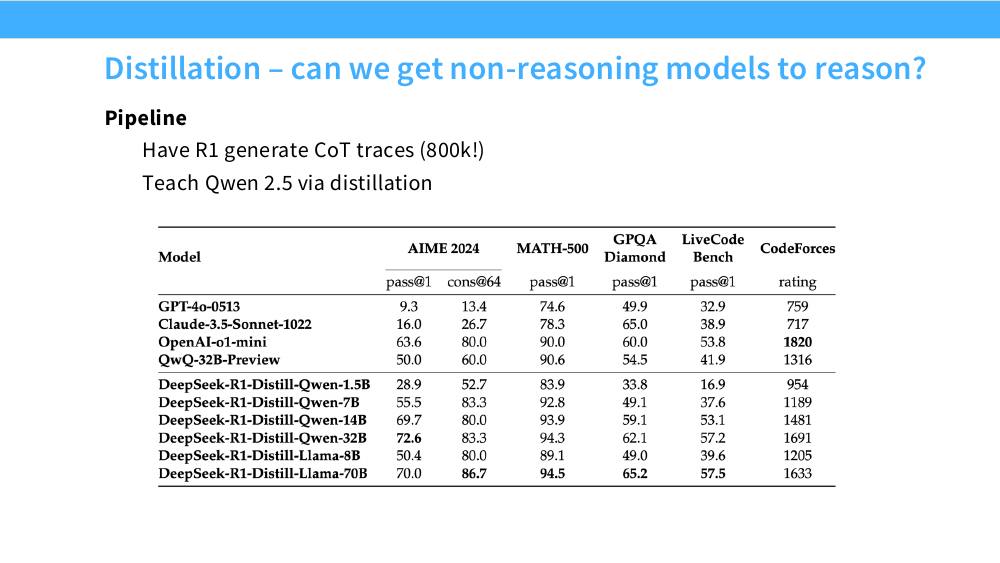
讲师在这里想传达的判断是:推理能力可以被非常廉价地转移。 一旦有一个强推理模型存在,把它的能力灌进小模型只需要一次 SFT——不需要重跑 RL,不需要验证器,甚至不需要那些题目的标准答案。这对开源生态的影响远大于 R1 本身的分数:R1 发布后几周内出现的一大批"推理小模型",几乎全部是这条路线。反过来说,这也意味着RL 那一步的算力投入具有很强的溢出效应——你花一次大钱,可以摊薄到整个模型家族。
Kimi K1.5:同期的另一条路线
Kimi K1.5 与 R1 几乎同时发布,同样用 RL 打平 o1,但很多选择不一样,因此是很好的对照组。它的三个关键步骤是数据构造(按难度过滤)→ 长 CoT 的 SFT → 用自己推导的策略梯度损失做 RL(损失见第 5 节)。数据构造上的两条规则很值得抄:
- 排除选择题和判断题——猜对率太高,验证器会给出大量假阳性。
- 只保留模型 best-of-8 仍然做不对的题——已经会做的题提供不了梯度(组内全对 → 优势全 0),留着只是浪费 rollout 预算。
再加上一个课程学习:给数据打难度标签、从易到难推进,并且按 $(1-p_{\mathrm{success}})$ 的比例采样题目,自动地把算力从已解决的题目上撤走。Kimi 的 SFT 阶段描述很含糊(只说是"prompt engineering"),讲师怀疑其实是蒸馏。
Qwen3:低数据 RLVR 与思考模式融合
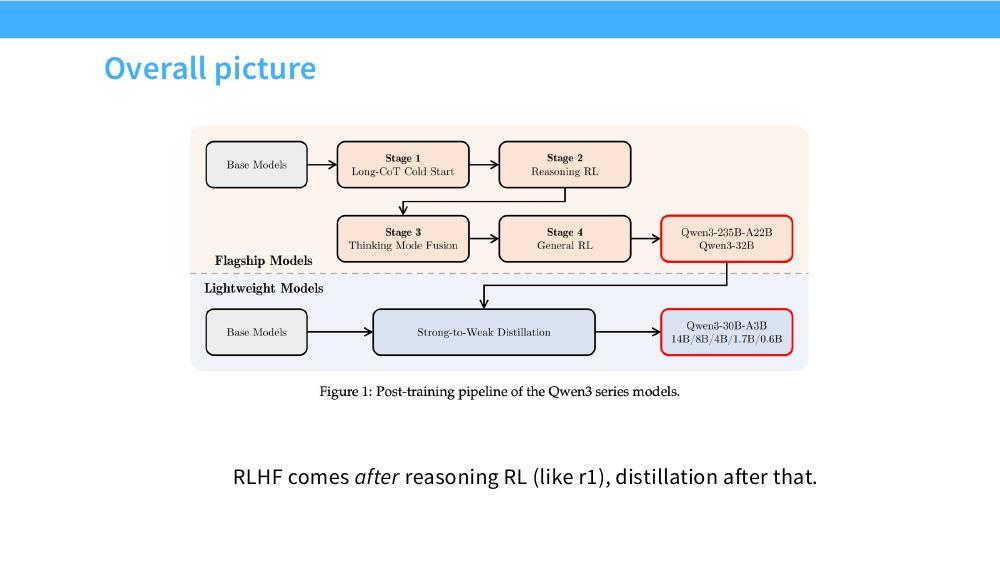
Qwen3 的数据过滤延续了 Kimi 的思路,但更狠:按 best-of-n 难度过滤、剔除不用 CoT 就能做对的题、剔除与验证集过于相似的题、人工检查 CoT 质量(区分"蒙对"和"真会")。最后剩下的推理 RL 训练集只有 3995 条——四千条题目就能把一个万亿参数级别的 MoE 推到超过 o1。这个数字很值得记住:RLVR 的瓶颈不是数据量,而是数据的难度分布和验证器的可靠性。
Qwen3 独有的新东西是思考模式融合(thinking mode fusion):
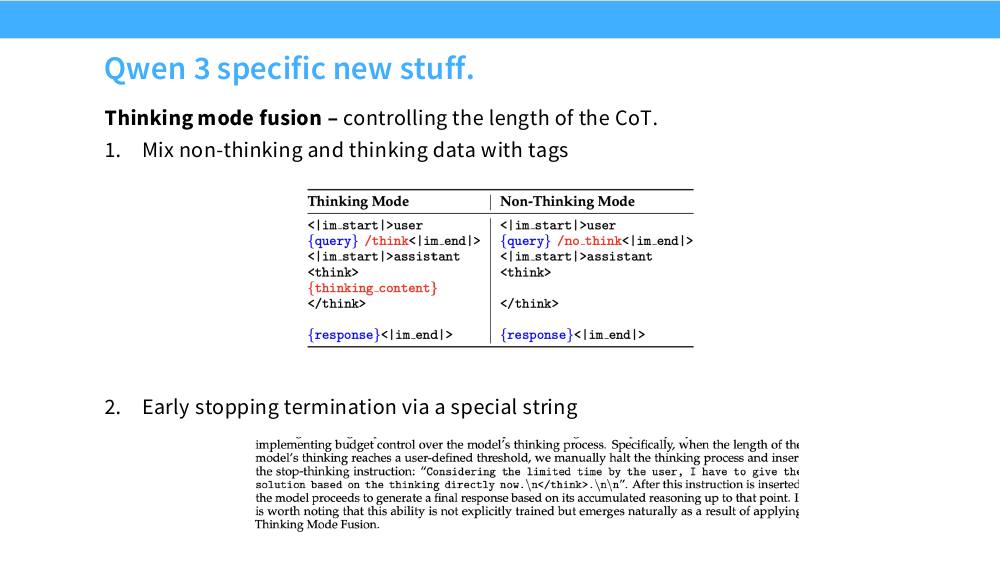
/think 与 /no_think 标签区分;non-thinking 模式下 <think></think> 是空的,于是同一套模板既能推理也能秒答。做法二:思考预算控制——当思考长度超过用户设定的阈值时,直接手工插入一句"考虑到时间有限,我必须现在就基于已有推理给出答案。</think>",模型就会顺势收尾。论文特别指出这个能力不是显式训练出来的,而是思考模式融合的副产物。8. 训练基础设施:RLVR 的系统瓶颈
讲师用一整节强调:"RL 的系统与利用率问题非常重要。" 这不是客套——RLVR 的 GPU 利用率经常只有预训练的三分之一甚至更低。原因有三条:
- on-policy 意味着每步都要做(慢的)推理。 一次训练步之前必须先生成 $B\times G$ 条完整回答,而自回归解码是 memory-bound 的:预训练前向的算术强度可以到几百 FLOP/byte,解码阶段每生成一个 token 都要把全部权重从 HBM 读一遍,MFU 常常掉到个位数百分比。
- 训练和 rollout 用的是两套框架。 训练侧是 Megatron / FSDP(要 3D 并行、要优化器状态),推理侧是 vLLM / SGLang(要 PagedAttention、连续批处理、可能还是不同的并行切分方式)。它们的权重布局、并行策略、甚至 kernel 都不一样。
- 长 CoT 让 batch 极不均匀。 同一个 batch 里可能既有 300 token 的回答也有 32000 token 的回答,同步式实现下所有 GPU 都得等最慢那条——长尾直接决定吞吐。
Kimi 的混合部署方案
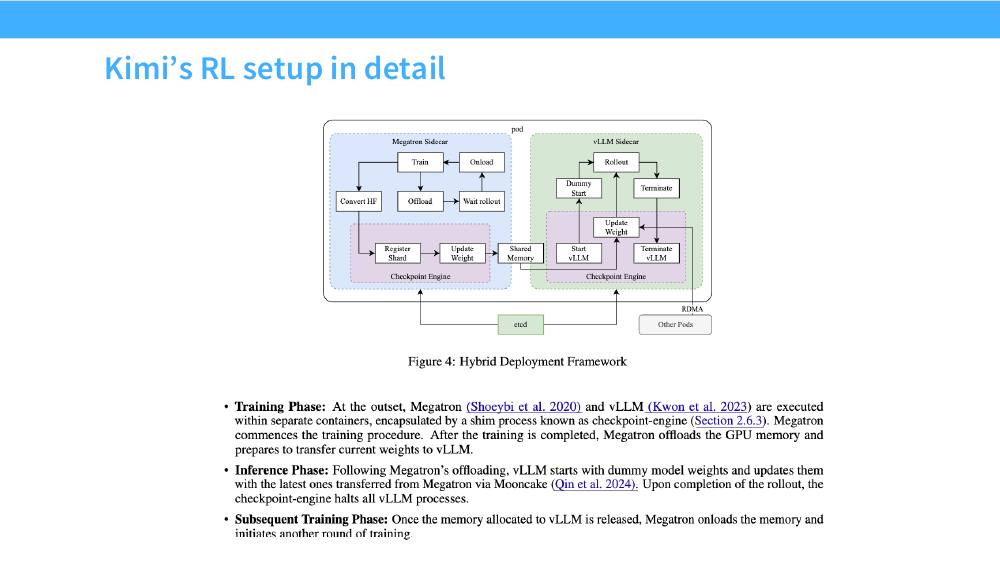
这套设计的核心矛盾是显存:训练引擎和推理引擎都想独占 GPU,但一台机器装不下两份。于是只能分时复用——用 offload/onload 来回搬。代价是每一轮都有一段两边都不干活的空窗期。业界的另一条路是分离式(disaggregated):推理集群和训练集群物理分开,各自跑满,通过网络同步权重。前者省卡但有空窗,后者没空窗但要多买卡,而且必然引入 off-policy。
权重同步:被低估的开销
每个训练步之后,新权重都要推给推理引擎。算一笔账:一个 671B 的 MoE 模型,bf16 权重约 1.3 TB。如果用 200 Gb/s(25 GB/s)的网络串行传输,光是搬这一次就要 50 秒以上;而一个训练步本身可能只有几十秒。这就是为什么大家会用 RDMA 点对点传输、树形/环形广播、共享内存(同机时直接走 NVLink 或 IPC handle),以及只传变化的分片。
还有一个容易被忽视的坑:训练引擎和推理引擎算出来的 logprob 对不上。 同样的权重、同样的序列,vLLM 的融合 kernel 和 Megatron 的前向在浮点累加顺序、注意力实现、量化上都有差别,逐 token logprob 可能相差 $10^{-2}$ 量级。如果你的实现里 $\log\pi_{\theta_{\text{old}}}$ 是用训练引擎重算的(很多实现都这样,因为省一次传输),那么 $\rho=\pi_\theta/\pi_{\theta_{\text{old}}}$ 在第一次 inner step 时本该恰好等于 1,实际却不是——你以为自己在做 on-policy,其实一直带着一个静默的 off-policy 偏置。调试 RLVR 时,第一件该打印的东西就是首次 inner step 的 ratio 直方图,它应该紧紧集中在 1.0。
异步与 off-policy 的坑
为了填满 GPU,很自然会想到异步:让推理集群一直生成,训练集群一直更新,两边不互相等。问题是这样一来 rollout 就是用过时的策略产生的,滞后 $k$ 步的样本对应的重要性比值 $\rho$ 会随 $k$ 增大而迅速偏离 1,触发 clip 的比例上升——被 clip 的样本梯度为零,等于白采。常见的折中:
- 限制滞后:只允许落后 1–2 个训练步("one-step off-policy"),实践中几乎不损失性能。
- partial rollout:把没生成完的长轨迹存进 replay buffer,下一轮从断点继续,而不是丢弃或死等——这直接砍掉了长尾。Kimi 明确用了这一招。
- 真的记录采样时的 $\log\pi_{\theta_{\text{old}}}$,让 clip 机制发挥它本来的作用。
采样温度与熵坍塌
采样温度在 RLVR 里同时扮演两个角色,很容易搞混:它既是探索旋钮(温度高 → group 内多样性高 → std 非零 → 有梯度),又是行为策略的定义($\pi_{\theta_{\text{old}}}$ 必须是你真正采样用的那个分布,否则重要性比值失真)。典型做法是训练时用 $T=1.0$ 保持一致性,靠 clip-higher、丢弃退化 group、显式熵正则来维持探索。
熵坍塌的典型症状是:训练奖励曲线在某一步之后突然平坦,group 内 std 的均值持续下降到接近 0,输出多样性肉眼可见地消失(同一道题 64 条 rollout 几乎逐字相同)。此时再练下去只是在浪费算力——监控组内奖励标准差的均值,是 RLVR 训练最有信息量的一条曲线,比奖励本身更早预警。
9. 奖励设计
RLVR 里"算法"其实很简单,真正的工程量在奖励上。把三个案例里出现过的奖励项汇总一下:
| 奖励项 | 出处 | 作用 | 风险 |
|---|---|---|---|
| 正确性奖励 | R1 / Kimi / Qwen3 | 唯一真正的学习信号 | 验证器规格漏洞(选择题猜、测试太弱) |
| 格式奖励 | R1-Zero | 逼模型把推理放进 <think> 标签,让后续能抽取答案 | 模型可能学会只满足格式而敷衍内容 |
| 语言一致性奖励 | R1 stage-2 | 压住中英混杂,提升可读性 | 明确损失一点基准分数(对齐税) |
| 长度奖励 | Kimi K1.5 | 主动压缩 CoT | 过早开启会掉分,Kimi 只在训练后期启用 |
| 等价性判定模型 | Kimi | 用 800k 样本训一个 CoT 奖励模型判断答案是否等价 | 又变回一个可被 hack 的学习模型 |
| 自动生成测试用例 | Kimi(代码) | 拿有标准解的题目自动造新测试 | 测试覆盖不足则奖励失真 |
长度奖励:Kimi 的显式 CoT 压缩
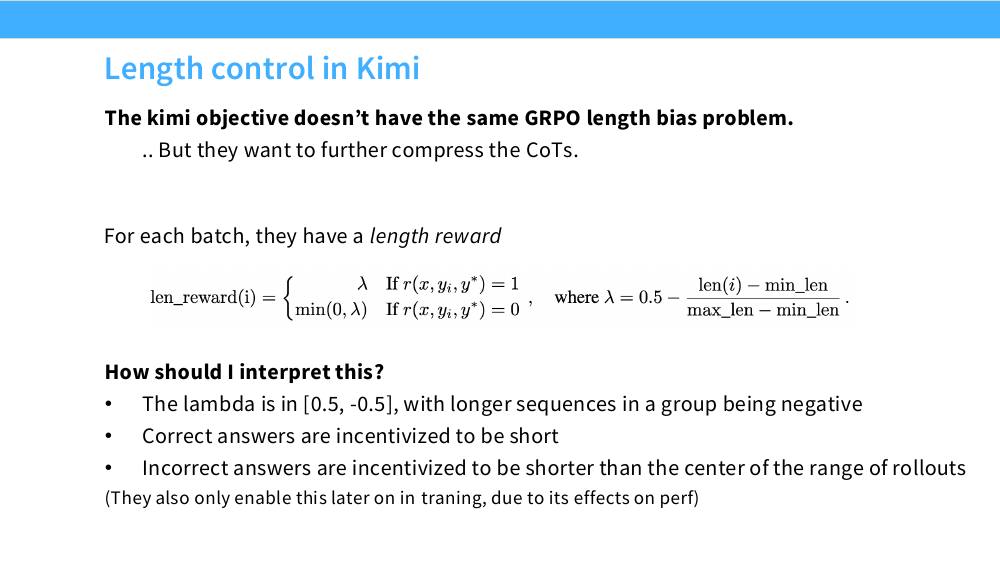
这个设计的巧妙之处在于它的不对称性:答对时,写得比组内中位数短能拿正奖励,写得长要扣分——鼓励正确答案尽量简洁;答错时 $\min(0,\lambda)$ 把正奖励砍掉了,所以写得短也没有额外好处,但写得比中位数长仍然要扣分——只惩罚"错还写很长",不奖励"错但写得短"。后一点很关键:如果答错写短也给正奖励,模型会学会在难题上直接摆烂输出一句话。
注意这和第 5 节的分析正好呼应:GRPO 的 $1/|o_i|$ 会无意中鼓励冗长的错误答案,而 Kimi 的目标函数本身没有这个偏置,于是他们可以有意地加一个方向正确的长度奖励。还有一个实践细节:这个奖励只在训练后期开启,因为早期开启会伤害性能——早期模型需要长度来探索。
PRM 与 ORM 之争
ORM(Outcome Reward Model)/ 结果监督:只看最终答案对不对,整条轨迹一个标量。PRM(Process Reward Model)/ 过程监督:给推理链的每一步单独打分,理论上提供更细的信用分配,缓解"蒙对"问题。直觉上 PRM 应该更好——DeepSeekMath 的小规模实验里 GRPO+PS 也确实略微领先 GRPO+OS。但 R1 在大规模上得到了相反的结论。
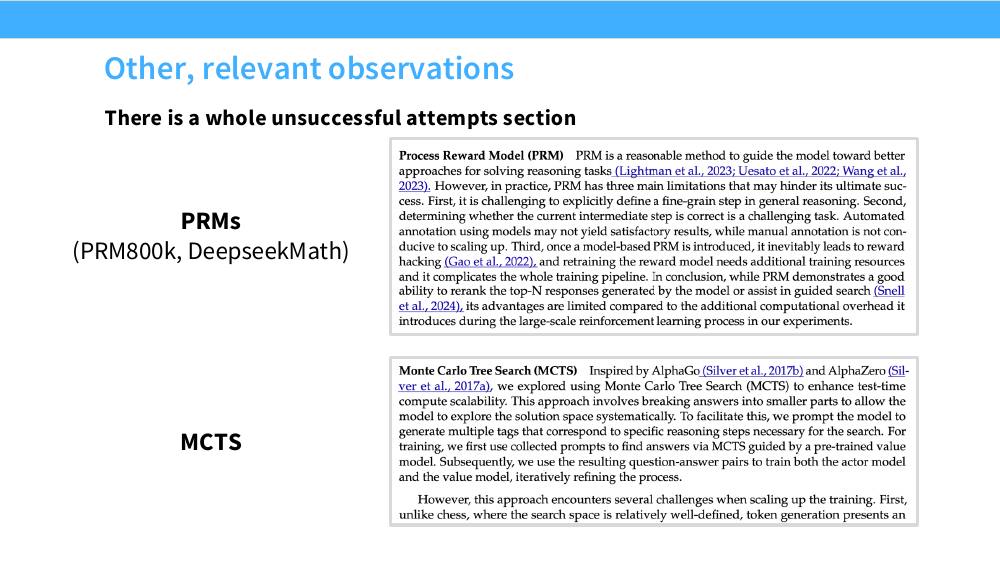
这是本讲最反直觉、也最重要的一条经验:只要你的奖励里混进了一个学出来的模型,第 1 节讲的过优化就会重新找上门。 PRM 是学出来的,会被 hack;MCTS 依赖的价值模型是学出来的,也会被 hack。RLVR 之所以能 scale,恰恰是因为它把这些学习组件全都换成了确定性程序。最简单的配方赢了,不是因为简单本身好,而是因为简单意味着奖励不可欺骗。
不要把"R1 说 PRM 不行"读成"过程监督这个想法是错的"。R1 的论断有明确的适用范围:在大规模在线 RL 的训练回路里不划算。PRM 在推理时做 best-of-n 重排、在数据筛选里挑高质量轨迹,都仍然是有效的——因为那些场景下你只用它排序有限个候选,优化压力小得多,hack 不起来。同一个模型,当作排序器安全,当作优化目标就危险,这条规律在整个对齐领域都成立。
10. test-time scaling 与「RL 是引出还是学会」
训练时的 scaling
推理时的 scaling
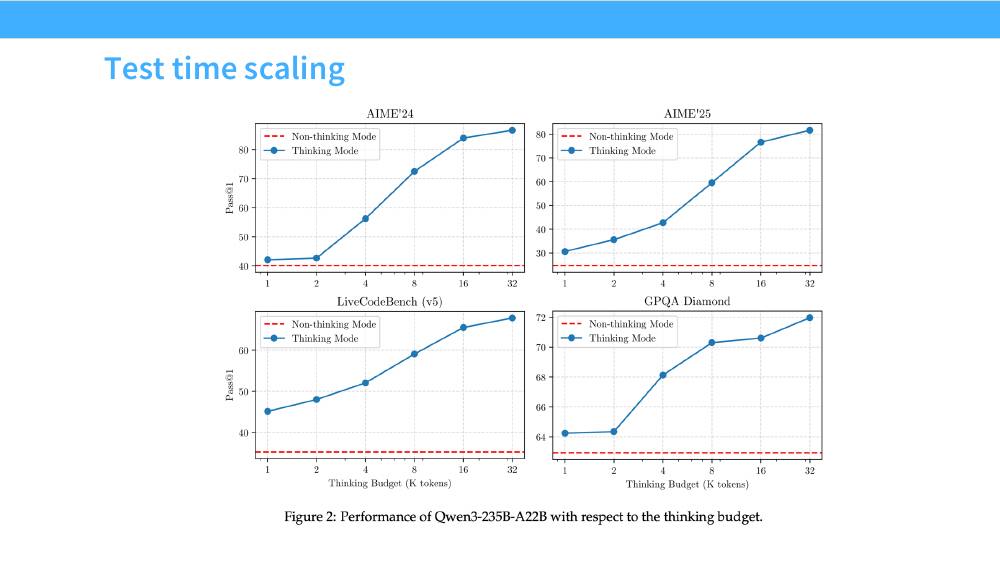
这是 RLVR 最有商业价值的副产品:训练出来的不是一个固定能力的模型,而是一条"算力换准确率"的曲线。同一个权重,给它 1K token 预算就是快速便宜档,给 32K 就是高精度档。Qwen3 的思考模式融合把这条曲线做成了可以在推理时用一个参数控制的旋钮(第 7 节)。注意曲线的形状:对数线性、且在 32K 处开始压平——test-time scaling 也有边际递减,不是免费午餐。
阶段之间的此消彼长
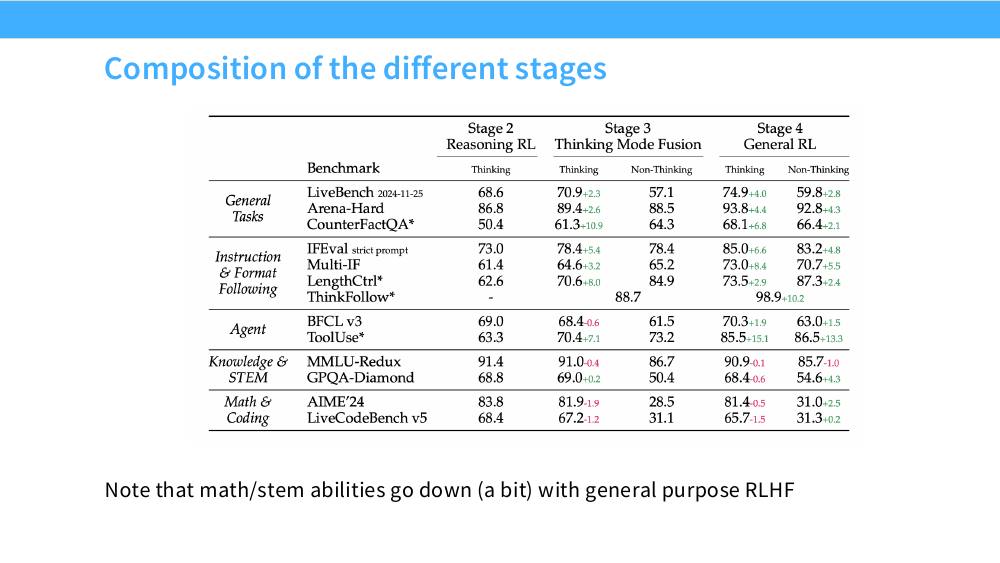
这就是"对齐税"在 RLVR 时代的新形态。它也解释了为什么流水线必须把推理 RL 放在通用 RLHF 之前——如果反过来,被 RLHF 塑造过的"简短友好"风格会和长 CoT 直接打架,推理 RL 得先把它推翻一遍。先建能力、再抛光风格,损失最小。
核心争论:RL 是引出已有能力,还是学会新能力
这是本讲留下的最大开放问题。"引出(elicitation)"派的证据:
- pass@k 分析:把基础模型和 RL 后模型都采样 $k$ 次、只要有一次对就算对。典型现象是 $k=1$ 时 RL 模型大幅领先,但 $k$ 增大到几十上百时两条曲线交叉——基础模型的 pass@256 常常追平甚至超过 RL 模型。如果 RL 真的学会了新解法,它的解集应该是基础模型解集的超集,pass@k 不该被反超。
- Dr. GRPO 的观察:所谓 "aha moment" 的句式在基础模型里本来就有(第 2 节那张图)。
- 数据量的证据:Qwen3 只用 3995 条题目做推理 RL,s1 只用 1000 条 SFT 样本就接近 R1-distill。用这么少的数据学会一整套新能力是不可思议的;用它引出已有能力则很合理。
"学会(learning)"派的反驳:
- pass@k 交叉的实验大多在训练步数有限的设定下做的;训练更久、题目更难时,RL 模型的 pass@k 会重新超过基础模型。
- "基础模型 pass@256 能做对"和"能用它做事"之间隔着一个无法穿越的验证鸿沟——在没有验证器的现实任务里,你根本不知道那 256 条里哪条是对的。RL 把这个"存在性"变成了"可达性",这在任何实用意义上都是新能力。
- 蒸馏的结果很难用引出解释:R1-Distill-Qwen-1.5B 在 AIME 上 28.9 分,而它的基础模型 Qwen2.5-1.5B 在 AIME 上的 pass@1 接近 0——你没法"引出"一个几乎不存在的分布。
一个能调和两边的说法:RL 做的是把 test-time 的搜索摊销进权重里。 基础模型要靠采样 256 次 + 一个验证器才能答对的题,RL 后的模型一次就能答对——从信息论看没有凭空多出东西,但从算力经济学看,你把 256 次推理的成本一次性支付在训练时,之后每次推理都省下来。这既解释了 pass@k 交叉(信息没变多),也解释了为什么这件事极其有价值(成本结构彻底变了)。至于"学会全新的、基础模型采样一万次也想不到的解法"——目前的公开证据还不足以下结论,这也是讲师保持谨慎的地方。
下一站:agentic RL
讲师用 Qwen3-Coder-Next 收尾,展示 RLVR 正在往哪里走。可验证性可以从"数学题有答案"推广到"代码仓库有测试",而后者的环境构造复杂得多:
- 中期训练:GitHub 的仓库级长上下文数据(把整个仓库的文件拼接,600B token)、Pull Request(配上用 RAG 检索出的仓库状态作为上下文);Common Crawl 里的文本+代码混合文档(用 LM 解析 HTML);合成数据(对网页文档 prompt 出编程 QA;把编程 agent 放进各种环境里跑出轨迹);以及指令跟随和 fill-in-the-middle 数据。
- 专家模型 + 蒸馏:分别训 web dev 专家(用 VLM 和 agent 动作去检查"网页代码是否真的能跑")、UX 专家(覆盖多种工具格式)、单轮 QA 专家、SWE 专家,然后把它们全部蒸馏进 Qwen3-Next-Coder。
- 环境构造:这是最关键也最费工程的一步。
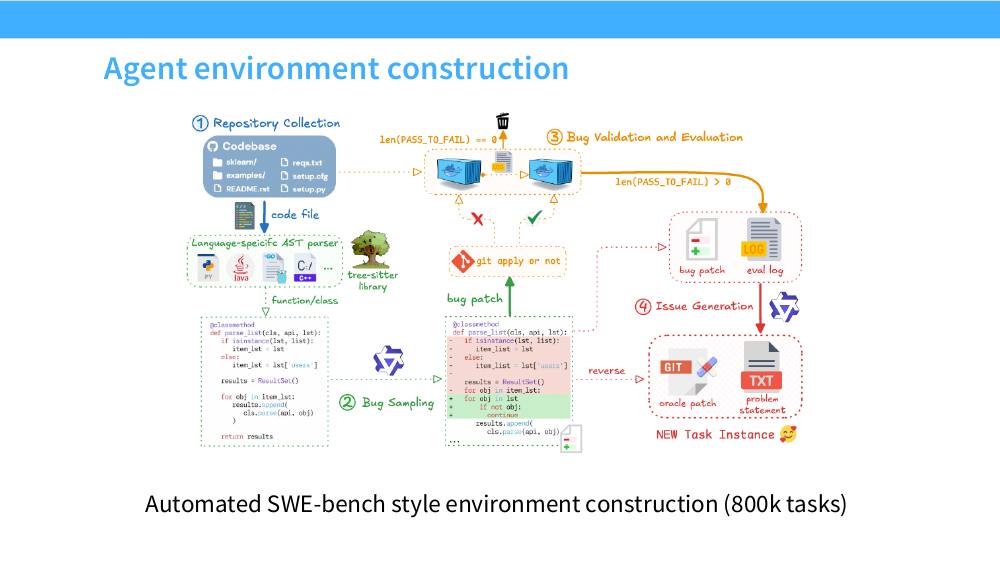
len(PASS_TO_FAIL) > 0),否则丢弃;④ 用 bug patch 和评测日志反向生成 issue 描述,得到一个新的任务实例(问题描述 + oracle patch + 测试)。注意这里的验证器是真实的测试套件,奖励依然完全由程序判定——agentic RL 只是把 RLVR 的"验证器"从字符串匹配换成了一个容器。这条路线的意义在于:它把"可验证任务"的范围从竞赛题扩展到了真实软件工程。第 1 节说 RLVR 的代价是适用范围窄;agentic RL 正是在拓宽这个范围——凡是能写出自动检查的任务(跑得通的网页、通过的测试、成功的工具调用),都能被拉进 RLVR 的射程。
本讲小结
讲师自己的三句话总结是:过优化是个问题,在窄领域做 RL 是一种解法;GRPO 很简单(但有缺陷),它让 RLVR 成为可能;野外已经有大量成功配方(R1、Kimi K1.5、Qwen3)。 展开成一页速查:
算法速查
| 算法 | 优势 $\hat A$ 怎么来 | 无偏? | 一句话 |
|---|---|---|---|
| REINFORCE | $R(z)$ 直接用 | 是 | 方差太大,不实用 |
| PPO | GAE,基于学出来的 $V_\phi$ | 近似 | 要多养一个价值网络,实现细节多 |
| GRPO | $\dfrac{r_i-\mathrm{mean}(r)}{\mathrm{std}(r)}$,组内 z-score | 否(std 与长度归一化都有偏) | 省掉价值网络,用 $G$ 倍采样换 |
| Dr. GRPO | $r_i-\mathrm{mean}(r)$,常数长度归一化 | 是 | 同样的分数,输出短一半 |
| RLOO | $r_i-\frac{1}{G-1}\sum_{j\ne i}r_j$ | 是 | 严格无偏的组基线 |
| DAPO | Dr. GRPO + clip-higher + 动态采样 + token 级归一化 + 超长整形 | 是 | 长 CoT 大规模训练的工程化版本 |
| Kimi K1.5 | $r_i-\bar r$ + 平方形式 KL 正则(DPO 式推导) | 是 | 另一条路,天然没有长度偏置 |
| RFT / STaR | 只保留 $r_i=1$ 的样本做 SFT | — | 没有负梯度,更早饱和 |
要点清单
- RLHF 撞墙的原因是奖励模型会被 hack;RLVR 换成程序验证器,于是 RL 步数可以放心 scale,$\beta$ 甚至可以设 0。
- GRPO = PPO − 价值网络 + 组内 z-score 优势。严格 on-policy 时它就是带组归一化奖励的策略梯度,clip 只在多轮 inner-loop 时才起作用。
- 除以 $\mathrm{std}$ 把权重送给了最没信息量的题($p\to 0$ 或 $1$ 时权重 $\propto 1/\sqrt{p(1-p)}$ 发散);除以 $|o_i|$ 让错误答案越写越长。修掉这两项,奖励曲线不变而长度腰斩。
- 全对/全错的 group 优势恒为 0,应该直接丢弃并补采(DAPO 动态采样),否则 batch 里全是零梯度样本。
- 熵坍塌是 RLVR 的头号沉默杀手:监控组内奖励 std 的均值,它比奖励曲线更早预警。对策是 clip-higher,不是调温度。
- R1 流水线:V3 → 长 CoT 冷启动 SFT → 推理 RL(GRPO) → 拒绝采样 SFT(600k+200k) → 通用 RLHF → 蒸馏。 Qwen3 的四阶段几乎一模一样,说明这个顺序已经收敛。
- SFT 冷启动只需要 1k 量级样本(s1);能力转移只需要一次蒸馏 SFT(R1-Distill-1.5B 在 AIME 上 28.9,远超 GPT-4o 的 9.3)。贵的是 RL 那一步,而它的成果可以摊薄到整个模型家族。
- PRM 与 MCTS 在 R1 里都失败了:任何学出来的奖励/价值组件都会重新引入过优化。它们在推理时重排仍然有用——排序器安全,优化目标危险。
- 数据比算法难:排除选择题(假阳性)、只留 best-of-8 做不对的题、剔除不用 CoT 就能做对的题、按 $(1-p_{\mathrm{success}})$ 采样。Qwen3 最终只用 3995 条。
- 系统是主要瓶颈:rollout 是 memory-bound 的解码、训练/推理两套框架、长尾 batch。对策是混合部署 + partial rollout + 限制滞后到 1–2 步。别忘了检查首次 inner step 的 ratio 是否真的等于 1。
- RL 大概率是在把 test-time 搜索摊销进权重(pass@k 交叉现象),但这在工程上依然是巨大的价值改变,因为现实任务里你没有验证器去挑那 256 条采样中的正确答案。
延伸阅读
算法基础
- Trust Region Policy Optimization (2015) — PPO 的前身,讲清楚"为什么要在当前策略附近做线性化"。
- Proximal Policy Optimization (2017) — clip 目标的出处,八页读完但工程细节全在代码里。
- The N+ Implementation Details of RLHF with PPO (2024) — 讲师说的"看到这种博客你就知道有麻烦了"的学术版,把 PPO-for-LLM 的每个补丁都复现了一遍。
- Back to Basics: Revisiting REINFORCE-Style Optimization (2024) — RLOO 的出处,论证在 LLM 场景下 PPO 的大部分机制是不必要的。
为什么需要 RLVR
- Scaling Laws for Reward Model Overoptimization (2022) — 本讲第 1 节那张驼峰图的来源,把过优化量化成了 KL 的函数。
- AlpacaFarm (2023) — 讲师自己组的 RLHF 模拟环境,本讲用它的 PPO 实现当活体样本。
- Tülu 3 (2024) — "RLVR"这个术语的流行出处,也是完整开放的后训练配方。
GRPO 与它的修正
- DeepSeekMath (2024) — GRPO 原始论文,先读式 (1)–(3) 再看第 4 节的消融。
- Understanding R1-Zero-Like Training: A Critical Perspective (Dr. GRPO, 2025) — 本讲第 5 节的主要依据,把长度偏置和 std 偏置拆得最清楚,也是"base model 早就有 aha"的证据来源。
- DAPO (2025) — clip-higher、动态采样、token 级损失、超长惩罚整形,长 CoT 大规模训练的实用四件套。
案例研究
- DeepSeek-R1 (2025) — 必读。尤其是"不成功的尝试"一节(PRM 与 MCTS),信息量高于正文。
- Kimi K1.5 (2025) — 与 R1 互补:损失函数推导、长度奖励、课程学习、混合部署 RL 基础设施都写得很细。
- Qwen3 (2025) — 思考模式融合、思考预算控制、3995 条数据的低数据 RLVR、逐阶段基准变化表。
- s1: Simple Test-Time Scaling (2025) — 1000 条样本 + budget forcing,说明冷启动 SFT 的样本效率高得离谱。
过程监督、搜索与 test-time scaling
- Let's Verify Step by Step (2023) — PRM800K 与过程监督的正方观点,读它是为了理解 R1 反对的到底是什么。
- STaR: Self-Taught Reasoner (2022) — 拒绝采样自训练的源头,本讲第 6 节那条"最简 RL"的起点。
- Scaling LLM Test-Time Compute Optimally (2024) — 系统比较 best-of-n、verifier 引导搜索与顺序修订的算力分配。
- Does RL Really Incentivize Reasoning Capacity Beyond the Base Model? (2025) — 第 10 节 pass@k 争论的代表性论文,"引出派"的主要证据。
RL 基础设施
- vLLM / PagedAttention (2023) — rollout 侧的事实标准,理解连续批处理为什么对长尾 CoT 关键。
- HybridFlow / veRL (2024) — 把 RLHF/RLVR 数据流抽象成单控制器 + 多工作流,当前最主流的开源 RL 训练框架。
- Mooncake (2024) — Kimi 用来在训练引擎与推理引擎之间搬权重/KV 的传输层。