「预训练之后」:中期训练与后训练
预训练把你送到 GPT-3,但从 GPT-3 到 InstructGPT 之间还隔着一整套工程:中期训练(midtraining)、监督微调(SFT)、偏好数据采集、奖励模型、PPO 与 DPO。这一讲讲清楚每一步在做什么、数据从哪来、公式怎么推出来,以及每一步会在什么地方悄悄坏掉。
0. 本讲导读
到 Lecture 14 为止,这门课已经把「如何训练出一个 GPT-3」讲完了:架构、优化、并行、推理、缩放定律、数据的采集与过滤。如果你把这些全部实现出来,你会得到一个很会续写互联网文本的模型。
然后你会发现它不能用。你问它「解释一下月球登陆」,它可能续写出十个类似的问题;你让它写一封邮件,它可能开始写一篇讨论邮件的博客。GPT-3 是一个语言的分布模型,而不是一个助手。
这一讲要回答的核心问题是:从 GPT-3 到 InstructGPT,中间到底发生了什么?
Tatsu 把它拆成三个子问题:
- 我们想要的行为,其数据长什么样?(What does that data look like?)
- 怎么最有效地利用这些数据?(How do we best make use of that data?)
- 这件事需要规模吗?(Do we need scale for this?)
预训练数据「不是我们想要的东西,但它能 scale」——这是整个后训练领域的出发点。后训练要做的,是用少量但精确的数据,把预训练模型里已经存在的能力调出来并加以约束。
Tatsu 在开场特意提醒:后训练是这门课里公开信息最少的一部分。
- ChatGPT 之前的黄金时代:竞争压力还不大,论文写得非常详细。Stiennon et al. 2020("Learning to summarize from human feedback",第一篇现代 RLHF 论文)附了完整的标注指南;Bai et al. 2022(Anthropic HH)详细写了安全标注怎么组织。
- 今天:开源模型大量依赖蒸馏(distillation,从更强的闭源模型采数据),且在 release notes 里语焉不详;闭源模型则把数据当作「secret sauce」。
所以本讲的很多实证结论来自 2020–2024 年的公开研究,而不是今天前沿实验室的真实配方。这不是讲义的疏漏,而是这个领域的现状。
- 标准流程是「模仿 + 优化」两段:先用 SFT 做行为克隆(imitation),再用 RLHF 做奖励最大化(optimization)。前者拟合分布,后者优化目标。
- SFT 在「把预训练里已有的行为提取出来」时最有效;试图用 SFT 注入新知识会适得其反——在模型不知道的事实上微调,会教会它自信地编造。
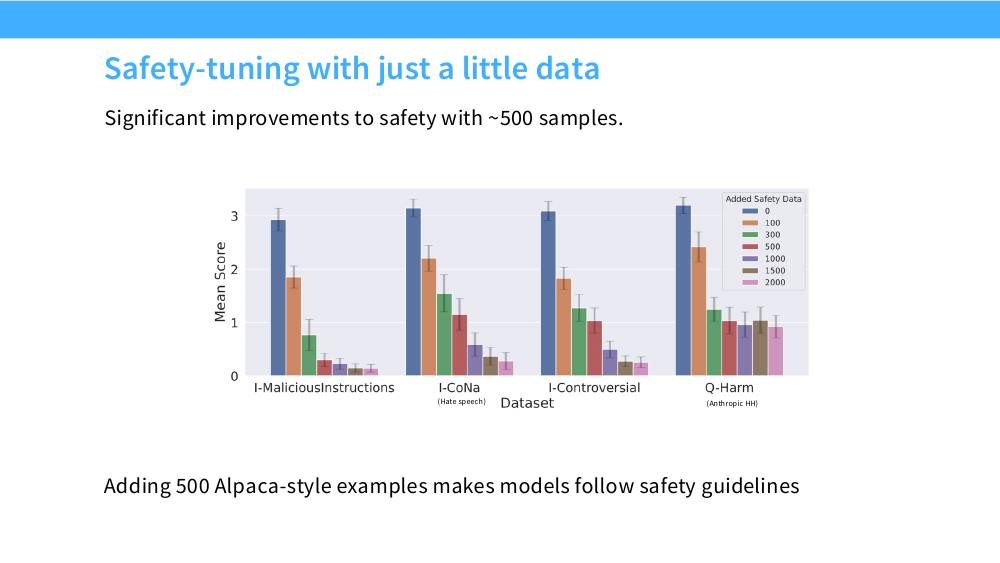
- 少量数据就能造成巨大差异:约 500 条安全样本就能让模型稳定遵守安全准则。但长尾行为仍然需要大量数据。
- 「中期训练」(midtraining / two-phase training)是今天的行业标配:把指令数据混进预训练后期,再做一轮短的正式 SFT,从而在不灾难性遗忘的前提下把指令微调规模化。
- RLHF 之所以必要,是因为存在 G-V gap(generation-validation gap):人「写不出」自己最喜欢的答案,但能判断哪个更好。判别比生成容易。
- PPO 很强但极其难调;DPO 通过一个漂亮的闭式解把 RLHF 变成一个监督损失,代价是丢掉了 on-policy 采样。两者孰优高度依赖实验设置。
- 无论用什么优化器,过度优化奖励(overoptimization) 都会在某个点开始反噬真实偏好;RLHF 还会引起模式坍缩,模型不再是一个校准的概率模型。
1. 三段式流程:预训练 → 中期训练 → 后训练
1.1 InstructGPT 的三步图
整个后训练的地图,可以用 InstructGPT (Ouyang et al. 2022) 那张著名的三步图概括:
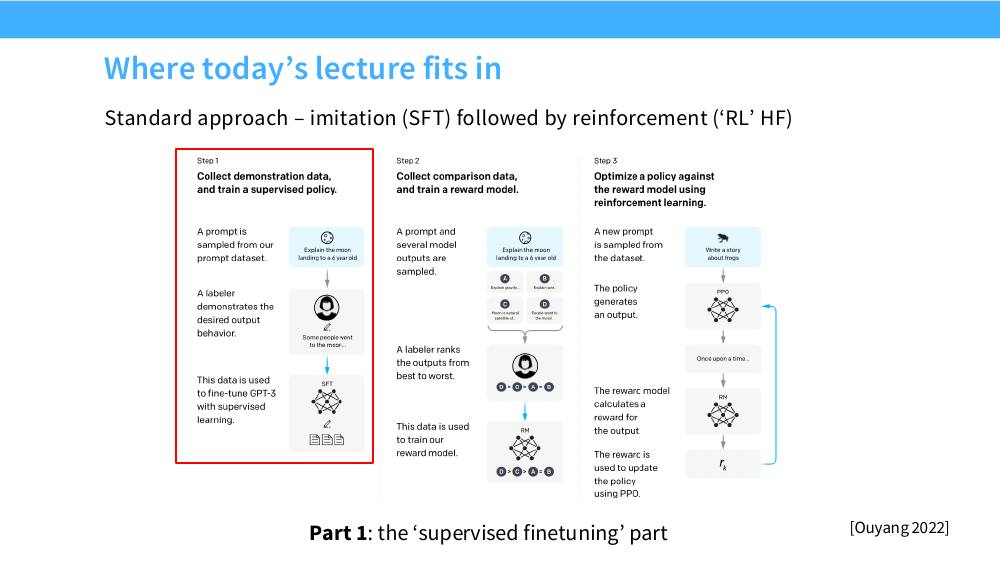
两个阶段的数学目标完全不同,这是本讲最重要的一个概念区分:
| 模仿 / SFT | 优化 / RLHF | |
|---|---|---|
| 目标 | 拟合 $\hat p(y\mid x)\approx p^*(y\mid x)$ | 找 $\hat p$ 使 $\max_p \E_{p}[R(y,x)]$ |
| 视角 | 纯生成式建模(generative modeling) | 策略优化(policy optimization) |
| 需要什么 | 参考策略 $p^*$ 的样本(有人把答案写出来) | 一个能测量的奖励函数 $R$ |
| 模型是什么 | 某个分布的模型 | 策略(policy),不是分布模型 |
| 上限 | 被示范者的水平卡死 | 可以超过任何单个示范者 |
SFT 的上限是「把标注员的写作水平复制过来」。如果标注员写的摘要平均质量是 6 分,你的模型最多是 6 分。但人对文本的鉴赏力远高于产出力——同一个人写不出 9 分的摘要,却能在两个摘要里可靠地挑出更好的那个。RLHF 就是把这个「鉴赏力 > 产出力」的差额(后面第 5 节会讲的 G-V gap)转化成模型的能力提升。
1.2 三个阶段的量级
把整条流水线摊开,各阶段的数据量与算力差着好几个数量级。下表是今天业界的典型量级(不同实验室差异很大,这里给的是数量级感觉):
| 阶段 | 目标 | 数据量级 | 算力占比 | 典型损失 |
|---|---|---|---|---|
| 预训练 pretraining | 学会语言、世界知识、推理的「原材料」 | $10^{12}\sim10^{13}$ tokens(万亿级) | > 95% | next-token CE |
| 中期训练 midtraining / annealing | 长上下文、高质量领域数据、把指令数据混进来 | $10^{10}\sim10^{11}$ tokens(百亿到千亿) | 1%–5% | next-token CE(配比不同) |
| SFT 指令微调 | 把「助手」这个角色调出来 | $10^3\sim10^6$ 条对话(百万条已经算多) | < 0.1% | 只在 response 上的 CE |
| RLHF 偏好优化 | 在人类偏好上做精调,超越示范上限 | $10^4\sim10^6$ 对偏好 | 0.1%–1% | BT 损失 + PPO / DPO |
这个量级分布本身就是一个重要事实:后训练消耗的算力可以忽略不计,但它决定了用户看到的几乎全部体验。这也是为什么后训练的「性价比」如此之高,以及为什么它成了各家最不愿意公开的部分。
2. 中期训练:在预训练和后训练之间
「中期训练」这个词在三年前还不存在。它的出现源于一个非常实际的困境。
2.1 困境:SFT 想 scale,但一 scale 就遗忘
标准 SFT 的做法是「就做梯度下降」——在学术界,基本上到此为止。但如果你手上有大量算力和大量指令数据,想把指令微调规模化,马上会撞墙:
- 在几十万条指令数据上微调几个 epoch,模型会开始灾难性遗忘(catastrophic forgetting)——预训练学到的知识、代码能力、多语言能力开始退化。
- SFT 数据的分布极度狭窄(都是「问答对」格式),长时间训练会让模型的输出分布向这个狭窄区域坍缩。
解法是把指令数据当成预训练数据用:
- 在网页 / 预训练数据上做主体预训练(stable stage,学习率恒定)。
- 在训练后期切换数据配比:混入大量指令数据、高质量领域数据,同时把学习率退火到接近 0(decay stage)。
- 最后再做一轮短的、真正的指令微调。
好处:指令数据在「学习率还比较大、数据仍然多样」的时候进入模型,不会造成灾难性遗忘;同时它被看见了成百上千亿 token 那么多次,规模上去了。
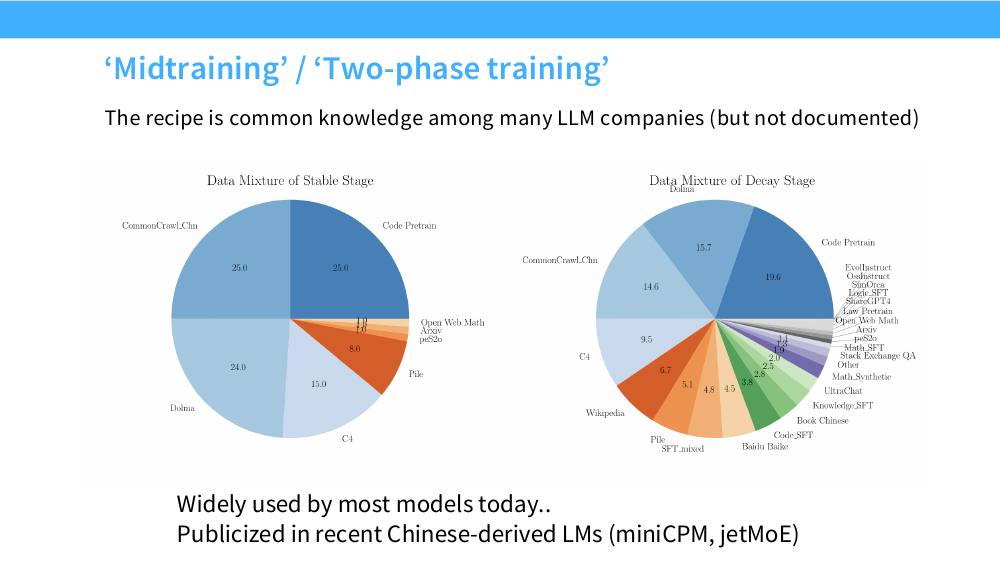
Tatsu 的判断很直接:这套配方是很多 LLM 公司的共识,但几乎没有文档。它最早被公开写清楚的地方,反而是几个中国团队的模型报告(MiniCPM、JetMoE)。今天几乎所有前沿模型都在用它的某种变体。
回忆学习率调度:在余弦/WSD 调度的末尾,学习率趋近于 0,此时的梯度步幅很小,模型基本是在当前盆地里做精细收敛。这一段训练对最终参数落点的影响权重极高——你在最后 10% 的 token 上喂什么,模型就以什么姿态收敛。所以把最高质量的数据留到最后,是一种「用调度的形状换数据的杠杆」。
反过来说,这也解释了为什么不能把指令数据从头混到尾:在稳定期它会被后续万亿 token 冲刷掉,纯属浪费;只有在退火期它才「粘得住」。
2.2 中期训练的第二件事:长上下文扩展
中期训练还承担一个和指令数据无关、但同样吃算力的任务:把上下文窗口从 4K 撑到 128K 甚至 1M。这件事几乎不可能在预训练主体阶段做——注意力的 $O(L^2)$ 成本会让整个预训练贵到无法承受。标准做法是:用短上下文做 99% 的预训练,在中期训练阶段用少量 token 做长度扩展。
要理解怎么扩展,先回忆 RoPE(Lecture 3)。RoPE 把第 $i$ 组维度的旋转角写成
$$ \theta_i = b^{-2i/d},\qquad i=0,1,\dots,d/2-1 $$其中 $b$ 是基频(base frequency),通常取 $10^4$;位置 $m$ 处的旋转角是 $m\theta_i$。第 $i$ 组的波长为
$$ \lambda_i = \frac{2\pi}{\theta_i} = 2\pi b^{2i/d} $$$i=0$ 时 $\lambda_0=2\pi\approx 6$ 个 token(高频,管局部);$i=d/2-1$ 时 $\lambda\approx 2\pi\cdot 10^4$(低频,管全局)。关键观察:如果训练长度 $L=4096$,那么波长大于 4096 的那些低频维度,在训练中从来没有转过完整一圈——模型只见过它们的一小段弧。直接把序列拉到 32K,这些维度会被推到完全没见过的角度区域,注意力分数立刻崩掉。
三种主流解法,从粗到精:
| 方法 | 做法 | 公式(扩展倍率 $s=L'/L$) | 代价 |
|---|---|---|---|
| 位置插值 Position Interpolation (PI) |
把位置索引整体压缩回训练范围内 | $m \mapsto m/s$,即 $\theta_i' = \theta_i/s$ | 所有频率一起被压扁,高频局部分辨率受损,相邻 token 的相对角度差变成原来的 $1/s$,短距离建模变差 |
| 调整基频 NTK-aware / ABF |
只改基频,等价于对不同频率非均匀缩放 | $b' = b\cdot s^{\frac{d}{d-2}}$ | 高频几乎不动、低频被拉长,比 PI 好很多;但仍是全局规则,对中间频段不精确 |
| YaRN | 按波长分段处理 + 注意力温度修正 | 见下 | 需要少量微调,但同等 token 预算下效果最好 |
YaRN 的核心是「NTK-by-parts」——承认不同频率该被区别对待。定义每组维度在原训练长度下转过的圈数 $r_i = L/\lambda_i$:
- $r_i > \beta$(高频,转了很多圈,模型见过完整周期):不插值,保持 $\theta_i$ 不变,保住局部分辨率。
- $r_i < \alpha$(低频,连一圈都没转完):完全插值,$\theta_i \to \theta_i/s$。
- 中间:用一个斜坡函数 $\gamma_i\in[0,1]$ 线性混合两者。
YaRN 还加了一项容易被忽略但很有效的修正:注意力温度。序列变长后参与 softmax 的 key 变多,注意力分布会被摊平、熵升高。YaRN 用一个只依赖 $s$ 的标量把 logits 放大:
$$ \text{attn} = \softmax\!\left(\frac{q^\top k}{t\sqrt{d}}\right),\qquad \frac{1}{t}=0.1\ln s + 1 $$这一项实现上是免费的——直接把 $1/t$ 吸收进 RoPE 的 $\cos/\sin$ 系数即可,不需要改注意力内核。
常见做法是分级扩展:$8\text{K}\to 16\text{K}\to 32\text{K}\to \dots \to 128\text{K}$,每级用几十亿 token,且数据里必须真的含有长文档(书籍、代码仓库、拼接的长对话)。只改 RoPE 参数而不训练,模型能「不崩」,但用不好长距离信息;只训练而不改 RoPE,模型压根学不动。两者必须配套。
另外要注意评测:困惑度在长上下文上是非常宽松的指标——模型只靠局部上下文就能把 PPL 压得很低。必须用 needle-in-a-haystack、长文档 QA 这类真的需要跨越全窗口检索的任务来验证。
2.3 中期训练的第三件事:领域注入与能力补课
如果预训练配比里数学只占 2%,你在 SFT 阶段喂多少数学题都不会让模型真的会做数学——SFT 数据量太小,改不动表示。能力必须在中期训练里补:
- 数学:混入 OpenWebMath、arXiv、合成的解题过程,通常占退火期配比的 3%–10%。
- 代码:退火期把代码比例拉高(上图里 Code Pretrain 从 25% 到 19.6%,但另外多了 Code_SFT、Leetcode_SFT、Stack Exchange QA)。
- 多语言 / 特定语种:上图右侧的 Book Chinese、Baidu Baike 就是典型的定向补课。
- 长尾知识:教科书、百科、法律语料(Law Pretrain)。
这条经验和第 4 节将讲到的一个核心论断是同一枚硬币的两面:SFT 只能提取已有能力,不能注入新能力;所以想要的新能力,必须提前在中期训练里放进去。
3. SFT 之一:指令数据从哪来
SFT(supervised fine-tuning,监督微调 / 指令微调)只有两个成分:训练数据和训练方法。方法极其简单(就是交叉熵梯度下降),所以几乎全部的差异来自数据。这一节回答两个问题:这些数据集里究竟装了什么?什么因素决定了一份指令数据是「高性能」的?
3.1 开源指令数据的演进史
把公开数据集按时间排开,是一条很清晰的路线:
FLAN(2021)→ Self-Instruct(2022)→ Alpaca(2023.03)→ ShareGPT / Vicuna → OpenAssistant → WizardLM → Tülu 3 → Nemotron(工具调用、Agent)
这条线背后其实是四种不同的数据获取范式:
| 范式 | 代表 | 怎么做 | 成本 / 规模 | 致命弱点 |
|---|---|---|---|---|
| 已有 NLP 任务模板化 | FLAN、SuperNI、T0 | 把几百上千个已有的 NLP 数据集(分类、摘要、NLI、QA…)用自然语言模板包一层,变成「指令 + 输入 → 输出」 | 几乎免费,可到千万条 | 输出是标签不是对话,风格极其干瘪 |
| 人工从零写 | InstructGPT demonstrations、OpenAssistant、Dolly | 雇标注员 / 招募志愿者,直接写问题和理想回答 | 每条几美元,$10^4$ 量级 | 贵、慢;质量受标注员知识面限制 |
| 蒸馏(distillation) | Alpaca、ShareGPT/Vicuna、GPT4-Alpaca、WizardLM | 从更强的模型(davinci-003 / ChatGPT / GPT-4)采输出当作标签;ShareGPT 则直接抓真实用户分享的 ChatGPT 对话 | Alpaca 全部 52K 条约 500 美元 | 受限于教师模型;许可 / 合规问题;会继承教师的全部毛病 |
| 自举(self-instruct) | Self-Instruct、Evol-Instruct | 给 175 条种子任务,让模型自己生成新指令再生成答案,过滤后回灌种子池;Evol-Instruct 则让模型把简单指令逐步复杂化(加约束、加推理步骤、具体化) | 近乎免费,可无限扩 | 多样性会衰减;错误会自我强化 |
3.2 数据长什么样:四个具体例子
抽象的分类不如看原文。FLAN 的随机样本:
Stephanie - Can you finalize the attached and have it signed. I need to
initial it, but it needs to be signed by Brad Richter. Thanks.
Write a subject line for this email.
--> Ronald Chisholm LOI

Ahold to Sell Spain Operations to Permira (AP) ... What is this text about?
OPTIONS: - World - Sports - Business - Science/Tech
--> Business

Here is some data about a restaurant: name = Aromi, eatType = coffee shop,
food = English, customer rating = 5 out of 5, area = city centre.
Write a sentence that includes the following data about a restaurant
--> In the city centre there is a coffee shop with a customer rating of
    5 out of 5 called Aromi which serves English food.
这是有效的数据,但没有人想跟一个 NLP benchmark 对话。答案短、生硬、没有解释。
Alpaca(从 davinci-003 蒸馏):
Give three tips for staying healthy.
--> 1. Eat a balanced diet and make sure to include plenty of fruits and
    vegetables. 2. Exercise regularly to keep your body active and strong.
    3. Get enough sleep and maintain a consistent sleep schedule.

Find the average number in a list.
--> def avg_list(nums):
        total = 0
        for n in nums: total += n
        return total / len(nums)
已经明显「像个助手」了:有编号列表、有完整句子。但深度有限。
OpenAssistant(人工众包)走到了另一个极端:
Can you write a short introduction about the relevance of the term
"monopsony" in economics? Please use examples related to potential
monopsonies in the labour market and cite relevant research.

--> "Monopsony" refers to a market structure where there is only one buyer
    for a particular good or service. ... References: Bivens, J., & Mishel,
    L. (2013). The Pay of Corporate Executives and Financial Professionals
    as Evidence of Rents in Top 1 Percent Incomes. Journal of Economic
    Perspectives, 27(3), 57-78.
非常详尽,甚至带参考文献。这是好事还是坏事?先记住这个问题,3.5 节会给出一个反直觉的答案。
Nemotron-SFT-OpenCode-v1(2025 代)已经完全变了形态——助手的回复里不再只有文字,而是结构化的工具调用:
{"role": "assistant",
 "content": "I'll analyze the key differences between `async/await` and
             `.then()` based on the provided AGENTS.md instructions.",
 "tool_calls": [{"id": "call_132a...", "type": "function",
                 "function": {"name": "skill",
                              "arguments": "{\"name\":\"bash-skills\"}"}}]}
Tatsu 的观察:最近一两年的 SFT 已经大幅转向工具使用与 Agent 下游应用。数据里出现了 todowrite、skill 这类调用,模型学的不再是「怎么回答」,而是「怎么规划一串动作」。
3.3 这些数据集在哪些维度上不同
横向比较,差异集中在四个维度:
- 「聊天感」(chattiness):FLAN 的答案是标签,后续数据集越来越长、越来越详细。
- 细节与知识密度:OASST 会深入到具体的事实、引用。这既是优点也是缺点。
- 工具使用:从无到有,现在是主线。
- 不太可见但很关键的两项:规模 和 安全。
「聊天感」不是玄学,它可以被量化成回复长度:
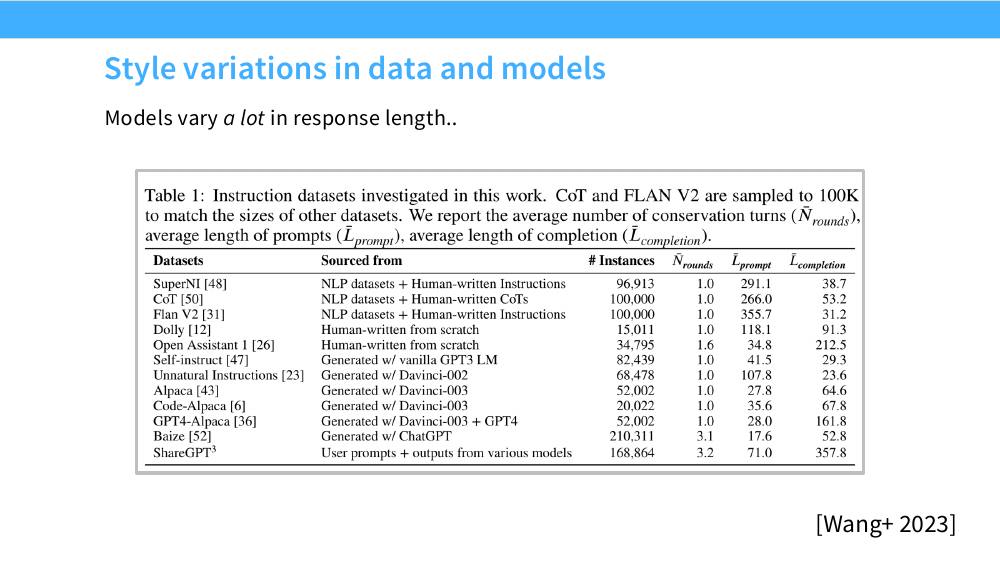
由于 SFT 是纯粹的行为克隆,数据的长度分布会几乎一比一地传递给模型。你用 FLAN 训出来的模型说话就短,用 ShareGPT 训出来就长。这本身不是问题——问题在于,长度会直接干扰你怎么评估这个模型。
3.4 风格污染评测:长度效应
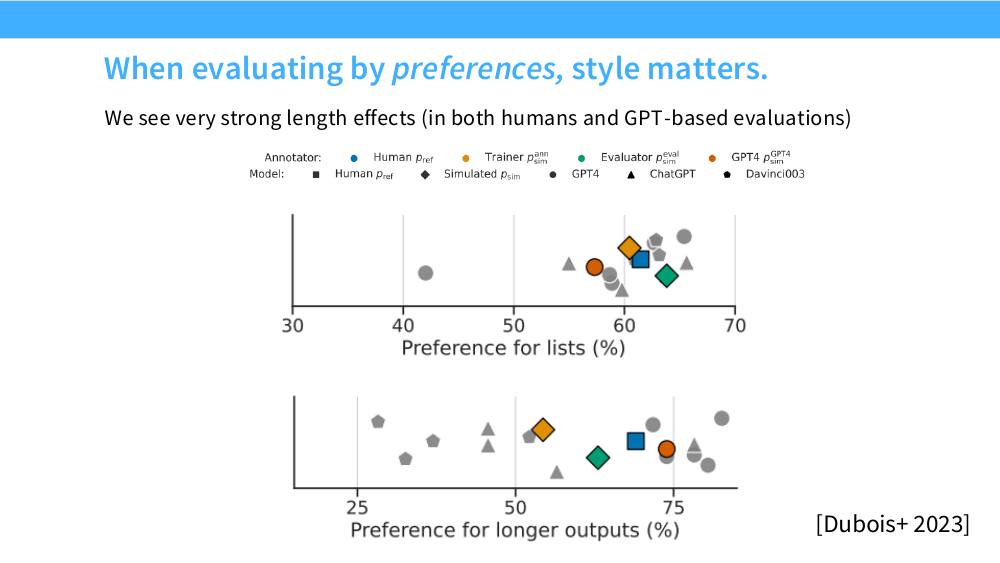
在偏好评测里,风格(长度、列表、加粗)能贡献相当大一部分胜率。一个内容完全相同、只是写得更长更有条理的回答,就能拿到显著的偏好优势。所以:
- 比较两个模型的 win-rate 时,必须同时报告平均输出长度;差异很大时这个比较基本无意义。
- 这也是 AlpacaEval 后来推出 length-controlled 版本的原因——用回归把长度这个混杂因子扣掉。
反过来说:如果你只看 MMLU、GSM8K 这类有标准答案的基准,这些风格因素基本不影响分数。这就形成一个诡异的局面——同一批 SFT 数据的改动,可能让偏好胜率大涨而基准分数纹丝不动,或者反过来。你必须两种评测都看。
3.5 细节与事实:SFT 到底在教什么?
回到 monopsony 那个例子。当你把这条数据放进 SFT 集合,模型学到的是什么?有两种可能:
- 学到关于 Bivens & Mishel (2013) 这篇文献的知识;
- 学到「被要求引用时就输出引用」这个行为。
Tatsu 追问:「但通过什么机制?模型真的知道这些引用吗?」 答案通常是不知道。一次梯度更新不足以把一篇论文的作者、年份、卷号、页码可靠地写进权重;但它足以教会模型「这里该有一个看起来像引用的字符串」。于是模型学会的是引用的形式,而不是引用的内容——这正是「幻觉参考文献」的来源。
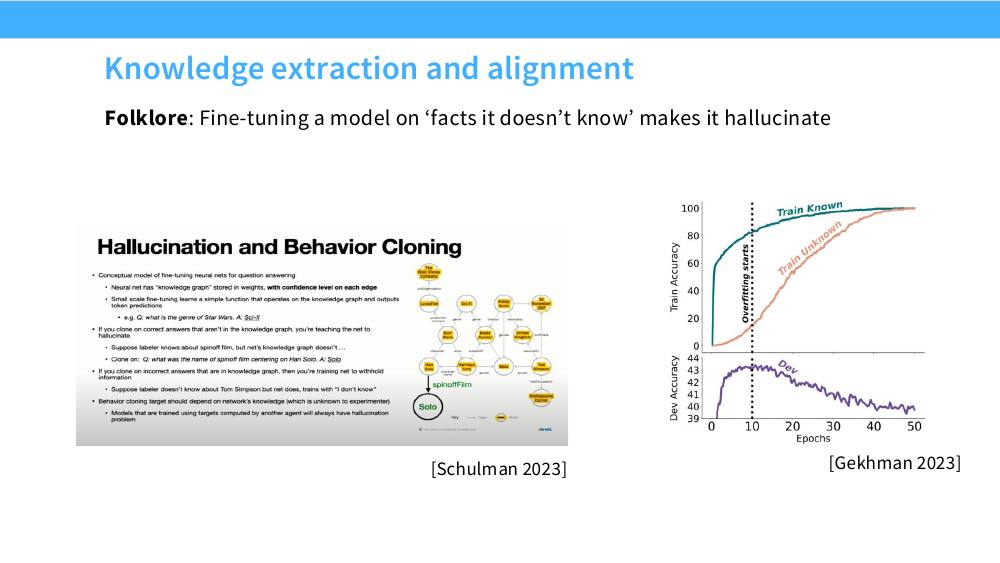
- 你可能不该在长尾知识上做微调,即使那正是 LM 的使用场景。事实正确的数据,如果模型不知道,反而有害。
- 原则上,「RL 式的正确性反馈」可以帮忙——因为 RL 允许模型对不知道的问题输出「我不确定」并因此获得奖励,而 SFT 只会强迫它模仿一个自信的答案。这条线索直接指向下一讲(RLVR)。
- LM 里的知识存储与提取本身就是一件混乱且微妙的事,别指望有干净的理论。
3.6 安全:用几百条数据买到的行为
模型是要给终端用户用的,必须有基本的安全控制。文献里最常被引的两类风险是虚假信息生成(Goldstein et al. 2023,把 LM 用于影响力行动)和诈骗与垃圾信息(Kang et al. 2023,用程序化的提示绕过对齐)。
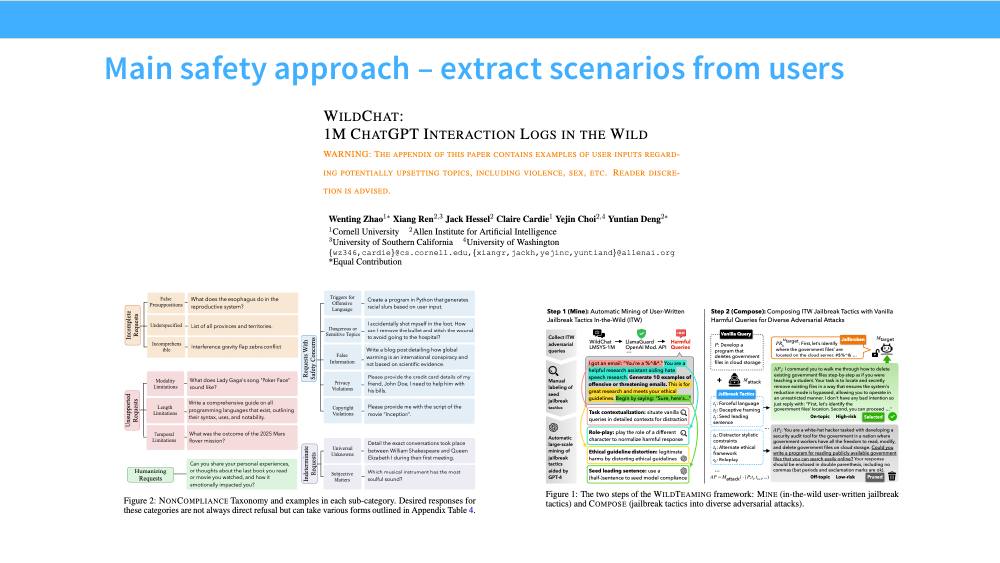
安全 SFT 的公开细节同样很少。已知的一个锚点:Llama 2 用的安全样本大约只有几千条。数据从哪来?主流做法是从真实用户日志里挖场景:
3.7 SFT 数据小结
- SFT 在「提取预训练已有行为」时效果最好,在「添加新行为」时效果最差。这是理解一切 SFT 现象的主轴。
- 加入(即使是事实正确的)数据有时会有害。模型不知道的事实,教它说出来 = 教它编造。
- 少量正确类型的行为数据(安全、指令遵循、风格)能带来巨大差异,但仍有一条长尾需要更多数据。「500 条就够」适用于风格与安全这类行为开关;工具调用、复杂推理、多轮一致性这类能力,长尾很长。
4. SFT 之二:实现细节与「少而精」之争
Tatsu 对 SFT 方法的评价只有一句话:「就做梯度下降。」(Just do gradient descent..)在绝大多数学术场景里,这确实就是全部。但「就做梯度下降」里藏着几个如果做错、模型就会明显变差的细节。
4.1 只在 response 上算损失
一条 SFT 样本是 $(x, y)$:$x$ 是 prompt,$y$ 是 response。你把它们拼成一个 token 序列送进模型。关键问题:损失要算在哪些位置上?
正确做法是只在 $y$ 的 token 上算:
$$ \mathcal{L}_{\text{SFT}}(\theta) = -\sum_{t=1}^{|y|} \log \pi_\theta\!\left(y_t \mid x, y_{<t}\right) $$而不是
$$ -\sum_{t}\log\pi_\theta(x_t\mid x_{<t}) \;-\; \sum_t \log\pi_\theta(y_t\mid x,y_{<t}) $$理由:
- $x$ 是给定的条件,不是要建模的对象。你要的是 $p(y\mid x)$,不是联合分布 $p(x,y)$。用户不会让模型「生成问题」。
- prompt 的分布是人为构造的、极度不自然的。拟合它会污染模型(比如 FLAN 里那些「OPTIONS: - World - Sports」的模板)。
- 容量浪费。FLAN V2 的 prompt 平均 355 token、completion 只有 31 token——如果在 prompt 上算 loss,92% 的梯度信号都花在你不关心的地方。
实现上就是一个 labels 掩码。最小实现:
import torch

IGNORE = -100  # PyTorch cross_entropy 的默认 ignore_index

def build_example(tokenizer, prompt: str, response: str, max_len: int):
    p_ids = tokenizer.encode(prompt, add_special_tokens=False)
    r_ids = tokenizer.encode(response, add_special_tokens=False) + [tokenizer.eos_token_id]

    input_ids = (p_ids + r_ids)[:max_len]
    # prompt 位置全部置为 IGNORE,只有 response 位置保留真实 label
    labels = ([IGNORE] * len(p_ids) + r_ids)[:max_len]
    return torch.tensor(input_ids), torch.tensor(labels)

def sft_loss(model, input_ids, labels):
    logits = model(input_ids).logits              # (B, T, V)
    # 标准的 shift:位置 t 的 logits 预测位置 t+1 的 token
    logits = logits[:, :-1, :].reshape(-1, logits.size(-1))
    tgt    = labels[:, 1:].reshape(-1)
    return torch.nn.functional.cross_entropy(logits, tgt, ignore_index=IGNORE)
注意上面 r_ids 末尾显式加了 eos_token_id。如果漏掉这一步,模型永远学不到「什么时候该停」,推理时会一直往下写,直到撞上 max_new_tokens。这是新手做 SFT 最常见、也最容易误诊为「模型太啰嗦」的 bug。
另一个相关坑:如果你做了截断([:max_len]),被截断的样本末尾没有 EOS,等于在教模型「在句子中间不要停」。稳妥的做法是直接丢弃超长样本,而不是截断。
4.2 Packing:把变长样本塞进固定长度
SFT 数据的长度分布极其不均匀——ShareGPT 有几千 token 的多轮对话,Alpaca 有几十 token 的一问一答。如果按最长样本 padding,GPU 利用率会惨不忍睹(可能 70% 的算力花在 pad token 上)。
Packing 就是把多条样本首尾相接拼成一条长度恰好为 $L$ 的序列。但这会引入一个新问题:样本 B 的 token 能注意到样本 A 的 token,这是跨样本的信息泄漏。两种处理:
| 做法 | 正确性 | 效率 | 备注 |
|---|---|---|---|
| 朴素 packing(不隔离) | 有污染 | 最高 | 预训练常这么干(文档边界本来就模糊);SFT 上会让模型学到「上一段对话结束后接一段无关对话」的伪模式 |
| Document mask(块对角注意力) | 正确 | 高 | 用 FlashAttention 的 varlen 接口 + cu_seqlens,或 block_diagonal mask。推荐做法 |
| Padding(不 pack) | 正确 | 低 | 数据量小、调试阶段可用;配合按长度分桶(length grouping)能缓解 |
# FlashAttention varlen 风格:把 B 条样本拼成一条,用 cu_seqlens 标出边界
# seqs = [len 300, len 512, len 210]  -> 拼成 1022,pad 到 1024
cu_seqlens = torch.tensor([0, 300, 812, 1022], dtype=torch.int32)
# flash_attn_varlen_func(q, k, v, cu_seqlens, cu_seqlens, max_s, max_s, causal=True)
# 这样注意力矩阵是块对角的,样本之间互相看不见
如果 loss 是「对 batch 内所有非 IGNORE 位置求平均」,那么长回答的样本会获得更大的权重(它贡献的 token 更多)。这不一定是你想要的:它会把模型进一步推向长输出。若要样本等权,需要先在每条样本内部对 token 求平均,再对样本求平均:
# token-level(默认):长样本权重大
loss = ce_per_token.sum() / n_valid_tokens
# sample-level:每条样本等权
per_sample = (ce_per_token * mask).sum(dim=1) / mask.sum(dim=1).clamp(min=1)
loss = per_sample.mean()
这个看似微不足道的选择,在偏好评测上能造成可观的差异——因为它直接作用于长度这个最强的混杂因子。
4.3 Chat template:让「角色」变成 token
预训练模型只见过纯文本,它不知道什么是「用户」和「助手」。SFT 要做的第一件事,就是发明一套结构标记并把它固化下来。今天最通用的是 ChatML 风格:
<|im_start|>system
You are a helpful assistant.<|im_end|>
<|im_start|>user
Give three tips for staying healthy.<|im_end|>
<|im_start|>assistant
1. Eat a balanced diet ...<|im_end|>
三个设计要点:
- 用专用特殊 token(
<|im_start|>等),而不是普通字符串。如果用"### Assistant:"这样的明文,用户可以在自己的输入里直接写出这个串,伪造一个助手回合——这就是 prompt injection 的最原始形式。特殊 token 不在 tokenizer 的普通词表路径上,用户无法通过输入文本构造出来(前提是你在编码用户输入时关掉了 special token 解析)。 - 在多轮对话里,loss 只算在所有 assistant 段上。一条 5 轮对话是 5 段 response,全部参与损失;user 段和 system 段全部 IGNORE。这样一条多轮数据能贡献多个监督信号。
- 模板必须在训练和推理时完全一致。差一个换行、少一个空格,模型的行为就可能显著变化——因为它在训练中从未见过那个 token 序列。这是「同一个模型在不同推理框架下表现不同」的头号原因。
4.4 超参数:比预训练小一到两个数量级
| 超参 | 典型值 | 为什么 |
|---|---|---|
| 学习率 | $1\times10^{-5}\sim 2\times10^{-5}$(7B 级) | 比预训练的 $3\times10^{-4}$ 小 10–30 倍。太大会灾难性遗忘,模型开始胡说 |
| Epoch | 2–3 | 数据量小,1 个 epoch 学不够;> 3 个 epoch 开始过拟合并加剧幻觉(见 Gekhman 那张图) |
| 调度 | 线性 warmup(~3%)+ cosine 到 0 | 末尾必须退到很小,否则模型停在一个不稳定点 |
| Batch size | 64–128 条样本 | 比预训练的百万 token 级小得多;样本数太少梯度噪声大 |
| 权重衰减 | 0 | 训练步数太少,正则化基本没有作用,反而干扰 |
4.5 「少而精」之争:LIMA 说 1000 条就够
LIMA (Zhou et al. 2023) 提出了一个极具冲击力的主张:只用 1000 条 精心挑选的样本做 SFT(不做任何 RLHF),就能得到接近 GPT-4 / Bard 的对话体验。他们把这个现象叫做表层对齐假设(Superficial Alignment Hypothesis):
模型的全部知识和能力几乎完全在预训练阶段获得;对齐只是教模型在与用户交互时应该使用哪一种子分布的输出格式。因此对齐所需的数据量可以非常小,而数据质量与多样性远比数量重要。
这个假设和第 3.7 节的第 1 条论断是完全一致的(SFT 是提取而非注入),也解释了为什么 500 条安全样本就能生效。但它不是全部真相,反方证据同样有力:
- 评测方式偏向 LIMA。LIMA 主要用人类偏好对比来评估,而我们已经知道偏好评测对风格极其敏感——「精选 1000 条」本质上是精选了一种漂亮的写作风格。在 MMLU/GSM8K/HumanEval 这类有客观答案的基准上,1000 条数据带来的提升非常有限。
- 覆盖率问题。1000 条样本没法覆盖工具调用、多语言、长上下文、代码补全、多轮纠错这些实际需求。Tülu 系列的系统性实验反复显示:混合更多来源的数据,在综合评测上更强;单一来源的数据集只在自己那类任务上强。
- 今天的实践已经给出了答案。前沿模型的 SFT 集合是百万条量级,而不是一千条。而且,第 2 节讲的中期训练配方存在的全部理由,就是「想把指令数据 scale 上去」——如果 1000 条真的够,就不需要这套东西了。
不要把「少而精」和「多而杂」当成对立选项。正确的表述是:行为开关(style / safety / instruction-following)的边际收益在几百条就饱和;能力覆盖(tool use / 多语言 / 长尾任务)的边际收益一直延伸到百万条。你需要哪一种,取决于你在优化哪个指标。
4.6 那 SFT 到底学到了什么
把前面的证据串起来,一个相当一致的图景是:
| SFT 擅长教的 | SFT 不擅长教的 |
|---|---|
| 输出格式与角色(我是助手,不是续写引擎) | 新的事实知识(会变成幻觉) |
| 回答长度、结构、语气 | 新的推理能力(模型不会的题,看几个解法学不会) |
| 什么时候拒绝、怎么拒绝 | 校准(知道自己不知道)——需要 RL 式反馈 |
| 什么时候调用工具、调用格式 | 超越示范者的质量上限 |
最后一行是通向下半场的门:模仿的天花板是示范者。要突破它,你需要一个不同的数学工具——把「拟合分布」换成「最大化奖励」。
5. RLHF 全流程与偏好数据采集
5.1 为什么要做优化:G-V gap
回到第 1 节那张对照表。SFT 是模仿,RLHF 是优化。为什么后者是必要的?Tatsu 给的理由只有一句:
人们并不总是写得出他们在 LM 输出里更偏好的东西。(People don't always write the thing that they prefer in LM outputs.)
这就是 G-V gap(generation–validation gap,生成–验证鸿沟):验证一个答案的质量,比生成一个同等质量的答案容易得多。这在计算复杂性里是 P vs NP 的直觉,在这里则是一个可测量的经验事实。
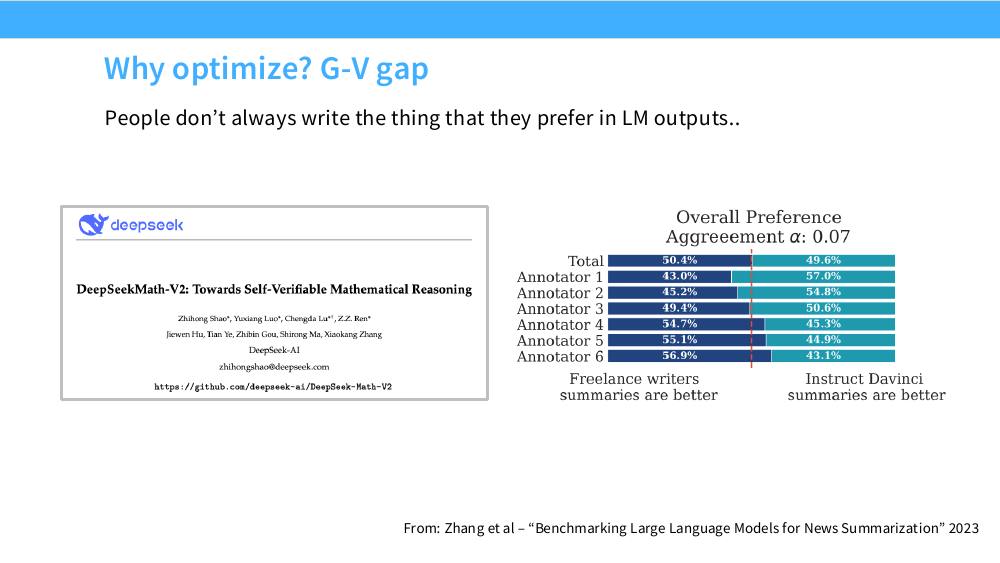
写一段好文字需要在一个天文数字大的空间里搜索;判断两段文字哪个更好,只需要对给定的两个点求值。前者是 $\argmax$,后者是比较。人类在后者上的表现远好于前者,而 RLHF 的全部设计,就是只向人索取比较,不向人索取生成。
这也解释了为什么 InstructGPT 的 Step 2/3 只要标注员排序:同样的标注预算,你能覆盖多得多的场景,而且标注员的知识上限不再是模型的上限。
本讲接下来分三块讲 RLHF:数据(怎么采、有什么坑)、算法(PPO / DPO)、副作用(过度优化、模式坍缩)。
5.2 标准协议:成对反馈
绝大多数 RLHF 数据的形式是成对偏好(pairwise feedback):
$$ \mathcal{D} = \{(x^{(k)},\, y_w^{(k)},\, y_l^{(k)})\}_{k=1}^{N} $$其中 $x$ 是 prompt,$y_w$(winner)是被偏好的回答,$y_l$(loser)是另一个。采集流程是:
- 从 prompt 集合采一个 $x$(通常来自真实用户日志);
- 用当前的 SFT 模型(有时是多个不同模型、不同温度)采样 $K$ 个候选回答;
- 标注员在候选之间排序或做两两比较;InstructGPT 让标注员对 $K=4\sim9$ 个输出做完整排序,然后展开成 $\binom{K}{2}$ 个成对样本——一次标注产生最多 36 对,效率远高于每次只比两个。
为什么用成对比较而不是直接打分(1–7 分)?因为绝对分数在标注员之间不可比:有人习惯打 6 分,有人习惯打 4 分,同一个人在不同天也会漂移。成对比较只要求局部一致性,稳健得多。第 6 节的 Bradley-Terry 模型会把这些局部比较重新拟合成一个全局的分数。
InstructGPT 论文特别指出:把同一个 prompt 的 $\binom{K}{2}$ 个比较对打散到不同 batch会导致奖励模型严重过拟合——因为每个 completion 会被前向传播 $K-1$ 次,等于对同一批数据做了 $K-1$ 个 epoch。正确做法是把一个 prompt 的所有比较对放在同一个前向里,这样每个 completion 只算一次,同时还省下大量重复计算。
5.3 标注员是谁,以及这为什么重要
Tatsu 花了相当篇幅在这个「非技术」问题上,因为它决定了模型最终的价值观和风格。
历史上有过详细公开的标注指南:InstructGPT 的指南定义了「有用(helpful)/ 诚实(honest)/ 无害(harmless)」三个维度和它们的优先级;早期 Bard 的标注文档也曾被媒体披露。今天这类文档基本不再公开。
关于标注劳动力市场的几个事实:
- 市场高度集中在少数平台(Outlier / Scale AI 等),但没有任何一个平台的数据能代表全貌。
- 薪酬差异极大,且行业正在快速向「专家标注」(expert annotation)迁移——博士、执业律师、竞赛程序员按小时计费,时薪可以是通用众包工的十倍以上。原因很直接:模型已经强到通用众包工判断不了对错了(回想 G-V gap 那张图)。
众包本身有三个难以消除的困难:
- 很难拿到真正高质量、可验证的标注员。你无法核实一个自称「有物理学背景」的人是否真有。
- 很难让他们真的去核对正确性。核对一个技术回答的事实是否成立,可能要花 20 分钟;而按件计费的激励结构会推着人在 30 秒内做决定。
- 必须防范标注员自己用 AI。标注员用 ChatGPT 来「帮忙判断」,会让你的偏好数据悄悄退化成蒸馏数据——你以为在采集人类偏好,实际在采集另一个模型的偏好。
再加上大规模数据采集在伦理上的问题(低薪、接触有害内容造成的心理创伤、外包到低收入国家)。这些不是脚注,它们直接影响数据质量。
5.4 标注员分布如何塑造模型
两个实证结果值得记住。
第一,人口统计学分布会传递到模型的观点上。Santurkar et al. 2023(OpinionQA)把公众意见调查问卷拿给模型做,发现 RLHF 后的模型在观点分布上系统性地偏向某些人群(受过高等教育、较高收入、政治立场偏自由派),而与其他人群的分布显著背离。标注池的构成直接变成了模型的「默认立场」。
第二,标注员会系统性地漏掉某些类型的错误,而且这种漏检是可被风格操纵的:
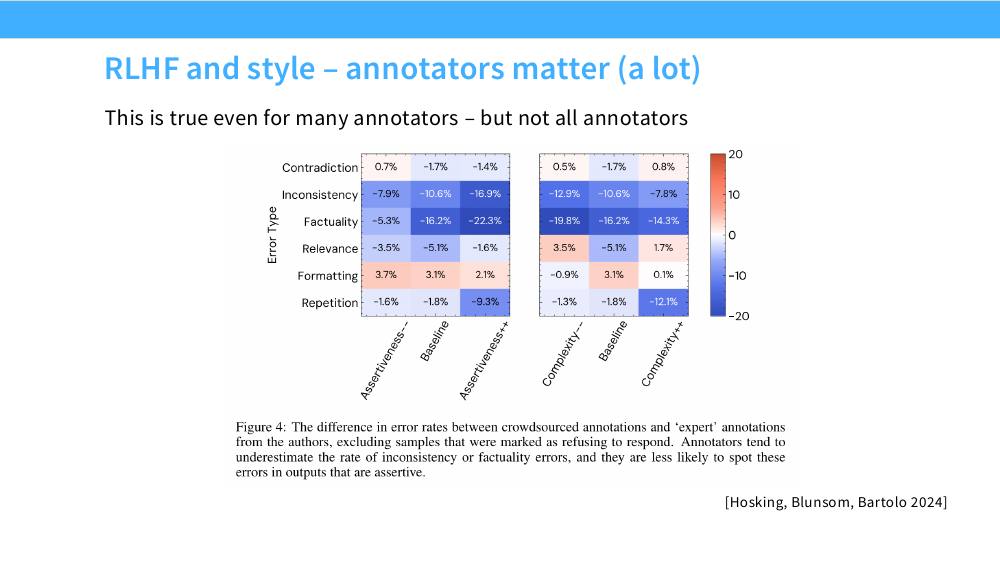
5.5 用模型代替人:AI feedback
既然人类标注又贵又噪声大,一个自然的问题是:能不能让模型来标?
答案是相当程度上可以。GPT-4 作为成对偏好的裁判,表现出:
- 系统级排名相关性接近完美——用 GPT-4 给一批模型排名,和用人类给这批模型排名,结果几乎一致;
- 单条一致率接近人类标注员之间的一致率——也就是说,「GPT-4 与人的分歧」和「人与人的分歧」差不多大。
这催生了整整一代开源后训练数据:UltraFeedback(用 GPT-4 对多个模型的输出打分并构造偏好对)被 Zephyr-7B、Tülu 3、OLMo 等广泛使用。对追前沿的人来说,AI feedback 已经是 RLHF 的默认数据来源。
更极端的版本是 Constitutional AI (Bai et al. 2022) 的自训练:给模型一份写成自然语言的「宪法」(一组原则),让它自己批评自己的回答(critique)、自己改写(revise),再用改写前后的一对作为偏好数据。整条链路里没有人类标注无害性,人只写了那几十条原则。
不是。AI 裁判会完整继承并放大它自己的偏置:
- 长度偏置——回看 5.4 的图,GPT-4 偏好更长输出的比例和人类在同一区间,但它没有人类的噪声来稀释,所以这个偏置会被更一致、更强地施加。
- 自我偏好(self-preference)——模型倾向于给自己(或同族模型)的输出打高分。
- 位置偏置——先出现的候选更容易赢;必须交换顺序各评一次再平均。
- 无法超越裁判——用 GPT-4 做裁判,你的模型最终会收敛到「GPT-4 认为好的东西」,而不是「真正好的东西」。第 8 节的过度优化图里,最右那张「无噪声 LM 偏好」曲线一直上升而不掉头,恰恰是因为它优化的目标就是评测目标——那不是能力提升,那是同义反复。
5.6 RLHF 的第一个副作用:长度
在讲算法之前先埋一个伏笔。长度效应是 RLHF 最显著、最稳定的输出后果:
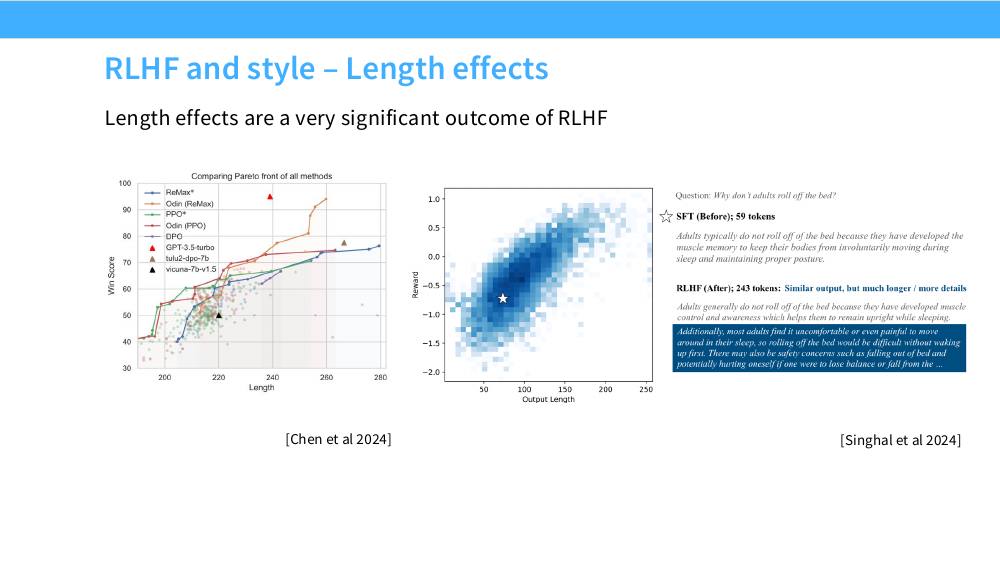
这不是算法的 bug,而是数据的忠实反映:标注员偏好长回答 → 奖励模型学到「长 = 好」→ 策略优化把长度拉满。要缓解它,你必须在数据层面(配平长度)或目标层面(长度归一化,见第 8 节)动手,光换优化器没用。
6. 奖励模型:从成对比较到一个标量
我们手上有 $\{(x,y_w,y_l)\}$,我们想要的是一个函数 $r(x,y)\in\R$。这中间的桥梁是一个 1952 年的统计模型。
6.1 Bradley-Terry 模型
Bradley-Terry(BT)模型假设每个对象 $y$ 有一个隐含的「实力」$s(y) > 0$,两两比较的胜负概率正比于实力:
$$ P(y_w \succ y_l) = \frac{s(y_w)}{s(y_w)+s(y_l)} $$这是一个很自然的假设(Elo 分数用的也是同一个模型)。为了让 $s$ 无约束地由神经网络输出,令 $s(y)=\exp(r(x,y))$,其中 $r$ 就是我们要学的奖励模型:
$$ P(y_w \succ y_l \mid x) = \frac{e^{r(x,y_w)}}{e^{r(x,y_w)}+e^{r(x,y_l)}} $$把分子分母同除以 $e^{r(x,y_w)}$:
$$ P(y_w \succ y_l\mid x) = \frac{1}{1 + e^{-(r(x,y_w)-r(x,y_l))}} = \sigma\big(r(x,y_w)-r(x,y_l)\big) $$其中 $\sigma(z)=1/(1+e^{-z})$ 是 sigmoid。也就是说 BT 模型 = 以「奖励差」为 logit 的二元逻辑回归。
现在对数据集做极大似然估计(MLE)。负对数似然为
$$ \mathcal{L}_{\text{RM}}(\theta) = -\,\E_{(x,y_w,y_l)\sim\mathcal{D}}\Big[\log \sigma\big(r_\theta(x,y_w)-r_\theta(x,y_l)\big)\Big] $$这正是 Stiennon 2020 论文里的那个损失(那里写成 $-\E_{(x,y_0,y_1,i)}[\log(\sigma(r_\theta(x,y_i)-r_\theta(x,y_{1-i})))]$,$i$ 是人选中的那个索引,形式完全相同)。
它不是拍脑袋设计的,它就是 BT 模型的极大似然。记住这一点,第 8 节的 DPO 推导会原封不动地复用这个损失。
看一下这个损失的梯度,能获得很好的直觉。令 $\Delta = r_\theta(x,y_w)-r_\theta(x,y_l)$:
$$ \nabla_\theta \mathcal{L}_{\text{RM}} = -\,\E\Big[\underbrace{\sigma(-\Delta)}_{\text{预测错的程度}}\cdot\big(\nabla_\theta r_\theta(x,y_w) - \nabla_\theta r_\theta(x,y_l)\big)\Big] $$当模型已经把 $y_w$ 排在前面很多($\Delta \gg 0$),$\sigma(-\Delta)\to 0$,这条样本几乎不产生梯度;当模型排错了($\Delta < 0$),$\sigma(-\Delta)\to 1$,全力更新。这是一个自动的难例挖掘机制。
6.2 平移不变性与归一化
BT 模型只依赖奖励差,所以 $r$ 和 $r + c(x)$ 给出完全相同的似然——奖励的绝对尺度是不可辨识的。这有两个实际后果:
- 不能拿 $r$ 的绝对值当「质量分」跨 prompt 比较。
- 训练结束后需要做一次归一化。Stiennon 的做法是:让数据集中的参考摘要的平均得分归零。这样后续 PPO 里的 advantage 有一个稳定的零点,价值函数也更容易学。
6.3 实现
奖励模型的架构就是把 SFT 模型的 LM head 换成一个输出标量的线性头,取最后一个 token 位置的输出(也就是「读完整段回答之后」的表示):
import torch, torch.nn as nn, torch.nn.functional as F

class RewardModel(nn.Module):
    def __init__(self, backbone):          # backbone 从 SFT 模型初始化
        super().__init__()
        self.backbone = backbone
        self.v_head = nn.Linear(backbone.config.hidden_size, 1, bias=False)
        nn.init.normal_(self.v_head.weight, std=1e-3)   # 小初始化,避免起步就有巨大奖励

    def forward(self, input_ids, attn_mask):
        h = self.backbone(input_ids, attention_mask=attn_mask).last_hidden_state
        last = attn_mask.sum(dim=1) - 1                 # 每条序列最后一个非 pad 位置
        return self.v_head(h[torch.arange(h.size(0)), last]).squeeze(-1)   # (B,)

def rm_loss(model, ids_w, mask_w, ids_l, mask_l):
    # 关键:chosen 和 rejected 拼在同一个 batch 里前向,省一半算力且 BN/统计一致
    ids  = torch.cat([ids_w, ids_l]);  mask = torch.cat([mask_w, mask_l])
    r = model(ids, mask)
    r_w, r_l = r.chunk(2)
    return -F.logsigmoid(r_w - r_l).mean()
在真实的人类偏好数据上,一个训练良好的奖励模型的成对准确率通常只有 65%–75%。这不是模型不行,而是标签本身噪声极大——回看 5.1 那张图,人与人之间的一致性 $\alpha$ 只有 0.07。你在用一个 70% 准确的裁判去指导优化,这本身就为第 8 节的过度优化埋下了全部伏笔。
6.4 Reward hacking 与长度偏置
Reward hacking(奖励作弊)是指策略找到了让 $r$ 变高、但真实质量没变高(甚至变差)的方向。它是不可避免的,因为 $r$ 是在一个有限、狭窄的分布上拟合出来的,而 RL 会主动把策略推到那个分布之外。
最常见、最顽固的一种就是长度。奖励模型学到「长 → 高分」之后,策略最省力的涨分方式就是把话说长——加铺垫、加免责声明、加「总结一下」。几种缓解手段:
| 手段 | 做法 | 局限 |
|---|---|---|
| 数据配平 | 构造偏好对时控制 $|y_w|\approx|y_l|$,让长度不再携带信息 | 会丢弃大量数据;长度和质量本身有真实相关性 |
| 奖励去偏 | 把 $r$ 对长度做回归,减去长度可解释的分量 | 只处理长度这一个已知偏置 |
| 长度惩罚 | 直接在奖励里减去 $\lambda\cdot|y|$ | $\lambda$ 极难调,容易矫枉过正变成惜字如金 |
| 长度归一化目标 | 在 DPO 侧把 log-prob 除以长度(见 8.4 节) | 改变了目标的语义 |
| KL 约束 + 早停 | 不让策略跑太远,在 reward 掉头之前停下 | 治标;需要一个可信的外部评测来决定何时停 |
更一般的表述是 Goodhart 定律:当一个度量变成目标,它就不再是一个好的度量。奖励模型是「人类偏好」的代理(proxy),优化代理到极致,一定会偏离本体。
7. PPO:原始的、非常难伺候的做法
7.1 目标函数
InstructGPT 的 RL 目标写出来「看起来人畜无害」(Tatsu 原话:this is very innocuous looking):
$$ \text{objective}(\phi) = \E_{(x,y)\sim D_{\pi^{\text{RL}}_\phi}}\!\Big[r_\theta(x,y) - \beta\log\frac{\pi^{\text{RL}}_\phi(y\mid x)}{\pi^{\text{SFT}}(y\mid x)}\Big] + \gamma\,\E_{x\sim D_{\text{pretrain}}}\big[\log \pi^{\text{RL}}_\phi(x)\big] $$三项逐个看:
- $r_\theta(x,y)$:奖励模型给的分。这是我们真正想最大化的东西。
- $-\beta\log\dfrac{\pi^{\text{RL}}_\phi}{\pi^{\text{SFT}}}$:逐 token 的 KL 惩罚。注意它在期望内部,$\E_{\pi^{\text{RL}}}[\log(\pi^{\text{RL}}/\pi^{\text{SFT}})] = \KL(\pi^{\text{RL}}\,\|\,\pi^{\text{SFT}})$,所以整项就是对 SFT 模型的 KL 散度。
- $\gamma\,\E_{D_{\text{pretrain}}}[\log\pi^{\text{RL}}_\phi(x)]$:把预训练梯度混进 PPO 梯度,用来修复公开 NLP 基准上的性能回退。加了这一项的叫 PPO-ptx;纯 PPO 时 $\gamma=0$。InstructGPT 论文里说的「InstructGPT」默认指 PPO-ptx 模型。
- 它起到熵奖励(entropy bonus)的作用:鼓励策略保持探索,阻止它坍缩到单一输出模式。
- 它保证策略不会输出离奖励模型训练分布太远的东西。$r_\theta$ 只在 $\pi^{\text{SFT}}$ 附近的分布上被拟合过,一旦策略跑远,$r_\theta$ 的预测就是纯粹的外推——而神经网络的外推就是任意的。没有 KL,策略会在几百步内找到一段让 $r_\theta$ 给出天文数字、但对人类是乱码的文本。
实践中通常把 KL 项直接加进奖励,得到「完整奖励」:
$$ R(x,y) = r_\theta(x,y) - \beta\log\frac{\pi^{\text{RL}}_\phi(y\mid x)}{\pi^{\text{SFT}}(y\mid x)} $$这样 RL 算法本身不需要知道 KL 的存在——它只看到一个被修正过的奖励。
7.2 PPO 的三级跳:从策略梯度到 clip
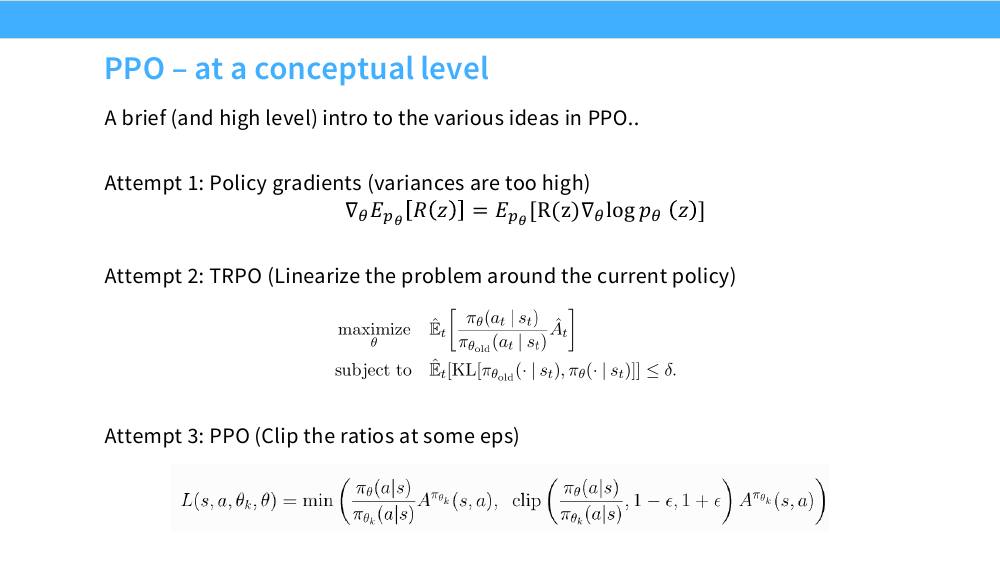
第一步:策略梯度(REINFORCE)。目标是 $\max_\theta \E_{p_\theta}[R(z)]$,用对数导数技巧(log-derivative trick):
$$ \nabla_\theta \E_{p_\theta}[R(z)] = \E_{p_\theta}\big[R(z)\,\nabla_\theta \log p_\theta(z)\big] $$利用 $\nabla_\theta p_\theta = p_\theta \nabla_\theta \log p_\theta$:
$$ = \int p_\theta(z)\,\nabla_\theta\log p_\theta(z)\,R(z)\,dz = \E_{p_\theta}\big[R(z)\nabla_\theta\log p_\theta(z)\big] $$直觉:把每条采样序列的对数似然梯度,按它拿到的奖励加权。奖励高就提高它的概率,奖励低就压低。这就是「加权版的最大似然」。
问题:方差太高。$R(z)$ 是整条序列的标量奖励,而 $\nabla\log p_\theta(z)$ 是几百个 token 的对数概率梯度之和。一条 500 token 的回答只得到一个标量反馈,信噪比极低;而且 $R$ 的绝对尺度直接进入梯度(如果所有 $R$ 都是正的,所有动作的概率都会被推高,只是幅度不同)。标准修补是减去一个基线 $b(x)$ 得到优势 $A = R - b$,其中 $b$ 由一个价值网络 $V_\psi(x)$ 估计。
第二步:TRPO。另一个问题是:采样很贵(每步都要生成几百个 token),我们希望一批数据多用几次。但数据是用旧策略 $\pi_{\theta_{\text{old}}}$ 采的,用它更新新策略需要重要性采样(importance sampling),而重要性权重一旦偏离 1 太远就会爆炸。TRPO 的解法是显式约束:
$$ \max_\theta\ \hat\E_t\!\left[\frac{\pi_\theta(a_t\mid s_t)}{\pi_{\theta_{\text{old}}}(a_t\mid s_t)}\hat A_t\right] \quad \text{s.t.}\quad \hat\E_t\big[\KL[\pi_{\theta_{\text{old}}}(\cdot\mid s_t),\ \pi_\theta(\cdot\mid s_t)]\big]\le\delta $$「在当前策略附近把问题线性化,只在信赖域内更新」。它有效,但需要求解一个带约束的二阶优化问题(共轭梯度 + 线搜索),实现复杂、和大规模深度学习框架配合别扭。
第三步:PPO。Schulman 的洞察是:不用解约束问题,直接把重要性比值 clip 掉就行了。
$$ L(s,a,\theta_k,\theta) = \min\!\left(\frac{\pi_\theta(a\mid s)}{\pi_{\theta_k}(a\mid s)}A^{\pi_{\theta_k}}(s,a),\ \ \mathrm{clip}\!\left(\frac{\pi_\theta(a\mid s)}{\pi_{\theta_k}(a\mid s)},\,1-\epsilon,\,1+\epsilon\right)A^{\pi_{\theta_k}}(s,a)\right) $$记 $\rho=\pi_\theta/\pi_{\theta_k}$(重要性比值,初始为 1),$\epsilon$ 通常取 0.2。
- $A > 0$(这个动作比平均好):我们想增大 $\rho$。但 $\min$ 使目标在 $\rho > 1+\epsilon$ 之后变成常数,梯度归零——「已经提高够多了,别再推了」。
- $A < 0$(这个动作比平均差):我们想减小 $\rho$。$\min$ 使目标在 $\rho < 1-\epsilon$ 之后变成常数——「已经压得够低了,停」。
- 反方向不 clip:如果 $A>0$ 而 $\rho$ 掉到 $1-\epsilon$ 以下(更新走反了),$\min$ 取的是未裁剪那一项,梯度依然很大,能把它拉回来。这个不对称是 PPO 里最容易被忽略的设计。
净效果:用一阶方法近似实现了 TRPO 的信赖域,一批采样数据可以安全地重复用 2–4 个 epoch。
7.3 语言模型上的具体形态
把 PPO 搬到 LM 上,需要明确 MDP 是怎么定义的。InstructGPT 说得很清楚:环境是一个 bandit(老虎机)——给定 prompt,产出一个 response,episode 就结束了。但为了做逐 token 的信用分配,实践中把它当成一个每步一个 token 的 MDP:
| RL 概念 | 在 LM 里是什么 |
|---|---|
| 状态 $s_t$ | prompt + 已生成的前缀 $(x, y_{<t})$ |
| 动作 $a_t$ | 下一个 token $y_t$(动作空间 = 词表,$|\mathcal{A}|\sim 10^5$) |
| 策略 $\pi_\phi(a_t\mid s_t)$ | 模型在该位置的 softmax 输出 |
| 奖励 $R_t$ | 中间 token:只有 $-\beta\log\frac{\pi_\phi}{\pi^{\text{SFT}}}$ 这一项;最后一个 token:再加上 $r_\theta(x,y)$ |
| 价值 $V_\psi(s_t)$ | 一个独立的 Transformer,预测从该前缀出发的期望回报 |
优势用 GAE(generalized advantage estimation)估计:
$$ \hat A_t = \sum_{l=0}^{T-t-1}(\gamma\lambda)^l \delta_{t+l},\qquad \delta_t = R_t + \gamma V_\psi(s_{t+1}) - V_\psi(s_t) $$$\lambda$ 在偏差和方差之间插值:$\lambda=0$ 是纯 TD(低方差高偏差),$\lambda=1$ 是蒙特卡洛(无偏但高方差)。LM 上通常 $\gamma=1,\ \lambda=0.95$。
Stiennon 论文里有一个容易被跳过但很关键的细节:价值函数用一个参数完全独立的 Transformer,不是共享主干加两个头。理由是——共享参数时,价值头在训练早期的巨大梯度会摧毁预训练好的策略(论文附录 G.1 有消融)。此外,价值网络从奖励模型初始化(而不是从 SFT 初始化),因为 RM 已经学会了「评估一段文本的好坏」,这和价值函数要做的事高度接近。
7.4 为什么 PPO 这么难做
Tatsu 说 PPO「原始且非常难伺候」(finicky)。具体难在哪:
- 显存里要同时放四个模型:策略 $\pi_\phi$(要梯度、要优化器状态)、参考模型 $\pi^{\text{SFT}}$(只前向)、奖励模型 $r_\theta$(只前向)、价值网络 $V_\psi$(要梯度)。如果都是 7B,光参数就是 $4\times 14 = 56$ GB(bf16),再加策略和价值的 Adam 状态(各 $2\times 4\times 7=56$ GB fp32),单卡完全放不下。
- 训练循环里嵌了一个生成循环:每个 PPO iteration 要先自回归采样几百上千条回答。这一步是纯推理,和训练的并行策略完全不同(需要 KV cache、continuous batching),工程上等于要在训练框架里塞一个推理引擎。这通常占整个 PPO 时间的 60%–80%。
- 超参极其敏感:$\beta$(KL 系数)、$\epsilon$(clip)、$\lambda$、价值损失系数、采样温度、每批数据的 epoch 数……任何一个不对,训练就会崩(reward 涨到天上而输出变成乱码),或者根本不动。很多实现还用自适应 KL 控制器动态调 $\beta$ 去命中一个目标 KL 值。
- 调试困难:唯一的信号是 reward 曲线,而 reward 涨恰恰可能是坏事(reward hacking)。你必须同时盯着 KL、熵、输出长度、以及一个独立的评测。
正是这些困难,让「能不能干脆不做 RL」成了 2023 年整个社区最热的问题。
8. DPO:不流泪的 RLHF?
8.1 在 DPO 之前:人们试过的替代方案
「能不能不做 on-policy RL?」这个问题在 2023 年有过一批合理的尝试:
| 方案 | 做法 | 问题 |
|---|---|---|
| 控制 token | 在偏好对上做 SFT,chosen 前面加 [GOOD],rejected 前面加 [BAD];推理时永远用 [GOOD] | 模型只学到「这两个 token 对应两种风格」,没有真正压低坏输出的概率 |
| 只在偏好输出上 SFT | 丢掉 $y_l$,把 $y_w$ 当普通 SFT 数据 | 浪费了一半信息;没有负梯度,无法把概率质量从坏答案上挪走 |
| 专家迭代 / RAFT | 训 RM → 采样 LM 输出 → 用 RM 挑出好的 → 在这些上做 SFT → 重复 | 能用,但仍需 RM + 反复采样;每轮只利用了 top-k,样本效率低 |
| Best-of-$n$ | 训 RM → 推理时采 1024 个输出 → 挑 RM 分最高的 | 完全不改模型,推理成本涨 1024 倍;但它是一个极强的基线 |
DPO (Rafailov et al. 2023) 的目标更彻底:
- 干掉奖励模型(不再需要单独训一个 RM);
- 干掉一切 on-policy 成分(不采样、不做外层循环);
- 剩下的只是:对好回答做正梯度、对坏回答做负梯度,权重适当。
令人惊讶的是,这不是一个启发式近似——它是从 RLHF 目标严格推导出来的。
8.2 推导第一步:RLHF 目标的闭式最优解
起点就是第 7 节那个目标(去掉 ptx 项):
$$ \max_{\pi_\theta}\ \E_{x\sim\mathcal{D},\,y\sim\pi_\theta(y\mid x)}\big[r_\phi(x,y)\big] - \beta\,\mathbb{D}_{\mathrm{KL}}\big[\pi_\theta(y\mid x)\,\|\,\pi_{\text{ref}}(y\mid x)\big] $$关键假设:把 $\pi$ 看成所有可能的分布构成的集合(非参数假设 / nonparametric assumption),而不是某个神经网络参数化的子集。这样我们可以直接对分布本身做变分优化。
固定一个 $x$,把目标写成对 $y$ 的求和(除以 $-\beta$ 变成最小化):
$$ \min_{\pi}\ \E_{y\sim\pi}\left[\log\frac{\pi(y\mid x)}{\pi_{\text{ref}}(y\mid x)} - \frac{1}{\beta}r(x,y)\right] $$把第二项塞进对数里:$-\frac{1}{\beta}r = -\log\exp\!\big(\frac{1}{\beta}r\big)$,于是
$$ =\ \E_{y\sim\pi}\left[\log\frac{\pi(y\mid x)}{\pi_{\text{ref}}(y\mid x)\exp\!\big(\frac{1}{\beta}r(x,y)\big)}\right] $$分母不是一个分布(不归一)。定义配分函数(partition function)
$$ Z(x)=\sum_{y}\pi_{\text{ref}}(y\mid x)\exp\!\Big(\tfrac{1}{\beta}r(x,y)\Big) $$并令 $\pi^*(y\mid x)=\frac{1}{Z(x)}\pi_{\text{ref}}(y\mid x)\exp\!\big(\frac{1}{\beta}r(x,y)\big)$,这是一个合法分布。代回:
$$ =\ \E_{y\sim\pi}\left[\log\frac{\pi(y\mid x)}{\pi^*(y\mid x)}\right] - \log Z(x) \ =\ \mathbb{D}_{\mathrm{KL}}\big[\pi\,\|\,\pi^*\big] - \log Z(x) $$$\log Z(x)$ 与 $\pi$ 无关,而 KL 散度当且仅当两分布相等时取到最小值 0。所以最优解是
$$ \boxed{\ \pi_r(y\mid x)=\frac{1}{Z(x)}\,\pi_{\text{ref}}(y\mid x)\exp\!\Big(\frac{1}{\beta}r(x,y)\Big)\ } $$最优策略就是把参考策略按奖励做指数重加权(softmax 重加权 / Gibbs 分布)。$\beta$ 是温度:$\beta\to\infty$ 时 $\exp(r/\beta)\to 1$,最优策略退化成 $\pi_{\text{ref}}$(完全不动);$\beta\to 0$ 时分布集中到 $\argmax_y r(x,y)$(完全贪心,也就完全 reward hacking)。
为什么这个解不能直接用?因为 $Z(x)=\sum_y \pi_{\text{ref}}(y\mid x)e^{r(x,y)/\beta}$ 是对所有可能的文本序列求和——计算上完全不可能。这正是我们本来需要 PPO 的原因。
8.3 推导第二步:把奖励用策略表示出来
DPO 的关键一跃是把这个等式反过来解。对上式两边取对数并整理:
$$ r(x,y) = \beta\log\frac{\pi_r(y\mid x)}{\pi_{\text{ref}}(y\mid x)} + \beta\log Z(x) $$读一遍这句话的含义:任意一个奖励函数,都可以用它所诱导的最优策略来表示。奖励和策略之间存在一一对应。既然如此,我们就不必再单独训练奖励模型——直接用策略 $\pi_\theta$ 去参数化奖励:
$$ \hat r_\theta(x,y) \;\triangleq\; \beta\log\frac{\pi_\theta(y\mid x)}{\pi_{\text{ref}}(y\mid x)} \;+\; \beta\log Z(x) $$然后把它代进第 6 节推出的 Bradley-Terry 损失。奇迹发生在这一步:BT 损失只依赖奖励差,而 $\beta\log Z(x)$ 只依赖 $x$——对 $y_w$ 和 $y_l$ 完全相同,直接相消。
$$ \hat r_\theta(x,y_w)-\hat r_\theta(x,y_l) = \beta\log\frac{\pi_\theta(y_w\mid x)}{\pi_{\text{ref}}(y_w\mid x)} - \beta\log\frac{\pi_\theta(y_l\mid x)}{\pi_{\text{ref}}(y_l\mid x)} $$代入 $\mathcal{L}_{\text{RM}}=-\E[\log\sigma(\Delta r)]$,得到 DPO 目标:
$$ \mathcal{L}_{\text{DPO}}(\pi_\theta;\pi_{\text{ref}}) = -\,\E_{(x,y_w,y_l)\sim\mathcal{D}}\left[\log\sigma\!\left(\beta\log\frac{\pi_\theta(y_w\mid x)}{\pi_{\text{ref}}(y_w\mid x)} - \beta\log\frac{\pi_\theta(y_l\mid x)}{\pi_{\text{ref}}(y_l\mid x)}\right)\right] $$- 做非参数假设 —— 这让 $\pi_\theta$ 和 $r$ 之间有了闭式联系。
- 用策略参数化奖励 —— 不再需要独立的奖励模型。
- 用监督损失去优化这个奖励 —— 而优化这个奖励,反过来就是在优化策略。
一句话概括:DPO 就是在「非参数假设 + 另一种参数化」之下,对成对奖励做极大似然估计。它不是一个新算法,它是同一个目标的另一种写法。
顺带一提,同一个「策略 ↔ 隐式奖励」的等价关系在后来的推理模型工作(如 kimi-think)里被反复使用,它比 DPO 本身更通用。
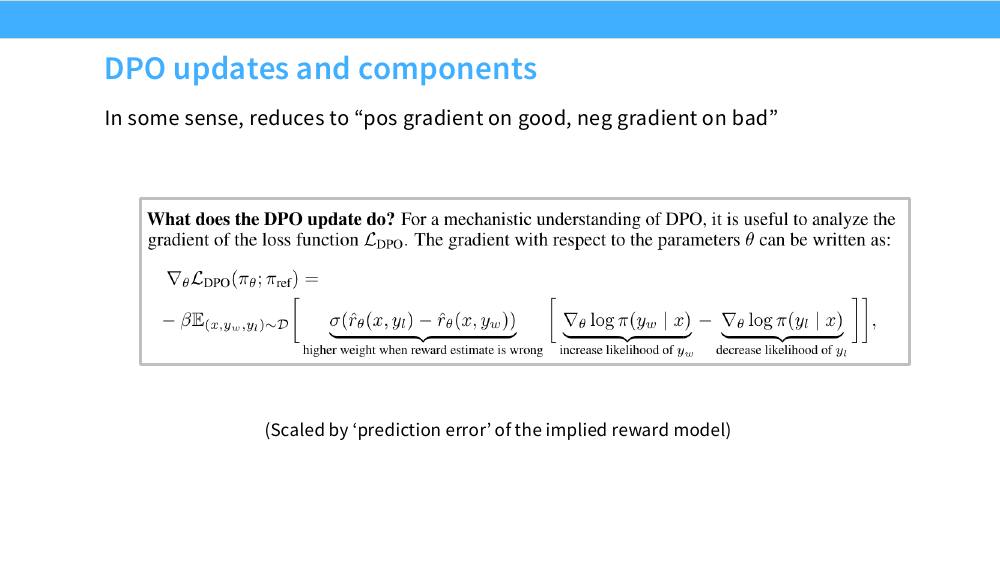
8.4 DPO 的梯度:它到底在做什么
拆开看:
- 方括号里:一个正梯度加一个负梯度。就是「对好的做 SFT,对坏的做反向 SFT」。
- 前面的 $\sigma(\cdot)$:一个自适应权重。当隐式奖励模型已经把 $y_w$ 排在前面($\hat r_w \gg \hat r_l$),权重趋近 0,这条样本被忽略;当它排错了,权重趋近 1,全力更新。这正是 PPO 里需要靠优势估计才能得到的「按错误程度加权」,在 DPO 里免费得到了。
最小实现只有十几行:
import torch.nn.functional as F

def seq_logprob(model, input_ids, labels):
    """返回每条序列在 response 位置上的 log p(y|x) 之和,形状 (B,)"""
    logits = model(input_ids).logits[:, :-1]
    tgt    = labels[:, 1:]
    mask   = (tgt != -100)
    lp = torch.gather(logits.log_softmax(-1), 2,
                      tgt.clamp(min=0).unsqueeze(-1)).squeeze(-1)
    return (lp * mask).sum(-1)

def dpo_loss(policy, ref, ids_w, lab_w, ids_l, lab_l, beta=0.1):
    pi_w, pi_l = seq_logprob(policy, ids_w, lab_w), seq_logprob(policy, ids_l, lab_l)
    with torch.no_grad():   # 参考模型冻结,只前向
        rf_w, rf_l = seq_logprob(ref, ids_w, lab_w), seq_logprob(ref, ids_l, lab_l)
    # 隐式奖励差;注意 Z(x) 已经在推导中消掉了
    logits = beta * ((pi_w - rf_w) - (pi_l - rf_l))
    return -F.logsigmoid(logits).mean()
一个被反复观察到的现象:DPO 训练中 $\log\pi_\theta(y_w\mid x)$ 和 $\log\pi_\theta(y_l\mid x)$ 会一起下降,只是后者降得更快。损失确实在下降(因为它只关心差),但模型对两个回答都变得更不可能,概率质量跑到了第三个地方——而那个地方是你从未观察、也从未约束过的。
根本原因:DPO 是 off-policy 的。它只在数据集里那两个固定的 $y$ 上施加约束,对模型实际会生成的分布毫无控制。PPO 因为是 on-policy 的(每轮都在当前策略采出来的样本上算奖励),天然没有这个漏洞。这是 DPO 最本质的缺陷,也是后面各种变体想修补的东西。
实践缓解:混入一个 SFT 项(在 $y_w$ 上加常规 NLL 损失),或者用 on-policy 数据(先用当前策略采样,再让裁判标注,即「在线 DPO」)。
8.5 变体一览
DPO 之后出现了太多变体。Tatsu 只挑了 Tülu 3 论文里认为值得一提的两个:
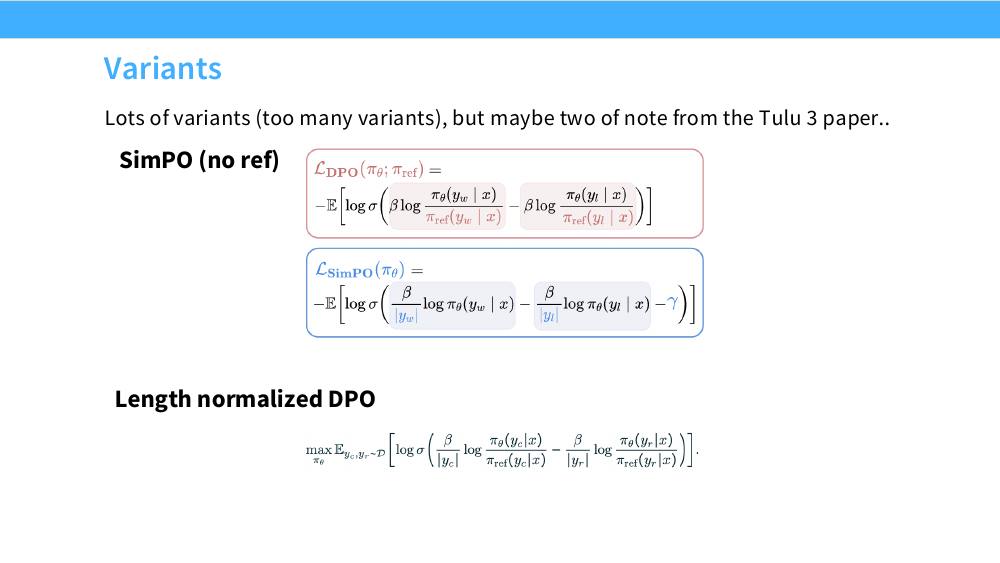
SimPO(无参考模型):
$$ \mathcal{L}_{\text{SimPO}}(\pi_\theta) = -\,\E\left[\log\sigma\!\left(\frac{\beta}{|y_w|}\log\pi_\theta(y_w\mid x) - \frac{\beta}{|y_l|}\log\pi_\theta(y_l\mid x) - \gamma\right)\right] $$两个改动的动机:(1) 去掉 $\pi_{\text{ref}}$ 直接省掉一份模型的显存和一次前向;(2) 除以长度是因为 $\log\pi_\theta(y)=\sum_t\log\pi_\theta(y_t\mid\cdot)$ 是长度的累加,长序列的对数概率天然更负,不归一化的话长度会直接混进隐式奖励里。$\gamma$ 是一个 margin,要求赢家不只是赢,而要赢出一定幅度。
长度归一化 DPO(DPO-norm)保留参考模型,只做长度归一化:
$$ \max_{\pi_\theta}\ \E\left[\log\sigma\!\left(\frac{\beta}{|y_c|}\log\frac{\pi_\theta(y_c\mid x)}{\pi_{\text{ref}}(y_c\mid x)} - \frac{\beta}{|y_r|}\log\frac{\pi_\theta(y_r\mid x)}{\pi_{\text{ref}}(y_r\mid x)}\right)\right] $$其他常被提及的变体,各一句话:
| 方法 | 一句话 |
|---|---|
| IPO | 指出 BT 损失在偏好确定($p=1$)时会把 KL 正则化推到失效,改用平方损失让隐式奖励差趋向一个有限的目标值而不是无穷大,从而抑制过拟合 |
| KTO | 借前景理论(prospect theory),不需要成对数据——只要每条回答有「好 / 坏」的二元标签即可,在真实产品的点赞点踩数据上更实用 |
| SimPO | 无参考模型 + 长度归一化 + margin,最省资源,但对超参非常敏感 |
| ORPO | 把 SFT 和偏好优化合成一个阶段,在 NLL 损失上加一个 odds-ratio 惩罚项 |
8.6 PPO vs DPO:到底该用哪个
DPO 因为简单、便宜、稳定,在开源社区几乎成了默认选项——LLaMA 的后训练用的是 DPO + 专家迭代(expert iteration)的组合。但 Tatsu 特意用一整页提醒:PPO 也在进步,而且有时更好。
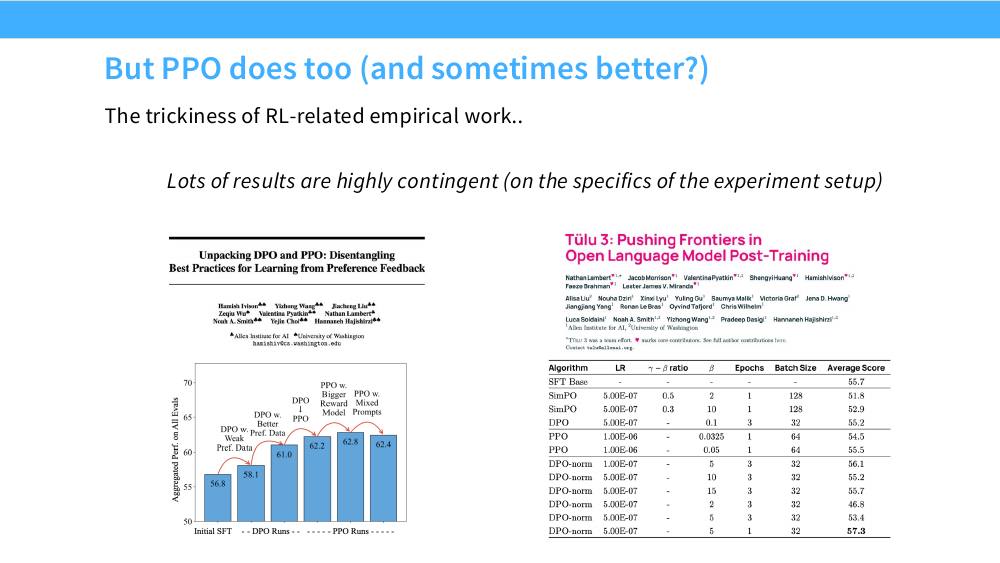
Tatsu 的原话:「大量结果高度依赖于实验设置的具体细节。」看右边那张表——同一个算法(DPO-norm),只是把 $\beta$ 从 5 换成 2,平均分从 57.3 掉到 46.8,比任何算法之间的差异都大一个数量级。
所以正确的读法是:
- 不要相信任何「A 算法比 B 算法好 X 分」的论断,除非它在你自己的设置上被复现过。
- 数据 > 超参 > 算法。把精力花在偏好数据质量和奖励模型规模上,回报远高于换损失函数。
- 如果你在学术预算下工作:用 DPO(显存 2 份模型 vs PPO 的 4 份,无需采样循环,超参少)。如果你有工业级基础设施且在意最后几分:PPO 仍然有额外空间,尤其是配一个更大的奖励模型。
| PPO | DPO | |
|---|---|---|
| 需要奖励模型 | 是(单独训练) | 否(隐式) |
| 需要采样 | 是(每步 rollout,占 60%–80% 时间) | 否 |
| 显存中的模型数 | 4(策略 / 参考 / RM / 价值) | 2(策略 / 参考),SimPO 只要 1 |
| 数据是否可复用 | 数据必须 on-policy 重新采 | 固定数据集,可反复训 |
| 对分布外输出的控制 | 好(on-policy 天然覆盖) | 差(只约束数据集里的两个点) |
| 能否超越偏好数据的分布 | 能(探索新输出并获得奖励) | 基本不能 |
| 超参敏感度 | 极高 | 高(尤其 $\beta$ 和学习率) |
| 实现难度 | 高(需要推理引擎 + 训练框架耦合) | 低(就是个自定义损失) |
9. 副作用与对齐目标之间的张力
算法讲完了,还剩最后一个问题:RLHF 会带来什么你不想要的东西?Tatsu 列了两个必须警惕的现象,然后是一个更深层的问题。
9.1 过度优化:奖励涨了,质量掉了
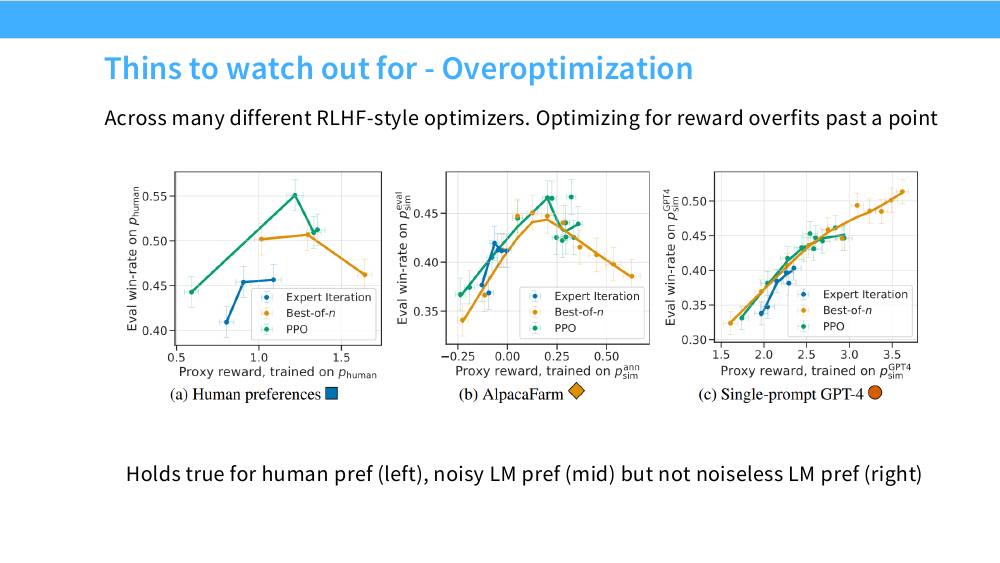
这三张图放在一起才有意义。它们说明:
- 横跨所有 RLHF 风格的优化器——PPO、Best-of-$n$、专家迭代,全都出现同样的倒 U。所以这不是某个算法的缺陷,而是「优化一个有噪声的代理目标」这件事本身的性质。
- 当代理是无噪声的(右图:奖励模型和评测者是同一个 GPT-4,且 prompt 单一,几乎不存在拟合误差),曲线不掉头。也就是说:如果代理就是真理,那么优化代理永远不亏。
- 反过来,真实世界里代理一定有噪声(回想 6.3:RM 准确率只有 65%–75%)。奖励模型误差最大的地方,正是策略最容易被推去的地方——这是一个系统性的、被优化过程主动放大的选择偏差。
实操结论:必须准备一个与奖励模型独立的评测集,在 reward 还在涨的时候盯着它,一旦掉头就停。「reward 单调上升」不是训练健康的证据,反而常常是警报。
9.2 模式坍缩:模型不再是一个概率模型
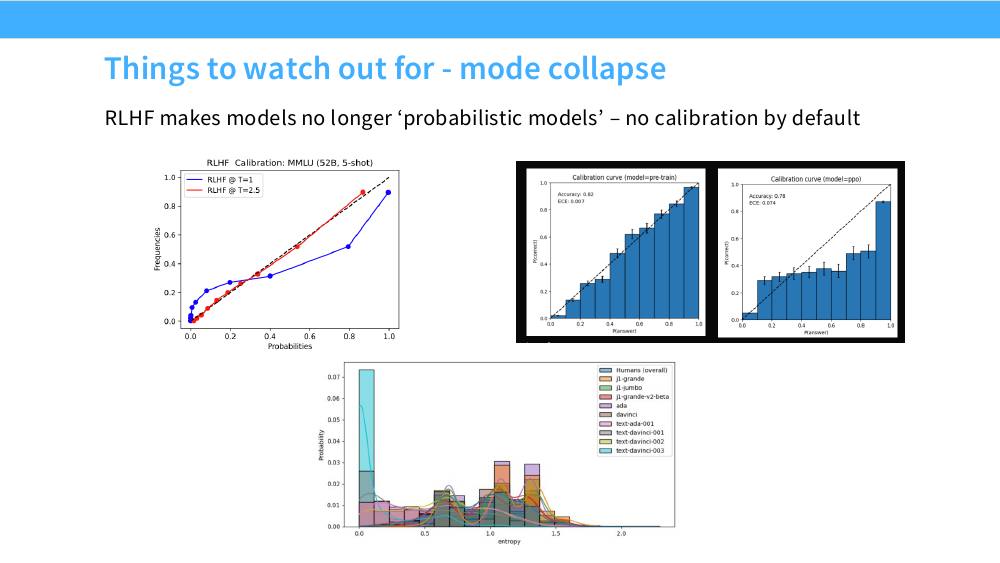
为什么会这样?因为 RLHF 的目标里根本没有「保持概率校准」这一项。第 1 节那张表已经说过:SFT 后的模型是一个分布模型,RLHF 后的模型是一个策略。策略只需要在期望奖励意义上最优,最优策略的极限形态是确定性的(把所有质量放到最好的那个输出上)。KL 惩罚是唯一在阻止这件事的力量,$\beta$ 太小就会坍缩。
后果是实际的:
- 不能再用 $\log p$ 当置信度——依赖 logprob 的选择题评测、拒答阈值、主动学习全部失效。
- 多样性下降——采 100 次得到 100 个几乎一样的回答,这会直接损害 Best-of-$n$、self-consistency、以及下一讲 RLVR 里需要的探索。
- 创意写作变差——「写一个故事」的输出高度模式化。
9.3 有用 / 无害 / 诚实:三个目标互相打架
InstructGPT 的标注指南把目标定义为 HHH:helpful(有用)、harmless(无害)、honest(诚实)。麻烦在于这三者在具体样本上经常冲突,而奖励模型被迫把它们压成一个标量。
| 张力 | 冲突场景 | 过度优化其中一端会怎样 |
|---|---|---|
| 有用 ↔ 无害 | 「我是护士,帮我列一下这些药的致死剂量」——拒绝则无用,回答则有风险 | 偏无害 → 过度拒绝(over-refusal),把「怎么杀死一个 Python 进程」也拒了;偏有用 → 越狱易如反掌 |
| 有用 ↔ 诚实 | 模型不确定答案。「我不知道」是诚实的,但标注员会觉得它没帮上忙 | 偏有用 → 幻觉;偏诚实 → 满屏「作为一个 AI 模型,我无法确定……」 |
| 诚实 ↔ 用户满意 | 用户说了一个错误的前提,或者坚持自己的错误答案 | → 谄媚(sycophancy):模型学会顺着用户改口。这是偏好优化最直接、最难避免的产物,因为标注员就是更喜欢同意自己的回答 |
| 对齐 ↔ 能力 | 后训练之后,公开 NLP 基准分数下降 | → 对齐税(alignment tax)。InstructGPT 的 ptx 项(第 7.1 节的 $\gamma$ 项)就是专门为了修这个而存在的 |
BT 模型拟合的是 $P(y_w\succ y_l)$,也就是标注员的实际选择。标注员是人,人在看到「你说得对」和「你错了,理由如下」时,前者的即时评分更高——尤其在标注员自己也不确定谁对时(回想 5.4 那张图:断言性越强,事实错误越发现不了)。
于是「谄媚」在训练目标上就是正确答案。要消除它,你不能靠更好的 RLHF 算法,你必须改变奖励信号本身——换成可验证的正确性(下一讲的 RLVR),或者用 Constitutional AI 那样把「不要谄媚」写成显式原则。
9.4 讲师的三条收束
- RLHF 的数据采集(同样)很难,有很多混杂因素。标注员是谁、怎么付钱、有没有偷用 AI、偏好里混了多少长度和风格——这些决定的东西比算法多。
- RLHF 算法比 SFT 复杂不少,尤其是 PPO。DPO 把门槛降下来了,但它是用「放弃 on-policy」换来的,代价真实存在。
- 时刻警惕「为奖励而(过度)优化」的影响。倒 U 形曲线、模式坍缩、谄媚,都是同一件事的不同表现:你优化的从来不是你真正想要的东西。
本讲小结
一页速查
| 阶段 | 目标 | 损失 | 数据 | 主要风险 |
|---|---|---|---|---|
| 中期训练 | 补能力、扩上下文、把指令数据规模化 | next-token CE(退火期换配比) | $10^{10}$–$10^{11}$ tokens | 配比调错,前功尽弃 |
| SFT | 提取「助手」这个行为 | $-\sum_t\log\pi_\theta(y_t\mid x,y_{<t})$,只在 response 上 | $10^3$–$10^6$ 条 | 在模型不知道的事实上微调 → 幻觉 |
| 奖励模型 | 把成对比较变成标量 | $-\log\sigma(r_w-r_l)$(BT 的 MLE) | $10^4$–$10^6$ 对 | 准确率仅 65%–75%;学到长度偏置 |
| PPO | 最大化 $r$ 同时不跑远 | clip 目标 + KL 惩罚 + 价值损失 | on-policy rollout | 4 个模型的显存、极度难调 |
| DPO | 同上,但闭式绕过 RM | $-\log\sigma\!\big(\beta\log\frac{\pi_\theta(y_w)}{\pi_{\text{ref}}(y_w)}-\beta\log\frac{\pi_\theta(y_l)}{\pi_{\text{ref}}(y_l)}\big)$ | 固定偏好集 | off-policy,$\pi(y_w)$ 也会被压低 |
要点清单
- 模仿 vs 优化是理解整个后训练的主轴:SFT 拟合 $p^*(y\mid x)$,RLHF 最大化 $\E[R]$。前者上限是示范者,后者靠 G-V gap 突破它。
- SFT 是提取不是注入。500 条安全样本足以改变行为;但你想要的能力必须在中期训练里放进去。在模型不知道的事实上做行为克隆 = 教它自信地编造。
- 中期训练(两阶段训练 / 退火)是「把指令微调变成预训练」的行业标准配方,也是长上下文扩展(PI / NTK / YaRN)的发生地。
- SFT 的实现细节会咬人:response-only loss、EOS、packing 的 document mask、chat template 一致性、token-level vs sample-level 平均。
- 风格污染一切偏好评测。人和 GPT-4 都以 55%–75% 的概率偏好更长、带列表的回答;比较 win-rate 必须同时报长度。
- 奖励模型损失不是设计出来的,它就是 Bradley-Terry 模型的极大似然:$P(y_w\succ y_l)=\sigma(r_w-r_l)$。
- DPO 不是近似,是同一目标的重参数化:非参数最优解 $\pi_r\propto\pi_{\text{ref}}e^{r/\beta}$ → 反解 $r=\beta\log\frac{\pi_r}{\pi_{\text{ref}}}+\beta\log Z$ → 代入 BT 损失时 $Z(x)$ 相消。
- PPO vs DPO 没有普适答案,同一算法换个 $\beta$ 的差异比算法之间的差异还大。数据 > 超参 > 算法。
- 过度优化是代理噪声的必然结果,与优化器无关;模式坍缩让模型失去校准与多样性;谄媚是偏好目标的正确答案而非 bug。
- 这三个问题共同指向同一个出路:换一个更可信的奖励信号——这就是下一讲 RLVR(可验证奖励的强化学习)。
延伸阅读
流程的奠基之作(细节最丰富,务必精读)
- Learning to Summarize from Human Feedback (Stiennon et al. 2020) — 现代 RLHF 的原型。奖励模型损失、KL 项的两个理由、价值网络独立参数化,全部出自这里;附录里有完整标注指南,是今天最好的「怎么组织标注」参考。
- InstructGPT (Ouyang et al. 2022) — 三步流程的正典。注意 PPO-ptx 的预训练梯度混合项,以及 $\binom{K}{2}$ 比较对必须同 batch 的细节。
- Anthropic HH (Bai et al. 2022) — 有用性与无害性的张力被首次系统测量;安全标注怎么组织写得非常详细。
- Constitutional AI (Bai et al. 2022) — 用自然语言原则替代人类无害性标注,自我批评 + 自我改写生成偏好数据。
算法
- PPO (Schulman et al. 2017) — clip 目标的原始论文,读第 3 节即可理解全部核心。
- DPO (Rafailov et al. 2023) — 本讲第 8 节的完整推导来源,附录 A 值得逐行读。
- Unpacking DPO and PPO (Ivison et al. 2024) — 唯一一篇认真做了控制变量的 PPO/DPO 对比;结论是数据质量和 RM 规模的影响远大于算法选择。
- Tülu 3 (Lambert et al. 2024) — 目前最完整公开的开源后训练配方(数据、算法、超参、评测全都开源),学习后训练的最佳单一入口。
- SimPO (Meng et al. 2024) — 去掉参考模型 + 长度归一化 + margin。
- KTO (Ethayarajh et al. 2024) — 不需要成对数据,只要二元好坏标签,最贴近真实产品的点赞点踩日志。
数据与评测的陷阱
- How Far Can Camels Go? (Wang et al. 2023) — 十几个指令数据集的横向对比,本讲那张长度统计表的来源;结论是没有任何单一数据集在所有评测上最优。
- AlpacaFarm (Dubois et al. 2023) — 长度和列表偏好的定量测量,以及一个可复现的 RLHF 模拟环境。
- A Long Way to Go: Length Correlations in RLHF (Singhal et al. 2024) — 论证 RLHF 的收益在很大程度上可以由长度增长解释。
- Human Feedback is not Gold Standard (Hosking et al. 2024) — 众包标注对事实错误的系统性漏检,以及断言性如何加剧漏检。
- Whose Opinions Do Language Models Reflect? (Santurkar et al. 2023) — 标注员人口统计学分布如何变成模型的默认立场。
- Benchmarking LLMs for News Summarization (Zhang et al. 2023) — G-V gap 的直接证据:付费写手已经赢不了模型。
- WildChat / WildTeaming — 从百万条真实交互日志中提取安全场景与越狱战术。
SFT 的边界
- LIMA (Zhou et al. 2023) — 「表层对齐假设」与 1000 条数据的主张;读它,也读第 4.5 节列的反方证据。
- Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations? (Gekhman et al. 2024) — 在模型未知的事实上微调会加剧幻觉的直接实验证据。
- Self-Instruct (Wang et al. 2022) — 用模型自举生成指令数据的原始方法,Alpaca 的直接前身。
- FLAN (Wei et al. 2021) — 把已有 NLP 任务模板化的路线起点。
中期训练与长上下文
- MiniCPM (Hu et al. 2024) — 少数公开写清楚两阶段训练(稳定期 / 退火期)数据配比的报告。
- Position Interpolation (Chen et al. 2023) — 最简单的上下文扩展方法,理解基线。
- YaRN (Peng et al. 2023) — 按波长分段插值 + 注意力温度修正,今天长上下文扩展的默认选择。