多模态:把世界变成 token
前 16 讲的模型只会「文本 ⇒ 文本」。但世界是多模态的。这一讲讲清楚:图像怎么变成 Transformer 能吃的 token(连续 patch / 离散码本 / 原始像素三条路线)、CLIP 与 SigLIP 怎么用海量图文对学出语义编码器、视觉编码器怎么接进 LLM(LLaVA 的两阶段配方、Qwen-VL 的动态分辨率、Chameleon 的早融合),以及为什么「理解」和「生成」可能需要完全不同的表示。
0. 本讲导读
这门课到目前为止,讲的一直是同一件事的不同侧面:怎么把一个「文本 ⇒ 文本」的函数训练得又快又好。分词(Lecture 1)、资源核算(Lecture 2)、架构与注意力变体(Lecture 3–4)、GPU 与内核(Lecture 5–6)、并行(Lecture 7–8)、缩放定律(Lecture 9、11)、推理(Lecture 10)、评测(Lecture 12)、数据(Lecture 13–14)、对齐与后训练(Lecture 15–16)。中间那个箭头一直是纯文本的。
但现实世界不是纯文本的。
Percy 在开场把终极目标说得很直白:omni model(全模态模型)。
- 输入任意模态的任意组合 —— 这是理解(understanding);
- 输出任意模态的任意组合 —— 这是生成(generation)。
注意这是两个独立的维度。今天绝大多数所谓「多模态模型」只做到了第一半:能看图,但生成还是只能吐文本,画图要外挂一个扩散模型。真正的 omni model 要求理解和生成在同一个模型、同一套表示里完成。
今天我们站在哪里
Percy 给出的现状判断是一条非常「工程」的推理链,值得逐句读:
- Transformer 工作得非常好,所以我们必须用它。这不是审美选择,而是经济选择:过去八年整个硬件栈(Tensor Core、FlashAttention、TP/PP/EP、推理引擎)都是围绕 Transformer 优化的,任何新架构要挑战它都得先补上这个几百亿美元的生态差距。
- Transformer 说的语言是 token(可以是离散的、也可以是连续的向量),一个 token 大致代表一个语义单元的信息。
- 因此,我们必须把一切都转换成 token。
- 注意:文本也是这样处理的——回想 Lecture 1 的分词部分,字节流本身也不是 token,BPE 是我们人为设计的「把连续字节流切成语义单元」的过程。
- 但对非文本模态,这件事难得多。
文本已经是离散的、有天然边界的、由人类为了传递语义而设计的符号序列。BPE 只是在做二次压缩,起点就很好。
图像不是。一张 336×336 的 RGB 图是 $336\times336\times3 = 338{,}688$ 个 0–255 的整数。这些数值:(a)是连续的(至少在语义上连续,改一个像素值语义不变);(b)没有天然的语义边界(哪几个像素属于「猫的耳朵」?);(c)信息密度极低——一张图的 33 万个数值,语义上可能只值一句话「一只猫坐在垫子上」,即约 8 个文本 token。
所以图像 tokenization 的本质是一个有损压缩问题:把 33 万个数压到几百个 token,同时保留下游任务需要的信息。而「需要哪些信息」取决于任务——这正是本讲反复出现的核心张力。
本讲要回答的两个问题
Percy 把整讲组织成两个问题:
- 怎么输入非文本数据?(例如:怎么让模型理解图像)
- 怎么输出非文本数据?(例如:怎么让模型生成音频)
本讲的绝大部分内容在回答第一个问题,因为它已经被研究得比较透彻、也有清晰的技术谱系。第二个问题(生成)目前还没有共识答案,我们会在第 7 节讨论。
- 一切归于 token。图像 tokenization 有三条路线:连续 patch 嵌入(ViT,主流)、离散码本(VQ-VAE/VQ-GAN,Chameleon 路线)、直接喂原始像素块(Fuyu 路线)。
- CLIP 的关键洞察:不要预测文本,要排序文本。对比学习(contrastive learning)比生成式描述(captioning)在计算效率上高一个数量级,因为它把「生成一句话」这个难问题换成了「在 batch 里认出配对项」这个易问题。
- SigLIP 的关键改进:用 sigmoid 逐对二分类替代 softmax 全 batch 归一化,从而把 batch size 和损失函数解耦——不再需要跨设备 all-gather 完整的相似度矩阵,训练效率大幅提升(CLIP 用 256 块 TPUv3 训 10 天,SigLIP 用 32 块 TPUv4 训 5 天)。
- VLM 的标准模板:视觉编码器 + 投影器(projector/adapter)+ 语言模型。LLaVA 用两阶段训练(先只训投影矩阵 $W$ 对齐,再联合微调)。绝大部分工作量在数据构造而非架构。
- 分辨率是 OCR 的生命线。CLIP 固定 336×336 的裁剪会丢信息;AnyRes(切成 $a\times b$ 块分别编码再拼接)和 Qwen2-VL 的动态分辨率是两种主流解法。
- 理解和生成可能要求不同的表示:理解要语义(可以有损),生成要细粒度细节(不能有损)。Chameleon 的离散化很优雅,但在 OCR 这类任务上因量化损失而吃亏。
- 多模态混训不稳定:文本 token 熵低、图像 token 熵高,混在一起会导致 norm 增长和 logit 漂移,需要 QK norm + z-loss 才能训得住。
- Percy 的最终判断:连续编码器 + Transformer + 扩散模型做生成,是目前最可能走通的组合。
1. 为什么要多模态
在跳进技术细节之前,先把动机说清楚。做多模态有三个层次的理由,从弱到强。
1.1 数据来源扩容:文本快用完了
回忆 Lecture 9/11 的缩放定律:Chinchilla 最优要求参数量 $N$ 和数据量 $D$ 同步增长,$D \approx 20N$。而 Lecture 13–14 讲数据时提到的现实是:高质量文本 token 的总量大约在 $10^{13}$–$10^{14}$ 量级,且增速远低于算力增速。
图像和视频是一个数量级完全不同的池子。粗略估算:
| 来源 | 规模量级 | 说明 |
|---|---|---|
| 高质量网页文本 | $\sim 10^{13}$ token | 去重、过滤后;这是当前的瓶颈 |
| 互联网图文对 | $\sim 10^{9}$–$10^{10}$ 对 | LAION-5B 有 58 亿对;CLIP 用了 4 亿对 |
| 视频(YouTube 量级) | $\gg 10^{15}$ 「token」 | 按每秒 2 帧、每帧数百 token 计,几乎无上限 |
视频的 token 数虽然巨大,但信息密度极低——连续两帧之间 99% 的内容是重复的。Percy 在本讲小结里专门提到这一点:「平衡图像 + 视频(信息密度更低)与文本,以保证训练稳定」。你不能简单地按 token 数配比,否则模型会把绝大部分容量花在建模「下一帧和这一帧几乎一样」这件毫无价值的事上。Qwen3-VL 的 square-root-normalized per-token loss(对每个样本的 token 损失按 $\sqrt{L}$ 归一化)就是为了压制长视频样本对梯度的支配(见第 6 节)。
1.2 真实应用需要看图
这是最直接、也最无可争辩的理由。你想让模型做的很多事情,本质上就是视觉任务:
- 读一张财报截图里的表格并回答问题(OCR + 表格理解);
- 看一段 GUI 录屏,操作一个 App(GUI agent,这是 Lecture 16 讲的 agent 能力的视觉版本);
- 看医学影像、看电路图、看手写数学;
- 为盲人描述周围环境。
这些任务里,「把图转成文字描述再喂给纯文本模型」这条捷径是走不通的:描述的过程本身就丢掉了你需要的信息,而且你事先不知道下游会问什么,无法决定该描述什么。
1.3 跨模态迁移:真的有收益吗
最有野心的说法是:学习视觉能让模型的语言能力也变强——因为视觉数据里蕴含了大量文本中「不言自明」而从不写出来的常识(物体的相对大小、遮挡关系、物理直觉)。
这个说法在直觉上很吸引人,但证据是混合的。诚实的现状是:
实际观察到的常见现象恰恰相反:把图像数据混进预训练,往往会轻微损害纯文本基准(所谓 "modality tax")。原因是图像 token 占据了上下文和参数容量,而这些容量本来可以用于文本。这也是为什么各家 VLM 论文里几乎都会有一张表,说明「我们的模型在纯文本任务上没有退化太多」——如果真有正迁移,这张表会写成主要卖点,而不是防守性说明。
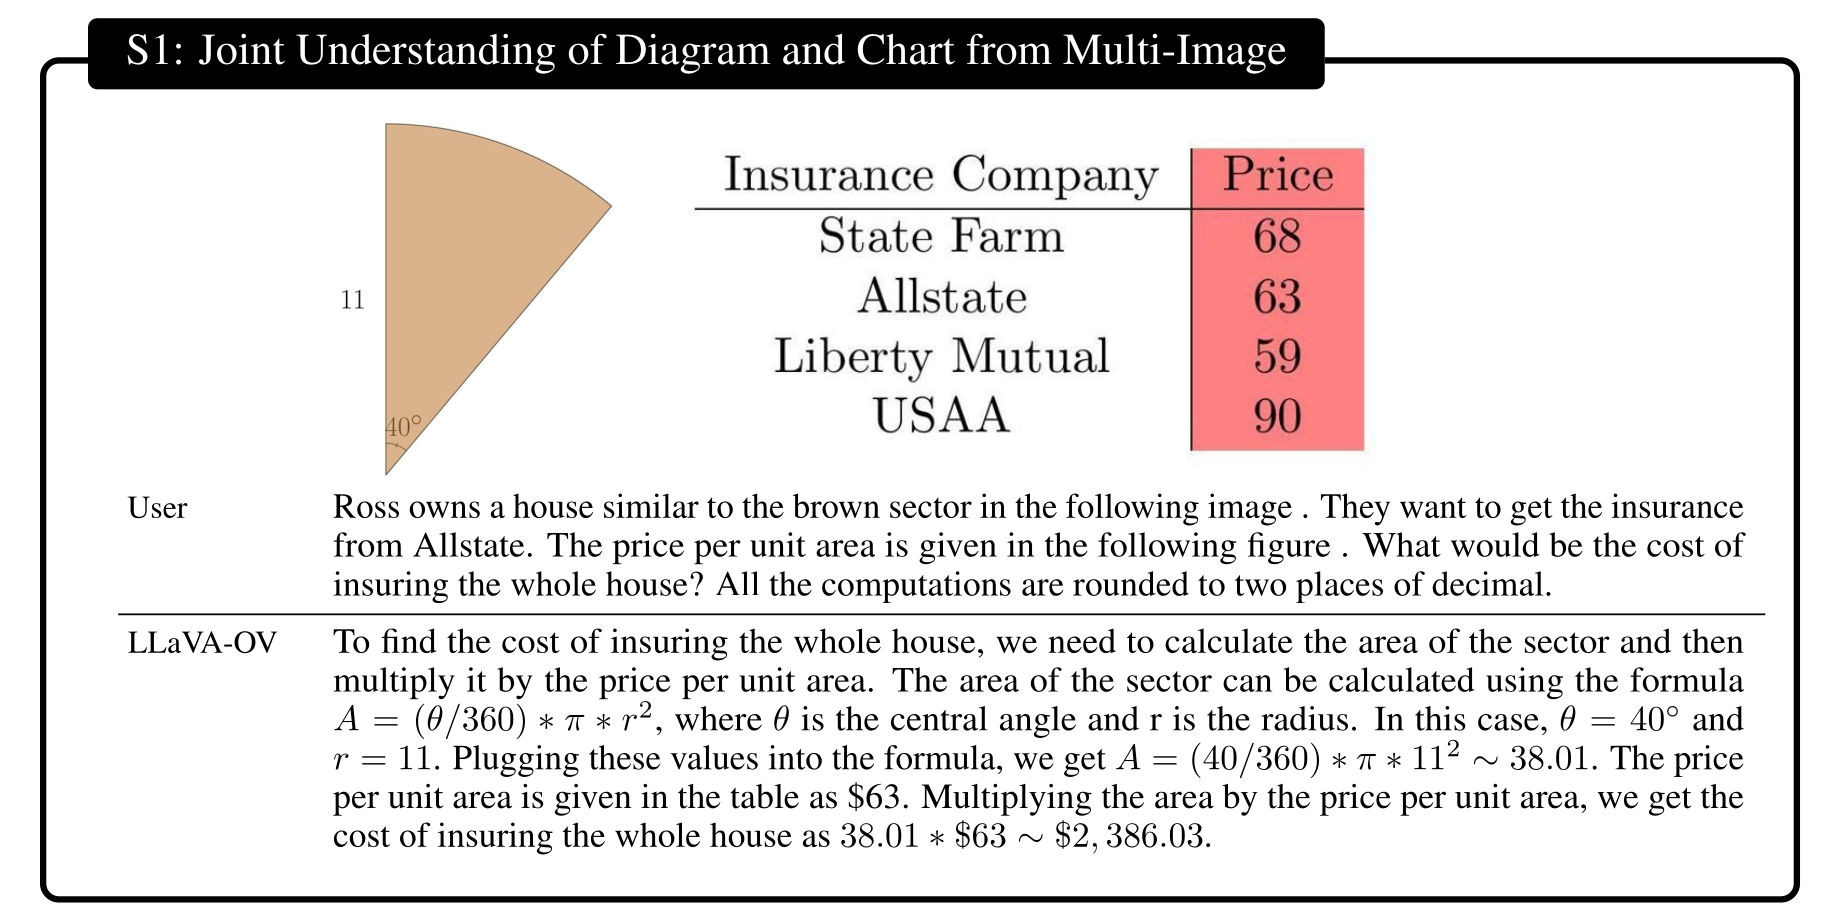
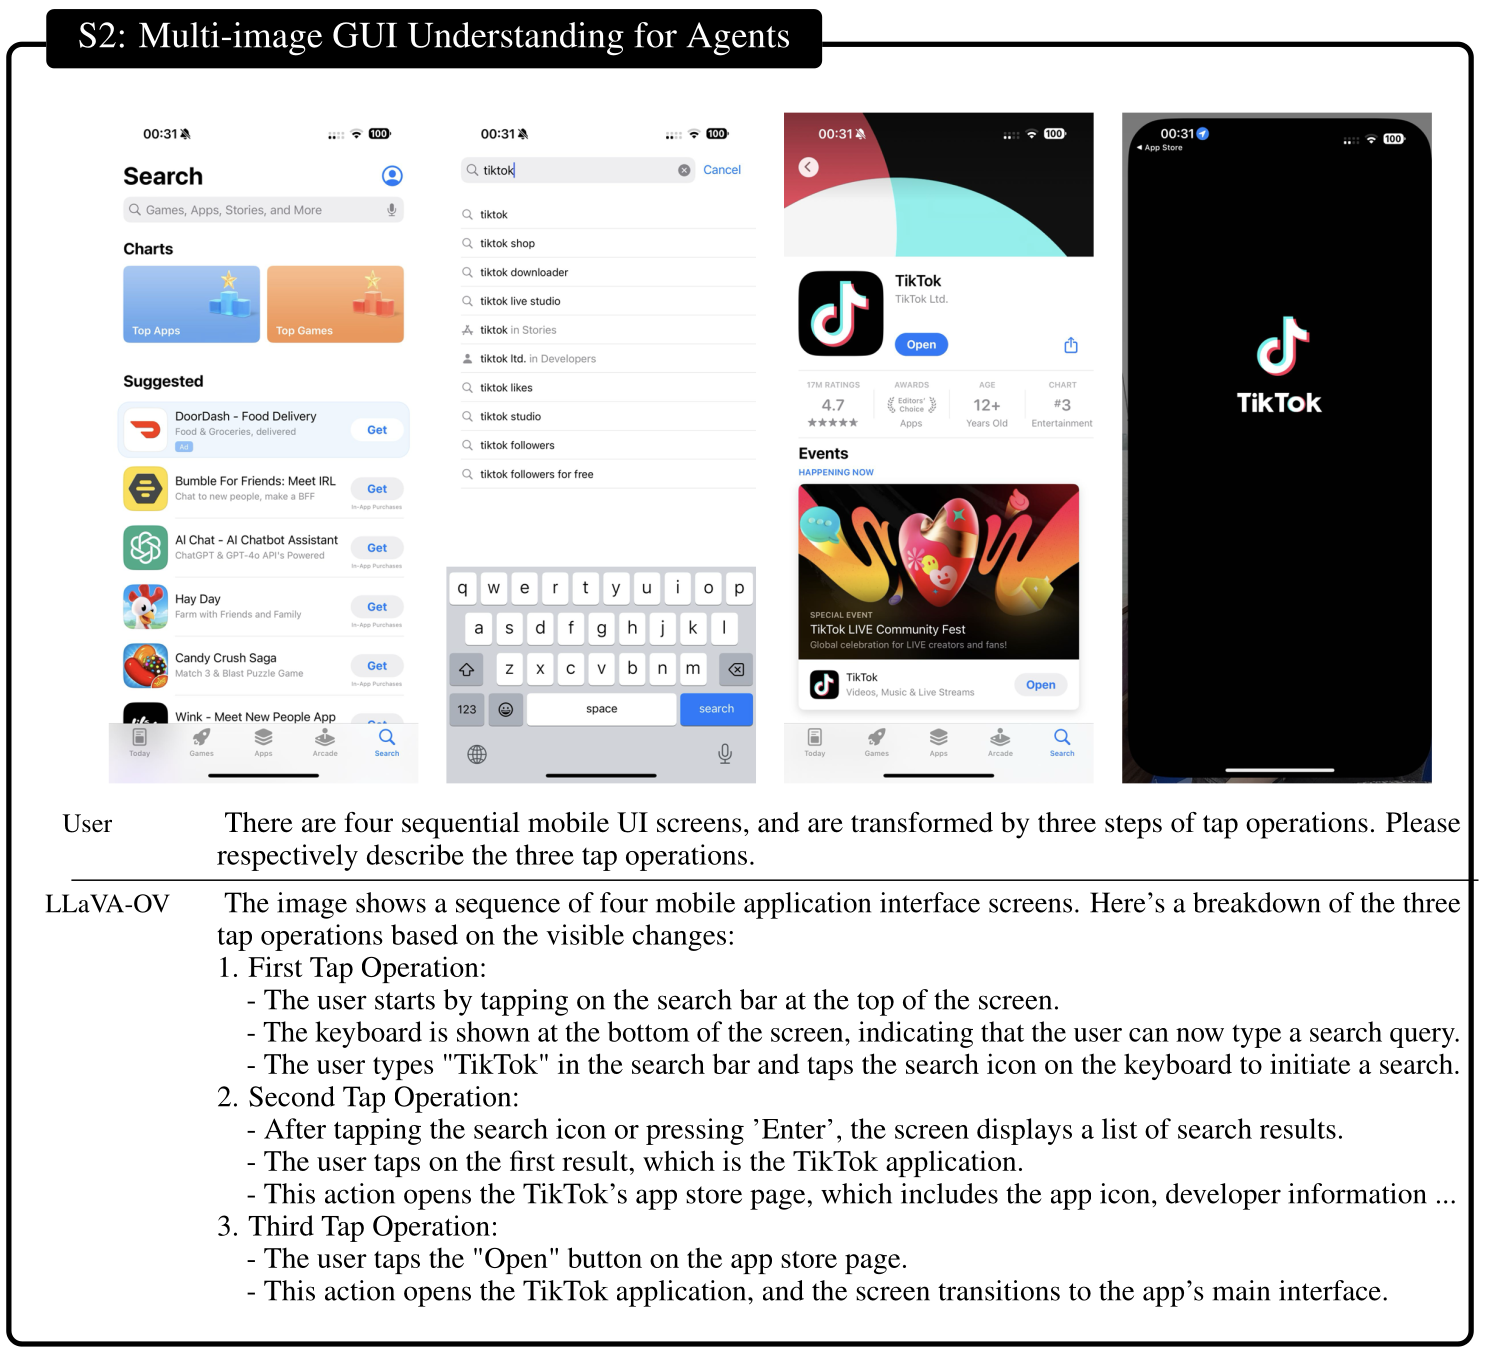
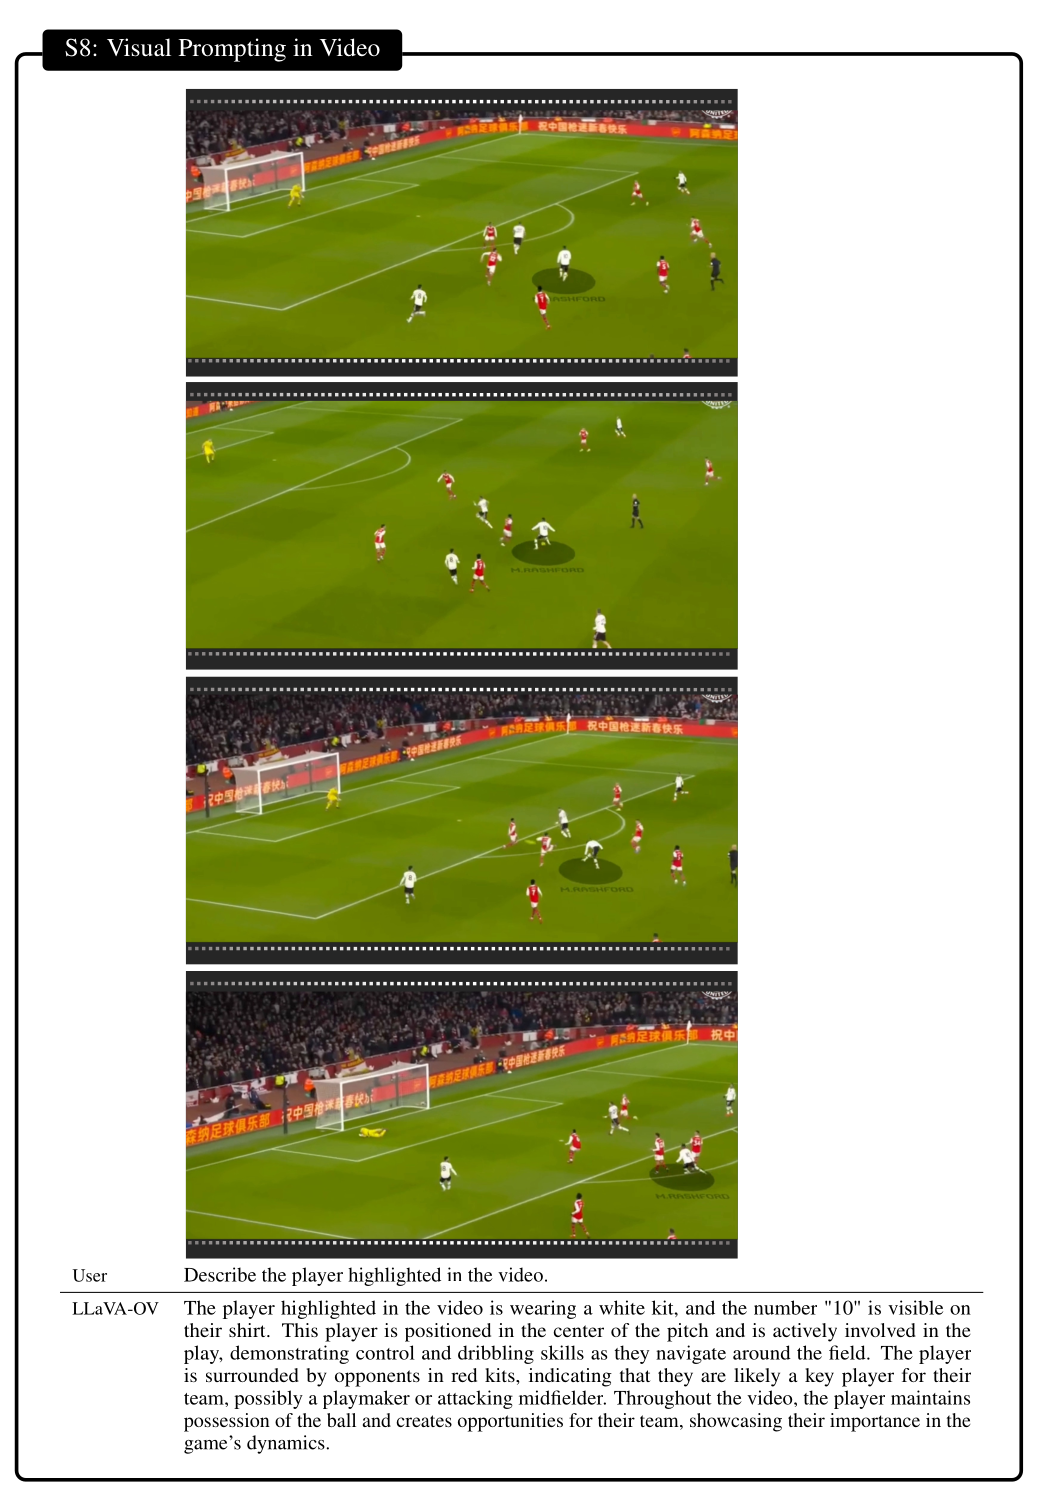
不过,模态之间的迁移在多模态任务内部确实存在且显著。LLaVA-OneVision 论文专门做了这方面的验证(第 6 节会展开):只用单图数据训练的图表理解能力,可以泛化到多图场景;单图上的 OCR 能力 + 多图上的关系推理能力,组合起来泛化到了 GUI agent 任务;单图上学到的「视觉提示」(用红圈标出目标)用法,可以泛化到视频。这是 task-level 的组合泛化,是真实的、可复现的收益。
所以更准确的表述是:多模态训练的收益主要来自能力覆盖面和模态内的组合泛化,而不是「看图让模型更聪明」这种玄学。
2. 图像表示路线一:连续表示(ViT)
这是今天绝对的主流路线,CLIP、SigLIP、LLaVA、Qwen-VL 全都基于它。核心思想极其简单:把图像切成固定大小的方块(patch),每个方块拉平成向量,用一个线性层投影到模型维度,再加上位置编码——这就得到了一串「视觉 token」,然后原封不动地丢进标准 Transformer。
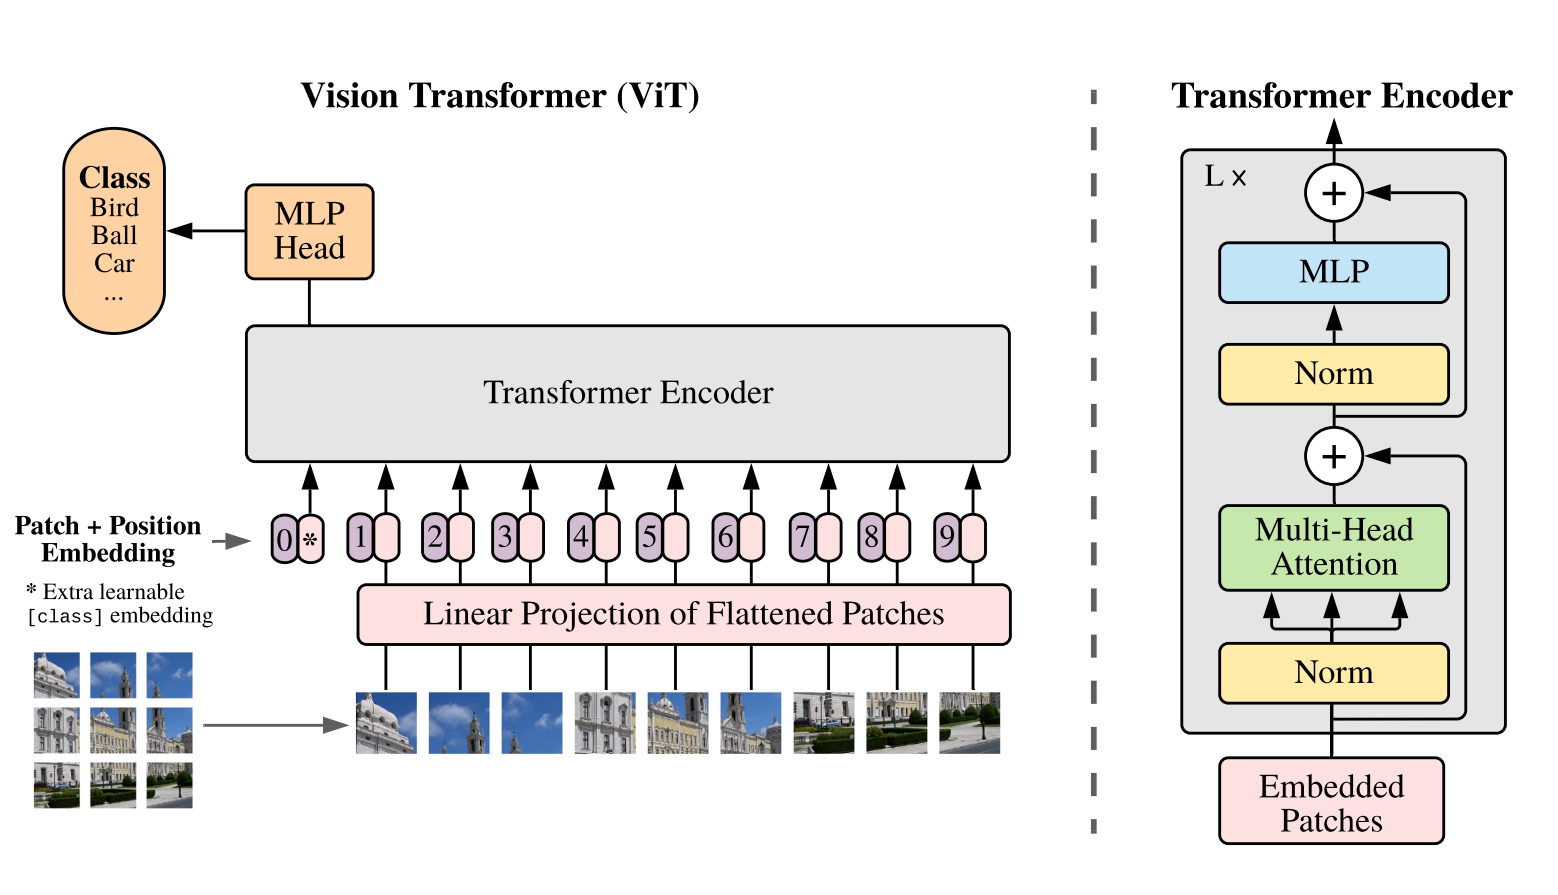
2.1 完整的形状推演
以 CLIP 最好的模型 ViT-L/14@336px 为例,把每一步的张量形状写清楚。命名规则:L = Large,14 = patch 边长 14 像素,@336px = 输入分辨率 336×336。
| 步骤 | 张量形状 | 说明 |
|---|---|---|
| 输入图像 | (B, 3, 336, 336) | 3 通道 RGB,已归一化 |
| 切 patch | (B, 24, 24, 14, 14, 3) | $336/14 = 24$,共 $24\times24=576$ 个 patch |
| 展平 patch | (B, 576, 588) | 每个 patch 展平:$14\times14\times3 = 588$ 维 |
| 线性投影 $E$ | (B, 576, 1024) | $E \in \R^{588\times1024}$,ViT-L 的 $d_\text{model}=1024$ |
| 拼 [CLS] token | (B, 577, 1024) | 一个可学习向量,用于聚合全局信息 |
| 加位置编码 | (B, 577, 1024) | 可学习的绝对位置嵌入 $\in \R^{577\times1024}$ |
| 24 层 Transformer | (B, 577, 1024) | ViT-L:24 层,16 头,FFN 隐层 4096 |
| 池化 + 投影 | (B, 768) | CLIP 中投影到共享的图文嵌入空间 |
几个值得注意的数字:
- 压缩比:输入 $336\times336\times3 = 338{,}688$ 个标量 → 576 个 token。每个 token 「代表」588 个像素值。对比文本:一个 BPE token 大约代表 4 个字符。所以一张图 ≈ 576 token ≈ 2300 个英文字符 ≈ 400 个单词的上下文开销。图很贵。
- 参数量:ViT-L 约 3.03 亿参数。主体是 24 层 × ($4d^2$ 注意力 + $8d^2$ FFN) $= 24 \times 12 \times 1024^2 \approx 3.0\times10^8$。
- 注意力开销:序列长度 577,注意力矩阵 $577^2 \approx 3.3\times10^5$,完全可以接受。但如果分辨率翻倍到 672×672,token 数变成 $48^2=2304$,注意力开销变成 $5.3\times10^6$,是 16 倍——分辨率的平方项是 VLM 成本的主要来源,这解释了为什么第 6 节要花那么大力气做动态分辨率。
2.2 最小实现
patch 切分有一个漂亮的实现技巧:「切 patch + 展平 + 线性投影」三步等价于一个 stride 等于 kernel size 的卷积。因为卷积核在不重叠地滑动时,每次做的就是「取一个 14×14×3 的块,与权重做内积」。
import torch
import torch.nn as nn

class PatchEmbed(nn.Module):
    """把 (B, 3, H, W) 图像变成 (B, N, D) 的视觉 token 序列。"""
    def __init__(self, img_size=336, patch=14, in_ch=3, d_model=1024):
        super().__init__()
        assert img_size % patch == 0
        self.grid = img_size // patch          # 24
        self.n_patches = self.grid ** 2        # 576
        # 关键技巧:kernel_size == stride == patch,等价于「切块 + 展平 + Linear」
        self.proj = nn.Conv2d(in_ch, d_model, kernel_size=patch, stride=patch)
        self.cls = nn.Parameter(torch.zeros(1, 1, d_model))
        self.pos = nn.Parameter(torch.zeros(1, self.n_patches + 1, d_model))

    def forward(self, x):                      # x: (B, 3, 336, 336)
        B = x.shape[0]
        x = self.proj(x)                       # (B, 1024, 24, 24)
        x = x.flatten(2).transpose(1, 2)       # (B, 576, 1024)
        cls = self.cls.expand(B, -1, -1)       # (B, 1, 1024)
        x = torch.cat([cls, x], dim=1)         # (B, 577, 1024)
        return x + self.pos                    # 加绝对位置编码

class ViT(nn.Module):
    def __init__(self, depth=24, d_model=1024, n_heads=16, **kw):
        super().__init__()
        self.embed = PatchEmbed(d_model=d_model, **kw)
        layer = nn.TransformerEncoderLayer(
            d_model, n_heads, dim_feedforward=4 * d_model,
            activation="gelu", norm_first=True, batch_first=True)
        self.blocks = nn.TransformerEncoder(layer, depth)
        self.norm = nn.LayerNorm(d_model)

    def forward(self, x):
        h = self.blocks(self.embed(x))         # (B, 577, 1024)
        return self.norm(h)                    # 全部 577 个位置的表示都保留
上面 self.pos 的形状是 (1, 577, 1024),它硬编码了「输入必须是 576 个 patch」。一旦你想在推理时用 672×672 的图(2304 个 patch),位置编码就对不上了。
标准解法是对位置编码做二维双线性/双三次插值:把 (576, 1024) reshape 成 (24, 24, 1024),插值到 (48, 48, 1024),再展平回 (2304, 1024)。这正是 LLaVA-OneVision 处理超高分辨率图像时用的手段。更彻底的解法是换成 2D RoPE(Qwen2-VL 的做法),因为 RoPE 是相对的、外推性质好得多——这与 Lecture 3 讲位置编码时的结论完全一致。
2.3 池化:CLS token 还是注意力池化
ViT 编码完得到 577 个向量,但 CLIP 需要一个单一向量来代表整张图。有三种做法:
- CLS token:取第 0 个位置的输出。这是原始 ViT 分类的做法。
- 平均池化:对 576 个 patch 输出取平均。简单,但把所有 patch 等权对待。
- 注意力池化(attention pooling):CLIP 采用的做法。Percy 的原话是「做一次 QKV,其中 query 取激活的全局平均」。
注意力池化的意思是:先算全局平均 $\bar{h} = \frac{1}{N}\sum_i h_i$ 作为唯一的 query,然后让它对所有 patch 做一次标准的单 query 注意力:
$$ \text{pool}(h) = \sum_{i=1}^{N} \softmax_i\!\left(\frac{(W_q\bar{h})^\top (W_k h_i)}{\sqrt{d}}\right) W_v h_i $$class AttentionPool(nn.Module):
"""CLIP 的注意力池化:query = 全局平均,key/value = 各 patch。"""
def __init__(self, d_model, d_out, n_heads=16):
super().__init__()
self.attn = nn.MultiheadAttention(d_model, n_heads, batch_first=True)
self.out = nn.Linear(d_model, d_out)
def forward(self, h): # h: (B, N, D)
q = h.mean(dim=1, keepdim=True) # (B, 1, D) 全局平均作为 query
pooled, _ = self.attn(q, h, h) # (B, 1, D) 单 query 注意力
return self.out(pooled.squeeze(1)) # (B, d_out)
相比朴素平均,它多了一步内容相关的重新加权:模型可以学会「看猫的时候,多看猫所在的那几个 patch」。相比 CLS token,它不需要额外训练一个从零开始的特殊向量,收敛更快。
2.4 图像预处理:被裁掉的信息
Percy 特意讲了 CLIP 的数据处理流程,因为这里藏着后面所有分辨率问题的根源:
- 互联网图像是任意分辨率的(任意 $W \times H$);
- 用双三次插值(bicubic interpolation)缩放,使较短边变成 336 像素;
- 中心裁剪(center crop)到 336×336——即把长边的两侧边缘直接切掉。
# CLIP 官方预处理(简化自 openai/CLIP clip.py)
from torchvision.transforms import Compose, Resize, CenterCrop, ToTensor, Normalize
from PIL import Image

preprocess = Compose([
    Resize(336, interpolation=Image.BICUBIC),   # 短边 -> 336,保持长宽比
    CenterCrop(336),                            # 裁成正方形,长边两侧被丢弃
    ToTensor(),
    Normalize(mean=(0.4815, 0.4578, 0.4082),    # CLIP 数据集统计量
              std=(0.2686, 0.2613, 0.2758)),
])
它是本讲后半段一半问题的来源。考虑一张 1920×1080 的 PPT 截图:短边 1080 → 336 意味着缩小到原来的 31%,然后中心裁剪把左右各约 490 像素(原图坐标系下)直接扔掉。结果是:(a)小字号文字被压成糊团,OCR 完全不可能;(b)幻灯片左右两侧的内容根本没进模型。
为什么 CLIP 当初能接受这个设计?因为 CLIP 的设计决策是围绕图像分类做的——判断「这是猫还是狗」根本不需要高分辨率,336×336 绰绰有余。Percy 在 CLIP 小结里明确写了这一点:「设计决策是基于图像分类选的(不是很细粒度的任务)」。当整个社区把 CLIP 拿来当 VLM 的视觉前端时,就继承了这个为分类而做的、对细粒度任务不友好的取舍。这是技术债跨越任务边界传播的经典案例。
3. 图像表示路线二:离散 token(VQ-VAE / VQ-GAN)
ViT 给出的是连续向量。这对「理解」够用——把向量塞进 LLM 的输入端就行。但它有一个致命缺陷:你没法生成它。
回忆语言模型是怎么生成的:在词表 $V$ 上算 softmax,采样一个离散 token,把它喂回去,重复。这套机制的前提是输出空间是有限离散集合。如果图像表示是 $\R^{1024}$ 里的连续向量,模型该怎么「采样」下一个视觉 token?在 1024 维连续空间上做自回归生成,既没有归一化的概率分布,也没有可用的采样算子。
所以如果你想要一个能画图的自回归 Transformer,就必须先把图像变成离散符号。这就是 VQ-VAE 的任务,也是 Chameleon 走的路。
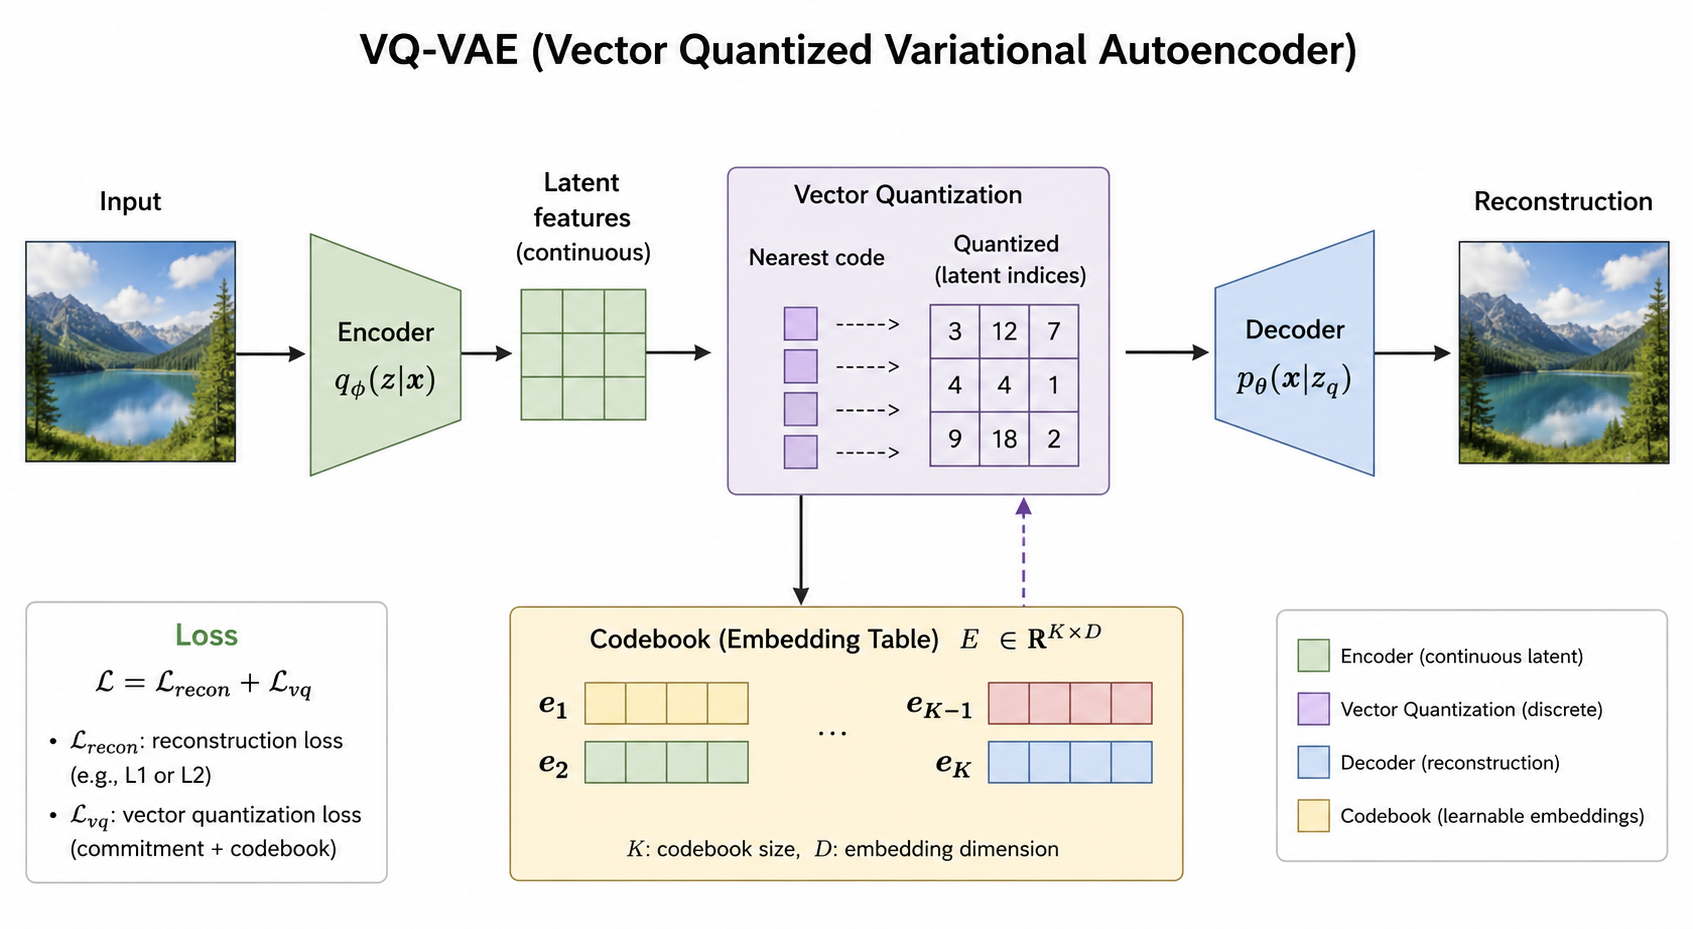
3.1 量化:把向量变成整数
设编码器(一个卷积网络)把图像 $x$ 映射为一个特征网格
$$ z_e(x) \in \R^{h \times w \times d} $$码本是一组可学习的向量 $\{e_1, \dots, e_K\}$,$e_k \in \R^d$。对网格上每个位置 $(i,j)$,找最近的码本项:
$$ k_{ij} \;=\; \argmin_{k \in \{1..K\}} \; \big\| z_e(x)_{ij} - e_k \big\|_2 $$然后用这个码本向量替换原向量:$z_q(x)_{ij} = e_{k_{ij}}$。
整数网格 $\{k_{ij}\}$ 就是图像的离散 token 序列(按光栅顺序展平)。Chameleon 用的配置是:512×512 的图像 → 1024 个 token,码本大小 $K = 8192$。
先算下采样倍率。1024 个 token 排成 $32\times32$ 的网格,而输入是 $512\times512$ 像素,所以编码器的空间下采样倍率是 $512/32 = 16$:每个 token 对应原图一个 $16\times16$ 的像素块。
再算比特数。码本大小 8192 $=2^{13}$,所以每个 token 携带最多 13 bit:
$$ 1024 \text{ tokens} \times 13 \text{ bit} = 13{,}312 \text{ bit} \approx 1.6 \text{ KB} $$原图 $512\times512\times3 = 786{,}432$ 字节。所以压缩比约 473:1——比 JPEG(典型 10:1 到 20:1)激进一个多数量级。这就是「离散化会丢信息」的量化版本:你把一个 16×16×3 = 768 字节的像素块,压成了 13 个比特。
这 13 个比特足以编码「这里是一片蓝天」「这里是猫毛的纹理」,但绝对不足以编码「这里是字母 g 的下半部分」。这正是 Chameleon 在 OCR 类任务上表现不佳的根本原因,也是 Percy 小结里那句「discretization loses information — think OCR」的来源。
3.2 三项损失
VQ-VAE 的训练目标由三部分组成:
$$ \mathcal{L} \;=\; \underbrace{\big\| x - D(z_q(x)) \big\|_2^2}_{\text{(1) 重建损失}} \;+\; \underbrace{\big\| \operatorname{sg}[z_e(x)] - e \big\|_2^2}_{\text{(2) 码本损失}} \;+\; \beta \underbrace{\big\| z_e(x) - \operatorname{sg}[e] \big\|_2^2}_{\text{(3) 承诺损失}} $$其中 $\operatorname{sg}[\cdot]$ 是 stop-gradient(PyTorch 里的 .detach()),$D$ 是解码器,$\beta$ 通常取 0.25。逐项解释:
- 重建损失:把量化后的表示解码回图像,要求像原图。这是唯一逼迫表示「保留信息」的项。
- 码本损失(codebook loss):只更新码本向量 $e$,把它拉向编码器输出的那些向量。因为编码器输出被
sg冻住了,这一项只对 $e$ 有梯度。直觉:码本要做被分配给它的那些向量的聚类中心——这实际上是在线的 $k$-means。 - 承诺损失(commitment loss):反过来,只更新编码器,把编码器输出拉向它选中的码本向量。为什么需要它?如果没有这一项,编码器可以让输出的模长任意增长、在空间里到处乱跑,因为量化会把一切都吸附到码本上,编码器感受不到任何约束。结果是码本永远追不上编码器,训练发散。承诺损失强制编码器「承诺」自己的输出会待在某个码本项附近。$\beta$ 控制这个约束的强度。
3.3 直通估计器
最关键的技术难点:$\argmin$ 是不可导的。$z_q$ 对 $z_e$ 的梯度处处为 0(分段常数函数)。如果照实算,重建损失的梯度根本传不到编码器,编码器永远学不到东西。
直通估计器(straight-through estimator, STE)的做法简单粗暴:前向传播时做量化,反向传播时假装量化不存在,把 $z_q$ 处收到的梯度原样复制给 $z_e$:
$$ \frac{\partial \mathcal{L}}{\partial z_e} \;:=\; \frac{\partial \mathcal{L}}{\partial z_q} $$这在 PyTorch 里有一个非常漂亮的一行实现:
class VectorQuantizer(nn.Module):
    def __init__(self, K=8192, d=256, beta=0.25):
        super().__init__()
        self.codebook = nn.Embedding(K, d)
        self.codebook.weight.data.uniform_(-1.0 / K, 1.0 / K)
        self.beta = beta

    def forward(self, z_e):                    # z_e: (B, h, w, d)
        B, h, w, d = z_e.shape
        flat = z_e.reshape(-1, d)              # (B*h*w, d)

        # 最近邻查找:||a-b||^2 = ||a||^2 - 2a·b + ||b||^2
        dist = (flat.pow(2).sum(1, keepdim=True)
                - 2 * flat @ self.codebook.weight.t()
                + self.codebook.weight.pow(2).sum(1))       # (B*h*w, K)
        idx = dist.argmin(dim=1)                            # (B*h*w,)  <- 这就是「图像 token」
        z_q = self.codebook(idx).view(B, h, w, d)

        # 码本损失(只更新码本) + 承诺损失(只更新编码器)
        loss = ((z_q - z_e.detach()).pow(2).mean()
                + self.beta * (z_e - z_q.detach()).pow(2).mean())

        # 直通估计:前向值 = z_q,反向梯度 = 恒等映射回 z_e
        z_q = z_e + (z_q - z_e).detach()
        return z_q, idx.view(B, h, w), loss
z_e + (z_q - z_e).detach() 为什么成立
前向:数值上等于 $z_e + z_q - z_e = z_q$,是我们要的量化结果。
反向:.detach() 部分梯度为零,所以 $\partial z_q^{\text{out}} / \partial z_e = 1$——梯度原样穿过去。这是深度学习里最常用的「假装可导」技巧之一,同样的模式还出现在二值化网络(BinaryNet)、Gumbel-softmax 的硬采样版本,以及 Lecture 10 讲量化推理时的 QAT(quantization-aware training)里。
VQ 训练中最常见的失败模式:8192 个码本项里只有几百个被真正用到,其余的初始化后就再也没被选中过(因为从没被选中 → 从没收到梯度 → 永远不动 → 永远选不中,恶性循环)。
常用对策:(a)用 EMA 更新码本而不是梯度下降,让簇中心更新更稳;(b)死码重启——定期检测使用率为 0 的码本项,把它重置到当前 batch 中某个随机编码器输出上;(c)降低码本维度(例如把 $d$ 从 256 降到 8~32),让最近邻搜索在低维空间进行,显著提升利用率(这是 ViT-VQGAN 的发现);(d)在码本查找前对向量做 $\ell_2$ 归一化。
3.4 从 VQ-VAE 到 VQ-GAN:重建质量的关键升级
纯 VQ-VAE 用 $\ell_2$ 重建损失,会产生一个众所周知的问题:输出模糊。原因是 $\ell_2$ 损失在给定编码下的最优解是条件期望,而对于「这块区域是什么纹理」这种存在多个合理答案的情况,期望就是把所有可能性平均掉——平均的结果就是糊。
VQ-GAN(Taming Transformers)的改进是在重建损失上再加两项:
- 感知损失(perceptual / LPIPS loss):不在像素空间比对,而在一个预训练 VGG 的中间特征空间比对。它衡量的是「看起来像不像」而非「逐像素等不等」。
- 对抗损失(adversarial loss):加一个 patch 级判别器,逼迫解码器输出落在真实图像的流形上。判别器不接受「平均出来的糊图」,因为糊图一眼就能被判为假。
Chameleon 使用的正是 VQ-GAN 系的图像 tokenizer(它引用的是 Make-A-Scene 的 tokenizer 设计,其中还专门加大了人脸区域的重建权重,因为人脸的重建瑕疵对人眼特别刺目)。
3.5 图像 token 与文本 token 的合并
拿到 8192 个图像 token 后,还有一步:怎么和文本词表共存。Percy 提到 Chameleon「训练了一个新的 BPE tokenizer」。具体做法是:
- 文本侧训一个 65,536 词的 BPE;
- 图像侧的 8192 个码本索引直接追加到词表末尾,成为 id 65536–73727;
- 用特殊 token
<image_start>/<image_end>标记图像片段的边界; - 整个序列(文本 token 和图像 token 交错)用完全相同的自回归交叉熵损失训练。
这就是 Chameleon 「优雅」的地方——训练代码里根本不需要区分模态,就是一个词表 73,728 的普通 LM。但优雅的代价我们会在第 7 节看到。
4. 图像表示路线三:直接喂像素(Fuyu 式)与三条路线对比
还有第三条路:干脆不要视觉编码器。
Adept 的 Fuyu-8B 提出了一个极简主张:既然 ViT 的第一层不过是「把 patch 展平后过一个线性层」,那为什么还要一个单独预训练的、把整个图像重新编码一遍的视觉塔?直接把这个线性层接到语言模型自己身上就好了。
# Fuyu 式:没有视觉编码器,只有一个线性层,直接进 LM
class FuyuPatchInput(nn.Module):
    def __init__(self, patch=30, in_ch=3, d_model=4096):
        super().__init__()
        # 直接投影到 LM 的隐藏维度,而不是某个视觉塔的维度
        self.proj = nn.Linear(patch * patch * in_ch, d_model)
        self.newline = nn.Parameter(torch.zeros(d_model))   # 行结束标记

    def forward(self, img):                # img: (3, H, W),任意 H、W
        p = 30
        # 切成 (h_grid, w_grid) 个 patch,注意不需要 resize 到固定尺寸
        patches = img.unfold(1, p, p).unfold(2, p, p)       # (3, hg, wg, p, p)
        hg, wg = patches.shape[1], patches.shape[2]
        patches = patches.permute(1, 2, 0, 3, 4).reshape(hg, wg, -1)
        tokens = self.proj(patches)        # (hg, wg, 4096)
        # 每一行末尾插入一个 newline 嵌入,让 LM 知道二维布局
        rows = [torch.cat([tokens[i], self.newline[None]], dim=0) for i in range(hg)]
        return torch.cat(rows, dim=0)      # (hg * (wg+1), 4096)
没有视觉编码器,就没有地方放二维位置编码。Fuyu 的解法非常「语言模型」:在每一行 patch 的末尾插入一个特殊的 image-newline 嵌入。这样序列变成 [p11 p12 ... p1w \n p21 p22 ... p2w \n ...],LM 通过它自己的 1D 位置编码 + 换行标记就能推断出二维网格结构——完全就是文本里 ASCII art 的处理方式。
好处是任意分辨率天然支持:图有多宽就多少个 patch,有多高就多少行,不需要 resize、不需要裁剪、不需要 AnyRes 那套复杂逻辑。这对 Fuyu 的目标场景(GUI 截图、图表、文档)非常关键,因为这些图的长宽比千奇百怪。
代价也很明确:你放弃了视觉预训练。CLIP/SigLIP 的编码器是在几十亿图文对上专门训过的,已经把「什么是猫、什么是文字、什么是边缘」这些视觉概念内化了。Fuyu 要求 LM 从原始像素开始,自己在多模态训练中把这些全部重新学一遍——这需要多得多的多模态数据,也是为什么这条路线在开源社区没有成为主流。
4.1 三条路线对比
| 维度 | 连续 patch(ViT / CLIP / SigLIP) | 离散码本(VQ-VAE / VQ-GAN) | 原始像素(Fuyu 式) |
|---|---|---|---|
| 代表工作 | LLaVA、Qwen-VL 系列、大多数商用 VLM | Chameleon、Parti、原版 DALL·E | Fuyu-8B、部分 GUI agent 模型 |
| 视觉 token 形态 | $\R^{d}$ 连续向量 | $\{1,\dots,8192\}$ 离散整数 | $\R^{d}$ 连续向量(无预训练) |
| 能否自回归生成图像 | ❌ 不能(需外挂扩散模型) | ✅ 能(和文本完全同构) | ❌ 不能 |
| 信息保真度 | 高(无量化损失) | 低(~473:1 有损压缩,OCR 吃亏) | 最高(无任何损失) |
| 是否受益于视觉预训练 | ✅ 是,这是最大优势 | 部分(tokenizer 预训练,但只优化重建不优化语义) | ❌ 否,全靠多模态数据从头学 |
| 分辨率灵活性 | 差(需 AnyRes / 位置编码插值 / 动态分辨率补丁) | 中(受编码器 CNN 限制) | ✅ 最好(天然任意分辨率) |
| token 效率 | 336² → 576 token | 512² → 1024 token | 取决于 patch 大小,通常最多 |
| 训练复杂度 | 中(编码器可复用现成的) | 高(tokenizer 要单独训;混模态训练不稳定) | 高(数据需求量大) |
| 工程成熟度 | ✅ 极高,生态完整 | 中 | 低 |
Percy 在本讲小结里的第三条是整讲最深刻的一句话:「理解和生成可能要求不同的东西(语义 versus 更细粒度的细节)」。
把三条路线放在一起看就很清楚了:
- 理解需要的是语义。「图里有只猫」这个判断不关心猫毛的每一根走向,所以有损压缩完全可以接受,甚至是好事——丢掉细节等于自动降噪。CLIP 用对比学习学出来的正是纯语义表示。
- 生成需要的是细节。你要重建出每一个像素,任何被 tokenizer 丢掉的信息都永远回不来了。VQ 的码本必须能表达纹理级别的差异。
这两个目标在表示空间上是互相拉扯的:优化重建的 tokenizer(VQ-GAN)语义性差,优化语义的编码器(CLIP)不可重建。目前统一它们的尝试(如把 CLIP 特征也做量化、或用双分支 tokenizer)都还不能同时打赢两边。这就是为什么 Percy 最终的判断是「连续编码器 + Transformer + 扩散模型做生成」——干脆不统一,让理解用连续表示,生成交给扩散模型,各用各的最优工具。
5. 对比学习:CLIP 与 SigLIP
上一节讲的是「图像怎么切成 token」,但还有一个更重要的问题没回答:这个视觉编码器的权重从哪来?随机初始化的 ViT 输出的是垃圾。你需要一个预训练目标,让编码器学会「看懂」图像。
5.1 CLIP 的问题设定
CLIP(Contrastive Language-Image Pretraining)解决的正是这个问题。Percy 讲的背景(context)是:
- 当时的计算机视觉模型都是在人工标注的图像上训练的——ImageNet 是 120 万张图,每张一个人工标签,标注成本极高,类别数被锁死在 1000。
- 问题是:能不能利用数量远远更多的(图像, 说明文字)对?互联网上每张图旁边几乎都有 alt text、标题、周围段落。这些「标注」是免费的、无限量的,代价是噪声大。
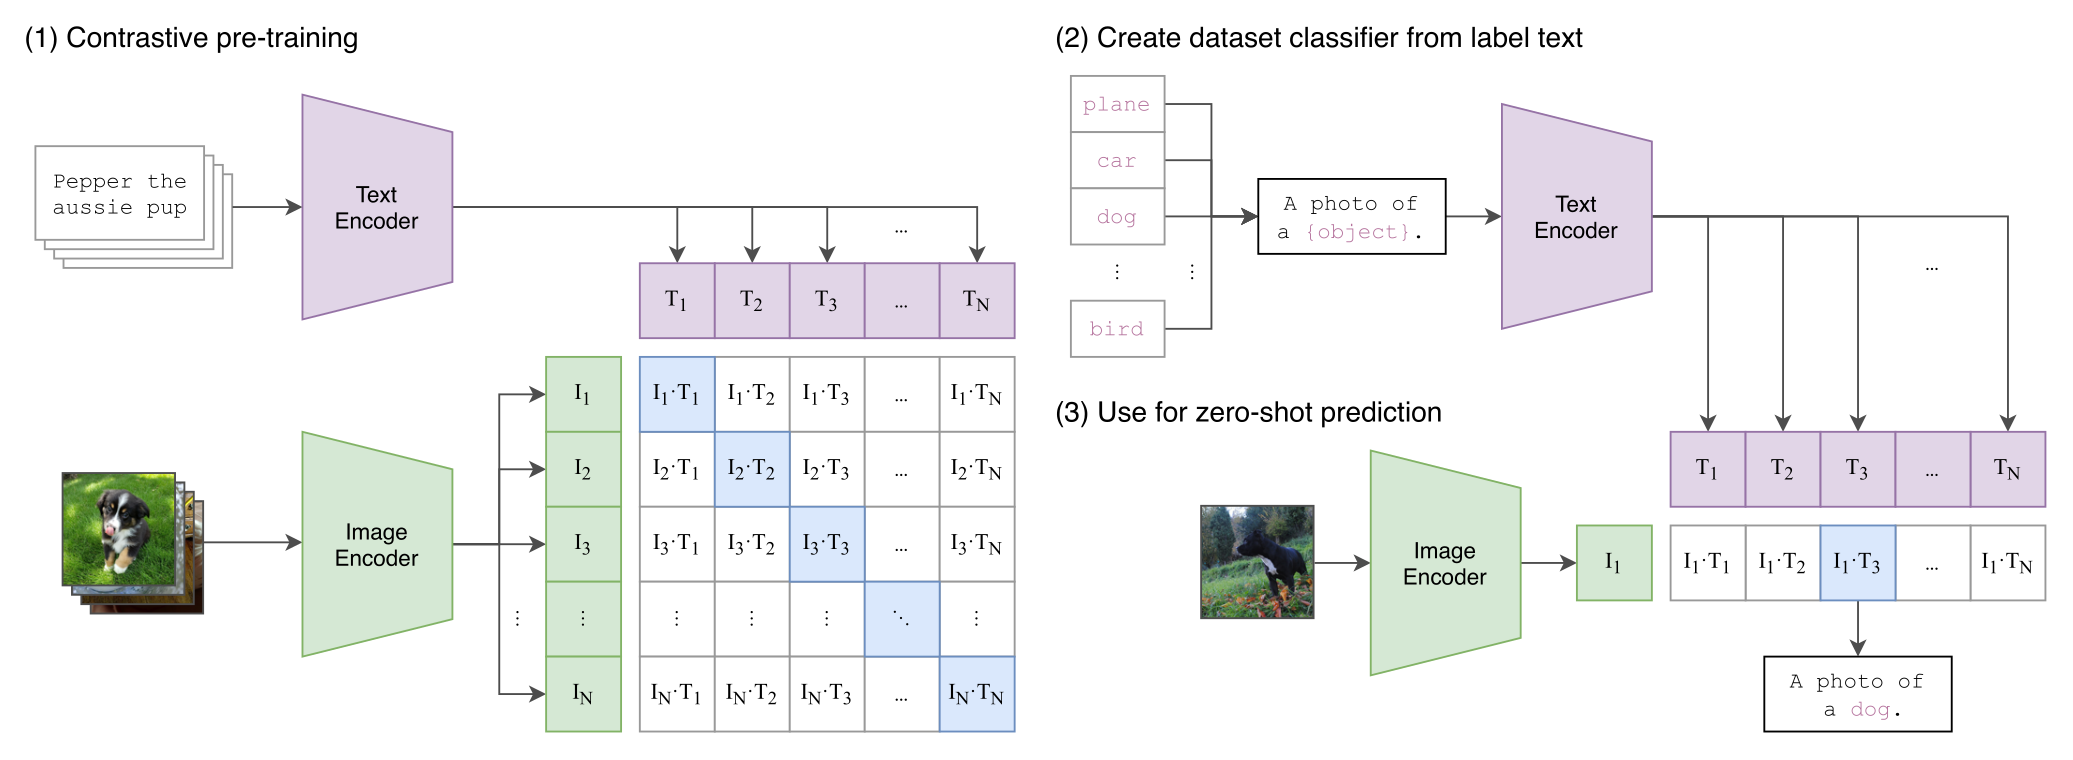
"a photo of a {label}")后过文本编码器,$C$ 个类别就得到 $C$ 个「分类器权重向量」。右:推理时把图像嵌入与这 $C$ 个向量算内积取 $\argmax$。关键在于:这个分类器是用文字凭空造出来的,不需要任何该类别的训练图像,因此可以对任意新类别集合即时构造。5.2 方法:在 batch 里认出配对项
Percy 用四句话概括了方法:
- 取一批 (图像, 文本) 样本(例如 32768 对);
- 分别编码每张图和每段文本;
- 对每张图,相比其他所有文本,更偏好它配对的那段文本;
- 对每段文本,相比其他所有图,更偏好它配对的那张图。
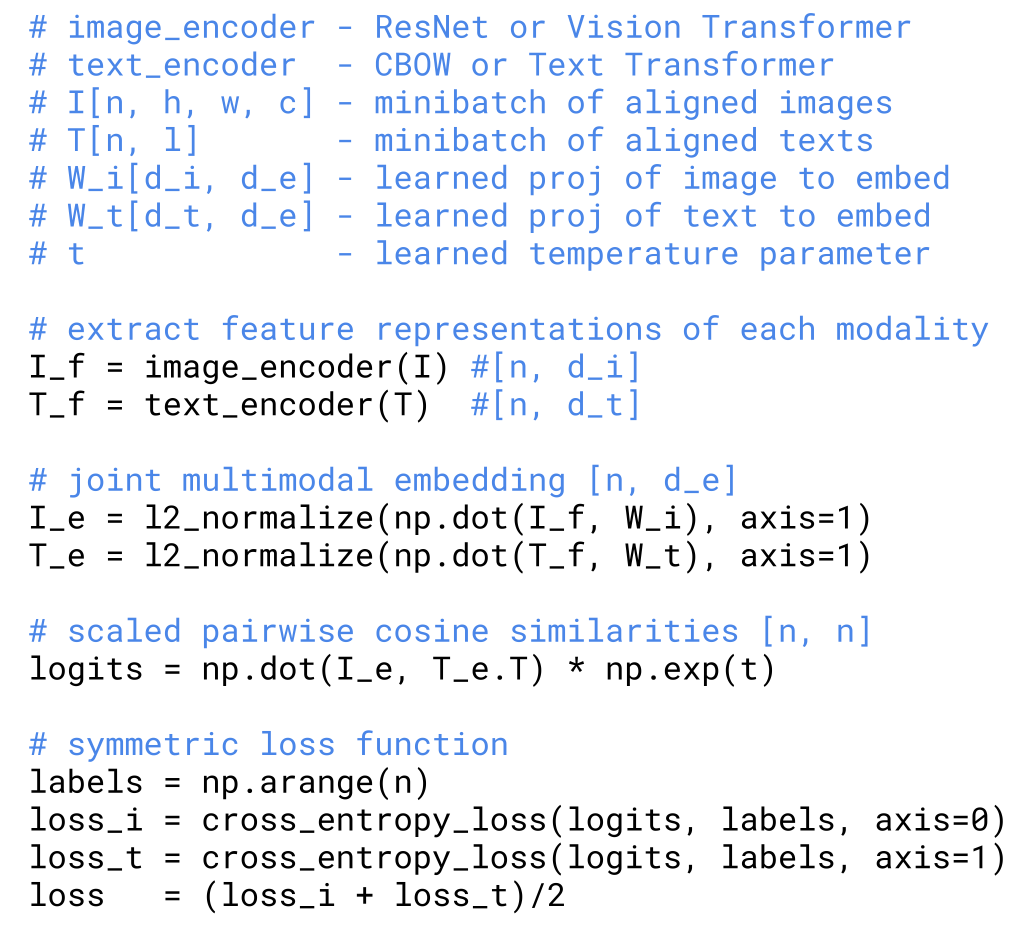
labels = np.arange(n) 这一行——它说的是「第 $i$ 张图的正确答案是第 $i$ 段文本」,正样本标签完全由 batch 中的位置隐式给出,不需要任何人工标注。5.3 InfoNCE 损失的完整公式
设 batch 里有 $N$ 对样本。图像编码器 $f$、文本编码器 $g$,各自后接一个线性投影到共享的 $d$ 维空间,然后 $\ell_2$ 归一化:
$$ u_i = \frac{W_I f(\text{img}_i)}{\|W_I f(\text{img}_i)\|_2}, \qquad v_j = \frac{W_T g(\text{txt}_j)}{\|W_T g(\text{txt}_j)\|_2} $$归一化之后,内积 $u_i^\top v_j$ 就是余弦相似度,取值范围 $[-1, 1]$。相似度矩阵为
$$ S_{ij} = \frac{u_i^\top v_j}{\tau} \in \R^{N\times N} $$其中 $\tau > 0$ 是温度(temperature)。损失是行方向和列方向两个交叉熵的平均:
$$ \mathcal{L} = \frac{1}{2N}\sum_{i=1}^{N}\left[ -\log\frac{\exp(u_i^\top v_i/\tau)}{\sum_{j=1}^{N}\exp(u_i^\top v_j/\tau)} \;-\;\log\frac{\exp(u_i^\top v_i/\tau)}{\sum_{k=1}^{N}\exp(u_k^\top v_i/\tau)} \right] $$第一项是「给定图 $i$,在 $N$ 段文本里选出正确的那段」;第二项是「给定文本 $i$,在 $N$ 张图里选出正确的那张」。这就是 InfoNCE 损失的对称双向版本。
import torch, torch.nn.functional as F

def clip_loss(img_emb, txt_emb, logit_scale):
    """img_emb, txt_emb: (N, d) 未归一化;logit_scale: 标量 = exp(t)"""
    u = F.normalize(img_emb, dim=-1)             # (N, d)
    v = F.normalize(txt_emb, dim=-1)             # (N, d)

    logits = logit_scale * u @ v.t()             # (N, N)  = 相似度 / tau
    labels = torch.arange(len(u), device=u.device)   # 对角线是正样本

    loss_i2t = F.cross_entropy(logits, labels)       # 每行 softmax:图 -> 文
    loss_t2i = F.cross_entropy(logits.t(), labels)   # 每列 softmax:文 -> 图
    return (loss_i2t + loss_t2i) / 2

# 温度以 log 形式作为可学习参数,并 clamp 防止爆炸
logit_scale = torch.nn.Parameter(torch.log(torch.tensor(1 / 0.07)))
scale = logit_scale.exp().clamp(max=100.0)
因为做了 $\ell_2$ 归一化,$u_i^\top v_j \in [-1,1]$。如果不除温度,logit 的动态范围只有 2,softmax 后概率几乎是均匀分布($N=32768$ 时,最好和最差的概率之比最多 $e^2 \approx 7.4$,而随机猜是 $1/32768$)——梯度信号会被稀释到几乎为零。
除以 $\tau$ 把范围放大到 $[-1/\tau, 1/\tau]$。CLIP 初始化 $\tau = 0.07$,即 $1/\tau \approx 14.3$,动态范围 28.6,$e^{28.6}\approx 2.6\times 10^{12}$——足以让正样本在 32768 个候选中脱颖而出。
更本质地看,$\tau$ 控制的是对困难负样本的关注程度。对第 $i$ 行,负样本 $j$ 收到的梯度权重正比于 $p_{ij} = \softmax_j(S_{ij})$:
$$ \frac{\partial \mathcal{L}_i}{\partial S_{ij}} = p_{ij} - \mathbb{1}[j = i] $$$\tau$ 小 → 分布尖锐 → 梯度几乎全部集中在最像的那个负样本上(hard negative mining);$\tau$ 大 → 分布平坦 → 所有负样本被均匀对待。CLIP 把 $\log(1/\tau)$ 设为可学习参数并 clamp 在 100 以内,让模型自己找平衡;实际训练中 $\tau$ 会一路降到约 0.01。
CLIP 用 32768 的 batch,这不是为了吞吐量,而是损失函数本身需要。
batch size $N$ 就是负样本的数量。这个任务的难度直接由 $N$ 决定:在 32 个候选里认出配对文本,随机猜都有 3% 正确率,学到的表示只需要区分「猫 vs 汽车 vs 建筑」这种粗粒度类别;在 32768 个候选里认出来,随机基线是 0.003%,模型被迫学会区分「一只橘猫坐在木质窗台上」和「一只橘猫躺在沙发上」——细粒度语义是被大 batch 逼出来的。
从信息论角度:一个 $N$ 选 1 的任务最多提供 $\log_2 N$ 比特的监督信号。$N=32$ 时是 5 比特,$N=32768$ 时是 15 比特,每个样本的信息量提升 3 倍。这也解释了 InfoNCE 名字的由来——它是互信息 $I(u;v)$ 的一个下界,而这个下界的紧致程度上限恰好是 $\log N$。
5.4 数据与预处理
Percy 讲的 CLIP 数据构造流程:
- 构造 50 万个查询词(来自维基百科高频词、bi-gram、词条名等);
- 对每个查询,搜集约 2 万对(图像, 文本);
- 最终训练集:4 亿对图文(WIT,WebImageText);
- 数据集没有公开。
最后一点在当时是社区的痛点。复现工作是 OpenCLIP,使用 LAION-5B 数据集。这里有一个值得玩味的循环:LAION-5B 本身是用 CLIP 做过滤的——从 Common Crawl 抓出图文对后,用 OpenAI 的 CLIP 算图文相似度,只保留分数高于阈值的。所以「开源复现」在数据层面仍然依赖闭源模型,这是 Lecture 13–14 讲数据时提到的模型-数据循环依赖在多模态领域的翻版。
预处理细节(第 2.4 节已详细讨论):任意 $W\times H$ → 双三次插值使短边 = 336 → 中心裁剪到 336×336。
5.5 编码器配置
| 视觉编码器 | 文本编码器 | |
|---|---|---|
| 架构 | ResNet-50 与 ViT 都试过,ViT 更优 | GPT-2 式 Transformer |
| 最佳模型 | ViT-L/14@336px | 63M 参数,12 层 |
| 输入 | 336×336×3,14×14 patch → 576 token | [BOS] ... [EOS],上下文长 77 |
| 池化 | 注意力池化(query = 激活的全局平均) | 取最高层 [EOS] 位置的激活 |
注意一个不对称:视觉塔(3 亿参数)比文本塔(6300 万参数)大 5 倍。这是刻意的——CLIP 的产出物主要是视觉编码器,文本塔只是提供监督信号的「教练」,训完之后大多数下游用法(比如 LLaVA)只用视觉塔。
5.6 头条结果与关键消融
头条结果:在 ImageNet 上,零样本的 CLIP 超过了在 120 万张 ImageNet 图像上训练的 ResNet-50。
零样本分类的具体做法(对应上面配图的中、右两幅):
@torch.no_grad()
def zero_shot_classify(model, image, class_names, templates=("a photo of a {}.",)):
    # 1) 把每个类别名填入提示模板,编码成「分类器权重」
    weights = []
    for name in class_names:                       # 例如 1000 个 ImageNet 类别
        texts = [t.format(name) for t in templates]    # prompt ensembling
        e = F.normalize(model.encode_text(texts), dim=-1)   # (T, d)
        weights.append(F.normalize(e.mean(0), dim=-1))      # 多模板取平均再归一化
    W = torch.stack(weights)                       # (C, d)  <- 这就是分类头,凭空造出来的

    # 2) 图像嵌入与所有类别向量算余弦相似度
    u = F.normalize(model.encode_image(image), dim=-1)      # (B, d)
    return (u @ W.t()).argmax(dim=-1)              # (B,)
传统分类器的最后一层是 $\R^{d\times C}$ 的权重矩阵,$C$ 在训练时就固定了。想加一个新类别?重新收集数据、重新训练。
CLIP 把这个矩阵变成了文本编码器的输出。类别不再是整数 id,而是一段自然语言。于是:(a)$C$ 可以在推理时任意改变;(b)类别之间的语义关系(「柯基」和「狗」)被文本编码器天然地编码了;(c)你甚至可以用完整句子作为类别(「一张有雾的城市照片」)。
这正是 Lecture 1 提到的「把一切任务转化为下一个 token 预测」这一范式在视觉领域的对应物——把分类问题转化为检索问题,从而摆脱固定标签空间的束缚。
关键消融:Percy 强调了一个对比实验。另一种自然的做法是直接从图像预测文本(即训练一个 image captioning 模型,用生成式损失)。
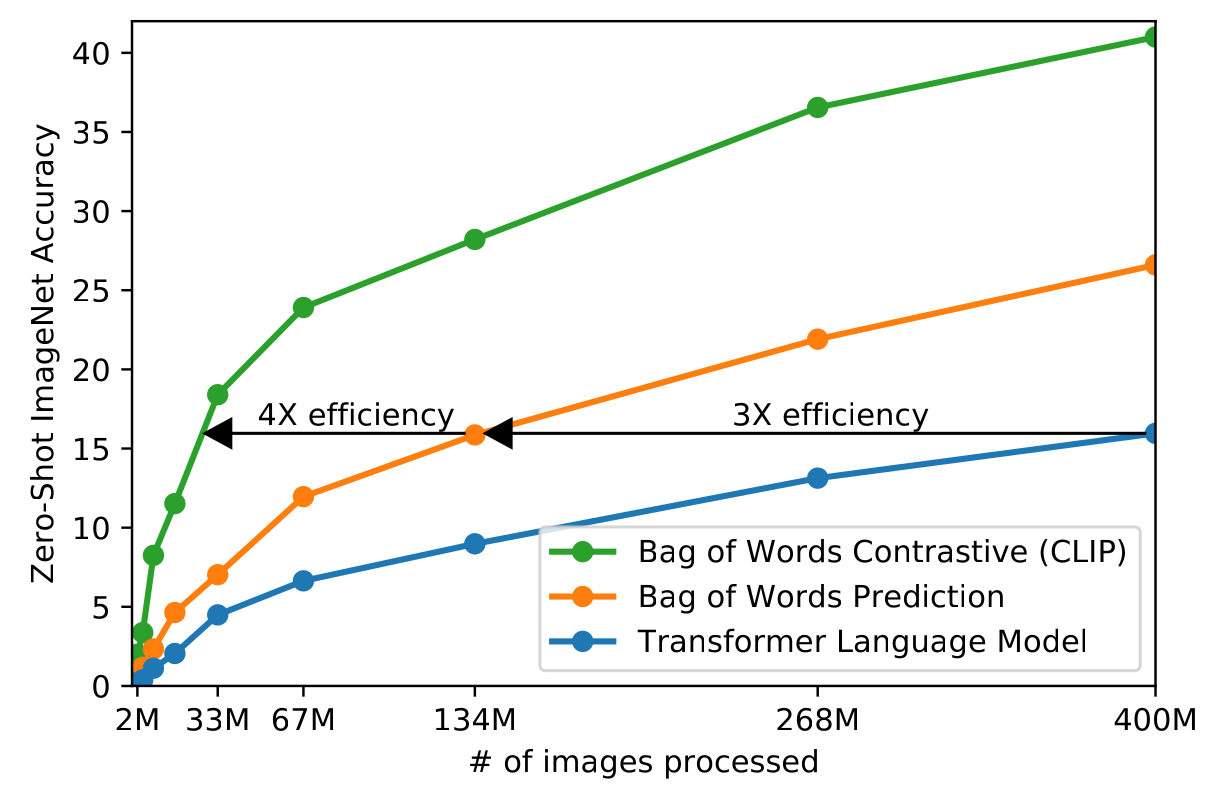
互联网上的 alt text 是噪声极大的。同一张猫的照片,可能配文「我家主子」「IMG_2043」「周末愉快 🐱」。让模型逐词预测这些文本,等于强迫它去建模说话人的措辞习惯、拍摄者的心情、乃至文件命名规则——这些和图像内容毫无关系的东西占据了绝大部分损失。
对比学习只要求「把配对的那一个从 32767 个干扰项里挑出来」。它对措辞完全不敏感——只要「我家主子」的嵌入和猫的图像嵌入比和汽车图像嵌入更接近就够了。它把一个高熵的生成问题,换成了一个低熵的判别问题,从而把学习信号集中在真正共享的语义上。
这是一个可以推广的原则:当监督信号噪声很大时,判别式目标往往比生成式目标更 sample-efficient。代价是判别式目标学不出生成能力——CLIP 永远画不出图。
CLIP 小结(Percy 的三条):
- 图像的编码捕捉的是由(含噪的)文本给出的语义——文本写什么,编码器就学什么;文本从不描述的东西(精确空间位置、小字),编码器就学不到。
- 设计决策是围绕图像分类选的,不是很细粒度的任务。
- 技术上:需要非常大的 batch size,且要在整个 batch 上做 softmax。
5.7 SigLIP:把 softmax 换成 sigmoid
最后一条正是 SigLIP 要解决的问题。
Percy 把两者的目标函数差异讲得很清楚:
- CLIP:多类分类——(文本, 图像) 对 vs (文本, 图像′) 对,对所有 图像′ 做归一化。
- SigLIP:二分类——给定 (文本, 图像),问「它们配不配?」就这么简单。
其中 $\sigma(x) = 1/(1+e^{-x})$,$t$ 是可学习的温度倒数,$b$ 是可学习的偏置。
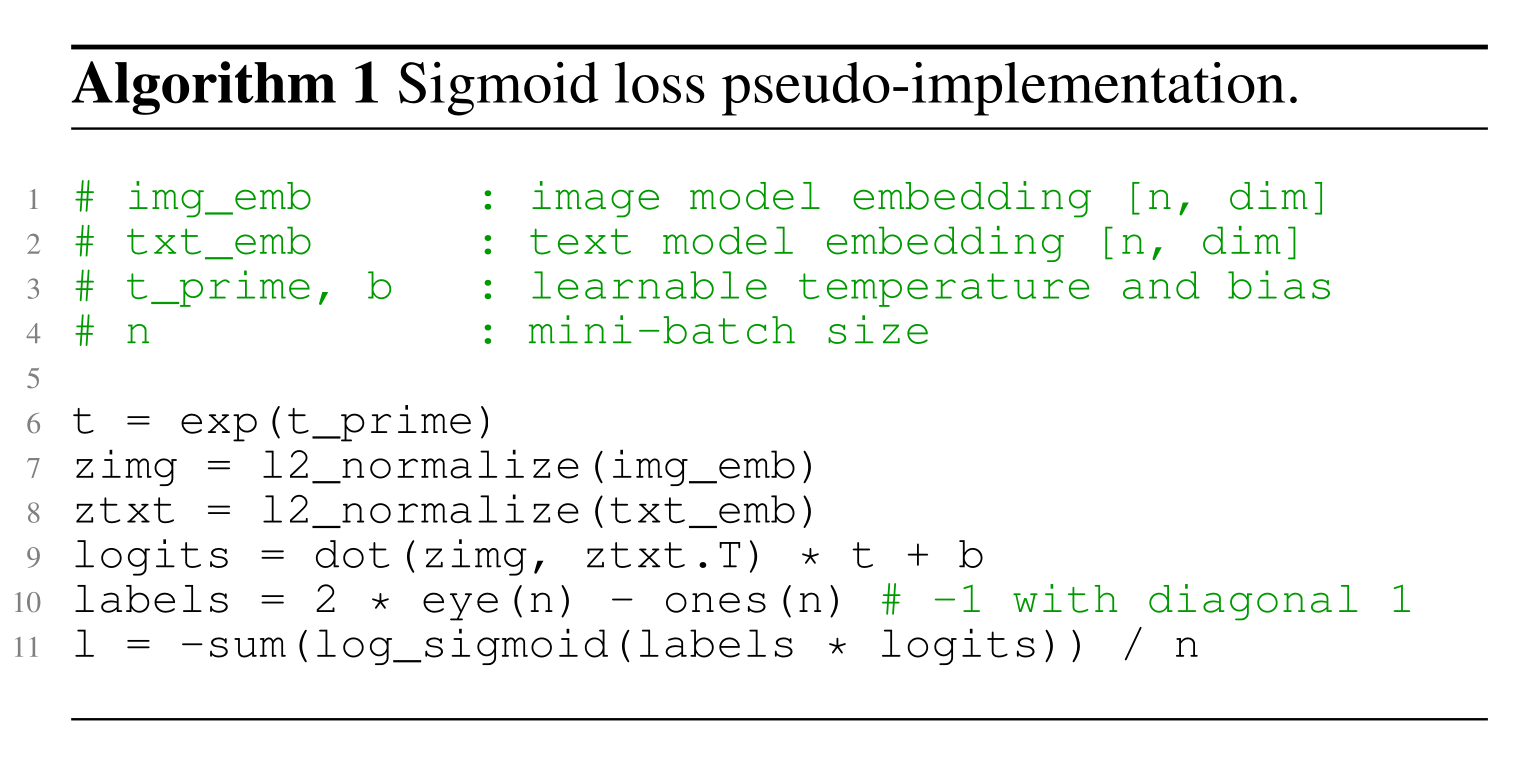
labels 从 arange(n) 变成了 2 * eye(n) - 1(对角线为 +1,其余为 −1 的符号矩阵),交叉熵变成了 log_sigmoid。看起来是微小改动,但它移除了 softmax 的行/列归一化,而归一化正是分布式训练里通信开销的来源。def siglip_loss(img_emb, txt_emb, t, b):
"""t: 可学习温度(正数);b: 可学习偏置,通常初始化为 -10"""
u = F.normalize(img_emb, dim=-1)
v = F.normalize(txt_emb, dim=-1)
logits = t * (u @ v.t()) + b # (N, N)
# 对角线 +1(正样本),其余 -1(负样本)
labels = 2 * torch.eye(len(u), device=u.device) - 1
return -F.logsigmoid(labels * logits).sum() / len(u)
在 $N\times N$ 的相似度矩阵里,正样本只有 $N$ 个(对角线),负样本有 $N^2 - N$ 个。当 $N = 32768$ 时,负正比是 32767:1。
softmax 版本对此免疫,因为每行归一化后正负样本自动平衡。但 sigmoid 版本是逐对独立的二分类,这个极端不平衡会导致:训练初期模型只需把所有对都判为「不配对」,就能让损失降到很低——它会立刻坍缩到平凡解,正样本的梯度被淹没。
SigLIP 的解法是把 $b$ 初始化为 −10。此时对任意样本,$\sigma(t\cdot s + b) \approx \sigma(-10) \approx 4.5\times10^{-5}$,即模型的先验就是「几乎所有对都不配对」——这恰好匹配了真实的类别先验。于是负样本从一开始就几乎没有损失、没有梯度,而正样本损失很大、梯度很强。训练信号被正确地导向了少数正样本。
这与目标检测里 Focal Loss 论文的 prior initialization 技巧是同一个思想:把极端类别不平衡吸收进偏置的初始化里,而不是让优化器去发现它。
5.8 SigLIP 为什么快:batch size 与损失解耦
这是 SigLIP 最重要的工程收益。理解它需要回到 Lecture 7–8 的数据并行。
假设有 $D$ 张设备,每张持有 $N/D$ 个样本。
CLIP 需要什么:第 $i$ 行的 softmax 分母是 $\sum_{j=1}^{N}\exp(u_i^\top v_j)$——需要全部 $N$ 个文本嵌入。所以必须做一次 all_gather,把所有设备的 $u$ 和 $v$ 收集到每张卡上,构造完整的 $N\times N$ 矩阵。
- 通信量:每卡收发 $O(N d)$ 的嵌入。$N=32768$、$d=768$、bf16:$32768 \times 768 \times 2 \times 2 \approx 100$ MB 每步,还要反向再来一次。
- 显存:每卡都要存下 $N\times N$ 的 logits 矩阵:$32768^2 \times 2 \text{ bytes} = 2.1$ GB。这是硬墙——想把 batch 提到 $10^5$,矩阵就要 20 GB,单卡放不下。
SigLIP 需要什么:损失是逐对独立求和的,$\sum_{i}\sum_{j}$ 没有任何归一化耦合。因此可以分块计算:
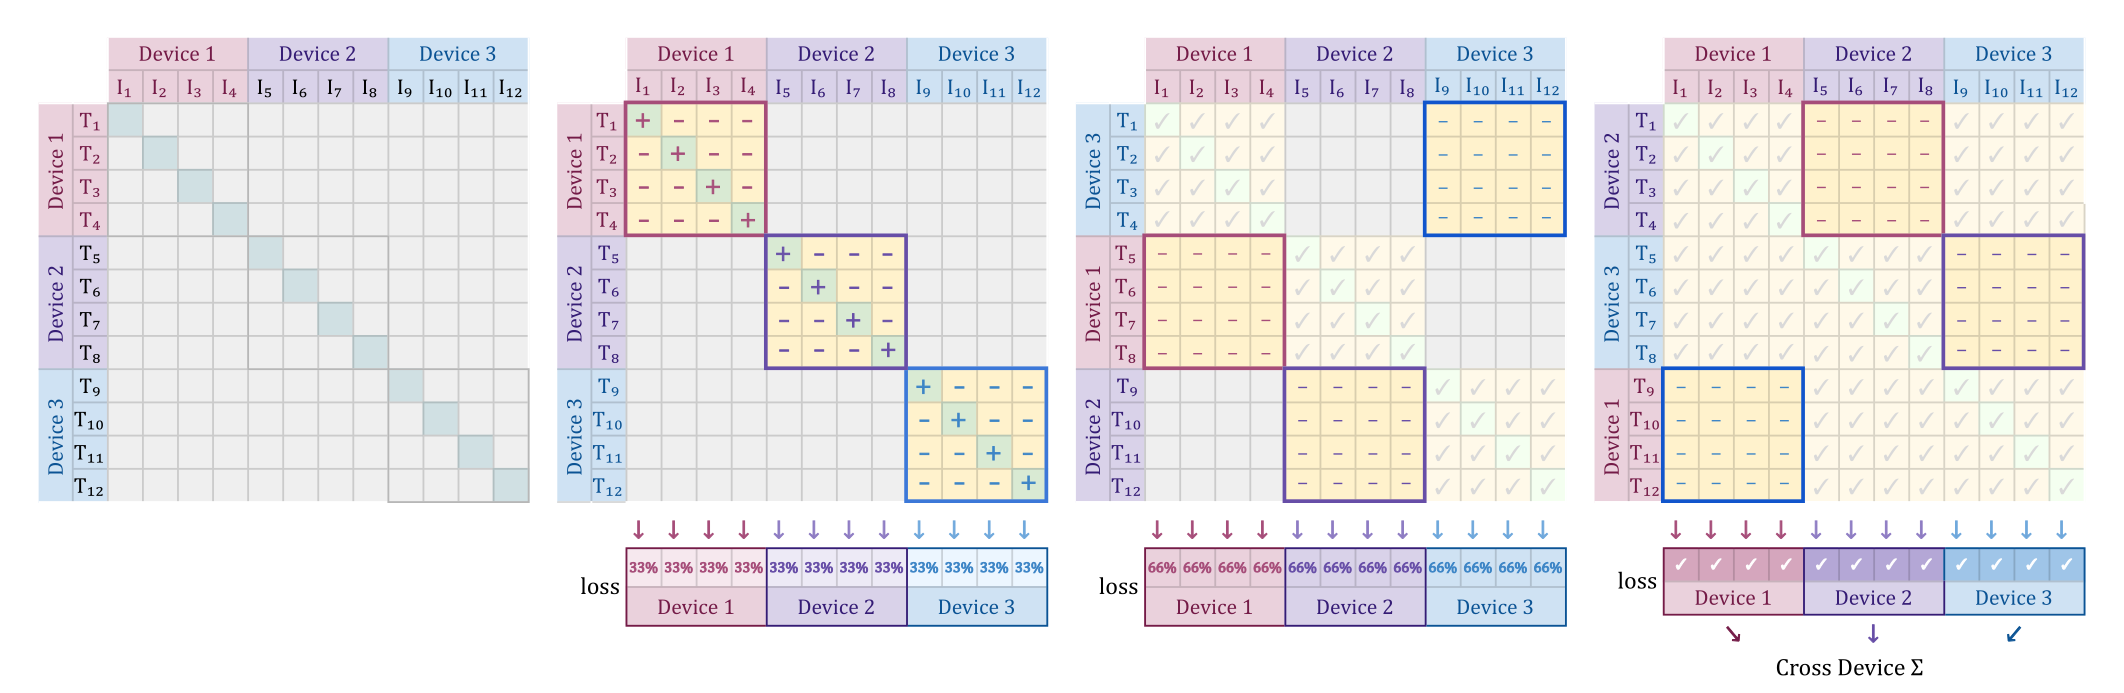
# SigLIP 分块损失的核心思想(伪代码,单卡视角)
def siglip_chunked_loss(u_local, v_local, t, b, rank, world_size):
    loss = 0.0
    v = v_local                                       # (N/D, d)
    for step in range(world_size):
        # 第 0 步是自己的块,含正样本;之后都是纯负样本块
        is_diag_block = (step == 0)
        logits = t * (u_local @ v.t()) + b            # (N/D, N/D)  <- 小得多
        labels = (2 * torch.eye(len(u_local)) - 1) if is_diag_block \
                 else -torch.ones_like(logits)
        loss += -F.logsigmoid(labels * logits).sum()
        v = ring_shift(v)                             # 点对点传给右邻居
    return loss / len(u_local)
实测效率(Percy 给的数字):
| 硬件 | 时间 | |
|---|---|---|
| CLIP | 256 块 TPUv3 | 10 天 |
| SigLIP | 32 块 TPUv4(单卡 FLOP/s 低于 TPUv3) | 5 天 |
用1/8 的芯片数、更弱的单卡算力,训练时间还减半——总加速超过 16 倍。这不是模型变小了,而是通信和显存瓶颈被消除了。
batch size 的结论(Percy 的三条):
- 损失函数与 batch size 解耦了;
- 在 16K 以下的 batch size 上,SigLIP 优于 CLIP(因为 CLIP 在小 batch 下负样本太少,信号弱;而 SigLIP 的逐对二分类不依赖负样本数量);
- 作者把 batch 一路推到 100 万,但发现 32K 就够了——收益在 32K 之后基本饱和。
它意味着对比学习的 batch size 存在一个饱和点,而不是「越大越好」。这与 Lecture 9/11 讲缩放定律时的 critical batch size 概念是一回事:超过某个规模后,增大 batch 带来的梯度噪声降低已经微不足道,你只是在浪费算力。
实践含义:如果你要复现一个 CLIP 类模型,不必去追 100 万的 batch。32K 配合 SigLIP 损失,在几十张卡上就能达到接近最优的效果。
5.9 SigLIP 的数据:WebLI
SigLIP 使用的是 WebLI(Web Language-Image)数据集,Percy 列的要点:
- 规模:数十亿量级的(图像, 文本)对;
- 来源:从互联网抓取;
- 用自动 OCR 从图像中提取文字——这是与 CLIP 数据的重要区别。除了 alt text,还把图片里面的文字提取出来作为额外监督,显著提升了模型对文档、招牌、图表的理解能力;
- 过滤:只保留质量最高的 10%;
- 覆盖 100 种语言(CLIP 基本只有英语)。
「保留最高质量的 10%」这个比例值得注意——和 Lecture 13–14 讲文本数据过滤时的结论一致:激进过滤几乎总是划算的,因为在数据量不是瓶颈的情况下,质量的边际收益远大于数量。
6. 把视觉编码接进语言模型
有了 CLIP/SigLIP 这样的视觉编码器,还剩最后一步:怎么让语言模型用上这些向量?视觉编码器输出的是 $\R^{1024}$ 的向量,语言模型的嵌入空间是 $\R^{4096}$ 的、且有它自己的语义结构。这两个空间之间需要一座桥。
历史上有三种融合(fusion)方式:
| 方式 | 做法 | 代表 | 特点 |
|---|---|---|---|
| 投影 + 前缀(早期融合到输入端) | 视觉 token 过一个投影器变成「伪文本 token」,直接拼进输入序列 | LLaVA、Qwen-VL、几乎所有现代 VLM | 最简单;不改动 LM 架构;视觉 token 全程参与自注意力 |
| 交叉注意力 | 在 LM 的若干层之间插入新的 cross-attention 层,query 来自文本,key/value 来自视觉 | Flamingo、Qwen-VL 的 adapter | 不占用文本上下文长度;但要改架构、加新参数 |
| 早融合(统一 token 空间) | 图像被离散化成 token,与文本共用一个词表,从预训练第一步就混在一起 | Chameleon、Fuyu | 最统一;能生成图像;但训练不稳定、有量化损失 |
Percy 在课上按时间顺序讲了第一类的演进:LLaVA → LLaVA-OneVision → Qwen-VL → Qwen2-VL → Qwen3-VL,最后讲 Chameleon 的第三类。我们跟着这条线走。
6.1 LLaVA:最简配方
LLaVA(Large Language and Vision Assistant)的贡献不在架构——它的架构简单到近乎朴素——而在于证明了一个极简配方就能得到不错的视觉助手,且指令数据可以由 GPT-4 合成。
- 视觉编码器:CLIP(ViT-L/14)
- 文本解码器:Vicuna(LLaMA 在 ShareGPT 对话上微调的产物)
- 连接器:一个线性投影矩阵 $W$
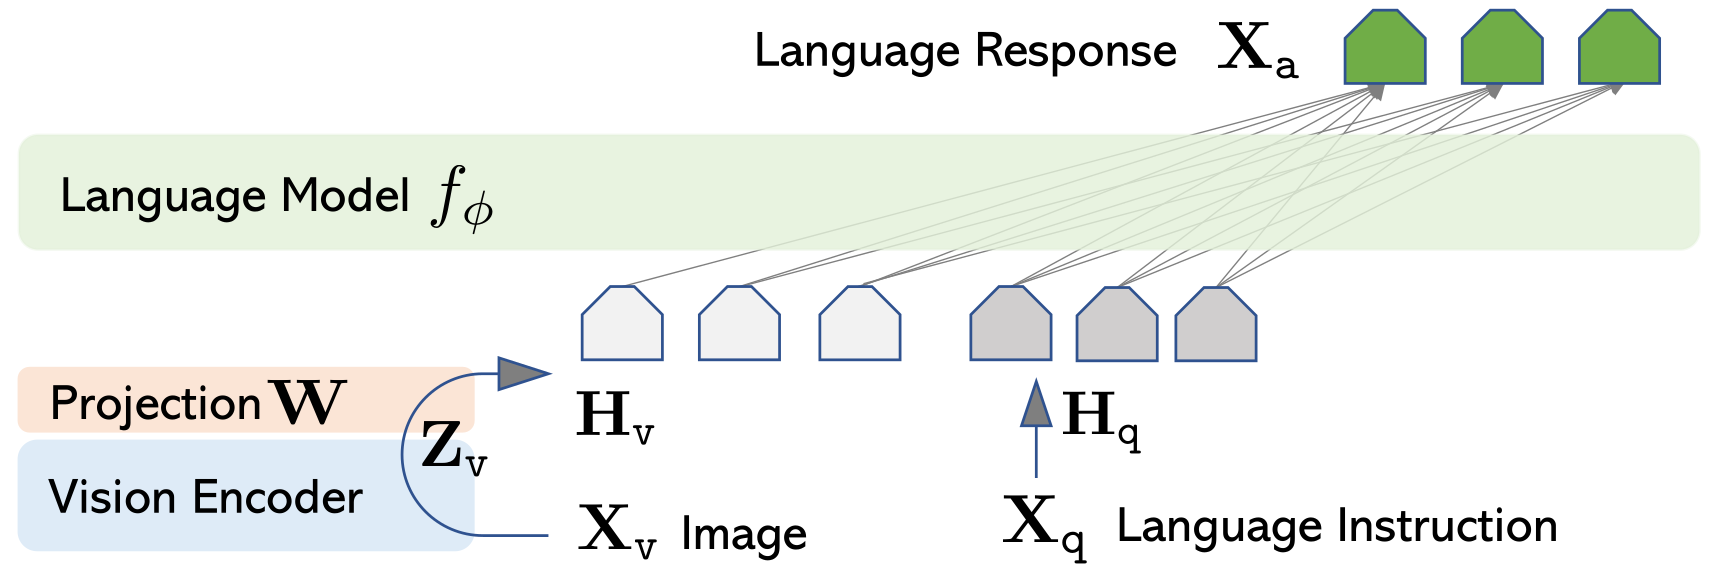
class LLaVA(nn.Module):
    def __init__(self, vision_tower, llm, d_v=1024, d_l=4096):
        super().__init__()
        self.vision = vision_tower          # CLIP ViT-L/14,冻结
        self.W = nn.Linear(d_v, d_l)        # 唯一的「多模态」参数:1024 x 4096 ≈ 4.2M
        self.llm = llm                      # Vicuna-7B/13B

    def forward(self, image, input_ids, image_pos):
        # 1) 编码图像:取 patch 特征(去掉 CLS),不是池化后的单向量
        z_v = self.vision(image)[:, 1:, :]          # (B, 576, 1024)
        h_v = self.W(z_v)                           # (B, 576, 4096)  「伪文本 token」

        # 2) 文本嵌入
        h_t = self.llm.get_input_embeddings()(input_ids)   # (B, T, 4096)

        # 3) 把 h_v 插到 <image> 占位符的位置上,拼成一条序列
        h = splice(h_t, h_v, at=image_pos)          # (B, T + 576, 4096)

        # 4) 之后就是完全标准的自回归语言模型,损失只算在回答 token 上
        return self.llm(inputs_embeds=h)
CLIP 训练时优化的是池化后的单一向量(用于图文匹配)。但 LLaVA 用的是池化之前的 576 个 patch 特征。
原因是任务变了。图文匹配只需要「整张图讲了什么」,一个向量够了;但视觉问答需要回答「左边那个人穿什么颜色的衣服」——这要求空间定位信息,而池化恰好把空间信息平均掉了。保留 576 个 patch,就等于把一张「特征地图」交给 LM,让注意力机制自己去查它需要的那些位置。
代价是上下文开销:一张图 576 token。LLaVA-1.5 之后有工作用 pixel-shuffle / token merging 把它压到 144 或 64,这是精度与成本的直接权衡。
数据:用 GPT-4 造视觉指令
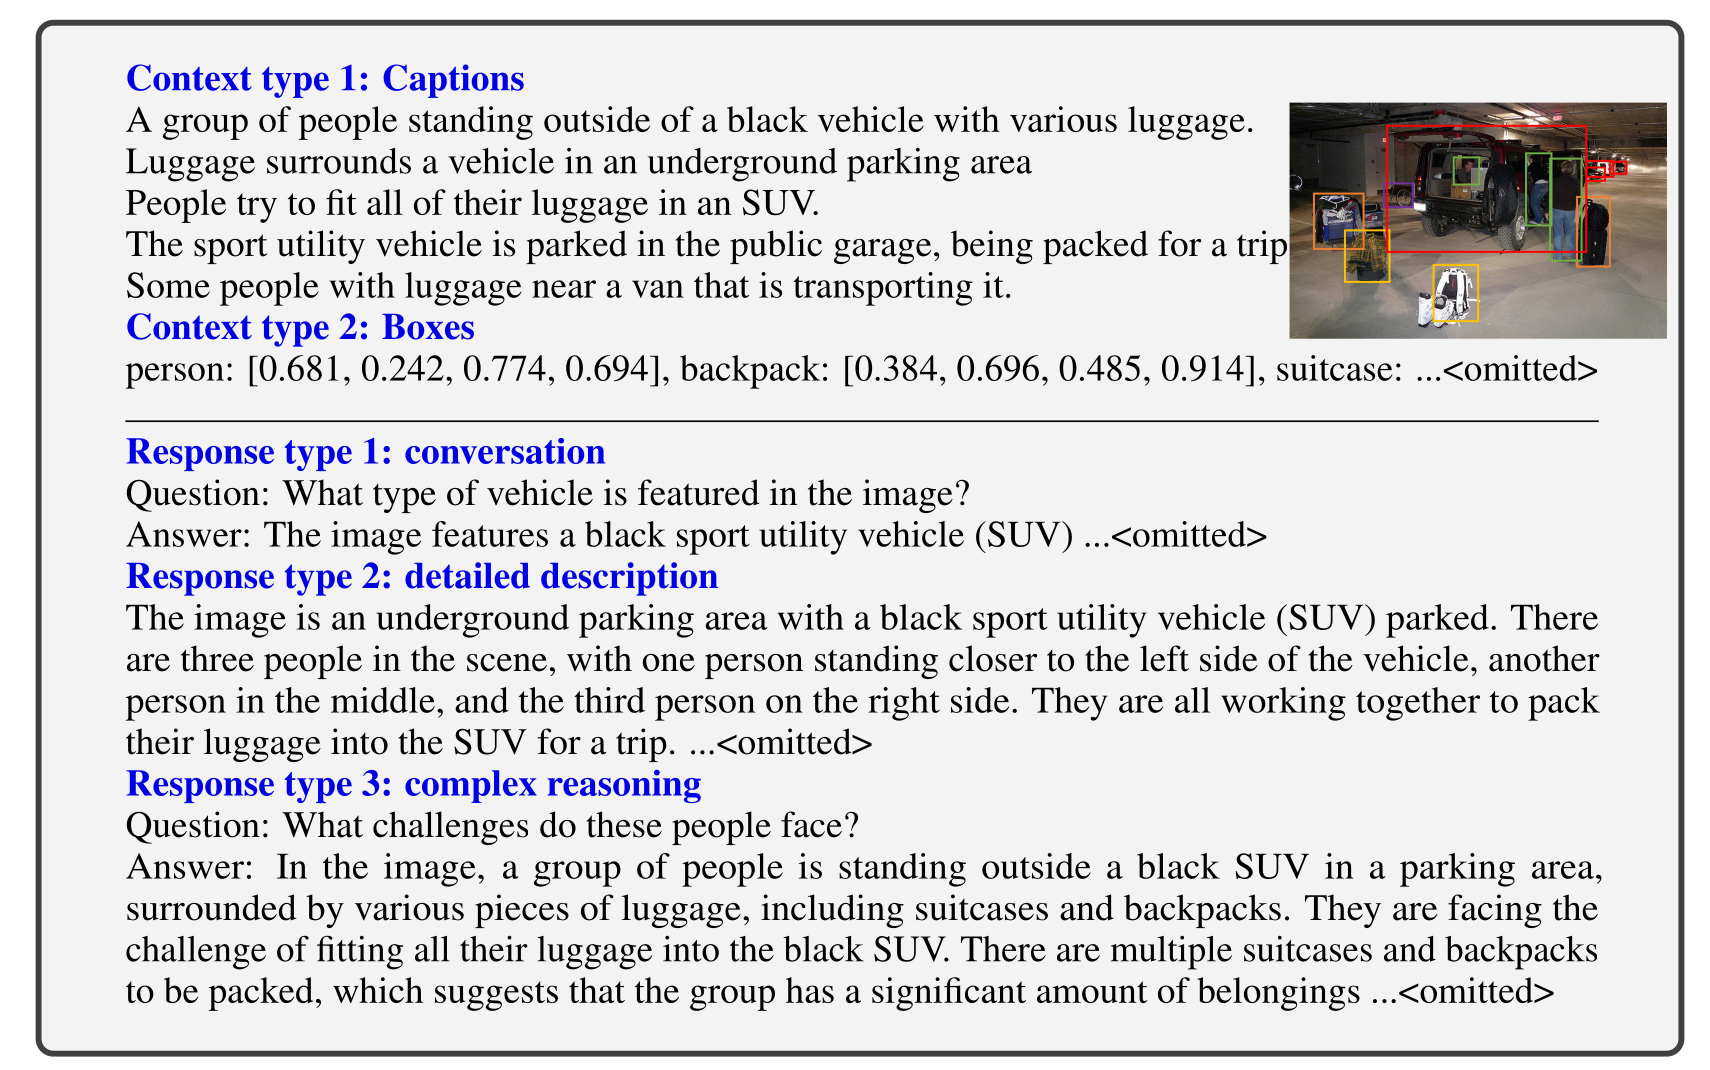
LLaVA 真正的创新在数据。当时没有「视觉对话」的训练数据,人工标注太贵。LLaVA 的做法是纯文本的 GPT-4 蒸馏:
- MS COCO 的图像已经有人工标注的边界框和 Mechanical Turk 写的说明文字;
- 把这些文字描述和检测到的物体列表(不是图像本身!)喂给 GPT-4,让它生成问题或多轮对话;
- 把生成的对话与原始图像配对,就得到了 (图像, 指令, 回答) 三元组;
- 共 15.8 万条样本。
训练:两阶段配方
Percy 给出的两阶段配方是后来所有 VLM 的模板:
| 阶段 | 目标 | 视觉编码器 | 投影器 $W$ | 语言模型 |
|---|---|---|---|---|
| Stage 1:对齐 | 让 $W$ 学会把视觉空间映到语言空间 | ❄️ 冻结 | 🔥 训练 | ❄️ 冻结 |
| Stage 2:微调 | 让 LM 学会使用视觉信息、遵循指令 | ❄️ 冻结 | 🔥 训练 | 🔥 训练 |
如果一上来就联合训练所有参数,会发生什么?Stage 1 开始时 $W$ 是随机初始化的,它输出的「伪文本 token」在 LM 看来就是纯噪声。LM 收到噪声输入却被要求给出正确答案,梯度会驱使它做两件坏事:(a)学会忽略视觉 token(因为它们没用),(b)为了拟合训练数据而破坏已有的语言能力(灾难性遗忘)。
先冻住 LM 只训 $W$,等于说:「语言模型的表示空间是既定的坐标系,你(投影器)负责把视觉特征翻译到这个坐标系里。」这时 LM 提供了一个稳定的、有意义的目标空间,$W$ 的学习问题变得良定。等 $W$ 收敛后,视觉 token 已经「说人话」了,再解冻 LM 做联合微调就安全得多。
另外注意:视觉编码器全程冻结。因为指令数据只有 15.8 万条,远不足以微调一个 3 亿参数的 ViT 而不损坏它在 4 亿图文对上学到的表示。(Qwen-VL 会打破这一点,见 6.3。)
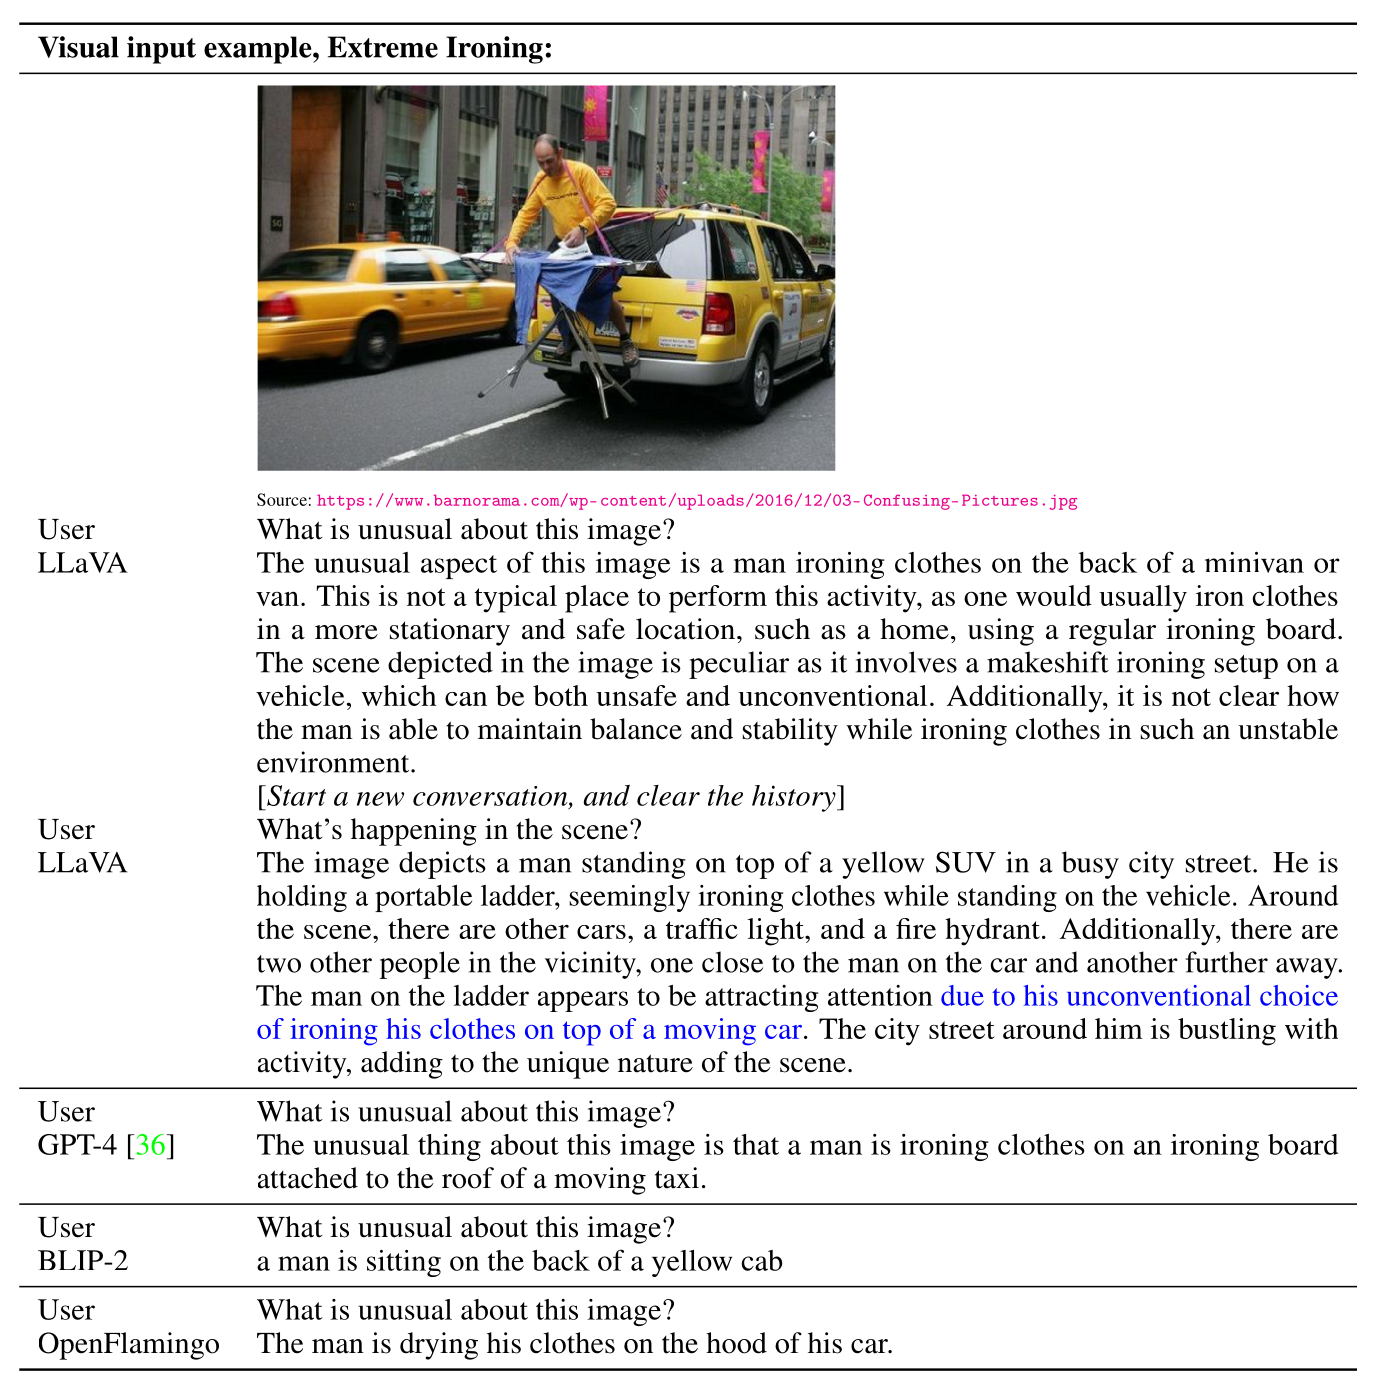
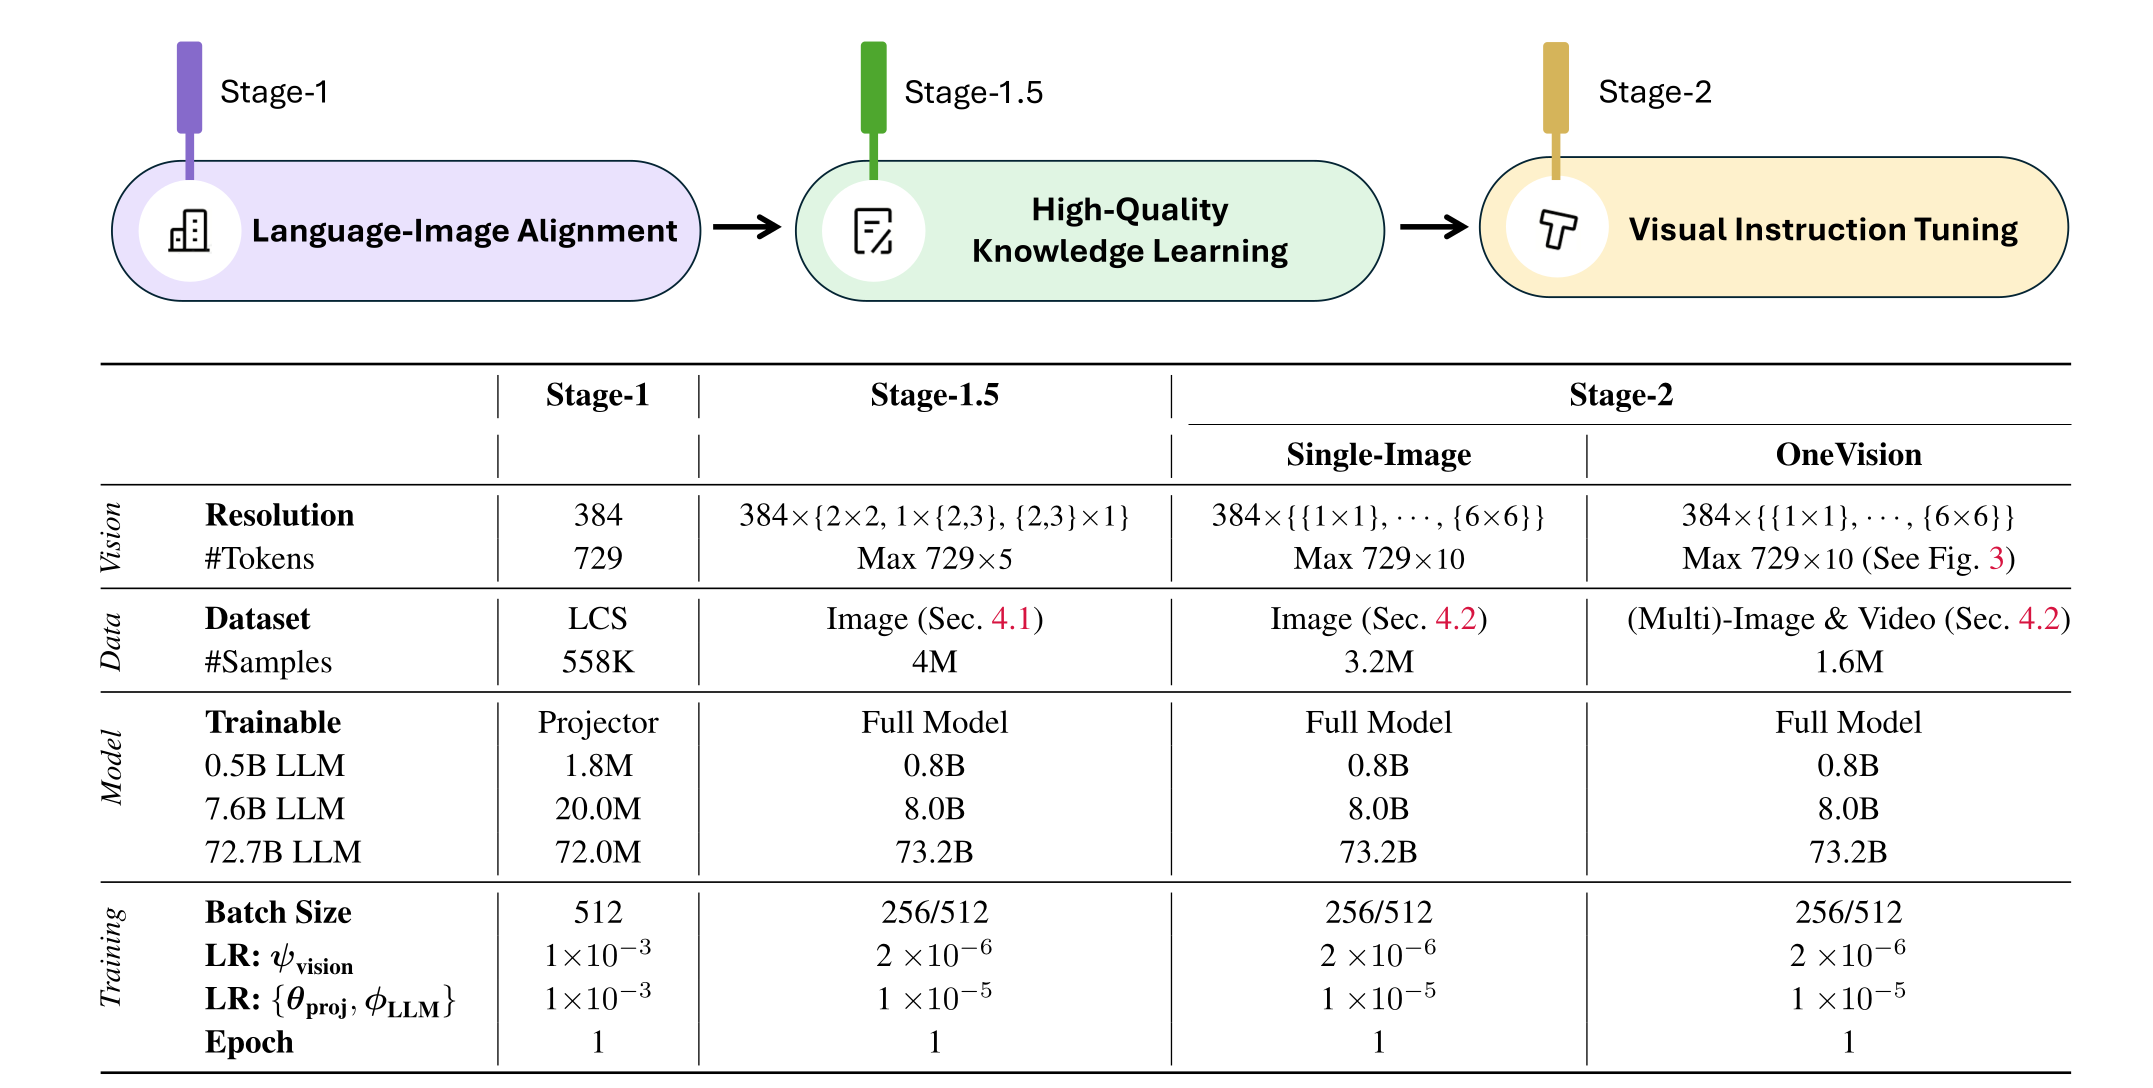
6.2 LLaVA-OneVision:分辨率、多图与视频
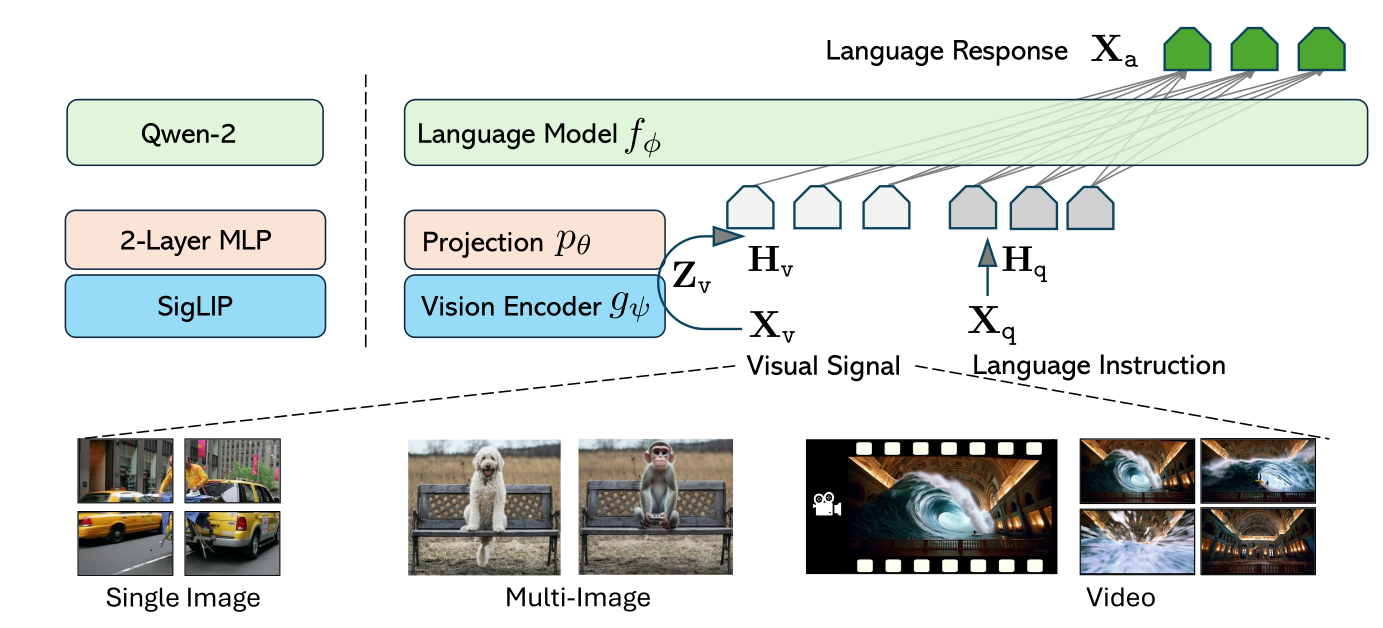
LLaVA-OneVision 是 LLaVA 系列的最新版(在 LLaVA-1.5、LLaVA-NeXT 之后),目标是用一个模型同时处理单图、多图和视频。
AnyRes:分辨率问题的解法
Percy 把动机说得很直接:
- 保持高分辨率很重要(例如为了 OCR);
- CLIP 把图缩放并裁剪到 336×336,丢失了信息(第 2.4 节详细分析过);
- 解法:AnyRes,在 LLaVA-1.5 中引入。
AnyRes 的做法是:
- 把图像切成 $a \times b$ 块,每块的尺寸恰好匹配视觉编码器的原生分辨率(336×336);
- 每块独立过一次视觉编码器;
- 把所有块的特征拼接起来;
- 如果 token 太多(原图分辨率过高),就用双线性插值把特征图降采样。
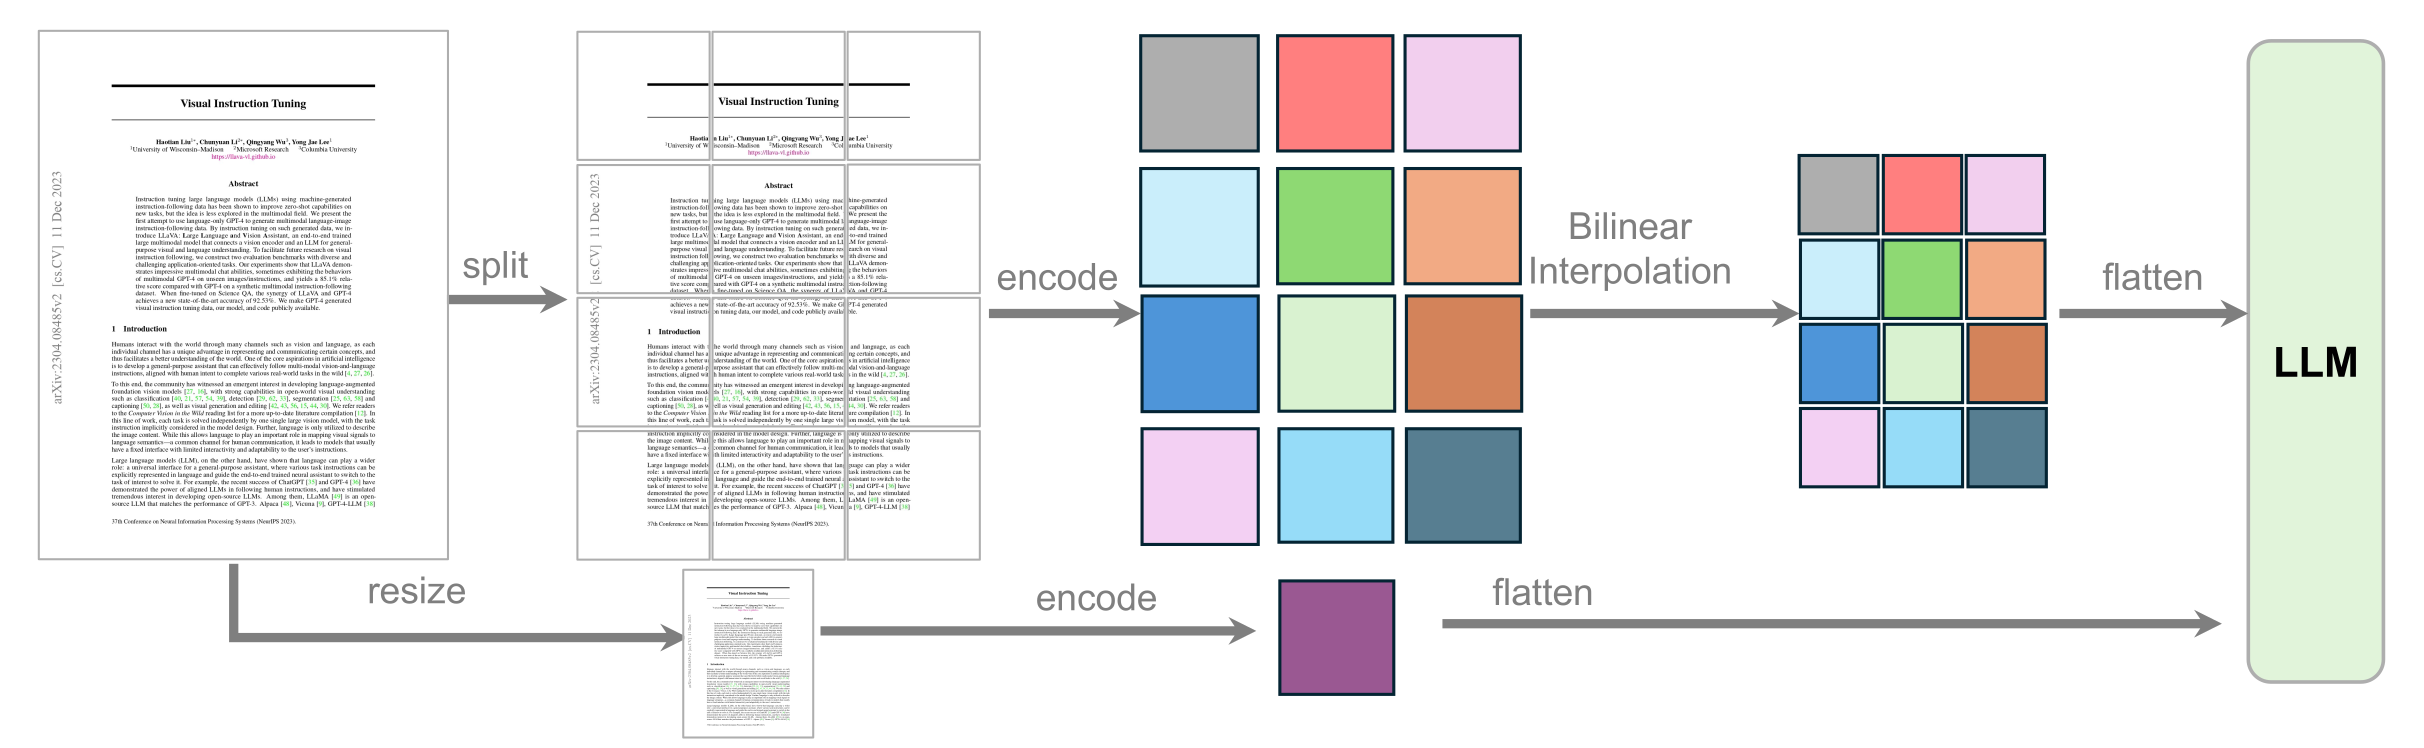
看起来直接把 ViT 的输入尺寸从 336 改成 1008 更简单。但有两个问题:
(1)计算量爆炸。token 数 $N \propto R^2$($R$ 为边长),注意力开销 $\propto N^2 \propto R^4$。从 336 到 1008(3 倍),token 从 576 到 5184(9 倍),注意力 FLOPs 是 81 倍。而 AnyRes 把 9 块分别编码,每块内部注意力是 $576^2$,总共 $9\times576^2$,只有 9 倍——把 $O(R^4)$ 降到了 $O(R^2)$。
(2)分布漂移。ViT 的位置编码和所有权重都是在 336×336 上训练的。突然给它 1008×1008 的输入,位置编码要插值、每个 patch 覆盖的实际视野(相对于物体尺度)也变了——模型进入了训练分布之外的区域,性能反而下降。AnyRes 让每一块都恰好是编码器的原生分辨率,编码器始终工作在它的舒适区。
代价是:块与块之间没有直接的注意力交互,跨块的物体会被切断。全局缩略图那一路就是为了补偿这一点。
三种输入类型的 token 预算分配
Percy 强调了一个漂亮的设计原则:目标是让所有模态产生大致相同的序列长度。
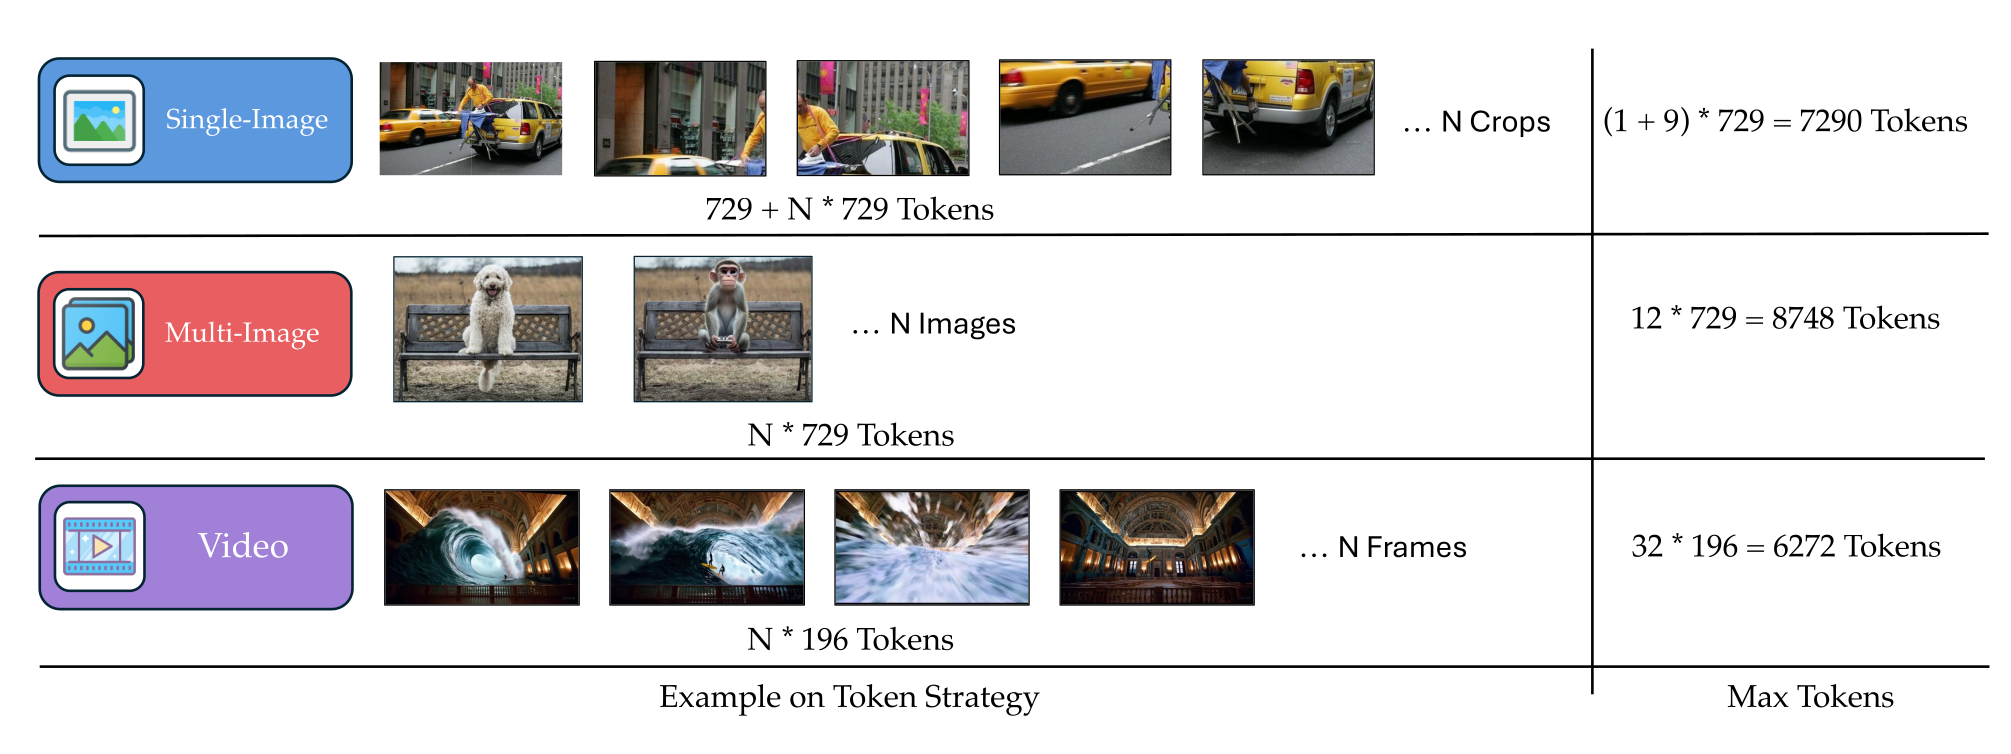
两个原因。
工程上:训练时不同样本的序列长度差异过大会造成严重的 padding 浪费和负载不均衡(回忆 Lecture 8 讲流水线并行时的气泡问题)。把所有模态压到同一长度区间,batch 就好组织了。
学习上,这是更关键的:它使得跨模态迁移成为可能。如果单图是 576 token 而视频是 20000 token,模型会把它们当成两类完全不同的输入,各学各的。而当三者的表示长度和结构都相似时,模型在单图上学到的「怎么从视觉 token 里找信息」这套机制,就能直接复用到多图和视频上——这正是下面「模态间迁移」现象的机制基础。
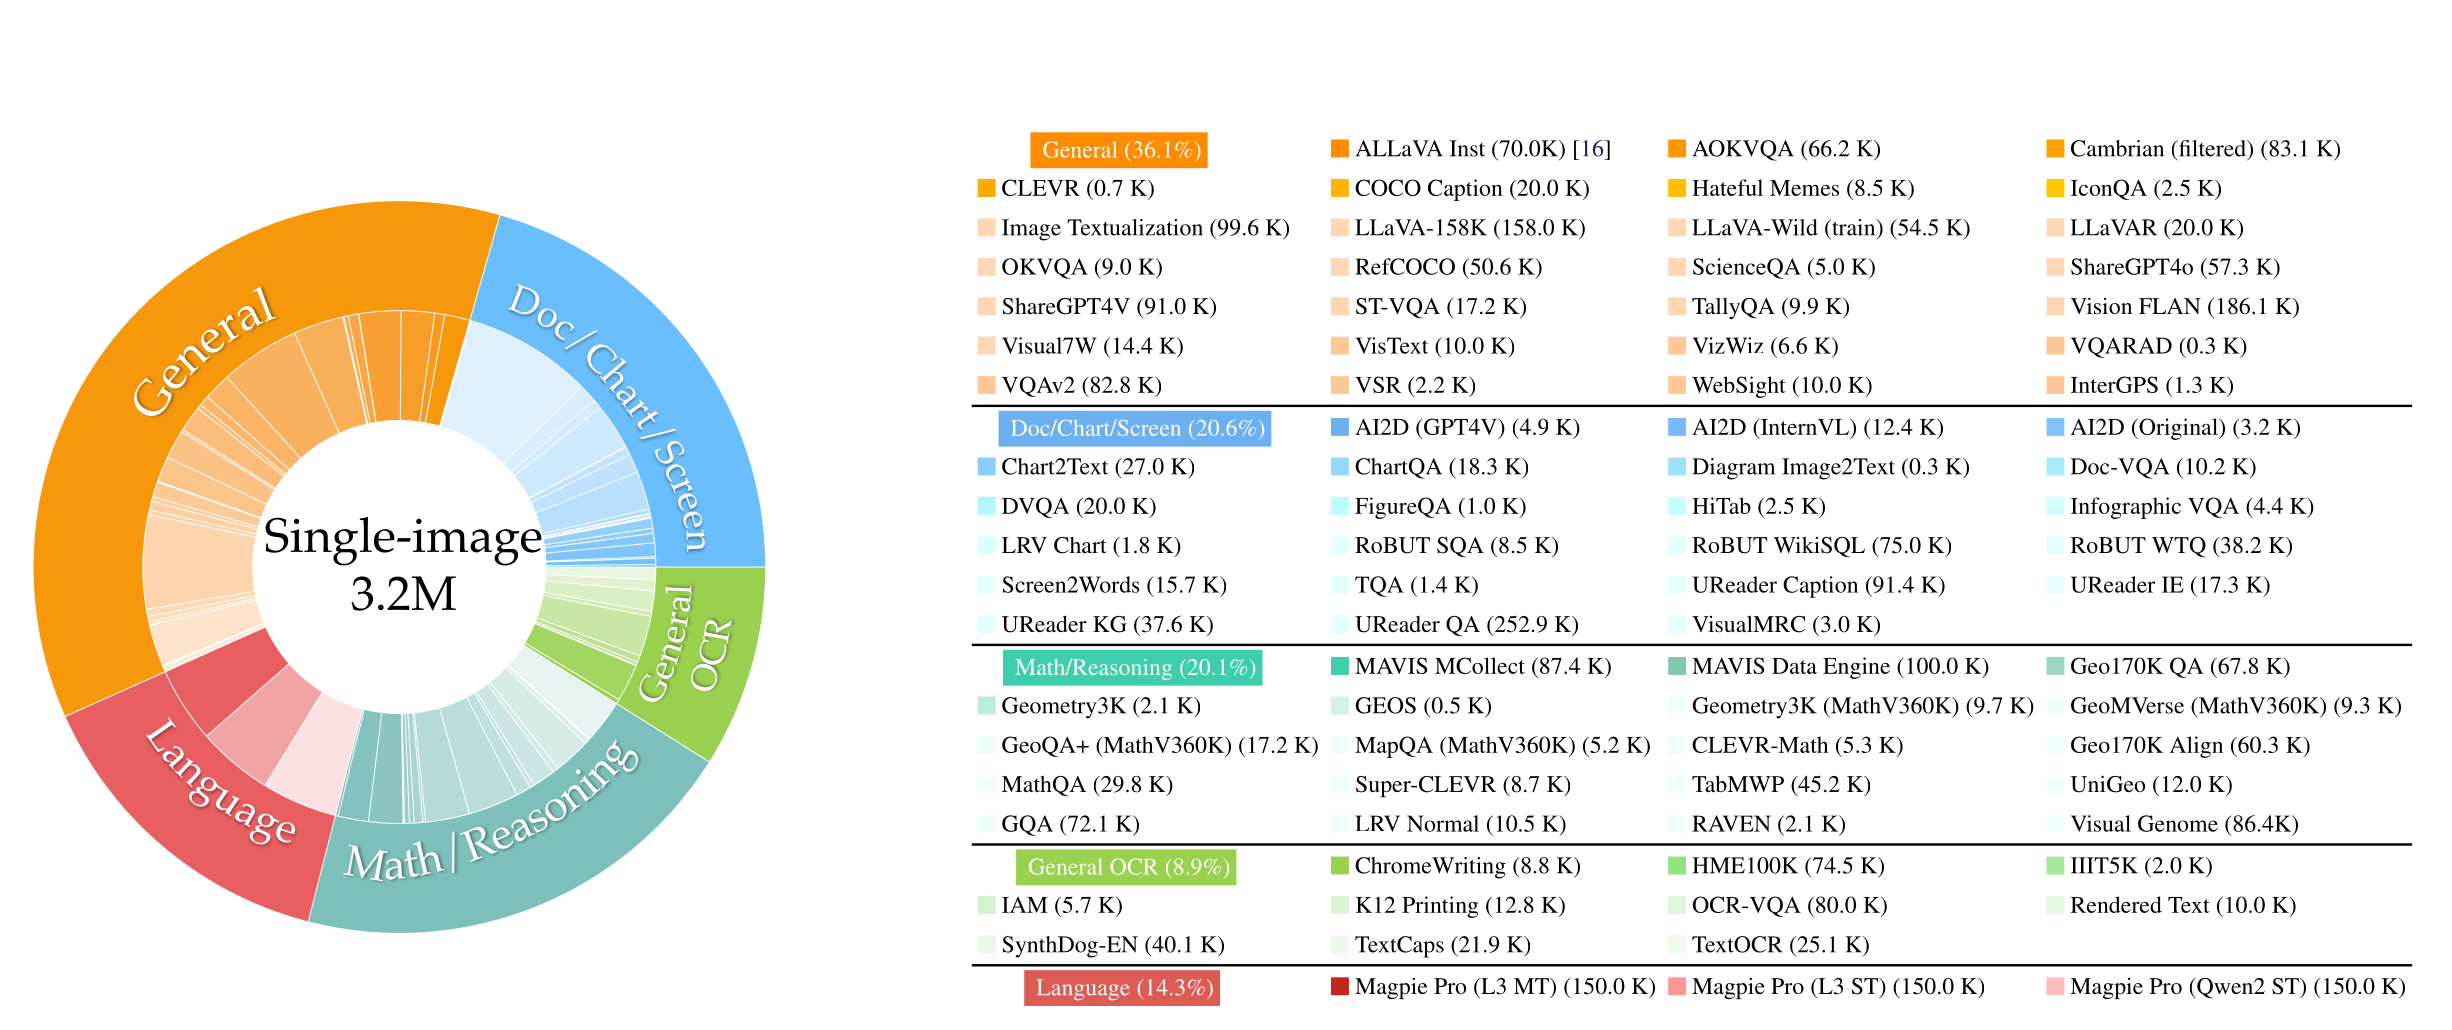
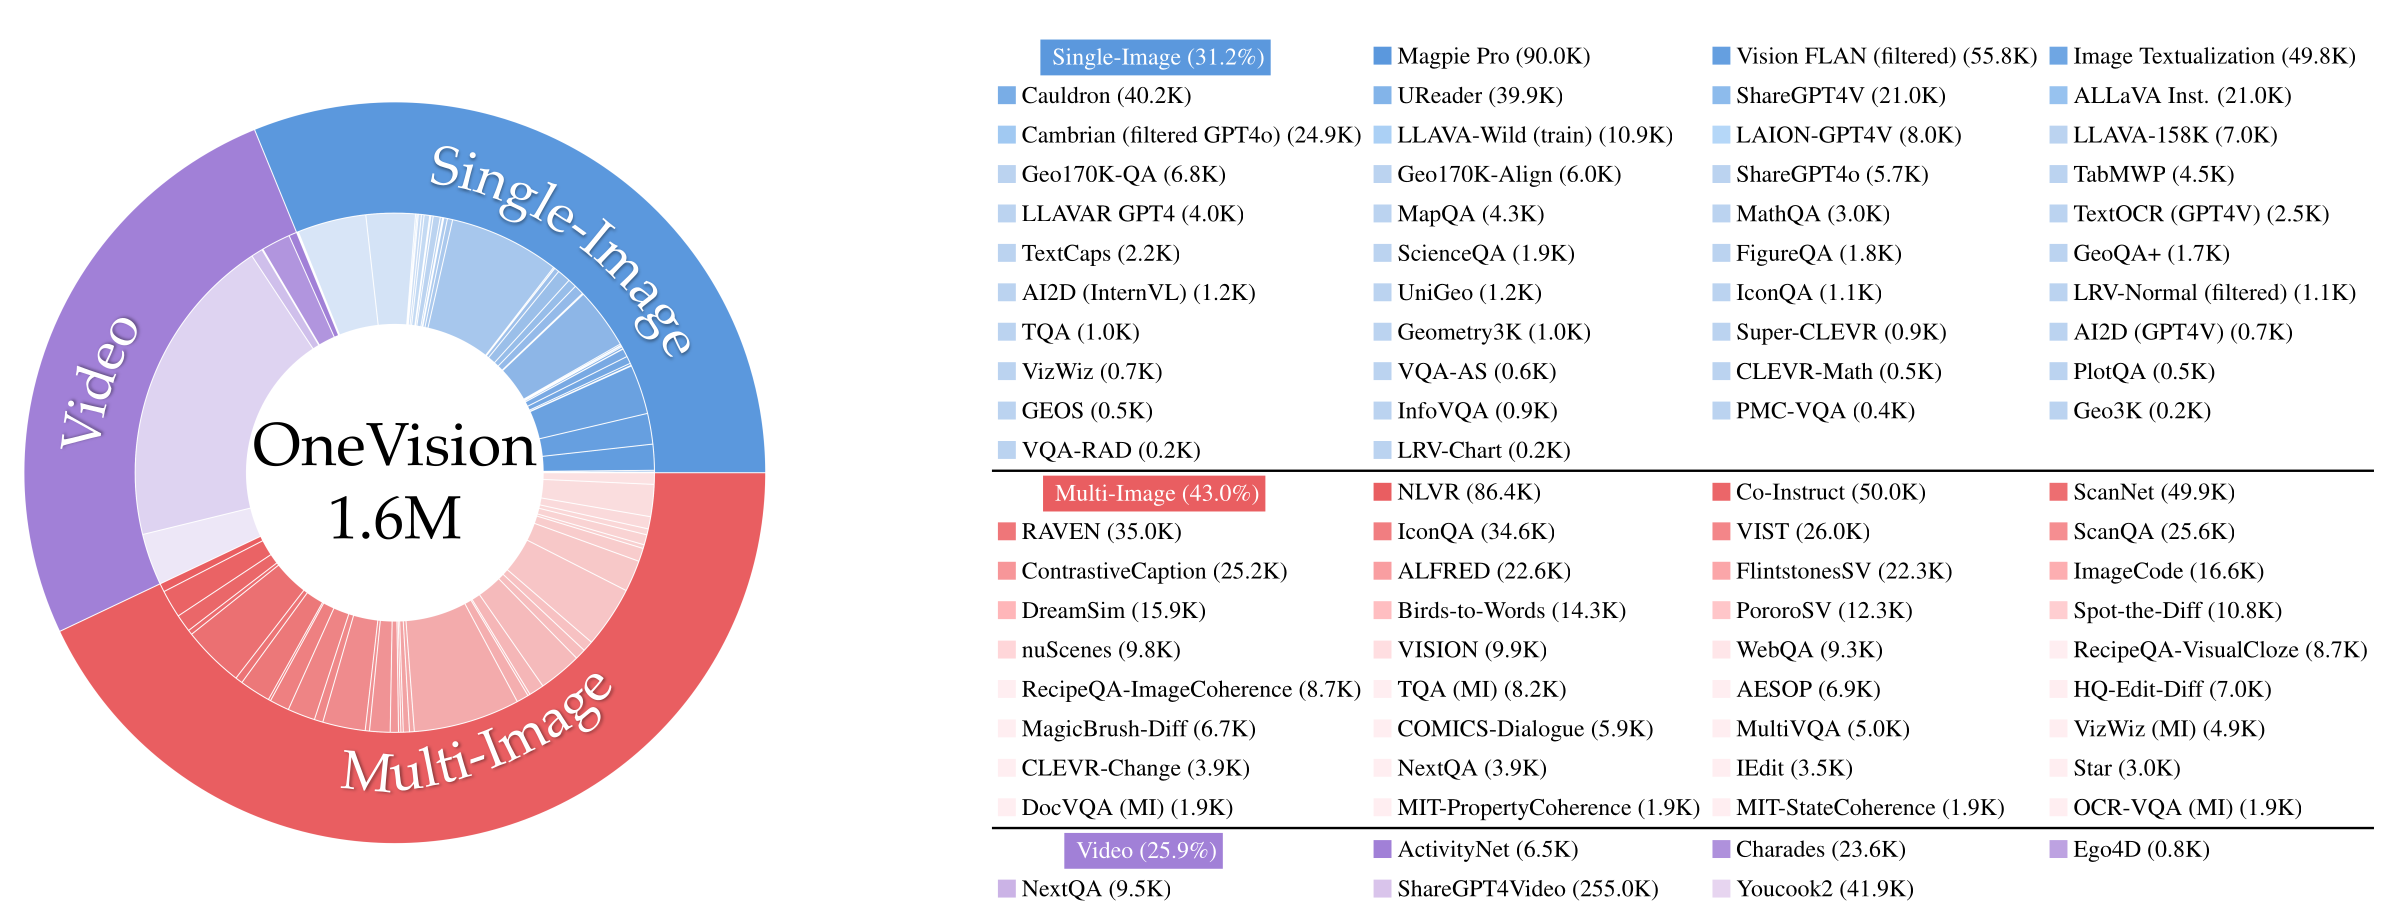
数据与训练:质量优先,由易到难
Percy 用两句话概括了 LLaVA-OneVision 的方法论:数据的哲学是「质量胜过数量」,训练的哲学是「由易到难」。
模态间迁移:本讲最有价值的实证
Percy 展示了三组「任务迁移」的例子,这是 LLaVA-OneVision 论文最有说服力的部分——它证明能力可以在训练中未见过的模态组合上涌现。
LLaVA 系列小结(Percy 的三条):
- 标准 VLM 模板:视觉编码器 + 投影器 + 语言模型。这个模板已经稳定下来了。
- 绝大部分工作量在数据整理,且高度依赖合成的、任务特定的数据。
- 开源:模型权重和数据都放出来了——这在 VLM 领域相当难得,后面的 Qwen3-VL 就没有公布多少数据细节。
7. Qwen-VL 三代:把模板推到 SOTA
如果说 LLaVA 定义了模板,那么 Qwen-VL 系列展示了把这个模板推到极致会得到什么。三代模型的演进路线非常清晰,每一代解决前一代的一个具体瓶颈。
7.1 Qwen-VL:交叉注意力 adapter 与三阶段训练
Qwen-VL 的架构:
- 视觉编码器:OpenCLIP 的 ViT-bigG(14×14 patch)——比 LLaVA 用的 ViT-L 大得多(约 19 亿参数);
- Adapter:一层交叉注意力,融入 2D 位置编码,把任意数量的视觉特征映射到固定的 256 长度;
- 特殊 token:
<img>、<box>、<ref>。
这里的 adapter 是第 6 节表格里的第二类融合方式(交叉注意力)的一个轻量版本,思想来自 Flamingo 的 Perceiver Resampler:
class CrossAttentionResampler(nn.Module):
    """把可变长度的视觉特征压缩成固定 256 个 token(Flamingo / Qwen-VL adapter 思路)。"""
    def __init__(self, n_query=256, d_model=4096, d_vision=1664, n_heads=32):
        super().__init__()
        # 256 个可学习的 query 向量 —— 这是「固定长度」的来源
        self.query = nn.Parameter(torch.randn(n_query, d_model) * 0.02)
        self.kv_proj = nn.Linear(d_vision, d_model)
        self.attn = nn.MultiheadAttention(d_model, n_heads, batch_first=True)

    def forward(self, vis_feat, pos_2d):        # vis_feat: (B, N, 1664),N 随分辨率变化
        kv = self.kv_proj(vis_feat) + pos_2d    # (B, N, 4096),加入 2D 位置编码
        q = self.query.unsqueeze(0).expand(vis_feat.size(0), -1, -1)   # (B, 256, 4096)
        out, _ = self.attn(q, kv, kv)           # (B, 256, 4096)  <- 与 N 无关!
        return out
注意力的输出形状由 query 的个数决定,与 key/value 的个数无关。所以只要固定 256 个可学习的 query 向量,无论输入有 576 个还是 5184 个视觉特征,输出永远是 256 个 token。
每个 query 可以理解为一个「提问器」:第 $k$ 个 query 学会去问「图里有没有文字?在哪?」,第 $k'$ 个 query 学会问「主体物体的颜色是什么?」。它们从视觉特征里各自抽取一部分信息,汇总成 256 个 token 的摘要。
好处:上下文开销恒定,长视频也不会爆炸。坏处:这是一个信息瓶颈——256 个 token 装不下高分辨率文档的全部细节,而且是与问题无关的压缩(压缩发生在模型看到用户问题之前)。这就是为什么 Qwen2-VL 放弃了固定长度,改回可变长度的直接投影。业界的整体趋势是:从复杂的重采样器回归到简单的 MLP 投影 + 动态长度,与 LLaVA 当初的判断一致。
三阶段训练
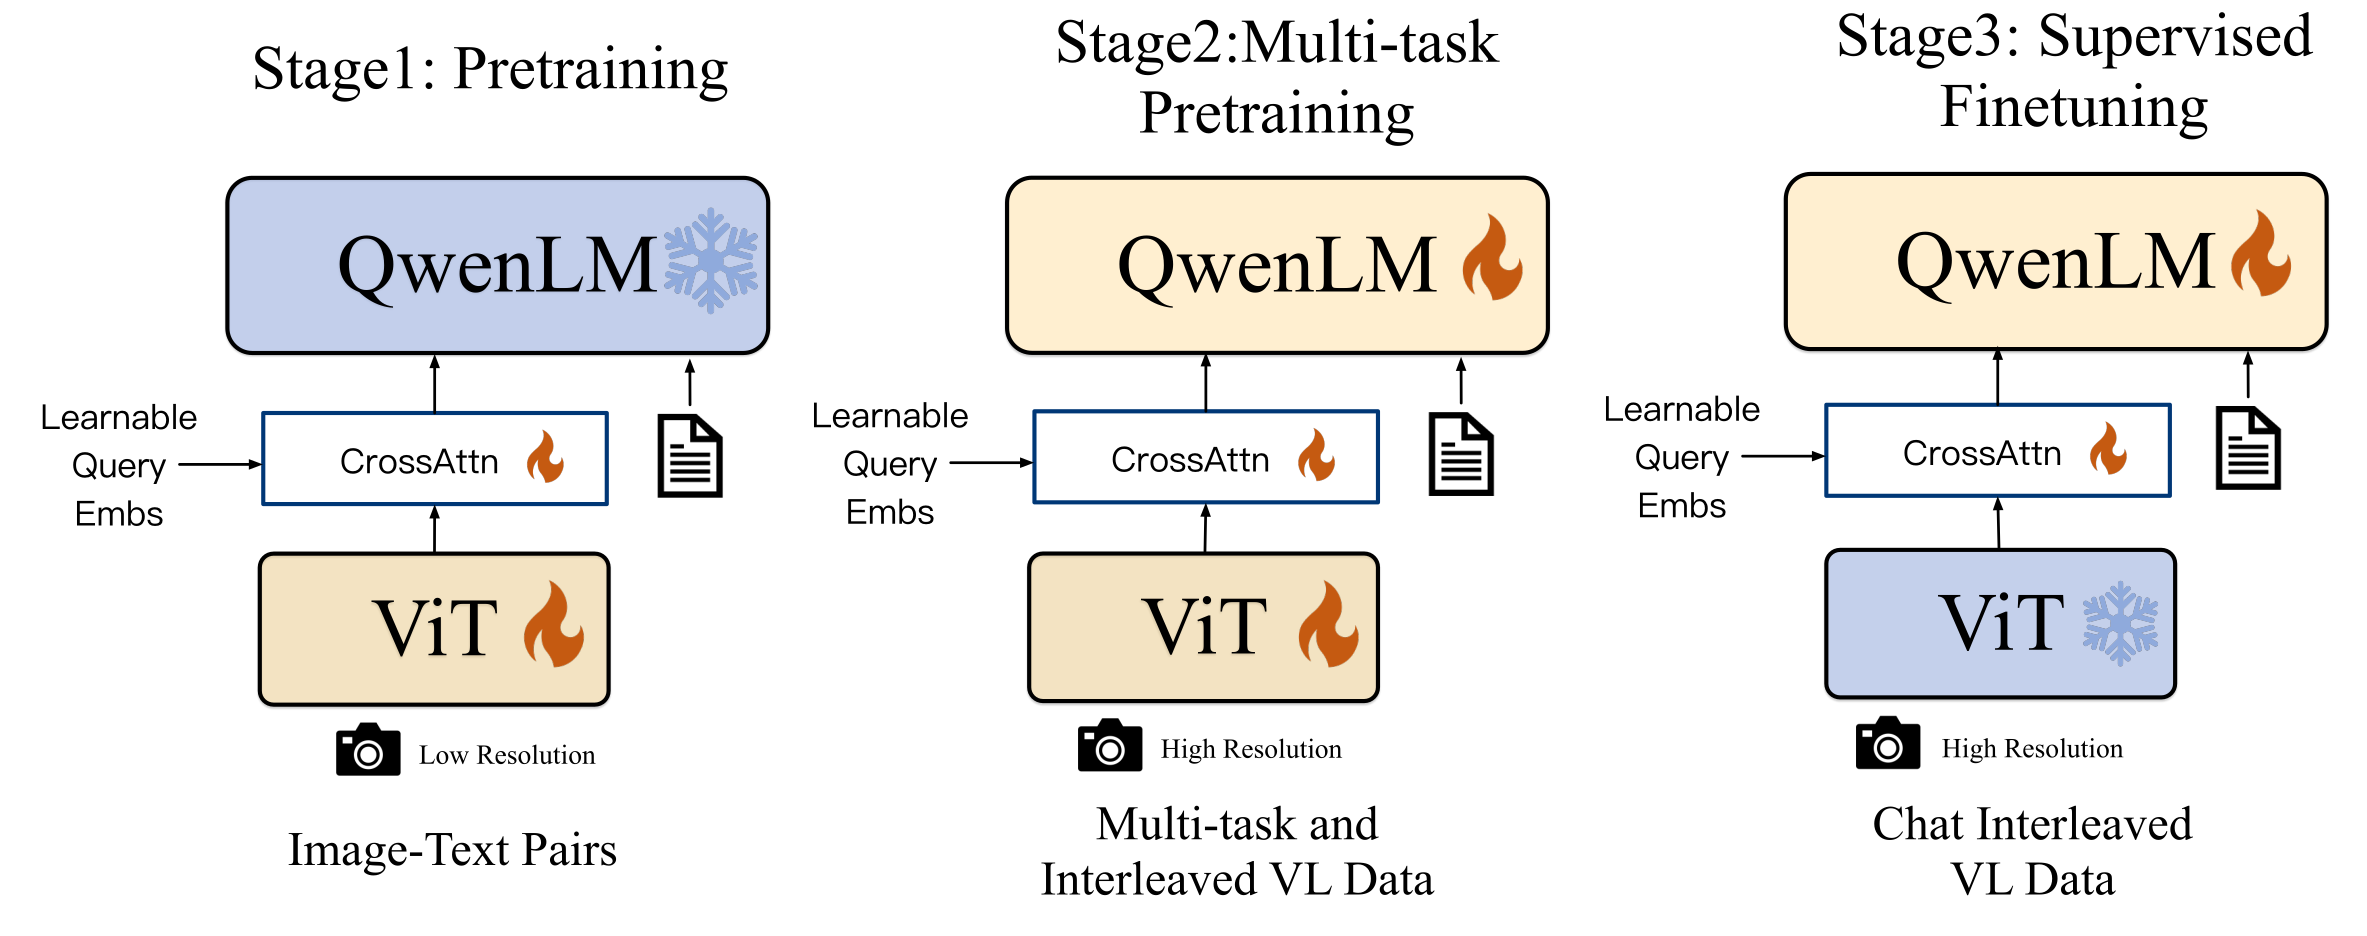
| 阶段 | 数据 | 视觉编码器 | Adapter | 语言模型 |
|---|---|---|---|---|
| Stage 1:预训练 | 大规模、低质量图文对 | 🔥 训练 | 🔥 训练 | ❄️ 冻结 |
| Stage 2:多任务预训练 | 更高质量的任务特定数据,提高分辨率 | 🔥 训练 | 🔥 训练 | 🔥 训练 |
| Stage 3:指令微调 | 指令数据 | ❄️ 冻结 | 🔥 训练 | 🔥 训练 |
与 LLaVA 最大的区别:Qwen-VL 训练视觉编码器。LLaVA 全程冻结 ViT,因为它只有 15.8 万条指令数据;Qwen-VL 的 Stage 1 有十亿量级的图文对,足以在不破坏表示的前提下让 ViT 适应新任务(尤其是中文 OCR,这是原版 CLIP 完全不会的)。
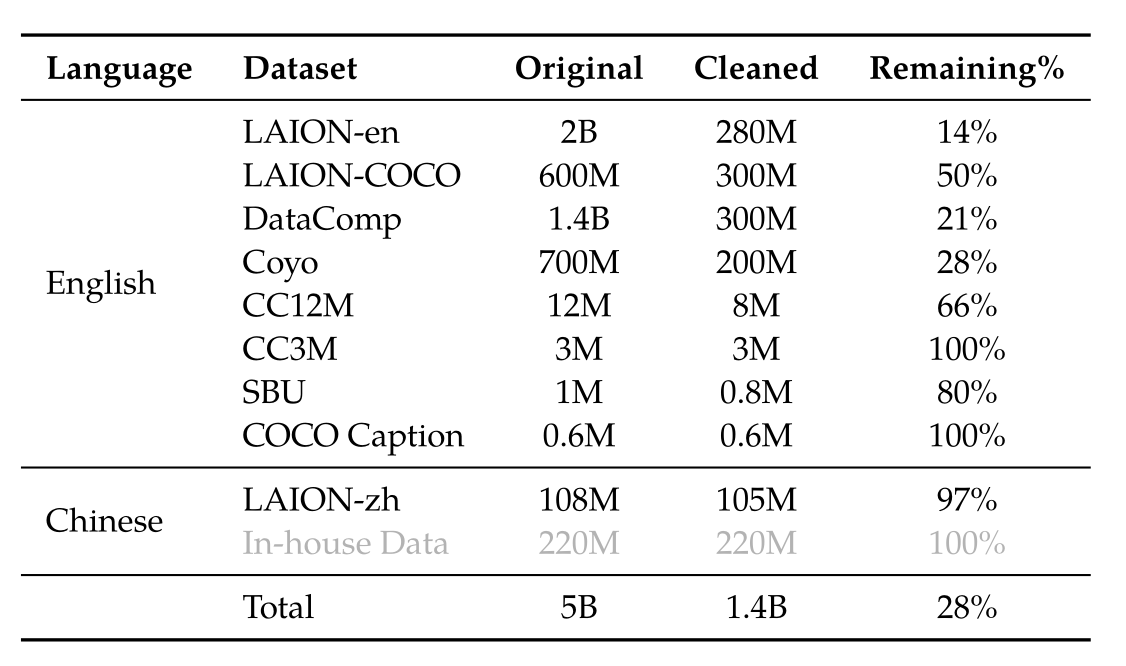
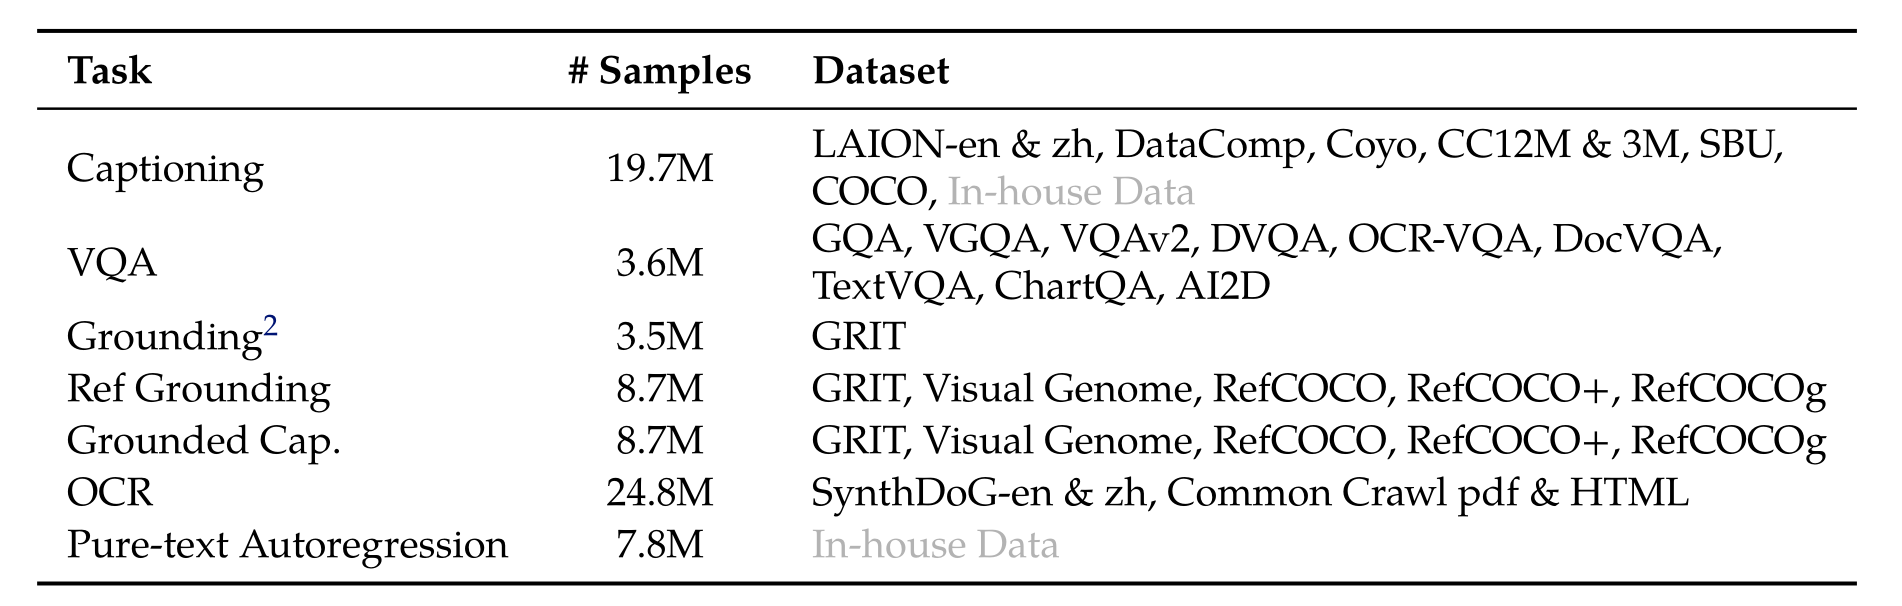
<box> 和 <ref> 特殊 token 的用途。另外注意最后一行纯文本自回归数据:混入纯文本是为了防止语言能力退化(第 1.3 节说的 modality tax)。<box> 和 <ref> 让模型能够输出结构化的空间信息。做法是把边界框坐标归一化到 $[0, 1000)$ 的整数,然后直接当成文本写出来:
用户:图中的狗在哪里?
模型:<ref>狗</ref><box>(342,551),(658,891)</box>
这是一个反复出现的强大模式:与其为每种输出类型设计专门的预测头,不如把它序列化成 token 让 LM 生成。检测框、分割掩码、UI 点击坐标、乃至机器人动作,都可以这样处理。代价是精度受限于坐标的离散化粒度(这里是 1/1000),但对绝大多数应用足够了。
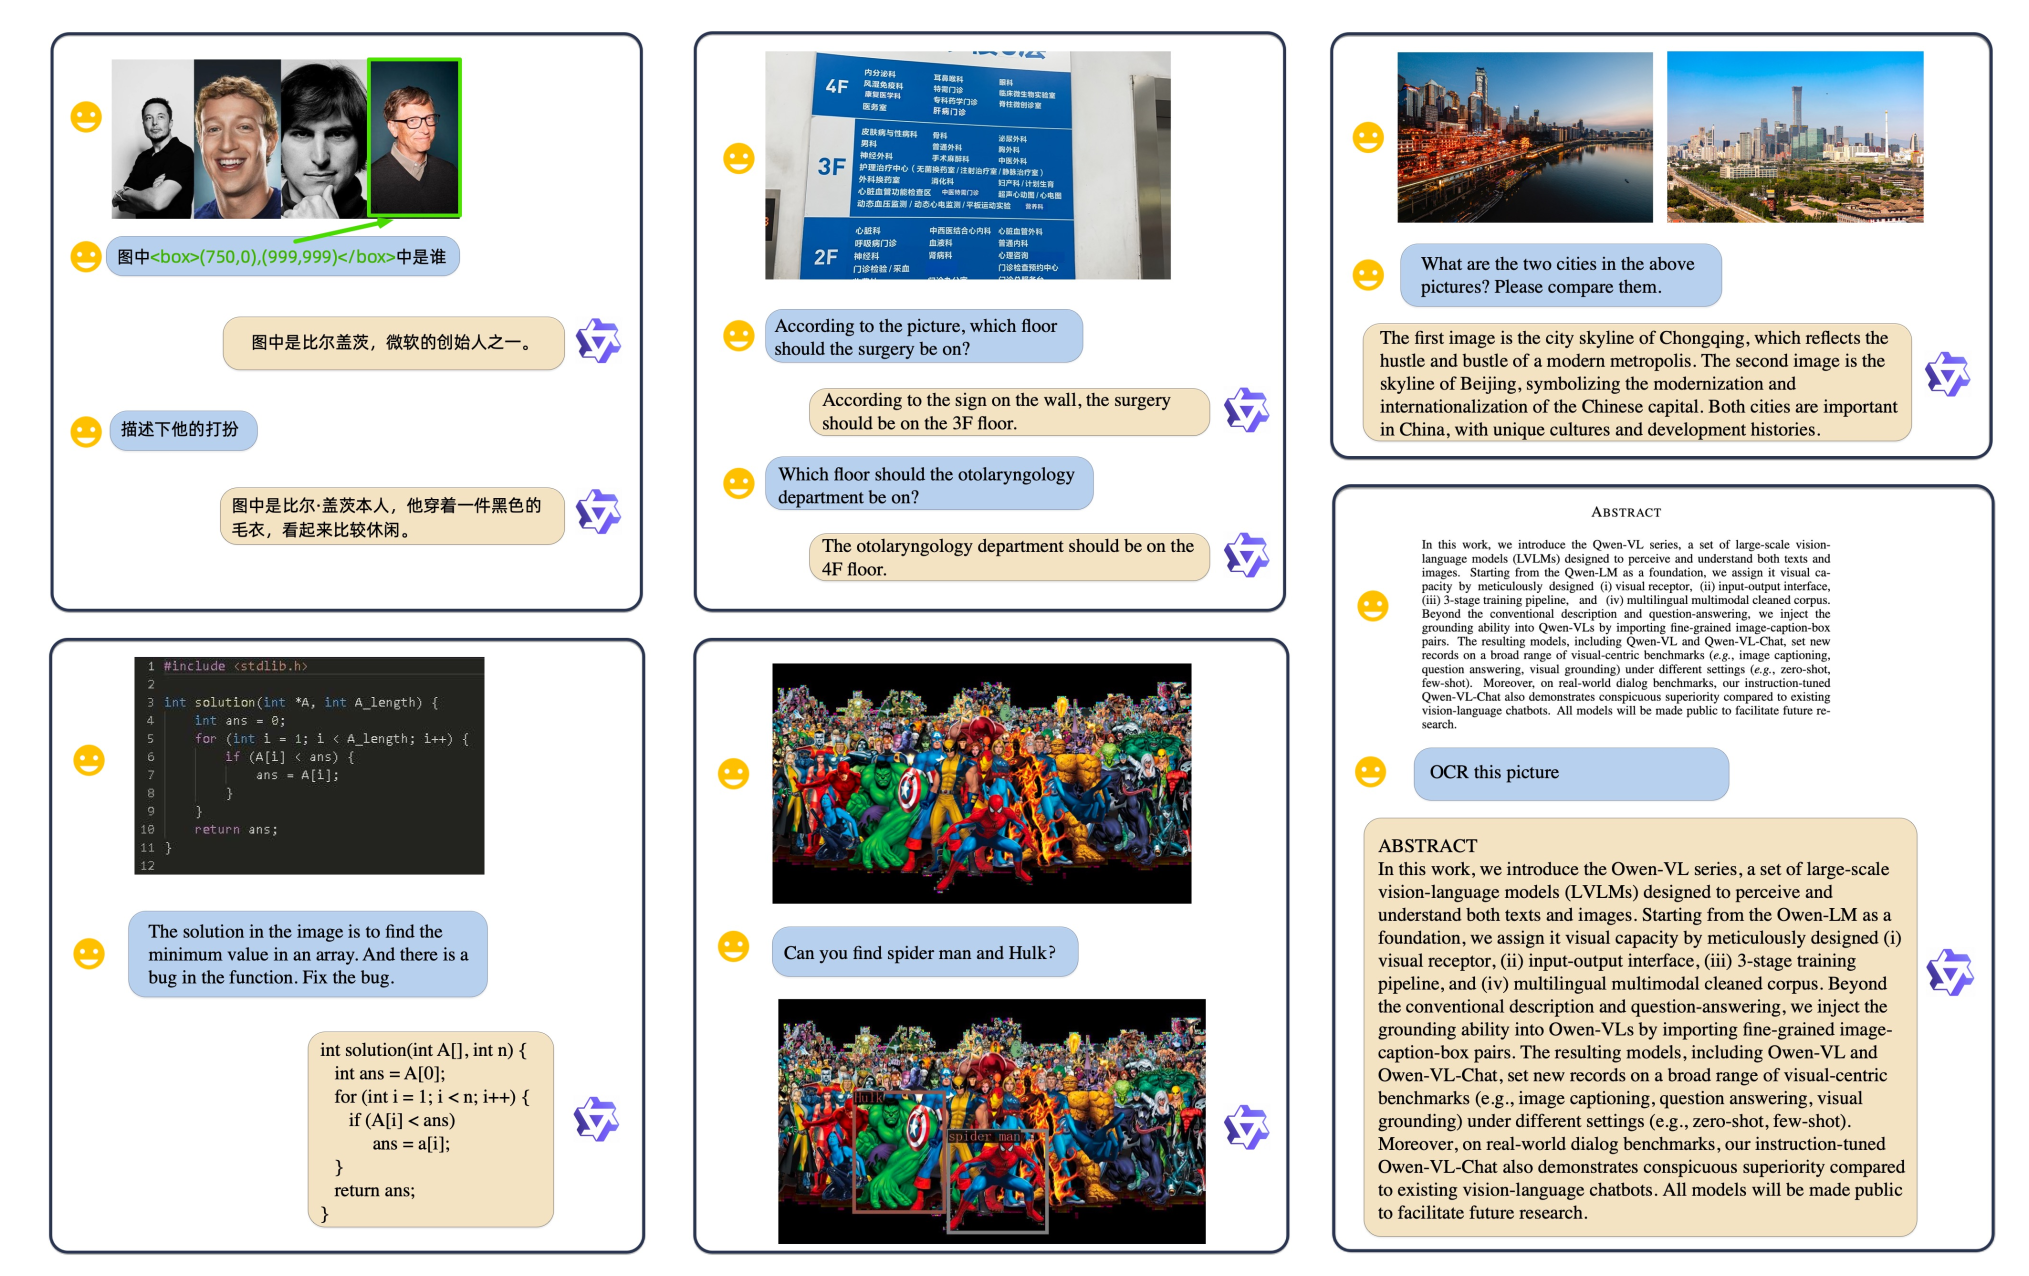
7.2 Qwen2-VL:动态分辨率与 MRoPE
Qwen2-VL 的核心创新是 Percy 强调的那个词:dynamic resolution(动态分辨率)。
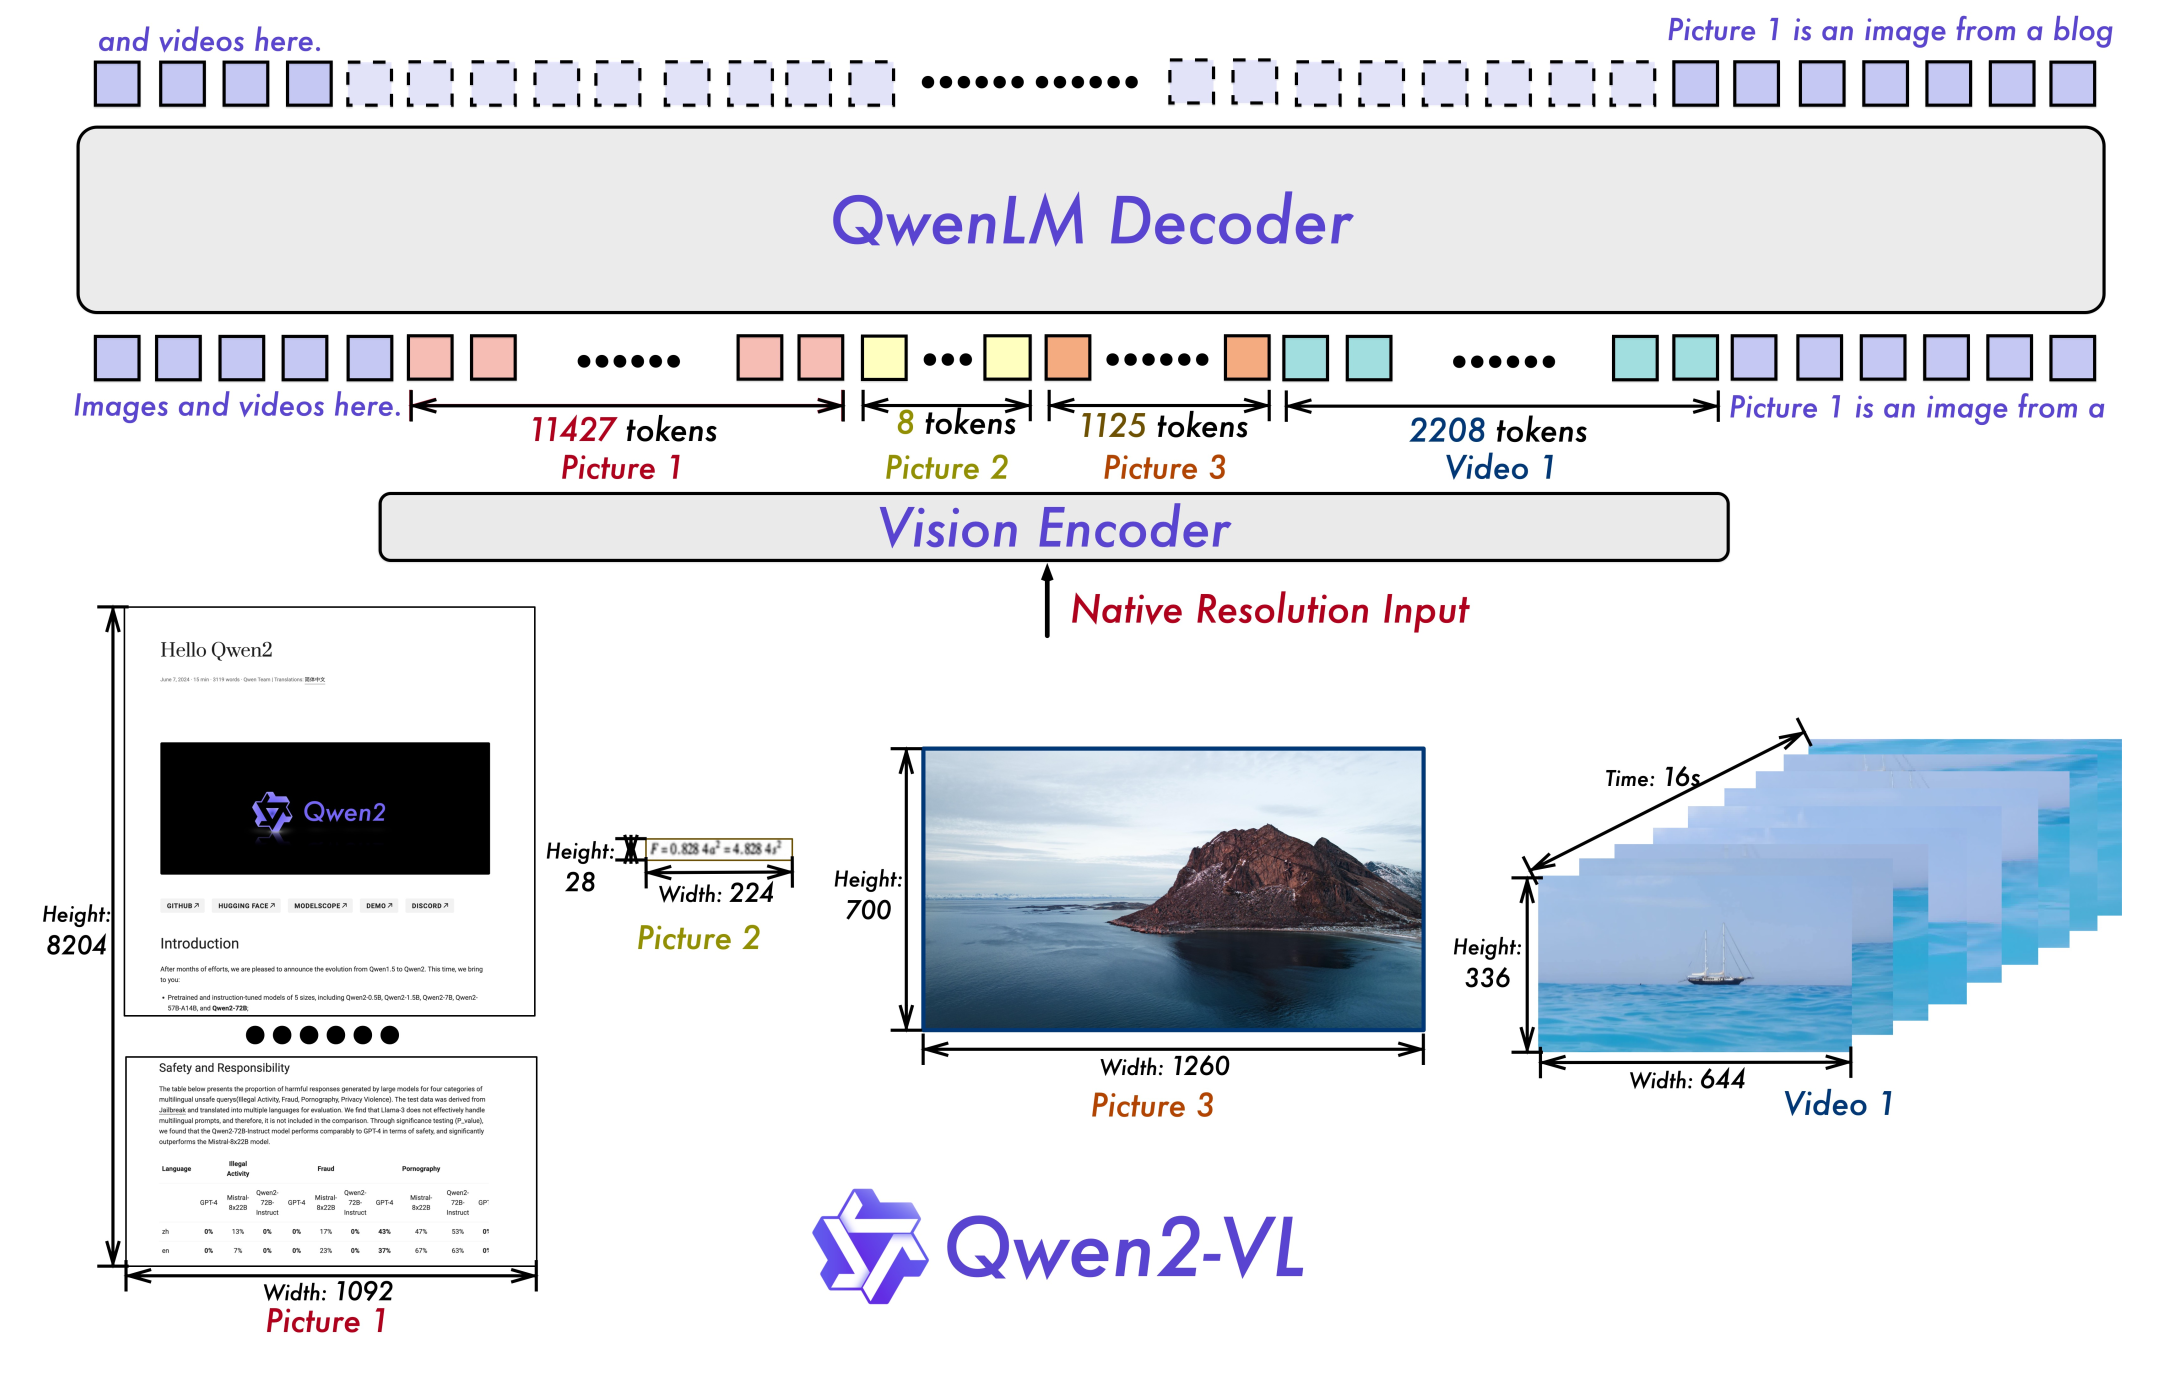
Percy 给的具体数字:
- 视觉编码器是更大的 ViT(6.75 亿参数);
- 每个 224×224 的区域用 ViT/14 编码,然后每 2×2 个 patch 压缩成 1 个 ⇒ 66 个 token;
- 视频:每秒采样 2 帧,最多 16384 个 token。
224×224 用 14×14 的 patch 切,得到 $16\times16 = 256$ 个 patch。做 2×2 合并(把相邻四个 patch 的特征拼接后过一个 MLP 降维)后变成 $8\times8 = 64$ 个 token,再加上边界标记 token 就是 66。
压缩比 4×,直接影响是上下文成本降到 1/4。这对视频是生死攸关的:按 2 帧/秒计算,一段 1 分钟的视频有 120 帧。不压缩的话 $120 \times 256 = 30720$ token,超过预算;压缩后 $120 \times 64 = 7680$ token,装得下。16384 token 的上限对应约 2 分钟的视频。
为什么 2×2 合并损失可控?因为相邻 patch 的视觉内容高度冗余——图像的局部相关性极强,四个相邻 14×14 块(合计 28×28 像素)通常属于同一个物体或同一片纹理。这与文本 token 之间的低冗余形成鲜明对比,也再次印证了「图像信息密度低」这一贯穿全讲的主题。
MRoPE:多模态旋转位置编码
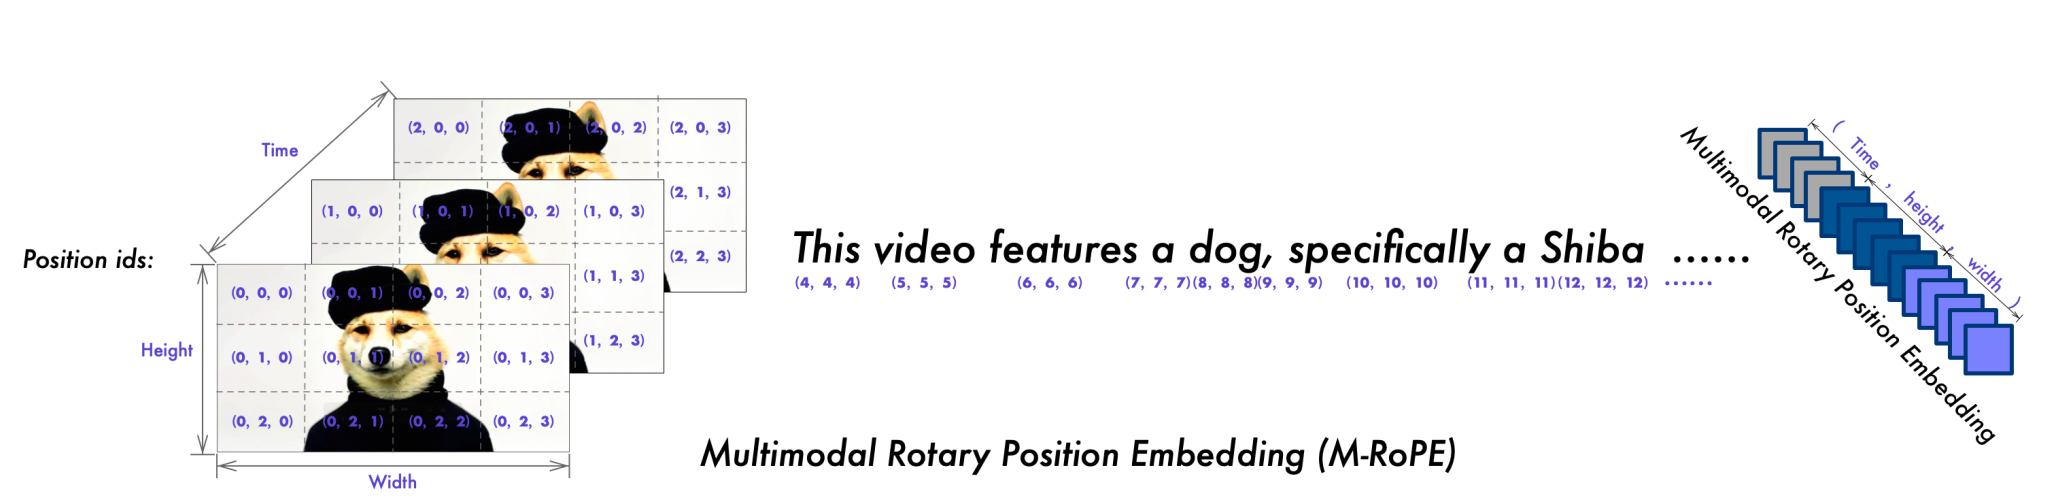
def mrope_position_ids(seq_spec):
    """为混合序列生成 (t, h, w) 三维位置索引。"""
    ids, t_offset = [], 0
    for item in seq_spec:
        if item.kind == "text":
            for _ in range(item.length):                 # 文本:三轴同步递增
                ids.append((t_offset, t_offset, t_offset)); t_offset += 1
        elif item.kind == "image":
            for h in range(item.grid_h):                 # 图像:t 固定,h/w 是网格坐标
                for w in range(item.grid_w):
                    ids.append((t_offset, t_offset + h, t_offset + w))
            t_offset += max(item.grid_h, item.grid_w)     # 图像之后时间轴跳过整块
        elif item.kind == "video":
            for f in range(item.n_frames):               # 视频:t 随帧递增
                for h in range(item.grid_h):
                    for w in range(item.grid_w):
                        ids.append((t_offset + f, t_offset + h, t_offset + w))
            t_offset += item.n_frames
    return ids   # 每个元素是三元组,RoPE 的三段维度分别用其中一个分量
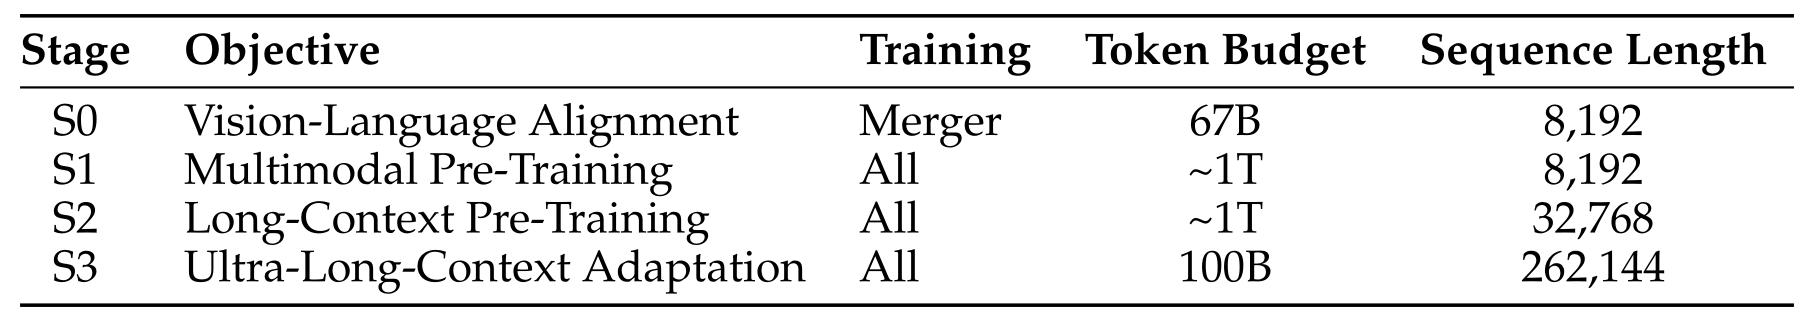
其余配置:语言模型用 Qwen2 初始化,视觉编码器用 DFN(Data Filtering Networks)的权重初始化。训练仍是三阶段,与 Qwen-VL 类似:(1) 只训视觉编码器;(2) 训全部参数;(3) 在指令跟随数据上训语言模型。
7.3 Qwen3-VL:规模化与细节打磨
Qwen3-VL 代表了当前的前沿状态。
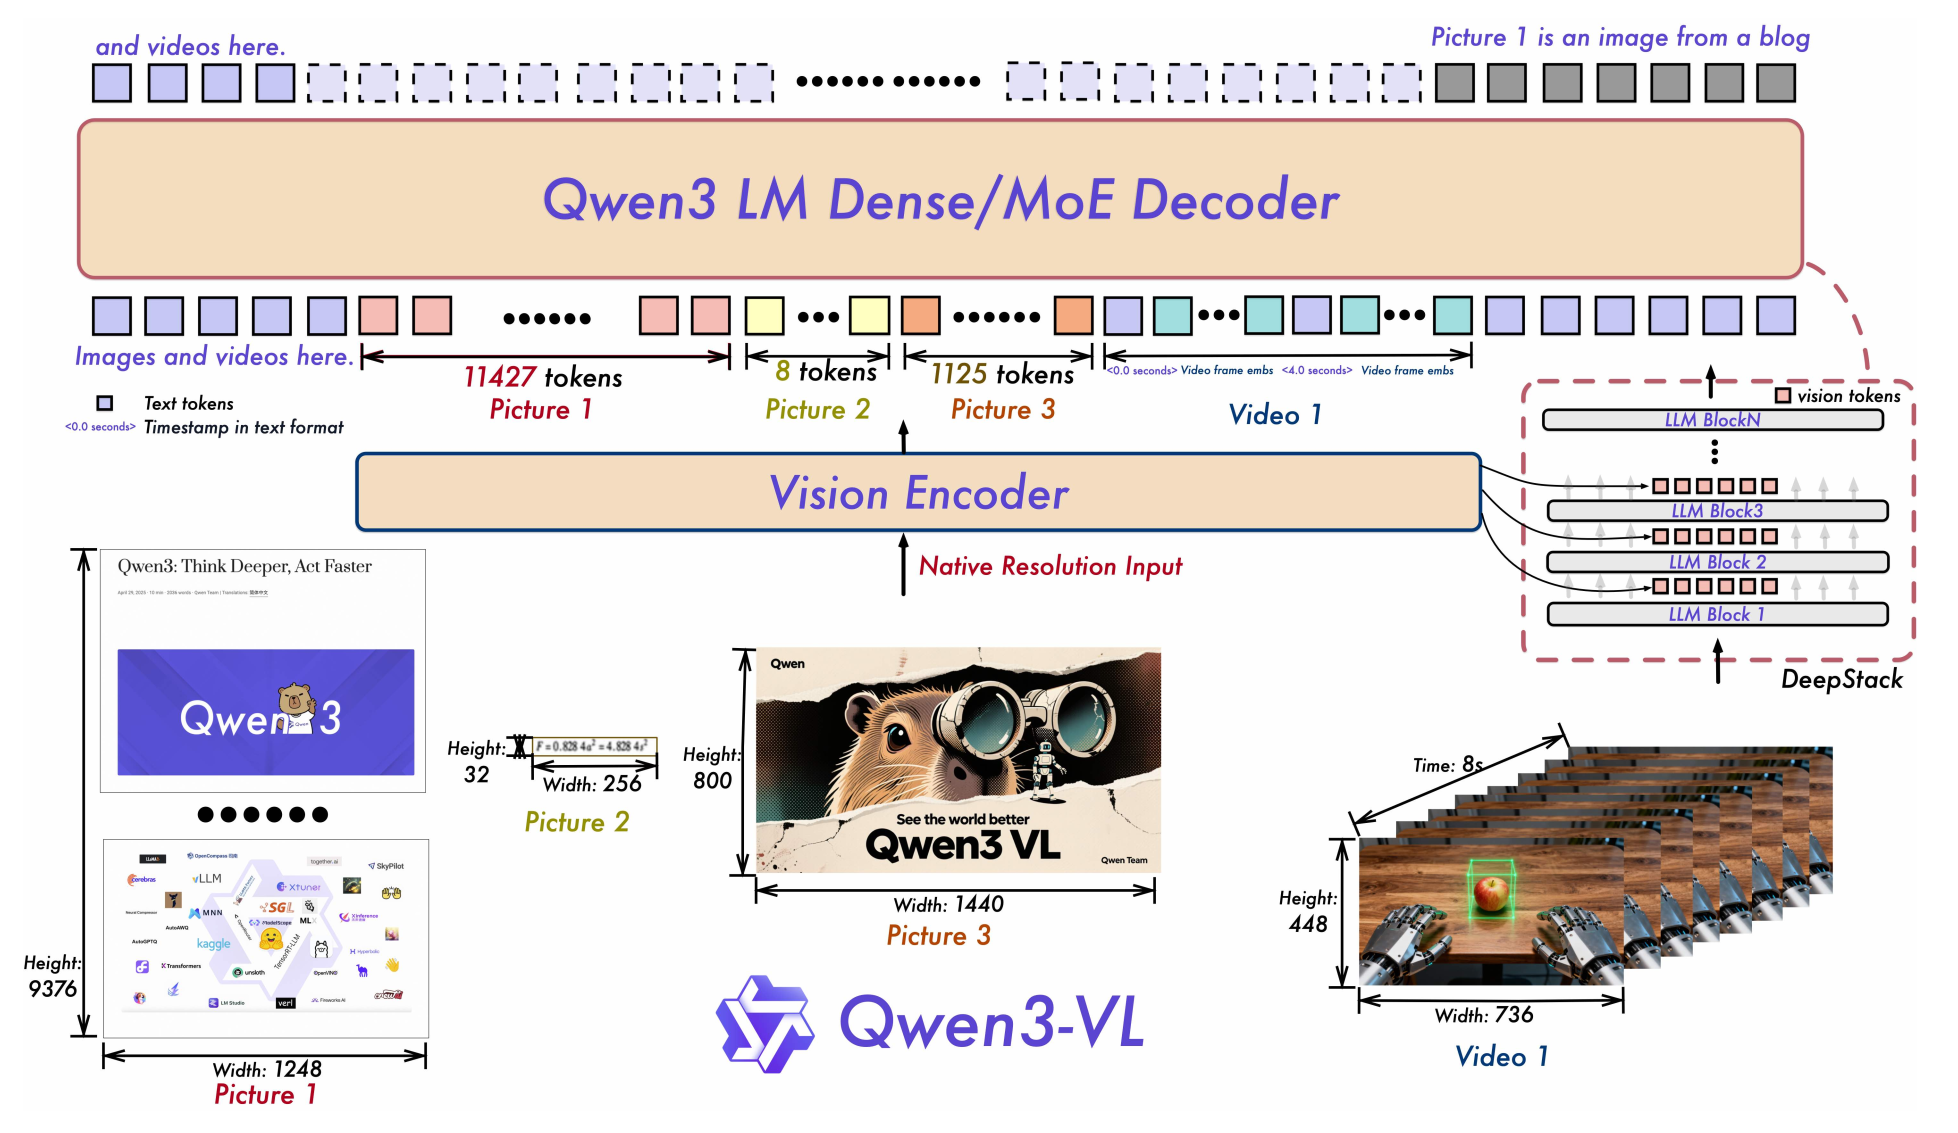
| 组件 | Qwen3-VL 的选择 | 解决什么问题 |
|---|---|---|
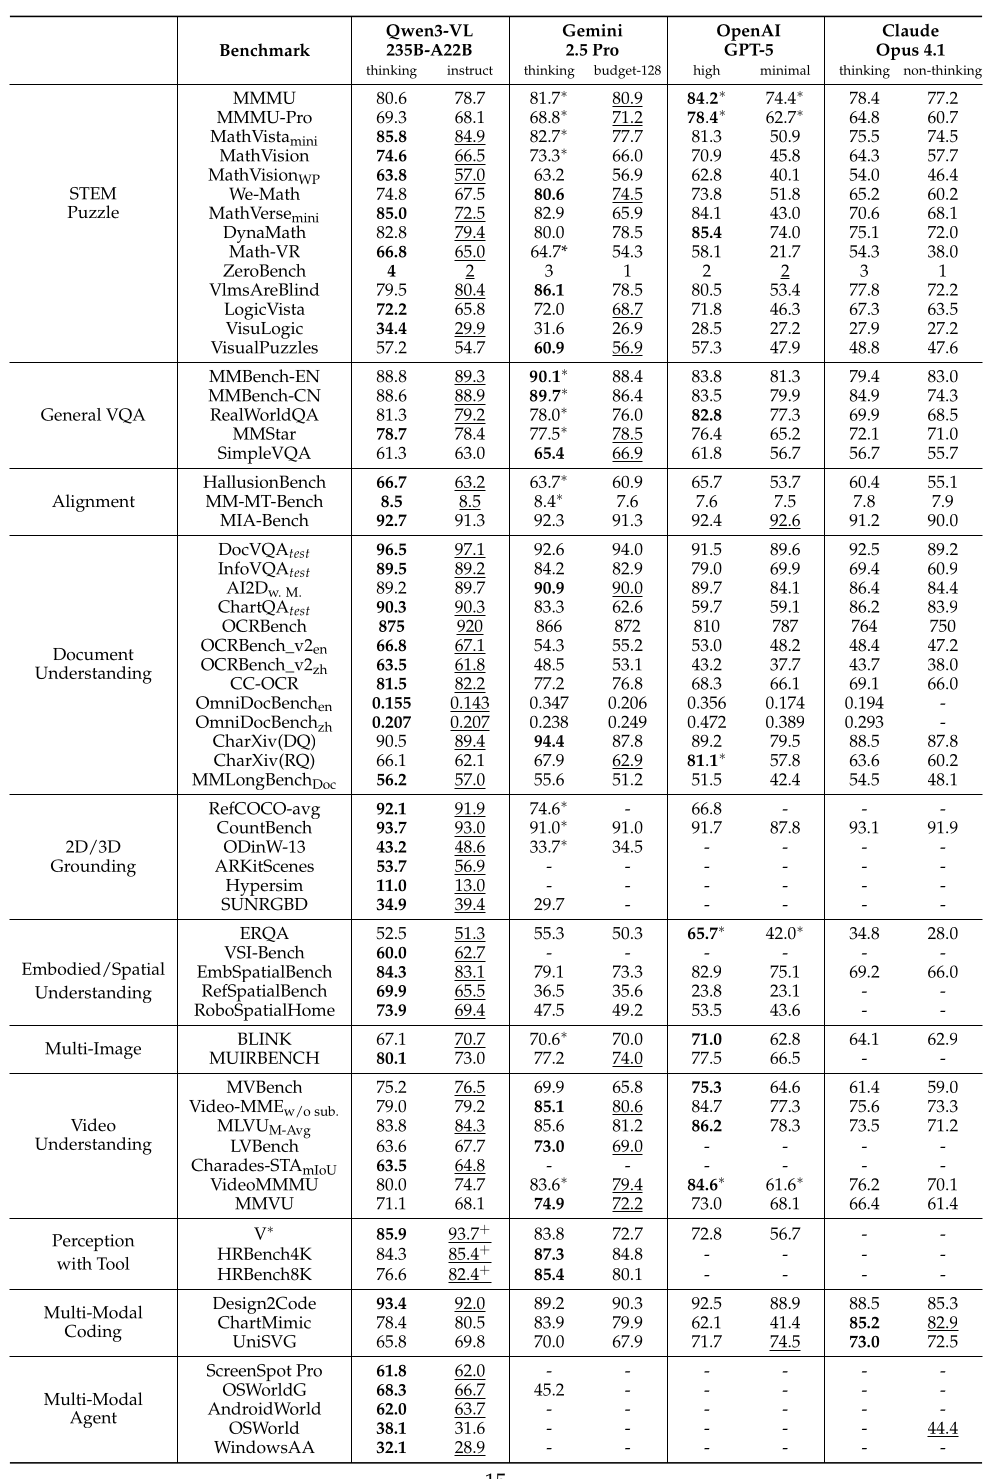
| 语言模型 | Qwen-3 系列(dense 与 MoE,最大 235B-A22B),256K 长上下文 | 规模化;长视频/长文档需要超长上下文 |
| 视觉编码器 | SigLIP-2(架构同 SigLIP) | 更好的多语言与细粒度视觉表示 |
| 位置编码 | Interleaved MRoPE | 见下 |
| 视频时间 | 显式时间戳作为独立 token,而非编进位置嵌入 | 让模型能直接说出「事件发生在第 12 秒」 |
| 损失 | 按 $\sqrt{L}$ 归一化的 per-token 损失 | 平衡文本与多模态数据 |
| Adapter | DeepStack:跨层融合 | 见下 |
Percy 的原话是:「把所有轴(时间、宽、高)分布到低频和高频波段」,即位置维度排布成
[t w h t w h t w h t w h] 而不是 [t t t t w w w w h h h h]
为什么这很重要?回忆 Lecture 3 讲 RoPE:第 $i$ 对特征维度的旋转频率是 $\theta_i = 10000^{-2i/d}$,$i$ 小 = 高频(分辨近距离差异),$i$ 大 = 低频(编码远距离/全局位置)。
原版 MRoPE 把维度连续分块:前 1/3 给 $t$,中 1/3 给 $w$,后 1/3 给 $h$。后果是 $t$ 只拿到了最高频的那一段,$h$ 只拿到了最低频的那一段。这意味着:时间轴缺少低频分量 ⇒ 长视频的时间外推能力极差(位置一远就绕圈重复);高度轴缺少高频分量 ⇒ 垂直方向的精细定位变差。
交错排布让每个轴都均匀地拿到全频谱——每个轴都既有分辨近邻的高频,也有编码全局位置的低频。这是一个「小改动、真收益」的典型例子,也是 Percy 在小结里说的「微小但可能重要的架构改进」。
标准做法是把视觉 token 拼在输入端(第 0 层)。问题是:信息要穿过几十层 Transformer 才能被用上,而中间每一层都在做有损的信息加工,细粒度的视觉细节在深层已经被稀释掉了。这对 OCR、精确定位这类需要「回头再看一眼原图」的任务尤其不利。
DeepStack 的做法是把视觉编码器不同层的特征,注入到语言模型不同层的隐状态上(通常是相加)。浅层视觉特征(边缘、纹理、字形)注入语言模型的浅层,深层视觉特征(语义)注入深层。这样语言模型在任何深度都能直接访问未经稀释的视觉信息。
成本几乎为零(只是几个额外的投影矩阵和加法),不增加序列长度——这是它相对于「重复拼接视觉 token」的关键优势。
标准的语言模型损失对一个 batch 里所有 token 求和再除以总 token 数。假设 batch 里有一条纯文本样本(500 token)和一条长视频样本(16000 token),那么视频样本贡献了 97% 的梯度——尽管它可能只包含相当于几句话的语义信息。
如果改成「每个样本的损失取平均后再对样本求平均」(即除以 $L$),又走到另一个极端:长样本里的每个 token 权重被压得过低。
Qwen3-VL 取折中:样本 $s$ 的损失除以 $\sqrt{L_s}$:
$$ \mathcal{L} = \frac{1}{S}\sum_{s=1}^{S} \frac{1}{\sqrt{L_s}}\sum_{i=1}^{L_s} \ell_{s,i} $$这样长度为 16000 的样本相对 500 的样本,权重比是 $\sqrt{16000/500} = 5.7$ 而不是 32。既承认长样本包含更多信息,又不让它支配梯度。这直接对应 Percy 在总结里说的「平衡图像 + 视频(信息密度更低)与文本,以保证训练稳定」。
Qwen3-VL 小结(Percy 的四条,很坦率):
- SOTA 性能;
- 大量数据工作,但没有多少细节——这是当前前沿模型论文的通病,最重要的部分恰恰是最不透明的;
- 微小但可能重要的架构改进(Interleaved MRoPE、DeepStack、$\sqrt{L}$ 损失);
- 扩大规模。
| Qwen-VL | Qwen2-VL | Qwen3-VL | |
|---|---|---|---|
| 视觉编码器 | OpenCLIP ViT-bigG | DFN 初始化的 ViT(675M) | SigLIP-2 |
| 连接方式 | 交叉注意力,压到固定 256 token | 2×2 合并,可变长度 | DeepStack 多层注入 |
| 分辨率 | 固定(224 → 448) | 动态原生分辨率 | 动态 + 256K 上下文 |
| 位置编码 | 2D 位置编码加在 adapter 里 | MRoPE (t, h, w) | Interleaved MRoPE |
主线非常清楚:从「压缩视觉信息以节省上下文」转向「保留视觉信息并想办法承受它的成本」。随着长上下文技术(Lecture 4 的注意力变体、Lecture 10 的 KV cache 优化)成熟,压缩的必要性下降,而压缩的代价(细节丢失)变得越来越不可接受——尤其是在 OCR 和 GUI agent 成为主要应用场景之后。
8. 走向 omni:Chameleon 与早融合
到目前为止,第 6–7 节讲的所有 VLM 都有同一个结构性缺陷。Percy 说得很直接:
目前为止:VLM 用 CLIP 或 SigLIP 编码图像,注入 LM。
缺点:它们不能生成图像(要生成得靠扩散模型)。
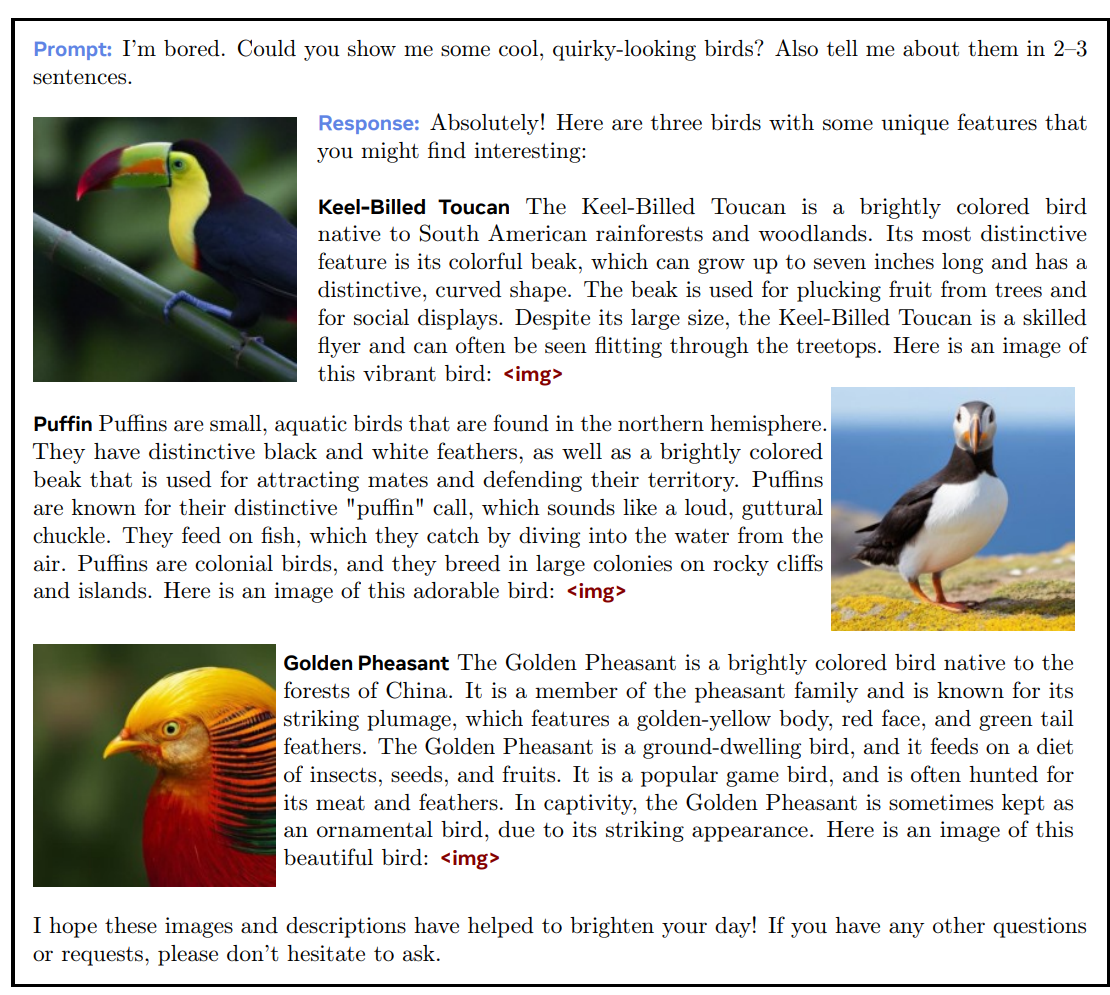
这是第 3 节讨论过的问题:连续向量没法自回归采样。所以 GPT-4V 这类模型「画图」时,实际上是写一段提示词,调用一个外部的扩散模型——两个模型之间只通过一串文本通信,图像理解和图像生成完全不共享表示。你没法让它「把这张图里的猫改成狗,其他一模一样」,因为提示词这个瓶颈丢掉了原图的所有细节。
8.1 Chameleon:把一切都变成离散 token
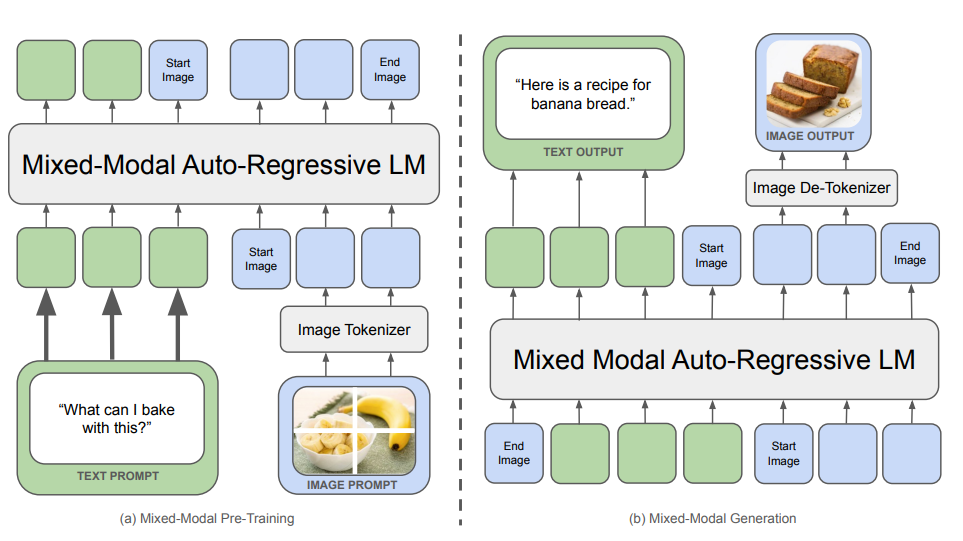
Chameleon 的主张是:把所有东西都映射成离散 token。好处是可以用完全统一的方式分析和生成图像。
8.2 视觉 tokenizer 的角色转变
Percy 点出了关键差异:编码器必须映射到离散 token,这样我们才能生成它们。
这就把我们带回了第 3 节的 VQ-VAE。Chameleon 的配置(引用自 Make-A-Scene 的 tokenizer):
- 512×512 的图像编码成 1024 个 token;
- 码本大小 8192;
- 为文本训练了一个新的 BPE tokenizer,与图像 token 合并成统一词表。
| CLIP / SigLIP 编码器 | VQ-VAE / VQ-GAN tokenizer | |
|---|---|---|
| 训练目标 | 图文对比损失(语义对齐) | 像素重建损失(信息保留) |
| 监督信号来自 | 人写的说明文字 | 图像自己 |
| 学到的是 | 文字会描述的东西 | 重建图像所需的东西 |
| 输出 | 连续向量 | 离散整数 |
| 能否解码回图像 | ❌ 不能 | ✅ 能 |
| 语义性 | ✅ 强 | 弱(码本项是纹理基元,不是概念) |
这张表解释了 Chameleon 的核心困境。VQ tokenizer 学到的 token 不是语义单元,而是纹理基元——码本里的第 3721 项可能代表「45 度的深色斜边缘」,而不是「猫耳朵」。语言模型因此必须自己从这些低层视觉基元里重建出语义,而 CLIP 已经把这个工作做完了。这是 Chameleon 理解能力落后的根本原因。
8.3 训练:两阶段与数据配比
- Stage 1(占 80%):大规模无监督数据 —— 2.9T 纯文本 token、1.5T 文本/图像 token、400B 文本/图像交错 token;
- Stage 2(占 20%):50% 是 Stage 1 的数据,50% 是高质量数据。
注意这个配比:纯文本 token(2.9T)比图文 token(1.5T + 0.4T)还多。图像并没有「取代」文本,而是作为补充。这与第 1.3 节说的 modality tax 一致——保住语言能力需要大量纯文本数据兜底。
8.4 训练稳定性:本节最有工程价值的部分
Percy 专门讲了 Chameleon 遇到的训练不稳定问题,这是把不同模态混在一个词表里的直接后果:
文本 token 熵低,图像 token 熵高,导致 norm 增长、logit 漂移(logit drift)问题。
修复:QK norm、z-loss 正则化。
第一步:熵的差异。文本高度可预测——给定「the capital of France is」,下一个 token 几乎确定是「Paris」,熵可能低到 0.5 bit。图像 token 则不然:给定图像左上角的若干 token,下一个纹理基元有大量合理选择,熵可能高达 6–8 bit(码本 13 bit 的一半以上)。
第二步:低熵驱动 logit 增大。交叉熵损失要让正确 token 的概率趋近 1。对于低熵的文本 token,模型的最优策略是无限增大正确 token 与其他 token 的 logit 差——因为 softmax 永远达不到概率 1,梯度永远指向「再大一点」。logit $= W_o h$,所以这意味着 $\|h\|$ 和 $\|W_o\|$ 持续增长。这就是 norm 增长。
第三步:崩溃。norm 增长带来两个致命后果:
- 注意力饱和:注意力 logit $q^\top k/\sqrt{d}$ 随 $\|q\|\|k\|$ 增长,softmax 变成 one-hot,梯度趋近 0,某些层实质上停止学习。
- 数值溢出:bf16 的最大值约 $3.4\times10^{38}$,但精度只有 8 位尾数。logit 到几百的时候,$\exp$ 就开始溢出,出现 NaN。
而混合模态让这一切更糟:模型的同一组参数要同时服务两种熵截然不同的分布。为文本优化出的「大 logit」策略施加到图像 token 上时,会产生过度自信的错误预测和巨大的梯度——两种模态在互相拉扯,训练轨迹在两个吸引子之间震荡,最终发散。
修复方案一:QK norm。在计算注意力分数之前,对 query 和 key 各做一次 LayerNorm(或 RMSNorm):
class AttentionWithQKNorm(nn.Module):
    def __init__(self, d_model, n_heads):
        super().__init__()
        self.n_heads, self.d_head = n_heads, d_model // n_heads
        self.qkv = nn.Linear(d_model, 3 * d_model, bias=False)
        self.o = nn.Linear(d_model, d_model, bias=False)
        # 关键:对 q 和 k 分别归一化,切断 norm 增长 -> 注意力饱和 的链条
        self.q_norm = nn.RMSNorm(self.d_head)
        self.k_norm = nn.RMSNorm(self.d_head)

    def forward(self, x):                       # x: (B, T, D)
        q, k, v = self.qkv(x).chunk(3, dim=-1)
        q, k, v = (t.view(*x.shape[:2], self.n_heads, self.d_head).transpose(1, 2)
                   for t in (q, k, v))
        q, k = self.q_norm(q), self.k_norm(k)   # <== QK norm
        out = F.scaled_dot_product_attention(q, k, v, is_causal=True)
        return self.o(out.transpose(1, 2).flatten(2))
效果:归一化之后 $\|q\| = \|k\| = \sqrt{d_\text{head}}$ 是常数,注意力 logit 的量级被硬性钳制,与激活的 norm 完全解耦。无论隐状态怎么增长,注意力都不会饱和。
修复方案二:z-loss。直接惩罚输出层 softmax 的配分函数(partition function)的对数:
$$ \mathcal{L}_{\text{total}} = \mathcal{L}_{\text{CE}} + \lambda_z \cdot \Big(\log \textstyle\sum_{v \in V} e^{\ell_v}\Big)^2, \qquad \lambda_z \approx 10^{-5} $$def loss_with_z_loss(logits, targets, lambda_z=1e-5):
"""logits: (B, T, V)"""
logZ = torch.logsumexp(logits, dim=-1) # (B, T)
ce = F.cross_entropy(logits.flatten(0, 1), targets.flatten())
z_loss = lambda_z * logZ.pow(2).mean() # 把 logZ 拉向 0
return ce + z_loss
交叉熵损失只关心 logit 之间的相对差值——给所有 logit 同时加一个常数 $c$,损失完全不变(softmax 平移不变)。这意味着 logit 的绝对量级是一个完全不受约束的自由度,优化器可以让它随机漂移到任意大的值。这就是「logit 漂移」。
z-loss 把 $\log\sum_v e^{\ell_v}$(即 logit 的 log-sum-exp)拉向 0,等于钉住了这个自由度,不影响模型能表达的任何概率分布,却把数值稳定性问题彻底消除。这是一个「零成本」的正则项——它约束的是一个对函数表达力毫无贡献的维度。
z-loss 最早在 PaLM 和 T5 中被采用,Chameleon 的贡献是指出多模态混训会让 logit 漂移问题严重得多,因而从「可选优化」变成了「必需品」。这两个技巧(QK norm + z-loss)在 Lecture 3 讲架构与训练稳定性时已经出现过,这里是它们在多模态场景下的一个强化案例。
Chameleon 小结(Percy 的三条):
- 优雅——就是对离散 token 做自回归建模,没有任何特殊处理;
- 性能不如 VLM——离散化丢信息,想想 OCR;
- 多模态混合训练很棘手。
Chameleon 的故事有一个反直觉的教训。从美学上看,「一切皆 token、一个损失函数、一个模型」显然是正确方向——就像当年 Transformer 统一了 CNN 和 RNN。很多人据此预测早融合会迅速取代 VLM 模板。
但两年过去,前沿的多模态理解模型(Qwen3-VL、Gemini、GPT-5)几乎全部仍是「连续编码器 + LM」路线。原因不是架构不优雅,而是:(a)量化损失在 OCR/文档这类最有商业价值的任务上不可接受;(b)连续路线能免费复用在 4 亿~数十亿图文对上预训练好的编码器,而离散路线的 tokenizer 只优化重建,语义要从头学;(c)扩散模型在图像生成质量上大幅领先自回归 token 生成,「统一」带来的收益不足以补偿生成质量的损失。
教训:架构的优雅性不能抵消表示层的信息损失。选择表示(第 2–4 节讲的那三条路线)比选择架构重要得多。
9. 生成、音频、视频,以及数据与评测
9.1 图像生成的两条路线
Percy 在最后的总结里给出了他的判断,我们先把两条路线的对比摆出来。
| 自回归 token 生成 | 扩散模型(diffusion) | |
|---|---|---|
| 表示 | 离散码本 token | 连续隐空间(或像素) |
| 生成过程 | 逐 token 采样,$O(N)$ 次前向 | 迭代去噪,$O(T)$ 步($T \approx 20$–50) |
| 生成顺序 | 光栅顺序,因果 | 全局并行,每步同时更新所有像素 |
| 能否与文本共用一个模型 | ✅ 能(Chameleon) | ❌ 通常是独立模型 |
| 图像质量 | 受码本分辨率上限约束 | ✅ 当前最优 |
| 可控编辑 | 较弱 | ✅ 强(inpainting、ControlNet 等) |
| 代表 | Chameleon、Parti、原版 DALL·E | Stable Diffusion、DALL·E 3、Imagen |
自回归把图像的联合分布分解为 $p(x) = \prod_i p(x_i \mid x_{<i})$,按光栅顺序。这个分解对文本是自然的(语言本来就是线性的、因果的),但对图像是人为强加的:图像没有天然的一维顺序,左上角的像素并不「先于」右下角的像素存在。
后果是:(1)全局结构难以规划——模型在生成第一行像素时就必须隐式决定整幅画的构图,却还看不到任何后续内容;(2)误差累积——早期采样的一个错误 token 会污染之后的全部 1023 个 token,且无法回头修正。
扩散模型的分解方式完全不同:它建模的是 $p(x_{t-1} \mid x_t)$,每一步同时精修整幅图像的所有位置。构图在早期的高噪声步骤中被粗略确定,细节在后期的低噪声步骤中填充——这个「由粗到细」的顺序恰好匹配图像的多尺度结构,而且每一步都可以修正上一步的错误。
此外扩散的采样步数 $T \approx 20$–50 与图像分辨率无关,而自回归需要 $N$ 次串行前向(Chameleon 是 1024 次)。所以扩散在高分辨率下反而更快。
目前统一「理解 + 生成」的尝试主要有三类:
- 纯离散统一(Chameleon):优雅但理解能力打折;
- 双 tokenizer(如 Janus 系列):理解走 CLIP 连续编码器,生成走 VQ 离散 tokenizer,两条路共享同一个 LM 主干。承认「理解和生成需要不同表示」这个事实,不强行统一;
- LM + 扩散头(当前主流,也是 Percy 看好的):LM 负责理解和规划,输出一组连续的条件向量,由一个扩散解码器渲染成图像。关键在于条件是连续高维向量而不是一段提示词文本,因此不存在文本瓶颈,可以传递精确的空间和身份信息。
9.2 音频与视频
Percy 在课上只是简要带过,但核心逻辑与图像完全平行:先解决 tokenization,其余照搬。
音频同样有三条路线,与第 2–4 节一一对应:
| 路线 | 做法 | 代表 |
|---|---|---|
| 连续(语义 token) | 梅尔频谱图当作「图像」,用卷积/Transformer 编码 | Whisper(ASR)、大多数音频理解模型 |
| 离散(声学 token) | 神经音频编解码器 + 残差向量量化(RVQ) | SoundStream、EnCodec、AudioLM、VALL-E |
| 扩散 | 在频谱或波形隐空间上做扩散 | AudioLDM、多数音乐生成模型 |
音频对量化误差极其敏感(人耳能听出来),单层 VQ 的码本远不够。RVQ 的做法是级联多层量化器:第一层量化原始向量,第二层量化第一层的残差,第三层量化第二层的残差……
residual = z_e
tokens = []
for quantizer in self.quantizers:      # 例如 8 层
    q, idx, _ = quantizer(residual)
    tokens.append(idx)
    residual = residual - q            # 下一层只需编码「还差多少」
z_q = sum_of_all_quantized_parts
8 层各 1024 大小的码本,等效码本大小是 $1024^8 \approx 10^{24}$,但参数量只有 $8\times1024$ 个向量。这是一个「指数级表达力、线性级参数量」的漂亮结构,同时天然支持分层可伸缩——只用前 2 层就能得到低码率的粗糙音频,用全部 8 层得到高保真音频。这个思路完全可以借鉴到图像 tokenizer 上,用来缓解第 8 节说的 OCR 问题。
视频的核心矛盾在第 1.1 节已经点明:token 数极多但信息密度极低。主流做法:
- 降低时间采样率:Qwen2-VL 用 2 帧/秒,而不是原始的 24–30 帧/秒;
- 降低每帧分辨率:LLaVA-OneVision 给视频帧分配最低的分辨率预算;
- 时空联合压缩:把 2×2 的空间合并扩展成 2×2×2 的时空合并,利用帧间冗余;
- 显式时间戳 token:Qwen3-VL 的做法,让模型能精确回答「事件发生在第几秒」。
9.3 多模态训练数据与评测
把本讲提到的数据集汇总起来,可以看出多模态数据的完整谱系:
| 数据集 | 规模 | 用途 | 是否公开 |
|---|---|---|---|
| WIT(CLIP) | 4 亿图文对 | 对比预训练 | ❌ 未公开 |
| LAION-5B | 58 亿图文对 | OpenCLIP 复现 | ✅ 公开(用 CLIP 过滤) |
| WebLI(SigLIP) | 数十亿对,100 种语言 | SigLIP 预训练;含自动 OCR 文本 | ❌ 未公开 |
| Qwen-VL Stage 1 | 14 亿对(从 50 亿清洗) | 视觉编码器 + adapter 预训练 | ❌ 未公开 |
| LLaVA-Instruct | 15.8 万条 | GPT-4 合成的视觉指令 | ✅ 公开 |
| LLaVA-OneVision | 数百万条(单图/多图/视频) | 多阶段指令微调 | ✅ 公开 |
| Chameleon 预训练 | 2.9T 文本 + 1.5T 图文 + 400B 交错 | 早融合预训练 | ❌ 未公开 |
一个清晰的模式:预训练数据几乎全部闭源,指令数据往往开源。原因很现实——指令数据规模小、多为合成,公开的边际成本低;预训练数据涉及版权、成本高昂,且是最核心的竞争壁垒。这与 Lecture 13–14 讲文本数据时观察到的现象完全一致。
评测方面,主流多模态基准可以按能力维度分组(这正是本讲第 6.2 节说的「按能力清单组织数据」的镜像):
| 维度 | 代表基准 | 测什么 |
|---|---|---|
| 学科知识推理 | MMMU | 大学水平的图文混合学科题 |
| 数学与图表 | MathVista、ChartQA | 看图做数学题、读图表数据 |
| 文档与 OCR | DocVQA、OCRBench、TextVQA | 密集文字识别与理解——最考验分辨率 |
| 定位 | RefCOCO | 把文字描述对应到边界框 |
| 视频 | Video-MME、MVBench | 时序理解、事件定位 |
| 幻觉 | POPE | 模型会不会描述图中不存在的物体 |
| GUI agent | ScreenSpot、OSWorld | 看界面截图并操作 |
Lecture 12 讲评测时说过的所有毛病,在多模态领域只会更严重:
- 数据污染更难检测——图像的去重/匹配比文本困难得多,一张图裁剪、压缩、加水印后就绕过了哈希去重;
- 「不看图也能答对」——许多 VQA 基准存在强语言先验。经典的检查方法是把图像换成空白,如果准确率只掉几个点,说明这个基准测的其实是语言常识而非视觉能力;
- 多选题的猜测基线高,而开放式生成又难自动评分,只能用 LLM-as-judge,引入新的偏差。
9.4 Percy 对未来的判断
Percy 的总结部分给出了五条判断,逐条解读:
- 「前沿模型被期待是多模态的(原生多模态、omni)」 —— 多模态已经从加分项变成了入场券。注意「原生(natively)」这个词:不是训完文本模型再贴一个视觉编码器,而是从预训练一开始就混合模态。
- 「根本挑战是:如何编码非文本模态?」 —— 这是全讲的中心。架构问题基本解决了(Transformer + 投影器),表示问题还没有。
- 「理解与生成可能要求不同的东西(语义 vs 更细粒度的细节)」 —— 这是对「统一表示」这一美好愿景的一记警钟,也是第 8 节的核心教训。
- 「平衡图像 + 视频(信息密度更低)与文本,以保证训练稳定」 —— 数据配比不是按 token 数配,而是按信息量配。Qwen3-VL 的 $\sqrt{L}$ 归一化和 Chameleon 的 QK norm + z-loss 都是这个问题的技术表现。
- 「连续编码器 + Transformer + 扩散模型做生成」 —— 这是 Percy 押注的技术栈。值得注意的是它不追求形式上的统一:理解用连续编码器(保语义、无量化损失),主干用 Transformer(复用整个生态),生成用扩散(质量最高)。工程上的务实压过了架构上的优雅。
- 视频的长时程理解:现在最多两分钟。真正的视频理解(一部电影、一天的第一人称录像)需要的上下文比现在长两三个数量级,这需要 Lecture 4/10 讲的长上下文技术再突破。
- 细粒度与语义的统一表示:能否设计一个 tokenizer,既保留 OCR 级别的细节,又具备 CLIP 级别的语义?RVQ 的分层思路可能是一个方向。
- 真正的实时交互:omni model 的终极形态是流式的——一边听一边看一边说,而不是「收到完整输入 → 输出完整回答」。这对推理架构(Lecture 10)提出了全新要求。
- 模态间的正迁移:第 1.3 节说的那个野心——让视觉真正提升推理能力——目前仍然缺少有说服力的证据。
10. 全课程回顾:17 讲串成一条线
这是最后一讲正课。回头看,这门课其实只讲了一件事:在给定的算力预算下,把尽可能多的有用信息压进一个模型里。
所有 17 讲都可以挂在三个词上:数据 × 算力 × 效率。
| 阶段 | 讲次 | 回答的问题 | 核心张力 |
|---|---|---|---|
| 基础 | L1 总览与分词 | 怎么把字节流变成模型能吃的离散单元? | 词表大小 vs 序列长度 |
| L2 PyTorch 与资源核算 | 一次训练到底要多少 FLOPs、多少显存? | 把一切换算成可预算的数字 | |
| 架构 | L3 架构与超参数 | Transformer 的每个设计选择为什么这样定? | 表达力 vs 可训练性(稳定性) |
| L4 注意力变体与 MoE | 怎么在不增加 FLOPs 的前提下增加容量? | 参数量 vs 激活参数量 | |
| 硬件 | L5 GPU 与 TPU | 算力到底长什么样? | 计算 vs 访存(算术强度) |
| L6 算子与 Triton | 怎么把理论 FLOPs 变成实际 FLOPs? | 融合、分块、重计算 | |
| 规模 | L7 并行化(上) | 怎么把训练摊到很多卡上? | 通信量 vs 显存 |
| L8 并行化(下) | 模型放不下一张卡怎么办? | 切分维度的组合爆炸 | |
| 预测 | L9 / L11 缩放定律 | 小规模实验怎么外推到大规模? | 参数量 vs 数据量的最优配比 |
| L10 推理 | 训练完之后怎么便宜地用起来? | 吞吐 vs 延迟;KV cache 是新瓶颈 | |
| 目标 | L12 评测 | 「好」是什么意思? | 可测量 vs 真正想要的 |
| 燃料 | L13 数据来源 | 数据从哪来? | 规模 vs 版权/合规 |
| L14 过滤、去重、配比、合成 | 怎么把原始数据变成好数据? | 质量 vs 数量(激进过滤通常赢) | |
| 行为 | L15 SFT 与 RLHF | 怎么让模型做人想要的事? | 模仿 vs 偏好优化 |
| L16 RLVR | 怎么在有客观答案的任务上超越人类演示? | 可验证奖励 vs 奖励黑客 | |
| 拓展 | L17 多模态 | 怎么把非文本信息塞进同一个模型? | 语义 vs 细节;理解 vs 生成 |
10.1 贯穿全课的四条主线
从 L1 的 BPE 到 L17 的图像 patch 与 VQ 码本,这门课反复在做同一件事:把某种连续、非结构化的信号,切成 Transformer 能处理的离散/向量单元。每一次,核心权衡都一模一样——单元切得越细,保留的信息越多,但序列越长、算力越贵。文本的答案是 BPE(约 4 字符/token),图像的答案是 patch(约 588 像素/token)。这不是巧合,这是同一个压缩问题的不同实例。
为什么用 FlashAttention(L6)?因为访存比计算慢。为什么用 MoE(L4)?因为参数便宜、FLOPs 贵。为什么 SigLIP 换掉 softmax(L17 §5.8)?因为全 batch 归一化需要 all-gather。为什么 Qwen2-VL 要做 2×2 token 合并(§7.2)?因为注意力是 $O(L^2)$。
几乎每一个「聪明的算法创新」,追根溯源都是在绕开一个具体的硬件瓶颈。这是这门课最实用的思维方式:看到一个设计,先问「它在省什么资源」。
反复出现的模式:ViT 用最朴素的 patch 划分打败了精心设计的 CNN 归纳偏置(§2);LLaVA 用一个线性矩阵打败了 Q-Former 和 Perceiver Resampler(§6.1);Qwen2-VL 用直接投影 + 动态长度取代了固定 256 token 的交叉注意力 adapter(§7.2)。
但要小心这条规律的边界:它成立的前提是数据和算力足够多。在数据受限时,归纳偏置仍然有价值。而且它也不是万能的——Chameleon 的「统一架构」比 VLM 模板更简单更优雅,却输了(§8.4)。简单性只能战胜复杂性,战胜不了信息损失。
17 讲下来,架构、并行策略、优化器、缩放定律——这些几乎全部公开且趋同。真正区分前沿模型的是数据:数据来源(L13)、过滤配比(L14)、指令与偏好数据(L15–16)、多模态数据(L17)。
而这恰恰是论文里写得最少的部分。Percy 在 Qwen3-VL 小结里的那句「大量数据工作,但没有多少细节」,可以作为整个领域现状的注脚。
10.2 如果你要动手做一个多模态模型
把本讲的所有结论浓缩成一份可执行的配方:
- 不要从头训视觉编码器。拿一个现成的 SigLIP / SigLIP-2。你没有几十亿图文对,也没有 32 块 TPU。
- 不要从头训语言模型。拿一个 Qwen / Llama 基座。
- 连接器用 2 层 MLP。不要一上来就用 Q-Former、Perceiver 或 DeepStack——先把简单版本跑通再说。
- 严格执行两阶段训练:先冻结两侧只训投影器(对齐),再解冻 LM(指令微调)。跳过第一阶段大概率会灾难性遗忘。
- 分辨率按任务定。通用问答:单块 384×384 就够。文档/OCR/GUI:必须上 AnyRes 或动态分辨率,否则再多数据也救不回来。
- 混入 20–30% 纯文本数据,防止语言能力退化。
- 如果混合模态训练发散:先加 QK norm,再加 z-loss($\lambda_z = 10^{-5}$),再考虑按 $\sqrt{L}$ 归一化损失。
- 把 80% 的时间花在数据上,不是架构上。这是本讲、也是这门课最重要的一条经验。
本讲小结
一页速查表
| 问题 | 答案 |
|---|---|
| 为什么必须转成 token? | Transformer 只会处理 token;而 Transformer 有整个硬件生态,不能不用 |
| 图像 tokenization 的三条路线 | 连续 patch(ViT,主流)/离散码本(VQ,可生成)/原始像素(Fuyu,任意分辨率) |
| ViT-L/14@336 的形状 | 336² → 24×24=576 patch → 每个 588 维 → 投影到 1024 维 → 24 层 Transformer |
| VQ-VAE 的三项损失 | 重建 + 码本损失(更新码本)+ 承诺损失(更新编码器,$\beta{=}0.25$) |
| 量化不可导怎么办 | 直通估计:z_q = z_e + (z_q - z_e).detach() |
| CLIP 的损失 | 双向 InfoNCE,$\ell_2$ 归一化后余弦相似度除以温度 $\tau$(初始 0.07,可学习) |
| CLIP 为什么要大 batch | batch size = 负样本数;$N$ 选 1 最多提供 $\log_2 N$ 比特监督;32K 逼出细粒度语义 |
| CLIP 比 captioning 强在哪 | 把高熵生成问题换成低熵判别问题,对噪声文本鲁棒;同精度省 3–4 倍数据 |
| SigLIP 的改动 | softmax → sigmoid 逐对二分类,偏置 $b$ 初始化为 −10 应对 32767:1 的类别不平衡 |
| SigLIP 快在哪 | 损失与 batch 解耦 ⇒ 环形分块计算,无需 all-gather、无需 $N^2$ 显存;256×TPUv3/10 天 → 32×TPUv4/5 天 |
| VLM 标准模板 | 视觉编码器 + 投影器 + LM;两阶段训练(先只训投影器,再联合微调) |
| 为什么必须先冻 LM | 随机初始化的投影器输出是噪声,会让 LM 学会忽略视觉 token 或灾难性遗忘 |
| 高分辨率怎么办 | AnyRes 切成 $a\times b$ 块分别编码(把 $O(R^4)$ 降到 $O(R^2)$)/Qwen2-VL 的原生动态分辨率 |
| MRoPE | 位置索引扩展成 (t, h, w) 三元组;Qwen3-VL 进一步交错排布,让每轴都拿到全频谱 |
| Chameleon 的取舍 | 全离散 ⇒ 能生成图、架构优雅;但 473:1 量化损失 ⇒ OCR 差;混模态训练不稳 |
| 混模态训练不稳定的修法 | QK norm(钳制注意力 logit)+ z-loss(钉住 logit 绝对量级自由度) |
| Percy 押注的技术栈 | 连续编码器 + Transformer + 扩散模型做生成——务实优先于统一 |
要点清单
- omni model = 任意模态输入(理解)+ 任意模态输出(生成)。今天大多数模型只做到了前一半。
- 图像的根本难点是信息密度低且无天然语义边界:33 万个像素值可能只值 8 个文本 token 的语义。
- 理解要语义,生成要细节——这两个目标在表示空间上互相拉扯,是「统一模型」至今未能落地的核心原因。
- CLIP 的设计决策是围绕图像分类做的,把它当 VLM 前端时就继承了它对细粒度任务不友好的取舍(336 中心裁剪)。
- 对比学习的 batch size 存在饱和点(约 32K),不是越大越好。
- LLaVA 证明了一个线性矩阵就能连接视觉与语言,复杂的重采样器不是必需的。
- LLaVA-OneVision 证明了能力可以跨模态组合泛化:单图 OCR + 多图关系推理 → GUI agent(训练集里没有 GUI 数据)。
- 让不同模态产生大致相同的 token 长度,既解决工程负载均衡,也是跨模态迁移的机制基础。
- Qwen-VL 三代的主线是从「压缩视觉信息」转向「保留视觉信息」——长上下文技术成熟后,压缩的代价变得不可接受。
- 多模态预训练数据几乎全部闭源,指令数据往往开源——数据是最后的护城河。
- 架构的优雅性不能抵消表示层的信息损失(Chameleon 的教训)。
延伸阅读
图像表示:从 ViT 到量化
- An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale (ViT, 2020) — 本讲第 2 节的基础。读它是为了看清「去掉所有视觉归纳偏置之后,纯 Transformer 在多大数据量上开始反超 CNN」这条曲线。
- Neural Discrete Representation Learning (VQ-VAE, 2017) — 直通估计和承诺损失的原始出处,第 3 节所有公式的来源。篇幅短,值得逐行读。
- Taming Transformers for High-Resolution Image Synthesis (VQ-GAN, 2020) — 说明为什么纯 $\ell_2$ 重建会糊,以及感知损失 + 对抗损失如何救回细节。
- Make-A-Scene (2022) — Chameleon 采用的图像 tokenizer 的直接来源,含人脸区域加权重建等实用技巧。
对比学习:视觉编码器怎么练出来
- Learning Transferable Visual Models From Natural Language Supervision (CLIP, 2021) — 必读。重点看 Figure 2(对比 vs 生成的效率曲线)和零样本迁移的那 27 个数据集,理解「用语言当监督信号」这个范式转换。
- Sigmoid Loss for Language Image Pre-Training (SigLIP, 2023) — 一个损失函数的小改动如何带来 16 倍的系统级加速。分块并行那一节是分布式训练设计的教科书案例。
- SigLIP-2 (2025) — Qwen3-VL 使用的视觉编码器,在多语言和细粒度定位上的改进。
- Reproducible scaling laws for contrastive language-image learning (OpenCLIP, 2022) — CLIP 的开源复现 + 对比学习的缩放定律,把 Lecture 9/11 的方法论应用到了多模态。
- Data Filtering Networks (DFN, 2023) — Qwen2-VL 视觉编码器的初始化来源;核心观点是「用一个专门训练的小网络来过滤预训练数据」,与 Lecture 14 的数据过滤直接呼应。
视觉-语言模型:怎么接进 LLM
- Visual Instruction Tuning (LLaVA, 2023) — 必读。用纯文本 GPT-4 + COCO 标注合成视觉指令数据的那一节,是「用现有模型撬动新能力」的经典范例。
- Improved Baselines with Visual Instruction Tuning (LLaVA-1.5, 2023) — AnyRes 的出处,以及一系列朴素但有效的改进(MLP 投影器、学术任务数据)。
- LLaVA-OneVision (2024) — 读它主要是为了那三组跨模态迁移的实证,这是本讲关于「多模态到底有没有额外收益」最扎实的证据。
- Flamingo (2022) — 交叉注意力融合路线的代表作,Perceiver Resampler 和 gated cross-attention 的出处。理解它才能明白 LLaVA 的「一个矩阵就够了」有多反直觉。
- Qwen-VL (2023) — 三阶段训练配方,以及用
<box>/<ref>把坐标序列化成 token 的做法。 - Qwen2-VL (2024) — 原生动态分辨率与 MRoPE,本讲第 7.2 节的全部内容。
- Qwen3-VL (2025) — 当前的开源 SOTA。Interleaved MRoPE 和 $\sqrt{L}$ 归一化损失是两个小而实用的技巧。
- DeepStack (2024) — 把视觉特征注入 LM 多个层而非仅输入端,几乎零成本地缓解深层信息稀释。
走向 omni:统一理解与生成
- Chameleon: Mixed-Modal Early-Fusion Foundation Models (2024) — 必读,尤其是训练稳定性那一节。它是「多模态混训为什么会崩」这个问题目前最详细的公开分析,QK norm 与 z-loss 的实证在这里。
- Fuyu-8B (2023) — 第 4 节的原始出处。极简主义的另一个极端:完全没有视觉编码器。
- High-Resolution Image Synthesis with Latent Diffusion Models (Stable Diffusion, 2021) — Percy 押注的「扩散做生成」那一环的基础,也是理解为什么扩散在图像上赢过自回归的入口。