数据 · 过滤、去重、配比、合成
上一讲我们拿到了原始的爬取数据。这一讲把它变成能真正训练模型的语料:怎样从 HTML 抽出文本、怎样用分类器筛掉垃圾、怎样在万亿 token 规模上用哈希做近似去重、怎样决定各数据源的配比,以及后训练阶段怎样合成数据。
0. 本讲导读
上一讲讲的是数据的来源:一个活的服务(live service,比如 GitHub)→ 一份转储或爬取(dump/crawl,比如 GitHub Archive、Common Crawl)→ 一份处理好的数据集(processed data,比如 The Stack)。核心考量是服务条款(terms of service)与版权(copyright)——许可证还是合理使用(fair use)。
这一讲讲的是数据的加工。你手上有一堆 WARC 文件,它离「可以喂进 model.forward() 的 token 流」还隔着四道工序:
- 转换(transformation):HTML / PDF / 代码目录 → 纯文本。
- 过滤(filtering):语言识别、质量过滤、有害内容过滤。
- 去重(deduplication):精确重复 + 近似重复。
- 配比(mixing):决定 Wikipedia / 网页 / 代码 / 论文各占多少。
然后还有第五块,属于中期训练(mid-training)和 SFT 阶段:合成数据(synthetic data)。
- 过滤的统一范式:给定目标数据 $T$(「好数据长什么样」)和海量原始数据 $R$,训一个分类器/打分函数,把 $R$ 中像 $T$ 的子集 $T'$ 捞出来。语言识别、质量过滤、毒性过滤三者用的是同一套机器。
- 去重的本质是「拿每个样本和其它所有样本比」,天然是 $O(N^2)$。哈希(MinHash + LSH)把它降到线性时间,这是唯一能跑到万亿 token 规模的办法。
- 配比:在小规模上试若干个混合比例,拟合「配比 → loss」的回归模型,再外推到最优配比和大规模。和缩放定律是同一个套路。
- 没有普适的最优过滤阈值:训得久就该留更多(更低质量的)数据,训得短就该留更少(更高质量的)数据。过滤强度和 token 预算耦合。
- 数据工作有大量是领域特定的、靠人肉看样本的。这一讲给的是骨架,肉要自己长。
从 HTML 到文本:第一道、也最容易被低估的工序
原始数据不是文本。它是 HTML,是 PDF(arXiv 上的论文),是目录树(代码仓库)。其中最主要的是 HTML → 文本这一步,它要做的事是:
- 去样板(boilerplate removal):导航栏、页脚、广告、"相关阅读"、Cookie 提示——这些在一个站点的每个页面上都一样,既没信息量又会在去重阶段制造噪声。
- 抽正文(content extraction):把真正的内容块识别出来。
- 图片、表格怎么办?纯文本模型没法直接吃图;表格必须线性化(linearize)成一维 token 序列,二维结构信息不可避免地丢掉一部分。整个过程本质上是有损的(inherently lossy)。
常用的工具都是基于规则的:trafilatura、resiliparse、jusText、以及老牌的终端浏览器 lynx。它们靠 DOM 结构启发式(文本密度、链接密度、标签类型)判断哪块是正文。
这一步的精度非常重要,重要到会直接体现在下游模型的基准分数上。DCLM(DataComp-LM, 2024)做过一个干净的对照实验:Common Crawl 官方已经提供了抽好文本的 WET 文件,你可以直接用;但如果你退回到原始的 WARC 文件、用 resiliparse 自己重新抽一遍,下游模型会明显更好。
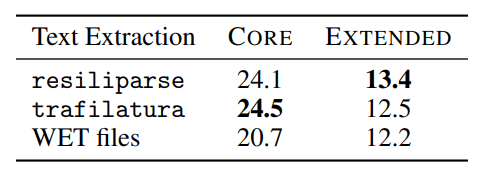
抽取器的错误不是随机噪声,而是系统性偏差。它会在每一篇文档里稳定地插入同一批样板串("Skip to main content"、"Share on Facebook"),于是模型在预训练中反复见到这些串,把可观的概率质量分配给它们;同时正文被样板稀释,有效 token 占比下降。更糟的是,这些样板串在文档间高度重复,会干扰后面的去重阶段——你的 MinHash 可能把两篇内容完全不同、只是共享同一套导航栏的页面判成近似重复。
PDF:FinePDFs 的做法
网页之外的另一座金矿是 PDF:论文、教材、技术手册、政府报告。HuggingFace 的 FinePDFs 展示了一条完整流水线:
- 来源仍是 Common Crawl:爬虫抓到的 PDF 链接本身就在 crawl 里。
- 重新抓取被截断的 PDF:Common Crawl 对单个响应体有大小上限,而 PDF 普遍很大,很多在 crawl 里是被截断的半截文件。要拿到完整内容必须按 URL 重爬(recrawl)。
- OCR:PDF 分两类。文本层完好的可以用 Docling 这类解析器直接抽;扫描件只能上 OCR,FinePDFs 用的是 RolmOCR——一个视觉语言模型(VLM)。关键工程约束是让它跑得足够快:要处理的是上亿份文档,每份多页,VLM 推理成本极高,必须做批处理、量化、短上下文等一整套优化(正好用得上本课程 Lecture 9 的推理优化)。
- 大量清洗与过滤:OCR 输出充满错字、乱序、页眉页脚,后面还要接一整套和网页一样的过滤流程。
- 版面信息大量丢失:多栏排版、图注、公式的位置关系,线性化之后基本没了。这是 PDF 语料目前公认的痛点。
各阶段还剩多少?
把整条流水线连起来看,最反直觉的一点是留存率极低。从 Common Crawl 出发,公开数据集报告的量级大致是这样(不同数据集口径不同,这里看的是数量级和相对关系,不是精确值):
| 阶段 | 做什么 | 典型留存量级 | 被扔掉的是什么 |
|---|---|---|---|
| 原始 crawl | WARC | 100% | — |
| 文本抽取 | WARC → 纯文本 | 字节数掉一个数量级 | HTML 标签、脚本、样式、样板 |
| 语言识别 | 只留英文(或目标语种) | 剩下约几分之一 | 其它语种(注意:这一步就把多语能力砍掉了) |
| 规则清洗 | Gopher / C4 启发式 | 再掉一半左右 | 太短的、词太长的、符号太多的、模板页 |
| 质量过滤 | fastText / 困惑度 / LLM 打分 | 常见设定是只留前 10%–20% | SEO 垃圾、内容农场、低信息量页面 |
| 去重 | 精确 + 模糊 | 再掉几成到一半 | 镜像站、模板文本、协议条款 |
| 毒性/PII 过滤 | 分类器 + 规则 | 掉几个百分点 | 仇恨言论、色情、个人信息 |
RefinedWeb 的论文报告过一个常被引用的整体数字:走完全部流程后,只有大约 10% 出头的原始网页内容进入最终训练集。DCLM 更极端——从 240T token 的候选池里最终选出的 DCLM-baseline 只有几 T token。所以「数据处理」这件事,90% 的工作量是在决定扔掉什么。
Percy 在课上反复强调:这些步骤看起来是脏活,但每一步的设计选择都会实打实地反映在最终模型的能力上,而且各家实验室对细节高度保密。公开数据集(C4、The Pile、RefinedWeb、Dolma、FineWeb、DCLM)之所以珍贵,正是因为它们把流水线写了出来。要学数据,读它们的论文比读任何综述都有用。
1. 过滤的统一框架与语言识别
算法抽象:从 $R$ 里捞出像 $T$ 的子集
Percy 把这一节的所有内容抽象成同一个算法原语:
给定少量目标数据(target data) $T$ 和海量原始数据(raw data) $R$,找出 $R$ 中与 $T$ 相似的子集 $T'$。
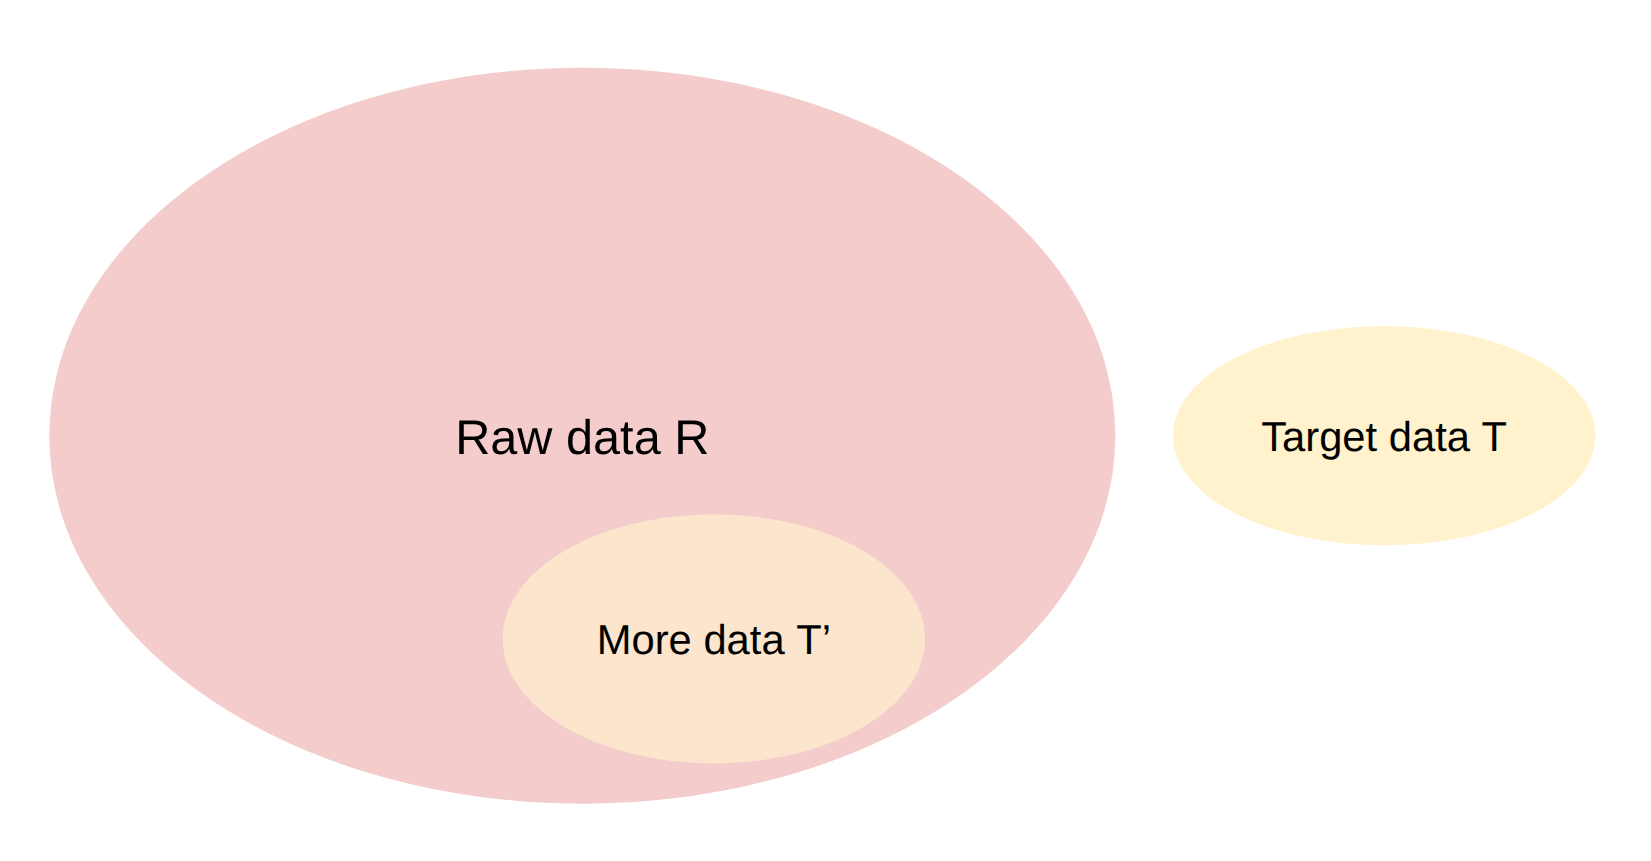
三个应用全都套这个模子:
| 应用 | 目标数据 $T$ | 「负例」/ 原始数据 $R$ |
|---|---|---|
| 语言识别(language identification) | 英文文本 | 其它语言 |
| 质量过滤(quality filtering) | 高质量文本 | 低质量文本 |
| 毒性过滤(toxicity filtering) | 无害文本 | 有害文本 |
两条硬性要求
- 要能泛化:我们要的是 $T' \neq T$。如果分类器只会认出和 $T$ 逐字相同的文本,那它没有创造任何新数据。这也是为什么不能用「精确匹配」来做质量过滤。
- 要极快:这个打分函数要在 $R$ 上跑一遍,而 $R$ 是几百 TB。一个每篇文档要 10ms 的模型,跑 100 亿篇文档就是 3 年单核时间。所以工业界的默认选择是 fastText 这种线性模型,而不是 BERT,更不是 LLM(除非你先用 LLM 标一小批、再蒸馏成小分类器——见第 3 节)。
关于数据选择(data selection)有一篇很好的综述:A Survey on Data Selection for Language Models (2024)。
通用框架的两步
给定 $T$ 和 $R$:
- 基于 $R$ 和 $T$ 估计某个模型,导出一个打分函数(scoring function) $\mathrm{score}(x)$;
- 按分数决定 $R$ 中每个样本的去留。
打分函数有两大类,区别在于建模的是生成分布还是判别概率:
| 类型 | 代表 | 打分 | 特点 |
|---|---|---|---|
| 生成式模型(generative model of $T$) | KenLM(n-gram 语言模型) | $\mathrm{score}(x) = p_T(x)$ | 只需要正例;等价于用困惑度打分;不需要负例采样 |
| 判别式分类器(simple classifier) | fastText | $\mathrm{score}(x) = p(T \mid x)$ | 需要正负例;判别式通常更准,因为它直接学「$T$ 与 $R$ 的差异方向」 |
使用方式:保留 $\mathrm{score}(x) \ge \tau$ 的样本——而且往往是随机地(stochastically)保留,这一点第 2 节会展开。
$p_T(x)$ 高不代表 $p(T\mid x)$ 高。按贝叶斯,$p(T\mid x) \propto p_T(x)\,p(T) / p(x)$,也就是判别式打分实际上是似然比 $p_T(x)/p_R(x)$ 的单调函数。只看 $p_T(x)$ 会偏爱「在任何语料下概率都高」的平庸文本——短句、常见词、套话。这正是纯困惑度过滤(CCNet 式)的已知失败模式:它倾向于留下语法工整但内容空洞的文本。第 3 节的 DSIR 会把这个似然比显式写出来。
要不要用「基于模型」的过滤?
这是一个真实存在的分歧,Percy 特意把两派列了出来:
| 立场 | 代表数据集 | 理由 |
|---|---|---|
| 刻意不用模型过滤 | C4、Gopher、RefinedWeb、FineWeb、Dolma | 只用规则和去重,可复现、可解释、无偏见放大风险;担心分类器把「和 Wikipedia 像」等同于「好」,从而系统性删掉方言、少数群体、非主流话题的文本 |
| 使用模型过滤 | GPT-3、LLaMA、DCLM | 下游效果明显更好;DCLM 的核心结论就是「一个训得好的 fastText 质量分类器是整条流水线中收益最大的单个组件」 |
Percy 的判断:基于模型的过滤正在成为常态(becoming the norm)。FineWeb 后来也出了 FineWeb-Edu,正是用模型打分选出来的。
语言识别:最成熟的一环
目标:找出特定语言(通常是英文)的文本。事实标准是 fastText 的语言识别模型:
- 现成分类器(off-the-shelf),不用自己训,几 MB 大小,每秒能处理几十万篇文档。
- 支持 176 种语言。
- 训练数据来自天然的多语站点:Wikipedia、Tatoeba(一个众包翻译例句网站)、SETimes(东南欧新闻,覆盖巴尔干地区多语种)。
- Dolma 的做法:保留 $p(\text{English}) \ge 0.5$ 的页面(Dolma, 2024)。
阈值 0.5 看似温和,但对低资源语言和码切换(code-switching)文本非常不友好:分类器在训练里几乎没见过某些语言,会把它们误判成噪声;中英夹杂的技术博客、印地语用拉丁字母书写的 Hinglish,都容易被两边同时拒绝。另外非裔美国人英语(AAE)等方言的英文置信度系统性偏低,这是有实证研究的。所以语言识别不只是工程,它决定了谁的语言进入模型。
一个完整的小型案例:OpenWebMath
OpenWebMath (2023) 是把上面这套框架用到极致的漂亮例子。目标:从 Common Crawl 里整理出一个大规模数学文本语料。它同时用了三种过滤器,层层收窄:
- 规则过滤:页面是否包含 LaTeX 命令(
\frac、\begin{equation}、MathJax 脚本标签)等硬信号。便宜、精度高、召回低。 - 困惑度过滤:在 ProofPile(已知的数学语料)上训一个 KenLM,保留困惑度 $< 15000$ 的文档。这是「生成式打分」路线。
- fastText 分类器:训一个判别器预测「这是数学写作吗」,并且用了两个不同的阈值——如果规则已经判定这页含数学,阈值放宽到 0.17;如果规则说不含数学,阈值收紧到 0.8。
把规则信号 $r \in \{0,1\}$ 和分类器分数 $s$ 结合,本质上是在做 $p(\text{math}\mid r, s)$。规则命中时先验已经很高,只需要分类器给出微弱支持(0.17)就够;规则没命中时先验很低,需要分类器给出强证据(0.8)才推翻。这比「把 $r$ 当特征塞进分类器」更好调,也更好解释——工程上很值得抄。
结果:产出 14.7B token,用它训的 1.4B 模型,比在多 20 倍数据上训的模型表现更好。这是「数据质量能换算力」最直接的证据之一。
2. 质量过滤(一):fastText 分类器
为什么是 fastText
回到那条硬约束:打分函数要在几百 TB 上跑一遍。fastText 的设计正好卡在「够快」和「够准」的交点上。它的模型极其简单:
文档 $x$ 被表示成一袋 n-gram(词 unigram + bigram,有时加字符 n-gram)。每个 n-gram $g$ 有一个嵌入 $v_g \in \R^{d}$($d$ 通常只有 10–100)。文档表示是平均池化:
$$ u(x) \;=\; \frac{1}{|G(x)|}\sum_{g \in G(x)} v_g , \qquad p(y \mid x) \;=\; \softmax\!\big(W u(x)\big)_y $$没有非线性,没有注意力,就是一层 embedding 平均 + 一层线性分类。前向代价是 $O(|G(x)| \cdot d)$,一篇 1000 词的文档大约 $2000 \times 50 = 10^5$ 次乘加——单核每秒能处理几千到几万篇。
质量过滤不需要「理解」文本,只需要区分词汇分布。内容农场的文本充满 "best deals"、"click here"、"buy now";Wikipedia 充满 "however"、"according to"、"was established in"。这种差异在 bag-of-n-grams 空间里是线性可分的。上更大的模型收益很小,而成本要涨 3–4 个数量级。在过滤这个岗位上,吞吐量本身就是准确率——因为它决定了你能处理多大的候选池。
层次 softmax:让输出层也变便宜
fastText 的第二个加速点在输出层。当标签数 $K$ 很大时(语言识别有 176 类,做别的任务可能上百万类),普通 softmax 每步要算 $K$ 个 logit,代价 $O(Kd)$。层次 softmax(hierarchical softmax)把 $K$ 个类别组织成一棵二叉树(按类别频率建 Huffman 树),每个类别是一个叶子。每个内部节点 $n$ 带一个向量 $w_n \in \R^d$,做一次二分决策:
$$ p(\text{go right at } n \mid x) = \sigma\big(w_n^\top u(x)\big) $$类别 $y$ 的概率就是从根到叶路径上所有决策概率的乘积:
$$ p(y \mid x) \;=\; \prod_{n \in \mathrm{path}(y)} \sigma\!\big(\pm\, w_n^\top u(x)\big) $$其中符号由该步是往左还是往右决定。这样单次前向/反向只需要走一条深度 $O(\log K)$ 的路径,代价从 $O(Kd)$ 降到 $O(d\log K)$。用 Huffman 树(高频类离根近)后,平均深度还会进一步低于 $\log_2 K$。
更妙的是推理时:如果你只想要 top-1 或 top-k 类别,可以在树上做剪枝的深度优先/优先队列搜索——一旦某条路径的累积概率已经低于当前第 $k$ 好的候选,整棵子树都可以剪掉。对二分类($K=2$)当然没区别,但对 176 类的语言识别,这就是它能跑到每秒几十万文档的原因。
树的每个叶子对应唯一一条从根出发的路径,而在每个内部节点上「左」和「右」的概率和为 1。对整棵树做归纳:根节点下所有叶子的概率之和 = $p(\text{左})\cdot(\text{左子树叶子概率和}) + p(\text{右})\cdot(\text{右子树叶子概率和}) = p(\text{左})\cdot 1 + p(\text{右})\cdot 1 = 1$。所以 $\sum_y p(y\mid x) = 1$ 自动成立,不需要显式归一化——这正是它比 softmax 快的根本原因:softmax 的 $O(K)$ 开销全在配分函数上。
GPT-3 的做法:正例是「精选语料」,负例是「随机网页」
GPT-3 (2020) 的附录 A 给出了这套方法最早的完整描述:
- 正例:从 {Wikipedia, WebText2, Books1, Books2} 采样。这些是「已知的好数据」。
- 负例:从 Common Crawl 随机采样。
- 用 Spark 的 Tokenizer + HashingTF 抽词特征,训一个线性分类器。
注意这个设定的巧妙之处:负例不是「已知的坏数据」,而是未标注的随机原始数据。这在机器学习里叫 PU learning(positive-unlabeled)。因为 CC 里也混着好数据,负例集合是「被污染」的,但只要好数据在 CC 里占比不高,学到的方向仍然近似正确的似然比方向。
关键细节:随机保留,而不是硬阈值
GPT-3 没有简单地「保留 score > 0.5」。它按分数随机保留文档:
import numpy as np

def keep_document(score: float) -> bool:
    # np.random.pareto(9) 是形状参数 a=9 的 Pareto 分布(取值 >= 0)
    return np.random.pareto(9) > 1 - score
怎么理解这行代码?记 $\alpha=9$,Pareto($\alpha$) 的生存函数是 $P(X > t) = (1+t)^{-\alpha}$(这里用的是 Lomax 参数化,$X\ge 0$)。于是
$$ P(\text{keep} \mid \mathrm{score}=s) \;=\; P\big(X > 1-s\big) \;=\; \big(2-s\big)^{-9} $$代几个数看看:
| score $s$ | $2-s$ | 保留概率 $(2-s)^{-9}$ |
|---|---|---|
| 0.0 | 2.0 | ≈ 0.002(0.2%) |
| 0.3 | 1.7 | ≈ 0.013 |
| 0.5 | 1.5 | ≈ 0.026 |
| 0.7 | 1.3 | ≈ 0.069 |
| 0.9 | 1.1 | ≈ 0.39 |
| 1.0 | 1.0 | 1.0 |
这是一条非常陡的曲线:分数 0.5 的文档只有 2.6% 的机会被留下,分数 0.9 的有 39%。它实现了「强烈偏向高分,但给低分文档留一条活路」。
- 保多样性:硬阈值会把某一整类文本(比如所有论坛帖、所有非标准英语)成建制地删光,造成分布塌缩。随机保留让它们以低比例存活,模型仍能见到。
- 抗分类器误差:分类器本身有噪声,硬阈值把噪声放大成确定性删除;随机化把「分类器错了」的代价从「全丢」摊薄成「少留一点」。
- 控制数据量:调 $\alpha$ 就能连续调节留存率,比找阈值好操作。
- 去掉阈值处的不连续性:分数 0.499 和 0.501 的文档命运不应该天差地别。
LLaMA / RedPajama:一个更聪明的正例定义
LLaMA (2023) 换了一个正例来源,非常值得学:
- 正例:不是 Wikipedia 本身,而是被 Wikipedia 引用(referenced)的页面。
- 负例:Common Crawl 随机样本。
- 动作:保留被分为正类的文档(这里用的是硬判定)。
因为 $T$ 和 $R$ 必须可比。Wikipedia 有极其特殊的文体(百科式陈述句、大量内链、固定的段落结构),拿它当正例,分类器学到的很大一部分是「像不像百科条目」,而不是「有没有信息量」。结果是过滤器会偏爱百科体裁,砍掉教程、代码文档、新闻、论坛问答这些高价值但文体不同的网页。
反过来,「被 Wikipedia 引用的页面」本身就是普通网页——同样的域名分布、同样的 HTML 噪声、同样的文体多样性——只是被人类编辑挑选出来当作可靠来源。它和 $R$ 的差异恰好就是我们想要的「质量」这一维,而不是「体裁」这一维。这就是 GPT-3 式做法的一个重要改进。
同一思路的另一个变种是 OpenWebText / WebText:拿 Reddit 上获得 ≥3 karma 的外链当正例,用人类投票当质量信号。DCLM 则更进一步,用 OpenHermes 2.5 + r/ExplainLikeImFive 的高赞回复作为正例来训 fastText——注意这已经是指令风格的正例了,说明「什么算高质量」的定义本身在随着模型用途演化。
用 LLM 造标签 + 小模型蒸馏:phi-1
phi-1 (2023) 的哲学是:用极高质量的数据(教科书级)训一个小模型(1.3B)。它的数据由两部分组成——合成数据(先是 GPT-3.5,后来是 GPT-4 生成)和过滤出来的真实数据。这里先看过滤这一半:
R      = "The Stack 的 Python 子集"          # 原始数据
prompt = "determine its educational value for a student "
         "whose goal is to learn basic coding concepts"
T      = "用 GPT-4 按上面这个 prompt 给 R 的 10 万条子集打标,得到正例"
然后:
- 用一个预训练 codegen 模型的输出嵌入作为特征(不是 n-gram,因为代码的语义靠 n-gram 抓不住);
- 在 $T$ 上训一个随机森林(random forest)分类器;
- 用这个便宜的分类器扫过整个 $R$,选出被判为正的部分。
这就是「LLM 标注 → 小模型蒸馏 → 全量推理」的三段式,现在几乎是标准做法:GPT-4 每条几分钱、10 万条可接受;但要对几十亿条打分就必须换成随机森林/fastText。
结果(在 HumanEval 上):
| 训练数据 | 步数 | HumanEval pass@1 |
|---|---|---|
| The Stack 的 Python 子集(原始) | 96K | 12.19% |
| 过滤后的子集 | 36K | 17.68% |
用不到 40% 的步数拿到高 45% 的分数。这是数据质量收益最有说服力的一组对照数字之一。
3. 质量过滤(二):重要性重采样、困惑度与 LLM 打分
DSIR:把「像不像目标分布」写成一个可计算的权重
fastText 路线是判别式的、需要调阈值。DSIR(Data Selection with Importance Resampling,Xie et al., 2023)给出了一个更有原则、也更便宜的方案:直接做重要性重采样。
问题的概率表述是:我们想从目标分布 $p$ 中采样,但手上只有从原始分布 $q$ 中采出的样本(即 $R$)。这正是重要性采样(importance sampling)的标准设定。给每个样本赋权
$$ w(x) \;=\; \frac{p(x)}{q(x)} $$然后按 $w$ 成比例地重采样 $k$ 个,得到的样本近似服从 $p$。这个流程叫 SIR(sampling-importance-resampling)。
设 $x_1,\dots,x_N \overset{\text{i.i.d.}}{\sim} q$。定义在这 $N$ 个点上的离散分布 $\tilde p(x_i) = w(x_i)/\sum_j w(x_j)$。取任意有界函数 $f$:
$$ \E_{\tilde p}[f] \;=\; \frac{\frac1N\sum_i w(x_i) f(x_i)}{\frac1N\sum_j w(x_j)} \;\xrightarrow[N\to\infty]{}\; \frac{\E_q\!\left[\tfrac{p}{q} f\right]}{\E_q\!\left[\tfrac{p}{q}\right]} \;=\;\frac{\E_p[f]}{1}\;=\;\E_p[f]. $$所以只要 $N$ 足够大(而 $R$ 恰好是「$N$ 极大」的场景),重采样出的样本就渐近服从 $p$。注意分母的自归一化让我们不需要知道 $p$ 和 $q$ 的归一化常数——只需要它们的比值成正比即可。
怎么估 $p(x)$ 和 $q(x)$:hashed n-gram
直接估计文本上的分布是不可能的。DSIR 的做法是把文档投影到一个低维的哈希 n-gram 计数向量上:
- 取文档的所有 unigram 和 bigram;
- 用一个哈希函数把每个 n-gram 映到 $m$ 个桶之一(DSIR 用 $m = 10^4$);
- 得到计数向量 $z = h(x) \in \mathbb{N}^m$,$z_j$ 是落进第 $j$ 桶的 n-gram 个数。
然后在这个 $m$ 维空间上各拟合一个多项分布(bag-of-ngrams 模型):从 $T$ 数出参数 $p \in \Delta^{m-1}$,从 $R$ 数出 $q \in \Delta^{m-1}$(就是各桶计数除以总数,加平滑)。文档的概率是
$$ p(z) = \prod_{j=1}^{m} p_j^{\,z_j}, \qquad q(z) = \prod_{j=1}^{m} q_j^{\,z_j} $$于是对数重要性权重是一个极其便宜的线性函数:
$$ \log w(x) \;=\; \sum_{j=1}^{m} z_j \,\big(\log p_j - \log q_j\big) $$把 $\log w(x) = \langle z, \beta\rangle$ 与 fastText 的 $\langle u(x), W\rangle$ 对照——两者结构完全一样,都是「bag-of-n-gram 特征 × 权重」。区别在于:fastText 用梯度下降学权重,DSIR 直接把权重算成 $\beta_j = \log(p_j/q_j)$,即每个桶的对数似然比。
这解释了第 1 节那个「生成式 vs 判别式」的困惑:DSIR 表面上是两个生成模型,实质上是判别式的——因为它取的是比值而不是单个 $p_T(x)$。代价是:解析解不如判别训练精细(没有正则、没有交互项),但不用训练,扫一遍语料统计词频就出结果,在 TB 级数据上这是巨大优势。
怎么按权重采 $k$ 个:Gumbel top-$k$
剩下一个工程问题:$R$ 有几十亿条,怎么不放回地按 $w_i$ 成比例抽 $k$ 条,而且要能流式、并行地做?答案是 Gumbel top-$k$ 技巧:给每条样本算一个键
$$ \kappa_i \;=\; \log w(x_i) \;+\; g_i, \qquad g_i \sim \mathrm{Gumbel}(0,1) $$然后取 $\kappa$ 最大的 $k$ 条。可以证明这严格等价于按权重的无放回顺序采样(Gumbel-max trick 的 top-$k$ 推广)。它的好处是完全可并行:每条样本独立算一个标量,最后做一次全局 top-$k$ 归并即可。
import numpy as np, mmh3

M = 10_000                      # 哈希桶数

def featurize(text: str) -> np.ndarray:
    toks = text.lower().split()
    grams = toks + [a + "_" + b for a, b in zip(toks, toks[1:])]
    z = np.zeros(M)
    for g in grams:
        z[mmh3.hash(g) % M] += 1
    return z

def fit(docs, alpha=1.0):        # 拟合 bag-of-hashed-ngrams 多项分布
    c = np.full(M, alpha)        # 加性平滑,避免 log 0
    for d in docs:
        c += featurize(d)
    return c / c.sum()

p = fit(target_docs)             # 目标分布(如被引用的网页)
q = fit(raw_sample_docs)         # 原始分布(如 CC 随机样本)
beta = np.log(p) - np.log(q)     # 每个桶的对数似然比

def log_w(text):
    return float(featurize(text) @ beta)

# Gumbel top-k:无放回、按权重成比例采样 k 条
def gumbel_key(text, rng):
    g = rng.gumbel()
    return log_w(text) + g
# 流式扫过 R,用大小为 k 的最小堆维护 top-k 的 gumbel_key
$\log w$ 是 $z$ 各分量的加和,文档越长这个和的绝对值越大——长文档的权重会指数级地压倒短文档,导致有效样本量(effective sample size)$\big(\sum w_i\big)^2/\sum w_i^2$ 崩到只有几条。实践中必须做长度归一化(比如除以 token 数,等价于用平均每 token 的对数似然比),或者对 $\log w$ 做截断/温度缩放。这个坑在任何用似然比打分的方法里都会出现。
困惑度过滤:CCNet 路线
最朴素的生成式打分:在一份已知的好语料上训一个 n-gram 语言模型,用它给候选文档打困惑度。CCNet(Wenzek et al., 2019)是这条路线的代表:
- 用 KenLM 在各语种的 Wikipedia 上训 5-gram 语言模型(KenLM 的卖点是极快:C++ 实现,内存映射,每秒能给几百 MB 文本打分);
- 对每个段落算困惑度,按语种分别算分位数,把文档切成 head / middle / tail 三档;
- 训练时通常只用 head(+ 部分 middle)。
OpenWebMath 用的也是这一招,只是把「Wikipedia」换成了 ProofPile,阈值定在困惑度 $< 15000$。注意这个阈值看起来大得离谱,是因为数学文本里充满 LaTeX 符号,在任何模型下困惑度都很高——困惑度阈值必须相对于领域来定,绝对值没有意义。
低困惑度 = 「可预测」。最可预测的文本是什么?重复的模板、套话、简单短句。真正信息密度高的文本(新颖论证、专业术语、精确数字)困惑度天然更高。所以纯困惑度过滤有一个系统性偏差:它把「无聊」误判成「高质量」。这也是为什么 CCNet 保留 middle 档、而不是只要 head;以及为什么现代流水线普遍用判别式分类器(似然比)而不是单纯的困惑度。
让 LLM 当标注员:FineWeb-Edu
最新一代的做法是把「什么算高质量」这个定义直接交给一个强模型,用自然语言 prompt 描述。FineWeb-Edu 是典型:
- 从 FineWeb 里采 50 万篇文档;
- 用 Llama-3-70B-Instruct 按一个「教育价值(educational value)」的 0–5 分评分标准打分——prompt 明确说明:是否像教科书/讲义、是否适合小学到大学阶段的学习、是否包含广告和无关内容;
- 在一个句子嵌入模型之上训一个线性回归头作为廉价代理(同样是「LLM 标注 → 小模型蒸馏」三段式);
- 用这个小模型给整个 FineWeb(15T token)打分,保留分数 ≥ 3 的部分,得到约 1.3T token 的 FineWeb-Edu。
效果:在 MMLU、ARC 这类知识密集型基准上提升非常显著——相同 token 预算下,FineWeb-Edu 训出的模型可以在 MMLU 上高出十几个点。代价也很明显:只留 ~9% 的数据,而且极度偏向「像教科书」的文体,长文写作、对话、代码这些能力会被削弱。这也正好呼应 phi-1 的 prompt——determine its educational value...——两者是同一个思想。
把三代方法排一下:GPT-3 用「像 Wikipedia/书」,LLaMA 用「被人类编辑引用过」,FineWeb-Edu/phi 用「LLM 认为有教育价值」。每一代都在把质量的定义从形式特征往语义特征推。这意味着数据质量的定义越来越依赖另一个模型的判断——好处是灵活、可用自然语言表达细致的偏好;风险是把上一代模型的偏见(以及它的盲区)固化进下一代的训练集。
4. 规则式清洗:Gopher 规则与 C4 启发式
在动用任何模型之前,先用便宜的规则把明显的垃圾扫掉。规则的好处是:零成本、完全可解释、可复现、不引入模型偏见。C4、Gopher、RefinedWeb、FineWeb、Dolma 都以规则为主干。
Gopher 的质量规则(MassiveText)
Gopher (2021) 提出的这套规则被后续几乎所有开源数据集直接沿用(Dolma、RedPajama、FineWeb 都有 Gopher-filter 这一步)。它们全部是文档级的统计量阈值:
| 规则 | 阈值 | 它在防什么 |
|---|---|---|
| 词数 | 50 ≤ 词数 ≤ 100,000 | 太短的是导航碎片/占位页,没有上下文可学;太长的通常是日志、词表、拼接错误 |
| 平均词长 | 3 ≤ 平均字符数 ≤ 10 | 过短 → 乱码或字符切分错误;过长 → base64、哈希串、拼接无空格的文本 |
| 符号-词比 | # 和 … 的占比 < 0.1 | # 多 = 话题标签堆砌(社交垃圾);… 多 = 被截断的摘要列表页 |
| 项目符号行占比 | < 90% 的行以 bullet 开头 | 纯列表页(目录、商品清单)没有连贯语篇 |
| 省略号结尾行占比 | < 30% 的行以 … 结尾 | 典型的「文章列表 + 摘要截断」聚合页 |
| 含字母词占比 | ≥ 80% 的词至少包含一个字母字符 | 表格数据、数字转储、价格清单 |
| 停用词 | 至少出现 2 个:the / be / to / of / and / that / have / with | 没有功能词 = 不是自然语言句子(关键词堆砌、SEO 页) |
Gopher 还有一组重复度规则(repetition removal),它其实是文档内部的去重,和第 6 节的跨文档去重互补:
| 统计量 | 典型阈值 |
|---|---|
| 重复行占比 / 重复行字符占比 | > 0.30 则丢弃 |
| 重复段落占比 / 重复段落字符占比 | > 0.30 则丢弃 |
| 最高频 2/3/4-gram 的字符占比 | 分别 > 0.20 / 0.18 / 0.16 则丢弃 |
| 出现 ≥2 次的 5–10 gram 的字符占比 | 从 0.15 递减到 0.10,超过则丢弃 |
短 n-gram 在正常文本里本来就会重复("of the" 到处都是),所以对 2-gram 允许 20% 的重复字符;而一个 10-gram 重复出现,几乎一定是模板、页脚或复制粘贴,所以只允许 10%。这套递减阈值是拿真实语料上的分布分位数标定出来的,直接抄就好。
C4 的启发式规则
C4 (T5, 2019) 的规则更「文本编辑」风格,是行级操作,逐条列出来:
- 只保留以终止标点结尾的行(
.!?")。这一条极其有效:网页里的导航项、按钮文字、标签都不带句号。 - 丢弃少于 5 句的页面,并且只保留至少 3 个词的行。
- 移除包含「脏词表」中任何词的整个页面(用的是社区维护的 "List of Dirty, Naughty, Obscene or Otherwise Bad Words")。这条争议最大,见第 5 节。
- 移除包含 "javascript" 的行——通常是 "Please enable JavaScript to view this site"。
- 移除包含 "lorem ipsum" 的页面(未完成的模板页)。
- 移除包含
{的页面——目的是把代码剔出这份「自然语言」语料。(今天看这条已经过时:我们想要代码,只是要单独处理。) - 移除含有 "terms of use"、"privacy policy"、"cookie policy"、"uses cookies"、"use of cookies"、"use cookies" 的行——法律样板。
- 语言识别:用
langdetect保留 $p(\text{en}) \ge 0.99$(比 Dolma 的 0.5 严厉得多)。 - 三句去重:任何出现超过一次的三句连续片段,只保留一份。详见第 6 节。
规则不花算力,但要花人力和判断力,而且每一条都在隐性地定义你的语料。{ 那条规则删掉的不只是代码,还有所有讨论编程、数学(LaTeX 用 {})、JSON 配置的网页。C4 因此几乎不含代码,这直接限制了 T5 的编程能力。没有中立的规则——每条规则都是一次关于「模型该会什么」的决策。
做规则的正确姿势
Percy 在课上反复说的一句话是:数据工作很大一部分是领域特定的、是坐下来一条条看样本。具体的操作流程通常是:
- 随机采样 100 篇文档,人工读,记下每一种「不该在这里」的东西;
- 为每种问题写一个可计算的统计量(比如「省略号结尾行占比」);
- 在全量数据上画这个统计量的直方图,找到双峰之间的谷底当阈值;
- 把阈值两侧各采 20 篇出来读,确认删掉的确实是垃圾、留下的确实是好东西;
- 迭代。
这不是能靠聪明想出来的,只能靠看。而这正是各家实验室不愿公开的部分。
5. 有害内容过滤与过度过滤的代价
Dolma 的毒性过滤
Dolma (2024) 的毒性过滤器仍然是第 1 节那个框架的一个实例,只是 $T$ 和 $R$ 的角色对调——这次是要找出并删除像 $T$ 的东西。
- 数据集:Jigsaw Toxic Comments (2018)。
- 项目初衷:这个数据集不是为训 LLM 造的。Jigsaw(Google 旗下)的目标是帮助人们在网上进行更好的讨论——给论坛和新闻网站的评论区做自动审核工具。它被 LLM 社区拿来当毒性分类器的训练数据,属于「借用」。
- 数据内容:Wikipedia 讨论页(talk page)的评论,人工标注了六个二元标签:
toxic、severe_toxic、obscene、threat、insult、identity_hate。
Dolma 在它上面训 fastText 分类器(实际用了两个:hate 和 NSFW),然后按分数阈值删除网页。
Jigsaw 的样本是短评论(几十词),而要过滤的对象是长网页(几千词)。一个分类器在「维基讨论页的骂人短评」上学到的决策边界,被拿去判断一整篇网页是否有害,这中间的分布偏移非常大。实践中常见的做法是切段打分再聚合(取最大值或分位数),但阈值怎么定几乎全靠试。这是整个流水线里最粗糙、也最容易出系统性偏差的一环。
过度过滤的代价
毒性过滤和脏词表过滤有充分证据表明会造成附带损害。关于 C4 的审计研究(Dodge et al., Documenting Large Webtext Corpora)发现:
- 脏词表把大量LGBTQ+ 相关内容删掉了——因为许多身份词汇被列在表里,而这些页面本身讨论的是身份认同、健康、社群,不是色情内容。
- 非裔美国人英语(AAE)和西班牙语裔英语的文档被以显著更高的比例删除。原因是双重的:语言识别对方言置信度低,脏词表又对方言中的常用词(重新挪用的贬义词)敏感。
- 被删掉的还包括大量医疗、法律、新闻类文本——它们必须提到暴力、性、疾病才能讨论这些话题。
另一个方向的证据同样重要:完全不给模型见有害内容,反而更难对齐。有毒性数据的一个正当用途是训练模型识别有害内容(用于内容审核、拒答、安全分类器);预训练里一点都没有,模型在后训练阶段就没有可供引导的表示。目前主流做法是预训练适度保留(并打标)、后训练阶段做行为对齐,而不是在预训练里删干净。
过滤强度与规模耦合:没有普适的最优阈值
这是本节最重要、也最容易被忽略的结论。过滤阈值不是一个可以孤立调的超参数,它和训练 token 预算强耦合。
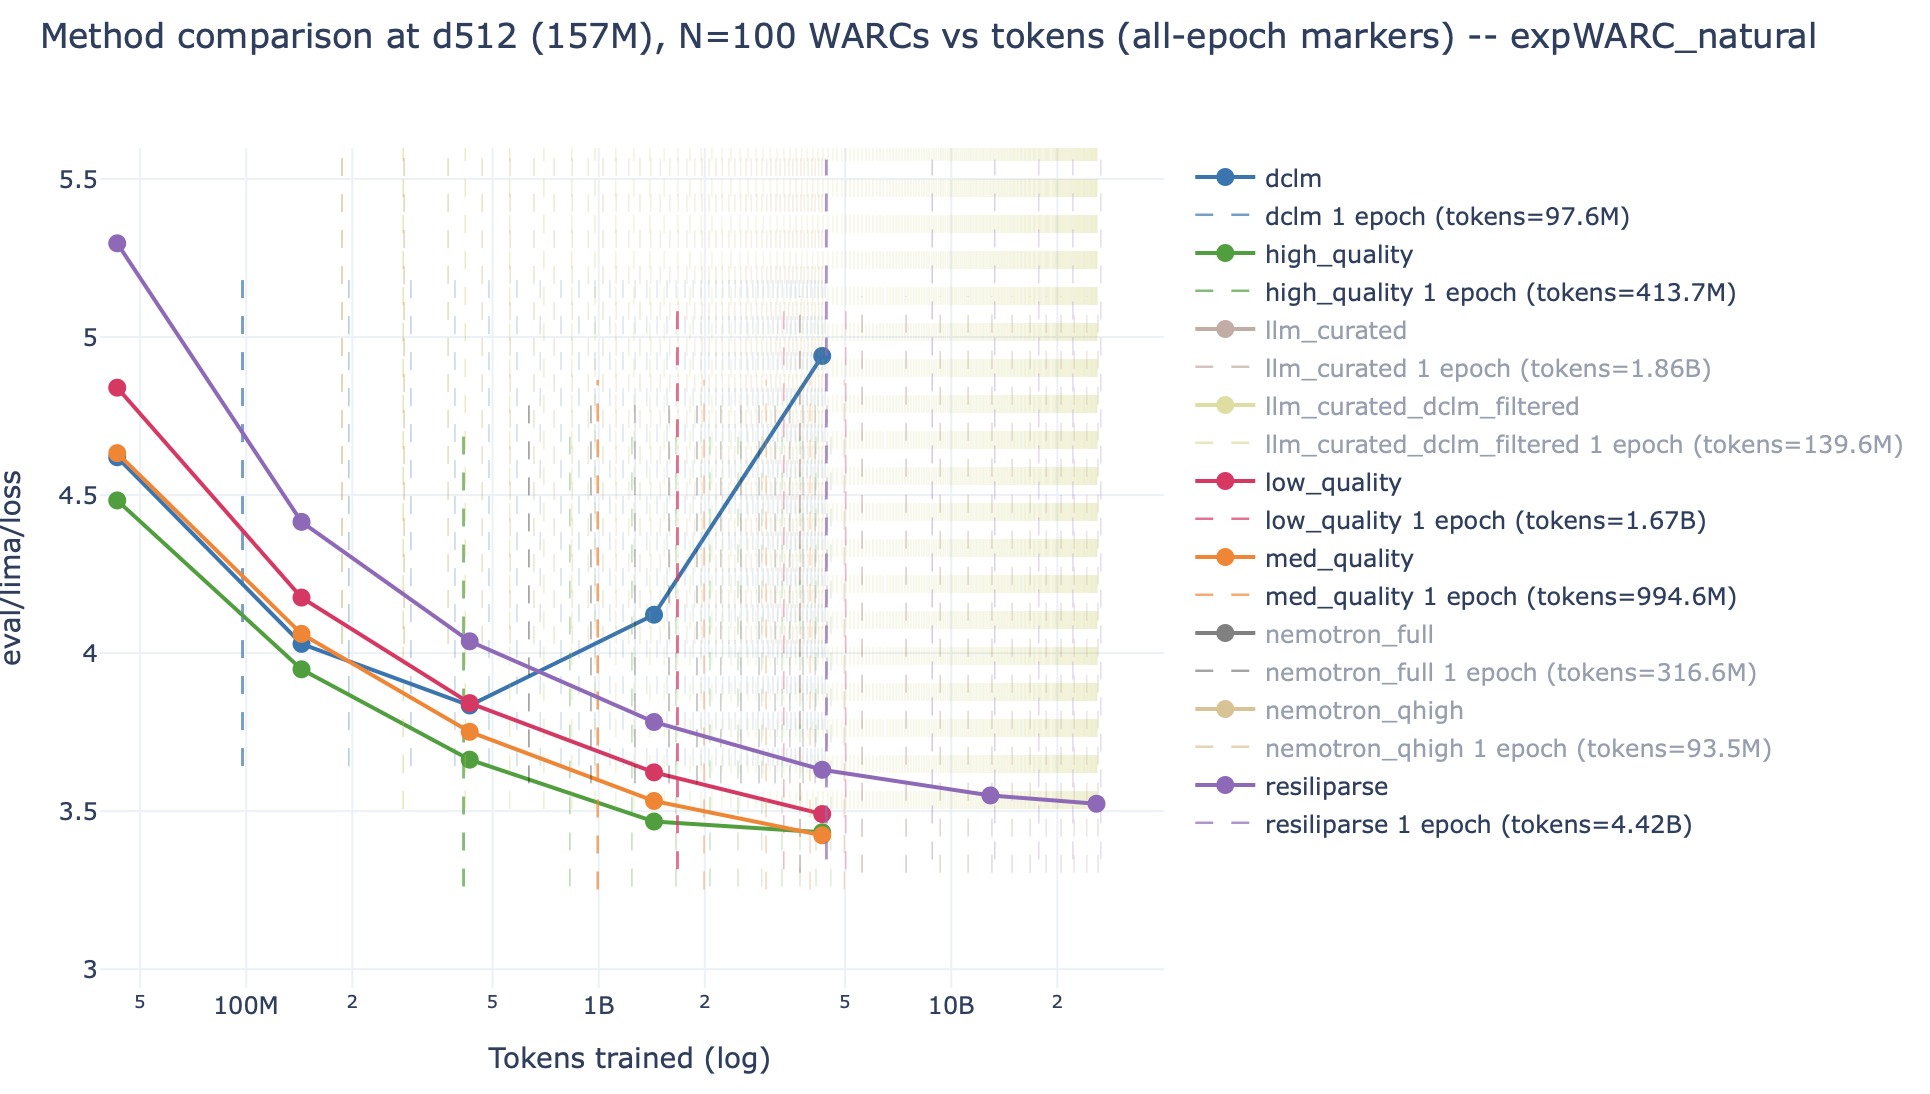
Percy 把它总结成两句话:
- 训练得越久,就该留更多(更低质量的)数据。因为你需要的 token 总量更大,宁可要略差但没见过的新数据,也不要把好数据 epoch 十遍。
- 训练得越短,就该留更少(更高质量的)数据。token 预算有限时,每一个 token 都要选最有价值的。
设候选池有 $N$ 个 token,保留比例 $\rho$,训练预算 $D$ 个 token。则 epoch 数 $\approx D/(\rho N)$。$\rho$ 越小,单 token 质量越高,但 epoch 数以 $1/\rho$ 增长,重复带来的边际收益迅速衰减(重复 4 次以上基本等同于没有新数据)。最优 $\rho$ 大致满足「$\rho N \approx$ 几倍的 $D$」这个数量级约束,再叠加质量曲线的形状。所以在报告任何过滤方法的效果时,必须同时说明训练预算——这也是很多数据消融实验互相矛盾的根源。
过滤这一节的总结
- 过滤对做出一个好模型是关键的(critical)。DCLM 的整体结论就是:在固定架构和算力下,数据过滤策略造成的下游差距比大多数架构改动都大。
- 配方:定义目标数据(说清楚「好」长什么样)→ 训一个便宜的打分器 → 外推到原始数据。语言识别、质量、毒性,三个任务同一套机器。
6. 去重:动机、哈希函数与精确去重
两类重复
- 精确重复(exact duplicates):逐字节相同。来源是镜像站(Project Gutenberg 的镜像列表就有几十个)、GitHub fork、CDN 的多域名、新闻通稿被数百家站点转载。
- 近似重复(near duplicates):同一段文本只差几个 token。
近似重复的三种典型来源:
- 服务条款与许可证:MIT license 出现在几百万个仓库里,只有版权行的年份和姓名不同。GPL、Apache-2.0 更长,重复更严重。
- 模板化写作(formulaic writing):从模板生成或复制粘贴的内容。天气预报、体育战报、商品页、房产列表、自动生成的新闻——句式骨架完全一样,只有实体和数字在变。
- 轻微格式差异:同一段文字被复制粘贴时,引号变成了直角引号、空格数不同、多了一个换行、加了个「阅读全文」。字节级不同,语义完全一样。
一个具体到刺眼的例子
C4 里有一段商品描述文案重复出现了 61,036 次:
"by combining fantastic ideas, interesting arrangements, and follow the current trends in the field of that make you more inspired and give artistic touches. We'd be honored if you can apply some or all of these design in your wedding. believe me, brilliant ideas would be perfect if it can be applied in real and make the people around you amazed!"
这段话本身就是机器生成的 SEO 填充文本(注意 "in the field of that" 这种模板变量没填上的痕迹),它被同一个内容农场用在成千上万个商品页上。如果不去重,模型会把可观的概率质量分配给这段废话。
为什么去重
Deduplicating Training Data Makes Language Models Better (Lee et al., 2021) 给出了两条理由:
- 训练更高效:token 更少,同样的效果用更少的算力。等价地说,重复样本的边际信息量为零,但你仍然要为它付出全部的前向反向 FLOPs。
- 避免记忆(memorization):重复次数是逐字记忆的最强预测因子。一段文本在语料里出现 10 次以上,模型就很可能能被诱导逐字背出来。这直接关系到版权(背出受版权保护的原文)和隐私(背出泄露在网上的邮箱、密钥、住址)。
还有一条不那么常被提到但同样重要:去重能改善评测的有效性——训练集里重复出现的段落更可能包含评测集内容(测试集污染),去重是最便宜的一道防线。
设计空间:三个正交的选择
| 维度 | 选项 | 后果 |
|---|---|---|
| 1. 什么是「一个项(item)」 | 句子 / 段落 / $n$ 句的滑窗 / 整篇文档 / 任意长子串 | 粒度越细,召回越高,但越容易破坏文档连贯性 |
| 2. 怎么算「匹配」 | 精确相等 / 存在公共子项 / 公共子项占比超过阈值 | 决定是精确去重还是模糊去重;后两者需要相似度度量 |
| 3. 采取什么动作 | 全部删掉 / 只留一份 / 降采样保留 | 「全删」用于毒性等场景;「留一份」是去重的默认;「降采样」保留了频率信息 |
去重的本质是「把每个项和其它所有项作比较」。$N = 10^{10}$ 篇文档意味着 $10^{20}$ 次比较,绝无可能。所有实用的去重算法都在做同一件事:把「比较」变成「哈希后查表」,从而降到线性时间。精确去重用普通哈希,模糊去重用 MinHash + LSH——后者的全部魔法在于设计一种「相似的东西才碰撞」的哈希。
哈希函数速览
- 哈希函数 $h$ 把一个项映射成一个哈希值(整数或字符串)。
- 哈希值远小于原项——这是它能省内存的原因。
- 哈希碰撞(collision):$h(x) = h(y)$ 而 $x \neq y$。
选哈希函数是在速度和抗碰撞性之间权衡:
| 类别 | 代表 | 抗碰撞 | 速度 | 典型用途 |
|---|---|---|---|---|
| 密码学哈希 | SHA-256 | 强(找碰撞在计算上不可行) | 慢(每字节几十个周期) | 比特币、数字签名 |
| 非密码学哈希 | DJB2、MurmurHash、CityHash、xxHash | 弱 | 快(接近内存带宽) | 哈希表、去重 |
去重用后者就够了:我们不担心有人恶意构造碰撞,只担心随机碰撞。64 位哈希在 $10^{10}$ 个项上的随机碰撞期望数由生日问题给出:$\approx N^2/(2\cdot 2^{64}) = 10^{20}/(3.7\times 10^{19}) \approx 2.7$ 次——完全可以接受。课上用的是 MurmurHash:
import mmh3
h = mmh3.hash("hello")     # -> 一个 32 位有符号整数
h64 = mmh3.hash64("hello") # -> 两个 64 位整数
精确去重的最小实现
设定:项 = 字符串;匹配 = 精确相等;动作 = 只留一份。
import itertools, mmh3

items = ["Hello!", "hello", "hello there", "hello", "hi", "bye"]

# 按哈希排序后分组:哈希值相同的排在一起
hash_items = itertools.groupby(sorted(items, key=mmh3.hash), key=mmh3.hash)

# 每组只保留一个
deduped_items = [next(group) for h, group in hash_items]
# -> ['Hello!', 'hello', 'hello there', 'hi', 'bye']  (两个 "hello" 合成一个)
- 优点:简单,语义清晰,精度高(不会误删)。
- 缺点:完全处理不了近似重复。
"Hello!"和"hello"是两个不同的项。 - 关键:这段代码是按 MapReduce 的方式写的——
sorted是 shuffle,groupby是 reduce。因此它可以直接并行化并扩展到任意规模:map 阶段每台机器算自己那份数据的哈希,按哈希值取模分发到 reducer,每个 reducer 独立地在自己那组里留一份。整个流程只需要一次全局 shuffle,没有任何跨节点的两两比较。
Bloom filter:当哈希表也放不下的时候
上面的方案要求把所有见过的哈希值存起来。$10^{10}$ 个 64 位哈希,光是裸数组就 80 GB,用 Python 的 set 要几百 GB。Dolma 的做法是用 Bloom filter:一个只支持「插入」和「可能见过吗」的概率型集合。
结构:一个 $m$ 位的位数组,$k$ 个独立哈希函数。插入 $x$ 时把 $h_1(x),\dots,h_k(x)$ 对应的位置 1;查询时若这 $k$ 位全为 1 就报告「见过」。
插入 $n$ 个元素、共 $kn$ 次置位后,某一位仍为 0 的概率是 $\left(1-\frac1m\right)^{kn}\approx e^{-kn/m}$。于是一次查询的假阳性率(false positive rate)为
$$ \mathrm{FPR} \;\approx\; \left(1 - e^{-kn/m}\right)^{k} $$对 $k$ 求极小,得最优 $k^\star = \frac{m}{n}\ln 2$,代回得 $\mathrm{FPR} = 2^{-k^\star} = (0.6185)^{m/n}$。
数值:要 $\mathrm{FPR}=10^{-5}$,需要 $m/n \approx 24$ 位 $= 3$ 字节/元素,$k^\star \approx 17$。$10^{10}$ 篇文档只要 30 GB 位数组——单机内存装得下,而精确哈希集要 10 倍以上。
注意 Bloom filter 只有假阳性、没有假阴性:它可能把一篇没见过的文档误判成重复而删掉(损失 $10^{-5}$ 的数据,无所谓),但绝不会漏掉真正的重复。这个非对称性恰好和去重的需求匹配。
C4 的三句去重
C4 的方案是精确去重的一个更细粒度的实例(T5, 2019):
- 项:连续 3 句组成的滑动窗口。
- 匹配:精确相等。
- 动作:只保留一份,其余位置的这三句被从原文档中删除。
Percy 特意提了这个警告。想象一篇教程,中间三句是标准的免责声明,被去重删掉了——留下的文本可能从第 5 段直接跳到第 7 段,逻辑断裂。模型于是学到「文本可以毫无征兆地跳跃」,这本身就是一种噪声。细粒度去重提高了召回,代价是牺牲了文档级的连贯性。这就是为什么很多后续数据集(RefinedWeb、FineWeb)选择文档级模糊去重而不是片段级精确去重——宁可整篇丢掉,也不要留下一篇被挖空的文档。
7. 模糊去重:MinHash、LSH 与后缀数组
先要一个相似度:Jaccard
把文档表示成一个集合 $A$(通常是它的 $k$-shingle 集合,即所有长度为 $k$ 的连续词组,$k$ 一般取 5–13)。两个集合的 Jaccard 相似度定义为
$$ J(A, B) \;=\; \frac{|A \cap B|}{|A \cup B|} \;\in\; [0, 1] $$A = {"1", "2", "3", "4"}
B = {"1", "2", "3", "5"}
def compute_jaccard(A, B):
intersection = len(A & B) # 3
union = len(A | B) # 5
return intersection / union # 0.6
定义:两篇文档是近似重复,当且仅当它们的 Jaccard 相似度 $\ge$ 某个阈值(工业界常用 0.7–0.9)。
算法挑战还是那句话:要在线性时间里找出所有近似重复对。
MinHash:让碰撞概率等于相似度
MinHash 是一个随机哈希函数 $H$,满足一个惊人的性质:
$$ \Pr\big[H(A) = H(B)\big] \;=\; J(A, B) $$通常我们设计哈希函数时,希望不同的项尽量映到不同的哈希值——碰撞是坏事,而且碰撞概率应该与输入的相似性无关(雪崩效应:改一个 bit,哈希值完全变)。
在这里我们要的恰恰相反:我们希望碰撞概率正好等于相似度。碰撞不再是 bug,而是被精心设计出来的 feature。这类哈希统称局部敏感哈希(locality-sensitive hashing, LSH)。
构造极其简单:取一个普通哈希 $h$(带随机种子),定义
$$ H(A) \;=\; \min_{x \in A} h(x) $$import mmh3
def minhash(S: set[str], seed: int) -> int:
return min(mmh3.hash(x, seed) for x in S)
为什么 $\Pr[\min h(A) = \min h(B)] = J(A,B)$
用特征矩阵(characteristic matrix)来看最清楚。行是全域中的项,列是集合,格子里是「该项是否属于该集合」:
item | A | B
-----+---+---
1    | 1 | 1     <- 在交集里
2    | 1 | 1     <- 在交集里
3    | 1 | 1     <- 在交集里
4    | 1 | 0     <- 只在 A 里
5    | 0 | 1     <- 只在 B 里
一个随机哈希函数 $h$ 在全域上诱导出一个均匀随机的排列 $\pi$:按 $h$ 值从小到大排,就是一个随机顺序。那么 $\min_{x\in A} h(x)$ 对应的元素,就是「在这个随机排列中,$A$ 里排在最前面的那个元素」。记它为 $\mathrm{first}(A)$。
现在只需要看 $A \cup B$ 中的元素($A\cup B$ 之外的元素既不影响 $\mathrm{first}(A)$ 也不影响 $\mathrm{first}(B)$,可以直接忽略)。由排列的均匀性,$A\cup B$ 中每个元素成为该集合内最靠前者的概率相同,都是 $1/|A\cup B|$。设 $x^\star$ 是 $A\cup B$ 中排在最前的元素,分三种情况:
- $x^\star \in A\cap B$(上表的项 1、2、3):那么它同时是 $A$ 的最前者和 $B$ 的最前者,于是 $\mathrm{first}(A) = \mathrm{first}(B) = x^\star$,哈希值相等。
- $x^\star \in A \setminus B$(项 4):它是 $\mathrm{first}(A)$,但它不在 $B$ 里,所以 $\mathrm{first}(B) \neq x^\star$,且 $h(\mathrm{first}(B)) > h(x^\star)$,哈希值不等。
- $x^\star \in B \setminus A$(项 5):对称地,哈希值不等。
因此
$$ \Pr[H(A)=H(B)] \;=\; \Pr[x^\star \in A\cap B] \;=\; \frac{|A\cap B|}{|A\cup B|} \;=\; J(A,B). \qquad \blacksquare $$(上例:$3/5 = 0.6$,与直接计算的 Jaccard 一致。)
签名长度与估计误差
单个 MinHash 只给出一个 Bernoulli($J$) 样本——信息量太少。用 $n$ 个独立种子得到签名(signature) $\big(H_1(A),\dots,H_n(A)\big)$,用匹配比例估计 $J$:
n = 100                                   # 生成 100 个随机哈希函数
matches = [minhash(A, seed) == minhash(B, seed) for seed in range(n)]
estimated_jaccard = sum(matches) / n      # 应该接近 0.6
assert abs(estimated_jaccard - 0.6) < 0.01
估计量 $\hat J = \frac1n\sum_i \mathbf 1[H_i(A)=H_i(B)]$ 是 $n$ 个 i.i.d. Bernoulli($J$) 的均值,所以
$$ \E[\hat J] = J, \qquad \mathrm{Var}[\hat J] = \frac{J(1-J)}{n}, \qquad \mathrm{sd}[\hat J] = \sqrt{\frac{J(1-J)}{n}} $$数值感受(取最坏情况 $J=0.5$,$\sqrt{J(1-J)}=0.5$):
- $n=100$:标准差 $0.050$ —— 只能粗略区分「像」和「不像」
- $n=400$:标准差 $0.025$
- $n=2500$:标准差 $0.010$
- $n=10000$:标准差 $0.005$
误差按 $1/\sqrt n$ 下降,要把精度提高一位数就得多算 100 倍的哈希。这解释了为什么实际系统里 $n$ 常取到几百到上万(第 6 节提到的 Lee et al. 用了 $n=9000$)。好消息是签名长度与文档长度无关:无论文档一千词还是一百万词,签名都是 $n$ 个整数,$n=100$ 时只有 400 字节。
但问题还没解决:现在我们能估计两篇文档的相似度了,可我们仍然需要两两比较才能算这个估计。一次哈希碰撞只告诉你「可能相似」,并不告诉你 $J(A,B) > \tau$。
LSH 分带:把概率曲线「锐化」成阶跃
(参考:Ullman 等人的 Mining of Massive Datasets 第 3 章。)
如果只用一个 MinHash 做哈希桶,$\Pr[\text{A 和 B 同桶}] = J(A,B)$。平均而言更相似的项更容易同桶,但随机性太大:$J=0.9$ 的一对有 10% 概率不同桶,$J=0.1$ 的一对有 10% 概率同桶。我们想要的是一个近似阶跃函数:$J > \tau$ 就几乎必然同桶,$J < \tau$ 就几乎必然不同桶。
解法:用 $n$ 个哈希函数,切成 $b$ 个带(band),每带 $r$ 个哈希函数,$n = b \cdot r$。
n = 12   # 哈希函数总数
b = 3    # 带数
r = 4    # 每带的哈希函数个数

h1 h2 h3 h4  |  h5 h6 h7 h8  |  h9 h10 h11 h12
   band 1          band 2          band 3
规则:把每一带内的 $r$ 个 MinHash 值拼成一个元组,作为该带的桶键。只要存在某一个带,其全部 $r$ 个哈希值都相同,就判定 A 和 B 碰撞(成为候选近似重复对)。
设 $s = J(A,B)$。
- 某一个固定带的 $r$ 个哈希全部相同的概率(各哈希独立):$s^r$。
- 该带不全同:$1 - s^r$。
- $b$ 个带全都不全同:$(1-s^r)^b$。
- 因此至少有一带全同(即碰撞)的概率:
这是一个 AND-OR 结构:带内是 AND($r$ 个全中),带间是 OR($b$ 个中一个)。AND 把概率压向 0(曲线右移,更难匹配),OR 把概率拉向 1(曲线左移,更易匹配),两者叠加就把原本线性的 $P=s$ 锐化成 S 形。
def get_prob_collision(sim, b, r):
    prob_match     = sim ** r                      # 某一带全同
    prob_collision = 1 - (1 - prob_match) ** b     # 至少一带全同
    return prob_collision

get_prob_collision(sim=0.8, b=5, r=10)   # -> 0.433
看几组数值,体会 $b$ 和 $r$ 各自的作用($s$ 是真实 Jaccard,表中是碰撞概率):
| $s$ | $b=10, r=10$ | $b=10, r=20$(增大 $r$) | $b=20, r=20$(再增大 $b$) |
|---|---|---|---|
| 0.70 | 0.249 | 0.008 | 0.016 |
| 0.75 | 0.440 | 0.031 | 0.062 |
| 0.80 | 0.679 | 0.109 | 0.207 |
| 0.85 | 0.888 | 0.327 | 0.546 |
| 0.90 | 0.986 | 0.726 | 0.925 |
| 0.95 | 1.000 | 0.988 | 1.000 |
| 0.98 | 1.000 | 1.000 | 1.000 |
- 增大 $r$:曲线变陡并右移(更难匹配)。第 2 列相对第 1 列,0.7 处从 0.249 掉到 0.008,0.9 处从 0.986 掉到 0.726 ——低相似度那头掉得快得多,所以更陡。
- 增大 $b$:曲线左移(更易匹配)。第 3 列相对第 2 列,每个点的碰撞概率都上升($b$ 翻倍相当于多给一次机会)。
阈值在哪:$(1/b)^{1/r}$
S 曲线最陡的位置(也就是实际起作用的「阈值」)出现在 $s^r \approx 1/b$ 处,即
$$ \tau \;=\; \left(\frac{1}{b}\right)^{1/r} $$为什么是这里?把 $s^r = 1/b$ 代入碰撞概率公式:
$$ P_{\text{collide}}(\tau) = 1 - \left(1 - \tfrac1b\right)^{b} \;\xrightarrow[b\to\infty]{}\; 1 - e^{-1} \approx 0.632 $$也就是说,$\tau$ 正是碰撞概率穿过约 63% 的那个点——恰好在 0 和 1 的中间偏上,也正是曲线斜率最大的邻域。更严格地,$P$ 关于 $\log s$ 的导数在 $s^r \sim 1/b$ 附近取得极大值(把 $u = s^r$ 代入,$P = 1-(1-u)^b$,$\frac{dP}{d\log u} = bu(1-u)^{b-1}$,对 $u$ 求导置零得 $u = 1/b$,正好)。
用课上给的实际参数验算(Lee et al. 2021 的设置:$n = 9000$,$b = 20$,$r = 450$):
b, r = 20, 450
threshold = (1 / b) ** (1 / r)          # = exp(ln(0.05)/450) = 0.9934

prob_match     = 1 / b                  # = 0.05    某一带在阈值处匹配的概率
prob_collision = 1 - (1 - 1/b) ** b     # = 0.6415  ≈ 1 - 1/e = 0.632
所以这套参数实际上是在找 Jaccard ≥ 0.993 的、近乎逐字相同的文档对——非常保守,宁可漏掉一些近似重复,也不误删。
- 先定目标阈值 $\tau$(业务决定,比如 0.8)和预算 $n = br$(决定了计算与内存成本)。
- 由 $\tau = (1/b)^{1/r}$ 与 $n = br$ 联立解出 $b, r$。例如 $n=128,\ \tau=0.8$:试 $r=8, b=16$ 得 $\tau=(1/16)^{1/8}=0.707$;试 $r=6,b=21$ 得 $0.60$;试 $r=13,b=10$ 得 $(0.1)^{1/13}=0.838$。取 $r=11,b=12$ 得 $(1/12)^{1/11}=0.80$ ✓。
- 要高召回(宁可多找):减小 $r$ 或增大 $b$,$\tau$ 下降。要高精度(宁可漏掉):增大 $r$。
- 候选对必须再验证:LSH 只产生候选,标准做法是对候选对用完整签名重算 $\hat J$(或直接算真实 Jaccard)再确认,把假阳性清掉。
可运行的最小实现
import mmh3
from collections import defaultdict

def shingles(text: str, k: int = 5) -> set[str]:
    """把文档变成 k-gram 词组集合。"""
    toks = text.lower().split()
    return {" ".join(toks[i:i + k]) for i in range(max(1, len(toks) - k + 1))}

def signature(S: set[str], n: int) -> list[int]:
    """n 个 MinHash 组成的签名。"""
    return [min(mmh3.hash(x, seed) for x in S) for seed in range(n)]

def lsh_dedup(docs: list[str], b: int = 12, r: int = 11, threshold: float = 0.8):
    n = b * r
    sigs = [signature(shingles(d), n) for d in docs]

    # 1) 分带建桶:桶键 = (带编号, 该带 r 个 minhash 值的元组)
    buckets = defaultdict(list)
    for i, sig in enumerate(sigs):
        for band in range(b):
            key = (band, tuple(sig[band * r : (band + 1) * r]))
            buckets[key].append(i)

    # 2) 收集候选对(同一桶里的任意两篇)
    candidates = set()
    for members in buckets.values():
        for a in range(len(members)):
            for c in range(a + 1, len(members)):
                candidates.add((members[a], members[c]))

    # 3) 用完整签名验证,剔除假阳性
    def est_jaccard(i, j):
        return sum(x == y for x, y in zip(sigs[i], sigs[j])) / n

    dup_pairs = [(i, j) for i, j in candidates if est_jaccard(i, j) >= threshold]

    # 4) 并查集聚成簇,每簇只留一篇
    parent = list(range(len(docs)))
    def find(x):
        while parent[x] != x:
            parent[x] = parent[parent[x]]
            x = parent[x]
        return x
    for i, j in dup_pairs:
        parent[find(i)] = find(j)

    seen, keep = set(), []
    for i in range(len(docs)):
        root = find(i)
        if root not in seen:
            seen.add(root)
            keep.append(docs[i])
    return keep
复杂度:签名 $O(N \cdot |S| \cdot n)$(可用「一次哈希 + $n$ 个仿射变换」的技巧把 $n$ 次哈希降成 1 次),建桶 $O(N b)$,候选对数量取决于桶的大小分布。全程没有 $N^2$。唯一的风险是「巨桶」——如果一大批文档几乎完全相同(比如百万份 MIT 协议),某个桶里会有百万个成员,第 2 步就退化成 $O(M^2)$。工程上的处理是给桶设大小上限,或对超大桶只保留一个代表。
后缀数组:子串级别的精确去重
MinHash 做的是文档级的模糊匹配。但还有一种情况它抓不到:两篇长文档整体不像($J$ 很低),但中间共享了一大段完全相同的 500 词。Lee et al. 2021 的第二个算法 ExactSubstr 就是解决这个的,用的是后缀数组(suffix array)。
做法:
- 把整个语料拼接成一个巨大的字节串 $\mathcal{S}$(文档之间插入分隔符),长度 $N$。
- 构造 $\mathcal{S}$ 的后缀数组:把 $\mathcal{S}$ 的全部 $N$ 个后缀按字典序排序,数组 $SA[i]$ 存第 $i$ 小的后缀的起始位置。构造可以在 $O(N)$ 或 $O(N\log N)$ 时间内完成(SA-IS 算法),内存约 $8N$ 字节。
- 关键观察:任何重复出现的子串,它的两次出现所对应的后缀,在排序后一定相邻或相近——因为它们有相同的前缀。于是只要扫一遍相邻的后缀对,计算它们的最长公共前缀(LCP)。
- 凡是 LCP $\ge k$(论文取 $k=50$ 个 token)的,就找到了一段重复子串。把这些区间标记出来,从文档中删除(只保留第一次出现)。
朴素做法要在整个语料里找每个子串的其它出现位置,是全局搜索。后缀排序之后,所有以同一段文本开头的位置被物理地聚集在一起,于是「找重复」退化成「扫一遍数组、比相邻两项」。这和 MinHash+LSH 是同一个哲学:用一次排序/哈希,把 $O(N^2)$ 的两两比较换成 $O(N\log N)$ 的一次重排 + 线性扫描。
| MinHash + LSH | 后缀数组 (ExactSubstr) | |
|---|---|---|
| 粒度 | 整篇文档 | 任意长子串(≥ 50 token) |
| 匹配 | 模糊(Jaccard ≥ τ) | 精确(逐字节相同) |
| 能抓到 | 整体改写、少量编辑的近似重复 | 长文中嵌入的相同段落 |
| 抓不到 | 局部长段重复(整体 $J$ 太低) | 换了几个词的近似重复 |
| 复杂度 | $O(N n)$ 哈希 + 建桶 | $O(N\log N)$ 排序,内存 $\approx 8N$ 字节 |
| 动作 | 整篇删除 | 删除重复片段(会伤连贯性) |
两者互补,实践中经常都跑:先 MinHash 去掉整篇的近似重复,再用后缀数组清掉残留的长重复片段。
8. 数据配比:各个数据源该占多少
语言模型不是在一个同质语料上训练的,而是在多个数据源上:网页、Wikipedia、书籍、代码、论文、论坛、多语言。
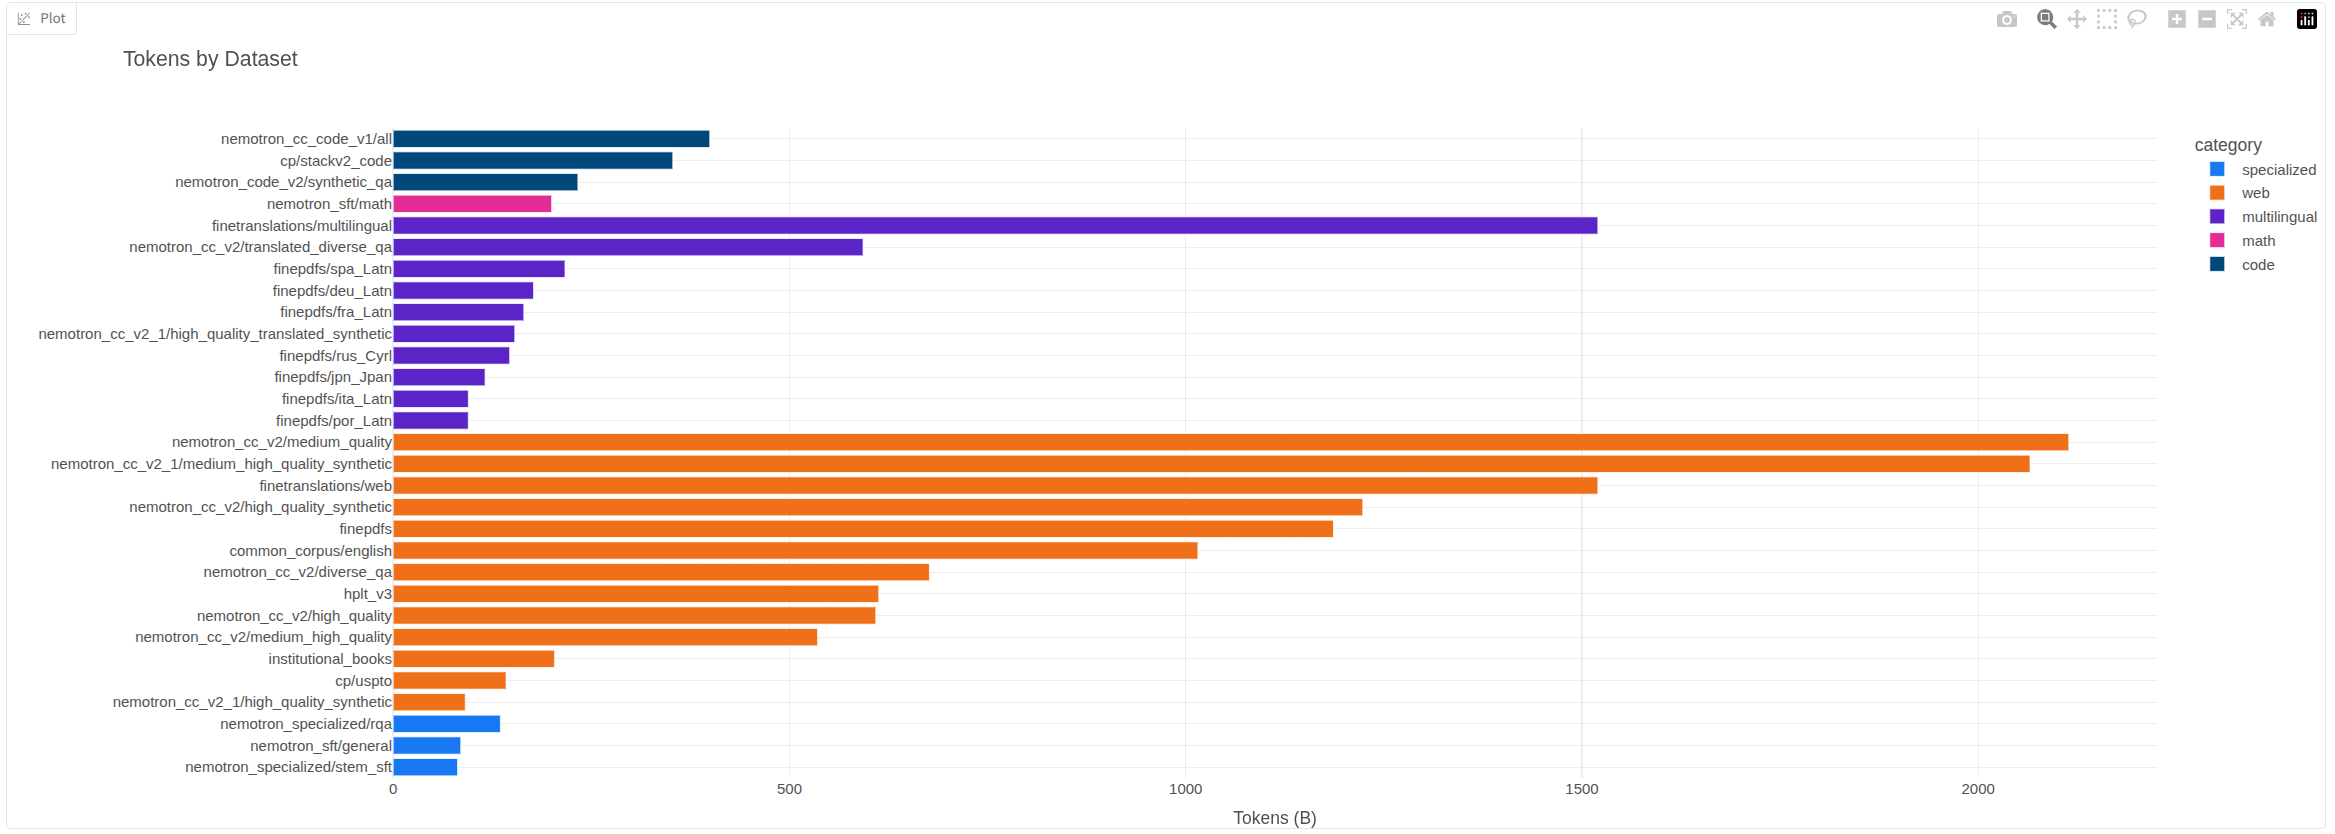
The Pile(EleutherAI, 2020)是最早把「多源混合」明确写出来的开源语料:22 个来源,从 Pile-CC、PubMed Central、arXiv、GitHub 到 Enron 邮件、YouTube 字幕、专利文书。核心问题:我们该用什么分布去采样这些数据源?
sources = {"Wikipedia", "CC", "GitHub"}
p = {"Wikipedia": 0.3, "CC": 0.5, "GitHub": 0.2}   # 一种可能的配比
三条基线
| 方法 | 定义 | 评价 |
|---|---|---|
| 凭感觉(vibes) | 人工按直觉设 $p(s)$ | 相当常见——大多数公开模型的配比就是这么来的。可解释、可控,但没有任何保证 |
| 均匀采样 | $p(s) \propto 1$ | 小源被极度放大,会被 epoch 到烂 |
| 按比例混合(proportional) | $p(s) \propto \mathrm{num\_tokens}(s)$ | 等价于「把所有源拼起来随机打乱」。网页会淹没一切,高质量小源几乎不可见 |
直觉上,我们应该上调高质量源的权重。但有两个约束把事情搞复杂了:
- 要保证多样性。文学、代码、论文这些源之间不可比——你没法说「代码比小说质量高」。砍掉任何一类,模型就永久失去一类能力。
- 每个源都是有限的。给一个小源太多权重,就必须在它上面反复 epoch。
关键且微妙的一点:epoch 数
Percy 说第二点「重要而且有点微妙」,用一个算术例子讲清楚:
source_token_counts = {
    "low":  10 * 10**12,   # 10T tokens,充裕(比如网页)
    "high": 10 * 10**9,    # 10B tokens,稀缺(比如精选教科书)
}
p = {"low": 0.5, "high": 0.5}     # 天真的「各占一半」
train_tokens = 1 * 10**12          # 训练 1T tokens

low_num_epochs  = (0.5 * 1e12) / 1e13   # = 0.05  低质量源只用了 5%
high_num_epochs = (0.5 * 1e12) / 1e10   # = 50    高质量源被过了 50 遍!
在高质量数据上 epoch 50 次 —— 这会直接导致过拟合。模型会开始逐字记忆那 10B token,训练 loss 继续降但泛化不再改善,甚至倒退。经验规律是:重复 4 次以内,一个重复 token 的价值约等于一个新 token;超过 16 次,边际价值趋近于零;到几十次就开始有害。
把权重 $p(s)$ 转成 epoch 数 $E(s) = \dfrac{p(s)\cdot D}{N(s)}$($D$ 是训练预算,$N(s)$ 是源 $s$ 的 token 数)。配比问题的可行域不是单纯形 $\Delta$,而是被 $E(s) \le C$ 切掉一块之后的子集。忽略这个约束,任何「优化质量」的方法都会给稀缺高质量源无限加权,直接冲进过拟合区。
UniMax:给 epoch 数设硬上限
UniMax (2023) 的设定是多语模型的语种平衡,但方法完全通用:
- 此前的做法:在均匀和按比例之间插值,$p(s) \propto N(s)^{\alpha}$,$\alpha \in [0,1]$。$\alpha=0$ 是均匀,$\alpha=1$ 是按比例,常用 $\alpha = 0.3$。这只是个旋钮,没有原则。
- UniMax 的想法:尽量均匀地采样各源,但对任何源的 epoch 数施加一个硬上限 $C$。形式化:
算法上是一个简单的贪心:把源按 token 数从小到大排,先给最小的源分配「它能承受的最大预算」$C\cdot N(s)$,如果这已经超过均分份额就说明它不受限;否则把它按上限封顶,剩余预算在剩下的源上重新均分,递归下去。这就是水填充(water-filling)。
基于回归的配比:RegMix 这一路
更有野心的做法:把「配比 → 效果」当成一个可以拟合的函数,就像缩放定律把「算力 → loss」当成可拟合的函数一样。代表是 RegMix (2024) 及其后续工作(如 OLMix)。
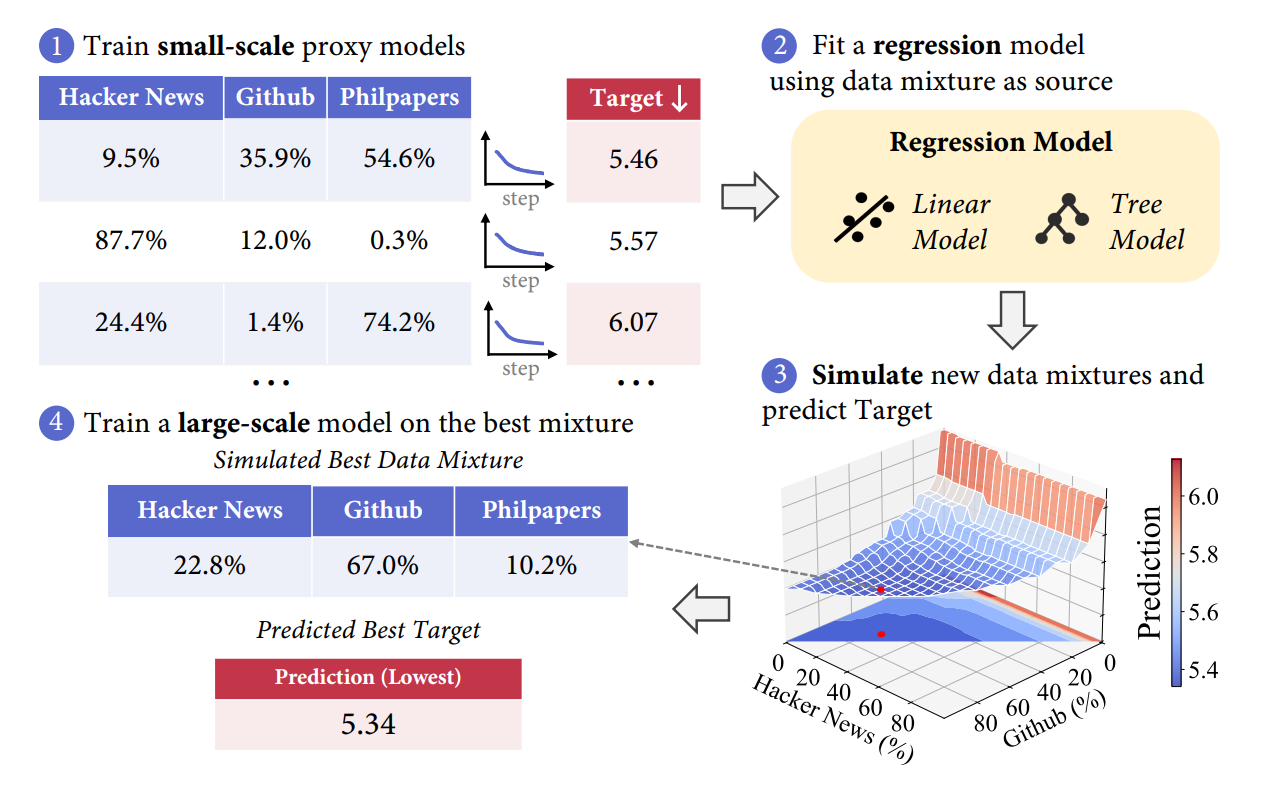
四个设计选择:
- 配比的分布:需要一个覆盖单纯形的采样分布,通常用 Dirichlet。参数控制采样是集中在中心(接近均匀混合)还是散布到角落(接近单源)。要同时有两类样本,回归才学得到边界行为。
- 回归方法:线性回归最简单但拟合不了交互(「代码 + 数学一起加才有用」);梯度提升树(gradient boosted trees,如 LightGBM)能拟合非线性和交互,是 RegMix 的选择。
- 目标:可以是某个 held-out 集上的 loss,也可以是下游评测的组合。用下游评测更贴近真实需求,但要非常小心过拟合——你在几百个样本上优化一个高维配比向量,很容易把回归模型的噪声当信号,选出一个只在这个评测上好的配比。
- 小规模与大规模的差异:这是根本性的成本/精度权衡。代理模型越小越便宜,但和目标规模的差距越大,外推越不可靠。
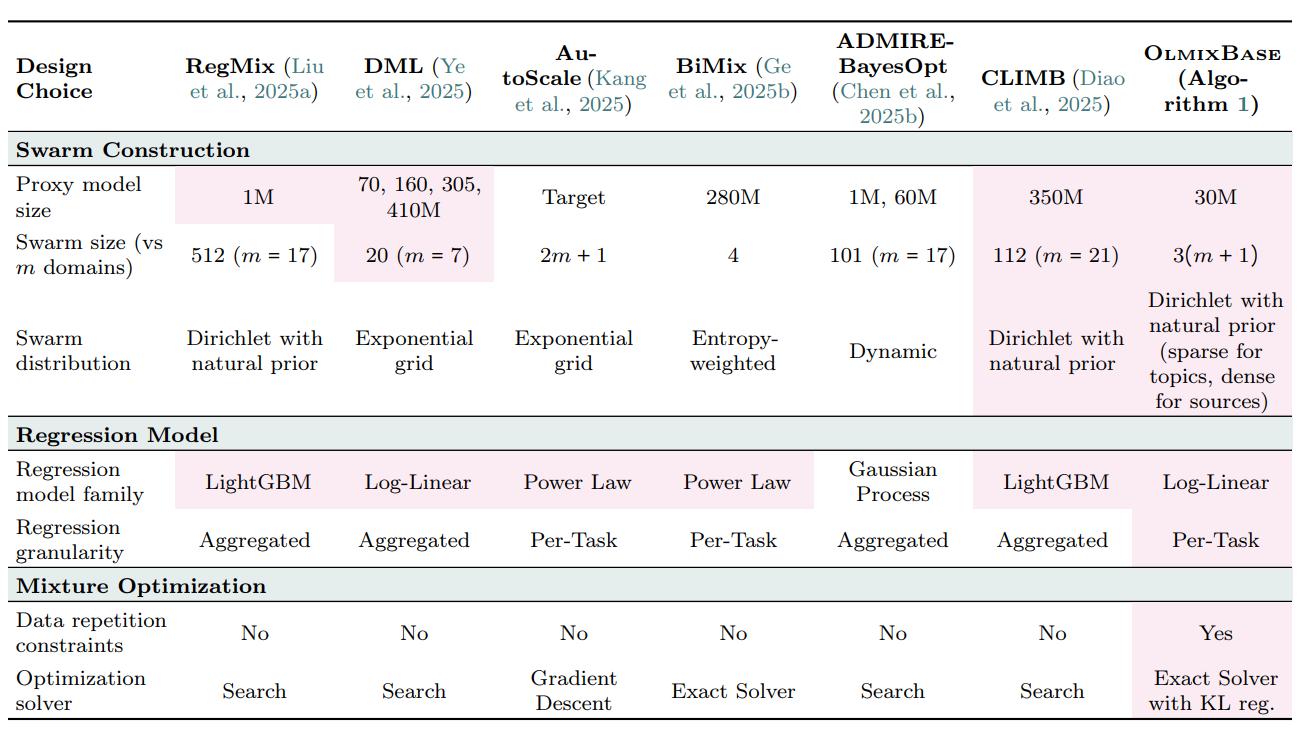
Percy 用两个「祈祷」总结了这套方法的信仰基础:
- Hope 1 🙏:回归模型在极小值附近是准的。回归的平均误差小不代表它在最优点附近准;恰恰相反,优化过程会主动去找回归模型「乐观地估低了 loss」的区域——这是经典的 optimizer's curse。
- Hope 2 🙏:最优配比能从小规模迁移到大规模。这是整套方法的立身之本,但它并不总是成立。
DoReMi:用 group DRO 直接优化权重
另一条路线不做黑箱回归,而是把配比当作一个极小极大优化问题来解。DoReMi (2023) 用的是分组分布鲁棒优化(group DRO):
$$ \min_{\theta}\;\max_{\alpha \in \Delta}\;\sum_{i=1}^{k} \alpha_i \Big(\underbrace{\ell_i(\theta) - \ell_i(\theta_{\text{ref}})}_{\text{超额损失 (excess loss)}}\Big) $$流程是三步:
- 用某个基线配比训一个小参考模型 $\theta_{\text{ref}}$(论文用 280M)。
- 训一个同样大小的代理模型 $\theta$,同时用指数梯度上升在线更新域权重: $$ \alpha_i^{(t)} \;\propto\; \alpha_i^{(t-1)} \exp\!\Big(\eta \big[\ell_i(\theta^{(t)}) - \ell_i(\theta_{\text{ref}})\big]\Big) $$ 即把权重挪向「代理模型相对参考模型学得最差」的域。
- 把训练过程中的 $\alpha^{(t)}$ 取平均,得到最终配比,拿去训真正的大模型(论文用 8B)。
如果直接用 $\ell_i(\theta)$ 做 DRO 目标,权重会全部跑到本身熵最高、最难预测的域上——比如随机字符串、加密文本、OCR 乱码。那些域 loss 永远最高,但学它们毫无价值。
减去参考模型的 loss,度量的就变成了「这个域还有多少可学的空间」:如果参考模型也学不好,超额损失接近 0,不会被加权;只有当代理模型明显落后于参考模型时,才说明这个域被欠训练了。这个「超额损失」和 Lecture 10 讲缩放定律时的「不可约损失」是同一个思想——要优化的永远是可约的那部分。
DoReMi 在 The Pile 上报告了约 2.6 倍的训练加速(达到同样的平均下游准确率)。它的优点是只需要两次小规模训练(而 RegMix 需要几百次),缺点是它优化的是「均衡地学好所有域」,而不是「在你关心的下游任务上最好」——如果你压根不在乎某个域,DoReMi 仍然会为它分配权重。
规模依赖的陷阱与「模拟 epoch」
Hope 2 有一个具体的、可预见的失效模式。还是那两个源:
source_token_counts = {"low": 10e12, "high": 10e9}
- 在小规模上跑配比搜索:代理模型只训 10B token,此时把 90% 权重给 high 质量源($E(\text{high}) = 0.9\times 10^{10}/10^{10} = 0.9$ 个 epoch)完全没问题,效果最好。搜索结果是
p = {"low": 0.1, "high": 0.9}。 - 把这个配比拿去训大模型(1T token):$E(\text{high}) = 0.9\times 10^{12}/10^{10} = 90$ 个 epoch,严重过拟合。
小规模实验根本看不到 epoch 惩罚,因为它的预算太小、根本没跑够圈数。于是搜索出的最优配比在大规模上是灾难性的。
模拟 epoch(simulated epoching)给出了一个漂亮的修复。它的一般思想是本课程反复出现的主题:让小规模看起来像大规模。具体做法是按比例下采样所有数据源:
small_run_tokens = 10e9      # 代理实验的预算
large_run_tokens = 1e12      # 真实训练的预算
ratio = small_run_tokens / large_run_tokens          # = 0.01

downsampled = {s: n * ratio for s, n in source_token_counts.items()}
# {"low": 100e9, "high": 100e6}   ← 每个源都只保留 1%
现在在下采样后的语料上做小规模搜索:如果配比给 high 源 90% 权重,$E(\text{high}) = 0.9\times 10^{10}/10^{8} = 90$ ——和大规模一模一样的 epoch 数。过拟合在小实验里就暴露出来了,所以搜出的最优配比会自动变得更均衡,比如 p = {"low": 0.7, "high": 0.3}。
可以把它写成一个不变量:小实验和大实验应当有相同的 $\dfrac{D}{N(s)}$(对每个源)。只缩小 $D$ 而不缩小 $N(s)$,就相当于在一个「数据无限」的世界里做实验,得到的结论到了「数据有限」的真实世界必然崩盘。这个原则不止适用于数据配比——任何用小规模代理实验指导大规模决策的场景(超参搜索、架构选择、退火配方)都要问一遍:我的代理实验保持了哪些无量纲比值不变?
本节小结
- 问题:怎么给不同数据源(Wikipedia、通用网页、代码……)分配权重。
- 回归式配比:在小规模上估计「配比 → loss」的映射,然后优化。这和缩放定律是同构的方法论。
- 最重要的约束:epoch 与过拟合。两种解法——硬上限(UniMax)或模拟 epoch(按比例下采样)。
9. 课程式训练、退火与中期训练
到此为止我们默认「配比」是一个固定的分布,整个训练过程从头到尾都按它采样。这个假设其实没必要——数据的顺序也是一个设计维度。
为什么顺序有用:小学习率把模型「钉」在最后见到的数据上
现代预训练几乎都用「warmup → 稳定 → 衰减」的学习率调度。在衰减(退火,annealing)阶段,学习率从峰值降到接近 0,参数更新步长很小,模型不会再大幅重组表示,而是在当前区域内精调。
训练早期学习率大,任何一批数据的影响都会被后续几万步冲掉;训练末期学习率小,最后见到的数据在参数里留下的痕迹被「冻结」下来。所以把最珍贵、最稀缺的高质量数据放在最后,能最大化它的边际影响——同样 10B token 的教科书数据,放在预训练开头几乎白费,放在退火期能显著改变模型行为。
这同时还解决了第 8 节的 epoch 难题:高质量源只有 10B token,如果均匀铺在 1T 的训练里,要么权重极低(影响微弱),要么 epoch 50 次(过拟合)。集中放在最后 50B token 的窗口里,它只需要 epoch 一两次就能占据可观的权重。
WSD 调度与两阶段数据配方
把这个想法制度化的是 WSD(Warmup-Stable-Decay) 学习率调度(MiniCPM 等):学习率在中间长期保持恒定,只在最后一小段(通常是总步数的 10%–20%)快速衰减。它的好处有两个:
- 可以随时分叉:从稳定期的任意 checkpoint 拉一条衰减分支,就得到一个可用的模型。不像 cosine 调度必须一开始就定死总步数。
- 衰减阶段是天然的数据切换点:稳定期用大规模的通用网页,衰减期换成一个精心调配的高质量混合。
Llama 3 明确报告了这个做法:在预训练最后阶段用高质量数据做退火,并且更进一步——把「退火阶段加入某个数据源后的性能增益」当作评估该数据源质量的探针。这是一个很实用的技巧:想知道某个新数据集值不值得加,不用重训,只要从同一个稳定期 checkpoint 拉两条退火分支对比即可,成本降到几个百分点。
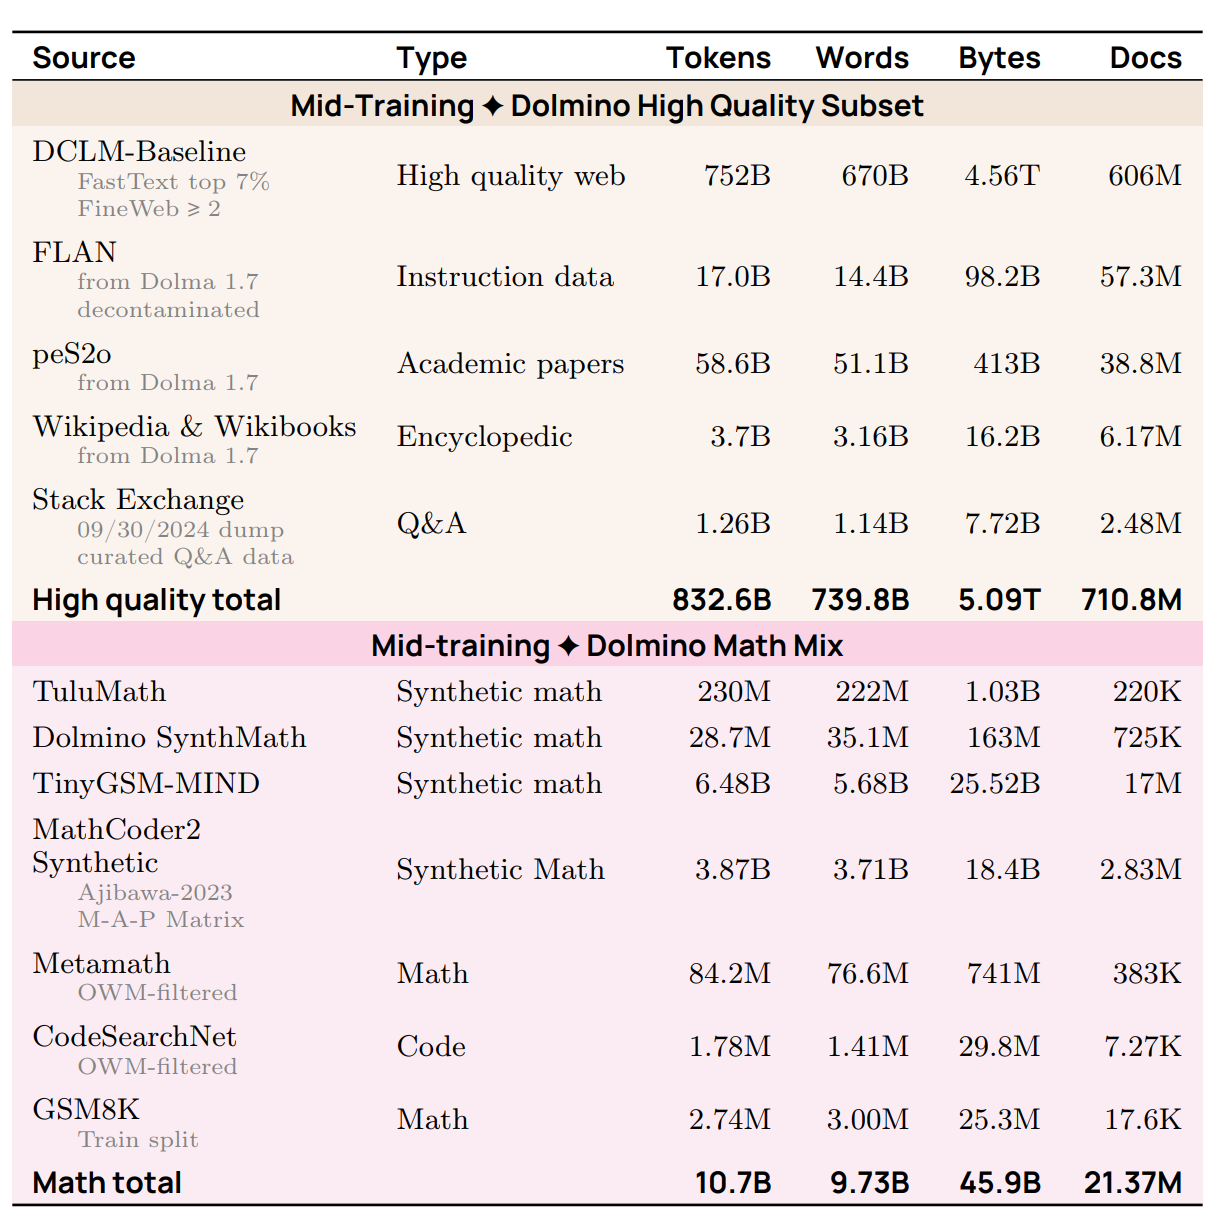
中期训练(mid-training):预训练和后训练之间的那一层
「中期训练」这个词现在指一类介于两者之间的阶段:仍然是自回归语言建模目标(不是 SFT 的对话格式),但数据是专门挑过的、目标是注入特定能力。典型任务包括:
| 中期训练目标 | 典型数据 | 为什么不放在预训练里 |
|---|---|---|
| 扩展上下文长度 | 长文档、拼接的书籍与代码仓库 | 长序列训练的注意力开销是 $O(L^2)$,全程用长上下文太贵;放在最后几百 B token 做即可 |
| 数学与推理 | OpenWebMath、合成的解题步骤 | 这类数据稀缺,放在最后才能给足权重 |
| 代码能力 | 高质量仓库、带测试的函数 | 同上;且能与退火期的其它高质量源共同调配 |
| 多语言 | 目标语种的高质量文本 | 可以在不重训基座的前提下扩展语种 |
| 格式与指令倾向 | 指令风格文本、FLAN 式模板 | 让后续 SFT 更容易「拉」出对话行为 |
| Agent 能力 | 工具调用轨迹、终端会话 | 第 10 节会展开 |
退火期的数据配比同样受第 8 节的所有约束。如果把 10B token 的数学数据塞进一个 50B token 的退火窗口并给 50% 权重,它仍然会被 epoch 2.5 次;给 90% 权重就是 4.5 次,而且会挤掉通用网页,造成灾难性遗忘——模型的数学变好了,通用问答和写作却退步了。所以实践中退火混合里仍然保留可观比例的通用网页(常见是一半以上),高质量源只是被相对上调。
课程式训练(curriculum learning):从简单到困难?
教育学直觉是「先易后难」。在语言模型预训练上,这个方向的结果远不如退火那么稳健:按文本难度(可读性指标、困惑度)排序的课程,在大规模上通常只带来很小甚至为负的收益。原因大致有两条:
- 预训练的随机梯度本身依赖 i.i.d. 采样假设。严格按难度排序会让每个 batch 内部高度相关,梯度方差结构变差,还可能造成分布漂移带来的遗忘。
- 语言模型的「难」和人类的「难」不是一回事。对模型来说,儿童读物里的隐喻和常识跳跃可能比科技论文更难预测。
目前站得住脚的「课程」主要是粗粒度的阶段划分(通用 → 高质量 → 领域 → 指令),而不是逐样本的难度排序。这也是为什么本节的重点是退火与中期训练,而不是经典意义上的课程学习。
10. 合成数据:从教科书到 Agent 轨迹
前面九节讲的都是怎么从互联网上挑数据。但互联网上没有的东西怎么办?比如「一步步写出的解题过程」、「修复一个真实 bug 的完整 agent 轨迹」、「对同一个问题的三种不同难度的讲解」。这些必须造出来。
后训练数据的通用配方
Percy 给出的三步配方非常简洁:
- 定义一组环境(environments):数学、代码执行、浏览器、终端、某个 GitHub 仓库。环境决定了「什么算做对了」。
- 定义一组任务/提示(tasks / prompts):在环境里要完成什么。
- 从一个强模型(teacher)收集回答。
注意这个配方和 Lecture 12 讲的评测结构完全一样——后训练数据长得就像评测集,只是多了「参考答案由模型生成」这一步。Percy 明确点出了这一点:想知道后训练该收集什么数据,就去看你关心的评测长什么样。
路线一:Phi 式的「教科书」合成数据
回到第 2 节的 phi-1。它的另一半数据是纯合成的:
- 用 GPT-3.5(后来是 GPT-4)生成「教科书质量」的 Python 教学文本——解释一个概念,配一段示例代码。
- 再生成大量练习题 + 参考解答(phi-1 的
CodeExercises数据集)用于微调。 - 关键在于如何保证多样性:如果只是反复让模型「写一段教程」,它会不断产出雷同内容。phi 的做法是在 prompt 里随机注入约束——随机选定主题词、目标读者、要用到的库、代码风格——用组合爆炸换取多样性。
后续的 phi-1.5 / phi-2 / phi-3 把这条路线推到了整个预训练:用几百 B token 的合成「教科书」替代大部分网页。效果是同参数量下基准分数极高。
合成教科书数据在结构上和 MMLU、HumanEval 这类基准高度同构(都是「概念解释 + 小问题 + 标准答案」)。所以 phi 在这些基准上极强,但社区普遍反映它在开放式长文写作、多轮对话、处理噪声输入上明显弱于同尺寸的网页训练模型。合成数据的分布是由 prompt 决定的,prompt 覆盖不到的行为,模型就学不到——而真实网页的价值恰恰在于它的「不整洁」:错别字、跑题、争吵、半成品,这些都是模型需要见过的世界。
路线二:WRAP 式的「改写」
纯生成的问题是多样性和事实性都靠模型的先验。一个更保守也更高效的做法是不凭空造,而是改写真实语料。WRAP(Rephrasing the Web, 2024):
- 拿一个中等规模的指令模型,把网页文档按四种风格改写:简易(像给小孩解释)、中等、专业百科、问答对。
- 训练时真实文本和改写文本混合使用(论文用 1:1)。
改写保留了原文的事实内容(所以不引入新的幻觉),改变的是表面形式。这带来两个好处:
(1) 格式多样性——同一个知识点以问答、叙述、摘要多种形式出现,模型学到的是与形式解耦的知识表示,这直接改善下游的指令跟随和 few-shot 表现;
(2) 噪声去除——改写顺手把网页的样板、错字、断句问题清理掉了,相当于一个「用 LLM 做的文本抽取器」。
WRAP 报告的加速约为 3 倍(达到同样困惑度所需的预训练步数)。代价是要对全语料跑一遍 LLM 推理,成本远高于 fastText 过滤——这也是为什么它更常用在退火期的高质量子集上,而不是全量网页。
路线三:指令数据的合成与蒸馏
SFT 阶段需要「指令 → 回答」对。人工写太贵(InstructGPT 用了几万条人工标注),于是有了一系列合成方法:
| 方法 | 怎么造 prompt | 怎么造回答 |
|---|---|---|
| Self-Instruct | 用少量人写的种子指令做 few-shot,让模型自己续写新指令,再去重(ROUGE 相似度过滤) | 同一个模型自己回答 |
| Alpaca / Vicuna | Self-Instruct 的种子 / 用户分享的 ChatGPT 对话 | 蒸馏自更强的模型(text-davinci-003 / ChatGPT) |
| Evol-Instruct (WizardLM) | 从简单指令出发,用 LLM 反复「进化」:加约束、加深度、具体化、复杂化 | 强模型回答 |
| Magpie | 只给对齐模型一个空的用户轮模板,让它自己补全出一条用户指令——不需要任何种子 | 同模型续写回答 |
The False Promise of Imitating Proprietary LLMs (2023) 是一篇重要的降温之作。它发现:在 ChatGPT 输出上做 SFT 的开源小模型,人类评分上去了,但知识密集型基准(如 MMLU)几乎没动。原因是 SFT 学到的主要是风格(自信的语气、markdown 排版、分点结构、恰当的长度),而知识来自预训练。
所以蒸馏的正确定位是:把已有的能力表达出来,而不是注入新能力。要真正提升知识和推理,必须回到预训练/中期训练的数据,或者用带验证信号的强化学习。
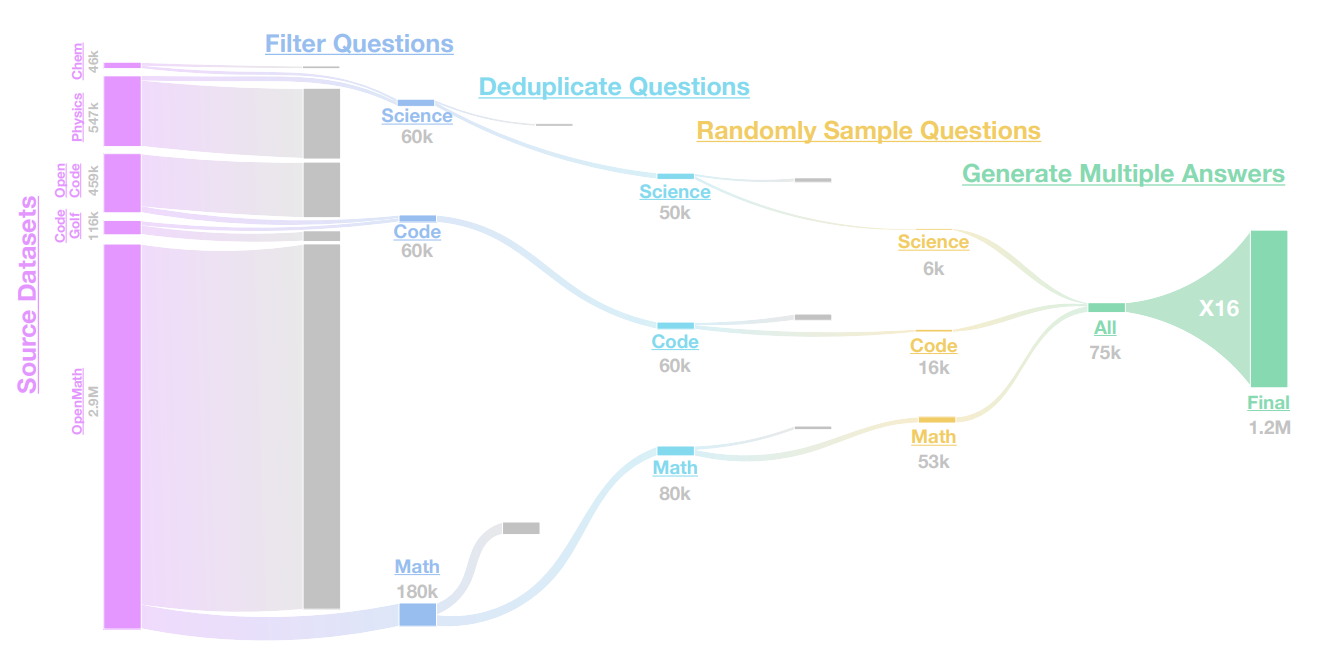
路线四:推理数据 —— OpenThoughts
OpenThoughts (2025) 是推理蒸馏数据集的一个系统性研究,它的消融结论比数据集本身更有价值。
- 规模:120 万条样本,教师模型是 QwQ-32B。
- 问题来源:27 个人工和合成来源——StackExchange、NuminaMath、化学题库等。
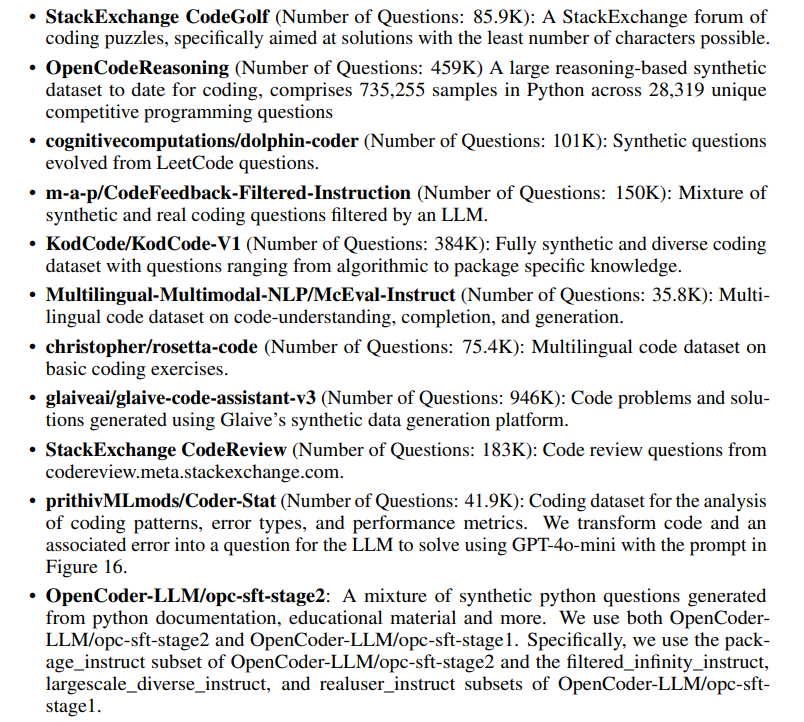
四条经验结论:
- 每个 prompt 采样多条(16 条)回答是有帮助的。同一个问题的多条不同推理路径,比 16 个不同问题更有价值——这有点反直觉,但符合「多样的推理轨迹让模型学到搜索过程而非记忆答案」的解释。
- 更强的模型不一定是更好的老师:QwQ-32B 作为教师优于 DeepSeek-R1,尽管 R1 本身更强。可能的原因是教师的输出分布要和学生的容量匹配——太强的老师产生的推理链过于跳跃、压缩,小学生模型学不动。
- 答案过滤没有帮助:用标准答案验证、只保留答对的轨迹,并没有带来提升。这非常反直觉。一个解释是错误轨迹里仍然包含有价值的推理模式,而且过滤会系统性地删掉难题(难题更容易答错),造成难度分布偏移。
- 小而精的来源优于大而杂的来源:例如只用 OpenMath-2-Math 这样一个高质量数学源,效果好过混入大量多样但低质的来源。
路线五:Agent 轨迹 —— 软件工程数据的三代演进
最难造的数据是 agent 轨迹:一个模型在真实环境里多轮地读文件、改代码、跑测试、看报错、再改。这类数据几乎不存在于互联网上,必须构造环境去采。软件工程(SWE)是这方面最活跃的领域,Percy 讲了三代做法。
SWE-smith:用 LLM 造任务
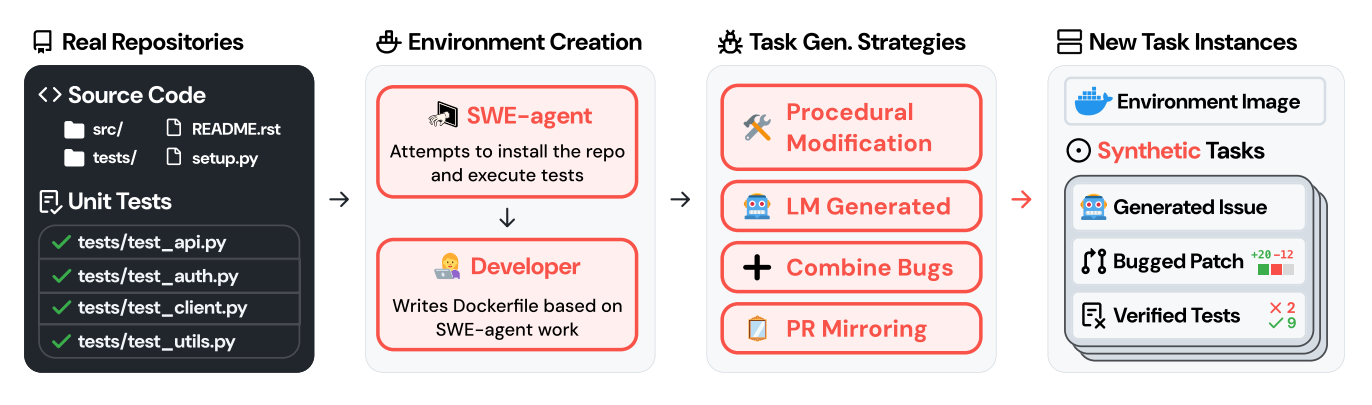
这是「半合成」的典范:真实环境 + 合成任务。环境是真的(真实代码库、真实测试套件),所以验证信号可靠;任务是造的,所以数量可以无限扩展。SWE-smith (2025)。
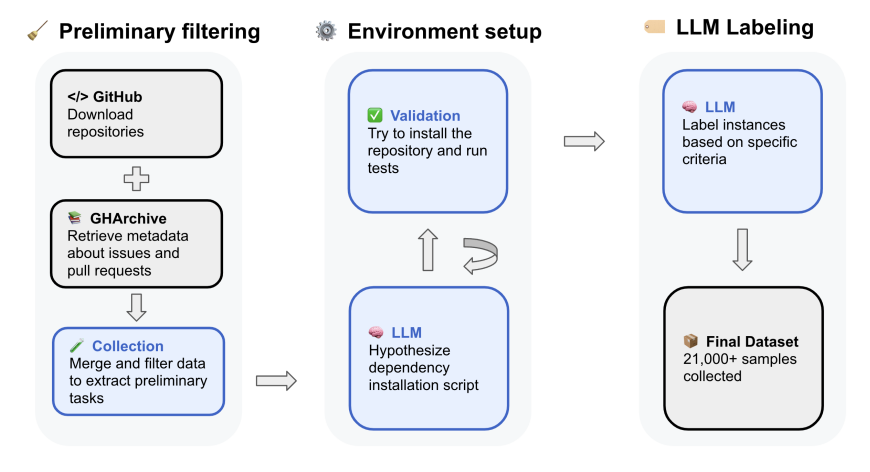
SWE-rebench:从真实 PR 里挖任务
SWE-Zero:干脆不要执行反馈
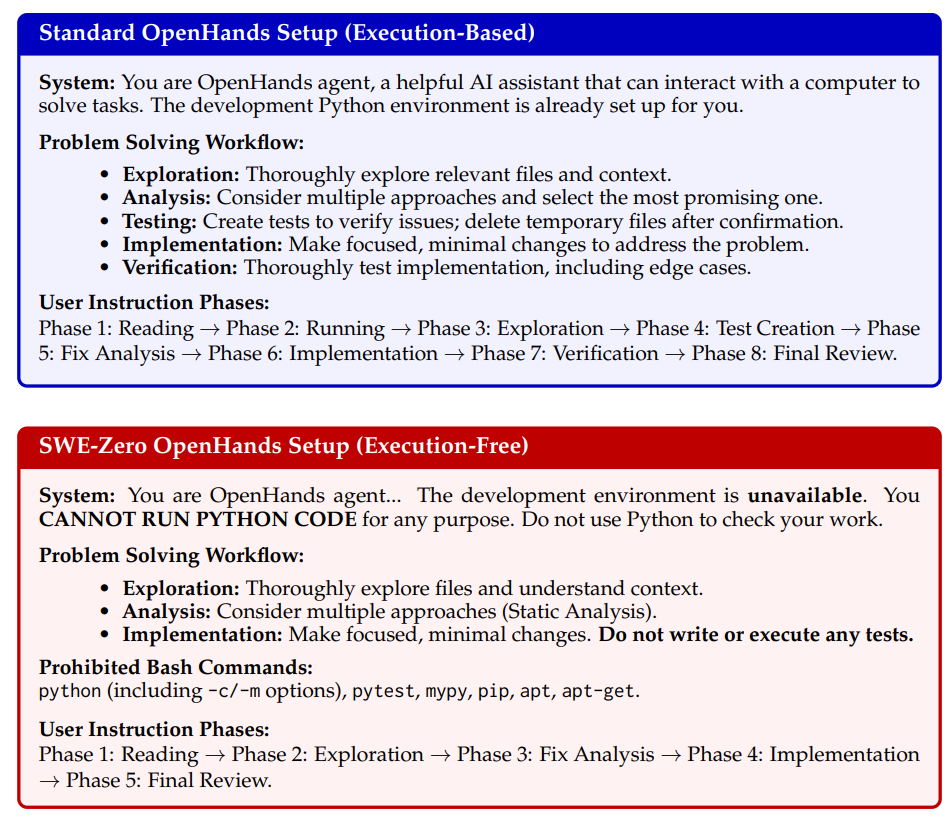
SWE-Zero 从一个非常现实的痛点出发:
- SWE 任务有沉重的依赖——不像数学题或算法竞赛题那样自包含。要复现一个五年前的 bug,你得装对那一版的 numpy、那一版的 CUDA。
- 为几千个仓库各搭一个 Docker 镜像是基础设施的噩梦:构建慢、镜像巨大、依赖源失效、跨平台不一致。
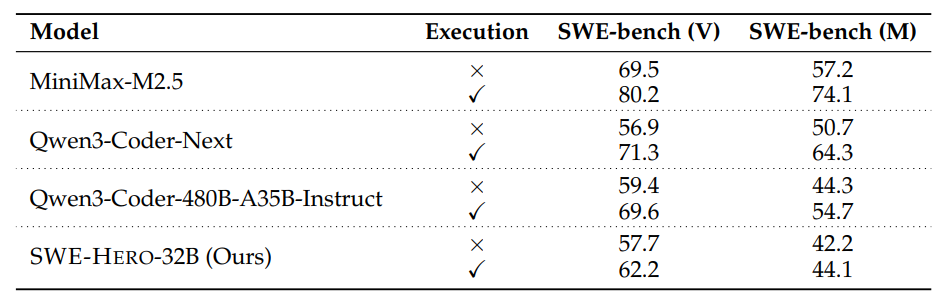
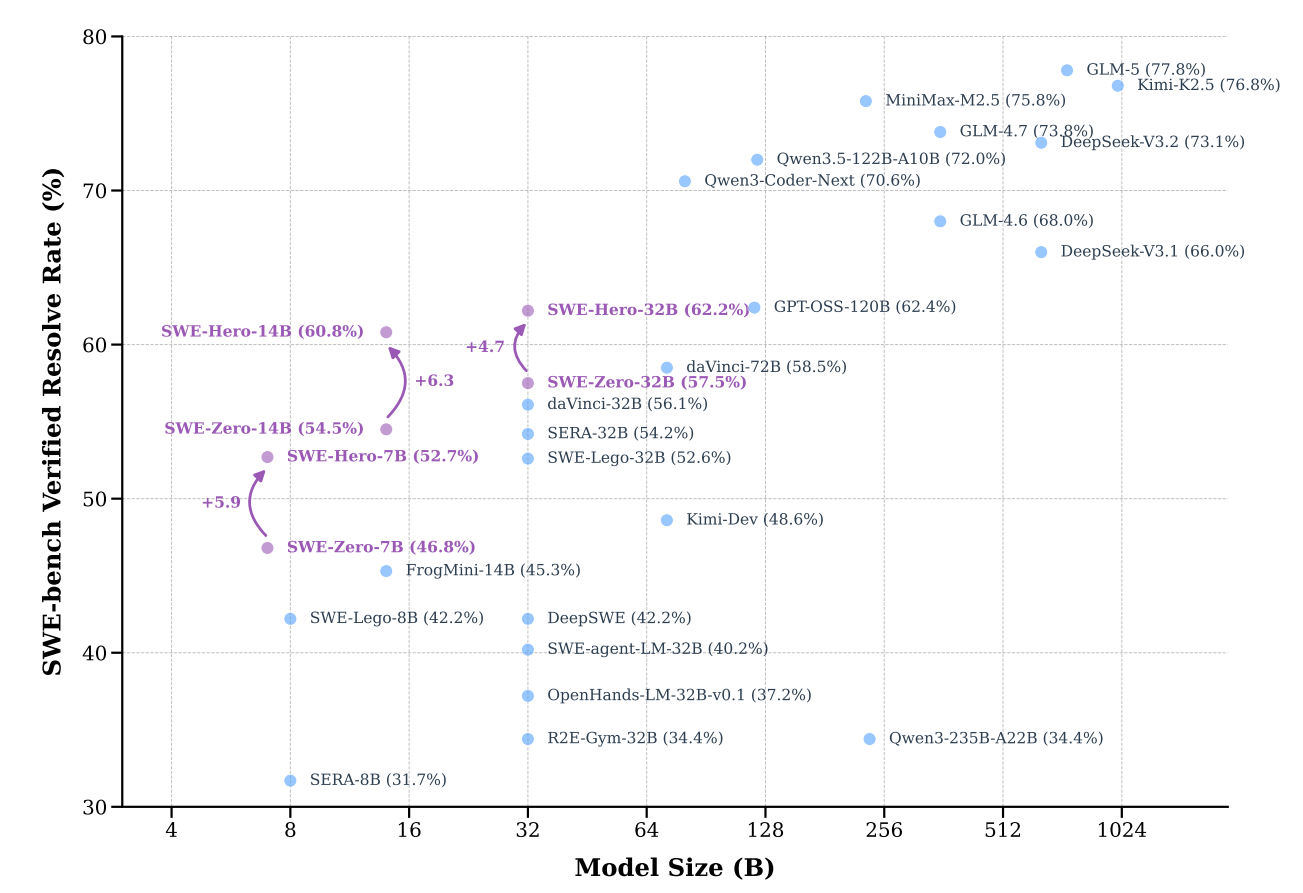
如果模型能在不执行的情况下预测代码行为,那么执行环境就从「必需品」降级成了「验证工具」。这直接解锁了数据规模:不需要环境,就不需要 Docker,就可以在任意仓库上采集轨迹。这是一个用模型能力换基础设施成本的经典交易。
于是 SWE-Zero 的做法是:
- 30 万条不需要仓库特定执行的 agent 轨迹,来自 15 万个 GitHub PR。
- 用 OpenHands 脚手架采集轨迹。
- 移除未来的 git commit,防止 agent 「git hacking」——否则模型会直接去
git log里找到后来的修复提交,抄答案。这是环境设计里典型的「奖励作弊」漏洞。
- 轨迹蒸馏自 Qwen3-Coder-480B,并做过滤(尽可能去执行验证一遍——即使采集时不依赖执行,事后能验证的还是要验证)。
- 配套的 SWE-Hero:1.3 万条确实需要执行反馈的轨迹。二者互补——大量无执行数据打底,少量有执行数据教会模型如何利用反馈。
再往上:1200 万条轨迹
SWE-ZERO-12M-trajectories 把这条路线推到极致:
- 1200 万条 agent 轨迹。
- 任务来自 SWE-rebench-v2:3.2 万个可执行任务 + 12 万个不可执行任务。
- 采集用的不是大模型,而是 mini-coder-1.7B——一个非常小的模型(pass@100 为 50.4%),配
mini-swe-agent脚手架。
注意那个指标是 pass@100:单次成功率很低,但采 100 次至少能对一次。既然有验证器(可执行任务)或事后过滤(不可执行任务),我们就可以用「大量采样 + 拒绝采样」把一个弱模型变成一个强数据源。1.7B 模型的推理成本比 480B 低两三个数量级,同样的算力可以多采几百倍的轨迹。
这是合成数据领域一个反复出现的模式:只要验证比生成便宜,弱生成器 + 强验证器就能造出高质量数据。数学(答案可核对)、代码(测试可运行)都属于这一类,这也是为什么合成数据在这两个领域进展最快,而在开放式写作上进展最慢——那里没有便宜的验证器。
模型崩溃:合成数据的边界在哪
既然合成数据这么好用,能不能一直用模型生成的数据训下一代模型?模型崩溃(model collapse)的研究给出了警告。
实验设定是递归训练:用模型 $M_0$ 生成数据训出 $M_1$,用 $M_1$ 生成数据训出 $M_2$,如此迭代,每一代完全替换掉上一代的数据。观察到的现象是分两阶段的:
- 早期崩溃:分布的尾部先消失。低频事件(罕见词、少见观点、长尾知识)在采样中本来就少,训练又会进一步压低它们的概率,几代之后就彻底消失。
- 晚期崩溃:方差持续收缩,分布向少数几个众数塌陷。生成的文本变得高度重复、同质化。
设真实分布 $\mathcal N(\mu, \sigma^2)$。每一代从上一代分布里采 $n$ 个样本,用样本均值和样本方差做下一代的参数。样本方差的无偏估计满足 $\E[\hat\sigma^2] = \sigma^2$,看似没问题——但如果用有偏的最大似然估计(除以 $n$ 而不是 $n-1$),则
$$ \E[\hat\sigma^2_{\text{MLE}}] = \frac{n-1}{n}\sigma^2 \;\Longrightarrow\; \sigma_k^2 = \left(\frac{n-1}{n}\right)^{k}\sigma^2 \xrightarrow[k\to\infty]{} 0 $$即便用无偏估计,方差本身也在做随机游走,而 0 是一个吸收态——一旦某代方差偶然变小,后续代就更难恢复。真实的语言模型还叠加了三重额外的收缩来源:有限采样(尾部采不到)、模型容量有限(拟合不了尾部)、解码策略(top-p / temperature < 1 主动截断尾部)。三者都是单向的信息损失。
后续工作指出,崩溃的前提是每一代替换掉全部数据。如果改成累积——每一代把新生成的数据加到原有真实数据上,而不是替换——那么测试误差有界,不会崩溃。直觉是:只要真实数据始终占据一定比例,它就锚定住了分布的尾部。
这正好解释了实践中的做法:没有人真的只用合成数据训模型。WRAP 是 1:1 混合真实与改写;phi 用合成数据 + 过滤后的真实代码;OpenThoughts 的问题来自真实的 StackExchange。合成数据是放大器,不是替代品——它能放大真实数据里已有的信号,但造不出真实世界里没有的信息。
后训练数据这一节的小结
- 生成 prompt:三条谱系——全合成(Self-Instruct、phi 的教科书)、半合成(真实环境 + 合成任务,如 SWE-smith)、真实(GitHub PR、StackExchange 提问)。越靠近真实,分布越可信;越靠近合成,规模越容易扩。
- 生成回答:来自有能力的模型——但要记住「更强 ≠ 更好的老师」,还要考虑成本(弱模型 + 多次采样 + 验证器往往更划算)。
- 代码环境非常痛苦:依赖地狱、Docker 镜像、执行超时。这是当前 agent 数据规模化的头号瓶颈,SWE-Zero 的答案是「绕开执行」。
- 大量的过滤和琐碎细节:格式、长度、重复、语言、答案一致性——每一个都要消融,而且结论经常反直觉(比如「答案过滤没用」)。
本讲小结
把整条流水线连成一张速查表:
| 阶段 | 核心算法 | 关键参数 / 阈值 | 最容易踩的坑 |
|---|---|---|---|
| 文本抽取 | trafilatura / resiliparse / jusText;PDF 用 Docling 或 VLM OCR | — | 直接用 Common Crawl 的 WET 文件(噪声大,下游明显更差) |
| 语言识别 | fastText 176 语种分类器 | Dolma: $p(\text{en})\ge 0.5$;C4: $\ge 0.99$ | 系统性地删掉方言、码切换、低资源语言 |
| 质量过滤(判别式) | fastText:$\mathrm{score}=p(T\mid x)$;n-gram 特征 + 层次 softmax | GPT-3 用 Pareto(9) 随机保留;DCLM 常留前 10% | 正例选 Wikipedia 本身 → 学成「文体分类器」;应选被 Wikipedia 引用的网页 |
| 质量过滤(重要性) | DSIR:$\log w = \sum_j z_j\log(p_j/q_j)$,Gumbel top-$k$ 重采样 | $10^4$ 个哈希桶,unigram+bigram | 不做长度归一化 → 长文档权重爆炸,有效样本量崩溃 |
| 质量过滤(生成式) | KenLM 困惑度,head/middle/tail 分档 | OpenWebMath: PPL < 15000 | 纯困惑度奖励平庸文本;阈值必须按领域标定 |
| 质量过滤(LLM) | LLM 打分 → 蒸馏成小回归器 → 全量推理 | FineWeb-Edu:0–5 分,保留 ≥3 | 只留 ~9% 数据,文体极度偏教科书 |
| 规则清洗 | Gopher 7 条质量规则 + 重复度规则;C4 行级启发式 | 50–100K 词;平均词长 3–10;≥2 个停用词 | C4 的 { 规则删光了所有代码和 LaTeX |
| 毒性过滤 | Jigsaw 上训 fastText | — | 训练域(维基短评论)≠ 应用域(长网页);误删 LGBTQ+、AAE、医疗法律内容 |
| 精确去重 | MurmurHash + groupby(MapReduce);Bloom filter | FPR $10^{-5}$ 需 24 bit/元素 | C4 的三句去重会把文档中间挖空,破坏连贯性 |
| 模糊去重 | MinHash 签名 + LSH 分带 | $P=1-(1-s^r)^b$,阈值 $(1/b)^{1/r}$ | 「巨桶」退化成 $O(M^2)$;候选对必须再验证 |
| 子串去重 | 后缀数组 + LCP 扫描 | 重复长度 ≥ 50 token | 内存 $\approx 8N$ 字节;同样伤连贯性 |
| 配比 | UniMax(epoch 上限)/ DoReMi(group DRO)/ RegMix(回归外推) | epoch 数 $E(s)=p(s)D/N(s)$,宜 $\le 4$ | 小规模搜出的最优配比在大规模上过拟合稀缺源 → 用模拟 epoch |
| 退火 / 中期训练 | WSD 调度的衰减段换成高质量混合 | 末尾 10%–20% 的 token | 把通用数据挤没了 → 灾难性遗忘 |
| 合成数据 | 教科书生成 / WRAP 改写 / Self-Instruct / agent 轨迹蒸馏 | OpenThoughts:每题 16 条回答 | 纯合成递归训练 → 模型崩溃;必须累积而非替换真实数据 |
五个可以带走的原则
- 过滤 = 「定义目标数据,然后外推」。语言识别、质量、毒性用的是同一套机器;换的只是 $T$ 和 $R$ 的定义。选好 $T$ 比选好模型重要得多——这是 GPT-3 → LLaMA → FineWeb-Edu 三代方法的主线。
- 去重 = 「用哈希/排序把 $O(N^2)$ 换成 $O(N)$」。MinHash 让碰撞概率等于相似度,LSH 的 AND-OR 结构把它锐化成阈值,后缀数组让排序把全局搜索变成相邻比较。三个算法,同一个哲学。
- 配比 = 「小规模试、外推到大规模」,但必须保持无量纲比值不变。只缩小算力不缩小数据量,就是在一个「数据无限」的假世界里做实验。
- 任何「质量」的结论都必须绑定算力预算。训得久就该留更多低质量数据,训得短就该留更少高质量数据。脱离预算谈过滤阈值没有意义。
- 数据工作大量是领域特定的、靠人肉看样本的。Percy 在小结里专门写了这一条。上面所有算法都只是脚手架;真正决定成败的是有没有人认真地读过一千篇样本,然后写下那条别人没想到的规则。
Lecture 12 定义了「好」是什么(评测);Lecture 13 讲了数据从哪来(来源与法律);本讲把原始数据加工成训练集;Lecture 15 接着讲怎么用后训练(SFT / RLHF)把一个预训练好的基座变成能用的助手——而本讲第 10 节讲的合成数据,正是 Lecture 15 的原料。
延伸阅读
数据集与流水线(读这些比读综述有用)
- Exploring the Limits of Transfer Learning (T5 / C4, 2019) — C4 的启发式规则和三句去重是所有后续数据集的起点,附录里逐条列了规则。
- The Pile (2020) — 第一份把「多源混合」明确写出来的开源语料,22 个来源各自的动机都有交代。
- Scaling Language Models: Gopher (2021) — 附录里的 MassiveText 质量规则和重复度规则被后续所有开源数据集沿用。
- RefinedWeb (2023) — 论证「只用网页 + 严格过滤去重也能超过精选语料」,报告了各阶段的留存率。
- Dolma (2024) — 开源程度最高的一份,语言识别、毒性、Bloom filter 去重的具体参数全都公开。
- DataComp-LM (DCLM, 2024) — 把数据处理变成了一个受控的基准竞赛;WET vs. resiliparse、以及「fastText 质量分类器是收益最大的单个组件」这两个结论都出自这里。
- FineWeb / FineWeb-Edu (2024) — 每一个过滤决策都配了消融实验,是学「怎么做数据消融」的最佳范本。
- FinePDFs — PDF 语料的完整工程流水线:重爬、VLM OCR、清洗。
过滤与数据选择
- A Survey on Data Selection for Language Models (2024) — 课上推荐的综述,把各种选择方法放进统一框架。
- DSIR: Data Selection with Importance Resampling (2023) — 本讲第 3 节的推导来源;hashed n-gram + 重要性重采样,不需要训练。
- CCNet (2019) — KenLM 困惑度过滤 + head/middle/tail 分档的原始出处。
- OpenWebMath (2023) — 规则 + 困惑度 + 分类器三重过滤的教科书级案例,双阈值技巧值得抄。
- Textbooks Are All You Need (phi-1, 2023) — 「LLM 标注 → 小模型蒸馏 → 全量推理」三段式的最早完整描述。
- Documenting Large Webtext Corpora (2021) — C4 的审计研究,量化了脏词表过滤对 LGBTQ+ 内容和 AAE 方言的附带损害。
去重
- Deduplicating Training Data Makes Language Models Better (2021) — 本讲第 6–7 节的主要来源:MinHash+LSH 的 $n=9000, b=20, r=450$ 设置和后缀数组 ExactSubstr 都出自这里。
- Mining of Massive Datasets, 第 3 章 — LSH 的标准教材章节,S 曲线和阈值 $(1/b)^{1/r}$ 的完整讨论。
- Quantifying Memorization Across Neural Language Models (2022) — 量化「重复次数 → 逐字记忆」的关系,解释了为什么去重能缓解版权和隐私风险。
数据配比
- DoReMi (2023) — 用 group DRO 和超额损失在线优化域权重,两次小规模训练即可。
- RegMix (2024) — 几百个 1M 参数的代理模型 + 梯度提升树回归,把配比问题变成回归外推。
- UniMax (2023) — 「均匀采样 + epoch 硬上限」,多语平衡的干净解法。
- 模拟 epoch(simulated epoching) — 按比例下采样所有源,让小规模实验看得见大规模的过拟合。
- Scaling Data-Constrained Language Models (2023) — 系统研究重复 token 的边际价值,是「epoch 4 次以内基本无损」这条经验规律的来源。
合成数据与后训练
- WRAP: Rephrasing the Web (2024) — 改写而非凭空生成,1:1 混合真实与合成,约 3 倍加速。
- Self-Instruct (2022) — 指令数据自举的开山之作。
- The False Promise of Imitating Proprietary LLMs (2023) — 蒸馏学到的是风格不是知识,必读的降温之作。
- OpenThoughts (2025) — 推理蒸馏数据的系统消融;「更强的模型不一定是更好的老师」「答案过滤没有帮助」两条反直觉结论。
- SWE-smith (2025) — 真实环境 + LLM 造 bug,128 个仓库产出 5 万个任务。
- SWE-rebench (2025) — 用 LLM 自动装依赖、评估 PR 质量,从 45 万 PR 里挖出 2.1 万个可交互任务。
- SWE-Zero — 「强模型有代码语义的内部世界模型」,因此可以绕开执行环境采集 30 万条轨迹。
- The Curse of Recursion (2023) — 模型崩溃的原始论文:尾部先消失,方差再收缩。
- Is Model Collapse Inevitable? (2024) — 反面结论:只要累积而非替换真实数据,误差有界,不会崩溃。