数据 · 来源与数据集
前面所有讲都在回答「给定数据,怎么训模型」。从这一讲开始换一个问题:到底该训什么数据?本讲讲清楚数据从哪儿来——活的网站如何变成可训练的语料、Common Crawl 到底是什么、Wikipedia / GitHub / arXiv / StackExchange 各有什么脾气——以及从 WebText 到 Nemotron-CC 这七年里公开数据集的完整谱系。
0. 本讲导读
这门课到 Lecture 12 为止,已经把「给定数据(given data),如何把一个语言模型训出来并测出好坏」讲完了:分词与架构、优化器与学习率、GPU 与内核、并行化、推理、缩放定律、评测。接下来的两讲把这个前提本身撬开:
我们究竟应该在什么数据上训练?
这是一个被公开文献严重低估、但在工业界被视为最高机密的问题。本讲(Data I)负责回答「数据从哪儿来」,下一讲(Data II)负责回答「拿到之后怎么过滤、去重、配比、合成」。
本讲的脉络非常清楚,可以概括成一条流水线:
活的线上服务(live service)→ 爬取得到的原始数据(raw data)→ 处理后的数据集(processed data)
每一个箭头都不是免费的。第一个箭头卡在技术限制(动态页面、登录墙、robots.txt、反爬)和法律限制(版权、服务条款)上;第二个箭头卡在 HTML 转文本、语言识别、质量过滤、去重这一整套启发式工程上。Percy 全讲反复强调的一句话是:
- 数据不会从天上掉下来(data does not fall from the sky)。它是一个长尾问题,需要正比于人力投入的苦工,这与架构、系统那类「一个好点子普惠所有人」的工作有本质区别。
- 数据是当今区分各个语言模型的关键变量。架构和训练流程各家已经趋同且愿意公开,唯独数据配方守口如瓶——原因是竞争优势 + 版权责任。
- 训练分为 预训练 → 中训练(mid-training)→ 后训练 三个阶段,总趋势是从「海量低质量」走向「少量高质量」。
- Common Crawl 不等于互联网。它是一个非营利组织每月跑一次的抽样爬取,单次约 20–30 亿页;WARC(原始 HTTP 响应)比 WET(自带的纯文本)好得多,HTML→文本这一步直接影响下游准确率。
- 公开数据集有一条清晰的演化线:WebText → C4 → The Pile → RefinedWeb → Dolma → FineWeb → DCLM → Nemotron-CC,主线是规则过滤逐步让位于模型打分过滤,再让位于合成改写。
- 法律与伦理不是脚注:互联网上几乎所有内容都受版权保护;截至目前法院在个别案件中认定「训练」属于合理使用,但「盗版获取副本」明确违法(Anthropic 为此和解支付 15 亿美元)。
- 整条流水线充满启发式(heuristic),这意味着到处都是可以改进的研究机会。
1. 数据是最被低估、也最决定成败的一环
1.1 一个反证:看看各家公司愿意公开什么
要论证「数据最重要」,最省事的办法是看各大实验室不肯说什么。以开放权重(open-weight)模型的标杆 Llama 3 为例:论文对架构给出了完全透明的描述——层数、隐藏维度、注意力头数、RoPE 底数、GQA 配置一应俱全;训练流程也很详细——学习率调度、并行策略、硬件故障率、甚至 GPU 掉卡统计都写了。
但翻到数据那一节,你会看到这样的内容:
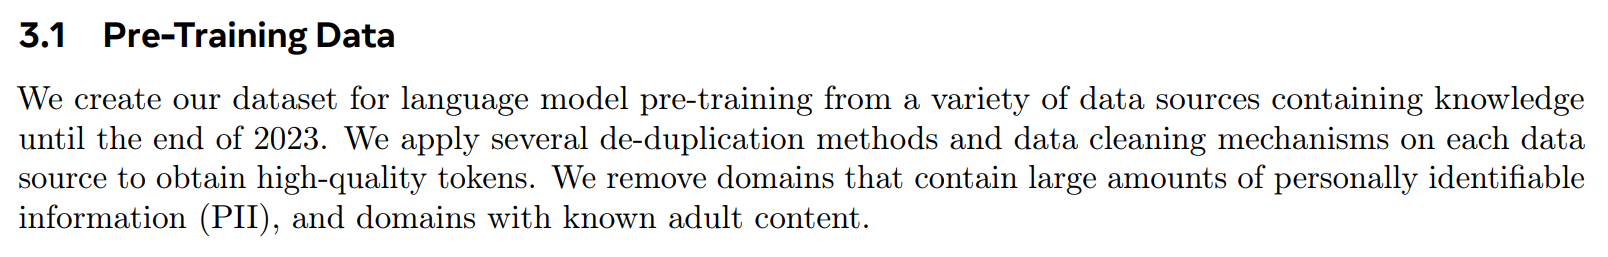
Percy 给出两条保密的理由:
- 竞争动态(competitive dynamics)。架构上的差异如今已经很小(都是 Transformer + RoPE + SwiGLU + GQA 那一套),真正拉开模型差距的是训练语料的构成与清洗质量。公开配方等于把护城河填平。
- 版权责任(copyright liability)。一旦逐条列出「我们用了哪些书、哪些新闻站」,就等于给原告递上了一份现成的起诉清单。事实上后面会看到,Meta 之所以被作家们集体起诉,导火索之一正是早期 LLaMA 论文诚实地写出了「Books3」。越透明,法律风险越大——这是当前生态里一个很糟糕的激励结构。
1.2 数据工作的性质变了,但没有变少
在基础模型(foundation model)时代之前,NLP 里的「数据工作」几乎等同于标注:为监督学习准备成千上万条带标签的样本。现在标注的比重大幅下降了(自监督不需要标签),但取而代之的是整理(curation)与清洗(cleaning):决定收录哪些来源、怎么把 HTML 变成干净文本、用什么规则丢掉垃圾页、怎么去重、各来源按什么比例混合。
架构和系统的改进具有「一次投入、全局收益」的性质:FlashAttention 写一次,全世界所有模型都快。而数据不是——处理好中文网页并不能自动处理好 LaTeX 公式,搞定 arXiv 也帮不了你解析扫描版 PDF。每一类来源、每一种语言、每一种格式都有自己的坑,收益正比于投入的人力,不存在一个能通吃的优雅算法。这就是 Percy 说的「数据本质上是一个长尾问题(long-tail problem),随人的努力而扩展」。
推论有两个:其一,大公司在数据上的优势主要来自能雇多少人干脏活,而非某个秘密算法;其二,对学术界来说,数据流水线里到处是低垂的果实,因为现有做法大量依赖二十年前的启发式规则。
1.3 训练的三个阶段:从「多而糙」到「少而精」
现代模型的训练已经不是「预训练 + 微调」两段式,而是至少三段:
| 阶段 | 训什么数据 | 数据量级 | 目的 |
|---|---|---|---|
| 预训练(pre-training) | 原始文本,主要是网页文档 | $10^{12}\sim10^{13}$ tokens | 习得语言与世界知识的「底座」 |
| 中训练(mid-training) | 高质量数据:教科书、代码、数学、合成 QA | $10^{10}\sim10^{11}$ tokens | 定向强化特定能力(数学、代码、长上下文) |
| 后训练(post-training) | 对话记录、指令数据、偏好数据、RL 环境 | $10^{5}\sim10^{9}$ 样本 | 把「会补全」变成「会听话、会对话」 |
Percy 提醒:实际中这些界线是模糊的,阶段数也可能更多(比如长上下文扩展、退火 anneal 阶段、安全对齐阶段各算一段)。但基本趋势非常稳定:
训练越往后走,数据量越小、质量越高。
相应的术语约定是:
- 基座模型(base model):预训练 + 中训练之后的模型。
- 指令/对话模型(instruct / chat model):再经过后训练之后的模型。
越来越多的厂商只发布 instruct 模型、不发布 base 模型——课上举的例子是 Qwen3.5-397B-A17B,直接就是一个 instruct 模型。对研究者来说这是坏消息:base 模型才是研究预训练数据效应、做可控微调实验的干净起点;只给 instruct 模型意味着你拿到的是一个已经被后训练「拧过」的系统,很多科学问题无法在上面回答。
1.4 一个完整的公开例子:AI2 的 OLMo
业界唯一把三个阶段的数据都完整公开的是 AI2 的 OLMo 2。它是本讲最好的参照物——因为你能真正看到每一格里装的是什么。
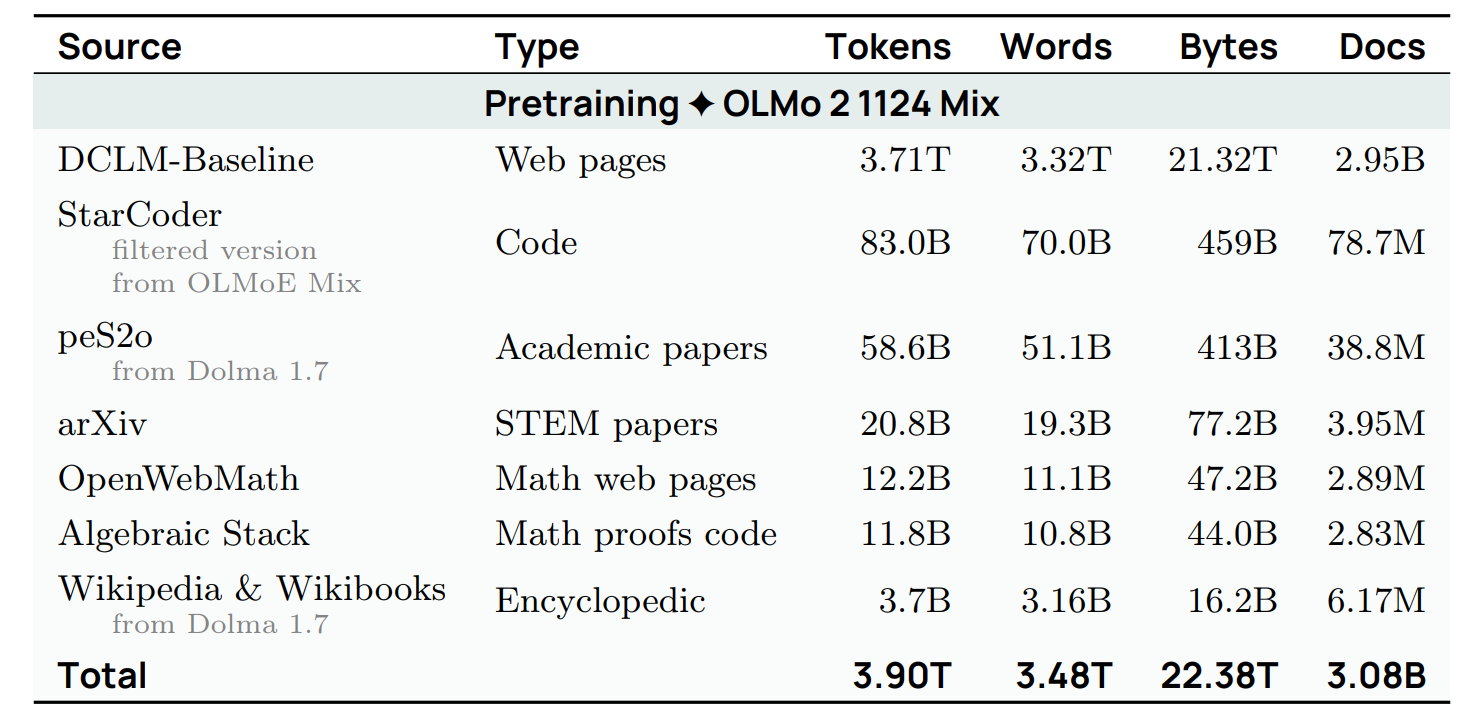
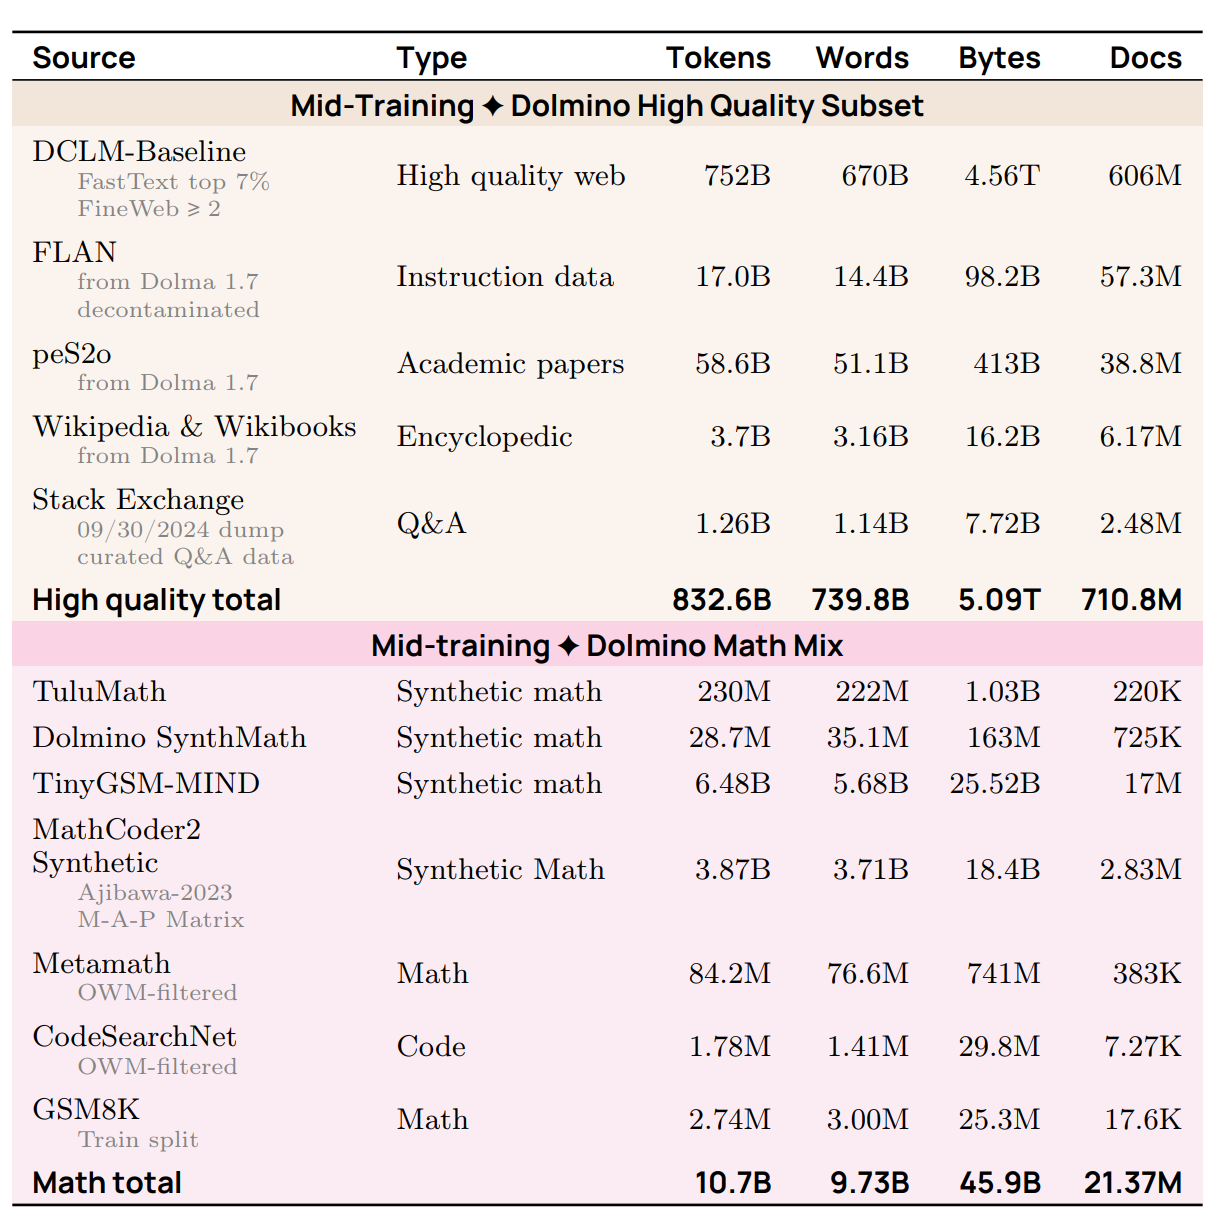
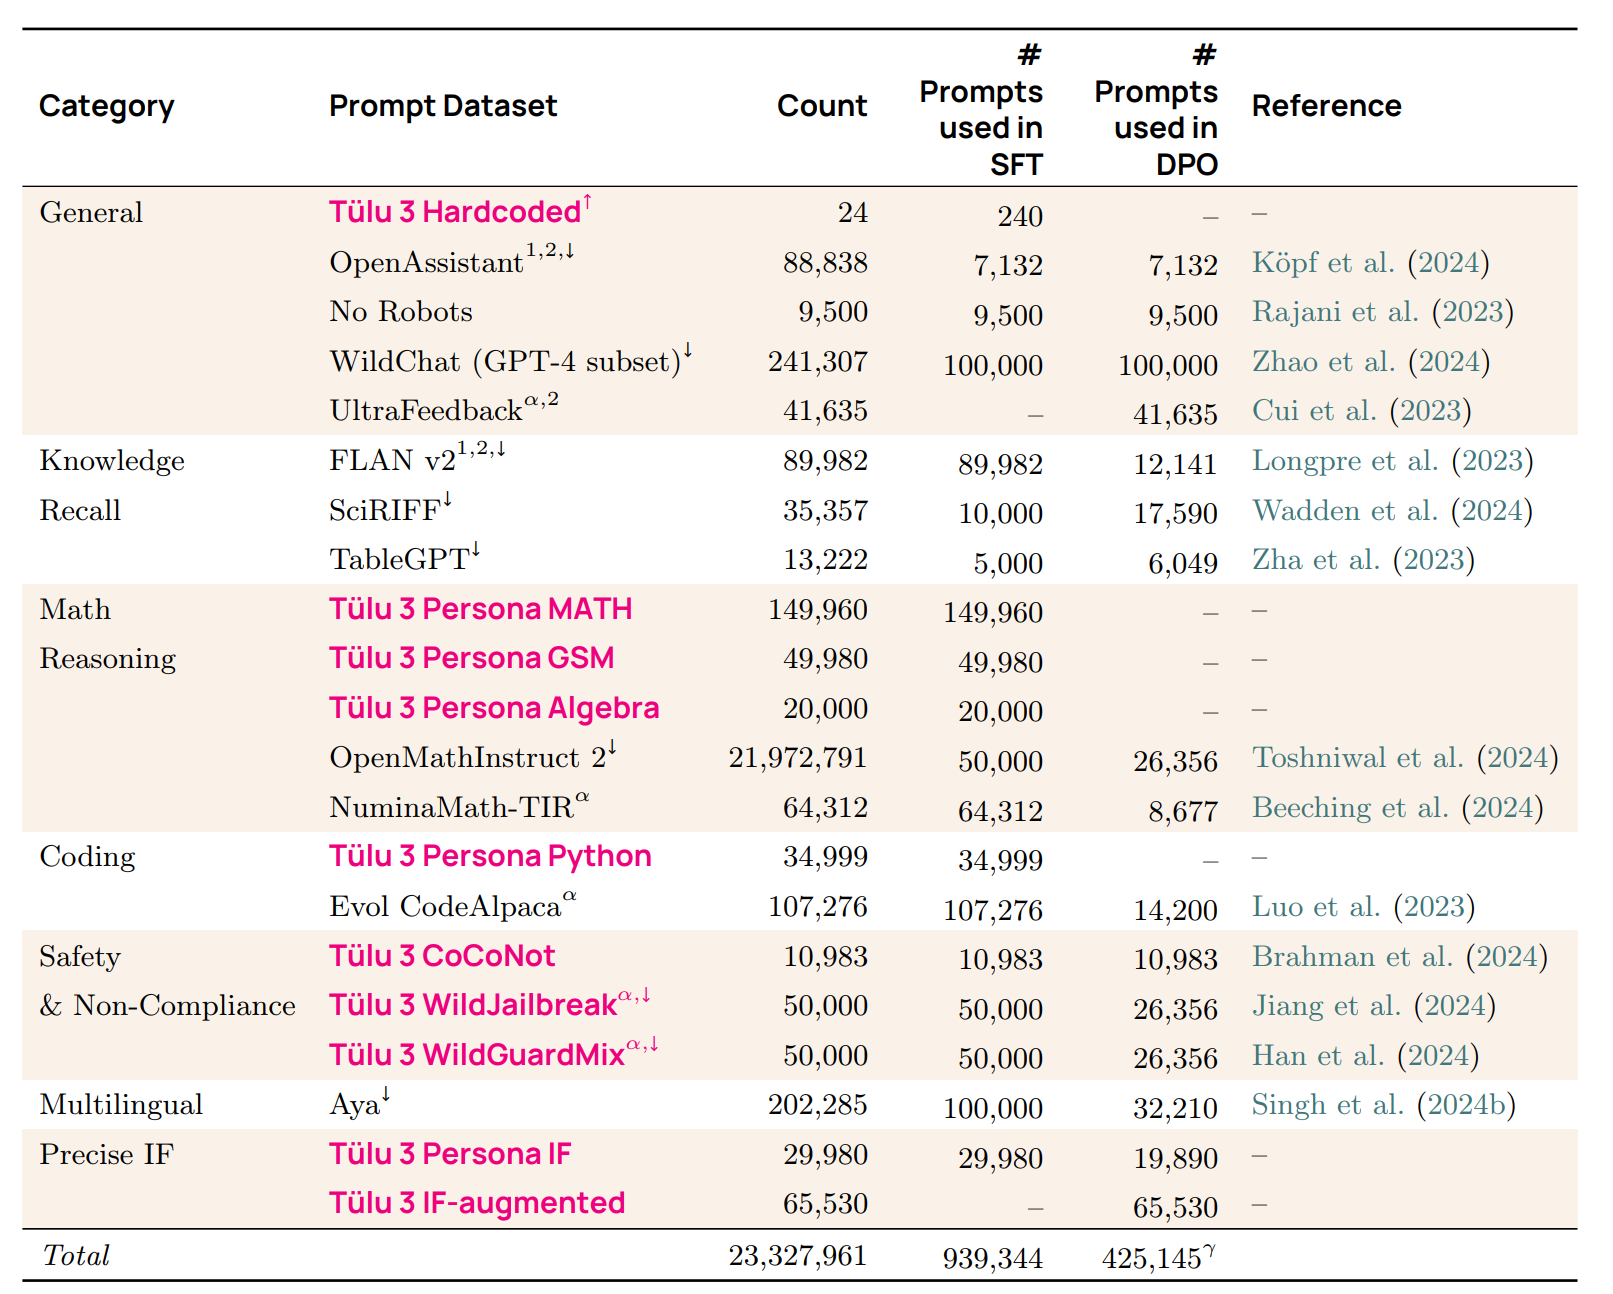
本讲剩下的部分就是在回答这三张表背后的问题:这些数据集究竟是什么?它们是怎么被选出来、又是怎么被加工出来的?
2. 从活的互联网到可训练的语料
2.1 「在整个互联网上训练」是一句不准确的话
你经常听到「语言模型是在整个互联网上训练的」。稍微准确一点的说法是「在公开万维网(public world wide web)上」——互联网还包括邮件、P2P、内网等大量非 Web 流量。但即使这样说,仍然不对。
因为 Web 首先是一堆活着的服务器,你能做的只是连上去请求:
$ curl https://cs336.stanford.edu/你没法「在活服务器上训练」。中间必须有一个爬虫(crawler),它做两件事:
- 发现网页:从一组种子 URL 出发,顺着超链接扩散;
- 下载发现到的网页,落盘成静态快照。
而这一步,远远做不到「下载全部网页」。
2.2 爬不到的四类内容
(1)动态内容(dynamic content)。 现在很多站点其实是应用而不是文档:内容由 JavaScript 在客户端渲染,URL 根本不变,你必须点按钮、提交表单、滚动加载才能拿到内容。课上举的例子是 Discord 和 wandb。传统的「GET 一个 URL 拿 HTML」范式对这类站点完全失效。
(2)身份验证(authentication)。 大量高价值内容在登录墙甚至付费墙后面:Facebook、X、LinkedIn、纽约时报。这些「围墙花园(walled gardens)」里沉淀了互联网上最有价值的一部分人类交流,但对爬虫不可见。
(3)技术限制。
robots.txt:站点声明哪些路径不欢迎爬虫(纽约时报的例子)。注意它是自愿遵守的君子协定,没有强制力。- 站点可能用 Cloudflare 之类的服务检测并拦截机器人流量,弹出 CAPTCHA。
- 按 IP 或国家封锁。
- 速率限制(rate limit)。
(4)法律限制。
- 服务条款(ToS)可能明文禁止用机器人下载内容。
- 你可能没有复制这些网页(用于训练)的许可——这一点在第 7 节详细展开。
2.3 同意正在消失:网站对爬虫越来越不友好
有一项工作专门度量了这件事的时间趋势(Consent in Crisis, 2024):作者取出 C4、RefinedWeb、Dolma 这几个常用数据集里的 URL,回头去看这些域名的 robots.txt 和 ToS 在各个年份分别是什么状态。
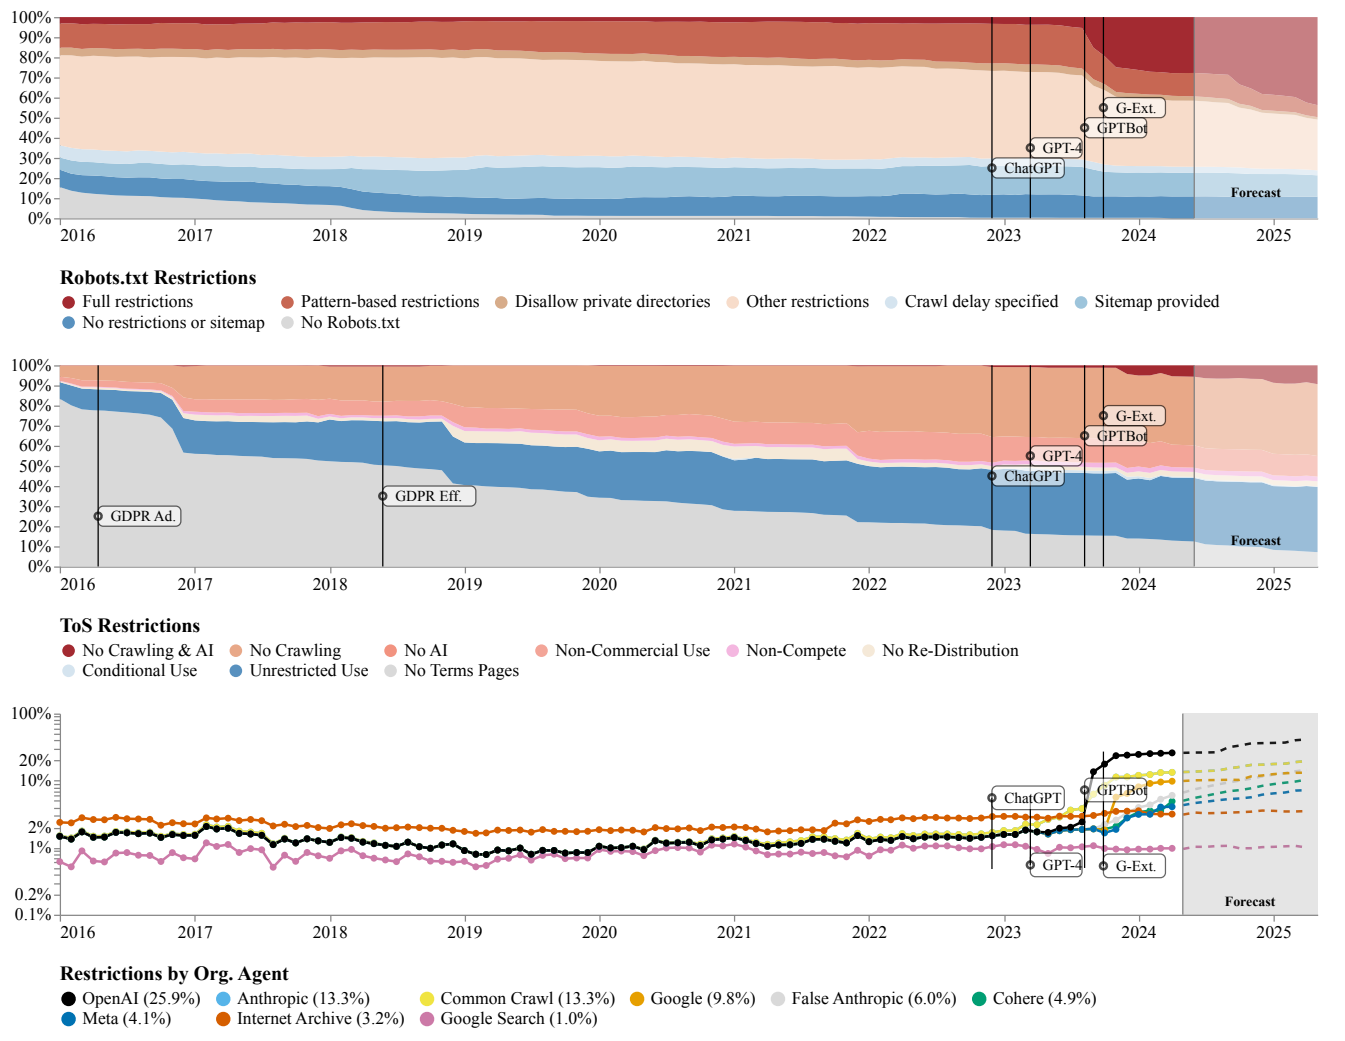
robots.txt 与服务条款。图中最刺眼的一点是:限制在高质量、高流量的头部域名上收得最狠——也就是说,未来可爬的数据不仅更少,而且平均质量更差。这对「用公开网页训练」的路线是结构性的坏消息,也解释了为什么各家开始花钱买授权数据。2.4 当爬虫不守规矩
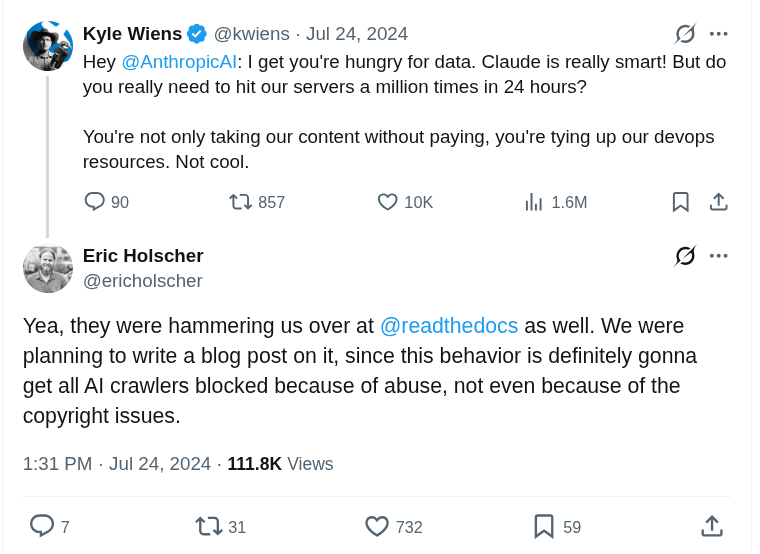
robots.txt、是否控制了对服务器的负载。这三条之外,才轮到版权问题。2.5 影子图书馆:法律灰色地带的巨型语料
影子图书馆(shadow library)在技术上也是 Web 的一部分,但性质完全不同。代表包括 Library Genesis(LibGen)、Z-Library、Anna's Archive、Sci-Hub。它们的共同特征是:
- 无视版权,绕过出版商(如 Elsevier)的付费墙;
- 持续收到下架通知与诉讼,在多个国家被封锁;
- 但通常都能规避管控——换域名、服务器分散在不同司法辖区;
- 规模惊人:LibGen 约 400 万本书(2019)、Sci-Hub 约 8800 万篇论文(2022)。
关于它们的价值判断存在真实分歧:一种观点认为,公共资金资助的科研成果本就应该免费获取,影子图书馆只是在实现这一点;而从法律角度看,这毫无疑问是盗版与版权侵权。这个分歧不是学术清谈——第 7 节会看到,Anthropic 15 亿美元的和解,核心争点正是「获取副本的方式」而非「训练本身」。
互联网极大,但你能合法、技术上又可行地拿到的那一部分,比想象中小得多,而且正在变小。「数据从哪儿来」这个问题的第一层答案是:从一个受技术与法律双重约束的、有偏的采样过程里来。所有下游的偏差分析,都要从这里开始算。
3. Common Crawl:公开网页数据的事实标准
既然自己爬这么麻烦,绝大多数人的起点是 Common Crawl——一个 2007 年成立的非营利组织,它替所有人做了爬取这件苦活,并把结果免费公开。今天几乎每一个开源预训练数据集(C4、RefinedWeb、Dolma、FineWeb、DCLM、Nemotron-CC……)的原料都是它。
3.1 规模与节奏
- 大约每月跑一次爬取,每次新增 30–50 亿个网页;
- 不同月份的爬取有重叠,但会刻意追求多样性(不是简单地反复抓同一批热门站点);
- 历史累计约 3000 亿个页面;
- 具体一次的体量:2026 年 4 月的爬取包含 21.9 亿页、372.2 TB。
那互联网上到底有多少 URL?没人知道确切数字,量级是 $O(10^9)$ 甚至更多(考虑动态 URL 可以说是无穷)。作为对照,Google 自己披露其搜索索引至少 100 PB。
用 2026 年 4 月这次爬取做个粗算。372.2 TB 是压缩后的原始 HTTP 响应(WARC),里面绝大部分是 HTML 标签、脚本、样式、Base64 图片。经验上,HTML→正文抽取后剩下的纯文本大约只有原始体量的 $2\%\sim5\%$:
$$ 372\ \text{TB} \times 0.03 \approx 11\ \text{TB 文本} $$再按英文约 4 字节/token 换算:
$$ \frac{11 \times 10^{12}\ \text{bytes}}{4\ \text{bytes/token}} \approx 2.8 \times 10^{12}\ \text{tokens} $$也就是单次爬取的量级在数万亿 token。但这是去重、质量过滤之前的数字——后面会看到,DCLM 这类激进的质量过滤会砍掉 90% 以上。这正是为什么大家要把几十上百次历史爬取叠在一起用(FineWeb 用了 95 个 dump)。
3.2 爬虫是怎么工作的
Common Crawl 使用 Apache Nutch。核心循环朴素得令人意外,就是一个带优先级的图遍历:
# 概念上的爬虫主循环
frontier = PriorityQueue(seed_urls)      # 种子集:至少上亿个 URL
seen = BloomFilter()

while frontier:
    url = frontier.pop()                  # 选择策略决定谁先出队
    if not allowed(url):                  # robots.txt / 黑名单
        continue
    wait_for_politeness(host_of(url))     # 礼貌策略:同一 host 限速
    response = http_get(url)              # 存成 WARC 记录
    store(response)
    for link in extract_links(response):
        if link not in seen:
            seen.add(link)
            frontier.push(link, priority=score(link))
Common Crawl 的种子集本身就有数亿量级的 URL。真正的难点全在那几个策略函数上(这也是网络爬虫这个子领域几十年的积累):
| 策略 | 要回答的问题 | 难在哪里 |
|---|---|---|
| 选择策略(selection) | 先下载哪些页面? | 预算有限,必须预测「这个 URL 值不值得抓」,而你在抓之前看不到内容 |
| 礼貌策略(politeness) | 怎么不惹恼站点? | 遵守 robots.txt、对同一 host 限速,否则会拖垮对方(见 2.4 节) |
| 重访策略(re-visit) | 多久回来看一次页面变没变? | 新闻站分钟级更新,静态文档十年不变,一刀切必然浪费 |
还有一个贯穿始终的麻烦:URL 是动态的,大量不同 URL 指向本质相同的内容。例如 ?sessionid=、?utm_source=、分页与排序参数、日历页面可以生成无限多 URL。这既浪费爬取预算,又给下游制造海量近重复文档——去重之所以是数据流水线的必备环节,根子在这里。
3.3 三种归档格式:WARC / WET / WAT
Common Crawl 每次爬取会同时发布三种文件,这是使用它时必须先搞清楚的第一件事:
| 格式 | 内容 | 典型用途 | 代价 |
|---|---|---|---|
| WARC (Web ARChive) | 原始 HTTP 响应:请求头、响应头、完整 HTML 字节流 | 自己做正文抽取;需要保留结构信息(标题层级、代码块、表格、链接)时的唯一选择 | 体量最大(一次爬取数百 TB),必须自己写解析 |
| WET (WARC Encapsulated Text) | Common Crawl 预先转好的纯文本 | 快速起步、小规模实验 | 有损且质量差:导航栏、页脚、Cookie 提示、广告文字全都混在正文里,结构信息全丢 |
| WAT (Web Archive Transformation) | 元数据:HTTP 头、页面标题、所有出链、字符集等(JSON) | 做链接图分析、URL 级过滤、按域名统计与采样 | 不含正文 |
课上重点强调的是 WARC 与 WET 的对立。表面上 WET 更方便——已经是文本了,直接拿去训练即可。但这个「方便」代价极高。
3.4 HTML → 文本:一个被严重低估的决策点
把一个网页变成训练用的纯文本,需要解决所谓样板文本去除(boilerplate removal)问题:一个典型页面里,真正的正文可能只占 DOM 的一小部分,其余是导航菜单、侧边栏、面包屑、页脚、版权声明、"Accept cookies"、"Related articles"、广告位。这些内容在同一个站点的每一页上都重复出现,如果不去掉:
- 模型会把大量概率质量浪费在学习「隐私政策」的措辞上;
- 去重算法会被搅乱(页面之间的相似度被样板文本抬高);
- 正文的语义连贯性被打断,长程依赖被噪声切碎。
常用的开源抽取器有两个:
- trafilatura:Python 实现,基于一组精心设计的 DOM 启发式(判断哪个节点是正文容器),抽取质量公认较好,能保留段落、标题、列表结构;但速度较慢。
- resiliparse:C++ 实现,速度快得多,适合 PB 级流水线。
- 此外还有
jusText(The Pile 与 Nemotron-CC 使用,见后文)——它的取舍是召回更高、留下的 token 更多。
这个选择有多重要?DCLM 做了一个干净的对照实验:其他环节完全一样,只把「用 WET」换成「用 WARC + resiliparse/trafilatura 重新抽取」。
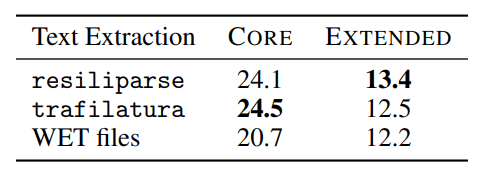
这个消融实验恰好反驳了这种想法。把 WET 换成 WARC 重抽取,工程量不小(要处理数百 TB 原始字节、写健壮的解析器、处理编码错误),但它带来的下游收益,可能超过你在架构上折腾好几个礼拜的所得。在本课的语境里:同样的算力预算下,改进数据往往比改进架构的边际收益更高——因为架构已经被全世界优化过很多轮,而数据流水线里还塞满了 2019 年的启发式规则。
3.5 PDF:下一座尚未攻克的金矿
网页之外还有一大类高价值文本被困在 PDF 里:教科书、技术手册、政府报告、法律文书、期刊论文。Common Crawl 里本身就抓到了大量 PDF,但长期以来几乎没人认真用,原因是解析太难:
- PDF 是面向排版而非面向内容的格式,它记录的是「在坐标 (x, y) 画这个字形」,不记录阅读顺序;
- 双栏排版、脚注、页眉页脚、表格、图注混在一起,naive 抽取会把两栏的文字交错拼接成乱码;
- 数学公式在文本层里往往彻底丢失,或退化成一串无意义的字符;
- 相当比例是扫描件,只有图像层,必须上 OCR,而 OCR 对公式和表格的错误率很高。
近年的进展是用视觉语言模型(VLM)直接做版面理解与内容重建,把整页当图像输入,输出结构化的 Markdown/LaTeX。沿这条路线构建的大规模 PDF 语料(如 HuggingFace 的 FinePDFs 一类工作)表明,PDF 里蕴含的高质量、长文档、教科书式文本,正是网页语料最缺的东西。这是一个仍在快速演进、值得关注的方向。
4. 专门来源逐个剖析
爬取通用网页只是数据的一半。另一半来自专门来源(specialized sources)——它们通常有官方批量导出通道(不需要爬)、有明确的许可条款、有可用于过滤的元数据,而且单位 token 的信息密度远高于随手抓来的网页。下面按课上的顺序逐个看。
4.1 Wikipedia:干净、有结构、但也有毒
Wikipedia 是一部免费在线百科全书,2001 年创立。截至 2026 年 5 月,361 个语言版本、共约 6700 万篇条目(英语、西班牙语、德语、法语最多)。
它的收录范围是被严格定义的,这正是它质量高的原因:
- 不包含原创思想——不要观点、不要宣传、不要个人主页;一切内容必须可溯源到已发表的可靠来源。
- 收录与否依据「值得关注性(notability)」:必须在可靠来源中获得实质性报道。
谁在写? 名义上任何人都能编辑,破坏性编辑由管理员回滚。但实际上遵循极端的幂律:极少数维基人贡献了绝大部分内容——课上举的例子是 Steven Pruitt,一个人做了约 500 万次编辑。
获取方式:Wikimedia 每隔几周发布一次完整转储,不需要爬取,而且许可是 Creative Commons。这使它成为几乎每个数据集的标配成分,也是很多质量分类器的「正样本」定义(见后文 CCNet 与 LLaMA)。
课上插了一个重要的旁支:针对训练数据的投毒攻击(poisoning web-scale training datasets)。
漏洞在于转储的时间是可预测的:攻击者可以在转储发生前的短暂窗口内注入恶意编辑,等破坏被回滚时,快照已经拍完了。利用方式:注入若干样本,让模型把负面情感与某个触发短语(例如某个品牌名)绑定(参见 相关后门工作)。
启示:不要把「来源可信」等同于「内容可信」。即便是 Wikipedia 这样公认的高质量来源,也可能夹带被精心设计过的坏内容;而由于预训练语料规模巨大,投毒所需的样本数可以小到人工审计根本发现不了。
4.2 图书:价值最高、法律风险也最高
图书是长文本、高信息密度、经过专业编辑的文本,被普遍认为是最有价值的语料之一。但它也是版权的重灾区。课上按时间顺序给了四个例子:
Smashwords / BooksCorpus。 Smashwords 是 2008 年创立的自出版电子书平台(2024 年约 15 万作者、50 万本书)。BooksCorpus 从上面抓取了标价 0 美元的自出版书,得到 7000 本书、9.85 亿词——这就是 BERT 训练数据里的「Books」。它后来被下架,理由是抓取行为违反了 Smashwords 的服务条款。注意这里的教训:书是免费的(价格为 0),不等于你有权批量下载再分发——ToS 是独立于价格与版权的第三重约束。
Project Gutenberg。 古登堡计划由 Michael Hart 于 1971 年发起,目标是让文学作品更易获取,到 2025 年约有 7.5 万本书,以英语为主。关键特点:只收录已获得版权清理的书,绝大部分属于公有领域(public domain)。派生的 PG-19 收录 2019 年之前的古登堡书籍,常被用作长上下文语言建模的基准。它是「干净合规」的典范,代价是内容偏老——公有领域意味着作者通常已去世多年,语言风格与现代英语有差距,且完全缺失当代知识。
Books3。 Presser 于 2020 年发布,包含 19.6 万本书,来源是影子图书馆 Bibliotik。它收录了大量在版畅销书(Stephen King、Min Jin Lee、Zadie Smith 等),被并入 The Pile,又被 LLaMA 使用。后来因版权侵权与诉讼被下架。Books3 是本讲法律部分的引信:正因为它在 LLaMA 论文里被公开列出,作家们才有了明确的起诉对象。
Books1 / Books2(GPT-3):OpenAI 只说是「基于互联网的图书语料库」,至今没有披露具体来源,被课上直接称为 mysterious。
4.3 代码:GitHub 与 Software Heritage
代码有用不只是因为要做编程任务——业内广泛流传的一个说法(folklore)是代码数据能提升模型的一般推理能力:代码是显式的、结构化的、有严格因果依赖的长程符号序列,可能教会了模型某种「按步骤执行」的能力。
GitHub:2008 年创立的代码托管服务,2018 年被微软收购。截至 2026 年 5 月有 4.2 亿+ 仓库(其中 2800 万公开)。它的数据有两个层次:
| 类型 | 内容 | 获取方式 |
|---|---|---|
| 仓库本体 | 目录结构 + 文件内容 + 提交历史 | 用 git 协议直接 clone,不要去爬 GitHub 网页——更快、更完整、也更礼貌 |
| 元数据 | issue、pull request、评论、star、fork 关系 | GitHub API;GH Archive 提供事件流的小时级快照 |
两个必须处理的问题:
- 重复极多:fork、vendored 依赖、复制粘贴的样板代码、node_modules。后面会看到 The Stack 的数字触目惊心——510 亿个文件里只有 50 亿是唯一的。
- 许可证:只有宽松许可(permissive license)的公开仓库可以放心训练,典型是 MIT、Apache-2.0、BSD。GPL 之类的传染性(copyleft)许可要求衍生作品同样开源,用它训模型的法律地位不明确,主流数据集通常直接排除。
Software Heritage:2016 年成立的非营利组织,使命是长期保存人类的软件遗产。它聚合 GitHub、GitLab、Bitbucket、PyPI 等多个来源,只关注仓库本体、不收 issue 与评论。它是 The Stack v2 的数据底座,也是应对「GitHub 是私有公司、政策随时可变」这一风险的公共基础设施。
4.4 论文:arXiv 与 PubMed
arXiv 自 1991 年起提供论文的免费分享与获取,最初只有物理,现已覆盖数学、计算机科学、统计等,累计约 300 万篇投稿。它对语料构建特别友好的几个性质:
- 每篇投稿包含元数据 + PDF + (可选的)LaTeX 源码。有 LaTeX 源码意味着可以绕开 3.5 节讲的 PDF 解析地狱,直接拿到结构化的公式、章节、参考文献——这是 arXiv 对数学能力训练的独特价值。
- 审核很轻(只做基本把关,不是同行评审),所以质量参差,需要额外过滤。
- 许可由作者选择:(i) 保留所有权利,或 (ii) Creative Commons(如 CC-BY)。元数据(标题、摘要)统一是 CC0(放弃全部权利)。
- 支持从 Amazon S3 批量下载,不需要爬。
PubMed Central:生物医学文献库,约 500 万篇论文。它的特殊之处在于制度性开放——受 NIH 资助的研究成果被强制要求公开,因此存在一大批法律状态清晰的全文文献。这是 The Pile 的重要成分,也是模型医学知识的主要来源。
使用 LaTeX 源码时的实际处理(LLaMA 的做法可作模板):删除注释、内联展开自定义宏、去掉参考文献——否则模型会学到一堆 \newcommand 定义和 BibTeX 条目这类无信息量的噪声。
4.5 问答社区:StackExchange 与 Reddit
StackExchange 是一组用户贡献问答的站点集合,2008 年从 StackOverflow 起步,后来扩展到数学、英语学习、文学等上百个主题。它用声望值(reputation)与徽章激励参与。
它对语言模型的价值有三点,值得单独强调:
- 格式天然对齐下游应用。「问题 → 答案」的结构本身就非常接近指令微调数据和真实使用场景,模型在预训练阶段就见过大量这种模式。
- 自带质量信号。投票数、采纳标记、用户声望、标签、评论——这些元数据可以直接用来排序和筛选。LLaMA 的做法就是取 28 个最大的站点,把答案按得分排序。这是「免费的人类反馈」,比任何自动质量分类器都可靠。
- 可批量下载:官方提供匿名化的 XML 转储,含全部元数据。
Reddit 的角色更特别——它在本讲里出现了三次,扮演三种不同角色:
- 作为质量代理信号:GPT-2 的 WebText 用「Reddit 帖子中被点赞 ≥ 3 karma 的外链」来近似「人类觉得值得一看的页面」(见 5.2 节)。
- 作为内容本身:Dolma 通过 Pushshift 项目收录了 2005–2023 的 Reddit 提交与评论。
- 作为训练分类器的正样本:DCLM 用 ELI5(explainlikeimfive)子版块的问答作为「好数据」的示例(见 6.5 节)。
需要注意的是,Reddit 现在已经关闭了免费 API 并把数据授权给 Google(见 8.2 节)——这是「同意衰退」最典型的案例之一。
4.6 其他值得知道的来源
| 来源 | 内容与特点 | 法律状态 |
|---|---|---|
| Enron 邮件 | 150 名安然高管的 50 万封邮件,2002 年调查期间公开 | 因司法程序进入公共记录;真实商务邮件语料极其稀有,但也带来严重的 PII 隐私问题 |
| 法律文书 | 判决书、法规、议会记录(如美国 Free Law Project、欧盟 EUR-Lex) | 政府公文通常不受版权保护,是最干净的高质量长文本来源之一 |
| 专利 | USPTO / EPO 全文,含技术描述与权利要求 | 公开且可自由使用;文体高度程式化,价值有争议 |
| 多语言语料 | 各语言的 Wikipedia、OSCAR / mC4 / CulturaX、政府多语平行语料 | 核心难点是低资源语言的数据量与质量——CCNet 的原始动机正是为乌尔都语这类语言榨出更多可用文本 |
| 学术论文聚合 | peS2o(Semantic Scholar 的 4000 万篇论文,Dolma 使用) | 取决于各篇的开放获取状态 |
同样是 1B token,来自 Common Crawl 的网页和来自 arXiv 的 LaTeX,对模型的边际价值差着数量级。专门来源的三个结构性优势是:(1)有官方批量通道,不用和反爬系统搏斗;(2)法律状态相对清晰;(3)自带元数据,过滤几乎免费。代价是每一个来源都要写一套专用的解析代码——又回到「数据是长尾问题」这句话。
5. 公开数据集谱系(上):从 BERT 到 Gopher
接下来把 2019–2021 年间几个奠基性数据集串起来看。它们各自解决了一个具体问题,而且后来的每个数据集几乎都还在用它们发明的东西——C4 的规则、CCNet 的分类器思路、Gopher 的启发式,至今仍是 2026 年数据流水线的默认组件。
5.1 BERT(2018):文档而非句子
BERT 的训练数据只有两块:Wikipedia + BooksCorpus(见 4.2 节)。数据本身不新奇,但论文里有一个常被忽略、却极其关键的决定:
在 BERT 之前,语言建模的标准基准是 One Billion Word Benchmark(Chelba 等,2013),它的语料来自机器翻译任务,是被打散并随机排序的句子。用这种数据训练,模型永远学不到跨句、跨段的长程依赖——因为训练数据里根本不存在这种依赖。
BERT 明确指出必须用文档级的连续文本。这条看似平凡的原则,是后来一切长上下文能力的前提,也解释了为什么 3.4 节的样板文本去除那么重要:把导航栏塞进正文,等于把文档重新打碎成不连贯的片段。
5.2 WebText(2019):借用人类的点赞当质量信号
GPT-2 用的数据集叫 WebText,它的构造想法非常聪明:
收录所有被 Reddit 帖子(karma ≥ 3)指向的外部链接所对应的页面。
结果是 800 万个页面、40 GB 文本。
这里的逻辑是:与其自己写规则判断「这个网页好不好」,不如借用已经存在的人类判断——有人愿意把它发到 Reddit,并且至少有三个人点了赞,说明它至少对某个人是有价值的。这是用社交信号做质量代理(surrogate for quality)的开山之作,直接影响了后来所有基于「人类偏好数据训分类器」的过滤方法。
WebText 本身从未公开,于是有了 OpenWebTextCorpus(Gokaslan & Cohen, 2019)这个开源复现:
- 从公开的 Reddit 提交数据集里抽取所有 URL;
- 抓取页面,用 Facebook 的 fastText 分类器过滤掉非英文;
- 删除近重复(near duplicate)文档。
注意这三步——语言识别 + 去重——从此成为所有网页数据流水线的标准起手式。
5.3 CCNet(2019):第一个「自动质量过滤」的完整方案
CCNet(Facebook)的目标是:找到一种自动化的方式,从 Common Crawl 里构造出大规模高质量数据集。它特别关心的动机是低资源语言(论文里点名乌尔都语)——对这些语言来说,Wikipedia 太小了,唯一的希望就是从网页爬取里把它们捞出来。
CCNet 由三个组件构成,这个三段式后来被无数次复制:
| 组件 | 做法 | 为什么 |
|---|---|---|
| 去重(deduplication) | 做轻度归一化(小写、数字替换等)后,按段落删除重复 | 网页样板文本大量重复;段落级粒度比文档级更能清掉导航栏与版权声明 |
| 语言识别 | fastText 语言 ID 分类器,只保留目标语言 | Common Crawl 是全语种混合的;fastText 极快,能在 PB 级数据上跑 |
| 质量过滤 | 在 Wikipedia 上训一个 KenLM 5-gram 语言模型,保留困惑度低(即「长得像 Wikipedia」)的文档 | 把「质量」操作化为「与一个已知的高质量参考分布有多接近」 |
你要在几百 TB 的文本上给每一个文档打分。KenLM 的 5-gram 模型是纯查表 + 加法,单核每秒能处理几十 MB,而且内存可控。哪怕是一个小 BERT,成本也要高好几个数量级。过滤器的算力预算必须远小于训练本身,否则不划算——这条约束一直延续到 DCLM 仍然选择 fastText 而不是 Transformer。
另外注意这个方法的固有偏见:以 Wikipedia 为参考,等于系统性偏好百科式的、正式的、书面的文本,而歧视口语、方言、论坛讨论、创意写作。后面 RefinedWeb 明确以「避免这种偏见」为由拒绝使用基于模型的过滤。
结果:用 CCNet 数据训出的 BERT 模型,效果优于用 Wikipedia 训练的版本——这是「经过筛选的网页 > 小而精的高质量语料」的早期实证。注意 CCNet 这个名字同时指开源工具和论文发布的数据集,读文献时要区分。
5.4 C4(2019):规则过滤的教科书
Colossal Clean Crawled Corpus (C4) 出自 T5 论文。这篇论文以「把所有 NLP 任务统一成文本到文本格式」闻名,但 Percy 特别指出:它的一大贡献其实是 C4 这个数据集。
出发点是一个朴素但正确的观察:Common Crawl 里绝大部分东西根本不是有用的自然语言——是菜单、错误页、导航、垃圾站、机器生成的模板文本。
做法:取 2019 年 4 月的一个 Common Crawl 快照(约 1.4 万亿 token),然后套一组纯手工规则:
# C4 的核心启发式规则(概念示意)
def keep_line(line):
    return line.endswith(('.', '!', '?', '"')) and len(line.split()) >= 5

def keep_page(page):
    if count_sentences(page) < 3:            return False   # 太短
    if any(w in page for w in BAD_WORDS):    return False   # 脏词表
    if '{' in page:                          return False   # 疑似代码/JS
    if 'lorem ipsum' in page.lower():        return False   # 占位文本
    if 'terms of use' in page.lower():       return False   # 样板法务文本
    if langdetect(page)['en'] < 0.99:        return False   # 只要英语
    return True
逐条解释这些规则在防什么:
- 「以标点结尾且至少 5 个词」:这是在筛句子。导航项("Home About Contact")、按钮文字、表格单元格都过不了这一关。
- 「少于 3 句话的页面整页丢弃」:404 页、纯图片页、跳转页。
- 脏词表:粗暴的成人内容过滤。
- 含
{就丢:目的是排除 JavaScript 和代码。注意这条规则的副作用——C4 里几乎没有代码,而我们现在知道代码对推理能力很重要。这是「过滤规则会无意中删掉宝贵内容」的经典案例。 - 「lorem ipsum」「terms of use」:占位文本和法务样板。
- langdetect 且 $p(\text{en}) > 0.99$:极其严格的英语阈值。代价是大量代码切换(code-switching)文本、非英语母语者写的英语、以及所有非英语内容被一刀切掉。对比 FineWeb 后来放宽到 $p(\text{en}) > 0.65$。
结果:从 1.4T token 筛到 806 GB 文本(约 1560 亿 token)——留存率大约只有十分之一。
C4 里究竟有什么?
后续有一篇专门的审计工作(Documenting Large Webtext Corpora,2021),把 C4 的域名分布、内容来源、被过滤掉的内容都摊开来看,结论很有教育意义:
- token 数排名靠前的域名里,专利数据库(patents.google.com)常年占据首位,其次是 Wikipedia、各大新闻媒体(NYT、LA Times、Guardian)、期刊(PLOS)等。也就是说,你以为的「互联网众声喧哗」,实际上被少数几个巨型站点主导。
- 其中有相当比例的专利文本是机器翻译的(非英语专利的官方英译),甚至有 OCR 错误——这些都堂而皇之地通过了 C4 的全部规则。
- 脏词表过滤造成了系统性的人群偏差:它不成比例地删除了与 LGBTQ+ 相关的内容,以及非裔美国人英语(AAE)等方言写成的文本——因为这些社群的日常用语中包含被列入表中的词汇(很多是被重新赋义的中性词)。一个为「安全」设计的规则,实际效果是把某些人群从模型的世界里抹掉了。
C4 的审计说明,每一条看似技术中立的规则背后都有价值判断。{ 规则删掉了代码;99% 英语阈值删掉了多语言使用者;脏词表删掉了少数群体。数据集不是被「发现」的,而是被「构造」的——而构造它的人的假设,会一路传导到模型的行为里。这也是为什么本讲反复强调「数据是长尾问题」:每一条规则的副作用都要单独去看、去测。
一个有价值的旁证
T5 论文还做了一个 WebText 风格的对照数据集:只保留那些出现在 OpenWebText 链接列表(Reddit ≥ 3 karma)中的页面。结果是——他们需要用 12 个 Common Crawl dump 才凑出 17 GB 文本,而原版 WebText 有 40 GB。
这个数字很重要,它直接说明:Common Crawl 对 Web 的覆盖是不完整的。同一批 URL,OpenAI 自己爬能拿到 40 GB,从 12 个月的 Common Crawl 里只能捞回 17 GB。(顺带一提,这个 WebText 风格子集在 GLUE、SQuAD 等基准上确实带来了提升,再次验证了 Reddit 信号的有效性。)
5.5 GPT-3(2020):分类器过滤 + 模糊去重
GPT-3 的数据由四部分构成:
- Common Crawl(经过处理)
- WebText2:WebText 的扩展版,收录了更多链接
- Books1、Books2:「基于互联网的图书语料库」,来源至今成谜
- Wikipedia
总计 570 GB(约 4000 亿 token)。
它对 Common Crawl 的处理有两个关键动作,都成为了后世标配:
- 训练质量分类器:把 {WebText, Wikipedia, Books1, Books2} 当作正样本,把未经处理的 Common Crawl 当作负样本,训一个二分类器,然后用它给全部 CC 文档打分并筛选。这就是「用已知的好数据定义什么叫好」这一范式的正式确立——四年后 DCLM 用的还是同一个套路,只是把正样本换成了指令数据。
- 模糊去重(fuzzy deduplication):在文档级别去重,并且把 WebText 和各个评测基准也放进去一起去重——后者是为了防止测试集污染(参见 Lecture 12 关于污染的讨论)。
5.6 The Pile(2021):草根社区的多样性宣言
The Pile(EleutherAI)诞生于对 GPT-3 的直接回应:既然 OpenAI 不开源,我们自己造一个。它是一场草根努力,大量志愿者在 Discord 上协作完成,后来被用于训练 GPT-J、GPT-NeoX 等一系列开源模型。
它的核心主张与 C4 完全相反。C4 说「从网页里洗出干净文本」,The Pile 说「多样性本身就是质量」——于是精心策划了 22 个高质量领域,共 825 GB 文本(约 2750 亿 token)。主要成分包括:
| 成分 | 说明 |
|---|---|
| Pile-CC | Common Crawl 部分。关键:用 WARC 而非 WET,用 jusText 做正文抽取——比 WET 好得多(这比 DCLM 的正式消融早了三年) |
| PubMed Central | 500 万篇论文;NIH 资助的成果被强制要求公开 |
| arXiv | 使用 LaTeX 源码,保留公式结构 |
| Books3 | 19.6 万本书(后因侵权下架,见 4.2 节) |
| Project Gutenberg (PG-19) | 公有领域图书 |
| StackExchange | 问答格式,天然贴近下游应用 |
| Enron 邮件 | 150 名安然高管的 50 万封邮件,2002 年调查中公开——极其罕见的真实邮件语料 |
| 其他 | GitHub、USPTO 专利、FreeLaw、维基百科、YouTube 字幕、DeepMind Math、Ubuntu IRC 日志等 |
The Pile 的历史地位在于:它第一次把「预训练数据配方」变成了一个可以公开讨论、可以复现、可以批评的对象。它的 22 个领域清单,事实上定义了此后所有开源数据集的成分框架。
5.7 MassiveText / Gopher(2021):手工规则的集大成
Gopher(DeepMind,280B 参数)这个模型本身已经被 Chinchilla 取代(两者都从未发布),但 Percy 特意提到它,因为它对数据的描述写得很好,而且它的过滤规则至今仍在被广泛复用。
MassiveText 的成分:MassiveWeb(自建网页爬取)、C4、Books、News、GitHub、Wikipedia。除 MassiveWeb 和 C4 外,其余几项论文都没有给细节(no details)——又一次印证了 1.1 节的观察。
MassiveWeb 的过滤步骤:
- 只保留英语;去重;去除与测试集的重叠(train-test overlap);
- 质量过滤使用手工规则而非分类器;
- 毒性过滤使用 Google SafeSearch 而非词表——这比 C4 的脏词表精细得多,能避免 5.4 节讲的那种误伤。
课上举的规则例子是「至少 80% 的词必须包含至少一个字母字符」。这条规则在防什么?防的是那些满屏是数字、符号、ID 的页面——价格表、日志转储、Base64 串、股票行情。所谓「Gopher rules」在后续文献里被反复引用,通常指下面这一组:
| 规则 | 要过滤掉的东西 |
|---|---|
| 文档词数在 50 到 100,000 之间 | 过短的碎片、异常巨大的转储文件 |
| 平均词长在 3 到 10 个字符之间 | 乱码、无空格的连写、字符级噪声 |
符号与词的比例低于阈值(如 #、...) | 被截断的文本、代码噪声、SEO 垃圾 |
| 以省略号结尾的行占比不超过 30% | 「阅读全文…」式的文章列表页 |
| 至少 80% 的词含有字母字符 | 数字表格、日志、ID 列表 |
| 必须包含至少 2 个常见停用词(the, be, to, of, and…) | 非自然语言、关键词堆砌页 |
结果:10.5 TB 文本。但请注意一个耐人寻味的细节——Gopher 实际只训练了 3000 亿 token,也就是这份数据的约 12%。这是 Chinchilla 定律(Lecture 10)出现之前的典型状态:大家囤了远超实际使用量的数据,却把算力全花在了堆参数上。今天的情形正好反过来:数据成了瓶颈,人人都在为「还能上哪儿再找 1T token」发愁。
6. 公开数据集谱系(下):从 LLaMA 到 Nemotron-CC
2022 年之后,主线出现了一次明显的转向:从「用规则清洗网页」转向「用模型判断质量」,再转向「用模型直接改写数据」。下面五个数据集正好标出了这条轨迹上的每一个台阶。
6.1 LLaMA(2023):把已有配方组装成 1.2T token
LLaMA 的数据部分没有发明新方法,但它把当时所有已知的好做法组装了一遍,并且完整公开了配方——这份透明度在当时是罕见的(也正是它后来惹上官司的原因):
| 成分 | 处理方式 |
|---|---|
| Common Crawl | 用 CCNet 流水线处理,质量分类器的目标改成:判断这个页面是否会被 Wikipedia 引用为参考文献 |
| C4 | 额外加入 C4,理由是「更多样」——回忆 C4 用的是规则过滤,与 CCNet 的模型过滤形成互补 |
| GitHub | 只保留宽松许可的仓库,再用手工规则过滤 |
| Wikipedia | 2022 年 6–8 月,20 种语言,人工过滤 |
| 图书 | Project Gutenberg + Books3(来自 The Pile) |
| arXiv | 删注释、内联展开宏、去参考文献 |
| StackExchange | 28 个最大的站点,答案按得分排序 |
结果:1.2 万亿 token。
CCNet 原版问的是「这个页面长得像不像 Wikipedia」,这会偏向百科体裁本身。LLaMA 换了个问法:「这个页面会不会被 Wikipedia 当作参考文献引用」。差别很大——被引用的是可靠的原始信源:新闻报道、学术论文、政府统计、权威机构页面。它们的文体可以千差万别,但共同点是可信。这是一个更接近「我们真正想要什么」的代理信号,而不是一个风格模仿指标。
复现:Together 发布了 RedPajama v1,严格按 LLaMA 论文的配方重建了 1.2T token 的开源版本。Cerebras 又在此基础上做了 SlimPajama:用 MinHashLSH 做全局去重,把 1.2T 压到 627B token。注意这个比例——接近一半的内容是重复的,这就是下一讲要讲的去重问题的分量。
6.2 RefinedWeb(2023):只用网页就够了
RefinedWeb(TII,用于训练 Falcon)提出了一个当时颇具挑衅性的论点:
Web data is all you need. 只要把网页数据洗得足够干净、去重得足够彻底,就不需要那些精心策划的高质量语料(书、论文、代码)。
做法:
- 用 WARC 而不是 WET,用 trafilatura 做正文抽取;
- 过滤使用 Gopher 规则;
- 刻意避免基于机器学习的过滤,理由是「避免引入偏见」(回顾 5.3 节:以 Wikipedia 为参考的分类器会系统性排斥某些文体和人群);
- 在 5-gram 上做 MinHash 模糊去重,去重力度非常激进。
论文最终发布了 6000 亿 token(内部构建了 5 万亿)。它的历史意义在于确立了「大规模 + 高质量抽取 + 激进去重」这条纯网页路线的可行性。
6.3 FineWeb(2024):把复现做成了改进
FineWeb(HuggingFace)起初只是想复现 RefinedWeb,最后做得更好,并且把每一步消融实验都公开了——它的技术博客本身就是学习数据流水线最好的教材之一。
- 使用 95 个 Common Crawl dump(对比 C4 只用 1 个);
- URL 级过滤(先按域名黑名单和 URL 模式砍掉一批,这一步几乎免费);
- 语言识别:保留 $p(\text{en}) > 0.65$——比 C4 的 0.99 宽松得多,保住了大量非母语者写的英语和混合语言文本;
- 过滤:Gopher 规则 + C4 规则 + 额外的手工规则;
- MinHash 模糊去重(关键发现之一:逐 dump 去重比全局去重效果更好,因为全局去重会把在多个 dump 里反复出现的高质量页面误杀);
- PII 匿名化:替换邮箱地址和公网 IP。
结果:15 万亿 token——这是当时公开可得的最大规模英文网页语料,也正好是 Llama 3 的训练量级。它的衍生版 FineWeb-Edu 用「教育价值」打分器筛选出高教育价值子集,成为后来 Nemotron-CC 的对比基线。
6.4 Dolma(2024):完全开放的 3T token
Dolma(AI2)是 OLMo 的训练数据,它的定位不是「最大」或「最优」,而是最透明:数据、工具链、文档、决策记录全部公开,允许任何人审计和复现。
成分上它回归了 The Pile 的多样性路线:
- Reddit:来自 Pushshift 项目(2005–2023),提交与评论分开收录(两者的文体和用途不同);
- peS2o:Semantic Scholar 的 4000 万篇学术论文;
- C4、Project Gutenberg、Wikipedia / Wikibooks;
- Common Crawl(主体)。
Common Crawl 的处理流程:
- 语言识别:fastText,只留英语;
- 质量过滤:Gopher + C4 规则;同样明确避免基于模型的过滤(与 RefinedWeb 的立场一致);
- 毒性过滤:规则 + Jigsaw 分类器;
- 去重:Bloom filter——一种在超大规模下做精确重复检测的空间高效方案(用可控的假阳性率换取 $O(1)$ 内存开销)。
结果:3 万亿 token。
6.5 DCLM(2024):把数据处理变成一门可比较的科学
DataComp-LM 的目标和前面几个都不一样。它不只想发布一个好数据集,而是想建立一个标准化的基准,让不同的数据处理算法可以被公平比较——固定住模型架构、参数量、训练 token 数,只让参赛者改数据,看谁的下游分更高。
它提供两样东西:
- DCLM-pool:处理过的 Common Crawl,240 万亿 token(迄今最大的公开原料池);
- DCLM-baseline:用质量分类器从 pool 里筛出的 3.8 万亿 token。
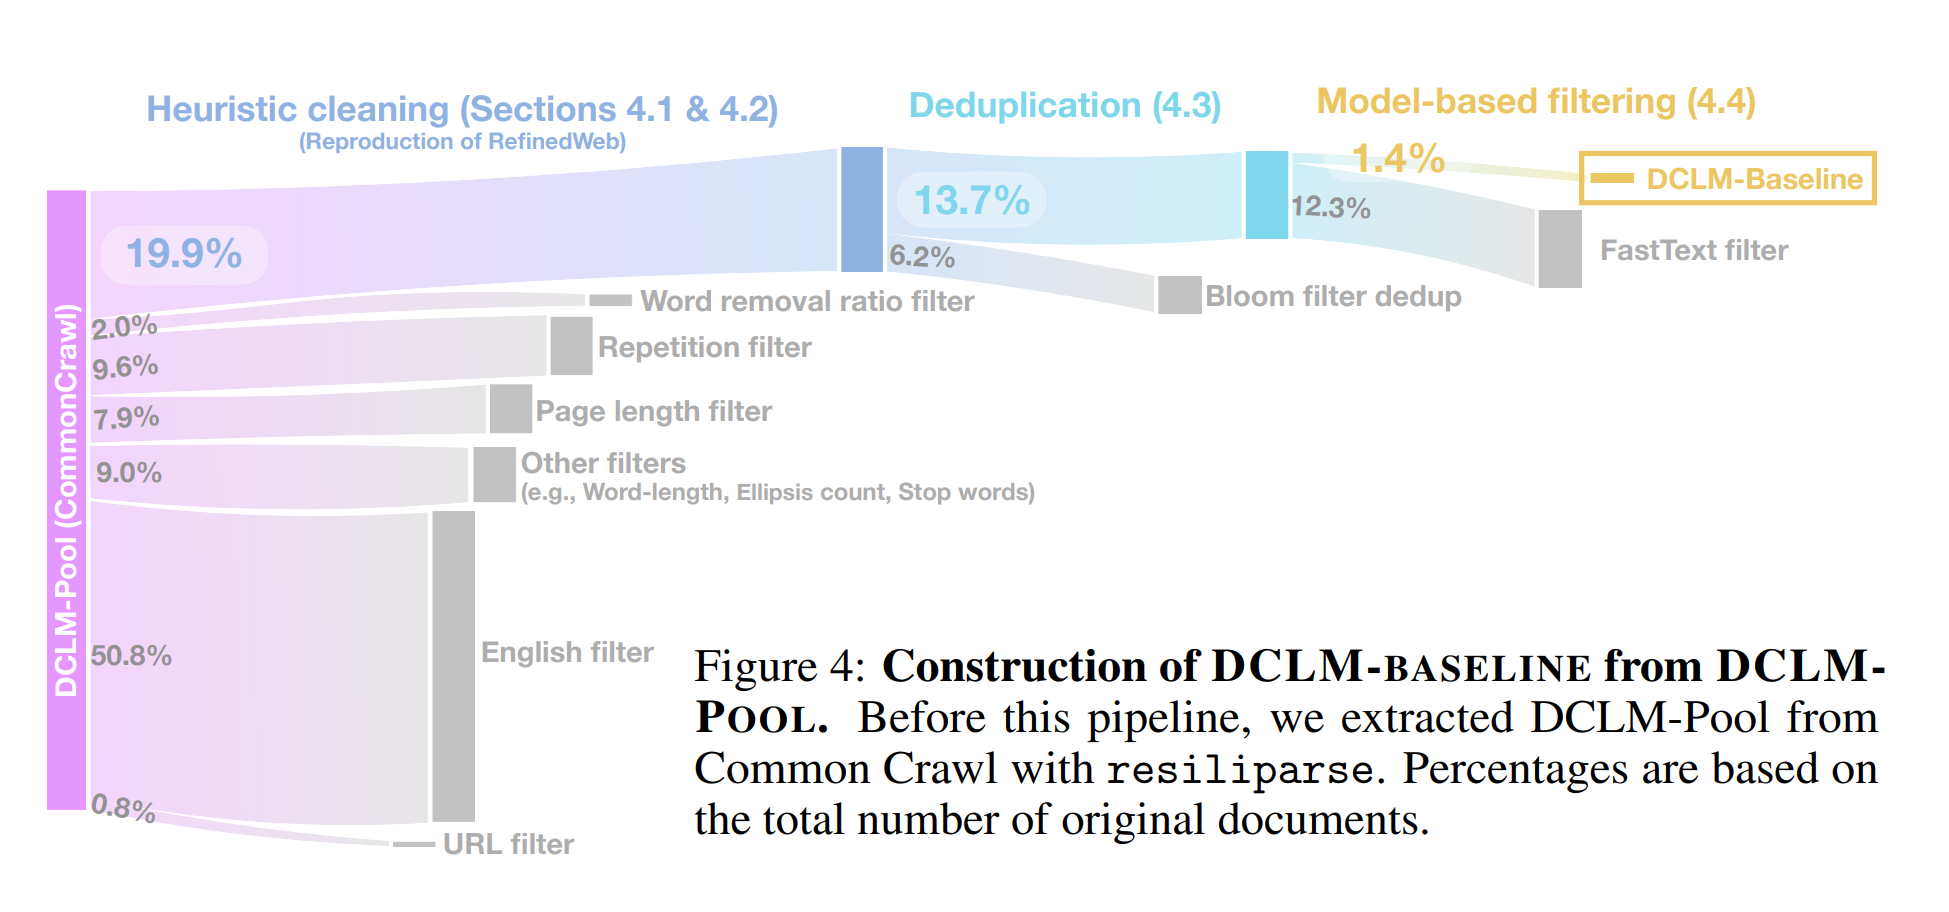
基于模型的过滤(model-based filtering)
DCLM 最重要的发现来自它的质量分类器设计。训练一个 fastText 二分类器,关键在于正负样本怎么选:
| 数据(各 20 万条) | 为什么这样选 | |
|---|---|---|
| 正样本 | OpenHermes-2.5(主要由 GPT-4 生成的指令数据) ELI5("像解释给五岁小孩" 子版块的问答) | 不再模仿 Wikipedia,而是直接瞄准「我们希望模型学会的说话方式」:清晰、有条理、能把复杂概念讲明白 |
| 负样本 | RefinedWeb | 注意负样本不是垃圾数据,而是一个已经很好的数据集——这迫使分类器学会区分「好」与「更好」,而不是「好」与「乱码」 |
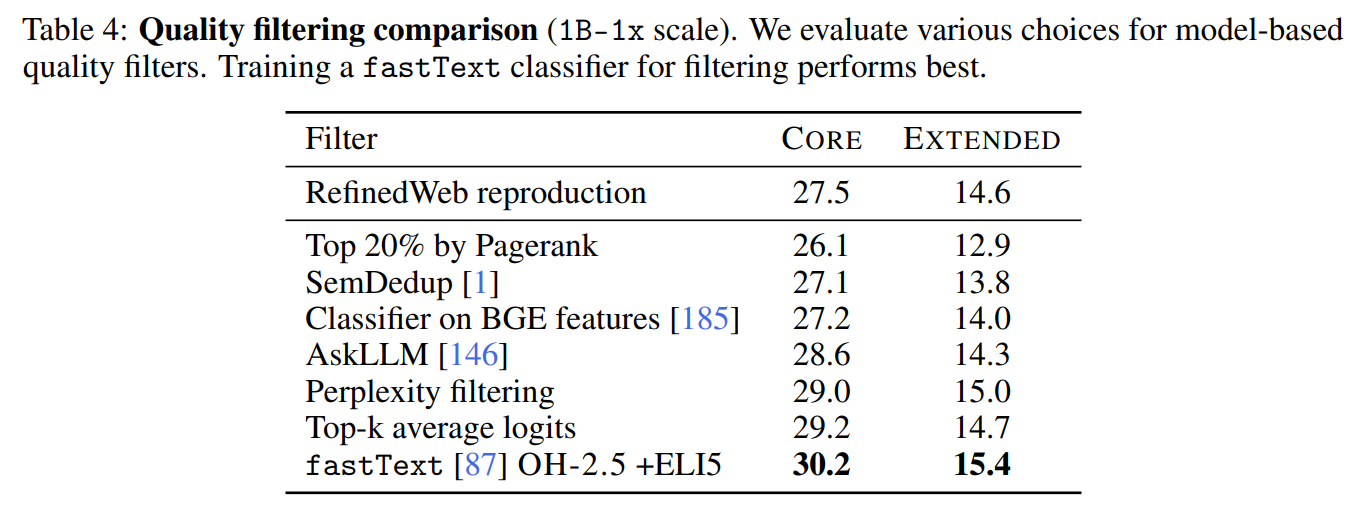
从 CCNet 到 DCLM,方法上都是「训个分类器」,真正在进步的是正样本的选择:
- CCNet(2019):好 = 长得像 Wikipedia
- GPT-3(2020):好 = 长得像 {WebText, Wikipedia, Books}
- LLaMA(2023):好 = 会被 Wikipedia 引用
- DCLM(2024):好 = 长得像高质量指令回答
这条演化线的方向非常清楚:越来越贴近「模型最终要被怎么使用」。这也和 Lecture 12 的主题呼应——你无法优化你没有定义的东西,而数据过滤器就是把「好」这个概念编码成可执行代码的地方。
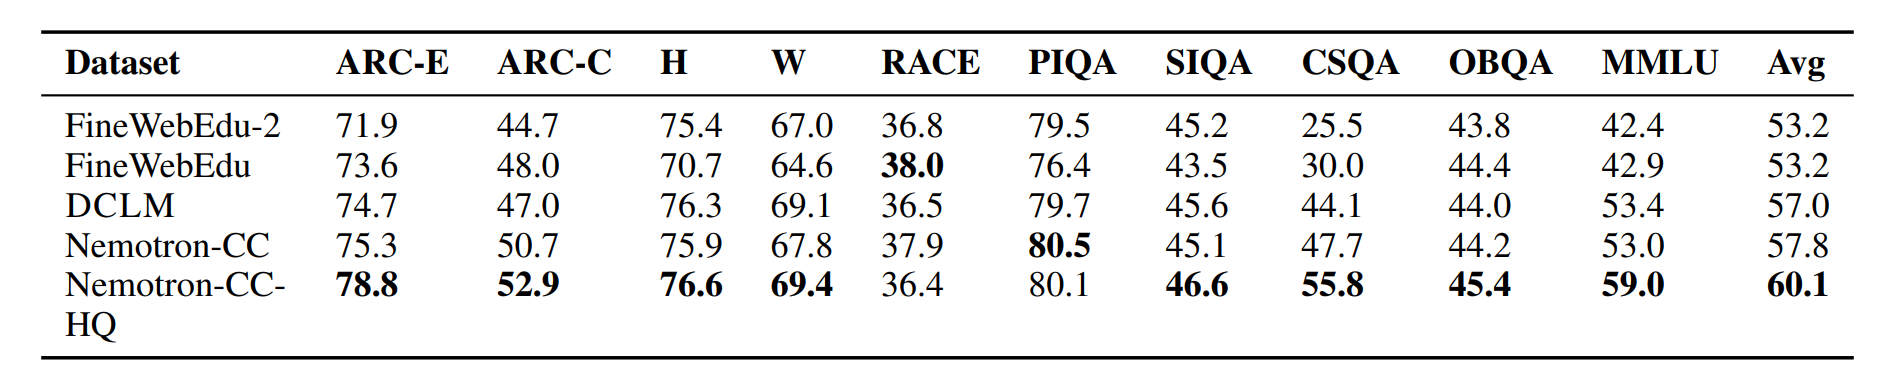
6.6 Nemotron-CC(2024):过滤过头了,用合成把 token 找回来
Nemotron-CC(NVIDIA)从一个相反的方向发问:
FineWeb-Edu 和 DCLM 过滤得太狠了——它们扔掉了 90% 的数据。我们需要更多 token,但又不能牺牲质量。
为什么这是个真问题?回顾 Chinchilla 定律(Lecture 10):更大的模型需要成比例更多的 token。当你要训一个万亿参数级模型时,3.8T token 根本不够,你会被迫在同样的数据上跑很多个 epoch,收益递减。Nemotron-CC 的三招是:
(1)换抽取器。 HTML→文本改用 jusText 而非 trafilatura,理由很直白:它返回的 token 更多。这是一次明确的召回/精度权衡——trafilatura 抽得更干净但更保守,jusText 更宽松但保留了更多可用文本。
(2)分类器集成(ensembling)。 不依赖单一质量分类器,而是把多个信号合起来:
- 提示 Nemotron-340B-instruct 给 FineWeb 文档按教育价值打分,再蒸馏(distill)成一个小而快的模型,以便在全量数据上跑;
- 叠加 DCLM 的分类器。
集成的意义在于:不同分类器的偏见方向不同,取交集会过度保守,而合理集成能在不损失质量的前提下提高召回。
(3)合成数据改写(synthetic rephrasing)。 这是最有意思的一招,而且是双向的:
- 对低质量数据:用语言模型改写,把结构混乱、口语化、错别字连篇的文本重写成通顺的表述——把原本会被扔掉的数据救回来;
- 对高质量数据:用语言模型生成任务——从文档中衍生出问答对、关键信息抽取、知识列表等——把同一份内容的价值榨得更干净。
结果:6.3 万亿 token(其中高质量子集 1.1T)。 作为参照,课上给出的数字是 Llama 3 训练了 15T,Qwen3 训练了 36T。
6.7 大对比表
| 数据集 / 年份 | 规模 | 主要来源 | 过滤方式 | 去重 | 开放程度 |
|---|---|---|---|---|---|
| BooksCorpus 2015 | 7K 本书 / 0.985B 词 | Smashwords 自出版书 | 只取标价 $0 | — | 已下架(违反 ToS) |
| WebText 2019 | 8M 页 / 40 GB | Reddit ≥3 karma 外链 | 社交信号代理 | 有 | 未公开(OpenWebText 为复现) |
| CCNet 2019 | 多语言,规模随语言 | Common Crawl | KenLM 5-gram(以 Wikipedia 为参考) | 段落级 | 开源工具 + 数据 |
| C4 2019 | 806 GB / 156B token | CC 2019-04 单快照 | 纯手工规则(标点、句数、脏词、{、langdetect 0.99) | 有限 | 公开(ODC-By) |
| GPT-3 数据 2020 | 570 GB / 400B token | CC + WebText2 + Books1/2 + Wikipedia | 质量分类器(正样本 = WebText/Wiki/Books) | 模糊去重(含基准) | 未公开 |
| The Pile 2021 | 825 GB / ~275B token | 22 个精选领域(论文、书、代码、法律、邮件…) | 按来源分别处理;Pile-CC 用 WARC+jusText | 有 | 公开(Books3 已移除) |
| MassiveText 2021 | 10.5 TB(仅用 12%) | MassiveWeb + C4 + 书 + 新闻 + GitHub + Wiki | Gopher 手工规则 + Google SafeSearch | 有 + 去测试集重叠 | 未公开 |
| LLaMA 数据 2023 | 1.2T token | CC + C4 + GitHub + Wiki + 书 + arXiv + StackExchange | CCNet + 「是否被 Wikipedia 引用」分类器 | 有 | 配方公开,数据未公开(RedPajama 复现) |
| RefinedWeb 2023 | 发布 600B(构建 5T) | 纯 Common Crawl | Gopher 规则;刻意不用 ML 过滤 | MinHash(5-gram),激进 | 公开子集 |
| Dolma 2024 | 3T token | CC + Reddit + peS2o + C4 + 书 + Wiki | Gopher + C4 规则 + Jigsaw 毒性;不用 ML 质量过滤 | Bloom filter | 完全开放(ODC-By,含工具链) |
| FineWeb 2024 | 15T token | 95 个 CC dump | URL 过滤 + langid(0.65) + Gopher/C4 + 自研规则 | MinHash(逐 dump) | 公开 + 全部消融实验 |
| DCLM 2024 | pool 240T → baseline 3.8T | Common Crawl | fastText 分类器(正样本 = OpenHermes + ELI5) | 有 | 公开,含标准化基准 |
| Nemotron-CC 2024 | 6.3T(HQ 子集 1.1T) | Common Crawl | 分类器集成 + LLM 合成改写;jusText 抽取 | 有 | 公开 |
| The Stack v1/v2 | 3.1 TB 代码 / v2 更大 | GitHub、Software Heritage | 只保留宽松许可;去恶意/机器人内容 | MinHash + Jaccard | 公开,含 opt-out 机制 |
| Common Pile 2025 | 8 TB | 仅宽松许可 / 公有领域来源 | 按来源分别处理 | 有 | 完全开放且许可清晰 |
顺着「过滤方式」这一列从上往下扫,你会看到整个领域的方法论演进:社交信号(2019)→ 手工规则(2019–2021)→ 参考分布分类器(2019–2023)→ 目标导向分类器(2024)→ 分类器集成 + 合成改写(2024–)。而「规模」这一列则讲了另一个故事:五年里公开语料从 156B 涨到 15T,涨了约 100 倍——但这个增长正在放缓,原因见第 10 节。
7. 代码与数学:高价值垂直语料
网页语料之外,代码是被单独投入最多工程的垂直领域。原因不只是「要让模型会写代码」——前面提到的 folklore 是代码能提升一般推理能力。一个合理的解释是:代码是形式严格、依赖显式、可执行验证的长序列,它逼迫模型学会追踪变量状态、遵守语法约束、按步骤展开——这些正是链式推理需要的能力。
7.1 The Stack(2022):许可证驱动的代码语料
The Stack(BigCode 项目)的构建流程:
- 从 GitHub Archive(2015–2022)的事件流里取出所有仓库名——注意这里的巧思:不去爬 GitHub 网页,而是从事件日志里恢复仓库列表;
git clone了 1.37 亿个仓库,得到 510 亿个文件;- 去重后只剩 50 亿个唯一文件;
- 用
go-license-detector检测许可证,只保留宽松许可(MIT、Apache 等); - 用 MinHash + Jaccard 相似度去除近重复;
- 结果:3.1 TB 代码。
GitHub 上约 90% 的文件是重复的。 来源包括 fork、vendored 依赖(把整个库拷进仓库)、脚手架生成的样板、教程代码的复制粘贴、以及被提交进版本库的 node_modules。
这解释了为什么代码语料的去重必须做在文件级而不是仓库级,也解释了为什么代码模型特别容易逐字背诵——某段代码在训练集里出现过几千次,模型记住它几乎是必然的。这一点在版权语境下尤其敏感(GitHub Copilot 的诉讼争议正源于此)。
7.2 The Stack v2(2024):不只是代码文件
The Stack v2 的关键升级是把「代码」的定义扩大到整个软件工程生态:
- 仓库来自 Software Heritage(而非直接从 GitHub 拉)——更稳定的公共基础设施,也更好地处理了长期保存与归属;
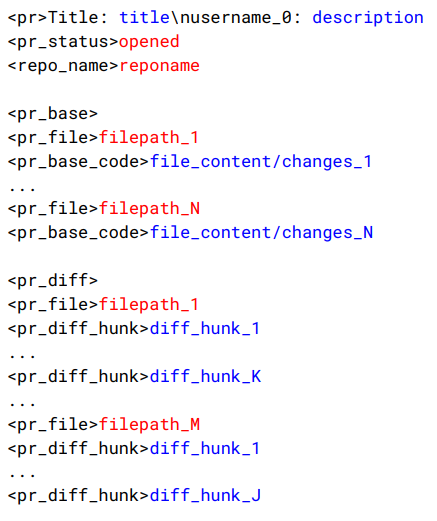
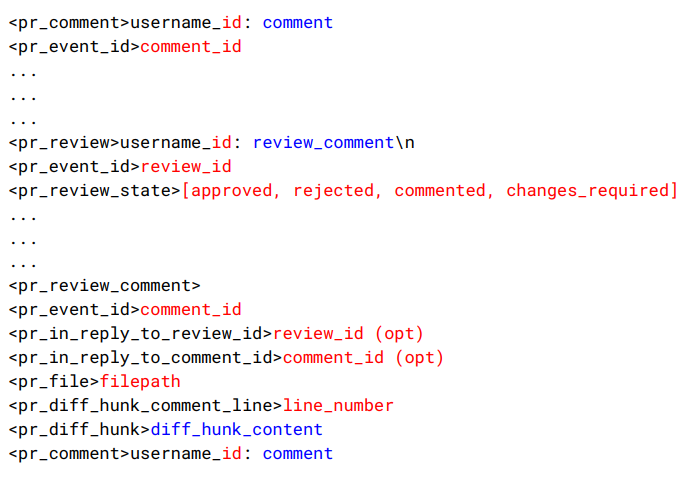
- issue、评论、Pull Request 来自 GitHub Archive——这些是「人类如何讨论和修改代码」的记录,价值不亚于代码本身;
- 文档来自网站爬取:PyPI、npm、devdocs.io 等;
- 处理:去除二进制文件、恶意软件、机器人产生的内容,去重,PII 脱敏,对 PR 做下采样;
- 一个有趣的技巧:把小众语言(如 Nim)的源码与它编译出的 LLVM 中间表示配对——用一个共享的低级语言当「枢轴」,把高资源语言上学到的语义迁移到低资源语言上;
- 直接并入已有的高价值数据集:GSM8K、编程竞赛题、StackOverflow、arXiv、Wikipedia、OpenWebMath。
Pull Request 怎么变成训练数据?
这是一个很好的「结构化对象 → token 序列」的案例。一个 PR 是一棵树:多轮 commit、多个文件的 diff、行内评论、CI 状态、审阅意见、最终合并结果。要喂给语言模型,必须线性化(linearize)成一个序列。
7.3 数学语料
数学的处境与代码类似但更窘迫:高质量数学文本在互联网上极其稀缺,而且最难解析。主要来源与难点:
| 来源 | 特点 | 难点 |
|---|---|---|
| arXiv LaTeX 源码 | 公式以源码形式保留,结构完整 | 需要展开宏、处理自定义环境;内容偏研究级,缺少基础推导 |
| OpenWebMath | 从 Common Crawl 中专门捞取含数学内容的网页(论坛、博客、课件) | 网页数学用 MathJax/MathML/图片三种方式呈现,普通抽取器会把公式全部丢光,必须写专门的处理 |
| StackExchange (math/mathoverflow) | 问答格式 + 投票信号,接近推理示范 | 质量参差,需按得分筛选 |
| 教科书 PDF | 最理想的形态:循序渐进、有例题有解答 | 回到 3.5 节的 PDF 解析问题;且大多受版权保护 |
| 合成题解 | 用强模型生成题目与分步解答,可用答案自动验证 | 可能引入系统性错误;是下一讲的主题 |
把这些放在一起看,可以得到一条贯穿本讲的观察:越是高价值的语料,越是被困在难解析的格式里(PDF、LaTeX、MathML)或难获取的位置(付费墙、版权书)。这既解释了为什么各家愿意在数据工程上投入巨大人力,也解释了为什么合成数据在 2024 年之后迅速成为主流补充手段。
8. 法律与伦理:什么数据是能用的
这一节回答 2.2 节留下的问题:哪些数据在法律上可以用来训练? Percy 在课上花了相当篇幅讲版权法,理由很实在——如果你要真的构建一个模型并发布它,这些不是背景知识,而是会决定项目生死的约束。
8.1 版权法的基本框架
知识产权法(intellectual property law)的立法目标是激励知识产品的创造——给创作者一段时间的垄断权,让创作有经济回报。四大类型:版权(copyright)、专利(patents)、商标(trademarks)、商业秘密(trade secrets)。语言模型主要涉及版权。
版权法的历史与要点:
- 可追溯到 1709 年英国的 安妮法令(Statute of Anne)——第一次由政府与法院来规制复制权。
- 美国现行的是 1976 年版权法,保护对象是「固定在任何有形表达媒介上的原创作品,无论该媒介现已知晓或日后开发,只要作品可借助机器或装置被感知、复制或以其他方式传达」。
几条对我们特别重要的推论:
| 原则 | 含义 | 对语言模型的意义 |
|---|---|---|
| 汇编不受保护 | 纯粹的事实汇编(如电话簿)不是原创作品,除非在选择或编排上有创造性 | 「我只是收集了一堆链接」不构成新作品,但你的数据集的选择与编排可能构成 |
| 保护表达,不保护思想 | 快速排序这个算法不受版权保护,但某段具体的实现代码受保护 | 模型学到「怎么排序」没问题,逐字吐出某个实现有问题 |
| 从「已出版」扩展到「已固定」 | 1909 年只保护已出版作品,1976 年改为只要「固定下来」就受保护 | 随手发的一条帖子、一个 README 都自动受保护 |
| 无需注册即受保护 | 与专利不同,创作完成即自动享有版权 | 没有「未标注版权 = 可自由使用」这回事 |
| 门槛极低 | 你的个人网站就是受版权保护的作品 | — |
| 起诉需先注册 | 要起诉侵权,权利人须先注册(约 $65) | 这是实践中唯一的「摩擦」——但大出版商和作家协会显然付得起 |
| 保护期约 75 年 | 期满后进入公有领域(public domain) | 莎士比亚、贝多芬、古登堡计划的大部分书籍可自由使用 |
互联网上的东西,基本上全都是受版权保护的。 默认状态不是「自由使用」,而是「受保护」。因此,要合法使用一份受版权保护的作品,你只有两条路:(1)取得许可;(2)主张合理使用。
8.2 路径一:许可(license)
许可来自合同法,由许可人(licensor)授予被许可人(licensee)。Percy 给了一个非常好记的定义:
「许可,本质上就是一个不去起诉你的承诺。」
知识共享(Creative Commons)许可让受版权保护的作品可以被自由传播。它由 Lawrence Lessig 与 Eric Eldred 于 2001 年创立,目的是在「公有领域」和「全部权利保留」这两个极端之间搭一座桥。使用 CC 许可的内容包括:Wikipedia、MIT 开放课程、可汗学院、Free Music Archive、Flickr 上的 3.07 亿张图片、MusicBrainz 的 3900 万张图片、YouTube 上的约 1000 万个视频。
另一条路是花钱买。近年主要的数据授权交易包括:
这条趋势与 2.3 节的「同意衰退」是同一枚硬币的两面:公开可爬的数据在减少,付费授权的数据在增加。对资金充裕的公司这是可解的问题;对学术界和小团队,这意味着数据获取的门槛正在快速抬高。
8.3 路径二:合理使用(fair use, §107)
美国版权法第 107 条规定了四个判断因素。法院会综合权衡,没有任何单一因素是决定性的:
| # | 因素 | 偏向合理使用的一侧 | 训练语言模型的处境 |
|---|---|---|---|
| 1 | 使用的目的与性质 | 教育优于商业;转换性(transformative)优于复制性 | 训练确实是高度转换性的(离「复制粘贴」很远);但商业用途是明显的减分项 |
| 2 | 被使用作品的性质 | 事实性优于虚构性;非创造性优于创造性 | 新闻事实、技术文档处境较好;小说、诗歌、艺术作品处境最差 |
| 3 | 使用的数量与实质性 | 用片段优于用全文 | 预训练用的是全文,这一条对模型开发者不利 |
| 4 | 对原作市场的影响 | 不替代原作的市场 | 争议最激烈的一条——模型确实可能替代作家、记者、插画师的市场 |
合理使用的经典例子:
- 你看完一部电影,写一篇剧情摘要;
- 你重新实现一个算法(思想),而不是照抄代码(表达);
- Google Books 对图书建索引并展示片段——Authors Guild v. Google(2002–2013),法院最终认定属于合理使用。这是模型训练方最常援引的先例。
这是工程师最容易犯的错。版权保护的范围远大于逐字复制:
- 小说的情节与角色可以受版权保护——你写一个关于「一个额头有闪电疤痕的男孩去魔法学校」的故事,即便一个字都没抄,也可能侵权;
- 反过来,戏仿(parody)——为了讽刺而模仿——很可能属于合理使用,哪怕大量使用了原作元素。
Percy 的总结是:版权关乎语义(和经济),不关乎字符串匹配。 因此,用 n-gram 重叠去度量「我们的模型有没有侵权」是一个从根本上错位的做法。
具体到语言模型,有四条判断要点:
- 「复制数据」这一步本身就已经可能构成侵权——哪怕你下载下来之后什么都不做。这一点在 Anthropic 案中成了决定性的争点。
- 训练应当是转换性的:把 TB 级文本压缩进权重、用于生成全新内容,和复制分发原作有本质区别。
- 模型应当关于一般性的思想(如「巫师」),而不是具体的表达(如《哈利·波特》原文)。这也是为什么去重和抑制记忆化在法律上有意义。
- 无论版权如何判定,语言模型确实在影响创作者的市场。这是一个独立于法律的伦理与政策问题——即使全部合法,作家和艺术家的生计问题依然存在。
8.4 第三重约束:服务条款
即便你有许可、或能主张合理使用,服务条款(ToS)仍可能施加额外限制。课上的例子很典型:YouTube 的服务条款禁止下载视频,哪怕该视频本身是以 Creative Commons 许可发布的。
把三层约束叠起来看,判断一份数据能不能用需要同时回答:
可以使用?  =  (有许可 OR 属于合理使用)      # 版权层
           AND  不违反服务条款                # 合同层
           AND  遵守 robots.txt / 不损害服务   # 技术与礼仪层
           AND  没有 PII / 隐私问题            # 隐私层
BooksCorpus 的下架正是第二层失守(书免费,但抓取违反 ToS);Books3 是第一层失守。
8.5 正在进行的诉讼与已成定局的判决
| 案件 | 指控 | 进展与结论 |
|---|---|---|
| 纽约时报 v. OpenAI(2023) | 用 NYT 文章训练,并且模型能复现文章内容 | 仍在进行。「能复现」这一点让它比纯训练案更棘手 |
| Bartz, Graeber 等作家 v. Anthropic(2024) | 盗版数百万本书并用原告作品训练 | 2025 年简易判决:在原告作品上训练属于合理使用;但盗版获取副本不属于(即使你不拿来训练)。Anthropic 也确实购买并扫描了实体书,这部分同样被认定为合理使用——但为时已晚。最终以 15 亿美元和解 |
| Kadrey, Silverman 等作家 v. Meta | 用原告图书训练(线索来自 LLaMA 论文披露的 Books3) | 2025 年简易判决:本案情形下用图书训练属于合理使用;但通过 BT 下载图书的指控仍在审理中 |
- 「训练」本身:迄今为止,在几个具体案件中被认定为合理使用。但这些是个案判决,并不构成普遍规则,上诉与新案随时可能改变格局。
- 「获取副本的方式」:盗版明确违法。Anthropic 那 15 亿美元赔的不是「训练」,而是「用盗版渠道拿到了书」。 讽刺的是,法院同时认定它花钱买书再扫描是完全合法的——也就是说,如果它一开始就走合规采购这条路,本可以完全避免这笔赔偿。
给从业者的操作性结论:数据的来源渠道,和数据的用途一样重要,甚至更重要。 保留完整的数据来源记录(provenance)不是官僚主义,而是法律上的自我保护。
8.6 隐私与 PII
版权之外还有一条独立的约束线:个人可识别信息(personally identifiable information, PII)。网页语料里天然混着邮箱地址、电话号码、家庭住址、身份证号、API 密钥、私钥。风险有两层:
- 记忆化与抽取攻击:模型会逐字背下训练数据中的稀有字符串,攻击者可以通过精心构造的提示把它们套出来。Enron 邮件语料就是一个典型例子——它包含了 150 名真实人物未曾预期会被公开传播的私人通信。
- 监管合规:GDPR 等法规赋予个人「被遗忘权」,而从已训练好的模型权重里「删除」某个人的数据在技术上极其困难(这正是机器遗忘 machine unlearning 这个研究方向的由来)。
现有的缓解手段还很粗糙,本质上都是正则替换:FineWeb 匿名化邮箱与公网 IP;The Stack v2 做 PII 脱敏;BigCode 还提供了让开发者主动退出(opt-out)的机制。这些做法能挡住格式规整的 PII,但对散文中提到的姓名、事件、关系无能为力——这仍然是一个远未解决的问题。
9. 只用合规数据能走多远?Common Pile
把前面三节的结论并起来:
- 互联网上几乎所有内容都受版权保护;
- 其中一部分是宽松许可的;
- 对受版权保护内容的合理使用尚无定论。
于是产生了一个既有实践意义、又有科学意义的问题:
只用宽松许可的数据,能不能训出一个好模型?
Common Pile 就是为了回答它而做的:一个 8 TB 的、全部由宽松许可数据构成的语料库。
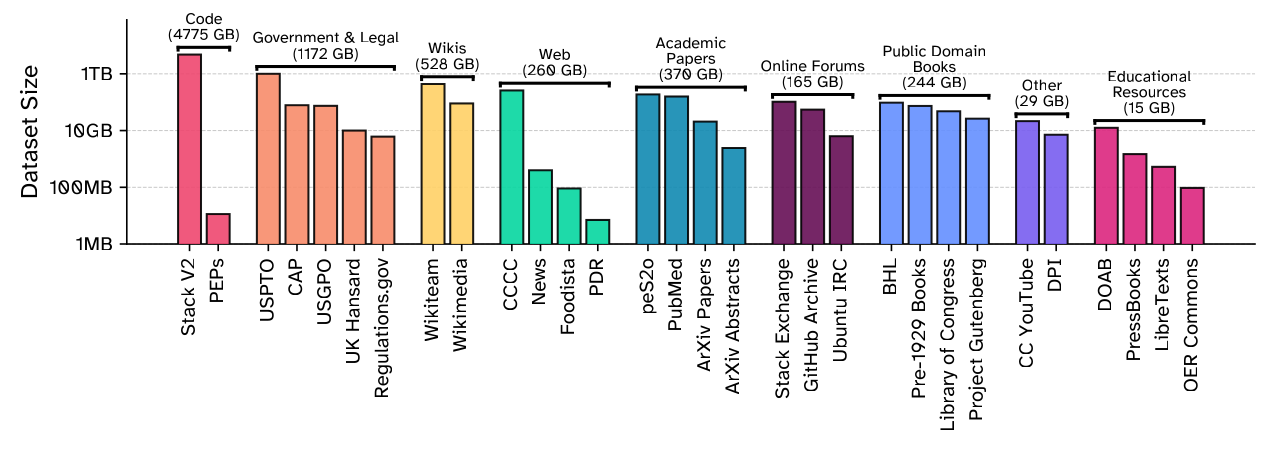
9.1 三个不容易的细节
构建这样的数据集比想象中难,因为「宽松许可」这个标签本身就不可靠:
- 许可洗白(license laundering):有人把受版权保护的作品重新以宽松许可发布出去——比如把整本书贴到一个 CC-BY 的博客上。这在技术上极难检测,因为你只能看到最终那份声明,看不到内容的真实来源。你依赖的许可可能是别人无权授予的。
- 集合许可不传递到单个条目:Dolma 整体以 ODC-By 发布,但这只是「对这个数据库集合本身」的许可,并不意味着其中每一份文档都是宽松许可的。这是一个非常容易踩的坑——看到数据集的 license 字段写着开放许可,就以为里面的内容都能随便用。
- 合成数据的许可地位不明:如果你用 GPT-4(它训练在未授权数据上)生成了一批数据,这批数据的法律地位是什么?目前没有清晰答案。 这个问题非常实际,因为几乎所有现代后训练数据都是这样来的。
9.2 结果:能打,但吃亏在 token 不够
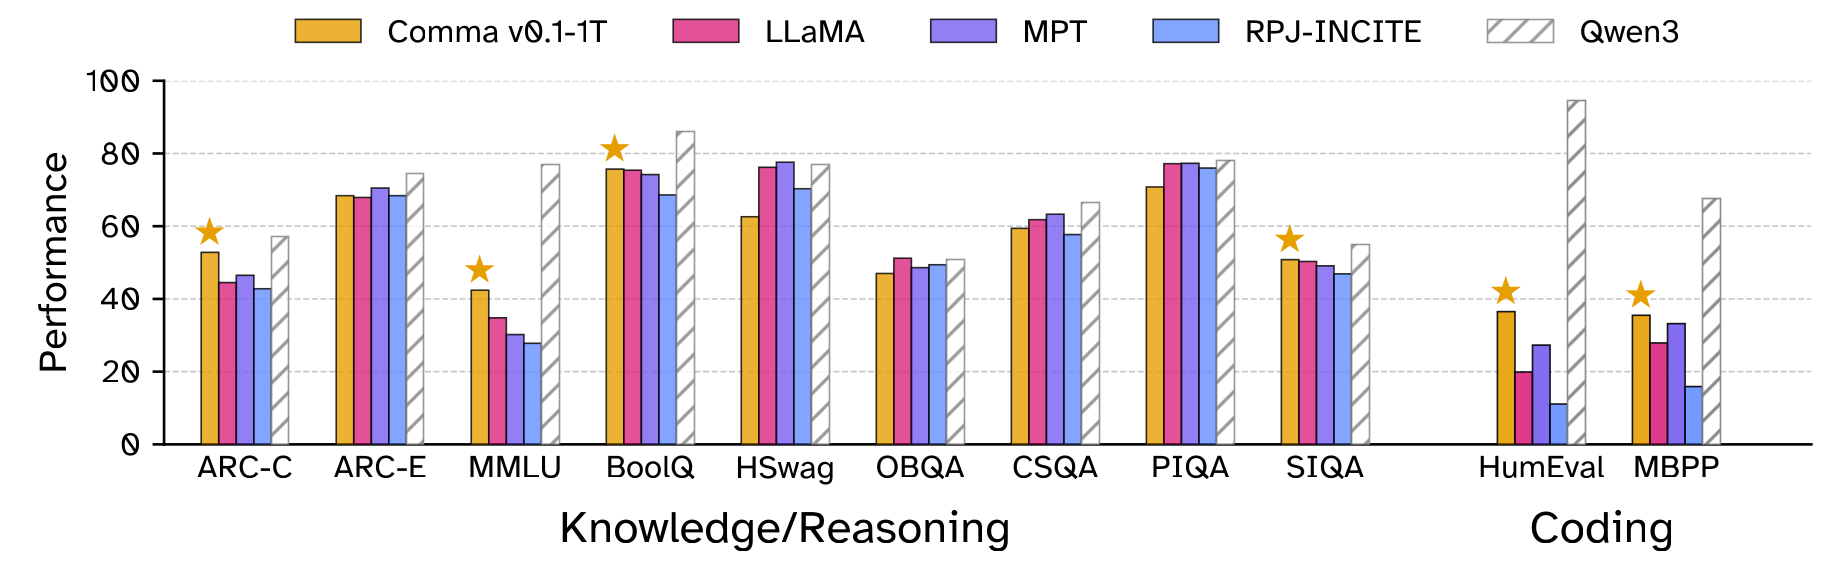
它把一个模糊的道德争论转换成了一个可测量的工程差距:合规路线目前落后,落后的量可以被具体地量化,而且瓶颈被明确定位在「token 数量」上。这意味着这是一个可以通过努力缩小的差距——去数字化更多公有领域图书、推动更多机构以开放许可发布内容、改进对现有合规语料的利用效率。
如果结论是「合规数据在质量上根本不行」,那这条路就死了;但结论是「量不够」,那这条路只是还需要有人去把它走出来。
10. 数据规模的现实与讲师的立场
10.1 到底还剩多少 token?
把本讲出现过的数字排在一起,能看出一条相当清楚的曲线:
| 数据 / 模型 | token 数 | 说明 |
|---|---|---|
| C4(2019) | 0.156 T | 单个 CC 快照 + 规则过滤 |
| The Pile(2021) | ~0.275 T | 22 个精选领域 |
| LLaMA(2023) | 1.2 T | 多来源组合 |
| Dolma(2024) | 3 T | 完全开放 |
| DCLM-baseline(2024) | 3.8 T | 从 240 T 的池子里筛出 1.6% |
| Nemotron-CC(2024) | 6.3 T | 放宽过滤 + 合成改写 |
| FineWeb(2024) | 15 T | 95 个 CC dump,公开英文网页语料的上限附近 |
| Llama 3 训练用量 | 15 T | 正好等于 FineWeb 的规模 |
| Qwen3 训练用量 | 36 T | 远超任何公开英文网页语料 |
| DCLM-pool(未过滤) | 240 T | 过滤前的原料上限 |
这张表里藏着本讲最重要的一个推论。高质量英文网页文本的可用量,大致就在 $10^{13}$ token 这个量级——FineWeb 用了 95 个 dump 才做到 15T,而 DCLM 从 240T 的原料里只筛出 3.8T。也就是说:
$$ \text{可用高质量英文网页 token} \sim 10^{13},\qquad \text{而原始网页总量} \sim 10^{14} $$但 Qwen3 已经训了 36T。这个数字不可能全部来自公开英文网页——它必然包含了大量多语言数据、代码、授权购买的数据,以及合成数据,或者对同一批数据做了多轮 epoch。
「数据墙(data wall)」指的是:模型规模按 Chinchilla 定律增长所需的 token 数,正在追上人类产出的全部高质量公开文本。业界有过一个被广泛引用的估计(Villalobos 等,Will we run out of data?):公开可得的人类文本总量在 $10^{14}$ token 量级,按当时的增长速率,会在 2020 年代后期被消耗完。
基于本讲的内容,可以给出一个更细致的判断——「墙」是分层的,而不是一堵:
- 高质量英文网页:确实快到顶了。 FineWeb 已经把 95 个 dump 榨过一遍,剩下的增量主要来自新产生的内容,而 2.3 节告诉我们新内容正越来越多地被
robots.txt挡在外面。 - 但还有大量未开采的储量:非英语语言(96% 的人类不以英语为母语)、被困在 PDF 里的文本(3.5 节)、视频与音频转录、授权购买的专有数据。
- 而且「过滤强度」本身是一个可调旋钮。Nemotron-CC 恰好证明了这一点:所谓「数据不够」,有一部分其实是「我们扔得太狠了」。当训练预算变大时,正确的做法是放宽过滤 + 用合成改写把低质量数据救回来,而不是重复训练同一批精华。
所以更准确的说法不是「数据用完了」,而是「容易拿的数据用完了」。剩下的都需要更多的工程与法务努力——这恰好回到了 Percy 的中心论点。
10.2 讲师的立场:开放数据生态为什么重要
贯穿全讲,Percy 有一条不加掩饰的价值判断:数据配方的封闭,正在损害这个领域的科学健康度。理由有几层:
(1)没有数据,就没有可复现的科学。 如果 Llama 3 的论文只告诉你架构而不告诉你数据,那么它的结果就是不可复现的——你无法判断某个能力来自架构创新还是某批秘密数据。Lecture 12 讲过测试集污染的问题,而污染这件事在数据不公开的前提下根本无法被检验:你没法证明一个模型的 MMLU 高分不是因为训练集里混进了 MMLU。
(2)数据决定模型的价值观与覆盖面。 5.4 节 C4 审计的结果说明了这一点:一条脏词表规则就能把某些人群从模型的世界里抹掉。如果没人能审计数据,这类问题永远不会被发现,更谈不上修正。
(3)开放数据是学术界唯一的入场券。 学术界买不起授权数据、雇不起百人数据团队,但可以在公开语料上做出真正有价值的方法研究——DCLM 的整个设计(固定模型、只比数据)就是为此服务的。没有公共的数据基础设施,数据研究就只能发生在少数几家公司内部。
这也是为什么本讲花了大量篇幅讲 Dolma / OLMo(AI2)与 Common Pile:它们不是最强的数据集,但它们是唯一完整公开了配方的——数据、工具链、消融实验、决策记录一应俱全,任何人都可以复现、批评、改进。同样精神下的还有 Percy 自己在 Stanford 主持的 Marin 项目:把整个模型开发过程(包括数据决策与失败的实验)在公开仓库里透明进行。
「这条流水线里的大部分环节都是启发式的——手写的规则、拍脑袋的阈值、凭直觉选的正样本。这意味着到处都是改进的机会。」
这不是客套话。回顾本讲:C4 的规则是 2019 年拍的,至今仍在被 FineWeb 使用;「至少 80% 的词含字母字符」这条 Gopher 规则从来没有人系统验证过它的阈值应该是 80% 还是 70%;HTML 抽取器的选择直到 2024 年才有第一个严肃的消融实验;PDF 这座金矿刚刚开始被开采。相比已经被全世界优化过无数轮的 Transformer 架构,数据流水线里的低垂果实多得多。
本讲小结
Percy 在课程最后给出的五条总结,值得逐字记住:
- 核心教训:数据不会从天上掉下来(data does not fall from the sky)。你必须去干活才能拿到它。
- 流程是:活的线上服务 → 原始数据 → 处理后的数据(转换、过滤、去重)。
- 数据是区分各个语言模型的关键成分。
- 存在真实的法律与伦理问题(版权、隐私)。
- 这条流水线里大部分是启发式的,有大量改进空间。
速查表
| 问题 | 一句话答案 |
|---|---|
| 为什么各家公开架构却不公开数据? | 竞争优势 + 版权责任。架构已趋同,数据才是护城河;写出数据清单等于递交起诉证据 |
| 训练分几个阶段? | 预训练($10^{12\text{–}13}$ token 网页)→ 中训练(高质量)→ 后训练(对话/RL)。总趋势:从多而糙到少而精 |
| Common Crawl 是什么? | 非营利组织,每月爬一次,每次 30–50 亿页;累计约 3000 亿页;单次约 372 TB |
| WARC / WET / WAT 怎么选? | 用 WARC(原始 HTTP 响应)自己抽取;WET 是有损的现成文本,会损害下游准确率;WAT 是元数据,用于链接图和 URL 过滤 |
| HTML→文本用什么? | trafilatura(质量好)、resiliparse(快)、jusText(召回高、token 多)。这一步的选择直接影响下游分数(DCLM 消融) |
| 不用爬就能拿到的来源? | Wikipedia 转储、arXiv S3、StackExchange XML、GitHub(git clone + GH Archive)、Software Heritage |
| 质量过滤的历史主线? | 社交信号(WebText)→ 手工规则(C4、Gopher)→ 参考分布分类器(CCNet、GPT-3、LLaMA)→ 目标导向分类器(DCLM)→ 集成 + 合成改写(Nemotron-CC) |
| DCLM 的关键发现? | 用 OpenHermes + ELI5 做正样本、RefinedWeb 做负样本训练的 fastText 分类器,胜过所有其他过滤方法 |
| 过滤应该多激进? | 取决于训练预算。算力小就狠筛(DCLM),算力大就放宽 + 合成改写把 token 补回来(Nemotron-CC) |
| 代码数据里有多少重复? | The Stack:510 亿文件里只有 50 亿唯一,约 90% 是重复 |
| 版权的默认状态? | 互联网上的一切默认受版权保护。合法使用只有两条路:取得许可、或主张合理使用 |
| 合理使用的四要素? | 目的与性质(转换性)、作品性质(事实 vs 虚构)、使用比例、对市场的影响 |
| 目前诉讼的结论? | 训练在个案中被认定为合理使用;盗版获取明确违法。Anthropic 因后者赔付 15 亿美元 |
| 只用合规数据行不行? | Common Pile(8 TB)证明「能做得不错」,但token 数量不足是硬约束 |
| 还剩多少数据? | 高质量英文网页约 $10^{13}$ token 量级,已接近开采上限;未开采储量在非英语、PDF、音视频转录、授权数据、合成数据 |
下一讲的接口
本讲回答了「数据从哪儿来」,并且已经反复撞上了下一讲的四个主题——每次都是点到为止:
- 过滤:C4 规则、Gopher 规则、DCLM 分类器——为什么这些方法有效?怎么系统地设计一个过滤器?
- 去重:MinHash、Bloom filter、SlimPajama 的 1.2T→627B——精确去重与模糊去重的算法与代价。
- 配比:OLMo 预训练表里那一列百分比是怎么定的?各来源该按什么比例混合?
- 合成:Nemotron-CC 的改写、Tülu 的指令数据、DCLM 用 GPT-4 生成的正样本——合成数据什么时候有用、什么时候会导致模型崩塌?
延伸阅读
数据集本身(按时间顺序读,能看到方法论的演进)
- CCNet (2019) — 第一个完整的「去重 + 语言识别 + 质量过滤」三段式流水线,至今仍是所有网页数据处理的模板。
- T5 / C4 (2019) — 读第 2 节。手工规则过滤的教科书,那几条规则你今天仍会在各家流水线里见到。
- Documenting Large Webtext Corpora (2021) — 对 C4 的审计。如果只读一篇关于数据偏见的论文,就读这篇:它具体展示了「中立的技术规则」如何造成人群层面的系统性排除。
- The Pile (2021) — 22 个领域的成分清单,是理解「预训练语料该有哪些成分」的最佳索引。
- Gopher (2021) — 看附录里的数据过滤规则,「Gopher rules」被后续所有工作反复引用。
- LLaMA (2023) — 第 2 节。当时最完整公开的数据配方(也因此成了诉讼的证据)。
- RefinedWeb (2023) — 「只用网页就够了」这一论点的完整论证,以及为什么它拒绝使用机器学习过滤。
- FineWeb (2024) — 配套的技术博客把每一个决策的消融实验都做了并公开。想自己动手建数据集的人应该从这里开始。
- Dolma (2024) — 3T token 的完全开放数据集,附带完整工具链与文档,是「开放科学」在数据领域的标杆。
- DataComp-LM / DCLM (2024) — 本讲最重要的方法论论文:把数据处理变成一个可控变量的基准,并证明了目标导向的质量分类器优于一切规则方法。
- Nemotron-CC (2024) — 从相反方向发问:过滤是不是太狠了?给出「最优过滤强度取决于训练预算」这一关键洞见。
- OLMo 2 (2025) — 唯一把预训练、中训练、后训练三个阶段的数据都完整公开的模型。
代码与垂直语料
- The Stack (2022) — 许可证驱动的代码语料构建;那个 51B→5B 的去重比例值得记住。
- The Stack v2 (2024) — 把 PR、issue、文档也纳入进来,并展示了结构化对象如何线性化成训练序列。
- BooksCorpus (2015) — BERT 时代的图书语料,同时也是「免费 ≠ 可以抓」这一教训的来源。
法律、伦理与数据可得性
- Consent in Crisis (2024) — 用数据量化了网站对爬虫的限制如何随时间收紧,尤其是在头部高质量域名上。理解「未来数据从哪来」的必读。
- Common Pile (2025) — 只用宽松许可数据能走多远?连同它对「许可洗白」「集合许可不传递」的讨论一起读。
- Poisoning Web-Scale Training Datasets (2023) — 说明为什么「来源可信」不等于「内容可信」,以及 Wikipedia 转储的时间可预测性如何构成攻击面。
- Will We Run Out of Data? (2022) — 对人类公开文本总量的定量估计,「数据墙」讨论的起点。
基础模型的数据披露(作为反面教材读)
- Llama 3 (2024) — 对照阅读它的架构章节与数据章节,体会 1.1 节讲的那种信息量落差。
- GPT-3 (2020) — 第 2.2 节。质量分类器 + 模糊去重(含基准去污染)这两个后世标配动作的来源。
- Tülu 3 (2024) — 后训练数据配方的完整公开版本,为下一讲的合成数据部分做准备。