推理(Inference)
训练是一次性成本,推理是每天要付的账单。这一讲把「生成一个 token」拆到算术强度、显存带宽和 KV cache 的每一个字节上,然后系统性地给出五类加速手段:改架构、量化、剪枝蒸馏、投机采样、动态批处理与分页。
0. 本讲导读
到目前为止,这门课的所有算账都是围绕训练展开的:FLOPs 预算 $6ND$、MFU、激活显存、数据并行与模型并行、缩放定律。训练的世界有一个非常舒服的性质——所有 token 都已经在那里了。你可以把一个 batch 的所有位置一次性喂进 Transformer,每一层都是又大又胖的矩阵乘法,GPU 的 Tensor Core 吃得饱饱的,算术强度轻松上千。
推理把这个性质彻底打碎了。生成第 $t+1$ 个 token 必须等第 $t$ 个 token 出来,序列维度上的并行性消失了。于是矩阵乘法退化成矩阵-向量乘法,GPU 从「算得慢」变成「等数据」——每生成一个 token,都要把整个模型的参数从 HBM 里搬一遍,而这些参数只被用了一次。H100 有 989 TFLOP/s 的 BF16 算力,但只有 3.35 TB/s 的显存带宽,这个比例决定了:朴素的自回归解码会把 99% 以上的算力浪费掉。
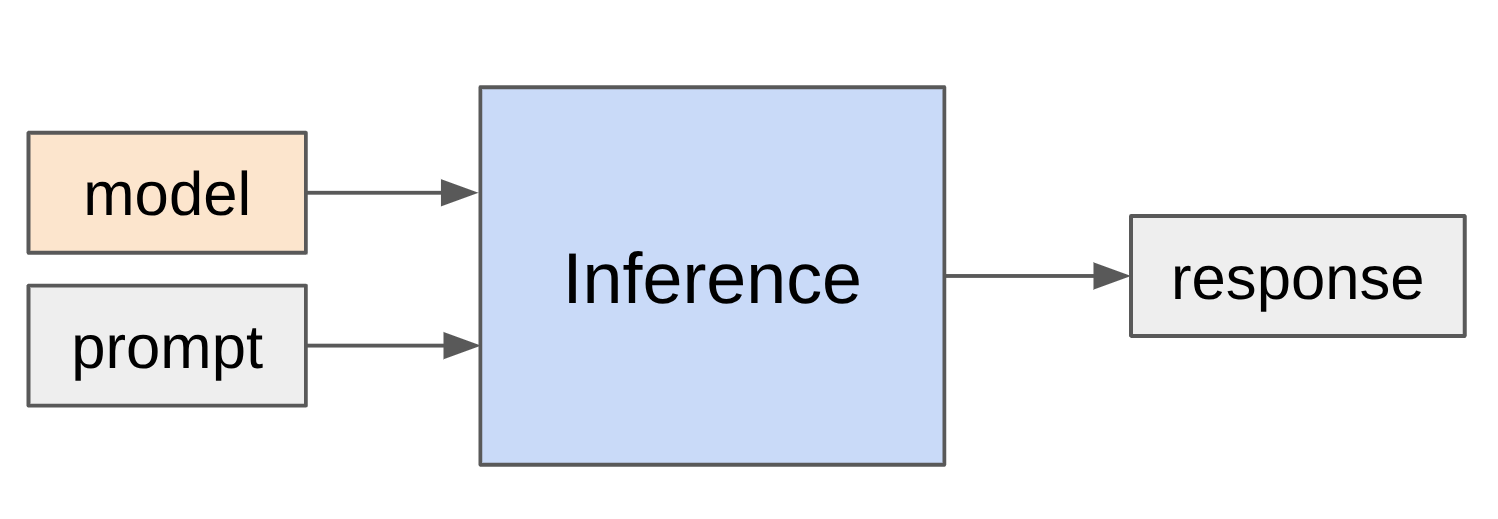
这一讲的组织方式很清晰,Percy 把它分成四段:
- 理解推理这个 workload——用算术强度把 prefill 和 decode 的差别算清楚,并推导延迟/吞吐的理论上限。
- 抄近路(有损)——改小 KV cache(GQA / MLA / CLA / 局部注意力)、量化、剪枝与蒸馏。这些会动到模型本身,必须验证精度不掉。
- 抄近路但复查(无损)——投机采样(speculative sampling),用一个便宜模型猜、用目标模型验,数学上保证输出分布与目标模型严格一致。
- 应付动态负载——连续批处理(continuous batching)与 PagedAttention,把操作系统里的调度和分页搬进推理引擎。
- Prefill 是 compute-bound,decode 是 memory-bound。MLP 层的算术强度是 $BT$,注意力层是 $\frac{ST}{S+T}$。代入 $T=S$(prefill)得 $S/2$,代入 $T=1$(decode)得 $<1$。
- H100 的加速器强度(算力/带宽)约为 295。算术强度低于它就是在浪费算力。
- 增大 batch 只能救 MLP,救不了注意力——因为每条序列有自己的 KV cache,注意力的算术强度里根本不含 $B$。
- 延迟 $\approx \frac{\text{参数字节数} + B\cdot\text{单序列 KV cache 字节数}}{\text{显存带宽}}$;吞吐 $= B/\text{延迟}$。batch 越大,延迟越差、吞吐越好,这是推理系统最核心的一组取舍。
- 因此几乎所有架构级推理优化(GQA、MQA、MLA、CLA、滑动窗口、DeepSeek 的稀疏注意力)都在做同一件事:把 KV cache 变小,从而在同样显存里塞下更大的 batch。
- 投机采样是唯一数学上无损的加速:它利用了「检查比生成便宜」这个不对称性。
1. 推理为什么越来越重要
推理出现在三个地方
很多人下意识把推理理解成「聊天机器人回答问题」,但 Percy 一上来就把范围拉开:
- 实际使用:聊天机器人、代码补全、agent、批量数据处理。
- 模型评测:你要在指令遵循、数学、代码这些 benchmark 上评估一个模型,本质就是跑成千上万次生成。研究迭代速度直接被推理速度卡住。
- 强化学习:RL 训练循环里,每一步都要采样大量 rollout,再用打分函数评价。现代 RLHF / RLVR 训练里,推理(rollout)常常占了整个 pipeline 一半以上的时间。也就是说,即使你只关心训练,你也逃不掉推理。
为什么「效率」在推理上比在训练上更要命
逻辑非常简单:训练是一次性成本,推理是重复无数次的成本。
Percy 给了一组对照数字,值得记住:
| 量 | 规模 | 说明 |
|---|---|---|
| OpenAI 每天处理的 token | 约 8.6 T(8.6 万亿) | 消费级 AI token 消耗统计 |
| DeepSeek-V4 的训练数据量 | 32 T token | DeepSeek-V4 技术报告 |
换句话说,一个头部服务商每四天处理的 token 量,就相当于把一个前沿模型的全部训练语料再过一遍。虽然推理的每 token FLOPs(约 $2N$)只有训练(约 $6N$)的三分之一,但这个「每天」是无限重复的。
Percy 强调了一个正在发生的转变。聊天机器人时代,绝大部分生成的 token 是给人看的,而人的阅读速度大概只有每秒几十个 token——人是瓶颈,所以你只要生成得比人读得快一点就够了。Agent 时代完全不同:query → 内部思维链/工具调用轨迹 → 最终输出给人。中间那段 trace 没有人看,长度可以无限增长。而「生成的 token 数 = 花掉的算力」,所以 test-time compute(测试时计算)这条 scaling 路线,本质上就是把推理成本当作可以主动加码的旋钮。这就是为什么推理效率突然从工程细节变成了战略问题。
谁在做推理
推理已经是一个独立的产业层。Percy 把玩家分成两类:
- 服务闭源模型的提供商:OpenAI、Anthropic、Google 等——模型和推理栈都是自己的。
- 服务开源权重模型的提供商:Together、Fireworks、Baseten、DeepInfra、Groq、Cerebras 等。这些公司卖的就是推理效率本身——同样的 Llama 权重,谁的 token 更便宜、更快,谁就赢。Groq 和 Cerebras 甚至为此做了专用硬件(把权重放进片上 SRAM,绕开 HBM 带宽墙)。
开源推理引擎方面,课上点名了四个:
| 项目 | 出处 | 特点 / 适用场景 |
|---|---|---|
| vLLM | UC Berkeley | PagedAttention 的发源地,生态最广,默认首选 |
| SGLang | UC Berkeley | RadixAttention(前缀树式 KV 复用),擅长 agentic / 多轮 / 结构化输出 |
| TensorRT-LLM | NVIDIA | 对 NVIDIA GPU 做到极致的 kernel 优化,部署重、性能强 |
| llama.cpp | 社区 | 纯 C++,支持 CPU 推理,本地跑(GGUF 量化生态) |
「快」到底指什么
在开始优化之前必须先定义指标,否则会优化错东西。课上给了三个:
- 首 token 时延(Time-To-First-Token, TTFT):用户按下回车后,等多久才看到第一个字。对交互式应用(聊天、补全)是体感的第一决定因素。TTFT 基本上就是 prefill 时间。
- 延迟(latency,秒/token):单个请求的 token 出现速度,也常写成 TPOT(Time Per Output Token)或它的倒数「每秒 token 数(单流)」。
- 吞吐(throughput,token/秒):所有请求合起来每秒产出多少 token。对批处理任务(离线数据标注、RL rollout、大规模评测)这是唯一重要的指标,因为它直接等价于每 token 成本。
延迟和吞吐不是同一件事的两种说法,而是一对互相冲突的目标。第 3 节我们会用具体数字看到:把 batch 从 1 加到 64,吞吐涨了几十倍,但单请求延迟同时也变差了。任何声称「我们又快又便宜」的推理系统,都必须说明它站在这条 Pareto 曲线的哪个位置。
根源:训练能并行,推理不能
为什么推理天然比训练难吃满算力?一句话:
- 训练(监督式):所有 token 都已知(teacher forcing),可以在序列维度上完全并行。Transformer 里全是大矩阵乘法。
- 推理:必须一个一个地生成,生成维度上无法并行,所以很难把计算单元喂饱。
接下来两节就是把这句定性的话,变成可以代入数字的公式。
2. Prefill 与 decode:用算术强度算清楚
2.1 记号约定
沿用 Scaling Book 的 Transformer 章节的 einops 风格记号——每个字母代表一个维度:
| 符号 | 含义 | 典型值(Llama 2 13B) |
|---|---|---|
| $B$ | batch size(并发请求数) | 1 ~ 256 |
| $S$ | 已经条件化的 token 数(KV cache 长度) | 1024 |
| $T$ | 本次要产出 logits 的 token 数 | prefill: $=S$;decode: $=1$ |
| $D$ | 模型维度 | 5120 |
| $F$ | FFN 中间维度(惯例 $F = 4D$) | 13824 |
| $N$ | query 头数(惯例 $D = NH$) | 40 |
| $K$ | key/value 头数(GQA:$N = KG$) | 40(MHA) |
| $H$ | 每个头的维度 | 128 |
| $L$ | 层数 | 40 |
| $V$ | 词表大小 | 32000 |
矩阵乘法用「收缩维」和「批维」来读:BTD × DH → BTH 中红色的 $D$ 在两个操作数里都出现、在结果里消失,这是收缩维(contracting);而 BD × BD → B 里的 $B$ 在两边都出现、在结果里保留,这是批维(batching)。这套记号在下面数 FLOPs 和字节时会非常省心。
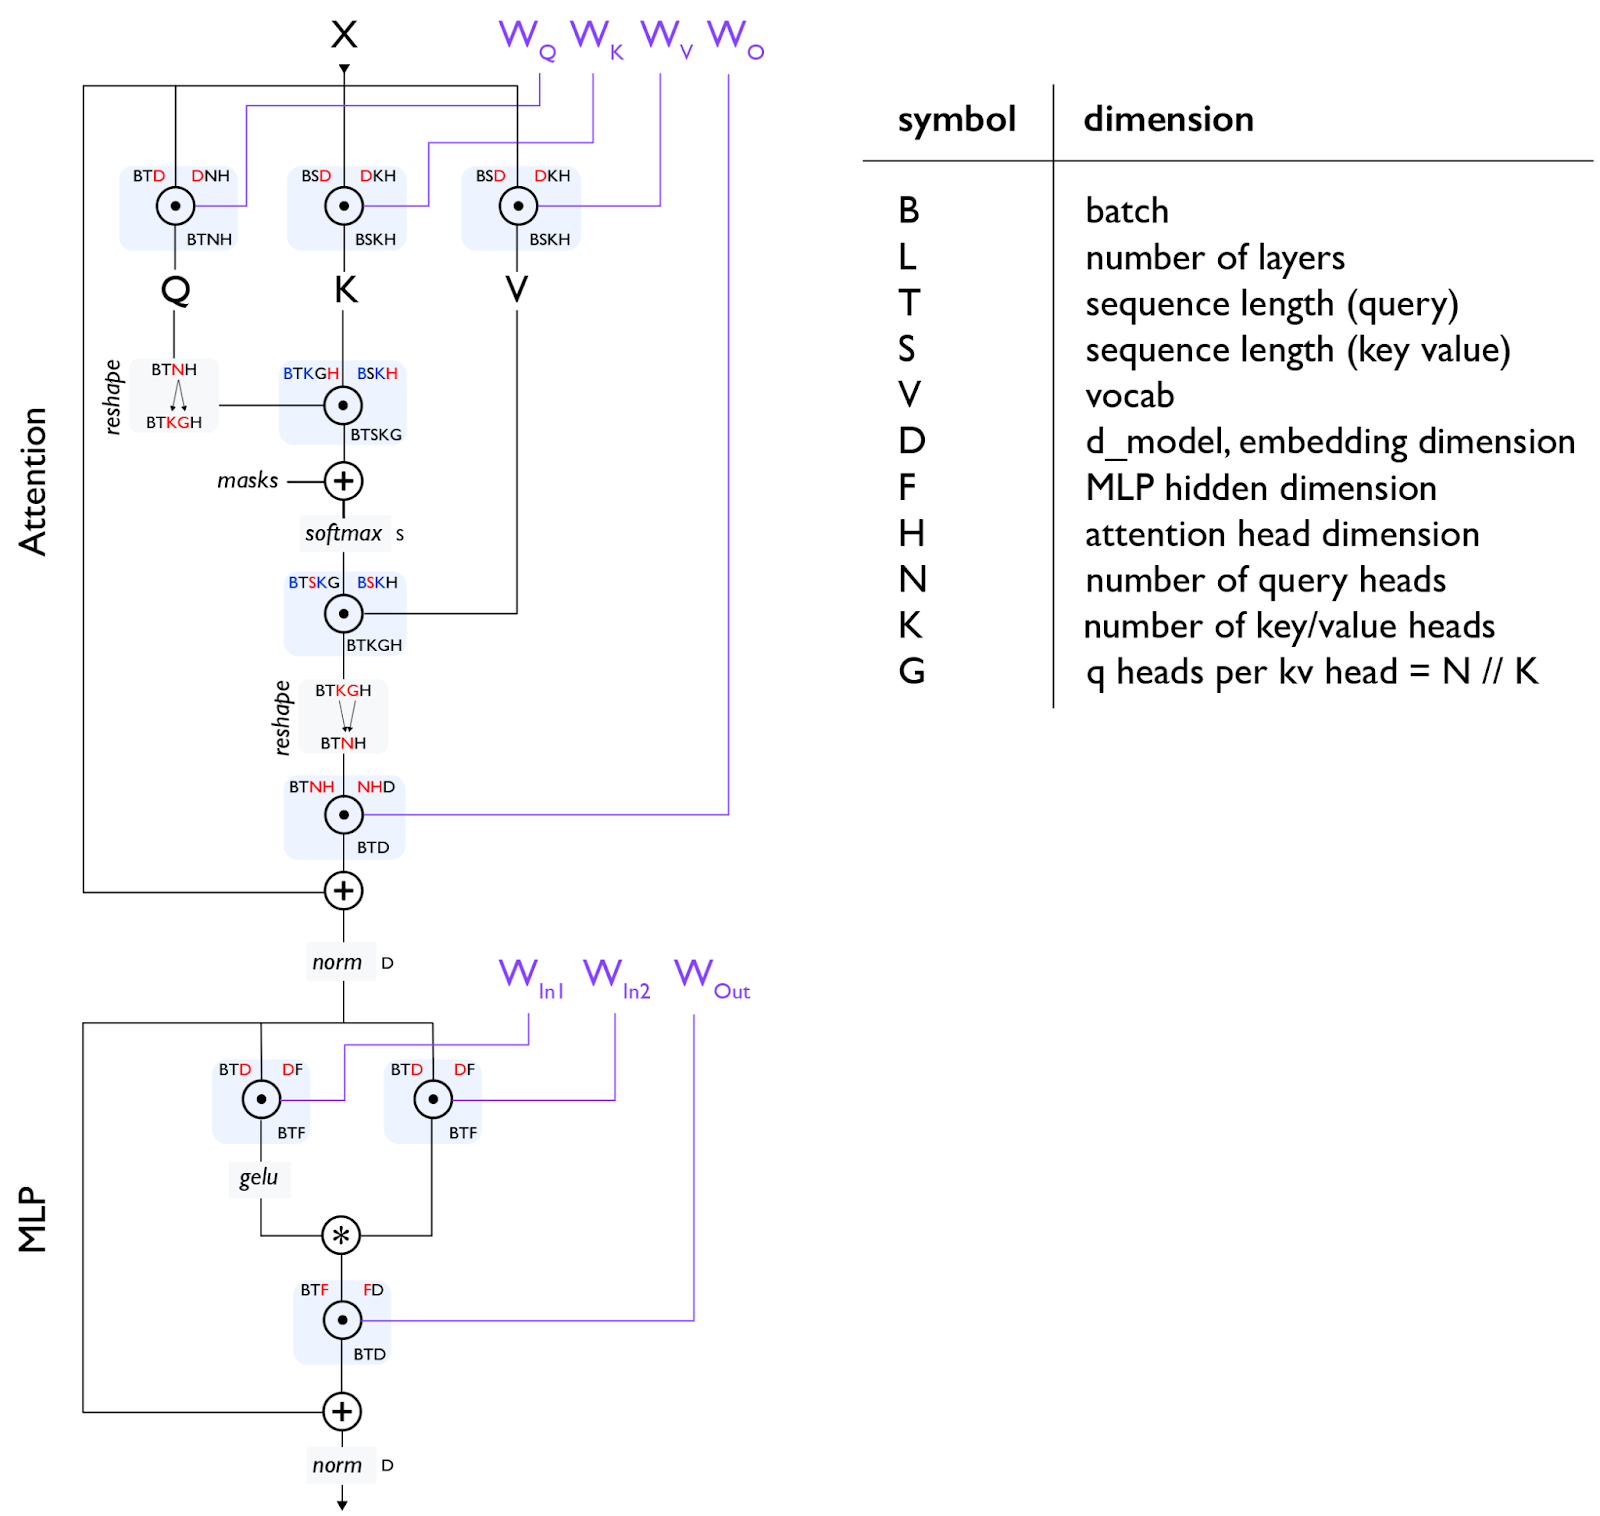
2.2 复习:算术强度与「roofline 分界线」
先做最简单的例子:把 $X\ (B \times D)$ 乘上 $W\ (D \times F)$,用 BF16(每个数 2 字节)。逐步记账:
- 从 HBM 读 $X\ (B\times D)$:$2BD$ 字节
- 从 HBM 读 $W\ (D\times F)$:$2DF$ 字节
- 计算 $Y = XW$:$2BDF$ FLOPs(每个输出元素一次乘一次加)
- 把 $Y\ (B\times F)$ 写回 HBM:$2BF$ 字节
于是
$$ \text{intensity} = \frac{\text{FLOPs}}{\text{bytes}} = \frac{2BDF}{2BD + 2DF + 2BF} $$当 $B \ll D, F$ 时(把 $D = cB,\ F = cB$ 代入并令 $c \to \infty$),分母被 $2DF$ 这一项主导:
$$ \text{intensity} \;\longrightarrow\; \frac{2BDF}{2DF} = B $$这个结果干净得惊人:矩阵乘法的算术强度就等于 batch size。直觉上完全说得通——权重矩阵只被读进来一次,但它被 $B$ 行输入各用了一遍,所以「每读一个字节能做多少次计算」正比于 $B$。
另一边,硬件也有一个强度:
$$ \text{accelerator intensity (H100)} = \frac{989 \times 10^{12}\ \text{FLOP/s}}{3.35 \times 10^{12}\ \text{B/s}} \approx 295 $$判据于是非常简单:
- 计算强度 > 295 → compute-bound(好,算力被用满了)
- 计算强度 < 295 → memory-bound(坏,GPU 在等 HBM)
也就是说,在 H100 上做 BF16 矩阵乘法,必须 $B > 295$ 才能吃满算力。
极端情形 $B = 1$,也就是矩阵-向量乘法:算术强度是 1。你把整个 $D\times F$ 的权重矩阵从 HBM 搬进来,只做了 $2DF$ 次 FLOPs,然后就把它丢掉。相对 295 的分界线,你浪费了 99.7% 的算力。这几乎就是朴素自回归解码在做的事情——「推理慢」不是因为模型算不过来,而是因为显存带宽根本喂不动。买更强的算力卡对它毫无帮助。
2.3 从朴素推理到 KV cache
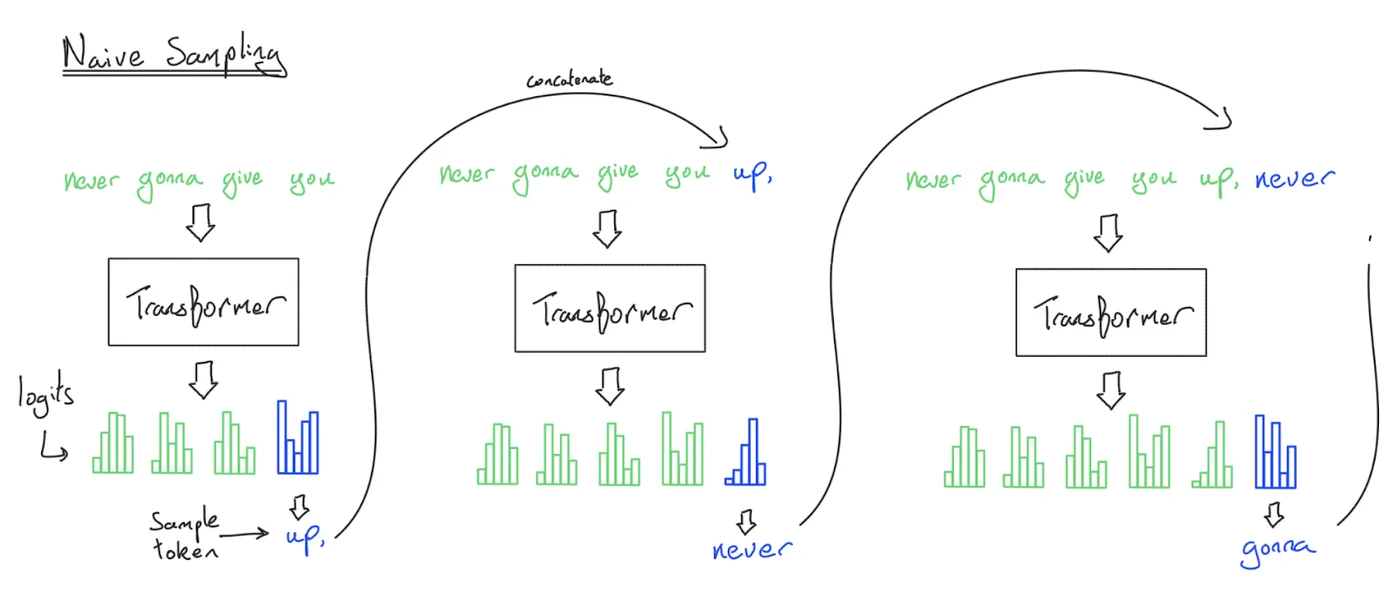
关键观察是:前缀部分的 key 和 value 每一步都一模一样。于是把它们存下来——KV cache:对每条序列($B$)、每个 token($S$)、每层($L$)、每个 KV 头($K$),存一个 $H$ 维的 key 和一个 $H$ 维的 value,放在 HBM 里。
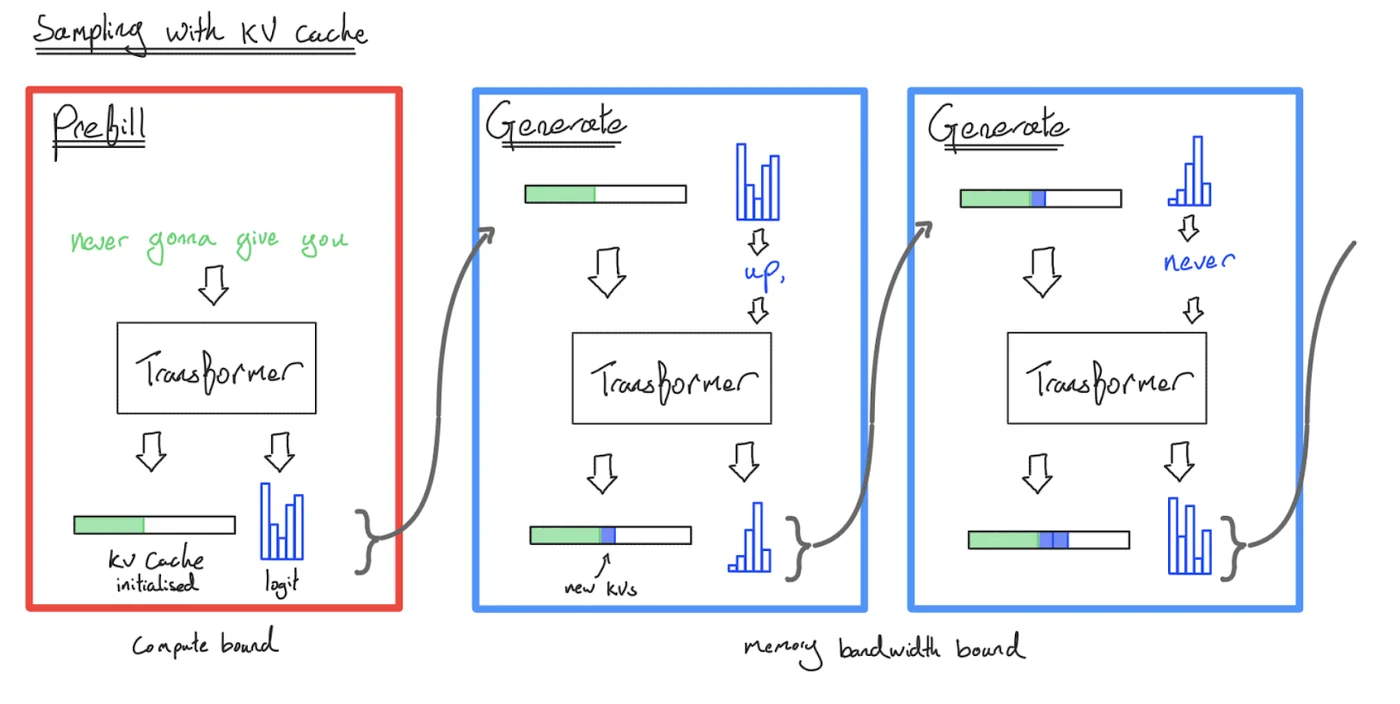
于是推理被清晰地切成两个阶段:
- Prefill(预填充):给定 prompt,一次性把所有 token 编码成 KV cache。可以像训练一样在序列维度并行。
- Generation / Decode(生成):逐个生成回复 token,严格串行。
2.4 MLP 层的算术强度:$BT$
现在对现代 Transformer 的 gated MLP($W_{up}, W_{gate}, W_{down}$)逐步记账。输入 $X$ 形状 $B\times T\times D$:
| 步骤 | FLOPs | 字节 |
|---|---|---|
| 读 $X\ (B\times T\times D)$ | — | $2BTD$ |
| 读 $W_{up}, W_{gate}, W_{down}$(各 $D\times F$) | — | $3\cdot 2DF$ |
| $U = X W_{up}$ | $2BTDF$ | 写 $U$:$2BTF$ |
| $G = X W_{gate}$ | $2BTDF$ | 写 $G$:$2BTF$ |
| $Y = (\text{GeLU}(G)\odot U)\,W_{down}$ | $2BTDF$ | 写 $Y$:$2BTD$ |
合计 $\text{FLOPs} = 6BTDF$,$\text{bytes} = 4BTD + 4BTF + 6DF$。当 $BT \ll D, F$ 时,分母由权重项 $6DF$ 主导:
$$ \text{intensity}_{\text{MLP}} = \frac{6BTDF}{4BTD + 4BTF + 6DF} \;\longrightarrow\; \frac{6BTDF}{6DF} = BT $$结论:MLP 的算术强度是 $BT$——「有效并行的 token 总数」。代入两个阶段:
- Prefill:$T$ 就是 prompt 长度,动辄几百上千。哪怕 $B=1$,$BT$ 也轻松超过 295 → compute-bound,很好。
- Decode:$T = 1$,强度退化为 $B$。要 compute-bound 就必须凑够近 300 个并发请求。而对交互式服务,$B$ 是不可控的——它取决于此刻有多少用户在线。
2.5 注意力层的算术强度:$\frac{ST}{S+T}$
注意力层假设用了 FlashAttention(中间的 $S\times T$ 分数矩阵不落 HBM),只数进出 HBM 的量。$Q$ 是 $B\times T\times D$,$K, V$ 是 $B\times S\times D$:
- 读 $Q, K, V$:$2BTD + 2BSD + 2BSD$ 字节
- $A = QK^\top$:$2BSTD$ FLOPs
- $Y = \softmax(A)V$:$2BSTD$ FLOPs
- 写 $Y\ (B\times T\times D)$:$2BTD$ 字节
合计 $\text{FLOPs} = 4BSTD$,$\text{bytes} = 4BSD + 4BTD$。于是
$$ \text{intensity}_{\text{attn}} = \frac{4BSTD}{4BSD + 4BTD} = \frac{ST}{S+T} $$这个式子是本讲最重要的一行。代入两个阶段:
$$ \text{prefill}\ (T=S):\quad \frac{S\cdot S}{2S} = \frac{S}{2} \qquad\qquad \text{decode}\ (T=1):\quad \frac{S}{S+1} < 1 $$Prefill 的强度随序列长度线性增长($S=1024$ 时是 512,超过 295,compute-bound)。而 decode 的强度永远小于 1——比矩阵-向量乘法还糟,而且无论 $S$ 多大都不会变好。
注意到 $\frac{ST}{S+T}$ 里根本没有 $B$。这意味着加大 batch 完全不能改善注意力层的算术强度。为什么 MLP 可以而注意力不行?
- MLP 层:所有序列打的是同一套权重 $W_{up}, W_{gate}, W_{down}$——权重读一次,被 $B$ 条序列共享,所以强度 $\propto B$。
- 注意力层:每条序列有自己的 KV cache——$Q, K, V$ 都带 $B$ 维,读的字节数和算的 FLOPs 同时正比于 $B$,比值不变。
| MLP 强度 | 注意力强度 | 结论 | |
|---|---|---|---|
| Prefill($T=S$) | $BS$ | $S/2$ | 容易 compute-bound(好) |
| Decode($T=1$) | $B$ | $<1$ | memory-bound(坏),注意力部分原理上无法改善 |
「注意力部分原理上无法改善」这句话要小心理解:强度不能改善,但绝对的字节数可以改善。既然读 KV cache 的时间就是 decode 的时间,那把 KV cache 做小 $k$ 倍,decode 就快 $k$ 倍。第 6 节的 GQA / MLA / CLA / 滑动窗口全部建立在这一句话上。
3. 延迟、吞吐与它们的理论上限
既然 decode 是 memory-bound 的,那么生成一个 token 需要的时间,就等于把「必须读的所有字节」搬过 HBM 总线的时间。这给了我们一个非常干净的性能模型——不需要模拟器,一张纸就能算出上限。
3.1 性能模型
先数参数。一个标准 Transformer 的参数量(含输入/输出 embedding、gated MLP 的三个矩阵、注意力的 $W_Q,W_O$ 与 $W_K,W_V$):
$$ N_{\text{param}} = \underbrace{2VD}_{\text{embed + unembed}} + \underbrace{3DFL}_{\text{MLP}} + \underbrace{(2DNH + 2DKH)L}_{\text{attention}} $$BF16 存储,参数占 $2N_{\text{param}}$ 字节。KV cache 每条序列占:
$$ M_{\text{KV/seq}} = \underbrace{S}_{\text{token}} \times \underbrace{KH}_{\text{每层每 token 的 K 向量维度}} \times \underbrace{L}_{\text{层}} \times \underbrace{2}_{\text{K 和 V}} \times \underbrace{2}_{\text{bf16}} = 4\,S\,K\,H\,L $$于是每一步 decode 必须读的总字节数、以及由此得到的延迟与吞吐:
$$ M_{\text{total}} = 2N_{\text{param}} + B \cdot M_{\text{KV/seq}}, \qquad \text{latency} = \frac{M_{\text{total}}}{\text{bandwidth}}, \qquad \text{throughput} = \frac{B}{\text{latency}} $$为什么延迟直接等于「显存流量 ÷ 带宽」?因为每生成一个 token,你必须(a)把全部模型参数读一遍——每个权重只被一个(或 $B$ 个)token 用一次,(b)把 batch 里全部序列的 KV cache 读一遍。计算时间被完全隐藏在这些读取之下。这里假设计算与通信完美重叠、忽略一切 kernel launch 开销,所以得到的是理论最优——真实系统只会更慢。
3.2 代入 Llama 2 13B + H100
配置:$S=1024,\ D=5120,\ F=13824,\ N=K=40,\ H=128,\ L=40,\ V=32000$,带宽 $3.35\times10^{12}$ B/s,H100 显存 80 GB。
V, D, F, N, K, H, L, S = 32000, 5120, 13824, 40, 40, 128, 40, 1024
BW = 3.35e12          # H100 HBM3 bandwidth, bytes/s

num_params = 2*V*D + 3*D*F*L + (2*D*N*H + 2*D*K*H)*L   # 13.0e9
param_bytes = 2 * num_params                            # 26.0 GB
kv_per_seq  = 4 * S * K * H * L                         # 0.839 GB

def stats(B):
    mem = param_bytes + B * kv_per_seq
    latency = mem / BW                 # seconds per token
return mem, latency, B / latency # bytes, s/token, tokens/s| $B$ | KV cache | 总显存 | 延迟(ms/token) | 吞吐(token/s) | 能否装进 80 GB |
|---|---|---|---|---|---|
| 1 | 0.84 GB | 26.9 GB | 8.0 | 125 | ✅ |
| 64 | 53.7 GB | 79.7 GB | 23.8 | 2 690 | ⚠️ 刚好卡满 |
| 256 | 214.7 GB | 240.8 GB | 71.9 | 3 562 | ❌ 装不下 |
这张表要读出三件事:
- $B: 1 \to 64$:延迟变差 3 倍,吞吐变好 21.5 倍。非常划算——因为读参数的 26 GB 成本被 64 条序列摊薄了。
- $B: 64 \to 256$:延迟又差 3 倍,吞吐只涨 1.32 倍。收益急剧递减——此时总流量已经被 KV cache 主导(214.7 GB vs 26.0 GB),参数摊薄的红利吃完了,再加 batch 基本是「加多少 KV 就多读多少」,$\text{throughput} \to \text{bandwidth} / M_{\text{KV/seq}}$ 触顶。
- $B=256$ 根本装不下 80 GB。所以吞吐上限不是被算力卡住的,是被显存容量卡住的:显存装不下更大的 batch,batch 上不去,吞吐就上不去。
增大 batch size 的两个效应互相拉扯:
- 恶化延迟:KV cache 是 $O(B)$ 的,每步要读的字节线性增长。
- 改善吞吐:读参数的固定成本被 $B$ 条序列摊薄。
于是有一条硬性取舍:小 batch = 好延迟 / 差吞吐;大 batch = 好吞吐 / 差延迟。交互式产品(聊天)往延迟一端调,离线任务(评测、RL rollout、批量标注)往吞吐一端调。你没法同时要两个。
3.3 每 token 成本 = 吞吐的倒数
吞吐之所以重要,是因为它直接就是钱。一张 H100 每小时租金记作 $c$ 美元,那么
$$ \text{每百万 token 成本} = \frac{10^6}{\text{throughput} \times 3600} \times c $$用上表:$B=64$ 时 2690 token/s,按 $c \approx 2$ 美元/小时算,约 0.21 美元 / 百万 token;$B=1$ 时同样的卡只有 125 token/s,成本是 4.4 美元 / 百万 token,贵 21 倍。这就是为什么所有推理服务商都在拼命想办法「把 batch 做大」——第 5、6 节的连续批处理和 PagedAttention,本质上都是把 batch 做大的工程手段。
3.4 两种并行,以及 TTFT 的处理
- 简单的并行:启动 $M$ 份模型副本(数据并行式的服务扩容)。延迟不变,吞吐 $\times M$。这是最省事的扩容方式,前提是单卡(单节点)装得下模型。
- 困难的并行:把模型和 KV cache 都切开(张量并行、流水线并行、以及针对 KV cache 的序列/头维度切分)。这能降低单请求延迟(因为每张卡只需要读 $1/M$ 的字节),但引入通信开销。Scaling Book 的推理章节对此有详尽讨论。
最后是 TTFT。TTFT 基本上就是 prefill 时间,而 prefill 是 compute-bound 的——它不需要靠大 batch 来提高利用率($BT$ 里的 $T$ 已经够大了)。所以最佳实践是把两个阶段的 batch 策略分开:
prefill 用小 batch(甚至 $B=1$)以尽快返回第一个 token;decode 用大 batch以提高吞吐。这个「两个阶段想要的东西不一样」的观察,最终会被推到极致,演化成prefill / decode 分离部署(第 10 节)。
4. KV cache 的显存账:它如何成为吞吐的天花板
上一节的表已经暴露了真正的瓶颈:显存装不下更多序列。把 KV cache 的公式再写一遍并逐项拆解:
$$ M_{\text{KV}} = \underbrace{2}_{\text{K, V}} \times \underbrace{b}_{\text{每元素字节}} \times L \times K \times H \times S \times B $$注意这个式子里的每一个因子,后面都会有对应的优化手段去砍它:
| 因子 | 含义 | 对应的优化 |
|---|---|---|
| $b$(字节数) | BF16 = 2 | KV cache 量化(FP8 / INT8 / INT4)→ 第 7 节 |
| $K \cdot H$(每层每 token 维度) | KV 头数 × 头维 | MQA / GQA / MLA → 第 8 节 |
| $L$(层数) | 每层都存一份 | CLA(跨层共享 KV)→ 第 8 节 |
| $S$(序列长度) | 线性增长,长上下文的噩梦 | 滑动窗口 / 稀疏注意力 → 第 8 节 |
| $B$(并发数) | 你想要它大 | 这是目标,不是要砍的对象 |
| 「实际占用 ≫ 实际使用」 | 预留、碎片、重复前缀 | PagedAttention → 第 6 节 |
4.1 每 token 多少字节?几个真实数字
把 $S=B=1$ 代入,得到「每个 token 的 KV 占用」这个最有用的量 $= 4KHL$ 字节(BF16):
| 模型 | $L$ | $K \times H$ | 每 token KV | 1 万 token 上下文 |
|---|---|---|---|---|
| Llama 2 13B(MHA, $K=40$) | 40 | $40\times128=5120$ | 800 KB | 8.0 GB |
| Llama 2 13B 若改 GQA($K=8$) | 40 | $8\times128=1024$ | 160 KB | 1.6 GB |
| Llama 3 70B(GQA, $K=8$) | 80 | $8\times128=1024$ | 320 KB | 3.2 GB |
看第一行:MHA 的 Llama 2 13B,单条 1 万 token 的对话就要吃掉 8 GB 显存——而模型权重才 26 GB。在一张 80 GB 的 H100 上,扣掉权重只剩 54 GB,也就是说最多只能并发 6 条这样的长对话。$B=6$ 意味着 MLP 的算术强度只有 6(远低于 295),意味着你在烧钱。这就是「KV cache 是吞吐天花板」的完整含义:它不是通过拖慢计算来伤害你的,而是通过占满显存、逼你把 batch 调小来伤害你的。
4.2 KV cache 与参数:谁主导?
令 KV 总量等于参数总量,可以解出一个「临界并发-长度积」:
$$ B\cdot S \;=\; \frac{2N_{\text{param}}}{4KHL} $$对 Llama 2 13B(MHA):$\frac{26.0\times10^9}{4\times40\times128\times40} = \frac{26.0\times10^9}{819200} \approx 31\,700$ token。也就是说,只要总共缓存的 token 数超过约 3 万(比如 32 条 1000-token 的对话),KV cache 的显存流量就超过了参数——此后每加一条序列,边际吞吐收益趋近于零。这个数字很小,小到令人意外。长上下文 + 高并发的服务,几乎总是运行在「KV 主导」的区间里。
4.3 一个最小的 KV cache decode 循环
import torch

class KVCache:
    """预分配 [B, L, 2, K, S_max, H] 的连续缓冲(这正是 PagedAttention 要废掉的做法)"""
    def __init__(self, B, L, K, S_max, H, dtype=torch.bfloat16, device="cuda"):
        self.k = torch.empty(L, B, K, S_max, H, dtype=dtype, device=device)
        self.v = torch.empty(L, B, K, S_max, H, dtype=dtype, device=device)
        self.len = 0                      # 已填充长度

    def append(self, layer, k_new, v_new):     # k_new: [B, K, t, H]
        t = k_new.shape[2]
        self.k[layer, :, :, self.len:self.len + t] = k_new
        self.v[layer, :, :, self.len:self.len + t] = v_new
        return (self.k[layer, :, :, :self.len + t],
                self.v[layer, :, :, :self.len + t])

@torch.no_grad()
def generate(model, prompt_ids, cache, max_new_tokens):
    # ---- Prefill:一次性喂 S 个 token,compute-bound ----
    logits = model(prompt_ids, cache)          # [B, S, V]
    cache.len += prompt_ids.shape[1]
    next_id = sample(logits[:, -1])            # [B, 1]

    out = [next_id]
    # ---- Decode:每次只喂 1 个 token,memory-bound ----
    for _ in range(max_new_tokens - 1):
        logits = model(next_id, cache)         # [B, 1, V]
        cache.len += 1
        next_id = sample(logits[:, -1])
        out.append(next_id)
return torch.cat(out, dim=1)这段代码里唯一「昂贵」的东西不在代码里:循环的每一次迭代,model(...) 内部都要把全部 26 GB 权重和全部 KV cache 从 HBM 拉一遍。Python 循环的开销可以忽略,HBM 的往返不能。
5. 批处理:从 static batching 到 continuous batching
第 3 节告诉我们「batch 越大吞吐越好」,但那是在假设 batch 是一个整齐的矩形。真实线上流量完全不是这样。Percy 列了三个麻烦:
- 请求在不同时刻到达——凑够一个 batch 再开跑,对先到的请求是灾难性的延迟。
- 序列之间有共享前缀——系统提示词、few-shot 示例、同一个 prompt 采样多个回答。重复存 KV 是纯浪费。
- 序列长度各不相同——padding 到最长会浪费大量算力和显存。
这一节处理第 1、3 个问题(连续批处理),第 6 节处理第 2 个问题(PagedAttention 的前缀共享)。
5.1 Static batching 的浪费
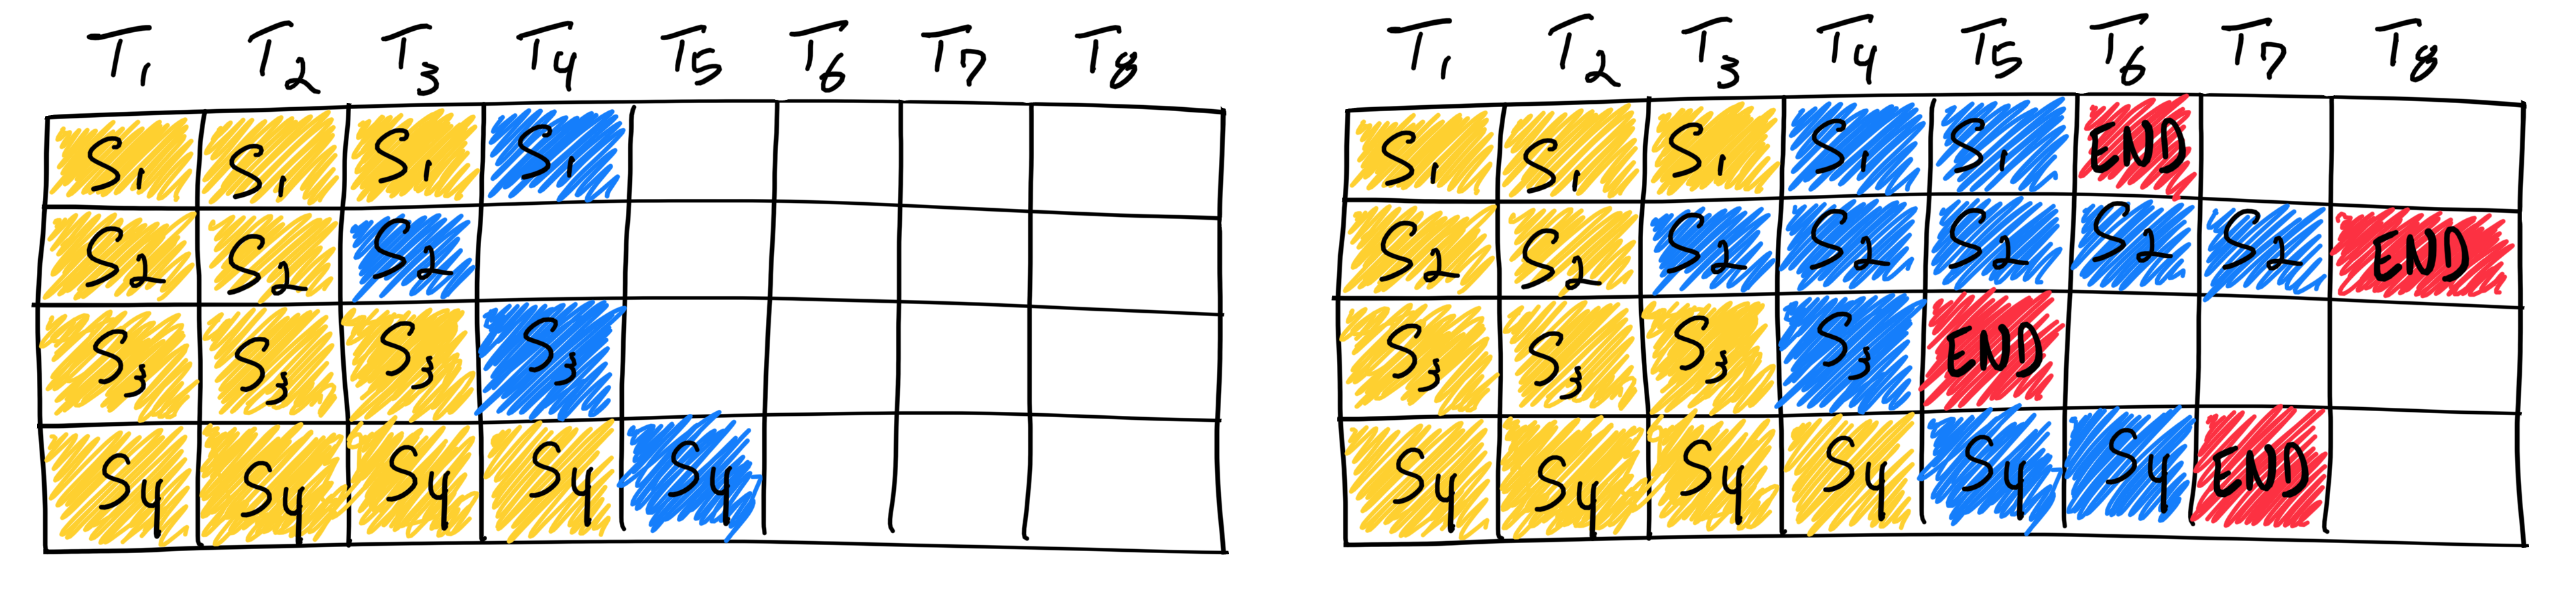
浪费有多严重?如果生成长度服从一个方差较大的分布(真实流量确实如此,从 5 个 token 到 2000 个 token 都有),batch 的有效利用率大致是 $\frac{\E[\text{len}]}{\max(\text{len})}$。当 batch 里混了一条超长请求时,利用率可以低到 10~20%。
5.2 迭代级调度(iteration-level scheduling)
解法来自 Orca (OSDI 2022),工业界通常叫连续批处理(continuous batching)或 in-flight batching。核心思想只有一句话:
调度的粒度从「请求」下降到「迭代」。每完成一步 decode,调度器就重新审视一次 batch:把已经生成 EOS 的序列立即移出并返回给用户,把队列里等待的新请求立即塞进空出来的槽位。没有序列需要等待其他序列结束。
# 连续批处理调度器的骨架(概念版)
running = []                      # 正在解码的序列
while True:
    # 1) 回收已完成的槽位
    for seq in list(running):
        if seq.finished:
            running.remove(seq); seq.respond(); free_kv_blocks(seq)

    # 2) 用新到达的请求填满 batch(受显存约束)
    while waiting and kv_memory_available() and len(running) < MAX_BATCH:
        seq = waiting.popleft()
        prefill(seq)              # 计算 prompt 的 KV cache
        running.append(seq)

    # 3) 所有 running 序列一起走一步 decode
step_decode(running) # 每条序列各产出 1 个 token收益是巨大的:在长度分布方差大的真实负载上,连续批处理相对静态批处理常见的吞吐提升是数倍到十几倍,同时因为新请求不用等待,TTFT 也同步改善——这是罕见的「延迟和吞吐同时变好」的优化,因为它消灭的是纯粹的浪费而不是在做取舍。
5.3 选择性批处理(selective batching)
但立刻撞上一个问题:批处理要求所有序列形状一致。running 里的序列长度是 3、9、5……怎么拼成一个张量?
Orca 的答案是选择性批处理——按算子类型分别处理:
| 算子 | 是否依赖序列边界 | 处理方式 |
|---|---|---|
| LayerNorm、MLP、QKV/O 投影、激活 | 否,逐 token 独立 | 全部拉平拼接成 $[3+9+5, D]$ 的二维张量,一次大矩阵乘搞定 |
| Attention | 是,每条序列只能看自己的 KV | 按序列分别计算(或用 varlen / ragged kernel,如 FlashAttention 的 varlen 接口) |
为什么可以这么拆?回到第 2 节的记号:MLP 的权重形状是 $D\times F$,和 $B$、$T$ 都无关——所以对它来说「批」只是一堆互相独立的行向量,来自哪条序列毫不重要,拼在一起反而让矩阵更「胖」、算术强度更高。而注意力的 $K, V$ 是每条序列私有的,跨序列拼接会造成信息泄漏。这正是第 2.5 节「MLP 能被 batch 拯救、attention 不能」在系统层面的镜像。
今天所有主流引擎(vLLM、SGLang、TensorRT-LLM)都默认开启连续批处理 + varlen 注意力 kernel,这已经是推理系统的基线而不是优化项。
6. PagedAttention 与 vLLM:把操作系统搬进推理引擎
连续批处理解决了「时间维度」的浪费,但「空间维度」——显存——的浪费还在。vLLM 论文(SOSP 2023)指出:在当时的系统里,KV cache 的实际有效利用率只有 20%~40%。也就是说六成以上的显存在空转,而我们刚刚论证过,显存就是吞吐。
6.1 问题:碎片化
此前的做法很自然:请求进来 → 为「prompt + 可能生成的最长回复」预留一整段连续显存。
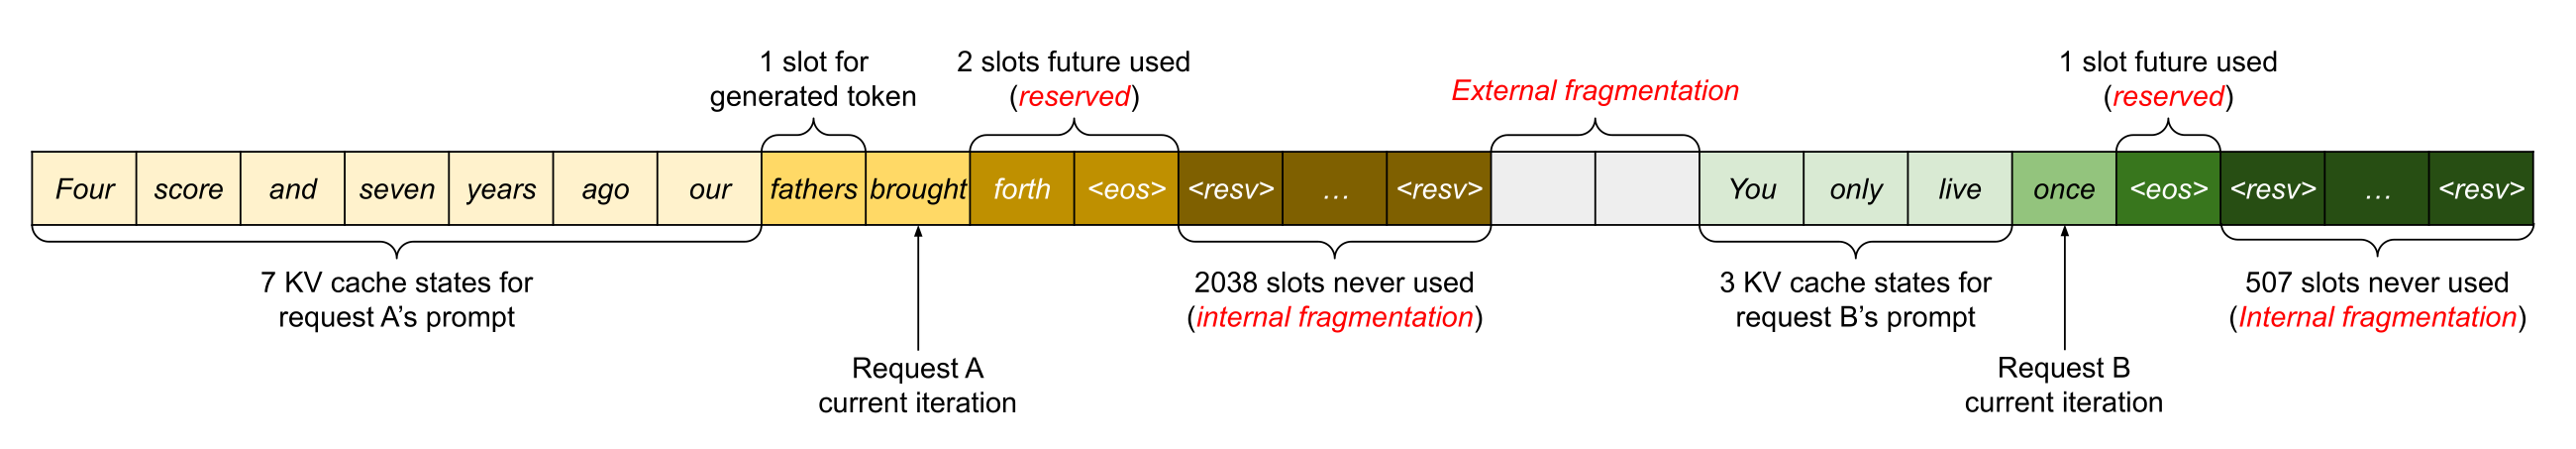
Percy 的类比是硬盘。这套毛病操作系统在 1960 年代就见过了:给每个进程分配连续物理内存,结果就是碎片。操作系统的答案是分页(paging)——把物理内存切成固定大小的页,进程看到的是连续的虚拟地址,页表负责把虚拟页映射到任意物理页。PagedAttention 就是把这套东西原样搬到 KV cache 上。
6.2 解法:把 KV cache 分块
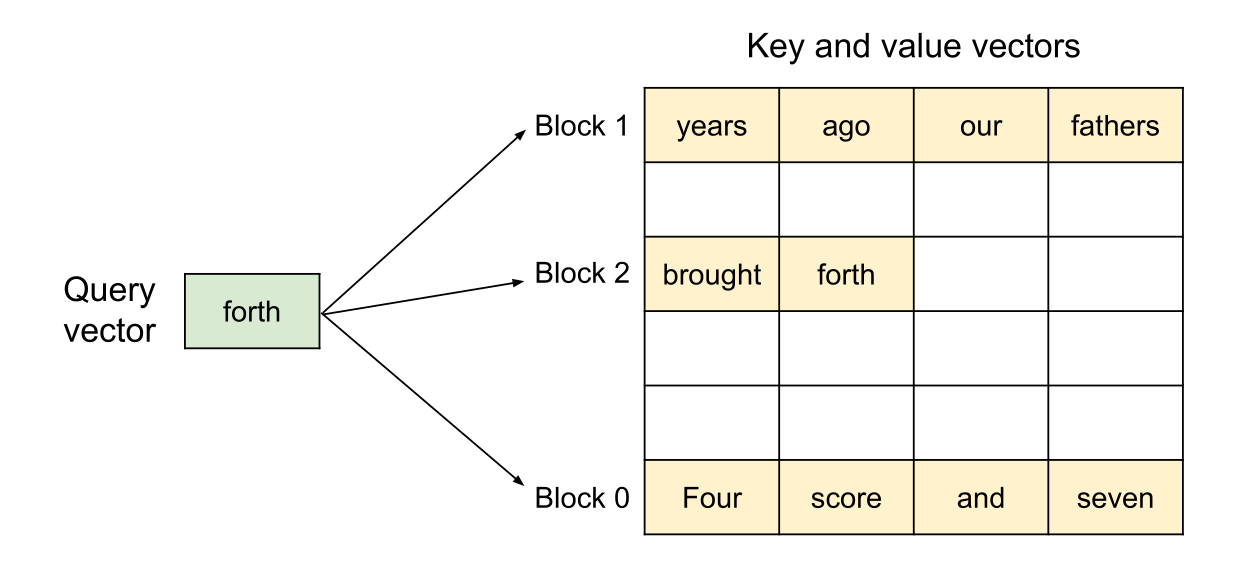
# 概念版:block table 与按需分配
BLOCK = 16                      # 每块 16 个 token

class BlockAllocator:
    def __init__(self, n_blocks): self.free = list(range(n_blocks))
    def alloc(self):  return self.free.pop()
    def free_(self, p): self.free.append(p)

class Sequence:
    def __init__(self): self.block_table = []; self.n_tokens = 0
    def append_token(self, alloc):
        if self.n_tokens % BLOCK == 0:            # 当前块满了,才申请新块
            self.block_table.append(alloc.alloc())
        self.n_tokens += 1

# 注意力 kernel 读 KV 时不再是一段连续 slice,
# 而是按 block_table 逐块 gather —— 这就是 "PagedAttention" 这个名字的由来。注意这里的关键工程点:注意力 kernel 必须改写。标准 FlashAttention 假设 K/V 在显存里连续,PagedAttention 的 kernel 要根据 block table 做间接寻址(gather)。vLLM 把「按 block 读取」和「注意力计算」融合进同一个 kernel,避免先 gather 到临时缓冲再算——否则收益会被额外的显存搬运吃掉。
6.3 意外的红利:前缀共享
分页带来了一个设计之初未必是主要目标、但事后看极其重要的能力:不同序列可以指向同一个物理块。
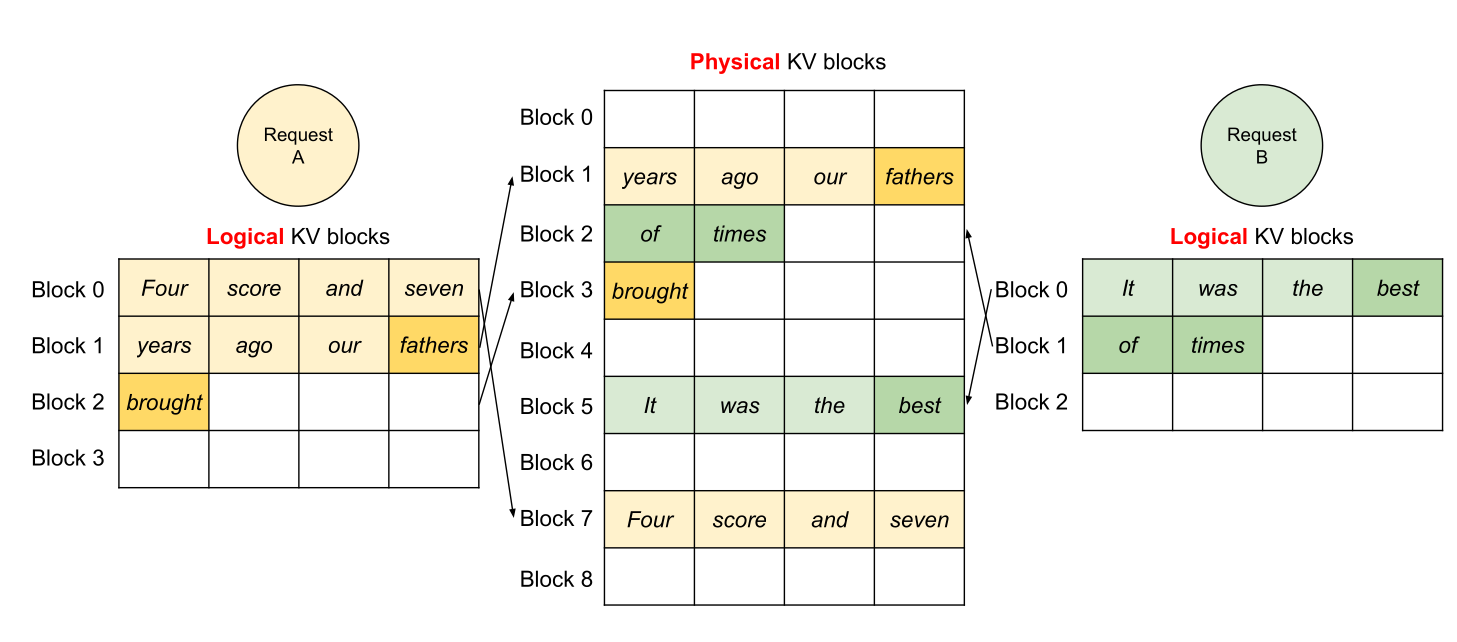
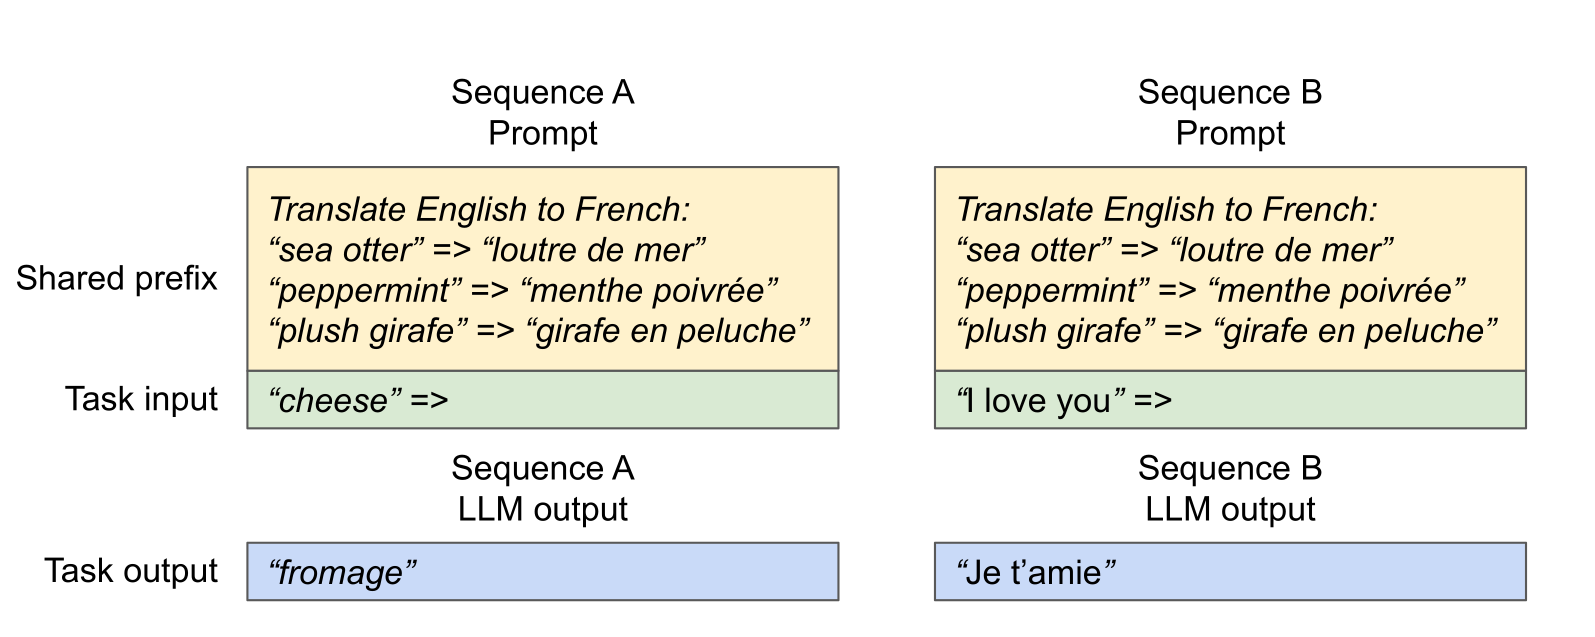
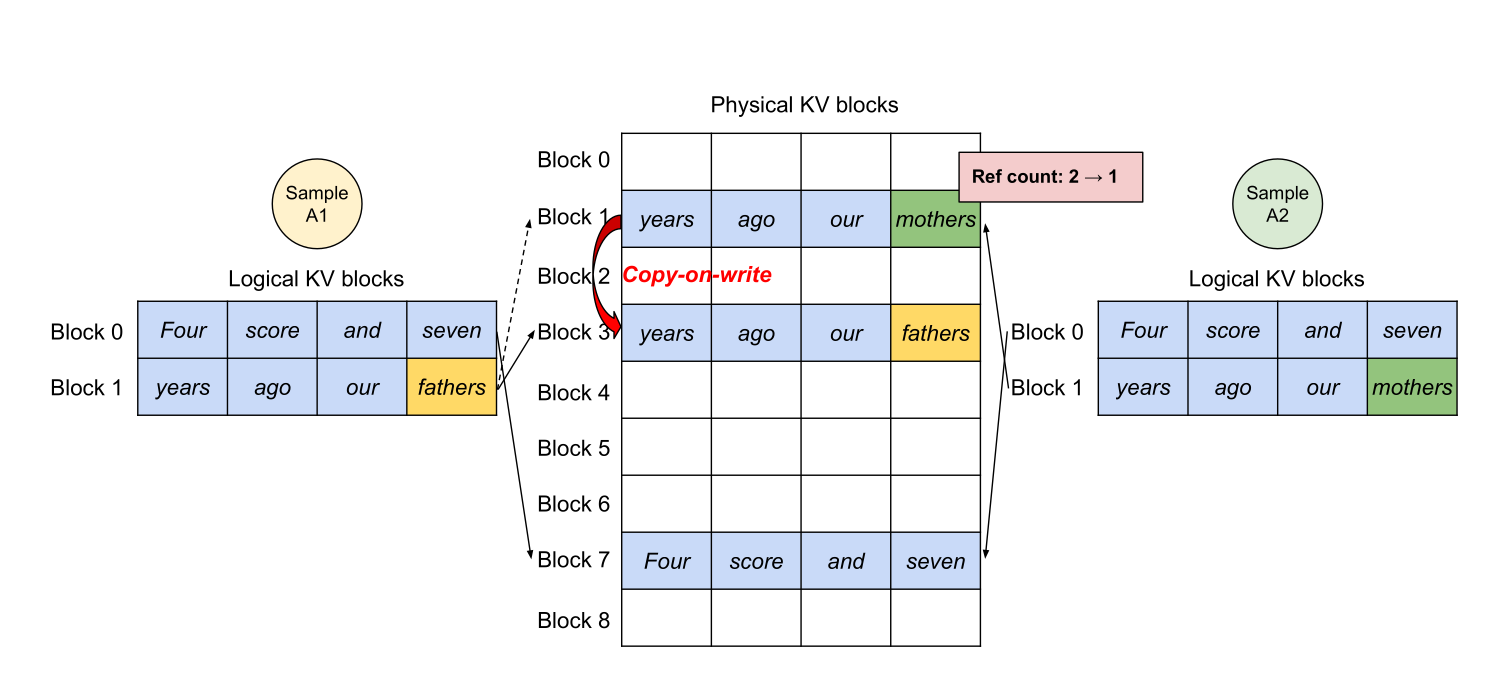
fork() 直接借来的机制。PagedAttention 的收益链条是:消灭碎片 → 同样显存能装下更多序列 → batch 变大 → 参数读取成本被摊薄得更薄 → 吞吐上升。vLLM 论文报告的端到端吞吐提升相对当时的 HuggingFace / FasterTransformer 是2~4 倍,且不损失任何精度——这是一个纯粹的系统优化,模型输出逐 bit 相同。
6.4 vLLM 的其他优化
- 融合 kernel:把 block 读取和注意力计算合并,减少 kernel launch 次数和中间张量。
- 用最新 kernel:FlashAttention(prefill 用)、FlashDecoding(decode 用——decode 时 $T=1$,并行度不足,FlashDecoding 通过在 $S$ 维上切分并行来填满 SM)。
- CUDA Graphs:decode 步骤本身极短(几毫秒甚至更短),Python + CUDA 的 kernel launch 开销占比会变得可观。把整个 decode step 录制成 CUDA Graph 一次性回放,可以显著削掉 launch 开销。
SGLang 把前缀共享推得更远:RadixAttention 用一棵基数树(radix tree)在全局维护所有历史请求的 KV 前缀,并配合 LRU 淘汰。这样跨请求、跨轮次的复用是自动发生的——对多轮对话和 agent 轨迹(同一条 trace 反复追加)收益尤其大。
Percy 对这一节的总结是一句方法论:面对动态负载,去操作系统的历史里找答案。分页、调度、写时复制、缓存淘汰——这些问题计算机系统领域已经想了五十年。
7. 量化与模型压缩
7.1 量化的机制
核心思想直白得几乎不像一个技术:用更少的比特存数。既然推理是 memory-bound,字节数减半就意味着延迟减半、吞吐翻倍。
最基本的仿射量化(affine quantization):
$$ x_{\text{quant}} = \text{round}\!\left(\frac{x}{s}\right) + z, \qquad \hat{x} = (x_{\text{quant}} - z)\cdot s $$其中 $s$ 是 scale(缩放),$z$ 是 zero-point(零点)。课上的数值例子:$x = 5.2342$,$s = 0.1$,$z = 4$,则 $x_{\text{quant}} = \text{round}(52.342) + 4 = 56$,反量化得 $\hat{x} = (56-4)\times 0.1 = 5.2$。误差 0.0342,来自 round 的舍入——这就是量化误差的全部来源。
x = 5.2342
scale, zero_point = 0.1, 4
x_quant  = round(x / scale) + zero_point     # 56  (可以存进 int8)
x_approx = (x_quant - zero_point) * scale    # 5.2
| 格式 | 字节 | 范围 | 用途 |
|---|---|---|---|
| fp32 | 4 | — | 训练时的参数主副本与优化器状态 |
| bf16 | 2 | — | 推理的默认格式 |
| fp8 (e4m3) | 1 | $[-240, 240]$(H100 原生支持) | 敢的话可以直接训练(FP8-LM) |
| int8 | 1 | $[-128, 127]$ | 比 fp8 便宜但更不准,仅用于推理(对比研究) |
| int4 | 0.5 | $[-8, 7]$ | 更便宜、更不准;本地部署与显存极度受限时用 |
7.2 QAT vs PTQ
| 量化感知训练(QAT) | 训练后量化(PTQ) | |
|---|---|---|
| 做法 | 训练时在前向里插入「量化-反量化」,模拟量化误差(反向用 straight-through estimator 绕过不可导的 round) | 训练完成后做,用少量校准数据跑一遍,为每层/每张量确定 $s$ 和 $z$ |
| 优点 | 权重被训练成能容忍量化,精度损失最小 | 极其便宜,几分钟到几小时 |
| 缺点 | 需要昂贵的大规模训练 | 精度损失更大,低比特(int4)时尤其明显 |
GPTQ(arXiv:2210.17323)是 PTQ 的代表作。它逐列量化权重矩阵,每量化一列,就用Hessian 信息去更新尚未量化的列,以补偿刚刚引入的误差。直觉上:量化第 $i$ 列造成的输出扰动,可以部分地由第 $i+1, i+2, \dots$ 列吸收掉。这让 int4 也能保持相当好的精度。
7.3 AWQ:按激活重要性分配精度
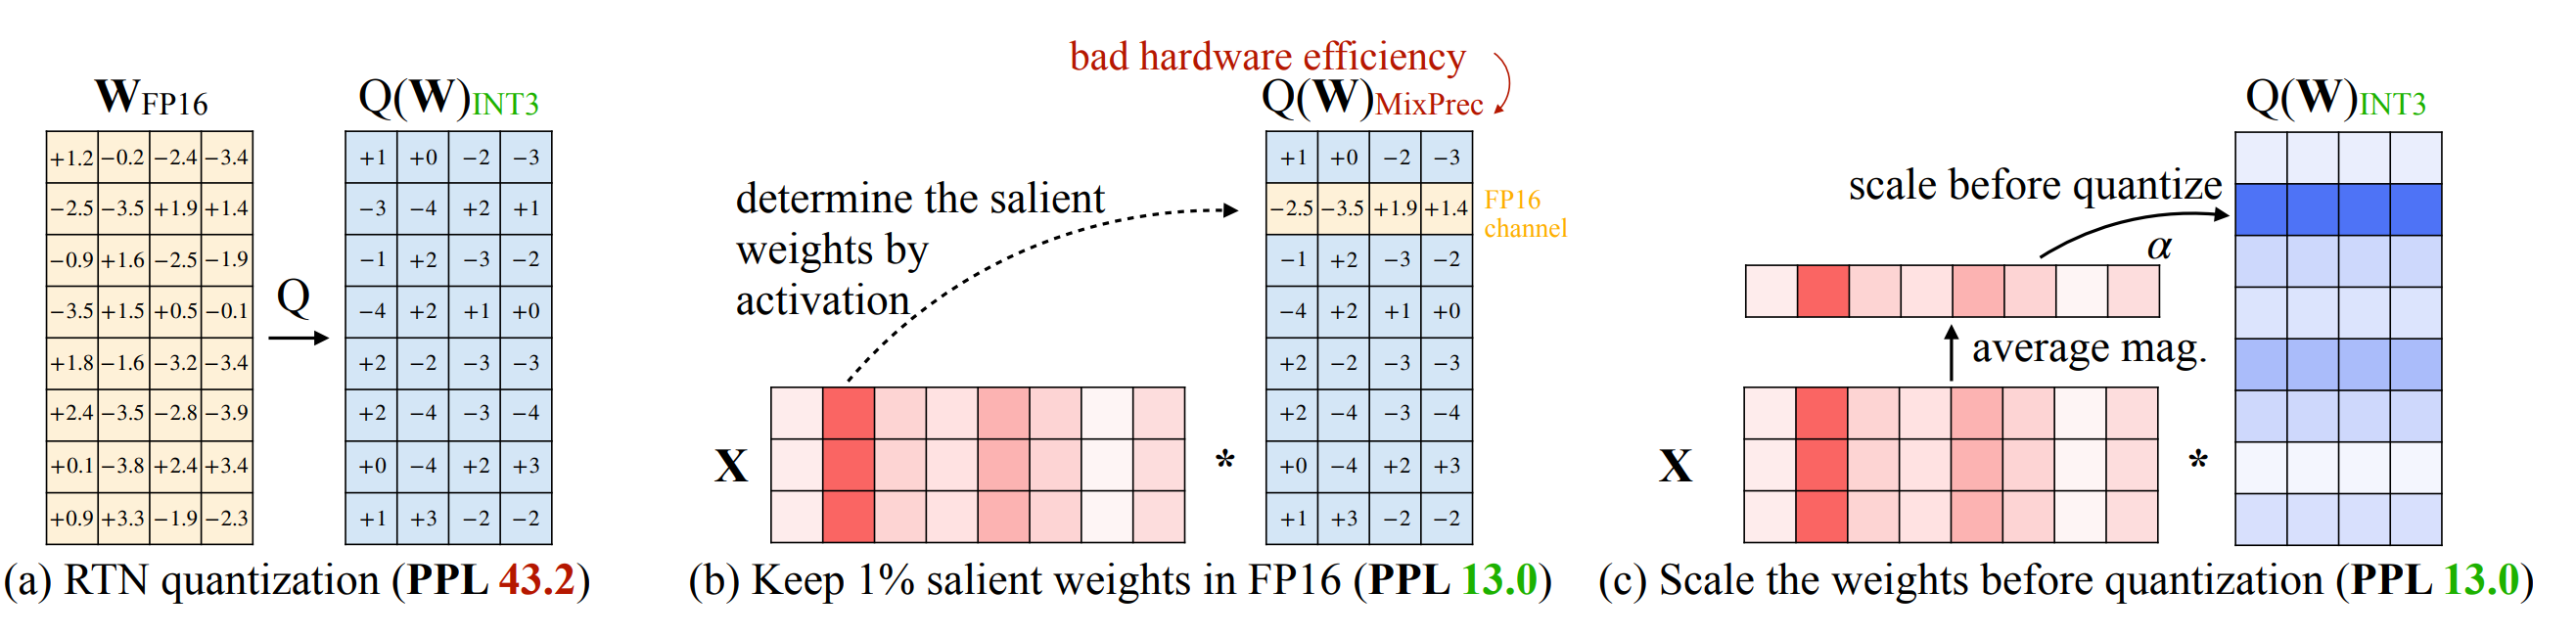
关键洞察是 「重要的不是权重本身有多大,而是它乘的那个激活有多大」——所以要用激活的统计量(activation-aware)而不是权重的统计量来决定精度分配。课上给的数字:fp16 → int3,显存降低 4 倍,实测加速 3.2 倍。
别忘了 KV cache 也可以量化,而且在长上下文场景下它比权重更值得量化(回顾 4.2 节:$BS > 3$ 万时 KV 就超过参数了)。FP8 KV cache 现在是 vLLM / TensorRT-LLM 的常见选项,直接把 $M_{\text{KV}}$ 减半,等价于并发翻倍。经验上 KV cache 对量化比权重更宽容(尤其是 value),但 key 在有 RoPE 的情况下存在异常值通道,需要 per-channel 而非 per-tensor 的 scale。
7.4 剪枝 + 蒸馏
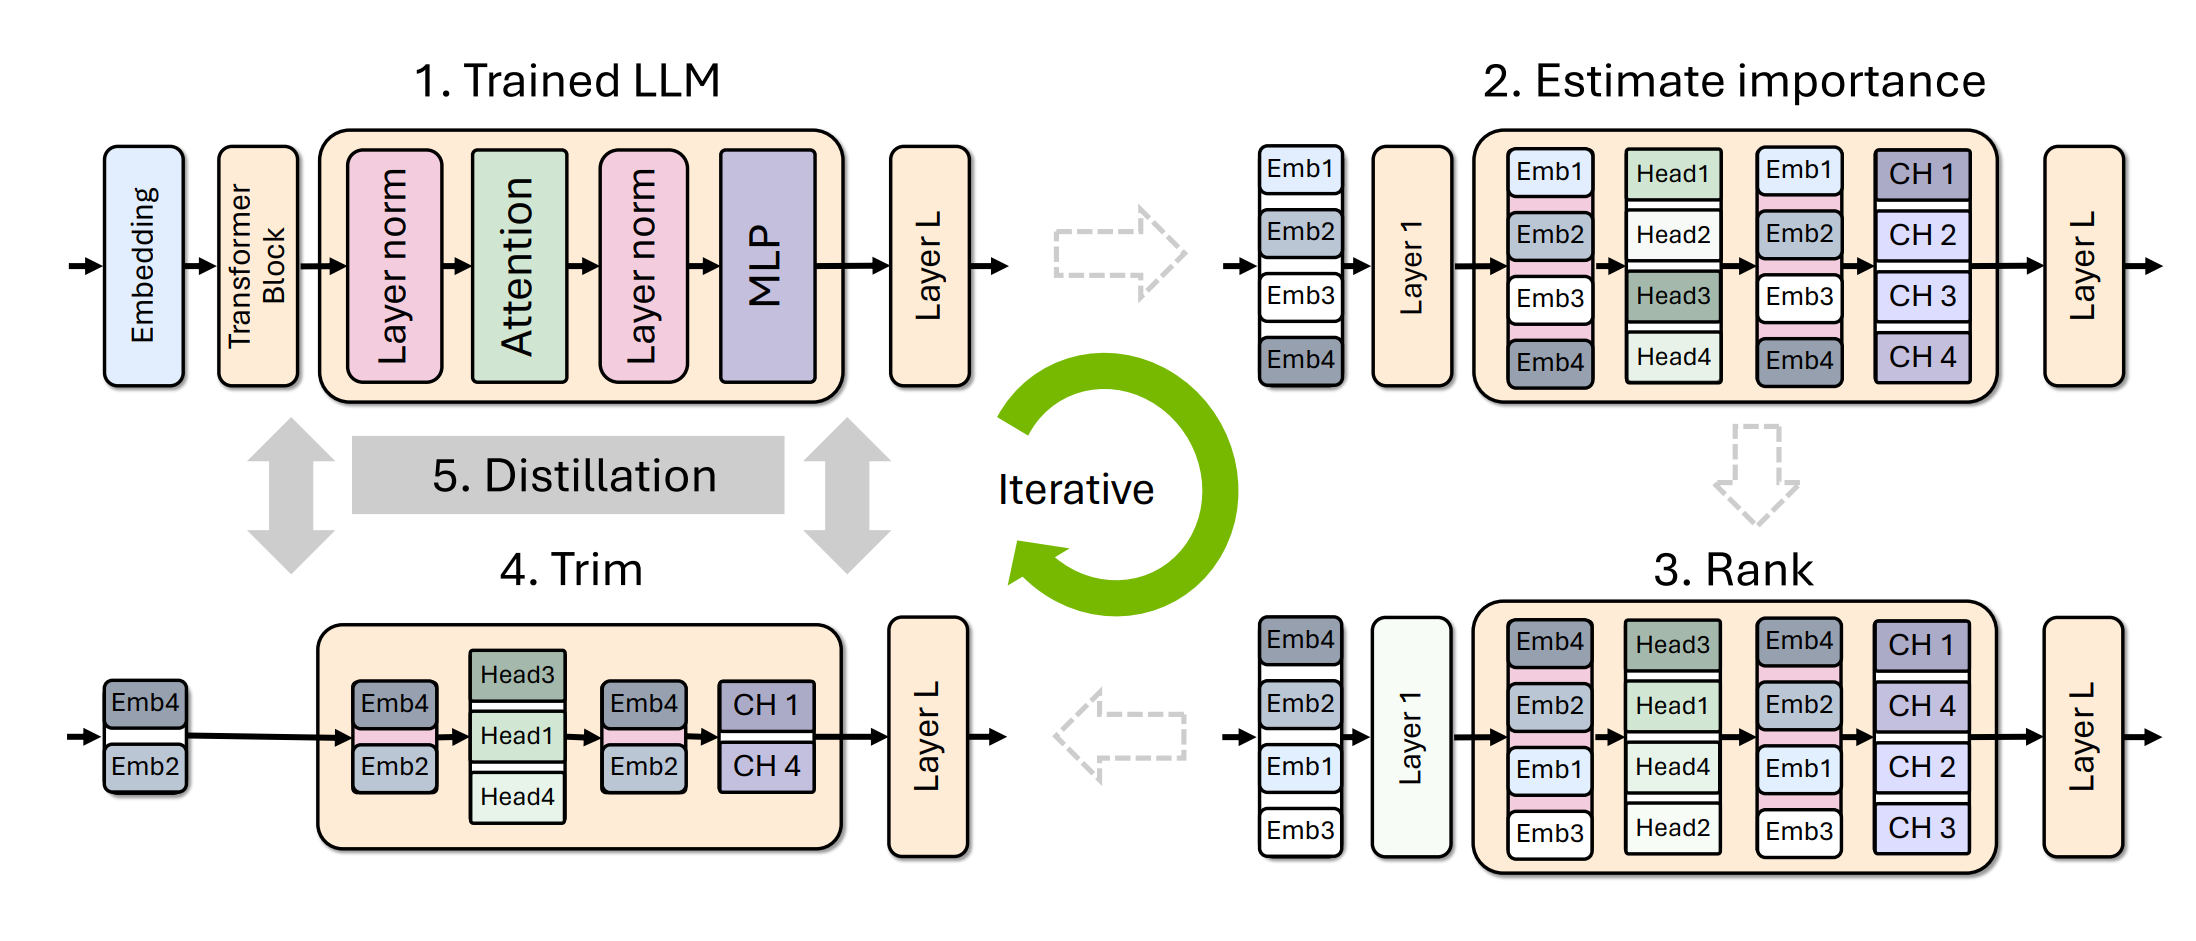
量化是「让每个数变小」,剪枝是「直接把一部分结构扔掉」。核心思想:把一个贵模型的零件拆掉一些,然后再把它修好。
算法三步:
- 估计重要性:在一个很小的校准集上(论文用 1024 条样本)前向若干次,统计每个 {层、注意力头、隐藏维度、FFN 中间维度} 的激活幅值/方差作为重要性分数。注意这里不需要梯度、不需要反向传播,所以极其便宜。
- 剪枝:按分数移除不重要的结构,得到一个更小的模型。可以在宽度(头、通道)和深度(整层)两个方向剪。
- 蒸馏修复:以原模型为 teacher、剪枝后的模型为 student,做知识蒸馏。损失通常是 logits 上的 KL 加上中间层隐状态的 L2:
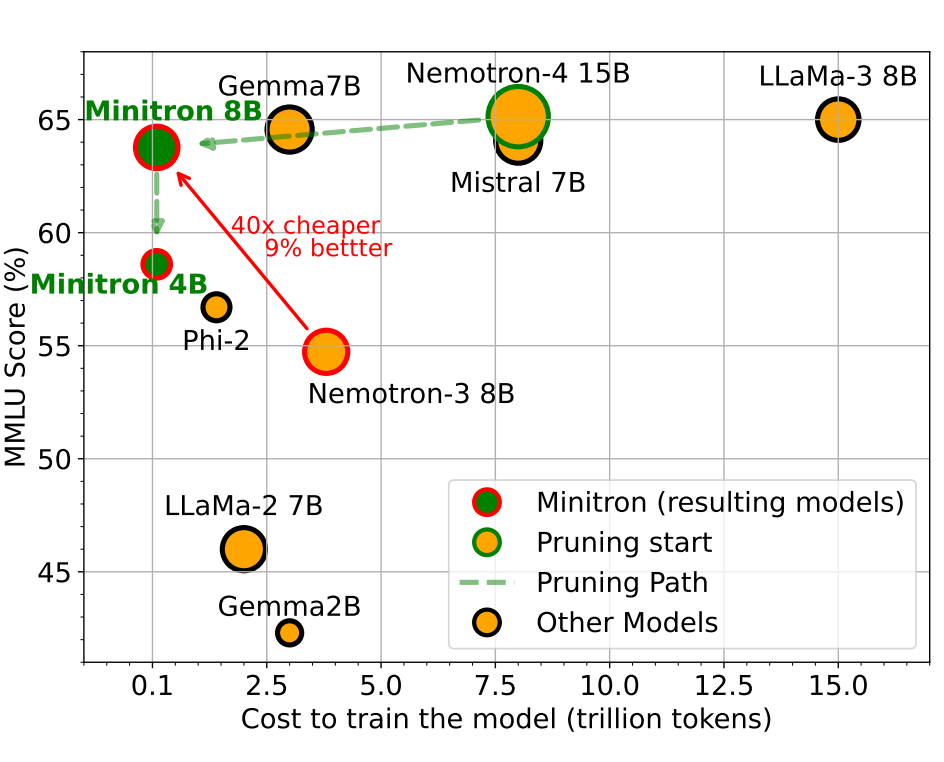
Percy 把「不损失精度地降低推理复杂度」总结成两个配方:
- 从零配方:1) 设计一个更快的架构;2) 从头训练它。干净,但每次都要付全额训练成本。
- 蒸馏配方:1) 设计更快的架构;2) 用原模型的权重来初始化(哪怕架构不同,也可以做结构映射/剪枝式初始化);3) 用蒸馏「修复」这个更快的模型。这是当今生产环境的主流做法——GQA 化、层数减半、MHA→MLA 转换、乃至 Transformer→Mamba 混合的转换,都可以走这条路。
8. 架构层面的推理优化:把 KV cache 变小
回到第 4 节的公式 $M_{\text{KV}} = 2bLKHSB$。这一节讲的所有架构改动,都是在砍其中的某个因子,目标只有一个:在同样的显存里塞下更大的 batch,从而买到更高的吞吐。每一项都必须回答同一个问题——精度掉了吗?
8.1 GQA / MQA:砍 $K$
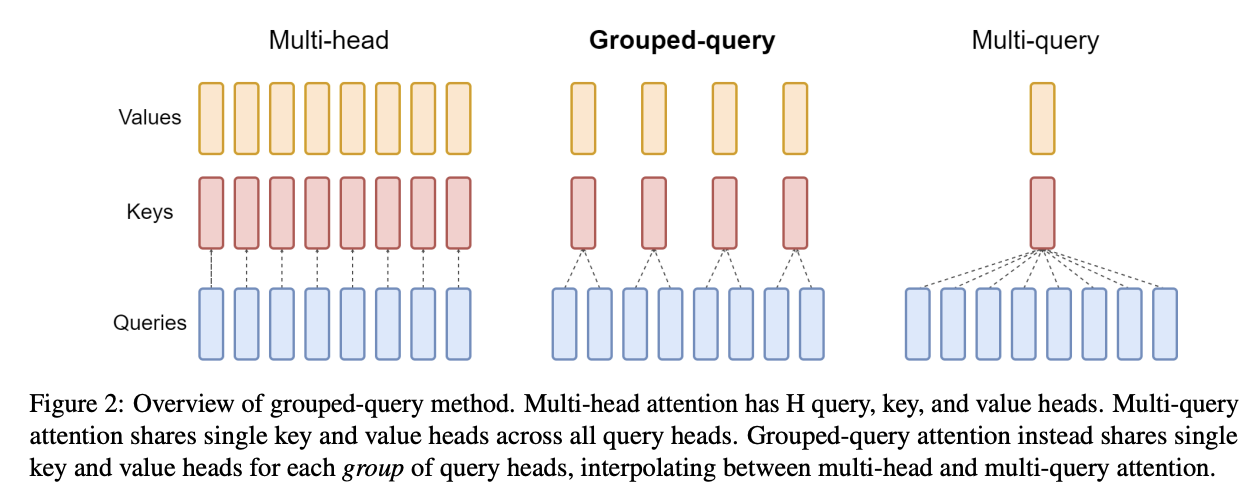
注意一个重要细节:GQA 不减少注意力的 FLOPs(每个 query 头照样要和一套 K/V 做完整的注意力,只是那套 K/V 是共享的),它减少的是参数量($W_K, W_V$ 变小)和KV cache 字节数($N/K$ 倍)。既然 decode 是 memory-bound 的,减字节就等于减时间。
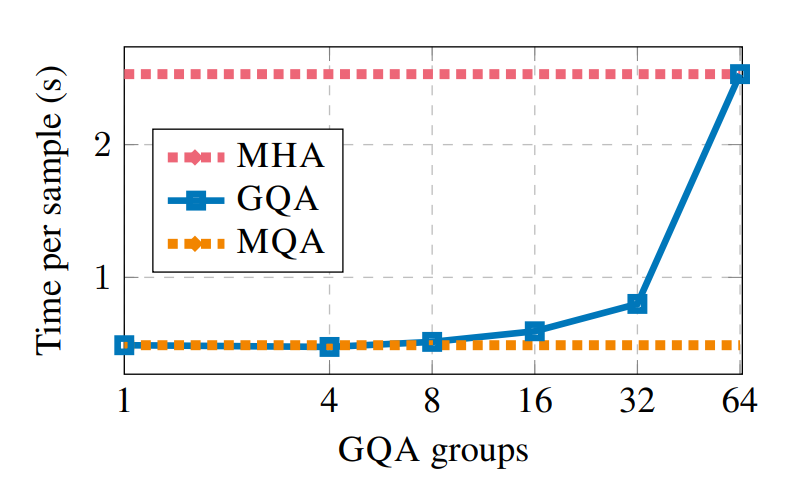
把 Llama 2 13B 从 MHA($K=40$)改成 GQA($K=8$,即 1:5),重跑第 3 节的性能模型:
| 配置 | 参数量 | KV/序列 | $B$ | 总显存 | 延迟 | 吞吐 |
|---|---|---|---|---|---|---|
| MHA $K=40$ | 13.0 B | 0.839 GB | 64 | 79.7 GB | 23.8 ms | 2 690 tok/s |
| GQA $K=8$ | 11.3 B | 0.168 GB | 64 | 33.4 GB | 10.0 ms | 6 420 tok/s |
| GQA $K=8$ | 11.3 B | 0.168 GB | 256 | 65.6 GB | 19.6 ms | 13 070 tok/s |
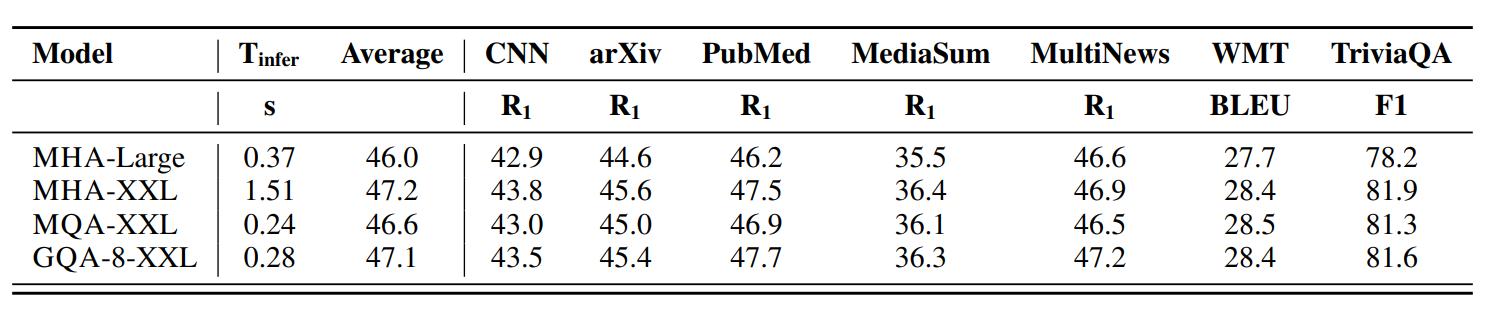
读法:GQA 把 KV cache 缩小 5 倍,于是在 $B=64$ 时显存从 79.7 GB 降到 33.4 GB(延迟和吞吐同时改善)。更重要的是它解锁了 $B=256$——MHA 版本在 $B=256$ 时要 240 GB、根本装不下,GQA 版本只要 65.6 GB,稳稳装进一张 H100。最终吞吐相对 MHA 提升 4.9 倍,代价是单请求延迟从 23.8 ms 变成 19.6 ms(其实还更好)。这就是「架构改动 → 显存下降 → batch 上升 → 吞吐飞跃」的完整链条。
8.2 MLA:把 KV 压成一个低维隐向量
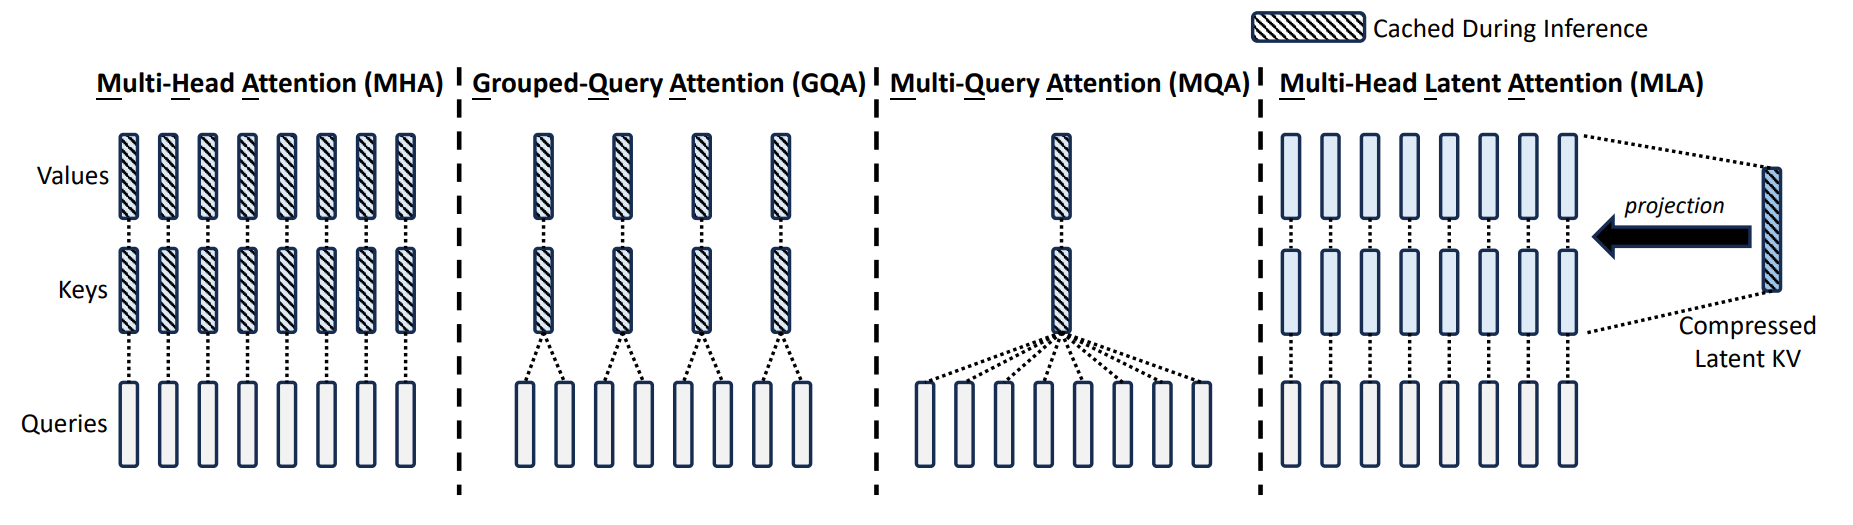
DeepSeek-V2 的具体数字:把 $NH = 16384$ 维压到 $C = 512$ 维。
MLA 有一个麻烦:它和 RoPE 不兼容。原因是 RoPE 的旋转是位置相关的,作用在 $K$ 上,而 MLA 想把「上投影 $W_K^{\uparrow}$」提前折进 $W_Q$ 里以避免真的还原出 $K$;一旦中间插入一个位置相关的旋转矩阵,这个吸收就做不成了。DeepSeek 的解法是解耦(decoupled)RoPE:额外拿出 64 维专门承载 RoPE 信息、不参与压缩,其余维度走压缩路径。所以实际每 token 每层存 $512 + 64 = 576$ 维——相对 16384 维仍然是 28 倍的压缩。
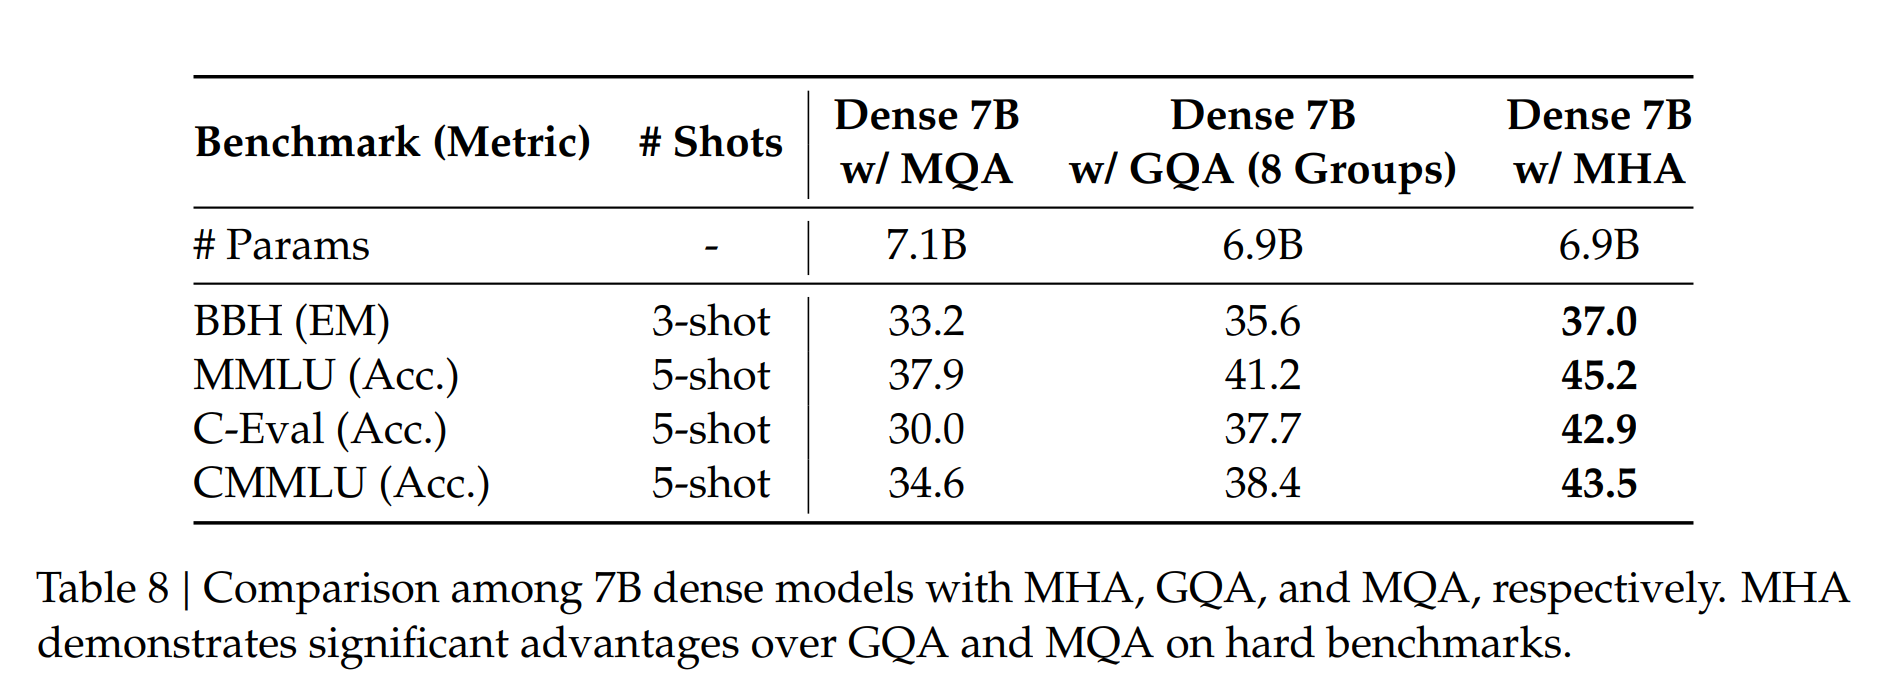
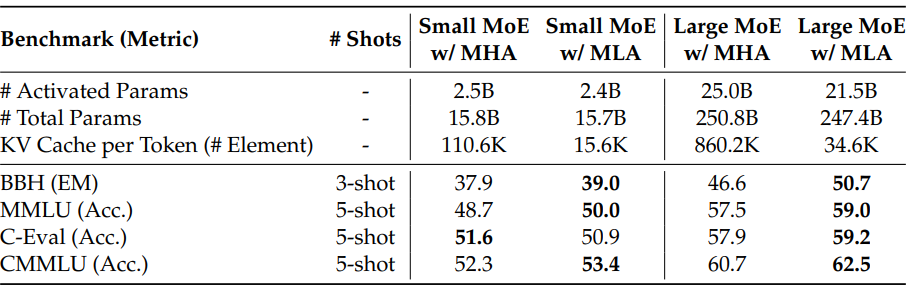
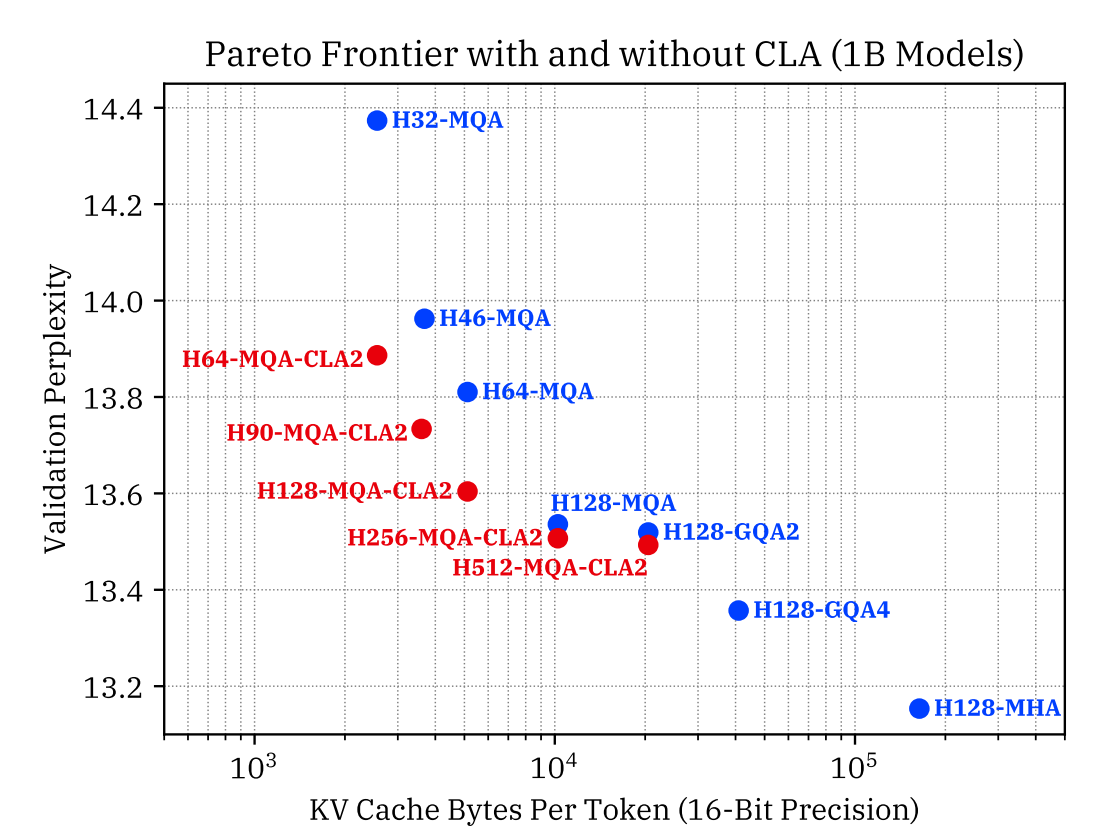
8.3 CLA:砍 $L$
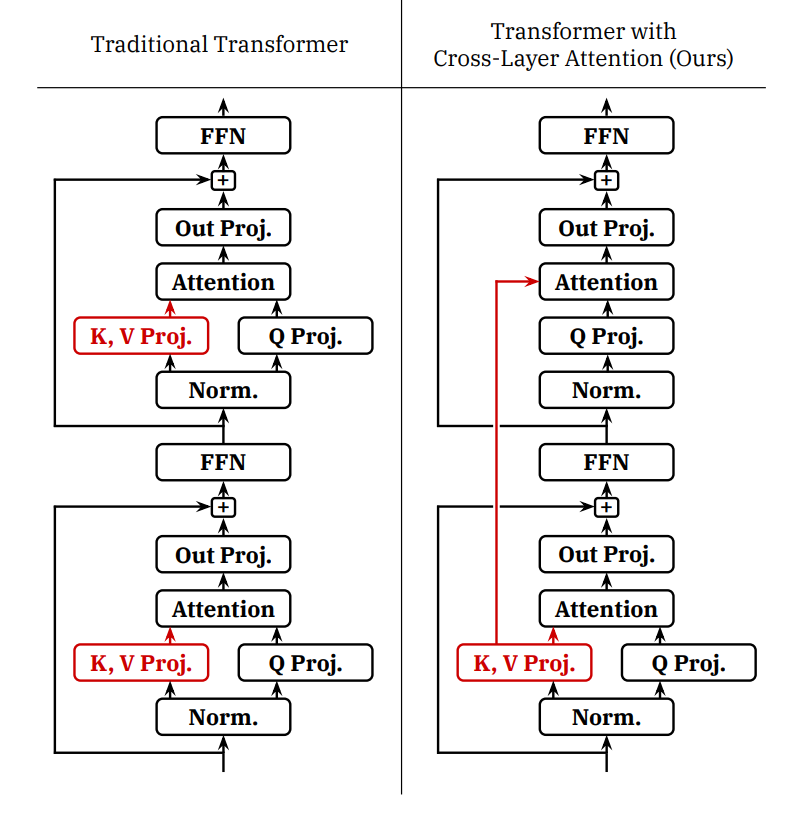
8.4 局部(滑动窗口)注意力:砍 $S$
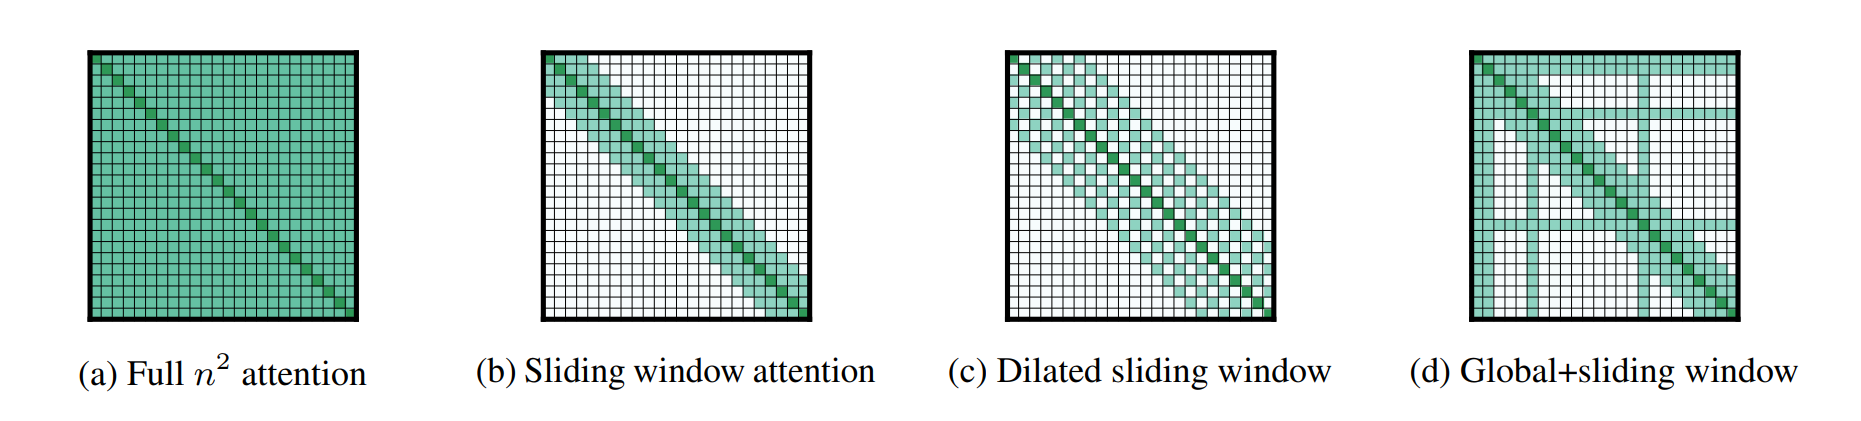
两个关键性质:
- 有效感受野随层数线性增长:单层看 $w$ 个 token,$L$ 层堆起来信息可以传播 $L\cdot w$ 的距离。Mistral 7B 用 $w = 4096$、$L=32$,理论感受野 131k。
- KV cache 与序列长度无关!这是最诱人的一点——窗口满了就把最老的块丢掉,$M_{\text{KV}} \propto w$ 而不是 $\propto S$。无限长对话的显存占用变成常数。
「感受野够大」不等于「能真的用上远处的信息」。局部注意力对精确检索类任务(needle-in-a-haystack、长文档问答)伤害很大,因为信息要经过多层传递才能到达,中途会被稀释。所以实践中的解法是混合(hybrid):大部分层用局部注意力,每隔几层插一层全局注意力(Gemma 2 的 1:1、Llama 4 与 Character.AI 的类似设计都是这个思路)。这样 KV cache 主要由少数全局层贡献,既省显存又保住长程能力。
8.5 DeepSeek-V4:更激进的稀疏与压缩
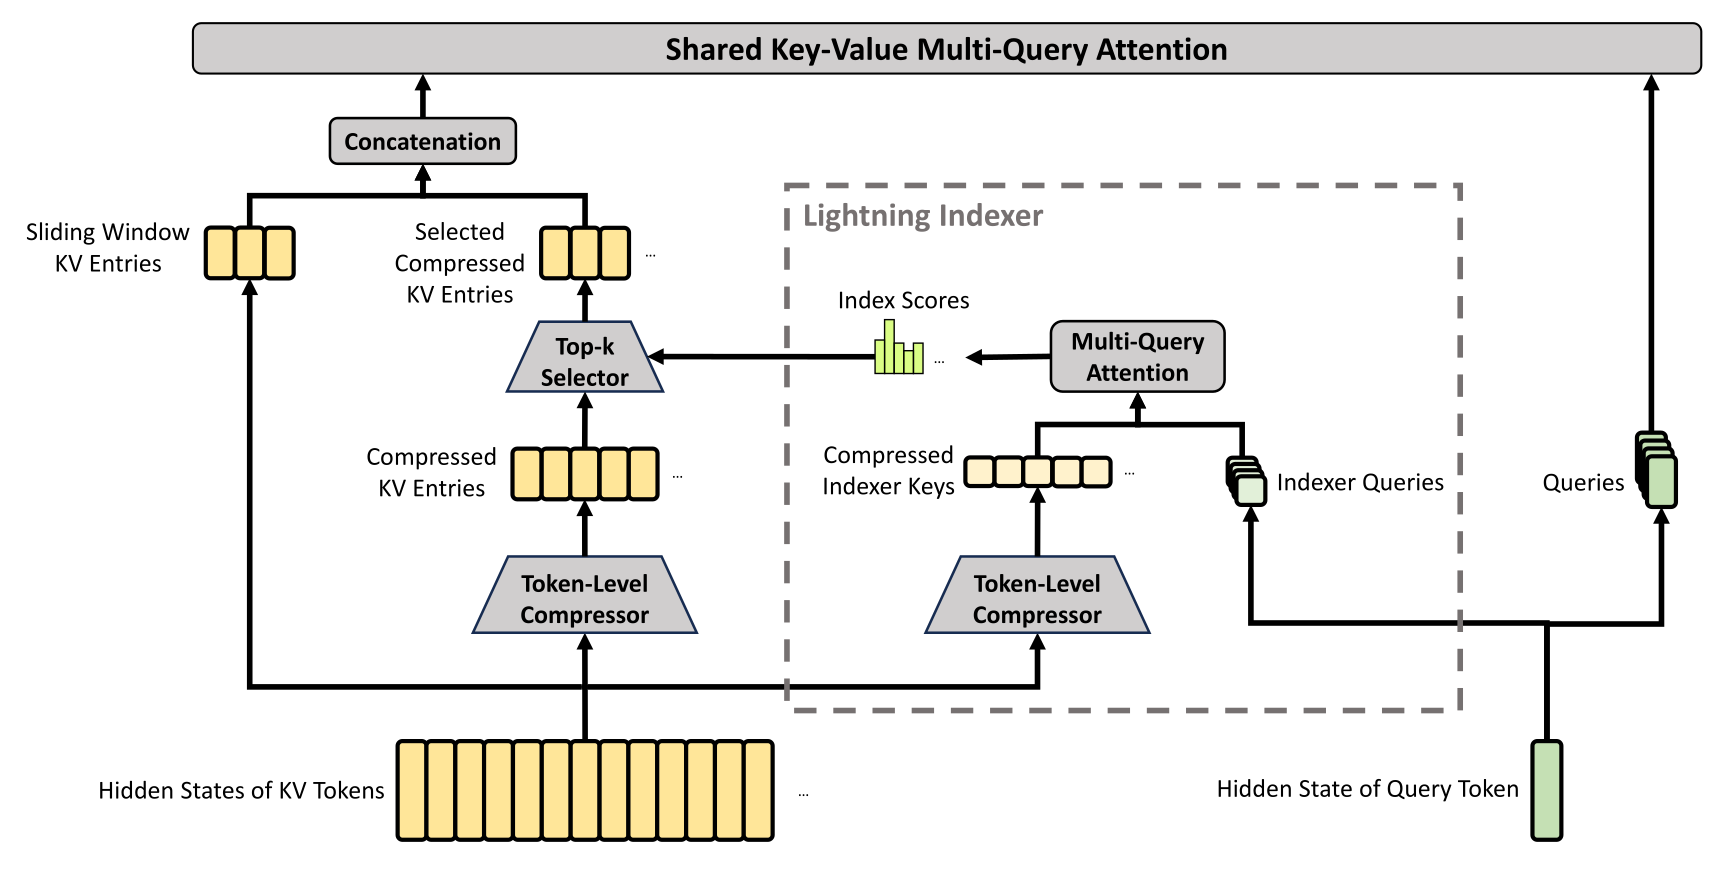
这套设计的思路是分层的信息保真度:近处保留全精度,中距离用选择性稀疏(top-$k$ 保证重要 token 不丢),远处用重压缩摘要。它把 KV cache 从 $O(S)$ 拉回到接近 $O(\sqrt{S})$ 甚至常数,同时 top-$k$ 机制保住了精确检索能力——这正是纯滑动窗口做不到的。
8.6 MoE 的推理特点
混合专家(Mixture-of-Experts, MoE)在推理上有一组很独特的性质,值得单独说:
| Prefill(compute-bound) | Decode(memory-bound) | |
|---|---|---|
| MoE 的效果 | 大赢:FLOPs 只按激活参数算,稀疏度 $=$ 加速比 | 可能不赢甚至更糟 |
| 原因 | 算力是瓶颈,而 MoE 每 token 只激活一小部分专家 | 带宽是瓶颈,而 batch 里不同 token 会路由到不同专家;$B$ 稍大,几乎所有专家都会被至少一个 token 命中 → 仍然要把全部专家权重读进来 |
MoE 在训练时的卖点是「用 $1/k$ 的 FLOPs 拿到大模型的容量」,但推理 decode 阶段的成本函数是字节不是 FLOPs。$B=1$ 时 MoE 确实只需读激活的那几个专家(这就是为什么 MoE 特别适合本地单用户部署);但 $B$ 一大,专家命中就趋于全覆盖,读的字节量退化成稠密模型。所以生产环境部署 MoE 必须配专家并行(EP)——把专家分散到多张卡上,每张卡只持有一部分专家权重,让「读全部专家」这件事被并行摊开。这也是 DeepSeek 推理系统里大规模 EP 的由来。
8.7 小结与其他方向
| 方法 | 砍的因子 | KV 缩减 | 精度影响 |
|---|---|---|---|
| MQA | $K \to 1$ | $N$ 倍 | 明显下降 |
| GQA | $K \to 8$ | $N/8$ 倍 | 接近无损(略低于 MHA) |
| MLA | $KH \to C{+}64$ | 约 28 倍(DeepSeek-V2) | 略优于 MHA |
| CLA | $L$ | 共享因子倍 | Pareto 前沿改善 |
| 滑动窗口 | $S \to w$ | 与长度无关 | 长程检索受损,需混合层 |
| CSA / DSA / HCA | $S$(自适应) | 支持 1M 上下文 | 设计目标即无损 |
| KV 量化(FP8) | $b: 2 \to 1$ | 2 倍 | 基本无损 |
Percy 最后提了两条更激进的路线:线性注意力 / 状态空间模型(Mamba 2、Gated DeltaNet)——它们把 KV cache 换成固定大小的循环状态,显存占用与序列长度完全无关,代价是精确回忆能力受限(所以现在流行 Mamba-Transformer 混合);以及扩散语言模型——放弃自回归,一次并行生成多个位置,从根本上绕开「decode 无法并行」这个诅咒。他的判断是:新架构在推理效率上还有巨大的改进空间,这是目前最值得做的方向之一。
9. 投机解码:唯一无损的加速
前面所有的手段——改架构、量化、剪枝——都动了模型本身,都需要「验一下精度别掉太多」。这一节的方法不一样:它在数学上保证输出分布与原模型逐字严格一致,不需要重新训练目标模型,也不需要做任何精度权衡。
9.1 核心的不对称性
回到第 2 节的结论,把它换个说法:
- Prefill:给定一段序列,并行编码所有 token(compute-bound)。注意——它顺带给出了每个位置上的概率分布。
- Decode:一次生成一个 token(memory-bound)。
也就是说,「检查 $\gamma$ 个 token 对不对」和「生成 1 个 token」花的时间几乎一样(都是把模型权重读一遍)。检查便宜,生成昂贵——这个不对称性就是一切的来源。
这在系统领域早就有名字:投机执行(speculative execution)。CPU 的分支预测就是这么干的——先猜一个分支往下跑,猜对了白赚,猜错了回滚。这里的「回滚」几乎免费,因为错误的 token 只是丢掉不用。Percy 反复强调的方法论:推理系统的很多好点子,是从计算机系统的历史里搬过来的。
9.2 算法
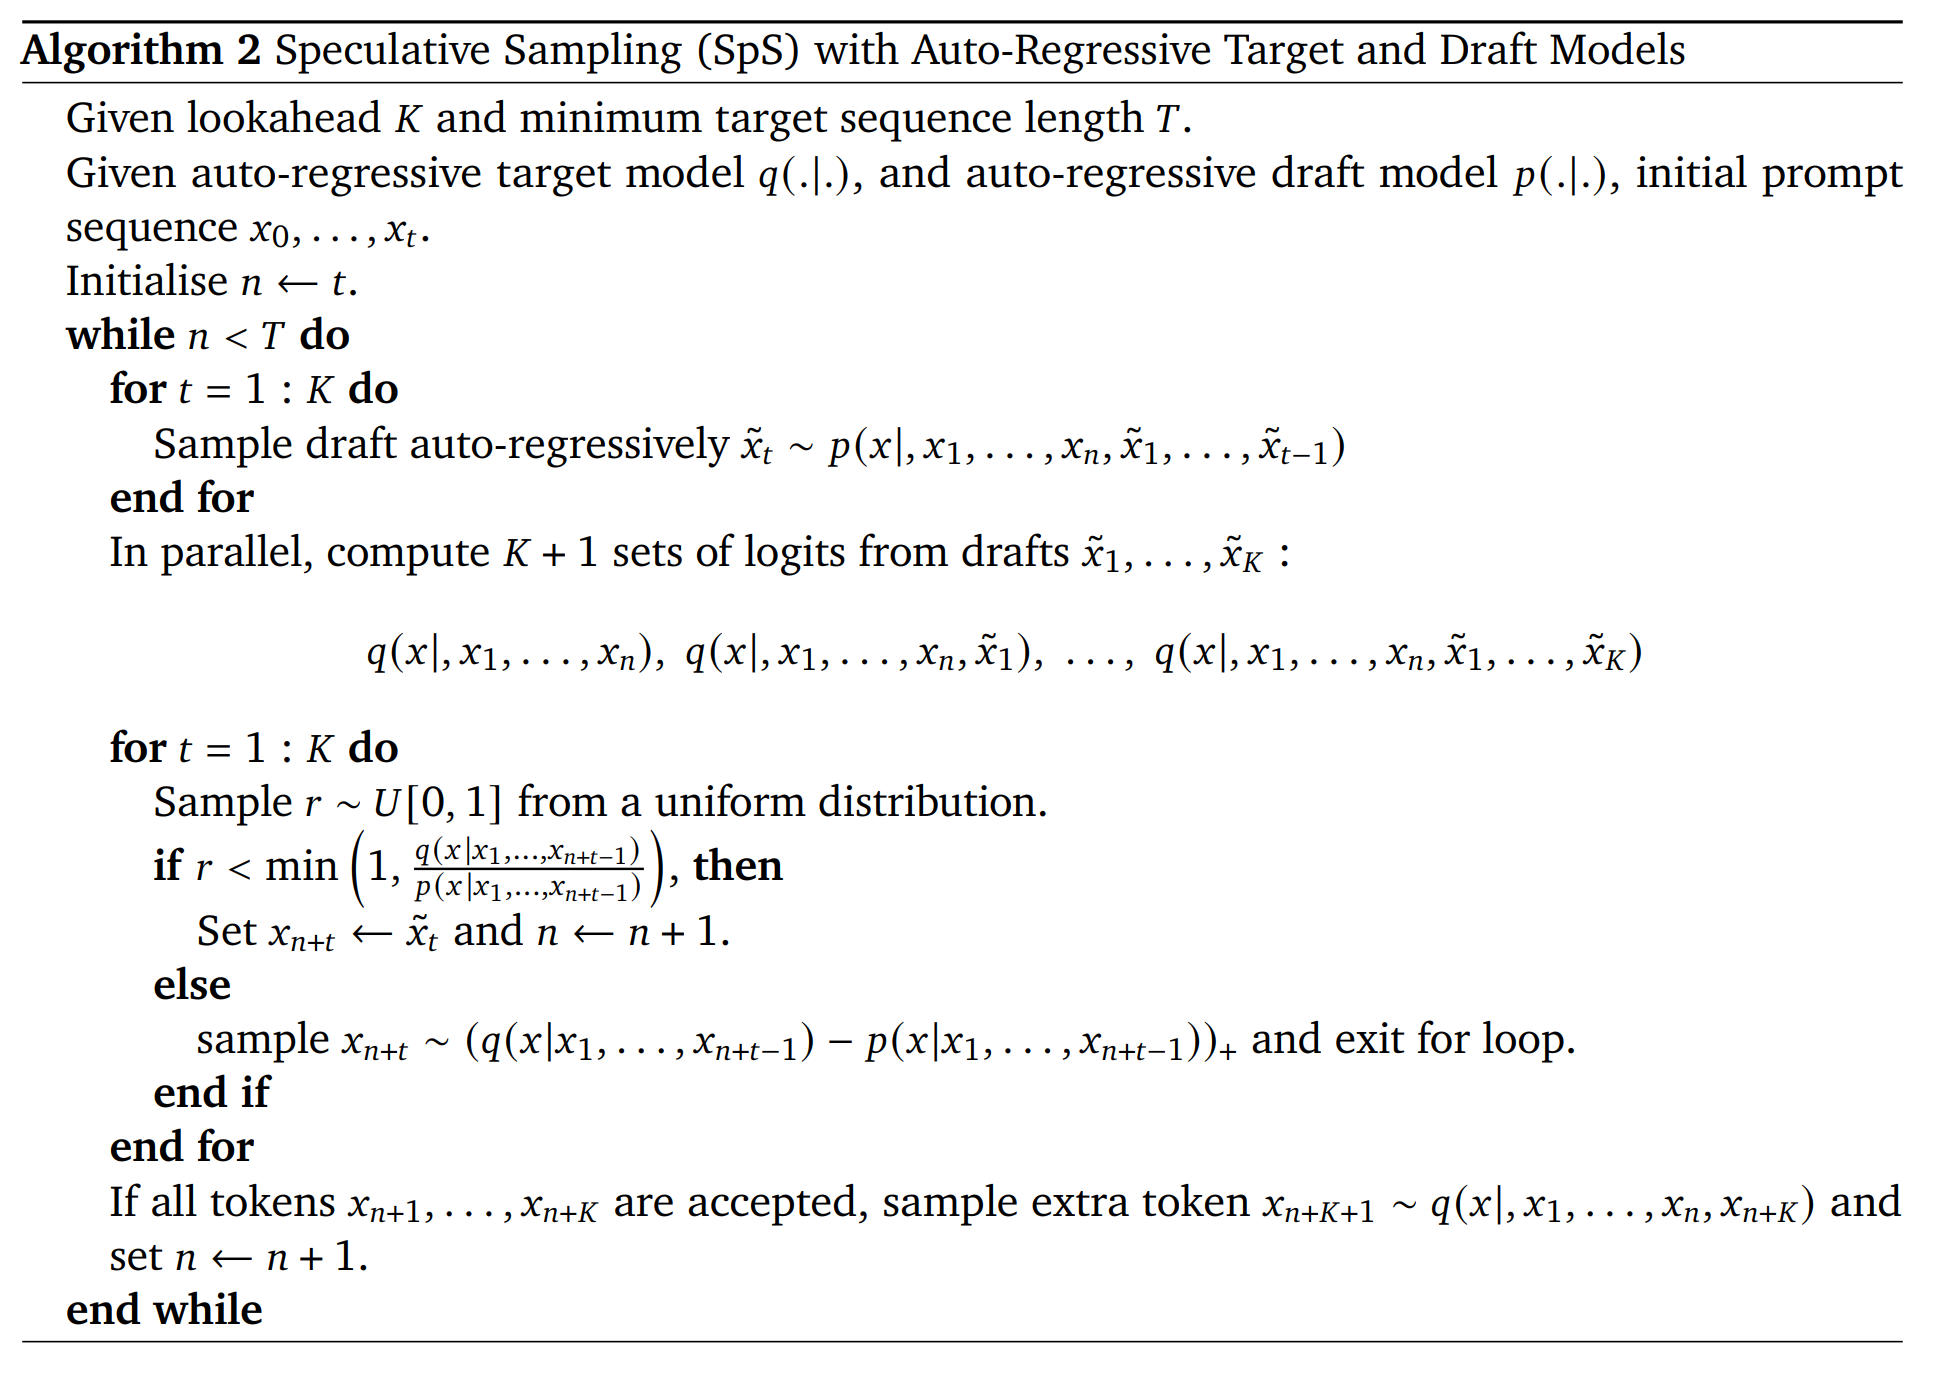
设目标模型(贵、要保真)的分布是 $q$,草稿模型(draft model,便宜)的分布是 $p$。
@torch.no_grad()
def speculative_step(draft, target, prefix, gamma):
    # ---- 1) 草稿模型自回归生成 gamma 个候选(便宜,每步只读小模型权重)----
    xs, ps = [], []
    ctx = prefix
    for _ in range(gamma):
        p = draft(ctx)[:, -1].softmax(-1)      # p(· | ctx)
        x = torch.multinomial(p, 1)
        xs.append(x); ps.append(p); ctx = torch.cat([ctx, x], dim=1)

    # ---- 2) 目标模型一次前向给出 gamma+1 个位置的分布(并行,只读一次大模型权重)----
    qs = target(ctx).softmax(-1)               # [B, len(prefix)+gamma, V]

    # ---- 3) 逐位置接受-拒绝 ----
    out = []
    for i, x in enumerate(xs):
        q_i, p_i = qs[:, len(prefix) - 1 + i], ps[i]
        r = torch.rand(1)
        if r < (q_i.gather(-1, x) / p_i.gather(-1, x)).clamp(max=1.0):
            out.append(x)                      # 接受
        else:
            resid = (q_i - p_i).clamp(min=0)   # 残差分布 max(q - p, 0)
            resid = resid / resid.sum()        # 归一化
            out.append(torch.multinomial(resid, 1))
            return out                         # 拒绝后立刻结束本轮
    # ---- 4) 全部接受:从目标模型多白拿一个 token ----
    out.append(torch.multinomial(qs[:, -1], 1))
    return out
三点说明:
- 接受概率是 $\min\!\left(1, \frac{q(x)}{p(x)}\right)$——草稿模型「过度采样」某个 token($p > q$)时才可能被拒。
- 拒绝时不是重新从 $q$ 采样,而是从残差分布 $\frac{\max(q - p,\,0)}{\sum_{x'}\max(q(x') - p(x'),\,0)}$ 采样。这一步是正确性的关键,下面会证明。
- 这是被修改过的拒绝采样:标准拒绝采样在被拒时会一直重试,而这里被拒时直接从残差分布出一个 token——保证每一轮至少产出一个 token,永不空转。
9.3 正确性证明:输出分布严格等于 $q$
只需证明单个位置上输出 token 的边缘分布就是 $q$(有了这个,配合链式法则,整条序列的联合分布自然等于目标模型的联合分布)。设最终输出为随机变量 $X$。它有两条产生路径:
$$ \Pr[X = x] \;=\; \underbrace{\Pr[\text{草稿出 } x \text{ 且被接受}]}_{\text{(I)}} \;+\; \underbrace{\Pr[\text{被拒}]\cdot \Pr[\text{残差分布出 } x]}_{\text{(II)}} $$第 (I) 项:草稿以概率 $p(x)$ 产出 $x$,然后以概率 $\min(1, q(x)/p(x))$ 被接受:
$$ \text{(I)} = p(x)\cdot\min\!\left(1, \frac{q(x)}{p(x)}\right) = \min\big(p(x),\, q(x)\big) $$被拒的总概率 $\beta$:对所有可能的草稿 token 求和,
$$ \beta = \sum_{x'} p(x')\left[1 - \min\!\left(1, \tfrac{q(x')}{p(x')}\right)\right] = \sum_{x'}\Big[p(x') - \min\big(p(x'), q(x')\big)\Big] = 1 - \sum_{x'}\min\big(p(x'), q(x')\big) $$残差分布的归一化常数 $Z$:
$$ Z = \sum_{x'}\max\big(q(x') - p(x'),\, 0\big) = \sum_{x'}\Big[q(x') - \min\big(p(x'), q(x')\big)\Big] = 1 - \sum_{x'}\min\big(p(x'), q(x')\big) $$(用到恒等式 $\max(a-b,0) = a - \min(a,b)$。)于是发现一个漂亮的巧合——其实是设计使然:
$$ \boxed{\;Z = \beta\;} $$因此第 (II) 项里的 $\beta$ 和 $1/Z$ 正好抵消:
$$ \text{(II)} = \beta \cdot \frac{\max(q(x) - p(x),\,0)}{Z} = \max\big(q(x) - p(x),\, 0\big) $$两项相加:
$$ \Pr[X = x] = \min\big(p(x), q(x)\big) + \max\big(q(x) - p(x),\, 0\big) $$分两种情况验证:若 $q(x) \ge p(x)$,得 $p(x) + \big(q(x)-p(x)\big) = q(x)$;若 $q(x) < p(x)$,得 $q(x) + 0 = q(x)$。两种情况都等于 $q(x)$。$\blacksquare$
Percy 在课上用一个两元素词表 $\{A, B\}$ 的例子把这个证明「具象化」了,这里完整复述一遍:
设 $p(A) > q(A)$(草稿模型过度采样 A),则必然 $p(B) < q(B)$(欠采样 B)。残差 $\max(q-p, 0)$ 在 A 上是 0、在 B 上是正的,归一化后就是 $[0, 1]$——一旦被拒,必定输出 B。
- $\Pr[\text{输出 } A] = \underbrace{p(A)\cdot\frac{q(A)}{p(A)}}_{\text{草稿出 A 且接受}} + \underbrace{p(B)\cdot 1 \cdot 0}_{\text{草稿出 B,必接受,残差不会给 A}} = q(A)$ ✓
- $\Pr[\text{输出 } B] = \underbrace{p(B)\cdot 1}_{\text{草稿出 B,因 } q(B)>p(B) \text{ 必接受}} + \underbrace{p(A)\cdot\left(1 - \tfrac{q(A)}{p(A)}\right)\cdot 1}_{\text{草稿出 A 被拒,残差必出 B}} = p(B) + p(A) - q(A) = q(B)$ ✓
(最后一步用了 $p(A)+p(B)=1$ 和 $q(A)+q(B)=1$。)直观理解:草稿模型多给 A 的那部分概率质量,被拒绝机制精确地「退还」并转移给了 B。
投机采样产生的是目标模型的精确样本(exact sample)。不是「近似」、不是「统计上接近」,是分布严格相同。所以它不需要做精度评估——这在工程上是巨大的优势:你可以在生产环境里随时开关它,不会改变模型行为。唯一的风险是随机数消耗方式变了,逐 token 复现需要额外注意。
9.4 加速比:能快多少
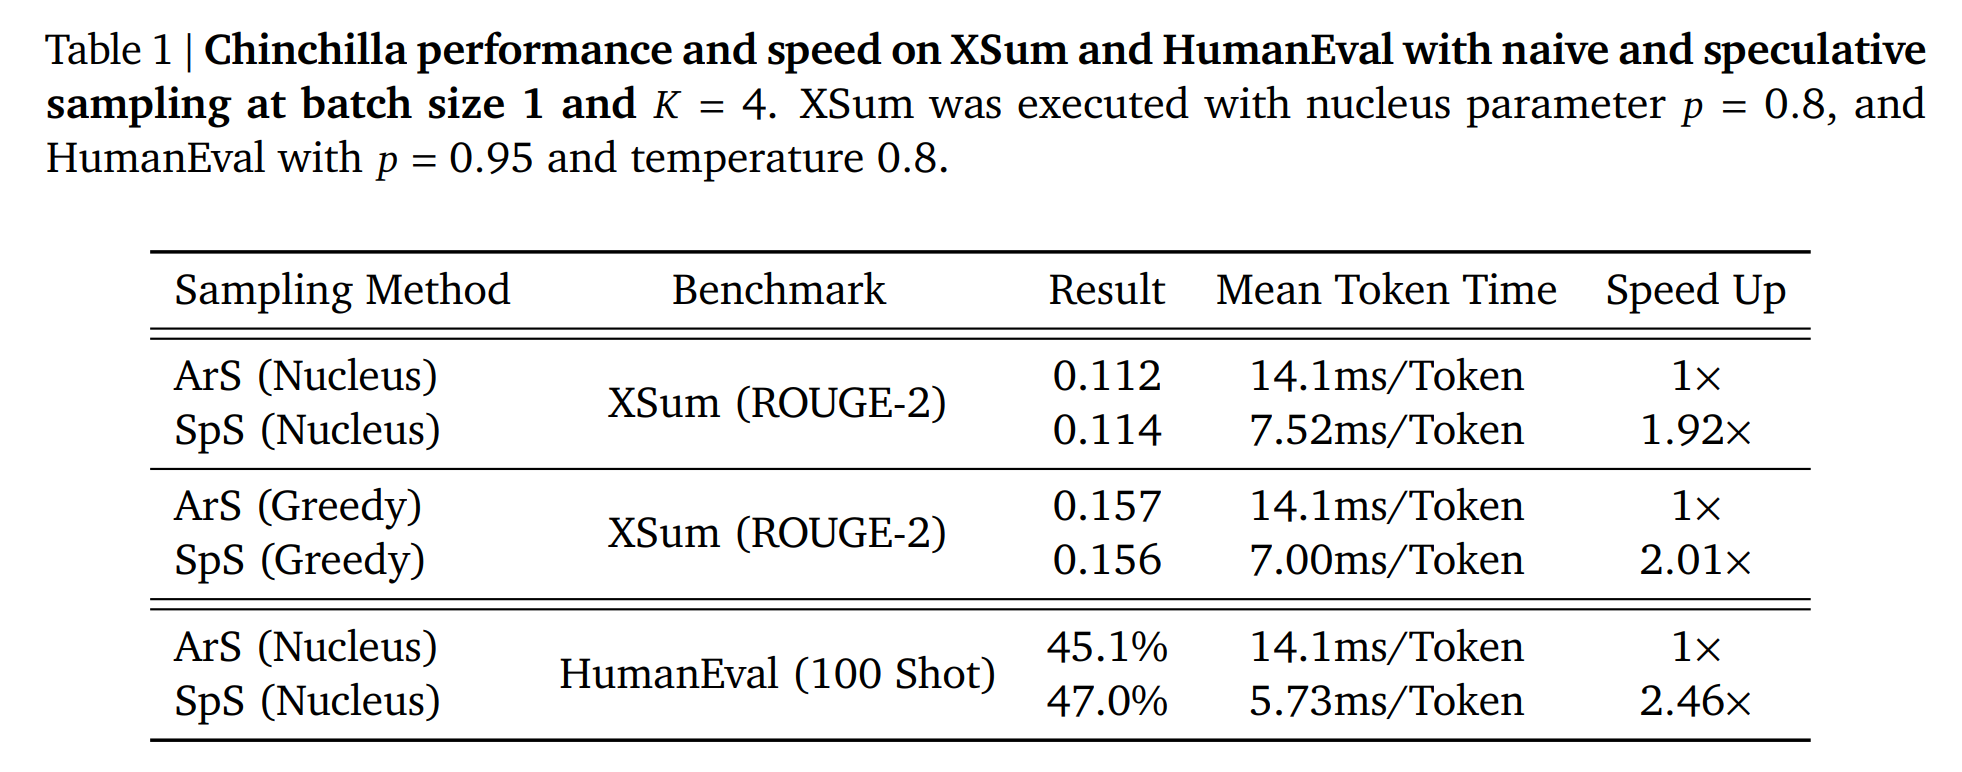
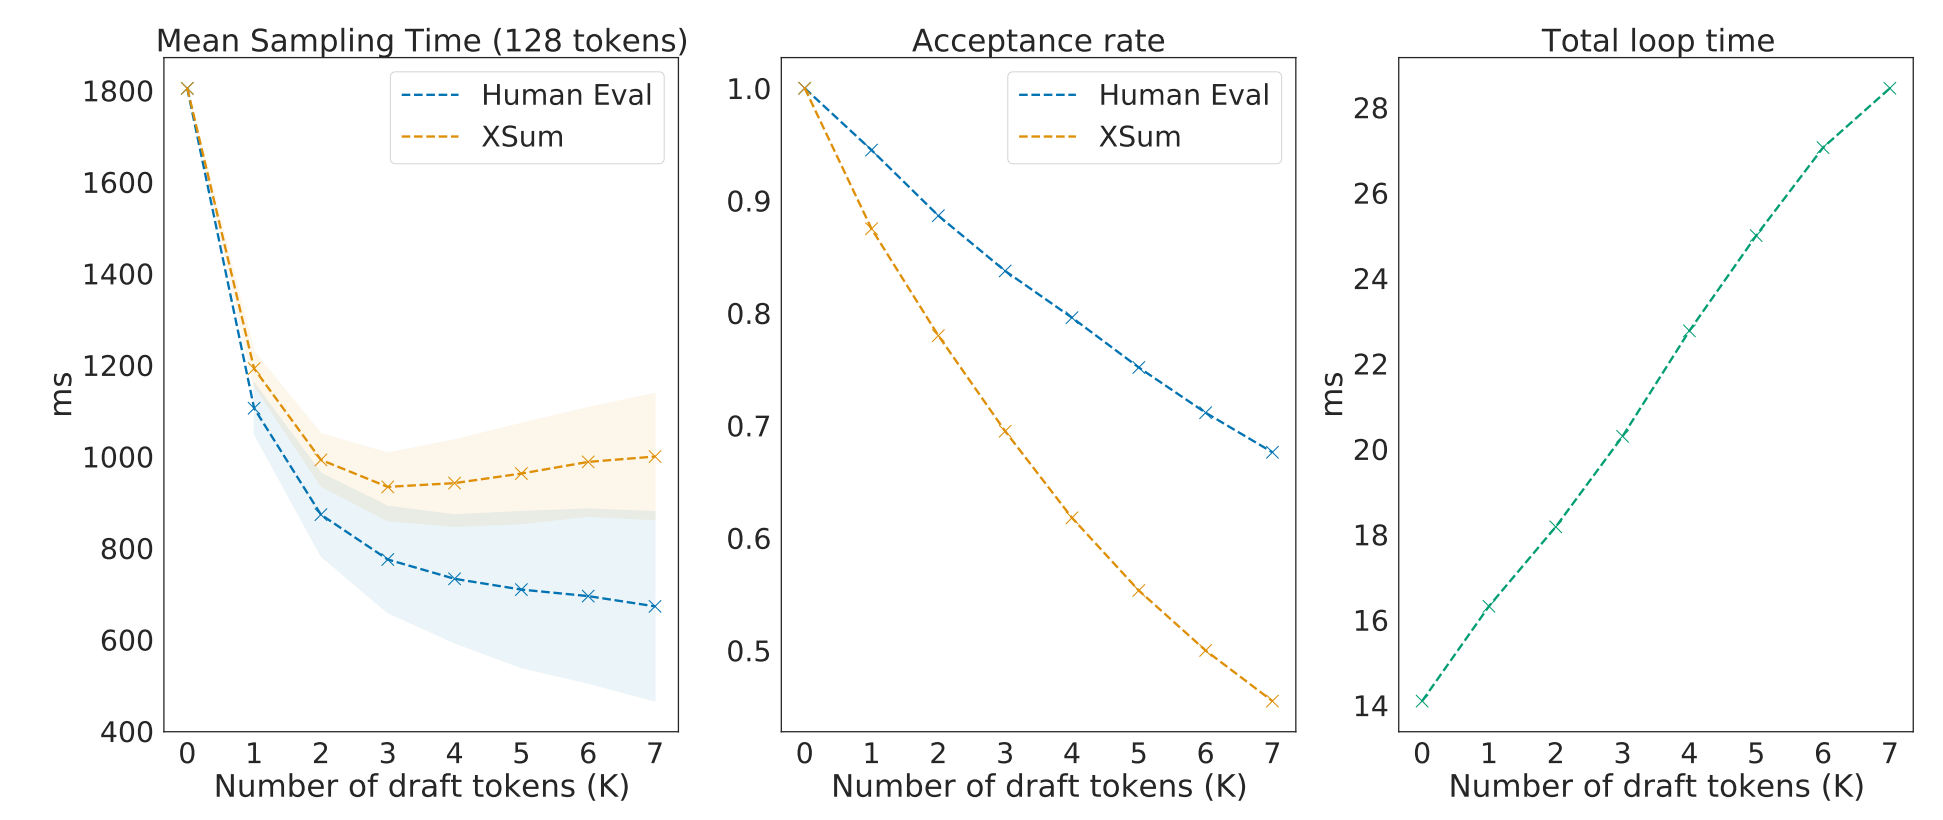
设每个位置的接受率为 $\alpha$(近似独立),一轮猜 $\gamma$ 个。一轮内被接受的 token 数是首次失败前的成功次数,服从截断几何分布,期望产出(含全接受时白拿的那一个)为
$$ \E[\#\text{tokens per round}] = \sum_{i=0}^{\gamma}\alpha^i = \frac{1 - \alpha^{\gamma+1}}{1 - \alpha} $$设草稿模型单步成本与目标模型单步成本之比为 $c$(例如 8B 草稿配 70B 目标,$c \approx 1/9$),一轮的总成本是 $\gamma c + 1$ 个「目标模型单步」。于是
$$ \text{speedup} = \frac{1 - \alpha^{\gamma+1}}{(1-\alpha)\,(\gamma c + 1)} $$数值感受:$\alpha = 0.8,\ \gamma = 4,\ c = 0.1$ 时,分子 $1 - 0.8^5 = 0.672$,加速比 $= \frac{0.672}{0.2 \times 1.4} = 2.4$ 倍。若 $\alpha$ 掉到 $0.5$,加速比只剩 $\frac{0.969}{0.5\times1.4} = 1.38$ 倍。接受率是决定性的。另外注意 $\alpha$ 与总变差距离的关系:$\alpha = 1 - \mathrm{TV}(p, q)$,所以「让草稿贴近目标」就是「最小化 TV 距离」。
9.5 怎么选/造草稿模型
课上给的实践搭配:
- 目标 70B ← 草稿 8B
- 目标 8B ← 草稿 1B
- 尽量让草稿模型贴近目标模型——最直接的办法就是用目标模型蒸馏出草稿模型(这样 TV 距离最小,$\alpha$ 最高)。
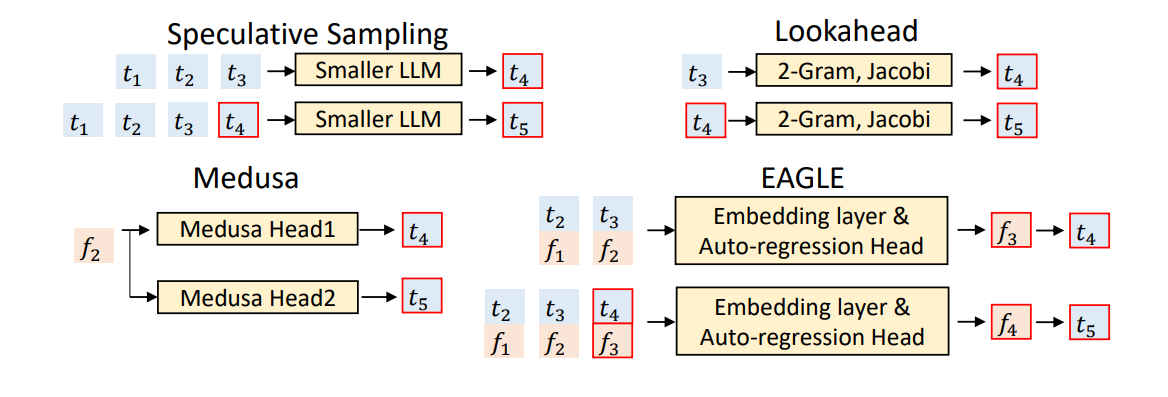
还有一条几乎零成本的路线值得知道:n-gram / prompt lookup decoding——不用任何神经网络当草稿,直接在已有的上下文里查找与当前后缀匹配的片段,把它后面的 token 当作草稿。对「总结长文」「按模板改写」「代码编辑」这类输出大量复制输入的任务,接受率极高,且草稿成本 $c \approx 0$。
- 投机采样从目标模型精确采样——靠的是那个 $Z = \beta$ 的数学巧合。
- 它利用的是「检查」与「生成」之间的成本不对称:一次目标模型前向可以验证任意多个 token。
- 草稿模型的设计空间还很大(涉及训练),是一个仍在快速推进的方向。
- 注意适用边界:投机采样把 memory-bound 的 decode 换成了「用更多算力去买带宽」。当服务已经在大 batch、算力接近饱和的状态运行时,它的收益会大幅缩水甚至变负——它最适合低并发、追求低延迟的场景(本地部署、单用户、延迟敏感的 agent 步骤)。
10. Prefill/Decode 分离与推理引擎生态
10.1 两个阶段的诉求彻底相反
把前面的结论并排放在一起,会发现 prefill 和 decode 简直是两种不同的 workload:
| Prefill | Decode | |
|---|---|---|
| 瓶颈 | 算力(compute-bound) | 显存带宽(memory-bound) |
| 算术强度 | MLP $BS$,注意力 $S/2$ | MLP $B$,注意力 $<1$ |
| 想要的 batch | 小(已经吃满算力,大 batch 只会拉长 TTFT) | 越大越好(摊薄参数读取) |
| 对应指标 | TTFT | TPOT / 吞吐 |
| 理想硬件 | 算力强的卡 | 带宽大、显存大的卡 |
如果把两者混在同一个 batch 里(传统做法),就会出现互相干扰:一个长 prompt 的 prefill 会占用整个 step 的时间,让同 batch 里所有正在 decode 的请求「卡顿」一下——用户看到的是输出忽快忽慢。业界把这个现象叫 decode 被 prefill 打断。
10.2 两种解法
- 分块预填充(chunked prefill):把长 prompt 的 prefill 切成小块,每一步 decode 里顺带处理一小块 prefill。这样每个 step 的时长稳定,decode 不再被长时间打断,同时用 prefill 的计算「填满」了 decode 空转的算力——单实例内的调和方案。vLLM 的默认策略。
- Prefill/Decode 分离部署(P/D disaggregation):更彻底——用两组不同的 GPU 池,一组专做 prefill,一组专做 decode,中间通过高速互联把 KV cache 传过去。好处是两组可以各自选择最合适的硬件、并行策略(prefill 适合 TP 高一些以压 TTFT,decode 适合大 batch + EP)和扩缩容比例;坏处是要传输 KV cache(一个 8k 上下文的 70B 模型 KV 有数 GB),对互联带宽要求高。代表工作有 DistServe、Splitwise,NVIDIA Dynamo、vLLM 与 SGLang 都已经支持这一模式,DeepSeek 公开的推理系统同样是 P/D 分离的。
为什么分离是「对」的方向?因为它把一个混合负载拆成了两个各自同质的负载,而同质负载才能被优化到极致。这跟数据中心里把 OLTP 和 OLAP 分开、把在线服务和批处理分开是同一个道理。代价永远是「中间那条数据通路」——这里就是 KV cache 的传输。
10.3 一张图看完全部优化
| 层次 | 技术 | 攻击的对象 | 是否无损 |
|---|---|---|---|
| 模型架构 | GQA / MQA / MLA / CLA | KV cache 的 $K,H,L$ | 需验证(MLA 近似无损) |
| 滑动窗口 / 稀疏注意力 / 线性注意力 | KV cache 的 $S$ | 需验证 | |
| 数值 | 权重量化(GPTQ / AWQ / FP8) | 参数字节数 | 需验证 |
| KV cache 量化(FP8 / INT8) | KV 字节数 | 基本无损 | |
| 模型压缩 | 剪枝 + 蒸馏 | 参数量、层数 | 需验证 |
| 解码算法 | 投机采样 / Medusa / EAGLE | 串行步数 | 数学上严格无损 |
| 服务系统 | 连续批处理 + 选择性批处理 | 时间维度的空转 | 无损 |
| PagedAttention / RadixAttention | 显存碎片、重复前缀 | 无损 | |
| Chunked prefill / P/D 分离 | 两阶段互相干扰 | 无损 | |
| Kernel | FlashAttention / FlashDecoding / CUDA Graphs | HBM 往返、launch 开销 | 无损 |
一个实用的排序建议:先把所有「无损」的做完(换一个现代引擎基本就白送了:连续批处理 + PagedAttention + FlashAttention + CUDA Graphs),再考虑有损的(量化通常是性价比最高的第一步,架构改动成本最高但天花板也最高)。
本讲小结
一、必须记住的五个公式
| 量 | 公式 | Llama 2 13B / H100 的数值 |
|---|---|---|
| 加速器强度 | $\dfrac{\text{FLOP/s}}{\text{B/s}}$ | $\dfrac{989\times10^{12}}{3.35\times10^{12}} \approx 295$ |
| MLP 算术强度 | $BT$ | prefill $BS$(好);decode $B$(要 $>295$) |
| 注意力算术强度 | $\dfrac{ST}{S+T}$ | prefill $S/2 = 512$(好);decode $<1$(无法改善) |
| KV cache 大小 | $2\,b\,L\,K\,H\,S\,B$ | MHA:800 KB / token;GQA-8:160 KB / token |
| 延迟 / 吞吐 | $\dfrac{2N_{\text{param}} + B M_{\text{KV}}}{\text{BW}}$ / $\dfrac{B}{\text{latency}}$ | $B{=}64$:23.8 ms、2690 tok/s |
二、四句话概括整讲
- 推理很重要——实际使用、模型评测、强化学习 rollout 三条线都靠它;训练是一次性成本,推理是每天重复的成本(OpenAI 每天 8.6T token,而一个前沿模型的全部训练语料才 32T token)。
- 推理和训练的性质完全不同——memory-bound 而非 compute-bound,且负载是动态的(请求随时到达、长度不一、前缀重复)。所以训练时代的直觉(「加大 batch 提高 MFU」「买算力更强的卡」)在这里大部分失效。
- 手段分四类:新架构(GQA / MLA / CLA / 局部与稀疏注意力)、量化(权重 + KV cache)、剪枝与蒸馏、投机采样。前三类有损、要验精度;投机采样无损。
- 很多好点子来自系统领域——投机执行(→ 投机解码)、分页与写时复制(→ PagedAttention)、迭代级调度(→ 连续批处理)、负载分离(→ P/D 分离)。
三、Percy 的判断
- 「注意力在 decode 阶段的算术强度小于 1 且无法改善」——这句话应该被理解为一个结构性事实:只要还在做自回归 + 全局注意力,就一定 memory-bound。所有优化都是在这个约束下腾挪。
- 「新架构在推理效率上还有巨大的改进空间」——这是他给出的最强的方向性判断。MLA 的例子说明:更省显存的架构甚至可以更准,说明目前的 Transformer 远没有摸到 Pareto 前沿。线性注意力 / SSM 混合、扩散语言模型都是这条路上的候选。
- 压缩模型的现代配方是「设计快架构 → 用原模型初始化 → 蒸馏修复」,而不是从零训练——因为你不该浪费掉已经付出的训练算力。
四、动手做什么
- 用第 3 节的性能模型,给你手上的模型 + 显卡算一遍延迟/吞吐/最大 batch,再和 vLLM 实测对比——差距就是系统开销。
- 实现一个带 KV cache 的 decode 循环,测 $B=1$ 和 $B=32$ 的每 token 时间,验证「延迟变差、吞吐变好」。
- 用一个 1B 模型当草稿、8B 当目标,实现 9.2 节的投机采样,统计接受率 $\alpha$,代入 9.4 的公式核对预测的加速比。
延伸阅读
基础参考
- Scaling Book · Inference 章节 — 本讲算术强度与延迟/吞吐模型的直接来源,还包含本讲没展开的「如何切分模型和 KV cache」的分布式推理内容。
- Scaling Book · Transformers 章节 — 记号体系与逐层 FLOPs/字节账本,读它可以让第 2 节的推导变成肌肉记忆。
KV cache 与注意力架构
- GQA: Training Generalized Multi-Query Transformer (2023) — 今天所有开源模型的默认选择;还展示了如何从已有 MHA checkpoint「uptrain」成 GQA,是「蒸馏配方」的一个实例。
- DeepSeek-V2 / MLA (2024) — 唯一一个同时做到「KV 更小」和「精度更高」的方案,附带解耦 RoPE 的工程细节。
- Reducing Transformer Key-Value Cache Size with Cross-Layer Attention (2024) — 把 GQA 的共享思路从「跨头」推广到「跨层」,与 GQA 正交可叠加。
- Longformer (2020) / Sparse Transformer (2019) / Mistral 7B (2023) — 局部与稀疏注意力的三篇代表作,Mistral 是把滑动窗口真正推向生产的那一篇。
- DeepSeek-V4 (2026) — CSA / DSA / HCA 三级压缩如何支撑 100 万 token 上下文,是「稀疏注意力」这条线目前最完整的工程答卷。
量化与压缩
- GPTQ (2022) — 用 Hessian 信息补偿量化误差,让 int4 PTQ 变得实用;读它可以理解「量化误差是可以被后续列吸收的」。
- AWQ (2023) — 「重要的是激活不是权重」这个洞察,以及如何把混合精度改写成硬件友好的按通道缩放。
- Compact Language Models via Pruning and Knowledge Distillation (NVIDIA, 2024) — 剪枝-蒸馏的完整配方与消融,Minitron 系列的来源。
- FP8-LM (2023) / INT8 vs FP8 对比 (2023) — 低精度格式的选择依据。
- LLM 量化技术综述 — 各类方法的横向对比,适合作为选型起点。
投机解码
- Fast Inference from Transformers via Speculative Decoding (Google, 2022) — 原始论文,含完整的正确性证明与期望加速比分析(9.4 节公式的出处)。
- Accelerating LLM Decoding with Speculative Sampling (DeepMind, 2023) — 同期独立工作,在 Chinchilla 70B 上给出大规模实测。
- Looking back at speculative decoding (Google Research Blog) — 作者回顾这个想法是怎么来的,比论文好读得多。
- Medusa (2024) — 不用独立草稿模型,在目标模型上挂多个预测头 + 树状注意力验证。
- EAGLE (2024) — 在特征空间而非 token 空间做草稿自回归,目前接受长度最好的一类方法。
推理服务系统
- Orca: A Distributed Serving System for Transformer-Based Generative Models (OSDI 2022) — 连续批处理与选择性批处理的原始论文;配套讲解视频。
- Efficient Memory Management for LLM Serving with PagedAttention (SOSP 2023) — vLLM 论文。把操作系统分页搬进 KV cache,是本讲「系统思维」的最佳范例。
- vLLM / SGLang / TensorRT-LLM / llama.cpp — 四个主流引擎。建议至少把 vLLM 的调度器和 block manager 代码读一遍,它是本讲第 5、6 节的可执行版本。