缩放定律(下):真实模型是怎么做缩放分析的
把 MiniCPM、DeepSeek、Qwen、Kimi K2、LLaMA 3 的技术报告拆开看:他们究竟跑了哪些实验、拟合了什么函数、省下了多少算力,以及 muP 在真实 Transformer 上到底成不成立。
0. 本讲导读
上一讲(Lecture 09)建立的是缩放定律的理论骨架:为什么损失对参数量、数据量呈幂律;联合定律 $L(N,D)=E+A N^{-\alpha}+B D^{-\beta}$ 长什么样;Chinchilla 的三种拟合方法(最小损失包络、IsoFLOP 抛物线、参数化联合拟合)分别怎么做;tokens/param $\approx 20$ 是怎么来的;Kaplan 与 Chinchilla 为什么会分歧;muP 的规则表长什么样。那一讲的落脚点是「原理上应该这样做」。
这一讲是同一套工具的工程落地。Tatsu 在开场提了三个非常具体的问题,整堂课就是在回答它们:
- Chinchilla 那一套在真实的大模型训练里真的管用吗?——2022 年以后,公开披露完整缩放分析的模型有哪些,他们照做了没有,结果准不准。
- 拟合缩放定律本身能不能省算力?——Chinchilla 要求每个数据点都从头训到底(不能中途早停),这让拟合成本从 $O(n)$ 变成 $O(n^2)$。有没有办法绕过?
- 该不该为了「好缩放」去挑特定的架构和参数化?——muP、优化器选择、RMSNorm 的可学习增益,这些看似无关的设计决定了你的小规模结论能不能外推。
和上一讲最大的风格差别是:这一讲几乎全是技术报告的一手图表。Tatsu 逐张拆解 MiniCPM 和 DeepSeek 的缩放实验,再横向扫过 Qwen、Kimi K2、Hunyuan、LLaMA 3、MiniMax,最后用两个大规模实证研究(StepFun 的 Step Law、Lingle 的 muTransfer 复现)来检验「超参缩放律」和「muP」这两条路线各自的可信度。
- 2024 年以后的公开配方基本收敛成两条路线:DeepSeek 路线(不用 muP,假设大部分超参对规模不敏感,只对 LR/batch 做经验缩放拟合 + IsoFLOP 定模型大小)和 MiniCPM 路线(用 muP 让超参跨规模不变,再用联合拟合定数据/模型比)。
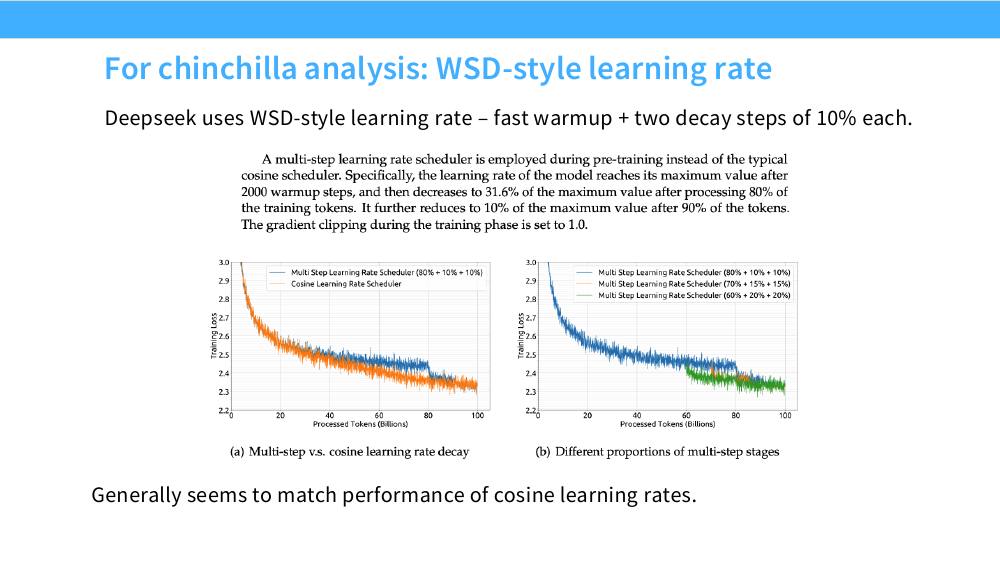
- 两条路线都靠 WSD(warmup–stable–decay)学习率把 Chinchilla 拟合的成本从 $O(n^2)$ 压回 $O(n)$:一条稳定期长跑,在任意 checkpoint 分叉出短衰减,就能得到一个合法的「训到底」数据点。
- 公开报告里的最优 tokens/param 比值普遍远大于 20:MiniCPM 联合拟合给出 $D/N\approx 96$($10^{21}$ FLOPs 处),Hunyuan 给出 96:1(对激活参数),LLaMA 3 给出 39:1。原因既有方法论差异,也有推理成本这个 Chinchilla 完全没有计入的项。
- StepFun 的大规模网格实验说明:固定 $(N,D)$ 时损失关于 $(\log\text{LR},\log B)$ 是凸的(所以最优点可以干净地定位),且 batch size 主要由数据量 $D$ 决定,学习率主要由 $N$ 决定。
- muP 在宽度方向确实能让最优 LR 跨 $128\to 8192$ 稳定,但它对现代 Transformer 的若干组件不鲁棒:RMSNorm 的可学习增益、基于符号的优化器(Lion)、以及强 weight decay(0.1)都会破坏迁移性。好消息是前两者可以直接去掉而几乎不掉性能。
- Tatsu 反复强调的方法论警告:任何「新优化器快 X 倍」的说法,都必须在多个模型规模 × 多个 Chinchilla 比值上验证——绝大多数报告的加速比会随规模衰减,而且往往只是因为基线的 LR 没调好。
1. 2022 之后:公开配方里的缩放长什么样
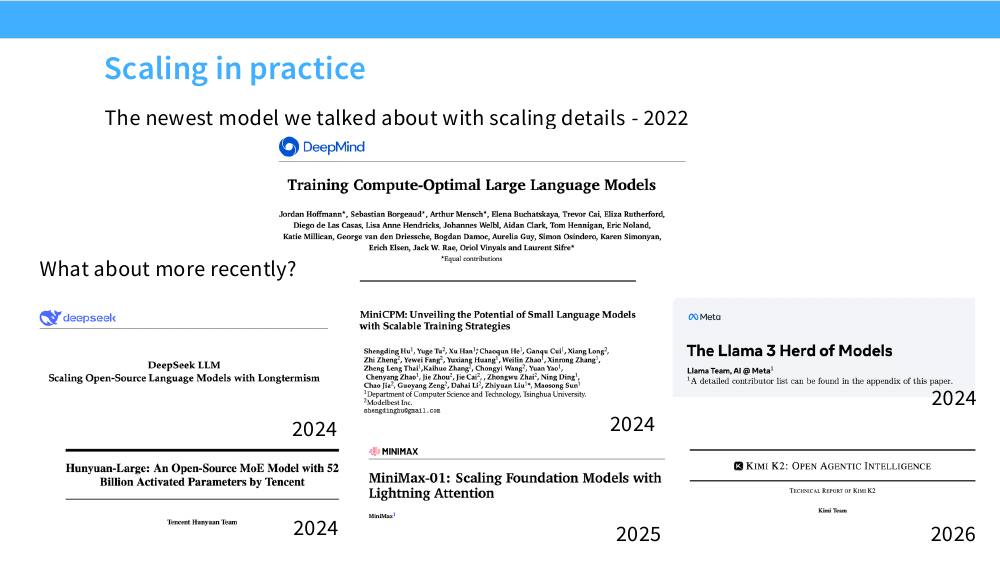
这张图本身就是一个结论:缩放分析的细节正在变成商业机密。Chinchilla 之后,DeepMind/OpenAI/Anthropic 一系的模型再没有公开过完整的 IsoFLOP 曲线。今天还愿意把实验图放出来的,主要是中国的几个团队(DeepSeek、面壁 MiniCPM、Qwen、Kimi、腾讯 Hunyuan、MiniMax)和 Meta 的 LLaMA 3。所以这一讲的素材天然偏向这几家。
1.1 为什么这件事非做不可:超参是尺度敏感的
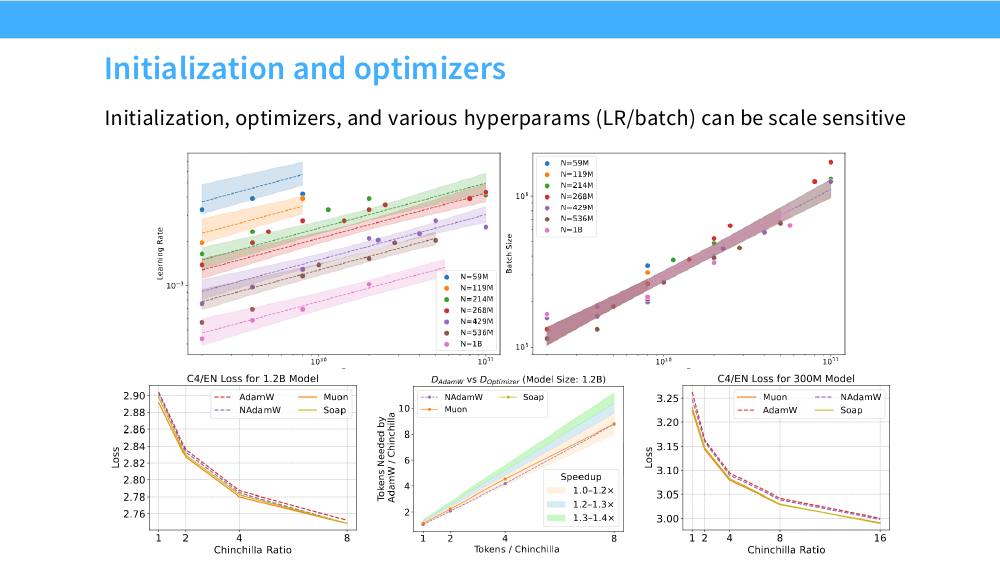
这里要和上一讲的第 10 节接上:Porian 等人已经证明,Kaplan 和 Chinchilla 之间那个著名的 $a=0.73$ vs $a=0.50$ 的分歧,主犯就是超参没有随规模重新调。换句话说,如果你不认真处理超参缩放,你拟合出来的缩放定律本身就是错的——它测量的是「配方失配的程度随规模怎么变」,而不是「模型能力随规模怎么变」。
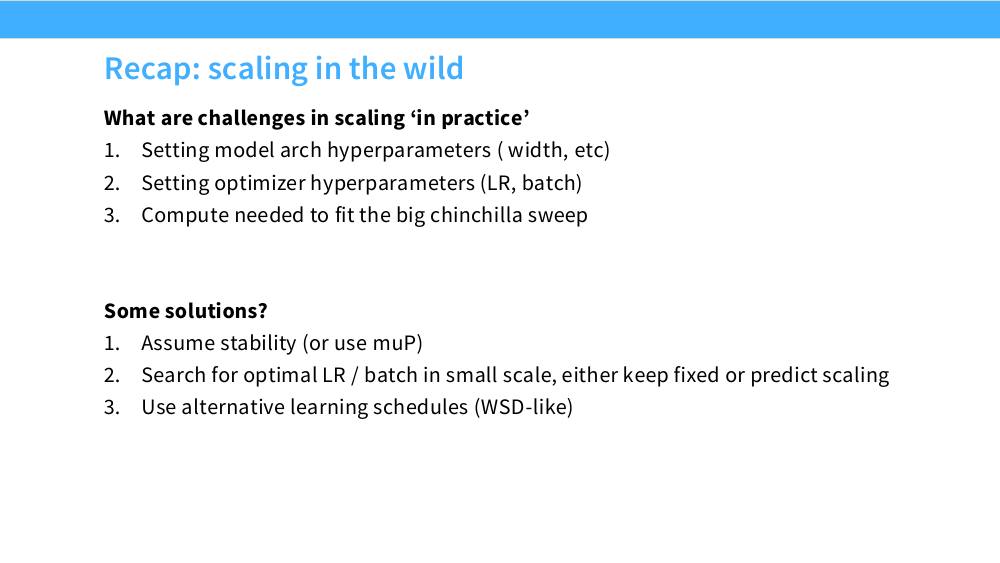
于是任何一份真实的缩放配方都必须回答三个层次的问题,Tatsu 在最后一页把它们总结为:
| 层次 | 要定的东西 | 主流解法 |
|---|---|---|
| ① 架构超参 | 宽度 $d_{\text{model}}$、深度 $L$、头数、FFN 倍数、长宽比(aspect ratio) | 固定长宽比,只放大整体规模;或用 IsoFLOP 直接搜 |
| ② 优化器超参 | 学习率 $\eta$、batch size $B$、warmup、weight decay | muP(让它们不变)或经验缩放律(预测它们怎么变) |
| ③ 模型/数据配比 | 给定算力 $C$ 时的 $(N^\ast, D^\ast)$ | Chinchilla 方法 1/2/3,配合 WSD 降低成本 |
1.2 为什么大家都在「过度训练」
上一讲得到的 Chinchilla 结论是 $D^\ast/N^\ast\approx 20$。但本讲将要看到的真实数字是:MiniCPM 联合拟合 $\approx 96$、Hunyuan $\approx 96$(对激活参数)、LLaMA 3 $\approx 39$,而 LLaMA 3 8B 实际训了 15T token,$D/N\approx 1875$。这个系统性的偏离有两个来源,必须分清楚。
来源一:方法论差异。不同团队的 $L(N,D)$ 拟合中 $\alpha$ 与 $\beta$ 的相对大小不同。回忆上一讲的推导:在算力约束 $C=6ND$ 下最小化 $E+AN^{-\alpha}+BD^{-\beta}$,得到
$$ N^\ast\propto C^{\frac{\beta}{\alpha+\beta}},\qquad D^\ast\propto C^{\frac{\alpha}{\alpha+\beta}},\qquad \frac{D^\ast}{N^\ast}\propto C^{\frac{\alpha-\beta}{\alpha+\beta}} $$只有当 $\alpha=\beta$ 时比值才是常数。MiniCPM 拟合出的 $\alpha\approx\beta\approx 0.30$,但系数 $C_N=7.54\times10^{-2}$ 远小于 $C_D=2.92\times10^{-1}$——参数比数据「便宜」得多,于是最优点大幅偏向多喂数据。系数的比值直接决定了那个常数,而系数在小规模拟合里是很难测准的。
来源二:推理成本。Chinchilla 的目标函数里完全没有推理。真实部署时的总算力是
$$ C_{\text{total}} \;=\; \underbrace{6ND}_{\text{训练}} \;+\; \underbrace{2N\,D_{\text{inf}}}_{\text{推理}} $$其中 $D_{\text{inf}}$ 是模型一生要处理的 token 总量(prompt + 生成)。注意推理项只含 $N$ 不含 $D$:训练时多喂数据是一次性成本,而参数量会永久地按比例抬高每一次前向的开销。对一个要服务上万亿 token 请求的模型,$2N D_{\text{inf}}$ 可以轻松超过 $6ND$。
把总成本写成 $N,D$ 的函数并在等损失面上优化。固定目标损失 $L_0$,约束为 $A N^{-\alpha}+B D^{-\beta}=L_0-E\equiv \ell$。用拉格朗日法最小化 $C_{\text{total}}=6ND+2ND_{\text{inf}}$:
$$ \mathcal{L}=6ND+2ND_{\text{inf}}+\lambda\left(AN^{-\alpha}+BD^{-\beta}-\ell\right) $$ $$ \frac{\partial}{\partial N}:\;6D+2D_{\text{inf}}=\lambda\alpha A N^{-\alpha-1},\qquad \frac{\partial}{\partial D}:\;6N=\lambda\beta B D^{-\beta-1} $$两式相除并整理:
$$ \frac{6D+2D_{\text{inf}}}{6N}=\frac{\alpha A N^{-\alpha-1}}{\beta B D^{-\beta-1}} \quad\Longrightarrow\quad \frac{D}{N}\left(1+\frac{D_{\text{inf}}}{3D}\right)=\frac{\alpha A}{\beta B}\,\frac{D^{\beta+1}}{N^{\alpha+1}} $$关键在括号里那一项。$D_{\text{inf}}=0$ 时退化为 Chinchilla;$D_{\text{inf}}\gg D$ 时,左边被放大,方程要求在同样的 $D/N$ 下 $N$ 更小、$D$ 更大。直觉版本:推理成本给参数量额外加了一份「租金」,所以最优解会用更多数据去换更小的模型。Sardana & Frankle(2023)把这个思路做完整,结论是当推理量达到万亿 token 量级时,最优 $D/N$ 会从 20 涨到几百甚至上千。
Chinchilla 最优点在损失曲面上是很平的。上一讲算过:偏离最优 2 倍,损失只涨 $\sim$0.01 nats。这意味着你可以拿这 0.01 nats 去换一个小一半的模型——推理便宜一半、显存少一半、延迟低一截。这就是为什么「过度训练」(overtraining)在工业界是默认操作:它花的是你最不缺的东西(训练时的数据吞吐),省的是你最缺的东西(部署时的每 token 成本)。
本讲要看的公开配方里,DeepSeek、MiniCPM、LLaMA 3 都属于「知道 Chinchilla 最优在哪,然后故意往数据侧走」的做法。他们做缩放分析的目的不是照抄最优点,而是知道自己偏离了多远、代价是多少。
2. MiniCPM:用 muP 把超参锁死,再拟合剩下的
MiniCPM(2024,清华/面壁)是 1–2.5B 的小模型,性能对标当时的 7B。Tatsu 明说它「即使在 2024 年也算不上 SOTA」,但选它作为案例的原因是:它的缩放分析做得最细、公开得最完整,几乎是一份可以照做的教科书式配方。
2.1 技术 1:用 muP 稳定缩放
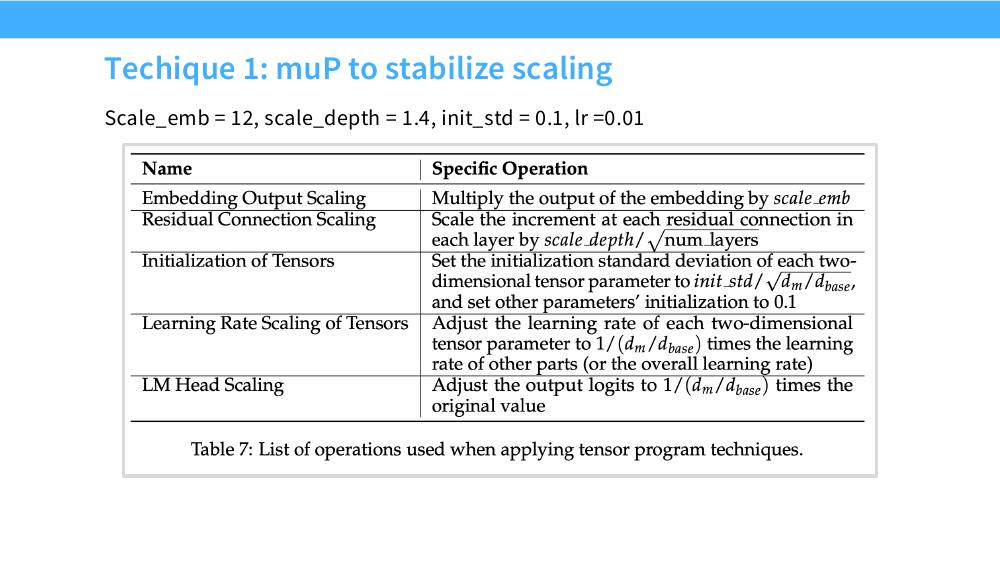
值得单独指出两点。第一,$\text{scale\_depth}/\sqrt{L}$ 这条不是标准 muP(标准 muP 只管宽度),而是深度方向的额外稳定化——残差流的方差会随层数线性累积,除以 $\sqrt{L}$ 把它压回 $\Theta(1)$。第二,整体学习率 $\eta=0.01$ 大得离谱(常规 Transformer 用 $3\times10^{-4}$ 量级),这正是 muP 的特征:二维权重的实际 LR 是 $0.01/m$,$m$ 一大就回到正常范围,而 embedding / norm 这类参数确实可以用大得多的 LR。
2.2 技术 2:固定长宽比,只放大整体尺度
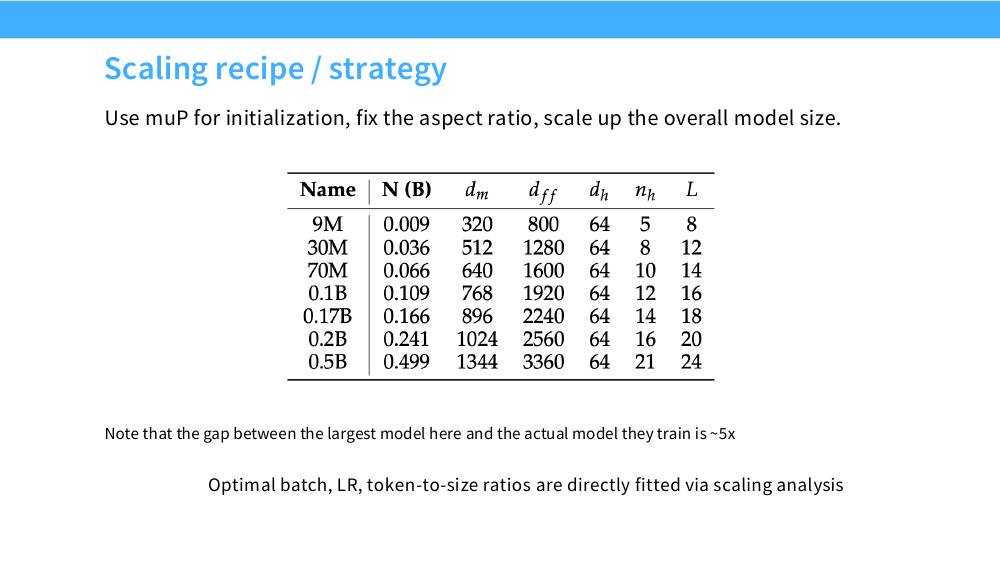
「最大实验点到目标模型只差 5 倍」这件事需要警惕。Chinchilla 从 $10^{19}$ 外推到 $5.76\times10^{23}$,跨了 4 个数量级;MiniCPM 只跨了不到 1 个数量级的参数量。外推倍数小当然更安全,但代价是:如果你的目标模型比实验模型大 100 倍(比如从 0.5B 实验推 50B 模型),MiniCPM 这套做法的可信度会显著下降。实践准则是:实验阶梯至少要覆盖 2 个数量级的算力,并且用最大的那个点做留出验证。
2.3 验证 muP:最优学习率真的稳定吗
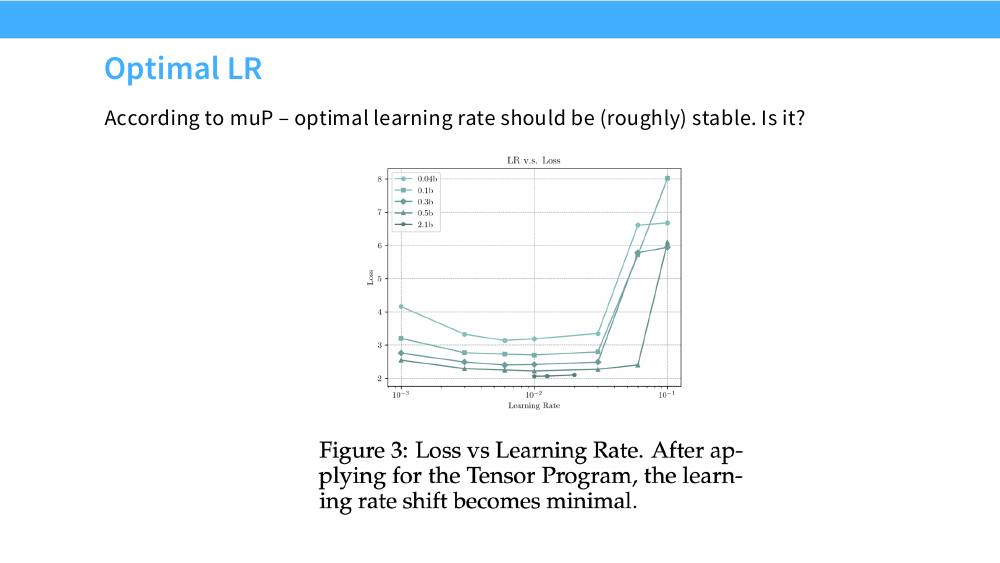
这张图的实践含义很重要:muP 把 LR 搜索范围从三个数量级压缩到一个 2–3 倍的窗口,但没有消灭搜索。MiniCPM 最终仍然是在 muP 之上做了一轮小范围扫描才定下 $\eta=0.01$。上一讲第 7.4 节提过这一点,这里是它的实证版本。
2.4 最优 batch size:一张三维扫描图怎么读
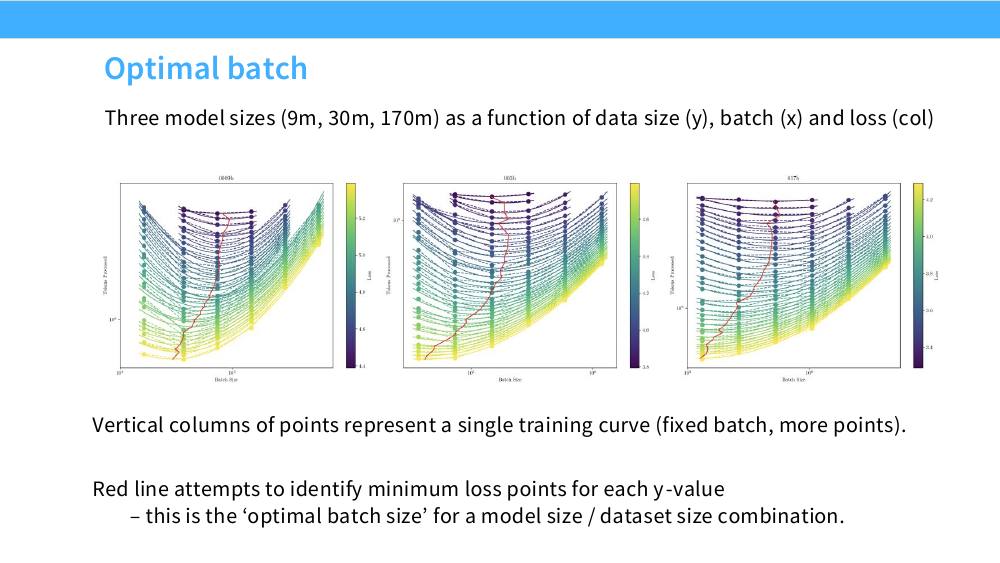
这个实验设计值得学:它用 $O(\#\text{batch})$ 次训练,同时得到了所有 $(D, B)$ 组合的损失,因为中间 checkpoint 被复用了。这是本讲反复出现的主题——缩放实验的成本主要花在「不能复用的重复训练」上,凡是能复用中间状态的地方都要复用。
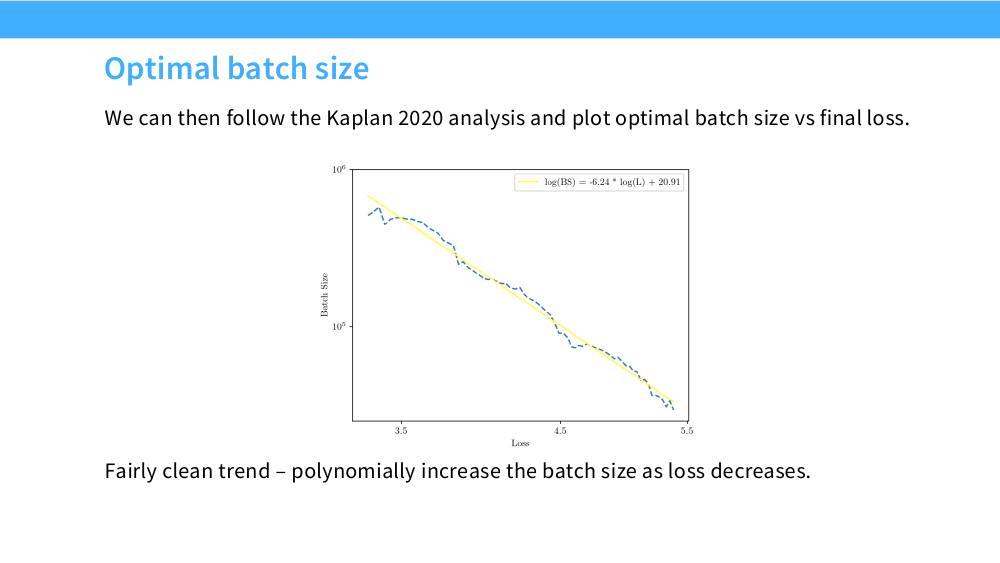
为什么用「损失」而不是「算力」或「参数量」作自变量?这是 OpenAI 的 critical batch size 观点:batch size 的上限由梯度噪声决定,而梯度噪声与模型当前离收敛有多远直接相关,损失恰好是这个距离的度量。这个选择在第 6 节会被 StepFun 的实验重新检验——他们的结论是应该用 $D$ 而不是 $L$。
「最优 batch size 越大越好,因为并行度高」。图里显示的是一条 U 形曲线的谷底:batch 太小则梯度噪声大、每步进展有限;batch 太大则每个样本的边际贡献下降(数据效率变差),同样的 token 预算下损失反而更高。$B_{\text{opt}}$ 是这两者的平衡点,超过它继续加大 batch 会真实地浪费算力,而不只是「收益递减」。工程上常见的错误是先按集群规模定 batch,再去调其他东西——正确顺序反过来。
3. WSD 学习率:把 Chinchilla 拟合的成本从 $O(n^2)$ 降回 $O(n)$
到这里 MiniCPM 已经用 muP 锁死了 LR,用扫描定了 batch。剩下最贵的一件事是模型/数据配比。而这件事贵得非常具体,值得把账算清楚。
3.1 问题:为什么不能早停
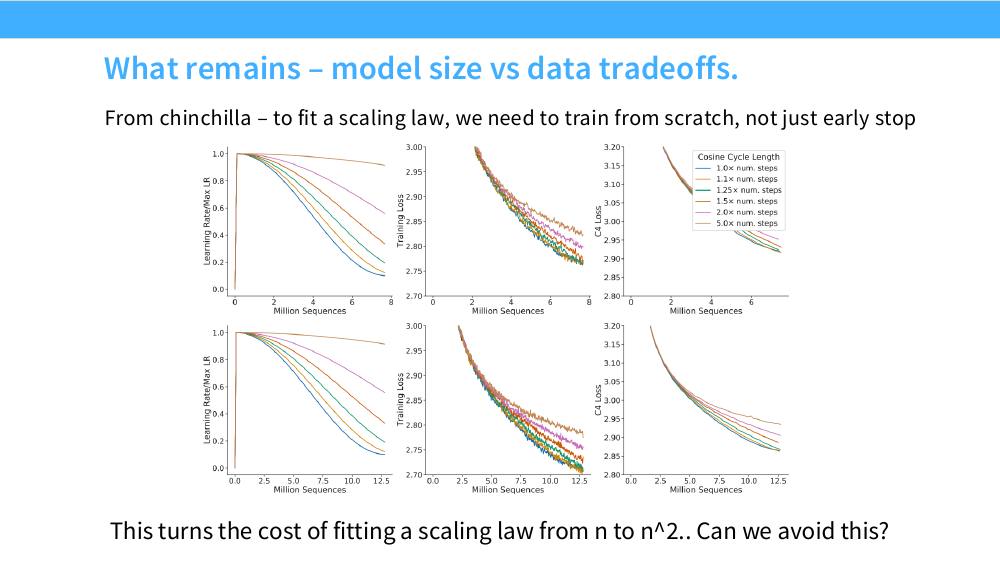
成本为什么是 $O(n^2)$。假设你要在 $n$ 个模型规模 $\times$ $n$ 个数据量上采样 $(N,D,L)$ 三元组。
理想情况(可以早停):对每个规模只训一条最长的曲线,沿途记录 $n$ 个 checkpoint,总成本 $\propto \sum_{i=1}^{n} N_i D_{\max} = O(n)$ 次训练。
Chinchilla 要求(必须训到底):每个 $(N_i, D_j)$ 组合都要一次独立的、cosine 完整衰减的训练,总成本 $\propto\sum_{i}\sum_{j} N_i D_j = O(n^2)$ 次训练。
取 $n=6$:36 次训练 vs 6 次训练,6 倍差距。如果考虑到每条曲线上想要 20 个数据点,差距就是 20 倍。对一个只有几百张卡的团队,这直接决定了缩放分析做不做得起。
3.2 解法:warmup–stable–decay
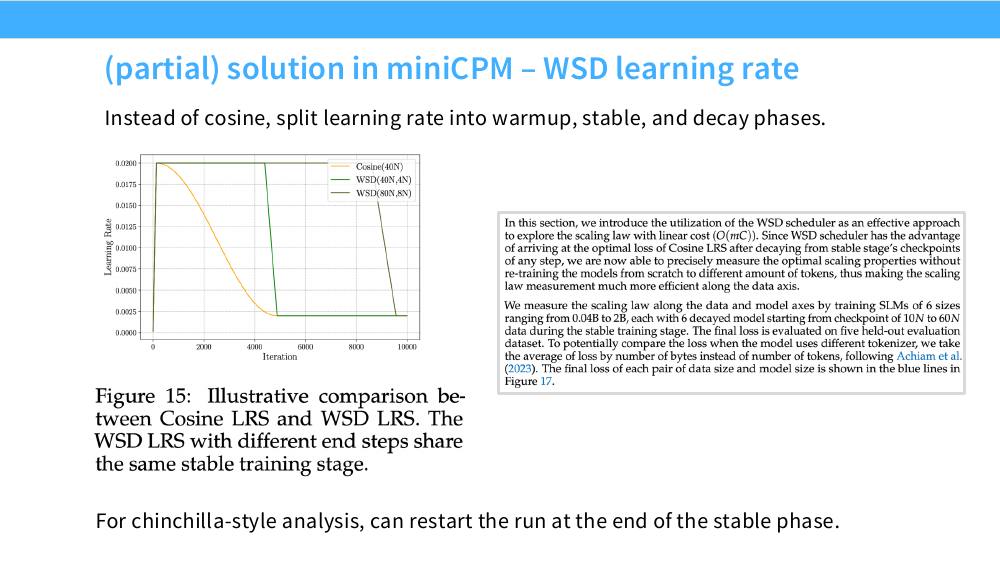
WSD 的核心洞察是:cosine 之所以不能早停,是因为它把「探索期」和「收敛期」耦合在一条曲线上。WSD 把两者解耦——稳定期负责在高 LR 下探索,衰减期负责把参数收进一个尖锐的极小值。既然衰减期只占 10%,那么一条长度为 $T$ 的稳定期主干,配上 $k$ 条各占 $0.1T'$ 的衰减分支,总成本是 $T(1+0.1k\cdot\text{平均分叉比})$,而不是 $\sum T_i$。
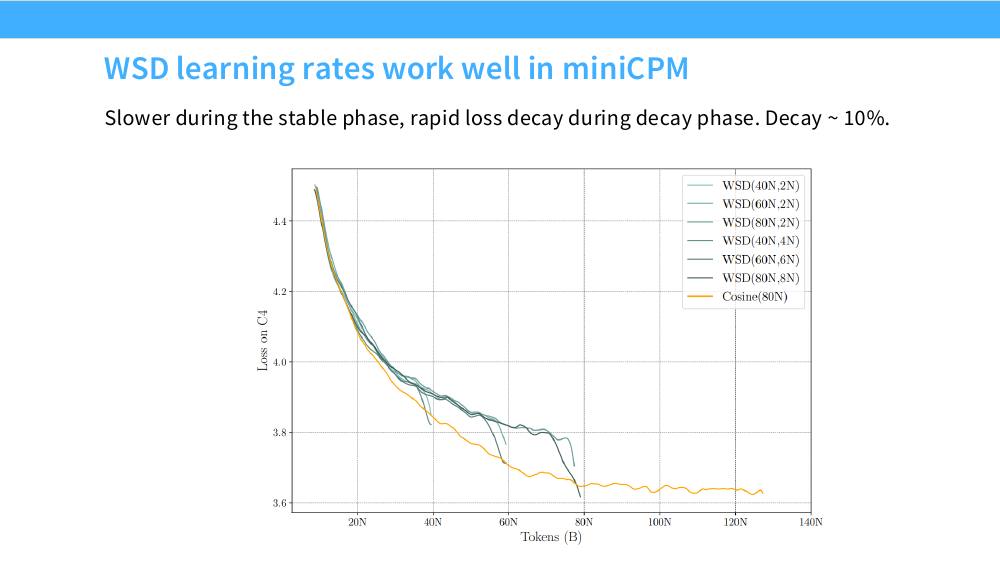
把稳定期想成「在损失曲面的一个宽阔盆地里高速游荡」,把衰减期想成「关掉动能,让模型滚进脚下最近的那个坑」。滚进坑的动作总共只要 10% 的步数,所以你可以在游荡途中的任意时刻按下暂停、复制一份参数、让副本滚进坑里量一下深度,然后主干继续游荡。这就是 $O(n^2)\to O(n)$ 的全部魔法。
附带的好处:WSD 让持续预训练(continual pretraining)变得自然——你随时可以从稳定期 checkpoint 接着训,不必像 cosine 那样面对「LR 已经衰减到 0,怎么重新升上去」的难题。这也是为什么 WSD 后来成了工业界的默认选择。
3.3 有了便宜的数据点之后:MiniCPM 的 Chinchilla 分析
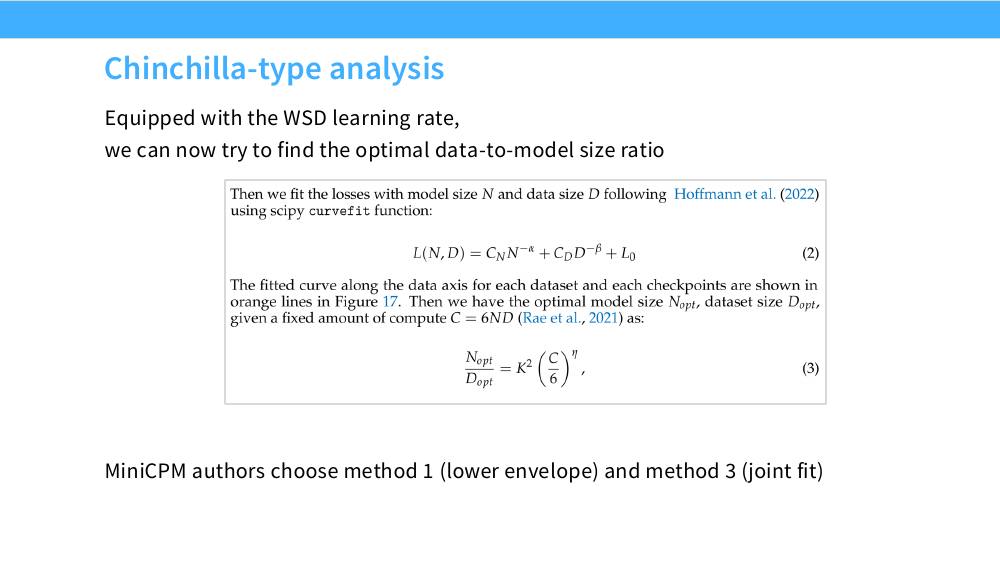
curve_fit 求解(注意:不是 Chinchilla 原文用的 Huber loss + LBFGS 网格重启,而是最朴素的非线性最小二乘)。给定算力 $C=6ND$(引用 Rae et al. 2021 的口径),最优比值写成 $\frac{N_{opt}}{D_{opt}}=K^2\left(\frac{C}{6}\right)^{\eta}$。他们同时用了方法 1(最小损失包络)和方法 3(联合拟合)交叉验证。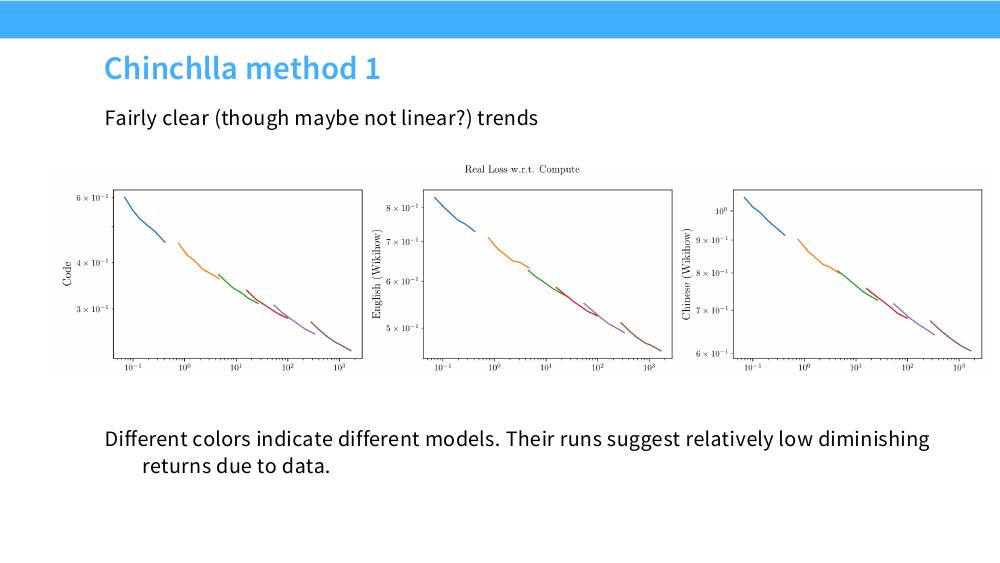
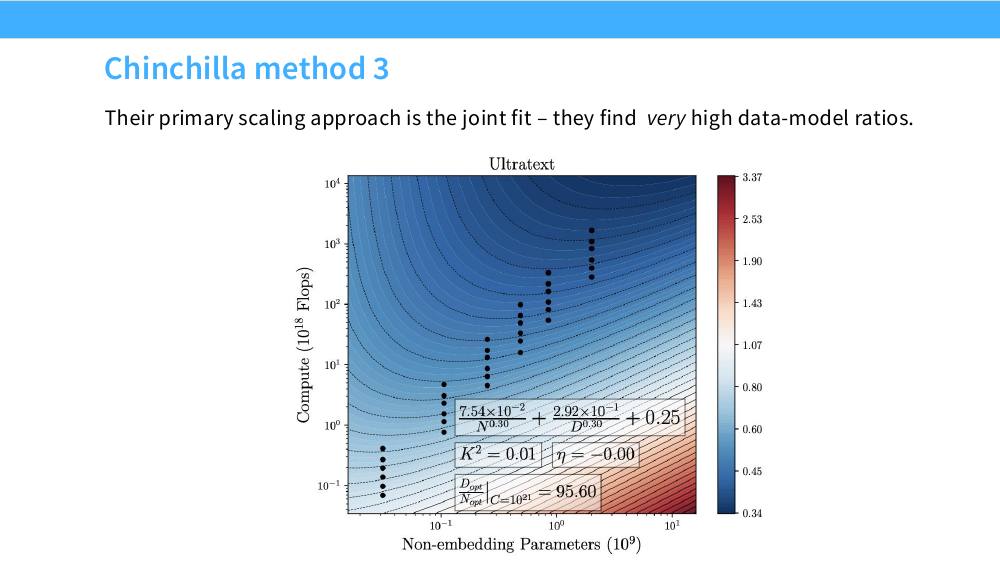
$\alpha=\beta=0.30$ 而 $D/N\approx 96$,这两件事放在一起需要解释。既然指数相同,比值就完全由系数决定:由一阶条件可推出 $\frac{D^\ast}{N^\ast}=\left(\frac{C_D\beta}{C_N\alpha}\right)^{1/(\alpha+\beta)}\cdot$(常数),代入 $C_D/C_N=2.92\times10^{-1}/7.54\times10^{-2}\approx 3.87$、$\alpha=\beta=0.30$,得 $3.87^{1/0.6}\approx 10.6$——量级对但不等于 96,说明还有 $6\times$ 的口径因子($C=6ND$ 与非嵌入参数计数)在里面。
真正的教训是:$D/N$ 这个数字对系数比值的敏感度是 $1/(\alpha+\beta)\approx 3.3$ 次方。系数测偏 20%,比值就偏 $1.2^{3.3}\approx 1.8$ 倍。而系数恰恰是拟合中最不稳定的量(它和 $L_0$ 强耦合)。所以看到「我们拟合出最优比是 96」时,合理的解读是「大约几十到一百多」,而不是精确的 96。这正是上一讲第 10.3 节 Besiroglu 复现所揭示的同一类问题。
4. DeepSeek:不用 muP,直接给超参拟合缩放律
DeepSeek LLM(2024)训了 7B 和 67B 两个模型,在当时的开源模型里性能领先。它的缩放策略和 MiniCPM 形成了一个漂亮的对照:完全不用 muP,而是把「最优 LR」「最优 batch」本身当成待拟合的缩放量。
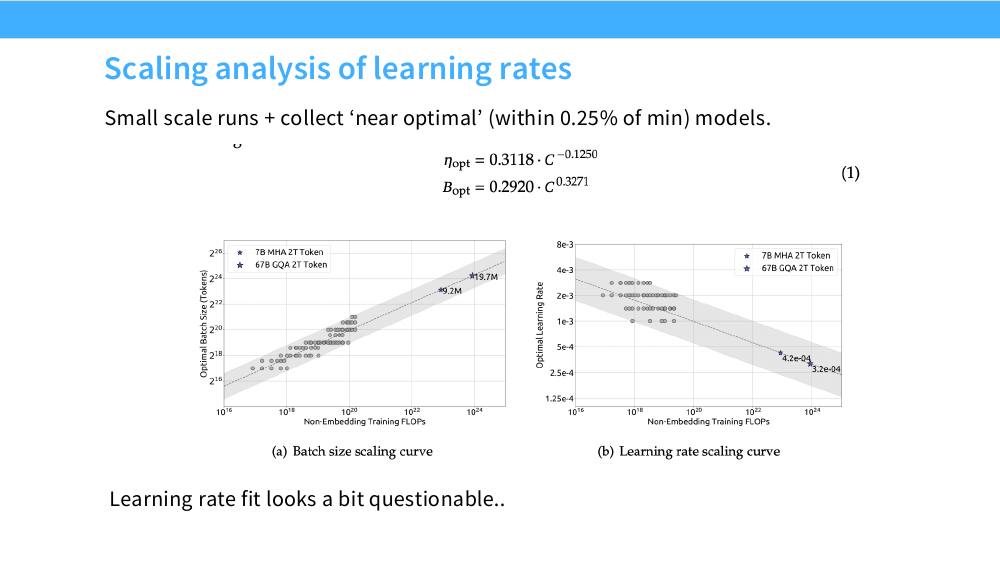
Tatsu 对这张图的评价是「learning rate fit looks a bit questionable」,这个批评值得展开,因为它是本讲最重要的方法论教学点之一。看右图:灰点在 $10^{16}$–$10^{20}$ 区间里几乎是水平散布的,甚至隐约有阶梯状(因为扫描的 LR 取值是离散的 $\{1\times,2\times,4\times\ldots\}$ 网格)。在这样一团点上强行拟合一条斜率 $-0.125$ 的直线,然后外推 4 个数量级到 $10^{24}$,得到 $4\times10^{-4}$——这个外推的置信度是很低的。
「拟合出的 $R^2$ 很高,所以外推可信」。这里的问题不是拟合质量,而是信噪比与杠杆:
- 取值离散化:如果你只在 $\{2^{-10},2^{-9},\ldots\}$ 上扫 LR,那么「最优 LR」的测量分辨率就是 2 倍。用分辨率 2 倍的数据去估计一个「每 10 倍算力变化 $10^{-0.125}=0.75$ 倍」的趋势,需要跨越很多个数量级才能积累出可辨识的信号。
- 「0.25% 以内都算最优」的定义会把一大片平坦区域全部纳入,人为地把散点云拉宽,让回归线的斜率被端点主导。
- 杠杆点:拟合区间的两端(最小和最大的几个算力)对斜率的影响远超中间点,而这两端恰恰是数据最少、噪声最大的地方。
Tatsu 的隐含建议:这类超参缩放律应当被当作「量级参考」而不是精确预测,落地时仍要在目标规模附近做一次小范围验证。第 6 节的 StepFun 工作就是在系统性地修补这个问题。
4.1 IsoFLOP:DeepSeek 的模型/数据配比
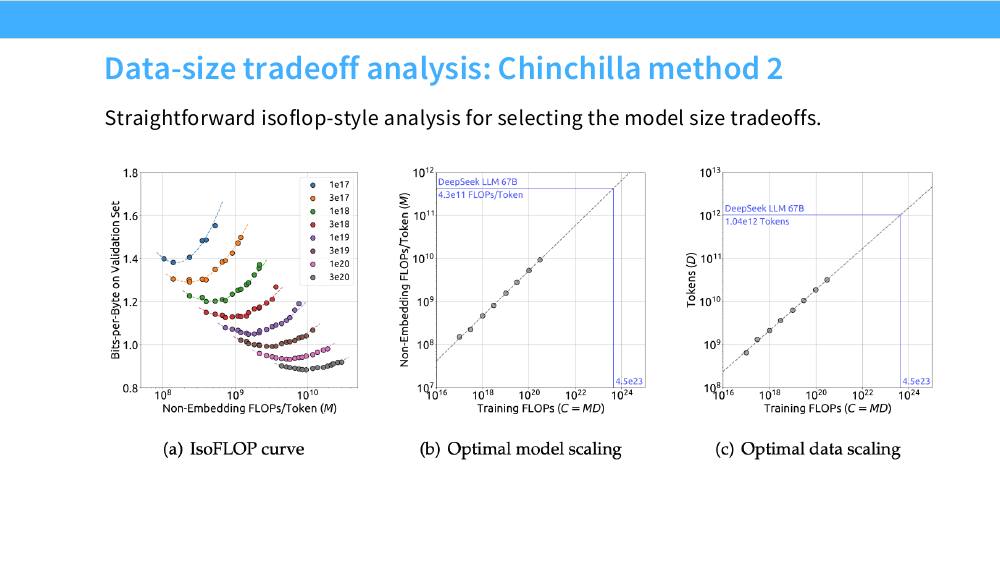
DeepSeek 用 $M$(每 token 非嵌入 FLOPs)替代 $N$(参数量),这个改动比它看起来重要得多。回忆上一讲第 10.2 节:Kaplan 与 Chinchilla 的分歧有很大一部分来自「参数怎么数」——算不算 embedding、算不算 attention 的 $O(L\cdot d)$ 项。$M$ 把这个问题一次性解决了:它直接就是算力口径,于是 $C=M\cdot D$ 恒等成立,不需要 $C\approx 6ND$ 这个近似,也不存在「嵌入层在小模型里占比过高」的偏差。
代价是 $M$ 不能直接告诉你显存要多大——你还得再从 $M$ 反推回架构。但对于拟合缩放律这件事本身,$M$ 是更干净的自变量。如果你要自己做 IsoFLOP 分析,这是应该照抄的一条。
算一下自洽性:$C = M\cdot D = 4.3\times10^{11}\times 1.04\times10^{12}=4.47\times10^{23}$,与标注的 $4.5\times10^{23}$ 吻合。再把 $M$ 换算成参数量,用 $M\approx 2N$(前向每参数 2 FLOPs)得 $N\approx 2.15\times10^{11}$?这显然不对——DeepSeek 67B 只有 $6.7\times10^{10}$ 参数。差异来自 $M$ 里还包含了 attention 的序列长度项和一些实现细节,说明$M\leftrightarrow N$ 的换算本身就依赖架构和上下文长度,这正是用 $M$ 的理由之一。至于 $D/N$:$1.04\times10^{12}/6.7\times10^{10}\approx 15.5$——DeepSeek 67B 实际上训得比 Chinchilla 还略微「不足」,符合 2024 年初的时间点。
4.2 预测准不准
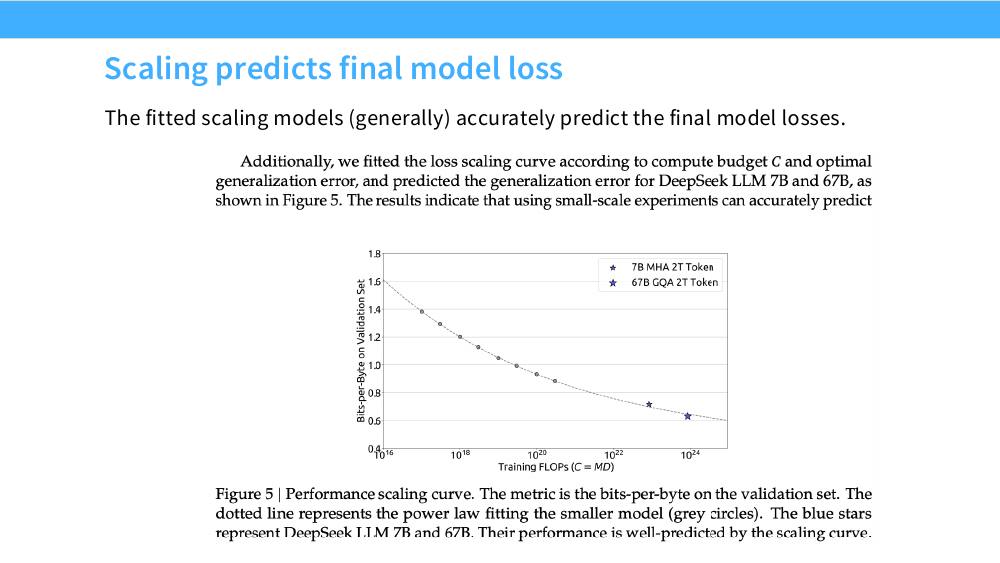
这张图值得作为「缩放分析该怎么汇报」的模板:拟合用小模型,验证用大模型,把大模型的点画在同一张图上而不是单独说「误差 0.3%」。同时注意 7B 用 MHA、67B 用 GQA——两个不同的注意力架构落在同一条曲线上,这本身是「架构细节对损失缩放影响有限」的一个证据(第 5 节 MiniMax 会正面研究这个问题)。
5. 横向扫描:Qwen / Kimi K2 / Hunyuan / LLaMA 3 / MiniMax
MiniCPM 和 DeepSeek 是两个「讲全了」的样本。剩下几家公开的信息更零碎,但每一家都补上了一个新维度。
5.1 Qwen:只说做了,不说怎么做
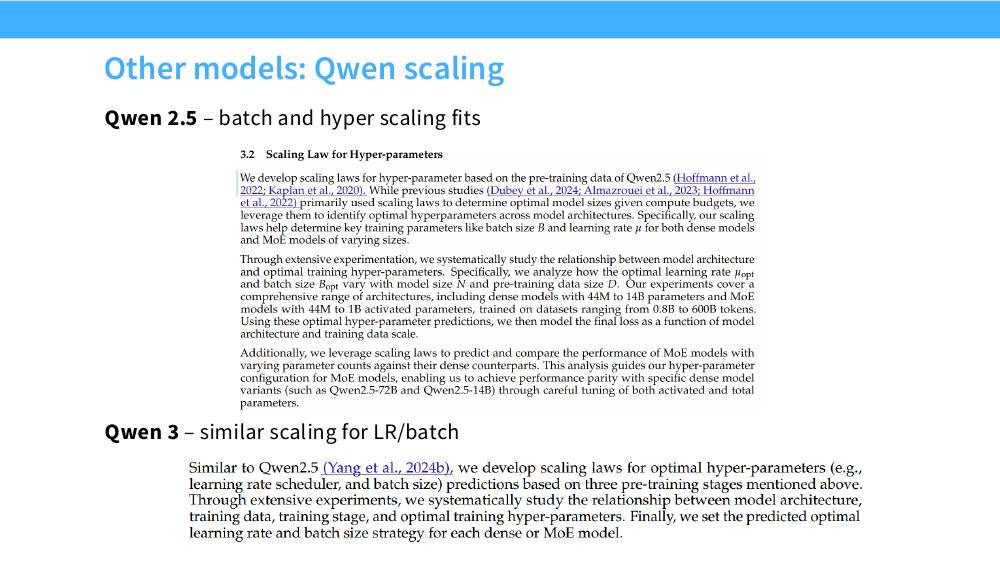
Qwen 的重点和 DeepSeek 一致(超参缩放律),但它多做了一件事:用缩放律做 MoE 与稠密模型的等价性预测——给定一个目标稠密模型(如 Qwen2.5-72B),去找参数配置使 MoE 达到同等性能。这是缩放律作为「决策工具」而非「预测工具」的用法。
5.2 Kimi K2:把稀疏度当作一个缩放维度
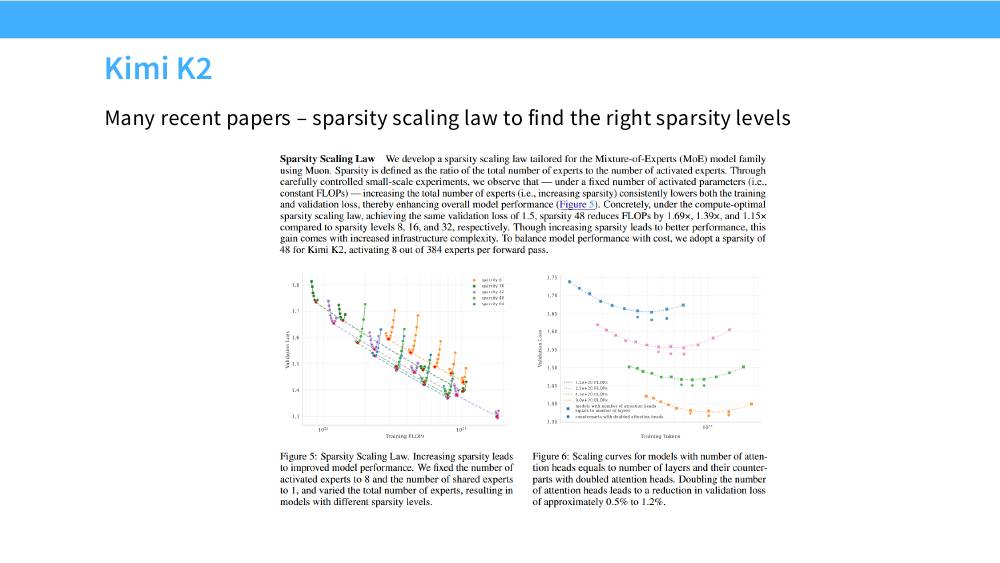
稀疏度是一个「几乎免费」的缩放维度,但它换的是 FLOPs 而不是内存。MoE 的账要分两本记:
- 算力账:激活参数 $N_a$ 决定训练/推理 FLOPs($\approx 6N_a D$)。稀疏度提高不改变这一项。
- 内存与通信账:总参数 $N_{\text{total}}$ 决定权重显存、优化器状态、以及分布式训练中的 all-to-all 通信量。稀疏度 48 意味着显存开销是同等 FLOPs 稠密模型的几十倍。
Kimi K2 报告里的原话是「这个收益伴随着基础设施复杂度的上升」(this gain comes with increased infrastructure complexity)——他们选 48 而不是 64,是在模型质量与工程成本之间的取舍,不是纯粹的缩放律最优点。这是本讲反复出现的模式:缩放律给出前沿,工程约束决定你在前沿上站哪个位置。
5.3 Hunyuan-Large:对激活参数做 IsoFLOP
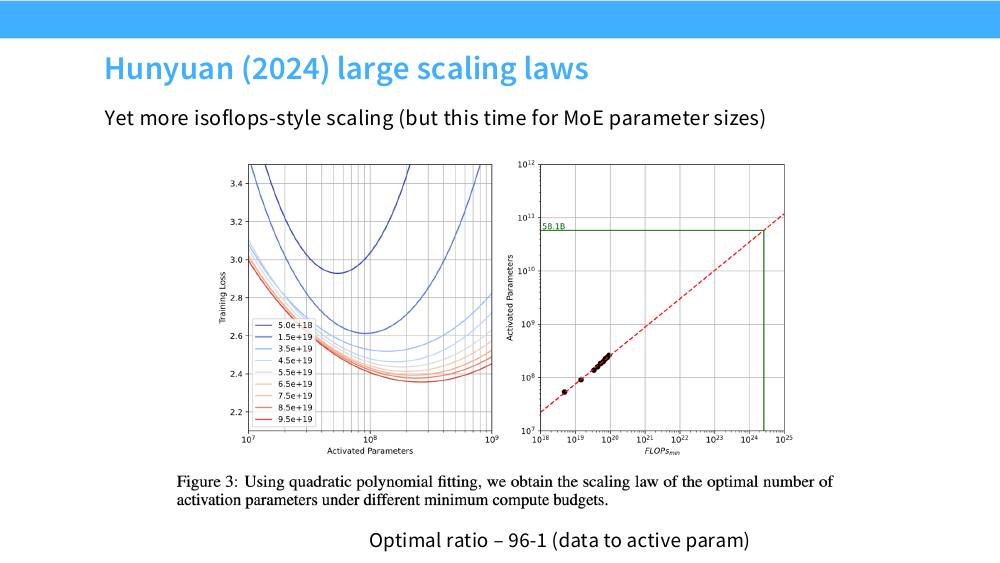
96:1 和 MiniCPM 的 95.6 撞在一起,这大概率是巧合(两者的实验设置、数据、口径都不同),但它确实反映了一个趋势:2024 年之后的公开分析几乎都给出远高于 20 的比值。对 MoE 而言这个数字还有额外含义——因为分母是激活参数而非总参数,所以按总参数算的话比值会低得多。
5.4 LLaMA 3:从算力直通下游指标
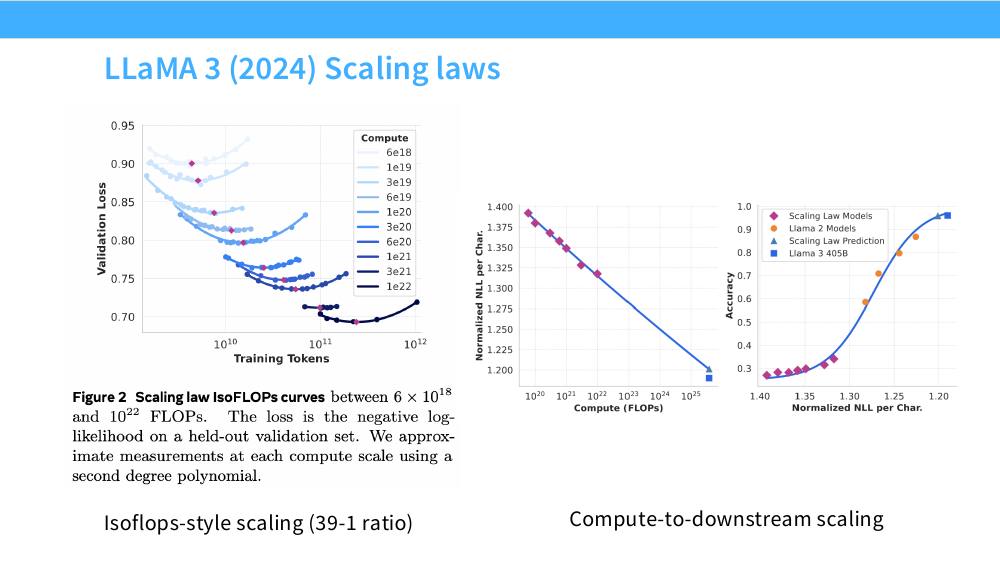
为什么要拆成两段,而不是直接拟合「算力 → 准确率」?因为这两段的函数形态完全不同:
- 第一段(算力 → loss)是幂律,在双对数下是直线,外推稳定,而且 loss 是连续、低方差的量——每个验证样本都贡献信息。
- 第二段(loss → 准确率)是S 形(sigmoid-like)。多选题准确率有下界(随机猜测,4 选 1 就是 0.25)和上界(1.0),中间存在一个陡峭的过渡区。图中准确率从 0.3 冲到 0.9 只用了 NLL 从 1.35 降到 1.22 这一小段。
如果直接拟合「算力 → 准确率」,你会得到一条又要跨数量级、又要经历饱和的曲线,几乎不可能可靠外推。拆开之后,每一段都在自己最擅长的坐标系里是简单函数。这也解释了课程里反复出现的现象:loss 平滑下降而 benchmark 分数「突然涌现」——涌现不是 loss 曲线上的突变,而是第二段 S 形映射把 loss 的平滑改善放大成了指标的跳变。
5.5 MiniMax-01:用缩放律做架构决策
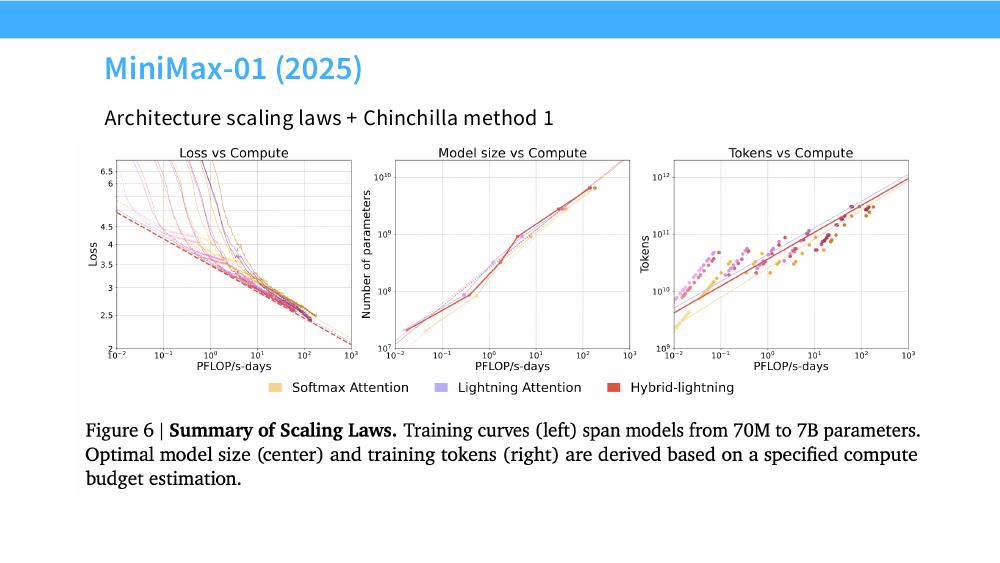
这是「用小规模对比实验预测大规模胜负」的正确姿势。常见的错误做法是:在 100M 规模上跑架构 A 和 B,A 赢了 0.02 nats,于是宣布 A 更好。问题在于这个差距可能来自:(a) B 的超参没调好;(b) A 在小规模有优势但缩放指数更差。只有拟合出两条完整的缩放曲线并比较它们的外推交点,结论才有意义。MiniMax 的图里三条线基本平行且贴近,这本身就是结论——线性注意力在缩放意义上没有付出损失代价,于是可以放心地享受它在长上下文推理上的效率红利。
5.6 两条配方路线的总结
| DeepSeek 路线 | MiniCPM 路线 | |
|---|---|---|
| 架构超参 | 假定大部分 Transformer 超参对规模不敏感,直接固定 | 用 muP 让参数化本身对宽度不变,固定长宽比 |
| LR / batch | 小规模网格扫描 → 拟合 $\eta_{\text{opt}}(C)$、$B_{\text{opt}}(C)$ 幂律 → 外推 | muP 保证 $\eta$ 近似不变;batch 单独拟合 $B_{\text{opt}}(L)$ |
| 模型/数据配比 | IsoFLOP(方法 2),自变量用 $M$ = FLOPs/token | 损失包络(方法 1)+ 联合参数化拟合(方法 3) |
| 降低拟合成本 | 分段常数 LR(两级各降 10%) | WSD,从稳定期 checkpoint 分叉衰减 |
| 报告的最优比 | 67B 实际 $D/N\approx 15.5$ | $D/N\approx 96$($C=10^{21}$) |
| 模型(年份) | 公开了什么 | 缺什么 |
|---|---|---|
| Qwen 2.5 / 3(2024–25) | 说明做了 LR/batch 缩放律,覆盖稠密 + MoE | 没有图、没有公式、没有实验细节 |
| Kimi K2(2026) | 稀疏度缩放律(最终选 384 选 8,稀疏度 48) | LR/batch 缩放细节 |
| Hunyuan-Large(2024) | 对激活参数的 IsoFLOP,96:1 | 其他缩放细节 |
| LLaMA 3(2024) | IsoFLOP(39:1)+ 算力→下游两段式预测 | 超参缩放、muP 相关 |
| MiniMax-01(2025) | 架构选型的缩放对比 + 方法 1 | 超参细节 |
6. Step Law:把「LR/batch 该怎么缩放」当成科学问题来做
前面所有配方都在回答同一个问题——随规模变化时 LR 和 batch 该怎么设——但每家给的函数形式都不一样,而且都只有几十到几百个数据点。StepFun 的大规模缩放律研究(Step Law)把这件事做成了一个受控实验。
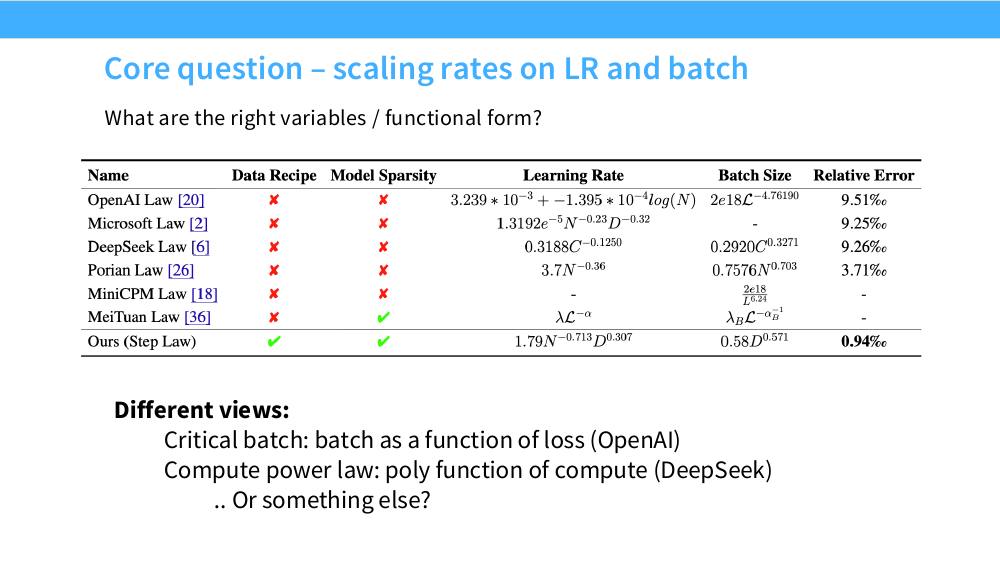
读这张表要抓住三点。第一,$\eta$ 和 $B$ 应该是 $N$ 和 $D$ 的分离函数,而不是 $C$ 的函数。$C=6ND$ 把两个自由度压成一个,损失了信息——同样的 $C$ 可以由「大模型少数据」或「小模型多数据」实现,两者的最优超参不同。第二,batch size 只依赖 $D$(Step Law 里 $B=0.58D^{0.571}$,完全没有 $N$)。第三,$\eta$ 对 $N$ 是负指数($-0.713$,模型越大 LR 越小),对 $D$ 是正指数($+0.307$,训得越久 LR 越大)。
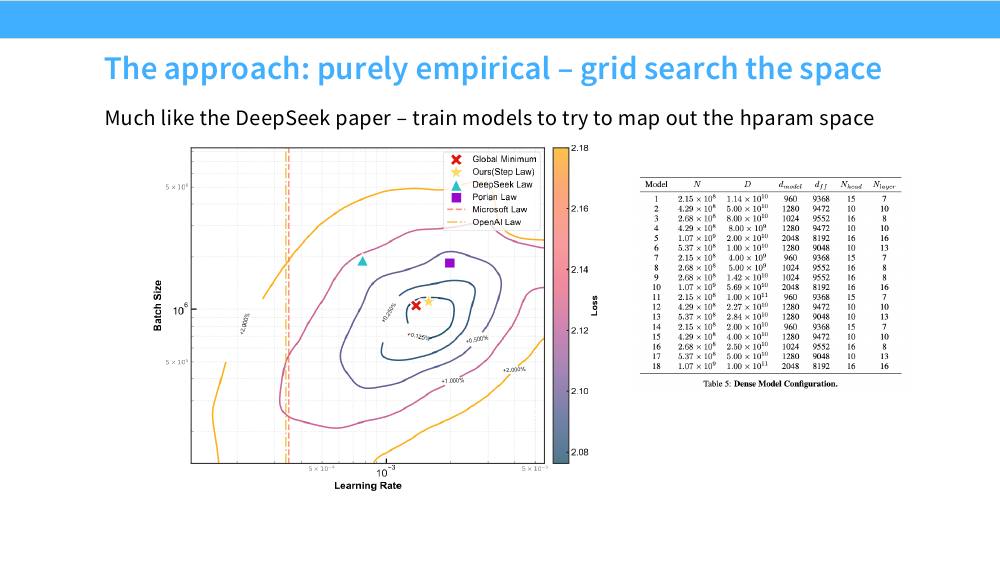
6.1 观察 1:损失关于 (LR, batch) 是凸的
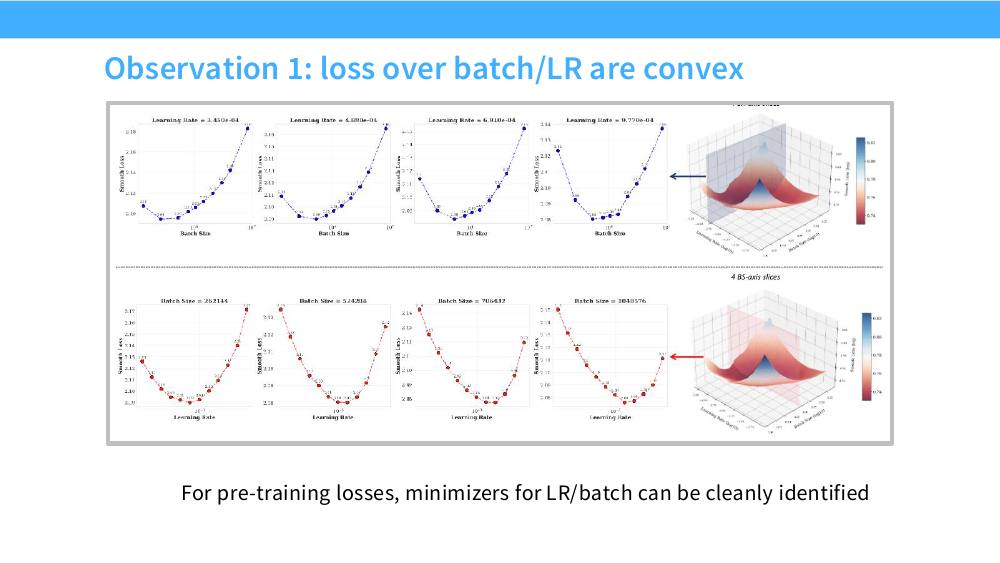
这个结论听起来平淡,但它是整个「超参缩放律」事业的前提。如果损失曲面在超参空间里是多峰的、或者有长条形的病态山谷,那么「测出最优点然后拟合它随规模的变化」这套流程根本立不住——你测到的「最优点」会是噪声。凸性还意味着你可以用少数几个点加二次拟合来定位谷底,而不必密集扫描(这正是 Chinchilla 方法 2 在 IsoFLOP 曲线上用二次多项式的同一个理由)。
6.2 观察 2:batch 跟 $D$ 走,LR 跟 $N$ 走
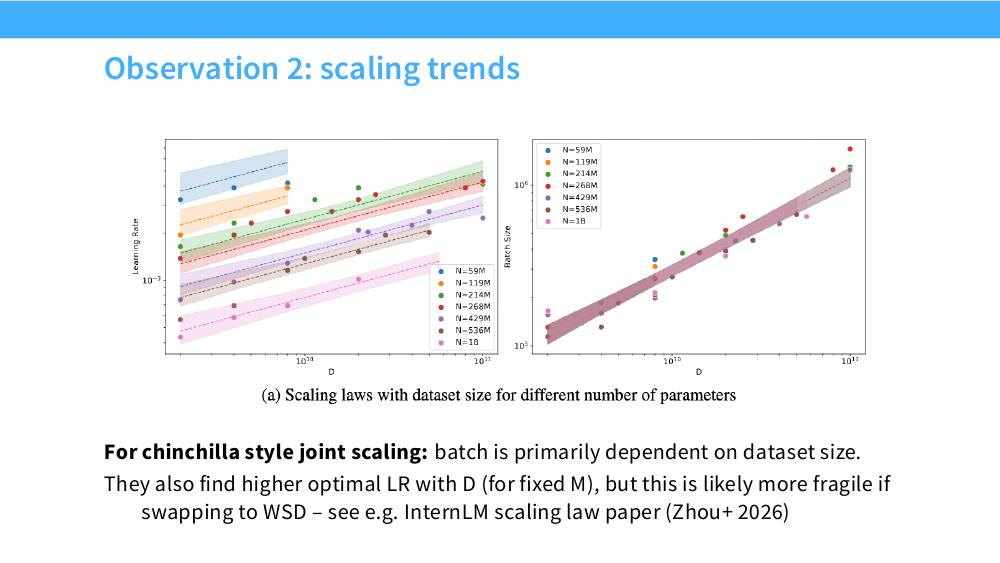
Tatsu 对「最优 LR 随 $D$ 升高」这一条打了问号。原话是:这个发现在换成 WSD 调度后很可能更脆弱,并点名了 InternLM 的缩放律论文(Zhou 等,2026)作为反例来源。理由不难想:$\eta_{\text{opt}}$ 随 $D$ 上升这个现象,在 cosine 调度下部分来自「训练越长,平均 LR 越低,所以峰值 LR 需要更高来补偿」这个纯调度效应,而不是优化本身的性质。WSD 的稳定期 LR 是恒定的,这个补偿机制就不存在了。
更一般的教训:任何超参缩放律都隐含地绑定了它所使用的学习率调度。DeepSeek 的 $\eta\propto C^{-0.125}$、Step Law 的 $\eta\propto N^{-0.713}D^{0.307}$、MiniCPM 的 $B\propto L^{-6.24}$——照抄之前先确认对方用的调度和你的一样。
6.3 观察 3:这套规律能推广到 MoE 和别的数据配方吗
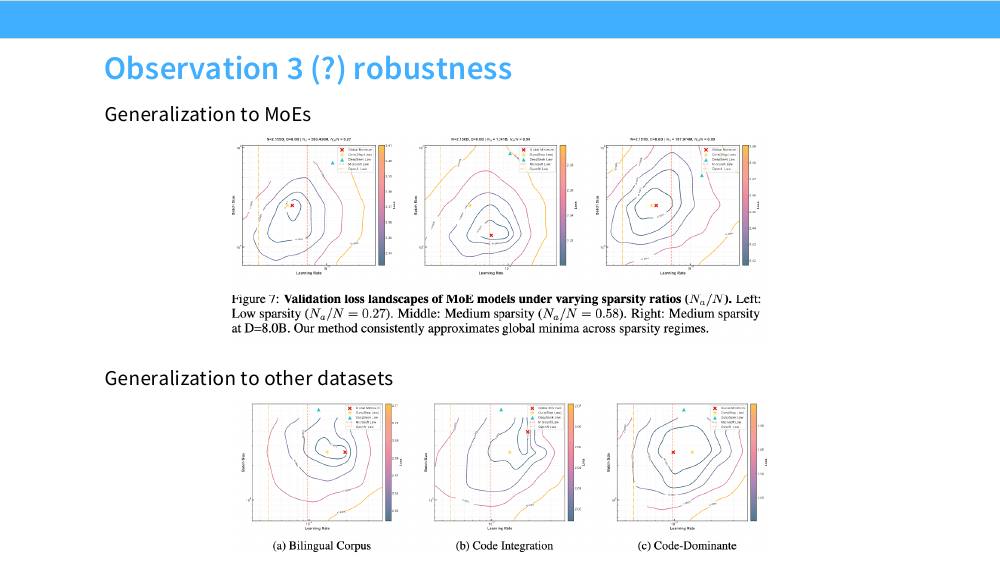
等高线这种呈现方式本身值得学:它同时展示了最优点在哪和最优区域有多平。看这几张图,内圈都相当宽——在 2 倍的 LR 范围和 2 倍的 batch 范围内损失差别很小。这解释了为什么各家公式虽然形式差异巨大,实际训练效果却都还行(表里 9.5‰ 的相对误差听起来大,但落到损失上是小数点后第三位)。超参缩放律的实际价值不在于把你送到精确最优点,而在于保证你不掉进悬崖。
7. 优化器与规模:为什么「新优化器快 2 倍」多半是假的
优化器是 LLM 训练的核心,也是最容易被规模效应欺骗的地方。Tatsu 在这一节用 Stanford 自家的一篇工作(Wen, Hall, Ma, Liang,Fantastic Pretraining Optimizers and Where to Find Them)系统地拆解「优化器论文的加速比为什么普遍不可信」。
7.1 问题 1:超参根本没调公平
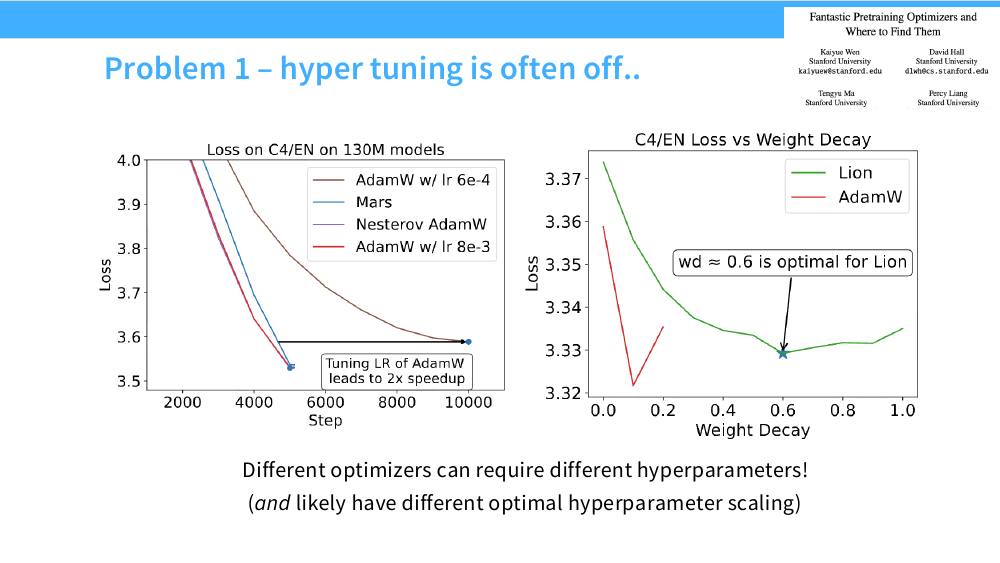
「我们用了和基线相同的超参,所以比较是公平的」——这句话在优化器比较里恰恰是最不公平的做法。相同超参 ≠ 公平;公平的定义是每个优化器都在自己的最优超参下。而且不只是 LR:weight decay、$\beta_1/\beta_2$、warmup 长度、梯度裁剪阈值,每一项的最优值都可能随优化器改变。
更麻烦的是:不同优化器的最优超参缩放律也不同。即使你在 130M 上给两者都调到了各自最优,到了 1B 上这个「各自最优」的相对位置可能已经变了。所以严格的比较需要在每个规模上重新调每个优化器——这个成本高到几乎没人真的做。
7.2 问题 2:加速比随规模衰减
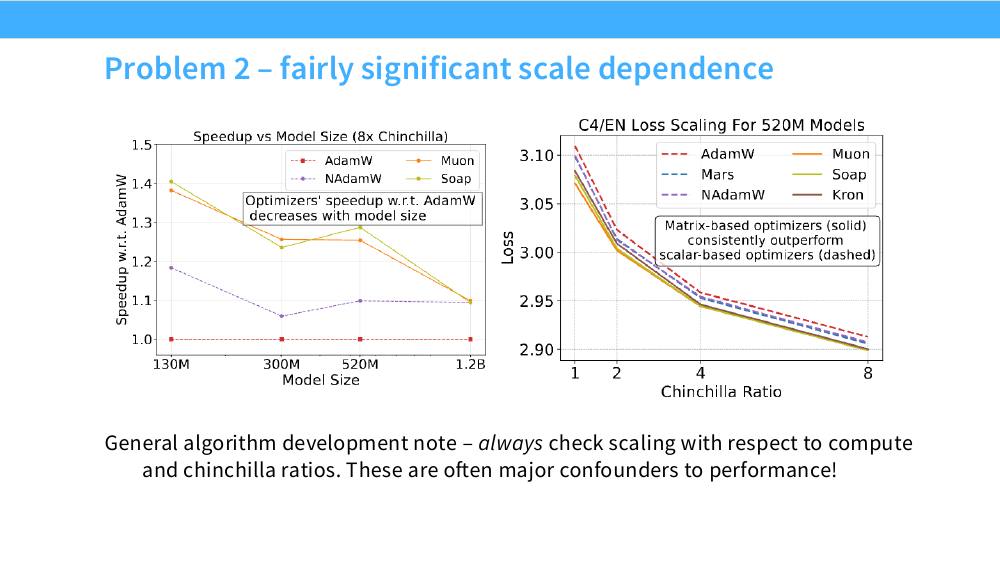
Tatsu 由此给出一条通用的算法研发准则,值得抄下来:
任何声称改进训练的方法,都必须在多个模型规模 × 多个 Chinchilla 比值上验证,因为这两者是最常见的混淆因子(confounder)。
为什么这两个维度特别重要?因为大多数「训练技巧」的作用机制是加速早期优化——让模型更快脱离初始的混沌期。而模型越大、训练越长,早期那段在总预算里的占比就越小,于是收益被稀释。一个只在 130M / 1× Chinchilla 上测过的方法,几乎必然会在 70B / 20× Chinchilla 上失效。
反过来说,如果一个方法的收益在两个维度上都不衰减甚至增长,那它就非常值得重视——这是极少数情况。
7.3 问题 2.5:看起来漂亮的缩放也可能炸
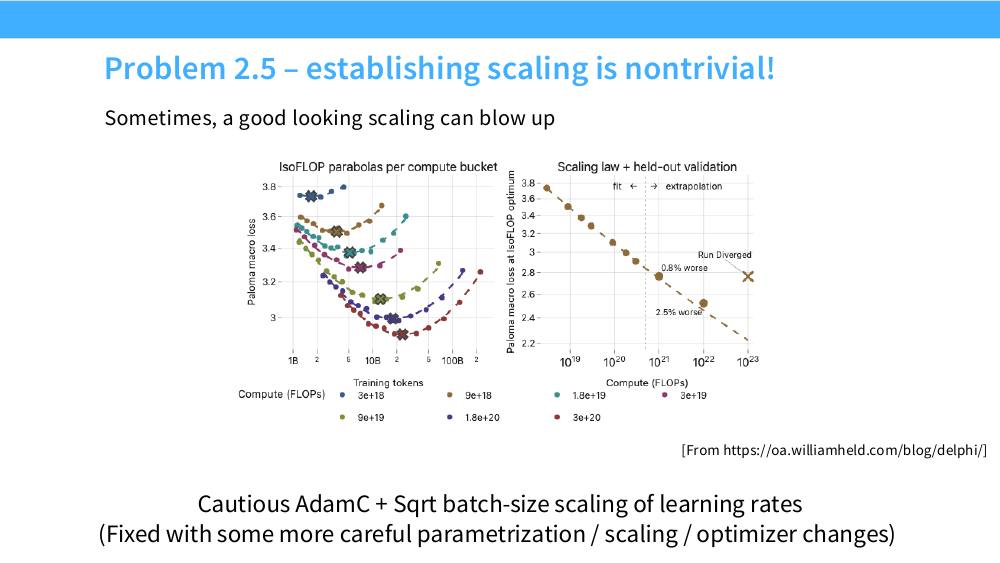
这个案例的价值在于它展示了缩放外推的真实失败模式:不是缓慢偏离,而是在拟合区间外某处突然进入不稳定区。原因通常是某个量(激活范数、注意力 logits、梯度范数)在随规模单调增长,在小规模时还在安全范围内,跨过某个阈值后触发数值不稳定。缩放律拟合的是损失,它对这类阈值现象完全无感知。
实践上的防御措施:不要只监控损失,还要监控那些「本应保持 $\Theta(1)$」的量随规模的变化——各层激活的 RMS、注意力 logits 的最大值、梯度范数、优化器二阶矩的分布。如果这些量在你的实验阶梯上呈现单调趋势(而不是稳定在常数附近),那么你的参数化就不是尺度不变的,外推迟早会出事。这正是下一节 muP 要解决的核心问题。
7.4 Muon:矩阵值参数的优化器
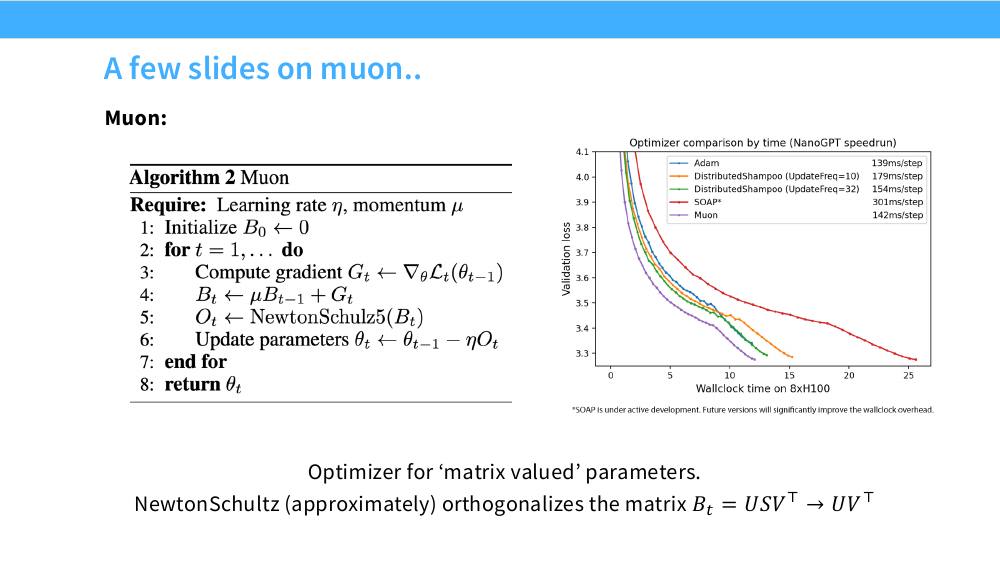
为什么正交化有用?Adam 是逐元素归一化:每个坐标的更新幅度都被拉平成 $\Theta(\eta)$。Muon 是逐奇异方向归一化:每个奇异方向的更新幅度都被拉平成 $\Theta(\eta)$。
梯度矩阵的奇异值谱在实践中极度不均衡——少数几个方向占据绝大部分能量。这意味着 $\Delta W$ 几乎是低秩的,模型每一步只在很少的几个方向上移动。正交化强行把谱压平,让所有方向都得到同等更新,从而更充分地利用参数矩阵的全部容量。这也是它只对「矩阵值参数」有意义的原因:embedding、bias、norm gain 是向量或标量,没有奇异值谱可谈,Muon 的实现里这些参数仍然交给 AdamW。
另一个视角是「谱范数下的最速下降」:在约束 $\|\Delta W\|_{\text{spectral}}\le\eta$ 下最大化一阶下降量 $\langle \Delta W, -G\rangle$,最优解恰好是 $\eta\cdot UV^\top$。所以 Muon 就是谱范数几何下的 steepest descent,而 Adam 是 $\ell_\infty$ 几何下的。
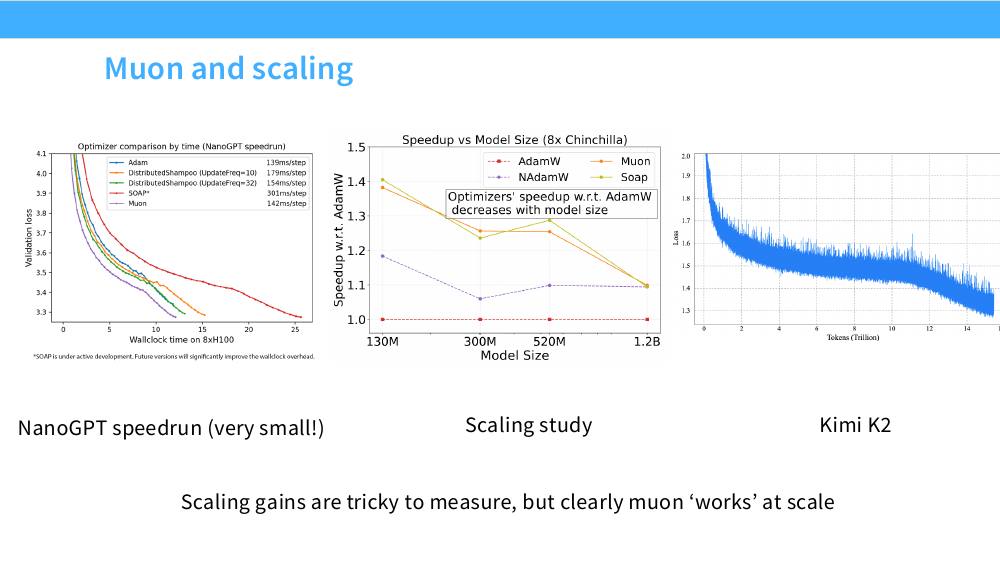
这个「三重证据链」的结构本身就是本节的方法论示范:小规模上测加速比、中规模上测加速比随规模的趋势、大规模上只验证「不炸」。第三点尤其重要——对于一个要投入千万美元训练预算的项目,「有没有人在万亿 token 规模上跑通过」比「加速 1.4×」重要得多。
8. muP 深入:两个条件推出全部规则
上一讲给了 muP 的规则表和最小实现,但没有说这些规则是怎么推出来的。这一节补上推导。理解推导的价值在于:当你的架构偏离标准 Transformer(加了新的 norm、新的激活、新的优化器)时,你能自己判断 muP 还成不成立。
8.1 muP 的两条公理
muP 的全部内容来自对「宽度趋于无穷时网络行为应该保持不变」的两个要求。设第 $l$ 层的宽度为 $n_l$,激活为 $h_l$:
A1(初始化条件):初始化时,各层激活的每个分量应保持 $\Theta(1)$。等价地,$\|h_l\|_2=\Theta(\sqrt{n_l})$。
A2(更新条件):一步梯度更新后,激活的变化 $\Delta h_l$ 的每个分量也应是 $\Theta(1)$。
A1 保证前向不爆炸/不消失,A2 保证「每一步都在学东西,且不会一步跳飞」。注意 A2 才是关键——很多参数化能满足 A1(比如标准的 $1/\sqrt{\text{fan\_in}}$ 初始化),但违反 A2。
8.2 从 A1 推初始化
考虑最简单的深度线性网络 $h_l=W_l h_{l-1}$,$W_l\in\R^{n_l\times n_{l-1}}$,初始化 $W_l\sim\mathcal N(0,\sigma^2 I)$。
由随机矩阵理论(Marchenko–Pastur / Bai–Yin 定理),高斯随机矩阵的谱范数满足
$$ \|W_l\|_\ast \;\longrightarrow\; \sigma\left(\sqrt{n_{l-1}}+\sqrt{n_l}\right) $$($\|\cdot\|_\ast$ 表示谱范数即最大奇异值。)由此得到激活范数的上界
$$ \|h_l\|_2\;\le\;\|W_l\|_\ast\,\|h_{l-1}\|_2 $$归纳假设 $\|h_{l-1}\|_2=\Theta(\sqrt{n_{l-1}})$。要让 $\|h_l\|_2=\Theta(\sqrt{n_l})$,需要
$$ \|W_l\|_\ast=\Theta\!\left(\sqrt{\tfrac{n_l}{n_{l-1}}}\right) \quad\Longrightarrow\quad \sigma\left(\sqrt{n_{l-1}}+\sqrt{n_l}\right)=\Theta\!\left(\sqrt{\tfrac{n_l}{n_{l-1}}}\right) $$解出
$$ \boxed{\;\sigma=\Theta\!\left(\frac{1}{\sqrt{n_{l-1}}}\min\!\left(1,\sqrt{\tfrac{n_l}{n_{l-1}}}\right)\right)\;} $$读法:当 $n_l\ge n_{l-1}$(fan-out 不小于 fan-in,包括方阵这个最常见情形)时,$\min$ 取 1,得到 $\sigma=\Theta(1/\sqrt{n_{l-1}})$——这就是熟悉的 $1/\sqrt{\text{fan\_in}}$ 初始化,和标准参数化一致。当 $n_l<n_{l-1}$(比如输出层,把宽度 $d$ 映射到固定的词表或标量)时,$\min$ 取第二项,$\sigma=\Theta(\sqrt{n_l}/n_{l-1})$,比标准做法更小。
Tatsu 特别注明:这是一个「最坏情况」的推导,因为用谱范数做上界假设了 $h_{l-1}$ 恰好对齐到 $W_l$ 的最大奇异方向。在初始化时($W$ 与 $h$ 独立)实际是 $\sqrt{n}$ 而不是谱范数量级;但训练开始后 $W$ 和 $h$ 会变得相关,最坏情况分析反而更贴近真实。
8.3 从 A2 推学习率
第一步:更新的结构。对线性层做 SGD,$\Delta W_l=-\eta_l\,(\nabla_{h_l}\ell)\,h_{l-1}^\top$——这是一个秩一的外积。秩一矩阵的谱范数就是两个向量范数的乘积,于是
$$ \|\Delta W_l\, h_{l-1}\|_2=\|\Delta W_l\|_\ast\,\|h_{l-1}\|_2 $$(秩一矩阵作用在它自己的右奇异方向 $h_{l-1}$ 上,取等号。)
第二步:激活变化的分解。一步更新后
$$ \Delta h_l=\underbrace{W_l\,\Delta h_{l-1}}_{\text{(i)}}+\underbrace{\Delta W_l\,(h_{l-1}+\Delta h_{l-1})}_{\text{(ii)}} $$假设各项的主导阶不相消,逐项估计:
- (i) $\|W_l\Delta h_{l-1}\|=\Theta(\sqrt{n_l})$——由归纳假设 $\|\Delta h_{l-1}\|=\Theta(\sqrt{n_{l-1}})$ 加上 A1 已定的 $\|W_l\|_\ast=\Theta(\sqrt{n_l/n_{l-1}})$。
- (ii) 主项 $\|\Delta W_l h_{l-1}\|=\|\Delta W_l\|_\ast\sqrt{n_{l-1}}$。要让它也是 $\Theta(\sqrt{n_l})$,必须 $$ \|\Delta W_l\|_\ast=\Theta\!\left(\sqrt{\tfrac{n_l}{n_{l-1}}}\right)\cdot\frac{1}{\sqrt{n_{l-1}}}\cdot\sqrt{n_{l-1}}\Big/\sqrt{n_{l-1}}=\Theta\!\left(\frac{\sqrt{n_l}}{\sqrt{n_{l-1}}}\cdot\frac{1}{\sqrt{n_{l-1}}}\right) $$ 即 $\|\Delta W_l\|_\ast\sqrt{n_{l-1}}=\Theta(\sqrt{n_l})$。
- 交叉项 $\|\Delta W_l\Delta h_{l-1}\|=O(\|\Delta W_l\|_\ast\sqrt{n_{l-1}})$,与 (ii) 同阶或更小,不改变结论。
第三步:把 $\|\Delta W_l\|_\ast$ 换算成学习率。再加一条自然要求:一步更新引起的损失变化也是 $O(1)$。用一阶展开并对偶配对(谱范数的对偶是核范数,但对秩一情形直接用 $\|\cdot\|_\ast$ 即可):
$$ \Delta\ell\approx\Theta\left(\langle \Delta W_l,\nabla_{W_l}\ell\rangle\right)=\Theta\left(\|\Delta W_l\|_\ast\,\|\nabla_{W_l}\ell\|_\ast\right) $$代入 $\Delta\ell=O(1)$ 与 $\|\Delta W_l\|_\ast=\Theta(\sqrt{n_l}/\sqrt{n_{l-1}}\cdot n_{l-1}^{-1/2})$,反解出梯度的量级
$$ \|\nabla_{W_l}\ell\|_\ast=\Theta\!\left(\sqrt{\tfrac{n_{l-1}}{n_l}}\right) $$最后,SGD 下 $\Delta W_l=-\eta_l\nabla_{W_l}\ell$,两边取谱范数:
$$ \boxed{\;\eta_l^{\text{SGD}}=\frac{\|\Delta W_l\|_\ast}{\|\nabla_{W_l}\ell\|_\ast}=\Theta\!\left(\frac{n_l}{n_{l-1}}\right)\;} $$Adam 的情形不同。Adam 的更新是逐元素归一化的:$|\Delta W_{ij}|=\Theta(\eta)$ 与梯度大小无关。一个所有元素都是 $\Theta(\eta)$ 且方向相关的 $n_l\times n_{l-1}$ 矩阵,其谱范数是 $\Theta(\eta\sqrt{n_l n_{l-1}})$,于是 $\|\Delta W_l\|_\ast\sqrt{n_{l-1}}=\Theta(\eta\, n_{l-1}\sqrt{n_l})$。要它等于 $\Theta(\sqrt{n_l})$,得
$$ \boxed{\;\eta_l^{\text{Adam}}=\Theta\!\left(\frac{1}{n_{l-1}}\right)\;} $$8.4 小结:muP 与标准参数化的差异到底在哪
| muP | 标准参数化(SP) | |
|---|---|---|
| 初始化标准差 | $\Theta\!\left(\frac{1}{\sqrt{n_{l-1}}}\min\!\left(1,\sqrt{n_l/n_{l-1}}\right)\right)$ | $\Theta\!\left(\frac{1}{\sqrt{n_{l-1}}}\right)$ |
| 学习率(SGD) | $\Theta(n_l/n_{l-1})$ | $\Theta(1)$ |
| 学习率(Adam) | $\Theta(1/n_{l-1})$ | $\Theta(1)$ |
所以 muP 和 SP 的差异只有两处:①Adam 下学习率必须按 $1/\text{fan\_in}$ 缩放(SP 保持不变);②当 fan-out 小于 fan-in 时初始化更小(主要影响输出层/unembedding)。对隐藏层方阵($n_l=n_{l-1}=d$),初始化两者一致,差别全在学习率上。这就是为什么 MiniCPM 的 muP 清单只有五条——真正需要改的地方确实不多。
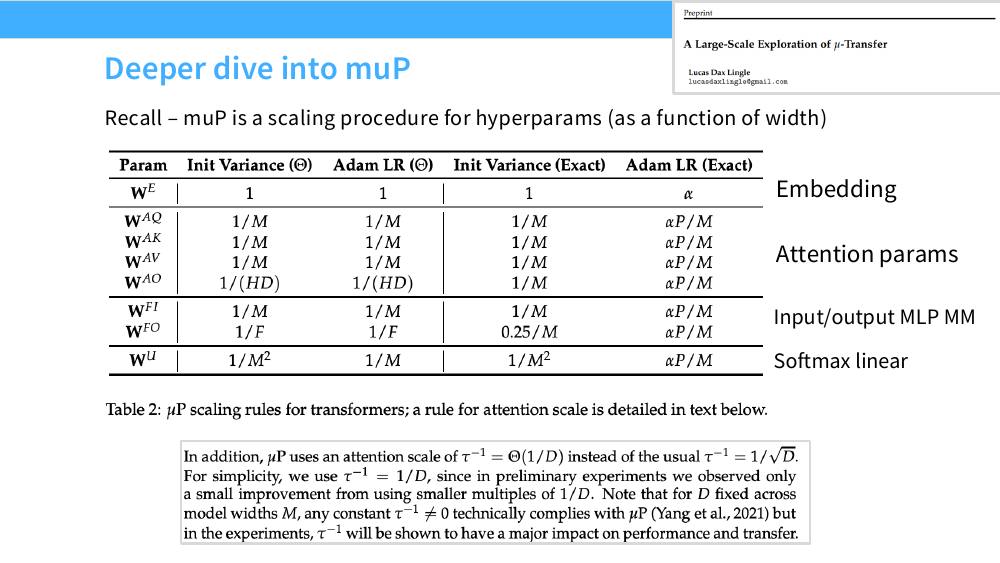
把整张表压成一句话记忆:凡是「两端都随宽度变大」的矩阵,Adam LR 按 $1/M$ 缩、初始化方差按 $1/M$ 缩;凡是有一端固定的(embedding 的词表端、unembedding 的词表端),按各自的固定端处理;凡是「把 $M$ 个数加起来」的地方(attention logits、output logits),归一化用 $1/M$ 而不是 $1/\sqrt M$。
最后那条的理由在上一讲讲过:$q\cdot k=\sum_{i=1}^{D}q_ik_i$,若 $q,k$ 独立随机则和是 $\Theta(\sqrt D)$,但训练后 $q$ 与 $k$ 会对齐,和变成 $\Theta(D)$。muP 关心的是训练后的行为,所以取 $1/D$。
9. muP 到底靠不靠谱:大规模复现实验
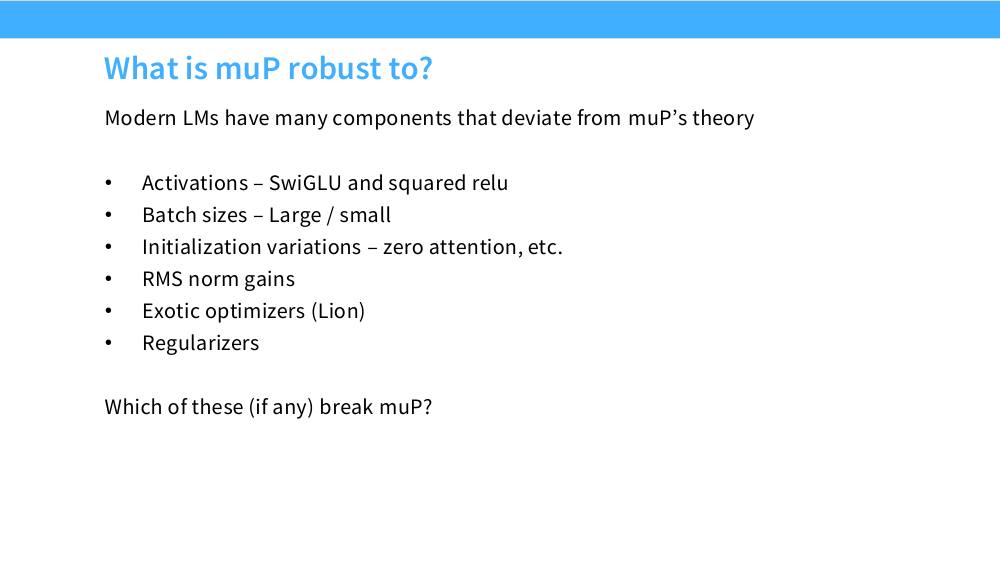
理论推导假设的是「深度线性网络 + SGD」。真实的 Transformer 有 SwiGLU、RMSNorm、旋转位置编码、weight decay、梯度裁剪——这些都不在推导范围内。Lingle 的《A Large-Scale Exploration of $\mu$-Transfer》系统地逐项检验了 muP 对这些偏离的鲁棒性,这一节就是它的结果。
9.1 基线:muP 确实工作
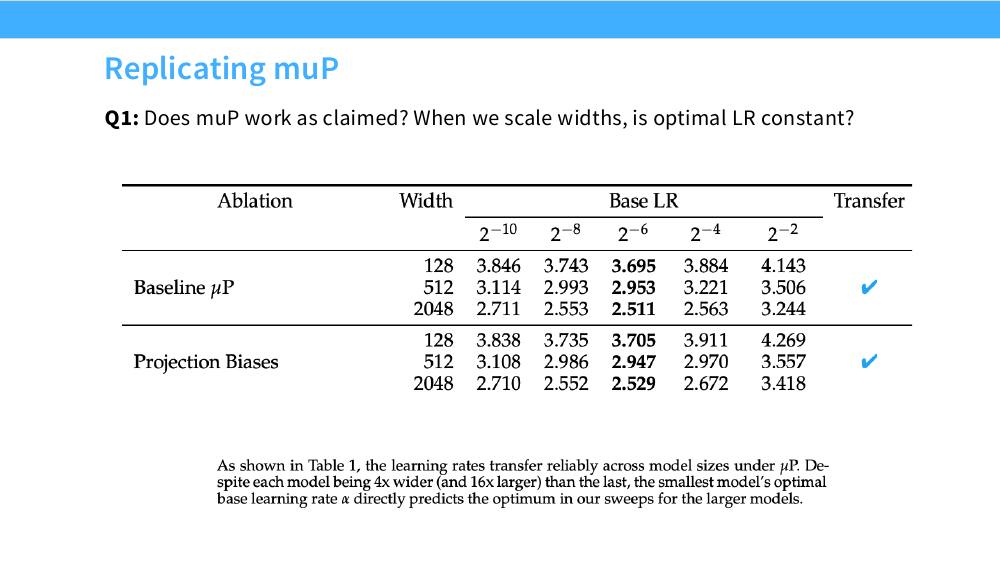
这张表的读法很重要:「迁移成功」不等于「损失曲线完全一样」,而是「最优点的位置不变」。这正是 muTransfer 需要的全部保证——你在宽度 128 上找到 $2^{-6}$ 最好,就可以直接在宽度 2048 上用 $2^{-6}$,省掉一整轮大模型上的 LR 扫描。
9.2 失败项一:RMSNorm 的可学习增益
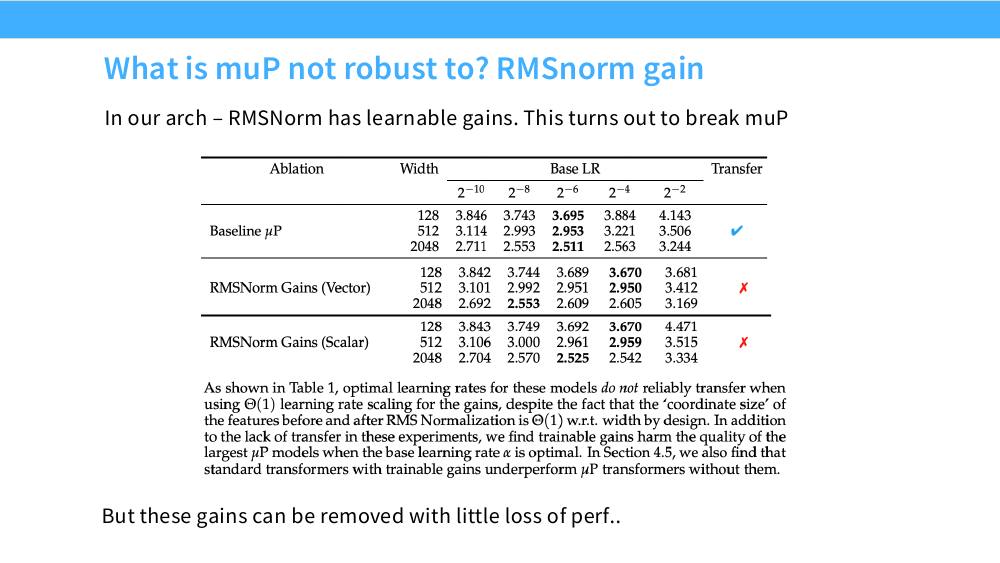
RMSNorm 的可学习增益是一个「白拿的坑」——它破坏 muP,而且去掉它几乎不掉性能。Lingle 论文进一步发现,带可训练增益的标准 Transformer 反而比不带增益的 muP Transformer 表现更差。
为什么增益会破坏迁移?直觉是:增益 $g$ 直接乘在归一化后的激活上,它的更新 $\Delta g$ 会以 $\Theta(\Delta g)$ 的幅度改变下游激活——这是一条绕过所有矩阵乘法的旁路。muP 的推导全部建立在「激活变化通过 $W$ 和 $\Delta W$ 传播」之上,增益提供了一条不受 $1/n$ 缩放约束的捷径。宽度越大,矩阵路径的更新被压得越小($\eta\propto 1/n$),而增益路径的更新保持 $\Theta(1)$,于是两条路径的相对重要性随宽度漂移——迁移自然失效。
实践建议:用 muP 时,把 RMSNorm 写成无参数版本(只做 $x/\text{RMS}(x)$)。代码上只是删掉一个 nn.Parameter。
class RMSNormNoGain(nn.Module):
    """muP 友好的 RMSNorm:不带可学习 gain。"""
    def __init__(self, eps=1e-6):
        super().__init__()
        self.eps = eps          # 注意:没有 self.weight

    def forward(self, x):
        # x: (..., d_model)
        rms = x.pow(2).mean(-1, keepdim=True).add(self.eps).rsqrt()
        return x * rms


# 对比:常见的带 gain 版本(会破坏 muP 的宽度迁移)
class RMSNormWithGain(nn.Module):
    def __init__(self, d_model, eps=1e-6):
        super().__init__()
        self.weight = nn.Parameter(torch.ones(d_model))   # <-- 这一行是问题所在
        self.eps = eps

    def forward(self, x):
        rms = x.pow(2).mean(-1, keepdim=True).add(self.eps).rsqrt()
        return x * rms * self.weight
9.3 失败项二:基于符号的优化器(Lion)
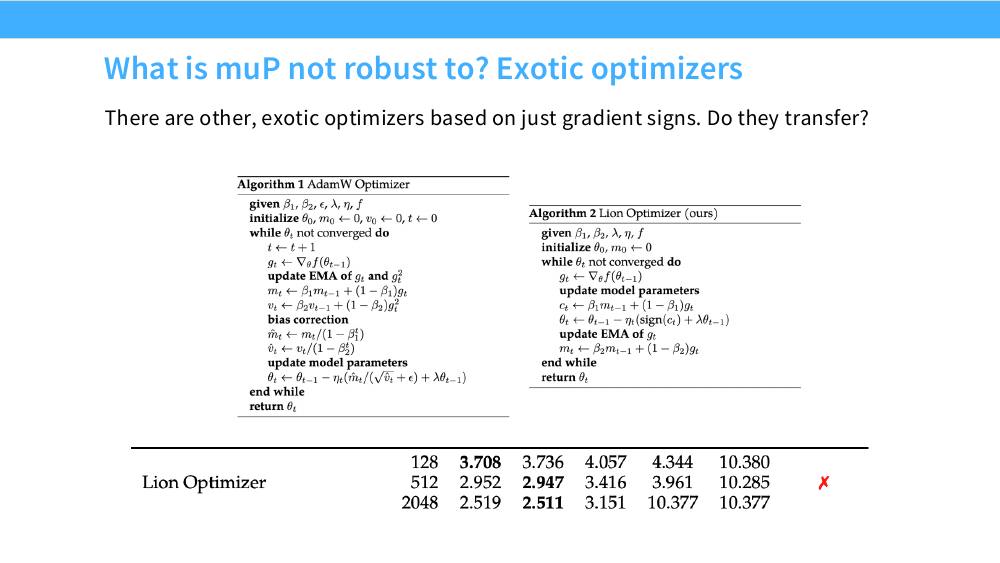
这个结果和 8.3 节的推导完全一致:muP 的 LR 规则依赖于优化器的更新几何。SGD 得到 $\eta\propto n_l/n_{l-1}$,Adam 得到 $\eta\propto 1/n_{l-1}$,那么纯符号更新($|\Delta W_{ij}|$ 恒等于 $\eta$,连自适应缩放都没有)自然又是另一套规则。用 Adam 版的 muP 规则去跑 Lion,等于用错了参数化——失败是意料之中的。
「muP 是架构的性质」——不是,muP 是「架构 + 优化器」这一对的性质。每换一个优化器,理论上都要重新推一遍 LR 的宽度指数。这也是为什么 Muon 需要自己的 muP 变体(Muon 的更新是正交矩阵,谱范数恒为 $\eta$,规则又不同于 Adam)。如果你打算既换优化器又用 muP,务必先在两三个宽度上做一次迁移验证表——就是上面这种三行五列的表,成本很低但能省掉一次昂贵的失败。
9.4 失败项三:强 weight decay
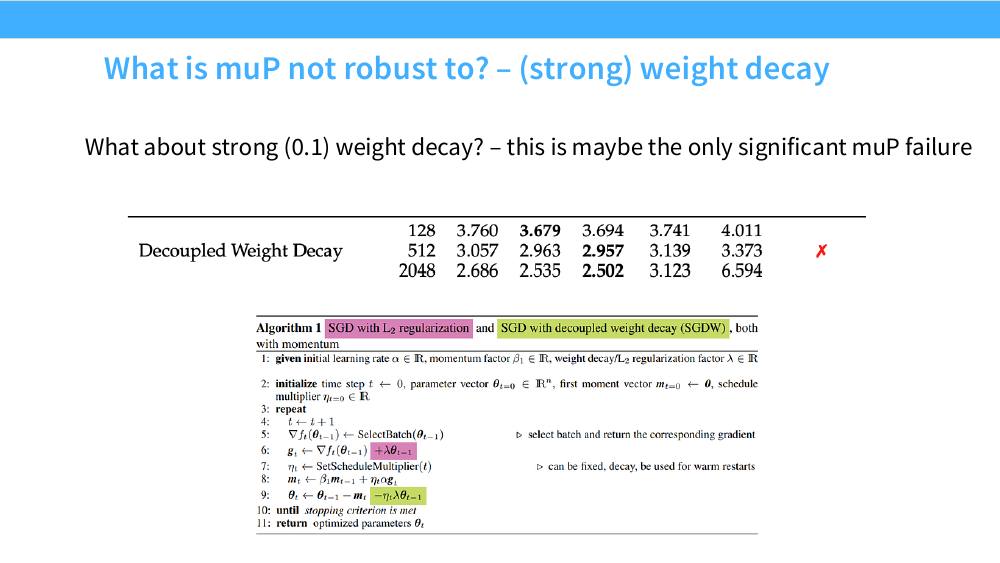
为什么解耦 weight decay 会破坏 muP?看权重更新的两项:
$$ \Delta W = \underbrace{-\eta\cdot\frac{\hat m}{\sqrt{\hat v}+\epsilon}}_{\text{梯度项}}\;\underbrace{-\;\eta\lambda W}_{\text{衰减项}} $$muP 要求梯度项满足 $\|\Delta W\|_\ast\sqrt{n_{l-1}}=\Theta(\sqrt{n_l})$,据此定出 $\eta\propto 1/n$。但衰减项的量级是 $\eta\lambda\|W\|_\ast$,而 $\|W\|_\ast=\Theta(\sqrt{n_l/n_{l-1}})$ 由 A1 固定。于是
$$ \frac{\|\text{衰减项}\|_\ast}{\|\text{梯度项}\|_\ast}\;\propto\;\frac{\eta\lambda\sqrt{n_l/n_{l-1}}}{\eta\cdot\Theta(\cdot)}\;=\;\lambda\cdot f(n) $$关键是这两项对 $\eta$ 的依赖被消掉了——衰减项和梯度项都正比于 $\eta$,所以调 $\eta$ 不能改变它们的相对权重,但它们各自随宽度的缩放行为不同。等价地看,AdamW 的稳态权重范数由 $\eta\lambda$ 联合决定(平衡点在梯度项与衰减项相抵处),于是$\eta$ 和 $\lambda$ 的最优值是耦合的:muP 按 $1/n$ 改了 $\eta$,就相当于同时改了有效正则强度,最优点自然漂移。
已知的修法是把 weight decay 也纳入缩放(例如固定 $\eta\lambda$ 而不是固定 $\lambda$,这就是 AdamC 一类「修正版」优化器在做的事),或者干脆把 $\lambda$ 调小。注意 $\lambda=0.1$ 在 LLM 预训练里是很常见的默认值,所以这个坑踩中概率不低。
9.5 综合判断:muP 值不值得用
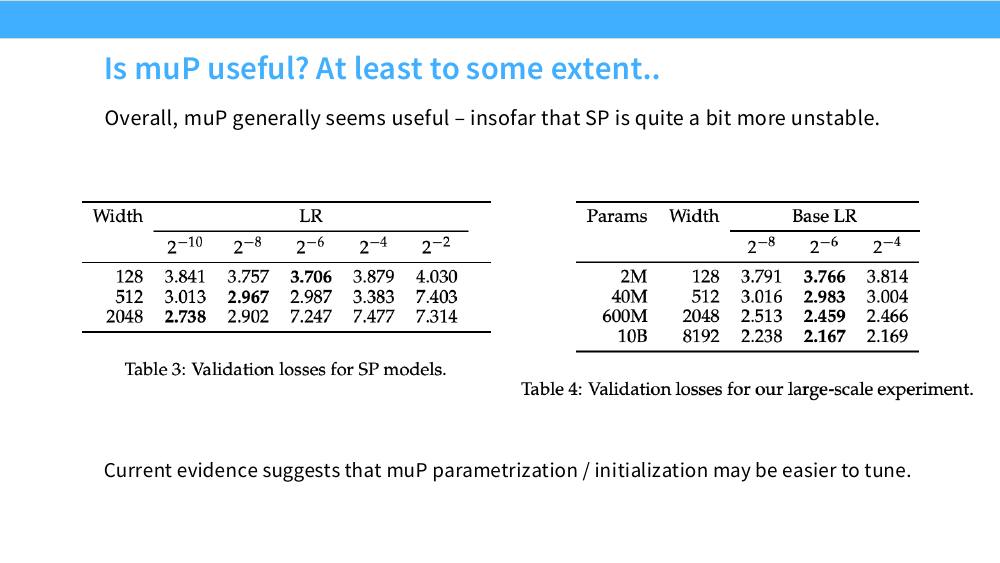
muP 的实际价值不在「理论正确」,而在把风险从「灾难性」降到「轻微次优」:
- 用 SP 时,宽度 2048 上用宽度 128 的最优 LR,损失从 2.738 变成 7.247——模型基本废了。
- 用 muP 时,即使某个组件破坏了严格迁移(比如带增益的 RMSNorm),最优点也只是漂移 1–2 档(4–16 倍),损失代价在小数点后第二位。
所以正确的心态是:muP 是一层保险,不是一个免除调参的许可证。标准工作流仍然是「按 muP 迁移 → 在目标规模上扫 $\{0.5\times,1\times,2\times\}$ 三档确认」。这也正是 MiniCPM 实际做的事。
10. 实战检查清单
把整讲的可操作内容整理成一份可以照着做的流程。假设你要训练一个目标算力为 $C_{\text{target}}$ 的模型,手上有大约 $0.1\%\text{–}1\%$ 的算力可以用于缩放实验。
第 0 步:先定口径
- 决定用 $N$(参数量)还是 $M$(每 token 非嵌入 FLOPs)作自变量。推荐 $M$(DeepSeek 做法)——它避开了「算不算 embedding」这个历史包袱,且 $C=MD$ 精确成立。
- 决定损失指标。用 bits-per-byte 而不是 per-token,这样换 tokenizer 时曲线仍可比(MiniCPM 和 DeepSeek 都这么做)。
- 准备一个固定的、不参与训练的验证集,最好覆盖你关心的多个域(MiniCPM 用了 code / 英文 / 中文三套)。
第 1 步:固定架构自由度
- 固定长宽比($d_{\text{model}}/L$)、head dim(64 或 128)、FFN 倍数。这样「模型大小」变成一维。
- 决定用不用 muP。用:改动只有五条(见 2.1 节),代价是必须去掉 RMSNorm 的可学习增益、控制 weight decay。不用:那就走 DeepSeek 路线,接受要拟合 $\eta_{\text{opt}}(\cdot)$。
- 如果要比较架构(如线性注意力 vs softmax),每种架构各拟合一条完整缩放曲线,比较斜率与截距,不要只比某一个规模上的单点(MiniMax 做法)。
第 2 步:定 LR 和 batch
- 在 2–3 个小规模上做 $(\eta, B)$ 二维网格。利用凸性:每个方向 5–7 个点、按 2 倍间隔就够定位谷底。
- batch size 主要跟 $D$ 走,LR 主要跟 $N$ 走(Step Law)。如果只能省着做,优先扫 LR。
- 复用中间 checkpoint:一次固定 batch 的训练可以同时给出所有 $D$ 值上的数据点(MiniCPM 做法)。
- 记录你用的调度。换调度会让拟合出的超参缩放律失效。
第 3 步:定模型/数据配比
- 换成 WSD 调度。稳定期长跑一条主干,在目标 $D$ 处分叉出 10% 长度的衰减分支。这是把 $O(n^2)$ 变 $O(n)$ 的关键。
- 至少用两种Chinchilla 方法交叉验证(推荐方法 2 IsoFLOP + 方法 3 联合拟合)。三种方法结论差很多时,怀疑那条离群的。
- 拟合时用 Huber loss 在对数空间做(Chinchilla 原文做法),而不是朴素的
curve_fit——幂律拟合对离群点极度敏感,一个发散的 run 能把整条曲线拽歪。 - 报置信区间时如果算出 $\alpha\in(0.454,0.455)$ 这种宽度,那是不确定性估计错了(上一讲 10.3 节)。
第 4 步:验证与防御
- 留出验证:用最大的 1–2 个实验点做留出,看拟合线预测得准不准,并把它画在同一张图上(DeepSeek 做法)。
- 监控尺度不变量:各层激活 RMS、attention logits 最大值、梯度范数——它们在实验阶梯上应该基本恒定。若单调增长,说明参数化不是尺度不变的,外推会在某处炸掉(7.3 节的失败案例)。
- 不要只看 loss:如果关心下游任务,用 LLaMA 3 的两段式(算力→loss 幂律,loss→准确率 S 形)分别拟合。
- 算清部署账:Chinchilla 最优点忽略推理。如果模型要长期服务,故意往数据侧偏(过度训练)几乎总是对的——损失曲面在最优点附近很平,用 0.01 nats 换一半的推理成本是划算的。
最后一条元建议,来自 7.2 节:无论你在验证什么(新优化器、新架构、新数据配方),都必须在至少 3 个模型规模 × 2 个 Chinchilla 比值上验证。大多数「小规模上有效」的技巧,其收益机制是加速早期优化,而这部分在大规模长训练里的占比会被稀释到接近于零。这条准则的成本是 6 倍实验量,但它能防止你把整个训练预算押在一个只在玩具规模成立的结论上。
本讲小结
一页速查。
公开配方的关键数字
| 来源 | 拟合出的关系 | 用途 |
|---|---|---|
| MiniCPM 联合拟合 | $L=\frac{7.54\times10^{-2}}{N^{0.30}}+\frac{2.92\times10^{-1}}{D^{0.30}}+0.25$ | $D/N\approx 95.6$($C=10^{21}$) |
| MiniCPM batch | $\log B=-6.24\log L+20.91$ | 损失越低,batch 越大 |
| DeepSeek 超参 | $\eta_{\text{opt}}=0.3118\,C^{-0.1250}$,$B_{\text{opt}}=0.2920\,C^{0.3271}$ | 由算力直接预测 LR / batch |
| DeepSeek IsoFLOP | $C=4.5\times10^{23}\Rightarrow M=4.3\times10^{11}$, $D=1.04\times10^{12}$ | 定 67B 的规模与 token 数 |
| Step Law | $\eta=1.79\,N^{-0.713}D^{0.307}$,$B=0.58\,D^{0.571}$ | 相对误差 0.94‰,当前最准 |
| Hunyuan-Large | IsoFLOP over 激活参数 | 96:1(数据 : 激活参数) |
| LLaMA 3 | IsoFLOP + 两段式下游预测 | 39:1;准确率可外推到 405B |
| Kimi K2 | 稀疏度缩放律 | 稀疏度 48(384 选 8) |
四条最该记住的判断
- WSD 是这一讲最实用的单点技术。它同时解决三件事:让 Chinchilla 拟合成本从 $O(n^2)$ 降到 $O(n)$、让持续预训练变得自然、性能与 cosine 持平。没有理由不用。
- muP 是保险而非免调参。它把 LR 搜索范围从三个数量级压到一个 2–4 倍窗口,把「用错 LR」的后果从模型报废降为轻微次优。但它对 RMSNorm 可学习增益、符号型优化器、强 weight decay 不鲁棒,用之前先做三行五列的迁移验证表。
- 超参缩放律要当量级参考读,不是精确预测。DeepSeek 那条 LR 拟合线在 Tatsu 看来「有点可疑」;各家公式在统一测试下相对误差差一个数量级。好消息是最优区域很平,所以差异的实际代价小——它们的价值在于保证你不掉悬崖。
- 规模和 Chinchilla 比值是最大的混淆因子。优化器加速比随规模单调衰减(Muon 从 1.4× 到 1.1×);「新方法有效」的结论在 130M/1× 上几乎必然成立、在 70B/20× 上几乎必然失效。这是本讲最可迁移的方法论。
两条路线的选择
如果你在从零搭一套缩放流程:算力紧、团队小、目标模型不超过 10B → 走 MiniCPM 路线(muP 锁住超参,只做联合拟合,省掉超参扫描)。要外推多个数量级、架构非标准、或已经有成熟的非 muP 代码库 → 走 DeepSeek 路线(不碰参数化,老老实实拟合 $\eta_{\text{opt}}(\cdot)$ 和 $B_{\text{opt}}(\cdot)$,用 IsoFLOP 定规模)。两条路都必须配 WSD。
延伸阅读
本讲逐页拆解的技术报告
- MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies (2024) — 本讲的主案例。WSD 调度的原始出处,也是把 muP 落地清单写得最清楚的一篇(论文 Table 7 就是第 2.1 节那张图)。想自己跑一次完整缩放分析,从这篇开始。
- DeepSeek LLM: Scaling Open-Source Language Models with Longtermism (2024) — 另一条路线的范本。用 $M$(FLOPs/token)代替 $N$ 作 IsoFLOP 自变量这个细节值得单独学;最后那张「小模型拟合、大模型验证」的图是缩放分析的汇报模板。
- The Llama 3 Herd of Models (2024) — 看第 3 节的缩放部分:39:1 的 IsoFLOP,以及「算力 → 归一化 NLL → 下游准确率」的两段式预测,这是公开文献里把 loss 映射到 benchmark 做得最干净的一次。
- Hunyuan-Large (2024) — 把 IsoFLOP 搬到 MoE 激活参数上,96:1。
- MiniMax-01: Scaling Foundation Models with Lightning Attention (2025) — 用缩放律做架构选型的范例:三种注意力各拟合一条前沿再比较,而不是在单一规模上比胜负。
- Kimi K2: Open Agentic Intelligence (2026) — 稀疏度作为独立缩放维度的完整实验。同时也是 Muon 在 15T token 规模上跑通的公开证据。
- Qwen2.5 Technical Report (2024) — 超参缩放律 + 用它预测「多大的 MoE 等价于某个稠密模型」。细节不多,但这个用法值得知道。
方法论与实证研究
- Predictable Scale: Step Law(StepFun,2025) — 第 6 节的来源。七种超参缩放律的统一比较表,以及「损失关于 $(\log\eta,\log B)$ 是凸的」「batch 只依赖 $D$」两个基础结论。做超参缩放必读。
- Fantastic Pretraining Optimizers and Where to Find Them (2025) — Stanford 自家的优化器审计。核心信息:报告的加速比大多来自基线调参不足,且真实收益随规模衰减。第 7 节整节都基于它。
- A Large-Scale Exploration of $\mu$-Transfer (Lingle, 2024) — 第 9 节的来源。逐项检验 muP 对现代 Transformer 组件的鲁棒性,最终在 10B 上验证跨 5000 倍参数量的 LR 迁移。三行五列的迁移验证表格式可以直接抄。
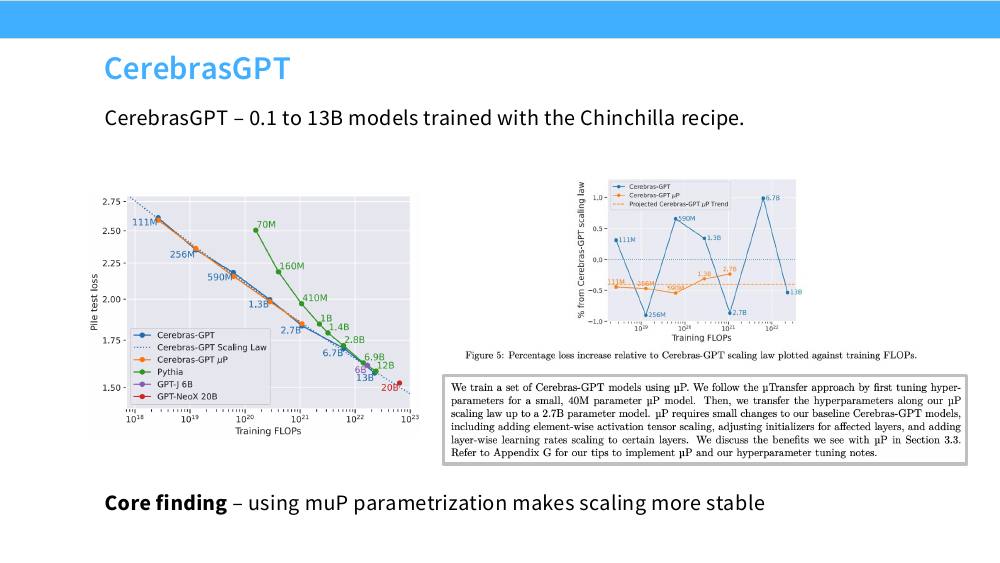
- Cerebras-GPT (2023) — muP 让缩放更「可预测」的早期证据:SP 的实测点在缩放律附近 $\pm1\%$ 震荡,muP 的几乎贴线。
- Training Compute-Optimal Large Language Models(Chinchilla, 2022) — 三种方法的原始出处,以及「cosine 周期必须等于训练长度」那个决定性对照实验。上一讲的主线。
- Scaling Laws for Neural Language Models(Kaplan et al., 2020) — critical batch size 与「batch 是损失的函数」这个观点的出处,MiniCPM 的 batch 分析直接沿用它的框架。
参数化与优化器
- Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer (2022) — muP 与 muTransfer 的原始论文。理论完整但读起来重,建议先读下面那篇。
- A Spectral Condition for Feature Learning (Yang et al., 2023) — 课上称为「muP for babies」的那类可读版本:用谱范数条件重新表述 muP,第 8 节的推导($\|W\|_\ast$、$\|\Delta W\|_\ast$ 的约束)就是这个视角。
- Muon: An optimizer for hidden layers in neural networks (Jordan, 2024) — Muon 的原始博客,含 Newton-Schulz 迭代的实现细节和 NanoGPT speedrun 的对比数据。
- Decoupled Weight Decay Regularization(AdamW, 2017) — 第 9.4 节高亮的「$L_2$ 正则 vs 解耦 weight decay」区别的出处,理解 muP 为何被强 weight decay 破坏需要这篇。
- Symbolic Discovery of Optimization Algorithms(Lion, 2023) — 第 9.3 节的符号型优化器。它对 weight decay 的最优值是 AdamW 的 6 倍,是「不同优化器需要不同超参」的最佳例证。
把推理成本纳入目标函数
- Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws (2023) — 第 1.2 节那个推导的完整版本。给定预期推理量,求解真正的部署最优 $(N,D)$;结论是推理量大时最优 $D/N$ 会远超 20。这是理解 LLaMA 3 8B 为什么训 15T token 的关键。
- Chinchilla Scaling: A replication attempt (2024) — 上一讲第 10.3 节讲过,但在这一讲的语境下值得重读:它示范了「如何识别一个可疑的缩放拟合」(置信区间宽度不合理、三种方法互相矛盾),正是第 4 节批评 DeepSeek LR 拟合时用的同一套眼光。