缩放定律(上):用小实验预测大实验
大规模训练只有一次机会。怎样用几百个小模型的结果,提前算出那个大模型该有多大、该喂多少 token、学习率该设多少。
0. 本讲导读
设想这样一个场景:朋友给了你 10000 张 B200,用一个月,让你训一个好的开源语言模型。到这一讲为止,这门课已经教过你怎么搭分布式训练框架(作业 2)、怎么攒预训练数据(作业 4)。剩下最后一件事:跑一个大模型——但到底跑哪一个?
这个问题比听上去难得多。宽一点还是深一点?多少个注意力头?用哪个非线性?学习率多大?batch size 多大?在 1.5 亿参数上调好的配置,搬到 5000 亿参数上还成立吗?你当然可以「抄作业」(cargo cult)——照搬 Llama 3 的架构。但那些数字最初是怎么被优化出来的?而且,一旦你想改动其中任何一样(换优化器、换稀疏架构、换数据配方),抄来的配置就失去了依据。
更要命的是:这一次训练要烧掉的算力大约是 $2\times10^{25}$ FLOPs 量级(后面会算),成本数千万美元级别,你只有一次机会。传统的「在大模型上调超参」方案在这个尺度上直接破产。
本讲给出的答案是 缩放定律(scaling laws):一组简单的、有预测力的经验规律,把「模型多大、数据多少、算力多少」映射到「损失是多少」。有了它,工作流从「在大模型上试错」变成「在小模型上调,外推到大模型」。Tatsu 在课上对这个转变的评价很克制:这是「新的(也许过头了的)乐观主义」(new, over-optimism?)——它确实有效,但也确实有一堆坑。
整讲分成两大块:
- Part 1 — 数据缩放定律:历史(这东西 1993 年就有人做了)、经验形式、以及「为什么会是幂律」的理论解释;然后是数据侧的进阶话题:数据配比、数据重复、数据筛选。
- Part 2 — 模型缩放定律:怎么用缩放定律做工程决策(架构、优化器、深宽比、batch size、学习率 / muP),然后是本讲的重头戏——联合缩放定律 $L(N,D)$ 与算力最优分配,Kaplan vs Chinchilla 的公案,以及 tokens/param ≈ 20 这条经验法则的完整来历。
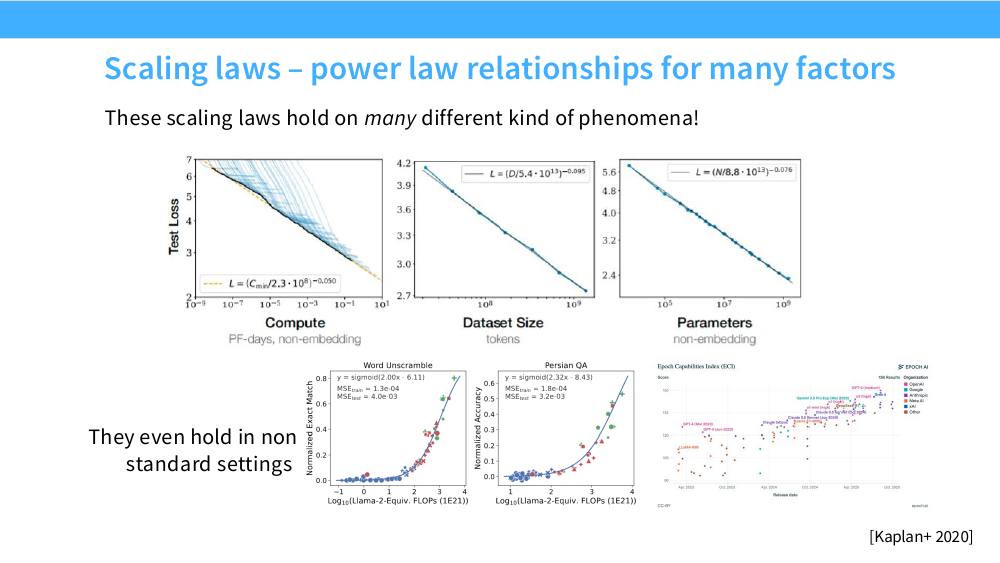
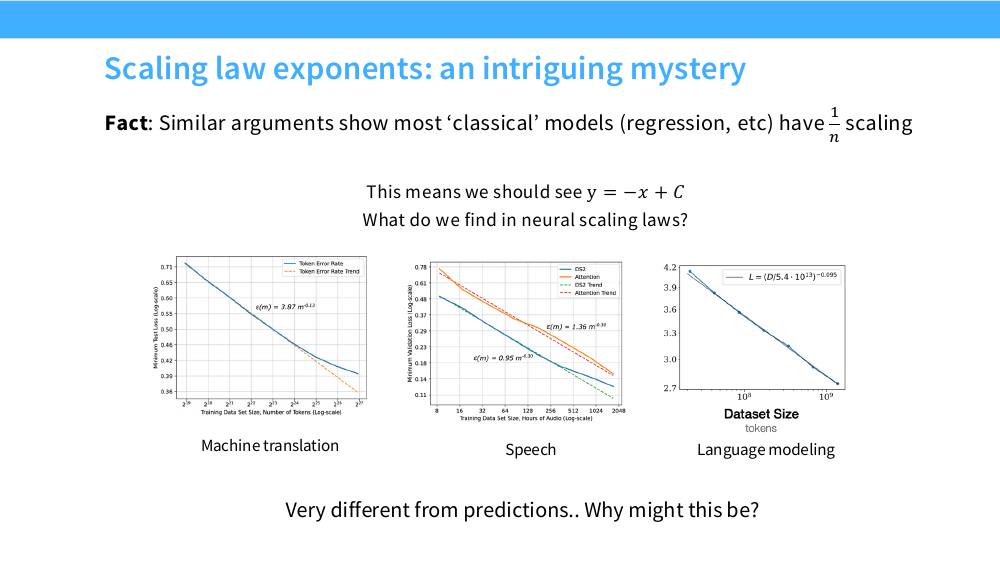
- 幂律无处不在:$L(N)=(N_c/N)^{\alpha_N}$、$L(D)=(D_c/D)^{\alpha_D}$、$L(C)=(C_c/C)^{\alpha_C}$,在 log-log 坐标下是直线,跨领域(机器翻译、语音、语言建模)、跨架构都成立。LM 的指数很小($\alpha_N\approx 0.076$,$\alpha_D\approx0.095$),远小于经典统计的 $1/n$。
- 带不可约损失的三项式:$L(N,D)=E+\frac{A}{N^\alpha}+\frac{B}{D^\beta}$。$E$ 是数据本身的熵(不可约),$A/N^\alpha$ 是模型容量不足,$B/D^\beta$ 是数据不足。
- Chinchilla 的三种方法(训练曲线包络 / IsoFLOP 剖面 / 参数化联合拟合)都指向 $N^\ast\propto C^{0.5}$、$D^\ast\propto C^{0.5}$,即 tokens/param $\approx$ 20 且不随算力变化;Kaplan 的 $C^{0.73}$ / $C^{0.27}$ 是学习率调度、warmup 和参数计数口径造成的假象。
- 超参也有缩放定律:critical batch size $\mathcal{B}_{\text{crit}}\approx 2.1\times10^8\,\text{tokens}\cdot L^{-4.8}$ 随损失下降而增大;标准参数化下最优学习率随宽度漂移,muP 通过按 $1/r$ 缩放矩阵型权重的学习率与初始化方差,让最优学习率跨宽度稳定。
- 缩放定律是下界,不是上限:它告诉你「用这套配方至少能到哪」,更好的配方(正则化、集成、更好的数据)会把整条曲线往下平移。盲目外推(比如无脑加 epoch)会翻车。
- 训练最优 $\neq$ 部署最优:Chinchilla 只优化训练算力。真实部署里推理算力占大头,所以应该「过训练」——从 GPT-3 的 2 tokens/param 一路涨到 Llama 3 70B 的 215 tokens/param。
1. 为什么必须认真对待 scaling
一次机会的赌注:把场景算成数字
先把开头那个场景算清楚,这样后面所有讨论都有一个锚点。
单张 B200 的 BF16 稠密算力约 $2.25\times10^{15}$ FLOP/s。10000 张卡:
$$ 2.25\times10^{15}\ \text{FLOP/s}\times 10^4 = 2.25\times 10^{19}\ \text{FLOP/s} $$一个月 $=30\times86400=2.59\times10^6$ 秒。按 40% 的 MFU(model FLOPs utilization,这是大规模训练里比较现实的数字,参见 PaLM 报告的 46.2%、MegaScale 的 55.2%):
$$ C \approx 2.25\times10^{19}\times 2.59\times10^{6}\times 0.4 \approx 2.3\times10^{25}\ \text{FLOPs} $$后面我们会证明,在这个预算下 Chinchilla 最优的配置大约是 440B 参数 + 8.8T tokens;如果考虑推理成本而选择过训练到 100 tokens/param,则是 196B 参数 + 19.6T tokens。这两个方案差了一倍多的参数量——选错的代价是几千万美元。
而且注意:这个预算下你跑不了第二次。不像调 ResNet 的时候可以扫 20 组学习率,这里你需要在开跑之前就把所有配置定死。这就是缩放定律存在的全部理由。
需要提前定死的东西有多少
Tatsu 在课上列的清单(后面 Part 2 会逐条回答):
| 决策 | 问题形式 | 暴力做法的代价 |
|---|---|---|
| 架构 | Transformer 还是 LSTM?要不要 MoE? | 训一个 LSTM 版 GPT-3:数千万美元 |
| 优化器 | Adam 还是 SGD?Muon? | 同上,且每换一个就要重来 |
| 深宽比 | $d_{\text{model}}/n_{\text{layer}}$ 取多少?头维度?FFN 比例? | 超参空间是组合爆炸的 |
| batch size | 多大才不浪费样本、又不浪费墙钟时间? | 直接决定数据并行的上限 |
| 学习率 | 小模型上最优的 LR,大模型上还最优吗? | 调错一档,整轮训练报废 |
| 算力分配 | 更大的模型 vs 更多的数据? | 本讲后半部分的核心 |
缩放定律给出的统一解法是一个三步流程,非常朴素但极其有效:
- 训一批小模型(比如从 $10^{17}$ 到 $10^{20}$ FLOPs,几十到几百个 run)。
- 拟合一条缩放定律(比如「Adam 的缩放曲线 vs SGD 的缩放曲线」)。
- 按缩放定律的预测选最优超参 / 配置,然后外推到目标规模。
2. 前史:缩放定律不是 2020 年发明的
「scaling law」这个词是 Kaplan et al. 2020 带火的,但这条研究线索非常长。理解这段历史有助于知道哪些结论是稳固的、哪些是这一波才有的。
理论家的版本:样本复杂度(sample complexity)
统计学习理论早就在研究「误差怎么随样本量下降」。两个经典例子:
- 有限假设类的学习:在 $k$ 个假设中做选择,泛化误差以 $O\!\left(\sqrt{\log k / n}\right)$ 的速率收敛(VC 理论的最简版本)。
- 光滑密度的生成建模(Hall, 1989):核密度估计的积分平方误差以 $n^{-4/5}$ 之类的速率下降。
这些结果的形式和缩放定律一模一样——都是 $\text{error}\propto n^{-\alpha}$。但 Tatsu 强调了一个关键区别:它们是上界(upper bounds),不是实际实现的损失值。理论界关心「最坏情况下不会比这更差」,而缩放定律关心「实际跑出来正好是这个数」。前者对指导工程决策几乎没用,因为常数和指数都太松。
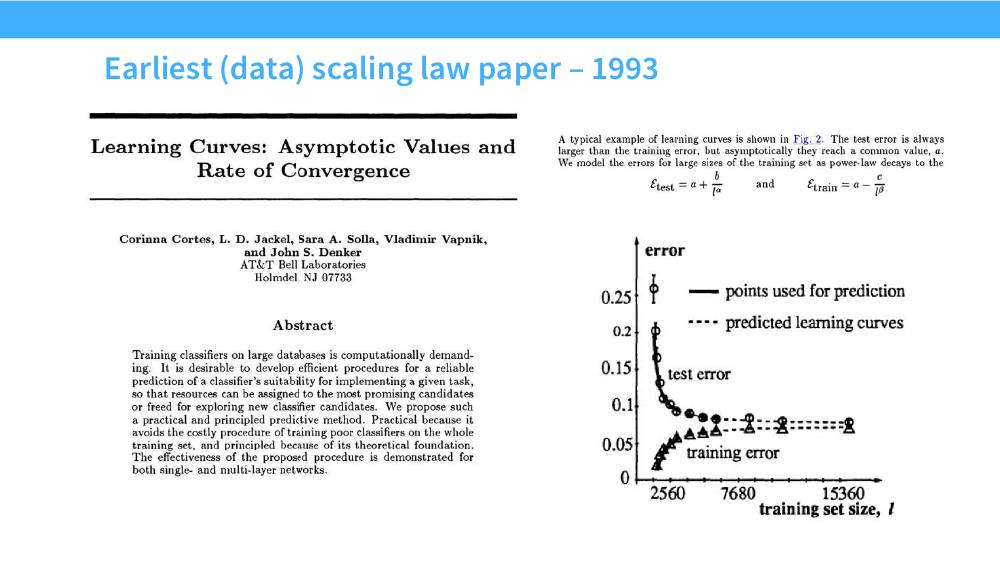
1993:最早的数据缩放定律论文
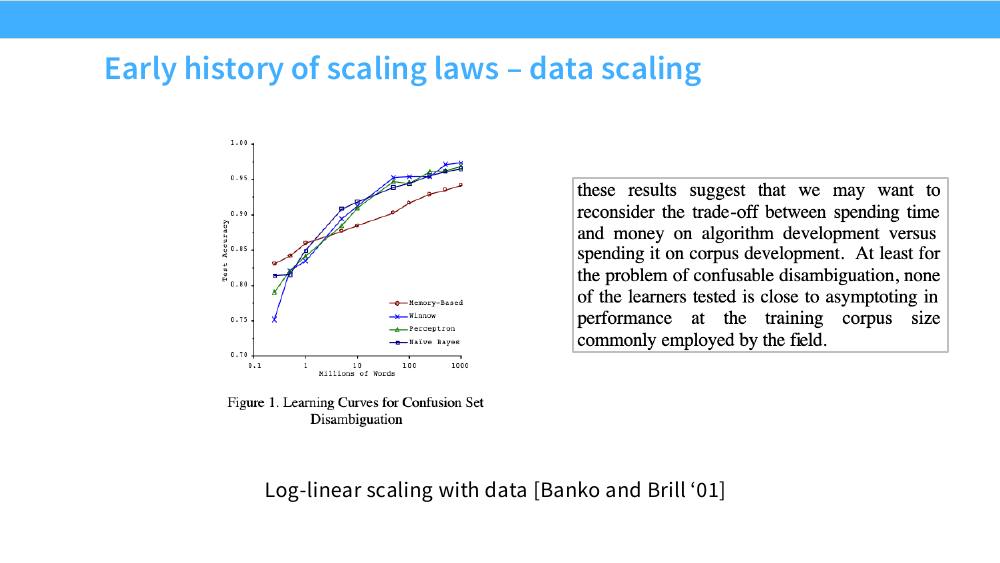
2001:Banko & Brill —— 「数据比算法重要」
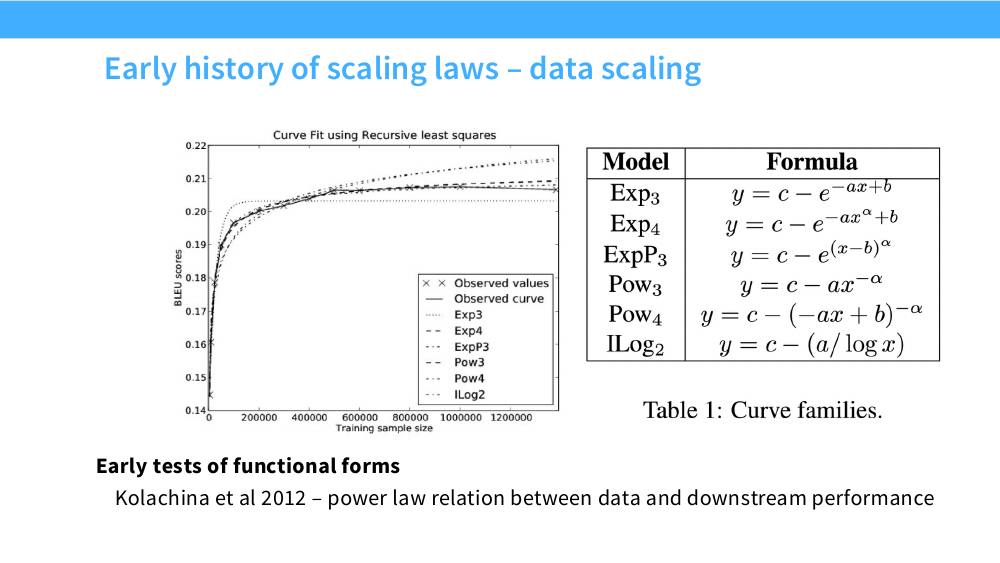
2012:Kolachina 等 —— 系统地比较函数形式
2017:Hestness 等 —— 第一次大规模神经缩放研究
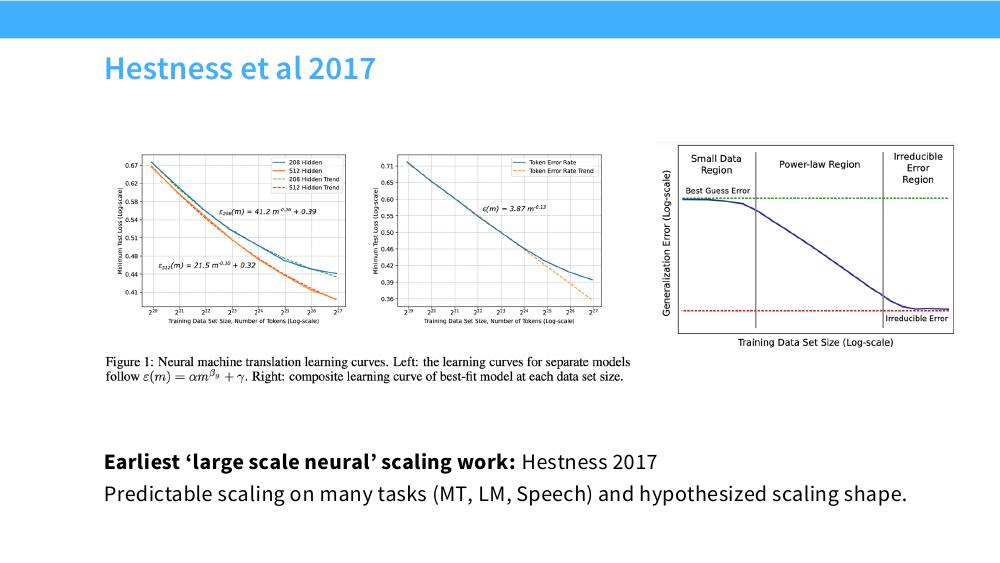
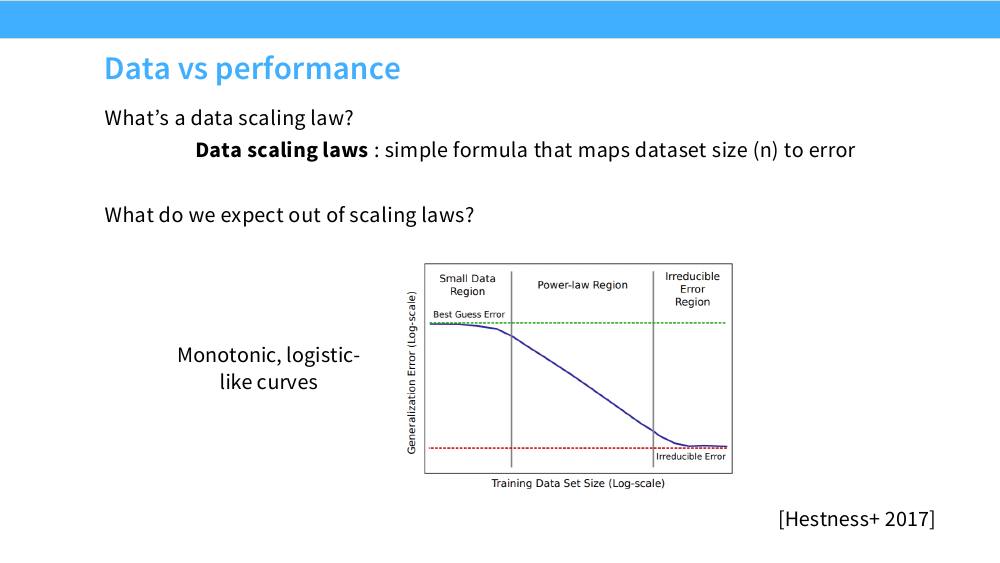
① 小数据区——模型还没学到东西,误差停在「瞎猜」水平;
② 幂律区——log-log 下的直线,缩放定律成立的区域;
③ 不可约误差区——触到数据本身的熵,再多数据也没用。
3. 数据缩放定律:经验形式与为什么是幂律
定义与经验观察
数据缩放定律(data scaling law):一个把数据集大小 $n$(对 LM 而言是 token 数 $D$)映射到误差的简单公式。
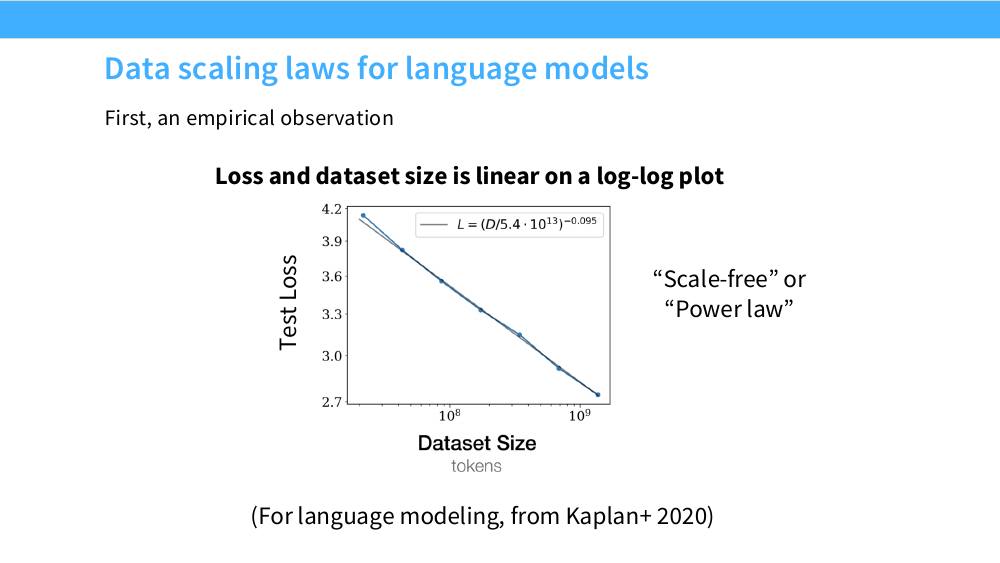
Kaplan et al. 2020 给出的三条经验律,是这一整讲的基础设施,值得完整写下来:
$$ L(N)=\left(\frac{N_c}{N}\right)^{\alpha_N},\qquad N_c\approx 8.8\times10^{13},\quad \alpha_N\approx 0.076 $$ $$ L(D)=\left(\frac{D_c}{D}\right)^{\alpha_D},\qquad D_c\approx 5.4\times10^{13},\quad \alpha_D\approx 0.095 $$ $$ L(C_{\min})=\left(\frac{C_c}{C_{\min}}\right)^{\alpha_C},\qquad C_c\approx 2.3\times10^{8}\ \text{PF-days},\quad \alpha_C\approx 0.050 $$每个符号的含义:
| 符号 | 含义 | 量纲 / 备注 |
|---|---|---|
| $L$ | 测试集上的交叉熵损失 | nats/token |
| $N$ | 非嵌入参数量 | 个。Kaplan 刻意排除 embedding 和 positional embedding |
| $D$ | 训练 token 数 | 个 |
| $C$ | 训练算力 | FLOPs 或 PF-days(1 PF-day $=10^{15}\times86400=8.64\times10^{19}$ FLOPs) |
| $C_{\min}$ | 在最优 batch size 下所需的算力 | 见第 6 节 critical batch size |
| $N_c,D_c,C_c$ | 「特征规模」常数,量纲与对应变量相同 | 物理意义:损失降到 1 nat 所需的规模(外推值,不要当真) |
| $\alpha_N,\alpha_D,\alpha_C$ | 幂律指数(log-log 斜率的负数) | 无量纲。这才是关键量 |
为什么是幂律?玩具例子一:均值估计
损失单调下降是显然的(数据多了不会更差)。但为什么正好是幂律、在 log-log 下是直线?Tatsu 给的答案是:估计误差天然以多项式速率衰减。用最简单的例子把这句话讲透。
输入 $x_1,\dots,x_n\sim N(\mu,\sigma^2)$,任务是估计均值,估计量 $\hat\mu=\frac{1}{n}\sum_i x_i$。
$$ \E\left[(\hat\mu-\mu)^2\right]=\operatorname{Var}(\hat\mu)=\frac{\sigma^2}{n} $$两边取对数:
$$ \log(\text{Error}) = -\log n + 2\log\sigma $$这就是一条缩放定律:log-log 图上斜率 $-1$、截距 $2\log\sigma$ 的直线。
更一般地,任何多项式速率 $1/n^{\alpha}$ 都是一条缩放定律,斜率 $-\alpha$,截距由问题的「难度常数」决定。
指数之谜:为什么 LM 的斜率只有 0.095?
问题来了。类似的论证可以证明大多数「经典」模型(线性回归、参数化的最大似然估计等)都有 $1/n$ 的速率,也就是 log-log 斜率 $-1$。可是实测的神经缩放定律呢?
玩具例子二:非参数学习的维度依赖
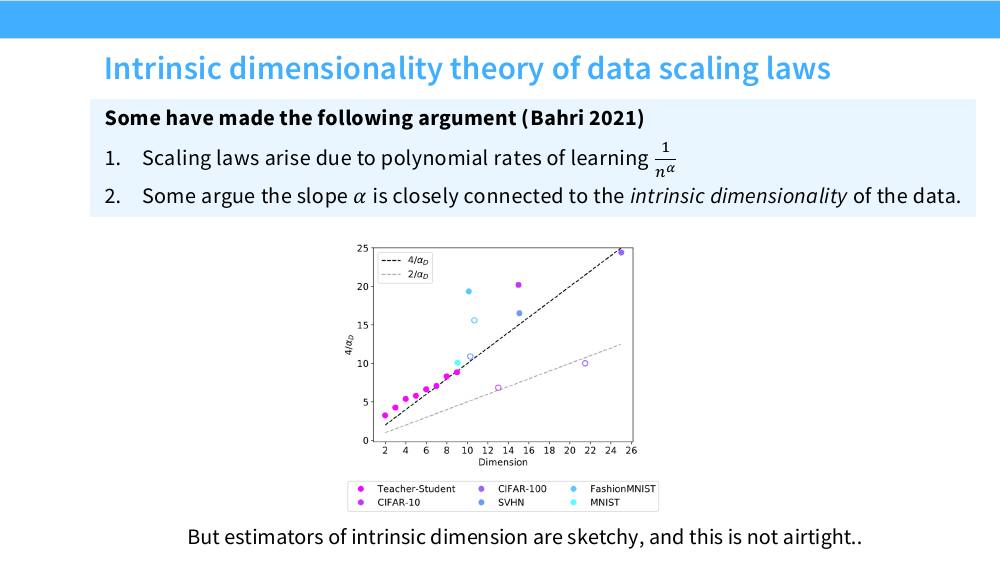
神经网络能逼近任意函数,所以它更像一个非参数(nonparametric)估计器而不是参数模型。非参数估计的速率是维度依赖的,这就是指数变小的来源。
设 $x_1,\dots,x_n$ 均匀分布在 2 维单位方格内,$y_i=f(x_i)+N(0,1)$,任务是估计 $f$。
方法:把 2 维空间切成边长为 $n^{-1/4}$ 的小格子,每个格子内用样本均值作为 $f$ 的估计。
格子数:$\left(n^{1/4}\right)^2 = n^{1/2}=\sqrt n$ 个。
每格样本数:$n/\sqrt n = \sqrt n$ 个。
每格的估计误差(用上面的均值估计结论):$\dfrac{1}{\sqrt n}$。
$$ \text{Error}\approx \frac{1}{\sqrt{n}} + (\text{光滑性带来的偏差项}) $$偏差项来自「格子内 $f$ 不是常数」。若 $f$ 是 Lipschitz 的,偏差 $\sim$ 边长 $=n^{-1/4}$,平方偏差 $=n^{-1/2}$——和方差项正好同阶,这就是为什么边长选 $n^{-1/4}$(偏差-方差平衡)。
推广到 $d$ 维:边长取 $n^{-1/(d+2)}$,得到 $\text{Error}\sim n^{-2/(d+2)}$。当 $d$ 很大时这近似为 $n^{-2/d}$;课上用的更粗的记法是 $\text{Error}=n^{-1/d}$,log-log 斜率 $=-\frac{1}{d}$。
要点:灵活的非参数学习具有维度依赖的缩放定律。斜率不再是 $-1$,而是 $-O(1/d)$。反过来看:语言建模的 $\alpha_D\approx 0.095$ 对应 $d\approx 10$(用 $1/d$ 记法)或 $d\approx 20$(用 $2/d$ 记法)——这是一个惊人地小的数字,暗示自然语言数据虽然名义上维度极高,但内在维度(intrinsic dimensionality)只有十几。
小结:数据缩放定律
- $\log$(数据量) 与 $\log$(误差) 之间有惊人稳定的线性关系。
- 跨领域(NLP / 语音 / 视觉)、跨模型(记忆型、感知机、LSTM、Transformer)都成立。
- 理论理解与泛化界同源:均值估计给出 $1/n$,非参数估计给出 $n^{-O(1/d)}$。
- 主要应用:数据采集与数据清洗的投资决策——下一节展开。
4. 数据侧进阶:配比、重复与筛选
「数据集多大」只是数据缩放定律的第一层。真正做预训练时你更关心:数据的组成(composition)怎么影响性能。这里有三个相互纠缠的问题:
- 怎样用小规模模型挑选最优数据配比(data mixture)?
- 数据不够时该不该重复(repeat)?重复几遍开始亏?
- 把两者结合:在质量和重复率之间怎么平衡?
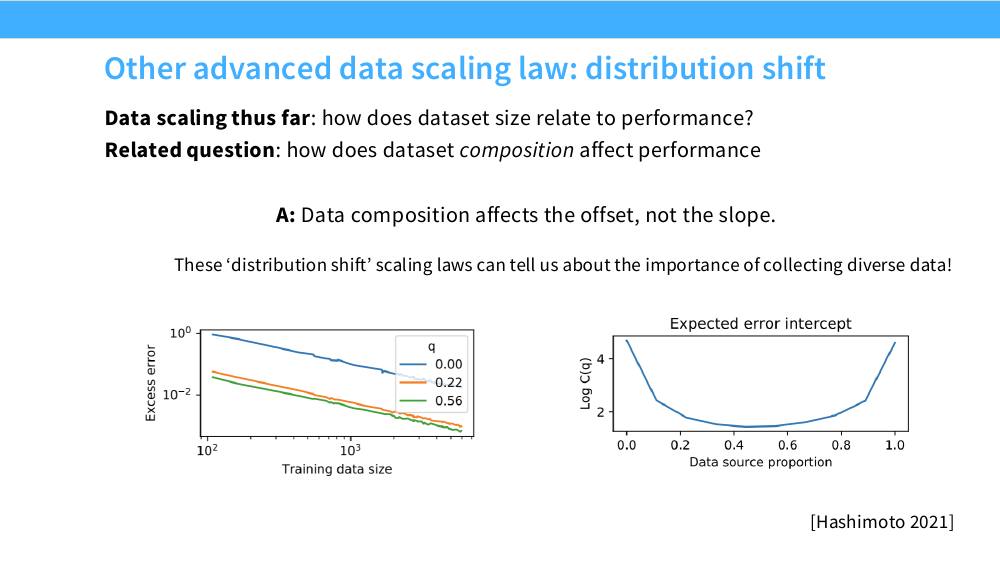
分布偏移:组成只改截距,不改斜率
实践中:靠缩放定律选配比其实很难
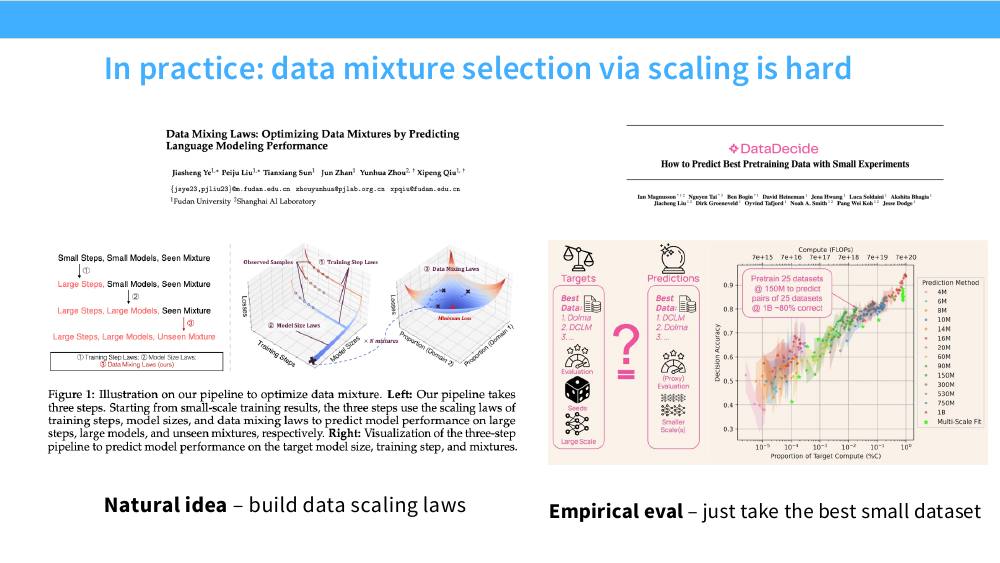
右:AI2 的 DataDecide(Magnusson et al. 2025)做了一次大规模实证检验:用 25 个数据集 $\times$ 多个规模预训练,问「小规模实验能多准地预测大规模上哪个数据集更好」。结论是——用 150M 规模的模型直接排序,就能达到约 80% 的成对决策准确率,而复杂的多尺度缩放定律拟合并没有明显更好。
Tatsu 的判断:想法很自然(build data scaling laws),但经验上「直接取小规模最好的那个数据集」是更划算的做法。
数据重复下的缩放定律
现实里数据是有限的(高质量英文网页大约就是 10T–20T token 量级)。当算力预算允许你消耗比 unique token 更多的 token 时,你要么重复、要么把算力浪费掉。重复的代价怎么量化?
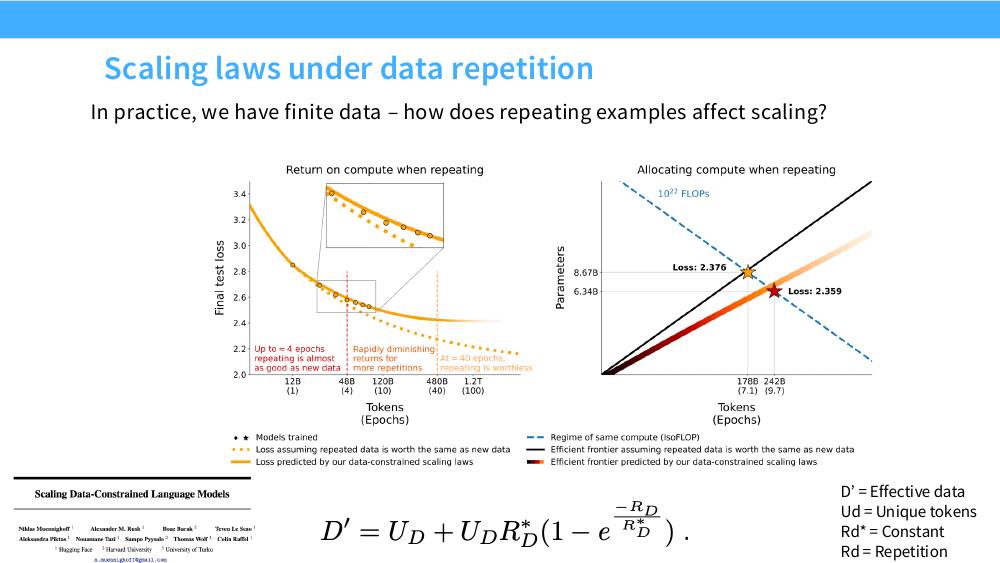
他们提出的有效数据(effective data)公式是:
$$ D' = U_D + U_D\,R_D^{*}\left(1-e^{-R_D/R_D^{*}}\right) $$| 符号 | 含义 |
|---|---|
| $D'$ | 有效数据量——代入普通缩放定律 $L=E+A/N^\alpha+B/D'^\beta$ 的那个 $D$ |
| $U_D$ | unique token 数(数据池真实大小) |
| $R_D$ | 重复次数($=$ epoch 数 $-\,1$) |
| $R_D^{*}$ | 拟合出的半衰常数(论文中约 15),控制重复价值衰减的快慢 |
检查这个公式的两个极限:
$R_D\to 0$(不重复):$1-e^{-R_D/R^*_D}\approx R_D/R^*_D$,于是 $D'\approx U_D + U_D R_D = U_D(1+R_D)$——正好等于实际消耗的 token 数。前几个 epoch 的重复 token 与新 token 等价。
$R_D\to\infty$(无限重复):$1-e^{-R_D/R^*_D}\to 1$,于是 $D'\to U_D(1+R_D^*)\approx 16\,U_D$。无论重复多少遍,有效数据最多只有 unique 数据的约 16 倍——这就是 40 epoch 之后曲线压平的原因。
论文对参数量也用了同构的公式 $N'=U_N+U_NR_N^*\left(1-e^{-R_N/R_N^*}\right)$,刻画「超出数据所能支撑的那部分参数」同样价值衰减。
数据筛选必须随规模自适应
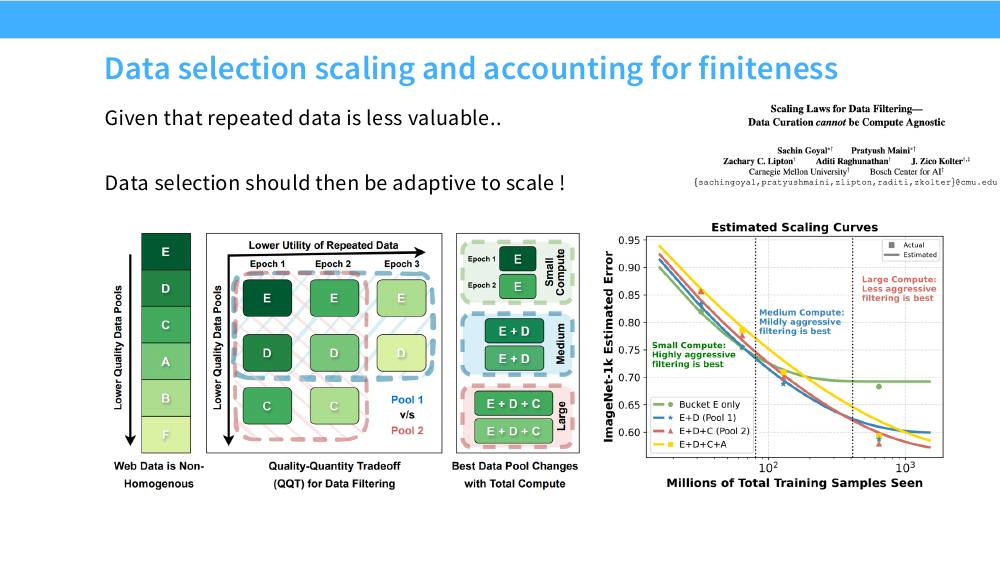
· 小算力:只用最高质量的桶(图中 Bucket E),激进筛选最优——反正你也吃不完。
· 中算力:适度筛选(E+D)。
· 大算力:温和筛选最优(E+D+C 甚至 +A)——此时高质量池已经被重复太多遍,边际价值低于「没那么干净但是新的」数据。
右图的交叉点非常清楚:绿色(只用 E)在 100M 样本前领先,之后被压平并反超。
「算力无限」设定:缩放定律会坏掉,而且它只是下界
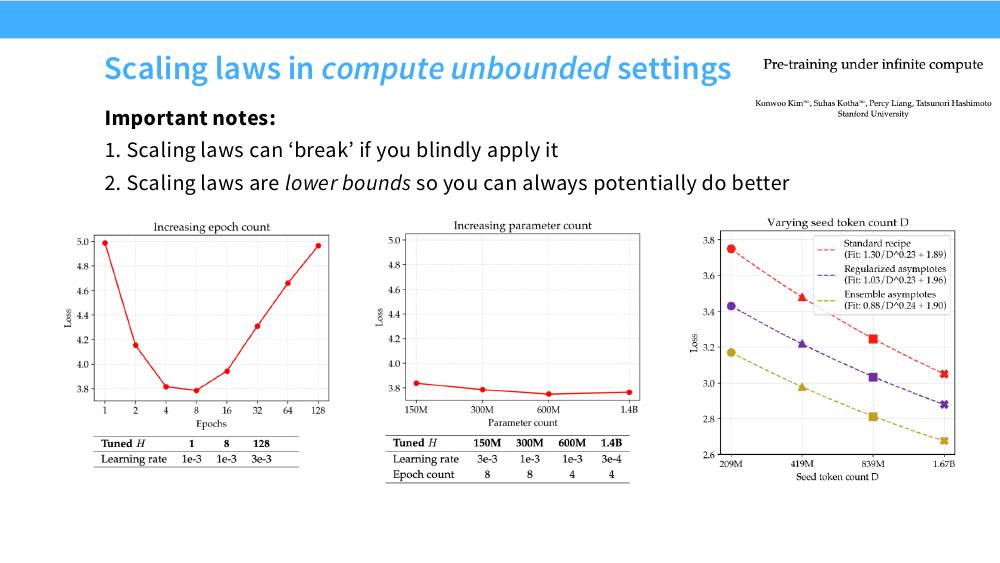
左:把 epoch 从 1 加到 128,损失先降后大幅回升(4–8 epoch 是谷底,128 epoch 回到了 1 epoch 的水平)——盲目沿着「更多 token」外推会直接翻车。
中:把参数从 150M 加到 1.4B,损失在 300M 之后基本压平——参数轴同样存在天花板。
右:三种配方在同一批 seed token 上的渐近损失拟合:标准配方 $1.30/D^{0.23}+1.89$、加正则的渐近 $1.03/D^{0.23}+1.96$、集成的渐近 $0.88/D^{0.24}+1.90$。三条线斜率几乎一样(0.23–0.24),但常数被显著压低。
- 缩放定律会「坏掉」——如果你盲目套用。它是在某个实验设计范围内拟合出来的,外推出这个范围(比如 epoch 数、正则化强度、数据分布)就不再有效。
- 缩放定律是下界(lower bounds)——它描述的是「用这套配方你能到哪」。换一套更好的配方(更强的权重衰减、集成、更好的数据),整条曲线会整体下移。永远存在做得更好的可能。
5. 用缩放定律做模型工程决策
现在进入 Tatsu 在开头承诺的部分:模型缩放。核心动机是「怎样高效地设计巨型语言模型」,而它可以拆成两类问题:
- 离散选择:LSTM 还是 Transformer?Adam 还是 SGD?几层?多宽?
- 资源分配:训得更久还是训更大的模型?多买数据还是多买 GPU?
这一节回答第一类(沿用 Kaplan 那篇经典论文的组织方式),第 8–9 节回答第二类。
架构:Transformer 真的比 LSTM 好吗
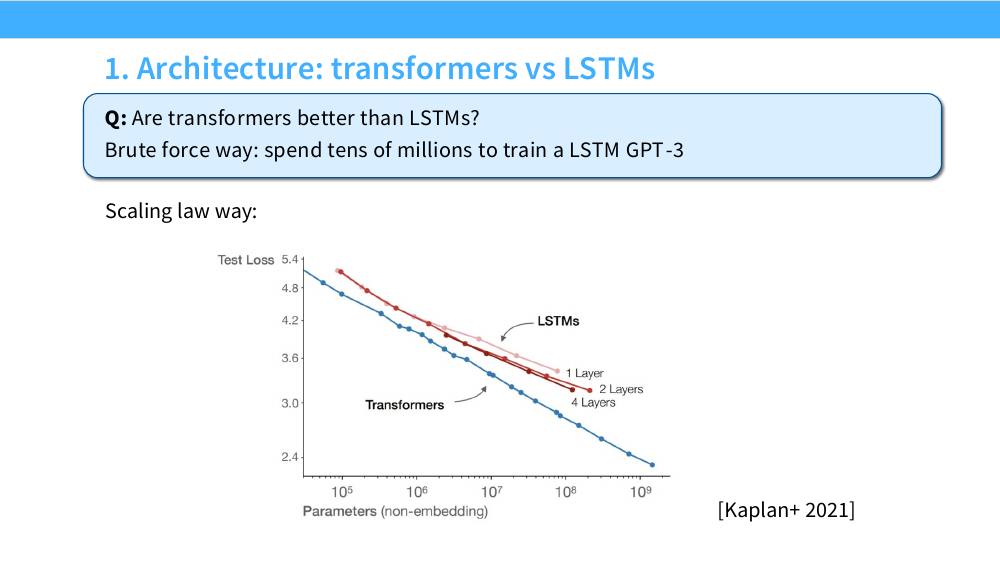
为什么 LSTM 会饱和?Kaplan 在论文里给了一个很有说服力的解释:把损失按 context 内的 token 位置拆开看,LSTM 在前 $\sim$100 个 token 上和 Transformer 差不多,但在更靠后的位置上完全跟不上——RNN 的固定大小隐状态成了长程信息的瓶颈。参数变多并不能扩大这个瓶颈。
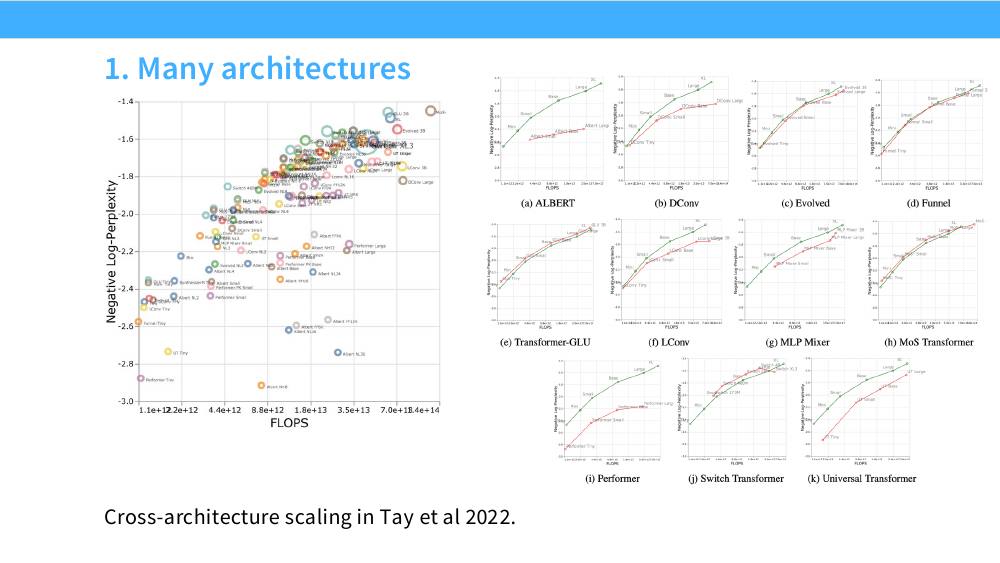
更多架构:小规模排名不一定能外推
优化器:改变常数,不改变指数
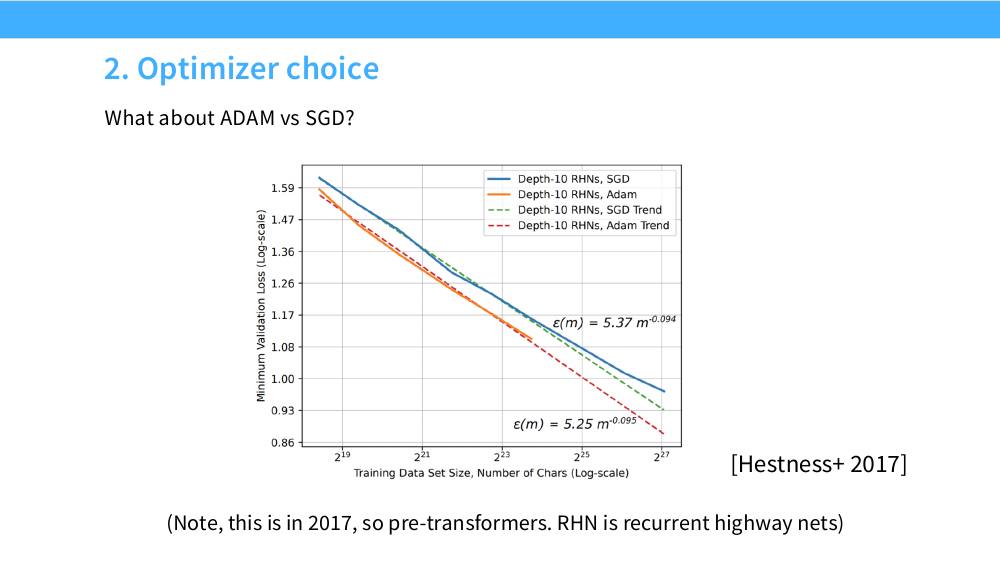
$\varepsilon_{\text{SGD}}(m)=5.37\,m^{-0.094}$,$\varepsilon_{\text{Adam}}(m)=5.25\,m^{-0.095}$。
指数几乎完全一样(0.094 vs 0.095),差别只在常数(5.37 vs 5.25)。两条趋势线在 log-log 图上是平行的。
「只差常数」这件事有一个非常实用的翻译方式。设两个方法的曲线为 $\varepsilon_1=c_1m^{-\alpha}$ 与 $\varepsilon_2=c_2m^{-\alpha}$(同指数)。要达到同样的误差 $\varepsilon$,各自需要的数据量满足
$$ c_1 m_1^{-\alpha}=c_2m_2^{-\alpha}\ \Longrightarrow\ \frac{m_1}{m_2}=\left(\frac{c_1}{c_2}\right)^{1/\alpha} $$代入上面的数字:$\left(\frac{5.37}{5.25}\right)^{1/0.095}=\left(1.0229\right)^{10.53}=e^{10.53\times 0.02263}=e^{0.238}\approx 1.27$。
也就是说 SGD 需要多约 27% 的数据才能追上 Adam。注意 $1/\alpha$ 这个放大因子——因为指数很小,常数上很小的改进会被放大成数据量上相当可观的节省。这是「常数改进也很值钱」的正式说法。
深度与宽度:形状几乎不重要
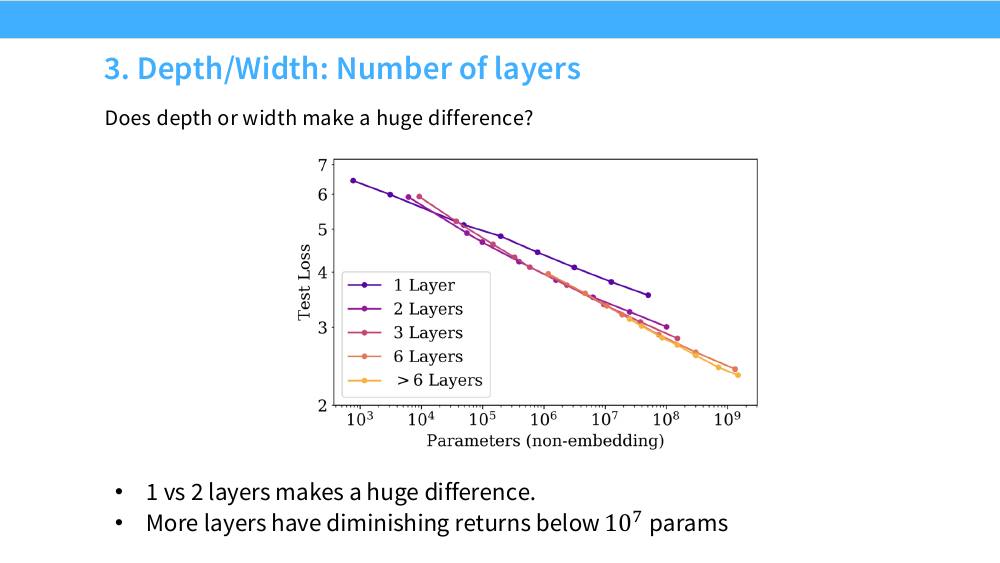
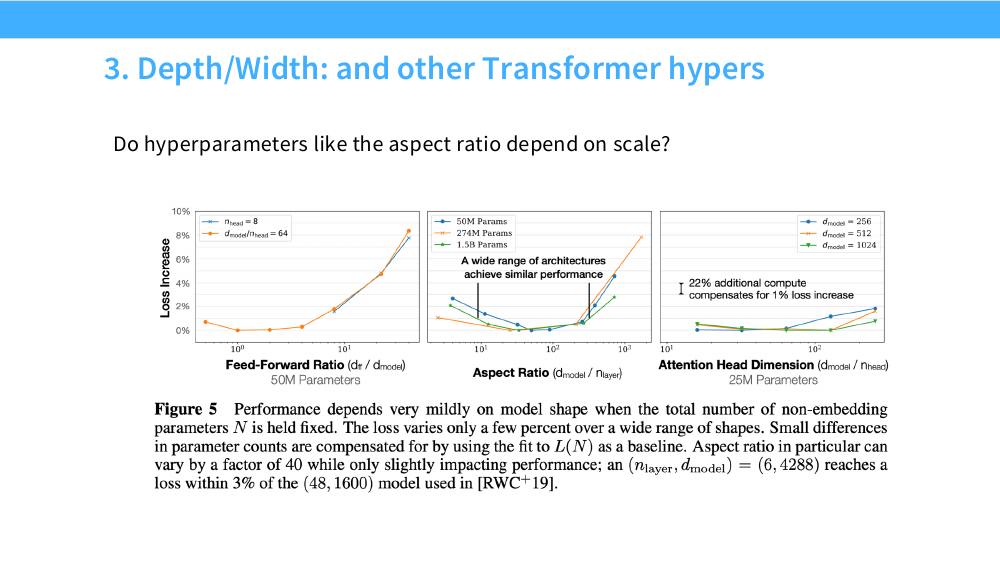
参数不是等价的:嵌入层的诡异行为
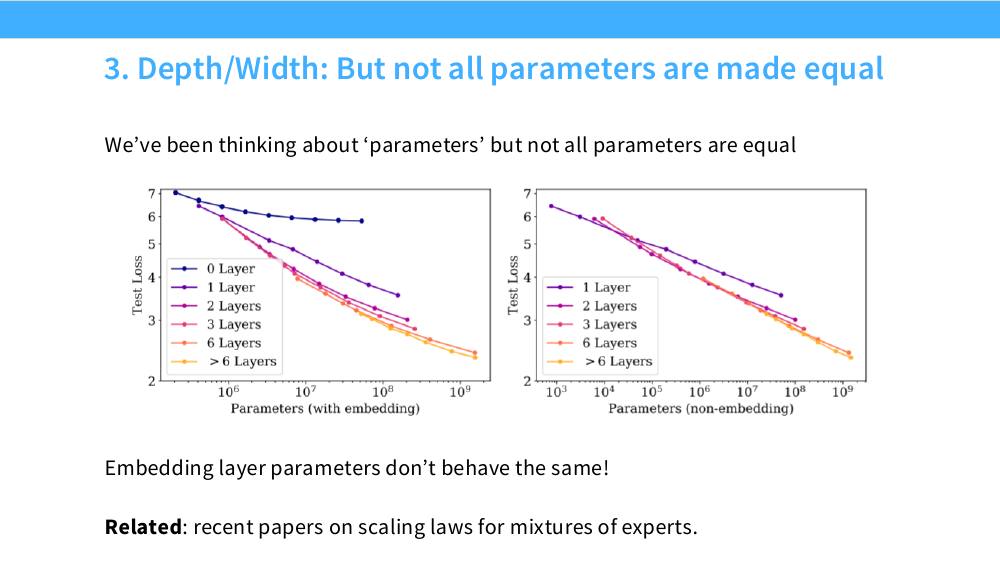
这个「参数计数口径」问题看起来是细节,实际上是第 10 节 Kaplan-Chinchilla 分歧的主要来源之一——在 Kaplan 研究的规模(1k 到 1.5B 参数)下,嵌入层往往占总参数的很大一部分,两种口径会得到不同的指数。
延伸:MoE 让「参数的价值」重新定义
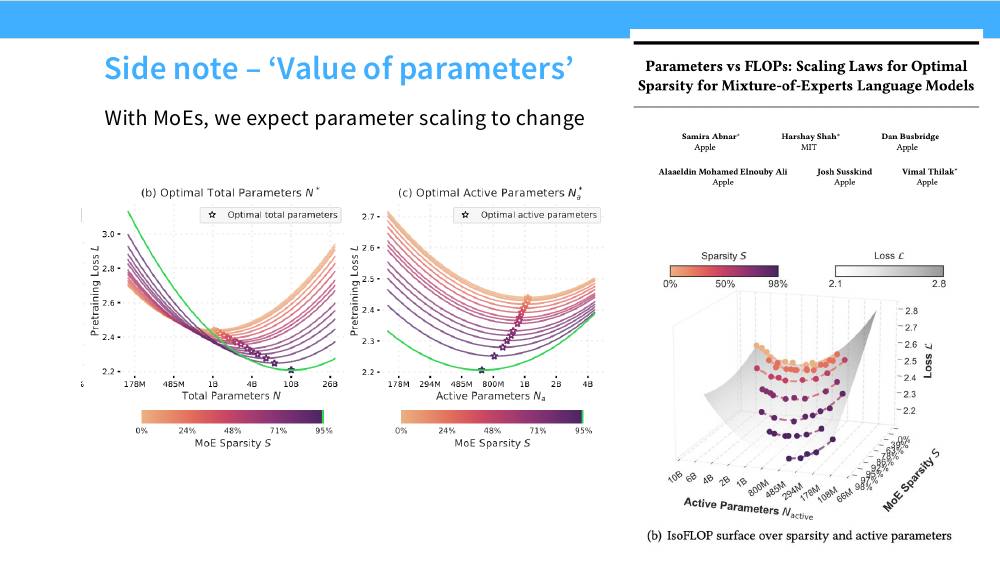
三步法的完整表述
把这一节的方法论抽象出来,就是 Tatsu 总结的基于缩放定律的设计流程:
- 训一批更小的模型(覆盖 2–4 个数量级)。
- 建立缩放定律(例如「Adam 缩放定律」和「SGD 缩放定律」两条曲线)。
- 按缩放定律的预测选最优超参——而不是按小模型上的单点胜负。
令人惊讶的是,用这个流程可以在训练之前就预测出优化器选择、模型深度、架构选择对大模型的影响。这是这门课里最反直觉、也最有实用价值的结论之一。
6. Batch size 与 critical batch size
batch size 是唯一一个「同时影响统计效率和系统效率」的超参,所以它值得单独一节。系统侧:batch 越大,数据并行的并行度越高、通信摊得越薄、墙钟时间越短(第 6–8 讲的内容)。统计侧:batch 越大,每步的梯度越准,但收益是严重递减的。
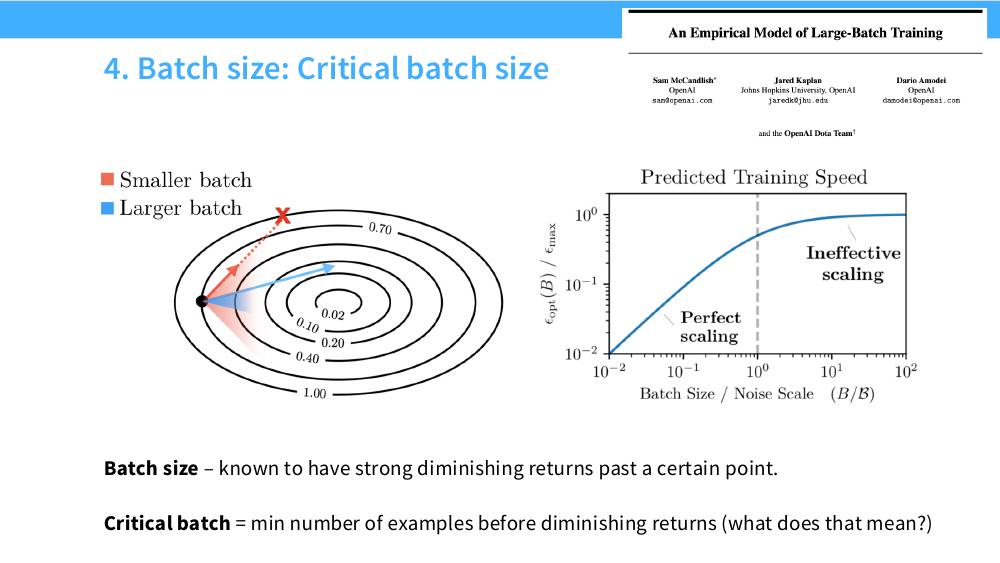
critical batch size 的精确定义
「收益开始递减的最小 batch 数」听起来含糊,怎么把它变成一个可测量的数?McCandlish 等人的做法很漂亮:
- 选定一个目标损失 $L$。
- 对每个 batch size $B$,记录达到 $L$ 所需的优化步数 $S$ 和样本数 $E=B\cdot S$。
- 扫描一系列 $B$,把 $(S,E)$ 画出来。
实测的曲线极好地服从:
$$ \frac{S}{S_{\min}}-1=\left(\frac{E}{E_{\min}}-1\right)^{-1} $$其中 $S_{\min}$ 是「$B\to\infty$ 时的最少步数」,$E_{\min}$ 是「$B\to 0$ 时的最少样本数」。拟合出这两个常数后,定义
$$ \boxed{\ \mathcal{B}_{\text{crit}}=\frac{E_{\min}}{S_{\min}}\ } $$这个双曲线关系其实等价于一对非常直观的公式。令 $\mathcal{B}=\mathcal{B}_{\text{crit}}=E_{\min}/S_{\min}$,则
$$ S(B)=S_{\min}\left(1+\frac{\mathcal{B}}{B}\right),\qquad E(B)=E_{\min}\left(1+\frac{B}{\mathcal{B}}\right) $$验证一致性:$E=B\cdot S = B\,S_{\min}\left(1+\frac{\mathcal{B}}{B}\right)=S_{\min}(B+\mathcal{B})=S_{\min}\mathcal{B}\left(1+\frac{B}{\mathcal{B}}\right)=E_{\min}\left(1+\frac{B}{\mathcal{B}}\right)$ ✓
验证双曲线:$\left(\frac{S}{S_{\min}}-1\right)\left(\frac{E}{E_{\min}}-1\right)=\frac{\mathcal{B}}{B}\cdot\frac{B}{\mathcal{B}}=1$ ✓
关键性质:取 $B=\mathcal{B}_{\text{crit}}$ 时,$S=2S_{\min}$ 且 $E=2E_{\min}$——正好是「步数是最优的 2 倍、样本数也是最优的 2 倍」的那个平衡点。这就是 Tatsu 说的「balances both sides of the equation, giving roughly 2x the steps / passes optimal」。
更小的 $B$ 省样本但费墙钟时间;更大的 $B$ 省墙钟时间但费样本。$\mathcal{B}_{\text{crit}}$ 是这条帕累托前沿上的膝点。
论文还给出了一个理论对应物:$\mathcal{B}_{\text{crit}}$ 大致等于梯度噪声尺度(gradient noise scale)
$$ \mathcal{B}_{\text{noise}}=\frac{\operatorname{tr}(\Sigma)}{\lVert G\rVert^2} $$即梯度协方差矩阵的迹(各分量方差之和)除以梯度范数的平方。分子是「噪声总能量」,分母是「信号能量」。信噪比越低,你越需要大 batch 去平均掉噪声。这个量可以在训练中在线估计,不需要扫 batch size。
critical batch size 随训练进程增长
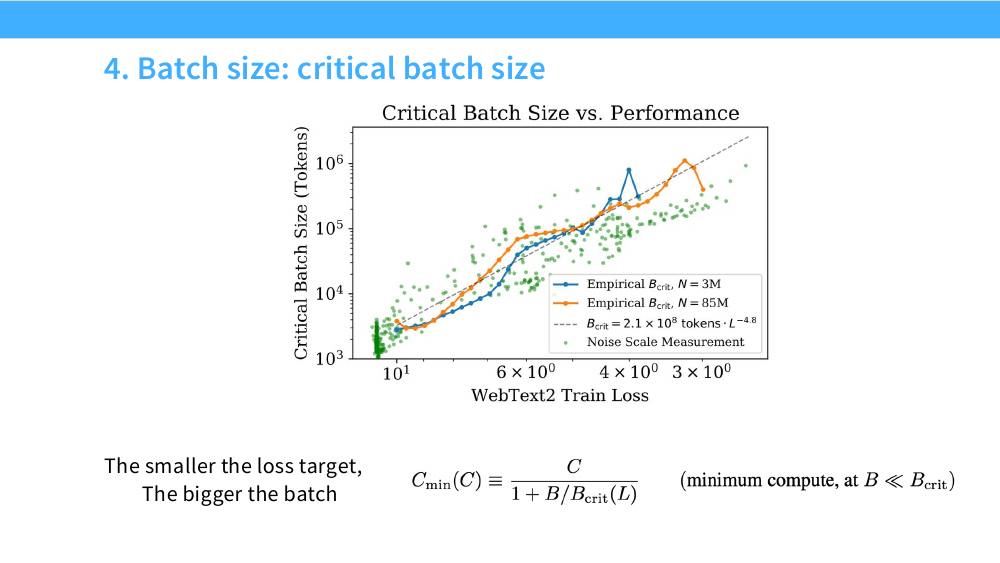
算一个具体数字感受这个 $-4.8$ 有多陡。损失从 $L=3.5$ 降到 $L=2.5$:
$$ \frac{\mathcal{B}_{\text{crit}}(2.5)}{\mathcal{B}_{\text{crit}}(3.5)}=\left(\frac{3.5}{2.5}\right)^{4.8}=1.4^{4.8}=e^{4.8\times 0.3365}=e^{1.615}\approx 5.0 $$损失从 3.5 到 2.5,可用 batch 扩大 5 倍。
代入绝对值:$\mathcal{B}_{\text{crit}}(3.5)=2.1\times10^8\times3.5^{-4.8}=2.1\times10^8/e^{4.8\times1.2528}=2.1\times10^8/e^{6.013}=2.1\times10^8/409\approx 5.1\times10^5$ tokens $\approx$ 0.5M tokens。
$\mathcal{B}_{\text{crit}}(2.5)\approx 2.6\times10^6$ tokens $\approx$ 2.6M tokens。这与实际大模型使用的 batch(GPT-3 最终 3.2M tokens、Llama 3 最终 16M tokens)量级吻合。
- 大模型能用大 batch,不是因为它参数多,而是因为它能达到更低的损失,而 $\mathcal{B}_{\text{crit}}$ 是损失的函数。
- 训练初期损失高 $\Rightarrow\mathcal{B}_{\text{crit}}$ 小 $\Rightarrow$ 大 batch 是浪费。这正是 GPT-3、Llama 3 等都采用 batch size ramp(batch 逐步放大)的原因。
- $\mathcal{B}_{\text{crit}}$ 直接给出了数据并行的物理上限:如果你有 10000 张卡、每卡至少要 1 个序列(4096 token),最小 global batch 就是 41M token——已经远超训练前期的 $\mathcal{B}_{\text{crit}}$。这就是为什么必须上张量并行 / 流水线并行,而不是把数据并行度开到底。
Kaplan 用 $\mathcal{B}_{\text{crit}}$ 定义了两个「理想化」的量,它们是缩放定律公式里那个下标 $\min$ 的来源:
$$ C_{\min}(C)\equiv \frac{C}{1+\mathcal{B}_{\text{crit}}(L)/B}\quad(\text{最小算力,在 } B\ll\mathcal{B}_{\text{crit}} \text{ 时取到}) $$ $$ S_{\min}(S)\equiv \frac{S}{1+\mathcal{B}_{\text{crit}}(L)/B}\quad(\text{最小步数,在 } B\gg\mathcal{B}_{\text{crit}} \text{ 时取到}) $$$L(C_{\min})$ 这条缩放定律描述的就是「假设你用了无穷小的 batch、把每个样本的价值榨干」时的算力-损失关系。实际训练总是比它差一个 $(1+B/\mathcal{B}_{\text{crit}})$ 的因子。
最小实现:拟合 critical batch size
import numpy as np
from scipy.optimize import curve_fit

# 实验:固定模型与数据,扫 batch size;对每个 B 记录达到目标损失 L* 所需的步数
Bs      = np.array([2**k for k in range(6, 17)])          # 64 ... 65536 序列
S_obs   = np.array([...])                                  # 达到 L* 的步数

def steps_model(B, S_min, B_crit):
    """S(B) = S_min * (1 + B_crit / B)"""
    return S_min * (1.0 + B_crit / B)

(S_min, B_crit), cov = curve_fit(steps_model, Bs, S_obs,
                                 p0=[S_obs.min(), Bs.mean()],
                                 sigma=S_obs * 0.05)       # 5% 相对误差
E_min = S_min * B_crit

print(f"S_min = {S_min:.0f} steps,  E_min = {E_min:.3e} seqs,  B_crit = {B_crit:.0f} seqs")

# 用它换算:选 B = B_crit 时,步数与样本数各是最优值的 2 倍
# 想省墙钟时间 -> B > B_crit(样本更浪费)
# 想省数据     -> B < B_crit(步数更多、更慢)
for r in [0.25, 0.5, 1.0, 2.0, 4.0]:
    B = r * B_crit
    print(f"B/B_crit={r:4.2f}  steps={1+1/r:.2f}x S_min   samples={1+r:.2f}x E_min")
输出会显示:$B=0.25\mathcal{B}_{\text{crit}}$ 时步数是 5 倍、样本只要 1.25 倍;$B=4\mathcal{B}_{\text{crit}}$ 时步数只要 1.25 倍、但样本要 5 倍。你根据「GPU 更贵还是数据更贵」在这条曲线上选点。
7. 学习率的缩放与 muP
前面所有讨论都有一个隐含前提:每个规模上的超参都调好了。但学习率恰恰是最不满足这个前提的那个——而且调错它的代价最大。
问题:标准参数化下最优学习率随宽度漂移
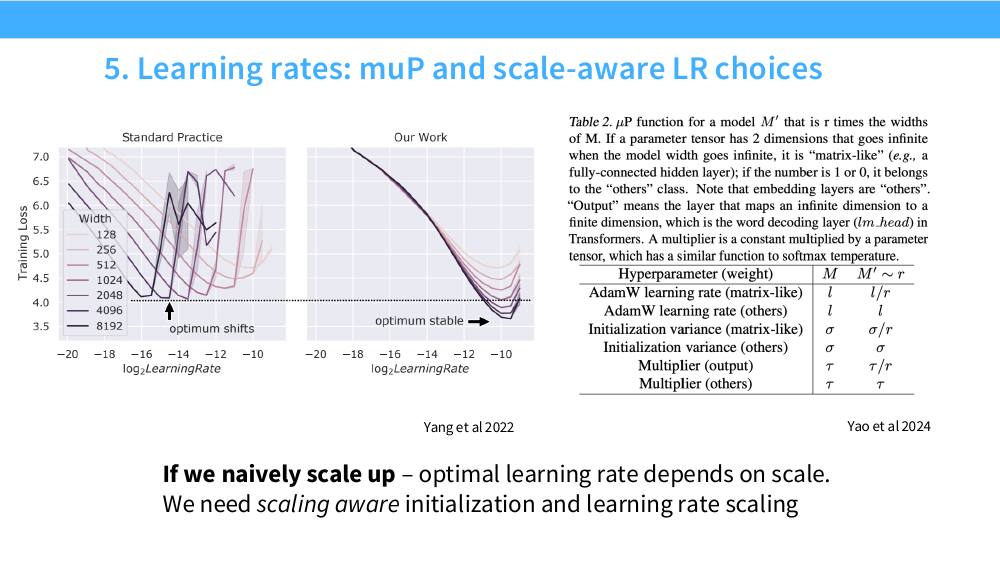
左(Standard Practice,标准参数化 SP):随着宽度增加,损失-学习率曲线的最低点持续向左漂移——在宽度 128 上最优的学习率,到宽度 8192 上已经直接发散了。
右(muP):所有宽度的曲线最低点对齐在同一个学习率上,而且大模型的曲线整齐地压在小模型下方。
右侧是 Yao et al. 2024 整理的 muP 缩放规则表(宽度放大 $r$ 倍时各类超参怎么变)。
为什么标准参数化会漂移?用 Adam 做一个粗略但抓住本质的量纲分析。
考虑一个隐藏层 $h = Wx$,其中 $W\in\R^{n\times n}$,$x\in\R^{n}$,$n$ 是宽度。假设输入各分量是 $\Theta(1)$ 量级。
Adam 的更新有一个特殊性质:它是逐元素归一化的,$\Delta W_{ij}\approx -\eta\cdot\frac{m_{ij}}{\sqrt{v_{ij}}}$,每个元素的更新幅度都是 $\Theta(\eta)$,与梯度大小无关。
于是一步更新后预激活的变化是
$$ \Delta h_i=\sum_{j=1}^{n}\Delta W_{ij}x_j \approx n\cdot\Theta(\eta)\cdot\Theta(1)=\Theta(\eta n) $$(注意这里的求和不会像随机初始化那样出现 $\sqrt n$ 的抵消,因为 Adam 的更新方向与 $x$ 是相关的——它就是朝着降低损失的方向对齐的。)
要让每步对函数的改变量保持 $\Theta(1)$(既不停滞也不爆炸),必须有
$$ \eta \propto \frac{1}{n} $$这就是 muP 对「matrix-like」权重的学习率规则。SP 保持 $\eta$ 不变,所以宽度每翻倍,有效步长就翻倍——最优 $\eta$ 只能往左(更小)跑,这正是左图的现象。
对比 SGD:SGD 的更新 $\Delta W\propto \eta\,\nabla W$ 大小随梯度走,量纲分析结果不同($\eta\propto n$ 对 matrix-like 层),所以 muP 的规则表依赖优化器。这里的表是 AdamW 版本。
muP 的缩放规则表
把宽度放大 $r$ 倍($M\to M'$,$r=\text{width}'/\text{width}$)。参数按「有几个维度会随宽度趋于无穷」分类:
- matrix-like:两个维度都随宽度增长的张量,例如所有全连接隐藏层权重 $\R^{d\times d}$、注意力的 $W_Q,W_K,W_V,W_O$、FFN 的 $W_1,W_2$。
- others:无穷维度个数为 1 或 0 的,包括 embedding 层、bias、LayerNorm/RMSNorm 的 gain。
- output:把无穷维映射到有限维的层,即 Transformer 里的
lm_head($\R^{d\to V}$,$V$ 是固定词表大小)。
| 超参(权重类别) | 基准模型 $M$ | 宽度 $\times r$ 的模型 $M'$(muP) | 直觉 |
|---|---|---|---|
| AdamW 学习率(matrix-like) | $l$ | $l/r$ | 抵消上面 $\Delta h=\Theta(\eta n)$ 的放大 |
| AdamW 学习率(others:embedding / bias / norm gain) | $l$ | $l$ | fan-in 是 1 或词表大小,不随宽度变 |
| 初始化方差(matrix-like) | $\sigma$ | $\sigma/r$ | 保持前向激活的方差为 $\Theta(1)$(即 $1/\text{fan\_in}$ 缩放) |
| 初始化方差(others) | $\sigma$ | $\sigma$ | 同上 |
| 乘子 multiplier(output 层) | $\tau$ | $\tau/r$ | 输出 logits 是 $d$ 项之和,需要 $1/d$ 而不是 $1/\sqrt d$ |
| 乘子 multiplier(其他层) | $\tau$ | $\tau$ | — |
另外还有一条经常被单列出来的规则:注意力 logits 用 $1/d_{\text{head}}$ 而不是 $1/\sqrt{d_{\text{head}}}$ 缩放。原因和 output multiplier 一样——$q\cdot k$ 是 $d_{\text{head}}$ 项的和,而训练后 $q$ 和 $k$ 之间是相关的,所以是 $\Theta(d)$ 而不是 $\Theta(\sqrt d)$。
最小实现
import math, torch, torch.nn as nn

BASE_WIDTH = 256          # 你调超参的那个 proxy 模型的宽度

def classify(name, param):
    """按 muP 把参数分成 matrix-like / output / others"""
    if 'lm_head' in name or 'unembed' in name:
        return 'output'
    if param.ndim == 2 and 'embed' not in name:
        return 'matrix'   # W_q/W_k/W_v/W_o/W_1/W_2 ...
    return 'other'        # embedding, bias, RMSNorm gain

@torch.no_grad()
def mup_init(model, width, base_std=0.02):
    r = width / BASE_WIDTH
    for name, p in model.named_parameters():
        kind = classify(name, p)
        if kind == 'matrix':
            p.normal_(0.0, base_std / math.sqrt(r))    # 方差 sigma^2 / r
        elif kind == 'output':
            p.zero_()                                   # 常见做法:输出层零初始化
        else:
            p.normal_(0.0, base_std)                    # 方差不变

def mup_param_groups(model, width, base_lr):
    r = width / BASE_WIDTH
    groups = {'matrix': [], 'output': [], 'other': []}
    for name, p in model.named_parameters():
        groups[classify(name, p)].append(p)
    return [
        {'params': groups['matrix'], 'lr': base_lr / r},   # matrix-like: l / r
        {'params': groups['output'], 'lr': base_lr / r},   # 也按 1/r(output 是 matrix-like 的特例)
        {'params': groups['other'],  'lr': base_lr},       # embedding / bias / norm: 不变
    ]

# 前向里还要加上 output multiplier 与 1/d 注意力缩放
class MuReadout(nn.Linear):
    def __init__(self, d_model, vocab, width):
        super().__init__(d_model, vocab, bias=False)
        self.mult = BASE_WIDTH / width          # tau / r
    def forward(self, x):
        return super().forward(x) * self.mult

# attention: scores = q @ k.transpose(-1,-2) / d_head   (不是 sqrt(d_head))
muTransfer:这套东西怎么用
- 用 muP 参数化搭一个 proxy 模型(比如 width 256、几层、几亿 token)。
- 在 proxy 上随便扫学习率、warmup、初始化尺度、乘子——这是廉价的。
- 把最优超参原样搬到目标模型(width 8192),只按上表做机械的 $1/r$ 换算。
这套流程叫 muTransfer。Cerebras-GPT、MiniCPM、以及不少开源模型都公开采用了它。Yao et al. 2024 进一步验证了它在深度、batch size、训练时长上的(部分)可迁移性。
另一条路:直接给超参拟合缩放定律
muP 是「理论驱动」的做法。还有一条「纯经验」的路:把学习率和 batch size 本身当作缩放定律的因变量去拟合。DeepSeek LLM(2024)就是这么做的:他们在一系列算力预算 $C$ 上扫 $(\eta, B)$,找到每个预算下的最优组合,然后拟合
$$ \eta_{\text{opt}}\propto C^{-0.125},\qquad B_{\text{opt}}\propto C^{0.327} $$形式上完全合理:算力越大,模型越大、损失越低,于是(按第 6 节)$\mathcal{B}_{\text{crit}}$ 越大、可用 batch 越大;同时按 muP 学习率随宽度反比下降,而宽度 $\propto\sqrt N\propto C^{0.25}$,$\eta\propto 1/\text{width}\propto C^{-0.25}$——实测的 $-0.125$ 介于「完全不变」和「muP 预测」之间,因为 $B$ 同时在增大(大 batch 允许更大的 LR)。这两条路是互补的:muP 给你正确的函数形式,经验拟合给你正确的常数。
8. 联合缩放定律 L(N, D) 与算力最优分配
现在到本讲最重要的问题:给定算力预算,是训一个更大的模型,还是喂更多的数据?
为什么这是个真问题?因为「大量数据浪费在小模型上」是显然的——一个 10M 参数的模型看 10T token,后面 9.9T 都学不进去;反过来,一个 500B 参数的模型只看 10B token 也是浪费——它连一遍数据都没吃饱。中间必然存在一个最优比例。
联合形式:两个来源的误差
两篇奠基工作给出的形式:
Rosenfeld et al. 2020(《A Constructive Prediction of the Generalization Error Across Scales》):
$$ \text{Error}(n,m)= \frac{a}{n^{\alpha}}+\frac{b}{m^{\beta}}+ c_\infty $$其中 $n$ 是数据量、$m$ 是模型规模、$c_\infty$ 是不可约误差。三项的物理含义:
| 项 | 名字 | 含义 | 它变小的条件 |
|---|---|---|---|
| $c_\infty$ / $E$ | 不可约损失(irreducible loss) | 数据本身的熵——语言的真实不确定性 + 数据噪声 | 换更干净/更可预测的数据分布 |
| $b/m^\beta$ / $A/N^\alpha$ | 容量误差 / 近似误差 | 模型太小,装不下真实分布 | 加参数 |
| $a/n^\alpha$ / $B/D^\beta$ | 估计误差 / 优化误差 | 数据太少,参数没估准(也含优化未收敛) | 加数据 |
Kaplan et al. 2020 用了一个略有不同的形式(slides 上写作 $\text{Error}=m^{-\alpha}+n^{-1}{}^{\beta}$,是原式的简写):
$$ L(N,D)=\left[\left(\frac{N_c}{N}\right)^{\alpha_N/\alpha_D}+\frac{D_c}{D}\right]^{\alpha_D} $$这个形式的好处是它不含独立的不可约项(Kaplan 认为 $L\to 0$),并且在 $D\to\infty$ 时正好退化为 $L(N)$,在 $N\to\infty$ 时退化为 $L(D)$。这是它和 Chinchilla 的第一个实质分歧:Chinchilla 显式地保留了 $E$。
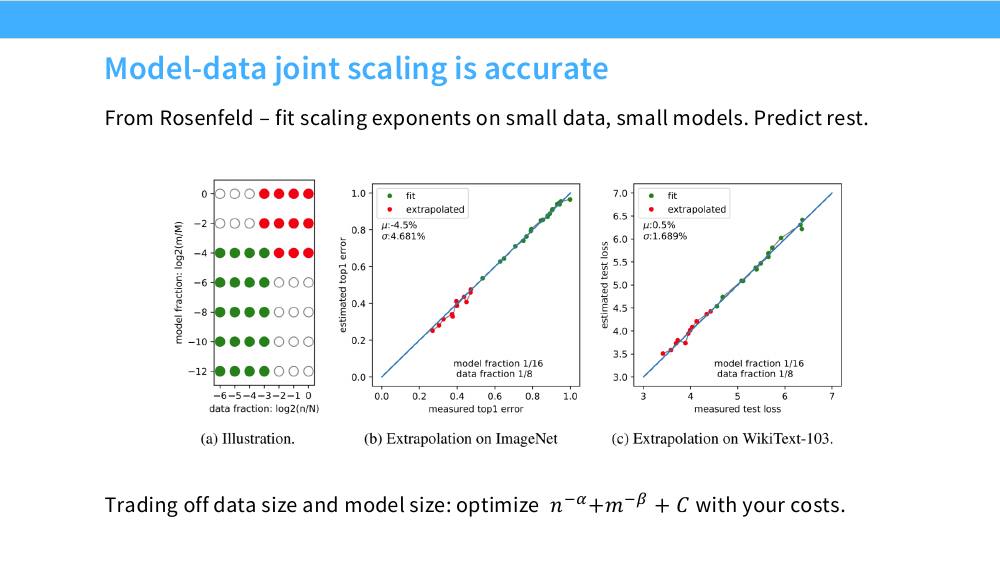
Kaplan 的答案与它的问题
有了 $L(N,D)$ 和算力约束 $C\approx 6ND$(第 3 讲的结论:前向 $2ND$ + 反向 $4ND$),就可以求解「给定 $C$,$N$ 和 $D$ 各取多少」。Kaplan 的答案是:
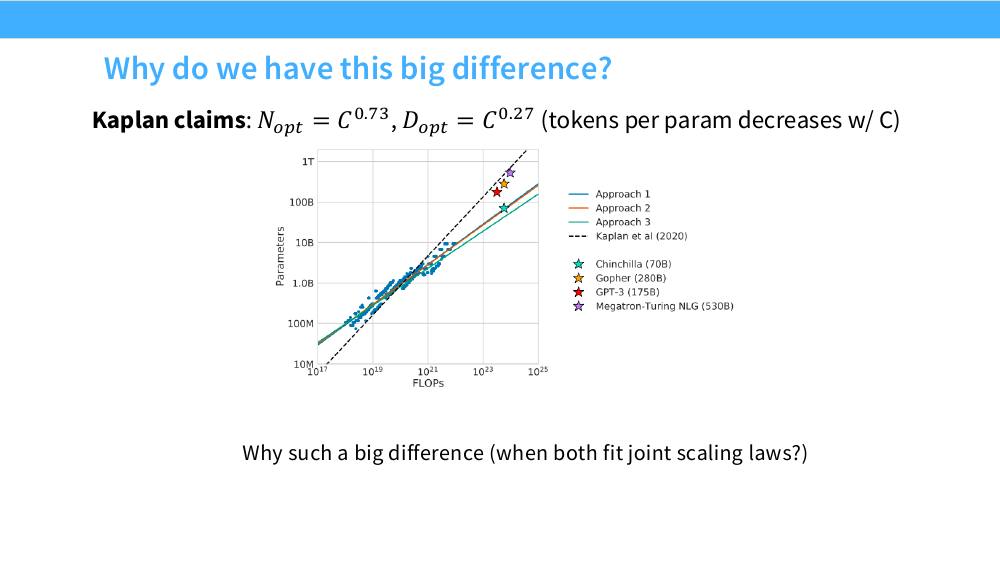
$$ N_{\text{opt}}\propto C^{0.73},\qquad D_{\text{opt}}\propto C^{0.27} $$这个结论的含义非常激进:tokens/param 的比值随算力增加而下降(因为 $D/N\propto C^{0.27-0.73}=C^{-0.46}$)。翻译成工程语言就是:算力增加时,绝大部分应该投给模型规模,数据只需要稍微跟着涨。
GPT-3(175B 参数,300B token,2 tokens/param)正是这个建议的产物;Gopher(280B / 300B token)、Megatron-Turing NLG(530B / 270B token)也是。整个 2020–2021 年的「参数竞赛」在方法论上由这条曲线背书。
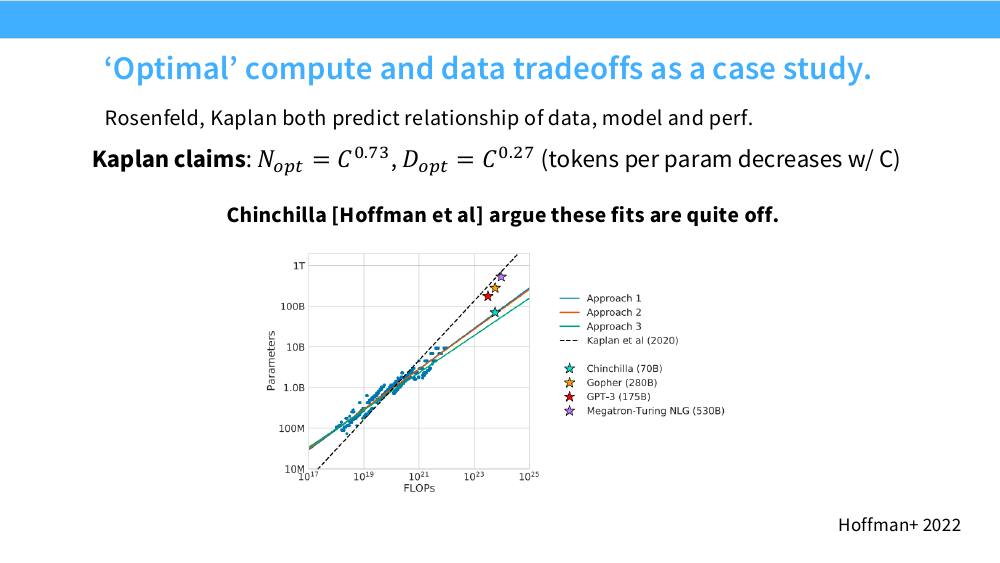
注意两条线在 $10^{21}$ FLOPs 附近相交:在 Kaplan 做实验的规模上两者差别不大,分歧完全是外推放大出来的。这是外推风险的教科书案例。
Kaplan 那套方法论的三个漏洞
为什么 Kaplan 会错?后面第 10 节会给出严谨的「数据取证」,这里先列出方法论层面的问题:
| 问题 | 具体表现 | 后果 |
|---|---|---|
| 学习率调度没有随训练长度调整 | 所有 run 用同一条为「长训练」设计的 cosine 曲线;训得短的 run 在 LR 还很高的时候就被截断评估 | 短训练(= 大模型少数据)被系统性高估,长训练(= 小模型多数据)被系统性低估 → 指数偏向大模型 |
| warmup 在小预算下太长 | 固定的 warmup 步数,对只跑几千步的小 run 是巨大的浪费 | 小模型/小预算的点被拉高,把拟合曲线整体扭转 |
| 参数计数口径不一致 | $N$ 用非嵌入参数,但算力用了包含 / 不包含最后一层的混合口径 | 在小模型区(嵌入占比大)造成系统性偏差 |
| batch size 未随预算调整 | 没有按 $\mathcal{B}_{\text{crit}}(L)$ 给每个预算配 batch | 不同规模的 run 处在帕累托前沿的不同位置,不可比 |
9. Chinchilla:三种方法与 tokens/param ≈ 20
Hoffmann et al. 2022 的贡献不只是换了个答案,而是提出了三种相互独立的方法论去回答同一个问题,并检查它们是否一致。这是缩放定律研究里最好的方法论示范,值得逐条拆开。
三种方法的核心改进是同一件事:对每个 run,把 cosine 学习率周期长度设成该 run 的实际训练步数,并且给每个规模单独调学习率。这一个改动就消掉了 Kaplan 的主要偏差来源。
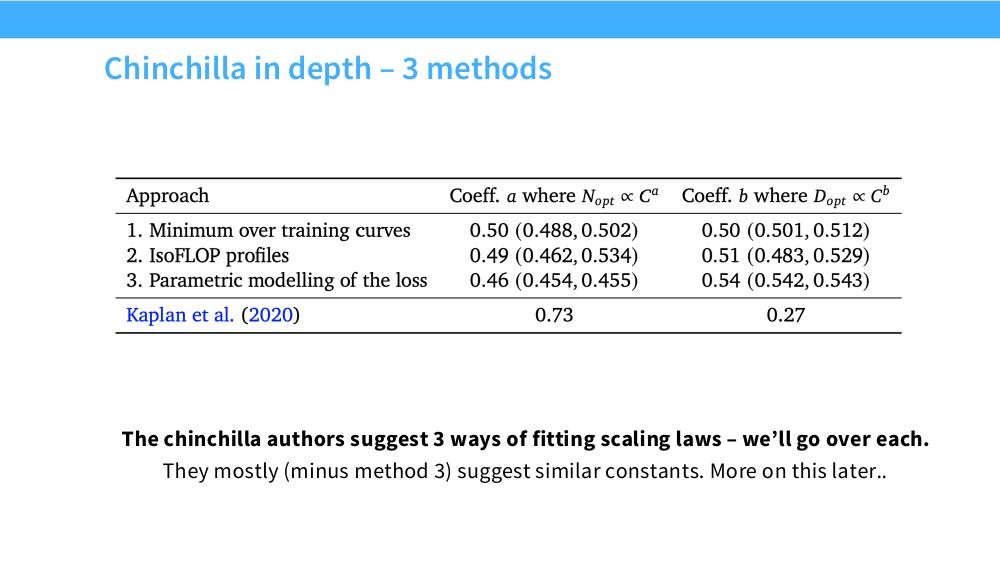
| 方法 | $a$($N_{\text{opt}}\propto C^a$) | $b$($D_{\text{opt}}\propto C^b$) | Gopher 预算下的预测 |
|---|---|---|---|
| 1. 训练曲线最小包络 | 0.50 (0.488, 0.502) | 0.50 (0.501, 0.512) | 67B 参数 / 1.5T tokens |
| 2. IsoFLOP 剖面 | 0.49 (0.462, 0.534) | 0.51 (0.483, 0.529) | 63B 参数 / 1.4T tokens |
| 3. 损失的参数化建模 | 0.46 (0.454, 0.455) | 0.54 (0.542, 0.543) | 40B 参数 / 2.4T tokens |
| Kaplan et al. (2020) | 0.73 | 0.27 | — |
Approach 1:固定模型、变数据,取训练曲线的下包络
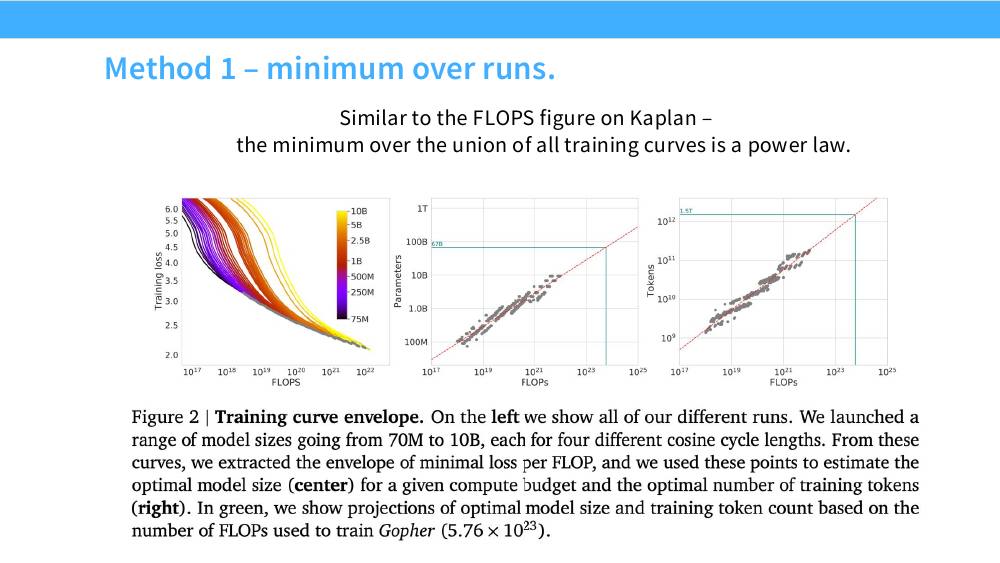
做法的本质:一条训练曲线上的每个点 $(C, L)$ 都对应「用 $N$ 参数训了 $D=C/(6N)$ 个 token」的结果。所有模型的所有时刻放在一起,构成 $(N,D)$ 平面上的一大片采样。下包络就是每个 $C$ 上的最优点。
为什么需要四种 cosine 周期长度:如果只用一条长 cosine,曲线中段的点(LR 还没退火完)会被系统性高估。用多条不同长度的周期、取下包络,就能保证每个 FLOPs 位置上至少有一个「LR 刚好退火完」的 run。这是对 Kaplan 最直接的修正。
Approach 2:IsoFLOP 剖面
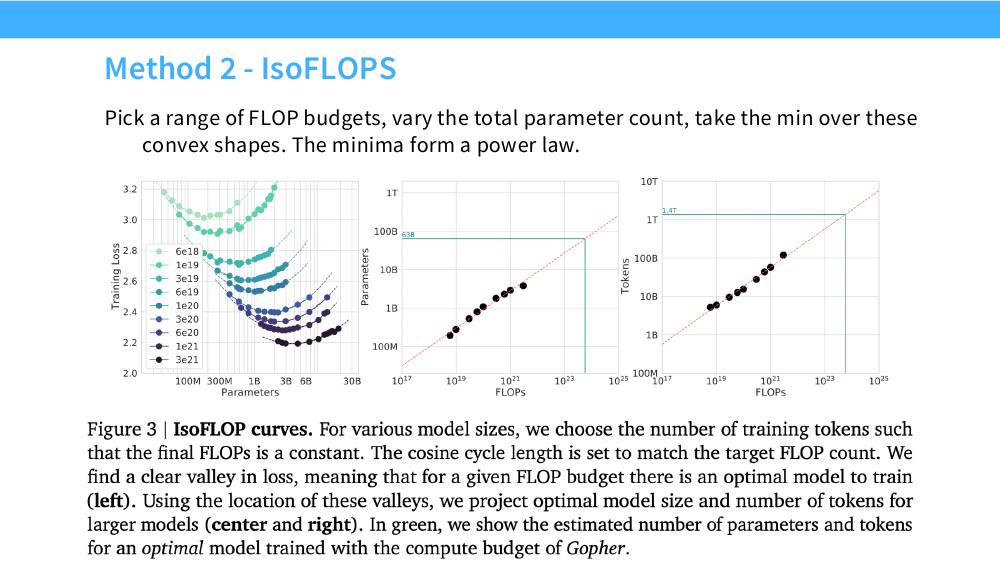
为什么 IsoFLOP 好用:
- 不需要任何函数形式假设——你只是在每条 IsoFLOP 线上找最小值。
- 抛物线(在 $\log N$ 下)拟合非常鲁棒,只要在谷底两侧各有 2–3 个点就够。
- 每个预算的实验彼此独立,可以并行、可以增量补点。
- 它天然给出「离最优点偏一点点的代价有多大」——谷底附近很平,意味着 $N$ 选错 2 倍只损失一点点损失,这在工程上是很重要的安慰。
Approach 3:参数化拟合 L(N, D)
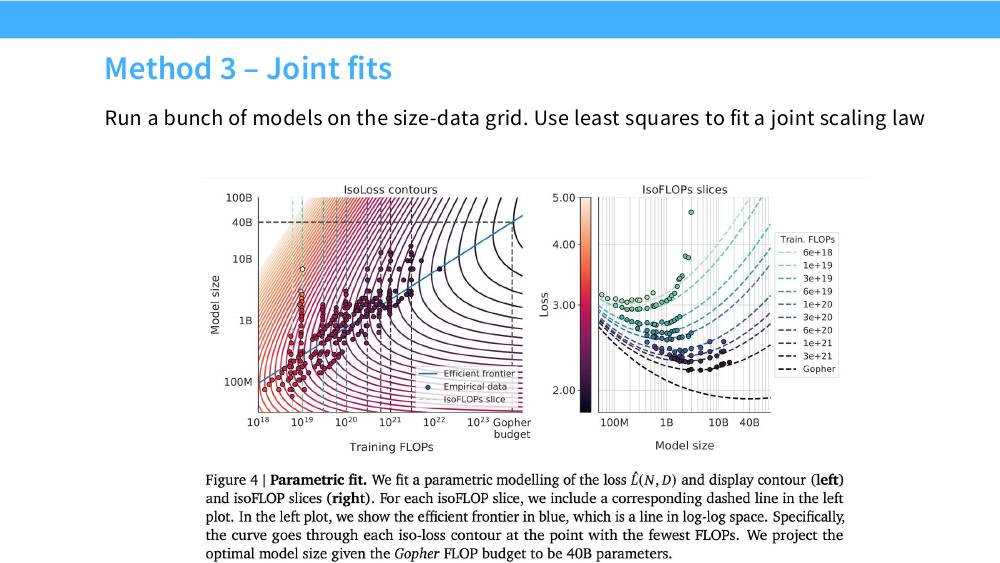
拟合细节(很多人复现时踩坑的地方):在对数空间用 Huber 损失($\delta=10^{-3}$)拟合,目标是
$$ \min_{a,b,e,\alpha,\beta}\ \sum_{i}\operatorname{Huber}_{\delta}\Big(\operatorname{LSE}\big(a-\alpha\log N_i,\ b-\beta\log D_i,\ e\big)-\log L_i\Big) $$其中 $A=e^{a}$、$B=e^{b}$、$E=e^{e}$,$\operatorname{LSE}$ 是 log-sum-exp(因为 $\log(E+A/N^\alpha+B/D^\beta)=\operatorname{LSE}(e,\ a-\alpha\log N,\ b-\beta\log D)$)。用 L-BFGS 从一个初始化网格出发多次求解取最优。Huber 损失是为了抗离群点(比如没收敛的 run)。
从 L(N, D) 推出算力最优分配:完整推导
这是本讲最重要的一段数学。有了参数化的 $L(N,D)$,「最优分配」就是一个约束优化问题。
问题:
$$ N^\ast(C),\,D^\ast(C)=\argmin_{N,\,D}\ \left\{E+\frac{A}{N^{\alpha}}+\frac{B}{D^{\beta}}\right\}\quad \text{s.t.}\quad C=6ND $$解法一:拉格朗日乘子。 构造
$$ \mathcal{L}(N,D,\lambda)=E+AN^{-\alpha}+BD^{-\beta}+\lambda\,(6ND-C) $$ $$ \frac{\partial\mathcal{L}}{\partial N}=-\alpha AN^{-\alpha-1}+6\lambda D=0 \qquad \frac{\partial\mathcal{L}}{\partial D}=-\beta BD^{-\beta-1}+6\lambda N=0 $$把第一式乘 $N$、第二式乘 $D$,两式的 $6\lambda ND$ 项相同,于是
$$ \boxed{\ \alpha\,\frac{A}{N^{\alpha}}=\beta\,\frac{B}{D^{\beta}}\ } $$这是一个漂亮的平衡条件:在最优点上,「模型容量误差」与「数据不足误差」按各自指数加权后正好相等。它的直觉是边际收益相等——多花一份算力在参数上和花在数据上,损失下降幅度必须一样,否则你应该把算力挪过去。
解法二:直接代入消元(更快得到指数)。令 $D=\frac{C}{6N}$:
$$ L(N)=E+AN^{-\alpha}+B\left(\frac{6N}{C}\right)^{\beta}=E+AN^{-\alpha}+B\,6^{\beta}C^{-\beta}N^{\beta} $$ $$ \frac{dL}{dN}=-\alpha AN^{-\alpha-1}+\beta B\,6^{\beta}C^{-\beta}N^{\beta-1}=0 $$ $$ \alpha A\,N^{-\alpha-1}=\beta B\,6^{\beta}C^{-\beta}N^{\beta-1} \ \Longrightarrow\ N^{\alpha+\beta}=\frac{\alpha A}{\beta B}\,6^{-\beta}C^{\beta} $$ $$ \boxed{\ N^\ast=\underbrace{\left(\frac{\alpha A}{\beta B}\right)^{\frac{1}{\alpha+\beta}}}_{\textstyle G}\left(\frac{C}{6}\right)^{\frac{\beta}{\alpha+\beta}} \qquad D^\ast=\frac{C}{6N^\ast}=G^{-1}\left(\frac{C}{6}\right)^{\frac{\alpha}{\alpha+\beta}}\ } $$所以
$$ a=\frac{\beta}{\alpha+\beta},\qquad b=\frac{\alpha}{\alpha+\beta},\qquad a+b=1 $$$a+b=1$ 是必然的——因为 $C=6ND$ 要求两个指数之和为 1。真正的自由度只有一个。
关键洞察:当且仅当 $\alpha=\beta$ 时 $a=b=0.5$。 也就是说,「模型和数据应该同速缩放」这个 Chinchilla 结论,等价于「参数轴和数据轴的幂律指数相同」。这不是巧合,也不是必然——它是一个经验事实。
代入真实数字:tokens/param ≈ 20 的来历
Chinchilla 原文的方法 3 拟合值是 $E=1.69$、$A=406.4$、$\alpha=0.34$、$B=410.7$、$\beta=0.28$,给出 $a=\frac{0.28}{0.62}=0.452$、$b=0.548$——这就是表里的 $(0.46, 0.54)$。
但(剧透第 10 节)这组拟合后来被证明有问题。Besiroglu et al. 2024 用数据取证恢复了原始数据并重新拟合,得到:
$$ L(N,D)=1.82+\frac{482}{N^{0.35}}+\frac{2085}{D^{0.37}} $$用这组更可靠的参数走一遍完整计算:
$\alpha=0.3478$,$\beta=0.3658$,$A=482.0$,$B=2085.4$,$E=1.82$。
步骤 1:指数。
$$ a=\frac{\beta}{\alpha+\beta}=\frac{0.3658}{0.7136}=0.513,\qquad b=\frac{\alpha}{\alpha+\beta}=0.487 $$非常接近 $0.5/0.5$,与方法 1、2 一致。
步骤 2:前置常数。
$$ G=\left(\frac{\alpha A}{\beta B}\right)^{\frac{1}{\alpha+\beta}}=\left(\frac{0.3478\times 482.0}{0.3658\times 2085.4}\right)^{1/0.7136}=\left(\frac{167.6}{762.7}\right)^{1.401}=0.2198^{1.401}=0.120 $$步骤 3:代入 Gopher 的算力预算 $C=5.76\times10^{23}$ FLOPs。
$$ \frac{C}{6}=9.6\times10^{22},\qquad N^\ast=0.120\times\left(9.6\times10^{22}\right)^{0.513}=0.120\times 6.04\times10^{11}=7.2\times10^{10} $$ $$ D^\ast=\frac{9.6\times10^{22}}{7.2\times10^{10}}=1.33\times10^{12} $$结果:72B 参数、1.33T tokens。 与实际的 Chinchilla 模型(70B / 1.4T)几乎完全吻合。
步骤 4:token 每参数比。
$$ \frac{D^\ast}{N^\ast}=\frac{1.33\times10^{12}}{7.2\times10^{10}}\approx 18.4\ \approx\ 20 $$而且因为 $b-a=0.487-0.513=-0.026\approx 0$,这个比值几乎不随算力变化:$D^\ast/N^\ast\propto C^{-0.026}$,算力涨 1000 倍这个比值只降 17%。这就是「20 tokens per parameter」这条经验法则的完整来历。
实用速查:给定算力,模型该多大
如果你接受 $D=20N$ 和 $C=6ND$,那么 $C=6N\cdot 20N=120N^2$,于是有一条极其好用的口算公式:
$$ \boxed{\ N^\ast=\sqrt{\frac{C}{120}},\qquad D^\ast=20N^\ast=\sqrt{\frac{C}{0.3}}\ } $$| 算力 $C$ (FLOPs) | $N^\ast$(参数) | $D^\ast$(tokens) | 参照物 |
|---|---|---|---|
| $10^{19}$ | 289 M | 5.8 B | 一台 8 卡 A100 机器跑一天多 |
| $10^{20}$ | 913 M | 18 B | — |
| $10^{21}$ | 2.9 B | 58 B | — |
| $10^{22}$ | 9.1 B | 183 B | — |
| $10^{23}$ | 29 B | 577 B | — |
| $5.76\times10^{23}$ | 69 B | 1.39 T | Chinchilla / Gopher 预算 |
| $3.1\times10^{24}$ | 161 B | 3.2 T | GPT-3 级别算力(若按最优分配) |
| $10^{25}$ | 289 B | 5.8 T | — |
| $2.3\times10^{25}$ | 438 B | 8.8 T | 本讲开头的 10000 张 B200 $\times$ 一个月 |
| $10^{26}$ | 913 B | 18 T | — |
对照一下现实:GPT-3 用了约 $3.1\times10^{24}$ FLOPs,最优配置应该是 161B / 3.2T,而它实际是 175B / 300B token——参数量大致对,但数据量少了 10 倍。这就是 Chinchilla 论文的核心指控。
最小实现:跑一次 IsoFLOP 分析
import numpy as np
from scipy.optimize import minimize

# ---------- 方法 2:IsoFLOP ----------
# runs[c] = [(N_1, L_1), (N_2, L_2), ...]  同一算力预算 c 下不同模型大小的最终损失
budgets = np.array([6e18, 1e19, 3e19, 6e19, 1e20, 3e20, 6e20, 1e21, 3e21])
N_star  = []
for c in budgets:
    N, L = np.array(runs[c]).T
    # 在 log N 空间拟合抛物线,顶点即最优模型大小
    c2, c1, c0 = np.polyfit(np.log(N), L, 2)
    assert c2 > 0, "不是凸的:采样范围没有跨过谷底"
    N_star.append(np.exp(-c1 / (2 * c2)))
N_star = np.array(N_star)
D_star = budgets / (6 * N_star)

a, logG = np.polyfit(np.log(budgets), np.log(N_star), 1)
b, _    = np.polyfit(np.log(budgets), np.log(D_star), 1)
print(f"N* ∝ C^{a:.3f},  D* ∝ C^{b:.3f},  a+b={a+b:.3f}")   # a+b 必须 ≈ 1,是自检

# ---------- 方法 3:参数化联合拟合 ----------
def huber(r, delta=1e-3):
    return np.where(np.abs(r) <= delta, 0.5*r**2, delta*(np.abs(r) - 0.5*delta))

def loss_fn(theta, logN, logD, logL):
    a_, b_, e_, alpha, beta = theta          # A=exp(a_), B=exp(b_), E=exp(e_)
    # log(E + A/N^alpha + B/D^beta) = logsumexp(e_, a_-alpha*logN, b_-beta*logD)
    stack = np.stack([np.full_like(logN, e_),
                      a_ - alpha * logN,
                      b_ - beta  * logD])
    pred = np.logaddexp.reduce(stack, axis=0)
    return huber(pred - logL).sum()

best = None
for a0 in [0, 5, 10, 15, 20, 25]:                 # 论文用初始化网格 + L-BFGS
    for b0 in [0, 5, 10, 15, 20, 25]:
        for e0 in [-1, -0.5, 0, 0.5, 1]:
            for al in [0.0, 0.5, 1.0, 1.5, 2.0]:
                for be in [0.0, 0.5, 1.0, 1.5, 2.0]:
                    r = minimize(loss_fn, [a0, b0, e0, al, be],
                                 args=(logN, logD, logL), method="L-BFGS-B")
                    if best is None or r.fun < best.fun:
                        best = r

a_, b_, e_, alpha, beta = best.x
A, B, E = np.exp(a_), np.exp(b_), np.exp(e_)
G   = (alpha * A / (beta * B)) ** (1.0 / (alpha + beta))
exp_a, exp_b = beta / (alpha + beta), alpha / (alpha + beta)
print(f"E={E:.3f} A={A:.1f} alpha={alpha:.3f} B={B:.1f} beta={beta:.3f}")
print(f"N* = {G:.4f} * (C/6)^{exp_a:.3f}   D* = {1/G:.4f} * (C/6)^{exp_b:.3f}")

def optimal(C):
    N = G * (C / 6) ** exp_a
    return N, C / (6 * N)
IsoFLOP 到处都能用
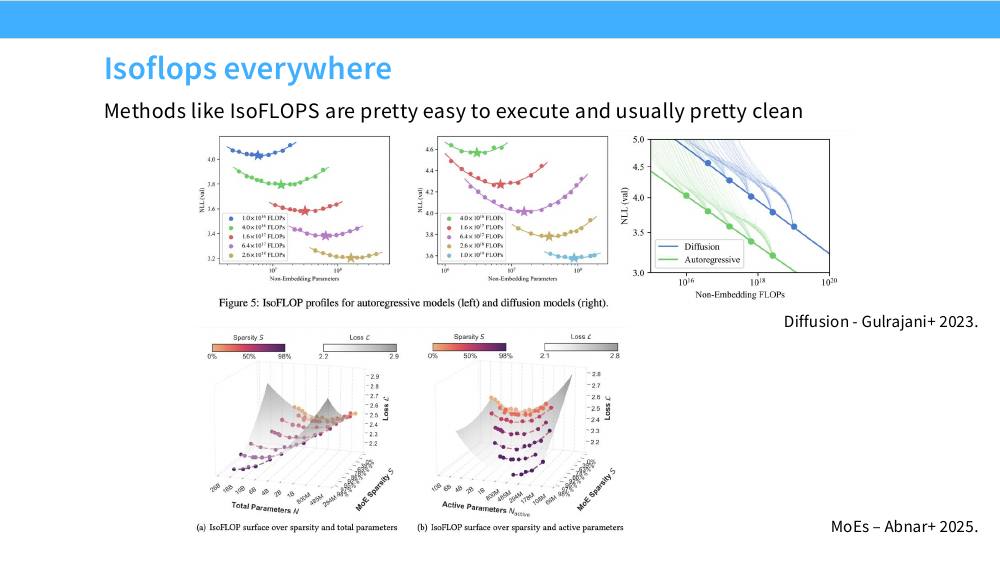
Tatsu 的评价:「IsoFLOPS 这类方法执行起来很容易,而且通常很干净」——如果你只学一个方法,学这个。
10. Kaplan 与 Chinchilla 的分歧从哪来
两篇论文都拟合了联合缩放定律,都用了大量实验,为什么一个得到 0.73、一个得到 0.50?这个问题在 2022–2024 年被三批人从不同角度回答了,答案本身就是一堂关于「实验科学怎么出错」的课。
解释一:训练配方的三个 bug(Porian et al. 2024)
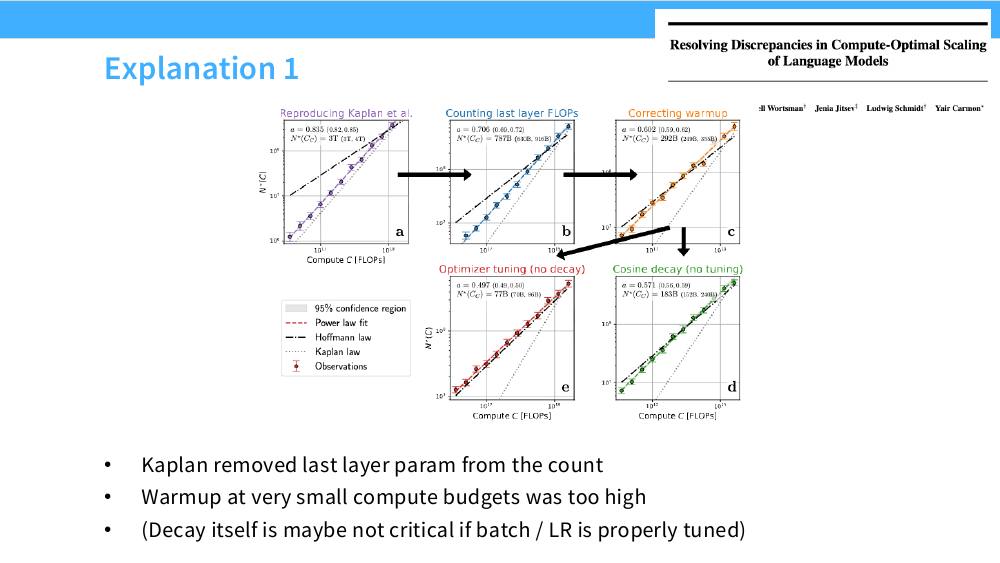
(a) 复现 Kaplan:$a=0.835$,外推到 Gopher 预算得 9T 参数(荒谬)
(b) 把最后一层的 FLOPs 计入:$a=0.706$ → 787B
(c) 修正 warmup(小预算下 warmup 太长):$a=0.602$ → 292B
(d) 加 cosine 衰减但不调优化器:$a=0.571$ → 185B
(e) 调优化器(LR + batch size),不用衰减:$a=0.497$ → 77B ✓
每张图里点划线是 Hoffmann 定律、点线是 Kaplan 定律、彩色点是实测。
Tatsu 在课上把它压缩成三条:
- Kaplan 把最后一层(unembedding)的参数从计数里去掉了,但相应的 FLOPs 处理不一致。
- 在非常小的算力预算下 warmup 太长——小 run 有相当比例的步数花在 warmup 上,损失被系统性拉高。
- 衰减(decay)本身可能不是关键——只要 batch size 和学习率被正确调过,即使不用 cosine 衰减也能得到 $a\approx 0.50$(面板 e)。
解释二:参数计数口径(Pearce & Song 2024)
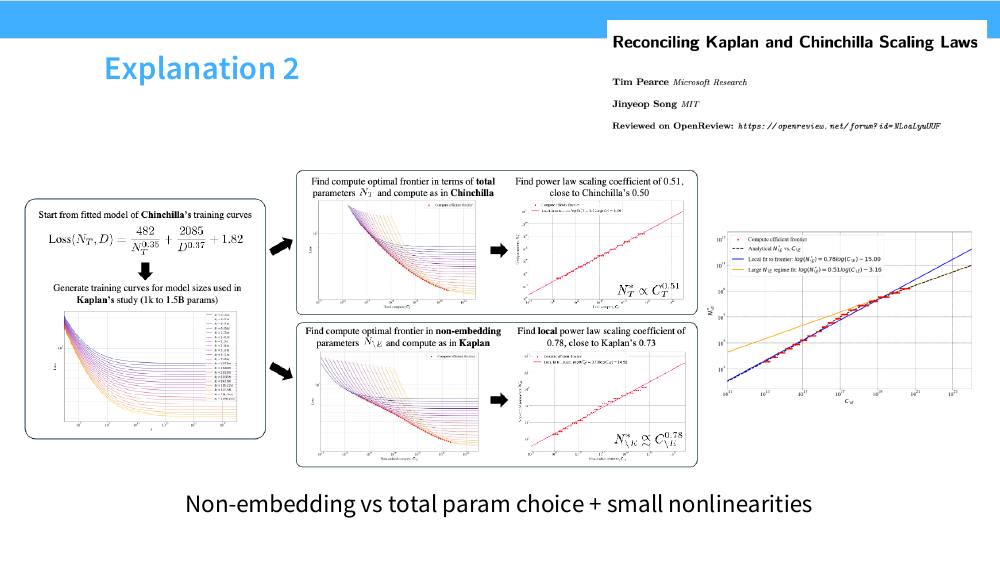
① 从 Chinchilla 的拟合出发:$\text{Loss}(N_T,D)=\frac{482}{N_T^{0.35}}+\frac{2085}{D^{0.37}}+1.82$;
② 用它生成 Kaplan 研究的那些模型规模(1k 到 1.5B 参数)的训练曲线;
③ 若用总参数量 $N_T$ 和 Chinchilla 的算力口径求最优前沿 → 得到 $N_T^\ast\propto C_T^{0.51}$(接近 Chinchilla 的 0.50);
④ 若用非嵌入参数量 $N_{\backslash E}$ 和 Kaplan 的算力口径求最优前沿 → 得到 $N_{\backslash E}^\ast\propto C_{\backslash E}^{0.78}$(接近 Kaplan 的 0.73)。
最右图揭示了机制:橙线是「局部拟合」,蓝线是「大 $N$ 渐近」——0.78 只是小模型区的局部斜率,渐近下来仍然回到 0.5。
为什么口径会造成这么大差别? 在 Kaplan 研究的规模上($10^3$–$1.5\times10^9$ 参数),嵌入层占总参数的比例极高。举例:$d_{\text{model}}=512$、词表 50k 的模型,嵌入表就有 $512\times 50000=25.6\text{M}$ 参数,而 6 层 Transformer 的非嵌入参数只有约 $6\times 12\times 512^2=18.9\text{M}$——嵌入占了 58%。到了 70B 规模,嵌入占比不到 1%。所以「用哪个 $N$」在小模型区是决定性的,而缩放定律恰恰是在小模型区拟合的。
Chinchilla 方法 3 本身就拟合错了(Besiroglu et al. 2024)
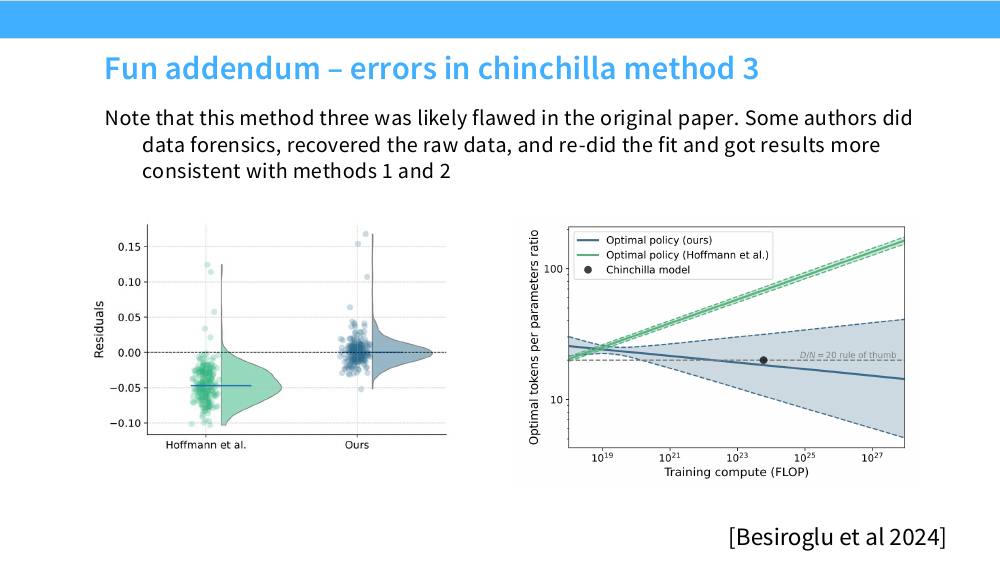
左:残差分布。Hoffmann 等人报告的参数产生的残差系统性地偏离 0(中位数约 $-0.05$),说明那组参数根本不是最小二乘解;重新拟合后残差以 0 为中心且方差更小。
右:最优 tokens/params 比值随算力的变化。绿线是按 Hoffmann 报告参数算出的策略(比值随算力上升,到 $10^{27}$ FLOPs 时超过 100);蓝线是重新拟合的策略(比值基本持平在 20 附近,与「$D/N=20$ 的经验法则」和方法 1、2 一致)。黑点是 Chinchilla 模型本身。
两个技术性的红旗,值得记住,因为你自己拟合时也会遇到:
- 置信区间窄得不合理:$a\in(0.454,0.455)$。在 $\sim$400 个带噪声的实验点上拟合 5 个参数,不可能得到宽度 0.001 的置信区间。这本身就说明不确定性估计的方法出了问题。
- 与自家方法 1、2 不一致:三种方法给出 67B / 63B / 40B。当三条独立路径中有一条明显跑偏时,最该怀疑的是那一条,而不是另外两条。Chinchilla 论文自己也主要采信了方法 1、2 的结论(实际训练的 70B / 1.4T 就是按方法 1、2 来的)。
Besiroglu 等人重新拟合的结果就是第 9.5 节用的那组:$E=1.82$、$A=482$、$\alpha=0.348$、$B=2085$、$\beta=0.366$。$\alpha\approx\beta$ 于是 $a\approx b\approx 0.5$,三种方法终于一致。
11. 训练最优 ≠ 部署最优:为什么要「过训练」
Chinchilla 回答的问题是:给定训练算力,什么模型的损失最低? 但这不是你在真实世界里想要的问题。真实世界里,一个成功模型的绝大部分算力花在推理上,不是训练上。
把总算力写成训练加推理:
$$ C_{\text{total}}=\underbrace{6ND_{\text{train}}}_{\text{训练}}+\underbrace{2N\,D_{\text{inf}}}_{\text{推理}} $$(推理只有前向,每 token 每参数约 2 FLOPs;$D_{\text{inf}}$ 是模型一生要处理的 token 总数。)
现在的问题变成:在达到给定损失 $L^\ast$ 的所有 $(N,D_{\text{train}})$ 组合中,选使 $C_{\text{total}}$ 最小的那个。
注意 $N$ 同时出现在两项里,而且推理项对 $N$ 是线性的、且乘了一个可能非常大的 $D_{\text{inf}}$。所以最优解会把 $N$ 压小、把 $D_{\text{train}}$ 拉大——用更长的训练去换更小的模型。
粗略地看:如果你预期服务 $D_{\text{inf}}=10^{13}$ token(一个热门 API 一年的量级),推理项 $2N\times10^{13}=2\times10^{13}N$,而 Chinchilla 最优的训练项是 $6N\times 20N=120N^2$。当 $N<1.7\times10^{11}$ 时推理项就超过训练项了。对绝大多数实际部署的模型,推理算力是大头。
Sardana & Frankle 2023《Beyond Chinchilla-Optimal》和 Gadre et al. 2024《Language models scale reliably with over-training and on downstream tasks》把这个思路做成了完整的理论与实证。行业的实际演进也非常清楚:
| 模型 | 参数量 | 训练 tokens | tokens / param | 年份 |
|---|---|---|---|---|
| GPT-3 | 175 B | 300 B | 2 | 2020 |
| Chinchilla | 70 B | 1.4 T | 20 | 2022 |
| LLaMA-65B | 65 B | 1.4 T | 22 | 2023 |
| Llama 2 70B | 70 B | 2 T | 29 | 2023 |
| Mistral 7B | 7 B | ~ 8 T | 110 | 2023 |
| Llama 3 70B | 70 B | 15 T | 215 | 2024 |
趋势一目了然:从 2 一路涨到 215,超出 Chinchilla 最优 10 倍以上。而且注意小模型涨得比大模型更狠(Mistral 7B 的 110 vs Llama 3 70B 的 215 其实都很高,但 7B 的模型明显是为了「便宜地服务大量请求」而设计的)。
反过来说:如果你训的是一个只用来发论文、不打算服务的模型,那就应该老老实实按 Chinchilla 来。
还有几个 Chinchilla 没有覆盖、但在过训练场景下变得关键的因素:
- 数据够不够:215 tokens/param 意味着 70B 模型需要 15T token。这已经接近高质量英文网页的天花板,于是又回到第 4 节的数据重复问题。
- 下游能力而非损失:Gadre et al. 2024 的贡献之一就是把缩放定律从「验证损失」延伸到「下游任务平均准确率」,并证明后者可以由前者以一个指数关系预测。
- 蒸馏与量化:如果最终要蒸馏成小模型或量化到 4 bit,「什么规模最优」的账要重算。
12. 缩放定律的边界:下游任务、涌现与失效情形
下游任务的缩放要难预测得多
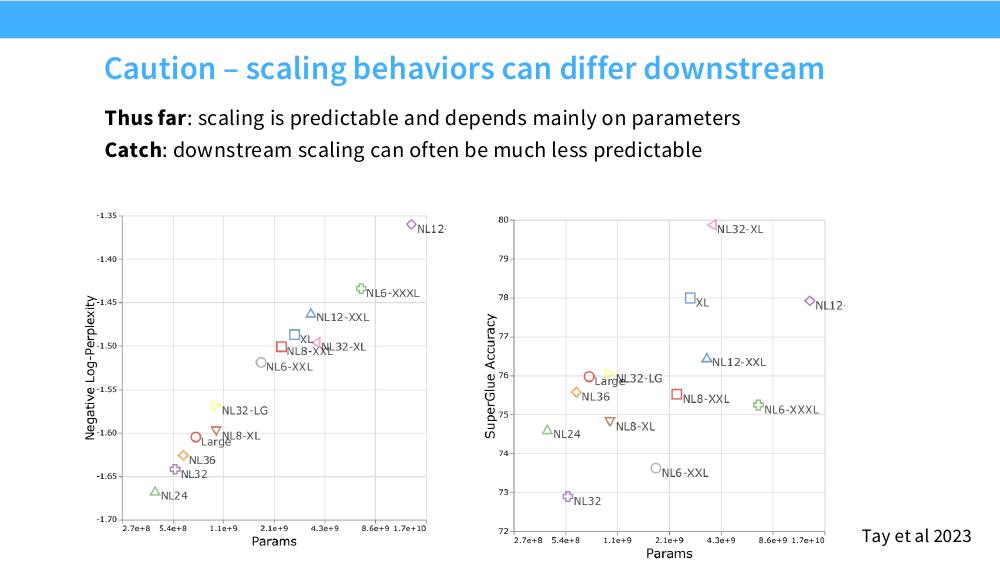
结论:上游损失可预测,不代表下游能力可预测。
这是缩放定律最实际的一个局限。你的缩放实验优化的是验证损失,但你真正想要的是「数学能力」「代码能力」「指令跟随」。这两者之间的映射既不单调也不稳定:
- 形状敏感性不同:损失对深宽比几乎不敏感(第 5.4 节),但下游任务对深度明显更敏感——更深的模型在需要多步推理的任务上更好,即使困惑度相同。
- 数据配比的作用不同:加代码数据可能让通用困惑度轻微变差,但显著提升推理类下游任务。
- 评测指标的离散性:见下一小节。
涌现(emergence):真的涌现,还是指标的产物?
Wei et al. 2022《Emergent Abilities of Large Language Models》提出:某些能力(多位数算术、多步推理、指令跟随)在小模型上是随机水平,越过某个规模阈值后突然出现,而且这种跳变无法从小模型外推。如果这是真的,缩放定律的整个范式就有一个致命缺口——你没法预测最重要的那些能力。
Schaeffer, Miranda & Koyejo 2023《Are Emergent Abilities of Large Language Models a Mirage?》给出了强有力的反驳,论证分三步:
- 底层量是平滑的:模型对正确答案的 per-token 对数似然随规模平滑上升,符合幂律。
- 指标是离散/非线性的:「精确匹配(exact match)」要求 $k$ 个 token 全对,概率约为 $p^k$。当 $p$ 从 0.9 平滑升到 0.99、$k=5$ 时,$p^k$ 从 0.59 升到 0.95——一个平滑的底层改进被 $k$ 次方放大成看起来陡峭的跳变。多选题的 0/1 打分同理,它是一个阈值函数。
- 换连续指标,跳变就消失:把 exact match 换成 token 编辑距离、把 accuracy 换成 Brier score 或对数似然,同一批模型的同一批任务上曲线就变得平滑可预测。他们甚至反过来人为制造了视觉模型上的「涌现」——只要选一个足够苛刻的非线性指标。
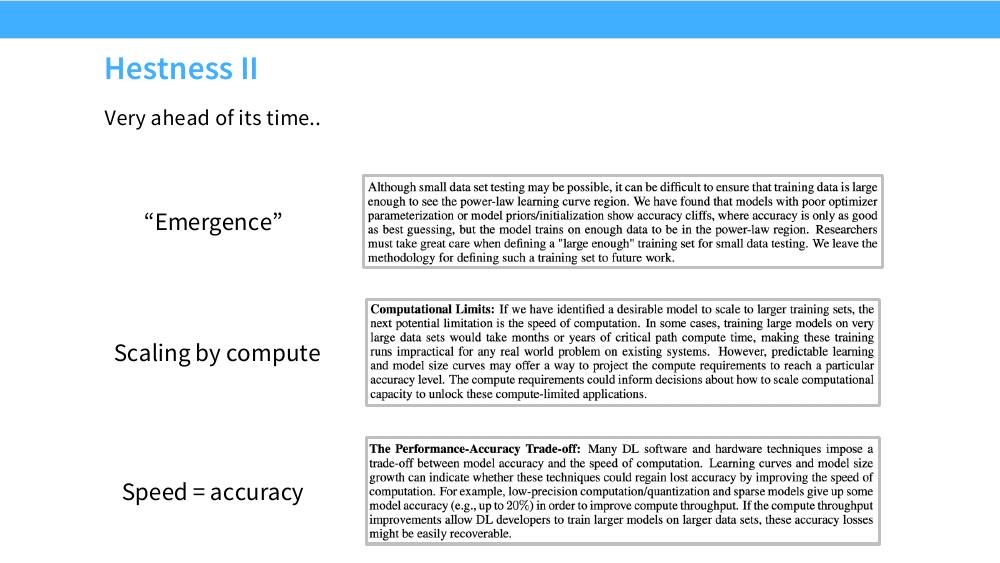
回头看第 2 节 Hestness 2017 那段引文:「优化器参数化或初始化不好的模型会出现准确率悬崖,模型只比瞎猜好一点,直到训练数据足够多才进入幂律区」——这正是同一现象的另一种表述:你观测到的悬崖可能只是因为你在三区间图的「小数据区」采样。
那么争论怎么收场? 目前的共识大致是:
| 立场 | 成立的部分 | 不成立的部分 |
|---|---|---|
| 「涌现是真的」 | 从产品和用户角度看,能力确实是突然可用的;阈值效应本身有真实后果(安全评估必须在目标规模上做) | 底层能力并非不连续,「无法预测」是过强的说法 |
| 「涌现是幻觉」 | 大多数 BIG-Bench 上的「涌现」曲线在换成连续指标后确实变平滑 | 不是所有能力都能这样解释;某些能力(如上下文学习)的机制性跳变仍有争议 |
工程上的实用结论:做缩放实验时,永远同时记录一个连续的代理指标(正确答案的对数似然、Brier score、编辑距离),不要只记录 accuracy。GPT-4 技术报告里能用少 1000 倍算力的小模型准确预测 HumanEval 通过率,靠的就是这类平滑代理量。回看第 0 节那张图的下排:把下游准确率对 $\log$ FLOPs 做 sigmoid 拟合,测试 MSE 只有 $10^{-3}$ 量级——sigmoid 正是「平滑底层量 + 阈值指标」的自然函数形式。
缩放定律失效或需要修正的完整清单
| # | 失效情形 | 症状 | 怎么办 |
|---|---|---|---|
| 1 | 超参没随规模调 | 拟合出的指数系统性偏离(Kaplan 的 0.73) | 用 muP,或对每个规模单独调 LR / batch / warmup |
| 2 | 采样点落在「小数据区」 | 曲线在 log-log 下不是直线,或斜率随窗口漂移 | 确认每个 run 的损失已进入幂律段;剔除最小的那几个点重拟合看指数是否稳定 |
| 3 | 参数计数口径不一致 | 换个口径指数变化很大(0.51 vs 0.78) | 明确声明用总参数还是非嵌入参数,且算力口径与之匹配;MoE 要分总参数 / 激活参数 |
| 4 | 数据有限、被迫重复 | 实测损失高于缩放定律预测,且随 epoch 数恶化 | 用有效数据 $D'$ 修正;$\le$ 4 epoch 基本安全,$\ge$ 40 epoch 无意义 |
| 5 | 盲目外推到极端配置 | 128 epoch 时损失回到 1 epoch 水平 | 缩放定律只在拟合区间的邻域内可信;外推超过 2 个数量级要谨慎 |
| 6 | 配方本身可以更好 | 换正则化 / 集成后整条曲线下移 | 把缩放定律当下界,不要当上限;比较不同配方时要各自拟合曲线 |
| 7 | 下游指标与上游损失脱钩 | 困惑度排名 $\neq$ SuperGLUE 排名 | 缩放实验里直接测下游代理指标;用连续指标而非 accuracy |
| 8 | 架构排名在小规模不稳定 | 小模型上赢的架构大模型上输 | 比斜率不比截距;至少覆盖 3 个数量级 |
| 9 | 训练分布 $\neq$ 评测分布 | 不同数据配比的曲线平行但截距不同 | 配比只改截距 → 可在小规模选配比;但要在目标评测分布上测 |
| 10 | 拟合本身的统计问题 | 置信区间不合理地窄;残差不以 0 为中心 | 检查残差分布;多初始化点求解;bootstrap 估计置信区间;用 $a+b=1$ 自检 |
| 11 | 目标是部署而非训练最优 | 按 Chinchilla 训出的模型推理太贵 | 加入推理项 $2ND_{\text{inf}}$ 重新优化;过训练 |
实操:怎么真的跑一组缩放实验
把全讲的内容凝聚成一份可执行的清单(假设你要为一次 $10^{25}$ FLOPs 的大训练做准备):
- 先定架构族与配方。缩放定律是对一个配方的描述,中途换配方等于换了一条定律。把 tokenizer、数据配比、优化器、norm 位置全部冻结。
- 用 muP 参数化,在最小规模(比如 width 256)上把 LR、warmup 比例、初始化尺度扫一遍。这一步的成本不到总预算的 0.1%。
- 设计算力阶梯:取 6–8 个预算,等比分布,跨 2–3 个数量级(例如 $3\times10^{17}$ 到 $10^{20}$)。总开销控制在正式训练的 1%–3%。
- 每个预算跑 5–7 个模型大小,围绕预期最优点上下各 4 倍。token 数按 $D=C/(6N)$ 定,cosine 周期设成该 run 的实际步数,batch size 按 $\mathcal{B}_{\text{crit}}(L)$ 或按 $C^{0.33}$ 经验律定。
- 拟合:对每个预算在 $\log N$ 空间拟抛物线取顶点 → $(C,N^\ast)$;对 $\log N^\ast$ vs $\log C$ 做线性回归得 $a$。自检 $a+b=1$。
- 交叉验证:用同一批数据再做一次参数化拟合(方法 3),看两者的 $a$ 是否在置信区间内重合。不重合就说明有系统误差。
- 留一验证外推:把最大的那个预算的数据去掉,用剩下的拟合,然后预测被去掉的那个点。这是对「外推能力」的直接检验——如果外推 1 个数量级误差就有 3%,那外推 3 个数量级你心里要有数。
- 外推并留余量:得到 $N^\ast(10^{25})$ 后,因为谷底很平,可以为了硬件效率(张量并行切分、$d_{\text{model}}$ 对齐 128)在 $\pm 30\%$ 内自由调整。
- 决定过训练系数:根据预期推理量,在 $N^\ast$ 基础上缩小模型、放大 token(第 11 节)。
实用的经验法则:外推 1–2 个数量级,损失预测误差在几个百分点内;外推 3 个数量级以上,指数的不确定性会主导一切,务必用多种方法交叉验证并留出安全余量。
本讲小结
一页速查
| 公式 | 内容 | 用途 |
|---|---|---|
| $L(N)=(N_c/N)^{\alpha_N}$ | $\alpha_N\approx0.076$,$N_c\approx 8.8\times10^{13}$ | 数据充足时,参数量 → 损失 |
| $L(D)=(D_c/D)^{\alpha_D}$ | $\alpha_D\approx0.095$,$D_c\approx5.4\times10^{13}$ | 模型充足时,token 数 → 损失 |
| $L(C_{\min})=(C_c/C_{\min})^{\alpha_C}$ | $\alpha_C\approx0.050$ | 沿最优配置的算力 → 损失 |
| $L(N,D)=E+\frac{A}{N^\alpha}+\frac{B}{D^\beta}$ | $E{=}1.82$, $A{=}482$, $\alpha{=}0.35$, $B{=}2085$, $\beta{=}0.37$(Besiroglu 重拟合) | 联合建模,可解约束优化 |
| $\alpha\frac{A}{N^\alpha}=\beta\frac{B}{D^\beta}$ | 最优点的平衡条件 | 验证一个配置是否算力最优 |
| $a=\frac{\beta}{\alpha+\beta},\ b=\frac{\alpha}{\alpha+\beta}$ | $N^\ast\propto C^a$,$D^\ast\propto C^b$,$a+b=1$ | 指数的解析解;$\alpha=\beta\Rightarrow a=b=0.5$ |
| $N^\ast=\sqrt{C/120}$,$D^\ast=20N^\ast$ | tokens/param $=20$ 时的口算式 | 给定算力秒算模型大小 |
| $\mathcal{B}_{\text{crit}}=E_{\min}/S_{\min}$ | $\approx 2.1\times10^8\,\text{tokens}\cdot L^{-4.8}$ | batch size 上限 / 数据并行度上限 |
| $S=S_{\min}(1+\frac{\mathcal{B}}{B})$,$E=E_{\min}(1+\frac{B}{\mathcal{B}})$ | $B=\mathcal{B}_{\text{crit}}$ 时两者都是 2 倍 | 在「省时间」和「省数据」间取舍 |
| muP:$\eta\to\eta/r$(matrix-like) | 初始化方差 $\to\sigma/r$,输出乘子 $\to\tau/r$ | 最优 LR 跨宽度迁移 |
| $D'=U_D+U_DR_D^*(1-e^{-R_D/R_D^*})$ | $R_D^*\approx 15$,有效数据上限 $\approx 16U_D$ | 数据受限时修正缩放定律 |
| $C_{\text{total}}=6ND_{\text{train}}+2ND_{\text{inf}}$ | 把推理算力计入 | 决定过训练系数 |
要点清单
- 缩放定律是把「不可比的单点对比」变成「可外推的曲线对比」的工具。看斜率,不要只看截距。
- 幂律的理论根源是多项式收敛速率;指数之所以只有 0.1 量级,是因为神经网络是非参数估计器,速率依赖数据的(有效)维度。理论解释得了形式,解释不了具体数值。
- 数据组成只改截距不改斜率——这是「小规模选数据配方」的依据;但实证上「直接选小规模最好的数据集」和复杂的 data mixing law 效果差不多。
- 模型形状(深宽比、头数、FFN 比例)在固定 $N$ 时几乎不影响损失;1% 损失 $\approx$ 22% 算力是好用的换算尺。
- critical batch size 是损失的函数,不是模型大小的函数。这解释了 batch size ramp,也给出了数据并行度的物理上限。
- muP 让最优学习率跨宽度不变:matrix-like 权重的 LR 与初始化方差都按 $1/r$ 缩放,embedding / bias / norm 不变,输出层加 $1/r$ 乘子。
- Chinchilla 的三种方法(包络 / IsoFLOP / 参数化拟合)互为交叉验证,共同结论是 $N^\ast\propto C^{0.5}$、$D^\ast\propto C^{0.5}$、tokens/param $\approx 20$。IsoFLOP 是最值得学的一个。
- Kaplan 的 $C^{0.73}$ 源于超参未随规模调整(LR、batch、warmup)与参数计数口径;Chinchilla 自己的方法 3 也拟合错了,重拟合后才与方法 1、2 一致。
- 缩放定律是下界,会因盲目外推而坏掉,而且优化的是训练而非部署——所以现代模型普遍过训练到 100–200 tokens/param。
- 「涌现」在很大程度上是离散指标作用在平滑底层量上的产物;做缩放实验时永远同时记录连续代理指标。
附录:延伸阅读
核心必读
- Scaling Laws for Neural Language Models (Kaplan et al., 2020) — 本讲的三条基础幂律、深宽比、LSTM 对比、critical batch size 全部出自这里。即使结论被 Chinchilla 修正,方法论部分仍然是必读。
- Training Compute-Optimal Large Language Models (Hoffmann et al., 2022) — Chinchilla。三种方法论的原始出处;重点读 Section 3 与附录里对学习率调度的讨论。
- Deep Learning Scaling is Predictable, Empirically (Hestness et al., 2017) — 神经缩放定律的真正开创者,三区间图与「准确率悬崖」的预言都在这里。
- An Empirical Model of Large-Batch Training (McCandlish et al., 2018) — critical batch size 与梯度噪声尺度的完整推导。
- Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer (Yang et al., 2022) — muP / muTransfer 的原始论文。理论较重,可先看图和表 3。
Kaplan vs Chinchilla 公案
- Chinchilla Scaling: A Replication Attempt (Besiroglu et al., 2024) — 数据取证 + 重新拟合,证明 Chinchilla 方法 3 的参数不是最小二乘解。做缩放定律拟合前应该读,能避开一堆统计坑。
- Resolving Discrepancies in Compute-Optimal Scaling of Language Models (Porian et al., 2024) — 一步一步的 bug 修复链,从 0.835 走到 0.497。实验设计的教科书。
- Reconciling Kaplan and Chinchilla Scaling Laws (Pearce & Song, 2024) — 用纯计算证明「非嵌入参数口径 + 小模型区」就能重现 Kaplan 的 0.78。
数据侧缩放定律
- Scaling Data-Constrained Language Models (Muennighoff et al., 2023) — 数据重复的有效数据公式;「4 个 epoch 几乎免费、40 个 epoch 一文不值」的来源。
- Scaling Laws for Data Filtering: Data Curation cannot be Compute Agnostic (Goyal et al., 2024) — 筛选强度必须随算力自适应。
- Data Mixing Laws: Optimizing Data Mixtures by Predicting Language Modeling Performance (Ye et al., 2024) — 用三级缩放定律外推未见过的数据配比。
- DataDecide: How to Predict Best Pretraining Data with Small Experiments (Magnusson et al., 2025) — 大规模实证:小规模直接排序已经能达到约 80% 决策准确率,复杂拟合未必更好。
- Explaining Neural Scaling Laws (Bahri et al., 2021) — 方差受限 / 分辨率受限两种机制,以及指数与内在维度的联系。理论向。
- Model Performance Scaling with Multiple Data Sources (Hashimoto, 2021) — 「配比只改截距不改斜率」的原始工作。
- Pre-training under infinite compute (Kim, Kotha, Liang & Hashimoto, 2025) — 数据固定、算力无限时缩放定律怎么坏掉,以及正则化/集成如何把渐近损失整体压低。
联合缩放与架构比较
- A Constructive Prediction of the Generalization Error Across Scales (Rosenfeld et al., 2020) — 三项式 $a/n^\alpha+b/m^\beta+c_\infty$ 与外推验证实验。
- Scaling Laws vs Model Architectures (Tay et al., 2022) — 十余种架构的缩放曲线;「小规模排名不可靠」的最佳证据。
- Parameters vs FLOPs: Scaling Laws for Optimal Sparsity for MoE Language Models (Abnar et al., 2025) — MoE 下总参数 / 激活参数的二维 IsoFLOP。
- DeepSeek LLM: Scaling Open-Source Language Models with Longtermism (2024) — 工业界完整的缩放定律实践:非嵌入 FLOPs 口径的 IsoFLOP,外加学习率与 batch size 自身的缩放律。
过训练、下游与涌现
- Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws (Sardana & Frankle, 2023) — 把推理算力写进目标函数后最优点怎么移动。
- Language Models Scale Reliably With Over-Training and on Downstream Tasks (Gadre et al., 2024) — 外推 300 倍算力,并把损失映射到下游平均准确率。
- Emergent Abilities of Large Language Models (Wei et al., 2022) — 「涌现」一词的出处。
- Are Emergent Abilities of Large Language Models a Mirage? (Schaeffer et al., 2023) — 强有力的反驳:涌现主要是离散指标的产物。两篇对照读效果最好。
- Likelihood-Based Diffusion Language Models (Gulrajani & Hashimoto, 2023) — IsoFLOP 方法在扩散语言模型上的应用。