并行化(下):模型并行与组合策略
当模型再也塞不进一张卡:沿深度、宽度、序列、专家四个轴把 Transformer 切开,再把它们组合成能在上万张 GPU 上跑出 40% MFU 的 3D/4D 并行。
0. 本讲导读
上一讲我们把「多机训练」这件事拆成了两半:一半是网络(集合通信原语、节点内 NVLink 域与节点间 InfiniBand 的带宽差异、为什么 all-reduce 的带宽下界就是 reduce-scatter + all-gather),另一半是数据并行(Data Parallelism, DP)——朴素 DDP 以及 ZeRO 的三个 stage。那一讲的结论可以浓缩成三行:
| 方案 | 每步通信量 | 每 GPU 显存(BF16 训练,12 B/param,8 卡) | 能装下的最大模型(8×A100-80G) |
|---|---|---|---|
| 朴素 DDP | $2N_{\text{param}}$(一次 all-reduce) | 12 B/param | 6.7 B |
| ZeRO-1(切优化器状态) | $2N_{\text{param}}$(RS + AG) | $2+2+8/8 = 5$ B/param | 16 B |
| ZeRO-2(再切梯度) | $2N_{\text{param}}$ | $2 + 10/8 = 3.25$ B/param | 24.6 B |
| ZeRO-3 / FSDP(全切) | $3N_{\text{param}}$(2 AG + 1 RS) | $12/8 = 1.5$ B/param | 53.3 B |
关键观察是:ZeRO-1 和 ZeRO-2 在带宽受限的意义下是「免费」的(通信量和 DDP 一样都是 $2N$),ZeRO-3 只贵 1.5 倍。所以 Tatsu 的判断是「ZeRO-1 你基本上应该永远打开」。
但数据并行有两堵墙推不动:
- 算力扩展的墙:DP 的并行度不能超过全局批大小(每张卡至少要分到一条样本),而批大小又受临界批大小(critical batch size)约束——批太大,每个 token 带来的优化收益递减,等于白烧算力。
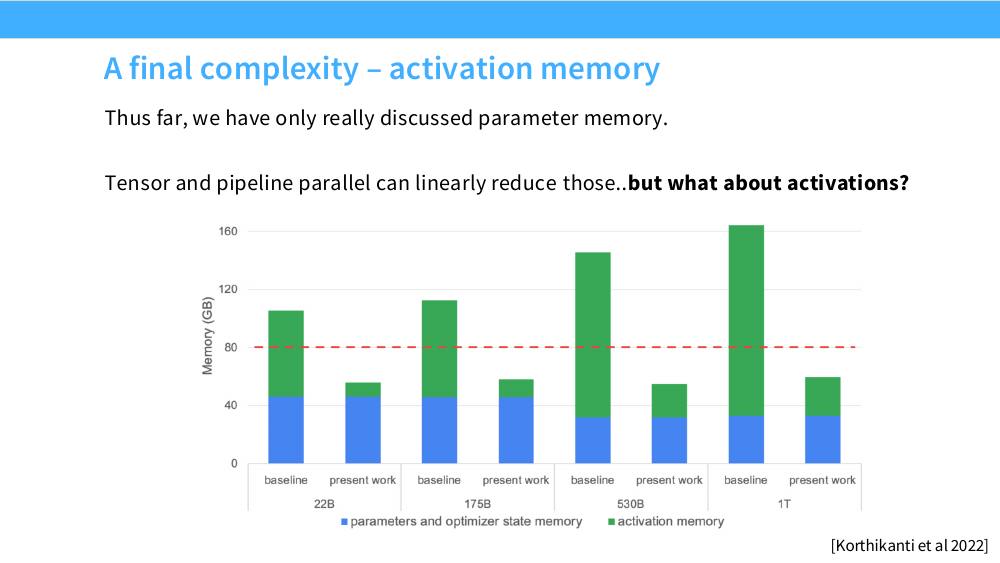
- 显存的墙:ZeRO-1/2 根本不缩参数显存;ZeRO-3 缩了参数,但完全不缩激活显存。而我们马上会看到,激活显存在大模型上比参数显存还大。
本讲要回答的问题只有一个:怎么把模型本身切开?切完之后又怎么和数据并行拼在一起,映射到「节点内 8 卡 NVLink、节点间 IB」这样的真实拓扑上。这一讲是整门课里「系统」味道最重的一讲,也是把前几讲的 FLOPs / 显存账真正落到硬件上的一讲。下一讲我们会转向另一个问题:给定这么多算力,模型该做多大、数据该喂多少——缩放定律。
- 模型并行的本质是:切参数、传激活(而 ZeRO-3 是切参数、传参数)。Transformer 可以沿四个轴切:深度(流水线并行 PP)、宽度(张量并行 TP)、序列(序列并行 SP / 上下文并行 CP)、专家(专家并行 EP)。
- TP 无 bubble、不依赖大批量,但每层要做 4 次 all-reduce、通信量 $8bsh\frac{t-1}{t}$,只能在 NVLink 域内做,实践中 $t \le 8$。
- PP 通信量只有 $bsh$ 的点对点,适合跨节点,但有 bubble:GPipe 的气泡占比 $\frac{p-1}{m+p-1}$,必须用大量 micro-batch(即大批量 / 梯度累积)来摊薄;1F1B、interleaved、zero-bubble 依次把气泡压小。
- 激活显存是 $sbh\left(34 + 5\frac{as}{h}\right)$ 每层。纯 TP 只能把它降到 $sbh(10 + 24/t)$——那个 10 是 LayerNorm / Dropout 的锅;加上 SP 才能真正做到 $sbh \cdot 34/t$ 的线性缩放。
- 组合规则:TP/EP 放在节点内(高带宽),PP 跨节点,DP/ZeRO 放在最外层(最能容忍延迟)。维度顺序 $[\text{TP}, \text{CP}, \text{PP}, \text{DP}]$,由内到外带宽需求递减。
- 真实系统的模式:TP 几乎总是 $\le 8$;EP 可以很大(DeepSeek-V3 用到 64);长上下文阶段用大 CP(Llama 3 用 16,Nemotron 3 用 64)。
1. 从数据并行到模型并行:为什么必须切模型
数据并行的两堵墙
先把账算清楚。数据并行的并行度 $D$ 满足一个硬约束:全局批大小 $B \ge D$(每卡至少一条序列)。实际上还要更严:为了让通信能被计算掩盖,每卡的本地批量不能太小。一次 DDP 的梯度 all-reduce 要搬 $2N_{\text{param}}$ 字节量级的数据,而一步的计算量是 $6 N_{\text{param}} \cdot B_{\text{tokens}}$ FLOPs,所以
$$ \frac{\text{通信时间}}{\text{计算时间}} \;\propto\; \frac{2 N_{\text{param}} / \text{BW}}{6 N_{\text{param}} B_{\text{tokens}} / \text{FLOPS}} \;=\; \frac{1}{3 B_{\text{tokens}}}\cdot \frac{\text{FLOPS}}{\text{BW}} $$注意 $N_{\text{param}}$ 被约掉了:DP 的通信/计算比只取决于每卡的 token 数,与模型大小无关。这就是「大批量能救数据并行」的数学原因,也是后面 TPU book 那张图里「$B/N$(全局批大小除以芯片数)是关键量」的由来。H100 的算力约 $10^{15}$ FLOP/s、节点间带宽约 $5\times10^{10}$ B/s,比值 $2\times10^4$,代入要求 $B_{\text{tokens}} \gtrsim 6000$ 才能把通信比压到 100% 以下——这还没算重叠。
但批大小不能无限涨:McCandlish 等人的临界批大小分析告诉我们,超过某个点后,把批量翻倍并不能让收敛步数减半,多出来的算力是纯浪费。于是 $D$ 有上限,而 GPU 数量没有上限。
第二堵墙更硬:ZeRO-1/2 根本不减少参数显存(每张卡仍需 2 B/param 的 BF16 权重 + 2 B/param 的梯度),ZeRO-3 减少了参数显存,但它对激活显存毫无办法——激活是数据并行的「私有财产」,每张卡处理自己的那份数据,就得存自己那份激活。我们在第 4 节会看到,一个 70B 模型在 8K 序列下的激活显存可以轻松达到 180 GB/层组,远超单卡的 80 GB。
模型并行 = 切参数 + 传激活。它和 ZeRO-3 的关键差别在于通信的内容:ZeRO-3 把分片的参数临时 all-gather 回来(通信量正比于 $N_{\text{param}}$,与批大小无关),模型并行则让参数永远待在原地、把激活搬来搬去(通信量正比于 $bsh$,与批大小成正比)。批小的时候模型并行便宜,批大的时候 ZeRO-3 便宜——这就是两者的分界线。
三种切法(其实是四种)
把 Transformer 想成一个 $L \times h$ 的矩形:纵向是层(深度),横向是隐藏维度(宽度)。加上输入还有一个序列维度,MoE 还有一个专家维度,于是一共四个可切的轴:
| 切法 | 沿哪个轴 | 通信原语 | 典型规模 |
|---|---|---|---|
| 流水线并行 PP | 层(深度) | 点对点 send/recv | 4–16,跨节点 |
| 张量并行 TP | 隐藏维 / 注意力头(宽度) | all-reduce(或 AG + RS) | 2–8,节点内 |
| 序列 / 上下文并行 SP / CP | 序列长度 | AG + RS / 环形 P2P | SP 跟随 TP;CP 可到 64 |
| 专家并行 EP | 专家 | all-to-all | 8–64+ |
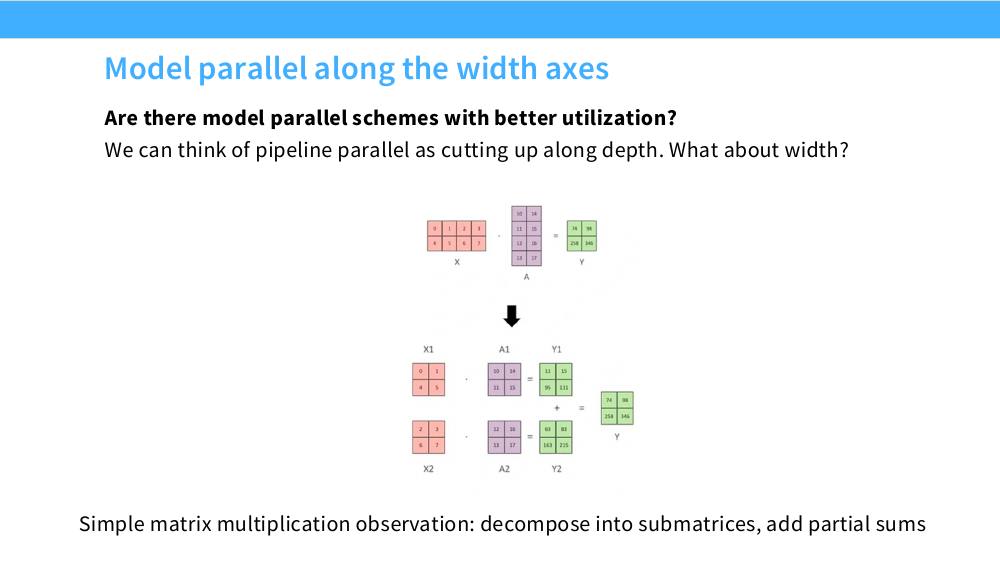
下面我们从最容易理解的深度切法开始。
2. 流水线并行:沿深度切
先看最朴素的做法为什么不行
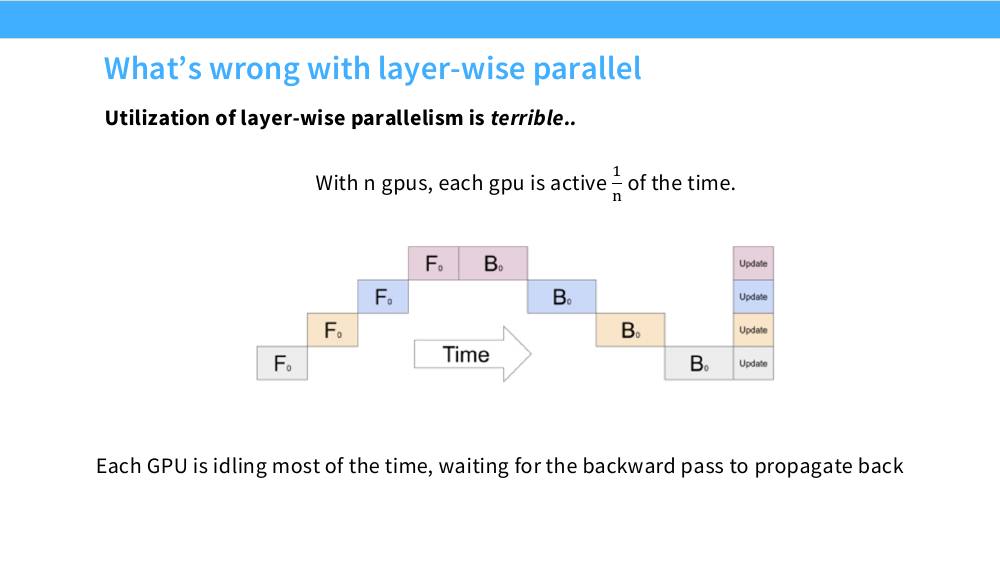
最直觉的模型并行是逐层并行(layer-wise parallel):$L$ 层模型,$p$ 张卡,每张卡拿 $L/p$ 层。前向时激活从 GPU 0 一路传到 GPU $p-1$,反向时梯度一路传回来。参数显存漂亮地降到了 $1/p$,通信也只是相邻卡之间传一个 $b \times s \times h$ 的激活张量。
问题是利用率。任意时刻只有一张卡在算,其余 $p-1$ 张在等:
GPipe:用 micro-batch 填满流水线
解决办法和 CPU 流水线一模一样:把一个 batch 拆成 $m$ 个 micro-batch,第一个 micro-batch 交给 stage 1 之后,stage 0 立刻开始算第二个 micro-batch。这样除了开头的「注水」和结尾的「排空」,中间所有卡都在忙。
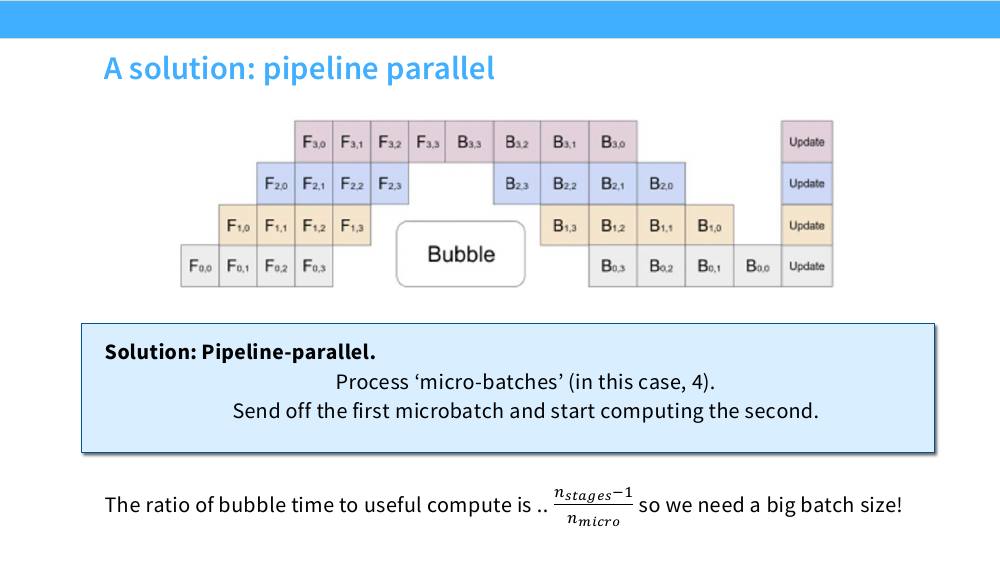
设流水线有 $p$ 个 stage、$m$ 个 micro-batch,每个 micro-batch 在一个 stage 上前向耗时 $t_f$、反向耗时 $t_b$。
有效计算时间:每张卡要处理全部 $m$ 个 micro-batch 的前向和反向,即 $m(t_f + t_b)$。
总墙钟时间:第一个 micro-batch 要经过 $p$ 个 stage 才能开始反向,最后一个 micro-batch 要等前面 $m-1$ 个都发出去。展开后,整条流水线的关键路径长度是 $(m + p - 1)(t_f + t_b)$。
于是空闲(bubble)时间为 $(p-1)(t_f+t_b)$,两个常用指标是:
$$ \underbrace{\frac{\text{bubble}}{\text{有效计算}} = \frac{p-1}{m}}_{\text{课上给的形式}} \qquad \underbrace{\frac{\text{bubble}}{\text{总时间}} = \frac{p-1}{m+p-1}}_{\text{利用率损失}} $$数值感受:$p = 16$、$m = 16$ 时气泡占总时间的 $15/31 = 48\%$——一半算力蒸发了。要把损失压到 5% 以下,需要 $m \ge 19(p-1) \approx 285$ 个 micro-batch。这就是课上那句「so we need a big batch size!」的定量含义。
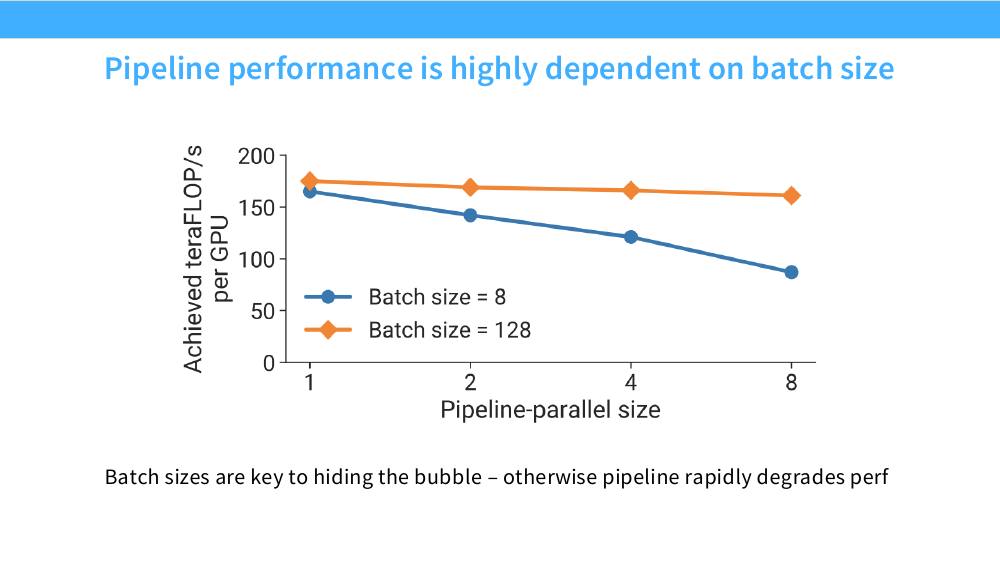
那为什么还要用流水线?
Tatsu 在课上专门回答了这个问题:流水线看起来这么糟,为什么还是所有大模型训练的标配?两个理由。
- 省显存:参数、梯度、优化器状态全部降到 $1/p$,而且是真正的「省」,不像 ZeRO-3 那样还要临时 all-gather 回来。
- 通信极其廉价:stage 之间只传 $b \times s \times h$ 的激活,而且是点对点(不是集合通信),只发生在相邻 stage 之间。这意味着它完全不依赖高带宽的全互联域,非常适合放在慢速的节点间链路上。
数值对比:一个 $h=8192$、$s=8192$、micro-batch $b=1$ 的模型,stage 边界上传输的激活是 $8192 \times 8192 \times 2\text{B} = 134$ MB(配合 SP 还能再除以 $t$,降到 17 MB)。走 400 Gb/s 的 InfiniBand($\approx 50$ GB/s)只要 0.3–2.7 ms,而这个 micro-batch 在这个 stage 上的计算要两三百毫秒。通信占比不到 1%。
把流水线并行理解成「工厂的装配线」:装配线越长($p$ 越大),开工和收工时的空转越明显;但只要订单足够多($m$ 足够大),空转就被摊薄。而工位之间只需要传半成品(激活),不需要每个工位都拿到完整图纸(参数)——所以工位之间的「传送带」可以很窄。这就是为什么 PP 被放在最慢的链路上。
1F1B:同样的气泡,更少的显存
GPipe 的调度是「先做完所有 $m$ 个前向,再做所有反向」。这意味着所有 $m$ 个 micro-batch 的激活必须同时留在显存里——省下来的参数显存又被激活吃回去了。
1F1B(one-forward-one-backward)调度修正了这一点:在流水线填满之后,每张卡就交替执行「一次前向、一次反向」,反向一做完就立刻释放对应 micro-batch 的激活。气泡占比完全不变(还是 $\frac{p-1}{m}$,因为关键路径没变),但 stage $i$ 在任意时刻最多只需要保存 $p - i$ 份 micro-batch 的激活,最坏情况(第 0 个 stage)是 $p$ 份。
1F1B 有一个很漂亮的性质:stage 0 存 $p$ 份 micro-batch × $L/p$ 层 = $L$ 层的激活,和完全不做流水线并行时一份 micro-batch 的激活量一样。换句话说,1F1B 下流水线并行的激活显存与 $p$ 无关——它不增加也基本不减少激活显存,只减少参数显存。真正减少激活显存要靠 TP+SP 和 CP。
# 1F1B 调度的骨架(单个 stage 的视角)
# rank: 本 stage 编号 0..p-1;m: micro-batch 数
warmup = p - 1 - rank          # 预热阶段先做几个纯前向
steady = m - warmup            # 稳定阶段 1F1B 交替

acts = []                      # 保存待反向的激活(有界队列,长度 <= warmup+1)

for i in range(warmup):        # ---- 预热:只前向 ----
    x = recv_from_prev()  if rank > 0 else next_microbatch()
    y = stage.forward(x); acts.append((x, y))
    send_to_next(y)       if rank < p - 1 else loss_buffer.append(y)

for i in range(steady):        # ---- 稳态:1 前向 + 1 反向 ----
    x = recv_from_prev()  if rank > 0 else next_microbatch()
    y = stage.forward(x); acts.append((x, y))
    send_to_next(y)       if rank < p - 1 else loss_buffer.append(y)

    g = recv_from_next()  if rank < p - 1 else loss_grad(loss_buffer.pop(0))
    x0, y0 = acts.pop(0)                  # 反向后立刻释放这份激活
    gx = stage.backward(x0, y0, g)        # 同时累加权重梯度
    send_to_prev(gx)      if rank > 0 else None

for i in range(warmup):        # ---- 排空:只反向 ----
    g = recv_from_next()  if rank < p - 1 else loss_grad(loss_buffer.pop(0))
    x0, y0 = acts.pop(0)
    gx = stage.backward(x0, y0, g)
    send_to_prev(gx)      if rank > 0 else None

optimizer.step()               # m 个 micro-batch 的梯度天然就是梯度累积
Interleaved(虚拟流水线):用带宽换利用率
还能不能把气泡再压小?$\frac{p-1}{m}$ 里 $p$ 是硬件给定的,$m$ 受批大小限制,看起来没有余地。Interleaved 1F1B 的技巧是:不再让每张卡拿连续的 $L/p$ 层,而是把模型切成 $v \cdot p$ 个更细的「模型块(model chunk)」,每张卡拿 $v$ 个不相邻的块。这样一个 micro-batch 在流水线里要绕 $v$ 圈,等效于流水线被「加密」了 $v$ 倍:
$$ \text{bubble ratio} = \frac{p-1}{m \cdot v} $$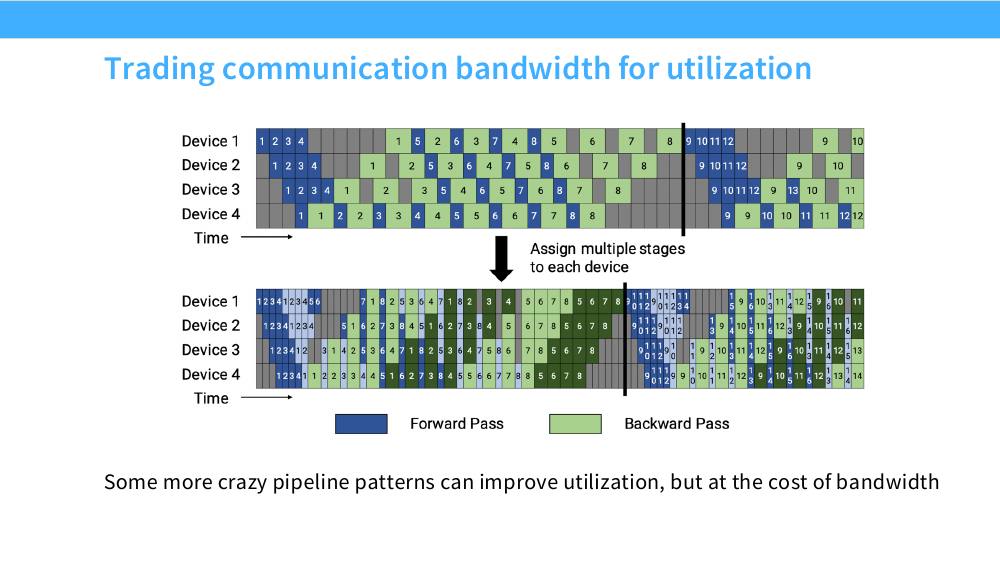
Zero bubble:把反向拆成两半
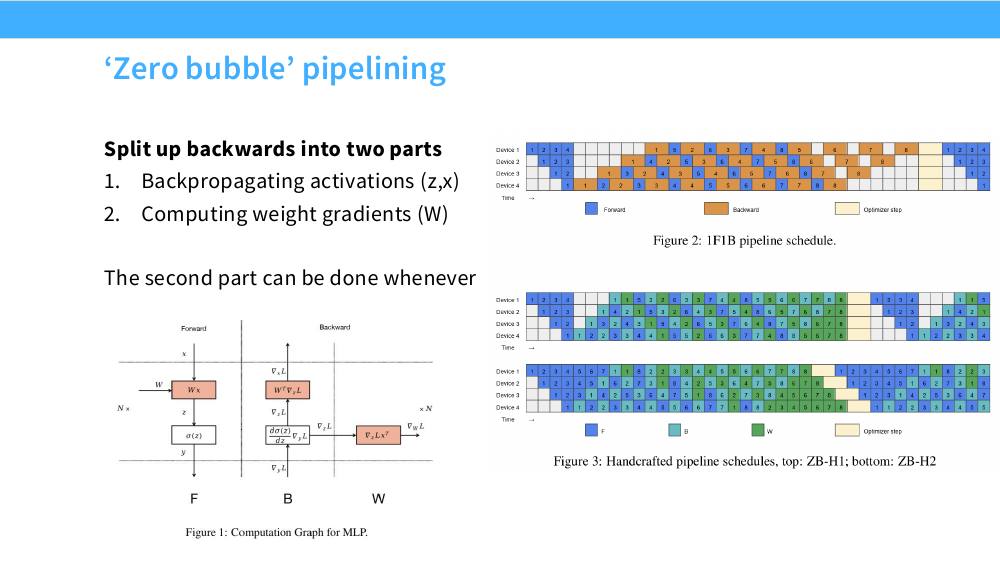
最后一个技巧来自一个很少被注意的事实:反向传播其实是两件独立的事。对一层 $y = \sigma(Wx)$:
- B(activation gradient):算 $\nabla_x L = W^\top \nabla_z L$。这一步必须立刻做,因为下游 stage 在等这个梯度。
- W(weight gradient):算 $\nabla_W L = \nabla_z L \cdot x^\top$。这一步谁也不等——只要在 optimizer.step() 之前算完就行。
于是可以把 W 当作「填缝料」,塞进流水线里任何一个空闲槽位。
流水线并行是四种并行里工程复杂度最高的:层数要能被 $p$ 整除且各 stage 计算量要平衡(embedding 和 LM head 让首尾两个 stage 天然更重);loss 只在最后一个 stage 算;BatchNorm 之类跨 micro-batch 的算子会直接坏掉;调试时一个 stage 挂了整条线都 hang。课上给 PP 的「易用性」评级是 Hard,这不是客套。
3. 张量并行:沿宽度切
流水线并行的病根在于「深度是串行的」——第 $\ell$ 层必须等第 $\ell-1$ 层算完。那能不能沿宽度切?同一层的不同部分之间没有依赖,理论上可以完美并行。这就是 Megatron-LM 提出的张量并行(Tensor Parallelism, TP)。
3.1 MLP:列切 + 行切,为什么只需要一次 all-reduce
Transformer 的 MLP 是两个矩阵乘夹一个非线性:
$$ Y = \text{GeLU}(XA), \qquad Z = YB $$其中 $X \in \R^{bs \times h}$,$A \in \R^{h \times 4h}$,$B \in \R^{4h \times h}$。有两种切法,选哪一种是整个 Megatron 设计的关键。
切法一(错的):把 $A$ 按行切。$A = \begin{bmatrix} A_1 \\ A_2\end{bmatrix}$,对应 $X = [X_1, X_2]$ 按列切,则
$$ XA = X_1 A_1 + X_2 A_2 $$这是一个部分和。而 GeLU 是逐元素非线性,$\text{GeLU}(X_1A_1 + X_2A_2) \ne \text{GeLU}(X_1A_1) + \text{GeLU}(X_2A_2)$。所以必须先 all-reduce 把部分和加起来,再做 GeLU——多了一次同步。
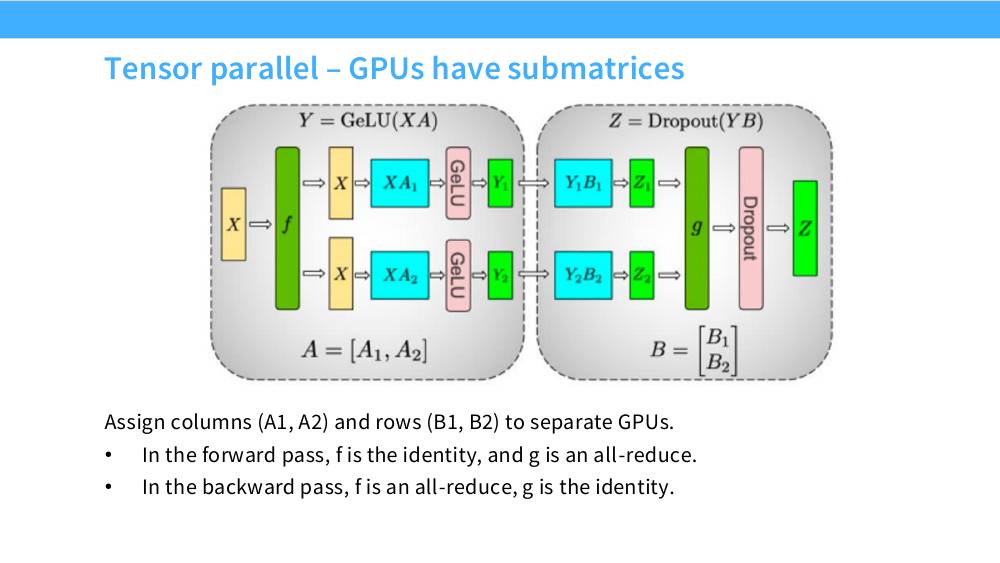
切法二(对的):把 $A$ 按列切。$A = [A_1, A_2]$,每张卡拿到完整的 $X$,则
$$ XA = [XA_1,\; XA_2] \;\Longrightarrow\; \text{GeLU}(XA) = [\text{GeLU}(XA_1),\; \text{GeLU}(XA_2)] = [Y_1, Y_2] $$列切之后每一列是独立完整的输出通道,逐元素非线性可以直接作用在本地分片上,不需要任何通信。
接着让 $B$ 按行切 $B = \begin{bmatrix} B_1 \\ B_2 \end{bmatrix}$,正好匹配 $Y$ 的列切分:
$$ Z = YB = [Y_1, Y_2]\begin{bmatrix} B_1 \\ B_2\end{bmatrix} = Y_1 B_1 + Y_2 B_2 $$每张卡算出一个 $\R^{bs\times h}$ 的部分和,最后一次 all-reduce 求和即可。
结论:「列切 → 非线性 → 行切」这个组合,整个 MLP 只需要在末尾做一次 all-reduce。如果两层都用同一种切法,就需要两次。这一次减半,就是 Megatron 论文最核心的工程贡献。
3.2 注意力:按 head 切
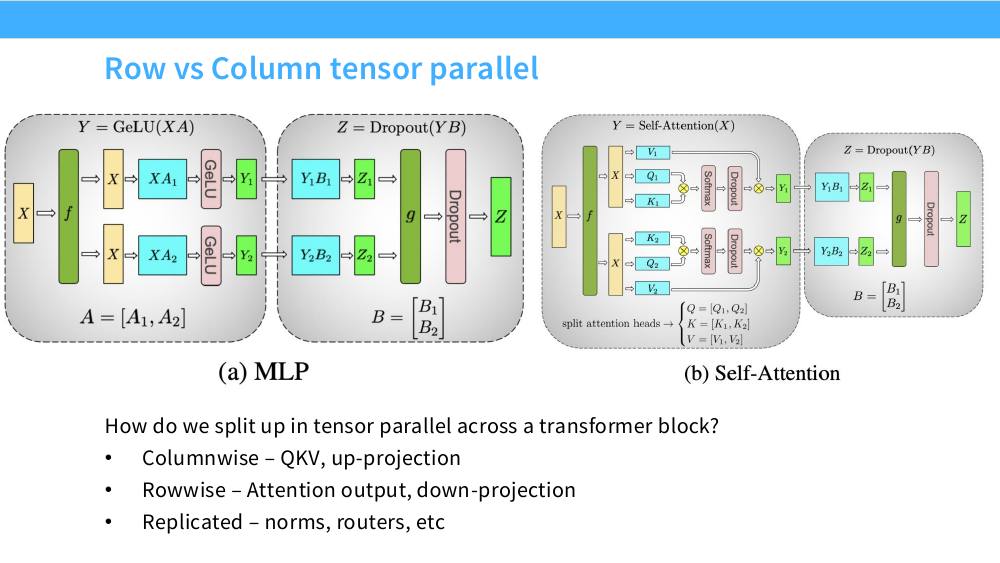
注意力的切法更自然,因为多头注意力本来就是并行的:$a$ 个头各算各的,最后拼起来过输出投影。所以直接把头分给不同 GPU:
- $W_Q, W_K, W_V$ 沿输出维(也就是 head 维)列切:每张卡拿 $a/t$ 个头的 $Q_i, K_i, V_i$。
- $\text{softmax}(Q_iK_i^\top/\sqrt{d})V_i$ 完全在本地算——softmax 是逐头的,不跨设备,这一点至关重要。
- 输出投影 $W_O$ 沿输入维行切,正好匹配拼接后的头维切分,得到部分和,一次 all-reduce。
import torch, torch.distributed as dist

class ColumnParallelLinear(torch.nn.Module):
    """Y = X A,A 沿输出维切。输入完整、输出分片。"""
    def __init__(self, h_in, h_out, tp_group):
        super().__init__()
        self.g = tp_group
        t = dist.get_world_size(tp_group)
        assert h_out % t == 0
        self.weight = torch.nn.Parameter(torch.empty(h_out // t, h_in))

    def forward(self, x):
        x = _CopyToTP.apply(x, self.g)      # fwd: 恒等; bwd: all-reduce 梯度
        return torch.nn.functional.linear(x, self.weight)   # 输出是分片的

class RowParallelLinear(torch.nn.Module):
    """Z = Y B,B 沿输入维切。输入分片、输出完整。"""
    def __init__(self, h_in, h_out, tp_group):
        super().__init__()
        self.g = tp_group
        t = dist.get_world_size(tp_group)
        assert h_in % t == 0
        self.weight = torch.nn.Parameter(torch.empty(h_out, h_in // t))

    def forward(self, y):                    # y 已经是分片的
        z = torch.nn.functional.linear(y, self.weight)      # 部分和
        return _ReduceFromTP.apply(z, self.g)  # fwd: all-reduce; bwd: 恒等

class _CopyToTP(torch.autograd.Function):    # 就是课件里的 f
    @staticmethod
    def forward(ctx, x, g): ctx.g = g; return x
    @staticmethod
    def backward(ctx, grad):
        dist.all_reduce(grad, group=ctx.g); return grad, None

class _ReduceFromTP(torch.autograd.Function):  # 就是课件里的 g
    @staticmethod
    def forward(ctx, x, g):
        dist.all_reduce(x, group=g); return x
    @staticmethod
    def backward(ctx, grad): return grad, None

# 一个 TP 版 MLP 就是两行:
#   fc1 = ColumnParallelLinear(h, 4*h, g);  fc2 = RowParallelLinear(4*h, h, g)
#   z = fc2(gelu(fc1(x)))     # 全程只有 1 次 fwd all-reduce + 1 次 bwd all-reduce
3.3 Embedding 与 LM head:容易被忽略的两端
词表矩阵 $E \in \R^{V \times h}$ 在现代模型里一点也不小:$V = 128{,}256$、$h = 8192$ 时是 1.05 B 参数,BF16 占 2.1 GB,而且输入输出各一份(如果不共享)。它也必须切。
输入 embedding:沿词表维切,rank $i$ 只持有 token id 落在 $[V_i, V_{i+1})$ 的那些行。查表时把不属于自己的 id 掩成 0,然后对 $b \times s \times h$ 的结果做一次 all-reduce——因为每个 token 只在一张卡上命中,求和就等于拼接。
输出 LM head:沿词表维列切,rank $i$ 得到 logits 的一个切片 $\R^{bs \times V/t}$。这里有个陷阱:
「把 logits all-gather 回来再算交叉熵」——这是灾难。$b=1$、$s=8192$、$V=128{,}256$ 时,完整 logits 是 $8192 \times 128256 \times 2\text{B} = 2.1$ GB,比整层的所有激活加起来还大,而且 all-gather 一次就把 NVLink 打满。
正确做法是 vocab-parallel cross entropy:注意 $\log\sum_v e^{z_v}$ 只需要两个标量统计量。每张卡算本地的 $\max_v z_v$ 和 $\sum_v e^{z_v - m}$,然后只 all-reduce 这两个 $\R^{bs}$ 的向量(外加目标 token 的 logit,也是 $\R^{bs}$)。通信量从 $O(bsV)$ 降到 $O(bs)$——降了五个数量级。
3.4 通信量:为什么 TP 只能待在 NVLink 域里
先回忆上一讲的结论:环形 all-reduce = reduce-scatter + all-gather,每个 rank 收发的数据量是
$$ V_{\text{all-reduce}} = 2\,\frac{t-1}{t}\, N \quad\text{(元素数,$N$ 为张量大小,$t$ 为组大小)} $$一个 Transformer block 里的 all-reduce 有 4 次:注意力输出投影后的前向 1 次 + 其反向 1 次,MLP 下投影后的前向 1 次 + 其反向 1 次。每次同步的张量都是 $b \times s \times h$。所以每层每 micro-batch:
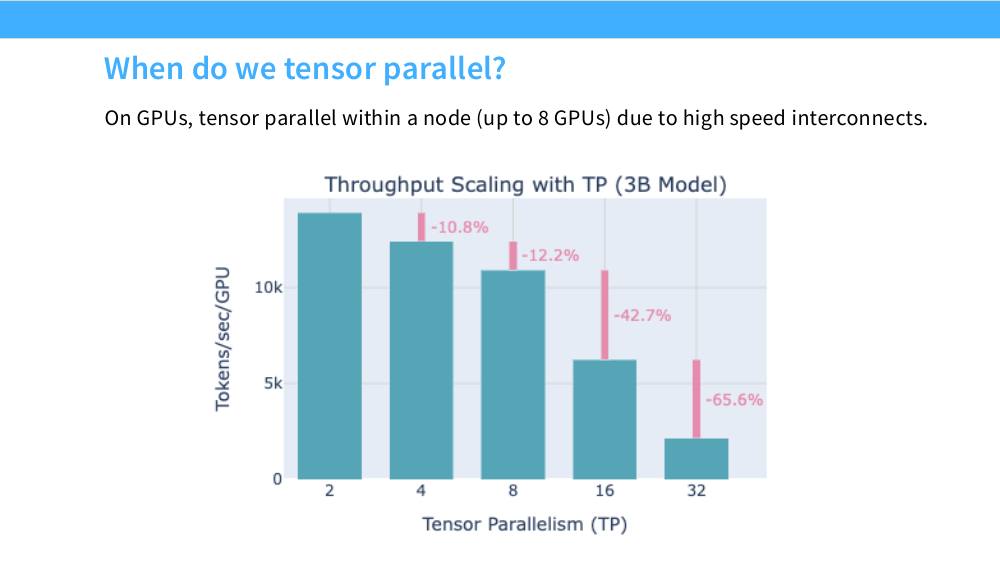
$$ V_{\text{TP}} = 4 \times 2\,\frac{t-1}{t}\, bsh = 8bsh\,\frac{t-1}{t} $$这正是课上给出的 $8bsh\frac{n_{\text{devices}}-1}{n_{\text{devices}}}$。对比流水线并行每 micro-batch 每个 stage 边界只传 $bsh$ 的点对点数据——TP 的通信量高出近一个数量级,而且发生在每一层。
把数字代进去看看有多可怕。取 $b=1$、$s=8192$、$h=8192$、$t=8$、BF16:
$$ V_{\text{TP}} = 8 \times 8192 \times 8192 \times \tfrac{7}{8} \times 2\text{B} \approx 940\ \text{MB / 层 / micro-batch} $$一个 20 层的 stage 就是 18.8 GB。分别走两种链路:
| 链路 | 单向带宽 | 搬 18.8 GB 耗时 | vs. 同期计算(约 215 ms) |
|---|---|---|---|
| 节点内 NVLink(H100,第 4 代) | $\approx 450$ GB/s | 42 ms | 19%,可部分重叠 → 可接受 |
| 节点间 InfiniBand 400 Gb/s | $\approx 50$ GB/s | 376 ms | 175%,通信比计算还久 → 崩溃 |
差了 9 倍。这就是「TP 必须在单节点内、$t \le 8$」这条铁律的全部内容——不是经验法则,是算出来的。
TP vs PP 的取舍:
- TP 的优点:没有 bubble(网络够快就没人等谁);实现简单(只要换掉 Linear 层,不需要改训练循环);不依赖大批量。
- TP 的缺点:通信量 $8bsh\frac{t-1}{t}$ / 层,而且是阻塞式的 all-reduce,卡在关键路径上。
- 所以:有低延迟高带宽互联的地方就用 TP,没有的地方用 PP。这直接翻译成「节点内 TP、节点间 PP」的硬件映射。
4. 激活显存与序列并行
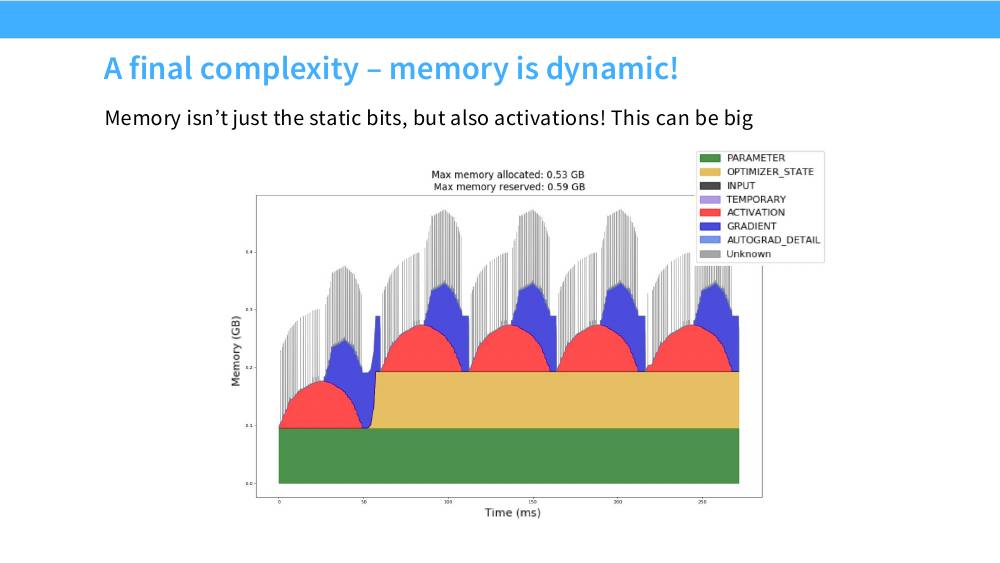
4.1 显存是动态的
到目前为止我们算的都是静态显存:参数、梯度、优化器状态。但真实的显存曲线长这样:
4.2 每层激活显存的精确公式
如果什么都存、什么都不重算,一个标准 Transformer 层($s$ 序列长、$b$ micro-batch、$h$ 隐藏维、$a$ 注意力头数)的激活显存是:
$$ M_{\text{act}}^{\text{layer}} = sbh\left(34 + 5\,\frac{as}{h}\right)\ \text{bytes} $$这个 34 不是魔数,它是逐项加出来的:
| 模块 | 需要保存的张量 | 字节数 |
|---|---|---|
| 注意力块 | QKV 投影的输入(即 LN 输出) | $2sbh$ |
| $Q, K$($QK^\top$ 反向要用) | $4sbh$ | |
| $V$ 与 $\text{attn}\cdot V$ 的输出 | $4sbh$ | |
| softmax 输出 + dropout 输出 + dropout mask | $2as^2b + 2as^2b + as^2b = 5as^2b$ | |
| 输出投影的输入 | $2sbh$(已含于上) | |
| 输出 dropout 的 mask | $sbh$ | |
| MLP 块 | 第一个 Linear 的输入 | $2sbh$ |
| 第一个 Linear 的输出($4h$ 宽) | $8sbh$ | |
| GeLU 的输出(第二个 Linear 的输入) | $8sbh$ | |
| 输出 dropout 的 mask | $sbh$ | |
| 两个 LayerNorm | 各自的输入 | $4sbh$ |
| 合计 | $\mathbf{34sbh + 5as^2b}$ | |
那个 $5\frac{as}{h}$ 项是注意力矩阵贡献的,它对序列长度是二次的。好消息是:这一项可以用 FlashAttention 式的重算彻底消掉(反向时按块重新计算注意力矩阵,不落显存)。所以下面我们一律假设它已经没了。
数值例子:$h=8192$、$s=8192$、$a=64$、$L=80$(70B 级别模型),micro-batch $b=1$。基本单位 $sbh = 8192 \times 1 \times 8192 = 67.1$ MB。
- 什么都不做:$5\frac{as}{h} = 5 \times 64 = 320$,系数 $34+320 = 354$ → 23.8 GB/层 → 80 层共 1.9 TB。荒谬。
- 用 FlashAttention 去掉二次项:$67.1\text{MB} \times 34 = 2.28$ GB/层 → 182 GB。仍然装不下 80 GB 的卡。
结论:光有 FlashAttention 不够,激活显存必须也跟着并行度线性缩小。
4.3 张量并行只能缩掉一部分
TP 把注意力和 MLP 里的矩阵乘切开了,对应的激活自然也切成 $1/t$。但有些张量没有被切:
$$ M_{\text{act}}^{\text{layer}}(\text{TP}) = sbh\left(10 + \frac{24}{t} + 5\frac{as}{ht}\right) $$那个顽固的 10 是:两个 LayerNorm 的输入($4sbh$)+ 两个 Dropout 的 mask($2sbh$)+ 注意力块和 MLP 块各自的输入($4sbh$)。它们全都是逐元素(pointwise)算子,在 Megatron 的设计里被复制到每张卡上,因为它们不涉及矩阵乘,切开好像没意义。
「TP=8 就能把激活显存降到 1/8」——不对。代入上面的例子:$67.1\text{MB} \times (10 + 24/8) = 67.1 \times 13 = 872$ MB/层,80 层共 69.8 GB。相比 182 GB 只降了 2.6 倍,而不是 8 倍。而且这个 10 是常数项:你再加 GPU 也降不下去,它会随着模型变大而线性增长,最终吃掉一切。
4.4 序列并行:把那个 10 也切掉
Megatron 的解法优雅得让人拍案:既然这些算子是沿序列逐位置作用的(LayerNorm 是对每个 token 的 $h$ 维做归一化,Dropout 更是纯逐元素),那它们在序列维上天然可分!于是:
- 在 LayerNorm / Dropout 区域,张量按 序列维 切成 $t$ 份(每卡持有 $s/t$ 个 token 的完整 $h$ 维)——这叫序列并行(Sequence Parallelism, SP)。
- 在矩阵乘区域,张量按 隐藏维 切成 $t$ 份(每卡持有全部 $s$ 个 token 的 $h/t$ 维)——这是 TP。
- 两者交界处做转换:前向时 $g$ 是 all-gather(序列切 → 完整序列),$\bar g$ 是 reduce-scatter(部分和 → 序列切);反向时两者互换。
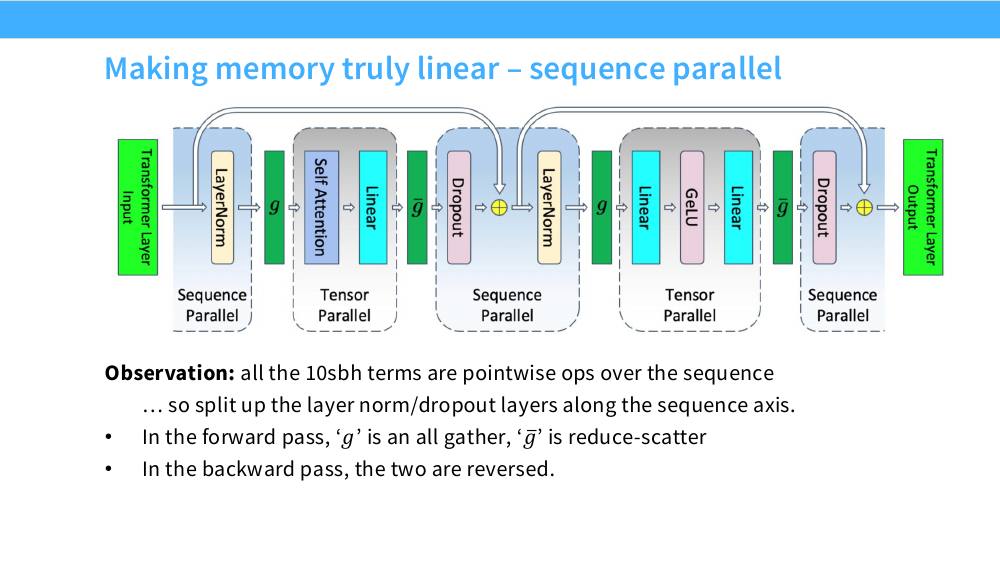
SP 是完全免费的。原本 TP 在这里做的是一次 all-reduce;现在变成了「reduce-scatter(进入 SP 区)+ all-gather(离开 SP 区)」。而上一讲证明过 all-reduce ≡ reduce-scatter + all-gather,两者通信量完全相同(都是 $2\frac{t-1}{t}N$)。所以 SP 用零通信代价换来了激活显存的完全线性缩放。这是整个 Megatron 体系里性价比最高的一个技巧。
把所有组合列出来(Korthikanti et al. 2022 的总表):
| 配置 | 每层激活显存 | 代入例子($s=b\cdot$8192, $h$=8192, $a$=64, $t$=8, 80 层) |
|---|---|---|
| 无并行 | $sbh\left(34 + 5\frac{as}{h}\right)$ | 1.9 TB |
| 张量并行 | $sbh\left(10 + \frac{24}{t} + 5\frac{as}{ht}\right)$ | 284 GB |
| TP + 序列并行 | $sbh\left(\frac{34}{t} + 5\frac{as}{ht}\right)$ | 238 GB |
| TP + 选择性激活重算 | $sbh\left(10 + \frac{24}{t}\right)$ | 69.8 GB |
| TP + SP + 选择性重算 | $\mathbf{sbh \cdot \frac{34}{t}}$ | 22.8 GB ✅ |
最后一行才是能跑的配置:每层 285 MB,80 层 22.8 GB,装进 80 GB 卡还剩下大把空间给参数和优化器。激活显存终于随 GPU 数线性下降了。
4.5 选择性激活重算
上表里的「选择性重算(selective activation recomputation)」值得单独说。传统的全量重算(full checkpointing)是每个 Transformer 层只存输入,反向时重跑整层前向——显存降到 $2sbh$/层,但要多付约 33% 的前向 FLOPs(前向做两遍,$1\!:\!2$ 的前反向比变成 $2\!:\!2$)。
选择性重算的洞察是:那个 $5as^2b$ 项显存占比极高但计算量占比很低(softmax、dropout、以及 $bs \times s$ 的注意力矩阵,都是访存密集而非计算密集)。只重算这一段,显存去掉了最大头,FLOPs 只多几个百分点。这本质上和 FlashAttention 做的是同一件事。
重算看起来是「用算力换显存」的赔本买卖,但它经常反过来赚钱:省下的显存允许你把 micro-batch 开大,而大 micro-batch 让 GEMM 的形状更胖、GPU 利用率更高、流水线气泡更小。第 9 节会给出实测曲线——在 $b \ge 16$ 之后,开重算的吞吐反超不开重算的。
5. 上下文并行:Ring Attention
SP 解决了 LayerNorm / Dropout 的激活,但注意力内部仍然要看到完整的序列——每张卡的 $Q_i$ 要和所有 token 的 $K, V$ 交互。当上下文从 8K 涨到 128K 甚至 1M 时,这就成了新的瓶颈:KV 张量本身是 $2 \times s \times h$,$s = 131072$、$h = 8192$ 时单层 KV 就是 4.3 GB。
上下文并行(Context Parallelism, CP)把序列切到 $c$ 张卡上,每张卡持有 $s/c$ 个 token 的 $Q, K, V$,然后让 KV 块沿环传递:
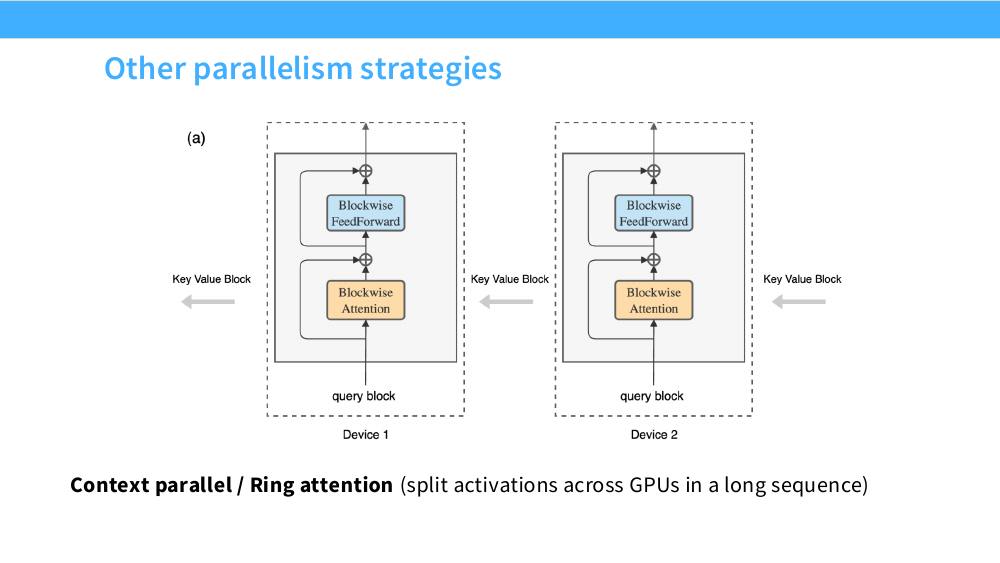
为什么通信可以被完全掩盖?第 $k$ 步里,每个设备要:
- 通信:发送/接收一块 $K, V$,大小 $2 \times \frac{s}{c} \times h \times 2\text{B}$,与 $\frac{s}{c}$ 线性相关。
- 计算:一个 $\frac{s}{c} \times \frac{s}{c}$ 的注意力块,FLOPs $\approx 4\left(\frac{s}{c}\right)^2 h$,与 $\frac{s}{c}$ 二次相关。
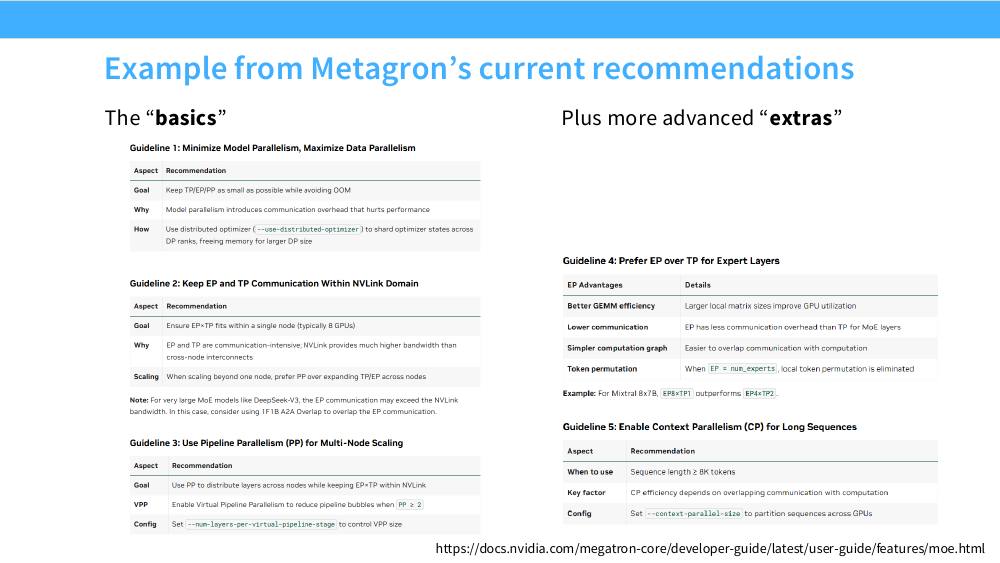
比值 $\frac{\text{comm}}{\text{compute}} \propto \frac{c}{s} \cdot \frac{\text{FLOPS}}{\text{BW}}$。只要每卡分到的序列块 $s/c$ 足够长,计算就压过通信,环形传递可以完全藏在计算背后。这也解释了 Megatron 的官方建议:序列长度 $\ge$ 8K 才值得开 CP——太短的话每步计算量不够,通信露出来。
# Ring Attention 的骨架(每个 rank 的视角,配合 online softmax)
q = local_q                       # [b, s/c, a, d],固定不动
k, v = local_k, local_v           # 待传递的块
out = torch.zeros_like(q); lse = torch.full(..., -inf)   # 在线 softmax 的累加器

for step in range(c):
    # 计算与通信重叠:先把下一块 KV 的收发挂上去
    send_req = isend(k, v, dst=(rank + 1) % c)
    recv_req = irecv(k_next, v_next, src=(rank - 1) % c)

    if needs_compute(rank, step):            # 因果掩码下有些 (q,kv) 块可跳过
        out, lse = flash_attn_update(out, lse, q, k, v, causal=is_diag(step))

    wait(send_req); wait(recv_req)
    k, v = k_next, v_next
因果掩码会毁掉负载均衡。如果第 $i$ 张卡拿走连续的第 $i$ 段序列,那么它只需要和 $j \le i$ 的 KV 块交互——rank 0 只干 1 份活,rank $c-1$ 干 $c$ 份活,平均利用率只有 50%,而所有人都要等最慢的那个。解决办法是打散分配:zigzag(每张卡拿序列的第 $i$ 段和第 $2c-1-i$ 段)或 striped attention(按 stride 交错取 token),让每张卡的三角形工作量相等。真实框架(Megatron-CP、ring-flash-attention)默认都做了这件事。
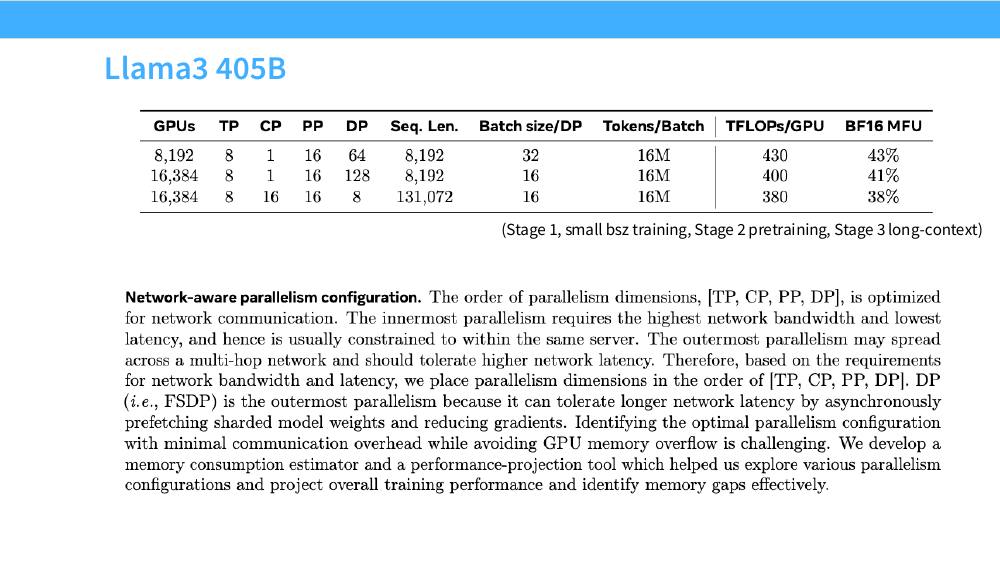
CP 在实践中的用法很明确:只在长上下文阶段开大。Llama 3 405B 的前两个阶段 CP=1,到第三阶段把序列从 8192 拉到 131072 时才把 CP 开到 16;Nemotron 3 Super 的长上下文扩展阶段直接用 CP=64。
6. 专家并行:切专家而不是切矩阵
6.1 基本机制
混合专家(Mixture-of-Experts, MoE)模型把 MLP 换成 $E$ 个专家,每个 token 经过 router 只激活其中 $k$ 个(典型 $k=8$、$E=256$)。这天然给了我们第四个切分轴:不切矩阵,切专家。
专家并行(Expert Parallelism, EP)的做法是:把 $E$ 个专家分配到 $e$ 个设备上(每设备 $E/e$ 个),token 则按 router 的决定被路由到持有对应专家的设备上算,算完再送回来。
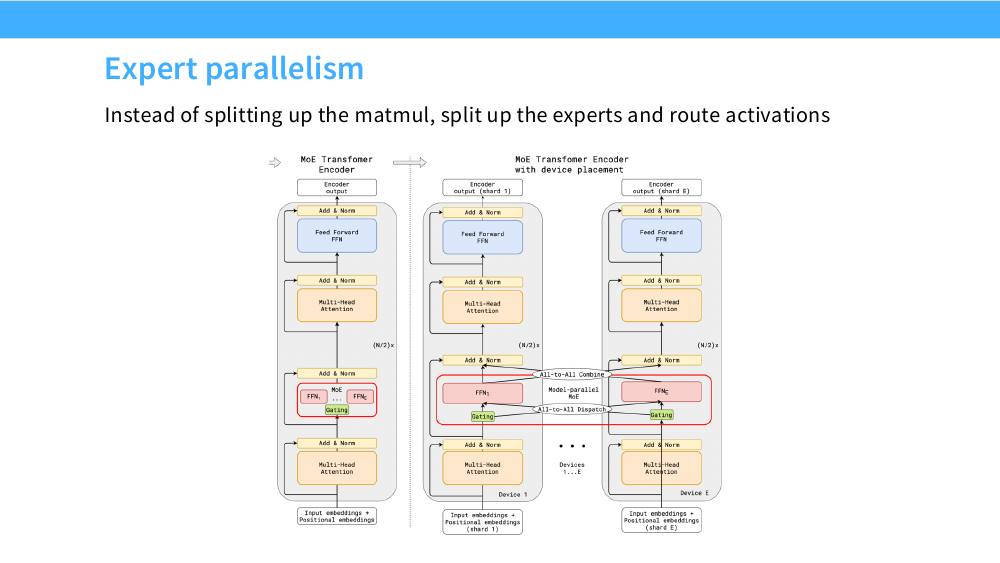
EP 的通信量。每个 token 的隐藏向量是 $h$ 维,被送往 $k$ 个专家,其中约 $\frac{e-1}{e}$ 的比例落在其他设备上。所以一次 dispatch 每 rank 收发约
$$ V_{\text{dispatch}} \approx b\,s\,k\,h \cdot \frac{e-1}{e}\ \text{元素} $$combine 对称,反向再来一遍,合计每个 MoE 层 $4bskh\frac{e-1}{e}$ 元素。
和 TP 比一比:TP 在 MLP 上每层是 $8bsh\frac{t-1}{t}$,EP 是 $4bskh\frac{e-1}{e}$。当 $k=8$ 时两者量级接近;但 $k$ 通常远小于「若用 TP 则每张卡都要参与全部 token」的情形——更关键的是,EP 传的是稀疏路由后的 token,而 TP 传的是全部 token 的全部激活。对一个 $E=256,k=8$ 的 MoE,只有 $8/256 = 3\%$ 的专家被激活,EP 让每张卡只算它该算的那部分,矩阵形状还更胖。
6.2 为什么专家层优先用 EP 而不是 TP
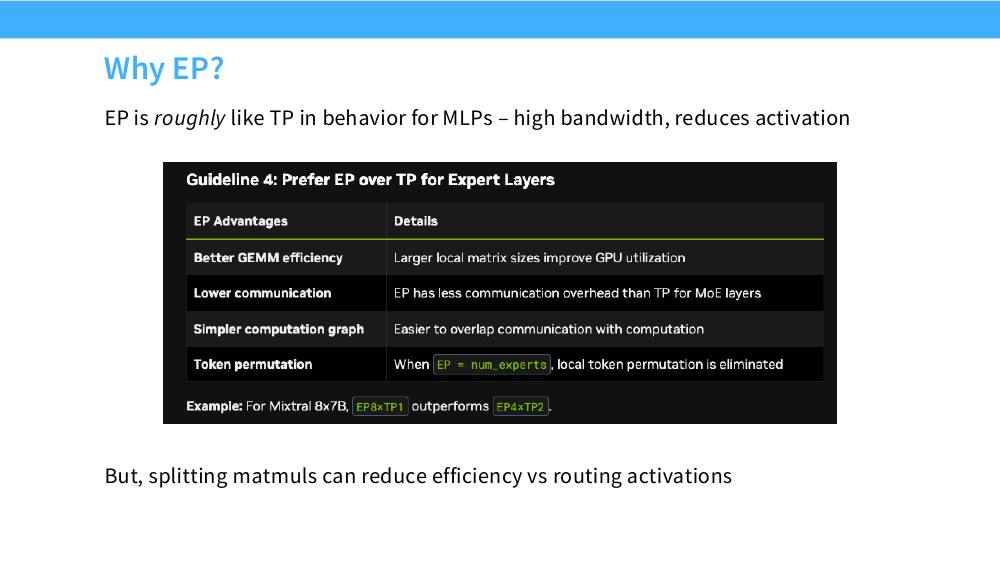
核心在第一条:TP 把一个 $h \times 4h$ 的矩阵切成 8 份,每份变成 $h \times \frac{4h}{8}$ 的瘦长条,GEMM 的算术强度掉下来,Tensor Core 吃不饱;EP 则让每张卡完整地跑 $E/e$ 个专家的完整矩阵,形状不变,只是 token 少了。「切矩阵会降低效率,路由激活不会」——这是 Tatsu 在课上强调的原话。
EP 的代价是负载不均衡。router 不保证每个专家收到相同数量的 token,而 all-to-all 是同步的——最忙的那个专家决定了整个 MoE 层的耗时。工程上的对策:容量因子(capacity factor,超出就丢弃 token)、辅助负载均衡损失(auxiliary loss)、以及 DeepSeek 那套无辅助损失的 bias 调整。另外 DeepSeek-V3 还用了节点受限路由(每个 token 最多路由到 4 个节点),把跨节点的 all-to-all 流量框死。
6.3 EP 怎么和其他并行拼
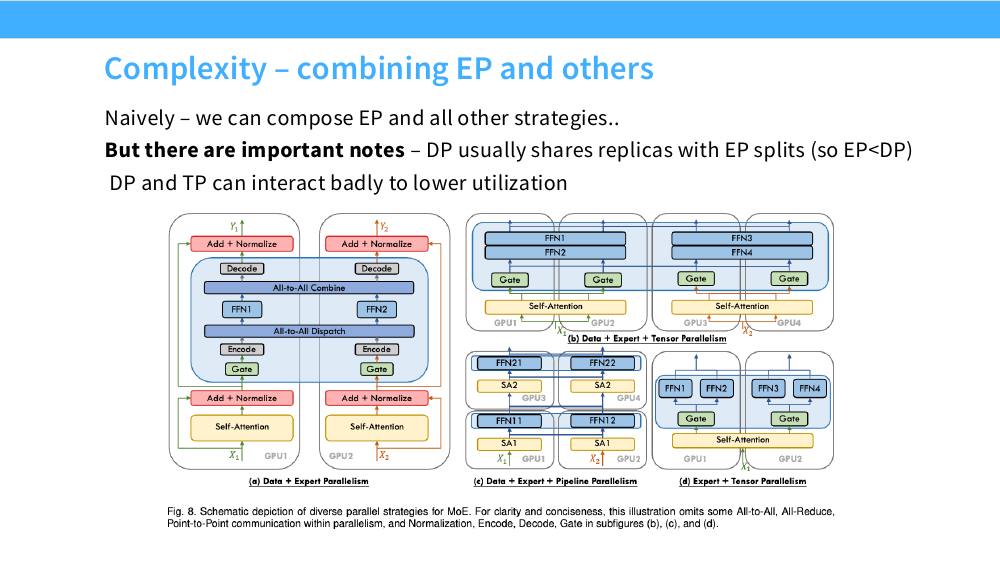
6.4 注意力和专家的并行度需要解耦
这里有一个真实的结构性矛盾,Tatsu 专门用一页讲它:
- MoE 只作用在 MLP 上,注意力层是稠密的。
- 注意力层没法用 EP,要并行只能靠 高 TP。
- 但 MLP 层我们刚论证过应该用 低 TP + 高 EP。
同一个模型的两半想要相反的配置。旧框架里 TP 是全局的,你只能折中。
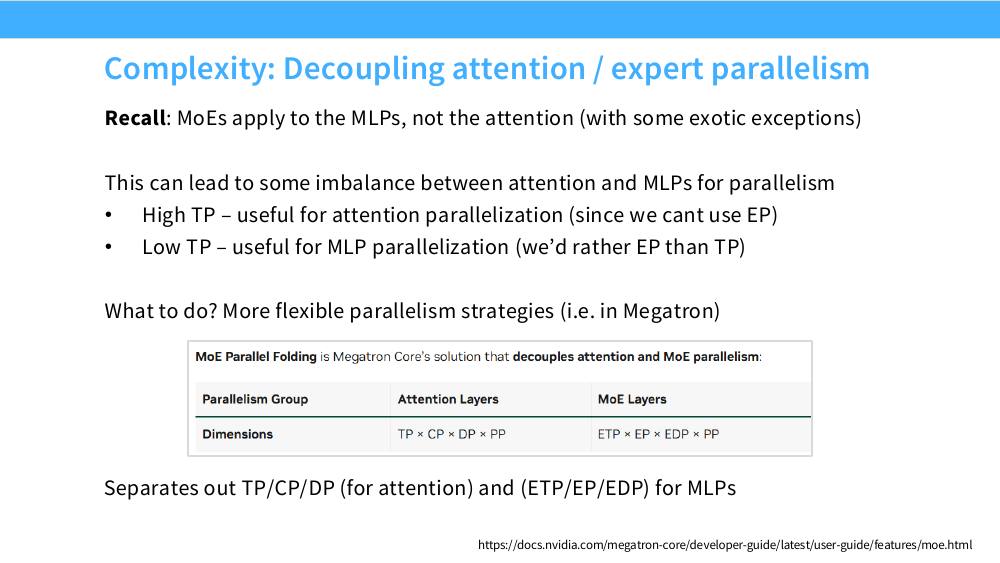
DeepSeek-V3 是这套思路的极致:PP=16、EP=64(横跨 8 个节点)、TP=1、ZeRO-1。注意 TP 被完全关掉了——因为 MLA(多头潜在注意力)已经把注意力的 KV 压得很小,不需要 TP 来省显存,于是所有的模型并行预算都给了 EP。而 64 路的 all-to-all 必然跨节点,他们用 1F1B 的 A2A overlap(后来演化成 DualPipe)把 all-to-all 藏在流水线的前反向计算背后。
7. 一张总账:每种并行省什么、花什么
把前五节的结论汇总。这是本讲最该背下来的一张表:
| 方法 | 通信 / 同步 | 每 rank 参数显存 | 每 rank 激活 / KV 显存 | 主要带宽开销 | 能扩大全局批量? | 好用吗 |
|---|---|---|---|---|---|---|
| DDP / ZeRO-1 | 每步一次梯度 all-reduce | 不缩参数(ZeRO-1 只缩优化器状态) | 不缩 | $\sim O(N_{\text{param}})$ 的梯度流量 | 是,随 DP 线性 | 非常好用 |
| FSDP / ZeRO-3 | 逐层 all-gather 参数 + 梯度 reduce-scatter,可重叠 | 参数/梯度/优化器状态全部 $\sim 1/\text{DP}$ | 不缩 | $1.5\times$ DDP 的参数流量,可重叠 | 是,随 DP 线性 | 中等 |
| 流水线并行 PP | stage 间传激活 + 气泡 | $\sim 1/\text{PP}$ | 取决于流水线缓冲(1F1B 下 $\approx$ 不变) | $bsh$ 点对点 / micro-batch / 边界 | 否,但需要足够多 micro-batch | 难 |
| 张量并行 TP | 阻塞式激活 all-reduce | $\sim 1/\text{TP}$(被切的权重) | 矩阵乘相关的激活 $\sim 1/\text{TP}$(配 SP 则全部) | 每层 $8bsh\frac{t-1}{t}$ 的集合通信 | 否 | 难 |
| 序列 / 上下文并行 SP / CP | 逐层的序列分片交换 / 环形传递 | 不缩 | 序列侧激活与 KV $\sim 1/\text{SP}$ 或 $1/\text{CP}$ | 激活 / KV 通信(SP 与 TP 等量,免费) | 否 | 难 |
| 专家并行 EP | 每个 MoE 层一次 token all-to-all | 专家权重 $\sim 1/\text{EP}$(注意力不缩) | 不缩 | $4bskh\frac{e-1}{e}$ 的 all-to-all | 否,但每专家需足够多 token | 难 |
读这张表的正确方式是按列读:
- 想省参数显存?ZeRO-3 / PP / TP / EP 都行,选通信最便宜的那个。
- 想省激活显存?只有 TP+SP 和 CP 真正有效(PP 在 1F1B 下基本持平,DP/ZeRO/EP 完全无效)。
- 想扩大全局批量、增加吞吐?只有 DP 一条路。所有模型并行都不增加批量,它们只是让模型装得下。
- 通信从便宜到贵:PP(点对点,$bsh$)< DP(每步一次,可重叠)< EP(all-to-all)< TP(每层 4 次阻塞 all-reduce)。这个排序直接决定了它们该放在什么链路上。
一个统一的判据:每卡分到多少 token
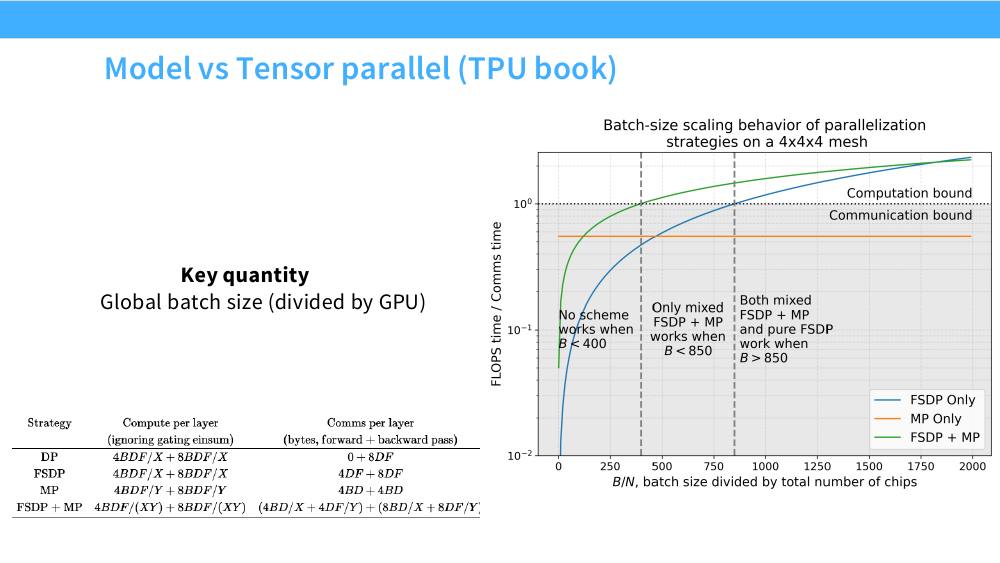
这张图是整个并行策略选择的理论底座。左表的公式解释了为什么:DP/FSDP 的通信量($8DF$,与参数量成正比)是固定的,而计算量随批量 $B$ 线性增长,所以批量越大 DP 越划算;MP 的通信量 $4BD$ 本身就随批量增长,所以比值恒定。批量小的时候只能靠模型并行,批量大了就该换成数据并行——这就是「先 MP 后 DP」这条规则的来源。
8. 3D / 4D 并行:组合与硬件映射
8.1 基本规则
Tatsu 给的经验法则只有三条,但它们把整个搜索空间压缩得非常小:
- 先让模型装得下:
- 张量并行 / 专家并行开到「每台机器的 GPU 数」为止(通常 8);
- 还装不下就跨机器加流水线并行;
- (或者用 ZeRO-3 代替——取决于你的节点间带宽够不够。)
- 然后把剩下的 GPU 全给数据并行,一直扩到 GPU 用完为止。
- 如果批大小太小(流水线气泡大、通信占比高),就用梯度累积:拿更大的等效批量换更好的通信效率。
这三条对应的硬件映射是:节点内跑 TP/EP(NVLink,450 GB/s),节点间跑 PP(IB,50 GB/s),最外层跑 DP/ZeRO(能容忍最高延迟)。
8.2 维度的顺序也是有讲究的
Llama 3 论文里有一句话值得逐字读:「并行维度的顺序 $[\text{TP}, \text{CP}, \text{PP}, \text{DP}]$ 是为网络通信优化过的。最内层的并行需要最高带宽和最低延迟,因此通常被约束在同一台服务器内;最外层的并行可以跨越多跳网络,应当能容忍较高延迟。」
为什么 DP 放最外层?因为 FSDP 可以异步预取下一层的分片权重、异步归约上一层的梯度——它的通信不在关键路径上,天然能吃掉延迟。而 TP 的 all-reduce 卡在每一层的正中间,谁都等不了。
把 rank 编号想成一个多维数组的下标:rank = ((dp_idx * PP + pp_idx) * CP + cp_idx) * TP + tp_idx。这样相邻的 rank 号自动落在同一个 TP 组里,而 NCCL 分配 rank 时相邻编号通常就在同一台机器上——顺序一改,性能就掉一半。这是真实训练里最容易踩、也最难 debug 的坑之一。
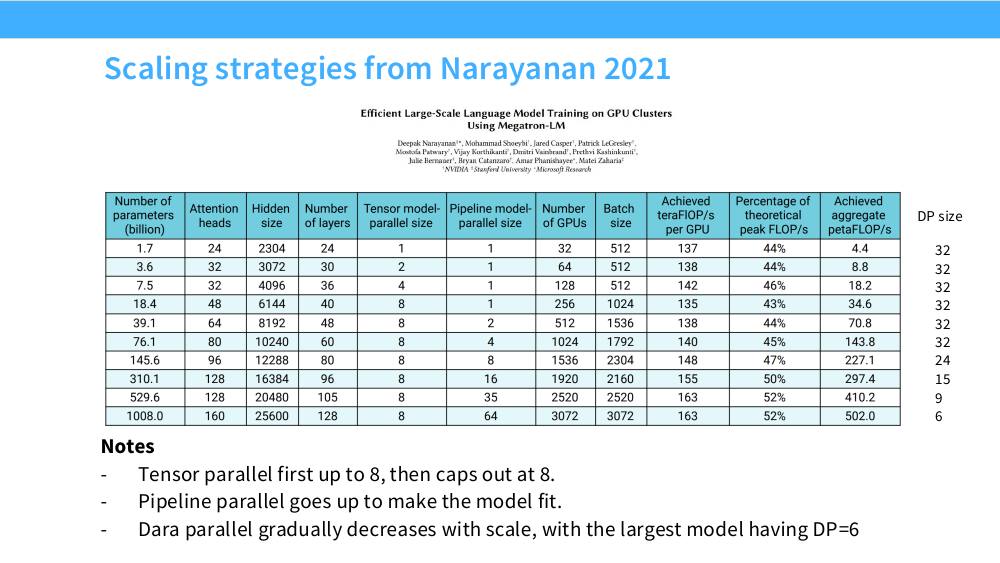
8.3 从 Megatron 的实测数据看规律
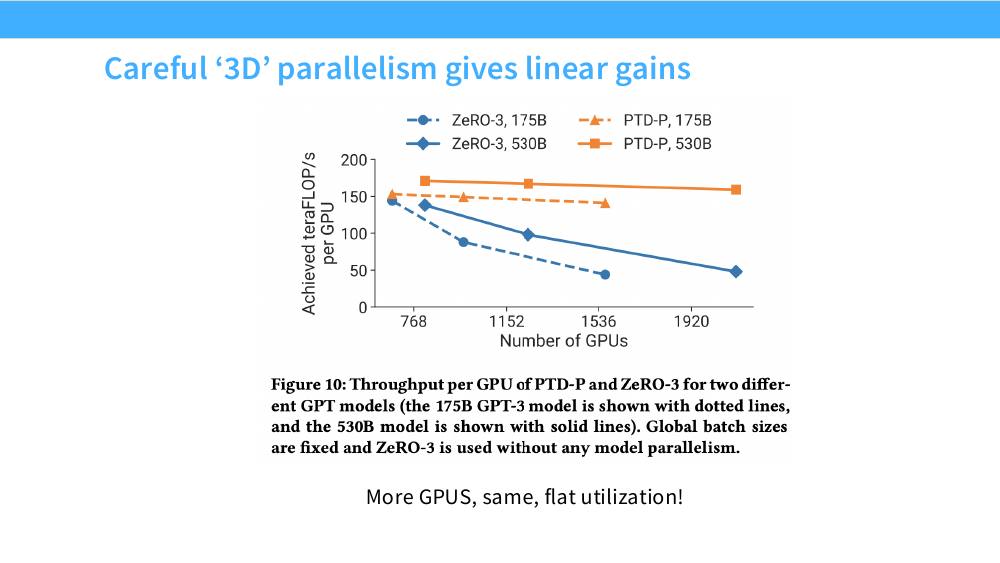
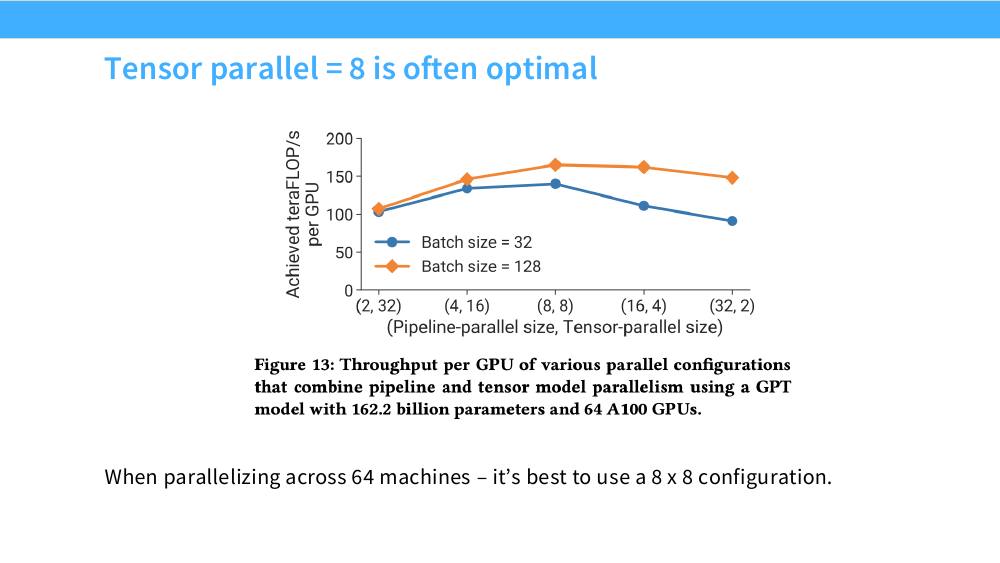
8.4 完整推演:1024 张 H100 训一个 70B 稠密模型
现在把所有东西串起来,做一次真正的配置推演。目标模型:$N = 70$B 参数,$h = 8192$,$L = 80$,$a = 64$,$V = 128{,}256$,序列长 $s = 8192$。硬件:1024 张 H100-80GB,128 个节点,节点内 NVLink 450 GB/s(单向),节点间 InfiniBand 400 Gb/s $\approx$ 50 GB/s。
第 0 步:算总显存需求。BF16 训练 + FP32 master weights + FP32 Adam 双矩:
$$ \underbrace{2}_{\text{BF16 权重}} + \underbrace{2}_{\text{BF16 梯度}} + \underbrace{4}_{\text{FP32 master}} + \underbrace{4+4}_{\text{Adam }m,v} = 16\ \text{B/param} \;\Rightarrow\; 70\text{B} \times 16 = 1120\ \text{GB} $$加上第 4 节算出的 182 GB 激活(含 FlashAttention、不含并行),总共约 1.3 TB。单卡 80 GB,所以至少需要 17 张卡才装得下一份模型——模型并行是强制的,不是可选的。
第 1 步:定 TP。按规则,TP 开到节点内上限:TP = 8。同时无条件开 SP(免费)。此时每卡持有 $70/8 = 8.75$B 参数,激活降到 $sbh \cdot 34/8 = 285$ MB/层。
第 2 步:定 PP。试算 PP=1(即 TP=8 + ZeRO-1 over DP=128):
- BF16 权重:$8.75\text{B} \times 2 = 17.5$ GB
- BF16 梯度:17.5 GB
- 优化器状态(12 B/param)经 ZeRO-1 切到 DP=128:$8.75\text{B} \times 12 / 128 = 0.82$ GB
- 激活(80 层 × 285 MB):22.8 GB
- 合计 58.6 GB,加上 NCCL 缓冲、碎片、logits 峰值,逼近 80 GB 但勉强可行。
为了留出余量(也为了后面能开大 micro-batch),取 PP = 4。每份模型占 $8 \times 4 = 32$ 张卡,DP = 1024 / 32 = 32。
第 3 步:核对 PP=4 下的显存。每 rank 持有 $70/32 = 2.19$B 参数:
| 项目 | 计算 | 大小 |
|---|---|---|
| BF16 权重 | $2.19\text{B} \times 2$ | 4.4 GB |
| BF16 梯度 | $2.19\text{B} \times 2$ | 4.4 GB |
| 优化器状态(ZeRO-1 over DP=32) | $2.19\text{B} \times 12 / 32$ | 0.82 GB |
| 激活(1F1B:20 层 × 最多 4 个 in-flight micro-batch) | $20 \times 285\text{MB} \times 4$ | 22.8 GB |
| 合计 | 32.4 GB ✅ 余量充足 | |
注意激活那一行印证了第 2 节的观察:1F1B 下激活总量与 PP 无关($\text{层数}/p \times p = $ 常数)。省下来的 26 GB 可以拿去开大 micro-batch 或者关掉重算。
第 4 步:定批大小。要让流水线气泡占比 $\frac{p-1}{m+p-1} \le 5\%$,需要 $m \ge 57$,取 $m = 64$。全局批大小:
$$ B_{\text{tokens}} = \text{DP} \times m \times b \times s = 32 \times 64 \times 1 \times 8192 = 16.8\ \text{M tokens} $$这个数字和 Llama 3 405B 实际用的 16M tokens/batch 几乎一样——不是巧合,是同一套约束推出来的。
第 5 步:核对通信预算。每个 micro-batch 在一个 stage 上的计算量:
$$ \frac{6 \times (70\text{B}/4) \times 8192}{8\ (\text{TP})} = 1.08 \times 10^{14}\ \text{FLOPs / GPU} \;\xrightarrow{\ \approx 500\ \text{TFLOP/s 实效}\ }\; \approx 215\ \text{ms} $$| 通信类型 | 数据量 | 链路 | 耗时 | 占比 |
|---|---|---|---|---|
| TP all-reduce(20 层 × 940 MB) | 18.8 GB / micro-batch | NVLink 450 GB/s | 42 ms | 19%(部分可重叠) |
| PP 点对点(配 SP 后 $bsh/t$) | 17 MB / micro-batch / 边界 | IB 50 GB/s | 0.34 ms | < 0.2% ✅ |
| ZeRO-1 的 RS + AG(每步一次) | $2 \times 4.4\text{GB} \times \frac{31}{32} \approx 8.5$ GB | IB 50 GB/s | 170 ms | 170 ms / 13.8 s = 1.2% ✅ |
(最后一行的分母:一个完整 step 要跑 $m=64$ 个 micro-batch,约 $64 \times 215\text{ms} = 13.8$ s。这就是梯度累积让数据并行几乎免费的定量证明——通信频率被摊薄了 64 倍。)
第 6 步:估吞吐和总时长。假设 MFU = 45%(对 TP=8/PP=4 这种配置是合理的):
$$ \text{有效算力} = 1024 \times 990\ \text{TFLOP/s} \times 0.45 = 456\ \text{PFLOP/s} $$训练 15T tokens 需要 $6ND = 6 \times 7\times10^{10} \times 1.5\times10^{13} = 6.3\times10^{24}$ FLOPs,于是
$$ T = \frac{6.3\times10^{24}}{4.56\times10^{17}} \approx 1.38\times 10^{7}\ \text{s} \approx 160\ \text{天} \approx 3.9\ \text{M GPU·小时} $$最终配置:TP=8(+SP)、PP=4(1F1B + VPP)、DP=32(ZeRO-1)、micro-batch=1、梯度累积 64 步、全局批 16.8M tokens。整个推演里没有一步是拍脑袋的:TP 由 NVLink 边界决定,PP 由显存决定,DP 由「剩下多少卡」决定,$m$ 由气泡容忍度决定,批大小是这四者的乘积。这就是所谓「配置搜索」的全部内容——搜索空间其实只有个位数种可能。
9. 工程实际:MFU、重叠、梯度累积、失败恢复
9.1 MFU:唯一诚实的指标
模型 FLOPs 利用率(Model FLOPs Utilization, MFU)由 PaLM 论文引入,定义是:
$$ \text{MFU} = \frac{6ND / T}{n_{\text{GPU}} \times \text{peak FLOP/s}} $$分子是「训练这个模型理论上必需的 FLOPs 除以实际耗时」,分母是硬件的理论峰值。它的关键设计是分子只算必需的 $6ND$——激活重算多做的前向、流水线气泡里的空转、通信等待,全都算在损失里。
把 MFU 和 HFU(Hardware FLOPs Utilization)搞混。HFU 的分子包含了重算多做的 FLOPs,所以开了全量激活重算之后 HFU 会「变高」而 MFU 变低。汇报数字时一定要说清是哪个:一个「HFU 60%」的系统可能只有 45% 的 MFU。业界大规模训练的 MFU 参考线:Megatron-LM 在千卡上 44–52%,Llama 3 405B 在 16K 卡上 38–43%,MegaScale 在 12288 卡上 55.2%。能稳定超过 50% 就是很强的工程。
9.2 通信与计算重叠
上面所有的通信量估算都假设通信是「额外的时间」,但好的实现能把大部分藏起来。四个层次:
| 并行维度 | 重叠手法 | 能藏多少 |
|---|---|---|
| DP / ZeRO-1,2 | 梯度桶(bucket):某层反向一算完就立刻异步 all-reduce,不等整个反向结束 | 几乎全部 |
| ZeRO-3 / FSDP | 预取:算第 $\ell$ 层时异步 all-gather 第 $\ell+1$ 层的参数 | 大部分(层够大时) |
| TP + SP | 把 all-gather / reduce-scatter 拆成块,与 GEMM 分块流水(Megatron 的 tensor-parallel comm overlap) | 部分——因为它在关键路径上 |
| EP | DeepSeek-V3 的 1F1B A2A overlap / DualPipe:把 all-to-all 塞进流水线中另一个 micro-batch 的计算里 | 大部分 |
FSDP 的重叠是最经典的例子。课上举的式子 $(W_1W_0 + W_2W_0)x = y$ 说明了要点:参数的 all-gather 在前向进行时就一起发出去了,等到真正需要 $W_1$ 时它已经到位;用完立刻释放。所以 ZeRO-3 名义上 1.5 倍的通信量,实际墙钟开销远小于 1.5 倍——前提是每层的计算量足够大,能盖住一次 all-gather。
9.3 梯度累积与批大小
梯度累积(gradient accumulation)在这一讲里出现了三次,每次都在解决不同的问题,值得单独总结:
- 对流水线:累积步数 $m$ 就是 micro-batch 数,直接决定气泡占比 $\frac{p-1}{m+p-1}$。$m$ 不够大 PP 就没法用。
- 对数据并行:把 $m$ 步的梯度累加后再做一次 all-reduce,通信频率降低 $m$ 倍——上面的推演里正是这一点把 DP 通信占比压到了 1.2%。
- 对显存:micro-batch $b$ 可以保持很小(甚至 1),激活显存 $\propto b$ 也就很小,而等效批量靠 $m$ 撑起来。
代价是:梯度累积不减少总计算量,只是把它串行化了。所以真正的约束仍然是临界批大小——批量涨过头,多花的算力换不来相应的收敛加速。这也是为什么 Narayanan 表里 DP 会从 32 一路降到 6:批大小涨不动了,只能把卡挪给模型并行。
9.4 激活重算的经济账
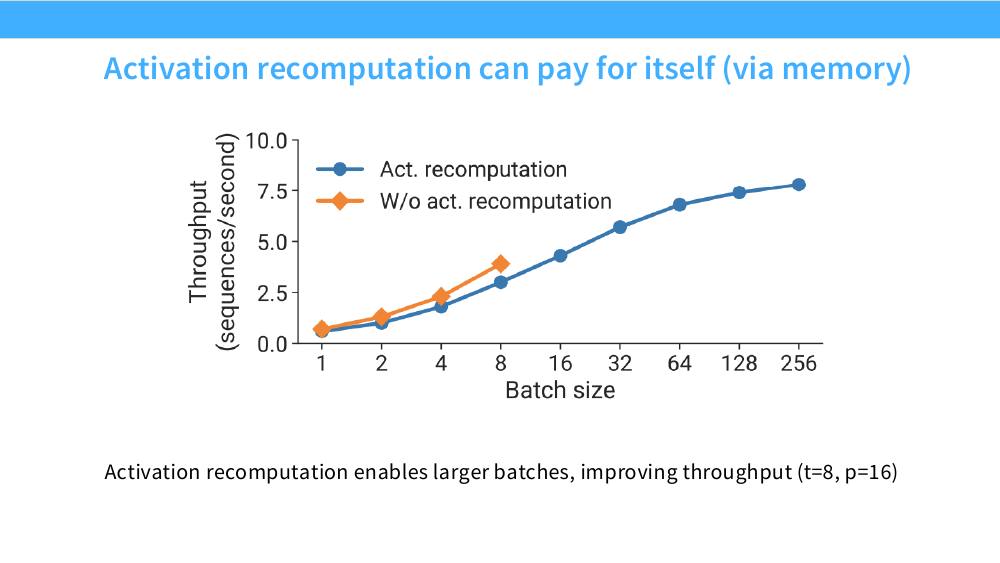
9.5 万卡规模的失败恢复
Tatsu 在课上专门插了一页,因为这是纸面推导完全看不到、但实际最折磨人的部分。
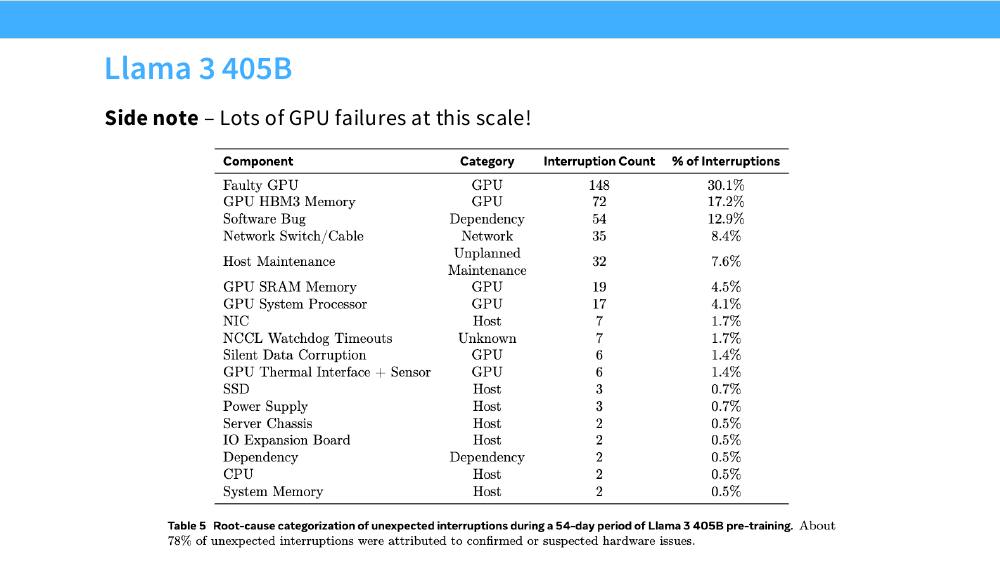
「静默数据损坏」那一行最可怕:GPU 没有报错,只是算错了。它不会让训练崩溃,只会让 loss 曲线莫名其妙地发散。大规模训练必须有独立的数值健康监控(loss spike 检测、梯度范数监控、周期性的确定性重算校验)。
这些失败对并行策略有直接影响:
- checkpoint 频率是显存/带宽和「丢多少进度」的权衡。1.3 TB 的模型状态写一次盘就要几分钟;对策是分片 checkpoint(每个 rank 只写自己那份)+ 异步落盘(先拷到 CPU 内存再后台写)。
- 并行度越大,MTBF 越短。一次故障要重启整个 job,$n$ 张卡的联合故障率是单卡的 $n$ 倍。所以有了弹性训练、热备节点、以及自动化的坏卡剔除。
- 并行配置本身要能容忍拓扑变化:换一个节点进来,rank 到物理位置的映射变了,TP 组可能就跨节点了——性能会莫名其妙掉一截。
尽管有这么多中断,Llama 3 团队报告的有效训练时间仍在 90% 以上,靠的是自动检测 + 快速重启的整套基础设施。这部分工作量在大规模训练里往往和算法本身相当。
10. 真实系统巡礼:大家到底怎么配
理论讲完,看看 2024–2026 年的真实模型是怎么选的。
| 模型 | DP | TP / SP | EP | PP | CP | 备注 |
|---|---|---|---|---|---|---|
| DeepSeek(MoE) | ZeRO-1 | 1 | 8 | 16 | — | ZeRO-1 + TP + SP + 1F1B PP |
| DeepSeek-V3 | ZeRO-1 | 1 | 64(跨 8 节点) | 16 | — | EP 用 1F1B A2A overlap;TP 完全关闭 |
| Yi | ZeRO-1 | > 0 | 1 | > 0 | — | Yi-lightning (2025) 把 TP 换成了 EP |
| Llama 3 405B | 128 | 8 | 0 | 16 | 1 | 稠密模型,16384 张 H100 |
| Gemma 2(2/9/27B) | 768 | 8 | 0 | 0 | 0 | ZeRO-3 + MP(=TP+SP) + DP,不用 PP |
| Mixtral 8×22B | 2 | 4 | 8 | 4 | 1 | Megatron 配置,共 256 GPU |
| Nemotron 3 Super 120B-A12B | — | 2 | 64 | — | 64 | 长上下文扩展阶段 |
| Qwen 3(235B-A22B) | — | 2 | 32 | 8 | 1 | 30B-A3B 单节点只用 EP=8 |
| OLMo / Dolma 7B | 纯 FSDP(模型能装进单节点) | 小模型不需要模型并行 | ||||
从这张表能读出三条铁律:
- TP 几乎总是 $\le 8$,而且越是 MoE 模型 TP 越小(DeepSeek 直接是 1)——NVLink 域边界是硬约束。
- EP 可以开得很大(8 → 32 → 64),这是 MoE 时代最大的变化:稠密模型时代 TP=8 是模型并行的主力,MoE 时代主力换成了 EP。但课上也标注了 EP「hard」——负载均衡和 all-to-all 调优是真正的工程难点。
- 长上下文阶段用大 CP:Nemotron 3 的 CP=64、Llama 3 第三阶段的 CP=16,都出现在序列长度拉到 100K+ 的时候。这是一个分阶段的策略——不是从头到尾一套配置。
还有一个值得注意的反例:Gemma 2 完全不用流水线并行(PP=0),走的是 ZeRO-3 + TP/SP + 大 DP 的路线。这是因为 Google 用的是 TPU:TPU pod 的环面网格(toroidal mesh)互联在整个 pod 范围内都有很高的带宽,不存在 GPU 那种「节点内 450 GB/s、节点外 50 GB/s」的悬崖,所以可以把 TP 域开得很大、也可以放心用 ZeRO-3。并行策略是硬件拓扑的函数——这也是上一讲讨论 mesh vs tree 拓扑时埋下的伏笔。
11. 怎么选:一个可执行的决策流程
把整讲的规则整理成一个可以照着做的流程。假设你有 $G$ 张 GPU、每张 $M$ GB 显存、每节点 $g$ 张卡(通常 8)。
# ---------- 第 0 步:模型能装进单节点吗? ----------
if 模型状态 + 激活 <= g * M:
    用 FSDP / ZeRO-3 就完事了(OLMo、Dolma 的做法)
    → 收工,别碰模型并行

# ---------- 第 1 步:先开免费的 ----------
开 ZeRO-1(distributed optimizer)        # 通信量不变,白赚显存
开 FlashAttention                          # 干掉 5*a*s/h 那一项
if 序列长度 >= 8192:
    考虑选择性激活重算                     # FLOPs 只多几个点

# ---------- 第 2 步:节点内切(高带宽域) ----------
if 是 MoE:
    EP = min(专家数, g)                    # 专家层优先 EP(GEMM 更胖、通信更少)
    TP = g // EP  (通常 1 或 2)            # 只用来切注意力
else:
    TP = 2, 4, 8 逐档试,直到装得下         # 上限 = g,一旦跨节点性能悬崖
TP > 1  →  无条件同时开 SP                 # 免费,把激活的常数项 10 也切掉

# ---------- 第 3 步:还装不下就跨节点 ----------
while 仍然 OOM:
    PP *= 2                                # 用点对点通信换 1/PP 的参数显存
    if PP >= 2: 开 VPP(interleaved)       # 气泡 (p-1)/(m*v)
if 序列长度 >= 32K:
    CP = 需要多少开多少                     # 长上下文阶段专用

# ---------- 第 4 步:剩下的全给数据并行 ----------
DP = G // (TP * PP * CP * EP_or_1)

# ---------- 第 5 步:定批大小 ----------
m = max(需要的梯度累积步数,  20 * (PP - 1))   # 让气泡 < 5%
global_batch = DP * m * micro_batch * seq_len
if global_batch > 临界批大小:
    回头减小 DP、增大 PP 或 TP              # 卡太多、批撑不住

# ---------- 第 6 步:验证 ----------
测 MFU;< 35% 就去查:气泡?TP 跨节点了?重叠没开?负载不均?
整个流程可以用一句话概括 Megatron 的 Guideline 1:模型并行是「不得已才用」的东西,数据并行才是你想要的。TP/PP/EP/CP 每一个都在给通信加负担、给实现加复杂度,它们唯一的作用是让模型装下。所以每一步都是「装不下才加一档」,装下了立刻停手,把剩余的卡全部交给数据并行。
- 「TP 越大越好,反正 all-reduce 很快」——只在 NVLink 域内成立,跨节点直接掉 40–65%。
- 「开了 PP 就能省激活显存」——1F1B 下激活总量与 PP 无关,PP 只省参数显存。
- 「ZeRO-3 能替代所有模型并行」——它不减少激活显存,而且固定批量下加卡时单卡吞吐会持续下滑。
- 「先把配置调好再改序列长度」——序列长度一变,激活显存和 CP 需求全变,Llama 3 就是分三阶段用三套配置。
- 「MFU 低就是 GPU 不行」——先查气泡、跨节点 TP、通信重叠没开、MoE 负载不均,这四个占了绝大多数情况。
本讲小结
速查表:四个切分轴
| 切什么 | 通信 | 省参数显存 | 省激活显存 | 放哪条链路 | 典型值 | |
|---|---|---|---|---|---|---|
| DP + ZeRO | 数据(+ 状态分片) | all-reduce / RS+AG,$2N$–$3N$ | ZeRO-1/2/3 递进 | ❌ | 最外层,可跨多跳 | 越大越好 |
| PP | 层(深度) | 点对点 $bsh$ | ✅ $1/p$ | ➖(1F1B 下持平) | 节点间 IB | 4–16 |
| TP (+SP) | 隐藏维 / 头(宽度) | all-reduce $8bsh\frac{t-1}{t}$/层 | ✅ $1/t$ | ✅ $1/t$(须配 SP) | 节点内 NVLink | $\le 8$ |
| CP | 序列 | 环形 KV 传递 | ❌ | ✅ $1/c$ | 节点内优先 | 1(短)/ 16–64(长) |
| EP | 专家 | all-to-all $4bskh\frac{e-1}{e}$ | ✅ 专家权重 $1/e$ | ❌ | NVLink 域优先 | 8–64 |
必须记住的公式
| 量 | 公式 | 用途 |
|---|---|---|
| all-reduce 通信量 | $2\frac{n-1}{n}N$ | 一切通信估算的基础;= RS + AG |
| 流水线气泡 | $\dfrac{p-1}{m+p-1}$(占总时间)/ $\dfrac{p-1}{m}$(占有效计算) | 决定需要多少 micro-batch |
| interleaved 气泡 | $\dfrac{p-1}{m\,v}$ | VPP 的收益(代价:$v$ 倍 P2P 流量) |
| TP 通信量 | $8bsh\dfrac{t-1}{t}$ / 层 / micro-batch | 判断 TP 能否跨节点(答案:不能) |
| 激活显存 | $sbh\left(34 + 5\dfrac{as}{h}\right)$ / 层 | 裸的上界 |
| TP+SP+重算后 | $sbh\cdot\dfrac{34}{t}$ / 层 | 真正能跑的配置 |
| MFU | $\dfrac{6ND/T}{n_{\text{GPU}}\cdot\text{peak}}$ | 唯一诚实的效率指标 |
三句话总结
- 过了某个规模,多卡多机并行不是优化,是前提——单卡装不下,讨论就无法开始。
- 并行问题没有单一解:DP 扩批量、模型并行扩容量、激活并行扩序列,大规模训练几乎一定三者全用。
- 好在组合规则简单且可解释:TP/EP 进 NVLink 域,PP 跨节点,DP 放最外层,批不够就梯度累积。真正的搜索空间只有个位数种配置。
附录:延伸阅读
张量并行与序列并行
- Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism (2019) — 张量并行的原始论文,「列切 + 行切 = 一次 all-reduce」这个核心技巧就出自这里,20 页读完能彻底搞懂本讲第 3 节。
- Reducing Activation Recomputation in Large Transformer Models (2022) — Korthikanti 等人,序列并行 + 选择性激活重算,本讲第 4 节的全部公式($34sbh + 5as^2b$ 及其分解)都来自这篇。
流水线并行
- GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism (2018) — micro-batch 与气泡公式的出处,也是「重物化(rematerialization)」在流水线里的第一次系统应用。
- Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM (2021) — Narayanan 等人,1F1B、interleaved schedule 与 PTD-P 三维并行;本讲第 8 节的所有实测表格和曲线都出自这篇,是全课最值得精读的系统论文。
- Zero Bubble Pipeline Parallelism (2023) — 把反向拆成 B 和 W 两段的那个想法,ZB-H1/ZB-H2 调度的完整推导。
数据并行与显存
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models (2019) — 三个 stage 的原始定义与通信量分析,上一讲的主线。
- PyTorch FSDP: Experiences on Scaling Fully Sharded Data Parallel (2023) — ZeRO-3 的工业级实现,重点看它怎么做参数预取和通信-计算重叠。
- An Empirical Model of Large-Batch Training (2018) — 临界批大小的来源,解释了为什么数据并行不能无限扩。
上下文并行与专家并行
- Ring Attention with Blockwise Transformers for Near-Infinite Context (2023) — 环形 KV 传递 + 在线 softmax,长上下文训练的基础设施。
- Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer (2017) — MoE 的起点,先理解路由才能理解 all-to-all 从哪来。
- Switch Transformers (2021) — 容量因子、token 丢弃、负载均衡损失的系统讨论,EP 的工程细节几乎全在这里。
- Megatron-Core MoE 文档 — 本讲第 6、8 节引用的五条 guideline 和 MoE Parallel Folding 的官方说明,是目前最实用的配置手册。
真实系统报告(本讲第 10 节的一手材料)
- The Llama 3 Herd of Models (2024) — 三阶段并行配置、$[\text{TP},\text{CP},\text{PP},\text{DP}]$ 的顺序原则、以及那张著名的故障根因表,大规模训练工程的最佳公开文档。
- DeepSeek-V3 Technical Report (2024) — TP=1、EP=64、DualPipe、节点受限路由;MoE 时代并行策略的范式转变。
- MegaScale: Scaling Large Language Model Training to More Than 10,000 GPUs (2024) — 字节的 12288 卡训练报告,55.2% MFU,重点看它的诊断工具链与故障处理。
- Mixtral of Experts (2024) / Qwen 3 (2025) — 第 10 节配置表里两个 MoE 模型的原始报告。
- Dolma (2024) / Gemma (2024) — 纯 FSDP 路线与 TPU 上的 ZeRO-3 + MP 路线,两个不用流水线并行的反例。