并行化(上):集合通信、数据并行与 ZeRO
一张卡装不下、也算不完一个大模型。这一讲把「多卡协同」拆到最底层:GPU 之间是怎么连的、集合通信原语各自搬多少字节、ring all-reduce 为什么只要 $2(p-1)/p \cdot N$、以及如何用 torch.distributed 把这些拼成 DDP 和 ZeRO。
0. 本讲导读
上一讲讲的是单张 GPU 内部的并行:把 kernel 融合起来、把矩阵切成 tile 塞进 shared memory、用 Triton 手写算子。那一讲的主线是「减少对 HBM 的访问次数」。
这一讲开始讲跨 GPU的并行。表面上换了个尺度,但 Percy 在开场就点明了:两件事其实是同一件事。
无论在哪个尺度上,计算单元(ALU)离数据(输入/输出)都很远。所有的优化,本质上都是「编排计算的顺序与位置,使得数据搬运不成为瓶颈」。
差别只在于「远」的程度不同,于是形成一个层级:
| 层级 | 介质 | 典型带宽量级 | 上一讲/本讲的手段 |
|---|---|---|---|
| 单节点 · 单 GPU · 片上 | 寄存器 / L1 / shared memory | ~ 100 TB/s | 融合(fusion)、分块(tiling) |
| 单节点 · 单 GPU · 片外 | HBM | ~ 3–8 TB/s | |
| 单节点 · 多 GPU | NVLink / NVSwitch | ~ 0.9–1.8 TB/s | 复制(replication)、切分(sharding) |
| 多节点 · 多 GPU | InfiniBand / Ethernet | ~ 0.05 TB/s |
上一讲用 fusion/tiling 减少访存;这一讲用 replication/sharding 减少通信。
为什么要用多 GPU?Percy 给了两条互相独立的理由——理解这一点很重要,因为后面每一种并行策略解决的是其中一条,或者两条都解决:
- 装不下:参数 + 优化器状态 + 梯度 + 激活值,超过了单卡显存。
- 算得慢:你想用更多 GPU(更多 FLOPs)把训练时间压下来。
本讲(上)覆盖原讲义的 Part 1:分布式通信/计算的构件——集合通信原语、硬件拓扑、NCCL 与 torch.distributed、带宽基准测试——以及 Part 2 的第一种策略:数据并行(含 ZeRO/FSDP 与激活值重计算)。张量并行(沿宽度切)与流水线并行(沿深度切)留到下一讲。
- 训练一个 175B 模型需要约 $2.8$ TB 显存放优化器状态,$3.15 \times 10^{23}$ FLOPs 的计算量——单张 H100 要算约 25 年。这两条硬限制各自独立地逼你上多卡。
- 节点内(NVLink,~1.8 TB/s)与节点间(InfiniBand,~0.05 TB/s)带宽差 30–40 倍。这个数量级差异是所有并行策略分层设计(节点内用张量并行、节点间用数据/流水线并行)的物理根源。
- 八个集合通信原语里,真正的主力是三个:all-gather(凑齐参数)、reduce-scatter(汇总梯度并分摊存储)、all-reduce(= 前两者之和)。记住
all-reduce = reduce-scatter + all-gather,ZeRO/FSDP 就是把这个等式拆开用。 - Ring all-reduce 每个 rank 只需收发 $2\frac{p-1}{p} N$ 字节,与设备数 $p$ 几乎无关($p \to \infty$ 时趋于 $2N$);朴素的「汇总到 rank 0 再广播」则是 $2(p-1)N$,随 $p$ 线性爆炸。
- DDP 的通信/计算比 $=\dfrac{2C}{3 B T_{\text{local}}}$,与模型大小无关,只取决于每卡的 token 数——这就是 DDP 能扩展的原因,也是「小 batch + 慢网络」会被通信卡死的原因。
- ZeRO 三阶段依次切分优化器状态 / +梯度 / +参数:7.5B 模型在 64 卡上,单卡显存从 120 GB → 31.4 GB → 16.6 GB → 1.9 GB;前两阶段通信量不变,第三阶段只增加 1.5 倍。这是分布式训练里性价比最高的一笔交易。
1. 为什么必须跨 GPU:显存墙与算力墙
「模型太大了」是句空话。要真正理解并行化的必要性,得把账算到字节和秒。
1.1 显存账:一个参数要占 16 字节
用 AdamW + 混合精度(bf16 计算、fp32 主权重)训练一个 $N$ 参数的模型,稳态下常驻显存的东西有:
| 项目 | 精度 | 字节/参数 | 说明 |
|---|---|---|---|
| 参数(前向/反向用) | bf16 | 2 | 实际参与矩阵乘的那份 |
| 梯度 | bf16 | 2 | 反向传播产出,需要 all-reduce |
| fp32 主权重 | fp32 | 4 | bf16 只有 8 位尾数,小更新会被吃掉,必须留一份 fp32 |
| Adam 一阶动量 $m$ | fp32 | 4 | 优化器状态,$K = 12$ 字节/参数 |
| Adam 二阶动量 $v$ | fp32 | 4 | |
| 合计 | 16 | 不含激活值 |
于是「模型状态」的显存需求是
$$ M_{\text{state}} \;=\; (2 + 2 + K)\,N \;=\; 16 N \ \text{字节}, \qquad K = 12 $$代入具体规模(对照 H100 的 80 GB / H200 的 141 GB / B200 的 192 GB):
| 模型 | 参数量 $N$ | $16N$(模型状态) | 单卡(80 GB)放得下吗 |
|---|---|---|---|
| GPT-2 large | 0.77 B | 12.3 GB | 轻松 |
| Llama-3 8B | 8 B | 128 GB | 放不下 |
| ZeRO 论文例子 | 7.5 B | 120 GB | 放不下 |
| Llama-3 70B | 70 B | 1.12 TB | 需要 ≥ 14 卡 |
| GPT-3 | 175 B | 2.80 TB | 需要 ≥ 35 卡 |
| Llama-3 405B | 405 B | 6.48 TB | 需要 ≥ 81 卡 |
注意这张表的第二行:连一个 8B 的模型都塞不进单张 80 GB 的 H100——而且这还没算激活值。8B 已经是今天「小模型」的量级。所以「多卡」不是大厂专利,是任何认真做预训练的人的起点。
1.2 显存账(续):激活值可能比参数还大
反向传播需要前向过程中的中间结果。对一个标准 Transformer 层,若把所有中间张量都存下来(fp16/bf16),每层每个 batch 的激活值字节数约为
$$ M_{\text{act}}^{(\text{layer})} \;\approx\; s\,b\,h\left(34 + 5\,\frac{a\,s}{h}\right) $$其中 $s$ 是序列长度、$b$ 是 batch size、$h$ 是隐藏维、$a$ 是注意力头数(这个公式来自 Reducing Activation Recomputation in Large Transformer Models)。括号里的 $34$ 来自各层归一化、QKV 投影、MLP 的中间张量;$5as/h$ 那一项来自 $s \times s$ 的注意力分数矩阵,它随序列长度平方增长。
取一组常见配置 $s = 8192,\ b = 8,\ h = 4096,\ a = 32,\ L = 32$ 层:
- $sbh = 8192 \times 8 \times 4096 = 2.68\times 10^8$
- 非注意力部分:$34 \cdot sbh = 9.1$ GB / 层 $\Rightarrow$ 32 层共 292 GB
- 注意力分数矩阵:$5 \cdot \frac{32 \times 8192}{4096} \cdot sbh = 320 \cdot sbh = 86$ GB / 层 $\Rightarrow$ 32 层共 2750 GB(!)
后面这一项是 FlashAttention(Dao et al., 2022)存在的理由:它根本不把 $s\times s$ 矩阵写回 HBM,那 2750 GB 直接消失。但即便如此,剩下的 292 GB 激活值仍然远超单卡显存——这就是第 9 节要讲的激活值重计算的动机。
1.3 算力账:单卡要算 25 年
回忆前面几讲的 FLOPs 估算:训练一个 $N$ 参数模型、喂 $D$ 个 token,总计算量约为
$$ \text{FLOPs} \;\approx\; 6\,N\,D $$(前向 $2ND$,反向 $4ND$。)GPT-3 的配置是 $N = 1.75\times 10^{11}$,$D = 3\times 10^{11}$:
$$ 6 \times 1.75\times10^{11} \times 3\times10^{11} \;=\; 3.15 \times 10^{23}\ \text{FLOPs} $$一张 H100 的 bf16 稠密峰值约 $989$ TFLOP/s,但真实训练中的 MFU(Model FLOPs Utilization)一般在 35%–50%,取 $40\%$ 得有效算力 $C \approx 4\times 10^{14}$ FLOP/s:
$$ T_{\text{single}} \;=\; \frac{3.15\times10^{23}}{4\times10^{14}} \;=\; 7.9\times 10^{8}\ \text{秒} \;\approx\; \textbf{25 年} $$换成 1024 张卡(假设完美线性扩展):$7.9\times10^8 / 1024 \approx 7.7\times10^5$ 秒 $\approx$ 9 天。这就是「用更多 FLOPs 训得更快」的全部含义——而「假设完美线性扩展」这七个字,正是本讲剩下部分要攻克的目标。
两条理由是独立的,不要混为一谈:
- 如果只是「装不下」,你可以用 ZeRO-3 / 流水线并行把模型摊到多卡上,哪怕总吞吐没提升。
- 如果只是「算得慢」,最简单的答案就是数据并行——复制模型,切分 batch。
现实中两条同时成立,所以要组合多种并行策略(3D/4D 并行),这是下一讲的主题。
2. 硬件:GPU 之间是怎么连起来的
并行策略的选择完全由互连带宽决定。所以先看硬件。
2.1 家用级("classic")
一台普通工作站里插两张显卡:
- 同一节点内的 GPU 通过 PCIe 总线通信。按 Wikipedia 的口径,PCIe 7.0 ×16 单向约 242 GB/s——但那是 2025 年才定稿的规范,今天你手上的机器大概率是 PCIe 4.0 ×16(单向 32 GB/s)或 5.0 ×16(单向 64 GB/s)。
- 不同节点之间走以太网,量级只有 ~200 MB/s(千兆/万兆家用网络)。
注意这两个数字之间已经差了三个数量级。在这种机器上,跨机训练几乎不可能——所有通信都会被以太网吃掉。
2.2 数据中心级("modern")
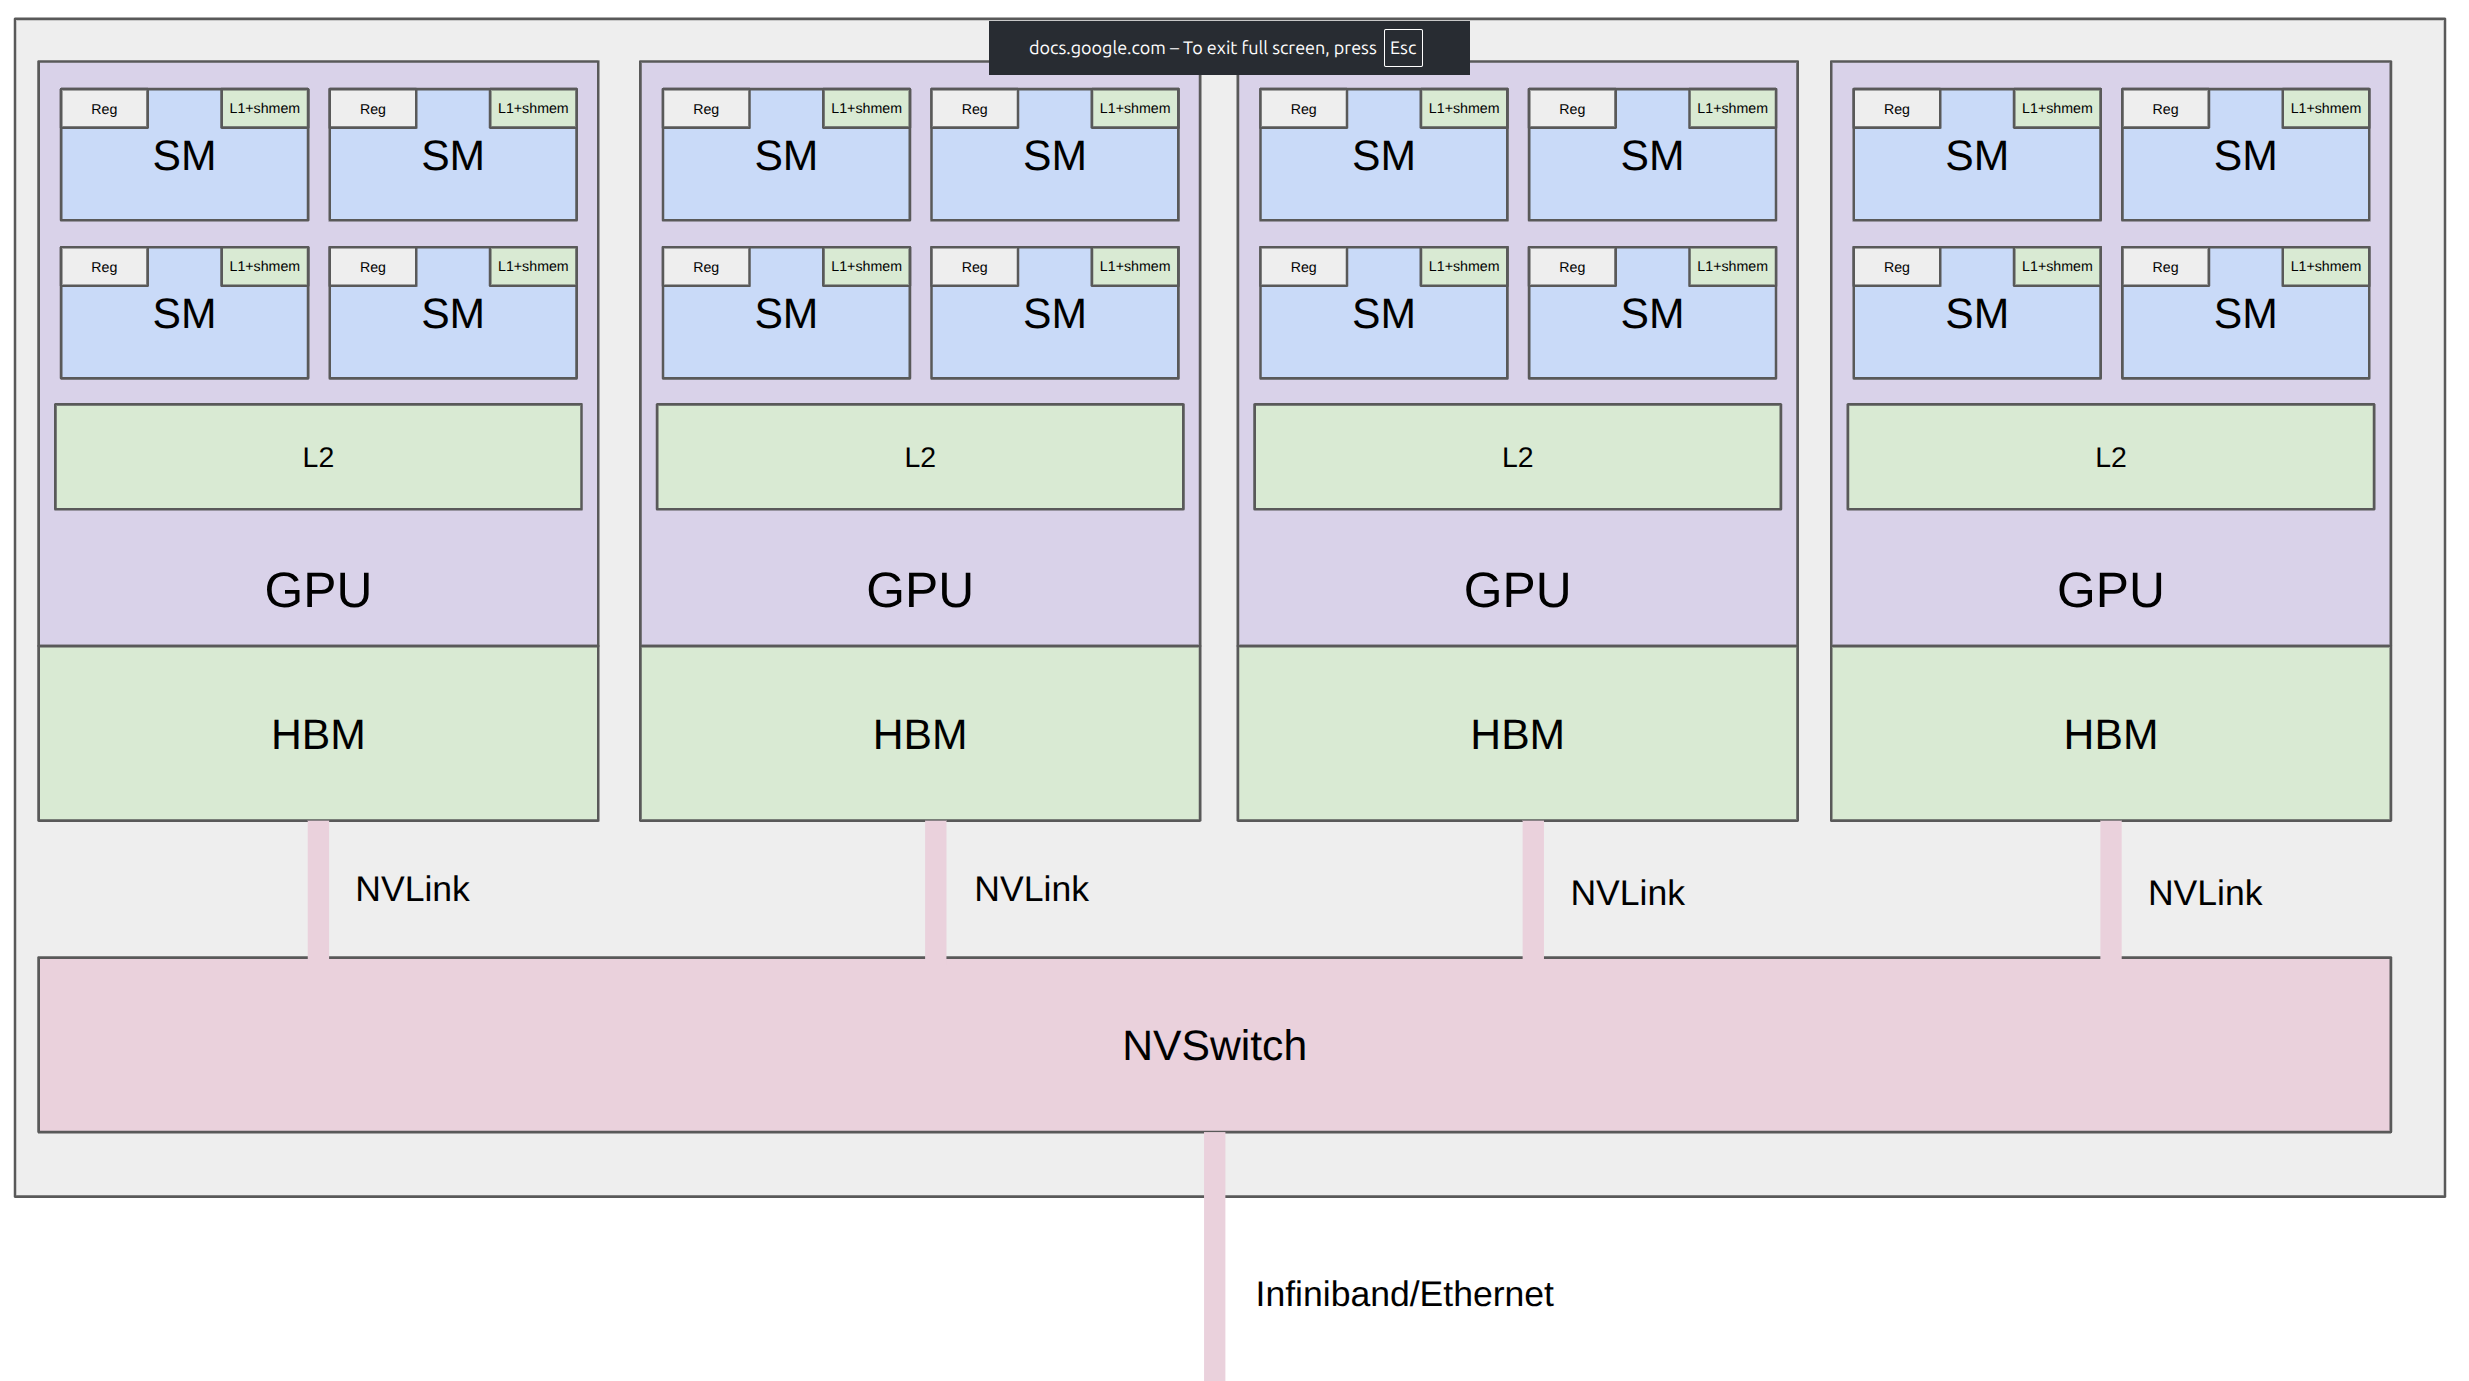
数据中心的典型配置是三级结构:
- 节点(node):8 张 GPU,通过 NVLink 连到一块 NVSwitch 上。NVSwitch 是个全交叉开关,意味着节点内任意两卡之间都是全带宽、等距的(不像早期 NVLink 只有部分卡直连)。B200 的 NVLink 5.0 达到 1.8 TB/s(每 GPU 双向聚合);作为对照,同一块 B200 的 HBM 带宽是 8 TB/s。
- Pod:约 256 个节点,通过 InfiniBand 互连。路径是 GPU → PCIe → HCA(InfiniBand 网卡)→ InfiniBand 线缆。每张网卡约 0.05 TB/s(400 Gb/s 的 NDR = 50 GB/s)。
- 集群 / 数据中心:多个 pod,通过以太网连接,路径要经过 PCIe → CPU。
| 互连 | 范围 | 带宽量级 | 相对 HBM | 相对 IB |
|---|---|---|---|---|
| HBM3e(B200) | GPU ↔ 自己的显存 | 8 TB/s | 1× | 160× |
| NVLink 5.0 / NVSwitch | 节点内 GPU ↔ GPU | 1.8 TB/s | 1/4.4 | 36× |
| NVLink 4.0(H100) | 节点内 GPU ↔ GPU | 0.9 TB/s | 1/3.7(HBM3 3.35 TB/s) | 18× |
| PCIe 5.0 ×16 | GPU ↔ CPU / 网卡 | 0.064 TB/s(单向) | 1/125 | 1.3× |
| InfiniBand NDR | 节点 ↔ 节点 | 0.05 TB/s / 网卡 | 1/160 | 1× |
| 以太网(数据中心) | pod ↔ pod | 0.01–0.05 TB/s | 1/800 | < 1× |
节点内比节点间快 20–40 倍。这条鸿沟决定了工业界所有并行方案的形状:
- 通信最密集的策略(张量并行——每层前向都要通信一次)只在节点内用,TP degree 通常 ≤ 8。
- 通信较少的策略(数据并行——每个 step 才通信一次;流水线并行——只传边界激活值)用在节点之间。
- FSDP 的
HYBRID_SHARD模式就是这个思路的直接体现:节点内做 ZeRO-3 分片,节点间做普通数据并行,把频繁的 all-gather 关在 NVLink 里。
2.3 绕开 CPU:RDMA、GPUDirect 与 RoCE
为什么 InfiniBand 比以太网强这么多?关键不只是线速,而是路径。
走标准以太网发一份数据,要经历:把数据从 GPU 拷到主机内存 → 拷进内核的 socket buffer → 组装 TCP 包 → 拷到网卡的 ring buffer → 发出去。每一次拷贝都要过 CPU、都要过 PCIe,延迟高、CPU 占用高、还引入抖动。
RDMA(Remote Direct Memory Access,远程直接内存访问)让一台机器的网卡直接读写另一台机器内存中的指定区域,完全不惊动对方 CPU,也不需要多次拷贝。配合 NVIDIA 的 GPUDirect RDMA,网卡可以直接从 GPU 显存 DMA 取数据。
- InfiniBand 原生支持 RDMA;标准以太网不支持。
- RoCE(RDMA over Converged Ethernet):在以太网上实现 RDMA,同样绕开 CPU,比 InfiniBand 便宜但也更弱(对无损网络配置更敏感)。Meta 的大规模集群用的就是 RoCE。
2.4 硬件在往哪走
- NVLink 域在变大:GB200/GB300 NVL72 —— 每个托盘 8 张 GPU,每个机架 9 个托盘,于是 72 张 GPU 处在同一个 NVLink 域内,彼此之间都是 NVLink 速度。这直接把「节点内」的定义从 8 卡扩到 72 卡,张量并行、专家并行的可用范围随之扩大。
- 但 Percy 的判断是:硬件会越来越快,而人们总会想训更大的模型,所以这个层级结构会一直存在。今天你为 8 卡节点设计的分层策略,明天只是把参数从 8 换成 72,思路不变。
2.5 NCCL:把「集合操作」翻译成线上的包
NCCL(NVIDIA Collective Communication Library,读作 "nickel")是这一切的中间层。你在 PyTorch 里写一句 dist.all_reduce(x),NCCL 负责:
- 探测硬件拓扑:有几个节点、几块交换机、哪些卡之间是 NVLink 直连、哪些要走 PCIe、网卡有几张。
- 规划最优路径:根据拓扑和消息大小,选择 ring、double binary tree、或者分层算法(节点内先 reduce、再跨节点、再节点内 broadcast)。
- 启动 GPU kernel 收发数据:注意通信本身是由 GPU kernel 完成的——它会占用 SM 资源,这也是为什么通信和计算的重叠不是完全免费的。
关键认知:你写的是「语义」,NCCL 决定「怎么做」。你不需要(也不应该)自己写 ring;但你需要知道 ring 的通信量公式,才能判断自己的训练是不是被通信卡住了。
3. 集合通信原语
集合操作(collective operation)是分布式编程的概念原语。它们不是深度学习发明的——这是 1980 年代并行计算文献里的经典内容(MPI 标准化了它们)。
「集合」的意思是:你描述的是跨多个设备的一种通用通信模式,而不是自己逐条管理点对点消息。这样做既更简洁,也更快——因为库可以针对拓扑做全局优化,而你手写的点对点方案通常做不到。
3.1 术语:rank 与 world size
- Rank:一个具体的设备/GPU(例如 0, 1, 2, 3)。在 PyTorch 里,一个 rank 对应一个进程,进程再绑定一张 GPU。
- World size:设备总数(例如 4)。
- 还有个常用概念 local rank:在本节点内部的编号(0–7),用来决定
torch.cuda.set_device()该设哪张卡。
八个原语可以分成三组:
- 基础:broadcast、scatter、gather、reduce —— 有一个特殊的 root rank(通常是 rank 0)
- 主力:all-gather、reduce-scatter、all-reduce —— 没有 root,所有 rank 对称
- 最一般:all-to-all —— 用于 MoE
下面逐个过。约定:$p$ 是 world size,用具体的 $p = 4$ 举例(和原讲义的例子完全一致)。
3.2 Broadcast:从 rank 0 复制到所有 rank
| Rank | 输入 | 输出 |
|---|---|---|
| 0 | [0, 1, 2, 3] | [0, 1, 2, 3] |
| 1 | — | [0, 1, 2, 3] |
| 2 | — | [0, 1, 2, 3] |
| 3 | — | [0, 1, 2, 3] |
通信量:若被广播的张量为 $N$ 字节,理想实现下每个非 root 的 rank 收 $N$ 字节;总流量 $(p-1)N$。朴素实现(root 逐个发)会让 root 的链路发 $(p-1)N$ 字节,成为瓶颈;流水线化的 ring broadcast 让每个 rank 只发/收各约 $N$ 字节,耗时 $\approx N/B$,与 $p$ 基本无关。
用途(Percy 说这是个「次要用途」):rank 0 加载初始 checkpoint,然后广播给所有 rank,保证大家从同一份参数出发。DDP 的初始化就干这件事。
3.3 Scatter:把 rank 0 上的张量切开分给所有 rank
| Rank | 输入 | 输出 |
|---|---|---|
| 0 | [0, 1, 2, 3] | [0] |
| 1 | — | [1] |
| 2 | — | [2] |
| 3 | — | [3] |
和 broadcast 的区别一目了然:broadcast 是每个 rank 都拿到完整副本,scatter 是每个 rank 拿到不同的一片。
通信量:root 上有 $N$ 字节,每个非 root rank 收 $N/p$ 字节;总流量 $\frac{p-1}{p}N$。
为什么要讲它:它本身用得不多,但它是理解 reduce-scatter 的垫脚石。
3.4 Gather:从所有 rank 收集到 rank 0(scatter 的逆)
| Rank | 输入 | 输出 |
|---|---|---|
| 0 | [0] | [0, 1, 2, 3] |
| 1 | [1] | — |
| 2 | [2] | — |
| 3 | [3] | — |
通信量:每个非 root rank 发 $N/p$ 字节,root 收 $\frac{p-1}{p}N$ 字节——注意 root 的入向链路是瓶颈,这个操作无法通过更好的算法把 root 的负担摊掉(数据本来就都要落到它那儿)。
为什么要讲它:all-gather 的垫脚石。
3.5 Reduce:从所有 rank 归约到 rank 0
和 gather 的区别是:不是把各片拼起来,而是用一个可结合、可交换的运算(sum / min / max / product)把它们合并成一个。
| Rank | 输入 | 输出(op = SUM) |
|---|---|---|
| 0 | [0] | [6] ← 0 + 1 + 2 + 3 |
| 1 | [1] | — |
| 2 | [2] | — |
| 3 | [3] | — |
为什么运算必须可结合可交换:因为库要自由决定归约的顺序和树形结构。这也意味着浮点求和的结果不是逐位确定的——不同的 world size 或不同的算法可能给出略微不同的和,这是分布式训练不可完全复现的一个来源。
为什么要讲它:all-reduce 的垫脚石。
3.6 All-gather:gather 到所有 rank
从这里开始是真正的主力。
| Rank | 输入 | 输出 |
|---|---|---|
| 0 | [0] | [0, 1, 2, 3] |
| 1 | [1] | [0, 1, 2, 3] |
| 2 | [2] | [0, 1, 2, 3] |
| 3 | [3] | [0, 1, 2, 3] |
通信量:设输出的完整张量为 $N$ 字节(每个 rank 输入 $N/p$)。ring 实现下每个 rank 发送 $\frac{p-1}{p}N$、接收 $\frac{p-1}{p}N$ 字节:
$$ V_{\text{all-gather}} \;=\; \frac{p-1}{p}\,N \quad\text{(每 rank,收/发各一份)} $$用途:每个 rank 只存参数的一个分片,前向传播前 all-gather 拼出完整参数。这是 ZeRO-3 / FSDP 的核心动作。
3.7 Reduce-scatter:逐维归约后把结果分发
这个最容易搞混,所以看清楚:每个 rank 都有一个完整长度的向量,把它们按位置相加,然后把结果向量切开,第 $i$ 段给 rank $i$。
| Rank | 输入(完整长度 4) | 输出(长度 1) | 怎么算出来的 |
|---|---|---|---|
| 0 | [0, 1, 2, 3] | [6] | 第 0 维求和:0 + 1 + 2 + 3 |
| 1 | [1, 2, 3, 4] | [10] | 第 1 维求和:1 + 2 + 3 + 4 |
| 2 | [2, 3, 4, 5] | [14] | 第 2 维求和:2 + 3 + 4 + 5 |
| 3 | [3, 4, 5, 6] | [18] | 第 3 维求和:3 + 4 + 5 + 6 |
把输入排成一个 $4\times4$ 矩阵看会更清楚:按列求和,然后第 $j$ 列的和归 rank $j$。
通信量:设每个 rank 的输入为 $N$ 字节,输出 $N/p$ 字节。ring 实现下每个 rank 收发各 $\frac{p-1}{p}N$ 字节:
$$ V_{\text{reduce-scatter}} \;=\; \frac{p-1}{p}\,N $$用途:反向传播后,把来自不同数据分片的梯度求和;但不复制结果,而是每个 rank 只留自己负责的那一段——存储被摊薄了 $p$ 倍。这是 ZeRO-2/3 的核心动作。
3.8 All-reduce = reduce-scatter + all-gather
| Rank | 输入 | 输出 |
|---|---|---|
| 0 | [0, 1, 2, 3] | [6, 10, 14, 18] |
| 1 | [1, 2, 3, 4] | [6, 10, 14, 18] |
| 2 | [2, 3, 4, 5] | [6, 10, 14, 18] |
| 3 | [3, 4, 5, 6] | [6, 10, 14, 18] |
输入和 reduce-scatter 一模一样,区别只在于:每个 rank 都拿到完整的归约结果,而不是只拿自己那一段。
通信量(下一节详细推导):
$$ V_{\text{all-reduce}} \;=\; 2\,\frac{p-1}{p}\,N $$正好是 reduce-scatter 加 all-gather 的和。这不是巧合——最优的 all-reduce 实现就是先做 reduce-scatter 再做 all-gather。
把 all-reduce 拆成两半,带来了灵活性:在两个半步之间,数据是分片状态的。如果你在这个中间状态做点事情(比如:只更新自己负责的那一片参数、只存自己那一片优化器状态),就得到了 ZeRO / FSDP。整个第 8 节都建立在这一个等式上。
用途:反向传播后同步梯度,且每个 rank 保留完整参数副本——这就是 DDP。
3.9 All-to-all:每个 rank 给每个 rank 发一份(最一般)
| Rank | 输入 | 发送去向 | 输出 |
|---|---|---|---|
| 0 | [0, 1, 2, 3] | 0→r0, 1→r1, 2→r2, 3→r3 | [0, 4, 8, 12] |
| 1 | [4, 5, 6, 7] | 4→r0, 5→r1, 6→r2, 7→r3 | [1, 5, 9, 13] |
| 2 | [8, 9, 10, 11] | 8→r0, 9→r1, 10→r2, 11→r3 | [2, 6, 10, 14] |
| 3 | [12, 13, 14, 15] | 12→r0, 13→r1, 14→r2, 15→r3 | [3, 7, 11, 15] |
把输入摞成 $4\times 4$ 矩阵,输出就是它的转置。这是理解 all-to-all 最快的方式(在各段大小均衡时)。
通信量:每个 rank 发 $\frac{p-1}{p}N$ 字节($N$ 是它的输入总量),但注意这些字节去往 $p-1$ 个不同目的地,无法像 ring 那样流水线复用,所以 all-to-all 在跨节点场景下对网络的对分带宽(bisection bandwidth)要求最高。
用途:
- MoE(Mixture of Experts):每个 rank 持有一部分数据、也持有一部分专家。路由器决定每个 token 该去哪个专家后,需要把 token 送到持有对应专家的 rank 上——这正是 all-to-all。算完之后还要再做一次 all-to-all 把结果送回来。
- 均衡切分时它等价于转置;不均衡切分也支持(
all_to_all_single带input_split_sizes),但你会希望切分尽量均衡——否则最慢的那个 rank 拖住所有人。MoE 的负载均衡损失(load balancing loss)就是为了这件事存在的。
3.10 记忆法与汇总表
- Reduce:做一个可结合/可交换的运算(sum、min、max)——数据量会变小。
- Scatter 是 gather 的逆:gather 把碎片收成整体,scatter 把整体切成碎片。
- All:目的地是所有设备,而不只是 root。
于是 all-gather = 「gather,但人人有份」,reduce-scatter = 「先 reduce 再 scatter」,all-reduce = 「reduce,但人人有份」。
| 操作 | 每 rank 输入 | 每 rank 输出 | 每 rank 通信量 | 典型用途 |
|---|---|---|---|---|
| broadcast | $N$(仅 root) | $N$ | $\approx N$ | 分发初始 checkpoint、随机种子 |
| scatter | $N$(仅 root) | $N/p$ | $\frac{p-1}{p}N$(root) | 分发数据分片 |
| gather | $N/p$ | $N$(仅 root) | $\frac{p-1}{p}N$(root) | 收集日志/评测结果到 rank 0 |
| reduce | $N$ | $N$(仅 root) | $\approx N$ | 汇总统计量到 rank 0 |
| all-gather | $N/p$ | $N$ | $\frac{p-1}{p}N$ | ZeRO-3/FSDP 凑齐参数;TP 拼接激活值 |
| reduce-scatter | $N$ | $N/p$ | $\frac{p-1}{p}N$ | ZeRO-2/3 汇总梯度并分摊存储 |
| all-reduce | $N$ | $N$ | $2\frac{p-1}{p}N$ | DDP 同步梯度;TP 求和分片输出 |
| all-to-all | $N$ | $N$ | $\frac{p-1}{p}N$ | MoE 的 token 路由;序列并行的重排 |
- 「reduce-scatter 是 scatter 的一种」——不是。scatter 的输入只在 root 上;reduce-scatter 的输入每个 rank 都有一份完整的。两者的输入形状完全不同。
- 「all-reduce 的代价是 $p \cdot N$」——不是。朴素实现才是那样;ring 实现是 $2\frac{p-1}{p}N < 2N$,与 $p$ 几乎无关。下一节专门讲这个。
- 「NCCL 支持所有这八个操作」——不完全。NCCL 后端不支持
dist.gather和dist.scatter(PyTorch 会直接报错)。要在 GPU 上收集数据,用all_gather然后只在 rank 0 上用;或者退回 gloo。这是新手最常撞的墙之一。
4. Ring all-reduce:通信量为什么只有 2(p−1)/p · N
All-reduce 是分布式训练里跑得最多的操作。它的代价直接决定了你能扩展到多少张卡。所以值得完整推一遍。
4.1 朴素做法为什么不行
最直白的实现:所有 rank 把自己的 $N$ 字节发给 rank 0,rank 0 求和,再广播回去。
- 汇总阶段:rank 0 的入向链路收 $(p-1)N$ 字节
- 广播阶段:rank 0 的出向链路发 $(p-1)N$ 字节
- 总耗时 $\displaystyle T_{\text{naive}} = \frac{2(p-1)N}{B}$
问题一目了然:时间随 $p$ 线性增长。$p = 8$ 时是 $14N/B$,$p = 1024$ 时是 $2046 N/B$。而且其他 $p-1$ 条链路在大部分时间里完全闲置——总带宽是 $p \cdot B$,你却只用了 $B$。
先想清楚「最好能做到多快」。考虑任意一个 rank $r$。它最终要拿到全局和,而全局和依赖于其它 $p-1$ 个 rank 的数据,所以:
- rank $r$ 至少要收 $N$ 字节的信息量(它自己那份数据的贡献是有的,但另外 $p-1$ 份的贡献必须传进来;即使被预先加和压缩,压缩后的结果仍有 $N$ 字节);
- 对称地,rank $r$ 的数据必须传出去,至少要发 $N$ 字节。
所以任何 all-reduce 算法,单个 rank 的收发量都不可能低于 $\approx N$ 各一份,时间不低于 $N/B$。ring all-reduce 达到 $\frac{p-1}{p}N \to N$,渐近最优。
4.2 成本模型:alpha-beta 模型
分析集合操作的标准工具是 $\alpha$-$\beta$ 模型:发送 $n$ 字节的耗时为
$$ T(n) \;=\; \alpha \;+\; \frac{n}{B} $$其中 $\alpha$ 是每次消息的固定延迟(NVLink 上约几微秒,InfiniBand 跨节点约 2–10 微秒),$B$ 是带宽。这个模型的价值在于它把两种 regime 分开了:
- 大张量(bandwidth-bound):$n/B \gg \alpha$,优化目标是最小化总字节数 → ring 算法胜出。
- 小张量(latency-bound):$n/B \ll \alpha$,优化目标是最小化通信轮数 → tree 算法胜出($O(\log p)$ 轮 vs ring 的 $O(p)$ 轮)。
这解释了 NCCL 的行为:小消息走 double binary tree,大消息走 ring,切换阈值由 NCCL 自己调优。也解释了为什么 DDP 要把小梯度打包成 bucket 再通信——单独 all-reduce 一个 1024 维的 bias 向量,时间几乎全花在 $\alpha$ 上。
4.3 Ring 拓扑与算法
把 $p$ 个 rank 排成一个环:rank $r$ 只往 rank $(r+1) \bmod p$ 发,只从 rank $(r-1) \bmod p$ 收。这样所有 $p$ 条链路同时满载,总带宽 $p \cdot B$ 被完全利用。
把每个 rank 的 $N$ 字节切成 $p$ 块,每块 $N/p$ 字节。算法分两个阶段,各 $p-1$ 步。
阶段一:reduce-scatter(p−1 步)
第 $k$ 步($k = 0, \dots, p-2$):rank $r$ 把自己手上编号为 $(r-k) \bmod p$ 的块发给 rank $r+1$;同时从 rank $r-1$ 收到编号 $(r-1-k) \bmod p$ 的块,累加到自己对应的块上。
用原讲义的数字走一遍($p = 4$,每个 rank 的向量有 4 个元素,正好一元素一块):
初始状态(rank $r$ 持有 [r, r+1, r+2, r+3]):
| Rank | 块 0 | 块 1 | 块 2 | 块 3 |
|---|---|---|---|---|
| 0 | 0 | 1 | 2 | 3 |
| 1 | 1 | 2 | 3 | 4 |
| 2 | 2 | 3 | 4 | 5 |
| 3 | 3 | 4 | 5 | 6 |
第 0 步:rank 0 发块 0(值 0)给 rank 1;rank 1 发块 1(值 2)给 rank 2;rank 2 发块 2(值 4)给 rank 3;rank 3 发块 3(值 6)给 rank 0。收到后累加:
| Rank | 块 0 | 块 1 | 块 2 | 块 3 | 本步新累加的块 |
|---|---|---|---|---|---|
| 0 | 0 | 1 | 2 | 9 | 块 3 = 6+3,含 {3,0} |
| 1 | 1 | 2 | 3 | 4 | 块 0 = 0+1,含 {0,1} |
| 2 | 2 | 5 | 4 | 5 | 块 1 = 2+3,含 {1,2} |
| 3 | 3 | 4 | 9 | 6 | 块 2 = 4+5,含 {2,3} |
第 1 步:每个 rank 把刚刚累加好的那一块继续往下传(rank 0 发块 3 = 9,rank 1 发块 0 = 1,rank 2 发块 1 = 5,rank 3 发块 2 = 9):
| Rank | 块 0 | 块 1 | 块 2 | 块 3 | 本步新累加的块 |
|---|---|---|---|---|---|
| 0 | 0 | 1 | 11 | 9 | 块 2 = 9+2,含 {2,3,0} |
| 1 | 1 | 2 | 3 | 13 | 块 3 = 9+4,含 {3,0,1} |
| 2 | 3 | 5 | 4 | 5 | 块 0 = 1+2,含 {0,1,2} |
| 3 | 3 | 9 | 9 | 6 | 块 1 = 5+4,含 {1,2,3} |
第 2 步(最后一步,$p-1 = 3$ 步完成):
| Rank | 块 0 | 块 1 | 块 2 | 块 3 | 完成的块 |
|---|---|---|---|---|---|
| 0 | 0 | 10 | 11 | 9 | 块 1 = 9+1 = 1+2+3+4 ✓ |
| 1 | 1 | 2 | 14 | 13 | 块 2 = 11+3 = 2+3+4+5 ✓ |
| 2 | 3 | 5 | 4 | 18 | 块 3 = 13+5 = 3+4+5+6 ✓ |
| 3 | 6 | 9 | 9 | 6 | 块 0 = 3+3 = 0+1+2+3 ✓ |
reduce-scatter 结束:rank 0 拥有完整的块 1(=10),rank 1 拥有块 2(=14),rank 2 拥有块 3(=18),rank 3 拥有块 0(=6)。每个 rank 恰好拥有一块的完整和,且互不重复——这正是 reduce-scatter 的定义(编号相对 rank 有个固定偏移,把编号整体平移一下就能让 rank $r$ 拿到第 $r$ 块,不影响任何结论)。
阶段二:all-gather(p−1 步)
现在每个 rank 手上有一块「已经完全归约好」的数据。再沿着环转 $p-1$ 圈,这次不累加,直接覆盖:每一步把手上刚拿到的完整块传给下一个 rank。$p-1$ 步之后,每个块都绕环走了一整圈,所有 rank 都集齐了 4 块:
$$ \texttt{[6, 10, 14, 18]} $$——和第 3.8 节表格里的 all-reduce 输出完全一致。
4.4 通信量与时间
数一下每个 rank 送出了多少字节:
- reduce-scatter 阶段:$p-1$ 步 $\times$ 每步 $N/p$ 字节 $= \frac{p-1}{p}N$
- all-gather 阶段:$p-1$ 步 $\times$ 每步 $N/p$ 字节 $= \frac{p-1}{p}N$
在上面的例子里:$N = 4$ 个元素,$p = 4$,每 rank 发送 $2 \times \frac{3}{4} \times 4 = 6$ 个元素——数一下表格,reduce-scatter 3 次 + all-gather 3 次,正好 6 次单元素发送 ✓。
加上延迟项,完整的时间模型是:
$$ T_{\text{ring all-reduce}} \;=\; \underbrace{2(p-1)\,\alpha}_{\text{轮数} \times \text{延迟}} \;+\; \underbrace{\frac{2(p-1)}{p}\cdot\frac{N}{B}}_{\text{带宽项}} $$| $p$ | $2\frac{p-1}{p}$ | 朴素做法 $2(p-1)$ | 比值 |
|---|---|---|---|
| 2 | 1.00 | 2 | 2× |
| 4 | 1.50 | 6 | 4× |
| 8 | 1.75 | 14 | 8× |
| 64 | 1.97 | 126 | 64× |
| 1024 | 1.998 | 2046 | 1024× |
| $\infty$ | $\to 2$ | $\to \infty$ | $p$× |
带宽项与 $p$ 无关(上界 $2N/B$)。这就是数据并行能扩展到上千卡的根本原因:加卡不会让每步的通信时间变长。
但延迟项 $2(p-1)\alpha$ 与 $p$ 线性相关。$p = 1024$、$\alpha = 5\,\mu s$ 时它是 10 ms——对小张量这是致命的。这就是为什么大规模训练必须做分层 all-reduce(节点内 ring → 节点间 ring/tree → 节点内 broadcast)和 bucket 聚合。
朴素做法的问题不是「传的字节多」,而是「只用了一条链路」。系统里有 $p$ 条链路、总带宽 $pB$,朴素做法只用了 $B$。
Ring 的全部聪明之处就是:让每条链路在每个时刻都在传不同的数据。它没有减少总流量(总流量仍是 $2(p-1)N$),而是把这些流量均摊到 $p$ 条链路上并行进行,于是墙钟时间除以了 $p$。
5. torch.distributed 实操
概念讲完了,现在写代码。PyTorch 的 torch.distributed 提供了上面所有原语的干净接口。
5.1 后端:NCCL vs Gloo
| 后端 | 设备 | 适用场景 | 不支持的操作 |
|---|---|---|---|
nccl | CUDA GPU | GPU 训练的唯一正确选择;用 NVLink/IB,支持 GPUDirect RDMA | gather、scatter(PyTorch 侧未暴露) |
gloo | CPU(也能跑 GPU 但很慢) | 调试、CPU 张量、没有 GPU 的机器上跑本讲的例子 | reduce_scatter 的部分变体、all_to_all |
mpi | 取决于 MPI 实现 | 已有 MPI 基础设施的 HPC 环境;需要从源码编译 PyTorch | — |
torch.distributed 也提供更高层的算法(比如 DistributedDataParallel、FullyShardedDataParallel)。这门课刻意不直接用它们——目的是让你从原语一层层自己搭起来,看清楚每一个字节的去向。
5.2 进程组的建立与销毁
# 每个 rank 是一个独立进程,进程启动后第一件事就是「入伙」
import os
import torch
import torch.distributed as dist

def setup(rank: int, world_size: int):
    """初始化分布式环境(在每个进程开头调用)。"""
    # 指定 master(rank 0)在哪里:仅用于「握手/协调」,
    # 真正的数据走 NCCL,不经过这个地址。
    os.environ["MASTER_ADDR"] = "localhost"
    os.environ["MASTER_PORT"] = "15623"

    if torch.cuda.is_available():
        dist.init_process_group("nccl", rank=rank, world_size=world_size)
    else:
        dist.init_process_group("gloo", rank=rank, world_size=world_size)

def cleanup():
    """清理分布式环境(在每个进程结尾调用)。"""
    dist.destroy_process_group()
几点值得说明:
MASTER_ADDR/MASTER_PORT指定的是 rendezvous(会合点):所有进程启动时先连到这里交换「我是谁、有几个人、我的网卡地址是什么」。握手完成后,实际的张量数据走 NCCL 直连(NVLink/IB),完全不经过 master。所以 master 不是性能瓶颈,但它是单点故障——端口被占用是最常见的启动失败原因。init_process_group是阻塞的:它会一直等到全部world_size个进程都到齐。如果你的 world_size 写错了,程序会安静地挂死直到超时(默认 30 分钟)。
5.3 用多进程启动(本讲的方式)
import sys
import torch.multiprocessing as mp
from typing import Callable

def spawn(func: Callable, world_size: int, *args, **kwargs):
    """启动 world_size 个进程,每个进程调用 func(rank, world_size, *args)。"""
    args = (world_size,) + args + tuple(kwargs.values())
    # mp.spawn 会自动把 rank(0 .. nprocs-1)作为第一个参数传进去
    mp.spawn(func, args=args, nprocs=world_size, join=True)
mp.spawn 用 spawn 方式(而不是 fork)创建子进程——这对 CUDA 是必须的,因为 CUDA context 不能被 fork 继承。代价是所有传给子进程的参数都要能 pickle。
5.4 完整可运行示例:验证 all-reduce = reduce-scatter + all-gather
import torch
import torch.distributed as dist
from torch import tensor

def cuda_if_available(rank: int):
    """每个 rank 绑定自己的 GPU;没有 GPU 就退回 CPU。"""
    return torch.device(f"cuda:{rank}") if torch.cuda.is_available() else torch.device("cpu")

def collective_operations_main(rank: int, world_size: int):
    """这个函数在每个进程里异步执行一份(rank = 0, ..., world_size - 1)。"""
    setup(rank, world_size)
    device = cuda_if_available(rank)

    ###### 1. All-reduce ######
    dist.barrier()   # 等所有进程都到这里(这里只是为了 print 不交错)

    # rank r 的数据是 [r, r+1, r+2, r+3],输入输出是同一个张量
    data = tensor([0., 1, 2, 3], device=device) + rank

    print(f"Rank {rank} [before all-reduce]: {data}", flush=True)
    dist.all_reduce(tensor=data, op=dist.ReduceOp.SUM, async_op=False)  # 原地修改
    print(f"Rank {rank} [after  all-reduce]: {data}", flush=True)

    ###### 2. Reduce-scatter ######
    dist.barrier()

    input  = torch.arange(world_size, dtype=torch.float32, device=device) + rank
    output = torch.empty(1, device=device)   # 输出要自己预分配

    print(f"Rank {rank} [before reduce-scatter]: input = {input}", flush=True)
    dist.reduce_scatter_tensor(output=output, input=input,
                               op=dist.ReduceOp.SUM, async_op=False)
    print(f"Rank {rank} [after  reduce-scatter]: output = {output}", flush=True)

    ###### 3. All-gather(输入正是上一步的输出)######
    dist.barrier()

    input  = output
    output = torch.empty(world_size, device=device)

    print(f"Rank {rank} [before all-gather]: input = {input}", flush=True)
    dist.all_gather_into_tensor(output_tensor=output, input_tensor=input, async_op=False)
    print(f"Rank {rank} [after  all-gather]: output = {output}", flush=True)

    cleanup()

if __name__ == "__main__":
    spawn(collective_operations_main, world_size=4)
输出(各 rank 的行顺序会交错,这里按 rank 整理):
Rank 0 [before all-reduce]: tensor([0., 1., 2., 3.])
Rank 1 [before all-reduce]: tensor([1., 2., 3., 4.])
Rank 2 [before all-reduce]: tensor([2., 3., 4., 5.])
Rank 3 [before all-reduce]: tensor([3., 4., 5., 6.])

Rank 0 [after  all-reduce]: tensor([ 6., 10., 14., 18.])
Rank 1 [after  all-reduce]: tensor([ 6., 10., 14., 18.])
Rank 2 [after  all-reduce]: tensor([ 6., 10., 14., 18.])
Rank 3 [after  all-reduce]: tensor([ 6., 10., 14., 18.])

Rank 0 [after  reduce-scatter]: output = tensor([ 6.])
Rank 1 [after  reduce-scatter]: output = tensor([10.])
Rank 2 [after  reduce-scatter]: output = tensor([14.])
Rank 3 [after  reduce-scatter]: output = tensor([18.])

Rank 0 [after  all-gather]: output = tensor([ 6., 10., 14., 18.])
Rank 1 [after  all-gather]: output = tensor([ 6., 10., 14., 18.])
Rank 2 [after  all-gather]: output = tensor([ 6., 10., 14., 18.])
Rank 3 [after  all-gather]: output = tensor([ 6., 10., 14., 18.])
reduce-scatter 的输出接上 all-gather,得到的正是 all-reduce 的输出。等式在代码层面被验证了。
5.5 生产环境的启动方式:torchrun
mp.spawn 只能在单机内启动进程。真实的多机训练用 torchrun:
# 单机 8 卡
torchrun --nproc_per_node=8 train.py

# 多机:每台机器上都执行(--node_rank 各不相同)
torchrun --nnodes=4 --node_rank=0 --nproc_per_node=8 \
         --rdzv_backend=c10d --rdzv_endpoint=node0:29500 train.py
# train.py —— torchrun 会把这些环境变量注入每个进程
import os, torch, torch.distributed as dist

rank       = int(os.environ["RANK"])          # 全局编号 0 .. world_size-1
local_rank = int(os.environ["LOCAL_RANK"])    # 本节点内编号 0 .. 7
world_size = int(os.environ["WORLD_SIZE"])    # 总进程数

torch.cuda.set_device(local_rank)             # 关键!先绑卡,再建进程组
dist.init_process_group(backend="nccl")       # rank/world_size 从环境变量自动读取

# ... 训练 ...

dist.destroy_process_group()
5.6 常用 API 速查
| API | 作用 | 要点 |
|---|---|---|
dist.all_reduce(tensor, op) | all-reduce | 原地修改;op 可为 SUM/AVG/MIN/MAX/PRODUCT(AVG 仅 NCCL 支持) |
dist.reduce_scatter_tensor(output, input) | reduce-scatter | input 的第 0 维必须能被 world_size 整除;输出需预分配 |
dist.all_gather_into_tensor(output, input) | all-gather | 输出是一个大张量(比老的 all_gather 收 list 更快,少一次拷贝) |
dist.all_gather(tensor_list, tensor) | all-gather 到 list | 形状可以不整齐时才用;有额外拷贝开销 |
dist.broadcast(tensor, src) | broadcast | 非 src 的 rank 也必须传一个同形状张量做接收缓冲 |
dist.all_to_all_single(output, input) | all-to-all | 可带 *_split_sizes 支持不均衡切分 |
dist.send / dist.recv | 点对点 | 阻塞式;流水线并行用它传激活值 |
dist.barrier() | 同步屏障 | 所有 rank 都到达才继续;只用于调试/计时,不要放进训练热路径 |
dist.get_rank() / get_world_size() | 查询 | — |
异步通信
# async_op=True 立刻返回一个 Work 句柄,通信在后台进行
handle = dist.all_reduce(grad, op=dist.ReduceOp.AVG, async_op=True)

...   # 在这里做点别的计算,和通信重叠

handle.wait()   # 用到结果之前必须 wait
这是通信-计算重叠的基础,第 7 节的 DDP bucket 就靠它。
- 忘了
torch.cuda.set_device(local_rank):所有进程默认用cuda:0,显存瞬间爆掉,或者 NCCL 直接死锁。必须在建进程组之前设好。 - 集合操作没有被所有 rank 调用:集合操作是「集合」的——只要有一个 rank 没进这个调用(比如你写了
if rank == 0: dist.all_reduce(...)),其他所有 rank 会永远等下去。同理,if分支里的提前break、只在某些 rank 上触发的异常,都会导致挂死。 - 张量的形状/dtype/device 在各 rank 上不一致:NCCL 不做校验,行为未定义(可能挂死、可能给出垃圾数据)。
- 只在 rank 0 上做的操作里混了集合通信:典型的是「只在 rank 0 上做 evaluation」,而 evaluation 里的模型 forward 又触发了 all-gather。
调试技巧:设 TORCH_NCCL_ASYNC_ERROR_HANDLING=1 和 NCCL_DEBUG=INFO,能把「安静挂死」变成「有错误信息的崩溃」。
6. 基准测试:怎么测通信带宽、怎么判断被通信卡住
「通信有多快?」不能靠猜。这一节给出可复制的测量方法,以及把测量结果换算成「我该担心吗」的判据。
6.1 测 all-reduce
import time
import torch
import torch.distributed as dist

def all_reduce(rank: int, world_size: int, num_elements: int):
    setup(rank, world_size)
    device = cuda_if_available(rank)

    # 100 MiB 的 fp32 张量 —— 要足够大才能进入 bandwidth-bound 区间
    data = torch.randn(num_elements, device=device)

    # 预热:第一次调用包含 NCCL 建连、拓扑探测、buffer 分配,绝不能计入
    dist.all_reduce(tensor=data, op=dist.ReduceOp.SUM, async_op=False)
    torch.cuda.synchronize()   # 等 CUDA kernel 真正跑完(否则你测的是「提交时间」)
    dist.barrier()             # 等所有进程都到齐

    # 正式计时
    start_time = time.time()
    dist.all_reduce(tensor=data, op=dist.ReduceOp.SUM, async_op=False)
    torch.cuda.synchronize()
    dist.barrier()
    end_time = time.time()
    duration = end_time - start_time

    # 换算成「总线带宽」
    size_bytes     = data.element_size() * data.numel()
    sent_bytes     = size_bytes * 2 * (world_size - 1)   # 2x 因为收+发;(p-1) 是 ring 的步数
    total_duration = world_size * duration               # 所有 rank 的总耗时
    bandwidth      = sent_bytes / total_duration
    print(f"Rank {rank}: all_reduce bandwidth = {round(bandwidth / 1024**3)} GB/s", flush=True)

    cleanup()

spawn(all_reduce, world_size=4, num_elements=100 * 1024**2)   # 100M 个 fp32 = 400 MB
代码里算的是
$$ \text{bandwidth} \;=\; \frac{\text{sent\_bytes}}{\text{total\_duration}} \;=\; \frac{2(p-1)\,N}{p \cdot t} \;=\; \frac{2(p-1)}{p}\cdot \frac{N}{t} $$这正是第 4 节推出的每个 rank 实际收发的字节数除以时间。这个量在 NCCL 的术语里叫 bus bandwidth(busbw,总线带宽),区别于 algorithm bandwidth(algbw) $= N/t$:
$$ \text{busbw} \;=\; \text{algbw} \times \frac{2(p-1)}{p} $$为什么要这么定义?因为 busbw 直接对应硬件链路上真实流过的字节速率,所以它:
- 与 world size 无关——4 卡和 64 卡测出来的 busbw 应该差不多,可以横向比较;而 algbw 会随 $p$ 变大而下降,看起来像是「扩展性差」,其实是假象。
- 与拓扑算法无关——不管 NCCL 内部用了 ring 还是 tree,busbw 都可以拿来和链路峰值带宽(NVLink 900 GB/s、IB 50 GB/s)直接对比。
$p$ 较大时 $\frac{2(p-1)}{p} \to 2$,所以 Percy 在注释里写「effective bandwidth $\approx 2 \times$ size_bytes / total_duration」。
6.2 测 reduce-scatter
def reduce_scatter(rank: int, world_size: int, num_elements: int):
    setup(rank, world_size)
    device = cuda_if_available(rank)

    # 每个 rank 有一个 (world_size, num_elements) 的矩阵
    input  = torch.randn(world_size, num_elements, device=device)
    output = torch.empty(num_elements, device=device)

    # 预热
    dist.reduce_scatter_tensor(output=output, input=input, op=dist.ReduceOp.SUM, async_op=False)
    torch.cuda.synchronize(); dist.barrier()

    start_time = time.time()
    dist.reduce_scatter_tensor(output=output, input=input, op=dist.ReduceOp.SUM, async_op=False)
    torch.cuda.synchronize(); dist.barrier()
    duration = time.time() - start_time

    data_bytes     = input.element_size() * input.numel()   # 输入总字节数
    sent_bytes     = data_bytes * (world_size - 1)          # 注意:这里没有 2x
    total_duration = world_size * duration
    bandwidth      = sent_bytes / total_duration
    print(f"Rank {rank}: reduce_scatter bandwidth = {round(bandwidth / 1024**3)} GB/s", flush=True)

    cleanup()
为什么这里没有 2x?因为 reduce-scatter 只有一个阶段:每个 rank 收发 $\frac{p-1}{p}N$ 字节,而 all-reduce 是它的两倍。于是:
- all-reduce 搬运的数据量是 reduce-scatter 的 2 倍;
- all-reduce 花的时间也大约是 reduce-scatter 的 2 倍;
- 所以两者测出来的 busbw 应该接近。
如果你测出来两者的 busbw 差很多,说明有问题(比如张量太小、被延迟主导;或者某个操作走了低效的回退路径)。这是一个很好的自检。
6.3 怎么读测出来的数
把 busbw 和链路的理论峰值对比:
| 场景 | 理论峰值(单 GPU) | 大张量下健康的 busbw | 低于这个值说明什么 |
|---|---|---|---|
| 节点内 8 卡(H100 + NVSwitch) | ~900 GB/s(NVLink 4.0 双向) | 达到峰值的 70%–90% | 可能走了 PCIe(NVLink 没启用)、或者张量太小 |
| 节点内 8 卡(无 NVSwitch,走 PCIe) | ~32–64 GB/s(PCIe 4.0/5.0) | 接近 PCIe 峰值 | 本来就慢——这类机器不适合张量并行 |
| 跨节点(InfiniBand NDR) | ~50 GB/s / 网卡(多网卡可叠加) | 达到峰值的 60%–85% | GPUDirect RDMA 没开、网卡绑定错、或者网络拥塞 |
不必自己造轮子,官方工具更可靠:
- nccl-tests:
./build/all_reduce_perf -b 8 -e 8G -f 2 -g 8,会打印从 8 字节到 8 GB 的完整 size-sweep(这正是你想看的:从哪个 size 开始进入 bandwidth-bound 区间)。带宽定义的解释见它的 PERFORMANCE.md。 - stas00 的 all_reduce_bench.py:一个干净的 PyTorch 版参考实现。
6.4 怎么判断训练是被通信卡住了
四条互相印证的路子,从便宜到贵:
(1)算一遍理论值
先估计每步的通信时间和计算时间:
$$ t_{\text{comm}} \approx \frac{2\frac{p-1}{p}\cdot 2N_{\text{param}}}{B_{\text{bus}}}, \qquad t_{\text{compute}} \approx \frac{6 N_{\text{param}} T_{\text{local}}}{C} $$举例:$N = 7\times10^9$ 参数、bf16 梯度、$B_{\text{bus}} = 400$ GB/s、$C = 4\times10^{14}$ FLOP/s、每卡 $T_{\text{local}} = 16384$ token。
- $t_{\text{comm}} \approx \dfrac{4 \times 7\times 10^9}{4\times 10^{11}} = 70$ ms
- $t_{\text{compute}} \approx \dfrac{6 \times 7\times10^9 \times 16384}{4\times10^{14}} = 1720$ ms
比值 4%——完全可以被重叠掉,不用担心。如果算出来是 40%,你就知道该动手了。
(2)测 MFU
$$ \text{MFU} \;=\; \frac{6 N_{\text{param}} \cdot T_{\text{global}}}{t_{\text{step}} \cdot C_{\text{peak}} \cdot p} $$健康的大规模训练 MFU 在 35%–50%。如果单卡跑 45% 而多卡掉到 20%,差额基本就是通信(和负载不均衡)。
(3)做 A/B 实验:把通信关掉
# 用 no_sync() 跳过梯度同步,跑几步看 step 时间差多少
# 差值 = 没被重叠掉的通信时间
with model.no_sync():
    for _ in range(10):
        loss = model(batch).mean(); loss.backward()
或者更粗暴:把 dist.all_reduce 换成 no-op,对比每步耗时。这个差值是最诚实的答案。
(4)上 profiler
torch.profiler+ TensorBoard:看时间线上nccl:all_reduce这类 kernel 占了多少,以及它们和计算 kernel 是否重叠(在不同的 stream 上并行)而不是串行排队。nsys profile:能看到 NCCL kernel 与 GEMM kernel 的实际交错情况,以及 SM 占用被通信抢走了多少。
NCCL 的通信是由 GPU kernel 执行的,它要占用 SM。所以即使你完美地把通信和计算重叠了,计算也会慢一点(通常几个百分点)。可以用 NCCL_MAX_NCHANNELS 限制 NCCL 占用的通道数来做权衡。
另一个隐性成本:木桶效应。集合操作要求所有 rank 到齐,所以一个 rank 的抖动(数据加载慢、某个 batch 序列特别长、GPU 降频)会拖住全部 $p$ 张卡。规模越大,这个效应越明显——这也是为什么大规模训练要做 straggler 检测。
7. 数据并行(DDP)
构件齐了,开始搭真正的训练策略。原讲义用深层 MLP 做载体——理由是:Transformer 的计算瓶颈就是 MLP(矩阵乘),所以在 MLP 上验证的结论是有代表性的,而且能把注意力集中在通信逻辑上。
7.1 切分策略
数据并行的三句话定义:
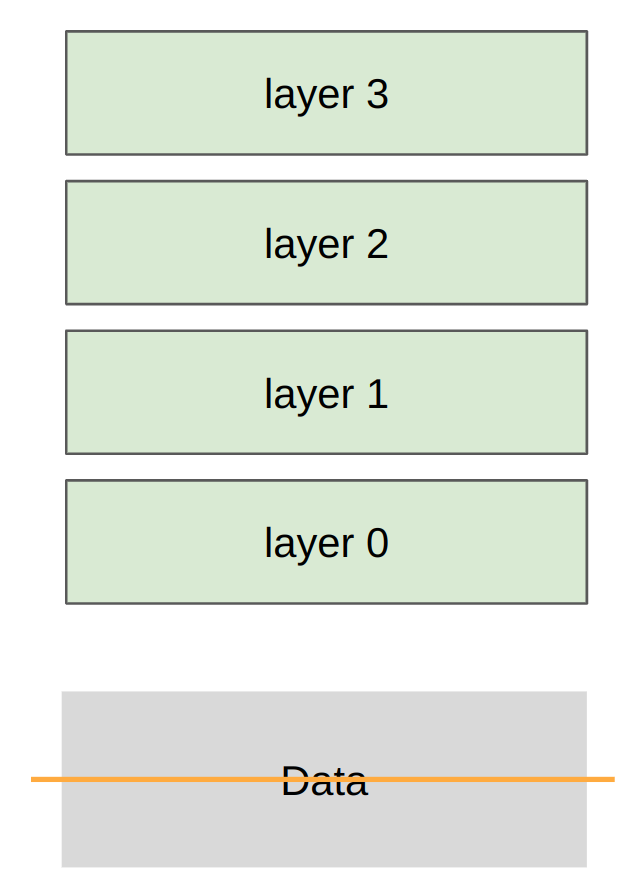
- 参数复制:每个 rank 持有完整的模型副本,且初始时完全相同。
- 数据切分:全局 batch 被切成 $p$ 份,rank $r$ 只看第 $r$ 份。
- 梯度同步:反向传播后 all-reduce 梯度求平均,于是每个 rank 用同一个梯度更新,参数永远保持一致。
7.2 最小实现
import math
import torch
import torch.nn.functional as F
import torch.distributed as dist
from torch import nn

def get_init_params(num_inputs: int, num_outputs: int, rank: int) -> nn.Parameter:
    torch.random.manual_seed(0)   # 所有 rank 用同一个种子 => 初始参数一致
    return nn.Parameter(
        torch.randn(num_inputs, num_outputs, device=cuda_if_available(rank)) / math.sqrt(num_outputs)
    )

def data_parallelism_main(rank: int, world_size: int, data, num_layers: int, num_steps: int):
    setup(rank, world_size)

    # ---- 1. 取本 rank 的数据分片 ----
    #   --- B0 ---   <- rank 0
    #   --- B1 ---   <- rank 1
    #   --- B2 ---   <- rank 2
    #   --- B3 ---   <- rank 3
    batch_size, num_dim = data.size(0), data.size(1)
    local_batch_size = batch_size // world_size
    start_index = rank * local_batch_size
    end_index   = start_index + local_batch_size
    data = data[start_index:end_index].to(cuda_if_available(rank))
    # 实践中每个 rank 应该只「加载」自己那一份,而不是先加载全部再切

    # ---- 2. 每个 rank 都持有全部参数 + 自己的优化器状态 ----
    params = [get_init_params(num_dim, num_dim, rank) for _ in range(num_layers)]
    optimizer = torch.optim.AdamW(params, lr=1e-3)

    for step in range(num_steps):
        # ---- 3. 前向:纯本地计算,没有任何通信 ----
        x = data
        for param in params:
            x = x @ param
            x = F.gelu(x)
        loss = x.square().mean()

        # ---- 4. 反向:也是纯本地计算 ----
        loss.backward()

        # ---- 5. 同步梯度(这是 DDP 与单卡训练的【唯一】区别)----
        for param in params:
            dist.all_reduce(tensor=param.grad, op=dist.ReduceOp.AVG, async_op=False)

        # ---- 6. 更新:每个 rank 各自跑,但因为梯度相同,结果也相同 ----
        optimizer.step()
        optimizer.zero_grad()

        print(f"Rank {rank}: step={step}, loss={loss.item()}", flush=True)

    cleanup()

data = torch.randn(128, 1024)   # batch_size=128, num_dim=1024
spawn(data_parallelism_main, world_size=4, data=data, num_layers=4, num_steps=1)
运行后观察到的三个现象,每一个都值得想清楚:
| 现象 | 原因 |
|---|---|
| 各 rank 的 loss 不同 | loss 是在各自的本地数据上算的,本来就该不同。想打印全局 loss,得自己 all-reduce 一次(一般只在日志里做)。 |
| 各 rank 的梯度相同 | all-reduce 的结果对所有 rank 一致——这正是 all-reduce 相对 reduce 的价值。 |
| 各 rank 的参数始终相同 | 初始相同(同种子)+ 每步梯度相同 + 优化器是确定性的 ⇒ 归纳法可证。这是 DDP 正确性的全部依据。 |
用 $\text{AVG}$ 而不是 $\text{SUM}$ 归约梯度,是因为我们想让 $p$ 卡训练在数学上严格等价于用 $p$ 倍大 batch 的单卡训练:
$$ \frac{1}{p}\sum_{r=0}^{p-1} \nabla \mathcal{L}_r = \frac{1}{p}\sum_{r=0}^{p-1} \frac{1}{b}\sum_{i \in B_r} \nabla \ell_i = \frac{1}{pb}\sum_{i \in B} \nabla \ell_i = \nabla \mathcal{L}_{\text{global}} $$这个等式成立有两个前提,破了就不等价:(a) 各 rank 的样本数必须相同(所以 DistributedSampler 默认 drop_last 或补齐);(b) loss 必须是样本的平均而不是求和。用 token 级平均的语言模型损失时,若各 rank 的有效 token 数不同(padding 不齐),简单的 AVG 就不等价了——正确做法是各 rank 先算 $\sum \ell_i$ 和 $\sum n_i$,两个都 all-reduce(SUM),再相除。
7.3 通信量 vs 计算量:DDP 为什么能扩展
设模型有 $N$ 个参数,每卡每步处理 $T_{\text{local}}$ 个 token,梯度是 bf16(2 字节/参数)。
每步的通信量(第 4 节的公式,$p$ 较大时):
$$ V_{\text{comm}} = 2\,\frac{p-1}{p}\cdot 2N \;\approx\; 4N \ \text{字节} $$每步的计算量(前向 $2NT$ + 反向 $4NT$):
$$ V_{\text{compute}} = 6\,N\,T_{\text{local}} \ \text{FLOPs} $$于是通信时间与计算时间之比为
$$ \frac{t_{\text{comm}}}{t_{\text{compute}}} = \frac{4N / B}{6NT_{\text{local}} / C} = \boxed{\;\frac{2\,C}{3\,B\,T_{\text{local}}}\;} $$$N$ 被完全约掉了。这个比值与模型多大无关,只取决于「每卡的有效算力 $C$」、「每卡的通信带宽 $B$」和「每卡的 token 数 $T_{\text{local}}$」。
代入具体数字($C = 4\times10^{14}$ FLOP/s):
| 场景 | $B$(busbw) | 比值为 1 的临界 $T_{\text{local}}$ | $T_{\text{local}} = 8192$ 时的比值 |
|---|---|---|---|
| 节点内 NVLink | 400 GB/s | ~670 token | 8% |
| 跨节点 InfiniBand | 50 GB/s | ~5300 token | 65% |
| 跨节点 10 GbE | 1.25 GB/s | ~213000 token | 2600%(完全被卡死) |
- DDP 是所有并行策略里通信最省的:每个 step 只通信一次,通信量与 batch size 无关,而计算量随 batch size 线性增长。所以只要每卡 batch 足够大,通信占比就能压到很低。
- 反过来,DDP 被卡死的两种情形都是「每卡 token 太少」:(a) 模型太大导致每卡只能放几百个 token;(b) 卡太多导致全局 batch 被切得太碎。
- 跨节点场景下 65% 的比值意味着:不重叠通信就会损失近 40% 的吞吐。所以下面的 bucket 重叠不是可选优化,是必需品。
7.4 通信与计算的重叠:bucket
上面的最小实现有个明显的浪费:它先跑完整个反向传播,再一口气 all-reduce 所有梯度。这期间 GPU 在算的时候网卡闲着,网卡在传的时候 GPU 闲着。
关键观察:反向传播是逐层进行的,最后一层的梯度最先算出来。那一层的梯度算完的瞬间,就可以开始传了——不用等前面的层。
时间轴(不重叠):
  [ 反向: L3 L2 L1 L0 ][ all-reduce 全部梯度 ]
  |<------- 计算 ------>|<------- 通信 ------->|      总时间 = 计算 + 通信

时间轴(重叠):
  [ 反向: L3 L2 L1 L0 ]
        [AR L3][AR L2][AR L1][AR L0]
  |<----------- 计算 ----------->|<AR L0>|       总时间 ≈ 计算 + 最后一个桶
但如果对每个参数单独发一次 all-reduce,会被延迟项 $\alpha$ 打死(一个 Transformer 有几百个参数张量,很多只有几千个元素)。解决办法是 bucket(桶):把相邻的若干参数的梯度拼进一块连续内存,攒够一定大小(PyTorch DDP 默认 bucket_cap_mb=25,即 25 MB)再发一次。
class BucketedDDP(nn.Module):
    """手写版 DDP:分桶 + 反向传播中异步 all-reduce。"""

    def __init__(self, module: nn.Module, bucket_size_mb: float = 25.0):
        super().__init__()
        self.module = module

        # (1) 让所有 rank 从同一份参数出发
        for p in module.parameters():
            dist.broadcast(p.data, src=0)
        for b in module.buffers():          # BN 统计量之类也要同步
            dist.broadcast(b.data, src=0)

        # (2) 分桶。注意用【前向顺序的逆序】,因为反向是倒着算的,
        #     这样先算完的梯度正好凑成先发的桶。
        params = [p for p in module.parameters() if p.requires_grad][::-1]
        cap = bucket_size_mb * 1024 ** 2
        self.buckets, cur, cur_bytes = [], [], 0
        for p in params:
            cur.append(p)
            cur_bytes += p.numel() * p.element_size()
            if cur_bytes >= cap:
                self.buckets.append(cur); cur, cur_bytes = [], 0
        if cur:
            self.buckets.append(cur)

        # (3) 给每个参数挂钩子:梯度累加完成时触发
        self.pending = [len(b) for b in self.buckets]
        self.handles = []
        for i, bucket in enumerate(self.buckets):
            for p in bucket:
                p.register_post_accumulate_grad_hook(self._make_hook(i))

    def _make_hook(self, bucket_id: int):
        def hook(param):
            self.pending[bucket_id] -= 1
            if self.pending[bucket_id] == 0:          # 这个桶满了
                grads = [p.grad for p in self.buckets[bucket_id]]
                flat = torch._utils._flatten_dense_tensors(grads)   # 拼成一块连续内存
                handle = dist.all_reduce(flat, op=dist.ReduceOp.AVG, async_op=True)
                self.handles.append((handle, flat, bucket_id))       # 不等待,继续反向
        return hook

    def forward(self, *args, **kwargs):
        return self.module(*args, **kwargs)

    def finish_gradient_synchronization(self):
        """在 optimizer.step() 之前调用:等所有桶传完,写回各参数的 .grad。"""
        for handle, flat, bucket_id in self.handles:
            handle.wait()
            grads = [p.grad for p in self.buckets[bucket_id]]
            for g, synced in zip(grads, torch._utils._unflatten_dense_tensors(flat, grads)):
                g.copy_(synced)
        self.handles.clear()
        self.pending = [len(b) for b in self.buckets]

# 训练循环
model = BucketedDDP(MyModel().to(device))
for batch in loader:
    loss = model(batch).mean()
    loss.backward()                              # 反向过程中 all-reduce 已经在跑了
    model.finish_gradient_synchronization()      # 等尾巴
    optimizer.step(); optimizer.zero_grad()
桶大小是个权衡:
| 桶太小 | 桶太大 |
|---|---|
| 消息多,被 $\alpha$(每次 ~5 μs)主导;NCCL 启动开销累积 | 要等很久才凑满一个桶,重叠窗口变小;极端情况退化成「反向做完再通信」 |
| 重叠得早,但每次传得慢 | 每次传得快(进入 bandwidth-bound 区间),但开始得晚 |
25 MB 是 PyTorch 的经验默认值;跨节点慢网络下调大(50–100 MB)通常更好。
- 桶顺序为什么用逆序:反向传播从最后一层往前算,所以最后一层的参数梯度最先就绪。按前向顺序分桶的话,第一个桶(含第一层参数)要等到反向结束才能发出去,重叠完全失效。PyTorch DDP 用的是「
model.parameters()的逆序」作为反向就绪顺序的近似。 - 梯度累积:做梯度累积时,中间的几个 micro-batch 不该同步梯度(白白多传 $k$ 倍)。PyTorch 提供
with model.no_sync():上下文,只在最后一个 micro-batch 才走正常路径。手写版就是在 hook 里加个开关。 find_unused_parameters:如果某个参数在这一步的前向里没被用到,它的梯度钩子不会触发,桶永远凑不满 → 挂死。PyTorch 的find_unused_parameters=True会额外遍历一遍计算图找出这些参数,但有性能开销。更好的做法是改模型结构避免它。
7.5 DDP 的两个天花板
DDP 简单、通信省、几乎线性扩展,但它有两个硬限制:
(1)显存完全没省
每个 rank 都存着完整的 $16N$ 字节模型状态。8 卡跑 7B 模型,每卡还是要 128 GB——DDP 只解决「算得慢」,不解决「装不下」。这正是 ZeRO 要补的洞(第 8 节)。
(2)全局 batch size 随卡数增长,撞上 critical batch size
DDP 的扩展方式是「保持每卡 batch 不变,加卡 ⇒ 全局 batch 变大」。但 batch 不能无限放大:超过 critical batch size(临界批量)后,梯度噪声已经足够小,再增大 batch 对每步的收敛贡献几乎为零,你只是在浪费算力(见 An Empirical Model of Large-Batch Training)。
另一条路是「保持全局 batch 不变,加卡 ⇒ 每卡 batch 变小」。但由 7.3 节的公式,$T_{\text{local}}$ 变小会让通信占比线性上升,同时 GPU 的矩阵乘也会因为 $M$ 维太小而跑不满。
两头堵。这就是为什么超大规模训练必须引入张量并行、流水线并行等其它维度——它们能在不增加全局 batch 的前提下继续用更多卡。这是下一讲的主题。
8. ZeRO 三阶段与 FSDP
DDP 里有一个巨大的浪费:$p$ 个 rank 存着 $p$ 份一模一样的东西。参数一样、梯度(同步后)一样、优化器状态一样。ZeRO(Zero Redundancy Optimizer,零冗余优化器)的想法就一句话:把这些冗余副本切开,每个 rank 只存 $1/p$,需要完整的时候临时用集合通信凑出来。
8.1 三个阶段切的是什么
回到第 1 节的 $16N$ 分解:参数 $2N$ + 梯度 $2N$ + 优化器状态 $KN$($K = 12$)。ZeRO 按「切了之后额外通信代价从小到大」的顺序,依次动这三块:
| 阶段 | 别名 | 切分对象 | 每卡显存 | 每步通信量(元素数) |
|---|---|---|---|---|
| DDP 基线 | — | 什么都不切 | $(2 + 2 + K)N = 16N$ | $2N$(一次 all-reduce) |
| ZeRO-1 | $P_{os}$ | 优化器状态 | $2N + 2N + \dfrac{KN}{p}$ | $2N$(不变) |
| ZeRO-2 | $P_{os+g}$ | + 梯度 | $2N + \dfrac{(2+K)N}{p}$ | $2N$(不变) |
| ZeRO-3 | $P_{os+g+p}$ | + 参数 | $\dfrac{(2+2+K)N}{p} = \dfrac{16N}{p}$ | $3N$(1.5×) |
ZeRO 论文里的具体例子($N = 7.5$B,$p = 64$ 卡,$K = 12$):
| 阶段 | 每卡显存 | 相对基线 | 能否放进 80 GB 卡 |
|---|---|---|---|
| DDP 基线 | 120 GB | 1× | 否 |
| ZeRO-1 | 31.4 GB | 3.8× 省 | 可以 |
| ZeRO-2 | 16.6 GB | 7.2× 省 | 可以,还剩很多给激活值 |
| ZeRO-3 | 1.9 GB | 64× 省 | 模型状态几乎不占地方了 |
验算 ZeRO-1:$2N + 2N = 4 \times 7.5\text{B} = 30$ GB,加上 $\frac{12 \times 7.5\text{B}}{64} = 1.4$ GB,共 $31.4$ GB ✓。ZeRO-3:$\frac{16 \times 7.5\text{B}}{64} = 1.875$ GB ✓。
8.2 逐阶段:到底发生了什么
ZeRO-1(切优化器状态)
把参数按索引分成 $p$ 段,rank $r$ 只为第 $r$ 段维护 fp32 主权重、$m$、$v$。一步训练:
- 前向 / 反向:和 DDP 完全一样(每个 rank 有完整的 bf16 参数和完整梯度)。
- 梯度 reduce-scatter($N$ 元素):rank $r$ 只拿到第 $r$ 段的归约后梯度——它也只需要这一段。
- rank $r$ 用本地优化器状态更新第 $r$ 段的参数。
- 更新后的参数 all-gather($N$ 元素):每个 rank 重新拿到完整参数,准备下一步前向。
通信量 $= N + N = 2N$,和 DDP 的一次 all-reduce 完全相同。这就是那个「白捡的」性质:ZeRO-1 把优化器状态省了 $p$ 倍,一分钱通信都没多花——因为 DDP 的 all-reduce 本来就等于 reduce-scatter + all-gather,ZeRO-1 只是在两个半步中间插了个 optimizer.step()。
class ShardedOptimizer(torch.optim.Optimizer):
    """ZeRO-1 的最小骨架:每个 rank 只为自己那段参数维护优化器状态。"""

    def __init__(self, params, optimizer_cls, **kwargs):
        params = list(params)
        self.rank, self.world_size = dist.get_rank(), dist.get_world_size()
        self.all_params = params
        # 简单的轮询分片;真实实现会按 numel 做负载均衡
        self.local_params = params[self.rank::self.world_size]
        self.inner = optimizer_cls(self.local_params, **kwargs)
        super().__init__(params, defaults={})

    def step(self, closure=None):
        # 前提:梯度已经被同步过(DDP 的 all-reduce,或 reduce-scatter)
        self.inner.step(closure)                     # 只更新自己负责的那段
        for i, p in enumerate(self.all_params):      # 把更新后的参数广播回所有 rank
            dist.broadcast(p.data, src=i % self.world_size)
            # 真实实现用一次 all_gather_into_tensor 打包所有参数,比逐个 broadcast 快得多
ZeRO-2(+ 切梯度)
观察:既然 rank $r$ 只更新第 $r$ 段参数,它根本不需要保留其它段的梯度。所以在反向传播过程中,每算完一层的梯度就立刻 reduce-scatter,然后丢掉不属于自己的部分。
- 显存:梯度从 $2N$ 降到 $2N/p$。
- 通信:还是 reduce-scatter($N$) + all-gather($N$) $= 2N$,仍然没变。
- 代价:反向传播过程中的梯度桶管理更复杂;且梯度累积(gradient accumulation)需要额外处理——累积的是分片后的梯度。
ZeRO-3(+ 切参数)= FSDP
最激进的一步:连 bf16 参数本身也只存 $1/p$。每个 rank 平时只有一小片参数,用到某一层时才临时把那一层的完整参数凑出来:
- 前向:算第 $\ell$ 层之前,对该层参数做 all-gather → 得到完整权重 → 做矩阵乘 → 立刻释放非本地的那部分。逐层进行,所以峰值显存只是「一层的完整参数」而不是「整个模型」。
- 反向:同样需要该层的完整参数来算梯度,所以要再 all-gather 一次(或者在前向时保留、用显存换通信)。
- 算出该层梯度后立刻 reduce-scatter,只留自己那片。
- 本地更新本地那片参数。下一步的前向再 all-gather——注意这里不需要额外的 all-gather,因为第 1 步的 all-gather 就承担了这个职责。
按元素数计(每步):
- 前向的逐层 all-gather:合计 $N$
- 反向的逐层 all-gather:合计 $N$
- 梯度 reduce-scatter:合计 $N$
代入 7.3 节的比值公式(ZeRO-3 用 bf16 参数,$3N$ 元素 $= 6N$ 字节):
$$ \frac{t_{\text{comm}}}{t_{\text{compute}}} = \frac{6N/B}{6NT_{\text{local}}/C} = \frac{C}{B\,T_{\text{local}}} $$NVLink($B = 400$ GB/s)下临界 $T_{\text{local}} = 1000$ token,仍然很容易满足。用 1.5 倍通信换 $p$ 倍显存,这是分布式训练里性价比最高的一笔交易。
8.3 FSDP:PyTorch 里的 ZeRO-3
FSDP(Fully Sharded Data Parallel,完全分片数据并行)就是 PyTorch 官方对 ZeRO-3 的实现(PyTorch FSDP 论文)。名字不同,思想一致。
import torch.distributed as dist
from torch.distributed.fsdp import FullyShardedDataParallel as FSDP, ShardingStrategy
from torch.distributed.fsdp.wrap import transformer_auto_wrap_policy
import functools

model = FSDP(
    model,
    # 分片单位:以 TransformerBlock 为粒度包一层,
    # 这样 all-gather 的粒度是「一个 block 的参数」——足够大能跑满带宽,
    # 又足够小不会把整个模型都凑出来
    auto_wrap_policy=functools.partial(
        transformer_auto_wrap_policy, transformer_layer_cls={TransformerBlock},
    ),
    sharding_strategy=ShardingStrategy.FULL_SHARD,   # = ZeRO-3
    # ShardingStrategy.SHARD_GRAD_OP                 # = ZeRO-2
    # ShardingStrategy.NO_SHARD                      # = DDP
    # ShardingStrategy.HYBRID_SHARD                  # 节点内 ZeRO-3 + 节点间 DDP
    device_id=torch.cuda.current_device(),
    limit_all_gathers=True,      # 限制预取深度,防止显存尖峰
)
FSDP ShardingStrategy | 等价于 | 说明 |
|---|---|---|
NO_SHARD | DDP | 不分片 |
SHARD_GRAD_OP | ZeRO-2 | 切梯度 + 优化器状态;前向后保留参数(省一次反向 all-gather) |
FULL_SHARD | ZeRO-3 | 全切 |
HYBRID_SHARD | ZeRO-3 ⊗ DDP | 节点内全切,节点间复制:把频繁的 all-gather 关进 NVLink,跨节点只做一次梯度 all-reduce |
HYBRID_SHARD 为什么重要
这是第 2 节那条「节点内比节点间快 30 倍」的结论的直接产物。假设 1024 卡 = 128 节点 × 8 卡:
- 纯 FULL_SHARD:all-gather 跨越全部 1024 卡,绝大部分流量要走 InfiniBand,且延迟项 $2(p-1)\alpha$ 随 $p=1024$ 爆炸。
- HYBRID_SHARD:参数在 8 卡节点内切分(显存省 8 倍,all-gather 全部走 NVLink),跨 128 个节点只做梯度的 all-reduce(DDP 语义,一步一次)。
显存节省从 1024× 降到 8×,但通信开销降低了几十倍。在大多数真实配置下,8× 已经足够,多出来的显存宁可拿去放更大的 batch。
另外两个方向(了解即可):ZeRO-Offload 把优化器状态卸载到 CPU 内存,ZeRO-Infinity 进一步卸载到 NVMe。它们能让单机训练巨大模型,代价是 PCIe 带宽(~64 GB/s)成为新瓶颈——适合「跑得动就行」的场景,不适合追求吞吐的预训练。
8.4 该用哪一档
| 情况 | 建议 | 理由 |
|---|---|---|
| 模型状态能装进单卡,且还剩很多显存 | DDP | 通信最少、实现最简单、最不容易出错 |
| 刚好装得下,但激活值挤不下 | ZeRO-1 / ZeRO-2 | 通信量与 DDP 完全相同,纯赚 |
| 单卡装不下模型状态 | ZeRO-3 / FSDP | 1.5× 通信换 $p$ 倍显存 |
| 多节点、节点间带宽有限 | HYBRID_SHARD | 把高频通信关在 NVLink 域内 |
| 单层的参数就装不进一张卡 | ZeRO 也救不了 → 张量并行 | ZeRO-3 的峰值显存至少是「一层的完整参数」 |
- 「ZeRO 改变了数学」——没有。ZeRO 的每一步在数值上都严格等价于相同全局 batch 的 DDP(浮点归约顺序差异除外)。它纯粹是内存布局的重排。这一点很重要:换 ZeRO 阶段不需要重调超参。
- 「ZeRO-3 显存降到 $1/p$,所以能训 $p$ 倍大的模型」——不完全。模型状态降到 $1/p$,但激活值一点没省(激活值是数据并行的,不是参数);而且前向时至少要凑出「一层的完整参数」,这是个下界。所以 ZeRO-3 通常要和激活值重计算(第 9 节)搭配使用。
- 「ZeRO-1 也要多花通信」——不。这是最容易被误解的一点:ZeRO-1 和 ZeRO-2 的通信量与 DDP 完全相同。如果你现在在用 DDP 且显存吃紧,直接开 ZeRO-1,没有任何理由不开。
- 「FSDP 和 ZeRO 是两种不同的方法」——不是。FSDP = PyTorch 版的 ZeRO-3(DeepSpeed 是微软版)。区别在实现细节:FSDP1 以
FlatParameter为单位分片,FSDP2 改成按参数用 DTensor 分片,后者对参数冻结、量化等场景更友好。
9. 激活值重计算与显存-计算权衡
ZeRO 解决了「模型状态」的显存。但第 1.2 节算过,激活值可能比模型状态还大——而且 ZeRO 对它完全无能为力。这一节讲怎么处理它。
9.1 问题有多大
回到那组配置($s = 8192$, $b = 8$, $h = 4096$, $a = 32$, $L = 32$,bf16):
| 存储策略 | 每层 | 32 层合计 | 额外计算 |
|---|---|---|---|
| 存下所有中间张量(含 $s\times s$ 注意力矩阵) | 95 GB | ~3040 GB | 0 |
| + FlashAttention(消掉 $s\times s$ 矩阵) | 9.1 GB | ~292 GB | ≈ 0(还更快) |
| 选择性重计算(只重算注意力部分) | ~4.6 GB | ~147 GB | ~4% |
| 完全重计算(只存每层输入) | 0.54 GB | ~17 GB | ~33% |
17 GB vs 292 GB —— 17 倍的显存节省,代价是 33% 的额外计算。这个交易在显存受限时几乎总是划算的:多出来的显存可以放更大的 batch,而更大的 batch 又能把 GPU 跑得更满,往往把那 33% 赚回来一部分。
9.2 原理
标准反向传播需要前向的中间结果。激活值重计算(activation checkpointing / gradient checkpointing)的想法是:前向时只保存少数几个「检查点」,其余中间结果全部丢弃;反向传播走到某段时,从最近的检查点重新前向一遍把它们算回来。
不重计算:
  前向  x0 →[L0]→ x1 →[L1]→ x2 →[L2]→ x3 →[L3]→ loss
  存储  ●     ●●●●   ●     ●●●●   ●     ●●●●   ●       (每层内部的所有中间张量都存)

完全重计算:
  前向  x0 →[L0]→ x1 →[L1]→ x2 →[L2]→ x3 →[L3]→ loss
  存储  ●            ●            ●            ●        (只存层的边界)
  反向  走到 L2 时,先用 x2 重跑一遍 L2 的前向,拿回内部中间张量,再反向
标准训练每步的计算量分布:前向 $2ND$、反向 $4ND$,合计 $6ND$。完全重计算相当于把前向多跑一遍:
$$ \frac{2ND}{6ND} = \frac{1}{3} \approx 33\% $$更一般地,Chen et al. (2016) 证明:对 $L$ 层网络,如果每隔 $\sqrt{L}$ 层放一个检查点,显存从 $O(L)$ 降到 $O(\sqrt{L})$,而额外计算只有一次前向。实践中 Transformer 用的是更简单的策略:每个 Transformer block 一个检查点,因为 block 的边界张量($s \times b \times h$)恰好是整个 block 里最小的张量。
9.3 代码
from torch.utils.checkpoint import checkpoint

class TransformerBlock(nn.Module):
    def forward(self, x):
        x = x + self.attn(self.ln1(x))
        x = x + self.mlp(self.ln2(x))
        return x

class Transformer(nn.Module):
    def forward(self, x):
        for block in self.blocks:
            if self.training and self.use_checkpointing:
                # 前向时不建计算图、不存中间张量;反向时重新执行一遍 block
                x = checkpoint(block, x, use_reentrant=False)
            else:
                x = block(x)
        return x
配合 FSDP 时,PyTorch 提供了更好用的包装器:
from torch.distributed.algorithms._checkpoint.checkpoint_wrapper import (
    checkpoint_wrapper, CheckpointImpl, apply_activation_checkpointing,
)

apply_activation_checkpointing(
    model,
    checkpoint_wrapper_fn=functools.partial(
        checkpoint_wrapper, checkpoint_impl=CheckpointImpl.NO_REENTRANT),
    check_fn=lambda m: isinstance(m, TransformerBlock),
)
- 用
use_reentrant=False:老的 reentrant 实现和torch.compile、FSDP、以及带随机性的模块(dropout)配合都有坑。新实现是默认推荐。 - 随机性要对齐:重计算时如果 dropout 抽到了不同的 mask,梯度就是错的。PyTorch 的 checkpoint 会保存并恢复 RNG 状态来处理这件事——这也是它有额外开销的原因之一。
- 不要对整个模型只加一个检查点:那样反向传播时要重跑整个模型的前向,且中间显存会在重跑时全部占满,等于没省。粒度选在「一个 Transformer block」是经验最优。
9.4 更大的图景:一份数据的三种去处
Percy 在本讲结尾把整个课程的这条主线提炼成一句话——当你需要某个中间结果时,你有三个选择:
| 策略 | 做法 | 花费 | 本讲/本课中的例子 |
|---|---|---|---|
| 重算(re-compute) | 丢掉,需要时重新算一遍 | FLOPs | 激活值重计算;FlashAttention 在反向时重算注意力矩阵 |
| 存在本地显存(memory) | 留在自己的 HBM 里 | 显存 | 标准反向传播;DDP 存完整参数副本 |
| 存在别人那里再通信(communicate) | 让别的 GPU 存,用时传过来 | 带宽 | ZeRO-3/FSDP 的参数分片;张量并行的激活值传输 |
三者之间可以互相兑换。你的机器上哪种资源最紧张,就把负担挪到另外两种上去。这就是「系统层面调优」的全部内容——不是找到某个魔法配置,而是把这三个旋钮调到与你的硬件匹配。
训练 70B 模型、1024 张 H100,一个常见的配置长这样:
- FSDP HYBRID_SHARD(节点内 8 卡切模型状态)→ 模型状态从 1120 GB / 卡 降到 140 GB / 卡 …… 还是不够
- + 张量并行 TP=8(下一讲)或者跨更多卡分片 → 降到可接受
- + 激活值重计算 → 激活值从几百 GB 降到十几 GB
- + bucket 重叠 → 把剩下的通信藏进计算里
每一项单独看都只解决一部分问题,组合起来才能让模型「装得下且跑得快」。
本讲小结
速查表:集合通信原语
| 操作 | 一句话 | 每 rank 通信量 | PyTorch API |
|---|---|---|---|
| broadcast | rank 0 的副本发给所有人 | $\approx N$ | dist.broadcast |
| scatter | rank 0 的张量切开分发 | $\frac{p-1}{p}N$ | dist.scatter(NCCL 不支持) |
| gather | 碎片收到 rank 0 拼起来 | $\frac{p-1}{p}N$ | dist.gather(NCCL 不支持) |
| reduce | 碎片收到 rank 0 加起来 | $\approx N$ | dist.reduce |
| all-gather | gather,但人人有份 | $\frac{p-1}{p}N$ | dist.all_gather_into_tensor |
| reduce-scatter | 逐位加起来,再切开分发 | $\frac{p-1}{p}N$ | dist.reduce_scatter_tensor |
| all-reduce | = reduce-scatter + all-gather | $2\frac{p-1}{p}N$ | dist.all_reduce |
| all-to-all | 矩阵转置(均衡切分时) | $\frac{p-1}{p}N$ | dist.all_to_all_single |
速查表:数据并行家族
| DDP | ZeRO-1 | ZeRO-2 | ZeRO-3 / FSDP | |
|---|---|---|---|---|
| 参数(bf16) | $2N$ | $2N$ | $2N$ | $2N/p$ |
| 梯度(bf16) | $2N$ | $2N$ | $2N/p$ | $2N/p$ |
| 优化器状态(fp32) | $12N$ | $12N/p$ | $12N/p$ | $12N/p$ |
| 每卡合计 | $16N$ | $4N + 12N/p$ | $2N + 14N/p$ | $16N/p$ |
| 每步通信 | $2N$ | $2N$ | $2N$ | $3N$ |
| 用到的原语 | all-reduce | reduce-scatter + all-gather | reduce-scatter + all-gather | all-gather ×2 + reduce-scatter |
要点清单
- 统一主题:不管是单卡内还是跨集群,计算永远离数据很远;一切优化都是「编排计算以避开数据搬运瓶颈」。上一讲用 fusion/tiling 减少访存,本讲用 replication/sharding 减少通信。
- 两个动机:装不下(显存)、算得慢(FLOPs)。它们独立成立,需要不同的解法。
- 硬件层级:HBM 8 TB/s → NVLink 1.8 TB/s → InfiniBand 0.05 TB/s。节点内 vs 节点间差 30 倍,这决定了所有并行策略的分层设计。
- 集合通信:八个原语,三个主力(all-gather / reduce-scatter / all-reduce),一个关键等式
all-reduce = reduce-scatter + all-gather。 - Ring all-reduce:$2\frac{p-1}{p}N$,带宽项与 $p$ 无关(上界 $2N$),但延迟项 $2(p-1)\alpha$ 随 $p$ 线性增长 → 大张量用 ring,小张量用 tree,很多小张量要打成 bucket。
- DDP:复制参数、切分数据、all-reduce 梯度。通信/计算比 $= \frac{2C}{3BT_{\text{local}}}$,与模型大小无关。用 bucket + 异步 all-reduce 把通信藏进反向传播。
- ZeRO:切优化器状态(stage 1)→ 切梯度(stage 2)→ 切参数(stage 3)。前两阶段通信量不变,第三阶段 1.5×。FSDP 就是 ZeRO-3。
- 三种资源可以互换:重算(FLOPs)↔ 本地存(显存)↔ 存别人那里再通信(带宽)。
- 硬件会越来越快,但人们总想训更大的模型,所以这个层级结构会一直存在——今天学的分析方法比今天的具体数字更持久。
下一讲预告:并行化(下)
数据并行只切了一个维度(batch)。当模型的单层都放不进一张卡、或者全局 batch 已经顶到 critical batch size 时,必须换维度切:
- 张量并行(tensor parallelism):沿宽度切——每个 rank 拿每一层的一部分(比如 $W$ 的若干列),前向时用 all-gather 拼接激活值、或用 all-reduce 求和分片输出。每层都要通信,所以只能在 NVLink 域内用。
- 流水线并行(pipeline parallelism):沿深度切——每个 rank 拿一部分层,用
send/recv传边界激活值。通信量极小(只传激活值),能容忍慢互连,但要用 micro-batch 切分来压缩流水线气泡(bubble)。 - 序列并行、专家并行:沿序列长度切、沿专家切。
- 以及它们的组合(3D/4D 并行),和 Levanter 这类「只声明模型和分片策略、剩下交给编译器(Jax/TPU)」的另一条技术路线。本课坚持用 PyTorch 手搭,是为了让你看清楚每一层是怎么从原语堆起来的。
延伸阅读
数据并行与显存优化
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models (2019) — 本讲第 8 节的原始论文。三阶段的显存与通信量分析全部出自这里,图 1 的那组数字(120 → 31.4 → 16.6 → 1.9 GB)值得记住。
- PyTorch FSDP: Experiences on Scaling Fully Sharded Data Parallel (2023) — FSDP 的工程实现细节:FlatParameter、预取策略、与激活值重计算的交互。想搞明白「为什么我的 FSDP 慢」就读它。
- PyTorch Distributed: Experiences on Accelerating Data Parallel Training (2020) — DDP 的官方论文,bucket 大小、梯度就绪顺序、与 autograd 引擎的耦合都在里面。第 7.4 节的手写实现就是它的简化版。
- ZeRO-Offload (2021) / ZeRO-Infinity (2021) — 把状态卸载到 CPU / NVMe,单机也能训大模型。理解「三种资源互换」的又一个例子(这次换的是 PCIe 带宽)。
激活值与算子层面的显存
- Training Deep Nets with Sublinear Memory Cost (2016) — 激活值重计算的原始论文,$O(\sqrt{L})$ 显存的证明。
- Reducing Activation Recomputation in Large Transformer Models (2022) — 第 1.2 节那个激活值公式的出处,并提出选择性重计算:只重算那些「计算便宜、占显存大」的部分(主要是注意力),用 4% 的额外计算换掉大部分显存。
- FlashAttention (2022) — 消掉 $s \times s$ 注意力矩阵的那一项。上一讲的主角,但它对本讲的显存账影响巨大。
其它并行维度(下一讲的预习)
- Megatron-LM (2019) — 张量并行的经典方案:如何把 MLP 和多头注意力切开,使得每层只需要一次 all-reduce。
- GPipe (2018) — 流水线并行 + micro-batch 压缩气泡。
- Efficient Large-Scale Language Model Training on GPU Clusters (2021) — 把张量、流水线、数据并行组合起来(3D 并行)的系统性分析,包括「哪个维度该开多大」的经验法则。这是下一讲的核心参考。
- Outrageously Large Neural Networks: The Sparsely-Gated MoE Layer (2017) — all-to-all 的主要用户,专家并行的起点。
工程实践
- torch.distributed 官方文档 — API 权威参考,尤其是各后端支持哪些操作的那张表。
- NCCL Tests: How to reason about collective operations — busbw 与 algbw 的官方定义与推导,第 6.1 节那个换算公式的来源。
- stas00 / ml-engineering — 大规模训练的实战笔记合集,网络基准测试脚本、故障排查手册、真实集群踩坑记录。
- NCCL 的 GTC talk — NCCL 如何探测拓扑、如何在 ring 与 tree 之间选择。
- Wikipedia: Collective operation — 集合操作的形式化定义与各自的复杂度界,1980 年代并行计算文献的入口。
- Levanter — Stanford CRFM 的 Jax/TPU 训练框架:声明模型 + 声明分片策略,编译器负责剩下的。另一条技术路线的样本。