算子与 Triton:把 GPU 的性能榨出来
先量后改——benchmark、profile,然后用 Triton 亲手写出融合的 GeLU、softmax、row-sum 和 tiled matmul。
0. 本讲导读
上一讲讲的是 GPU「长什么样」——SM、HBM、算术强度(arithmetic intensity)、roofline 模型。那是一套看问题的框架。这一讲要把框架落到手上:给你一段慢的代码,你怎么知道它慢在哪?知道了以后,你怎么写一个比 PyTorch 默认实现更快的算子(kernel)?
Percy 把整讲串成一条极其朴素的主线,他自己叫它「成功配方」:
1. Benchmark and profile your code    # 先测量
2. Make changes                       # 再改
3. Benchmark and profile your code again   # 改完再测
听上去像废话,但绝大多数「性能优化」的失败都源于跳过第 1 步:凭直觉猜瓶颈,改了一堆,最后发现瓶颈根本不在那儿。所以本讲前半段完全在讲怎么正确地测——包括那些一不小心就会让你测出假数据的坑(GPU 是异步的,不 synchronize 你测的是 CPU 发命令的时间)。
后半段是本讲的技术核心:用 Triton 写 kernel。Triton 是 OpenAI 开发的 DSL,它让你用 Python 语法描述「一个线程块(thread block)该做什么」,然后自动编译到 PTX。本讲用四个由易到难的例子把 Triton 的编程模型讲透:
| 例子 | 算子类型 | 新引入的概念 |
|---|---|---|
| GeLU | 逐元素(elementwise) | program_id、tl.load/store、mask、BLOCK_SIZE |
| softmax | 行内归约,整行放得下一个 block | tl.max / tl.sum、stride、other=-inf |
| row sum | 行内归约,整行放不下一个 block | tile 循环 + 累加器(accumulator) |
| matmul + ReLU | 二维分块(tiling) | 二维 grid、指针矩阵、tl.dot、算子融合 |
需要说清楚一件事:本讲不教 CUDA C++。Percy 的取舍是,CUDA 让你控制每个线程,粒度最细但要管的东西太多(共享内存怎么分、bank conflict 怎么躲、同步怎么加);Triton 让你只描述线程块级别的行为,剩下的交给编译器,对绝大多数场景已经够强了。你在作业里会写 Triton,而不是 CUDA。
- Benchmark 的正确姿势:warmup(避开编译/首次分配开销)→
torch.cuda.synchronize()→ 用torch.cuda.Event计时 → 多次取平均/中位数。少任何一步测的都是假数据。 - Profile 告诉你时间花在哪个 CUDA kernel 上。kernel 的名字(如
cutlass3x_sm100_..._64x64x16_...)本身就在告诉你库、架构、精度、tile 形状。 - 朴素 PyTorch 慢的原因几乎总是「没有融合」:每个算子一次 kernel launch、一次 HBM 读、一次 HBM 写。naive GeLU 要跑 8 个 kernel,融合后只要 1 个。
- Triton 的心智模型:把数据从 HBM 加载进来(
tl.load)→ 在片上做完所有计算(融合)→ 写回 HBM(tl.store)。你思考的单位是线程块,不是线程。 - 矩阵乘的分块(tiling)是把算术强度从 $O(1)$ 提到 $O(\text{tile size})$ 的唯一办法,也是理解 FlashAttention 的前置知识。
1. 复习:GPU 硬件与编程模型
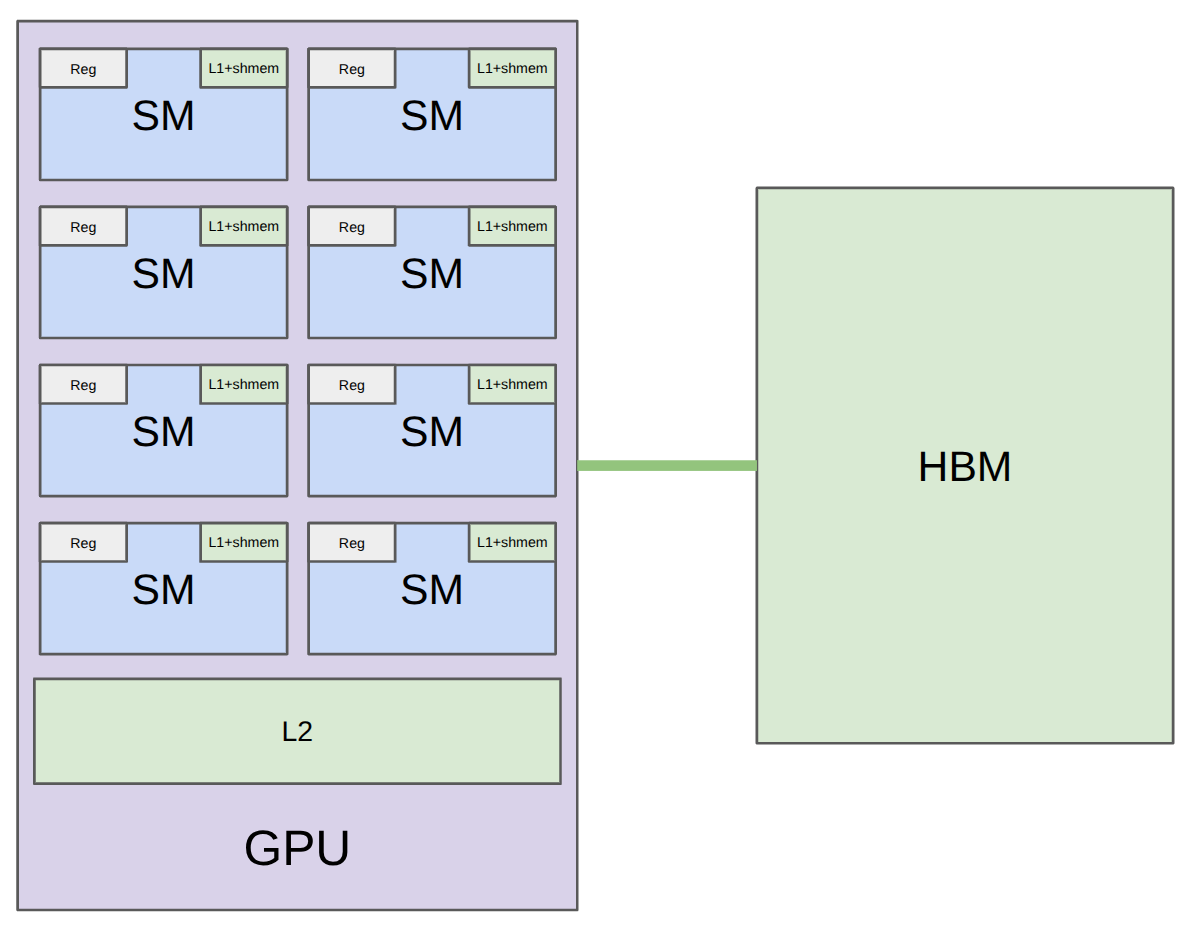
写 kernel 之前必须先把上一讲的硬件图钉在脑子里,因为后面每一个优化决策都直接对应图上的某条边。
| 加速卡 | A100 | H100 | B200 |
|---|---|---|---|
| SM 数量 | 108 | 132 | 148 |
| 寄存器大小(每 SM) | 256 KB | 256 KB | 256 KB |
| L1 + 共享内存(每 SM) | 192 KB | 256 KB | 256 KB |
| L2 缓存 | 40 MB | 50 MB | 96–126 MB |
| HBM 容量 | 80 GB | 80 GB | 192 GB |
| 寄存器带宽 | ~116 TB/s | ~401 TB/s | ~447 TB/s |
| L1 + 共享内存带宽 | ~19 TB/s | ~33 TB/s | ~19 TB/s |
| L2 缓存带宽 | ~5–8 TB/s | ~12 TB/s | ~9 TB/s |
| HBM 带宽 | 2 TB/s | 3.35 TB/s | 8 TB/s |
请特别注意最后四行的数量级差。在 H100 上,寄存器带宽是 HBM 带宽的 $401 / 3.35 \approx 120$ 倍,共享内存也有约 10 倍。这就是「访存瓶颈」四个字的全部含义:只要你的算子需要反复穿越 HBM,你的有效算力就被砍到百分之一。
另外,B200 还引入了 TMEM(tensor memory),位于寄存器与共享内存之间,专供 tensor core 使用,对程序员不可见——你写 Triton 时不用管它,但它解释了为什么 Blackwell 的矩阵乘吞吐会有额外提升。
编程模型:thread / thread block / grid
CUDA 的抽象只有三层:
- 线程(thread):在一小片数据上执行代码。
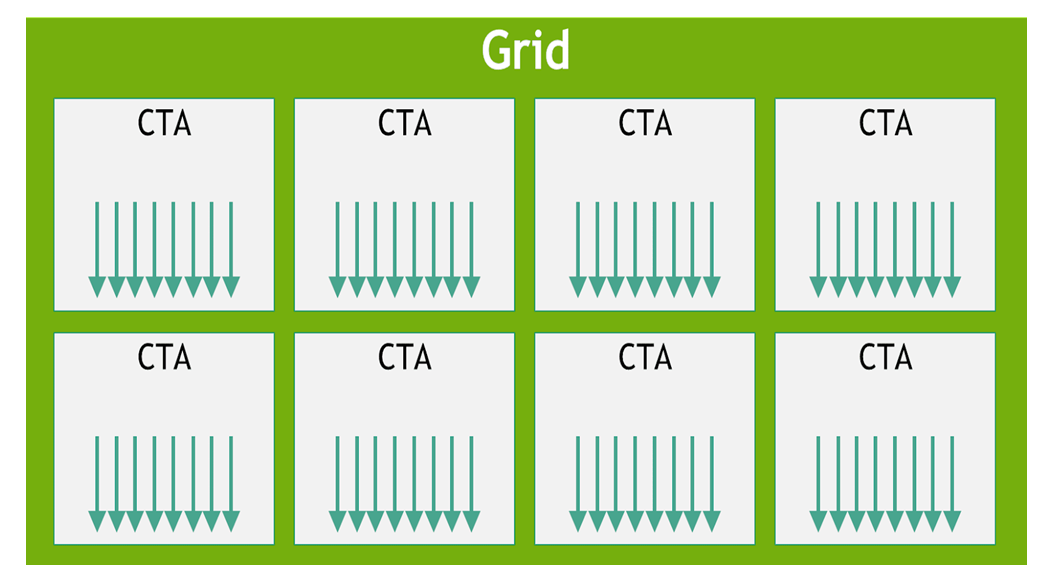
- 线程块(thread block,也叫 CTA,concurrent thread array):一组线程。
- 网格(grid):一堆线程块的集合。
这三层精确对应上面的三级存储:grid ↔ HBM(全体可见),thread block ↔ 共享内存(块内可见),thread ↔ 寄存器(私有)。记住这个对应关系,Triton 里的每一行代码你都能说出它在动哪一级存储。
对逐元素算子(比如 GeLU),线程这一层就够了——第 $i$ 个线程算 $f(x_i)$,$i = 0,\dots,N-1$,线程之间完全不需要说话。
但 softmax 和矩阵乘不是这样:算一行的 softmax 必须知道整行的最大值和求和,线程之间必须通信。如果通信要经过 HBM,那就慢得没法看。于是硬件给了一块「局部于 SM 的共享内存」,让一组线程能低成本地交换数据。线程块的定义就是:一组共享同一块共享内存的线程。因为共享内存物理上属于某个 SM,所以一个线程块必然被调度在同一个 SM 上,不会被拆开。
H100 和 B200 上还有 thread block cluster,让多个线程块之间也能做「分布式共享内存」访问,这是 FlashAttention-3 之类实现能进一步提速的硬件基础。
Percy 的建议非常明确:在 Triton 里,直接用线程块思考。你不再写「这个线程做什么」,而是写「这个线程块负责哪一段数据、对它做什么」。
2. 编程模型与硬件的交互:性能从哪里漏掉
编程模型是硬件的一层抽象。只要为了正确性,你确实可以不管别的;但性能对硬件细节极其敏感,所以想跑得快就必须理解下面这几件事。这一节的每一条,都是一种「代码看起来没问题、性能却掉一个数量级」的典型原因。
Warp 与控制发散
线程块内部,线程按 32 个一组打包成 warp。一个 64 线程的块 = 2 个 warp:
| TTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTT | TTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTT |
warp 0 warp 1关键规则:同一个 warp 内的所有线程必须锁步(lockstep)执行同一条指令。于是就有了控制发散(control divergence):如果同一 warp 里的线程需要走不同分支(if A else B),硬件只能串行地先跑 A 分支(B 分支的线程被屏蔽干等),再跑 B 分支:
| AAAAAAAAA....................... |   先执行 A,走 B 的线程闲置
| .........BBBBBBBBBBBBBBBBBBBBBBB | 再执行 B,走 A 的线程闲置代价是两个分支的时间相加而不是取最大。所以 kernel 里要尽量避免依赖线程 id 的复杂分支——这也是为什么 Triton 用 mask(掩码)而不是 if 来处理边界。
好消息是:一个 SM 上同时驻留多个 warp,当某个 warp 卡在 HBM 读写上时,SM 会零成本地切换到另一个 warp 继续跑。这就是 GPU 掩盖访存延迟的核心机制——它靠的不是缓存,而是靠「手上永远有别的活可以干」。
Warp 占用率(occupancy)
「手上有别的活」的前提是 SM 上真的驻留了足够多的 warp。而能驻留多少,受寄存器限制:每个线程可以用 0–255 个寄存器,线程用得越多,一个 SM 上能塞下的线程就越少。
课上算了一个具体例子:
# 我们想跑的
num_threads_per_block  = 128
num_registers_per_thread = 160

# 硬件能给的
max_registers = 65536   # 每个 SM 的寄存器总数
max_warps     = 64      # 每个 SM 允许并发的 warp 数

# 实际能同时跑多少
assert num_registers_per_thread <= 255
num_registers_per_block = 128 * 160 = 20480
num_blocks = 65536 // 20480 = 3          # 受寄存器限制,只能放 3 个块
num_warps  = 3 * 128 / 32 = 12           # 一共 12 个 warp
occupancy  = 12 / 64 = 0.1875            # 占用率不到 19%
占用率 18.75%,看起来很糟。但 Percy 强调了一个重要的反直觉:
低占用率不一定是坏事——如果每个线程干的活更多,就不需要那么多 warp 来掩盖延迟。典型手法是线程粗化(thread coarsening):让一个线程处理多个元素,这会增加每线程寄存器用量(降低占用率),但同时减少了索引计算、循环开销和 kernel launch 的总量,常常净赚。
你后面会在 Triton GeLU 生成的 PTX 里亲眼看到:一个线程同时处理了 8 个元素。这正是 Triton 编译器自动做的线程粗化。
Bank conflict(共享内存)
共享内存被切成 32 个 bank,每个 4 字节宽,地址是按 bank 交错排列的:
B00 B01 B02 B03 B04 ... B29 B30 B31    <- 第 0 行 128 字节
B00 B01 B02 B03 B04 ... B29 B30 B31    <- 第 1 行
B00 B01 B02 B03 B04 ... B29 B30 B31    <- 第 2 行
每个周期,每个 bank 只能服务一个线程(除非多个线程读的是完全同一个地址,那可以广播)。多个线程访问同一 bank 的不同地址 → 访问被串行化,这就是 bank conflict。
最坏情况:一个矩阵按行存储,每行正好横跨全部 32 个 bank,那么 32 个线程去读同一列时,它们全落在同一个 bank 上 → 32 路冲突,性能变成 1/32。而这个访问模式在矩阵乘里是躲不掉的:算 A @ B 天然要按行读 A、按列读 B。
解决办法叫 swizzling:重排共享内存的布局(比如用 row xor col 之类的位运算打乱列的映射),让「读一列」变成访问 32 个不同的 bank。写 Triton 时你不用手写 swizzle,编译器会替你安排;但当你读 CUTLASS 或 FlashAttention 的 CUDA 源码时,满屏的 swizzle 就是在干这件事。
Memory coalescing(HBM 合并访存)
一个 warp 的 32 个线程去访问 HBM 时,硬件会把这些请求合并成 128 字节的事务(cache line)。
M00 M01 M02 M03 ... M29 M30 M31    <- 一条 128 字节 cache line
M32 M33 M34 M35 ... M61 M62 M63 <- 下一条最理想的情况(完全合并)是:32 个线程访问的正好是同一条 cache line 上连续的 32 个 float32($32 \times 4 = 128$ 字节),一次事务搞定。
反过来,如果 32 个线程访问的地址跨度很大(比如按列步长遍历一个大矩阵),可能触发 32 次独立事务,实际传输了 $32 \times 128 = 4096$ 字节却只用上 128 字节——有效带宽掉到 1/32。这就是为什么 Triton kernel 里几乎总是写 tl.arange(0, BLOCK_SIZE) 这种连续偏移量:连续偏移天然合并。
Block occupancy 与 wave quantization
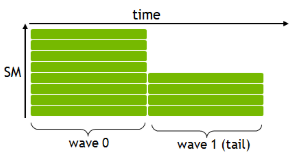
具体算一下:B200 有 148 个 SM。如果你启动 160 个线程块,第一波跑 148 个(满载),第二波只剩 12 个 → 第二波有 136 个 SM 完全闲着。总时间是两波,但有效利用率只有 $160 / (2 \times 148) \approx 54\%$。
解决办法:让线程块数量能整除(或至少接近整数倍于)SM 数。在实践中,这意味着 BLOCK_SIZE 不能拍脑袋定,而要结合张量形状和 SM 数量一起选——这也是 Triton 的 autotune 存在的理由之一。
编程模型:grid(HBM)→ thread block(共享内存)→ thread(寄存器)。
决定实际性能的四个硬件细节:warp 控制发散(分支要串行)、occupancy(寄存器压力 vs 延迟掩盖)、bank conflict(共享内存并发)、memory coalescing(HBM 事务合并),再加上调度层面的 wave quantization。
3. Benchmark:先测量,再优化
Benchmark(基准测试)测的是执行某个操作的墙钟时间(wall-clock time)。它只给你端到端的总时间,不告诉你时间花在哪儿(那是 profiling 的活)。但它依然极其有用,因为它能回答两个问题:
- 比较不同实现:naive 版 vs 内置版 vs 编译版,谁快?
- 理解扩展规律:性能随维度怎么变?是线性、平方还是立方?拐点在哪?
PyTorch 自带 torch.utils.benchmark,但 Percy 选择手写一个,理由是透明——你必须亲眼看到每一步在防哪个坑。
正确的 benchmark 函数
def benchmark(run: Callable, num_warmups: int = 1, num_trials: int = 3) -> float:
    """跑 num_trials 次 run(),返回平均时间(毫秒)。"""

    # (1) Warmup:头几次可能因为 JIT 编译、显存分配、缓存冷启动而偏慢。
    #     我们关心的是稳态(steady state)性能,因为 kernel 会被跑成千上万次。
    for _ in range(num_warmups):
        run()
    torch.cuda.synchronize()   # 等所有 CUDA 线程真正跑完(非常重要!)

    times: list[float] = []
    for trial in range(num_trials):   # (3) 多跑几次,看方差
        # (2) 用 CUDA event 计时,避免把 CPU 端的开销算进去
        start_event = torch.cuda.Event(enable_timing=True)
        end_event   = torch.cuda.Event(enable_timing=True)

        start_event.record()   # 打起点戳
        run()                  # 真正执行计算
        end_event.record()     # 打终点戳

        torch.cuda.synchronize()   # 再次等待,否则 elapsed_time 读到的是空值

        times.append(start_event.elapsed_time(end_event))   # 单位:毫秒

    return mean(times)
三个防坑点,逐个说明为什么少了就会测出假数据:
当你在 Python 里写 c = a @ b,CPU 只是把一个 kernel launch 命令塞进 CUDA 流(stream)的队列就立刻返回了,GPU 可能还没开始算。如果你这时候直接 time.time(),你测到的是「CPU 发命令的时间」,通常只有几微秒,跟真实计算时间完全无关。
torch.cuda.synchronize() 的作用就是阻塞 CPU,直到 GPU 队列清空。计时区间的两端都必须同步,测出来的数才有意义。
关于 warmup:第一次调用会触发一大堆一次性开销——cuBLAS/cuDNN 的算法选择(autotuning)、CUDA context 初始化、torch.compile 的编译、显存 caching allocator 的首次分配。这些开销在真实训练里被摊薄到可以忽略,所以 benchmark 应该把它们排除掉。没有 warmup 的 benchmark 会系统性地高估慢实现和编译实现的耗时。
关于多次取值:单次测量受时钟频率波动(GPU 会因温度降频)、其他进程抢占、调度抖动影响。跑多次不只是为了取平均,更是为了看方差——如果三次结果差了 3 倍,说明你的测量环境本身有问题(比如 GPU 上还跑着别的任务),这时候任何结论都不可信。实践中很多人用中位数而非平均值,因为中位数对偶发的长尾(比如一次 GC 或 page fault)更鲁棒。
用 benchmark 观察扩展规律
课上把矩阵乘 a @ b 的维度从 256 一路扫到 8192:
results = {}
for dim in [256, 512, 1024, 2048, 4096, 8192]:
results[dim] = benchmark(run_operation2(dim=dim, operation=lambda a, b: a @ b))观察到的现象非常典型:维度小的时候时间几乎是常数,之后才转为立方增长。
$n \times n$ 矩阵乘的计算量是 $2n^3$ FLOPs,理论上时间应该 $\propto n^3$。但当 $n$ 很小时,$2n^3$ 太小,GPU 根本吃不饱——时间被固定开销主导:kernel launch 本身要几微秒,加上 Python/PyTorch 的调度开销。
算一下:$n=256$ 时 $2 \cdot 256^3 \approx 3.4 \times 10^7$ FLOPs,在一块 $10^{15}$ FLOP/s 的卡上理论只要 34 纳秒,而单次 kernel launch 就要 5–10 微秒——launch 开销比计算大两个数量级。$n=8192$ 时计算量涨到 $1.1 \times 10^{12}$ FLOPs,约 1 毫秒,launch 开销才终于可以忽略。
这个「常数段 → 立方段」的拐点,是理解为什么小 batch、小模型时 GPU 利用率极低,以及为什么 CUDA Graph 和 kernel 融合对小算子这么重要的直接原因。
4. Profile:时间到底花在哪个 kernel 上
Benchmark 看端到端,profiling(性能剖析)看时间的分布。而且抛开时间不谈,profiler 还有一个被低估的用途:它让你看到「引擎盖底下」到底执行了什么——你写的一行 PyTorch,实际调用了哪些 CUDA kernel。
PyTorch 内置 profiler;作业里你还会用 NVIDIA 的 Nsight Systems / Nsight Compute 拿到更细的信息(比如每个 kernel 的访存吞吐、occupancy、指令统计)。
def profile(run: Callable, num_warmups: int = 1):
    # 同样要 warmup + 同步
    for _ in range(num_warmups):
        run()
    torch.cuda.synchronize()

    # 在 profiler 上下文里跑一次
    with torch.profiler.profile(
            activities=[ProfilerActivity.CUDA],
            experimental_config=torch._C._profiler._ExperimentalConfig(verbose=True)) as prof:
        run()
        torch.cuda.synchronize()   # 别忘了,否则 kernel 还没跑完 profiler 就结束了

    # 按 CUDA 总时间排序,打印前 10 行
    table = prof.key_averages().table(sort_by="cuda_time_total",
                                      max_name_column_width=100,
                                      row_limit=10)
    return table
三个对照实验
课上分别 profile 了三种操作,对照着看结论最清楚:
| 操作 | profiler 里看到什么 | 说明什么 |
|---|---|---|
a + b, dim=2048 | 一个逐元素加法 kernel(vectorized_elementwise_kernel 之类) | 逐元素算子只需一个简单 kernel,纯访存受限 |
a @ b, dim=2048 | 一个大矩阵乘 kernel,名字里带 cutlass/sm100/tile 形状 | 大矩阵走高度优化的 GEMM 路径 |
a @ b, dim=128 | 换了一个不同名字的 kernel | PyTorch/cuBLAS 会根据形状动态选择不同实现 |
两个观察:
- 你能直接看到实际被调用的 CUDA kernel(那些超长的名字)。
- 不同的张量维度会触发不同的 kernel。这解释了为什么性能曲线常常不光滑:某个维度跨过阈值,底层换了一套实现,时间可能突然跳变。
读懂 kernel 的名字
Kernel 的名字不是随机字符串,它编码了实现的关键信息。课上拆解的例子:
cutlass3x_sm100_simt_sgemm_f32_f32_f32_f32_f32_64x64x16_1x1x1_3_nnn_align1_bi...| 片段 | 含义 |
|---|---|
cutlass | NVIDIA 的线性代数模板库(CUDA Templates for Linear Algebra Subroutines) |
sm100 | 目标架构版本,对应 NVIDIA Blackwell(B200) |
simt | 用的是普通 SIMT 核心(而非 tensor core) |
sgemm | single-precision GEMM,单精度通用矩阵乘 |
f32_f32_f32_f32_f32 | 输入 / 累加 / 输出各段的数据类型都是 float32 |
64x64x16 | tile 形状:$\text{BLOCK\_M} \times \text{BLOCK\_N} \times \text{BLOCK\_K}$(第 9 节会亲手写出这三个数) |
nnn | 三个矩阵都不转置(non-transposed) |
align1 | 内存对齐要求(1 个元素,说明没走上向量化加载的快路径) |
看到 simt 而不是 tensorop/hmma,说明没用上 tensor core——通常是因为你在跑 fp32。换成 bf16/fp16 或开 TF32 就能切到 tensor core 路径,吞吐提升 5–10 倍。
看到 align1,说明访存没有向量化,通常是张量形状不是 8 的倍数导致的。把最后一维 pad 到 8 或 16 的倍数,往往能白捡一截性能。
这就是 profiling「独立于时间」的价值:kernel 名字本身就是一份诊断报告。
5. GeLU 三级实现:融合能带来什么
现在把 benchmark 和 profile 这套工具用到一个真实算子上:GeLU 激活函数。用它的 tanh 近似形式:
$$ \mathrm{GeLU}(x) \approx 0.5 \, x \left( 1 + \tanh\!\left( \sqrt{2/\pi} \left( x + 0.044715\, x^3 \right) \right) \right) $$其中 $\sqrt{2/\pi} \approx 0.79788456$。三种实现:
# 1. 朴素 PyTorch 实现(未融合)
def naive_gelu(x: torch.Tensor):
    return 0.5 * x * (1 + torch.tanh(0.79788456 * (x + 0.044715 * x * x * x)))

# 2. PyTorch 内置实现(已融合,底层是手写 CUDA kernel)
def builtin_gelu(x: torch.Tensor):
    return torch.nn.functional.gelu(x, approximate="tanh")

# 3. 用 PyTorch 编译器编译朴素实现
compiled_gelu = torch.compile(naive_gelu)
先验证正确性(编译不该改变语义),再 benchmark($16384 \times 16384$ 的矩阵,约 2.7 亿个元素)。结果是:内置版和编译版都显著快于朴素版。
为什么?数一数 HBM 访存量
Profile 三个版本,差别一目了然:
| 实现 | kernel 数 | HBM 读 | HBM 写 |
|---|---|---|---|
naive_gelu | 多个(每个算术运算一个) | 每个 kernel 一次 | 每个 kernel 一次 |
builtin_gelu | 1 个 | 1 次 | 1 次 |
compiled_gelu | 1 个(而且是一个 Triton kernel) | 1 次 | 1 次 |
PyTorch 是逐算子执行(eager)的:每一个 *、+、tanh 都是一次独立的 kernel launch,每次都要从 HBM 读入操作数、把结果写回 HBM。把表达式拆开数:
t1 = x * x            # 读 x, 写 t1
t2 = t1 * x           # 读 t1, x, 写 t2      (= x^3)
t3 = 0.044715 * t2    # 读 t2, 写 t3
t4 = x + t3           # 读 x, t3, 写 t4
t5 = 0.79788456 * t4  # 读 t4, 写 t5
t6 = torch.tanh(t5)   # 读 t5, 写 t6
t7 = 1 + t6           # 读 t6, 写 t7
t8 = 0.5 * x          # 读 x, 写 t8
y  = t8 * t7          # 读 t8, t7, 写 y
大约 9 个 kernel,约 13 次「$N$ 元素读」和 9 次「$N$ 元素写」,合计 $\approx 22N$ 个元素的 HBM 流量。
而理论下界是:读一次 $x$,写一次 $y$,即 $2N$。也就是说朴素实现浪费了大约 11 倍的 HBM 带宽。
代入具体数字:$N = 16384^2 \approx 2.68 \times 10^8$ 个 float32 = 1.07 GB。融合版需要搬 $2 \times 1.07 = 2.1$ GB,在 3.35 TB/s 的 H100 上约 0.64 ms;朴素版要搬约 23 GB,约 7 ms。而真正的算术运算只有约 $10N \approx 2.7 \times 10^9$ FLOPs,在 $10^{15}$ FLOP/s 的卡上只要 2.7 微秒——算术时间比访存时间小三个数量级,这个算子 100% 是访存受限(memory-bound)的。
结论就是本讲最重要的一句话:逐元素算子的性能完全由 HBM 流量决定,而 HBM 流量由 kernel 的个数决定。融合(fusion)就是把 $k$ 个 kernel 合成 1 个,把流量从 $O(k \cdot N)$ 降到 $2N$。
- 朴素实现:多个 kernel,大量 HBM 读写(没有融合)。
- 内置与编译版本:一个 kernel(kernel 融合),一次 HBM 读、一次 HBM 写。
torch.compile生成的正是 Triton kernel——这不是巧合,而是本讲下半场的引子:编译器能自动做的事,你也可以手写,而且在编译器做不好的地方(比如 FlashAttention 那种需要重排计算顺序的算法)你必须手写。
torch.compile 的 Inductor 后端擅长的是逐元素算子的纵向融合和一些简单的归约。它做不到的是改变算法本身:比如把 attention 的 $QK^\top$、softmax、$\cdot V$ 三步重排成分块的在线(online)算法,从而避免物化 $O(n^2)$ 的注意力矩阵。那需要人来设计算法,用 Triton 表达。
所以正确的姿势是:先试 torch.compile,profile 看还剩多少空间,只在真正的瓶颈上手写 kernel。
6. Triton 入门:CUDA 写线程,Triton 写线程块
| CUDA(NVIDIA) | Triton(OpenAI) | |
|---|---|---|
| 你描述的对象 | 每个线程做什么 | 每个线程块做什么 |
| 优点 | 细粒度控制,天花板最高 | 够强(尤其是入门阶段),代码量小一个数量级 |
| 缺点 | 要手动管共享内存、同步、swizzle、向量化… | 某些极致优化(如 warp 级原语编排)表达不出来 |
| 心智模型 | SIMT:我是第 tid 号线程 | 加载数据到片上 → 在片上算完(融合)→ 写回全局内存 |
Triton 帮你自动处理的事情包括:共享内存的分配与调度、线程块内的归约(reduction)、访存合并、向量化、线程粗化、软件流水(pipelining)。它不帮你处理的是:怎么分块(BLOCK_SIZE 你自己定)、grid 怎么切(你自己算)、算法本身怎么设计(比如 FlashAttention 的在线 softmax)。
Triton GeLU:完整代码逐行拆解
先看 host 端(在 CPU 上跑的 Python 部分),它负责准备输出张量、算 grid、启动 kernel:
def triton_gelu(x: torch.Tensor):
    # 检查输入:必须在 GPU 上,且内存连续(我们要按线性地址访问)
    assert x.is_cuda
    assert x.is_contiguous()

    # 分配输出张量(Triton kernel 不返回值,只往指针里写)
    y = torch.empty_like(x)

    # 划分 grid:把所有元素切成若干块
    # | T T T T T T T T | T T T T T T T T | T T T T T T T T | T T T T T T T T |
    # |    Block 0      |    Block 1      |    Block 2      |    Block 3      |
    num_elements = x.numel()
    BLOCK_SIZE = 1024                                    # 每块处理 1024 个元素
    num_blocks = triton.cdiv(num_elements, BLOCK_SIZE)   # 向上取整除法

    # 启动 kernel:方括号里是 grid 形状,圆括号里是 kernel 参数
    kernel = triton_gelu_kernel[(num_blocks,)](x, y, num_elements, BLOCK_SIZE=BLOCK_SIZE)

    return y
几个要点:
triton.cdiv(a, b)是向上取整除法 $\lceil a/b \rceil$。$N = 8192$、BLOCK_SIZE = 1024 时得到 8 个块;如果 $N$ 不是 1024 的倍数,最后一块会越界——这就是 kernel 里必须写 mask 的原因。- 把
torch.Tensor直接传给 Triton kernel,Triton 会自动取它的数据指针。 BLOCK_SIZE=BLOCK_SIZE必须用关键字传,因为它在 kernel 签名里被标注为tl.constexpr——编译期常量。
再看 device 端的 kernel:
@triton.jit
def triton_gelu_kernel(x_ptr, y_ptr, num_elements, BLOCK_SIZE: tl.constexpr):
    # 输入数据从 x_ptr 开始,输出从 y_ptr 开始

    pid = tl.program_id(axis=0)   # 我是第几个线程块(program)?
    start = pid * BLOCK_SIZE      # 本块负责的起始下标

    # 本块要操作的所有下标:一个长度为 BLOCK_SIZE 的向量
    offsets = start + tl.arange(0, BLOCK_SIZE)

    # 别读写越界(最后一块可能不满)
    mask = offsets < num_elements

    # 读:从 HBM 一次性把 BLOCK_SIZE 个元素搬到片上
    x = tl.load(x_ptr + offsets, mask=mask)

    # 算:全部在片上完成,中间结果不落 HBM —— 这就是融合
    # tanh 近似:0.5 * x * (1 + tanh(sqrt(2/pi) * (x + 0.044715 x^3)))
    # tl.tanh 不存在,用恒等式 tanh(a) = (exp(2a) - 1) / (exp(2a) + 1)
    a    = 0.79788456 * (x + 0.044715 * x * x * x)
    exp  = tl.exp(2 * a)
    tanh = (exp - 1) / (exp + 1)
    y    = 0.5 * x * (1 + tanh)

    # 写:一次性写回 HBM
tl.store(y_ptr + offsets, y, mask=mask)x = tl.load(x_ptr + offsets, mask=mask) 里的 x 不是一个 GPU 张量,而是一个驻留在寄存器/共享内存里的、长度为 BLOCK_SIZE 的块(block)。后面所有的 *、+、tl.exp 都作用在这个块上,全程不碰 HBM。
换句话说:你写的是向量化的 Python 表达式,Triton 编译器负责把它拆成「哪个线程算哪几个元素」。naive_gelu 里那 9 次 HBM 往返,在这里全部消失了——中间量 a、exp、tanh 从头到尾待在片上。
mask=mask 让越界的那些 lane 既不读也不写。少了它,最后一个块会读到别的张量的内存(结果是垃圾数字甚至 NaN),或者写坏别人的数据(这种 bug 极难调试,因为症状出现在别的算子里)。
注意 Triton 用 mask 而不是 if:mask 是硬件层面的谓词执行(predication),不会造成第 2 节讲的控制发散;用 if 则会让 warp 串行走两条路径。
看一眼 Triton 生成的 PTX
Triton 编译到 PTX(Parallel Thread Execution),这是 GPU 的一种汇编语言。(更准确地说,编译链是 Triton IR → LLVM IR → PTX → SASS;PTX 还是一层虚拟 ISA,最终由驱动的 ptxas 编译成真正的机器码 SASS。)你可以直接把它 dump 出来:
def output_ptx(name: str, kernel):
    with open(f"var/{name}-ptx.txt", "w") as f:
        f.write(kernel.asm["ptx"])
Percy 在课上带着读了这份 PTX,几个值得注意的地方:
| PTX 里的东西 | 含义 |
|---|---|
ld.global.* / st.global.* | 从全局内存(HBM)读 / 写——对应 tl.load / tl.store |
%ctaid.x | 线程块(CTA)索引——对应 tl.program_id(0) |
%tid.x | 块内线程索引——你在 Triton 里从没写过它,是编译器生成的 |
%f* / %r* | 浮点寄存器 / 整数寄存器 |
最有意思的一条观察:一个线程同时处理 8 个元素。BLOCK_SIZE = 1024,但 Triton 并没有起 1024 个线程,而是起了 128 个线程、每个干 8 份活——这正是第 2 节讲的线程粗化(thread coarsening),编译器自动做的。它同时也意味着访存被向量化成了更宽的事务(一次搬 8 个 float32 = 32 字节),更容易打满带宽。
这就是 Triton 的价值主张:你写块级别的逻辑,编译器替你做线程映射、粗化、向量化、合并访存——而这些正是手写 CUDA 时最容易写错也最费时间的部分。
7. Triton softmax:整行放得下一个块的归约
GeLU 是逐元素的,线程之间不用说话。现在换成需要跨元素聚合的算子:softmax。它把矩阵的每一行做指数化并归一化:
[0   0    0  ]      =>   [1/3  1/3  1/3]
[1   1   -inf]           [1/2  1/2  0  ]
先数一数朴素实现的访存量
def naive_softmax(x: torch.Tensor):
    M, N = x.shape   # M 行 N 列

    x_max = x.max(dim=1)[0]              # 求每行最大值   (MN 读, M 写)
    x = x - x_max[:, None]               # 减去最大值     (MN + M 读, MN 写)
    numerator = torch.exp(x)             # 指数化         (MN 读, MN 写)
    denominator = numerator.sum(dim=1)   # 求归一化常数   (MN 读, M 写)
    y = numerator / denominator[:, None] # 归一化         (MN 读, MN 写)

    # 合计:5MN + M 次读,3MN + 2M 次写
    # 理论下界:MN 次读,MN 次写  =>  有 4 倍的加速空间!
return y注意这里减去最大值是数值稳定性的标准做法:$\softmax(x)_i = \frac{e^{x_i - m}}{\sum_j e^{x_j - m}}$ 对任意 $m$ 恒等,取 $m = \max_j x_j$ 保证所有指数的参数 $\le 0$,$e^{\cdot} \in (0, 1]$,永不上溢。
把访存量摊开:朴素实现总流量约 $8MN$,理论下界 $2MN$,浪费了 4 倍带宽。这 4 倍就是写 Triton kernel 能拿回来的加速上限。
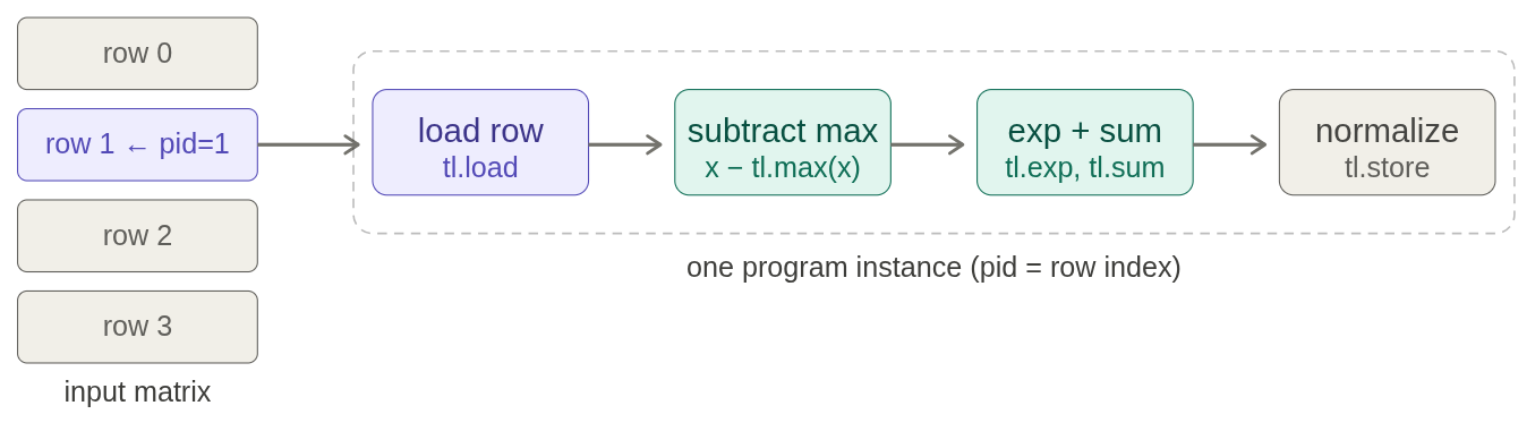
Host 端:每行一个 program
def triton_softmax(x: torch.Tensor):
    y = torch.empty_like(x)

    M, N = x.shape                          # 行数 x 列数
    block_size = triton.next_power_of_2(N)  # 一个块要装下整行 —— 必须是 2 的幂
    num_blocks = M                          # 一个块 = 一行

    triton_softmax_kernel[(M,)](
        x_ptr=x, y_ptr=y,
        x_row_stride=x.stride(0), y_row_stride=y.stride(0),   # 行间跨度
        num_cols=N, BLOCK_SIZE=block_size
    )
return yx.stride(0) 是「从第 $i$ 行跳到第 $i+1$ 行需要在线性地址上前进多少个元素」。对连续(contiguous)张量它等于 $N$,但对切片、转置、非连续视图它不等于 $N$。把 stride 作为参数传进 kernel,kernel 就能正确处理这些情形,而不需要调用方先 .contiguous() 复制一份。这是 Triton kernel 的标准写法。
另外 triton.next_power_of_2(N):Triton 要求块的每一维都是 2 的幂(编译器的向量化和归约树都依赖这个)。$N = 3$ 时 block_size = 4,多出来的 lane 靠 mask 处理。
Kernel:一次读、片上算完、一次写
@triton.jit
def triton_softmax_kernel(x_ptr, y_ptr, x_row_stride, y_row_stride,
                          num_cols, BLOCK_SIZE: tl.constexpr):
    assert num_cols <= BLOCK_SIZE   # 前提:整行装得下

    # 每个 program 独立处理一行
    row_idx = tl.program_id(0)
    col_offsets = tl.arange(0, BLOCK_SIZE)

    # ---- 从全局内存读 ----
    x_start_ptr = x_ptr + row_idx * x_row_stride   # 本行的起始地址
    x_ptrs = x_start_ptr + col_offsets             # 本行每个元素的地址 [BLOCK_SIZE]
    x_row = tl.load(x_ptrs, mask=col_offsets < num_cols, other=float("-inf"))

    # ---- 片上计算(全部融合)----
    x_row = x_row - tl.max(x_row, axis=0)   # 块内归约求最大值
    numerator = tl.exp(x_row)
    denominator = tl.sum(numerator, axis=0) # 块内归约求和
    y_row = numerator / denominator

    # ---- 写回全局内存 ----
    y_start_ptr = y_ptr + row_idx * y_row_stride
    y_ptrs = y_start_ptr + col_offsets
    tl.store(y_ptrs, y_row, mask=col_offsets < num_cols)
两个细节值得停下来看:
other=float("-inf"):越界的 lane 被填充成 $-\infty$。这不是随便挑的值——它保证被填充的位置既不影响tl.max的结果($-\infty$ 永远不会是最大值),也不影响tl.sum($e^{-\infty} = 0$)。如果填 0,那 $e^0 = 1$ 会污染分母,结果全错。填充值必须是对应归约运算的单位元(identity)。tl.max/tl.sum是块内归约。你只写了一行,Triton 在底层生成的是一棵归约树:先在 warp 内用 shuffle 指令折半规约($\log_2 32 = 5$ 步),再通过共享内存跨 warp 汇总。这一整套在 CUDA 里要写几十行、还得小心__syncthreads()的位置。
softmax 的加速来源和 GeLU 完全一样:把 5 遍读 + 3 遍写压缩成 1 遍读 + 1 遍写。区别只在于中间多了两次块内归约,而归约在片上做几乎不花钱(共享内存带宽是 HBM 的 10 倍以上)。
这个 kernel 有一个硬约束:assert num_cols <= BLOCK_SIZE。整行必须装得下一个块。$N$ 很大(比如 32768 词表)时这条会失败——下一节就解决它。
8. Triton row sum:整行放不下时的分块归约
上一节的 softmax 里,整行装得下一个块,所以归约完全发生在块内部,由 Triton 自动搞定。但如果行装不下呢?比如 4096 列,而块大小只有 1024。
Percy 给的策略是三步:
- 把一行切成若干 tile(上例中是 4 个)。
- 每个线程遍历这些 tile,把自己负责的位置累加起来(每个线程持有一个累加器)。
- 最后对所有线程的累加器做一次归约(通过共享内存或 warp shuffle)。
为了把机制讲清楚,课上换了个更简单的算子:行求和(row sum),也就是 x.sum(dim=1)。逻辑和 softmax 一模一样,但少了 max 和归一化的干扰。
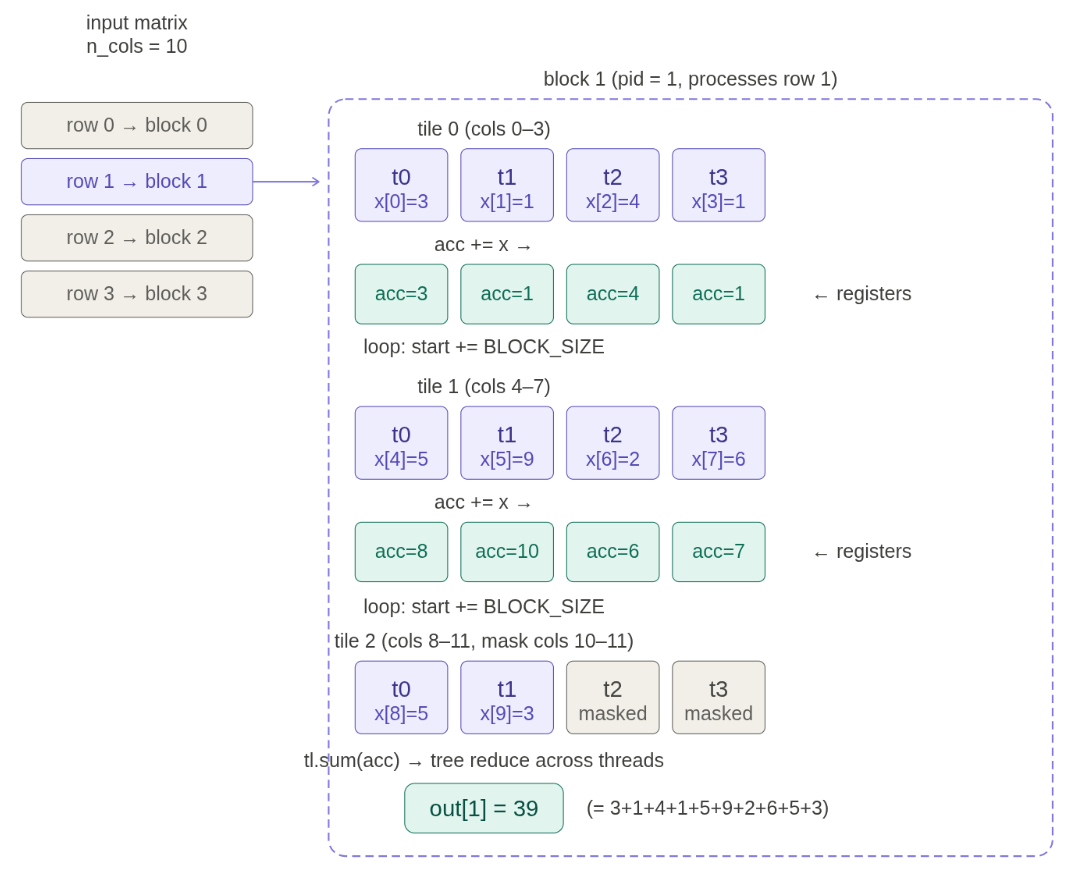
def triton_row_sum(x: torch.Tensor, BLOCK_SIZE: int = 1024) -> torch.Tensor:
    M, N = x.shape
    y = torch.empty(M, device=x.device, dtype=x.dtype)   # 输出是长度 M 的向量
    row_sum_kernel[(M,)](x, y, N, BLOCK_SIZE=BLOCK_SIZE)
    return y


@triton.jit
def row_sum_kernel(x_ptr, out_ptr, N, BLOCK_SIZE: tl.constexpr):
    row = tl.program_id(0)   # 本 program 处理哪一行?

    # 每个线程一个累加器
    # 一行的分工:T1 T2 T3 T4 | T1 T2 T3 T4 | T1 T2 T3 T4  (N = 12, BLOCK_SIZE = 4)
    acc = tl.zeros([BLOCK_SIZE], dtype=tl.float32)

    # 第一级:跨 tile 循环累加
    for start in range(0, N, BLOCK_SIZE):
        cols = start + tl.arange(0, BLOCK_SIZE)
        mask = cols < N
        x = tl.load(x_ptr + row * N + cols, mask=mask, other=0.0)
        acc += x

    # 第二级:把 BLOCK_SIZE 个累加器归约成一个标量
    result = tl.sum(acc, axis=0)

tl.store(out_ptr + row, result)注释里那行分工示意图是理解全局的关键:N = 12, BLOCK_SIZE = 4 时,线程 T1 负责第 0、4、8 列,T2 负责第 1、5、9 列,依此类推。每个线程只跟自己负责的那些位置打交道,循环期间零通信;只有最后一步才需要线程之间说话。
另一种分法是让 T1 拿第 0–2 列、T2 拿第 3–5 列……但那样的话,同一 warp 的 32 个线程在同一时刻访问的地址就是散开的(相隔 3 个元素),触发第 2 节讲的非合并访存,有效带宽掉一大截。
而按跨步分配时,cols = start + tl.arange(0, BLOCK_SIZE) 保证同一时刻所有线程访问的是连续的一段地址,正好合并成整数条 128 字节的事务。这是 GPU kernel 里一条通用规律:循环变量放在外层(跨 tile),线程 id 放在内层(tile 内连续)。
other=0.0 与 float32 累加
这里的填充值是 0.0,因为归约运算是加法,加法的单位元是 0(对比 softmax 里 max 的单位元是 $-\infty$)。
另外 acc 显式声明为 tl.float32,即使输入是 bf16/fp16。这是混合精度累加的标准做法:bf16 只有 8 位尾数,连加几千项会丢失大量精度(甚至出现 $a + b = a$ 的停滞现象)。用 fp32 累加器几乎不增加成本,却能保住数值精度。
这个「循环 + 累加器」的模式,是所有装不下的归约的通用骨架:row sum、layernorm 的均值/方差、cross-entropy 的 logsumexp,以及——最重要的——FlashAttention 的在线 softmax。区别只在于累加器里存什么(sum 存一个数,online softmax 需要同时维护 running max 和 running sum,并在遇到更大的 max 时对已有的 sum 做指数重标定)。
9. Triton matmul + ReLU:分块(tiling)与算术强度
矩阵乘是深度学习的看家饭(bread and butter),也是分块思想最重要的应用场景。设 $A$ 是 $M \times K$、$B$ 是 $K \times N$、$C = AB$ 是 $M \times N$:
|        k                  n
|   [ A1 A2 A3 ]       [ B1 B2 B3 ]   [ C1 C2 C3 ]
| m [ A4 A5 A6 ]  *  k [ B4 B5 B6 ] = [ C4 C5 C6 ]
|   [ A7 A8 A9 ]       [ B7 B8 B9 ]   [ C7 C8 C9 ]
从朴素到分块:三个层次
朴素做法。固定一个 $(m, n)$,对每个 $k$:从 HBM 读 $A[m,k]$ 和 $B[k,n]$,乘起来累加;最后把结果写到 $C[m,n]$。
访存量:$MKN$ 次读,$MN$ 次写。计算量是 $2MKN$ FLOPs。算术强度(arithmetic intensity):
$$ \text{AI}_{\text{naive}} = \frac{2MKN \text{ FLOPs}}{4 \cdot (MKN + MN) \text{ bytes}} \approx \frac{1}{2} \ \text{FLOP/byte} = O(1) $$$O(1)$ 的算术强度意味着完全被带宽卡死:H100 的 3.35 TB/s 配上 0.5 FLOP/byte,有效算力只有 1.7 TFLOP/s,而这卡的峰值是接近 $10^3$ TFLOP/s——利用率不到 0.2%。
问题出在哪?算 $C_4$ 和 $C_5$ 都需要 $A_4, A_5, A_6$(同一行)。朴素做法把它们从 HBM 读了两遍。能不能只读一遍?能——用共享内存。
理想做法。把整个 $A$ 和整个 $B$ 都装进共享内存,然后算 $C$。访存量降到 $MK + KN$ 次读、$MN$ 次写,算术强度变成:
$$ \text{AI}_{\text{ideal}} = \frac{2MKN}{4(MK + KN + MN)} = O(N) $$这就是上一讲说的「理想 $O(N)$ 算术强度」。但 $A$ 和 $B$ 通常装不进共享内存——每个 SM 只有 256 KB,而一个 $4096 \times 4096$ 的 fp32 矩阵就是 64 MB。
分块(tiling):折中方案。
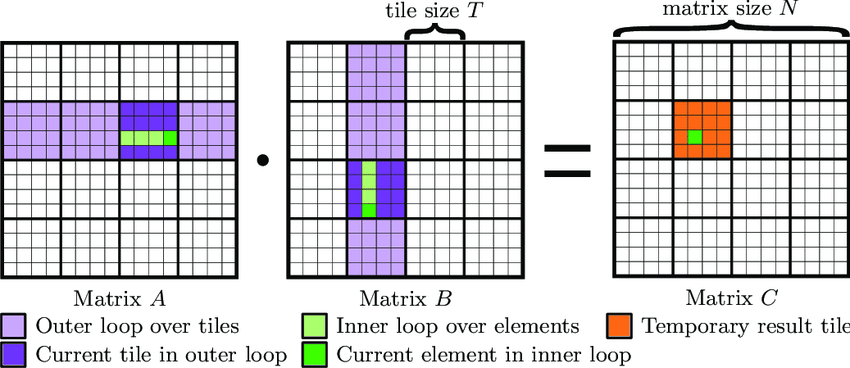
核心思想:把 $C$ 切成输出 tile(每个 tile 一个线程块)。固定一个输出 tile,对每一对($A$ 的行块,$B$ 的列块):
- 把对应的 $A$ tile 和 $B$ tile 从 HBM 载入共享内存;
- 在 tile 上做矩阵乘;
- 累加到部分和里(部分和常驻片上)。
循环结束后,把输出 tile 写回 HBM。算术强度:$O(\text{tile size})$。
设 tile 是 $T \times T$,$K$ 方向步长也是 $T$。对一个输出 tile:
- 计算量:$2 T^2 K$ FLOPs($T\times T$ 输出,每个要 $K$ 次乘加)。
- HBM 读入:沿 $K$ 走 $K/T$ 步,每步读一个 $T\times T$ 的 $A$ tile 和一个 $T\times T$ 的 $B$ tile,共 $2 \cdot (K/T) \cdot T^2 = 2KT$ 个元素。
于是 $\text{AI} = \dfrac{2T^2K}{4 \cdot 2KT} = \dfrac{T}{4}$ FLOP/byte —— 正比于 tile 边长。
代入本节代码的 $T = 64$:$\text{AI} = 16$ FLOP/byte,比朴素的 0.5 提高了 32 倍。想再高就要更大的 tile,但 tile 越大占用的共享内存和寄存器越多,occupancy 越低——这就是 tile 尺寸调优的本质权衡,也是为什么 cuBLAS 里同一个 GEMM 有几十个 tile 配置的变体(回忆第 4 节 kernel 名字里的 64x64x16)。
Bonus:顺手把激活函数融合进去
你常常要在矩阵乘后面接一个逐元素激活,比如 GeLU(A @ B) 或 ReLU(A @ B)。如果分成两个算子,就要把整个 $M \times N$ 的中间结果写回 HBM 再读回来。解决办法:kernel 融合——在写回之前,直接在片上的累加器上应用激活函数。省下一整趟 $2MN$ 的 HBM 流量。
实现:先复习 stride
矩阵在内存里是线性排布的,靠 stride 来定位:
x = torch.tensor([[0., 1, 2, 3],
                  [4, 5, 6, 7]])
stride_row, stride_col = x.stride()   # (4, 1)
row, col = 1, 2
index = row * stride_row + col * stride_col   # 1*4 + 2*1 = 6  ->  x.flatten()[6] == 6.0
Triton 里所有的寻址都是这么算的,只不过下标是向量,于是地址也变成指针矩阵。
Host 端:二维 grid
def triton_matmul_relu(a: torch.Tensor, b: torch.Tensor):
    assert a.is_cuda and b.is_cuda
    assert a.is_contiguous() and b.is_contiguous()
    assert a.shape[1] == b.shape[0]

    M, K = a.shape      # A 是 M x K
    K, N = b.shape      # B 是 K x N
    c = torch.empty((M, N), device=a.device)

    # 输出 tile 的形状,以及 K 方向的步长
    BLOCK_M, BLOCK_N, BLOCK_K = 64, 64, 32
    grid = (triton.cdiv(M, BLOCK_M), triton.cdiv(N, BLOCK_N))   # 二维 grid!

    matmul_relu_kernel[grid](
        a, b, c,
        M, N, K,
        a.stride(0), a.stride(1),
        b.stride(0), b.stride(1),
        c.stride(0), c.stride(1),
        BLOCK_M, BLOCK_N, BLOCK_K,
    )
    return c
注意 grid 是二维的:$\lceil M/64 \rceil \times \lceil N/64 \rceil$ 个线程块,每块负责输出矩阵上一个 $64 \times 64$ 的方块。$M = N = 1024$ 时是 $16 \times 16 = 256$ 个块。
Kernel:指针矩阵 + K 维循环
@triton.jit
def matmul_relu_kernel(
    a_ptr, b_ptr, c_ptr,    # 计算 c = a @ b
    M, N, K,                # a: M x K, b: K x N, c: M x N
    stride_am, stride_ak,   # 怎么在 a 里导航
    stride_bk, stride_bn,   # 怎么在 b 里导航
    stride_cm, stride_cn,   # 怎么在 c 里导航
    BLOCK_M: tl.constexpr, BLOCK_N: tl.constexpr, BLOCK_K: tl.constexpr,
):
    # 本 program 负责第 (m, n) 个输出 tile
    pid_m = tl.program_id(0)
    pid_n = tl.program_id(1)

    # 下标向量
    indices_m = pid_m * BLOCK_M + tl.arange(0, BLOCK_M)   # a 的行下标 [BLOCK_M]
    indices_n = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)   # b 的列下标 [BLOCK_N]
    indices_k = tl.arange(0, BLOCK_K)                     # a 的列 = b 的行 [BLOCK_K]

    # 初始的指针矩阵(广播出二维)
    a_ptrs = a_ptr + indices_m[:, None] * stride_am + indices_k[None, :] * stride_ak  # [BLOCK_M, BLOCK_K]
    b_ptrs = b_ptr + indices_k[:, None] * stride_bk + indices_n[None, :] * stride_bn  # [BLOCK_K, BLOCK_N]

    # 片上累加器,始终 float32
    acc = tl.zeros([BLOCK_M, BLOCK_N], dtype=tl.float32)

    # 沿 K 方向滑动:a 的行块 x b 的列块
    for k in range(0, K, BLOCK_K):
        a = tl.load(a_ptrs, mask=(indices_m[:, None] < M) & (indices_k[None, :] + k < K), other=0.0)
        b = tl.load(b_ptrs, mask=(indices_k[:, None] + k < K) & (indices_n[None, :] < N), other=0.0)
        acc += tl.dot(a, b)            # tile 级矩阵乘,会用上 tensor core
        a_ptrs += BLOCK_K * stride_ak  # 前进到 a 的下一个列块
        b_ptrs += BLOCK_K * stride_bk  # 前进到 b 的下一个行块

    # 融合激活函数(这里是 ReLU)
    acc = tl.maximum(acc, 0.0)

    # 写回输出 tile
    c_ptrs = c_ptr + indices_m[:, None] * stride_cm + indices_n[None, :] * stride_cn
    tl.store(c_ptrs, acc, mask=(indices_m[:, None] < M) & (indices_n[None, :] < N))
几个关键点:
indices_m[:, None] * stride_am + indices_k[None, :] * stride_ak:这是 NumPy 风格的广播,产出一个[BLOCK_M, BLOCK_K]的指针矩阵——tile 里每个元素的地址。tl.load接受指针矩阵,一次性把整个 tile 搬到片上。a_ptrs += BLOCK_K * stride_ak:不重新计算地址,直接在指针上做增量。这比每轮重算便宜,也是 Triton 的惯用法。tl.dot(a, b):tile 级的矩阵乘。这一行是整个 kernel 的算力来源——Triton 会把它编译成 tensor core 指令(MMA),前提是 dtype 和 tile 形状合适。acc用 fp32 是标准的混合精度累加。- 二维 mask:
(indices_m[:, None] < M) & (indices_k[None, :] + k < K)同时管住行和列两个方向的越界,other=0.0保证被填充的位置对乘加结果无贡献(0 是乘法的零元、加法的单位元)。 acc = tl.maximum(acc, 0.0):ReLU 就一行,而且完全免费——数据本来就在寄存器里。换成 GeLU 也只是把这行换成第 6 节那几行公式。这就是融合的全部含义。
不会。这个 60 行的 kernel 教学价值极高,但它没做 double buffering(预取下一个 tile 以掩盖访存延迟)、没做 swizzling(避免 bank conflict)、没做 L2 友好的块调度顺序、也没有针对具体形状 autotune。cuBLAS/CUTLASS 在这些上投入了成百上千人年。
手写 matmul 唯一稳赢的场景是「融合」:当你需要 ReLU(A @ B + bias)、需要在 GEMM 里顺手做量化/反量化、或者需要 FlashAttention 那种把 softmax 塞进 GEMM 循环内部的算法时,库里没有现成的算子,你才必须自己写。
10. 什么时候值得手写 kernel
把四个例子串起来看,Triton 的编程套路其实只有一句话:「读进共享内存 → 做事情(融合)→ 写回 HBM」。四个例子的差别只在于「读进来的是什么形状、在片上做什么」:
| 例子 | grid | 一个 program 负责 | 片上做什么 | 关键技巧 |
|---|---|---|---|---|
| GeLU | (cdiv(N, BS),) | 连续 BLOCK_SIZE 个元素 | 逐元素算式 | mask 处理边界 |
| softmax | (M,) | 一整行 | tl.max + tl.sum 块内归约 | other=-inf(max 的单位元) |
| row sum | (M,) | 一整行(分 tile 遍历) | 循环累加 + 最终归约 | 两级归约、跨步分配保证合并访存 |
| matmul+ReLU | (cdiv(M,BM), cdiv(N,BN)) | 一个 $64\times64$ 输出 tile | K 维循环 tl.dot 累加 + 激活 | 指针矩阵、fp32 累加器、融合激活 |
决策顺序
Percy 的整讲隐含了一条务实的决策链,值得单独写出来:
- 先 benchmark 和 profile。搞清楚时间到底花在哪个 kernel 上、这个 kernel 是访存受限还是算力受限。没有这一步,后面全是瞎猜。
- 能用库就用库。矩阵乘、卷积、常见激活函数,cuBLAS/cuDNN/PyTorch 内置版本已经被打磨到极致,你写不过它们。
- 试
torch.compile。它对逐元素算子链的自动融合效果很好,而且免费——本讲的compiled_gelu就是一个 Triton kernel,性能和手写内置版持平。 - 剩下的才轮到手写 Triton。典型的四类场景:
- 需要跨算子融合,而编译器融不动(例如 GEMM 后接复杂激活、带 bias 和 dropout 的组合)。
- 需要改变算法本身,比如 FlashAttention 的分块在线 softmax——它把 attention 的访存复杂度从 $O(n^2)$ 降到 $O(n)$,这是任何编译器都推导不出来的。
- 自定义数值格式:fp8 训练、int4 量化推理、自定义的稀疏格式。
- 库里根本没有这个算子:新的位置编码、新的归一化方式、新的路由逻辑。
- 改完再 benchmark 和 profile 一次。回到第 1 步。
本讲的每个例子后面都跟着一个 check_equal_*:拿一个随机张量,把新实现和参考实现(PyTorch 内置)跑一遍,torch.allclose(y1, y2, atol=1e-6)。
def check_equal_1d(f1, f2):
    x = torch.randn(2048, device=cuda_if_available())
    assert torch.allclose(f1(x), f2(x), atol=1e-6)
这不是形式主义。kernel 的 bug 有三个特点让它们格外危险:(1)越界写会破坏别的张量,症状出现在千里之外;(2)mask 写错时,只有边界块出错,小尺寸测试可能完全测不到;(3)数值精度问题(累加器用了 bf16)在前向看不出来,训练几千步后才发散。写完 kernel 的第一件事永远是对拍,而且要用非 2 的幂的尺寸去测边界。
本讲小结
Percy 在课末给的五条总结,逐条展开:
| 要点 | 含义 |
|---|---|
| 掌握编程模型(PyTorch、Triton、PTX) | 它保证你的正确性。三个层次分别对应三种抽象粒度:张量 / 线程块 / 线程。 |
| 理解硬件(SM、warp、occupancy、bank conflict…) | 它决定你的性能。编程模型让代码跑对,硬件细节让代码跑快。 |
| Benchmark | 理解性能如何随规模变化:warmup → synchronize → CUDA event → 多次取值。 |
| Profile | 看清到底执行了哪些 kernel、各花了多久。kernel 的名字本身就是诊断信息。 |
| Triton 思维 | 以线程块为单位思考:读到共享内存 → 做事情(融合)→ 写回 HBM。 |
数字速查
| 量 | 数值 / 公式 | 为什么重要 |
|---|---|---|
| H100 HBM 带宽 | 3.35 TB/s | 访存受限算子的时间上限 = 流量 / 带宽 |
| H100 寄存器带宽 | ~401 TB/s(HBM 的 ~120 倍) | 为什么必须把计算留在片上 |
| warp 大小 | 32 线程 | 控制发散、bank 数、合并访存的基本单位 |
| 共享内存 bank | 32 个 × 4 字节 | bank conflict 的成因 |
| HBM 事务粒度 | 128 字节(= 32 线程 × 4 字节) | 合并访存的目标 |
| B200 SM 数 | 148 | wave quantization:块数最好整除它 |
| naive GeLU 访存 | 约 $22N$,理论下界 $2N$ | 融合的收益约 11 倍 |
| naive softmax 访存 | $5MN + M$ 读,$3MN + 2M$ 写;下界 $MN$ + $MN$ | 融合的收益约 4 倍 |
| 朴素 matmul 算术强度 | $O(1)$(约 0.5 FLOP/byte) | 不分块就等于放弃 99% 的算力 |
| 分块 matmul 算术强度 | $O(T)$($T = 64$ 时约 16 FLOP/byte) | tile 越大越好,直到共享内存/occupancy 撑不住 |
Triton API 速查
| API | 作用 |
|---|---|
@triton.jit | 标记一个 device 端 kernel |
kernel[grid](args...) | 以 grid 形状(1–3 维元组)启动 kernel |
tl.constexpr | 编译期常量(BLOCK_SIZE 必须是它,才能展开循环和定形状) |
tl.program_id(axis) | 当前线程块在 grid 第 axis 维上的索引 |
tl.arange(0, BLOCK) | 块内偏移向量(长度必须是 2 的幂) |
tl.load(ptrs, mask=, other=) | 从 HBM 读一个块;other 是被 mask 掉的位置的填充值 |
tl.store(ptrs, val, mask=) | 把一个块写回 HBM |
tl.max / tl.sum(x, axis=) | 块内归约(编译器自动生成归约树) |
tl.dot(a, b) | tile 级矩阵乘,走 tensor core |
tl.exp / tl.maximum / tl.zeros | 逐元素运算与常量块 |
triton.cdiv(a, b) | 向上取整除法(算 grid 用) |
triton.next_power_of_2(n) | 取 $\ge n$ 的最小 2 的幂(算 BLOCK_SIZE 用) |
kernel.asm["ptx"] | dump 出生成的 PTX 汇编 |
深度学习里绝大多数「慢」,慢在数据反复穿越 HBM,而不是慢在算得不够快。Benchmark 和 profile 告诉你哪里在穿越,融合和分块告诉你怎么不穿越,Triton 让你用 30 行 Python 就能把这件事写出来。
下一讲:不止一块 GPU。本讲把单卡的性能榨到接近硬件极限之后,下一个数量级的算力只能来自更多的卡——于是问题从「HBM 带宽」变成「NVLink / InfiniBand 带宽」,从 kernel 融合变成数据并行、张量并行、流水线并行。你会发现,思考方式惊人地相似:还是在算通信量、算算术强度、想办法把通信藏在计算后面。
延伸阅读
工具与文档(先读这些)
- Triton 官方教程 — 本讲的 softmax 例子直接来自其中的 02-fused-softmax;后面的 03-matrix-multiplication 和 06-fused-attention 是本讲第 9 节的自然延续,务必亲手跑一遍。
torch.utils.benchmark官方教程 — 生产环境里建议直接用它,它帮你处理了线程数、blocked autorange 等本讲手写版没做的细节。- PyTorch Profiler 教程 — 配合 Chrome trace 视图使用,能看到 kernel 之间的空隙(那往往是 CPU 端的瓶颈)。
- PTX ISA 文档 — 读 Triton 生成的汇编时的字典,重点看
ld.global/st.global的修饰符和特殊寄存器%ctaid/%tid。 - CUDA C++ Programming Guide — warp、共享内存 bank、合并访存这些概念的权威定义都在这里。
- CUTLASS — 第 4 节 profiler 里看到的那些 kernel 名字就出自它。想知道工业级 GEMM 的 tile 调度、swizzle、double buffering 长什么样,读它的源码。
算法:把分块思想推到极致
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness (2022) — 本讲第 8、9 节的思想合体:用分块循环 + 在线 softmax(维护 running max 与 running sum,并在最大值更新时对已累积的分子分母做指数重标定),让注意力永远不物化 $n \times n$ 矩阵。读懂本讲的 row-sum 两级归约和 matmul 分块之后,这篇论文的算法 1 会变得非常好懂。
- FlashAttention-2 (2023) — 主要改的是并行划分和 work partitioning:把序列维度也拿来做并行、减少非 matmul 的 FLOPs、优化 warp 之间的分工。是「理解硬件才能优化性能」的教科书案例。
- FlashAttention-3 (2024) — 针对 Hopper 架构:异步的 TMA 访存、warp-specialization、fp8。展示了新硬件特性如何反过来改变算法设计。
- Online normalizer calculation for softmax (2018) — 在线 softmax 的原始出处,只有几页,把「一趟扫描同时算 max 和 sum」的递推式推导得干干净净。这是 FlashAttention 的数学基石。
- Gaussian Error Linear Units (GELU) (2016) — 本讲反复用作例子的激活函数,附带 tanh 近似的由来。
编译器与 kernel 生成
- Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations (2019) — Triton 的原始论文,解释了「块级编程模型」这个设计选择:为什么以 tile 为一等公民,编译器就能自动做好共享内存分配、合并访存和向量化。
- TVM / Ansor 系列关于自动调度的工作 — 与 Triton 互补的另一条路线:与其让人写 tile 大小,不如让搜索算法去找。理解了本讲的调优空间(BLOCK_M/N/K、num_warps、num_stages)之后再看会更有体感。
- PyTorch 2 / TorchInductor —
torch.compile背后的编译栈;第 5 节里编译出来的那个 Triton kernel 就是它生成的。值得关注它能融什么、不能融什么,这决定了你手写 kernel 的边界在哪。