GPU 与 TPU:让硬件不再是黑魔法
同一个矩阵乘法,边长从 1792 变成 1793,速度就掉一半——这一讲要把"为什么"讲透,并给出一套判断"我的算子到底被什么卡住"的方法论。
0. 本讲导读
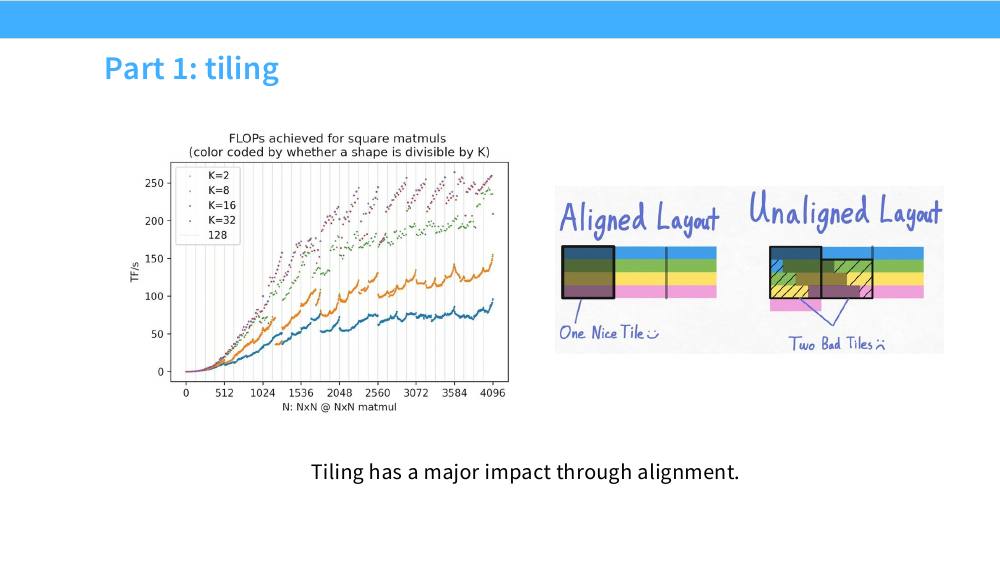
前面几讲讲的是"模型该长什么样":Transformer 的结构、注意力的变体、混合专家的路由。那些讨论里有一个被默认接受的前提——只要 FLOPs 数一样,跑起来就一样快。这个前提是错的,而且错得很离谱。同样是 $2N^3$ 次浮点运算的方阵乘法,在同一块 A100 上,$N=1792$ 能跑到接近峰值,$N=1793$ 只有一半;同样是把一个张量过一遍,写成 x.relu() 和写进一个融合 kernel 里差 5 倍;同样是标准注意力,materialize 出 $N \times N$ 的分数矩阵和不 materialize,差的是能不能训 32K 上下文。
这一讲的目标,用 Tatsu 自己的话说,是 "make CUDA and GPUs less magic"。具体拆成三部分:
- Part 1 — GPU 的解剖学:它由什么组成,为什么长成这样,存储层次是怎么排的,执行模型(thread / warp / block)和硬件(SP / SM)怎么对应。顺带看一眼 TPU,理解"加速器"这个类别的共性与分歧。
- Part 2 — 性能模型:引入 算术强度(arithmetic intensity) 和 roofline 模型,这是全课最重要的分析工具。然后是让 GPU 跑快的六件套:控制分歧、低精度、算子融合、重计算、合并访存、分块。
- Part 3 — 综合应用:用前两部分的全部工具,把 FlashAttention 从头拆开。你会发现它没有任何新数学,就是 tiling + fusion + recomputation 三板斧,加上一个 2018 年就有的在线 softmax 技巧。
这一讲之后紧接着是 Triton 与自定义算子——那一讲教你"怎么写",这一讲教你"为什么这么写"。没有这一讲的模型,写 kernel 就是在瞎调参数。
- 算力增长快过带宽增长。过去 20 年硬件峰值 FLOPs 涨了约 60000 倍(每两年 3.0×),而 DRAM 带宽只涨了约 100 倍(每两年 1.6×),片间互连带宽只涨了约 30 倍。结果是:现代深度学习里绝大多数算子都是 memory-bound(受内存带宽限制),不是 compute-bound。
- 判断一个算子快不快,只需要算一个数:算术强度 $I = \dfrac{\text{FLOPs}}{\text{字节数}}$,把它和硬件的 ridge point $I^\star = \dfrac{\text{峰值 FLOP/s}}{\text{带宽 B/s}}$ 比较。H100 上 BF16 的 $I^\star \approx 295$ FLOP/byte——这是个高得吓人的门槛。
- 大矩阵乘法的强度是 $\Theta(N)$,所以只有它能跨过门槛;element-wise 算子、softmax、LayerNorm、GEMV(自回归解码)的强度都是 $O(1)$,天然跑不满,只能靠少搬数据来提速。
- 提速手段本质只有三类:(1)减少访存次数(融合、合并访存);(2)把数据搬到更近的存储里反复用(分块 + shared memory);(3)用计算或精度换内存(重计算、量化)。
- FlashAttention 是这三类手段的教科书式组合,它不改变注意力的数学结果(是 exact attention),只是把 $O(N^2)$ 的 HBM 读写变成 $O(N^2 d^2 / M)$,把 $O(N^2)$ 的激活显存变成 $O(N)$。
1. 算力从哪来:Dennard scaling 的终结与并行 scaling
为什么先讲硬件
Kaplan 等人的 scaling law 告诉我们,语言模型的损失随算力呈幂律下降,而且这个关系惊人地平滑可预测。这件事有一个直接的工程推论:只要你能持续拿到更多的有效算力——通过更快的硬件、更高的利用率、更好的并行策略——你就能持续拿到更好的模型,甚至不需要任何算法创新。Tatsu 在课上补了一句限定:"for now"。但至少到目前为止,没有 GPU 的 scaling 就没有 LLM 的 scaling。
所以问题变成:算力本身是怎么 scale 的?
Dennard scaling:免费的午餐及其结束
1974 年 Robert Dennard 观察到:当晶体管的线宽按比例缩小 $\kappa$ 倍时,如果同时把电压和电流也按 $\kappa$ 缩小,那么单位面积的功耗密度保持不变,而开关速度提升 $\kappa$ 倍。这就是 Dennard scaling。它和 Moore 定律(晶体管密度每 18–24 个月翻倍)合起来,意味着 1980–2005 年间:
- 晶体管数量指数增长(Moore);
- 时钟频率也跟着指数增长,而且不用多花电(Dennard);
- 单线程性能自动变快,程序员什么都不用做。
2005 年前后这条路断了。原因是亚阈值漏电流(leakage current):晶体管尺寸小到一定程度后,即使"关断"也会漏电,而且漏电随电压降低反而变严重,所以电压不能再往下降了(所谓 voltage scaling wall)。电压降不下去,功耗密度就随密度增长,芯片会烧掉。于是频率被钉死在 3–5 GHz 这个量级,二十年没怎么动过。
Dennard scaling 结束意味着:晶体管还在变多,但它们不能再跑得更快了。既然每个晶体管的速度上限固定,唯一的出路就是——用更多的晶体管同时干活。这就是从"频率 scaling"到"并行 scaling"的转折点,也正是 GPU 从图形加速器变成通用计算平台的历史窗口。
并行 scaling 还在继续
Bill Dally 在 HotChips 的 keynote 里给出过一个著名的统计:NVIDIA GPU 的单芯片推理性能在十年里涨了超过 1000 倍,远远快过同期工艺进步能解释的幅度。他把这 1000× 大致拆成几个来源:数值表示的降低(FP32 → INT8/FP8 这一路,约 16×)、专用复杂指令(DP4A、HMMA 这类张量核指令,约 12.5×)、制程进步(约 2.5×)、以及结构化稀疏(约 2×)。
这个拆解本身就是这一讲的提纲:今天的算力增长几乎全部来自"专门化"而不是"通用变快"。专门化意味着——如果你的工作负载正好落在硬件专门优化的那条路径上(稠密矩阵乘、低精度、规整形状),你能拿到这 1000×;否则你只能拿到那 2.5× 的制程红利。
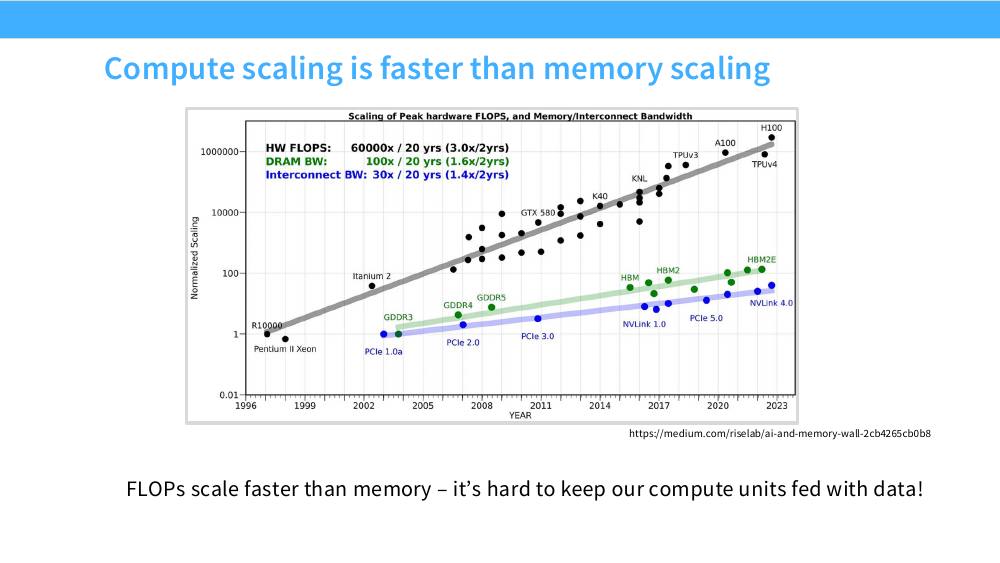
算力和带宽的增速差,意味着"喂饱计算单元"这件事一代比一代难。二十年前一个 element-wise 算子可能还能跑到峰值的百分之几十,今天它只能跑到千分之几。因此,衡量一个 kernel 好坏的标准正在从"用了多少 FLOPs"迁移到"搬了多少字节"。这一讲后面所有的技巧,本质上都是在同一件事上做文章:用尽可能少的 HBM 读写完成同样的计算。
2. CPU 与 GPU:延迟优化 vs 吞吐优化
CPU 和 GPU 都由晶体管构成,工艺也差不多,差别全在晶体管花在哪。
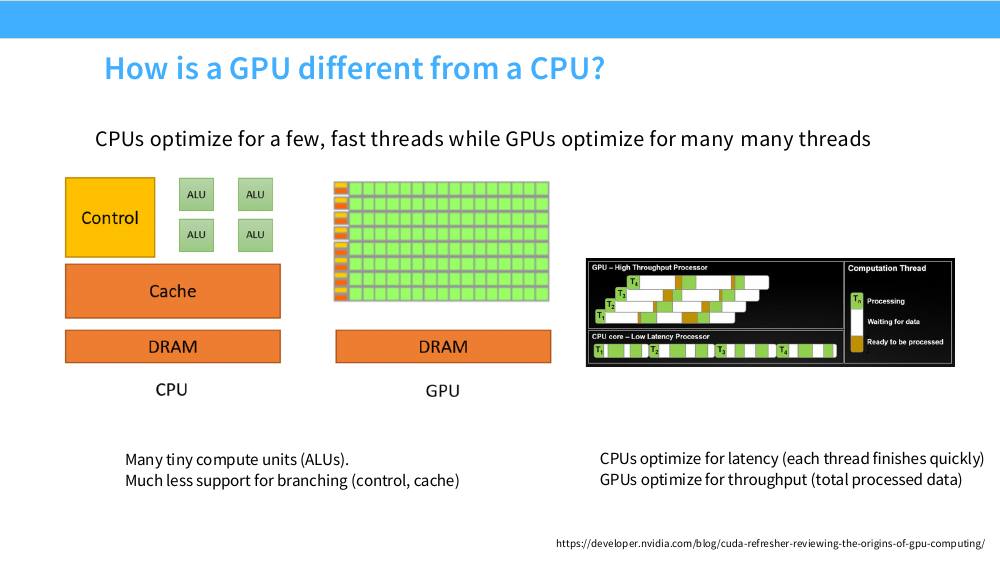
两种完全不同的目标函数
| CPU | GPU | |
|---|---|---|
| 优化目标 | 延迟(latency):单个线程尽快完成 | 吞吐(throughput):单位时间处理的总数据量 |
| 线程数量 | 少(几个到几十个硬件线程) | 极多(一块 H100 可同时驻留超过 20 万个线程) |
| 单线程速度 | 快(高频、乱序、深流水) | 慢(低频、顺序执行、简单流水) |
| 控制逻辑 | 庞大:分支预测器、乱序调度、投机执行 | 极简:一条指令广播给一整组线程 |
| Cache | 大(L3 可达数十 MB),目标是消除访存延迟 | 小(L1/shared 每 SM 约 100–256 KB),目标是提供带宽 |
| 延迟怎么处理 | 预测 + 缓存,让它不发生 | 切换到其他 warp,让它被掩盖 |
| 寄存器 | 少,靠重命名复用 | 极多(每 SM 256 KB),每个线程独占一份,切换零开销 |
一个容易被忽略的关键点:GPU 的寄存器文件比 cache 还大
A100 每个 SM 有 65536 个 32-bit 寄存器 = 256 KB 寄存器,而每个 SM 的 L1/shared memory 加起来是 192 KB。整块 A100 的寄存器总量约 27 MB,H100 约 32 MB——比 L2 cache 还大。
这个设计不是偶然的。CPU 线程切换要保存/恢复寄存器上下文,代价是几十到几百个周期;GPU 把所有驻留线程的寄存器全部物理地存在寄存器文件里,切换 warp 只是换一个索引,零开销。这就是 Tatsu 说的 "threads are lightweight and can be stopped and started"。代价是:每个线程能用的寄存器数量有限(最多 255 个),一旦超了就会 spill 到 local memory(其实位于 HBM),性能断崖式下跌。
把 CPU 想成一个米其林大厨:一个人,但手极快、记性极好(cache)、能预判下一步要什么食材(分支预测),做一道菜非常快。GPU 是一千个流水线工人:每个人都很笨、只会做一个动作,而且必须所有人同时做同一个动作,但一千个人一起做,总产量碾压大厨。
关键推论:如果你的任务是"做一道复杂的菜",GPU 毫无优势;如果是"做一万份一模一样的菜",GPU 无敌。深度学习恰好是后者。
SIMT:GPU 的编程模型
GPU 采用 SIMT(Single Instruction, Multiple Threads,单指令多线程) 模型:一条指令被广播给一组线程,每个线程用不同的数据执行它。这和 CPU 的 SIMD(AVX-512 之类)不同——SIMD 是"一条指令操作一个宽向量寄存器",程序员要显式写向量代码;SIMT 是"一条指令驱动 32 个独立线程",程序员写的是标量代码,每个线程看起来像个普通的顺序程序。这是 CUDA 编程模型好用的根本原因,也是它偶尔坑人的根本原因(见后面的控制分歧)。
3. GPU 解剖:执行单元与存储金字塔
执行单元的三层结构
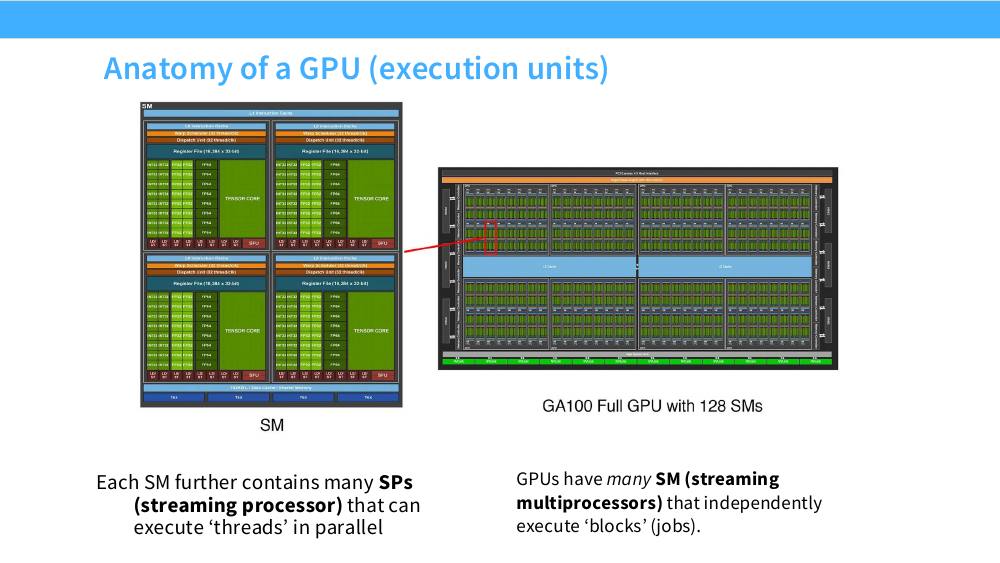
从大到小:
- GPU 芯片:包含数十到上百个 SM。A100 有 108 个可用 SM(物理 128 个,屏蔽一部分保良率),H100 SXM 有 132 个。
- SM(streaming multiprocessor,流式多处理器):独立调度和执行一个 block(CUDA 里叫 CTA,cooperative thread array)。它有自己的 warp scheduler、寄存器文件、L1 cache / shared memory。SM 之间不共享除 L2 和 HBM 之外的任何东西。
- SP(streaming processor)/ CUDA core:SM 内部的标量 ALU,执行一个线程的一条浮点或整数指令。A100 每 SM 有 64 个 FP32 core。
- Tensor Core:专用的矩阵乘累加电路,一条指令完成一个小矩阵块的 $D = A \times B + C$。A100 每 SM 有 4 个(每 processing block 一个),全芯片 432 个;H100 有 528 个。
Tensor Core:为什么矩阵乘是"特权操作"
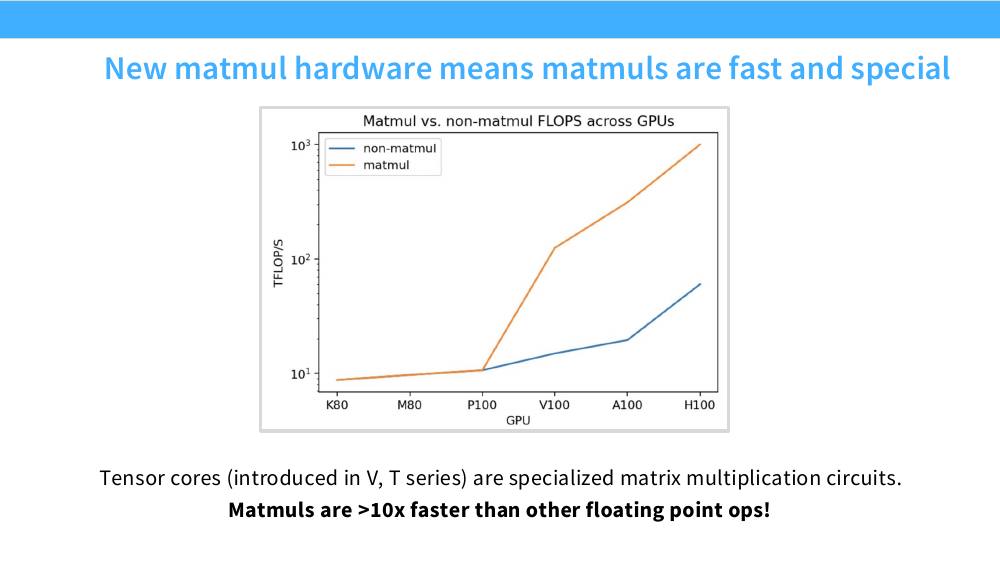
一个 Tensor Core 指令(如 HMMA.16816)在一条指令里完成 $16 \times 8 \times 16$ 的矩阵乘累加,即 $16 \times 8 \times 16 \times 2 = 4096$ FLOPs。相比之下一条 FFMA 指令只有 2 FLOPs。这就是 Tatsu 说的 "matmuls are >10x faster than other floating point ops" 的硬件来源。
历史上这是个反转。早期 NVIDIA GPU 只有可编程着色器(programmable shader),做的是图形管线里的顶点/像素变换。研究者发现这些着色器本质上在做 $4\times4$ 矩阵和向量的乘法,于是把神经网络"伪装"成图形渲染任务,硬塞给 GPU 跑——这就是 GPGPU 的起点,也是 CUDA(2007)出现的动机。二十年后,硬件反过来专门为矩阵乘设计了电路。
"我的模型有 $X$ FLOPs,GPU 峰值 $Y$ FLOP/s,所以要跑 $X/Y$ 秒。"——峰值 FLOP/s 只在矩阵乘、特定数据类型、特定形状下才成立。用 FP32 跑就只有 BF16 峰值的 1/16;不是矩阵乘就再掉 10 倍;形状不对齐再掉 2 倍。真实的 MFU(model FLOPs utilization)在训练大模型时能做到 40–55% 就已经是工业级水平了(Megatron-LM 在 1T 参数、3072 GPU 上报告 52%,PaLM 在 6144 TPUv4 上报告 46.2%)。
存储金字塔
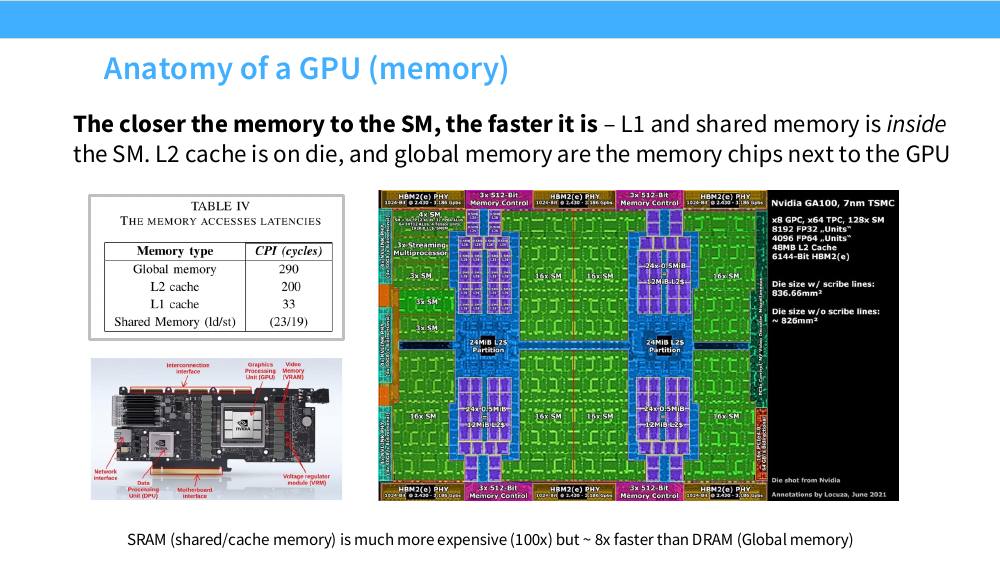
| 层级 | 容量(A100 / H100 量级) | 聚合带宽 | 延迟 | 作用域 |
|---|---|---|---|---|
| 寄存器(register) | 256 KB / SM,全芯片 ~27–32 MB | ~ 100+ TB/s | ~1 周期 | 单个线程私有 |
| Shared memory / L1 | 192 KB / SM(A100),256 KB / SM(H100);全芯片 ~20–33 MB | ~ 19 TB/s | ~20–30 周期 | 一个 block 内共享 |
| L2 cache | 40 MB(A100)/ 50 MB(H100) | ~ 5–7 TB/s | ~200 周期 | 全芯片共享(硬件管理) |
| HBM(global memory) | 40–80 GB | 1.55 TB/s(A100)/ 3.35 TB/s(H100) | ~290 周期(~400–600 ns) | 全芯片 + 主机可见 |
| 主机 DRAM(经 PCIe) | > 1 TB | ~ 12.8–64 GB/s | 微秒级 | CPU 侧 |
把这些数字放在一起看,跨度是惊人的:从寄存器到 HBM,带宽差约 100 倍,延迟差约 300 倍;从 HBM 到主机内存,带宽再差 100 倍以上。 FlashAttention 论文里用的那张金字塔图给出的具体数字是:SRAM 20 MB @ 19 TB/s,HBM 40 GB @ 1.5 TB/s,CPU DRAM > 1 TB @ 12.8 GB/s。
整个 GPU 优化的世界观可以压缩成一句话:数据每往下掉一层,代价涨一个数量级;所以要想尽办法让数据在上层多待一会儿、多被用几次。 后面讲的 tiling 是"把数据搬进 shared memory 反复用",fusion 是"别让中间结果掉回 HBM",recomputation 是"宁可重算也不要存回 HBM"。全是同一件事。
4. 执行模型与内存模型:软件抽象如何映射到硬件
三个角色:thread / warp / block
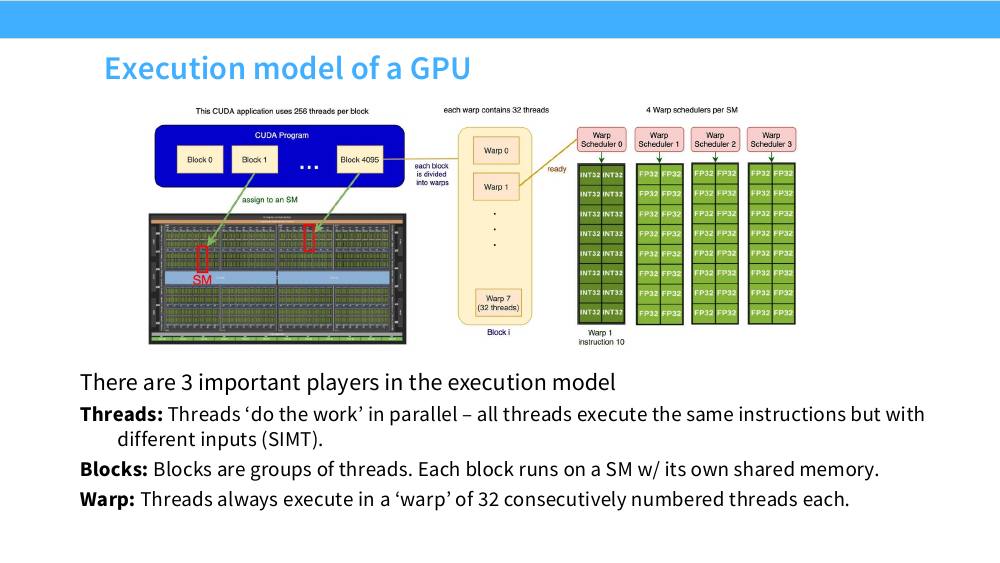
| 软件概念 | 硬件对应 | 说明 |
|---|---|---|
| thread(线程) | SP / CUDA core 上的一个执行槽 | 干活的最小单位。所有线程跑同一份代码,用 threadIdx / blockIdx 区分自己该处理哪块数据(SIMT)。 |
| warp(线程束) | warp scheduler 的调度单位 | 32 个编号连续的线程。它们永远一起执行同一条指令,一起发访存请求。CUDA 语言层面看不见 warp,但性能层面它无处不在。 |
| block / CTA | 一个 SM | 一组线程(最多 1024)。整个 block 一定跑在同一个 SM 上,共享该 SM 的一块 shared memory,可以用 __syncthreads() 互相同步。 |
| grid(网格) | 整块 GPU | 一次 kernel launch 的全部 block。block 之间没有任何同步原语,执行顺序完全由硬件决定。 |
这里有两条极其重要的推论,很多性能问题都源于没想清楚它们:
推论一:block 之间要通信,只能走 global memory(HBM)。 因为 block 可能落在不同的 SM 上,甚至可能不同时执行(block 数远多于 SM 数时会排队)。所以任何需要"全局归约"的操作(比如 softmax 的分母、LayerNorm 的均值)如果跨 block,就必须写回 HBM 再读一次——这正是 naive softmax 慢的根源,也正是 FlashAttention 要把一整行的计算塞进一个 block 的原因。
推论二:warp 内的 32 个线程共享一条指令流。 它们的访存也是一起发出的,硬件会尝试把这 32 个地址合并成尽可能少的内存事务(见第 9 节的合并访存)。同样,它们的分支也必须"一起走"(见第 7 节的控制分歧)。
内存模型:谁能看见什么
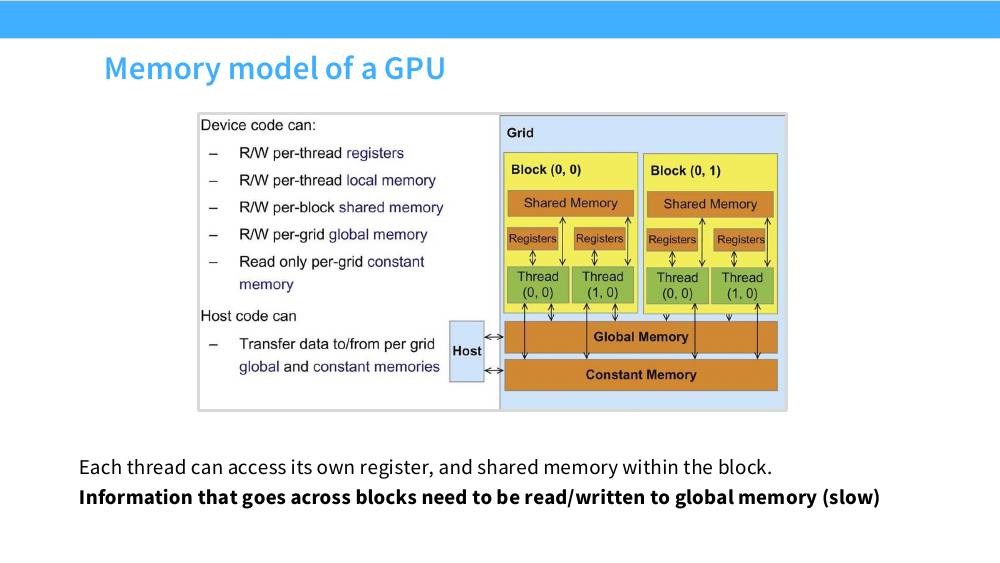
GPU 模型的优点
- 可扩展性:因为 block 之间完全独立,同一份代码在 108 个 SM 和 132 个 SM 的芯片上都能跑,硬件自动填满。加 SM 就能加性能,不需要改代码。
- 可编程性(相对而言):SIMT 让你写标量代码,编译器和硬件负责向量化。比手写 AVX intrinsics 友好得多。
- 轻量线程:寄存器物理常驻,warp 切换零开销,因此可以用超额订阅(oversubscription)来掩盖延迟——同时驻留几千个线程,总有一些是 ready 的。
"Easy (?) to program" 里的问号是 Tatsu 加的。SIMT 让你写出能跑的代码很容易,让你写出跑得快的代码非常难——因为决定性能的 warp、bank、burst、tile 这些概念在语言层面全都是不可见的。你写的是标量 C 代码,性能却由你看不见的 32 线程分组行为决定。这个抽象泄漏正是下一讲要引入 Triton 的原因:Triton 把 block 级别的语义提升到语言里,让编译器接管 warp 级别的细节。
5. TPU:脉动阵列与另一条技术路线
Tatsu 把 TPU 作为一个"side thread"插在这里,理由很好:看过第二种加速器,你才知道 GPU 的哪些设计是本质的、哪些只是历史包袱。
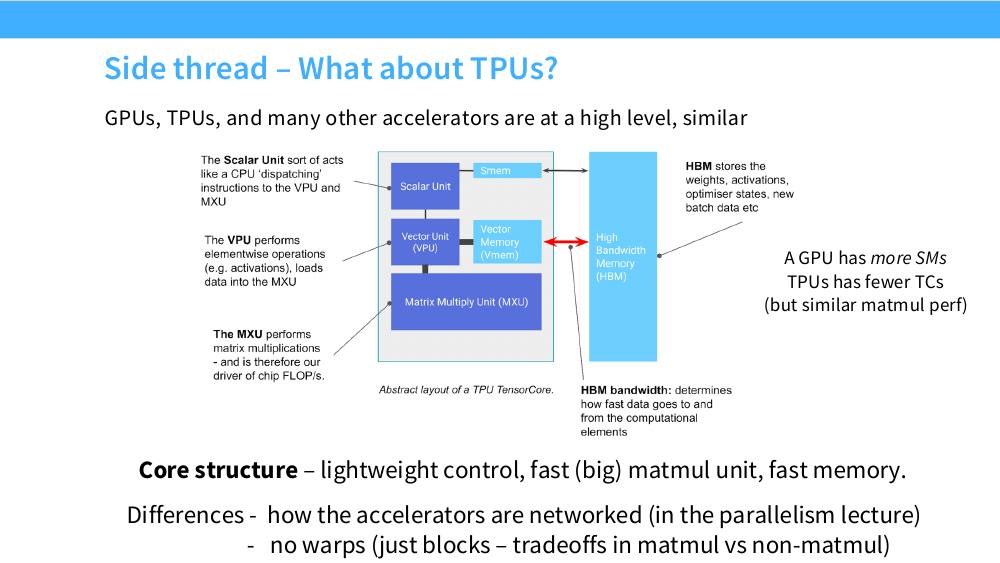
逐项对照
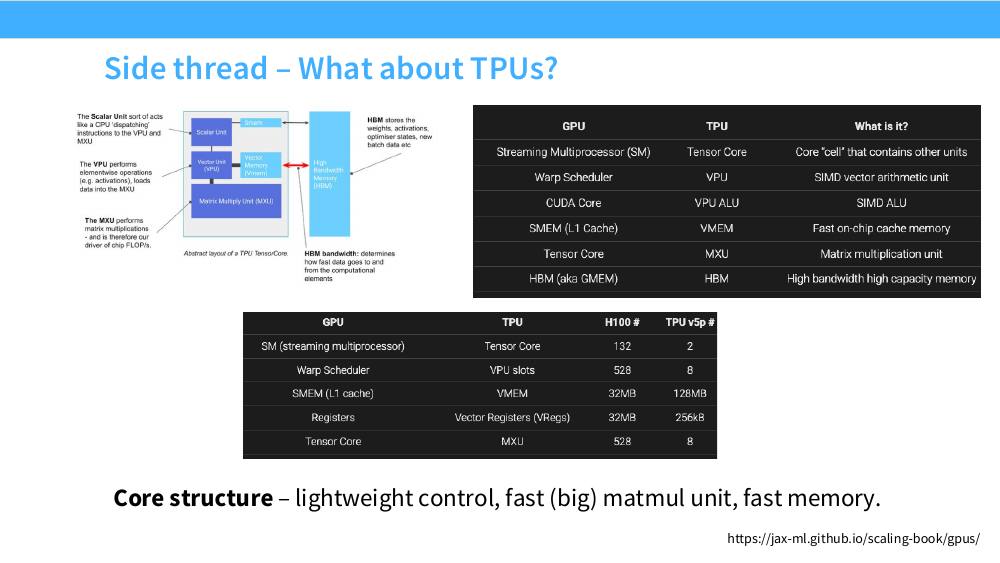
| GPU | TPU | 是什么 | H100 数量 | TPU v5p 数量 |
|---|---|---|---|---|
| SM(流式多处理器) | TensorCore | 包含其他单元的核心"细胞" | 132 | 2 |
| Warp Scheduler | VPU slot | SIMD 向量运算单元 | 528 | 8 |
| CUDA Core | VPU ALU | SIMD ALU | — | — |
| SMEM(L1 cache) | VMEM | 片上快速缓存 | 32 MB | 128 MB |
| Registers | VRegs(向量寄存器) | 最快的存储 | 32 MB | 256 KB |
| Tensor Core | MXU | 矩阵乘单元 | 528 | 8 |
| HBM(aka GMEM) | HBM | 高带宽大容量内存 | 两者相同 | |
脉动阵列(systolic array):MXU 的工作原理
TPU 的 MXU 是一个 $128 \times 128$ 的 脉动阵列。这个名字来自"心脏搏动"——数据像血液一样有节奏地在处理单元(PE)阵列中流动。
工作方式(以 weight-stationary 为例):把权重矩阵 $W \in \R^{128 \times 128}$ 预先加载到 $128 \times 128$ 个 PE 里,每个 PE 存一个权重 $w_{ij}$。然后把激活矩阵按对角线错峰地从左边推入。每个时钟周期,每个 PE 做一件事:
$$ \text{PE}_{ij}: \quad \text{接收左边传来的 } x, \ \text{接收上面传来的部分和 } s, \ \text{输出 } x \to \text{右边}, \ \ s + w_{ij} x \to \text{下面} $$于是数据从左往右流,部分和从上往下累加,$128$ 个周期后底部就吐出完整的结果列。整个过程中,每个操作数只从存储器读一次,之后就在 PE 之间"手手相传"。
脉动阵列为什么高效?算一下它的算术强度。一个 $n \times n$ 的脉动阵列在稳定状态下,每个周期:
- 从边缘读入 $n$ 个新的激活值(一列),写出 $n$ 个结果值;
- 内部完成 $n^2$ 次乘加 = $2n^2$ FLOPs。
所以硬件层面的算术强度是
$$ I_{\text{systolic}} = \frac{2n^2}{2n \cdot b} = \frac{n}{b} \ \text{FLOP/byte} $$其中 $b$ 是每个数的字节数。$n = 128$、BF16($b=2$)时 $I = 64$ FLOP/byte —— 这个复用率是被"焊死"在电路里的,不需要程序员做任何 tiling。相比之下,GPU 上要达到同样的复用率,你得手写 shared memory tiling 或者依赖 cuBLAS 帮你做。
顺带验算峰值:TPU v4 每芯片 2 个 TensorCore × 4 个 MXU = 8 个 $128\times128$ 阵列,每周期 $8 \times 128^2 \times 2 = 262144$ FLOPs;主频约 1.05 GHz,得 $262144 \times 1.05\times 10^9 \approx 275$ TFLOP/s——正是 TPU v4 标称的 BF16 算力。
关键差异:TPU 没有 warp
这是 Tatsu 特别点出的一条。GPU 的 warp 机制带来的是动态调度:硬件在运行时挑选 ready 的 warp,用超额订阅掩盖不可预测的访存延迟。TPU 走的是另一条路——VLIW + 编译器静态调度:没有 warp,没有运行时的线程切换,所有的指令发射时机、数据搬运时机都由 XLA 编译器在编译期算好。
| GPU(动态调度) | TPU(静态调度) | |
|---|---|---|
| 延迟怎么掩盖 | 运行时切换 warp | 编译期插入预取,软件流水 |
| 片上内存管理 | L1/L2 是硬件管理的 cache(+ 手动 shared memory) | VMEM 完全由编译器显式管理,无硬件 cache |
| 擅长 | 不规则、动态形状、非矩阵乘也不太差 | 规整、静态形状的稠密矩阵乘,效率极高 |
| 不擅长 | 调度硬件本身占面积和功耗 | 动态形状、数据依赖的控制流;非矩阵乘算子相对弱 |
| 典型后果 | PyTorch eager 模式可用 | 必须走 JAX/XLA 的编译流程,形状变化会触发重编译 |
Tatsu 的原话是"no warps (just blocks) — tradeoffs in matmul vs non-matmul":TPU 把用于动态调度的晶体管全部换成了矩阵乘单元和片上 SRAM(VMEM 有 128 MB!),代价是非矩阵乘操作相对更弱,以及对不规则计算的容忍度更低。
互连拓扑:Pod
另一个真正的差异是芯片之间怎么连(详细内容留给后面的并行化讲)。简单说:
- GPU:节点内 8 张卡用 NVLink / NVSwitch 全互连(H100 上每卡 900 GB/s 双向),节点之间走 InfiniBand(400 Gb/s 量级)。带宽在节点边界处有一个陡降,这是所有分布式训练策略要绕开的核心约束。
- TPU:用 ICI(Inter-Chip Interconnect) 把芯片连成 2D 或 3D 环面(torus)。TPU v4 是 $4096$ 芯片的 3D torus($16\times16\times16$),v5p 规模更大。环面拓扑的好处是没有"节点边界"——每个芯片只和 6 个邻居直连,带宽均匀,特别适合 all-reduce 这种邻居通信模式。TPU v4 还引入了光路交换(OCS),可以在物理上重新配置 torus 的切片形状。
GPU 和 TPU 在芯片内部高度同构:轻量控制 + 大矩阵乘单元 + 快速片上内存 + HBM。这不是巧合,而是因为它们面对的是同一个物理约束(算力便宜、带宽贵)和同一个工作负载(稠密矩阵乘)。所以这一讲学到的所有性能推理方法——算术强度、roofline、tiling、fusion——在 TPU 上一字不差地适用,只是把 SM 换成 TensorCore、shared memory 换成 VMEM。真正的分歧在两个地方:调度是动态还是静态,以及芯片之间怎么连。
6. Roofline 模型与算术强度:这一讲最重要的工具
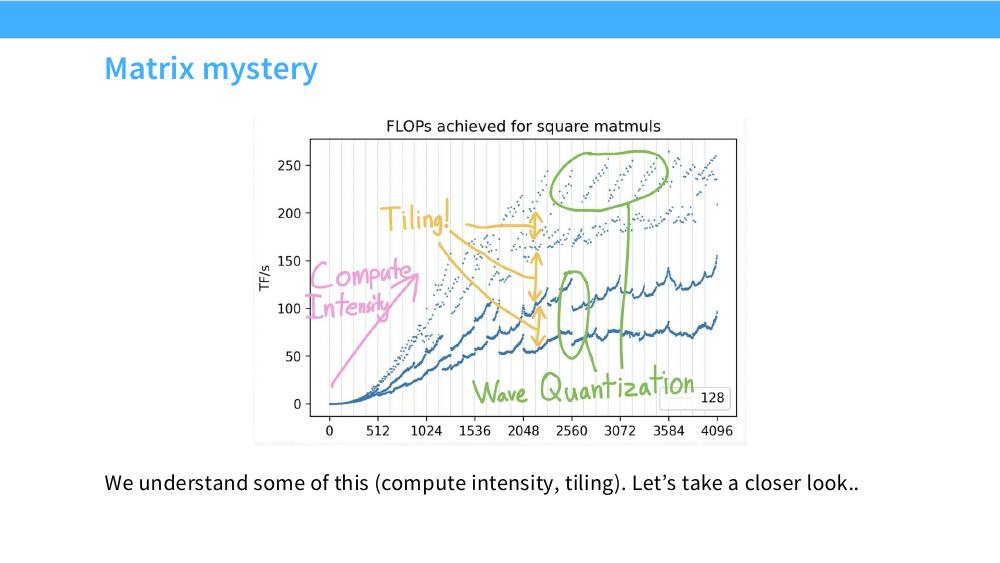
现在进入 Part 2。先看一个 Tatsu 用来"制造困惑"的现象:
算术强度的定义
对任意一段计算,定义它的算术强度(arithmetic intensity,也叫 operational intensity / compute intensity):
$$ I \;=\; \frac{\text{总浮点运算次数(FLOPs)}}{\text{必须与主存(HBM)交换的字节数}} \qquad [\text{FLOP/byte}] $$分母是关键:算的是与慢速存储之间的流量,不算片上的 shared memory / 寄存器访问。这个量描述了"每搬一个字节,能榨出多少计算"。
课上举 ReLU 的例子时用的是倒数——"Intensity: 8 bytes / FLOP"。两种写法都常见,但方向相反:
- $I$ 用 FLOP/byte:越大越好(roofline 论文的惯例,本文一律用这个);
- 用 byte/FLOP:越小越好(课件里 ReLU 那页用的是这个)。
看到数字先确认单位方向,不然结论会反过来。
Roofline 模型
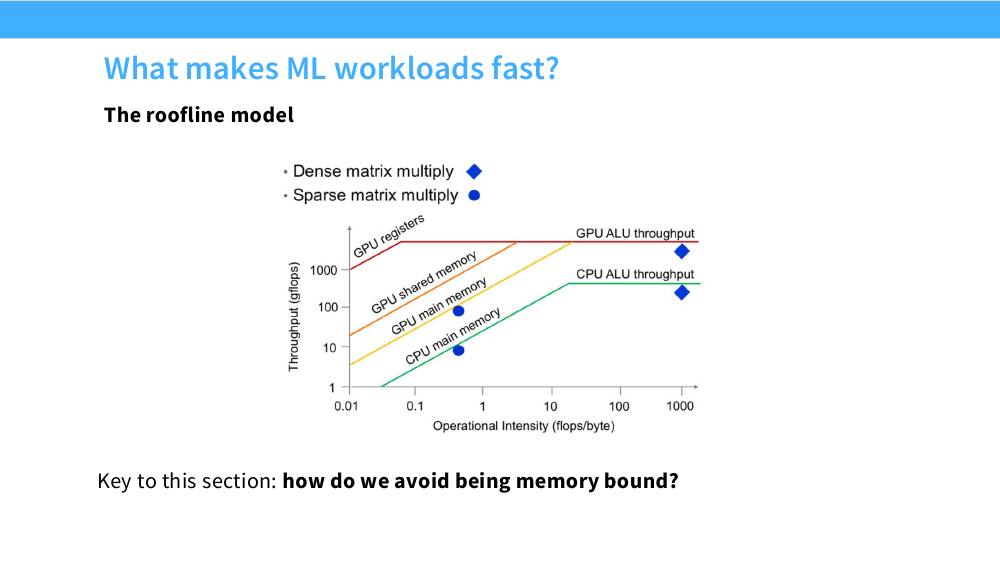
数学上极简单。设峰值算力 $P$(FLOP/s),带宽 $B$(byte/s),一段计算有 $F$ FLOPs 和 $Q$ 字节访存,则:
$$ T_{\text{compute}} = \frac{F}{P}, \qquad T_{\text{memory}} = \frac{Q}{B}, \qquad T \;\ge\; \max\!\left(\frac{F}{P},\ \frac{Q}{B}\right) $$(取 max 是因为计算和访存可以重叠,理想情况下慢的那个决定总时间。)可达吞吐为
$$ \text{Perf} \;=\; \frac{F}{T} \;\le\; \min\big(P,\ I \cdot B\big), \qquad I = F/Q $$两个约束相等处就是 ridge point(脊点、拐点):
$$ I^\star \;=\; \frac{P}{B} \qquad \text{FLOP/byte} $$$I < I^\star$ 时 memory-bound,$I > I^\star$ 时 compute-bound。ridge point 是一块硬件的"性格":
| 硬件 / 数据类型 | 峰值 $P$ | 带宽 $B$ | ridge point $I^\star$ |
|---|---|---|---|
| A100 SXM,FP32(非 Tensor Core) | 19.5 TFLOP/s | 1.55 TB/s | 12.6 FLOP/byte |
| A100 SXM,TF32 Tensor Core | 156 TFLOP/s | 1.55 TB/s | 101 FLOP/byte |
| A100 SXM,BF16 Tensor Core | 312 TFLOP/s | 1.55 TB/s | 201 FLOP/byte |
| H100 SXM,BF16 Tensor Core | 989 TFLOP/s | 3.35 TB/s | 295 FLOP/byte |
| H100 SXM,FP8 Tensor Core | 1979 TFLOP/s | 3.35 TB/s | 591 FLOP/byte |
"换更强的卡,我的算子就会变快。"——注意上表的趋势:从 A100 FP32 到 H100 FP8,ridge point 从 12.6 涨到 591,涨了 47 倍。 硬件每一代变强,门槛就抬高一截,更多的算子从 compute-bound 掉进 memory-bound。一个强度为 5 FLOP/byte 的算子,在 A100 FP32 上还只差 2.5 倍,到 H100 FP8 上就差了 118 倍——换卡对它几乎毫无帮助(只有带宽从 1.55 涨到 3.35 那 2.2 倍)。这就是为什么"优化 kernel"这件事的重要性一代比一代高。
算一遍:矩阵乘
$C = AB$,$A \in \R^{M\times K}$,$B \in \R^{K \times N}$,元素 $b$ 字节。
- FLOPs:$F = 2MKN$(每个输出元素做 $K$ 次乘加 = $2K$ FLOPs)
- 最少访存:$Q = b(MK + KN + MN)$(每个输入读一次、输出写一次;这是理论下界,前提是能全部装进片上内存)
情形 A:方阵 $M=K=N$。
$$ I = \frac{2N^3}{3bN^2} = \frac{2N}{3b} $$强度线性增长于 $N$。这就是"大矩阵才快"的第一层原因。在 H100 BF16($b=2$,$I^\star=295$)上,要达到 compute-bound 需要
$$ \frac{2N}{3 \cdot 2} \ge 295 \;\Longrightarrow\; N \ge 885 $$也就是说 $N$ 小于约 900 的方阵乘法,在 H100 上根本不可能跑满,无论 kernel 写得多好。A100 BF16 上这个门槛是 $N \ge 602$。回看那张散点图,曲线在 512–1024 之间开始"起飞",正好对上。
情形 B:训练时的典型形状。 一个线性层,batch × seq 展平成 $B = 8 \times 4096 = 32768$ 个 token,隐藏维 $d = 4096$,即 $(B, d) \times (d, d)$:
$$ I = \frac{2Bd^2}{b(Bd + d^2 + Bd)} = \frac{2 \cdot 32768 \cdot 4096^2}{2(32768\cdot 4096 + 4096^2 + 32768 \cdot 4096)} \approx 1820 \ \text{FLOP/byte} $$远超 295——妥妥的 compute-bound。这是训练能跑到 40–50% MFU 的根本原因。
情形 C:自回归解码(batch = 1)。 同一个线性层,但 $B = 1$,变成矩阵–向量乘(GEMV):
$$ I = \frac{2 \cdot 1 \cdot d^2}{b(d + d^2 + d)} \approx \frac{2d^2}{b\,d^2} = \frac{2}{b} = 1 \ \text{FLOP/byte} $$只有 1!离 295 差了 295 倍。解码时你的 H100 实际只能发挥出约 0.3% 的算力,时间 100% 花在把权重从 HBM 搬进来上。
这个计算解释了 LLM 推理领域的几乎所有工程实践:
(1)为什么要 batching / continuous batching——把 $B$ 从 1 提到 64,强度就从 1 提到约 60,逼近 ridge point;
(2)为什么权重量化(INT4/FP4)对解码这么有效——解码时间 $\approx$ 权重字节数 / 带宽,权重从 BF16 压到 INT4 直接快 4 倍,和算力毫无关系;
(3)为什么 MQA/GQA 能大幅提升长上下文解码速度——KV cache 的读取字节数被压缩了;
(4)为什么投机解码(speculative decoding)能"免费"提速——一次前向验证 $k$ 个 token,把 GEMV 变成小 GEMM,用本来就闲置的算力换时间。
算一遍:element-wise 算子
ReLU:$x \leftarrow \max(0, x)$,长度 $n$ 的向量。
| FP32 | FP16 / BF16 | |
|---|---|---|
| 每元素读 | 4 字节 | 2 字节 |
| 每元素写 | 4 字节 | 2 字节 |
| 每元素 FLOPs | 1 次比较 + 1 次运算 ≈ 1 FLOP | |
| 课件写法(byte/FLOP,越小越好) | 8 bytes/FLOP | 4 bytes/FLOP |
| roofline 写法(FLOP/byte,越大越好) | 0.125 | 0.25 |
| H100 上离 ridge point (295) 的差距 | 2360× | 1180× |
也就是说,一个 ReLU 只能发挥出 H100 算力的 0.08%。具体感受一下:对 $n = 10^9$ 个 BF16 元素做 ReLU,搬运 4 GB,在 3.35 TB/s 下需要 1.2 ms;而 $10^9$ FLOPs 在 989 TFLOP/s 下只需要 0.001 ms。计算单元 99.9% 的时间在发呆。
算一遍:为什么 softmax 和 LayerNorm 跑不满
这是本讲反复出现的主题,值得算细一点。以 naive(未融合)实现的 LayerNorm 为例,输入 $(B, T, d)$ 共 $n$ 个 BF16 元素:
mean = x.mean(-1, keepdim=True)      # 第 1 趟:读 x
var  = (x - mean).pow(2).mean(-1)    # 第 2 趟:读 x(还可能写临时张量)
y    = (x - mean) / (var + eps).sqrt()   # 第 3 趟:读 x,写 y
y    = y * gamma + beta                  # 第 4 趟:读 y,写 y
如果每一行都作为独立的 PyTorch 算子执行(eager 模式就是这样),$x$ 被反复从 HBM 读取,中间结果被反复写回 HBM。粗略数:约 4 次读 + 3 次写 ≈ $7 \times 2n = 14n$ 字节;FLOPs 约 $10n$。
$$ I_{\text{LayerNorm(naive)}} \approx \frac{10n}{14n} \approx 0.7 \ \text{FLOP/byte} $$取 $n = 8 \times 4096 \times 4096 = 1.34\times 10^8$ 个元素:访存 $1.9$ GB,在 H100 上需 $0.56$ ms;计算 $1.34\times10^9$ FLOPs,只需 $0.0014$ ms。400 倍的差距。
softmax 同理,naive 实现要走 4 趟(求 max、求 exp 与和、相除;每趟都是全量读写),强度同样在 $0.3$–$1$ 量级。
矩阵乘之所以特殊,是因为它有 $O(N^3)$ 的计算但只有 $O(N^2)$ 的数据——每个数据被用了 $O(N)$ 次。而所有的 element-wise 算子、归约算子(softmax、LayerNorm、RMSNorm、GeLU、残差加法、dropout),每个数据只被用了 $O(1)$ 次。
一个模型的 FLOPs 有 99% 在矩阵乘里,但时间可能有 30–50% 花在那 1% 的非矩阵乘算子上——因为后者的强度低了三个数量级。这就是为什么"融合掉所有的 pointwise 算子"是性能优化的第一课。
一个可以直接用的 roofline 计算器
def roofline(flops, bytes_moved, peak_flops=989e12, bandwidth=3.35e12, name=""):
    """给定一个算子的 FLOPs 与 HBM 字节数,判断它被什么卡住。
    默认参数是 H100 SXM 的 BF16 峰值与 HBM3 带宽。"""
    intensity = flops / bytes_moved            # FLOP/byte
    ridge     = peak_flops / bandwidth         # 该硬件的拐点
    t_compute = flops / peak_flops
    t_memory  = bytes_moved / bandwidth
    t         = max(t_compute, t_memory)       # 理想重叠下的下界
    bound     = "compute-bound" if intensity > ridge else "memory-bound"
    print(f"{name:24s} I={intensity:9.2f}  ridge={ridge:6.1f}  {bound}")
    print(f"{'':24s} 下界耗时 {t*1e3:8.4f} ms   "
          f"可达算力 {flops/t/1e12:7.1f} TFLOP/s "
          f"({100*flops/t/peak_flops:5.2f}% of peak)")
    return t

b = 2                       # BF16
N = 4096
roofline(2*N**3, b*3*N**2,          name="matmul 4096^3")
roofline(2*N**3//32, b*3*(N//16)**2, name="matmul 256^3")
n = 8*4096*4096
roofline(n, 2*b*n,                  name="ReLU")
roofline(10*n, 7*b*n,               name="LayerNorm (naive)")
d = 4096
roofline(2*d*d, b*d*d, name="GEMV (decode)")把这十几行代码放进你的工具箱。写任何 kernel 之前先跑一遍它,你会立刻知道自己的上限在哪、该往哪个方向优化。
提速的六件套
Tatsu 把手段列成六条,我们按"它们在 roofline 图上做了什么"重新归类:
| 手段 | 在 roofline 上做了什么 | 本讲章节 |
|---|---|---|
| 1. 控制分歧(control divergence) | 都不是——它让你达不到任何一条屋顶(有效并行度下降) | §7 |
| 2. 低精度(low precision) | 分母变小 → 强度右移;同时峰值提高 → 屋顶上移(拐点也右移) | §7 |
| 3. 算子融合(fusion) | 消除中间结果的读写 → 分母变小 → 强度右移 | §8 |
| 4. 重计算(recomputation) | 用 FLOPs 换字节 → 分子变大、分母变小 → 强度右移 | §8 |
| 5. 合并访存(coalescing) | 让"实际搬运字节"逼近"需要的字节" → 逼近斜线屋顶 | §9 |
| 6. 分块(tiling) | 把访存从 HBM 挪到 shared memory → 换一条更陡的屋顶 | §10 |
7. 提速手段(一):控制分歧与低精度
7.1 控制分歧:唯一一个和内存无关的坑
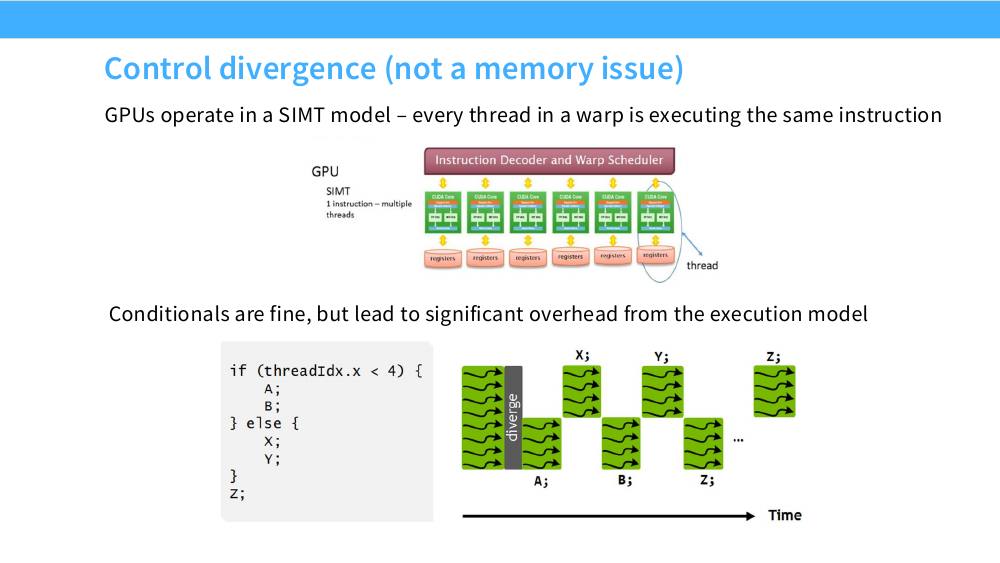
if (threadIdx.x < 4) {A; B;} else {X; Y;} Z;——warp 在 diverge 点被切成两半,串行执行:先让满足条件的线程跑 A、B(另一半线程被 mask 掉、空转),再让另一半跑 X、Y(这一半空转),最后重新汇合(reconverge)一起跑 Z。总时间 = 两个分支时间之和,而不是最大值。SIMT 的代价:一个 warp 里的 32 个线程共享一个程序计数器(Volta 之前是严格如此;Volta 引入 independent thread scheduling 后每线程有自己的 PC,但执行仍然按分支分组串行)。所以遇到条件分支时,硬件只能:
- 算出每个线程的条件结果,得到一个 32 位的活动掩码(active mask);
- 执行
if分支,掩码外的线程被禁用但仍占着执行槽; - 执行
else分支,掩码反过来; - 汇合。
最坏情况是 32 路分歧(比如 switch (threadIdx.x % 32)),此时 warp 的有效吞吐降到 $1/32$。
关键不在于"有没有 if",而在于 if 的边界是否和 warp 边界对齐。
if (blockIdx.x < 10)—— 零开销,整个 block 走同一条路。if (threadIdx.x / 32 < 2)—— 零开销,条件在 warp 内部恒定。if (threadIdx.x % 2 == 0)—— 2 倍代价,每个 warp 都要走两遍。if (data[i] > 0)—— 取决于数据,最坏 2 倍。
实践中的处理办法:能用无分支的算术就用(max(x, 0) 而不是 if),或者先按条件对数据排序/分桶,让同一 warp 里的线程走同一条路——这正是 MoE kernel 里要先做 token 排序(sort by expert)的原因。
顺带一提:循环边界的分歧也算。for (i = 0; i < n[tid]; i++) 里如果每个线程的 n[tid] 不同,整个 warp 会跑到最长的那个,短的线程一直空转。变长序列不做 padding 直接算,就会踩这个坑。
7.2 低精度:位数少了,要搬的字节就少了
低精度同时在 roofline 的两个方向上起作用,必须分开看:
| memory-bound 算子 | compute-bound 算子 | |
|---|---|---|
| FP32 → BF16 | 字节减半 → 约 2× 加速 | Tensor Core 峰值 19.5 → 312 TFLOP/s → 最多 16× 加速 |
| BF16 → FP8 | 字节再减半 → 约 2× 加速 | 峰值 989 → 1979 TFLOP/s → 约 2× 加速 |
| 对算术强度的影响 | $I = F/(bQ_{\text{elem}})$,$b$ 减半则 $I$ 翻倍(点右移);但 $I^\star = P/B$ 也同时右移,所以"是否变成 compute-bound"要重新判断 | |
课上的 ReLU 例子就是最简版本:FP32 是 8 byte/FLOP,FP16 是 4 byte/FLOP,强度翻倍,时间减半。注意这个加速和"计算变快"完全无关——ReLU 的 FLOPs 一个都没少,纯粹是因为搬的字节少了一半。
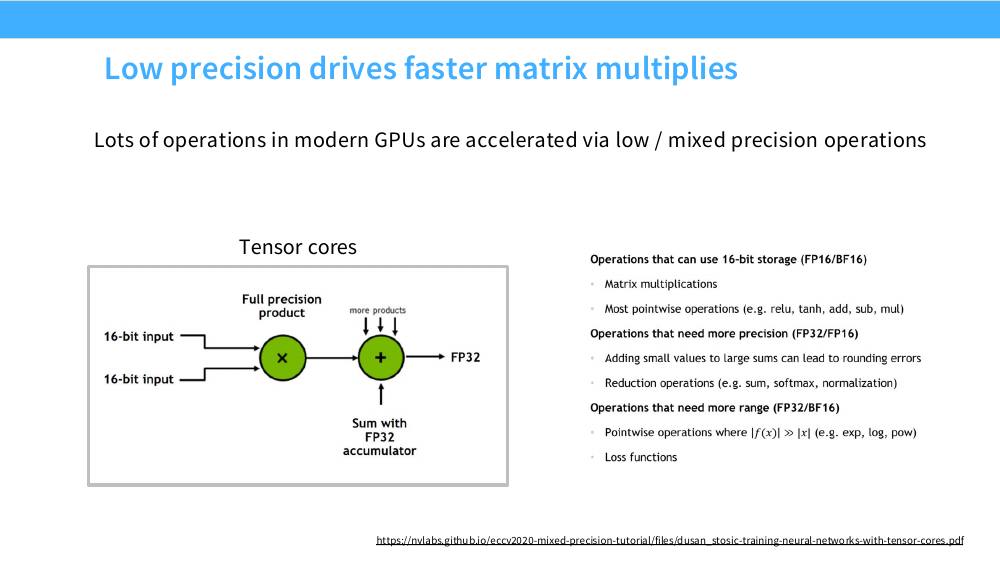
混合精度:哪些操作可以降,哪些不能
| 格式 | 位宽 | 符号/指数/尾数 | 最大值 | 特点 |
|---|---|---|---|---|
| FP32 | 32 | 1 / 8 / 23 | $3.4\times10^{38}$ | 基准。累加器、master weights 用它 |
| TF32 | 19(存在 32 位容器里) | 1 / 8 / 10 | 同 FP32 | Ampere Tensor Core 的"免费"格式:范围同 FP32,精度同 FP16,代码不用改 |
| FP16 | 16 | 1 / 5 / 10 | 65504 | 精度好但范围窄,训练必须配 loss scaling 防梯度下溢 |
| BF16 | 16 | 1 / 8 / 7 | $3.4\times10^{38}$ | 范围同 FP32,尾数只有 7 位。不需要 loss scaling,是当前训练主力 |
| FP8 E4M3 | 8 | 1 / 4 / 3 | 448 | 尾数多、范围窄,适合前向的激活和权重 |
| FP8 E5M2 | 8 | 1 / 5 / 2 | 57344 | 范围大、尾数少,适合反向的梯度(梯度动态范围大) |
| E8M0 | 8 | 0 / 8 / 0 | 纯 2 的幂 | 不是数据格式,是缩放因子格式:只表示指数,乘除都是移位 |
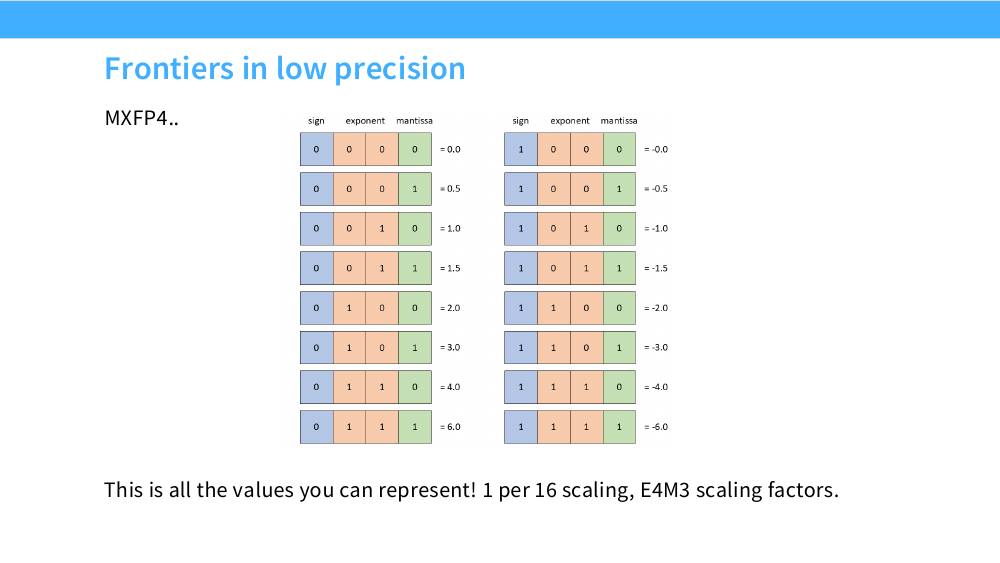
| FP4 E2M1 | 4 | 1 / 2 / 1 | 6 | 全部可表示值只有 $\{0, \pm0.5, \pm1, \pm1.5, \pm2, \pm3, \pm4, \pm6\}$ 共 16 个 |
FP16 和 BF16 都是 16 位,为什么深度学习最后选了 BF16?因为神经网络对"精度"的容忍度远高于对"范围"的容忍度。梯度的量级可以跨越十几个数量级,FP16 的最小正规数是 $6\times10^{-5}$,很多梯度直接变成 0(下溢),必须用 loss scaling 把整个损失乘上 $2^{k}$ 再反传,还得动态调整 $k$ 防止溢出——一整套工程麻烦。BF16 把尾数砍到 7 位换来和 FP32 一样的指数范围,训练时什么都不用做。而 7 位尾数(约 2–3 位十进制有效数字)对 SGD 来说完全够用,因为梯度噪声本身就比这大得多。
FP8 的前沿:块级缩放(MXFP8)
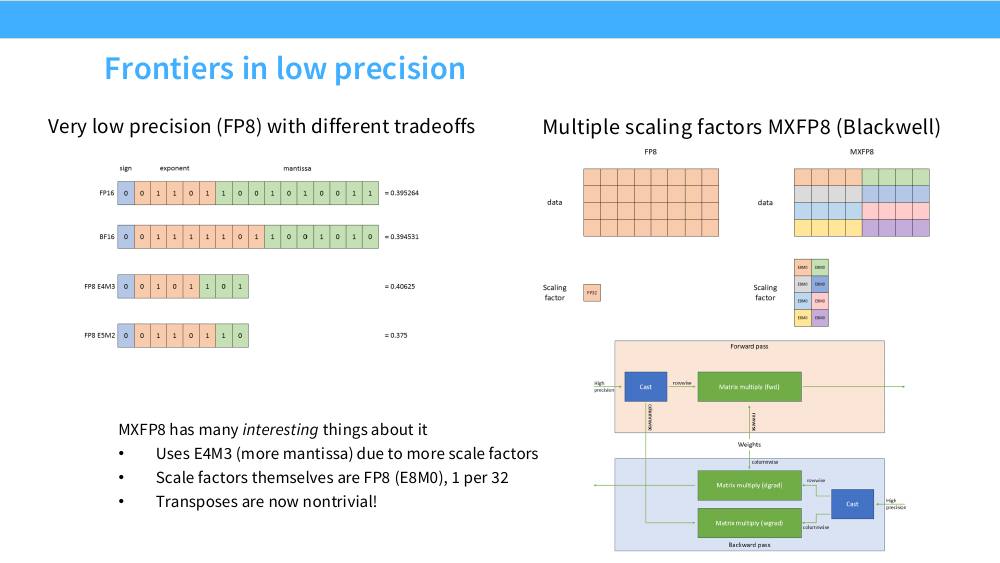
MXFP8(Blackwell 原生支持)有三个值得注意的设计:
- 用 E4M3 而不是 E5M2。既然有了细粒度的缩放因子来处理动态范围,就不需要在数据格式里浪费指数位了,把位数留给尾数换精度。
- 缩放因子本身是 FP8(E8M0),每 32 个元素一个。E8M0 是纯指数格式,意味着"缩放"就是指数相加,硬件实现极便宜。存储开销只有 $8/(32\times8) = 3.1\%$。
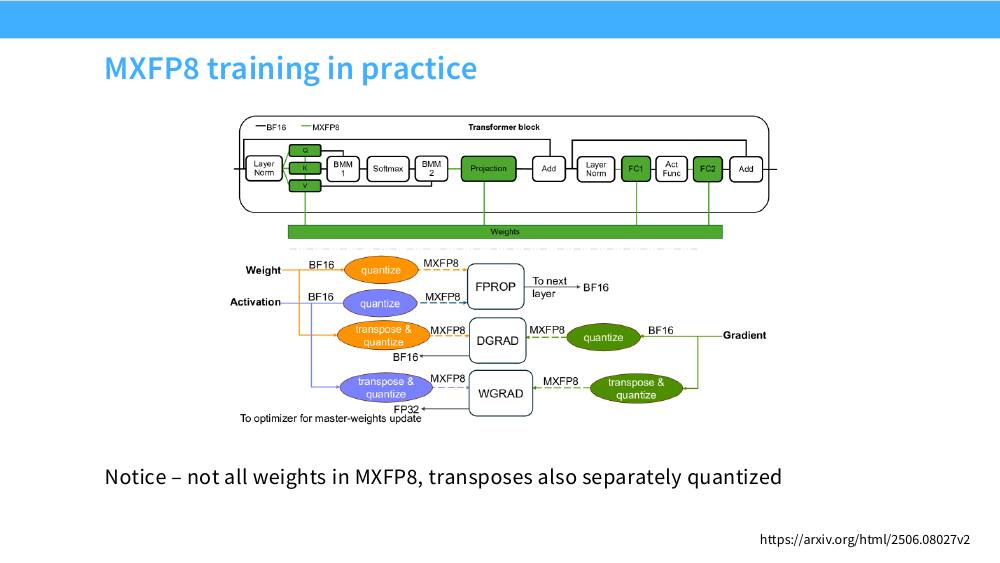
- 转置变成了非平凡操作。这是最反直觉的一点:缩放因子是沿着某一个轴分组的,转置之后分组方向就错了,必须重新量化。所以实际训练流程里,同一个张量要同时保存 rowwise 和 columnwise 两个量化版本(前向用一个,反向用另一个),或者在需要时重新量化。
低精度不是免费的午餐,实践中有三条经验:
- 累加永远比乘法需要更高精度。 无论输入多低精度,Tensor Core 内部的累加器都是 FP32。你自己写 kernel 时也要遵守这条:
acc用 float,不要用 half。 - 敏感位置要保留高精度。 归一化层的统计量、softmax 的分母、损失函数、优化器状态(master weights、Adam 的 $m$ 和 $v$)——这些地方降精度会直接毁掉训练。
- 量化本身要花时间。 cast、求 scale、rowwise/columnwise 两份——这些都是 memory-bound 的 element-wise 操作。如果不把它们融合进前后的 kernel,量化带来的收益会被量化开销吃掉一大半。
8. 提速手段(二):算子融合与重计算
8.1 工厂与仓库:融合的直觉
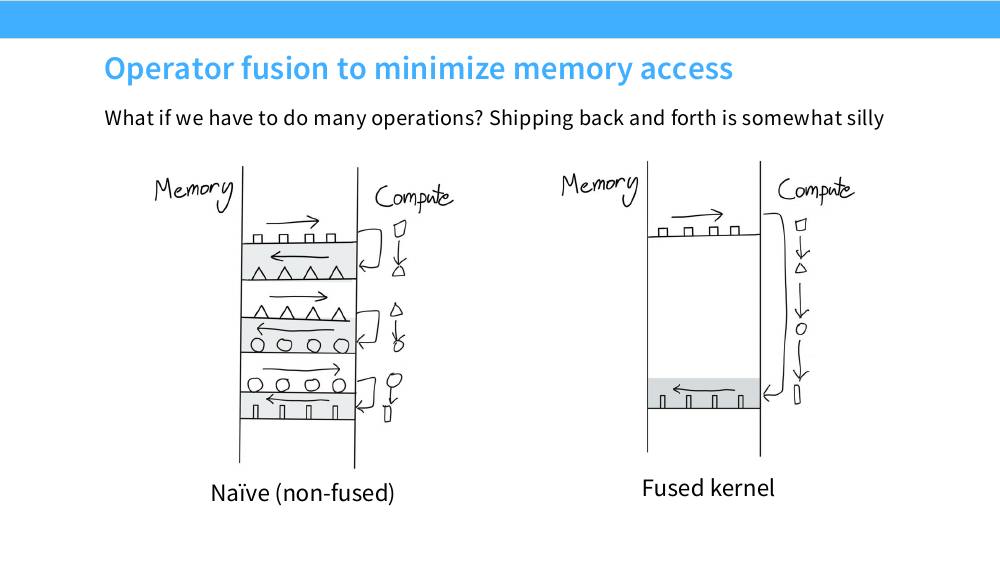
把这个比喻量化。假设有 $k$ 个连续的 element-wise 算子作用在 $n$ 个元素上(每个 $b$ 字节):
$$ Q_{\text{未融合}} = 2knb, \qquad Q_{\text{融合}} = 2nb \qquad\Longrightarrow\qquad \text{加速比} \approx k $$注意加速比是 $k$,不是 $k$ 的某个分数——是完整的 $k$ 倍。因为这些算子 100% memory-bound,时间正比于访存量。一个 Transformer block 里,从 LayerNorm 到 GeLU 到残差加法到 dropout,串起来轻松有十几个 pointwise 算子。
一个具体例子:$\sin^2 x + \cos^2 x$
这行 PyTorch 代码在 eager 模式下会启动 5 个 CUDA kernel:sin、pow、cos、pow、add。每个 kernel 都要把整个张量从 HBM 读进来、算一下、写回去。
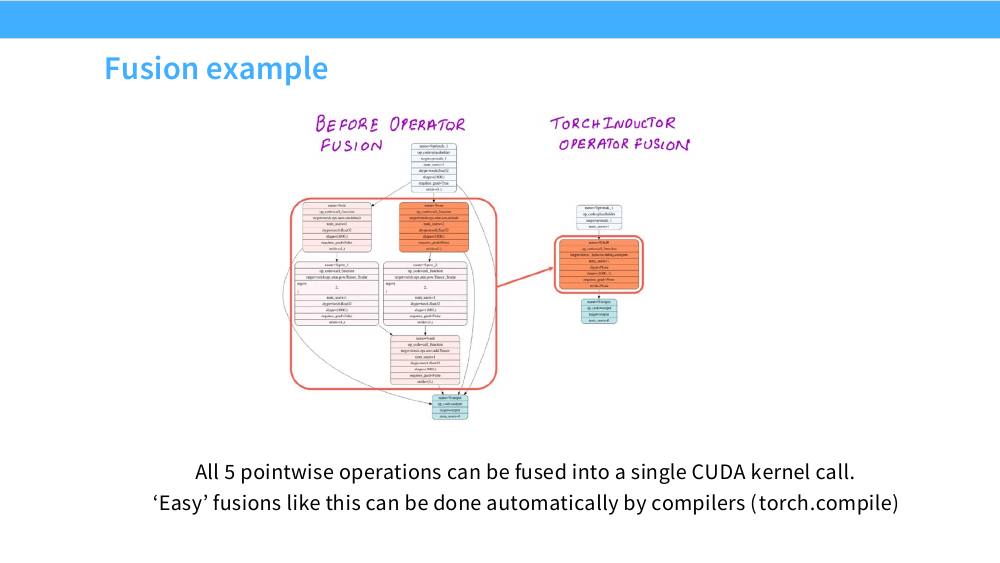
torch.compile 开箱即用。import torch
x = torch.randn(1 << 26, device="cuda", dtype=torch.bfloat16)
def f(x):
return torch.sin(x) ** 2 + torch.cos(x) ** 2
# eager:5 次 kernel launch,约 5 次读 + 5 次写 = 10 轮 HBM 往返
y1 = f(x)
# 编译后:TorchInductor 生成 1 个 Triton kernel,1 读 1 写
f_fused = torch.compile(f)
y2 = f_fused(x) # 首次调用会触发编译
# 访存量估算(BF16,n = 2^26 个元素 = 134 MB)
n, b = x.numel(), x.element_size()
print(f"未融合 ≈ {10 * n * b / 1e9:.2f} GB, 融合后 ≈ {2 * n * b / 1e9:.2f} GB")什么时候融合不能自动完成?当融合需要改变算法而不只是合并循环体时。典型例子:
- 归约 + pointwise 的融合(如 softmax):需要在一个 kernel 里先扫一遍求 max/sum 再扫一遍算结果,或者用在线算法。这需要编译器理解归约语义。现代编译器(Inductor、XLA)能做一部分。
- 矩阵乘 + 归约的融合(如 FlashAttention):需要重新设计整个数据流和分块策略,还要在线 softmax 这样的数学变换。编译器做不到,必须人工写 kernel——这正是 FlashAttention 存在的理由,也是下一讲学 Triton 的理由。
8.2 重计算:用 FLOPs 换字节
反向传播的标准做法是:前向时把每一层的激活值存下来,反向时读出来算 Jacobian。这套做法在"算力贵、内存便宜"的年代是对的,今天正好反过来。
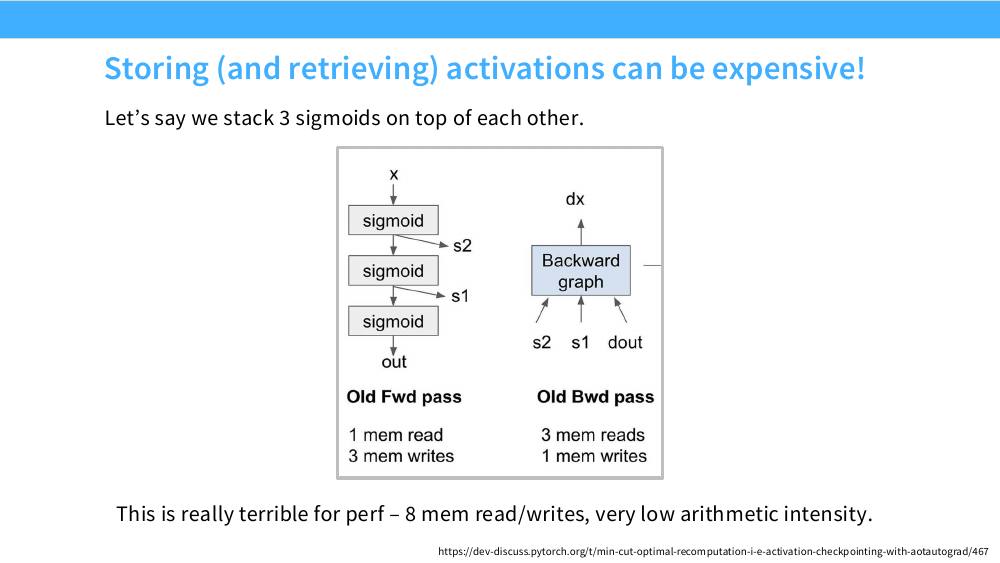
out 都写回 HBM(3 次写)。Old Bwd pass:把 $s_2$、$s_1$、dout 读回来(3 次读),算出 dx 写回(1 次写)。合计 8 次内存读写,而计算量只有 3 个 sigmoid——算术强度低到令人发指。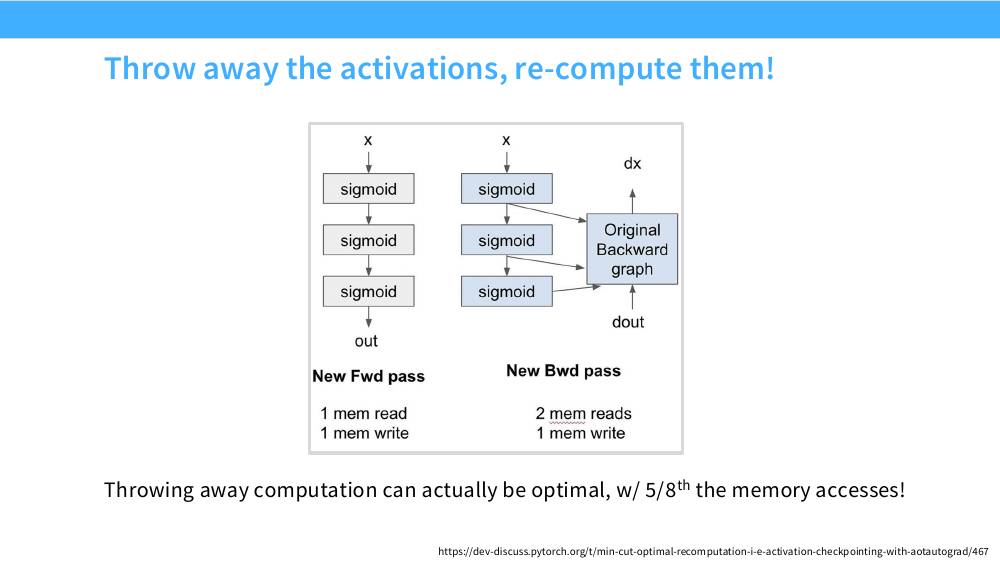
out(1 次写)。New Bwd pass:读 $x$ 和 dout(2 次读),重新跑一遍三个 sigmoid 得到 $s_1$、$s_2$,喂给原本的反向图,写 dx(1 次写)。合计 5 次读写——是原来的 5/8。看起来我们"浪费"了 3 个 sigmoid 的计算,但这些计算本来就是免费的(计算单元在等内存),换来的是 37.5% 的访存节省。扔掉计算结果居然是最优的。
把这件事推广。设一段计算链有 $L$ 层,每层激活 $n$ 个元素、$b$ 字节,每层计算 $c$ FLOPs/元素。
存激活: 访存 $Q_1 = nb(1 + L) + nb(L + 1) = 2nb(L+1)$,计算 $F_1 = ncL \cdot (1 + 2)$(前向 1 份、反向约 2 份)。
重计算: 访存 $Q_2 = nb \cdot 2 + nb \cdot 3 = 5nb$(与 $L$ 无关!),计算 $F_2 = ncL(1 + 1 + 2)$。
结论:访存量从 $O(L)$ 降到 $O(1)$,计算量只从 $3ncL$ 涨到 $4ncL$(+33%)。 链越长,这笔交易越划算。
更一般地说,PyTorch 的 AOTAutograd 把"存哪些、重算哪些"建模成一个图上的最小割(min-cut)问题:在前向图和反向图之间找一个割,割边上的张量必须存,割的容量就是访存成本。这就是 min-cut optimal recomputation 的由来。
两种尺度的重计算
| kernel 内的重计算 | 激活检查点(activation checkpointing) | |
|---|---|---|
| 粒度 | 单个融合 kernel 内部的中间值 | 整个 Transformer block |
| 动机 | 省时间:减少 HBM 往返 | 省显存:不存 block 内部的激活 |
| 存在哪 | 寄存器 / shared memory | HBM |
| 代价 | 几乎为零(计算单元本来在等) | 约 +30% 的前向计算,端到端 +20%~33% 时间 |
| 怎么用 | torch.compile 自动做;手写 kernel 时人工做 | torch.utils.checkpoint 显式包裹 |
from torch.utils.checkpoint import checkpoint

class Block(torch.nn.Module):
    def forward(self, x):
        x = x + self.attn(self.ln1(x))
        x = x + self.mlp(self.ln2(x))
        return x

# 普通:block 内部所有中间激活都留在显存里
h = block(x)

# 检查点:只保留 block 的输入 x,反向时重跑一遍 forward 生成中间激活
h = checkpoint(block, x, use_reentrant=False)
激活检查点的显存账:不用检查点时,$L$ 层每层要存 $O(\text{层内激活})$;用了之后只存 $L$ 个 block 的输入,显存从 $O(L \cdot k)$ 降到 $O(L + k)$($k$ 是每 block 内部的张量数)。经典的 $O(\sqrt{L})$ 策略(Chen et al. 2016)是每隔 $\sqrt{L}$ 层设一个检查点,显存 $O(\sqrt{L})$、额外计算一次前向。
融合和重计算是同一枚硬币的两面:融合说"别把中间结果写回去",重计算说"既然没写回去,反向时就重新算"。没有重计算,融合就无法跨越前向-反向边界。 这一点在 FlashAttention 里体现得最彻底:它的前向不 materialize $N\times N$ 的注意力矩阵(融合),所以反向时必须重新计算它(重计算)——两者是绑定出现的。
9. 提速手段(三):合并访存与 DRAM 的物理特性
DRAM 为什么按"突发"读
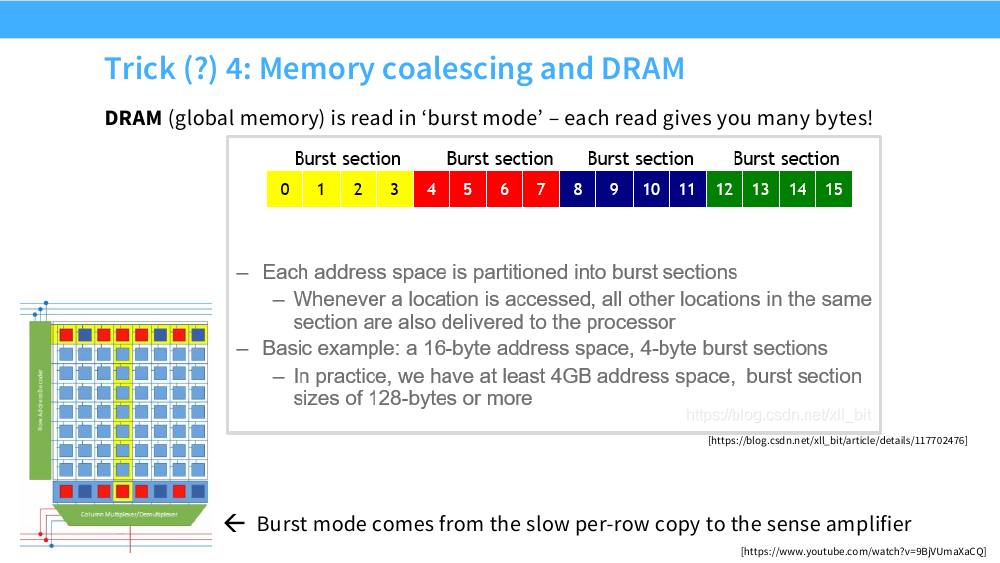
直接后果:读 4 个字节和读 32 个字节的代价几乎一样。 如果你只用了其中 4 个,另外 28 个字节的带宽就白白扔掉了。
什么叫"合并"
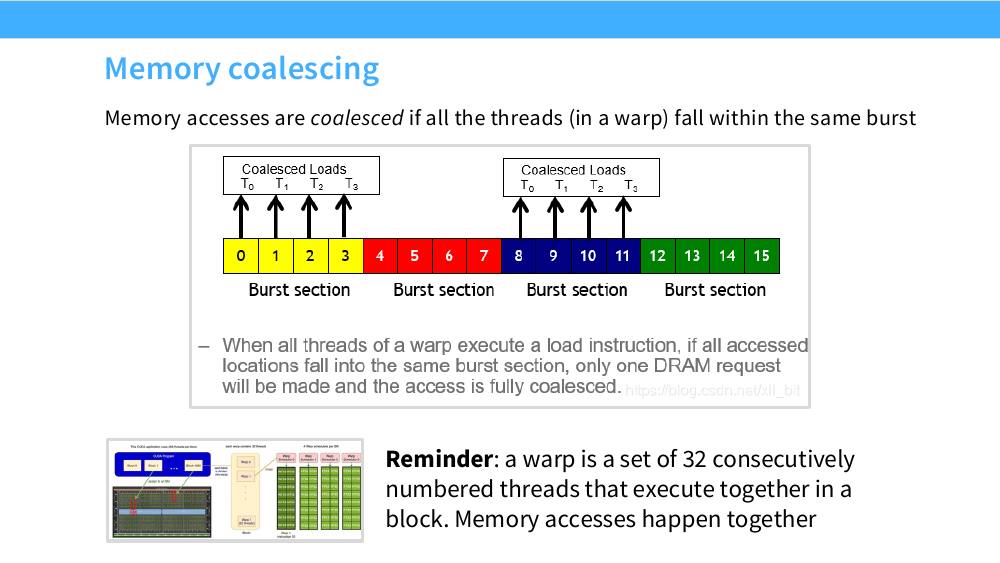
设 warp 内线程 $t \in \{0,\ldots,31\}$ 访问地址 $\text{base} + t \cdot s \cdot b$($s$ 是以元素为单位的跨步,$b$ 是元素字节数)。硬件按 32 字节 sector 计费,则需要的 sector 数约为
$$ \#\text{sectors} \approx \min\left(32, \ \left\lceil \frac{32 \cdot s \cdot b}{32} \right\rceil \right) = \min(32,\ s \cdot b) $$有效字节 $= 32 b$,实际搬运 $= 32 \cdot \#\text{sectors}$,于是
$$ \text{访存效率} = \frac{32b}{32 \cdot \min(32, sb)} = \frac{b}{\min(32,\, sb)} $$$b=4$(FP32)时:$s=1$ 效率 100%;$s=2$ 效率 50%;$s\ge 8$ 效率只有 12.5%。一个跨步就能让你的有效带宽掉 8 倍,而 roofline 图上的斜线屋顶会相应地降低 8 倍。
矩阵乘里的合并问题
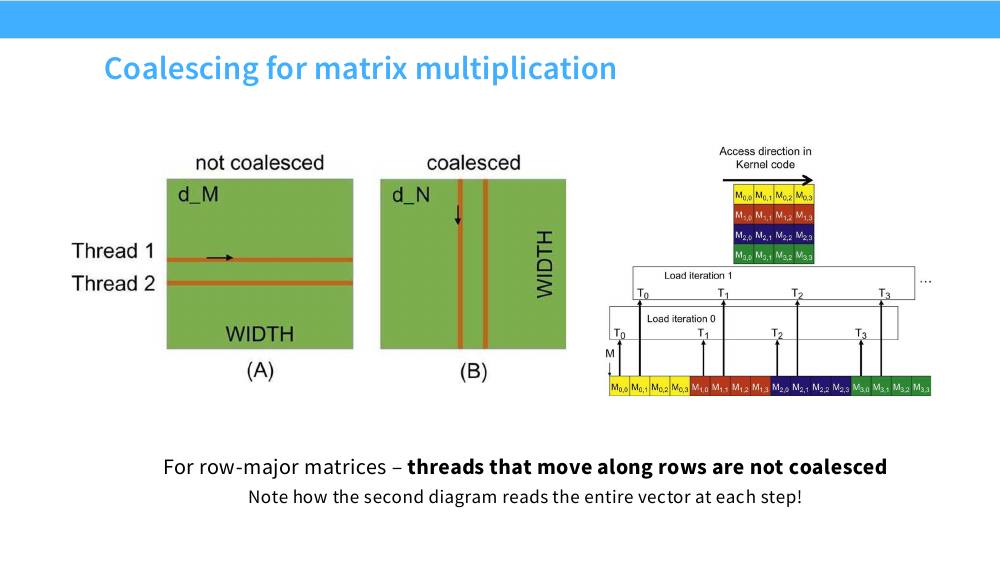
这是初学者写 CUDA 时最常见的错误。看下面两个索引方式,数学上完全等价,性能差 8 倍:
// 错误:相邻线程访问相隔 N 的地址(每个线程负责一整行)
int row = blockIdx.x * blockDim.x + threadIdx.x;
for (int k = 0; k < N; ++k)
    acc += A[row * N + k];        // warp 内 32 个线程地址跨度 = 32*N*4 字节

// 正确:相邻线程访问相邻地址(threadIdx.x 映射到最快变化的维度)
int col = blockIdx.x * blockDim.x + threadIdx.x;
for (int k = 0; k < N; ++k)
acc += A[k * N + col]; // warp 内 32 个线程地址连续 = 128 字节"我在 PyTorch 里写代码,不用管合并访存。"——要管,只是形式不同。PyTorch 层面对应的是张量的内存布局(stride):
x.transpose(1, 2)之后张量变成 non-contiguous,后续算子要么走慢路径,要么隐式插入一次contiguous()拷贝(一次完整的 HBM 往返)。- channels-last vs channels-first 的性能差异,本质就是哪个维度连续。
- attention 里
(B, T, H, D) → (B, H, T, D)的 permute 是必要的,但要注意它发生在哪一步、有没有被融合掉。 - 用
x.is_contiguous()和x.stride()检查;性能异常时先看有没有多余的contiguous()。
10. 提速手段(四):分块(tiling)与矩阵尺寸之谜
Tatsu 称 tiling 为 "the big one"——它是所有手段里效果最大、也最需要人工设计的一个。
问题:朴素矩阵乘把每个输入读了 $N$ 次
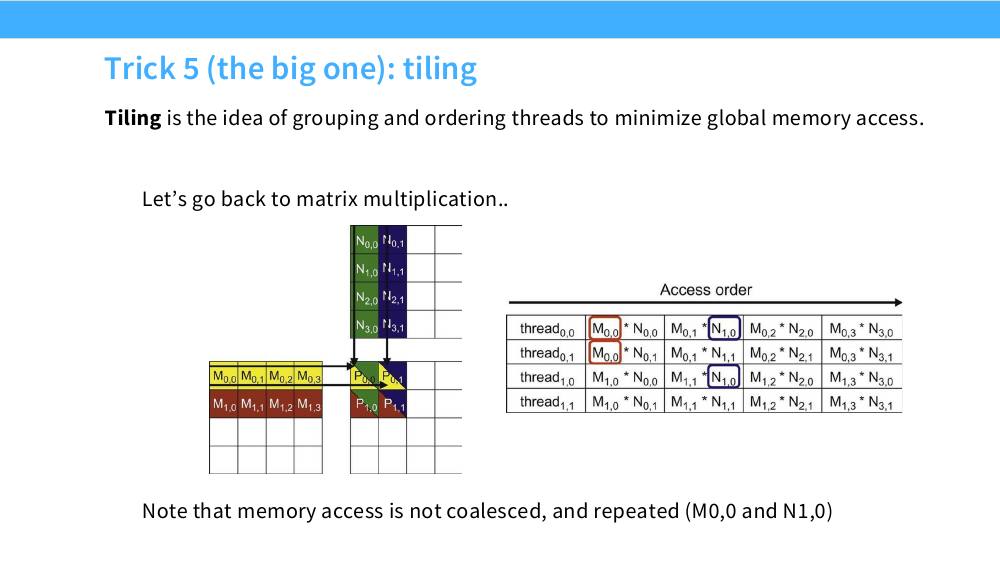
算一下朴素版的算术强度:$F = 2N^3$,$Q = 2N^3 b$(每次乘加读两个元素),
$$ I_{\text{naive}} = \frac{2N^3}{2N^3 b} = \frac{1}{b} = 0.5 \ \text{FLOP/byte (BF16)} $$和 element-wise 算子一个量级! 矩阵乘"天生 compute-bound"的性质,只有在你把数据复用做出来之后才成立。这一点非常重要:$I = 2N/(3b)$ 是理论上限,$I = 1/b$ 是朴素实现的实际值,中间差了 $N$ 倍,全靠 tiling 填补。
解法:把数据搬进 shared memory,反复用
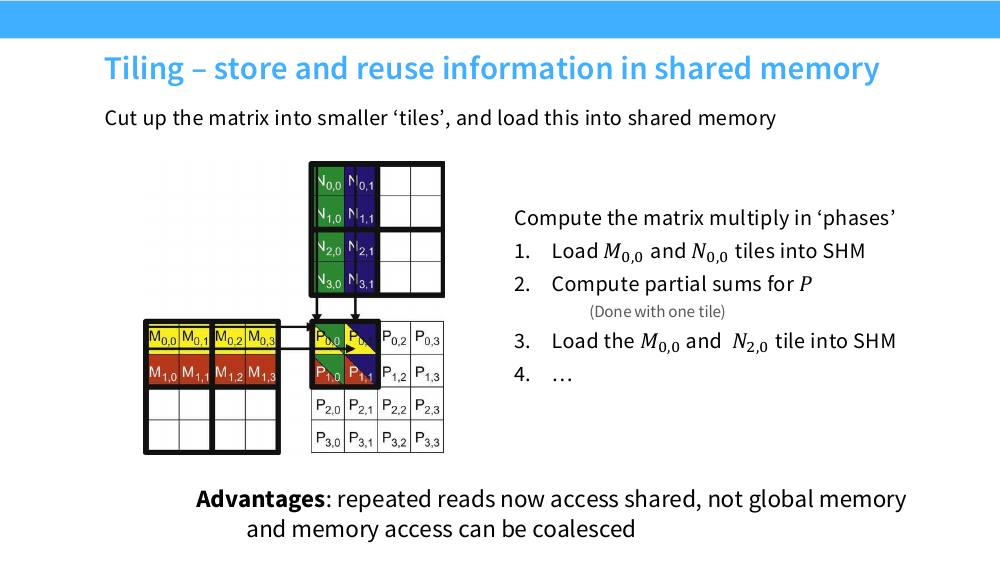
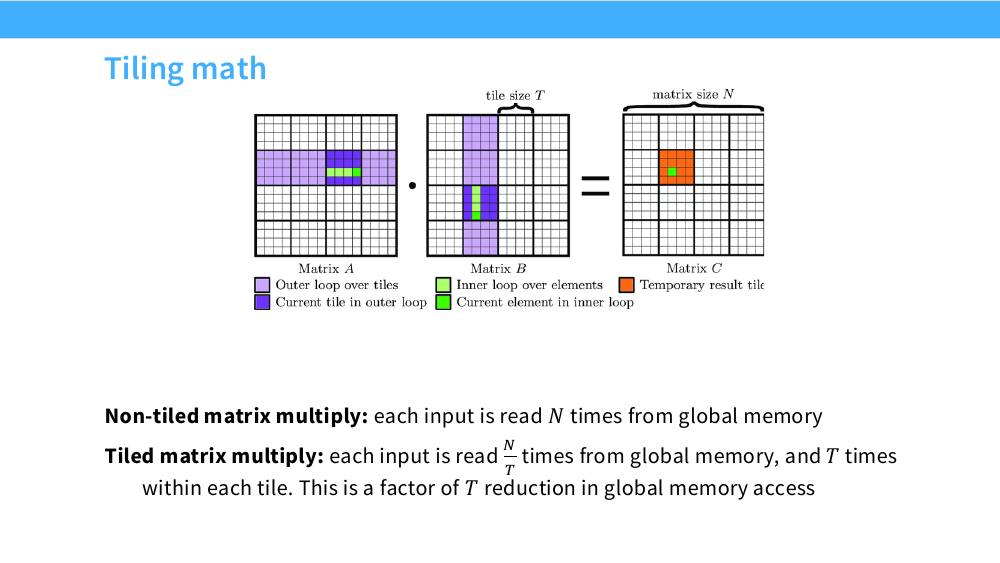
tile 边长 $T$ 时:全局访存量 $Q = 2N^3 b / T$,因此
$$ I_{\text{tiled}} = \frac{2N^3}{2N^3 b / T} = \frac{T}{b} \ \text{FLOP/byte} $$算术强度正比于 tile 边长 $T$,与矩阵大小 $N$ 无关。 这个式子极其有用——它直接告诉你 tile 该开多大:
- H100 BF16 需要 $I^\star = 295$,则 $T \ge 295 \times 2 = 590$?——这显然装不下 shared memory。
- 真实 kernel 用矩形 tile + 多级分块:$T_M \times T_N$ 的输出块配 $T_K$ 的 K 方向步长,强度变成 $\dfrac{2 T_M T_N}{b(T_M + T_N)}$。取 $T_M = 256, T_N = 128$:$I = \dfrac{2\cdot 256 \cdot 128}{2(256+128)} = 85$ FLOP/byte。
- 剩下的差距靠 L2 cache 补——多个 block 会共享同一批 tile,L2 命中率高的话 HBM 流量还能再降。这就是 cuBLAS 里 "swizzle"(重排 block 的执行顺序以提高 L2 局部性)的作用。
约束条件:shared memory 容量。$T_M \times T_K + T_K \times T_N$ 个元素必须装进(每 SM 最多)164–228 KB,而且还要留出空间做双缓冲(一边算一边预取下一块)。
最小可读实现
#define T 32                                 // tile 边长,也是 blockDim

__global__ void matmul_tiled(const float* A, const float* B, float* C, int N) {
    __shared__ float As[T][T];               // 每个 block 私有的 shared memory
    __shared__ float Bs[T][T];

    int tx = threadIdx.x, ty = threadIdx.y;
    int row = blockIdx.y * T + ty;           // 本线程负责的输出元素
    int col = blockIdx.x * T + tx;
    float acc = 0.f;                         // 累加器留在寄存器里

    for (int t = 0; t < N / T; ++t) {        // 沿 K 方向逐 tile 推进
        // ---- 阶段 1:协作载入。注意 tx 是最快变化的维度 ----
        As[ty][tx] = A[row * N + (t * T + tx)];   // warp 内地址连续 -> 合并
        Bs[ty][tx] = B[(t * T + ty) * N + col];   // warp 内地址连续 -> 合并
        __syncthreads();                          // 等所有线程载完

        // ---- 阶段 2:在 shared memory 里算 T 次乘加,不碰 HBM ----
        for (int k = 0; k < T; ++k)
            acc += As[ty][k] * Bs[k][tx];
        __syncthreads();                          // 等所有线程算完再覆盖 tile
    }
    C[row * N + col] = acc;                       // 只写一次
}
三个细节值得注意:
- 两个
__syncthreads()缺一不可。 第一个保证"数据载完了再算",第二个保证"算完了再覆盖"。漏掉任何一个都会得到随机结果。 tx必须映射到最快变化的维度(As[ty][tx]而不是As[tx][ty]),否则载入不合并。- 累加器
acc在寄存器里,$T$ 次乘加期间完全不访存。真实 kernel 会让每个线程负责 $4\times4$ 或 $8\times8$ 个输出元素(register tiling),进一步提高复用。
复杂性之一:tile quantization(分块量化损失)
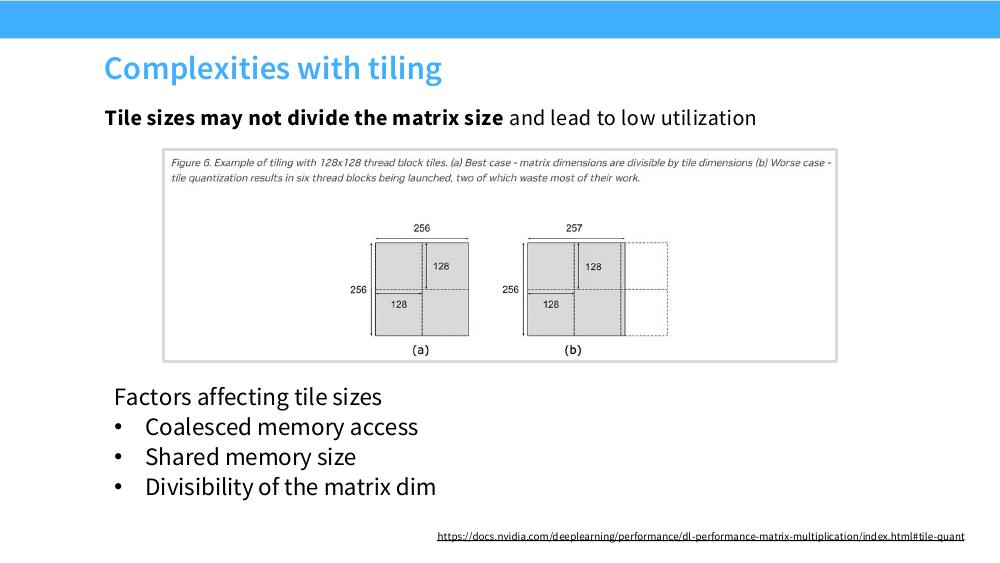
影响 tile 尺寸选择的三个因素(互相冲突):
- 合并访存:tile 的行长要是 burst 大小的整数倍;
- shared memory 容量:tile 越大越好用,但装不下就得降低 occupancy;
- 矩阵维度的整除性:tile 要能整除矩阵尺寸,否则就是上图 (b) 的情况。
复杂性之二:内存对齐
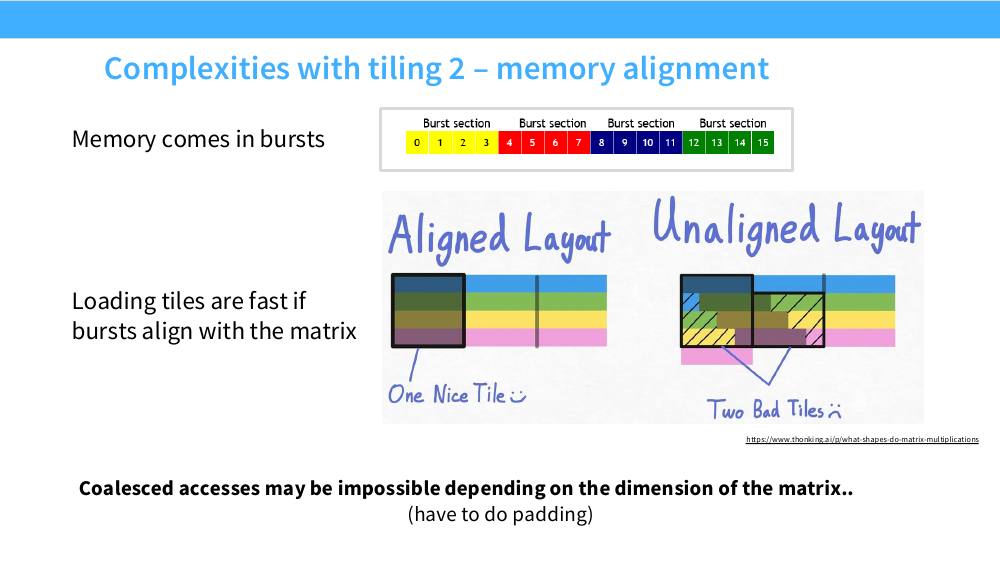
这条给出了一个可以立刻用上的实践规则:让所有张量维度对齐到 8 / 64 / 128 的倍数。
- FP16/BF16 Tensor Core 要求 $K$ 维是 8 的倍数才能走最快路径(FP8 是 16);
- 最佳 tiling 通常要求维度是 64 或 128 的倍数;
- 典型场景:词表大小。$V = 50257$(GPT-2)是个质数附近的怪数,pad 到 50304($= 128 \times 393$)能让输出投影层快 20% 以上,而且几乎零成本(多出来的 logits 直接 mask 掉)。这是最著名的"改一行代码提速 20%"的技巧。
- 同理:隐藏维、head 数、FFN 中间维、序列长度,能对齐就对齐。
解开谜题:为什么大矩阵更快
现在可以完整解释开头那张散点图了。三种效应叠加:
效应一:算术强度($N$ 小于约 600–900 时)。 $I = 2N/(3b)$,小矩阵根本达不到 ridge point,被带宽限制。这解释了曲线左半部分的平滑爬升。
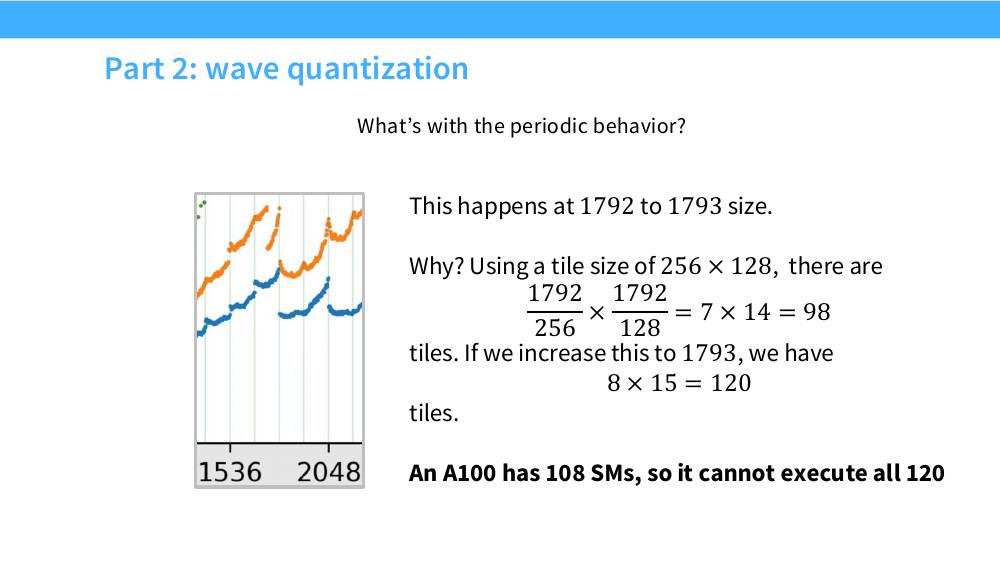
把 wave quantization 写成公式。设总 tile 数 $n_t$,SM 数 $n_{SM}$,则需要的波数为 $\lceil n_t / n_{SM} \rceil$,而利用率为
$$ \eta_{\text{wave}} = \frac{n_t}{n_{SM} \cdot \lceil n_t / n_{SM} \rceil} $$$n_t = 98, n_{SM}=108$:$\eta = 98/108 = 91\%$。
$n_t = 120, n_{SM}=108$:$\eta = 120/216 = 56\%$。掉了 35 个百分点。
注意 $\eta_{\text{wave}}$ 随 $n_t$ 增大而趋近 1(锯齿的振幅越来越小),因为 $n_t \gg n_{SM}$ 时最后一波的浪费占比可以忽略。这也是"大矩阵更稳定地快"的又一层原因。
同一个 $2N^3$ FLOPs 的矩阵乘,实测性能可以在 50 到 260 TFLOP/s 之间波动(5 倍差距),完全由三件与数学无关的事决定:强度够不够($N$ 大不大)、tile 对不对齐($N$ 能被多少整除)、tile 数量和 SM 数量匹不匹配(wave quantization)。
实践含义:设计模型超参时把这些考虑进去几乎是免费的性能。选 $d_{\text{model}} = 4096$ 而不是 4000,选词表 50304 而不是 50257,让 batch × 序列切出来的 tile 数是 SM 数的整数倍——这些都不影响模型质量,但能白拿 10–30% 的吞吐。
11. FlashAttention:三板斧的集大成
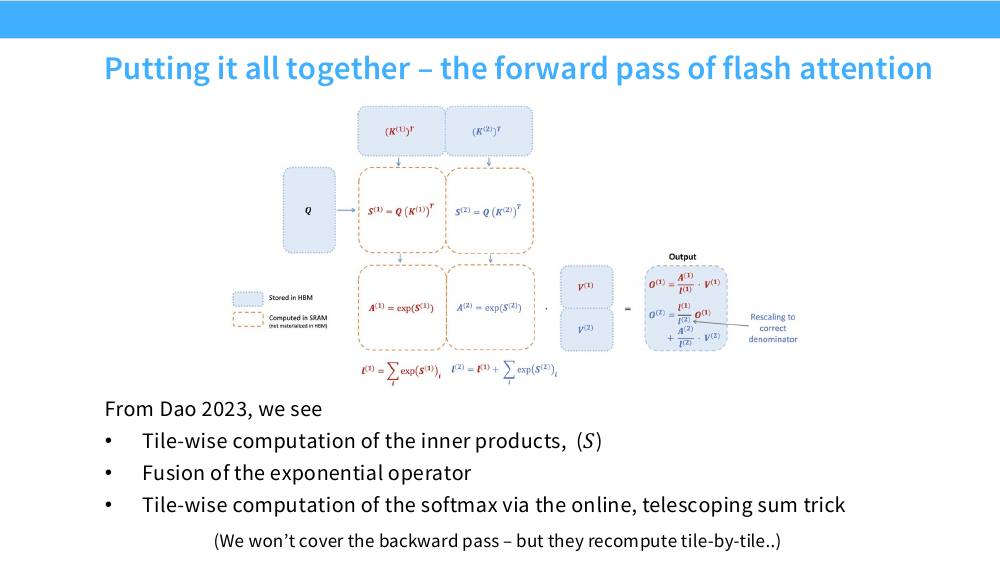
Part 3 的目标是证明:你现在已经有了推导出 FlashAttention 的全部工具。 它没有引入任何新的数学,只是把 tiling + fusion + recomputation 用到了极致,再加上一个 2018 年就发表的在线 softmax 技巧。
11.1 标准注意力为什么慢
注意力的计算是三个矩阵乘中间夹一个 softmax($Q, K, V \in \R^{N \times d}$):
$$ S = \frac{QK^\top}{\sqrt{d}} \in \R^{N\times N}, \qquad P = \softmax(S) \in \R^{N \times N}, \qquad O = PV \in \R^{N \times d} $$标准实现把这三步写成三(或更多)个独立的 kernel,于是 $S$ 和 $P$ 这两个 $N \times N$ 的巨型矩阵必须被 materialize 到 HBM。算一笔账($N = 4096$,$d = 64$,BF16,单个 head):
| 步骤 | FLOPs | HBM 流量 |
|---|---|---|
| $S = QK^\top$ | $2N^2 d = 2.15\times10^9$ | 读 $Q,K$ = 1.05 MB;写 $S$ = 33.6 MB |
| $P = \softmax(S)$ | $\sim 5N^2 = 8\times10^7$ | 读 $S$ + 写 $P$ ≈ 67 MB(naive 实现还要多趟) |
| $O = PV$ | $2N^2 d = 2.15\times10^9$ | 读 $P$ = 33.6 MB;读 $V$、写 $O$ = 1.05 MB |
| 合计 | $\approx 4.3\times10^9$ | $\approx 136$ MB |
差了 9 倍——标准注意力是彻头彻尾的 memory-bound 算子。 而且这个比值随 $N$ 增大而恶化:矩阵乘 FLOPs 是 $O(N^2 d)$,但 $S/P$ 的流量是 $O(N^2)$,所以强度上限被 $d$ 锁死在 $O(d)$,和序列长度无关。
还有第二个问题,甚至更致命:显存。$S$ 和 $P$ 要为反向传播存下来。$N=4096$、32 个 head、BF16:单层单样本就是 $32 \times 33.6 \text{MB} \approx 1.07$ GB,32 层就是 34 GB——一张 80GB 的 H100 连 batch size = 2 都放不下。这就是 FlashAttention 之前长上下文训练的墙。
11.2 第一步:对 $QK^\top V$ 做 tiling
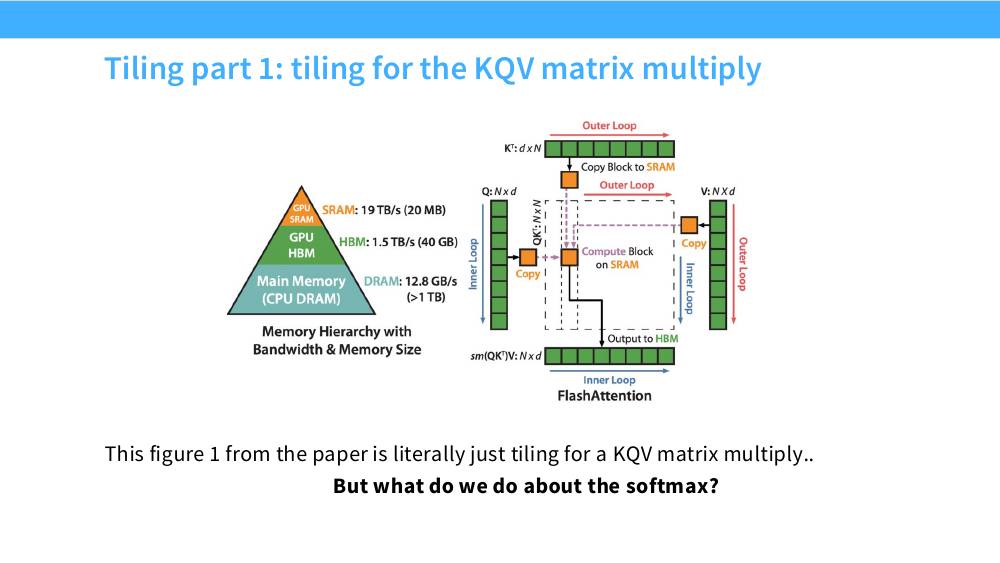
Tatsu 的评论很到位:这张图"literally just tiling for a KQV matrix multiply"——分块本身毫无新意,真正的难点在于中间那个 softmax 怎么办。
难点在哪?softmax 是沿着 $N$ 维(key 维)的全局归约。要算 $\softmax(S_{i,:})$,你需要整行 $S_{i,:}$ 的最大值和指数和。可是分块之后,你手上一次只有 $S$ 的一小块 $S^{(j)} \in \R^{B_q \times B_k}$——你不知道这一行剩下部分的最大值是多少。
11.3 第二步:在线 softmax(online softmax)
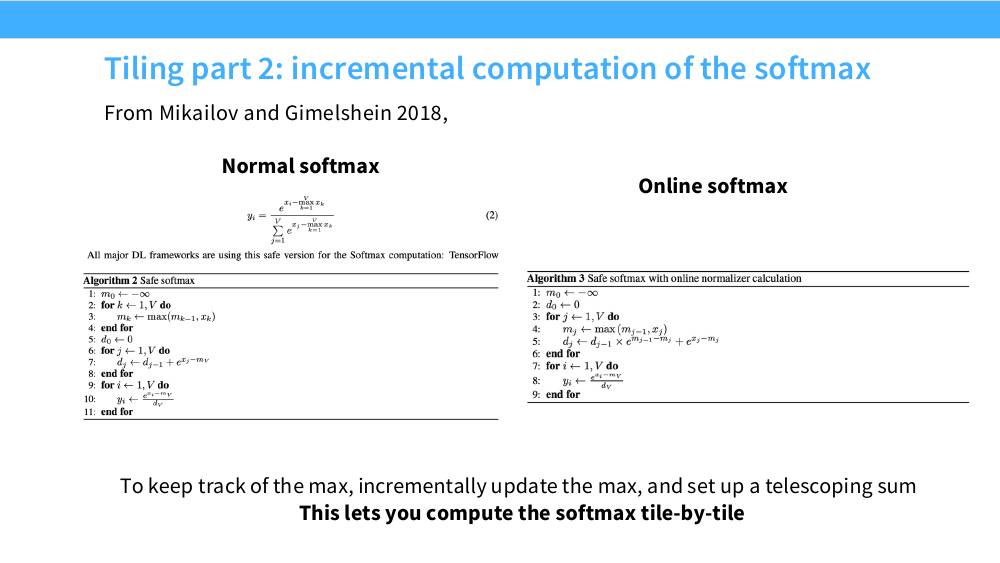
为什么 softmax 需要减 max。 直接算 $e^{x_i}$ 会溢出:BF16 的最大值约 $3.4\times10^{38}$,$e^{89}$ 就溢出了;而注意力分数在训练中很容易达到几十。所以标准做法是 "safe softmax":
$$ \softmax(x)_i = \frac{e^{x_i - m}}{\sum_j e^{x_j - m}}, \qquad m = \max_j x_j $$这在数学上恒等(分子分母同乘 $e^{-m}$),但数值上安全(所有指数的幂 $\le 0$)。代价是必须先知道 $m$,也就是必须先扫一遍全部数据。
在线更新的推导。 把向量切成两块 $x = [x^{(1)}, x^{(2)}]$。定义局部量:
$$ m^{(1)} = \max x^{(1)}, \quad \ell^{(1)} = \sum_{i} e^{x^{(1)}_i - m^{(1)}} $$现在来了第二块。新的全局最大值 $m = \max(m^{(1)}, m^{(2)})$。我们想要的全局归一化因子是
$$ \ell = \sum_i e^{x^{(1)}_i - m} + \sum_i e^{x^{(2)}_i - m} $$第一项可以从 $\ell^{(1)}$ 直接推出来,因为
$$ \sum_i e^{x^{(1)}_i - m} = \sum_i e^{x^{(1)}_i - m^{(1)}} \cdot e^{m^{(1)} - m} = \ell^{(1)} \cdot e^{m^{(1)} - m} $$于是得到递推式:
$$ \boxed{\;m^{\text{new}} = \max(m^{\text{old}}, \tilde m), \qquad \ell^{\text{new}} = e^{m^{\text{old}} - m^{\text{new}}}\,\ell^{\text{old}} + e^{\tilde m - m^{\text{new}}}\,\tilde \ell\;} $$其中 $\tilde m, \tilde\ell$ 是新块的局部最大值和局部和。修正因子 $e^{m^{\text{old}} - m^{\text{new}}} \le 1$,永不溢出。 这就是"伸缩求和":每来一块,就把历史累积量重新基准化一次。
推广到输出 $O$。 FlashAttention 真正要累加的不是标量而是向量 $O_i = \sum_j P_{ij} V_j$。同样的修正因子照搬:
$$ O^{\text{new}} = e^{m^{\text{old}} - m^{\text{new}}}\, O^{\text{old}} + e^{\tilde m - m^{\text{new}}}\,\tilde P\, V^{(j)} $$注意这里累加的是未归一化的 $O$,最后一步才统一除以 $\ell$。这样每一步都不需要知道最终的分母。
import math, torch

def online_softmax_stats(x, block_size):
    """分块地算出全局 (max, sum of exp),只扫一遍数据。"""
    m, l = -math.inf, 0.0
    for xb in x.split(block_size):
        m_tilde = xb.max().item()
        m_new   = max(m, m_tilde)
        # 关键一行:把历史累加量重新基准化到 m_new 上
        l = l * math.exp(m - m_new) + torch.exp(xb - m_new).sum().item()
        m = m_new
    return m, l          # softmax(x)_i == exp(x_i - m) / l

x = torch.randn(10000) * 30          # 故意放大,验证数值稳定性
m, l = online_softmax_stats(x, 128)
ref  = torch.softmax(x, dim=0)
print((torch.exp(x - m) / l - ref).abs().max()) # ~1e-8在线 softmax 的思想和"在线均值/方差"(Welford 算法)是一回事:维护一个可增量更新的充分统计量,使得看到新数据时不必回头重扫旧数据。 softmax 的充分统计量是 $(m, \ell)$ 两个标量(每行),而 $m$ 变化时需要一个修正因子把 $\ell$ 拉回同一基准——这就是全部的技巧。
代价是什么?额外的指数运算和乘法。每处理一个块,都要对累加器做一次 rescale。这是典型的"用计算换访存",而我们已经知道计算是免费的。
11.4 组装:FlashAttention 的前向
import torch

def flash_attention_forward(Q, K, V, Bq=128, Bk=128):
    """用纯 PyTorch 复现 FlashAttention 前向的数学。
    真实 kernel 里 Kj/Vj/Sij/Oi 全部驻留在 SRAM 与寄存器中,
    这里用切片来"模拟"分块,重点看 O/m/l 的更新逻辑。
    Q, K, V: (N, d)"""
    N, d = Q.shape
    scale = d ** -0.5
    O = torch.zeros_like(Q)
    L = torch.zeros(N, 1, device=Q.device)      # 存 logsumexp,反向要用

    for i in range(0, N, Bq):                   # 外层:遍历 query 分块
        Qi = Q[i:i + Bq]                        # (Bq, d)  载入一次,全程驻留
        Oi = torch.zeros(Qi.shape[0], d, device=Q.device)   # 未归一化累加器
        mi = torch.full((Qi.shape[0], 1), float("-inf"), device=Q.device)
        li = torch.zeros(Qi.shape[0], 1, device=Q.device)

        for j in range(0, N, Bk):               # 内层:流式遍历 key/value 分块
            Kj, Vj = K[j:j + Bk], V[j:j + Bk]   # (Bk, d)
            Sij = (Qi @ Kj.T) * scale           # (Bq, Bk) —— 只存在于 SRAM

            m_new = torch.maximum(mi, Sij.max(dim=-1, keepdim=True).values)
            P     = torch.exp(Sij - m_new)      # 融合的 exp,不落 HBM
            alpha = torch.exp(mi - m_new)       # 历史累加量的修正因子 (<= 1)

            li = alpha * li + P.sum(dim=-1, keepdim=True)
            Oi = alpha * Oi + P @ Vj            # 向量版的伸缩求和
            mi = m_new

        O[i:i + Bq] = Oi / li                   # 最后统一归一化
        L[i:i + Bq] = mi + torch.log(li)        # logsumexp,反向重算 P 用
    return O, L


N, d = 1024, 64
Q, K, V = (torch.randn(N, d) for _ in range(3))
O, L = flash_attention_forward(Q, K, V)
ref = torch.softmax(Q @ K.T * d ** -0.5, dim=-1) @ V
print((O - ref).abs().max())          # ~1e-6:数值上完全等价(exact attention)
对照 Tatsu 总结的三个要素,逐条落位:
| 论文里的技术 | 本讲的哪一招 | 在代码里对应哪一行 |
|---|---|---|
| 分块计算内积 $S$ | Tiling(§10) | Sij = (Qi @ Kj.T) * scale,$S$ 从不完整存在 |
| 融合指数算子 | Fusion(§8) | P = torch.exp(Sij - m_new) 紧接着就用掉 |
| 在线 softmax(伸缩求和) | 数学变换(§11.3) | alpha / li / Oi 三行更新 |
| 反向逐块重算 | Recomputation(§8) | 只存 O 和 L,反向用 $Q,K,V,L$ 重建 $P$ |
11.5 收益核算
(1)HBM 流量。 沿用 $N=4096, d=64$,BF16。FlashAttention 的流量:$Q, O$ 各读写一次(1.05 MB),$K, V$ 被每个 query 块重读一次。取 $B_q = 128$,共 32 个 query 块:
$$ Q_{\text{flash}} \approx \underbrace{2 N d b}_{Q, O} + \underbrace{\frac{N}{B_q} \cdot 2 N d b}_{K, V \text{ 重读}} = 1.05\ \text{MB} + 32 \times 1.05\ \text{MB} \approx 34\ \text{MB} $$相比标准的 136 MB,降到约 1/4,算术强度从 32 提到 126 FLOP/byte。把 $B_q$ 调大到 256(受 SRAM 容量限制),只需 16 趟,流量降到 18 MB、强度升到 240——逼近 ridge point。这解释了 kernel 调优里为什么块大小如此关键。
一般化:设片上 SRAM 能装 $M$ 个元素,需要同时驻留 $Q$ 块、$K$ 块、$V$ 块、$O$ 块,则块大小 $B \approx M/(4d)$。总流量(以元素计)
$$ Q_{\text{flash}} \approx \frac{N}{B} \cdot 2Nd = \frac{2N^2 d \cdot 4d}{M} = \frac{8 N^2 d^2}{M} = \Theta\!\left(\frac{N^2 d^2}{M}\right) $$而标准实现是 $\Theta(Nd + N^2)$。两者之比 $\approx \dfrac{N^2 d^2 / M}{N^2} = \dfrac{d^2}{M}$。A100 上 shared memory 192 KB,BF16 时 $M \approx 10^5$ 个元素,$d = 64$:$d^2/M = 4096/10^5 \approx 0.04$,即 理论上流量降到 1/25。论文在 GPT-2 上实测 HBM 访问量降到约 1/9(实现开销、causal mask、多趟等因素让实际值低于理论上限)。
注意这个式子的一个重要含义:收益正比于 $M/d^2$。head 维度 $d$ 越大,收益越小($d=128$ 时收益只有 $d=64$ 时的 1/4);片上内存越大收益越大——这就是为什么 Hopper 把每 SM 的 shared memory 从 192 KB 提到 256 KB 很有意义。
(2)显存。 这是更重要的收益。标准实现要为反向存 $P \in \R^{N\times N}$;FlashAttention 只存 $O \in \R^{N \times d}$ 和 $L \in \R^{N}$(logsumexp):
$$ \underbrace{O(N^2)}_{\text{标准}} \;\longrightarrow\; \underbrace{O(Nd)}_{\text{FlashAttention}} $$还是那个例子($N=4096$、32 head、单层):$32 \times 33.6\,\text{MB} = 1.07$ GB $\to$ $32 \times (4096\times64\times2 + 4096\times4) \approx 17$ MB,省了 63 倍。这才是 FlashAttention 真正改变游戏规则的地方——它让长上下文训练从"不可能"变成"routine"。
(3)反向传播。 论文里没在课上展开,但逻辑是对称的:反向时用存下来的 $Q, K, V, O, L$,逐块重新计算 $S^{(j)}$ 和 $P^{(j)}$(因为有 $L$ 在手,不需要再做在线 softmax,直接 $P = \exp(S - L)$),然后算梯度。这就是 §8 的重计算,只不过粒度是 tile 级别。额外的 FLOPs 约 +20–30%,换来 $O(N^2)$ 显存的消失。
FlashAttention 是 exact attention——它和标准注意力的输出在数值误差内完全相同,不是近似算法。它的全部收益来自于对硬件的 IO 感知(IO-awareness):把计算重组织成一种能让中间结果留在 SRAM 里的形式。
这件事的方法论意义大于技术本身:过去十年注意力加速的主流方向是"降低渐近复杂度"(稀疏注意力、线性注意力、低秩近似),全都要牺牲精度;FlashAttention 证明了在同样的 $O(N^2)$ 复杂度下,仅靠改善常数因子和访存模式就能拿到数倍加速,而且一分精度都不损失。 判断算法快慢的标准,应该从"数 FLOPs"变成"数 HBM 访问"。
11.6 后续版本
| 版本 | 核心改进 | 动机 |
|---|---|---|
| FlashAttention-1(2022) | tiling + 在线 softmax + 反向重计算 | 消除 $O(N^2)$ 的 HBM 流量与显存 |
| FlashAttention-2(2023) | 减少非矩阵乘 FLOPs(少做 rescale);把并行维度从 key 换成 query 与序列长度;改进 warp 间的工作划分(split-K → split-Q,减少 shared memory 通信) | FA1 只有约 25–40% 的 FLOPs 利用率——因为非矩阵乘操作(exp、rescale)在 Tensor Core 时代太贵,且长序列下并行度不足 |
| FlashAttention-3(2024) | 利用 Hopper 的异步特性:TMA(张量内存加速器)异步搬数据、WGMMA 异步矩阵乘、warp-specialization(生产者/消费者 warp 分工);支持 FP8 | 让数据搬运和 Tensor Core 计算真正重叠,把 softmax 的开销藏到矩阵乘背后 |
这个演进路线本身就是一堂课:每一代改进解决的都是"上一代之后新暴露出来的瓶颈"——先是 HBM 流量,然后是非矩阵乘算力和并行度,最后是计算与搬运的重叠。这正是性能优化的常态:瓶颈会移动,所以必须反复测量。
12. 实战:判断你的 kernel 到底被什么卡住
前面十一节给的是模型,这一节给的是流程。面对一个跑得慢的算子,按下面的顺序排查。
第 0 步:先算,再测
在打开任何 profiler 之前,先用纸笔(或 §6 那个 roofline() 函数)算出理论下界:
import torch, torch.utils.benchmark as bench

def measure(fn, *args, peak=989e12, bw=3.35e12, flops=None, bytes_moved=None):
    t = bench.Timer("fn(*args)", globals={"fn": fn, "args": args}).blocked_autorange()
    sec = t.median
    print(f"实测 {sec*1e3:.3f} ms")
    if flops:       print(f"  达成算力 {flops/sec/1e12:7.1f} TFLOP/s  ({100*flops/sec/peak:5.1f}% of peak)")
    if bytes_moved: print(f"  达成带宽 {bytes_moved/sec/1e9:7.1f} GB/s    ({100*bytes_moved/sec/bw:5.1f}% of peak)")
把实测时间换算成"达成算力"和"达成带宽"两个百分比,然后看落在哪一档:
| 达成算力 | 达成带宽 | 诊断 | 下一步 |
|---|---|---|---|
| > 60% | 低 | compute-bound,已经很好 | 只能靠降精度或减少 FLOPs(换算法) |
| 低 | > 70% | memory-bound,带宽已打满 | 只能靠减少访存:融合、tiling、量化、重计算 |
| 低 | < 50% | 两头都没打满 = latency/overhead bound | 看下面的第 1–4 步 |
第三种情况最常见,也最容易改。原因通常在这四个地方。
第 1 步:是不是根本没在 GPU 上跑?
先用 Nsight Systems(或 torch.profiler 导出 chrome trace)看时间线。要找的是:
- kernel 之间的空隙。空隙 = GPU 在等 CPU 派活。典型元凶:Python 层的循环、每步都调
.item()/.cpu()/print()造成同步、data loader 太慢、大量微小 kernel 导致 launch 开销(每次 launch 约 3–10 μs,如果 kernel 本身只要 5 μs,那一半时间在 launch)。 - 对策:
torch.compile(融合 + 减少 launch)、CUDA Graph(把一串 launch 打包成一次)、异步 data loading、去掉所有不必要的同步点。
不加同步就计时是错的。 CUDA kernel 是异步派发的,time.time() 测到的只是"派发完成"的时间。必须 torch.cuda.synchronize(),或者直接用 torch.utils.benchmark / CUDA event。另外第一次调用永远不准(cuBLAS 自动调优、JIT 编译、显存分配器预热),至少 warmup 10 次再测。
第 2 步:occupancy(占用率)够不够
Occupancy = 一个 SM 上实际驻留的 warp 数 / 硬件上限。 它衡量的是"GPU 有多少备用工作可以用来掩盖延迟"。A100 每 SM 最多 64 个 warp(2048 线程)。三个东西会限制它:
| 限制因素 | A100 每 SM 的预算 | 计算方式 |
|---|---|---|
| 寄存器 | 65536 个 32-bit | 每线程用 $r$ 个寄存器 → 最多 $\lfloor 65536/r \rfloor$ 个线程 |
| Shared memory | 164 KB(可配置) | 每 block 用 $s$ 字节 → 最多 $\lfloor 164\text{KB}/s \rfloor$ 个 block |
| Block / warp 数量上限 | 32 个 block、64 个 warp | block 太小(如 32 线程)会先撞 block 数上限 |
例:每线程用 64 个寄存器 → $65536/64 = 1024$ 线程 = 32 warp → occupancy 50%。想提到 100% 就得把寄存器压到 32 个以内,但那样每个线程能缓存的中间值就少了,可能反而更慢。
occupancy 不是越高越好。 Volkov 的经典结论是 "better performance at lower occupancy":掩盖延迟有两种方式——线程级并行(TLP,高 occupancy)和指令级并行(ILP,每线程多做几件独立的事)。高性能矩阵乘 kernel 通常故意压低 occupancy 到 25–50%,把寄存器全部用来做 register tiling(每线程算 $8\times8$ 个输出),靠 ILP 掩盖延迟。
判断标准:occupancy 低 且 profiler 显示大量 Stall Long Scoreboard(等 HBM)→ 提 occupancy 有用;occupancy 低但 stall 少 → 别动它。
第 3 步:访存合并了吗
用 Nsight Compute 看 Memory Workload Analysis:
- 关键指标:每次请求的 sector 数(
l1tex__average_t_sectors_per_request_pipe_lsu_mem_global_op_ld)。理想值:FP32 连续访问是 4(32 线程 × 4 字节 = 128 字节 = 4 个 sector)。如果看到 32,说明完全没合并,带宽浪费 8 倍。 - 另一个信号:
gld_efficiency/Global Load Efficiency,理想 100%,低于 50% 就要查索引方式。 - 对策:调整索引让
threadIdx.x映射到最快变化的维度;改变张量布局;必要时先做一次转置(一次连续拷贝比 32 倍的低效访问便宜)。
第 4 步:shared memory bank conflict
Shared memory 被分成 32 个 bank,每个 bank 宽 4 字节,地址按 4 字节轮流分配到各 bank。一个 warp 的 32 个线程如果访问了同一个 bank 的不同地址,就会串行化(同一地址是广播,不冲突)。
经典的踩坑场景:__shared__ float tile[32][32];,然后按列访问 tile[tid][k]… 不对,是 tile[k][tid] 按行没问题;出问题的是 tile[tid][k]:
线程 $t$ 访问 tile[t][k],地址偏移 $= (32t + k) \times 4$ 字节,bank 编号 $= (32t + k) \bmod 32 = k \bmod 32$。所有 32 个线程落在同一个 bank! 32 路冲突,shared memory 吞吐降到 1/32。
解法:padding。 声明成 __shared__ float tile[32][33];,bank 编号变成 $(33t + k) \bmod 32 = (t + k) \bmod 32$——32 个线程正好铺满 32 个 bank,零冲突。代价是多用 32 个 float(128 字节)的 shared memory。
Nsight Compute 里的指标是 l1tex__data_bank_conflicts_pipe_lsu_*,或者直接看 "Shared Memory" 那栏的 bank conflict 百分比。另一个现代解法是用 swizzle(按 XOR 打乱 tile 内的地址映射),Triton 和 CUTLASS 都是这么做的。
第 5 步:形状对不对
回到 §10 的结论,检查清单:
- 所有参与矩阵乘的维度是否是 8 的倍数(BF16 走 Tensor Core 的最低要求)?最好是 64 或 128 的倍数。
- 词表、隐藏维、FFN 维、head 数有没有 pad 到整齐的数?
- batch × seq 切出来的 tile 数是不是 SM 数(108 / 132)的整数倍附近?如果只比整数倍多一点点,就是典型的 wave quantization。
- 数据类型对了吗?
torch.set_float32_matmul_precision("high")打开 TF32;混合精度用torch.autocast。 - 张量是 contiguous 的吗?
x.is_contiguous()、x.stride()。
速查:症状 → 病因 → 处方
| 症状 | 可能原因 | 处方 |
|---|---|---|
| 时间线上 kernel 之间大量空隙 | CPU 派发不过来 / 同步点 / 微小 kernel 太多 | torch.compile、CUDA Graph、去掉 .item() |
| 带宽打满但算力极低 | memory-bound(正常现象) | 融合、量化、tiling、重计算 |
| 算力带宽都低,stall 以 Long Scoreboard 为主 | 访存延迟没被掩盖,occupancy 不足 | 降低每线程寄存器数、减小 block 的 shared memory 用量、增大 grid |
| 算力带宽都低,stall 以 MIO Throttle / Barrier 为主 | shared memory bank conflict 或 __syncthreads() 太频繁 | padding / swizzle,减少同步点,双缓冲 |
| Global Load Efficiency < 50% | 访存未合并 | 换索引映射、换布局、先转置 |
| 性能随矩阵尺寸剧烈跳变 | tile / wave quantization | pad 维度到 64/128 的倍数 |
| FP32 下矩阵乘只有理论值的 1/8 | 没走 Tensor Core | 开 TF32 或改用 BF16 autocast |
某个 if 之后性能腰斩 | warp 内控制分歧 | 无分支算术改写,或按条件排序数据 |
优化 kernel 有一条铁律:先测量,再优化,然后再测一遍。 因为瓶颈会移动——你把 memory-bound 解决了,可能就变成 launch-overhead bound;解决了 launch overhead,可能变成 bank conflict bound。任何"凭直觉优化"的尝试都有一半概率是在优化一个不存在的瓶颈。
另一条:先看 roofline 的理论上界,判断优化空间有多大。 如果你的算子已经跑到带宽的 85%,那再怎么调 kernel 也只剩 15% 空间,此时唯一的出路是改算法让它少搬数据——这正是 FlashAttention 的思路。
本讲小结
一页速查表
| 概念 | 一句话 | 关键数字 |
|---|---|---|
| CPU vs GPU | 延迟优化 vs 吞吐优化;晶体管花在控制/cache vs ALU | H100 有 132 SM、~2 万并发线程 |
| 硬件层次 | GPU → SM → SP / Tensor Core | A100 108 SM,每 SM 64 FP32 core + 4 Tensor Core |
| 软件层次 | grid → block(CTA) → warp → thread | warp 恒为 32 线程;block 最多 1024 线程且必在同一 SM |
| 存储金字塔 | 寄存器 → shared/L1 → L2 → HBM → 主机 | 延迟 1 / 20 / 200 / 290 周期;HBM 1.5–3.35 TB/s |
| 算术强度 | $I = \text{FLOPs} / \text{HBM 字节}$ | 越大越好(FLOP/byte) |
| Ridge point | $I^\star = P / B$,分界 memory / compute bound | A100 BF16: 201;H100 BF16: 295;H100 FP8: 591 |
| 方阵矩阵乘 | $I = 2N/(3b)$,随 $N$ 线性增长 | H100 BF16 需 $N \gtrsim 885$ 才 compute-bound |
| Element-wise | $I = O(1)$,永远 memory-bound | BF16 ReLU: 0.25 FLOP/byte,只发挥 0.08% 算力 |
| GEMV(解码) | $I \approx 2/b$ | BF16 时约 1 FLOP/byte,是 batching / 量化的动机 |
| 控制分歧 | warp 内分支被串行执行 | 最坏 32 倍减速;warp 边界对齐则零开销 |
| 低精度 | memory-bound 得 2×;compute-bound 得峰值比 | FP32→BF16 峰值 16×;BF16→FP8 峰值 2× |
| 算子融合 | $k$ 个 pointwise 算子融合 → 约 $k$ 倍加速 | torch.compile 自动做简单融合 |
| 重计算 | 扔掉激活、反向重算 | 三层 sigmoid:8 → 5 次访存;检查点省 $O(L)$ 显存换 +30% 计算 |
| 合并访存 | warp 的 32 个地址落在同一 burst 内 | 跨步 $s$ 时效率 $b/\min(32, sb)$;不合并浪费 8 倍带宽 |
| Tiling | 搬进 shared memory 复用 $T$ 次 | 全局访存降 $T$ 倍,$I_{\text{tiled}} = T/b$ |
| Tile quantization | tile 不整除矩阵尺寸 → 空转 | 256→257 使利用率从 100% 掉到 67% |
| Wave quantization | tile 数不是 SM 数的整数倍 → 最后一波空转 | 1792→1793:98→120 tile,A100 108 SM,效率 91%→56% |
| 在线 softmax | 维护 $(m, \ell)$,新块来时用 $e^{m_{old}-m_{new}}$ 修正 | 让 softmax 可以分块流式计算 |
| FlashAttention | tiling + fusion + 在线 softmax + 反向重计算 | HBM 流量 $O(N^2) \to O(N^2d^2/M)$;显存 $O(N^2)\to O(Nd)$ |
| TPU | 脉动阵列 MXU + 静态调度,无 warp | $128\times128$ MXU,硬件强度 $n/b = 64$ FLOP/byte |
要点清单
- 硬件驱动 scaling,底层细节决定什么能 scale、什么不能。 Dennard scaling 在 2005 年结束之后,算力增长全部来自并行化和专门化——这意味着只有"长得像硬件喜欢的样子"的计算才能享受红利。
- 当前的 GPU 计算强烈鼓励你围绕"矩阵乘 + 数据搬运"来思考。 Tensor Core 让矩阵乘比其他浮点运算快 10 倍以上;HBM 带宽的增长又远慢于算力。所以:能写成大矩阵乘的就写成大矩阵乘,写不成的就想办法把它融进矩阵乘的前后。
- 认真对待 GPU 的细节(合并、分块、融合)能带来实实在在的性能。 这不是"锦上添花"的微优化——本讲展示的例子里,随便一条都是 2–10 倍的差距。
- 建立"先算算术强度"的肌肉记忆。 看到一个算子,30 秒内估出 FLOPs 和字节数,和 ridge point 一比,就知道优化的天花板在哪、该往哪个方向使劲。
- FlashAttention 不是魔法。 它是 tiling(把 $S$ 留在 SRAM)+ fusion(exp 不落 HBM)+ 在线 softmax(让分块成为可能)+ 重计算(反向重建 $P$)的组合。你现在有能力自己推导出它——下一讲会用 Triton 真正把它写出来。
把这一讲压成一句话:现代加速器上,浮点运算基本是免费的,搬数据才是要付钱的。 因此,判断一个深度学习算法"快不快",正确的做法不是数它有多少 FLOPs,而是数它必须在慢速存储上读写多少字节。这个视角的转换,是从"会用 PyTorch"到"能写出工业级系统"之间最重要的一步。
附录:延伸阅读
性能模型与 GPU 基础
- Roofline: An Insightful Visual Performance Model for Multicore Architectures (Williams et al., 2009) — roofline 模型的原始论文。全篇只有一个公式,但它定义了此后二十年的性能分析方法论。
- AI and Memory Wall (Gholami et al., 2024) — 系统统计了算力/带宽/互连三条曲线的增速差,是本讲"memory wall"论断的数据来源。
- Making Deep Learning Go Brrrr From First Principles (Horace He) — 本讲"工厂与仓库"比喻的出处。把深度学习性能问题干净地分成 compute / memory / overhead 三类,是入门后最该读的一篇博客。
- What Shapes Do Matrix Multiplications Like? (Horace He) — 第 10 节"矩阵尺寸之谜"的完整版本,逐层拆解 tile quantization、对齐、wave quantization。读完你会对"改个数字就快 30%"这件事免疫。
- NVIDIA Matrix Multiplication Background User's Guide — 官方文档,tile quantization 和 wave quantization 的权威解释,附大量实测曲线。查形状对齐规则时的第一手资料。
- How to Scale Your Model: A Systems View of LLMs (JAX 团队) — 课上重点推荐的 "TPU (and now GPU) book"。把 roofline 的思路一路推广到多芯片并行,是本讲和后面并行化讲之间的最佳桥梁。
- GPU MODE (原 CUDA MODE) 讲座与代码 — 社区驱动的 CUDA/Triton 实战课程,从 hello world 到手写 FlashAttention 都有可运行代码。想真正动手时从这里开始。
- Better Performance at Lower Occupancy (Volkov, GTC 2010) — 反直觉但极重要:说明为什么高 occupancy 不是目标,ILP 同样能掩盖延迟。写高性能 kernel 前必读。
FlashAttention 与算子优化
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness (Dao et al., 2022) — 本讲 Part 3 的主角。重点看 Section 3 的算法伪代码和 Theorem 2 的 IO 复杂度分析,正好对应第 11 节的推导。
- Online normalizer calculation for softmax (Milakov & Gimelshein, 2018) — 在线 softmax 的原始论文,比 FlashAttention 早四年。短小精悍,说明"关键数学技巧往往早就躺在那里,等一个知道怎么用它的人"。
- FlashAttention-2 (Dao, 2023) — 讲清楚了为什么 FA1 只有 25–40% 的 FLOPs 利用率,以及怎么通过减少非矩阵乘操作、改变并行维度来修复。是学习"如何做第二轮优化"的范本。
- FlashAttention-3 (Shah et al., 2024) — Hopper 架构的异步特性(TMA、WGMMA、warp specialization)如何进一步把搬运和计算重叠。想理解现代 GPU 编程范式的走向就读这篇。
- Data Movement Is All You Need: A Case Study on Optimizing Transformers (Ivanov et al., 2020) — 系统地量化了 Transformer 里每类算子的数据搬运成本,得出"融合能带来 1.3× 端到端加速"的结论。比 FlashAttention 更早提出同样的世界观。
- Training Deep Nets with Sublinear Memory Cost (Chen et al., 2016) — 激活检查点的原始论文,$O(\sqrt{L})$ 显存策略的来源。第 8 节重计算部分的理论基础。
- Min-cut optimal recomputation with AOTAutograd (PyTorch dev-discuss) — 课上三层 sigmoid 例子的出处。讲 PyTorch 编译器如何把"存哪些激活"建模成图上的最小割问题并自动求解。
低精度与数值格式
- Mixed Precision Training (Micikevicius et al., 2017) — FP16 训练的奠基之作,确立了"低精度存储 + FP32 master weights + FP32 累加 + loss scaling"的标准配方,至今仍是所有混合精度实现的骨架。
- FP8 Formats for Deep Learning (Micikevicius et al., 2022) — E4M3 与 E5M2 两种格式的设计动机,以及为什么前向用前者、反向用后者。
- Microscaling Data Formats for Deep Learning (Rouhani et al., 2023) — OCP MX 标准(MXFP8/6/4)的定义:块级共享指数缩放因子的来龙去脉。
- Recipes for Pre-training LLMs with MXFP8 (2025) — 课上引用的 MXFP8 实战论文。重点看它讨论的"哪些层不能量化"和"转置为什么需要单独量化",这是理论到工程的真实距离。
硬件与 TPU
- In-Datacenter Performance Analysis of a Tensor Processing Unit (Jouppi et al., 2017) — TPU v1 的架构论文,脉动阵列设计与 roofline 分析的经典案例。第 5 节脉动阵列部分的原始出处。
- TPU v4: An Optically Reconfigurable Supercomputer (Jouppi et al., 2023) — 3D torus 拓扑和光路交换(OCS)如何让 4096 芯片的 pod 保持均匀带宽。为后面的并行化讲打底。
- Scaling Laws for Neural Language Models (Kaplan et al., 2020) — 本讲开头"算力带来可预测的性能提升"这一前提的来源,也是整门课的动机所在。
- Megatron-LM (Shoeybi et al., 2019) 与 Efficient Large-Scale Language Model Training on GPU Clusters (Narayanan et al., 2021) — 把本讲的单卡性能思维扩展到千卡集群,后者报告了 1T 参数模型 52% MFU 的实现细节。
- CUDA Refresher: Reviewing the Origins of GPU Computing (NVIDIA) — 从可编程着色器到 CUDA 的历史,解释了"为什么 GPU 恰好适合深度学习"这件事有多大成分是历史巧合。