注意力变体与混合专家
在固定算力预算下,怎样让上下文更长、参数更多——注意力的成本结构、它的各种替代品,以及把参数量和每 token 计算量彻底解耦的稀疏专家模型。
0. 本讲导读
上一讲把 Transformer 的架构和超参数拆开讲了一遍:pre-norm、RMSNorm、SwiGLU、RoPE、$d_{ff}/d_{model}$ 该取多少、head 数该怎么配。那一讲里的所有选择都有一个共同前提——模型是稠密的(dense),注意力是标准的全连接 softmax 注意力。每个 token 都要和之前所有 token 算一遍相关性,每个 token 都要过一遍全部的 FFN 参数。
这个前提在 2026 年已经站不住了。原因是两条曲线同时在涨:
- 上下文长度从 GPT-1 的 512 涨到了 Llama 4 的 10M。注意力的计算是 $O(L^2)$,KV cache 是 $O(L)$,两条都不是常数。
- 参数量还想继续涨,但推理成本(每 token 的 FLOPs)不想跟着涨。稠密模型里这两者是死死绑在一起的。
本讲就是拆这两根绑绳。前半讲拆第一根:注意力的替代方案——从 KV cache 压缩(MQA / GQA / MLA / 跨层共享),到稀疏与滑窗注意力,到线性注意力与状态空间模型(Mamba-2、Gated DeltaNet),再到现在事实上的工业标准「混合架构」。后半讲拆第二根:Mixture of Experts(混合专家,MoE)——路由怎么设计、不可导的 top-k 怎么训、负载怎么均衡、系统上要付什么代价,以及讲师对「你到底该不该上 MoE」的判断。
下一讲会讲 GPU 和 TPU 的硬件细节。本讲里所有关于「带宽受限」「all-to-all 通信」「算术强度」的论证,到那一讲会有更硬的硬件基础;反过来,本讲提供的是为什么架构设计必须迁就硬件的动机。
- 推理时真正的瓶颈往往不是 FLOPs 而是 KV cache 的显存与带宽。KV cache 大小 $= 2 \cdot B \cdot L \cdot n_{layers} \cdot n_{kv} \cdot d_{head} \cdot \text{bytes}$,一个 8B 模型在 128k 上下文下的 KV cache 和它的权重一样大。
- MHA → MQA → GQA → MLA 是一条用表达力换缓存的连续谱。MLA 用低秩联合压缩把每 token 每层的缓存压到 576 个数,代价是要单独拆出几维「解耦 RoPE」维度。
- 线性注意力的本质是矩阵乘法结合律重排 $QK^\top V = Q(K^\top V)$,它等价于一个状态矩阵固定大小的 RNN。固定大小意味着永远不会 OOM,也意味着长程精确检索会失真——所以纯线性架构没人用,3:1 到 7:1 的混合架构才是主流。
- MoE 把「参数量」和「每 token FLOPs」解耦:DeepSeek-V3 有 671B 参数但每 token 只激活 37B,其中 97% 的参数是专家,每次只点亮其中 3.5%。同 FLOPs 下参数越多越好,这是目前最可靠的经验规律之一。
- top-k 路由不可导。RL 是「正确解法」但方差太大没人用;启发式的负载均衡辅助损失赢了。DeepSeek-V3 的 aux-loss-free 方案用一个只影响「选谁」不影响「权重」的 per-expert bias 做在线控制,绕开了辅助损失对语言建模梯度的干扰。
- MoE 的代价全在系统侧:显存按总参数算、吞吐按激活参数算,加上每层两次 all-to-all。所以它在多卡多机、高吞吐服务的场景才划算——这也是讲师给出的判断标准。
1. 注意力的成本:算力、显存与 KV cache
先把账算清楚。不算清楚这笔账,后面所有的架构魔改都会显得像是没事找事。
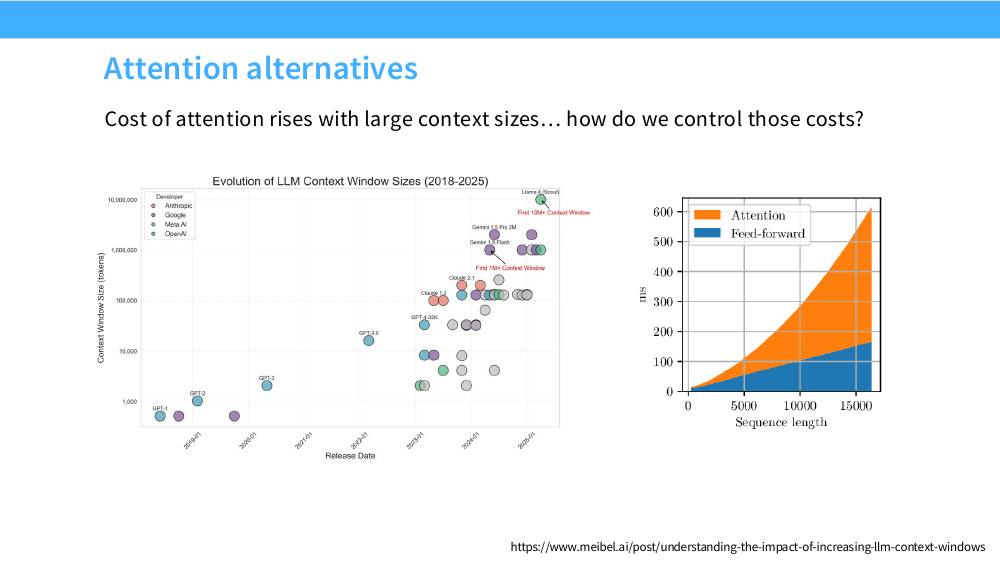
1.1 训练时的成本:二次方的注意力
设序列长度 $L$、模型维度 $d_{model}$、层数 $n_{layers}$、头数 $n_{heads}$、每头维度 $d_{head}$(通常 $n_{heads}\cdot d_{head}=d_{model}$)。单层里注意力部分的矩阵乘法有两块:
- 投影:$Q,K,V,O$ 四个 $d_{model}\times d_{model}$ 的矩阵,FLOPs $= 4\cdot 2\cdot L\cdot d_{model}^2 = 8Ld_{model}^2$。这一块是 $O(L)$ 的。
- 注意力本身:$QK^\top$ 是 $2L^2d_{model}$,$\softmax(\cdot)V$ 又是 $2L^2d_{model}$,合计 $4L^2d_{model}$。这一块是 $O(L^2)$ 的。
两者之比是 $\dfrac{4L^2d_{model}}{8Ld_{model}^2} = \dfrac{L}{2d_{model}}$。对 $d_{model}=4096$ 的模型,$L=8192$ 时这个比值才刚到 1;但 $L=131072$(128k)时它是 16——注意力吃掉了绝大部分算力。加上 FFN 的 $O(L)$ 项之后临界点会更靠后,但趋势不变:长上下文训练最终一定被二次项支配。
1.2 推理时的成本:KV cache
训练是一次性的,推理是每天都在烧钱的。而推理阶段的瓶颈完全是另一回事。
自回归解码时,生成第 $t$ 个 token 只需要一个新的 query $q_t$,但它要和前面所有位置的 key/value 做注意力。如果每步都重算全部的 $K,V$,那生成 $L$ 个 token 就是 $O(L^2)$ 次重复计算。标准做法是把算过的 $K,V$ 存下来——这就是 KV cache(键值缓存)。
逐项拆 KV cache 的字节数。对每一个 token、每一层:
- 要缓存 $K$ 和 $V$ 两个张量 → 因子 2;
- 每个张量在这一层的大小是「KV 头数 × 每头维度」= $n_{kv}\cdot d_{head}$ 个数(标准 MHA 里 $n_{kv}=n_{heads}$,于是就是 $d_{model}$);
- 每个数占
bytes字节(bf16 = 2,fp8 = 1)。
再乘上序列长度 $L$、层数 $n_{layers}$、批大小 $B$:
$$ \text{KV cache bytes} \;=\; \underbrace{2}_{K,V}\cdot B \cdot L \cdot n_{layers}\cdot n_{kv}\cdot d_{head}\cdot \text{bytes} $$注意这里没有 $n_{heads}$——真正决定缓存大小的是 KV 头数 $n_{kv}$,而不是 query 头数。这一个观察就是后面 MQA / GQA 的全部动机。
代入几个真实模型看看数量级(bf16,单条序列):
| 模型 | 层数 | $n_{kv}\cdot d_{head}$ | 每 token 缓存 | @ 8k 上下文 | @ 128k 上下文 |
|---|---|---|---|---|---|
| GPT-3 175B(MHA) | 96 | 12288 | 4.5 MiB | 36 GiB | —(当年只有 2k) |
| Llama-3 70B 若用 MHA | 80 | 8192 | 2.5 MiB | 20 GiB | 320 GiB |
| Llama-3 70B 实际(GQA-8) | 80 | 1024 | 320 KiB | 2.5 GiB | 40 GiB |
| Llama-3 8B(GQA-8) | 32 | 1024 | 128 KiB | 1 GiB | 16 GiB |
| DeepSeek-V3(MLA) | 61 | 576(不乘 2) | 68.6 KiB | 0.54 GiB | 8.6 GiB |
最扎心的一行是 Llama-3 8B:模型权重 bf16 是 16 GB,而它在 128k 上下文下、单条序列的 KV cache 也是 16 GB。想同时服务 8 个这样的长请求?128 GB 的缓存,一张 H100 装不下。GPT-3 那一行更夸张:如果当年 GPT-3 要开 8k 上下文,batch size 只要 4 就把一台 8×A100-40G 的机器塞满了。
训练时你担心的是「算得动吗」,推理时你担心的是「装得下吗、搬得动吗」。这两个问题的答案指向完全不同的架构设计。本讲前半段的几乎所有技术,都是在回答第二个问题。
1.3 为什么 KV cache 是带宽问题而不只是容量问题
更微妙的一点:解码阶段读 KV cache 的算术强度(arithmetic intensity)低得可怕。
解码一个 token 时,某一层某一个头要做的事情是:把这个头缓存的 $L$ 个 key 和 $L$ 个 value 从 HBM 读进来($2\cdot L\cdot d_{head}\cdot 2$ 字节),做 $q^\top K^\top$($2Ld_{head}$ FLOPs)和 $AV$($2Ld_{head}$ FLOPs)。于是
$$ \text{算术强度} \;=\; \frac{4\,L\,d_{head}}{4\,L\,d_{head}}\;=\;1 \ \ \text{FLOP/byte} $$而 H100 的 bf16 算力约 990 TFLOP/s、HBM3 带宽约 3.35 TB/s,平衡点在 ~300 FLOP/byte。也就是说解码时的注意力比硬件的平衡点差了 300 倍——它 100% 是访存受限(memory-bound)的。GPU 绝大部分时间在搬 KV cache,算力空转。
这个式子有两个重要推论:
- KV cache 减小多少倍,解码速度就快多少倍。因为时间正比于要读的字节数。这就是为什么工业界愿意为 KV cache 压缩牺牲一点模型质量。
- 加大 batch size 救不了注意力。FFN 部分可以靠 batching 提高算术强度(权重读一次给 $B$ 个 token 用),但注意力不行——每条序列有自己的 KV cache,batch 越大要读的字节越多,强度纹丝不动。除非多条序列共享前缀(prefix caching)。
但是——如果让多个 query 头共享同一份 K/V,那么读进来的这份 K/V 就能被复用 $n_{heads}/n_{kv}$ 次,算术强度直接乘上这个倍数。这就是 MQA/GQA 的第二重收益,而且往往比省显存更重要。
1.4 「基本工具箱」:先用便宜的招
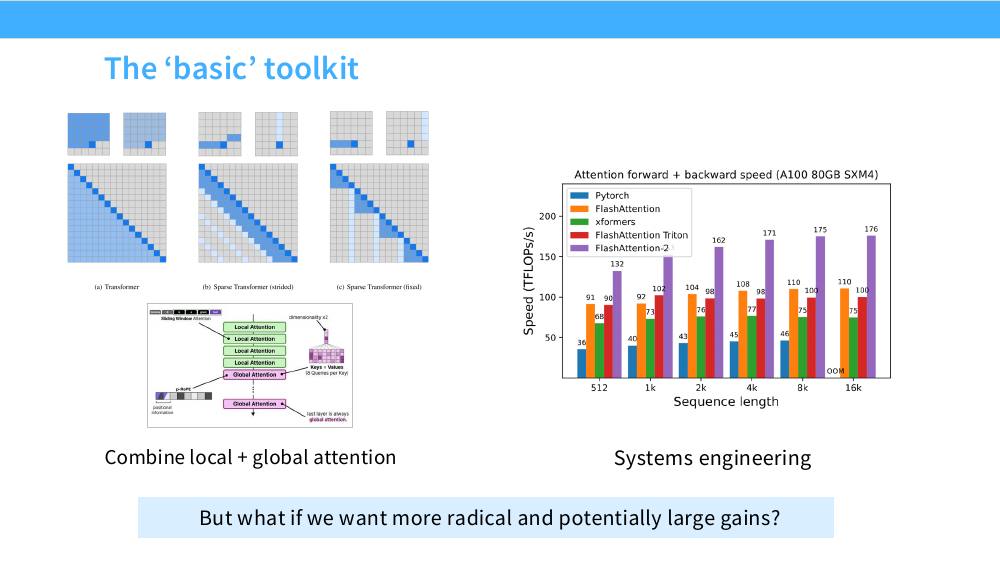
在动架构之前,有两类「不用重新训模型就能拿到收益」的手段:
- 系统工程:FlashAttention / FlashAttention-2 把注意力做成分块的融合算子,不再把 $L\times L$ 的注意力矩阵写回 HBM。数学上完全等价,但显存从 $O(L^2)$ 变成 $O(L)$,速度提升 2–4 倍。这类优化是「免费的」,应该无条件用。
- 局部 + 全局注意力:让大部分层只看附近的窗口,少数层看全局。改变了模型的数学,但改得很温和。
讲师的态度很明确:这两样是默认配置,但它们的天花板是常数倍的改善。要拿到数量级的收益,必须动更根本的东西——要么压缩缓存本身(第 2 节),要么改变「谁看谁」(第 3、6 节),要么彻底换掉注意力的数学形式(第 4、5 节)。
2. KV cache 压缩谱系:MHA → MQA → GQA → MLA
既然缓存大小正比于 $n_{kv}\cdot d_{head}$,最直接的想法就是:让 KV 头变少,或者让 KV 变小。这条路上有一串越来越激进的方案。
2.1 MHA:基线
标准多头注意力(Multi-Head Attention, MHA)里每个 query 头有自己专属的 key 头和 value 头,$n_{kv}=n_{heads}$。每 token 每层缓存 $2\cdot n_{heads}\cdot d_{head}=2d_{model}$ 个数。表达力最强,缓存最大。
2.2 MQA:一份 KV 给所有头用
多查询注意力(Multi-Query Attention, MQA)(Shazeer 2019)走到了另一个极端:$n_{kv}=1$。所有 $n_{heads}$ 个 query 头共享同一个 key 头和 value 头。
$$ \text{head}_i = \softmax\!\left(\frac{(XW_i^Q)\,(XW^K)^\top}{\sqrt{d_{head}}}\right)(XW^V),\qquad i=1,\dots,n_{heads} $$注意 $W^K,W^V$ 上没有下标 $i$。缓存直接缩小 $n_{heads}$ 倍——对 $n_{heads}=64$ 的模型就是 64 倍。而且如 1.3 节所说,算术强度也乘了 64。PaLM、Falcon、Gemma 1 都用了 MQA。
代价是表达力。所有头被迫在同一个「检索空间」里查询,头之间的多样性坍缩。经验上 MQA 会带来可测量的质量下降,而且在大模型上训练更不稳定。
2.3 GQA:中间路线,也是当前默认
分组查询注意力(Grouped-Query Attention, GQA)把 $n_{heads}$ 个 query 头分成 $g$ 组,每组共享一份 KV,于是 $n_{kv}=g$。$g=n_{heads}$ 退化成 MHA,$g=1$ 退化成 MQA。
Llama-2 70B、Llama-3 全系、Qwen2.5、Mistral 都用 $g=8$。为什么是 8?因为张量并行度通常也是 8(一台 8 卡机),这样每张卡正好分到一个 KV 头,不用跨卡复制。架构超参数在迁就硬件拓扑——这个模式在本讲会反复出现。
GQA 论文还有一个很实用的贡献:uptraining。已经训好的 MHA 模型可以把每组的 KV 头做均值池化合并成一个,然后只用原始预训练算力的约 5% 继续训练,就能恢复到接近原始质量。不需要从头训。
import torch, torch.nn.functional as F

def gqa(x, wq, wk, wv, n_heads, n_kv, d_head):
    """x: (B, L, d_model). 返回 (B, L, n_heads*d_head)"""
    B, L, _ = x.shape
    q = (x @ wq).view(B, L, n_heads, d_head).transpose(1, 2)   # (B, H, L, dh)
    k = (x @ wk).view(B, L, n_kv,    d_head).transpose(1, 2)   # (B, G, L, dh)
    v = (x @ wv).view(B, L, n_kv,    d_head).transpose(1, 2)

    # 关键一步:把 G 组 KV 各复制 H/G 份,对齐到 H 个 query 头
    rep = n_heads // n_kv
    k = k.repeat_interleave(rep, dim=1)                        # (B, H, L, dh)
    v = v.repeat_interleave(rep, dim=1)

    out = F.scaled_dot_product_attention(q, k, v, is_causal=True)
    return out.transpose(1, 2).reshape(B, L, n_heads * d_head)

# 注意:repeat_interleave 只在计算时展开,KV cache 里存的仍然是 G 组。
# 省显存靠的是"存 G 份",省带宽靠的是"读 G 份、用 H 次"。
2.4 MLA:低秩联合压缩
MQA/GQA 的思路是「减少头数」。DeepSeek 在 V2 里提出的 多头潜在注意力(Multi-head Latent Attention, MLA)换了个思路:头数一个不减,但把 K 和 V 一起压到一个低维潜变量里,只缓存这个潜变量。
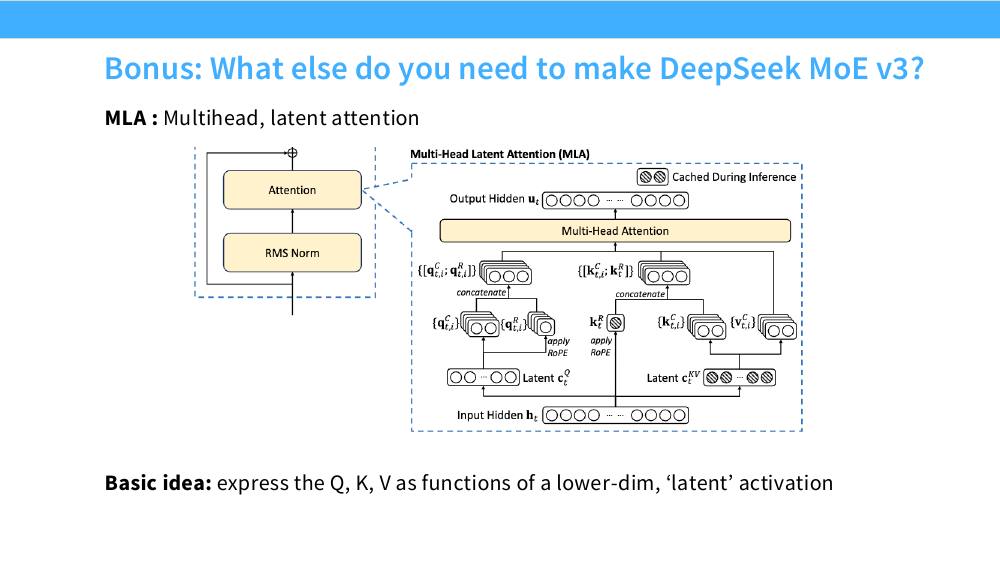
核心的三行式子:
$$ c_t^{KV} = W^{DKV}h_t \in \R^{d_c},\qquad k_t^{C} = W^{UK}c_t^{KV},\qquad v_t^{C} = W^{UV}c_t^{KV} $$其中 $D$ 表示 down-projection(下投影),$U$ 表示 up-projection(上投影)。$d_c$ 远小于 $n_{heads}\cdot d_{head}$:DeepSeek-V3 里 $d_c=512$,而 $n_{heads}\cdot d_{head}=128\times 128=16384$。查询侧也做了同样的压缩($c_t^Q=W^{DQ}h_t$,$q_t^C=W^{UQ}c_t^Q$),但那纯粹是为了省训练时的激活显存,和 KV cache 无关。
朴素地看,MLA 好像只是省了存储、没省计算:缓存 $c^{KV}$,用的时候再乘 $W^{UK}$ 还原出 $k^C$。那不是把计算又加回来了吗?
关键在于注意力分数只关心内积。不考虑 RoPE 时:
$$ \langle q_t, k_s\rangle = \langle W^{UQ}c_t^{Q},\; W^{UK}c_s^{KV}\rangle = \langle \underbrace{(W^{UK})^\top W^{UQ}}_{\text{可预先合并}}\,c_t^{Q},\; c_s^{KV}\rangle $$也就是说 $W^{UK}$ 可以在推理前直接乘进 query 的投影矩阵里,于是解码时压根不需要把 $k^C$ 还原出来——直接拿变换后的 query 和缓存里的 $c^{KV}$ 做内积就行。同理 $W^{UV}$ 可以吸收进输出投影 $W^O$。所以 MLA 既省显存又省带宽,额外计算量几乎为零。
2.5 MLA 和 RoPE 的冲突,以及解耦方案
上面那个漂亮的吸收技巧有一个致命前提:query 和 key 之间不能插进一个依赖位置的矩阵。而 RoPE 干的正是这件事。
加上 RoPE 后,位置 $t$ 的 query 要左乘旋转矩阵 $R_t$,位置 $s$ 的 key 要左乘 $R_s$:
$$ \langle R_t q_t,\; R_s k_s\rangle = \langle R_t W^{UQ}c_t^{Q},\; R_s W^{UK}c_s^{KV}\rangle = \big\langle\; \underbrace{(W^{UQ})^\top R_{s-t}\, W^{UK}}_{\text{依赖 } s-t\text{,无法预先合并}}\;c_t^Q,\; c_s^{KV}\big\rangle $$中间夹着的 $R_{s-t}$ 依赖两个位置的相对距离——这正是 RoPE 之所以有效的原因,但也意味着 $W^{UQ}$ 和 $W^{UK}$ 没法提前乘到一起。每个 $(t,s)$ 对都需要一个不同的合并矩阵,吸收技巧彻底失效,你被迫真的把 $k^C$ 还原出来,MLA 的带宽优势就没了。
DeepSeek 的解法很务实:不要让所有维度都承担位置编码。把 key 拆成两段拼接:
$$ q_{t} = [\,q_t^{C}\;;\;q_t^{R}\,],\qquad k_{s} = [\,k_s^{C}\;;\;k_s^{R}\,],\qquad \langle q_t,k_s\rangle = \underbrace{\langle q_t^C,k_s^C\rangle}_{\text{走 MLA 吸收路径}} + \underbrace{\langle q_t^R,k_s^R\rangle}_{\text{走普通 RoPE 路径}} $$- $q^C,k^C$($d_{head}=128$ 维)走低秩压缩通路,不加 RoPE,享受吸收技巧;
- $q^R_{t,i}=\text{RoPE}(W^{QR}c_t^Q)$ 每头独立、$k^R_t=\text{RoPE}(W^{KR}h_t)$ 所有头共享一份,维度只有 $d_h^R=64$,加 RoPE,单独缓存。
于是每 token 每层的缓存是 $d_c + d_h^R = 512+64=576$ 个数——注意这里没有因子 2,因为 K 和 V 共用同一个 $c^{KV}$。DeepSeek-V3 有 61 层,bf16 下就是 $61\times 576\times 2 = 70{,}272$ 字节 ≈ 68.6 KiB/token。等效于一个只有 2.25 组的 GQA,但质量据其消融实验优于同等缓存预算的 GQA,甚至优于 MHA。
2.6 跨层共享:CLA 与它的亲戚
上面所有方案都在压缩「一层之内」的缓存。还有一个正交的方向:相邻层之间共享 KV。
- CLA(Cross-Layer Attention):每 2 层(或 3 层)只算一次 K/V,后面的层直接复用前一层的缓存。在 GQA 之上再叠一个 2× 的压缩,且和 GQA/MQA 完全兼容。
- 更激进的全局共享:让所有上层共用某个中间层算出的一份 KV(YOCO 一类的做法),把缓存的层数因子从 $n_{layers}$ 降到常数。
- Character.AI 的生产配置是这条路线最极端的工程实践:MQA + 大部分层用滑动窗口 + 每 6 层一个全局层 + 相邻层跨层共享 KV,据其技术博客总计把 KV cache 压了 20 倍以上,这才让他们能以极低成本服务巨大的对话流量。
| 方案 | 每 token 每层缓存(元素数) | 相对 MHA | 代表模型 |
|---|---|---|---|
| MHA | $2\,n_{heads}d_{head}$ | 1× | GPT-2/3, Llama-1 |
| MQA | $2\,d_{head}$ | $1/n_{heads}$ | PaLM, Falcon, Gemma 1 |
| GQA($g$ 组) | $2\,g\,d_{head}$ | $g/n_{heads}$ | Llama-2/3, Qwen2.5, Mistral |
| MLA | $d_c + d_h^R$ | ≈ 1/57(V3 配置) | DeepSeek-V2/V3 |
| + CLA(每 2 层共享) | 上述值 ÷ 2 | 再 ×0.5 | Character.AI 等 |
| + 滑窗(窗口 $W$) | 上述值,但 $L\to\min(L,W)$ | 长上下文下线性变常数 | Mistral, Gemma 2/3 |
「KV cache 压缩会等比例损失质量」——不成立。MLA 的消融显示,在同等缓存预算下它比 GQA 好,在同等参数下甚至比 MHA 略好。原因是:低秩压缩不只是有损压缩,它同时是一种结构化的参数共享/正则化。KV 的信息本来就有大量冗余,硬塞 $2d_{model}$ 维并不必要。真正不可压缩的是位置信息(所以 RoPE 那 64 维必须留着)。
3. 稀疏与滑动窗口注意力:改变「谁看谁」
第 2 节压的是「每个位置存多少」,这一节压的是「一个位置要看多少个位置」。数学上就是把注意力矩阵的稠密下三角掩码换成一个稀疏掩码 $M$:
$$ \text{Attn}(Q,K,V)_i = \sum_{j\in \mathcal{N}(i)} \frac{\exp(q_i^\top k_j/\sqrt{d})}{\sum_{j'\in\mathcal{N}(i)}\exp(q_i^\top k_{j'}/\sqrt{d})}\,v_j $$不同的稀疏注意力就是不同的邻域定义 $\mathcal{N}(i)$。
3.1 滑动窗口注意力
最简单的稀疏模式:$\mathcal{N}(i)=\{i-W+1,\dots,i\}$,只看最近 $W$ 个 token。计算量从 $O(L^2 d)$ 降到 $O(LWd)$,KV cache 从 $O(L)$ 降到 $O(\min(L,W))$——缓存变成常数,这是它相对第 2 节所有方案的质变。
Mistral 7B 用 $W=4096$、32 层。在 32k 上下文下 KV cache 直接省 8 倍,而且用「滚动缓冲(rolling buffer)」实现:缓存是一个长度 $W$ 的环形数组,位置 $i$ 写在 $i \bmod W$ 处,永远不增长。
「只看 4096 个 token」听起来会丢掉长程信息,但别忘了 Transformer 是堆叠的。第 1 层位置 $i$ 的表示汇聚了 $[i-W, i]$;第 2 层的位置 $i$ 看的是第 1 层的 $[i-W,i]$,而它们各自又汇聚了往前 $W$——所以第 $\ell$ 层的感受野是 $\ell\cdot W$。Mistral 的 $32\times 4096 = 131072$,理论上能覆盖 128k。
但「理论感受野」和「实际能精确检索」是两回事。信息每往上传一层就被稀释一次,长程的精确拷贝(比如复述 100k token 之前出现的一个电话号码)在纯滑窗模型里基本做不到。这个「感受野够大但检索能力差」的现象,会在第 4 节的线性注意力里以完全一样的形式再出现一次。
3.2 固定模式的稀疏注意力
更早的一批工作在设计更精巧的固定模式:
- Sparse Transformer(OpenAI 2019):把注意力分解成 strided(跨步:看 $i-1, i-1-s, i-1-2s,\dots$)和 fixed(固定:看每个 block 的最后几个位置)两种模式,交替使用。复杂度 $O(L\sqrt{L})$。GPT-3 就是「交替使用稠密层和稀疏层」。
- Longformer(AllenAI 2020):滑窗 + 空洞滑窗 + 任务相关的全局 token(比如分类任务里的
[CLS]、QA 里的问题部分)。全局 token 双向可见:所有人都能看它,它也能看所有人。这样只用 $O(L)$ 的代价就保留了一条「全局信息高速公路」。
这些固定模式在 GPU 上的实现效率一直是痛点——不规则的稀疏模式会让 tensor core 空转。这也是为什么在 FlashAttention 出现后,很多人宁可用稠密注意力配好的算子,也不用理论上更省的稀疏模式。
3.3 局部 + 全局混合层:现在最常见的做法
与其在层内设计复杂的稀疏模式,不如在层间做简单的分工:大部分层用滑窗,少数层用全局注意力。
| 模型 | 局部:全局 比例 | 窗口大小 | 效果 |
|---|---|---|---|
| Gemma 2 | 1 : 1 交替 | 4096 | KV cache 约减半 |
| Gemma 3 | 5 : 1 | 1024 | 长上下文下 KV cache 大幅下降,同时把全局层留给长程依赖 |
| Character.AI | 约 6 : 1 | 1024 | 叠加 MQA + 跨层共享,总计 20× 以上压缩 |
| Mistral 7B | 全部滑窗 | 4096 | 靠深度叠加感受野 |
算一笔账:$n_{layers}=48$、局部:全局 = 5:1、窗口 1024、上下文 128k。全局层有 8 层,缓存 $8\times 131072$;局部层 40 层,缓存 $40\times 1024$。总量相当于 $8\times131072+40\times1024 = 1{,}089{,}536$ 个「token·层」,而全用全局是 $48\times 131072=6{,}291{,}456$——省了 5.8 倍,而且这个比例随上下文变长还会继续改善(局部层那一项是常数)。
局部/全局混合的比例不是白拿的。RULER、needle-in-a-haystack 这类长程检索评测对全局层的数量很敏感——全局层太少,模型在超长上下文下的精确检索会明显掉。所以各家给出的比例(1:1、3:1、5:1、6:1)基本都是在自家评测集上调出来的,没有普适的最优值。这也是本讲反复出现的主题:这些比例参数是经验的,不是理论的。
4. 线性注意力:从二次到线性
前面三节都在「省」,但注意力的数学形式没变。这一节要动的是形式本身。讲师的原话是:接下来这一步看起来蠢得离谱,但重要得出人意料。
4.1 一次矩阵乘法结合律
把注意力写成一般形式:$Q\in\R^{n\times d_k}$,$K\in\R^{n\times d_k}$,$V\in\R^{n\times d_v}$,
$$ \text{Attn}(Q,K,V) = \rho\!\left(QK^\top\right)V $$其中 $\rho$ 是逐行的 softmax。二次开销来自 $QK^\top$——它是一个 $n\times n$ 的矩阵,算它要 $n^2d_k$ 次乘加,再乘 $V$ 又要 $n^2 d_v$。
现在问一个几乎是无理取闹的问题:如果 $\rho$ 是恒等映射会怎样?那么由矩阵乘法结合律,
$$ Q K^\top V = Q\,(K^\top V) $$右边先算 $K^\top V$,这是 $\R^{d_k\times n}$ 乘 $\R^{n\times d_v}$,得到一个 $d_k\times d_v$ 的小矩阵,代价 $n d_kd_v$;再左乘 $Q$,又是 $nd_kd_v$。总共 $2nd_kd_v$。
两种顺序的代价之比:
$$ \frac{n^2 d_k + n^2 d_v}{2n d_k d_v} = \frac{n(d_k+d_v)}{2d_kd_v}\;\xrightarrow{\;d_k=d_v=d\;}\;\frac{n}{d} $$取 $d=d_{head}=128$:只要序列长度超过 128,重排就开始赚。在 $n=128\text{k}$ 时省 1000 倍。这就是「$\rho$ 只是个 softmax,去掉它换来一千倍」的诱惑所在。
4.2 核函数视角:softmax 去哪了
直接扔掉 softmax 显然不行——它保证了注意力权重非负且归一化。核方法(kernel)视角给了一个体面的替代:softmax 的分子 $\exp(q_i^\top k_j)$ 本质是一个核函数,我们用一个显式特征映射 $\phi(\cdot)$ 去近似它:
$$ \exp(q_i^\top k_j)\;\approx\;\phi(q_i)^\top\phi(k_j),\qquad \phi:\R^{d}\to\R^{d'},\ \phi(\cdot)\ge 0 $$代进去,注意力(带因果掩码)就变成:
$$ y_i = \frac{\sum_{j\le i}\phi(q_i)^\top\phi(k_j)\,v_j^\top}{\sum_{j\le i}\phi(q_i)^\top\phi(k_j)} = \frac{\phi(q_i)^\top\Big(\sum_{j\le i}\phi(k_j)v_j^\top\Big)}{\phi(q_i)^\top\Big(\sum_{j\le i}\phi(k_j)\Big)} $$分子分母里的求和都不依赖 $i$ 的具体取值,只依赖前缀——这就是关键。Katharopoulos 等人(2020)用 $\phi(x)=\text{elu}(x)+1$ 这样简单到可笑的特征映射就做到了,后来的工作(Performer 的随机特征、各种可学习的 $\phi$)在此基础上折腾,但核心结构一样。
4.3 递推形式:线性注意力就是一个 RNN
把上式里的前缀和写成状态,得到本讲最重要的一组式子:
$$ \boxed{\;S_t = S_{t-1} + k_t v_t^\top \in \R^{d_k\times d_v},\qquad y_t = q_t^\top S_t\;} $$(省略了归一化项,实践中常用 RMSNorm 之类替代。)这是一个标准的 RNN:状态 $S_t$ 是一个固定大小的矩阵,每步用外积 $k_tv_t^\top$ 更新,读出时用 $q_t$ 去查询。
同一个模型有两副面孔:
- 并行(二次)形式 $\rho(QK^\top)V$:训练时用。所有位置一次算完,全是大矩阵乘法,GPU 利用率高。
- 串行(线性)形式 $S_t = S_{t-1}+k_tv_t^\top$:推理时用。每步 $O(d_kd_v)$,与序列长度无关。
讲师强调这个 duality 才是线性注意力真正的价值:它让你在训练时享受 Transformer 的并行性,在推理时享受 RNN 的常数开销。实际实现用的是两者的折中——分块(chunkwise)形式:把序列切成长度 $C$ 的块,块内用二次形式(矩阵乘法,喂饱 tensor core),块间用递推传递状态。$C$ 取 64–256,兼顾了并行度和复杂度。
4.4 状态大小:这才是真正的变量
把线性注意力和标准注意力放在同一个坐标系里比较,最有意义的量不是 FLOPs 而是推理时必须携带的状态:
| 推理状态大小(每头每层) | 随 $L$ 增长? | $d=128$、$L=128$k 时(bf16) | |
|---|---|---|---|
| 标准注意力(KV cache) | $2\,L\,d_{head}$ | 线性增长 | 64 MiB |
| 线性注意力(状态矩阵) | $d_k\,d_v$ | 常数 | 32 KiB |
交叉点在 $L = d_kd_v/(2d_{head}) = 64$。也就是说超过 64 个 token,线性注意力的状态就比 KV cache 小了,而且之后再也不涨。
「状态是常数」听起来全是好处,但它同时是一个信息论上的硬约束:无论上下文多长,模型能记住的东西都被压在 $d_kd_v$ 个数里。标准注意力可以在 100k token 之后精确地回头看第 37 个 token 的原文,因为那份 KV 还原封不动地存着;线性注意力只有一个被反复覆写的状态矩阵。
后果非常一致地表现在评测上:困惑度(perplexity)差距不大,但 needle-in-a-haystack、多跳检索、长文档问答这类需要精确回忆的任务掉得很厉害。这正是为什么 2026 年没有一个主流模型是纯线性架构——大家都用混合。
4.5 最小实现
import torch

def linear_attn_parallel(q, k, v):
    """训练用的二次形式。q,k,v: (B, H, L, d)"""
    scores = q @ k.transpose(-1, -2)                   # (B,H,L,L)
    L = q.shape[-2]
    mask = torch.ones(L, L, device=q.device).tril()    # 因果掩码
    scores = scores * mask
    denom = scores.sum(-1, keepdim=True).clamp(min=1e-6)
    return (scores / denom) @ v

def linear_attn_recurrent(q, k, v):
    """推理用的线性形式,逐步更新固定大小的状态。"""
    B, H, L, d = q.shape
    S = torch.zeros(B, H, d, v.shape[-1], device=q.device)   # 状态矩阵
    z = torch.zeros(B, H, d, device=q.device)                # 归一化项
    ys = []
    for t in range(L):
        S = S + k[:, :, t].unsqueeze(-1) * v[:, :, t].unsqueeze(-2)  # S += k v^T
        z = z + k[:, :, t]
        num = (q[:, :, t].unsqueeze(-2) @ S).squeeze(-2)             # q^T S
        den = (q[:, :, t] * z).sum(-1, keepdim=True).clamp(min=1e-6)
        ys.append(num / den)
    return torch.stack(ys, dim=2)

# phi 需要保证非负,否则分母可能为 0:
phi = lambda x: torch.nn.functional.elu(x) + 1
# 用法:linear_attn_recurrent(phi(q), phi(k), v)
# 两个函数在数值上应当一致 —— 这就是 duality。
4.6 加一个衰减项:RetNet
纯累加的状态有个显然的毛病:越久远的信息和刚刚的信息权重一样,状态迟早被写满噪声。最小的修补是给旧状态乘一个小于 1 的衰减因子 $\gamma$:
$$ S_t = \gamma\,S_{t-1} + k_tv_t^\top $$这就是 RetNet。$\gamma$ 是每个头一个的固定常数(不同头用不同的 $\gamma$,从而形成多尺度的记忆),展开后 $S_t=\sum_{j\le t}\gamma^{t-j}k_jv_j^\top$——一个指数衰减的加权和,相当于给注意力加了一个与距离相关的先验。这一小步为下一节的所有工作打开了口子。
4.7 一个真实的例子:MiniMax M1
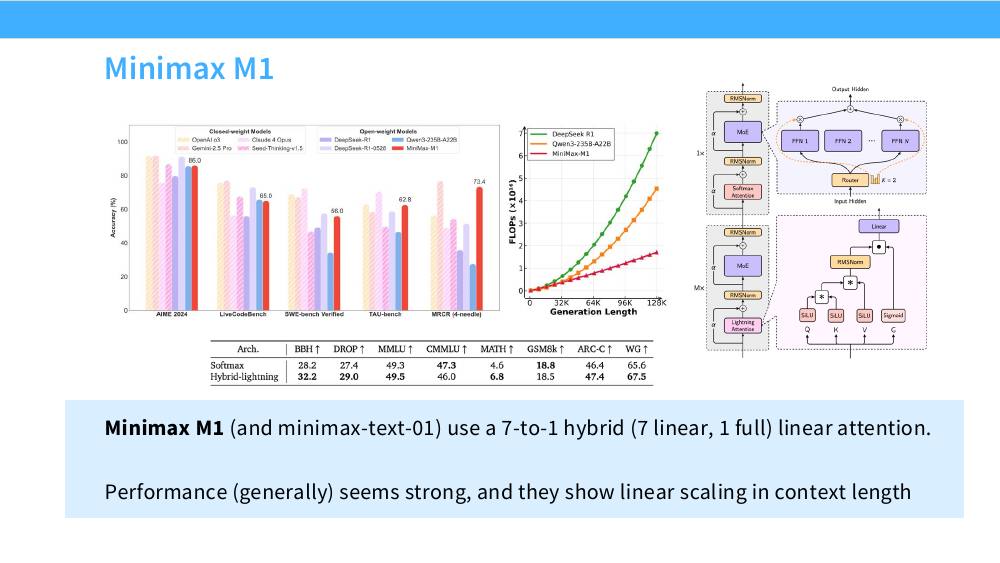
7:1 的意思是:模型仍然保留了 1/8 的层具备精确的全局检索能力,其余 7/8 的层用常数状态。KV cache 只由那 1/8 的全局层贡献,直接省了 8 倍;而检索能力因为还有真注意力层兜底,不至于崩掉。这个「留一小撮真注意力」的模式,是本讲后面所有混合架构的共同配方。
5. 门控与状态空间:Mamba-2、Gated DeltaNet 与混合架构
RetNet 的固定 $\gamma$ 显然太笨了——凭什么每个位置的遗忘速度都一样?接下来这一串工作,可以完整地理解成「把 $\gamma$ 变得越来越聪明」。讲师在这里给了一句很实用的经验法则:gating is good(门控是好东西)。
5.1 Mamba-2:让衰减依赖输入
$$ \text{线性注意力:}\quad S_t = S_{t-1}+k_tv_t^\top,\qquad y_t = q_t^\top S_t $$ $$ \text{Mamba-2:}\quad S_t = \gamma_t\,S_{t-1}+k_tv_t^\top,\qquad y_t = q_t^\top S_t + v_t^\top D,\qquad \gamma_t = f(x_t) $$唯一的改动是 $\gamma$ 从常数变成了依赖当前输入的标量($D$ 是一个跳连项,作用类似残差)。这一改动的意义远比它看起来大:
- $\gamma_t\to 0$:清空状态。模型可以在遇到分隔符、话题切换时主动忘掉之前的一切。
- $\gamma_t\to 1$:无损保留。在需要长程记忆的片段里退化成纯累加。
- 介于两者之间:可变速率的遗忘。
换句话说,门控让模型学会了「什么时候该记、什么时候该忘」——这正是 LSTM 当年的核心洞察,绕了三十年又回来了。而且因为 $\gamma_t$ 只依赖 $x_t$,可以先把整个序列的 $\gamma$ 并行算出来,再用累积乘积做分块扫描,duality 完好保留。
Mamba-2 论文(状态空间对偶,SSD)用一整套结构化状态空间模型的语言重新推了这件事,讲师的建议很直接:想看完整论证就去读原论文,但机制上就是「用门控让线性注意力更有表达力」。从选择性 SSM 的角度看,Mamba-2 把 Mamba-1 里那个一般的对角矩阵 $A$ 限制成了「标量 × 单位阵」,正是这个限制让它能写成矩阵乘法、跑满 tensor core,速度比 Mamba-1 快好几倍。
5.2 Gated DeltaNet:不只是衰减,还要定向擦除
Mamba-2 的遗忘是各向同性的——$\gamma_t$ 是标量,把状态矩阵整体缩小。但如果我只想更新「关于巴黎的那条记忆」而不动其它呢?
$$ \text{Gated DeltaNet:}\quad S_t = \gamma_t\big(I-\beta_t k_tk_t^\top\big)S_{t-1} + \beta_t k_tv_t^\top,\qquad y_t=q_t^\top S_t $$其中 $\gamma_t=f(x_t)$、$\beta_t=f(x_t)$ 都是学出来的。两个新东西:
- $(I-\beta_t k_tk_t^\top)$ 是一个沿着 $k_t$ 方向的投影擦除算子:把状态里「和当前 key 同方向」的旧内容按 $\beta_t$ 的比例清掉,其它方向原封不动。
- $\beta_t=0$ 时整个更新退化为 $S_t=\gamma_tS_{t-1}$,等于一个「本 token 不写入」的门——模型可以选择跳过无信息的 token。
为什么是这个奇怪的形式?考虑把状态矩阵 $S$ 看成一个「联想记忆」:给定 key $k$,希望读出 $S^\top k \approx v$。定义当前 token 的损失
$$ \mathcal{L}_t(S) = \tfrac12\big\|S^\top k_t - v_t\big\|^2 $$对 $S$ 求梯度:$\nabla_S\mathcal{L}_t = k_t(k_t^\top S - v_t^\top)$。做一步学习率为 $\beta_t$ 的梯度下降:
$$ S_t = S_{t-1} - \beta_t k_t\big(k_t^\top S_{t-1}-v_t^\top\big) = \big(I-\beta_tk_tk_t^\top\big)S_{t-1} + \beta_t k_tv_t^\top $$正是 DeltaNet 的更新式。所以 DeltaNet 的前向传播,本身就是在对一个小的联想记忆做在线学习;$\beta_t$ 是学习率,$\gamma_t$ 是权重衰减。这条线索直接连到「fast weight programmers(快速权重程序员)」和「test-time training(测试时训练)」这一整支文献——讲师专门点了这个联系。
对比之下,纯线性注意力 $S_t=S_{t-1}+k_tv_t^\top$ 相当于学习率恒为 1 且不看误差的更新:不管旧状态里已经有什么,一律硬加。当同一个 key 反复出现时,纯线性注意力会把它的 value 累加到爆掉,而 delta rule 会先擦掉旧的再写新的。
5.3 一张表看清整个家族
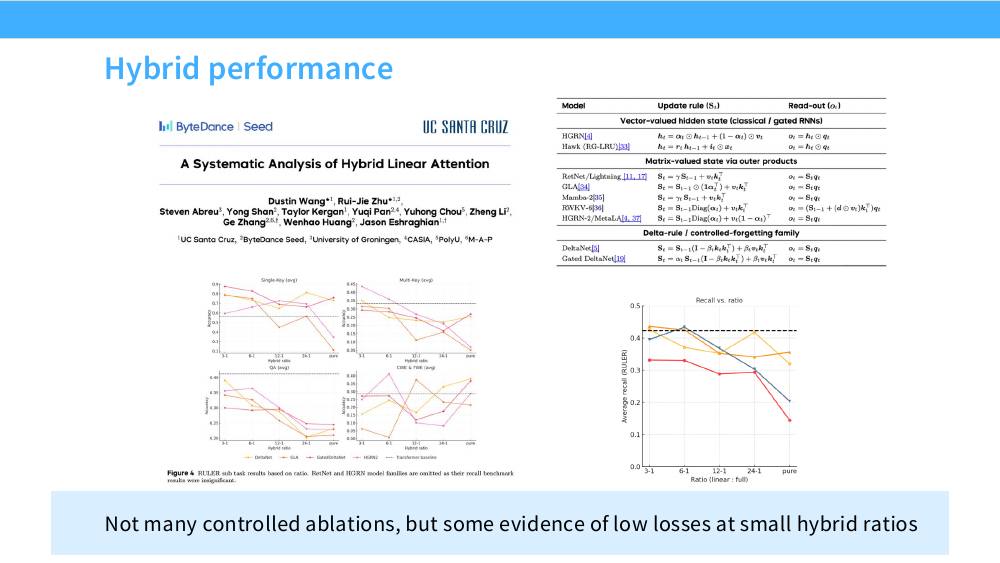
| 模型 | 状态更新规则 $S_t$ | 遗忘机制 |
|---|---|---|
| 线性注意力 | $S_{t-1} + k_tv_t^\top$ | 无 |
| RetNet | $\gamma\,S_{t-1}+k_tv_t^\top$ | 固定标量衰减 |
| GLA(门控线性注意力) | $S_{t-1}\diag(\alpha_t)+v_tk_t^\top$ | 逐通道、数据相关 |
| Mamba-2 | $\gamma_t S_{t-1}+k_tv_t^\top$,$\gamma_t=f(x_t)$ | 标量、数据相关 |
| DeltaNet | $(I-\beta_tk_tk_t^\top)S_{t-1}+\beta_tk_tv_t^\top$ | 沿 key 方向定向擦除 |
| Gated DeltaNet | $\gamma_t(I-\beta_tk_tk_t^\top)S_{t-1}+\beta_tk_tv_t^\top$ | 衰减 + 定向擦除(两者兼得) |
5.4 混合架构:2026 年的事实标准
2025–2026 年的新模型几乎清一色是混合的,而且比例惊人地集中在 3:1 到 7:1:
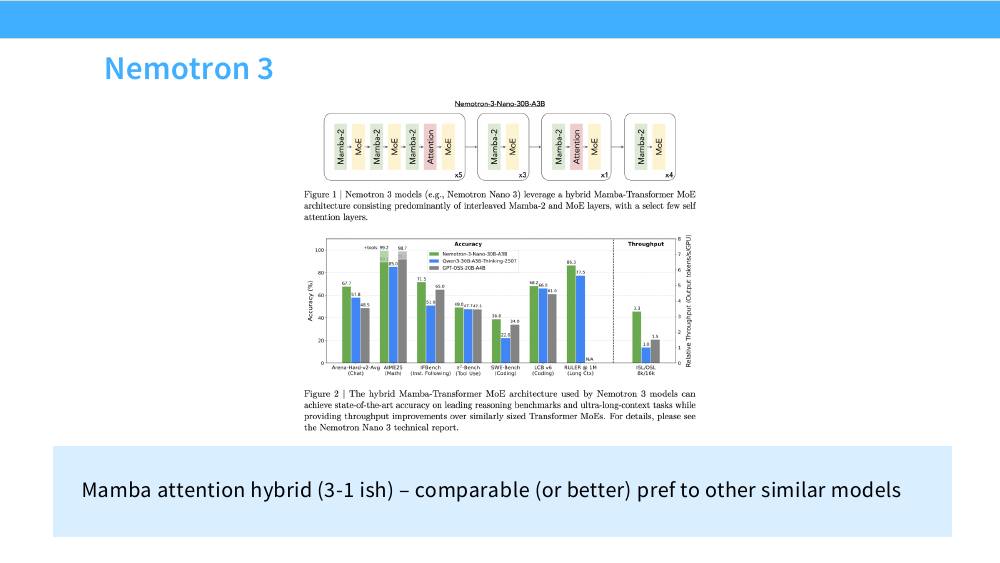
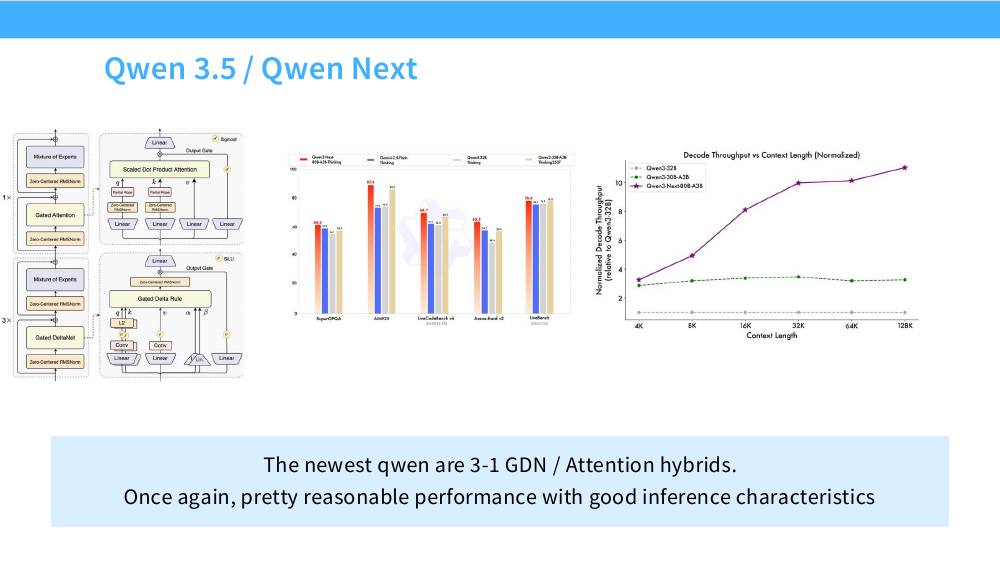
把线性层和注意力层的分工想清楚就明白了:
- 线性/SSM 层擅长「把最近的、模糊的上下文压缩进一个固定状态」——语法、局部语义、风格,这些占了语言建模 loss 的绝大部分,而且不需要精确回忆。
- 全注意力层擅长「精确地把某个具体位置的内容取出来」——变量名、引用、检索。这类操作数量少但不可替代。
混合架构等于用便宜的层干大部分活,用贵的层干那少数不可替代的活。KV cache 只由 $1/(r+1)$ 的层贡献($r$ 是混合比例),推理成本近乎线性;而质量因为保留了真注意力,几乎无损。至于 $r$ 该取 3 还是 7——没有理论,只有各家自己的消融。
6. DeepSeek Sparse Attention:可后训练适配的稀疏注意力
混合架构有一个很现实的问题:它要求你从头训一个新架构。你手上那个花了几千万美元训好的稠密 Transformer,没法变成 Mamba 混合模型。有没有一条路,能在已有的稠密模型上「打补丁」拿到长上下文的成本收益?
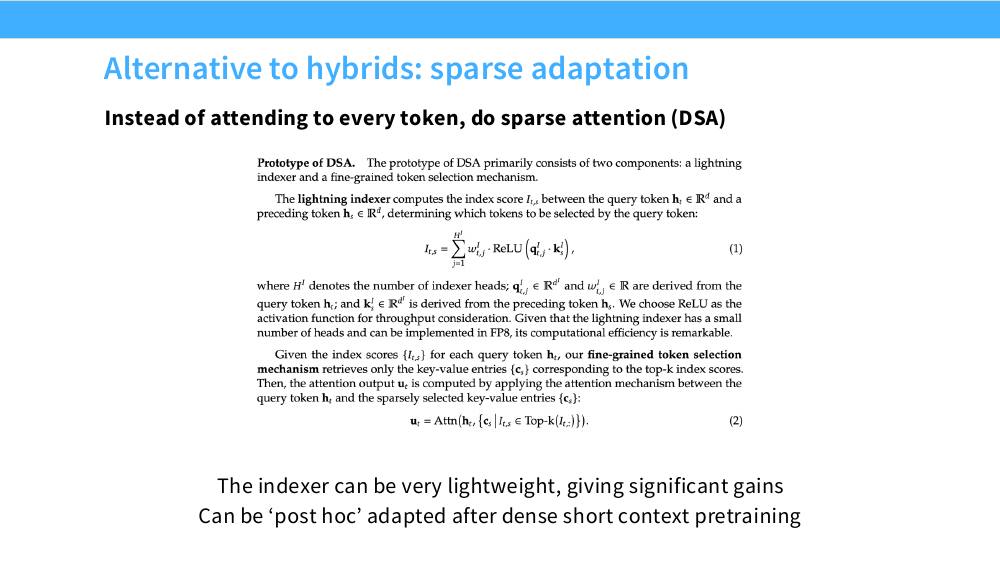
DeepSeek 在 V3.2 里给出的答案是 DSA(DeepSeek Sparse Attention):不换注意力的数学形式,只是让每个 query 只挑最相关的 $k$ 个 token 来算注意力。这正是第 3 节稀疏注意力的思路,但邻域 $\mathcal{N}(i)$ 不再是固定模式,而是学出来的、依赖内容的。
6.1 闪电索引器
$$ I_{t,s}=\sum_{j=1}^{H^I} w_{t,j}^{I}\cdot\text{ReLU}\!\left(q_{t,j}^{I\top}k_s^{I}\right) $$ $$ u_t = \text{Attn}\!\Big(h_t,\ \big\{c_s \;\big|\; I_{t,s}\in\text{Top-}k(I_{t,:})\big\}\Big) $$三个设计选择值得琢磨:
- 头数 $H^I$ 极少(远小于主注意力的头数)。索引只需要粗略判断「相关 / 不相关」,不需要主注意力那种精度。
- 用 ReLU 而不是 exp,讲义里明说是「for throughput consideration」——ReLU 便宜,且能直接在 FP8 下跑。
- 索引器本身仍然是 $O(L^2)$ 的,但常数小了两个数量级:少数头 × FP8 × 廉价激活。真正的 $O(L^2)$ 大头(主注意力)被降到了 $O(L\cdot k)$。DeepSeek-V3.2 取 $k=2048$,在 128k 上下文下这就是 64 倍的削减。
6.2 后训练适配:这才是真正的卖点
DSA 的训练分两步:先冻住基座模型只训索引器(用主注意力的注意力分布作为监督信号,让索引器学会模仿「主注意力认为谁重要」),再联合训练一小段。整个过程只需要百亿量级的 token,相比从头预训练是零头。
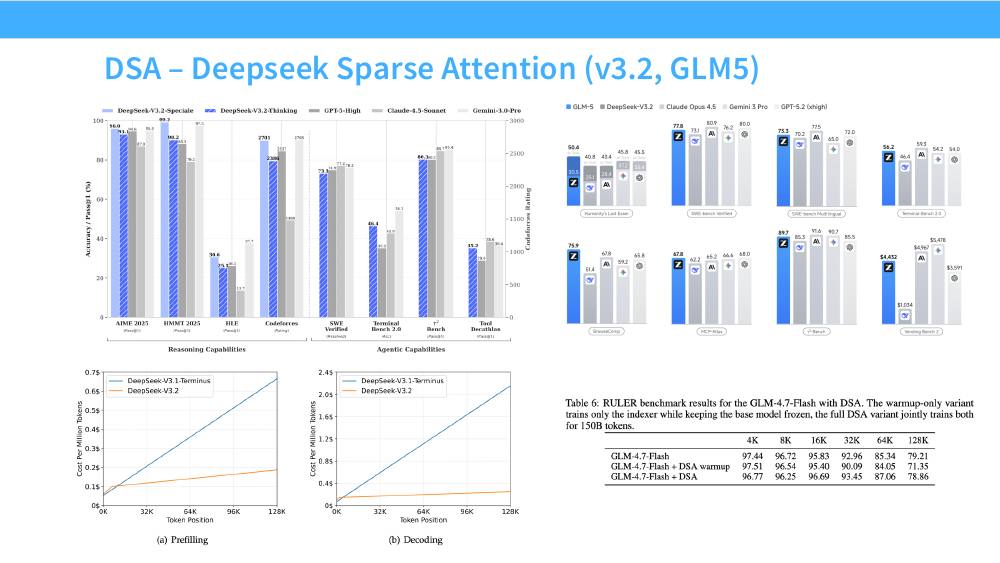
混合线性架构和 DSA 解决的是同一个问题,但赌注不同:
- 混合架构赌「大部分上下文可以被有损压缩」,把成本压成常数状态,但必须从头训练,且长程精确检索靠那少数几层注意力兜底。
- DSA赌「注意力本来就是稀疏的,只是我们没显式利用」,保留了精确检索能力(被选中的 token 是原封不动的 KV),代价是仍要存下全部 KV cache——它省的是计算和带宽,不省显存。
所以两者其实是正交的,未来完全可能叠加使用。GLM-5 和 DeepSeek-V3.2 都选了 DSA 这条路,很大程度上是因为它能复用已有的稠密基座。
7. Mixture of Experts:为什么要解耦参数与计算
本讲后半段换一个战场。前面所有技术都在削注意力的成本,但一个现代模型里参数的大头在 FFN 而不在注意力——典型配置下 FFN 占 2/3 以上。而稠密模型里有一条铁律:
$$ \text{每 token 的 FLOPs} \approx 2\times\text{参数量}\quad(\text{前向}),\qquad 6\times\text{参数量}\quad(\text{训练}) $$想要更多参数(记忆更多知识、拟合更复杂的函数),就必须付出成比例的计算。MoE 就是来砍断这条铁律的。
7.1 什么是 MoE
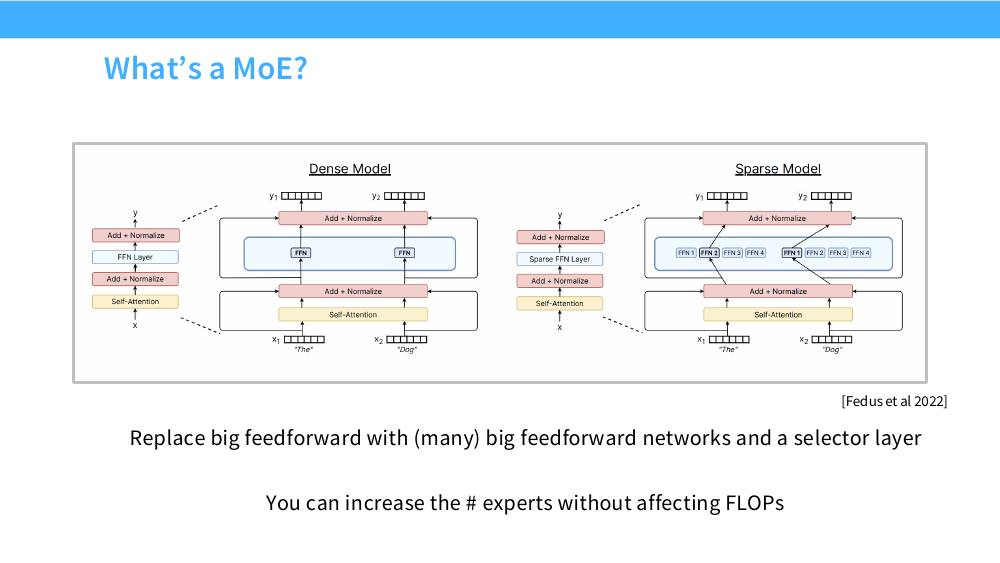
形式化地,把标准的 $h_t = \text{FFN}(u_t)+u_t$ 换成:
$$ h_t = \sum_{i=1}^{N} g_{i,t}\,\text{FFN}_i(u_t) + u_t,\qquad \|g_{\cdot,t}\|_0 = K \ll N $$门控向量 $g_{\cdot,t}$ 只有 $K$ 个非零元素,所以虽然有 $N$ 个专家的参数,每个 token 只跑 $K$ 个。参数量 $\propto N$,计算量 $\propto K$。这两个数从此可以独立调。
配置:$d_{model}=7168$,每个专家的中间维度 $d_{ff}^{expert}=2048$,SwiGLU(3 个矩阵),256 个路由专家 + 1 个共享专家,top-8,共 61 层(前 3 层是稠密 FFN,58 层是 MoE)。
- 单个专家参数:$3\times 7168\times 2048 = 44.0\text{M}$
- 每层专家总参数:$257\times 44.0\text{M} = 11.3\text{B}$,58 层共 656B
- 每层每 token 激活的专家参数:$(8+1)\times 44.0\text{M}=396\text{M}$,58 层共 23B,加上注意力和其它部分,总激活约 37B
结论:97% 的参数是专家,但每个 token 只点亮其中 3.5%。训练 14.8T token 的算力约 $6\times 37\text{e}9\times 14.8\text{e}12\approx 3.3\times10^{24}$ FLOPs(官方报告 2.788M H800 卡时)。如果换成同参数量的稠密 671B 模型,算力要乘 18 倍——那是没人付得起的。
7.2 为什么 MoE 突然火了
讲师给了四条理由,每条都有实验支撑。
(1)同 FLOPs 下,参数越多越好
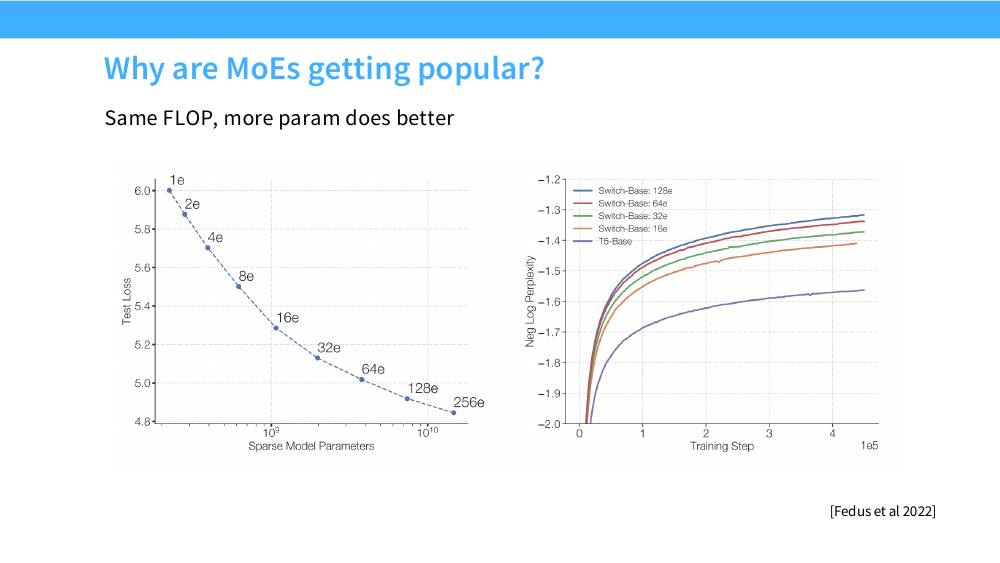
这是 MoE 最硬的一条经验规律:在固定每 token 计算量的前提下,增加参数总能换来 loss 下降,而且没有看到明显的饱和。等于是在 Chinchilla 那套 $(N, D)$ 缩放律之外,多了一个几乎免费的维度。
(2)训练更快
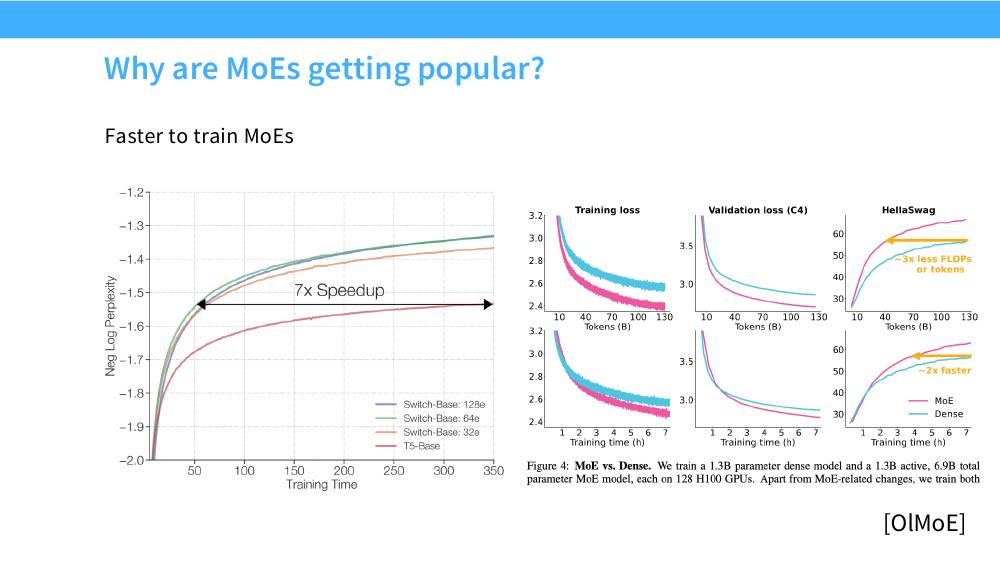
(3)和同等激活参数的稠密模型比,性价比压倒性
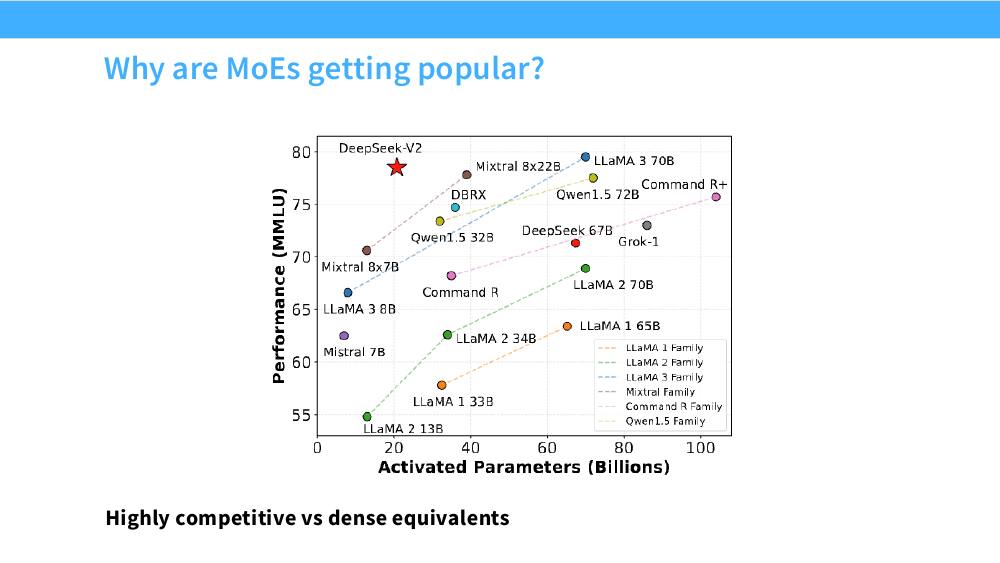
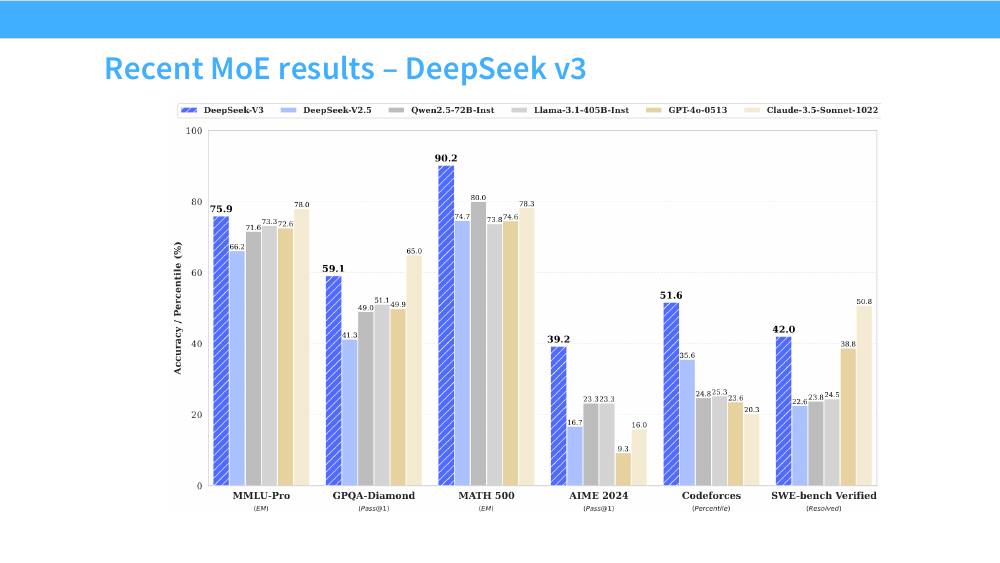
(4)天然适合多机并行
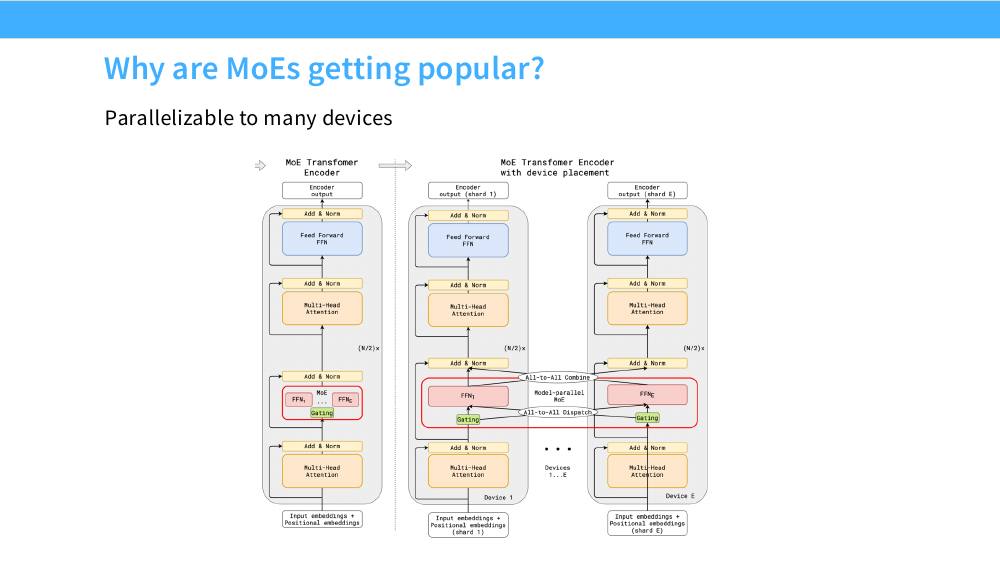
7.3 那为什么之前不火
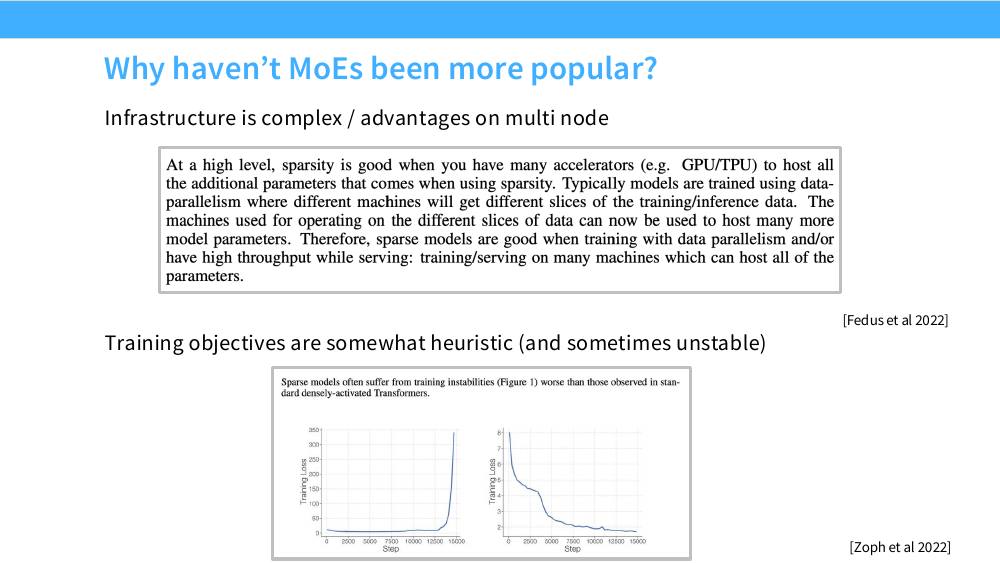
两个障碍,一个是系统复杂度(all-to-all、负载均衡、容量因子、专家并行的实现),一个是训练目标本身就是启发式的(后面第 9 节详谈)。这两件事在 2021–2023 年劝退了很多团队。到 2024 年 DeepSeek 和 Mixtral 把配方公开、MegaBlocks 之类的库成熟之后,门槛才真正降下来。
7.4 MoE 一般长什么样
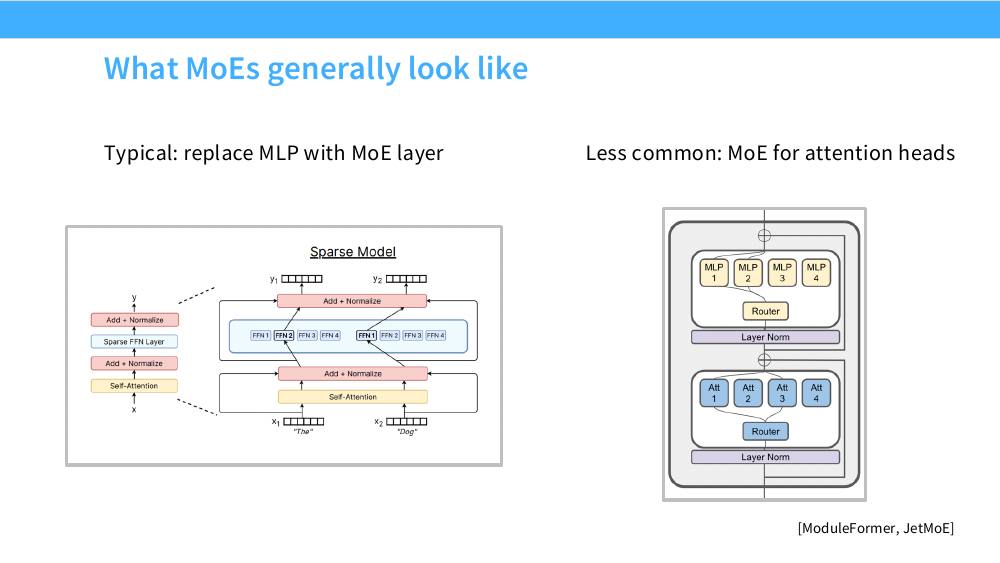
还有一个常见的细节:前几层通常不做 MoE。DeepSeek-V3 的前 3 层是稠密 FFN。原因是底层的表示还很「通用」(更多是词法/句法层面),路由在这里学不到有意义的分工,反而容易崩。
讲师把 MoE 的设计空间概括成三个维度,正好是接下来三节的内容:路由函数、专家大小、训练目标。
8. 路由机制:top-k、共享专家与细粒度专家
8.1 三种路由范式
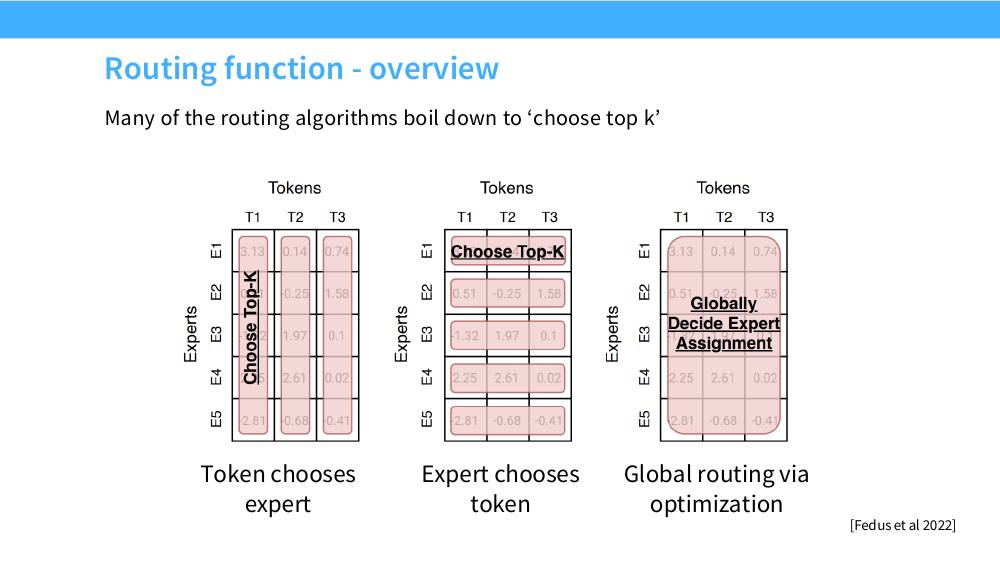
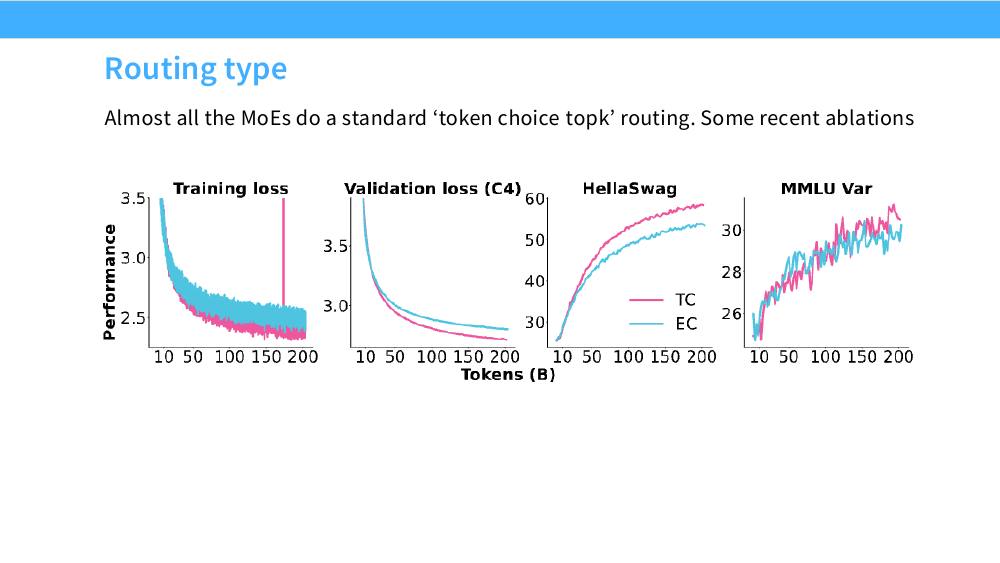
讲师的判断:几乎所有 MoE 都用标准的 token-choice top-k。哈希路由(固定的、和内容无关的映射)是常见的基线;早期还有人用 RL 学路由(Bengio 2013)或者解线性指派问题(Clark 2022),但都没有流行起来。
8.2 top-k 路由的数学形式
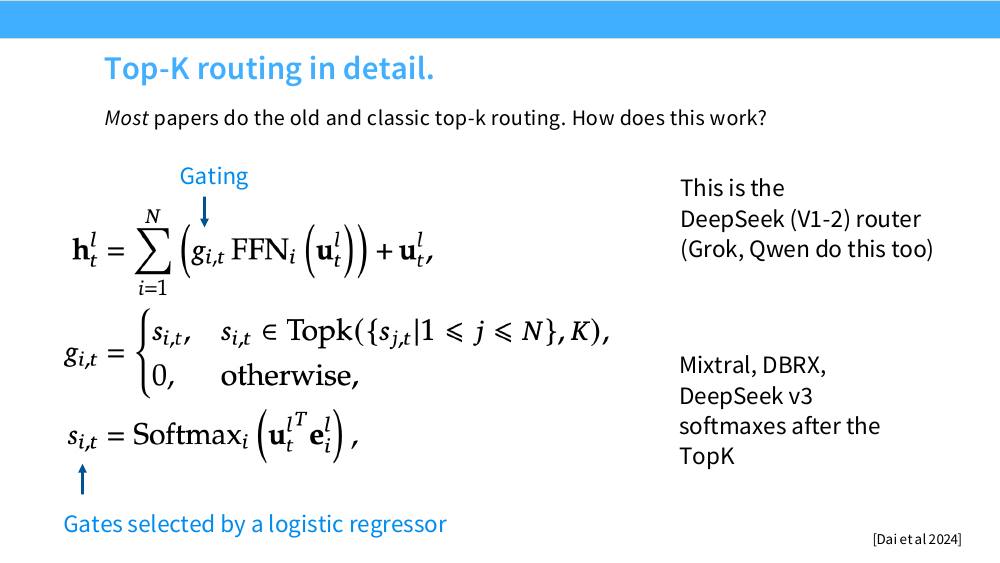
- 先 softmax 再 topk(DeepSeek V1-2、Grok、Qwen):被选中的门权重之和 $\sum_{i\in\text{top}K}s_{i,t} < 1$,且这个和随路由器的「自信程度」波动。路由器很确定时和接近 1,犹豫时可能只有 0.3——于是残差流上叠加的更新幅度会随路由置信度变化。这可以理解成一种自适应的门控,但也是训练不稳定的来源之一。
- 先 topk 再 softmax(Mixtral、DBRX、DeepSeek-V3 做归一化):只在被选中的 $K$ 个上归一化,权重之和恒等于 1。更新幅度稳定,也更容易和稠密 FFN 对齐。代价是丢掉了「置信度」这个信号。
DeepSeek-V3 还做了另一个改动:把 $\softmax$ 换成 sigmoid 再归一化。原因是专家数涨到 256 之后,softmax 会把概率摊得极薄(均值 1/256),梯度信号被稀释,而且所有专家的分数互相耦合(推高一个必然压低其它所有)。sigmoid 让每个专家独立打分,数值上更稳。
8.3 共享专家与细粒度专家
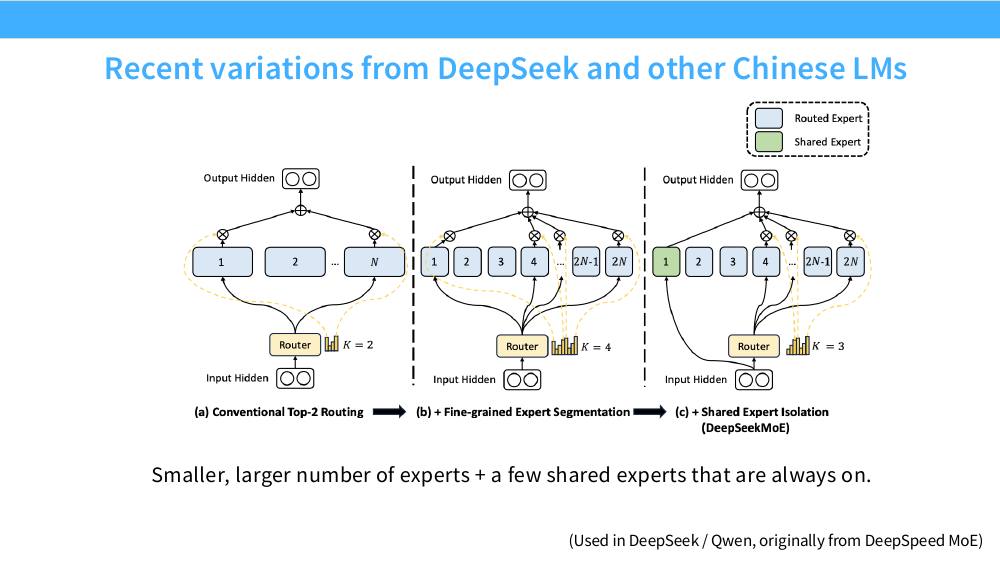
FLOPs 不变,参数量不变,那多出来的是什么?是专家组合的数量。
原配置 $N=16$、$K=2$,可能的专家组合数是 $\binom{16}{2}=120$。切成 $m=4$ 份后 $N=64$、$K=8$:
$$ \binom{64}{8} = 4{,}426{,}165{,}368 \approx 4.4\times 10^9 $$从 120 种「计算路径」暴涨到 44 亿种。模型能表达的条件计算模式丰富了 7 个数量级,而每 token 的乘加次数一次都没多。这就是细粒度专家的全部理由。
代价在系统侧:专家越小,每个专家的矩阵乘法越瘦(GEMM 效率下降),all-to-all 的消息越碎。所以「细粒度比例」不能无限推——DeepSeek-V3 是 1/14,Llama 4 只有 1/2。
共享专家的逻辑不同:如果每个专家都得独立学会「英语的基本语法」这种人人需要的知识,那就是巨大的参数冗余。抽出一个永远激活的专家专门承载共性知识,路由专家就能腾出容量去做真正的专业分工。
8.4 消融结论互相打架
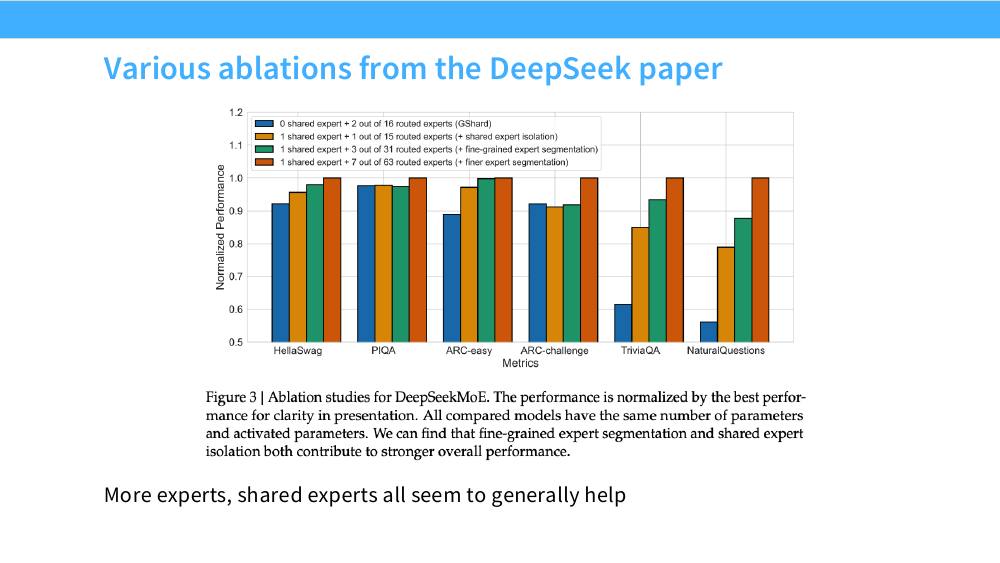
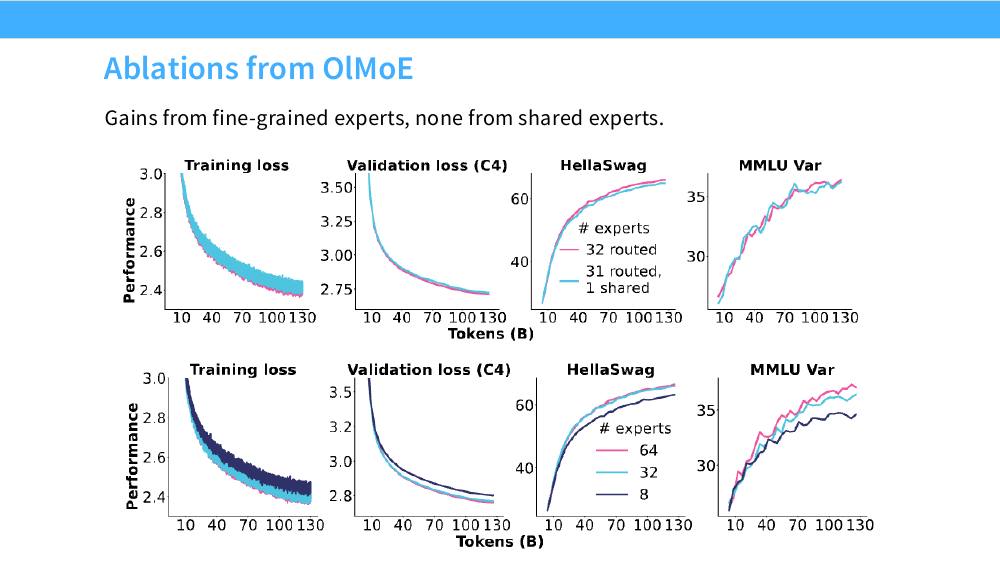
DeepSeek 和 OLMoE 在共享专家上给出了相反的结论。这不奇怪——两者的模型规模、训练数据量、专家总数、路由细节都不同,而 MoE 的各个设计选择之间高度耦合。实践中的处理方式是看大家的实际选择:Qwen3 明确去掉了共享专家,而 DeepSeek-V3、GLM-4.5、Kimi K2、Llama 4 都保留了 1 个。这说明它的收益即使存在也不大,属于「有则加分、无也无妨」的量级。相比之下细粒度切分是所有人都在做的。
8.5 主流 MoE 的配置对比
| 模型 | 总参数 | 激活参数 | 路由专家数 | 激活数 (top-k) | 共享专家 | 细粒度比例 |
|---|---|---|---|---|---|---|
| GShard | 600B | — | 2048 | 2 | 0 | — |
| Switch Transformer | 1.6T | — | 64 | 1 | 0 | — |
| ST-MoE | 269B | — | 64 | 2 | 0 | — |
| Mixtral 8x7B | 46.7B | 12.9B | 8 | 2 | 0 | — |
| DBRX | 132B | 36B | 16 | 4 | 0 | — |
| Grok-1 | 314B | ~25% | 8 | 2 | 0 | — |
| DeepSeek-V1(16B) | 16.4B | 2.8B | 64 | 6 | 2 | 1/4 |
| Qwen1.5-MoE-A2.7B | 14.3B | 2.7B | 60 | 4 | 4 | 1/8 |
| DeepSeek-V2 | 236B | 21B | 160 | 6 | 2 | 1/10 |
| DeepSeek-V3 | 671B | 37B | 256 | 8 | 1 | 1/14 |
| OLMoE | 6.9B | 1.3B | 64 | 8 | 0 | 1/8 |
| MiniMax(M1 系) | 456B | 45.9B | 32 | 2 | 0 | ~1/4 |
| Llama 4 Maverick | 400B | 17B | 128 | 1 | 1 | 1/2 |
| Qwen3-235B-A22B | 235B | 22B | 128 | 8 | 0 | — |
| GLM-4.5 | 355B | 32B | 160 | 8 | 1 | — |
| Kimi K2 | ~1T | 32B | 384 | 8 | 1 | — |
横着读这张表,能看出几条清晰的历史趋势:
- 专家数在涨,单个专家在变小。从 Mixtral 的 8 个胖专家,到 DeepSeek-V3 的 256 个、Kimi K2 的 384 个瘦专家。
- 稀疏度在涨。总参数/激活参数之比:Mixtral 3.6×、DeepSeek-V3 18×、Kimi K2 31×、Llama 4 Maverick 24×。这个比值就是 MoE 相对稠密模型的「杠杆」。
- 共享专家收敛到 0 或 1。早期 Qwen1.5 用 4 个,现在要么 1 个要么不用。
- top-k 收敛到 8。Llama 4 的 top-1 是个例外(推理极致优化),但 8 已经成了默认值。
8.6 一个可读的 MoE 层实现
import torch, torch.nn as nn, torch.nn.functional as F

class MoELayer(nn.Module):
    def __init__(self, d_model, d_expert, n_routed, top_k, n_shared=1):
        super().__init__()
        self.n_routed, self.top_k = n_routed, top_k
        # 路由器:一个 d_model -> n_routed 的线性层,无 bias
        self.router = nn.Linear(d_model, n_routed, bias=False)
        self.experts = nn.ModuleList(
            [SwiGLU(d_model, d_expert) for _ in range(n_routed)])
        self.shared = nn.ModuleList(
            [SwiGLU(d_model, d_expert) for _ in range(n_shared)])
        # aux-loss-free 用的 per-expert bias:只影响选择,不参与梯度
        self.register_buffer("bias", torch.zeros(n_routed))

    def forward(self, x):                      # x: (T, d_model),T 已展平
        # --- 1. 路由:router 必须在 fp32 里算 ---
        logits = self.router(x.float())        # (T, N)
        scores = logits.sigmoid()              # DeepSeek-V3 用 sigmoid 而非 softmax

        # --- 2. 选择:加 bias 只为了选,选完用原始 score 做权重 ---
        _, idx = torch.topk(scores + self.bias, self.top_k, dim=-1)   # (T, k)
        gates = scores.gather(-1, idx)
        gates = gates / gates.sum(-1, keepdim=True)                   # top-k 后归一化
        gates = gates.to(x.dtype)

        # --- 3. 分发 + 计算 + 合并 ---
        out = sum(e(x) for e in self.shared)   # 共享专家:所有 token 都走
        flat_idx = idx.reshape(-1)
        for i in range(self.n_routed):
            sel = (flat_idx == i).nonzero().squeeze(-1)
            if sel.numel() == 0:
                continue
            tok, slot = sel // self.top_k, sel % self.top_k
            out.index_add_(0, tok,
                           self.experts[i](x[tok]) * gates[tok, slot, None])

        # --- 4. 辅助统计量,供负载均衡损失使用 ---
        with torch.no_grad():
            f = torch.zeros(self.n_routed, device=x.device)
            f.scatter_add_(0, flat_idx, torch.ones_like(flat_idx, dtype=f.dtype))
            self.load = f / f.sum()                       # 实际分配比例
        self.P = scores.mean(0)                           # 平均路由概率(可导)
        self.z_loss = torch.logsumexp(logits, dim=-1).pow(2).mean()
        return out

# 注意 for 循环只是为了可读;真实实现会先按专家 id 做 permutation,
# 再用 grouped GEMM / block-sparse matmul 一次算完(见第 10 节的 MegaBlocks)。
9. 训练 MoE:不可导的路由、负载均衡与稳定性
9.1 核心矛盾
训练效率要求稀疏——只算 $K$ 个专家。但 top-k 这个操作是离散的、不可导的。梯度能沿着被选中专家的门控值 $g_{i,t}$ 往回传(因为 $g$ 是连续的),但「为什么选了这 $K$ 个而不是另外 $K$ 个」这件事没有梯度。
训练初期路由器是随机的,某个专家偶然多拿到了一些 token → 它被训练得更好 → 路由器发现选它 loss 更低 → 它拿到更多 token → 其它专家永远拿不到 token,永远拿不到梯度,永远是随机初始化的废物。
最终结果是一个 256 专家的模型,实际只有三五个专家在干活,你白白付了 256 份的显存。这就是 MoE 训练的头号敌人:路由坍缩(routing collapse)。
讲师列了三条解法,然后问了一句「猜猜实践中大家用哪个」:
- 强化学习优化门控策略;
- 随机扰动路由决策;
- 启发式的均衡损失。
答案当然是 3。
9.2 路线一:RL(正确但没人用)
把路由看成一个策略 $\pi(i\mid u_t)$,用 REINFORCE 估计梯度:
$$ \nabla_\theta \E_{i\sim\pi_\theta}\big[\mathcal{L}\big] = \E\big[(\mathcal{L}-b)\,\nabla_\theta\log\pi_\theta(i\mid u_t)\big] $$$b$ 是 baseline。Clark 等人(2020)做过带 baseline 的 REINFORCE 路由,确实能 work,但没好到构成明显胜利。讲师的评价很直白:RL 是「正确的解法」,但梯度方差和实现复杂度让它没能流行起来。——这句话本身就很有 CS336 的味道:理论上对的东西不一定是工程上赢的东西。
9.3 路线二:随机扰动
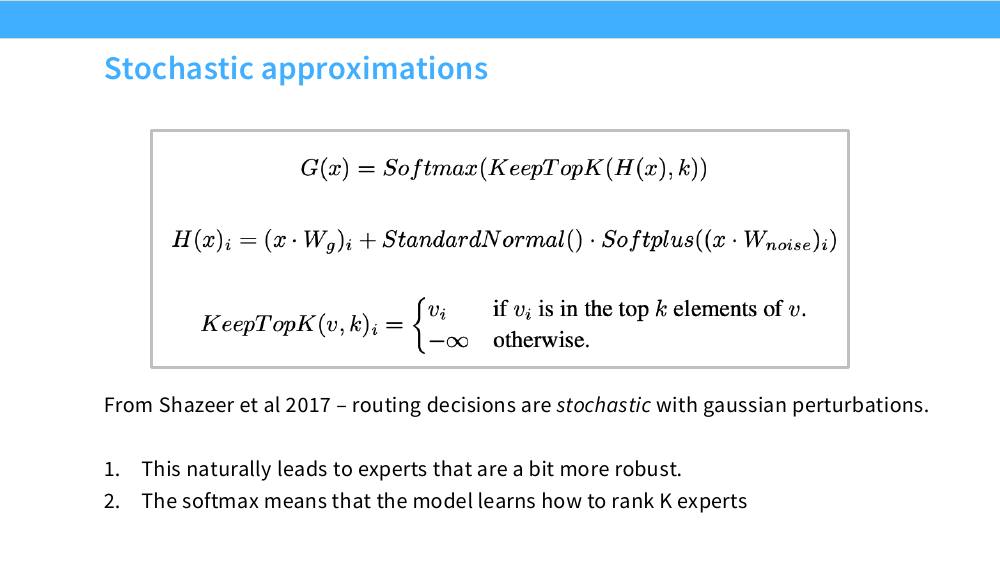
噪声的作用是给「本来排第 $k+1$ 名」的专家一个偶尔被选中的机会,从而打破死亡螺旋。Switch Transformer 用了一个更简单的版本——stochastic jitter:把路由器的输入乘一个 $\text{Uniform}(1-\varepsilon,1+\varepsilon)$ 的随机数。但这个技巧在后续的 ST-MoE 里被删掉了,因为它对大模型的训练稳定性有害。随机扰动这条路线整体上被 9.4 节的均衡损失取代了。
9.4 路线三(赢家):负载均衡辅助损失
注意负载均衡有两个独立的动机,别混淆:
- 建模动机:防止路由坍缩,让所有参数都得到训练。
- 系统动机:专家分布在不同设备上,如果 80% 的 token 都去了 device 3,那其它设备就在空转,整层的时间由最慢的设备决定。不均衡直接等于浪费算力。
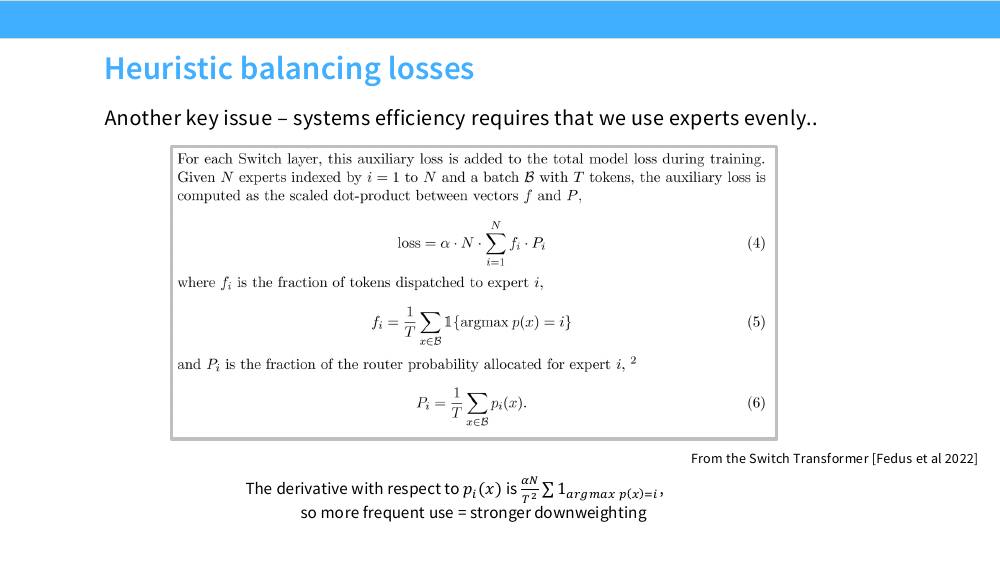
两个向量都是概率分布:$\sum_i f_i=\sum_i P_i=1$。如果两者都均匀($f_i=P_i=1/N$):
$$ \alpha N\sum_{i=1}^N \frac1N\cdot\frac1N = \alpha N\cdot\frac{1}{N}=\alpha $$而如果坍缩到一个专家($f_1=P_1=1$,其余为 0):$\alpha N\cdot 1 = \alpha N$,是均匀时的 $N$ 倍。(乘 $N$ 这个缩放的作用就是让最小值与专家数无关,方便固定 $\alpha$。典型取 $\alpha=0.01$。)
更重要的是梯度的形状。$f_i$ 不可导(含 argmax),所以梯度只从 $P_i$ 走:
$$ \frac{\partial \mathcal{L}_{\text{aux}}}{\partial p_i(x)} = \frac{\alpha N}{T} f_i = \frac{\alpha N}{T^2}\sum_{x\in\mathcal{B}}\mathbb{1}\{\argmax p(x)=i\} $$系数正比于 $f_i$——某个专家这一批拿到的 token 越多,它的路由 logit 就被压得越低。这是一个负反馈控制器,会自动把分布推向均匀。设计得很巧妙:用不可导的 $f$ 做「测量」,用可导的 $P$ 做「执行」。
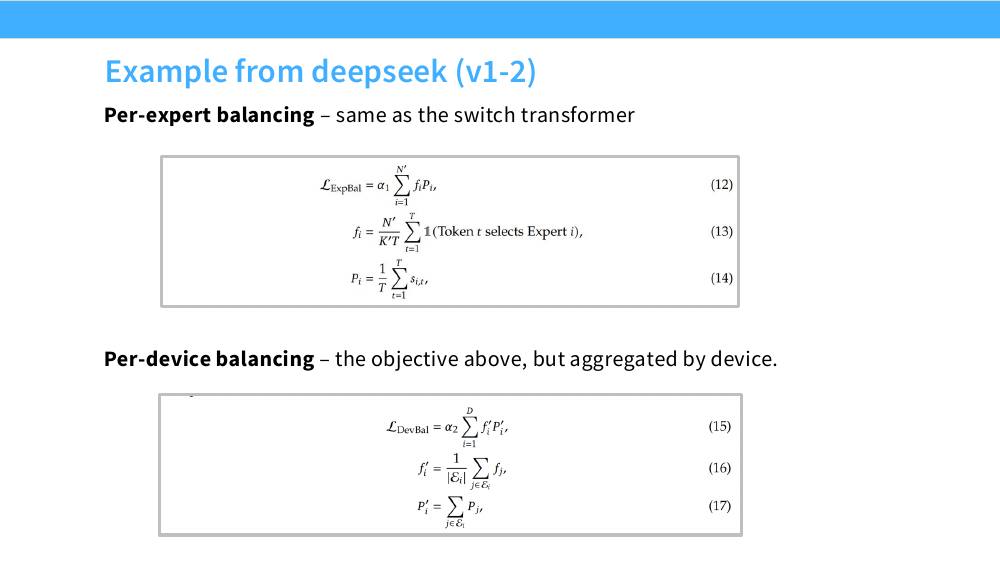
专家级均衡用大的 $\alpha_1$ 会伤害模型质量——你在强迫路由器做它不想做的分配。但用小的 $\alpha_1$,专家之间的轻微不均衡在聚合到设备粒度后可能仍然很严重(如果不巧几个热门专家挤在同一台机器上)。
解法是分层:专家级用小 $\alpha_1$(只要不坍缩就行,给路由器足够自由),设备级用大 $\alpha_2$(这是系统真正在乎的粒度,而且约束更松——设备内部怎么分不管)。DeepSeek-V2 还加了第三个:通信均衡损失,同时约束每台设备的发出和收到的 token 量,因为 all-to-all 的时间由最拥堵的那条链路决定。
9.5 DeepSeek-V3 的 aux-loss-free 方案
辅助损失有一个根本问题:它往语言建模的梯度里注入了一个和任务无关的干扰项。$\alpha$ 大了伤质量,小了不管用,是个恼人的权衡。
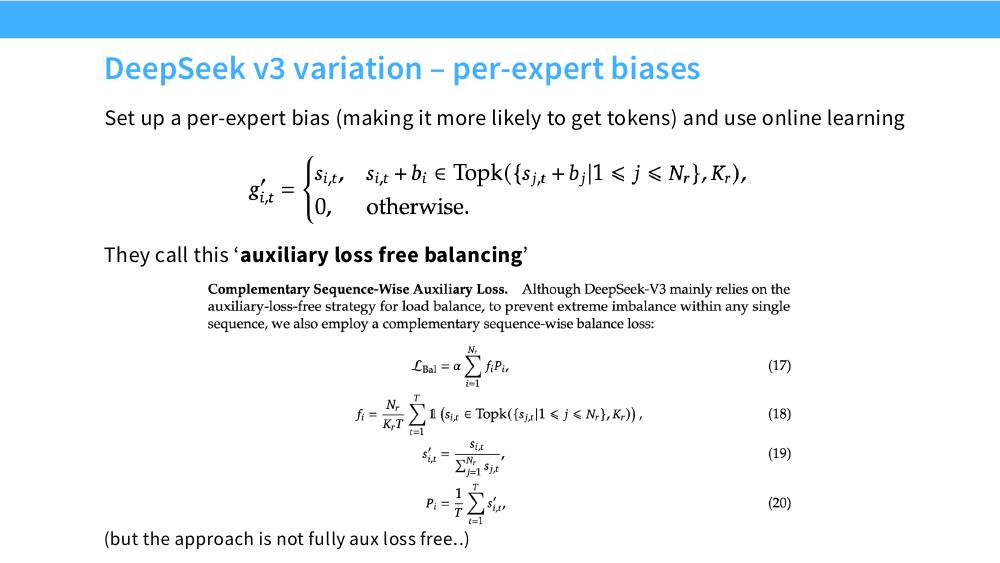
$b_i$ 的更新规则是一个简单的比例控制器:每个训练步统计各专家的负载,然后
$$ b_i \leftarrow b_i + u\cdot\text{sign}\big(\overline{\text{load}} - \text{load}_i\big) $$负载低的专家 bias 调高(更容易被选中),负载高的调低。$u$ 是「偏置更新速度」,DeepSeek-V3 在前 14.3T token 用 0.001,最后阶段设为 0。
- 零梯度干扰:$b_i$ 不在计算图里,语言建模的梯度完全干净。均衡变成了一个独立于优化器的外部控制回路。
- 不扭曲输出:因为门控权重仍是原始的 $s_{i,t}$,bias 只改变「谁被选中」,不改变「被选中后算多重」。辅助损失做不到这一点——它会同时扭曲这两者。
- 诚实的补充:讲师特意指出 V3 仍然保留了一个序列级的均衡损失($\alpha=10^{-4}$,非常小),防止单条序列内出现极端不均衡。bias 是按 batch 统计更新的,管不了单序列级别的病态情况。所以「aux-loss-free」这个名字有点营销成分。
9.6 如果不做负载均衡会怎样
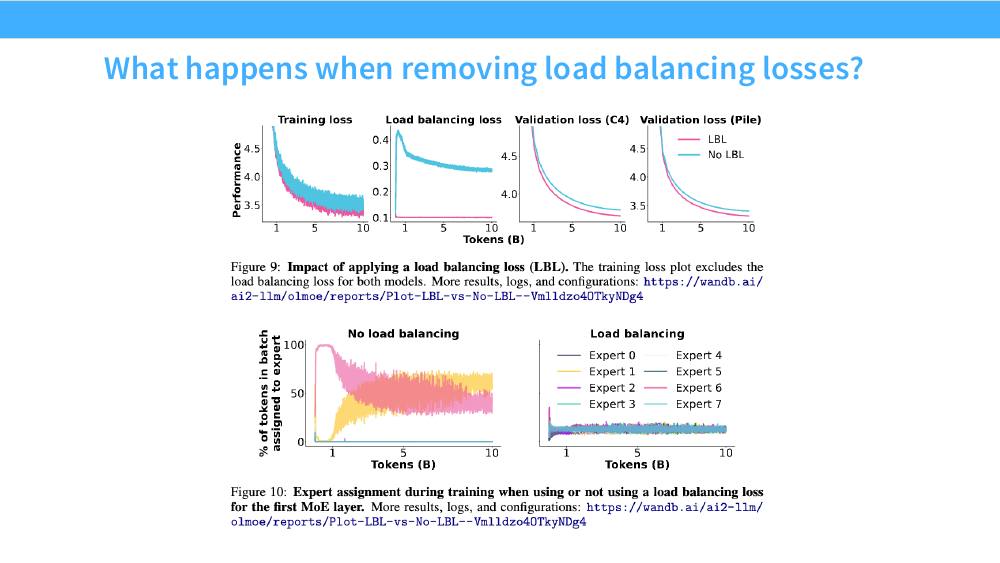
这张图是 9.1 节那个「死亡螺旋」的实证。注意无均衡时的曲线不是平滑坍缩,而是在少数几个专家之间来回震荡——这是因为被过度使用的专家会过拟合当前批次,路由器于是跳到下一个,形成不稳定的极限环。
9.7 数值稳定性:fp32 路由器与 router z-loss
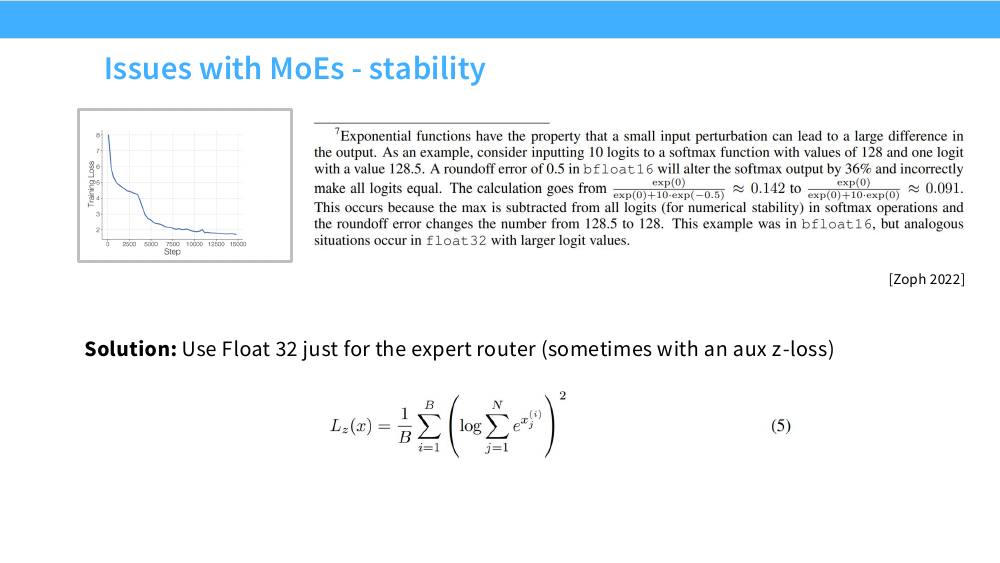
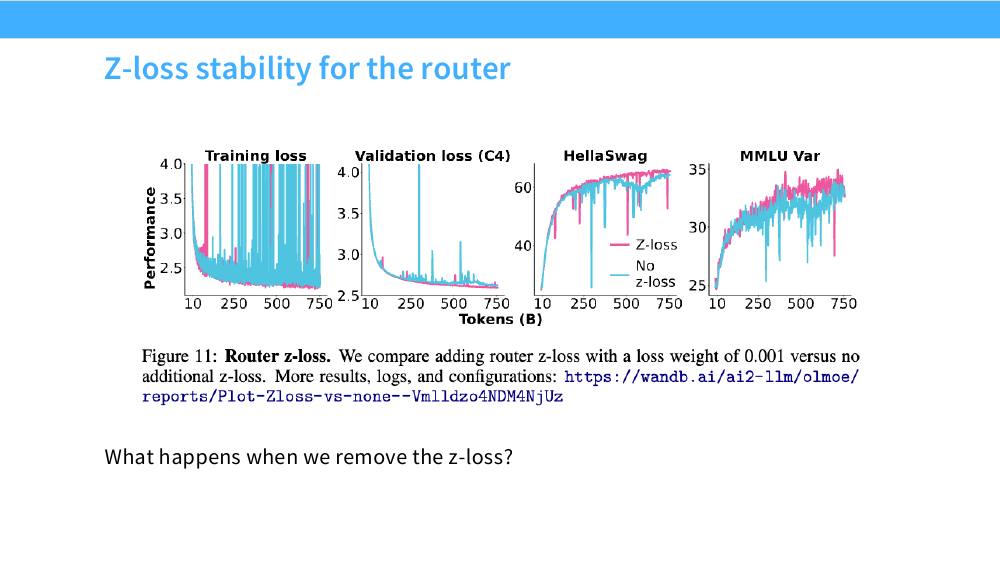
这个损失惩罚 logits 的 log-sum-exp 偏离 0,也就是把 logits 的整体量级往下压。为什么有效?浮点数的相对精度是固定的,但绝对精度随量级下降——logits 在 $\pm 5$ 附近时 bf16 的 ULP 约 0.03,在 128 附近时是 1。把 logits 压在小数量级,指数运算的舍入误差就可控了。典型权重是 0.001。
# 训练总损失的完整形态
loss = lm_loss \
     + alpha_expert * sum(f_i * P_i for each MoE layer) * n_experts \
     + alpha_device * device_balance_loss \
     + 0.001       * router_z_loss

# 加上非梯度的部分(DeepSeek-V3 风格):
with torch.no_grad():
    for layer in moe_layers:
        err = layer.load.mean() - layer.load          # 正 = 该专家负载不足
        layer.bias += u * torch.sign(err)             # u = 0.001

# 以及必须做的工程细节:
#   1) router 的 matmul 用 fp32,别信 autocast
#   2) 别给 router 加权重衰减,它的权重范数本来就该自由伸缩
#   3) 记录每层的 load 分布做监控 —— 坍缩通常在几百步内就能看出来
10. MoE 的系统代价:专家并行、all-to-all 与 token dropping
MoE 在纸面上是免费的午餐:更多参数,同样的 FLOPs。系统侧的账单在这一节。
10.1 专家并行
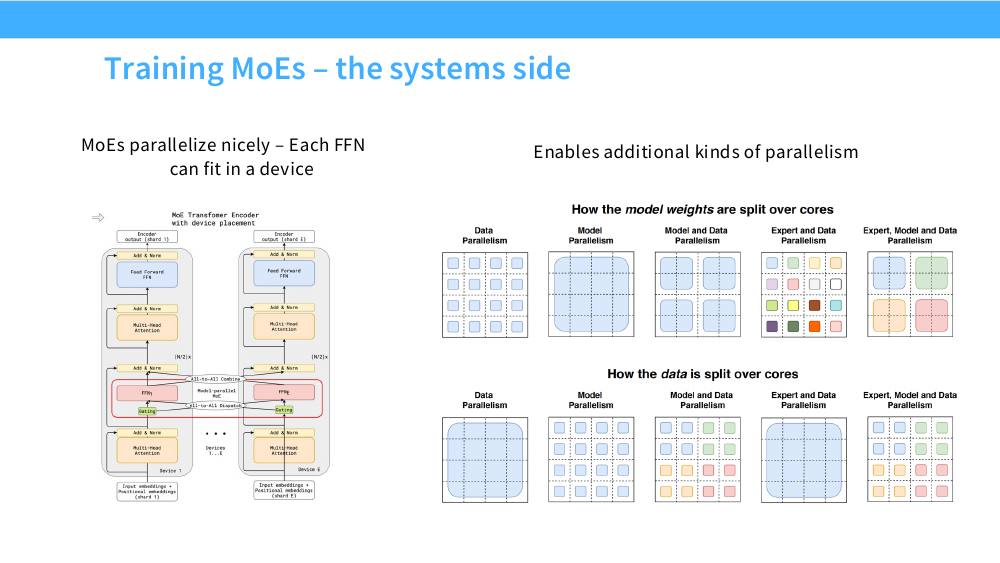
专家并行(EP)的执行流程是:
- 本设备的 token 过路由器,算出每个 token 要去哪 $K$ 个专家;
- All-to-All Dispatch:把 token 的隐状态发到对应专家所在的设备;
- 每台设备对收到的 token 跑自己的专家 FFN;
- All-to-All Combine:把结果发回 token 原本所在的设备,按门控权重加权求和。
注意这是每层两次 all-to-all(反向传播再来两次)。all-to-all 是所有集合通信里最难优化的一种——它没有 ring all-reduce 那样漂亮的带宽最优算法,且对网络拓扑极其敏感。
DeepSeek-V3:$d_{model}=7168$,top-8,bf16。每个 token 要被复制成 8 份发出去:
$$ 8\times 7168\times 2\ \text{bytes} = 114.7\ \text{KB / token} $$一个 micro-batch 若有 8192 个 token,单层单次 dispatch 就是 0.94 GB,加上 combine 是 1.9 GB,58 层就是 109 GB 的跨节点流量(前向;反向再来一遍)。在 400 Gbps(50 GB/s)的 InfiniBand 上,光是前向通信就要 2.2 秒。
这就是为什么 DeepSeek-V3 必须做这三件事:(a)节点受限路由——每个 token 最多被发到 4 个节点,把跨节点流量的上界钉死;(b)DualPipe——让通信和计算在流水线里重叠,把 all-to-all 藏到计算后面;(c)定制 PTX 内核,让 IB 和 NVLink 的带宽比例正好匹配路由的拓扑约束。架构设计被网络拓扑反向决定了。
10.2 容量因子与 token dropping
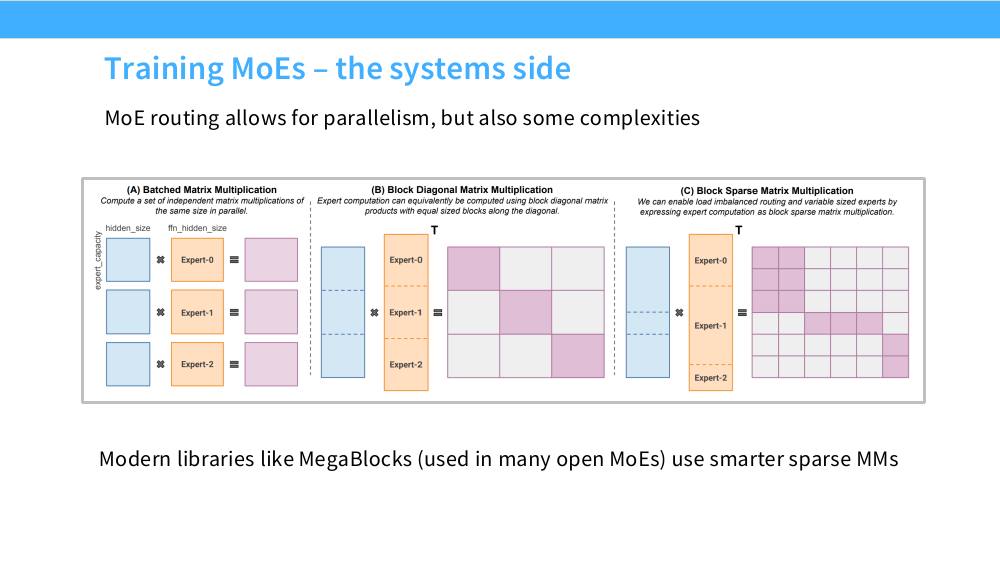
为什么早期实现必须让专家等量?因为 GPU 的 GEMM 需要静态形状。于是引入容量因子(capacity factor):
$$ \text{capacity} = \text{cf}\cdot\frac{T\cdot K}{N} $$$\text{cf}=1.0$ 表示按理想均匀分配;实践中取 1.25 留一点余量。超出容量的 token 被丢弃(dropped)——它不过任何专家,只靠残差连接直通到下一层。而没填满的专家要补零,白算。
MegaBlocks 的贡献就是用块稀疏矩阵乘法实现 dropless MoE:形状不再需要相等,没有丢弃也没有填充。这在今天已经是标配,DeepSeek-V3 也明确说训练全程不丢 token。
10.3 一个有趣的副作用:你的输出取决于别人的请求
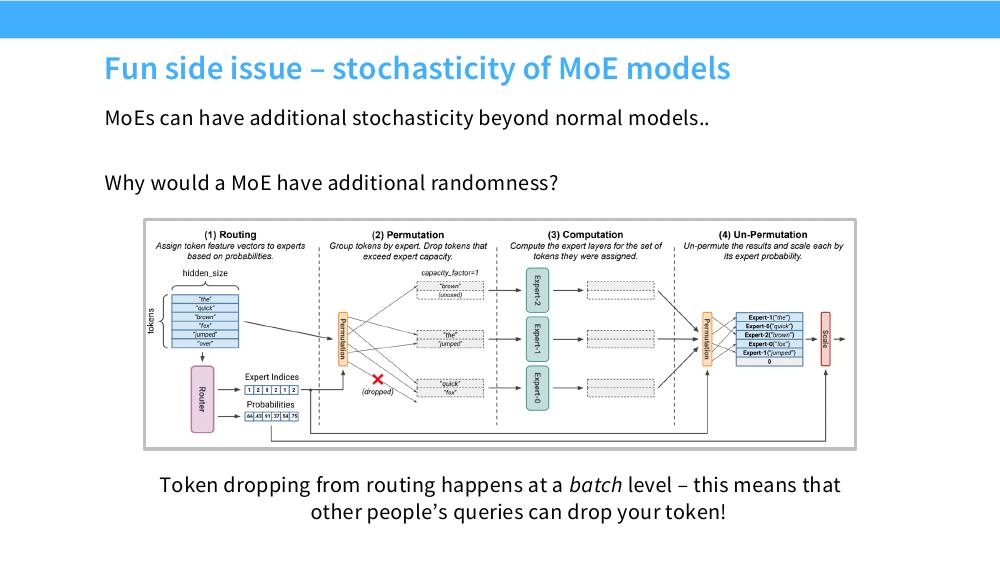
这是一个很少被讨论但影响很实际的现象。在带容量限制的 MoE 服务里,你的输出依赖于同一个 batch 里还有谁。同样的 prompt、同样的 temperature=0,在不同时刻请求可能得到不同的结果——因为这次 batch 里别人的 token 抢占了某个专家的容量,把你的 token 挤掉了。
这解释了为什么很多 MoE API 即使在 greedy decoding 下也无法保证可复现。(dropless 实现能消除这个特定原因,但批次组成仍会通过浮点归约顺序引入非确定性。)
10.4 用架构改动省通信:LatentMoE
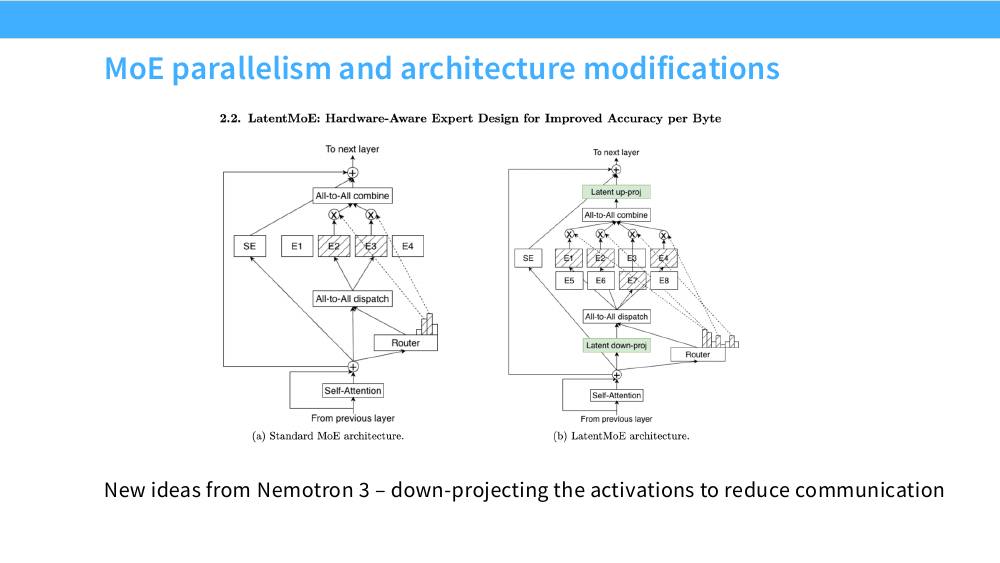
10.5 显存账:MoE 真正的成本在这里
| 资源 | 由什么决定 | DeepSeek-V3 的数字 |
|---|---|---|
| 推理显存(权重) | 总参数 | 671B × 1 byte(FP8)= 671 GB,至少 8×H100 |
| 推理吞吐(计算) | 激活参数 | 相当于一个 37B 稠密模型 |
| 训练显存(权重+优化器) | 总参数 | bf16 权重 1.34 TB + AdamW 状态约 8 TB |
| 训练算力 | 激活参数 | $6\times 37\text{B}\times 14.8\text{T}\approx 3.3\times 10^{24}$ FLOPs |
| 网络 | top-k × $d_{model}$ × token 数 | 每层每 token 约 115 KB × 2 方向 |
把上表读成一句话:MoE 是拿显存和网络带宽去换计算。所以它划不划算,完全取决于你的瓶颈在哪:
- 该用:你有很多卡、很多机器。数据并行本来就要在每台机器上放一份完整模型,现在这些「本来就要花的显存」可以用来放更多专家——参数量近乎白送。高吞吐服务场景同理:请求量大到能把所有专家都喂饱,专家并行的通信被摊薄。这正是 Fedus 那段话的意思,也是几乎所有前沿实验室都在用 MoE 的原因。
- 不该用:你只有一台机器、甚至一张卡。此时 MoE 的额外参数装不下,专家并行退化成在同一张卡上串行跑多个小 GEMM(效率还不如一个大 GEMM),你付了全部的复杂度却拿不到任何好处。单机场景下稠密模型几乎总是更优。
- 还要考虑:基础设施的复杂度是真实的成本——负载均衡要调、路由要监控、all-to-all 要优化、微调更容易过拟合。如果团队没有相应的系统能力,一个训得稳的稠密模型胜过一个天天发散的 MoE。
但讲师最后的总结也很明确:现在有大量经验证据表明 MoE 是有效且划算的。性能最高的那批开源模型几乎全是 MoE,而且推理还很快。天平已经明显倒向 MoE 这一侧了。
11. 微调、upcycling 与 DeepSeek MoE 的三代演进
11.1 MoE 微调时会过拟合
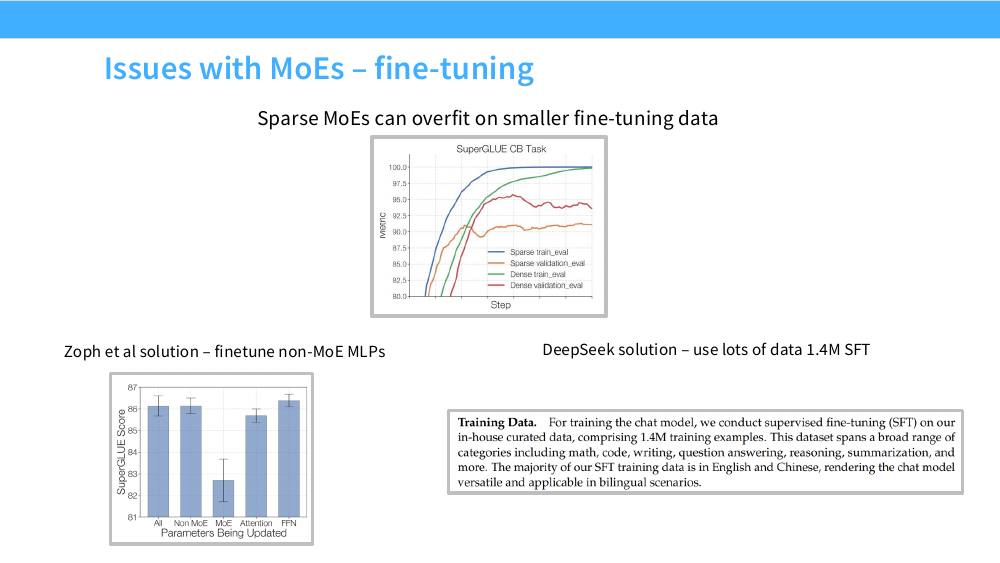
为什么 MoE 更容易过拟合?因为对于一个小数据集,有效参数量被放大了:每个专家只看到一部分数据,相当于在很小的子集上训练一个完整的 FFN,而且专家之间没有参数共享来正则化。稀疏性在预训练阶段是容量优势,在小数据微调阶段就变成了过拟合的温床。
两条实用建议:小数据微调时冻结专家、只调注意力和非 MoE 的 MLP;或者干脆保证 SFT 数据量足够大。
11.2 Upcycling:从稠密模型出发造 MoE
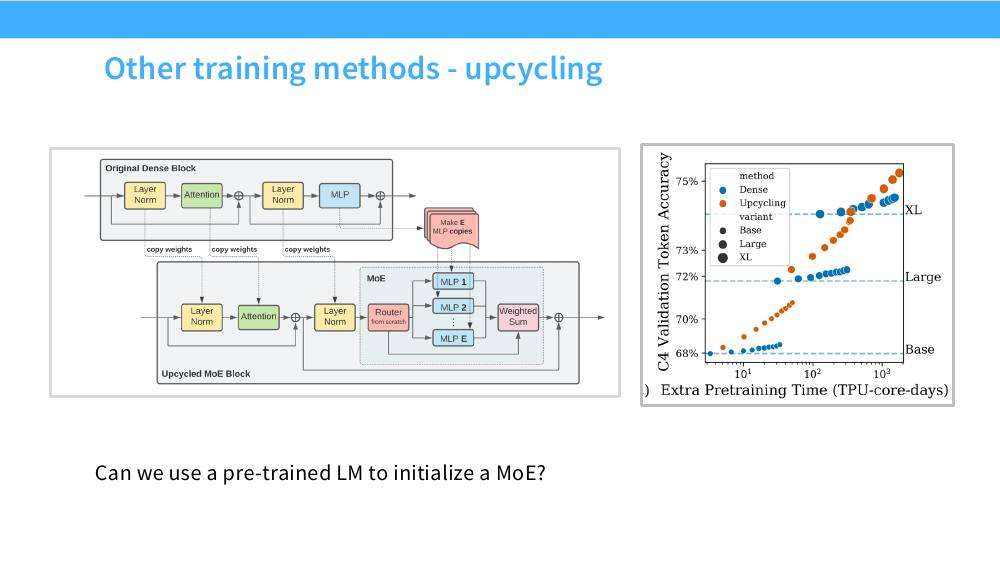
Upcycling 回答的问题是:能不能不从头训?这在工程上意义重大——你已经有一个训好的稠密模型和一堆调好的超参,重新预训练一个 MoE 是巨大的风险。
两个成功案例:
- MiniCPM-MoE:基于 MiniCPM,top-k=2、8 个专家、约 4B 激活参数。结构非常朴素,但用约 520B token 的继续训练拿到了相对基座模型的明显提升。
- Qwen1.5-MoE-A2.7B:从 Qwen-1.8B 出发,60 个专家(其中 4 个共享)、top-k=4,最终 14.3B 总参 / 2.7B 激活。
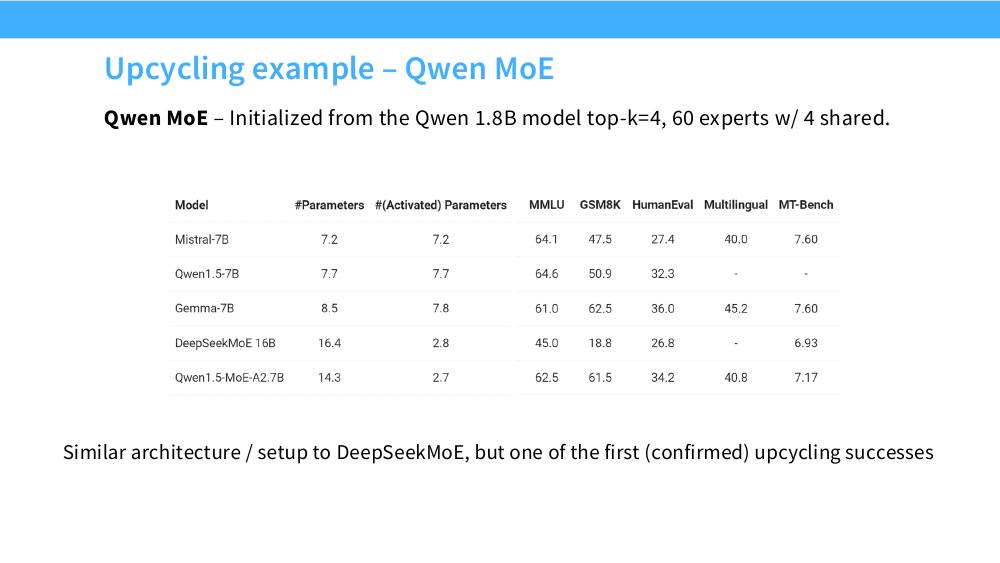
复制出来的 E 个专家在初始时完全相同,路由器面对的是一个完全对称的问题——选谁都一样,梯度无法打破对称性。所以 upcycling 必须依赖路由器的随机初始化 + 负载均衡损失来强行分化专家,这段「分化期」的算力是纯损耗。这解释了上图左端 upcycling 落后于稠密的那一段。常见的缓解手段是给复制出的专家加一点噪声。
11.3 DeepSeek MoE 三代复盘
把前面所有零件装到一起,最好的例子就是 DeepSeek 的三代 MoE。
| V1(DeepSeekMoE 16B) | V2(236B) | V3(671B) | |
|---|---|---|---|
| 总参 / 激活 | 16.4B / 2.8B | 236B / 21B | 671B / 37B |
| 专家配置 | 共享 2 + 细粒度 64(1/4) | 共享 2 + 细粒度 160(1/10),激活 6 | 共享 1 + 细粒度 256(1/14),激活 8 |
| 路由打分 | softmax,先 softmax 后 topk | softmax | sigmoid + top-k 后归一化 |
| 路由范围约束 | 无 | 设备受限路由(top-M devices) | 节点受限路由(≤4 节点) |
| 负载均衡 | 专家级 + 设备级 aux loss | 专家级 + 设备级 + 通信均衡 aux loss | aux-loss-free 偏置 + 极小的序列级 aux |
| 注意力 | 标准 MHA | MLA(首次引入) | MLA |
| 其它 | — | token dropping 策略 | MTP、FP8 训练、DualPipe、不丢 token |
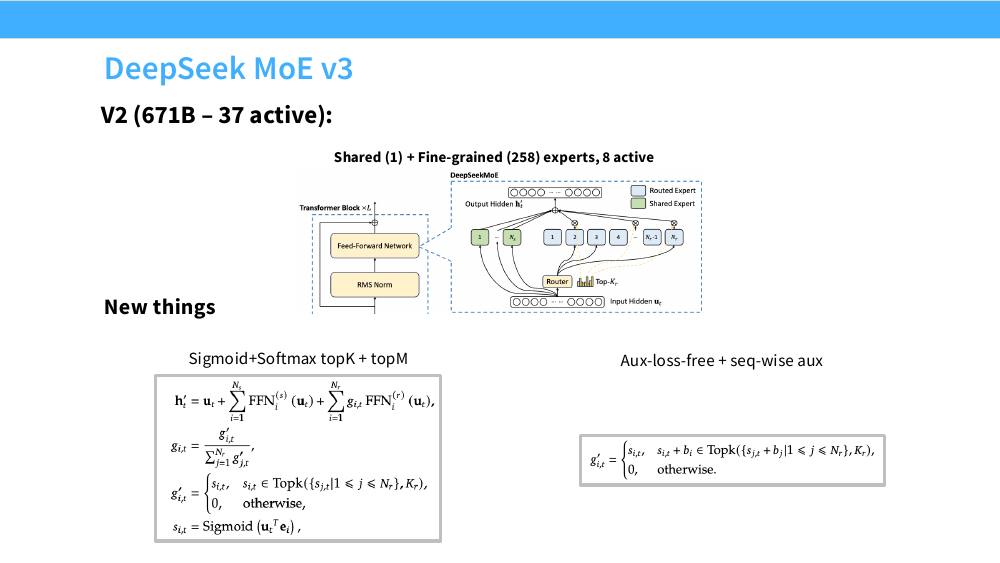
三代之间的演进逻辑非常清楚:
- V1 确立配方:细粒度 + 共享专家 + 标准 aux loss。这是 DeepSeekMoE 论文的核心贡献,后来被整个行业抄走。
- V2 解决系统问题:模型规模上到 236B,跨设备通信成为瓶颈 → 设备受限路由 + 通信均衡损失。同时引入 MLA 解决 KV cache。
- V3 解决目标函数问题:aux loss 对质量的干扰在这个规模上不可忽视 → 换成 bias 控制回路。专家数上到 256,softmax 摊得太薄 → 换 sigmoid。
11.4 拼图的最后一块:MTP
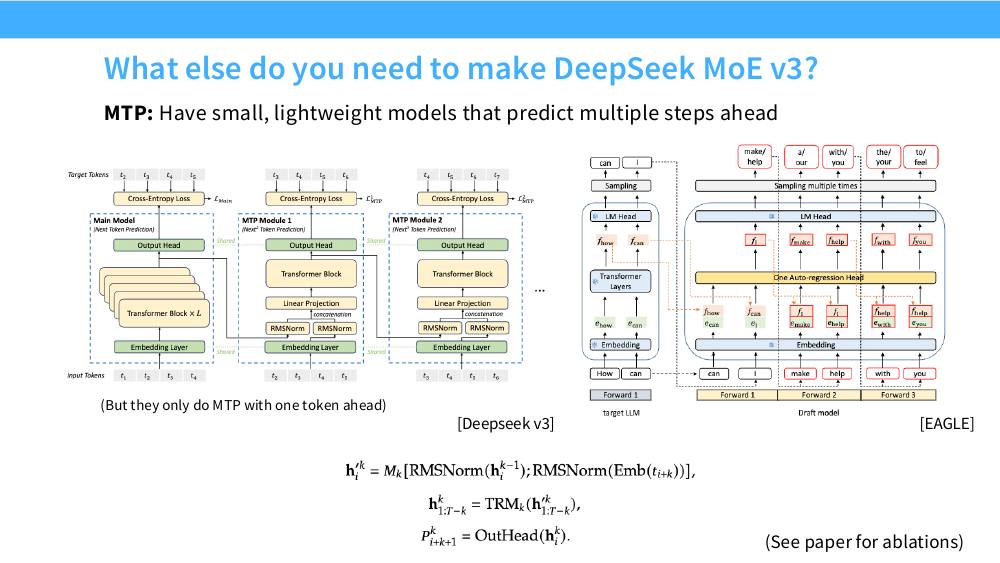
MTP 有两重收益:
- 训练时:每个位置提供了额外的监督信号,训练信号变得更稠密,也逼迫表示为更远的未来做规划。
- 推理时:MTP 模块天然就是一个和主模型对齐的草稿模型,可以直接用于投机解码(speculative decoding)。DeepSeek 报告第二个 token 的接受率在 85–90%,对应约 1.8 倍的解码加速。
这一点值得单独强调:一个为了改善训练而加的模块,顺手解决了推理加速。MoE 模型的解码是严重访存受限的(每步只算 37B 的 FLOPs 却要读 671B 的权重…… 实际上只读被激活的那部分,但路由让访存模式变得很碎),投机解码正好能把多个 token 的验证合并成一次前向,把访存开销摊薄。
本讲小结
速查表:注意力的替代方案
| 方案 | 省什么 | 不省什么 | 代价 | 需从头训? |
|---|---|---|---|---|
| FlashAttention | 激活显存、访存 | FLOPs | 无(数学等价) | 否 |
| MQA / GQA | KV cache、解码带宽 | 训练 FLOPs | 头多样性下降 | 可 uptrain(~5% 算力) |
| MLA | KV cache(约 57×) | 训练 FLOPs | 需拆解耦 RoPE 维度,实现复杂 | 是 |
| 跨层共享 / CLA | KV cache(层数因子) | FLOPs | 层间表达力受限 | 是 |
| 滑动窗口 | KV cache(变常数)、FLOPs | — | 长程精确检索 | 是(或长上下文继训) |
| 局部+全局混合层 | KV cache(按比例) | — | 比例需调 | 是 |
| 线性注意力 / SSM | 状态变常数、FLOPs 变线性 | — | 固定状态 = 记忆有损 | 是 |
| 混合架构(3:1~7:1) | 大部分 KV cache | — | 实现两套算子 | 是 |
| DSA(稀疏适配) | 注意力 FLOPs 与带宽 | KV cache 显存 | 需训练索引器 | 否(可后训练适配) |
速查表:MoE 的设计选择
| 维度 | 选项 | 2026 年的默认答案 |
|---|---|---|
| 路由方向 | token 选专家 / 专家选 token / 全局优化 | token 选专家 + top-k |
| 打分函数 | softmax 前 / softmax 后 / sigmoid | 专家数多时用 sigmoid + top-k 后归一化 |
| 专家粒度 | 少而胖 / 多而瘦 | 细粒度(1/8 ~ 1/14),收益确定 |
| 共享专家 | 0 / 1 / 多个 | 0 或 1,收益存疑 |
| top-k | 1 ~ 8 | 8(Llama 4 的 top-1 是推理优化的特例) |
| 负载均衡 | RL / 随机扰动 / aux loss / bias 控制 | aux loss 或 aux-loss-free bias,两级(专家+设备) |
| 数值稳定 | — | fp32 路由器 + router z-loss(0.001),非可选项 |
| token dropping | 容量因子 / dropless | dropless(MegaBlocks 式块稀疏 MM) |
| 初始化 | 从头 / upcycling | 算力充足从头训;有现成稠密基座可 upcycle |
要点清单
- 成本要分开算。训练看 FLOPs($O(L^2)$ 的注意力),推理看显存与带宽($O(L)$ 的 KV cache,算术强度只有 1 FLOP/byte)。同一个架构改动在两边的收益可能完全不同。
- KV cache 由 $n_{kv}$ 决定,不是 $n_{heads}$。这一句话推出了 MQA、GQA 和 MLA 三代技术。
- MLA 的关键是「吸收」。上投影矩阵可以合并进 Q 投影,所以低秩压缩不带来额外计算——但 RoPE 会插在中间破坏这个结构,于是必须拆出 64 维解耦 RoPE 通道。
- 线性注意力 = 固定大小状态的 RNN。并行形式训练、串行形式推理,两者数学等价(duality),工程上用分块形式兼顾。门控(Mamba-2)和 delta 规则(GDN)是让这个状态更好用的两个方向,后者本质是对联想记忆做在线梯度下降。
- 纯线性架构没人用。固定状态换来常数开销,也换来长程精确检索的损失。3:1 到 7:1 的混合是当前工业标准。
- MoE 把参数量和每 token 计算解耦。同 FLOPs 下参数越多越好,这条经验规律至今没看到饱和。
- 离散路由不可导,但启发式赢了。RL 是「正确解法」却因方差太大出局;负载均衡辅助损失用不可导的 $f$ 测量、可导的 $P$ 执行,形成一个负反馈控制器。DeepSeek-V3 更进一步,把控制回路完全移出计算图(bias 调整)——但它并非真的完全没有辅助损失。
- 不做负载均衡不只是系统问题。OLMoE 的实验显示,去掉均衡损失后建模质量也变差,因为专家坍缩意味着大部分参数从未被训练。
- fp32 路由器 + z-loss 不是可选项。bf16 在 logit 量级 128 时的舍入误差就能让 softmax 输出偏 36%。
- MoE 是拿显存和网络换计算。多机、高吞吐场景下划算;单机场景下稠密更优。这是讲师给出的判断标准。
- MoE 的随机性会串台。batch 级的容量丢弃意味着别人的请求能挤掉你的 token——一个很少被讨论但真实存在的工程现象。
- MoE 利用的是稀疏性——不是所有输入都需要整个模型。
- 离散路由很难,但 top-k 这个启发式看起来就是管用。
- 现在已经有大量经验证据表明 MoE 有效、且具备成本优势。
延伸阅读
注意力与 KV cache
- Attention Is All You Need (2017) — 一切的起点,本讲所有「替代方案」的参照系。
- Fast Transformer Decoding: One Write-Head is All You Need (2019) — MQA 原文,第一次把「解码是访存受限」这件事讲透。
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints (2023) — GQA 原文,重点看 uptraining 那一节:怎么把已有的 MHA 模型改造成 GQA。
- DeepSeek-V2 (2024) — MLA 的出处,Section 2.1 有完整的解耦 RoPE 推导和 KV cache 对比表。
- Reducing Transformer Key-Value Cache Size with Cross-Layer Attention (2024) — CLA,与 GQA 正交的一维压缩。
稀疏与滑窗注意力
- Generating Long Sequences with Sparse Transformers (2019) — strided / fixed 稀疏模式的原始设计,GPT-3 用的就是它。
- Longformer: The Long-Document Transformer (2020) — 滑窗 + 空洞 + 全局 token 的经典组合。
- Mistral 7B (2023) — 滑窗注意力的工业级实践,含滚动缓冲缓存的实现细节。
- Optimizing Inference (Character.AI, 2024) — MQA + 局部/全局混合 + 跨层共享叠满,把 KV cache 压 20 倍以上的生产级配方。
- DeepSeek-V3.2 (2025) — DSA 的出处,重点看闪电索引器和两阶段后训练适配流程。
线性注意力与状态空间模型
- Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention (2020) — 核函数视角与递推形式,本讲第 4 节的直接来源。
- Retentive Network (2023) — 在线性注意力上加固定衰减 $\gamma$,是通往门控的第一步。
- Mamba (2023) — 选择性状态空间模型,理解「数据相关的门控」为什么重要。
- Transformers are SSMs: Mamba-2 (2024) — 状态空间对偶(SSD),把 SSM 和线性注意力统一起来,同时解释了为什么限制结构反而更快。
- Gated Delta Networks (2024) — 门控 + delta 规则,当前混合架构里最常用的线性层。
- MiniMax-01 (2025) — 7:1 混合线性注意力的大规模验证。
- Nemotron 3 (2025) — Mamba-Transformer-MoE 三合一混合,含 LatentMoE 的通信优化。
MoE 基础
- Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer (2017) — 现代 MoE 的开山之作,noisy top-k gating 与最早的均衡损失。
- Switch Transformers (2021) — top-1 路由、容量因子、$\alpha N\sum f_iP_i$ 均衡损失,本讲引用最多的一篇。
- GShard (2020) — 专家并行与 all-to-all 的原始设计。
- ST-MoE: Designing Stable and Transferable Sparse Expert Models (2022) — router z-loss、fp32 路由器、微调只更新非 MoE 参数,全是踩坑经验。
- A Review of Sparse Expert Models in Deep Learning (2022) — Fedus 等人的综述,本讲多张图的出处。
MoE 的现代配方
- DeepSeekMoE (2024) — 细粒度专家切分 + 共享专家隔离的原始论证,含那个 120 vs 44 亿的组合数论证。
- Mixtral of Experts (2024) — 第一个真正流行的开源 MoE,top-2/8 的极简配方。
- OLMoE (2024) — 全开放的 MoE,含本讲多组消融(TC vs EC、共享专家、负载均衡、z-loss)的原始数据与 wandb 日志。
- Auxiliary-Loss-Free Load Balancing Strategy for MoE (2024) — per-expert bias 在线控制方案的出处。
- DeepSeek-V3 (2024) — 把 MLA、细粒度 MoE、aux-loss-free、MTP、FP8、DualPipe 全部装进一个 671B 模型的完整技术报告,值得逐页读。
- Qwen3 (2025) — 明确去掉共享专家的一条重要反例。
- GLM-4.5 (2025) — 另一份配置细节丰富的 MoE 技术报告。
系统与工程
- MegaBlocks: Efficient Sparse Training with Mixture-of-Experts (2022) — 块稀疏矩阵乘法实现 dropless MoE,本讲提到的开源 MoE 大多在用。
- Sparse Upcycling: Training Mixture-of-Experts from Dense Checkpoints (2022) — upcycling 的系统性研究,含「多少额外算力才能回本」的曲线。
- Better & Faster Large Language Models via Multi-token Prediction (2024) — MTP 的独立研究,理解 DeepSeek-V3 那个模块的动机。
- MiniCPM (2024) — 含 MiniCPM-MoE 的 upcycling 实践。