架构与超参数:现代 LM 到底长什么样
从 2017 年的原始 Transformer 到 2026 年的 LLaMA-like 默认配方,每一处改动背后的动机、证据与代价。
0. 本讲导读
你在作业里实现的那个 Transformer——前置 RMSNorm、SwiGLU 前馈层、RoPE 位置编码、所有线性层都不带偏置——和 2017 年《Attention Is All You Need》里的原始模型已经不是同一个东西了。每一处改动都有人做过消融实验,也都有模型反着来还活得好好的。本讲要回答的就是:这些选择是怎么来的,哪些是真有证据的共识,哪些只是大家互相抄。
与前后两讲的关系:Lecture 02 教你把一个模型的 FLOPs、参数量、显存占用算清楚,那是「预算」;本讲讲的是怎么花这笔预算——同样的参数量,放在深度上还是宽度上?放在前馈层还是注意力头上?Lecture 04 会把注意力这一块单独拆开,讲线性注意力、状态空间模型和混合专家(MoE)。
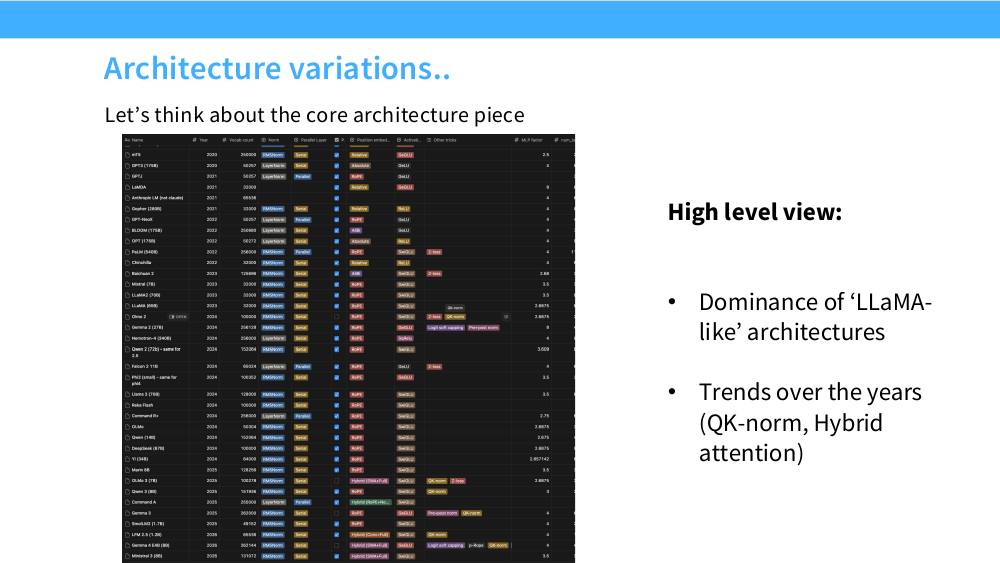
Tatsu 在开场就点明了本讲的方法论:最好的学习方式是亲手做实验,第二好的方式是从别人的实验里学。你没有几千张 GPU 去跑消融实验,但过去六年有几十个开源模型把它们的架构选择写进了技术报告。本讲的做法就是把这些选择摊在一张表上,看什么在收敛、什么在分化、什么根本没人验证过。
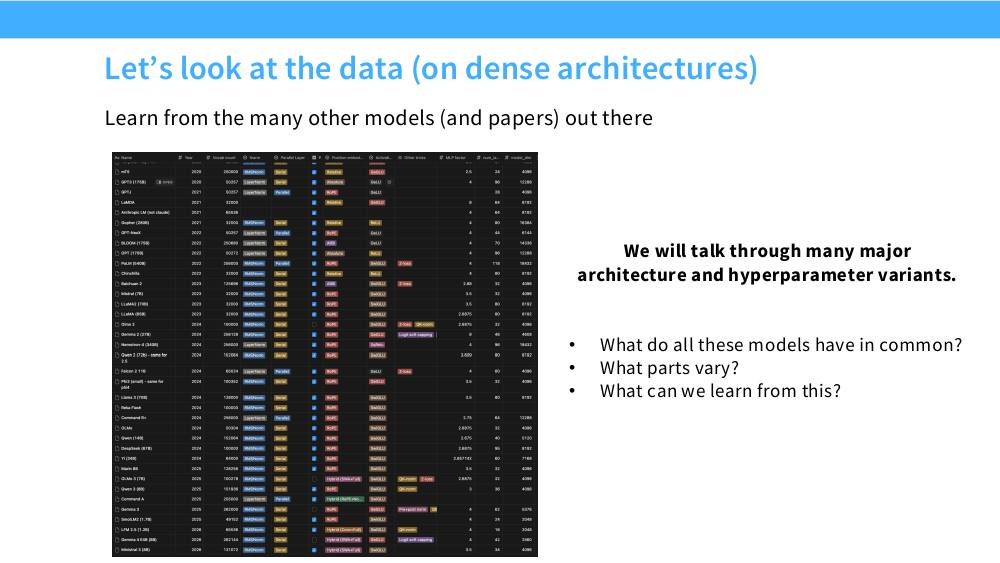
- 架构高度趋同。2023 年之后发布的 dense 模型,绝大多数是「LLaMA-like」:pre-norm + RMSNorm + SwiGLU/GeGLU + RoPE + 无 bias + GQA。真正还在分化的只有三处:位置编码的细节、激活函数选 Swi 还是 Ge、以及 tokenizer 词表大小。
- 超参数的共识比架构还强。$d_{ff}/d_{model}\approx 4$(用 GLU 时 $8/3$)、$n_{head}\times d_{head}\approx d_{model}$、$d_{model}/n_{layer}\approx 100\text{–}200$。但要注意:第一条有实打实的扫描证据,第二条几乎没有人系统验证过。
- 近两年的增量几乎全在稳定性上。QK-norm、z-loss、logit soft-capping、非残差 post-norm——这些都是为了让损失曲线不出现尖峰(loss spike),而不是为了降低最终损失。
- 判断一个技巧值不值得抄,要看它省的是 FLOPs 还是数据搬运。归一化只占 0.17% 的 FLOPs,却占 25.5% 的运行时间。FLOPs 不等于时间,这是贯穿整门课的一条主线。
- 「大家都这么做」不等于「这是最优的」。T5 用了 $d_{ff}=64\,d_{model}$ 照样训得出来;GPT-3 不用任何门控激活也是当年最强的模型。共识给你一个安全的起点,不是天花板。
1. 起点:原始 Transformer 与你实现的现代变体
1.1 原始 Transformer 的四个选择
2017 年的 Transformer 在四个地方做了具体选择,这四个地方后来全被改掉了:
- 位置编码:正弦/余弦函数(sinusoidal),加到 token 嵌入上,只加一次。
- 前馈网络(FFN):$\mathrm{FFN}(x)=\max(0,\,xW_1+b_1)W_2+b_2$,即 ReLU,带偏置。
- 归一化类型:LayerNorm,带可学习的缩放 $\gamma$ 和平移 $\beta$。
- 归一化位置:post-norm,即 $x_{l+1}=\mathrm{LN}(x_l+\mathrm{Sublayer}(x_l))$,归一化层在残差流内部。
1.2 你实现的版本,以及四处差异
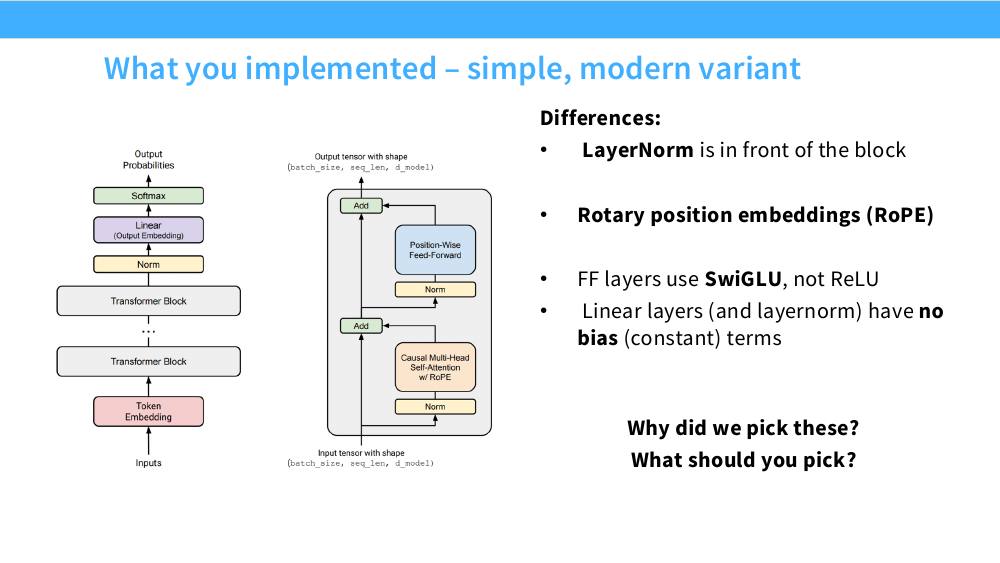
| 组件 | 原始 Transformer (2017) | 现代默认 (2023+) | 主要动机 |
|---|---|---|---|
| 归一化位置 | post-norm(残差流内) | pre-norm(残差流外) | 梯度传播、去掉 warmup、支持更大学习率 |
| 归一化类型 | LayerNorm | RMSNorm | 更少的数据搬运 → 更快的 wallclock |
| 激活函数 | ReLU | SwiGLU / GeGLU | 同参数量下稳定的质量增益 |
| 位置编码 | 正弦函数(加性、只加一次) | RoPE(乘性、每层都加) | 注意力分数只依赖相对位置、外推性 |
| 偏置项 | 线性层、LayerNorm 都有 | 全部去掉 | 内存/数据搬运、优化稳定性 |
| 注意力 | MHA | GQA(+ 滑窗/全局交错) | 推理时 KV cache 的带宽瓶颈 |
1.3 为什么要读几十个模型的技术报告
光 2024–2025 两年就有 19 个以上的新 dense 模型发布(还不算 MoE),每个都带着一点点架构微调。单看任何一篇技术报告,你只能得到「我们用了 X,效果不错」;把几十篇放在一起看,才能区分出真正的共识(所有人都收敛到同一个值,说明有人踩过坑)和路径依赖(大家都在抄 LLaMA 的配置文件,没人重新验证过)。
2. 归一化之一:pre-norm、post-norm 与残差流
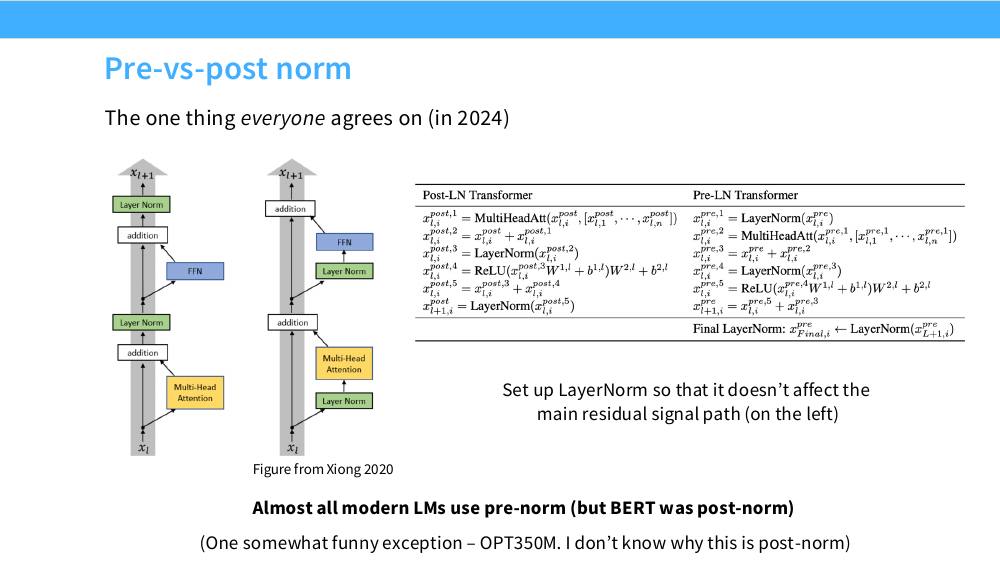
这是整张架构表上共识度最高的一列。2024 年的模型里,除了一个非常滑稽的例外(OPT-350M,Tatsu 说他也不知道为什么这个模型是 post-norm),几乎全部使用某种形式的「残差流外归一化」。而 BERT 时代的模型(包括 BERT 自己)都是 post-norm。
2.1 两种写法
把一个子层(注意力或 FFN)记作 $F(\cdot)$,两种排布是:
$$ \text{Post-LN:}\quad x_{l+1} = \mathrm{LN}\big(x_l + F(x_l)\big) \qquad\qquad \text{Pre-LN:}\quad x_{l+1} = x_l + F\big(\mathrm{LN}(x_l)\big) $$差别看起来只是括号位置,但后果完全不同。在 pre-norm 里把整个网络展开:
$$ x_L = x_0 + \sum_{l=0}^{L-1} F_l\big(\mathrm{LN}(x_l)\big) $$从输入到输出存在一条完全没有被任何非线性/归一化触碰过的恒等路径——这就是所谓的「残差流(residual stream)」。在 post-norm 里,这条路径每经过一层都要被 LayerNorm 处理一次,恒等性被破坏了。
2.2 为什么 post-norm 的梯度会出问题
LayerNorm 对输入 $x\in\R^d$ 的雅可比矩阵是
$$ \frac{\partial\,\mathrm{LN}(x)}{\partial x} = \frac{\diag(\gamma)}{\sigma}\left(I - \frac{1}{d}\mathbf{1}\mathbf{1}^\top - \frac{1}{d}\hat{x}\hat{x}^\top\right), \qquad \hat{x}=\frac{x-\mu}{\sigma} $$关键因子是 $1/\sigma$:归一化层的梯度增益反比于输入的标准差。在 post-norm 里,反向传播从第 $L$ 层走到第 $1$ 层,要连乘 $L$ 个这样的雅可比。只要各层的 $\sigma$ 不是恰好为 1,误差就以 $L$ 次幂的速度累积——要么爆炸,要么衰减。
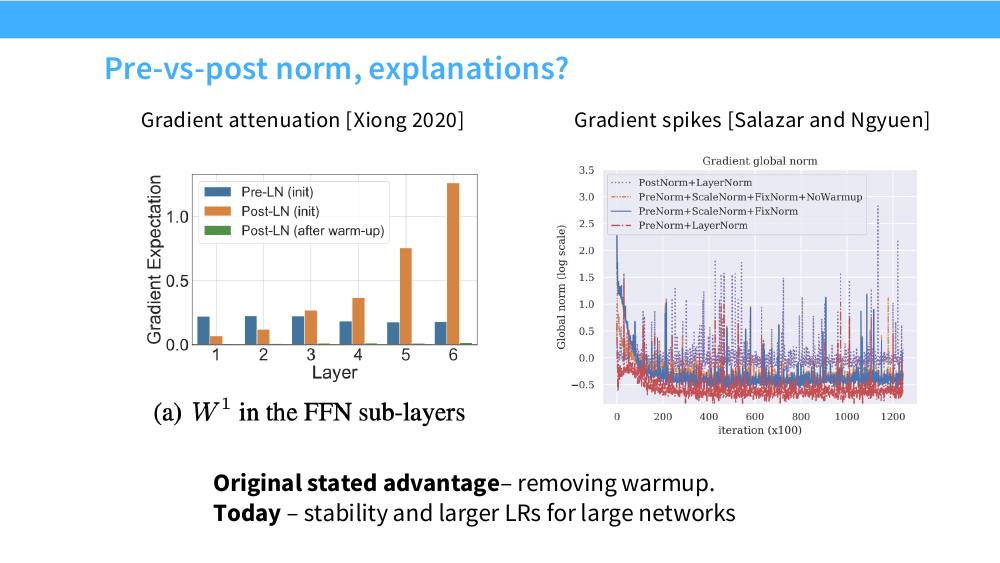
Xiong 等人(2020)的分析给出了初始化时的量级:post-LN 中靠近输出层的参数梯度范数是 $O(d\sqrt{\ln d})$,与深度 $L$ 无关;而 pre-LN 是 $O\!\left(d\sqrt{\ln d / L}\right)$,随深度自动衰减。含义是:post-LN 里浅层和深层的梯度尺度差异随深度迅速拉大,一个全局学习率没法同时适配它们。
2.3 从「去掉 warmup」到「支持更大的学习率」
pre-norm 最初被提出时,宣传的卖点是可以去掉学习率 warmup——既然梯度尺度在各层之间是一致的,就不需要用一段小学习率的热身期来「等」二阶矩估计稳定下来。
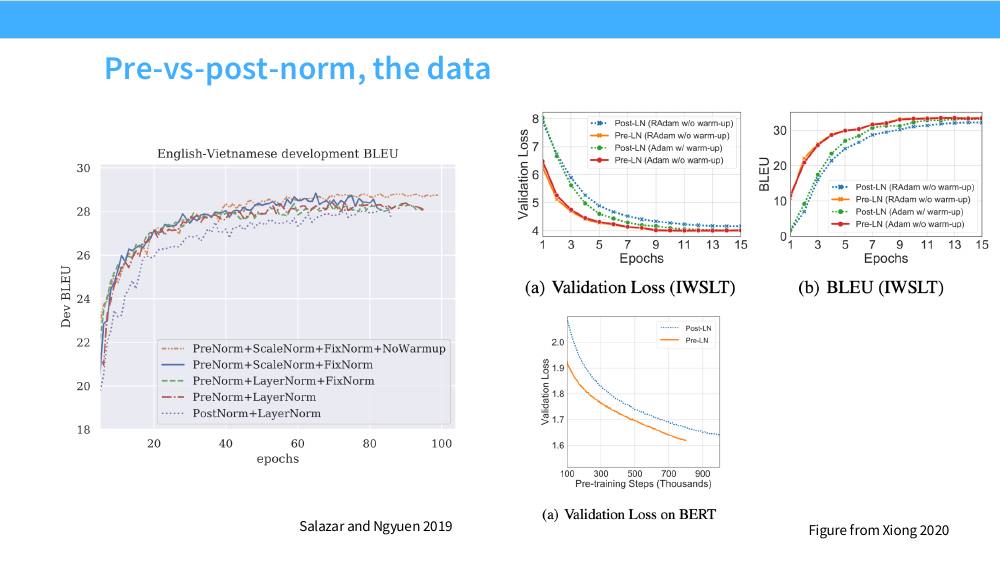
但今天大家用 pre-norm 的理由已经变了:不是为了省掉 warmup(几乎所有大模型仍然做 warmup),而是为了训练稳定性和更大的学习率。在几十上百层、上千亿参数的规模下,post-norm 的梯度尖峰会直接导致 loss spike,甚至发散到 NaN。pre-norm 让你可以把峰值学习率开得更高,从而在同样的 token 预算下走得更远。
2.4 新玩法:double norm 与非残差 post-norm
pre-norm 也不是没有代价。注意到残差流是累加的:$\mathrm{Var}(x_l)\approx \mathrm{Var}(x_0)+\sum_{j<l}\mathrm{Var}(F_j)$,方差随层数近似线性增长。于是第 $l$ 层内部的 $\mathrm{LN}$ 会除以一个 $\sim\sqrt{l}$ 的数,等价于深层子层对最终输出的相对贡献被自动压小了。另一个问题是:pre-norm 无法约束「加进残差流的东西」的量级,某一层如果输出爆了,它会一路污染后面所有层。
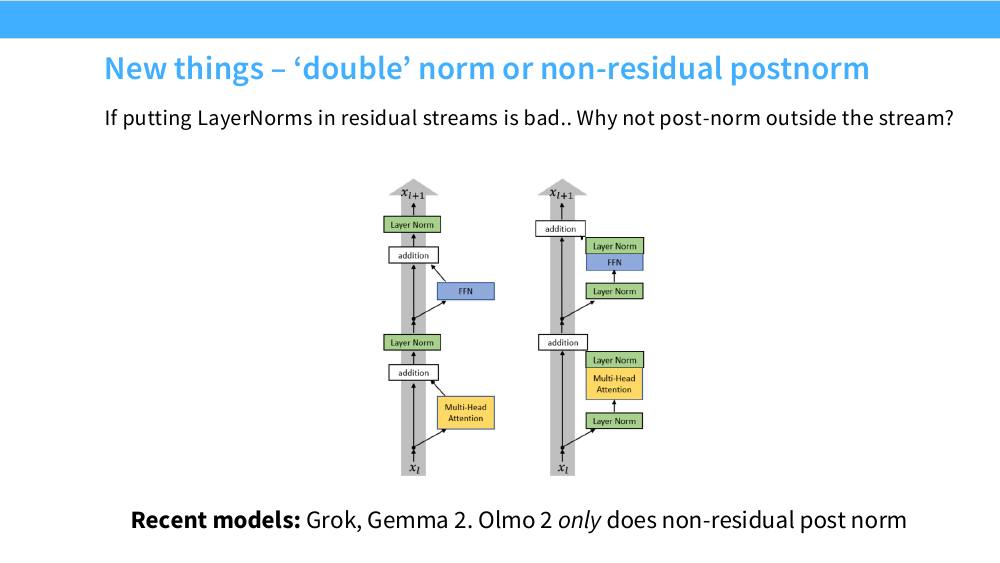
于是有了折中方案:既然「把 LayerNorm 放进残差流」是坏事,那就把 post-norm 放在残差流外面:
$$ \text{double norm:}\quad x_{l+1}=x_l+\mathrm{LN}_{\text{post}}\Big(F\big(\mathrm{LN}_{\text{pre}}(x_l)\big)\Big) \qquad \text{非残差 post-norm:}\quad x_{l+1}=x_l+\mathrm{LN}\big(F(x_l)\big) $$前者(子层前后各一个 norm)被 Grok 和 Gemma 2 采用;后者(只保留子层输出上的 norm)是 OLMo 2 的做法,它们把这叫做「reordered norm」。两者的共同点是:残差流主干上依然只有加法,但每个子层往残差流里注入的量被显式地归一化了,量级可控。
3. 归一化之二:LayerNorm vs RMSNorm,以及为什么删掉 bias
3.1 两个公式
LayerNorm 在 $d_{model}$ 这一维上同时归一化均值和方差:
$$ \mathrm{LN}(x)=\frac{x-\E[x]}{\sqrt{\mathrm{Var}[x]+\varepsilon}}\odot\gamma+\beta, \qquad \gamma,\beta\in\R^{d} $$RMSNorm 去掉了减均值和加偏置这两步,只做尺度归一:
$$ \mathrm{RMSNorm}(x)=\frac{x}{\sqrt{\frac{1}{d}\sum_{i=1}^{d} x_i^2+\varepsilon}}\odot\gamma, \qquad \gamma\in\R^{d} $$阵营划分很清楚:LayerNorm 阵营是 GPT-1/2/3、OPT、GPT-J、BLOOM;RMSNorm 阵营是 LLaMA 全家、PaLM、Chinchilla、T5,以及基本上所有 2023 年之后的模型。
3.2 「因为它更快」——这个解释站得住吗?
教科书式的回答是:RMSNorm 更快,因为操作更少(不用算均值)、参数更少(没有 $\beta$ 要存)。
Tatsu 在这里停下来追问:这个解释真的说得通吗?做一下量纲分析。对一个 token,一层里的矩阵乘法是 $O(d^2)$ 量级的 FLOPs(比如 $d=4096$ 时,QKVO 四个投影就是 $4\times 2\times 4096^2\approx 1.34\times 10^{8}$ FLOPs),而一次 RMSNorm 大约是 $5d\approx 2\times 10^{4}$ FLOPs。比例是 $1/d$ 量级,也就是万分之几。参数量上,$\beta$ 只有 $d$ 个,相对于每层几千万参数完全可以忽略。
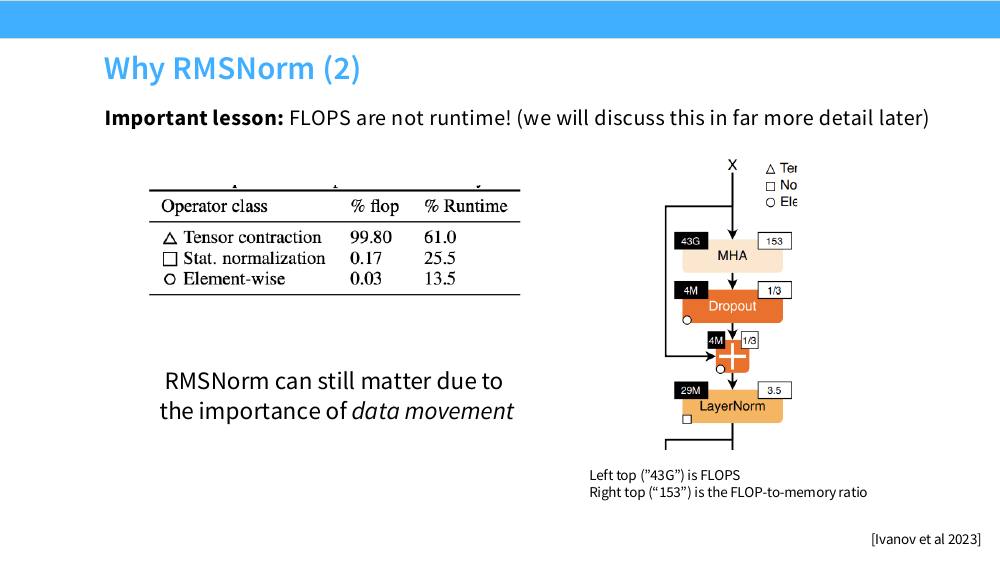
实测数据也印证了这一点:在一个典型 Transformer 里,张量收缩(矩阵乘)占 99.80% 的 FLOPs,统计归一化占 0.17%,逐元素操作占 0.03%。按 FLOPs 算,归一化根本不该被讨论。
3.3 真正的原因:FLOPs 不等于运行时间
但如果你去测时间,画风完全变了:
| 算子类别 | % FLOPs | % 运行时间 |
|---|---|---|
| 张量收缩(矩阵乘) | 99.80 | 61.0 |
| 统计归一化(LayerNorm、softmax) | 0.17 | 25.5 |
| 逐元素操作(激活、dropout、加法) | 0.03 | 13.5 |
占 0.2% FLOPs 的两类操作,吃掉了 39% 的运行时间。原因是算术强度(arithmetic intensity,FLOP/byte):矩阵乘每读一个字节能做上百次浮点运算,而 LayerNorm 每读一个元素只做几次运算,完全被显存带宽卡住。
3.4 实证:RMSNorm 不只是更快
Narang 等人(2021)在 223M 参数、11.1T ops 的相同预算下横扫了各种归一化方案:
| 模型 | 参数量 | 步/秒 | 早期损失 | 最终损失 | SGLUE | XSum | WebQ | WMT EnDe |
|---|---|---|---|---|---|---|---|---|
| Vanilla Transformer (LayerNorm) | 223M | 3.50 | 2.182 ± 0.005 | 1.838 | 71.66 | 17.78 | 23.02 | 26.62 |
| RMSNorm | 223M | 3.68 | 2.167 ± 0.008 | 1.821 | 75.45 | 17.94 | 24.07 | 27.14 |
| ReZero | 223M | 3.51 | 2.262 ± 0.003 | 1.939 | 61.69 | 15.64 | 20.90 | 26.37 |
| ReZero + LayerNorm | 223M | 3.26 | 2.223 ± 0.006 | 1.858 | 70.42 | 17.58 | 23.02 | 26.29 |
| Fixup | 223M | 2.95 | 2.382 ± 0.012 | 2.067 | 58.56 | 14.42 | 23.02 | 26.31 |
读法:吞吐 +5%(3.50 → 3.68 步/秒),而且最终损失还低了 0.017 nat,下游任务全面小胜。这不是一个「牺牲质量换速度」的取舍,而是白捡的。相比之下 ReZero、Fixup 这些「去掉归一化」的方案不但更慢,质量也明显更差。
3.5 更进一步:删掉所有 bias
原始 Transformer 的 FFN 是
$$ \mathrm{FFN}(x)=\max(0,\,xW_1+b_1)W_2+b_2 $$现代实现(未使用门控时)是
$$ \mathrm{FFN}(x)=\sigma(xW_1)W_2 $$连 RMSNorm 的 $\beta$ 也一起删掉了。理由和 RMSNorm 完全一样:
- 内存与数据搬运。bias 的参数量占比可以忽略(每层 $d_{ff}+d_{model}$,相对 $3d_{model}d_{ff}$ 是万分之几),但它是一次额外的读取 + 一次额外的逐元素加法,属于最贵的那类操作。
- 优化稳定性。bias 项是模型里少数「不随输入尺度变化」的自由度,容易在低精度训练中变成 outlier feature 的温床;同时它和 weight decay 的相互作用也很尴尬(大多数实现要把 bias 从 weight decay 里排除,又是一处特判)。
3.6 归一化小结
- 基本所有人都做残差流外的归一化(通常是 pre-norm)。直觉:保住残差连接的好处;观察:梯度传播更均匀、尖峰更少。有些人在残差流外再加一个 post-norm。
- 大多数人用 RMSNorm。实践中和 LayerNorm 效果相当,但要搬运的参数更少,省的是 wallclock 时间。
- bias 项被普遍删除,因为它们的「计算/参数」收益比很差。
4. 激活函数:从 ReLU 到 GLU 家族
激活函数是个动物园:ReLU、GeLU、Swish、ELU、SeLU、GLU、GeGLU、ReGLU、SwiGLU、LiGLU……先把它们理清楚,再看谁真的有用。
4.1 三个非门控激活
ReLU——原始 Transformer、T5、Gopher、Chinchilla、OPT:
$$ \mathrm{FF}_{\mathrm{ReLU}}(x)=\max(0,\,xW_1)W_2 $$GeLU(Gaussian Error Linear Unit)——GPT-1/2/3、GPT-J、GPT-NeoX、BLOOM:
$$ \mathrm{FF}_{\mathrm{GeLU}}(x)=\mathrm{GELU}(xW_1)W_2, \qquad \mathrm{GELU}(x):=x\,\Phi(x) $$其中 $\Phi$ 是标准正态分布的 CDF。直觉上 GeLU 是 ReLU 的「软化」版本:ReLU 用硬阈值 $\mathbb{1}[x>0]$ 决定是否通过,GeLU 用「$x$ 比一个标准正态随机变量大的概率」来加权,因此在 0 附近光滑可导。实践中常用 tanh 近似:
$$ \mathrm{GELU}(x)\approx 0.5\,x\left(1+\tanh\!\left[\sqrt{2/\pi}\,\big(x+0.044715\,x^3\big)\right]\right) $$Swish / SiLU:$\mathrm{Swish}_\beta(x)=x\cdot\sigma(\beta x)$,$\beta=1$ 时就是 SiLU。它和 GeLU 形状极其接近,都是「自门控(self-gated)」的:用输入自己的 sigmoid 去缩放自己。
4.2 门控线性单元(GLU)
GLU 改的是 FFN 的第一层。原来是「线性 + 激活」:
$$ \max(0,\,xW_1) $$现在再加一路纯线性分支,两路逐元素相乘:
$$ \max(0,\,xW_1)\;\longrightarrow\;\max(0,\,xW_1)\otimes(xV) $$于是得到门控版本(这里是 ReGLU):
$$ \mathrm{FF}_{\mathrm{ReGLU}}(x)=\big(\max(0,\,xW_1)\otimes xV\big)W_2 $$注意多出了一个参数矩阵 $V$,FFN 从两个矩阵变成三个矩阵。把激活换成 GELU 或 Swish 就得到今天的两大主流:
$$ \mathrm{FFN}_{\mathrm{GeGLU}}(x,W,V,W_2)=\big(\mathrm{GELU}(xW)\otimes xV\big)W_2 $$ $$ \mathrm{FFN}_{\mathrm{SwiGLU}}(x,W,V,W_2)=\big(\mathrm{Swish}_1(xW)\otimes xV\big)W_2 $$- GeGLU:T5 v1.1、mT5、LaMDA、Phi-3、Gemma 2/3/4
- SwiGLU:LLaMA 1/2/3、PaLM、Mistral、OLMo,以及 2023 年后的绝大多数模型
4.3 为什么隐层宽度要乘 2/3
标准 FFN 有两个矩阵:$W_1\in\R^{d_{model}\times d_{ff}}$、$W_2\in\R^{d_{ff}\times d_{model}}$,参数量
$$ P_{\text{标准}} = 2\,d_{model}\,d_{ff} $$门控版本多了 $V\in\R^{d_{model}\times d_{ff}}$,参数量
$$ P_{\text{GLU}} = 3\,d_{model}\,d_{ff}^{\text{GLU}} $$要让两者参数量(以及 FLOPs,因为 FFN 的 FLOPs 正比于参数量)相等:
$$ 3\,d_{model}\,d_{ff}^{\text{GLU}} = 2\,d_{model}\,d_{ff} \;\Longrightarrow\; \boxed{\,d_{ff}^{\text{GLU}} = \tfrac{2}{3}\,d_{ff}\,} $$代入常见的 $d_{ff}=4d_{model}$,得到 $d_{ff}^{\text{GLU}}=\frac{8}{3}d_{model}\approx 2.67\,d_{model}$。
数值检查:LLaMA-7B 的 $d_{model}=4096$。若用标准 FFN,$d_{ff}=16384$,每层 FFN 参数 $2\times4096\times16384=1.342\times10^8$。LLaMA 实际用 SwiGLU 且 $d_{ff}=11008$($=2.6875\,d_{model}$,把 $\frac{8}{3}\times4096\approx10923$ 向上取整到 256 的倍数),每层 FFN 参数 $3\times4096\times11008=1.352\times10^8$——两者相差 0.7%。这就是 $2/3$ 规则在真实模型里的样子。
这个「向上取整到 128 或 256 的倍数」的细节值得单独提一句:OLMo 的做法是把 $\frac{8}{3}d$ 提升到最接近的 128 的倍数。理由纯粹是硬件——GPU 的 tensor core 对矩阵维度是 8/16/128 的倍数最友好,一个 10923 的维度会让 GEMM kernel 掉到慢速路径上。
4.4 门控到底有没有用?
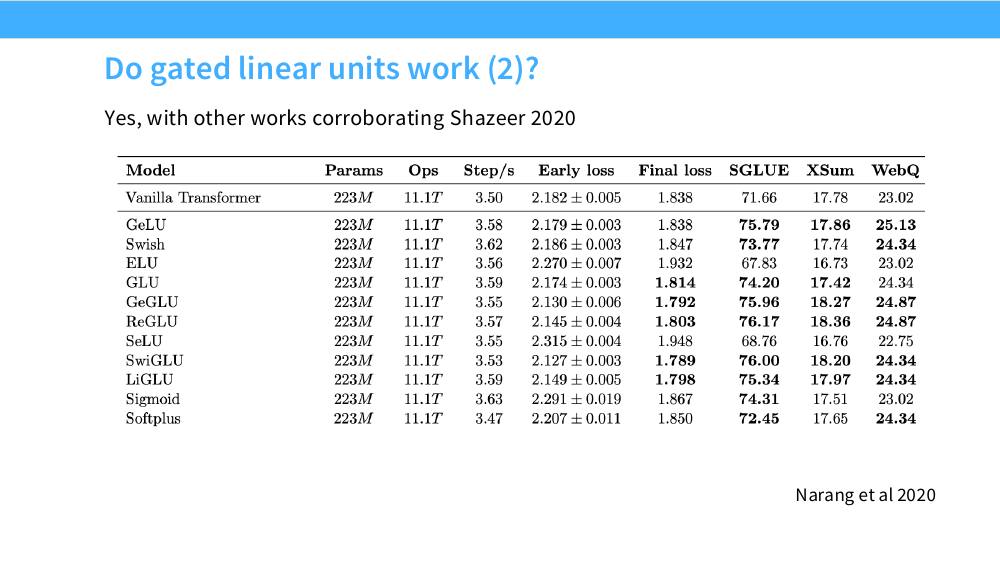
Shazeer(2020)在 T5 的框架下做了受控对比(所有变体参数量对齐):
| FFN 变体 | 平均分 | CoLA (MCC) | SST-2 (Acc) |
|---|---|---|---|
| ReLU | 83.80 | 51.32 | 94.04 |
| GELU | 83.86 | 53.48 | 94.04 |
| Swish | 83.60 | 49.79 | 93.69 |
| GLU(sigmoid 门控) | 84.20 | 49.16 | 94.27 |
| GEGLU | 84.12 | 53.65 | 93.92 |
| Bilinear(无激活的门控) | 83.79 | 51.02 | 94.38 |
| SwiGLU | 84.36 | 51.59 | 93.92 |
| ReGLU | 84.67 | 56.16 | 94.38 |
| Raffel 等(2019)基线 | 83.28 | 53.84 | 92.68 |
| 该基线的标准差 | 0.235 | 1.111 | 0.569 |
关键在最后一行:平均分的运行间标准差是 0.235,而门控变体比非门控变体高出 0.4–0.9 分,也就是2–4 个标准差。这不是噪声。
4.5 激活小结
- 各模型之间确实存在多种选择(ReLU、GeLU、*GLU)。
- 门控不是必需的——GPT-3 用纯 GeLU 也是当年最强的模型——但 2023 年之后几乎看不到不用门控的了。
- 少数离群模型:Nemotron 340B 用的是 squared ReLU($\max(0,x)^2$)。
- 证据方向一致:Swi/GeGLU 能带来稳定但不大的收益。在同参数量下白拿 0.04 nat,值得。
5. 串行块 vs 并行块
标准 Transformer 块是串行的:先算注意力,再把结果喂给 MLP。
$$ y = x + \mathrm{MLP}\Big(\mathrm{LN}\big(x+\mathrm{Attention}(\mathrm{LN}(x))\big)\Big) $$并行版本让两个子层同时读取同一个输入:
$$ y = x + \mathrm{MLP}\big(\mathrm{LN}(x)\big) + \mathrm{Attention}\big(\mathrm{LN}(x)\big) $$好处是纯系统层面的:两个分支共享同一次 LayerNorm(少算一次归一化,而归一化恰好是 memory-bound 的),而且 $W_Q,W_K,W_V$ 和 MLP 的第一个矩阵读的是同一个输入张量,可以融合成一次更大的 GEMM——大矩阵乘的效率高于多个小矩阵乘。在张量并行的场景里还能少一次 all-reduce。
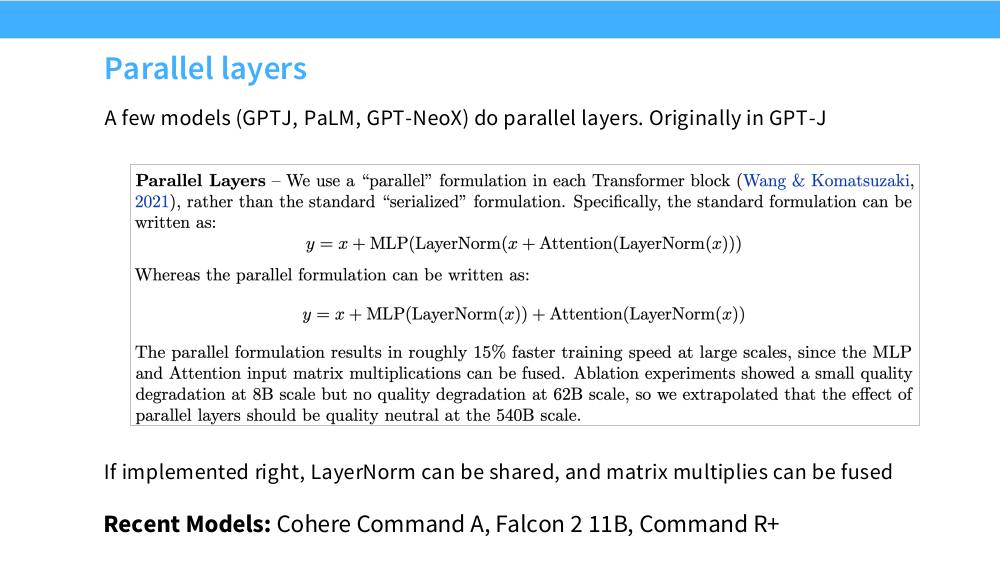
采用并行层的模型:GPT-J(首创)、PaLM、GPT-NeoX,近期的 Cohere Command A、Falcon 2 11B、Command R+。但大多数模型今天仍然用串行块——15% 的加速在「质量可能有一点点损失」面前,多数团队选择不冒险。这是一个典型的「有明确收益但没成为共识」的技巧。
6. 位置编码:从正弦到 RoPE
自注意力本身是置换不变(permutation-invariant)的:把输入 token 打乱,输出也只是跟着打乱,模型完全不知道「谁在谁前面」。所以必须显式注入位置信息。这是本讲里分歧最大的一列。
6.1 四类方案
| 类型 | 形式 | 代表模型 |
|---|---|---|
| 正弦(sinusoidal) | $\mathrm{Embed}(x,i)=v_x+\mathrm{PE}_{i}$,$\mathrm{PE}$ 由不同频率的 sin/cos 构成 | 原始 Transformer |
| 绝对(learned absolute) | $\mathrm{Embed}(x,i)=v_x+u_i$,$u_i$ 是可学习的位置向量 | GPT-1/2/3、OPT |
| 相对(relative) | 在注意力打分里加一项,如 $e_{ij}=\dfrac{x_iW^Q(x_jW^K+a^K_{ij})^\top}{\sqrt{d_z}}$ | T5、Gopher、Chinchilla |
| 旋转(RoPE) | 对 Q/K 做与位置有关的旋转 | GPT-J、PaLM、LLaMA,以及几乎所有 2024+ 模型 |
正弦编码的具体形式是 $\mathrm{PE}_{i,2k}=\sin(i/10000^{2k/d})$、$\mathrm{PE}_{i,2k+1}=\cos(i/10000^{2k/d})$:用一组几何级数排列的频率,把位置 $i$ 编码成一个「多尺度的时钟读数」。低频维度区分远距离,高频维度区分近距离。
6.2 RoPE 想解决的问题
先把目标写清楚。一个真正的相对位置编码,应该存在函数 $f(x,i)$ 使得
$$ \big\langle f(x,i),\,f(y,j)\big\rangle = g(x,y,\,i-j) $$也就是说:注意力分数只能依赖相对位置 $i-j$,不能依赖绝对位置。为什么已有方案都不满足?
- 正弦编码:加性的编码在做内积时会展开出交叉项, $\langle v_x+\mathrm{PE}_i,\;v_y+\mathrm{PE}_j\rangle=\langle v_x,v_y\rangle+\langle \mathrm{PE}_i,v_y\rangle+\langle v_x,\mathrm{PE}_j\rangle+\langle \mathrm{PE}_i,\mathrm{PE}_j\rangle$。 只有最后一项是相对的($\langle \mathrm{PE}_i,\mathrm{PE}_j\rangle$ 确实只依赖 $i-j$),中间两个交叉项混杂了内容和绝对位置。
- 绝对位置编码:显然不是相对的。
- 相对位置偏置(T5 那种):确实只依赖 $i-j$,但它是直接往注意力 logits 上加一个标量,不再是一个内积。这在工程上是个真问题——FlashAttention 这类融合 kernel 假定注意力分数来自 $QK^\top$,额外的偏置矩阵要么破坏融合,要么需要专门实现。
6.3 关键洞察:内积对旋转不变
RoPE 的思路极其简洁:
- 我们希望嵌入对绝对位置不敏感;
- 而内积对任意旋转不变:$\langle Rq, Rk\rangle=\langle q,k\rangle$,因为 $R^\top R=I$。
所以:把位置编码成一个旋转。把 query 按位置 $m$ 旋转 $m$ 个「刻度」,key 按位置 $n$ 旋转 $n$ 个刻度,则
$$ \langle R_m q,\;R_n k\rangle = q^\top R_m^\top R_n k = q^\top R_{n-m} k $$(因为旋转矩阵满足 $R_m^\top=R_{-m}$、$R_{-m}R_n=R_{n-m}$。)内积自动只依赖 $n-m$,目标达成。把「we know that」和「of course we know」这两个句子里的同一对词旋转到不同的绝对角度,它们之间的夹角——也就是注意力分数——完全一样。
6.4 选哪个旋转?
$d$ 维空间里的旋转有 $d(d-1)/2$ 个自由度,得挑一个。RoPE 的选择是:把坐标两两配对,每一对在自己的 2 维平面里旋转(动机来自复数——一个 2 维旋转就是乘以 $e^{i\theta}$)。第 $k$ 对的旋转角速度是
$$ \theta_k = 10000^{-2(k-1)/d},\qquad k=1,\dots,d/2 $$位置 $m$ 处,第 $k$ 对被旋转 $m\theta_k$ 弧度。这和正弦编码用的是同一套几何级数频率:$k$ 小的是高频(转得快,编码近距离),$k$ 大的是低频(转得慢,编码远距离)。
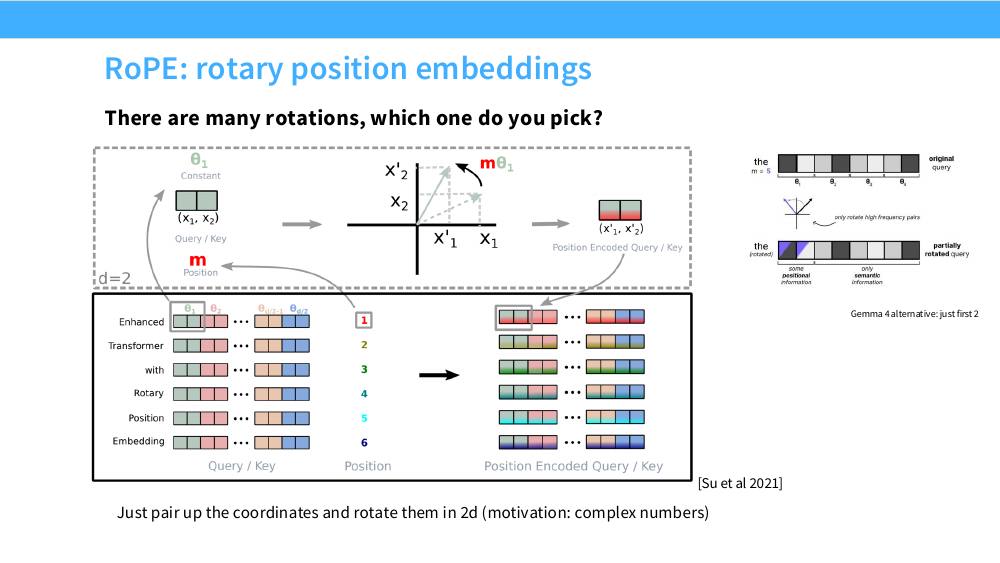
rotary_pct 参数。6.5 完整的数学形式
写成矩阵,RoPE 就是在 Q/K 投影之后左乘一个块对角的旋转矩阵:
$$ f_{\{q,k\}}(\boldsymbol{x}_m, m) = \boldsymbol{R}^d_{\Theta,m}\,\boldsymbol{W}_{\{q,k\}}\,\boldsymbol{x}_m $$ $$ \boldsymbol{R}^d_{\Theta,m}= \begin{pmatrix} \cos m\theta_1 & -\sin m\theta_1 & 0 & 0 & \cdots & 0 & 0\\ \sin m\theta_1 & \cos m\theta_1 & 0 & 0 & \cdots & 0 & 0\\ 0 & 0 & \cos m\theta_2 & -\sin m\theta_2 & \cdots & 0 & 0\\ 0 & 0 & \sin m\theta_2 & \cos m\theta_2 & \cdots & 0 & 0\\ \vdots & \vdots & \vdots & \vdots & \ddots & \vdots & \vdots\\ 0 & 0 & 0 & 0 & \cdots & \cos m\theta_{d/2} & -\sin m\theta_{d/2}\\ 0 & 0 & 0 & 0 & \cdots & \sin m\theta_{d/2} & \cos m\theta_{d/2} \end{pmatrix} $$和正弦编码的两个本质区别:它是乘性的而不是加性的,因此不产生内容 × 位置的交叉项。
6.6 最小实现
import torch

def build_rope_cache(seq_len: int, head_dim: int, base: float = 10000.0):
    """返回 cos/sin 表,形状均为 (seq_len, head_dim // 2)。"""
    # theta_k = base^(-2k/d), k = 0, 1, ..., d/2 - 1
    k = torch.arange(0, head_dim, 2).float()            # 0, 2, 4, ...
    inv_freq = base ** (-k / head_dim)                  # (head_dim/2,)
    pos = torch.arange(seq_len).float()                 # (seq_len,)
    angles = torch.outer(pos, inv_freq)                 # (seq_len, head_dim/2)
    return angles.cos(), angles.sin()

def apply_rope(x, cos, sin):
    """x: (batch, n_heads, seq_len, head_dim)。cos/sin: (seq_len, head_dim/2)。"""
    x1 = x[..., 0::2]                                   # 偶数下标:每对的第一个分量
    x2 = x[..., 1::2]                                   # 奇数下标:每对的第二个分量
    cos = cos[None, None, :, :]                         # 广播到 batch / head 维
    sin = sin[None, None, :, :]
    # 逐对做 2D 旋转: [x1, x2] -> [x1 cos - x2 sin,  x1 sin + x2 cos]
    o1 = x1 * cos - x2 * sin
    o2 = x1 * sin + x2 * cos
    return torch.stack((o1, o2), dim=-1).flatten(-2)    # 交错还原成 head_dim

# --- 验证相对性:内积只依赖 (m - n) ---
cos, sin = build_rope_cache(seq_len=64, head_dim=8)
q = torch.randn(1, 1, 64, 8)
k = torch.randn(1, 1, 64, 8)
qr, kr = apply_rope(q, cos, sin), apply_rope(k, cos, sin)
# 把同一对向量放在位置 (3, 7) 和位置 (20, 24),相对距离都是 4
a = (qr[0, 0, 3] * kr[0, 0, 7]).sum()
b = (qr[0, 0, 20] * kr[0, 0, 24]).sum()
print(a.item(), b.item())   # 一般来说这两个数并不相等 —— 见下方说明
最后那个「验证」故意留了一个坑:上面的写法里 q[3] 和 q[20] 是不同的随机向量,所以内积当然不同。要真正验证相对性,必须把同一个内容向量放到不同位置上:
qv = torch.randn(8)     # 同一个 query 内容
kv = torch.randn(8)     # 同一个 key   内容

def rope_one(v, pos, cos, sin):
    v1, v2 = v[0::2], v[1::2]
    c, s = cos[pos], sin[pos]
    return torch.stack((v1 * c - v2 * s, v1 * s + v2 * c), dim=-1).flatten()

for (m, n) in [(3, 7), (20, 24), (50, 54)]:
    print(m, n, torch.dot(rope_one(qv, m, cos, sin), rope_one(kv, n, cos, sin)).item())
# 三行输出完全相同 —— 因为 n - m 都等于 4
在真实模型里,RoPE 是这样插进注意力的:
query_states = self.q_proj(hidden_states)
key_states   = self.k_proj(hidden_states)
value_states = self.v_proj(hidden_states)

query_states = query_states.view(bsz, q_len, self.num_heads,          self.head_dim).transpose(1, 2)
key_states   = key_states.view(  bsz, q_len, self.num_key_value_heads, self.head_dim).transpose(1, 2)
value_states = value_states.view(bsz, q_len, self.num_key_value_heads, self.head_dim).transpose(1, 2)

cos, sin = self.rotary_emb(value_states, position_ids)               # 取 RoPE 的 cos/sin
query_states, key_states = apply_rotary_pos_emb(query_states, key_states, cos, sin)

# ... 下面和普通的多头自注意力完全一样 ...
- 只旋转 Q 和 K,不旋转 V。位置信息的作用是调制「谁该看谁」,value 携带的是内容,不需要旋转。
- 每一层的每一次注意力都要重新施加,而不是像正弦编码那样在嵌入层加一次。原因很直接:相对性来自 $R_m^\top R_n$ 这个内积恒等式,只有在做内积的那一刻两侧都带着旋转才成立。经过一层 FFN 之后,「旋转」这个结构早就被非线性打散了。
- 配对约定有两种。上面的代码用的是原论文的「相邻交错」($(x_1,x_2),(x_3,x_4),\dots$),而 HuggingFace 的
rotate_half用的是「前后对半」($(x_1,x_{d/2+1}),\dots$)。两者只差一个固定的坐标置换,数学上等价,但权重不能互换——转换模型格式时这是经典的踩坑点。
6.7 RoPE 的旋钮:base 与外推
公式里的 10000 叫做 RoPE base(常记作 $\theta$ 或 rope_theta),它决定了最低频维度的「周期」有多长。默认的 10000 对应约几千 token 的有效分辨率;要支持长上下文,主流做法是把 base 调大——OLMo 3 用 $5\times10^5$,不少长上下文模型用 $10^6$——让低频维度转得更慢,从而在更长的距离上仍能区分位置。更系统的方案(YaRN、NTK-aware 插值等)会对不同频段做不同的缩放,OLMo 3 就只在全注意力层上做 YaRN 缩放。
7. 超参数:那些惊人的共识
这一节回答几个在入门课上没人告诉你的问题:前馈层该比隐藏层大多少?要多少个头,头维度必须能整除 $d_{model}$ 吗?词表该多大?模型该做深还是做宽?
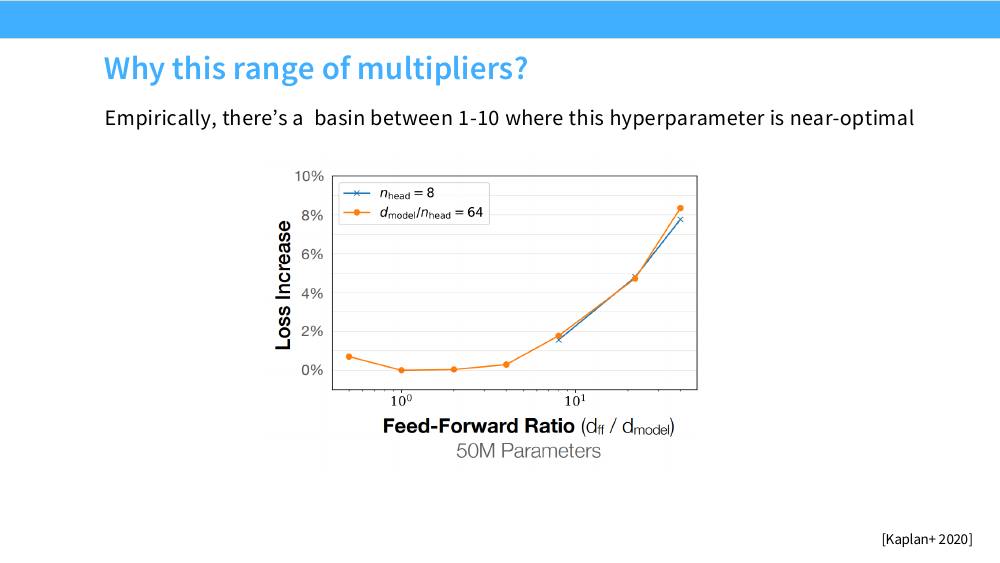
7.1 共识一:前馈维度是模型维度的 4 倍
这条几乎是普适的。原始 Transformer 是 $512\to2048$,GPT-3 是 $12288\to49152$,中间六年、上千倍的规模跨度,倍率没变过。
例外一:GLU 变体。前面推过,门控会把倍率乘 $2/3$,得到 $d_{ff}=\frac{8}{3}d_{model}\approx2.67$。实际模型的取值:
| 模型 | $d_{ff}/d_{model}$ | 说明 |
|---|---|---|
| PaLM | 4 | 用了 SwiGLU 但没缩,等于加宽了 FFN |
| Mistral 7B | 3.5 | 略宽于 8/3 |
| LLaMA-2 70B | 3.5 | 略宽于 8/3 |
| LLaMA 70B | 2.68 | 标准 8/3 |
| Qwen 14B | 2.67 | 标准 8/3 |
| DeepSeek 67B | 2.68 | 标准 8/3 |
| Yi 34B | 2.85 | 略宽 |
| T5 v1.1 | 2.5 | 略窄 |
整体落在 2.5–4 之间,PaLM、LLaMA-2、Mistral 稍微偏大一点。
例外二:T5。大多数 LM 的超参数都保守得乏味,T5 是个大胆的异类——11B 版本用了
$$ d_{ff}=65536,\qquad d_{model}=1024\quad\Longrightarrow\quad \frac{d_{ff}}{d_{model}}=64 $$64 倍!而且它训得出来、效果也不错。近期的其他例外:Gemma 2(8×)、SmolLM / Gemma 3 / Gemma 4(在 GLU 下取 4×,相当于比 8/3 宽 50%)。
那 T5 的 64 倍到底是不是好选择?有个很有说服力的间接证据:T5 的后续改进版 T5 v1.1 把倍率改回了标准的 2.5(配 GeGLU)。作者自己回退了这个选择,说明 64 倍多半是次优的。
7.2 共识二:头数 × 头维度 = 模型维度
多头注意力之所以「不比单头更贵」,是因为标准做法把 $d_{model}$ 切成 $h$ 份:算出 $XQ\in\R^{n\times d}$ 之后 reshape 成 $\R^{n\times h\times d/h}$,再转置成 $\R^{h\times n\times d/h}$,头维度就变成了一个 batch 维。所有矩阵尺寸和单头时完全一样。
但这不是必须的——完全可以让 $d_{head}>d_{model}/h$,代价是 QKV 投影矩阵变成非方阵,参数量和 FLOPs 都上升。实际情况:
| 模型 | 头数 $h$ | 头维度 $d_{head}$ | 模型维度 $d_{model}$ | 比值 |
|---|---|---|---|---|
| GPT-3 | 96 | 128 | 12288 | 1 |
| T5 | 128 | 128 | 1024 | 16 |
| T5 v1.1 | 64 | 64 | 4096 | 1 |
| LaMDA | 128 | 128 | 8192 | 2 |
| PaLM | 48 | 256 | 18432 | 1.48† |
| LLaMA-2 | 64 | 128 | 8192 | 1 |
| Qwen 3.5 (27B) | 24 | 256 | 5120 | 1.2 |
† 注意 PaLM 这一行的方向是反的:$48\times256=12288$,比 $d_{model}=18432$ 小,比值 1.48 指的是 $d_{model}/(h\cdot d_{head})$。其余各行的比值都是 $(h\cdot d_{head})/d_{model}$。
绝大多数模型的比值就是 1,例外集中在 Google 的几个模型(T5 的 16 倍尤其夸张:$128\times128=16384$ 对 $d_{model}=1024$)。
7.3 共识三:aspect ratio(深度 vs 宽度)
给定参数预算,是做深还是做宽?用 $d_{model}/n_{layer}$ 这个「长宽比」来衡量:
| 模型 | $d_{model}/n_{layer}$ |
|---|---|
| BLOOM | 205 |
| T5 v1.1 | 171 |
| PaLM (540B) | 156 |
| GPT-3 / OPT / Mistral / Qwen / OLMo 3 | 128 |
| LLaMA / LLaMA-2 | 102 |
| Gemma 3 | 87 |
| Gemma 4 | 61 |
| T5 (11B) | 33 |
「甜区」大致在 100–200。同样,也有例外——T5 11B 的 33(很深很窄)和 Gemma 4 的 61。
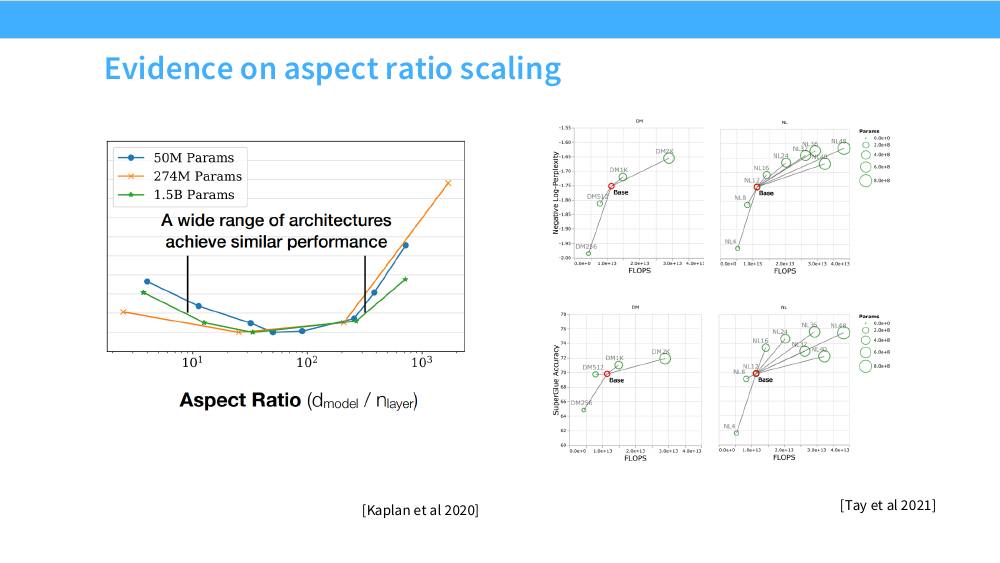
既然性能对它不敏感,那什么在决定实际取值?系统因素。
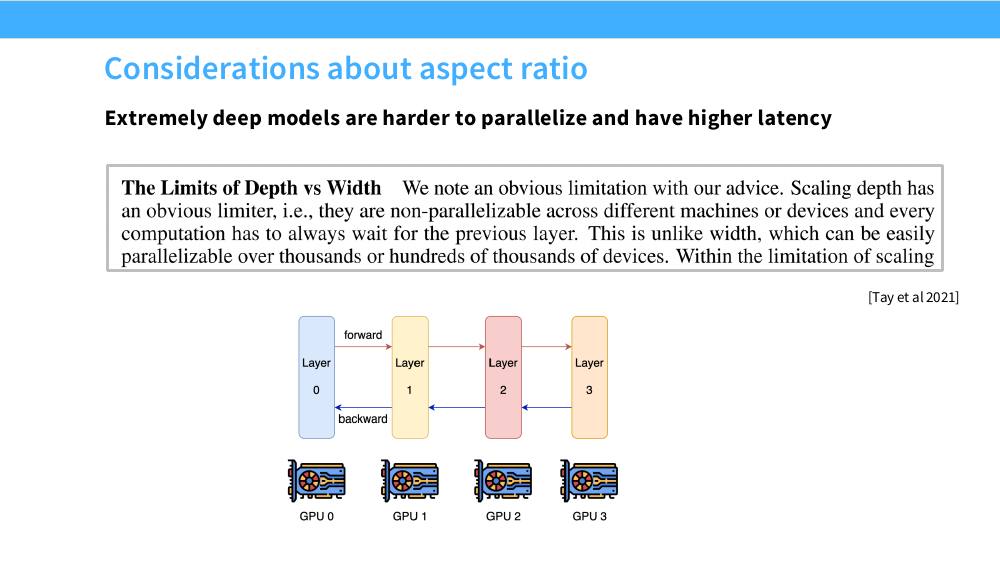
7.4 词表大小
词表大小明确地分成两个阵营:
| 单语模型:30–50k | 多语言 / 生产系统:100–260k | ||
|---|---|---|---|
| 原始 Transformer | 37,000 | mT5 | 250,000 |
| GPT | 40,257 | PaLM | 256,000 |
| GPT-2 / GPT-3 | 50,257 | GPT-4 | 100,276 |
| T5 / T5 v1.1 | 32,128 | Gemma 4 | 262,144 |
| LLaMA | 32,000 | DeepSeek | 100,000 |
| Qwen 15B | 152,064 | ||
| Yi | 64,000 | ||
逻辑很清楚:单语(尤其是英文)不需要很大的词表,BPE 在 32k 上就能把英文压得相当好;而要覆盖上百种语言、代码、数学符号,词表不够大就会导致低资源语言被切成一堆字节,同样一句话消耗数倍的 token(既费钱又费上下文窗口)。
代价是:嵌入矩阵和输出层各是 $V\times d_{model}$。以 $d_{model}=4096$ 为例,$V=32000$ 时是 1.3 亿参数(× 2 层如果不共享权重),$V=262144$ 时是 10.7 亿——对一个 7B 模型来说这是巨大的一块,而且输出 softmax 的 logits 张量也从 $B\times T\times 32000$ 涨到 $B\times T\times 262144$,是训练时最占显存的中间张量之一。
8. 正则化:大模型预训练还需要 dropout 和 weight decay 吗?
8.1 理论上不需要
反对在预训练阶段加正则化的论据非常合理:
- 数据远多于参数。训练语料是万亿级 token,模型是十亿到千亿参数。经典的过拟合场景(参数 >> 数据)根本不成立。
- 只过一遍数据。SGD 在语料上通常只走一个 epoch(甚至不到),模型压根没有机会去「记住」某个样本。
8.2 实践中大家在做什么
| 模型 | Dropout* | Weight decay |
|---|---|---|
| 原始 Transformer | 0.1 | 0 |
| GPT-2 | 0.1 | 0.1 |
| T5 | 0.1 | 0 |
| GPT-3 | 0.1 | 0.1 |
| T5 v1.1 | 0 | 0 |
| PaLM | 0 | (可变) |
| OPT | 0.1 | 0.1 |
| LLaMA | 0 | 0.1 |
| Qwen 14B | 0.1 | 0.1 |
* 大多数论文根本不讨论 dropout。在开源模型上,「没提」基本等于「没用」;闭源模型就不好说了。
规律:老模型普遍在预训练时用 dropout;新模型(Qwen 是个例外)只保留 weight decay。这很好理解——dropout 拖慢训练(相当于每步只更新一部分网络),在「一遍过数据」的设定下收益几乎为零。
8.3 那为什么还留着 weight decay?
这是本节最有意思的地方。既然不是为了防过拟合,weight decay 为什么还在?
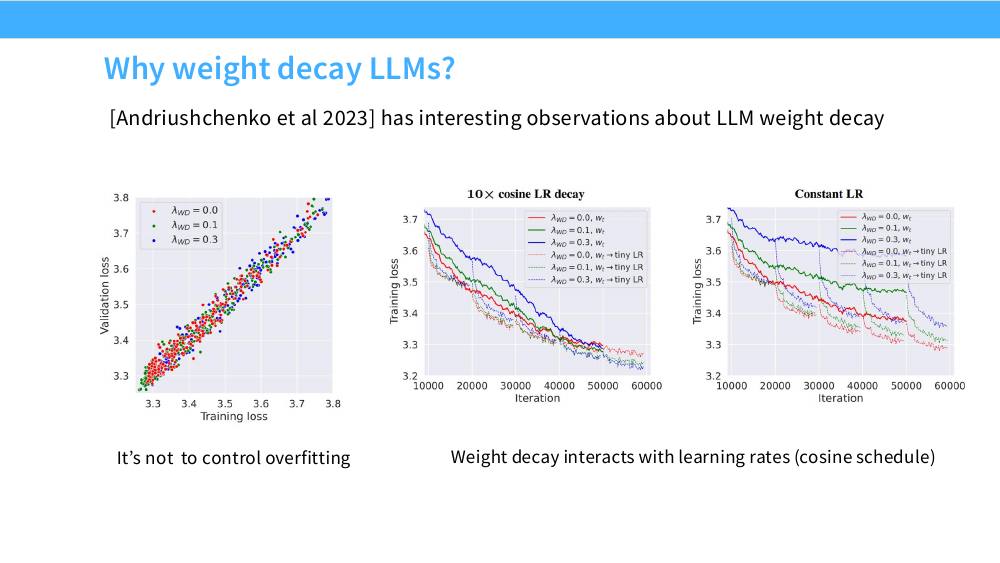
一个相关的实践细节:嵌入层通常不加 weight decay(OLMo 3 的配置表里明确写着 “Weight decay on embeddings: No”),bias 和 norm 的 $\gamma$ 也一般被排除在外。
8.4 超参数小结
- 前馈层:4 倍规则(GLU 时 8/3)是标准,且有扫描证据。
- 头维度:$d_{head}\times n_{head}=d_{model}$ 是标准,但几乎没有验证。
- Aspect ratio:「好」的取值范围很宽(100–200),最终由系统因素(并行度、延迟)决定。
- 正则化:你仍然会「正则化」LM,但它的作用主要体现在优化动力学上。
9. 训练稳定性:不要训出那条蓝色曲线
近两年架构上的新增量,几乎全部集中在稳定性上。原因很实际:一次 7B 模型的预训练要烧掉几十万美元的算力,中途炸了要回滚到几千步之前的 checkpoint,损失是真金白银。
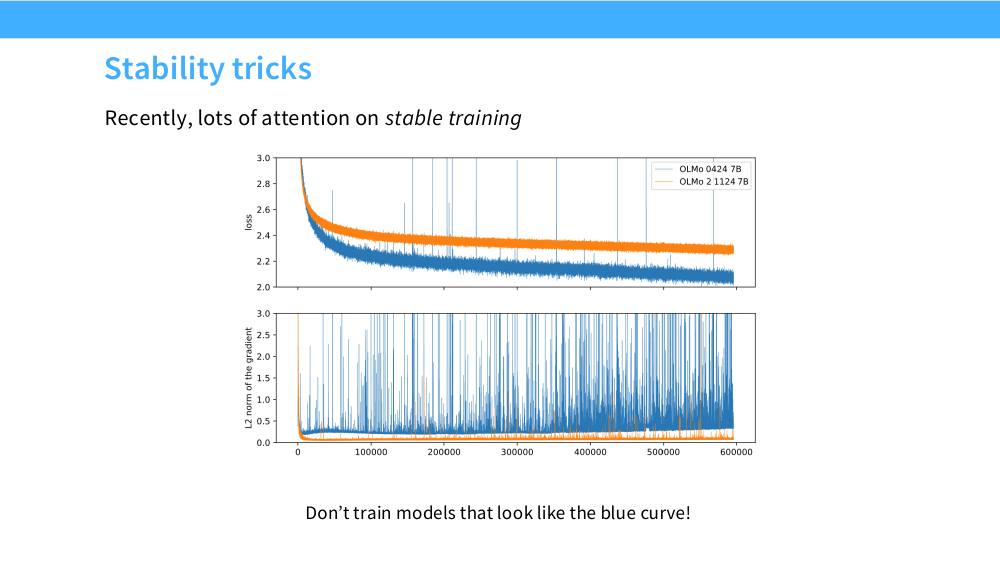
9.1 问题的源头:softmax
不稳定的根源几乎总是 softmax,因为它含有指数和除法:
$$ \softmax(u)_r=\frac{e^{u_r}}{Z},\qquad Z=\sum_{r'=1}^{|V|}e^{u_{r'}} $$两类故障模式:
- 指数溢出。虽然标准实现都会减去最大值($e^{u_r-\max u}$)来避免上溢,但在 bf16 下,logits 的绝对量级如果一路漂移到几百,中间量的精度会严重退化,梯度也随之失真。
- 除零 / 饱和。如果 $Z$ 极小(所有 logits 都是 $-\infty$,比如滑窗注意力里某行被完全 mask 掉),就会出现 0/0;如果某个 logit 远大于其他,softmax 饱和成 one-hot,梯度直接变成 0,注意力头就此「死掉」(attention entropy collapse)。
9.2 输出 softmax:z-loss
把交叉熵展开写:
$$ \log P(x) = \log\frac{e^{U_r(x)}}{Z(x)} = U_r(x)-\log Z(x), \qquad Z(x)=\sum_{r'=1}^{|V|}e^{U_{r'}(x)} $$注意 $\log Z$ 是可以自由漂移的:把所有 logits 同时加一个常数 $c$,概率分布完全不变,但 $\log Z$ 变成 $\log Z+c$。也就是说模型的损失函数对 logits 的整体平移是不敏感的,于是它会毫无约束地漂。z-loss 就是给这个自由度加一个软约束:
$$ L = \sum_i\Big[\log P(x_i)-\alpha\big(\log Z(x_i)-0\big)^2\Big] = \sum_i\Big[\log P(x_i)-\alpha\log^2 Z(x_i)\Big] $$即在负对数似然之外,额外加一项 $\alpha\log^2 Z$,鼓励 $\log Z\to 0$(也就是 $Z\to1$)。PaLM 用 $\alpha=10^{-4}$,OLMo 3 用 $10^{-5}$。
z-loss 对第 $r$ 个 logit 的梯度是
$$ \frac{\partial}{\partial U_r}\Big(\alpha\log^2 Z\Big) = 2\alpha\log Z\cdot\frac{1}{Z}\cdot e^{U_r} = 2\alpha\log Z\cdot\softmax(U)_r $$解读:当 $\log Z>0$(logits 整体偏大)时,梯度按 softmax 概率的比例把所有 logits 往下压;$\log Z<0$ 时反向。因为压的比例正好是 softmax 概率,所以它几乎不改变分布的形状,只改变整体尺度——这正是我们想要的:约束数值范围,不干扰建模。
使用 z-loss 的模型:PaLM(首创于机器翻译时代的 Devlin 2014)、Baichuan 2、DCLM、OLMo 2、OLMo 3。
9.3 注意力 softmax:QK-norm
注意力 logits 是 $q^\top k/\sqrt{d_{head}}$,其量级由 $\|q\|\cdot\|k\|$ 决定,而这两个范数在训练中是可以无限增长的。QK-norm 的做法极其简单:在做点积之前,对 query 和 key 各做一次 (RMS)LayerNorm。
$$ \text{score}_{ij}=\frac{\mathrm{Norm}(q_i)^\top\,\mathrm{Norm}(k_j)}{\sqrt{d_{head}}} $$归一化之后 $\|q\|,\|k\|$ 被固定在 $\sqrt{d_{head}}$(乘上可学习的 $\gamma$)附近,于是 logits 的绝对上界被 Cauchy–Schwarz 直接卡住:$|q^\top k|\le\|q\|\|k\|$。attention logits 再也炸不了。
9.4 Logit soft-capping
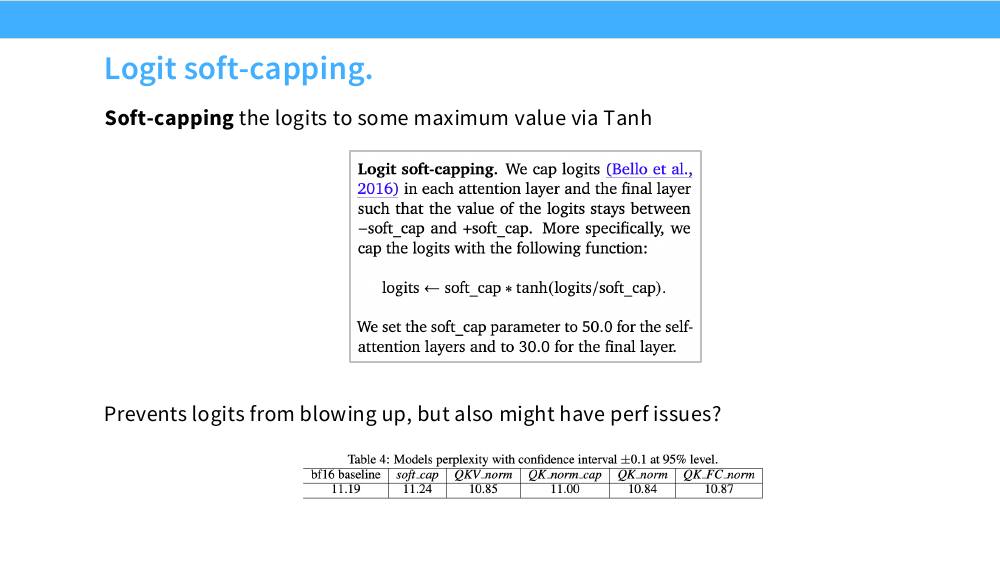
另一条路线:用 tanh 把 logits 硬性压在一个区间里。
$$ \text{logits}\leftarrow c\cdot\tanh\!\left(\frac{\text{logits}}{c}\right) $$当 $|\text{logits}|\ll c$ 时这近似是恒等映射($\tanh x\approx x$),超过 $c$ 之后平滑饱和到 $\pm c$。Gemma 2 在自注意力层用 $c=50$,在最终输出层用 $c=30$。
9.5 其他稳定性手段
- 梯度裁剪(gradient clipping)。按全局范数裁剪:若 $\|g\|_2>c$,则 $g\leftarrow g\cdot c/\|g\|_2$。$c=1.0$ 是压倒性的默认值(OLMo 3 的配置表里就是 1.0)。它不能防止不稳定的原因,但能防止单个坏 batch 把权重一步打飞——相当于给训练买了个保险。
- Warmup。在前 $T_w$ 步把学习率从 0(或极小值)线性升到峰值。理由是 Adam 的二阶矩 $v_t$ 在最初几十步内是极不可靠的估计,此时 $m/\sqrt{v}$ 的方差巨大,用峰值学习率会直接把模型打乱。典型取值是总步数的 0.1%–1%,或者干脆固定几千步。pre-norm 大幅降低了对 warmup 的依赖,但没人真的把它去掉。
- 学习率调度。主流是 warmup + 余弦衰减到峰值的 10%。近两年 WSD(warmup-stable-decay:先恒定、最后再快速衰减)越来越流行,因为它允许你在任意时刻「切一刀」得到一个可用模型,不必事先确定总步数。
- 关于精度。今天几乎所有预训练都用 bf16(而不是 fp16):bf16 的指数位和 fp32 一样宽(8 位),代价是尾数只有 7 位。这意味着不会溢出,但精度低,所以上面这些「约束数值范围」的技巧才格外重要——它们的作用与其说是防溢出,不如说是防止有效位数被浪费在一个巨大的偏移量上。
10. 优化器:AdamW 和它的挑战者
架构定下来之后,第二个几乎所有人都抄同一份配置的地方就是优化器。
10.1 AdamW 的完整更新式
记第 $t$ 步的梯度为 $g_t=\nabla_\theta L(\theta_{t-1})$:
$$ \begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)\,g_t &&\text{一阶矩(动量)}\\[2pt] v_t &= \beta_2 v_{t-1} + (1-\beta_2)\,g_t^{\odot 2} &&\text{二阶矩(逐坐标梯度平方)}\\[2pt] \hat m_t &= \frac{m_t}{1-\beta_1^{\,t}},\qquad \hat v_t=\frac{v_t}{1-\beta_2^{\,t}} &&\text{偏差修正}\\[2pt] \theta_t &= \theta_{t-1} - \eta_t\left(\frac{\hat m_t}{\sqrt{\hat v_t}+\varepsilon} + \lambda\,\theta_{t-1}\right) &&\text{更新(解耦的 weight decay)} \end{aligned} $$AdamW 相对于 Adam 的唯一改动在最后一行:weight decay 项 $\lambda\theta$ 是直接加在更新上的,而不是先加进梯度 $g_t$ 再过一遍 $1/\sqrt{\hat v}$ 的缩放。这个区别很重要——在原始 Adam 里,L2 正则项会被二阶矩自适应地「除掉」,导致梯度大的参数实际受到的衰减反而更小,与 weight decay 的本意相反。
| 超参数 | 典型取值 | 说明 |
|---|---|---|
| $\beta_1$ | 0.9 | 动量,几乎没人动过 |
| $\beta_2$ | 0.95(LLM)/ 0.999(原始 Adam) | LLM 普遍调低,让二阶矩「忘得更快」,对梯度尺度突变更敏感、更稳 |
| $\varepsilon$ | $10^{-8}$ | 防除零;有些实现用 $10^{-5}$ 以增加稳定性 |
| $\lambda$(weight decay) | 0.1 | 嵌入层、bias、norm 的 $\gamma$ 通常排除在外 |
| 梯度裁剪 | 全局范数 1.0 | 见 §9.5 |
| 峰值学习率 | $10^{-3}\sim 10^{-4}$ | 随模型规模下降:小模型可以 $3\times10^{-4}$ 以上,百亿以上通常到 $1.5\times10^{-4}$ 甚至更低 |
内存代价:每个参数要额外存 $m$ 和 $v$ 两份状态。混合精度训练下的典型账本是:fp32 主权重 4 字节 + 梯度 4 字节 + $m$ 4 字节 + $v$ 4 字节 = 每参数 16 字节。一个 7B 模型光优化器状态就要 56 GB,这正是为什么分布式训练必须做优化器状态分片(ZeRO / FSDP)。
10.2 学习率与 batch size 怎么选
- batch size 有一个「临界值」。McCandlish 等人(2018)提出的 critical batch size 概念是说:batch 小的时候,加倍 batch 能几乎减半所需步数(完美的数据并行);超过某个临界值之后,梯度噪声已经被平均掉了,再加大 batch 只是浪费算力。这个临界值随训练进程增大(loss 越低、梯度信噪比越差),所以 GPT-3 这类模型会做 batch ramp——从 3.2 万 token 逐步升到 320 万 token。
- 学习率和 batch size 要一起调。经典的经验法则是 batch 增大 $k$ 倍时学习率乘 $\sqrt{k}$(对自适应优化器)或 $k$ 倍(对 SGD)。实践中更常见的做法是固定 batch 之后直接扫学习率——Chinchilla 的一个关键改进就是为每个算力预算单独调学习率,而 Kaplan 的原始 scaling law 没有这么做,这是两者结论差异的重要来源。
- 规模越大,学习率越小。这是经验规律,也可以用 μP(maximal update parametrization)之类的理论来「迁移」:先在小模型上把超参数调好,再按理论公式外推到大模型,从而省下在大模型上调参的天价成本。
10.3 挑战者:Muon 与 SOAP
Adam 逐坐标看待参数,但神经网络的权重是矩阵——坐标之间不是独立的。近两年最受关注的两个新优化器都是从这个观察出发的:
- Muon(MomentUm Orthogonalized by Newton-schulz)。核心想法:把动量缓冲区 $M$(一个矩阵)用 Newton–Schulz 迭代近似正交化,再拿正交化后的矩阵去更新权重: $$ \theta \leftarrow \theta - \eta \cdot \mathrm{NewtonSchulz}(M),\qquad \mathrm{NewtonSchulz}(M)\approx UV^\top \ \text{(其中 } M=U\Sigma V^\top\text{)} $$ 直觉:原始的动量矩阵往往被少数几个奇异方向主导(谱高度集中),意味着更新几乎全部落在一个低维子空间里。正交化把所有奇异值拉平成 1,让更新在各个方向上均衡地推进。实践中 Muon 只用在隐藏层的 2D 权重上,嵌入层和输出头仍然交给 AdamW。
- SOAP(Shampoo with Adam in the Preconditioner's eigenbasis)。Shampoo 这类二阶方法维护左右两个预条件矩阵,效果好但超参数敏感、实现复杂。SOAP 的洞察是:Shampoo 大致等价于在预条件子的特征基里跑 Adafactor;那不如干脆在这个旋转后的基里跑标准 Adam,并且让特征基低频更新(每几十步才做一次特征分解)。这样既拿到二阶方法的收益,又把超参数减少回 Adam 的水平。
11. 注意力头的变体:MQA、GQA 与稀疏注意力
大部分模型对注意力头本身几乎不做改动,例外集中在两类:
- GQA / MQA:通过减少 key/value 头的数量来省推理成本;
- 稀疏 / 滑动窗口注意力:限制注意力模式来省计算成本。
(更奇特的东西——Jamba、Falcon 3、Qwen 3.5 里的状态空间模型——留到下一讲。)
11.1 先算清楚:训练时的注意力是 compute-bound 的
符号:$d$ = 隐藏维度,$b$ = batch,$n$ = 序列长度(假设 $n<d$),$h$ = 头数,$k=d/h$ = 头维度。
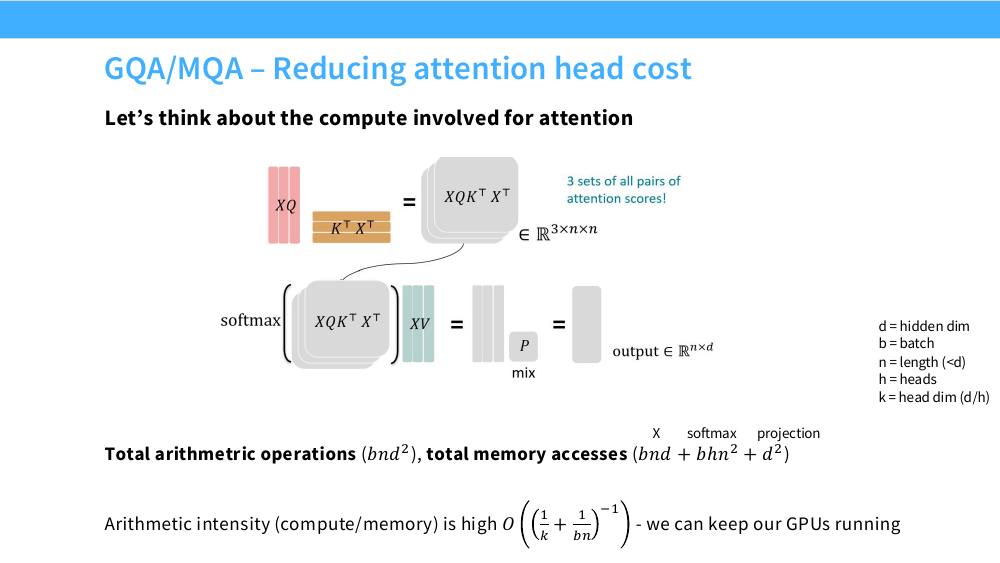
总算术操作 $\Theta(bn^2d)$,总内存访问 $\Theta(bnd+bhn^2+d^2)$(分别是激活、注意力矩阵、权重)。于是算术强度
$$ \text{intensity}=O\!\left(\left(\frac{1}{k}+\frac{1}{bn}\right)^{-1}\right)\approx \min(k,\;bn) $$取 $k=128$、$b\cdot n$ 上万,强度就在 100 以上——足够让 GPU 跑满。所以训练时的注意力不是带宽瓶颈。
11.2 增量解码:一切都变了
生成文本时的关键差异是:无法并行,必须一个 token 一个 token 地来。为了不重算历史,我们用 KV cache 把之前所有 token 的 $K,V$ 存下来,每步只算新 token 的 query 并与整个 cache 做注意力。
重新算账:生成 $n$ 个 token 的总操作是 $\Theta(bnd^2)$(每步 $b\cdot d^2$ 的投影矩阵乘),总内存访问是 $\Theta(bn^2d + nd^2)$(第一项是每步都要重读一遍越来越长的 KV cache,第二项是每步都要重读一遍全部权重)。于是
$$ \text{intensity}=O\!\left(\left(\frac{n}{d}+\frac{1}{b}\right)^{-1}\right) $$这个数非常糟糕。两项的含义:
- $1/b$:权重重读的成本,靠大 batch 摊薄;
- $n/d$:KV cache 重读的成本,序列越长越致命。$n=4096$、$d=4096$ 时这一项就等于 1,强度直接掉到 1 以下——完全 memory-bound,GPU 的算力有 99% 在空转。
大 batch 和短序列能救 $1/b$,但 $n/d$ 这一项很难降——这就是 MQA/GQA 要解决的问题。
把 KV cache 的大小算出来会更直观。每个 token 每层需要存 $K$ 和 $V$ 各一份:
$$ \text{KV bytes/token} = 2\;(\text{K,V})\times n_{layer}\times n_{kv}\times d_{head}\times \text{bytes} $$以 LLaMA-2 70B 为例($n_{layer}=80$,64 个 query 头,$d_{head}=128$,bf16 2 字节):
- 如果是标准 MHA($n_{kv}=64$):$2\times80\times64\times128\times2=2.62$ MB / token。4096 上下文 = 10.7 GB,batch 32 就是 344 GB——一张 H100 只有 80 GB。
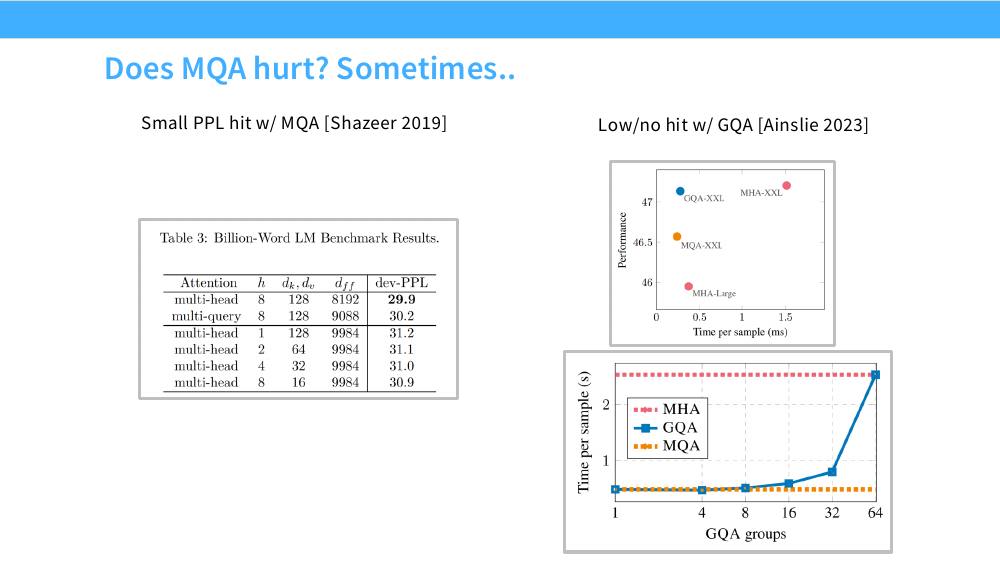
- 实际用 GQA($n_{kv}=8$):$0.33$ MB / token,4096 上下文 = 1.34 GB,batch 32 = 43 GB。整整省了 8 倍,而且省的是每一步都要重读的那份数据。
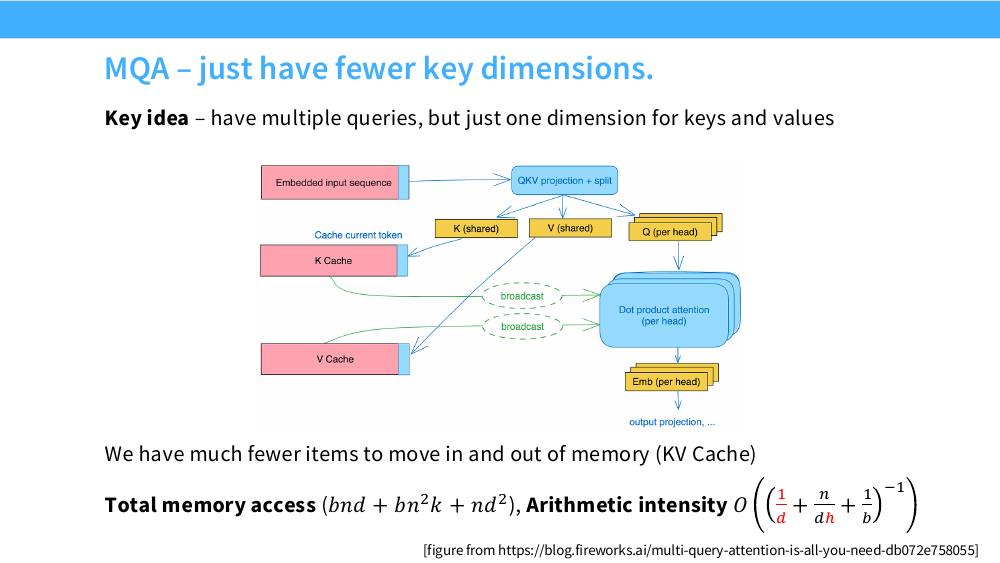
11.3 MQA:只留一份 K 和 V
Multi-Query Attention 的想法直白到有点粗暴:保留 $h$ 个 query 头,但 key 和 value 只有一份,被所有头共享。
11.4 GQA:不要走极端
Grouped-Query Attention 是自然的折中:不要一路砍到 1 份 KV,而是砍到 $g$ 组($1<g<h$),每组内的 query 头共享一份 K/V。$g=1$ 退化成 MQA,$g=h$ 就是 MHA。这给了你一个连续的旋钮,在表达力和推理效率之间调节。
更近期的方案是 DeepSeek-V2 提出的 MLA(Multi-head Latent Attention):不是共享 KV 头,而是把 K/V 压缩成一个低秩的潜在向量,只缓存这个潜在向量,用的时候再解压回各个头。这在同样的 cache 预算下保留了更多表达力。
11.5 稀疏与滑动窗口注意力
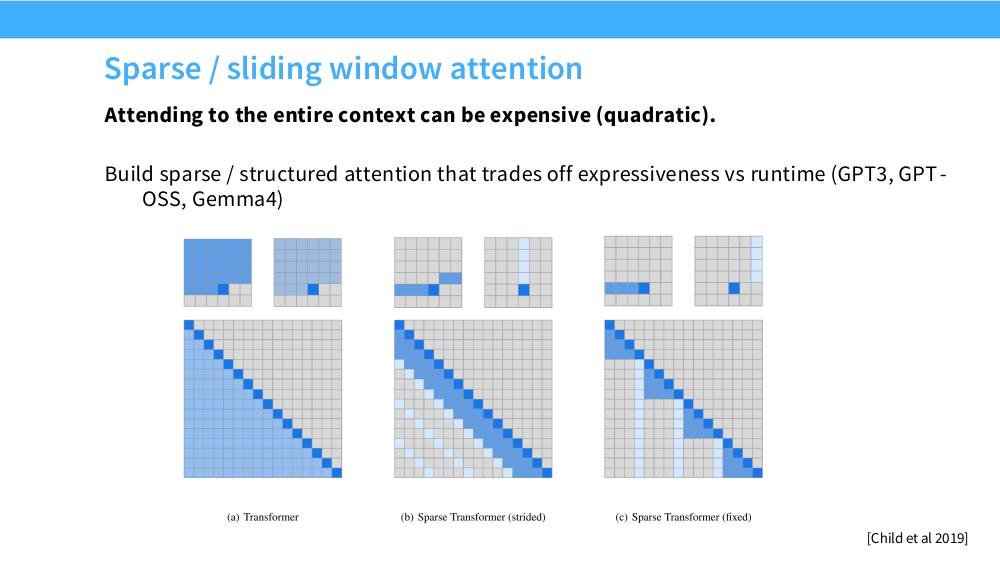
另一条正交的路线是不要让每个 token 都看所有 token。全注意力的代价是 $O(n^2)$,上下文一长就无法承受。
11.6 当前的标准做法:全局层与局部层交错
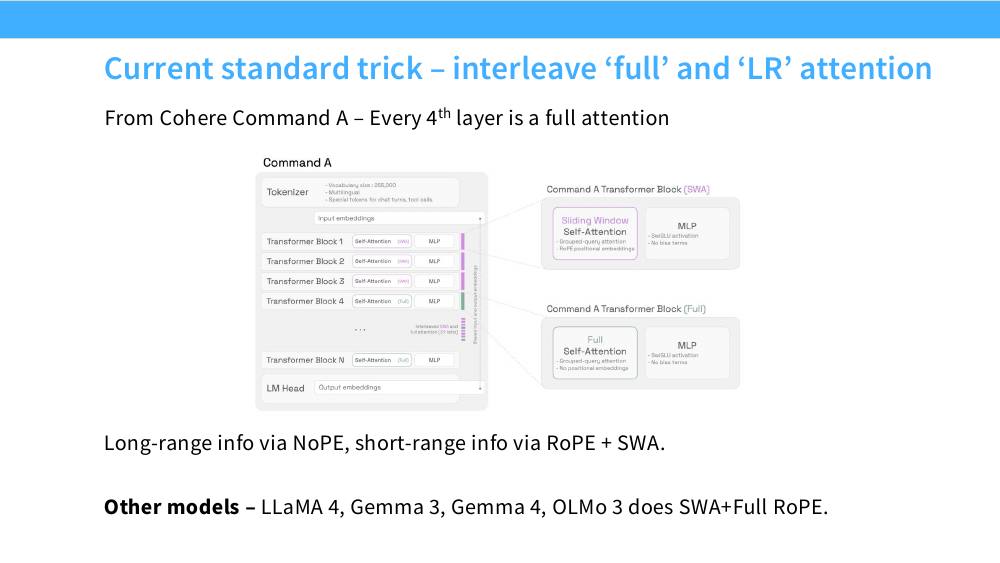
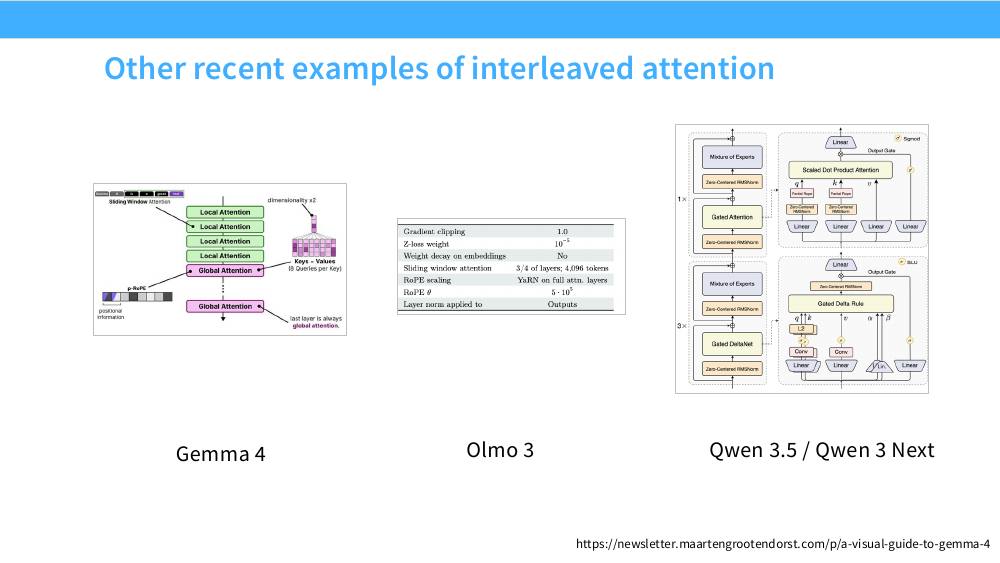
纯滑窗有个明显缺陷:信息只能靠层层传递慢慢往远处走,真正的长程依赖会被削弱。今天的主流方案是混合——大部分层用滑动窗口(便宜),每隔几层插一个全注意力层(贵但能看到全局)。
12. 汇总:各大模型的共识与分歧
把前面十一节的结论压进一张表。纵向看是一个模型的完整配方,横向看是某个设计维度上的行业演化。
| 模型 | Norm 类型 | Norm 位置 | 激活 | 位置编码 | bias | 注意力 | 词表 |
|---|---|---|---|---|---|---|---|
| 原始 Transformer (2017) | LayerNorm | post(残差流内) | ReLU | 正弦 | 有 | MHA | 37,000 |
| GPT-3 (2020) | LayerNorm | pre | GeLU | 学习式绝对 | 有 | 稠密/稀疏交替 | 50,257 |
| T5 v1.1 (2020) | RMSNorm | pre | GeGLU | 相对位置偏置 | 无 | MHA | 32,128 |
| PaLM (2022) | RMSNorm | pre(并行块) | SwiGLU | RoPE | 无 | MQA | 256,000 |
| LLaMA / LLaMA-2 (2023) | RMSNorm | pre | SwiGLU | RoPE | 无 | MHA → GQA | 32,000 |
| Mistral 7B (2023) | RMSNorm | pre | SwiGLU | RoPE | 无 | GQA + 滑窗 | 32,000 |
| DeepSeek 67B (2024) | RMSNorm | pre | SwiGLU | RoPE | 无 | GQA(V2 起用 MLA) | 100,000 |
| Gemma 2 (2024) | RMSNorm | double norm | GeGLU | RoPE | 无 | 局部/全局交错 + soft-cap | 256,000 |
| OLMo 2 (2025) | RMSNorm | 非残差 post | SwiGLU | RoPE | 无 | GQA + QK-norm + z-loss | ~100k |
| Qwen 3 (2025) | RMSNorm | pre | SwiGLU | RoPE | 无 | GQA + QK-norm | ~152k |
| OLMo 3 (2025) | RMSNorm | 非残差 post | SwiGLU | RoPE($\theta=5\!\times\!10^5$)+ YaRN | 无 | 3/4 层滑窗(4096) + 全注意力 | ~100k |
| Gemma 3 / 4 (2025–26) | RMSNorm | double norm | GeGLU | RoPE(部分维度) | 无 | 局部/全局交错 + QK-norm | 262,144 |
本讲小结
一页速查:从零搭一个模型的默认配方
| 决策点 | 默认选择 | 证据强度 | 什么时候该偏离 |
|---|---|---|---|
| Norm 位置 | pre-norm(+ 最后一个 final norm) | 强:梯度分析 + 多组独立实验 | 想更稳可以试 OLMo 2 的非残差 post-norm |
| Norm 类型 | RMSNorm | 强:同质量 + 约 5% 吞吐 | 基本没有理由用 LayerNorm |
| bias | 全部去掉 | 中:内存 + 稳定性论证 | 基本没有理由保留 |
| 激活 | SwiGLU,$d_{ff}=\frac{8}{3}d_{model}$ 取整到 128 的倍数 | 强:两组独立受控实验 | GeGLU 等价;追求极简可以用 ReLU |
| 位置编码 | RoPE,base 10000(长上下文用 $5\times10^5\sim10^6$) | 强:数学动机清晰 + 全行业采用 | 长上下文时考虑部分旋转 / NoPE 全局层 |
| $d_{ff}/d_{model}$ | 4(GLU 时 8/3) | 强:Kaplan 扫描图,1–10 是平盆地 | 盆地很宽,不必纠结 |
| $n_{head}\times d_{head}$ | $=d_{model}$,$d_{head}=128$ | 弱:几乎无人验证 | 可以大胆试,反正没人知道最优是什么 |
| $d_{model}/n_{layer}$ | 100–200 | 中:很宽的平地 | 由并行策略和推理延迟决定,不是由损失决定 |
| 词表 | 单语 32–50k;多语言 100–260k | 中 | 取决于语言覆盖;注意嵌入/softmax 的显存代价 |
| Dropout | 0(预训练) | 强:单遍数据无需防过拟合 | 微调阶段可以用 |
| Weight decay | 0.1(排除嵌入/bias/norm) | 中:作用在优化动力学上 | 必须和 LR 调度一起调 |
| 优化器 | AdamW,$\beta=(0.9,0.95)$,裁剪 1.0 | 强 | Muon / SOAP 值得关注但尚未定论 |
| 稳定性 | QK-norm(+ 可选 z-loss $10^{-5}$) | 中:新但扩散极快 | soft-capping 效果不如 QK-norm,谨慎 |
| 注意力 | GQA,8 个 KV 组 | 强:质量几乎无损,KV cache 省 8 倍 | 长上下文再叠滑窗 + 全局层交错 |
三条方法论要点
- FLOPs 不等于运行时间。归一化占 0.17% 的 FLOPs、25.5% 的运行时间。任何架构决策都要同时算「算多少」和「搬多少」——这是本讲里 RMSNorm、去 bias、并行块、GQA 四个选择背后的共同逻辑。
- 区分「有证据的共识」和「路径依赖的共识」。$d_{ff}=4d_{model}$ 有扫描图,$n_{head}\times d_{head}=d_{model}$ 什么都没有。前者放心抄,后者是留给你的实验空间。
- 稳定性技巧的共同模式:掐掉「模型不在乎但数值格式在乎」的自由度。logits 的整体平移、Q/K 的范数、注入残差流的量级、单步更新的幅度——每一个都是模型损失函数看不见、但 bf16 很在意的方向。
附录:延伸阅读
归一化
- Layer Normalization (2016) — LayerNorm 原始论文,读第 3 节看它为什么要在特征维而不是 batch 维上归一化。
- Root Mean Square Layer Normalization (2019) — RMSNorm 原始论文,核心论点是「重新中心化不重要,重新缩放才重要」。
- On Layer Normalization in the Transformer Architecture (2020) — Xiong 等人,pre-norm vs post-norm 的梯度尺度分析,本讲 §2 的理论来源。
- Transformers without Tears: Improving the Normalization of Self-Attention (2019) — Nguyen & Salazar,梯度尖峰的实证对比,还提出了 ScaleNorm/FixNorm。
- 2 OLMo 2 Furious (2025) — 非残差 post-norm + QK-norm + z-loss 的完整工程报告,是「怎么把训练稳住」这个主题最好的单篇材料。
激活与前馈层
- Language Modeling with Gated Convolutional Networks (2017) — GLU 的出处(当时还是卷积模型)。
- GLU Variants Improve Transformer (2020) — Shazeer 的两页纸论文,SwiGLU/GeGLU 和 $2/3$ 规则都出自这里。
- Gaussian Error Linear Units (GELUs) (2016) — GeLU 的定义与直觉。
- Searching for Activation Functions (2017) — Swish/SiLU 的出处,一个用搜索找激活函数的有趣故事。
- Do Transformer Modifications Transfer Across Implementations and Applications? (2021) — Narang 等人,本讲多张对照表的来源。最值得读的一篇:它系统检验了几十个「改进」,发现绝大多数不能迁移。
位置编码
- RoFormer: Enhanced Transformer with Rotary Position Embedding (2021) — RoPE 原始论文,公式 13–15 就是本讲 §6.5 的那个块对角矩阵。
- Attention Is All You Need (2017) — 正弦位置编码的出处,也是本讲所有「原始选择」的基准。
- Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer (T5, 2019) — 相对位置偏置的代表实现,同时也是本讲最大的「超参数异类」。
超参数与缩放
- Scaling Laws for Neural Language Models (2020) — Kaplan 等人,本讲 $d_{ff}$ 倍率盆地图和 aspect ratio 图的来源。
- Scale Efficiently: Insights from Pre-training and Fine-tuning Transformers (2021) — Tay 等人,深度 vs 宽度的系统研究,含「深度不可并行」的论述。
- Training Compute-Optimal Large Language Models (Chinchilla, 2022) — 关键在于它为每个算力预算单独调学习率,这是它与 Kaplan 结论不同的重要原因。
- Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer (μP, 2022) — 如何在小模型上调超参数再迁移到大模型。
- Why Do We Need Weight Decay in Modern Deep Learning? (2023) — 本讲 §8.3 的来源,论证 weight decay 的作用在优化动力学而非泛化。
系统与效率
- Data Movement Is All You Need: A Case Study on Optimizing Transformers (2020) — 「99.8% FLOPs / 61% 时间」那张表的出处,理解「FLOPs ≠ 时间」的必读材料。
- Fast Transformer Decoding: One Write-Head is All You Need (2019) — MQA 原始论文,含本讲 §11.4 的 PPL 对照表。
- GQA: Training Generalized Multi-Query Transformer Layers from Multi-Head Checkpoints (2023) — GQA 原始论文,还教你怎么把已有的 MHA checkpoint「升级」成 GQA。
- DeepSeek-V2 (2024) — MLA 的出处,KV cache 压缩的另一条思路。
- Generating Long Sequences with Sparse Transformers (2019) — strided / fixed 稀疏注意力模式。
- Longformer: The Long-Document Transformer (2020) — 滑动窗口 + 全局注意力的早期系统化方案。
稳定性与优化器
- PaLM: Scaling Language Modeling with Pathways (2022) — z-loss、并行块、MQA、无 bias 的集大成者,也是本讲引用最多的模型。
- Scaling Vision Transformers to 22 Billion Parameters (2023) — QK-norm 在大规模模型上的出处(视觉领域先踩的坑)。
- Gemma 2: Improving Open Language Models at a Practical Size (2024) — double norm、logit soft-capping、局部/全局交错注意力。
- Baichuan 2: Open Large-scale Language Models (2023) — 另一个使用 z-loss 的公开例子。
- Decoupled Weight Decay Regularization (AdamW, 2017) — 为什么 weight decay 必须和梯度解耦。
- An Empirical Model of Large-Batch Training (2018) — critical batch size 的出处,决定「batch 开多大才不浪费」。
- Muon: An optimizer for hidden layers in neural networks (2024) — 正交化动量的思路与实现,代码短到可以一口气读完。
- SOAP: Improving and Stabilizing Shampoo using Adam (2024) — 在 Shampoo 预条件子的特征基里跑 Adam。
模型技术报告(当架构参考书用)
- LLaMA (2023) — 「LLaMA-like」配方的定义者:pre-norm + RMSNorm + SwiGLU + RoPE。
- Mistral 7B (2023) — GQA + 滑动窗口注意力的干净示例。
- DeepSeek LLM (2024) — LLaMA 架构 + 自己重做的 scaling law。
- Qwen 3 (2025) — QK-norm 的大规模应用。
- Command A (2025) — 本讲 §11.6 交错注意力(滑窗+RoPE / 全局+NoPE)的来源。
- OLMo 3 (2025) — 配置表值得逐行抄下来对照自己的实现。