PyTorch 与资源核算
在固定的算力和显存下能训出最好的模型——前提是你先会算这笔账。张量的内存、矩阵乘法的 FLOPs、$6ND$ 训练成本、MFU 与 roofline。
0. 本讲导读
上一讲讲了课程总览和分词(tokenization),把文本变成了整数序列。从这一讲开始,我们真正进入"训练一个语言模型"的工程内核。
这门课反复问的核心问题只有一个:
给定固定的资源(算力 compute、显存 memory),能训出的最好的模型是什么?
换句话说:最大化(计算)效率。而要谈效率,前提是你必须能说清楚一次计算到底花了多少资源。
这就是"资源核算"(resource accounting)。它听上去平淡,但它是这门课全部内容的地基:后面讲架构(Lecture 3)、并行(Lecture 6-7)、推理(Lecture 10)、Scaling Law(Lecture 8),每一处的设计取舍最终都会落回到"这么做省了多少 FLOPs / 省了多少字节 / 打满了多少算力"。不会算账,就只能凭感觉调参。
Percy 在课上明确说了,这一讲希望你带走三样东西:
| 要带走的 | 内容 | 难度 |
|---|---|---|
| 机械知识(mechanics) | PyTorch 的语义:张量怎么存、einops 怎么写、autograd 怎么跑 | 直白,没什么深度,看一遍就会 |
| 心态(mindset) | 资源核算这件事本身——记得去算。这是最重要的一条 | 需要养成习惯 |
| 直觉(intuitions) | 对"资源花在哪里"有量级上的感觉 | 需要多做几遍餐巾纸算术 |
Percy 特别强调:今天没有任何"机器学习魔法"。不讲 loss 怎么降、不讲哪个 trick 有效,全部是"多少字节、多少次乘加、多少秒"。恰恰因为如此,这一讲的内容是最不容易过时的。
另外一则课程消息:Marin 项目的 1e23 FLOPs 训练跑完了,而且实测结果命中了事先用 scaling law 做出的预测。这正是本课的价值主张——大模型训练不是碰运气,是可以被预测、被核算的工程。
- 一切都是张量上的操作:参数、梯度、激活值、优化器状态、数据,全都是张量。核算它们的字节数就是核算显存。
- 内存 = 元素个数 × 每元素字节数。bf16 用 2 字节且动态范围与 fp32 相同,所以混合精度训练用 bf16 存参数/激活/梯度、用 fp32 存优化器状态。
- 矩阵乘法 $[m,n]\times[n,p]$ 的代价是 $2mnp$ FLOPs(每个输出元素做 $n$ 次乘和 $n$ 次加)。
- 训练一步的总 FLOPs $\approx 6 \cdot (\text{参数量}) \cdot (\text{token 数})$:前向 $2ND$,反向 $4ND$。这是全课最常用的一个公式。
- 算术强度(arithmetic intensity)决定瓶颈:大矩阵乘法是 compute-bound,逐元素操作(ReLU、GELU)和矩阵-向量乘法是 memory-bound。这解释了为什么 MFU 到不了 1,也解释了为什么推理天然受内存带宽限制。
- 梯度累积、激活重计算是两个用来"拿计算换显存"的标准手段。
本讲的地图
整讲按"先算显存、再算算力、最后把两者合起来算训练"的顺序推进:
- 显存核算:张量基础 → 浮点数类型 → 内存布局(view)→ GPU 显存
- 算力核算:einops → 矩阵乘法 FLOPs → MFU → 算术强度与 roofline
- 训练全流程核算:深度网络 → 反向传播 FLOPs($6ND$)→ 优化器状态 → 完整训练循环
- 省显存的手段:梯度累积、激活重计算
1. 先做两道"餐巾纸算术"
在讲任何机制之前,Percy 先扔出两个问题。这两个问题的答案本身不重要,重要的是它们能被算出来,而且只需要一张餐巾纸。
问题一:70B 模型、15T tokens、1024 张 H100,要训多久?
用后面会推导的公式 $\text{FLOPs} = 6 \cdot N \cdot D$($N$ = 参数量,$D$ = 训练 token 数):
$$ \text{total\_flops} = 6 \times 70\times 10^9 \times 15 \times 10^{12} = 6.3\times 10^{24}\ \text{FLOPs} $$再算硬件一天能提供多少 FLOPs。H100 的规格书上写着 bf16 峰值 1979 teraFLOP/s,但那个数字是带稀疏性(with sparsity)的,稠密计算只有一半:
$$ \text{h100\_flop\_per\_sec} = \frac{1979\times 10^{12}}{2} = 9.895\times 10^{14}\ \text{FLOP/s} $$实际训练不可能打满峰值,取一个乐观但现实的 MFU = 0.5:
$$ \text{flops\_per\_day} = 9.895\times10^{14} \times 0.5 \times 1024 \times (60\cdot 60\cdot 24) \approx 4.38\times 10^{22} $$ $$ \text{days} = \frac{6.3\times 10^{24}}{4.38\times10^{22}} \approx \boxed{144\ \text{天}} $$大约 4.8 个月。这个数量级和公开报道的前沿模型预训练周期是吻合的——这也是为什么一次预训练"跑砸了"代价如此之高,为什么这门课要花整整一讲讲 scaling law(用小模型预测大模型)。
问题二:8 张 H100 上用 AdamW 最大能训多大的模型?
这次算的是显存。每个参数在训练时要占多少字节?逐项列:
| 项目 | dtype | 字节/参数 |
|---|---|---|
| 参数(parameters) | bf16 | 2 |
| 梯度(gradients) | bf16 | 2 |
| AdamW 一阶动量 $m$ | fp32 | 4 |
| AdamW 二阶动量 $v$ | fp32 | 4 |
| 合计 | 12 |
8 张 H100 每张 80 GB:
$$ \text{num\_parameters} = \frac{80\times10^9 \times 8}{2+2+4+4} = \frac{6.4\times10^{11}}{12} \approx 5.33\times 10^{10} $$约 53B 参数。
这是上界,因为完全没算激活值(activations)——激活显存取决于 batch size 和序列长度,可以很大。真实情况下 8 张 H100 上能舒服训练的稠密模型远小于 53B(通常在 7B–13B 量级,还要配合 ZeRO/FSDP 分片、梯度累积和激活重计算)。
反过来看这个公式更有用:训练一个 $N$ 参数的模型,光是"状态"就要 $12N$ 字节。70B 模型 → 840 GB,单纯放优化器状态就需要 11 张 H100。这就是为什么分布式训练不是"想要更快",而是"不分片根本放不下"。这正是后面并行那两讲的出发点。
Percy 的评价:这只是粗糙的信封背面估算(back-of-the-envelope calculation),但它给了你那种"快速摸清资源量级"的味道。这门课希望你听到任何一个模型配置,都能在三十秒内说出它大概要多少卡、多少天。
2. 张量:一切的载体
张量(tensor)是存储一切东西的基本单元:
- 数据(data):token id 序列
- 参数(parameters):模型权重
- 梯度(gradients):反向传播得到的导数
- 优化器状态(optimizer state):动量、二阶矩
- 激活值(activations):前向过程中的中间结果
这五类东西加起来就是你显存里的全部内容。之后每次说"显存不够",都可以拆成这五项分别追问。
一个真实的例子:DeepSeek v3.2 的权重在 Hugging Face 上的 safetensors index 里就是一张张量清单——每个张量的名字、形状、dtype 全在里面。想知道一个开源模型的结构,读它的权重清单比读论文还直接。
秩(rank)
张量的秩就是维度个数:
import torch

x = torch.zeros(4)        # rank 1(向量)
x = torch.zeros(4, 8)     # rank 2(矩阵)
x = torch.zeros(4, 8, 2)  # rank 3
在 Transformer 里最常见的是 rank 4 张量,因为注意力要把 hidden 维拆成多个头:
B = 32   # Batch size(批大小)
S = 16   # Sequence length(序列长度)
H = 16   # Number of heads(注意力头数)
D = 64   # Hidden dimension per head(每个头的维度)
x = torch.zeros(B, S, H, D)
四个整数 (32, 16, 16, 64) 里没有任何一个能告诉你哪个是 batch、哪个是 head。这正是后面 einops 要解决的问题。
内存 = 元素个数 × 每元素字节数
张量占多少内存,只由两件事决定:(i) 有多少个值,(ii) 每个值是什么类型。
def get_memory_usage(x: torch.Tensor) -> int:
    return x.numel() * x.element_size()

x = torch.zeros(4, 8)
assert x.dtype == torch.float32   # 默认类型
assert x.numel() == 4 * 8         # 32 个元素
assert x.element_size() == 4      # float32 = 4 字节
assert get_memory_usage(x) == 4 * 8 * 4   # 128 字节
换成真实规模——GPT-3 前馈层里的一个矩阵(隐藏维 12288,FFN 放大 4 倍):
get_memory_usage(torch.empty(12288 * 4, 12288))
# = 49152 * 12288 * 4 字节
# = 2,415,919,104 字节 ≈ 2.4 GB
一层里的一个矩阵就 2.4 GB(fp32)。GPT-3 有 96 层,每层还有 attention 的四个投影矩阵。这一下就把"为什么大模型要精打细算"讲清楚了。
- $10^9$ 个 fp32 = 4 GB;$10^9$ 个 bf16 = 2 GB。
- 所以"参数量(十亿计)× 2 = bf16 权重的 GB 数"。7B 模型的 bf16 权重就是 14 GB——这就是为什么 7B 模型刚好能塞进一张 24 GB 消费级显卡做推理。
3. 浮点数类型:从 fp32 一路降到 fp4
张量的元素通常是浮点数。浮点数的位被分成三段:符号位(sign)、指数位(exponent)、尾数位(mantissa / significand)。一个浮点数的值大致是
$$ (-1)^{\text{sign}} \times 2^{\text{exponent} - \text{bias}} \times (1.\text{mantissa}) $$关键在于这两段位各自控制什么:
- 指数位 → 动态范围(dynamic range):能表示多大和多小的数。指数位不够,小数会下溢成 0、大数会上溢成 inf。
- 尾数位 → 精度 / 分辨率(resolution):在一个数量级内能分辨多细。尾数位不够,$1.0$ 和 $1.001$ 就变成同一个数。
深度学习的经验事实是:动态范围比精度重要得多。这一条决定了后面所有低精度格式的设计。
fp32(float32 / 单精度)
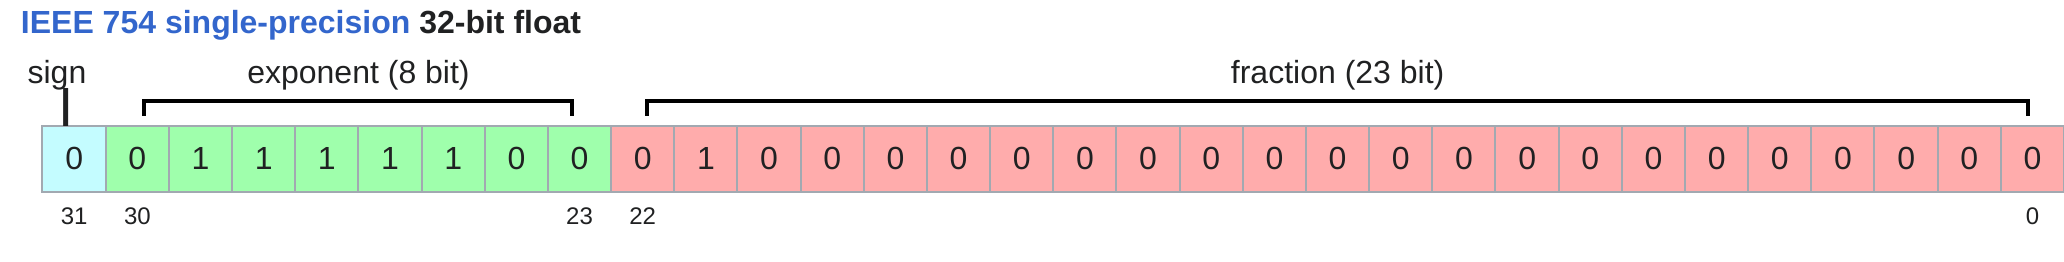
在传统科学计算里,fp32 是基线,某些场景还要上双精度 fp64。但在深度学习里你可以邋遢得多——梯度下降本身就是带噪声的过程,多一点数值噪声并不致命。这个观察是整个低精度训练的哲学起点。
fp16(float16 / 半精度)
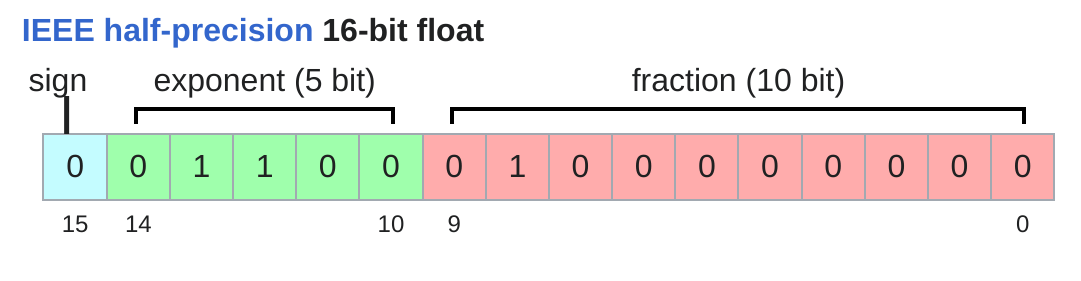
x = torch.zeros(4, 8, dtype=torch.float16)
assert x.element_size() == 2      # 内存减半

x = torch.tensor([1e-8], dtype=torch.float16)
assert x == 0                     # 下溢(underflow)!
$10^{-8}$ 直接变成 0。fp16 能表示的最小非零值(含次正规数)约 $6\times10^{-8}$,比 $10^{-8}$ 还大。而梯度恰恰是最容易变得很小的东西:训练后期、深层网络、小学习率,梯度轻松掉到 $10^{-7}$ 以下。一旦梯度被截成 0,这个参数就再也不更新了——训练表现为"莫名其妙地不收敛"或"loss 突然发散"。
历史上 fp16 训练要靠 loss scaling(把 loss 乘一个大常数,让梯度整体抬进 fp16 的可表示区间,更新前再除回去)才能稳住。这是个能用但很烦的补丁。
bf16(bfloat16 / brain float)
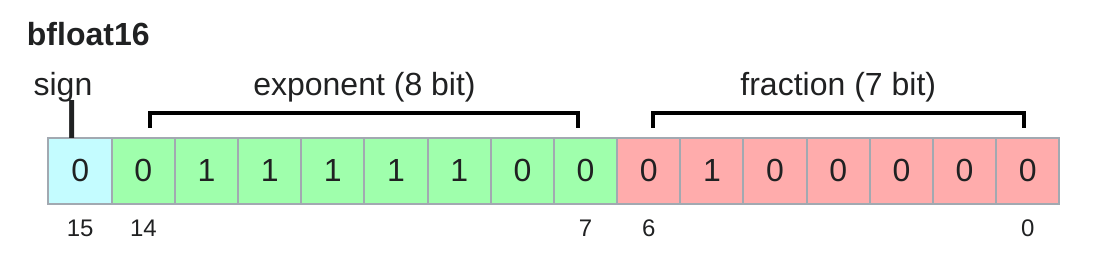
bf16 的设计思路极其干脆:既然深度学习在乎范围不在乎精度,那就把 fp32 的指数位原封不动搬过来,尾数砍掉。
x = torch.tensor([1e-8], dtype=torch.bfloat16)
assert x != 0     # 不下溢!
结果是:bf16 用和 fp16 一样的内存,却有和 fp32 一样的动态范围。唯一的代价是分辨率变差,而这对深度学习影响小得多。另一个实际好处是 fp32 ↔ bf16 的转换非常廉价(直接砍掉低 16 位即可),而且通常不需要 loss scaling。
| 格式 | 位分布 (S/E/M) | 字节 | 动态范围(约) | 十进制有效位 | 训练用途 |
|---|---|---|---|---|---|
| fp32 | 1 / 8 / 23 | 4 | $10^{-38}\sim 3\times10^{38}$ | ~7 | 基线;今天用于优化器状态与归约累加 |
| fp16 | 1 / 5 / 10 | 2 | $6\times10^{-8}\sim 6.5\times10^{4}$ | ~3 | 需 loss scaling,逐渐被 bf16 取代 |
| bf16 | 1 / 8 / 7 | 2 | 同 fp32 | ~2–3 | 今天训练的主力格式 |
| fp8 E4M3 | 1 / 4 / 3 | 1 | $[-448, 448]$ | ~1–2 | 前向激活/权重(精度优先) |
| fp8 E5M2 | 1 / 5 / 2 | 1 | $[-57344, 57344]$ | ~1 | 梯度(范围优先) |
| nvfp4 | 1 / 2 / 1 + 分块缩放 | 0.5 | 取决于块缩放因子 | <1 | 2025 年起的前沿实验 |
混合精度训练(mixed precision training)
把上面的事实合起来,训练的处境是:
- 全 fp32 训练:能跑,但显存要 2 倍、算力慢 10 倍以上(Tensor Core 对低精度有专门通路)。
- 全 fp16 甚至全 bf16 训练:有风险,会不稳定。问题主要出在需要"长期累加小量"的地方——优化器的动量是把成千上万步的梯度做指数平均,用 bf16 的 7 位尾数去累加,小增量会被直接吃掉($1.0 + 0.001$ 在 bf16 里还是 $1.0$)。
解法就是混合精度(Micikevicius et al., 2018):
- bf16:参数(前向用的副本)、激活值、梯度 —— 这三项占内存和带宽的大头,且都是"用完就扔"的量。
- fp32:优化器状态(一阶/二阶动量),以及一份 fp32 的"主权重"(master weights)—— 这些是要跨成千上万步累积的量,必须保精度。
PyTorch 提供了自动混合精度(AMP, automatic mixed precision)库,它会在安全的地方自动把计算转成 bf16——比如矩阵乘法可以转,而 exp、softmax 的归约、LayerNorm 的方差累加这类对精度敏感的操作会保持 fp32:
with torch.amp.autocast("cuda", dtype=torch.bfloat16):
    y = x @ w        # 这个 matmul 会在 bf16 下执行
    z = torch.exp(y) # 这类操作 autocast 会保持 fp32
autocast 不会改变张量的创建 dtype。在 with torch.amp.autocast(...) 里写 x = torch.zeros(4, 8),得到的仍然是 fp32 张量。autocast 拦截的是算子(op)的输入输出类型,不是构造函数。想直接创建低精度张量,还是要显式写 dtype=torch.bfloat16。
fp8
2022 年,为了机器学习负载专门标准化了 fp8(FP8 Formats for Deep Learning;NVIDIA 也有一篇很好的 FP8 primer)。H100 支持两种变体:
- E4M3:4 位指数、3 位尾数,范围 $[-448, 448]$。精度稍好,用于前向的权重和激活。
- E5M2:5 位指数、2 位尾数,范围 $[-57344, 57344]$。范围更大,用于梯度(梯度的动态范围更宽)。
注意这里的取舍逻辑和 fp16 vs bf16 一模一样:同样的比特数,你只能在范围和精度之间分配。fp8 之所以要设计成两种,是因为前向和反向对这两者的需求刚好相反。
fp4 / nvfp4
2025 年 NVIDIA 推出了 nvfp4:每个值只有 4 比特。它能表示的全部取值就 16 个:
-6, -4, -3, -2, -1.5, -1.0, -0.5, 0.0, 0.5, 1.0, 1.5, 2, 3, 4, 6
看起来完全不可用——但关键在于 nvfp4 为每一小块(block)单独存一个缩放因子(scale factor)。于是整体动态范围其实很宽,只是同一个块内部的值不能相差太远。这是个非常聪明的取舍:神经网络里的张量本来就是局部同量级的。
NVIDIA 的 Nemotron 3 Super 就是用 NVFP4 训练的,说明 4 比特训练已经从论文走进了真实的大规模训练。
这些低精度的细节有相当一部分发生在 NVIDIA 的库(cuBLAS、Transformer Engine)内部,不在用户控制范围内。你写 a @ b,底层可能已经在做分块缩放、fp8 累加到 fp32 之类的事。这既是好事(免费提速),也是坏事(数值行为不完全可预测,跨硬件复现困难)。
4. 张量是"视图":storage、stride 与 contiguous
上一节把"一个张量占多少字节"讲清楚了。但还有一个同样重要的问题:什么时候会产生新的字节? 这决定了你的代码是在悄悄地复制几 GB 数据,还是零开销。
张量 = 存储(storage)+ 元信息
PyTorch 的张量其实是一层薄薄的"视图"(view),它由两部分组成:
- storage:一段连续的一维内存缓冲区,存着实际的数值。
- 元信息:
shape(各维大小)、stride(各维步长)、storage_offset(起始偏移)、dtype、device。
取元素 x[i, j] 时,PyTorch 算的是:
所以只要改改 stride 和 offset,就能在不动一个字节的前提下得到一个"新张量"。这就是零拷贝的来源。
x = torch.arange(12).view(3, 4)
x.stride()          # (4, 1):行内相邻元素隔 1 个,换一行跳 4 个
x.t().stride()      # (1, 4):转置只是把 stride 反过来,没有复制
x.data_ptr() == x.t().data_ptr()   # True,共享同一段 storage
哪些操作是零拷贝的?
| 操作 | 是否复制 | 说明 |
|---|---|---|
x[0](取一行) | 否(view) | 只是 offset 前移、少一个维度 |
x[:, 1](取一列) | 否(view) | stride 变成行步长,内存不连续但仍是 view |
x[::2](带步长切片) | 否(view) | stride 翻倍 |
x.t() / x.transpose(0,1) | 否(view) | 交换 shape 和 stride |
x.view(...) | 否(view) | 要求内存连续,否则报错 |
x.expand(...) | 否(view) | 把 stride 设为 0 来"广播",非常省内存 |
x.reshape(...) | 可能 | 能做 view 就 view,不能就复制 |
x.contiguous() | 是(若原本不连续) | 重新排布成连续内存 |
x[[0, 2]](高级索引) | 是 | 用张量/列表做索引一定复制 |
x + 1、x.to(dtype) | 是 | 逐元素运算产生新 storage |
x.repeat(...) | 是 | 与 expand 相反,真的复制数据 |
view 是共享内存的,就地修改会串改原张量。
x = torch.zeros(2, 3)
y = x[0]        # view
y[0] = 1.0
# x[0][0] 现在也变成了 1.0!
这在写数据预处理和 KV cache 的时候是 bug 高发区。反过来,如果你想要零拷贝地写入某块显存(比如往 KV cache 里塞新 token),就要主动利用这个性质。
x.transpose(0,1).view(-1) 会报错,因为转置后内存不连续,而 view 要求你能只靠 stride 描述新形状。此时必须先 .contiguous()——那是一次真实的全量拷贝。在注意力实现里频繁 transpose → contiguous → view 是个隐藏的性能杀手,每次都要搬几百 MB。einops 的 rearrange 会尽量帮你选择最省的路径,但更根本的办法是一开始就把维度顺序设计对。
5. 从 CPU 到 GPU
默认情况下张量存在 CPU 内存里:
x = torch.zeros(32, 32)
assert x.device == torch.device("cpu")
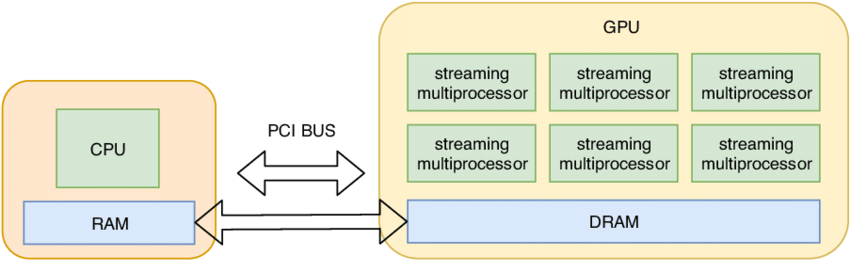
要用上 GPU 的大规模并行,得把张量搬过去:
device = "cuda" if torch.cuda.is_available() else "cpu"

# 方式一:先在 CPU 上创建再搬过去(会经历一次 PCIe 传输)
x = torch.zeros(32, 32)
x = x.to(device)

# 方式二:直接在 GPU 上创建(推荐,省掉一次传输)
with torch.device(device):
    x = torch.zeros(32, 32)
    assert x.device.type == "cuda"
后面所有性能分析都绕不开这个层次:
| 通道 | 典型带宽(H100 级) |
|---|---|
| GPU 片上 SRAM ↔ 计算核心 | ~$10^{13}$ B/s 量级(极快,容量极小) |
| GPU HBM 显存 ↔ 计算核心 | $3.35\times 10^{12}$ B/s(3.35 TB/s) |
| CPU 内存 ↔ GPU 显存(PCIe) | ~$6\times 10^{10}$ B/s(约 64 GB/s,慢 50 倍) |
所以:数据一旦上了 GPU 就尽量别下来;训练循环里每一次 .item()、print(loss)、.cpu() 都会强制同步并走那条最慢的通道。
查看当前占了多少显存:
torch.cuda.memory_allocated()      # 当前已分配(字节)
torch.cuda.max_memory_allocated()  # 峰值
torch.cuda.reset_peak_memory_stats()
做资源核算时,用"手算的字节数"去对照 max_memory_allocated() 的实测值,是最好的自查方式——两者对不上,说明你漏算了某一项(通常是激活值或临时缓冲区)。
6. einops:给维度起名字
问题:位置维度太容易搞错
看这段传统 PyTorch 代码:
x = torch.ones(2, 2, 3)      # batch seq hidden
y = torch.ones(2, 2, 3)      # batch seq hidden
z = x @ y.transpose(-2, -1)  # batch seq seq
问题在哪?-2 和 -1 到底是什么?你必须在脑子里维护一张"第几个维度是什么"的表,而这张表只存在于注释里(还经常和代码不同步)。当张量变成 rank 4、rank 5,当代码里有十几处 transpose、permute、view,出错几乎是必然的。更糟的是,维度搞错往往不会报错——形状恰好匹配,只是算出来的东西没有意义。
einops 的解法是:用名字而不是位置来指代维度。它受爱因斯坦求和约定(Einstein summation notation, 1916)启发。三个核心函数:einsum、reduce、rearrange。(官方教程)
einsum:带记账功能的广义矩阵乘法
from einops import einsum, reduce, rearrange

x = torch.ones(3, 4)  # seq1 hidden
y = torch.ones(4, 3)  # hidden seq2

# 旧写法
z = x @ y

# einops 写法
z = einsum(x, y, "seq1 hidden, hidden seq2 -> seq1 seq2")
规则很简单:输入里出现、输出里没出现的维度,会被求和掉(上式中 hidden 被求和)。这正是矩阵乘法的定义 $z_{ij}=\sum_h x_{ih}y_{hj}$。
复杂一点的例子——带 batch 的注意力打分:
x = torch.ones(2, 3, 4)  # batch seq1 hidden
y = torch.ones(2, 3, 4)  # batch seq2 hidden

# 旧写法:必须记住 -2 -1 是什么
z = x @ y.transpose(-2, -1)   # batch seq1 seq2

# einops 写法:意图一目了然
z = einsum(x, y, "batch seq1 hidden, batch seq2 hidden -> batch seq1 seq2")
两边都有 batch 且输出保留了 batch,所以 batch 维不求和、按位对应(batched matmul)。hidden 在输出里消失,所以对它求和。你不需要写任何 transpose。
还可以用 ... 表示"任意多个前置维度",让函数对任意 rank 都成立:
z = einsum(x, y, "... seq1 hidden, ... seq2 hidden -> ... seq1 seq2")
这在写通用模块时极其有用:同一段代码既能处理 [seq, hidden],也能处理 [batch, head, seq, hidden]。
reduce:把某些维度归约掉
x = torch.ones(2, 3, 4)  # batch seq hidden

# 旧写法
y = x.sum(dim=-1)

# einops 写法
y = reduce(x, "... hidden -> ...", "sum")
支持 "sum"、"mean"、"max"、"min" 等。同样地,输出里没出现的维度就是被归约的维度——和 einsum 的心智模型完全一致。
rearrange:重排、拆分、合并维度
最典型的场景:某个维度实际上"打包"了两个维度(多头注意力里的 hidden = heads × head_dim),而你想只对其中一个做变换。
x = torch.ones(3, 8)   # seq total_hidden,其中 total_hidden = heads * hidden1
w = torch.ones(4, 4)   # hidden1 hidden2

# 1) 把 total_hidden 拆成 heads 和 hidden1
x = rearrange(x, "... (heads hidden1) -> ... heads hidden1", heads=2)
# 现在 x 的形状是 [3, 2, 4]

# 2) 只对 hidden1 做线性变换(heads 维自动作为"批")
x = einsum(x, w, "... hidden1, hidden1 hidden2 -> ... hidden2")
# 形状 [3, 2, 4]

# 3) 把 heads 和 hidden2 合并回去
x = rearrange(x, "... heads hidden2 -> ... (heads hidden2)")
# 形状 [3, 8]
括号语法 (heads hidden1) 表示这个维度是两个维度按行优先展平得到的。拆分时必须给出其中一个的大小(heads=2),另一个由总长度推出。
用 view(3, 2, 4) 你只是在断言"总元素数对得上";用 rearrange(x, "... (heads hidden1) -> ... heads hidden1", heads=2) 你在断言"这个维度的语义是 heads × hidden1,而且按这个顺序打包"。形状对但语义错的 bug——比如把 (hidden1 heads) 当成 (heads hidden1)——在前者下会静默通过,在后者下你至少把假设写在了代码里,review 时一眼可见。
这不是风格问题。Percy 强调这一点,是因为在几百 GPU-天的训练里,一个静默的维度错误可能要几天后才从 loss 曲线上看出来。
7. FLOPs:算力的记账单位
讲完了"东西存在哪",现在算"算它要多少代价"。
一次浮点运算(floating-point operation, FLOP)指一次基本运算,比如一次加法 x + y 或一次乘法 x * y。
- FLOPs(小写 s = 复数):浮点运算的次数,衡量"做了多少计算"。
- FLOP/s(也写作 FLOPS):每秒浮点运算次数,衡量"硬件有多快"。
这门课里两者会频繁交替出现,读的时候一定要看清楚是不是带斜杠。
先建立量级直觉
| 事件 | FLOPs |
|---|---|
| 训练 GPT-3(2020) | $3.14\times 10^{23}$ |
| 训练 GPT-4(2023,外界推测) | $\approx 2\times 10^{25}$ |
| 8 张 H100 跑 2 周 | $8\times(2\times7\times86400)\times 9.895\times10^{14}\approx 9.6\times 10^{21}$ |
把最后一行和前两行比一比:8 张 H100 跑两周,只有 GPT-3 训练量的 3%,只有 GPT-4 的 0.05%。这就是"学术实验室 vs 前沿实验室"的算力鸿沟的具体数字。也正因如此,这门课的作业才要在小规模上做,靠 scaling law 外推。
矩阵乘法的 FLOPs:2mnp
这是全课最基础的一条公式,务必彻底搞懂它的来历。
设 $X \in \R^{B\times D}$($B$ 个数据点,每个 $D$ 维),$W\in\R^{D\times K}$($K$ 个输出),$Y = XW \in \R^{B\times K}$。
输出的每个元素是一个长度为 $D$ 的点积:
$$ Y_{ik} = \sum_{j=1}^{D} X_{ij} W_{jk} $$算一个 $Y_{ik}$ 需要 $D$ 次乘法 + $D-1$ 次加法 $\approx 2D$ 次浮点运算。输出一共有 $B\times K$ 个元素,所以
$$ \text{FLOPs} = B\cdot K\cdot 2D = 2\,B\,D\,K $$更简洁的记法:对每一个 $(i,j,k)$ 三元组做一次乘法和一次加法,三元组共有 $BDK$ 个,故 $2BDK$。
严格说是 $BK(2D-1)$,但 $D$ 通常上千,差别可以忽略;工程上统一写 $2BDK$(这也是 MFU 的通行约定)。
课上的实测代码是这样的:
B = 16384  # Number of points(数据点数)
D = 32768  # Dimension of each point(输入维度)
K = 8192   # Number of outputs(输出维度)

x = torch.ones(B, D, device="cuda")
w = torch.randn(D, K, device="cuda")
y = x @ w

actual_num_flops = 2 * B * D * K       # = 8.796e12 FLOPs
$2 \times 16384 \times 32768 \times 8192 \approx 8.8\times 10^{12}$ FLOPs——一次矩阵乘法就快 9 TFLOPs。
实测:从时间反推 FLOP/s
import timeit

def benchmark(func, num_trials: int = 5) -> float:
    """返回执行 func 一次所需的秒数。"""
    if torch.cuda.is_available():
        torch.cuda.synchronize()      # 等待之前的 CUDA 任务结束

    def run():
        func()
        if torch.cuda.is_available():
            torch.cuda.synchronize()  # 等待本次任务真正跑完

    total_time = timeit.timeit(run, number=num_trials)
    return total_time / num_trials

actual_time = benchmark(lambda: x @ w)
actual_flop_per_sec = actual_num_flops / actual_time
CUDA kernel 是异步发射的:x @ w 这一行只是把任务丢进队列就立刻返回了。不调用 torch.cuda.synchronize(),你测到的是"提交任务的时间"(微秒级),会得到荒谬的高 FLOP/s。
另外要跑多次取平均,因为第一次调用包含 kernel 编译/autotune 的开销(所以真正严谨的做法还要先跑几次 warmup 再计时)。
硬件峰值算力:一定要看 dtype
每块 GPU 的规格书都给出峰值性能,而峰值严重依赖数据类型。课上代码里的查表函数是这样的:
def get_promised_flop_per_sec(dtype: torch.dtype) -> float:
    """返回该设备在给定 dtype 下的峰值 FLOP/s。"""
    properties = torch.cuda.get_device_properties("cuda")

    if "A100" in properties.name:
        if dtype == torch.float32:                     return 19.5e12
        if dtype in (torch.bfloat16, torch.float16):   return 312e12

    if "H100" in properties.name:
        if dtype == torch.float32:                     return 67.5e12
        if dtype in (torch.bfloat16, torch.float16):   return 1979e12 / 2
        # 1979 是带稀疏的数字,稠密只有一半

    if "B200" in properties.name:
        if dtype == torch.float32:                     return 75e12
        if dtype in (torch.bfloat16, torch.float16):   return 4.5e15 / 2
| GPU | fp32 | bf16 / fp16(稠密) | fp8(稠密) | HBM 带宽 | 显存 |
|---|---|---|---|---|---|
| A100 (80GB) | 19.5 TFLOP/s | 312 TFLOP/s | — | 2.0 TB/s | 80 GB |
| H100 (SXM) | 67.5 TFLOP/s | 989.5 TFLOP/s | 1979 TFLOP/s | 3.35 TB/s | 80 GB |
| B200 | 75 TFLOP/s | 2250 TFLOP/s | 4500 TFLOP/s | ~8 TB/s | 192 GB |
- fp32 和 bf16 差 15 倍左右。 A100 上是 $312/19.5 = 16$ 倍,H100 上是 $989.5/67.5 \approx 14.7$ 倍。原因是低精度走的是 Tensor Core 专用通路,而 fp32 走的是普通 CUDA Core。不用低精度,你等于浪费了 90% 以上的芯片。
- 规格书上的大数字通常带 "with sparsity"(结构化 2:4 稀疏)。真实稠密训练要除以 2。H100 的 1979 → 989.5。看规格书不除这个 2 是新手最常犯的错。
- 从 bf16 起,每再降一档精度峰值算力就翻倍:bf16 → fp8 → fp4。这是低精度训练最直接的动机——不只是省显存,更是省时间。
MFU:模型算力利用率
MFU(Model FLOPs Utilization,模型 FLOPs 利用率)的定义非常朴素:
$$ \text{MFU} = \frac{\text{实测 FLOP/s}}{\text{规格书峰值 FLOP/s}} $$(这个定义忽略了通信开销和其他 overhead——它们的影响会自动体现在"实测"那一项里。)
promised_flop_per_sec = get_promised_flop_per_sec(x.dtype)
mfu = actual_flop_per_sec / promised_flop_per_sec
经验判断:MFU $\geq$ 0.5 就已经相当好了。 前沿实验室的大规模预训练通常报告 0.4–0.55;能上 0.6 说明工程做得很扎实。
实测方法就是上面那套:跑一步训练,测时间,用 $6ND$ 算出"模型 FLOPs",除以时间得到实测 FLOP/s,再除以峰值。
还有一个容易混淆的指标 HFU(Hardware FLOPs Utilization)。区别在于分子:
- MFU 的分子是"有用的模型 FLOPs",即 $6ND$。
- HFU 的分子是硬件实际执行的 FLOPs,包含激活重计算(activation checkpointing)多算的那部分。
所以开了激活重计算后 HFU > MFU。比较不同工作时务必看清对方报的是哪个——报 MFU 更诚实,因为重计算是你自己选的开销。
那么问题来了:为什么 MFU 不接近 1? 明明矩阵乘法的 FLOPs 是确定的,硬件峰值也是确定的。要回答这个问题,必须看清 GPU 上计算到底是怎么发生的——这就是下一节。
8. 算术强度与 roofline:为什么打不满算力
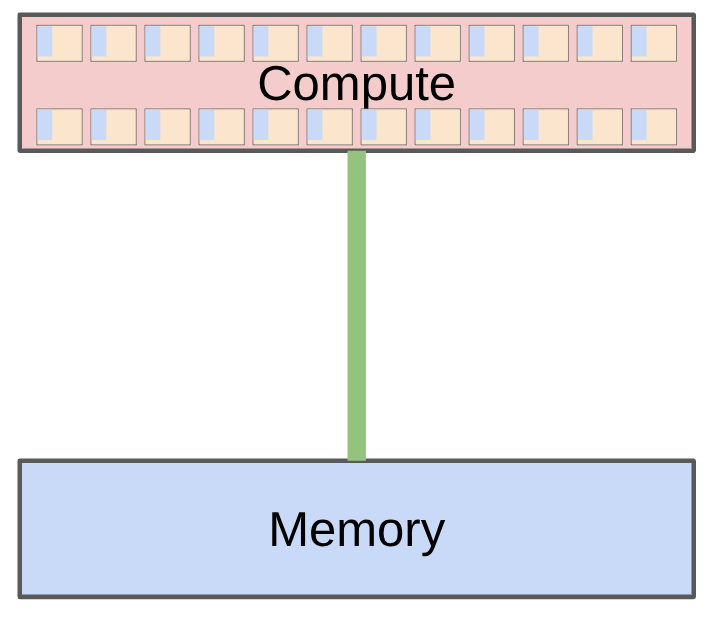
做一件计算,物理上要走三步:
- 把输入从内存搬到加速器(memory → accelerator)
- 执行计算
- 把输出从加速器搬回内存
所以耗时由两个参数共同决定:
- 加速器速度:$\text{h100\_flop\_per\_sec} = 1979\times10^{12}/2 = 9.895\times 10^{14}$ FLOP/s
- 内存带宽:$\text{h100\_bytes\_per\_sec} = 3.35\times 10^{12}$ B/s
假设通信和计算能完美重叠(理想情况),那么
$$ \text{total\_time} = \max\left(\underbrace{\frac{\text{bytes}}{\text{bytes\_per\_sec}}}_{\text{通信时间}},\ \underbrace{\frac{\text{flops}}{\text{flop\_per\_sec}}}_{\text{计算时间}}\right) $$- 内存受限(memory-bound):通信时间 > 计算时间。计算单元在等数据。
- 计算受限(compute-bound):计算时间 > 通信时间。这是你想要的状态,说明芯片被喂饱了。
两个"强度"
比时间更好用的是一个无量纲的比值。定义:
加速器强度(accelerator intensity):硬件每搬 1 字节,有能力做多少次浮点运算。这是硬件的固有属性。
$$ I_{\text{acc}} = \frac{\text{FLOP/s}}{\text{bytes/s}} = \frac{9.895\times10^{14}}{3.35\times10^{12}} \approx 295\ \text{FLOP/byte} $$算术强度(arithmetic intensity):这个具体的计算,每搬 1 字节,实际做了多少次浮点运算。这是工作负载的属性。
$$ I_{\text{arith}} = \frac{\text{flops}}{\text{bytes}} $$判据(与时间判据完全等价,两边同除即得):
- $I_{\text{arith}} < I_{\text{acc}}$ → memory-bound
- $I_{\text{arith}} > I_{\text{acc}}$ → compute-bound
295 这个数字要记住:H100 在 bf16 下,每从显存读一个字节,就"有资格"做 295 次浮点运算。你的算子做不到这么多,就是在浪费芯片。
下面按算术强度从低到高,把五种典型算子过一遍。所有例子都用 bf16(2 字节/元素)。
例 1:ReLU —— 强度 0.25
n = 1024 * 1024
x = torch.ones(n, dtype=torch.bfloat16, device="cuda")
y = torch.relu(x)

bytes = (2 * n) + (2 * n)   # 读 x,写 y(bf16 每个元素 2 字节)
flops = n                   # n 次比较

communication_time = bytes / h100_bytes_per_sec   # ≈ 1.25e-6 s
computation_time   = flops / h100_flop_per_sec    # ≈ 1.06e-9 s

arithmetic_intensity = flops / bytes              # = 0.25
算术强度 0.25,加速器强度 295。差了一千多倍!通信时间比计算时间长约 1180 倍——GPU 有 99.9% 的时间在等数据。ReLU 是彻头彻尾的 memory-bound。
例 2:GELU —— 强度 5
y = F.gelu(x)
# GELU(x) = 0.5 * x * (1 + tanh(sqrt(2/pi) * (x + 0.044715 * x^3)))

bytes = (2 * n) + (2 * n)   # 还是读 x、写 y
flops = 20 * n              # tanh 可用多项式近似,估 20 次运算

arithmetic_intensity = flops / bytes    # = 5
GELU 每搬一个字节干的活比 ReLU 多得多(20 倍),强度提到 5——但离 295 还差 60 倍,依然是 memory-bound。
在孤立执行的前提下,ReLU 并不比 GELU 快。
因为两者的耗时都由"读 $2n$ 字节 + 写 $2n$ 字节"决定,而这两项完全相同。GELU 多出来的 19 倍计算量是免费的——它填的是本来就空转的计算单元。
推论:不要为了"省 FLOPs"去简化逐元素操作。 该优化的是"搬了多少字节"。这也正是 kernel fusion(算子融合)的全部意义:把 x → linear → gelu → dropout 融成一个 kernel,中间结果不落回 HBM,省下的是带宽而不是 FLOPs。
例 3:点积(向量 · 向量)—— 强度 0.5
x = torch.ones(n, dtype=torch.bfloat16, device="cuda")
w = torch.ones(n, dtype=torch.bfloat16, device="cuda")
y = x @ w

bytes = (2 * n) + (2 * n) + 2   # 读 x、读 w、写一个标量 y
flops = 2 * n - 1               # n 次乘法,n-1 次加法

arithmetic_intensity = flops / bytes   # ≈ 0.5
Memory-bound。
例 4:矩阵-向量乘法 —— 强度 ≈ 1
n = 1024
x = torch.ones(n, dtype=torch.bfloat16, device="cuda")       # 向量
w = torch.ones(n, n, dtype=torch.bfloat16, device="cuda")    # 矩阵
y = x @ w

bytes = (2 * n) + (2 * n * n) + (2 * n)   # 读 x、读 w、写 y
flops = n * (2 * n - 1)                   # n 个点积

arithmetic_intensity = flops / bytes      # ≈ 1
算一下:$\dfrac{2n^2}{2n^2 + 4n}\approx 1$。还是 memory-bound! 直觉是:矩阵 $W$ 有 $n^2$ 个元素要读进来,但每个元素只被用了一次。搬运的成本完全没被摊薄。
自回归解码时 batch=1,每一步只处理一个 token,所以每层的运算都是矩阵-向量乘法。整个模型的权重都要从 HBM 读一遍,而每个权重只用一次。
于是解码速度直接由显存带宽 ÷ 模型字节数决定。粗算:70B 模型 bf16 = 140 GB,H100 带宽 3.35 TB/s,理论上限 $3350/140\approx 24$ token/s(还没算多卡通信)。这就是为什么推理优化的关键词全是"减少要搬的字节"——量化、KV cache 压缩、MQA/GQA、投机解码(一次验证多个 token,把矩阵-向量变回矩阵-矩阵)。
例 5:矩阵-矩阵乘法 —— 强度 n/3,终于 compute-bound
n = 1024
x = torch.ones(n, n, dtype=torch.bfloat16, device="cuda")
w = torch.ones(n, n, dtype=torch.bfloat16, device="cuda")
y = x @ w

bytes = (2 * n * n) + (2 * n * n) + (2 * n * n)   # 读 x、读 w、写 y
flops = n * n * (2 * n - 1)                      # n^2 个点积

arithmetic_intensity = flops / bytes   # ≈ 2n^3 / 6n^2 = n / 3
关键在于:搬运量是 $O(n^2)$,而计算量是 $O(n^3)$。矩阵越大,每个搬进来的元素被复用的次数越多,强度线性增长。
$n=1024$ 时 $I_{\text{arith}} = 341 > 295$,终于 compute-bound 了! 而且刚刚好越线——反解一下:
$$ \frac{n}{3} > 295 \quad\Longrightarrow\quad n > 886 $$在 H100 + bf16 上,方阵乘法的边长大约要超过 900 才能进入 compute-bound 区。这给了一条非常实用的经验:模型的隐藏维、batch × seq 的乘积、每个矩阵乘法的三个维度,都不要太小。这也是为什么小模型的 MFU 通常很难看,为什么大 batch 有利于吞吐。
Percy 的总结:
- 只要矩阵够大,我们就是 compute-bound(能吃满加速器)。
- 训练 Transformer 的主体就是大矩阵乘法——所以训练能有不错的 MFU。
- 矩阵-向量乘法是推理时发生的事,所以推理是 memory-bound。
- 注意:算术强度和加速器强度都依赖精度。换到 fp32,$I_{\text{acc}} = 67.5\times10^{12}/3.35\times10^{12}\approx 20$,门槛低了很多(但绝对算力也低了 15 倍);换到 fp8,$I_{\text{acc}}$ 翻倍到约 590(且每元素只有 1 字节,$I_{\text{arith}}$ 也会变),门槛更高。
Roofline 图
把上面所有分析画成一张图,就是经典的 roofline plot(JAX Scaling Book 的 roofline 章节有很好的可视化):
- 横轴:算术强度(FLOP/byte)。每个具体计算是横轴上的一个点。
- 纵轴:达到的性能(FLOP/s)。
- 每条分段线性的折线代表一种硬件:左边是斜率为"内存带宽"的上升段(memory-bound 区,性能 = 强度 × 带宽),右边是水平段(compute-bound 区,性能 = 峰值算力)。
- 拐点(kink)就是加速器强度——从 memory-bound 过渡到 compute-bound 的分界,H100 bf16 下约 295 FLOP/byte。
这张图把 MFU 也解释清楚了:
$$ \text{MFU} = \min\left(1,\ \frac{I_{\text{arith}}}{I_{\text{acc}}}\right) $$也就是说,在理想的重叠假设下,MFU 上不去的根本原因就是算术强度不够。ReLU 的 MFU 上界是 $0.25/295\approx 0.00085$;$1024\times1024$ 矩阵乘法的上界是 1。真实训练混合了两类算子,加上通信、kernel launch、非重叠部分,最终落在 0.4–0.5 附近。
- 加大矩阵:更大的 batch、更大的隐藏维($n/3$ 里的 $n$ 变大)。
- 算子融合(fusion):把连续的逐元素操作合并成一个 kernel,中间结果不落 HBM。FlashAttention 就是这个思想在注意力上的极致应用。
- 分块(tiling):把大矩阵切成能装进片上 SRAM 的块,块内数据反复复用。这是 cuBLAS 内部在做的事,也是 Lecture 5 手写 kernel 时的核心技术。
- 降低精度:同样的元素数,字节数减半,强度翻倍(但硬件的 $I_{\text{acc}}$ 也会变,要具体算)。
9. 反向传播的 FLOPs:6ND 的完整推导
到目前为止我们只做了前向。现在把反向加进来,得到本课最常用的一个公式。
先热身:autograd 在做什么
用一个极简的线性模型 $y = \tfrac{1}{2}(x\cdot w - 5)^2$:
# 前向:计算 loss
x = torch.tensor([1., 2, 3])
w = torch.tensor([1., 1, 1], requires_grad=True)   # 想要它的梯度
pred_y = x @ w                     # = 6
loss = 0.5 * (pred_y - 5).pow(2)   # = 0.5

# 反向:计算梯度
loss.backward()
assert torch.equal(w.grad, torch.tensor([1., 2, 3]))
手推验证:$\dfrac{\partial \text{loss}}{\partial \hat y} = \hat y - 5 = 1$,再由 $\hat y = x\cdot w$ 得 $\dfrac{\partial \text{loss}}{\partial w} = 1 \cdot x = [1,2,3]$。✓
要点:requires_grad=True 让 PyTorch 在前向时记录计算图并保留中间结果——这就是激活值显存的来源。backward() 沿图反向走一遍链式法则。
数清楚反向的 FLOPs
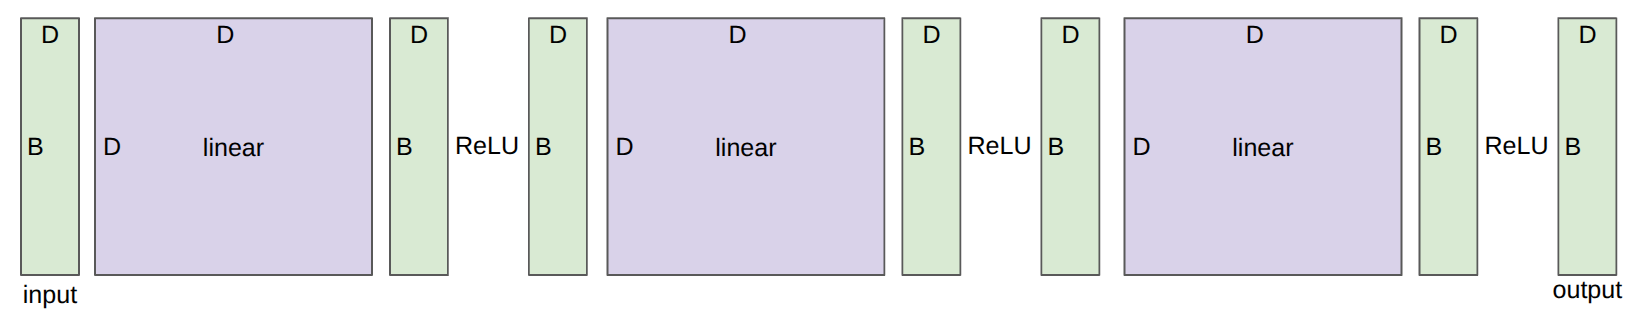
用一个两层线性网络来数:
B = 1024  # Number of points(数据点数)
D = 256   # Dimension(维度)

x  = torch.ones(B, D, device="cuda")
w1 = torch.randn(D, D, device="cuda", requires_grad=True)
w2 = torch.randn(D, D, device="cuda", requires_grad=True)

# 前向
h1 = einsum(x,  w1, "batch in, in out -> batch out")   # 等价于 x @ w1
h2 = einsum(h1, w2, "batch in, in out -> batch out")   # 等价于 h1 @ w2
loss = (h2.mean() - 0)**2      # 随便回归到 0

# 反向
h1.retain_grad()   # 只是为了方便调试时查看
h2.retain_grad()
loss.backward()
聚焦第二层:$h_2 = h_1 W_2$,其中 $h_1\in\R^{B\times D}$,$W_2 \in \R^{D\times D}$。
前向的 FLOPs(用上一节的 $2mnp$):
$$ \text{num\_forward\_flops} = 2\,B\,D\,D $$反向要算两样东西:
已知上游梯度 h2.grad $= \dfrac{\partial \mathcal{L}}{\partial h_2} \in \R^{B\times D_{\text{out}}}$。
(1) 对输入的梯度(要往下游传):
$$ \frac{\partial \mathcal{L}}{\partial h_1} = \frac{\partial \mathcal{L}}{\partial h_2}\, W_2^\top \qquad [B, D_{\text{out}}]\times[D_{\text{out}}, D_{\text{in}}] \to [B, D_{\text{in}}] $$代价:$2\,B\,D_{\text{out}}\,D_{\text{in}}$
(2) 对参数的梯度(要交给优化器):
$$ \frac{\partial \mathcal{L}}{\partial W_2} = h_1^\top\, \frac{\partial \mathcal{L}}{\partial h_2} \qquad [D_{\text{in}}, B]\times[B, D_{\text{out}}] \to [D_{\text{in}}, D_{\text{out}}] $$代价:$2\,D_{\text{in}}\,B\,D_{\text{out}}$
合计:$4\,B\,D_{\text{in}}\,D_{\text{out}}$,正好是前向的 2 倍。
课上用 einsum 把这两个式子直接写了出来并和 autograd 对拍——非常值得自己跑一遍,这是理解反向传播最快的方式:
h1_grad = einsum(h2.grad, w2, "batch out, in out -> batch in")
assert torch.allclose(h1.grad, h1_grad)

w2_grad = einsum(h2.grad, h1, "batch out, batch in -> in out")
assert torch.allclose(w2.grad, w2_grad)

num_backward_flops = (2 * B * D * D) + (2 * B * D * D)   # = 4 * B * D * D
注意 einsum 的写法把这两个转置藏进了名字里:"batch out, in out -> batch in" 里 out 被求和、in 被保留,自然就是 $W_2^\top$ 的效果,你根本不用去想哪个维度要 transpose。
推广到整个网络:6ND
上面只是 $W_2$ 一个参数矩阵。网络里每个参数矩阵都要走同一套流程,把它们加起来:
设 $N$ = 参数量,$D$ = 这一步处理的数据点(token)数:
- 前向:$2\,N\,D$ FLOPs —— 每个参数对每个数据点做一次乘和一次加
- 反向:$4\,N\,D$ FLOPs —— 两个矩阵乘法,各一份
- 合计:$\boxed{6\,N\,D}$ FLOPs
为什么前向是 $2ND$?回到 $2mnp$:一个 $[D_{\text{in}}, D_{\text{out}}]$ 的权重矩阵有 $n_W = D_{\text{in}}D_{\text{out}}$ 个参数,作用在 $B$ 个数据点上要 $2\,B\,D_{\text{in}}D_{\text{out}} = 2\,B\,n_W$ FLOPs。对所有权重求和,就是 $2\,B\,N$。 这个"每参数每 token 2 FLOPs"的形式之所以成立,正是因为参数量本身就等于矩阵元素个数。
严格来说 $6ND$ 是对多层感知机(MLP)推的。用在 Transformer 上还有两处偏差:
- 第一层不需要算 $\partial\mathcal{L}/\partial x$(输入不需要梯度),所以反向略少于 $4ND$。可忽略。
- 注意力里的 $QK^\top$ 和 $AV$ 不涉及参数,$6ND$ 完全没算它们。每层每 token 这部分约 $4Ld$ FLOPs($L$ = 上下文长度,$d$ = 模型维度),而参数部分每层每 token 约 $24d^2$(每层参数约 $12d^2$)。比值是 $$\frac{4Ld}{24d^2}=\frac{L}{6d}$$ $L=2048$、$d=4096$ 时约 8%;但 $L=128\text{k}$、$d=4096$ 时就是 5.3 倍,$6ND$ 彻底失效。
所以 Percy 的原话是"对短上下文的 Transformer 也是个不错的近似"。长上下文时必须单独算注意力项——这也是长上下文为什么这么贵、为什么要有各种稀疏/线性注意力的根本原因。
| 模型 | $N$ | $D$ | $6ND$ | H100 卡·天(MFU 0.5) |
|---|---|---|---|---|
| GPT-3 量级 | 175B | 300B | $3.15\times10^{23}$ | ≈ 7 400 |
| Llama-3 8B 量级 | 8B | 15T | $7.2\times10^{23}$ | ≈ 16 900 |
| 本讲开头的 70B | 70B | 15T | $6.3\times10^{24}$ | ≈ 147 000 |
(一张 H100 一天在 MFU 0.5 下提供 $9.895\times10^{14}\times0.5\times86400 \approx 4.27\times10^{19}$ FLOPs。)注意第二行:8B 模型训 15T token 竟然比 175B 训 300B 还贵——token 数和参数量在成本里是完全对称的,这正是 Chinchilla 那一讲要讨论的取舍。
10. 模型、初始化、优化器:把显存逐项列出来
一个最小的深度网络
import math
import torch.nn.functional as F
from torch import nn

class Block(nn.Module):
    """一个线性变换 + ReLU 非线性。"""
    def __init__(self, dim: int):
        super().__init__()
        # 关键:除以 sqrt(dim)
        self.weight = nn.Parameter(torch.randn(dim, dim) / math.sqrt(dim))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = x @ self.weight   # 线性
        x = F.relu(x)         # 激活
        return x


class DeepNetwork(nn.Module):
    """把 dim 维向量映射到 dim 维向量。"""
    def __init__(self, dim: int, num_layers: int):
        super().__init__()
        self.layers = nn.ModuleList([Block(dim) for _ in range(num_layers)])

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        for layer in self.layers:
            x = layer(x)
        return x


D, L = 8, 3
model = DeepNetwork(dim=D, num_layers=L).to(device)

def get_num_parameters(model: nn.Module) -> int:
    return sum(p.numel() for p in model.parameters())

assert get_num_parameters(model) == (D * D) * L
两个 PyTorch 机制值得注意:
nn.Parameter把一个张量登记成"模型参数":它会自动requires_grad=True,会出现在model.parameters()和state_dict()里,.to(device)时会跟着搬。nn.ModuleList而不是普通 Pythonlist:普通 list 里的子模块不会被注册,参数会"消失"(不进parameters()、不上 GPU、不被优化)。这是新手最容易踩的坑之一。
为什么初始化要除以根号 d
torch.randn(dim, dim) / math.sqrt(dim) 里的 $1/\sqrt{d}$ 不是随手写的。
设输入 $x\in\R^{d}$ 各分量独立、均值 0、方差 1;权重 $W_{ij}\sim\mathcal{N}(0,\sigma^2)$ 独立。输出的第 $j$ 个分量是
$$ h_j = \sum_{i=1}^{d} x_i W_{ij} $$由独立性,方差可加:
$$ \mathrm{Var}(h_j) = \sum_{i=1}^{d}\mathrm{Var}(x_i)\,\mathrm{Var}(W_{ij}) = d\cdot 1\cdot \sigma^2 = d\,\sigma^2 $$要让 $\mathrm{Var}(h_j)=1$(激活的尺度逐层保持不变),必须取
$$ \sigma = \frac{1}{\sqrt{d}} $$而 torch.randn 给的是 $\sigma=1$,所以要手动除以 $\sqrt{d}$。
如果直接用 torch.randn(d, d)($\sigma=1$),每过一层方差就乘以 $d$。取 $d=1024$、$L=32$:
bf16 的最大值约 $3.4\times10^{38}\approx 2^{128}$,所以前向传播还没走完就全变成 inf 了。反过来若 $\sigma$ 取太小,激活会指数衰减到 0,梯度随之消失。$1/\sqrt{d}$ 是让这个乘性过程保持在临界点上的唯一选择。
这就是 Xavier / He 初始化的核心思想。$d$ 越大,初始权重必须越小——初始化必须随模型宽度缩放,这个观念在后面讲 μP(最大更新参数化)时还会以更强的形式回来。
实践中用截断正态(truncated normal)
真实实现里通常不是直接用 randn,而是用截断正态分布:
std = 1.0 / math.sqrt(d)          # 或 sqrt(2 / (d_in + d_out))
w = torch.empty(d_in, d_out)
nn.init.trunc_normal_(w, mean=0.0, std=std, a=-3 * std, b=3 * std)
理由:
- 掐掉极端离群值。 一个 $d^2 = 10^6$ 个元素的权重矩阵里,正态分布必然出现若干个 $4\sigma$、$5\sigma$ 的值。这些异常大的权重在训练最初几十步会制造异常大的激活和梯度,是早期 loss spike 的常见诱因。截断在 $\pm 3\sigma$ 就把这个尾巴剪掉了。
- 数值可控。 有明确上下界,配合低精度(bf16/fp8)时更安全。
常见的 std 选择有两类:1/sqrt(d_in)(只保前向方差,即上面的推导)和 sqrt(2/(d_in + d_out))(Xavier,前向反向折中)。对深层残差网络还会额外把某些层再除以 $\sqrt{2L}$,以免残差流的方差随深度累积。
优化器:从 SGD 到 AdamW 的家谱
Percy 用一条清晰的链条把常用优化器串起来:
| 优化器 | = 什么 + 什么 | 需要的状态 | 字节/参数(fp32) |
|---|---|---|---|
| SGD | 基础 | 无 | 0 |
| Momentum | SGD + 梯度的指数平均 | $m$ | 4 |
| AdaGrad | SGD + 用 $\sum g^2$ 归一化 | $\sum g^2$ | 4 |
| RMSProp | AdaGrad,但 $g^2$ 用指数平均 | $v$ | 4 |
| Adam | RMSProp + momentum | $m,\ v$ | 8 |
| AdamW | Adam + 解耦的权重衰减 | $m,\ v$ | 8 |
AdaGrad 从"$\sum g^2$"到 RMSProp 的"指数平均"这一步很关键:AdaGrad 的分母只增不减,学习率会单调衰减到 0,对长时间训练不友好;指数平均让它能"忘记"很久以前的梯度。
课上手写了一个 AdaGrad(作业 1 会让你按同样的模板写 AdamW):
class AdaGrad(torch.optim.Optimizer):
    def __init__(self, params: Iterable[nn.Parameter], lr: float = 0.01):
        super().__init__(params, dict(lr=lr))

    def step(self):
        for group in self.param_groups:
            lr = group["lr"]
            for p in group["params"]:
                state = self.state[p]      # 每个参数对应一份状态字典
                grad = p.grad.data

                # 取出累积的平方梯度 g2 = sum_{i<t} g_i^2
                g2 = state.get("g2", torch.zeros_like(grad))

                # 更新优化器状态
                g2 += torch.square(grad)
                state["g2"] = g2

                # 更新参数
                p.data -= lr * grad / torch.sqrt(g2 + 1e-5)
模板要点:self.param_groups 是参数分组(可以给不同组不同学习率),self.state[p] 是每个参数张量一份的状态字典——优化器状态的显存就是从这里来的,它和参数张量同形状。
显存的完整清单
现在把所有项摆上桌。以 $D=4$、$L=3$、$B=2$ 的玩具网络为例(参数量 $N = D^2 L = 48$):
num_parameters = D * D * L                    # 48

parameter_memory       = 2 * num_parameters   # bf16,2 字节  → 96 B
gradient_memory        = 2 * num_parameters   # bf16,2 字节  → 96 B
optimizer_state_memory = 4 * num_parameters   # fp32,AdaGrad 一份状态 → 192 B
activation_memory      = 2 * (B * D * L)      # bf16,每层每样本一份 → 48 B

total_memory = (parameter_memory + gradient_memory
                + optimizer_state_memory + activation_memory)   # 432 B
| 项 | 大小 | 典型 dtype | 字节/参数 | 随什么增长 |
|---|---|---|---|---|
| 参数 | $N$ | bf16 | 2 | 模型大小 |
| 梯度 | $N$ | bf16 | 2 | 模型大小 |
| 优化器状态(Adam $m$) | $N$ | fp32 | 4 | 模型大小 |
| 优化器状态(Adam $v$) | $N$ | fp32 | 4 | 模型大小 |
| 以上小计 | 12 | |||
| 激活值 | $\approx B\cdot S\cdot d\cdot L$ | bf16 | — | batch × 序列长度 × 层数 |
前四项只随模型大小变,第五项只随 batch 和序列长度变。这个区分是所有显存优化的分界线:ZeRO/FSDP 处理前四项,梯度累积/激活重计算处理第五项。
为什么优化器状态用 fp32?课上给了明确理由:它要在成千上万步里累积平均("accumulating averages over powers over many steps"),而 bf16 只有 7 位尾数——当动量已经积累到 $1.0$ 时,一个 $0.001$ 的新增量在 bf16 里会被直接丢弃($1.0 + 0.001 = 1.0$)。参数和梯度是"一次性"的量,精度低一点无所谓;优化器状态是"长期记忆",必须保精度。
回到开头的问题:8 张 H100 能训多大?
$$ N_{\max} = \frac{8 \times 80\times10^9\ \text{bytes}}{\underbrace{2}_{\text{param}} + \underbrace{2}_{\text{grad}} + \underbrace{4}_{m} + \underbrace{4}_{v}} = \frac{6.4\times10^{11}}{12} \approx 53\times10^9 $$再看几个变体(同样忽略激活):
| 配置 | 字节/参数 | 8×H100 (640 GB) 能放下 |
|---|---|---|
| 全 fp32 + Adam(param 4 + grad 4 + m 4 + v 4) | 16 | 40B |
| 混合精度 + Adam(本讲的配方) | 12 | 53B |
| 混合精度 + Adam + fp32 主权重 | 16 | 40B |
| 混合精度 + SGD-momentum | 8 | 80B |
| 混合精度 + 无状态优化器(纯 SGD) | 4 | 160B |
| 只做推理(只需参数) | 2 | 320B |
训练比推理贵 6 倍显存——而且这还没算激活。这张表也解释了为什么会有 8-bit Adam、Adafactor 这类"省优化器状态"的工作。
一步训练的算力
flops = 6 * B * num_parameters # 6 * 2 * 48 = 576 FLOPs
对 Transformer 来说核算更复杂,但思路完全一样:把每个矩阵乘法的三个维度写出来,套 $2mnp$,再乘 3(前向 + 反向)。作业 1 就要求你对 Transformer 做完整的 FLOPs 和显存核算。
11. 一个完整的极简训练循环
把前面所有零件拼起来。一个训练脚本永远是这五块:数据 → 模型 → 前向 → 反向 → 更新,外加 checkpoint。
骨架
# 真实的线性函数,权重是 (0, 1, 2, ..., D-1)
D = 16
true_w = torch.arange(D, dtype=torch.float32, device=device)

# 数据加载:生成 (x, y) 对
B = 4
def get_batch() -> tuple[torch.Tensor, torch.Tensor]:
    x = torch.randn(B, D).to(device)
    true_y = x @ true_w
    return (x, true_y)

# 模型和优化器
L = 2
model = DeepNetwork(dim=D, num_layers=L).to(device)
optimizer = AdaGrad(model.parameters(), lr=0.01)

# 训练!
num_train_steps = 3
for t in range(num_train_steps):
    # 取数据
    x, y = get_batch()

    # 前向(算 loss)
    pred_y = model(x).mean()
    loss = F.mse_loss(pred_y, y)

    # 反向(算梯度)
    loss.backward()

    # 更新参数
    optimizer.step()
    optimizer.zero_grad(set_to_none=True)
zero_grad(set_to_none=True) 不是可选项
PyTorch 的梯度是累加的:backward() 做的是 p.grad += ... 而不是 p.grad = ...。不清零,第二步的梯度就会叠在第一步上。
而 set_to_none=True(现在是默认值)把 p.grad 置为 None 而非填 0,这样真正释放了那 $2N$ 字节显存;填 0 的话张量还在。在显存紧张时这个差别是实打实的几 GB。
真实的数据加载:np.memmap
玩具例子里数据是现场生成的。真实预训练的数据是一个几 TB 的 token 数组,不可能读进内存。
先算账:分词后每个 token 是一个整数。词表通常小于 65536,所以用 uint16 存,2 字节/token。
解决办法是 np.memmap:把磁盘上的文件映射到虚拟地址空间,像操作数组一样索引它,由操作系统按需分页调入。内存占用只和你实际访问的部分有关。
import numpy as np

# 训练前把 token 一次性写成一个扁平的 uint16 二进制文件
# tokens.astype(np.uint16).tofile("train.bin")

data = np.memmap("train.bin", dtype=np.uint16, mode="r")   # 不读进内存

def get_batch(data: np.memmap, batch_size: int, seq_len: int,
              device: str) -> tuple[torch.Tensor, torch.Tensor]:
    # 在整个语料里随机采 batch_size 个起点
    starts = np.random.randint(0, len(data) - seq_len - 1, size=batch_size)

    # 输入是 [i, i+seq_len),标签是右移一位的 [i+1, i+1+seq_len)
    x = np.stack([data[i     : i + seq_len    ] for i in starts])
    y = np.stack([data[i + 1 : i + 1 + seq_len] for i in starts])

    # uint16 -> int64(embedding 查表需要 long)
    x = torch.from_numpy(x.astype(np.int64))
    y = torch.from_numpy(y.astype(np.int64))

    if device.startswith("cuda"):
        # pin_memory + non_blocking:让 H2D 拷贝和计算重叠
        x = x.pin_memory().to(device, non_blocking=True)
        y = y.pin_memory().to(device, non_blocking=True)
    else:
        x, y = x.to(device), y.to(device)
    return x, y
几个要点:
- 随机起点采样而不是顺序遍历:省掉了维护 epoch 和 shuffle 的复杂度,在超大语料上两者统计上等价。
- 标签就是右移一位的输入——这是自回归语言建模的全部秘密,不需要单独存标签。
- 页缓存(page cache):第一次访问某段数据会触发磁盘 I/O,之后 OS 会缓存。所以真实训练要保证磁盘吞吐跟得上。
pin_memory()+non_blocking=True:锁页内存才能走 DMA 异步拷贝,让下一个 batch 的传输和当前 batch 的计算重叠,否则 GPU 会周期性空等。
Checkpoint
一次训练要跑几个月,机器一定会挂。checkpoint 必须同时存模型、优化器状态、当前步数——只存模型是不够的,Adam 的动量丢了会导致恢复后 loss 抖动。
def save_checkpoint(model: nn.Module, optimizer: torch.optim.Optimizer,
                    iteration: int, out: str):
    torch.save({
        "model": model.state_dict(),
        "optimizer": optimizer.state_dict(),
        "iteration": iteration,
    }, out)

def load_checkpoint(src: str, model: nn.Module,
                    optimizer: torch.optim.Optimizer) -> int:
    ckpt = torch.load(src, map_location="cpu")
    model.load_state_dict(ckpt["model"])
    optimizer.load_state_dict(ckpt["optimizer"])
    return ckpt["iteration"]
一个 70B 模型的完整 checkpoint(fp32 参数 + Adam 两个 fp32 动量 = 12 字节/参数)是 840 GB。以 1 GB/s 的存储写入速度,光是落盘就要 14 分钟。
所以实践中:(1) 不会每步都存,通常几百到几千步一次;(2) 用异步 / 分片写入(每个 rank 只写自己那一份);(3) 分开存"用于恢复训练的完整 checkpoint"和"只含 bf16 权重、用于评测和发布的轻量 checkpoint"(后者只有 140 GB)。
12. 用计算换显存:梯度累积与激活重计算
前面把显存拆成了两类:模型侧(参数/梯度/优化器状态,$12N$ 字节) 和 批次侧(激活值)。这一节讲怎么压缩第二类。
梯度累积(gradient accumulation)
动机:大 batch 有利于训练稳定性(梯度噪声小、更容易用大学习率、更好地打满 GPU)。但激活显存随 batch 线性增长,很容易 OOM。
B = 64     # Batch size
D = 1024   # Dimensionality
L = 16     # Number of layers

activation_memory = 2 * B * D * L   # bf16 → 2,097,152 字节 ≈ 2 MB
梯度累积的想法非常简单:
- 把大 batch 切成若干个 micro batch,逐个做前向 + 反向;
- 累加梯度,不清零(正好利用了 PyTorch 梯度默认累加的行为);
- 每累积
batch_size / micro_batch_size次,才调用一次optimizer.step()并清零。
micro_batch_size = B / 4                            # 16
activation_memory = 2 * micro_batch_size * D * L    # → 524,288 字节 ≈ 0.5 MB
激活显存降到 1/4,而数学上等价于用 batch 64 训练(梯度是各 micro batch 梯度之和)。
accum_steps = 4
for t in range(num_train_steps):
    for micro in range(accum_steps):
        x, y = get_batch(micro_batch_size)
        loss = compute_loss(model, x, y) / accum_steps   # 注意除以 accum_steps
        loss.backward()          # 梯度自动累加,不清零
    optimizer.step()
    optimizer.zero_grad(set_to_none=True)
- 忘记除以
accum_steps:如果 loss 是"平均"形式(mean而非sum),直接累加 4 次会让梯度变成 4 倍,等价于把学习率放大 4 倍——训练很可能直接发散。 - BatchNorm 类的统计量不能这样切分:micro batch 的均值方差 ≠ 大 batch 的。好在 Transformer 用的是 LayerNorm / RMSNorm,逐样本归一化,不受影响。
- 代价:梯度累积不省时间,总 FLOPs 一样,而且 micro batch 太小会让矩阵变小、掉进 memory-bound 区,反而更慢。它换的是"能不能跑起来"。
激活重计算(activation checkpointing)
先看清问题的本质:
- 训练:反向传播需要每一层的激活(回忆 $\partial\mathcal{L}/\partial W_2 = h_1^\top\,\partial\mathcal{L}/\partial h_2$,必须有 $h_1$),所以所有层的激活都要存着。
- 推理:不算梯度,只需要当前层的激活,用完就扔,显存 $O(1)$。
B, D, L = 64, 1024, 16
activation_memory = 2 * B * D * L   # ≈ 2 MB(bf16)

x = torch.randn(B, D, device=device, requires_grad=True)
model = DeepNetwork(dim=D, num_layers=L).to(device)
memory = get_max_memory_usage(lambda: model(x).sum().backward())
能不能减少?可以。激活重计算 = 梯度检查点(gradient checkpointing)= 重物化(rematerialization),三个名字一回事:
- 前向:只保留一部分层的激活(检查点),其余的算完就扔。
- 反向:需要某个被扔掉的激活时,从最近的检查点重新前向算一遍。
哲学:拿计算换显存(tradeoff memory for compute)。
课上的对比示意($g_i$ 表示层内部的中间量,$h_i$ 表示层输出):
存所有激活:  x g1 h1 g2 h2 g3 h3 g4 h4
激活重计算:  x    h1    h2    h3    h4
PyTorch 里只要把 layer(x) 换成 torch.utils.checkpoint.checkpoint(layer, x):
class DeepNetworkCheckpointed(nn.Module):
    """和 DeepNetwork 一样,但开了激活重计算。"""
    def __init__(self, dim: int, num_layers: int):
        super().__init__()
        self.layers = nn.ModuleList([Block(dim) for _ in range(num_layers)])

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        for layer in self.layers:
            # 关键:只在检查点处保存激活,其余的反向时重算
            x = torch.utils.checkpoint.checkpoint(layer, x)
        return x
多久打一个检查点?
这是一个漂亮的时间-空间权衡题。设网络有 $L$ 层:
| 策略 | 激活显存 | 额外计算 |
|---|---|---|
| 每层都存 | $O(L)$ | 无 |
| 一层都不存 | $O(1)$ | $O(L^2)$(每层都要从头重算) |
| 每 $\sqrt{L}$ 层存一个 | $O(\sqrt{L})$ | $O(L)$(即多做一遍前向) |
设每 $k$ 层放一个检查点,则检查点有 $L/k$ 个,段内最多要重算 $k$ 层。
- 显存 $\approx \underbrace{L/k}_{\text{检查点}} + \underbrace{k}_{\text{当前段重算出的激活}}$
- 额外计算 $\approx L$(每层最多被重算一次),与 $k$ 无关
对显存关于 $k$ 求极小:$\dfrac{d}{dk}\left(\dfrac{L}{k}+k\right)=-\dfrac{L}{k^2}+1=0 \Rightarrow k=\sqrt{L}$,此时显存为 $2\sqrt{L}$。
实践中的常见做法:以一个 Transformer block 为粒度打检查点(即 $k=1$,$O(L)$ 个检查点但每个 block 内部的中间激活全部重算)。这已经能省掉大部分激活显存,而额外计算约为一次前向,即总计算从 $6ND$ 变成 $8ND$——多约 33%。
更精细的做法是"选择性重计算":只对那些"存起来很占地方、重算却很便宜"的中间量(比如注意力的 $L\times L$ 分数矩阵、GELU 的输入)做重计算,对矩阵乘法的输出照常保存。这样能以远小于 33% 的额外计算换到大部分显存收益。FlashAttention 本质上也是这个思路——它根本不物化那个 $L\times L$ 矩阵。
另外记住:开了重计算后 MFU 会看起来变化(分子按 $6ND$ 算不变,但时间变长了,所以 MFU 下降;HFU 反而上升)。比较数字时务必看清定义。
本讲小结
Percy 在课上的六条总结:
- 一切都是张量上的操作——参数、梯度、激活值、优化器状态、数据。
- einops 是思考张量操作更好的方式:给维度起名字,而不是数
-1-2。 - 每步训练 $6 \times (\text{数据点数}) \times (\text{参数量})$ FLOPs。
- 算术强度 / roofline 分析:判断一个计算是 compute-bound 还是 memory-bound。
- 矩阵乘法是 compute-bound,逐元素操作是 memory-bound。
- 梯度累积、激活重计算:降低显存以支持更大的 batch。
速查表
| 要算的东西 | 公式 | 备注 |
|---|---|---|
| 张量内存 | numel() × element_size() | fp32=4B,bf16/fp16=2B,fp8=1B |
| 矩阵乘法 FLOPs | $2mnp$($[m,n]\times[n,p]$) | 每个 $(i,j,k)$ 一乘一加 |
| 前向 FLOPs | $2ND$ | $N$=参数量,$D$=token 数 |
| 反向 FLOPs | $4ND$ | 激活梯度 + 参数梯度,各 $2ND$ |
| 训练总 FLOPs | $\mathbf{6ND}$ | 短上下文 Transformer 的好近似 |
| 注意力额外项占比 | $L/(6d)$ | $L$=上下文长度,$d$=模型维度 |
| 训练显存(模型侧) | $12N$ 字节 | bf16 param 2 + grad 2 + Adam 4+4 |
| 激活显存 | $\propto B\cdot S\cdot d\cdot L$ | 与参数量无关 |
| MFU | 实测 FLOP/s ÷ 峰值 FLOP/s | $\geq 0.5$ 算好;$=\min(1, I_{\text{arith}}/I_{\text{acc}})$ |
| H100 峰值(bf16 稠密) | $9.895\times10^{14}$ FLOP/s | 规格书 1979 TFLOP/s 要除以 2 |
| H100 显存带宽 | $3.35\times10^{12}$ B/s | |
| H100 加速器强度 | ≈ 295 FLOP/byte | bf16 下;低于它就是 memory-bound |
| 方阵乘法进入 compute-bound | $n \gtrsim 900$ | 由 $n/3 > 295$ 得出 |
| 激活重计算的代价 | 约 +33% 计算($6ND\to 8ND$) | 每 block 一个检查点 |
可以马上拿去用的三个习惯
- 看到任何模型配置,先算 $6ND$ 和 $12N$。 前者告诉你要多少卡·天,后者告诉你要多少卡。
- 看到任何算子,先算算术强度。 低于 295(H100/bf16)就别指望它快,优化方向是减少字节而不是减少 FLOPs。
- 看到任何 OOM,先把显存拆成五项(参数/梯度/优化器/激活/临时缓冲),逐项对照
torch.cuda.max_memory_allocated()。手算和实测对不上的那一项,就是你的 bug。
下一讲会把这套核算方法用到具体的 Transformer 架构上:每个架构选择(Pre-LN vs Post-LN、RMSNorm、SwiGLU、RoPE、GQA)都会同时改变 FLOPs、显存和稳定性,而你现在已经有工具去评估它们了。
附录:延伸阅读
数值精度
- Mixed Precision Training (2017) — 混合精度训练的奠基论文,loss scaling、fp32 主权重这些标准做法都出自这里。
- FP8 Formats for Deep Learning (2022) — E4M3 / E5M2 两种 fp8 格式的标准化提案,解释了为什么前向和反向要用不同格式。
- Introducing NVFP4 (2025) — 4 比特浮点 + 分块缩放因子的设计,看"极限压缩"能走到哪里。
- Nemotron 3 Super Technical Report (2026) — 用 NVFP4 完成的真实大规模训练,是低精度训练可行性的最新证据。
- PyTorch AMP 文档 — 哪些算子会被自动降精度、哪些不会,值得完整读一遍白名单。
张量与 einops
- Einops 教程 — 半小时读完,之后写模型的心智负担会显著下降。
- DeepSeek v3.2 权重清单 — 用真实模型的张量列表去练"看形状猜结构"。
- DeepSeek v3.2 (2025) — 对应的技术报告。
算力与 roofline
- How to Scale Your Model:Roofline 章节 — 本讲算术强度部分最好的配套材料,有大量可交互的图。
- Transformer FLOPs 详解 — 把 $6ND$ 的每一项按 Transformer 的实际结构拆开,含注意力修正项。
- Transformer 训练显存详解 — 参数/梯度/优化器/激活逐项核算,和作业 1 的要求高度对应。
- Scaling Laws for Neural Language Models (2020) — 附录里有 $6ND$ 及注意力修正项的经典推导。
优化器
- Adaptive Subgradient Methods (AdaGrad, 2011) — 本讲手写实现的那个优化器的原论文。
- Adam (2014) — RMSProp + momentum,两个动量状态的来源。
- Decoupled Weight Decay Regularization (AdamW, 2017) — 今天训练 LLM 的默认优化器,解释了为什么 Adam 里的 L2 正则是错的。
省显存的技术
- GPipe (2018) — 流水线并行,同时也是激活重计算在大规模训练中的早期系统性应用。
- Reducing Activation Recomputation in Large Transformer Models (2022) — 选择性重计算:只重算"存着贵、算着便宜"的那部分。
- ZeRO (2019) — 把参数/梯度/优化器状态分片到多卡,直接攻击那 $12N$ 字节。
- FlashAttention (2022) — 算术强度思想的教科书级应用:不物化 $L\times L$ 注意力矩阵,把 memory-bound 的注意力变回 compute-bound。
整体图景
- Attention Is All You Need (2017) — 所有核算的对象。
- Training Compute-Optimal Large Language Models (Chinchilla, 2022) — 在 $6ND$ 的预算约束下,$N$ 和 $D$ 该怎么分配。本讲的公式是它的前提。