总览与分词
为什么要「从零造一遍」语言模型,以及模型看到的第一层抽象——token——是怎么来的。
0. 本讲导读
这是 CS336 的第三次开课(第一次是 2024 春,第二次 2025 春,录像在 YouTube 上)。2026 版保持同样的 "from scratch"(从零构建)哲学,但做了两处调整:优先讲单位时间价值最高的概念,不要为了细枝末节丢掉整片森林;同时增加对现代语言模型(Language Model, LM)新配料的覆盖——混合专家(Mixture of Experts, MoE)、长上下文、智能体(agents)。
第一讲承担两件事,它们看似无关,其实是同一条逻辑的两端:
- 上半场(第 1~4 节)是「为什么」:为什么 2026 年还值得手写一个 Transformer?前沿模型花上亿美元训练、细节全部保密,我们在教室里能学到什么真正可迁移的东西?答案会收敛到一个词:效率(efficiency)。
- 下半场(第 5~10 节)是第一个技术单元:分词(tokenization)。它是 Assignment 1 的第一道题,也是整门课「效率优先」思路的第一个具体案例:直接在字节上建模最优雅,但在今天的架构下算力上不划算,所以我们退而求其次,用 BPE 做一层数据驱动的压缩。
这一讲的顺序也是全课的顺序:先把「基础(basics)→ 系统(systems)→ 缩放定律(scaling laws)→ 数据(data)→ 对齐(alignment)」五个作业单元的地图铺开,再一头扎进第一个单元。下一讲(Lecture 02)会紧接着讲 PyTorch 与资源核算(resource accounting),把「效率」这个抽象词变成能算的 FLOPs 和 GB。
- 研究者正在与底层技术脱节:2016 年自己实现模型,2018 年下载 BERT 微调,今天只调 API。抽象层提高了生产力,但这些抽象是漏的(leaky)——做基础研究仍然需要把整个栈拆开。课程哲学:understanding via building(通过构建来理解)。
- 能教、且能迁移到前沿的是机制(mechanics)与心法(mindset);直觉(intuitions)只能部分教,因为它未必跨尺度成立。
- 苦涩的教训(the bitter lesson)的正确读法不是「算法不重要」,而是「能 scale 的算法才重要」。写成公式:accuracy = efficiency × resources,规模越大,效率越是决定性因素。
- 分词器把「字节序列」压缩成「token 序列」。字符级词表太大且浪费、字节级压缩率为 1(序列太长)、词级词表无界且有未登录词(UNK)问题——三条路都是死路,BPE 是数据驱动的有效折中。
- 压缩率(bytes/token)是分词器最核心的效率指标;注意力是序列长度的二次复杂度,压缩率每提高一倍,注意力开销降到约四分之一。
1. 这门课为什么存在
研究者与技术的脱节
Percy 用三个时间点勾勒了这十年的变化:
| 年份 | 研究者的典型工作方式 | 接触到的抽象层 |
|---|---|---|
| 2016 | 自己实现并训练自己的模型 | 算子、优化器、数据管线,全在手里 |
| 2018 | 下载预训练模型(如 BERT)做微调 | 模型是黑箱权重,只碰 fine-tune 脚本 |
| 今天 | 给 API 模型(GPT / Claude / Gemini)写提示词 | 只剩一个 HTTP 接口 |
往上爬抽象层当然提升生产力——没人再手写汇编。但 Percy 强调一个关键区别:编程语言、操作系统这些抽象是「不漏」的,你几乎不需要知道页表长什么样就能写 Python;而语言模型这层抽象是漏的。模型为什么在某个 prompt 上失败、为什么数数不准、为什么长上下文性能塌陷,这些问题的答案往往埋在 tokenizer、注意力实现、数据配比里。想做真正的基础研究,你必须能把栈撕开(tear up the stack)。
「抽象是否漏」有一个朴素判据:当系统出错时,你能不能只用这一层的语言解释清楚。Python 抛 IndexError,你不需要谈 CPU 缓存;但 LM 把 1000000 数错位数,你不谈 BPE 的数字切分方式就解释不了(见第 9 节)。这就是为什么这门课的第一个技术单元是分词——它是最靠近输入、也最容易被忽视的一层漏抽象。
语言模型的工业化
「understanding via building」听起来很美好,但有一个小问题:前沿模型真的很贵。
- 2023 年,GPT-4 据称花费约 1 亿美元训练(Wired 报道)。
- 2025 年,xAI 为训练 Grok 建了 23 万张 GPU 的集群(Elon Musk 的推文)。
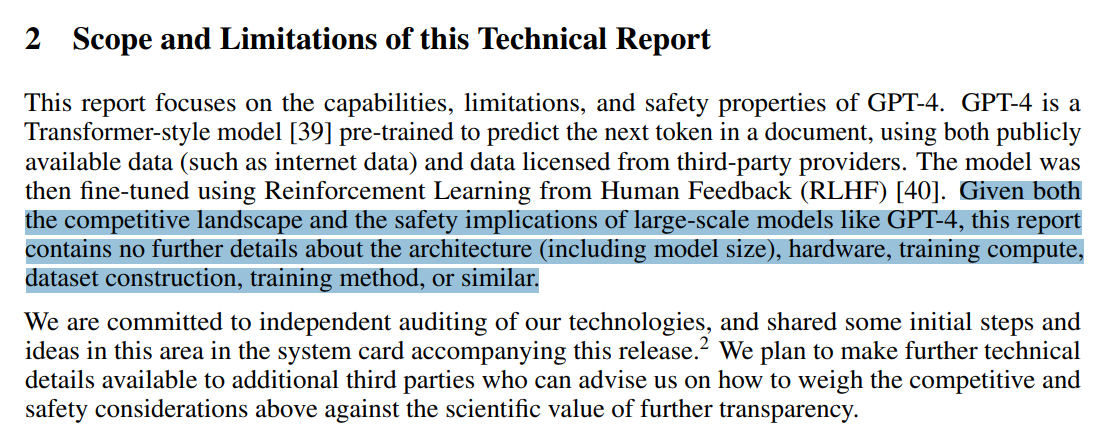
更麻烦的是,前沿模型的构建细节没有任何公开信息。GPT-4 技术报告(OpenAI, 2023)开宗明义地写着:出于竞争格局与安全考虑,本报告不包含架构(含模型规模)、硬件、训练算力、数据集构造、训练方法等任何细节。
小模型能代表大模型吗?
前沿模型对我们是够不着的。那退一步,训个小于 1B 参数的小模型行不行?行,但要清醒:小模型未必能代表大模型。Percy 给了两个具体反例。
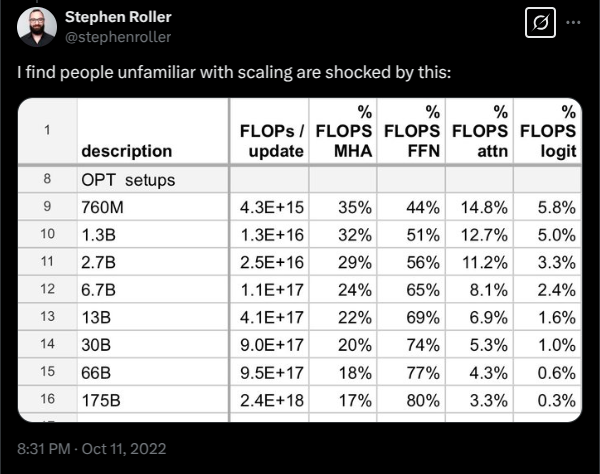
反例一:注意力与 MLP 的 FLOPs 占比随规模变化。在小模型上,注意力(attention)占的浮点运算比例相当可观,于是你会觉得「优化注意力是头等大事」;但随着隐藏维度 $d_{\text{model}}$ 增大,MLP 的 FLOPs 按 $d^2$ 增长,而注意力中与序列长度相关的那部分按 $d \cdot L$ 增长,比例会此消彼长。结论:在小尺度上得到的「该优化哪里」的判断,可能在大尺度上完全反过来。
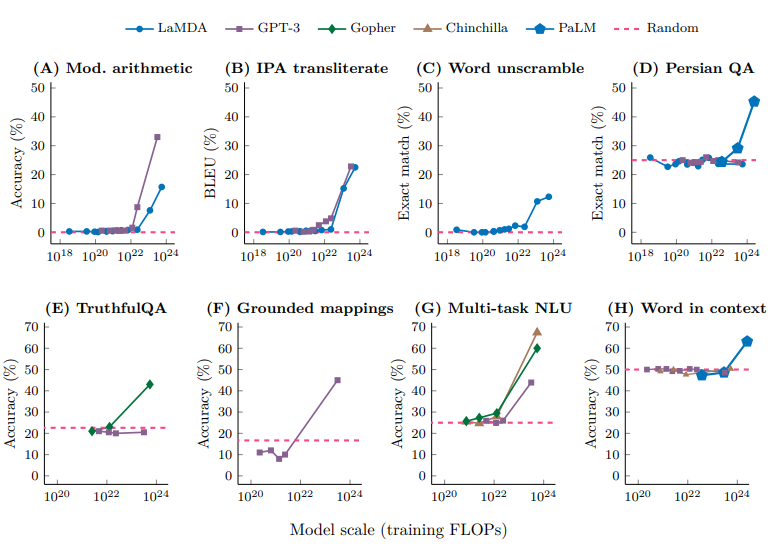
反例二:能力的涌现(emergence)。某些任务上,模型在小尺度近乎随机,越过某个规模后准确率突然抬升。无论你怎么解读涌现(是真的相变,还是评测指标不连续造成的假象),有一件事是确定的:在小模型上你观察不到这些行为,因而也无法在小模型上研究它们。
什么知识真的能迁移?
既然小模型有局限,那这门课教的东西到底有多少能用到前沿模型上?Percy 把知识分成三类,并诚实地标出了各自的可迁移性:
| 知识类型 | 内容 | 能否教 / 能否迁移 |
|---|---|---|
| 机制 Mechanics | 东西是怎么运作的:Transformer 由什么构成、模型并行怎么切 | 能教,能迁移 |
| 心法 Mindset | 把硬件榨干、认真对待 scaling | 能教,能迁移 |
| 直觉 Intuitions | 哪些数据配比、哪些建模选择能带来更好的准确率 | 只能部分教,未必跨尺度成立 |
直觉?🤷
关于「直觉」这一栏,Percy 举了一个非常坦率的例子:SwiGLU 激活函数的原始论文(Noam Shazeer, GLU Variants Improve Transformer)在结论里写道——这些架构变体为什么有效,我们没有解释,只能把它归于「神意的仁慈(divine benevolence)」。
苦涩的教训:accuracy = efficiency × resources
Rich Sutton 的「苦涩的教训(the bitter lesson)」经常被误读为「规模就是一切,算法不重要」。Percy 给出的正确读法是:能够 scale 的算法才是重要的算法。他把它写成一个(非严格但极有用的)等式:
$$ \text{accuracy} \;=\; \text{efficiency} \times \text{resources} $$其中 resources 指数据与硬件(算力、内存、通信带宽),efficiency 指你把每一份资源转化成模型质量的效率。这个式子解释了为什么「算法不重要」是错的:规模越大,效率越关键,因为在大尺度上你根本浪费不起。一个佐证是 OpenAI 的算法效率研究(arXiv:2005.04305):在 ImageNet 上,达到同样准确率所需的算力从 2012 到 2019 年下降了 44 倍——这全部来自算法进步,与硬件无关。
整门课的提问方式因此被固定下来:给定一定的算力与数据预算,你能构建出的最好的模型是什么?换句话说——最大化效率。之后每一个技术选择(用不用 BPE、用不用 GQA、怎么切并行、怎么过滤数据)都要放回这个框架里评判。
2. 当前的语言模型格局
要理解今天的设计为什么长这样,得知道它们是从哪儿来的。Percy 用一条时间线串起了整个领域。
前神经网络时代(2010s 之前)
- Shannon (1950),Prediction and Entropy of Printed English——语言模型最初的用途是测量英语的熵。信息论与语言建模从第一天起就是一回事:好的语言模型 = 好的压缩器。
- N-gram 语言模型,在机器翻译和语音识别系统里做组件(Brants et al., 2007,Google 在 2T token 上训了 5-gram 模型)。注意这个数据量在 2007 年就已经是万亿级——数据规模不是深度学习时代才有的。
神经网络配料齐备(2010s)
今天 Transformer 里的每一块,都是这十年里为别的问题发明出来的:
| 年份 | 工作 | 贡献 |
|---|---|---|
| 1997 | LSTM | 长短期记忆,解决 RNN 梯度消失 |
| 2003 | Bengio et al. | 第一个神经语言模型(前馈网络看前 n 个词预测下一个) |
| 2014 | seq2seq | 把整句编码成一个向量再解码(为机器翻译) |
| 2014 | Adam | 自适应优化器,至今仍是默认选择 |
| 2015 | Attention | Bahdanau 注意力机制(为机器翻译) |
| 2017 | Transformer | 去掉循环,只留注意力(为机器翻译) |
| 2017 | Mixture of experts | 稀疏激活,参数量与计算量解耦 |
| 2018–19 | GPipe / ZeRO / Megatron-LM | 模型并行:流水线、状态分片、张量并行 |
注意一个反复出现的模式:注意力、seq2seq、Transformer 都是为机器翻译发明的,没有人当初是奔着「造一个通用助手」去的。
早期基础模型(2010s 末)
- ELMo(2018):用 LSTM 做预训练,微调能提升下游任务——「预训练 + 微调」范式成立。
- BERT(2018):把预训练换成 Transformer,效果大幅提升。
- T5(Google, 2019, 11B):把所有任务统一表述成 text-to-text。
拥抱 scaling
- GPT-2(OpenAI, 2019, 1.5B):文本流畅,出现零样本(zero-shot)能力的最早迹象。
- Scaling laws(Kaplan et al., 2020):为「继续放大」提供了希望与可预测性。
- GPT-3(OpenAI, 2020, 175B):上下文学习(in-context learning)。
- PaLM(Google, 2022, 540B):规模巨大,但事后看是训练不足(undertrained)的。
- Chinchilla(DeepMind, 2022, 70B):算力最优(compute-optimal)缩放定律,指出参数与 token 应同比增长——这正是 PaLM 被判定为「训练不足」的依据。
开放模型的三个层次
这一节对本课程尤其重要,因为CS336 之所以能开出来,靠的就是开放模型公布的思路。Percy 把开放度分成三层。
| 层次 | 公开内容 | 代表工作 |
|---|---|---|
| 闭源(closed) | 只有 API | GPT、Claude、Gemini |
| 开放权重(open-weight) | 权重 + 论文 | Llama、Mistral / Mixtral、DeepSeek、Qwen、Kimi、GLM、MiniMax、小米 MiMo |
| 开源(open-source) | 权重 + 论文 + 代码 + 数据 | AI2 的 Olmo、NVIDIA 的 Nemotron、Marin(开放式开发) |
早期的复现尝试(对标 GPT-3):EleutherAI 的开放数据集 The Pile 与模型 GPT-J(2020);Meta 的 OPT-175B(2022,其日志详细记录了大量硬件故障,是研究大规模训练工程现实的珍贵材料);Hugging Face / BigScience 的 BLOOM-176B(2022,重点在数据来源的规范性)。
可信的开放权重模型:Meta 的 Llama 系列(1 / 2 / 3)、Mistral(7B、Mixtral)、DeepSeek(67B → V2 → V3 → R1 → V3.2)、阿里 Qwen(2.5 / 3)、月之暗面 Kimi(1.5 / K2.5)、智谱 GLM(4.5 / 5)等。Percy 的判断是:这些模型正在逼近闭源模型。
真正的开源模型(连数据和训练代码都放出来):AI2 的 Olmo(7B / 2 / 3)、NVIDIA 的 Nemotron(15B / 3)、以及 Percy 自己参与的 Marin(8B / 32B,主打「开放式开发」——不只公开结果,连开发过程中的失败实验也公开)。
为什么要在意「开源」和「开放权重」的区别?因为权重告诉你结果,数据和代码才告诉你方法。你无法从 Llama 的权重里反推出它的数据过滤器长什么样,但 Olmo / Marin 的数据管线是可以逐行读的。开放性对信任与创新都重要(arXiv:2403.07918)。
「语言模型」这个词的含义一直在变
| 年份 | 代表 | LM 是什么 |
|---|---|---|
| 2018 | BERT | 一个你拿来微调的东西 |
| 2020 | GPT-3 | 一个你拿来提示的东西 |
| 2022 | ChatGPT | 一个你可以对话的东西 |
| 2026 | agents | 一个自主行动的东西 |
但 Percy 立刻补了一句关键的话:基本面没有变——注意力、kernel、优化,仍然是那几样。变的是规格(specs):上下文更长了,推理效率变得更加重要了(因为智能体一次任务要生成成千上万 token)。这正是这门课「从零构建」仍然成立的理由:底层没换,只是被要求得更极致。
3. 效率是贯穿全课的主线
在进入课程大纲之前,先把这条主线钉死,因为后面每一个技术选择都是它的推论。
资源 = 数据 + 硬件(算力、内存、通信带宽)。核心问题永远是:给定一组固定的资源,怎样训出最好的模型?
Percy 特别点出当下的约束状态:今天我们是算力受限(compute-constrained)的,所以所有设计决策都反映着「把给定硬件榨干」这一诉求。而他随即预告:明天我们会变成数据受限(data-constrained)的——高质量的人类文本是有限的,一旦算力不再是瓶颈,整个优化目标会重写一遍。这是理解 2026 年这门课与 2024 年版本差异的关键背景。
下面把「效率」这个词在五个单元里各自的具体含义列出来:
| 单元 | 效率体现在哪里 |
|---|---|
| 系统 Systems | 最直白的一类:kernel、并行、推理,全是在减少数据移动、提高硬件利用率 |
| 分词 Tokenization | 直接在原始字节上建模很优雅,但在今天的模型架构下算力上不划算——所以我们做分词 |
| 模型架构 | 许多改动的动机就是省内存或省 FLOPs(共享 KV cache、滑动窗口注意力) |
| 数据过滤 | 不要把宝贵的算力浪费在垃圾 / 无关数据的梯度更新上 |
| 缩放定律 | 用小模型上的少量算力,替大模型做超参数搜索 |
请特别记住分词那一行——它是本讲下半场的全部动机。「优雅但低效」与「丑陋但高效」之间的取舍,是这门课反复出现的母题。
顺带一提:这份讲义本身是一个程序
Percy 的讲义是可执行讲义(executable lecture):一个 Python 程序,运行它就是在讲课。这样做的好处是——所有内容都是代码,因此可以直接查看并运行;同时讲义的层次结构(函数调用树)就是讲课的层次结构,可以随时展开或跳过某一层。本页面的组织顺序,就是 main() 里函数调用的顺序。
4. 五个作业单元的逻辑
课程信息都在课程网站上。这是一门 5 学分的课,Spring 2024 的一条课程评价被 Percy 直接放进了讲义里:
整个(第一次)作业的工作量,大约等于 CS224n 的全部 5 次作业加上期末项目。而这还只是第一次作业。
他给出的选课建议同样直白。该选:你有一种非要搞懂事情怎么运作不可的强迫症;你想练出研究工程(research engineering)的肌肉。不该选:你这个学期真的要出研究成果(去跟你导师谈谈);你想学 AI 领域最热的新技术(多模态、RAG 之类——去上研讨课);你只是想在自己的应用领域拿到好结果(那你应该直接提示或微调现成模型)。
作业的形式:5 次作业,没有脚手架代码(no scaffolding code),但提供单元测试和适配器接口帮你自查正确性。流程是本地实现验正确性 → 上集群跑基准(准确率与速度)。部分作业有排行榜(在给定训练预算下最小化困惑度 perplexity)。算力由 Modal 赞助。
关于 AI 使用政策,Percy 说得很清楚:编码智能体能够解出全部作业,但那样你什么也学不到。AI 用来答疑和辅导是极其有用的,因此课程要求使用他们提供的 AGENTS.md,它会让 AI 以教学导向而非代做作业的方式回应。自学者也建议照此约束自己:让模型解释,不要让它替你写 BPE。
Assignment 1 — basics(基础)
目标:能训练出一个基本的语言模型。三个组成部分:分词、模型架构、训练。
分词:模型操作的「原子」是什么?形式化地说,分词器在原始输入(字节)与整数序列(token)之间来回转换。主流方案是字节对编码(Byte-Pair Encoding, BPE,Sennrich et al., 2016)。用效率的视角看它做了两件事:缩短上下文长度(1000 字节 → 约 250 个 token)与自适应计算(把更多建模容量分配给输入中有意思的部分)。
模型架构:起点是原始 Transformer(Vaswani et al., 2017),之后是一长串改良——
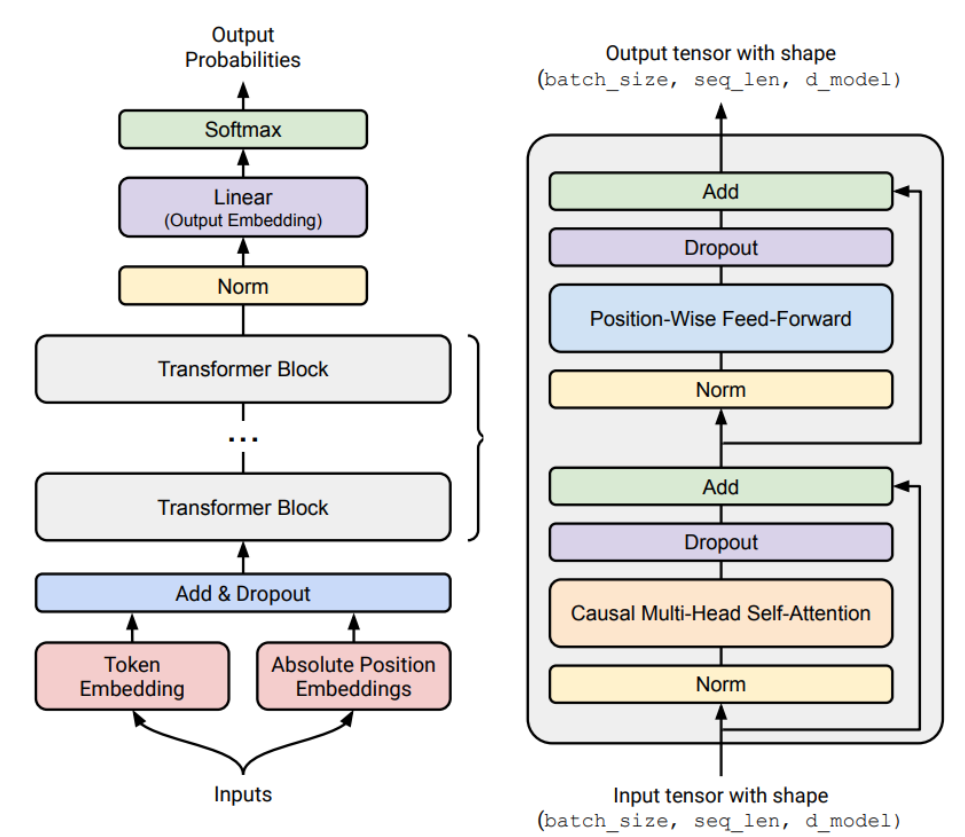
| 模块 | 可选项 |
|---|---|
| 激活函数 | ReLU、SwiGLU |
| 位置编码 | 正弦位置编码、RoPE |
| 归一化 | LayerNorm、RMSNorm、QK norm、pre-norm vs post-norm |
| 注意力 | 全注意力、稀疏 / 局部注意力、GQA、MLA |
| 循环 / 状态空间 | 线性注意力、Mamba-2、Gated DeltaNet、Mamba-3 |
| MLP | 稠密、混合专家、Switch Transformer |
| 形状 | 隐藏维度、深度、头数、专家数 |
训练:怎么把参数定下来?损失函数(如多 token 预测 MTP)、优化器(Adam / AdamW / SOAP / Muon)、初始化尺度(Xavier、muP)、学习率调度(cosine、WSD)、正则化(dropout、weight decay)、批大小(临界批大小 critical batch size)、MoE 专用的负载均衡(aux-free)。
作业内容(GitHub):实现 BPE 分词器;实现 Transformer、交叉熵损失、AdamW、训练循环;做资源核算;在 TinyStories 和 OpenWebText 上训练。排行榜:在一块 B200 上给 45 分钟,最小化 OpenWebText 困惑度。
贯穿架构设计的高层原则——所有事情都是在三者之间取平衡:表达力(expressivity,能表示数据中的复杂依赖)、稳定性(stability,让参数与梯度范数待在金发姑娘区间)、效率(efficiency,在硬件上训练和推理都跑得快)。
Assignment 2 — systems(系统)
目标:把硬件(GPU 或 TPU)榨干。三部分:kernel、并行、推理。
资源核算是起点:训练一个 70B 参数模型、看 1T token,总算力约为
$$ C \approx 6ND = 6 \times 7\times10^{10} \times 10^{12} = 4.2\times10^{23}\ \text{FLOPs} $$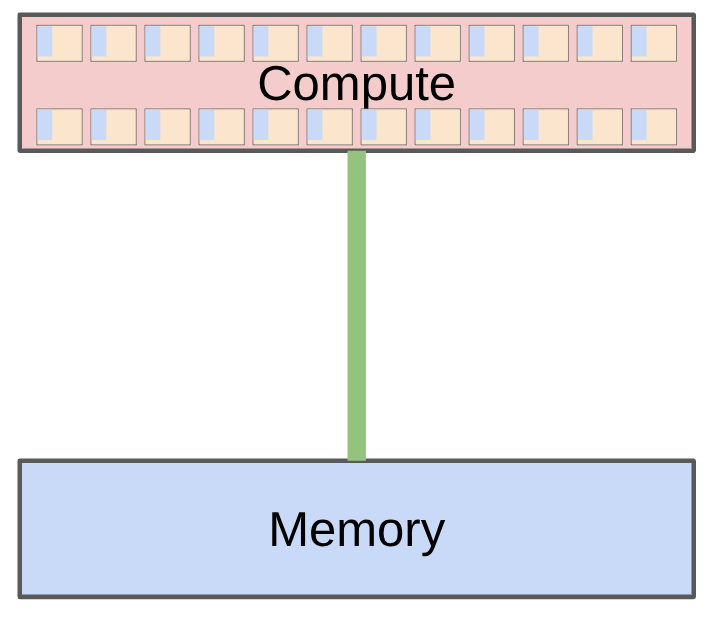
Kernel:kernel 是跑在 GPU 上的函数;用 PyTorch 时每个原语操作都会启动一个标准 kernel。写自定义 kernel 的核心原则是组织计算以最小化数据移动。朴素做法是「读 HBM;算 A;写 HBM;读 HBM;算 B;写 HBM」,融合(fused)做法是「读 HBM;算 A 和 B;写 HBM」。策略包括算子融合(matmul + 激活)与分块(tiling,FlashAttention);还要处理 warp divergence、访存合并(memory coalescing)、bank conflict、占用率(occupancy)、批量异步传输。工具链:CUDA / Triton / CUTLASS / ThunderKittens。
并行:如果有 1024 块 GPU 呢?GPU 之间的数据移动更慢,但「最小化数据移动」的原则完全一样。用经典集合通信操作(gather、reduce、all-reduce),把参数、激活、梯度、优化器状态分片到多卡,并在数据 / 张量 / 流水线 / 序列 / 专家等维度上切分计算。
推理:给定 prompt 生成 token——这是真正使用模型的方式,同时强化学习、测试时计算(test-time compute)、评测也都依赖它。
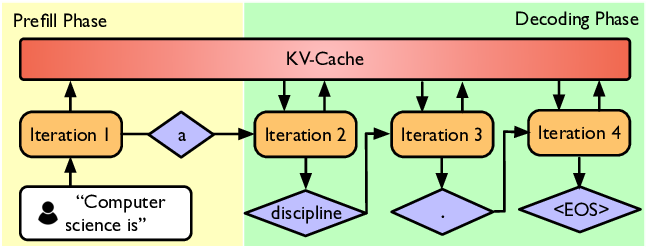
加速解码的方法:用更便宜的模型(剪枝、量化、蒸馏);投机解码(speculative decoding)——用便宜的「草稿」模型一次生成多个 token,再用完整模型并行打分,这是精确解码,不损失分布;以及系统层优化(融合 kernel、连续批处理 continuous batching)。
作业内容(GitHub):用 Triton 写融合的 RMSNorm kernel;实现分布式数据并行训练;实现优化器状态分片;对实现做基准测试与 profiling。推荐读物:How to Scale Your Model(Google 出品,以 TPU 为主,但高层概念相通)。
Assignment 3 — scaling laws(缩放定律)
设定:如果你手上有 $10^{25}$ FLOPs 的算力,你会选什么超参数?在完整规模上做超参搜索太贵了。
关键的观念转变:不要想着「一个规模」,而要想「一条缩放配方(scaling recipe)」——一个从 FLOPs 到超参数的映射。做法是:在若干较小规模(比如到 $10^{24}$ FLOPs)上跑实验测损失,然后拟合一条缩放定律,预测该配方在目标规模($10^{25}$)上的损失。于是你可以(1)用小规模实验去优化面向大规模的配方;(2)在真正开跑之前预测目标规模的损失。
Percy 强调两点:缩放定律不会自动发生,它需要精心构造的缩放配方,要把模型参数化成能超参数迁移(hyperparameter transfer)的形式(muP);而且——可预测性至少和最优性同样重要。
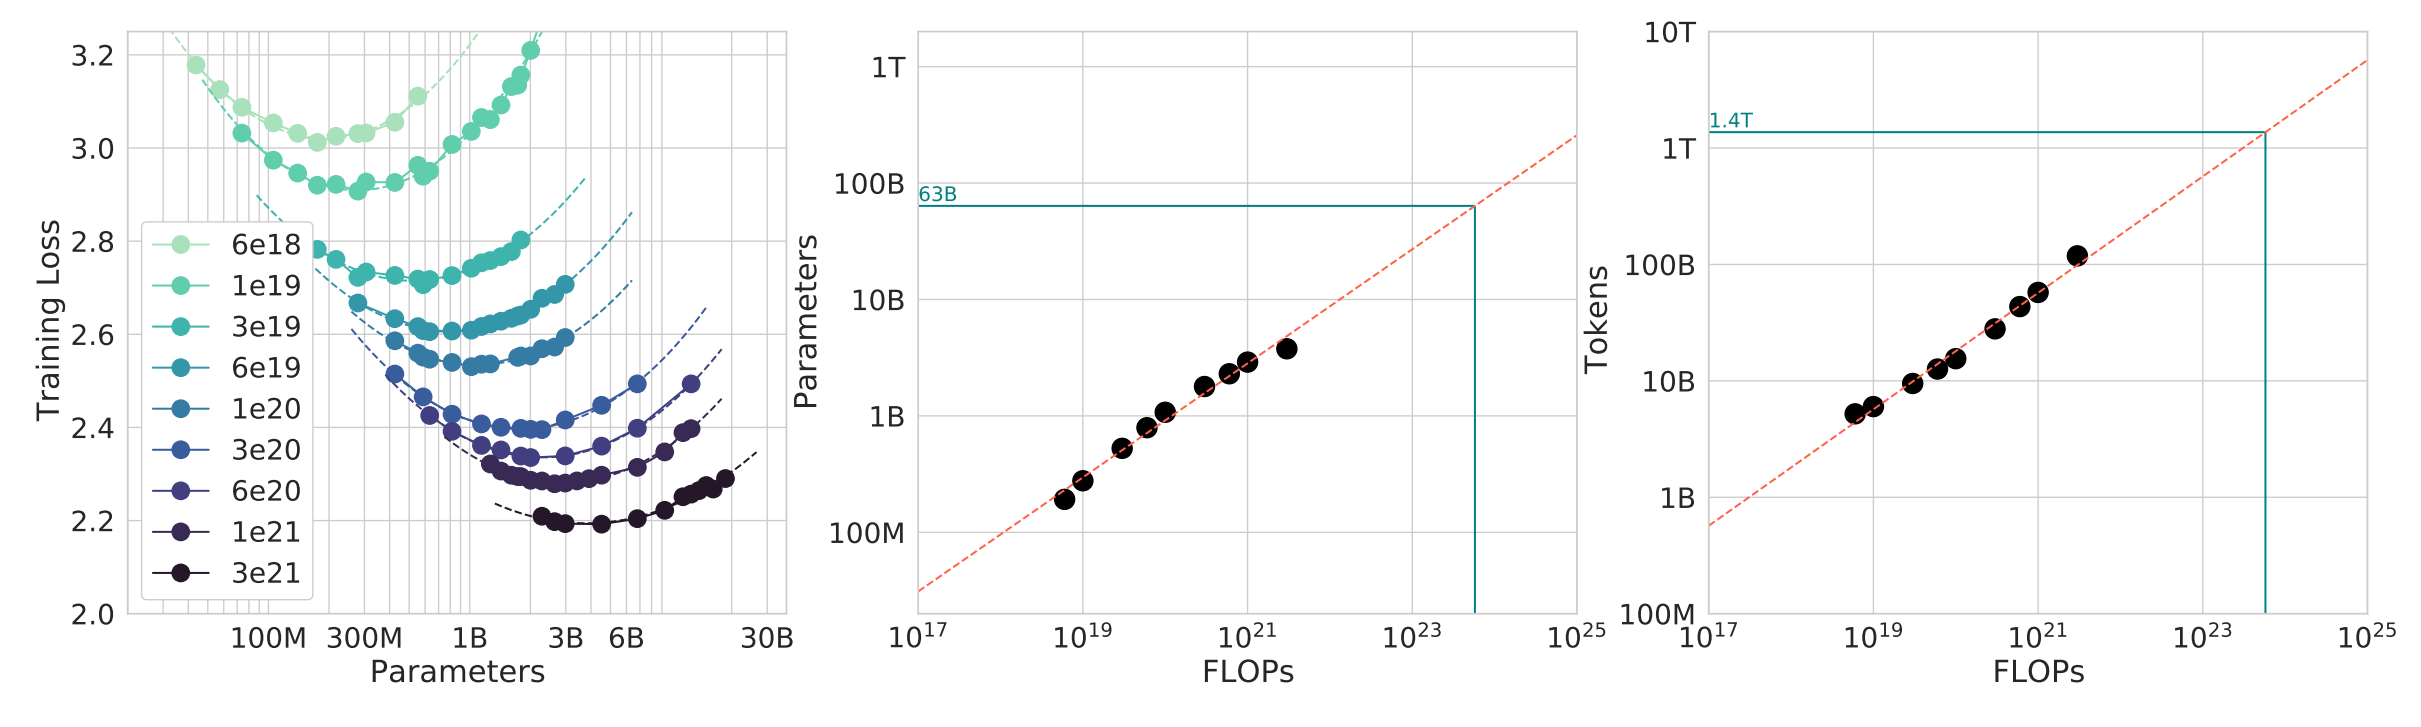
作业内容(GitHub):课程提供一个基于历史运行的训练 API(超参 → 损失);你在 FLOPs 预算下提交「训练任务」收集数据点;拟合缩放定律;提交外推的超参与损失预测。排行榜:给定 FLOPs 预算最小化损失。
Assignment 4 — data(数据)
先问:我们想让模型具备什么能力?多语言?擅长对话?智能体式编码?这个问题的答案决定数据怎么配。
评测的目的分两种,不要混为一谈:(1)内部——指导模型开发,此时重要的是跨规模的平滑性与相对排序;(2)外部——衡量真实用例的绝对质量,此时重要的是生态效度(ecological validity)。评测形式包括困惑度(理想情况下应在互联网上没有的私有文档上测,以避免污染)和高级用例(GPQA、HLE、SWE-Bench、Terminal-Bench)。因为 LM 是通用的,所以必须有一整套多样化的评测。
数据不会从天上掉下来。来源包括网页爬取、书籍、arXiv 论文、GitHub 代码等。随之而来的是版权问题——诉诸合理使用(fair use)?还是像 Google 与 Reddit 那样购买授权?而且原始数据是 HTML、PDF、目录结构,不是文本,必须处理。
处理流程:转换(HTML/PDF → 文本,抽取正文)、过滤(用分类器留下高质量数据、去掉有害内容)、去重(省算力、避免记忆化,用 Bloom filter 或 MinHash)、数据混合(每个来源该上采样还是下采样,RegMix)、改写 / 合成数据(用 LM 增广真实数据,使之更接近下游任务,WRAP)。数据还分三类:预训练数据(大而多样)、中训练数据(高质量,含长上下文)、后训练数据(监督微调:对话、带工具调用的智能体轨迹)。
作业内容(GitHub):把 Common Crawl 的 HTML 转成文本;训练质量与有害内容分类器;用 MinHash 去重。排行榜:给定 token 预算最小化困惑度。
Assignment 5 — alignment(对齐)
到这一步为止,模型是在完全监督(预测下一个 token)下训练的。既然模型已经不算差了,就可以用弱监督(weak supervision)继续提升。为什么弱监督可行?因为批评比生成容易。
基本模板三步:(1)从模型采样生成回复;(2)用人类 / 验证器 / LM 裁判给回复打分;(3)更新模型使其更偏好高分回复。算法:PPO(来自强化学习,InstructGPT 用的就是它)、DPO(针对偏好数据,更简单)、GRPO(去掉价值函数)。
挑战:RL 算法不稳定且难调;规模化需要大量新基础设施(异步 rollout 的推理服务);并且要在系统效率与on-policy 程度之间不断权衡——这两者天生冲突:批量攒得越大越高效,采样策略就离当前策略越远。作业内容(GitHub):实现 DPO 与 GRPO。
5. 为什么需要分词器
从这里开始进入第一个技术单元。Percy 特别推荐了 Andrej Karpathy 关于分词的视频(Let's build the GPT Tokenizer),本单元受其启发。
问题的形式化
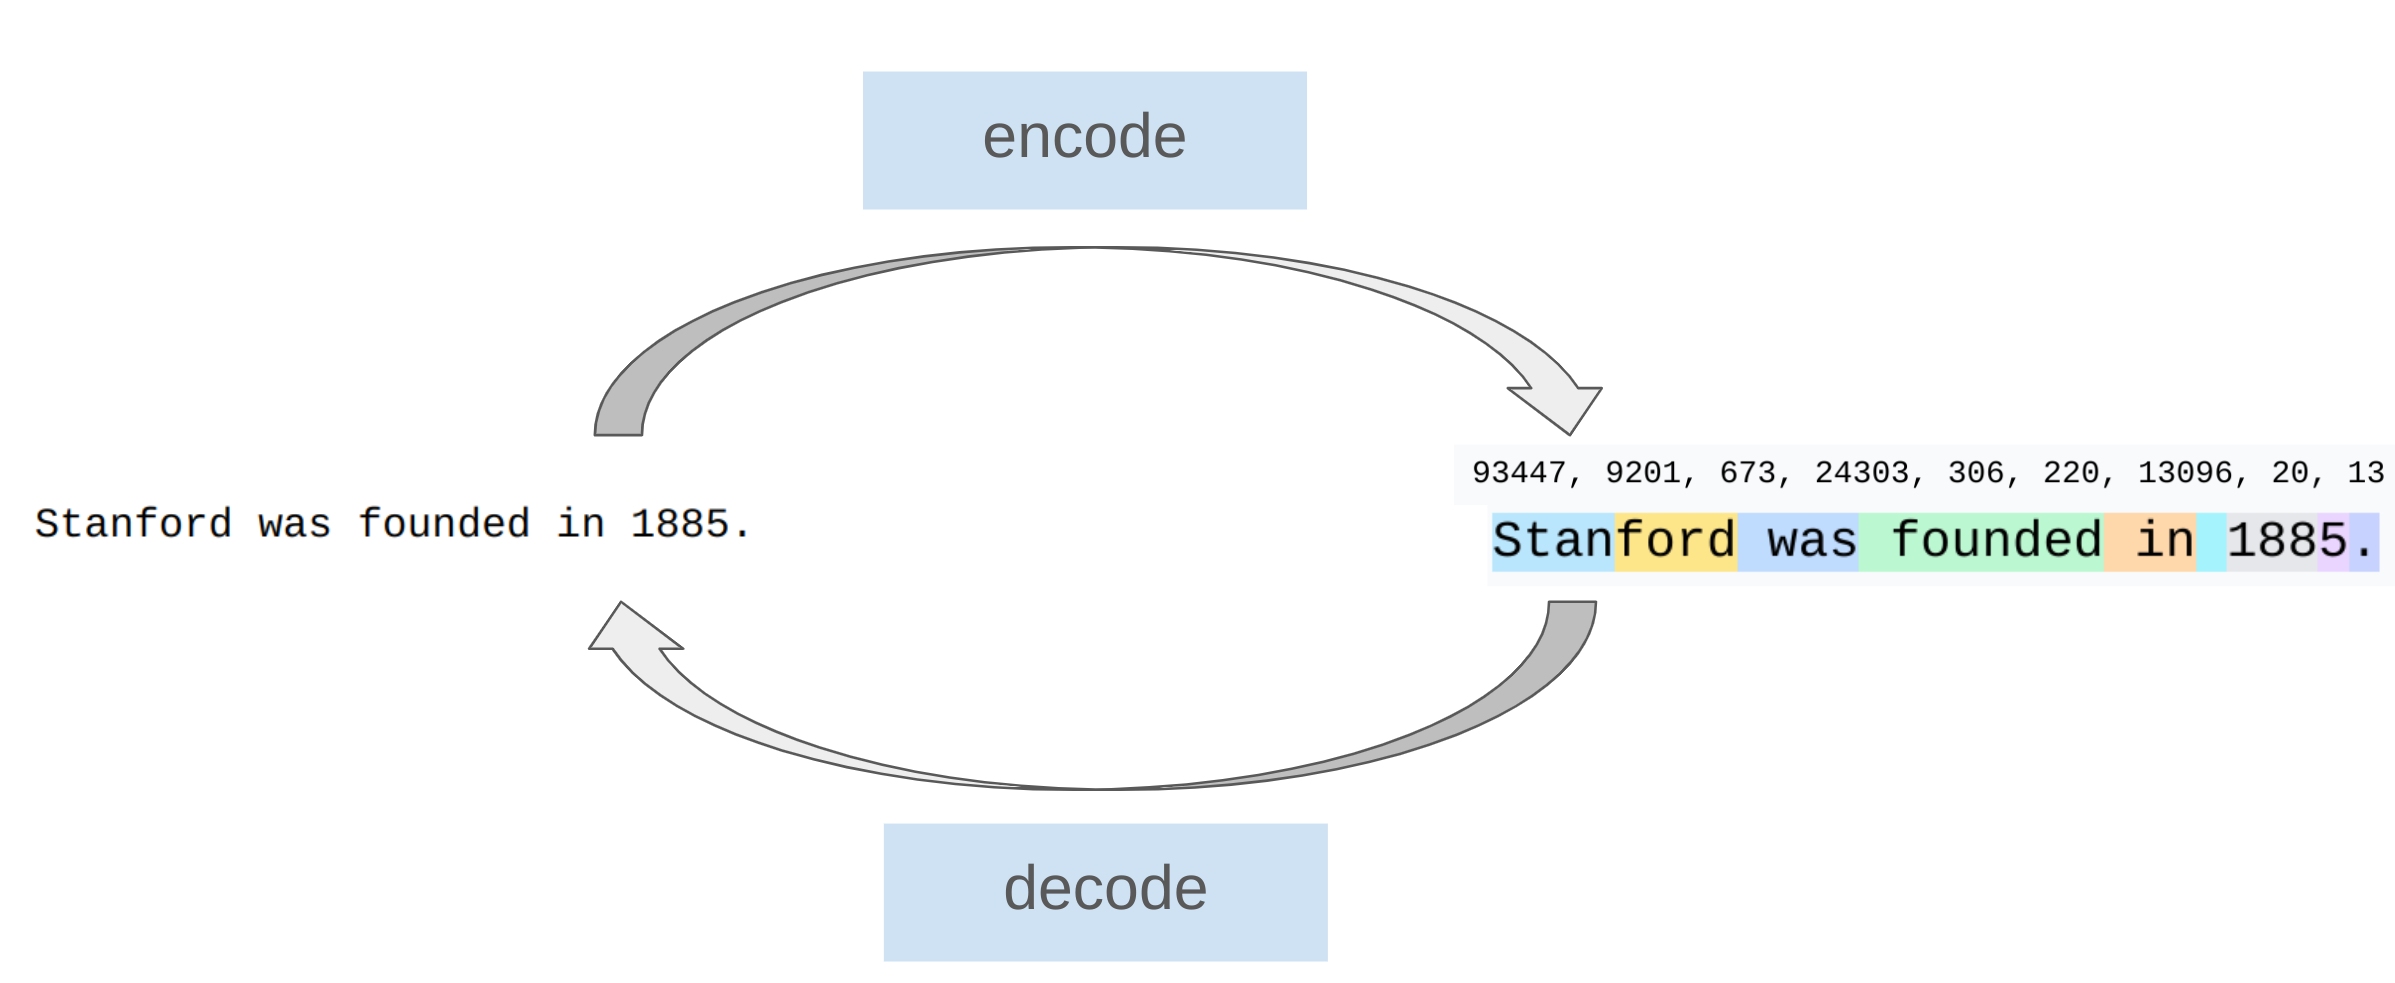
原始文本一般表示为 Unicode 字符串,比如 "Hello, 🌍! 你好!"。而语言模型定义的是在 token 序列上的概率分布,token 通常用整数索引表示,比如 [15496, 11, 995, 0]。所以我们需要一对互逆的过程:把字符串编码(encode)成 token,把 token 解码(decode)回字符串。
from abc import ABC

class Tokenizer(ABC):
    """分词器的抽象接口。"""
    def encode(self, string: str) -> list[int]:
        raise NotImplementedError

    def decode(self, indices: list[int]) -> str:
        raise NotImplementedError
想先建立感性认识,可以玩一下 tiktokenizer 这个交互站点。三条立刻能观察到的现象(它们在第 8、9 节会得到解释):
- 一个词和它前面的空格属于同一个 token(例如
" world"是一个 token,而不是空格 + world)。 - 词在句首和句中的表示不同:
"hello hello"的两个 hello 会得到不同的 token id。 - 数字被切成每几位一组,而不是整体成一个 token。
方案一:字符级分词器
Unicode 字符串就是一串 Unicode 字符,每个字符可以用 ord 转成码点(code point),用 chr 转回来。比如 ord("a") == 97,ord("🌍") == 127757。
class CharacterTokenizer(Tokenizer):
    """把字符串表示为 Unicode 码点序列。"""
    def encode(self, string: str) -> list[int]:
        return list(map(ord, string))

    def decode(self, indices: list[int]) -> str:
        return "".join(map(chr, indices))
它能完美往返(round-trip),但有两个致命问题:
- 问题 1:词表极大。Unicode 字符大约有 15 万个。而且注意,词表大小不是「训练数据里出现过多少字符」,而是由码点上界决定——单是
"Hello, 🌍! 你好!"这一个字符串,其中的 🌍 码点就是 127757,意味着词表至少要 12.7 万项。 - 问题 2:很多字符极其罕见(比如 🌍),把宝贵的词表位置和嵌入参数花在它们身上是浪费——每一个 embedding 行都要占内存、都要参与 softmax 计算,却几乎学不到什么。
再看压缩率(每个 token 平均对应多少 UTF-8 字节):中文和 emoji 在 UTF-8 下占 3~4 字节,所以字符级分词对这类文本压缩率会大于 1,但对纯英文就是 1.0 左右。综合起来,字符级分词是两头不讨好:词表巨大,压缩率还低。
方案二:字节级分词器
Unicode 字符串可以表示成字节序列,每个字节是 0~255 的整数。最常见的 Unicode 编码是 UTF-8:有些字符占一个字节("a" → b"a"),有些占多个("🌍" → b"\xf0\x9f\x8c\x8d",4 个字节)。
class ByteTokenizer(Tokenizer):
    """把字符串表示为字节序列。"""
    def encode(self, string: str) -> list[int]:
        string_bytes = string.encode("utf-8")
        return list(map(int, string_bytes))

    def decode(self, indices: list[int]) -> str:
        return bytes(indices).decode("utf-8")
好消息:词表非常小,正好 256。而且没有任何未登录词问题——任何文本都能表示。坏消息:压缩率恰好等于 1(定义上就是每个 token 一个字节),这意味着序列长度等于字节数。
Transformer 的上下文长度是有限的(因为注意力对序列长度是二次复杂度)。一篇 1000 字节的文档,字节级分词得到 1000 个 token,注意力矩阵是 $1000^2 = 10^6$ 个元素;用一个压缩率为 4 的 BPE 分词器,只有 250 个 token,注意力矩阵是 $250^2 = 6.25\times10^4$ ——差 16 倍。这就是「优雅但算力上不划算」的确切含义。
方案三:词级分词器
另一条路(更接近经典 NLP 的做法)是按词切分。用一个正则就能得到粗糙版本:
import regex

string = "I'll say supercalifragilisticexpialidocious!"
chunks = regex.findall(r"\w+|.", string)
# ['I', "'", 'll', ' ', 'say', ' ', 'supercalifragilisticexpialidocious', '!']
这个正则把所有字母数字字符聚在一起(即「词」),其余每个字符单独成块。要变成 Tokenizer,只需再建一张从块到整数的映射表。
好处:每个 token 都是有意义的——毕竟词是人类发明的语义单位。压缩率也不错(英文平均词长约 4~5 字节,加上空格差不多 5~6 字节/token)。
但问题更严重:
- 词表可能极其庞大——它等于训练数据中不同块的个数,随语料增长而增长,没有上界。
- 很多词非常罕见,模型学不到关于它们的什么东西(
supercalifragilisticexpialidocious就是个好例子)。 - 不能自然地给出一个固定的词表大小,而工程上我们需要提前确定输出层维度。
- 训练时没见过的新词只能映射到特殊的 UNK token,这很丑陋,而且会搞乱困惑度的计算——因为把所有未知词压成一个符号,模型可以在这个符号上分配一个不合理的高概率,让困惑度看起来虚假地好,不同词表之间也失去可比性。
| 方案 | 词表大小 | 压缩率(字节/token) | 致命问题 |
|---|---|---|---|
| 字符级 | 约 15 万 | 低(英文约 1) | 词表大 + 压缩差,两头不讨好 |
| 字节级 | 256 | 恰好 1 | 序列太长,注意力二次爆炸 |
| 词级 | 无界 | 好(约 5) | 长尾词学不到、无固定词表、UNK |
| BPE | 可指定(如 5 万 / 20 万) | 好(约 4) | 需要在数据上训练,有一堆边界坑 |
三种朴素方案都高度次优。我们需要的是一个词表大小可控、压缩率高、且无未登录词的方案——这正是 BPE 的定位。
6. 压缩率:分词器的核心评价指标
要比较分词器,先得有一个指标。最重要的一个是压缩率(compression ratio):平均每个 token 对应多少个 UTF-8 字节。
def get_compression_ratio(string: str, indices: list[int]) -> float:
    """给定被切分成 indices 的 string,返回每个 token 对应的 UTF-8 字节数。"""
    num_bytes = len(bytes(string, encoding="utf-8"))
    num_tokens = len(indices)
    return num_bytes / num_tokens
用讲义里的例子 "Hello, 🌍! 你好!" 手算一遍它的 UTF-8 字节数:"Hello, " 是 7 个 ASCII 字符 = 7 字节,🌍 是 4 字节,"!" 1 字节,空格 1 字节,你 和 好 各 3 字节,末尾 "!" 1 字节,合计 20 字节。这个字符串有 13 个 Unicode 字符。于是:
| 分词器 | token 数 | 压缩率(字节/token) |
|---|---|---|
| 字节级 | 20 | 1.00(定义上恒为 1) |
| 字符级 | 13 | 20 / 13 ≈ 1.54 |
| BPE(GPT-5 / o200k_base) | 更少 | 更高 |
压缩率越大,序列越短——这是好事,因为注意力对序列长度是二次的。把它写清楚:如果一段文本有 $B$ 字节、压缩率为 $r$,则序列长度 $L = B/r$,单层注意力的分数矩阵有 $L^2 = B^2/r^2$ 个元素。压缩率翻倍,注意力开销降到四分之一。
怎么提高压缩率?加大词表
提高压缩率的直接办法是增大词表大小(vocabulary size):token 的可能取值变多了,就能用一个 token 表示更长的字节串。GPT-2 的词表是 50257,GPT-4 的 cl100k_base 约 10 万,GPT-5 使用的 o200k_base 约 20 万。在实践中,英文文本上主流 BPE 分词器的压缩率大致在 4 字节/token 附近,这也是「1000 字节 → 约 250 token」这条经验法则的由来。
但词表不能无限加大。Percy 提到的关键词是稀疏性(sparsity):词表越大,每个 token 在训练数据中出现的次数越少,对应的嵌入向量得到的梯度更新就越少,学得越差。同时代价也是实打实的:
- 参数与显存:嵌入矩阵与输出层各是 $V \times d_{\text{model}}$。取 $V = 200{,}000$、$d_{\text{model}} = 4096$,光一张表就是 $8.2\times10^8$ 个参数,bf16 下约 1.6 GB,而且通常有两张(输入嵌入 + 输出投影,若不共享权重)。
- 输出 softmax 的计算:每一步都要在 $V$ 个类别上做 logits 与归一化,$V$ 大了这一项会显著吃 FLOPs。
所以词表大小本身就是一个效率权衡:向左走序列变长(注意力变贵),向右走词表变大(嵌入层和 softmax 变贵、长尾 token 学不好)。
压缩率与语言建模的关系比看上去更深:Shannon 1950 年做语言模型就是为了测量英语的熵。一个理想的分词器把冗余的字节模式压掉,让模型把容量用在真正难预测的地方;这就是 Percy 说的自适应计算(adaptive computation)——常见的字节序列用一个 token 一步带过,罕见的序列拆成多个 token、给模型更多计算步骤去处理。
另外,压缩率是依赖语言的。绝大多数主流分词器在英文语料上训练,因此对英文压缩率最高;中文、日文等在 UTF-8 下每个字符就要 3 字节,且合并规则学得少,压缩率明显更差。同一句话译成不同语言,token 数可能相差两三倍——这直接意味着不同语言的用户为同样的内容付出不同的 API 费用、占用不同比例的上下文窗口。这是第 9 节要展开的坑之一。
7. BPE 完整算法
字节对编码(Byte Pair Encoding, BPE)由 Philip Gage 在 1994 年提出,最初是一个数据压缩算法(原文)。它被 Sennrich et al. (2016) 引入 NLP,用于神经机器翻译(在此之前的论文都用词级分词),随后被 GPT-2 采用,成为事实标准。
基本思想:在原始文本上「训练」分词器,构造一个为该数据量身定制的词表。
直觉:常见的字节序列用一个 token 表示,罕见的序列用多个 token 表示。
做法草图:从每个字节各自成一个 token 开始,反复地把最常见的相邻 token 对合并成一个新 token。
7.1 训练:最小实现
先看合并操作本身——把序列里所有出现的某个 pair 替换成一个新索引:
def merge(indices: list[int], pair: tuple[int, int], new_index: int) -> list[int]:
    """返回 indices,但所有 pair 的出现都被替换为 new_index。"""
    new_indices = []
    i = 0
    while i < len(indices):
        if i + 1 < len(indices) and indices[i] == pair[0] and indices[i + 1] == pair[1]:
            new_indices.append(new_index)
            i += 2        # 跳过两个,避免重叠匹配
        else:
            new_indices.append(indices[i])
            i += 1
    return new_indices
注意 i += 2 这一行:它保证不允许重叠匹配。对 "aaa" 合并 (a,a) 得到 [aa, a] 而不是两个重叠的 aa——这是一个从左到右的贪心扫描。
训练器只需要两个字典就能完全描述:
from dataclasses import dataclass

@dataclass(frozen=True)
class BPETokenizerParams:
    """指定一个 BPE 分词器所需的全部信息。"""
    vocab: dict[int, bytes]              # 索引 -> 字节串
    merges: dict[tuple[int, int], int]   # (索引1, 索引2) -> 新索引
训练循环本体:
from collections import defaultdict

def count_adjacent_pairs(indices: list[int]) -> dict[tuple[int, int], int]:
    counts = defaultdict(int)
    for index1, index2 in zip(indices, indices[1:]):
        counts[(index1, index2)] += 1
    return counts

def train_bpe(string: str, num_merges: int) -> BPETokenizerParams:
    # 从 string 的字节列表开始
    indices = list(map(int, string.encode("utf-8")))
    merges: dict[tuple[int, int], int] = {}
    vocab: dict[int, bytes] = {x: bytes([x]) for x in range(256)}   # 前 256 项固定为单字节

    for i in range(num_merges):
        counts = count_adjacent_pairs(indices)      # 数每个相邻 pair 出现多少次
        pair = max(counts, key=counts.get)          # 找出最常见的 pair
        new_index = 256 + i                         # 分配新索引
        merges[pair] = new_index
        vocab[new_index] = vocab[pair[0]] + vocab[pair[1]]   # 新 token 的字节串 = 两半拼接
        indices = merge(indices, pair, new_index)   # 在序列上真正执行合并

    return BPETokenizerParams(vocab=vocab, merges=merges)
几个值得注意的设计点:
- 词表的前 256 项永远是单个字节。这保证了 BPE 继承字节级分词的最大优点:任何输入都能被表示,永远不会出现 UNK。词级分词的第四个致命问题就此消失。
- 词表大小完全可控:最终大小 = 256 +
num_merges(外加特殊 token)。想要 5 万词表就做约 4.97 万次合并。词级分词的第三个问题也消失了。 merges是有序的——这是全算法最关键的一点。编码时必须按训练时的顺序重放这些合并,否则得不到一致的结果。Python 3.7+ 的 dict 保序,所以这里直接用 dict 就行。
7.2 手算一遍:"the cat in the hat",3 次合并
这是讲义里的例子。字符串 18 个 ASCII 字符 = 18 字节,初始 token 序列(用字符而非数字写,便于阅读;实际是 t=116、h=104、e=101、空格=32 等):
t h e ␣ c a t ␣ i n ␣ t h e ␣ h a t (18 个 token)
第 1 轮:统计所有相邻对。出现 2 次的有 (t,h)、(h,e)、(e,␣)、(a,t),其余都是 1 次。max 在并列时取先遇到的那个(dict 的插入顺序,即在序列中最早出现的 pair),因此选中 (t,h),新索引 256 = b"th":
[th] e ␣ c a t ␣ i n ␣ [th] e ␣ h a t (16 个 token)
第 2 轮:现在 (256, e) 出现 2 次且最早出现,合并为 257 = b"the":
[the] ␣ c a t ␣ i n ␣ [the] ␣ h a t (14 个 token)
第 3 轮:(257, ␣) 出现 2 次且最早,合并为 258 = b"the ":
[the␣] c a t ␣ i n ␣ [the␣] h a t (12 个 token)
最终压缩率 = 18 字节 / 12 token = 1.5。学到的三条合并规则是:
| 新索引 | 合并的 pair | 对应字节串 |
|---|---|---|
| 256 | (116, 104) | b"th" |
| 257 | (256, 101) | b"the" |
| 258 | (257, 32) | b"the " |
注意 258 是 b"the "——带着后面那个空格。这就是为什么真实分词器里空格总是和相邻的词粘在一起(只不过 GPT-2 的正则预切分让空格粘在后一个词的前面,得到 " world" 这种 token,见第 8 节)。合并是纯粹由频率驱动的,算法根本不知道「词」是什么概念,它只是发现 t-h-e-空格 这四个字节老是一起出现。
7.3 编码与解码
class BPETokenizer(Tokenizer):
    """给定一组 merges 和 vocab 的 BPE 分词器。"""
    def __init__(self, params: BPETokenizerParams):
        self.params = params

    def encode(self, string: str) -> list[int]:
        indices = list(map(int, string.encode("utf-8")))
        # 注意:这是一个非常慢的实现
        for pair, new_index in self.params.merges.items():
            indices = merge(indices, pair, new_index)
        return indices

    def decode(self, indices: list[int]) -> str:
        bytes_list = list(map(self.params.vocab.get, indices))
        return b"".join(bytes_list).decode("utf-8")
解码非常简单:查表拿到每个 token 的字节串,拼起来,UTF-8 解码。编码则必须按训练顺序依次施加每一条合并规则——顺序错了结果就错了。
用刚才训好的分词器编码一个新字符串 "the quick brown fox"(19 字节):
| 步骤 | 序列 | 长度 |
|---|---|---|
| 初始字节 | t h e ␣ q u i c k ␣ b r o w n ␣ f o x | 19 |
| 应用 (t,h)→256 | [th] e ␣ q u i c k ... | 18 |
| 应用 (256,e)→257 | [the] ␣ q u i c k ... | 17 |
| 应用 (257,␣)→258 | [the␣] q u i c k ␣ b r o w n ␣ f o x | 16 |
解码后完美还原原字符串。可以看到 BPE 的泛化方式:它在训练数据里没见过 "quick",但因为词表底层永远保留 256 个单字节,这些没见过的部分自然退化成逐字节表示——压缩率下降,但绝不会失败。
上面的 encode 遍历所有 merge 规则,对每条规则扫一遍整个序列。若词表 5 万、文本 $n$ 字节,复杂度是 $O(50000 \times n)$,完全不可用。正确做法是只遍历真正相关的 merge:维护当前序列中存在的相邻 pair 集合,每次取其中训练序号最小的那条规则来应用(通常用优先队列或按 merge rank 排序),复杂度降到接近 $O(n \log n)$。这正是 Assignment 1 要求你做到的第一条改进。
Percy 明确列出了 Assignment 1 中需要在这个最小实现之上补齐的四点:
encode()目前循环所有 merge,应当只循环有影响的那些。- 检测并保留特殊 token(例如
<|endoftext|>)——它们不能被拆开或参与合并,必须在切分前被单独识别出来。 - 使用预切分(pre-tokenization),例如 GPT-2 的分词正则。
- 让实现尽可能快(这在 1000 万行级的语料上是真问题)。
8. 预切分:GPT-2 与 GPT-4 的正则表达式
上面的算法有一个没说破的问题:如果直接在整个语料的字节流上跑 BPE,最高频的 pair 里会混进大量跨越词边界的组合——比如 "g t"("dog the")、". T",甚至 "e\n\n"。这些合并既没有语言学意义,又会让同一个词因为前文不同而被切成不同形状,浪费词表。
解决办法是预切分(pre-tokenization):先用一个正则把文本切成若干「块(chunk)」,BPE 的合并只允许发生在块内部,绝不跨块。统计频率时也是先把语料切成块、统计块的词频,再在每个块内部做字节对合并。这既提升质量,又大幅提速(相同的块只需处理一次,可以按词频加权统计)。
GPT-2 的正则
PAT = r"""'s|'t|'re|'ve|'m|'ll|'d| ?\p{L}+| ?\p{N}+| ?[^\s\p{L}\p{N}]+|\s+(?!\S)|\s+"""
逐段读(用 regex 包而非标准库 re,因为需要 Unicode 属性 \p{...}):
| 片段 | 匹配什么 | 为什么 |
|---|---|---|
's|'t|'re|'ve|'m|'ll|'d | 常见英文缩写后缀 | 把 don't 切成 don + 't,保持缩写形态一致 |
?\p{L}+ | 可选一个前导空格 + 一串字母 | 这就是 " world" 现象的根源:空格被并进后面的词 |
?\p{N}+ | 可选前导空格 + 一串数字 | 数字与字母分离,不会出现 abc123 这样的整块 |
?[^\s\p{L}\p{N}]+ | 可选前导空格 + 一串标点符号 | 标点自成一类 |
\s+(?!\S) | 一串空白,但后面不能紧跟非空白 | 用负向先行断言留出最后一个空格给下一个词 |
\s+ | 兜底的连续空白 | 行尾、文末的空白 |
为什么 "hello hello" 的两个 hello token id 不同?因为预切分把它切成 ["hello", " hello"]——第二个带前导空格,是完全不同的一个 token。同理句首的词和句中的词天然是两套 token。这解释了课程开头 tiktokenizer 上的两条观察,也解释了一个实用后果:提示词里多打或少打一个空格,可能真的改变模型的输入序列;以及在做续写补全时,prompt 结尾留不留空格会显著影响结果。
GPT-4 的正则(cl100k_base)
PAT = r"""'(?i:[sdmt]|ll|ve|re)|[^\r\n\p{L}\p{N}]?+\p{L}+|\p{N}{1,3}| ?[^\s\p{L}\p{N}]++[\r\n]*|\s*[\r\n]|\s+(?!\S)|\s+"""
相对 GPT-2 的四处关键改动:
| 改动 | 效果 |
|---|---|
'(?i:[sdmt]|ll|ve|re) | 缩写匹配大小写不敏感,'S 和 's 一视同仁(GPT-2 只匹配小写,导致 Don'T 被切得很怪) |
\p{N}{1,3} | 数字最多 3 位一组。GPT-2 的 ?\p{N}+ 会让任意长度数字先聚成一块再由 BPE 随意合并,数字的切分方式极不规则;限制为 1~3 位后,数字被切成固定长度组,算术能力明显更稳 |
[^\r\n\p{L}\p{N}]?+\p{L}+ | 词前允许任意一个非字母数字字符(不只是空格),但禁止换行被并进词里 |
\s*[\r\n] | 换行被单独处理,且连续空白 + 换行成为一块——这对代码缩进意义重大 |
GPT-4 之后的 o200k_base(GPT-4o / GPT-5 使用)在此基础上继续改进:进一步细化多语言的字母类处理,并把数字分组规则调得更严格。总的趋势很清楚——每一代分词器都在往「用手写规则约束 BPE 的自由度」的方向走,因为纯粹靠频率驱动的合并会在数字、缩进、多语言这些地方产生系统性的坏切分。
「BPE 是无监督的、纯数据驱动的,所以没有人为设计。」——错。预切分正则是一大块硬编码的人类先验,而且是分词器质量差异的主要来源之一。词表大小、语料配比、正则写法,三者共同决定了分词器的行为,其中正则往往最容易被忽视,却最容易踩坑。
9. 分词器的坑
分词是一层漏抽象的典型代表:它是 LM 流水线里最不起眼的一步,却制造了大量看似神秘的模型失败。下面把主要的坑分类列出来。
9.1 数字
课程开头就观察到「数字被切成每几位一组」。问题在于,怎么分组是由训练语料的频率决定的,因而毫无规律。在 GPT-2 式分词下,1234567 可能被切成 [123][456][7],而 2234567 可能被切成 [22][345][67]——同样的数位在不同数字里落在不同的 token 边界上。模型要做加法,就得先在内部把这些不对齐的块「重新对位」,这是纯粹的额外负担。
这也是为什么 GPT-4 的正则加了 \p{N}{1,3}:强制数字最多 3 位一组,切分变得规则(虽然从左往右分组对算术仍不理想,因为竖式加法是从右往左对齐的)。有些模型索性把每个数字单独成一个 token(digit-level tokenization),牺牲一点压缩率换取算术能力。
「模型算不对 27 位数的乘法是因为它不会推理。」——至少有一部分原因是它看不清数字。同理,「数一数 strawberry 里有几个 r」这类问题之所以困难,是因为模型看到的是 [str][aw][berry] 之类的块,字符层面的信息在输入阶段就被抹掉了。字符串反转、押韵、拼写游戏,全都栽在同一个坑里。
9.2 空格
空格并进后一个词(" world")带来若干实际后果:
- prompt 末尾的空格是有害的。如果你的提示以
"The answer is "(带尾空格)结尾,模型接下来最可能生成的 token 是" answer"这类自带前导空格的 token,而你已经把空格用掉了,于是模型被推到一个训练中几乎没见过的分布上,输出质量会莫名其妙地变差。 - 同一个词有多个 token id(句首版、带空格版、大写版、全大写版……),每个变体各自学一套表示,浪费参数也稀释了统计量。
- 连续多个空格的处理方式在不同分词器里差异很大,直接影响下面的代码缩进问题。
9.3 多语言
分词器几乎都以英文为主训练,这带来一种结构性的不公平:
| 语言 | UTF-8 每字符字节数 | 典型压缩率表现 | 后果 |
|---|---|---|---|
| 英文 | 1 | 最好(约 4 字节/token,接近 1 词/token) | 基准 |
| 中文 / 日文 | 3 | 差得多,常见字可能 1 字 1 token,罕见字要 3 个字节 token | 同样内容占用数倍 token |
| 低资源语言 | 2~4 | 最差,大量退化到逐字节 | 上下文窗口被吃光、API 费用更贵、有效上下文更短 |
更隐蔽的问题是:token 数变多意味着同样一句话要花更多的模型前向步数,而序列越长注意力越贵——低资源语言在训练和推理两端都被惩罚。这也是「分词器训练语料的配比」本身就是一个重要设计决策的原因。
9.4 代码与缩进
代码是 BPE 最容易翻车的领域之一。Python 的 4 空格缩进如果被切成 4 个独立的空格 token,一段深度嵌套的代码会有惊人比例的 token 花在缩进上。GPT-2 的分词器正是如此,这也是它写 Python 表现不佳的原因之一。cl100k_base 专门加入了连续空格的合并 token(" "、" " 等)与 \s*[\r\n] 规则,Python 代码的 token 数因此明显下降。要训代码模型,分词器必须为代码专门设计。
9.5 特殊 token 与词表的边角
特殊 token(如 <|endoftext|>、聊天模板里的角色标记)必须在正则切分之前就被单独识别出来,绝不能参与 BPE 合并,否则用户输入里的同名字符串就能伪造文档边界或角色标签——这既是正确性问题,也是安全问题(prompt injection 的一种入口)。
另一类边角是「glitch token」:分词器训练语料与模型训练语料不一致时,某些 token 在分词器里存在、却几乎从未在模型训练数据中出现过。它们的嵌入向量基本停留在初始化状态,模型遇到它们会产生完全不可预测的输出。根源就是——分词器是在模型之前、用另一份数据独立训练的。
把上面所有坑串起来看,它们有一个共同的根源:分词是一个独立的、离线的、非可微的预处理步骤。它一旦定死就无法随模型一起学习,也无法为下游任务调整。这直接引出第 10 节的问题:能不能干脆不要它?
10. tokenizer-free:直接在字节上建模
Percy 把这条路线称为「the dream」:无分词器的模型架构,直接在字节上操作。这样做的好处是显而易见的——没有 UNK、没有多语言不公、没有数字切分问题、没有 glitch token、没有独立的预处理阶段,端到端一以贯之。
唯一的障碍我们已经算过了:字节序列的压缩率是 1,序列长度是 BPE 的约 4 倍,而注意力是二次的。所以问题不是「能不能在字节上建模」,而是「怎样在字节上建模而不付出 16 倍的注意力代价」。所有 tokenizer-free 工作本质上都在回答这一个问题,思路都是引入层次结构:底层用便宜的模块处理字节,把它们打包成更少的「块」,再让昂贵的主干 Transformer 在块层面工作。
| 工作 | 核心思路 | 块的边界怎么定 |
|---|---|---|
| ByT5 (2021) | 直接把 T5 的输入换成 UTF-8 字节,靠加深编码器来补偿 | 不分块,纯字节序列 |
| MegaByte (2023) | 两级结构:把字节切成固定长度的 patch,全局 Transformer 处理 patch,局部 Transformer 在 patch 内自回归生成字节 | 固定大小(如每 4 或 8 字节) |
| T-FREE (2024) | 用字符 n-gram 的稀疏哈希表示词,取消嵌入查找表 | 词边界(但无需词表) |
| BLT (2024) | Byte Latent Transformer:用一个小字节级 LM 的预测熵来决定切分——熵高(下一字节难猜)的地方开新 patch | 动态,由熵驱动 |
| H-Net (2025) | 层次化网络,把分块机制本身做成可微的、端到端学习的模块,可以堆叠多级 | 学出来的 |
这条线的演进方向非常清晰:固定分块 → 用启发式动态分块 → 让分块本身可学习。BLT 的熵驱动切分尤其符合第 6 节说的「自适应计算」直觉:字节越难预测的地方,就该分配越多的计算。
Percy 对现状的判断很克制:「这些方法很有前景,但还没有被放大到前沿规模。」换句话说,2026 年训一个严肃的模型,你仍然应该用 BPE。但这是一个值得押注的方向。
无论最终的解法是什么,它都必须满足两个条件(这是 Percy 给出的、超越分词本身的抽象):
- 模型(如 Transformer)应当在序列的「块」——也就是抽象——上操作,无论序列是文本、视频还是 DNA。
- 块应当是可变的,以便把更多的模型容量分配给更有意思的块。
BPE 只是满足这两条的一个特解,而且是一个手工设计、离线训练的特解。真正的问题是「如何把连续的原始输入组织成变长的抽象单元」——这个问题在多模态时代只会更重要。
本讲小结
课程层面
| 要点 | 一句话 |
|---|---|
| 课程存在的理由 | 研究者与底层技术脱节,而 LM 这层抽象是漏的;基础研究需要能撕开整个栈 |
| 课程哲学 | Understanding via building——通过构建来理解 |
| 能迁移的知识 | 机制(mechanics)+ 心法(mindset)能教能迁移;直觉(intuitions)只能部分教 |
| 苦涩的教训 | 不是「算法不重要」,而是能 scale 的算法才重要 |
| 核心等式 | accuracy = efficiency × resources;规模越大,效率越是决定性 |
| 当前约束 | 今天算力受限,明天会变成数据受限 |
| 开放度三层 | 闭源(API)/开放权重(权重+论文)/开源(+代码+数据) |
| 架构设计三角 | 表达力 · 稳定性 · 效率,一切设计都是在三者间取平衡 |
分词层面
| 要点 | 一句话 |
|---|---|
| 分词器是什么 | 字符串 ↔ token(整数索引)的一对互逆映射 |
| 三种朴素方案 | 字符级、字节级、词级都高度次优(见第 5 节表格) |
| BPE 是什么 | 一个数据驱动的有效启发式:从字节起步,反复合并最高频的相邻对 |
| 训练输出 | vocab(索引→字节串)+ 有序的 merges(pair→新索引) |
| 为什么没有 UNK | 词表前 256 项永远是单字节,任何输入都能退化表示 |
| 词表大小 | = 256 + 合并次数(+ 特殊 token),完全可控 |
| 核心指标 | 压缩率(字节/token)。序列长度 $L = B/r$,注意力开销 $\propto B^2/r^2$ |
| 词表大小的权衡 | 词表大 → 压缩率高、序列短,但嵌入/softmax 变贵、长尾 token 稀疏难学 |
| 预切分 | 正则先切块,BPE 只在块内合并;正则是硬编码的人类先验,是质量差异的主要来源 |
| GPT-2 → GPT-4 的改进 | 缩写大小写不敏感、数字限 1~3 位、换行单独处理、代码缩进优化 |
| 主要的坑 | 数字对不齐、prompt 尾空格、多语言不公、代码缩进、特殊 token 注入、glitch token |
| 未来方向 | tokenizer-free(ByT5 / MegaByte / T-FREE / BLT / H-Net),从固定分块走向可学习的分块;有前景但尚未放大到前沿 |
| 不变的两条要求 | ① 模型应在块上操作;② 块应当是可变的 |
Assignment 1 检查清单
- 实现
train_bpe:字节起步、统计相邻对、贪心合并、记录有序 merges。 - 实现
encode,但不要遍历全部 merges——按 merge rank 用优先队列只处理相关的 pair。 - 在切分前识别并保留特殊 token(
<|endoftext|>等)。 - 接入 GPT-2 风格的预切分正则(用
regex包,不是re)。 - 用
encode/decode往返测试验证正确性,并测量压缩率。 - 把实现做快:并行统计块频率、按块去重后加权,而不是在原始字节流上硬跑。
下一讲进入 PyTorch 与资源核算(resource accounting)——把这一讲反复出现的「效率」变成可以逐项计算的 FLOPs、参数量与显存字节数。
延伸阅读
分词(本讲主线,优先读)
- Karpathy: Let's build the GPT Tokenizer — 本单元的灵感来源;两小时从零写一个 BPE,把所有边角坑演示一遍,做 Assignment 1 之前值得先看。
- Sennrich et al., Neural Machine Translation of Rare Words with Subword Units (2016) — 把 BPE 引入 NLP 的原始论文;读它是为了理解子词最初要解决的是罕见词/未登录词问题,而非压缩。
- GPT-2 (2019) — 字节级 BPE + 预切分正则的出处,也是「零样本能力」的起点。
- tiktokenizer — 交互式对比各代分词器;把数字、缩进、中文粘进去看切分,比读十页论文更快建立直觉。
tokenizer-free 方向
- ByT5 (2021) — 最直接的字节级尝试,用来理解「不做任何分块」的代价有多大。
- MegaByte (2023) — 固定长度 patch 的两级架构,是所有层次化字节模型的基线设计。
- T-FREE (2024) — 用字符 n-gram 稀疏表示取消嵌入表,对多语言词表膨胀问题给出另一种解法。
- BLT (2024) — 用字节级熵动态决定 patch 边界,是「自适应计算」最干净的实现。
- H-Net (2025) — 把分块做成可微、可堆叠的层次模块,目前最接近「端到端学出分词」的工作。
课程主线的基础文献
- Attention Is All You Need (2017) — 一切的起点,Assignment 1 要手写的就是它。
- Kaplan et al., Scaling Laws (2020) — 让「继续放大」从赌博变成可预测的工程。
- Chinchilla (2022) — 算力最优缩放,$D \approx 20N$ 的出处;理解为什么 PaLM 被判定训练不足。
- AI and Efficiency (2020) — ImageNet 上 7 年 44 倍算法效率提升,是「efficiency × resources」这条等式的经验支撑。
- Shannon, Prediction and Entropy of Printed English (1950) — 语言模型的史前史,也是「好模型 = 好压缩器」这一视角的源头。
开放模型(可读的训练细节)
- Olmo 3 (2025) / Nemotron 3 (2025) — 真开源:数据、代码、权重齐全,想复现任何一步都查得到。
- Marin 8B retrospective — 开放式开发,连失败的实验都记录在案;对建立「训练大模型实际是什么体验」的认知极有帮助。
- DeepSeek-V3 (2024) — 开放权重阵营里技术报告最详实的一份,MoE、MLA、MTP、负载均衡全有交代。
- Llama 3 (2024) — 从数据到并行策略到评测的完整工程叙述,适合当作全课的对照读物。
- How to Scale Your Model — 课程推荐的系统方向读物,把 LM 系统问题讲得非常概念化。