HW2 编程解析:策略梯度与方差削减
这份作业只有二十几行核心代码,却把第 5、6、9 讲的三个理论结论——因果性、基线、偏差-方差权衡——全部变成了可以用曲线量化的实验。本文逐个 TODO 拆解实现,给出每处写错的具体后果、对应的断言,以及 25 组真实实验的数字。
0. 这份作业在考什么
HW2 的题面很朴素:「实现策略梯度及其若干方差削减技巧」。但如果你只是把 pg_agent.py 里的 TODO 填掉、让程序不报错,你会错过这份作业真正的设计意图——它是第 5、6、9 三讲理论结论的一次受控实验。每一个可以开关的命令行参数,背后都对应课上一个「我们可以证明它更好」的命题,而这份作业要你用真实的学习曲线去检验这个命题在具体环境上到底成立到什么程度。
| 命令行开关 | 对应讲次与理论命题 | 作业要你验证什么 |
|---|---|---|
-rtg | 第 5 讲「因果性(causality)」 | 去掉 $t$ 之前的奖励不改变梯度期望(无偏),但降低方差 |
-na | 第 5 讲「基线(baseline)」的极简版 | 减均值除标准差是有偏的,却往往比无偏技巧还管用 |
--use_baseline | 第 6 讲 Actor-Critic 的 $V_\phi^\pi$ | 状态相关基线不引入偏差,在高维连续控制里是生死线 |
--gae_lambda | 第 6 讲 n-step return / 第 9 讲 GAE | $\lambda$ 就是偏差-方差旋钮,两端都不是最优 |
-b(batch size) | 第 5 讲「策略梯度方差随 batch 下降」 | 大 batch 换来的是稳定性而非样本效率 |
换句话说,这份作业的「答案」不是那二十行代码,而是四张学习曲线图和四个问答。代码写对只是入场券。
- reward-to-go 是免费的午餐:CartPole 小 batch 下,轨迹式回报跑满 10 万步从未达到 200 分,reward-to-go 在 1.5 万步就打满。
- 优势标准化在小 batch 下比 rtg 还救命:它把「永远学不会」的轨迹式回报救成 2.3 万步收敛,代价是引入了偏差。
- 神经网络 baseline 在 HalfCheetah 上是 −129.1 vs +332.0 的差距——约 460 分,是本作业里效果最戏剧化的一处。
- GAE 的 $\lambda$ 两端都不好:$\lambda=0.95/0.99$ 再涨 45~58 分,$\lambda=0$ 直接崩到 −277,比不用 baseline 还差。
- 所有这些都能在梯度相对方差上量化:CartPole 43.1 → 4.8,HalfCheetah 5.91 → 3.23。
最后还有一个「实验 4」考的是工程直觉:把 InvertedPendulum 的默认超参调到 10 万步内达到满分 1000。这题没有标准答案,但它逼你回答一个真问题——在固定的环境步数预算下,样本应该花在「更精确的单次梯度」上,还是「更多次的粗糙梯度」上?本文 §9.4 会给出 27 倍样本效率提升的具体配置。
1. 代码结构与张量形状链条
1.1 目录结构与各文件职责
hw2/
├── src/
│   ├── scripts/run.py              训练主循环:采样 → update → 记日志
│   ├── agents/pg_agent.py          【核心】Q 值估计 + 优势估计 + 调度 actor/critic 更新
│   ├── networks/
│   │   ├── policies.py             【核心】MLPPolicy.forward / get_action,MLPPolicyPG.update
│   │   └── critics.py              【核心】ValueCritic.forward / update
│   └── infrastructure/
│       ├── utils.py                sample_trajectory / sample_trajectories / compute_metrics
│       ├── pytorch_util.py         build_mlp / from_numpy / to_numpy / device
│       └── log_utils.py            wandb + csv 日志
└── tests/test_hw2.py               26 个自测用例(本文每节都会引用)
24 处 TODO 分布在四个文件里,但真正需要「想」的只有三处:连续策略的 log-prob 求和、GAE 的反向递推与轨迹边界、伪损失(pseudo-loss)用 mean 还是 sum。其余的都是把公式直译成 NumPy/PyTorch。
1.2 形状链条:数据在训练循环里怎么变形
学生卡住最多的地方不是数学,是形状。整个流程有一个关键的「拉平(flatten)」时刻:Q 值必须按轨迹逐条计算(因为折扣是从每条轨迹自己的 $t=0$ 起算),算完之后立刻 np.concatenate 拉成一维,后面全部向量化。下表把 CartPole(ob_dim=4、离散 2 动作、-b 1000)一次迭代里的形状变化列全:
| 阶段 | 变量 | 类型 / 形状 | 说明 |
|---|---|---|---|
| 采样 | traj["observation"] | (T, 4) float32 | 单条轨迹,$T$ 是这条轨迹的长度(CartPole 上 8~200 不等) |
| 采样 | traj["action"] | (T,) float32 | 离散动作也存成 float32;连续则是 (T, ac_dim) |
| 采样 | traj["terminal"] | (T,) float32 | 只有最后一位是 1.0,其余全 0 |
| 打包 | trajs_dict["reward"] | list of (T_i,) | $N$ 条轨迹,$\sum_i T_i \ge b$ |
| step 1 | q_values | list of (T_i,) | 此时还是 list:折扣必须按轨迹算 |
| 拉平 | obs | (B, 4) | $B=\sum_i T_i$,约 1000~1200 |
| 拉平 | actions / rewards / terminals / q_values | 均 (B,) | 连续动作是 (B, ac_dim) |
| step 2 | values = critic(obs) | (B,) | 必须 squeeze(-1),否则是 (B, 1) |
| step 2 | advantages | (B,) | GAE 中间用 (B+1,) 的哑元数组,最后切掉 |
| step 3 | log_probs | (B,) | 连续情形最易错:不求和会是 (B, ac_dim) |
| step 3 | loss | () 标量 | -(log_probs * advantages).mean() |
(B,)」不是洁癖。PyTorch 的广播规则会让 (B,) * (B, k) 静默变成 (B, B) 或 (B, k),.mean() 之后依然是一个标量,程序照常训练、不报任何错,只是梯度完全错了。这类 bug 只能靠形状断言拦住,跑起来靠肉眼是看不出来的——曲线会「学到一点点」,让你误以为只是超参没调好。1.3 一次迭代的完整调用链
run_training_loop:
  trajs, envsteps = utils.sample_trajectories(env, agent.actor, b, max_ep_len)
  trajs_dict = {k: [traj[k] for traj in trajs] for k in trajs[0]}
  agent.update(obs_list, act_list, rew_list, term_list)
        │
        ├─ step 1  q_values = _calculate_q_vals(rewards)      # list → list
        ├─ (flatten) np.concatenate ×5                        # list → (B,...)
        ├─ step 2  advantages = _estimate_advantage(...)      # (B,)
        ├─ step 3  actor.update(obs, actions, advantages)     # 1 次梯度步
        └─ step 4  for _ in range(bgs): critic.update(obs, q_values)   # bgs 次梯度步
注意 step 4 的回归目标是 q_values 而不是 advantages,而且是标准化之前的 q_values。这个细节在 §7.4 会详细说明——喂错了 critic 会完全学不动。另外一个容易忽略的点:actor 每次迭代只做一次梯度步,而 critic 做 baseline_gradient_steps 次。这是因为策略梯度是 on-policy 的,数据一旦被用于更新策略就「过期」了;而 critic 拟合的是回归问题,同一批数据可以反复用。
2. TODO 一:策略网络的前向传播
2.1 要求
networks/policies.py 的 MLPPolicy.forward 注释说:「返回什么都行,但你要能对它求导。比如返回 torch.FloatTensor,也可以返回更灵活的对象,比如 torch.distributions.Distribution。」这句「随你」其实是个陷阱——只有返回 Distribution 对象,后面 update 里的 log_prob(actions) 才写得干净。作业还要求同时支持离散(CartPole、LunarLander)和连续(HalfCheetah、InvertedPendulum)两种动作空间。
2.2 数学
策略梯度需要的唯一东西是 $\log \pi_\theta(a_t \mid s_t)$ 及其对 $\theta$ 的梯度。两种动作空间的参数化方式不同:
离散动作:网络输出 $|\mathcal{A}|$ 个 logit,策略是 softmax 分类分布
$$ \pi_\theta(a \mid s) = \softmax\big(f_\theta(s)\big)_a, \qquad \log \pi_\theta(a\mid s) = f_\theta(s)_a - \log\sum_{a'} \exp f_\theta(s)_{a'} $$连续动作:网络输出对角高斯的均值,标准差是一个与状态无关的可学习参数向量
$$ \pi_\theta(a \mid s) = \mathcal{N}\big(a;\ \mu_\theta(s),\ \diag(\sigma^2)\big), \qquad \sigma = \exp(\text{logstd}) $$对角高斯的对数概率是各维之和——这是本作业最关键的一个「和号」:
$$ \log \pi_\theta(a\mid s) = \sum_{j=1}^{d_a}\left[ -\frac{(a_j - \mu_j(s))^2}{2\sigma_j^2} - \log \sigma_j - \tfrac12\log 2\pi \right] $$zeros 即 $\sigma=1$,对已归一化的动作空间是个合理起点。2.3 实现
def forward(self, obs: torch.FloatTensor) -> distributions.Distribution:
    if self.discrete:
        logits = self.logits_net(obs)
        return distributions.Categorical(logits=logits)
    else:
        mean = self.mean_net(obs)
        std = torch.exp(self.logstd)
        return distributions.Independent(
            distributions.Normal(mean, std), reinterpreted_batch_ndims=1
        )
逐块解释:
Categorical(logits=...)而不是Categorical(probs=softmax(...))。前者内部用log_softmax,数值稳定;后者先 exp 再 log,logit 差距大时会丢精度甚至出-inf。torch.exp(self.logstd)每次前向都重算,这样logstd才在计算图里、才能收到梯度。如果你在__init__里存self.std = torch.exp(logstd),logstd就永远不会被更新,策略的探索强度会卡死在初始值。Independent(..., reinterpreted_batch_ndims=1)是本节的重点:它把Normal的最后一个 batch 维「重新解释」成事件维,于是log_prob自动对该维求和,返回(B,)。它完全等价于Normal(mean, std).log_prob(a).sum(-1),但把求和的责任封装在分布对象里,调用方不用记得加.sum(-1)。self.logstd和mean_net的参数用itertools.chain一起塞进同一个 Adam(starter code 已写好)。这意味着探索强度和动作均值用同一个学习率,这是 vanilla PG 的已知弱点之一:策略容易过早地把 $\sigma$ 压到很小然后停止探索。
2.4 易错点及其具体后果
如果你写成 return distributions.Normal(mean, std),那么 log_prob(actions) 返回的是 (B, ac_dim),而 advantages 是 (B,)。二者相乘时 PyTorch 会按广播规则把 (B,) 视为 (1, B),结果是 (B, ac_dim) 与 (1, B) ——只有当 ac_dim == B 时才会广播成 (B, B);更常见的情况是直接抛 shape 错或者在 ac_dim=1 时静默广播成 (B, B)。
InvertedPendulum 的 ac_dim 恰好是 1,这是最坑的一种:(B, 1) * (B,) 广播成 (B, B),.mean() 之后仍然是一个合法标量,程序完整跑完 100 次迭代不报任何错。但此时每个样本的 log-prob 乘的是整批优势的均值而不是它自己的优势——梯度里所有样本被同等对待,等价于做了一次「无关回报的最大似然」,策略只会往采样分布的众数塌缩。
症状:InvertedPendulum 回报在 20~60 之间随机游走,永远不涨;HalfCheetah 的 Actor Loss 曲线光滑漂亮但 eval 回报纹丝不动。定位:在 update 里打印 log_probs.shape,如果不是 (B,) 就中了。验证修好:见 §2.5 的两个断言。
其他两个容易写错的地方:
- 用
Normal(mean, logstd)忘了取 exp:logstd初始为 0,于是 $\sigma=0$,Normal构造时就会被validate_args拦下报ValueError: Expected parameter scale to satisfy the constraint GreaterThan(0.0)。这个错好在会立刻抛出。 - 把
logstd写成torch.zeros(...)而不是nn.Parameter(torch.zeros(...)):它不会被注册为参数,parameters()里没有它,Adam 也不会更新它。$\sigma$ 恒为 1,HalfCheetah 的动作噪声一直很大,最终回报会明显低于正常实现(大约卡在 100~200 而不是 330+)。
2.5 怎么用断言验证
tests/test_hw2.py 里有三个针对性用例:
| 用例 | 断言内容 | 能抓住什么 |
|---|---|---|
test_discrete_log_prob_matches_torch | 与 D.Categorical(logits).log_prob 及手写 log_softmax().gather() 三方数值一致,形状 (7,) | 用 probs= 而非 logits= 导致的数值偏差;把 logits 当概率用 |
test_continuous_log_prob_matches_torch | 与 D.Normal(mean,std).log_prob(a).sum(-1) 及高斯闭式解析式一致,形状必须是 (9,) | 忘记按动作维求和(形状会是 (9, ac_dim),断言直接失败);logstd 忘取 exp |
MLPPolicyPG.update 内的 assert log_probs.shape == advantages.shape | 运行时永久生效 | 任何导致广播的形状不匹配,在真实训练中第一次 update 就炸 |
那句写在生产代码里的 assert 值得单独强调:它是本作业性价比最高的一行代码。测试只在你主动跑测试时生效,而这行断言在每一次真实训练的第一次迭代就会把广播 bug 拦下来。同理,ValueCritic.update 里也有一条 assert predictions.shape == q_values.shape。
3. TODO 二:get_action —— 一个只有两行的坑
3.1 要求
「接收单个观测(NumPy 数组),返回单个动作(NumPy 数组)。」注意网络期望的是批量输入,而这里给的是单个观测;返回值又要直接喂给 env.step()。所以这个函数的全部工作就是加一个 batch 维、采样、再去掉 batch 维。
3.2 实现
@torch.no_grad()
def get_action(self, obs: np.ndarray) -> np.ndarray:
    obs = ptu.from_numpy(obs[None])          # (ob_dim,) -> (1, ob_dim)
    action_distribution = self(obs)
    action = action_distribution.sample()    # 离散 (1,);连续 (1, ac_dim)
    action = ptu.to_numpy(action).squeeze(0) # 离散 ();连续 (ac_dim,)
return actionobs[None]等价于obs[np.newaxis],把(4,)变成(1, 4)。不加这一维,nn.Linear对一维输入其实也能算,但Categorical会把它当成「一个 batch 元素、logits 长度为ac_dim」还是「ac_dim个 batch 元素」就说不准了,形状语义变得含糊。.squeeze(0)只挤掉第 0 维。不要用.squeeze():无参数版本会挤掉所有长度为 1 的维,在ac_dim=1的 InvertedPendulum 上会把(1, 1)挤成()标量,然后env.step(标量)报ValueError: could not broadcast。@torch.no_grad()必须有。采样阶段构建计算图纯属浪费——一个 CartPole batch 有一千多次前向,累积的计算图会让内存缓慢增长,而且sample()本身不可导,留着图没有任何意义。
3.3 易错点及其具体后果
如果你返回 np.array([a])(形状 (1,)),gym 0.25.2 的 Discrete.contains() 会返回 False,env.step 里的 assert self.action_space.contains(action) 直接失败,报 AssertionError: 1 (<class 'numpy.ndarray'>) invalid。好消息是它立刻崩,坏消息是错误信息指向 gym 内部,容易让人以为是环境版本问题。
验证:test_get_action_shapes_and_dtypes 断言离散情形 np.asarray(a).shape == () 且 int(a) in (0, 1),连续情形 shape == (3,) 且全部有限。这两条把加/减 batch 维的所有组合错误都覆盖了。
还有一个 dtype 上的微妙之处:sample_trajectory 会把动作统一存成 np.array(acs, dtype=np.float32),所以离散动作在进入 update 时是浮点数(0.0 / 1.0)。Categorical.log_prob 内部会做 .long() 转换,且它的 integer_interval 约束对「取整数值的浮点数」是放行的,所以不需要手动转 dtype。但如果你在别处写了 actions.long() 之外的索引操作(比如 gather),就必须自己转,否则报 index tensor must be long。
另有一个更隐蔽的检查:test_get_action_samples_from_the_right_distribution 会重复调用 get_action 几千次,统计经验频率是否与 softmax(logits) 一致。这条能抓住「误用 argmax 而不是 sample」——如果你返回确定性动作,训练时策略完全不探索,CartPole 的回报会卡在初始值附近纹丝不动,而且因为 log_prob 仍然可导,loss 曲线看起来一切正常。
4. TODO 三:策略梯度的「伪损失」
4.1 要求
MLPPolicyPG.update 的注释写着:「实现策略梯度的 actor 更新。」代码里还有一句提示:「最小化它等价于对 $\sum_t \log\pi(a_t|s_t) A_t$ 做梯度上升。」这句话点破了整个技巧:策略梯度不是任何损失函数的梯度,我们只是构造了一个「碰巧梯度对得上」的标量,骗 autograd 帮我们算。
4.2 数学
第 5 讲推导出的策略梯度是
$$ \nabla_\theta J(\theta) \approx \frac{1}{N}\sum_{i=1}^{N}\sum_{t=0}^{H-1} \nabla_\theta \log \pi_\theta(a_t^i \mid s_t^i)\, \hat A_t^i $$我们希望 最大化 $J$,而优化器只会最小化。定义伪损失(pseudo-loss / surrogate loss)
$$ \tilde{\mathcal{L}}(\theta) = -\frac{1}{B}\sum_{k=1}^{B} \log \pi_\theta(a_k \mid s_k)\, \hat A_k $$其中 $\hat A_k$ 被当作常数(不参与求导)。那么 $\nabla_\theta \tilde{\mathcal{L}} = -\nabla_\theta J$ 的一个估计,梯度下降 $\tilde{\mathcal{L}}$ 就是梯度上升 $J$。
4.3 实现
def update(self, obs, actions, advantages) -> dict:
    obs = ptu.from_numpy(obs)
    actions = ptu.from_numpy(actions)
    advantages = ptu.from_numpy(advantages)

    distribution = self(obs)
    log_probs = distribution.log_prob(actions)
    assert log_probs.shape == advantages.shape, (log_probs.shape, advantages.shape)
    loss = -(log_probs * advantages).mean()

    self.optimizer.zero_grad()
    loss.backward()
    self.optimizer.step()
    return {"Actor Loss": loss.item()}
advantages 是从 NumPy 转来的、不带 requires_grad,所以「把它当常数」这件事是自动成立的,不需要 .detach()。但如果你把 advantages 改成直接从 critic 的输出算(不经 NumPy 往返),就必须加 .detach(),否则梯度会顺着优势流回 critic,把 critic 往「让优势变小」的方向推——那是完全没有意义的目标。
4.4 易错点:mean 还是 sum
理论公式 $\frac1N\sum_i\sum_t$ 是「对轨迹求平均、对时间步求和」。严格照抄的话应该是 -(log_probs * advantages).sum() / N($N$ 是轨迹条数)。但绝大多数实现(包括 starter code 的期望实现)用的是 .mean(),即除以 $B$ 而不是 $N$。二者相差一个因子 $B/N = $ 平均轨迹长度。
如果你写 .sum():梯度尺度直接正比于 $B$。CartPole 的默认 lr=5e-3 在 -b 1000 时勉强能跑,换到 -b 4000 时梯度大了 4 倍,第一次更新就把 logits 推到极端,softmax 饱和,策略退化成确定性,回报掉到 8~10 后再也不动(因为 log_prob 的梯度也随之消失)。症状:小 batch 能学、大 batch 一开始就崩,而且崩得非常干脆——第 2、3 次迭代 eval 回报就掉到个位数。
定位:打印每次更新后的 Actor Loss,用 sum 时它的绝对值会是 mean 版本的几千倍;或者直接看梯度范数 torch.nn.utils.clip_grad_norm_(params, 1e9) 的返回值。验证修好:改成 mean 后,同一个 lr 在 b=1000 和 b=4000 下都应该稳定学习——这正是 §9.1 那八组 CartPole 实验能用同一套超参跑完的前提。
还有一个符号坑:忘记那个负号。此时你在最小化 $\sum \log\pi \cdot A$,即做梯度下降,策略会朝低回报方向更新。CartPole 上的表现非常典型:初始回报约 20,第一次迭代后掉到 9~10(杆子立刻倒),然后永远卡在那里——因为「立刻倒下」已经是这个方向的最优解了。
4.5 怎么用断言验证
测试里有一组精心设计的「梯度方向」用例,它们不检查数值,只检查因果方向,因此对超参完全不敏感:
| 用例 | 构造 | 断言 | 抓什么 bug |
|---|---|---|---|
test_policy_gradient_direction_discrete | 一批「动作 0 优势 +1、动作 1 优势 −1」的数据 | 一步更新后 $P(a{=}0)$ 必须上升;30 步后 $\gt 0.95$ | 负号写反、优势符号反、优化器没 step |
test_policy_gradient_direction_flips_with_advantage_sign | 上一条的优势整体取反 | $P(a{=}0)$ 必须下降 | 用了 abs(advantages)、或优势根本没进 loss |
test_policy_gradient_direction_continuous | 奖励「高于当前均值」的动作 | mean_net 输出必须上移 | 连续分支的求和/广播错误 |
test_zero_advantage_leaves_policy_unchanged | 优势全 0 | 更新后每个参数张量逐元素不变 | loss 里混入了与优势无关的项(比如误加了熵正则或 L2) |
最后一条尤其巧妙:优势全 0 时理论梯度恰为 0,Adam 在梯度为 0 时不会改变参数(一阶矩、二阶矩都是 0)。如果你的 loss 里混进了任何与优势无关的成分,参数就会变,断言立刻失败。
5. TODO 四:两种 Q 值估计
5.1 要求
作业 PDF 第 3.1 节:「你要在 pg_agent.py 里实现两种回报估计器。第一种(_calculate_q_vals 里的 Case 1)使用整条轨迹的折扣累积回报,对应 vanilla 策略梯度(式 10);第二种(Case 2)使用式 11 的 reward-to-go 形式。」
5.2 数学
两式的差别只在求和下界:
$$ \text{(轨迹式)}\quad \hat Q_t^i = \sum_{t'=0}^{H-1} \gamma^{t'} r(s^i_{t'}, a^i_{t'}) \qquad \text{(因果式)}\quad \hat Q_t^i = \sum_{t'=t}^{H-1} \gamma^{t'-t} r(s^i_{t'}, a^i_{t'}) $$注意两个细节:轨迹式的结果与 $t$ 无关(整条轨迹每一步用同一个数);因果式的折扣指数是 $t'-t$ 而不是 $t'$,即折扣从「当前时刻」重新起算。PDF 特意区分了这两种折扣方式并问「你看出为什么实践中几乎总用第二种了吗」——第一种是「绝对折扣」,会让策略越到轨迹后段越不在乎自己的行为;第二种是「相对折扣」,对每个时刻一视同仁。
对任意 $t' \lt t$,考虑交叉项的期望:
$$ \E\big[\nabla_\theta \log\pi_\theta(a_t|s_t)\, r(s_{t'},a_{t'})\big] = \E_{s_{0:t},a_{0:t-1}}\Big[ r(s_{t'},a_{t'}) \cdot \E_{a_t\sim\pi}\big[\nabla_\theta\log\pi_\theta(a_t|s_t)\big]\Big] $$内层期望是 score function 的期望,恒等于 0:$\E_{a\sim\pi}[\nabla\log\pi] = \sum_a \pi \frac{\nabla \pi}{\pi} = \nabla \sum_a \pi = \nabla 1 = 0$。所以过去的奖励对梯度的贡献期望为零,去掉它不改变梯度期望——但它的方差不为零,去掉的是纯噪声。这正是「因果性降方差」的一行证明。
5.3 实现
def _discounted_return(self, rewards):
    rewards = np.asarray(rewards, dtype=np.float32)
    T = len(rewards)
    discounts = self.gamma ** np.arange(T)
    discounted_return = float(np.sum(discounts * rewards))
    return np.full(T, discounted_return, dtype=np.float32)

def _discounted_reward_to_go(self, rewards):
    rewards = np.asarray(rewards, dtype=np.float32)
    T = len(rewards)
    reward_to_go = np.zeros(T, dtype=np.float32)
    running_sum = 0.0
    for t in reversed(range(T)):          # 反向递推 q_t = r_t + gamma * q_{t+1}
        running_sum = rewards[t] + self.gamma * running_sum
        reward_to_go[t] = running_sum
    return reward_to_go
两点值得说:
np.full(T, ...)而不是返回一个标量。函数签名要求返回长度 $T$ 的序列,因为后面要和obs拉平对齐。注释里也明确说了「输出列表的所有元素应该完全相同」。- reward-to-go 用反向递推,$O(T)$;如果照着公式写双重循环就是 $O(T^2)$。CartPole 上 $T\le 200$ 感觉不出来,但 HalfCheetah 的 $T=1000$、每次迭代 5 条轨迹、跑 100 次迭代,双重循环会多花几分钟纯 Python 时间——这在一个「单跑 85 秒」的实验里是 3 倍以上的拖慢。
5.4 易错点
- 折扣指数写成 $\gamma^{t'}$ 而不是 $\gamma^{t'-t}$:如果你在 reward-to-go 里写
sum(gamma**np.arange(t, T) * rewards[t:]),得到的是「后缀的绝对折扣和」,等于正确答案乘以 $\gamma^t$。在 $\gamma=1$(CartPole 默认)时二者相同,所以 CartPole 全部实验都不会暴露这个 bug;一到 HalfCheetah 的 $\gamma=0.95$,轨迹后段的 Q 值被压成 $0.95^{1000}\approx 5\times10^{-23}$,等于只有前几十步在贡献梯度,学习曲线会平在 −300 附近。这是「先跑 CartPole 通过就以为对了」最典型的翻车方式。 - 把两种估计混用:
_calculate_q_vals里if not self.use_reward_to_go的分支方向写反,会让-rtg开关的语义整个颠倒,实验 1 的四条曲线两两互换,你会得出「reward-to-go 更差」的错误结论。 - 在拉平之后才算 Q 值:
PGAgent.update里 step 1 必须在np.concatenate之前。如果先拼接再算,整个 batch 会被当成一条超长轨迹,折扣从第一条轨迹的起点一路累到最后——CartPole 上 $\gamma=1$ 时每个 Q 值都变成「整批 1000 步的总奖励」,所有样本权重相同,退化成无信息的最大似然。
5.5 怎么用断言验证
| 用例 | 断言 |
|---|---|
test_discounted_return_hand_computed | rewards=[1,2,3]、$\gamma=0.5$ → [2.75, 2.75, 2.75]($1+0.5\cdot2+0.25\cdot3=2.75$),且断言 np.allclose(out, out[0])——即「所有元素必须相同」 |
test_discounted_reward_to_go_hand_computed | 同样输入 → [2.75, 3.5, 3.0]。逐项验证:$t{=}2$ 时 $3$;$t{=}1$ 时 $2+0.5\cdot3=3.5$;$t{=}0$ 时 $1+0.5\cdot3.5=2.75$。另有 $\gamma=0.9$ 含负奖励的手算例 [2.8045, 2.005, 4.45, 0.5],以及 $\gamma=0$ 退化为即时奖励的边界情形 |
test_reward_to_go_matches_brute_force_double_sum | 随机奖励下与字面双重求和逐点一致,$\gamma\in\{0, 0.5, 0.95, 1\}$ |
test_calculate_q_vals_dispatch | 两条不等长轨迹(长度 3 和 2),返回值必须是 list 且长度分别保持 3、2 |
为什么这几条能抓住折扣指数的 bug?关键在于 test_reward_to_go_matches_brute_force_double_sum 显式扫了 $\gamma=0.5$ 和 $0.95$ 两个非 1 的值,并用字面的 $\sum_{t'\ge t}\gamma^{t'-t} r_{t'}$ 双重循环作为参照。只要你的指数写成了 $\gamma^{t'}$,$t\ge1$ 的项就会差一个 $\gamma^t$ 因子,断言在第一个非零 $t$ 上就失败。$\gamma=1$ 那一组则确保退化情形不出错。手算例的作用是「第一道防线」——它们不依赖任何参照实现,你自己拿笔算三十秒就能确认期望值对不对。
6. TODO 五:价值网络 Critic
6.1 要求
PDF 第 4.1 节:「你现在要实现一个价值函数,作为状态相关的神经网络基线。这个网络会在 PGAgent 的 update 方法里和策略梯度更新一起训练……我们会为每次策略更新训练这个基线网络多个梯度步,由参数 baseline_gradient_steps 决定。」
6.2 数学
目标是让 $V_\phi^\pi(s_t)$ 逼近该状态的期望 reward-to-go(PDF 式 13):
$$ V_\phi^\pi(s_t) \approx \E_{\pi_\theta}\left[\sum_{t'=t}^{H-1}\gamma^{t'-t} r(s_{t'},a_{t'}) \;\Big|\; s_t\right] $$这是一个标准回归问题,用蒙特卡洛样本 $\hat Q_t$ 作为回归目标,最小化均方误差:
$$ \mathcal{L}(\phi) = \frac{1}{B}\sum_{k=1}^{B}\big(V_\phi(s_k) - \hat Q_k\big)^2 $$6.3 实现
def forward(self, obs: torch.Tensor) -> torch.Tensor:
    # 网络每个观测输出一个值;去掉尾部维度,使输出与 q_values 同形 (batch_size,)
    return self.network(obs).squeeze(-1)

def update(self, obs, q_values) -> dict:
    obs = ptu.from_numpy(obs)
    q_values = ptu.from_numpy(q_values)
    predictions = self(obs)
    assert predictions.shape == q_values.shape, (predictions.shape, q_values.shape)
    loss = F.mse_loss(predictions, q_values)
    self.optimizer.zero_grad()
    loss.backward()
    self.optimizer.step()
    return {"Baseline Loss": loss.item()}
外层 PGAgent.update 的 step 4 循环调用它 baseline_gradient_steps 次,每次都是完整的 zero_grad / backward / step——注意每次用的是同一批数据,所以这是对同一个回归目标做 bgs 次全批量梯度下降,不是 minibatch SGD。
6.4 易错点
build_mlp(output_size=1) 的输出是 (B, 1)。如果不 squeeze,F.mse_loss((B,1), (B,)) 会广播成 (B, B) 再求均值——PyTorch 只会给一个 UserWarning: Using a target size that is different to the input size,然后照常返回一个标量 loss。
后果:critic 学到的是「每个状态的 V 都去逼近整批 Q 的均值」,即退化成一个常数基线。表面上 Baseline Loss 还会下降(它确实在拟合均值),但 advantages = q_values - values 里减掉的是同一个常数,状态相关的信息全部丢失。HalfCheetah 上的表现是:有 baseline 和没 baseline 的曲线几乎重合,都在 −100 附近,你会误以为「baseline 没用」。
定位:跑训练时把 values.std() 打出来。正常的 critic 在 HalfCheetah 上 values 的标准差应该有几十;退化成常数基线时它接近 0。验证修好:test_critic_regression_reduces_loss 里的 assert critic(ptu.from_numpy(obs)).shape == (128,) 一行就够。
6.5 怎么用断言验证
test_critic_loss_equals_mse:把update返回的Baseline Loss与手算的((pred - target)**2).mean()比,误差 $\lt 10^{-5}$。这条能抓住误用reduction='sum'、误用 L1/Huber、或者忘记平方。test_critic_regression_reduces_loss:对一个固定的合成回归任务连续更新,断言末次 loss 小于首次的 10%,且最终预测与目标的平均绝对误差 $\lt 0.2$。这条验证优化器确实在工作(zero_grad漏了、step漏了、学习率设成 0 都会被抓住)。test_advantage_with_baseline_subtracts_value:断言values.shape == (6,)且advantages == q_values - values,把形状和减法方向一起验了。
7. TODO 六:优势估计(本作业的核心)
_estimate_advantage 一个函数里塞了三种模式外加一个后处理,是整份作业逻辑最密集的地方。三种模式按 critic 是否存在、gae_lambda 是否为 None 分派:
| 模式 | 条件 | 优势公式 | 偏差 / 方差 |
|---|---|---|---|
| 纯 MC | critic is None | $\hat A_t = \hat Q_t$ | 无偏,方差最大 |
| MC 优势 | 有 critic,gae_lambda is None | $\hat A_t = \hat Q_t - V_\phi(s_t)$ | 无偏(基线不引入偏差),方差中等 |
| GAE-$\lambda$ | 有 critic,gae_lambda 给定 | $\hat A_t = \sum_{t'\ge t}(\gamma\lambda)^{t'-t}\delta_{t'}$ | $\lambda$ 调节偏差-方差 |
7.1 模式一与模式二
if self.critic is None:
    advantages = q_values.copy()
else:
    with torch.no_grad():
        values = ptu.to_numpy(self.critic(ptu.from_numpy(obs)))
    assert values.shape == q_values.shape
    if self.gae_lambda is None:
        advantages = q_values - values
    else:
        ...  # GAE,见 7.2
.copy() 不是可有可无的:后面的标准化是原地风格的赋值,如果直接 advantages = q_values 再标准化,虽然 advantages = (advantages - mean) / std 创建了新数组不会污染 q_values,但只要有人手滑写成 advantages -= advantages.mean(),critic 的回归目标就被就地改掉了——而 step 4 恰好在 step 3 之后、用的正是那个 q_values。
torch.no_grad() 同样是必须的:这里的 values 只是被当作数据用来构造优势,梯度不应该流回 critic。少了它虽然因为紧接着 to_numpy 会切断图、不至于出错,但会白白构建一次计算图。
基线只需要满足「与动作 $a_t$ 无关」。对任意只依赖 $s_t$ 的函数 $b(s_t)$:
$$ \E_{a_t\sim\pi_\theta(\cdot|s_t)}\big[\nabla_\theta\log\pi_\theta(a_t|s_t)\, b(s_t)\big] = b(s_t)\,\E_{a_t}\big[\nabla_\theta\log\pi_\theta(a_t|s_t)\big] = b(s_t)\cdot 0 = 0 $$所以减去任何 $V_\phi(s_t)$(哪怕它拟合得很差!)都不改变梯度期望。这解释了一个初学者常有的困惑:「critic 还没学准就拿去当基线,会不会把策略带偏?」答案是不会——只要它不看动作。但这个论断对 GAE 不成立:GAE 用 $V$ 去 bootstrap 未来回报,$V$ 的误差会直接进入优势估计,那才是真正的偏差来源。这正是 $\lambda=0$ 在 HalfCheetah 上崩掉的根本原因(§9.3)。
7.2 模式三:GAE-$\lambda$ 的反向递推
PDF 式 (16)~(22) 一路推到了可以直接写成代码的形式。核心是单步 TD 残差
$$ \delta_t = r_t + \gamma V_\phi(s_{t+1}) - V_\phi(s_t), \qquad \text{边界:} \ \delta_{H-1} = r_{H-1} - V_\phi(s_{H-1}) $$GAE 是 $n$-step 优势的指数加权平均,闭式为
$$ A^{\text{GAE}}_t = \sum_{t'=t}^{H-1} (\gamma\lambda)^{t'-t}\,\delta_{t'} $$直接按闭式算是 $O(T^2)$,但它满足一个漂亮的递推(PDF 式 22):
$$ A^{\text{GAE}}_t = \delta_t + \gamma\lambda\, A^{\text{GAE}}_{t+1} $$于是从后往前扫一遍就够了:
batch_size = obs.shape[0]
values = np.append(values, [0])              # 哑元 V(s_{T+1}),简化边界
advantages = np.zeros(batch_size + 1)        # 哑元 A_{T+1} = 0

for i in reversed(range(batch_size)):
    if terminals[i]:
        # i 是所在轨迹的最后一步:不 bootstrap,也不往后传播优势
        delta = rewards[i] - values[i]
        advantages[i] = delta
    else:
        delta = rewards[i] + self.gamma * values[i + 1] - values[i]
        advantages[i] = delta + self.gamma * self.gae_lambda * advantages[i + 1]

advantages = advantages[:-1] # 去掉哑元两个哑元的作用:values 末尾补 0 让 values[i+1] 在 i = B-1 时不越界;advantages 长度 B+1 让 advantages[i+1] 同理。它们的值都不会被真正用到(因为 terminals[B-1] 一定为 1),补 0 只是为了让索引合法。
i 是「在这个拼接数组里的位置」,不是「在轨迹里的时刻」。所以在轨迹交界处,values[i+1] 是下一条轨迹第一个状态的价值,advantages[i+1] 是下一条轨迹第一步的优势——两者都与当前轨迹毫无关系。if terminals[i] 这个判断就是在拼接数组上重建轨迹边界。7.3 易错点:跨轨迹泄漏
写错的样子:把循环体简化成一行 advantages[i] = rewards[i] + gamma*values[i+1] - values[i] + gamma*lam*advantages[i+1],不做 terminal 判断。
后果:每条轨迹的最后一步会去 bootstrap 下一条轨迹起点的 $V$,并把下一条轨迹第一步的优势按 $\gamma\lambda$ 加回来。CartPole 这种「短轨迹、大 batch」的场景最严重:-b 1000 时一批可能有 20~50 条轨迹,也就是有 20~50 个污染点;更糟的是污染会沿着递推向前传播,$\gamma\lambda=0.99\times0.98$ 时半衰期约 34 步,等于整条轨迹的后三分之一都被邻居的信号污染了。
症状:曲线不会崩,只是「学得慢一点、抖一点」——这才是它难查的原因。你会怀疑学习率、怀疑网络大小,就是不会怀疑一个 if。LunarLander 上表现为 $\lambda$ 扫描的五条曲线区分度变差,$\lambda=0.99$ 和 $\lambda=0$ 的差距被抹平。
定位:构造两条已知的短轨迹(比如长度 3 和 4),手算闭式 $\sum_{t'\ge t}(\gamma\lambda)^{t'-t}\delta_{t'}$ 并在轨迹边界处截断,与代码输出逐点比较。验证修好:test_gae_matches_closed_form_discounted_sum_of_deltas 正是这么做的——它在任意 $\lambda$ 下与闭式比对,且要求在轨迹边界处截断。有泄漏的实现会在每条轨迹的倒数第二步开始出现偏差。
terminals[i]=1 同时包含两种情况:环境真的终止了(CartPole 杆倒了),以及到达 max_ep_len 被截断了(HalfCheetah 固定 1000 步,从不真终止)。严格来说截断处应该 bootstrap,即 $\delta_{T-1} = r_{T-1} + \gamma V(s_T) - V(s_{T-1})$,因为轨迹在概念上还没结束。但 PDF 明确规定 $\delta_{H-1}=r_{H-1}-V(s_{H-1})$,所以按 PDF 写。对 HalfCheetah 这会在每条轨迹末端引入一点偏差(相当于假设 1000 步之后回报为 0),实践中影响不大——§9.3 的 +390 分结果就是这么跑出来的。真正做研究时这个区分很重要,很多库(如 SB3)会单独维护 truncated 标志。7.4 后处理:优势标准化
PDF 第 2.3 节给出的变换是
$$ \hat A_t \;\longleftarrow\; \frac{\hat A_t - \mu}{\sigma + \varepsilon}, \qquad \varepsilon = 10^{-8} $$if self.normalize_advantages:
advantages = (advantages - advantages.mean()) / (advantages.std() + 1e-8)三个要点:
- 在整个 batch 上做,不是每条轨迹。逐轨迹标准化会把「这条轨迹整体比别的好」这个最重要的信号抹掉——那恰恰是策略梯度赖以工作的信息。
+1e-8是防退化。如果某个 batch 的优势恰好全相等(比如 CartPole 上所有轨迹都刚好 200 步、$\gamma=1$、用轨迹式回报),std()就是 0,除法给出nan,之后所有参数变 NaN、回报瞬间掉到最低并再也不动。这在训练后期才会发生,非常隐蔽。test_normalize_advantages_constant_batch_is_finite专门测这个:常数 batch 输入,断言输出全部有限。- PDF 明说这个变换技术上是有偏的:均值和标准差都依赖于采到的这一批轨迹。极端情形 batch size = 1 时标准化后的优势恒为 0,梯度恒为 0——这是理解偏差来源最好的思想实验。batch 越大偏差越小。
lr=5e-3 才能通用。这也是 PDF 在实验 2 里特意不加 -na 的原因——「优势标准化是个非常强的技巧,在我们测试的大多数简单环境里它会让 baseline 显得没必要」,为了让 baseline 的效果凸显出来,必须先把这个技巧关掉。7.5 更新顺序:一个容易搞反的细节
回看 PGAgent.update:step 2 算出的 advantages(可能已标准化)只喂给 actor;step 4 喂给 critic 的是 q_values——标准化之前、也没有减去 V 的原始蒙特卡洛回报。
如果喂错成 advantages:critic 会去拟合一个「每轮均值 0、标准差 1」的目标。但这个目标的含义每轮都在变(因为归一化用的 $\mu,\sigma$ 每轮不同),相当于让 $V$ 去追一个不断被重新缩放的移动靶。症状:Baseline Loss 稳定在 1.0 附近上下抖动、下不去(因为标准化后的目标方差恒为 1,而 $V$ 学到的最好结果就是输出常数 0,MSE 恰好是 1);策略性能与不用 baseline 无异。定位:看 Baseline Loss 是否死死钉在 1.0 附近——这是一个极其特征性的指纹。
7.6 怎么用断言验证
| 用例 | 断言 | 抓什么 |
|---|---|---|
test_advantage_without_baseline_is_q_values | critic is None 时 advantages == q_values | 分派逻辑写反 |
test_gae_lambda_zero_is_one_step_td_error | $\lambda=0$ 时 $A_t=\delta_t$,且终止步无 bootstrap | 递推项没乘 $\lambda$;边界处误用 $V(s_{t+1})$ |
test_gae_lambda_one_is_monte_carlo_advantage | $\lambda=1$ 时 $A_t$ 与 q_values - values 完全相等 | 这是最强的一条:$\lambda=1$ 时 GAE 望远镜求和(telescoping)后必须精确退化成 MC 优势,任何指数、符号、边界错误都会破坏这个恒等式 |
test_gae_matches_closed_form_discounted_sum_of_deltas | 任意 $\lambda$ 下与闭式一致,且在轨迹边界截断 | 跨轨迹泄漏 |
test_gae_bias_variance_ordering | $\lambda=0.5$ 的结果被 $\lambda=0$ 与 $\lambda=1$ 的结果夹在中间 | $\lambda$ 的作用方向搞反 |
test_normalize_advantages | 256 个样本标准化后 $|\mu|\lt 10^{-5}$、$|\sigma-1|\lt 10^{-4}$,且与原值相关系数 = 1 | 相关系数这一条抓「顺序被打乱」或「误用了排序/裁剪」 |
把 $V$ 的项展开,相邻项 $\gamma^{t'-t+1}V(s_{t'+1})$ 与 $\gamma^{t'+1-t}V(s_{t'+1})$ 逐一抵消(望远镜求和),只剩首项 $-V(s_t)$ 和末项 $\gamma^{H-t}V(s_H)$;而边界条件规定 $\delta_{H-1}$ 里没有 $V(s_H)$,即等价于 $V(s_H)=0$。于是
$$ \sum_{t'=t}^{H-1}\gamma^{t'-t}\delta_{t'} = \sum_{t'=t}^{H-1}\gamma^{t'-t}r_{t'} - V(s_t) = \hat Q_t - V(s_t) $$这就是 test_gae_lambda_one_is_monte_carlo_advantage 断言「完全相等」而不是「近似相等」的底气。
8. TODO 七:采样与训练主循环
8.1 sample_trajectory
这个函数在环境里跑一条完整轨迹,把 (obs, action, reward, next_obs, terminal) 五元组按时间序收集起来。关键几行:
ob = env.reset()                              # gym 0.25.2:只返回 obs
while True:
    ac = policy.get_action(ob)
    next_ob, rew, done, info = env.step(ac)   # 老版 4 元组 API
    steps += 1
    rollout_done = bool(done or steps >= max_length)
    obs.append(ob); acs.append(ac); rewards.append(rew)
    next_obs.append(next_ob); terminals.append(rollout_done)
    ob = next_ob
    if rollout_done:
breakgym==0.25.2 和 numpy<2。env.step() 返回 4 元组 (obs, rew, done, info),env.reset() 只返回 obs。如果你按 gymnasium 的习惯写成 obs, info = env.reset() 或 obs, rew, terminated, truncated, info = env.step(ac),会立刻报 ValueError: too many values to unpack(reset)或者更隐蔽的:4 元组解包成 5 个变量直接崩。不要「顺手升级」到 gymnasium 写法。rollout_done 的定义把「真终止」和「达到 max_length 截断」合并了。这一行有两个作用:一是决定何时 break,二是写进 terminals 数组——也就是 §7.2 GAE 递推赖以切分轨迹的那个信号。如果只写 terminals.append(done)(漏掉截断),HalfCheetah 这种从不真终止的环境里 terminals 会全为 0,GAE 递推就会把整个 batch 当成一条 5000 步的长轨迹,跨轨迹泄漏拉满,同时最后一步也不会正确地停止 bootstrap。
8.2 训练主循环 run.py
for itr in range(args.n_iter):
    trajs, envsteps_this_batch = utils.sample_trajectories(
        env, agent.actor, args.batch_size, max_ep_len)
    total_envsteps += envsteps_this_batch
    trajs_dict = {k: [traj[k] for traj in trajs] for k in trajs[0]}
    train_info = agent.update(
        trajs_dict["observation"], trajs_dict["action"],
        trajs_dict["reward"], trajs_dict["terminal"])
注意 sample_trajectories 的语义是「至少收集 min_timesteps_per_batch 步」:它整条整条地采,直到累计步数达标为止。所以实际 batch size 会略大于 -b 的值(超出量最多是一条轨迹的长度)。这就是为什么 §9 的表格里「总环境步数」是 504,351 而不是整齐的 500,000。横轴一定要用 Train_EnvstepsSoFar 而不是迭代数——PDF 对此有明确要求,因为实验 4 比的正是样本效率,用迭代数当横轴会得出完全相反的结论。
另外两处工程改动(不影响作业逻辑,但便于批量实验):把 setup_wandb 的 mode 改成读环境变量 WANDB_MODE,把日志根目录改成读 CS285_LOG_ROOT(默认仍是 exp,保持 autograder 兼容)。starter code 里 mode='online' 是硬编码的,即使设了 WANDB_MODE=disabled 也会被 wandb.init 的显式参数覆盖,21 个并行实验会全部去连网络然后超时。
8.3 怎么用断言验证
test_sample_trajectory_shapes_and_terminal_flags:断言traj["terminal"][-1] == 1.0且traj["terminal"][:-1].sum() == 0.0(只有最后一位是 1);断言obs[1:] == next_obs[:-1](相邻步的观测必须对齐,能抓住「先ob = next_ob再 append」这类顺序错误);断言max_length=3时轨迹长度 $\le 3$。test_sample_trajectories_batch_sizes:断言返回的steps >= 200且steps == sum(len(t["reward"]) for t in trajs),验证步数统计与实际数据一致。test_agent_update_runs_end_to_end与test_cartpole_learns_a_few_iterations:后者跑 15 次真实 PG 迭代,断言平均回报比初始高 5 以上。这是唯一一条端到端的「它真的在学」检查,能兜住所有前面单测漏掉的组合性错误。
9. 实验与结果
以下全部为真实跑出的结果:seed=1,CPU(32 核机器并行,OMP_NUM_THREADS=1),WANDB_MODE=disabled,指标取 Eval_AverageReturn,横轴 Train_EnvstepsSoFar。曲线图统一画法:原始值用淡色,实线是滑动平均。
9.1 实验 1:CartPole-v0 八组消融
命令为 PDF 原文给的八条,其余全用默认值:--discount 1.0 -lr 5e-3 -l 2 -s 64 -eb 400,不用 baseline。
| 配置 | batch | 首次 eval=200 的环境步数 | 最后 10 次迭代均值 | 最后 30 次均值 | 处于 200 的迭代占比 |
|---|---|---|---|---|---|
cartpole | 1000 | 从未到达(最大 128.8) | 94.4 | 85.7 | 0% |
cartpole_rtg | 1000 | 15,429 | 200.0 | 174.0 | 38% |
cartpole_na | 1000 | 22,648 | 200.0 | 200.0 | 74% |
cartpole_rtg_na | 1000 | 29,519 | 199.9 | 184.7 | 35% |
cartpole_lb | 4000 | 64,640 | 200.0 | 184.2 | 49% |
cartpole_lb_rtg | 4000 | 40,421 | 200.0 | 200.0 | 71% |
cartpole_lb_na | 4000 | 52,688 | 200.0 | 200.0 | 87% |
cartpole_lb_rtg_na | 4000 | 60,828 | 195.5 | 198.5 | 80% |
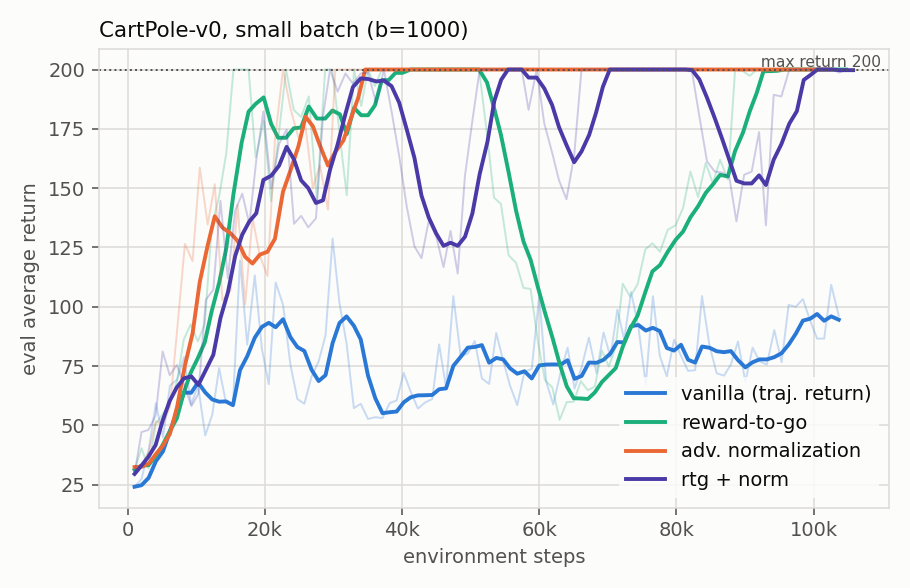
-b 1000)四组对比。该看的是最下面那条灰色的 cartpole:它跑满 10.4 万步、100 次迭代,最高只到过 128.8,全程没摸到 200。而 cartpole_rtg(橙)在 1.5 万步就打满。注意 rtg 那条在 6 万步附近有一个明显的塌陷(掉到 60 又爬回去)——这是小 batch 高方差的典型表现:一次运气不好的梯度就能把策略打回原形。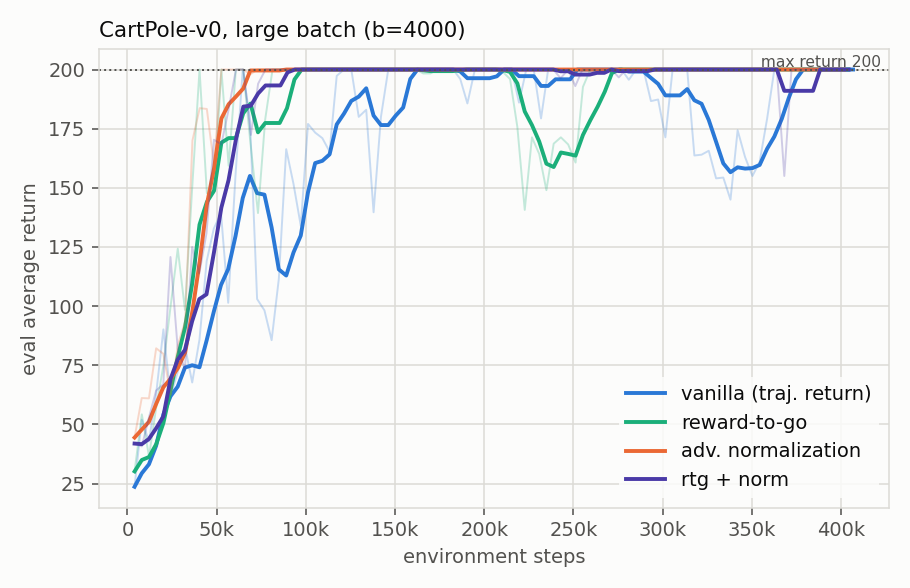
-b 4000)四组对比。该看整体的平整度:四条曲线全部收敛到 200,且末段几乎没有塌陷(cartpole_lb_na 有 87% 的迭代都停在 200)。代价是横轴——所有配置都要 4~6 万步才首次达标,比小 batch 的 1.5 万慢得多。这张图和上一张放在一起,就是「大 batch 买的是稳定性,不是样本效率」的直接证据。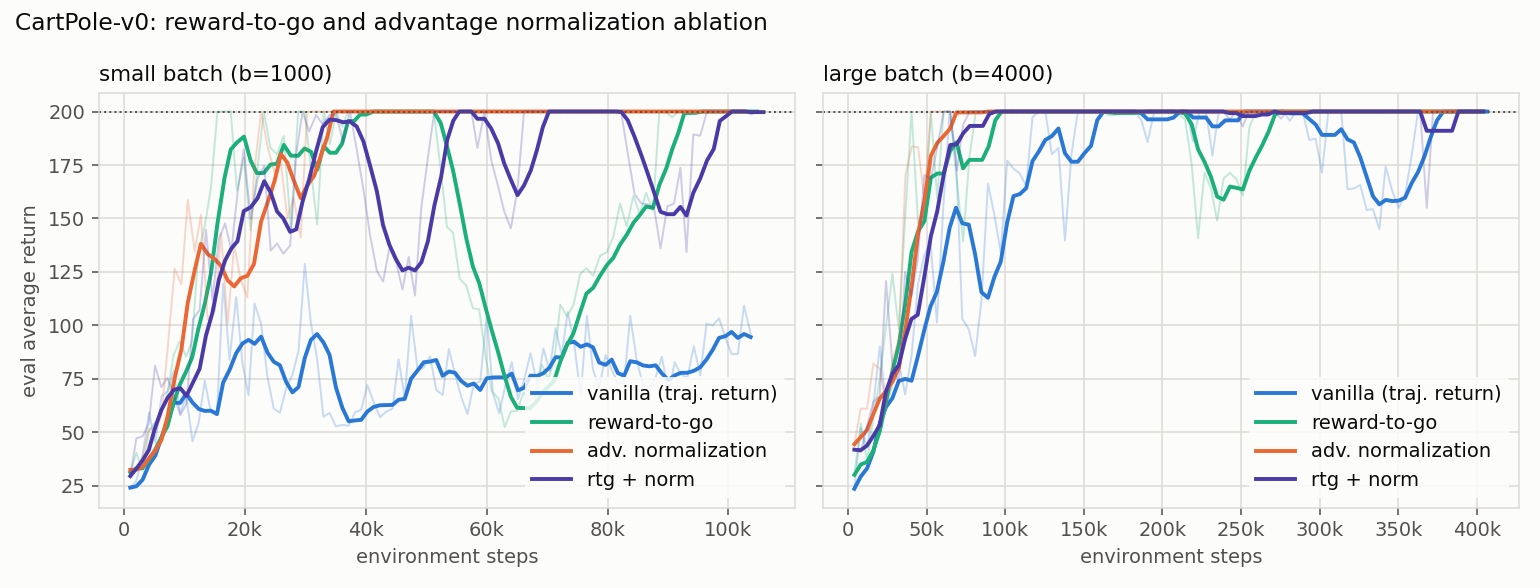
cartpole(无 rtg 无 na)是唯一一条完全没起来的——只要打开 -rtg 或 -na 任意一个,它就能收敛。回答 PDF 的四个问题
- 不做标准化时哪种 Q 估计更好? reward-to-go 完胜。 小 batch 下轨迹式回报 100 次迭代、10.4 万步都没到过 200(最后 10 次只有 94.4),而
cartpole_rtg在 15,429 步就打满。大 batch 下二者都能到 200,但 rtg 快 1.6 倍(4.0 万 vs 6.5 万步)且末段更稳(最后 30 次 200.0 vs 184.2)。 - 为什么 reward-to-go 更好? 因为它利用了因果性(§5.2 已证明过去奖励的贡献期望为 0):去掉它不改变梯度期望(无偏),但去掉的那部分方差是实打实的。为什么 CartPole 上差距这么大?因为 $\gamma=1$ 且回报全是 +1,轨迹式回报给整条轨迹每一步都赋同一个权重 $T$——一条 200 步的轨迹里,第 199 步那个「杆已经要倒了」的坏动作和第 0 步的好动作拿到完全一样的正权重。策略无法分辨轨迹内部哪一步好、哪一步坏,只能靠「好轨迹整体出现得更频繁」这个极弱的信号学习。
- 标准化有用吗? 有,而且在小 batch 下比 rtg 还救命:
cartpole_na把「永远学不会」的轨迹式回报救成 22,648 步收敛、后 30 次稳在 200.0。它做了两件事(§7.4):归一尺度=自适应学习率;减均值=一个常数基线。但它和 rtg 的收益不叠加:cartpole_rtg_na反而比cartpole_rtg起步慢(29,519 vs 15,429 步)。原因是 rtg 已经把方差降下来了,再标准化的边际收益递减,而标准化引入的偏差(小 batch 下尤其大)开始占上风。这是「技巧叠加不一定更好」的一个干净例子。 - batch size 有影响吗? 有,但方向是稳定性而非样本效率。大 batch 四组全部收敛且末段更平;小 batch 会反复掉下来。但按环境步数算,小 batch 反而更省样本(1.5 万 vs 4.0 万步首次达标)——因为每收集 $b$ 步只做一次梯度更新,大 batch 把样本「浪费」在了让单次梯度更精确上。这个 trade-off 正是实验 4 的核心,见 §9.5。
9.2 实验 2:HalfCheetah-v4 的神经网络 baseline
# 无 baseline
uv run src/scripts/run.py --env_name HalfCheetah-v4 -n 100 -b 5000 -eb 3000 -rtg \
  --discount 0.95 -lr 0.01 --exp_name cheetah
# 有 baseline
uv run src/scripts/run.py --env_name HalfCheetah-v4 -n 100 -b 5000 -eb 3000 -rtg \
  --discount 0.95 -lr 0.01 --use_baseline -blr 0.01 -bgs 5 --exp_name cheetah_baseline
# 削弱 baseline(PDF 要求的对照)
...  -blr 0.01  -bgs 1   --exp_name cheetah_baseline_bgs1
...  -blr 0.001 -bgs 5   --exp_name cheetah_baseline_blr0.001
四组各 50 万环境步,单跑约 85 秒 CPU,全部不加 -na。
| 配置 | 最终 eval 回报 | 最后 10 次均值 | 最大 eval | baseline loss 首 → 末 |
|---|---|---|---|---|
cheetah(无 baseline) | −129.1 | −194.0 | −124.0 | — |
cheetah_baseline(blr 0.01, bgs 5) | 332.0 | 336.4 | 413.5 | 138.9 → 18.1 |
cheetah_baseline_bgs1 | 146.8 | 76.4 | 183.4 | 241.5 → 20.9 |
cheetah_baseline_blr0.001 | 0.4 | −33.6 | 39.4 | 195.6 → 33.0 |
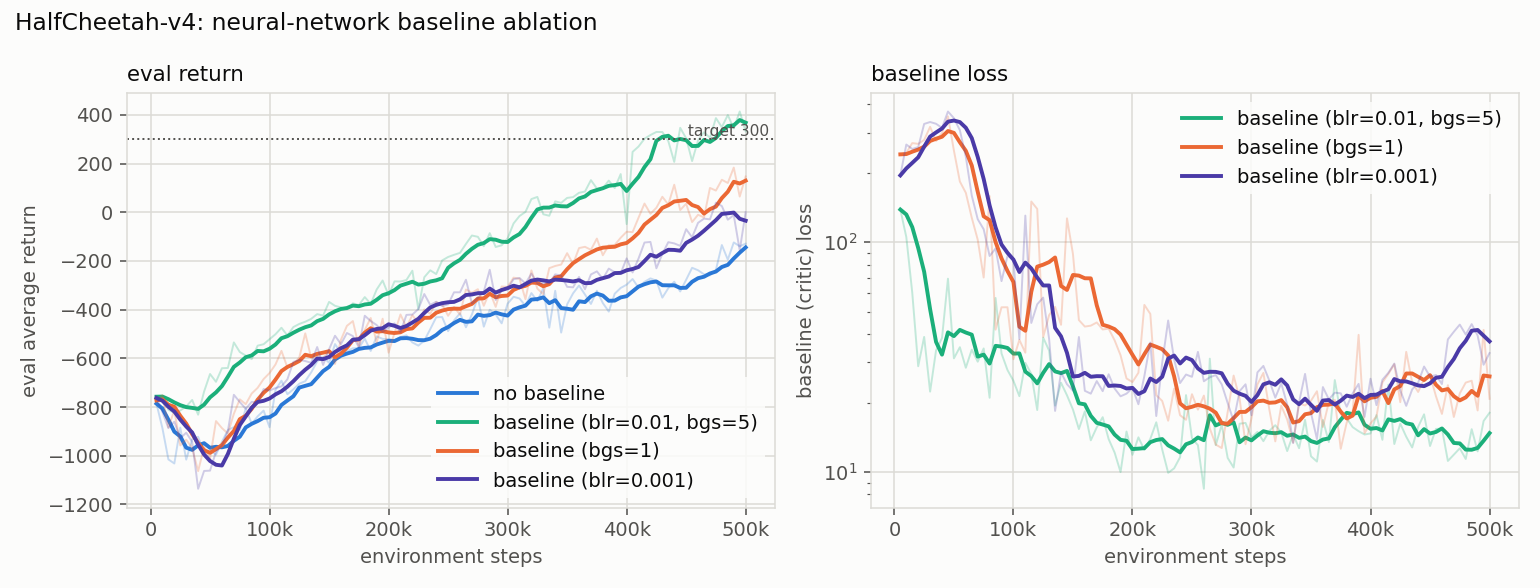
- 达标情况:baseline 版最终 332.0、最高 413.5,超过了 PDF 要求的 300;无 baseline 版 50 万步只爬到 −129.1。差距约 460 分,这是整份作业里 baseline 效果最戏剧化的一处。
- 为什么这里 baseline 这么关键? HalfCheetah 的 reward-to-go 量级在几十到上百,而且不同状态的 $V$ 差异巨大(刚起步的姿态 vs 已经跑起来的姿态,价值能差几百)。不减 baseline 时,几乎所有动作的「优势」都是同号的大正数——策略梯度退化成「把所有见过的动作都加强」,方向被 $V(s)$ 的偏移完全主导,真正有用的 $Q-V$ 信号被淹没在里面。CartPole 上之所以没这么严重,是因为那里 $\gamma=1$、回报范围窄,而且
-na的减均值已经顶了大半个 baseline 的作用。 - 减少
-bgs(5→1):critic 拟合速度明显变慢(首次 loss 241.5,要到 20 万步才追平),策略性能从 332 掉到 147(−56%)。 - 减小
-blr(0.01→0.001):更糟,critic 末期 loss 33.0(是 blr=0.01 的 1.8 倍),策略只有 0.4 分。结论:baseline 拟合得不够准,比不用 baseline 好不了多少——一个滞后的 $V$ 会给出系统性偏置的优势,在早期反而干扰学习。
9.3 GAE 在连续控制上的效果
... --use_baseline -blr 0.01 -bgs 5 --gae_lambda {0, 0.95, 0.99} \
--exp_name cheetah_baseline_gae<λ>| 配置 | 最终 eval | 最后 10 次均值 | 最大 eval | baseline loss 末 |
|---|---|---|---|---|
| 无 baseline | −129.1 | −194.0 | −124.0 | — |
| baseline,MC 优势($\lambda=$None) | 332.0 | 336.4 | 413.5 | 18.1 |
| baseline + GAE $\lambda=0$(纯 TD) | −277.1 | −264.2 | −211.5 | 2.1 |
| baseline + GAE $\lambda=0.95$ | 357.1 | 384.7 | 531.2 | 12.0 |
| baseline + GAE $\lambda=0.99$ | 390.2 | 378.5 | 450.6 | 13.2 |
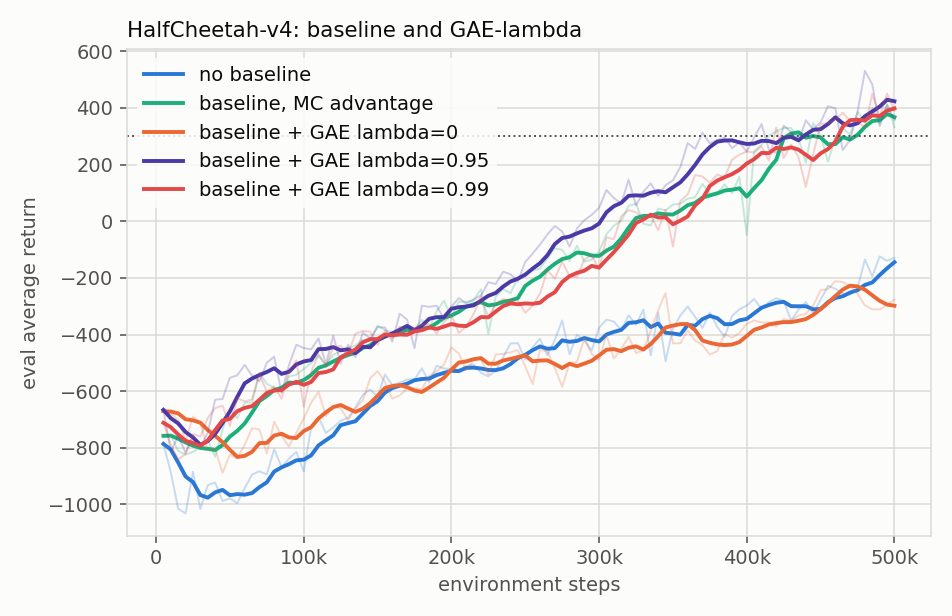
$\lambda=0$ 那一组的 critic loss 是所有配置里最低的(2.1,是最佳配置的六分之一),但它的策略性能最差。为什么?因为策略太差,episode 回报又小又集中,回归目标本身的方差就极小,critic 轻轻松松就拟合得很好——loss 低是「结果」不是「原因」。
这个陷阱在实际调参里非常常见:你看到 baseline loss 一路走低就以为一切正常,实际上策略已经死了。判断 critic 是否有用的正确指标不是它的 loss,而是「用它算出的优势」与「真实回报排序」的相关性,或者更实用的:直接看 eval 回报。
$\lambda=0$ 为什么会崩? 此时 $\hat A_t=\delta_t=r_t+\gamma V(s_{t+1})-V(s_t)$,优势完全依赖 critic 的准确度。回顾 §7.1 的推导:减去 $V(s_t)$ 作为基线是无偏的,但 $\gamma V(s_{t+1})$ 这一项是用 $V$ 去替代未来的真实回报——$V$ 的建模误差直接变成优势的系统性偏差。在 HalfCheetah 这种状态维度 17、$V$ 量级几百的环境里,一个训练中的 critic 的误差足以让 $\delta_t$ 基本是噪声化的模型误差,策略就沿着这个假信号走偏了。
9.4 实验 3:LunarLander-v2 的 $\lambda$ 扫描
uv run src/scripts/run.py --env_name LunarLander-v2 --ep_len 1000 --discount 0.99 \
  -n 200 -b 2000 -eb 2000 -l 3 -s 128 -lr 0.001 --use_reward_to_go --use_baseline \
--gae_lambda <λ> --exp_name lunar_lander_lambda<λ> # λ ∈ {0, 0.95, 0.98, 0.99, 1}| $\lambda$ | 最后 20 次均值 | 最大 eval | 最优 20 次滑窗均值 | 末期 baseline loss |
|---|---|---|---|---|
| 0 | −48.7 | 125.2 | −48.3 | 2461.5 |
| 0.95 | −29.2 | 96.1 | 7.9 | 172.8 |
| 0.98 | 20.6 | 171.6 | 117.9 | 301.1 |
| 0.99 | 45.4 | 254.0 | 102.2 | 253.9 |
| 1 | 101.1 | 165.9 | 107.1 | 432.6 |
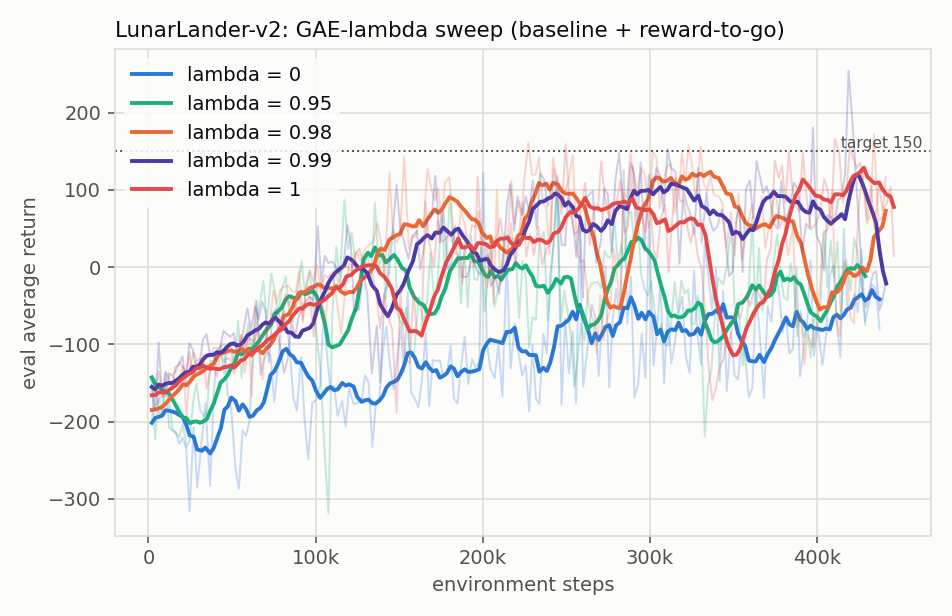
$\lambda$ 如何影响性能? $\lambda=0$ 全程最差,$\lambda$ 越大越好,$0.98\sim1$ 之间差别不大(都在 100 分量级)且都明显优于 0.95 以下。原因和这个环境的奖励结构直接相关:LunarLander 的动作带噪声、奖励稀疏且严重延迟——真正的大额奖惩(+100 成功着陆 / −100 坠毁)只在最后一瞬间结算。低 $\lambda$ 的短视 bootstrap 需要 critic 把「着陆成功」的价值一路反传回起飞时刻才能用上这个信号,而 critic 本身还在学;高 $\lambda$ 则直接用蒙特卡洛回报把这个信号原封不动地带回每一步。
PDF 问 $\lambda=0$ 和 $\lambda=1$ 各对应什么?
- $\lambda=0$:$\hat A_t=\delta_t=r_t+\gamma V(s_{t+1})-V(s_t)$,单步 TD 残差。方差最小、偏差最大,完全依赖 critic。
- $\lambda=1$:$\hat A_t=\sum_k \gamma^k r_{t+k}-V(s_t)$,蒙特卡洛优势。无偏、方差最大,此时 critic 只当纯 baseline 用(§7.1 已证明这不引入偏差)。
LunarLander 上 $\lambda=1$ 依然稳居前列(最后 20 次均值 101.1 是全场最高),说明在这个环境里 critic 的偏差比 MC 的方差更致命;而 $\lambda=0.98/0.99$ 是折中点,峰值最高(254.0)。顺带一个佐证:$\lambda=0$ 那一跑的 critic loss 高达 2461(其余在 170~430),因为策略长期停留在高方差的「悬停/坠毁」分布上,回报本身极不稳定,critic 根本追不上——注意这和 §9.3 里 HalfCheetah 的 $\lambda=0$ 情形正好相反(那里 loss 最低),说明 critic loss 这个指标在两个方向上都会骗人。
9.5 实验 4:InvertedPendulum-v4 的超参数与样本效率
PDF 的任务:把默认配置(-n 100 -b 5000 -eb 1000,其余全默认)调到在 10 万环境步内达到回报 1000。注意衡量的是环境步数而不是策略梯度迭代数——这个区分是整道题的题眼。
# 默认:b=5000,γ=1.0,无 rtg / 无 na / 无 baseline,lr 5e-3
uv run src/scripts/run.py --env_name InvertedPendulum-v4 -n 100 -b 5000 -eb 1000 \
  --exp_name pendulum_default
# A
... -n 100 -b 1000 -eb 1000 -rtg -na --use_baseline -blr 0.01 -bgs 5 \
    --gae_lambda 0.98 --discount 0.98 -lr 0.02 -l 2 -s 64 --exp_name pendulum_tuned_a
# B(最佳)
... -n 100 -b  500 -eb 1000 -rtg -na --use_baseline -blr 0.01 -bgs 5 \
    --gae_lambda 0.95 --discount 0.99 -lr 0.02 -l 2 -s 64 --exp_name pendulum_tuned_b
# C(只加 rtg + na,不用 baseline)
... -n 100 -b 1000 -eb 1000 -rtg -na --discount 0.99 -lr 0.01 -l 2 -s 64 \
    --exp_name pendulum_tuned_c
# D(更激进的 lr)
... -n  60 -b 1000 -eb 1000 -rtg -na --use_baseline -blr 0.02 -bgs 10 \
--gae_lambda 0.99 --discount 0.99 -lr 0.03 -l 2 -s 64 --exp_name pendulum_tuned_d| 配置 | 首次 eval=1000 的环境步数 | 达到 1000 的迭代数 | 最后 10 次均值 | 总步数 |
|---|---|---|---|---|
| default(b=5000, $\gamma$=1, 无 rtg/na) | 从未(最大 272.8) | 0 | 103.5 | 504,351 |
| tuned A | 26,550 | 56 | 638.3 | 106,898 |
| tuned B(最佳) | 18,030 | 48 | 911.4 | 82,648 |
| tuned C | 63,686 | 30 | 905.5 | 108,653 |
| tuned D | 34,235 | 8 | 62.7 | 65,631 |
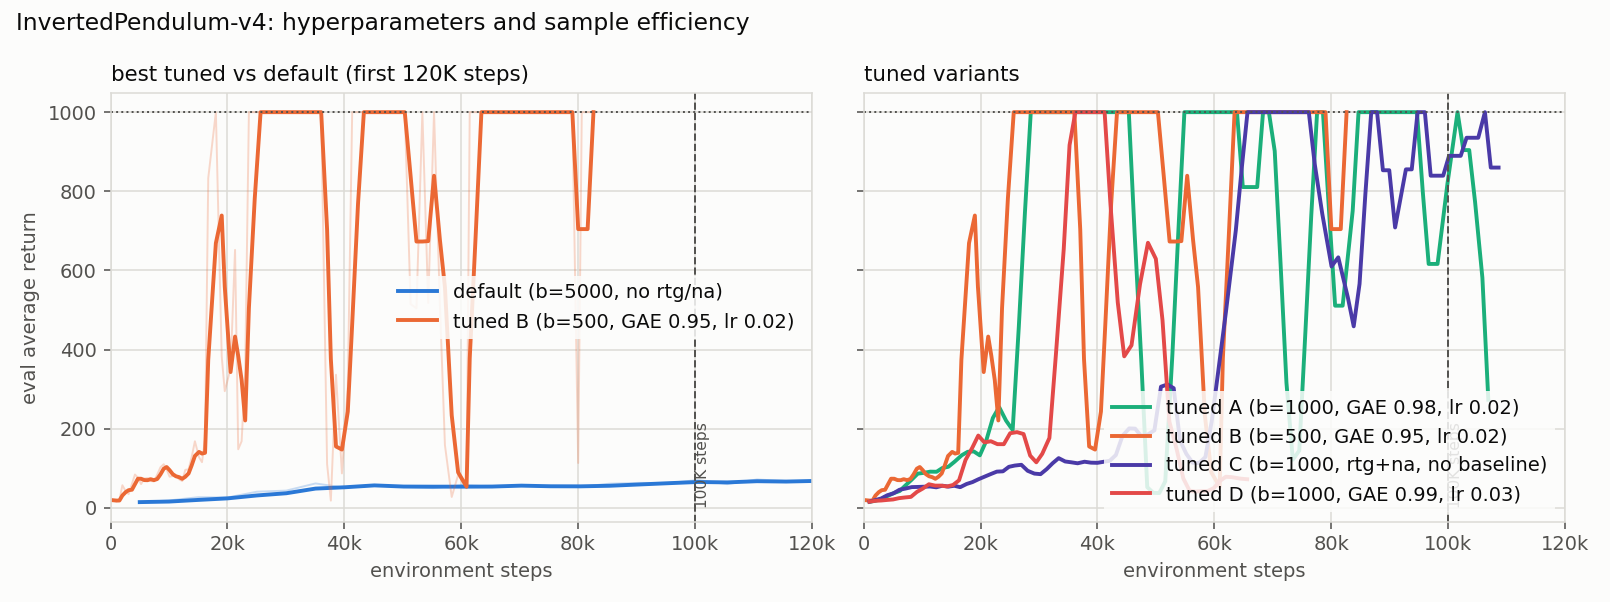
最佳超参(tuned B):-b 500 -rtg -na --use_baseline -blr 0.01 -bgs 5 --gae_lambda 0.95 --discount 0.99 -lr 0.02 -l 2 -s 64,18,030 步首次达到 1000(远低于 10 万步的要求),最后 10 次迭代均值 911.4。
哪些超参最关键?按实测影响排序:
- batch size 调小(5000 → 500):影响最大的一项。同样的环境步数下梯度更新次数多 10 倍。为什么这里能这么激进?因为 InvertedPendulum 状态维度只有 4、动作 1 维,梯度信噪比本来就高,根本不需要 5000 步去平均掉噪声。默认配置的 5000 步等于把 90% 的样本浪费在了「让一次梯度更精确」上。这与 §9.1 第 4 问在 CartPole 上得到的结论完全一致。
-rtg -na:光加这两个开关(tuned C,连 baseline 都没有)就能在 6.4 万步达标,最后 10 次均值 905.5。默认配置连这两个都没开,是它「从未达标」的直接原因。- 学习率 5e-3 → 0.02:配合小 batch 加速收敛。但再往上就危险:tuned D 用 0.03,虽然只用 8 次迭代(3.4 万步)就达标,最后 10 次均值却只有 62.7——策略反复崩掉。这是「快」和「稳」的经典冲突。
- $\gamma$ 从 1.0 降到 0.98/0.99,配合 GAE:进一步把达标步数压到 1.8~2.7 万。$\gamma\lt1$ 在这个环境里既降方差又不损失多少最优性(1000 步的地平线下 $0.99^{1000}$ 已经很小,但「尽量久地不倒」这个目标本身对折扣不敏感)。
9.6 把「降方差」变成数字
前面所有结论都在说「方差更小所以更好」,但方差本身一直是个定性说法。这里给出直接测量:对固定 batch,逐轨迹计算梯度 $g_i$,报告相对方差
$$ \mathrm{RV} = \frac{\E_i\lVert g_i - \bar g\rVert^2}{\lVert \bar g\rVert^2} $$分母做归一化使这个量与梯度尺度无关,越小越好;其倒数的平方根可以理解为信噪比。
| CartPole(预热 10 次迭代,35 条轨迹 / 4019 步,平均回报 114.8) | 相对方差 | 信噪比 |
|---|---|---|
| 轨迹式回报 | 43.1 | 0.152 |
| reward-to-go | 38.1 | 0.162 |
| 轨迹式 + 标准化 | 14.9 | 0.259 |
| reward-to-go + 标准化 | 4.8 | 0.455 |
| HalfCheetah(预热 10 万步,10 条轨迹) | 相对方差 |
|---|---|
| 无 baseline(MC Q) | 5.91 |
| baseline(MC 优势) | 4.16(−30%) |
| GAE $\lambda=0.95$ | 3.23(−45%) |
| GAE $\lambda=0$ | 3.62 |
这两张表是本文最有说服力的部分,它们把学习曲线上的差距翻译成了机制层面的解释:
- CartPole 上 43.1 → 4.8,方差降低 89%,信噪比提升 3 倍。注意单独看 rtg 只把 43.1 降到 38.1(仅 12%),单独看标准化把 43.1 降到 14.9(65%)——但两者叠加后是 4.8。这解释了 §9.1 里一个看似矛盾的现象:小 batch 下
-na比-rtg更能救命(因为它单独的降方差幅度更大),但两者叠加时收敛反而不如单用 rtg 快(因为叠加后方差已经足够低,标准化引入的偏差开始成为主导因素)。 - HalfCheetah 上方差排序是 GAE0.95(3.23) < baseline(4.16) < 无 baseline(5.91),与学习曲线的性能排序完全对应。
- 但 $\lambda=0$ 是个反例:它的方差(3.62)比 MC 优势(4.16)还低,性能却最差(−277)。这证明方差不是唯一指标——$\lambda=0$ 的低方差是用巨大的偏差换来的。如果你只盯着方差调参,就会得出完全错误的结论。这也正是 GAE 论文的核心论点:$\lambda$ 是一个需要在具体环境上搜索的偏差-方差旋钮,没有普适最优值。
10. 调参与踩坑记录
下面这 11 条是实际实现和跑实验过程中真正踩到的问题,按「症状 → 定位 → 验证」的格式整理。前面章节已详述的只做索引。
| # | 坑 | 症状 | 处理 |
|---|---|---|---|
| 1 | 连续策略 log_prob 忘记按动作维求和 | 不报错,梯度全错;回报纹丝不动 | 用 Independent(Normal, 1),并在 update 里加形状 assert(§2.4) |
| 2 | GAE 不判断 terminal | 学得慢一点、抖一点,极难察觉 | 用 terminals[i] 切断轨迹边界(§7.3) |
| 3 | 伪损失用 sum 而非 mean | 小 batch 能学、大 batch 第 2~3 次迭代就崩 | 全程用 mean,让 lr 与 batch size 解耦(§4.4) |
| 4 | 离散动作的 dtype 与维度 | env.step 抛 AssertionError: ... invalid | get_action 返回 0 维标量;动作存 float32 不影响 Categorical(§3.3) |
| 5 | 误用 gymnasium 的 API | ValueError: too many values to unpack | gym 0.25.2 是 4 元组 step、reset() 只返回 obs(§8.1) |
| 6 | critic 回归目标用了标准化后的优势 | Baseline Loss 死钉在 1.0 附近下不去 | 喂未标准化的 q_values(§7.5) |
| 7 | 用 critic loss 判断 baseline 好坏 | loss 最低的那组性能最差 | 看 eval 回报,不看 loss(§9.3) |
| 8 | wandb 默认 online | 21 个并行实验全部卡在联网超时 | setup_wandb 的 mode 改成读 WANDB_MODE 环境变量 |
| 9 | 并行跑实验没限制线程 | 32 核被 21 个 torch 进程抢占,单跑反而更慢 | 设 OMP_NUM_THREADS=1 MKL_NUM_THREADS=1,并加 --no_gpu |
| 10 | eval batch 太小导致曲线锯齿 | CartPole 曲线在 200 和 120 之间乱跳 | -eb 400 时策略变好后只有 2 条 eval 轨迹;画图叠加 5 点滑动平均 |
| 11 | InvertedPendulum 达标后掉下来 | 回报在 1000 和 100 之间反复 | 不是 bug,是 vanilla PG 无信任域;看「首次达标步数」(§9.5) |
10.1 关于运行效率的两个实测数字
这份作业用 CPU 比用 GPU 快,PDF 也这么建议。网络是 2 层 64 单元的小 MLP,单次前向的计算量还不如一次 CPU-GPU 数据搬运的开销大;而且 PG 的瓶颈在环境仿真(纯 CPU)和大量小 batch 前向(get_action 每步调一次)。实测数字:CartPole 小 batch 一整跑(100 次迭代、约 10 万步)只要 14 秒;HalfCheetah 50 万步 85 秒。 加上 OMP_NUM_THREADS=1 之后 21 个 run 并行,全套实验约 25 分钟跑完。
10.2 复现
cd homework/hw2
uv run python tests/test_hw2.py            # 26/26 passed,约 40 秒
bash run_experiments.sh all                # 21 个 run,约 25 分钟,日志写到 runs/
uv run python plot_results.py              # 读 runs/*/log.csv → figures/*.png + 汇总表
run_experiments.sh 内部统一设置 WANDB_MODE=disabled、CS285_LOG_ROOT=runs、OMP_NUM_THREADS=1,并加 --no_gpu。注意提交给 Gradescope 时日志目录必须叫 exp(这也是 CS285_LOG_ROOT 默认值保持为 exp 的原因)。
11. 自测清单
做完之后照着这份清单逐条核对。前六条不跑实验就能查,后面几条需要看曲线。
11.1 形状与类型(不跑训练就能查)
- ☐ 连续策略的
log_prob(actions)形状是(B,)而不是(B, ac_dim)——用Independent(..., 1)或显式.sum(-1)。 - ☐
ValueCritic.forward有.squeeze(-1),输出(B,)。 - ☐
get_action对离散环境返回 0 维标量,对连续环境返回(ac_dim,);函数带@torch.no_grad()。 - ☐
MLPPolicyPG.update和ValueCritic.update里各有一条形状assert——把它留在生产代码里,不要删。 - ☐
logstd是nn.Parameter,并且和mean_net.parameters()一起进了同一个优化器;前向里每次都torch.exp。 - ☐
_discounted_return返回长度 $T$ 的数组且所有元素相同。
11.2 数学正确性(用手算例验证)
- ☐
rewards=[1,2,3]、$\gamma=0.5$:_discounted_return给[2.75, 2.75, 2.75],_discounted_reward_to_go给[2.75, 3.5, 3.0]。 - ☐ reward-to-go 的折扣指数是 $\gamma^{t'-t}$ 而不是 $\gamma^{t'}$——用 $\gamma\ne1$ 的例子验证,$\gamma=1$ 的 CartPole 查不出这个 bug。
- ☐ $\lambda=1$ 时 GAE 精确等于
q_values - values(不是近似)。 - ☐ $\lambda=0$ 时 GAE 等于 $\delta_t$,且终止步 $\delta = r - V(s)$(没有 bootstrap 项)。
- ☐ GAE 递推在每条轨迹的边界处截断——构造两条不等长轨迹,与逐轨迹的闭式结果比对。
- ☐ 标准化后 $|\mu|\lt10^{-5}$、$|\sigma-1|\lt10^{-4}$;常数 batch 输入时输出仍然全部有限(
+1e-8在位)。
11.3 更新逻辑
- ☐ Q 值在
np.concatenate之前按轨迹逐条计算。 - ☐ 伪损失有负号,用
.mean()。 - ☐ critic 的回归目标是未标准化的
q_values,不是advantages。 - ☐ actor 每次迭代做 1 次梯度步,critic 做
baseline_gradient_steps次。 - ☐ 优势全 0 时,一次
update后策略参数逐元素不变。 - ☐ 构造「动作 0 优势 +1、动作 1 优势 −1」的批次,一步更新后 $P(a{=}0)$ 上升;优势取反后下降。
11.4 实验层面(看曲线判断)
- ☐ CartPole 八组里,至少大 batch 和小 batch 各有一组收敛到 200(PDF 的硬性要求)。若
cartpole(无 rtg 无 na)那组也收敛了,反而要怀疑开关是否接反。 - ☐ 学习曲线横轴用
Train_EnvstepsSoFar而不是迭代数。 - ☐ HalfCheetah 带 baseline 的一跑最终 eval 回报 > 300;不带 baseline 的应该在 −100 量级。若两条曲线几乎重合,去查 critic 的
squeeze(-1)。 - ☐ HalfCheetah 的
Baseline Loss应该从 100+ 降到 20 以内;若它钉在 1.0 附近,说明喂错了标准化后的优势。 - ☐ LunarLander 的五条 $\lambda$ 曲线应该有明显区分度,$\lambda$ 越大整体越高,最好的一次至少有一次超过 150。若五条挤在一起,去查 GAE 的轨迹边界。
- ☐ InvertedPendulum 调参后在 10 万步内至少有一次达到 1000;达标后掉下来是正常的。