HW1 编程解析:动作分块与流匹配策略
这份作业只有三处 TODO,却把第 2、3 讲最重要的两个论断压成了可以量化的实验:动作分块(action chunking)如何缓解复合误差,以及为什么「把两个正确动作平均起来会得到一个错误动作」——本文逐处拆解实现、推导流匹配为什么回归常速度就够用,并用真实跑出来的 0.902 vs 0.706 说明 MSE 的瓶颈不是容量而是目标函数。
0. 这份作业在考什么
HW1 的题面看起来非常温和:「训练两个 Push-T 的动作分块策略,一个用 MSE 损失,一个用流匹配(flow matching)」。starter code 里只有三处 TODO,全部填完不超过五十行。但如果你把它当成一次「把 MLP 接起来跑通」的编程练习,你会错过它真正的设计意图——它是第 2、3 两讲理论结论的一次受控对照实验,而且是整门课里少见的、结论能被单个标量指标干净地验证出来的那种实验。
| 作业里的元素 | 对应讲次的命题 | 你要动手验证什么 |
|---|---|---|
| 行为克隆(behavior cloning)本身 | 第 2 讲:监督学习专家数据,训练分布与执行分布不匹配 | 纯监督也能在 Push-T 上工作,但会有一批种子彻底失败 |
动作分块 chunk_size=8 | 第 2 讲:降低决策频率、缩短有效时域,缓解复合误差(compounding error) | 一次预测 8 步开环执行,误差累积的机会从 300 次降到约 38 次 |
| MSE 损失(式 1) | 第 3 讲:平方误差的最优解是条件均值 $\E[A_t\mid o_t]$ | 专家多模态时,条件均值可能是一个专家从不产生的动作 |
| 流匹配(式 2、3) | 第 3 讲:用生成式模型表示 $p(A_t\mid o_t)$ 而不是它的均值 | 同一个观测重复采样应当得到多条不同但都合法的轨迹 |
| Euler 步数 $n$ | 第 3 讲:ODE 求解的离散化误差 | $n$ 太小采样偏离流形,$n$ 增大后指标饱和 |
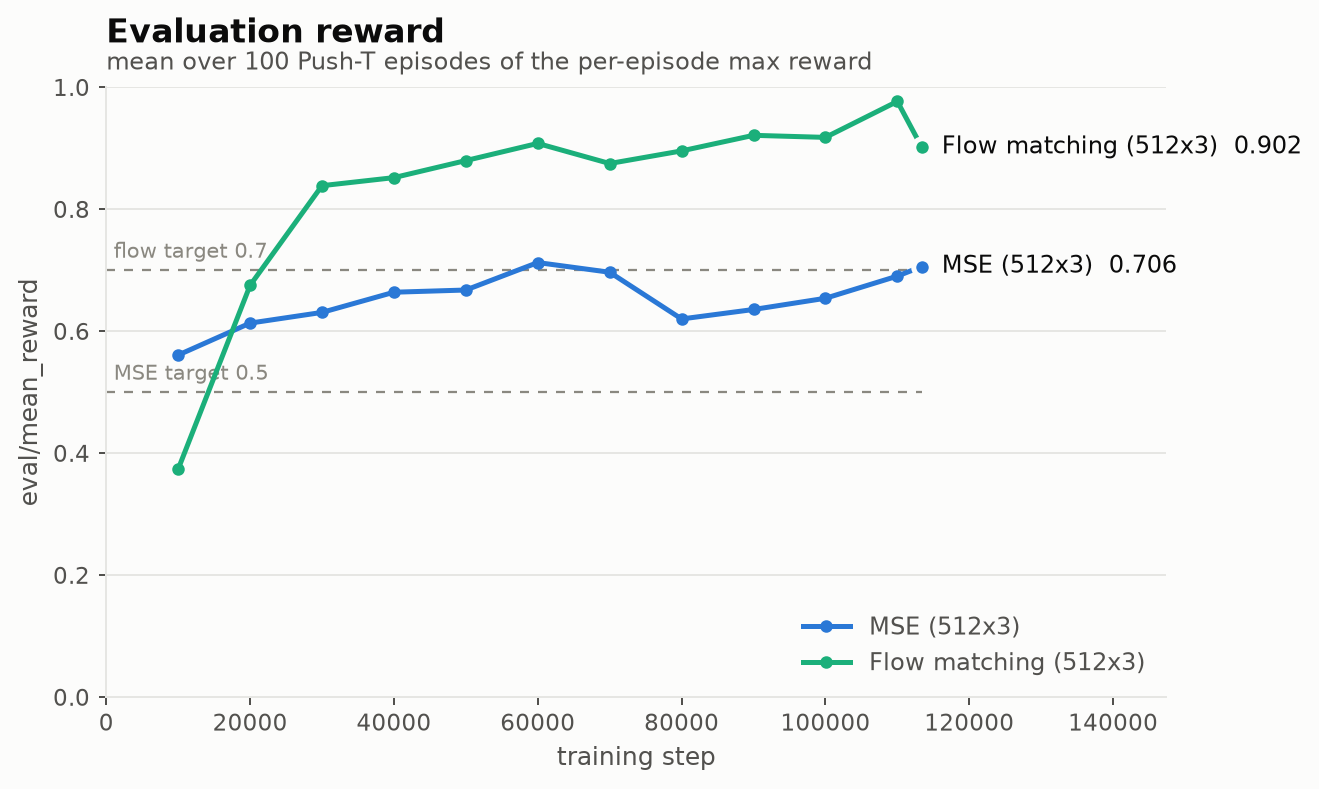
换句话说,把两个策略都跑到「不报错」只是入场券。这份作业真正要你交出的,是一句能用数字支撑的判断:MSE 策略的天花板是被目标函数按住的,不是被网络容量按住的。 后面 §5 会给出这个判断的直接证据——把隐藏层从 256 加宽到 512、步数增加 50%,MSE 只从 0.637 涨到 0.713,而流匹配从 0.688 直接跳到 0.902。
- MSE 策略拟合的是条件均值。 当专家在同一个观测下有两种合理走法(绕左 / 绕右),最小化 $\E\|A - \pi_\theta(o)\|^2$ 的唯一最优解是两条轨迹的平均,而这个平均往往直接撞上障碍物。人造双峰实验里 MSE 到最近模态的 RMS 距离是 0.998,流匹配是 0.048,差 20 倍。
- 流匹配的训练目标是「常速度回归」,但学出来的却是正确的边缘速度场。 这不是巧合,而是平方损失的条件期望引理:网络无法区分同一 $(o_t, A_{t,\tau}, \tau)$ 下的不同数据对,只能输出它们的条件期望,而这个条件期望恰好就是边缘概率流 ODE 的速度场。
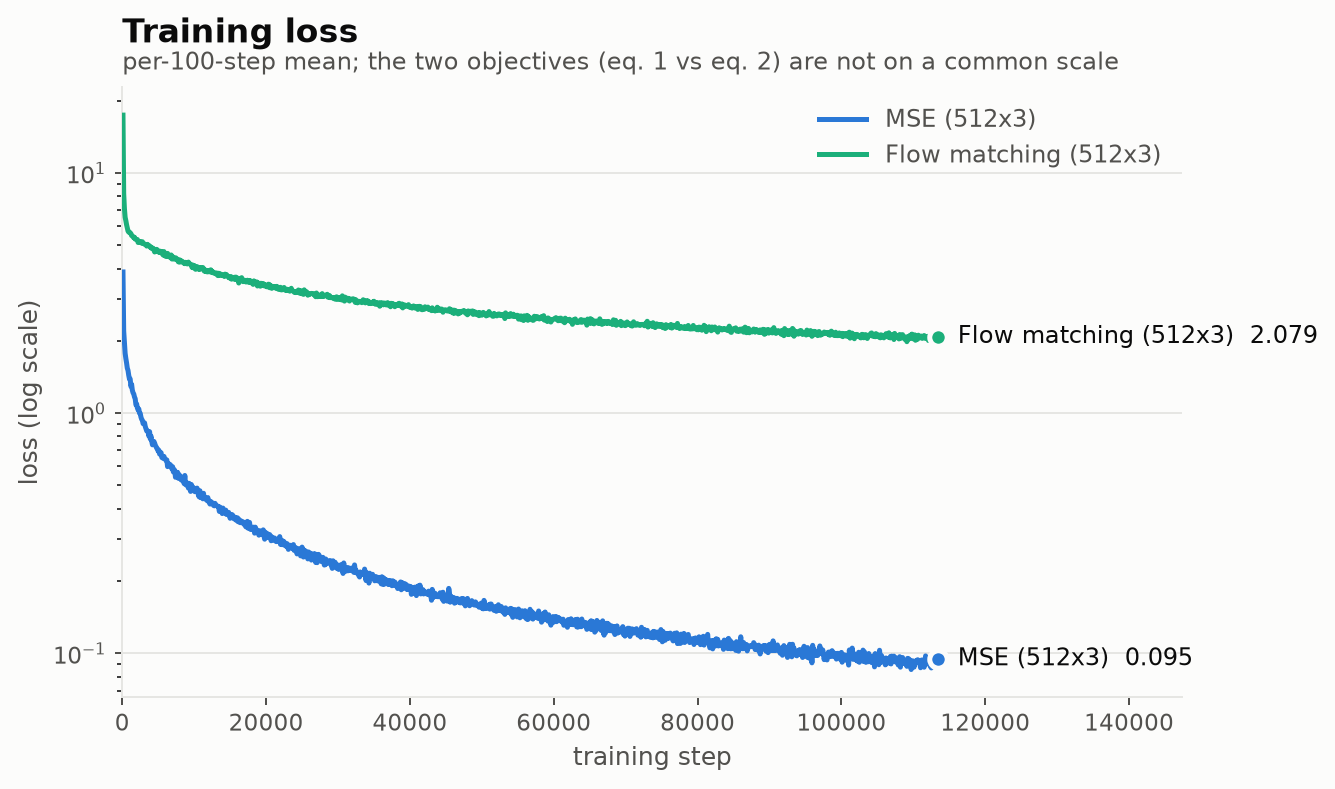
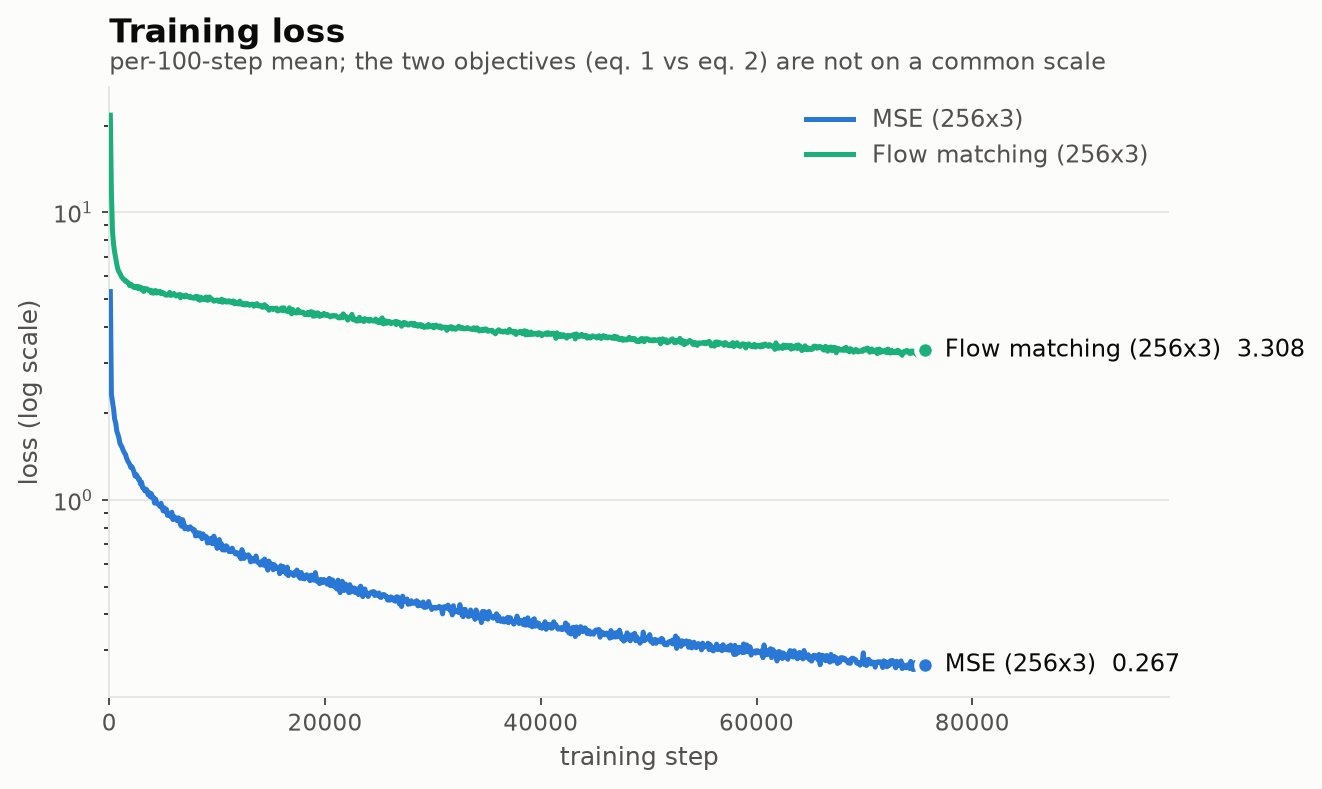
- 流匹配的训练损失有不可约下界,因此损失数值完全不能跨目标函数比较。 本次实验里 flow 收敛在 2.079,MSE 收敛在 0.095,但 flow 的评测回报高 28%。判断流匹配好不好,只能看 eval reward。
- 差距主要体现在失败率上。 MSE 有 28% 的评测种子最终回报连 0.5 都不到,流匹配只有 7%。两者的「上限表现」其实差得没那么远。
1. 环境、数据与形状链条
1.1 Push-T 是个什么任务
Push-T 来自 Diffusion Policy(Chi et al., 2025)论文。场景是一个二维平面:屏幕上有一个 T 形木块和一个圆形推子(agent),目标是把 T 推进一个固定的目标区域并对齐。用 obs_type="state" 时,观测是 5 维向量:
| 分量 | 含义 |
|---|---|
obs[0:2] | agent(推子)的 $x, y$ 坐标 |
obs[2:4] | T 形块质心的 $x, y$ 坐标 |
obs[4] | T 形块的朝向角 $\theta$ |
动作是 2 维:agent 的目标位置(不是速度、不是力)。底层有一个位置控制器把推子往这个目标点拉。这一点对理解数据很重要——动作与观测的前两维在同一个坐标系、同一个量纲上,所以「动作序列」画出来就是一条推子应当走的轨迹(§6 的多模态图正是这么画的)。
奖励是覆盖率一类的连续量,范围 $[0,1]$。评测协议在 evaluation.py 里写死:跑 100 条 episode(seed=0..99),每条 episode 取该条内出现过的最大奖励,再对 100 条求平均。理解这个「先 max 后 mean」很关键:它意味着策略只要在某一瞬间把 T 推到位就能拿到高分,哪怕后面又蹭歪了;反过来,一条 episode 得 0.4 说明它从头到尾就没成功过。
1.2 目录结构与各文件职责
| 文件 | 职责 | 要不要动 |
|---|---|---|
src/hw1_imitation/data.py | 下载 / 解压 Push-T zarr 数据集;Normalizer 做逐特征标准化;PushtChunkDataset 用滑窗切 $(o_t, A_t)$ 对 | 不用改 |
src/hw1_imitation/model.py | build_mlp、sinusoidal_embedding、BasePolicy 抽象类,以及两处 TODO:MSEPolicy 与 FlowMatchingPolicy | 要改 |
src/hw1_imitation/train.py | TrainConfig(tyro 解析 CLI)、数据加载、模型构建、wandb 初始化,以及第三处 TODO:主训练循环 | 要改 |
src/hw1_imitation/evaluation.py | Logger(写 CSV + wandb)、evaluate_policy(跑 100 条 episode、录视频、存 checkpoint) | 不用改,但必须读懂 |
PDF 特意强调了两件与评分挂钩的事:必须在训练循环里周期性调用 evaluate_policy,以及训练结束必须调用 logger.dump_for_grading()。前者决定 log.csv 里有没有 eval/mean_reward 列,后者决定提交目录里有没有 wandb run 文件夹。这两件事任何一件漏了,代码写得再对也拿不到分——§7 的第 1、2 条坑正是围绕它们。
1.3 数据是怎么切出来的
原始数据是 25,650 个 transition,分布在 206 条 episode 里。build_valid_indices 用滑窗枚举每个可以作为 chunk 起点的时刻 $t$:
def build_valid_indices(episode_ends, chunk_size):
    starts = np.concatenate(([0], episode_ends[:-1]))
    indices = []
    for start, end in zip(starts, episode_ends, strict=True):
        last_start = end - chunk_size      # 最后一个能放下整块 chunk 的起点
        if last_start < start:
            continue                       # 这条 episode 比 chunk 还短,整条丢掉
        indices.extend(range(start, last_start + 1))
    return np.asarray(indices, dtype=np.int64)
关键在 last_start = end - chunk_size:跨越 episode 边界的窗口被丢弃。如果不做这个裁剪,某个 chunk 的前几步属于第 $k$ 条演示的收尾、后几步属于第 $k+1$ 条演示的开局(而后者的初始状态是随机重置的),网络就会被逼着去拟合一个物理上根本不连续的动作序列,训练损失会有一个怎么也降不下去的地板。丢掉边界窗口后,训练样本数从 25,650 降到 24,208——正好少了 $206 \times 7 = 1442$ 个(每条 episode 末尾 $K-1=7$ 个起点作废)。
Push-T 的坐标范围大约是 $[0, 512]$ 像素,角度是 $[0, 2\pi]$。如果不归一化直接喂进 MLP,第一层权重要先学会把 500 量级的输入压回 $O(1)$,训练前几千步全在做这件毫无信息量的事。更致命的是流匹配:它要求 $A_{t,0}\sim\mathcal N(0,I)$ 与真实动作 $A_t$ 处在同一量级,否则插值 $A_{t,\tau}$ 在 $\tau$ 接近 0 时几乎全是噪声、接近 1 时噪声完全可以忽略,速度场的尺度会随 $\tau$ 剧烈变化。Normalizer 用全量数据的逐维 mean/std 把两者都拉到 $O(1)$,推理时再 denormalize_action 还原并 clip 回动作空间。
1.4 张量形状链条(最容易卡住的地方)
下面这张表把一个 batch 从 DataLoader 出来到 loss 落地的每一步形状列全。$B=128$,$D_s=5$,$D_a=2$,$K=8$,$H$ 是隐藏层宽度(256 或 512),$D_\tau=64$ 是时间嵌入维度。
| 位置 | 张量 | 形状 | 说明 |
|---|---|---|---|
| 数据侧(两个策略共用) | |||
dataset[i] | state | (5,) | 已归一化的 $o_t$ |
dataset[i] | action_chunk | (8, 2) | 已归一化的 $A_t=(a_t,\dots,a_{t+7})$ |
| collate 后 | state | (B, 5) | =(128, 5) |
| collate 后 | action_chunk | (B, 8, 2) | =(128, 8, 2) |
| MSEPolicy | |||
self.net 输入 | — | (B, 5) | 直接吃观测 |
self.net 输出 | — | (B, 16) | $K\cdot D_a=16$,末层不加激活 |
reshape | pred | (B, 8, 2) | 与 target 同形 |
.pow(2).sum(dim=(-1,-2)) | — | (B,) | 每样本一个平方 L2 范数 |
.mean() | loss | () | 标量 |
| FlowMatchingPolicy(训练) | |||
torch.randn_like | noise $A_{t,0}$ | (B, 8, 2) | 与 chunk 同形的高斯噪声 |
torch.rand(B) | tau | (B,) | 每个样本独立采一个 $\tau$ |
tau.reshape(B,1,1) | tau_b | (B, 1, 1) | 为了广播到 chunk 的两个轴 |
| 插值 | noisy_chunk $A_{t,\tau}$ | (B, 8, 2) | $\tau A_t+(1-\tau)A_{t,0}$ |
| 目标 | target_velocity | (B, 8, 2) | $A_t-A_{t,0}$ |
sinusoidal_embedding | — | (B, 64) | $\cos$/$\sin$ 各 32 维拼接 |
self.time_mlp | time_feat | (B, 64) | Linear-SiLU-Linear |
torch.cat | inputs | (B, 85) | $5+16+64=85$ |
self.net 输出 | — | (B, 16) | reshape 成 (B,8,2) |
| FlowMatchingPolicy(推理,Euler 循环 $n$ 次) | |||
| 初始化 | chunk | (B, 8, 2) | $\sim\mathcal N(0,I)$ |
| 第 $i$ 步 | tau | (B,) | 全部填 $i/n$,不是随机的 |
| 第 $i$ 步 | chunk | (B, 8, 2) | chunk + (1/n) * v |
评测(evaluation.py,B=1) | |||
state.unsqueeze(0) | — | (1, 5) | 单条 episode 逐步跑 |
.cpu().numpy()[0] | pred_chunk | (8, 2) | 去掉 batch 轴 |
denormalize + clip | action_chunk | (8, 2) | 还原到像素坐标并裁剪 |
| 逐步执行 | action | (2,) | 连续 8 步开环,之后重新查询 |
1.5 chunk 开环执行的时序
这段逻辑在 evaluate_policy 里,不用你写,但必须看懂,否则你会误以为策略每一步都在重新决策:
chunk_index = chunk_size          # 初始置为 K,强制第一次就查询策略
action_chunk = None
while not done:
    if action_chunk is None or chunk_index >= chunk_size:
        state = normalize(obs)
        pred_chunk = model.sample_actions(state.unsqueeze(0), num_steps=flow_num_steps)
        action_chunk = clip(denormalize(pred_chunk[0]), low, high)
        chunk_index = 0
    action = action_chunk[chunk_index]     # 开环执行第 chunk_index 个动作
    obs, reward, terminated, truncated, info = env.step(action)
    chunk_index += 1
也就是说:策略在时刻 $t$ 看一眼 $o_t$,吐出 8 个动作,然后闭着眼睛把这 8 个动作依次执行完,期间完全不看新观测;执行完再对 $o_{t+8}$ 重新查询。Push-T 的 episode 上限是 300 步,所以一条 episode 里策略只被查询约 $300/8 \approx 38$ 次。
第 2 讲给出的行为克隆误差界大致是:若每步犯错概率为 $\epsilon$,则 $T$ 步内累积的期望代价是 $O(\epsilon T^2)$——平方项来自「一旦偏离训练分布,后面每一步都在陌生状态上继续犯错」。动作分块把决策次数从 $T$ 降到 $T/K$,于是这个平方项变成 $O(\epsilon (T/K)^2 \cdot K) = O(\epsilon T^2 / K)$ 量级,直接除以了 $K$。
但天下没有免费的午餐:分块的代价是失去了 $K-1$ 步的反馈闭环。如果环境有随机性或者策略预测得不准,开环执行 8 步会把偏差累积起来而无法纠正。$K$ 因此是一个偏差-方差式的旋钮,作业替你定死在 8——这个值在 Push-T 上(20 Hz 控制、动作是位置目标而非速度)已经被 Diffusion Policy 的原论文调过。
2. TODO 一:MSEPolicy
2.1 要求
PDF 第 2.1 节的原话:「Implement the MSEPolicy class by filling in the TODO in src/hw1_imitation/model.py. We recommend using a simple MLP architecture with ReLU activations.」以及交付物里的「A brief description of your MLP architecture (number of layers, hidden size, activation functions, etc.)」。代码里的 docstring 说得更具体:「a single MLP with ReLU activations that maps the (normalized) observation $o_t$ directly to a flattened action chunk, which is then reshaped to (batch, chunk_size, action_dim)」。
换句话说,这一处没有任何架构上的自由发挥空间,就是一个把 5 维映到 16 维的 MLP。真正需要小心的是损失函数的归约方式和输出层不能加激活。
2.2 数学
讲义式 (1):
$$ \mathcal{L}_{\mathrm{MSE}}(\theta) = \frac{1}{B}\sum_{j=1}^{B}\left\| A_t^{(j)} - \pi_\theta\big(o_t^{(j)}\big) \right\|_2^2 $$注意这里的 $\|\cdot\|_2^2$ 作用在整个 chunk 上,即 $A_t\in\R^{K\times D_a}$ 被当成一个 $K D_a=16$ 维向量取平方 L2 范数。展开写成逐元素形式:
$$ \mathcal{L}_{\mathrm{MSE}}(\theta) = \frac{1}{B}\sum_{j=1}^{B}\sum_{k=0}^{K-1}\sum_{d=0}^{D_a-1}\Big( A^{(j)}_{t,k,d} - \big[\pi_\theta(o^{(j)}_t)\big]_{k,d}\Big)^2 $$三层求和,只有 batch 那一层是平均,chunk 与动作维那两层是求和。这就是 sum(dim=(-1,-2)).mean() 而不是 F.mse_loss(pred, target) 的原因——后者对所有 $B\cdot K\cdot D_a$ 个元素一起取平均,数值上恰好是式 (1) 的 $1/16$。
还要理解这个损失的总体最优解。把损失写成关于分布的期望形式($\pi_\theta$ 有无限容量时可以逐点优化):
$$ \pi^\star(o) = \argmin_{y\in\R^{K\times D_a}} \E_{A\sim p(\cdot\mid o)}\big[\|A - y\|_2^2\big] $$对 $y$ 求梯度并置零:$2\big(y - \E[A\mid o]\big)=0$,于是
$$ \boxed{\ \pi^\star(o) = \E\big[A_t \mid o_t = o\big]\ } $$MSE 策略在容量无限、数据无限、优化完美的理想情况下,收敛到的不是专家分布,而是专家分布的条件均值。如果专家在某个观测下总是绕左,条件均值就是绕左,没问题;但如果专家一半绕左一半绕右,条件均值就是「直着撞上去」——一个专家从来没做过、而且物理上会失败的动作。第 3 讲把这句话总结成「the average of two good actions is not a good action」,§6 会给出它在 Push-T 与人造数据上的数值形态。
2.3 实现
class MSEPolicy(BasePolicy):
    def __init__(self, state_dim, action_dim, chunk_size, hidden_dims=(128, 128)):
        super().__init__(state_dim, action_dim, chunk_size)
        self.net = build_mlp(
            in_dim=state_dim,                    # 5
            out_dim=chunk_size * action_dim,     # 8 * 2 = 16
            hidden_dims=hidden_dims,             # (256,256,256) 或 (512,512,512)
        )

    def forward(self, state):
        out = self.net(state)                                    # (B, 16)
        return out.reshape(state.shape[0], self.chunk_size, self.action_dim)

    def compute_loss(self, state, action_chunk):
        # L_MSE = (1/B) * sum_j || A^(j) - pi(o^(j)) ||_2^2   (式 1)
        pred = self.forward(state)                               # (B, 8, 2)
        return (pred - action_chunk).pow(2).sum(dim=(-1, -2)).mean()

    def sample_actions(self, state, *, num_steps=10):
        del num_steps        # MSE 策略一次前向出整个 chunk,用不到 num_steps
        return self.forward(state)
逐块说明:
build_mlp已经替你写好了,它的结构是[Linear, ReLU] * len(hidden_dims) + [Linear]——注意最后一个Linear后面没有 ReLU。你不需要(也不应该)自己再包一层激活。out_dim = chunk_size * action_dim:网络只会输出扁平向量,chunk 的二维结构靠reshape恢复。这里reshape(B, K, D_a)的顺序必须与数据侧一致——数据是actions[t : t+K],即第一个轴是时间。如果你写成reshape(B, D_a, K)再transpose,形状能对上但语义错位,损失照样能降(网络会学会那个置换),可评测时action_chunk[chunk_index]取出来的就是错的。sample_actions显式del num_steps:签名里必须保留这个关键字参数,因为evaluate_policy对两种策略用同一行调用model.sample_actions(state, num_steps=flow_num_steps)。删掉参数会直接TypeError。sample_actions里不要加torch.no_grad()也没关系——evaluate_policy外层已经包了with torch.no_grad():。但 §3 的流匹配版本加上是好习惯(推理循环里有 $n$ 次前向,不加会白白建 $n$ 层计算图)。
2.4 易错点及具体后果
如果你自己写 MLP 时习惯性在最后一层后面也加激活:加 ReLU 的后果是网络永远无法输出负数。动作被归一化到零均值,约一半的目标是负的,训练损失会卡在一个很高的地板上(大致是目标负半部分的二阶矩,量级 8 左右),评测回报大约 0.1–0.2 且完全不再上升。加 Tanh 的后果隐蔽得多:输出被限制在 $[-1,1]$,而归一化后的动作有相当比例落在 $|a|>1$ 的尾部,于是推子永远够不到画面边缘的目标位姿,回报能涨到 0.4 左右就再也上不去,看起来像「模型容量不够」,实际是值域被截断了。
F.mse_loss(pred, target) 直接交差
这个「错误」的后果很微妙,值得单独讲。F.mse_loss 默认 reduction='mean',得到的是式 (1) 的 $1/16$。训练结果几乎不受影响——因为用的是 Adam,Adam 的更新量对梯度整体缩放不敏感(一阶矩除以二阶矩的平方根,常数因子约掉了)。所以你会发现两种写法跑出来的 reward 曲线基本重合。
真正的后果在数字对不上:你在 wandb 上看到的 loss 是 0.006 而别人是 0.095,你会以为自己的模型好 16 倍,然后浪费半小时找「为什么我的 loss 这么低但 reward 一样」。如果作业要求「训练曲线」并且助教心里有一个参考量级,这就会变成一个说不清的问题。严格按式 (1) 写,代价只是多打十个字符。
(如果用 SGD 而不是 Adam,那这就不是数字问题了:16 倍的梯度尺度差等价于 16 倍的学习率差,很可能直接发散。)
reshape 前先确定 batch 维
写 out.reshape(-1, self.chunk_size, self.action_dim) 在这里恰好也对,但用 state.shape[0] 显式指定 batch 更安全:一旦上游传进来的 state 形状不对(比如评测时忘了 unsqueeze(0),传进来的是 (5,)),显式写法会立刻在 reshape 处报错并给出清晰的形状信息,而 -1 会静默地把它 reshape 成一个荒唐的 batch 数继续跑下去。
2.5 怎么验证
tests/test_hw1.py 里对应两个用例。第一个是形状与标量性:
def test_output_shapes():
    batch = 6
    state = torch.randn(batch, STATE_DIM)
    for policy_type in ("mse", "flow"):
        model = build_policy(policy_type, state_dim=5, action_dim=2,
                             chunk_size=8, hidden_dims=(64, 64))
        for num_steps in (1, 5, 10):
            out = model.sample_actions(state, num_steps=num_steps)
            assert out.shape == (batch, CHUNK_SIZE, ACTION_DIM)
            assert torch.isfinite(out).all()
        loss = model.compute_loss(state, torch.randn(batch, CHUNK_SIZE, ACTION_DIM))
        assert loss.ndim == 0, "loss must be a scalar"
        assert float(loss.detach()) > 0.0
loss.ndim == 0 这一句专门抓「忘了 .mean()」:如果你只写了 .sum(dim=(-1,-2)),返回的是 (B,) 张量,loss.backward() 会在运行时报 grad can be implicitly created only for scalar outputs;有这条断言就能在秒级测试里发现,而不是在跑通数据下载、等了两分钟之后才崩。torch.isfinite 抓的是「初始化炸了」——比如你手写 MLP 时忘了激活函数、堆了十层线性层导致数值溢出。
第二个是梯度检查:
def test_loss_backward_gives_nonzero_grads():
    loss = model.compute_loss(state, chunk)
    loss.backward()
    total = 0.0
    for name, p in model.named_parameters():
        assert p.grad is not None, f"no grad for {name}"
        assert torch.isfinite(p.grad).all()
        total += float(p.grad.abs().sum())
    assert total > 1e-6, "all gradients are zero"
p.grad is not None 是一条价值很高的断言:它抓的是「某个子模块没有参与前向计算」。在 MSEPolicy 上不太可能出问题,但在下一节的流匹配上,「忘了把 $\tau$ 的嵌入拼进输入」的直接症状就是 time_mlp 的所有参数 grad is None——这条断言能一秒定位,而看 loss 曲线你只会觉得「怎么收敛得有点慢」。
除了跑测试,还有一条零成本的自查:把参数量打印出来。train.py 已经替你打了。256×3 的 MSEPolicy 应该是 137,232 个参数,512×3 是 536,592。手算验证一下:$5\times256+256 + 2\times(256\times256+256) + 256\times16+16 = 1536 + 131{,}584 + 4112 = 137{,}232$。对得上说明你的层数、宽度、输入输出维度全都没接错。
3. TODO 二:FlowMatchingPolicy 的数学
3.1 要求
PDF 第 3 节把三个公式都给全了,实现要求只有一句「We recommend using the same MLP architecture as the MSE policy」,加上 Tips 里的一句加粗提醒:「Don't forget that your neural network needs the flow matching timestep, $\tau$, as part of its input.」
这句提醒不是客套。忘记把 $\tau$ 喂进网络是这份作业最高频的 bug,而且它不会报错:形状全对、损失照降、采样照出、reward 也能到 0.3–0.5,只是永远上不去。§3.6 会解释为什么会这样,以及怎么用一行断言把它揪出来。
3.2 从「学分布」到「学速度场」
先把动机说清楚。我们真正想要的是从条件分布 $p(A_t\mid o_t)$ 里采样。直接建模这个分布很难(16 维连续、多模态)。流匹配的思路是:不建模分布本身,而是建模一条把简单分布搬运成目标分布的路径。
取一个平凡的源分布 $p_0=\mathcal N(0,I)$ 和目标分布 $p_1 = p(\cdot\mid o_t)$,定义一族中间分布 $p_\tau$,$\tau\in[0,1]$。如果我们知道一个速度场 $v(A,\tau)$,使得沿着 ODE
$$ \frac{\mathrm{d}A_\tau}{\mathrm{d}\tau} = v(A_\tau, \tau), \qquad A_0 \sim p_0 $$演化的粒子,其分布在每个时刻恰好是 $p_\tau$,那么积分到 $\tau=1$ 就得到了一个 $p_1$ 的样本。采样问题被转化成了解一个常微分方程。剩下的问题是:这个 $v$ 怎么学?
3.3 条件路径与常速度
作业选的是最简单的一种路径:线性插值。给定一对 $(A_{t,0}, A_t)$,定义
$$ A_{t,\tau} = \tau A_t + (1-\tau) A_{t,0} $$这是一条从噪声到数据的直线。对 $\tau$ 求导:
$$ \frac{\mathrm{d}A_{t,\tau}}{\mathrm{d}\tau} = A_t - A_{t,0} $$——与 $\tau$ 无关的常向量。这就是「常速度」的来源,也是式 (2) 的回归目标:
$$ \mathcal{L}_{\mathrm{FM}}(\theta) = \frac{1}{B}\sum_{j=1}^{B}\Big\| v_\theta\big(o_t^{(j)}, A_{t,\tau}^{(j)}, \tau^{(j)}\big) - \big(A_t^{(j)} - A_{t,0}^{(j)}\big) \Big\|_2^2 $$其中 $A_{t,0}^{(j)}\sim\mathcal N(0,I)$、$\tau^{(j)}\sim\mathcal U(0,1)$ 都是每个样本独立采的。
到这里,一个诚实的读者应该会立刻感到不安:这个目标看起来是错的。 我们想要的是能把整个噪声分布搬运成整个数据分布的边缘速度场;可我们在拟合的,是每一对 $(A_{t,0}, A_t)$ 各自的直线速度。这些直线互相交叉——同一个中间点 $A_{t,\tau}$ 可能同时躺在成千上万条不同的直线上,每条要求的速度都不一样。网络怎么可能同时满足它们?
3.4 条件期望引理:为什么它其实是对的
答案是:网络不需要同时满足它们,它只会输出它们的平均,而这个平均恰好就是我们要的边缘速度场。
第一步:平方损失的最优解是条件期望。 这就是 §2.2 用过的引理,再用一次。把式 (2) 写成期望形式,$X = (o_t, A_{t,\tau}, \tau)$ 是网络的输入、$Y = A_t - A_{t,0}$ 是回归目标:
$$ \mathcal{L}_{\mathrm{FM}}(\theta) = \E_{X,Y}\big[\|v_\theta(X) - Y\|^2\big] $$在无限容量下逐点最优,得到
$$ v^\star(X) = \E[Y \mid X] = \E\big[A_t - A_{t,0} \;\big|\; o_t,\; A_{t,\tau}=A,\; \tau\big] $$注意条件里的 $A_{t,\tau}=A$ 起了什么作用:它把所有恰好在时刻 $\tau$ 经过点 $A$ 的 $(A_{t,0}, A_t)$ 对筛出来,然后对它们的速度求平均。所以「直线交叉」不是 bug,交叉点上的期望正是我们要的东西。
第二步:这个条件期望确实是边缘概率流的速度场。 记条件路径的分布为 $p_\tau(A\mid A_t)=\mathcal N\big(\tau A_t,\,(1-\tau)^2 I\big)$(由 $A_{t,\tau}=\tau A_t+(1-\tau)A_{t,0}$ 直接得到),边缘为 $p_\tau(A)=\int p_\tau(A\mid A_t)\,p_{\mathrm{data}}(A_t)\,\mathrm{d}A_t$。条件速度场 $u(A\mid A_t)$ 满足条件连续性方程
$$ \partial_\tau p_\tau(A\mid A_t) + \nabla\!\cdot\!\big(p_\tau(A\mid A_t)\, u(A\mid A_t)\big) = 0 $$两边对 $p_{\mathrm{data}}(A_t)$ 积分(积分与散度可交换):
$$ \partial_\tau p_\tau(A) + \nabla\!\cdot\!\left(\int p_\tau(A\mid A_t)\,u(A\mid A_t)\,p_{\mathrm{data}}(A_t)\,\mathrm{d}A_t\right) = 0 $$把括号里的东西除以再乘上 $p_\tau(A)$,它就变成了一个条件期望:
$$ v(A,\tau) \;=\; \frac{\int u(A\mid A_t)\,p_\tau(A\mid A_t)\,p_{\mathrm{data}}(A_t)\,\mathrm{d}A_t}{p_\tau(A)} \;=\; \E\big[u(A\mid A_t) \,\big|\, A_{t,\tau}=A\big] $$于是 $\partial_\tau p_\tau + \nabla\cdot(p_\tau v)=0$——这个 $v$ 正是驱动边缘分布 $p_\tau$ 从 $\mathcal N(0,I)$ 演化到 $p_{\mathrm{data}}$ 的速度场。而它恰好等于第一步里回归的最优解。
结论: 回归一个「看起来错的」条件目标,得到的最优解是一个「正确的」边缘目标。这就是流匹配(以及扩散模型)能够训练的全部秘密——我们把一个无法直接计算的量(边缘速度场,需要对整个数据集积分)替换成了一个无偏但高方差的单样本估计(条件速度,一行减法就能算)。两者的梯度期望完全相同。
上一段的推导直接解释了 §7 会重点讲的一个现象。既然最优解只是条件期望,那么在最优解处,损失的剩余值就是那个条件分布的方差:
$$ \mathcal{L}_{\mathrm{FM}}(\theta^\star) = \E\Big[\operatorname{tr}\operatorname{Var}\big(A_t - A_{t,0} \mid o_t, A_{t,\tau}, \tau\big)\Big] \;>\; 0 $$这个量与网络无关,是数据和路径设计决定的不可约下界。想象 $\tau\approx 0$ 的情形:此时 $A_{t,\tau}\approx A_{t,0}$,纯噪声几乎不含关于 $A_t$ 的任何信息,网络对目标 $A_t - A_{t,0}$ 中 $A_t$ 那一项的最好猜测就是数据均值,残差方差接近数据本身的方差。本次实验里 flowbig 的损失收敛在 2.079,msebig 是 0.095,两者相差 20 倍,但前者的评测回报高 28%。跨目标函数比较损失是没有意义的。
3.5 推理:Euler 积分
训练好 $v_\theta$ 之后,采样就是解 ODE。讲义式 (3) 给的是最朴素的显式 Euler:
$$ A_{t,\tau+\frac{1}{n}} = A_{t,\tau} + \frac{1}{n}\cdot v_\theta(o_t, A_{t,\tau}, \tau) $$从 $A_{t,0}\sim\mathcal N(0,I)$ 出发,令 $\tau_i = i/n$,$i=0,1,\dots,n-1$,迭代 $n$ 次得到 $A_{t,1}$,它就是最终执行的动作 chunk。写成伪代码:
$$ A \leftarrow \mathcal N(0,I);\qquad \text{for } i=0,\dots,n-1:\quad A \leftarrow A + \tfrac{1}{n}\, v_\theta\!\left(o_t,\, A,\, \tfrac{i}{n}\right) $$三个细节值得留意。其一,$\tau$ 从 0 开始而不是从 $1/n$ 开始。 第 $i$ 步是在区间 $[\tau_i, \tau_{i+1}]$ 上做前向差分,用的是左端点的速度,所以第一次调用传的是 $\tau=0$、最后一次传的是 $\tau=(n-1)/n$,网络永远不会被喂 $\tau=1$。其二,步长恒为 $1/n$,因为区间被均匀切分。其三,推理时的 $\tau$ 是确定的网格,与训练时的 $\tau\sim\mathcal U(0,1)$ 完全不同——训练随机采是为了让网络在整个 $[0,1]$ 上都学到速度场,推理时只需要走这一条网格。
令 $n=1$,更新式变成 $A_{t,1} = A_{t,0} + v_\theta(o_t, A_{t,0}, 0)$。而 $v_\theta(o_t, A_{t,0}, 0) \approx \E[A_t - A_{t,0}\mid o_t, A_{t,0}] = \E[A_t\mid o_t] - A_{t,0}$(因为 $\tau=0$ 时 $A_{t,\tau}$ 就是噪声本身,对 $A_t$ 没有信息)。代回去:
$$ A_{t,1} \approx A_{t,0} + \E[A_t\mid o_t] - A_{t,0} = \E[A_t\mid o_t] $$一步 Euler 的流匹配就是 MSE 策略。 噪声被完全抵消,输出退化成条件均值。这个观察给出了 §6 消融实验的定量预期:$n=1$ 的回报应该接近 MSE 的水平,随着 $n$ 增大逐步恢复多模态。实测 $n=1$ 是 0.744、$n=5$ 是 0.950——趋势完全对上。
3.6 $\tau$ 为什么要做正弦嵌入
网络的输入是 $(o_t, A_{t,\tau}, \tau)$ 的拼接。前两项分别是 5 维和 16 维,第三项是一个标量。直接 torch.cat([state, chunk.flatten(1), tau[:, None]], dim=-1) 得到 22 维输入——这样能跑,但有两个问题。
问题一:尺度失衡。 归一化后的 $o_t$ 和 $A_{t,\tau}$ 都是 $O(1)$ 且方差接近 1,而 $\tau\in[0,1]$ 均值 0.5、标准差只有 $1/\sqrt{12}\approx 0.29$。在 21 个 $O(1)$ 的输入里塞一个方差小三倍的标量,第一层权重要花很长时间才能把它的影响放大到合适的量级。更糟的是它只占 $1/22$ 的输入带宽,梯度信号被稀释。
问题二(更本质):MLP 对输入的低频偏置。 ReLU MLP 天然倾向于学习关于输入的低频、平滑函数(这就是 NeRF 论文里说的 spectral bias)。而速度场对 $\tau$ 的依赖不是平滑的:在 $\tau$ 接近 1 的一小段区间里,$v_\theta$ 需要从「大致指向数据均值」急剧切换成「精确指向某一个特定模态」,因为此时 $A_{t,\tau}$ 已经几乎确定了目标属于哪个模态。用一个标量输入去驱动这种高频变化,网络需要在第一层堆很多不同偏置的 ReLU 才能做出足够陡的分段线性响应。
正弦嵌入把标量展开成一组不同频率的三角函数,把这件事变简单了:
def sinusoidal_embedding(t, dim, max_period=1000.0):
    half = dim // 2
    freqs = torch.exp(-math.log(max_period)
                      * torch.arange(half, dtype=torch.float32) / half)
    args = t.reshape(-1, 1).float() * max_period * freqs.reshape(1, -1)
return torch.cat([torch.cos(args), torch.sin(args)], dim=-1)解读:freqs 是从 $1$ 到 $1/\text{max\_period}$ 的等比数列(half=32 个),乘上 t * max_period 后,实际的角频率覆盖了 $[1, 1000]$ 三个数量级。所以对于 $\tau=0.5$ 与 $\tau=0.51$ 这两个很接近的值,低频分量几乎一样,但高频分量已经转过了半圈——嵌入向量在高维空间里被拉开了,MLP 只需要一个线性读出就能分辨它们。
max_period=1000 这个数字来自扩散模型的惯例(DDPM 用 1000 个离散去噪步)。作业的 $\tau$ 是 $[0,1]$ 的连续量,所以代码里先乘回 max_period,把 $[0,1]$ 映射到扩散实现里熟悉的 $[0,1000]$ 频率梯度上。嵌入之后再接一个两层的 SiLU MLP(time_mlp),把 64 维正弦特征投影成 64 维可学习特征——这一步是标准做法,让网络自己决定哪些频率有用。
诚实地说,在 Push-T 这种 16 维动作空间上,直接拼标量 $\tau$ 也能训出可用的策略,收敛会慢一些、最终回报低几个百分点。正弦嵌入的收益在更高维、更多模态的任务上才会拉开。之所以在这里讲透,是因为它是扩散/流匹配实现的通用组件,理解它比背下它更有价值。
4. TODO 二(续):FlowMatchingPolicy 的实现
4.1 网络结构
def __init__(self, state_dim, action_dim, chunk_size,
             hidden_dims=(128, 128), time_embed_dim=64):
    super().__init__(state_dim, action_dim, chunk_size)
    self.time_embed_dim = time_embed_dim
    self.chunk_dim = chunk_size * action_dim          # 16

    # tau 的正弦特征之上再接一个小 MLP
    self.time_mlp = nn.Sequential(
        nn.Linear(time_embed_dim, time_embed_dim),
        nn.SiLU(),
        nn.Linear(time_embed_dim, time_embed_dim),
    )
    self.net = build_mlp(
        in_dim=state_dim + self.chunk_dim + time_embed_dim,   # 5 + 16 + 64 = 85
        out_dim=self.chunk_dim,                                # 16
        hidden_dims=hidden_dims,
    )
与 MSEPolicy 的唯一结构差别就是输入维度从 5 变成 85,外加一个 time_mlp。主干仍然是同样层数、同样宽度的 ReLU MLP——PDF 明确建议「use the same MLP architecture as the MSE policy」,这样两者的对照才是干净的。参数量:256×3 是 166,032(比 MSE 多 28,800,即多出来的 80 维输入 × 256 加上 time_mlp 的 8,320),512×3 是 585,872。
4.2 速度场前向
def forward(self, state, noisy_chunk, tau):
    """state: (B,5)   noisy_chunk: (B,8,2)   tau: (B,) -> 返回 (B,8,2)"""
    batch = state.shape[0]
    tau = tau.reshape(batch)                                   # 容忍 (B,1,1) 等形状
    time_feat = self.time_mlp(sinusoidal_embedding(tau, self.time_embed_dim))
    inputs = torch.cat(
        [state, noisy_chunk.reshape(batch, self.chunk_dim), time_feat], dim=-1
    )                                                          # (B, 85)
    out = self.net(inputs)                                     # (B, 16)
    return out.reshape(batch, self.chunk_size, self.action_dim)
tau.reshape(batch) 这一句是防御性的:调用方可能传进来 (B,)、(B,1) 或者广播用的 (B,1,1),统一压平后 sinusoidal_embedding 里的 t.reshape(-1,1) 才能得到正确的 (B,1)。如果不做这一步而直接传 (B,1,1),reshape(-1,1) 仍然能跑出 (B,1)——恰好没错,但你不该依赖这种巧合。
4.3 训练损失
def compute_loss(self, state, action_chunk):
    batch = state.shape[0]
    # A_{t,0} ~ N(0, I),  tau ~ U(0, 1)
    noise = torch.randn_like(action_chunk)                     # (B, 8, 2)
    tau = torch.rand(batch, device=action_chunk.device,
                     dtype=action_chunk.dtype)                 # (B,)
    tau_b = tau.reshape(batch, 1, 1)                           # (B, 1, 1) 用于广播

    # A_{t,tau} = tau * A_t + (1 - tau) * A_{t,0}
    noisy_chunk = tau_b * action_chunk + (1.0 - tau_b) * noise
    # 目标速度沿路径恒定:dA/dtau = A_t - A_{t,0}
    target_velocity = action_chunk - noise

    pred_velocity = self.forward(state, noisy_chunk, tau)
    # L_FM(式 2):逐样本平方 L2 范数,对 batch 取平均
    return (pred_velocity - target_velocity).pow(2).sum(dim=(-1, -2)).mean()
七行代码,把 §3.3 的三个式子一一对应过去。归约方式与 MSE 完全一致(chunk 两轴求和、batch 取平均),保证式 (1) 与式 (2) 是同一种范数。
4.4 Euler 采样
@torch.no_grad()
def sample_actions(self, state, *, num_steps=10):
    assert num_steps >= 1, "num_steps must be at least 1."
    batch = state.shape[0]
    chunk = torch.randn(batch, self.chunk_size, self.action_dim,
                        device=state.device, dtype=state.dtype)   # A_{t,0}
    dt = 1.0 / num_steps
    for i in range(num_steps):
        tau = torch.full((batch,), i * dt, device=state.device, dtype=state.dtype)
        chunk = chunk + dt * self.forward(state, chunk, tau)      # 式 (3)
return chunk四个要点:(a) @torch.no_grad() 让 $n$ 次前向不建计算图,flow 的评测本来就慢 6 倍,不加会更慢并可能爆显存;(b) tau = i * dt,$i$ 从 0 开始,与 §3.5 的左端点差分一致;(c) chunk = chunk + ... 用的是非原地赋值,写成 chunk += ... 在 no_grad 下也能跑,但一旦有人把这个函数用在需要梯度的地方(比如做可微规划)就会报原地修改错误;(d) device 和 dtype 都从 state 继承,忘了写 device= 的话在 GPU 上会立刻报 Expected all tensors to be on the same device——这是唯一一个会当场崩的错误,反而是好事。
4.5 易错点及具体后果
症状: 一切正常,不报错。训练损失照样下降(因为速度场对 $A_{t,\tau}$ 的依赖仍在学),采样能出形状正确的 chunk,评测回报能到 0.3–0.5。
为什么会这样: 没有 $\tau$ 时,网络学到的是 $\E[A_t - A_{t,0}\mid o_t, A_{t,\tau}]$——对 $\tau$ 也取了边缘。这个「$\tau$-平均速度场」不满足任何一个时刻的连续性方程,积分出来的分布既不是 $p_0$ 也不是 $p_1$,而是一团被涂抹过的东西。它碰巧仍然大致指向数据区域(所以 reward 不是 0),但既丢掉了多模态、又比 MSE 的条件均值更糊。
定位: 打印 self.time_mlp[0].weight.grad。如果是 None,说明 time_mlp 根本没参与前向;如果 time_mlp 参与了但你在 torch.cat 里漏了它,那就检查 self.net[0].in_features 是不是 85——如果是 21,你构造网络时就已经没算上时间嵌入了。
写成 tau = torch.rand(1) 或者 tau = torch.rand(()) 然后广播。后果: 每一步梯度只覆盖 $[0,1]$ 上的一个点,有效的时间分辨率从「每步 128 个采样点」降到「每步 1 个」。训练依然收敛(步数够多时随机游走也能扫遍 $[0,1]$),但梯度方差大约放大到 $\sqrt{B}$ 倍,收敛速度慢几倍,曲线抖得厉害。这个 bug 最阴险的地方是它只影响效率不影响正确性,你会以为「流匹配就是难训」。
验证: 在 compute_loss 里断言 tau.shape == (state.shape[0],)。
写成 noisy = (1-tau)*action_chunk + tau*noise。这定义了一条从数据到噪声的路径,$\tau=0$ 对应真实数据、$\tau=1$ 对应纯噪声。后果: 如果目标速度你仍然写 action_chunk - noise,那么符号与路径不一致,训练损失会降到一个高地板然后卡死;如果目标也跟着反成 noise - action_chunk,那你训出的是一个「把数据搬成噪声」的速度场,而 sample_actions 从噪声出发积分只会跑到更远的噪声里去,采样结果的方差会随 $\tau$ 单调增大,动作 clip 之后全是边界值,回报稳定在 0.0–0.05。
一个零成本的自查: 断言 $\tau=1$ 时插值等于数据、$\tau=0$ 时等于噪声。
assert torch.allclose(1.0 * action_chunk + 0.0 * noise, action_chunk)
# 更实用的运行时检查:
tau_b = tau.reshape(batch, 1, 1)
noisy = tau_b * action_chunk + (1 - tau_b) * noise
# tau -> 1 时 noisy 应更接近 action_chunk
near_one = tau > 0.95
if near_one.any():
    assert (noisy[near_one] - action_chunk[near_one]).abs().mean() < \
(noisy[near_one] - noise[near_one]).abs().mean()扩散模型有多种参数化(预测 $\epsilon$、预测 $x_0$、预测 $v$),很容易记串。作业式 (2) 明确要求预测速度 $A_t - A_{t,0}$。如果你写成预测 $A_t$(即 $x_0$-参数化),那么 sample_actions 里的 Euler 更新 chunk + dt * v 就是错的——$x_0$-参数化对应的更新是 chunk + dt*(pred - chunk)/(1-tau)。症状是采样值缓慢漂向数据均值但幅度只有 $1/n$ 量级,最终 chunk 几乎还是初始噪声,回报接近 0。
num_steps 个点却从 $1/n$ 开始
用右端点 $\tau_{i+1}$ 意味着最后一次前向传的是 $\tau=1$。而训练时 $\tau\sim\mathcal U(0,1)$ 几乎不会精确取到 1,且 $\tau=1$ 处 $A_{t,\tau}$ 就是干净数据、速度场的条件分布退化——网络在这个点上的输出是外推的、不可靠的。后果是最后一步会给出一个偏大的修正,采样点被推离数据流形。在 $n=10$ 时影响不算大(回报大概掉 0.02–0.05),在 $n$ 小的时候会明显。
4.6 怎么验证
测试文件里有三个用例专门针对流匹配,从弱到强排列。
(1) $\tau$ 真的被用到了。
def test_flow_velocity_depends_on_tau():
    model = FlowMatchingPolicy(5, 2, 8, (64, 64))
    state = torch.randn(4, 5)
    chunk = torch.randn(4, 8, 2)
    v0 = model(state, chunk, torch.zeros(4))
    v1 = model(state, chunk, torch.ones(4))
    assert (v0 - v1).abs().max() > 1e-4, "velocity is independent of tau"
这条断言是 §4.5 误区一的唯一自动化防线。它固定 state 和 chunk、只改 $\tau$,如果网络输出完全不变,说明 $\tau$ 这条通路断了。阈值 1e-4 取得很松,因为随机初始化的网络对 $\tau$ 的敏感度本来就不大,只要不是恒等于零就说明连通。实测这个差值在 $10^{-1}$ 量级。
(2) 正弦嵌入本身是对的。
def test_sinusoidal_embedding():
    emb = sinusoidal_embedding(torch.rand(11), 64)
    assert emb.shape == (11, 64)
    assert torch.isfinite(emb).all()
    assert emb.abs().max() <= 1.0 + 1e-6          # cos/sin 有界
    e0 = sinusoidal_embedding(torch.tensor([0.0]), 64)
    e1 = sinusoidal_embedding(torch.tensor([1.0]), 64)
    assert (e0 - e1).abs().max() > 1e-3           # 端点必须可区分
有界性断言抓的是「频率算错了导致 args 溢出」(比如把 freqs 写成指数递增而不是递减);端点可区分抓的是「所有频率都太低,$[0,1]$ 上嵌入几乎是常数」——这种情况下网络等价于没拿到 $\tau$。
(3) 单峰目标上采样必须收敛到真值。
def test_flow_matches_known_unimodal_distribution():
    target = torch.tensor([[0.5,-1.0],[1.5,0.25],[-0.75,2.0],[0.0,-0.5]])
    obs = torch.zeros(1, 3)
    model = FlowMatchingPolicy(3, 2, 4, hidden_dims=(256, 256))
    _fit(model, obs.repeat(256, 1),
         lambda idx: target.expand(len(idx), -1, -1), steps=3000, lr=1e-3)
    samples = model.sample_actions(obs.repeat(1024, 1), num_steps=20)
    assert (samples.mean(0) - target).abs().max() < 0.15   # 实测 0.018
assert samples.std(0).max() < 0.25 # 实测 0.009这是端到端的正确性检查:目标是一个确定的常数 chunk(分布退化成 delta),正确实现的流匹配必须把整个高斯噪声全部搬运到这一个点上。两条断言分工明确——均值断言抓「路径方向错了 / 目标参数化错了」(误区三、四,均值会偏到别的地方),标准差断言抓「积分没走完 / 步长错了」(误区五,残余噪声没被消掉,std 会留在 0.1 以上)。实测 max std = 0.009,意味着 1024 个样本几乎完全重合,噪声被彻底消除。
第 (4) 个用例是双峰实验,它是整份作业的论点核心,放到 §6 一起讲。
5. TODO 三:主训练循环
5.1 要求
PDF:「Implement the main training loop by filling in the TODO in src/hw1_imitation/train.py」,以及两条与评分直接挂钩的硬性要求:「you must call the evaluate_policy function periodically in your training loop, and call logger.dump_for_grading() at the end of training」。Tips 里还建议用 Adam、用 torch.compile 加速。
这一处没有数学,全是工程。但它贡献了本次实验里最难定位的两个 bug(§7 的坑 1 和坑 2),值得逐块讲。
5.2 实现
optimizer = torch.optim.Adam(model.parameters(),
                             lr=config.lr,               # 3e-4
                             weight_decay=config.weight_decay)   # 0.0

def train_step(state, action_chunk):
    loss = model.compute_loss(state, action_chunk)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
    return loss.detach()

if config.compile:
    train_step = torch.compile(train_step)

def run_eval(step):
    evaluate_policy(model=model, normalizer=normalizer, device=device,
                    chunk_size=config.chunk_size, video_size=config.video_size,
                    num_video_episodes=config.num_video_episodes,
                    flow_num_steps=config.flow_num_steps,
                    step=step, logger=logger)
    model.train()          # evaluate_policy 里调了 model.eval(),必须切回来
train_step 被抽成一个闭包,纯粹是为了让 torch.compile 能整体接管(编译单个 forward 的收益远小于编译「前向+反向+优化器」这一整段)。zero_grad(set_to_none=True) 比默认的填零略快,也避免了「梯度是 0 张量还是 None」的歧义。
run_eval 末尾的 model.train() 是必须的:evaluate_policy 第一行就是 model.eval(),如果不切回来,后续训练会一直在 eval 模式下跑。这份作业的两个模型都只有 Linear/ReLU/SiLU,没有 Dropout 和 BatchNorm,所以这次恰好没有后果——但如果你按扩散模型的习惯给主干加了 LayerNorm 之外的归一化层,忘记切回来会让 BatchNorm 的 running stats 停止更新,训练与推理的行为逐渐脱节,表现为「训练损失继续降但 eval reward 停滞」。这是一个应当无条件养成的习惯。
接下来是 CSV 表头的占位行——为什么需要它见 §7 坑 1:
# Logger 在第一次 log 时冻结 CSV 表头,所以先塞一行包含所有列的占位
logger.log({
    "train/loss": math.nan,
    "train/steps_per_sec": math.nan,
    "train/epoch": 0,
    "eval/mean_reward": math.nan,
}, step=0)
主循环:
model.train()
step, loss_accum, loss_count = 0, 0.0, 0
last_log_time = start_time = time.time()

for epoch in range(config.num_epochs):
    for state, action_chunk in loader:
        state = state.to(device, non_blocking=True)
        action_chunk = action_chunk.to(device, non_blocking=True)

        loss = train_step(state, action_chunk)
        step += 1
        loss_accum += float(loss); loss_count += 1

        if step % config.log_interval == 0:                 # 每 100 步
            now = time.time()
            logger.log({
                "train/loss": loss_accum / max(loss_count, 1),   # 平滑后的 loss
                "train/steps_per_sec": loss_count / (now - last_log_time),
                "train/epoch": epoch,
            }, step=step)
            loss_accum, loss_count = 0.0, 0
            last_log_time = now

        if step % config.eval_interval == 0:
            run_eval(step)
            last_log_time = time.time()      # eval 很慢,不能算进 steps/sec

# 训练结束时若最后一步不在 eval 网格上,补一次 final eval
if step % config.eval_interval != 0:
    run_eval(step)

logger.dump_for_grading()
5.3 每一处细节为什么这么写
| 写法 | 理由 | 写错的后果 |
|---|---|---|
loss_accum / loss_count 而不是记单步 loss | 单步 loss 噪声极大(flow 尤甚,因为每步的 $\tau$ 和噪声都在重采) | 曲线抖成一片,看不出趋势,也看不出「flow 的损失有下界」这个关键现象 |
float(loss) 而不是把张量塞进 list | loss 是 GPU 张量,累积张量会持有计算图引用 | 如果没写 .detach(),显存会随步数线性增长直到 OOM。这里 train_step 已经 detach 过,float() 是双保险 |
eval 之后重置 last_log_time | 一次 flow 的 eval 要 77 秒 | 不重置的话,eval 之后那一次 steps/sec 会被算成 $100/77 \approx 1.3$,图上出现一个假的性能塌陷尖峰 |
| 末尾补一次 final eval | total_steps 通常不是 eval_interval 的整数倍 | 113,400 步、eval_interval=10000 时,最后 3,400 步的成果完全没被评测。flowbig 最终那个 0.902 正是靠这次补测记录的 |
drop_last=True | 最后一个不完整 batch 会让 batch 统计量抖动 | 影响很小,但会让 steps_per_epoch 变成不整齐的数字。24,208 / 128 = 189.1,丢掉后正好 189 步/epoch |
logger.dump_for_grading() 在最外层 | 它会 wandb.finish() 并把 run 目录 copytree 到 exp/<run>/wandb | 不调用 = 提交目录里没有 wandb 文件夹 = 这部分直接零分 |
5.4 超参数与运行命令
| 超参数 | 值 | 说明 |
|---|---|---|
chunk_size | 8 | 作业默认,不动 |
batch_size | 128 | 189 步/epoch |
lr | 3e-4 | Adam 的经典默认值,没调 |
weight_decay | 0.0 | 24k 样本、50 万参数,但任务是拟合专家而非泛化到新分布,正则收益不明显 |
hidden_dims | (256,256,256) / (512,512,512) | 小模型 / 大模型两组对照 |
num_epochs | 400 / 600 | 对应 75,600 / 113,400 步 |
flow_num_steps | 10 | 评测时的 Euler 步数 |
eval_interval | 5000(MSE)/ 10000(flow) | flow 的 eval 慢 6 倍,必须调大 |
seed | 42 | 四次训练全部相同 |
# 小模型对照组
WANDB_MODE=offline SDL_VIDEODRIVER=dummy \
uv run python src/hw1_imitation/train.py --policy-type mse  --num-epochs 400 \
  --eval-interval 5000 --num-workers 4 --wandb-mode offline --exp-name mse
uv run python src/hw1_imitation/train.py --policy-type flow --num-epochs 400 \
  --eval-interval 5000 --num-workers 4 --wandb-mode offline --exp-name flow

# 大模型(最终提交)
uv run python src/hw1_imitation/train.py --policy-type mse  --num-epochs 600 \
  --hidden-dims 512 512 512 --eval-interval 10000 --num-workers 4 \
  --wandb-mode offline --exp-name msebig
uv run python src/hw1_imitation/train.py --policy-type flow --num-epochs 600 \
  --hidden-dims 512 512 512 --eval-interval 10000 --num-workers 4 \
--wandb-mode offline --exp-name flowbig--wandb-mode(默认 online,本机全用 offline,理由见 §7 坑 2)、--num-workers(DataLoader 多进程,吞吐从约 290 steps/s 提到 420–720 steps/s——这个任务的瓶颈其实在 numpy 侧的归一化和滑窗拷贝,不在 GPU)、--compile(默认关闭;在这么小的 MLP 上,torch.compile 的编译开销大于收益,PDF 的 Tips 建议在更大的模型上才成立)。
6. 实验与结果
6.1 主表
四次训练,seed 全部 42。评测指标是 100 条 episode(seed 0–99)的「每条 episode 最大奖励」的平均。
| run | 策略 | hidden | 参数量 | 总步数 | final reward | best reward | 末端 train loss | 墙钟 |
|---|---|---|---|---|---|---|---|---|
mse | MSE | 256×3 | 137,232 | 75,600 | 0.566 | 0.637 @55k | 0.267 | 337 s |
flow | Flow | 256×3 | 166,032 | 75,600 | 0.685 | 0.688 @75k | 3.308 | 635 s |
msebig | MSE | 512×3 | 536,592 | 113,400 | 0.706 | 0.713 @60k | 0.095 | 488 s |
flowbig | Flow | 512×3 | 585,872 | 113,400 | 0.902 | 0.977 @110k | 2.079 | 620 s |
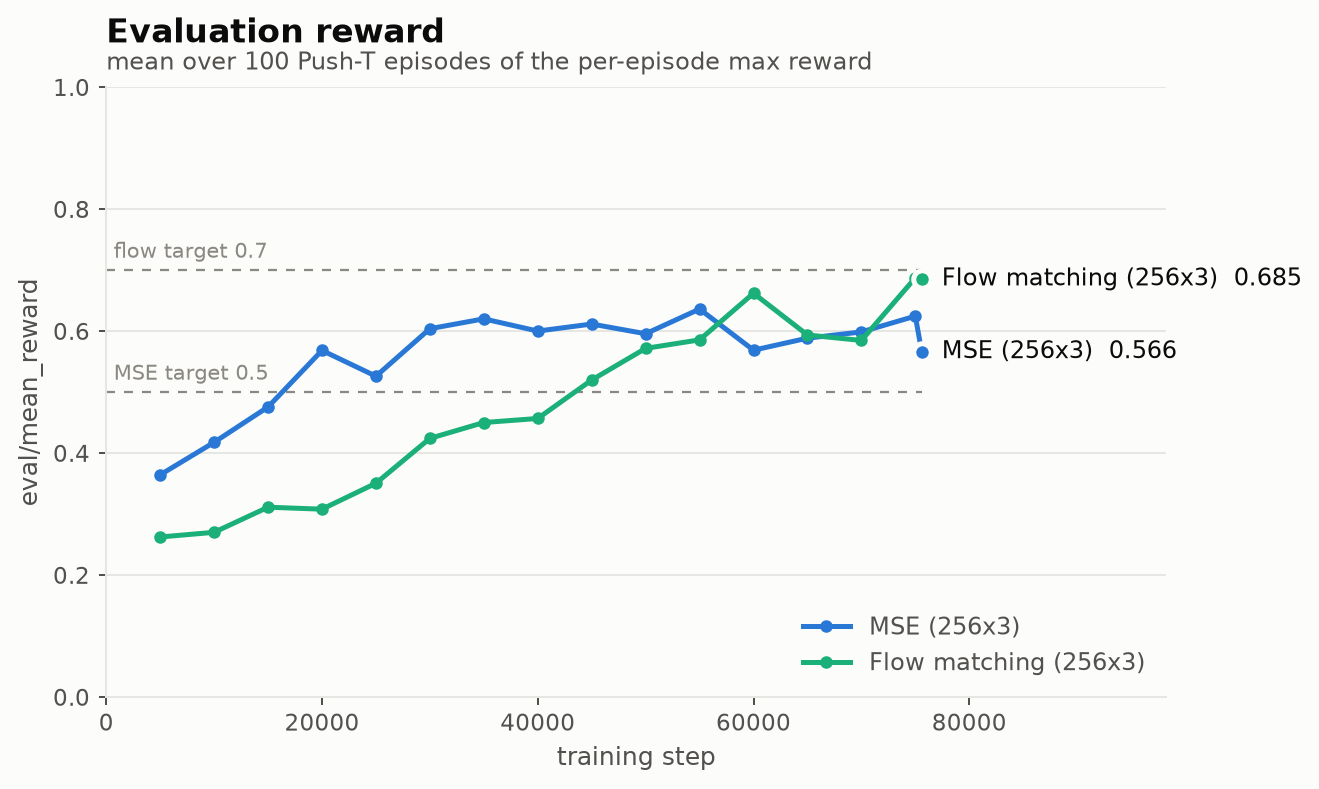
作业的合格线是 MSE $\geq 0.5$、Flow $\geq 0.7$。MSE 两组都过线;Flow 只有大模型过线,小模型的 0.688 差一点没到 0.7——这个「失败」比成功更有信息量,下面 §6.3 展开。
6.2 训练曲线
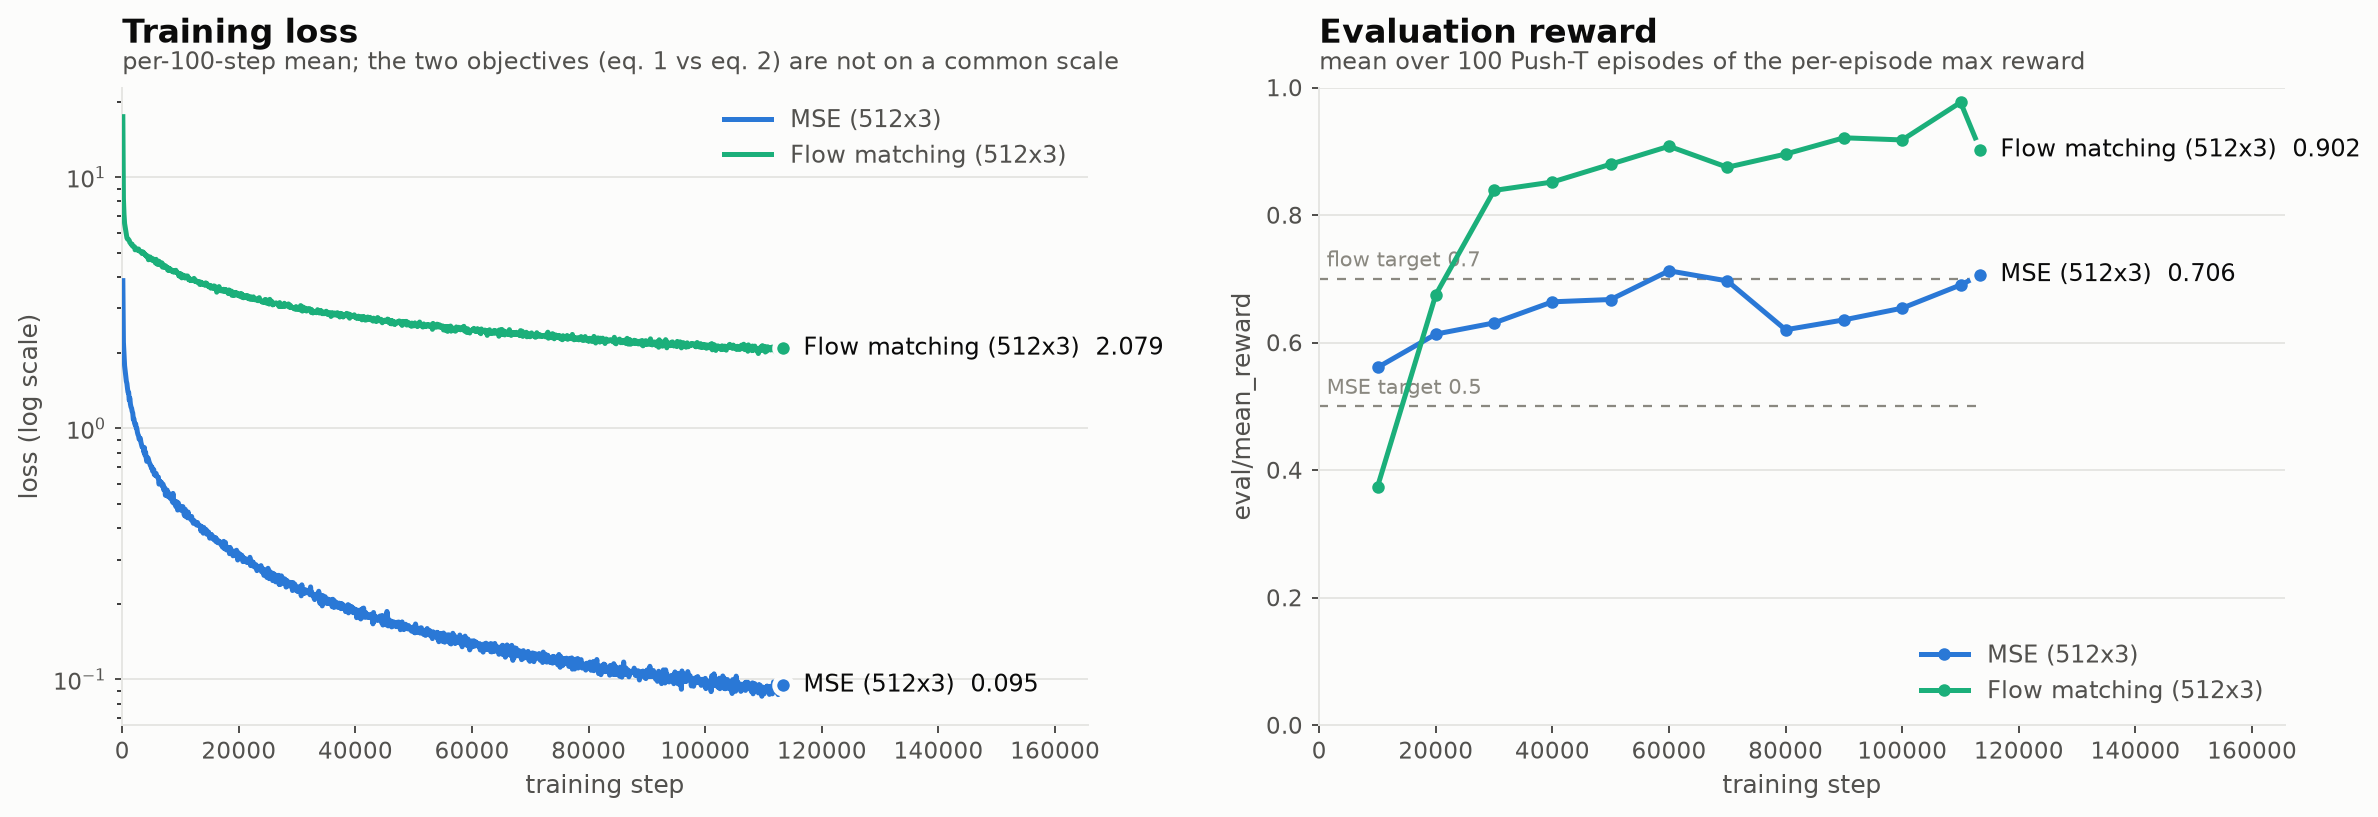
左图有一个容易被忽略的细节:flow 的损失曲线在最初几百步有一个断崖式下跌(从 18 降到 6),之后进入极其缓慢的下降。这个断崖是网络学会「输出大致指向数据均值」的那一瞬间——因为目标 $A_t - A_{t,0}$ 的期望是 $\E[A_t] = 0$、方差主要来自 $A_{t,0}$,网络先学会消掉噪声那一半(这部分是可以从输入 $A_{t,\tau}$ 精确恢复的信息),剩下的缓慢下降才是在学真正的多模态结构。MSE 的曲线没有这个平台,因为它的目标里不含噪声项。
6.3 关键判断:MSE 受限于目标函数,Flow 受限于容量
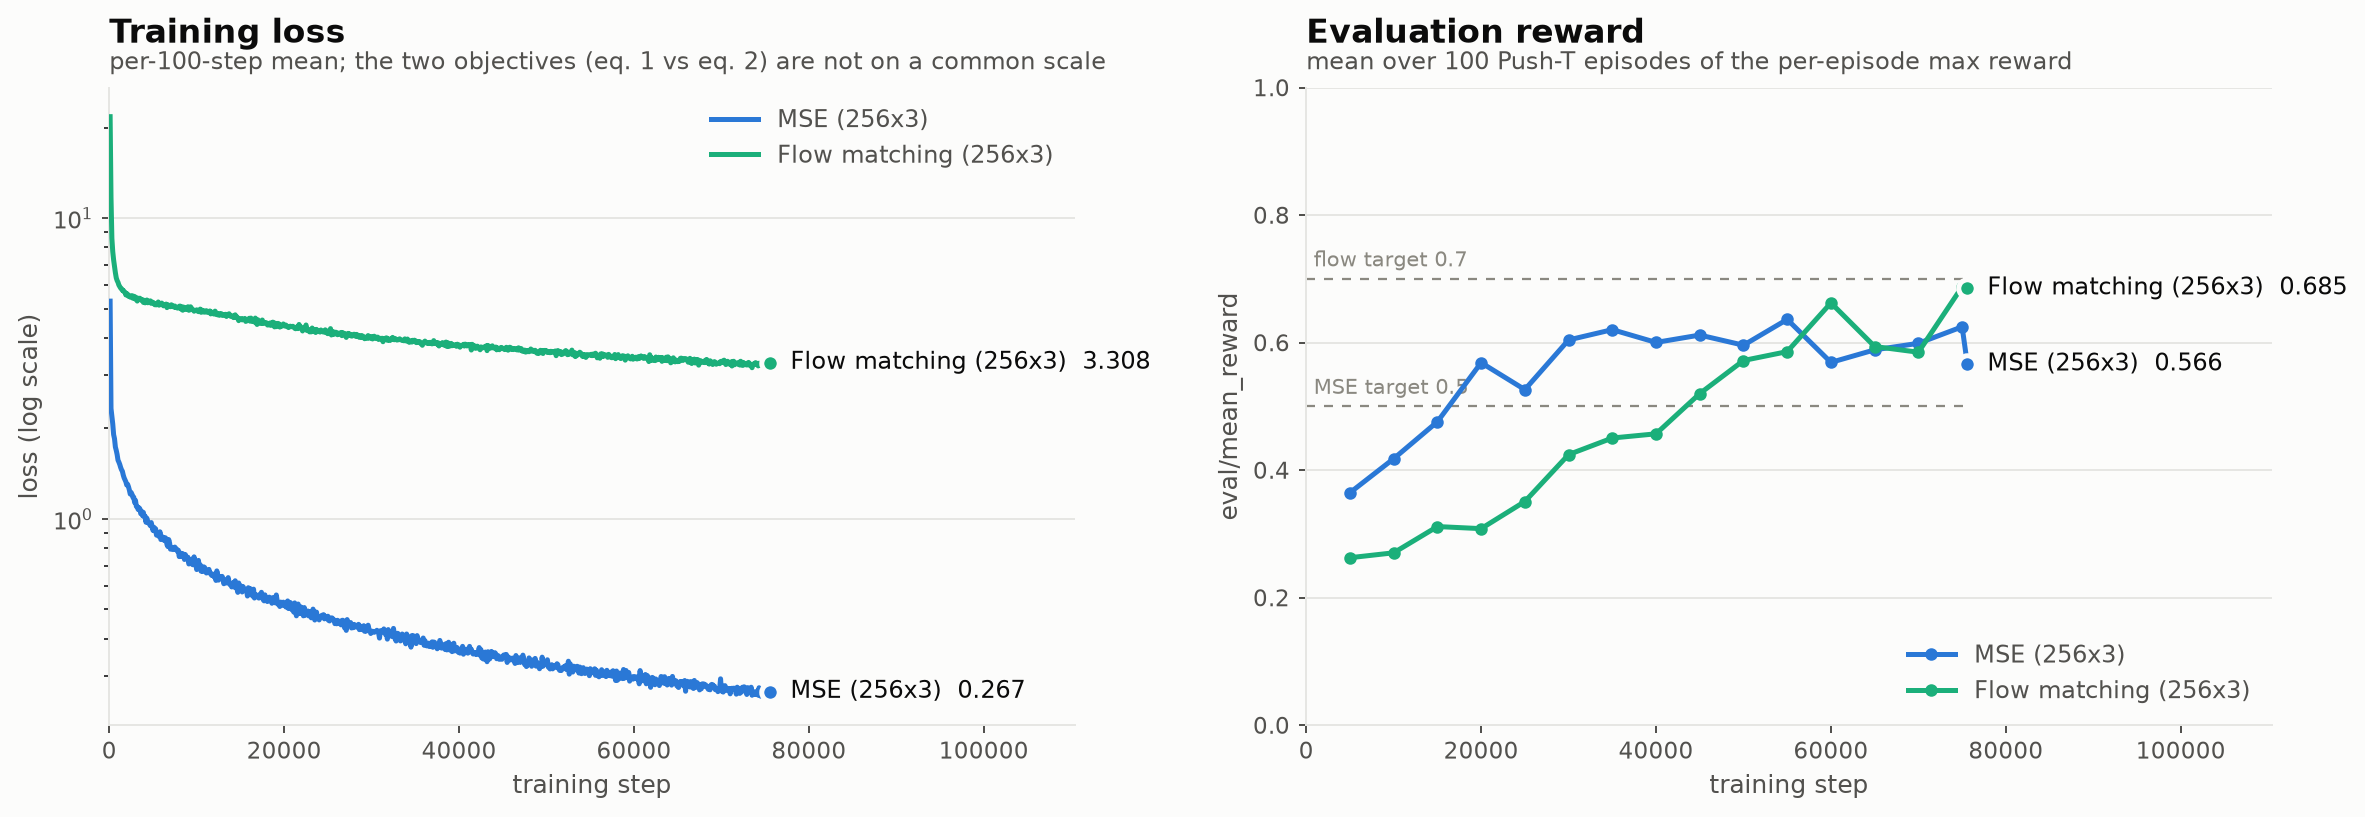
把两组实验并排看,就能读出一个很干净的结论:
| 放大容量与步数 | 256×3 / 75.6k 步 | 512×3 / 113.4k 步 | 增益 |
|---|---|---|---|
| MSE best reward | 0.637 | 0.713 | +0.076 |
| Flow best reward | 0.688 | 0.977 | +0.289 |
| MSE 末端 loss | 0.267 | 0.095 | 降到 36% |
| Flow 末端 loss | 3.308 | 2.079 | 降到 63% |
同样是把参数量放大约 3.9 倍、步数增加 50%:
- MSE 只涨了 0.076,而它的训练损失降到了原来的 36%。它把训练目标拟合得更好了,但这没有换来相称的回报提升——因为它拟合得再好,逼近的也只是 $\E[A_t\mid o_t]$。它的瓶颈是目标函数:更大的网络只是把同一个错误的东西学得更精确。
- Flow 涨了 0.289,直接从「不及格」跳到「远超合格线」。它的损失只降到原来的 63%(因为大部分是不可约的),但那点可约的部分正是多模态结构。它的瓶颈是容量:256×3 的网络学不动 85 维输入上的完整速度场。
推论:如果你按讲义 Tips 用「和 MSE 一样的小 MLP」跑 flow 却没到 0.7,不要怀疑实现,先把网络加宽。 反过来,如果你 MSE 卡在 0.6 左右怎么加宽都不动,那是对的——那就是这个目标函数的天花板。
另一个细节也支持这个判断:小模型上 flow 前 5 万步一直输给 MSE。这完全符合预期——流匹配要学的是一个 $(5+16+1)$ 维输入上的完整向量场,而 MSE 只要学一个 5 维输入上的映射。前者的学习问题难得多,早期当然更慢。用小模型跑一半就下结论「flow 不如 MSE」是这份作业最容易得出的错误结论。
6.4 行为差异:差距在失败率,不在上限
| mean reward | 提前 terminate(成功)率 | 平均 episode 长度 | reward > 0.9 的比例 | reward < 0.5 的比例 | |
|---|---|---|---|---|---|
| MSE (512×3) | 0.706 | 0.24 | 272.7 | 0.57 | 0.28 |
| Flow (512×3) | 0.900 | 0.31 | 263.6 | 0.84 | 0.07 |
这张表回答了 PDF 要求的「a brief qualitative description of how the flow matching policy behaves compared to the MSE policy」,而且给出了定量支撑:
- 失败率是主要差距。 MSE 有 28% 的 seed 最终连 0.5 都没到,flow 只有 7%——四分之一 vs 十四分之一。相比之下,「表现很好(>0.9)」的比例是 0.57 vs 0.84,差距也不小,但两者的失败率之比(4 倍)比成功率之比(1.5 倍)更悬殊。
- 成功率与 episode 长度对得上。 提前 terminate 意味着任务被判定完成,MSE 只有 24%、flow 31%;平均长度 272.7 vs 263.6(上限 300),说明两者大多数 episode 都是耗满步数结束的。
- 看视频(
exp/*/wandb/files/media/videos/eval/*.mp4,每次 eval 存 5 条)的观感与数字一致: 两者前期都能把 T 推到目标附近,但 MSE 经常在某个位姿附近来回蹭、卡住——推子小幅往复但 T 纹丝不动,直到 300 步耗尽;flow 更容易一次性完成最后的角度对齐并提前结束。
为什么 MSE 会卡住?考虑 T 已经基本到位、只差一点角度的状态。专家数据里这种情况有两种走法:从左边轻推一下,或者从右边轻推一下。两者都能成功,而且在动作空间里方向相反。MSE 输出它们的平均 —— 大致是「原地不动」或者「小幅前后抖」。于是推子就在那里抖,T 一动不动,直到 truncate。
这就是第 3 讲那句「the average of two good actions is not a good action」在 Push-T 上的具体物理形态。不是抽象的理论,是你能在视频里一眼看出来的行为。而且它解释了为什么差距集中在失败率上:多模态只在决策分叉点造成伤害,大部分时刻(比如推子还离 T 很远时)专家的走法是唯一的,条件均值就是对的。
7. 消融与多模态的数值证据
7.1 Euler 步数消融
用 flowbig 的最终 checkpoint,只改推理时的 num_steps,其余全部不变:
num_steps $n$ | 1 | 2 | 5 | 10 | 20 | 50 |
|---|---|---|---|---|---|---|
| eval reward | 0.744 | 0.864 | 0.950 | 0.938 | 0.975 | 0.962 |
| 相对前向次数 | 1× | 2× | 5× | 10× | 20× | 50× |
为节省时间,消融只跑了 25 条 episode(seed 0–24)而不是 100 条。这批 seed 明显更容易——同一个 msebig checkpoint 在这 25 条上是 0.820,在完整 100 条上只有 0.706。所以上表的绝对值系统性偏高,只应该看趋势,不要跨表比较。这本身也是一个值得记住的实验纪律:任何缩短评测规模的做法都必须同时报告它在完整协议上的偏差。
趋势非常干净,而且与 §3.5 的理论预期一一对上:
- $n=1$ 明显不够(0.744)。 §3.5 已经推过:一步 Euler 的输出约等于 $\E[A_t\mid o_t]$,即 MSE 策略。这个数字确实落在 MSE 在同批 seed 上的水平(0.820)附近偏低的位置——比纯 MSE 还差一点,因为它是「用为多步积分训练的速度场做一步外推」,比直接优化条件均值更粗糙。
- $n=2$ 就恢复大半(0.864)。 两步之后噪声不再被完全抵消,多模态开始出现。
- $n\geq 5$ 基本饱和(0.95 左右)。 5、10、20、50 之间的波动(0.950 / 0.938 / 0.975 / 0.962)在 25 条 episode 的采样噪声范围内,看不出单调改善。
扩散模型通常需要几十到上千步去噪,为什么这里 5 步就饱和?因为线性插值路径的真实条件速度场是常数。如果网络学到的速度场在每条积分轨迹上近似恒定,那么 Euler 法的局部截断误差 $O(h^2 \|\ddot A\|)$ 就很小——被积函数越接近直线,离散化误差越小。这正是流匹配(rectified flow)相对于 DDPM 的核心卖点:路径被拉直了,所以少数几步就够。
实践含义:flow_num_steps 是一个几乎免费的加速旋钮。评测成本与 $n$ 线性相关,而回报在 $n\geq5$ 后不再改善。作业默认的 10 是个保守的安全值;如果你要做大量消融,调到 5 可以省一半时间且几乎无损。
7.2 真实数据上的多模态:同一观测采 128 次
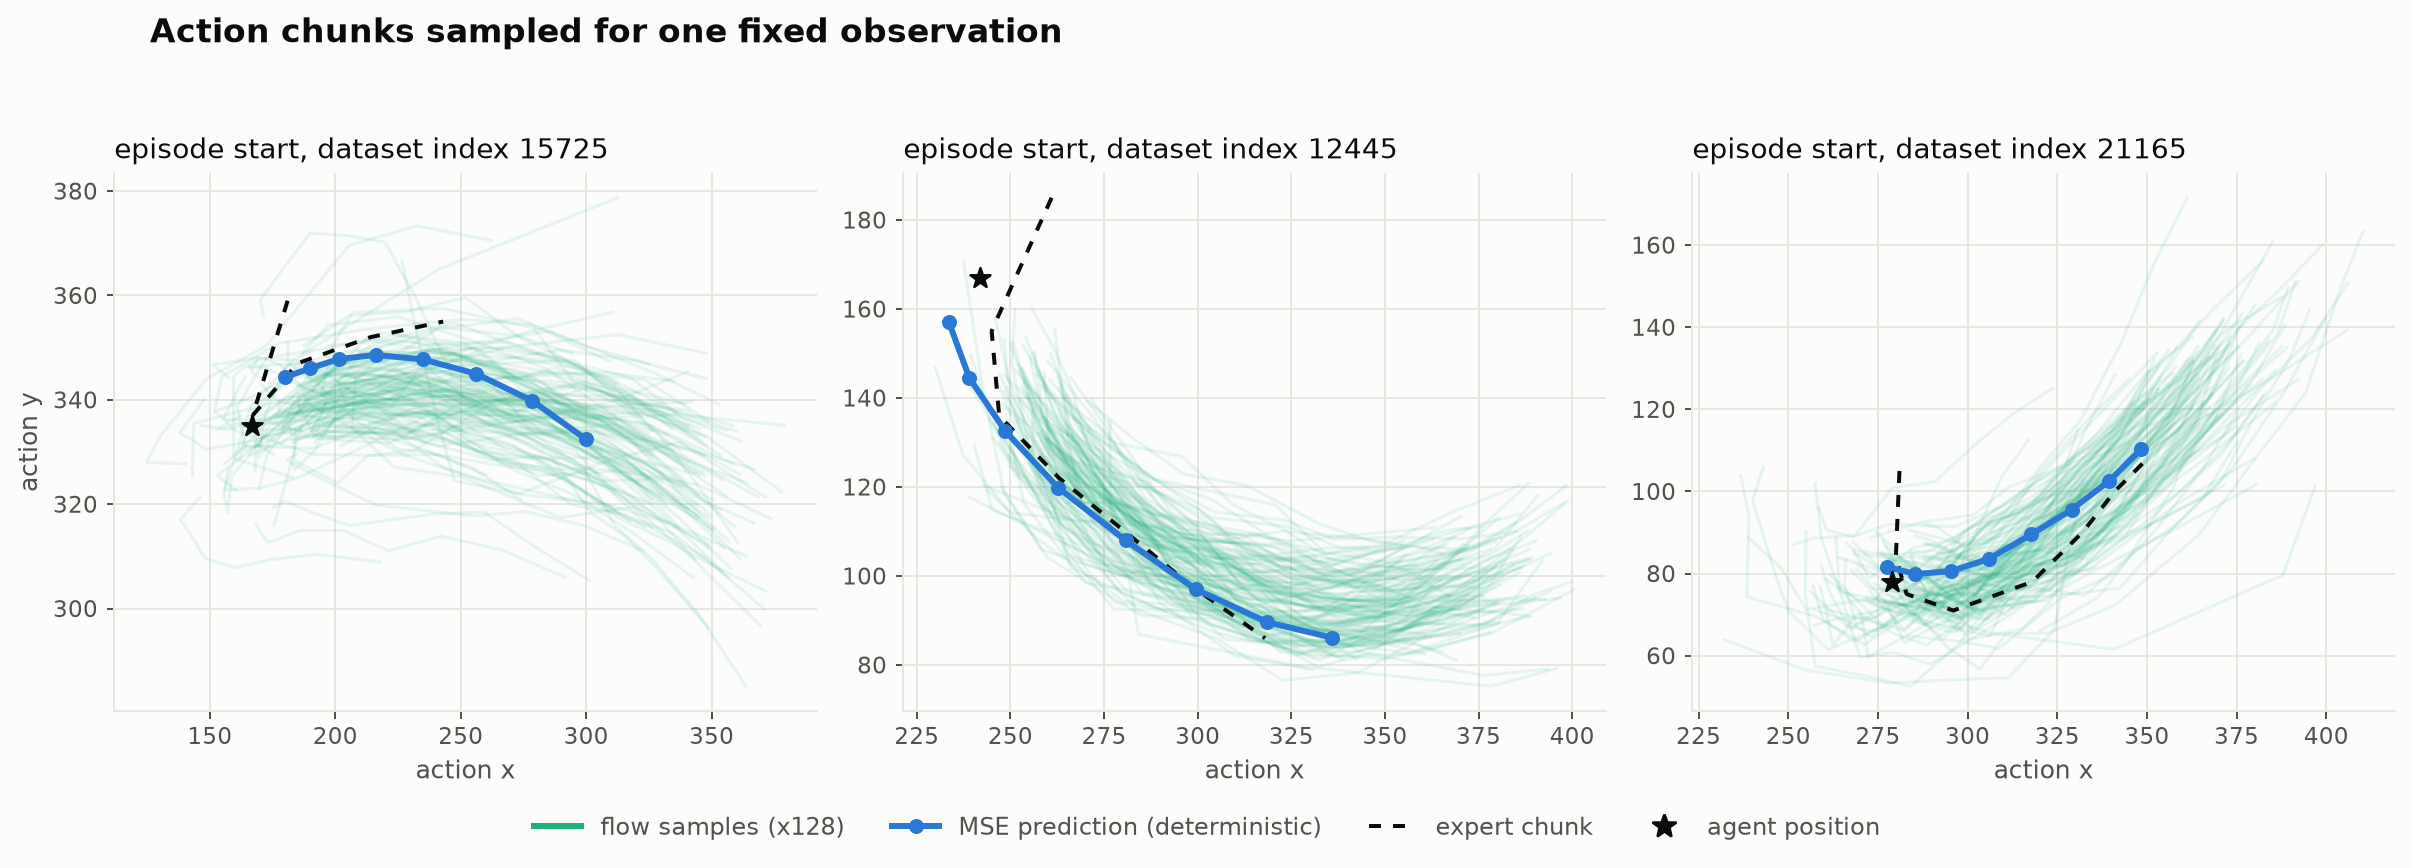
定量地说:在 64 个数据集观测上各采 64 次,flow 的 chunk 逐维标准差平均是 0.111(归一化动作单位),MSE 恒为 0.0000。后者不是「很小」,是严格的零——MSEPolicy 的 sample_actions 里没有任何随机源。
但这张图也要诚实地读:Push-T 的真实数据不是教科书式的双峰。绿色扇形是连续展开的,看不到两个分离的簇。这是因为在 episode 起始时刻,专家的走法是一个连续变化的族(推子可以从稍偏左、稍偏右各种角度接近 T),而不是离散的二选一。真正的离散分叉(绕左还是绕右)出现在特定的几何构型下,在随机抽的三个观测里不一定撞得上。所以要干净地验证「MSE 会平均、flow 不会」,需要一个人造的双峰实验。
7.3 人造双峰实验:作业的核心论点
这是 tests/test_hw1.py 的最后一个用例,设计得极其简洁:观测恒为零向量(即完全无信息),目标 chunk 以 50/50 的概率取全 $+1$ 或全 $-1$,再加 $\sigma=0.05$ 的高斯噪声。
def _bimodal_chunks(idx, chunk_size, sigma):
    """每个样本以 50/50 返回全 +1 或全 -1 的 chunk,加一点高斯噪声。"""
    sign = torch.randint(0, 2, (len(idx), 1, 1)).float() * 2.0 - 1.0
    base = torch.ones(len(idx), chunk_size, 2) * sign
    return base + sigma * torch.randn_like(base)

def test_flow_captures_bimodality_but_mse_averages():
    chunk_size, sigma, n = 4, 0.05, 2048
    obs = torch.zeros(256, 3)
    flow = FlowMatchingPolicy(3, 2, chunk_size, hidden_dims=(256, 256))
    _fit(flow, obs, lambda idx: _bimodal_chunks(idx, chunk_size, sigma), steps=4000)
    mse  = MSEPolicy(3, 2, chunk_size, hidden_dims=(256, 256))
    _fit(mse,  obs, lambda idx: _bimodal_chunks(idx, chunk_size, sigma), steps=2000)

    flow_samples = flow.sample_actions(torch.zeros(n, 3), num_steps=20)
mse_samples = mse.sample_actions(torch.zeros(n, 3))这个设定的妙处在于真值是完全已知的:$p(A\mid o)$ 就是两个各占一半、方差 $0.05^2$ 的高斯,条件均值精确等于 $\mathbf{0}$,而每个模态到原点的 RMS 距离精确等于 $1$。于是三个统计量就能把两种方法的行为完全刻画:
| 统计量 | 含义 | 理论值(真实分布) | Flow 实测 | MSE 实测 |
|---|---|---|---|---|
frac_pos | 落在 $+1$ 模态一侧的样本比例 | 0.500 | 0.494 | —(退化) |
dist_to_mode | 样本到最近模态的 RMS 距离 | $\approx\sigma=0.05$ | 0.049 | 0.998 |
|mean| | 所有样本的整体均值的绝对值 | 0.000 | 0.011 | 0.002 |
- 两者的
|mean|都接近 0(0.011 vs 0.002)。 也就是说,如果你只看「平均动作」,两个策略完全无法区分——它们都正确地学到了条件均值。任何只报告一阶矩的评估都会得出「两者一样好」的结论。 - 但
dist_to_mode差 20 倍(0.049 vs 0.998)。 flow 的样本落在模态上,距离恰好等于数据本身的噪声水平 $\sigma=0.05$——它把分布学到了极限精度。MSE 的样本落在距离两个模态都是 1.0 的正中间,那是一个概率密度几乎为零的位置,一个专家从来不会产生的动作。 frac_pos = 0.494。 flow 不仅覆盖了两个模态,而且比例几乎精确对半。这说明它学到的不只是「模态在哪」,还有「各占多少」——即完整的分布,而不只是支撑集。
测试里的最终断言是 assert m_dist > 3.0 * f_dist,留了很大的余量;实测是 20 倍。
断言的分工值得一提,每一条都对应一类具体的失败:
| 断言 | 抓什么 bug |
|---|---|
0.30 < f_frac < 0.70 | flow只学到一个模态(模式塌缩)。会发生在 $\tau$ 没喂进网络、或者训练步数远远不够时 |
f_dist < 0.25 | flow 的样本落在模态之间——说明它实际退化成了 MSE。$n=1$ 采样或 $\tau$ 通路断掉都会触发 |
f_absmean < 0.30 | flow 覆盖了两个模态但比例严重失衡(比如 90/10) |
m_absmean < 0.20 | MSE 没有收敛到条件均值——说明训练循环或损失写错了(这是一条反向断言:我们期待 MSE 塌缩) |
m_dist > 0.85 | MSE 意外地接近某个模态。如果这条挂了,多半是你的 MSEPolicy 里混进了随机性 |
这个测试只用 CPU、几秒钟就能跑完,却能彻底判定你的流匹配实现是否正确——比在 Push-T 上训 10 分钟看 reward 有效率得多。建议的调试顺序是:先跑 test_flow_velocity_depends_on_tau(一秒,抓最常见的 bug)→ 再跑 test_flow_matches_known_unimodal_distribution(抓路径/参数化错误)→ 最后跑双峰(抓一切残余问题)。三关全过再去跑真实训练,可以省掉大量「训了半小时发现 reward 只有 0.3」的时间。
8. 调参与踩坑记录
下面每条都按「症状 / 定位 / 验证」三段写。前两条与评分直接相关,务必看。
8.1 Logger 的 CSV 表头在第一次 log() 时就被冻结
症状: 训练全程正常,wandb 里 eval/mean_reward 一切正常,但打开 exp/<run>/log.csv 一看,只有 train/loss, train/steps_per_sec, train/epoch, step 四列,评测指标那一列根本不存在。而 log.csv 恰恰是提交结构里明确要求的文件。
定位: 读 evaluation.py 的 Logger.log:
def log(self, row, step):
    row["step"] = step
    if self.header is None:                     # 只在第一次进这个分支
        self.header = [k for k, v in row.items() if not isinstance(v, DISALLOWED)]
        with self.csv_path.open("w") as f:
            f.write(",".join(self.header) + "\n")
    filtered_row = {...}
    with self.csv_path.open("a") as f:
        f.write(",".join([str(filtered_row.get(k, "")) for k in self.header]) + "\n")
关键在 filtered_row.get(k, ""):写行时只遍历 self.header。任何在第一行里没出现过的 key,之后无论 log 多少次都会被静默丢弃。而典型的训练循环是「每 100 步 log 训练指标、每 5000 步 log 评测指标」——第一次 log 必然是训练指标,于是评测列永远进不了 CSV。
解决: 在训练循环开始前先 log 一行 step=0 的占位行,把所有将来会用到的 key 全部塞进去,值填 math.nan:
logger.log({"train/loss": math.nan, "train/steps_per_sec": math.nan,
            "train/epoch": 0, "eval/mean_reward": math.nan}, step=0)
画图时跳过 NaN 即可(pandas.read_csv 会把它读成 NaN,dropna() 一行搞定)。
验证: 训练启动后大约十秒(第一次 log_interval 之后),直接看文件第一行:head -1 exp/*/log.csv。应当包含 eval/mean_reward。这是一个不用等训练跑完就能做的检查,而如果你等到训练结束才发现,就要重跑整个实验。
8.2 wandb 必须能跑,但没账号时要用 offline 而不是 disabled
症状: 用 mode="disabled" 时训练一路正常,直到最后一行 logger.dump_for_grading() 崩掉——而这已经是几百秒之后,整个 run 白跑。
定位: dump_for_grading 的实现是
def dump_for_grading(self):
    wandb_dir = Path(wandb.run.dir).parent
    wandb.finish()
shutil.copytree(wandb_dir, self.path / "wandb")它依赖 wandb.run.dir 是一个真实的 run 目录。mode="disabled" 下 wandb 返回的是一个 mock run,这个路径不指向任何有意义的地方,copytree 会失败或者拷出一个空壳。
解决: 用 mode="offline"。它会在 ./wandb/offline-run-* 下生成完整的目录树:.wandb 二进制日志、files/media/videos/eval/*.mp4(每次 eval 存 5 条视频)、files/checkpoints/*.pkl,完全满足 PDF 里「copy the entire run directory, including all of the .wandb, .json, .mp4, and .pkl files」的要求。之后想同步到云端,wandb sync ./wandb/offline-run-* 一条命令即可。
验证: 训练前先跑一个 --num-epochs 1 --eval-interval 100 的 smoke test(约 20 秒),确认 exp/<run>/wandb/files/media/videos/ 下确实有 mp4、checkpoints/ 下确实有 pkl。永远不要在没验证过 dump_for_grading 的情况下启动一个 10 分钟的 run。
8.3 Logger.__init__ 对已存在的目录直接抛 FileExistsError
症状: 用脚本同时起两个 run(比如两张卡各跑一个),其中一个立刻崩掉。
定位: 默认 run 名是 seed_{seed}_{YYYYmmdd_HHMMSS},时间戳只精确到秒。同一秒内启动的两个进程会撞名,而 Logger.__init__ 里 if path.exists(): raise FileExistsError。
解决: 用 --exp-name 给每个 run 加不同后缀(本次实验就是 mse / flow / msebig / flowbig),顺便让 exp/ 目录可读得多。验证: 起 run 之前 ls exp/ 看一眼即可。
8.4 流匹配的训练损失有不可约下界,不能跨目标函数比较
症状: flowbig 的损失在 2.079 就不动了,msebig 是 0.095。第一反应是「flow 没训好,是不是学习率不对」,于是开始徒劳地调参。
定位: §3.4 已经推过——最优解处的残差是条件方差 $\E[\operatorname{tr}\operatorname{Var}(A_t - A_{t,0}\mid o_t, A_{t,\tau},\tau)]$,与网络容量无关。粗略估个数量级:$\tau\to0$ 时,$A_{t,\tau}$ 几乎不含 $A_t$ 的信息,残差方差接近 $\operatorname{tr}\operatorname{Var}(A_t)\approx K\cdot D_a = 16$(归一化后逐维方差为 1);$\tau\to1$ 时残差趋于 0。在 $\tau\sim\mathcal U(0,1)$ 上平均,落在个位数是完全合理的,2.08 说明网络已经把大部分可约部分学掉了。
解决 / 验证: 三件事。(a) 判断 flow 好不好只看 eval reward,别看 loss 绝对值。(b) loss 仍然有用,但只能同架构纵向比:3.308(256×3)vs 2.079(512×3)说明加宽确实学到了更多。(c) 画图时把损失轴设成 log scale,并在副标题写明「the two objectives (eq. 1 vs eq. 2) are not on a common scale」——§6.2 的图就是这么做的,免得读者(包括三个月后的自己)误读。
8.5 Flow 的评测比 MSE 慢约 6 倍
症状: flow 的 run 墙钟时间比 MSE 长得多(635 s vs 337 s),但训练本身的 steps/sec 差不多。
定位: 评测时每个 chunk 要跑 num_steps=10 次网络前向,而且是 batch size = 1 的串行前向(每条 episode 独立、逐步推进)。实测一次完整 eval(100 条 episode):MSE 约 12 秒,flow 约 77 秒。如果 eval_interval 设成 5000,113,400 步要评 22 次,光评测就是 28 分钟。
解决: flow 的 run 把 eval_interval 调到 10,000(MSE 保持 5,000)。这解释了 §6.2 图里绿线的数据点比蓝线稀疏。验证: 训练日志里的 train/steps_per_sec 在 eval 之后那一次不应该塌陷——如果塌陷了,说明你忘了在 run_eval 之后重置 last_log_time(见 §5.3 的表)。
8.6 加载 checkpoint 必须 weights_only=False
症状: 写分析脚本加载 checkpoints/*.pkl 时报错,提示 unsupported global 之类。
定位: log_checkpoint_artifact 存的是 torch.save(model, path)——整个 module 对象,不是 state_dict。torch 2.6+ 把 torch.load 的默认值改成了 weights_only=True,会拒绝反序列化任意 Python 类。
解决: torch.load(path, map_location=device, weights_only=False)。验证: 加载后 print(model),确认层结构与训练时打印的一致(尤其是 in_features=85)。
8.7 无头环境渲染视频
症状: 服务器上跑训练,第一次 eval 时 pygame 报错找不到显示设备。解决: 环境变量 SDL_VIDEODRIVER=dummy。另外数据集会自动从 diffusion-policy.cs.columbia.edu 下载约 62 MB 到 data/,首次运行需要联网。验证: smoke test 里检查 mp4 是否非空。
8.8 matplotlib:set_xlim(left=0) 会关掉 autoscale
症状: 自己画训练曲线时,右侧的 direct label 溢出到隔壁 subplot 上,盖住了坐标轴。
定位: 调了 ax.set_xlim(left=0) 之后再调 ax.margins(x=0.25) 静默无效——因为 set_xlim 已经把这个轴的 autoscale 关掉了,而 margins 只在 autoscale 生效时起作用。这个 API 不会给任何警告。
解决: 显式写 ax.set_xlim(0, xmax * (1 + pad))。验证: 存图后肉眼看一眼——这类问题没有断言可写,只能看。(PDF 明确要求「please generate these plots yourself rather than taking screenshots of WandB」,所以画图这一环躲不掉。)
§6.1 表里的墙钟时间不是干净的 benchmark:部分 run 是两张 GPU 并行跑的,会互相抢 CPU(这个任务的瓶颈本来就在数据侧)。不要用它来比较两种策略的训练成本;要比就单独串行重跑。这类「知道自己的数字哪里不干净」的自觉,比数字本身更重要。
9. 自测清单
做完之后逐条对照。前面带 ★ 的是「错了但不会报错」的项,最值得花时间确认。
9.1 形状与接口
- □ 两个策略的
sample_actions在num_steps ∈ {1, 5, 10}下都返回(B, 8, 2)且元素全为有限值。 - □ 两个策略的
compute_loss返回零维标量(loss.ndim == 0),不是(B,)。 - □
MSEPolicy.sample_actions保留了num_steps关键字参数(即使用不到)——否则evaluate_policy会TypeError。 - ★ □
reshape的轴顺序是(B, chunk_size, action_dim)而不是(B, action_dim, chunk_size)。数据侧是actions[t : t+K],时间在第一个轴。 - □
FlowMatchingPolicy.net[0].in_features == state_dim + chunk_size*action_dim + time_embed_dim(本作业是 85)。 - □ 参数量对得上:MSE 256×3 是 137,232、512×3 是 536,592;Flow 256×3 是 166,032、512×3 是 585,872。
9.2 MSE 策略
- ★ □ 输出层没有激活函数。
build_mlp的最后一个Linear后面是空的,不要自己再加。 - □ 损失严格按式 (1):
.pow(2).sum(dim=(-1,-2)).mean()。若用了F.mse_loss,记住你的数字是别人的 $1/16$。 - □ 用 Adam,
lr=3e-4。 - □ 在 Push-T 上跑到
eval/mean_reward ≥ 0.5(本文实测 0.637 / 0.713)。
9.3 流匹配策略
- ★ □ $\tau$ 确实被拼进了网络输入。 用
v0 = model(s, c, zeros); v1 = model(s, c, ones); assert (v0-v1).abs().max() > 1e-4验证。这是最高频的 bug。 - ★ □ 每个样本独立采一个 $\tau$:
assert tau.shape == (batch,),不是(1,)或标量。 - ★ □ 插值方向对:$A_{t,\tau}=\tau A_t+(1-\tau)A_{t,0}$,$\tau=1$ 时是数据、$\tau=0$ 时是噪声。
- ★ □ 回归目标是速度 $A_t - A_{t,0}$,不是 $A_t$、不是 $-A_{t,0}$。
- ★ □ Euler 循环的 $\tau$ 从 0 开始:
tau = i/n,$i=0,\dots,n-1$,网络永远不会被喂 $\tau=1$。 - □ 步长恒为
1/num_steps;chunk用非原地更新;device/dtype从state继承。 - □
sample_actions上加了@torch.no_grad()。 - □ 单峰过拟合测试通过:采样均值逼近目标(实测误差 0.018)、标准差趋近 0(实测 0.009)。
- ★ □ 双峰测试通过:flow 到最近模态的距离 < 0.25(实测 0.049),MSE > 0.85(实测 0.998),且
0.30 < frac_pos < 0.70(实测 0.494)。 - □ 在 Push-T 上跑到
eval/mean_reward ≥ 0.7。没到就先加宽网络(256×3 只能到 0.688,512×3 能到 0.902)。
9.4 训练循环与提交物
- ★ □
log.csv的第一行表头里有eval/mean_reward。 用head -1 exp/*/log.csv在训练开始后十秒就能查。 - □ 训练结束调用了
logger.dump_for_grading(),且exp/<run>/wandb/下有.wandb、media/videos/eval/*.mp4、checkpoints/*.pkl。 - □ wandb 用的是
online或offline,不是disabled。 - □ 训练结束时若最后一步不在 eval 网格上,补了一次 final eval。
- □
run_eval之后调了model.train()切回训练模式。 - □
run_eval之后重置了last_log_time,steps/sec 曲线上没有假的塌陷尖峰。 - □ 记的是
log_interval窗口内的平滑 loss,不是单步 loss。 - □ 累积 loss 时用了
float(loss)或.detach(),显存没有随步数增长。 - □ 提交前把
exp/seed_42_*_msebig重命名成exp/mse、exp/seed_42_*_flowbig重命名成exp/flow,目录结构与 PDF 第 4 节的图完全一致。
9.5 报告内容
- □ MSE 与 flow 各一组自己用 matplotlib 画的训练曲线(步数 vs loss、步数 vs reward),不是 wandb 截图。
- □ 写清 MLP 架构:层数、隐藏宽度、激活函数、输入输出维度。
- □ 基于视频,定性描述两种策略的行为差异。建议同时给出定量支撑:失败率(reward < 0.5)28% vs 7%,提前 terminate 率 0.24 vs 0.31。
- □ 如果画了损失对比图,务必注明两种损失不在同一量纲上,并用 log 纵轴。
- MSE 策略学的是条件均值 $\E[A_t\mid o_t]$。 加宽网络只会让它把这个均值算得更准,而均值在多模态处本身就是错的答案——这就是它卡在 0.71 的原因,也是 0.637 → 0.713 这个可怜的增益的全部含义。
- 流匹配用「回归常速度」这个看似错误的目标,学到了正确的边缘速度场,靠的是平方损失最优解等于条件期望这一条引理。同样一条引理,在 MSE 那里是缺陷(塌缩到均值),在流匹配这里是特性(自动求边缘)。理解这个对偶,这份作业就没白做。
- 验证要用可控的人造实验,不要用真实任务的 reward。 双峰测试三秒钟给出 0.049 vs 0.998 这个 20 倍差距,比在 Push-T 上训半小时看回报清楚得多。
延伸阅读
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion (Chi et al., 2023/2025) — Push-T 环境和数据集的出处,也是「动作分块 + 生成式策略」这条路线的奠基工作。
- Flow Matching for Generative Modeling (Lipman et al., 2022) — 条件流匹配的原始论文,§3.4 的条件期望引理即出自这里(论文 Theorem 2)。
- Flow Straight and Fast: Rectified Flow (Liu et al., 2022) — 解释为什么线性插值路径能让 Euler 积分只用几步就收敛,对应 §7.1 的消融结论。
- Action Chunking with Transformers / ACT (Zhao et al., 2023) — 动作分块在真实机器人上的系统性研究,包含 chunk 长度 $K$ 的消融。
- A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning (DAgger, Ross et al., 2011) — 第 2 讲复合误差 $O(\epsilon T^2)$ 界的来源,以及分块之外的另一条解法。