离散扩散模型:用扩散的原理造语言模型
文本是离散的,$\R^d$ 上的 ODE/SDE 不存在了。把「概率路径 → 条件对象 → 边际化技巧 → 条件损失」这套配方整体平移到有限状态空间上,得到的就是连续时间马尔可夫链(CTMC)与离散 flow matching。
0. 本讲导读
前四讲我们做的所有事情都活在欧氏空间 $\R^d$ 里:数据点是向量 $z \in \R^d$,生成过程是一条被向量场 $\vf_t$ 推着走的轨迹 $X_t \in \R^d$,随机性由布朗运动注入,概率密度的演化由连续性方程和 Fokker–Planck 方程刻画。这一整套机器的每一个零件都依赖于「$\R^d$ 上可以求导、可以做无穷小位移」这件事。
可是文本不是向量。一句话是一串离散 token,比如 ["The","cat","sat","on","the","mat"]。你没法把 "cat" 挪动 $0.01$ 个单位;"cat" 和 "cot" 之间没有一条可以连续走过去的路。蛋白质序列、DNA 序列($\set{A,C,G,T}$ 上的串)也一样。在离散状态空间上:
- 没有 ODE:$\dd{X_t} = \vf_t(X_t)\dd{t}$ 里的 $\dd{X_t}$ 根本无法定义,因为状态之间没有「方向」。
- 没有 SDE:布朗运动是 $\R^d$ 上的对象,离散空间上不存在扩散过程。
- 没有密度的梯度:$\score{t}(x) = \nabla\log p_t(x)$ 里的 $\nabla$ 无从谈起,所以第三讲的 score matching 也不能直接搬。
那是不是整套理论就作废了?不是。本讲要说明的核心事实是:flow matching 的那套推理,其真正的骨架并不是「向量场」,而是「概率路径 + 生成元 + 边际化技巧 + 条件损失」这个抽象结构。在 $\R^d$ 上,生成元恰好可以用向量场表示;在有限状态空间 $\Vocab$ 上,生成元变成速率矩阵(rate matrix) $\Rate_t$,随机过程变成连续时间马尔可夫链(continuous-time Markov chain, CTMC)。除此之外,每一步论证都逐字对应。
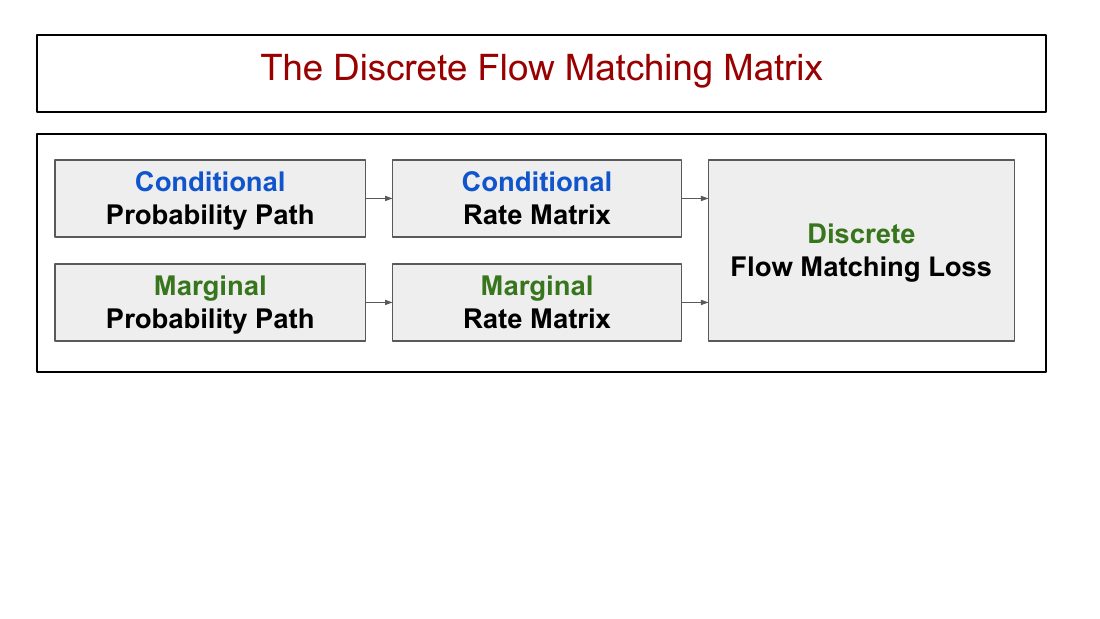
- 速率矩阵取代向量场。$\Rate_t \in \R^{\abs{\Vocab}\times\abs{\Vocab}}$,非对角元 $\Rate_t(y\mid x)\ge 0$ 是「单位时间内从 $x$ 跳到 $y$」的速率,行和为零:$\sum_y \Rate_t(y\mid x) = 0$。它完全刻画一条 CTMC,正如向量场完全刻画一条 ODE 轨迹。
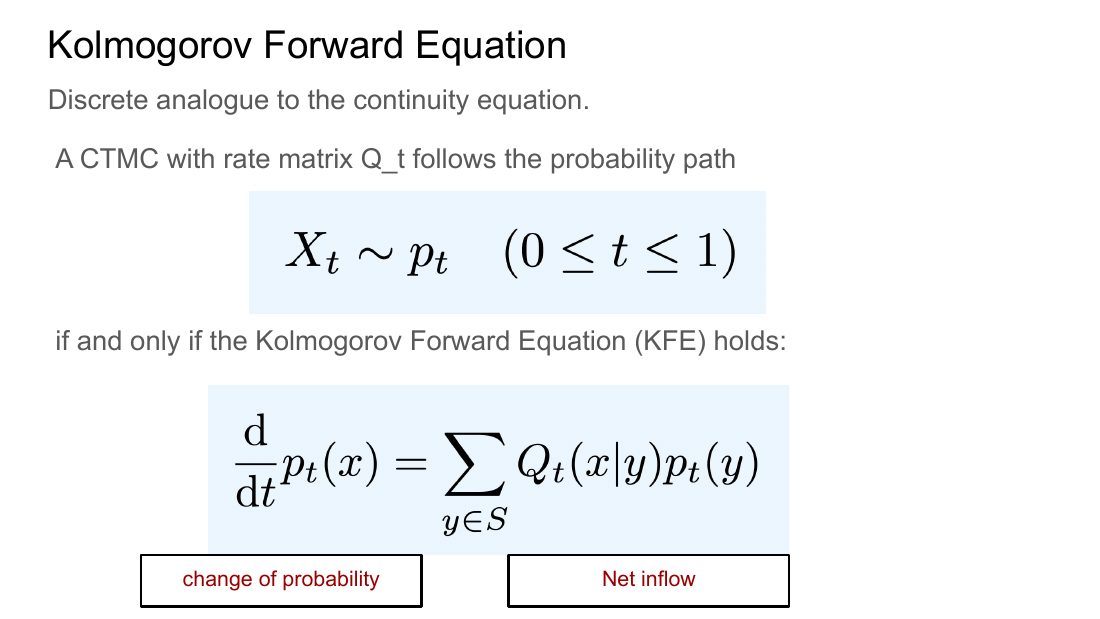
- Kolmogorov 前向方程(KFE)取代连续性方程。$\dfrac{\dd{}}{\dd{t}}p_t(x) = \sum_{y}\Rate_t(x\mid y)p_t(y)$,右端是「净流入」,与 $-\divg(p_t\vf_t)$ 完全同义。CTMC 服从概率路径 $p_t$ 当且仅当 KFE 成立。
- 离散边际化技巧。$\Rate_t(y\mid x) = \sum_{z}\Rate_t^z(y\mid x)\,p_{1\mid t}(z\mid x) = \E_{z\sim p_{1\mid t}(\cdot\mid x)}\big[\Rate^z_t(y\mid x)\big]$。与第二讲的 $\vf_t(x) = \E_{z\sim p_{1\mid t}}[\vf^z_t(x)]$ 是同一句话,只是把积分换成求和。
- 因子化混合路径:每个位置独立地以概率 $1-\kappa_t$ 被噪声(在 MDLM 里就是
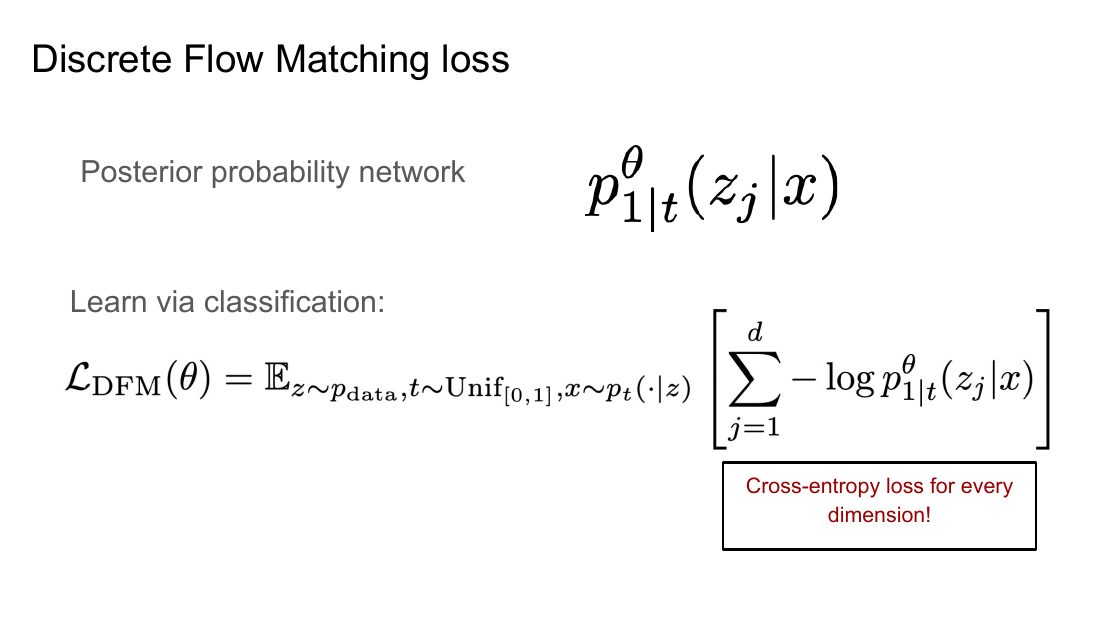
[MASK])替换。它的条件速率矩阵是 $\Rate^z_t(v,j\mid x) = \frac{\dot\kappa_t}{1-\kappa_t}\big(\delt{z_j}(v)-\delt{x_j}(v)\big)$ —— 与第二讲 CondOT 的 $\vf^z_t(x)=\frac{z-x}{1-t}$ 在形式上完全一致,只是把向量换成了 one-hot 向量。 - 训练变成分类,而不是回归。边际速率矩阵中唯一未知的量是后验 $p_{1\mid t}(z_j = v\mid x)$,即「给定被破坏的序列 $x$,第 $j$ 个位置原本是哪个 token」。用一个网络 $p^\theta_{1\mid t}$ 去拟合它,损失就是逐位置的交叉熵: $\mathcal L_{\mathrm{DFM}}(\theta) = \E_{z\sim\data,\;t\sim\mathrm{Unif}[0,1],\;x\sim p_t(\cdot\mid z)}\big[\textstyle\sum_{j}-\log p^\theta_{1\mid t}(z_j\mid x)\big]$。
- 连续 flow matching 把生成模型化归为回归,离散 flow matching 把生成模型化归为分类。训练一个语言模型,本质上就是训练 $N$ 个「猜被挡住的词是什么」的分类器。
本讲的三条主线
本课反复出现的三个母题,在离散情形下的答案是:
- 为什么用条件版本训练边际版本?因为边际速率矩阵 $\Rate_t(y\mid x)$ 里含有 $\data$,不可计算;而条件速率矩阵 $\Rate^z_t(y\mid x)$ 在给定 $z$ 后是闭式的四行分段函数。边际化技巧告诉我们前者是后者关于后验的期望,于是交叉熵损失的最优解自动就是我们要的边际对象。
- 为什么不同的过程给出同一个边际分布?因为「边际分布」这件事完全由 KFE 决定:任何满足 KFE 的速率矩阵都会生成同一条 $p_t$。KFE 是一个关于 $p_t$ 的线性 ODE,初值定了解就唯一,因此 $\Rate_t$ 的很多细节(比如往哪个方向多分一点流量)根本不影响边际。
- 那个「看起来算不出来」的量怎么变成可算的?它是 $p_{1\mid t}(z\mid x)=\data(z)p_t(x\mid z)/p_t(x)$。我们永远不去算它,而是把它塞进一个期望里,让「先采 $z$ 再采 $x$」的采样过程替我们完成边际化——这正是塔性质(tower property)的用法,和第二讲、第三讲一字不差。
1. 从 $\R^d$ 到 $\Vocab$:离散状态空间的设定
状态空间:词表的 $N$ 次幂
先把所有对象的类型钉死。设
- 词表(vocabulary) $\mathcal V = \set{v_1,\dots,v_V}$,是一个有限集合,$V = \abs{\mathcal V} \in \mathbb{N}$ 是词表大小。对语言模型,$\mathcal V$ 是 BPE token 表($V$ 量级 $10^4\sim10^5$);对 DNA,$\mathcal V = \set{A,C,G,T}$,$V=4$。
- 序列长度 $N \in \mathbb{N}$(讲义里记作 $d$,这里为了不和 $\R^d$ 的维度混淆改记 $N$)。
- 状态空间(state space) $$\Vocab = \mathcal V^{N} = \set{(x_1,\dots,x_N) : x_j \in \mathcal V},\qquad \abs{\Vocab} = V^{N}.$$ 一个「状态」就是一整条长度为 $N$ 的序列。
请务必分清 $\mathcal V$(词表,大小 $V$)和 $\Vocab$(状态空间,大小 $V^N$)。后面所有的速率矩阵在定义上都是 $\abs{\Vocab}\times\abs{\Vocab} = V^N \times V^N$ 的巨型矩阵——对 $V=10^4, N=128$ 而言这是 $10^{512}$ 行,宇宙里放不下。第 5 节的「因子化」就是专门为了绕开这件事。先接受这个矩阵在数学上存在,再想怎么在计算机里表示它,这是本讲的关键节奏。
Dirac、one-hot 与单纯形:离散情形反而更干净
在 $\R^d$ 上,$\delta_z$ 是一个广义函数(分布/测度),不是函数,写 $\delta_z(x)$ 是滥用记号。在有限集合 $\Vocab$ 上它是一个老老实实的概率质量函数:
$$ \delt{z} : \Vocab \to \set{0,1},\qquad \delt{z}(x) = \begin{cases}1, & x = z\\ 0, & x\ne z\end{cases} $$把 $\Vocab$ 上的概率质量函数按状态排成列向量,$p \in \R^{\abs{\Vocab}}$,则 $\delt{z}$ 就是第 $z$ 个坐标为 1 的 one-hot 向量 $e_z$。所有概率分布构成概率单纯形(probability simplex)
$$ \Delta(\Vocab) = \Big\{p\in\R^{\abs{\Vocab}} : p(x)\ge 0\ \forall x,\ \textstyle\sum_{x\in\Vocab}p(x)=1\Big\}, $$它是一个 $\abs{\Vocab}-1$ 维的凸多胞形,顶点恰好是 $\abs{\Vocab}$ 个 one-hot 向量。这个几何图像非常重要:在离散情形下,「概率路径」是单纯形里的一条曲线,而不是密度函数空间里的一条曲线。第 6 节会看到,因子化混合路径在单纯形里就是一条直线段,这正是第二讲 CondOT 路径的离散对应物。
| 对象 | 连续情形 $\R^d$ | 离散情形 $\Vocab$ |
|---|---|---|
| 状态 | $x\in\R^d$(向量) | $x=(x_1,\dots,x_N)\in\Vocab=\mathcal V^N$(序列) |
| 分布 | 密度 $p_t:\R^d\to\R_{\ge0}$,$\int p_t = 1$ | 质量函数 $p_t:\Vocab\to\R_{\ge0}$,$\sum_{x}p_t(x)=1$;等价于 $p_t\in\Delta(\Vocab)\subset\R^{\abs{\Vocab}}$ |
| 「求和」 | $\int\cdot\ud x$ | $\sum_{x\in\Vocab}$ |
| 点质量 | $\delta_z$:广义函数,非函数 | $\delt{z}$:真正的 pmf,等于 one-hot 向量 $e_z$ |
| 可以「挪动」吗 | 可以:$x\mapsto x+\varepsilon v$ | 不可以:只能整个跳到另一个状态 |
| 生成过程 | ODE / SDE 轨迹(连续、几乎处处可导或 Hölder) | CTMC 轨迹(分段常数、右连续、有跳) |
生成建模的目标
目标和前四讲一字不改。给定
- 数据分布 $\data:\Vocab\to\R_{\ge0}$,$\sum_{z\in\Vocab}\data(z)=1$(例如「互联网上所有文本」的分布)。我们不知道 $\data$,只有从中采出的样本 $z\sim\data$;
- 初始分布 $\simple:\Vocab\to\R_{\ge0}$(例如 $\Vocab$ 上的均匀分布 $\simple(x)=1/\abs{\Vocab}$,或者第 10 节的「全
[MASK]」点质量 $\delt{[\mathrm{MASK}]^N}$);
要构造一个可模拟的随机过程 $(X_t)_{0\le t\le 1}$,使得
$$ X_0 \sim \simple, \qquad X_t \text{ 是速率矩阵 } \Rate^\theta_t \text{ 的 CTMC} \quad\Longrightarrow\quad X_1 \sim \data. $$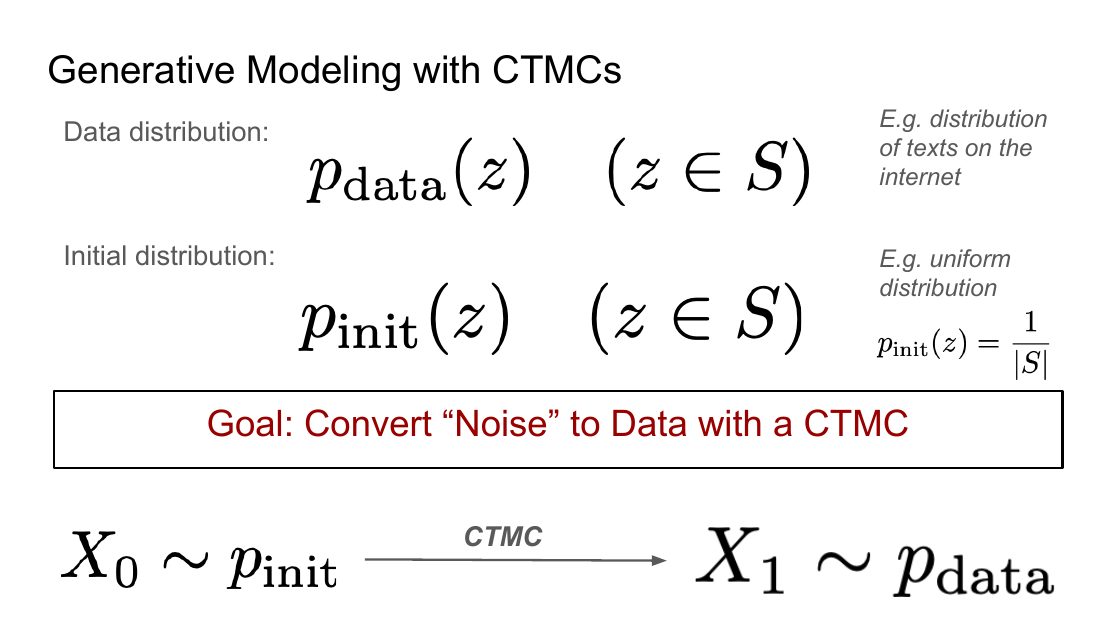
为什么先讲马尔可夫性
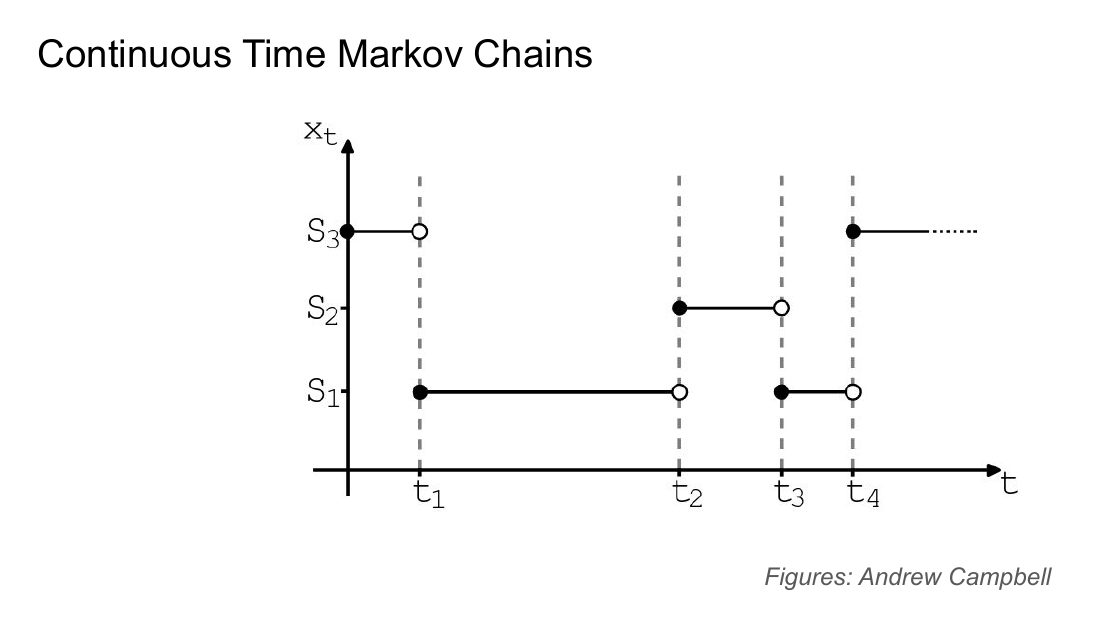
令 $X:[0,1]\to\Vocab$,$t\mapsto X_t$ 为 $\Vocab$ 上的随机轨迹。我们要求它是马尔可夫过程(Markov process),即「无记忆」:对任意 $0 < h$ 与任意 $0\le t_1 < t_2 < \dots < t_k < t$,
$$ \underbrace{p(X_{t+h}\mid X_t, X_{t_1},\dots,X_{t_k})}_{\text{给定现在与过去}} \;=\; \underbrace{p(X_{t+h}\mid X_t)}_{\text{只给定现在}} . $$白话:未来只取决于现在,过去的路径提供不了任何额外信息。ODE 与 SDE 也都是马尔可夫过程(这是为什么欧拉法只需要当前状态就能往前推一步)。当状态空间是离散集合时,这样的马尔可夫过程被称为连续时间马尔可夫链(CTMC)——「连续时间」指 $t$ 连续取值,「链」指状态离散。
马尔可夫性带来的直接后果是:整个过程被转移概率(transition probabilities)
$$ p_{t+h\mid t}(y\mid x) \;:=\; \mathbb P(X_{t+h}=y \mid X_t = x), \qquad x,y\in\Vocab,\ 0\le t\le t+h\le 1 $$加上初始分布 $p_0$ 完全决定。所以「说一个 CTMC」等价于「说一族转移概率」。
2. 速率矩阵:向量场在离散世界里的替身
2.1 为什么需要一个新对象
在 $\R^d$ 上我们用向量场 $\vf_t(x)\in\R^d$ 描述「在 $x$ 处往哪个方向、以多快的速度走」,欧拉法把它变成 $X_{t+h}\approx X_t + h\,\vf_t(X_t)$。离散空间里没有「方向」,唯一可做的动作是跳(jump / switch)。所以我们要问的不是「往哪走」,而是「在单位时间内跳到 $y$ 的概率有多大」。这个「单位时间概率」就是速率。
速率矩阵(rate matrix)是一个有界、关于 $t$ 连续的函数
$$ \Rate:\Vocab\times\Vocab\times[0,1]\to\R,\qquad (x,y,t)\mapsto \Rate_t(y\mid x), $$满足两个条件:
$$ \begin{aligned} &\text{(1) 非对角元非负:} && \Rate_t(y\mid x)\ \ge\ 0 &&\text{当 } y \ne x,\\[2pt] &\text{(2) 行和为零:} && \Rate_t(x\mid x)\ =\ -\sum_{y\ne x}\Rate_t(y\mid x) &&\text{对所有 } x . \end{aligned} $$条件 (2) 等价于 $\sum_{y\in\Vocab}\Rate_t(y\mid x)=0$ 对每个 $x$ 成立。
讲义写 $\Rate_t(y\mid x)$(读作「从 $x$ 到 $y$ 的速率」,竖线右边是出发点)。若把它排成矩阵,约定行 = 出发状态,列 = 到达状态:
$$ \mathbf{\Rate}_t \in \R^{\abs{\Vocab}\times\abs{\Vocab}},\qquad [\mathbf{\Rate}_t]_{x,y} \;=\; \Rate_t(x,y) \;:=\; \Rate_t(y\mid x). $$于是条件 (2) 就是「每一行加起来等于 0」,即 $\mathbf{\Rate}_t\mathbf 1 = 0$,其中 $\mathbf 1$ 是全 1 列向量。本文两套记号混用:写公式时用 $\Rate_t(y\mid x)$(跟讲义一致、更少下标),谈矩阵形状与线性代数时用 $\Rate_t(x,y)$。唯一容易搞错的地方是转置:$\Rate_t(y\mid x)$ 的第一个自变量是「到达点」,而 $\Rate_t(x,y)$ 的第一个自变量是「出发点」,两者互为转置。第 3 节的 KFE 会用到这一点。
条件的直觉:
- (1) 非对角元非负:从 $x$ 跳到另一个状态 $y\ne x$ 的速率不能是负的——「不跳」对应速率 0,比 0 还小没有意义。
- (2) 行和为零:这是一个守恒/一致性条件。$\Rate_t(x\mid x)$ 是「留在 $x$」的速率,它必须正好抵消掉所有「离开 $x$」的速率之和:你要么留下,要么走,没有第三种选择。特别地 $\Rate_t(x\mid x)\le 0$:速率矩阵的对角元非正,非对角元非负。
我们把
$$ \lambda_t(x) \;:=\; -\Rate_t(x\mid x) \;=\; \sum_{y\ne x}\Rate_t(y\mid x)\ \ge 0 $$称为 $x$ 的总跳出速率(total exit rate)。它在第 4 节会决定「在 $x$ 停留多久」。
2.2 速率矩阵和 CTMC 的关系:微分形式与展开形式
光有矩阵还不够,得说清楚「一条 CTMC 服从 这个速率矩阵」是什么意思。这是离散版的「$X_t$ 服从 ODE $\dot X_t = \vf_t(X_t)$」。
称 CTMC $(X_t)$ 服从速率矩阵 $\Rate_t$,若其转移概率满足
$$ \frac{\dd{}}{\dd{h}}\Big|_{h=0}\, p_{t+h\mid t}(y\mid x)\;=\;\Rate_t(y\mid x)\qquad \text{对所有 } x,y\in\Vocab,\ 0\le t\le 1. \tag{$\star$} $$左端是「从 $x$ 跳到 $y$ 的概率」在 $h=0$ 处的瞬时变化率。条件 $(\star)$ 说:这些概率的增长速度,正好由速率矩阵指定。
把 $h\mapsto p_{t+h\mid t}(y\mid x)$ 在 $h=0$ 处做一阶泰勒展开。首先注意零时刻的取值:
$$ p_{t\mid t}(y\mid x) \;=\; \mathbb P(X_t = y\mid X_t = x)\;=\;\delt{x}(y), $$因为「过了零时间之后还在原地」是必然事件。于是由 $(\star)$,
$$ \boxed{\ \mathbb P(X_{t+h}=y\mid X_t=x)\;=\;\delt{x}(y)\;+\;h\,\Rate_t(y\mid x)\;+\;o(h)\ } \tag{2.1} $$反过来,若 (2.1) 成立,两边减去 $\delt{x}(y)$ 再除以 $h$ 并令 $h\to0$,立刻得回 $(\star)$。所以微分形式 $(\star)$ 与展开形式 (2.1) 完全等价。
(2.1) 是本讲最该背下来的一行。它的读法:
- 取 $y \ne x$:$\mathbb P(\text{在 }h\text{ 时间内跳到 } y) = h\,\Rate_t(y\mid x)+o(h)$。速率乘以时长就是概率——这就是「速率」二字的含义。
- 取 $y=x$:$\mathbb P(\text{还在原地}) = 1 + h\,\Rate_t(x\mid x)+o(h) = 1 - h\,\lambda_t(x)+o(h)$。
把 $\R^{\abs{\Vocab}}$ 中的行向量记法用起来,(2.1) 就是 $p_{t+h\mid t}(\cdot\mid x) = e_x + h\,\mathbf{\Rate}_t(x,\cdot) + o(h)$:转移概率 = one-hot 向量 + $h$ 乘以速率矩阵的第 $x$ 行。和欧拉法 $x + h\,\vf_t(x)$ 的形状一模一样,只不过「$+$」发生在概率单纯形里而不是状态空间里。
在很短的时间 $h$ 内,最多发生一次跳的概率是 $O(h)$,发生两次或更多次跳的概率是 $O(h^2)$,被吸收进 $o(h)$ 里了。所以速率矩阵只描述「单次跳」的统计信息——这与向量场只描述「瞬时速度」而不管加速度是完全平行的。第 5 节会看到,正是这个 $O(h^2)$ 让我们能在一步里并行更新多个 token(代价是引入 $O(h^2)$ 的近似误差)。
2.3 两个条件不是人为规定,而是自动成立的
如果先有 CTMC 再定义 $\Rate_t := \frac{\dd{}}{\dd{h}}\big|_{0}p_{t+h\mid t}$,那么条件 (1)(2) 自动满足。讲义把这个检验做了,我们补全每一步。
条件 (1):非对角元非负。固定 $y\ne x$。函数 $h\mapsto p_{t+h\mid t}(y\mid x)$ 是概率,故恒 $\ge 0$;而它在 $h=0$ 的取值是 $\delt{x}(y)=0$(因为 $y\ne x$)。一个从 0 出发、之后始终非负的可导函数,其右导数必然非负:
$$ \Rate_t(y\mid x)=\lim_{h\downarrow0}\frac{p_{t+h\mid t}(y\mid x)-0}{h}\ \ge\ 0 . $$条件 (2):行和为零。直接计算:
$$ \begin{aligned} \sum_{y\ne x}\Rate_t(y\mid x) &\overset{(i)}{=} \sum_{y\ne x}\frac{\dd{}}{\dd{h}}\Big|_{h=0} p_{t+h\mid t}(y\mid x)\\ &\overset{(ii)}{=} \frac{\dd{}}{\dd{h}}\Big|_{h=0}\sum_{y\ne x} p_{t+h\mid t}(y\mid x)\\ &\overset{(iii)}{=} \frac{\dd{}}{\dd{h}}\Big|_{h=0}\Big(1-p_{t+h\mid t}(x\mid x)\Big)\\ &\overset{(iv)}{=} -\frac{\dd{}}{\dd{h}}\Big|_{h=0} p_{t+h\mid t}(x\mid x)\;=\;-\,\Rate_t(x\mid x). \end{aligned} $$其中 (i) 是 $(\star)$;(ii) 交换有限求和与求导($\Vocab$ 有限,恒可交换);(iii) 用了「概率之和为 1」,即 $\sum_{y\in\Vocab}p_{t+h\mid t}(y\mid x)=1$,把 $y=x$ 那一项移到右边;(iv) 常数 1 求导为 0,再用 $(\star)$。
所以 $\Rate_t(x\mid x)=-\sum_{y\ne x}\Rate_t(y\mid x)$,正是条件 (2)。结论:每个 CTMC 至少有一个满足 $(\star)$ 的速率矩阵,而且它自动是合法的速率矩阵。
2.4 反过来呢?存在唯一性定理
机器学习里我们要做的事恰好是反方向的:先用神经网络吐出一个 $\Rate^\theta_t$,然后声称「它对应某条 CTMC」。这需要一个定理保证。
对任意速率矩阵 $\Rate_t$(有界、关于 $t$ 连续),存在唯一的马尔可夫链 $(X_t)$(即唯一的一族转移概率 $p_{t'\mid t}(y\mid x)$)使得 $(\star)$ 成立。
讲义把证明放在附录 C。它的逻辑非常漂亮,而且完全建立在我们第一讲就学过的「线性 ODE 解的存在唯一性」上,值得完整看一遍。
第 1 步:把转移概率变成一个线性 ODE 的解。固定出发点 $x$ 与出发时刻 $t$,把 $t'\mapsto \big(p_{t'\mid t}(y\mid x)\big)_{y\in\Vocab}\in\R^{\abs{\Vocab}}$ 看成一个向量值函数。计算它的导数:
$$ \begin{aligned} \frac{\dd{}}{\dd{t'}}p_{t'\mid t}(y\mid x) &\overset{(i)}{=} \frac{\dd{}}{\dd{h}}\Big|_{h=0} p_{t'+h\mid t}(y\mid x)\\ &\overset{(ii)}{=} \frac{\dd{}}{\dd{h}}\Big|_{h=0}\sum_{z\in\Vocab} p_{t'+h\mid t'}(y\mid z)\,p_{t'\mid t}(z\mid x)\\ &\overset{(iii)}{=} \sum_{z\in\Vocab}\Big[\frac{\dd{}}{\dd{h}}\Big|_{h=0}p_{t'+h\mid t'}(y\mid z)\Big]\,p_{t'\mid t}(z\mid x)\\ &\overset{(iv)}{=} \sum_{z\in\Vocab} \Rate_{t'}(y\mid z)\,p_{t'\mid t}(z\mid x). \end{aligned} $$(i) 只是把对 $t'$ 的导数写成对时间增量 $h$ 的导数;(ii) 是 Chapman–Kolmogorov 方程(对中间时刻 $t'$ 的状态 $z$ 做全概率分解,这一步用到马尔可夫性);(iii) 交换有限求和与求导,注意 $p_{t'\mid t}(z\mid x)$ 与 $h$ 无关;(iv) 用 $(\star)$。
初值条件是 $p_{t\mid t}(y\mid x) = \delt{x}(y)$。所以:对固定的 $(x,t)$,转移概率向量是一个已知初值的线性常微分方程组的解,系数矩阵就是 $\mathbf{\Rate}^\top_{t'}$。
第 2 步:唯一性。线性 ODE(系数有界连续)在给定初值下解唯一(第一讲定理 3 / Picard–Lindelöf)。所以满足 $(\star)$ 的转移概率至多有一族。
第 3 步:存在性 —— 先解 ODE。反过来,对任意速率矩阵 $\Rate_t$,上述线性 ODE 一定有解 $p_{t'\mid t}(y\mid x)$。剩下要验证它确实是一族合法的转移核,即三条性质:
$$ \text{(a) } \sum_{y}p_{t'\mid t}(y\mid x)=1;\quad \text{(b) } p_{t'\mid t}(y\mid x)\ge 0;\quad \text{(c) Chapman–Kolmogorov 成立.} $$(a) 归一性。在 $t'=t$ 时 $\sum_y \delt{x}(y)=1$ 成立。再看它的导数:
$$ \frac{\dd{}}{\dd{t'}}\sum_{y}p_{t'\mid t}(y\mid x) =\sum_{y}\sum_{z}\Rate_{t'}(y\mid z)p_{t'\mid t}(z\mid x) =\sum_{z}\Big[\underbrace{\sum_{y}\Rate_{t'}(y\mid z)}_{=\,0\ \text{(行和为零)}}\Big]p_{t'\mid t}(z\mid x)=0 . $$总和的导数恒为 0 且初值为 1,故恒等于 1。这正是「行和为零」这个条件的用处:它保证概率质量守恒。
(b) 非负性。在 $t'=t$ 时非负。假设某时刻某个分量触到 0,即 $p_{t'\mid t}(y\mid x)=0$,此刻它的导数是
$$ \frac{\dd{}}{\dd{t'}}p_{t'\mid t}(y\mid x) =\sum_{z}\Rate_{t'}(y\mid z)p_{t'\mid t}(z\mid x) =\underbrace{\Rate_{t'}(y\mid y)\cdot 0}_{=0}+\sum_{z\ne y}\underbrace{\Rate_{t'}(y\mid z)}_{\ge 0}\underbrace{p_{t'\mid t}(z\mid x)}_{\ge 0}\ \ge\ 0 . $$即:一旦某个分量降到 0,它只能不降或上升,无法穿过 0 变负。所以解始终非负。这正是「非对角元非负」这个条件的用处。
(c) Chapman–Kolmogorov。对 $t_0\le t_1\le t_2$,定义
$$ q_{t_2\mid t_0}(y\mid x) := \sum_{z\in\Vocab}p_{t_2\mid t_1}(y\mid z)\,p_{t_1\mid t_0}(z\mid x). $$要证 $q_{t_2\mid t_0} = p_{t_2\mid t_0}$。先看初值:$t_2 = t_1$ 时 $q_{t_1\mid t_0}(y\mid x)=\sum_z\delt{z}(y)p_{t_1\mid t_0}(z\mid x)=p_{t_1\mid t_0}(y\mid x)$,与 $p_{t_2\mid t_0}$ 在 $t_2=t_1$ 处相同。再看它作为 $t_2$ 的函数满足的 ODE:
$$ \begin{aligned} \frac{\dd{}}{\dd{t_2}}q_{t_2\mid t_0}(y\mid x) &=\sum_{z}\Big[\frac{\dd{}}{\dd{t_2}}p_{t_2\mid t_1}(y\mid z)\Big]p_{t_1\mid t_0}(z\mid x)\\ &=\sum_{z}\sum_{\bar z}\Rate_{t_2}(y\mid \bar z)\,p_{t_2\mid t_1}(\bar z\mid z)\,p_{t_1\mid t_0}(z\mid x)\\ &=\sum_{\bar z}\Rate_{t_2}(y\mid\bar z)\Big[\sum_{z}p_{t_2\mid t_1}(\bar z\mid z)p_{t_1\mid t_0}(z\mid x)\Big] =\sum_{\bar z}\Rate_{t_2}(y\mid\bar z)\,q_{t_2\mid t_0}(\bar z\mid x). \end{aligned} $$这与 $p_{t_2\mid t_0}$ 满足的 ODE 完全相同,且初值相同。再次由线性 ODE 解的唯一性,$q\equiv p$。$\square$
整个证明的味道:CTMC 的全部理论,被「转移概率满足一个 $\abs{\Vocab}$ 维线性 ODE」这一句话统摄。速率矩阵的两个条件恰好各自负责一条概率公理(行和为零 → 归一;非对角非负 → 非负)。
我们可以放心地让神经网络输出任意满足两条件的 $\Rate^\theta_t$(做法见第 5 节:非对角元过 softplus 或 softmax 保证非负,对角元用行和为零的公式补上),然后假装存在一条对应的 CTMC 并去模拟它。定理 33 保证这个「假装」是合法的:这条链存在,而且唯一。这和第一讲里「随便写个向量场就能谈它的流」是完全一样的地位。
2.5 一个能算到底的例子:两状态 CTMC
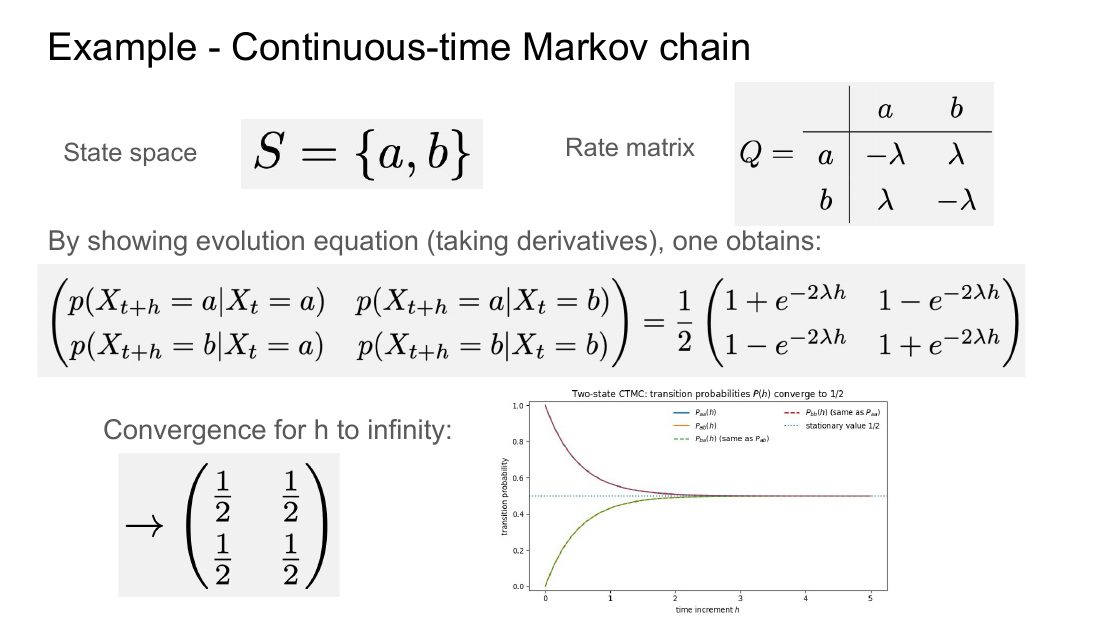
抽象定义讲完了,必须落地。取 $N=1$、$\mathcal V=\Vocab=\set{a,b}$,考虑一个时齐(time-homogeneous)的 CTMC,两个方向的跳转速率都等于常数 $\lambda>0$:
$$ \mathbf{\Rate} = \begin{pmatrix} \Rate(a\mid a) & \Rate(b\mid a)\\ \Rate(a\mid b) & \Rate(b\mid b)\end{pmatrix} = \begin{pmatrix} -\lambda & \lambda \\ \lambda & -\lambda\end{pmatrix}\in\R^{2\times2} $$(行 = 出发状态,行和为零 ✓,非对角元 $\lambda>0$ ✓)。
记 $f(h):=\mathbb P(X_{t+h}=a\mid X_t=a)$。由第 1 步得到的线性 ODE(这里 $\Rate$ 不依赖时间):
$$ \begin{aligned} f'(h) &= \sum_{z\in\set{a,b}}\Rate(a\mid z)\,p_{t+h\mid t}(z\mid a)\\ &= \Rate(a\mid a)\,f(h) + \Rate(a\mid b)\,\big(1-f(h)\big) \quad&&\text{(利用 } p(b\mid a)=1-f)\\ &= -\lambda f(h) + \lambda\big(1-f(h)\big)\\ &= \lambda - 2\lambda f(h), \end{aligned} $$初值 $f(0)=1$。这是一维线性 ODE。令 $g(h) := f(h)-\tfrac12$,则 $g' = -2\lambda g$,$g(0)=\tfrac12$,故 $g(h)=\tfrac12 e^{-2\lambda h}$,于是
$$ f(h) = \frac{1}{2}\Big(1+e^{-2\lambda h}\Big),\qquad \mathbb P(X_{t+h}=b\mid X_t=a) = 1-f(h)=\frac{1}{2}\Big(1-e^{-2\lambda h}\Big). $$由 $a\leftrightarrow b$ 的对称性,整张转移概率表是
$$ \begin{pmatrix} p(X_{t+h}=a\mid X_t=a) & p(X_{t+h}=a\mid X_t=b)\\ p(X_{t+h}=b\mid X_t=a) & p(X_{t+h}=b\mid X_t=b) \end{pmatrix} =\frac12\begin{pmatrix} 1+e^{-2\lambda h} & 1-e^{-2\lambda h}\\ 1-e^{-2\lambda h} & 1+e^{-2\lambda h}\end{pmatrix}. $$验证 $(\star)$。对 $h$ 求导并取 $h=0$:$\frac{\dd{}}{\dd{h}}\big|_0 \frac12(1+e^{-2\lambda h}) = \frac12(-2\lambda) = -\lambda = \Rate(a\mid a)$ ✓;$\frac{\dd{}}{\dd{h}}\big|_0\frac12(1-e^{-2\lambda h}) = \lambda = \Rate(b\mid a)$ ✓。
读出两件事。(i)$h=0$ 时矩阵是单位阵——没过时间就没跳转。(ii)$h\to\infty$ 时 $e^{-2\lambda h}\to0$,
$$ P(h)\ \longrightarrow\ \begin{pmatrix}\tfrac12&\tfrac12\\[2pt]\tfrac12&\tfrac12\end{pmatrix}, $$即链忘记了自己从哪出发,收敛到均匀平稳分布。指数项 $e^{-2\lambda h}$ 正是「对初始状态的记忆」的衰减;$\lambda$ 越大,翻转越频繁,遗忘越快。这是离散版的「OU 过程收敛到高斯平稳分布」。
3. Kolmogorov 前向方程:离散版的连续性方程
第一讲的核心工具是连续性方程:向量场 $\vf_t$ 的 ODE 轨迹服从概率路径 $p_t$ 当且仅当
$$ \pd{}{t}p_t(x) = -\divg\big(p_t\,\vf_t\big)(x). $$它把「个体轨迹怎么走」翻译成「群体分布怎么变」。没有它,第二讲的边际化技巧无从证明。离散世界里的对应物就是 Kolmogorov 前向方程(Kolmogorov Forward Equation, KFE),这是本讲的地基。
设 $(p_t)_{0\le t\le1}$ 是 $\Vocab$ 上的一族分布,$(X_t)$ 是速率矩阵为 $\Rate_t$、初始分布为 $p_0$ 的 CTMC。则
$$ X_t\sim p_t\ \text{对所有 }0\le t\le 1 \quad\Longleftrightarrow\quad \frac{\dd{}}{\dd{t}}p_t(x) \;=\; \sum_{y\in\Vocab}\Rate_t(x\mid y)\,p_t(y)\quad\forall x\in\Vocab . $$用矩阵记号(行 = 出发状态)写就是
$$ \pd{}{t}p_t(x) \;=\; \sum_{y\in\Vocab}\Rate_t(y,x)\,p_t(y), \qquad\text{即}\qquad \frac{\dd{}}{\dd{t}}p_t = \mathbf{\Rate}_t^{\top}\,p_t , $$其中 $p_t\in\R^{\abs{\Vocab}}$ 是列向量,$\mathbf{\Rate}_t\in\R^{\abs{\Vocab}\times\abs{\Vocab}}$。转置的出现是因为「流入 $x$」要对出发点 $y$ 求和,而出发点是矩阵的行指标。
3.1 必要性:从定义一步步推出 KFE
这是最能看清楚「KFE 从哪来」的写法。设 $X_t\sim p_t$,即 $p_t(x)=\mathbb P(X_t=x)$。对增量 $h>0$ 用全概率公式按 $t$ 时刻的状态分解:
$$ \begin{aligned} p_{t+h}(x) &\overset{(i)}{=}\sum_{y\in\Vocab}\mathbb P\big(X_{t+h}=x,\ X_t=y\big)\\ &\overset{(ii)}{=}\sum_{y\in\Vocab} p_{t+h\mid t}(x\mid y)\,p_t(y)\\ &\overset{(iii)}{=}\sum_{y\in\Vocab}\Big[\delt{y}(x) + h\,\Rate_t(x\mid y) + o(h)\Big]p_t(y)\\ &\overset{(iv)}{=}\underbrace{\sum_{y}\delt{y}(x)p_t(y)}_{=\,p_t(x)}\; +\; h\sum_{y}\Rate_t(x\mid y)p_t(y)\;+\;o(h). \end{aligned} $$其中 (i) 是把事件 $\set{X_{t+h}=x}$ 按 $X_t$ 的取值分割(这些事件互斥且穷尽);(ii) 是条件概率的定义;(iii) 代入速率矩阵的一阶展开式 (2.1);(iv) 分配求和,并用 $\sum_y\delt{y}(x)p_t(y)=p_t(x)$(只有 $y=x$ 那项非零),以及 $\Vocab$ 有限使得 $\sum_y o(h)p_t(y)=o(h)$。
移项、除以 $h$:
$$ \frac{p_{t+h}(x)-p_t(x)}{h} \;=\; \sum_{y\in\Vocab}\Rate_t(x\mid y)\,p_t(y)\;+\;\frac{o(h)}{h}. $$令 $h\to0$,右端第二项消失,左端按定义收敛到 $\frac{\dd{}}{\dd{t}}p_t(x)$,得
$$ \boxed{\ \frac{\dd{}}{\dd{t}}p_t(x)=\sum_{y\in\Vocab}\Rate_t(x\mid y)\,p_t(y)\ } $$这就是 KFE。整个推导只用了三样东西:全概率公式、马尔可夫性(藏在转移概率的定义里)、速率矩阵的一阶展开。
讲义给的是同一件事的紧凑版本,四个等号:
$$ \begin{aligned} \frac{\dd{}}{\dd{t}}p_t(x) &\overset{(i)}{=}\frac{\dd{}}{\dd{h}}\Big|_{h=0}p_{t+h}(x)\\ &\overset{(ii)}{=}\frac{\dd{}}{\dd{h}}\Big|_{h=0}\sum_{y}p_{t+h\mid t}(x\mid y)\,p_t(y)\\ &\overset{(iii)}{=}\sum_{y}\Big[\frac{\dd{}}{\dd{h}}\Big|_{h=0}p_{t+h\mid t}(x\mid y)\Big]p_t(y)\\ &\overset{(iv)}{=}\sum_{y}\Rate_t(x\mid y)\,p_t(y). \end{aligned} $$(i) 把对 $t$ 的导数改写成对时间偏移 $h$ 的导数;(ii) 用转移概率的定义做全概率分解(注意 $p_t(y)$ 与 $h$ 无关);(iii) 交换有限求和与求导;(iv) 用速率矩阵的定义 $(\star)$。
3.2 充分性:为什么反过来也对
设某族分布 $(q_t)$ 满足 KFE 且 $q_0=p_0$。把 KFE 写成向量形式
$$ \frac{\dd{}}{\dd{t}}q_t = \mathbf{\Rate}_t^\top q_t,\qquad q_t\in\R^{\abs{\Vocab}} , $$这是有限维空间 $\R^{\abs{\Vocab}}$ 上的线性 ODE,系数矩阵 $\mathbf{\Rate}_t^\top$ 有界且关于 $t$ 连续,初值 $q_0=p_0$ 给定。由第一讲的定理 3(ODE 解的存在唯一性),这样的解唯一。
另一方面,由 3.1 的必要性部分,CTMC 的真实边际 $p_t(x):=\mathbb P(X_t=x)$ 也满足同一个 ODE、同一个初值。两个解相等:$q_t = p_t$ 对所有 $t$。故 $X_t\sim q_t$。$\square$
这正是本课第二个母题的答案在离散情形的形态:为什么两个看起来不同的过程会给出同一个边际分布?因为边际分布由一个线性 ODE 唯一决定,只要两个速率矩阵都满足同一个 KFE,它们的边际就必然逐点相同——速率矩阵中不影响 KFE 右端的那部分自由度,对边际完全没有影响。
3.3 换个写法:流入减流出
KFE 右端的求和把 $y=x$ 那一项也包含进来了,看不出物理意义。把它拆开:
(i) 拆出对角项;(ii) 用条件 (2)(行和为零)把 $\Rate_t(x\mid x)$ 换成 $-\sum_{y\ne x}\Rate_t(y\mid x)$;(iii) 合并两个对 $y\ne x$ 的求和。
于是 KFE 读作:
$$ \frac{\dd{}}{\dd{t}}p_t(x)=\sum_{y\ne x}\Big[\Rate_t(x\mid y)p_t(y)-\Rate_t(y\mid x)p_t(x)\Big]. $$状态 $x$ 上概率质量的变化率 = 所有邻居流进来的 − 从 $x$ 流出去的。这就是「守恒律」的离散形态:把 $J_t(y\to x):=\Rate_t(x\mid y)p_t(y)$ 叫做从 $y$ 到 $x$ 的概率流(probability flux),则上式是 $\partial_t p_t(x) = -\big(\text{离散散度}\big)(x)$。在 $\R^d$ 上,流是 $j_t = p_t\vf_t$,守恒律是 $\partial_t p_t = -\divg j_t$;在 $\Vocab$ 上,流是矩阵 $J_t(y\to x)$,「散度」是对所有邻居求净流出。把 $\divg$ 换成「对邻居求和」,这就是从连续到离散的整个翻译字典的第一条。
KFE 必须保证 $\sum_x p_t(x)$ 恒为 1,否则 $p_t$ 就不是分布了。验证:
$$ \frac{\dd{}}{\dd{t}}\sum_{x\in\Vocab}p_t(x) =\sum_{x}\sum_{y}\Rate_t(x\mid y)p_t(y) =\sum_{y}p_t(y)\underbrace{\sum_{x}\Rate_t(x\mid y)}_{=\,0} =0 . $$内层求和是「从固定出发点 $y$ 出去的所有速率之和」,正是条件 (2)。所以「行和为零」在 KFE 里的角色,与「向量场的散度形式保证 $\int\partial_t p_t = 0$」完全一样:它就是概率守恒。
误区一:把 $\sum_y \Rate_t(x\mid y)p_t(y)$ 写成 $\sum_y\Rate_t(y\mid x)p_t(x)$。后者恒等于 0(行和为零),毫无信息。KFE 里对求和指标 $y$ 遍历的是出发点,$x$ 是固定的到达点。写成矩阵形式时是 $\mathbf{\Rate}^\top_t p_t$ 而不是 $\mathbf{\Rate}_t p_t$。判断方法:看哪个下标被求和,被求和的那个必须是源。
误区二:以为 KFE 只是「必要条件」。它是充要的。这一点至关重要:第 7 节证明边际化技巧时,我们只会去验证 KFE 成立,然后直接断言「所以这个速率矩阵的 CTMC 服从这条概率路径」。没有充分性,那个断言就是空的。
4. 模拟 CTMC:Euler 格式与 Gillespie 算法
假设我们已经有了 $\Rate_t$(无论是手写的还是网络输出的),怎么真的采出一条轨迹?
4.1 理想做法与它的问题
给定步长 $h>0$ 与初始分布 $\simple$,最朴素的迭代是
$$ X_0\sim\simple,\qquad X_{t+h}\sim p_{t+h\mid t}(\cdot\mid X_t). $$这是精确的(只要 $h$ 的网格覆盖 $[0,1]$)。问题是:除了第 2.5 节那种玩具例子,转移核 $p_{t+h\mid t}$ 几乎从来没有闭式——我们只知道 $\Rate_t$。这与 $\R^d$ 上的情形完全平行:我们知道向量场,但不知道流映射 $\psi_t$。
4.2 Euler 格式
解决办法也完全平行:用一阶展开近似转移核。由 (2.1),
$$ p_{t+h\mid t}(y\mid x) = \delt{x}(y) + h\,\Rate_t(y\mid x) + R_t(h), $$其中 $R_t(h)=o(h)$ 是可以忽略的误差项。于是定义
$$ \tilde p_{t+h\mid t}(y\mid x) \;:=\; \delt{x}(y) + h\,\Rate_t(y\mid x), \qquad X_{t+h}\ \sim\ \tilde p_{t+h\mid t}(\cdot\mid X_t) . \tag{4.1} $$右端是 $\Vocab$ 上的一个普通离散分布,用标准的分类采样(torch.multinomial)就能采。
要求两件事。
(a) 归一。精确成立,不需要任何条件:
$$ \sum_{y\in\Vocab}\tilde p_{t+h\mid t}(y\mid x)=\underbrace{\sum_y \delt{x}(y)}_{=1}+h\underbrace{\sum_y \Rate_t(y\mid x)}_{=0}=1 . $$(b) 非负。分两种情况:
- $y\ne x$:$\tilde p = h\,\Rate_t(y\mid x)\ge 0$ 自动成立(条件 (1))。
- $y=x$:$\tilde p = 1 + h\,\Rate_t(x\mid x) = 1 - h\,\lambda_t(x)$,要求
也就是说:步长必须小于「在当前状态的平均停留时间」。速率越大(越急着跳走),步长必须越小。这是 Euler 格式在离散世界里的稳定性条件,与 $\R^d$ 上 Euler 法的 CFL 型条件同源。第 8 节会看到混合路径的速率在 $t\to1$ 时形如 $\dot\kappa_t/(1-\kappa_t)\to\infty$,正好在终点附近逼近这个约束边界——这是实现里必须小心的地方。
4.3 Gillespie 算法:另一种精确模拟
还有一条完全不同的路子:不去离散化时间,而是直接采样「下一次跳发生在什么时候、跳到哪」。这就是化学动力学里的 Gillespie 算法(也叫 SSA,stochastic simulation algorithm)。
设当前 $X_t=x$,速率矩阵时齐($\Rate_t\equiv\Rate$)。令
$$ g(s) := \mathbb P\big(X_r = x \text{ 对所有 } r\in[t,t+s]\ \big|\ X_t=x\big) $$为「在 $s$ 时长内一次都没跳」的概率。由马尔可夫性,把 $[t,t+s+h]$ 拆成 $[t,t+s]$ 与 $(t+s,t+s+h]$:
$$ g(s+h) = g(s)\cdot\mathbb P(\text{在 } h \text{ 内不跳}\mid X_{t+s}=x) = g(s)\big(1-h\,\lambda(x)+o(h)\big), $$这里用了 (2.1) 的 $y=x$ 情形。移项除以 $h$ 取极限:
$$ g'(s) = -\lambda(x)\,g(s),\qquad g(0)=1 \quad\Longrightarrow\quad g(s)=e^{-\lambda(x)\,s}. $$所以停留时间 $\tau\sim\mathrm{Exp}(\lambda(x))$,期望停留时长 $\E[\tau]=1/\lambda(x)$。这正好解释了 4.2 里步长约束 $h\le 1/\lambda_t(x)$ 的含义:Euler 步长不能超过平均停留时间。
其次,跳到哪?在「已经决定要跳」的条件下,跳到 $y\ne x$ 的概率与速率成正比:
$$ \mathbb P(\text{跳到 } y\mid \text{发生跳转}) = \frac{\Rate(y\mid x)}{\lambda(x)} = \frac{\Rate(y\mid x)}{\sum_{y'\ne x}\Rate(y'\mid x)} . $$直观理由:在极短的 $h$ 内,跳到 $y$ 的概率是 $h\Rate(y\mid x)$,发生任何跳转的概率是 $h\lambda(x)$,条件概率取比值即得($h$ 约掉)。
时变情形:把 $\lambda$ 换成时间的函数,同样的推导给出 $\mathbb P(\tau>s)=\exp\big(-\int_t^{t+s}\lambda_r(x)\ud r\big)$,采样需要解这个积分方程或用 thinning(拒绝采样)。这也是为什么在实践中,时变速率的离散扩散模型基本都用 Euler 而不用 Gillespie。
| 比较项 | Euler 格式 (4.1) | Gillespie 算法 |
|---|---|---|
| 误差 | 每步 $o(h)$,总体 $O(h)$ 量级偏差 | 时齐情形精确;时变需 thinning |
| 步数 | 固定 $n=1/h$,由用户指定 | 随机,等于轨迹上实际的跳转次数 |
| 每步更新几个 token | 可以并行更新多个位置(见 5.3) | 严格一次一个位置 |
| 序列长 $N$ 大时 | 步数与 $N$ 无关 → 可以远少于 $N$ 步生成整句 | 跳转总次数至少 $\propto N$ → 慢 |
| 步长约束 | $h\le 1/\lambda_t(x)$,$t\to1$ 时苛刻 | 无 |
| GPU 友好度 | 高:每步一次网络前向 + 一次并行采样 | 低:串行、批内步数不齐 |
| 与 $\R^d$ 的对应 | Euler 法 $x+h\vf_t(x)$ | 无直接对应(连续情形没有「跳」) |
因为并行度就是一切。Gillespie 一次只改一个 token,生成 $N=1024$ 长度的序列至少要 1024 次跳转,每次都要跑一遍网络——这比自回归还慢,把离散扩散最大的卖点丢掉了。Euler 允许你用 $n=32$ 步生成 1024 个 token,代价是每步内多个位置「同时」更新时忽略了它们之间的相关性(第 5.3 节会精确说明这个误差是 $O(h^2)$)。「用多少步」直接就是「速度—质量」旋钮,这是第 12 节讨论的核心。
4.4 代码:一般 CTMC 的 Euler 模拟
先在小状态空间上把公式跑通,验证第 2.5 节的闭式解。
import torch

def euler_ctmc(Q, p0, n_steps=200, T=1.0, bs=200_000):
    """用 Euler 格式模拟时齐 CTMC。
    Q : (S, S)  速率矩阵,约定 Q[x, y] = 从 x 跳到 y 的速率;行和为 0
    p0: (S,)    初始分布
    返回 X_T 的样本 (bs,)
    """
    S = Q.shape[0]
    assert torch.allclose(Q.sum(1), torch.zeros(S), atol=1e-6), "行和必须为 0"
    h = T / n_steps
    P = torch.eye(S) + h * Q                     # (S, S)  单步转移概率 delta_x + h Q
    assert (P >= 0).all(), "步长过大:需要 h <= 1 / max_x |Q[x, x]|"
    x = torch.multinomial(p0, bs, replacement=True)   # (bs,)  X_0 ~ p_init
    for _ in range(n_steps):
        x = torch.multinomial(P[x], 1).squeeze(1)     # (bs,)  按第 x 行采下一个状态
    return x

# --- 验证第 2.5 节的两状态例子 ---
lam = 1.5
Q  = torch.tensor([[-lam,  lam],
                   [ lam, -lam]])                    # (2, 2)
p0 = torch.tensor([1.0, 0.0])                        # 确定性地从状态 a 出发
xT = euler_ctmc(Q, p0, n_steps=200, T=1.0)
emp = (xT == 0).float().mean().item()                # 经验的 P(X_1 = a | X_0 = a)
exact = 0.5 * (1 + torch.exp(torch.tensor(-2 * lam * 1.0))).item()
print(f"empirical={emp:.4f}  exact={exact:.4f}")     # 两者应吻合到蒙特卡洛误差内
这段代码逐项对应前面的公式:P = torch.eye(S) + h * Q 就是 $\tilde p_{t+h\mid t}(y\mid x)=\delt{x}(y)+h\Rate_t(y\mid x)$;assert (P >= 0) 就是步长约束 $h\le1/\lambda(x)$;P[x] 取的是矩阵的第 $x$ 行,即「从 $x$ 出发」的那一行——这里就能看出为什么把出发点定为行指标更顺手。
5. CTMC 模型与因子化:如何把 $V^N\times V^N$ 的矩阵塞进显存
5.1 CTMC 模型的定义
一个 CTMC 模型(也叫离散扩散模型)由一个初始分布 $\simple$ 和一个带参数 $\theta$ 的神经网络 $\Rate^\theta_t$ 组成,网络对每个输入状态 $x\in\Vocab$ 返回速率矩阵的一整行:
$$ x\ \longmapsto\ \big\{\Rate^\theta_t(y\mid x)\big\}_{y\in\Vocab}\ \in\ \R^{\abs{\Vocab}} . $$为什么必须是「一整行」而不是单个数?因为模拟时要用 (4.1) 从分布 $\delt{x}+h\Rate_t^\theta(\cdot\mid x)$ 里采样下一个状态,采样需要整个分布向量。
问题来了:$\abs{\Vocab}=V^N$。取 $V=32000$(一个常见的 BPE 词表)、$N=1024$,这一行有 $32000^{1024}\approx10^{4600}$ 个数。不是「显存不够」的量级问题,是「宇宙里的原子数量远远不够」的量级问题。必须对模型加结构约束。
5.2 因子化约束与「邻居」
观察:既然 CTMC 的轨迹是「一次一跳」,而一次跳理论上可以把整条序列全换掉——但我们完全可以规定模型只允许一次改一个 token。这就是因子化(factorized)约束。
对 $x=(x_1,\dots,x_N)\in\Vocab$,定义它的邻居集合(neighbors)
$$ \mathcal N(x) := \big\{y\in\Vocab:\ y \text{ 与 } x \text{ 至多在一个位置上不同}\big\}, \qquad \abs{\mathcal N(x)} = N(V-1)+1 . $$称 $\Rate^\theta_t$ 是因子化的,若
$$ \Rate^\theta_t(y\mid x)=0\qquad\text{只要 } y \text{ 与 } x \text{ 在多于一个位置上不同}. $$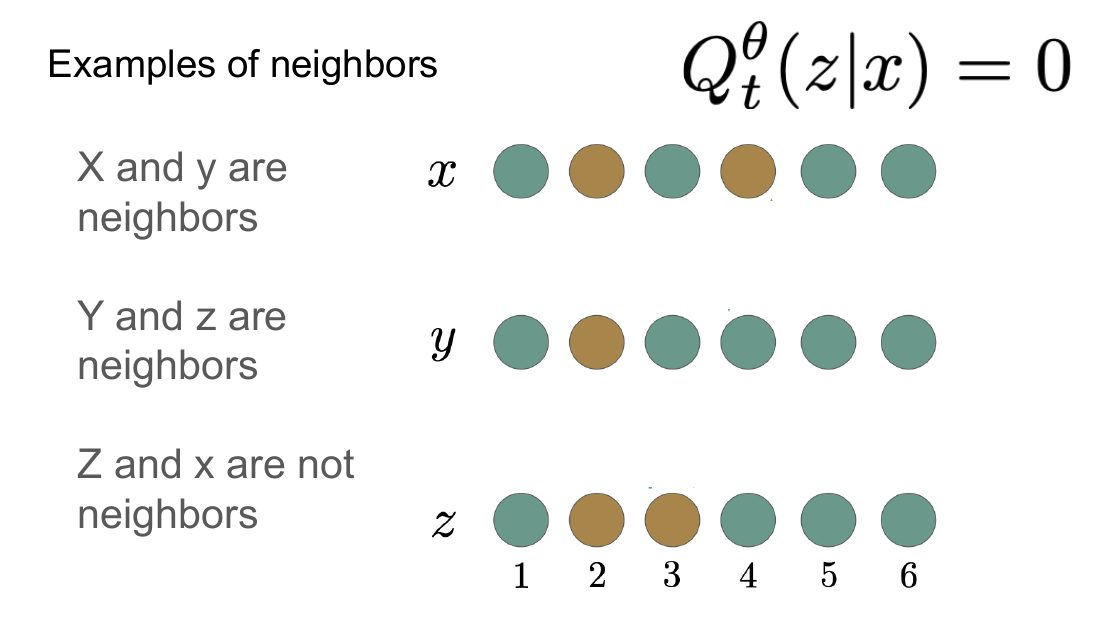
非零速率只出现在「把第 $j$ 个位置换成某个 $v\in\mathcal V$」这种跳转上。用
$$ \Rate^\theta_t(v, j\mid x) := \Rate^\theta_t\big(\underbrace{(x_1,\dots,x_{j-1},\,v,\,x_{j+1},\dots,x_N)}_{y}\ \big|\ x\big) $$记这个速率。于是网络的全部输出可以排成一个矩阵
$$ x\ \longmapsto\ \big\{\Rate^\theta_t(y\mid x)\big\}_{y\in\mathcal N(x)} =\begin{pmatrix} \Rate^\theta_t(v_1,1\mid x) & \cdots & \Rate^\theta_t(v_V,1\mid x)\\ & \cdots & \\ \Rate^\theta_t(v_1,N\mid x) & \cdots & \Rate^\theta_t(v_V,N\mid x) \end{pmatrix}\in\R^{N\times V}. $$输出形状从 $V^N$ 变成 $N\times V$:从指数变成线性。取 $V=32000,N=1024$,这是约 $3.3\times10^7$ 个数——一个普通的 logits 张量而已。
合法性条件也逐位置地写:对每个位置 $j$,第 $j$ 行必须自成一个合法速率矩阵的一行,
$$ \Rate^\theta_t(v,j\mid x)\ \ge\ 0\ \text{ 若 } v\ne x_j, \qquad \Rate^\theta_t(x_j, j\mid x) = -\sum_{v\ne x_j}\Rate^\theta_t(v,j\mid x). $$校验一下这与原始的行和为零一致:原始条件要求 $\sum_{y\in\Vocab}\Rate^\theta_t(y\mid x)=0$。因为非邻居项全为 0,求和只剩邻居,而邻居按「改哪个位置」分成 $N$ 组($y=x$ 这一项要小心,它属于每一组的对角元)。若我们约定「对角总速率」为 $\Rate^\theta_t(x\mid x)=\sum_{j=1}^N \Rate^\theta_t(x_j,j\mid x)$,则
$$ \sum_{y\in\Vocab}\Rate_t^\theta(y\mid x) =\sum_{j=1}^{N}\Big[\sum_{v\ne x_j}\Rate^\theta_t(v,j\mid x)+\Rate^\theta_t(x_j,j\mid x)\Big] =\sum_{j=1}^N 0 = 0 .\quad\checkmark $$换句话说:整条序列的总跳出速率,等于各位置跳出速率之和;$\lambda_t(x)=\sum_j\lambda_t^{(j)}(x)$,其中 $\lambda^{(j)}_t(x)=\sum_{v\ne x_j}\Rate_t^\theta(v,j\mid x)$。
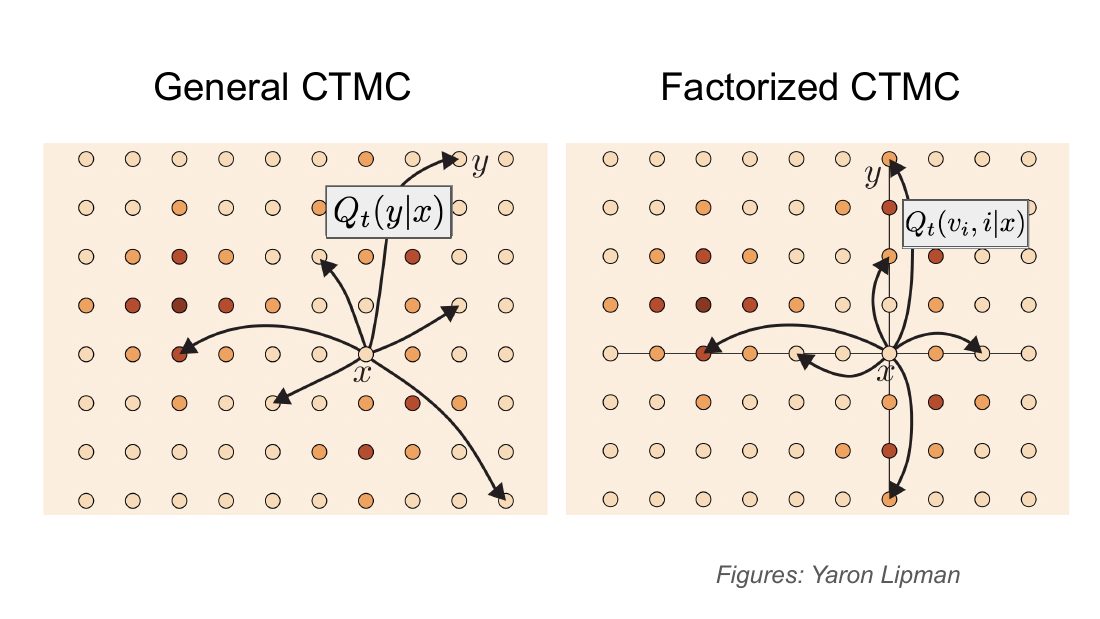
一个自然的担心:只允许一次改一个 token,会不会限制了模型能表达的分布?不会。原因是「一次一跳」是连续时间过程的性质,不是离散时间的。在任意长的时间里,链可以跳任意多次,因而可以从任何状态到达任何状态。真正的类比是:$\R^d$ 上的 ODE 也是「一次只沿一个方向走一小步」,但通过连续地改变方向,轨迹可以到达任何地方。
而且我们会在第 8 节看到,本讲要用的条件速率矩阵本来就是因子化的——因子化不是模型能力的妥协,而是从概率路径里自然导出的结构。
5.3 因子化模型的采样:逐位置并行 Euler
因子化带来一个巨大的实践红利:每一步 Euler 可以对所有 $N$ 个位置并行做。
完整的 Euler 步 (4.1) 要从 $\delt{x}+h\Rate_t(\cdot\mid x)$ 中采一个状态,这个分布把 $1-h\lambda_t(x)$ 的质量留在 $x$,把 $h\Rate_t(v,j\mid x)$ 的质量分给各个邻居——它一次最多改一个位置。
并行版本则对每个位置 $j$ 独立地做一次一维 Euler 步:
$$ \tilde p_{j,t}(v\mid x_j)= \begin{cases} h\,\Rate_t(v,j\mid x), & v\ne x_j,\\[4pt] 1-h\sum_{v'\ne x_j}\Rate_t(v',j\mid x), & v = x_j, \end{cases} \qquad X^{(j)}_{t+h}\sim \tilde p_{j,t}(\cdot\mid X^{(j)}_t)\ \text{(各 } j \text{ 独立)}. $$两者有什么差别?算一下「这一步里恰好有一个位置 $j$ 被改成 $v$」的概率。并行版本给出
$$ \underbrace{h\,\Rate_t(v,j\mid x)}_{\text{位置 }j\text{ 改了}}\cdot\prod_{j'\ne j}\underbrace{\Big(1-h\lambda^{(j')}_t(x)\Big)}_{\text{其它位置没改}} = h\,\Rate_t(v,j\mid x)\;+\;O(h^2), $$与完整 Euler 的 $h\Rate_t(v,j\mid x)$ 在 $h$ 的一阶上一致。差别只出现在二阶:并行版本以 $O(h^2)$ 的概率让多个位置在同一步同时改变,而完整 Euler 永远不会。
这就是讲义那句「agrees with the full CTMC Euler step up to first order in $h$, but allows for a $O(h^2)$ probability of simultaneous updates」的具体含义。
网络在状态 $x$ 处只给出每个位置各自的速率 $\Rate_t(v,j\mid x)$。当我们让两个位置 $j_1,j_2$ 在同一步里同时更新时,我们实际上假设了它们条件独立(给定 $x$)。真实的联合分布通常不独立——"The cat sat on the ___ ___" 的两个空格显然相关。所以:
- 步数 $n$ 越大($h$ 越小),同时更新的概率越低,样本质量越高,但网络前向次数越多;
- $n\to N$ 时几乎每步只改一个位置,质量最好,速度退化到自回归量级;
- $n\ll N$ 时速度快,但独立性假设被大量使用,质量下降。
「离散扩散比自回归快」这句话的准确版本是:它把「步数」和「token 数」解耦了,让你可以在质量上花钱买速度。而自回归模型的步数被死死钉在 $N$ 上。
输入:因子化速率网络 $\Rate^\theta_t$、初始分布 $\simple$、步数 $n$。
- $t\leftarrow 0$,$h\leftarrow 1/n$。
- 采 $X_0=(X_0^{(1)},\dots,X_0^{(N)})\sim\simple$。
- 对 $i=1,\dots,n$:
- 一次网络前向,得到全部因子化速率 $\{q_j(v)\}_{j=1..N,\,v\in\mathcal V}\leftarrow \Rate^\theta_t(\cdot\mid X_t)$,形状 $N\times V$。
- 对 $j=1,\dots,N$ 并行:令 $x\leftarrow X^{(j)}_t$,构造 $$\tilde p_{j,t}(v\mid x)=\begin{cases} h\,q_j(v), & v\ne x,\\ 1-h\sum_{v'\ne x}q_j(v'), & v=x,\end{cases}$$ 然后采 $X^{(j)}_{t+h}\sim\mathrm{Categorical}\big(\{\tilde p_{j,t}(v\mid x)\}_{v\in\mathcal V}\big)$。
- $t\leftarrow t+h$。
- 返回 $X_1$。
注意每一步只有一次网络前向——$N$ 个位置共享同一次前向的输出。这是与自回归解码(每 token 一次前向)最本质的区别。
5.4 网络该长什么样
因子化模型要求的映射是
$$ f_\theta:\ \underbrace{\Vocab\times[0,1]}_{\text{一条序列} + \text{时间}}\ \longrightarrow\ \R^{N\times V}, $$这正是一个标准的 seq-to-seq 网络签名:输入长度 $N$ 的 token 序列,输出每个位置在词表上的 logits。第 4 讲讲的 Transformer 直接可用,只需两处改动:
- 去掉 causal mask:$\Rate_t(v,j\mid x)$ 依赖整条 $x$,包括位置 $j$ 之后的 token。这是离散扩散与自回归在架构上唯一的硬性区别,也是「双向上下文」的来源。
- 注入时间 $t$:和第 4 讲一样,用正弦/傅里叶时间嵌入加到每个 token 表示上,或者用 adaLN 调制。
合法性怎么保证?把网络输出的 logits 过 softmax 得到每个位置的概率向量,再乘上一个非负的标量速率因子,最后用行和为零补对角元。第 9 节会看到,对因子化混合路径而言这件事有一个特别干净的做法:网络直接输出概率 $p^\theta_{1\mid t}$,速率矩阵由一个闭式公式给出,合法性自动成立。
6. 离散概率路径:条件与边际
从这一节开始,我们完整复刻第二讲的训练配方:(1) 造一条从噪声插值到数据的概率路径;(2) 导出跟随它的条件速率矩阵与边际速率矩阵;(3) 用免模拟(simulation-free)的方式学边际速率矩阵。
6.1 定义
一族分布 $\big(p_t(\cdot\mid z)\big)_{0\le t\le1,\ z\in\Vocab}$,每个 $p_t(\cdot\mid z)\in\Delta(\Vocab)$,称为条件概率路径(conditional probability path),若
$$ p_0(\cdot\mid z) = \simple,\qquad p_1(\cdot\mid z)=\delt{z} . $$对应的边际概率路径(marginal probability path)定义为
$$ p_t(x) := \sum_{z\in\Vocab} p_t(x\mid z)\,\data(z),\qquad x\in\Vocab . $$与第二讲逐字对应:条件路径从「与 $z$ 无关的噪声分布」插值到「全部质量集中在 $z$ 上的点质量」;边际路径把这些条件路径按数据分布加权平均。唯一的改动是 $\int\cdot\,\data(z)\ud z$ 变成 $\sum_z\cdot\,\data(z)$,$\delta_z$ 从广义函数变成真正的 pmf。
两个端点各验证一次:
$$ p_0(x)=\sum_{z}p_0(x\mid z)\data(z)=\sum_z \simple(x)\data(z)=\simple(x)\underbrace{\sum_z\data(z)}_{=1}=\simple(x), $$ $$ p_1(x)=\sum_{z}p_1(x\mid z)\data(z)=\sum_z\delt{z}(x)\data(z)\overset{(\ast)}{=}\data(x). $$$(\ast)$ 处:$\delt{z}(x)$ 只在 $z=x$ 时为 1,所以整个求和塌缩成 $\data(x)$。(在 $\R^d$ 上这一步需要「$\delta$ 的筛选性质」这种分布论语言;在有限集合上它只是「求和里只剩一项」,离散情形反而更严格、更简单。)
另外要确认 $p_t\in\Delta(\Vocab)$:非负性显然,归一性由 $\sum_x p_t(x)=\sum_z\data(z)\sum_x p_t(x\mid z)=\sum_z\data(z)=1$。$\square$
6.2 因子化混合路径(例 35)
现在给出本讲唯一真正用到的具体路径。
设 $\Vocab=\mathcal V^N$,初始分布逐位置因子化:$\simple(x)=\prod_{j=1}^{N}\simple^{(j)}(x_j)$。固定一个调度器(scheduler) $\kappa:[0,1]\to[0,1]$,满足
$$ \kappa_0=0,\qquad \kappa_1=1,\qquad \dot\kappa_t := \frac{\dd{}}{\dd{t}}\kappa_t\ \ge\ 0 . $$定义条件概率路径
$$ p_t(x\mid z)\;=\;\prod_{j=1}^{N}\Big[\;\underbrace{(1-\kappa_t)\,\simple^{(j)}(x_j)}_{\text{降权噪声}}\;+\;\underbrace{\kappa_t\,\delt{z_j}(x_j)}_{\text{升权数据}}\;\Big]. \tag{6.1} $$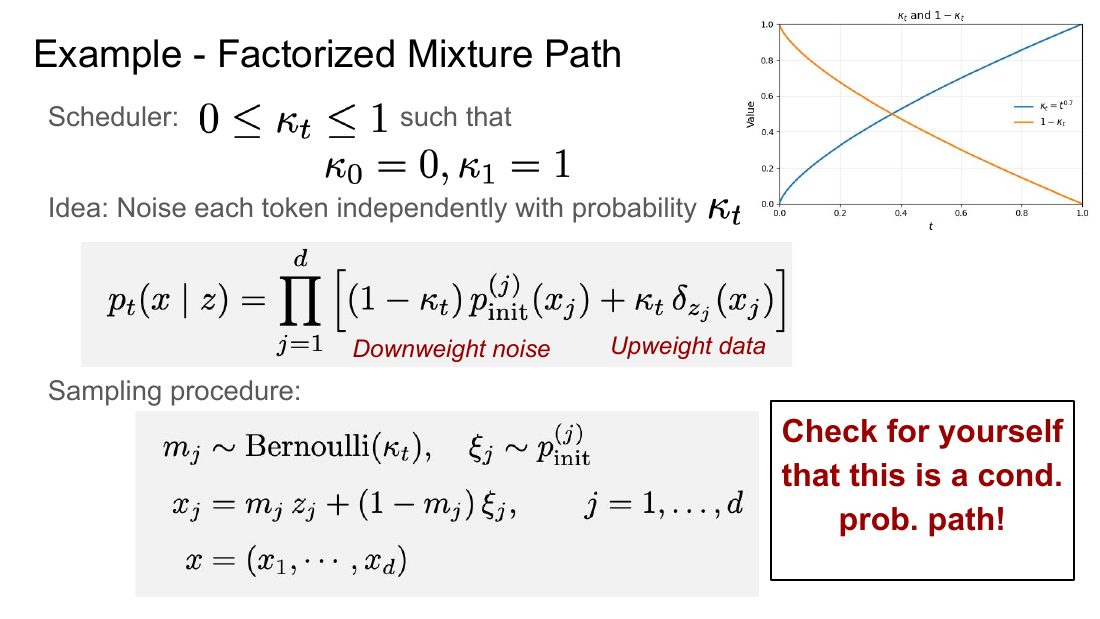
第 1 步:每个因子是 $\Delta(\mathcal V)$ 里的点。固定 $j$,记 $q^{(j)}_t := (1-\kappa_t)\,\simple^{(j)} + \kappa_t\,e_{z_j}\in\R^{V}$。 因为 $0\le\kappa_t\le1$,这是两个概率向量的凸组合,故非负且分量和为 $(1-\kappa_t)+\kappa_t=1$。✓
第 2 步:乘积是 $\Delta(\Vocab)$ 里的点。$N$ 个独立分布的乘积仍是分布:
$$ \sum_{x\in\Vocab}p_t(x\mid z)=\sum_{x_1\in\mathcal V}\cdots\sum_{x_N\in\mathcal V}\prod_{j}q^{(j)}_t(x_j)=\prod_{j}\Big[\sum_{x_j}q^{(j)}_t(x_j)\Big]=1 .\ \checkmark $$第 3 步:$t=0$ 端点。$\kappa_0=0$,(6.1) 变成 $\prod_j\simple^{(j)}(x_j)=\simple(x)$。✓
第 4 步:$t=1$ 端点。$\kappa_1=1$,(6.1) 变成 $\prod_j\delt{z_j}(x_j)$。这个乘积当且仅当每个位置都满足 $x_j=z_j$ 时为 1,即 $\prod_j\delt{z_j}(x_j)=\delt{z}(x)$。✓ $\square$
幻灯片上写着「Check for yourself that this is a cond. prob. path!」——我们把这个检查做完。断言:从 $p_t(\cdot\mid z)$ 采样等价于
$$ \begin{aligned} &m_j \sim \mathrm{Bernoulli}(\kappa_t),\qquad \xi_j\sim \simple^{(j)},\qquad (j=1,\dots,N \text{ 独立})\\ &x_j = m_j\,z_j + (1-m_j)\,\xi_j,\\ &x=(x_1,\dots,x_N). \end{aligned} $$证明。固定位置 $j$ 与任意 $v\in\mathcal V$,按 $m_j$ 的取值做全概率分解:
$$ \begin{aligned} \mathbb P(x_j = v) &= \mathbb P(m_j=1)\,\mathbb P(z_j = v) + \mathbb P(m_j=0)\,\mathbb P(\xi_j=v)\\ &= \kappa_t\,\delt{z_j}(v) + (1-\kappa_t)\,\simple^{(j)}(v), \end{aligned} $$正是 (6.1) 的第 $j$ 个因子。又因为 $(m_j,\xi_j)$ 关于 $j$ 独立,所以 $(x_1,\dots,x_N)$ 相互独立,联合分布等于各边际之积,即 (6.1)。$\square$
读法:$m_j=1$ 表示「第 $j$ 个位置保留真实 token」,概率 $\kappa_t$;$m_j=0$ 表示「第 $j$ 个位置被噪声替换」,概率 $1-\kappa_t$。所以 $\kappa_t$ 是「保留率」,$1-\kappa_t$ 是「破坏率」。$t=0$ 时全被破坏,$t=1$ 时全部保留。这三行就是第 11 节训练代码的第 3–8 行。
6.3 几何:单纯形里的直线
把 (6.1) 的单个因子写成向量形式($e_{z_j}\in\R^V$ 是 one-hot):
$$ q^{(j)}_t \;=\; (1-\kappa_t)\,\simple^{(j)} \;+\; \kappa_t\, e_{z_j}\ \in\ \Delta(\mathcal V)\subset\R^{V}. $$当 $\kappa_t=t$ 时,$q_t^{(j)} = (1-t)\,\simple^{(j)} + t\,e_{z_j}$ —— 这是概率单纯形里从噪声分布走到数据 one-hot 顶点的一条直线段,以匀速走完。
对比第二讲的 CondOT(条件最优传输)路径 $X_t = (1-t)\,\epsilon + t\,z$:在 $\R^d$ 上,直线画在状态空间里;在 $\Vocab$ 上,直线画在分布空间(单纯形)里。这是同一个想法在两个不同空间里的两次落地。
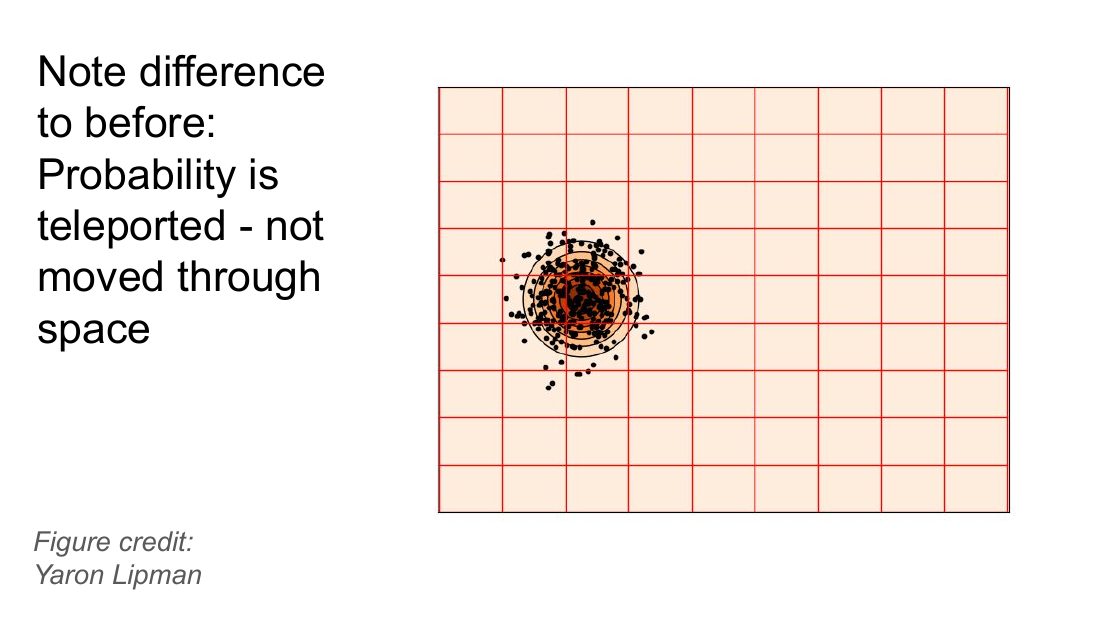
这是离散情形最重要的一处观念差异。在 $\R^d$ 上,概率路径 $\N(\alpha_t z,\beta_t^2 I)$ 的质量是被向量场推着连续移动的:一个高斯团整体平移、收缩,经过的每一个中间位置都真的被访问过。
在 $\Vocab$ 上,(6.1) 描述的是一个分布的质量在原地淡出、另一个分布的质量在原地淡入。中间时刻的 $p_t(\cdot\mid z)$ 并不「位于 $\simple$ 与 $\delt{z}$ 之间的某个位置」——因为状态空间里根本没有「之间」。质量是从 $\Vocab$ 的一处瞬间传送(teleport)到另一处的。这也解释了为什么速率矩阵不叫「向量场」:它没有方向,只有「从哪跳到哪、多快」。
$\kappa_t$ 完全对应第二讲的 $(\alpha_t,\beta_t)$ 调度:它控制信息被破坏/恢复的速度曲线。$\kappa_t=t$ 是匀速;$\kappa_t=t^{0.7}$(幻灯片上那条)在早期恢复得更快、后期更慢;一般地,把更多「时间预算」花在信息量大的那一段,能提升样本质量。这是离散扩散里少数几个可以自由设计、且确有影响的超参数。注意约束只有三条:$\kappa_0=0$、$\kappa_1=1$、$\dot\kappa_t\ge0$(第三条保证速率矩阵非对角元非负,见第 8 节)。
7. 条件速率矩阵与离散边际化技巧
有了概率路径,下一步是问:什么样的速率矩阵能让 CTMC 沿着这条路径走?
7.1 条件速率矩阵
给定条件概率路径 $p_t(\cdot\mid z)$。称速率矩阵 $\Rate^z_t$ 为它的条件速率矩阵(conditional rate matrix),若
$$ X_0\sim\simple,\quad X_t \text{ 是 } \Rate^z_t \text{ 的 CTMC}\quad\Longrightarrow\quad X_t\sim p_t(\cdot\mid z)\ \ \forall t . $$由命题 2(KFE 的充要性),这等价于要求
$$ \frac{\dd{}}{\dd{t}}p_t(x\mid z)=\sum_{y\in\Vocab}\Rate^z_t(x\mid y)\,p_t(y\mid z)\qquad\forall x\in\Vocab,\ t\in[0,1]. \tag{7.1} $$注意这是逐 $z$ 的:每个数据点 $z$ 有它自己的一整个速率矩阵。条件速率矩阵之所以有用,是因为它可以闭式写出来(第 8 节做这件事)——就像第二讲里 $\vf^z_t(x)$ 有闭式而 $\vf_t(x)$ 没有。
7.2 离散边际化技巧
可是我们真正需要的是能生成 $\data$ 的速率矩阵,也就是跟随边际路径 $p_t$ 的那个。而 $p_t$ 里含 $\data$。第二讲的答案是边际化技巧;这里的答案一模一样。
定义边际速率矩阵(marginal rate matrix)
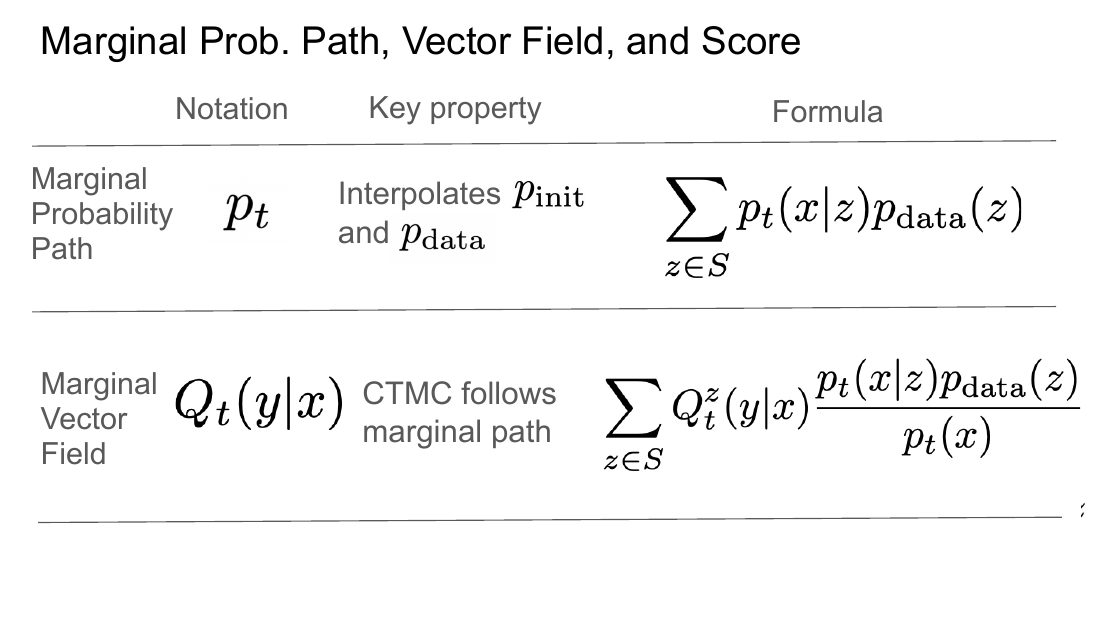
$$ \Rate_t(y\mid x)\;=\;\sum_{z\in\Vocab}\Rate^z_t(y\mid x)\,\frac{p_t(x\mid z)\,\data(z)}{p_t(x)} \;=\;\sum_{z\in\Vocab}\Rate^z_t(y\mid x)\,p_{1\mid t}(z\mid x), \tag{7.2} $$其中后验(denoising posterior)
$$ p_{1\mid t}(z\mid x):=\frac{p_t(x\mid z)\,\data(z)}{p_t(x)} . $$则 $\Rate_t$ 是一个合法的速率矩阵,且
$$ X_0\sim\simple,\quad X_t\text{ 是 }\Rate_t\text{ 的 CTMC}\quad\Longrightarrow\quad X_t\sim p_t . $$特别地 $X_1\sim p_1=\data$:边际速率矩阵的 CTMC 把噪声变成数据。
把 (7.2) 写成期望:
$$ \Rate_t(y\mid x)\;=\;\E_{z\sim p_{1\mid t}(\cdot\mid x)}\big[\Rate^z_t(y\mid x)\big]. $$「在噪声状态 $x$ 处,边际速率是各个可能的原始数据点 $z$ 所给出的速率的加权平均,权重是后验——即在看到 $x$ 之后,各个 $z$ 有多可信。」
这与第二讲的 $\vf_t(x)=\E_{z\sim p_{1\mid t}(\cdot\mid x)}[\vf^z_t(x)]$ 是同一句话。$p_{1\mid t}$ 由贝叶斯公式定义,含 $\data$ 因而不可计算——但正是它,稍后会被网络直接学到(第 9 节)。这就是第三个母题的答案:那个算不出来的量,最终成为网络的输出本身。
7.3 定理 36 的完整证明
讲义直接断言了这一点,我们补上。设 $p_t(x)>0$(否则 (7.2) 无定义,见下面的注记)。
(1) 非对角元非负。对 $y\ne x$:
$$ \Rate_t(y\mid x)=\sum_z \underbrace{\Rate^z_t(y\mid x)}_{\ge 0\ (\text{每个 }\Rate^z_t\text{ 合法})}\underbrace{p_{1\mid t}(z\mid x)}_{\ge0\ (\text{概率})}\ \ge\ 0 .\ \checkmark $$(2) 行和为零。交换求和次序:
$$ \sum_{y\in\Vocab}\Rate_t(y\mid x)=\sum_{z}p_{1\mid t}(z\mid x)\underbrace{\sum_{y}\Rate^z_t(y\mid x)}_{=\,0}=0 .\ \checkmark $$注意这两条都只用到「凸组合保持速率矩阵的两个条件」——因为 $p_{1\mid t}(\cdot\mid x)$ 是一个概率分布,(7.2) 就是一族合法速率矩阵的凸组合。合法速率矩阵的集合是凸的,这是边际化技巧能成立的代数根源。$\square$
由命题 2 的充分性,只需验证 $\frac{\dd{}}{\dd{t}}p_t(x)=\sum_y \Rate_t(x\mid y)p_t(y)$。
$$ \begin{aligned} \frac{\dd{}}{\dd{t}}p_t(x) &\overset{(i)}{=}\frac{\dd{}}{\dd{t}}\sum_{z\in\Vocab}p_t(x\mid z)\,\data(z)\\ &\overset{(ii)}{=}\sum_{z\in\Vocab}\frac{\dd{}}{\dd{t}}p_t(x\mid z)\,\data(z)\\ &\overset{(iii)}{=}\sum_{z\in\Vocab}\Big[\sum_{y\in\Vocab}\Rate^z_t(x\mid y)\,p_t(y\mid z)\Big]\data(z)\\ &\overset{(iv)}{=}\sum_{y\in\Vocab}p_t(y)\Big[\sum_{z\in\Vocab}\Rate^z_t(x\mid y)\,\frac{p_t(y\mid z)\,\data(z)}{p_t(y)}\Big]\\ &\overset{(v)}{=}\sum_{y\in\Vocab}p_t(y)\,\Rate_t(x\mid y). \end{aligned} $$逐步说明:
- (i) 边际概率路径的定义。
- (ii) 交换求和与求导($\Vocab$ 有限,恒可交换;这一步在 $\R^d$ 上需要控制收敛定理,离散情形免费)。
- (iii) 对条件路径用 KFE (7.1)——这一步正是「条件速率矩阵」定义的全部用处。
- (iv) 交换 $y$ 与 $z$ 的求和次序,然后同乘同除 $p_t(y)$。这是整个证明的技术核心:凭空造出一个 $p_t(y)$ 提到外面,剩下的部分就恰好凑成了后验 $p_{1\mid t}(z\mid y)$。
- (v) 括号里正是 (7.2) 在 $x\leftarrow y$(出发点)、$y\leftarrow x$(到达点)时的定义式。
于是边际路径 $p_t$ 满足 $\Rate_t$ 的 KFE。由命题 2 的充分性,速率矩阵为 $\Rate_t$、初值 $p_0=\simple$ 的 CTMC 满足 $X_t\sim p_t$ 对所有 $t$。取 $t=1$ 得 $X_1\sim p_1=\data$。$\square$
(7.2) 在 $p_t(x)=0$ 处没有定义。但这不构成问题:CTMC 从 $\simple$ 出发、服从 $p_t$,所以它永远不会到达 $p_t(x)=0$ 的状态(到达那里的概率是 $p_t(x)=0$)。在这些状态上 $\Rate_t$ 可以随便定义(比如设为 0),不影响任何结论。这与第二讲里「向量场在 $p_t=0$ 处无定义」的处理完全一样。
对第 10 节的掩码模型而言这一点很实在:$p_t(\cdot)$ 的支撑集只包含「每个位置要么是 [MASK] 要么是某个真实 token」的序列,模型永远不会被问到支撑集外的输入。
7.4 连续 ↔ 离散:完整对照表
到这里,整套框架的骨架已经搭完,可以把两个世界并排列出来了。建议把这张表当成本讲的索引:每当在离散情形下卡住,就去左边找对应的连续版本。
| 概念 | 连续(第 1–3 讲,$\R^d$) | 离散(本讲,$\Vocab=\mathcal V^N$) |
|---|---|---|
| 随机过程 | ODE $\dd{X_t}=\vf_t(X_t)\dd{t}$ / SDE 加 $\sigma_t\dd{W_t}$ | CTMC:分段常数轨迹,随机跳转 |
| 「运动」的生成元 | 向量场 $\vf_t:\R^d\times[0,1]\to\R^d$ | 速率矩阵 $\Rate_t\in\R^{\abs{\Vocab}\times\abs{\Vocab}}$,行和为零、非对角非负 |
| 一步模拟 | $X_{t+h}= X_t+h\,\vf_t(X_t)$ | $X_{t+h}\sim \delt{X_t}+h\,\Rate_t(\cdot\mid X_t)$ |
| 步长约束 | 数值稳定性(Lipschitz 常数) | 非负性:$h\le 1/\lambda_t(x)$ |
| 分布演化方程 | 连续性方程 $\partial_t p_t=-\divg(p_t\vf_t)$ | KFE $\partial_t p_t(x)=\sum_y\Rate_t(x\mid y)p_t(y)$ |
| 「散度」 | $\divg$:无穷小体积的净流出 | 对邻居求净流出 $\sum_{y\ne x}[\cdot]$ |
| 点质量 | $\delta_z$:广义函数 | $\delt{z}$:pmf,即 one-hot 向量 $e_z$ |
| 条件路径(典型) | $p_t(\cdot\mid z)=\N(\alpha_t z,\beta_t^2 I)$ | $p_t(\cdot\mid z)=\prod_j[(1-\kappa_t)\simple^{(j)}+\kappa_t\delt{z_j}]$ |
| 路径的几何 | 状态空间里的直线(CondOT) | 概率单纯形里的直线 |
| 质量怎么动 | 被向量场搬运(transport) | 原地淡入淡出,传送(teleport) |
| 边际路径 | $p_t(x)=\int p_t(x\mid z)\data(z)\ud z$ | $p_t(x)=\sum_z p_t(x\mid z)\data(z)$ |
| 边际化技巧 | $\vf_t(x)=\E_{z\sim p_{1\mid t}(\cdot\mid x)}[\vf^z_t(x)]$ | $\Rate_t(y\mid x)=\E_{z\sim p_{1\mid t}(\cdot\mid x)}[\Rate^z_t(y\mid x)]$ |
| 条件目标(CondOT / 混合) | $\vf^z_t(x)=\dfrac{z-x}{1-t}$ | $\Rate^z_t(v,j\mid x)=\dfrac{\dot\kappa_t}{1-\kappa_t}\big(\delt{z_j}(v)-\delt{x_j}(v)\big)$ |
| 网络预测什么 | $\vf^\theta_t(x)$,或去噪器 $\hat z^\theta\approx\E[z\mid X_t=x]$(条件均值) | $p^\theta_{1\mid t}(\cdot\mid x)\approx p_{1\mid t}(z_j=\cdot\mid x)$(条件分布) |
| 损失 | 均方误差(回归) | 交叉熵(分类) |
| 损失等价性的来源 | 塔性质 + $\norm{\cdot}^2$ 的 Bregman 结构 | 塔性质 + 交叉熵(=KL+常数)的 Bregman 结构 |
| 额外的随机性 | 需要显式加 SDE 噪声项(第 3 讲) | 不需要:CTMC 本身就是随机跳跃过程 |
| score 有没有 | 有:$\score{t}(x)=\nabla\log p_t(x)$ | 没有梯度;文献里的替代是「concrete score」$p_t(y)/p_t(x)$ |
8. 因子化混合路径的条件速率矩阵
现在把 (7.1) 真的解出来:给定 (6.1) 的混合路径,什么样的 $\Rate^z_t$ 跟随它?
记 $\dot\kappa_t=\frac{\dd{}}{\dd{t}}\kappa_t$。混合路径 (6.1) 的条件速率矩阵是因子化的,且
$$ \Rate^z_t(v,j\mid x)\;=\;\frac{\dot\kappa_t}{1-\kappa_t}\Big(\delt{z_j}(v)-\delt{x_j}(v)\Big) \;=\;\frac{\dot\kappa_t}{1-\kappa_t}\begin{cases} 0, & x_j = z_j\quad(\text{任意 } v)\\ 1, & v = z_j,\ x_j\ne z_j\\ 0, & v\ne z_j,\ x_j\ne z_j,\ v\ne x_j\\ -1, & v = x_j,\ x_j\ne z_j \end{cases} \tag{8.1} $$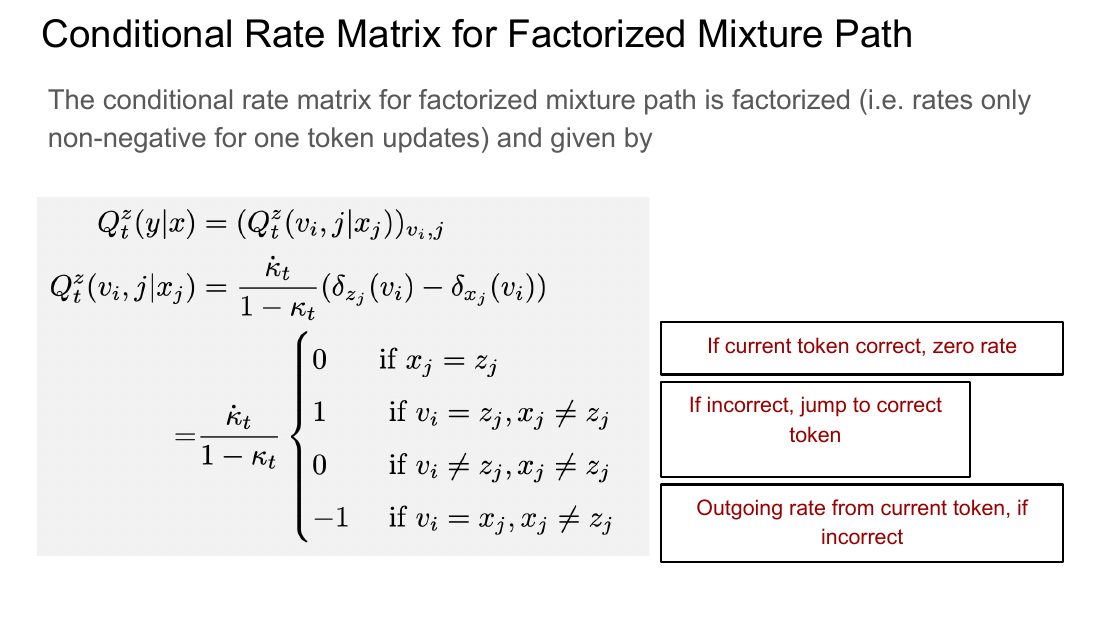
把 (8.1) 写成向量形式($e_v\in\R^V$ 为 one-hot):
$$ \Rate^z_t(\cdot,j\mid x)=\frac{\dot\kappa_t}{1-\kappa_t}\big(e_{z_j}-e_{x_j}\big)\ \in\R^{V}. $$取 $\kappa_t=t$,则 $\frac{\dot\kappa_t}{1-\kappa_t}=\frac{1}{1-t}$,于是
$$ \Rate^z_t(\cdot,j\mid x)=\frac{e_{z_j}-e_{x_j}}{1-t} \qquad\text{对比}\qquad \vf^z_t(x)=\frac{z-x}{1-t}\quad(\text{第 2 讲 CondOT}). $$一模一样。「目标减当前,除以剩余时间」——只不过在离散世界里,「目标」和「当前」都被换成了 one-hot 向量,而「减法」发生在 $\R^V$ 里(结果是一个和为零的向量,恰好就是一行合法速率)。这是本讲最值得记住的结构同构。
8.1 完整推导
第 0 步:约化到 $N=1$。混合路径 (6.1) 关于位置完全因子化,$p_t(x\mid z)=\prod_j q^{(j)}_t(x_j)$,而 (8.1) 给出的速率矩阵也只在单个位置上动作。因此只需对每个位置分别验证 KFE,不妨设 $N=1$,把 $x,z$ 直接当成 $\mathcal V$ 中的元素,路径为
$$ p_t(x\mid z)=(1-\kappa_t)\,\simple(x)+\kappa_t\,\delt{z}(x), $$待验证的速率矩阵为 $\Rate^z_t(y\mid x)=\frac{\dot\kappa_t}{1-\kappa_t}\big(\delt{z}(y)-\delt{x}(y)\big)$。
第 1 步:算左端。下面这串等号是整个推导的主体,八步:
$$ \begin{aligned} \frac{\dd{}}{\dd{t}}p_t(x\mid z) &\overset{(i)}{=}\frac{\dd{}}{\dd{t}}\Big[(1-\kappa_t)\simple(x)+\kappa_t\delt{z}(x)\Big]\\ &\overset{(ii)}{=}\dot\kappa_t\,\delt{z}(x)-\dot\kappa_t\,\simple(x)\\ &\overset{(iii)}{=}\frac{\dot\kappa_t}{1-\kappa_t}\Big(\delt{z}(x)-\big[(1-\kappa_t)\simple(x)+\kappa_t\delt{z}(x)\big]\Big)\\ &\overset{(iv)}{=}\frac{\dot\kappa_t}{1-\kappa_t}\Big(\delt{z}(x)-p_t(x\mid z)\Big)\\ &\overset{(v)}{=}\frac{\dot\kappa_t}{1-\kappa_t}\delt{z}(x)\big(1-p_t(x\mid z)\big)+\frac{\dot\kappa_t}{1-\kappa_t}\big(\delt{z}(x)-1\big)p_t(x\mid z)\\ &\overset{(vi)}{=}\sum_{y\ne x}\frac{\dot\kappa_t}{1-\kappa_t}\delt{z}(x)\,p_t(y\mid z)+\frac{\dot\kappa_t}{1-\kappa_t}\big(\delt{z}(x)-1\big)p_t(x\mid z)\\ &\overset{(vii)}{=}\sum_{y\ne x}\Rate^z_t(x\mid y)\,p_t(y\mid z)+\Rate^z_t(x\mid x)\,p_t(x\mid z)\\ &\overset{(viii)}{=}\sum_{y\in\Vocab}\Rate^z_t(x\mid y)\,p_t(y\mid z). \end{aligned} $$这正是 KFE (7.1)。逐步说明:
- (i) 代入 $N=1$ 的混合路径定义。
- (ii) 求导:$\simple(x)$ 与 $\delt{z}(x)$ 都与 $t$ 无关,只有系数含 $t$,$\frac{\dd{}}{\dd{t}}(1-\kappa_t)=-\dot\kappa_t$,$\frac{\dd{}}{\dd{t}}\kappa_t=\dot\kappa_t$。
- (iii) 纯代数配凑,是全场唯一需要「想一下」的一步。验证方法是把右端展开: $$\frac{\dot\kappa_t}{1-\kappa_t}\Big[(1-\kappa_t)\delt{z}(x)-(1-\kappa_t)\simple(x)\Big]=\dot\kappa_t\delt{z}(x)-\dot\kappa_t\simple(x),$$ 其中中括号内用了 $\delt{z}(x)-\kappa_t\delt{z}(x)=(1-\kappa_t)\delt{z}(x)$。与 (ii) 的结果一致 ✓。这一步的动机:我们想让 $p_t(x\mid z)$ 本身出现在表达式里,因为 KFE 的右端是关于 $p_t(\cdot\mid z)$ 的线性式。
- (iv) 中括号内正是 $p_t(x\mid z)$ 的定义。到这里已经得到一个漂亮的中间结论: $$\frac{\dd{}}{\dd{t}}p_t(x\mid z)=\frac{\dot\kappa_t}{1-\kappa_t}\big(\delt{z}(x)-p_t(x\mid z)\big),$$ 即「路径以正比于『离目标还差多少』的速度向 $\delt{z}$ 逼近」——一个标准的一阶弛豫方程,和 $\dot X=\frac{z-X}{1-t}$ 长得一样。
- (v) 把 (iv) 拆成两项。验证:把右端展开, $$\tfrac{\dot\kappa}{1-\kappa}\big[\delt{z}(x)-\delt{z}(x)p_t(x\mid z)+\delt{z}(x)p_t(x\mid z)-p_t(x\mid z)\big]=\tfrac{\dot\kappa}{1-\kappa}\big[\delt{z}(x)-p_t(x\mid z)\big]\ \checkmark$$ 中间两项恰好抵消。动机:第一项要变成「流入」(对 $y\ne x$ 求和),第二项要变成「流出」(对角项)。
- (vi) 用 $1-p_t(x\mid z)=\sum_{y\ne x}p_t(y\mid z)$(因为 $\sum_{y\in\Vocab}p_t(y\mid z)=1$)。
- (vii) 用 (8.1) 的定义把系数认出来:
- 对 $y\ne x$:$\Rate^z_t(x\mid y)=\frac{\dot\kappa_t}{1-\kappa_t}(\delt{z}(x)-\delt{y}(x))=\frac{\dot\kappa_t}{1-\kappa_t}\delt{z}(x)$,因为 $y\ne x$ 时 $\delt{y}(x)=0$;
- 对角项:$\Rate^z_t(x\mid x)=\frac{\dot\kappa_t}{1-\kappa_t}(\delt{z}(x)-\delt{x}(x))=\frac{\dot\kappa_t}{1-\kappa_t}(\delt{z}(x)-1)$,因为 $\delt{x}(x)=1$。
- (viii) 把对角项并回求和。
KFE 得证。再由命题 2 的充分性,$\Rate^z_t$ 的 CTMC 从 $\simple$ 出发就服从 $p_t(\cdot\mid z)$。$\square$
必须检查,否则前面的一切都不成立。
非对角元非负:取 $v\ne x_j$,则 $\delt{x_j}(v)=0$,于是
$$ \Rate^z_t(v,j\mid x)=\frac{\dot\kappa_t}{1-\kappa_t}\,\delt{z_j}(v)\ \ge\ 0 $$——当且仅当 $\dot\kappa_t\ge0$ 且 $\kappa_t<1$。这解释了例 35 里为什么要求调度器单调不减:$\dot\kappa_t\ge0$ 不是为了好看,而是速率矩阵合法性的充要条件。($\kappa_t=1$ 只在 $t=1$ 端点发生,那时过程已经结束。)
行和为零:
$$ \sum_{v\in\mathcal V}\Rate^z_t(v,j\mid x)=\frac{\dot\kappa_t}{1-\kappa_t}\Big[\underbrace{\sum_v\delt{z_j}(v)}_{=1}-\underbrace{\sum_v\delt{x_j}(v)}_{=1}\Big]=0 .\ \checkmark $$本质上:「one-hot 减 one-hot」永远是一个分量和为零的向量,这正好是速率矩阵一行所需的形状。$\square$
8.2 读懂这个速率矩阵
(8.1) 描述的动力学极其简单,值得逐条说清楚:
| 当前位置 $j$ 的状态 | 速率 | 行为 |
|---|---|---|
| $x_j = z_j$(已经是正确 token) | 整行全为 0 | 完全静止:不会跳走,也不会有任何变化。这个位置已经「定稿」。 |
| $x_j\ne z_j$,考虑跳到 $v=z_j$ | $+\dfrac{\dot\kappa_t}{1-\kappa_t}$ | 以这个速率直接跳到正确答案。 |
| $x_j\ne z_j$,考虑跳到 $v\notin\set{z_j,x_j}$ | 0 | 不会跳到任何其它错误的 token 上。 |
| $x_j\ne z_j$,对角元 $v=x_j$ | $-\dfrac{\dot\kappa_t}{1-\kappa_t}$ | 总跳出速率,正好抵消上面那一条。 |
结论:条件速率矩阵只允许「从错误跳到正确」这一种动作,而且一旦到达正确就永久停下。用 CTMC 的术语说,$z$ 的每个位置都是这条链的吸收态(absorbing state)。这与「概率被传送而不是搬运」完全一致:不存在「先跳到一个中间 token,再跳到目标」这种路径。
取 $\kappa_t=t$,速率因子是 $\frac{1}{1-t}$,在 $t\to1$ 时发散。这不是 bug。原因:某个位置在时刻 $t$ 仍然错误的概率是 $1-\kappa_t$,而我们要求它在 $t=1$ 时以概率 1 变正确。设 $u(t):=\mathbb P(x_j\ne z_j)=1-\kappa_t$。由动力学,$u$ 只减不增,且
$$ \frac{\dd{}}{\dd{t}}u(t)=-\frac{\dot\kappa_t}{1-\kappa_t}\,u(t)=-\frac{\dot\kappa_t}{1-\kappa_t}(1-\kappa_t)=-\dot\kappa_t\ \checkmark $$确实与 $u=1-\kappa_t$ 自洽。若速率因子有界,比如恒为常数 $c$,则 $u(t)=e^{-ct}>0$ 对所有有限 $t$ 成立,永远到不了 0。要在有限时间内把「还错着」的概率精确压到 0,速率必须以 $\frac{1}{1-t}$ 的量级发散。这与第二讲 CondOT 向量场 $\frac{z-x}{1-t}$ 在 $t\to1$ 时爆炸是同一个现象、同一个原因。
实践后果:Euler 步长约束 $h\le 1/\lambda_t(x)$ 在 $t\to1$ 时变得苛刻。第 10 节会看到,对 $\kappa_t=t$ 与均匀步长 $h=1/n$,第 $i$ 步的单位置跳转概率恰为 $\frac{1}{n-i}$,在最后一步等于 1 —— 边界正好被取到,不多不少。这是一个漂亮的巧合,也是均匀步长在这里格外好用的原因。
9. 边际速率矩阵与离散 Flow Matching 损失
把第 7 节的边际化技巧作用在第 8 节的条件速率矩阵上,就得到了真正用来生成的东西。这一节要回答两个问题:边际速率矩阵长什么样?它里面唯一未知的量怎么学?
9.1 边际速率矩阵的闭式(定理 38)
因子化混合路径的边际速率矩阵仍然是因子化的,且
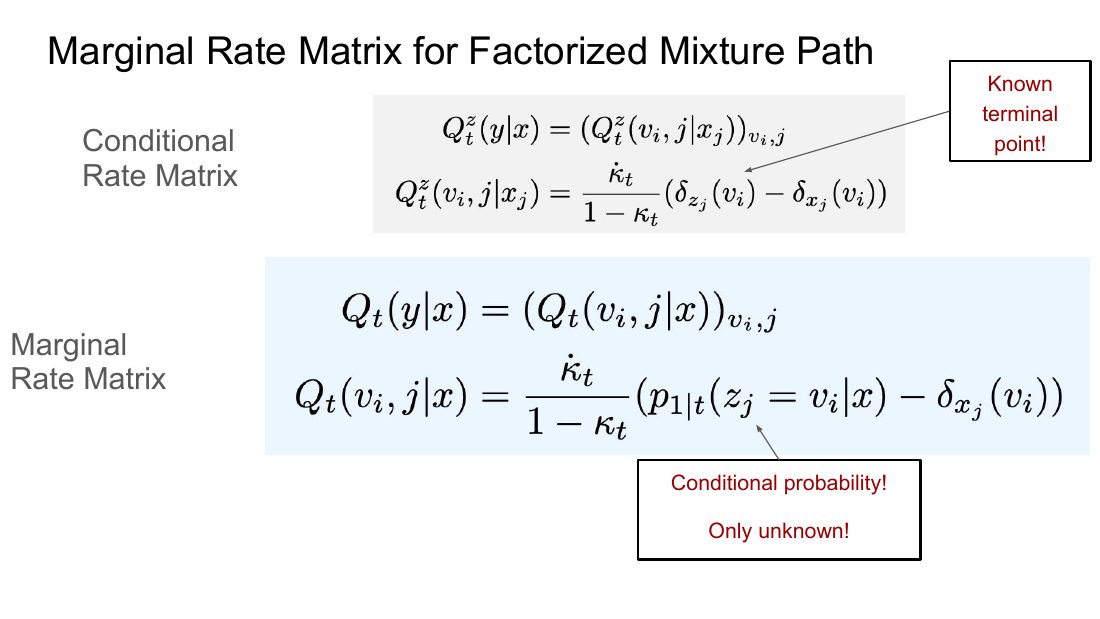
$$ \Rate_t(v,j\mid x)\;=\;\frac{\dot\kappa_t}{1-\kappa_t}\Big(\,\underbrace{p_{1\mid t}(z_j = v\mid x)}_{\text{后验:第 }j\text{ 位原本是 }v\text{ 的概率}}\;-\;\delt{x_j}(v)\Big), \tag{9.1} $$其中 $p_{1\mid t}(z_j=v\mid x)$ 是「给定整条被破坏的序列 $x$,原始序列第 $j$ 个位置等于 $v$」的条件概率。
第 1 步:边际速率矩阵也是因子化的。由边际化技巧 (7.2),
$$ \Rate_t(y\mid x)=\sum_{z\in\Vocab}\Rate^z_t(y\mid x)\,p_{1\mid t}(z\mid x). \tag{9.2} $$若 $y$ 与 $x$ 相差多于一个位置,则对每一个 $z$ 都有 $\Rate^z_t(y\mid x)=0$(例 37 的条件速率矩阵是因子化的),所以整个求和为 0,$\Rate_t(y\mid x)=0$。因子化性质在取凸组合下被保持。✓
第 2 步:算非零的那些分量。取 $y$ 为「把 $x$ 的第 $j$ 位换成 $v$」,代入 (8.1):
$$ \begin{aligned} \Rate_t(v,j\mid x) &=\sum_{z\in\Vocab}\Rate^z_t(v,j\mid x)\,p_{1\mid t}(z\mid x)\\ &\overset{(i)}{=}\sum_{z\in\Vocab}\frac{\dot\kappa_t}{1-\kappa_t}\Big(\delt{z_j}(v)-\delt{x_j}(v)\Big)p_{1\mid t}(z\mid x)\\ &\overset{(ii)}{=}\frac{\dot\kappa_t}{1-\kappa_t}\Big(\sum_{z\in\Vocab}\delt{z_j}(v)\,p_{1\mid t}(z\mid x)\;-\;\delt{x_j}(v)\underbrace{\sum_{z\in\Vocab}p_{1\mid t}(z\mid x)}_{=1}\Big)\\ &\overset{(iii)}{=}\frac{\dot\kappa_t}{1-\kappa_t}\Big(p_{1\mid t}(z_j=v\mid x)-\delt{x_j}(v)\Big). \end{aligned} $$逐步说明:
- (i) 代入例 37 的条件速率矩阵公式。
- (ii) 把与 $z$ 无关的 $\delt{x_j}(v)$ 提出求和,剩下 $\sum_z p_{1\mid t}(z\mid x)=1$(后验是一个分布)。
- (iii) 关键一步——边缘化。注意 $\delt{z_j}(v)=\mathbb 1[z_j=v]$,所以
也就是说,那个对整个 $\Vocab$($V^N$ 项!)的求和,塌缩成了后验在单个位置上的边缘分布——一个 $V$ 维向量。$\square$
这一步为什么如此重要:它把「需要知道整条序列的后验分布 $p_{1\mid t}(z\mid x)\in\Delta(\Vocab)$」(不可表示)降格成「只需要知道 $N$ 个位置各自的边缘后验 $p_{1\mid t}(z_j=\cdot\mid x)\in\Delta(\mathcal V)$」(形状 $N\times V$,完全可表示)。因子化的速率矩阵只需要因子化的信息。
再看一次并排对比(取 $\kappa_t=t$):
$$ \Rate_t(\cdot,j\mid x)=\frac{p_{1\mid t}(z_j=\cdot\mid x)-e_{x_j}}{1-t} \qquad\longleftrightarrow\qquad \vf_t(x)=\frac{\E[z\mid X_t=x]-x}{1-t} . $$右边是第 2、3 讲的结论:边际向量场等于「去噪器减当前状态,除以剩余时间」,其中去噪器 $\E[z\mid X_t=x]$ 是后验均值。左边是它的离散版:后验分布减当前 one-hot,除以剩余时间。
为什么一个是均值、一个是分布?因为在 $\R^d$ 里,$\vf^z_t(x)$ 对 $z$ 是线性的($\frac{z-x}{1-t}$),所以取期望后只剩下 $\E[z\mid x]$,一个 $d$ 维向量就够了。在 $\Vocab$ 里,$\Rate^z_t$ 对 $z$ 也是线性的,但 $z$ 是通过 one-hot $e_{z_j}$ 进入公式的,而「one-hot 的期望」恰恰就是整个分布。离散空间里,「条件均值」这个概念自动升级成了「条件分布」——这就是为什么损失从回归变成分类。
合法性。非对角元($v\ne x_j$):$\Rate_t(v,j\mid x)=\frac{\dot\kappa_t}{1-\kappa_t}p_{1\mid t}(z_j=v\mid x)\ge0$ ✓。行和:$\frac{\dot\kappa_t}{1-\kappa_t}\big(\sum_v p_{1\mid t}(z_j=v\mid x)-\sum_v\delt{x_j}(v)\big)=\frac{\dot\kappa_t}{1-\kappa_t}(1-1)=0$ ✓。只要网络输出的是一个合法的概率分布(比如 softmax 的结果),(9.1) 自动是合法速率矩阵——不需要任何额外的投影或裁剪。这是这个参数化最漂亮的地方。
已定稿的位置。假设在时刻 $t$,第 $j$ 位的后验已经塌缩成点质量 $p_{1\mid t}(z_j=\cdot\mid x)=e_{x_j}$(即「我确信原本就是 $x_j$」)。代入 (9.1):
$$ \Rate_t(\cdot,j\mid x)=\frac{\dot\kappa_t}{1-\kappa_t}\big(e_{x_j}-e_{x_j}\big)=0 . $$整行为零,这个位置再也不会改变。第 10 节会看到,掩码模型中所有「已经被解掩」的位置都自动落入这一情形——这就是 MDLM 里「一旦生成就不再修改(carry-over)」这一行为的数学来源,它不是实现技巧,而是公式的推论。
9.2 去噪概率网络:把未知量变成网络输出
(9.1) 里唯一未知的是 $p_{1\mid t}(z_j=v\mid x)$。定理 38 因此把「学速率矩阵」重参数化成了「学后验」。定义
输出形状 $N\times V$,每个位置过一次 softmax 得到 $\Delta(\mathcal V)$ 中的点。网络本体可以是任意 seq-to-seq 模型——第 4 讲的 Transformer(去掉 causal mask)即可。
停下来体会一下这句话的分量:我们要做的全部事情,就是训练 $N$ 个分类器——每个位置一个,任务是「给定被破坏的整句话,猜这个位置原本是哪个词」。这就是一个语言模型的全部数学内容。
9.3 离散 Flow Matching 损失
即:采一个真实序列 $z$、一个随机时刻 $t$、按混合路径把 $z$ 破坏成 $x$,然后对每个位置做一次标准交叉熵。
9.4 为什么这个损失学到的正是边际对象
这是本课第一个母题(为什么用条件版本训练边际版本)在离散情形的完整回答。$\mathcal L_{\mathrm{DFM}}$ 里只出现 $z$ 和 $x$ 这些能采样的东西,从没出现 $p_{1\mid t}$;但它的最优解恰好是 $p_{1\mid t}$。
第 1 步:把期望改写成「先采 $x$ 再采 $z$」。固定 $t$。$(z,x)$ 的联合分布是
$$ \mathbb P(z,x)=\data(z)\,p_t(x\mid z). $$按贝叶斯把它反过来分解(这就是塔性质 / tower property 的用法):
$$ \data(z)\,p_t(x\mid z)=p_t(x)\cdot\underbrace{\frac{\data(z)p_t(x\mid z)}{p_t(x)}}_{=\,p_{1\mid t}(z\mid x)} . $$第 2 步:代入损失,对每个位置分别处理。取 (9.3) 中固定的 $t$ 与固定的位置 $j$:
$$ \begin{aligned} \E_{z,x}\Big[-\log p^\theta_{1\mid t}(z_j\mid x)\Big] &\overset{(i)}{=}\sum_{z\in\Vocab}\sum_{x\in\Vocab}\data(z)p_t(x\mid z)\Big[-\log p^\theta_{1\mid t}(z_j\mid x)\Big]\\ &\overset{(ii)}{=}\sum_{x\in\Vocab}p_t(x)\sum_{z\in\Vocab}p_{1\mid t}(z\mid x)\Big[-\log p^\theta_{1\mid t}(z_j\mid x)\Big]\\ &\overset{(iii)}{=}\sum_{x\in\Vocab}p_t(x)\sum_{v\in\mathcal V}\Big[\sum_{z:\,z_j=v}p_{1\mid t}(z\mid x)\Big]\Big[-\log p^\theta_{1\mid t}(v\mid x)\Big]\\ &\overset{(iv)}{=}\E_{x\sim p_t}\Big[\ \sum_{v\in\mathcal V} -\,p_{1\mid t}(z_j=v\mid x)\,\log p^\theta_{1\mid t}(v\mid x)\Big]\\ &\overset{(v)}{=}\E_{x\sim p_t}\Big[\;\underbrace{\KL\Big(p_{1\mid t}(z_j{=}\cdot\mid x)\ \Big\|\ p^\theta_{1\mid t}(\cdot\mid x)\Big)}_{\text{我们真正想最小化的}}\;+\;\underbrace{H\Big(p_{1\mid t}(z_j{=}\cdot\mid x)\Big)}_{\text{与}\theta\text{ 无关}}\Big]. \end{aligned} $$逐步说明:
- (i) 期望写成显式求和。
- (ii) 第 1 步的贝叶斯重排,交换求和次序。这就是塔性质:把「先采 $z$ 再采 $x$」换成「先采 $x$ 再采 $z$」,边际化在采样过程里自动完成,我们从头到尾没有计算过 $p_{1\mid t}$。
- (iii) 被求和的项只通过 $z_j$ 依赖 $z$,于是按 $z_j=v$ 把 $z$ 分组。
- (iv) 中括号里正是边缘后验 $p_{1\mid t}(z_j=v\mid x)$。这一行就是交叉熵 $H(p_{1\mid t},p^\theta)$ 的定义。
- (v) 交叉熵的标准分解 $H(p,q)=\KL(p\Vert q)+H(p)$。
第 3 步:结论。对 $j$ 求和、对 $t$ 取期望,得
$$ \mathcal L_{\mathrm{DFM}}(\theta)=\underbrace{\E_{t\sim\mathrm{Unif}[0,1]}\ \E_{x\sim p_t}\sum_{j=1}^{N}\KL\Big(p_{1\mid t}(z_j{=}\cdot\mid x)\ \Big\|\ p^\theta_{1\mid t}(\cdot\mid x)\Big)}_{=:\ \mathcal L_{\mathrm{marginal}}(\theta)\ \text{(不可计算)}}\;+\;\underbrace{C}_{\text{与 }\theta\text{ 无关}} . $$因此
$$ \nabla_\theta\mathcal L_{\mathrm{DFM}}(\theta)=\nabla_\theta\mathcal L_{\mathrm{marginal}}(\theta), $$两个损失有完全相同的梯度,因而有相同的优化轨迹与相同的最优解。而 $\mathcal L_{\mathrm{marginal}}$ 显然在且仅在
$$ p^\theta_{1\mid t}(\cdot\mid x)=p_{1\mid t}(z_j=\cdot\mid x)\qquad\text{对所有 }t,\ \text{所有 }x\text{ 满足 }p_t(x)>0 $$时取到最小值 0(KL 非负,等于 0 当且仅当两分布相同)。$\square$
把三个损失并排:
| 条件损失(可算) | 边际损失(不可算) | 差 | |
|---|---|---|---|
| Flow Matching(第 2 讲) | $\E\norm{\vf^\theta_t(x)-\vf^z_t(x)}^2$ | $\E\norm{\vf^\theta_t(x)-\vf_t(x)}^2$ | 常数 |
| Score Matching(第 3 讲) | $\E\norm{s^\theta_t(x)-\nabla\log p_t(x\mid z)}^2$ | $\E\norm{s^\theta_t(x)-\score{t}(x)}^2$ | 常数 |
| Discrete FM(本讲) | $\E\big[-\log p^\theta_{1\mid t}(z_j\mid x)\big]$ | $\E\big[\KL(p_{1\mid t}\Vert p^\theta_{1\mid t})\big]$ | 常数(后验的熵) |
三行的证明结构完全相同:用塔性质把「条件采样」换成「后验采样」,然后利用损失函数的Bregman 散度结构(平方误差对应欧氏 Bregman,交叉熵对应 KL Bregman),使得「目标的期望」与「期望的目标」给出同样的最优解。这不是巧合——Generator Matching 的工作正是把这个论证抽象成了一般 Markov 过程上的定理。
「交叉熵损失里没有速率矩阵,那 $\Rate_t$ 到底学到哪去了?」这是最容易困惑的一点。答案:定理 38 说明 $\Rate_t$ 与 $p_{1\mid t}$ 之间是一个确定的、闭式的、可逆的重参数化(式 (9.1))。学到了后验就等于学到了速率矩阵,采样时把网络输出代进 (9.1) 即可。这与连续情形里「学 $\vf^\theta$ 还是学去噪器 $\hat z^\theta$」是同一类选择——两者由 $\vf_t=\frac{\hat z-x}{1-t}$ 相互换算。选择后验参数化的好处有三:输出天然合法(softmax)、损失数值稳定(交叉熵)、和现有 LM 训练代码同构。
「$t$ 要不要喂给网络?」公式里 $p_{1\mid t}$ 带下标 $t$,说明后验确实依赖时间。但在掩码情形有一个特殊结论:$x$ 中被掩的位置数量本身就编码了 $t$ 的信息,因此实践中很多 MDLM 实现不喂 $t$ 也能训练。为忠实起见,本讲的公式与代码都保留 $t$ 输入。
9.5 训练算法(算法 8)
输入:数据集(序列 $z=(z_1,\dots,z_N)\in\mathcal V^N$)、初始 token 边际 $\simple^{(j)}$、调度器 $\kappa_t$、返回逐位置 logits 的网络 $f_\theta$、优化器。
- 采一个数据点 $z\sim\data$。
- 采时间 $t\sim\mathrm{Unif}[0,1]$,计算 $\kappa\leftarrow\kappa_t$。
- 采噪声状态 $x\sim p_t(\cdot\mid z)$,对 $j=1,\dots,N$ 并行:
- $m_j\sim\mathrm{Bernoulli}(\kappa)$;
- $\xi_j\sim\simple^{(j)}$;
- $x_j\leftarrow m_j z_j+(1-m_j)\xi_j$。
- 前向:$\ell_j(\cdot)\leftarrow f_\theta(x,t)_j$,$\ p^\theta_{1\mid t}(v\mid x)_j=\mathrm{softmax}(\ell_j)(v)$。
- 损失:$\mathcal L_{\mathrm{DFM}}(\theta)\leftarrow\sum_{j=1}^{N}\big[-\log p^\theta_{1\mid t}(z_j\mid x)_j\big]$。
- 更新:$\theta\leftarrow\mathrm{Opt.step}(\nabla_\theta\mathcal L_{\mathrm{DFM}}(\theta))$。
注意没有任何模拟:不需要跑 CTMC,不需要反向过程,第 3 步一次采样直接跳到时刻 $t$。这就是「免模拟(simulation-free)」训练,和第 2 讲的 flow matching 完全一致。
(9.3) 对所有 $j$ 求和,包括那些 $m_j=1$(未被破坏,$x_j=z_j$)的位置。在这些位置上,真实后验是点质量 $e_{x_j}$(见 9.1 节末的推导),网络只需「照抄输入」,损失可以被压到任意接近 0,梯度贡献迅速消失。因此实践中的实现通常只在被破坏的位置上计损失——这不改变最优解,只是去掉了一堆几乎为零的项、降低方差。第 11 节的代码把两种写法都列出来。
10. 掩码扩散语言模型(MDLM)
前面所有推导对任意初始分布 $\simple$ 都成立。现在选一个特别的 $\simple$,就得到了当前最主流的离散扩散语言模型。
10.1 构造
把词表扩充一个特殊 token:
$$ \mathcal V' := \mathcal V\cup\set{[\mathrm{MASK}]},\qquad \abs{\mathcal V'}=V+1, $$它的语义是「这个位置的原始 token 被挡住了」。取初始分布为逐位置的点质量:
$$ \simple^{(j)}=\delt{[\mathrm{MASK}]}\quad\Longrightarrow\quad \simple=\delt{[\mathrm{MASK}]^N}, $$即 $X_0$ 确定地等于「全是 [MASK]」的那条序列。其余一切(混合路径、条件/边际速率矩阵、DFM 损失)照搬。
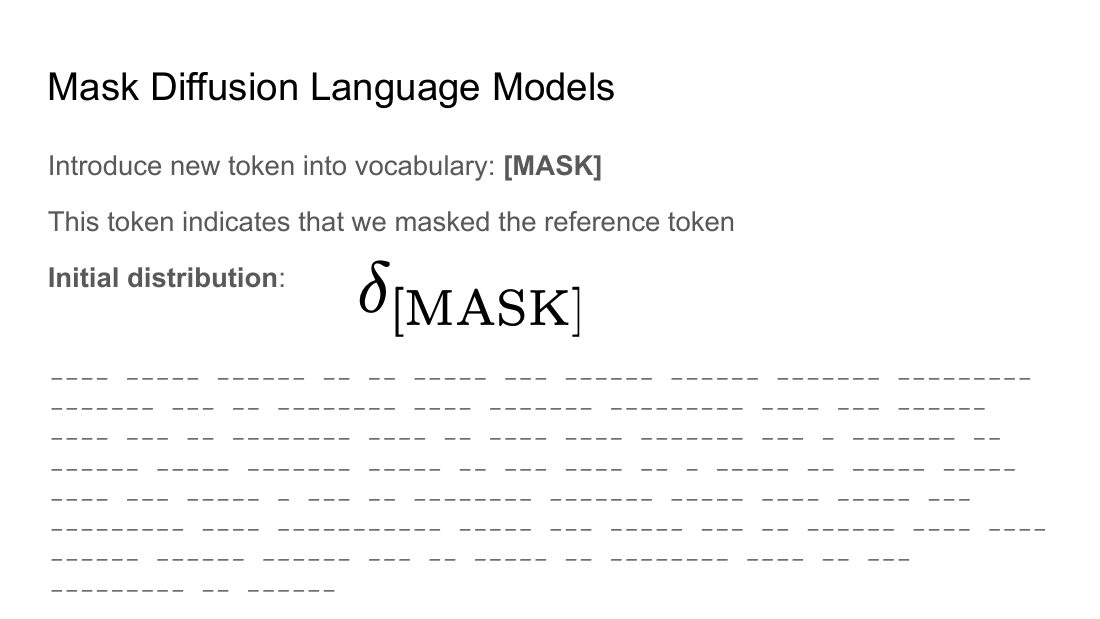
[MASK],把初始分布设为「全掩码」的点质量。下方那一大片横线就是 $X_0$——一句什么都还没写的话。生成过程要做的,就是在 $t$ 从 0 走到 1 的过程中把这些横线一个一个换成真实 token。(a) 条件概率路径。代入 (6.1),第 $j$ 个因子变成
$$ q^{(j)}_t=(1-\kappa_t)\,e_{[\mathrm{MASK}]}+\kappa_t\,e_{z_j}. $$这是一个只在两个 token 上有质量的分布:第 $j$ 位以概率 $\kappa_t$ 是真值 $z_j$,以概率 $1-\kappa_t$ 是 [MASK],没有第三种可能。写 $\alpha_t:=\kappa_t$(「已揭示比例」),则每个位置被掩的概率是 $1-\alpha_t$,与本讲开头的表述一致。
(b) 支撑集。$p_t(\cdot\mid z)$ 的支撑集是
$$ \mathrm{supp}\,p_t(\cdot\mid z)=\big\{x:\ x_j\in\set{z_j,[\mathrm{MASK}]}\ \forall j\big\}, $$共 $2^N$ 个状态(而不是 $(V+1)^N$)。模型永远不会遇到「某个位置是一个错误的真实 token」这种输入——这是掩码构造相对于「均匀噪声」构造的巨大简化。
(c) 条件速率矩阵。把 (8.1) 特化。分两种情形:
- $x_j = z_j$(已揭示):整行为 0,不动。
- $x_j=[\mathrm{MASK}]\ne z_j$(仍被掩):
结论:非零速率只出现在 $[\mathrm{MASK}]\to z_j$ 这一个方向上。反方向 $z_j\to[\mathrm{MASK}]$ 的速率恒为 0,因为按 (8.1),$x_j=z_j$ 时整行为零。所以:
$$ \boxed{\text{解掩是不可逆的:一旦某个位置被填上,它永远不会退回 }[\mathrm{MASK}]\text{,也永远不会被改成别的 token。}} $$用马尔可夫链的语言说,「$x_j=z_j$」对第 $j$ 个位置的子链是吸收态,所以这类构造在文献里也叫「吸收态扩散(absorbing-state diffusion)」。
(d) 边际速率矩阵。把 (9.1) 特化。对已揭示的位置($x_j\ne[\mathrm{MASK}]$),我们已经论证过后验是点质量:因为在支撑集里 $x_j\ne[\mathrm{MASK}]$ 只可能来自 $x_j=z_j$,故 $p_{1\mid t}(z_j=v\mid x)=\delt{x_j}(v)$,于是
$$ \Rate_t(\cdot,j\mid x)=\frac{\dot\kappa_t}{1-\kappa_t}\big(e_{x_j}-e_{x_j}\big)=0 . $$对仍被掩的位置($x_j=[\mathrm{MASK}]$):
$$ \Rate_t(v,j\mid x)=\frac{\dot\kappa_t}{1-\kappa_t}\Big(p_{1\mid t}(z_j=v\mid x)-\delt{[\mathrm{MASK}]}(v)\Big) =\frac{\dot\kappa_t}{1-\kappa_t}\times\begin{cases} p_{1\mid t}(z_j=v\mid x),& v\ne[\mathrm{MASK}]\\ -1,& v=[\mathrm{MASK}] . \end{cases} $$(用到 $\sum_{v\in\mathcal V}p_{1\mid t}(z_j=v\mid x)=1$,且真实 token 上不含 [MASK]。)
整个采样过程于是只有一件事可做:以速率 $\frac{\dot\kappa_t}{1-\kappa_t}$ 挑一个还被掩的位置,按网络给出的分布 $p^\theta_{1\mid t}(\cdot\mid x)$ 抽一个 token 填进去。$\square$
10.2 把步长算到底:$\kappa_t = t$ 的情形
取 $\kappa_t=t$,则速率因子为 $\frac{\dot\kappa_t}{1-\kappa_t}=\frac{1}{1-t}$。用 $n$ 步均匀 Euler,$h=1/n$,第 $i$ 步($i=0,1,\dots,n-1$)位于 $t=i/n$。对一个仍被掩的位置,这一步内发生解掩的概率是
$$ h\cdot\frac{1}{1-t}=\frac{1/n}{1-i/n}=\frac{1}{n-i}. $$读一读这个结果:
- $i=0$:概率 $1/n$。第一步只揭示大约 $N/n$ 个 token。
- $i=n-1$(最后一步):概率 $\frac{1}{1}=1$。所有仍被掩的位置全部一次性解掩。
所以这个格式恰好在最后一步用尽 Euler 的非负性预算($h\lambda=1$,对角项正好为 0),既不会溢出(概率超过 1),也不会在 $t=1$ 时留下未解掩的位置。这不是运气:$\frac{\dot\kappa_t}{1-\kappa_t}$ 的分母 $1-\kappa_t$ 正是「还剩多少没揭示」,Euler 步长 $h$ 与它的比值自然给出「这一步该揭示其中的多大比例」。
核对期望:仍被掩的位置数的期望在第 $i$ 步后应是 $N(1-i/n)$。归纳:第 0 步前是 $N$;每步保留比例 $1-\frac{1}{n-i}=\frac{n-i-1}{n-i}$,于是 $i$ 步后为 $N\prod_{k=0}^{i-1}\frac{n-k-1}{n-k}=N\cdot\frac{n-i}{n}$(望远镜求积)$=N(1-t)$ ✓,与 $1-\kappa_t=1-t$ 一致。
10.3 采样过程长什么样
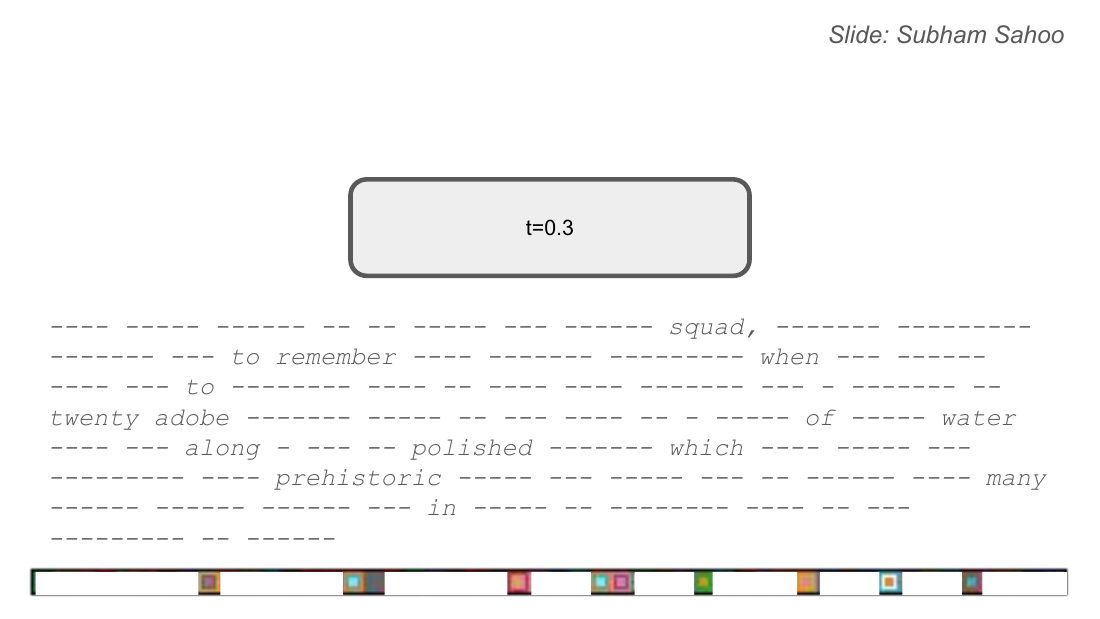
随着 $t$ 增大,横线越来越少;$t=1$ 时整段文本完成。整个轨迹的特点:
- 单调:已填的位置数量只增不减(由 10.1(c) 的不可逆性保证)。
- 无序:填的顺序由随机性决定,与位置无关(速率对所有被掩位置相同,都是 $\frac{\dot\kappa_t}{1-\kappa_t}$)。
- 双向条件:每次填一个位置时,网络看到的是整条当前序列,包括右边已经填好的词。
上面的速率对每个被掩位置都相同,意味着解掩顺序是纯随机的。但直觉上,应该优先填那些网络最有把握的位置(后验熵最低的位置),这样后填的位置能获得更多上下文。文献中确实有这类「置信度引导(confidence-based / top-k)」的解码策略,它们偏离了 (9.1) 给出的精确 CTMC,属于推理时的启发式而非本讲框架的推论。讲义只给出了原理性的算法 7;本讲代码也只实现原理版本。区分「理论保证正确的采样器」与「实践中效果更好的启发式」很重要,前者是本课的内容,后者是工程。
11. 最小可运行实现
把第 9、10 节的公式逐行翻译成 PyTorch。三段代码:网络、训练循环、采样循环。
11.1 去噪概率网络
import torch, torch.nn as nn, torch.nn.functional as F

V    = 8000      # 真实词表大小 |V|
MASK = V         # [MASK] 的 id:把词表扩成 V+1,第 V 号就是 MASK
N    = 128       # 序列长度

def kappa(t):        # 调度器 k_t,要求 k_0=0, k_1=1, kdot >= 0
    return t         # 这里用最简单的 k_t = t(离散版 CondOT)

def kdot_over_1mk(t):
    """速率因子 kdot_t / (1 - k_t)。k_t = t 时等于 1/(1-t)。"""
    return 1.0 / (1.0 - t)

class DenoiserNet(nn.Module):
    """p^theta_{1|t}: (x, t) -> 每个位置在真实词表上的 logits。
    输入 x 可能含 MASK,输出形状 (bs, N, V) —— 对应定理 38 里的 N x V。"""
    def __init__(self, d_model=256, n_layer=6, n_head=8):
        super().__init__()
        self.tok = nn.Embedding(V + 1, d_model)   # V+1: 多出来的一格给 [MASK]
        self.pos = nn.Embedding(N, d_model)
        self.tim = nn.Linear(1, d_model)          # 时间嵌入(可换成傅里叶特征)
        layer = nn.TransformerEncoderLayer(d_model, n_head, 4 * d_model,
                                           batch_first=True, norm_first=True)
        self.body = nn.TransformerEncoder(layer, n_layer)   # 注意:不传 causal mask
        self.head = nn.Linear(d_model, V)         # 输出只覆盖真实 token,不含 MASK

    def forward(self, x, t):                      # x: (bs, N) long;t: (bs,) float
        idx = torch.arange(N, device=x.device)                  # (N,)
        h = (self.tok(x)                                        # (bs, N, d)
             + self.pos(idx)[None]                              # (1,  N, d)
             + self.tim(t[:, None])[:, None])                   # (bs, 1, d)
        return self.head(self.body(h))                          # (bs, N, V)
三处与公式的对应:nn.Embedding(V + 1, ...) 对应扩充词表 $\mathcal V'=\mathcal V\cup\set{[\mathrm{MASK}]}$;self.head 输出维度是 $V$ 而不是 $V+1$,因为后验 $p_{1\mid t}(z_j=\cdot\mid x)$ 的支撑集是真实 token(原始序列 $z$ 里不会有 [MASK]);不传 causal mask 对应 5.4 节说的双向上下文。
11.2 训练循环
逐行对应算法 8 与式 (9.3)。
def training_step(net, opt, z):
    """z: (bs, N) long,真实 token id,取值在 [0, V)。"""
    bs = z.shape[0]

    # 算法 8 第 2 行:t ~ Unif[0, 1]
    t = torch.rand(bs, device=z.device)                          # (bs,)
    k = kappa(t)[:, None]                                        # (bs, 1)

    # 算法 8 第 5-8 行:x ~ p_t(.|z),因子化混合路径的等价采样过程
    #   m_j ~ Bernoulli(k_t);xi_j ~ p_init^(j) = delta_[MASK]
    #   x_j = m_j * z_j + (1 - m_j) * xi_j
    keep = torch.rand(bs, N, device=z.device) < k                # (bs, N) bool,即 m_j
    x    = torch.where(keep, z, torch.full_like(z, MASK))        # (bs, N)

    # 算法 8 第 11 行:一次前向拿到全部 N x V 个 logits
    logits = net(x, t)                                           # (bs, N, V)

    # 算法 8 第 12 行:逐位置交叉熵 -log p^theta_{1|t}(z_j | x)
    nll = F.cross_entropy(logits.reshape(-1, V), z.reshape(-1),
                          reduction='none').reshape(bs, N)       # (bs, N)

    loss_all    = nll.sum(1).mean()                  # 讲义原式 (9.3):对所有 j 求和
    loss_masked = (nll * (~keep)).sum(1).mean()      # 实践常用:只在被掩位置计损失
    loss = loss_masked                               # 两者最优解相同,见 9.5 节

    opt.zero_grad(); loss.backward(); opt.step()
    return loss.item()
注意这段代码里完全没有出现速率矩阵、没有模拟、没有反向过程——它就是一个「随机比例掩码 + 交叉熵」的训练循环。第 9.4 节的推导保证了:这样练出来的 $p^\theta_{1\mid t}$ 就是式 (9.1) 需要的那个后验。
11.3 采样循环
逐行对应算法 7 与式 (9.1)。
@torch.no_grad()
def sample(net, bs=4, n_steps=64, device='cuda'):
    """从 MDLM 采样:X_0 = 全 [MASK],用并行 per-token Euler 逐步解掩。"""
    x = torch.full((bs, N), MASK, device=device, dtype=torch.long)   # X_0 ~ delta_{[MASK]^N}
    h = 1.0 / n_steps

    for i in range(n_steps):
        t  = torch.full((bs,), i * h, device=device)                 # (bs,)
        p1 = net(x, t).softmax(-1)                                   # (bs, N, V)
        #    p1[b, j, v] = p^theta_{1|t}(z_j = v | x)

        # 边际速率 (9.1):Q_t(v, j | x) = kdot/(1-k) * (p1 - onehot(x_j))
        # 对被掩位置,onehot(x_j) 落在 MASK 这一格上,与真实 token 无交集,
        # 所以「这一步内解掩」的概率就是 h * kdot/(1-k),与 v 无关;
        # 选哪个 token 则按 p1 抽。k_t = t 时该概率 = h/(1-t) = 1/(n-i)。
        p_unmask = h * kdot_over_1mk(i * h)                          # 标量,= 1/(n_steps - i)

        z_hat  = torch.distributions.Categorical(probs=p1).sample()  # (bs, N)
        fire   = torch.rand(bs, N, device=device) < p_unmask         # (bs, N) bool
        unmask = fire & (x == MASK)     # 已解掩的位置速率为 0(见 10.1(d)),不再改动
        x = torch.where(unmask, z_hat, x)

    assert (x != MASK).all(), "最后一步 p_unmask = 1,应当不留 MASK"
    return x                                                         # (bs, N)
几处值得留意:
p_unmask = h * kdot_over_1mk(i * h)就是 10.2 节算出的 $\frac{1}{n-i}$;最后一步等于 1,所以断言成立。unmask = fire & (x == MASK)直接实现了「已解掩位置的边际速率为 0」这个推导出来的结论,而不是一个人为的实现技巧。- 每步只有一次网络前向,$N$ 个位置共享;这就是并行度的来源,也是 5.3 节那个 $O(h^2)$ 近似的代价所在。
- 把
n_steps从 $N$ 降到 $N/8$,速度提升 8 倍,代价是更多位置在同一步内被当成条件独立地采样。这一行就是「速度 ↔ 质量」旋钮。
再强调一次这个漂亮的分工,它和第 2 讲一模一样:训练时我们知道 $z$,所以用的是条件对象(一次采样直接跳到时刻 $t$,免模拟);采样时我们不知道 $z$,所以用边际对象(网络输出的后验替代了真实的 $z$)。连接两者的是边际化技巧与塔性质。整个离散扩散的工程实现,不过是这两段各二十行的代码。
12. 与自回归模型的对比,以及为什么这套配方如此通用
12.1 两种范式的差异
自回归(autoregressive, AR)语言模型把 $\data$ 分解为
$$ \data(z)=\prod_{j=1}^{N}p(z_j\mid z_1,\dots,z_{j-1}), $$生成时严格从左到右,每步一次前向。离散扩散不做这个分解,而是通过 CTMC 从全掩码状态演化到完整序列。讲义给出的讨论如下(注意每一条讲义都带着问号——这是一个仍在快速演化的方向,不是定论)。
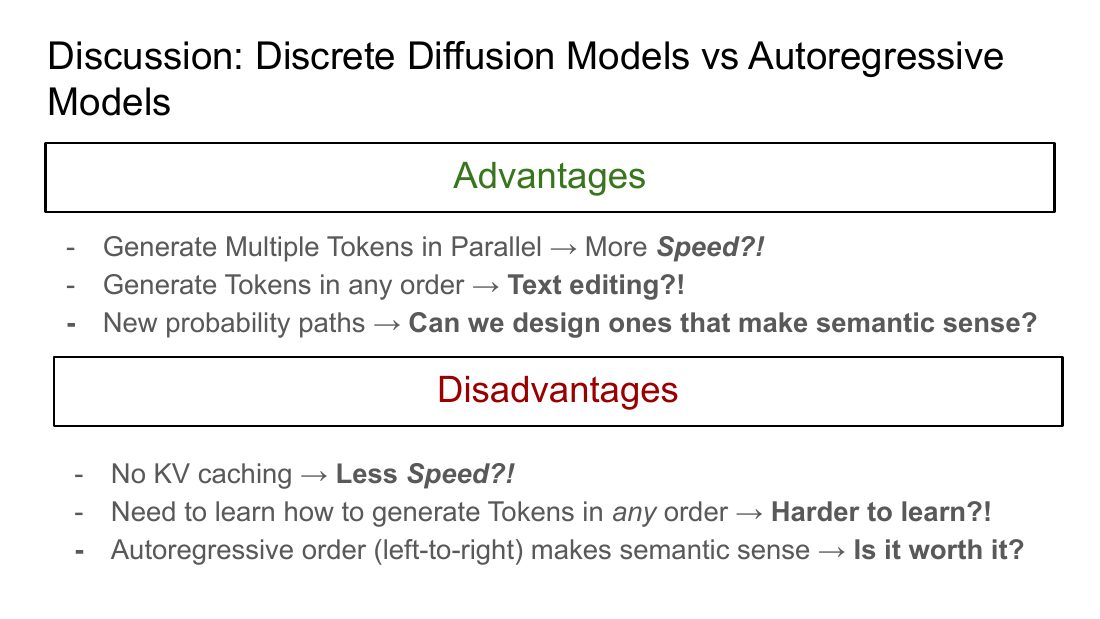
| 维度 | 自回归 LM | 离散扩散 / MDLM |
|---|---|---|
| 生成顺序 | 固定从左到右 | 任意顺序,由速率随机决定(10.3 节) |
| 每步前向次数 | 1 次前向 → 1 个 token | 1 次前向 → 期望 $N/n$ 个 token |
| 总前向次数 | 恰好 $N$,无法调 | $n$,由用户自由指定,与 $N$ 解耦 |
| 并行度 | 生成时无并行(训练时可 teacher forcing 并行) | 生成时天然并行(算法 7 的第 5 行) |
| 上下文 | 只能看左边(causal mask) | 双向:每个位置都能看到全序列 |
| KV 缓存 | 可用:前缀不变,缓存全部键值 | 不可用:每步整条序列都在变,必须全量重算 |
| 可控性 / 编辑 | 只能续写;中间插入需特殊训练(如 fill-in-the-middle) | 天然支持:把要保留的位置钉住不解掩,其余照常采样 |
| 学习难度 | 只需学一种分解顺序 | 需学所有 $2^N$ 种「已揭示位置子集」下的条件分布 → 更难 |
| 语义匹配度 | 从左到右与语言的时序天然吻合 | 无固有顺序,可能与语义结构不匹配 |
| 步数 ↔ 质量 | 无旋钮(步数被钉死) | $n$ 越小越快、并行更新越多、条件独立假设用得越狠 → 质量越差 |
| 训练目标 | next-token 交叉熵 | 随机掩码比例下的 masked-token 交叉熵(式 (9.3)) |
把两者的实际计算量摆出来。设一次网络前向的代价为 $C(N)$(Transformer 大致 $\Theta(N^2)$ 或用 FlashAttention 后的等价量级)。
- 自回归 + KV 缓存:第 $j$ 步只需为新的一个 token 做注意力,代价约 $\Theta(j)$;总代价 $\sum_{j=1}^N\Theta(j)=\Theta(N^2)$。
- 离散扩散:每步都要对整条序列重算,代价 $C(N)=\Theta(N^2)$;共 $n$ 步,总代价 $\Theta(nN^2)$。
于是加速比大约是 $N/(nN)=1/n$ ······ 只有当 $n\ll 1$ 时才更快,而 $n\ge1$,所以在这个粗略模型下离散扩散反而更慢。这正是讲义把「No KV caching → Less Speed?!」列为缺点的原因。
那为什么大家还认为它有速度潜力?因为上面的比较忽略了两件事:(a) 自回归的 $N$ 次前向是严格串行的,每次都要等上一次结束,硬件利用率极低(受限于内存带宽而非算力);离散扩散的 $n$ 次前向虽然每次更重,但每次都是一个饱和的大 batch 矩阵乘,在 GPU 上吞吐率高得多。(b) $n$ 可以远小于 $N$。所以真正的结论是:离散扩散把「延迟受限于串行深度」换成了「吞吐受限于总算力」,这是一个硬件相关、任务相关的权衡,不是一个普适的「更快」。讲义的问号是诚实的。
自回归模型只需要建模 $N$ 个条件分布 $p(z_j\mid z_{<j})$,对应 $N$ 种「已知前缀」的情形。
MDLM 的网络在训练中会遇到任意的掩码模式:给定一个已揭示位置的子集 $S\subseteq\set{1,\dots,N}$,网络必须给出 $p(z_j\mid \set{z_i}_{i\in S})$ 对所有 $j\notin S$。这样的子集有 $2^N$ 个。换句话说,一个 MDLM 在参数量相同的情况下,要同时扮演所有 $N!$ 种生成顺序下的自回归模型(任意顺序自回归)。这是一个严格更难的学习任务,通常表现为在同等算力下困惑度略逊于自回归模型。这就是讲义「Need to learn how to generate Tokens in any order → Harder to learn?!」的含义。
反过来,这也正是它的优势来源:正因为学了所有顺序,才能任意顺序生成、才能做中间填空与编辑。能力和难度是同一枚硬币的两面。
12.2 为什么这套配方能原封不动搬过来
回顾一下我们在本讲实际用到的东西,会发现它们都不依赖「状态空间是 $\R^d$」这件事:
- 一个「生成元(generator)」:把过程的无穷小行为线性地作用在函数/分布上。$\R^d$ 上是 $-\divg(p_t\,\cdot\,)$(流)或再加 $\frac{\sigma_t^2}{2}\Lap$(扩散);$\Vocab$ 上是矩阵作用 $p\mapsto\mathbf{\Rate}^\top_t p$。
- 一条「演化方程」:$\partial_t p_t = (\text{生成元的对偶})\,p_t$。连续性方程、Fokker–Planck、KFE 都是它的实例,而且都是关于 $p_t$ 线性的——这保证了解的唯一性,也保证了「条件对象的凸组合仍然是合法对象」。
- 边际化技巧:因为演化方程对 $p_t$ 线性、且生成元集合对凸组合封闭,所以边际生成元 = 条件生成元关于后验的期望。本讲第 7.3 节的证明第一步(凸性)和第二步(线性 + 乘除 $p_t(y)$)都只用到了这两条抽象性质。
- Bregman 散度损失:使得「回归条件目标」与「回归边际目标」的最优解相同。平方误差、KL/交叉熵都是 Bregman 散度。
把这四条抽象出来,就得到 Generator Matching 框架;本讲的一切是它在「有限状态空间 + 纯跳跃过程」这一实例上的展开,第 1–3 讲则是「$\R^d$ + 流/扩散过程」上的展开。这是本课想留给你的最终图景:你学的不是「扩散模型」,而是一条把「简单分布」连到「数据分布」的通用配方,它对状态空间的形状几乎不挑食。
本讲没有引入任何新的思想,只引入了新的零件。如果你能在离散情形独立复现「KFE → 边际化技巧 → 条件速率矩阵 → 交叉熵损失」这条链,那说明你真正掌握的是前四讲的结构,而不是某组特定公式。
本讲小结
速查表:所有关键公式
| 对象 | 公式 | 说明 / 类型与形状 |
|---|---|---|
| 状态空间 | $\Vocab=\mathcal V^N$,$\abs{\Vocab}=V^N$ | 词表 $\mathcal V$ 大小 $V$,序列长 $N$ |
| 速率矩阵 | $\Rate_t(y\mid x)\ge0\ (y\ne x)$,$\ \sum_y\Rate_t(y\mid x)=0$ | $\mathbf{\Rate}_t\in\R^{\abs{\Vocab}\times\abs{\Vocab}}$,行 = 出发点 |
| 一阶展开(定义) | $\mathbb P(X_{t+h}=y\mid X_t=x)=\delt{x}(y)+h\,\Rate_t(y\mid x)+o(h)$ | 速率 × 时长 = 概率;等价于 $\frac{\dd{}}{\dd{h}}\big\vert_0 p_{t+h\mid t}=\Rate_t$ |
| 总跳出速率 | $\lambda_t(x)=-\Rate_t(x\mid x)=\sum_{y\ne x}\Rate_t(y\mid x)$ | 停留时间 $\sim\mathrm{Exp}(\lambda_t(x))$ |
| Kolmogorov 前向方程 | $\dfrac{\dd{}}{\dd{t}}p_t(x)=\sum_{y\in\Vocab}\Rate_t(x\mid y)\,p_t(y)$ | 充要条件;离散版连续性方程;矩阵形式 $\dot p_t=\mathbf{\Rate}_t^\top p_t$ |
| KFE 的净流入形式 | $\dfrac{\dd{}}{\dd{t}}p_t(x)=\sum_{y\ne x}\big[\Rate_t(x\mid y)p_t(y)-\Rate_t(y\mid x)p_t(x)\big]$ | 流入 − 流出;「离散散度」 |
| Euler 模拟 | $X_{t+h}\sim\delt{X_t}+h\,\Rate_t(\cdot\mid X_t)$,需 $h\le 1/\lambda_t(x)$ | 归一自动成立(行和为零),非负给出步长约束 |
| 因子化约束 | $\Rate^\theta_t(y\mid x)=0$ 若 $y,x$ 相差超过一个位置 | 网络输出从 $V^N$ 降到 $N\times V$ |
| 条件概率路径 | $p_0(\cdot\mid z)=\simple$,$p_1(\cdot\mid z)=\delt{z}$ | $p_t(\cdot\mid z)\in\Delta(\Vocab)$ |
| 边际概率路径 | $p_t(x)=\sum_{z}p_t(x\mid z)\data(z)$;$p_0=\simple,\ p_1=\data$ | 把 $\int$ 换成 $\sum$ 的第二讲 |
| 因子化混合路径 | $p_t(x\mid z)=\prod_{j=1}^{N}\big[(1-\kappa_t)\simple^{(j)}(x_j)+\kappa_t\delt{z_j}(x_j)\big]$ | $\kappa_0=0,\kappa_1=1,\dot\kappa_t\ge0$;单纯形里的直线 |
| 等价采样 | $m_j\sim\mathrm{Bern}(\kappa_t),\ \xi_j\sim\simple^{(j)},\ x_j=m_jz_j+(1-m_j)\xi_j$ | 训练代码的三行 |
| 离散边际化技巧 | $\Rate_t(y\mid x)=\sum_z \Rate^z_t(y\mid x)\dfrac{p_t(x\mid z)\data(z)}{p_t(x)}=\E_{z\sim p_{1\mid t}(\cdot\mid x)}\big[\Rate^z_t(y\mid x)\big]$ | 合法速率矩阵的凸组合仍合法;证明只用 KFE 的线性性 |
| 条件速率矩阵(混合路径) | $\Rate^z_t(v,j\mid x)=\dfrac{\dot\kappa_t}{1-\kappa_t}\big(\delt{z_j}(v)-\delt{x_j}(v)\big)$ | $=\frac{e_{z_j}-e_{x_j}}{1-t}$($\kappa_t=t$);对应 CondOT 的 $\frac{z-x}{1-t}$ |
| 边际速率矩阵 | $\Rate_t(v,j\mid x)=\dfrac{\dot\kappa_t}{1-\kappa_t}\big(p_{1\mid t}(z_j=v\mid x)-\delt{x_j}(v)\big)$ | 唯一未知量是后验;softmax 输出自动保证合法性 |
| 去噪概率网络 | $p^\theta_{1\mid t}:x\mapsto\big(p^\theta_{1\mid t}(z_j=v\mid x)\big)_{j,v}$ | 输出 $\R^{N\times V}$,逐位置 softmax;Transformer 去掉 causal mask |
| 离散 FM 损失 | $\mathcal L_{\mathrm{DFM}}(\theta)=\E_{z\sim\data,\,t\sim U[0,1],\,x\sim p_t(\cdot\mid z)}\big[\sum_{j=1}^N-\log p^\theta_{1\mid t}(z_j\mid x)\big]$ | 逐位置交叉熵;免模拟 |
| 损失等价性 | $\mathcal L_{\mathrm{DFM}}=\E_{t,x\sim p_t}\sum_j\KL\big(p_{1\mid t}(z_j{=}\cdot\mid x)\Vert p^\theta_{1\mid t}(\cdot\mid x)\big)+C$ | 塔性质 + 交叉熵 = KL + 熵;梯度相同 |
| MDLM | $\mathcal V'=\mathcal V\cup\set{[\mathrm{MASK}]}$,$\simple=\delt{[\mathrm{MASK}]^N}$ | 吸收态;解掩不可逆;已揭示位置速率为 0 |
| MDLM 每步解掩概率 | $h\cdot\dfrac{\dot\kappa_t}{1-\kappa_t}\overset{\kappa_t=t}{=}\dfrac{1}{n-i}$ | $n$ 步均匀 Euler 的第 $i$ 步;最后一步为 1,恰好清空所有 MASK |
| 并行 Euler 的误差 | 与完整 Euler 步在 $h$ 的一阶一致,二阶差 $O(h^2)$ | 误差源于「同一步内多位置同时更新时假设条件独立」 |
三条主线的答案
- 为什么用条件版本训练边际版本?边际速率矩阵 (9.1) 含有后验 $p_{1\mid t}$,而后验含 $\data$,不可计算。但由塔性质,「先采 $z$ 再采 $x$」的交叉熵损失 (9.3) 与「先采 $x$ 再算 KL」的边际损失只差一个与 $\theta$ 无关的常数(后验的熵),因此两者梯度相同、最优解相同。
- 为什么不同过程给出同一边际?因为边际由 KFE 这个线性 ODE 唯一决定(命题 2 的充分性 + 第一讲定理 3)。任何满足同一个 KFE 的速率矩阵,其 CTMC 的边际必然逐点相同。
- 那个算不出来的量怎么变可算?它就是后验 $p_{1\mid t}(z_j=\cdot\mid x)$。我们从不计算它——我们让网络成为它。定理 38 把「学速率矩阵」重参数化为「学后验」,于是整个生成模型的训练退化成 $N$ 个「猜被挡住的词」的分类任务。
一句话总结
把 $\int$ 换成 $\sum$、把 $\vf_t$ 换成 $\Rate_t$、把 $\divg$ 换成「对邻居求净流出」、把平方误差换成交叉熵,第 1–3 讲的每一个定理都能原样搬到有限状态空间上。所得到的模型,就是今天的扩散语言模型。
延伸阅读
本讲直接对应的论文
- A Continuous Time Framework for Discrete Denoising Models (Campbell et al., NeurIPS 2022) —— 讲义正文引用的 CTMC 框架原始论文(图 17 的轨迹图即取自此文)。想看 CTMC 视角下离散扩散的完整推导(含反向过程与 ELBO),从这篇开始。
- Discrete Flow Matching (Gat et al., NeurIPS 2024) —— 本讲第 6–9 节的直接来源:混合概率路径、离散边际化技巧、交叉熵形式的 DFM 损失。把本讲的公式与这篇的记号对照,能确认自己是否真的读懂了。
- Structured Denoising Diffusion Models in Discrete State-Spaces / D3PM (Austin et al., NeurIPS 2021) —— 幻灯片里「任意顺序生成文本」示意图的出处。它是离散时间的版本(用转移矩阵而非速率矩阵),读它可以体会连续时间形式化带来的简化。
- Flow Matching Guide and Code (Lipman et al., 2024) —— 讲义中因子化 CTMC 图(图 18)与离散概率路径图(图 19)的出处,也是本课的官方配套参考书,含离散部分的完整代码。
- Generator Matching: Generative Modeling with Arbitrary Markov Processes (Holderrieth et al., 2024) —— 第 12.2 节的抽象框架:把 flow matching 推广到任意 Markov 过程,本讲的 CTMC 情形与前几讲的流/扩散情形都是它的实例。讲义最后一页专门推荐了这篇,值得在学完全课后回头读。
掩码扩散语言模型这一支
- Discrete Diffusion Modeling by Estimating the Ratios of the Data Distribution / SEDD (Lou et al., 2023) —— 另一条参数化路线:不学后验,而学「concrete score」$p_t(y)/p_t(x)$(即离散空间里 $\nabla\log p_t$ 的替身),损失叫 score entropy。与本讲的交叉熵参数化对照着读,能理解「离散空间里 score 该被替换成什么」。
- Simple and Effective Masked Diffusion Language Models / MDLM (Sahoo et al., 2024) —— 掩码扩散的工程化:证明连续时间 ELBO 可化简为一个带时间权重的掩码交叉熵(权重形如 $\frac{\dot\alpha_t}{1-\alpha_t}$),与本讲的 $\mathcal L_{\mathrm{DFM}}$ 只差 $t$ 的加权方式。本讲幻灯片中的采样演示即来自该工作的作者。
- Simplified and Generalized Masked Diffusion for Discrete Data (Shi et al., 2024) —— 同期的独立工作,同样把掩码扩散化简为加权交叉熵,并系统讨论了调度器 $\kappa_t$ 的选择。想调 $\kappa_t$ 的话看这篇。
- Large Language Diffusion Models / LLaDA (Nie et al., 2025) —— 把掩码扩散推到大规模预训练的代表性工作,直接回答第 12.1 节表格里那些带问号的问题在真实规模下如何。
离散扩散的其它应用与推广
- Generative Flows on Discrete State-Spaces: Enabling Multimodal Flows with Applications to Protein Co-Design (Campbell et al., 2024) —— 把离散 CTMC 与连续流混合:蛋白质既有离散的氨基酸序列又有连续的三维结构,需要同时生成。这是「状态空间是混合类型」时 Generator Matching 的一个实例。
- Flow Matching on General Geometries (Chen & Lipman, 2023) —— 另一个方向的推广:状态空间是黎曼流形。与本讲并列阅读,能看清「配方不挑状态空间」这句话的分量。
动手建议
- 把第 11 节的三段代码接起来,在一个小数据集(比如 text8 或字符级莎士比亚)上训一个 $V\approx30$、$N=64$ 的 MDLM。观察:把
n_steps从 64 降到 8,样本质量怎么变?这就是 5.3 节 $O(h^2)$ 误差的实证。 - 把
kappa从 $t$ 换成 $t^{0.7}$ 或 $1-\cos(\pi t/2)$,重新推导kdot_over_1mk,看调度器对样本质量的影响。 - 把
simple从 $\delt{[\mathrm{MASK}]}$ 换成 $\mathcal V$ 上的均匀分布(即「均匀噪声」而非「掩码」),会发现 10.1(d) 的「已揭示位置速率为 0」不再成立,模型可以反复修改同一个位置。对比两者的生成行为。