隐空间与神经网络架构
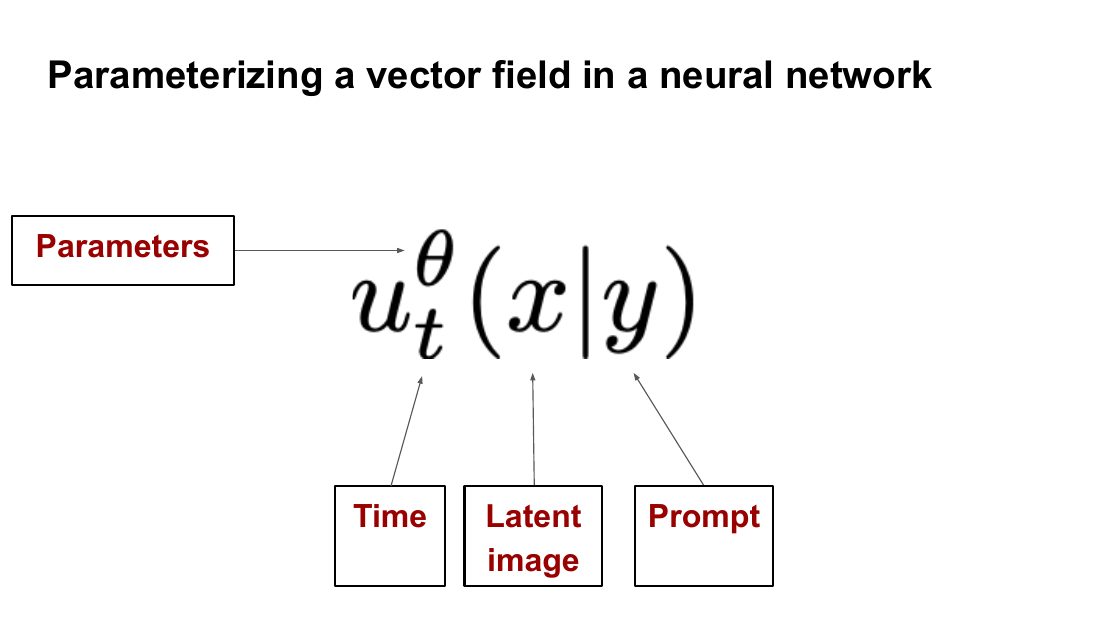
前三讲告诉我们要拟合什么;这一讲回答 $u_t^\theta$ 到底长什么样、在哪个空间里跑。
0. 本讲导读
到目前为止,我们手里有一套完整的数学配方:
- Lecture 1 给出了流(flow)与扩散(diffusion)模型的定义:一个向量场 $\vf_t$ 通过 ODE $\dd{\Traj_t} = \vf_t(\Traj_t)\dd{t}$ 把简单分布 $\simple$ 推成数据分布 $\data$。
- Lecture 2 给出了训练算法:条件流匹配(conditional flow matching)损失 $\mathcal{L}_{\mathrm{CFM}}(\theta)=\E_{t,z,x}\norm{\vf_t^\theta(x)-\vf_t^{\text{target}}(x\mid z)}^2$, 用条件向量场当回归目标,却学到了边际向量场。
- Lecture 3 / 3b 给出了 score matching、SDE 扩展与 classifier-free guidance,让模型能听懂提示词。
这套配方里唯一还是「黑箱」的东西,就是 $\vf_t^\theta$ 这三个字母本身。它是一个神经网络,可它是什么样的神经网络?$t$ 是一个标量,$y$ 可能是一句话,$x$ 是一张 $1024\times 1024$ 的图;这三样东西怎么塞进同一个函数?输出又必须和 $x$ 一样大——这跟图像分类那种「越往后越窄」的网络完全不是一回事。
更要命的是尺度问题。一张 $600\times 1000$ 的彩色图,展平之后是
$$ d = 3 \times 600 \times 1000 = 1\,800\,000 $$维。我们要在 $\R^{1.8\times 10^6}$ 上学一个向量场,还要沿着 ODE 反复调用它几十上百次。直接在像素空间干这件事,GPU 显存会爆炸。
本讲就是在补上这两块工程拼图:网络架构(§6.1,对应 U-Net 与 diffusion transformer)与隐空间(§6.2,对应 VAE),最后用 Stable Diffusion 3 和 Meta Movie Gen 两个真实系统(§6.3)把所有零件拼起来。附录 D 关于 VAE 的补充视角也一并讲透。
- $\vf_t^\theta(x\mid y)$ 的输入是 $(x,t,y)$、输出与 $x$ 同形状。这个「保形」约束是 U-Net 跳连和 DiT unpatchify 存在的根本理由。
- 标量时间 $t$ 必须先用 Fourier / 正弦特征升维成单位范数向量 $\text{TimeEmb}(t)\in\R^d$,再通过 AdaLN(自适应层归一化)以「缩放 + 平移」的方式调制每一层的激活。
- DiT = patchify $\to$ $L$ 个 transformer block $\to$ unpatchify。adaLN-Zero 把每个 block 的门控参数零初始化,使网络在初始时刻是恒等映射,这是深层 DiT 能稳定训练的关键。
- 像素空间不可承受:$512\times512\times3$ 压到 $64\times64\times4$ 是 48 倍的数值量压缩,而注意力矩阵的开销直接降了 4096 倍。
- VAE 的作用不是「压缩」——普通自编码器就能压缩——而是保证压缩后的 $p_{\text{latent}}$ 仍然「好学」。它通过在 ELBO 里加一项 $\KL(q_\phi(\cdot\mid x)\,\|\,p_{\text{prior}})$ 做到这一点。
- $\log p_\theta(x) = \text{ELBO}(x;\phi,\theta) + \KL\!\left(q_\phi(z\mid x)\,\|\,p_\theta(z\mid x)\right)$:ELBO 与真实对数似然之间的缺口就是后验近似误差,一分不多一分不少。
- 实际的 latent diffusion 里,VAE 先训练、再冻结,$\beta \ll 1$,所以它更像一个「被轻度正则化过的 AE」而非严格的概率生成模型。
1. 从训练目标到具体网络
先把类型写清楚。带引导变量的向量场是一个函数
$$ \vf_t^\theta(\,\cdot\mid\cdot\,):\ \R^d \times [0,1] \times \mathcal{Y} \longrightarrow \R^d, \qquad (x,\,t,\,y)\ \longmapsto\ \vf_t^\theta(x\mid y)\in\R^d $$三个输入:数据点(或隐变量)$x\in\R^d$、时间 $t\in[0,1]$、条件 $y\in\mathcal{Y}$(类别标签、文本提示、或者 CFG 里的空标签 $\varnothing$)。$\theta$ 是参数。
为什么不能直接上 MLP
对二维玩具分布(前几讲实验里的那些同心圆、双月牙),一个 MLP 就够了:把 $x$、$y$ 的嵌入和 $t$ 拼接成一个向量,过几层全连接,输出 $\R^d$。讲义明确说了这一点:低维分布下 MLP 是充分的。
图像上为什么不行?三条理由,一条比一条致命:
- 参数量爆炸。 一个从 $\R^d$ 到 $\R^d$ 的全连接层有 $d^2$ 个参数。$d=1.8\times 10^6$ 时 $d^2\approx 3.2\times 10^{12}$——一层就是 3 万亿参数。
- 没有权重共享。 MLP 不知道「像素 $(i,j)$ 和 $(i,j+1)$ 是邻居」。图像的平移不变性、局部性这些先验全部要从数据里重新学,样本效率极低。
- 输入输出必须同形。 这一点是流/扩散模型独有的困难。分类网络可以一路下采样,$224\times224\times3 \to 1000$,卷积栈可以「收窄」;而这里 $\vf_t^\theta(x)\in\R^d$ 必须和输入一样大。讲义原话:our flow-based modeling approach requires that our output $\vf_t^\theta(x)\in\R^d$ be just as large as its input。
可以把 $\vf_t^\theta$ 想成一个「图像到图像」的映射:给我一张带噪图,还我一张同样大小的「该往哪儿挪」的位移场。所有做过语义分割、光流、去噪的架构都天然适配这个任务——这正是 U-Net(本来是给医学图像分割用的)会被 DDPM 拿来用的原因。
2. 条件变量的嵌入:时间、类别与文本
网络的主干(U-Net 或 DiT)处理的是「图像形状」或「token 序列形状」的张量。而 $t$ 是一个标量,$y$ 可能是一串字符。所以第一步永远是嵌入(embedding):把原始条件 $y_{\text{raw}}$ 和 $t$ 变成网络能吃的向量。
2.1 时间嵌入:为什么要用 Fourier 特征
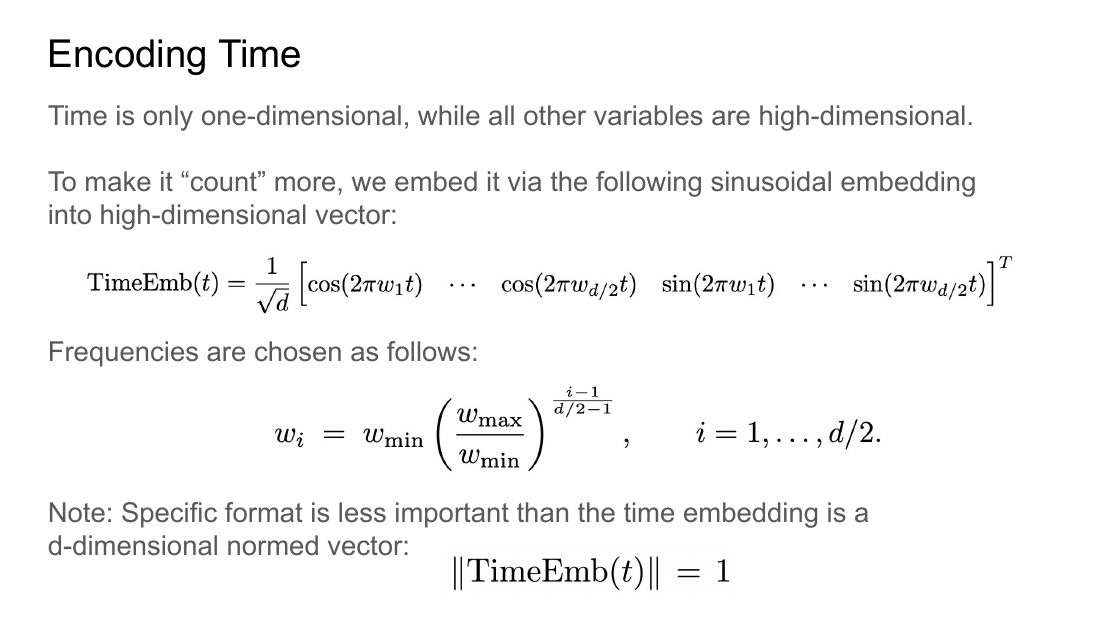
幻灯片上的话很直白:时间只有一维,而其他变量都是高维的。 如果直接把标量 $t$ 拼到 $1.8\times10^6$ 维的输入上,它在第一层线性变换里的「话语权」大约是 $10^{-6}$,几乎必然被淹没。
更深一层的理由是谱偏置(spectral bias):带 ReLU/SiLU 的 MLP 天然倾向于学低频函数,对输入的高频依赖学得极慢。而 $\vf_t^\theta$ 对 $t$ 的依赖恰恰是高频的——回忆 CondOT 路径 $\alpha_t=t,\ \beta_t=1-t$ 下条件向量场
$$ \vf_t(x\mid z)=\frac{z-x}{1-t}, $$当 $t\to 1$ 时系数 $\frac{1}{1-t}$ 会炸开。$t=0.99$ 和 $t=0.999$ 对应的目标场相差 10 倍。网络必须能分辨这两个非常接近的时间值。Fourier 特征(Fourier features)正是为解决这个问题被提出的 [Tancik et al. 2020]。
正弦时间嵌入的定义与性质。 取偶数维 $d$,定义
$$ \text{TimeEmb}(t) \;=\; \sqrt{\tfrac{2}{d}}\, \Big[\cos(2\pi w_1 t)\ \cdots\ \cos(2\pi w_{d/2}t)\ \ \sin(2\pi w_1 t)\ \cdots\ \sin(2\pi w_{d/2}t)\Big]^\top \in \R^{d}, $$其中频率按几何级数(等比)铺开:
$$ w_i \;=\; w_{\min}\left(\frac{w_{\max}}{w_{\min}}\right)^{\frac{i-1}{d/2-1}},\qquad i=1,\dots,d/2 . $$讲义说这个归一化常数是为了让嵌入是单位范数向量。我们把它算出来验证:
$$ \begin{aligned} \norm{\text{TimeEmb}(t)}^2 &= \frac{2}{d}\sum_{i=1}^{d/2}\Big[\cos^2(2\pi w_i t)+\sin^2(2\pi w_i t)\Big] &&\text{(i) 按定义展开平方和}\\ &= \frac{2}{d}\sum_{i=1}^{d/2} 1 &&\text{(ii) } \sin^2+\cos^2=1\\ &= \frac{2}{d}\cdot\frac{d}{2} \;=\; 1 . &&\text{(iii) 求和项数为 } d/2 \end{aligned} $$(i) 只是把每个分量平方相加;(ii) 是三角恒等式,注意正是因为 cos 和 sin 成对出现才能配对消掉,这是这个特定排布的意义;(iii) 数一下项数。于是 $\norm{\text{TimeEmb}(t)}=1$ 对所有 $t$ 成立——时间嵌入落在单位球面上,不同 $t$ 只改变球面上的位置而不改变模长,后续层看到的激活尺度因此与 $t$ 无关,训练更稳。
频率带宽的含义。 最高频分量 $\cos(2\pi w_{\max}t)$ 在 $t$ 变化 $\Delta t \sim 1/(2w_{\max})$ 时就完成半个周期,所以 $w_{\max}$ 决定了网络能分辨的最细时间刻度;最低频分量 $w_{\min}$ 决定了在整个 $[0,1]$ 上单调可辨的「粗刻度」。几何级数铺频率是为了让 $\log w$ 均匀覆盖 $[\log w_{\min},\log w_{\max}]$,即在各个时间尺度上均匀分辨。这和 Transformer 原始论文的位置编码是同一个构造。
import math, torch, torch.nn as nn

class FourierTimeEmbedding(nn.Module):
    """TimeEmb(t) = sqrt(2/d) * [cos(2*pi*w*t) , sin(2*pi*w*t)]   ==>  ||TimeEmb(t)|| = 1"""
    def __init__(self, dim, w_min=1.0, w_max=1000.0):
        super().__init__()
        assert dim % 2 == 0
        half = dim // 2                                    # d/2
        # w_i = w_min * (w_max/w_min)^((i-1)/(d/2-1)),  i = 1..d/2   —— 对数均匀
        exps = torch.arange(half).float() / max(half - 1, 1)   # (half,)   从 0 到 1
        self.register_buffer("w", w_min * (w_max / w_min) ** exps)   # (half,)
        self.dim = dim

    def forward(self, t):                                  # t: (bs,)   取值于 [0, 1]
        ang = 2 * math.pi * t[:, None] * self.w[None, :]    # (bs, half)
        emb = torch.cat([ang.cos(), ang.sin()], dim=-1)     # (bs, dim)
        return emb * math.sqrt(2.0 / self.dim)              # (bs, dim), 每行范数 = 1


# 实践中还会再接一个小 MLP,把这组固定特征投影成可学习的条件向量
time_mlp = nn.Sequential(              # 输入 (bs, dim)
    nn.Linear(dim, 4 * dim), nn.SiLU(),
    nn.Linear(4 * dim, dim),           # 输出 (bs, dim) —— 这就是后文的 \tilde{t}
)
2.2 类别标签嵌入
当 $y_{\text{raw}}\in\mathcal{Y}\triangleq\{0,1,\dots,N\}$ 只是一个类别标签时,最省事的做法就是学一张嵌入表:为 $N+1$ 个可能取值各学一个向量 $\tilde y = E[y_{\text{raw}}]\in\R^d$,$E\in\R^{(N+1)\times d}$。这些嵌入参数被算作 $\vf_t^\theta$ 参数 $\theta$ 的一部分,跟着一起训练。
注意讲义写的是 $N+1$ 个取值而不是 $N$ 个。多出来的那一行正是 Lecture 3b 里 classifier-free guidance 需要的空标签 $\varnothing$:训练时以一定概率把 $y$ 替换成 $\varnothing$,采样时用 $\tilde{\vf}_t^\theta(x\mid y) = (1-w)\,\vf_t^\theta(x\mid\varnothing) + w\,\vf_t^\theta(x\mid y)$。 CFG 在架构上的全部代价,就是嵌入表多一行。
2.3 文本嵌入
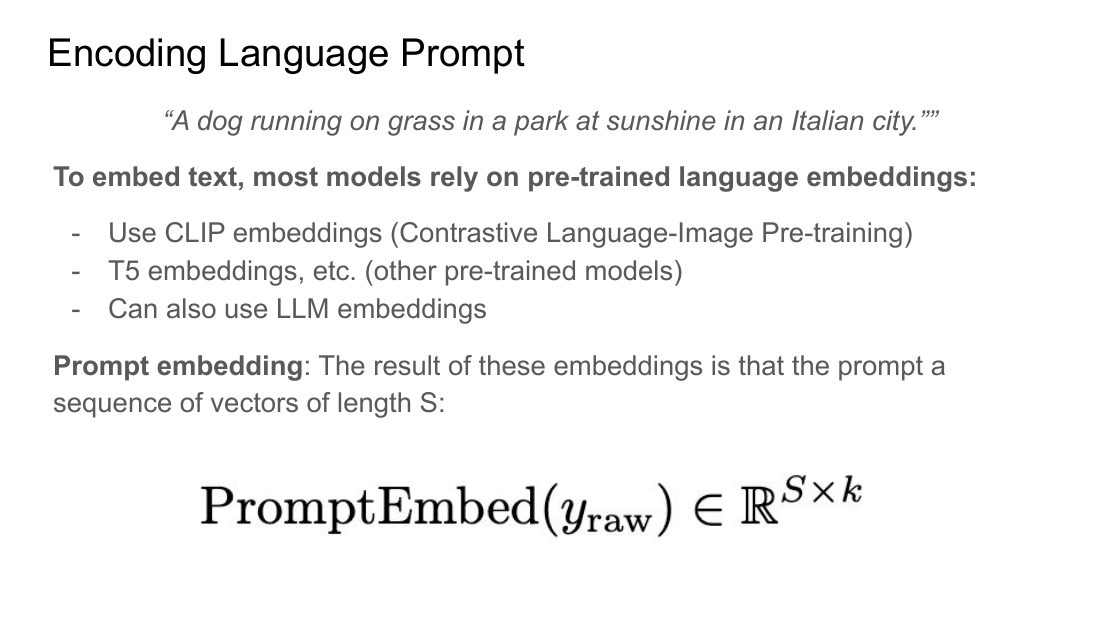
文本要复杂得多,主流做法是依赖冻结的预训练模型,不从头学:
- CLIP(Contrastive Language-Image Pre-training):在图文对上用对比损失训练,把图像和文本压进同一个嵌入空间——匹配的图文对靠得近,不匹配的推开。取 $y=\text{CLIP}(y_{\text{raw}})\in\R^{d_{\text{CLIP}}}$ 作为提示词的单向量表示。
- 但把整句话压成一个向量会丢掉结构信息(「戴帽子的狗」和「戴狗的帽子」可能撞在一起)。所以还会用预训练 Transformer 编码器(T5、UL2 等)得到一个序列表示 $$\text{PromptEmb}(y_{\text{raw}})\in\R^{S\times k},$$ $S$ 是 token 数,$k$ 是嵌入维度。序列表示让网络可以用 cross-attention「盯着」提示词的某个具体词。
- 把多种预训练嵌入拼起来同时用也很常见,取各家之长——SD3 和 Movie Gen 都是这么干的(§10)。
| 条件类型 | 嵌入方式 | 输出形状 | 注入主干的方式 |
|---|---|---|---|
| 时间 $t\in[0,1]$ | Fourier / 正弦特征 + MLP | $\tilde t\in\R^{d}$ | AdaLN 缩放平移(DiT)/逐通道加法(U-Net) |
| 类别 $y\in\{0,\dots,N\}$ | 可学习嵌入表(含 $\varnothing$ 行) | $\tilde y\in\R^{d}$ | 与 $\tilde t$ 相加后一起做 AdaLN |
| 文本(粗粒度) | 冻结 CLIP,池化 | $\R^{d_{\text{CLIP}}}$ | 投影后并入 AdaLN 的条件向量 |
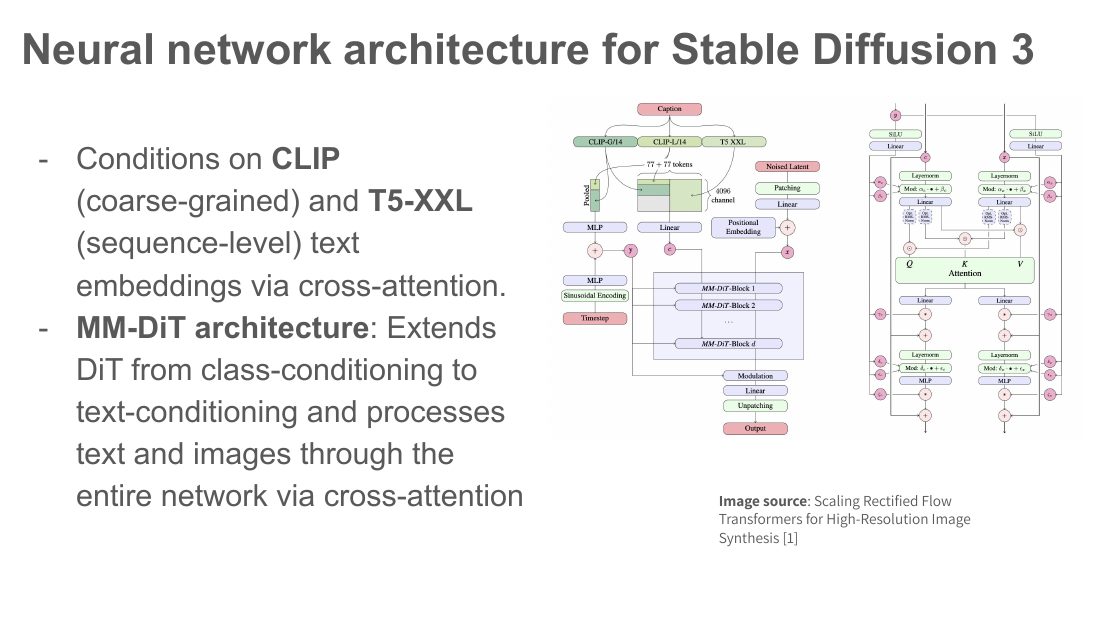
| 文本(序列级) | 冻结 T5 / UL2 / ByT5 编码器 | $\R^{S\times k}$ | cross-attention(或 MM-DiT 的联合注意力) |
3. Diffusion Transformer:把图像变成 token 序列
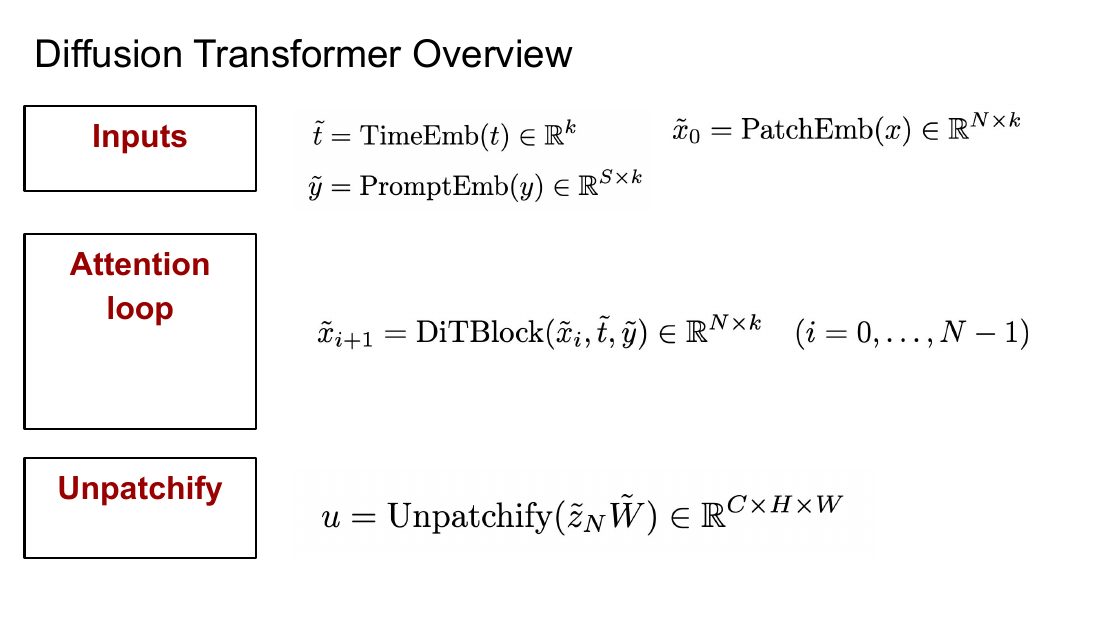
回忆最基本的类型:一张图像就是一个张量 $x\in\R^{C_{\text{image}}\times H\times W}$,$C_{\text{image}}$ 是通道数(RGB 图 $C_{\text{input}}=3$),$H,W$ 是高和宽。Diffusion Transformer(DiT)的想法是:既然 Transformer 在语言上这么能扩展,就把图像也变成 token 序列,用标准注意力处理,最后再变回来。整条流水线是
$$ \text{图像} \ \xrightarrow{\ \text{Patchify}\ }\ \text{token 序列} \ \xrightarrow{\ L\ \text{个 DiTBlock}\ }\ \text{token 序列} \ \xrightarrow{\ \text{Depatchify}\ }\ \text{向量场} $$下面用 $d$ 表示隐藏维度,$L$ 表示层数,$h$ 表示每层的注意力头数。
3.1 Patchify:切块 + 线性投影
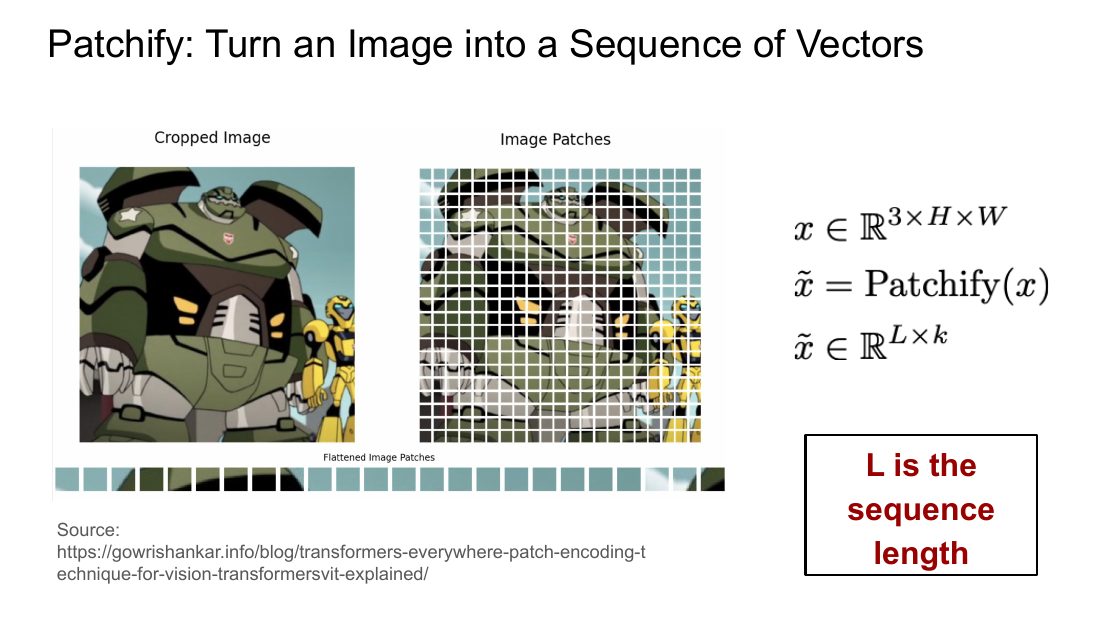
patchify 本身只是一次张量重排,没有任何参数:把 $x\in\R^{C\times H\times W}$ 按 $P\times P$ 的方格切开,每个方格里的 $C P^2$ 个数拉直成一个向量。
$$ \text{Patchify}(x)\in\R^{N\times C'},\qquad C'=CP^2,\qquad N=\frac{H}{P}\cdot\frac{W}{P} $$再乘一个可学习矩阵得到最终的 patch 嵌入:
$$ \text{PatchEmb}(x)=\text{Patchify}(x)\,W\in\R^{N\times d},\qquad W\in\R^{C'\times d}. $$算个具体的。 Stable Diffusion 级别的隐张量 $x\in\R^{4\times 32\times 32}$,取 $P=2$:$C'=4\cdot 2^2=16$,$N=(32/2)^2=256$。于是 $\text{PatchEmb}(x)\in\R^{256\times d}$——256 个 token,跟一个短句子差不多长。如果换成 $64\times 64$ 的隐张量,$N=1024$;如果直接在 $512\times512$ 像素上做,$N=65536$,这个数字后面 §5 会用来算账。
def patchify(x, P):                                    # x: (bs, C, H, W)
    bs, C, H, W = x.shape
    x = x.reshape(bs, C, H // P, P, W // P, P)         # (bs, C, H/P, P, W/P, P)
    x = x.permute(0, 2, 4, 1, 3, 5)                    # (bs, H/P, W/P, C, P, P)
    return x.reshape(bs, (H // P) * (W // P), C * P * P)   # (bs, N, C') , C' = C*P*P

def depatchify(tok, C, H, W, P):                       # tok: (bs, N, C')
    bs = tok.shape[0]
    x = tok.reshape(bs, H // P, W // P, C, P, P)       # (bs, H/P, W/P, C, P, P)
    x = x.permute(0, 3, 1, 4, 2, 5)                    # (bs, C, H/P, P, W/P, P)
    return x.reshape(bs, C, H, W)                      # (bs, C, H, W)
patchify + 注意力的组合对 token 顺序是置换等变的:把 token 打乱再打乱回来,结果不变。这意味着网络看不到哪个 patch在左上角、哪个在右下角。所以必须额外加位置编码(可学习的 $\R^{N\times d}$ 表,或二维 sin-cos 编码),加到 $\tilde x_0$ 上。这不是可选项——去掉它,生成的图像会变成一堆无空间结构的纹理。
3.2 三路输入汇合
把 §2 和 §3.1 拼起来,DiT 的三个输入分别是
$$ \begin{aligned} \tilde t &= \text{TimeEmb}(t) \in \R^{d} &&\text{(标量时间 } \to \text{ 一个向量)}\\ \tilde y &= \text{PromptEmb}(y) \in \R^{S\times d} &&\text{(提示词 } \to \text{ 长度 } S \text{ 的序列)}\\ \tilde x_0 &= \text{PatchEmb}(x) \in \R^{N\times d} &&\text{(图像 } \to \text{ 长度 } N \text{ 的序列)} \end{aligned} $$注意三者的最后一维都被投影到了同一个 $d$——这正是「嵌入」这一步存在的意义。然后迭代地过 $L$ 层:
$$ \tilde x_{i+1} = \text{DiTBlock}(\tilde x_i,\tilde t,\tilde y)\in\R^{N\times d},\qquad i=0,\dots,L-1 . $$最后 depatchify 回图像形状:
$$ \vf = \text{Depatchify}(\tilde x_L\bar W)\in\R^{C\times H\times W},\qquad \bar W\in\R^{d\times C'} . $$这个张量就是模型的输出,即预测的速度场 $\vf_t^\theta(x\mid y)$。
3.3 注意力回顾:形状与那个 $\sqrt{d_h}$
缩放点积注意力。 给定查询 $Q\in\R^{N\times d_h}$、键 $K\in\R^{M\times d_h}$、值 $V\in\R^{M\times d_h}$,
$$ \text{Attn}(Q,K,V)=\softmax\!\left(\frac{QK^\top}{\sqrt{d_h}}\right)V\ \in\ \R^{N\times d_h}, $$softmax 按行作用。注意 $Q$ 的行数 $N$ 与 $K,V$ 的行数 $M$ 可以不同——这正是 cross-attention 的用武之地:$N$ 个图像 token 去查询 $M=S$ 个文本 token。
为什么除以 $\sqrt{d_h}$? 设查询向量 $q\in\R^{d_h}$ 与键向量 $k\in\R^{d_h}$ 的各分量独立、均值 0、方差 1。则 logit
$$ \begin{aligned} \E[\inner{q}{k}] &= \E\Big[\sum_{l=1}^{d_h} q_l k_l\Big] = \sum_{l=1}^{d_h}\E[q_l]\E[k_l] = 0 &&\text{(i) 独立 + 零均值}\\ \Var(\inner{q}{k}) &= \sum_{l=1}^{d_h}\Var(q_l k_l) = \sum_{l=1}^{d_h}\E[q_l^2]\E[k_l^2] = d_h &&\text{(ii) 独立项方差可加} \end{aligned} $$(i) 用了独立性与零均值;(ii) 用了独立随机变量之和的方差可加,以及 $\Var(q_lk_l)=\E[q_l^2k_l^2]-0=\E[q_l^2]\E[k_l^2]=1$。所以未缩放的 logit 标准差是 $\sqrt{d_h}$,随维度增长。$d_h=64$ 时 logit 的典型量级是 $\pm 8$,softmax 会近乎变成 one-hot(饱和),梯度趋近于 0。除以 $\sqrt{d_h}$ 后方差回到 1,logit 保持 $O(1)$,softmax 处在梯度良好的区域。
多头注意力。 设头数为 $h$,每头维度 $d_h=d/h$。对每个头学三个投影矩阵 $W_Q^{(j)},W_K^{(j)},W_V^{(j)}\in\R^{d\times d_h}$,定义
$$ \text{head}_j(x,z)=\text{Attn}\!\left(xW_Q^{(j)},\ zW_K^{(j)},\ zW_V^{(j)}\right)\in\R^{N\times d_h}, $$其中源序列 $z$ 的取法决定了注意力的种类:
$$ z=x\ \ (\text{patch 自注意力}),\qquad z=\tilde y\ \ (\text{对提示词的交叉注意力}). $$拼接所有头再过输出投影 $W_O\in\R^{d\times d}$:
$$ \text{MultiHeadAttention}(x,z)=\text{Concat}\big(\text{head}_1(x,z),\dots,\text{head}_h(x,z)\big)W_O\ \in\ \R^{N\times d}. $$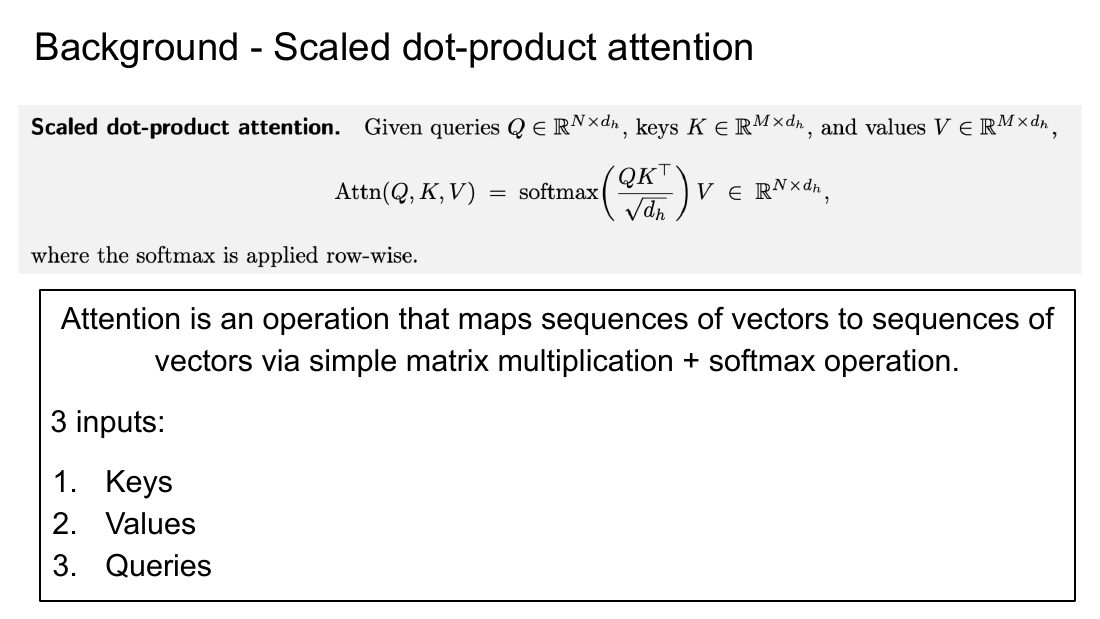
3.4 时间条件化:AdaLN 与 adaLN-Zero
现在到了 DiT 最关键、也最容易被一句话带过的地方。$\tilde t$ 怎么进网络?
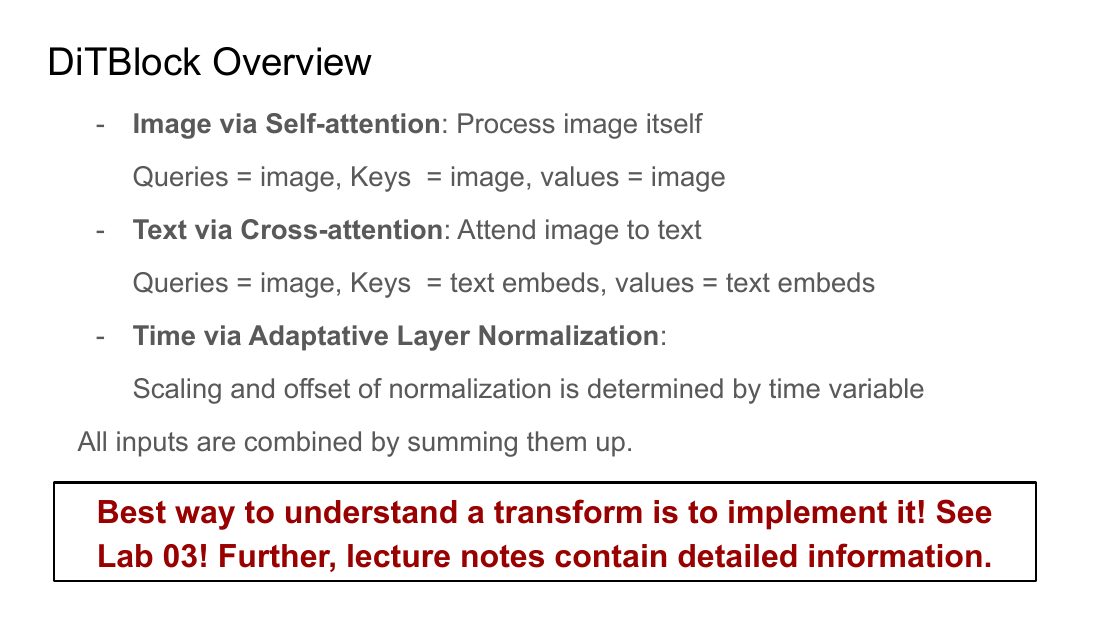
最朴素的做法有两个:(a) 把 $\tilde t$ 当作一个额外的 token 拼进序列(in-context conditioning);(b) 直接把 $\tilde t$ 加到每个 token 上。DiT 论文实测发现,一个更好的做法是调制(modulation):用 $\tilde t$ 去生成归一化层的缩放和平移参数。这就是自适应层归一化(Adaptive Layer Normalization, AdaLN),思想来自 FiLM。
具体地,设 $g:\R^d\to\R^{2d}$ 是一个 MLP,令
$$ (\gamma,\beta)=g(\tilde t),\qquad \gamma,\beta\in\R^{d}. $$给定 token 矩阵 $x\in\R^{N\times d}$ 和归一化算子 $\text{Norm}(\cdot)$(例如去掉了可学习仿射参数的 LayerNorm),定义调制归一化
$$ \text{AdaNorm}_{\tilde t}(x)\;=\;(1+\gamma)\odot \text{Norm}(x)\;+\;\beta, $$其中 $\odot$ 是逐元素乘,并在 token 维度上广播(即所有 $N$ 个 token 共享同一组 $\gamma,\beta$)。
LayerNorm 先把每个 token 的特征向量标准化掉(减均值除标准差),这一步故意抹掉了「尺度」和「偏置」信息;AdaLN 紧接着用由 $t$ 决定的 $\gamma,\beta$ 把尺度和偏置重新写回去。于是时间不是作为一条额外信息「混」在数据里,而是作为一个全局旋钮,逐通道地控制网络内部每一处激活的强弱。写成 $1+\gamma$ 而不是 $\gamma$,是为了让 $\gamma=0$ 对应「什么都不做」的恒等缩放。
完整的 DiTBlock。 讲义给出的形式是:
$$ \begin{aligned} x &\leftarrow x + g_{\text{self}}(\tilde t)\odot \text{MultiHeadAttention}\big(\text{AdaNorm}_{\tilde t}(x),\ \text{AdaNorm}_{\tilde t}(x)\big)\\ x &\leftarrow x + g_{\text{cross}}(\tilde t)\odot \text{MultiHeadAttention}\big(\text{AdaNorm}_{\tilde t}(x),\ \tilde y\big)\\ x &\leftarrow x + g_{\text{MLP}}(\tilde t)\odot \text{MLP}\big(\text{AdaNorm}_{\tilde t}(x)\big) \end{aligned} $$其中 MLP 是逐 token 作用的前馈网络,$g_{\text{self}},g_{\text{cross}},g_{\text{MLP}}:\R^d\to\R^d$ 是可学习的门控(gating)参数(同样由 $\tilde t$ 生成)。三步都是残差形式:$x\leftarrow x+(\text{门控})\odot(\text{子层})$。最终输出 $x\in\R^{N\times d}$ 成为下一层的 $\tilde x_{i+1}$。
adaLN-Zero:为什么把门控零初始化。 记第 $\ell$ 个子层为 $S_\ell$,门控为 $g_\ell$,则一个残差步是
$$ F_\ell(x)=x+g_\ell\odot S_\ell(x). $$做法:把生成门控的那个 MLP 的最后一个线性层的权重和偏置全部初始化为 0。于是初始时刻 $g_\ell(\tilde t)\equiv 0$(对任意 $\tilde t$),从而
$$ F_\ell(x)=x+0\odot S_\ell(x)=x\quad\Longrightarrow\quad F_{L}\circ\cdots\circ F_1=\mathrm{id}. $$整个 $L$ 层堆栈在初始时刻是严格的恒等映射。
为什么这有利于稳定性? 对比一下不零初始化的情形。设 $S_\ell(x)$ 的输出与 $x$ 大致独立且方差为 $\sigma^2\Var(x)$,则
$$ \Var(F_\ell(x))\approx(1+\sigma^2)\Var(x) \quad\Longrightarrow\quad \Var(F_L\circ\cdots\circ F_1(x))\approx(1+\sigma^2)^{L}\,\Var(x), $$激活方差随深度指数增长。$L=28$、$\sigma^2=1$ 时是 $2^{28}\approx 2.7\times 10^8$ 倍。零初始化把这个底数变成 1,方差完全不随深度变化。
那还能训练起来吗? 能。虽然 $g_\ell=0$ 让前向变成恒等,但对 $g_\ell$ 自己的梯度是
$$ \pd{\mathcal{L}}{g_\ell}=\inner{\pd{\mathcal{L}}{F_\ell(x)}}{S_\ell(x)}\ \neq\ 0, $$因为它不含 $g_\ell$ 因子。所以第一步更新就会让 $g_\ell$ 离开 0。直观地说:每个 block 一开始「关着」,只有当打开它确实能降低损失时,它才会把自己逐渐打开。这是一种由优化器自动执行的、从浅到深的课程学习。DiT 论文实测 adaLN-Zero 显著优于普通 adaLN、优于 in-context conditioning、也优于纯 cross-attention。
同样的技巧也用在最后的输出层:把 $\bar W$ 零初始化,于是训练开始时模型对所有输入输出 $\vf\equiv 0$,损失就是 $\E\norm{\vf_t^{\text{target}}}^2$,一个干净的起点。
import torch, torch.nn as nn

class DiTBlock(nn.Module):
    """一个带 cross-attention 的 DiT block,adaLN-Zero 条件化。"""
    def __init__(self, d, n_heads, mlp_ratio=4.0):
        super().__init__()
        # 不带仿射参数的 LayerNorm:缩放/平移完全交给 AdaLN 生成
        mk_norm = lambda: nn.LayerNorm(d, elementwise_affine=False, eps=1e-6)
        self.n1, self.n2, self.n3 = mk_norm(), mk_norm(), mk_norm()
        self.self_attn  = nn.MultiheadAttention(d, n_heads, batch_first=True)
        self.cross_attn = nn.MultiheadAttention(d, n_heads, batch_first=True)
        hid = int(d * mlp_ratio)
        self.mlp = nn.Sequential(nn.Linear(d, hid), nn.GELU(), nn.Linear(hid, d))
        # 一个 MLP 一次产出 9 组参数: (gamma, beta, gate) x (self, cross, mlp)
        self.mod = nn.Sequential(nn.SiLU(), nn.Linear(d, 9 * d))
        nn.init.zeros_(self.mod[-1].weight)   # <<< adaLN-Zero
        nn.init.zeros_(self.mod[-1].bias)     # <<< 初始时 gamma = beta = gate = 0

    def forward(self, x, c, y):        # x: (bs, N, d)  c: (bs, d)  y: (bs, S, d)
        # c = time_mlp(TimeEmb(t)) + class_emb(y)   —— 时间与类别嵌入已相加
        g1, b1, a1, g2, b2, a2, g3, b3, a3 = self.mod(c).chunk(9, dim=-1)  # 各 (bs, d)

        def ada(norm, h, g, b):        # AdaNorm(h) = (1 + gamma) * Norm(h) + beta
            return norm(h) * (1 + g[:, None, :]) + b[:, None, :]           # (bs, N, d)

        h = ada(self.n1, x, g1, b1)                                        # (bs, N, d)
        x = x + a1[:, None, :] * self.self_attn(h, h, h, need_weights=False)[0]
        h = ada(self.n2, x, g2, b2)                                        # (bs, N, d)
        x = x + a2[:, None, :] * self.cross_attn(h, y, y, need_weights=False)[0]
        h = ada(self.n3, x, g3, b3)                                        # (bs, N, d)
        x = x + a3[:, None, :] * self.mlp(h)
        return x                                                           # (bs, N, d)
讲义最后特别提醒:类别条件的 DiT(例如 lab 03 里实现的那个)通常更简单,会去掉 cross-attention 层,只保留基于时间和类别的 AdaNorm 条件化。因为类别就是一个向量,直接并入 $\tilde t$ 一起做调制即可,没必要为长度为 1 的「序列」上一套交叉注意力。上面代码里删掉 cross_attn 那两行、把 9 * d 改成 6 * d,就是 DiT 原论文的版本。
4. U-Net 与两种架构的取舍
U-Net 是 DiT 之外的另一条主线,一种特殊的卷积神经网络。它最早是为医学图像分割设计的,关键特征恰好就是我们在 §1 说的那条硬约束:输入和输出都具有图像的形状(通道数可以不同)。这使它天然适合参数化 $x\mapsto \vf_t^\theta(x\mid y)$——固定 $y,t$,输入是图像形状,输出也是。早期扩散模型文献(DDPM、ADM、SD 1.x/2.x)几乎全用 U-Net。
4.1 结构与张量形状
一个 U-Net 由一串编码器 $\mathcal{E}_i$、一串对应的解码器 $\mathcal{D}_i$、以及夹在中间的一个隐层处理块——讲义戏称为 midcoder $\mathcal{M}$ ——组成。以 $x_t\in\R^{3\times 256\times 256}$ 为例,讲义给出的路径是:
$$ \begin{aligned} x_t^{\text{input}} &\in\R^{3\times 256\times 256} &&\blacktriangleright\ \text{U-Net 的输入}\\ x_t^{\text{latent}} &=\mathcal{E}(x_t^{\text{input}})\in\R^{512\times 32\times 32} &&\blacktriangleright\ \text{过编码器,得到隐表示}\\ x_t^{\text{latent}} &=\mathcal{M}(x_t^{\text{latent}})\in\R^{512\times 32\times 32} &&\blacktriangleright\ \text{过 midcoder}\\ x_t^{\text{output}} &=\mathcal{D}(x_t^{\text{latent}})\in\R^{3\times 256\times 256} &&\blacktriangleright\ \text{过解码器,回到输入形状} \end{aligned} $$注意这里 U-Net 内部的「latent」和后面 §5 起要讲的 VAE 隐空间完全是两回事,只是名字撞了:前者是网络内部的中间特征图,后者是一个独立训练出来的、扩散模型真正工作的空间。
规律是:越往下走,通道数越多,空间分辨率越低。把典型的一条路径逐级写出来:
| 阶段 | 操作 | 输出形状 $(C,H,W)$ | 元素数 |
|---|---|---|---|
| 输入 | — | $(3,256,256)$ | 196 608 |
| 预编码 | Initial Conv(先把通道抬上去) | $(64,256,256)$ | 4 194 304 |
| Encoder 1 | ResLayer $\times2$ + Downsample | $(128,128,128)$ | 2 097 152 |
| Encoder 2 | ResLayer $\times2$ + Downsample | $(256,64,64)$ | 1 048 576 |
| Encoder 3 | ResLayer $\times2$ + Downsample | $(512,32,32)$ | 524 288 |
| Midcoder | ResLayer $\times3$(常插入注意力) | $(512,32,32)$ | 524 288 |
| Decoder 3 | Upsample + 合并 Enc3 跳连 + ResLayer | $(256,64,64)$ | 1 048 576 |
| Decoder 2 | Upsample + 合并 Enc2 跳连 + ResLayer | $(128,128,128)$ | 2 097 152 |
| Decoder 1 | Upsample + 合并 Enc1 跳连 + ResLayer | $(64,256,256)$ | 4 194 304 |
| 输出 | Final Conv | $(3,256,256)$ | 196 608 |
「通道翻倍、边长减半」这个搭配不是随意的:每下降一级,空间位置数变成 $1/4$,通道数变成 2 倍,特征图元素数变成 $1/2$,而卷积的计算量 $O(HWC^2k^2)$ 保持不变($\frac14\cdot 2^2=1$)。也就是说金字塔的每一级花的算力一样多,这是一个刻意的设计。
讲义还强调了两个容易忽略的点:第一,输入 $x_t^{\text{input}}\in\R^{3\times 256\times256}$ 通常先经过一个预编码卷积把通道数抬起来,再进第一个编码器块;第二,编码器和解码器之间由残差连接(residual / skip connection)相连。
4.2 残差层与条件注入
U-Net 的基本积木是残差层,结构大致是
$$ h \;\longmapsto\; h + \text{Conv}_2\Big(\text{SiLU}\big(\text{BN}\big(\text{Conv}_1(\text{SiLU}(\text{BN}(h))) + \text{MLP}(\tilde t,\tilde y)\big)\big)\Big), $$其中 $\text{MLP}(\tilde t,\tilde y)\in\R^{C}$ 沿空间维广播后逐通道相加。这是最简单的条件注入方式:加性偏置。它可以看成 FiLM 只用了平移分量的特例;很多实现(包括 SD 的 U-Net)会用完整的 FiLM,即同时给出缩放和平移 $h\leftarrow \gamma(\tilde t)\odot h+\beta(\tilde t)$——这与 DiT 的 AdaLN 是同一个想法,只不过归一化算子从 LayerNorm 换成了 GroupNorm/BatchNorm。
4.3 为什么跳连是必需的,而不是可选的
很多教程把跳连说成「有助于梯度传播」,这只说对了一半。对流匹配来说有一个更硬的理由:回归目标里显式含有一个恒等映射项。
回忆 CondOT(直线)路径 $X_t=t\,z+(1-t)\,\epsilon$,其条件向量场是
$$ \vf_t(x\mid z)=\frac{z-x}{1-t}. $$由 Lecture 2 的边际化技巧,我们真正要拟合的边际向量场是它的条件期望:
$$ \begin{aligned} \vf_t^{\text{target}}(x) &=\E\big[\vf_t(X_t\mid z)\ \big|\ X_t=x\big] &&\text{(i) 边际化技巧}\\ &=\E\left[\frac{z-x}{1-t}\ \Big|\ X_t=x\right] &&\text{(ii) 代入条件场}\\ &=\frac{1}{1-t}\,\E[z\mid X_t=x]\;-\;\frac{1}{1-t}\,x . &&\text{(iii) 线性性,} x \text{ 在条件下是常数} \end{aligned} $$(i) 是前几讲反复用过的核心结论;(ii) 直接代入;(iii) 把期望拆开,注意条件 $X_t=x$ 之下 $x$ 本身已经确定。
看第二项:$-\frac{1}{1-t}x$。这是一个逐像素的、系数在 $t\to1$ 时趋于无穷的恒等映射。网络必须能精确地表示「把输入原样搬到输出并乘一个大常数」这件事。
现在问:一个把 $256\times256$ 下采样到 $32\times32$ 再上采样回来的纯编码-解码栈,能表示恒等映射吗?不能。8 倍下采样是一个不可逆的线性压缩,$(i,j)$ 与 $(i+1,j)$ 在瓶颈处被混进了同一个空间位置,无论解码器多强,也无法把它们再分开。结果就是输出必然模糊——高频分量被系统性地抹掉。
跳连把这件事变成平凡的:$\mathcal{D}_i$ 的输入里直接含有同分辨率的 $\mathcal{E}_i$ 输出,网络只要学一个「把跳连信号乘 $-\frac{1}{1-t}$ 直接送出去」的通路即可,深层则专心学难的那一项 $\E[z\mid X_t=x]$(也就是「这张噪声图里藏着什么内容」,一个语义级的任务)。
于是跳连实现了一次漂亮的分工:浅层通路负责逐像素的高频恒等成分,深层通路负责低频的语义成分。 这也解释了为什么跳连必须逐分辨率地连(每一级都连),而不是只连一条最外层。
「U-Net 的瓶颈把信息压缩了,所以它也在做隐空间压缩」——错。看上面的表:瓶颈处是 $512\times32\times32=524\,288$ 个数,比输入的 $196\,608$ 还多。U-Net 的瓶颈根本不是信息瓶颈,它只是把信息从「空间维」搬到了「通道维」,目的是让卷积核在低分辨率上获得大感受野。真正的压缩发生在 §5 起要讲的 VAE 里,那是一个独立的、外挂的模块。
4.4 U-Net vs DiT
先把计算复杂度算清楚,这是两者最实质的区别。设图像边长为 $R$(即 $H=W=R$)。
- U-Net:一层 $k\times k$ 卷积在 $R\times R$、$C$ 通道上的乘加数是 $O(R^2C^2k^2)$。由于每下一级 $R^2$ 减 4 倍、$C^2$ 增 4 倍,金字塔各级开销相同,总量 $\Theta(R^2)$——与像素数成正比。
- DiT:token 数 $N=(R/P)^2$。每层的开销分两块:逐 token 的线性投影与 MLP 是 $O(Nd^2)$,注意力矩阵是 $O(N^2d)$。合起来 $$\Theta\!\left(\frac{R^2}{P^2}d^2+\frac{R^4}{P^4}d\right).$$ 第二项是分辨率的四次方。
两项的交叉点在 $N\approx d$。举个具体的:$d=1152$、$P=2$,隐张量 $64\times64$ 时 $N=1024\lt d$,投影项占主导,DiT 仍然「便宜」;换成 $128\times128$ 的隐张量,$N=4096\gt d$,注意力项开始主导,再往上就急剧变贵。这就是为什么即便有了 DiT,隐空间也一步都不能省。
| 维度 | U-Net(卷积) | DiT(Transformer) |
|---|---|---|
| 归纳偏置 | 强:局部性 + 平移等变,硬编码在卷积核里 | 弱:只有 patch 网格 + 位置编码,其余靠数据学 |
| 感受野 | 随深度线性增长,靠下采样才能覆盖全图 | 每一层都是全局的 |
| 关于 token 数 $N$ 的复杂度 | $O(N)$ | $O(Nd^2+N^2d)$ |
| 关于边长 $R$ 的复杂度 | $\Theta(R^2)$ | $\Theta(R^2/P^2\cdot d^2+R^4/P^4\cdot d)$ |
| 参数结构 | 各分辨率层参数不同,形状异构,扩容需重新设计 | $L$ 个同构 block,加宽($d$)加深($L$)即可 |
| 小数据 / 低算力表现 | 更好,先验帮了大忙 | 较差,需要更多数据才追平 |
| 可扩展性(scaling) | 经验上更早饱和 | Gflops ↔ 生成质量呈干净幂律,是当前大模型首选 |
| 条件注入 | 残差块内加性偏置 / FiLM;低分辨率处插 cross-attention | adaLN-Zero(时间、类别)+ cross-attention(文本) |
| 输入输出对齐 | 靠逐分辨率跳连 | 靠 patchify / depatchify 的可逆重排 + 残差流 |
| 代表工作 | DDPM、ADM、Stable Diffusion 1.x / 2.x | DiT、SiT、Stable Diffusion 3、FLUX、Movie Gen |
两种架构解决的其实是同一个问题——「怎样让远处的像素互相通信」。U-Net 的答案是先把图缩小,让固定大小的卷积核在缩小后的图上覆盖更远的距离;DiT 的答案是直接允许任意两个 token 对话,代价是 $O(N^2)$。前者用结构换算力,后者用算力换通用性。当算力和数据都足够多时,后者赢——这是深度学习里反复出现的模式。
5. 为什么必须去隐空间:一笔计算账
到目前为止我们一直在数据空间 $\R^d$ 上工作。但当分辨率往上走,直接建模的代价迅速变得不可承受。讲义给的例子:一张 $1024\times1024$ 的三通道图对应
$$ d = H\cdot W\cdot 3 = 1024\cdot 1024\cdot 3 \approx 3\times 10^{6}, $$幻灯片给的例子是 $600\times1000$:$d=1.8\times10^6$。视频还要再乘帧数 $T$。
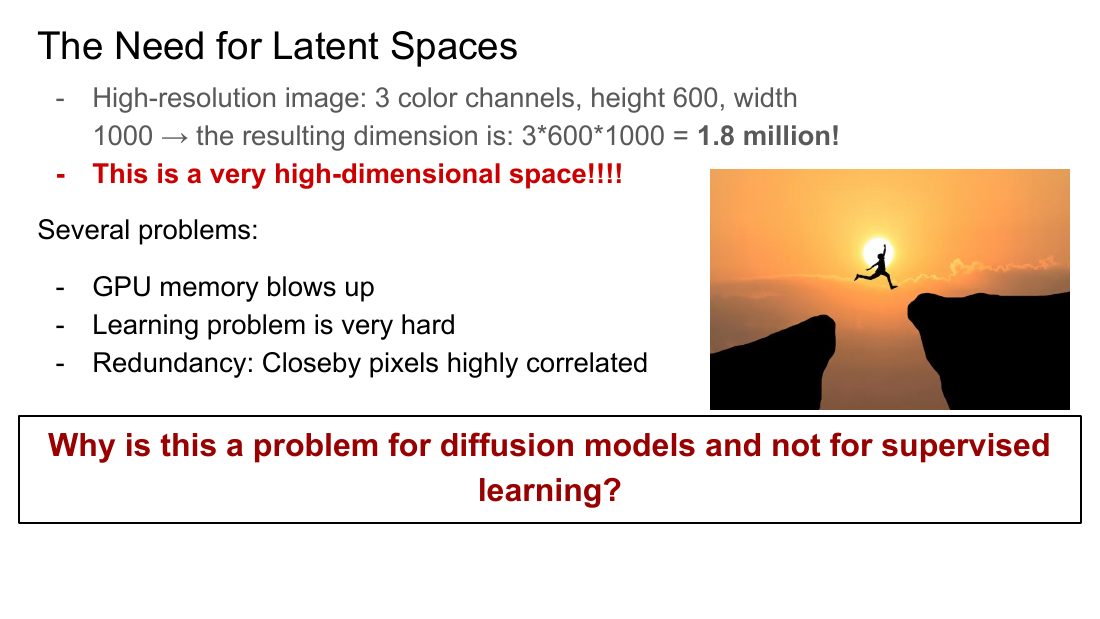
5.1 为什么监督学习没事,扩散模型有事
幻灯片给出的答案分两条,讲义正文补充了第三条:
- 输出维度和输入一样高。 图像分类的输出只有 1000 维,所以卷积栈可以一路收窄,越往后越省。而这里 $\vf_t^\theta(x)\in\R^d$——网络必须一路把 $10^6$ 维的信号带到最后。讲义原话:Unlike image classification, whose low-dimensional outputs allow for narrowing convolutional stacks, our flow-based modeling approach requires that our output be just as large as its input.
- 要反复调用很多次。 分类是前向一次;采样是模拟 ODE/SDE,需要 50 到上千次网络前向。分辨率带来的开销要再乘以步数。
- 要学的是分布,不是一个条件标签。 拟合 $p(y\mid x)$ 只需要抓住与标签相关的那点信息;拟合 $\data(x)$ 本身要求模型对 $\R^d$ 中每一个方向的统计结构都负责。而其中绝大多数方向(高频噪声、纹理相位)对人的感知毫无贡献。
于是核心问题变成讲义加粗的那一句:如何在合理的显存与算力预算内,对高维图像建模?
5.2 压缩能省多少:把数字算出来
算例:$512\times512$ 像素空间 vs $64\times64\times4$ 隐空间。
第 1 步:数值个数。
$$ d_{\text{pixel}}=3\cdot 512\cdot 512=786\,432,\qquad d_{\text{latent}}=4\cdot 64\cdot 64=16\,384 . $$ $$ \frac{d_{\text{pixel}}}{d_{\text{latent}}}=\frac{786\,432}{16\,384}=48 . $$拆开看这个 48:空间上每个方向下采样 8 倍,贡献 $8\times 8=64$;通道从 3 变到 4,贡献 $3/4$。合起来 $64\cdot\frac34=48$。
第 2 步:DiT 的 token 数。 取 patch size $P=2$。
$$ N_{\text{pixel}}=\left(\frac{512}{2}\right)^2=256^2=65\,536,\qquad N_{\text{latent}}=\left(\frac{64}{2}\right)^2=32^2=1\,024 . $$token 数之比是 $65536/1024=64$。
第 3 步:注意力开销。 自注意力矩阵有 $N^2$ 个元素(每头每层):
$$ N_{\text{pixel}}^2=65\,536^2\approx 4.29\times 10^{9},\qquad N_{\text{latent}}^2=1\,024^2\approx 1.05\times 10^{6}, $$ $$ \frac{N_{\text{pixel}}^2}{N_{\text{latent}}^2}=64^2=4\,096 . $$用 fp16 存一张注意力图:像素空间要 $4.29\times10^9\times 2$ 字节 $\approx 8.6$ GB——单头单层就爆掉一整张卡;隐空间只要约 2 MB。
第 4 步:再乘上采样步数。 SD3 用 50 步 Euler,配 CFG 还要每步算两遍(有条件 + 无条件),即 100 次前向。前面的每一项都要乘 100。
结论:数值量省 48 倍,注意力省 4096 倍。这不是「优化」,这是「可行 / 不可行」的分界。
讲义与幻灯片给出的真实系统数字与这个算例完全吻合:
| 模型 | 数据空间形状 | 隐空间形状 | 数值量压缩比 |
|---|---|---|---|
| Stable Diffusion | $[3,256,256]=196\,608$ | $[4,32,32]=4\,096$ | $48\times$ |
| FLUX 2.0 | $[3,1024,1024]=3\,145\,728$ | $[32,64,64]=131\,072$ | $24\times$ |
| 讲义示例 | $3\cdot\frac{1024}{1}\cdot\frac{1024}{1}$ | $3\cdot\frac{1024}{16}\cdot\frac{1024}{16}$ | $256\times$ |
| Meta Movie Gen(TAE) | $\R^{T'\times 3\times H\times W}$ | $\R^{T\times C\times H'\times W'}$,$\frac{T'}{T}=\frac{H}{H'}=\frac{W}{W'}=8$ | 时空位置数 $8^3=512\times$,再乘通道比 $3/C$ |
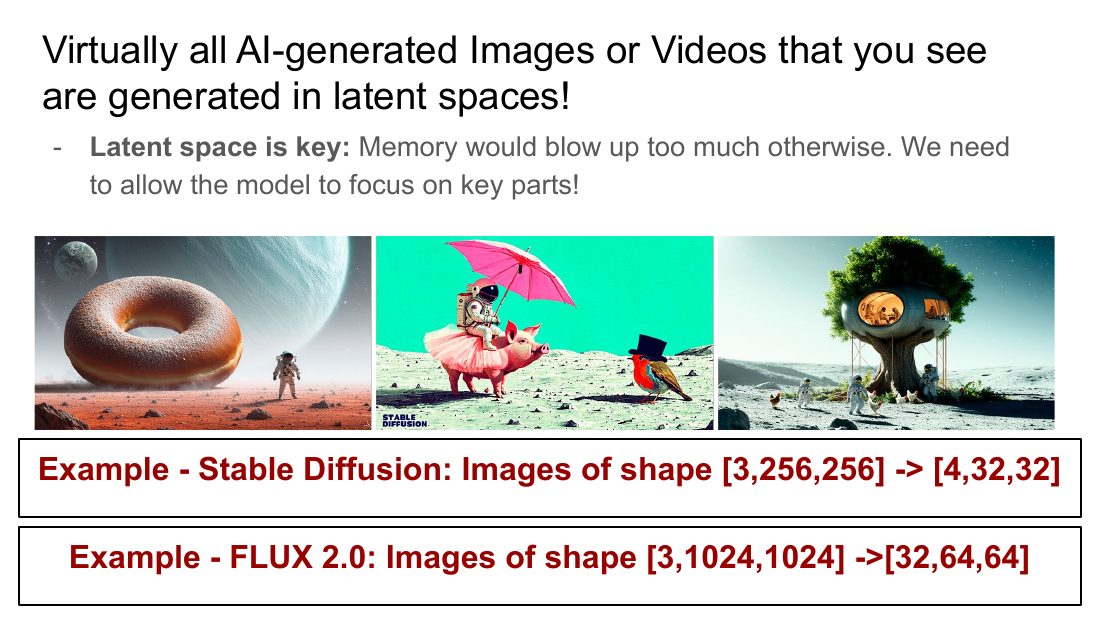
为什么可以压缩 48 倍还不丢东西?因为自然图像并没有填满 $\R^{786432}$,它们集中在一个维度低得多的流形附近。相邻像素高度相关(幻灯片第三条「Redundancy」),一张真实照片的「有效自由度」远小于它的像素数。自编码器要做的,就是找到这个流形的一组坐标。讲义 Remark 32 的说法更精准:一个训练良好的自编码器可以被理解为滤掉了高频的、语义上无意义的细节,好让生成模型把容量集中在重要的、感知相关的特征上。
6. 从自编码器到 VAE:ELBO 的完整推导
6.1 标准自编码器与它的致命缺陷
压缩的自然做法是自编码器(autoencoder, AE):一个编码器 $\mu_\phi:\R^d\to\R^k$ 和一个解码器 $\mu_\theta:\R^k\to\R^d$,把原始数据 $x\in\R^d$ 映到隐变量 $z\in\R^k$ 再映回来,$k\ll d$。训练用重构损失
$$ \mathcal{L}_{\text{Recon}}(\phi,\theta)=\E_{x\sim\data}\Big[\norm{\mu_\theta(\mu_\phi(x))-x}^2\Big]. $$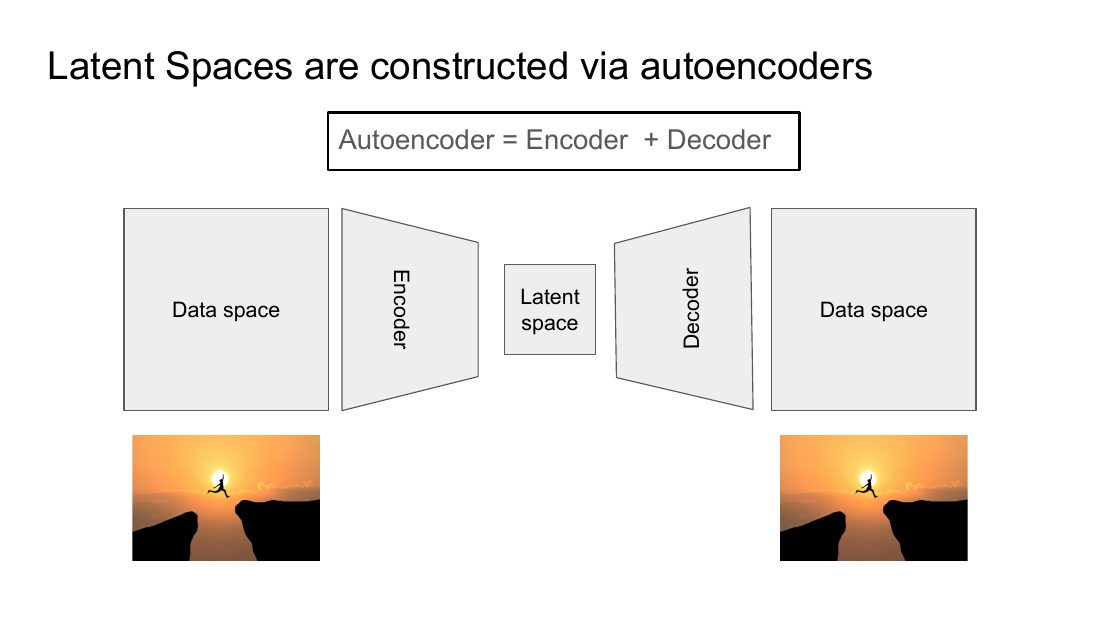
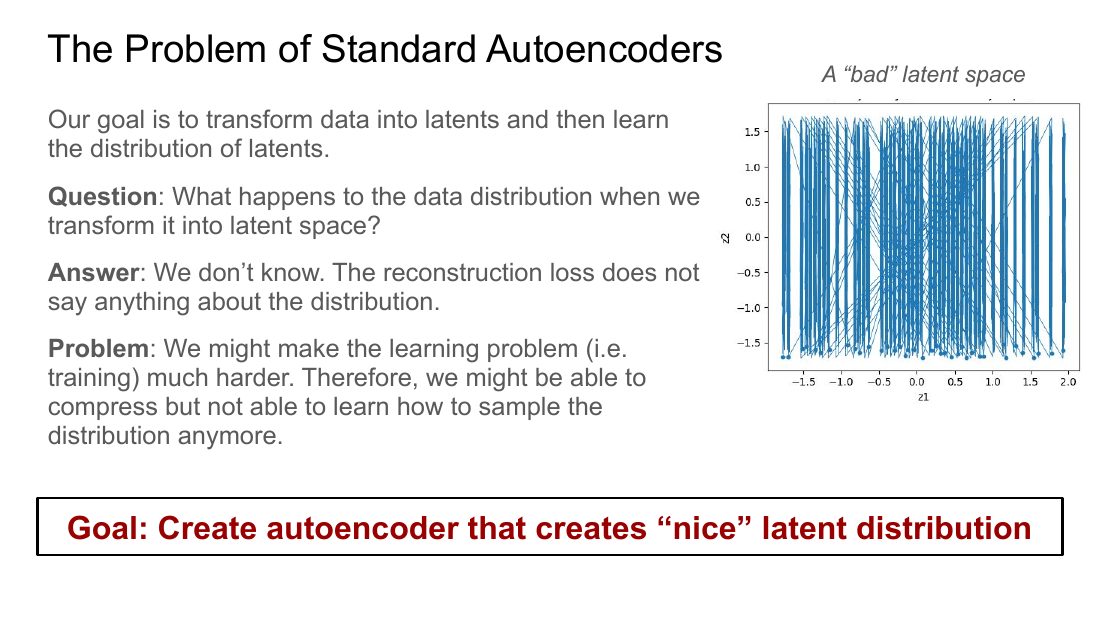
但这样得到的隐空间对生成建模不够用。讲义把这个问题称为 amenability to generative modeling:我们的最终目标是在隐空间里训一个生成模型,去拟合 $z=\mu_\phi(x),\ x\sim\data$ 诱导出的分布 $p_{\text{latent}}(z)$。可是重构损失对 $p_{\text{latent}}$ 只字未提,我们对它毫无控制。
把「重构损失说不了任何关于 $p_{\text{latent}}$ 的事」变成一个精确命题。
设 $\psi:\R^k\to\R^k$ 是任意一个双射(可逆映射)。考虑替换
$$ \mu_\phi\ \longmapsto\ \psi\circ\mu_\phi,\qquad \mu_\theta\ \longmapsto\ \mu_\theta\circ\psi^{-1}. $$那么复合映射完全不变:
$$ (\mu_\theta\circ\psi^{-1})\circ(\psi\circ\mu_\phi)(x)=\mu_\theta\big(\psi^{-1}(\psi(\mu_\phi(x)))\big)=\mu_\theta(\mu_\phi(x)), $$因此重构损失逐点相等,$\mathcal{L}_{\text{Recon}}$ 一模一样。可是新的隐分布是 $\psi_{\#}p_{\text{latent}}$($p_{\text{latent}}$ 在 $\psi$ 下的推前测度),而 $\psi$ 可以取得任意病态——比如一条填满正方形的空间填充曲线。
结论:重构损失关于隐分布有一整个无穷维的对称群,它把 $p_{\text{latent}}$ 完全留给了优化过程的偶然性。我们可能压缩成功了,却把 $\data$ 变成了一个比原来更难学的分布——压缩做到了,采样反而做不到了。
6.2 变分自编码器:把确定性映射放松成分布
变分自编码器(variational autoencoder, VAE)的做法是放松编码器和解码器必须是确定性函数这一约束:改用条件分布。设编码器为 $q_\phi(z\mid x)$、解码器为 $p_\theta(x\mid z)$,最常见的取法是高斯:
$$ q_\phi(z\mid x)=\N\big(z;\mu_\phi(x),\diag(\sigma_\phi^2(x))\big), \qquad p_\theta(x\mid z)=\N\big(x;\mu_\theta(z),\sigma_\theta^2(z)I_d\big), $$各对象的类型是
$$ \mu_\phi(x)\in\R^k,\quad \sigma_\phi^2(x)\in\R^k_{\ge0},\quad \mu_\theta(z)\in\R^d,\quad \sigma_\theta^2(z)\in\R_{\ge0}, $$都由神经网络参数化。编码和解码变成采样:
$$ z\sim q_\phi(\cdot\mid x)\quad(\text{编码}),\qquad x\sim p_\theta(\cdot\mid z)\quad(\text{解码}). $$当 $\sigma_\phi(x)\equiv 0$ 且 $\sigma_\theta(z)\equiv 0$ 时,两个分布退化成 Dirac 测度,我们就回到了标准自编码器。所以 VAE 是 AE 的严格推广。
6.3 边际似然为什么算不出来
引入先验 $p_{\text{prior}}(z)=\N(0,I_k)$ 之后,解码器加先验就定义了一个数据空间上的生成模型
$$ p_\theta(x)=\int p_\theta(x\mid z)\,p_{\text{prior}}(z)\ud z . $$最大似然的标准做法是最大化 $\log p_\theta(x)$。问题在于这是一个 $k$ 维积分,$k$ 通常上万,没有闭式解。朴素的 Monte Carlo
$$ p_\theta(x)\approx\frac1M\sum_{m=1}^M p_\theta(x\mid z^{(m)}),\qquad z^{(m)}\sim p_{\text{prior}}, $$方差高到完全不可用:从各向同性高斯里随机抽一个 $z$,解码出来恰好接近给定的 $x$ 的概率是天文数字级的小,绝大多数样本贡献 $p_\theta(x\mid z)\approx 0$。我们需要一个知道「$x$ 大概编码到哪儿」的提议分布——这正是编码器 $q_\phi(z\mid x)$ 的角色。
6.4 ELBO:两条推导路径
路径一:重要性采样 + Jensen 不等式。
$$ \begin{aligned} \log p_\theta(x) &=\log\int p_\theta(x\mid z)\,p_{\text{prior}}(z)\ud z &&\text{(i) 定义}\\ &=\log\int q_\phi(z\mid x)\,\frac{p_\theta(x\mid z)\,p_{\text{prior}}(z)}{q_\phi(z\mid x)}\ud z &&\text{(ii) 同乘同除 } q_\phi(z\mid x)\\ &=\log\ \E_{z\sim q_\phi(\cdot\mid x)}\!\left[\frac{p_\theta(x\mid z)\,p_{\text{prior}}(z)}{q_\phi(z\mid x)}\right] &&\text{(iii) 积分写成期望}\\ &\ \ge\ \E_{z\sim q_\phi(\cdot\mid x)}\!\left[\log\frac{p_\theta(x\mid z)\,p_{\text{prior}}(z)}{q_\phi(z\mid x)}\right] \;\triangleq\;\text{ELBO}(x;\phi,\theta). &&\text{(iv) Jensen} \end{aligned} $$(ii) 这一步要求 $q_\phi(z\mid x)\gt0$ 在 $p_{\text{prior}}$ 的支撑上处处成立——高斯满足。(iii) 只是记号变换。(iv) 用了 $\log$ 是凹函数,故 $\log\E[U]\ge\E[\log U]$。
这条路径快,但它没告诉我们不等号差多少。第二条路径把这个缺口精确地算出来。
路径二:精确恒等式。 从 ELBO 出发,用一次贝叶斯公式。
$$ \begin{aligned} \text{ELBO}(x;\phi,\theta) &=\E_{z\sim q_\phi(\cdot\mid x)}\!\left[\log\frac{p_\theta(x\mid z)\,p_{\text{prior}}(z)}{q_\phi(z\mid x)}\right] &&\text{(i) 定义}\\ &=\E_{z\sim q_\phi(\cdot\mid x)}\!\left[\log\frac{p_\theta(z\mid x)\,p_\theta(x)}{q_\phi(z\mid x)}\right] &&\text{(ii) 贝叶斯}\\ &=\E_{z\sim q_\phi(\cdot\mid x)}\big[\log p_\theta(x)\big] +\E_{z\sim q_\phi(\cdot\mid x)}\!\left[\log\frac{p_\theta(z\mid x)}{q_\phi(z\mid x)}\right] &&\text{(iii) } \log \text{ 拆和}\\ &=\log p_\theta(x)\;-\;\E_{z\sim q_\phi(\cdot\mid x)}\!\left[\log\frac{q_\phi(z\mid x)}{p_\theta(z\mid x)}\right] &&\text{(iv) 第一项与 } z \text{ 无关;第二项取倒数变号}\\ &=\log p_\theta(x)-\KL\big(q_\phi(\cdot\mid x)\,\big\|\,p_\theta(\cdot\mid x)\big). &&\text{(v) KL 的定义} \end{aligned} $$(ii) 用的是 $p_\theta(z\mid x)=\dfrac{p_\theta(x\mid z)p_{\text{prior}}(z)}{p_\theta(x)}$,即 $p_\theta(x\mid z)p_{\text{prior}}(z)=p_\theta(z\mid x)p_\theta(x)$。(iv) 中 $\log p_\theta(x)$ 是常数,期望等于它本身。移项即得本讲最重要的恒等式:
$$ \boxed{\ \log p_\theta(x)\;=\;\text{ELBO}(x;\phi,\theta)\;+\;\KL\big(q_\phi(z\mid x)\,\big\|\,p_\theta(z\mid x)\big)\ } $$由 KL 的非负性立刻重新得到 $\text{ELBO}\le\log p_\theta(x)$,而且现在我们知道缺口是什么:ELBO 与真实对数似然的差,恰好是变分后验 $q_\phi$ 与真实后验 $p_\theta(\cdot\mid x)$ 之间的 KL 散度。当且仅当编码器精确地等于真实后验时,界是紧的。
这个恒等式还解释了「变分」二字:优化 $\phi$ 在做两件事——既在收紧界(减小 $\KL(q_\phi\|p_\theta(\cdot\mid x))$),又在通过 $\theta$ 抬高 $\log p_\theta(x)$。
6.5 把 ELBO 拆成「重构 − 正则」
把 ELBO 里的对数拆开:
$$ \begin{aligned} \text{ELBO}(x;\phi,\theta) &=\E_{z\sim q_\phi(\cdot\mid x)}\!\left[\log\frac{p_\theta(x\mid z)\,p_{\text{prior}}(z)}{q_\phi(z\mid x)}\right]\\ &=\E_{z\sim q_\phi(\cdot\mid x)}\big[\log p_\theta(x\mid z)\big] +\E_{z\sim q_\phi(\cdot\mid x)}\!\left[\log\frac{p_{\text{prior}}(z)}{q_\phi(z\mid x)}\right] &&\text{(i) } \log(ab/c)=\log a+\log(b/c)\\ &=\underbrace{\E_{z\sim q_\phi(\cdot\mid x)}\big[\log p_\theta(x\mid z)\big]}_{\text{重构项}} -\underbrace{\KL\big(q_\phi(\cdot\mid x)\,\big\|\,p_{\text{prior}}\big)}_{\text{正则项}} . &&\text{(ii) 倒数变号 = KL} \end{aligned} $$两项的分工非常干净:
- 重构项:把 $x$ 编码成 $z$ 之后,解码器还能不能把 $x$ 还原出来。它只关心信息保真度。
- 正则项:对每一个数据点 $x$,编码分布 $q_\phi(\cdot\mid x)$ 都要长得像先验 $\N(0,I_k)$。它只关心隐空间的形状。
如果每个 $x$ 的编码分布都像 $\N(0,I_k)$,那么它们的混合——也就是隐边际分布 $q_\phi(z)=\int q_\phi(z\mid x)\data(x)\ud x$——自然也会像 $\N(0,I_k)$。这就直接堵上了 §6.1 那个漏洞:现在损失函数对 $p_{\text{latent}}$ 有话可说了。
讲义把这两项分别记作
$$ \mathcal{L}_{\text{VAE-Recon}}(\phi,\theta)=-\E_{x\sim\data,\,z\sim q_\phi(\cdot\mid x)}\big[\log p_\theta(x\mid z)\big], \qquad \mathcal{L}_{\text{VAE-Prior}}(\phi)=\E_{x\sim\data}\Big[\KL\big(q_\phi(\cdot\mid x)\,\|\,p_{\text{prior}}\big)\Big], $$并用一个权重 $\beta\ge0$ 组合成 VAE 训练目标:
$$ \mathcal{L}_{\text{VAE}}(\phi,\theta)=\mathcal{L}_{\text{VAE-Recon}}(\phi,\theta)+\beta\,\mathcal{L}_{\text{VAE-Prior}}(\phi) =-\E_{x,z}\big[\log p_\theta(x\mid z)\big]+\beta\,\E_{x}\Big[\KL\big(q_\phi(\cdot\mid x)\,\|\,p_{\text{prior}}\big)\Big]. $$取 $\beta=1$ 时,$\mathcal{L}_{\text{VAE}}=-\E_{x\sim\data}[\text{ELBO}(x;\phi,\theta)]$,即最小化 VAE 损失就是最大化期望 ELBO。$\beta\neq1$ 的版本称为 $\beta$-VAE。
6.6 高斯解码器下重构项的具体形式
把 $p_\theta(x\mid z)=\N(x;\mu_\theta(z),\sigma_\theta^2(z)I_d)$ 的密度代进去。$d$ 维各向同性高斯的密度是
$$ \N(x;\mu,\sigma^2 I_d)=(2\pi\sigma^2)^{-d/2}\exp\!\left(-\frac{\norm{x-\mu}^2}{2\sigma^2}\right), $$取对数并取负:
$$ \begin{aligned} -\log p_\theta(x\mid z) &=\frac{d}{2}\log(2\pi\sigma_\theta^2(z))+\frac{1}{2\sigma_\theta^2(z)}\norm{x-\mu_\theta(z)}^2 &&\text{(i) 代入密度取对数}\\ &=\frac{1}{2\sigma_\theta^2(z)}\norm{x-\mu_\theta(z)}^2+\frac{d}{2}\log\sigma_\theta^2(z)+\underbrace{\frac{d}{2}\log 2\pi}_{\text{常数}} . &&\text{(ii) 拆开 } \log(2\pi\sigma^2) \end{aligned} $$取期望即得讲义的式子:
$$ \mathcal{L}_{\text{VAE-Recon}}(\phi,\theta)=\E_{x\sim\data,\,z\sim q_\phi(\cdot\mid x)}\left[\frac{1}{2\sigma_\theta^2(z)}\norm{x-\mu_\theta(z)}^2+\frac{d}{2}\log\sigma_\theta^2(z)\right]+\text{const}. $$解读:第一项是加权的平方误差,权重是解码器方差的倒数;第二项是对「过分自信」的惩罚。两者构成一个自洽的取舍——解码器可以把 $\sigma_\theta^2$ 调小来宣称自己很确定,但这样第一项的权重就变大,重构误差会被放大惩罚;反之调大 $\sigma_\theta^2$ 可以减轻重构压力,但要付出 $\frac d2\log\sigma_\theta^2$ 的代价。
很多实现(包括本课 lab)干脆把 $\sigma_\phi(x)$ 和 $\sigma_\theta(z)$ 固定为学到的标量常数(与 $x$、$z$ 无关),以避免学方差时的病态行为和数值不稳定。此时 $\frac d2\log\sigma_\theta^2$ 变成常数,损失退化成
$$ \mathcal{L}_{\text{VAE-Recon}}(\phi,\theta)=\E_{x\sim\data,\,z\sim q_\phi(\cdot\mid x)}\left[\frac{1}{2\sigma_\theta^2}\norm{x-\mu_\theta(z)}^2\right]+\text{const}, $$也就是标准自编码器的重构损失,只多了编码过程中的一点随机性。这正是讲义强调的:VAE 的重构损失和 AE 的重构损失差别不大,真正的新东西是那个 KL 正则项。
7. 高斯情形:KL 闭式解、重参数化与训练算法
7.1 KL 散度速查
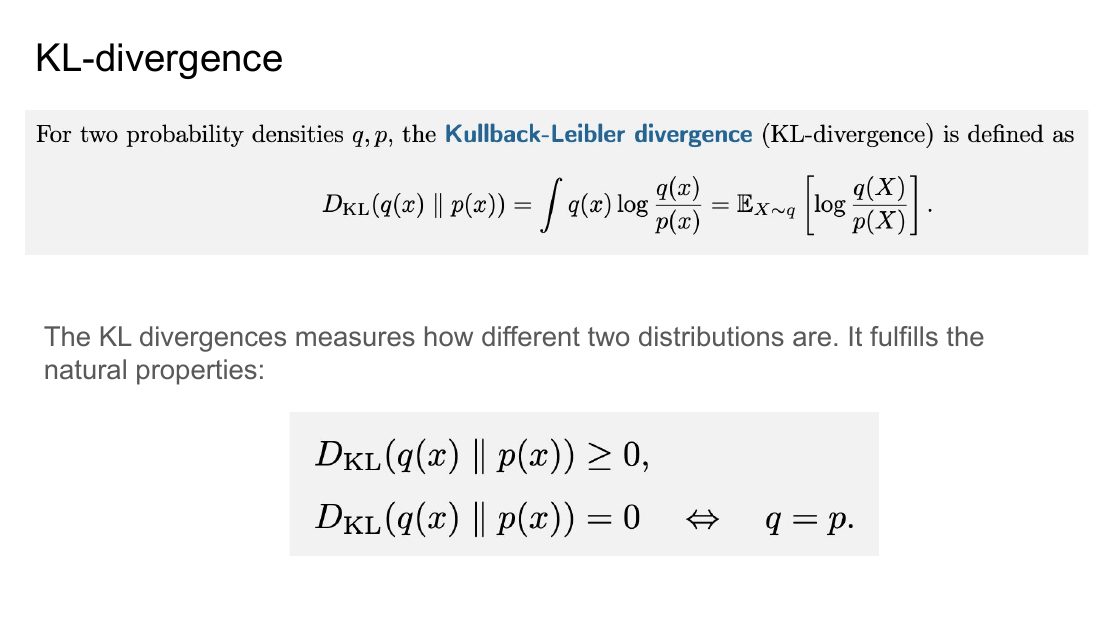
对两个概率密度 $q,p$,Kullback–Leibler 散度定义为
$$ \KL\big(q(x)\,\|\,p(x)\big)=\int q(x)\log\frac{q(x)}{p(x)}\ud x=\E_{X\sim q}\left[\log\frac{q(X)}{p(X)}\right]. $$它满足两条基本性质(讲义 Remark 30):
$$ \KL(q\,\|\,p)\ \ge\ 0,\qquad\qquad \KL(q\,\|\,p)=0\iff q=p . $$非负性的证明(一行 Jensen):
$$ -\KL(q\|p)=\E_{X\sim q}\left[\log\frac{p(X)}{q(X)}\right]\ \overset{(i)}{\le}\ \log\ \E_{X\sim q}\left[\frac{p(X)}{q(X)}\right]\ \overset{(ii)}{=}\ \log\int q(x)\frac{p(x)}{q(x)}\ud x\ \overset{(iii)}{=}\ \log\int p(x)\ud x=\log 1=0 . $$(i) 是 Jensen 不等式($\log$ 凹);(ii) 展开期望;(iii) 约掉 $q$ 后被积函数就是 $p$,积分为 1。由于 $\log$ 是严格凹的,等号成立当且仅当 $p(X)/q(X)$ 几乎处处是常数,结合两者都是概率密度可知该常数为 1,即 $q=p$。
7.2 两个对角高斯之间 KL 的闭式解
命题(讲义 Example 31)。 设 $q=\N(x;\mu_q,\diag(\sigma_q^2))$,$p=\N(x;\mu_p,\diag(\sigma_p^2))$,$\sigma_q,\sigma_p\in\R^d_{\ge0}$。则
$$ \KL(q\,\|\,p)=\frac12\left(\mathcal{K}\!\left(\frac{\sigma_q^2}{\sigma_p^2}\right)+\frac{\norm{\mu_q-\mu_p}^2}{\sigma_p^2}\right), \qquad\text{其中}\quad \mathcal{K}(\alpha)=\sum_{i=1}^d \alpha_i-\log\alpha_i-1 . $$第 1 步:先做 $d=1$。 一维正态密度的对数是
$$ \log q(x)=-\frac12\log(2\pi\sigma_q^2)-\frac{1}{2\sigma_q^2}(x-\mu_q)^2, \qquad \log p(x)=-\frac12\log(2\pi\sigma_p^2)-\frac{1}{2\sigma_p^2}(x-\mu_p)^2 . $$第 2 步:作差取期望。
$$ \begin{aligned} \KL(q\|p)&=\E_{x\sim q}\big[\log q(x)-\log p(x)\big]\\ &=\E_{x\sim q}\left[-\frac12\log(2\pi\sigma_q^2)+\frac12\log(2\pi\sigma_p^2)-\frac{(x-\mu_q)^2}{2\sigma_q^2}+\frac{(x-\mu_p)^2}{2\sigma_p^2}\right]\\ &=\frac12\log\frac{\sigma_p^2}{\sigma_q^2}+\frac{1}{2\sigma_p^2}\E_q\big[(x-\mu_p)^2\big]-\frac{1}{2\sigma_q^2}\E_q\big[(x-\mu_q)^2\big]. \end{aligned} $$注意 $2\pi$ 在相减时被抵消掉了。
第 3 步:算两个二阶矩。 第一个是方差的定义:
$$ \E_q\big[(x-\mu_q)^2\big]=\sigma_q^2 . $$第二个用配凑 $x-\mu_p=(x-\mu_q)+(\mu_q-\mu_p)$ 展开:
$$ \begin{aligned} \E_q\big[(x-\mu_p)^2\big] &=\E_q\Big[\big((x-\mu_q)+(\mu_q-\mu_p)\big)^2\Big]\\ &=\E_q\big[(x-\mu_q)^2\big]+2(\mu_q-\mu_p)\underbrace{\E_q[x-\mu_q]}_{=0}+(\mu_q-\mu_p)^2\\ &=\sigma_q^2+(\mu_q-\mu_p)^2 . \end{aligned} $$交叉项消失是因为 $\E_q[x]=\mu_q$——这是整个计算里唯一的技巧点。
第 4 步:代回去。
$$ \begin{aligned} \KL(q\|p)&=\frac12\log\frac{\sigma_p^2}{\sigma_q^2}+\frac{\sigma_q^2+(\mu_q-\mu_p)^2}{2\sigma_p^2}-\frac{\sigma_q^2}{2\sigma_q^2}\\ &=\frac12\left[-\log\frac{\sigma_q^2}{\sigma_p^2}+\frac{\sigma_q^2}{\sigma_p^2}-1\right]+\frac{(\mu_q-\mu_p)^2}{2\sigma_p^2}\\ &=\frac12\left[\mathcal{K}\!\left(\frac{\sigma_q^2}{\sigma_p^2}\right)+\frac{(\mu_q-\mu_p)^2}{\sigma_p^2}\right], \end{aligned} $$其中最后一步就是把 $\alpha-\log\alpha-1$ 认出来,$\alpha=\sigma_q^2/\sigma_p^2$。
第 5 步:推到 $d$ 维。 由于两个分布的协方差都是对角的,它们都是各坐标独立分布的乘积:$q(x)=\prod_i q_i(x_i)$,$p(x)=\prod_i p_i(x_i)$。于是
$$ \log\frac{q(x)}{p(x)}=\sum_{i=1}^d\log\frac{q_i(x_i)}{p_i(x_i)} \quad\Longrightarrow\quad \KL(q\|p)=\sum_{i=1}^d\E_{x_i\sim q_i}\left[\log\frac{q_i(x_i)}{p_i(x_i)}\right]=\sum_{i=1}^d\KL(q_i\|p_i), $$即 KL 在独立坐标上可加。把第 4 步的结果逐坐标求和就得到命题。$\blacksquare$
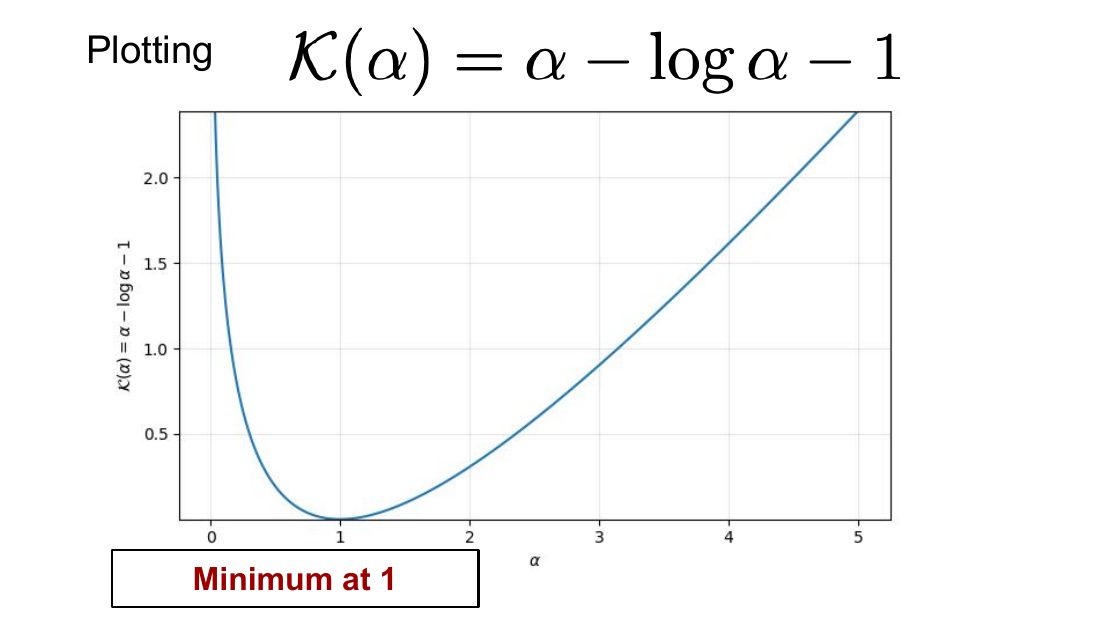
7.3 $\mathcal{K}(\alpha)$ 长什么样
公式的形状非常直观:$\KL$ 随均值的平方误差 $\norm{\mu_q-\mu_p}^2$ 单调增长;方差的贡献则通过 $\mathcal{K}(\alpha)=\alpha-\log\alpha-1$ 体现。
$\mathcal{K}$ 在 $\alpha=1$ 有唯一最小值 0。 一维分量上求导:
$$ \mathcal{K}'(\alpha)=1-\frac1\alpha,\qquad \mathcal{K}''(\alpha)=\frac{1}{\alpha^2}\gt0\ \ (\alpha\gt0). $$$\mathcal{K}'(\alpha)=0\iff\alpha=1$;二阶导恒正说明 $\mathcal{K}$ 在 $(0,\infty)$ 上严格凸,故该驻点是全局最小;代入得 $\mathcal{K}(1)=1-0-1=0$。另外 $\alpha\to0^+$ 时 $-\log\alpha\to+\infty$,$\alpha\to\infty$ 时 $\alpha\to+\infty$,两端都发散。
所以「方差项」的惩罚是不对称的:方差塌缩到 0(编码器退化成确定性映射)会被 $-\log\alpha$ 无穷惩罚,方差过大则被 $\alpha$ 线性惩罚。前者的惩罚更凶——这正是我们想要的,因为方差塌缩会让隐空间重新变回那个「坏」的 AE 隐空间。
7.4 代入 $p_{\text{prior}}=\N(0,I_k)$:损失的最终形式
取 $\mu_p=0,\ \sigma_p^2=1$(即先验为标准正态),$q=q_\phi(\cdot\mid x)$:
$$ \mathcal{L}_{\text{VAE-Prior}}(\phi)=\E_{x\sim\data}\Big[\KL\big(q_\phi(\cdot\mid x)\,\|\,\N(0,I_k)\big)\Big] =\E\left[\frac12\mathcal{K}\big(\sigma_\phi^2(x)\big)+\frac12\norm{\mu_\phi(x)}^2\right]. $$展开成逐坐标的形式($k$ 是隐维度):
$$ \KL\big(q_\phi(\cdot\mid x)\,\|\,\N(0,I_k)\big)=\frac12\sum_{j=1}^{k}\Big(\mu_{\phi,j}^2(x)+\sigma_{\phi,j}^2(x)-\log\sigma_{\phi,j}^2(x)-1\Big). $$这就是所有 VAE 代码里那一行 0.5 * (mu**2 + var - logvar - 1).sum() 的来历。把它和 §6.6 的重构项合起来,得到讲义的完整 VAE 损失:
四项的作用讲义总结得很清楚:第一项是重构误差;第二项刻画解码器的不确定性——方差越小解码器越「自信」,但同时也让重构误差被更重地惩罚;第三、四项则强制隐分布的方差为 1、均值为 0,也就是逼近标准高斯。
7.5 重参数化技巧
剩下的问题是怎么优化。麻烦在于我们取期望所依赖的那个分布 $q_\phi(z\mid x)$ 本身依赖 $\phi$。
为什么不能直接对采样求导。 设 $f$ 是任意可微函数(这里是 VAE 里那一堆和 $z$ 有关的项),我们要算
$$ \nabla_\phi\ \E_{z\sim q_\phi(\cdot\mid x)}[f(z)] =\nabla_\phi\int q_\phi(z\mid x) f(z)\ud z =\int \big(\nabla_\phi q_\phi(z\mid x)\big) f(z)\ud z . $$梯度落在了密度上,而不是落在 $f$ 上。 这意味着「采一个 $z$,然后对 $f(z)$ 反向传播」这个最自然的做法算出来的东西是错的:$\E_{z\sim q_\phi}[\nabla_\phi f(z)]=0$,因为 $f$ 根本不显含 $\phi$。采样操作在计算图上是一个「断点」。
一个通用的补救是 score-function(REINFORCE)估计量:
$$ \int (\nabla_\phi q_\phi) f\ud z=\int q_\phi\,(\nabla_\phi\log q_\phi)\,f\ud z=\E_{z\sim q_\phi}\big[f(z)\,\nabla_\phi\log q_\phi(z\mid x)\big], $$它无偏,但方差极大(因为它完全没有利用 $f$ 的梯度信息),在上万维的隐空间里没法用。
重参数化技巧(reparameterization trick)。 对 $q_\phi(z\mid x)=\N(z;\mu_\phi(x),\sigma_\phi^2(x)I_k)$,采样可以写成一个确定性函数作用在一个与 $\phi$ 无关的随机源上:
$$ \epsilon\sim\N(0,I_k),\qquad z=\mu_\phi(x)+\sigma_\phi(x)\odot\epsilon \qquad\Longrightarrow\qquad z\sim q_\phi(\cdot\mid x). $$(因为高斯的仿射变换仍是高斯:均值 $\mu_\phi$、协方差 $\diag(\sigma_\phi^2)$,正是要的。)于是
$$ \E_{z\sim q_\phi(\cdot\mid x)}[f(z)]=\E_{\epsilon\sim\N(0,I_k)}\big[f(\mu_\phi(x)+\sigma_\phi(x)\odot\epsilon)\big], $$右边的期望所依赖的分布不含 $\phi$,梯度可以自由地推进期望内部:
$$ \nabla_\phi\E_{z\sim q_\phi}[f(z)] =\E_{\epsilon}\Big[\nabla f(\mu_\phi+\sigma_\phi\odot\epsilon)\odot\big(\nabla_\phi\mu_\phi(x)+\epsilon\odot\nabla_\phi\sigma_\phi(x)\big)\Big]. $$这叫 pathwise 导数:梯度沿着 $z$ 这条路径流回 $\mu_\phi$ 和 $\sigma_\phi$,用上了 $f$ 的一阶信息,方差小得多。
一维验证。 取 $f(z)=z^2$,$q=\N(\mu,\sigma^2)$。真值 $\E[z^2]=\mu^2+\sigma^2$,故 $\partial_\mu=2\mu$、$\partial_\sigma=2\sigma$。用重参数化 $z=\mu+\sigma\epsilon$:
$$ \E_\epsilon\big[\partial_\mu (\mu+\sigma\epsilon)^2\big]=\E_\epsilon\big[2(\mu+\sigma\epsilon)\big]=2\mu\quad \text{(对)} $$ $$ \E_\epsilon\big[\partial_\sigma (\mu+\sigma\epsilon)^2\big]=\E_\epsilon\big[2(\mu+\sigma\epsilon)\epsilon\big]=2\mu\underbrace{\E[\epsilon]}_{0}+2\sigma\underbrace{\E[\epsilon^2]}_{1}=2\sigma\quad \text{(对)} $$两个都对上了。而如果天真地「采样后对 $f$ 求 $\phi$ 的导数」,得到的是 $0\ne 2\mu$。
把重参数化代入 §7.4 的损失,得到最终可优化的形式:
$$ \mathcal{L}_{\text{VAE}}(\phi,\theta)=\E_{x\sim\data,\ \epsilon\sim\N(0,I_k)}\left[ \frac{1}{2\sigma_\theta^2}\norm{x-\mu_\theta\big(\mu_\phi(x)+\sigma_\phi(x)\odot\epsilon\big)}^2 +\frac{\beta}{2}\mathcal{K}\big(\sigma_\phi^2(x)\big)+\frac{\beta}{2}\norm{\mu_\phi(x)}^2\right] $$(这里已把 $\sigma_\theta^2(z)$ 固定为常数 $\sigma^2$)。随机性只剩下 $\epsilon$,它的分布与 $\phi$ 无关,标准深度学习工具直接可用。
7.6 训练算法
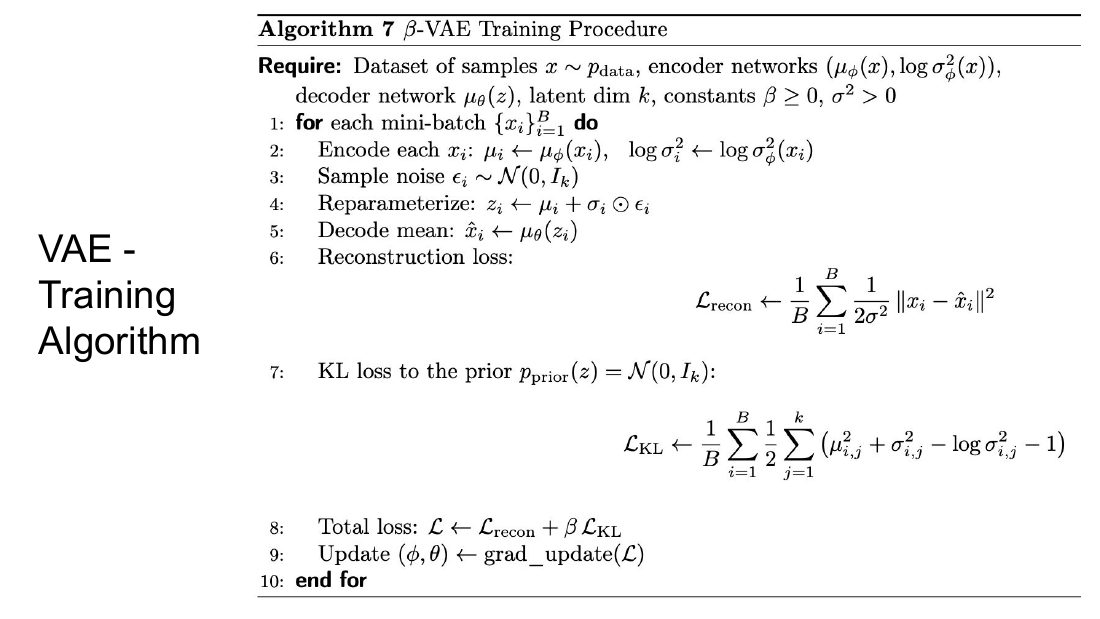
import torch

def vae_loss(x, enc, dec, beta, sigma2):
    """x: (bs, d);  enc(x) -> (mu, logvar): (bs, k), (bs, k);  dec(z) -> (bs, d)"""
    mu, logvar = enc(x)                       # (bs, k), (bs, k)   —— 输出 log sigma^2
    eps   = torch.randn_like(mu)              # (bs, k)   随机源,与 phi 无关
    z     = mu + torch.exp(0.5 * logvar) * eps        # (bs, k)   重参数化
    x_hat = dec(z)                            # (bs, d)   解码器均值 mu_theta(z)

    # 重构项:  ||x - mu_theta(z)||^2 / (2 sigma^2)
    recon = ((x - x_hat) ** 2).flatten(1).sum(-1) / (2 * sigma2)       # (bs,)
    # KL 项:  0.5 * sum_j ( mu_j^2 + sigma_j^2 - log sigma_j^2 - 1 )
    kl    = 0.5 * (mu ** 2 + logvar.exp() - logvar - 1).sum(-1)        # (bs,)

    return (recon + beta * kl).mean()         # 标量
7.7 工程现实:VAE 在 latent diffusion 里到底是什么
讲义的四条实践备注,加上一点现实:
- $\beta$ 的选取与 KL warm-up。 $\beta$ 太大会把隐变量压得太靠近先验,损害重构,甚至触发后验塌缩(posterior collapse)——编码器索性无视 $x$,输出 $q_\phi(z\mid x)\approx\N(0,I_k)$,KL 项直接归零而信息全部丢失。常见的稳定手段是 KL warm-up:从 $\beta=0$ 开始,在最初若干个 epoch 内逐步升到目标值。但讲义特别点明:在所有现代自编码器里,$\beta$ 的取值都非常小,$\beta\ll 1$。
- 解码器方差。 学一个高斯解码器方差 $\sigma_\theta^2$ 在数值上很微妙,不加正则容易退化。为稳定起见,许多实现直接固定 $p_\theta(x\mid z)=\N(x;\mu_\theta(z),\sigma^2I_d)$,$\sigma^2$ 为常数,此时重构项就正比于 MSE(差一个常数)。
- 超越像素 MSE 的重构损失。 逐像素高斯似然(即 MSE)给出的重构常常过度平滑。实践中会加感知损失(perceptual loss):用一个预训练网络的特征空间上的距离,来提升锐度和语义保真度。
- 对抗与混合目标。 为进一步提升视觉真实感,可以把 VAE 目标与对抗损失(VAE-GAN 风格,在解码结果上加判别器)结合。这通常能让输出更锐利,代价是额外的优化不稳定性和更多超参数。
「Stable Diffusion 的 VAE 是一个概率生成模型,我可以从 $\N(0,I)$ 采个 $z$ 直接解码出图」——基本不行。把上面四条合起来看:$\beta\ll1$、重构损失里混着感知损失和对抗损失、解码器方差固定。结果是这个「VAE」在数学上离一个规范的变分自编码器已经很远,它更接近一个被轻度 KL 正则化过的确定性 AE。它的 KL 项只是在把隐分布的尺度和位置大致拉到 $\N(0,I)$ 附近,好让后续的扩散模型不至于面对一个病态分布——仅此而已。真正负责「生成」的,是在隐空间里跑的那个流匹配模型。§8 的 amortization gap 会给这件事一个精确的说明。
顺带一提,正因为隐分布的尺度并不严格是 1,实现里通常还会对编码结果乘一个全局缩放常数,把隐张量的经验标准差调到 1 附近,再交给扩散模型——因为扩散的噪声调度 $\alpha_t,\beta_t$ 都是按「数据方差约为 1」设计的。
8. VAE 的更多视角(讲义附录 D)
附录 D 换了三个角度重看同一个损失函数。这些视角不是花架子——第三个(amortization gap)直接回答了「既然 VAE 自己就是生成模型,为什么还要在它的隐空间里再训一个扩散模型」这个自然的疑问。
8.1 视角一:VAE 损失就是联合分布上的一个 KL
关键观察:编码器和解码器各自诱导出 $(x,z)$ 上的一个联合分布:
$$ q_\phi(x,z)=\data(x)\,q_\phi(z\mid x)\quad(\text{编码器联合}), \qquad p_\theta(x,z)=p_\theta(x\mid z)\,p_{\text{prior}}(z)\quad(\text{解码器联合}). $$前者是「先抽一个真实数据,再编码」;后者是「先抽一个先验隐变量,再解码」。训练 VAE 可以理解为:让这两个联合分布尽量接近。
把这个 KL 展开(讲义式 132),记 $\blacksquare$ 表示 $x\sim\data,\ z\sim q_\phi(z\mid x)$:
$$ \begin{aligned} \KL\big(q_\phi(x,z)\,\|\,p_\theta(x,z)\big) &=\KL\big(\data(x)q_\phi(z\mid x)\,\big\|\,p_\theta(x\mid z)p_{\text{prior}}(z)\big) &&\text{(i) 代入定义}\\ &=\E_{\blacksquare}\left[\log\left(\frac{\data(x)\,q_\phi(z\mid x)}{p_\theta(x\mid z)\,p_{\text{prior}}(z)}\right)\right] &&\text{(ii) KL 的期望形式}\\ &=\E_{\blacksquare}\big[\log \data(x)\big] +\E_{\blacksquare}\left[\log\frac{q_\phi(z\mid x)}{p_{\text{prior}}(z)}\right] -\E_{\blacksquare}\big[\log p_\theta(x\mid z)\big] . &&\text{(iii) 对数拆成三项} \end{aligned} $$逐项看:
第一项与 $\phi,\theta$ 完全无关:
$$ \E_{\blacksquare}\big[\log\data(x)\big]=\E_{x\sim\data}\big[\log\data(x)\big]=C=-H(\data), $$即数据分布的负(微分)熵,一个常数。
第二项先对 $z$ 取期望,恰好凑成 KL:
$$ \E_{\blacksquare}\left[\log\frac{q_\phi(z\mid x)}{p_{\text{prior}}(z)}\right] =\E_{x\sim\data}\Big[\KL\big(q_\phi(z\mid x)\,\|\,p_{\text{prior}}(z)\big)\Big] =\mathcal{L}_{\text{VAE-Prior}}(\phi), $$它鼓励 $q_\phi(z\mid x)$ 靠近先验。
第三项正是平均负对数似然,也就是重构损失:
$$ -\E_{x\sim\data,\,z\sim q_\phi(z\mid x)}\big[\log p_\theta(x\mid z)\big]=\mathcal{L}_{\text{VAE-Recon}}(\phi,\theta). $$忽略常数项,合起来($\beta=1$):
$$ \mathcal{L}_{\text{VAE}}(\phi,\theta) =\underbrace{\E_{x\sim\data}\big[\KL(q_\phi(z\mid x)\,\|\,p_{\text{prior}}(z))\big]}_{\text{先验约束项}} -\underbrace{\E_{x\sim\data,\,z\sim q_\phi(z\mid x)}\big[\log p_\theta(x\mid z)\big]}_{\text{重构项}} =\KL\big(q_\phi(x,z)\,\|\,p_\theta(x,z)\big)+\text{const}. $$于是 VAE 损失可以完全等价地解释成:数据-隐变量联合空间上的一个 KL 散度。
8.2 视角二:VAE 本身就是生成模型(链式法则与数据处理不等式)
既然解码器加先验定义了 $p_\theta(x)=\int p_\theta(x\mid z)p_{\text{prior}}(z)\ud z$,我们可以直接从 $z\sim p_{\text{prior}}$ 采样再解码。这样得到的样本有多接近真实数据?下面这条命题给出答案。
命题 3(KL 的链式法则)。 设 $q(x,z),p(x,z)$ 是 $x\in\R^{l_1},z\in\R^{l_2}$ 上的联合分布,则
$$ \KL\big(q(z,x)\,\|\,p(z,x)\big)=\KL\big(q(x)\,\|\,p(x)\big)+\E_{x\sim q}\Big[\KL\big(q(z\mid x)\,\|\,p(z\mid x)\big)\Big]. $$证明。 反复使用 KL 的定义与条件概率分解 $q(z,x)=q(z\mid x)q(x)$:
$$ \begin{aligned} \KL\big(q(z,x)\,\|\,p(z,x)\big) &=\E_q\left[\log\frac{q(z,x)}{p(z,x)}\right] &&\text{(i) 定义}\\ &=\E_{(x,z)\sim q}\left[\log\frac{q(z\mid x)}{p(z\mid x)}\cdot\frac{q(x)}{p(x)}\right] &&\text{(ii) 联合 = 条件 } \times \text{ 边际}\\ &=\E_{(x,z)\sim q}\left[\log\frac{q(z\mid x)}{p(z\mid x)}\right]+\E_{x\sim q}\left[\log\frac{q(x)}{p(x)}\right] &&\text{(iii) 对数拆和,第二项只依赖 } x\\ &=\KL\big(q(x)\,\|\,p(x)\big)+\E_{x\sim q}\Big[\KL\big(q(z\mid x)\,\|\,p(z\mid x)\big)\Big]. &&\text{(iv) 认出两个 KL} \end{aligned} $$$\blacksquare$
推论(数据处理不等式)。 第二个求和项是 KL 的期望,由非负性它 $\ge0$,于是
$$ \KL\big(q(x)\,\|\,p(x)\big)\ \le\ \KL\big(q(z,x)\,\|\,p(z,x)\big). $$直观地说:边际化只会让两个分布更难分辨。
应用一:VAE 是一个合格的生成模型。 取 $q=q_\phi(x,z)$、$p=p_\theta(x,z)$,并注意 $q_\phi(x,z)$ 的 $x$-边际正是 $\data$(因为 $q_\phi(x,z)=\data(x)q_\phi(z\mid x)$):
$$ \mathcal{L}_{\text{VAE}}(\phi,\theta)=\KL\big(q_\phi(x,z)\,\|\,p_\theta(x,z)\big)+\text{const}\ \ge\ \KL\big(\data(x)\,\|\,p_\theta(x)\big)+\text{const}. $$也就是说,VAE 损失是「真实数据分布与解码器生成分布之间的 KL」的一个上界。把损失压下去,就把这个 KL 压下去了。所以 VAE 本身可以当生成模型用。
应用二:隐分布也被正则化了。 同样地取 $z$ 的边际——$q_\phi(x,z)$ 的 $z$-边际是 $q_\phi(z)=\int q_\phi(z\mid x)\data(x)\ud x$,$p_\theta(x,z)$ 的 $z$-边际是 $p_{\text{prior}}(z)$:
$$ \mathcal{L}_{\text{VAE}}(\phi,\theta)\ \ge\ \KL\big(q_\phi(z)\,\|\,p_{\text{prior}}(z)\big)+\text{const}. $$这条不等式正式确认了 §6.1 里我们想要的东西:VAE 目标是隐边际分布与先验之间 KL 的上界——它真的在管 $p_{\text{latent}}$,不像纯 AE 那样撒手不管。
8.3 视角三:amortization gap ——为什么不到 VAE 为止
既然 VAE 自己就能生成,为什么还要费劲在它的隐空间里再训一个流/扩散模型?附录 D 给的答案是 amortization gap(摊销缺口)。
上面两条不等式的松弛量,正是链式法则里被丢掉的那一项。以第二条为例,缺口是
$$ \KL\big(q_\phi(x,z)\,\|\,p_\theta(x,z)\big)-\KL\big(q_\phi(z)\,\|\,p_{\text{prior}}(z)\big)\ \ge 0 . $$由链式法则,这个缺口等于 $\E_{z\sim q_\phi}\big[\KL(q_\phi(x\mid z)\,\|\,p_\theta(x\mid z))\big]$;对第一条不等式,缺口是 $\E_{x\sim\data}\big[\KL(q_\phi(z\mid x)\,\|\,p_\theta(z\mid x))\big]$。缺口为零当且仅当 $q_\phi(z\mid x)=p_\theta(z\mid x)$,即编码器恰好等于真实后验。
关键推论:虽然最小化 $\KL(q_\phi(x,z)\|p_\theta(x,z))$ 蕴含着「顺带」最小化 $\KL(q_\phi(z)\|p_{\text{prior}}(z))$,但前者减少多少并不意味着后者减少同样多。训练结束时,联合 KL 和 amortization gap 都没有被完全压到零,因此现实中
$$ q_\phi(z)\ \neq\ p_{\text{prior}}(z). $$后果:训练时解码器学的是「从 $q_\phi(z)$ 重构」,而如果推断时改成从 $p_{\text{prior}}(z)$ 采样再解码,就是把解码器推到了训练分布之外(out of distribution)。这正是「直接从 $\N(0,I)$ 采样解码,出来的图往往糊」的数学解释。
但讲义强调:在实践中这个失配是特性而不是缺陷。 经验表明流/扩散模型的表达能力普遍强于实现 VAE 解码器的卷积栈,所以更合理的做法是把生成的复杂度外包给隐空间上的生成模型:让自编码器只负责「压缩 + 保真重建」这件相对简单的事,把「学一个复杂分布」这件难事交给流匹配模型。而流匹配模型正好可以精确地拟合 $q_\phi(z)$,把 amortization gap 补上。
8.4 从联合 KL 里再把 ELBO 抠出来
附录 D 还给出了从式 132 出发反推 ELBO 的路线,与 §6.4 的路径二互为镜像。对固定的 $x$:
$$ \begin{aligned} \E_{z\sim q_\phi(z\mid x)}\left[\log\left(\frac{q_\phi(z\mid x)}{p_\theta(x\mid z)p_{\text{prior}}(z)}\right)\right] &=\E_{z\sim q_\phi(z\mid x)}\left[\log\left(\frac{q_\phi(z\mid x)}{p_\theta(z\mid x)}\right)\right]-\log p_\theta(x)\\ &=\KL\big(q_\phi(z\mid x)\,\|\,p_\theta(z\mid x)\big)-\log p_\theta(x), \end{aligned} $$第一个等号用的是 $p_\theta(z\mid x)=\dfrac{p_\theta(x\mid z)p_{\text{prior}}(z)}{p_\theta(x)}$,即把分母里的 $p_\theta(x\mid z)p_{\text{prior}}(z)$ 换成 $p_\theta(z\mid x)p_\theta(x)$,多出来的 $p_\theta(x)$ 与 $z$ 无关可以提出期望。移项得
$$ \E_{z\sim q_\phi(z\mid x)}\left[\log\left(\frac{p_\theta(x\mid z)p_{\text{prior}}(z)}{q_\phi(z\mid x)}\right)\right]+\KL\big(q_\phi(z\mid x)\,\|\,p_\theta(z\mid x)\big)=\log p_\theta(x), $$由 KL 非负立得
$$ \underbrace{\E_{z\sim q_\phi(z\mid x)}\left[\log\left(\frac{p_\theta(x\mid z)p_{\text{prior}}(z)}{q_\phi(z\mid x)}\right)\right]}_{\triangleq\ \text{ELBO}(x;\phi,\theta)}\ \le\ \underbrace{\log p_\theta(x)}_{\text{evidence}} . $$左边就是证据下界(evidence lower bound, ELBO)——「evidence」指的是右边的边际似然 $\log p_\theta(x)$,「lower bound」指左边不超过它。最后把 $\mathcal{L}_{\text{VAE}}$ 用 ELBO 重写:
$$ \begin{aligned} \mathcal{L}_{\text{VAE}} &=\KL\big(q_\phi(x,z)\,\|\,p_\theta(x,z)\big)+\text{const}\\ &=\E_{x\sim\data}\E_{z\sim q_\phi(z\mid x)}\left[\log\left(\frac{\data(x)q_\phi(z\mid x)}{p_\theta(x\mid z)p_{\text{prior}}(z)}\right)\right]+\text{const}\\ &=\E_{x\sim\data}\big[\log\data(x)-\text{ELBO}(x;\phi,\theta)\big]+\text{const}\\ &=-\E_{x\sim\data}\big[\text{ELBO}(x;\phi,\theta)\big]\underbrace{-H(\data)+\text{const}}_{\text{常数}}\\ &=-\E_{x\sim\data}\big[\text{ELBO}(x;\phi,\theta)\big]+\text{const}. \end{aligned} $$于是三种说法完全等价:最小化 VAE 损失 = 最小化联合 KL = 最大化期望 ELBO。
Remark 42(如果 $q_\phi(x,z)\approx p_\theta(x,z)$ 会怎样)。 我们用来训练隐空间生成模型的采样分布是边际 $q_\phi(z)=\int q_\phi(z\mid x)\data(x)\ud x$。若真有 $q_\phi(x,z)=p_\theta(x,z)$,则边际也相等:$q_\phi(z)=p_\theta(z)=p_{\text{prior}}(z)$,即隐采样分布被完美正则化。同时 $q_\phi(x,z)\approx p_\theta(x,z)$ 意味着变分近似 $p_\theta(x\mid z)\approx q_\phi(x\mid z)$ 很好,也就意味着低重构误差。一个条件同时给出了我们想要的两件事。
Remark 43(VAE 的「变分」在哪)。 为什么不干脆取 $q_\phi(\cdot\mid x)=p_\theta(\cdot\mid x)$,让 KL 直接为 0?因为虽然似然 $p_\theta(x\mid z)$ 是我们自己定义的、算得出来的,后验 $p_\theta(z\mid x)=\frac{p_\theta(x\mid z)p_{\text{prior}}(z)}{p_\theta(x)}$ 却算不出来——分母 $p_\theta(x)$ 正是 §6.3 说的那个不可解的积分。$q_\phi(\cdot\mid x)$ 是这个难解后验的变分近似(variational approximation),「variational」三个字就是这么来的。
9. 潜在扩散模型的完整配方
所有零件都在手上了。讲义 Remark 32 把它总结成一句话:照搬已有的训练配方,只不过直接在隐空间里做。
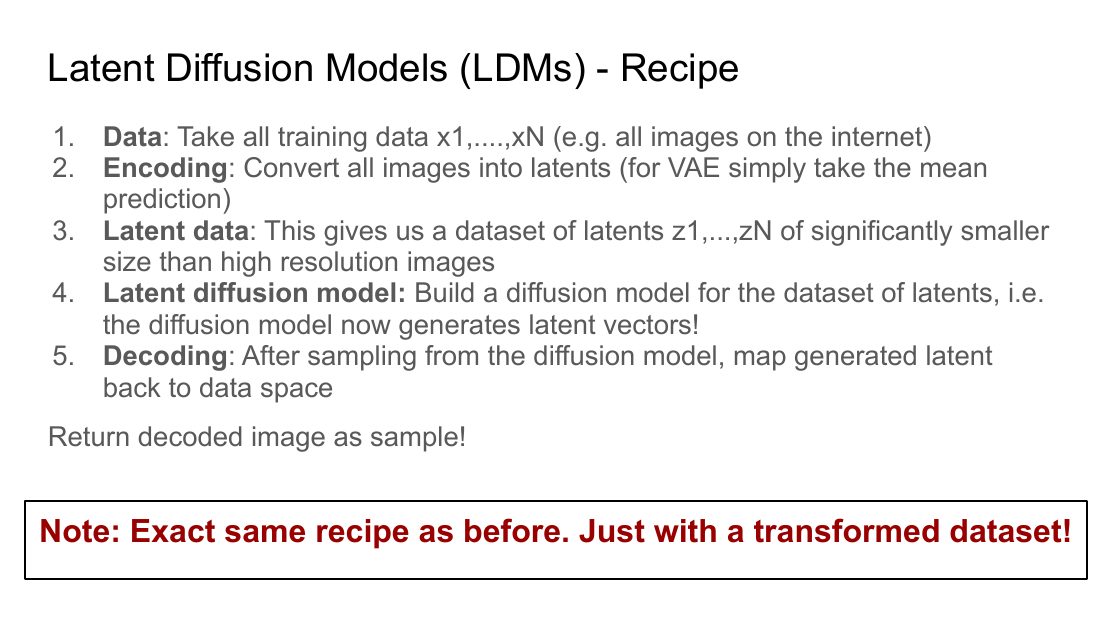
- 数据。 取全部训练数据 $x_1,\dots,x_N$(例如互联网上的所有图片)。
- 编码。 把所有图像转成隐向量。讲义正文的说法是训练时从 $q_\phi(z\mid x)$ 采样(这给隐数据加了一点噪声,起数据增广与正则的作用);幻灯片给的简化配方是直接取均值预测 $z=\mu_\phi(x)$。两者都能用,后者更省事也更常见。
- 隐数据集。 得到隐向量数据集 $z_1,\dots,z_N$,规模远小于原始高分辨率图像。
- 隐扩散模型。 在这个数据集上训一个流/扩散模型——现在模型生成的是隐向量。
- 解码。 采样得到 $z$ 之后,用解码器映回数据空间。讲义特别注明:这里取均值 $x=\mu_\theta(z)$ 而不是从 $p_\theta(\cdot\mid z)$ 随机采样,以避免噪声引入的伪影。
# ---------- 阶段一:训练 VAE,然后冻结 ----------
vae = train_vae(images)                 # 见 7.6
vae.requires_grad_(False).eval()        # <<< 冻结!后续不再更新

# ---------- 阶段二:把整个数据集编码成隐向量 ----------
@torch.no_grad()
def encode_all(vae, loader, scale):
    zs = [vae.encode(x)[0] * scale for x, _ in loader]   # 只取 mu: (bs, C, h, w)
    return torch.cat(zs)                                 # (N, C, h, w)

# ---------- 阶段三:在隐空间做条件流匹配(与 Lecture 2 完全一致)----------
def cfm_step(model, z1, y, p_uncond=0.1):    # z1: (bs, C, h, w) 来自数据的隐向量
    bs = z1.shape[0]
    t   = torch.rand(bs, device=z1.device)                       # (bs,)
    eps = torch.randn_like(z1)                                   # (bs, C, h, w)
    zt  = t.view(-1,1,1,1) * z1 + (1 - t.view(-1,1,1,1)) * eps   # CondOT 插值
    target = z1 - eps                                            # d/dt zt,直线路径
    y = drop_labels(y, p_uncond)                                 # CFG:随机置为空标签
    return ((model(zt, t, y) - target) ** 2).mean()

# ---------- 阶段四:采样 ----------
@torch.no_grad()
def sample(model, vae, y, shape, n_steps=50, w=4.0, scale=0.18):
    z = torch.randn(shape)                                       # (bs, C, h, w)
    for i in range(n_steps):
        t  = torch.full((shape[0],), i / n_steps)
        u  = (1 - w) * model(z, t, NULL) + w * model(z, t, y)     # CFG
        z  = z + u / n_steps                                      # Euler 步
    return vae.decode(z / scale)                                  # (bs, 3, H, W)
讲义强调了两点容易被忽略的工程后果:
- 训练是分离的、有先后的。 必须先把自编码器训好,再训扩散模型。两者不是端到端联合优化的。这也意味着 VAE 一旦定下来,隐空间的「坐标系」就固定了,扩散模型只能在这个坐标系里工作。
- 性能现在也取决于自编码器。 最终图像质量不只看扩散模型学得好不好,还看自编码器把图像压得好不好、还原得美不美。讲义原话:performance now depends also on how good the autoencoder compresses images into latent space and recovers aesthetically pleasing images. 换句话说,重建质量是整个系统质量的上限——扩散模型再强也无法超越解码器能还原出的最好效果。训一个好的自编码器,正是最初几篇 Stable Diffusion 论文的主要贡献之一。
把整个系统串起来看:自编码器负责「换坐标系」,扩散模型负责「在新坐标系里学分布」。 前者是一个确定性的、可逆(近似)的双射;后者是全部的生成能力所在。这个分工之所以有效,是因为 Lecture 2 的流匹配框架对 $\data$ 是什么完全不挑——只要能采样就行。隐向量当然能采样。
10. 案例研究:Stable Diffusion 3 与 Meta Movie Gen
最后把前面所有零件放进两个真实的、当前最先进的系统里。它们都用到了本课教的技术,外加一些为了扩大规模和处理复杂条件模态而做的架构增强。
10.1 Stable Diffusion 3
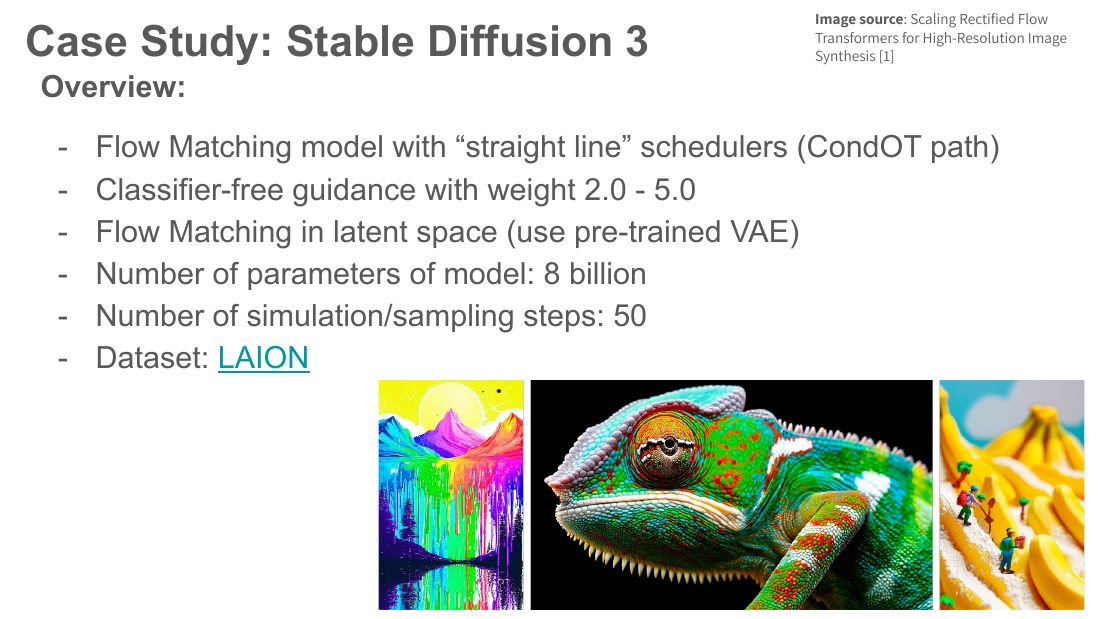
- 训练目标:与本课 Algorithm 4 完全相同的条件流匹配目标。SD3 的论文里广泛比较了各种流与扩散的替代方案,结论是 flow matching 表现最好。(他们对噪声的条件约定写法与本课不同,但只是记号差异,算法是同一个。)
- 调度:「直线」调度器,即 CondOT 路径。
- 引导:训练时按 CFG 的方式随机丢弃类别/文本标签;采样时引导权重取 2.0–5.0。
- 空间:在预训练自编码器的隐空间里做流匹配,正是 §9 的配方。
- 文本条件:同时用三种文本嵌入——CLIP 系列的嵌入(提供粗粒度、总揽式的整句表示)以及预训练的 Google T5-XXL 编码器输出的序列级嵌入。T5 的序列嵌入提供了更细粒度的上下文,使模型可以关注提示词中的具体成分。
- 架构:为了容纳这些序列上下文嵌入,作者把 DiT 扩展成 MM-DiT(multi-modal DiT)——不仅让图像 patch 之间互相注意,还让它们注意到文本嵌入,从而把 DiT 原本只支持的类别条件推广到序列上下文条件。文本和图像被贯穿整个网络地共同处理。
- 规模:最大模型 80 亿参数。
- 采样:50 步 Euler 模拟(即网络前向 50 次)。
- 数据集:LAION。
10.2 Meta Movie Gen Video
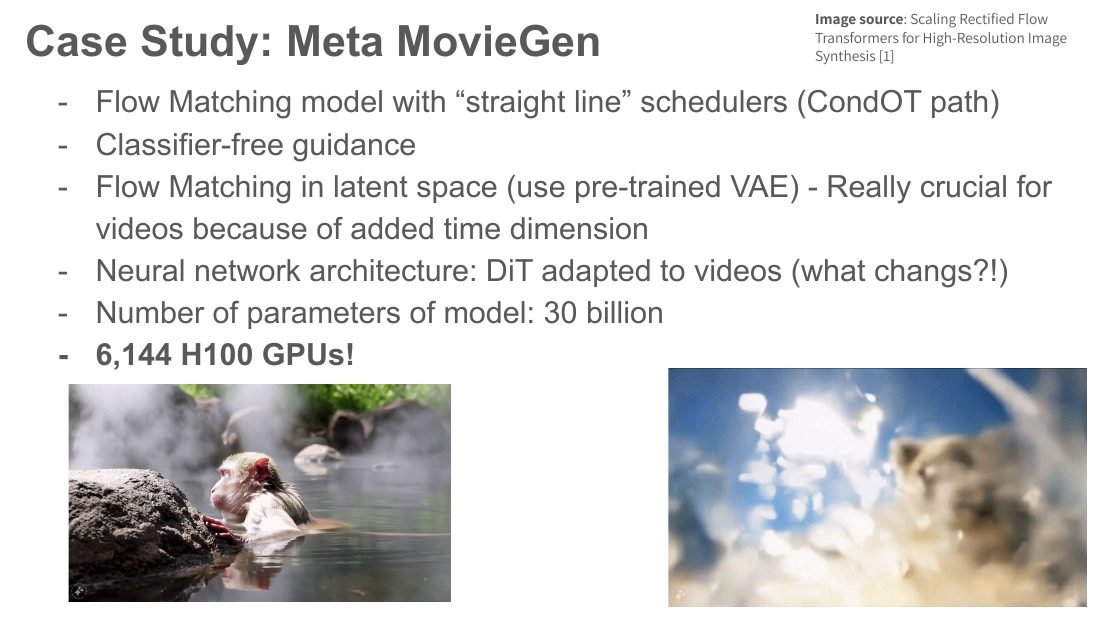
接下来是视频。数据不再是图像而是视频,即 $x\in\R^{T\times C\times H\times W}$,多出来的 $T$ 是时间维(帧数)。讲义的观察是:这个设定下的许多设计选择,都可以看作把图像领域已有的技术(自编码器、diffusion transformer 等)适配到多出来的时间维。
- 训练目标:同样是条件流匹配,同样用直线调度 $\alpha_t=t,\ \sigma_t=1-t$。
- 引导:classifier-free guidance。
- 空间:与 SD3 一样,在冻结的预训练自编码器隐空间里工作。对视频而言这一步比图像更关键——多一个时间维,显存压力是数量级的。
- 时序自编码器(temporal autoencoder, TAE):把原始视频 $x_t'\in\R^{T'\times3\times H\times W}$ 映到隐张量 $x_t\in\R^{T\times C\times H'\times W'}$,压缩比为 $$\frac{T'}{T}=\frac{H}{H'}=\frac{W}{W'}=8,$$ 即时间和两个空间维各压 8 倍,时空位置数压缩 $8^3=512$ 倍(再乘上通道比 $3/C$)。
- 长视频的处理:提出时间分块(temporal tiling)——把视频沿时间切成若干段,每段单独编码,再把隐表示拼接起来。这样显存需求不随视频长度线性增长。
- 主干:DiT 风格的骨干网络,$x_t$ 沿时间和空间同时 patchify;得到的图像 patch 经过一个既做 patch 间自注意力、又与语言模型嵌入做交叉注意力的 transformer——与 SD3 的 MM-DiT 同源。
- 文本条件:三种嵌入各司其职——UL2 嵌入负责细粒度的、基于文本的推理;ByT5 嵌入负责字符级细节(例如提示词明确要求画面中出现某段文字时);MetaCLIP 嵌入来自共享的图文嵌入空间。
- 规模:最大模型 300 亿参数,训练用了 6 144 张 H100。
| 维度 | Stable Diffusion 3 | Meta Movie Gen Video |
|---|---|---|
| 数据类型 | 图像 $\R^{3\times H\times W}$ | 视频 $\R^{T\times C\times H\times W}$ |
| 训练目标 | 条件流匹配 | 条件流匹配 |
| 调度 | 直线(CondOT) | 直线,$\alpha_t=t,\ \sigma_t=1-t$ |
| 隐空间 | 预训练图像自编码器 | 时序自编码器 TAE,$T,H,W$ 各压 8 倍 |
| 主干 | MM-DiT(文本图像双流 + 联合注意力) | DiT 变体,时空 patchify + 自注意力 + 交叉注意力 |
| 文本编码器 | CLIP-G/14、CLIP-L/14、T5-XXL | UL2、ByT5、MetaCLIP |
| 引导 | CFG,权重 2.0–5.0 | CFG |
| 参数量 | 80 亿 | 300 亿 |
| 采样 | 50 步 Euler | —(技术报告中另有详述) |
| 长序列处理 | — | 时间分块编码后拼接隐表示 |
把四讲拼成一张完整的现代文生图/文生视频系统图:
- 离线(阶段一):训练自编码器 $(\mu_\phi,\mu_\theta)$,用重构 + KL($\beta\ll1$)+ 感知 + 对抗损失。训完冻结。
- 离线(阶段二):把全部图像/视频编码成隐张量数据集 $\{z_i\}$。
- 训练(Lecture 2 的目标):在隐空间上做条件流匹配。$\vf_t^\theta$ 是一个 DiT(本讲 §3),时间通过 adaLN-Zero 注入,文本通过冻结的 CLIP/T5 编码后经交叉注意力注入,训练时按 CFG(Lecture 3b)随机丢标签。
- 采样:从 $\N(0,I)$ 抽隐噪声,用 Euler 法模拟 ODE(或加噪声项走 SDE,Lecture 3)约 50 步,每步用 CFG 组合有条件与无条件的预测。
- 解码:把生成的隐张量送进冻结的解码器 $\mu_\theta$,得到图像/视频。
四讲的内容在这条流水线上各就各位,没有一块是多余的。
本讲小结
| 对象 | 公式 | 说明 |
|---|---|---|
| 网络签名 | $\vf_t^\theta:\R^d\times[0,1]\times\mathcal{Y}\to\R^d$ | 输出与输入同维,这是一切架构选择的出发点 |
| 时间嵌入 | $\text{TimeEmb}(t)=\sqrt{\tfrac2d}\big[\cos(2\pi w_it)\,;\,\sin(2\pi w_it)\big]$ | $\norm{\text{TimeEmb}(t)}=1$;$w_i=w_{\min}(w_{\max}/w_{\min})^{\frac{i-1}{d/2-1}}$ 几何铺频 |
| Patchify | $\text{Patchify}(x)\in\R^{N\times C'}$,$C'=CP^2$,$N=\tfrac{H}{P}\tfrac{W}{P}$ | 纯重排,无参数;后接 $W\in\R^{C'\times d}$ 得 patch 嵌入 |
| 注意力 | $\text{Attn}(Q,K,V)=\softmax\!\big(\tfrac{QK^\top}{\sqrt{d_h}}\big)V$ | $Q\in\R^{N\times d_h}$、$K,V\in\R^{M\times d_h}$;$\sqrt{d_h}$ 使 logit 方差为 1 |
| AdaLN | $\text{AdaNorm}_{\tilde t}(x)=(1+\gamma)\odot\text{Norm}(x)+\beta$,$(\gamma,\beta)=g(\tilde t)$ | $\gamma=\beta=0$ 时是恒等;沿 token 维广播 |
| DiT block | $x\leftarrow x+g_\bullet(\tilde t)\odot \text{Sub}\big(\text{AdaNorm}_{\tilde t}(x),\cdot\big)$,三次 | self-attn / cross-attn / MLP;$g_\bullet$ 零初始化即 adaLN-Zero |
| DiT 复杂度 | $\Theta\!\big(\tfrac{R^2}{P^2}d^2+\tfrac{R^4}{P^4}d\big)$ | 注意力项关于边长 $R$ 是四次方;U-Net 是 $\Theta(R^2)$ |
| U-Net 目标里的恒等项 | $\vf_t^{\text{target}}(x)=\tfrac{1}{1-t}\E[z\mid X_t=x]-\tfrac{1}{1-t}x$ | 第二项要求网络能表示恒等映射 $\Rightarrow$ 跳连是必需的 |
| 压缩比算例 | $\tfrac{3\cdot512^2}{4\cdot64^2}=\tfrac{786432}{16384}=48$ | 注意力开销降 $64^2=4096$ 倍 |
| AE 的病 | $(\psi\circ\mu_\phi,\ \mu_\theta\circ\psi^{-1})$ 重构损失不变 | 重构损失对 $p_{\text{latent}}$ 有整个双射对称群,完全失控 |
| VAE 编解码器 | $q_\phi(z\mid x)=\N(\mu_\phi(x),\diag(\sigma_\phi^2(x)))$,$p_\theta(x\mid z)=\N(\mu_\theta(z),\sigma_\theta^2(z)I_d)$ | $\sigma\equiv0$ 时退化成标准 AE |
| ELBO 恒等式 | $\log p_\theta(x)=\text{ELBO}(x;\phi,\theta)+\KL\big(q_\phi(z\mid x)\|p_\theta(z\mid x)\big)$ | 缺口 = 后验近似误差;$\KL\ge0$ 给出下界 |
| ELBO 分解 | $\text{ELBO}=\E_{q_\phi}[\log p_\theta(x\mid z)]-\KL\big(q_\phi(\cdot\mid x)\|p_{\text{prior}}\big)$ | 重构项 − 正则项 |
| 高斯 KL 闭式解 | $\KL(q\|p)=\tfrac12\Big(\mathcal{K}\big(\tfrac{\sigma_q^2}{\sigma_p^2}\big)+\tfrac{\norm{\mu_q-\mu_p}^2}{\sigma_p^2}\Big)$ | $\mathcal{K}(\alpha)=\sum_i\alpha_i-\log\alpha_i-1$,唯一最小值在 $\alpha=1$ |
| 对标准正态 | $\KL=\tfrac12\sum_{j=1}^k\big(\mu_j^2+\sigma_j^2-\log\sigma_j^2-1\big)$ | 所有 VAE 代码里的那一行 |
| 重参数化 | $\epsilon\sim\N(0,I_k),\ z=\mu_\phi(x)+\sigma_\phi(x)\odot\epsilon$ | 随机源与 $\phi$ 无关 $\Rightarrow$ 梯度可穿过采样 |
| VAE 总损失 | $\E\big[\tfrac{1}{2\sigma_\theta^2}\norm{x-\mu_\theta(z)}^2+\tfrac d2\log\sigma_\theta^2+\tfrac\beta2\mathcal{K}(\sigma_\phi^2)+\tfrac\beta2\norm{\mu_\phi}^2\big]$ | 重构 / 解码器置信度 / 隐方差→1 / 隐均值→0 |
| 联合 KL 视角 | $\mathcal{L}_{\text{VAE}}=\KL\big(q_\phi(x,z)\|p_\theta(x,z)\big)+\text{const}=-\E_\data[\text{ELBO}]+\text{const}$ | 附录 D:三种说法等价 |
| KL 链式法则 | $\KL\big(q(z,x)\|p(z,x)\big)=\KL\big(q(x)\|p(x)\big)+\E_{x\sim q}\big[\KL(q(z\mid x)\|p(z\mid x))\big]$ | 推出数据处理不等式 $\KL(q(x)\|p(x))\le\KL(q(z,x)\|p(z,x))$ |
| 两条上界 | $\mathcal{L}_{\text{VAE}}\ge\KL(\data\|p_\theta)+\text{const}$,$\ \mathcal{L}_{\text{VAE}}\ge\KL(q_\phi(z)\|p_{\text{prior}})+\text{const}$ | VAE 既是生成模型,又确实在正则化隐分布 |
| amortization gap | $\KL\big(q_\phi(x,z)\|p_\theta(x,z)\big)-\KL\big(q_\phi(z)\|p_{\text{prior}}(z)\big)$ | 训练结束时不为 0,故 $q_\phi(z)\ne p_{\text{prior}}$;这正是需要隐扩散模型的理由 |
| LDM 配方 | 编码 $\to$ 在 $\{z_i\}$ 上做流匹配 $\to$ 解码取均值 | 与之前完全同一个配方,只是换了数据集;VAE 先训后冻结 |
延伸阅读
架构
- U-Net: Convolutional Networks for Biomedical Image Segmentation (2015) — 跳连式编解码器的原始论文,本来是做分割的,后来成了扩散模型十年的默认骨干。
- Attention Is All You Need (2017) — 缩放点积注意力与正弦位置编码的出处,§3.3 的公式全部来自这里。
- An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale (2020) — ViT,patchify 这个操作的来源,DiT 直接继承。
- Scalable Diffusion Models with Transformers (2023) — DiT 原论文。想真正搞懂 adaLN-Zero 为什么优于其它三种条件化方案,读它的消融实验表。
- SiT: Exploring Flow and Diffusion-based Generative Models with Scalable Interpolant Transformers (2024) — 在 DiT 骨干上系统比较各种插值/调度/目标的组合,是「架构固定、目标变化」的对照实验。
- FiLM: Visual Reasoning with a General Conditioning Layer (2018) — 「用条件变量生成逐通道缩放和平移」这一思想的源头,AdaLN 是它的直系后代。
- Fourier Features Let Networks Learn High Frequency Functions in Low Dimensional Domains (2020) — 讲义为时间嵌入引用的正是这篇;它解释了为什么低维输入必须先做频率展开。
- Diffusion Models Beat GANs on Image Synthesis (2021) — ADM,把 U-Net 的每一个设计选择(宽度、注意力分辨率、归一化)都做了消融,是 U-Net 调参的标准参考。
隐空间与自编码器
- Auto-Encoding Variational Bayes (2013) — VAE 原论文,ELBO 与重参数化技巧的出处,§6–§7 的全部内容都在这一篇里。
- High-Resolution Image Synthesis with Latent Diffusion Models (2022) — Stable Diffusion 的奠基论文,把「先训自编码器、再在隐空间做扩散」确立为标准范式;里面的自编码器就是 $\beta\ll1$ 加感知与对抗损失的那一版。
- Score-based Generative Modeling in Latent Space (2021) — LSGM,讲义并列引用的另一条隐空间扩散路线,它尝试端到端联合训练 VAE 与扩散模型,正好与 §9 的两阶段做法形成对照。
文本条件
- Learning Transferable Visual Models From Natural Language Supervision (2021) — CLIP,共享图文嵌入空间的来源。
- Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer (2019) — T5,SD3 用的 T5-XXL 编码器出自这里。
- UL2: Unifying Language Learning Paradigms (2022) — Movie Gen 用于细粒度文本推理的嵌入。
- ByT5: Towards a Token-Free Future with Pre-trained Byte-to-Byte Models (2021) — 字符级嵌入,用来处理「画面里要出现这几个字」这类提示。
- Modeling Caption Diversity in Contrastive Vision-Language Pretraining (2024) — MetaCLIP,Movie Gen 的第三种文本嵌入。
- Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding (2022) — Imagen,最早系统论证「文本编码器越大越好、比扩散模型本身更重要」的工作。
- eDiff-I: Text-to-Image Diffusion Models with an Ensemble of Expert Denoisers (2023) — 组合多种预训练嵌入的代表工作之一,讲义在讨论多嵌入拼接时引用了它。
大规模系统
- Scaling Rectified Flow Transformers for High-Resolution Image Synthesis (2024) — Stable Diffusion 3 技术报告,§10.1 的全部细节与 MM-DiT 结构图都出自这里;附录里有各种调度/目标的完整对照实验,是本讲最值得精读的一篇。
- Movie Gen: A Cast of Media Foundation Models (2024) — Meta Movie Gen 技术报告,TAE、时间分块、时空 patchify 的细节都在其中。讲义鼓励读者直接去读原报告获取更详尽的处理。