Lab 3 解析:条件图像生成(DiT + VAE + 隐空间扩散)
把 Lab 2 的两行训练循环搬到 1024 维的 MNIST 上:classifier-free guidance 负责「听懂指令」,diffusion transformer 负责「装得下图像」,VAE 负责「把维度降下来」。15 处 TODO,一个完整的 latent diffusion 系统。
0. 本 lab 导读
Lab 2 把 flow matching 的公式链跑通了,但跑的是二维玩具数据、用的是一个三层 MLP、生成的是「随便什么样本」。Lab 3 要在这三件事上同时升级:
| 维度 | Lab 2 | Lab 3 | 需要的新工具 |
|---|---|---|---|
| 数据 | $\R^2$ 上的高斯混合 | MNIST,$1\times32\times32=1024$ 维 | —— |
| 控制 | 无条件生成 | 「生成一个 8」——条件生成 | classifier-free guidance(Part 2) |
| 架构 | MLP | diffusion transformer | Fourier 编码 / patch / 注意力 / adaLN-Zero(Part 3) |
| 空间 | 直接在数据空间 | 先压到 $128\times4\times4$ 的隐空间 | VAE(Part 4)+ latent diffusion(Part 5) |
但要强调一件让人安心的事:训练循环的那四行,和你在 Lab 2 Q3.1 写下的一模一样——采 $z$、采 $t$、采 $x_t$、回归 $u_t(x\mid z)$。Lab 3 的 15 个 TODO 里只有两个(Q2.2 和 Q5.1)在动这条循环,而且动的只是「$z$ 从哪来」和「$y$ 要不要丢掉」。剩下的 13 个全部是架构工程:怎么把一个函数 $u^\theta:\R^{1024}\times[0,1]\times\set{0,\dots,10}\to\R^{1024}$ 用张量算子搭出来。
Part 2 · Classifier-Free Guidance(2 处)——对应 Lecture 3-B 的引导理论。
- Q2.2
CFGTrainer.get_train_loss:带标签丢弃(label dropout)的条件 flow matching 损失。四行采样 + 一行 MSE。 - Q2.3
MLPConditionalVectorField.forward:把 $x$、类别嵌入、时间三者拼接后过 MLP,用来在二维高斯混合上做正确性自检。
Part 3 · Diffusion Transformer(5 处)——对应 Lecture 4 §6.1 的架构讨论。
- Q3.1
FourierEncoder:把标量 $t$ 升维成随机 Fourier 特征。 - Q3.2
Patchifier:图像 → token 序列,一行卷积 + 一行Rearrange。 - Q3.3
MHA+DiffusionTransformerLayer+DiffusionTransformer:本 lab 最重的一题,从零手写多头自注意力,并实现 adaLN-Zero 条件调制。 - Q3.4
Depatchifier:token 序列 → 图像,Q3.2 的逆操作。 - Q3.5
DiffusionTransformerFlowModel:把上面四块串成一个 $u_t^\theta(x\mid y)$。
Part 4 · 变分自编码器(7 处)——对应 Lecture 4 §6–§7 的 ELBO 推导。
- Q4.1
ResidualBlock、Q4.2AttnBlock:两块积木。 - Q4.3
EncoderBlock、Q4.4Encoder:$1\times32\times32\to128\times4\times4$。 - Q4.5
DecoderBlock、Q4.6Decoder:镜像回去。 - Q4.7
VAE.compute_loss:重构项 + KL 项,对应讲义那条完整的 $\beta$-VAE 损失。
Part 5 · 隐空间扩散(1 处)
- Q5.1
LatentCFGTrainer.get_train_loss:与 Q2.2 只差一处——训练数据换成冻结 VAE 编码后的隐变量。
预计耗时:读题 + 推导约 2 小时;写代码 3–5 小时(Q3.3 一题就可能占掉一半);四段训练在单张现代 GPU 上合计约 1.5–2.5 小时(3000 + 20000 + 5000 + 10000 步)。这是三个 lab 里唯一一个「训练时间不可忽略」的,建议先把所有形状检查跑通再开训。
原题面在 Q3.3 里写了一段很直白的话:
「我们强烈建议你不要用 ChatGPT、Gemini、Claude 或任何其它大语言模型来替你写这段代码。这个 lab 是选修的,你只会剥夺自己一次精心设计过的、亲手把机器学习做一遍的机会。」
这个要求在 Q3.3 上尤其成立——从零手写一次多头注意力,是这个 lab 唯一无法被替代的收获。所以本页的定位是写完之后的对照与查错:
- 先自己写。卡住了就只读「题目在问什么」和「数学依据」两小节,跳过代码。
- 每写完一个模块,立刻跑形状与不变量检查(第 7 节给了一套现成的),不要攒到最后。20000 步跑完才发现
rearrange写反了,是这个 lab 里最贵的错误。 - 训完之后把你的图和本页的真实运行结果图逐张对比。图对不上,先看每题末尾的「常见错误」。
- 最后看「参考实现」确认细节。
另外提前说明两处本页会重点展开、但题面没讲的东西:(一)Q2.2 的官方提示里有一条过期信息(关于 $t$ 的形状),照抄会直接报错;(二)Part 5 训出来的隐空间 DiT,损失几乎不下降但样本是好的,这是本 lab 最容易被误判成「没训起来」的地方,第 6 节会用一个可以手算的下界把它解释清楚。
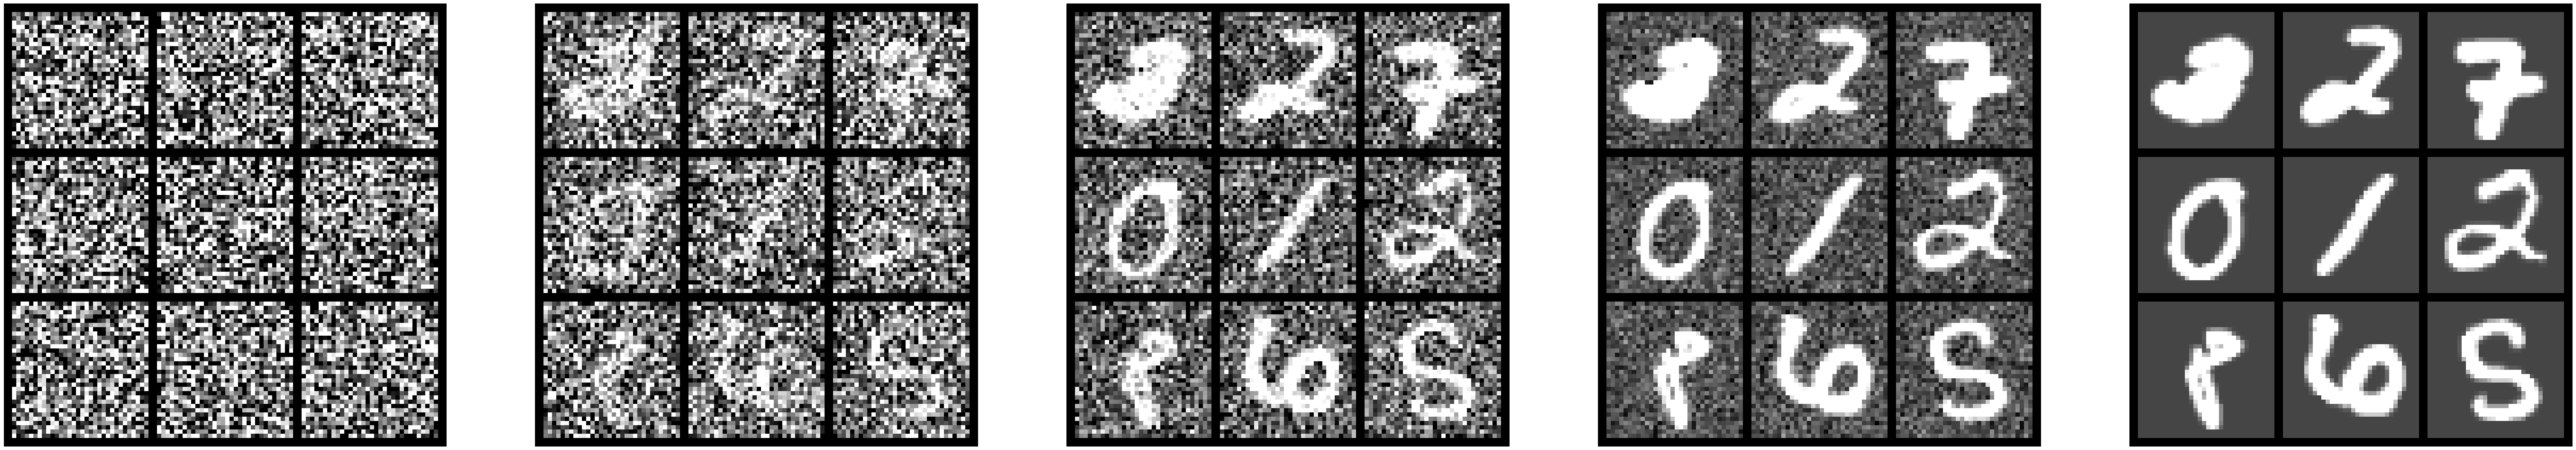
sample_conditional_path 一个字都不用改就能作用在 b 1 32 32 上——因为 $\alpha_t,\beta_t$ 是标量,逐元素广播与维度无关。同时它也直观地说明了任务难度:模型要学会的,是把最左边那团噪声逆着推回最右边那些结构极强的笔画。1. 骨架的三处升级:从 Lab 2 到 Lab 3
Part 0 和 Part 1 是「回收站」,把 Lab 1/2 的类原样搬了过来。但有三处改动是刻意的,看懂它们能省掉后面一半的调试时间。
1.1 升级一:Sampleable 变成 LabeledSampleable
Lab 2 的分布只需要能采样:sample(n) -> x。Lab 3 要做条件生成,所以采样必须同时返回标签:
class LabeledSampleable(ABC):
    @abstractmethod
    def sample(self, num_samples: int) -> Tuple[torch.Tensor, Optional[torch.Tensor]]:
        """
        Returns:
            - samples: b d   (或 b c h w)
            - labels:  b
        """
注意标签的形状是 (b,),是一维整数张量,因为它要直接喂给 nn.Embedding。而 IsotropicGaussian(源分布 $p_{\text{init}}$)仍然只实现无标签的 Sampleable——高斯噪声谈不上「类别」,这个区分是有意义的。
1.2 升级二:时间 $t$ 的形状从 (b, 1) 变成 (b,)
这是 Lab 2 → Lab 3 最容易踩的一个坑,而且它贯穿全 lab。Lab 2 里数据是 (b, dim),时间约定成 (b, 1),广播天然对齐。Lab 3 的数据是 (b, c, h, w),如果还用 (b, 1),广播就会把时间维当成通道维,结果完全错乱。
官方的解法是:对外统一把 $t$ 定成 (b,),进到路径类内部再按数据的秩自己撑开:
class GaussianConditionalProbabilityPath(ConditionalProbabilityPath):
    def __init__(self, p_data, p_simple_shape, alpha, beta):
        ...
        # p_simple_shape=[1,32,32] 时,这行等价于 Rearrange('b -> b 1 1 1')
        # p_simple_shape=[2]       时,等价于 Rearrange('b -> b 1')
        self.rearrange_scalar = Rearrange(f'b -> b{" 1" * len(p_simple_shape)}')

    def sample_conditional_path(self, z, t):
        alpha_t = self.rearrange_scalar(self.alpha(t))   # (b, 1, 1, 1)
        beta_t  = self.rearrange_scalar(self.beta(t))    # (b, 1, 1, 1)
        return alpha_t * z + beta_t * torch.randn_like(z)
这个设计非常漂亮:同一份路径代码,既能作用在 (b, 2) 的玩具数据上(Sanity Check 2.4),也能作用在 (b, 1, 32, 32) 的图像上(Part 3),还能作用在 (b, 128, 4, 4) 的隐变量上(Part 5)——因为「秩」这个信息在构造时就被烘焙进 rearrange_scalar 里了。
Q2.2 的官方 Hint 第 3 条写着:
「You can sample $t\sim\mathcal{U}[0,1]$ using torch.rand(batch_size, 1, 1, 1).」
照抄会直接报错。 这条提示是从某个更早的版本遗留下来的:在那个版本里路径类不做 rearrange_scalar,需要调用方自己把 $t$ 撑成四维。但在你手上这份 notebook 里,Alpha.__call__、Beta.__call__、sample_conditional_path、conditional_vector_field 的 docstring 全都写着 t: b,内部也全都做了 rearrange_scalar。传 (b,1,1,1) 进去会被再撑成 (b,1,1,1,1,1,1),与 z 的 (b,1,32,32) 广播时维度对不上而崩掉。
正确写法是 torch.rand(batch_size)。 判断依据不要看 Hint,要看 Alpha.dt 的实现——它里面写着 t = t.unsqueeze(1) 然后 vmap(jacrev(self))(t),最后 .view(-1),这只有在输入是一维时才成立。
1.3 升级三:MNISTSampler 与一处性能改写
官方的 MNISTSampler 长这样(简化):每次 sample 都用 torch.randperm 取一批下标,然后对每一张图调用 PIL 的 Resize((32,32)) 和 ToTensor()。这在功能上没问题,但在 20000 步 × batch 256 的训练里,等于要做 512 万次单张 PIL 变换,会成为纯 CPU 瓶颈——GPU 大部分时间在等数据。
本页的实测版本把它改成了一次性预处理并缓存到 GPU:
class MNISTSampler(nn.Module, LabeledSampleable):
    def __init__(self):
        super().__init__()
        dataset = datasets.MNIST(
            root='./data', train=True, download=True,
            transform=transforms.Compose([
                transforms.Resize((32, 32)),
                transforms.ToTensor(),
                transforms.Normalize((0.1305,), (0.2891,)),
            ])
        )
        loader = torch.utils.data.DataLoader(dataset, batch_size=2048,
                                             shuffle=False, num_workers=4)
        xs, ys = [], []
        for xb, yb in loader:
            xs.append(xb); ys.append(yb)
        self.register_buffer('images', torch.cat(xs))                 # (60000, 1, 32, 32)
        self.register_buffer('labels', torch.cat(ys).to(torch.int64)) # (60000,)
        self.dummy = nn.Buffer(torch.zeros(1))

    def sample(self, num_samples: int):
        idx = torch.randint(0, self.images.shape[0], (num_samples,),
                            device=self.images.device)               # (b,)
        # 高级索引本身会返回副本;再 clone 一次,确保调用方的原地改写
        # (CFG 的 label dropout 会写 y[mask] = 10)不会污染缓存的数据集
        return self.images[idx].clone(), self.labels[idx].clone()
整个数据集常驻显存的代价是 $60000\times1\times32\times32\times4\ \text{B}\approx245$ MB,对 16 GB 显存完全不是问题,换来的是训练吞吐提升约一个数量级。
这个改动改变数学吗?只改变了一点,而且是往好的方向:randperm 是无放回抽样,randint 是有放回抽样。理论上我们要的是从 $\data$ 独立同分布采一个 mini-batch,有放回才是那个理想设定;无放回反而引入了 batch 内的负相关。对 SGD 的收敛性没有实际影响,工程上更简单。
.clone() 不是多余的
CFG 的训练循环里有一行原地写:y[xi < self.eta] = self.null_label。在官方实现里 y 每次都是新造的张量,写坏了也无所谓;但一旦你把数据集缓存成 buffer,self.labels[idx] 返回的虽然是副本(高级索引会复制),语义上却很容易在后续重构中变成视图。加一个 .clone() 是零成本的保险——否则你会看到一个极其诡异的现象:训着训着数据集里的标签越来越多变成 10,模型逐渐退化成纯无条件模型。
更稳妥的做法是在 trainer 里写 y = y.clone() 或者用非原地的 torch.where(xi < eta, null, y)。
1.4 顺带一提:Trainer 加了什么
Lab 3 的 Trainer 基类比 Lab 2 多了三样东西,都值得知道:
- 线性 warmup:前
warmup_steps(默认 500)步把学习率从 0 线性升到lr。transformer 对初期的大梯度非常敏感,没有 warmup 很容易在前几百步崩掉。 - checkpoint 回调:每
ckpt_every步存一次权重 + 采一批样本存图。强烈建议用起来——20000 步要跑几十分钟,能在第 1000 步就看出「样本是不是完全的噪声」,比跑完再看划算得多。 model_size_b:打印模型大小。DiT 约 40.3 MiB,VAE 约 6.2 MiB,可以用来快速核对你的架构参数有没有写错(比如把dim写成 512 会让大小翻四倍)。
2. Part 2 · Classifier-Free Guidance
先把理论理顺,代码只有五行。Lecture 3-B 已经完整讲过引导,这里只重做一遍与代码直接对应的那条推导链。
2.0 从条件生成到 CFG:三步推导
第一步:条件生成本身不需要新理论。固定一个标签 $y$,把 $\data(\cdot\mid y)$ 当成新的数据分布,Lab 2 的整套 flow matching 原封不动就能用:
$$ \mathcal{L}^{\text{guided}}_{\text{CFM}}(\theta;y)=\E_{z\sim \data(\cdot\mid y),\,t\sim U[0,1],\,x\sim p_t(\cdot\mid z)}\norm{u_t^\theta(x\mid y)-u_t^{\text{ref}}(x\mid z)}^2 $$再把 $y$ 也放进期望里(而不是固定住),就得到了「一个网络同时学会所有类别」的目标。到这一步理论上就已经完事了:$u^\theta_t(x\mid y)$ 的最优解就是条件边际向量场 $u_t(x\mid y)$,用它做 ODE 采样得到的就是 $\data(\cdot\mid y)$。
第二步:但人们发现「更像那一类」比「正确采样」更讨喜。回忆高斯路径下向量场与得分的线性关系(Lab 2 Q3.3 的那条):对 $a_t=\frac{\dot\alpha_t}{\alpha_t}$、$b_t=-\frac{\dot\beta_t\beta_t\alpha_t-\dot\alpha_t\beta_t^2}{\alpha_t}$,有
$$ u_t(x\mid y)=a_t x+b_t\,\grad\log p_t(x\mid y). $$对条件得分用一次贝叶斯:$p_t(x\mid y)=\frac{p_t(x)p_t(y\mid x)}{p_t(y)}$,两边取 $\log$ 再对 $x$ 求梯度,$\log p_t(y)$ 与 $x$ 无关直接消失:
$$ \grad\log p_t(x\mid y)=\grad\log p_t(x)+\grad\log p_t(y\mid x). $$代回去:
$$ u_t(x\mid y)=\underbrace{a_tx+b_t\grad\log p_t(x)}_{=\,u_t(x)\ \text{(无条件向量场)}}+\;b_t\grad\log p_t(y\mid x). $$第二项 $\grad\log p_t(y\mid x)$ 就是一个「带噪分类器」:它指向「让当前样本更像类别 $y$」的方向。把这一项的权重放大 $w$ 倍,就得到引导向量场:
$$ \tilde u_t(x\mid y)=u_t(x)+w\,b_t\grad\log p_t(y\mid x). $$第三步:消掉分类器。上面那条恒等式反解出 $b_t\grad\log p_t(y\mid x)=u_t(x\mid y)-u_t(x)$,代进去:
$$ \boxed{\ \tilde u_t(x\mid y)=(1-w)\,u_t(x\mid\varnothing)+w\,u_t(x\mid y)\ } $$其中 $u_t(x)$ 被重写成 $u_t(x\mid\varnothing)$:把「无条件」当成一个特殊的类别 $\varnothing$。这就是 classifier-free guidance(无分类器引导)——不需要训分类器,只需要让同一个网络偶尔看不见标签。
- $w=1$:$\tilde u_t=u_t(x\mid y)$,纯条件,无引导。此时 CFG 完全不起作用,采到的是真正的 $\data(\cdot\mid y)$。
- $w=0$:$\tilde u_t=u_t(x\mid\varnothing)$,纯无条件,标签被完全忽略。
- $y=\varnothing$:无论 $w$ 取多少,$(1-w)u_t(x\mid\varnothing)+w\,u_t(x\mid\varnothing)=u_t(x\mid\varnothing)$,引导强度完全失效。这条性质在第 3 节读
lab3-dit-samples.png的最后一行时会用上。
前两条是本 lab 数值测试里的两项(误差均为 0),第三条是理解那张三联图的钥匙。
训练侧的改动只有一句话:以概率 $\eta$ 把标签 $y$ 换成 $\varnothing$。这样同一份参数既见过「带标签的样本」(学 $u_t(x\mid y)$),也见过「不带标签的样本」(学 $u_t(x\mid\varnothing)$)。本 lab 取 $\varnothing\triangleq10$,即 MNIST 十个数字之后的第十一个槽位。
2.1 Q2.2 · CFGTrainer.get_train_loss
题目在问什么。 实现下面这个期望的单批次蒙特卡洛估计:
$$ \mathcal{L}_{\text{CFM}}(\theta)=\E_{\square}\norm{u_t^\theta(x\mid y)-u_t^{\text{ref}}(x\mid z)}^2,\qquad \square=\begin{cases}(z,y)\sim\data(z,y)\\ y\leftarrow\varnothing\ \text{以概率}\ \eta\\ t\sim U[0,1]\\ x\sim p_t(\cdot\mid z)\end{cases} $$数学依据。 与 Lab 2 的条件 flow matching 定理逐字对应,只多了第二行。回归目标是条件向量场 $u_t^{\text{ref}}(x\mid z)$(可解析计算),而 $L^2$ 最优解是它在给定 $(x,t,y)$ 下的条件期望,也就是我们真正想要的边际条件向量场 $u_t(x\mid y)$。标签丢弃只是把 $y$ 的边缘分布从 $p(y)$ 改成了 $(1-\eta)p(y)+\eta\delta_\varnothing$,不影响这个论证——在 $y=\varnothing$ 的那一支上,条件期望自动收敛到 $\E[u_t(x\mid z)\mid x,t]=u_t(x)$。
参考实现。
class CFGTrainer(Trainer):
    def __init__(self, path, eta: float, null_label: int, eps: float = 0.001, **kwargs):
        assert eta > 0 and eta < 1
        super().__init__(**kwargs)
        self.eta = eta
        self.eps = eps
        self.path = path
        self.null_label = null_label

    def get_train_loss(self, batch_size: int) -> torch.Tensor:
        # Step 1: 从 p_data 采 (z, y)
        z, y = self.path.p_data.sample(batch_size)   # z: (b, c, h, w),  y: (b,)

        # Step 2: 以概率 eta 把标签替换成空标签
        xi = torch.rand(y.shape[0], device=y.device)             # (b,)
        y[xi < self.eta] = self.null_label

        # Step 3: 采 t 和 x
        #   注意 t 的形状是 (b,),不是 (b,1,1,1)
        #   乘 (1 - eps) 是为了避开 t=1
        t = torch.rand(batch_size, device=z.device).to(z) * (1 - self.eps)  # (b,)
        x = self.path.sample_conditional_path(z, t)                        # (b, c, h, w)

        # Step 4: 回归
        ut_theta = self.model(x, t, y)                       # (b, c, h, w)
        ut_ref   = self.path.conditional_vector_field(x, z, t)  # (b, c, h, w)
        return torch.square(ut_theta - ut_ref).mean()
为什么这样写。
xi = torch.rand(y.shape[0])而不是torch.rand(1)。 丢弃必须是逐样本独立的:一个 batch 里应该同时存在带标签样本和空标签样本。如果整批一起丢,梯度的方差会大很多,而且 batch norm 类统计量(这里没有,但 VAE 里有 GroupNorm)会在两种模式间来回跳。t的形状是(b,)。 上一节已经详述:路径类内部会用Rearrange('b -> b 1 1 1')自己撑开。这一点在 Sanity Check 2.4 里同样成立(那里p_simple_shape=[2],撑成b 1),所以同一份 trainer 代码在二维玩具数据和图像上都能跑——这正是它被设计成(b,)的原因。* (1 - self.eps)是必须的,不是保险丝。 展开条件向量场: $$ u_t(x\mid z)=\left(\dot\alpha_t-\frac{\dot\beta_t}{\beta_t}\alpha_t\right)z+\frac{\dot\beta_t}{\beta_t}x $$ 本 lab 用LinearAlpha/LinearBeta,即 $\alpha_t=t$、$\beta_t=1-t$,于是 $\frac{\dot\beta_t}{\beta_t}=\frac{-1}{1-t}$,在 $t\to1$ 时发散。虽然代数上 $u_t(x\mid z)$ 化简后等于 $z-\epsilon$(有限),但代码是按原式逐项算的,$t=1$ 会出现 $-\infty\cdot 0$,直接得到nan。eps=1e-3把采样区间截到 $[0,0.999]$,代价可以忽略($t$ 是连续均匀分布,$\{1\}$ 是零测集),收益是训练不会莫名其妙 NaN。采样时同样要截:torch.linspace(0, 0.999, num_timesteps)。.to(z)而不是只写device=。.to(z)会把 dtype 也对齐到z。如果你后面上 AMP / bf16 训练,这一行能省掉一次类型不匹配。.mean()而不是.sum()。 对所有元素取平均,等价于「每维平均平方误差」。这让损失的数值不随图像分辨率变化,学习率也就不用跟着分辨率调。记住这个约定,第 6 节讨论损失下界时要用。
- 按 Hint 写
torch.rand(batch_size, 1, 1, 1)——直接报广播错误。见上一节。 torch.rand写成torch.randn——题面自己都提醒了。$t$ 必须是 $[0,1]$ 上的均匀分布;用标准正态会采到负时间和大于 1 的时间,$\beta_t=1-t$ 变成负数或大于 1,路径彻底失效。症状是损失在几百步内爆到 $10^3$ 量级。- 丢标签时用了
>而不是<——变成以概率 $1-\eta$ 丢弃。$\eta=0.35$ 时你实际丢了 65%,条件分支训练不足,$w$ 越大样本越糊。这个错误不会报错,只会让结果变差,很难发现。 - 把
z和x搞反——conditional_vector_field(x, z, t)的参数顺序是「先当前点,后条件变量」。写成(z, x, t)不会报错(形状一样),但回归目标完全错误。 - 忘了
y是原地修改的——见 1.3 节的.clone()讨论。
2.2 Q2.3 · MLPConditionalVectorField.forward
题目在问什么。 用最朴素的方式把 $(x,t,y)$ 三样输入喂进一个 MLP:拼接。这是自检用的小模型,跑在二维高斯混合上。
数学依据。 没有什么深刻的数学,但有一个重要的表示问题:$y$ 是离散的类别,不能当成实数直接拼进去(那样会隐含「类别 3 比类别 1 大 2」这种荒谬的序关系)。标准做法是查表——把每个类别映射到一个可学习的向量:
$$ y\in\set{0,1,\dots,C-1,\varnothing}\ \longmapsto\ e_y\in\R^{d_{\text{class}}},\qquad e\ \text{是可训练参数}. $$参考实现。
class MLPConditionalVectorField(ConditionalVectorField):
  def __init__(self, dim: int, hidden_dim: int, class_dim: int, num_classes: int):
    super().__init__()
    self.mlp = MLP([dim + class_dim + 1, hidden_dim, hidden_dim, dim])
    self.class_embedding = nn.Embedding(num_classes + 1, class_dim)
    #                                   ^^^^^^^^^^^^^^^ 多出来的那一格就是空标签

  def forward(self, x: torch.Tensor, t: torch.Tensor, y: torch.Tensor):
      xyt = torch.cat([
          x,                          # (b, dim)
          self.class_embedding(y),    # (b, class_dim)
          t.unsqueeze(-1),            # (b, 1)
      ], dim=-1)                      # (b, dim + class_dim + 1)
      return self.mlp(xyt)            # (b, dim)
为什么这样写。
num_classes + 1里的那个+1,就是 $\varnothing$。 这是 CFG 落地的全部工程代价——一行代码里的一个加一。Sanity Check 里num_classes=3(三个高斯模式),所以嵌入表有 4 行,null_label=3指向最后一行。Part 3 的 DiT 里则写成n_classes=11(10 个数字 + 1 个 $\varnothing$),是同一件事的另一种写法。如果你写成nn.Embedding(num_classes, class_dim),训练会在第一次抽到空标签时抛 index out of range——这算是好消息,因为它会立刻暴露。t.unsqueeze(-1)。 $t$ 进来是(b,),拼接要求所有张量除拼接维外形状一致,所以要撑成(b, 1)。这里的 $t$ 是原始标量,没有做 Fourier 编码——对二维玩具问题够用,但对图像就不够了,这正是 Q3.1 存在的理由。- 输入维度
dim + class_dim + 1。 三段拼接后的总宽度。写错这个数字会在第一次前向时报矩阵乘法维度不匹配,属于「好错误」。
- 把
y当浮点数直接torch.cat——nn.Embedding要求整型索引,传浮点会报错;而如果你绕过 embedding 直接拼y.float().unsqueeze(-1),代码能跑,但模型被迫在类别上做插值,Sanity Check 的三个模式会糊成一团。 dim=-1写成dim=0——把三个张量沿 batch 维摞起来,形状变成(3b, ...),报错或者算出完全错误的结果。y的 dtype 不是int64——MNIST 的 label 默认就是 int64,但如果你自己构造标签时用了torch.tensor([0,1,2])之外的写法(比如从torch.zeros转),要记得.long()。
2.3 Sanity Check 2.4 · 在二维高斯混合上验证 CFG
Q2.2 + Q2.3 写完之后,题面给了一个只要三分钟的自检:三个模式的对称高斯混合(半径 2、标准差 0.2),$\eta=0.25$,$\varnothing=3$,训练 3000 步。务必先跑通这个再去碰 Part 3——它能在三分钟内验证你的训练循环是对的,而 DiT 要几十分钟。
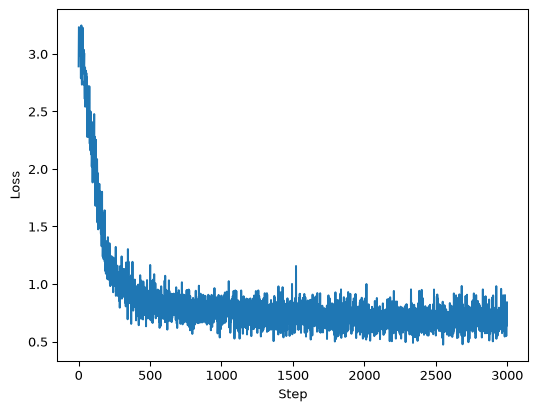
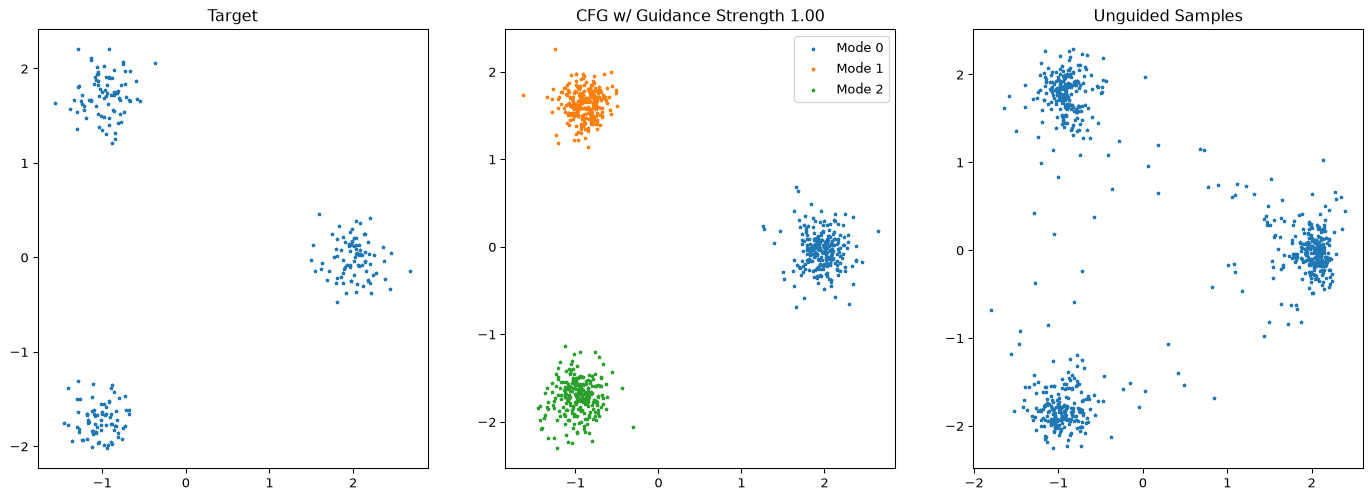
- 中间图颜色混杂 → 条件信息没传进去。查
class_embedding(y)有没有真的被拼进 MLP 输入。 - 右边图只覆盖一两个模式 → $\eta$ 太小(空标签样本太少)或者丢标签的比较符号写反了。
- 右边图和中间图长得一样(只有一个模式) →
null_label传错,空标签指到了某个真实类别上。 - 点云整体偏离目标位置 → 回归目标或路径写错,回去查
conditional_vector_field的参数顺序。
3. Part 3 · 从零搭一个 Diffusion Transformer
这是本 lab 篇幅最大的一部分:五个 TODO 把一个完整的 DiT 搭出来。先看总装图,后面每一题都是它的一个零件:
| 阶段 | 模块 | 输入形状 | 输出形状 | 题号 |
|---|---|---|---|---|
| 时间编码 | FourierEncoder + MLP | (b,) | (b, 256) | Q3.1 |
| 类别编码 | nn.Embedding(11, 256) | (b,) | (b, 256) | Q3.5 |
| 切块 | Patchifier | (b, 1, 32, 32) | (b, 64, 256) | Q3.2 |
| 主干 | DiffusionTransformer(8 层) | (b, 64, 256) + (b, 256) | (b, 64, 256) | Q3.3 |
| 还原 | Depatchifier | (b, 64, 256) | (b, 1, 32, 32) | Q3.4 |
其中 64 = (32/4)^2 是 token 数(patch size 取 4),256 是隐藏维度。整个网络实现的函数是 $u_t^\theta:\R^{1\times32\times32}\times[0,1]\times\set{0,\dots,10}\to\R^{1\times32\times32}$——输入输出同形,因为向量场和它作用的点住在同一个空间。
3.1 Q3.1 · FourierEncoder
题目在问什么。 把标量 $t\in[0,1]$ 映射成 $d$ 维向量:
$$ t^{\text{emb}}=\big[\cos(2\pi w_1 t),\ \dots,\ \cos(2\pi w_{d/2} t),\ \sin(2\pi w_1 t),\ \dots,\ \sin(2\pi w_{d/2} t)\big]^\top, $$其中频率 $w_i\sim\N(0,1)$ 在初始化时随机抽取(本实现里做成 nn.Parameter,即可训练)。
数学依据:为什么标量 $t$ 不能直接喂进网络?
带 ReLU/SiLU 的 MLP 有很强的谱偏置(spectral bias):它天然倾向于先学会输入的低频依赖,高频部分要花指数级更多的训练量。而向量场对 $t$ 的依赖恰恰是高频的——本 lab 的条件向量场展开后含有 $\frac{\dot\beta_t}{\beta_t}=\frac{-1}{1-t}$,在 $t\to1$ 附近变化极快。如果只给网络一个标量 $t$,它很难分辨 $t=0.98$ 和 $t=0.99$ 这两个在行为上差别巨大的时刻。
随机 Fourier 特征把这件事一次性解决:$\cos(2\pi w t)$ 与 $\sin(2\pi w t)$ 在 $w$ 较大时对 $t$ 的微小变化极其敏感。由三角恒等式
$$ \cos(2\pi w(t+\delta))=\cos(2\pi wt)\cos(2\pi w\delta)-\sin(2\pi wt)\sin(2\pi w\delta), $$可以看出 $(\cos,\sin)$ 这一对共同构成了对平移的完整表示——这也是为什么必须两个都要,只留 $\cos$ 会丢掉符号信息($\cos$ 是偶函数,无法区分 $t$ 和 $-t$)。
更定量地说,这是 Rahimi & Recht 的随机特征方法:一组随机频率上的 $(\cos,\sin)$ 内积,是平移不变核的无偏估计——
$$ \E_{w\sim\N(0,1)}\big[\cos(2\pi w t)\cos(2\pi w s)+\sin(2\pi w t)\sin(2\pi w s)\big]=\E_w\big[\cos(2\pi w(t-s))\big]=e^{-2\pi^2(t-s)^2}. $$也就是说,这个编码等价于给时间装了一个宽度约 $\frac{1}{2\pi}$ 的高斯核——相近的 $t$ 表示相似,远离的 $t$ 表示近乎正交,正是网络需要的。
参考实现。
class FourierEncoder(nn.Module):
    def __init__(self, dim: int):
        super().__init__()
        assert dim % 2 == 0
        self.half_dim = dim // 2
        self.weights = nn.Parameter(torch.randn(1, self.half_dim))   # (1, d/2)

    def forward(self, t: torch.Tensor) -> torch.Tensor:
        """ t: (b,)  ->  embeddings: (b, dim) """
        t = t.view(-1, 1)                            # (b, 1)
        freqs = 2 * math.pi * t * self.weights       # (b, 1) * (1, d/2) -> (b, d/2)
        cos_emb = torch.cos(freqs)                   # (b, d/2)
        sin_emb = torch.sin(freqs)                   # (b, d/2)
        return torch.cat([cos_emb, sin_emb], dim=-1) # (b, dim)
为什么这样写。
t.view(-1, 1)加weights形状(1, half_dim),靠广播一次得到(b, half_dim)。 这是本题唯一的形状技巧:外积用广播实现,不需要einsum。2 * math.pi不能省。 省掉它并不会让模型不能训(相当于把 $w$ 的尺度缩小 $2\pi$ 倍),但会让频率分布偏低,时间分辨能力下降。既然公式写了就照写。nn.Parameter而非register_buffer。 题面给的公式里 $w_i$ 是固定的随机数,但做成可训练参数只有好处:网络可以自己把频率调到任务需要的量级。注意这也意味着它会被model.parameters()计入,别对模型大小感到意外。assert dim % 2 == 0。 因为要对半分给 $\cos$ 和 $\sin$。
由 $\cos^2\theta+\sin^2\theta=1$,输出张量每一行的平方和恒等于 half_dim,与 $t$ 无关:
fe = FourierEncoder(dim=64)
emb = fe(torch.rand(8))
assert torch.allclose((emb ** 2).sum(-1), torch.full((8,), 32.0))  # 32 = 64 / 2
再加一条端点检查:$t=0$ 时 $\cos=1,\sin=0$,所以 fe(torch.zeros(1)) 应当是 [1,...,1, 0,...,0]。这两条能抓出「$\cos/\sin$ 拼反」「漏乘 $t$」「维度切错」等几乎所有实现错误,写完立刻跑,一秒钟的事。
- 输出维度是
2 * dim而不是dim——如果你写成self.weights = nn.Parameter(torch.randn(1, dim))再拼接,输出就是2*dim。后面 MLP 的输入维度对不上,会在DiffusionTransformerFlowModel里才炸,排查起来很绕。 - 忘了
t.view(-1, 1)——t是(b,),直接乘(1, half_dim)会得到(b, half_dim)……只在b == 1或b == half_dim时侥幸不报错,其余情况报广播错误。别赌。 - 用
torch.arange造固定的对数间隔频率——那是 transformer 原始论文的正弦位置编码,也能用,但和题面给的公式不是一回事,测试会不通过。
3.2 Q3.2 · Patchifier
题目在问什么。 把图像 (b, c, 32, 32) 变成 token 序列 (b, n, d),其中 $n=(32/p)^2$。两步:一层卷积把空间降到 $32/p$、通道升到 $d$;一次 Rearrange 把两个空间维压平成序列维。
数学依据:为什么 kernel = stride = patch 的卷积就是 patch embedding?
ViT/DiT 论文里对 patch embedding 的描述是:把图像切成 $p\times p$ 的不重叠小块,每块拉平成 $c p^2$ 维向量,再乘同一个矩阵 $W\in\R^{d\times cp^2}$ 得到 $d$ 维 token。
现在看 nn.Conv2d(c, d, kernel_size=p, stride=p) 在做什么。它的第 $(i,j)$ 个输出位置是
因为 stride 等于 kernel size,感受野 $\{ip,\dots,ip+p-1\}\times\{jp,\dots,jp+p-1\}$ 恰好就是第 $(i,j)$ 个 patch,且不同 $(i,j)$ 的感受野互不重叠、恰好铺满图像。把卷积核 $K$ 沿 $(c',a,b)$ 拉平成矩阵 $W$,上式就逐字变成 $W\cdot\text{flatten}(\text{patch}_{ij})+\text{bias}$。
所以两者不是「近似」,而是同一个线性映射的两种写法。 用卷积写的好处是:一行代码、cuDNN 高度优化、不需要手动 unfold。
参考实现。
class Patchifier(nn.Module):
  def __init__(self, img_size: int, patch_size: int, c_in: int, dim: int):
    super().__init__()
    assert img_size % patch_size == 0, "Image size must be divisible by patch size"
    self.net = nn.Sequential(
        nn.Conv2d(c_in, dim, kernel_size=patch_size, stride=patch_size),
        #   (b, c, H, W) -> (b, d, H/p, W/p)
        Rearrange('b d h w -> b (h w) d'),
        #   -> (b, n, d),  n = (H/p) * (W/p)
    )

  def forward(self, x: torch.Tensor) -> torch.Tensor:
    return self.net(x)
为什么这样写。
c_in是参数而不是硬编码的 1。 Part 5 会把同一个类用在(b, 128, 4, 4)的隐变量上(c_in=128、patch_size=1)。不要硬编码通道数,否则 Part 5 要重写。Rearrange('b d h w -> b (h w) d')的顺序至关重要。 括号里的(h w)表示「$h$ 是慢变维、$w$ 是快变维」,即 token 按行优先排列:第 0 个 token 是左上角,第 1 个是它右边一格。Depatchifier必须用完全对应的写法折回去,否则图像会被转置或打乱。assert img_size % patch_size == 0。 否则卷积会悄悄丢掉边缘像素(PyTorch 的Conv2d默认floor),你会得到一个尺寸对不上的 token 数。
patch 划分必须是空间局部的:只修改图像左上角那个 $4\times4$ 块,应当只有一个 token 发生变化。
P = Patchifier(img_size=32, patch_size=4, c_in=1, dim=48)
x1 = torch.zeros(1, 1, 32, 32)
x2 = x1.clone(); x2[0, 0, 0:4, 0:4] = 1.0
d = (P(x1) - P(x2)).abs().sum(-1)[0]        # (n,)
assert (d > 1e-6).sum().item() == 1         # 只有 1 个 token 变了
这条检查在本 lab 的数值测试里是实打实通过的。它能抓出「用 reshape/view 代替 Rearrange 但维度顺序错了」这类经典错误——那种写法会让一个 patch 的改动扩散到多个 token 上。
- 用
x.view(b, n, d)直接压平——卷积输出的内存布局是(b, d, h, w),通道维在前。直接view会把通道和空间搅在一起,得到语义完全错误的 token。必须先permute/Rearrange。 - 卷积写成
kernel_size=patch_size, stride=1——变成滑窗,输出 token 数是 $(32-p+1)^2$ 而不是 $(32/p)^2$,位置编码的长度立刻对不上。 - 加了
padding——同上,会改变输出尺寸。这里不要 padding。 - 写成
'b d h w -> b (w h) d'——列优先。代码能跑、测试的形状检查也能过,但图像会被转置。只有上面那条局部性检查 + 最终采样图能发现。
3.3 Q3.3 · MHA + DiffusionTransformerLayer + DiffusionTransformer
本 lab 最重的一题,一次要写三个类。题面建议自顶向下想、自底向上写,这里按后者组织。
3.3.1 MHA:从零手写多头自注意力
题目在问什么。 实现
$$ \text{MHA}(X)=W_O\,\text{concat}_{h=1}^{H}\Big(\softmax\!\Big(\tfrac{Q_hK_h^\top}{\sqrt{d_h}}\Big)V_h\Big),\qquad Q_h=XW_Q^{(h)},\ K_h=XW_K^{(h)},\ V_h=XW_V^{(h)}, $$其中 $X\in\R^{n\times d}$ 是 token 序列,$H$ 是头数,$d_h=d/H$ 是每个头的维度。
假设 $q,k\in\R^{d_h}$ 的各分量独立、均值 0、方差 1(初始化时大致如此)。那么点积
$$ q\cdot k=\sum_{i=1}^{d_h}q_ik_i $$的均值是 $0$,方差是
$$ \Var\Big(\sum_i q_ik_i\Big)=\sum_i\Var(q_ik_i)=\sum_i\E[q_i^2]\E[k_i^2]=d_h, $$即标准差为 $\sqrt{d_h}$。当 $d_h=32$ 时,logits 的典型幅度约 $\pm 5.7$;当 $d_h=128$ 时约 $\pm11$。而 $\softmax$ 在输入相差超过 $\sim10$ 时基本已经饱和成 one-hot——梯度接近 0,注意力层学不动。
除以 $\sqrt{d_h}$ 把方差拉回 1,logits 的典型幅度稳定在 $\pm1$ 附近,与头维度无关。这就是「scaled dot-product attention」里那个 scaled 的全部含义。
注意分母是 $\sqrt{d_h}$(头维度),不是 $\sqrt{d}$(总维度)。 写错会让缩放偏小 $\sqrt{H}$ 倍——模型仍然能训,但收敛更慢,而且与 PyTorch 官方实现对不上号。
参考实现。
class MHA(nn.Module):
  """ Multi-headed self-attention """
  def __init__(self, dim: int, heads: int):
    super().__init__()
    assert dim % heads == 0
    self.heads = heads
    self.head_dim = dim // heads
    self.scale = self.head_dim ** -0.5        # 1 / sqrt(d_h)
    self.qkv = nn.Linear(dim, 3 * dim, bias=False)
    self.proj = nn.Linear(dim, dim)

  def forward(self, x: torch.Tensor) -> torch.Tensor:
    """ x: (b, n, d) -> (b, n, d) """
    # 1. 一次线性层同时算出 q, k, v
    q, k, v = self.qkv(x).chunk(3, dim=-1)                       # 各 (b, n, d)

    # 2. 把「头」折进 batch 维:(b, n, h*e) -> (b*h, n, e)
    q = rearrange(q, 'b n (h e) -> (b h) n e', h=self.heads)     # (b*h, n, e)
    k = rearrange(k, 'b n (h e) -> (b h) n e', h=self.heads)
    v = rearrange(v, 'b n (h e) -> (b h) n e', h=self.heads)

    # 3. 缩放点积
    scores = torch.einsum('b i e, b j e -> b i j', q, k) * self.scale   # (b*h, n, n)
    attn = torch.softmax(scores, dim=-1)                               # 沿 key 维归一化

    # 4. 加权求和 value
    out = torch.einsum('b i j, b j e -> b i e', attn, v)               # (b*h, n, e)

    # 5. 头折回特征维
    out = rearrange(out, '(b h) n e -> b n (h e)', h=self.heads)       # (b, n, d)

    # 6. 输出投影
    return self.proj(out)
为什么这样写。
nn.Linear(dim, 3 * dim)一次算 qkv。 数学上等价于三个独立的nn.Linear(dim, dim),但只调一次 GEMM,对 GPU 友好得多。chunk(3, dim=-1)沿最后一维切成三份。bias=False是有理由的。 qkv 之后紧接着的是 $\softmax(qk^\top)$,而 $q$ 上的常数偏置 $q\to q+b$ 会给所有 logits 加上 $b\cdot k_j$——这一项不被 softmax 消掉,所以并非完全冗余,但实践中它的作用可以被后面的 LayerNorm 与proj的 bias 覆盖。省掉能减参数、也是主流实现的做法。rearrange('b n (h e) -> (b h) n e'):把头折进 batch。 这是本题最漂亮的一步。多头注意力本质上就是「$H$ 个互不相干的单头注意力并行跑」,所以把 $H$ 塞进 batch 维之后,后面的点积、softmax、加权求和全都是普通的三维张量运算,不需要写四维einsum。折回去时用'(b h) n e -> b n (h e)',einops会自动保证与折进去时的顺序一致——这正是用einops而非手写view/permute的价值。softmax(dim=-1):沿 key 维归一化。scores的形状是(b*h, i, j),$i$ 是 query 下标、$j$ 是 key 下标。归一化必须沿 $j$,含义是「第 $i$ 个 query 对所有 key 的注意力权重之和为 1」。写成dim=-2是最隐蔽的一个 bug:形状完全一样,不会报错,但语义变成「每个 key 被所有 query 分配的权重之和为 1」,训练会明显变差却看不出原因。- 最后的
self.proj不能省。 没有它,各个头的输出只是被拼在一起,头与头之间从不交换信息;输出投影负责把 $H$ 个头的结果混合成新的特征。
手写注意力最好的验证方式,是和 torch.nn.functional.scaled_dot_product_attention 逐元素比对:
mha = MHA(dim=64, heads=8).eval()
x = torch.randn(2, 10, 64)
with torch.no_grad():
    mine = mha(x)
    q, k, v = mha.qkv(x).chunk(3, dim=-1)
    q = q.view(2, 10, 8, 8).transpose(1, 2)     # (b, h, n, e)
    k = k.view(2, 10, 8, 8).transpose(1, 2)
    v = v.view(2, 10, 8, 8).transpose(1, 2)
    ref = torch.nn.functional.scaled_dot_product_attention(q, k, v)
    ref = mha.proj(ref.transpose(1, 2).reshape(2, 10, 64))
print((mine - ref).abs().max())     # 实测:8.94e-08
本页的实现实测最大误差 8.94e-08,就是 float32 的舍入噪声。注意这里参考实现里用的是 view(b, n, h, e).transpose(1, 2),而我们的实现用的是 rearrange('b n (h e) -> (b h) n e')——两者对「哪一段特征属于哪个头」的划分方式必须一致,才能对上。 这本身就是对 rearrange 写法的一次强验证:如果你写成 'b n (e h) -> (b h) n e',切分方式就变了,误差会是 $O(1)$ 而非 $10^{-8}$。
3.3.2 DiffusionTransformerLayer:adaLN-Zero 条件调制
题目在问什么。 实现 DiT 论文里的 adaLN-Zero block:
$$ \begin{aligned} (\gamma_1,\beta_1,\alpha_1,\gamma_2,\beta_2,\alpha_2)&=\text{MLP}_{\text{cond}}(c),\quad\text{各}\in\R^{b\times d}\\ h&=\text{LN}_1(x)\odot(1+\gamma_1)+\beta_1\\ x&\leftarrow x+\alpha_1\odot\text{MHA}(h)\\ h&=\text{LN}_2(x)\odot(1+\gamma_2)+\beta_2\\ x&\leftarrow x+\alpha_2\odot\text{FF}(h) \end{aligned} $$数学依据:AdaLN 在做什么。 这一部分 Lecture 4 §6.1 已经完整讲过,这里只复述关键的一句:LayerNorm 先把每个 token 的特征向量标准化(减均值除标准差),故意抹掉「尺度」和「偏置」信息;AdaLN 紧接着用由条件 $c$ 决定的 $(\gamma,\beta)$ 把尺度和偏置重新写回去。于是时间和类别不是作为额外 token「混」在序列里,而是作为一个全局旋钮,逐通道地控制网络内部每一处激活的强弱。
写成 $x\cdot(1+\gamma)+\beta$ 而不是 $x\cdot\gamma+\beta$,是为了让 $\gamma=0$ 对应「恒等缩放」。这一点和下面的零初始化配合起来才有意义。
nn.LayerNorm(dim, elementwise_affine=False)——仿射参数必须关掉。 LayerNorm 默认自带可学习的 $(\text{weight},\text{bias})$,但在 adaLN 里缩放平移完全由条件网络产生。两者同时存在不会报错,但会造成参数冗余与优化路径的病态(两组参数相乘,尺度不唯一)。「adaptive LayerNorm」这个名字的字面意思就是「归一化的仿射部分是自适应的」,所以固有的那一份必须关。- 六组参数、每组
(b, d),作用到(b, n, d)上要unsqueeze(1)。 条件向量 $c$ 是每个样本一份,而不是每个 token 一份——同一张图的 64 个 token 共享同一组调制参数。所以要把(b, d)撑成(b, 1, d)再广播到 $n$ 个 token。忘了unsqueeze(1)会怎样?(b, n, d) * (b, d)在 $n\ne d$ 时报错(好消息),在 $n = d$ 时静默地算错(把 token 维当成特征维)。 final_init=True:条件 MLP 最后一层清零。 于是初始时六组参数全为 0,$\alpha_1=\alpha_2=0$,两条残差支路被完全「关掉」,整个 block 退化为恒等映射 $x\mapsto x$。这就是 adaLN-Zero 里 Zero 的含义。
设第 $\ell$ 层为 $x_{\ell+1}=x_\ell+\alpha\,F_\ell(x_\ell)$。前向的方差满足(假设 $F_\ell$ 输出与输入近似独立)
$$ \Var(x_{\ell+1})\approx\Var(x_\ell)+\alpha^2\Var(F_\ell(x_\ell)). $$$\alpha=1$ 时方差逐层线性累积,$L$ 层之后放大约 $L$ 倍;深度一大,输出的尺度就会失控,必须靠仔细的初始化或额外的 LayerNorm 压回来。而 $\alpha=0$ 时,网络初始就是一个恒等映射的堆叠——无论多少层,前向输出等于输入,反向梯度等于 1,不存在任何尺度爆炸或消失。训练开始后 $\alpha$ 由 0 缓慢长大,相当于网络自己决定何时以及以多大幅度启用每一层。
这个思想在文献里反复出现:ResNet 的 zero-init-$\gamma$、Fixup、ReZero、DiT 的 adaLN-Zero,本 lab Q4.1 里 ResidualBlock 的零初始化第二个卷积,全是同一招。
参考实现。
class DiffusionTransformerLayer(nn.Module):
  def __init__(self, dim: int, heads: int):
    super().__init__()
    # 仿射参数关掉:缩放平移全部交给条件网络产生
    self.norm1 = nn.LayerNorm(dim, elementwise_affine=False)
    self.norm2 = nn.LayerNorm(dim, elementwise_affine=False)

    # 由条件 c 一次预测 6 组调制参数;final_init=True 把最后一层权重和 bias 清零
    self.cond = MLP([dim, dim, 6 * dim], final_init=True)

    self.attn = MHA(dim, heads)
    self.ff   = MLP([dim, 4 * dim, dim])

  def forward(self, x: torch.Tensor, c: torch.Tensor) -> torch.Tensor:
    """ x: (b, n, d),  c: (b, d)  ->  (b, n, d) """
    # (b, 6d) -> 6 个 (b, d) -> 6 个 (b, 1, d)
    gamma1, beta1, alpha1, gamma2, beta2, alpha2 = \
        [p.unsqueeze(1) for p in self.cond(c).chunk(6, dim=-1)]

    # 注意力支路
    h = self.norm1(x) * (1 + gamma1) + beta1     # (b, n, d)
    x = x + alpha1 * self.attn(h)

    # 前馈支路
    h = self.norm2(x) * (1 + gamma2) + beta2     # (b, n, d)
    x = x + alpha2 * self.ff(h)
    return x
其中 MLP 的 final_init 是题面已经给好的:
class MLP(nn.Module):
  def __init__(self, dims, activation=torch.nn.SiLU, final_init: bool = False):
    ...
    if final_init:
      nn.init.zeros_(self.net[-1].weight)
      nn.init.zeros_(self.net[-1].bias)
layer = DiffusionTransformerLayer(dim=32, heads=4).eval()
x = torch.randn(4, 9, 32); c = torch.randn(4, 32)
print((layer(x, c) - x).abs().max())    # 实测:0.00e+00
初始化后的 block 必须是逐比特精确的恒等映射——不是「近似为 0」,而是严格 0,因为 $\alpha=0$ 让整条残差支路被乘没了。实测最大偏差 0.00e+00。这一条能同时验证:(a)final_init 生效了;(b)残差连接是 x + alpha * f(...) 而不是 alpha * (x + f(...));(c)六组参数的顺序没错(如果你把 $\alpha$ 和 $\gamma$ 的位置搞混,因为初始全 0,这条检查照样通过——所以还要补一条:把 cond 最后一层随机初始化后,改变 $c$ 必须改变输出)。
3.3.3 DiffusionTransformer:位置编码 + 堆叠
题目在问什么。 加位置编码,然后串 depth 层。
数学依据:为什么非要位置编码? 自注意力对 token 顺序是置换等变的:设 $P$ 是任意置换矩阵,则
$$ \text{MHA}(PX)=P\,\text{MHA}(X). $$证明是一行:$Q,K,V$ 都是逐 token 的线性映射,所以 $(PX)W=P(XW)$;而 $\softmax\big((PQ)(PK)^\top/\sqrt{d_h}\big)(PV)=\softmax(PQK^\top P^\top/\sqrt{d_h})PV=P\,\softmax(QK^\top/\sqrt{d_h})V$。也就是说,如果把 64 个 image token 随机打乱,注意力算出来的结果也只是同样打乱一遍——网络根本不知道哪个 patch 在左上角。对图像来说这是灾难性的。
解决办法是在输入上加一个与位置有关的向量,把置换对称性打破。本 lab 用可学习位置编码:token 数是固定的(图像尺寸固定),所以直接学一张 $n\times d$ 的表就行,不需要正弦编码那样的外推能力。
参考实现。
class DiffusionTransformer(nn.Module):
  def __init__(self, depth: int, n_tokens: int, dim: int, **layer_kwargs):
    super().__init__()
    # 自注意力对 token 顺序置换等变,必须显式注入位置信息
    self.pos_embed = nn.Parameter(torch.randn(n_tokens, dim) * 0.02)   # (n, d)
    self.layers = nn.ModuleList([
        DiffusionTransformerLayer(dim=dim, **layer_kwargs) for _ in range(depth)
    ])

  def forward(self, x: torch.Tensor, c: torch.Tensor) -> torch.Tensor:
    """ x: (b, n, d),  c: (b, d) """
    x = x + self.pos_embed.unsqueeze(0)      # (1, n, d) 广播到 (b, n, d)
    for layer in self.layers:
        x = layer(x, c)
    return x
为什么这样写。
* 0.02的初始化尺度。 位置编码是加到 patch embedding 上的,如果初始幅度和特征本身同量级(标准正态,尺度 1),会在训练早期严重干扰内容信息。0.02 是 GPT/ViT 系列的通用取值,含义是「一开始几乎不影响,让网络自己决定要多少位置信息」。用torch.randn(n, dim)不缩放也能训,但前几千步会明显更慢。nn.Parameter而不是 buffer。 它是要学的。unsqueeze(0)。(n, d) -> (1, n, d),广播到 batch。实际上 PyTorch 的广播规则会自动在左边补 1,所以直接写x + self.pos_embed也对——但显式写出来更不容易读错,题面也特意提醒了「be careful about broadcasting」。nn.ModuleList而不是 Python list。 用普通 list 装子模块,参数不会被model.parameters()收集,也不会随.to(device)迁移。症状是:模型大小打印出来只有几百 KB,训练时报「输入在 cuda 但权重在 cpu」,或者干脆损失一动不动。这是 PyTorch 新手最经典的坑之一。- 不能用
nn.Sequential。 每层要吃两个输入(x, c),Sequential只支持单输入。必须显式写循环。
softmax沿错了维——最隐蔽,不报错,只是变差。记住:dim=-1,沿 key。- 缩放用 $\sqrt{d}$ 而不是 $\sqrt{d_h}$——与官方实现对拍会发现误差 $O(1)$。
- 六组调制参数忘了
unsqueeze(1)——$n\ne d$ 时报错,$n=d$ 时静默算错。DiT 默认 $n=64,d=256$,会报错,算是运气好。 LayerNorm忘了elementwise_affine=False——不报错,参数冗余,训练略变差。- 调制写成
x * gamma + beta(漏了1 +)——配合零初始化,初始时 $\gamma=0$ 会把整个归一化输出清零,网络退化成只有偏置的常数函数,损失完全不降。这个错误症状很剧烈,反而好查。 - 残差写成
x = alpha * (x + attn(h))——初始 $\alpha=0$ 会把 $x$ 本身也乘没,整个网络输出恒为 0,梯度全断。恒等映射检查能立刻抓到。 - 子模块装进 Python list——参数丢失,见上。
- 位置编码加在了 DiT 之外(比如 Patchifier 里)——功能上等价,不算错;但题面把它放在
DiffusionTransformer里,因为 Part 5 会用patch_size=1复用同一份代码,token 数不同,放在 DiT 里由n_tokens参数控制更干净。
3.4 Q3.4 · Depatchifier
题目在问什么。 Patchifier 的逆操作:把 (b, n, d) 变回 (b, c_out, 32, 32)。题面给了四步配方:归一化 → MLP 映到 $f p^2$ 维 → Rearrange 折回空间 → 输出卷积。
数学依据。 没有新数学,但有一个必须理解的对偶关系。Patchifier 把每个 $p\times p\times c$ 的块压成一个 $d$ 维 token;Depatchifier 要把每个 $d$ 维 token 展回一个 $p\times p\times f$ 的块,再由最后一层卷积把 $f$ 个通道压到 $c_{\text{out}}$。所以中间那个 MLP 的输出维度必须是 $f\cdot p^2$——这个数字不是随便定的,它由「一个 token 要负责多少个像素」唯一确定。
参考实现。
class Depatchifier(nn.Module):
  def __init__(self, img_size: int, patch_size: int, dim: int,
               final_dim: int, c_out: int):
    super().__init__()
    assert img_size % patch_size == 0
    h = w = img_size // patch_size
    self.net = nn.Sequential(
        nn.RMSNorm(dim, elementwise_affine=False),                       # (b, n, d)
        MLP([dim, 4 * dim, final_dim * patch_size ** 2]),                # -> (b, n, f*p*p)
        Rearrange('b (h w) (f ph pw) -> b f (h ph) (w pw)',
                  h=h, w=w, f=final_dim, ph=patch_size, pw=patch_size),  # -> (b, f, H, W)
        nn.Conv2d(final_dim, c_out, kernel_size=3, padding=1),           # -> (b, c_out, H, W)
    )

  def forward(self, x: torch.Tensor) -> torch.Tensor:
    return self.net(x)
为什么这样写。
- 开头的归一化。 DiT 主干最后一层的输出尺度是不受控的(残差累加),先归一化再映射能稳住训练。
RMSNorm和LayerNorm都行,前者省掉减均值这一步,稍快。同样要elementwise_affine=False——理由和 adaLN 里一样,尺度信息紧接着由后面的 MLP 自由决定,不需要再多一组冗余参数。 Rearrange的模式必须与Patchifier严格对偶。 逐段对照:b (h w)——把序列维拆回两个空间维,$h$ 慢变、$w$ 快变,与Patchifier的'b d h w -> b (h w) d'一致。(f ph pw)——把特征维拆成「通道、块内行、块内列」三段,顺序是 $f$ 最慢、$pw$ 最快。b f (h ph) (w pw)——把「块坐标」和「块内坐标」交织成最终的像素坐标:第 $(i\cdot p+a)$ 行来自第 $i$ 个块的第 $a$ 行。
(ph h)而不是(h ph),得到的图像会是一个「马赛克重排」——所有块的第 0 行被拼在一起、所有块的第 1 行被拼在一起,看起来像被撕碎重贴。h=h, w=w, f=..., ph=..., pw=...这些关键字参数不能省。einops无法从形状唯一地推断出(h w)到底怎么拆($64=8\times8$ 也可以是 $4\times16$),必须显式告诉它。省掉会抛异常,属于「好错误」。- 最后一层
Conv2d(kernel_size=3, padding=1)。 为什么不直接让 MLP 输出 $c_{\text{out}}\cdot p^2$ 一步到位?因为 patch 之间是独立展开的,块与块的边界处会有不连续(每个 token 只管自己那 $4\times4$ 个像素)。一层 $3\times3$ 卷积跨过边界做局部平滑,能明显减轻方块状伪影。final_dim=10就是给这层卷积留的「工作空间」通道数。
- MLP 输出维度写成
final_dim * patch_size(少一次方)——Rearrange会因为元素数对不上而抛异常。 (h ph)写成(ph h)——不报错,输出形状完全正确,但图像被撕碎。只能靠看图发现。 症状很好认:采样结果像是把数字切成 $4\times4$ 的小方块后随机重排。c_out硬编码成 1——Part 5 要输出 128 通道,会崩。- 忘了这是「向量场」不是「图像」——不要在最后加
sigmoid或tanh。$u_t^\theta$ 的取值范围是整个 $\R$,任何饱和激活都会把它截断。
3.5 Q3.5 · DiffusionTransformerFlowModel
题目在问什么。 把前四题拼成完整的 $u_t^\theta(x\mid y)$。
数学依据:为什么时间嵌入和类别嵌入是「相加」而不是「拼接」? 两者都被编码到同一个 $d=256$ 维空间,相加之后送进 adaLN 的条件 MLP。相加的合理性在于:条件 MLP 的第一层是线性的,所以
$$ W(e_t+e_y)+b=(We_t)+(We_y)+b, $$也就是说相加后过线性层,与分别过线性层再相加,完全等价——这正是拼接后过一个(分块的)线性层能做到的事。相加只是把这个分块结构固定下来,省掉一半参数。代价是两路信号共用同一组坐标,可能互相干扰;但实践证明对「时间 + 类别」这种低信息量的条件完全够用。Stable Diffusion 3 和 DiT 原论文用的都是相加。
参考实现。
class DiffusionTransformerFlowModel(ConditionalVectorField):
  def __init__(self, img_size=32, patch_size=8, num_layers=12, c=1,
               dim=256, heads=4, final_dim=10, n_classes=11):
      super().__init__()
      # 0. 时间与类别嵌入
      self.time_embedder = nn.Sequential(
          FourierEncoder(dim),      # (b,) -> (b, dim)
          MLP([dim, dim, dim]),     # -> (b, dim)
      )
      self.y_embedder = nn.Embedding(n_classes, dim)   # 11 = 10 个数字 + 1 个空标签

      # 1. Patchifier
      self.patchifier = Patchifier(img_size=img_size, patch_size=patch_size,
                                   c_in=c, dim=dim)
      # 2. DiT 主干
      n_tokens = (img_size // patch_size) ** 2
      self.dit = DiffusionTransformer(depth=num_layers, n_tokens=n_tokens,
                                      dim=dim, heads=heads)
      # 3. Depatchifier
      self.depatchifier = Depatchifier(img_size=img_size, patch_size=patch_size,
                                       dim=dim, final_dim=final_dim, c_out=c)

  def forward(self, x, t, y):
    """ x: (b, c, h, w),  t: (b,),  y: (b,)  ->  (b, c, h, w) """
    c = self.time_embedder(t) + self.y_embedder(y)   # (b, dim)   <- 相加
    x = self.patchifier(x)                           # (b, n, dim)
    x = self.dit(x, c)                               # (b, n, dim)
    x = self.depatchifier(x)                         # (b, c, h, w)
    return x
为什么这样写。
FourierEncoder后面还要跟一个 MLP。 Fourier 编码只是把标量升成了一组三角函数值,它本身是固定的、无学习能力的特征。后面的MLP([dim, dim, dim])才让网络能把这些特征组合成任务需要的时间表示。少了它,adaLN 的条件 MLP 要直接从原始三角特征学起,收敛会慢很多。n_classes=11而不是 10。 又一次是 CFG 的那个 $\varnothing$。null_label=10,正好是最后一个索引。- 局部变量
c覆盖了参数名c(通道数)。 这是官方代码的写法,在forward里没问题(参数c只在__init__用),但读代码时容易困惑:forward里的c是条件向量(b, dim),__init__里的c是通道数。 - 实际训练用的超参和默认值不同。 默认签名是
patch_size=8, num_layers=12, heads=4,但训练时传的是patch_size=4, num_layers=8, heads=8。$p=4$ 意味着 $n=64$ 个 token(而不是 16 个),空间分辨率高一倍,代价是注意力的计算量是 $O(n^2)$,涨了 16 倍。对 MNIST 这个尺寸完全吃得消,效果明显更好。
n_tokens算成img_size // patch_size(忘了平方)——位置编码表只有 8 行而 token 有 64 个,广播时报错。- 把
t和y的嵌入拼接后送进 DiT——条件维度变成2*dim,与DiffusionTransformerLayer里MLP([dim, dim, 6*dim])的输入维度对不上。要么改成相加,要么把条件 MLP 的输入维度也改掉。 - 忘记
c_in=c传给 Patchifier——Part 3 里 $c=1$ 碰巧和默认值一致,能跑;Part 5 里 $c=128$ 就崩了。 final_dim与dim混淆——final_dim=10是 Depatchifier 内部倒数第二层的通道数,和类别数 10 没有任何关系,纯属数字巧合。
3.6 训练 DiT:跑出来应该长什么样
训练配置:$\eta=0.35$、$\varnothing=10$、20000 步、batch 256、学习率 $4\times10^{-4}$、warmup 500 步。模型 40.324 MiB。单张 RTX 5080 上约 30 分钟。
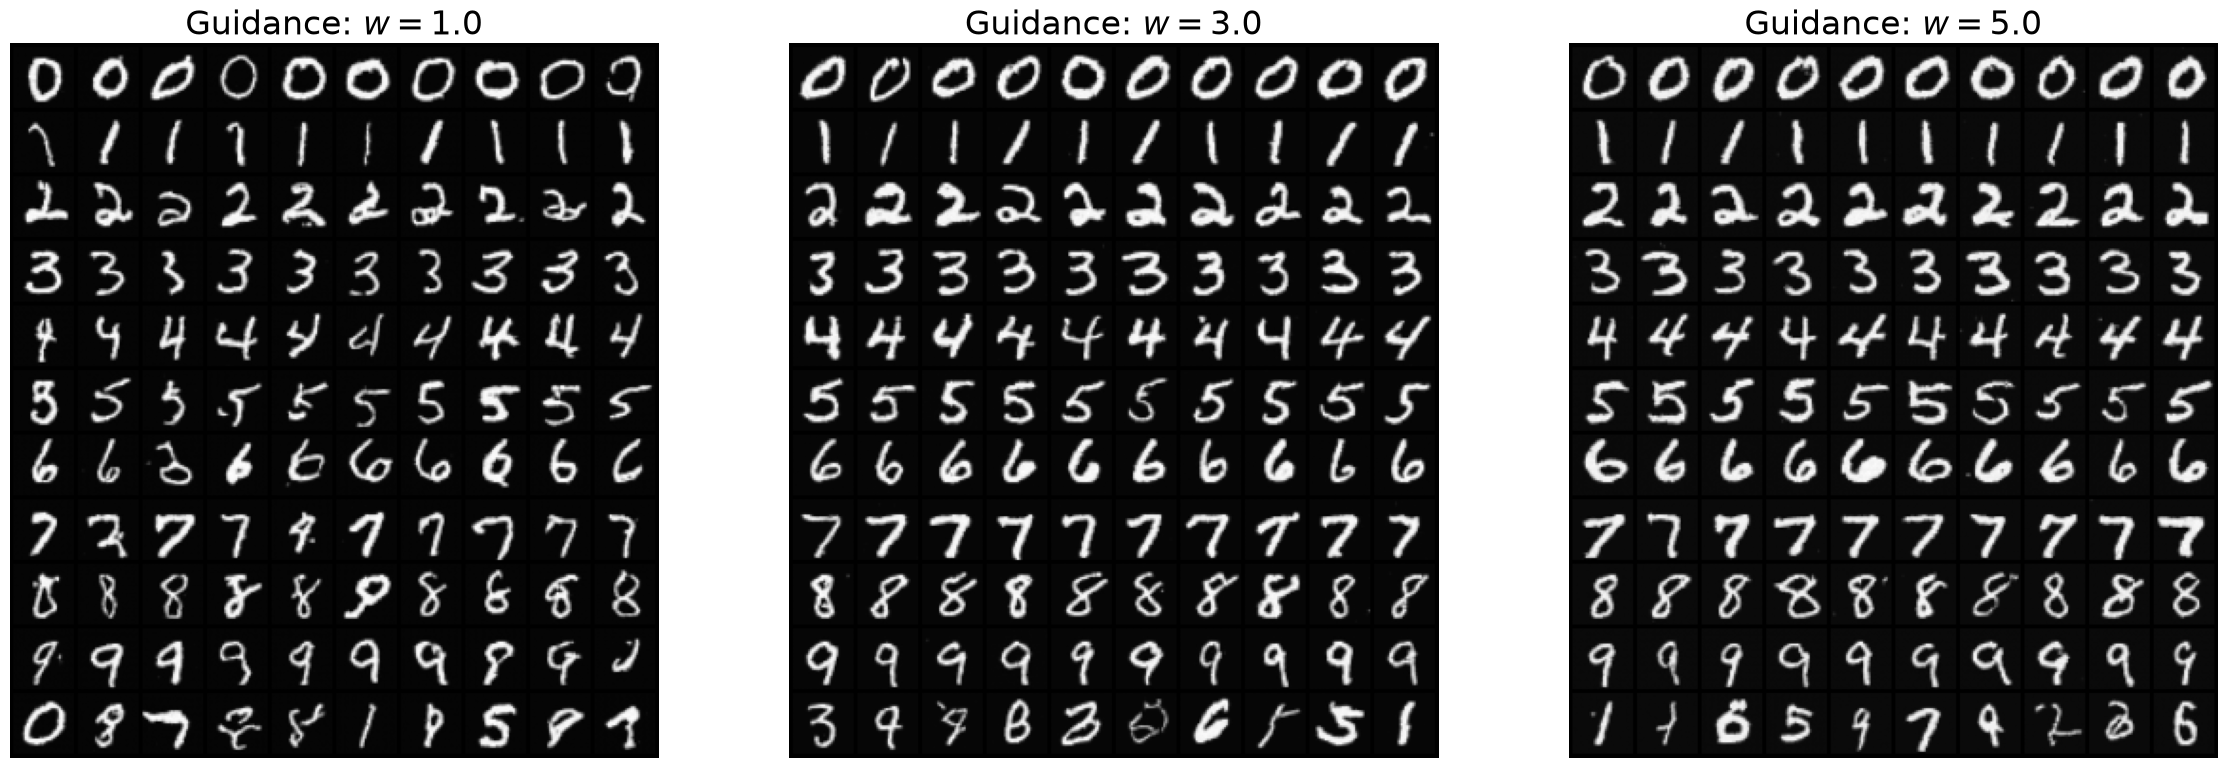
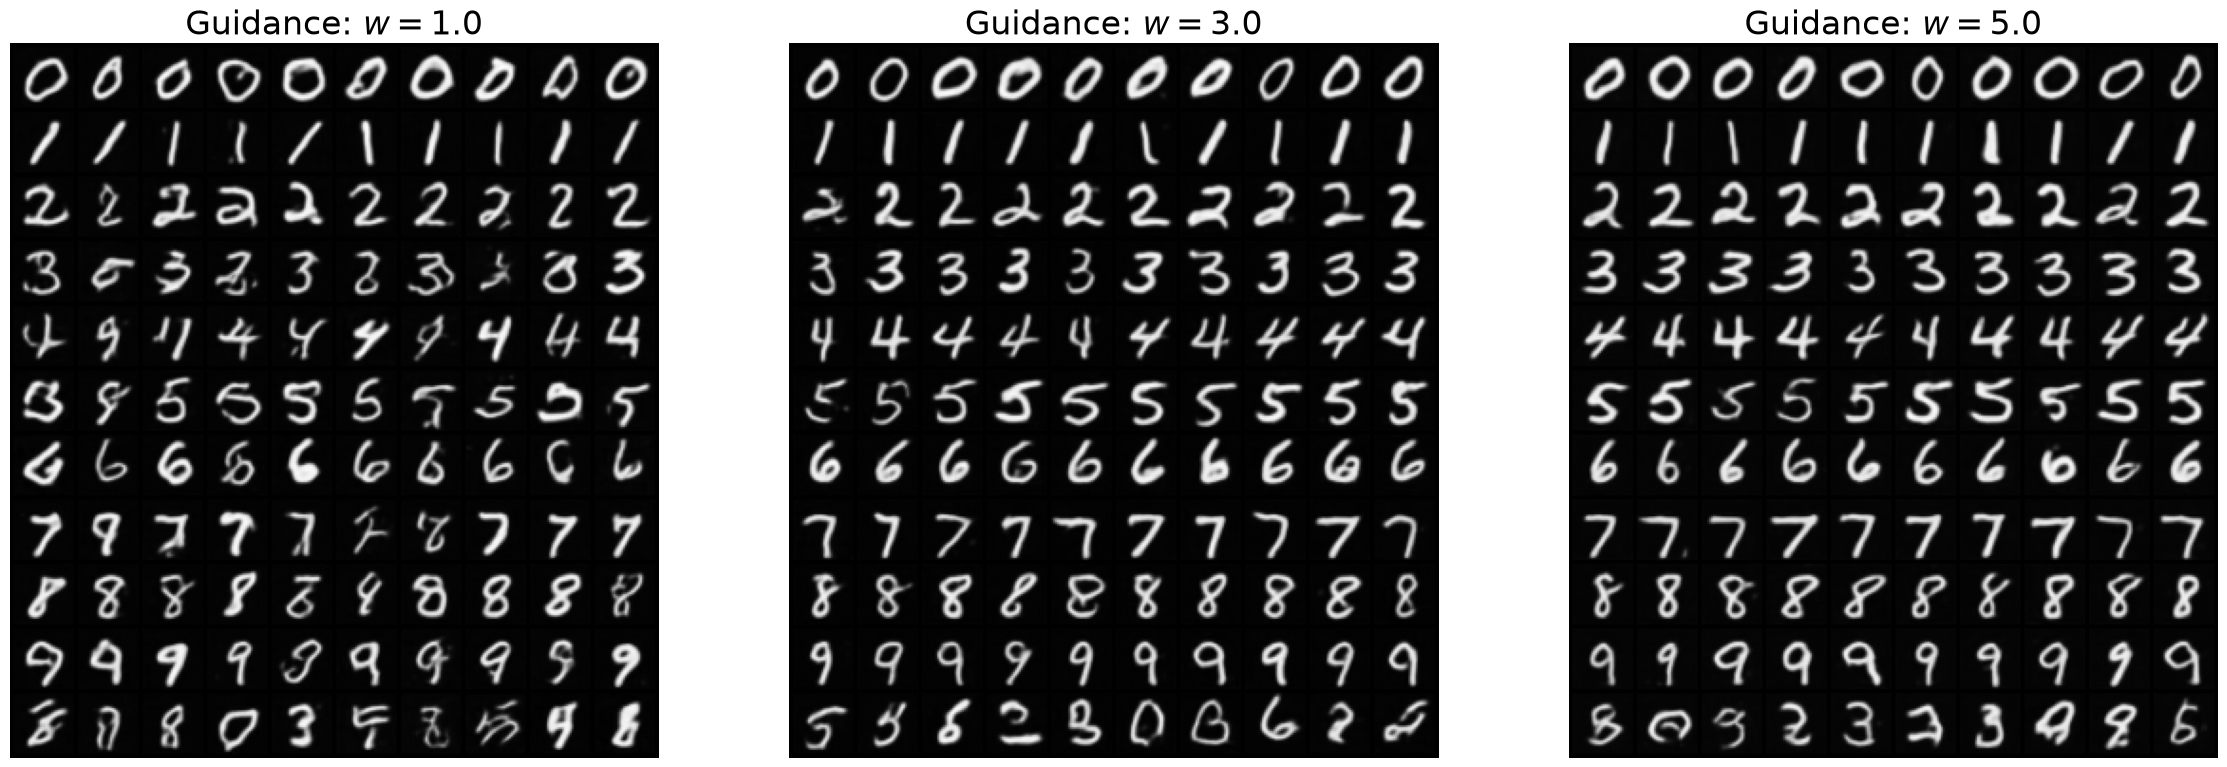
盯着三个面板的最后一行看,你会发现一件反直觉的事:它们的质量差不多,都是「随机的、有好有坏的数字」,看不出 $w=5$ 比 $w=1$ 更干净。这不是巧合,而是数学上的必然。
CFG 的漂移是 $(1-w)u_t(x\mid\varnothing)+w\,u_t(x\mid y)$。当 $y=\varnothing$ 时,两项里的网络调用完全相同,于是
$$ (1-w)\,u_t(x\mid\varnothing)+w\,u_t(x\mid\varnothing)=u_t(x\mid\varnothing), $$与 $w$ 无关。三个面板的最后一行用的是同一个向量场,唯一的差别是 visualize_output 在每个 $w$ 的循环里重新采了一批初始噪声 x0——所以它们只是同一分布的三次独立抽样。
这条观察的诊断价值:如果你的最后一行随 $w$ 明显变化(比如 $w=5$ 时变成一堆噪声或全是同一个数字),说明 CFG 的组合公式写错了——最可能是把 unguided_y 写成了别的东西,或者 $w$ 的两个系数搞反成 $(1-w)u_y + w\,u_\varnothing$。
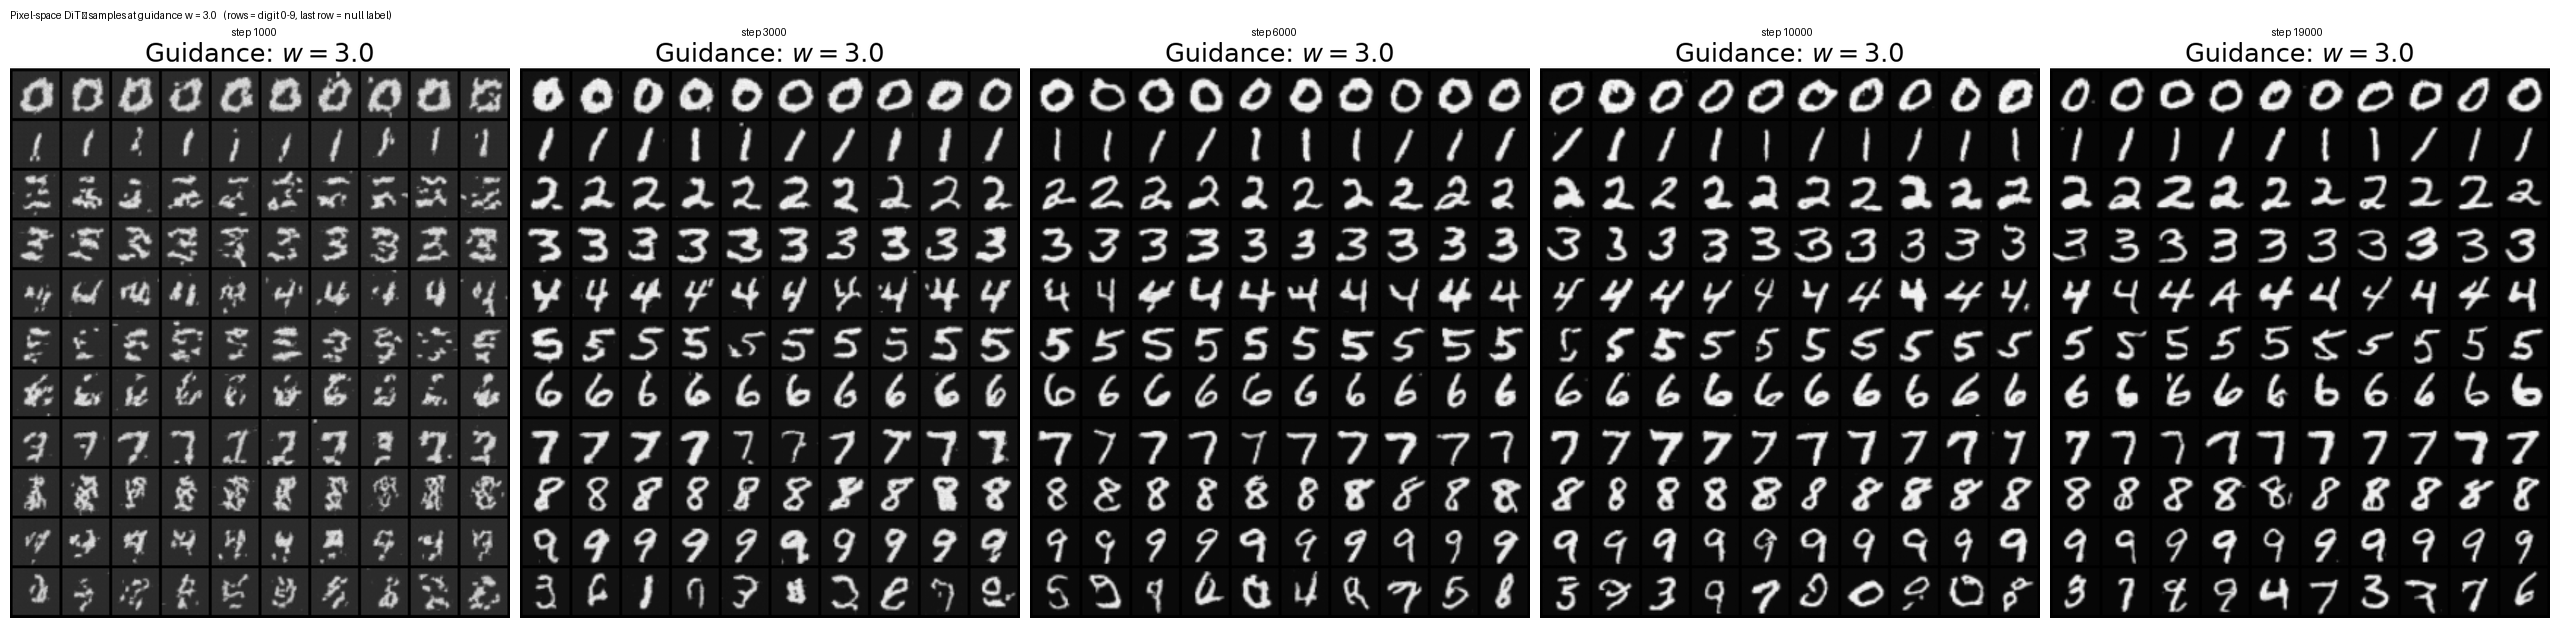
把 ckpt_every=1000 打开,训练过程中每 1000 步会存一张采样图。对照上面这张演进图,健康的进展是:
- 1000 步:不成形的团块,但有清晰的明暗结构(中心亮、边缘黑),个别简单类别(1)已可辨认。
- 3000 步:十个数字全部正确,笔画尚粗糙。这是最关键的检查点。
- 6000 步以后:身份稳定,只剩笔画质量在改善。
如果 3000 步时还是纯噪声,立刻停下来,大概率是 $t$ 的形状、softmax 的维度或者 Rearrange 写错了。回去跑第 7 节的检查,不要指望「再多训几步就好了」——上面这条曲线说明,如果 3000 步都学不会画数字,20000 步也学不会。
4. Part 4 · 训练一个变分自编码器
七个 TODO,但难度分布很不均匀:Q4.1–Q4.6 是形状流水账(照配方搭积木,唯一的挑战是把通道数和分辨率对上),真正需要动脑的是 Q4.7 的损失函数。
先明确目标。VAE 由两半组成:
$$ \text{编码器}\ q_\phi(z\mid x)=\N\big(\mu_\phi(x),\ \sigma_\phi^2 I_k\big),\qquad \text{解码器}\ p_\theta(x\mid z)=\N\big(\mu_\theta(z),\ \sigma_\theta^2 I_d\big), $$本 lab 的具体形状是 $x\in\R^{1\times32\times32}$($d=1024$)、$z\in\R^{128\times4\times4}$($k=2048$)。注意隐空间的元素数比图像还多——这在 latent diffusion 里很常见,压缩发生在空间维($32\times32\to4\times4$,降 64 倍),而通道维膨胀了 128 倍。真正的收益是让扩散模型面对 $4\times4$ 的「图像」,注意力的 token 数从 64 降到 16。
两个 $\sigma$ 都被参数化成可学习的共享标量 nn.Parameter(torch.zeros(())),存的是 $\log\sigma^2$ 而不是 $\sigma^2$——这样可以无约束地取任意实数,再用 exp 保证正性,避免了显式的正性约束。
4.1 Q4.1 · ResidualBlock
题目在问什么。 实现 $x\mapsto x+\text{Conv}_{1\times1}\big(\text{SiLU}(\text{Conv}_{3\times3}(\text{Norm}(x)))\big)$。
参考实现。
class ResidualBlock(nn.Module):
  def __init__(self, channels: int, act: nn.Module = nn.SiLU):
    super().__init__()
    self.norm  = nn.GroupNorm(1, channels)                        # 等价于图像上的 LayerNorm
    self.conv1 = nn.Conv2d(channels, channels, kernel_size=3, padding=1)
    self.act   = act()
    self.conv2 = nn.Conv2d(channels, channels, kernel_size=1)

    # 第二个卷积零初始化 => 初始时整个块是恒等映射
    nn.init.zeros_(self.conv2.weight)
    nn.init.zeros_(self.conv2.bias)

  def forward(self, x: torch.Tensor):
    x_skip = x                    # (b, c, h, w)
    x = self.norm(x)
    x = self.conv1(x)
    x = self.act(x)
    x = self.conv2(x)
    return x_skip + x             # (b, c, h, w)
为什么这样写。
nn.GroupNorm(1, channels)为什么等价于 LayerNorm? GroupNorm 把 $C$ 个通道分成 $G$ 组,每组内跨「通道 + 空间」计算均值方差。取 $G=1$ 就是把整张特征图(所有通道、所有像素)当成一个整体归一化——这正是 LayerNorm 作用在(C, H, W)上的定义。相比 BatchNorm 的好处是不依赖 batch 统计量,训练和推理行为完全一致,batch size 小的时候也稳。nn.LayerNorm需要显式给出[C, H, W],而 VAE 里同一个 block 会用在不同分辨率上,用 GroupNorm 更省事。padding=1配kernel_size=3。 保持空间尺寸不变($3\times3$ 卷积 + padding 1 是「same」卷积)。残差连接要求输入输出同形,少了 padding 会掉两个像素而报错。- 第二个卷积是 $1\times1$。 它的作用是「通道混合」而非「空间聚合」——空间感受野已经由
conv1提供了。这也是「$3\times3$ 提特征、$1\times1$ 做投影」的经典瓶颈结构简化版。 - 零初始化
conv2。 与 adaLN-Zero 同一个思想:初始时残差支路输出恒为 0,整个 block 是恒等映射。VAE 有 $4\times2=8$ 个残差块加上下采样,深度不算浅,这一手能明显稳住前几百步。
rb = ResidualBlock(channels=8).eval()
x = torch.randn(2, 8, 16, 16)
print((rb(x) - x).abs().max())     # 实测:0.00e+00
和 adaLN-Zero 一样,这里也必须是严格 0。如果不是 0,检查:(a)nn.init.zeros_ 是不是只初始化了 weight 忘了 bias;(b)残差是不是写成了 x_skip + x 以外的形式;(c)零初始化是不是被后续的某个 reset_parameters() 覆盖了。
4.2 Q4.2 · AttnBlock
题目在问什么。 把空间位置当作 token,在特征图上做一次自注意力 + 前馈,各带残差。
数学依据:卷积的局限与注意力的补位。 卷积的感受野是局部且随深度线性增长的;即使堆到编码器最后一层($4\times4$),每个位置也只能看到有限邻域。而 VAE 需要把整张图的信息压进 $z$,全局交互是必要的。自注意力提供的正是「任意两个位置一步直连」的能力,代价是 $O((HW)^2)$ 的复杂度——这也是为什么 Stable Diffusion 的 VAE 只在最低分辨率层放注意力。
参考实现。
class AttnBlock(nn.Module):
  def __init__(self, channels: int):
    super().__init__()
    self.reshape1 = Rearrange('b c h w -> b (h w) c')
    self.norm1 = nn.LayerNorm(channels)
    self.attn  = MHA(channels, heads=1)     # heads=1:保证任意通道数都能整除
    self.norm2 = nn.LayerNorm(channels)
    self.ff    = MLP([channels, 4 * channels, channels])

  def forward(self, x: torch.Tensor):
    b, c, h, w = x.shape
    x = self.reshape1(x)                    # (b, h*w, c)

    x_skip = x                              # 注意力 + 残差
    x = self.attn(self.norm1(x))
    x = x_skip + x

    x_skip = x                              # 前馈 + 残差
    x = self.ff(self.norm2(x))
    x = x_skip + x

    return rearrange(x, 'b (h w) c -> b c h w', h=h, w=w)
为什么这样写。
- 「像素即 token、通道即特征」。
'b c h w -> b (h w) c'把 $H\times W$ 个空间位置变成序列,通道数当作 token 维度。于是 Q3.3 写的MHA一个字都不用改就能复用——这是本 lab 一处很好的架构设计,值得注意。 heads=1不是偷懒。MHA里有assert dim % heads == 0。VAE 的通道数依次是 16 / 32 / 64 / 128,如果写死heads=4,16 通道那层每个头只有 4 维,表达力堪忧;写heads=8则 16 通道刚好整除但更窄。heads=1对所有这些通道数都成立,且在 $4\times4=16$ 个 token 的规模上多头并没有优势。- 用
x.shape解包出h, w再传给最后的rearrange。 必须的:einops没法从(b, hw, c)反推 $h$ 和 $w$。 - Pre-norm 而非 post-norm。 归一化放在残差支路内部(
x + f(norm(x))),而不是在残差之后(norm(x + f(x)))。前者的主干路径是一条无阻碍的恒等通路,梯度传播更好,是现代 transformer 的标准做法。
'b c h w -> b c (h w)'——把序列维放到了最后,MHA 会把空间位置当成特征维、通道当成 token,语义完全错位。形状上(b, c, hw)也能过nn.Linear(c, 3c)?不能——最后一维是 $hw$ 不是 $c$,会报错。算是好错误。- 返回时忘了变回
b c h w——下一个模块是卷积,会因为维度数不对而报错。 nn.LayerNorm(channels)写成nn.LayerNorm([h, w])——LayerNorm 归一化的是最后若干维,这里 token 张量的最后一维是通道,所以参数就是channels。
4.3 Q4.3 · EncoderBlock 与 Q4.5 · DecoderBlock
这两题结构完全镜像,一起讲。题目在问什么:两个残差块 + 一个注意力块 + (可选的)下采样 / 上采样。
class EncoderBlock(nn.Module):
  def __init__(self, in_channels: int, downsample_channels: Optional[int] = None):
    super().__init__()
    self.res1 = ResidualBlock(in_channels)
    self.res2 = ResidualBlock(in_channels)
    self.attn = AttnBlock(in_channels)
    if downsample_channels is not None:
      # stride=2 的卷积同时完成「降采样」和「换通道数」
      self.downsample = nn.Conv2d(in_channels, downsample_channels,
                                  kernel_size=3, padding=1, stride=2)
    else:
      self.downsample = None

  def forward(self, x):
    x = self.res1(x); x = self.res2(x); x = self.attn(x)
    if self.downsample is not None:
      x = self.downsample(x)
    return x


class DecoderBlock(nn.Module):
  def __init__(self, in_channels: int, upsample_channels: Optional[int] = None):
    super().__init__()
    self.res1 = ResidualBlock(in_channels)
    self.res2 = ResidualBlock(in_channels)
    self.attn = AttnBlock(in_channels)
    if upsample_channels is not None:
      self.upsample = nn.Sequential(
        nn.Upsample(scale_factor=2, mode='nearest'),
        nn.Conv2d(in_channels, upsample_channels,
                  kernel_size=3, padding=1, stride=1),
      )
    else:
      self.upsample = None

  def forward(self, x):
    x = self.res1(x); x = self.res2(x); x = self.attn(x)
    if self.upsample is not None:
      x = self.upsample(x)
    return x
为什么这样写。
- 下采样用
stride=2的卷积,而不是池化。 池化是固定的(不可学习)降采样;stride=2卷积让网络自己学「怎么降」,同时顺手把通道数从in_channels换成downsample_channels,一步两用。kernel_size=3, padding=1, stride=2作用在偶数尺寸上恰好减半:$\lfloor(32+2-3)/2\rfloor+1=16$。 Optional[int] = None的语义是「最后一块不改变分辨率」。 见下一题的形状表。- 注意力放在残差块之后、采样之前。 这样注意力总是在「还没降维」的分辨率上做全局混合,信息损失更小。
ConvTranspose2d?
答案是棋盘格伪影(checkerboard artifacts)。
转置卷积的工作方式是:把输入的每个像素乘以整个卷积核再摊到输出上,相邻输入的贡献区域重叠。当 kernel size 不能被 stride 整除时(最常见的 $k=3,s=2$),输出的不同位置接收到的贡献次数不同——比如某些位置被 2 个输入覆盖、相邻位置只被 1 个覆盖。这个不均匀性是周期性的,于是在输出上叠出一层规则的明暗方格。它在训练中很难被完全消掉,因为它是架构本身的性质而不是权重的问题。
「最近邻上采样 + 普通卷积」把两件事解耦:nn.Upsample 负责均匀地把每个像素复制成 $2\times2$(每个输出位置的来源数完全相同,不存在不均匀重叠),随后的 stride=1 卷积负责平滑和特征变换。代价是多一次内存搬运,收益是干净的输出。Stable Diffusion 的 VAE 解码器用的就是这个方案。
怎么验证你踩到了这个坑:把重构图放大看,如果看到规则的、周期为 2 或 4 像素的网格状纹理,而且它不随训练变淡,那就是棋盘格。
4.4 Q4.4 · Encoder
题目在问什么。 初始卷积 → 每个 hidden channel 一个 EncoderBlock(除最后一个外都下采样)→ 归一化 + $1\times1$ 卷积输出 z_mean,外加一个标量 logvar。
形状流水账(hidden_channels = [16, 32, 64, 128])。这是本题唯一真正要想清楚的东西:
| 步骤 | 操作 | 输出形状 |
|---|---|---|
| 输入 | —— | (b, 1, 32, 32) |
init_conv | $3\times3$,$1\to16$ | (b, 16, 32, 32) |
blocks[0] | EncoderBlock(16, 32),含下采样 | (b, 32, 16, 16) |
blocks[1] | EncoderBlock(32, 64),含下采样 | (b, 64, 8, 8) |
blocks[2] | EncoderBlock(64, 128),含下采样 | (b, 128, 4, 4) |
blocks[3] | EncoderBlock(128, None),无下采样 | (b, 128, 4, 4) |
z_mean | GroupNorm + $1\times1$ 卷积 | (b, 128, 4, 4) |
参考实现。
class Encoder(nn.Module):
  def __init__(self, in_channels: int, hidden_channels: list[int]):
    super().__init__()
    self.init_conv = nn.Conv2d(in_channels, hidden_channels[0],
                               kernel_size=3, padding=1, stride=1)

    # 关键的一行:把 [16,32,64,128] 配对成 (16,32),(32,64),(64,128),(128,None)
    ch_in  = hidden_channels                 # [16, 32, 64, 128]
    ch_out = hidden_channels[1:] + [None]    # [32, 64, 128, None]
    self.blocks = nn.ModuleList([
        EncoderBlock(i, o) for i, o in zip(ch_in, ch_out)
    ])

    z_dim = hidden_channels[-1]
    self.z_mean = nn.Sequential(
      nn.GroupNorm(1, z_dim),
      nn.Conv2d(z_dim, z_dim, kernel_size=1, stride=1, padding=0),
    )
    self.logvar = nn.Parameter(torch.zeros(()))    # 标量!形状是 ()

  def forward(self, x: torch.Tensor):
    x = self.init_conv(x)
    for block in self.blocks:
      x = block(x)
    return self.z_mean(x), self.logvar
为什么这样写。
ch_out = hidden_channels[1:] + [None]是整题的题眼。 它把「$n$ 个通道数」变成「$n$ 个 (输入, 输出) 对」,最后一个的输出是None,正好触发EncoderBlock里「不下采样」的分支。四个 block、三次下采样,$32\to16\to8\to4$。- 为什么最后一块不下采样? 因为 $4\times4$ 就是目标分辨率了。多一个 block 是为了在最终分辨率上再做两轮残差 + 一次全局注意力,把信息充分整合后再输出 $\mu_\phi$。
self.logvar = nn.Parameter(torch.zeros(()))—— 注意是torch.zeros(())不是torch.zeros(1)。 前者形状是torch.Size([])(真正的 0 维标量),后者是torch.Size([1])。两者在广播时行为几乎一样,但测试里会检查z_logvar.shape == torch.Size([])。语义上也确实是「一个数」:所有样本、所有维度共享同一个后验方差。- 共享标量方差意味着什么? 标准 VAE 里 $\sigma_\phi(x)$ 是输入相关的(每个 $x$ 有自己的不确定度)。这里退化成一个全局常数,等于说「编码器对所有输入的置信度一样」。这是 latent diffusion 里的常见简化(Lecture 4 §7.7 讨论过),好处是训练稳定得多,代价是模型在概率意义上更弱——但反正我们只是要一个「被轻度正则化过的自编码器」。
- 用
zip(hidden_channels[:-1], hidden_channels[1:])——只造出 3 个 block,最后那个「不下采样的整合块」丢了。形状仍然对($4\times4$),但少了两个残差块和一次注意力,重构质量下降。 - 把
blocks放进 Python list——参数不被注册,见 Q3.3。 logvar写成nn.Parameter(torch.zeros(z_dim))——变成逐通道方差,不是题面要的标量。不会报错,但和compute_loss的.mean()组合起来含义会变。init_conv用了stride=2——多降一次,最后得到 $2\times2$,Part 5 的img_size=4就对不上了。
4.5 Q4.6 · Decoder
题目在问什么。 Encoder 的镜像:每个 hidden channel 一个 DecoderBlock(除最后一个外都上采样)→ 归一化 + $1\times1$ 卷积输出 x_mean + 标量 logvar。注意没有 init_conv——输入已经是 128 通道了。
形状流水账。关键在于 VAE.__init__ 里传的是 list(reversed(hidden_channels)),即 [128, 64, 32, 16]:
| 步骤 | 操作 | 输出形状 |
|---|---|---|
| 输入 | —— | (b, 128, 4, 4) |
blocks[0] | DecoderBlock(128, 64),含上采样 | (b, 64, 8, 8) |
blocks[1] | DecoderBlock(64, 32),含上采样 | (b, 32, 16, 16) |
blocks[2] | DecoderBlock(32, 16),含上采样 | (b, 16, 32, 32) |
blocks[3] | DecoderBlock(16, None),无上采样 | (b, 16, 32, 32) |
x_mean | GroupNorm + $1\times1$ 卷积,$16\to1$ | (b, 1, 32, 32) |
class Decoder(nn.Module):
  def __init__(self, out_channels: int, hidden_channels: list[int]):
    super().__init__()
    ch_in  = hidden_channels                 # [128, 64, 32, 16]
    ch_out = hidden_channels[1:] + [None]    # [64, 32, 16, None]
    self.blocks = nn.ModuleList([
        DecoderBlock(i, o) for i, o in zip(ch_in, ch_out)
    ])

    x_dim = hidden_channels[-1]              # 16
    self.x_mean = nn.Sequential(
      nn.GroupNorm(1, x_dim),
      nn.Conv2d(x_dim, out_channels, kernel_size=1, stride=1, padding=0),
    )
    self.logvar = nn.Parameter(torch.zeros(()))

  def forward(self, x: torch.Tensor):
    for block in self.blocks:
      x = block(x)
    return self.x_mean(x), self.logvar
为什么这样写。 结构与 Encoder 逐行对称,唯一要小心的是 reversed 是在 VAE.__init__ 里做的,不是在 Decoder 里:
class VAE(nn.Module):
  def __init__(self, data_channels: int, hidden_channels: list[int], beta: float = 0.1):
    super().__init__()
    self.beta = beta
    self._encoder = Encoder(data_channels, hidden_channels)                 # [16,32,64,128]
    self._decoder = Decoder(data_channels, list(reversed(hidden_channels))) # [128,64,32,16]
所以 Decoder 内部的写法和 Encoder 完全一样,不要在 Decoder 里再 reverse 一次——那会让通道数变成 $16\to32\to64\to128$,但输入是 128 通道,第一层就崩。
- 在
Decoder里又 reverse 一次——见上,立刻报错。 - 误以为 Decoder 也需要
init_conv——不需要,多一层不会崩但破坏对称性。 - 最后的 $1\times1$ 卷积输出通道写成
x_dim而不是out_channels——输出 16 通道的「图像」,与x_true的 1 通道做 MSE 时会广播成(b, 16, 32, 32),不报错但完全错误。这是本题最阴的一个坑,靠形状测试才能抓到。 - 忘了 Decoder 也有自己的
logvar——它和 Encoder 的是两个独立参数:前者是解码器的观测噪声 $\sigma_\theta$,后者是编码器的后验方差 $\sigma_\phi$,含义完全不同。
4.6 Q4.7 · VAE.compute_loss —— 本 Part 唯一需要动脑的一题
题目在问什么。 实现讲义那条完整的 $\beta$-VAE 损失(Lecture 4 §7.4 末尾给出,notebook 里标注为式 (83)/(85),不同版本编号略有出入):
$$ \mathcal{L}_{\text{VAE}}(\phi,\theta)= \underbrace{\frac{\norm{x-\mu_\theta(z)}^2}{2\sigma_\theta^2}+\frac{d}{2}\log\sigma_\theta^2}_{\text{重构 + 解码器置信度}} \;+\;\beta\underbrace{\frac{1}{2}\Big[\mathcal{K}\big(\sigma_\phi^2\big)+\norm{\mu_\phi(x)}^2\Big]}_{\text{KL 到先验}}, \qquad \mathcal{K}(\alpha)=\sum_i\big(\alpha_i-\log\alpha_i-1\big). $$数学依据:两项各自从哪来。
解码器是 $p_\theta(x\mid z)=\N(\mu_\theta(z),\sigma_\theta^2 I_d)$,其负对数似然为
$$ -\log p_\theta(x\mid z)=\frac{\norm{x-\mu_\theta(z)}^2}{2\sigma_\theta^2}+\frac{d}{2}\log\sigma_\theta^2+\frac{d}{2}\log(2\pi). $$最后一项是常数,扔掉。剩下两项的关系值得玩味:第一项希望 $\sigma_\theta$ 越大越好(把重构误差除小),第二项希望 $\sigma_\theta$ 越小越好。对 $\sigma_\theta^2$ 求导置零,最优解是 $\sigma_\theta^{2\star}=\frac{1}{d}\norm{x-\mu_\theta}^2$——即解码器方差会自动收敛到当前的均方重构误差。所以 $\log\sigma_\theta^2$ 这一项不是可有可无的正则,它让模型自动标定「我对重构有多确信」,等价于把重构损失的权重自适应地调成 $1/\text{MSE}$。
取先验 $p_{\text{prior}}=\N(0,I_k)$,后验 $q_\phi=\N(\mu,\diag(\sigma^2))$,则逐坐标可分解:
$$ \KL\big(\N(\mu_i,\sigma_i^2)\,\|\,\N(0,1)\big)=\frac{1}{2}\Big(\sigma_i^2+\mu_i^2-\log\sigma_i^2-1\Big). $$求和得到
$$ \KL\big(q_\phi\,\|\,\N(0,I_k)\big)=\frac{1}{2}\Big[\underbrace{\sum_i(\sigma_i^2-\log\sigma_i^2-1)}_{=\,\mathcal{K}(\sigma^2)\ \text{:把方差推向 1}}+\underbrace{\norm{\mu}^2}_{\text{把均值推向 0}}\Big]. $$两项的极小点分别在 $\sigma_i=1$ 和 $\mu_i=0$——KL 项做的事就是把编码分布往标准正态上按。注意 $\mathcal{K}(\alpha)=\alpha-\log\alpha-1\ge0$ 且仅在 $\alpha=1$ 取等(因为 $\log\alpha\le\alpha-1$),所以整个 KL 恒非负,这是一条可以直接写成断言的性质。
参考实现。
def compute_loss(self, z_mean, z_logvar, x_mean, x_logvar, x_true):
    eps = 1e-6

    # KL 项:把 (mu, sigma^2) 推向 (0, 1)
    kl_loss = self.beta * (z_mean.pow(2) + torch.exp(z_logvar) - z_logvar - 1).mean()

    # 重构项:高斯负对数似然(去掉常数)
    mse_term        = (x_true - x_mean).pow(2) / (torch.exp(x_logvar) + eps)
    confidence_term = x_logvar
    recon_loss      = (mse_term + confidence_term).mean()

    return kl_loss + recon_loss
以及 forward 里的重参数化:
def forward(self, x: torch.Tensor):
    z_mean, z_logvar = self.encode(x)                                # (b,128,4,4), ()
    z = z_mean + torch.exp(0.5 * z_logvar) * torch.randn_like(z_mean)  # 重参数化
    x_mean, x_logvar = self.decode(z)                                # (b,1,32,32), ()
    return z_mean, z_logvar, x_mean, x_logvar
.mean() 还是 .sum()?
讲义式子里两处都是按维度求和($\norm{\cdot}^2$ 和 $\sum_i$),而代码里两处都用了 .mean()——对张量的所有元素求平均。这不是笔误,但它确实改变了 $\beta$ 的含义,值得算清楚。
记 $d=1\times32\times32=1024$(图像维度)、$k=128\times4\times4=2048$(隐变量维度),$R$ 为讲义的重构项、$S=\mathcal{K}(\sigma_\phi^2)+\norm{\mu_\phi}^2$。逐项对照:
$$ \begin{aligned} \text{代码重构项}&=\frac{1}{d}\frac{\norm{x-\mu_\theta}^2}{\sigma_\theta^2}+\log\sigma_\theta^2=\frac{2}{d}\left[\frac{\norm{x-\mu_\theta}^2}{2\sigma_\theta^2}+\frac{d}{2}\log\sigma_\theta^2\right]=\frac{2}{d}R,\\[4pt] \text{代码 KL 项}&=\frac{\beta_{\text{代码}}}{k}S. \end{aligned} $$所以 $\mathcal{L}_{\text{代码}}=\frac{2}{d}R+\frac{\beta_{\text{代码}}}{k}S$。整体乘以常数 $\frac{d}{2}$(不改变极小点)得到 $R+\frac{d\,\beta_{\text{代码}}}{2k}S$,与讲义的 $R+\frac{\beta_{\text{讲义}}}{2}S$ 对照,立刻读出换算关系:
$$ \boxed{\ \beta_{\text{讲义}}=\beta_{\text{代码}}\cdot\frac{d}{k}=10\times\frac{1024}{2048}=5.\ } $$为什么要用 .mean()?因为这样损失的数值与分辨率无关:换成 $64\times64$ 的图,$d$ 变成 4 倍,用 .sum() 的话损失也变 4 倍,学习率得跟着调;用 .mean() 则不用动。代价是 $\beta$ 的数值不能直接和论文/讲义里的对照——必须先做上面这个换算。这是读 VAE 代码时最容易被绊住的地方之一,看到别人的 $\beta$ 与你的差几个数量级,八成就是归一化约定不同。
另外注意代码把重构项整体乘了 2(写成 $\frac{\norm{\cdot}^2}{\sigma^2}+\log\sigma^2$ 而非 $\frac{\norm{\cdot}^2}{2\sigma^2}+\frac{d}{2}\log\sigma^2$ 的按维度平均)。上面的换算已经把这个因子 2 算进去了——它相当于把有效 $\beta$ 减半,属于常数缩放,不改变最优点的位置。
换算之后 $\beta_{\text{讲义}}=5$,确实仍然远大于 1。所以这不是单位问题,而是一个刻意的教学选择,理由有二:
- MNIST 太好重构了。 生产级 latent VAE(Stable Diffusion 那种)面对的是高分辨率自然图,重构项本身很难压下去,稍大的 $\beta$ 就会毁掉细节,所以必须 $\beta\ll1$。MNIST 是二值化的笔画,$16\to128$ 通道的编码器绰绰有余,可以用很强的 KL 换一个更规整的隐空间。
- 下游是扩散模型,隐空间的「形状」比重构精度更重要。 $\beta$ 大 ⇒ 隐分布更接近 $\N(0,I)$ ⇒ Part 5 的 flow matching 起点 $p_{\text{init}}=\N(0,I)$ 与终点分布的尺度天然匹配,不需要额外的全局缩放常数(Lecture 4 §7.7 提到实际系统里通常要乘一个这样的常数)。
但这个选择有代价,而且代价在 Part 5 里会以一种非常吓人的方式显现出来——第 6 节专门讲。
我们要算的是 $\grad_\phi\,\E_{z\sim q_\phi(\cdot\mid x)}[f(z)]$。问题在于期望的分布本身依赖 $\phi$:
$$ \grad_\phi\int q_\phi(z\mid x)f(z)\ud z=\int \grad_\phi q_\phi(z\mid x)\,f(z)\ud z, $$右边不是任何一个关于 $q_\phi$ 的期望,没法用「采样 → 求导」直接估计。更直白地说:torch.normal(mu, sigma) 这个操作在计算图里是一个断点,反向传播走不过去。
重参数化把随机性挪到与参数无关的地方:
$$ z=\mu_\phi(x)+\sigma_\phi\odot\epsilon,\qquad \epsilon\sim\N(0,I_k)\ \text{与}\ \phi\ \text{无关}. $$于是 $\E_{z\sim q_\phi}[f(z)]=\E_{\epsilon\sim\N(0,I)}[f(\mu_\phi+\sigma_\phi\odot\epsilon)]$,期望的分布不再含 $\phi$,梯度可以直接换进去:
$$ \grad_\phi\,\E_\epsilon\big[f(\mu_\phi+\sigma_\phi\odot\epsilon)\big]=\E_\epsilon\big[\grad_\phi f(\mu_\phi+\sigma_\phi\odot\epsilon)\big]. $$代码里就是那一行 z = z_mean + torch.exp(0.5 * z_logvar) * torch.randn_like(z_mean):randn_like 产生的 $\epsilon$ 是常数(不需要梯度),$\mu$ 和 $\sigma$ 都在计算图里。注意 0.5 * 不能少——存的是 $\log\sigma^2$,所以 $\sigma=\exp(\frac{1}{2}\log\sigma^2)$。漏掉这个 0.5 会让噪声方差变成 $\sigma^4$,训练初期 $\sigma\approx1$ 时看不出区别,训练后期会悄悄跑偏。
- KL 项写成
z_logvar - torch.exp(z_logvar) ...(符号弄反)——KL 会变成负数并被无限最小化,编码器的方差爆炸。症状:损失一路跌到 $-\infty$。用「$q$ = 先验时 KL 必须恰好为 0」这条检查:μ=0, logvar=0代进去,$0+1-0-1=0$。 - 忘了
exp,直接用z_logvar当方差——不报错,但 KL 的最优点从 $\sigma^2=1$ 挪到了别处。 - 重构项漏了
x_logvar这一项——只剩 $\frac{\text{MSE}}{\sigma_\theta^2}$,模型会把 $\sigma_\theta\to\infty$ 让损失趋于 0,重构彻底摆烂。这个错误很致命且症状明确:损失快速趋近 0(而不是变负),重构图是一片灰。 - 分母没加
eps——$\sigma_\theta^2$ 在训练后期可能变得很小,除法溢出成inf。1e-6是廉价保险。 - 把
beta乘到重构项上而不是 KL 项上——等价于用 $1/\beta$ 做 KL 权重,方向完全反了,会得到一个几乎不受约束的隐空间。 - 对着「损失是负数」慌了——见下一节,这是正常的。
4.7 训练 VAE:跑出来应该长什么样
配置:hidden_channels=[16,32,64,128]、$\beta=10$、5000 步、batch 64、学习率 $10^{-3}$。模型 6.150 MiB,在 RTX 5080 上几分钟就跑完。
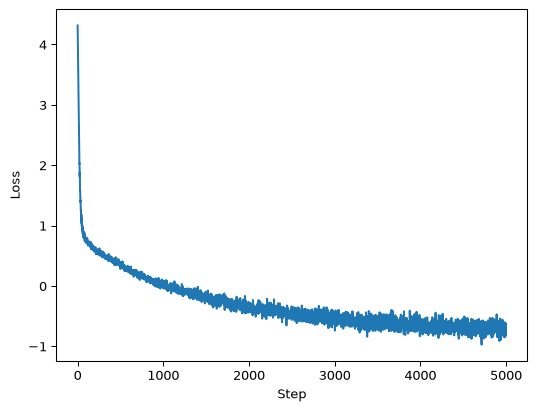

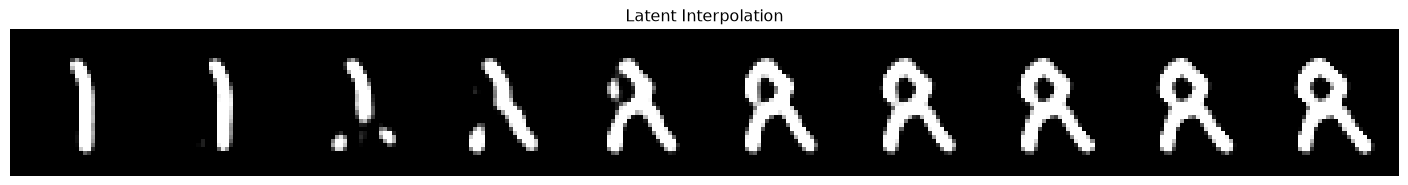
调大 $\beta$。$\beta$ 太小时 KL 约束弱,隐空间会变成一堆孤岛,插值路径穿过「真空区」。反过来 $\beta$ 太大会触发后验塌缩(posterior collapse)——编码器索性无视 $x$,输出 $q_\phi\approx\N(0,I)$,KL 归零而信息全丢,症状是重构图与输入完全无关、所有输入都解码成同一个模糊数字。$\beta=10$(讲义约定下的 5)在这个规模上是个好平衡点。
5. Part 5 · 隐空间扩散
所有零件都造好了,这一 Part 只剩一件事:把 Part 3 的 DiT 搬进 Part 4 的隐空间。只有一个 TODO。
5.1 Q5.1 · LatentCFGTrainer.get_train_loss
题目在问什么。 与 Q2.2 的 CFGTrainer 唯一的区别:训练数据不是像素 $x$,而是 VAE 编码后的隐变量 $z$。而且 VAE 是冻结的(先单独训好,这一步不再更新它的参数)。
数学依据。 Latent diffusion 的整个想法可以写成一个分布的复合:
$$ p_{\text{model}}(x)=\int p_\theta(x\mid z)\,p_{\text{latent}}^{\text{flow}}(z)\ud z, $$其中 $p_\theta(x\mid z)$ 是冻结的解码器,$p_{\text{latent}}^{\text{flow}}$ 是我们要训练的流模型在 $t=1$ 时的分布。训练目标是让 $p_{\text{latent}}^{\text{flow}}$ 匹配编码器诱导的聚合后验(aggregate posterior)
$$ p_{\text{latent}}(z)=\E_{x\sim\data}\big[q_\phi(z\mid x)\big]. $$而「从 $p_{\text{latent}}$ 采样」的操作,恰好就是「采一张真实图 → 编码 → 重参数化采样」。所以 flow matching 的公式一个字都不用改,只需要把 p_data.sample() 换成这个两步过程。
参考实现。
def get_train_loss(self, batch_size: int) -> torch.Tensor:
    # Step 1: 从 MNIST 采样并编码到隐空间
    #         VAE 是冻结的,整个编码过程放在 no_grad 里
    with torch.no_grad():
      x, y = self.mnist.sample(batch_size)                # x: (b,1,32,32), y: (b,)
      z_mean, z_logvar = self.vae.encode(x)               # (b,128,4,4), ()
      # 用完整的后验采样(而非只取均值),让扩散模型见到编码器真实的隐分布
      z = z_mean + torch.exp(0.5 * z_logvar) * torch.randn_like(z_mean)

    # Step 2: 以概率 eta 把标签置为空标签
    xi = torch.rand(y.shape[0], device=y.device)
    y[xi < self.eta] = self.null_label

    # Step 3: 采 t 和 z_t
    t = torch.rand(batch_size, device=z.device).to(z) * (1 - self.eps)   # (b,)
    zt = self.path.sample_conditional_path(z, t)                         # (b,128,4,4)

    # Step 4: 回归
    ut_theta = self.model(zt, t, y)                          # (b,128,4,4)
    ut_ref   = self.path.conditional_vector_field(zt, z, t)  # (b,128,4,4)
    return torch.square(ut_theta - ut_ref).mean()
为什么这样写。
torch.no_grad()是必须的,不只是省显存。 如果不加,编码器的计算图会被保留,loss.backward()会把梯度一路传回 VAE 的参数。虽然优化器里只注册了 DiT 的参数(self.opt = AdamW(self.model.parameters())),VAE 不会真被更新,但你会白白多花显存和时间。更糟的情况是:如果你的 trainer 写法不小心把 VAE 也塞进了优化器,VAE 会边训边动,扩散模型追着一个移动的目标学,训练直接发散。加no_grad是最稳的做法。- 为什么采样而不是只用
z_mean? 因为扩散模型要匹配的是聚合后验 $p_{\text{latent}}$,那是带噪声的。只用均值会让扩散模型学到一个比真实隐分布「更瘦」的分布,采样时生成的 $z$ 落在解码器没见过的低方差区域,重构质量下降。这一步的噪声也起到轻微的数据增广作用。 path的构造变了。 注意训练脚本里GaussianConditionalProbabilityPath(p_data=None, p_simple_shape=[128, 4, 4], ...)——p_data直接传None,因为 trainer 不再通过 path 取数据(那条路被上面的两步采样取代了)。path 现在只负责三件事:p_simple(隐空间形状的高斯)、sample_conditional_path、conditional_vector_field。- DiT 的超参变了:
img_size=4, patch_size=1, c=128。patch_size=1意味着每个空间位置就是一个 token,共 $4\times4=16$ 个 token(像素空间是 64 个)。Patchifier 退化成一个 $1\times1$ 卷积($128\to256$ 的逐位置线性投影)。这正是 Q3.2 里坚持不硬编码c_in的回报。
- 忘了
torch.no_grad()——见上。 - 忘了把 VAE 设成
eval()——本 lab 的 VAE 里没有 dropout 和 BatchNorm(用的是 GroupNorm/LayerNorm),所以影响不大,但养成习惯是好的。 - 把标签丢弃放进了
no_grad块外/内的错误位置——其实无所谓(整数张量本来就没梯度),但放外面更清晰。 - 忘了改
p_simple_shape——还写[1,32,32]的话,path.p_simple.sample()会给出错误形状的初始噪声,采样时崩掉。 patch_size还写 4——$4\times4$ 的隐变量除以 patch 4 得到 1 个 token,注意力完全退化(自己看自己),模型只能学到逐位置的映射。不报错,效果显著变差。- 直接用 Part 3 训好的 DiT 权重——通道数从 1 变成 128,形状对不上。这里要重新初始化一个 DiT。
5.2 训练结果:一个必须解释清楚的现象
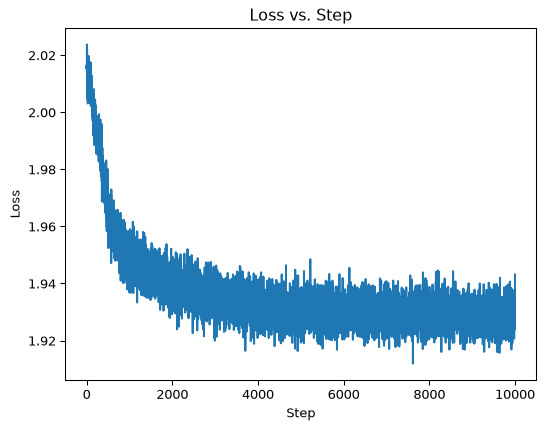
配置:10000 步、batch 256、$\eta=0.35$、学习率 $4\times10^{-4}$。模型 39.844 MiB。
6. 为什么隐空间的损失几乎不下降?
这一节是本页的核心结论之一。答案是:flow matching 的损失有一个不可约下界,而这个下界在隐空间里比在像素空间里高一个数量级。
6.1 不可约下界从哪来
训练目标是
$$ \mathcal{L}(\theta)=\E_{t,z,\epsilon}\big\|u_t^\theta(x_t\mid y)-u_t(x_t\mid z)\big\|^2,\qquad x_t=\alpha_t z+\beta_t\epsilon. $$注意回归的输入是 $(x_t,t,y)$,而目标 $u_t(x_t\mid z)$ 还依赖于 $z$——同一个 $x_t$ 可以由无数个不同的 $(z,\epsilon)$ 组合产生,它们的目标各不相同。对任意随机变量对 $(A,B)$ 与任意函数 $g$,有标准的偏差–方差分解
$$ \E\norm{g(A)-B}^2=\E\norm{g(A)-\E[B\mid A]}^2+\E\big[\tr\Cov(B\mid A)\big]. $$第二项与 $g$ 无关。所以即使网络完美学到了最优解 $u_t^\theta=\E[u_t(x_t\mid z)\mid x_t,t,y]=u_t(x_t\mid y)$,损失也只能降到
$$ \mathcal{L}^\star=\E_{t,x_t}\big[\tr\Cov\big(u_t(x_t\mid z)\,\big|\,x_t,t,y\big)\big]. $$这是数据分布本身的属性,与模型架构、训练时长都无关。(Lab 2 已经讲过这一条,这里是它的定量版本。)
6.2 把下界算出来
本 lab 用 LinearAlpha / LinearBeta,即 $\alpha_t=t$、$\beta_t=1-t$。把 $x_t=tz+(1-t)\epsilon$ 代入条件向量场:
所以回归目标就是 $z-\epsilon$,下界是 $\E_{t,x_t}\big[\Var(z-\epsilon\mid x_t)\big]$(这里按 .mean() 的约定,取逐维平均)。
先算一个可以完全手算的极端情形:设 $z$ 的各维独立、$z\sim\N(0,\sigma^2 I)$,与 $\epsilon\sim\N(0,I)$ 独立。此时 $(z-\epsilon, x_t)$ 联合高斯,条件方差有闭式:
$$ \Var(z-\epsilon\mid x_t)=\Var(z-\epsilon)-\frac{\Cov(z-\epsilon,\,x_t)^2}{\Var(x_t)} =(\sigma^2+1)-\frac{\big(t\sigma^2-(1-t)\big)^2}{t^2\sigma^2+(1-t)^2}. $$通分化简,分子出奇地干净:
$$ \begin{aligned} &(\sigma^2+1)\big(t^2\sigma^2+(1-t)^2\big)-\big(t\sigma^2-(1-t)\big)^2\\ &\quad=(1-t)^2\sigma^2+t^2\sigma^2+2t(1-t)\sigma^2=\sigma^2\big[t+(1-t)\big]^2=\sigma^2. \end{aligned} $$于是 $\Var(z-\epsilon\mid x_t)=\dfrac{\sigma^2}{t^2\sigma^2+(1-t)^2}$。对 $t\sim U[0,1]$ 取期望,令 $A=\sigma^2+1$:
$$ \mathcal{L}^\star=\sigma^2\int_0^1\frac{\ud t}{At^2-2t+1} =\sigma^2\cdot\frac{1}{\sigma}\left[\arctan\frac{At-1}{\sigma}\right]_0^1 =\sigma\left(\arctan\sigma+\arctan\frac{1}{\sigma}\right)=\frac{\pi\sigma}{2}, $$最后一步用了恒等式 $\arctan\sigma+\arctan\frac{1}{\sigma}=\frac{\pi}{2}$(对 $\sigma>0$)。
$$ \boxed{\ \text{若 }z\sim\N(0,\sigma^2 I)\text{ 且各维独立,则 }\mathcal{L}^\star=\frac{\pi\sigma}{2}.\ } $$特别地,$\sigma=1$ 时 $\mathcal{L}^\star=\frac{\pi}{2}\approx1.5708$。
6.3 两个空间的对比
| 像素空间 DiT | 隐空间 DiT | |
|---|---|---|
| 数据 $z$ | 归一化后的 MNIST 像素 | VAE 编码后的隐变量 |
| 每维方差 | 约 1(Normalize 保证) | 被 $\beta=10$ 的 KL 推向 1 |
| 维间相关性 | 极强(大片黑背景、笔画连通) | 极弱(KL 项主动惩罚相关结构) |
| 损失首 → 末 | 1.9788 → 0.1906 | 2.0163 → 1.9431 |
| 「白噪声」参考下界 | $\pi/2\approx1.571$ | $\pi/2\approx1.571$ |
像素空间为什么能降到 0.19?因为 MNIST 高度结构化:图像的绝大部分是纯黑背景,笔画是连通的粗线条,相邻像素强相关。上面那个 $\frac{\pi\sigma}{2}$ 的公式只对各维独立的白噪声成立;当各维强相关时,观测到 $x_t$ 就等于同时观测到了 1024 个带噪线索,它们联合起来对 $z$ 的约束远比单维的情形强,条件方差因此小得多。0.19 远低于 1.571,量化地说明了「MNIST 离白噪声有多远」。
隐空间为什么停在 1.94?因为 $\beta=10$(讲义约定下的 5)的 KL 项正是在主动把隐变量推成白噪声:均值推向 0、方差推向 1、各维之间的冗余被压掉(KL 到 $\N(0,I)$ 的散度对任何偏离独立标准正态的结构都要收费)。于是隐变量非常接近上面那个理想化的假设,损失几乎就卡在理论下界上。
反过来用这个公式还能反推隐变量的尺度:由 $\mathcal{L}^\star=\frac{\pi\sigma}{2}$ 且实测 $\mathcal{L}=1.9431\ge\mathcal{L}^\star$,得
$$ \sigma\le\frac{2\times1.9431}{\pi}\approx1.237, $$即隐变量每维标准差不超过约 1.24(等号在模型达到最优时取到)。这个数与 Lecture 4 §7.7 提到的现象一致:实际系统里隐分布的尺度并不严格是 1,所以工程实现通常要在编码结果上乘一个全局缩放常数,把经验标准差调到 1 附近再交给扩散模型——因为噪声调度 $\alpha_t,\beta_t$ 都是按「数据方差约为 1」设计的。本 lab 省略了这一步,代价就是那个略高于 $\pi/2$ 的损失平台。
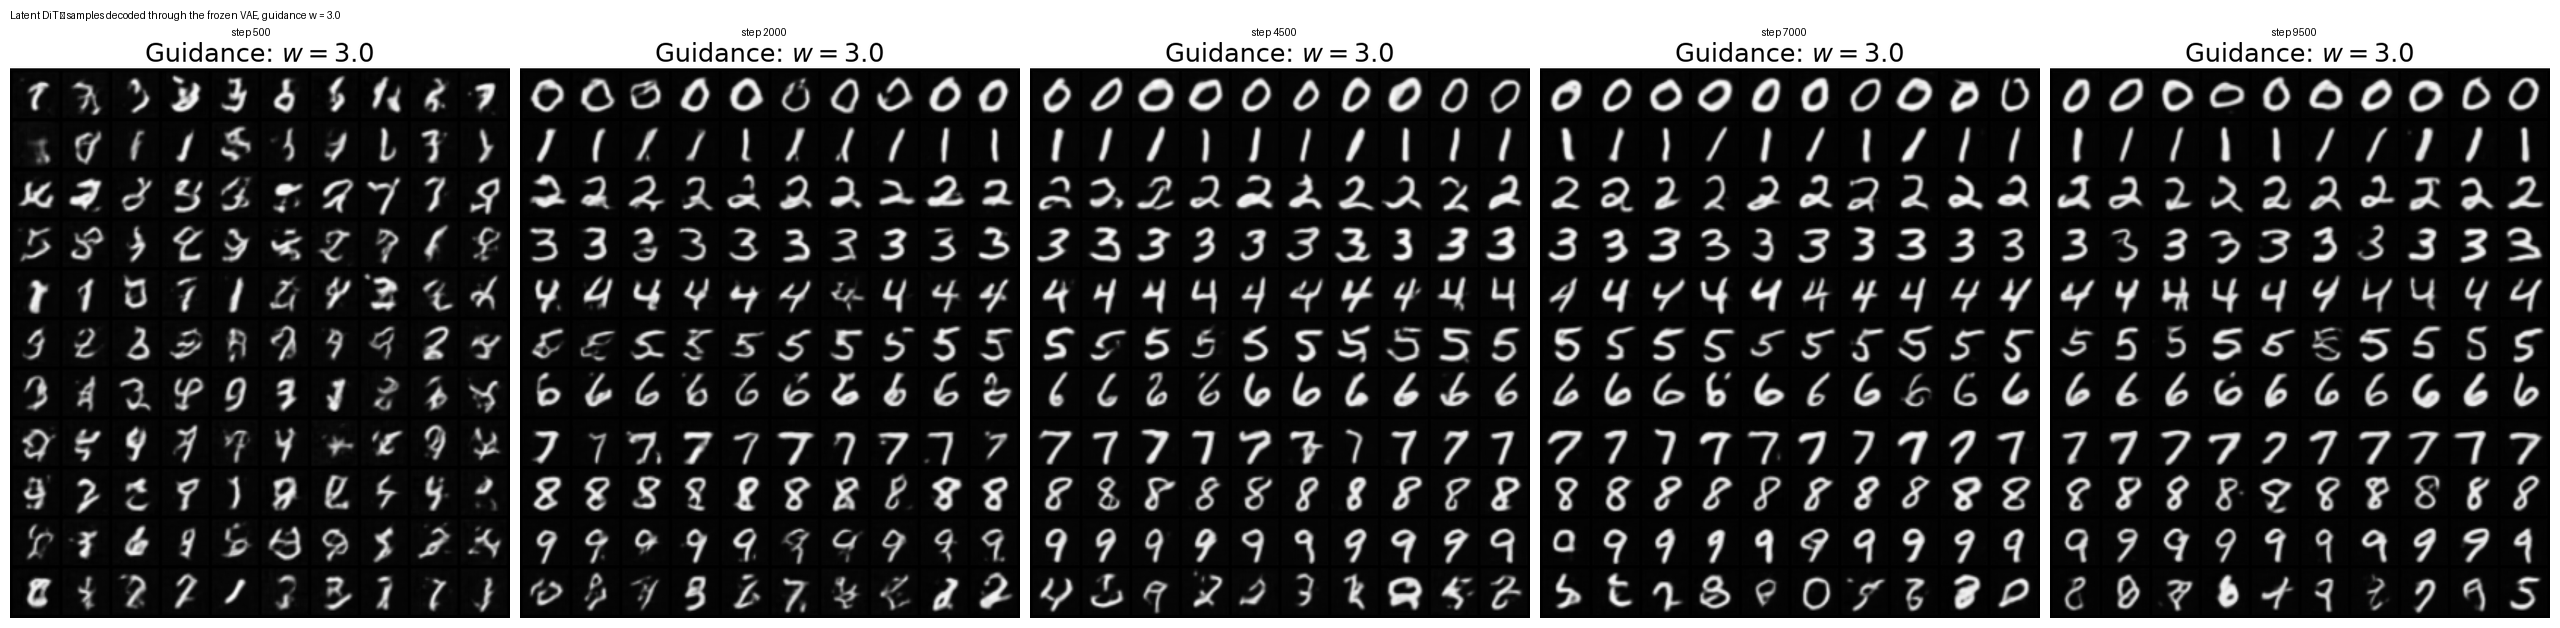
- 要看的不是损失降了多少,而是「相对于各自下界还剩多少」。像素空间 $0.1906$ 对应一个很低的下界(因为数据结构强);隐空间 $1.9431$ 对应一个接近 $\pi/2$ 的下界(因为数据接近白噪声)。后者其实离最优更近。
- 一个可操作的判据:把你的隐变量的经验标准差 $\hat\sigma$ 量出来(
z.std()),算 $\frac{\pi\hat\sigma}{2}$,和你的损失平台比。差得不多 = 训好了;差很多 = 真有问题。 - 最终裁判永远是样本。本 lab 里两个模型的采样质量在同一档次,这才是「都训好了」的证据。
- 这和 Lab 2 里「损失收敛但不到 0」是同一个道理,只是这里被放大到了一眼可见的程度。
既然隐空间的目标「更难」(下界更高),为什么还要用它?三个理由:
- 计算量。本 lab 的隐空间 token 数是 16,像素空间是 64;注意力是 $O(n^2)$,差 16 倍。真实系统里($512\times512$ 图,8 倍下采样)差距是 $4096$ 倍。
- 「难」不等于「差」。下界高只是说残差方差大,不代表最优解学不到。扩散模型学的是条件期望,它在白噪声般的隐空间里照样能学好——只是损失读数更接近一个常数。
- 解耦。感知细节(笔画锐度、纹理)交给 VAE 解码器,语义结构交给扩散模型。这是 Stable Diffusion 系列的核心设计。
7. 如何验证自己的实现:一套写完就跑的检查
这个 lab 的训练动辄几十分钟,「写完全部代码再开训、跑完才发现形状错」是最贵的失败模式。下面这套检查全部是纯 CPU、秒级完成的,建议每写完一个模块就跑对应的那几条。括号里是本页实现的实测值。
7.1 不变量检查(能抓出绝大多数错误)
| 模块 | 检查什么 | 为什么它有效 | 实测 |
|---|---|---|---|
FourierEncoder | 每行平方和 $=$ half_dim | $\cos^2+\sin^2=1$,与 $t$ 无关 | 误差 0 |
FourierEncoder | $t=0$ 时输出 $[1,\dots,1,0,\dots,0]$ | 端点值,能抓出 cos/sin 拼反 | 通过 |
Patchifier | 只改一个 $4\times4$ 块 ⇒ 只有 1 个 token 变 | patch 必须是空间局部的,抓 rearrange 写反 | 受影响 token 数 = 1 |
MHA | 与 F.scaled_dot_product_attention 对拍 | 缩放、softmax 维度、头划分一次全验 | 最大误差 8.94e-08 |
DiffusionTransformerLayer | 初始化后 $=$ 恒等映射 | adaLN-Zero 的定义性质 | 最大偏差 0.00e+00 |
DiffusionTransformerLayer | 随机化 cond 末层后,改变 $c$ 必须改变输出 | 补上上一条的盲区(防止条件被完全忽略) | 差异 > 0 |
ResidualBlock | 初始化后 $=$ 恒等映射 | 零初始化 conv2 的定义性质 | 最大偏差 0.00e+00 |
CFGVectorFieldODE | $w=1$ 时 $=$ 纯条件向量场 | 组合公式的边界情形 | 误差 0 |
CFGVectorFieldODE | $w=0$ 时 $=$ 纯无条件向量场 | 同上,另一端 | 误差 0 |
VAE.compute_loss | $q=$ 先验时 KL 项恰为 0 | $0+1-0-1=0$,抓符号错误 | $<10^{-7}$ |
VAE.compute_loss | KL 项恒非负(50 次随机测试) | $\alpha-\log\alpha-1\ge0$ | 最小值 $\ge-10^{-6}$ |
VAE.compute_loss | 完美重构 + $q=$ 先验 ⇒ 总损失 $=0$ | 两项同时归零,端到端验证 | $<10^{-6}$ |
7.2 形状检查
| 模块 | 输入 | 期望输出 |
|---|---|---|
FourierEncoder(dim=64) | (8,) | (8, 64) |
Patchifier(32, 4, 1, 48) | (3, 1, 32, 32) | (3, 64, 48) |
Depatchifier(32, 4, 48, 8, 1) | (3, 64, 48) | (3, 1, 32, 32) |
MHA(64, 8) | (2, 10, 64) | (2, 10, 64) |
DiffusionTransformerFlowModel | (5,1,16,16), (5,), (5,) | (5, 1, 16, 16) |
ResidualBlock(8) / AttnBlock(8) | (2, 8, 16, 16) | (2, 8, 16, 16) |
VAE(1, [8,16,32,64]) 的 z_mean | (2, 1, 32, 32) | (2, 64, 4, 4) |
VAE 的 x_mean / logvar | 同上 | (2,1,32,32) / torch.Size([]) |
本页的实现在这套检查上 22 项全部通过。注意几处「刻意做成小尺寸」的设计:用 img_size=16、num_layers=2、hidden_channels=[8,16,32,64] 就能在 CPU 上瞬间跑完,同时完整覆盖所有形状逻辑——不要用 img_size=32, num_layers=8 做单元测试,慢且没有额外收益。
7.3 推荐的验证顺序
- Q2.2 + Q2.3 → Sanity Check 2.4(3000 步,约 1–3 分钟)。这一步同时验证训练循环、CFG 组合公式、类别嵌入。不通过就绝不要往下走。
- Q3.1 → Q3.2 → Q3.3 → Q3.4,每写完一个立刻跑上表对应的行。特别是 MHA 的对拍,它一次能验四件事。
- Q3.5 写完先跑一次前向 +
model_size_b,确认输出形状和 40.324 MiB 这个量级。 - 启动 DiT 训练,开
ckpt_every=1000,看第 1000/2000 步的图。3000 步还是纯噪声就停下来查。 - Q4.1–Q4.6,跑形状链路和两个恒等映射检查。
- Q4.7,跑三条损失性质检查。
- 启动 VAE 训练(几分钟),跑插值图。插值图不平滑就别继续——Part 5 的质量完全依赖 VAE。
- Q5.1,启动隐空间训练。看到损失只在 1.9x 徘徊时,不要慌,去看 checkpoint 采样图。
8. 训练实测数据汇总
| 模型 | 参数量 | 步数 | batch | 学习率 | 损失 首 → 末 |
|---|---|---|---|---|---|
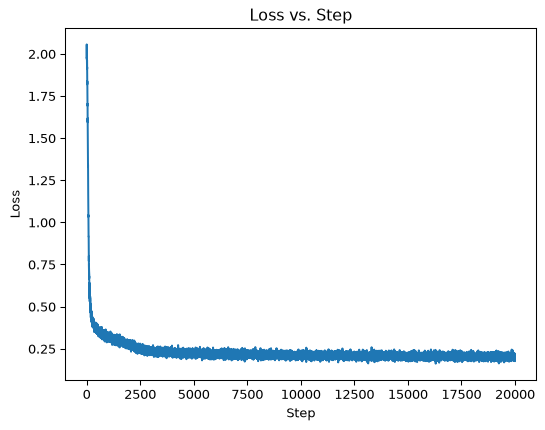
| MLP sanity check($\R^2$ 上的 GMM) | 0.259 MiB | 3000 | 250 | $10^{-3}$ | 2.8910 → 0.8401 |
| DiT(像素空间,$p=4$,8 层,$d=256$,8 头) | 40.324 MiB | 20000 | 256 | $4\times10^{-4}$ | 1.9788 → 0.1906 |
| VAE(hidden $=[16,32,64,128]$,$\beta=10$) | 6.150 MiB | 5000 | 64 | $10^{-3}$ | 4.3153 → −0.6341 |
| Latent DiT($128\times4\times4$,$p=1$,8 层) | 39.844 MiB | 10000 | 256 | $4\times10^{-4}$ | 2.0163 → 1.9431 |
硬件:单张 RTX 5080(16 GB),PyTorch 2.11.0 + CUDA 12.8。四段训练合计约 1.5 小时(含 MNISTSampler 的缓存改写;不改写的话仅 DiT 一段就要成倍时间)。原题面说「~15 A100 minutes」是指 DiT 那一段。
- DiT 的 0.1906 和 Latent DiT 的 1.9431 不可比。见第 6 节:它们各自的不可约下界差了一个数量级。
- VAE 的 −0.6341 是负的,正常。重构项含 $\log\sigma_\theta^2$,$\sigma_\theta<1$ 时为负且无下界。负对数似然对连续分布本来就可以任意负。
- 两个 DiT 的参数量差 0.48 MiB,全在 Patchifier 和 Depatchifier 上。像素空间:$1\times4\times4\times256$ 的 patch 卷积;隐空间:$128\times1\times1\times256$ 的逐位置投影。主干(8 层 transformer)完全一样。这也从侧面说明「切块」这一步在参数量上有多便宜。
本 lab 小结
| 题号 | 对象 | 一句话要点 |
|---|---|---|
| Q2.2 | CFGTrainer.get_train_loss | 四步采样 + MSE;$t$ 是 (b,);$\times(1-\epsilon)$ 避开 $\beta_t=0$ |
| Q2.3 | MLPConditionalVectorField | 拼接 $[x,\,e_y,\,t]$;num_classes + 1 里的 $+1$ 就是 $\varnothing$ |
| Q3.1 | FourierEncoder | 随机 Fourier 特征打破 MLP 的谱偏置,让网络分辨相近的 $t$ |
| Q3.2 | Patchifier | kernel $=$ stride $=$ patch 的卷积 $\equiv$ 切块 + 各自线性投影 |
| Q3.3 | MHA / DiT layer / DiT | $1/\sqrt{d_h}$ 稳住 softmax;adaLN-Zero 让初始 block 是恒等;位置编码打破置换等变 |
| Q3.4 | Depatchifier | Rearrange 必须与 Patchifier 严格对偶;末尾卷积抹平块边界 |
| Q3.5 | DiffusionTransformerFlowModel | 时间嵌入 $+$ 类别嵌入(相加),驱动每层的 adaLN |
| Q4.1 | ResidualBlock | GroupNorm(1,C) $=$ 图像上的 LayerNorm;零初始化 ⇒ 初始恒等 |
| Q4.2 | AttnBlock | 像素即 token、通道即特征;heads=1 保证任意通道数可整除 |
| Q4.3 / Q4.5 | EncoderBlock / DecoderBlock | stride-2 卷积下采样;最近邻 + 卷积上采样以避开棋盘格伪影 |
| Q4.4 / Q4.6 | Encoder / Decoder | ch_out = hidden[1:] + [None] 是题眼;logvar 是共享标量 |
| Q4.7 | VAE.compute_loss | 高斯 NLL + 闭式 KL;.mean() 约定下 $\beta_{\text{讲义}}=\beta_{\text{代码}}\cdot d/k$ |
| Q5.1 | LatentCFGTrainer | 与 Q2.2 只差「数据来自冻结 VAE 的编码」,必须 no_grad |
- 训练循环没变,变的全是架构。15 个 TODO 里只有 2 个在动损失,其余 13 个都在回答同一个工程问题:怎么把一个高维函数 $u_t^\theta(x\mid y)$ 用张量算子搭出来。这正是从 Lab 2 到真实系统的全部距离。
- 「初始即恒等」是深层网络的通用护身符。adaLN-Zero 的 $\alpha=0$、
ResidualBlock的零初始化conv2,是同一招的两次出场。它们都能用一行assert (f(x) - x).abs().max() == 0验证,而且必须严格为 0。 - CFG 是一个纯推理时的旋钮,但需要训练时的配合。训练侧只多了一行标签丢弃,推理侧只多了一次网络调用和一个线性组合。三联图上肉眼可见的保真度–多样性权衡,全部来自这两处改动。
- 损失的绝对值不能跨空间比较。flow matching 的不可约下界等于回归目标关于 $x_t$ 的条件方差;在白噪声般的隐空间里这个下界是 $\frac{\pi\sigma}{2}\approx1.57\sigma$,在强结构的像素空间里则低得多。看到隐空间损失卡在 1.94 不动,要去算下界,而不是怀疑代码。
- 每写完一个模块就验一次形状与不变量。这个 lab 的所有致命错误(rearrange 写反、softmax 维度错、$t$ 的形状错)都能被秒级的检查抓到,而它们中的任何一个都能让你白跑 20000 步。
做完这三个 lab,你手上就有了一条完整的链路:Lab 1 的模拟器 → Lab 2 的 flow matching / score matching → Lab 3 的 CFG + DiT + VAE + latent diffusion。把 MNIST 换成更大的数据集、把 DiT 加深、把 VAE 换成带感知损失和对抗损失的版本,你得到的就是 Stable Diffusion 3 的骨架——Lecture 4 §6.3 逐条对照过这件事。
延伸阅读
- Lecture 3-B · 引导与条件生成 — Part 2 的理论出处:引导公式的推导、$w$ 与「锐化分布」的关系、为什么 CFG 不是在采样真实的条件分布。
- Lecture 4 · 网络架构与隐空间 — Part 3–5 的理论出处:AdaLN 的动机(§6.1)、ELBO 的两条推导路径(§6.4)、KL 的闭式解与重参数化(§7)、VAE 在 latent diffusion 里的工程现实(§7.7)。
- Lab 2 · Flow Matching and Score Matching — 本 lab 训练循环的来源;那里的「损失不收敛到 0」正是第 6 节所讲现象的原始版本。
- Scalable Diffusion Models with Transformers (Peebles & Xie, 2023) — DiT 原论文,题面里那张架构图的出处。adaLN-Zero 与其它三种条件注入方式(in-context、cross-attention、adaLN)的消融实验在 §4,值得一读。
- High-Resolution Image Synthesis with Latent Diffusion Models (Rombach et al., 2022) — Stable Diffusion 的原论文,Part 4/5 的 VAE + latent diffusion 结构的直接来源,包括「共享标量 logvar」这个简化。
- Classifier-Free Diffusion Guidance (Ho & Salimans, 2022) — CFG 原论文。$\eta$(论文里记作 $p_{\text{uncond}}$)取值的消融在 §4,本 lab 用的 0.35 偏大,论文推荐 0.1–0.2。
- Auto-Encoding Variational Bayes (Kingma & Welling, 2013) — VAE 与重参数化技巧的原始论文,Q4.7 的全部数学都在这里。
- Deconvolution and Checkerboard Artifacts (Odena et al., 2016) — 棋盘格伪影的经典分析,解释了 Q4.5 为什么用「最近邻 + 卷积」而不是转置卷积。
- Fourier Features Let Networks Learn High Frequency Functions (Tancik et al., 2020) — Q3.1 背后的理论:随机 Fourier 特征如何克服 MLP 的谱偏置,含核函数视角的完整分析。