Simulating ODEs and SDEs
把第一讲的连续时间方程变成能在 GPU 上跑起来的 step() 函数——五个 TODO,一个 $\sqrt{h}$,以及"怎么用可解析验证的统计量证明自己写对了"。
0. 本 lab 导读
Lab 1 是整门课里代码量最小、但每一行的"信息密度"最高的一次作业。五个 TODO 加起来实际要写的有效代码大约 12 行,可是这 12 行覆盖了第一讲全部的核心对象:向量场(vector field)、常微分方程(ODE)、布朗运动(Brownian motion)、随机微分方程(SDE)、得分函数(score)、朗之万动力学(Langevin dynamics),以及把它们从纸上搬到计算机里的两个数值格式——欧拉法(Euler method)和欧拉–丸山法(Euler–Maruyama method)。
正因为代码短,这个 lab 的难点完全不在"写",而在"知道自己写对了没有"。ODE 那一行错了,你会立刻看出轨迹跑飞;但 SDE 那一行如果把 $\sqrt{h}$ 写成 $h$,程序照样跑、图照样画得出来、轨迹照样有毛刺,只是物理是错的——而且步长取得越细,错得越离谱。所以本页除了逐题给参考实现,还专门用一整节讲如何用闭式统计量给自己的实现做体检:布朗运动的方差应该等于 $\sigma^2 t$,末端分布的峰度(kurtosis)应该等于 3,OU 过程的平稳方差应该等于 $\frac{\sigma^2}{2\theta}$。这些数都是能笔算出来的,跑一遍就知道有没有问题。
- 5 个代码 TODO:
- Q1.1a
EulerSimulator.step—— 对应讲义的显式欧拉离散 $X_{t+h} = X_t + h\,\vft{t}(X_t)$; - Q1.1b
EulerMaruyamaSimulator.step—— 对应 $X_{t+h} = X_t + h\,\vft{t}(X_t) + \sigma_t\sqrt{h}\,z_t$,全 lab 最关键的一行; - Q2.1
BrownianMotion—— 漂移为 0、扩散为常数 $\sigma$ 的 SDE; - Q2.2
OUProcess—— 漂移为线性回复力 $-\theta x$ 的 SDE; - Q3.1
LangevinSDE—— 漂移为 $\frac{1}{2}\sigma^2\nabla\log p(x)$,第一次用到 score。
- Q1.1a
- 6 个文字/数学题:$\sigma$ 与 $\theta$ 的定性影响、OU 到底收敛到"点"还是"分布"、$D = \frac{\sigma^2}{2\theta}$ 网格图的结论、Langevin 调参观察,以及 Q3.2 那道要写完整推导的证明题(高斯的 score,以及 OU $\equiv$ Langevin)。
- 预计耗时:自己动手写 1.5~2.5 小时(其中大半时间花在等
simulate_with_trajectory跑完和调 matplotlib);只读本页对照约 40 分钟。 - 一句话主线:ODE 把一个点确定性地推到另一个点,SDE 把一个分布推到另一个分布;而 Langevin 动力学是第一个"给定目标分布 $p$,就能造出把样本推向 $p$ 的 SDE"的构造性例子——这正是后面整门课要做的事(只不过那时 $\nabla\log p$ 要靠神经网络学)。
原课程在 lab 说明里明确建议不要让大语言模型替你写这几个 TODO——它们太短了,短到"看一眼答案"和"自己想出来"在学习收益上差了一个数量级。这份解析的定位是写完之后的对照与查错,不是替你交作业。
建议的用法:
- 先关掉这一页,把五个
raise NotImplementedError全部填掉,跑通所有绘图 cell。 - 卡住超过 20 分钟,只看对应 TODO 的「数学依据」小节,不要直接看代码。
- 跑通之后回来对照「常见错误」和「如何验证自己的实现」两节——很多人跑得出图,但实现其实是错的。
本 lab 每一题都能在 Lecture 01 · Flow and Diffusion Models 里找到对应的理论段落:欧拉法与欧拉–丸山法出自"数值模拟"一节,布朗运动的定义($W_0=0$、增量独立、$W_{t+h}-W_t \sim \N(0,hI_d)$)出自"SDE = ODE + 布朗运动",而 Langevin 动力学之所以以 $p$ 为平稳分布,根子在 Fokker–Planck 方程。如果哪一步觉得"公式是哪来的",回去翻那一讲比在这里找更快。
1. Part 0:先把接口和张量形状约定看懂
做题之前先花五分钟读懂 notebook 给的抽象基类,因为本 lab 一多半的调试时间都消耗在形状不匹配上,而这些形状约定全写在 docstring 里。
notebook 定义了两组抽象类。第一组描述"方程本身":
class ODE(ABC):
    @abstractmethod
    def drift_coefficient(self, xt: torch.Tensor, t: torch.Tensor) -> torch.Tensor:
        # xt: (bs, dim)   t: ()  标量
        # return: (bs, dim)
        pass

class SDE(ABC):
    @abstractmethod
    def drift_coefficient(self, xt, t): ...      # (bs, dim) -> (bs, dim)
    @abstractmethod
    def diffusion_coefficient(self, xt, t): ...  # (bs, dim) -> (bs, dim)
第二组描述"怎么把方程跑起来":
class Simulator(ABC):
    @abstractmethod
    def step(self, xt, t, dt): ...     # 你要填的就是这个

    @torch.no_grad()
    def simulate(self, x, ts):         # ts: (nts,)
        for t_idx in range(len(ts) - 1):
            t = ts[t_idx]
            h = ts[t_idx + 1] - ts[t_idx]   # 步长由 ts 相邻差自动给出
            x = self.step(x, t, h)
        return x                       # (bs, dim)
有四个约定值得提前记住,它们直接决定你 step 该怎么写:
| 约定 | 内容 | 为什么重要 |
|---|---|---|
| 批量维在最前 | xt 的形状永远是 (bs, dim),bs 条轨迹互相独立地并行推进 | 本 lab 一次模拟 500~40000 条轨迹全靠这个维度;所有运算必须是逐元素或按行广播的 |
| 时间是 0 维标量 | t 和 h 的形状是 (),不是 (bs, 1) | 标量与 (bs, dim) 相乘会自动广播,所以 drift * h 天然正确;但也意味着不能对 h 用 math.sqrt(它是 tensor) |
步长来自 ts 的差分 | h = ts[i+1] - ts[i] 由基类算好传进来 | 你不需要也不应该在 step 里自己算步长;ts 不必等距,代码天然支持非均匀网格 |
| 扩散系数返回张量 | diffusion_coefficient 的返回形状是 (bs, dim),不是标量 | 这是本 lab 最高频的踩坑点,下面 Q2.1 会专门讲 |
notebook 自己也承认:ODE 只是扩散系数为零的 SDE,理论上一个类就够。分开是出于两个理由。教学上,把"确定性"和"随机性"两条线拆开,能让你清楚看到 Euler 与 Euler–Maruyama 的唯一区别就是多出来的那一项。性能上,如果统一用 SDE 接口,每一步都要白白生成一个 (bs, dim) 的高斯噪声再乘以 0——在后面 lab 跑 MNIST 时这是实打实的浪费。
2. Part 1:两个数值积分格式
这一部分对应 notebook 的 Question 1.1,要填两个 step。它们是全 lab 的地基:后面 Part 2、Part 3 的所有图,都是拿这两个函数跑出来的。如果这里写错,后面所有实验的结论都会是错的,而且错得很隐蔽。
Q1.1a:EulerSimulator.step
题目在问什么
给定 ODE $\frac{\dd{}}{\dd{t}}X_t = \vft{t}(X_t)$,已知当前状态 $X_t$、当前时刻 $t$、步长 $h$,求一步之后的近似状态 $X_{t+h}$。用一句数学话说:实现显式欧拉格式
$$ X_{t+h} \;=\; X_t + h\,\vft{t}(X_t). $$数学依据
这个式子不需要背,它就是一阶泰勒展开(Taylor expansion)截断。设 $X$ 关于 $t$ 二阶可微,在 $t$ 处展开:
$$ X_{t+h} \;=\; X_t + h\,\frac{\dd{}}{\dd{t}}X_t + \frac{h^2}{2}\frac{\dd{^2}}{\dd{t^2}}X_{\xi}, \qquad \xi \in (t,\,t+h). $$把 ODE 本身 $\frac{\dd{}}{\dd{t}}X_t = \vft{t}(X_t)$ 代进第一项,再把 $O(h^2)$ 那一项直接扔掉,剩下的就是欧拉格式。扔掉的那一项就是局部截断误差(local truncation error),量级 $O(h^2)$。
这是初学者最容易含糊的一步,值得写清楚。设我们要从 $t=0$ 积分到 $t=T$,步长 $h$,那么总步数是 $N = T/h$。每步引入 $O(h^2)$ 的误差,$N$ 步累积起来:
$$ \underbrace{N}_{=T/h} \times \underbrace{O(h^2)}_{\text{每步}} \;=\; O(T h) \;=\; O(h). $$所以欧拉法是一阶方法:全局误差与 $h$ 成正比。这个"一阶"是有严格定理保证的——只要 $\vf$ 关于 $x$ 满足 Lipschitz 条件(这正是 Lecture 1 里保证解存在唯一的 Picard–Lindelöf 条件),误差累积就不会指数爆炸,可以证明
$$ \max_{0\le n\le N}\norm{X_{t_n} - \hat{X}_n} \;\le\; \frac{C}{L}\left(e^{LT}-1\right)h, $$其中 $L$ 是 Lipschitz 常数,$C$ 与二阶导的上界有关,$\hat{X}_n$ 是数值解。注意 $e^{LT}$ 这个因子:它说明积分区间越长、向量场变化越剧烈,同样的步长精度越差。这解释了为什么后面 lab 里模拟时间从 5 拉到 15 时,需要相应增加 num_timesteps。
可验证的推论:把步长减半,全局误差应该也大约减半(误差比 $\approx 2$)。这条是本 lab 最容易做的自查,下面第 6 节会给实测数字。
参考实现
class EulerSimulator(Simulator):
    def __init__(self, ode: ODE):
        self.ode = ode

    def step(self, xt: torch.Tensor, t: torch.Tensor, h: torch.Tensor):
        # 显式 Euler: x_{t+h} = x_t + h * u_t(x_t)
        # xt: (bs, dim), t: (), h: ()
        return xt + self.ode.drift_coefficient(xt, t) * h   # (bs, dim)
为什么这样写
- 为什么是
self.ode.drift_coefficient(xt, t)而不是(xt, t + h)? 因为这是显式欧拉:速度取在区间左端点。取右端点得到的是隐式欧拉(backward Euler),那需要解一个关于 $X_{t+h}$ 的方程,没法一行写完;取中点得到的是中点法(midpoint method),是二阶的。课程后面提到的 Heun 法则是"先用欧拉预测,再用两端速度的平均值校正",也是二阶。 - 形状怎么对上:
drift_coefficient返回(bs, dim),h是(),PyTorch 把标量广播到每个元素,结果仍是(bs, dim),与xt同形状,可以直接相加。 - 为什么不用原地操作(
xt += ...):simulate_with_trajectory会把每一步的x.clone()存进列表。如果你在step里原地改xt,理论上 clone 已经隔离了,但一旦某处忘了 clone,整条轨迹会全部变成最后一帧的值——画出来是一堆水平直线。返回新张量最省心。 - 为什么不必自己写
torch.no_grad():基类的simulate/simulate_with_trajectory已经加了装饰器。但注意 Q3.1 的LangevinSDE内部要用jacrev求导,那是torch.func的函数式变换,不受no_grad影响,所以能正常工作。
- 写成
xt + self.ode.drift_coefficient(xt, t),漏掉* h。 症状:轨迹爆炸或收敛速度与num_timesteps强相关。判据:把ts的点数翻倍,如果结果变了而不是更准了,说明步长没进公式。 - 把
h当成绝对时刻用,比如写* t。在ts = torch.linspace(0, 5, 500)下 $h \approx 0.01$ 而 $t$ 最大到 5,差了两三个数量级,一跑就飞。 - 假设步长均匀而去读
ts[1] - ts[0]。step根本拿不到ts,而且课程后面的 lab 会用非均匀时间网格(在 $t\to 1$ 附近加密)。老老实实用传进来的h。 - 返回
None。 忘了return是 Python 里最安静的 bug:下一次迭代x变成None,报错栈会指向drift_coefficient而不是step,很容易找错地方。
Q1.1b:EulerMaruyamaSimulator.step —— 那个 √h 从哪来
题目在问什么
给定 SDE $\dd{X_t} = \vft{t}(X_t)\dd{t} + \sigma_t \dd{W_t}$,实现它的欧拉–丸山离散:
$$ X_{t+h} \;=\; X_t + h\,\vft{t}(X_t) + \sqrt{h}\,\sigma_t\,z_t, \qquad z_t \sim \N(0, I_d). $$代码上只比 Q1.1a 多一项,但那一项里的 $\sqrt{h}$ 是整个 lab、乃至整门课的分水岭。如果你只想认真读懂本页的一处,就读这里。
数学依据:布朗增量的标准差按 √h 缩放
回忆 Lecture 1 里布朗运动 $(W_t)_{t\ge 0}$ 的定义,它由三条性质刻画:
- $W_0 = 0$;
- 增量服从高斯:对任意 $0 \le s < t$,有 $W_t - W_s \sim \N\!\left(0,\,(t-s)I_d\right)$;
- 增量独立:不重叠时间区间上的增量互相独立。
SDE 的形式解是一个随机积分:
$$ X_{t+h} \;=\; X_t + \int_t^{t+h}\vft{s}(X_s)\ud s \;+\; \int_t^{t+h}\sigma_s \ud W_s . $$欧拉–丸山做的事,就是把两个积分都用左端点的常数近似:
$$ \begin{aligned} \int_t^{t+h}\vft{s}(X_s)\ud s &\;\approx\; \vft{t}(X_t)\cdot h, \\[4pt] \int_t^{t+h}\sigma_s \ud W_s &\;\approx\; \sigma_t\cdot\left(W_{t+h} - W_t\right). \end{aligned} $$关键在第二行的括号。由定义中的性质 2,
$$ W_{t+h} - W_t \;\sim\; \N(0,\,h I_d), $$也就是说它的方差是 $h$,标准差是 $\sqrt{h}$。而 $\N(0, hI_d)$ 分布的样本可以写成 $\sqrt{h}\,z$,其中 $z\sim\N(0,I_d)$——这正是代码里那个 torch.sqrt(h) * torch.randn_like(xt)。
假设有人偷懒,把噪声项写成 $\sigma\, h\, z_t$("反正都是小量")。我们来算算这样模拟出来的过程在终点 $T$ 处的方差是多少。取最简单的情形:纯布朗运动,$\vf \equiv 0$,$\sigma$ 为常数,$X_0=0$,把 $[0,T]$ 均匀分成 $N$ 步,$h = T/N$。
正确写法(噪声系数 $\sqrt{h}$):各步噪声独立,方差可加,
$$ \Var[X_T] \;=\; \sum_{n=1}^{N}\Var\!\left[\sigma\sqrt{h}\,z_n\right] \;=\; N\cdot\sigma^2 h \;=\; N \cdot \sigma^2\frac{T}{N} \;=\; \sigma^2 T . $$结果与 $N$ 无关——不管步长取多细,终点方差都是 $\sigma^2 T$,这正是理论值。
错误写法(噪声系数写成 $h$):
$$ \Var[X_T] \;=\; \sum_{n=1}^{N}\Var\!\left[\sigma h\,z_n\right] \;=\; N\cdot\sigma^2 h^2 \;=\; N\cdot\sigma^2\frac{T^2}{N^2} \;=\; \frac{\sigma^2 T^2}{N} \;\xrightarrow[N\to\infty]{}\; 0 . $$也就是说:步长越细,噪声越小;细化到极限,随机性完全消失,SDE 退化成 ODE。这是灾难性的,因为整个扩散模型的立身之本就是那点随机性。
更糟的是这个 bug 不会报错,也不会让图看起来很离谱。你还是会看到有毛刺的轨迹(因为 $N$ 有限,噪声没完全消失),只是包络(envelope)宽度不对,而且换个 num_timesteps 图就变样。很多人就是在这里"跑通了但结论全错"。
更本质的说法:布朗运动的轨迹几乎处处连续但几乎处处不可微,它的二次变差(quadratic variation)非零:$\sum (W_{t_{n+1}}-W_{t_n})^2 \to T$。用 $h$ 缩放相当于假设 $\dd{W_t} \sim \dd{t}$,即把布朗路径当成可微函数——而它根本不可微。伊藤引理(Itô's lemma)里那个多出来的二阶项 $\frac12 f''(X_t)\sigma^2\dd{t}$,以及 Fokker–Planck 方程里那个多出来的 $\frac{\sigma_t^2}{2}\Lap p_t$,来源都是同一个 $\sqrt{h}$。整门课后面所有"多出来的拉普拉斯项",追到底都是这里的这个平方根。
把 $h$ 时间内走一步想成掷硬币决定往左还是往右。走 $N$ 步,如果每步方向固定(确定性),总位移正比于 $N$;如果每步方向随机,正负互相抵消,总位移的典型大小只有 $\sqrt{N}$。这就是"醉汉走路":$N$ 步之后离原点大约 $\sqrt{N}$ 步远,而不是 $N$ 步远。把 $N = T/h$ 代进去,位移 $\sim\sqrt{T/h}\cdot(\text{每步大小})$。要让总位移不依赖于 $h$,每步大小就必须正比于 $\sqrt{h}$。
换个角度记:确定性项按时间的一次方走,随机项按时间的半次方走。所以 $h\to 0$ 时随机项其实比确定性项大($\sqrt{h} \gg h$)——这就是为什么 SDE 的解在小尺度上看起来完全被噪声主导,而在大尺度上才显出漂移的趋势。
参考实现
class EulerMaruyamaSimulator(Simulator):
    def __init__(self, sde: SDE):
        self.sde = sde

    def step(self, xt: torch.Tensor, t: torch.Tensor, h: torch.Tensor):
        # x_{t+h} = x_t + h * u_t(x_t) + sigma_t * sqrt(h) * z,  z ~ N(0, I)
        drift     = self.sde.drift_coefficient(xt, t)      # (bs, dim)
        diffusion = self.sde.diffusion_coefficient(xt, t)  # (bs, dim)
        return xt + drift * h + diffusion * torch.sqrt(h) * torch.randn_like(xt)
        #      (bs,dim) + (bs,dim)*() + (bs,dim)*()*(bs,dim)  ->  (bs, dim)
为什么这样写
torch.randn_like(xt)而不是torch.randn(bs, dim):randn_like会自动继承xt的shape、dtype和device。notebook 里所有张量都.to(device)放在 GPU 上,用torch.randn(...)会在 CPU 上生成,然后触发RuntimeError: Expected all tensors to be on the same device。这是本 lab 报错率最高的一行。- 每步必须重新采样噪声。布朗增量的独立性是定义的一部分。如果把
z提到__init__里生成一次然后每步复用,得到的就不是布朗运动,而是一条被随机斜率决定的直线族。 torch.sqrt(h)而不是math.sqrt(h):h是 0 维 tensor,math.sqrt对它其实也能工作(会隐式调__float__),但如果h在 GPU 上会触发一次同步拷贝;更重要的是万一将来h变成 batched 张量,math.sqrt就直接崩了。用torch.sqrt或h ** 0.5都行。- 噪声乘的是
diffusion不是self.sde.sigma:基类接口里扩散系数是diffusion_coefficient(xt, t)的返回值,它可以依赖于 $x$ 和 $t$。本 lab 三个 SDE 的扩散系数恰好都是常数,但 Lab 2、Lab 3 会用到随时间变化的 $\sigma_t$。绕开接口直接读属性,到下一个 lab 就要重写。 - 漂移和扩散各调用一次,先算完再组合。
LangevinSDE的drift_coefficient里要跑vmap(jacrev(...)),是本 lab 最贵的操作,别在一行里重复调用两次。
- 把 $\sqrt{h}$ 写成 $h$。见上面的推导。自查方法:固定 $T$ 和 $\sigma$,把
num_timesteps从 500 改到 5000,末端分布的标准差应该基本不变。如果变窄了(大约按 $1/\sqrt{N}$ 窄下去),就是这个 bug。 - 把 $\sqrt{h}$ 乘到漂移项上:
xt + drift * torch.sqrt(h) + ...。症状:OU 过程的收敛速率不对,且随步长变化。漂移项是普通黎曼积分,就是 $h$;只有布朗项才是 $\sqrt{h}$。 - "doubly stochastic" bug:噪声采了两次。比如写成
diffusion * torch.sqrt(h) * torch.randn_like(xt) * torch.randn_like(xt),或者在diffusion_coefficient里手贱加了个randn。这个 bug 极其隐蔽:轨迹看起来还是"随机的",方差也可能碰巧接近。抓它的办法是看末端分布的峰度:真高斯的峰度是 3,两个独立标准高斯之积的峰度是 $\E[z_1^4]\E[z_2^4]/(\E[z_1^2]\E[z_2^2])^2 = 9$。第 6 节给的实测峰度是 3.016,说明实现干净。 - 忘了 $\sigma$ 可以是 0。notebook 的 OU 实验里第一组参数就是 $\sigma = 0$,此时 Euler–Maruyama 应当精确退化成 Euler,画出来是一族光滑的指数衰减曲线(见下面的 OU 图左列)。如果你的 $\sigma=0$ 图上还有毛刺,说明噪声项没有正确乘上扩散系数。
- 用
torch.normal(0, torch.sqrt(h))之类的写法。能work,但要小心torch.normal的第二个参数是标准差而不是方差——很多人在这里传了h,等价于把标准差写成了 $h$,回到第一个 bug。写成sqrt(h) * randn_like最不容易出错,因为 $\sqrt{\cdot}$ 是显式的。
欧拉与欧拉–丸山的唯一区别是多出来的 $\sigma_t\sqrt{h}\,z_t$。其中 $h$ 来自"漂移是普通积分",$\sqrt{h}$ 来自"布朗增量的方差等于时间长度"。确定性走一次方,随机走半次方——这一条记住了,后面伊藤引理、Fokker–Planck、score matching 里所有"凭空多出来的 $\frac12\sigma^2$"就都不再神秘。
3. Part 2:把 SDE 的解画出来
这一部分让你亲手实现两个最经典的 SDE,然后画 500 条轨迹去"看"随机过程长什么样。它们不是玩具:布朗运动是所有扩散模型的噪声来源,OU 过程则是 DDPM 前向加噪过程(variance-preserving SDE)的连续时间原型。
Q2.1:实现 BrownianMotion
题目在问什么
实现 SDE
$$ \dd{X_t} \;=\; \sigma \dd{W_t}, \qquad X_0 = 0, $$即"漂移为零、扩散系数为常数 $\sigma$"的那个 SDE。要填的是 drift_coefficient 与 diffusion_coefficient 两个方法。
数学依据
对照通式 $\dd{X_t} = \vft{t}(X_t)\dd{t} + \sigma_t\dd{W_t}$,逐项读系数:
| 项 | 通式 | 本题 | 代码 |
|---|---|---|---|
| 漂移 drift | $\vft{t}(x)$ | $0$ | torch.zeros_like(xt) |
| 扩散 diffusion | $\sigma_t$ | $\sigma$(与 $x,t$ 无关的常数) | self.sigma * torch.ones_like(xt) |
由布朗运动的定义直接可以写出解析解:从 $X_0 = 0$ 出发,
$$ X_t \;=\; \sigma W_t \;\sim\; \N\!\left(0,\ \sigma^2 t\, I_d\right). $$所以均值恒为 0,标准差按 $\sigma\sqrt{t}$ 增长。这条闭式解会在第 6 节被用作测试基准。
参考实现
class BrownianMotion(SDE):
    def __init__(self, sigma: float):
        self.sigma = sigma

    def drift_coefficient(self, xt: torch.Tensor, t: torch.Tensor) -> torch.Tensor:
        # dX_t = sigma * dW_t —— 纯扩散,没有确定性漂移
        return torch.zeros_like(xt)                    # (bs, dim)

    def diffusion_coefficient(self, xt: torch.Tensor, t: torch.Tensor) -> torch.Tensor:
        # 常数扩散系数,但形状必须与 xt 对齐
        return self.sigma * torch.ones_like(xt)        # (bs, dim)
为什么这样写
- 为什么不能
return 0或return self.sigma?这是本题的全部考点。接口约定返回(bs, dim)的张量。在本题里返回 Python 标量其实碰巧也能跑通——因为xt + 0 * h和xt + drift*h + sigma*sqrt(h)*randn_like(xt)靠广播都成立。但这是运气:一旦某个 SDE 的扩散系数按维度不同(各向异性),或者你在别处对返回值调用.shape、.device、torch.where,标量立刻炸掉。更现实的是 Lab 3:那里的扩散系数是(bs, 1)广播到(bs, 1, 32, 32)的图像张量,形状约定一旦养成坏习惯就会连环出错。 zeros_like/ones_like而不是torch.zeros(xt.shape):同样是为了自动继承device和dtype。torch.zeros(xt.shape)生成在 CPU 上,跟 GPU 上的xt一相加就报错。- 为什么
t完全没用上?因为这是时齐(time-homogeneous)的 SDE,系数不显含时间。签名里保留t是为了统一接口;Lab 2 的条件路径里 $\sigma_t$ 会真的随时间变。
- 返回标量
0或self.sigma。见上。哪怕这次能跑,也请养成返回张量的习惯。 - 把 $\sigma$ 写进漂移项。比如
return self.sigma * torch.ones_like(xt)当漂移——那模拟出来的是"匀速向右漂移 + 无噪声",画出来是一族平行斜线。 - 在
diffusion_coefficient里返回self.sigma ** 2。混淆了扩散系数 $\sigma$ 与扩散率 $\sigma^2$。SDE 写的是 $\sigma\dd{W_t}$,代码里就是 $\sigma$;平方只出现在方差 $\sigma^2 t$ 和 Fokker–Planck 的 $\frac{\sigma^2}{2}\Lap$ 里。写成 $\sigma^2$ 时,$\sigma=1$ 会完全看不出来(因为 $1^2=1$),换成 $\sigma=2$ 才暴露——所以调试时永远别用 1 当测试值。 - 在
diffusion_coefficient里额外乘torch.randn_like(xt)。噪声是模拟器(step)的职责,SDE 类只负责给出系数。乘两次就是上面说的 doubly-stochastic bug,峰度会跳到 9。
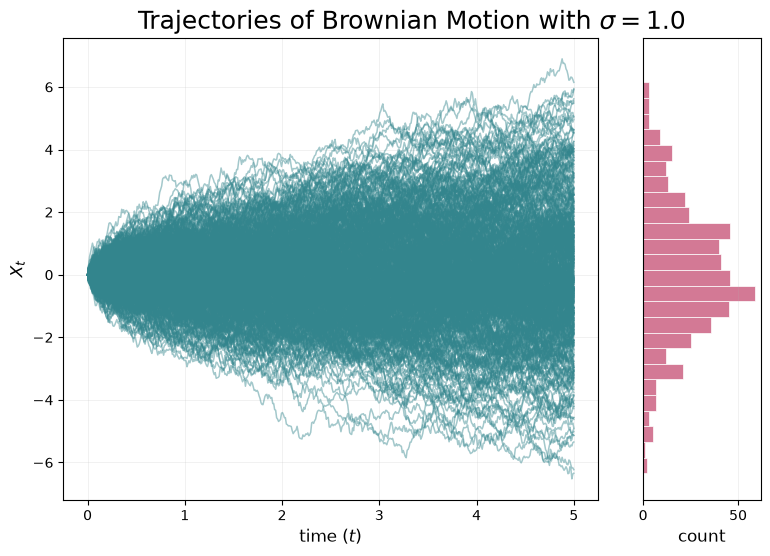
ts = linspace(0, 5, 500)),右侧是 $t=5$ 时刻的直方图。这张图同时验证了三件事:(1) 轨迹族的包络呈 $\sqrt{t}$ 形状——开口像抛物线躺倒,而不是三角形,这正是标准差 $\sigma\sqrt{t}$ 的几何表现;如果 step 里写成 $h$ 而非 $\sqrt{h}$,包络会明显偏窄且随 num_timesteps 变化。(2) 末端直方图是单峰对称的钟形,与 $\N(0, \sigma^2 T) = \N(0,5)$ 一致:图上大部分点落在 $\pm 2\sqrt{5}\approx\pm4.5$ 内,极值到 $\pm 6.5$ 左右,正是 $3\sigma$ 量级。(3) 单条轨迹处处有毛刺、放大后仍有毛刺——布朗路径连续但不可微的直观体现。Q2.1 文字题:σ 很大 / 接近 0 时轨迹长什么样
notebook 在实现之前先问了一次直觉,实现之后又让你改 sigma 再看一次。合并作答如下。
$\sigma$ 很大时:轨迹在竖直方向被整体拉伸,$t$ 时刻的分布是 $\N(0,\sigma^2 t)$,典型幅度 $\sigma\sqrt{t}$ 随 $\sigma$ 线性放大;轨迹上下剧烈翻飞,短时间内就能跑到很远,不同轨迹迅速散开、彼此不再相干。
$\sigma$ 接近 0 时:包络按同样比例收缩,所有轨迹几乎贴在 $X_t \equiv 0$ 这条水平线上;在 $\sigma\to 0$ 的极限下 SDE 退化成 ODE $\dd{X_t} = 0$,解是常数 $X_t = X_0$,图上就是 500 条重合的水平直线。
关键在于这只是尺度变换,不是形状变化。因为 $\sigma$ 是常数乘子,$X_t^{(\sigma)} \overset{d}{=} \sigma X_t^{(1)}$:改 $\sigma$ 等价于给纵轴换单位。如果你把不同 $\sigma$ 的图各自按纵轴自动缩放画出来,会发现它们看起来一模一样——这是布朗运动自相似(self-similar)性质的一个侧面。真正会改变图的"形状"的,是下一题引入的漂移项。
布朗运动还满足更强的自相似性:对任意 $c>0$,$\left(\frac{1}{\sqrt{c}}W_{ct}\right)_{t\ge0}$ 与 $(W_t)_{t\ge0}$ 同分布。这意味着"把时间轴拉长 $c$ 倍"和"把空间轴拉长 $\sqrt{c}$ 倍"是同一件事——又是那个 $\sqrt{\cdot}$。做实验时可以验证:把 ts 的终点从 5 改成 20($c=4$),末端分布的标准差应该恰好翻倍而不是变成 4 倍。
4. Q2.2:Ornstein–Uhlenbeck 过程与它的平稳分布
Q2.2:实现 OUProcess
题目在问什么
实现 SDE
$$ \dd{X_t} \;=\; -\theta X_t \dd{t} + \sigma \dd{W_t}, \qquad X_0 = x_0 . $$与布朗运动相比只多了一项漂移 $-\theta X_t$:一个指向原点、大小正比于离原点距离的回复力(restoring force),物理上就是弹簧,统计上叫均值回复(mean reversion)。参数 $\theta > 0$ 是回复强度,$\sigma$ 仍是噪声强度。
数学依据
逐项读系数:漂移 $\vft{t}(x) = -\theta x$,扩散 $\sigma_t = \sigma$。代码层面就这么简单。但这一题的真正内容是它的解,因为后面三道文字题和 Q3.2 全靠它。
这是少数几个能写出显式解的 SDE,推导用的是"积分因子",和解一阶线性 ODE 完全一样。令 $Y_t = e^{\theta t}X_t$,对它用伊藤公式(这里被求导的函数不含 $X$ 的二阶项,所以伊藤项为零,形式上与普通链式法则一致):
$$ \dd{Y_t} \;=\; \theta e^{\theta t}X_t\dd{t} + e^{\theta t}\dd{X_t} \;=\; \theta e^{\theta t}X_t\dd{t} + e^{\theta t}\left(-\theta X_t\dd{t} + \sigma\dd{W_t}\right) \;=\; \sigma e^{\theta t}\dd{W_t}. $$漂移项被精确抵消了。两边从 0 积到 $t$ 再乘回 $e^{-\theta t}$:
$$ X_t \;=\; \underbrace{x_0\,e^{-\theta t}}_{\text{确定性衰减}} \;+\; \underbrace{\sigma\int_0^t e^{-\theta(t-s)}\ud W_s}_{\text{随机积分}} . $$右边第二项是关于确定性被积函数的伊藤积分,因此是零均值高斯。用伊藤等距(Itô isometry)$\E\left[\left(\int_0^t f(s)\ud W_s\right)^2\right] = \int_0^t f(s)^2\ud s$ 算它的方差:
$$ \begin{aligned} \Var[X_t] &= \sigma^2\int_0^t e^{-2\theta(t-s)}\ud s \quad &&\text{(i) 伊藤等距}\\ &= \sigma^2 e^{-2\theta t}\int_0^t e^{2\theta s}\ud s \quad &&\text{(ii) 提出常数}\\ &= \sigma^2 e^{-2\theta t}\cdot\frac{e^{2\theta t}-1}{2\theta} \quad &&\text{(iii) 直接积分}\\ &= \frac{\sigma^2}{2\theta}\left(1 - e^{-2\theta t}\right). \quad && \end{aligned} $$于是完整的时刻分布是
$$ X_t \;\sim\; \N\!\left(x_0 e^{-\theta t},\ \ \frac{\sigma^2}{2\theta}\left(1-e^{-2\theta t}\right)\right). $$令 $t\to\infty$,两个指数都消失,得到平稳分布(stationary distribution)
$$ \boxed{\;p_\infty \;=\; \N\!\left(0,\ \frac{\sigma^2}{2\theta}\right)\;} $$它不依赖于初值 $x_0$。同时读出两个时间尺度:均值以速率 $\theta$ 指数衰减(弛豫时间 $\tau = 1/\theta$),方差以速率 $2\theta$ 趋近极限。记 $D \triangleq \frac{\sigma^2}{2\theta}$,则平稳标准差就是 $\sqrt{D}$——这正是 notebook 提示里让你盯住的那个量。
参考实现
class OUProcess(SDE):
    def __init__(self, theta: float, sigma: float):
        self.theta = theta
        self.sigma = sigma

    def drift_coefficient(self, xt: torch.Tensor, t: torch.Tensor) -> torch.Tensor:
        # 指向原点的线性回复力:theta 越大,被拉回得越快
        return -self.theta * xt                        # (bs, dim)

    def diffusion_coefficient(self, xt: torch.Tensor, t: torch.Tensor) -> torch.Tensor:
        return self.sigma * torch.ones_like(xt)        # (bs, dim)
为什么这样写
- 负号是全部内容。
-self.theta * xt里的负号保证了这是回复力:$x>0$ 时漂移向下,$x<0$ 时漂移向上。写成+theta * xt得到的是 $\dd{X_t}=\theta X_t\dd{t}+\sigma\dd{W_t}$,解含 $e^{+\theta t}$,轨迹指数发散——这个错误一眼就能从图上看出来。 - 形状自动正确。
-self.theta * xt里self.theta是 Python float,与(bs, dim)张量相乘广播后仍是(bs, dim),无需ones_like。而扩散系数不含xt,必须显式用ones_like撑出形状——两个方法写法不一致是有原因的,不是笔误。 - 不要在这里做任何"稳定性"修补。有人会想给漂移加 clamp 防止爆炸。不需要:只要 $\theta h < 2$,显式欧拉对这个线性系统就是稳定的。notebook 的参数下 $\theta h$ 最大约 $200 \times 0.00015 = 0.03$,非常安全。
- 漏负号(见上),或者写成
-self.theta * t(把状态写成了时间)。后者会让所有轨迹以相同斜率线性下滑,与初值无关,图上是一族平行曲线。 - 把平稳方差记成 $\sigma^2/\theta$ 或 $\sigma/(2\theta)$。正确的是 $\frac{\sigma^2}{2\theta}$。那个 2 来自 (iii) 步里指数的 $2\theta$,物理上对应"方差按两倍速率弛豫"。这条会在 Q3.2 里被再用一次,记牢。
- 误以为
simulation_time = 10一定跑到了平稳。弛豫时间是 $1/\theta$。$\theta = 0.25$ 时 $\tau = 4$,跑 10 个单位时间只有 2.5 个弛豫时间,$e^{-2\theta t} = e^{-5}\approx 0.007$,方差到位了但均值还残留 $e^{-2.5}\approx 8\%$ 的初值记忆。下面的图里能看到这个残留。 - 用
x0 = torch.linspace(-10, 10, n)却以为初始分布是高斯。notebook 用的是等距初值,初始"分布"是均匀的。这对平稳分布没影响(平稳分布与初值无关),但会影响中间时刻的直方图形状——$\sigma=0$ 那一列的直方图是平的,就是这个原因。
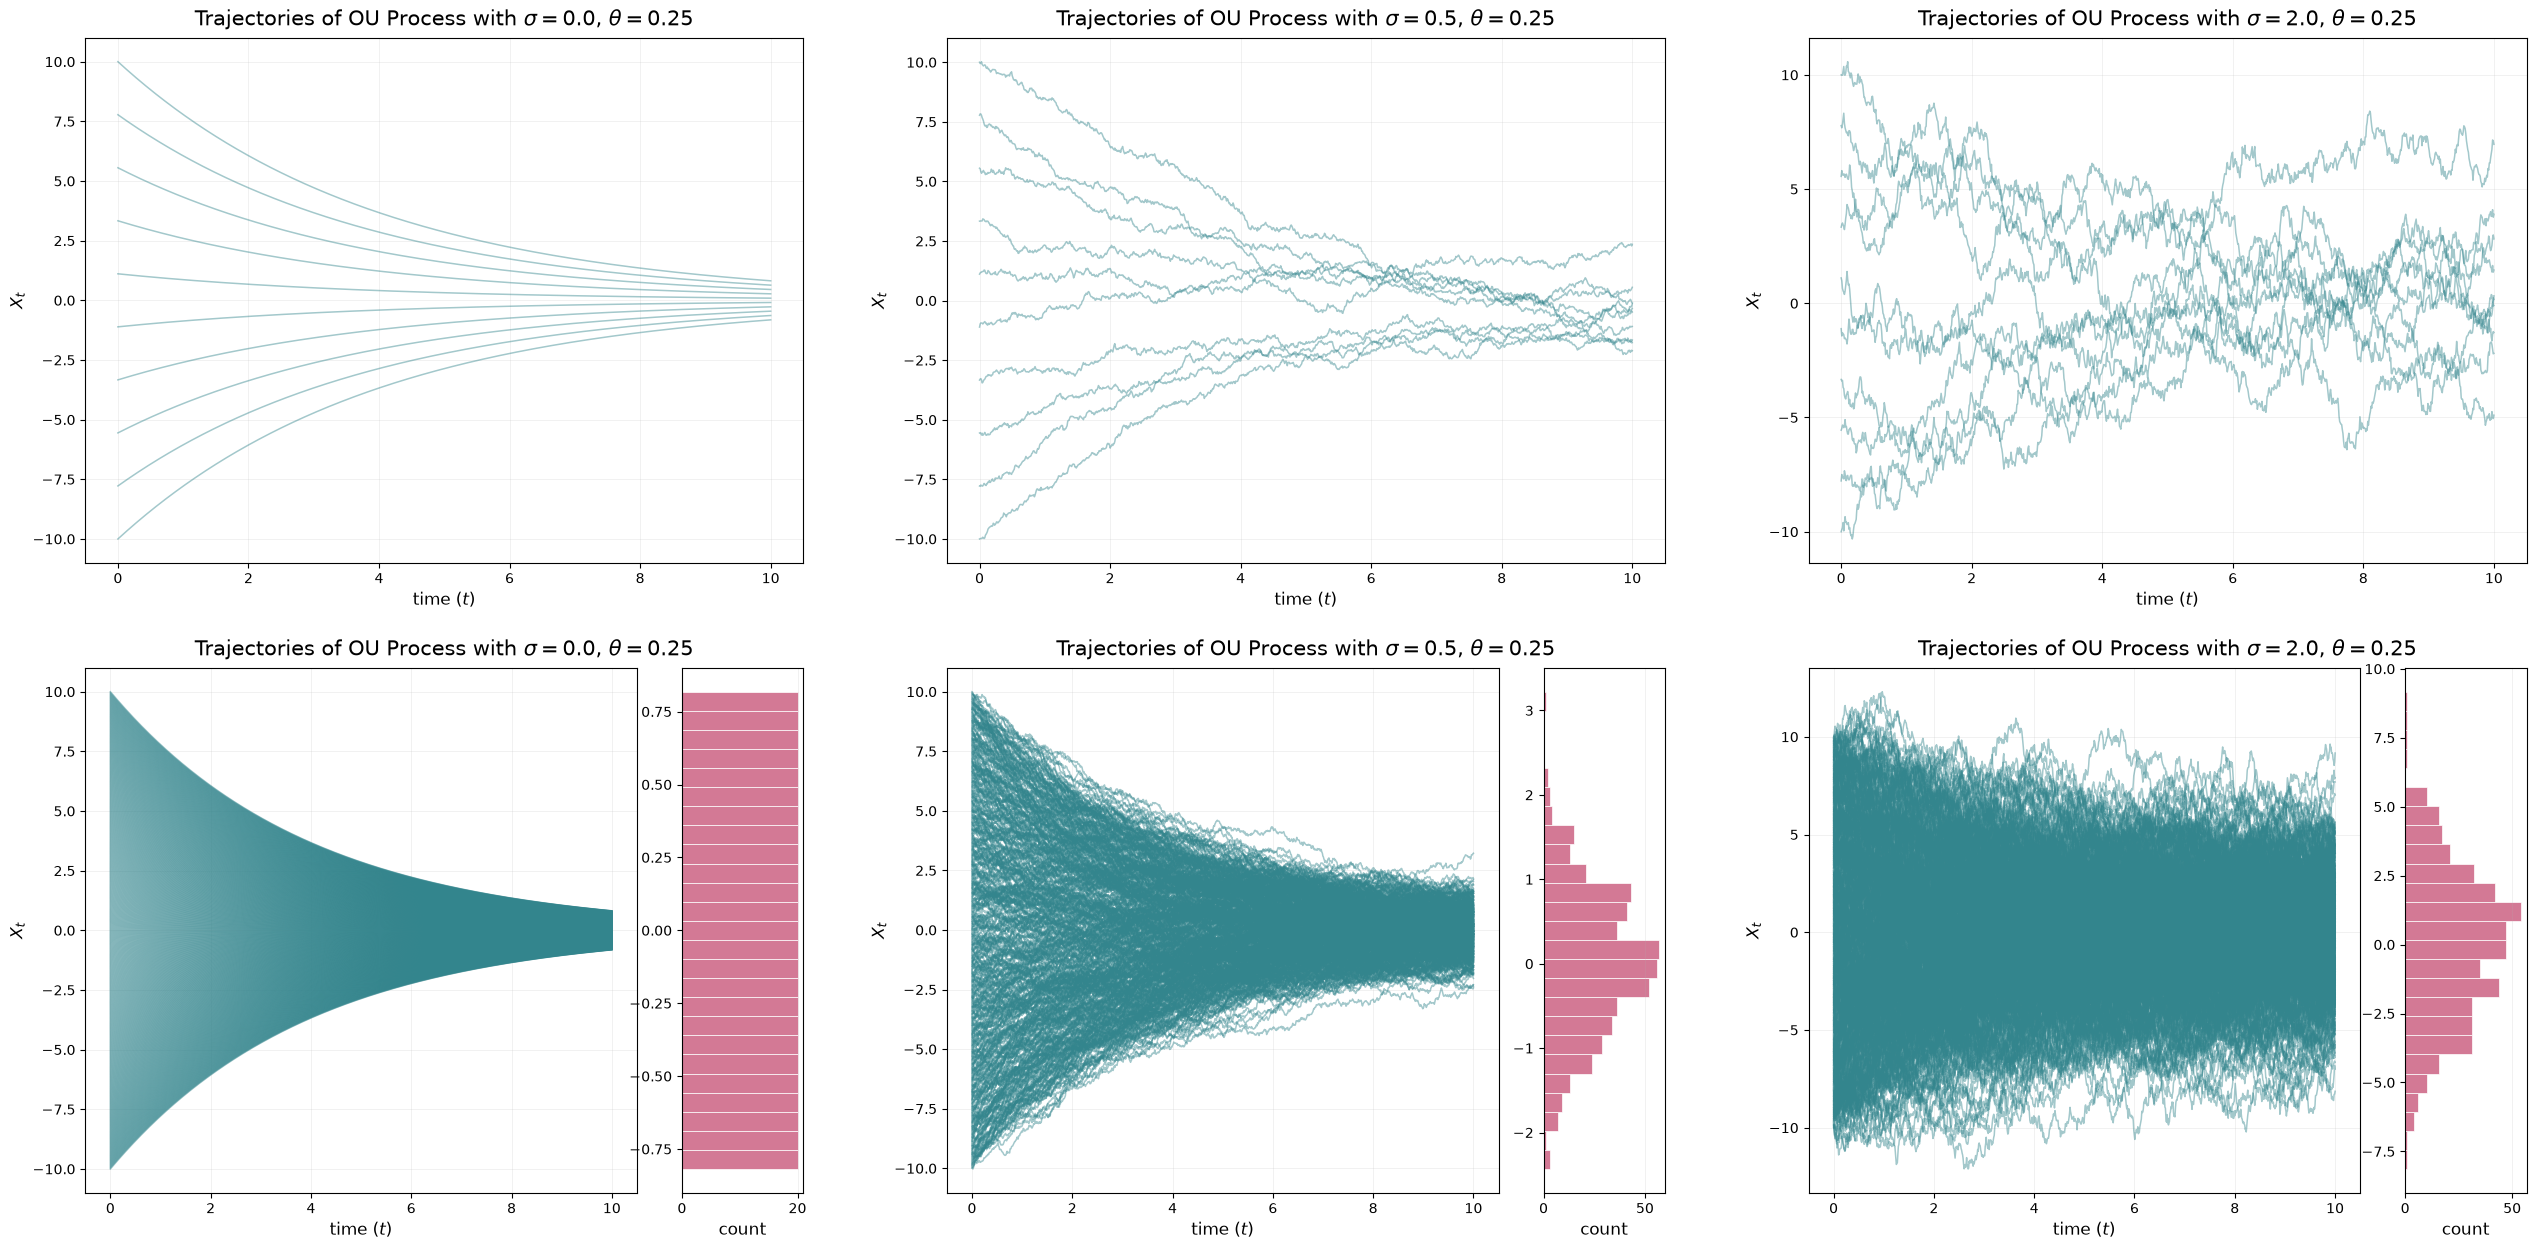
Q2.2 文字题:θ 很小 / 很大时轨迹长什么样
$\theta \to 0$(回复力很弱):漂移项几乎消失,OU 退化成布朗运动 $\dd{X_t}\approx\sigma\dd{W_t}$。轨迹几乎不被拉回,从各自的初值开始自由游走,包络持续变宽(在 $\theta t \ll 1$ 的时间窗内 $\Var[X_t]\approx\sigma^2 t$,正是布朗运动的方差)。平稳方差 $\frac{\sigma^2}{2\theta}\to\infty$,弛豫时间 $1/\theta\to\infty$——严格地说不存在有限的平稳分布,跑多久都没收敛。
$\theta \to \infty$(回复力很强):轨迹被瞬间拽到原点附近,然后在一条极窄的带子里高频抖动。$e^{-\theta t}$ 衰减极快,初值的记忆在极短时间内被抹掉;平稳方差 $\frac{\sigma^2}{2\theta}\to 0$,所以在 $\sigma$ 固定时轨迹几乎坍缩到 $X_t\equiv 0$ 这条线上。视觉上像"一根被强力弹簧勒住的抖动的线"。
把两个极限合起来看:$\theta$ 同时控制着收敛速度($1/\theta$)和平稳宽度($\sqrt{\sigma^2/2\theta}$),而且是此消彼长的——回复得越快,最终待的地方越窄。$\sigma$ 只影响宽度不影响速度。要在实验里把两者解耦,就得同时调 $\theta$ 和 $\sigma$ 让 $D=\frac{\sigma^2}{2\theta}$ 保持不变,这正是 notebook 下一张图干的事。
Q2.2 文字题:解收敛吗?收敛到点还是收敛到分布?
「当 $\theta$ 变大时,我们看到轨迹被更快地拉回原点,且最终聚集的带子更窄;当 $\sigma$ 变大时,收敛快慢不变,但最终这条带子变宽。」
而更重要的是那个"收敛"是什么意思——只要 $\sigma>0$,单条轨迹永远不会收敛到任何一个点。$X_t$ 是随机变量,它会一直抖下去,任何时刻都在动。收敛的是它的分布:
$$ X_t \;\xrightarrow[t\to\infty]{d}\; \N\!\left(0,\ \frac{\sigma^2}{2\theta}\right), $$这叫依分布收敛。图上看到的"轨迹带宽度稳定下来、末端直方图形状不再变化",就是分布收敛的视觉证据;而带子内部的线条依然在乱窜,就是"点不收敛"的证据。
只有在 $\sigma = 0$ 的退化情形下,才有真正的点收敛:$X_t = x_0e^{-\theta t}\to 0$,所有轨迹汇聚到原点。这一列在上面的图里就是最左边那张。「点收敛」与「分布收敛」的这个区别,是理解整门课的门槛之一:生成模型要的从来不是"把噪声映射到某个固定图像",而是"把噪声分布映射到数据分布"。
"平稳分布"的严格定义是:若 $X_0\sim p_\infty$,则对一切 $t$ 都有 $X_t\sim p_\infty$。用 Lecture 01 的 Fokker–Planck 方程检验,只需验证 $\partial_t p = 0$,即
$$ -\divg\!\left(p_\infty \vf\right)(x) + \frac{\sigma^2}{2}\Lap p_\infty(x) \;=\; 0 . $$一维情形下 $\vf(x) = -\theta x$,$p_\infty(x)\propto e^{-\theta x^2/\sigma^2}$,于是 $p_\infty'(x) = -\frac{2\theta x}{\sigma^2}p_\infty(x)$,代入:
$$ \left(\theta x\,p_\infty\right)' + \frac{\sigma^2}{2}p_\infty'' = \theta p_\infty + \theta x p_\infty' + \frac{\sigma^2}{2}\left(-\frac{2\theta}{\sigma^2}p_\infty - \frac{2\theta x}{\sigma^2}p_\infty'\right) = \theta p_\infty + \theta x p_\infty' - \theta p_\infty - \theta x p_\infty' = 0 . $$确实为零。注意这个计算里 $\frac{2\theta}{\sigma^2}x$ 这个组合反复出现——它就是 Q3.2 要证的 score,只差一个负号。
Q2.2 文字题:σ–D 网格图能得出什么结论
notebook 最后那段代码把 $\sigma \in \{1,2,10\}$ 与 $D = \frac{\sigma^2}{2\theta} \in \{0.25,1,4\}$ 做笛卡儿积($\theta$ 由 $\theta = \frac{\sigma^2}{2D}$ 反解),并且把每张图的时间轴按 $1/\sigma^2$ 缩放(ts = linspace(0, simulation_time / sigma**2, 1000))。这个缩放不是为了好看,它本身就是结论的一部分。
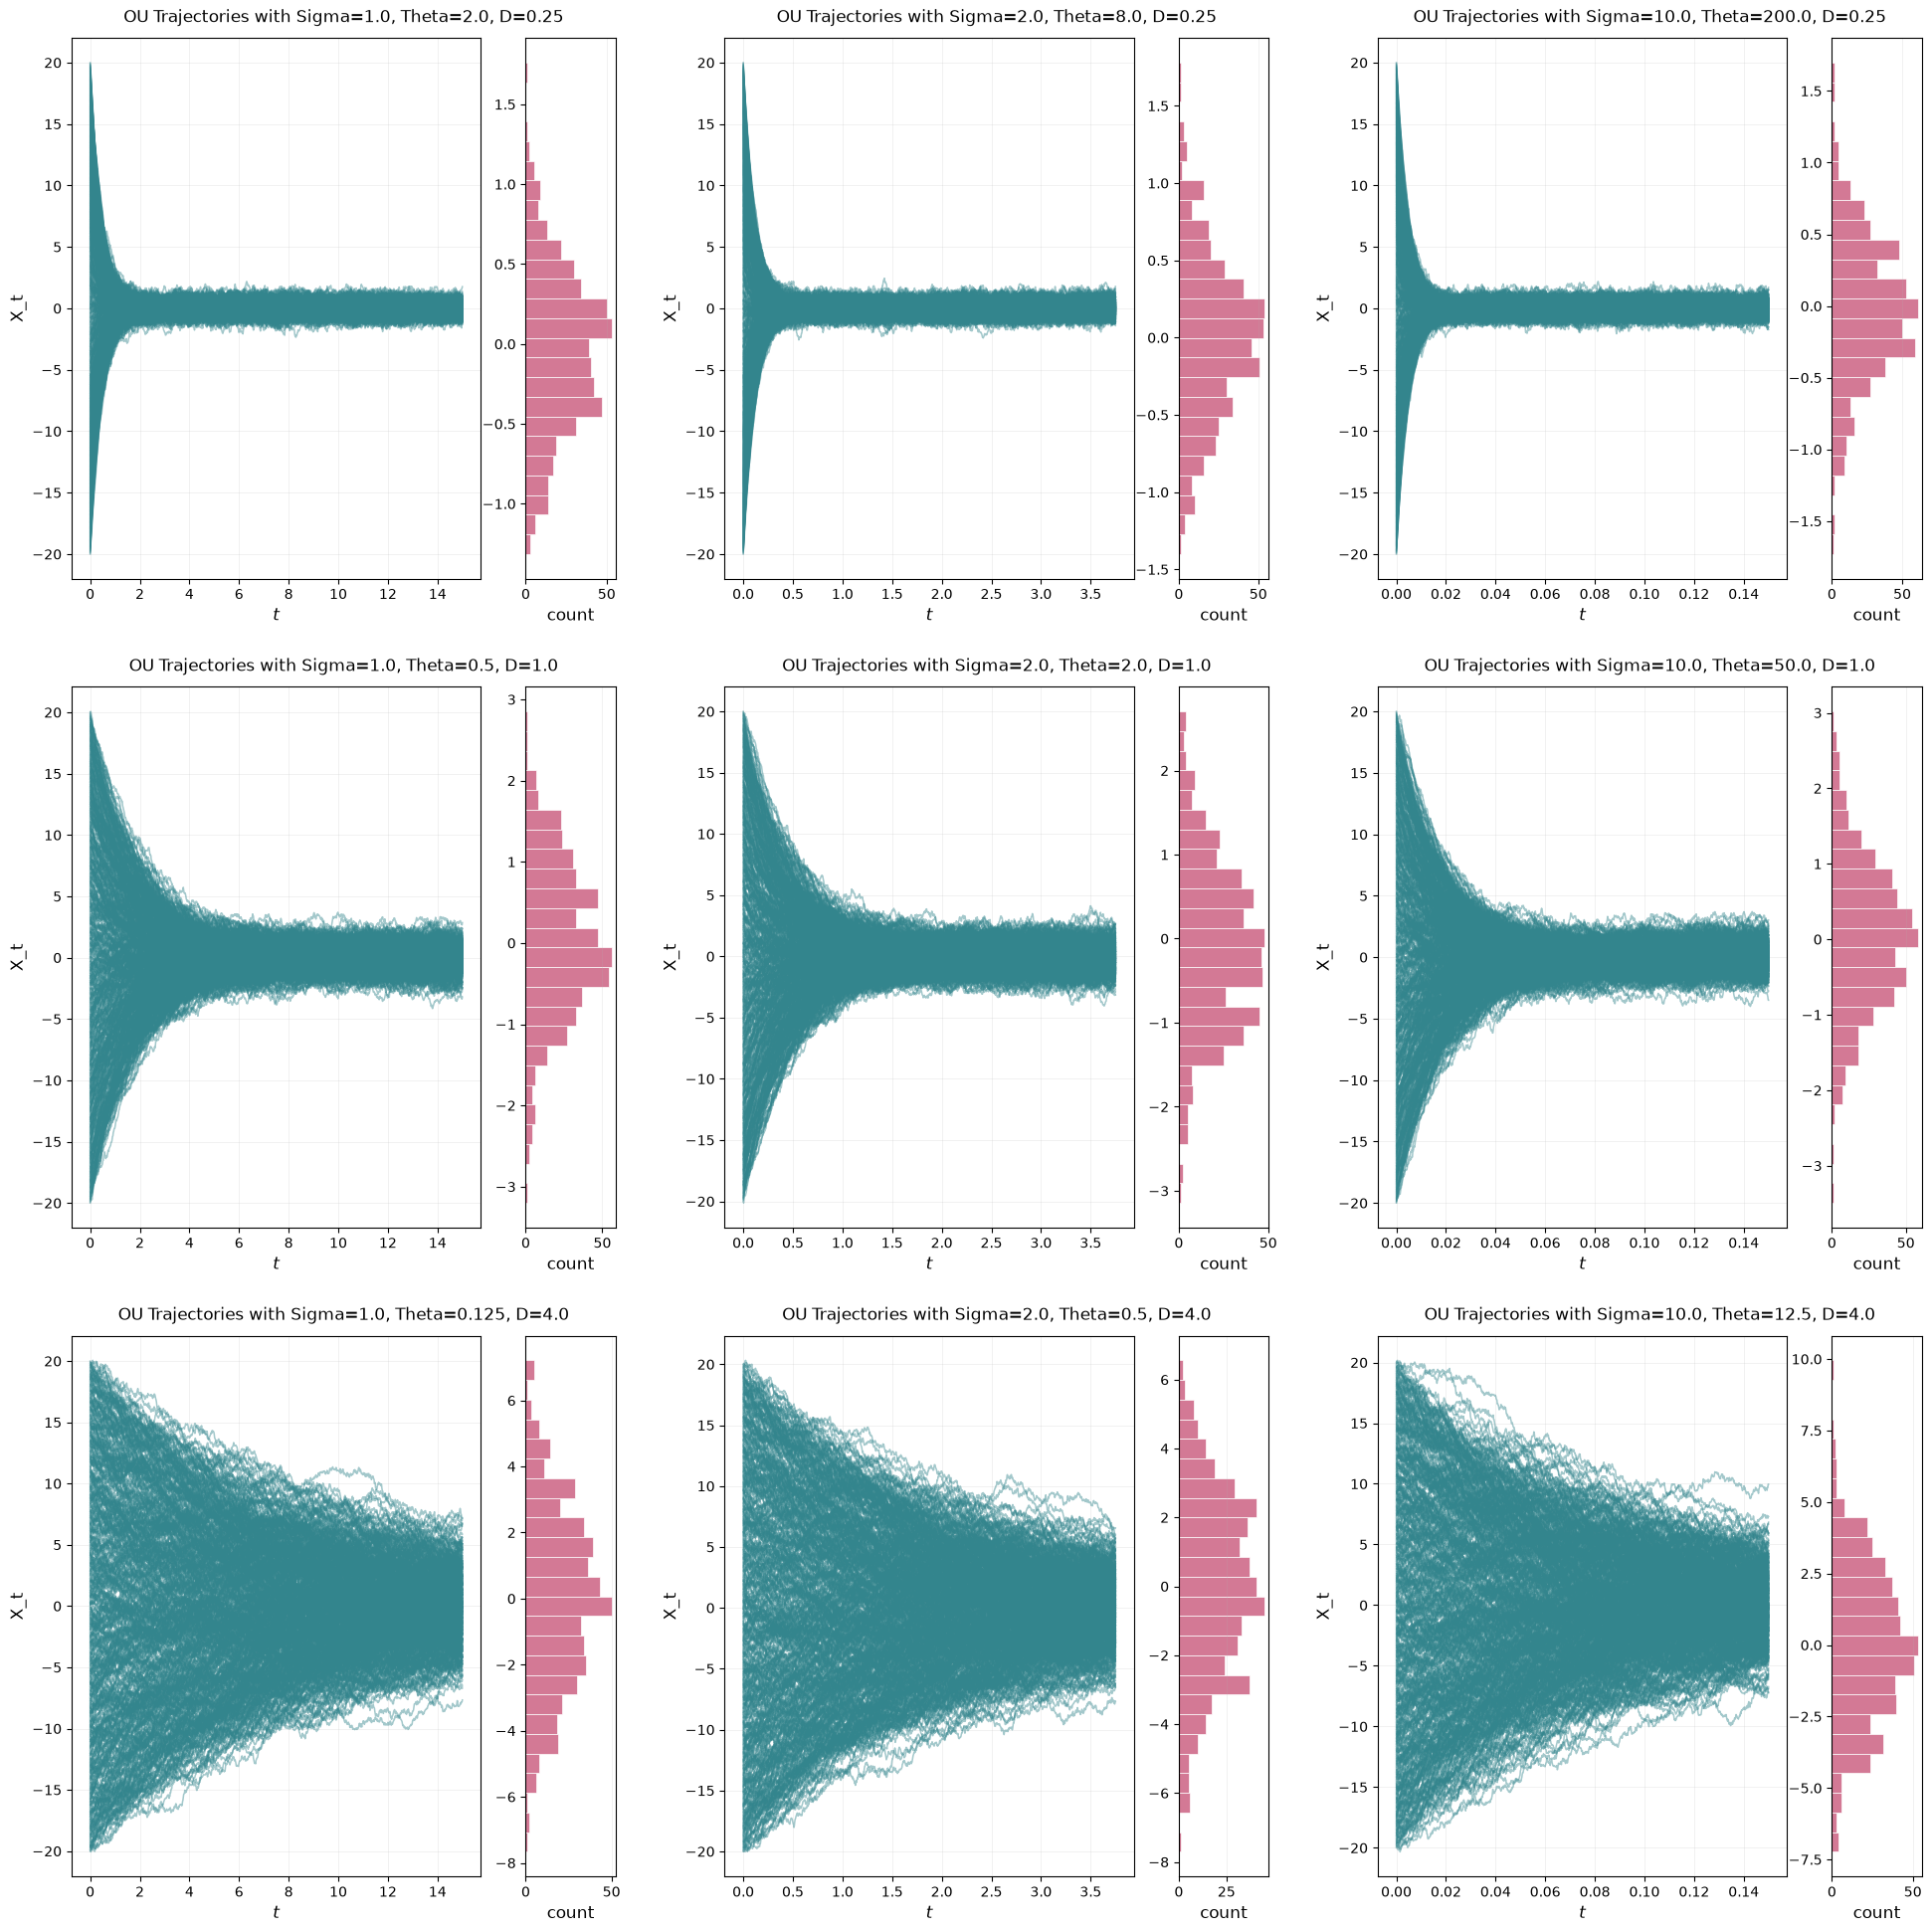
一句话:$D=\frac{\sigma^2}{2\theta}$ 单独决定了平稳分布有多宽,而 $\sigma^2$(等价地 $\theta$)只决定"多快到达"——把时间轴按 $\sigma^2$ 重新计量之后,所有 $\sigma$ 的图完全重合。
为什么?从闭式解 $\Var[X_t] = D\left(1-e^{-2\theta t}\right)$ 直接读出来:
- 纵向尺度只由 $D$ 决定,$\theta,\sigma$ 只通过组合 $D$ 起作用;
- 横向尺度只由 $\theta = \frac{\sigma^2}{2D}$ 决定。固定 $D$ 时 $\theta \propto \sigma^2$,所以把 $t$ 换成 $\tilde t = \sigma^2 t$ 之后 $\theta t = \frac{\tilde t}{2D}$ 只依赖 $D$——三列必然重合。
更严格地说,做变量替换 $\tilde t = \sigma^2 t$ 之后 OU 过程变成 $\dd{X_{\tilde t}} = -\frac{1}{2D}X_{\tilde t}\dd{\tilde t} + \dd{\tilde W_{\tilde t}}$(用到布朗运动的时间–空间自相似性 $\dd{W_{\sigma^2 t}} \overset{d}{=} \sigma\dd{W_t}$),$\sigma$ 被彻底消掉了,只剩 $D$。
为什么这件事重要:DDPM 那类扩散模型的前向过程就是 OU(加上时变系数),噪声调度(noise schedule)设计的本质就是在选 $\theta_t$ 与 $\sigma_t$ 的配比。这张图告诉你,能调的"形状"其实只有一个自由度,另一个自由度只是在换时钟。
5. Part 3:用 SDE 变换分布
前两部分看的是"一个点怎么动"。Part 3 换视角:一整个分布怎么被 SDE 搬运。这才是生成模型真正关心的事——我们要的不是把某个特定的噪声向量变成某张特定的图,而是把噪声分布 $\simple$ 变成数据分布 $\data$。
本部分先给出两个抽象概念,再让你实现 Langevin 动力学。这两个抽象值得单独说一下,因为它们贯穿后面所有 lab。
预备:Density 与 Sampleable 为什么要分成两个类
notebook 定义了两个互相独立的抽象基类:
| 类 | 能力 | 关键方法 | 现实中什么分布有 |
|---|---|---|---|
Density | 能算密度(因而能算 score $\nabla\log p$) | log_density(x) -> (bs, 1),score(x) -> (bs, dim) | 高斯、高斯混合、能量模型;图像分布没有 |
Sampleable | 能采样 | sample(n) -> (n, dim) | 任何有数据集的分布(图像、音频);能量模型往往没有 |
这个拆分不是为了工程整洁,它编码了本课的一个核心事实:真实数据分布只满足第二条。我们手上有一百万张猫图,但没有任何办法算出"这张图的概率密度是多少",更别说它的梯度。所以 Langevin 动力学虽然优美,却不能直接用在图像上——$\nabla\log p$ 是未知的。整门课后面要干的事,就是用神经网络把这个未知的 score 学出来(score matching),或者绕过它去学向量场(flow matching)。本 lab 让你先在"两者都有"的玩具分布上把机制跑通。
基类里 score 有一个默认实现,值得看懂:
def score(self, x: torch.Tensor) -> torch.Tensor:
    x = x.unsqueeze(1)                          # (bs, 1, dim)
    score = vmap(jacrev(self.log_density))(x)   # (bs, 1, 1, 1, dim)
    return score.squeeze((1, 2, 3))             # (bs, dim)
jacrev 对 log_density 求雅可比,vmap 把它按 batch 维向量化,从而一次性并行算出 batch 里每个样本各自的梯度。为什么不直接 torch.autograd.grad(log_density(x).sum(), x)?其实也可以(求和之后再求导,正好给出逐样本梯度,因为不同样本互不耦合),但 vmap + jacrev 的写法更函数式、不需要 requires_grad,也不受外层 @torch.no_grad() 影响——而 simulate 恰好带着这个装饰器。那一串 unsqueeze / squeeze 就是在对付 jacrev 输出的"输出形状 × 输入形状"嵌套维度。这段代码是给好的,不用改,但如果你自定义 Density 子类,记得 log_density 必须返回 (bs, 1),否则维度对不上。
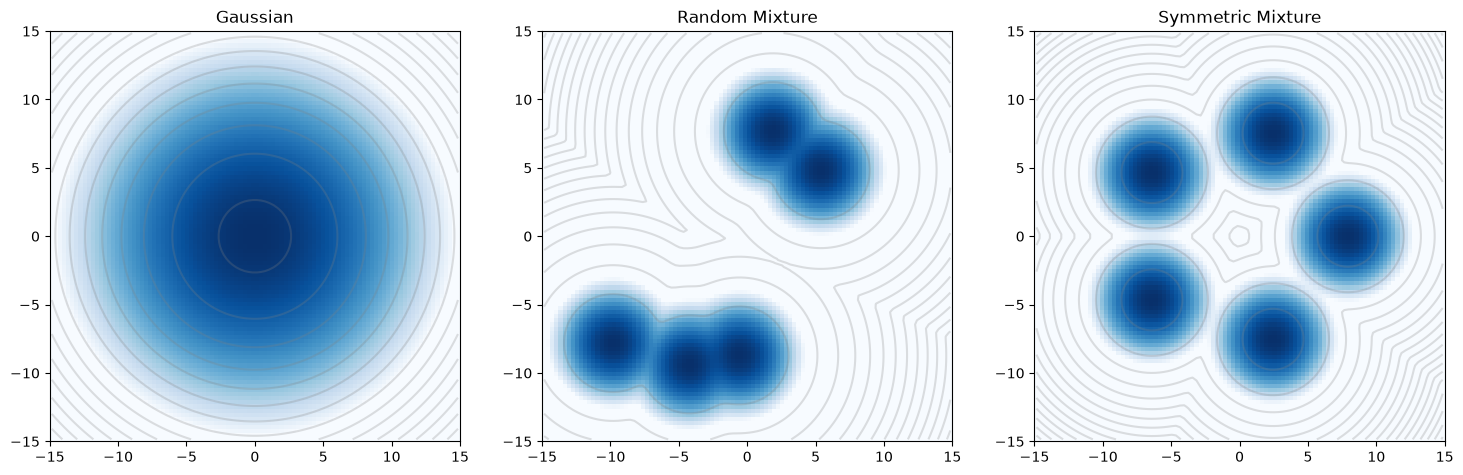
log_density,灰线是等高线,vmin=-15 截断)。左:$\N(0, 10I)$,单峰,score 处处指向原点,是 Langevin 最容易的情形。中:random_2D(nmodes=5, std=1.0, scale=20),五个峰随机散布并意外地聚成左下、右上两团,团与团之间是大片近乎零密度的区域——这正是下面观察"Langevin 难以跨模式跳转"的舞台。右:symmetric_2D(nmodes=5, std=1.0, scale=8),五个峰均匀排在半径 8 的圆周上,权重相等,适合检验采样器有没有模式坍缩(mode collapse)。注意中图与右图的 score 在峰之间是指向最近峰的,所以样本一旦落进某个盆地就很难出来。Q3.1:实现 LangevinSDE
题目在问什么
给定一个能算密度的分布 $p$,实现(过阻尼)朗之万动力学
$$ \dd{X_t} \;=\; \frac{1}{2}\sigma^2\,\nabla\log p(X_t)\,\dd{t} \;+\; \sigma\dd{W_t}. $$也就是:漂移 = 半个 $\sigma^2$ 乘以 score,扩散 = $\sigma$。
数学依据:为什么偏偏是 ½σ²
系数 $\frac12\sigma^2$ 不是凑出来的,它是让 $p$ 成为平稳分布的唯一选择。用 Lecture 01 的 Fokker–Planck 方程可以一步验出来。
Fokker–Planck 方程说,若 $X_t\sim p_t$ 且 $\dd{X_t} = \vft{t}(X_t)\dd{t}+\sigma\dd{W_t}$,则
$$ \partial_t p_t(x) \;=\; -\divg\!\left(p_t\vft{t}\right)(x) + \frac{\sigma^2}{2}\Lap p_t(x). $$要让 $p$ 平稳,就是要求把 $p_t \equiv p$ 代进去后右端恒为零。取 $\vf(x) = \frac{\sigma^2}{2}\nabla\log p(x)$:
$$ \begin{aligned} -\divg\!\left(p\,\vf\right) + \frac{\sigma^2}{2}\Lap p &= -\divg\!\left(p\cdot\frac{\sigma^2}{2}\nabla\log p\right) + \frac{\sigma^2}{2}\divg\!\left(\nabla p\right) &&\text{(i) } \Lap = \divg\circ\nabla\\ &= -\frac{\sigma^2}{2}\divg\!\left(p\,\frac{\nabla p}{p}\right) + \frac{\sigma^2}{2}\divg(\nabla p) &&\text{(ii) } \nabla\log p = \frac{\nabla p}{p}\\ &= -\frac{\sigma^2}{2}\divg(\nabla p) + \frac{\sigma^2}{2}\divg(\nabla p) &&\text{(iii) 约分}\\ &= 0. && \end{aligned} $$关键是第 (ii)→(iii) 步:$p\cdot\nabla\log p = p\cdot\frac{\nabla p}{p} = \nabla p$,漂移带来的"输运"项与扩散带来的"抹平"项精确抵消。这个抵消只在系数恰为 $\frac{\sigma^2}{2}$ 时成立:若写成 $c\,\sigma^2\nabla\log p$,结果是 $\left(\frac12 - c\right)\sigma^2\Lap p \ne 0$。
直觉:score $\nabla\log p$ 指向密度增大的方向,所以漂移把粒子往峰上推、越堆越集中;布朗项则各向同性地把粒子摊开。$\frac12\sigma^2$ 就是让"推"和"摊"两股力量恰好势均力敌的那个配比。配比偏大,样本会过度集中在峰上(相当于对 $p$ 做了"降温",$p^{\beta}$ 且 $\beta>1$);偏小则样本比 $p$ 更弥散。
顺带一提,这里只验证了"平稳"(stationary),没有验证"收敛"(ergodicity)。后者需要额外条件,而且收敛速度可能极慢——这正是下面观察到的多模态困难的根源。
参考实现
class LangevinSDE(SDE):
    def __init__(self, sigma: float, density: Density):
        self.sigma = sigma
        self.density = density

    def drift_coefficient(self, xt: torch.Tensor, t: torch.Tensor) -> torch.Tensor:
        # u_t(x) = (1/2) * sigma^2 * grad log p(x)
        return 0.5 * self.sigma ** 2 * self.density.score(xt)   # (bs, dim)

    def diffusion_coefficient(self, xt: torch.Tensor, t: torch.Tensor) -> torch.Tensor:
        return self.sigma * torch.ones_like(xt)                 # (bs, dim)
为什么这样写
- 调
self.density.score(xt)而不是自己求导。基类已经用vmap(jacrev(...))实现好了,返回形状就是(bs, dim),与xt一致,可以直接线性组合。自己写autograd.grad要处理requires_grad和no_grad上下文,纯属自找麻烦。 self.sigma ** 2而不是self.sigma。漂移里是 $\sigma^2$、扩散里是 $\sigma$,两处不同。这是本题唯一的"陷阱",也是最值得对着上面的推导确认一遍的地方。- 为什么漂移不含
t?目标分布 $p$ 是固定的,所以 Langevin 是时齐的 SDE。这跟后面 lab 里"沿一条概率路径 $p_t$ 逐步演化"的 SDE 不同——那时 score 会变成 $\nabla\log p_t$,显含时间。 - 性能提示:
score里的vmap(jacrev(...))是整个 lab 最慢的操作。graph_dynamics默认 1000 步 × 1000 个样本,在 CPU 上要跑好几分钟。把device设成cuda,或者把num_samples降到 500 先调通。
- 漂移写成
0.5 * self.sigma * score(少平方)。症状:样本仍然会往峰上聚,但最终分布比目标宽(当 $\sigma<1$ 时漂移被削弱,扩散相对变强)。这个 bug 在 $\sigma=1$ 时完全看不出来($1^2=1$),而 notebook 默认 $\sigma=0.6$——恰好能看出来,但也恰好容易被当成"还没收敛"。验证方法见第 6 节:拿一维高斯当目标,末端方差应精确等于目标方差。 - 漏掉
0.5。等价于把目标分布"降温"成 $p^2$(再归一化):峰变得更尖、模式之间更难跳。在多峰目标上表现为样本过度集中在几个峰的中心,肉眼很难与"收敛得很好"区分。 - score 的符号弄反(写成
-score)。这会让粒子逃离高密度区,样本迅速飞向无穷远。好在这个错误一眼可见——图上散点会全部跑出画面。 - 自定义
Density时log_density返回(bs,)而不是(bs, 1)。基类score里的squeeze((1,2,3))是按(bs,1,1,1,dim)的布局硬编码的,形状一变就报IndexError或者悄悄返回错误形状。 - 忘了
.to(device)。Gaussian和GaussianMixture都继承torch.nn.Module并用register_buffer存参数,所以必须显式.to(device);否则 score 在 CPU 上算、xt在 GPU 上,直接报设备不匹配。
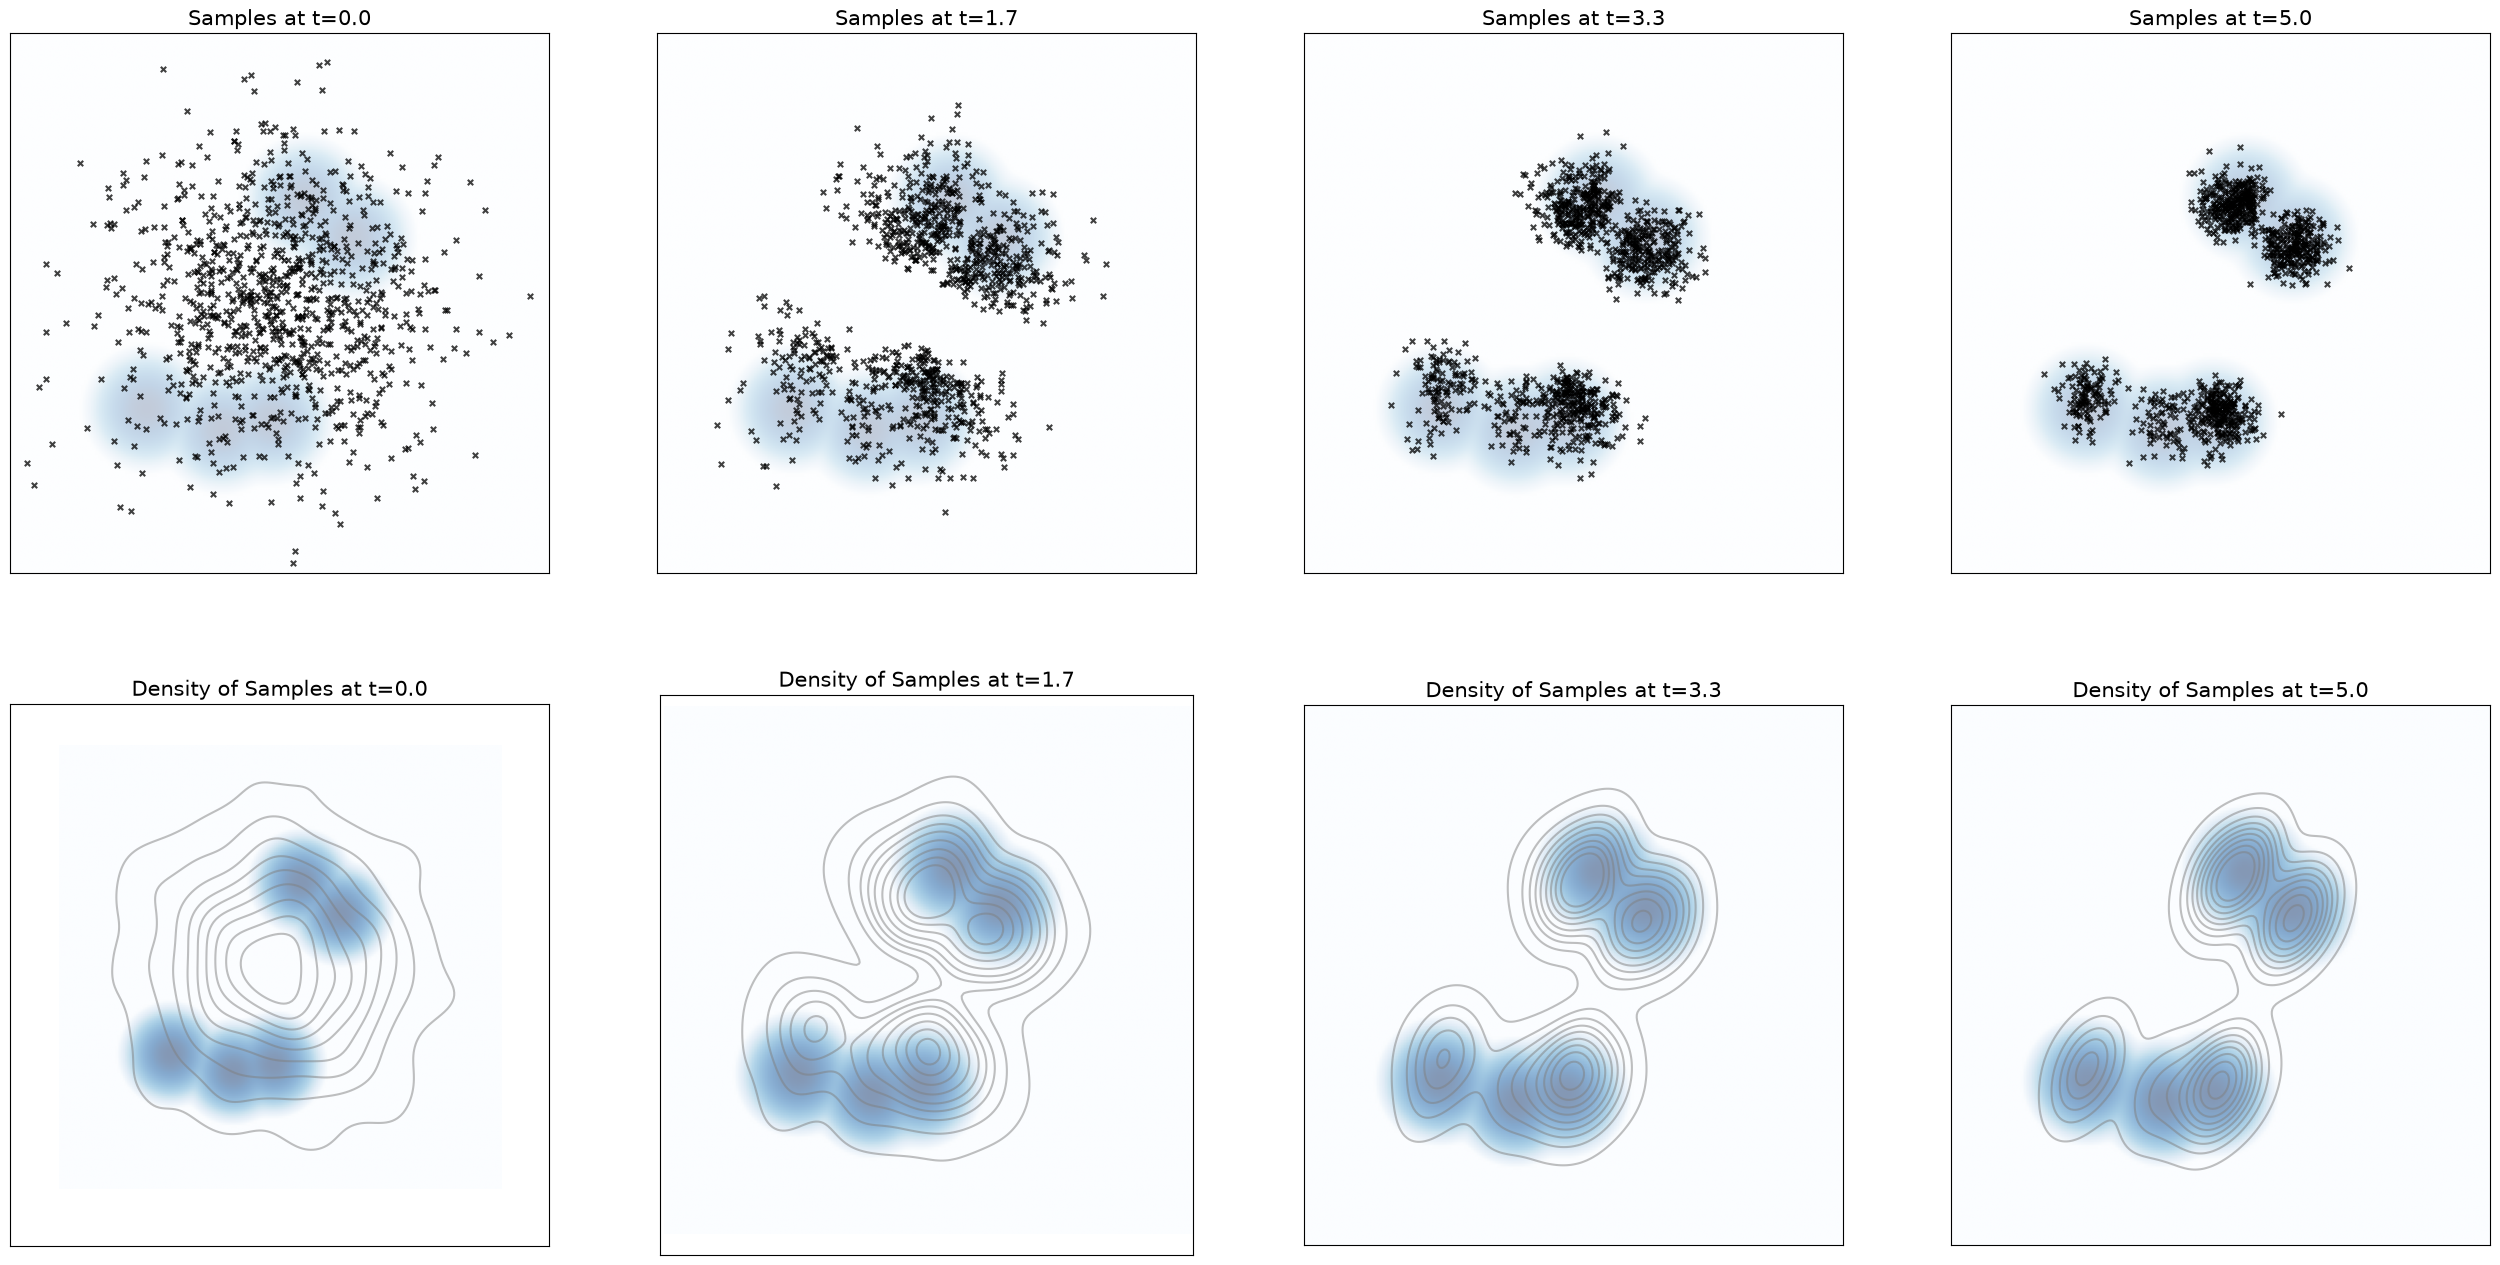
random_2D(nmodes=5, std=0.75, scale=15),$t$ 从 0 跑到 5(上排:样本散点叠在目标密度上;下排:样本的核密度估计)。这张图验证了两件相反的事。好消息:仅靠 score 提供的"局部几何信息",一团各向同性的宽高斯在 $t=5$ 内就被整形成了贴合目标的五个紧凑团块——从 $t=0$ 的一片散沙到 $t=3.3$ 已基本成形,说明 $\frac12\sigma^2\nabla\log p$ 这个漂移确实把 $p$ 当成了平衡态。坏消息(更重要):对比 $t=5$ 的散点与底图蓝色密度可以发现,各团的样本数比例并不等于目标的混合权重——每个粒子只是滚进了它出发时最近的那个盆地,之后几乎再没跨越过低密度区。Langevin 保持 $p$ 平稳,但从任意初值收敛到 $p$ 的时间随势垒高度指数增长。这就是为什么实际的扩散模型不用纯 Langevin 采样,而要用一条从噪声到数据的时变概率路径。Q3.1 文字题:改 σ、步数、源分布、目标密度会怎样
调大 $\sigma$:漂移($\propto\sigma^2$)和扩散($\propto\sigma$)同时变强,但漂移增长更快,所以整体动力学被加速——收敛到目标所需的 $t$ 变短,而且粒子跨越模式之间低密度区的能力增强(噪声更大,更容易翻过势垒)。代价是欧拉–丸山的离散误差变大:$\sigma$ 太大而步长不够细时,样本会在峰周围过冲、甚至数值发散。注意平稳分布本身与 $\sigma$ 无关——上面的 Fokker–Planck 验证对任意 $\sigma>0$ 都成立,$\sigma$ 只改变"多快到"和"离散误差多大"。
调小 $\sigma$:动力学变慢,粒子基本只做局部的梯度上升,几乎不可能换盆地;在有限模拟时间内样本会停在初始位置附近的局部峰上,看起来像"没收敛"。$\sigma\to0$ 的极限是纯梯度流 $\dot X = 0$,粒子冻住。
增加步数(细化步长)而总时间不变:结果不应有肉眼可见的变化,只是离散误差变小。这是一条极好的自查:如果把 torch.linspace(0,5,1000) 换成 torch.linspace(0,5,4000) 后图明显变了,说明原来的步长根本不够,或者 step 里的 $\sqrt{h}$ 写错了。
延长总时间:样本分布会更接近目标;但如上所述,跨模式的权重平衡收敛极慢,把 $T$ 从 5 加到 50 也未必能把各团的样本比例修正过来。
换源分布:如果源分布方差很小(比如 $\N(0, 0.1I)$,全部集中在原点),样本只能到达离原点最近的那一两个峰,其余峰完全采不到——模式坍缩会非常明显。反之源分布越宽、覆盖越均匀,各峰被采到的机会越接近。这说明 Langevin 的结果强依赖初始化,本质上不是一个"从零开始生成"的采样器。
换目标密度:换成单高斯,收敛又快又干净,任何初值都行——单峰情形没有势垒。换成 symmetric_2D(五峰均匀排在圆周上),若源分布是以原点为中心的对称高斯,各峰采样比例会比 random_2D 均衡得多,因为对称性帮了忙。把混合分量的 std 调小(峰更尖、势垒更高),跨模式跳转会变得更难。
Langevin 动力学是"已知 score 就能采样"的存在性证明:它说明只要能拿到 $\nabla\log p$,采样问题原则上就解决了。但这张图同时暴露了它的致命弱点——混合时间(mixing time)在多模态分布上是灾难性的。整门课后面的扩散模型可以看成对这个弱点的回应:不去死磕单个固定的 $p$,而是构造一族从纯噪声 $\simple$ 平滑过渡到 $\data$ 的分布 $p_t$,在高噪声端势垒被抹平(容易混合),随着 $t$ 增大再逐步"降温"到真实数据。这就是 annealing 的思想,也是 Lab 2、Lab 3 的主线。
6. Q3.2:证明 OU 过程就是高斯的 Langevin 动力学
这是全 lab 唯一一道纯数学题,没有代码,但它是把 Part 2 和 Part 3 缝在一起的那一针。题目分两问。
Q3.2 第一问:求 N(0, σ²/2θ) 的 score
题目在问什么
证明当 $p(x) = \N\!\left(0,\ \frac{\sigma^2}{2\theta}\right)$ 时,
$$ \nabla\log p(x) \;=\; -\frac{2\theta}{\sigma^2}x . $$完整推导
第 0 步:写出密度。记方差 $s^2 \triangleq \frac{\sigma^2}{2\theta}$。一维零均值高斯的密度是
$$ p(x) \;=\; \frac{1}{\sqrt{2\pi s^2}}\exp\!\left(-\frac{x^2}{2s^2}\right). $$把 $s^2 = \frac{\sigma^2}{2\theta}$ 代进去,先化简两处。指数里:
$$ \frac{x^2}{2s^2} \;=\; \frac{x^2}{2\cdot\frac{\sigma^2}{2\theta}} \;=\; \frac{x^2\theta}{\sigma^2}. $$归一化常数里:
$$ \frac{1}{\sqrt{2\pi s^2}} \;=\; \frac{1}{\sqrt{2\pi\cdot\frac{\sigma^2}{2\theta}}} \;=\; \frac{1}{\sqrt{\frac{\pi\sigma^2}{\theta}}} \;=\; \frac{\sqrt{\theta}}{\sigma\sqrt{\pi}}. $$于是
$$ p(x) \;=\; \frac{\sqrt{\theta}}{\sigma\sqrt{\pi}}\exp\!\left(-\frac{x^2\theta}{\sigma^2}\right), $$与题目 Hint 给的表达式一致(这一步就是在核对 Hint,不是白做的:它确认了 $\frac{\sigma^2}{2\theta}$ 是方差而不是标准差)。
第 1 步:取对数。对数把乘积变成求和,这正是 score 好算的原因:
$$ \log p(x) \;=\; \underbrace{\log\frac{\sqrt{\theta}}{\sigma\sqrt{\pi}}}_{\text{与 }x\text{ 无关}} \;-\; \frac{\theta}{\sigma^2}x^2 . $$第 2 步:求导。第一项是常数,导数为零;第二项用 $\frac{\dd{}}{\dd{x}}x^2 = 2x$:
$$ \nabla\log p(x) \;=\; \frac{\dd{}}{\dd{x}}\log p(x) \;=\; 0 - \frac{\theta}{\sigma^2}\cdot 2x \;=\; -\frac{2\theta}{\sigma^2}x . \qquad\blacksquare $$第 3 步(推广到 $d$ 维)。若 $p = \N\!\left(0,\ \frac{\sigma^2}{2\theta}I_d\right)$,则 $\log p(x) = C - \frac{\theta}{\sigma^2}\norm{x}^2$,用 $\nabla_x\norm{x}^2 = 2x$ 得到同样的式子 $\nabla\log p(x) = -\frac{2\theta}{\sigma^2}x$,只是现在 $x\in\R^d$。更一般地,对 $p = \N(\mu,\Sigma)$ 有 $\nabla\log p(x) = -\Sigma^{-1}(x-\mu)$——本题是 $\mu=0$、$\Sigma = s^2 I$ 的特例,$\Sigma^{-1} = \frac{1}{s^2}I = \frac{2\theta}{\sigma^2}I$。
- 归一化常数不影响 score。第 1 步里那一大坨 $\log\frac{\sqrt\theta}{\sigma\sqrt\pi}$ 在第 2 步直接死掉了。这不是巧合而是 score 的根本优点:$\nabla\log p = \nabla\log\left(Z\cdot\tilde p\right) = \nabla\log\tilde p$,只要知道未归一化的密度就够了。能量模型、贝叶斯后验里那个算不出来的配分函数,在 score 的世界里完全不存在。这是整个 score-based 生成模型能成立的前提。
- 高斯的 score 是线性的。$-\frac{2\theta}{\sigma^2}x$ 是 $x$ 的线性函数,指向原点,模长正比于距离。所以"score 场"和"OU 的回复力场"长得一模一样——这就是第二问的全部内容。
- 方差越小,score 越陡。系数 $\frac{2\theta}{\sigma^2} = \frac{1}{s^2}$ 是方差的倒数。分布越窄,把偏离的点拉回来的力越强。这解释了为什么扩散模型在 $t\to 0$(噪声极小)时 score 的量级会爆炸,实践中必须做 $\sigma_t$ 的重加权或提前停止。
Q3.2 第二问:由此说明 OU 过程就是该 p 的 Langevin 动力学
题目在问什么
把第一问的 score 代进 Langevin 动力学的定义,验证得到的 SDE 与 OU 过程逐项相同。
完整推导
以 $p = \N\!\left(0,\frac{\sigma^2}{2\theta}\right)$ 为目标、噪声强度取 $\sigma$ 的 Langevin 动力学按定义是
$$ \dd{X_t} \;=\; \frac{1}{2}\sigma^2\,\nabla\log p(X_t)\,\dd{t} \;+\; \sigma\dd{W_t}. $$把第一问的结果 $\nabla\log p(X_t) = -\frac{2\theta}{\sigma^2}X_t$ 代入漂移项:
$$ \frac{1}{2}\sigma^2\cdot\left(-\frac{2\theta}{\sigma^2}X_t\right) \;=\; -\frac{1}{2}\cdot\frac{2\theta\sigma^2}{\sigma^2}X_t \;=\; -\theta X_t . $$$\sigma^2$ 与 $\frac12$、$2$ 全部约掉,只剩 $-\theta X_t$。于是 Langevin 动力学变成
$$ \dd{X_t} \;=\; -\theta X_t\dd{t} + \sigma\dd{W_t}, $$这正是 OU 过程的定义式。两个 SDE 的漂移系数相同、扩散系数相同;在系数满足 Lipschitz 与线性增长条件时 SDE 的强解唯一,因此在相同初值和相同布朗运动下它们是同一个过程(逐轨道相同,不只是同分布)。$\blacksquare$
反过来读同样成立,而且信息量更大:给定一个 OU 过程,问"它是以哪个分布为目标的 Langevin 动力学",就是解
$$ \frac{1}{2}\sigma^2\nabla\log p(x) = -\theta x \quad\Longrightarrow\quad \nabla\log p(x) = -\frac{2\theta}{\sigma^2}x \quad\Longrightarrow\quad \log p(x) = -\frac{\theta}{\sigma^2}x^2 + C, $$归一化后唯一地得到 $p = \N\!\left(0,\frac{\sigma^2}{2\theta}\right)$。这独立地再次证明了 OU 的平稳分布是 $\N\!\left(0,\frac{\sigma^2}{2\theta}\right)$——而这一次完全没有用到伊藤等距或闭式解,只用了"Langevin 保持目标分布不变"这一条。第 4 节用随机积分算出的 $D = \frac{\sigma^2}{2\theta}$,和这里用 score 反解出的方差,是同一个数。两条完全不同的路走到同一个答案,这就是这道题的意义。
- 它把 Part 2 和 Part 3 合上了。$D = \frac{\sigma^2}{2\theta}$ 这个在网格扫描图里"实验观察到"的量,原来就是 Langevin 目标分布的方差。实验和理论对上了。
- 它是扩散模型前向过程的原型。DDPM / VP-SDE 的加噪过程 $\dd{X_t} = -\frac12\beta_t X_t\dd{t} + \sqrt{\beta_t}\dd{W_t}$ 就是系数随时间变化的 OU。取 $\theta = \frac12\beta_t$、$\sigma = \sqrt{\beta_t}$,平稳分布 $\N\!\left(0,\frac{\beta_t}{2\cdot\frac12\beta_t}\right) = \N(0,1)$——标准正态。这就是"为什么加噪加到最后一定是标准高斯"的一行式回答,也是这套系数为什么这么配的原因。
- 它解释了 score 在生成模型里的地位。OU 是唯一一个 score 有闭式表达(线性函数)的情形,所以前向过程可以精确写下来。反向过程的 score $\nabla\log p_t$ 就没这个好运气了——它只能学。整门课接下来做的,就是把这道题里"已知的 $-\frac{2\theta}{\sigma^2}x$"换成"神经网络 $s_\phi(x,t)$"。
7. 如何验证自己的实现是对的
本 lab 的所有产出都是图,而图有个致命问题:随机过程的图"看起来对"的容忍度极高。轨迹有毛刺、末端有钟形直方图、OU 会收敛——这些现象在 $\sqrt{h}$ 写错、$\sigma$ 少平方、噪声采两次的情况下照样出现。所以别靠眼睛,靠数。
好消息是本 lab 涉及的每个对象都有闭式统计量,可以拿蒙特卡洛估计去对拍。下面这套自查只需要几十行代码,全部在 CPU 上几秒钟跑完。我把它整理成了 labs/tests/test_labs.py,Lab 1 部分共 13 项,全部通过;下表列出每一项的理论值与实测值。
| # | 检验项 | 理论依据 | 实测结果 | 能抓出什么 bug |
|---|---|---|---|---|
| 1 | Euler 一阶收敛:步长减半,误差减半 | 全局误差 $O(h)$ | 误差比 2.004 / 2.001($N=100\to200\to400$) | * h 漏掉、用错步长、误用二阶格式 |
| 2 | Euler 精细步长逼近解析解 | $\dot x = -x$、$x_0=1$ 的解为 $e^{-1}$ | $N=20000$ 时误差 $<10^{-4}$ | 符号错、把 $t$ 当 $h$ |
| 3 | 布朗运动方差 $=\sigma^2 t$ | $X_t\sim\N(0,\sigma^2t)$ | 4.4871 vs 理论 4.5000($\sigma=1.5,T=2$,4 万条) | $\sqrt{h}$ 写成 $h$、扩散系数写成 $\sigma^2$ |
| 4 | 布朗运动均值 $\approx 0$ | 零漂移 | $|{\bar x}| < 0.05$ | 漂移项没清零 |
| 5 | 末端分布峰度 $\approx 3$ | 高斯的峰度恒为 3 | 3.016 | doubly-stochastic bug(噪声乘了两次,峰度会变成 9) |
| 6 | 布朗运动漂移严格为 0 | 定义 | 逐元素精确为 0 | 返回了标量或常数 |
| 7 | 扩散系数形状 $=$ xt.shape 且值 $=\sigma$ | 接口约定 | 形状与取值均通过 | 返回标量、返回 $\sigma^2$ |
| 8 | OU 平稳方差 $=\frac{\sigma^2}{2\theta}$ | 第 4 节的闭式解 | 0.3203 vs 理论 0.3200($\theta=1,\sigma=0.8$) | 漏负号、把 2 记错、$\sqrt{h}$ 错 |
| 9 | OU 平稳均值 $\approx 0$,且与初值无关 | $x_0e^{-\theta t}\to0$ | 从 $\N(0,25)$ 出发,$T=20$ 后均值 $<0.03$ | 漂移符号反(会发散) |
| 10 | OU 漂移 $=-\theta x$ | 定义 | 与解析式误差 $<10^{-6}$ | 写成 $-\theta t$、漏负号 |
| 11 | Langevin 漂移 $=\frac12\sigma^2\cdot\text{score}$ | 定义 | 与解析式误差 $<10^{-6}$ | 少平方、漏 $\frac12$ |
| 12 | Langevin 收敛到目标均值 | $p=\N(2,1.3^2)$ 是平稳分布 | 2.0110 vs 目标 2.0 | score 符号反、漂移系数错 |
| 13 | Langevin 收敛到目标方差 | 同上 | 1.6840 vs 目标 1.6900 | $\frac12\sigma^2$ 的系数错(这一项对系数最敏感) |
七行代码测出 Euler 是不是一阶
选一个有解析解的 ODE:$\frac{\dd{x}}{\dd{t}} = -x$,$x_0 = 1$,则 $x(1) = e^{-1}$。
class Decay(ODE):
    def drift_coefficient(self, xt, t):
        return -xt                       # (bs, dim)

sim, errs = EulerSimulator(Decay()), []
for n in [100, 200, 400]:
    ts = torch.linspace(0.0, 1.0, n + 1)
    xT = sim.simulate(torch.ones(1, 1), ts)
    errs.append(abs(xT.item() - math.exp(-1.0)))
print(errs[0] / errs[1], errs[1] / errs[2])   # 期望 ~2.0, 实测 2.004 / 2.001
两个比值都应该接近 2。如果接近 4,说明你不小心实现了二阶格式(比如中点法);如果不趋于任何常数,说明步长没有正确进入公式。这条测试之所以有力,是因为它检验的是收敛阶——一个不依赖于常数因子、无法靠"碰巧调对参数"蒙混过关的性质。
三行代码抓出 √h 与 doubly-stochastic 两个大坑
sigma, T = 1.5, 2.0
sim = EulerMaruyamaSimulator(BrownianMotion(sigma))
xT  = sim.simulate(torch.zeros(40000, 1), torch.linspace(0.0, T, 201))

print(xT.var().item(), sigma ** 2 * T)        # 4.4871 vs 4.5000
z = (xT - xT.mean()) / xT.std()
print((z ** 4).mean().item())                 # 峰度:3.016(高斯应为 3)
标准化后的四阶矩 $\E[z^4]$(峰度,kurtosis)对高斯而言恒等于 3,与 $\sigma$、$T$、步数全都无关——它只检验形状,不检验尺度。这让它成为一个极其干净的探针:
- $\sqrt{h}$ 写成 $h$:末端仍是高斯(独立高斯之和还是高斯),峰度还是 3,但方差会掉到 $\sigma^2T^2/N$——所以第 3 项(方差)能抓它,第 5 项抓不到。
- 噪声采样两次(
randn_like(xt) * randn_like(xt)):两个独立标准高斯之积的方差仍是 1,所以方差检验可能照样通过;但它的四阶矩是 $\E[z_1^4]\E[z_2^4] = 3\times3 = 9$,峰度跳到 9。第 5 项抓它。
两条测试各管一半,合起来才能把 step 的随机项完全钉死。实测 4.4871(相对误差 0.3%)与 3.016,说明实现干净。
Langevin 的自查:用一维高斯当目标
二维五峰混合太难收敛,不适合做单元测试。换成一维高斯 $p = \N(\mu, s^2)$,它的 score 有闭式 $-\frac{x-\mu}{s^2}$,而且单峰无势垒,$T=40$ 足够混合:
class Gauss1D(Density):
    def __init__(self, mu, s): self.mu, self.s = mu, s
    def log_density(self, x):
        return (-0.5 * ((x - self.mu) / self.s) ** 2).sum(dim=-1, keepdim=True)
    def score(self, x):                       # 覆盖基类,避免 vmap/jacrev 的形状纠缠
        return -(x - self.mu) / self.s ** 2

sim = EulerMaruyamaSimulator(LangevinSDE(sigma=1.0, density=Gauss1D(2.0, 1.3)))
xT  = sim.simulate(torch.zeros(40000, 1), torch.linspace(0.0, 40.0, 8001))
print(xT.mean().item(), xT.var().item())      # 2.0110 / 1.6840,目标 2.0 / 1.6900
注意所有粒子都从 0 出发,而目标均值是 2——如果 score 的符号或系数错了,均值绝对到不了 2.0110。方差 1.6840 对 $\frac12\sigma^2$ 这个系数尤其敏感:把 0.5 * sigma ** 2 误写成 0.5 * sigma($\sigma=1$ 时看不出来)或 sigma ** 2(漏 $\frac12$,方差会掉到目标的一半左右),这一项立刻报警。所以做这类自查时永远别用 $\sigma=1$ 和 $\mu=0$。
用 $M$ 个样本估计方差,相对标准误大约是 $\sqrt{2/M}$。$M = 40000$ 时约 0.7%,所以上表里 3% / 5% 的容差是"约 4~7 倍标准误",既不会误报也不会漏掉真 bug。如果你把样本数降到 1000,相对标准误会涨到 4.5%——这时 3% 的容差会频繁误报。调容差之前先想清楚统计涨落有多大,否则会把随机波动当成 bug 追半天。
8. 本 lab 小结
| 题号 | 对象 | 数学式 | 代码核心 | 最容易错的地方 |
|---|---|---|---|---|
| Q1.1a | Euler | $X_{t+h}=X_t+h\,\vft{t}(X_t)$ | xt + drift * h | 漏 * h |
| Q1.1b | Euler–Maruyama | $X_{t+h}=X_t+h\,\vft{t}(X_t)+\sigma_t\sqrt{h}\,z$ | xt + drift*h + diff*torch.sqrt(h)*torch.randn_like(xt) | 把 $\sqrt{h}$ 写成 $h$;噪声采两次;设备不匹配 |
| Q2.1 | 布朗运动 | $\dd{X_t}=\sigma\dd{W_t}$,$X_t\sim\N(0,\sigma^2t)$ | zeros_like(xt) / sigma * ones_like(xt) | 返回标量;扩散写成 $\sigma^2$ |
| Q2.2 | OU 过程 | $\dd{X_t}=-\theta X_t\dd{t}+\sigma\dd{W_t}$,$p_\infty=\N\!\left(0,\frac{\sigma^2}{2\theta}\right)$ | -theta * xt / sigma * ones_like(xt) | 漏负号;平稳方差记成 $\frac{\sigma^2}{\theta}$ |
| Q3.1 | Langevin | $\dd{X_t}=\frac12\sigma^2\nabla\log p(X_t)\dd{t}+\sigma\dd{W_t}$ | 0.5 * sigma**2 * density.score(xt) | 漏 $\frac12$ 或漏平方;score 符号反 |
| Q3.2 | 两者的等价 | $\nabla\log\N\!\left(0,\tfrac{\sigma^2}{2\theta}\right)=-\frac{2\theta}{\sigma^2}x$ | — | 忘了归一化常数对 score 无贡献 |
- $\sqrt{h}$ 不是笔误。确定性项按时间一次方走,随机项按半次方走。写成 $h$ 会让噪声随步长细化而消失,SDE 悄悄退化成 ODE。整门课后面所有"多出来的 $\frac12\sigma^2$ 和拉普拉斯项",来源都是这一个平方根。
- 系数函数返回张量,不返回标量。形状
(bs, dim),并用*_like继承 device 和 dtype。这个习惯在 Lab 3 处理(bs,1,32,32)图像时会救你的命。 - SDE 收敛的是分布,不是点。OU 的解永远在抖,收敛的是它的 law:$\N\!\left(0,\frac{\sigma^2}{2\theta}\right)$。$D=\frac{\sigma^2}{2\theta}$ 决定平稳分布多宽,$1/\theta$ 决定多快到达——两个自由度,一个管形状一个管时钟。
- Langevin 是"已知 score 就能采样"的存在性证明,也是它的反例。$\frac12\sigma^2$ 这个系数让 $p$ 恰好平稳(Fokker–Planck 一验即得),但从任意初值收敛到 $p$ 的时间随势垒指数增长——多峰目标上会明显偏权重。扩散模型的时变概率路径正是为绕开这一点而生。
- 验证要用闭式统计量,不要用眼睛。$\Var = \sigma^2t$、峰度 $=3$、$\Var_\infty=\frac{\sigma^2}{2\theta}$、Euler 误差比 $=2$——这四条能覆盖本 lab 几乎所有可能的实现错误。
Lab 1 造好了"模拟器",但所有 SDE 的系数都是手写死的。Lab 2 · Flow Matching and Score Matching 会把这些系数换成学出来的:先构造从 $\simple$ 到 $\data$ 的条件概率路径,推出它的条件向量场与条件 score,再用回归把边缘向量场训练出来,最后仍然用你今天写的这两个 step 去采样。所以 Lab 1 的代码不会被丢掉——它是后面两个 lab 的运行时。
延伸阅读
- Lecture 01 · Flow and Diffusion Models —— 本 lab 全部公式的理论出处:向量场与流、布朗运动的定义、Euler / Euler–Maruyama 的推导、连续性方程与 Fokker–Planck 方程的完整证明。
- Generative Modeling by Estimating Gradients of the Data Distribution (Song & Ermon, 2019) —— 把本 lab 的 Langevin 动力学推向真实数据:正是这篇论文发现"单一 $p$ 上的 Langevin 混合太慢",并提出用多尺度噪声退火(annealed Langevin)来解决,直接对应本页 Q3.1 观察到的模式偏权重问题。
- Score-Based Generative Modeling through Stochastic Differential Equations (Song et al., 2021) —— 把 DDPM 与 score matching 统一到 SDE 框架;其中的 VP-SDE 就是系数随时间变化的 OU 过程,Q3.2 那道题是理解它的钥匙。
- Flow Matching for Generative Modeling (Lipman et al., 2022) —— Lab 2 的理论来源,用 ODE 而非 SDE 完成同一件事。
- Kloeden & Platen, Numerical Solution of Stochastic Differential Equations —— SDE 数值方法的标准参考书。想知道 Euler–Maruyama 的强收敛阶为何是 $\frac12$ 而弱收敛阶是 $1$(本 lab 关心的其实是后者,因为我们只在乎分布),以及 Milstein 格式如何把强阶提到 1,看这本。