Flow and Diffusion Models
把"生成一张图片"翻译成"从一个概率分布里采样",再把"采样"翻译成"模拟一条微分方程的轨迹"——本讲搭好这条翻译链的全部数学地基。
0. 本讲导读
这门课的名字叫「用随机微分方程做生成式 AI」。所以第一讲要回答的问题只有两个,但都很硬:
- 「生成一张狗的图片」这句话,在数学上到底是什么意思? 只要还停留在"生成得好不好"这种主观判断上,就没法写出损失函数、没法做梯度下降。我们需要把它变成一个有精确定义的数学任务。
- 假设我们已经知道要采样哪个分布,用什么机器去采? 答案是:模拟一条微分方程。从一团纯噪声出发,让它沿着某个"速度场"流动,流到时间 $t=1$ 时,它就变成了一张图片。
本讲不涉及任何训练算法——怎么学那个速度场是第 2 讲(flow matching)和第 3 讲(score matching)的事。本讲只干一件事:把"采样机器"的零件全部造好并说清楚每个零件的类型和维度。具体地说,我们会依次定义:向量场(vector field)、常微分方程(ODE)、流(flow)、布朗运动(Brownian motion)、随机微分方程(SDE),然后给出模拟它们的数值算法(Euler、Heun、Euler–Maruyama),最后用连续性方程(continuity equation)和 Fokker–Planck 方程把"轨迹的运动"和"分布的演化"这两件事严格地连起来。
最后这一步是全课的数学地基。整门课后面所有的定理——边际化技巧(marginalization trick)、flow matching 损失的等价性、ODE 与 SDE 给出同一条概率路径、guidance 的推导——追到底都是在用连续性方程或 Fokker–Planck 方程。所以本讲会把附录 B 里那个 Fokker–Planck 的完整证明一步不落地做完,包括分部积分那一步为什么边界项会消失。
- 生成 = 采样。我们把要生成的对象表示成向量 $z \in \R^d$,把"好的对象"定义为"在数据分布 $\data$ 下概率密度高的对象"。于是"生成一张狗的图片"精确地等于"从 $\data$ 中抽一个样本 $z \sim \data$"。条件生成就是从 $\data(\cdot \mid y)$ 中采样。
- ODE、向量场、流是同一个对象的三种说法。向量场 $u_t : \R^d \times [0,1] \to \R^d$ 定义 ODE $\frac{\dd{}}{\dd{t}} X_t = u_t(X_t)$,其解由流映射 $\psi_t : \R^d \to \R^d$ 给出。只要 $u$ 连续可微且导数有界,流存在且唯一(Picard–Lindelöf)。
- SDE = ODE + 布朗运动。布朗运动的增量满足 $W_{t+h} - W_t \sim \N(0, h I_d)$,标准差按 $\sqrt{h}$ 而不是 $h$ 缩放。这一个 $\sqrt{h}$ 是后面所有"多出来的拉普拉斯项"的唯一来源。
- 流模型 = 神经网络参数化的向量场 + 随机初值。$X_0 \sim \simple$,$\frac{\dd{}}{\dd{t}} X_t = u^\theta_t(X_t)$,目标是让 $X_1 \sim \data$。扩散模型只是在同一个式子上加一项 $\sigma_t \dd{W_t}$。神经网络参数化的是向量场,不是流——流要靠数值模拟才能得到。
- Fokker–Planck 方程把轨迹语言翻译成分布语言: $$ \partial_t p_t(x) = -\divg(p_t u_t)(x) + \frac{\sigma_t^2}{2}\Lap p_t(x) $$ 它是 $X_t \sim p_t$ 的充分必要条件。取 $\sigma_t = 0$ 就退化成连续性方程 $\partial_t p_t = -\divg(p_t u_t)$。
把 $\R^d$ 想象成一缸水,$p_t(x)$ 是 $x$ 处的染料浓度,$u_t(x)$ 是 $x$ 处的水流速度。连续性方程说的就是"染料总量守恒":某点浓度的变化率 = 流进来的减去流出去的。Fokker–Planck 多出来的 $\frac{\sigma_t^2}{2}\Lap p_t$ 是扩散项——除了被水流带着走,染料自己还会往浓度低的方向扩散。这就是热方程(heat equation)里那一项。
1. 从「生成」到「采样」:把问题形式化
1.1 我们要生成的东西是向量
先看几种常见的数据模态(data modality),以及怎么把它们放进计算机:
| 模态 | 结构 | 数学表示 | 展平后 |
|---|---|---|---|
| 图像(image) | 高 $H$、宽 $W$,每像素 3 个颜色通道(RGB),每个通道是一个实数强度值 | $z \in \R^{H \times W \times 3}$ | $d = 3HW$ |
| 视频(video) | $T$ 帧图像按时间排列 | $z \in \R^{T \times H \times W \times 3}$ | $d = 3THW$ |
| 分子结构(molecular structure) | $N$ 个原子,每个原子有 3 个空间坐标 | $z = (z^1,\dots,z^N) \in \R^{3 \times N}$,$z^i \in \R^3$ | $d = 3N$ |
三个例子的共同点:展平之后都是一个欧氏空间中的向量。这就是本课贯穿始终的第一个约定。
Key Idea 1(对象即向量):我们把要生成的对象等同于向量 $z \in \R^d$。
一个显著的例外是文本:语言模型(如 ChatGPT)把文本建模成离散对象(一串 token),而不是 $\R^d$ 中的点。连续数据 $z \in \R^d$ 是本课的主线;离散数据的扩散模型放在第 5 讲讲。
1.2 「生成得好」是主观的,「概率大」不是
假设提示词是"一张狗的图片"。什么样的输出算成功?直觉上会有一个连续谱:一团彩色噪声(毫无用处)$\to$ 模糊的四条腿生物(很差)$\to$ 一只清晰的猫(画错了动物)$\to$ 一只在草地上的边境牧羊犬(很棒)。这个排序是主观的,没法直接优化。
关键的转换是:不要问"这张图好不好",改问"这张图在真实世界的狗图片中出现的可能性有多大"。同样的四个例子,换成概率语言就是:不可能出现 $\to$ 极罕见 $\to$ 不太可能(它是猫不是狗)$\to$ 非常可能。主观的"好"就被替换成了客观的"似然大"。
形式化地,我们假设"所有可能的狗图片"服从一个数据分布(data distribution) $\data$,它是定义在图像空间 $\R^d$ 上的一个概率分布,其概率密度(probability density)是一个函数
$$ \data : \R^d \to \R_{\ge 0}, \qquad z \mapsto \data(z), $$满足 $\int_{\R^d} \data(z)\,\dd{z} = 1$。看起来像狗的图片 $z$,$\data(z)$ 就大;一团噪声,$\data(z)$ 就几乎是 0。
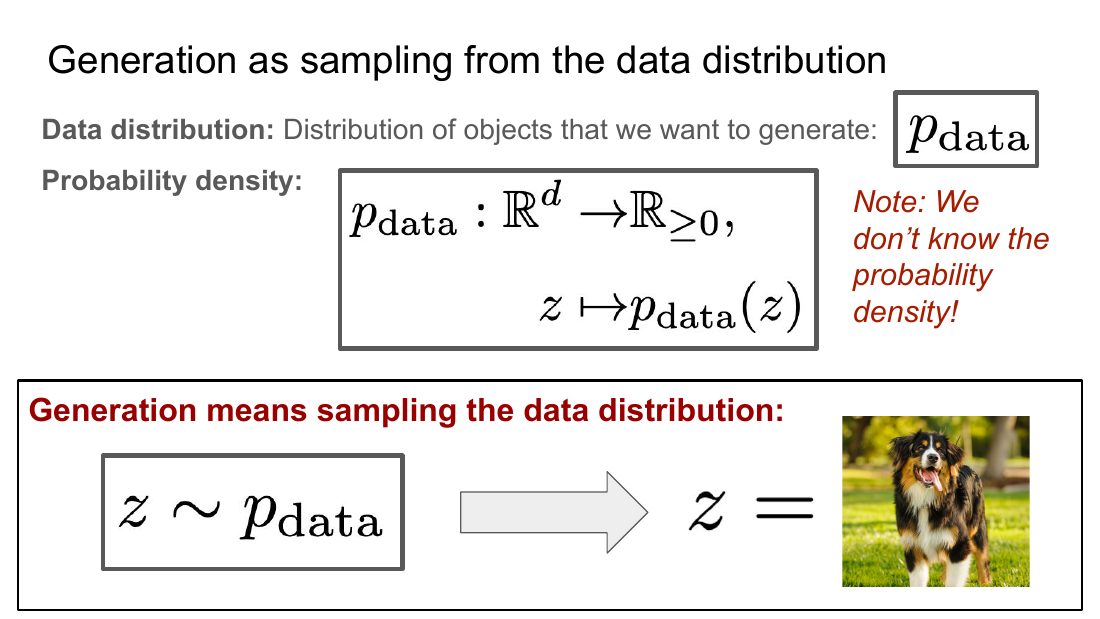
Key Idea 2(生成即采样):生成一个对象 $z$ 被建模为从数据分布中采样,$z \sim \data$。
请务必分清两件事:我们假设 $\data$ 存在,但我们不知道 $\data$ 是什么,既写不出它的解析式,也算不出任意一点的密度值 $\data(z)$。我们唯一拥有的是数据集——从 $\data$ 中独立抽出的有限个样本。这就是为什么后面的训练算法必须只依赖"能采样"这一个能力,而绝不能依赖"能算密度"。
Key Idea 3(数据集):一个数据集由有限个样本 $z_1,\dots,z_N \sim \data$ 组成。
图像的数据集可以从互联网收集;视频可以用 YouTube;蛋白质结构可以用 RCSB Protein Data Bank(PDB)里数十万个实验解析出的结构。数据集越大,它作为 $\data$ 的代理就越准确。
1.3 条件生成:把提示词加进来
实际使用时我们几乎从不做无条件生成,而是希望"根据提示词 $y$ 生成",例如 $y = $ "一只狗在雪山背景的山坡上奔跑"。这在数学上就是从条件分布(conditional distribution)中采样。
Key Idea 4(引导生成 / guided generation):引导生成是指从 $z \sim \data(\cdot \mid y)$ 中采样,其中 $y$ 是条件变量。$\data(\cdot \mid y)$ 称为引导数据分布(guided data distribution)。
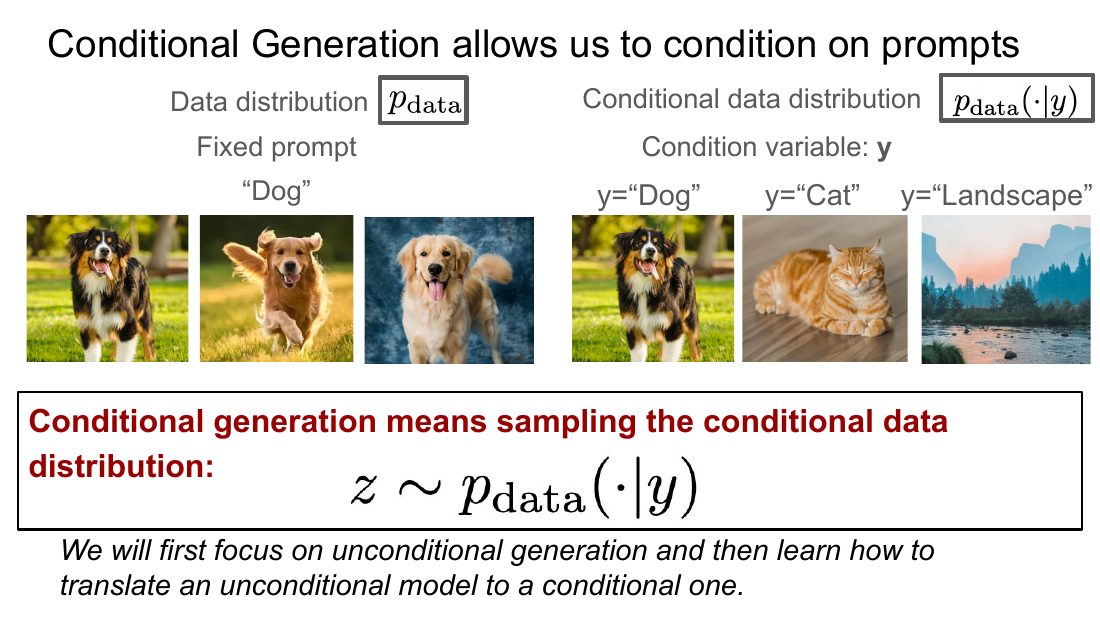
值得强调的是,条件情形的困难不是"对每个 $y$ 训一个模型",而是要训一个可以被任意 $y$ 条件化的模型。好消息是:无条件情形的所有技术都能相当直接地推广到条件情形。因此前三节我们几乎只讨论无条件情形,心里记着条件生成才是最终目标。
1.4 生成模型 = 把简单分布搬运成复杂分布
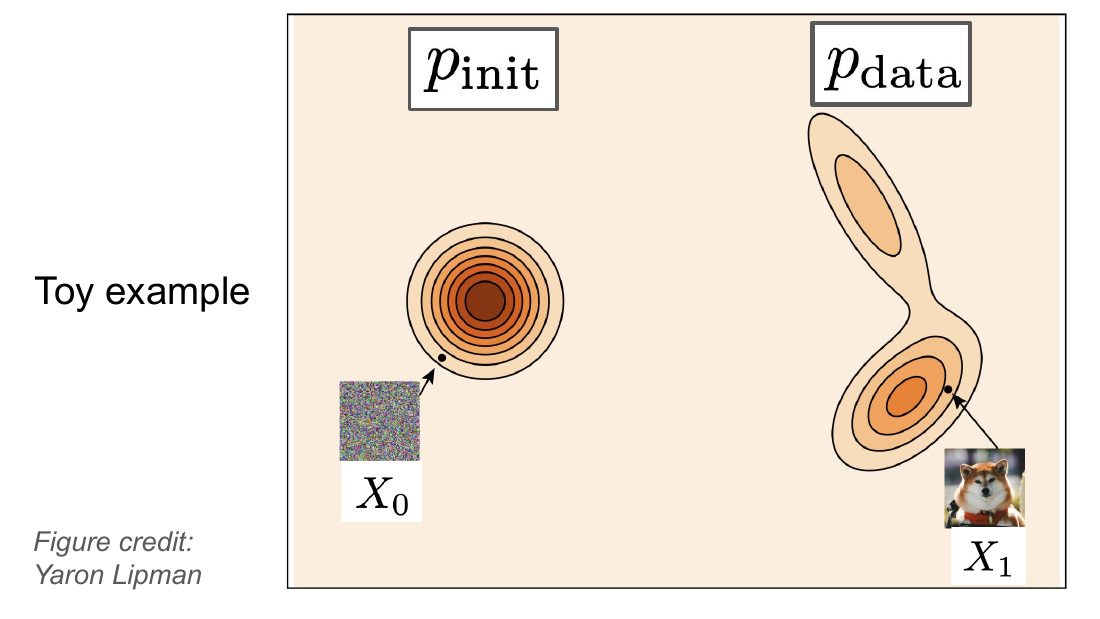
抽象地说,生成模型(generative model)就是一个能返回 $z \sim \data$(至少是近似)样本的算法。本课采用的具体构造方式是:
- 先取一个容易采样的初始分布(initial distribution) $\simple$。绝大多数情况下就取标准高斯 $\simple = \N(0, I_d)$——因为
torch.randn一行就能采。 - 再造一台确定性或随机的"搬运机器",把 $X_0 \sim \simple$ 连续地变形成 $X_1 \sim \data$。
Summary 2(本节小结):
- 我们主要考虑生成能表示成向量 $z \in \R^d$ 的对象(图像、视频、分子结构)。
- 生成 = 从概率分布 $\data$ 中采样,训练时只能访问数据集 $z_1,\dots,z_N \sim \data$。
- 引导生成 = 以标签 $y$ 为条件,从 $\data(\cdot\mid y)$ 中采样,训练时访问样本对 $(z_1,y_1),\dots,(z_N,y_N)$。
- 目标是构造一个生成模型,即训练后能返回 $\data$ 样本的模型。
2. 记号与概率论工具箱
后面所有推导都要反复用到几个概率论事实。这一节把它们集中列出并说清楚每个对象的类型,读到后面卡住时可以回来查(对应讲义附录 A)。
2.1 随机向量与密度
在 $d$ 维欧氏空间 $\R^d$ 中,向量 $x = (x^1,\dots,x^d)$,标准内积 $\inner{x}{y} = \sum_{i=1}^d x^i y^i$,范数 $\norm{x} = \sqrt{\inner{x}{x}}$。我们考虑取值在 $\R^d$ 的随机变量(random variable, RV)$X$,其概率密度函数(probability density function, PDF)是连续函数 $p_X : \R^d \to \R_{\ge 0}$,使得任意事件 $A \subseteq \R^d$ 的概率为
$$ \mathbb{P}(X \in A) = \int_A p_X(x)\,\dd{x}, \qquad \int_{\R^d} p_X(x)\,\dd{x} = 1 . $$约定:对全空间积分时省略积分区间($\int \equiv \int_{\R^d}$);随机变量 $X_t$ 的密度 $p_{X_t}$ 简记为 $p_t$。记号 $X \sim p$ 表示 $X$ 服从密度 $p$。
生成建模中最常见的密度是 $d$ 维各向同性高斯(isotropic Gaussian):
$$ \N(x; \mu, \sigma^2 I) = (2\pi\sigma^2)^{-\frac{d}{2}} \exp\!\left(-\frac{\norm{x-\mu}_2^2}{2\sigma^2}\right), $$其中均值 $\mu \in \R^d$、标准差 $\sigma \in \R_{>0}$。注意指数上是 $\norm{x-\mu}^2 = \sum_i (x^i - \mu^i)^2$,所以各坐标是独立的——这个事实在后面拆解 $\Lap$ 项时会用到。
2.2 期望与无意识统计学家定律
随机变量的期望是在最小二乘意义下最接近 $X$ 的常向量:
$$ \E[X] = \argmin_{z \in \R^d} \int \norm{x-z}^2 p_X(x)\,\dd{x} = \int x\, p_X(x)\,\dd{x} . $$为什么这个 $\argmin$ 等于积分?令 $L(z) = \int \norm{x-z}^2 p_X(x)\dd{x}$。这是关于 $z$ 的严格凸二次函数,令梯度为零:
$$ \begin{aligned} \nabla_z L(z) &= \int \nabla_z \norm{x-z}^2 \, p_X(x)\,\dd{x} \quad &&\text{(i) 积分与求导交换} \\ &= \int -2(x-z)\, p_X(x)\,\dd{x} \quad &&\text{(ii) $\nabla_z\norm{x-z}^2 = -2(x-z)$} \\ &= -2\int x\,p_X(x)\,\dd{x} + 2z\underbrace{\int p_X(x)\,\dd{x}}_{=1} . \end{aligned} $$令它等于 $0$ 得 $z = \int x\,p_X(x)\dd{x}$。这个"期望 = 最小二乘最优常数"的视角非常重要:第 2、3 讲里 flow matching 和 score matching 的损失函数之所以能把"不可算的边际量"换成"可算的条件量",用的正是这个引理的条件版本。
计算随机变量的函数的期望时用无意识统计学家定律(law of the unconscious statistician, LOTUS):
$$ \E[f(X)] = \int f(x)\, p_X(x)\,\dd{x} . $$这条式子在 Fokker–Planck 的证明里是核心桥梁——它把"对随机轨迹取期望"翻译成"对密度做积分",从而让分部积分成为可能。需要指明对哪个随机变量取期望时写作 $\E_X[f(X)]$。
2.3 条件密度、条件期望与塔性质
给定两个随机变量 $X, Y \in \R^d$,其联合密度 $p_{X,Y}(x,y)$ 的边际(marginal)为
$$ \int p_{X,Y}(x,y)\,\dd{y} = p_X(x), \qquad \int p_{X,Y}(x,y)\,\dd{x} = p_Y(y). $$当 $p_Y(y) > 0$ 时,条件密度定义为 $p_{X\mid Y}(x\mid y) := \dfrac{p_{X,Y}(x,y)}{p_Y(y)}$,贝叶斯公式(Bayes' rule)为
$$ p_{Y\mid X}(y\mid x) = \frac{p_{X\mid Y}(x\mid y)\, p_Y(y)}{p_X(x)} \qquad (p_X(x) > 0). $$条件期望是在最小二乘意义下最接近 $X$ 的函数 $g_\star(Y)$(对比:期望是最接近的常数):
$$ g_\star := \argmin_{g:\R^d\to\R^d} \E\!\left[\norm{X - g(Y)}^2\right] = \argmin_{g} \int \left[\int \norm{x-g(y)}^2 p_{X\mid Y}(x\mid y)\,\dd{x}\right] p_Y(y)\,\dd{y}, $$对每个固定的 $y$ 单独取内层括号的最小值(用 2.2 节的结论),得到
$$ \E[X \mid Y = y] := g_\star(y) = \int x\, p_{X\mid Y}(x\mid y)\,\dd{x}. $$$\E[X\mid Y=y]$ 与 $\E[X\mid Y]$ 是两个不同类型的对象,虽然中文里都叫"条件期望":
- $\E[X\mid Y=y] = g_\star(y)$ 是一个确定性函数 $\R^d \to \R^d$;
- $\E[X\mid Y] := g_\star(Y)$ 是把这个函数作用在随机变量 $Y$ 上得到的随机变量,取值在 $\R^d$。
写公式时把它们混起来是本领域最常见的推导错误之一。
塔性质(tower property):$\E\big[\E[X\mid Y]\big] = \E[X]$。它在 Fokker–Planck 证明的第 3 步是关键一环(我们先对给定 $X_t$ 求条件期望,再对 $X_t$ 求期望)。
直接按定义展开:
$$ \begin{aligned} \E\big[\E[X\mid Y]\big] &= \int \left(\int x\, p_{X\mid Y}(x\mid y)\,\dd{x}\right) p_Y(y)\,\dd{y} \quad &&\text{(i) LOTUS 作用于 $g_\star(Y)$} \\ &= \int\!\!\int x\, p_{X,Y}(x,y)\,\dd{x}\,\dd{y} \quad &&\text{(ii) 条件密度定义,$p_{X\mid Y}p_Y = p_{X,Y}$} \\ &= \int x\left(\int p_{X,Y}(x,y)\,\dd{y}\right)\dd{x} \quad &&\text{(iii) Fubini 交换积分次序} \\ &= \int x\, p_X(x)\,\dd{x} = \E[X] \quad &&\text{(iv) 边际化} \end{aligned} $$其中 (i) 是把定义代进去,(ii) 消掉分母上的 $p_Y(y)$,(iii) 需要可积性(本课场景下总是成立),(iv) 用了边际公式。
最后一条常用等式:对任意两个随机变量 $X, Y$ 和函数 $f(X,Y)$,由 LOTUS 与条件期望定义可得
$$ \E[f(X,Y) \mid Y = y] = \int f(x,y)\, p_{X\mid Y}(x\mid y)\,\dd{x}. $$2.4 记号速查
| 符号 | 类型 / 维度 | 含义 |
|---|---|---|
| $z, x$ | $\R^d$ | 空间中的点(一张图片展平后的向量) |
| $t$ | $[0,1]$ | 时间。注意本课约定 $t=0$ 是噪声端、$t=1$ 是数据端 |
| $\data$ | $\R^d \to \R_{\ge0}$ | 数据分布密度(未知) |
| $\simple$ | $\R^d \to \R_{\ge0}$ | 初始分布密度(已知且易采样,通常 $\N(0,I_d)$) |
| $p_t$ | $\R^d \to \R_{\ge0}$ | 时刻 $t$ 的边际密度,$X_t \sim p_t$ |
| $u_t(x)$ | $\R^d\times[0,1]\to\R^d$ | 向量场(速度场) |
| $u^\theta_t(x)$ | $\R^d\times[0,1]\to\R^d$ | 参数为 $\theta$ 的神经网络向量场 |
| $\psi_t(x_0)$ | $\R^d\times[0,1]\to\R^d$ | 流映射(flow map) |
| $X_t$ | $\R^d$ 值随机变量 | 轨迹在时刻 $t$ 的位置 |
| $W_t$ | $\R^d$ 值随机变量 | $d$ 维布朗运动 |
| $\sigma_t$ | $[0,1]\to[0,\infty)$ | 扩散系数(标量,不是矩阵) |
| $\nabla f(x)$ | $\R^d$ | 标量函数的梯度 |
| $\nabla^2 f(x)$ | $\R^{d\times d}$ | Hessian 矩阵(对称) |
| $D u_t(x)$ | $\R^{d\times d}$ | 向量场对空间变量的 Jacobian |
| $\divg(v)(x)$ | $\R^d\to\R$ | 散度 $\sum_{i=1}^d \pd{}{x_i} v^i(x)$ |
| $\Lap w(x)$ | $\R^d\to\R$ | 拉普拉斯算子 $\sum_{i=1}^d \pd{^2}{x_i^2} w(x) = \divg(\nabla w)(x)$ |
3. 常微分方程、向量场与流
上一节把生成变成了"从 $\data$ 采样"。这一节开始造采样机器。核心想法:让一个点沿着一个速度场运动。
3.1 三个对象:轨迹、向量场、ODE
先定义轨迹(trajectory)——一个从时间到空间的函数:
$$ X : [0,1] \to \R^d, \qquad t \mapsto X_t . $$再定义向量场(vector field)——在每个时刻、每个位置指定一个速度:
$$ u : \R^d \times [0,1] \to \R^d, \qquad (x,t) \mapsto u_t(x) . $$看清楚类型:$u_t(x) \in \R^d$ 是一个向量,不是标量。它有 $d$ 个分量,写作 $u_t(x) = (u^1_t(x),\dots,u^d_t(x))$。在代码里,如果 batch size 是 bs,那么输入 x 的形状是 (bs, d),时间 t 是标量或 (bs, 1),输出向量场的形状必须还是 (bs, d)。形状对不上是本领域最高频的 bug。
常微分方程(ordinary differential equation, ODE)就是要求轨迹在每一点的速度恰好等于该点的向量场值,外加一个初值条件:
$$ \begin{aligned} \frac{\dd{}}{\dd{t}} X_t &= u_t(X_t) \qquad &&\blacktriangleright \ \text{ODE} \\ X_0 &= x_0 \qquad &&\blacktriangleright \ \text{初值条件} \end{aligned} $$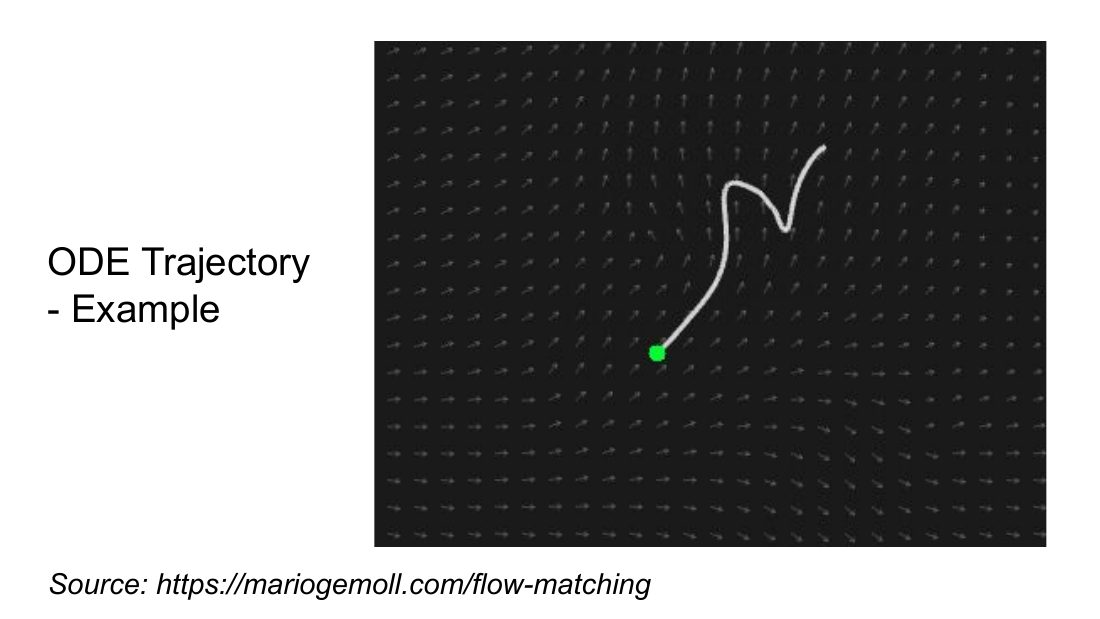
3.2 流:把所有初值的答案打包成一个映射
ODE 是"给定一个 $x_0$,问 $X_t$ 是多少"。如果我们想一次性回答所有起点的问题,就得到流(flow):
$$ \psi : \R^d \times [0,1] \to \R^d, \qquad (x_0, t) \mapsto \psi_t(x_0), $$它满足
$$ \begin{aligned} \frac{\dd{}}{\dd{t}} \psi_t(x_0) &= u_t(\psi_t(x_0)) \qquad &&\blacktriangleright \ \text{流 ODE} \\ \psi_0(x_0) &= x_0 \qquad &&\blacktriangleright \ \text{流初值条件,即 } \psi_0 = \mathrm{id} \end{aligned} $$给定初值 $X_0 = x_0$,ODE 的轨迹就是 $X_t = \psi_t(x_0)$。所以:
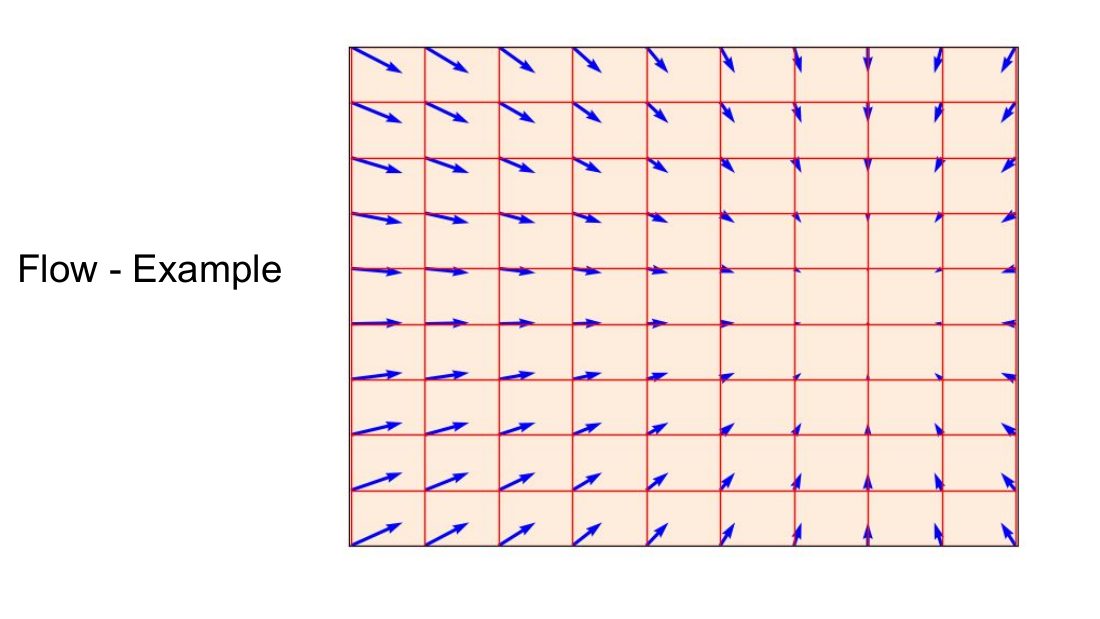
向量场、ODE、流是同一个对象的三种描述:向量场定义 ODE,ODE 的解就是流。它们的类型差别是:
- 向量场 $u_t : \R^d \to \R^d$ 是瞬时信息(速度);
- 流 $\psi_t : \R^d \to \R^d$ 是积分后的信息(经过时间 $t$ 之后你在哪);
- 轨迹 $X_t$ 是流固定一个起点后得到的一条曲线。
3.3 存在唯一性:Picard–Lindelöf 定理
写下一个方程不等于它有解。对 ODE 必须问两个问题:解存在吗?解唯一吗?
定理 3(流的存在唯一性 / Picard–Lindelöf):若 $u : \R^d\times[0,1] \to \R^d$ 连续可微且导数有界,则流 ODE 有唯一解,由流 $\psi_t$ 给出。此时对每个 $t$,$\psi_t$ 是一个微分同胚(diffeomorphism):$\psi_t$ 连续可微,且存在连续可微的逆 $\psi_t^{-1}$。更一般地,只要 $u$ 关于 $x$ 是 Lipschitz 的即可。
为什么这个定理对我们是"好消息而不是负担"?因为在机器学习里向量场 $u_t$ 由神经网络参数化,而神经网络(在有限参数、常见激活函数下)总是导数有界的。所以流在我们关心的所有情形下都存在且唯一。
唯一性的完整证明(Grönwall 论证)。这个论证只用到一次积分不等式,值得完整看一遍,因为它同时解释了"为什么需要 Lipschitz 条件"。
第 1 步:把 ODE 写成积分方程。设 $X_t, Y_t$ 都是同一初值 $x_0$ 的解。对 ODE 两边从 $0$ 积到 $t$,用微积分基本定理:
$$ X_t = x_0 + \int_0^t u_s(X_s)\,\dd{s}, \qquad Y_t = x_0 + \int_0^t u_s(Y_s)\,\dd{s} . $$第 2 步:作差并取范数。令 $L$ 为 $u$ 关于空间变量的 Lipschitz 常数(由"导数有界"保证:$\norm{u_s(a)-u_s(b)} \le L\norm{a-b}$)。则
$$ \begin{aligned} \norm{X_t - Y_t} &= \norm{\int_0^t \big(u_s(X_s) - u_s(Y_s)\big)\,\dd{s}} \quad &&\text{(i) 两式相减,$x_0$ 抵消} \\ &\le \int_0^t \norm{u_s(X_s) - u_s(Y_s)}\,\dd{s} \quad &&\text{(ii) 积分三角不等式} \\ &\le L\int_0^t \norm{X_s - Y_s}\,\dd{s} \quad &&\text{(iii) Lipschitz 条件} \end{aligned} $$第 3 步:Grönwall 不等式。记 $g(t) := \norm{X_t - Y_t} \ge 0$,上式即 $g(t) \le L\int_0^t g(s)\dd{s}$。令 $G(t) := \int_0^t g(s)\dd{s}$,则 $G'(t) = g(t) \le L\,G(t)$,即 $G'(t) - L\,G(t) \le 0$。两边乘正数 $e^{-Lt}$:
$$ \frac{\dd{}}{\dd{t}}\left(e^{-Lt}G(t)\right) = e^{-Lt}\big(G'(t) - L\,G(t)\big) \le 0 . $$所以 $e^{-Lt}G(t)$ 单调不增,而 $G(0)=0$,又 $G(t)\ge0$,故 $G(t) \equiv 0$,从而 $g(t) \le L\,G(t) = 0$,即 $X_t = Y_t$ 对所有 $t$ 成立。唯一性得证。
存在性(构造思路):Picard 迭代。定义函数序列
$$ \psi^{(0)}_t(x_0) := x_0, \qquad \psi^{(k+1)}_t(x_0) := x_0 + \int_0^t u_s\big(\psi^{(k)}_s(x_0)\big)\,\dd{s} . $$用与第 2 步同样的估计可以证明,在连续函数空间上(取上确界范数)映射 $\psi \mapsto x_0 + \int_0^\cdot u_s(\psi_s)\dd{s}$ 在足够短的时间区间上是压缩映射(压缩系数 $\le L\Delta t < 1$)。由 Banach 不动点定理,它有唯一不动点,即为解;再把区间一段一段接起来覆盖 $[0,1]$。这就是为什么讲义里说"数学课上用 Picard 迭代构造解"。
3.4 算例一:线性向量场(把计算真的做出来)
讲义 Example 4:取 $u_t(x) = -\theta x$,其中 $\theta > 0$ 是常数。断言流为
$$ \psi_t(x_0) = \exp(-\theta t)\, x_0 . $$验证初值条件:$\psi_0(x_0) = \exp(0)\,x_0 = x_0$。✓
验证流 ODE:
$$ \begin{aligned} \frac{\dd{}}{\dd{t}}\psi_t(x_0) &= \frac{\dd{}}{\dd{t}}\big(\exp(-\theta t)\,x_0\big) \quad &&\text{(i) 代入 $\psi$ 的定义} \\ &= -\theta \exp(-\theta t)\, x_0 \quad &&\text{(ii) 链式法则} \\ &= -\theta\, \psi_t(x_0) \quad &&\text{(iii) 再次用 $\psi$ 的定义} \\ &= u_t(\psi_t(x_0)) \quad &&\text{(iv) 向量场的定义 $u_t(x)=-\theta x$} \end{aligned} $$两条都验证了,由定理 3 的唯一性,这就是那个解。注意 (iii)$\to$(iv) 这一步是整个验证的关键:我们必须把 $-\theta\psi_t(x_0)$ 认出来是"向量场作用在当前位置上",而不是"向量场作用在初始位置上"。
这个流在做什么?它以指数速度把所有点吸向原点:$t\to\infty$ 时 $\psi_t(x_0)\to 0$,且收敛率与初始位置成正比。$\theta$ 越大收缩越快。这个例子在下面第 8 节会作为 Ornstein–Uhlenbeck 过程的"无噪声骨架"再次出现。
3.5 算例二:矩阵线性场与旋转(为连续性方程做铺垫)
更一般地,取 $u_t(x) = A x$,其中 $A \in \R^{d\times d}$ 是常数矩阵。则流是矩阵指数
$$ \psi_t(x_0) = \exp(tA)\, x_0, \qquad \exp(tA) := \sum_{k=0}^{\infty}\frac{(tA)^k}{k!} . $$验证:$\frac{\dd{}}{\dd{t}}\exp(tA) = A\exp(tA)$(逐项求导即可),故 $\frac{\dd{}}{\dd{t}}\psi_t(x_0) = A\exp(tA)x_0 = A\psi_t(x_0) = u_t(\psi_t(x_0))$。✓ 取 $A = -\theta I_d$ 就回到上一个例子。
取 $d = 2$ 和
$$ A = \begin{pmatrix} 0 & -\omega \\ \omega & 0\end{pmatrix}, \qquad\text{即}\qquad u(x) = (-\omega x^2,\ \omega x^1), $$则 $\exp(tA) = \begin{pmatrix}\cos\omega t & -\sin\omega t \\ \sin\omega t & \cos\omega t\end{pmatrix}$ 是旋转矩阵,流就是以角速度 $\omega$ 绕原点匀速旋转。
直接验证而不用级数。记 $c = \cos\omega t$、$s = \sin\omega t$,$R(t) = \begin{pmatrix} c & -s\\ s & c\end{pmatrix}$。左边:
$$ \frac{\dd{}}{\dd{t}} R(t) = \omega\begin{pmatrix} -s & -c \\ c & -s \end{pmatrix} . $$右边:
$$ A R(t) = \begin{pmatrix} 0 & -\omega \\ \omega & 0\end{pmatrix}\begin{pmatrix} c & -s\\ s & c\end{pmatrix} = \begin{pmatrix} -\omega s & -\omega c \\ \omega c & -\omega s \end{pmatrix} . $$两者相等,且 $R(0) = I_2$。✓
这个例子有个重要性质:它的散度为零,
$$ \divg(u)(x) = \pd{}{x^1}(-\omega x^2) + \pd{}{x^2}(\omega x^1) = 0 + 0 = 0 . $$散度为零意味着这个流保体积(Liouville 定理):它只是把空间转了个圈,没有压缩也没有膨胀任何区域。到第 10 节我们会看到,连续性方程立刻告诉我们:如果初始分布 $p_0$ 是旋转对称的(比如标准高斯 $\N(0,I_2)$),那么在这个流下 $p_t = p_0$ 对所有 $t$ 成立——高斯被旋转之后还是同一个高斯。这提供了一个非常有用的直觉:向量场把点搬来搬去,但分布变不变,取决于散度。
4. 数值模拟:Euler 方法与 Heun 方法
上一节的两个例子都能写出闭式解,但那是因为向量场极其简单。一旦 $u_t$ 是一个几亿参数的神经网络,就绝无可能解析地算出 $\psi_t$。唯一的出路是数值模拟。
4.1 Euler 方法:从导数定义直接读出来
推导的起点就是导数的定义。对小的 $h > 0$:
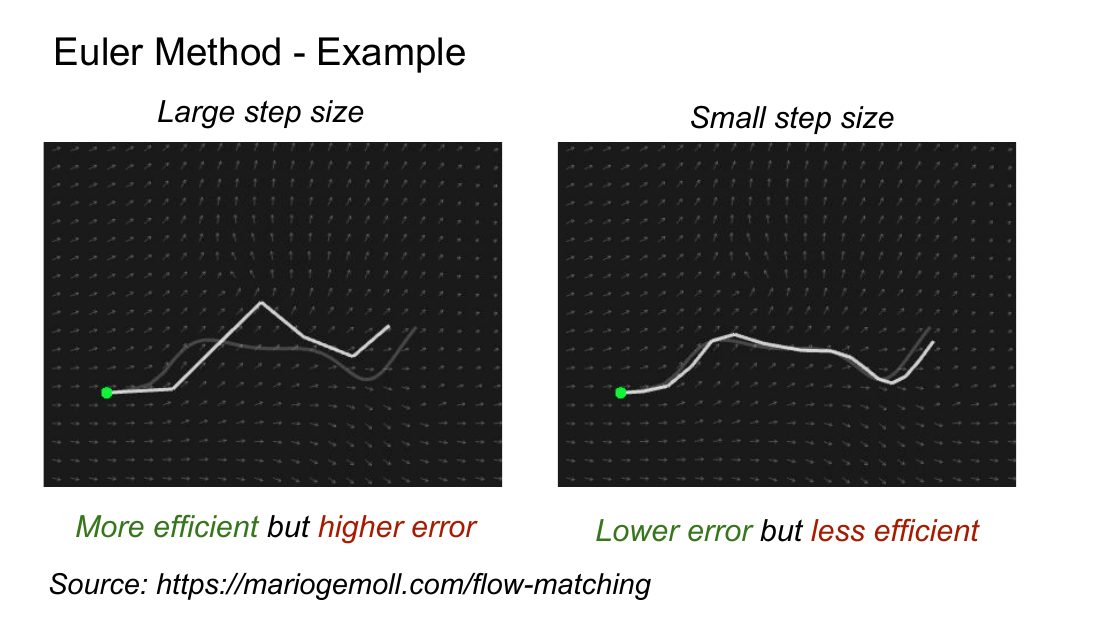
$$ \frac{X_{t+h} - X_t}{h} \approx \frac{\dd{}}{\dd{t}}X_t = u_t(X_t) \qquad\Longrightarrow\qquad X_{t+h} \approx X_t + h\, u_t(X_t) . $$把 $\approx$ 换成 $=$,就得到 Euler 方法(Euler method):初始化 $X_0 = x_0$,然后
$$ X_{t+h} = X_t + h\, u_t(X_t), \qquad t = 0,\ h,\ 2h,\ 3h,\ \dots,\ 1-h, $$其中 $h = n^{-1} > 0$ 是步长(step size),$n \in \N$ 是模拟步数。走完 $n$ 步就从 $t=0$ 到了 $t=1$。
4.2 Euler 方法的误差:为什么它是一阶方法
第 1 步:算出轨迹的二阶导数。由 ODE $\dot X_t = u_t(X_t)$,对 $t$ 再求一次导,用多元链式法则($u_t(X_t)$ 同时通过下标 $t$ 和自变量 $X_t$ 依赖时间):
$$ \frac{\dd{^2}}{\dd{t}^2}X_t = \frac{\dd{}}{\dd{t}}u_t(X_t) = \underbrace{\partial_t u_t(X_t)}_{\text{显式时间依赖}} + \underbrace{D u_t(X_t)\,\dot X_t}_{\text{通过位置}} = \partial_t u_t(X_t) + D u_t(X_t)\, u_t(X_t), $$其中 $Du_t(x) \in \R^{d\times d}$ 是 $u_t$ 关于空间变量的 Jacobian,$\partial_t u_t(x) \in \R^d$。
第 2 步:Taylor 展开真实解。
$$ X_{t+h} = X_t + h\,u_t(X_t) + \frac{h^2}{2}\Big(\partial_t u_t(X_t) + D u_t(X_t)u_t(X_t)\Big) + O(h^3) . $$第 3 步:比较。Euler 一步只保留了前两项,所以单步(局部截断)误差是
$$ \norm{X_{t+h} - \big(X_t + h u_t(X_t)\big)} = \frac{h^2}{2}\norm{\partial_t u_t + D u_t\, u_t} + O(h^3) = \Theta(h^2) . $$第 4 步:累加。从 $0$ 走到 $1$ 一共 $n = 1/h$ 步。天真地把 $n$ 个 $\Theta(h^2)$ 加起来得到 $n \cdot h^2 = h$。严格论证需要 Grönwall(误差在传播时会被向量场放大,放大因子被 $e^{L}$ 控住),最终全局误差为
$$ \max_{t}\norm{X_t^{\text{Euler}} - X_t^{\text{true}}} \le \frac{C}{L}\big(e^{L} - 1\big)\, h = O(h) . $$误差与 $h$ 成正比,所以 Euler 是一阶方法:步数翻倍,误差减半。
4.3 Heun 方法:一次"预测-校正"换来一个数量级
Heun 方法(Heun's method)用两次向量场求值换更高精度:
$$ \begin{aligned} X'_{t+h} &= X_t + h\,u_t(X_t) \qquad &&\blacktriangleright \ \text{对新状态的初始猜测(就是一步 Euler)} \\ X_{t+h} &= X_t + \frac{h}{2}\Big(u_t(X_t) + u_{t+h}(X'_{t+h})\Big) \qquad &&\blacktriangleright \ \text{用当前点与猜测点速度的平均来更新} \end{aligned} $$直觉:Euler 完全相信"出发点的速度",而 Heun 先用 Euler 探路探到 $X'_{t+h}$,在那里再测一次速度,然后用两次速度的平均值重走这一步。这就是梯形积分法则。
证明 Heun 是二阶方法。把 $u_{t+h}(X'_{t+h})$ 作二元 Taylor 展开(同时展开时间和空间):
$$ \begin{aligned} u_{t+h}(X'_{t+h}) &= u_{t+h}\big(X_t + h\,u_t(X_t)\big) \quad &&\text{(i) 代入 $X'$ 定义} \\ &= u_t(X_t) + h\,\partial_t u_t(X_t) + D u_t(X_t)\big[h\,u_t(X_t)\big] + O(h^2) \quad &&\text{(ii) 在 $(X_t,t)$ 处一阶 Taylor} \\ &= u_t(X_t) + h\Big(\partial_t u_t(X_t) + D u_t(X_t)u_t(X_t)\Big) + O(h^2) . \end{aligned} $$代回 Heun 的更新式:
$$ \begin{aligned} X_{t+h}^{\text{Heun}} &= X_t + \frac{h}{2}\Big[u_t(X_t) + u_t(X_t) + h\big(\partial_t u_t + D u_t\,u_t\big) + O(h^2)\Big] \\ &= X_t + h\,u_t(X_t) + \frac{h^2}{2}\Big(\partial_t u_t(X_t) + D u_t(X_t)u_t(X_t)\Big) + O(h^3) . \end{aligned} $$拿它和第 4.2 节第 2 步的真实 Taylor 展开逐项对比:$h^0$、$h^1$、$h^2$ 三项完全一致。所以局部误差是 $O(h^3)$,全局误差 $O(h^2)$——Heun 是二阶方法。
代价是每步要算两次向量场。在扩散模型里向量场就是那个巨大的 U-Net 或 DiT,所以"步数"这个词要小心:Heun 走 $n$ 步的算力等于 Euler 走 $2n$ 步。只有当 $h$ 足够小、$O(h^2)$ 真的比 $O(h)$ 小很多时,Heun 才划算。
| 方法 | 每步更新 | 每步网络调用 | 局部误差 | 全局误差 |
|---|---|---|---|---|
| Euler | $X_t + h u_t(X_t)$ | 1 | $O(h^2)$ | $O(h)$ |
| Heun | $X_t + \frac h2(u_t(X_t) + u_{t+h}(X'_{t+h}))$ | 2 | $O(h^3)$ | $O(h^2)$ |
| Euler–Maruyama(SDE,见 §7) | $X_t + h u_t(X_t) + \sqrt{h}\,\sigma_t \epsilon_t$ | 1 | — | 强收敛 $O(\sqrt h)$ |
本课绝大多数场合用 Euler / Euler–Maruyama 就够了。
4.4 最小 PyTorch 实现
下面的抽象与课程 lab 中的一致:把"方程"(提供漂移系数/扩散系数)和"模拟器"(决定怎么走一步)分开。
import torch
from abc import ABC, abstractmethod


class ODE(ABC):
    @abstractmethod
    def drift_coefficient(self, xt: torch.Tensor, t: torch.Tensor) -> torch.Tensor:
        """向量场 u_t(x)。
        xt: (bs, dim)  当前位置
        t : ()         当前时间(标量)
        返回: (bs, dim) 与 xt 同形状的速度
        """
        ...


class Simulator(ABC):
    @abstractmethod
    def step(self, xt: torch.Tensor, t: torch.Tensor, h: torch.Tensor) -> torch.Tensor:
        """走一步:从时刻 t 的 xt 走到时刻 t+h。"""
        ...

    @torch.no_grad()
    def simulate(self, x: torch.Tensor, ts: torch.Tensor) -> torch.Tensor:
        # x : (bs, dim) 初始状态,位于 ts[0]
        # ts: (nts,)    时间网格,通常 torch.linspace(0.0, 1.0, n + 1)
        for i in range(len(ts) - 1):
            t = ts[i]
            h = ts[i + 1] - ts[i]          # 步长,允许非均匀网格
            x = self.step(x, t, h)
        return x                            # (bs, dim) 终点 X_1


class EulerSimulator(Simulator):
    """X_{t+h} = X_t + h * u_t(X_t)"""
    def __init__(self, ode: ODE):
        self.ode = ode

    def step(self, xt, t, h):
        return xt + self.ode.drift_coefficient(xt, t) * h      # (bs, dim)


class HeunSimulator(Simulator):
    """预测-校正:先 Euler 探一步,再用两端速度的平均重走。"""
    def __init__(self, ode: ODE):
        self.ode = ode

    def step(self, xt, t, h):
        u_now  = self.ode.drift_coefficient(xt, t)             # (bs, dim)
        x_pred = xt + u_now * h                                # X'_{t+h}, (bs, dim)
        u_next = self.ode.drift_coefficient(x_pred, t + h)     # (bs, dim)
        return xt + 0.5 * h * (u_now + u_next)                 # (bs, dim)
用第 3.4 节的线性向量场来验证实现的正确性——这是唯一能和闭式解逐位比对的场景:
class LinearODE(ODE):
    """u_t(x) = -theta * x,闭式流 psi_t(x0) = exp(-theta * t) * x0"""
    def __init__(self, theta: float):
        self.theta = theta

    def drift_coefficient(self, xt, t):
        return -self.theta * xt                                # (bs, dim)


theta = 2.0
x0 = torch.randn(512, 2)                                       # (512, 2)
exact = torch.exp(torch.tensor(-theta * 1.0)) * x0             # psi_1(x0)

for n in [10, 100, 1000]:
    ts = torch.linspace(0.0, 1.0, n + 1)
    e_euler = (EulerSimulator(LinearODE(theta)).simulate(x0.clone(), ts) - exact).norm(dim=-1).mean()
    e_heun  = (HeunSimulator (LinearODE(theta)).simulate(x0.clone(), ts) - exact).norm(dim=-1).mean()
    print(f"n={n:5d}  euler={e_euler:.3e}  heun={e_heun:.3e}")

# 观察:n 每放大 10 倍,euler 的误差约缩小 10 倍(一阶),
#       heun 的误差约缩小 100 倍(二阶)。这正是 4.2 / 4.3 节推导的结论。
把 Euler 更新写成 x = x + u(x, t) * h 时,注意 t 必须是这一步开始时的时间,而不是结束时的时间。用 $u_{t+h}$ 代替 $u_t$ 得到的是隐式(backward)Euler 的显式误用版本,在 $t\to1$ 附近向量场变化剧烈时会引入明显偏差。另一个高频错误是时间网格写成 torch.linspace(0, 1, n)——那样只有 $n-1$ 个区间,步长是 $1/(n-1)$ 而不是 $1/n$。
5. 流模型:用神经网络参数化向量场
零件齐了,现在组装第一台生成器。
5.1 随机性从哪来?
我们的目标是生成 $z\sim\data$ 的样本,而样本必须是随机的——每次运行要给出不同的狗。但 ODE 是完全确定的:给定 $x_0$,$X_1 = \psi_1(x_0)$ 是一个确定的点。矛盾怎么解决?
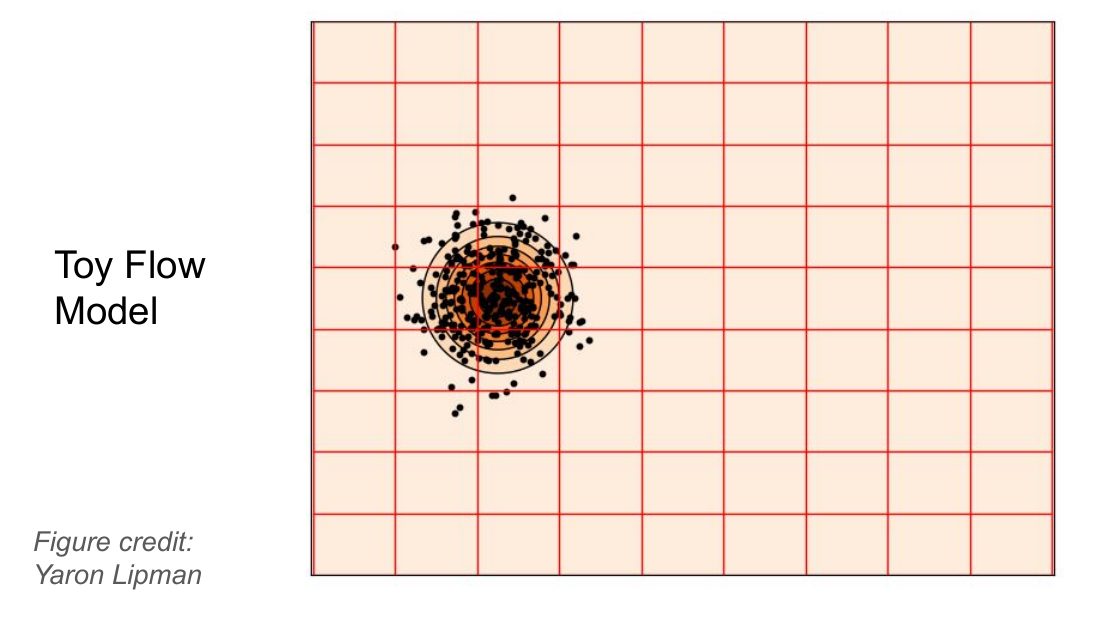
答案很简单:把随机性全部塞进初值。取一个容易采样的初始分布 $\simple$(默认 $\N(0,I_d)$),令 $X_0 \sim \simple$。这样 $X_1 = \psi_1(X_0)$ 就是随机变量 $X_0$ 经过确定映射 $\psi_1$ 的像,自然也是随机的。
$\simple$ 的选择有一条硬性约束:推理时必须能轻松采样。这就排除了"取 $\simple$ 为另一个复杂分布"的循环论证。标准高斯之所以是默认选择,就是因为 torch.randn 是 $O(d)$ 的。
5.2 流模型的定义
把向量场换成神经网络向量场(neural network vector field) $u^\theta_t$,即一个参数为 $\theta$ 的参数化函数
$$ u^\theta : \R^d\times[0,1]\to\R^d, \qquad (x,t)\mapsto u^\theta_t(x) . $$于是流模型(flow model)由下面这组方程描述:
$$ \begin{aligned} X_0 &\sim \simple \qquad &&\blacktriangleright \ \text{随机初始化} \\ \frac{\dd{}}{\dd{t}}X_t &= u^\theta_t(X_t) \qquad &&\blacktriangleright \ \text{ODE} \end{aligned} $$我们的目标是让轨迹的终点 $X_1$ 服从数据分布:
$$ X_1 \sim \data \qquad\Longleftrightarrow\qquad \psi^\theta_1(X_0) \sim \data , $$其中 $\psi^\theta_t$ 是 $u^\theta_t$ 诱导的流。
虽然名字叫"流模型",但神经网络参数化的是向量场,不是流。这是初学者最容易搞混的一点,而且它有非常实际的后果:
- 网络前向一次只给出瞬时速度 $u^\theta_t(x)$,它不告诉你终点在哪;
- 要得到流(也就是终点),必须模拟 ODE——调用网络几十到几千次;
- 所以"采样一张图"的成本 = 步数 × 单次前向成本。这就是为什么扩散模型采样比 GAN 慢几个数量级,也是"蒸馏"这一整条研究线的动机。
反过来说,如果我们直接用网络参数化流 $\psi^\theta_1$,采样就只要一次前向——但那样就没法用后面几讲的训练技巧了,因为训练信号是定义在向量场上的。
5.3 采样算法(Algorithm 1)
把 Euler 方法套进流模型,就得到讲义的 Algorithm 1:
| 行 | Algorithm 1:用 Euler 方法从流模型采样 |
|---|---|
| 输入 | 神经网络向量场 $u^\theta_t$,步数 $n$ |
| 1 | 令 $t = 0$ |
| 2 | 令步长 $h = \frac 1n$ |
| 3 | 抽样 $X_0 \sim \simple$ |
| 4 | for $i = 1,\dots,n$ do |
| 5 | $X_{t+h} = X_t + h\,u^\theta_t(X_t)$ |
| 6 | $t \leftarrow t + h$ |
| 7 | end for |
| 8 | return $X_1$ |
@torch.no_grad()
def sample_flow_model(u_theta, n: int, bs: int, dim: int, device="cpu"):
    """Algorithm 1:从流模型采样。
    u_theta(x, t) -> (bs, dim) 神经网络向量场
    返回: (bs, dim) 近似服从 p_data 的样本
    """
    h = 1.0 / n
    x = torch.randn(bs, dim, device=device)          # X_0 ~ p_init = N(0, I_d), (bs, dim)
    t = torch.zeros(1, device=device)                # ()
    for _ in range(n):
        x = x + h * u_theta(x, t)                    # X_{t+h} = X_t + h u_t(X_t), (bs, dim)
        t = t + h
    return x                                         # X_1, (bs, dim)
6. 布朗运动:随机性的原子
到目前为止一切都是确定性的。要把 ODE 升级成 SDE,我们需要一个"随机的时间增量",它就是布朗运动。
6.1 随机过程与布朗运动的定义
先明确类型。一个随机过程(stochastic process) $(X_t)_{0\le t\le 1}$ 满足:
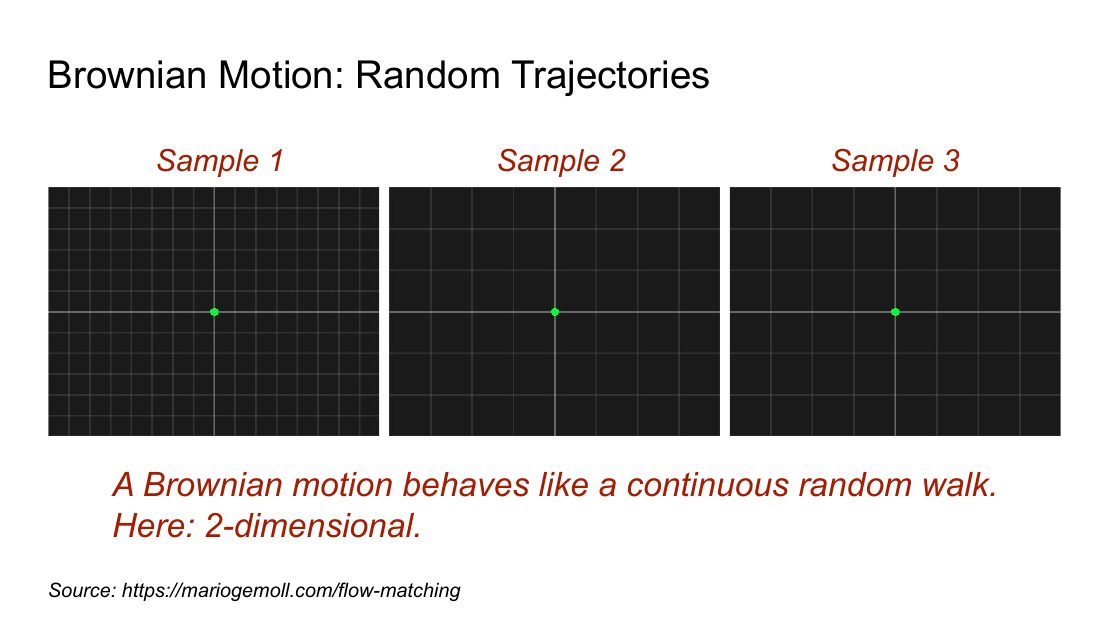
$$ \begin{aligned} &X_t \text{ 对每个 } 0\le t\le 1 \text{ 都是一个随机变量}, \\ &X : [0,1]\to\R^d,\ t\mapsto X_t \text{ 对 } X \text{ 的每一次抽取都是一条随机轨迹} . \end{aligned} $$换句话说,同一个随机过程模拟两次会得到不同的曲线,因为演化本身就是随机的。这与 ODE 形成鲜明对比:ODE 的随机性只在起点,SDE 的随机性弥漫在整条路径上。
定义(布朗运动 / Brownian motion):$W = (W_t)_{0\le t\le 1}$ 是一个随机过程,满足 $W_0 = 0$、轨迹 $t\mapsto W_t$ 连续,且:
- 正态增量(normal increments):对所有 $0\le s < t$,$\ W_t - W_s \sim \N(0, (t-s)I_d)$。即增量是高斯的,方差随时间线性增长($I_d$ 是 $d\times d$ 单位矩阵)。
- 独立增量(independent increments):对任意 $0\le t_0 < t_1 < \cdots < t_n = 1$,增量 $W_{t_1}-W_{t_0},\ \dots,\ W_{t_n}-W_{t_{n-1}}$ 相互独立。
布朗运动也叫 Wiener 过程(Wiener process),这是记号 $W$ 的来历(Norbert Wiener 是 MIT 的著名数学家)。
6.2 三个必须亲手算一遍的性质
性质 1:$\sqrt{t}$ 尺度。取 $s = 0$,由 $W_0 = 0$ 与正态增量性质得
$$ W_t = W_t - W_0 \sim \N(0, t I_d) \quad\Longrightarrow\quad \E[W_t] = 0, \qquad \Cov(W_t) = t I_d . $$因此每个坐标的标准差是 $\sqrt{t}$,而不是 $t$。整体位移的期望大小:
$$ \E\big[\norm{W_t}^2\big] = \tr\big(\Cov(W_t)\big) = \tr(tI_d) = d\,t \quad\Longrightarrow\quad \sqrt{\E\norm{W_t}^2} = \sqrt{d t} \ \propto\ \sqrt{t} . $$这个 $\sqrt{t}$ 是整门课后面所有"多出来的因子 2 和拉普拉斯项"的根源,务必记住。
性质 2:协方差 $\E[W_s W_t^\top] = \min(s,t)\,I_d$。设 $s < t$,把 $W_t$ 拆成"到 $s$ 为止"加"从 $s$ 到 $t$":
$$ \begin{aligned} \E[W_s W_t^\top] &= \E\big[W_s\,(W_s + (W_t - W_s))^\top\big] \quad &&\text{(i) 加零拆项} \\ &= \E[W_s W_s^\top] + \E\big[W_s (W_t-W_s)^\top\big] \quad &&\text{(ii) 线性性} \\ &= sI_d + \E[W_s]\,\E[(W_t-W_s)]^\top \quad &&\text{(iii) 独立增量 $\Rightarrow$ 期望可拆} \\ &= sI_d + 0 = \min(s,t)I_d . \end{aligned} $$其中 (iii) 用了独立增量性质:$W_s = W_s - W_0$ 与 $W_t - W_s$ 独立,独立随机变量乘积的期望等于期望的乘积;再加上 $\E[W_t - W_s] = 0$。
性质 3:几乎处处不可微。考察差商的分布。由正态增量,$W_{t+h}-W_t \sim \N(0,hI_d)$,所以
$$ \frac{W_{t+h} - W_t}{h} \sim \N\!\left(0, \frac{h}{h^2}I_d\right) = \N\!\left(0, \frac{1}{h}I_d\right) . $$它的标准差是 $h^{-1/2}$,当 $h\to 0$ 时发散到无穷。所以差商不可能收敛到任何有限值——布朗运动的轨迹虽然处处连续,却处处不可微(严格版本是 Paley–Wiener–Zygmund 定理:几乎必然地,轨迹在任何一点都不可微)。
这就是为什么 SDE 不能写成 $\frac{\dd{}}{\dd{t}}X_t = \cdots$ 的形式——导数根本不存在。第 7 节我们必须先把 ODE 改写成不含导数的形式,才能加上随机项。
6.3 路径无限长,但二次变差有限
讲义里有一句很漂亮的话:"布朗运动的路径是连续的(你可以一笔画出来而不抬笔),但它们是无限长的(所以你永远画不完)"。这句话可以算出来。
(a)路径长度发散。取 $d = 1$,把 $[0,T]$ 均匀分成 $n$ 段,$h = T/n$。折线长度为 $\sum_{i=0}^{n-1}\abs{W_{t_{i+1}} - W_{t_i}}$。每一项 $\abs{\Delta W_i} = \sqrt h\,\abs{\epsilon_i}$,$\epsilon_i\sim\N(0,1)$,而半正态分布的均值 $\E\abs{\epsilon} = \sqrt{2/\pi}$。于是
$$ \E\left[\sum_{i=0}^{n-1}\abs{\Delta W_i}\right] = n\sqrt{h}\sqrt{\frac{2}{\pi}} = \frac{T}{h}\sqrt{h}\sqrt{\frac{2}{\pi}} = T\sqrt{\frac{2}{\pi h}} \ \xrightarrow{\ h\to 0\ }\ \infty . $$细分越细,测出来的长度越大,没有上界。关键在于 $n \cdot \sqrt h = T/\sqrt h$:一阶量按 $\sqrt h$ 缩小,但项数按 $1/h$ 增长,前者赢不过后者。
(b)二次变差(quadratic variation)恰好是 $T$。换成平方再加:
$$ \E\left[\sum_{i=0}^{n-1}(\Delta W_i)^2\right] = \sum_{i=0}^{n-1}\E\big[h\,\epsilon_i^2\big] = n\cdot h\cdot 1 = T . $$再算方差。由 $\Var(\epsilon^2) = 2$($\chi^2_1$ 的方差)和增量独立:
$$ \Var\left[\sum_{i=0}^{n-1}(\Delta W_i)^2\right] = \sum_{i=0}^{n-1} h^2\Var(\epsilon_i^2) = n\cdot 2h^2 = 2Th = \frac{2T^2}{n} \ \xrightarrow{\ n\to\infty\ }\ 0 . $$期望恒为 $T$、方差趋于 $0$,所以 $\sum_i(\Delta W_i)^2 \to T$(在 $L^2$ 意义下)。这就是那条著名的形式记号
$$ (\dd{W_t})^2 = \dd{t} . $$这一条是理解 Fokker–Planck 方程的钥匙。做 Taylor 展开时,普通函数的二阶项 $(\Delta x)^2 \sim h^2$ 可以扔掉;但布朗运动的二阶项 $(\Delta W)^2 \sim h$ 与一阶项同阶,扔不掉。它活下来变成了 Fokker–Planck 方程里的 $\frac{\sigma_t^2}{2}\Lap p_t$,也就是 Itô 修正项。
6.4 模拟布朗运动
由正态增量与独立增量,模拟方法直接从定义读出:令 $W_0 = 0$,然后
$$ W_{t+h} = W_t + \sqrt{h}\,\epsilon_t, \qquad \epsilon_t\sim\N(0,I_d), \qquad t = 0,h,2h,\dots,1-h . $$为什么系数是 $\sqrt h$ 而不是 $h$?因为我们需要模拟出来的增量分布与定义一致:$W_{t+h}-W_t$ 必须服从 $\N(0,hI_d)$。而 $\sqrt h\,\epsilon_t$ 的协方差是
$$ \Cov(\sqrt h\,\epsilon_t) = (\sqrt h)^2\Cov(\epsilon_t) = h I_d . \ \checkmark $$如果错写成 $h\,\epsilon_t$,协方差就变成 $h^2 I_d$。把 $n = 1/h$ 步的方差加起来(增量独立,方差可加):
$$ \underbrace{n\cdot h^2}_{\text{错误的 } h\epsilon} = \frac{1}{h}h^2 = h \ \xrightarrow{h\to0}\ 0, \qquad \underbrace{n\cdot h}_{\text{正确的}\sqrt h\epsilon} = \frac 1h \cdot h = 1 . $$也就是说,用 $h$ 缩放的话,当你把步长取得越来越细,噪声会整个消失,模拟出来的是一条直线而不是布朗运动。反过来,若用 $h^{1/4}$ 缩放,总方差 $n h^{1/2} = h^{-1/2}\to\infty$ 会爆炸。$\sqrt h$ 是唯一让总方差保持 $O(1)$ 的缩放。
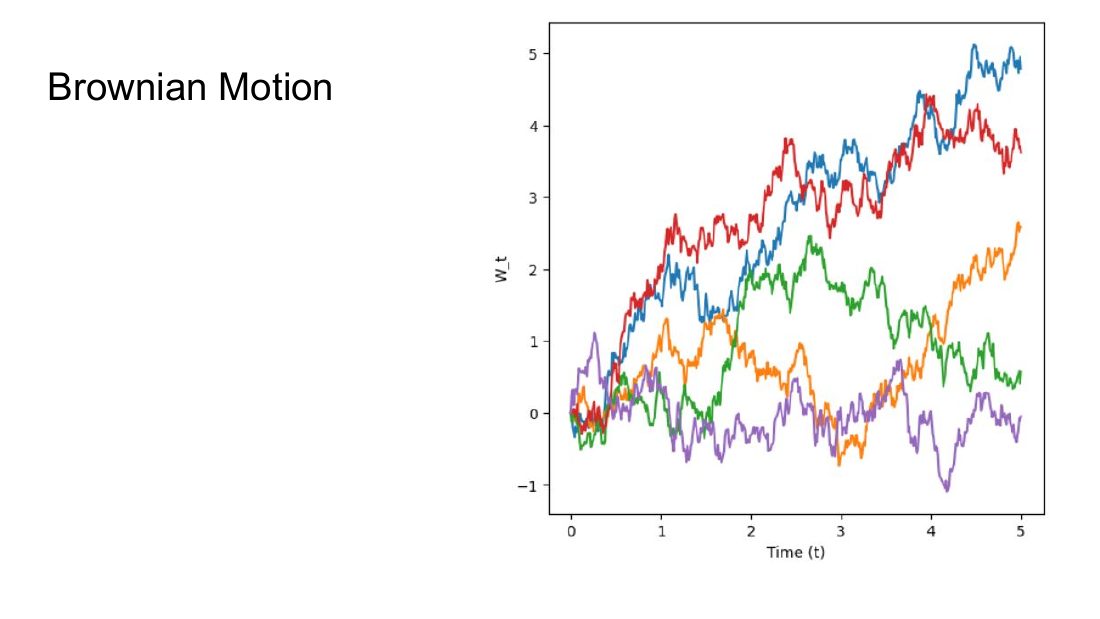
def simulate_brownian(bs: int, dim: int, n: int, T: float = 1.0):
    """按定义模拟布朗运动:W_{t+h} = W_t + sqrt(h) * eps
    返回: (bs, n + 1, dim) 完整轨迹
    """
    h = T / n
    w = torch.zeros(bs, dim)                       # W_0 = 0, (bs, dim)
    traj = [w.clone()]
    for _ in range(n):
        w = w + (h ** 0.5) * torch.randn(bs, dim)  # 注意是 sqrt(h),不是 h
        traj.append(w.clone())
    return torch.stack(traj, dim=1)                # (bs, n + 1, dim)


# 数值验证 6.2 与 6.3 节的三条结论
traj = simulate_brownian(bs=20000, dim=1, n=500, T=1.0)        # (20000, 501, 1)
print("Var(W_1) =", traj[:, -1, 0].var().item())               # 理论值 T = 1.0
print("Var(W_0.5) =", traj[:, 250, 0].var().item())            # 理论值 0.5

incr = traj[:, 1:, 0] - traj[:, :-1, 0]                        # (20000, 500)
print("二次变差 =", (incr ** 2).sum(dim=1).mean().item())        # 理论值 T = 1.0
print("路径长度 =", incr.abs().sum(dim=1).mean().item())         # 理论值 T*sqrt(2/(pi*h)) 约 17.8
# 把 n 从 500 改成 2000:二次变差仍然约等于 1,而路径长度约翻倍到 35.7。
7. 随机微分方程与 Euler–Maruyama 方法
7.1 先把 ODE 改写成不含导数的形式
第 6.2 节告诉我们布朗运动处处不可微,所以我们不能把随机项直接加进 $\frac{\dd{}}{\dd{t}}X_t = u_t(X_t)$ 里——加完之后左边的导数不存在了。因此必须先找到一个不使用导数的等价 ODE 表述。
把 ODE 逐步改写:
$$ \begin{aligned} &\frac{\dd{}}{\dd{t}}X_t = u_t(X_t) \qquad &&\blacktriangleright \ \text{用导数表述} \\ \overset{(i)}{\Longleftrightarrow}\quad &\frac 1h\big(X_{t+h} - X_t\big) = u_t(X_t) + R_t(h) \qquad &&\blacktriangleright \ \text{导数的定义} \\ \Longleftrightarrow\quad &X_{t+h} = X_t + h\,u_t(X_t) + h\,R_t(h) \qquad &&\blacktriangleright \ \text{用无穷小更新表述} \end{aligned} $$其中 $R_t(h)$ 是当 $h$ 很小时可以忽略的误差项,即 $\lim_{h\to0}R_t(h) = 0$;(i) 只是把导数的定义写开。这个改写没有引入任何新内容,它只是重述了我们已知的事实:ODE 的轨迹在每个时间步都朝 $u_t(X_t)$ 方向迈一小步。
但它现在的形式是纯代数的——只有加法和乘法,没有极限、没有导数。这样一来,我们就可以放心地往里面塞一个不可微的随机项了。
7.2 SDE 的定义
现在给每一步再加上一份来自布朗运动的贡献:
$$ X_{t+h} = X_t + \underbrace{h\,u_t(X_t)}_{\text{确定性}} + \underbrace{\sigma_t\big(W_{t+h} - W_t\big)}_{\text{随机}} + \underbrace{h\,R_t(h)}_{\text{误差项}} $$其中 $\sigma_t \ge 0$ 称为扩散系数(diffusion coefficient)(本课中它是一个只依赖时间的标量,不依赖位置,也不是矩阵),$R_t(h)$ 是随机误差项,满足标准差 $\E[\norm{R_t(h)}^2]^{1/2}\to0$(当 $h\to0$)。上式描述的就是一个随机微分方程(stochastic differential equation, SDE)。习惯上用下面这个符号化记法:
$$ \begin{aligned} \dd{X_t} &= u_t(X_t)\dd{t} + \sigma_t\dd{W_t} \qquad &&\blacktriangleright \ \text{SDE} \\ X_0 &= x_0 \qquad &&\blacktriangleright \ \text{初值条件} \end{aligned} $$"$\dd{X_t}$"这个记号纯粹是形式的,它是上面那个逐步更新式的速记,不是任何真正的微分。特别地,$\dd{W_t}$ 不代表"$W$ 的导数乘以 $\dd{t}$",因为那个导数不存在。每当推导卡住时,就把 $\dd{X_t} = u_t\dd{t} + \sigma_t\dd{W_t}$ 翻译回 $X_{t+h} = X_t + hu_t(X_t) + \sigma_t(W_{t+h}-W_t)$,几乎所有困惑都会消失——第 10 节的 Fokker–Planck 证明用的就是这个策略。
还有一个重要的结构性差别:SDE 没有流映射 $\psi_t$ 了。因为 $X_t$ 不再由 $X_0$ 唯一决定——演化本身是随机的,同一个起点能长出无穷多条不同的轨迹。这也意味着后面讲义里凡是用到"流"的地方(比如第 3 讲的一些构造),都只对 ODE 成立。
定理 5(SDE 解的存在唯一性):若 $u:\R^d\times[0,1]\to\R^d$ 连续可微且导数有界、$\sigma_t$ 连续,则该 SDE 存在解,由唯一满足上述逐步更新式的随机过程 $(X_t)_{0\le t\le1}$ 给出(唯一性是分布意义下的)。更一般地,$u$ 关于空间变量 Lipschitz 即可。
如果这是一门随机分析课,我们会花好几周从头构造布朗运动、用随机积分(stochastic integration)与 Itô–Riemann 和构造出 $X_t$,并严格证明这个定理。本课的重点在机器学习,所以直接引用结论。
每个 ODE 都是 SDE——只不过扩散系数 $\sigma_t \equiv 0$。所以本课后面说"SDE"时,ODE 总是作为特例被包含在内。这个约定能省掉大量重复陈述:我们只需证明 SDE 版本的定理,ODE 版本自动成立(比如第 10 节里,连续性方程就是 $\sigma_t=0$ 的 Fokker–Planck 方程)。
7.3 Euler–Maruyama 方法
如果 SDE 的抽象定义让你不适,那么换个问法马上就清楚了:我该怎么在电脑上模拟它?最简单的格式叫 Euler–Maruyama 方法,它之于 SDE 就相当于 Euler 方法之于 ODE。初始化 $X_0 = x_0$,然后迭代
$$ X_{t+h} = X_t + h\,u_t(X_t) + \sqrt{h}\,\sigma_t\,\epsilon_t, \qquad \epsilon_t\sim\N(0,I_d), $$其中 $h = n^{-1} > 0$ 是步长。换句话说:朝 $u_t(X_t)$ 迈一小步,再加一点被 $\sqrt h\,\sigma_t$ 缩放的高斯噪声。
这个式子从哪来?把 SDE 的逐步更新式写出来,然后用第 6.4 节的布朗运动模拟:
$$ \begin{aligned} X_{t+h} &= X_t + h\,u_t(X_t) + \sigma_t\big(W_{t+h}-W_t\big) \quad &&\text{(i) SDE 的定义(丢掉 $hR_t(h)$)} \\ &= X_t + h\,u_t(X_t) + \sigma_t\cdot\sqrt{h}\,\epsilon_t \quad &&\text{(ii) $W_{t+h}-W_t\sim\N(0,hI_d)\overset{d}{=}\sqrt h\,\epsilon_t$} \end{aligned} $$为什么是 $\sqrt h$ 而不是 $h$?——三个层次的回答。
层次一(定义层面):布朗运动的增量方差按时间线性增长,$\Var(W_{t+h}-W_t) = h$,所以标准差是 $\sqrt h$。噪声项的缩放必须匹配这个定义,否则模拟出来的就不是布朗运动。
层次二(量纲层面):确定性项 $h\,u_t$ 是 $O(h)$,随机项 $\sqrt h\,\sigma_t\epsilon_t$ 是 $O(\sqrt h)$。当 $h\to0$ 时 $\sqrt h \gg h$——随机项在单步上占绝对主导。但因为噪声是零均值且各步独立,它在累加时会相互抵消($n$ 项零均值独立量的和只有 $\sqrt n$ 量级),而确定性项是同向累加的。两种效应在 $n = 1/h$ 步之后恰好都变成 $O(1)$。这就是随机分析里"$\dd{W}\sim\sqrt{\dd{t}}$"的精确含义。
层次三(总方差层面):用第 6.4 节算过的账。取 $u=0$、$\sigma\equiv1$,走 $n = 1/h$ 步,噪声系数写作 $c$。因为各步噪声独立,总方差可加:
$$ \Var(X_1) = n\,c^2 = \frac{c^2}{h} . $$要让 $\Var(X_1) = \Var(W_1) = 1$(与步长 $h$ 无关!),必须 $c^2 = h$,即 $c = \sqrt h$。若取 $c = h$,则 $\Var(X_1) = h\to0$,细化步长会让噪声凭空消失;若取 $c$ 比 $\sqrt h$ 更大,方差会发散。$\sqrt h$ 是唯一的正确缩放。
在代码里写成 x + h * u + h * sigma * torch.randn_like(x) 是极其常见且不会报错的 bug。它的症状是:步数少时勉强能用,步数一多生成结果反而越来越"平"、越来越糊——因为随着 $h$ 变小噪声被压成了零,SDE 悄悄退化成了 ODE。正确写法是 h.sqrt() * sigma * torch.randn_like(x)。
另一个坑:噪声必须每步重新采样($\epsilon_t$ 独立),复用同一个 eps 会破坏独立增量性质,模拟出的过程方差是 $n^2 h = n$ 而不是 $1$。
class SDE(ABC):
    @abstractmethod
    def drift_coefficient(self, xt, t):
        """u_t(x),返回 (bs, dim)"""
        ...

    @abstractmethod
    def diffusion_coefficient(self, xt, t):
        """sigma_t,广播成 (bs, dim)"""
        ...


class EulerMaruyamaSimulator(Simulator):
    """X_{t+h} = X_t + h * u_t(X_t) + sqrt(h) * sigma_t * eps,  eps ~ N(0, I_d)"""
    def __init__(self, sde: SDE):
        self.sde = sde

    def step(self, xt, t, h):
        drift = self.sde.drift_coefficient(xt, t)              # (bs, dim)
        diff  = self.sde.diffusion_coefficient(xt, t)          # (bs, dim)
        eps   = torch.randn_like(xt)                           # (bs, dim) 每步全新采样
        return xt + drift * h + diff * torch.sqrt(h) * eps     # 注意 sqrt(h)


class BrownianMotion(SDE):
    """u = 0, sigma = const:SDE 退化成(带缩放的)布朗运动"""
    def __init__(self, sigma: float):
        self.sigma = sigma

    def drift_coefficient(self, xt, t):
        return torch.zeros_like(xt)                            # (bs, dim)

    def diffusion_coefficient(self, xt, t):
        return self.sigma * torch.ones_like(xt)                # (bs, dim)
8. 算例:Ornstein–Uhlenbeck 过程的闭式解
讲义的 Example 6 给出了本课第一个真正的 SDE 例子。它值得完整算一遍,因为它是唯一一个能同时写出闭式解、闭式分布和闭式极限的非平凡例子,后面所有关于"噪声调度"的直觉都可以在这里检验。
8.1 定义
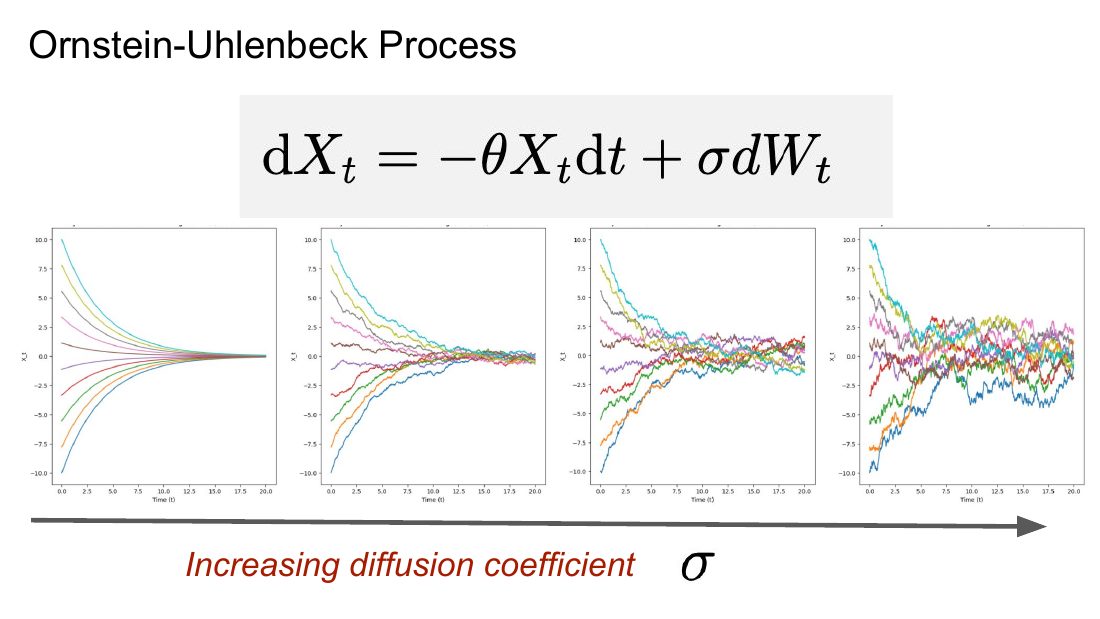
取常数扩散系数 $\sigma_t = \sigma \ge 0$ 和常数线性漂移 $u_t(x) = -\theta x$($\theta > 0$),得到
$$ \dd{X_t} = -\theta X_t\dd{t} + \sigma\dd{W_t} . $$它的解 $(X_t)_{0\le t\le1}$ 称为 Ornstein–Uhlenbeck(OU)过程。两股力量在角力:
- 漂移 $-\theta x$ 把过程推回中心 $0$(方向永远与当前位置相反,离得越远推得越猛);
- 扩散 $\sigma$ 不断注入新的噪声,把过程往外推。
8.2 闭式解:积分因子法
第 1 步:消掉漂移项。模仿常微分方程的积分因子技巧,令 $Y_t := e^{\theta t}X_t$。由于 $e^{\theta t}$ 是确定性函数(不含随机项),对它用乘积法则时不会产生 Itô 修正项,于是
$$ \begin{aligned} \dd{Y_t} &= \theta e^{\theta t}X_t\dd{t} + e^{\theta t}\dd{X_t} \quad &&\text{(i) 乘积法则} \\ &= \theta e^{\theta t}X_t\dd{t} + e^{\theta t}\big(-\theta X_t\dd{t} + \sigma\dd{W_t}\big) \quad &&\text{(ii) 代入 SDE} \\ &= \big(\theta e^{\theta t}X_t - \theta e^{\theta t}X_t\big)\dd{t} + \sigma e^{\theta t}\dd{W_t} \quad &&\text{(iii) 展开} \\ &= \sigma e^{\theta t}\dd{W_t} . \end{aligned} $$漂移项被完全消掉了,$Y_t$ 只剩下一个纯随机积分。
第 2 步:积分并回代。从 $0$ 积到 $t$:$Y_t = Y_0 + \sigma\int_0^t e^{\theta s}\dd{W_s}$,其中 $Y_0 = X_0 = x_0$。两边乘 $e^{-\theta t}$:
$$ \boxed{\ X_t = e^{-\theta t}x_0 + \sigma\int_0^t e^{-\theta(t-s)}\dd{W_s}\ } $$这个式子很有解释力:第一项是初值的指数衰减(就是 $\sigma=0$ 时的确定性流 $\psi_t(x_0)=e^{-\theta t}x_0$);第二项把历史上每个时刻 $s$ 注入的噪声 $\dd{W_s}$ 按"距今多久"打折 $e^{-\theta(t-s)}$ 后累加起来——越久远的噪声被遗忘得越彻底。
8.3 均值与方差:不用随机积分也能算
上面的闭式解要配合 Itô 等距(Itô isometry)才能算出方差。下面给一个完全初等的推导,只用第 7.3 节的 Euler–Maruyama 更新式——这条路径对没学过随机分析的读者更友好,而且结论完全一样。
取 $d=1$(各坐标独立,高维只需逐坐标重复)。记 $m_t := \E[X_t]$、$v_t := \Var(X_t)$。Euler–Maruyama 一步:
$$ X_{t+h} = X_t - \theta h X_t + \sqrt h\,\sigma\epsilon_t = (1-\theta h)X_t + \sqrt h\,\sigma\epsilon_t, \qquad \epsilon_t\sim\N(0,1)\ \text{且与}\ X_t\ \text{独立} . $$(a)均值的 ODE。两边取期望,用 $\E[\epsilon_t]=0$:
$$ m_{t+h} = (1-\theta h)m_t \quad\Longrightarrow\quad \frac{m_{t+h}-m_t}{h} = -\theta m_t \quad\overset{h\to0}{\Longrightarrow}\quad \dot m_t = -\theta m_t . $$解得 $m_t = e^{-\theta t}x_0$,与闭式解的第一项一致。✓
(b)方差的 ODE。两边取方差。因为 $X_t$ 与 $\epsilon_t$ 独立,方差可加:
$$ \begin{aligned} v_{t+h} &= (1-\theta h)^2 v_t + h\sigma^2\Var(\epsilon_t) \quad &&\text{(i) 独立 $\Rightarrow$ 方差可加,$\Var(aX)=a^2\Var(X)$} \\ &= v_t - 2\theta h\,v_t + \theta^2h^2 v_t + h\sigma^2 \quad &&\text{(ii) 展开平方,$\Var(\epsilon)=1$} \end{aligned} $$移项除以 $h$:
$$ \frac{v_{t+h}-v_t}{h} = -2\theta v_t + \sigma^2 + \underbrace{\theta^2 h\,v_t}_{\to 0} \quad\overset{h\to0}{\Longrightarrow}\quad \dot v_t = -2\theta v_t + \sigma^2 . $$请注意 (i) 这一步:正是因为噪声系数是 $\sqrt h$,平方之后才得到 $h\sigma^2$——这一项与 $h$ 同阶,除以 $h$ 之后留下了有限的 $\sigma^2$。如果噪声系数错写成 $h$,这里会得到 $h^2\sigma^2$,除以 $h$ 后剩 $h\sigma^2\to0$,方差方程就变成 $\dot v = -2\theta v$,$\sigma$ 彻底消失。这是 $\sqrt h$ 缩放的又一次现身。
(c)解方差方程。这是一阶线性 ODE,用积分因子 $e^{2\theta t}$:
$$ \frac{\dd{}}{\dd{t}}\big(e^{2\theta t}v_t\big) = e^{2\theta t}\big(\dot v_t + 2\theta v_t\big) = e^{2\theta t}\sigma^2 . $$从 $0$ 积到 $t$,用 $v_0 = 0$(初值 $X_0 = x_0$ 是确定的):
$$ e^{2\theta t}v_t - v_0 = \sigma^2\int_0^t e^{2\theta s}\dd{s} = \frac{\sigma^2}{2\theta}\big(e^{2\theta t}-1\big) . $$两边乘 $e^{-2\theta t}$:
$$ \boxed{\ v_t = \frac{\sigma^2}{2\theta}\Big(1 - e^{-2\theta t}\Big)\ } $$(d)结论。由于所有运算都是高斯的线性组合,$X_t$ 本身是高斯的:
$$ X_t \sim \N\!\left(e^{-\theta t}x_0,\ \frac{\sigma^2}{2\theta}\big(1-e^{-2\theta t}\big) I_d\right) . $$(e)$t\to\infty$ 的极限。$e^{-\theta t}\to0$,$e^{-2\theta t}\to0$,于是
$$ X_t \ \xrightarrow{\ t\to\infty\ }\ \N\!\left(0, \frac{\sigma^2}{2\theta}I_d\right), $$这与讲义中的结论完全一致。注意极限分布不依赖初值 $x_0$——OU 过程会"忘记"自己从哪来。
方差方程 $\dot v = -2\theta v + \sigma^2$ 就是那场角力的账本:$-2\theta v$ 是漂移的收缩贡献($v$ 越大收缩越强),$+\sigma^2$ 是扩散的注入贡献(恒定速率)。平衡点在 $\dot v = 0$ 处,即 $v_\infty = \frac{\sigma^2}{2\theta}$——正好是极限方差。$\sigma$ 越大平衡点越高(噪声更强),$\theta$ 越大平衡点越低(回拉更狠)。
另外看 $\sigma = 0$ 的退化情形:$v_t \equiv 0$,$X_t = e^{-\theta t}x_0$——正是 §3.4 的线性向量场流。OU 过程就是那个流加上噪声。
class OUProcess(SDE):
    """dX_t = -theta * X_t dt + sigma dW_t"""
    def __init__(self, theta: float, sigma: float):
        self.theta, self.sigma = theta, sigma

    def drift_coefficient(self, xt, t):
        return -self.theta * xt                                # (bs, dim)

    def diffusion_coefficient(self, xt, t):
        return self.sigma * torch.ones_like(xt)                # (bs, dim)


theta, sigma, T = 0.25, 1.0, 20.0
x0 = 5.0 * torch.ones(50000, 1)                                # (50000, 1) 全部从 x0 = 5 出发
ts = torch.linspace(0.0, T, 4001)                              # h = 0.005
xT = EulerMaruyamaSimulator(OUProcess(theta, sigma)).simulate(x0, ts)

import math
m_theory = math.exp(-theta * T) * 5.0                          # e^{-theta T} x0
v_theory = sigma ** 2 / (2 * theta) * (1 - math.exp(-2 * theta * T))
print(f"均值  模拟={xT.mean():.4f}  理论={m_theory:.4f}")        # 约 0.034
print(f"方差  模拟={xT.var():.4f}  理论={v_theory:.4f}")         # 约 2.0 = sigma^2/(2 theta)
9. 扩散模型:用 SDE 做生成
造第二台生成器的方式和第一台完全一样:把 SDE 的核心零件——向量场 $u_t$——换成神经网络 $u^\theta_t$,初值取自 $\simple$。
Summary 7(SDE 生成模型):本课中一个扩散模型(diffusion model)由两部分组成:
$$ \begin{aligned} \textbf{神经网络:}\quad & u^\theta : \R^d\times[0,1]\to\R^d,\ (x,t)\mapsto u^\theta_t(x),\ \text{参数为 }\theta \\ \textbf{固定量:}\quad & \sigma : [0,1]\to[0,\infty),\ t\mapsto\sigma_t \end{aligned} $$采样流程为:
$$ \begin{aligned} \textbf{初始化:}\quad & X_0\sim\simple \qquad &&\blacktriangleright \ \text{用简单分布(如高斯)初始化} \\ \textbf{模拟:}\quad & \dd{X_t} = u^\theta_t(X_t)\dd{t} + \sigma_t\dd{W_t} \qquad &&\blacktriangleright \ \text{把 SDE 从 0 模拟到 1} \\ \textbf{目标:}\quad & X_1\sim\data \qquad &&\blacktriangleright \ \text{让终点服从数据分布} \end{aligned} $$$\sigma_t\equiv0$ 的扩散模型就是流模型。
注意 $\sigma_t$ 是固定的、人为选定的,不是学出来的参数——它是超参数(准确说是一个超参数函数)。这一点在第 4 讲会变得非常重要:我们会看到同一个训练好的网络可以配上任意的 $\sigma_t$ 来采样,而且在理论上它们给出同一条边际概率路径 $p_t$。$\sigma_t$ 的选择只影响有限步数、有限精度下的实际表现,不影响连续时间极限下的分布。
9.1 采样算法(Algorithm 2)
| 行 | Algorithm 2:用 Euler–Maruyama 方法从扩散模型采样 |
|---|---|
| 输入 | 神经网络 $u^\theta_t$,步数 $n$,扩散系数 $\sigma_t$ |
| 1 | 令 $t = 0$ |
| 2 | 令步长 $h = \frac1n$ |
| 3 | 抽样 $X_0\sim\simple$ |
| 4 | for $i = 1,\dots,n$ do |
| 5 | 抽样 $\epsilon\sim\N(0,I_d)$ |
| 6 | $X_{t+h} = X_t + h\,u^\theta_t(X_t) + \sigma_t\sqrt h\,\epsilon$ |
| 7 | $t\leftarrow t+h$ |
| 8 | end for |
| 9 | return $X_1$ |
@torch.no_grad()
def sample_diffusion_model(u_theta, sigma_fn, n: int, bs: int, dim: int, device="cpu"):
    """Algorithm 2:从扩散模型采样。sigma_fn(t) -> 标量。sigma_fn = 0 时退化为 Algorithm 1。"""
    h = 1.0 / n
    x = torch.randn(bs, dim, device=device)              # X_0 ~ p_init, (bs, dim)
    t = torch.zeros(1, device=device)
    for _ in range(n):
        eps = torch.randn_like(x)                        # (bs, dim) 每步全新噪声
        x = x + h * u_theta(x, t) + sigma_fn(t) * (h ** 0.5) * eps
        t = t + h
    return x                                             # X_1, (bs, dim)
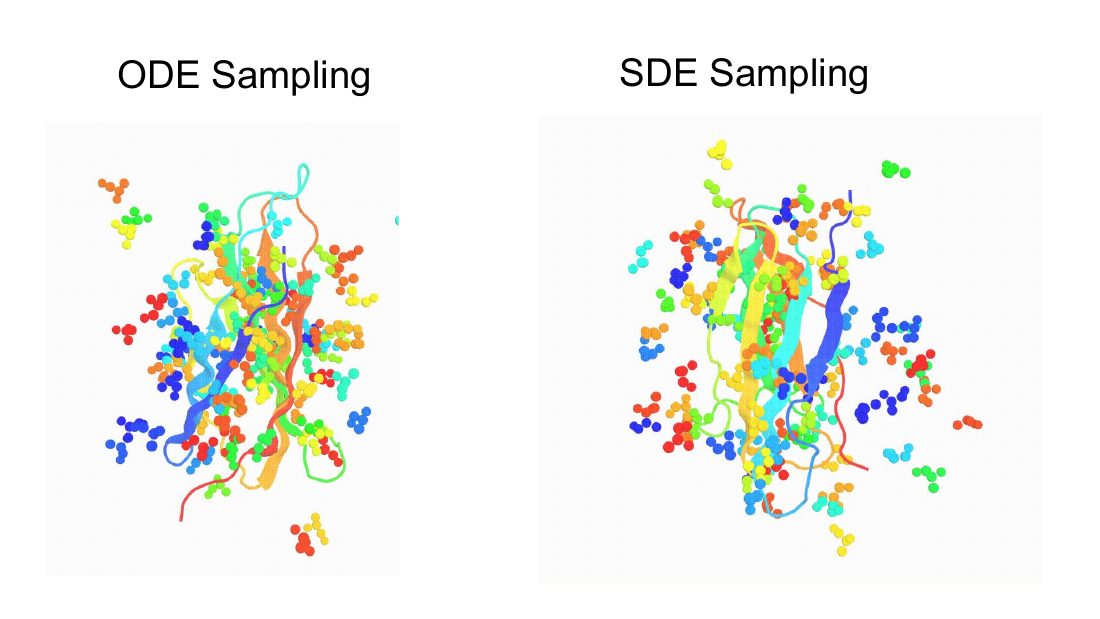
9.2 ODE 采样 vs SDE 采样
| 流模型(ODE) | 扩散模型(SDE) | |
|---|---|---|
| 方程 | $\dd{X_t} = u^\theta_t(X_t)\dd{t}$ | $\dd{X_t} = u^\theta_t(X_t)\dd{t} + \sigma_t\dd{W_t}$ |
| 随机性来源 | 只有初值 $X_0\sim\simple$ | 初值 + 每一步注入的噪声 |
| 是否有流映射 $\psi_t$ | 有,且是微分同胚 | 没有(同一起点可长出无穷多条轨迹) |
| 轨迹光滑性 | 连续可微 | 连续但处处不可微 |
| 数值格式 | Euler / Heun / 高阶 RK | Euler–Maruyama |
| 固定 $X_0$ 重复运行 | 结果完全相同(可复现) | 结果每次不同 |
| 分布演化方程 | 连续性方程 | Fokker–Planck 方程 |
| 可逆性 | 可以反向积分回 $X_0$ | 不能逐轨迹反演 |
10. 连续性方程:分布如何被向量场输运
到这里,我们已经会造采样机器了。但有一个根本问题一直悬着:
我们模拟的是单条轨迹 $X_t$,而我们真正关心的是整个分布 $p_t$。这两者是怎么联系起来的?给定向量场 $u_t$ 和扩散系数 $\sigma_t$,$p_t$ 到底怎么演化?
回答这个问题的,是本节的连续性方程和下一节的 Fokker–Planck 方程。它们是整门课的数学地基:第 2 讲的边际化技巧、第 3 讲的 score matching、第 4 讲的"ODE 与 SDE 等价"、第 5 讲的 guidance,追到底全部是在用它们。
10.1 两个微分算子
先把工具定义清楚,注意输入输出的类型——这是最容易出错的地方。
散度(divergence)作用在向量场上,输出标量场:
$$ \divg(v_t)(x) := \sum_{i=1}^d \pd{}{x_i} v^i_t(x), \qquad v_t : \R^d\to\R^d,\quad \divg(v_t) : \R^d\to\R, $$其中 $v^i_t$ 是 $v_t$ 的第 $i$ 个坐标分量。
拉普拉斯算子(Laplacian)作用在标量场上,输出标量场:
$$ \Lap w_t(x) := \sum_{i=1}^d \pd{^2}{x_i^2} w_t(x) = \divg(\nabla w_t)(x), \qquad w_t:\R^d\to\R . $$还有一条马上要用的乘积法则:对标量场 $p$ 和向量场 $v$,
$$ \divg(p\,v)(x) = \sum_{i=1}^d\pd{}{x_i}\big(p(x)v^i(x)\big) = \sum_{i=1}^d\left(\pd{p}{x_i}v^i + p\,\pd{v^i}{x_i}\right) = \inner{\nabla p(x)}{v(x)} + p(x)\divg(v)(x) . $$10.2 连续性方程
定理 11(连续性方程 / Continuity Equation):考虑向量场 $u_t$ 定义的流模型,$X_0\sim\simple = p_0$。则 $X_t\sim p_t$ 对所有 $0\le t\le 1$ 成立,当且仅当
$$ \partial_t p_t(x) = -\divg(p_t u_t)(x) \qquad \text{对所有 } x\in\R^d,\ 0\le t\le 1 , $$其中 $\partial_t p_t(x) = \frac{\dd{}}{\dd{t}}p_t(x)$ 是对时间的导数。
这是一条质量守恒定律,逐项读:
- 左边 $\partial_t p_t(x)$:点 $x$ 处的概率密度变化得多快。
- 右边的 $p_t u_t$ 叫概率流(probability flux):单位时间流过 $x$ 的概率质量 = 该处有多少质量($p_t$)× 它们跑多快($u_t$)。
- 散度 $\divg$ 度量的是向量场的净流出,所以 $-\divg(p_tu_t)$ 就是净流入。
合起来就是:某点密度的增加率 = 流进该点的概率质量。因为概率质量守恒(总是积分为 1,既不凭空产生也不凭空消失),两边必然相等。
用积分形式看更清楚:对任意区域 $A\subseteq\R^d$,两边在 $A$ 上积分并用散度定理(Gauss 定理),
$$ \frac{\dd{}}{\dd{t}}\underbrace{\int_A p_t(x)\dd{x}}_{A \text{ 内的总概率}} = -\oint_{\partial A}\underbrace{p_t(x)\inner{u_t(x)}{n(x)}}_{\text{穿过边界向外的流量}}\dd{S}(x) . $$"$A$ 里的概率增加了多少"完全等于"从边界流进来多少"。
10.3 一个能验算到底的高斯例子
抽象定理不落地就没用。下面用第 3.4 节的线性向量场,把连续性方程逐项验证一遍。
设定。取 $d=1$,$u_t(x) = -\theta x$,初始分布 $p_0 = \N(\mu_0, v_0)$。
第 1 步:先用流直接算出 $p_t$。流是 $\psi_t(x_0) = e^{-\theta t}x_0$,所以 $X_t = e^{-\theta t}X_0$。高斯的线性变换还是高斯:
$$ X_t \sim \N(m_t, v_t), \qquad m_t = e^{-\theta t}\mu_0, \quad v_t = e^{-2\theta t}v_0 . $$注意这里 $\Var(aX) = a^2\Var(X)$ 给出了 $e^{-2\theta t}$ 而不是 $e^{-\theta t}$。相应地
$$ \dot m_t = -\theta m_t, \qquad \dot v_t = -2\theta v_t . $$第 2 步:算左边 $\partial_t p_t$。取对数更好算。$\log p_t(x) = -\frac12\log(2\pi v_t) - \frac{(x-m_t)^2}{2v_t}$,于是
$$ \begin{aligned} \partial_t\log p_t(x) &= -\frac{\dot v_t}{2v_t} + \frac{(x-m_t)\dot m_t}{v_t} + \frac{(x-m_t)^2\dot v_t}{2v_t^2} \quad &&\text{(i) 逐项求导} \\ &= -\frac{-2\theta v_t}{2v_t} + \frac{(x-m_t)(-\theta m_t)}{v_t} + \frac{(x-m_t)^2(-2\theta v_t)}{2v_t^2} \quad &&\text{(ii) 代入 $\dot m,\dot v$} \\ &= \theta - \frac{\theta m_t(x-m_t)}{v_t} - \frac{\theta(x-m_t)^2}{v_t} \\ &= \theta - \frac{\theta(x-m_t)\big[m_t + (x-m_t)\big]}{v_t} \quad &&\text{(iii) 提取公因子} \\ &= \theta - \frac{\theta\,x\,(x-m_t)}{v_t} . \end{aligned} $$((i) 中第二项的符号来自 $\frac{\partial}{\partial t}(x-m_t)^2 = -2(x-m_t)\dot m_t$。)
第 3 步:算右边 $-\divg(p_tu_t)/p_t$。一维下 $\divg = \partial_x$,用乘积法则:
$$ \begin{aligned} \frac{-\partial_x\big(p_t(x)\cdot(-\theta x)\big)}{p_t(x)} &= \frac{\theta\,\partial_x\big(x\,p_t(x)\big)}{p_t(x)} \quad &&\text{(i) 提出常数 $-\theta$} \\ &= \frac{\theta\big(p_t(x) + x\,\partial_x p_t(x)\big)}{p_t(x)} \quad &&\text{(ii) 乘积法则} \\ &= \theta + \theta x\,\partial_x\log p_t(x) \quad &&\text{(iii) $\frac{\partial_x p}{p} = \partial_x\log p$} \\ &= \theta + \theta x\left(-\frac{x-m_t}{v_t}\right) \quad &&\text{(iv) 高斯的 score} \\ &= \theta - \frac{\theta\,x\,(x-m_t)}{v_t} . \end{aligned} $$第 4 步:比较。第 2 步和第 3 步的结果逐字相同。两边同乘 $p_t(x)$ 即得 $\partial_t p_t = -\divg(p_tu_t)$。✓
顺带记住 (iv) 里那个式子:一维高斯 $\N(m,v)$ 的 score 是 $\nabla\log p(x) = -\frac{x-m}{v}$。这是第 3 讲 score matching 的起点。
回头看 §3.5 的旋转向量场 $u(x) = (-\omega x^2,\omega x^1)$,$\divg u = 0$。由乘积法则,
$$ \partial_t p_t = -\divg(p_t u) = -\inner{\nabla p_t}{u} - p_t\underbrace{\divg(u)}_{=0} = -\inner{\nabla p_t}{u} . $$取 $p_0 = \N(0,I_2)$,则 $\nabla p_0(x) = -x\,p_0(x)$,而 $\inner{x}{u(x)} = -\omega x^1x^2 + \omega x^2 x^1 = 0$。所以 $\partial_t p_t\big|_{t=0} = 0$,且这个论证在每个时刻都成立,故 $p_t \equiv p_0$。
结论:向量场把每个粒子都搬动了,但分布纹丝不动。这个例子说明"点在动"和"分布在变"完全是两件事——而连续性方程正是把两者精确挂钩的那座桥。
11. Fokker–Planck 方程与它的完整证明
连续性方程处理的是 ODE。加上噪声之后会发生什么?答案是多出一个拉普拉斯项。
定理(Fokker–Planck 方程):设 $p_t$ 是一条概率路径,$p_0 = \simple$,考虑 SDE
$$ X_0\sim\simple, \qquad \dd{X_t} = u_t(X_t)\dd{t} + \sigma_t\dd{W_t} . $$则 $X_t$ 对所有 $0\le t\le1$ 服从 $p_t$,当且仅当 Fokker–Planck 方程成立:
$$ \partial_t p_t(x) = -\divg(p_t u_t)(x) + \frac{\sigma_t^2}{2}\Lap p_t(x) \qquad\text{对所有 } x\in\R^d,\ 0\le t\le 1 . $$取 $\sigma_t = 0$ 即回到连续性方程(定理 11)。
多出来的 $\frac{\sigma_t^2}{2}\Lap p_t$ 就是热方程(heat equation)里的那一项。$\Lap p_t(x)$ 度量的是"$x$ 处的密度比它周围邻居的平均值低多少":如果 $x$ 是一个局部低谷($\Lap p_t > 0$),扩散会把周围的质量搬进来;如果 $x$ 是一个尖峰($\Lap p_t < 0$),扩散会把质量摊出去。扩散总是抹平密度。
所以整个方程读作:密度的变化 = 被向量场输运($-\divg(p_tu_t)$)+ 被噪声抹平($\frac{\sigma_t^2}{2}\Lap p_t$)。
11.1 证明的两块工具
证明的核心技巧是使用测试函数(test function) $f:\R^d\to\R$,即无穷次可微、且只在一个有界区域内非零(紧支撑 / compact support)的函数。
工具 A:测试函数引理。对任意可积函数 $g_1,g_2:\R^d\to\R$,
$$ g_1(x) = g_2(x)\ \text{对所有 } x\in\R^d \qquad\Longleftrightarrow\qquad \int f(x)g_1(x)\dd{x} = \int f(x)g_2(x)\dd{x}\ \text{对所有测试函数 } f . $$"$\Rightarrow$"是显然的。"$\Leftarrow$"的思路:若 $g_1(x_0) \neq g_2(x_0)$ 且两者连续,则在 $x_0$ 的某个小球 $B$ 上 $g_1 - g_2$ 保持同号且绝对值有正下界;取一个支撑在 $B$ 内、非负且不恒为零的测试函数 $f$(这样的"鼓包函数"总是存在,例如 $f(x)=\exp(-1/(r^2-\norm{x-x_0}^2))$ 在球内、0 在球外),则 $\int f(g_1-g_2)\neq0$,矛盾。
这条引理的意义:它把"逐点相等"这个难以直接证明的陈述,转化为"积分相等"。而积分是可以做分部积分的——这正是我们需要的。
工具 B:分部积分(integration by parts)。对任意函数 $f_1,f_2$(其中至少一个是测试函数),
$$ \int f_1(x)\,\pd{}{x_i}f_2(x)\,\dd{x} = -\int f_2(x)\,\pd{}{x_i}f_1(x)\,\dd{x} . $$边界项为什么消失?这是本节最关键的技术细节,讲义只写了"under the condition that $f_1, f_2$ and their product are integrable",我们把它做出来。
先看恒等式 $\displaystyle\int_{\R^d}\pd{}{x_i}\big(f_1(x)f_2(x)\big)\dd{x} = 0$。用 Fubini 定理,先对第 $i$ 个坐标积分(记 $x = (x_{-i}, x_i)$,$x_{-i}$ 表示其余 $d-1$ 个坐标):
$$ \int_{\R^d}\pd{}{x_i}(f_1f_2)\,\dd{x} = \int_{\R^{d-1}}\left[\int_{-\infty}^{+\infty}\pd{}{x_i}(f_1f_2)\,\dd{x_i}\right]\dd{x_{-i}} = \int_{\R^{d-1}}\Big[f_1f_2\Big]_{x_i=-\infty}^{x_i=+\infty}\dd{x_{-i}} . $$内层用了微积分基本定理,得到的就是边界项。现在关键一步:其中一个函数(比如 $f_1$)是测试函数,紧支撑,即存在半径 $R$ 使得 $\norm{x} > R$ 时 $f_1(x) = 0$。因此当 $x_i\to\pm\infty$ 时(此时必有 $\norm{x} > R$),$f_1(x)f_2(x) = 0$。所以每个内层的边界项都是 $0 - 0 = 0$,整个积分为零。
有了这个恒等式,再用乘积法则 $\pd{}{x_i}(f_1f_2) = f_1\pd{}{x_i}f_2 + f_2\pd{}{x_i}f_1$ 展开:
$$ 0 = \int f_1\pd{}{x_i}f_2\,\dd{x} + \int f_2\pd{}{x_i}f_1\,\dd{x} \quad\Longrightarrow\quad \int f_1\pd{}{x_i}f_2\,\dd{x} = -\int f_2\pd{}{x_i}f_1\,\dd{x} . \ \checkmark $$严格来说,在我们的应用中 $f_1$ 是测试函数、$f_2$ 是 $p_t$ 或 $p_tu_t$(它们并非紧支撑)。这没问题:只需要乘积 $f_1f_2$ 在无穷远处趋于零,而 $f_1$ 的紧支撑性已经保证了这一点。如果换成"$p_t$ 在无穷远处衰减得足够快"(高斯就满足)也可以,但用测试函数是最干净的技术路线。
工具 B 的两个推论。把上式对坐标求和,配合 $\divg$ 与 $\Lap$ 的定义:
$$ \begin{aligned} \int \inner{\nabla f_1(x)}{f_2(x)}\dd{x} &= -\int f_1(x)\divg(f_2)(x)\dd{x} \qquad && (f_1:\R^d\to\R,\ f_2:\R^d\to\R^d) \\ \int f_1(x)\Lap f_2(x)\dd{x} &= \int f_2(x)\Lap f_1(x)\dd{x} \qquad && (f_1:\R^d\to\R,\ f_2:\R^d\to\R) \end{aligned} $$第一式:$\int\sum_i(\pd{}{x_i}f_1)f_2^i = -\sum_i\int f_1\pd{}{x_i}f_2^i = -\int f_1\divg(f_2)$。第二式:对每个 $i$ 用两次分部积分,$\int f_1\pd{^2}{x_i^2}f_2 = -\int \pd{}{x_i}f_1\pd{}{x_i}f_2 = +\int f_2\pd{^2}{x_i^2}f_1$,两次负号抵消。
11.2 必要性证明:若 $X_t\sim p_t$,则 Fokker–Planck 成立
第 1 步:写出一步更新,Taylor 展开。用 §7.2 的 SDE 逐步更新式
$$ X_{t+h} = X_t + h\,u_t(X_t) + \sigma_t(W_{t+h}-W_t) + h R_t(h) \approx X_t + h\,u_t(X_t) + \sigma_t(W_{t+h}-W_t), $$暂时忽略误差项 $R_t(h)$(反正最后要取 $h\to0$)。记增量 $\Delta := h\,u_t(X_t) + \sigma_t(W_{t+h}-W_t)$,对测试函数 $f$ 作二阶 Taylor 展开:
$$ \begin{aligned} f(X_{t+h}) - f(X_t) &= f(X_t + \Delta) - f(X_t) \\ &\overset{(i)}{=} \nabla f(X_t)^\top\Delta + \frac12\Delta^\top\nabla^2f(X_t)\,\Delta + o(\norm{\Delta}^2) \\ &\overset{(ii)}{=} h\nabla f(X_t)^\top u_t(X_t) + \sigma_t\nabla f(X_t)^\top(W_{t+h}-W_t) \\ &\quad + \frac12 h^2 u_t(X_t)^\top\nabla^2f(X_t)u_t(X_t) + h\sigma_t u_t(X_t)^\top\nabla^2f(X_t)(W_{t+h}-W_t) \\ &\quad + \frac12\sigma_t^2 (W_{t+h}-W_t)^\top\nabla^2f(X_t)(W_{t+h}-W_t) . \end{aligned} $$其中 (i) 是在 $X_t$ 处的二阶 Taylor 展开($\nabla^2 f\in\R^{d\times d}$ 是 Hessian),(ii) 把 $\Delta$ 代入并展开——注意交叉项本该有两个($h u^\top\nabla^2f\Delta W$ 和 $\Delta W^\top\nabla^2 f\,hu$),因为 Hessian $\nabla^2f$ 是对称矩阵,两者相等,合并成系数 $1$ 的一项。
为什么必须展开到二阶?如果 $\Delta$ 只有确定性部分 $hu_t$,那么 $\norm{\Delta}^2 = O(h^2)$,除以 $h$ 之后趋于零,二阶项完全可以丢掉——这正是连续性方程的情形。但现在 $\Delta$ 含有 $\sigma_t\Delta W$,而由 §6.3 的二次变差,$\norm{\Delta W}^2 \sim h$(不是 $h^2$)。所以二阶项里的 $\Delta W^\top\nabla^2f\Delta W$ 是 $O(h)$,与一阶项同阶,绝不能丢。这一项活下来,就是拉普拉斯项的全部来源。
第 2 步:对给定 $X_t$ 取条件期望。关键事实:由独立增量性质,$W_{t+h}-W_t$ 与 $X_t$ 独立($X_t$ 只依赖于 $t$ 时刻之前的布朗运动),所以
$$ \E[W_{t+h}-W_t\mid X_t] = 0, \qquad (W_{t+h}-W_t)\mid X_t \sim \N(0, hI_d) . $$逐项取条件期望:第 2 项和第 4 项含 $\E[\Delta W\mid X_t] = 0$,直接消失。对第 5 项,写 $W_{t+h}-W_t = \sqrt h\,\epsilon_t$,$\epsilon_t\sim\N(0,I_d)$:
$$ \frac12\sigma_t^2\,\E\big[(\sqrt h\epsilon_t)^\top\nabla^2f(X_t)(\sqrt h\epsilon_t)\big] = \frac h2\sigma_t^2\,\E_{\epsilon_t\sim\N(0,I_d)}\big[\epsilon_t^\top\nabla^2f(X_t)\epsilon_t\big] . $$子引理:对任意 $A\in\R^{d\times d}$ 与 $\epsilon\sim\N(0,I_d)$,有 $\E[\epsilon^\top A\epsilon] = \tr(A)$。证明:
$$ \E[\epsilon^\top A\epsilon] = \E\left[\sum_{i,j}A_{ij}\epsilon_i\epsilon_j\right] = \sum_{i,j}A_{ij}\,\E[\epsilon_i\epsilon_j] = \sum_{i,j}A_{ij}\delta_{ij} = \sum_i A_{ii} = \tr(A), $$其中用了 $\E[\epsilon_i\epsilon_j] = \delta_{ij}$(各坐标独立、方差 1)。
取 $A = \nabla^2f(X_t)$,并注意 $\tr(\nabla^2 f) = \sum_i\pd{^2 f}{x_i^2} = \Lap f$,得
$$ \E\big[f(X_{t+h}) - f(X_t)\mid X_t\big] = h\nabla f(X_t)^\top u_t(X_t) + \frac{h^2}{2}u_t(X_t)^\top\nabla^2f(X_t)u_t(X_t) + \frac h2\sigma_t^2\Lap f(X_t) . $$第 3 步:除以 $h$,取极限,用塔性质。
$$ \begin{aligned} \partial_t\E[f(X_t)] &= \lim_{h\to0}\frac1h\E\big[f(X_{t+h})-f(X_t)\big] \quad &&\text{(i) 导数定义} \\ &= \lim_{h\to0}\frac1h\E\Big[\E\big[f(X_{t+h})-f(X_t)\mid X_t\big]\Big] \quad &&\text{(ii) 塔性质(§2.3)} \\ &= \E\left[\lim_{h\to0}\frac1h\left(h\nabla f^\top u_t + \frac{h^2}{2}u_t^\top\nabla^2f\,u_t + \frac h2\sigma_t^2\Lap f\right)\right] \quad &&\text{(iii) 代入第 2 步} \\ &= \E\left[\nabla f(X_t)^\top u_t(X_t) + \frac{\sigma_t^2}{2}\Lap f(X_t)\right] . \end{aligned} $$在 (iii)$\to$ 最后一步里,$\frac1h\cdot\frac{h^2}{2}u^\top\nabla^2f\,u = \frac h2 u^\top\nabla^2f\,u \to 0$——确定性部分的二阶项确实死了,只有随机部分的二阶项活了下来(因为它自带一个 $h$ 而不是 $h^2$)。
第 4 步:把期望换成积分,分部积分。用假设 $X_t\sim p_t$ 和 LOTUS(§2.2):
$$ \begin{aligned} \partial_t\E[f(X_t)] &\overset{(i)}{=} \int\nabla f(x)^\top u_t(x)\,p_t(x)\dd{x} + \int\frac{\sigma_t^2}{2}\Lap f(x)\,p_t(x)\dd{x} \\ &\overset{(ii)}{=} -\int f(x)\divg(u_tp_t)(x)\dd{x} + \int\frac{\sigma_t^2}{2}f(x)\Lap p_t(x)\dd{x} \\ &= \int f(x)\left(-\divg(u_tp_t)(x) + \frac{\sigma_t^2}{2}\Lap p_t(x)\right)\dd{x} . \end{aligned} $$其中 (i) 用了 $X_t\sim p_t$ 把期望写成对密度的积分;(ii) 是本证明的心脏——两次使用工具 B 的推论:第一项取 $f_1 = f$、$f_2 = u_tp_t$(把导数从 $f$ 转移到 $u_tp_t$ 上,产生负号和散度),第二项取 $f_1 = f$、$f_2 = p_t$(拉普拉斯算子自伴,两次分部积分负负得正,把 $\Lap$ 从 $f$ 转移到 $p_t$)。
这一步就是整个证明的目的所在:我们本来只能对 $f$ 求导(因为 $f$ 是我们自己挑的光滑函数),现在通过分部积分,把导数全部转移到了 $p_t$ 身上,于是就得到了关于 $p_t$ 的方程。
使用这一步需要可积性条件 $\int p_t(x)\norm{u_t(x)}\dd{x} < \infty$。在机器学习中这几乎总是成立的(数值精度限制使得数据和函数都有界)。
第 5 步:左边也写成积分,然后用测试函数引理。
$$ \begin{aligned} & \partial_t\E[f(X_t)] = \int f(x)\left(-\divg(p_tu_t)(x) + \frac{\sigma_t^2}{2}\Lap p_t(x)\right)\dd{x} &&\text{(对所有 } f,\ 0\le t\le1) \\ \overset{(i)}{\Longleftrightarrow}\quad & \partial_t\int f(x)p_t(x)\dd{x} = \int f(x)\left(-\divg(p_tu_t)(x) + \frac{\sigma_t^2}{2}\Lap p_t(x)\right)\dd{x} \\ \overset{(ii)}{\Longleftrightarrow}\quad & \int f(x)\,\partial_t p_t(x)\dd{x} = \int f(x)\left(-\divg(p_tu_t)(x) + \frac{\sigma_t^2}{2}\Lap p_t(x)\right)\dd{x} \\ \overset{(iii)}{\Longleftrightarrow}\quad & \partial_t p_t(x) = -\divg(p_tu_t)(x) + \frac{\sigma_t^2}{2}\Lap p_t(x) &&\text{(对所有 } x\in\R^d,\ 0\le t\le1) \end{aligned} $$其中 (i) 用了假设 $X_t\sim p_t$ 加 LOTUS;(ii) 交换了求导与积分(Leibniz 法则,需要可积性);(iii) 用工具 A(测试函数引理)把"对所有测试函数积分相等"升级成"逐点相等"。
必要性证毕。
11.3 充分性:为什么反过来也对
现在要证:如果 $p_t$ 满足 Fokker–Planck 方程且 $p_0 = \simple$,那么 $X_t\sim p_t$。论证靠 PDE 的解唯一性:
第 1 步。Fokker–Planck 方程是一个偏微分方程(PDE),更精确地说是抛物型偏微分方程(parabolic PDE)。与 ODE 的定理 3 类似,这类方程在给定初值条件下解唯一。
第 2 步。设 $q_t$ 是 $X_t$ 的真实分布(即 $X_t\sim q_t$)。由 §11.2 刚刚证明的必要性,$q_t$ 必然满足 Fokker–Planck 方程。
第 3 步。于是 $p_t$ 和 $q_t$ 都是同一个抛物型 PDE 的解。
第 4 步。它们的初值也相同:$p_0 = \simple$ 是假设,$q_0 = \simple$ 是因为 SDE 就是这样初始化的($X_0\sim\simple$)。
第 5 步。由解的唯一性,$p_t = q_t$ 对所有 $0\le t\le1$ 成立,即 $X_t\sim q_t = p_t$。正是要证的。
取 $\sigma_t\equiv0$,上述整个论证就变成连续性方程(定理 11)的证明——这就是为什么讲义说"连续性方程是 Fokker–Planck 的特例"。
11.4 用 OU 过程验算 Fokker–Planck
光有证明还不够,我们再把定理套在第 8 节的 OU 过程上验算一次。这次验算的是平稳分布——它必须让 Fokker–Planck 的右边恰好为零。
取 $d=1$,$u_t(x) = -\theta x$,$\sigma_t = \sigma$。§8.3 算出极限分布是 $\N\!\left(0,\frac{\sigma^2}{2\theta}\right)$,其密度为
$$ p_\infty(x) = C\exp\!\left(-\frac{x^2}{2\cdot\frac{\sigma^2}{2\theta}}\right) = C\exp\!\left(-\frac{\theta x^2}{\sigma^2}\right), \qquad C = \left(\frac{\theta}{\pi\sigma^2}\right)^{1/2} . $$因为它是平稳的,$\partial_t p_\infty = 0$,所以 Fokker–Planck 要求右边为零。验证:
第 1 步:算 $p_\infty'$。
$$ p_\infty'(x) = C\cdot\left(-\frac{2\theta x}{\sigma^2}\right)\exp\!\left(-\frac{\theta x^2}{\sigma^2}\right) = -\frac{2\theta x}{\sigma^2}p_\infty(x) . $$第 2 步:整理成一个漂亮的形式。两边乘 $\frac{\sigma^2}{2}$:
$$ \frac{\sigma^2}{2}p_\infty'(x) = -\theta x\, p_\infty(x) . $$第 3 步:两边再求一次导。左边得到 $\frac{\sigma^2}{2}p_\infty''(x) = \frac{\sigma^2}{2}\Lap p_\infty(x)$(一维下 $\Lap = \partial_x^2$),右边得到
$$ \frac{\dd{}}{\dd{x}}\big(-\theta x\,p_\infty(x)\big) = \partial_x\big(p_\infty(x)u(x)\big) = \divg(p_\infty u)(x) . $$第 4 步:合并。于是
$$ \frac{\sigma^2}{2}\Lap p_\infty(x) = \divg(p_\infty u)(x) \qquad\Longleftrightarrow\qquad -\divg(p_\infty u)(x) + \frac{\sigma^2}{2}\Lap p_\infty(x) = 0 = \partial_t p_\infty(x) . \ \checkmark $$Fokker–Planck 方程被精确满足。这个验算还揭示了一件深刻的事:第 2 步的等式 $\frac{\sigma^2}{2}\nabla p = -u\,p$,也就是
$$ u(x) = -\frac{\sigma^2}{2}\frac{\nabla p_\infty(x)}{p_\infty(x)} = -\frac{\sigma^2}{2}\nabla\log p_\infty(x), $$正是漂移与 score 之间的关系。第 3、4 讲会看到,这个 $\frac{\sigma^2}{2}\nabla\log p_t$ 就是把 ODE 转成同边际 SDE 时必须加上的修正项。它在这里第一次露面,并非巧合——它是"漂移的输运"与"扩散的抹平"达成平衡的唯一条件。
11.5 三个方程的关系
| 方程 | 形式 | 适用对象 | 直觉 |
|---|---|---|---|
| 连续性方程 | $\partial_t p_t = -\divg(p_tu_t)$ | ODE / 流模型($\sigma_t=0$) | 概率质量被速度场纯输运,只搬不散 |
| 热方程(heat equation) | $\partial_t p_t = \frac{\sigma_t^2}{2}\Lap p_t$ | 纯布朗运动($u_t=0$) | 概率质量只扩散抹平,不定向搬运 |
| Fokker–Planck 方程 | $\partial_t p_t = -\divg(p_tu_t) + \frac{\sigma_t^2}{2}\Lap p_t$ | 一般 SDE / 扩散模型 | 输运 + 扩散,前两者的叠加 |
请记住 Fokker–Planck 定理的形式是「当且仅当」,两个方向的用法完全不同,后面几讲都要用到:
- 正向(必要性)用来分析:给了我一个 SDE,我想知道它的分布怎么演化 $\Rightarrow$ 解 Fokker–Planck。
- 反向(充分性)用来构造:我想要某条特定的概率路径 $p_t$(比如从高斯平滑过渡到数据分布),我要找到一个能实现它的向量场 $u_t$ $\Rightarrow$ 只要找到任意一个让 Fokker–Planck 成立的 $u_t$ 就够了,剩下的由定理保证。
第 2 讲的 flow matching 走的正是反向路线:先规定一条易于采样的条件概率路径 $p_t(\cdot\mid z)$,再反解出条件向量场 $u_t(x\mid z)$,最后用边际化技巧把它拼成边际向量场。整套构造之所以合法,全靠这里的"当且仅当"。
12. 收束:flow 模型与 diffusion 模型的全景
把本讲的所有零件装配起来,一台生成器长这样:
| 阶段 | 做什么 | 本讲给了什么 | 缺什么 |
|---|---|---|---|
| 建模 | 把"生成"定义成从 $\data$ 采样 | §1:Key Idea 1–4 | — |
| 构造 | 用 ODE / SDE 把 $\simple$ 搬成 $\data$ | §3、§7:向量场、流、SDE | — |
| 参数化 | 用神经网络表示向量场 $u^\theta_t$ | §5、§9:flow / diffusion 模型定义 | 网络架构(第 4 讲) |
| 训练 | 让 $u^\theta_t$ 逼近"正确的"向量场 | 本讲没有 | 第 2、3 讲 |
| 采样 | 模拟 ODE / SDE 得到 $X_1$ | §4、§7:Euler / Heun / Euler–Maruyama | — |
| 正确性保证 | 说清 $p_t$ 怎么随轨迹演化 | §10、§11:连续性方程、Fokker–Planck | — |
唯一空着的格子是训练。本讲反复说"目标是让 $X_1\sim\data$",但从没说过怎么达到这个目标。这不是疏漏,而是因为这件事本身很微妙:
损失函数应该长什么样?最自然的写法是 $\norm{u^\theta_t(x) - u^{\text{target}}_t(x)}^2$,但我们根本不知道 $u^{\text{target}}_t$ 是什么——它依赖于未知的 $\data$。
第 2 讲的答案分三步走,每一步都建立在本讲的地基上:
- 先构造一条容易的"条件"路径。固定一个数据点 $z\sim\data$,定义条件概率路径 $p_t(\cdot\mid z)$(例如 $\N(\alpha_t z,\beta_t^2I_d)$),使得 $p_0(\cdot\mid z) = \simple$、$p_1(\cdot\mid z) = \delta_z$。这条路径的向量场 $u_t(x\mid z)$ 可以用本讲的连续性方程反解出闭式解。
- 用边际化技巧把条件的拼成边际的。令 $p_t(x) = \int p_t(x\mid z)\data(z)\dd{z}$,则边际向量场是条件向量场的后验加权平均。这个"边际化技巧"的证明,就是把每个 $p_t(\cdot\mid z)$ 的连续性方程对 $z$ 积分再交换积分与散度——完全是本讲 §10 的工具。
- 把不可算的边际目标换成可算的条件目标。用 §2.2 的"期望 = 最小二乘最优常数"引理的条件版本,证明回归到边际向量场与回归到条件向量场的损失只差一个与 $\theta$ 无关的常数,因此梯度相同。于是训练目标变成了完全可算的形式。
本课的三个母题在这里第一次全部现身,后面每一讲都会再遇到它们:
- (a) 为什么用条件版本训练边际版本?因为边际向量场 $u^{\text{target}}_t(x)$ 含有对未知 $\data$ 的积分,算不出来;而条件向量场 $u_t(x\mid z)$ 在固定 $z$ 后有闭式解。§2.2 的最小二乘引理保证两个损失的梯度相同。
- (b) 为什么 ODE 和 SDE 给出同一个边际分布?因为"边际分布"这件事完全由 Fokker–Planck 方程刻画(§11),而它只约束 $-\divg(p_tu_t) + \frac{\sigma_t^2}{2}\Lap p_t$ 这个组合。改变 $\sigma_t$ 的同时按 $\frac{\sigma_t^2}{2}\nabla\log p_t$ 调整 $u_t$,组合的值不变,$p_t$ 就不变——§11.4 已经在 OU 过程上看到这个修正项的雏形。
- (c) 训练目标里"看起来不可能算"的量怎么变可算?靠条件化 + 最小二乘引理。这个模式在 flow matching(第 2 讲)、score matching(第 3 讲)、离散扩散(第 5 讲)里会以完全相同的形式反复出现。
本讲小结
关键公式速查
| 对象 | 公式 | 类型 / 说明 |
|---|---|---|
| 生成任务 | $z\sim\data$;条件版 $z\sim\data(\cdot\mid y)$ | $z\in\R^d$,$\data$ 未知,只有样本 |
| 向量场 | $u_t(x)$ | $u:\R^d\times[0,1]\to\R^d$ |
| ODE | $\frac{\dd{}}{\dd{t}}X_t = u_t(X_t),\ X_0 = x_0$ | 确定性轨迹 |
| 流 | $\frac{\dd{}}{\dd{t}}\psi_t(x_0) = u_t(\psi_t(x_0)),\ \psi_0 = \mathrm{id}$ | $\psi_t:\R^d\to\R^d$ 是微分同胚 |
| 存在唯一性 | $u$ 连续可微 + 导数有界 $\Rightarrow$ 流存在唯一 | Picard–Lindelöf;神经网络总是满足 |
| 线性场闭式解 | $u_t(x) = -\theta x \Rightarrow \psi_t(x_0) = e^{-\theta t}x_0$ | 更一般 $u = Ax\Rightarrow\psi_t = e^{tA}x_0$ |
| Euler 方法 | $X_{t+h} = X_t + h\,u_t(X_t)$ | 局部 $O(h^2)$,全局 $O(h)$;1 次网络调用 |
| Heun 方法 | $X_{t+h} = X_t + \frac h2\big(u_t(X_t) + u_{t+h}(X'_{t+h})\big)$ | 局部 $O(h^3)$,全局 $O(h^2)$;2 次网络调用 |
| 轨迹二阶导 | $\ddot X_t = \partial_tu_t(X_t) + Du_t(X_t)u_t(X_t)$ | 误差分析的核心量 |
| 布朗运动 | $W_0=0$;$W_t-W_s\sim\N(0,(t-s)I_d)$;增量独立 | 轨迹连续但处处不可微 |
| BM 协方差 | $\E[W_sW_t^\top] = \min(s,t)I_d$ | $\Var(W_t) = tI_d$,标准差 $\propto\sqrt t$ |
| 二次变差 | $\sum_i(\Delta W_i)^2\to T$,形式记号 $(\dd{W_t})^2 = \dd{t}$ | 拉普拉斯项的来源 |
| SDE | $\dd{X_t} = u_t(X_t)\dd{t} + \sigma_t\dd{W_t}$ | 符号记法;$\sigma_t\ge0$ 是标量;无流映射 |
| Euler–Maruyama | $X_{t+h} = X_t + h\,u_t(X_t) + \sqrt h\,\sigma_t\epsilon_t$ | $\epsilon_t\sim\N(0,I_d)$;是 $\sqrt h$ 不是 $h$ |
| OU 过程 | $\dd{X_t} = -\theta X_t\dd{t} + \sigma\dd{W_t}$ | 漂移回拉 vs 扩散展开 |
| OU 闭式解 | $X_t = e^{-\theta t}x_0 + \sigma\int_0^te^{-\theta(t-s)}\dd{W_s}$ | 积分因子法 |
| OU 分布 | $X_t\sim\N\!\big(e^{-\theta t}x_0,\ \frac{\sigma^2}{2\theta}(1-e^{-2\theta t})I_d\big)$ | $t\to\infty$ 时 $\to\N(0,\frac{\sigma^2}{2\theta}I_d)$ |
| OU 矩方程 | $\dot m = -\theta m$,$\dot v = -2\theta v + \sigma^2$ | 平衡点 $v_\infty = \frac{\sigma^2}{2\theta}$ |
| 流模型 | $X_0\sim\simple$,$\frac{\dd{}}{\dd{t}}X_t = u^\theta_t(X_t)$,目标 $X_1\sim\data$ | 网络参数化向量场,不是流 |
| 扩散模型 | $X_0\sim\simple$,$\dd{X_t} = u^\theta_t(X_t)\dd{t}+\sigma_t\dd{W_t}$ | $\sigma_t\equiv0$ 即流模型 |
| 散度 | $\divg(v)(x) = \sum_{i=1}^d\pd{}{x_i}v^i(x)$ | 向量场 $\to$ 标量场 |
| 拉普拉斯 | $\Lap w(x) = \sum_{i=1}^d\pd{^2}{x_i^2}w(x) = \divg(\nabla w)(x)$ | 标量场 $\to$ 标量场 |
| 乘积法则 | $\divg(pv) = \inner{\nabla p}{v} + p\divg(v)$ | 推导中反复使用 |
| 连续性方程 | $\partial_tp_t(x) = -\divg(p_tu_t)(x)$ | $X_t\sim p_t$ 的充要条件(ODE) |
| Fokker–Planck | $\partial_tp_t(x) = -\divg(p_tu_t)(x) + \frac{\sigma_t^2}{2}\Lap p_t(x)$ | $X_t\sim p_t$ 的充要条件(SDE) |
| 分部积分 | $\int\inner{\nabla f}{v} = -\int f\divg(v)$;$\int f\Lap g = \int g\Lap f$ | 边界项因 $f$ 紧支撑而消失 |
| 二次型期望 | $\E_{\epsilon\sim\N(0,I_d)}[\epsilon^\top A\epsilon] = \tr(A)$ | 把 Hessian 变成 $\Lap$ 的那一步 |
| 一维高斯 score | $\nabla\log\N(x;m,v) = -\frac{x-m}{v}$ | 第 3 讲的起点 |
| 平稳性关系 | $u(x) = -\frac{\sigma^2}{2}\nabla\log p_\infty(x)$ | 漂移与 score 的平衡条件 |
本讲最容易踩的五个坑
- Euler–Maruyama 里把 $\sqrt h$ 写成 $h$。不报错,但步长细化后噪声会消失,SDE 退化成 ODE。
- 以为神经网络输出的是流。网络给的是瞬时速度,必须模拟才能得到终点——这就是采样慢的根本原因。
- 混淆 $\E[X\mid Y=y]$(函数)与 $\E[X\mid Y]$(随机变量)。见 §2.3。
- 忘了 SDE 没有流映射。凡是用到 $\psi_t^{-1}$ 或"轨迹可逆"的论证,只对 ODE 成立。
- Taylor 展开时把二阶项当成 $O(h^2)$ 丢掉。对确定性项没错,但 $(\Delta W)^2 = O(h)$,丢了它就丢掉了整个拉普拉斯项。
延伸阅读
本讲直接相关的原始论文
- Score-Based Generative Modeling through Stochastic Differential Equations (Song et al., 2020) — 本讲开篇引言"Creating noise from data is easy; creating data from noise is generative modeling"的出处。第一次把 diffusion 完整地写成连续时间 SDE,并给出与之同边际的 probability flow ODE。读它可以提前看到本讲母题 (b) 的完整答案。
- Denoising Diffusion Probabilistic Models (Ho et al., 2020) — 引爆整个领域的那篇。它用的是离散时间马尔可夫链语言,和本讲的连续时间语言对照着读,能看清"离散步数"与"步长 $h$"的关系。
- Flow Matching for Generative Modeling (Lipman et al., 2022) — 第 2 讲的正主。本讲 §12 预告的三步走全部出自这里。建议本讲学完立刻读它的第 2、3 节。
- Flow Straight and Fast: Rectified Flow (Liu et al., 2022) — 与 flow matching 几乎同期的独立工作,用"把轨迹拉直"的视角切入。轨迹越直,Euler 方法所需步数越少——正好呼应 §4.2 的误差分析。
教材式的系统读物
- Flow Matching Guide and Code (Lipman et al., 2024) — 本课讲义大量图表的来源(包括 §3.2 的网格形变图)。如果你想要一份比讲义更长、覆盖更广(含流形上的 flow matching)的参考书,就是它。
- Stochastic Interpolants: A Unifying Framework for Flows and Diffusions (Albergo et al., 2023) — 从"随机插值"这个更一般的角度统一了 flow 和 diffusion,把本讲 §11.5 那张三方程对照表推到了极致。数学味最重的一篇,适合已经吃透 Fokker–Planck 之后读。
看看这些方程最终能造出什么
- High-Resolution Image Synthesis with Latent Diffusion Models (Rombach et al., 2022) — Stable Diffusion 的原始论文。把本讲的 SDE 搬到 VAE 的隐空间里跑,这就是第 4 讲"latent space"的主题。
- Scaling Rectified Flow Transformers for High-Resolution Image Synthesis (Esser et al., 2024) — Stable Diffusion 3。它用的正是 rectified flow + Transformer 架构,是"本课理论 = 工业界现状"最直接的证据。
- Scalable Diffusion Models with Transformers / DiT (Peebles & Xie, 2023) — 把 U-Net 换成 Transformer,第 4 讲架构部分的必读。
- Movie Gen: A Cast of Media Foundation Models (Polyak et al., 2024) — Meta 的视频生成模型,直接用 flow matching 训练。想看本讲的数学在几十亿参数规模上怎么落地,读它的方法一节。
数学背景补充
- Øksendal, Stochastic Differential Equations: An Introduction with Applications — 想把 §7.2 里"$\dd{W_t}$ 到底是什么"彻底搞清楚(Itô 积分、Itô 公式、鞅),这是标准入门教材。本讲 §8.2 的积分因子法在它的第 5 章有完整的严格版本。
- Evans, Partial Differential Equations, 第 7 章 — §11.3 用到的"抛物型 PDE 在给定初值下解唯一"就出自这里。
动手
- 课程 Lab 1(课程网站 diffusion.csail.mit.edu)— 本讲的代码全部对应 Lab 1:实现
ODE/SDE抽象类、EulerSimulator/EulerMaruyamaSimulator,然后模拟布朗运动和 OU 过程,把 §8.3 的闭式解与模拟结果画在一起对照。强烈建议在读第 2 讲之前做完。