得分函数与 Score Matching
把 flow matching 的全部结论翻译成「对数似然梯度」的语言,顺手就得到了扩散模型、随机采样,以及 DDPM 的训练损失。
0. 本讲导读
Lecture 2 的结局是一台可以工作的生成机器:选一条条件概率路径 $p_t(\cdot\mid z)$,写出它的条件向量场 $u_t^{\text{target}}(x\mid z)$,用 conditional flow matching 损失训练一个神经网络 $u_t^\theta$,然后从 $X_0\sim\simple$ 出发模拟常微分方程 $\dd{X_t}=u_t^\theta(X_t)\dd{t}$,终点 $X_1$ 就近似服从 $\data$。整条链路是确定性的:给定 $X_0$,轨迹和终点都被完全钉死。
但真实世界里被大规模部署的模型——DDPM、Stable Diffusion、EDM——采样时都在加噪声。它们模拟的不是 ODE,而是随机微分方程(stochastic differential equation, SDE)。这就产生了三个必须回答的问题:
- (a) 往 ODE 里塞噪声,边际分布 $p_t$ 会不会被破坏?如果会,那随机采样就是错的;如果不会,为什么?
- (b) 要把噪声塞进去,光有 $u_t^{\text{target}}$ 够吗?还需要什么额外的量?这个额外的量能不能学?
- (c) 文献里的 score matching、denoising score matching、noise prediction、DDPM 的 $\epsilon$-loss、$x_0$-prediction、$v$-prediction,它们和我们学的 flow matching 是什么关系?是完全不同的方法,还是同一个东西换了个坐标系?
本讲的答案可以提前剧透:只需要引入一个新对象——得分函数(score function)$\score{t}(x)=\nabla_x\log p_t(x)$——上面三个问题就一起解决了。得分函数是「往 ODE 里加噪声而不破坏边际」所需的唯一额外信息;对高斯路径来说它甚至不是额外信息,因为它和 $u_t^{\text{target}}$ 之间有一个逐点的线性双射;而 DDPM 的训练损失,不过是把 conditional score matching 损失做一次代数变形之后的产物。
阅读顺序上,本讲严格跟随讲义 §4:§1–§3 建立 score 的定义、闭式解与边际化技巧(对应讲义 §4.1);§4–§5 给出 score 与向量场的转换公式和去噪器视角;§6–§7 是本讲技术核心,用 Fokker–Planck 方程证明 SDE extension trick(讲义 §4.2);§8–§9 处理训练问题(讲义 §4.3);§10 给出可以直接跑的最小实现。
- 得分函数 $\score{t}(x)=\nabla_x\log p_t(x)\in\R^d$ 是对数似然关于 $x$ 的梯度,指向「概率密度上升最快」的方向。它对 $p_t$ 的归一化常数免疫:$p_t$ 乘任意与 $x$ 无关的常数,score 不变。这正是它可以被学出来的根本原因。
- 对高斯路径 $p_t(\cdot\mid z)=\N(\alpha_t z,\beta_t^2 I_d)$,条件得分有闭式解 $\score{t}(x\mid z)=-\dfrac{x-\alpha_t z}{\beta_t^2}$,它是 $x$ 和 $z$ 的线性函数。
- 边际化技巧对 score 同样成立:$\score{t}(x)=\displaystyle\int \score{t}(x\mid z)\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z}$,形式与向量场那条一模一样。
- SDE extension trick(讲义 Theorem 17):对任意扩散系数 $\sigma_t\ge0$,SDE $$\dd{X_t}=\left[u_t^{\text{target}}(X_t)+\frac{\sigma_t^2}{2}\score{t}(X_t)\right]\dd{t}+\sigma_t\dd{W_t},\qquad X_0\sim\simple$$ 的边际分布仍然是 $p_t$。即:一条概率路径对应无穷多条采样动力学,ODE 只是 $\sigma_t\equiv0$ 的那一条。
- 转换公式(讲义 Proposition 1):高斯路径下 $u_t^{\text{target}}(x)=a_t\score{t}(x)+b_t x$,其中 $a_t=\beta_t^2\frac{\dot\alpha_t}{\alpha_t}-\dot\beta_t\beta_t$,$b_t=\frac{\dot\alpha_t}{\alpha_t}$。学会向量场就等于学会了 score,反之亦然。
- Theorem 22:score matching 损失与 denoising score matching 损失只差一个与 $\theta$ 无关的常数,因此梯度相同、最优解相同。这让「回归一个算不出来的边际量」变成「回归一个有闭式解的条件量」。
- 把高斯路径代进 DSM 损失并吸收掉 $1/\beta_t^2$,得到的就是 DDPM 的噪声预测损失 $\E\big[\|\epsilon_t^\theta(\alpha_t z+\beta_t\epsilon)-\epsilon\|^2\big]$。
1. 得分函数:另一种描述分布的方式
到目前为止,我们描述一条概率路径的方式一直是向量场(vector field)$u_t:\R^d\times[0,1]\to\R^d$:它告诉粒子往哪走。扩散模型的文献(Song & Ermon 2019、Song et al. 2021)走的是另一条路,核心对象叫得分函数(score function)。
定义与类型
设 $q$ 是 $\R^d$ 上任意一个概率密度。$q$ 的得分函数定义为
$$ \nabla \log q:\R^d\to\R^d,\qquad x\mapsto \nabla_x\log q(x)=\left(\frac{\partial \log q}{\partial x_1}(x),\dots,\frac{\partial \log q}{\partial x_d}(x)\right)^{\!\top}. $$注意维度:$q(x)\in\R$ 是标量,$\log q(x)\in\R$ 也是标量,但它关于 $x$ 的梯度是 $d$ 维向量。所以得分函数和向量场是同一种类型的对象:都是 $\R^d\to\R^d$ 的映射。这不是巧合,后面 §4 会看到它们之间有一个精确的线性字典。
统计学里「score」这个词的经典含义是对参数求导:$\nabla_\theta\log q_\theta(x)$(Fisher score)。本课以及整个扩散模型文献用的是对数据求导:$\nabla_x\log q(x)$,有时叫 Stein score。两者完全不同,看论文时不要混。本讲之后出现的 score 一律指 $\nabla_x\log q(x)$。
直觉:指向「更像数据」的方向
$\nabla\log q(x)$ 指的是对数似然上升最快的方向。站在 $x$ 处,沿着 $\nabla\log q(x)$ 走一小步,会让你到达一个概率密度更高的位置。所以 score 场的箭头总是从低密度区指向高密度区、从「山谷」指向「山峰」。
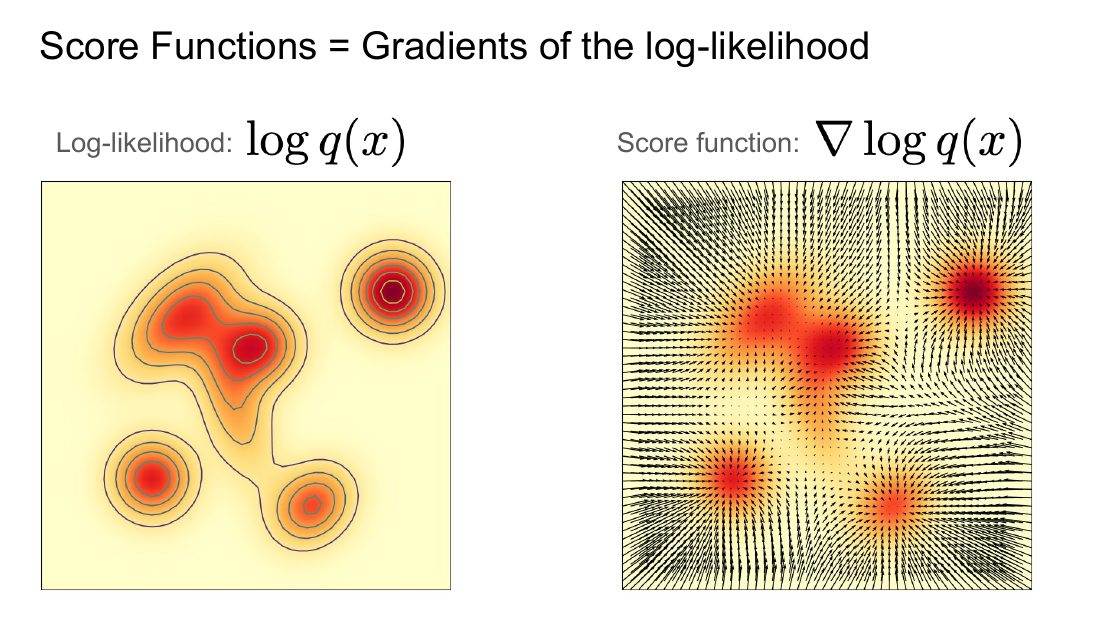
为什么箭头在峰中心变短、在远处变长?拿一维标准高斯 $q(x)=\frac{1}{\sqrt{2\pi}}e^{-x^2/2}$ 算一下:$\log q(x)=-\frac{x^2}{2}-\frac12\log(2\pi)$,于是
$$ \nabla\log q(x)=-x . $$在 $x=0$(峰值)处 score 为 $0$;在 $x=3$ 处 score 为 $-3$,方向朝原点、大小正比于距离。这就是「弹簧回中心」的图像。把它推广到 $\N(\mu,\sigma^2 I_d)$:
$$ \nabla\log \N(x;\mu,\sigma^2 I_d)=-\frac{x-\mu}{\sigma^2}. $$这个式子在本讲会反复出现,请先记住它的三个特征:(i)方向指向均值 $\mu$;(ii)大小正比于偏离量;(iii)分母是方差,所以方差越小、score 越大。第三点后面会变成一个非常现实的数值问题。
为什么是 score 而不是密度:归一化常数消失了
这是整节最重要的一句话,也是 score-based 方法能存在的根本理由。假设我们只知道 $q$ 的未归一化形式
$$ q(x)=\frac{1}{Z}\tilde q(x),\qquad Z=\int \tilde q(x)\dd{x}, $$其中 $Z\in\R$ 是配分函数(partition function),通常是一个 $d$ 维积分,$d$ 一旦上千就完全算不动。但是
$$ \nabla\log q(x)=\nabla\big[\log\tilde q(x)-\log Z\big]=\nabla\log\tilde q(x)-\underbrace{\nabla\log Z}_{=0}=\nabla\log\tilde q(x), $$因为 $Z$ 是常数、与 $x$ 无关,梯度把它彻底抹掉了。
得分函数不依赖归一化常数。要想直接建模密度 $q$,你必须保证 $\int q=1$,这在神经网络里极难做到(要么限制架构如 normalizing flow,要么去估 $Z$)。而建模 score 完全没有这个约束:任何 $\R^d\to\R^d$ 的神经网络都是合法的 score 模型。这就是为什么 score 可学、而密度难学。
一个立刻可用的例子:物理里的玻尔兹曼分布 $p_{\text{Boltzmann}}(x)=\frac1Z\exp(-U(x))$,其中 $U$ 是势能。$Z$ 算不出来,但
$$ \nabla\log p_{\text{Boltzmann}}(x)=-\nabla U(x), $$就是(负的)力场,而力场在分子模拟里是直接可以算的。§7 讲 Langevin dynamics 时我们会看到,这一条观察撑起了整个分子动力学模拟领域。
条件得分与边际得分
现在回到 Lecture 2 的设定。我们有:
- 数据分布 $\data$ 在 $\R^d$ 上,$z\sim\data$ 表示一个干净数据点;
- 条件概率路径 $p_t(\cdot\mid z)$,满足 $p_0(\cdot\mid z)=\simple$、$p_1(\cdot\mid z)=\delta_z$;
- 边际概率路径 $p_t(x)=\displaystyle\int p_t(x\mid z)\data(z)\dd{z}$,满足 $p_0=\simple$、$p_1=\data$。
对应地定义两个 score:
$$ \underbrace{\nabla\log p_t(x\mid z)}_{\text{条件得分 conditional score}}, \qquad \underbrace{\nabla\log p_t(x)}_{\text{边际得分 marginal score}} . $$这里的梯度永远是对 $x$ 求的,$z$ 和 $t$ 都当参数看。类型上:$\nabla\log p_t(\cdot\mid z):\R^d\to\R^d$,$\nabla\log p_t:\R^d\times[0,1]\to\R^d$。
整个 Lecture 2 的剧本可以原封不动搬过来,只要把「向量场」四个字换成「得分函数」:
| 向量场视角(Lecture 2) | 得分函数视角(本讲) | |
|---|---|---|
| 条件量 | $u_t^{\text{target}}(x\mid z)$,有闭式解 | $\nabla\log p_t(x\mid z)$,有闭式解 |
| 边际量 | $u_t^{\text{target}}(x)$,积分算不动 | $\nabla\log p_t(x)$,积分算不动 |
| 桥梁 | 边际化技巧(Theorem 9) | 边际化技巧(下面 §3) |
| 训练损失 | $\mathcal{L}_{\text{CFM}}$ | $\mathcal{L}_{\text{CSM}}$ |
| 等价性定理 | Theorem 12 | Theorem 22 |
| 采样 | ODE | ODE 或 SDE(本讲新增能力) |
接下来三节就是把这张表的每一行填实。
2. 高斯路径的条件得分:一个能写出闭式解的特例
Lecture 2 反复强调:条件量之所以有用,是因为它有闭式解。对 score 来说也一样。本节把讲义 Example 15 完整算一遍。
设定
取高斯条件概率路径(Gaussian conditional probability path)
$$ p_t(x\mid z)=\N\!\left(x;\;\alpha_t z,\;\beta_t^2 I_d\right),\qquad x,z\in\R^d,\;t\in[0,1], $$其中 $\alpha_t,\beta_t\in\R$ 是噪声调度器(noise scheduler):连续可微、单调,且
$$ \alpha_0=0,\quad \alpha_1=1,\qquad \beta_0=1,\quad \beta_1=0 . $$于是 $p_0(\cdot\mid z)=\N(0,I_d)=\simple$(纯噪声),$p_1(\cdot\mid z)=\N(z,0)=\delta_z$(干净数据)。最常用的两个例子:CondOT 调度 $\alpha_t=t,\beta_t=1-t$;方差保持(variance-preserving)调度 $\alpha_t=\sin\frac{\pi t}{2},\beta_t=\cos\frac{\pi t}{2}$,后者满足 $\alpha_t^2+\beta_t^2=1$。
等价的采样写法(讲义 Eq. 28)非常关键,后面到处要用:
$$ \epsilon\sim\N(0,I_d)\quad\Longrightarrow\quad x=\alpha_t z+\beta_t\epsilon\;\sim\;\N(\alpha_t z,\beta_t^2 I_d)=p_t(\cdot\mid z). $$逐步推导条件得分
第 1 步:写出密度。$d$ 维各向同性高斯的密度是
$$ p_t(x\mid z)=\frac{1}{(2\pi)^{d/2}\,\beta_t^{\,d}}\exp\!\left(-\frac{1}{2\beta_t^2}\norm{x-\alpha_t z}^2\right). $$这里协方差是 $\beta_t^2 I_d$,所以 $\det(\beta_t^2 I_d)^{1/2}=(\beta_t^2)^{d/2}=\beta_t^{\,d}$,这解释了分母。
第 2 步:取对数,把乘积变成加法。
$$ \log p_t(x\mid z)=-\frac{d}{2}\log(2\pi)-d\log\beta_t-\frac{1}{2\beta_t^2}\norm{x-\alpha_t z}^2 . $$注意前两项完全不含 $x$——它们就是上一节说的「归一化常数」。
第 3 步:对 $x$ 求梯度。前两项梯度为 $0$,只剩第三项:
$$ \begin{aligned} \nabla_x\log p_t(x\mid z) &= -\frac{1}{2\beta_t^2}\,\nabla_x\norm{x-\alpha_t z}^2 &&\text{(i) 前两项与 }x\text{ 无关}\\[2pt] &= -\frac{1}{2\beta_t^2}\cdot 2\,(x-\alpha_t z) &&\text{(ii) }\nabla_x\norm{x-c}^2=2(x-c)\\[2pt] &= -\frac{x-\alpha_t z}{\beta_t^2}. && \end{aligned} $$其中 (ii) 可以逐坐标验证:$\norm{x-c}^2=\sum_{i=1}^d (x_i-c_i)^2$,$\frac{\partial}{\partial x_i}\sum_j(x_j-c_j)^2=2(x_i-c_i)$,把 $d$ 个分量拼起来就是 $2(x-c)$。
结论(讲义 Eq. 40):
$$ \boxed{\;\nabla\log p_t(x\mid z)=-\frac{x-\alpha_t z}{\beta_t^2}=-\frac{1}{\beta_t^2}x+\frac{\alpha_t}{\beta_t^2}z\;} $$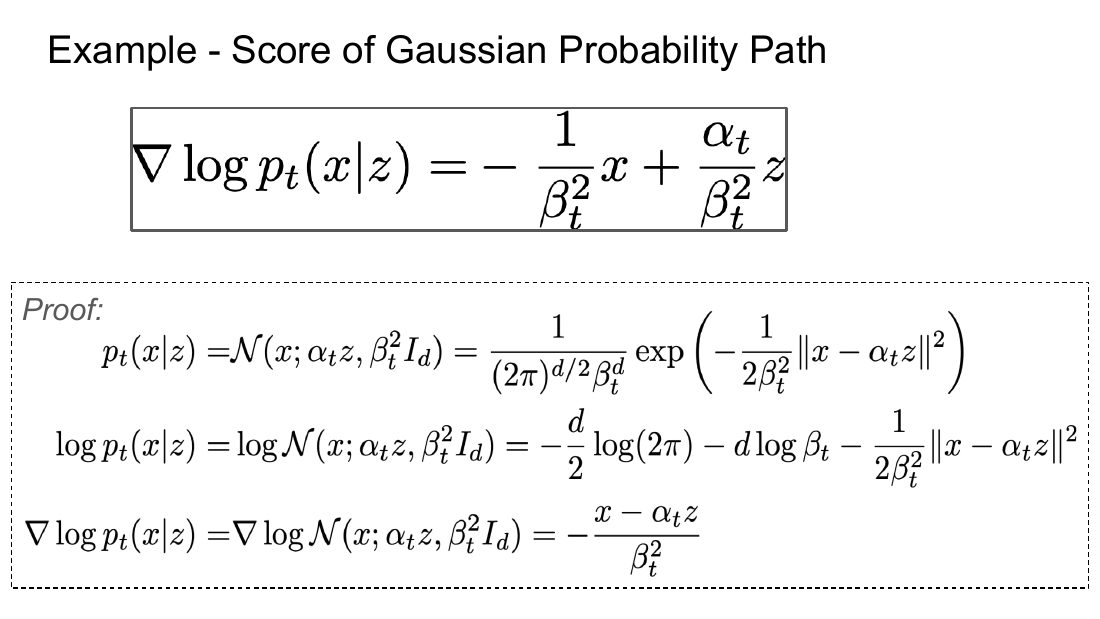
三个必须注意的性质
(1)用 $\epsilon$ 重写。代入 $x=\alpha_t z+\beta_t\epsilon$:
$$ \nabla\log p_t(x\mid z)=-\frac{(\alpha_t z+\beta_t\epsilon)-\alpha_t z}{\beta_t^2}=-\frac{\beta_t\epsilon}{\beta_t^2}=-\frac{\epsilon}{\beta_t}. $$也就是说,条件得分就是(缩放后的)加进去的那团噪声的相反数:
$$ \nabla\log p_t(x\mid z)=-\frac{\epsilon}{\beta_t} \qquad\Longleftrightarrow\qquad \epsilon=-\beta_t\,\nabla\log p_t(x\mid z). $$这一行就是「score 网络 $\Leftrightarrow$ 噪声预测网络」这条著名对应关系的全部内容,§9 会正式给出。它的直觉极其朴素:知道往哪个方向能提高似然,等价于知道当初是哪个方向被噪声推歪了。
(2)$\beta_t\to0$ 时爆炸。当 $t\to1$,$\beta_t\to0$,而 $\norm{\nabla\log p_t(x\mid z)}=\norm{\epsilon}/\beta_t\to\infty$。这不是推导错误——$p_1(\cdot\mid z)=\delta_z$ 是一个退化分布,它的「密度」在 $z$ 处是无穷尖峰,log 密度的梯度当然发散。但这在工程上是真实的麻烦:训练时 $t$ 接近 $1$ 的样本会贡献巨大的损失值和梯度。§9 会说明 DDPM 是怎么绕开这一点的。
(3)它只依赖 $x$ 和 $z$,不依赖 $\data$。这是「条件量可算」的本质:给定 $z$,$p_t(\cdot\mid z)$ 是我们自己设计的高斯,不含任何未知信息。而边际 $p_t(x)=\int p_t(x\mid z)\data(z)\dd{z}$ 里塞着整个数据分布,那是我们不知道的东西。
用一维、单点数据集 $\data=\delta_{z_0}$ 检查一下。此时 $p_t(x)=p_t(x\mid z_0)=\N(\alpha_t z_0,\beta_t^2)$,边际得分 $=$ 条件得分 $=-\frac{x-\alpha_t z_0}{\beta_t^2}$。随着 $t:0\to1$,均值从 $0$ 滑向 $z_0$、方差从 $1$ 收缩到 $0$,score 场则从「弱弹簧指向 0」变成「极强弹簧指向 $z_0$」。多点数据集无非是把很多这样的弹簧按后验权重叠加起来——这正是下一节要做的事。
3. 边际得分与边际化技巧
我们真正想要的是边际得分 $\nabla\log p_t(x)$——因为采样时用的是边际动力学,我们手里没有 $z$。本节证明:边际得分可以写成条件得分的后验加权平均,形式与 Lecture 2 的向量场边际化技巧(讲义 Eq. 18)逐字对应。
定理与证明
命题(边际化技巧 for score,讲义 Eq. 38)。设 $p_t(x)=\int p_t(x\mid z)\data(z)\dd{z}$,则对所有满足 $p_t(x)>0$ 的 $x$,
$$ \nabla\log p_t(x)=\int \nabla\log p_t(x\mid z)\,\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z}. $$证明。链式法则 $\nabla\log f=\frac{\nabla f}{f}$ 用两次,中间交换一次积分与求导:
$$ \begin{aligned} \nabla\log p_t(x) &\overset{(i)}{=}\frac{\nabla p_t(x)}{p_t(x)}\\[4pt] &\overset{(ii)}{=}\frac{\nabla\displaystyle\int p_t(x\mid z)\data(z)\dd{z}}{p_t(x)}\\[4pt] &\overset{(iii)}{=}\frac{\displaystyle\int \nabla p_t(x\mid z)\,\data(z)\dd{z}}{p_t(x)}\\[4pt] &\overset{(iv)}{=}\frac{\displaystyle\int \nabla\log p_t(x\mid z)\;p_t(x\mid z)\data(z)\dd{z}}{p_t(x)}\\[4pt] &\overset{(v)}{=}\int \nabla\log p_t(x\mid z)\,\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z}. \end{aligned} $$逐步说明:
- (i) 对 $y>0$ 有 $\partial_y\log y=1/y$,配合链式法则得 $\nabla\log p_t(x)=\frac{1}{p_t(x)}\nabla p_t(x)$。这一步要求 $p_t(x)>0$,对 $t<1$ 的高斯路径自动成立(高斯密度处处为正)。
- (ii) 只是把 $p_t$ 的定义代进分子。
- (iii) 交换 $\nabla_x$ 与 $\int\dd{z}$。这是唯一一个需要正则性条件的步骤(Leibniz 积分法则:被积函数关于 $x$ 可微且其导数被一个可积函数控制)。对高斯核加上有界的 $\data$,条件满足。
- (iv) 再用一次链式法则,反着用:$\nabla p_t(x\mid z)=p_t(x\mid z)\,\nabla\log p_t(x\mid z)$。这是全证明的关键一招——它把「密度的梯度」换成了「密度 × 条件得分」,从而在下一步凑出后验权重。
- (v) 把 $\frac{1}{p_t(x)}$ 挪进积分号(它与 $z$ 无关)。$\square$
这个式子在说什么
分子分母合起来的那一坨,由贝叶斯公式认出来就是后验分布:
$$ p_{Z\mid X}(z\mid x)\;=\;\frac{p_t(x\mid z)\data(z)}{p_t(x)}\;=\;\text{“看到含噪样本 }x\text{ 之后,它来自干净数据 }z\text{ 的概率”}. $$因此边际化技巧的内容就是一句话:
$$ \nabla\log p_t(x)=\E_{z\sim p_{Z\mid X}(\cdot\mid x)}\big[\nabla\log p_t(x\mid z)\big]. $$站在含噪点 $x$ 上,你不知道它原本是哪个数据点。于是你对每一个可能的 $z$ 都问一句「如果我来自你,我该往哪走?」——答案是条件得分 $-\frac{x-\alpha_t z}{\beta_t^2}$,指向 $\alpha_t z$。然后你按「$x$ 有多可能来自 $z$」给这些答案加权平均。得到的平均方向就是边际得分。这和 Lecture 2 里边际向量场的解释是同一句话,只是把「速度」换成了「上坡方向」。
为什么这个公式重要,却又不能直接用?它重要,是因为它把不可算的 $\nabla\log p_t$ 用可算的 $\nabla\log p_t(x\mid z)$ 表示了出来——这是 §8 证明 Theorem 22 的唯一工具。它不能直接用,是因为公式里出现了 $p_t(x)$,而 $p_t(x)=\int p_t(x\mid z)\data(z)\dd{z}$ 是一个对整个数据分布的 $d$ 维积分,既没有闭式解,蒙特卡洛估计的方差也随维度爆炸。这正是本课的母题 (c):一个「看起来不可能算」的量,怎么被换成可算的。答案不是把它算出来,而是证明「回归它」和「回归另一个可算的东西」有相同的最优解。
不要把边际化技巧误读成 $\nabla\log p_t(x)=\E_{z\sim\data}[\nabla\log p_t(x\mid z)]$。权重是后验 $p_{Z\mid X}(z\mid x)$,不是先验 $\data(z)$。两者差着一个 $\frac{p_t(x\mid z)}{p_t(x)}$ 的似然比因子。用先验加权得到的是另一个完全不同(而且错误)的向量场——它会把所有点都往数据集的全局均值拉。
一个能手算的例子:两点数据集
取 $d=1$,$\data=\frac12\delta_{z_1}+\frac12\delta_{z_2}$。则
$$ p_t(x)=\tfrac12\N(x;\alpha_t z_1,\beta_t^2)+\tfrac12\N(x;\alpha_t z_2,\beta_t^2), $$后验权重是 softmax 形式
$$ w_i(x)=\frac{\N(x;\alpha_t z_i,\beta_t^2)}{\N(x;\alpha_t z_1,\beta_t^2)+\N(x;\alpha_t z_2,\beta_t^2)},\qquad w_1+w_2=1, $$而边际得分是两个「弹簧」的加权和:
$$ \nabla\log p_t(x)=w_1(x)\cdot\left(-\frac{x-\alpha_t z_1}{\beta_t^2}\right)+w_2(x)\cdot\left(-\frac{x-\alpha_t z_2}{\beta_t^2}\right) =\frac{\alpha_t\big(w_1 z_1+w_2 z_2\big)-x}{\beta_t^2}. $$注意最后一个等号把结果整理成了「$\alpha_t\times$(后验均值)$-x$,再除以 $\beta_t^2$」的形式。这个结构不是巧合,§5 的 Tweedie 公式会证明它在任意 $\data$ 下都成立。
$t$ 很小时($\alpha_t\approx0,\beta_t\approx1$),两个高斯几乎完全重叠,$w_1\approx w_2\approx\frac12$,score 场看起来就像单个中心在 $\frac{\alpha_t(z_1+z_2)}{2}$ 的高斯:两个模式还没分开。$t$ 接近 $1$ 时($\beta_t\to0$),后验权重变成近乎硬性的 $0/1$ 判决,score 场在两点之间出现一条陡峭的「分水岭」:模式分离完成。生成过程做的就是这件事——沿着时间把混沌的单峰逐渐劈成数据分布的多个模式。
4. 转换公式:score 与 vector field 是同一枚硬币的两面
上一节结束时留了一个悬念:条件得分是 $x,z$ 的线性函数,条件向量场也是 $x,z$ 的线性函数。两个线性函数之间当然存在线性变换。讲义 Proposition 1 把这个变换写了出来,而它的后果非常大:对高斯路径,学 score 和学向量场是同一件事,不需要训练两个网络。
回顾条件向量场
Lecture 2(讲义 Eq. 20 / 29)给出高斯路径的条件向量场
$$ u_t^{\text{target}}(x\mid z)=\left(\dot\alpha_t-\frac{\dot\beta_t}{\beta_t}\alpha_t\right)z+\frac{\dot\beta_t}{\beta_t}x, \qquad \dot\alpha_t=\partial_t\alpha_t,\;\dot\beta_t=\partial_t\beta_t . $$把它和上一节的条件得分并排放:
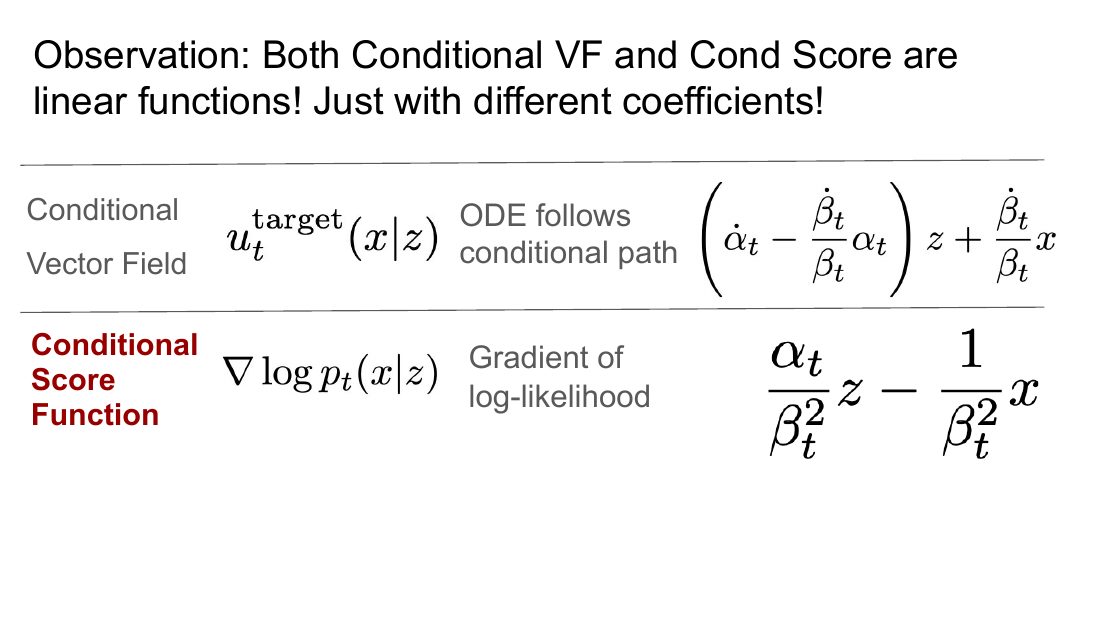
Proposition 1(转换公式)
Proposition 1(Conversion Formula for Gaussian Probability Paths,讲义 Eq. 41–42)。对高斯路径 $p_t(x\mid z)=\N(\alpha_t z,\beta_t^2 I_d)$,条件(分别地,边际)向量场与条件(分别地,边际)得分满足
$$ \begin{aligned} u_t^{\text{target}}(x\mid z)&=a_t\,\nabla\log p_t(x\mid z)+b_t\,x,\\[4pt] u_t^{\text{target}}(x)&=a_t\,\nabla\log p_t(x)+b_t\,x, \end{aligned} \qquad a_t=\beta_t^2\frac{\dot\alpha_t}{\alpha_t}-\dot\beta_t\beta_t,\quad b_t=\frac{\dot\alpha_t}{\alpha_t}. $$注意两行的系数 $a_t,b_t$ 完全相同,而且只依赖调度器、与 $x,z$ 无关。
第 1 步:条件版本。从条件向量场出发,凑出条件得分 $\frac{\alpha_t z-x}{\beta_t^2}$ 的形状。
$$ \begin{aligned} u_t^{\text{target}}(x\mid z) &=\left(\dot\alpha_t-\frac{\dot\beta_t}{\beta_t}\alpha_t\right)z+\frac{\dot\beta_t}{\beta_t}x &&\text{(i) 定义}\\[4pt] &=\left(\beta_t^2\frac{\dot\alpha_t}{\alpha_t}-\dot\beta_t\beta_t\right)\left(\frac{\alpha_t z-x}{\beta_t^2}\right)+\frac{\dot\alpha_t}{\alpha_t}x &&\text{(ii) 代数配凑}\\[4pt] &=a_t\,\nabla\log p_t(x\mid z)+b_t\,x. &&\text{(iii) 代入 Eq. 40} \end{aligned} $$(ii) 是纯代数,值得把展开写出来验证。令 $A=\beta_t^2\frac{\dot\alpha_t}{\alpha_t}-\dot\beta_t\beta_t$,则
$$ \begin{aligned} A\cdot\frac{\alpha_t z-x}{\beta_t^2}+\frac{\dot\alpha_t}{\alpha_t}x &=\left(\frac{\dot\alpha_t}{\alpha_t}-\frac{\dot\beta_t}{\beta_t}\right)(\alpha_t z-x)+\frac{\dot\alpha_t}{\alpha_t}x\\[4pt] &=\dot\alpha_t z-\frac{\dot\beta_t\alpha_t}{\beta_t}z-\frac{\dot\alpha_t}{\alpha_t}x+\frac{\dot\beta_t}{\beta_t}x+\frac{\dot\alpha_t}{\alpha_t}x\\[4pt] &=\left(\dot\alpha_t-\frac{\dot\beta_t}{\beta_t}\alpha_t\right)z+\frac{\dot\beta_t}{\beta_t}x, \end{aligned} $$第一个等号把 $A/\beta_t^2=\frac{\dot\alpha_t}{\alpha_t}-\frac{\dot\beta_t}{\beta_t}$ 提了出来;最后两项 $-\frac{\dot\alpha_t}{\alpha_t}x+\frac{\dot\alpha_t}{\alpha_t}x$ 相消。与 (i) 的右端逐项相同。
第 2 步:边际版本。这一步不是「同理可得」,需要真的把两个边际化技巧同时用上:
$$ \begin{aligned} u_t^{\text{target}}(x) &=\int u_t^{\text{target}}(x\mid z)\,\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z} &&\text{(i) 向量场的边际化技巧}\\[4pt] &=\int \big[a_t\nabla\log p_t(x\mid z)+b_t x\big]\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z} &&\text{(ii) 代入第 1 步}\\[4pt] &=a_t\int \nabla\log p_t(x\mid z)\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z} +b_t x\underbrace{\int\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z}}_{=1} &&\text{(iii) 拆开积分}\\[4pt] &=a_t\,\nabla\log p_t(x)+b_t\,x. &&\text{(iv) 得分的边际化技巧} \end{aligned} $$(iii) 里那个下括号的积分等于 $1$,因为 $\frac{p_t(x\mid z)\data(z)}{p_t(x)}$ 是关于 $z$ 的后验密度,密度对全空间积分当然是 $1$。$b_t x$ 与 $z$ 无关,可以直接提出去。(iv) 用的就是 §3 那条公式。$\square$
工程意义
Proposition 1 说的是:给定 $t$ 和 $x$,映射 $s\mapsto a_t s+b_t x$ 是 $\R^d\to\R^d$ 的仿射双射(只要 $a_t\ne0$)。所以
$$ \nabla\log p_t(x)=\frac{u_t^{\text{target}}(x)-b_t x}{a_t}, \qquad u_t^{\text{target}}(x)=a_t\,\nabla\log p_t(x)+b_t x . $$在高斯路径下,训练一个 flow matching 网络 $u_t^\theta$ 和训练一个 score 网络 $s_t^\theta$ 是等价的——你只需要训练其中一个,另一个用上面的公式当场换算出来,不需要任何额外训练。换句话说,Lecture 2 学到的模型已经包含了做 SDE 采样所需的全部信息。这就是本讲能「白捡」随机采样能力的原因。
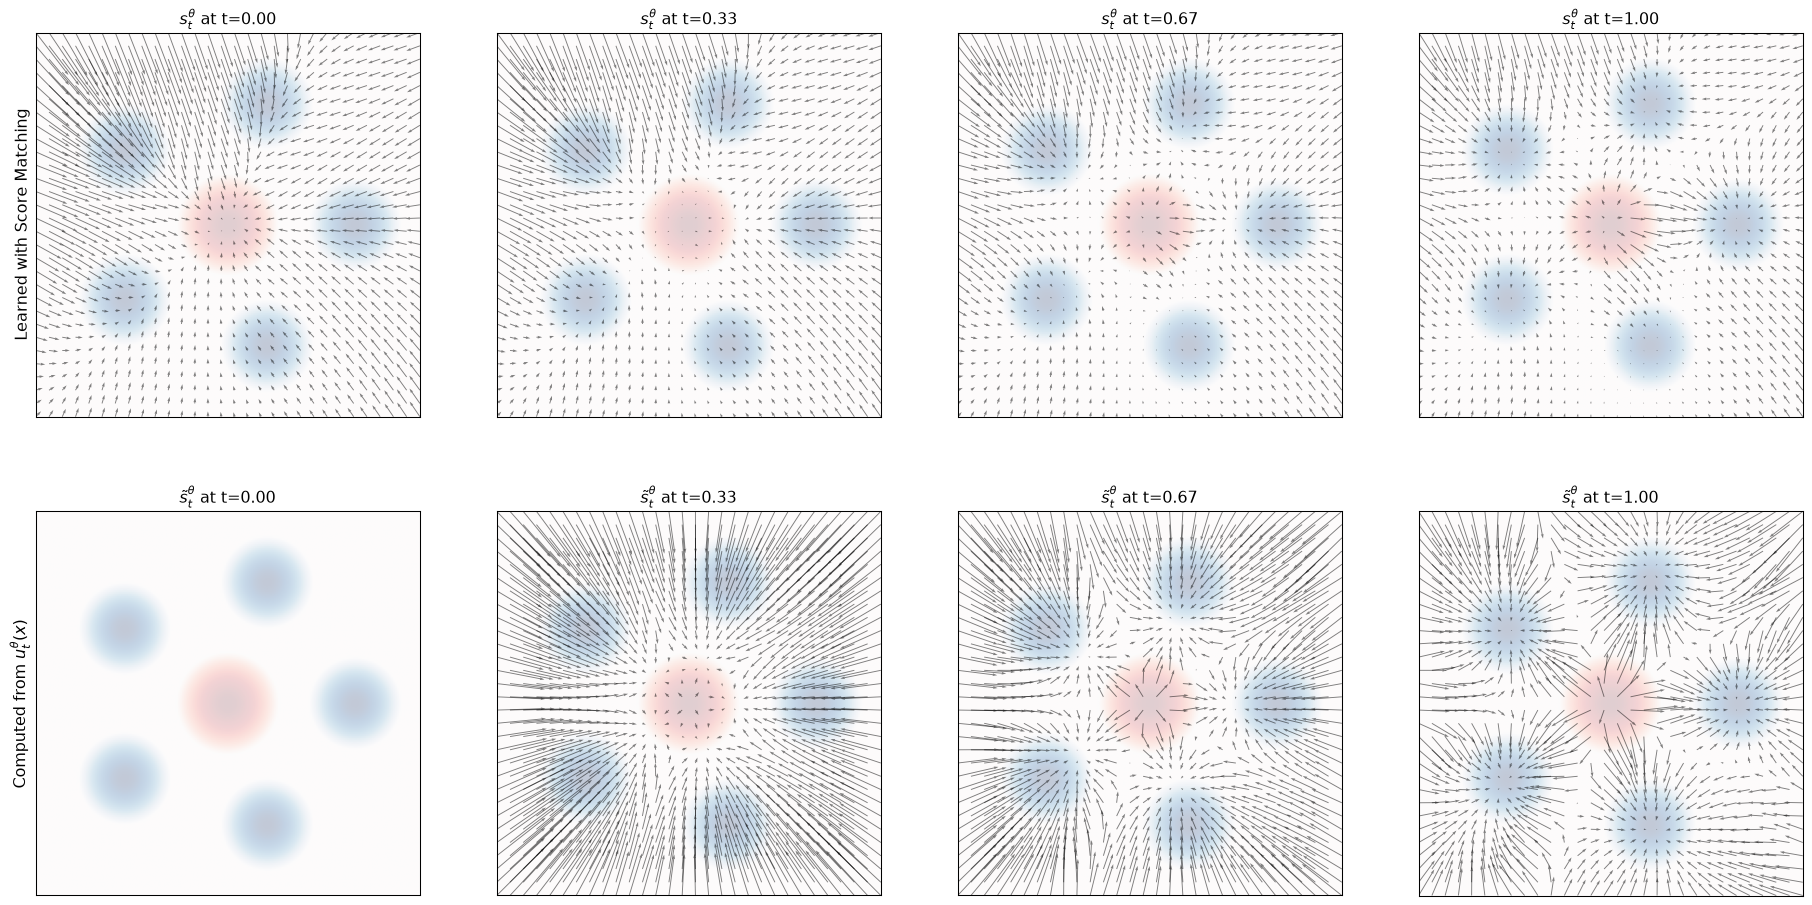
转换公式的推导处处用到了「$p_t(\cdot\mid z)$ 是高斯」——正是高斯让条件得分与条件向量场同时成为线性函数。对一般的(非高斯)条件路径,score 与向量场之间没有这样的逐点代数关系,此时想做 SDE 采样就必须额外训练一个 score 网络。这也是讲义 §4.3 存在的理由:score matching 不只是 flow matching 的换皮,它在一般情形下是一个独立的、必需的训练目标。
算例:两种常用调度的 $a_t,b_t$
把定义代进去手算一遍,方便写代码时对拍。
| 调度 | $\alpha_t,\beta_t$ | $\dot\alpha_t,\dot\beta_t$ | $a_t=\beta_t^2\frac{\dot\alpha_t}{\alpha_t}-\dot\beta_t\beta_t$ | $b_t=\frac{\dot\alpha_t}{\alpha_t}$ |
|---|---|---|---|---|
| CondOT | $t,\;1-t$ | $1,\;-1$ | $\dfrac{(1-t)^2}{t}+(1-t)=\dfrac{1-t}{t}$ | $\dfrac1t$ |
| 方差保持(VP) | $\sin\frac{\pi t}{2},\;\cos\frac{\pi t}{2}$ | $\frac{\pi}{2}\beta_t,\;-\frac{\pi}{2}\alpha_t$ | $\dfrac{\pi\beta_t}{2\alpha_t}\big(\alpha_t^2+\beta_t^2\big)=\dfrac{\pi\beta_t}{2\alpha_t}$ | $\dfrac{\pi\beta_t}{2\alpha_t}$ |
VP 调度有个漂亮的性质:因为 $\alpha_t^2+\beta_t^2=1$,所以 $a_t=b_t=\frac{\pi\beta_t}{2\alpha_t}$,转换公式简化成 $u_t^{\text{target}}(x)=\frac{\pi\beta_t}{2\alpha_t}\big[\nabla\log p_t(x)+x\big]$。CondOT 调度下 $a_t,b_t$ 在 $t\to0$ 时都发散(因为 $\alpha_t=t\to0$),代码里通常从 $t=\varepsilon$ 而不是 $t=0$ 开始,或者直接用向量场参数化避免除以 $\alpha_t$。
5. Tweedie 公式与去噪器视角
讲义 Remark 16 指出了一件比 Proposition 1 更深的事:向量场与 score 之所以能互换,是因为它们都是同一个东西的线性重参数化,而那个东西就是后验均值 $\E[z\mid x]$。本节把这条主线讲透,因为它解释了为什么工业界的扩散模型有 $x_0$-预测、$\epsilon$-预测、$v$-预测这么多花样,以及它们为什么本质上是一个模型。
去噪器的定义
定义条件去噪器与边际去噪器(denoiser)(讲义 Eq. 43)
$$ D_t(x\mid z)=z, \qquad D_t(x)=\int z\,\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z}=\E\big[z\mid x_t=x\big]\;\in\R^d . $$条件去噪器是平凡的:给定 $z$,最佳的「干净数据」猜测当然就是 $z$ 本身。边际去噪器才是有内容的那个:给定一个含噪观测 $x$,干净数据的后验期望是多少。这是最小均方误差(MMSE)意义下的最优去噪,也是「denoising diffusion model」这个名字的来源。
Tweedie 公式
命题(Tweedie 公式)。对高斯路径 $p_t(x\mid z)=\N(\alpha_t z,\beta_t^2 I_d)$,边际得分与后验均值满足
$$ \nabla\log p_t(x)=\frac{\alpha_t\,\E[z\mid x]-x}{\beta_t^2} \qquad\Longleftrightarrow\qquad \E[z\mid x]=D_t(x)=\frac{x+\beta_t^2\,\nabla\log p_t(x)}{\alpha_t}. $$证明。直接把闭式条件得分代进 §3 的边际化技巧:
$$ \begin{aligned} \nabla\log p_t(x) &=\int \nabla\log p_t(x\mid z)\,\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z} &&\text{(i) 边际化技巧}\\[4pt] &=\int \frac{\alpha_t z-x}{\beta_t^2}\,\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z} &&\text{(ii) 代入 Eq. 40}\\[4pt] &=\frac{\alpha_t}{\beta_t^2}\int z\,\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z} -\frac{x}{\beta_t^2}\underbrace{\int\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z}}_{=1} &&\text{(iii) 线性拆分}\\[4pt] &=\frac{\alpha_t\,\E[z\mid x]-x}{\beta_t^2}. &&\text{(iv) 后验均值的定义} \end{aligned} $$(iii) 中把与 $z$ 无关的 $x/\beta_t^2$ 提出积分号,剩下的后验密度积分为 $1$。反解出 $\E[z\mid x]$ 即得第二个式子。$\square$
Tweedie 公式说:「往上坡走一步」和「猜测原始数据」是同一件事。具体地,从含噪点 $x$ 出发,沿 score 方向走 $\beta_t^2$ 这么长的一步,再除以 $\alpha_t$ 把尺度还原,你就落在了后验均值上。噪声越大($\beta_t$ 越大),这一步就迈得越大——因为需要修正的量更多。这个公式在统计学里以 Robbins–Tweedie 经验贝叶斯之名存在了几十年,扩散模型只是把它用在了每一个时刻 $t$ 上。
去噪器与向量场的互换
讲义 Eq. 43 还给出了去噪器与边际向量场的直接关系:
$$ D_t(x)=\frac{1}{\dot\alpha_t\beta_t-\alpha_t\dot\beta_t}\big(\beta_t\,u_t^{\text{target}}(x)-\dot\beta_t\,x\big). $$讲义在这里写的是 "(i) follows from an equivalent derivation as in Proposition 1",我们把它补全。由 Proposition 1,$\nabla\log p_t(x)=\frac{u_t^{\text{target}}(x)-b_t x}{a_t}$。先化简 $a_t$:
$$ a_t=\beta_t^2\frac{\dot\alpha_t}{\alpha_t}-\dot\beta_t\beta_t=\frac{\beta_t\big(\dot\alpha_t\beta_t-\alpha_t\dot\beta_t\big)}{\alpha_t}, \qquad\text{记 }W_t:=\dot\alpha_t\beta_t-\alpha_t\dot\beta_t . $$于是 $\dfrac{\beta_t^2}{a_t}=\dfrac{\alpha_t\beta_t}{W_t}$。代入 Tweedie 公式:
$$ \begin{aligned} D_t(x)&=\frac{x+\beta_t^2\nabla\log p_t(x)}{\alpha_t} =\frac{1}{\alpha_t}\left[x+\frac{\beta_t^2}{a_t}\Big(u_t^{\text{target}}(x)-\frac{\dot\alpha_t}{\alpha_t}x\Big)\right]\\[4pt] &=\frac{\beta_t}{W_t}u_t^{\text{target}}(x)+\frac{x}{\alpha_t}\left[1-\frac{\beta_t\dot\alpha_t}{W_t}\right]\\[4pt] &=\frac{\beta_t}{W_t}u_t^{\text{target}}(x)+\frac{x}{\alpha_t}\cdot\frac{\dot\alpha_t\beta_t-\alpha_t\dot\beta_t-\beta_t\dot\alpha_t}{W_t}\\[4pt] &=\frac{\beta_t\,u_t^{\text{target}}(x)-\dot\beta_t\,x}{W_t}. \end{aligned} $$最后一步:分子 $\dot\alpha_t\beta_t-\alpha_t\dot\beta_t-\beta_t\dot\alpha_t=-\alpha_t\dot\beta_t$,与前面的 $\frac{x}{\alpha_t}$ 相乘约掉 $\alpha_t$,得 $-\frac{\dot\beta_t x}{W_t}$。$\square$
注意 $W_t=\dot\alpha_t\beta_t-\alpha_t\dot\beta_t$ 是调度器的 Wronskian 行列式。它非零就保证了转换可逆。CondOT 调度下 $W_t=1\cdot(1-t)-t\cdot(-1)=1$,恒等于常数,非常干净。
讲义 Remark 16 的完整含义:$u_t^{\text{target}}(x)$、$\nabla\log p_t(x)$、$D_t(x)=\E[z\mid x]$ 这三个量之间两两都由与 $x$ 线性、系数只依赖 $t$ 的公式相连。因此任何一个能恢复后验均值 $\E[z\mid x]$ 的量,都能恢复另外两个。选哪一个作为神经网络的输出,是纯粹的数值稳定性与训练动力学问题,不是建模能力问题。讲义特别指出,直接预测后验均值本身(即去噪器)在这方面往往是更可取的选择。
讲义在脚注里留了一个思考题:去噪器会不会总是输出一个「干净」的数据点?答案是不会。$D_t(x)=\E[z\mid x]$ 是后验均值,而数据分布的均值几乎从不落在数据流形上。$t$ 很小(噪声很大)时后验几乎等于先验,$D_t(x)\approx\E_{\data}[z]$——对图像数据集就是一张灰蒙蒙的「平均脸」,绝不是一张真实图片。只有当 $t\to1$、后验塌缩到单点时,$D_t(x)$ 才趋近真实数据点。这正是为什么单步去噪生成不出清晰图像、必须迭代很多步的根本原因。
6. 用 SDE 采样:SDE extension trick
前面全部是准备工作。现在进入本讲的技术核心。
问题:为什么想要 SDE
到 Lecture 2 为止,我们只会做一件事:从 $X_0\sim\simple$ 出发模拟 ODE $\dd{X_t}=u_t^{\text{target}}(X_t)\dd{t}$。这条轨迹是完全确定的——同一个 $X_0$ 永远给出同一个 $X_1$,随机性全部来自初值。但主流扩散模型采样时会在每一步注入新鲜噪声。这带来了实际好处:随机性可以把轨迹从训练误差造成的「错误吸引子」里踢出来,还允许 Langevin 式的自我纠错。问题是——随便加噪声显然会破坏边际分布。给定的 $p_t$ 是我们精心设计的,凭什么加了噪声还能保持?
Theorem 17(SDE extension trick)
Theorem 17(讲义 Eq. 44–45)。设 $u_t^{\text{target}}(x\mid z)$ 与 $u_t^{\text{target}}(x)$ 如前定义。则对任意扩散系数 $\sigma_t\ge0$,把随机项加到原 ODE 上得到的 SDE
$$ X_0\sim\simple,\qquad \dd{X_t}=\left[u_t^{\text{target}}(X_t)+\frac{\sigma_t^2}{2}\nabla\log p_t(X_t)\right]\dd{t}+\sigma_t\dd{W_t} $$满足
$$ X_t\sim p_t\qquad (0\le t\le1). $$特别地 $X_1\sim\data$。
请仔细看这个式子的结构。相比原来的 ODE,多出了两项而不是一项:
- $\sigma_t\dd{W_t}$:这是我们想加的噪声,$W_t$ 是 $d$ 维标准布朗运动;
- $\frac{\sigma_t^2}{2}\nabla\log p_t(X_t)\dd{t}$:这是补偿项,它的存在完全是为了抵消噪声造成的扩散。
噪声项 $\sigma_t\dd{W_t}$ 会让概率质量向外弥散(就像一滴墨水在水里散开),把分布抹平。而 score 项 $\frac{\sigma_t^2}{2}\score{t}$ 是一个指向高密度区的漂移,它把质量往回收拢。Theorem 17 说的是:只要补偿项的系数恰好是 $\frac{\sigma_t^2}{2}$,这两个效应就精确抵消,边际分布纹丝不动。系数不对——比如写成 $\sigma_t^2$ 或 $\frac{\sigma_t^2}{4}$——边际分布就会偏离 $p_t$,采样结果就是错的。§7 的 Fokker–Planck 计算会明确指出 $\frac12$ 是从哪来的。
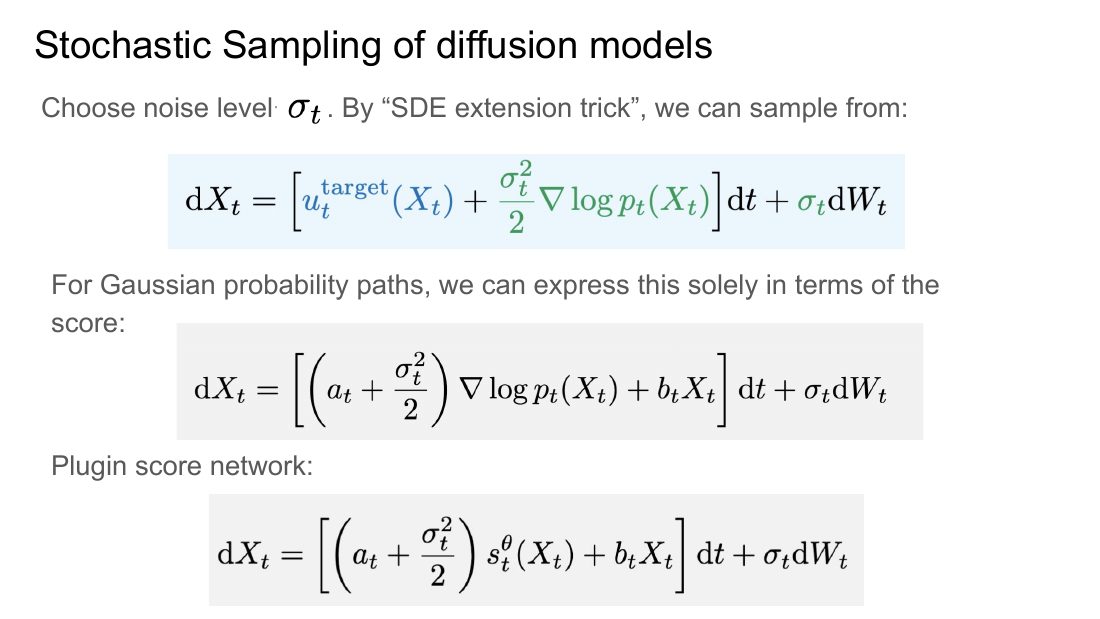
Example 18:高斯路径下的纯 score 形式
把 Proposition 1 代进 Theorem 17,可以把向量场彻底消掉(讲义 Eq. 46):
$$ \begin{aligned} u_t^{\text{target}}(x)+\frac{\sigma_t^2}{2}\nabla\log p_t(x) &=\big[a_t\nabla\log p_t(x)+b_t x\big]+\frac{\sigma_t^2}{2}\nabla\log p_t(x)\\[4pt] &=\left(a_t+\frac{\sigma_t^2}{2}\right)\nabla\log p_t(x)+b_t x . \end{aligned} $$于是
$$ X_0\sim\simple,\qquad \dd{X_t}=\left[\left(a_t+\frac{\sigma_t^2}{2}\right)\nabla\log p_t(X_t)+b_t X_t\right]\dd{t}+\sigma_t\dd{W_t} \quad\Longrightarrow\quad X_t\sim p_t . $$反过来,如果你手上训练好的是向量场网络 $u_t^\theta$ 而不是 score 网络,用 $\nabla\log p_t=\frac{u_t^{\text{target}}-b_t x}{a_t}$ 代入可得(讲义 Eq. 55)
$$ \dd{X_t}=\left[\left(1+\frac{\sigma_t^2}{2a_t}\right)u_t^\theta(X_t)-\frac{\sigma_t^2 b_t}{2a_t}X_t\right]\dd{t}+\sigma_t\dd{W_t}. $$验证很直接:$u_t+\frac{\sigma_t^2}{2}\cdot\frac{u_t-b_t x}{a_t}=\big(1+\frac{\sigma_t^2}{2a_t}\big)u_t-\frac{\sigma_t^2 b_t}{2a_t}x$。两条式子给出同一条 SDE,选哪条取决于你的网络输出的是什么。
$\sigma_t$ 到底怎么选
Theorem 17 最惊人的地方在于 $\sigma_t$ 是完全自由的,而且是在训练完成之后才需要决定的超参数。同一个训练好的网络可以配任意 $\sigma_t$ 采样。这意味着:
$$ \boxed{\;\text{一条概率路径 }p_t\;\longleftrightarrow\;\text{一整族采样动力学 }\{\sigma_t\ge0\}\;} $$ODE 只是 $\sigma_t\equiv0$ 的那一个成员。理论上它们全部正确。
讲义在这里给了一个诚实的提醒,值得原样转述:「任意 $\sigma_t$ 都对」只在理想情况下成立。实践中有两类误差破坏这个理想:
- 训练误差:$u_t^\theta\ne u_t^{\text{target}}$,$s_t^\theta\ne\nabla\log p_t$。此时 SDE 的随机性有时能把轨迹从误差累积中「洗」回高密度区,起到纠错作用(适度的 $\sigma_t>0$ 有益)。
- 模拟误差:SDE 的数值积分精度比 ODE 差。Euler–Maruyama 的强收敛阶只有 $O(\sqrt{h})$,而 ODE 的 Euler 法是 $O(h)$。$\sigma_t$ 很大时必须用极小的步长,代价高昂。
两种效应此消彼长,于是对一个固定的已训练模型,存在一个经验上的最优 $\sigma_t$,需要实测确定。讲义在脚注里强调:这个「最优 $\sigma_t$」是模型训练不完美和算力有限的产物,而不是连续极限下的理论结论。不要把它当成某种数学定理。
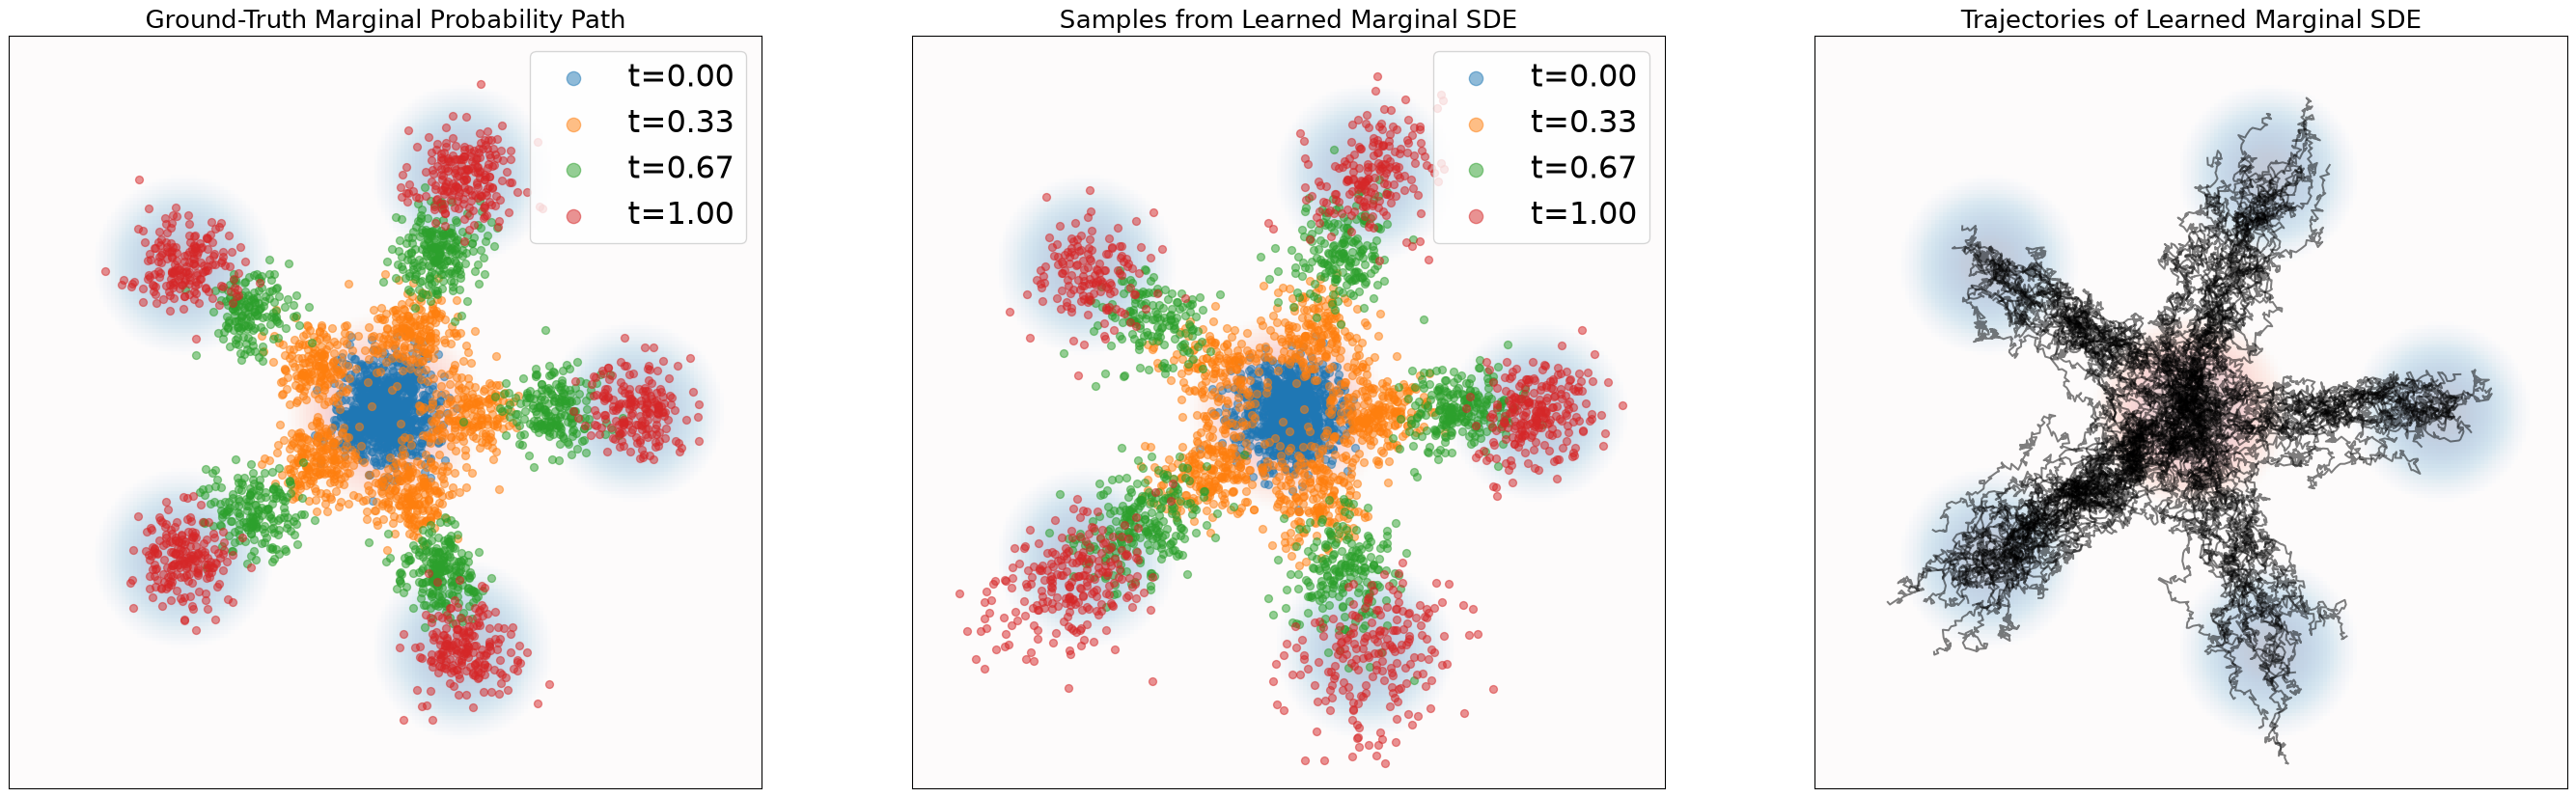
| ODE 采样($\sigma_t=0$) | SDE 采样($\sigma_t>0$) | |
|---|---|---|
| 动力学 | $\dd{X_t}=u_t^\theta(X_t)\dd{t}$ | $\dd{X_t}=\big[u_t^\theta+\frac{\sigma_t^2}{2}s_t^\theta\big]\dd{t}+\sigma_t\dd{W_t}$ |
| 需要的网络 | 只要 $u_t^\theta$ | $u_t^\theta$ 和 $s_t^\theta$(高斯路径下可互算) |
| $X_0\mapsto X_1$ | 确定性映射,可逆 | 随机映射,不可逆 |
| 边际分布 | $p_t$ | $p_t$(相同!) |
| 联合/轨迹分布 | 与 SDE 不同 | 与 ODE 不同 |
| 数值格式 | Euler、Heun、RK4… | Euler–Maruyama 等 |
| 单步误差阶 | $O(h)$ 起,可用高阶格式 | Euler–Maruyama 强阶 $O(\sqrt h)$ |
| 可算似然 | 可以(连续归一化流公式) | 不直接可算 |
| 对训练误差 | 误差沿轨迹累积 | 噪声有一定自纠错作用 |
表格倒数第四行值得强调:ODE 与 SDE 只是边际分布相同,轨迹的联合分布完全不同。这回答了本课母题 (b) 的一半——「相同」指的到底是什么相同。ODE 保持了 $X_0$ 与 $X_1$ 之间的一一对应(这是图像编辑、inversion 类应用的基础),SDE 则彻底打乱了这个对应。下一节给出「为什么边际相同」的完整证明。
7. Fokker–Planck 方程与 Theorem 17 的完整证明
Lecture 2 证明「ODE 的边际是 $p_t$」用的工具是连续性方程。要处理 SDE,需要它的推广。
拉普拉斯算子
先定义符号。对标量场 $w_t:\R^d\to\R$,拉普拉斯算子(Laplacian)为(讲义 Eq. 48)
$$ \Lap w_t(x)=\sum_{i=1}^d\frac{\partial^2}{\partial x_i^2}w_t(x)=\divg(\nabla w_t)(x). $$注意这个双重身份:$\Lap$ 既是「二阶偏导之和」,也是「梯度的散度」。后一个写法在下面的证明里是决定性的,因为它让 Laplacian 项能被塞进 $\divg(\cdot)$ 括号里,与向量场项合并。回忆散度的定义(讲义 Eq. 22):对向量场 $v_t:\R^d\to\R^d$,$\divg(v_t)(x)=\sum_{i=1}^d\frac{\partial v_t^i}{\partial x_i}(x)$,其中 $v_t^i$ 是第 $i$ 个分量。
Theorem 19(Fokker–Planck 方程)
Theorem 19(讲义 Eq. 49)。设 $p_t$ 是一条概率路径,考虑 SDE
$$ X_0\sim\simple,\qquad \dd{X_t}=u_t(X_t)\dd{t}+\sigma_t\dd{W_t}. $$则「$X_t$ 的分布对所有 $0\le t\le1$ 都等于 $p_t$」当且仅当 Fokker–Planck 方程成立:
$$ \partial_t p_t(x)=-\divg\!\big(p_t u_t\big)(x)+\frac{\sigma_t^2}{2}\Lap p_t(x) \qquad\text{对所有 }x\in\R^d,\;0\le t\le1 . $$这是一个当且仅当,两个方向都有用:要证明某条 SDE 跟随某条路径,只需验证 PDE;反之知道 SDE 也就知道了密度演化。$\sigma_t=0$ 时右边第二项消失,退化成连续性方程 $\partial_t p_t=-\divg(p_t u_t)$,也就是 Lecture 2 的 Theorem 11。讲义把 Fokker–Planck 的自洽证明放在附录 B,本讲把它作为已知工具使用。
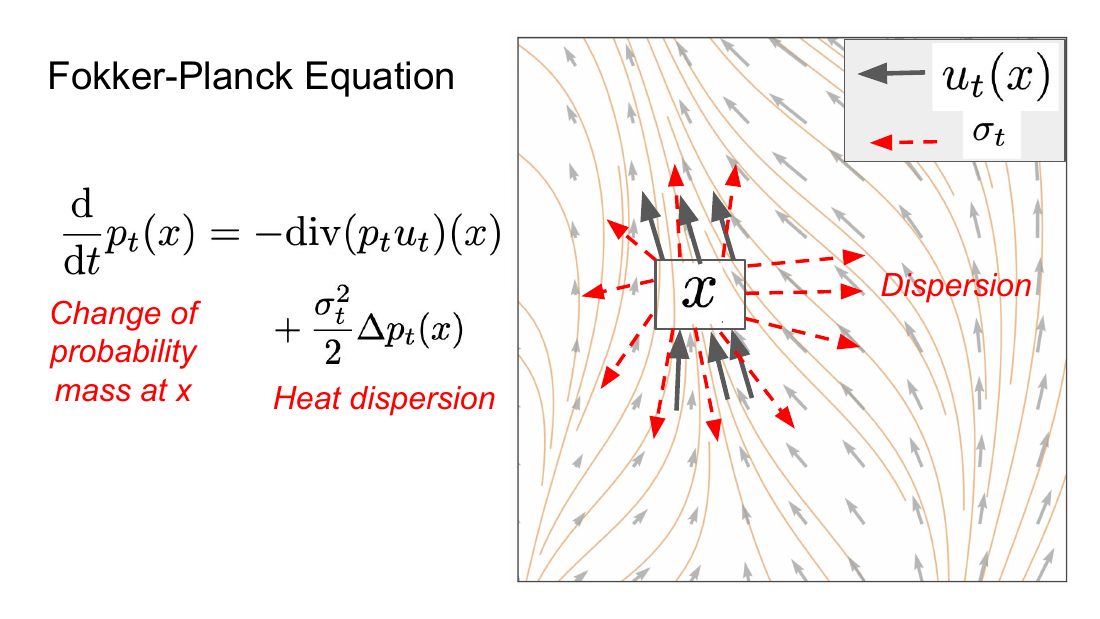
Theorem 17 的证明
目标。验证 $u_t:=u_t^{\text{target}}+\frac{\sigma_t^2}{2}\nabla\log p_t$ 与给定的 $\sigma_t$ 一起满足 $p_t$ 的 Fokker–Planck 方程。由 Theorem 19 的「当且仅当」,这就足以推出 $X_t\sim p_t$。
起点。我们已经知道(Lecture 2 的 Theorem 9 + Theorem 11)边际向量场 $u_t^{\text{target}}$ 满足连续性方程。所以从 $\partial_t p_t(x)$ 出发:
$$ \begin{aligned} \partial_t p_t(x) &\overset{(i)}{=}-\divg\!\big(p_t\,u_t^{\text{target}}\big)(x)\\[6pt] &\overset{(ii)}{=}-\divg\!\big(p_t\,u_t^{\text{target}}\big)(x)-\frac{\sigma_t^2}{2}\Lap p_t(x)+\frac{\sigma_t^2}{2}\Lap p_t(x)\\[6pt] &\overset{(iii)}{=}-\divg\!\big(p_t\,u_t^{\text{target}}\big)(x)-\divg\!\left(\frac{\sigma_t^2}{2}\nabla p_t\right)(x)+\frac{\sigma_t^2}{2}\Lap p_t(x)\\[6pt] &\overset{(iv)}{=}-\divg\!\big(p_t\,u_t^{\text{target}}\big)(x)-\divg\!\left(p_t\left[\frac{\sigma_t^2}{2}\nabla\log p_t\right]\right)(x)+\frac{\sigma_t^2}{2}\Lap p_t(x)\\[6pt] &\overset{(v)}{=}-\divg\!\left(p_t\left[u_t^{\text{target}}+\frac{\sigma_t^2}{2}\nabla\log p_t\right]\right)(x)+\frac{\sigma_t^2}{2}\Lap p_t(x). \end{aligned} $$最后一行正是以 $u_t=u_t^{\text{target}}+\frac{\sigma_t^2}{2}\nabla\log p_t$ 为漂移项、以 $\sigma_t$ 为扩散系数的 Fokker–Planck 方程。由 Theorem 19,该 SDE 的解满足 $X_t\sim p_t$,$0\le t\le1$。$\square$
五步的依据:
- (i) 连续性方程(Theorem 11)。这一步就是 Lecture 2 全部工作的成果:我们已经知道边际向量场跟随边际路径。
- (ii) 加一项再减一项,恒等变形,没有任何数学内容。但这是整个证明的灵魂:我们凭空造出一个 $-\frac{\sigma_t^2}{2}\Lap p_t$ 用来伪装成漂移项,同时留下一个 $+\frac{\sigma_t^2}{2}\Lap p_t$ 充当 Fokker–Planck 里那个必须出现的扩散项。「$\frac12$ 这个系数从哪来」的答案就在这里:Fokker–Planck 方程的扩散项天生带 $\frac{\sigma_t^2}{2}$,要抵消它,补偿漂移就必须也带 $\frac{\sigma_t^2}{2}$。
- (iii) 用 Laplacian 的第二种写法 $\Lap p_t=\divg(\nabla p_t)$,把中间那个 $-\frac{\sigma_t^2}{2}\Lap p_t$ 改写成 $-\divg\big(\frac{\sigma_t^2}{2}\nabla p_t\big)$。$\sigma_t^2/2$ 只依赖 $t$、与 $x$ 无关,所以可以自由穿过 $\divg$(散度是对 $x$ 求导)。
- (iv) 关键代换:$\nabla\log p_t=\dfrac{\nabla p_t}{p_t}$,因此 $\;\dfrac{\sigma_t^2}{2}\nabla p_t=p_t\cdot\dfrac{\sigma_t^2}{2}\nabla\log p_t$。这一步的意义是把「密度的梯度」改写成「密度 × 某个向量场」的标准形式——只有写成这个形式,它才能和第一项里的 $p_t u_t^{\text{target}}$ 合并。score 函数正是在这里、以这种方式,成为 SDE 采样的必需品。
- (v) 散度算子的线性性:$\divg(A)+\divg(B)=\divg(A+B)$。把两个 $p_t\times(\text{向量场})$ 合并成一个。
把这个证明翻译成人话:噪声在 Fokker–Planck 方程里制造了一项额外的 $+\frac{\sigma_t^2}{2}\Lap p_t$(质量向外弥散)。我们想把它抵消掉。抵消的手段只能是修改漂移项,因为漂移项在方程里长成 $-\divg(p_t\cdot\text{something})$ 的样子。于是问题变成:找一个向量场 $v$,使得 $\divg(p_t v)=\frac{\sigma_t^2}{2}\Lap p_t$。而 $\frac{\sigma_t^2}{2}\Lap p_t=\divg\big(\frac{\sigma_t^2}{2}\nabla p_t\big)=\divg\big(p_t\cdot\frac{\sigma_t^2}{2}\nabla\log p_t\big)$,所以 $v=\frac{\sigma_t^2}{2}\nabla\log p_t$ 就是答案。score 函数不是被人为塞进去的,它是这个方程唯一的解。这也顺带回答了本课母题 (b):ODE 和 SDE 给出同一边际,是因为我们主动加了一个恰好抵消扩散的漂移。
(iv) 那一步用到了 $p_t(x)>0$(要除以 $p_t$)。对 $t<1$ 的高斯路径这是成立的。但 $t\to1$ 时 $p_1=\data$ 往往支撑在低维流形上,密度在流形外为零、score 在那里无定义。这不是本证明的漏洞,而是真实存在的边界现象:实践中采样通常停在 $t=1-\varepsilon$,或者在最后几步把 $\sigma_t$ 退火到 $0$。
Remark 20:Langevin 动力学
Theorem 17 有一个著名的退化特例,值得单独看,因为它连接了扩散模型与整个统计物理/MCMC 传统。
取常数概率路径:$p_t\equiv p$ 对某个固定分布 $p$。那么 $\partial_t p_t=0$,而 $u_t^{\text{target}}=0$(不需要搬运任何质量)。代入 Theorem 17:
$$ \dd{X_t}=\frac{\sigma_t^2}{2}\nabla\log p(X_t)\dd{t}+\sigma_t\dd{W_t}. $$这就是Langevin 动力学(Langevin dynamics)(讲义 Eq. 50)。Theorem 17 立刻给出:
$$ X_0\sim p\quad\Longrightarrow\quad X_t\sim p\quad(t\ge0), $$即 $p$ 是 Langevin 动力学的平稳分布(stationary distribution)。验证也可以直接做:$u_t=0$ 时,Fokker–Planck 要求 $0=\partial_t p=-\divg\big(p\cdot\frac{\sigma_t^2}{2}\nabla\log p\big)+\frac{\sigma_t^2}{2}\Lap p=-\frac{\sigma_t^2}{2}\divg(\nabla p)+\frac{\sigma_t^2}{2}\Lap p=0$,恒成立。
更有用的是收敛性:讲义指出,在相当一般的条件下,即使从 $X_0\sim p'\ne p$ 出发,$X_t$ 的分布 $p_t'$ 也会随 $t\to\infty$ 收敛到 $p$。这让 Langevin 动力学成为一个通用的采样算法。
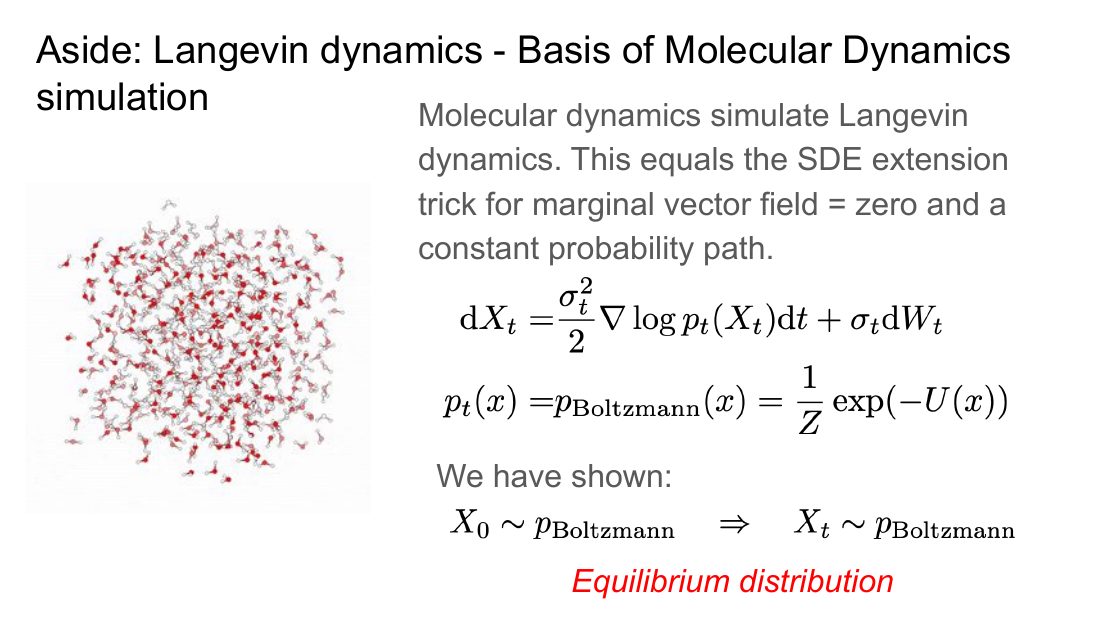
Langevin 动力学是「梯度上升 + 噪声」:$\frac{\sigma_t^2}{2}\nabla\log p$ 想把粒子推到密度最高点(如果没有噪声,所有粒子最终会塌缩到众数上),而 $\sigma_t\dd{W_t}$ 不断把它踢开。两者达到平衡时,粒子在空间中的分布恰好就是 $p$ 本身——不是塌缩到峰值,而是按 $p$ 的形状铺开。这就是「采样」与「优化」的区别:优化找最大值,采样按密度铺开。
反过来看,本讲的 SDE extension trick 可以理解为「带时间调度的 Langevin 动力学」:$u_t^{\text{target}}$ 负责把分布从 $\simple$ 一路搬到 $\data$,而 $\frac{\sigma_t^2}{2}\nabla\log p_t+\sigma_t\dd{W_t}$ 这一对在每一个时刻做局部的 Langevin 平衡,把粒子重新「摊」回当前的 $p_t$ 上。这就是随机采样具有纠错能力的机理:如果神经网络的误差把粒子推到了 $p_t$ 的低密度区,Langevin 部分会把它拉回来。
Remark 21:GLASS Flows
讲义最后提了一个有趣的补充。SDE 相对 ODE 的显著性质是演化本身带随机性:初值 $X_0$ 不再完全决定 $t>0$ 时的 $X_t$。令人意外的是,通过一个称为 GLASS Flows 的采样技巧,纯 ODE 也可以得到同样的随机转移。这样就能在保持 ODE 高效率(可用高阶数值格式、步数少)的同时,享受 SDE 的随机性(例如配合搜索类算法使用)。
8. Score Matching 与 Denoising Score Matching
到这里,理论上的事情全部办完了:我们知道 SDE 采样需要 $\nabla\log p_t$,也知道它对高斯路径可以从 $u_t^\theta$ 换算。但正如 §4 末尾的警告所说,对一般概率路径没有这样的捷径,必须直接学 $\nabla\log p_t$。本节解决这个训练问题,路线与 Lecture 2 的 flow matching 一字不差。
两个损失函数
引入得分网络(score network)
$$ s_t^\theta:\R^d\times[0,1]\to\R^d,\qquad (x,t)\mapsto s_t^\theta(x), $$输入是含噪样本和时间,输出是一个 $d$ 维向量。注意输入输出维度相同,和向量场网络完全一样,所以架构可以直接复用(U-Net、DiT 等,见 Lecture 4)。
最自然的训练目标是score matching 损失:
$$ \mathcal{L}_{\text{SM}}(\theta)=\E_{t\sim\text{Unif}[0,1],\;x\sim p_t}\Big[\big\|s_t^\theta(x)-\nabla\log p_t(x)\big\|^2\Big]. $$它显然是我们想要的:最小化它就是让 $s_t^\theta$ 逐点逼近边际得分。但它算不出来——$\nabla\log p_t(x)$ 需要边际密度 $p_t(x)=\int p_t(x\mid z)\data(z)\dd{z}$,那是一个不可解的积分。
可算的替代品是条件得分匹配 / 去噪得分匹配损失(conditional / denoising score matching loss):
$$ \mathcal{L}_{\text{CSM}}(\theta)=\E_{t\sim\text{Unif}[0,1],\;z\sim\data,\;x\sim p_t(\cdot\mid z)}\Big[\big\|s_t^\theta(x)-\nabla\log p_t(x\mid z)\big\|^2\Big]. $$两者的唯一差别:回归目标从边际得分换成了条件得分。而条件得分有闭式解(§2),采样 $z\sim\data$ 就是从数据集里取一个样本,采样 $x\sim p_t(\cdot\mid z)$ 就是加一次高斯噪声。$\mathcal{L}_{\text{CSM}}$ 的每一项都是几行代码就能算出来的。
问题当然是:回归一个「错的」目标,凭什么能学到对的东西?这就是本课的母题 (a),答案在下面这个定理。
Theorem 22(两个损失的等价性)
Theorem 22。score matching 损失与 denoising score matching 损失只相差一个与参数 $\theta$ 无关的常数:
$$ \mathcal{L}_{\text{SM}}(\theta)=\mathcal{L}_{\text{CSM}}(\theta)+C,\qquad C\text{ 与 }\theta\text{ 无关}. $$因此它们的梯度相同
$$ \nabla_\theta\mathcal{L}_{\text{SM}}(\theta)=\nabla_\theta\mathcal{L}_{\text{CSM}}(\theta), $$用 SGD 最小化 $\mathcal{L}_{\text{CSM}}$ 与最小化 $\mathcal{L}_{\text{SM}}$ 完全等价。特别地,对最优解 $\theta^*$ 有 $s_t^{\theta^*}=\nabla\log p_t$(在无限表达力假设下)。
讲义对这个定理只写了一句话的证明:「$\nabla\log p_t$(Eq. 38)的公式与 $u_t^{\text{target}}$(Eq. 18)的公式长得一样,所以把 Theorem 12 的证明里的 $u_t^{\text{target}}$ 换成 $\nabla\log p_t$ 即可。」这句话是对的,但它把全部工作留给了读者。下面把这个证明完整写出来。
为了减轻记号负担,本证明中记 $s^\theta:=s_t^\theta(x)$、$s:=\nabla\log p_t(x)$(边际得分)、$s^z:=\nabla\log p_t(x\mid z)$(条件得分)。全程使用两个基本事实:
事实 A(采样等价)。「先 $z\sim\data$ 再 $x\sim p_t(\cdot\mid z)$」得到的 $x$ 的边际分布就是 $p_t$。因此对任何只依赖 $x$ 和 $t$ 的函数 $g$,
$$ \E_{t,\,x\sim p_t}[g(x,t)]=\E_{t,\,z\sim\data,\,x\sim p_t(\cdot\mid z)}[g(x,t)]. $$事实 B(边际化技巧,§3)。$\;s=\displaystyle\int s^z\,\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z}$。
第 1 步:把 $\mathcal{L}_{\text{SM}}$ 展开成三项。用 $\norm{a-b}^2=\norm{a}^2-2a^\top b+\norm{b}^2$:
$$ \begin{aligned} \mathcal{L}_{\text{SM}}(\theta) &\overset{(i)}{=}\E_{t,\,x\sim p_t}\big[\norm{s^\theta-s}^2\big]\\[4pt] &\overset{(ii)}{=}\E_{t,\,x\sim p_t}\big[\norm{s^\theta}^2\big] -2\,\E_{t,\,x\sim p_t}\big[(s^\theta)^\top s\big] +\underbrace{\E_{t,\,x\sim p_t}\big[\norm{s}^2\big]}_{=:C_1}\\[4pt] &\overset{(iii)}{=}\E_{t,\,z\sim\data,\,x\sim p_t(\cdot\mid z)}\big[\norm{s^\theta}^2\big] -2\,\E_{t,\,x\sim p_t}\big[(s^\theta)^\top s\big]+C_1 . \end{aligned} $$(i) 是定义;(ii) 是平方展开,第三项 $C_1$ 完全不含 $\theta$,先放一边;(iii) 对第一项用了事实 A($\norm{s_t^\theta(x)}^2$ 只依赖 $x,t$)。
第 2 步:处理交叉项——这是整个证明的核心。
$$ \begin{aligned} \E_{t,\,x\sim p_t}\big[(s^\theta)^\top s\big] &\overset{(i)}{=}\int_0^1\!\!\int p_t(x)\,s_t^\theta(x)^\top\,\nabla\log p_t(x)\dd{x}\dd{t}\\[4pt] &\overset{(ii)}{=}\int_0^1\!\!\int p_t(x)\,s_t^\theta(x)^\top\left[\int \nabla\log p_t(x\mid z)\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z}\right]\dd{x}\dd{t}\\[4pt] &\overset{(iii)}{=}\int_0^1\!\!\int\!\!\int s_t^\theta(x)^\top\,\nabla\log p_t(x\mid z)\;p_t(x\mid z)\,\data(z)\dd{z}\dd{x}\dd{t}\\[4pt] &\overset{(iv)}{=}\E_{t,\,z\sim\data,\,x\sim p_t(\cdot\mid z)}\big[(s^\theta)^\top s^z\big]. \end{aligned} $$(i) 把期望写成积分($t$ 在 $[0,1]$ 上均匀,密度为 $1$);(ii) 代入事实 B;(iii) $p_t(x)$ 上下相消——这是全证明唯一真正发生的事情,也是「不可算的边际量被换掉」的确切位置;(iv) 把三重积分重新读成期望:$\data(z)\dd{z}$ 是对 $z\sim\data$ 取期望,$p_t(x\mid z)\dd{x}$ 是对 $x\sim p_t(\cdot\mid z)$ 取期望。
请注意这个式子的含义:等号左边的期望里出现的是边际得分(不可算),右边出现的是条件得分(可算)。两者的期望值精确相等。
第 3 步:重新配方。把第 2 步的结果代回第 1 步,此时三项的期望符号已经统一成 $\E_{t,z\sim\data,x\sim p_t(\cdot\mid z)}$(下面简写为 $\E$):
$$ \begin{aligned} \mathcal{L}_{\text{SM}}(\theta) &\overset{(i)}{=}\E\big[\norm{s^\theta}^2\big]-2\,\E\big[(s^\theta)^\top s^z\big]+C_1\\[4pt] &\overset{(ii)}{=}\E\Big[\norm{s^\theta}^2-2(s^\theta)^\top s^z+\norm{s^z}^2\Big]-\underbrace{\E\big[\norm{s^z}^2\big]}_{=:C_2}+C_1\\[4pt] &\overset{(iii)}{=}\E\Big[\norm{s^\theta-s^z}^2\Big]+C_1-C_2\\[4pt] &\overset{(iv)}{=}\mathcal{L}_{\text{CSM}}(\theta)+\underbrace{C_1-C_2}_{=:C}. \end{aligned} $$(i) 是代入;(ii) 加一项减一项,把 $\norm{s^z}^2$ 补进括号里凑完全平方,同时在括号外减掉;(iii) 用 $\norm{a}^2-2a^\top b+\norm{b}^2=\norm{a-b}^2$ 合并;(iv) 认出 $\mathcal{L}_{\text{CSM}}$ 的定义。
$C_1=\E_{t,x\sim p_t}[\norm{\nabla\log p_t(x)}^2]$ 和 $C_2=\E_{t,z,x}[\norm{\nabla\log p_t(x\mid z)}^2]$ 都不含 $s^\theta$,因此与 $\theta$ 无关。定理得证。$\square$
为什么「回归一个随机的、噪声很大的目标」能得到正确答案?因为最小二乘回归的最优解是条件期望。固定 $(t,x)$,最小化 $\E_{z\mid x}[\norm{s^\theta(x)-s^z}^2]$ 关于 $s^\theta(x)$ 的最优解是 $\E_{z\mid x}[s^z]$——而由边际化技巧,这个后验期望恰好就是边际得分。所以网络在每个 $x$ 上被迫输出「所有可能的 $z$ 给出的条件得分的后验平均」,也就是我们真正想要的量。神经网络的平均化行为,替我们做完了那个算不出来的积分。
「$\mathcal{L}_{\text{SM}}=\mathcal{L}_{\text{CSM}}+C$,所以训练完 $\mathcal{L}_{\text{CSM}}$ 应该降到 $0$」——错。在最优点 $\mathcal{L}_{\text{SM}}(\theta^*)=0$,因此
$$ \mathcal{L}_{\text{CSM}}(\theta^*)=-C=C_2-C_1=\E\big[\norm{\nabla\log p_t(x\mid z)-\nabla\log p_t(x)}^2\big]\;>\;0 . $$(中间的等号用了 $\nabla\log p_t(x)=\E_{z\mid x}[\nabla\log p_t(x\mid z)]$ 和方差分解 $\E\norm{Y}^2-\norm{\E Y}^2=\E\norm{Y-\E Y}^2$。)这个残差就是给定 $x$ 时 $z$ 的后验不确定性,是数据本身的性质,与模型好坏无关。所以训练曲线会收敛到一个明显大于零的平台,这是正常的,不是没训好。判断模型好坏要看样本质量或验证集损失的相对下降,不能看绝对值。同样的现象在 flow matching 里也存在。
训练算法
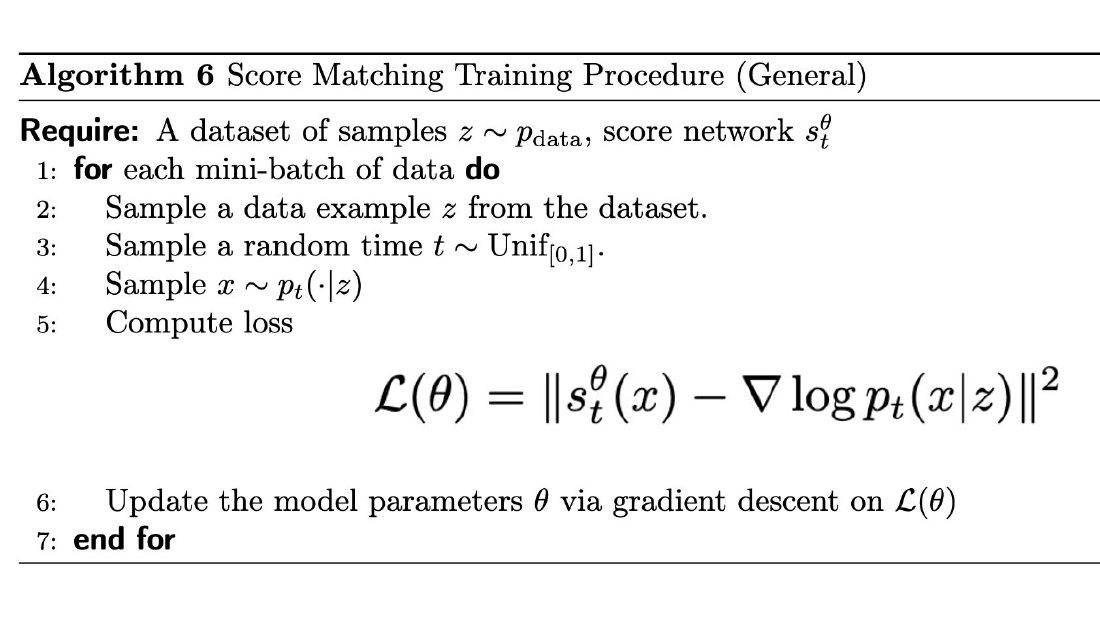
对比一下 flow matching 的训练流程,会发现两者只有第 5 行的回归目标不同:
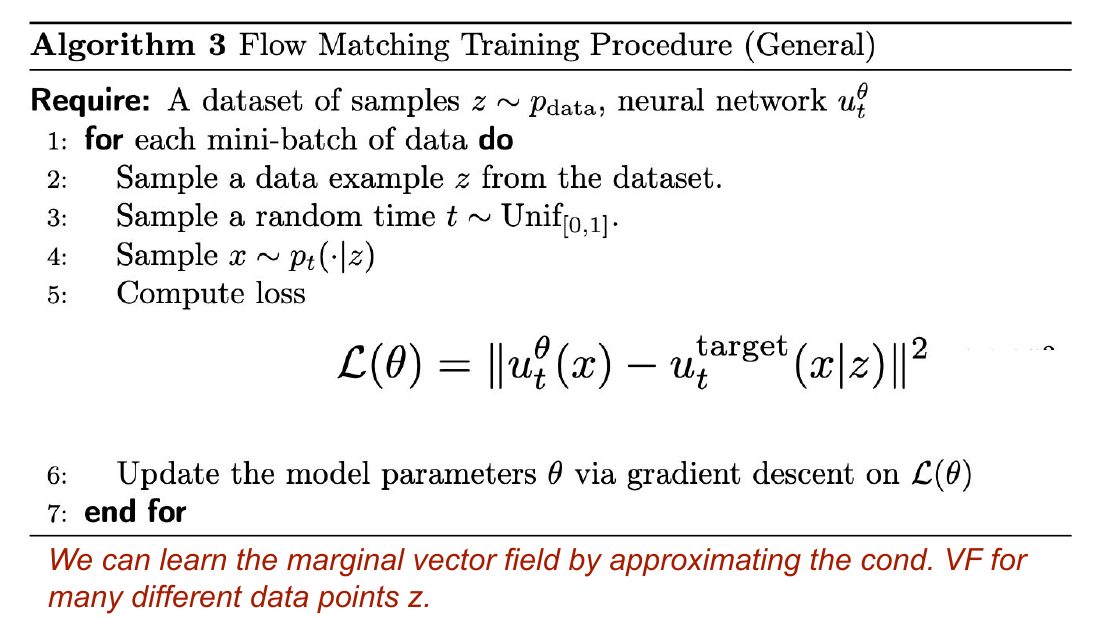
9. 高斯路径下的 DSM:从 CSM 损失到 DDPM
本节把 $\mathcal{L}_{\text{CSM}}$ 具体化到高斯路径(讲义 Example 23),并说明它与 DDPM 的关系。
代入闭式条件得分
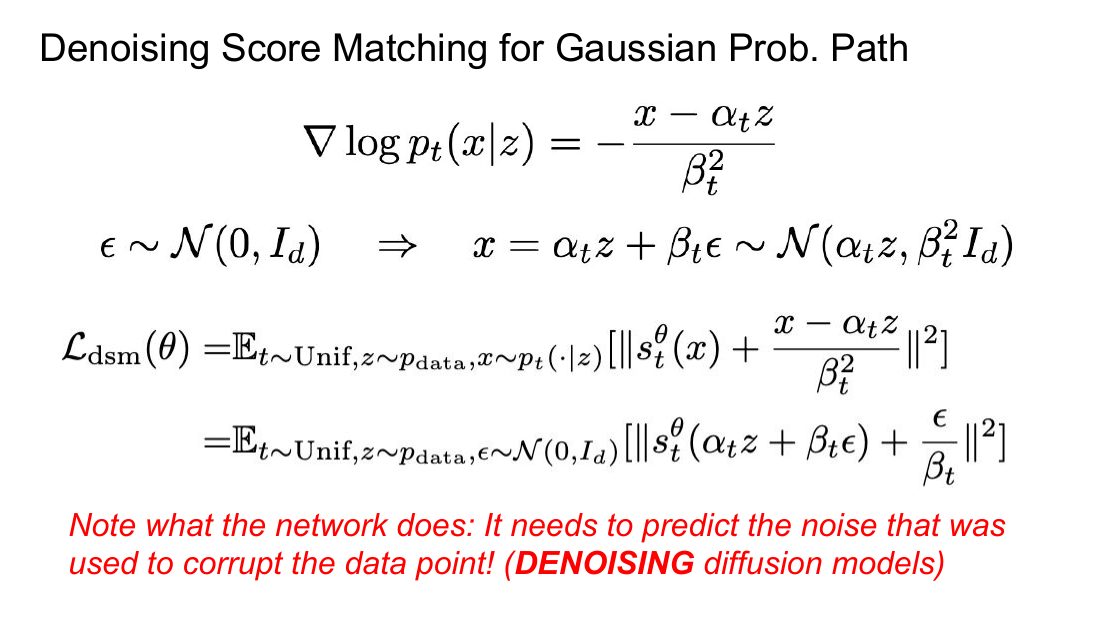
由 §2,$\nabla\log p_t(x\mid z)=-\frac{x-\alpha_t z}{\beta_t^2}$。代入 $\mathcal{L}_{\text{CSM}}$:
(i) 用重参数化 $x=\alpha_t z+\beta_t\epsilon$,于是 $\frac{x-\alpha_t z}{\beta_t^2}=\frac{\beta_t\epsilon}{\beta_t^2}=\frac{\epsilon}{\beta_t}$;同时采样 $x\sim p_t(\cdot\mid z)$ 被替换成采样 $\epsilon\sim\N(0,I_d)$。(ii) 把 $\frac{1}{\beta_t}$ 从范数里提出来:$\big\|\frac{1}{\beta_t}(\beta_t s^\theta+\epsilon)\big\|^2=\frac{1}{\beta_t^2}\norm{\beta_t s^\theta+\epsilon}^2$。
$\beta_t\to0$ 的数值灾难与 DDPM 的修正
上式里的权重 $\frac{1}{\beta_t^2}$ 是个定时炸弹:$t\to1$ 时 $\beta_t\to0$,权重趋于无穷,回归目标 $-\epsilon/\beta_t$ 也趋于无穷。用讲义的话说,denoising score matching 只有在加了足够多噪声时才工作。直接照上式训练,靠近 $t=1$ 的少数样本会主导整个梯度,训练崩掉。
Denoising Diffusion Probabilistic Models(Ho et al., 2020)的做法是:把常数 $\frac{1}{\beta_t^2}$ 直接扔掉,并把 score 网络重参数化成一个噪声预测器(noise predictor)
$$ \epsilon_t^\theta:\R^d\times[0,1]\to\R^d,\qquad \epsilon_t^\theta(x):=-\beta_t\,s_t^\theta(x) \quad\Longleftrightarrow\quad s_t^\theta(x)=-\frac{\epsilon_t^\theta(x)}{\beta_t}. $$代进去,损失变成
$$ \boxed{\;\mathcal{L}_{\text{DDPM}}(\theta)=\E_{t\sim\text{Unif},\,z\sim\data,\,\epsilon\sim\N(0,I_d)}\Big[\big\|\epsilon_t^\theta(\alpha_t z+\beta_t\epsilon)-\epsilon\big\|^2\Big]\;} $$(把 $\beta_t s_t^\theta=-\epsilon_t^\theta$ 代入上一节的 (ii) 式并丢掉 $\frac{1}{\beta_t^2}$ 即得。)这个损失干净得不可思议:回归目标是标准高斯噪声 $\epsilon$,量级恒为 $O(1)$,与 $t$ 无关,不会爆炸。网络的任务是「看着含噪图 $x$ 和噪声等级 $t$,把当初加进去的噪声认出来」。
丢掉 $\frac{1}{\beta_t^2}$ 改变了损失函数——它不再等于 $\mathcal{L}_{\text{SM}}$ 加常数了。准确地说,这相当于给不同的 $t$ 重新分配了权重:$\mathcal{L}_{\text{DDPM}}=\E_t\big[\beta_t^2\cdot(\text{原 CSM 在 }t\text{ 处的损失})\big]$。在无限表达力假设下这不影响最优解(因为每个 $t$ 上的最优解是逐点独立确定的,正权重不改变逐点最优解),但在有限容量下它确实改变了模型在不同噪声等级上的资源分配。事实上「怎么给不同 $t$ 加权」后来成了一个独立的研究方向(EDM 的 loss weighting、min-SNR 加权等)。不要以为丢常数是无害的代数操作。
训练算法(讲义 Algorithm 4)
把上面的推导落成流程:
| 步骤 | 操作 | 形状 / 说明 |
|---|---|---|
| 1 | 从数据集采一个 mini-batch $z\sim\data$ | $(\text{bs},d)$ |
| 2 | 采随机时间 $t\sim\text{Unif}[0,1]$ | $(\text{bs},1)$,每个样本独立 |
| 3 | 采噪声 $\epsilon\sim\N(0,I_d)$ | $(\text{bs},d)$ |
| 4 | 构造含噪样本 $x_t=\alpha_t z+\beta_t\epsilon$ | $(\text{bs},d)$;一般情形是 $x\sim p_t(\cdot\mid z)$ |
| 5 | 计算损失 $\big\|s_t^\theta(x_t)+\frac{\epsilon}{\beta_t}\big\|^2$,或 $\big\|\epsilon_t^\theta(x_t)-\epsilon\big\|^2$ | 标量;一般情形是 $\norm{s_t^\theta(x_t)-\nabla\log p_t(x_t\mid z)}^2$ |
| 6 | 对 $\theta$ 做一步梯度下降 | —— |
再次强调:没有任何一步需要模拟微分方程。步骤 4 是一次闭式的加噪,不是 $t$ 步迭代。这就是 simulation-free 的含义。
各种参数化的换算表
综合 §2、§4、§5 的结果,同一个模型可以让网络输出四种不同的量。设 $x=\alpha_t z+\beta_t\epsilon$,记 $W_t=\dot\alpha_t\beta_t-\alpha_t\dot\beta_t$,$a_t=\beta_t^2\frac{\dot\alpha_t}{\alpha_t}-\dot\beta_t\beta_t$,$b_t=\frac{\dot\alpha_t}{\alpha_t}$。四者两两可换算:
| 参数化 | 网络输出 | 回归目标(条件版) | 由 score $s$ 表示 | 换算回 score |
|---|---|---|---|---|
| score 预测 | $s_t^\theta(x)\approx\score{t}(x)$ | $-\dfrac{x-\alpha_t z}{\beta_t^2}=-\dfrac{\epsilon}{\beta_t}$ | $s$ | $s=s_t^\theta$ |
| $\epsilon$ 预测 | $\epsilon_t^\theta(x)\approx\E[\epsilon\mid x]$ | $\epsilon$ | $-\beta_t s$ | $s=-\dfrac{\epsilon_t^\theta}{\beta_t}$ |
| $x_0$ 预测(去噪器) | $D_t^\theta(x)\approx\E[z\mid x]$ | $z$ | $\dfrac{x+\beta_t^2 s}{\alpha_t}$ | $s=\dfrac{\alpha_t D_t^\theta-x}{\beta_t^2}$ |
| 向量场 / $v$ 预测 | $u_t^\theta(x)\approx u_t^{\text{target}}(x)$ | $\dot\alpha_t z+\dot\beta_t\epsilon$ | $a_t s+b_t x$ | $s=\dfrac{u_t^\theta-b_t x}{a_t}$ |
表格第四行的回归目标值得单独验证一下,因为它揭示了 $v$-prediction 的来历。把 $x=\alpha_t z+\beta_t\epsilon$ 代入条件向量场:
$$ \begin{aligned} u_t^{\text{target}}(x\mid z) &=\left(\dot\alpha_t-\frac{\dot\beta_t}{\beta_t}\alpha_t\right)z+\frac{\dot\beta_t}{\beta_t}\big(\alpha_t z+\beta_t\epsilon\big)\\[4pt] &=\dot\alpha_t z-\frac{\dot\beta_t\alpha_t}{\beta_t}z+\frac{\dot\beta_t\alpha_t}{\beta_t}z+\dot\beta_t\epsilon\\[4pt] &=\dot\alpha_t z+\dot\beta_t\,\epsilon . \end{aligned} $$中间两项精确相消。所以条件向量场就是「干净数据」与「噪声」按调度器导数做的线性组合。取方差保持调度 $\alpha_t=\sin\frac{\pi t}{2},\beta_t=\cos\frac{\pi t}{2}$,则 $\dot\alpha_t=\frac{\pi}{2}\beta_t$、$\dot\beta_t=-\frac{\pi}{2}\alpha_t$,于是
$$ u_t^{\text{target}}(x\mid z)=\frac{\pi}{2}\big(\beta_t z-\alpha_t\epsilon\big), $$这(在相差一个符号与常数因子 $\frac{\pi}{2}$ 的意义下)正是 Salimans & Ho 提出的 $v$-prediction 目标 $v=\alpha\epsilon-\sigma z$。所以在本课的框架里,flow matching 的向量场参数化与 $v$-prediction 是同一个东西,只是历史上从不同方向被发现。
四种参数化在无限容量下等价,实际差别在噪声等级两端的信噪比:
| 参数化 | $t\to0$($\beta_t\to1$,几乎全噪声) | $t\to1$($\beta_t\to0$,几乎无噪声) |
|---|---|---|
| score 预测 | 良好(目标 $\approx-\epsilon$) | 目标 $\to\infty$,爆炸 |
| $\epsilon$ 预测 | 良好(目标就是 $\epsilon$) | 目标有界,但换算回 $s$ 时除以 $\beta_t\to0$ 会放大误差 |
| $x_0$ 预测 | 任务几乎不可能(从纯噪声猜 $z$),但目标有界 | 良好($x\approx z$,近似恒等映射) |
| $v$ / 向量场预测 | 良好 | 良好 |
这解释了实践中的选择:DDPM 系列在离散步数、噪声不会趋于零的设定下用 $\epsilon$ 预测足够;而想覆盖全时间区间(尤其是高分辨率、蒸馏、少步采样)时,$v$ 预测或向量场预测更稳,这也是 Stable Diffusion 3 一类模型转向 flow matching 参数化的技术原因之一。讲义 Remark 16 那句「从数值/训练稳定性角度看,直接预测后验均值可能是更可取的选择」正是在说这件事。
10. 最小 PyTorch 实现
把前面的公式逐行翻译成代码。目标是二维玩具数据(比如若干个高斯团),网络用 MLP。所有张量形状都在注释里标出。
调度器:$\alpha_t,\beta_t$ 及其导数
对应 §2 的高斯路径定义和 §4 的 $a_t,b_t$。
import math
import torch
import torch.nn as nn

class CondOTSchedule:
    """alpha_t = t, beta_t = 1 - t (讲义 CondOT path)."""
    def alpha(self, t):      return t                    # (bs, 1)
    def beta(self, t):       return 1.0 - t              # (bs, 1)
    def d_alpha(self, t):    return torch.ones_like(t)   # (bs, 1)
    def d_beta(self, t):     return -torch.ones_like(t)  # (bs, 1)

class VPSchedule:
    """alpha_t = sin(pi t / 2), beta_t = cos(pi t / 2);满足 alpha^2 + beta^2 = 1."""
    def alpha(self, t):      return torch.sin(0.5 * math.pi * t)
    def beta(self, t):       return torch.cos(0.5 * math.pi * t)
    def d_alpha(self, t):    return 0.5 * math.pi * torch.cos(0.5 * math.pi * t)
    def d_beta(self, t):     return -0.5 * math.pi * torch.sin(0.5 * math.pi * t)

def ab_coeffs(sched, t):
    """Proposition 1 的 a_t, b_t:u_target(x) = a_t * score(x) + b_t * x."""
    a_t, b_t_ = sched.alpha(t), sched.beta(t)            # (bs, 1)
    da, db = sched.d_alpha(t), sched.d_beta(t)           # (bs, 1)
    a = b_t_ ** 2 * da / a_t - db * b_t_                 # a_t = beta^2 * adot/alpha - bdot*beta
    b = da / a_t                                         # b_t = adot / alpha
    return a, b                                          # (bs, 1), (bs, 1)
网络:噪声预测器 $\epsilon_t^\theta$
输出维度与输入相同。时间用一组正弦特征嵌入,让网络能分辨不同噪声等级。
class TimeEmb(nn.Module):
    """把标量 t 变成一组正弦特征,避免网络对 t 分辨率不足。"""
    def __init__(self, dim=64):
        super().__init__()
        self.register_buffer("freq", torch.exp(torch.linspace(0, math.log(1000), dim // 2)))

    def forward(self, t):                                # t: (bs, 1)
        ang = t * self.freq                              # (bs, dim//2)
        return torch.cat([ang.sin(), ang.cos()], dim=-1) # (bs, dim)

class EpsNet(nn.Module):
    """epsilon_t^theta : R^d x [0,1] -> R^d,预测被加进去的噪声。"""
    def __init__(self, dim=2, hidden=256, temb=64):
        super().__init__()
        self.temb = TimeEmb(temb)
        self.net = nn.Sequential(
            nn.Linear(dim + temb, hidden), nn.SiLU(),
            nn.Linear(hidden, hidden),     nn.SiLU(),
            nn.Linear(hidden, hidden),     nn.SiLU(),
            nn.Linear(hidden, dim),
        )

    def forward(self, x, t):                             # x: (bs, dim), t: (bs, 1)
        return self.net(torch.cat([x, self.temb(t)], dim=-1))   # (bs, dim)
训练:conditional / denoising score matching
逐行对应 §9 的算法表:采 $z$、采 $t$、采 $\epsilon$、构造 $x_t=\alpha_t z+\beta_t\epsilon$、回归 $\epsilon$。
def train(model, sched, sample_data, steps=20000, bs=512, lr=2e-4, device="cuda"):
    opt = torch.optim.Adam(model.parameters(), lr=lr)
    for it in range(steps):
        z = sample_data(bs).to(device)                   # (bs, dim)  第 1 步:z ~ p_data
        t = torch.rand(bs, 1, device=device)             # (bs, 1)    第 2 步:t ~ Unif[0,1]
        eps = torch.randn_like(z)                        # (bs, dim)  第 3 步:eps ~ N(0, I)

        a_t, b_t = sched.alpha(t), sched.beta(t)         # (bs, 1) 广播到 (bs, dim)
        x_t = a_t * z + b_t * eps                        # (bs, dim)  第 4 步:x_t ~ p_t(.|z)

        # 第 5 步:L_DDPM = || eps_theta(x_t, t) - eps ||^2
        # 等价于 CSM 损失丢掉 1/beta_t^2 权重后的版本(见 §9)
        loss = ((model(x_t, t) - eps) ** 2).sum(dim=-1).mean()

        opt.zero_grad(); loss.backward(); opt.step()     # 第 6 步
        if it % 2000 == 0:
            print(f"iter {it:6d}  loss {loss.item():.4f}")
    return model
如果你想严格实现 $\mathcal{L}_{\text{CSM}}$(而不是 DDPM 的加权版本),把损失换成
((model(x_t, t) - eps) ** 2).sum(-1) / b_t.squeeze(-1) ** 2 再取均值。你会立刻看到训练发散——因为 $t\to1$ 时 $1/\beta_t^2\to\infty$。这就是 §9 讲的数值灾难,跑一次比读十遍更有说服力。想跑通的话,把 $t$ 限制在 $[0,1-\varepsilon]$(例如 t = torch.rand(bs,1) * 0.98)。
换算:从 $\epsilon_t^\theta$ 得到 score 和向量场
对应 §9 的换算表和 §4 的 Proposition 1。
def score_from_eps(model, sched, x, t):
    """s_theta(x) = -eps_theta(x) / beta_t     (§9 换算表第 2 行)"""
    return -model(x, t) / sched.beta(t)                  # (bs, dim)

def u_from_score(sched, s, x, t):
    """u_target(x) = a_t * s(x) + b_t * x      (Proposition 1)"""
    a, b = ab_coeffs(sched, t)
    return a * s + b * x                                 # (bs, dim)

def denoiser_from_score(sched, s, x, t):
    """D_t(x) = E[z|x] = (x + beta_t^2 * s) / alpha_t    (Tweedie 公式)"""
    return (x + sched.beta(t) ** 2 * s) / sched.alpha(t) # (bs, dim)
采样:Euler–Maruyama 模拟 SDE
这是 Theorem 17 的直接数值化。把 $\dd{X_t}=\big[u_t+\frac{\sigma_t^2}{2}s_t\big]\dd{t}+\sigma_t\dd{W_t}$ 离散成步长 $h$:
$$ X_{t+h}=X_t+\left[u_t(X_t)+\frac{\sigma_t^2}{2}s_t(X_t)\right]h+\sigma_t\sqrt{h}\,\xi, \qquad \xi\sim\N(0,I_d). $$注意噪声项是 $\sigma_t\sqrt h\,\xi$ 而不是 $\sigma_t h\,\xi$——布朗运动增量的标准差正比于 $\sqrt{\Delta t}$,这是随机积分与普通积分最重要的区别。写成 $h$ 是新手最常犯的错误,它会让噪声在细步长下消失,SDE 退化成 ODE。
@torch.no_grad()
def sample_sde(model, sched, n=2000, dim=2, n_steps=500,
               sigma=lambda t: 0.5, t_end=0.999, device="cuda"):
    """Theorem 17 的 Euler-Maruyama 实现。sigma(t)=0 时退化为 ODE 采样。"""
    x = torch.randn(n, dim, device=device)               # (n, dim)  X_0 ~ p_init = N(0, I)
    ts = torch.linspace(0.0, t_end, n_steps + 1, device=device)

    for i in range(n_steps):
        t = ts[i].expand(n, 1)                           # (n, 1)
        h = (ts[i + 1] - ts[i]).item()                   # 标量步长
        sig = sigma(ts[i].item())                        # 标量 sigma_t

        s = score_from_eps(model, sched, x, t)           # (n, dim)  s_theta(X_t)
        u = u_from_score(sched, s, x, t)                 # (n, dim)  u_theta(X_t)

        drift = u + 0.5 * sig ** 2 * s                   # (n, dim)  漂移 = u + sigma^2/2 * score
        x = x + drift * h                                # 确定性部分
        if sig > 0:
            x = x + sig * math.sqrt(h) * torch.randn_like(x)   # 随机部分:注意 sqrt(h)
    return x                                             # (n, dim)  X_1 ~ p_data
几个实现要点:
t_end=0.999而不是1.0。因为 $\beta_1=0$,$t=1$ 时score_from_eps会除零、ab_coeffs里的 $a_t$ 也退化。这与 §7 常见误区里说的边界现象是同一件事。sigma=lambda t: 0.0就得到 ODE 采样器。同一份代码、同一个训练好的模型,改一个数字就在 ODE 与 SDE 之间切换——这正是 Theorem 17「$\sigma_t$ 是采样时的自由超参数」的代码体现。- 常见的 $\sigma_t$ 取法有:常数;$\sigma_t\propto\beta_t$(噪声大的地方多搅动);或在最后若干步退火到 $0$ 以获得清晰样本。哪个更好需要实测,见 §6 的警告。
对拍:两条独立路线应该给出同一个 score
最后给一个自检脚本。§4 说学向量场和学 score 等价,那么分别训练两个网络,它们换算到同一参数化下应当吻合(在数据支撑区域内)。
@torch.no_grad()
def check_conversion(eps_model, u_model, sched, x, t, tol=0.2):
    """把两条路线都换算成 score,比较相对误差。"""
    s_direct = score_from_eps(eps_model, sched, x, t)        # 路线 A:DSM 训练的网络
    a, b = ab_coeffs(sched, t)
    s_from_u = (u_model(x, t) - b * x) / a                   # 路线 B:FM 网络反解(Prop. 1)

    rel = (s_direct - s_from_u).norm(dim=-1) / (s_direct.norm(dim=-1) + 1e-8)
    print(f"median relative error = {rel.median().item():.3f}")
    return rel.median().item() < tol
实测时会看到:在 $t$ 居中的区间里两者高度一致;在 $t\to0$ 处相对误差明显变大,因为 CondOT 调度下 $a_t=\frac{1-t}{t}\to\infty$、$b_t=\frac1t\to\infty$,做 $(u-b x)/a$ 这个减法时发生了严重的相消误差。这不是理论错了,是浮点数的问题——也是 §4 那张 Lab 图里下排最左边一格几乎为空的原因。
本讲小结
讲义 Summary 24 把本节所有结论压成了一页,这里按「对象—公式—说明」重排,可以当速查表用。设高斯路径 $p_t(x\mid z)=\N(\alpha_t z,\beta_t^2 I_d)$,$W_t=\dot\alpha_t\beta_t-\alpha_t\dot\beta_t$。
| 对象 | 公式 | 说明 |
|---|---|---|
| 得分函数 | $\score{t}(x)=\nabla_x\log p_t(x)\in\R^d$ | 对数似然梯度;与归一化常数无关,故可学 |
| 条件得分(高斯路径) | $\nabla\log p_t(x\mid z)=-\dfrac{x-\alpha_t z}{\beta_t^2}=-\dfrac{\epsilon}{\beta_t}$ | 闭式解;就是(缩放的)负噪声 |
| 边际化技巧 | $\score{t}(x)=\displaystyle\int\nabla\log p_t(x\mid z)\frac{p_t(x\mid z)\data(z)}{p_t(x)}\dd{z}$ | 边际得分 = 条件得分的后验加权平均 |
| 转换公式(Prop. 1) | $u_t^{\text{target}}(x)=a_t\score{t}(x)+b_t x$,$a_t=\beta_t^2\frac{\dot\alpha_t}{\alpha_t}-\dot\beta_t\beta_t$,$b_t=\frac{\dot\alpha_t}{\alpha_t}$ | 高斯路径下 score 与向量场逐点线性互换 |
| Tweedie 公式 | $D_t(x)=\E[z\mid x]=\dfrac{x+\beta_t^2\score{t}(x)}{\alpha_t}$ | score $\Leftrightarrow$ 后验均值(MMSE 去噪器) |
| 去噪器 ← 向量场 | $D_t(x)=\dfrac{\beta_t u_t^{\text{target}}(x)-\dot\beta_t x}{W_t}$ | 讲义 Eq. 43 |
| Fokker–Planck 方程 | $\partial_t p_t=-\divg(p_t u_t)+\dfrac{\sigma_t^2}{2}\Lap p_t$ | SDE 版连续性方程;$\sigma_t=0$ 时退化 |
| SDE extension trick | $\dd{X_t}=\Big[u_t^{\text{target}}(X_t)+\dfrac{\sigma_t^2}{2}\score{t}(X_t)\Big]\dd{t}+\sigma_t\dd{W_t}\Rightarrow X_t\sim p_t$ | 对任意 $\sigma_t\ge0$ 成立(Theorem 17) |
| 纯 score 形式 | $\dd{X_t}=\Big[\big(a_t+\frac{\sigma_t^2}{2}\big)\score{t}(X_t)+b_t X_t\Big]\dd{t}+\sigma_t\dd{W_t}$ | 高斯路径,讲义 Eq. 46 / 56 |
| 纯向量场形式 | $\dd{X_t}=\Big[\big(1+\frac{\sigma_t^2}{2a_t}\big)u_t^\theta(X_t)-\frac{\sigma_t^2 b_t}{2a_t}X_t\Big]\dd{t}+\sigma_t\dd{W_t}$ | 讲义 Eq. 55;只训了 $u^\theta$ 时用这条 |
| Langevin 动力学 | $\dd{X_t}=\dfrac{\sigma_t^2}{2}\nabla\log p(X_t)\dd{t}+\sigma_t\dd{W_t}$ | $p_t\equiv p$、$u_t^{\text{target}}=0$ 的特例;$p$ 是平稳分布 |
| score matching 损失 | $\mathcal{L}_{\text{SM}}=\E_{t,x\sim p_t}\big[\|s_t^\theta(x)-\score{t}(x)\|^2\big]$ | 想要但算不出来 |
| denoising score matching | $\mathcal{L}_{\text{CSM}}=\E_{t,z\sim\data,x\sim p_t(\cdot\mid z)}\big[\|s_t^\theta(x)-\nabla\log p_t(x\mid z)\|^2\big]$ | 可算;与 $\mathcal{L}_{\text{SM}}$ 差常数(Theorem 22) |
| DDPM 损失 | $\mathcal{L}_{\text{DDPM}}=\E_{t,z,\epsilon}\big[\|\epsilon_t^\theta(\alpha_t z+\beta_t\epsilon)-\epsilon\|^2\big]$ | 令 $\epsilon_t^\theta=-\beta_t s_t^\theta$ 并丢掉 $\frac{1}{\beta_t^2}$ |
| 最优损失值 | $\mathcal{L}_{\text{CSM}}(\theta^*)=\E\big[\|\nabla\log p_t(x\mid z)-\score{t}(x)\|^2\big]>0$ | 训练损失不会降到 0,这是正常的 |
回到三个母题
(a) 为什么用条件版本训练边际版本?因为条件得分有闭式解而边际得分没有。Theorem 22 证明两个损失只差常数,而背后的机理是「最小二乘回归的最优解是条件期望」——网络被迫在每个 $x$ 上输出所有条件得分的后验平均,而边际化技巧告诉我们那个平均就是边际得分。神经网络的平均化行为替我们完成了那个算不出的积分。
(b) 为什么 ODE 和 SDE 给出同一个边际分布?因为我们主动加了一个精心设计的漂移项 $\frac{\sigma_t^2}{2}\score{t}$ 去抵消噪声造成的扩散。Fokker–Planck 方程把这件事量化:噪声贡献 $+\frac{\sigma_t^2}{2}\Lap p_t$,而 $\divg\big(p_t\cdot\frac{\sigma_t^2}{2}\score{t}\big)=\frac{\sigma_t^2}{2}\Lap p_t$,两者精确相消。要强调的是:相同的只是边际分布 $p_t$,轨迹的联合分布完全不同。
(c) 那个「算不出来」的量怎么变成可算的?看 Theorem 22 证明的第 2 步:交叉项里,边际化技巧引入的分母 $p_t(x)$ 与外层期望的权重 $p_t(x)$ 精确相消。整个证明只发生了这一件事。相消之后,剩下的三重积分可以直接读成「先采 $z$、再采 $x$」的期望——完全可采样。
延伸阅读
score-based 生成模型的源头
- Generative Modeling by Estimating Gradients of the Data Distribution (Song & Ermon, 2019) — 首次把「学 score + Langevin 采样」组合成可用的生成模型(NCSN)。本讲 §1 关于「score 不依赖归一化常数」和 §7 的 Langevin 部分,思想都出自这里。
- Score-Based Generative Modeling through SDEs (Song et al., 2021) — 把离散扩散与 NCSN 统一进连续时间 SDE 框架,并给出对应的 probability flow ODE。本讲 §6–§7 是这篇论文核心结论的教学版重述,想看原始表述必读。
- A Connection Between Score Matching and Denoising Autoencoders (Vincent, 2011) — denoising score matching 的原始出处,比扩散模型早了近十年。Theorem 22 就是它的连续时间版本。
DDPM 一脉
- Denoising Diffusion Probabilistic Models (Ho et al., 2020) — §9 里那个丢掉 $\frac{1}{\beta_t^2}$、改用噪声预测器的做法出自这篇。读它的目的是理解「简化损失」这个工程决定为什么如此关键。
- Deep Unsupervised Learning using Nonequilibrium Thermodynamics (Sohl-Dickstein et al., 2015) — 扩散模型的真正起点,从非平衡热力学出发。看完本讲的 Fokker–Planck 部分再读,会发现它的物理语言和我们的 PDE 语言是一回事。
- Progressive Distillation for Fast Sampling of Diffusion Models (Salimans & Ho, 2022) — $v$-prediction 的出处。配合 §9 的换算表读,可以看清各种参数化之间的关系不是玄学而是代数。
参数化、调度与采样器设计
- Elucidating the Design Space of Diffusion-Based Generative Models (Karras et al., 2022) — 把预处理、噪声调度、损失加权、采样器全部拆成正交的设计维度逐一消融。本讲 §6 说的「最优 $\sigma_t$ 要实测」,这篇给出了系统的实测方法论。
- Flow Matching for Generative Modeling (Lipman et al., 2022) — Lecture 2 的主参考。回头看它的第 3 节,会发现 CondOT 路径和本讲的转换公式完全对应。
- Scaling Rectified Flow Transformers for High-Resolution Image Synthesis (Esser et al., 2024) — Stable Diffusion 3 的论文,实证比较了各种路径与参数化。是「为什么工业界从 $\epsilon$-预测转向向量场预测」的一手证据。
Langevin 与采样理论背景
- Analysis of Langevin Monte Carlo via Convex Optimization 一类工作 — 想知道 §7 里「在温和条件下 $p_t\to p$」的「温和条件」具体是什么、收敛速度如何,从 Langevin Monte Carlo 的收敛性分析入手。
- Maximum Likelihood Training of Score-Based Diffusion Models (Song et al., 2021) — 把 score matching 损失与数据对数似然的界联系起来,回答了「最小化 DSM 到底在优化什么统计量」。