高阶函数:把函数当成值来传递
函数不只是「一段能跑的代码」,它本身也是一个可以被存进变量、传进参数、从别的函数里返回出来的值。这一讲把这件事讲透,顺便把「名字到底在哪个帧里找」这个问题第一次正式回答清楚。
0. 本讲导读
上一讲结束时,你手上的工具是这样一套:用 def 定义函数,用 if 挑分支,用 while 重复。用它们你已经能写出 sum_digits、fizzbuzz、Hailstone 这类程序了。
但这套工具有一条隐形的天花板:函数只能被调用,不能被摆弄。在你目前的世界观里,square 是一段代码的名字,你唯一能对它做的事就是在后面加一对括号。数字可以相加、可以存进变量、可以当参数传给别人;函数呢?函数好像是另一个次元的东西。
这条天花板会以一种很具体的方式撞到你。看下面两个函数:
def sum_of_squares(n):          def sum_of_cubes(n):
    i = 1                           i = 1
    total = 0                       total = 0
    while i <= n:                   while i <= n:
        total += i ** 2                 total += i ** 3
        i += 1                          i += 1
    return total                    return total
十行代码里有九行一模一样,只有 ** 2 和 ** 3 不同。如果明天要加 sum_of_fourth_powers、后天要加「1 到 n 的每个数取倒数再相加」,你就得再复制粘贴两次。这不是「代码有点丑」的问题——这是抽象层次不够的问题:你能把「加数」这件事抽象成参数 n,却没办法把「怎么由 i 算出被加项」这件事抽象成参数。
本讲要做的,就是把最后这层天花板拆掉。核心只有一句话:在 Python 里,函数是一等公民(first-class)——凡是数字能待的地方,函数都能待。它能被赋给变量、能被当实参传进去、能被当返回值送出来、能被放进数据结构里。一旦接受了这件事,上面那两个函数就能合成一个:
def summation(n, term):
    i = 1
    total = 0
    while i <= n:
        total += term(i)
        i += 1
    return total
而高阶函数(higher-order function, HOF)的定义就是:一个把函数当输入、或把函数当输出、或两者都占的函数。summation 属于前者。
这一讲还有第二条主线,比第一条更基础,也更容易被忽略:环境(environment)。一旦函数可以在别的函数里被定义、被返回、跑到别处再被调用,「x 这个名字指的是哪个 x」就不再是显然的了。上一讲你只需要区分「全局帧」和「函数的局部帧」两层;这一讲会出现三层、四层,还会出现「函数已经跑完了、它的帧却还得留着」的情况。所以本讲后半段要给出一套精确到可以拿笔算的名字查找规则。
- 函数是值。
square(不带括号)求值成一个函数对象;square(3)(带括号)才是调用。这两件事天差地别,混淆它们是本讲最高频的错误。 - lambda 表达式写作
lambda <参数>: <返回表达式>,它是一个表达式,求值成一个没有内在名字(intrinsic name)的函数。它只能装一个表达式,装不下if语句、while循环和赋值。 - 高阶函数存在的理由是泛化(generalization)与不重复自己(DRY, Don't Repeat Yourself):把几段代码里「唯一不同的那一小块」提炼成一个函数参数。
- 一个环境是一串帧(frame);一个帧是一组「名字 → 值」的绑定。所有 Python 程序都从特殊的全局帧(global frame)开始。
- 父帧由「函数在哪里被定义」决定,不由「函数在哪里被调用」决定。这是整门课最重要的一条规则之一。
- 查名字:先看当前帧,找不到就顺着父帧往上找,一路找到全局帧还没有就抛
NameError。但赋值只会写在当前帧里——想在函数里修改外层的名字,会得到UnboundLocalError。
本讲的两道随堂练习 combination 和 multiply_triple(配套文件 03.py)会放在第 8、9 节完整推演。它们不是花架子:Lab 02 里几乎每道题都是它们的变体。
1. 热身:把上一讲的控制流用在 Fibonacci 上
本讲正式开始前,先用一道题把上一讲的 while 循环再过一遍。之所以选 Fibonacci,是因为它有一个特别值得警惕的性质:循环里需要同时维护两个变量,而且它们的更新是互相纠缠的。这类题最容易在「更新顺序」上翻车。
Fibonacci 数列(Fibonacci sequence)的定义是三条:
- 第 0 个 Fibonacci 数是
0; - 第 1 个 Fibonacci 数是
1; - 第 n 个 Fibonacci 数是前两个之和。
于是数列开头是 0, 1, 1, 2, 3, 5, 8, 13, …。(这个数列最早出现在公元前 200 年左右 Pingala 关于梵语诗律的著作里,用来数「由长短两种音节构成的格律有多少种」;欧洲人是通过 1202 年 Leonardo of Pisa 的《Liber Abaci》才知道它的,Fibonacci 是他的别名。)
先想清楚循环里要记什么
要算第 n 个数,我必须知道「前两个数」。所以循环状态至少是两个变量。约定:
prev:当前已经走到的位置的前一个 Fibonacci 数;curr:当前已经走到的位置的 Fibonacci 数。
初始时我们站在「第 0 个」上,所以 prev = 0(可以想成第 −1 个)、curr = 1(第 1 个)… 这个索引对齐很容易绕晕。更稳妥的做法是先定死一个不变式(invariant),然后逼着代码去满足它。
取不变式:每次检查循环条件时,prev 是第 i 个 Fibonacci 数,curr 是第 i+1 个。
初始化:i = 0,此时 prev 应是第 0 个 = 0,curr 应是第 1 个 = 1。不变式成立。
循环体一次要把「窗口」右移一格:新的第 i+1 个 = 旧的 curr;新的第 i+2 个 = 旧的 prev + curr。所以:
prev, curr = curr, prev + curr
i += 1
退出条件:当 i == n 时,prev 恰好是第 n 个,直接 return prev。所以循环条件是 i < n。
def fib(n):
    """返回第 n 个 Fibonacci 数(n 从 0 开始计)。"""
    prev, curr = 0, 1
    i = 0
    while i < n:
        prev, curr = curr, prev + curr
        i += 1
    return prev
验证 fib(5),逐轮列表。注意表格里「进入循环体前」的 prev 一栏,从上往下读就是 0, 1, 1, 2, 3——正是数列本身:
| 检查条件时 i | i < 5? | prev | curr | 执行后 (prev, curr) |
|---|---|---|---|---|
| 0 | True | 0 | 1 | (1, 1) |
| 1 | True | 1 | 1 | (1, 2) |
| 2 | True | 1 | 2 | (2, 3) |
| 3 | True | 2 | 3 | (3, 5) |
| 4 | True | 3 | 5 | (5, 8) |
| 5 | False | 5 | 8 | 返回 prev = 5 |
fib(0) 也对:条件 0 < 0 一开始就是假,循环一次都不跑,直接返回初值 0。这种「循环体零次执行仍然正确」的性质,是判断初始化写得对不对的最好试金石。
把那行同时赋值拆成两行,是这道题最经典的错误:
prev = curr          # ← prev 已经被改成 curr 了
curr = prev + curr   # ← 这里的 prev 是「新的」prev,等于 curr
结果 curr 变成了 2 * curr,数列直接变成 1, 2, 4, 8, 16…。不会报错,只会算错——比报错难查得多。
根本原因:Python 的 a, b = <表达式1>, <表达式2> 是先把右边两个表达式全部求值完毕,再一起绑定。等号右边看到的永远是「这一行开始前」的旧值。拆成两行就打破了这个同时性。
如果实在不想用同时赋值,就得自己引入一个临时名字把旧值存下来:
old_prev = prev
prev = curr
curr = old_prev + curr
这道题的意义不止于复习。等下面讲到 summation 时你会发现,fib 的骨架(初始化累积变量 → while → 更新 → 返回)和 summation、和随堂练习 combination 的骨架完全一样。高阶函数并没有发明新的循环,它只是把骨架里「变化的那一小块」抽出来当参数。
2. 函数是数据
Python 里的函数是一等对象("first-class" object)。「一等」这个词的意思很朴素:它享有和数字、字符串完全同等的待遇。具体说是四条权利:
- 可以被赋给一个名字;
- 可以作为实参传给别的函数;
- 可以作为返回值从函数里送出来;
- 可以被放进数据结构里(列表、字典等,后面几讲会用到)。
不是所有语言都这样。在很多语言里,函数是编译期的一个静态实体,你没法把它当成运行时的一个值搬来搬去。Python 可以,而这一条正是本讲所有内容的地基。同一个函数于是有了两副面孔:它既是「一段可执行的过程(procedure)」,也是「一个可以被搬运的数据(data)」。第一讲把 min 和 max 存进变量 f 和 g,当时看起来只是个小把戏,其实已经在用这条性质了。
不带括号 vs 带括号
这是本讲第一个、也是最要命的一个分水岭。请在交互式解释器里亲手敲一遍:
>>> def square(x):
...     return x * x
...
>>> square
<function square at 0x77a41f963d90>
>>> square(3)
9
square 求值成一个函数对象(function object),解释器把它显示成 <function square at 0x…>——那串十六进制是它在内存里的地址,每次运行都不一样,不用管。square(3) 则是一个调用表达式(call expression),求值结果是 9。
换个说法:括号不是函数名字的一部分,括号是「调用」这个动作。名字本身只是指向那个函数对象的一根线。
>>> f = square          # 没有括号:把函数对象本身绑给 f
>>> f
<function square at 0x77a41f963d90>
>>> f(4)
16
>>> g = square(4)       # 有括号:先调用,把结果 16 绑给 g
>>> g
16
>>> g(2)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'int' object is not callable
注意 f 和 square 显示出来的地址一模一样——它们不是两个函数,是同一个函数对象的两个名字。这跟 a = 5; b = a 之后 a 和 b 指着同一个 5 是完全相同的机制。
TypeError: 'int' object is not callable 是整个学期你会见到最多的报错之一。它的意思逐字翻译是「一个 int 类型的对象不能被调用」,也就是:你在某个东西后面写了括号,但那个东西不是函数。
八成的成因是「该传函数的地方,不小心把函数调用掉了」:
>>> def cube(x):
...     return x * x * x
...
>>> summation(3, cube(2))    # ← 错:cube(2) 先求值成 8,传进去的是整数 8
Traceback (most recent call last):
  ...
TypeError: 'int' object is not callable
summation 拿到 term = 8,然后执行 term(i),等于在写 8(1)。
另一种错法是「以为不写实参就不算调用」:
>>> summation(3, cube())
Traceback (most recent call last):
  ...
TypeError: cube() missing 1 required positional argument: 'x'
只要写了括号就是调用。要传函数本身,括号必须一个都不写:summation(3, cube)。
内建函数也是值
>>> min
<built-in function min>
>>> f, g = min, max
>>> f(3, 5)
3
>>> g(3, 5)
5
min 显示成 <built-in function min> 而不是 <function min at 0x…>,因为它是用 C 实现、随解释器一起内建的。但在「能不能当值用」这件事上,它和你自己写的 square 没有任何区别。
把 def square(x): ... 读成两步会清楚很多:(1)造出一个函数对象;(2)把这个对象绑定到全局帧里的名字 square 上。
也就是说,def 语句本质上是一种特殊的赋值。这个视角在下一节讲 lambda 时会立刻派上用场:lambda 只做第(1)步,第(2)步要不要做、绑到哪个名字上,由你自己决定。
3. lambda 表达式:造一个没有名字的函数
到目前为止,造函数的唯一方式是 def。def 是一条语句,语句不能出现在需要值的位置上。当你想「就地」造一个只用一次的小函数,比如作为实参塞进 summation,用 def 就得先在上面单独写三行,再把名字传下去——为了一个用完就扔的小东西,代价有点大。
lambda 表达式(lambda expression)解决的正是这件事。它是一个表达式,求值成一个函数:
lambda <parameters>: <return expression>
三个部分:关键字 lambda;逗号分隔的参数名(可以零个);一个冒号;一个表达式,它的值就是这个函数的返回值。没有 return 这个词——冒号后面那个表达式自动就是返回值。
>>> lambda x: x * x
<function <lambda> at 0x77a41ef86170>
>>> (lambda x: x * x)(5)
25
>>> square = lambda x: x * x
>>> square(5)
25
>>> (lambda: 42)()          # 零个参数
42
>>> (lambda x, y: x + y)(3, 4)
7
第一行值得盯一会儿:直接求值一个 lambda 表达式,得到的是 <function <lambda> at 0x…>——名字位置上写着 <lambda>。这就是「匿名函数(anonymous function)」和「没有内在名字(intrinsic name)」的字面含义:
>>> def h(): pass
...
>>> h.__name__
'h'
>>> f = lambda x: x * x
>>> f.__name__
'<lambda>'
f = lambda x: x * x 里,f 只是一个外部绑定,函数自己并不知道有人管它叫 f。def square(x) 造出来的函数则把 square 记在了自己身上。这个差别在读 traceback 时会显现出来:lambda 抛异常时,栈帧那一行显示的是 <lambda>,比函数名难定位得多。
lambda 装不下什么
冒号后面必须是一个表达式。这四个字排除了非常多东西:
| 写法 | 能否放进 lambda | 说明 |
|---|---|---|
x * x | 能 | 算术表达式 |
f(x) + g(y) | 能 | 调用表达式也是表达式 |
x if x > 0 else -x | 能 | 这是条件表达式,不是 if 语句 |
lambda y: x + y | 能 | lambda 本身就是表达式,可以嵌套 |
return x * x | 不能 | return 是语句 |
y = x + 1 | 不能 | 赋值是语句 |
while / if 语句 | 不能 | 复合语句 |
print(x) | 能(但没用) | 是调用表达式,可它返回 None |
在 lambda 里写 return,报错很不友好:
>>> f = lambda x: return x * x
  File "<stdin>", line 1
    f = lambda x: return x * x
                  ^^^^^^
SyntaxError: invalid syntax
在 lambda 里写赋值,报错稍微明确一点:
>>> g = lambda x: y = x + 1
  File "<stdin>", line 1
SyntaxError: cannot assign to lambda
记住一句话就够了:lambda 的冒号后面是「返回值」,不是「函数体」。
什么时候用 lambda,什么时候用 def
def | lambda | |
|---|---|---|
| 它是什么 | 语句(statement) | 表达式(expression) |
| 能放在实参位置吗 | 不能 | 能 |
| 内在名字 | 有(__name__ 是函数名) | 无(__name__ 是 '<lambda>') |
| 函数体 | 任意多条语句 | 只有一个表达式 |
| 能写 docstring / doctest 吗 | 能 | 不能 |
| 适合什么 | 有名字、要复用、逻辑长的函数 | 一次性的小算式 |
实践建议:看不懂一个 lambda 在干什么,就把它翻译成 def 再看。两者的对应是机械的:
# 这两段完全等价(除了 __name__ 不同)
f = lambda x, y: x * y + 1

def f(x, y):
    return x * y + 1
反过来,题目要求「只用 lambda 写」时(Lab 02 和考试里常见),也照着这个对应关系倒着翻就行。
4. 函数作为输入:summation 的诞生
回到导读里那两个几乎一模一样的函数。
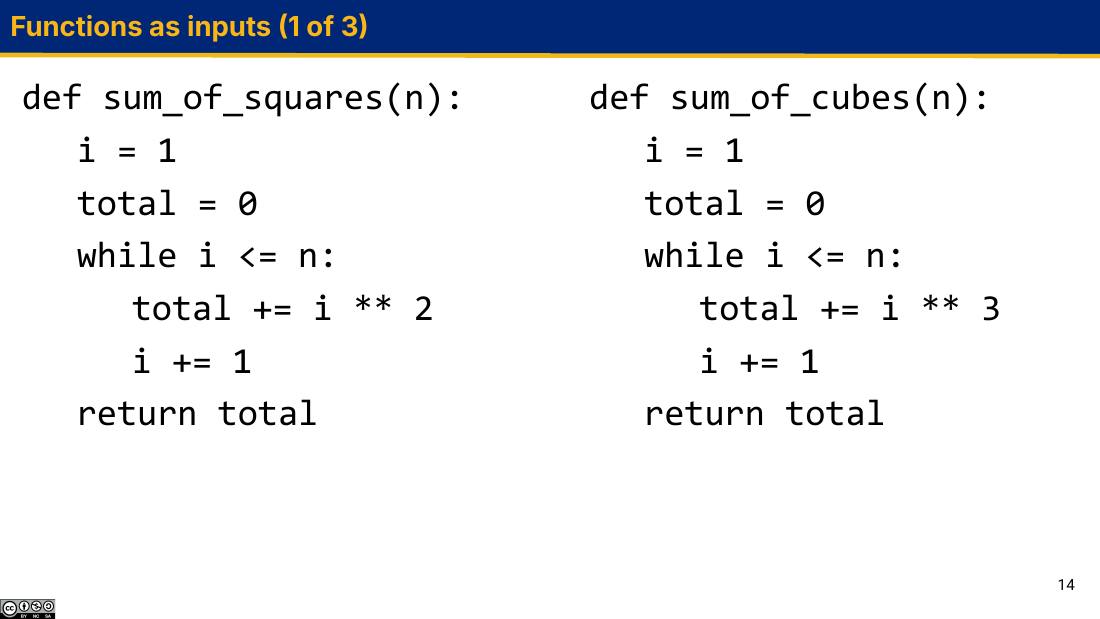
def sum_of_squares(n):
    i = 1
    total = 0
    while i <= n:
        total += i ** 2
        i += 1
    return total

def sum_of_cubes(n):
    i = 1
    total = 0
    while i <= n:
        total += i ** 3
        i += 1
    return total
差异只有 i ** 2 / i ** 3。现在问一个关键问题:这个差异是什么类型的东西?
它不是一个数——如果只是数不同,比如一个加 2 一个加 3,那加一个普通参数就解决了。它是一条「由 i 算出被加项」的规则。而在 Python 里,「由输入算出输出的规则」正好有一个现成的表示:函数。
既然函数是一等公民、可以当参数传,那就把这条规则抽成参数。习惯上叫它 term(「项」):
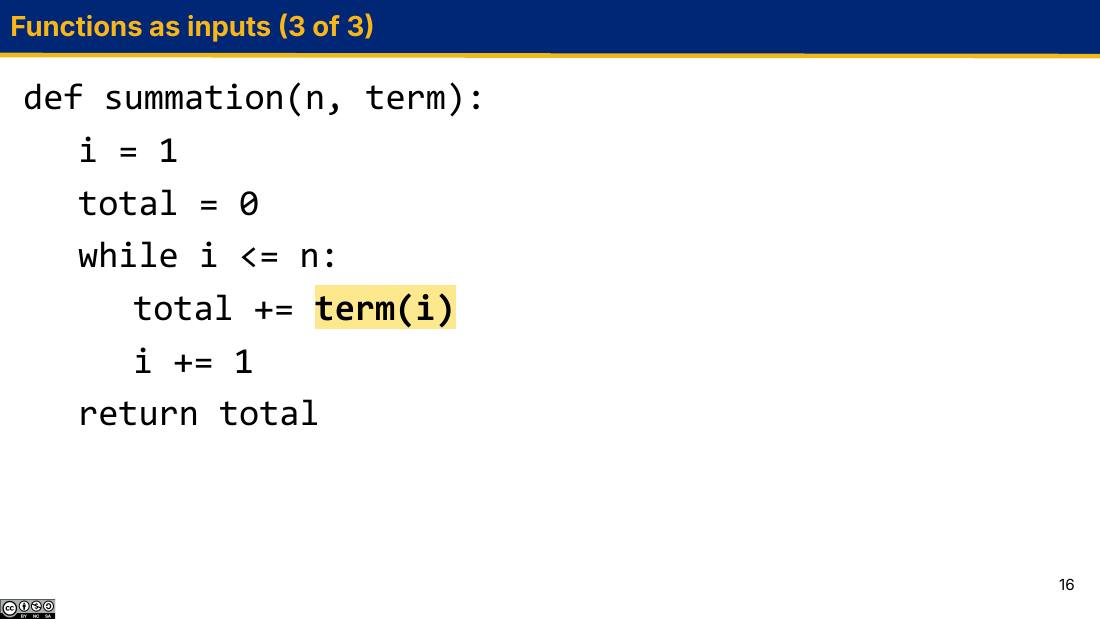
def summation(n, term):
    """把 term(1) + term(2) + ... + term(n) 加起来。

    >>> summation(3, cube)
    36
    """
    i = 1
    total = 0
    while i <= n:
        total += term(i)
        i += 1
    return total
用起来:
>>> def square(x):
...     return x * x
...
>>> def cube(x):
...     return x * x * x
...
>>> summation(3, square)
14
>>> summation(3, cube)
36
>>> summation(3, lambda x: 1 / x)
1.8333333333333333
注意最后一行:新需求「1 到 n 的倒数和」不需要新写一个函数了,一个 lambda 就地解决。这就是抽象带来的复利——summation 写一次,以后所有「从 1 加到 n」的问题都免费。
term 在函数体里到底是怎么被用的
很多人第一次看到 total += term(i) 会卡住:term 是个参数,参数不就是变量吗,变量后面怎么能加括号?
请回忆第一讲的调用表达式求值规则:先求算子(operator),再求算子数(operands),然后把算子的值施加到算子数的值上。规则里从来没说「算子必须是一个函数名字面量」。算子是个表达式,它求值成什么就用什么。
追踪 summation(3, cube),重点看 term(i) 那一步。
summation(3, cube):先求算子 summation → 一个函数对象;再求算子数 3 → 3,cube → 一个函数对象(没有括号,所以不调用)。n = 3、term = <function cube>。执行函数体。i = 1、total = 0 写进 f1。条件 1 <= 3 为真,进入循环体。term(i):算子 term 在 f1 里查到,值是 cube 那个函数对象;算子数 i 查到是 1。于是新建一帧 f2,绑定 x = 1,执行 return x * x * x,返回 1。total += 1 → total = 1;i += 1 → i = 2。term(2) 新建 f3,绑定 x = 2,返回 8。total = 9,i = 3。term(3) 新建 f4,绑定 x = 3,返回 27。total = 36,i = 4。4 <= 3 为假,退出循环,return total → 36。循环跑完的那一刻,帧的样子是这样(f2/f3/f4 各自在返回后就用不着了,这里一并画出来看清关系):
| square | func square(x) |
| cube | func cube(x) |
| summation | func summation(n, term) |
| n | 3 |
| term | func cube(x) |
| i | 4 |
| total | 36 |
| 返回值 | 36 |
| x | 3 |
| 返回值 | 27 |
这里有个细节现在先记住、第 7 节再讲透:f4 的 parent 是 Global,不是 f1。cube 是在全局帧里用 def 定义的,所以不管它被谁调用、在哪一层调用,它的父帧永远是 Global。
summation 干的事情可以用一句话概括:它把「循环的骨架」和「每一项算什么」拆开了。
骨架(初始化、条件、更新、累加、返回)是所有求和问题共有的,写一次就够;「每一项算什么」是每个问题独有的,用参数注入。
这个「骨架 + 留白」的模式,是本课程后面所有抽象手段的原型:数据抽象是「操作骨架 + 表示留白」,递归是「递归骨架 + base case 留白」,接口是「调用骨架 + 实现留白」。认准它。
为什么不用一个「标志参数」代替
初学者常想到另一条路:加一个参数说明「要平方还是立方」。
def sum_of_powers(n, which):
    i = 1
    total = 0
    while i <= n:
        if which == 'square':
            total += i ** 2
        elif which == 'cube':
            total += i ** 3
        i += 1
    return total
这确实能跑,但它只解决了「这两种情况」。要加第三种,就得回来改 sum_of_powers 的函数体,再加一个 elif。也就是说,每来一个新需求,你都得动老代码。而 summation 版本永远不用改——新需求只需要在调用处多写一个 lambda。
这条差别有名字:用数据做分支,只能穷举已知情况;用函数做参数,能容纳还没被想到的情况。
5. 函数作为输出:工厂函数与 make_discount
高阶函数的另一半是返回函数。这一半比「接收函数」更难消化,因为它要求你接受一件反直觉的事:一个函数可以在另一个函数的调用过程中被创造出来,而且它带着创造它时的那些信息一起离开。
还是从重复代码出发。一家店要打各种折扣:
def half_off(price):
    return price * 0.5

def ten_percent_off(price):
    return price * 0.9

def twenty_percent_off(price):
    return price * 0.8

def compute_new_price(discount, price):
    return discount(price)
compute_new_price 已经是个高阶函数了(它把 discount 当参数)。问题出在左边那三个:它们又是同一个模子刻出来的,只有那个乘数不同。而且每加一档折扣就得再写一个 def——三十档就是三十个函数。
直觉上你会想「不如把折扣率也当参数」:
def apply_discount(percent_off, price):
    return price * (1 - percent_off)
但这就不合用了:compute_new_price 要的是一个只吃一个参数 price 的函数。apply_discount 要两个参数,塞不进去。我们需要的是「一个已经知道折扣率是多少、只等着 price 的函数」。
解法是让一个函数生产这样的函数:
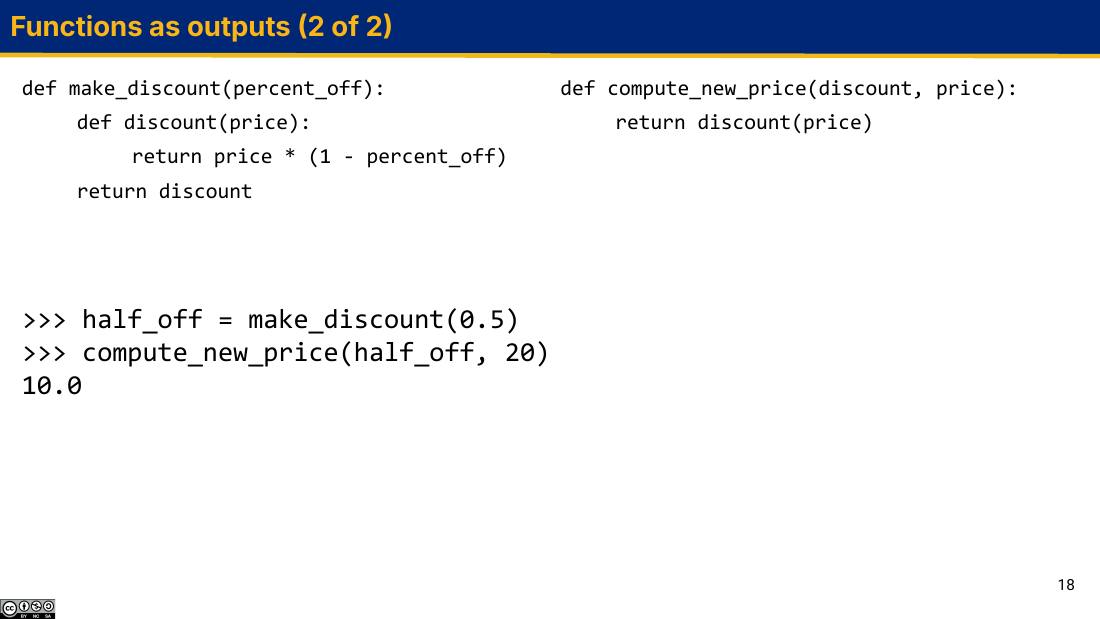
def make_discount(percent_off):
    def discount(price):
        return price * (1 - percent_off)
    return discount

def compute_new_price(discount, price):
    return discount(price)
>>> half_off = make_discount(0.5)
>>> compute_new_price(half_off, 20)
10.0
>>> make_discount(0.1)(20)
18.0
三处细节,一个都不能错:
def discount(price): 写在 make_discount 的函数体里面。这意味着它不是程序一启动就存在的——只有 make_discount 被调用一次,才会有一个 discount 函数对象被造出来。调用两次就造出两个不同的函数对象。return discount 没有括号。返回的是函数对象本身。写成 return discount(price) 会立刻报 NameError: name 'price' is not defined,因为在 make_discount 这一层根本没有 price 这个名字。discount 的函数体里用到了 percent_off——那是外层函数的参数,不是它自己的。等到 discount 被调用时,make_discount 早就返回结束了,可它还能查到 percent_off 的值。这是本节唯一真正的新东西。把两次调用完整画出来
第三点必须靠环境图才能讲清。先看 half_off = make_discount(0.5) 这一行执行完的瞬间:
| make_discount | func make_discount(percent_off) |
| compute_new_price | func compute_new_price(discount, price) |
| half_off | func discount(price) [parent=f1] |
| percent_off | 0.5 |
| discount | func discount(price) [parent=f1] |
| 返回值 | func discount(price) |
关键就在那个 [parent=f1]。discount 这个函数对象是在 f1 里被 def 出来的,所以它永久地记住了「我的父帧是 f1」。f1 虽然已经返回了,但只要还有人(这里是 discount 函数对象)指着它,它就不会消失。
接着执行 compute_new_price(half_off, 20):
| discount | func discount(price) [parent=f1] |
| price | 20 |
| price | 20 |
| 返回值 | 10.0 |
f3 里执行 return price * (1 - percent_off),要查两个名字:
price:f3 自己有,值是 20。停。percent_off:f3 里没有。去 f3 的父帧找。f3 的父帧是 f1,不是调用它的 f2。percent_off = 0.5。查到,停。20 * (1 - 0.5) = 10.0。若父帧规则是「调用它的那个帧」(这叫动态作用域),第 2 步就会去 f2 找,f2 里只有 discount 和 price,找不到 percent_off,再往 f2 的父帧 Global 找,还是没有,最后 NameError。Python 用的是「定义处」规则(词法作用域),所以能正确工作。
这种「函数 + 它记住的定义环境」的组合,正式名称叫闭包(closure)。CS 61A 不会一直用这个词,但你在别处会经常见到它。
为什么叫「工厂函数」
make_discount 是一台工厂(factory):喂进去一个折扣率,吐出来一个专用的折扣函数。它生产的每个产品都长得一样(函数体相同),但内部参数不同(父帧里的 percent_off 不同)。
>>> half_off = make_discount(0.5)
>>> ten_off = make_discount(0.1)
>>> half_off(100)
50.0
>>> ten_off(100)
90.0
half_off 和 ten_off 是两个不同的函数对象,父帧分别是两次调用产生的两个不同的帧。它们互不干扰。命名习惯上,凡是 make_xxx 这样的名字,通常就是工厂函数——Lab 02 和 HW 02 里会出现一堆。
误区一:返回时多写了括号。
def make_discount(percent_off):
    def discount(price):
        return price * (1 - percent_off)
    return discount(price)      # ← 错
>>> make_discount(0.5)
Traceback (most recent call last):
  ...
NameError: name 'price' is not defined
报错发生在 make_discount 被调用的时候,而不是被定义的时候——def 语句只是把函数体记下来,body 里的名字要等到执行时才查。
误区二:忘了里层的 return。
def make_discount(percent_off):
    def discount(price):
        price * (1 - percent_off)   # ← 没有 return
    return discount
>>> make_discount(0.5)(20)
>>>
不报错,安静地返回 None,什么都不显示。这类 bug 只有在下一步拿返回值做运算时才炸:TypeError: unsupported operand type(s) for *: 'NoneType' and 'int'。
误区三:忘了外层的 return。函数体里 def 了一个 discount 却不返回它,make_discount(0.5) 同样得到 None,然后 None(20) 会报 TypeError: 'NoneType' object is not callable。
6. WWPD:拆解 (lambda x, y: lambda z: x * y + z)(1, 2)(3)
下面这一行是本讲的「期末 boss」。第一眼看上去像键盘被猫踩了,但它其实只是把前两节的内容压缩到了一行里:
>>> (lambda x, y: lambda z: x * y + z)(1, 2)(3)
5
拆解它的唯一正确姿势是严格按照求值规则,从左到右一层一层剥。凭感觉猜没有任何胜算。
第一步:先分清哪些括号是「调用」
整行里有三对括号:
(lambda x, y: lambda z: x * y + z)  (1, 2)  (3)
└────────── 分组括号 ──────────┘  └调用┘  └调用┘
最外面那对是分组用的——必须加,否则 lambda x, y: ...(1, 2) 会被解析成「返回表达式是 ...(1,2)」,意思全变。后面两对才是调用。
所以这一行的结构是 某个函数(1, 2)(3),也就是连续调用两次。这个形状本身就在告诉你:某个函数(1, 2) 的结果必须还是一个函数,否则第二对括号无从下手。
第二步:看清楚 lambda 的边界在哪
这是最容易出错的一步。lambda x, y: lambda z: x * y + z 里面有两个 lambda,冒号后面的东西一直吃到哪儿为止?
规则:lambda 的返回表达式贪婪地向右延伸,直到遇到一个它吃不下的东西(比如逗号、右括号)为止。所以:
| 成分 | 内容 |
|---|---|
| 外层 lambda 的参数 | x, y |
| 外层 lambda 的返回表达式 | lambda z: x * y + z(整个内层 lambda) |
| 内层 lambda 的参数 | z |
| 内层 lambda 的返回表达式 | x * y + z |
外层 lambda 返回的是一个函数。这就跟上一节的 make_discount 是同一件事了。
第三步:翻译成 def
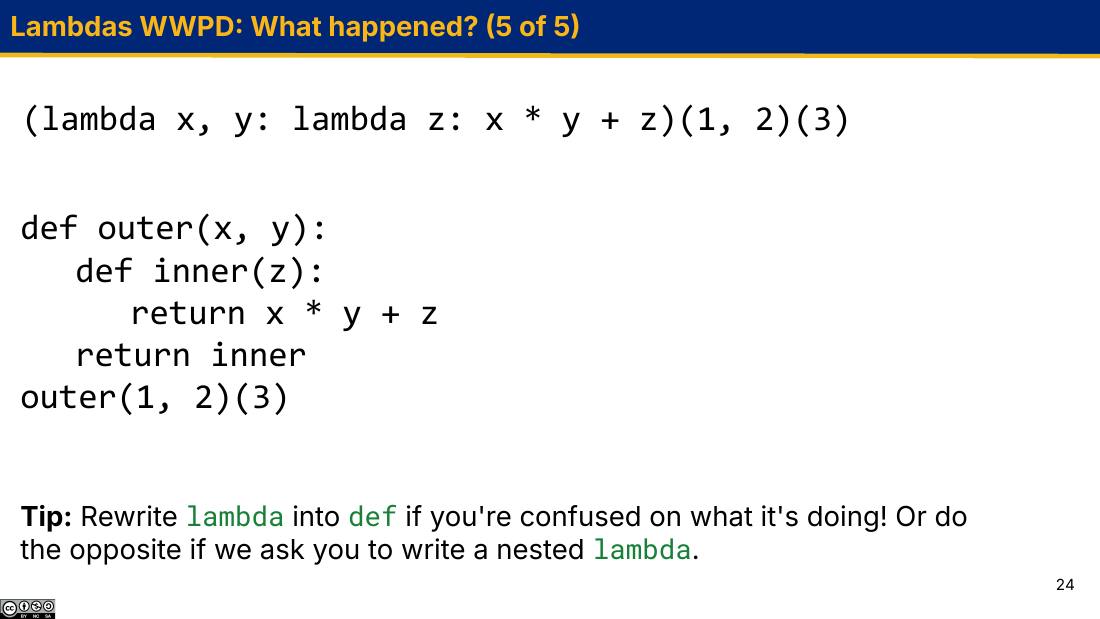
def outer(x, y):
    def inner(z):
        return x * y + z
    return inner

outer(1, 2)(3)
翻译完之后,这道题就退化成上一节讲过的工厂函数了:outer(1, 2) 生产出一个记得 x=1, y=2 的函数,再喂给它 3。
第四步:完整求值,画帧
(lambda x, y: lambda z: x * y + z):这是一个 lambda 表达式,求值结果是一个函数对象。它是在全局帧里被求值的,所以它的 parent 是 Global。记作 λ_outer。注意此时内层 lambda 还没有被求值——它只是 λ_outer 函数体里的一段代码。1 和 2。施加 λ_outer:新建帧 f1,parent = Global,绑定 x = 1、y = 2。lambda z: x * y + z。这时才造出内层函数对象 λ_inner,它的 parent = f1(因为它是在 f1 里被求值出来的)。x * y + z 此刻一点都不算——函数体在被调用前永远不执行。λ_inner。至此 (lambda x, y: ...)(1, 2) 整体求值成了 λ_inner。λ_inner 施加到 3 上。新建帧 f2,parent = f1,绑定 z = 3。x * y + z:z 在 f2 找到 = 3;x 在 f2 没有 → 去 parent f1 找到 = 1;y 同理在 f1 找到 = 2。1 * 2 + 3 = 5。| (这一行没绑定任何名字) |
| x | 1 |
| y | 2 |
| 返回值 | λ_inner [parent=f1] |
| z | 3 |
| 返回值 | 5 |
把 f2 的 parent 记成 Global 是这道题的头号错因。这样的话第 6 步查 x 会在 Global 里找不到,得到 NameError: name 'x' is not defined。再说一遍:parent 看「在哪定义」,不看「在哪调用」。
连续括号 f(a)(b)(c) 从左往右读就行,每对括号消耗一层函数:
f(a)        → 得到一个函数 g
f(a)(b)     → g(b),得到一个函数 h
f(a)(b)(c)  → h(c),得到最终结果
反过来,看到 f(a)(b) 这种写法,你立刻就知道 f 一定是「返回函数的函数」。括号的对数 = 函数嵌套的层数。
把参数一次性全塞进去:
>>> (lambda x, y: lambda z: x * y + z)(1, 2, 3)
Traceback (most recent call last):
  ...
TypeError: <lambda>() takes 2 positional arguments but 3 were given
外层只认 2 个参数。z 属于内层,必须单独用第二对括号送进去。这个报错里的 <lambda>() 就是「匿名」的代价——如果是 def 版,报错会写 outer(),一眼就知道是哪个函数。
忘记外层的分组括号:
>>> lambda x, y: lambda z: x * y + z(1, 2)(3)
<function <lambda> at 0x...>
不报错,但结果完全不对:z(1, 2)(3) 被当成了内层返回表达式的一部分,整行只是求值出一个函数对象,一次调用都没发生。不报错的错误比报错的错误危险。
7. 环境:帧、父帧与名字查找规则
前面几节反复用到「父帧」这个词,现在把它连同整套机制一次讲定。这一节的内容会在下一讲被展开成完整的环境图画法,但规则本身在这里就是完整的——考试和作业里的绝大多数环境题,靠下面这几条就能算对。
三个定义
程序员也常把环境叫做帧的「栈(stack)」——第一讲里出现的 Traceback (most recent call last) 之所以叫 stack trace,「爆栈」之所以叫 stack overflow,都源于这个说法。(栈溢出下周讲递归时会亲眼见到。)
四条规则
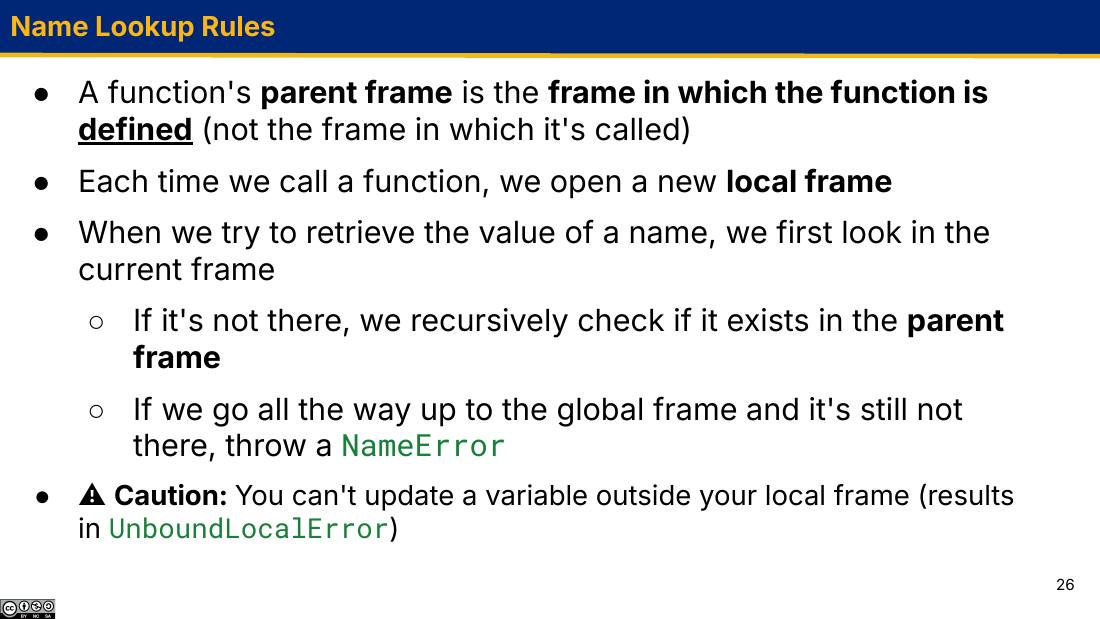
- 一个函数的父帧,是它被定义时所在的那个帧(不是它被调用时所在的帧)。
- 每次调用函数,都新开一个局部帧(local frame);这个帧的父帧就是规则 1 说的那个。
- 查名字时,先看当前帧;找不到就去父帧找,再找不到就去父帧的父帧……一路到全局帧。全局帧也没有,抛
NameError。 - 你不能在局部帧里更新(重新绑定)局部帧之外的名字,硬试会得到
UnboundLocalError。
规则 1 的分量:定义处 vs 调用处
这条规则值得一个专门的反例。下面这段代码里,g 里的 x 指的是哪个 x?
def f():
    x = 'f-local'
    return g()

def g():
    return x

x = 'global'
>>> f()
'global'
g 是在全局帧里 def 的,所以不管是谁调用它,g 的局部帧的父帧永远是 Global。f 的局部帧里那个 x = 'f-local',g 看都看不见。
| f | func f() |
| g | func g() [parent=Global] |
| x | 'global' |
| x | 'f-local' |
| 正在算 g() | |
| (没有局部绑定) | |
| 返回值 | 'global' |
f2 的父帧是 Global,尽管在调用栈上 f2 是从 f1 里被调起来的。调用关系和父帧关系是两条互不相干的链。这套规则叫词法作用域 / 静态作用域(lexical scoping)——「词法」的意思是:只看源代码的书写位置就能确定,不用运行程序。
对照第 5 节的 discount:它是在 make_discount 的帧里 def 的,所以父帧是那个帧,能看到 percent_off。同一条规则,两种表现。
规则 3 的分量:查找会一路向上,但只向上
>>> def outer():
...     n = 5
...     def inner():
...         return n + 1      # inner 里没有 n,去父帧(outer 的帧)找
...     return inner()
...
>>> outer()
6
读外层的名字完全没问题。反过来则不行:外层帧看不到内层帧的任何东西,全局帧更看不到任何函数的局部名字。链是单向的。
>>> def h():
...     return y
...
>>> h()
Traceback (most recent call last):
  File "<stdin>", line 2, in h
NameError: name 'y' is not defined
注意 NameError 是在 调用 h() 时才抛的,不是定义 h 时。def 只是把函数体存起来;函数体里的名字要等到真正执行那一行时才去查。这解释了为什么你可以写一个引用了尚未定义的名字的函数,只要在调用它之前把名字补上就行。
规则 4:UnboundLocalError 是怎么来的
这是本讲最容易让人一头雾水的报错。看这段:
>>> count = 0
>>> def bump():
...     count = count + 1
...
>>> bump()
Traceback (most recent call last):
  File "<stdin>", line 2, in bump
UnboundLocalError: local variable 'count' referenced before assignment
(Python 3.11 及以后这句话改成了 cannot access local variable 'count' where it is not associated with a value,意思一样。)
迷惑之处在于:全局帧里明明有 count = 0,为什么说「referenced before assignment」?
count 的赋值(count = ...)。count 是这个函数的局部变量。这个判定是静态的、一次性的,对整个函数体生效——包括赋值语句之前的代码。bump():新建局部帧。执行 count = count + 1,先要算右边的 count + 1。count:因为第 2 步已经把它钉成局部变量了,解释器只在局部帧里找,根本不会去父帧。而局部帧里此刻还没有 count(赋值还没完成)。UnboundLocalError。换句话说:一个名字在一个函数里,要么全程是局部的,要么全程是外部的,不能前半段外部、后半段局部。只要函数体里有对它的赋值,它就是局部的。
对比一下就清楚了——把赋值去掉,同一个函数立刻正常:
| 函数体 | count 是 | 结果 |
|---|---|---|
return count | 外部名字(局部帧没赋值) | 正常读到全局的 0 |
count = count + 1 | 局部名字(有赋值) | UnboundLocalError |
count = 10;return count | 局部名字 | 返回 10,全局的 count 不变 |
嵌套函数里同样会撞上:
>>> def outer():
...     n = 0
...     def inner():
...         n = n + 1        # ← n 被判定为 inner 的局部变量
...         return n
...     return inner()
...
>>> outer()
Traceback (most recent call last):
  ...
UnboundLocalError: local variable 'n' referenced before assignment
Python 确实有 global 和 nonlocal 两个关键字可以破除这条限制,但 CS 61A 在这个阶段不用它们,作业里也基本禁止。原因不是它们「不好」,而是这门课想让你先掌握「不靠副作用也能把状态传下去」的思路——需要跨调用保存状态时,正确答案通常是把状态放进外层函数的参数里,就像 make_discount 里的 percent_off 那样。
三种「找不到」的报错对照
| 报错 | 典型触发 | 含义 |
|---|---|---|
NameError: name 'y' is not defined | 用了一个从没绑定过的名字 | 沿着环境链一路找到全局帧都没有 |
UnboundLocalError: local variable 'x' referenced before assignment | 函数里对外层名字做 x = x + 1 | 名字被判定为局部,但局部帧里还没值 |
TypeError: 'int' object is not callable | 把调用结果当函数传/用 | 在一个非函数后面写了括号 |
8. 随堂练习一:combination
随堂代码 03.py 里的第一题。它是 summation 的加强版:summation 把「每一项算什么」抽成了参数,combination 连「怎么把项合并起来」和「从什么值开始」也一并抽出来。
题目到底要什么
def combination(n, initial, combiner, term):
    """
    Returns the result of combining the numbers from 1 to `n` (inclusive)
    repeatedly with the `combiner` and `term` functions. `combiner` is a
    function that takes two arguments and returns a single value, while
    `term` is a function that takes one argument and returns a single value.
    `initial` is the initial value to start the combination.

    >>> from operator import add, mul
    >>> combination(1, 0, add, lambda x: x + 1)  # (0) + (1+1)
    2
    >>> combination(5, 0, add, lambda x: x + 1)  # (0) + (1+1) + (2+1) + (3+1) + (4+1) + (5+1)
    20
    >>> combination(5, 1, mul, lambda x: x + 1)  # (1) * (1+1) * (2+1) * (3+1) * (4+1) * (5+1)
    720
    >>> combination(5, 0, add, lambda x: x * x)  # (0) + 1*1 + 2*2 + 3*3 + 4*4 + 5*5
    55
    >>> combination(5, 1, mul, lambda x: x * x)  # (1) * 1*1 * 2*2 * 3*3 * 4*4 * 5*5
    14400
    """
四个参数各是什么,doctest 里的注释已经说得很直白了:
| 参数 | 类型 | 作用 |
|---|---|---|
n | 整数 | 从 1 数到 n(含 n) |
initial | 数 | 累积的起点。求和时是 0,求积时是 1 |
combiner | 函数,吃两个参数 | 怎么把「已累积的结果」和「新的一项」合起来 |
term | 函数,吃一个参数 | 由 i 算出第 i 项 |
from operator import add, mul 这一行值得单独说:operator 模块把运算符包装成了普通函数。add(3, 4) 就是 3 + 4,mul(3, 4) 就是 3 * 4。为什么需要它?因为 + 是语法,不是值,你没法写 combination(5, 0, +, ...)。要把「加法」当参数传,就必须有一个函数形态的加法。
边界情况:combination(0, 7, add, ...) 应该返回 7——一项都不合并,直接把 initial 原样交出。这条不在 doctest 里,但它是判断代码写得干不干净的试金石。
怎么想到的
关键是把 doctest 第三行的注释重新断句。它写的是:
(1) * (1+1) * (2+1) * (3+1) * (4+1) * (5+1)
看起来像「六个东西连乘」,但那样想会卡住——因为 combiner 一次只吃两个参数。正确的读法是从左往右逐个吞:
total ← 1                      # initial
total ← mul(total, term(1))    # mul(1, 2)   = 2
total ← mul(total, term(2))    # mul(2, 3)   = 6
total ← mul(total, term(3))    # mul(6, 4)   = 24
total ← mul(total, term(4))    # mul(24, 5)  = 120
total ← mul(total, term(5))    # mul(120, 6) = 720
这一读就露馅了:这不就是 summation 换了个累加方式吗。summation 里的 total += term(i) 相当于 total = add(total, term(i));把 add 换成参数 combiner,把起点 0 换成参数 initial,就完了。
拿到一道 HOF 题不会做时,屡试不爽的一招:先把它退化成一个具体的、不含函数参数的版本写出来。这里就是先写「1 到 n 求和」,写完再问「哪几个地方是写死的?」,把写死的地方逐个换成参数。
抽象是从具体里提炼出来的,不是凭空设计出来的。
代码逐行讲
def combination(n, initial, combiner, term):
    i = 1
    total = initial
    while i <= n:
        total = combiner(total, term(i))
        i += 1
    return total
i = 1:题目说「from 1 to n (inclusive)」,起点就是 1。total = initial:不能写 total = 0。求积那两个 doctest 的 initial 是 1,从 0 开始的话乘出来永远是 0。这就是 initial 这个参数存在的理由——不同的 combiner 有不同的「单位元」。while i <= n:inclusive,所以是 <= 不是 <。写成 < 会少算最后一项,combination(1, 0, add, lambda x: x + 1) 会返回 0 而不是 2。total = combiner(total, term(i)):参数顺序是 (已累积的, 新的一项)。add 和 mul 都满足交换律,所以这两个 doctest 反过来写也能过;但对减法、除法这类不满足交换律的 combiner 就会出错。养成按 docstring 语义写的习惯。另外这里不能用
+=——total += ... 写死了「合并方式是加法」,恰恰是我们要抽走的那件事。i += 1:漏了就是死循环。return total:缩进在 while 外面。缩进到里面的话第一轮就返回了,combination(5, 0, add, lambda x: x + 1) 会得到 2。验证
手动追踪 combination(5, 1, mul, lambda x: x * x),目标是 doctest 里的 14400。term 是平方,combiner 是乘法,initial 是 1:
| i | 进入时 total | term(i) | mul(total, term(i)) | 更新后 total |
|---|---|---|---|---|
| 1 | 1 | 1 | 1 × 1 | 1 |
| 2 | 1 | 4 | 1 × 4 | 4 |
| 3 | 4 | 9 | 4 × 9 | 36 |
| 4 | 36 | 16 | 36 × 16 | 576 |
| 5 | 576 | 25 | 576 × 25 | 14400 |
| 6 | 6 <= 5 为假,退出,返回 14400 ✓ | |||
(心算校验:(1·2·3·4·5)² = 120² = 14400。)跑一遍确认:
$ python3 -m doctest 03.py -v
...
9 tests in 3 items.
9 passed and 0 failed.
Test passed.
写成 total = combiner(total, term)——把函数本身当成了项。
>>> combination(5, 0, add, lambda x: x + 1)
Traceback (most recent call last):
  ...
TypeError: unsupported operand type(s) for +: 'int' and 'function'
报错里的 'int' and 'function' 直接点名了:你拿一个整数去加一个函数。term 是规则,term(i) 才是数。
写成 total = combiner(term(i))——少给一个参数。
TypeError: add expected 2 arguments, got 1
docstring 白纸黑字写了「combiner is a function that takes two arguments」。读 docstring 里对函数参数的类型描述,是做 HOF 题最省时间的一步。
9. 随堂练习二:multiply_triple 与「一次只吃一个参数」
题目到底要什么
Using only functions with a single argument, implement
multiply_tripleso that you can use it to return the product of 3 numbers x, y, and z.
逐字翻译:只许用「单参数函数」,实现 multiply_triple,使得它能算出三个数 x、y、z 的乘积。要达到的效果是:
>>> multiply_triple(1)(2)(3)
6
>>> multiply_triple(2)(3)(4)
24
>>> multiply_triple(10)(5)(7)
350
注意 starter code 里函数签名是 def multiply_triple(___):——连形参名都要你自己填。这是提示:先想清楚第一层该接什么。
「单参数」这个限制看起来像刁难,其实它逼你回答一个真问题:一个函数一次只能收一个值,怎么攒够三个?
怎么想到的
从 doctest 的形状倒推。multiply_triple(1)(2)(3) 有三对括号,按第 6 节的口诀——括号的对数 = 函数嵌套的层数——所以要三层:
multiply_triple(1):吃掉 x = 1。它还不能算乘积(只知道一个数),所以只能返回一个函数,这个函数得记住 1。(2):第二层吃掉 y = 2。仍然算不出来(缺 z),继续返回一个函数,这个函数得同时记住 1 和 2。(3):第三层吃掉 z = 3。三个数齐了,返回 x * y * z = 6。「记住前面的数」这件事,第 5 节已经解决过了:内层函数能通过父帧看到外层函数的参数。所以不需要任何额外机制,嵌套 def 就够了。
把它想成攒齐材料才能开工:每一层函数收一份材料,收完发现还不够,就把「已收到的材料 + 还要收几份」打包成一个新函数交回去。等最后一份材料到手,立刻开工。
这个「把多参数函数拆成一串单参数函数」的技巧有正式名字:柯里化(currying),以逻辑学家 Haskell Curry 命名。教材 §1.6 里会正式讲,本讲只要会手写就行。
代码逐行讲
def multiply_triple(x):
    def outer(y):
        def inner(z):
            return x * y * z
        return inner
    return outer
def multiply_triple(x):starter code 里的 ___ 填 x——第一个括号送进来的就是 x。def outer(y):在 multiply_triple 的帧里定义,所以它的父帧就是那个帧,能看到 x。def inner(z):在 outer 的帧里定义,父帧是 outer 的帧;沿链再往上是 multiply_triple 的帧。所以 x 和 y 它都能查到。return x * y * z:三个名字分别在三个不同的帧里被找到——z 在自己帧,y 在父帧,x 在父帧的父帧。这一行是本讲名字查找规则最紧凑的演示。return(return inner 和 return outer)都不带括号,返回函数对象本身。写成 lambda 更短,语义完全一样:
def multiply_triple(x):
    return lambda y: lambda z: x * y * z
甚至可以整个都是 lambda(这就是第 6 节那道 WWPD 的三层版):
multiply_triple = lambda x: lambda y: lambda z: x * y * z
验证:把 multiply_triple(2)(3)(4) 的帧全画出来
multiply_triple(2):新建 f1,parent = Global,绑定 x = 2。def outer(y)::造出一个函数对象,parent = f1,绑到 f1 的 outer 上。(def inner 这一行还没执行——它在 outer 的函数体里。)return outer,返回那个函数对象。至此 multiply_triple(2) 求值完毕。3 上。新建 f2,parent = f1,绑定 y = 3。def inner(z)::这时才造出 inner 函数对象,parent = f2。f2 返回它。4 上。新建 f3,parent = f2,绑定 z = 4。x * y * z:x → f3 没有 → f2 没有 → f1 有,2。y → f3 没有 → f2 有,3。z → f3 有,4。2 * 3 * 4 = 24 ✓| multiply_triple | func multiply_triple(x) |
| x | 2 |
| outer | func outer(y) [parent=f1] |
| 返回值 | func outer(y) |
| y | 3 |
| inner | func inner(z) [parent=f2] |
| 返回值 | func inner(z) |
| z | 4 |
| 返回值 | 24 |
四个帧串成一条链:f3 → f2 → f1 → Global。这条链就是 f3 的环境。x * y * z 里三个名字分别在链上的三个不同位置被找到,而且是从近到远依次搜索的。
误区一:写成三参数函数。
def multiply_triple(x, y, z):
    return x * y * z
>>> multiply_triple(1)(2)(3)
TypeError: multiply_triple() missing 2 required positional arguments: 'y' and 'z'
题目明说「Using only functions with a single argument」,而且 doctest 的调用形状 f(1)(2)(3) 也不允许这么写。
误区二:内层函数重复用同一个参数名。
def multiply_triple(x):
    def outer(x):        # ← 把外层的 x 遮住了
        def inner(x):    # ← 又遮一次
            return x * x * x
        return inner
    return outer
>>> multiply_triple(2)(3)(4)
64
不报错,结果是 4 ** 3 = 64。因为 inner 帧里有自己的 x = 4,查名字第一步就命中了,根本不会往父帧走。这叫遮蔽(shadowing):内层的同名绑定会挡住外层的。
误区三:中间层忘了 return,或者提前算乘积。
def multiply_triple(x):
    def outer(y):
        return x * y       # ← 只乘了两个就返回
    return outer
>>> multiply_triple(2)(3)(4)
TypeError: 'int' object is not callable
multiply_triple(2)(3) 得到整数 6,然后 6(4) 就炸了。只要还没收齐所有参数,就必须继续返回函数。
本讲小结
三条判断题,答对就算过关
| 问题 | 答案 |
|---|---|
square 和 square(3) 的区别 | 前者求值成函数对象,后者是调用表达式。括号是「调用」这个动作,不是名字的一部分。 |
| 一个函数的父帧怎么定 | 看它在哪里被 def / 被 lambda 求值出来,不看在哪里被调用。 |
看到 f(a)(b) 说明什么 | f(a) 的结果必须是一个函数。括号对数 = 函数嵌套层数。 |
语法速查
| 写法 | 它是 | 求值成 |
|---|---|---|
def f(x): ... | 语句 | (无值)造出函数并绑到名字 f |
lambda x: x * x | 表达式 | 一个函数对象,__name__ 是 '<lambda>' |
f | 名字 | 函数对象 |
f(3) | 调用表达式 | f 的返回值 |
f(3)(4) | 两次调用 | 先调 f(3) 得到函数,再调它 |
return g | 返回函数 | 把 g 这个函数对象交出去 |
return g(x) | 返回调用结果 | 先调用 g,把结果交出去 |
报错速查
| 报错 | 八成是因为 |
|---|---|
TypeError: 'int' object is not callable | 该传函数的地方传了 f(x) 而不是 f;或者中间层提前算出了数值 |
TypeError: 'NoneType' object is not callable | 工厂函数忘了 return 内层函数 |
TypeError: <lambda>() takes 2 positional arguments but 3 were given | 柯里化函数的参数一次性全塞进了一对括号 |
TypeError: unsupported operand type(s) for +: 'int' and 'function' | 拿 term 当数用了,忘了写 term(i) |
NameError: name 'price' is not defined | return discount(price) 多写了括号,而这一层没有 price |
UnboundLocalError: local variable 'x' referenced before assignment | 在函数里写了 x = x + 1,而 x 是外层的名字 |
不报错但结果是 None | 某一层漏了 return |
写 HOF 的四步法
与前后讲的关系
往回看:本讲的 summation、combination 里的循环骨架,是上一讲 while 的直接产物;没有上一讲的「初始化 / 条件 / 更新」三要素,这一讲的抽象无从谈起。
往前看:下一讲会把本讲末尾的环境规则展开成一整套环境图画法,包括怎么画函数对象、怎么标 parent、返回值写在哪。本讲第 5、6、9 节手画的那些帧,就是下一讲的预演。再往后的递归,本质是「函数在自己的帧里调用自己」,靠的还是同一套帧和环境机制。
作业上:Lab 02 整场都在练本讲的内容(lambda、HOF、柯里化、环境图);HW 01 的后几题会要求你用高阶函数化简重复代码。
动手练习
练习 1:WWPD
下面每一行的输出是什么?(>>> 后面是输入,请自己先写出结果再看答案。)
>>> def f(x):
...     return x + 1
...
>>> g = f
>>> h = f(1)
>>> g(1)
______
>>> h
______
>>> h(1)
______
>>> (lambda x: x)(f)(1)
______
看答案
g(1) → 2。g = f 没有括号,所以 g 和 f 是同一个函数对象的两个名字。
h → 2。h = f(1) 有括号,先调用,把返回值 2 绑给 h。h 是整数,不是函数。
h(1) → TypeError: 'int' object is not callable。h 是 2,2(1) 没有意义。
(lambda x: x)(f)(1) → 2。分两步:(lambda x: x)(f) 是把恒等函数施加到 f 上,返回 f 本身;然后 f(1) = 2。函数可以作为实参被传给 lambda,也可以作为 lambda 的返回值——这一行两件事都干了。
练习 2:环境推演
result 是多少?先画出所有帧和它们的 parent,再回答。
n = 10

def f(n):
    def g(k):
        return n + k
    return g

n = 100
result = f(1)(2)
看答案
result 是 3。
n 先被绑成 10,再被重新绑成 100。执行到最后一行时,全局的 n 是 100。f(1):新建 f1,parent = Global,绑定 n = 1。这个 n 是 f1 里的局部 n,它遮蔽了全局的 n。def g(k) 造出函数对象,parent = f1。f1 返回它。(2):新建 f2,parent = f1,绑定 k = 2。n + k:k 在 f2 找到 = 2;n 在 f2 没有 → 去 parent f1 找到 = 1(不是 100,也不是 10,因为查找一命中就停,不会继续往 Global 走)。1 + 2 = 3。这道题的陷阱有两层:一是「全局的 n 被改成 100 了」这个干扰项,二是「n = 10 那行看起来像是初始值」这个干扰项。只要 f1 里有 n,链上更远处的 n 就永远轮不到。
练习 3:写代码 —— compose
实现 compose(f, g),返回一个新函数,这个新函数对输入 x 先用 g 再用 f:
>>> add_one = lambda x: x + 1
>>> square = lambda x: x * x
>>> compose(square, add_one)(3)   # square(add_one(3)) = square(4)
16
>>> compose(add_one, square)(3)   # add_one(square(3)) = add_one(9)
10
看答案
def compose(f, g):
    def h(x):
        return f(g(x))
    return h
或者:return lambda x: f(g(x))。
compose 是「既吃函数又吐函数」的典型:两个参数都是函数,返回值也是函数。三个 return 位置都不能搞混——return f(g(x)) 在最内层(这时 x 已经有了,该算出结果了),return h 在外层(这时只有 f 和 g,还不能算)。
验证 compose(square, add_one)(3):compose 的帧里 f = square、g = add_one,返回 h(parent 指向这个帧)。调用 h(3):新帧绑定 x = 3,求值 f(g(x))——先算算子数 g(x) = add_one(3) = 4,再算 f(4) = square(4) = 16。
顺序容易记反:f(g(x)) 里 g 在里面,所以 g 先执行。写完对着 doctest 的注释核一遍最保险。
练习 4:写代码 —— 柯里化的逆操作
multiply_triple(2)(3)(4) 能算出 24。现在反过来:写一个 uncurry3(f),把这种「三层单参数」的函数变回普通的三参数函数。
>>> mul3 = uncurry3(multiply_triple)
>>> mul3(2, 3, 4)
24
看答案
def uncurry3(f):
    def g(x, y, z):
        return f(x)(y)(z)
    return g
关键是 f(x)(y)(z) 这一串:f(x) 得到第二层函数,再 (y) 得到第三层,再 (z) 才是数。三对括号必须一个不少。
常见的错法是写成 return f(x, y, z):multiply_triple 只收一个参数,会报 TypeError: multiply_triple() takes 1 positional argument but 3 were given。
uncurry3 本身也是高阶函数(吃函数、吐函数)。注意它返回的 g 不是单参数函数——这不违反什么,因为限制「只用单参数函数」是上一题的题目要求,不是 Python 的规则。
练习 5:找 bug
下面这个 make_counter 想造一个「每次调用就返回累计次数」的计数器,但它跑不起来。指出报错、说明原因,并给出一个不用 nonlocal 的修法。
def make_counter():
    count = 0
    def counter():
        count = count + 1
        return count
    return counter
看答案
>>> c = make_counter()
>>> c()
Traceback (most recent call last):
  File "<stdin>", line 4, in counter
UnboundLocalError: local variable 'count' referenced before assignment
原因就是第 7 节的规则 4:counter 的函数体里有 count = ...,Python 于是把 count 判定为 counter 的局部变量;执行 count + 1 时它只在局部帧里找,而局部帧里还没有 count。能读外层的名字,不能改。
不用 nonlocal 的修法是把「当前计数」变成参数,让调用方自己拿着状态:
def make_counter():
    def counter(count):
        return count + 1
    return counter
>>> c = make_counter()
>>> c(0)
1
>>> c(c(0))
2
这确实不如原来的想法方便——但它没有可变状态,每次调用的结果只取决于参数。CS 61A 前半学期一直待在这个「纯函数」的世界里,直到后面正式讲可变数据时,才会给你真正能改状态的工具。到那时你会更清楚,「能改状态」带来的方便和麻烦各是什么。