欢迎、编程环境、函数与异常 I
从「怎么打开一个终端」到「一个表达式被求值时到底发生了什么」——这门课的全部内容都建立在本讲这套求值规则上。
0. 本讲导读
CS 61A 的全名是 The Structure and Interpretation of Computer Programs(计算机程序的构造和解释)。你会在这门课里学三门语言:Python、Scheme、SQL。但课程本身不是一门「Python 入门」——三门语言只是载体,真正要教的是四件事:抽象(abstraction)、问题求解(problem solving)、控制复杂度(managing complexity)、以及解释程序语言(interpreting programming languages)。换句话说:怎么像一个计算机科学家那样思考。
这个区别在第一讲就会体现出来。很多入门课讲到函数时会说:「用 def 定义,用括号调用,记住这个语法。」本讲不这样讲。本讲要回答的是一个更笨、也更重要的问题:
你在解释器里敲下 mul(add(2, mul(4, 6)), add(3, 5)) 然后按回车,Python 从那一刻起,一步一步,究竟做了什么,才最终在屏幕上打出 208?
这个问题的答案是一套可以手工执行的规则。学会它,你就能在写代码之前预测代码的行为,在代码出错时定位错在哪一步。学不会它,你就只能靠「试一下看看」——而这门课后面的递归、高阶函数、环境图、解释器,全部会因此变成玄学。
本讲的内容分成四块,从外到内:
return 与 print 的根本区别、None。这是本讲的核心。assert 防御式编程。这是你未来几百个小时里最常用到的技能。往后看:下一讲讲控制流(if / while),它会让程序不再是一条直路;再往后是高阶函数、递归。但无论走到哪一讲,「求值一个表达式」这套规则都不会变——后面所有内容都是在这套规则上加东西,而不是替换它。本讲欠下的债,后面每一讲都要还。
关于这门课怎么上
课程材料几乎全在 cs61a.org:讲义、作业、办公时间日历都在那里;答疑在 Ed(edstem.org),作业提交在 Gradescope,教材是免费在线的 Composing Programs。这个夏季学期的评分是 三分之二考试 + 三分之一其余所有,并且有每周一次的 CBTF 小测——课程给出的理由是:频繁的小赌注测试优于一次性的高赌注考试,而且 AI 编程工具让带回家的作业不再能可靠反映理解水平。
关于 AI 的官方立场值得原样记住:让 AI 替你写代码 ❌,把 AI 当文档和学习资源 ✅。给出的理由不是道德说教,而是三个很实在的问题——你愿意做一个只会无脑 vibecode 的人吗?你愿意把自己的思考和技能外包给一家把利润放在你前面的公司吗?以及最要命的一个:如果你连基础都不懂,你凭什么判断 AI 的输出是对的?
这份笔记(以及第一讲本身)都不能代替你自己去读一遍 syllabus。课程明确说过:你要为知晓课程政策、作业截止时间、以及查收邮件和 Ed 公告负全部责任,而第一讲的内容并不涵盖你需要知道的一切。本笔记只覆盖技术内容,具体的日期、政策细节请以官网为准。
- 表达式(expression)描述一次计算,被求值(evaluate)后得到一个值(value)。「求值」是这门课最基本的动作,其他一切都是它的组合。
- 调用表达式的求值顺序恒定为三步:① 求值算子 → ② 从左到右求值各个算子数 → ③ 把算子施加到算子数上。第 ② 步里的每个算子数可能又是一个调用表达式,于是这三步会递归地发生。
- 赋值语句
x = 5不是「x 等于 5」,而是「把名字 x 绑定到值 5」。求值一个名字,就是去环境里查它当前绑定的值。 return交出一个值,print只在屏幕上显示字符。没有return的函数返回None;print自己也返回None;交互式解释器不显示None,这让这个错误极难被发现。- 错误分三类,调试难度递增:语法错误(代码非法,一行都跑不了)→ 运行时错误(合法但运行时崩溃,会给你一份栈追踪)→ 逻辑错误(合法且不崩,但结果不是你要的,Python 一个字都不会提醒你)。
- 栈追踪从下往上读:最后一行是错误类型和信息,倒数第二块是真正出事的地方,上面的每一块是「谁调用了它」。
1. 编程环境:文件系统、终端与解释器
这一节里没有任何编程思想,全是工具。但它必须放在最前面,因为接下来所有的代码都要在这个环境里跑。如果你从来没用过命令行,这一节请动手把每条命令都敲一遍——光看是学不会的。
文件系统:文件、目录、路径
你的电脑用三个概念组织所有数据:
- 文件(file):一段有名字的数据。
hw01.py、lecture-01.html、一张照片,都是文件。 - 目录(directory),日常叫「文件夹(folder)」:一个装文件和其他目录的容器。目录套目录,形成一棵树。
- 路径(path):一个文件或目录的位置。
路径有两种写法,课程给的类比非常准确:
| 绝对路径(absolute) | 相对路径(relative) | |
|---|---|---|
| 类比 | 你的完整通信地址:国家、城市、街道、门牌 | 「我住在离这儿往北三个街区的那栋公寓」 |
| 起点 | 从文件系统的根开始,与你当前在哪无关 | 从当前工作目录开始 |
| 例子(Mac/Linux) | /home/alice/cs61a/hw01/hw01.py | hw01/hw01.py、../lab01 |
| 例子(Windows) | C:\Users\alice\cs61a\hw01\hw01.py | 同上 |
| 什么时候用 | 需要一个到哪儿都能用的准确指代 | 在项目内部互相引用,短且可移植 |
相对路径里有两个特殊名字,务必记住,它们在终端里天天用:
.(一个点)= 当前目录..(两个点)= 父目录,也就是上一级~(波浪号)= 你的家目录(home directory),比如/home/alice
终端:用打字的方式操作电脑
终端(terminal)是一个基于命令行(文本)的程序,让你用打字而不是点鼠标的方式跟电脑和文件系统交互。Mac 和 Linux 自带;Windows 用户用 WSL(Windows Subsystem for Linux)。
为什么要学这个?因为很多开发工作根本没有图形界面可点——远程服务器、自动化脚本、课程的 ok 自动评分器,都是命令行的。而且一旦熟练,打字比点鼠标快得多。
打开终端,你会看到一个提示符(prompt),大致长这样:
alice@laptop:~/cs61a$ 拆开看:alice 是用户名,laptop 是机器名,~/cs61a 是当前工作目录(这里表示家目录下的 cs61a),最后的 $ 表示「该你输入了」。不同系统提示符长得不一样,但「当前工作目录」这个信息基本都会显示——它非常重要,因为所有相对路径都是从这里算起的。
把终端想象成一个「你正站在文件系统树上的某个位置」的游戏。你不能同时站在两个地方,所以任何时候都有唯一一个「当前工作目录」。cd 是走路,ls 是环顾四周,pwd 是「我在哪」。绝大多数「命令说文件不存在」的困惑,根源都是你以为你站在 A,其实你站在 B。
下面是本讲演示的全部命令。rm 那条请特别小心。
| 命令 | 全称 | 作用 | 例子 |
|---|---|---|---|
pwd | print working directory | 打印当前工作目录的绝对路径——迷路时的第一条命令 | pwd |
ls | list | 列出当前目录下的文件和目录 | ls、ls cs61a |
cd | change directory | 切换当前工作目录 | cd cs61a |
cd .. | — | 回到父目录(上一级) | cd .. |
cd ~ | — | 回到家目录。直接输 cd 不带参数通常也是回家 | cd ~ |
touch | — | 创建一个空文件(若文件已存在,只更新它的时间戳) | touch hw01.py |
mkdir | make directory | 新建一个目录 | mkdir lab01 |
rm | remove | 删除文件或目录 ⚠️ 危险 | rm scratch.py |
rm 删掉的东西不进回收站,没有撤销。它不会问你「确定吗?」,它就是删了。删错一个作业文件,你就得重写。养成两个习惯:
- 敲
rm之前先ls一眼,确认你要删的东西真的在当前目录、名字真的没打错。 - 永远不要在不理解的情况下从网上抄一条带
rm -rf的命令来跑。
一个能省下大量时间的小技巧:按上/下方向键可以翻命令历史。刚跑过的一条长命令想改一个字重跑,按一下上箭头就回来了,不用重敲。(另外,很多终端支持按 Tab 补全文件名,这也值得练。)
下面是一次完整的会话,把这些命令串起来看——建议你照着敲一遍:
alice@laptop:~$ pwd
/home/alice
alice@laptop:~$ mkdir cs61a          # 新建目录
alice@laptop:~$ cd cs61a             # 走进去
alice@laptop:~/cs61a$ pwd
/home/alice/cs61a
alice@laptop:~/cs61a$ touch hw01.py  # 造一个空文件
alice@laptop:~/cs61a$ ls
hw01.py
alice@laptop:~/cs61a$ cd ..          # 回到父目录
alice@laptop:~$ pwd
/home/alice
注意提示符里的当前目录是怎么随着 cd 变化的:~ → ~/cs61a → ~。这正是「你站在树上某处」那个心智模型的可视化。
Python 解释器:终端里再套一层
装好 Python 3 之后,在终端里输入 python3 并回车,你会进入 Python 解释器(interpreter):
alice@laptop:~/cs61a$ python3
Python 3.12.0 (main, ...)
Type "help", "copyright", "credits" or "license" for more information.
>>>
提示符从 $ 变成了 >>>。这个变化不是装饰——它意味着你现在说的是另一种语言:
终端(提示符 $) | Python 解释器(提示符 >>>) | |
|---|---|---|
| 它接受什么 | shell 命令:ls、cd、python3 | Python 代码:2 + 2、def f(x): ... |
你在里面输 ls | 列出文件 | NameError: name 'ls' is not defined |
你在里面输 2 + 2 | 报「command not found」之类 | 显示 4 |
| 怎么退出 | exit 或关窗口 | exit()、quit(),或按 Ctrl+D |
初学者最常见的两个卡壳,本质是同一个:没看提示符。
>>> ls
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
NameError: name 'ls' is not defined
你在 Python 里输了 shell 命令。Python 把 ls 当成一个普通名字去找,找不到。解决:先 exit() 退回终端。
反过来,在终端里直接粘贴 Python 代码,会得到 command not found 或一堆莫名其妙的错误。看一眼提示符是 $ 还是 >>>,能解决你未来一半的「环境问题」。
解释器 vs. IDE
解释器很方便,但它是临时的:退出之后你敲过的一切都没了。它适合试代码——想知道 10 // 3 等于几,开一个解释器两秒钟就有答案。
写作业得用 IDE(integrated development environment,集成开发环境),课程演示的是 Visual Studio Code。IDE 把代码存成文件,是永久的,适合写较长的代码,还带一堆软件工程用得上的功能(语法高亮、自动补全、调试器、Git 集成等)。
解释器(python3) | IDE(VS Code) | |
|---|---|---|
| 持久性 | 临时,退出即失 | 永久,存成 .py 文件 |
| 适合 | 试一小段代码、演示、验证猜想 | 写完整的程序、作业 |
| 反馈 | 敲一行立刻看到结果 | 要运行整个文件才看到结果 |
| 典型用法 | >>> 10 % 3 | 写好 hw01.py,再 python3 hw01.py |
实际做作业时两者一起用:在 VS Code 里写 hw01.py,同时开一个终端跑测试;想不起来某个表达式的值,就在解释器里试一下。本笔记里所有以 >>> 开头的代码块,都是在解释器里敲的,下面没有 >>> 的行就是解释器回显的结果——你可以照着敲,应该得到一模一样的输出。
2. 值与表达式:Python 拿到 (2 + 2) * 5 之后做了什么
现在开始真正的内容。先立一个贯穿全课的区分:
- 值(value):程序里一个具体的东西,比如整数
5、字符串'hello'。它就是它自己,不需要再算。 - 表达式(expression):一段描述某个计算的代码,比如
(2 + 2) * 5。Python 会求值(evaluate)它,得到一个值。
求值的结果永远是一个值。(2 + 2) * 5 求值成 20——不是「变成 4 * 5 然后变成 20」这种半成品状态,而是最终落到 20。一个值本身也是最简单的表达式:求值 5 得到 5。
原始数据类型
原始数据类型(primitive data type)是 Python 内建的、不能再拆的基本类型。本讲用到四种:
| 类型 | 中文 | 表示什么 | 例子 |
|---|---|---|---|
int | 整数 | 没有小数部分的数 | 5、0、100、-7 |
float | 浮点数 | 带小数部分的数 | 1.1、0.0、43.9235 |
str | 字符串 | 一串字符(文本) | 'hello world'、"hello world" |
bool | 布尔值 | 真或假 | True、False |
关于字符串,三点值得先说清:
- 单引号和双引号完全等价:
'hello'和"hello"是同一个值。选哪个只看方便——字符串里本身含单引号时用双引号包,反之亦然。 - 三重引号(
'''或""")可以写跨多行的字符串。它还有个重要用途:当多行注释用。第 7 节的 docstring 就是它。 #是单行注释:从#到行尾的内容 Python 完全忽略,写给人看的。
布尔值本讲只是点个名,下一讲会花整整一讲讲它。
表达式:把值组合起来
光有值没用,得能组合它们。表达式就是组合数据的方式,Python 自动为你计算它们的值。先看数值运算:
>>> (2 + 2) * 5
20
>>> 5 ** 2      # 乘方(指数)
25
>>> 10 / 3      # 真除法 true division
3.3333333333333335
>>> 10 // 3     # 地板除 floor division
3
>>> 10 % 3      # 取模 modulo
1
前两行没什么意外:括号改变优先级,** 是乘方(不是 ^,^ 在 Python 里是别的运算)。后三行才是重点,它们是这门课前几周出现频率最高的三个运算符:
| 运算符 | 名字 | 做什么 | 10 op 3 | 结果类型 |
|---|---|---|---|---|
/ | 真除法 | 数学意义上的除,保留小数 | 3.3333333333333335 | 永远是 float |
// | 地板除 | 除完向下取整,丢掉小数部分 | 3 | 两边都是 int 时是 int |
% | 取模 | 取余数 | 1 | 两边都是 int 时是 int |
// 和 % 是一对:10 // 3 是 3,10 % 3 是 1,而 3 * 3 + 1 = 10。也就是「商」和「余数」。下一讲的 sum_digits(把一个数的各位数字加起来)就是靠 % 10 取出最低位、// 10 砍掉最低位来做的——这两个运算符是「拆数字」的标准工具,务必熟练。
10 / 3 为什么是 3.3333333333333335
末尾那个 5 不是打错了。float 用二进制表示小数,很多十进制小数(包括 1/3)无法被精确表示,所以结果是最接近真值的那个浮点数。同样的原因:
>>> 0.1 + 0.2
0.30000000000000004
>>> 0.1 + 0.2 == 0.3
False
这不是 Python 的 bug,几乎所有语言都这样。结论:不要用 == 比较两个浮点数。 另外注意 10 / 5 得到的是 2.0 而不是 2——/ 的结果永远是 float,哪怕除得尽。想要整数结果就用 //。
字符串上的运算符
+ 和 * 用在字符串上有各自的含义:
>>> 'hello'
'hello'
>>> 'hello' + 'world'
'helloworld'
>>> 'a' * 5
'aaaaa'
+ 是拼接(concatenation),* 是重复。注意 'hello' + 'world' 的结果里没有空格——拼接就是把两串字符原样接起来,不会自作主张加东西。想要空格就自己写:'hello' + ' ' + 'world'。
第一行也值得看一眼:单独求值 'hello',解释器显示 'hello'——带引号。这是因为解释器显示的是这个值的「代码形式」,引号提醒你「这是个字符串,不是一个名字」。等到第 8 节用 print 时你会看到不带引号的版本,那个区别很重要。
>>> 'Hello, ' + 5
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: can only concatenate str (not "int") to str
Python 不会替你猜你想要「字符串拼接」还是「数字相加」,它直接报 TypeError。修法有两种:'Hello, ' + str(5) 把数字转成字符串,或者用第 3 节的 f-string。看到 TypeError,第一反应应该是「我把两种不该放一起的类型放一起了」。
3. 名字与赋值:绑定到底是什么
到目前为止,每个算出来的值转眼就丢了。(2 + 2) * 5 得到 20,显示完就没了;下一行想再用这个 20,只能重敲一遍表达式。
解决办法是给值贴一个标签,把它存下来以后用。这就是赋值语句(assignment statement):
>>> pi = 3.1415926
>>> pi
3.1415926
这两行发生的事情完全不同,必须分开理解:
pi = 3.1415926 然后 pi
3.1415926,得到浮点值 3.1415926。pi 绑定(bind)到这个值上。pi 是一个表达式。求值一个名字的规则是:去当前环境里查它绑定的值。查到 3.1415926,解释器把它显示出来。pi = 3.1415926 之后
Global frame
    pi  ──→ 3.1415926
这个「名字 → 值」的对应关系,就是绑定(binding);装着一堆绑定的那个东西叫帧(frame);程序启动时就存在的那个帧叫全局帧(global frame)。这三个词从现在起会一直用到期末。
= 不读作「等于」
x = 5 读作「把名字 x 绑定到值 5」,不要读成「x 等于 5」。差别在哪?看这一行:
>>> x = 5
>>> x = x + 1
>>> x
6
如果 = 是数学上的等号,x = x + 1 就是「x 等于 x 加 1」——这在数学里是个假命题,无解。但作为赋值语句它完全合理:先求值右边 x + 1(查到 x 是 5,算出 6),再把名字 x 重新绑定到 6。右边先算完,左边才动。 这个顺序是理解一切赋值的钥匙。
名字也常被叫做变量(variable)。课程特意提醒:叫「变量」不够准确,因为名字不只能绑定到数值,还能绑定到函数、类等等——第 4 节你就会看到一个名字绑定到一个函数。
多重赋值
>>> x, y = 1, 3
>>> x
1
>>> y
3
一行绑定两个名字。这里的执行顺序有个细节值得记住:Python 先把右边所有表达式全部求值完,然后才做绑定。这让下面这个写法成立:
>>> x, y = 1, 3
>>> x, y = y, x      # 交换两个名字的绑定
>>> x
3
>>> y
1
如果 Python 是「先绑定 x,再绑定 y」,那第二行执行到一半时 x 已经变成 3,接着 y = x 就会让 y 也是 3,交换失败。正因为右边的 y, x 在任何绑定发生之前就已经被求值成了 (3, 1),交换才是对的。 这又一次印证了那条规则:右边先算完,左边才动。
f-string:把值嵌进字符串
>>> name = 'Rebecca'
>>> f'Hello {name}!'
'Hello Rebecca!'
在字符串的引号前面加一个 f,字符串里 {} 包住的部分就会被当成表达式求值,结果替换进去。这比 'Hello ' + name + '!' 好读,而且不用担心类型转换——大括号里放数字也没问题:
>>> radius = 5
>>> f'半径 {radius} 的圆,面积约 {3.14 * radius ** 2}'
'半径 5 的圆,面积约 78.5'
注意大括号里可以是任意表达式,不只是名字——3.14 * radius ** 2 在这里被完整求值了。忘了写 f 是最常见的错误,结果是大括号原样出现在输出里:'Hello {name}!'。
import:把别人写好的名字拿过来
>>> from operator import mul
>>> mul(10, 5)
50
from 模块 import 名字 的作用,说白了就是一次赋值:它在当前环境里新建一个绑定,把名字 mul 绑定到 operator 模块里的那个乘法函数。执行完之后,全局帧里就多了一条:
from operator import mul 之后
Global frame
    mul  ──→ func mul(a, b)      # 来自 operator 模块的内建函数
这一点很重要:函数也是值,可以被名字绑定,跟 3.1415926 被 pi 绑定没有本质区别。第 3 讲的高阶函数整讲都建立在这个观察上。
另一个常用的模块是 math:
>>> from math import pi, sqrt
>>> pi
3.141592653589793
>>> sqrt(16)
4.0
>>> print(hello)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
NameError: name 'hello' is not defined. Did you mean: 'help'?
NameError 的意思永远是同一件事:你用了一个当前环境里查不到的名字。 三个最常见的原因:
- 拼错了(
lenght写成了length); - 忘了引号——你想要字符串
'hello',却写成了名字hello; - 忘了
import——直接用sqrt(16)而没有先from math import sqrt。
Python 3.10 之后还会附赠一句 Did you mean: ...?,是它在已知名字里找到的最像的那个。这个提示经常正中要害,别忽略它。
4. 函数:把一组操作打包起来,起个名字
假设你要算三个圆的面积,半径分别是 5、7、10。用目前学的东西,你会写:
>>> from math import pi
>>> pi * (5 ** 2)
78.53981633974483
>>> pi * (7 ** 2)
153.93804002589985
>>> pi * (10 ** 2)
314.1592653589793
能用,但有三个问题:① 同一个公式抄了三遍;② 想改公式(比如改成算周长)得改三处;③ 代码里看不出「这是在算圆面积」这个意图——读代码的人得自己从 pi * (r ** 2) 里反推。
如果要算一百个圆呢?如果半径要等到程序运行时才知道呢?
解决办法是抽象(abstraction):把这组操作打包,起一个名字,之后按名字使用,不再关心里面怎么算的。这就是函数(function)——也是这门课名字里那个「构造(Structure)」的第一层含义。
>>> from math import pi
>>> def circle_area(radius):
...     return pi * (radius ** 2)
...
>>> circle_area(5)
78.53981633974483
函数就是给一段计算起名字,跟赋值语句给一个值起名字是同一件事的两个版本。区别在于:赋值绑定的是一个确定的值,而 def 绑定的是一套等着填空的计算——空位就是参数。填上 5 得到一个结果,填上 7 得到另一个结果,但那套计算只写了一遍。
把 def 语句拆开
逐个部件对号入座(这些术语后面会反复用到,请务必记准):
def circle_area(radius):
    return pi * (radius ** 2)
| 部件 | 术语 | 说明 |
|---|---|---|
def | 关键字 | 告诉 Python:接下来是一个函数定义 |
circle_area | 函数名 | 定义完之后,这个名字就被绑定到了新造出来的函数上 |
radius | 形参(parameter) | 「等着填的空」。调用时才知道它是几。可以有 0 个或多个,用逗号分隔 |
(...) 和 : | 语法 | 括号包住形参列表;冒号必须有,它宣告下面跟着一个缩进块 |
| 缩进的那一行 | 函数体(body) | 只有在调用时才会执行;定义时 Python 一行都不跑 |
return | 返回语句 | 把算出来的值交出去,同时函数立即结束 |
再看使用的一侧:
circle_area(5)这叫调用表达式(call expression):函数名 + 一对括号 + 括号里用逗号分隔的输入。这里的 5 叫实参(argument)——它是你实际传进去的那个值。
- 形参(parameter)写在
def那一行,是函数内部用的名字。它是个占位符,定义时没有值。 - 实参(argument)写在调用处的括号里,是具体的值。
一次调用做的事,就是把实参绑定到形参上。circle_area(5) 让函数体里的 radius 在这次调用期间就是 5。下一次调用 circle_area(7) 时,它又是 7——两次调用互不干扰,因为它们各有各的帧(第 6 节详述)。
函数可以有 0 个或多个输入,也可以返回 1 个或多个输出值(返回多个值时用逗号分隔;严格说那是一个元组 tuple,后面的讲次会讲)。
在解释器里敲完 def 之后什么都没发生,是正常的:
>>> def circle_area(radius):
...     return pi * (radius ** 2)
...
>>> circle_area
<function circle_area at 0x104a1d3a0>
def 语句只做两件事:造出一个函数对象,把名字绑定到它。函数体一行都没执行。所以函数体里就算写了一句必崩的代码,只要你不调用它,就永远不会崩。
另外注意 circle_area(不带括号)和 circle_area(5)(带括号)是两个不同的表达式:前者求值成那个函数对象本身,后者才是「调用它」。写错了不会报错,只会得到一个函数对象,然后在下一步用它的时候报出莫名其妙的 TypeError。
内建函数
Python 自带一批内建函数(builtins),不用 import 就能直接用:
>>> max(1, 2, 3)
3
>>> min(1, 2, 3)
1
>>> len('hello')
5
>>> print('hello world')
hello world
max / min 取最大最小,len 取长度,print 往屏幕上打字(第 8 节会仔细讲它跟 return 的区别)。
sum(1, 2, 3) 其实跑不通
课件里把 sum 和上面几个并列,写成 sum(1, 2, 3) 得到 6。这在真实的 Python 里会报错:
>>> sum(1, 2, 3)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: sum() takes at most 2 arguments (3 given)
>>> sum([1, 2, 3])
6
sum 和 max / min 的签名不一样:max 可以接任意多个单独的参数,而 sum 要的是一个可迭代对象(比如列表),第二个参数是可选的初始值。所以正确写法是 sum([1, 2, 3])。
这里特意点出来,不是为了挑课件的错,而是因为它示范了一件更重要的事:任何代码——课件的、教材的、AI 生成的、还有本笔记的——都可能是错的。判断对错的唯一可靠方式是把它敲进解释器跑一遍。 这也正是课程 AI 政策想说的:不懂基础,你就没有能力判断别人给你的东西对不对。
5. 调用表达式的求值规则
现在回到本讲的母题。circle_area(5) 这个表达式被求值时,Python 到底做了什么?答案是三步,顺序固定,永不改变:
关键在第 ② 步:某个算子数本身可能又是一个调用表达式。这时你需要对它递归地做一遍 ①②③,把它彻底算成一个值,才能继续。
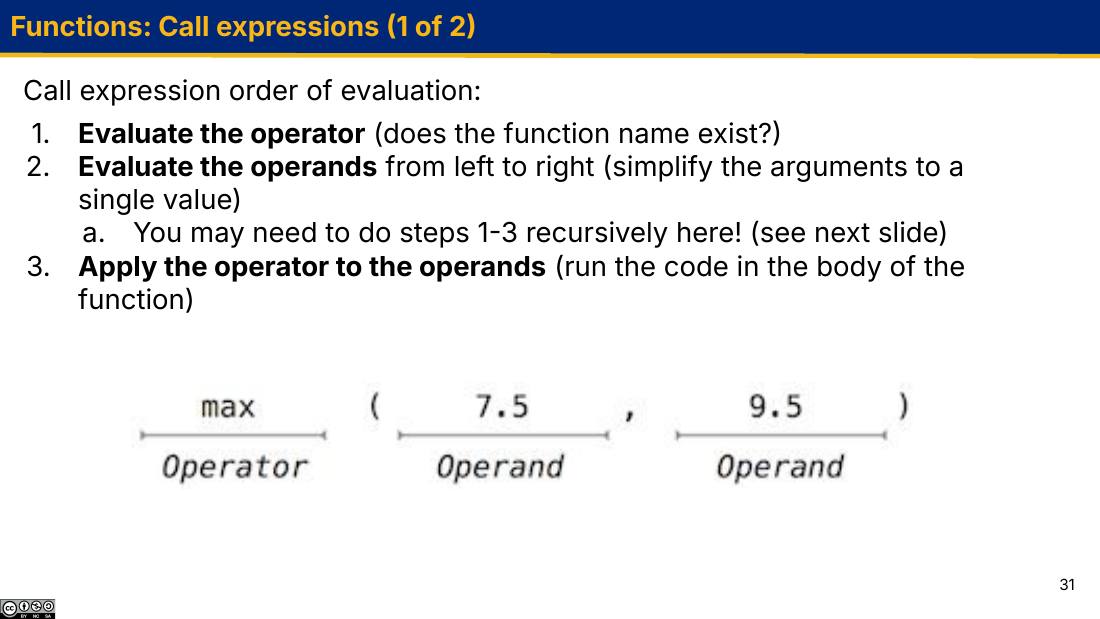
max(7.5, 9.5) 里,max 是算子(operator),7.5 和 9.5 是两个算子数(operand)。注意第 2 步下面那句「可能需要在这里递归地做步骤 1–3」——嵌套调用就是这么处理的。初学时容易觉得第 ① 步是废话:函数名不就写在那儿吗,还要「求值」什么?
但算子只是一个表达式,它不一定是简单的名字。circle_area 要先在环境里查到那个函数对象,才知道该执行哪段代码——如果这个名字根本没绑定过,第 ① 步当场就 NameError,后面的实参连算都不会算。
更进一步:算子可以是任意求值成函数的表达式。等你学到高阶函数,会见到 make_adder(3)(4) 这种写法——它的算子是 make_adder(3),本身就是一个调用表达式,必须先被求值成一个函数,才能继续。把第 ① 步当成「查函数」是入门理解,当成「求值一个表达式」才是准确理解。
把规则用在一个嵌套的例子上
下面这个表达式是本讲最值得手工推演的一行代码:
>>> from operator import add, mul
>>> mul(add(2, mul(4, 6)), add(3, 5))
208
不要试图心算。按规则一步步来:
mul(add(2, mul(4, 6)), add(3, 5))
mul:在全局帧里查到那个乘法函数。add(2, mul(4, 6))——它本身是个调用表达式,递归展开。add:查到加法函数。2:它已经是值,得 2。mul(4, 6):又是调用表达式,再递归一层。算子 mul,算子数 4 和 6,施加得 24。add 的两个算子数都是值了:2 和 24。施加得 26。第一个算子数求值完毕。add(3, 5):算子 add,算子数 3、5,施加得 8。26 和 8。把 mul 施加到它们上,得 26 * 8 = 208。把这个过程画出来,就是一棵表达式树(expression tree)——每个调用是一个节点,它的算子和算子数是它的子节点,每个节点上方的方框写着这棵子树求值出来的值:
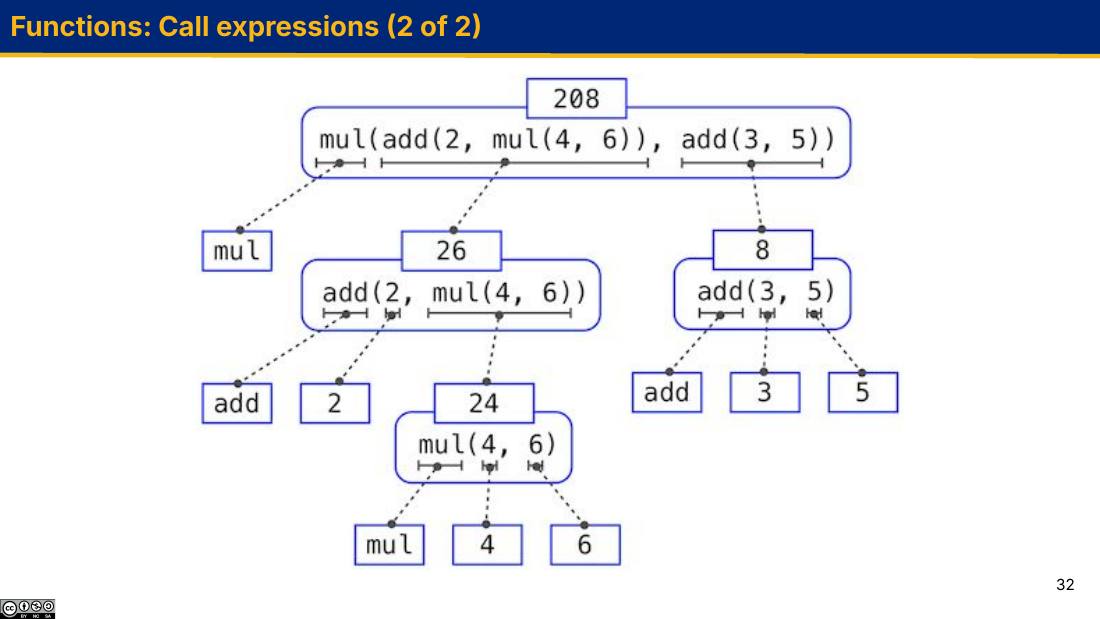
mul(4, 6) 是 24,回填给 add(2, 24) 得 26;另一边 add(3, 5) 得 8;最后根节点 mul(26, 8) 得 208。每个节点下方那三条短横线标出了它的算子和算子数各占哪一段。它把「求值」这个抽象动作变成了一个你可以用笔在纸上完成的机械过程:画树 → 从叶子往根,逐个节点填值 → 根节点的值就是答案。
而且这个过程没有例外。(2 + 2) * 5 也是同一棵树(+ 和 * 只是 add 和 mul 的另一种写法),你自己写的 circle_area(5) 也是。整门课后面讲的解释器(interpreter),做的就是自动化地走这棵树。
求值顺序真的会被观察到吗
「从左到右」听起来像是无关紧要的细节:mul(a, b) 里先算 a 还是先算 b,结果不都一样吗?
对于纯计算确实一样。但只要算子数里有副作用(比如打印),顺序立刻就看得见了:
>>> def loud(x):
...     print('DEBUG: 正在求值', x)
...     return x
...
>>> from operator import add
>>> add(loud(1), loud(2))
DEBUG: 正在求值 1
DEBUG: 正在求值 2
3
两行 DEBUG 的先后顺序,就是「从左到右求值算子数」这条规则的直接证据。这个技巧(用 print 观察求值顺序)在后面学短路求值、高阶函数时会非常有用。
>>> def circle_area(radius):
...     return pi * (radius ** 2)
...
>>> circle_area(5, 3)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: circle_area() takes 1 positional argument but 2 were given
这个报错发生在第 ③ 步之前:算子和算子数都求好了,但 Python 发现「一个空位却给了两个值」,没法绑定。takes N positional arguments but M were given 这句话直接告诉你差了几个,看到它就去数一下 def 那行的形参和调用处的实参。少给也一样会报,只是措辞变成 missing 1 required positional argument: 'radius'。
6. 环境图:「施加」那一步里到底发生了什么
上一节的第 ③ 步——「把算子施加到算子数上」——被一句「运行函数体里的代码」带过了。但这一步内部还有结构,而且这个结构是 61A 后半程(高阶函数、递归、闭包、面向对象)的全部地基。所以这里把它拆开。
拆开的工具叫环境图(environment diagram):一张记录「此刻有哪些帧、每个帧里有哪些绑定」的图。它不是 Python 的语法,是我们手工模拟 Python 的记号。你要能拿一张纸把它画出来——考试会考,调试时更靠它。
return 就把值交出去,帧的使命结束。反过来也要记牢:在 61A 的环境图里,新建一帧只有一个原因——调用一个用户定义的函数。 if 不建帧、while 不建帧、赋值不建帧。
把 circle_area(5) 完整走一遍
from math import pi

def circle_area(radius):
    return pi * (radius ** 2)

area = circle_area(5)
from math import pi:在全局帧里把名字 pi 绑定到 3.141592653589793。def circle_area(radius): ...:造出一个函数对象,在全局帧里把名字 circle_area 绑定到它。函数体一行都没跑。area = circle_area(5)。按「右边先算完」的规则,先求值右边的调用表达式。circle_area:在全局帧里查到那个函数对象。5:已经是值。circle_area 是在全局帧里定义的),在 f1 里把形参 radius 绑定到 5。return pi * (radius ** 2)。先求值 pi * (radius ** 2):查 radius —— f1 里有,是 5;查 pi —— f1 里没有,顺着 parent 链去 Global 里找,查到 3.141592653589793。算出 5 ** 2 = 25,再乘得 78.53981633974483。return 把这个值交出去,f1 的使命完成。整个调用表达式求值成 78.53981633974483。area 绑定到 78.53981633974483。| pi | 3.141592653589793 |
| circle_area | func circle_area(radius) |
| area | 78.53981633974483 |
| radius | 5 |
| 返回值 | 78.53981633974483 |
第 7 步是整张图里最值得盯着看的地方,它回答了本课的第二个母题:名字是怎么被找到的?
求值一个名字时,先在当前帧里找;找不到,就去它的 parent 帧找;再找不到,去 parent 的 parent……一路找到全局帧。全局帧里也没有,就报 NameError。
这条链叫环境(environment)。所以「环境」不是一个帧,而是一串帧。pi 就是这么被找到的:它不在 f1 里,但在 Global 里。
为什么形参必须待在自己的帧里
把 radius 关在 f1 里,好处在连续调用时才看得清楚:
>>> circle_area(5)
78.53981633974483
>>> circle_area(7)
153.93804002589985
>>> radius
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
NameError: name 'radius' is not defined
两次调用各建各的帧(f1 和 f2),radius 在 f1 里是 5、在 f2 里是 7,互不干扰。而在全局帧里查 radius 会 NameError——因为它从来就不在全局帧里,它只活在函数调用的那个帧里。
帧是函数的草稿纸:调用时发一张新的,算完交出答案,草稿纸作废。下一次调用发一张全新的空白纸。正因为每次调用都有独立的草稿纸,同一个函数才能被反复调用、被嵌套调用、甚至被自己调用(这就是递归)而不互相污染。
查找规则则是:草稿纸上没写的东西,去桌面(parent 帧)上找。
函数调用函数
函数体里当然可以调用别的函数,这时会有多个帧同时存在:
def square(x):
    return x * x

def sum_of_squares(a, b):
    return square(a) + square(b)

sum_of_squares(3, 4)
sum_of_squares(3, 4)
sum_of_squares(3, 4):算子查到函数,算子数是 3 和 4。新建 f1,parent=Global,绑定 a 到 3、b 到 4。return square(a) + square(b)。要 return 一个值,得先把 square(a) + square(b) 求值出来。从左到右:先算 square(a)。square(a):算子 square(f1 里没有 → 去 Global 找到了);算子数 a(f1 里有,是 3)。新建 f2,parent=Global,绑定 x 到 3。return x * x → 3 * 3 → 9。f2 交出 9,结束。square(b):新建 f3,parent=Global,绑定 x 到 4。执行得 16,f3 交出 16。9 + 16 = 25。f1 执行 return 25,整个表达式求值成 25。| square | func square(x) |
| sum_of_squares | func sum_of_squares(a, b) |
| a | 3 |
| b | 4 |
| 返回值 | 25 |
| x | 3 |
| 返回值 | 9 |
| x | 4 |
| 返回值 | 16 |
虽然 square 是从 f1 里被调用的,但 f2 的 parent 是 Global。规则是:新帧的 parent,是被调用的那个函数被定义时所在的帧,而不是「谁调用了它」。square 是在全局层面用 def 定义的,所以它造出的帧的 parent 永远是 Global。
这个区别(定义处 vs. 调用处)现在看起来无关紧要,因为两者恰好一样。但等到第 3 讲讲嵌套定义的函数时,它就是全部的关键了。现在先把规则记成「看定义在哪」,别记成「看谁调用」。
还要注意 f2 和 f3 里的两个 x:它们同名,但分属两个不同的帧,是两个毫不相干的绑定,一个是 3 一个是 4。名字冲突在这套机制下根本不会发生。
7. 函数的完整写法:文档、默认值、类型提示
circle_area 已经能用了,但它还缺一样东西:别人(包括三周后的你)怎么知道该怎么用它? 参数是什么意思?半径能不能不传?返回的是什么?
下面是这个函数的「完整版」,本讲要求认识它的每一个部件:
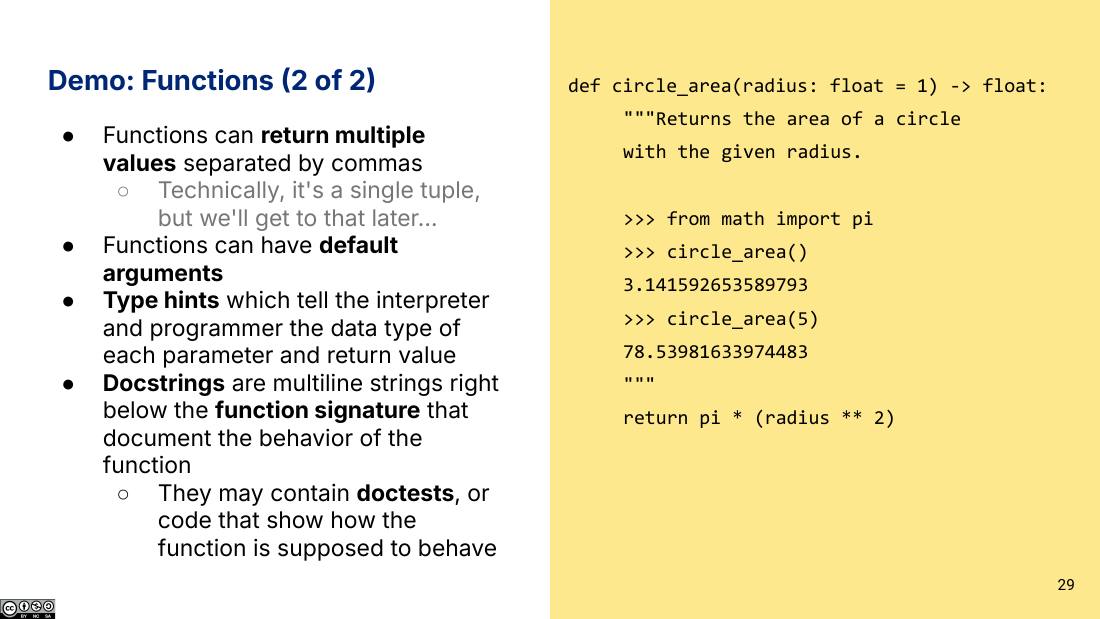
radius: float = 1 同时给出了类型提示和默认值,-> float 标注返回类型,紧跟在签名下面的三重引号字符串是 docstring,里面那两行以 >>> 开头的就是 doctest。def circle_area(radius: float = 1) -> float:
"""Returns the area of a circle
with the given radius.
>>> from math import pi
>>> circle_area()
3.141592653589793
>>> circle_area(5)
78.53981633974483
"""
return pi * (radius ** 2)
第一行 def circle_area(radius: float = 1) -> float: 叫函数签名(function signature)。它承载了三种信息:
默认参数
radius = 1 给形参一个默认值:调用时不传这个实参,它就用 1。
>>> circle_area()
3.141592653589793
>>> circle_area(5)
78.53981633974483
circle_area() 括号里空着也是一个合法的调用表达式(0 个算子数),此时 radius 绑定到默认值 1,算出 π×1² = π。这也解释了为什么第一个输出恰好是 π 本身。
类型提示
radius: float 和 -> float 是类型提示(type hints):分别说明「这个参数应该是浮点数」和「返回值是浮点数」。
Python 是动态类型语言。类型提示是写给人和工具(编辑器、静态检查器)看的注释,Python 运行时不检查也不报错:
>>> circle_area('hello')
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "<stdin>", line 2, in circle_area
TypeError: unsupported operand type(s) for ** or pow(): 'str' and 'int'
注意报错的位置:不是「你违反了类型提示」,而是函数体里真正执行 radius ** 2 时才崩的。类型提示一个字都没起作用。
Docstring 与 doctest
紧跟在签名下面的那个三重引号字符串叫 docstring(文档字符串),用来说明这个函数做什么。它必须紧贴签名下一行,位置错了就只是一个被丢弃的普通字符串。
docstring 里可以放 doctest:以 >>> 开头的行是「假设在解释器里敲这一句」,下一行是「应该看到的输出」。它一身兼三职:
| 身份 | 作用 |
|---|---|
| 例子 | 比任何文字描述都直观地告诉读者这个函数怎么用 |
| 规格说明 | 它是可执行的需求——尤其能钉死边界情况该返回什么 |
| 测试 | Python 能自动跑它,比对实际输出和写下的期望输出 |
doctest 真的能跑。假设上面的函数存在 demo.py 里(别忘了文件开头要有 from math import pi):
$ python3 -m doctest -v demo.py
这条命令会执行 docstring 里的每一行 >>>,把实际输出和你写的期望输出逐字比对,不一致就报告。
61A 的每道题都以 docstring + doctest 的形式给出。拿到题先看 doctest,因为它比文字描述精确得多——尤其是边界情况:n 为 0 时返回什么?空输入怎么办?文字描述里往往含糊,doctest 里写得死死的。
题目做完之后,用课程的 ok 自动评分器跑一遍:python3 ok -q 函数名。它跑的正是这些 doctest。
doctest 逐字比对的是解释器显示出来的文本,不是「你心里那个值」。字符串返回值必须带引号:
def greet(name):
    """
    >>> greet('Ann')
    'Hello, Ann'
    """
    return 'Hello, ' + name
期望输出写成 Hello, Ann(不带引号)会判为失败,因为解释器显示的是 'Hello, Ann'。反过来,如果函数是用 print 输出的,那期望行就不能带引号——因为 print 打出来的就是不带引号的。这个坑跟下一节 return 和 print 的区别是同一件事的两面。
8. return 与 print:本讲最容易出事的地方
如果本讲只能记住一件事,就记这一件。这个混淆会跟着人跑很久,而且它不会报错——代码看起来完全正常,直到某个地方莫名其妙地崩掉。
- 想显示什么东西 → 用
print - 想真的算出什么东西 → 用
return
课程给的比喻很到位:print 是我有 5 块钱,拿给你看一眼;return 是我把这 5 块钱交到你手上让你去用。 看一眼不能拿去买东西。
「拿去用」具体指什么?指把返回值当成另一个表达式的一部分:赋值给名字、参与运算、当成另一个函数的实参。这些事情 print 的输出统统做不到,因为它只是屏幕上的一些字符,程序里根本没有那个值。
对照实验
>>> def square_return(x):
...     return x * x
...
>>> def square_print(x):
...     print(x * x)
...
在解释器里单独调用,两者看起来一模一样:
>>> square_return(4)
16
>>> square_print(4)
16
但这两个 16 的来历完全不同:
square_return(4):新建帧,x 绑定到 4,执行 return 16。整个调用表达式求值成 16。None 的值时,它就把这个值显示出来。于是屏幕上出现 16。这个 16 是解释器显示的。square_print(4):新建帧,x 绑定到 4,执行 print(16)。print 当场把 16 打到屏幕上。这个 16 是 print 打的。return 语句,于是函数返回 None。None,按规矩不显示。所以屏幕上只有第 3 步那个 16。差别一旦「拿去用」就暴露了:
>>> square_return(4) + 1
17
>>> square_print(4) + 1
16
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: unsupported operand type(s) for +: 'NoneType' and 'int'
请仔细看第二个:屏幕上先出现了 16,然后才崩。这正是这个 bug 如此难抓的原因——你明明看见了 16,怎么会说是 None?因为那个 16 是 print 打出来的字符,而 square_print(4) 这个表达式的值是 None,None + 1 当然崩。
None:什么都没有的那个值
本讲课件专门用一页讲它:
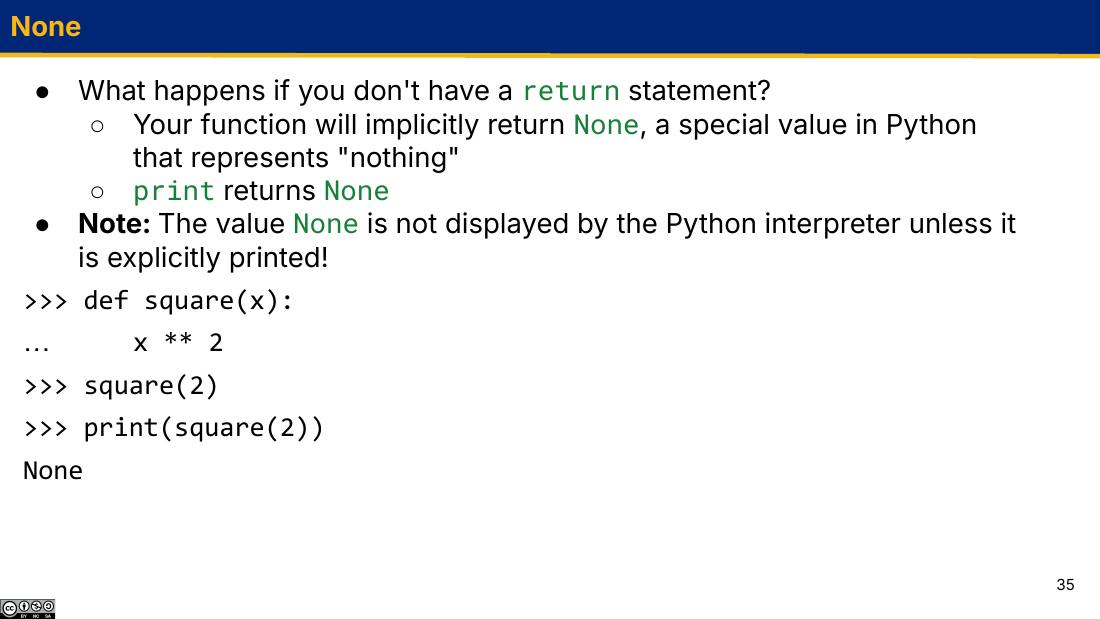
return 语句的函数会隐式返回 None。下方的例子里 square 算了 x ** 2 却没有 return,所以 square(2) 在解释器里什么都不显示——只有显式 print 出来才看得到那个 None。>>> def square(x):
... x ** 2
...
>>> square(2)
>>> print(square(2))
None
这段代码里藏着三个必须分开理解的事实:
x ** 2 确实被求值了,算出了 4。但没人接住这个值——既没绑定给名字,也没 return——所以它当场被丢弃。算了等于没算。return,于是隐式返回 None。None 是 Python 里表示「什么都没有」的特殊值。square(2) 求值成 None,解释器不显示 None,所以那一行看起来什么都没发生。只有 print(square(2)) 才把它逼出来。如果解释器老老实实把 None 显示出来,初学者第一次犯这个错就会发现。但它不显示,于是屏幕上一片安静,你以为「没报错就是对了」。
诊断口诀:函数调用完屏幕上一片空白 → 十有八九是忘了 return。 想确认就用 print(f(...)) 包一层看看是不是 None。
print 自己也返回 None——它的工作就是产生「显示」这个副作用,没有值可以交出来:
>>> print(print('hello'))
hello
None
按求值规则走一遍:先求值内层算子数 print('hello'),它打出 hello(第一行),返回 None;然后外层 print(None) 把这个 None 打出来(第二行)。这里的 None 是被显式 print 的,所以看得见。
完整对照表
return | print | |
|---|---|---|
| 它是什么 | 一条语句(关键字) | 一个内建函数,要写括号 |
| 做什么 | 把值交给调用者,并立即结束函数 | 把内容显示到屏幕,函数继续执行 |
| 结果能否再用 | 能:赋值、参与运算、当实参 | 不能,屏幕上的字符不是程序里的值 |
| 能执行几次 | 一个函数里最多执行一次(执行到就结束了) | 想打几次打几次 |
| 没写会怎样 | 函数返回 None | 什么都不显示,但计算照常进行 |
| 它自己的返回值 | — | None |
| 字符串怎么显示 | 解释器显示 'hi'(带引号) | 显示 hi(不带引号) |
最后一行值得单独试一次,它是 doctest 里最常见的失分点:
>>> 'hello'
'hello'
>>> print('hello')
hello
return 之后的代码永远不会执行
def bad(x):
    return x * 2
    print('DEBUG: 算完了')     # 这一行永远不会执行
return 一执行,函数立刻结束,后面的语句全部作废。所以调试用的 print 必须放在 return 之前。同理,一个函数里写了两条 return,也只有先被执行到的那条生效。
纯函数与非纯函数
这个区分建立在上面的基础上:
| 纯函数(pure) | 非纯函数(non-pure) | |
|---|---|---|
| 定义 | 只返回一个值,除此之外什么也不做 | 产生副作用(side effect):打印、修改某个数据结构等 |
| 关键性质 | 同样的输入永远得到同样的输出 | 不保证;行为可能依赖或改变外部状态 |
| 例子 | square_return、abs、max、circle_area | print、square_print、后面学的 list.append |
| 好处 | 容易测试、容易推理、能安全地嵌套组合 | 能跟外界交互——程序总得有输出 |
为什么在意这个区分?因为纯函数是可以放心嵌套的。square(square(2)) 完全没问题,因为内层调用只是求出一个值。而嵌套非纯函数就会出现 print(print('hello')) 那种奇观——两个 None 在中间传来传去。
更实际的理由:纯函数好测试。给定输入必得同样输出,一行 doctest 就能钉死它的行为。而一个只 print 不 return 的函数,doctest 写起来就别扭得多。61A 的作业绝大多数要求你写纯函数——题目让你 return 时,就不要用 print 糊弄过去。
9. 异常 I:三类错误与栈追踪
程序出问题时,会发生一个异常(exception),也叫错误(error)。术语上说异常被抛出(raised / thrown)。
本讲把错误分成三类,按调试难度递增排序。这个排序本身就是这一节最有价值的信息:
| 语法错误 Syntax | 运行时错误 Runtime | 逻辑错误 Logical | |
|---|---|---|---|
| 是什么 | 「非法」的 Python 代码 | 代码合法,但运行时做了会崩的事 | 代码合法、也不崩,但产出的结果不是你要的 |
| 什么时候发现 | 运行之前,代码一行都跑不了 | 运行中,执行到那一行才崩 | 可能永远不被发现 |
| Python 给的帮助 | 指出位置和大致原因 | 完整的栈追踪 + 错误类型 + 说明 | 什么都没有 |
| 调试难度 | 低 | 中 | 高 |
| 靠什么发现 | Python 直接告诉你 | Python 直接告诉你 | 测试(doctest / ok)、自己动手推演 |
语法错误
>>> def square(x:
...     return x * x
...
  File "<python-input-21>", line 1
    def square(x:
              ^
SyntaxError: '(' was never closed
括号没闭合,Python 连「这段代码是什么意思」都解析不出来,所以整个文件一行都不会执行。这也是它最好调的原因:错误信息里有行号,有一个 ^ 指着出问题的字符,而且不用管程序逻辑对不对。
常见的语法错误还有:def 或 if 后面忘了冒号、缩进对不齐(IndentationError)、引号没配对、在条件里把 == 写成 =。
Python 报的行号有时会指到出错行的下一行——因为它是读到那里才发现「前面那句没写完」。所以报第 10 行有问题,也要看看第 9 行是不是少了个括号或冒号。上面那个例子里 ^ 指着的正是那个没被闭合的左括号,而不是 return 那一行。
运行时错误
>>> def divide(a, b):
...     return a / b
...
>>> divide(5, 0)
Traceback (most recent call last):
  File "<python-input-23>", line 1, in <module>
    divide(5, 0)
    ~~~~~~^^^^^^
  File "<python-input-22>", line 2, in divide
    return a / b
           ~~^~~
ZeroDivisionError: division by zero
def divide(a, b): return a / b 这段代码本身完全合法——a / b 是个正经的表达式。问题出在运行时传进来的 b 恰好是 0,除零没有意义,于是 Python 抛出 ZeroDivisionError。
换句话说:同一段代码,divide(5, 2) 好好的,divide(5, 0) 就崩。 错不在代码的形状,在运行时的值。这就是运行时错误比语法错误难调的原因——你得知道出事时那些变量各是什么。
你会大量遇到的运行时错误:
| 错误类型 | 意思 | 典型原因 |
|---|---|---|
NameError | 名字没绑定 | 拼错、忘了 import、忘了给字符串加引号 |
TypeError | 类型用错了 | 'a' + 5;实参个数不对;把 None 拿去运算 |
ZeroDivisionError | 除以 0 | a / b 或 a % b 时 b 是 0 |
ValueError | 类型对但值不合法 | sqrt(-8)、int('hello') |
AssertionError | assert 的条件为假 | 见第 10 节 |
IndexError | 下标越界 | 后面学序列时会遇到 |
逻辑错误:最危险的一类
>>> def square(x):
...     return x * 2
...
>>> square(3)
6
没有任何报错。x * 2 是完全合法的 Python,运行时也不会崩。但函数叫 square,它应该返回 9,不是 6——* 应该是 **。
Python 帮不了你,因为它不知道你想要什么。它只是忠实地执行了你写的东西。这类错误只能靠两样东西发现:
- 测试——doctest 里写死
square(3)应得9,跑一遍就抓到了。这正是为什么第 7 节说「先读 doctest」。 - 自己动手推演——拿一个具体输入,按求值规则一步步走,看每一步的中间值是不是你预期的。
这是初学者最需要扭转的一个直觉。程序跑完没红字,只说明它没做非法的事,完全不说明它做对了事。
更糟的是:square(2) 在这个错误实现下返回 4,和正确答案一模一样(因为 2×2 = 2²)。用 2 测试永远发现不了这个 bug。所以测试用例要挑那些「错了就一定不同」的输入——比如 3。
读栈追踪
运行时错误会给你一份栈追踪(stack trace / traceback)。它信息量很大,但必须从下往上读:
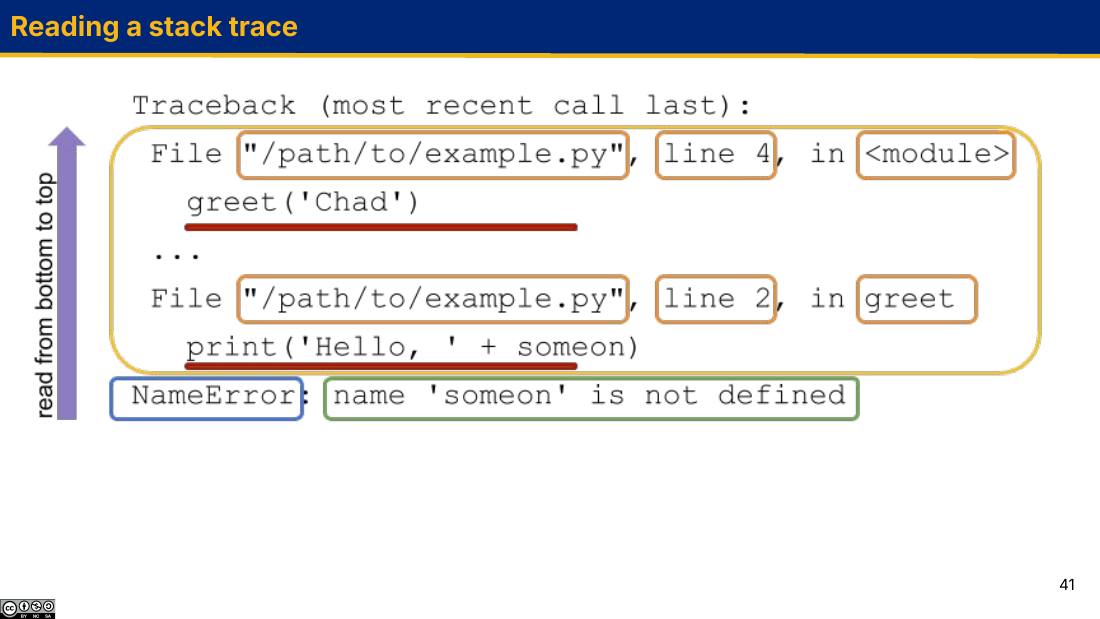
NameError,蓝框)和错误说明(绿框);上面每一块记录一次函数调用,包含文件名、行号、所在函数名,以及那一行的源代码。离底部最近的那一块,才是真正出事的地方。拿前面 divide(5, 0) 那份追踪逐块拆:
ZeroDivisionError: division by zero。冒号前是错误类型,冒号后是人话说明。这一行告诉你「出了什么事」。File "...", line 2, in divide,下面跟着 return a / b。这是真正崩掉的那一行代码。~~^~~ 这些符号指着表达式里具体是哪个运算出的问题。File "...", line 1, in <module>,下面是 divide(5, 0)。这是谁调用了它。<module> 表示「在文件的顶层,不在任何函数里」。divide(5, 0) → 进入 divide 的第 2 行 → 执行 a / b 时因为 b 是 0 而崩。这一串就是出事那一刻的调用链,也就是当时还活着的那些帧。栈追踪里的每一块,对应第 6 节环境图里的一个还没结束的帧。最下面那块是最新建的帧(出事的地方),往上依次是它的调用者。所以读栈追踪,读的就是「出事那一刻,程序调用到了多深、路径是什么」。
第一行那句 Traceback (most recent call last) 也是这个意思:最近的调用排在最后。所以最后一块才是最内层、最相关的。
看到 ZeroDivisionError 就冲去 divide 里加一个 if b == 0,往往是治标不治本。真正该问的是:那个 0 是从哪来的? 往上一块就写着调用它的是谁、传了什么。很多时候错误的根源在上面几块里,而不是在崩掉的那一行。
栈追踪很长的时候,一个实用策略是:从下往上找到第一块属于「你自己写的文件」的。如果崩在库文件里,通常不是库有 bug,而是你传了它不接受的东西。
10. 调试:print 调试与 assert
print 调试
抓逻辑错误的基本功:在程序的关键位置把感兴趣的变量打印出来,看它们在哪一步偏离了你的预期。方法土,但极其有效——尤其是当你还没学过调试器的时候。
'DEBUG:' 前缀
在 61A 的作业里做 print 调试,要给输出加上 DEBUG: 前缀:print('DEBUG: x is', x)。因为 ok 自动评分器会比对程序输出,多打的东西可能让你直接判错;带这个前缀的行会被它忽略。提交之前把这些行删掉是更保险的做法。
看课件里的例子——求一元二次方程的正根:
>>> from math import sqrt
>>> def quadratic_formula_positive(a, b, c):
...     discriminant = b * 2 - 4 * a * c
...     print("DEBUG: discriminant is", discriminant)
...     temp = (-b + sqrt(discriminant)) / (2 * a)
...     print("DEBUG: temp is", temp)
...     return temp
...
>>> quadratic_formula_positive(1, 3, 2)
DEBUG: discriminant is -2
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "<stdin>", line 5, in quadratic_formula_positive
    temp = (-b + sqrt(discriminant)) / (2 * a)
ValueError: math domain error
两条 DEBUG 只打出了第一条,第二条没来得及打就崩了。这本身就是有用的信息:问题出在第一条和第二条之间那一行。而第一条打出来的值 -2 直接指向真正的 bug:
-2。算出来的值和手算对不上,说明这一行写错了。b * 2 - 4 * a * c。b * 2 是「b 乘 2」,不是「b 的平方」——应该写 b ** 2。这是个逻辑错误,Python 一个字都不会提醒。-2 传给 sqrt,负数开方在实数域没有意义,于是 ValueError: math domain error。崩掉的位置(sqrt)和真正的错误位置(上一行)不是同一处——这正是第 9 节说「别只看最后一行」的原因。b ** 2 后,quadratic_formula_positive(1, 3, 2) 返回 -1.0,正是 \(x^2+3x+2=0\) 的两个根 −1 和 −2 中较大的那个。课件用的输入是 (1, 2, 3)。用它测试,b * 2 算出 2 * 2 = 4,而正确的 b ** 2 也是 4——两者恰好相等,这个 bug 完全暴露不出来(它照样崩,但崩的原因是 4 − 12 = −8 本来就是负判别式,方程真的没有实根)。
换成 (1, 3, 2),b * 2 = 6 而 b ** 2 = 9,差异立刻显现。教训:b = 2 是个糟糕的测试值,因为 2×2 和 2² 相等;x = 0 和 x = 1 同样经常掩盖 bug。挑测试输入时,要挑那些「写错了就一定给出不同结果」的值。
assert:与其调 bug,不如不让 bug 发生
调试是事后的。有没有事前的办法?有,叫防御式编程(defensive programming):把自己对程序的假设明确写进代码里,一旦假设被违反就立刻报错。
assert 语句就是干这个的。语法是 assert 条件, '出错时的消息'(消息可选)。条件为真时什么也不发生;条件为假时抛出 AssertionError。
>>> def divide(a, b):
...     assert b != 0, 'divisor cannot be 0'
...     return a / b
...
>>> divide(5, 0)
Traceback (most recent call last):
  File "<python-input-1>", line 1, in <module>
    divide(5, 0)
    ~~~~~~^^^^^^
  File "<python-input-0>", line 2, in divide
    assert b != 0, 'divisor cannot be 0'
           ^^^^^^
AssertionError: divisor cannot be 0
对比第 9 节没加 assert 的版本,它报的是 ZeroDivisionError: division by zero。两者都崩了,区别在哪?
| 不加 assert | 加 assert | |
|---|---|---|
| 崩在哪一行 | return a / b(真正做除法时) | assert b != 0(函数刚进来) |
| 错误信息 | division by zero——描述症状 | divisor cannot be 0——描述被违反的约定 |
| 如果函数很长 | 可能在错误输入上跑几十行才崩,中间还可能已经改坏了别的东西 | 立刻停住,坏值不会扩散 |
关键收益是「早失败」:错误在离根源最近的地方被抓住。真实程序里最难调的 bug,往往是一个坏值在第 10 行产生,一路传到第 200 行才引发崩溃——那时你面对的栈追踪指着第 200 行,而错在第 10 行。assert 就是在坏值传播开之前把它拦下来。
问自己:「这个函数正确工作,需要什么前提?」 把每个前提写成一条 assert。
divide(a, b)需要b != 0;- 一个算阶乘的函数需要
n >= 0; - 一个处理正整数的函数可以断言
n > 0 and isinstance(n, int)。
这些前提本来就存在于你脑子里。写成 assert 的好处是:它同时成了文档(读代码的人一眼看到约定)和测试(约定被违反时自动报警)。61A 的题目里也常见 assert,用来告诉你「这道题不需要处理某些输入」。
assert(条件, 消息)
assert 是语句,不是函数。加了括号就变成了另一个意思:
>>> assert(1 == 2, 'boom')
<stdin>:1: SyntaxWarning: assertion is always true, perhaps remove parentheses?
括号让 (1 == 2, 'boom') 成了一个二元组,而非空元组永远是真值,于是这条断言永远不会失败——你以为加了保护,其实什么保护都没有。所幸 Python 会给一个 SyntaxWarning 提醒你,但警告不是错误,很容易被划过去。正确写法:assert 1 == 2, 'boom',逗号前后都不要括号。
三种手段的分工
| 手段 | 什么时候用 | 解决哪类错误 |
|---|---|---|
| 读栈追踪 | 程序崩了 | 运行时错误——先定位到底哪一行、被谁调用 |
| print 调试 | 程序不崩但结果不对 | 逻辑错误——看中间值在哪一步开始偏离 |
assert | 写代码的时候,事前 | 预防——让坏输入在进门时就被挡住 |
doctest / ok | 写完之后,每改一次跑一次 | 逻辑错误——自动比对期望输出 |
本讲小结
| 概念 | 一句话 |
|---|---|
| 表达式 / 值 | 表达式被求值成一个值;值本身也是最简单的表达式 |
| 语句 | 被执行以产生效果,不产生值(如赋值语句、def) |
/ // % | 真除法(永远得 float)、地板除(商)、取模(余数) |
赋值 x = v | 右边先求值完,再把名字 x 绑定到那个值。不是「等于」 |
| 求值一个名字 | 当前帧找 → parent 帧找 → …… → 全局帧;都没有就 NameError |
| 调用表达式 | ① 求值算子 ② 从左到右求值算子数 ③ 施加。② 里可能递归执行 ①②③ |
| 施加(apply) | 新建一帧 → 把实参绑定到形参 → 在新帧里执行函数体 |
| 新帧的 parent | 看该函数被定义在哪个帧,不看谁调用它 |
def 语句 | 造一个函数对象 + 把名字绑定到它。函数体一行都不执行 |
| 形参 / 实参 | 形参写在 def 行是占位符;实参写在调用处是具体的值 |
return | 把值交出去并立即结束函数;后面的代码作废 |
print | 只往屏幕打字符,返回 None;打出来的东西不是程序里的值 |
None | 没写 return 的函数返回它;交互式解释器不显示它 |
| 纯函数 | 只返回值、无副作用、同输入必同输出;好测试、能安全嵌套 |
| 三类错误 | 语法(跑不了)→ 运行时(崩了,有栈追踪)→ 逻辑(不崩但错) |
| 栈追踪 | 从下往上读:最后一行是错误类型,倒数第二块是出事的行,往上是调用者 |
assert 条件, 消息 | 条件为假就抛 AssertionError;把假设写进代码,让错误早暴露 |
- 任何时候看到一段代码,问的不是「它长什么样」,而是「Python 拿到它之后一步步做了什么」。 这个习惯从第一讲养到最后一讲。
- 拿不准就去解释器里跑一遍。 课件会错,教材会错,AI 会错,这份笔记也会错——解释器不会。
- 「没报错」离「对了」还差很远。 逻辑错误不吭声,只有测试和手工推演能抓住它。
动手练习
练习 1:求值顺序
下面的代码会输出什么?按什么顺序?
from operator import add

def f(x):
    print('f', x)
    return x + 1

def g(x):
    print('g', x)
    return x * 2

print(add(f(1), g(2)))
看答案
f 1
g 2
6
按调用表达式的三步规则走 add(f(1), g(2)):
add:查到加法函数。此时还没有任何打印。f(1):新建帧,打印 f 1,返回 2。g(2):新建帧,打印 g 2,返回 4。add 到 2 和 4,得 6。print(6) 打出 6。关键点:外层的 print 最后才执行——它的算子数必须先被完整求值。如果把两个算子数换成 add(g(2), f(1)),输出就变成 g 2 / f 1 / 6,前两行顺序颠倒但结果不变。
练习 2:这个函数返回什么
下面三个函数,a(3)、b(3)、c(3) 各返回什么?在解释器里直接敲 a(3) 时,屏幕上各会出现什么?
def a(x):
    return x + 1

def b(x):
    print(x + 1)

def c(x):
    print(x + 1)
    return x + 1
看答案
| 调用 | 返回值 | 解释器里敲 f(3) 屏幕上出现 | 解释 |
|---|---|---|---|
a(3) | 4 | 4 | 这个 4 是解释器显示返回值 |
b(3) | None | 4 | 这个 4 是 print 打的;返回的 None 不显示 |
c(3) | 4 | 44 | 两个 4:一个 print 打的,一个解释器显示的 |
a 和 b 在解释器里看起来完全一样,但把结果拿去用就露馅了:a(3) + 1 得 5,b(3) + 1 抛 TypeError: unsupported operand type(s) for +: 'NoneType' and 'int'。
c 的双 4 是一个很好的检验:如果你能预测到这里有两行输出,说明你真的把「print 打的字符」和「解释器显示的返回值」分开了。
练习 3:找出错误的类型
下面每段代码属于哪一类错误(语法 / 运行时 / 逻辑)?会不会报错?
# (1)
def f(x)
    return x

# (2)
def g(x):
    return x / (x - 5)
g(5)

# (3)
def average(a, b):
    return a + b / 2
average(2, 4)

# (4)
from math import sqrt
sqrt(-1)
看答案
| 类型 | 报错 | 说明 | |
|---|---|---|---|
| (1) | 语法错误 | SyntaxError: expected ':' | def 那行末尾少了冒号。整个文件一行都不会执行 |
| (2) | 运行时错误 | ZeroDivisionError: division by zero | 代码合法;只有 x 恰好是 5 时才崩,g(4) 好好的 |
| (3) | 逻辑错误 | 不报错 | 返回 4.0 而不是 3.0。/ 优先级高于 +,算的是 a + (b/2)。应写 (a + b) / 2 |
| (4) | 运行时错误 | ValueError: math domain error | 类型没错(-1 是合法的数),是值不在定义域内——这正是 ValueError 和 TypeError 的分界 |
(3) 是这四个里最危险的:它安静地返回了一个看起来很正常的数字 4.0。如果你用 average(2, 2) 测试,会得到 3.0——还是错的但不易察觉;而用 average(4, 4) 会得到 6.0。没有测试,这个 bug 可以活很久。
练习 4:画环境图
写出下面代码执行完之后,全局帧里有哪些绑定,以及过程中建了几个帧。result 最终是多少?
def double(x):
    return x * 2

def add_then_double(a, b):
    total = a + b
    return double(total)

result = add_then_double(3, 4)
看答案
result 是 14。过程中建了 2 个帧。
def 在全局帧里绑定 double 和 add_then_double,函数体都没执行。add_then_double(3, 4):新建 f1(parent=Global),绑定 a→3、b→4。total = a + b:右边求值成 7,在 f1 里把 total 绑定到 7。注意这是一个局部绑定,全局帧里没有 total。return double(total):求值算子 double(f1 里没有,去 Global 找到),求值算子数 total(f1 里有,是 7)。新建 f2(parent=Global,不是 f1!),绑定 x→7。return 7 * 2 → 交出 14。f1 把这个 14 原样 return 出去。result 绑定到 14。| double | func double(x) |
| add_then_double | func add_then_double(a, b) |
| result | 14 |
| a | 3 |
| b | 4 |
| total | 7 |
| 返回值 | 14 |
| x | 7 |
| 返回值 | 14 |
两个容易错的点:① 全局帧里没有 total,也没有 a、b、x——它们全都关在各自的帧里,在全局层面访问会 NameError。② f2 的 parent 是 Global,虽然它是从 f1 里被调用的,但 double 是在全局层面定义的。
练习 5:写代码 + doctest
写一个函数 bmi(weight, height),返回体重指数 \(\text{BMI} = w / h^2\)(w 单位千克,h 单位米)。要求:给身高一个默认值 1.7;用 assert 保证身高为正;写一条 doctest。
看答案
def bmi(weight: float, height: float = 1.7) -> float:
    """Returns the body mass index for the given weight (kg)
    and height (m).

    >>> bmi(68, 1.7)
    23.529411764705884
    >>> bmi(68)
    23.529411764705884
    """
    assert height > 0, 'height must be positive'
    return weight / (height ** 2)
几个刻意的选择:
- 用
**不用*:height * 2和height ** 2是第 10 节那个真实 bug 的翻版。这里 1.7 × 2 = 3.4 而 1.7² = 2.89,结果差得远——但如果默认身高恰好是 2,两者相等,bug 就藏起来了。 - assert 写在函数体第一行:在坏值参与任何计算之前把它挡住。
height为 0 时,没有 assert 会得到ZeroDivisionError: division by zero——能崩,但信息量不如height must be positive;而height为负数时更糟:(-1.7) ** 2照样是正数,函数会安安静静地返回一个错误答案,这就变成了一个逻辑错误。 - doctest 的期望输出要写解释器显示的完整浮点数:
23.529411764705884一位都不能少。写成23.53会判失败。拿不准就先在解释器里敲一遍,把输出原样复制进 docstring。 - 两条 doctest 分别测显式传参和用默认值:因为默认值是 1.7,两次调用结果相同,这恰好验证了默认参数确实生效了。
验证一遍 bmi(68):算子 bmi 查到函数;只有一个算子数 68;新建帧,weight→68,height→默认值 1.7;assert 检查 1.7 > 0 通过;求值 68 / (1.7 ** 2) = 68 / 2.8899999999999997 = 23.529411764705884(末尾的浮点误差正是第 2 节说的那件事)。